ナレッジグラフとは?
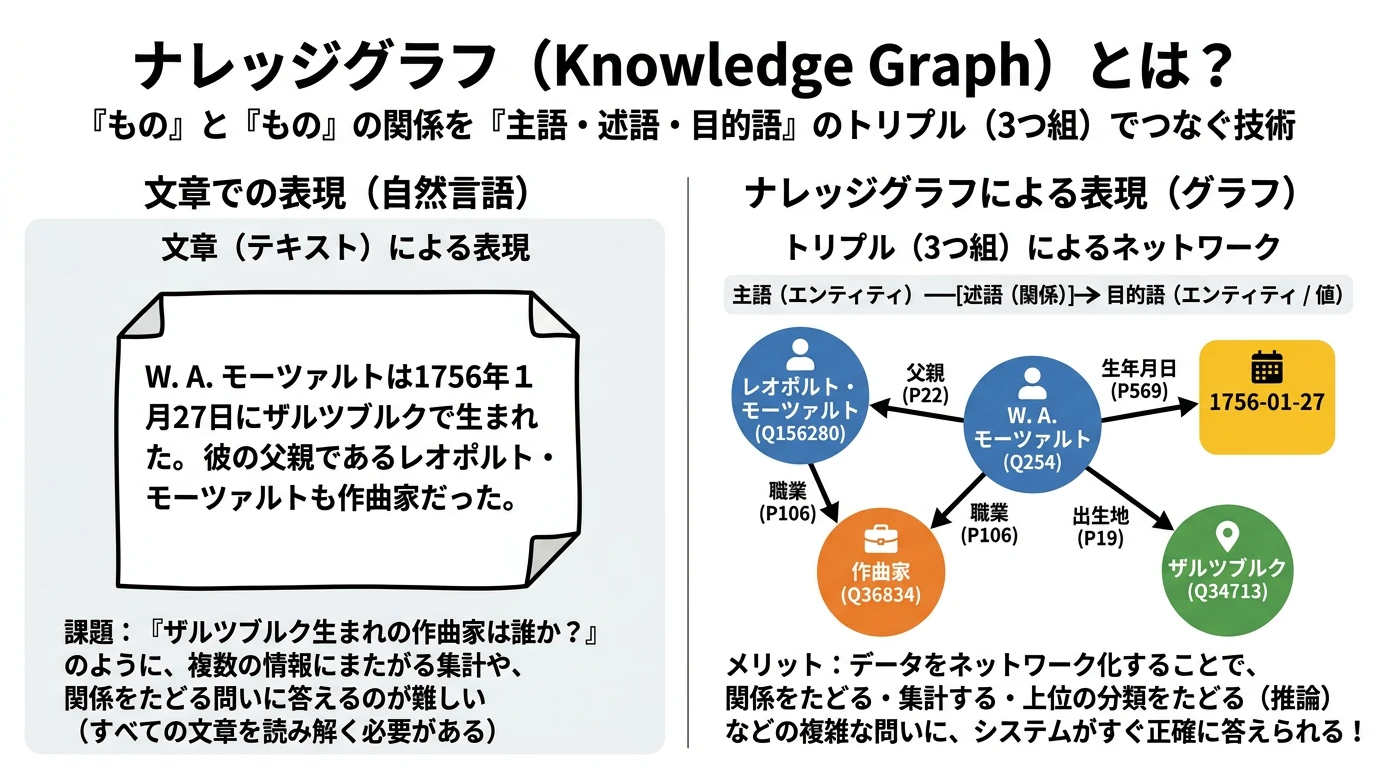 (画像は、Geminiで作成)
「もの」(エンティティ)と「もの」の関係を、主語・述語・目的語のトリプルで表す ナレッジグラフ(Knowledge Graph, KG) の考え方を理解すること。同じ知識を文章で持つ場合と比べて、ナレッジグラフなら関係をたどる・集計する・上位の分類をたどって推論する問いに、すぐ正確に答えられる理由を説明でき、Wikidata に SPARQL で問い合わせられるようになること。RDF とプロパティグラフの違いと、ナレッジグラフにできないこと(書かれていない関係、名前の曖昧さ)も説明できるようになること。
参考文献: A Survey on Knowledge Graphs: Representation, Acquisition and Applications (Ji et al., IEEE TNNLS 2022)、Knowledge Graphs (Hogan et al., ACM Computing Surveys 2021)
概要
人や組織、場所、作品についての知識の多くは、文章として書かれています。「Mozart はザルツブルクで生まれた」と1人の人物について調べるなら、その人物の記事を読めば十分です。しかし、「ザルツブルクで生まれた作曲家は誰か」「オーストリアのどの都市で、作曲家が多く生まれたか」のように、多くの人物にまたがって関係を集める問い になると、記事を1つずつ読むしかなくなります。
ナレッジグラフ は、知識を「Mozart ─ 出生地 → ザルツブルク」のような (主語, 述語, 目的語)の3つ組(トリプル) に分けて持つ方法です。「もの」(エンティティ)をノード、関係をエッジにしたグラフ(ネットワーク)なので、関係をたどる・数える・分類をたどるといった問いに、グラフの上で答えられます。Google は2012年に、検索結果の横に人物や場所の情報を表示するために、自社のナレッジグラフを発表しました(Google のブログ記事「Introducing the Knowledge Graph: things, not strings」、2012年5月)。発表時点で、5億以上の「もの」と、35億以上の事実を持っていました。
本記事では、Wikipedia の姉妹プロジェクトで、誰でも編集できる公開のナレッジグラフ Wikidata を使います。同じ知識を文章(Wikipedia)で持つ場合と、トリプル(Wikidata)で持つ場合を比べたうえで、ナレッジグラフの構造、問い合わせの言語 SPARQL、RDF とプロパティグラフの違い、ナレッジグラフにできないことを順に見ていきます。
文章のままでは、集計する問いに答えにくい
「ザルツブルクで生まれた作曲家は誰か」に、文章とナレッジグラフのそれぞれで答えます。
- 対象の人物: Wikidata で職業が作曲家で、ザルツブルクで「生まれた」「亡くなった」「活動した」のどれかの関係を持ち、英語版 Wikipedia に記事がある人物を集めます。ザルツブルクの名前は、生まれた人物の記事にも、亡くなった人物や活動した人物の記事にも出てくるので、文章から見分ける練習になります。
- 文章の答え: 英語版 Wikipedia の記事の導入部(最初の見出しまでの文章)を読み、簡単な規則で「ザルツブルク生まれか」を判定します。
- ナレッジグラフの答え: Wikidata の「出生地がザルツブルク」というトリプルがあるかで判定し、これを正解とみなします(Wikidata の誤りについては、後の節で触れます)。
準備:Python の環境
requests・pandas・networkx・rdflib を使います。Google Colab では、rdflib だけインストールが必要です。GPU は使いません。
!pip install rdflib
- 記事のコードは、Wikidata の問い合わせ(SPARQL)を合わせて12回、Wikipedia の API を4回、Wikidata の検索の API を1回呼びます。全体の実行時間は、通信を含めて1〜2分です。どちらのサービスも、連絡先を書いた User-Agent を付けて呼ぶよう求めているので、実行する前に、実験1のコードの CONTACT を、ご自身のメールアドレスかサイトの URL に書き換えてください。書き換えないまま実行すると、assert で止まります。
- Wikidata と Wikipedia は日々編集されるので、人数や件数は、実行する日によって少し変わります。記事の数値は、2026年10月30日に取得したデータで、Python 3.13・requests 2.34.2・pandas 3.0.5・networkx 3.7・rdflib 7.6.0 を使って実行したものです。
実験1:文章とナレッジグラフで「ザルツブルク生まれの作曲家」を答える
import re
from urllib.parse import unquote
import requests
import pandas as pd

# Wikidata と Wikipedia の API は、問題があったときに連絡が取れるよう、連絡先(メールアドレスかサイトの URL)を含む User-Agent を付けて呼ぶよう求めている
CONTACT = "your-name@example.com"   # ← ご自身のメールアドレスか、サイトの URL に書き換えてください
assert CONTACT != "your-name@example.com", "CONTACT を、ご自身のメールアドレスかサイトの URL に書き換えてください"
HEADERS = {"User-Agent": f"knowledge-graph-tutorial/1.0 ({CONTACT})"}


def sparql(query):
    """Wikidata の SPARQL エンドポイントに問い合わせ、結果を表(DataFrame)にする"""
    r = requests.get("https://query.wikidata.org/sparql", params={"query": query, "format": "json"},
                     headers=HEADERS, timeout=60)
    r.raise_for_status()
    rows = []
    for b in r.json()["results"]["bindings"]:
        row = {}
        for k, v in b.items():
            value = v["value"]
            if v["type"] == "uri" and "wikidata.org/" in value:
                # URI のままでは表が読みにくく、Q34713 のような ID と比べにくいので、末尾の ID だけにする
                value = value.rsplit("/", 1)[-1]          # http://www.wikidata.org/entity/Q34713 → Q34713
            row[k] = value
        rows.append(row)
    return pd.DataFrame(rows)


# 1. ナレッジグラフ(Wikidata)から:職業が作曲家で、ザルツブルクで「生まれた」「亡くなった」「活動した」の
#    どれかの関係を持つ人物と、その人物の英語版 Wikipedia の記事を集める。
#    生まれた人物だけでなく、亡くなった人物・活動した人物も入れるのは、記事に Salzburg が出てきても
#    生まれたとは限らない人物を混ぜて、文章の規則が「生まれた」を見分けられるかを試すため
links = sparql("""
SELECT ?person ?personLabel ?rel ?article WHERE {
  VALUES ?rel { wdt:P19 wdt:P20 wdt:P937 }    # 出生地・死没地・活動場所
  ?person wdt:P106 wd:Q36834 ;                # 職業(P106)が作曲家(Q36834)
          ?rel wd:Q34713 .                    # 関係の先がザルツブルク(Q34713)
  ?article schema:about ?person ;
           schema:isPartOf <https://en.wikipedia.org/> .
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}""")
links["title"] = links["article"].str.replace("https://en.wikipedia.org/wiki/", "").map(unquote).str.replace("_", " ")
# 生まれて亡くなった人物などは関係ごとに別の行になるので、人物ごとに1行にまとめる(規則の判定と人物単位で比べるため)
people = (links.groupby(["title", "personLabel"])["rel"].agg(lambda s: set(s))
          .reset_index().sort_values("title", ignore_index=True))
people["born_kg"] = people["rel"].map(lambda s: "P19" in s)     # ナレッジグラフの答え:出生地がザルツブルクか
print(f"ザルツブルクと関係のある作曲家: {len(people)} 人"
      f"(出生地 {people.born_kg.sum()} 人、死没地 {people.rel.map(lambda s: 'P20' in s).sum()} 人、"
      f"活動場所 {people.rel.map(lambda s: 'P937' in s).sum()} 人。重複あり)")


# 2. 文章(Wikipedia)から:同じ人物の記事の導入部(最初の見出しまでの文章)を取得する。
#    導入部は、生没年や出身など人物の要点がまず書かれる部分なので、規則で読む対象にする
def wiki_intros(titles):
    texts = {}
    for i in range(0, len(titles), 20):                   # API は1回に20記事まで
        r = requests.get("https://en.wikipedia.org/w/api.php", params={
            "action": "query", "prop": "extracts", "exintro": 1, "explaintext": 1, "exlimit": 20,
            "titles": "|".join(titles[i:i + 20]), "format": "json", "formatversion": 2,
        }, headers=HEADERS, timeout=60)
        r.raise_for_status()
        for page in r.json()["query"]["pages"]:
            texts[page["title"]] = page.get("extract", "")
    return texts


intros = wiki_intros(list(people["title"]))
people["intro"] = people["title"].map(intros).fillna("")
print(f"導入部の文字数: 合計 {people.intro.str.len().sum():,}  1人あたり平均 {people.intro.str.len().mean():.0f}")

# 3. 文章から「ザルツブルク生まれ」を判定する2つの規則。規則A は広く拾う(見落としは少ないが、誤りが多くなるはず)、
#    規則B は絞る(誤りは少ないが、見落としが多くなるはず)。両極端の規則で、文章から答える難しさを見る
born_pattern = re.compile(r"\bborn\b[^.]*\bSalzburg\b", re.IGNORECASE)      # 「born」と「Salzburg」が同じ文にある
people["rule_mention"] = people["intro"].str.contains("Salzburg")             # 規則A:導入部に Salzburg が出てくる
people["rule_born"] = people["intro"].map(lambda t: bool(born_pattern.search(t)))   # 規則B

print()
for rule, name in [("rule_mention", "規則A(Salzburg が出てくる)"), ("rule_born", "規則B(born … Salzburg)")]:
    pred, truth = people[rule], people["born_kg"]
    print(f"{name:26s} 正しく拾えた: {(pred & truth).sum():2d}  誤って含めた: {(pred & ~truth).sum():2d}"
          f"  見落とした: {(~pred & truth).sum():2d}")


# 4. 判定を誤った例:規則がなぜ誤るのかを、Salzburg の前後の文章で確かめる
def around(text, word="Salzburg", width=45):
    """text の中で最初に word が出てくる箇所の、前後 width 文字"""
    i = text.find(word)
    return "…" + text[max(0, i - width): i + len(word) + width].replace("\n", " ") + "…"


print("\n規則Aで誤って含めた例(ザルツブルク生まれではない):")
for _, r in people[people.rule_mention & ~people.born_kg].head(3).iterrows():
    print(f"  {r.title}: {around(r.intro)}")
print("\n規則Bで誤って含めた例:")
for _, r in people[people.rule_born & ~people.born_kg].iterrows():
    print(f"  {r.title}: {born_pattern.search(r.intro).group(0)}")
print("\n規則Bで見落とした例(導入部に Salzburg は出てくる):")
for _, r in people[people.born_kg & people.rule_mention & ~people.rule_born].iterrows():
    print(f"  {r.title}: {around(r.intro)}")
missing = people[people.born_kg & ~people.rule_mention]
print(f"\n導入部に Salzburg が出てこない({len(missing)} 人):", ", ".join(missing.title))

# 5. ナレッジグラフなら:ザルツブルク生まれの作曲家を、1回の問い合わせで生年順に並べられる
born = sparql("""
SELECT ?person ?personLabel (MIN(?birth) AS ?born) WHERE {
  ?person wdt:P106 wd:Q36834 ;                # 職業が作曲家
          wdt:P19 wd:Q34713 .                 # 出生地(P19)がザルツブルク
  OPTIONAL { ?person wdt:P569 ?birth . }      # 生年月日(P569)。ない人物もいる
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}
GROUP BY ?person ?personLabel""")
born["year"] = born["born"].str[:4].astype("Int64")
born = born.sort_values(["year", "personLabel"], na_position="last", ignore_index=True)
print(f"\nWikidata のザルツブルク生まれの作曲家: {len(born)} 人(生年月日がない人物: {born.year.isna().sum()} 人)")
print(born[["person", "personLabel", "year"]].head(5).to_string(index=False))
Wikidata から対象の人物を集め、その人物の Wikipedia の導入部から2つの規則で「ザルツブルク生まれか」を判定して、Wikidata の答えと比べるコードです。
- SPARQL の呼び出し: sparql は、Wikidata の SPARQL のエンドポイント(https://query.wikidata.org/sparql)に問い合わせを送り、JSON で返る結果を pandas の表にします。以降の実験で何度も問い合わせるので、関数にまとめています。結果の値は http://www.wikidata.org/entity/Q34713 のような URI で返ってきますが、そのままでは表が読みにくく、Q34713 のような ID と比べにくいので、末尾の ID だけにします。HEADERS の User-Agent は、Wikidata と Wikipedia が API の利用者に付けるよう求めているもので、付けないと拒否されることがあります。中の連絡先 CONTACT は、問題があったときにサービスの運営者が実行した人に連絡するためのものなので、記事のコードをそのまま使わず、読者ご自身の連絡先にします。書き換え忘れたまま API を呼ばないよう、例の値のままなら assert で止めます。
- 対象の人物: 1つ目の問い合わせは、職業(P106)が作曲家(Q36834)で、ザルツブルク(Q34713)との間に、出生地(P19)・死没地(P20)・活動場所(P937)のどれかの関係 ?rel を持つ人物を集めます。生まれた人物だけでなく、亡くなった人物や活動した人物も入れるのは、記事に「Salzburg」が出てきても生まれたとは限らない人物を混ぜて、文章の規則が「生まれた」を本当に見分けられるかを試すためです。schema:about と schema:isPartOf の行は、その人物の英語版 Wikipedia の記事の URL を取り出します。記事がない人物は、文章の答えと比べられないので、ここで除かれます。SERVICE wikibase:label は、?personLabel に英語の名前を入れる Wikidata 独自の機能です(SPARQL の書き方は、後の節で説明します)。
- 人物ごとにまとめる: 問い合わせの結果は「人物 × 関係」ごとに1行なので、ザルツブルクで生まれて亡くなった人物は2行になります。文章の規則の判定は人物ごとに1つなので、比べられるように、groupby で人物ごとに1行にし、関係を集合 rel にまとめます。出生地(P19)を含むかどうかが、ナレッジグラフの答え born_kg です。記事の URL では、ö のような文字が %C3%B6 の形になっているので、unquote で元に戻して、API に渡す記事名 title を作ります。
- 導入部の取得: wiki_intros は、Wikipedia の API で、記事の導入部(exintro)をプレーンテキスト(explaintext)で受け取ります。導入部は、生没年や出身など人物の要点がまず書かれる部分なので、規則で読む対象にしました。API は1回に20記事までしか導入部を返さないので、記事名を「|」でつないで20件ずつ問い合わせます。
- 文章の規則: 性格の違う2つの規則を用意します。規則A(rule_mention)は、導入部に「Salzburg」が出てくれば生まれたとみなす、広く拾う規則で、見落としは少ない代わりに、誤りが多くなるはずです。規則B(rule_born)は、「born」と「Salzburg」が同じ文の中に出てくる(間にピリオドがない)場合だけに絞る規則で、誤りは少ない代わりに、見落としが多くなるはずです。両極端の規則を比べることで、規則の工夫だけでは文章から正確に答えにくいことを確かめます。文頭の「Born in Salzburg」も拾えるよう、re.IGNORECASE で大文字・小文字を区別しないようにしています。
- 比較: Wikidata の答え born_kg を正解として、それぞれの規則が、正しく拾えた人数・誤って含めた人数・見落とした人数を数えます。人数だけでは規則がなぜ誤るのかが分からないので、誤った人物について、around で「Salzburg」の前後45文字を切り出して表示し、どんな書き方が規則を誤らせたかを確かめます。
- ナレッジグラフの答え: 最後の問い合わせは、同じ問いにナレッジグラフなら1回で答えられることを示すためのものです。出生地がザルツブルクの作曲家を、Wikipedia の記事の有無にかかわらずすべて集め、生年の順に並べます。生年月日(P569)が登録されていない人物も数に入れたいので OPTIONAL にし、生年月日が複数登録された人物(出典ごとに違う日付があるなど)も1人1行にしたいので、MIN(最も早い日付)と GROUP BY を使います。
実行結果
ザルツブルクと関係のある作曲家: 74 人(出生地 17 人、死没地 49 人、活動場所 19 人。重複あり)
導入部の文字数: 合計 30,566  1人あたり平均 413

規則A(Salzburg が出てくる)        正しく拾えた:  8  誤って含めた: 23  見落とした:  9
規則B(born … Salzburg)       正しく拾えた:  4  誤って含めた:  1  見落とした: 13

規則Aで誤って含めた例(ザルツブルク生まれではない):
  Alois Taux: …ser. He was important in the musical life of Salzburg, and initiated music festivals there dedicat…
  Andreas Hofer (composer): …Franz von Biber, whose predecessor he was in Salzburg in his office of Inspector and Hofkapellmeis…
  Anton Cajetan Adlgasser: … 1777) was a German organist and composer at Salzburg Cathedral. He composed a good deal of liturg…

規則Bで誤って含めた例:
  Anton Cajetan Adlgasser: Born in Inzell, Bavaria, he moved to Salzburg

規則Bで見落とした例(導入部に Salzburg は出てくる):
  Ignaz Assmayer: …l music. An organist at St. Peter's Abbey in Salzburg, he lived in Vienna from 1815, and was in 18…
  Josef Wallnig: …ür Musik und darstellende Kunst Mozarteum in Salzburg, and also studied piano, composition, and co…
  Joseph Balthasar Hochreither: …Joseph Balthasar Hochreither (Salzburg, 16 April 1669 - Salzburg, 14 December 1731)…
  Maria Anna Mozart: …e Nannerl, was a distinguished musician from Salzburg. In her childhood, she developed into an out…

導入部に Salzburg が出てこない(9 人): Alexis Agrafiotis, David Behrman, Franz Jakob Freystädtler, Joseph Mohr, Joseph Woelfl, Michael Frankenberger, Paul Csonka, Sigismund von Neukomm, Viktor Keldorfer

Wikidata のザルツブルク生まれの作曲家: 81 人(生年月日がない人物: 2 人)
   person                  personLabel  year
Q94903732          Rupert Unterholtzer  1505
 Q1086211        Christoph von Lamberg  1550
  Q496635     Andreas Christoph Clamer  1633
 Q1706569 Joseph Balthasar Hochreither  1669
  Q695765          Carl Heinrich Biber  1681
(和訳)
- Alois Taux:「…ザルツブルクの音楽活動で重要な役割を果たし、モーツァルトをたたえる音楽祭を始めた…」
- Andreas Hofer:「…ザルツブルクでの監督官・宮廷楽長の職で、Biber の前任者だった…」
- Anton Cajetan Adlgasser:「…ザルツブルク大聖堂のドイツ人オルガン奏者・作曲家だった…」。規則Bに一致したのは「バイエルン州の Inzell に生まれ、ザルツブルクに移った」
- Ignaz Assmayer:「…ザルツブルクの聖ペーター修道院のオルガン奏者で、1815年からウィーンに住み…」
- Josef Wallnig:「…ザルツブルクのモーツァルテウム音楽大学で…を学び…」
- Joseph Balthasar Hochreither:「(ザルツブルク、1669年4月16日 - ザルツブルク、1731年12月14日)」
- Maria Anna Mozart:「…ザルツブルク出身の卓越した音楽家だった…」
ザルツブルクと関係のある作曲家は74人で、そのうちザルツブルク生まれは17人でした。
2つの規則の結果を並べると、次のようになります。
(図は、diagram-designで作成)
導入部に「Salzburg」が出てくるかで判定する 規則A は、17人のうち8人を拾いましたが、生まれていない23人も含めてしまいました。ザルツブルクで活動した人物や、亡くなった人物の記事にも、「Salzburg」は出てくるからです。
「born … Salzburg」に絞った 規則B は、誤りが1人に減りましたが、拾えたのは4人だけで、13人を見落としました。見落とした理由は、さまざまです。
- 書き方が違う: Hochreither は「(Salzburg, 16 April 1669 - Salzburg, 14 December 1731)」と、生まれた場所と亡くなった場所を日付と並べて書いています。Maria Anna Mozart は「ザルツブルク出身の(from Salzburg)」です。
- 導入部に書かれていない: 9人は、導入部に「Salzburg」が一度も出てきません。出生地は、本文の「生涯」の節などに書かれているか、どこにも書かれていません。
- 誤って一致する: 規則Bの誤り(Adlgasser)は、「Inzell で生まれ、ザルツブルクに移った」という文で、「born」と「Salzburg」が同じ文に出てきたためです。
規則を工夫すれば少しずつ良くなりますが、書き方の揺れは人物の数だけあり、導入部に書かれていない情報は、規則では拾えません。文章を読んで正確に答えるには、すべての記事を読んで、出生地を書いた箇所を探す必要があります。
一方、ナレッジグラフでは、「出生地がザルツブルク」という関係が、決まった形のトリプルで持たれているので、1回の問い合わせで答えが出ます。英語版 Wikipedia に記事がない人物も含めると81人で、生年の順に並べることもすぐにできました(生年月日が登録されていない2人は、末尾に回しています)。
ナレッジグラフの基本:エンティティ・関係・トリプル
ナレッジグラフは、次の3つの要素でできています。
- エンティティ: 人物・場所・組織・作品・概念など、知識の対象になる「もの」です。グラフのノードにあたります。
- 関係(述語、プロパティ): 「出生地」「父」「職業」のような、エンティティ同士のつながりの種類です。グラフのエッジの種類(ラベル)にあたります。
- リテラル: 生年月日や人口のような、エンティティではない「値」です。
1つの事実は、トリプル(主語, 述語, 目的語)で表します。主語はエンティティ、述語は関係、目的語はエンティティかリテラルです。エンティティの集合を 、関係の集合を 、リテラルの集合を とすると、ナレッジグラフは、トリプルの集合
です。トリプル は、ノード からノード への、種類 の向きのあるエッジと見なせるので、ナレッジグラフは、エッジに種類のラベルが付いた 有向グラフ になります(グラフの記事の有向グラフに、エッジの種類を加えたものです)。同じ2つのノードの間に、種類の違うエッジが何本あってもかまいません。
(図は、diagram-designで作成)
図では、W. A. Mozart から出た5本の矢印と、Maria Anna Mozart・Leopold Mozart から出た矢印が、ザルツブルクや Leopold Mozart のノードで合流しています。「Mozart の父は Leopold」「Maria Anna の父は Leopold」「Leopold は作曲家」は、文章なら別々の記事の別々の文に書かれる事実ですが、ナレッジグラフでは同じノードを共有するので、「父親も作曲家である人物」を、矢印を2本たどるだけで見つけられます。
スキーマ(オントロジー)
トリプルを集めるだけでは、「出生地の目的語は場所であるべき」「ザルツブルクは都市の一種である」といった、知識の枠組み は表せません。この枠組みを スキーマ または オントロジー と呼びます。オントロジーでは、主に次のことを決めます。
- クラス: 「人間」「都市」「作曲家」のような、エンティティの種類です。エンティティがどのクラスに属するかも、トリプル(Wikidata では「P31: instance of」)で表します。
- クラスの階層: 「大都市は都市の一種」のような、クラスの上下の関係です(Wikidata では「P279: subclass of」)。
- 関係の制約: 「出生地の主語は人、目的語は場所」のような、関係がとる値の種類の制約です。
クラスの階層があると、「ザルツブルクは大都市」「大都市は都市の一種」の2つのトリプルから、書かれていない「ザルツブルクは都市」を導けます。このように、決まった規則で、明示されていない事実を導くことを 推論 と呼びます(後の節の実験3)。
Wikidata の構造:Q番号と P番号
Wikidata では、エンティティ(Wikidata では 項目、item)に「Q」で始まる番号、関係(プロパティ)に「P」で始まる番号を付けます。Mozart は Q254、ザルツブルクは Q34713、出生地は P19 です。名前ではなく番号で持つのは、同じ名前の別のもの(ザルツブルク市とザルツブルク州など)を区別し、言語によらず同じものを指すためです。英語や日本語の名前(ラベル)は、項目に付けた属性の1つにすぎません。
Mozart について、いくつかのプロパティの値を取り出し、トリプルとして並べます。
# 1. Mozart(Q254)について、いくつかの関係(プロパティ)の値を取り出す。Mozart には数百の文があるので、
#    トリプルの形の違いが分かる7つ(分類・場所・日付のリテラル・家族の関係・値が複数ある職業)に絞る
PROPS = ["P31", "P19", "P20", "P569", "P22", "P3373", "P106"]
mozart = sparql(f"""
SELECT ?prop ?propLabel ?value ?valueLabel WHERE {{
  VALUES ?prop {{ {" ".join("wd:" + p for p in PROPS)} }}
  ?prop wikibase:directClaim ?wdt .           # プロパティ P19 に対応する述語 wdt:P19
  wd:Q254 ?wdt ?value .                       # 主語 Mozart、述語 ?wdt、目的語 ?value のトリプル
  SERVICE wikibase:label {{ bd:serviceParam wikibase:language "en". }}
}}""")
mozart["order"] = mozart["prop"].map(PROPS.index)
mozart = mozart.sort_values(["order", "valueLabel"], ignore_index=True)

# 2. 同じトリプルを、ID の形と、ラベル(英語の名前)の形で並べる
for _, r in mozart.iterrows():
    is_item = bool(re.fullmatch(r"Q\d+", r.value))
    value_id = r.value if is_item else f'"{r.value[:10]}"'            # 日付などのリテラル(値そのもの)は引用符で囲む
    value_label = r.valueLabel if is_item else f'"{r.value[:10]}"'
    print(f"{'(Q254, ' + r.prop + ', ' + value_id + ')':28s} (Mozart, {r.propLabel}, {value_label})")

# 3. 文(ステートメント)に付いた修飾子:配偶者(P26)と、結婚した日(P580)。
#    「いつから配偶者か」のような条件は、主語・述語・目的語の3つに収まらない。Wikidata がそれをどう持っているかを見る
spouse = sparql("""
SELECT ?value ?valueLabel ?start WHERE {
  wd:Q254 p:P26 ?statement .                  # Mozart の、配偶者についての文
  ?statement ps:P26 ?value .                  # その文の値(配偶者)
  OPTIONAL { ?statement pq:P580 ?start . }    # その文の修飾子:開始時点(P580)
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}""")
print("\n配偶者の文:")
print(spouse.to_string(index=False))
Mozart(Q254)の7つのプロパティの値をトリプルとして取り出し、ID の形とラベルの形で並べたうえで、配偶者の文に付いた修飾子を取り出すコードです。
- プロパティを指定する: Mozart には数百の文があるので、トリプルの形の違いが分かる7つのプロパティに絞ります。分類(P31)、場所との関係(出生地 P19・死没地 P20)、目的語がリテラルになる生年月日(P569)、人との関係(父 P22・きょうだい P3373)、値が複数ある職業(P106)です。これらを VALUES ?prop に並べます。Wikidata では、プロパティそのもの(wd:P19)と、トリプルの述語として使う名前(wdt:P19)が別なので、wikibase:directClaim で対応を取ってから、wd:Q254 ?wdt ?value のトリプルを探します。
- 並べる: 同じ知識が、ID の形(コンピュータが扱う形)とラベルの形(人が読む形)で同じトリプルであることを見せるため、両方を並べて表示します。PROPS の順に並べ、同じプロパティの値は名前の順にします。値が Q番号ならエンティティ、そうでなければ生年月日のようなリテラルなので、引用符で囲んで区別します。
- 修飾子: 「いつから配偶者か」のような条件は、主語・述語・目的語の3つに収まりません。Wikidata がこの条件をどう持っているかを見るため、3つ目の問い合わせで、配偶者(P26)の「文」を取り出します。p:P26 で Mozart から文のノード ?statement へ進み、ps:P26 でその文の値(配偶者)、pq:P580 でその文に付いた開始時点を取り出します。修飾子がない文もあるので、OPTIONAL にしています。この形は、後の節(RDF とプロパティグラフ)の説明につながります。
実行結果
(Q254, P31, Q5)              (Mozart, instance of, human)
(Q254, P19, Q34713)          (Mozart, place of birth, Salzburg)
(Q254, P20, Q1741)           (Mozart, place of death, Vienna)
(Q254, P569, "1756-01-27")   (Mozart, date of birth, "1756-01-27")
(Q254, P22, Q156280)         (Mozart, father, Leopold Mozart)
(Q254, P3373, Q157928)       (Mozart, sibling, Maria Anna Mozart)
(Q254, P106, Q36834)         (Mozart, occupation, composer)
(Q254, P106, Q158852)        (Mozart, occupation, conductor)
(Q254, P106, Q16145150)      (Mozart, occupation, music educator)
(Q254, P106, Q639669)        (Mozart, occupation, musician)
(Q254, P106, Q765778)        (Mozart, occupation, organist)
(Q254, P106, Q486748)        (Mozart, occupation, pianist)
(Q254, P106, Q1259917)       (Mozart, occupation, violinist)

配偶者の文:
 value       valueLabel                start
Q84464 Constanze Mozart 1782-08-04T00:00:00Z
(和訳)
- 左から:分類 = 人間、出生地 = ザルツブルク、死没地 = ウィーン、生年月日 = 1756年1月27日、父 = Leopold Mozart、きょうだい = Maria Anna Mozart、職業 = 作曲家・指揮者・音楽教育者・音楽家・オルガン奏者・ピアニスト・ヴァイオリン奏者
Mozart についての知識が、(Q254, P19, Q34713) のようなトリプルに分かれています。職業(P106)には7つの値があり、同じ主語と述語のトリプルが7本あります。生年月日(P569)の目的語は、エンティティではなく日付のリテラルです。
Wikidata は、1つの事実を、単なるトリプルではなく 文(statement)として持っています。文には、値のほかに次の情報を付けられます。
- 修飾子(qualifier): 事実の条件です。配偶者の文には「開始時点:1782年8月4日」が付いていて、いつから配偶者だったかが分かります。役職の任期や、人口を数えた年なども修飾子で表します。
- 出典(reference): その事実の根拠になった文献や Web ページです。
- ランク: 同じプロパティに値が複数あるとき、どれを優先するかです。
wdt: で始まる述語は、修飾子や出典を省いて、優先される値だけを主語と目的語で直接結んだトリプルです。単純な問いには wdt:、修飾子まで見たいときは p:・ps:・pq: を使います。修飾子をトリプルでどう表しているかは、後の節(RDF とプロパティグラフ)で見ます。
SPARQL:グラフのパターンで問い合わせる
Wikidata のように、トリプルで持ったナレッジグラフに問い合わせる言語が SPARQL です。SPARQL の問い合わせの中心は、変数を含んだトリプルのパターン です。
SELECT ?child ?father WHERE {
  ?child  wdt:P19  wd:Q34713 .     # ?child の出生地はザルツブルク
  ?child  wdt:P22  ?father .       # ?child の父は ?father
  ?father wdt:P106 wd:Q36834 .     # ?father の職業は作曲家
}
? で始まる名前が変数です。SPARQL は、ナレッジグラフの中から、3つのパターンを 同時に 満たすように変数に値を当てはめた組をすべて探し、SELECT の変数の値を返します。3つのパターンは ?child と ?father を共有しているので、これは「ザルツブルク ← ?child → ?father → 作曲家」という形の部分グラフを、グラフの中から探すことにあたります。表のデータで言えば、トリプルの表を自分自身と結合(JOIN)する操作です。
このほかに、次のような書き方を使います。
- 集計: COUNT と GROUP BY で、変数の値ごとに数えます。SQL と同じ考え方です。
- プロパティパス: wdt:P31/wdt:P279* のように、関係を / でつないで続けてたどり、* で同じ関係を0回以上くり返したどります。くり返しの回数が決まっていない関係(上位の分類、上位の行政区画など)をたどるのに使います。
- OPTIONAL・FILTER: 値がなくても行を残す(OPTIONAL)、条件で行を絞る(FILTER)ことができます。
次のコードで、ナレッジグラフが得意な3種類の問い(関係をたどる・集計する・推論する)を、Wikidata に問い合わせます。
実験2:関係をたどる・集計する・推論する
# 1. たどる:ザルツブルク生まれの作曲家で、父親(P22)も作曲家である人物
two_hops = sparql("""
SELECT ?childLabel ?fatherLabel WHERE {
  ?child  wdt:P106 wd:Q36834 ;                # 子は作曲家で、
          wdt:P19  wd:Q34713 ;                # ザルツブルク生まれで、
          wdt:P22  ?father .                  # 父親(P22)がいて、
  ?father wdt:P106 wd:Q36834 .                # 父親も作曲家
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}
ORDER BY ?childLabel""")
print("父親も作曲家であるザルツブルク生まれの作曲家:")
print(two_hops.to_string(index=False))

# 2. 集計する:オーストリア(Q40)の地名を出生地とする作曲家を、出生地ごとに数える
by_place = sparql("""
SELECT ?place ?placeLabel (COUNT(DISTINCT ?person) AS ?composers) WHERE {
  ?person wdt:P106 wd:Q36834 ;
          wdt:P19  ?place .
  ?place  wdt:P17  wd:Q40 .                   # 出生地の国(P17)がオーストリア
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}
GROUP BY ?place ?placeLabel
ORDER BY DESC(?composers)
LIMIT 5""")
print("\nオーストリアの出生地ごとの作曲家の数(上位5):")
print(by_place.to_string(index=False))

# 3. 推論する:ザルツブルクは「都市(Q515)」か。直接の分類(P31)と、上位の分類(P279)をたどった場合を比べる
classes = sparql("""
SELECT ?class ?classLabel ?isCity WHERE {
  wd:Q34713 wdt:P31 ?class .                  # ザルツブルクの分類(P31: instance of)
  BIND(EXISTS { ?class wdt:P279* wd:Q515 } AS ?isCity)   # その分類から、上位の分類(P279)を0回以上たどって「都市」に着くか
  SERVICE wikibase:label { bd:serviceParam wikibase:language "en". }
}
ORDER BY ?classLabel""")
print("\nザルツブルクの分類:")
print(classes.to_string(index=False))

# 推論(上位の分類をたどる)を使うかどうかで、答えがどれだけ変わるかを、同じ問いの人数で比べる
for name, pattern in [("直接の分類だけ", "wdt:P31"), ("上位の分類もたどる", "wdt:P31/wdt:P279*")]:
    n = sparql(f"""
SELECT (COUNT(DISTINCT ?place) AS ?places) (COUNT(DISTINCT ?person) AS ?composers) WHERE {{
  ?person wdt:P106 wd:Q36834 ;
          wdt:P19  ?place .
  ?place  wdt:P17  wd:Q40 ;
          {pattern} wd:Q515 .                 # 出生地が「都市」
}}""")
    print(f"オーストリアの「都市」で生まれた作曲家({name}): 都市 {n.places[0]}  作曲家 {n.composers[0]} 人")
ザルツブルク生まれの作曲家の父親をたどる、オーストリアの出生地ごとに作曲家を数える、上位の分類をたどってザルツブルクが都市かを調べる、の3つの問い合わせのコードです。
- たどる: 1つ目の問い合わせは、関係を2本たどる問い(子 → 父 → 職業)の例です。文章なら子と父の記事を両方読まないと答えられない問いが、パターン1つで答えられることを見せます。直前に示した SPARQL のパターンに、子も作曲家であるという条件(?child wdt:P106 wd:Q36834)を加えています。; は、同じ主語のトリプルを続けて書く省略記法です。
- 集計する: 2つ目の問い合わせは、多くの人物にまたがって数える問いの例です。作曲家の出生地 ?place のうち、国(P17)がオーストリア(Q40)であるものに絞り、GROUP BY ?place と COUNT(DISTINCT ?person) で出生地ごとに人数を数えて、多い順に5つを表示します。DISTINCT にするのは、出生地が複数登録された人物などで、同じ人物が二重に数えられないようにするためです。
- ザルツブルクの分類: 3つ目の問い合わせは、推論が必要になる理由を見るためのものです。ザルツブルクの分類(P31)をすべて取り出し、それぞれの分類から上位の分類(P279)を0回以上たどって「都市(Q515)」に着くかを、EXISTS で調べて ?isCity に入れます。ザルツブルクに「都市」という分類が直接付いているかどうかと、上位の分類をたどれば都市だと分かるかを、見比べられます。
- 推論の有無で数える: 推論(上位の分類をたどること)を使うかどうかで、答えがどれだけ変わるかを数で確かめます。「出生地が都市である作曲家」を、出生地の分類が直接「都市」であるもの(wdt:P31)だけで数える場合と、上位の分類をたどって「都市」に着くもの(wdt:P31/wdt:P279*)も数える場合で比べます。問い合わせの違いは、このパターンの部分だけです。
実行結果
父親も作曲家であるザルツブルク生まれの作曲家:
              childLabel               fatherLabel
       Alexis Agrafiotis       Dimitris Agrafiotis
     Carl Heinrich Biber            Heinrich Biber
         Cäcilia Eberlin      Johann Ernst Eberlin
Franz Jakob Freystädtler Johann Jakob Freystädtler
       Maria Anna Mozart            Leopold Mozart
 Wolfgang Amadeus Mozart            Leopold Mozart

オーストリアの出生地ごとの作曲家の数(上位5):
 place placeLabel composers
 Q1741     Vienna      1516
Q13298       Graz       155
Q41329       Linz       101
Q34713   Salzburg        81
 Q1735  Innsbruck        61

ザルツブルクの分類:
    class                            classLabel isCity
 Q1549591                              big city   true
  Q902814                           border city   true
  Q871419                   district of Austria  false
  Q667509               municipality of Austria  false
Q13539802 place with town rights and privileges  false
  Q262882             statutory city of Austria   true
オーストリアの「都市」で生まれた作曲家(直接の分類だけ): 都市 9  作曲家 182 人
オーストリアの「都市」で生まれた作曲家(上位の分類もたどる): 都市 25  作曲家 2153 人
(和訳)
- ザルツブルクの分類:big city = 大都市、border city = 国境の都市、district of Austria = オーストリアの郡、municipality of Austria = オーストリアの基礎自治体、place with town rights and privileges = 都市権を持つ場所、statutory city of Austria = オーストリアの憲章都市
集計と推論の結果を並べると、次のようになります。
(図は、diagram-designで作成)
たどる: ザルツブルク生まれで、父親も作曲家である人物が6人見つかりました。Mozart と姉の Maria Anna(父 Leopold)、Carl Heinrich Biber(父 Heinrich Biber)などです。文章から答えるには、ザルツブルク生まれの作曲家の記事をすべて読んで父親の名前を探し、さらに父親の記事を読んで職業を確かめる必要があります。ナレッジグラフなら、関係を2本たどるだけです。
集計する: オーストリアで作曲家が最も多く生まれた場所は、ウィーン(1,516人)で、グラーツ(155人)、リンツ(101人)、ザルツブルク(81人)と続きました。実験1の81人と一致しています。
推論する: ザルツブルクの分類は6つありましたが、その中に「都市(Q515)」そのものはありません。「大都市」「国境の都市」「オーストリアの憲章都市」の3つが、上位の分類をたどると「都市」に着きます。そのため、分類が直接「都市」である場所だけを数えると、ザルツブルクは数に入りません。オーストリアの「都市」で生まれた作曲家は、直接の分類だけでは9都市・182人でしたが、上位の分類もたどると25都市・2,153人になりました。作曲家が1,516人生まれたウィーンも、直接の分類だけでは数に入っていません(182人より多いため)。
ナレッジグラフの知識は、「何が書かれているか」だけでなく、「どの分類に、どの粒度で書かれているか」に左右されます。オントロジーの階層をたどる推論を使うと、書いた人によって粒度の違う分類を、同じ問いでまとめて扱えます。
RDF とプロパティグラフ
ナレッジグラフをコンピュータで持つ方法には、大きく分けて RDF と プロパティグラフ の2つがあります。
| RDF | プロパティグラフ | |
|---|---|---|
| 基本の単位 | トリプル(主語, 述語, 目的語)だけ | ノードとエッジ。どちらにも属性(キーと値)を付けられる |
| 名前 | URI(世界中で一意の名前) | データベースの中で一意の ID |
| エッジの属性(修飾子) | 直接は付けられない。文そのものをノードにして表す | エッジの属性として、そのまま付けられる |
| 標準 | W3C の標準(RDF・SPARQL・RDFS・OWL) | 製品ごとの言語(Cypher など)。ISO の GQL が2024年に標準化 |
| 向いている用途 | 組織をまたいだ知識の公開と結合(Wikidata など) | 1つのアプリの中での、関係をたどる処理 |
RDF は、W3C(Web の標準化団体)が定めた形式で、すべてをトリプルで表します。名前に URI を使うので、Wikidata の http://www.wikidata.org/entity/Q254 のように、別の組織が作ったナレッジグラフの同じエンティティを指して、知識をつなげられます。一方、トリプルの述語には属性を付けられないので、「1782年から」のような修飾子を付けるには工夫が要ります。
(図は、diagram-designで作成)
Wikidata は、図の左のように、文そのものを1つのノードにして、そこに値と修飾子をトリプルでつなげています。実験2の p:・ps:・pq: は、この形をたどるためのものでした。次のコードで、同じ事実を、RDF(rdflib)とプロパティグラフ(networkx)の両方で持ってみます。このコードは Wikidata に問い合わせず、手元だけで動きます。
import networkx as nx
from rdflib import Graph, Literal, Namespace
from rdflib.namespace import XSD

# 1. 実験で取り出した Mozart の家族の事実の一部。Wikidata に問い合わせずに手元で比べられるよう書き写し、
#    ID を Wikidata と同じにしておく(同じ SPARQL がそのまま使える)
facts = [   # (主語, 述語, 目的語)
    ("Q254", "P19", "Q34713"), ("Q254", "P20", "Q1741"), ("Q254", "P22", "Q156280"), ("Q254", "P106", "Q36834"),
    ("Q157928", "P19", "Q34713"), ("Q157928", "P22", "Q156280"),
    ("Q156280", "P20", "Q34713"), ("Q156280", "P106", "Q36834"),
    ("Q254", "P26", "Q84464"),
]
names = {"Q254": "Wolfgang Amadeus Mozart", "Q157928": "Maria Anna Mozart", "Q156280": "Leopold Mozart",
         "Q84464": "Constanze Mozart", "Q34713": "Salzburg", "Q1741": "Vienna", "Q36834": "composer"}

# 2. RDF:すべてをトリプル(主語・述語・目的語)で表す。名前は URI
WD = Namespace("http://www.wikidata.org/entity/")
WDS = Namespace("http://www.wikidata.org/entity/statement/")
WDT = Namespace("http://www.wikidata.org/prop/direct/")
P = Namespace("http://www.wikidata.org/prop/")
PS = Namespace("http://www.wikidata.org/prop/statement/")
PQ = Namespace("http://www.wikidata.org/prop/qualifier/")

rdf = Graph()
for s, p, o in facts:
    rdf.add((WD[s], WDT[p], WD[o]))
print("RDF のトリプル(修飾子なし):", len(rdf))

# 「Mozart の配偶者は Constanze」という文に「開始時点」を付けるには、文そのものをノードにする
statement = WDS["Q254-P26-1"]
rdf.add((WD.Q254, P.P26, statement))                                 # Mozart → 配偶者についての文
rdf.add((statement, PS.P26, WD.Q84464))                              # 文 → 値(Constanze)
rdf.add((statement, PQ.P580, Literal("1782-08-04", datatype=XSD.date)))   # 文 → 修飾子(開始時点)
print("RDF のトリプル(修飾子を付けた後):", len(rdf))

PREFIXES = """PREFIX wd: <http://www.wikidata.org/entity/>   PREFIX wdt: <http://www.wikidata.org/prop/direct/>
PREFIX p: <http://www.wikidata.org/prop/>   PREFIX ps: <http://www.wikidata.org/prop/statement/>
PREFIX pq: <http://www.wikidata.org/prop/qualifier/>
"""
rows = rdf.query(PREFIXES + """
SELECT ?child ?father WHERE {
  ?child  wdt:P19  wd:Q34713 ;      # ザルツブルク生まれで、
          wdt:P22  ?father .        # 父親がいて、
  ?father wdt:P106 wd:Q36834 .      # 父親が作曲家
}""")
print("RDF に SPARQL で問い合わせ:", sorted((names[c.split("/")[-1]], names[f.split("/")[-1]]) for c, f in rows))
rows = rdf.query(PREFIXES + "SELECT ?spouse ?start WHERE { wd:Q254 p:P26 ?st . ?st ps:P26 ?spouse ; pq:P580 ?start . }")
print("RDF の修飾子:", [(names[s.split("/")[-1]], str(t)) for s, t in rows])

# 3. プロパティグラフ:ノードとエッジに、属性(キーと値)を直接持たせる。
#    MultiDiGraph にするのは、関係に向き(主語 → 目的語)があり、同じ2人の間に種類の違う関係が複数ありうるため
pg = nx.MultiDiGraph()
for qid, name in names.items():
    pg.add_node(qid, name=name)                                      # ノードの属性:名前
for s, p, o in facts:
    pg.add_edge(s, o, key=p)                                         # エッジの種類(P19 など)をキーにする
pg.edges["Q254", "Q84464", "P26"]["start"] = "1782-08-04"            # 修飾子は、エッジの属性として付けるだけ
print("\nプロパティグラフのエッジ:", pg.number_of_edges(), " 配偶者のエッジの属性:", pg.edges["Q254", "Q84464", "P26"])

# SPARQL のパターン(?child P19 ザルツブルク、?child P22 ?father、?father P106 作曲家)を、
# エッジを手でたどる処理に書き直し、RDF と同じ答えになるかを確かめる
children = [c for c, _, k in pg.in_edges("Q34713", keys=True) if k == "P19"]             # ザルツブルクに P19 で入るエッジ
pairs = [(pg.nodes[c]["name"], pg.nodes[f]["name"])
         for c in children for _, f, k in pg.out_edges(c, keys=True)
         if k == "P22" and pg.has_edge(f, "Q36834", key="P106")]
print("プロパティグラフをたどる:", sorted(pairs))
Mozart の家族の9つの事実を、RDF とプロパティグラフで表し、同じ問い(ザルツブルク生まれで、父親が作曲家である人物)に答えるコードです。
- 事実: facts は、実験で取り出した Wikidata の事実の一部を、(主語, 述語, 目的語) の ID で書き写したものです(図のグラフと同じ9本です)。Wikidata に問い合わせずに、手元で RDF とプロパティグラフを比べられるようにするためです。ID を Wikidata と同じにしておくと、Wikidata に送ったのと同じ形の SPARQL を、そのまま手元のグラフに使えます。names は、表示用の名前です。
- RDF: rdflib の Graph は、RDF のトリプルを集めて持つ入れ物です。Wikidata と同じ URI でトリプルを入れます。Namespace は URI の共通部分で、WD["Q254"] と書くと http://www.wikidata.org/entity/Q254 になるので、長い URI を毎回書かずに済みます。
- RDF の修飾子: RDF の述語には属性を付けられないので、「Mozart の配偶者は Constanze」という文そのものをノード statement にして、そこに修飾子を付けます。Mozart から文へ(p:P26)、文から Constanze へ(ps:P26)、文から日付のリテラルへ(pq:P580)の3本のトリプルを足します。修飾子1つのために、トリプルが何本増えるかを確かめるため、足す前と後でトリプルの数を表示します。Literal(..., datatype=XSD.date) は、ただの文字列ではなく日付の型を持つ値で、日付として比べたり並べたりできます。
- RDF への問い合わせ: RDF は SPARQL で問い合わせられる標準の形式なので、rdflib でも、Wikidata に送ったのと同じ形の問い合わせが動きます。それを確かめるため、手元のグラフに問い合わせます。PREFIXES は、wd: などの略記が、どの URI を指すかの宣言です。Wikidata の問い合わせでは最初から宣言されていますが、rdflib では自分で書く必要があります。
- プロパティグラフ: networkx の MultiDiGraph に、述語をエッジのキーにして、事実を入れます。MultiDiGraph を使うのは、関係に向き(主語 → 目的語)があり、同じ2人の間に種類の違う関係(父と同居人など)が複数ありうるためです。修飾子は、pg.edges["Q254", "Q84464", "P26"]["start"] のように、エッジの属性として付けるだけです。RDF と比べて、エッジの数が増えないことを確かめるため、エッジの数を表示します。
- プロパティグラフをたどる: プロパティグラフには SPARQL がないので、SPARQL のパターン(?child P19 ザルツブルク、?child P22 ?father、?father P106 作曲家)を、エッジを手でたどる処理に書き直し、RDF と同じ答えになるかを確かめます。ザルツブルクに P19 のエッジで入ってくるノード(ザルツブルク生まれの人物)を in_edges で集め、そこから P22 のエッジで父親へ進み、父親から作曲家への P106 のエッジがあるかを has_edge で確かめます。
実行結果
RDF のトリプル(修飾子なし): 9
RDF のトリプル(修飾子を付けた後): 12
RDF に SPARQL で問い合わせ: [('Maria Anna Mozart', 'Leopold Mozart'), ('Wolfgang Amadeus Mozart', 'Leopold Mozart')]
RDF の修飾子: [('Constanze Mozart', '1782-08-04')]

プロパティグラフのエッジ: 9  配偶者のエッジの属性: {'start': '1782-08-04'}
プロパティグラフをたどる: [('Maria Anna Mozart', 'Leopold Mozart'), ('Wolfgang Amadeus Mozart', 'Leopold Mozart')]
RDF でもプロパティグラフでも、同じ2人(Mozart と Maria Anna、父は Leopold)が見つかりました。違いは、修飾子の持ち方です。RDF では、修飾子を付けるために、トリプルが9本から12本に増えました(文のノードを経由する3本)。プロパティグラフでは、エッジは9本のままで、配偶者のエッジに start の属性が付いただけです。
修飾子の多い知識をアプリの中でたどるならプロパティグラフ、組織をまたいで知識を公開し、つなげるなら RDF、という使い分けが一般的です。どちらも、エンティティをノード、関係をエッジにしたグラフである点は同じで、以降の話はどちらにも当てはまります。
ナレッジグラフにできないこと
ナレッジグラフは、書かれた関係をたどったり数えたりするのは得意ですが、万能ではありません。
# 1. 書かれていない関係:作曲家のうち、出生地(P19)・生年月日(P569)が登録されている人物の割合。
#    ナレッジグラフに「書かれていない事実」がどれだけあるかを、数で確かめる
counts = {}
for name, condition in [("作曲家", ""),
                        ("出生地あり", "FILTER EXISTS { ?person wdt:P19 [] }"),
                        ("生年月日あり", "FILTER EXISTS { ?person wdt:P569 [] }")]:
    n = sparql(f"SELECT (COUNT(?person) AS ?n) WHERE {{ ?person wdt:P106 wd:Q36834 . {condition} }}")
    counts[name] = int(n.n[0])
for name, n in counts.items():
    print(f"{name:8s}: {n:7,d} 人({n / counts['作曲家']:.1%})")


# 2. 名前は1つに決まらない:「Salzburg」という名前の項目の候補。
#    文章や質問に出てくる名前から Q番号を決める作業(エンティティリンキング)が、なぜ要るのかを確かめる
def search_entities(name, limit=7):
    r = requests.get("https://www.wikidata.org/w/api.php", params={
        "action": "wbsearchentities", "search": name, "language": "en", "type": "item",
        "limit": limit, "format": "json",
    }, headers=HEADERS, timeout=60)
    r.raise_for_status()
    return [(e["id"], e.get("label", ""), e.get("description", ""), e["match"]["type"], e["match"]["text"])
            for e in r.json()["search"]]


print()
for qid, label, description, match_type, match_text in search_entities("Salzburg"):
    print(f"{qid:11s} {label:21s} 一致: {match_type:5s} {match_text:9s} {description[:60]}")
作曲家のうち、出生地と生年月日が登録されている人物の割合を数え、「Salzburg」という名前で Wikidata の項目を検索するコードです。
- 登録されている割合: ナレッジグラフに「書かれていない事実」がどれだけあるかを、数で確かめます。作曲家の総数と、そのうち出生地(P19)・生年月日(P569)のトリプルを持つ人物の数を数えます。FILTER EXISTS は「そのトリプルが1本でもあれば残す」条件で、値が複数ある人物も1人として数えられます。[] は「何でもよい値」を表し、値が何であるかは問いません。
- 名前の検索: 文章や質問に出てくる名前から Q番号を決める作業(エンティティリンキング)が、なぜ要るのかを確かめます。search_entities は、Wikidata の API(wbsearchentities)で、名前(ラベル)か別名がその文字列に一致する項目を探し、ID・ラベル・一致した種類(ラベルか別名か)・説明を返します。同じ名前の候補がいくつ、どんな種類で見つかるかを見ます。
実行結果
作曲家     : 134,815 人(100.0%)
出生地あり   :  92,017 人(68.3%)
生年月日あり  : 117,837 人(87.4%)

Q34713      Salzburg              一致: label Salzburg  city in Austria, eponymous capital city of the federal state
Q43325      Salzburg              一致: label Salzburg  federal state in the North-West of Austria
Q1307356    Salzburgwiki          一致: label Salzburgwiki wiki for the Austrian state of Salzburg
Q994811     FC Red Bull Salzburg  一致: alias Salzburg  Austrian professional football club
Q106455030  Salzburg              一致: label Salzburg  family name
Q186719     Ocna Sibiului         一致: alias Salzburg  town in Sibiu County, Romania
Q1087994    Sălacea               一致: alias Salzburg  village in Bihor County, Romania
(和訳)
- Q34713:オーストリアの都市。同名のザルツブルク州の州都
- Q43325:オーストリア北西部の州
- Q1307356:オーストリアのザルツブルク州についての wiki
- Q994811:オーストリアのプロのサッカークラブ
- Q106455030:姓
- Q186719:ルーマニアのシビウ県の町
- Q1087994:ルーマニアのビホル県の村
出生地と生年月日が登録されている作曲家の数を並べると、次のようになります。
(図は、diagram-designで作成)
書かれていない関係は、分からない
Wikidata の作曲家約13万5千人のうち、出生地が登録されているのは68.3%で、残りの約4万3千人は出生地が分かりません。実験1の「ザルツブルク生まれの作曲家は81人」は、正確には「Wikidata に、出生地がザルツブルクと 書かれている 作曲家は81人」で、本当の人数はそれより多いかもしれません。
ナレッジグラフでは、トリプルがないことは「その事実がない」ことを意味しません。この考え方を 開世界仮説(open world assumption)と呼びます。「ザルツブルク生まれではない作曲家」を数えようとすると、出生地が分からない人物をどう扱うかで、答えが変わってしまいます。
名前から、どの「もの」かを決める必要がある
「Salzburg」で検索すると、ザルツブルク市(Q34713)、ザルツブルク州(Q43325)、サッカークラブ、姓、さらに別名が「Salzburg」であるルーマニアの町や村まで見つかりました。ナレッジグラフは Q番号で「もの」を区別するので、名前の曖昧さはありませんが、その代わりに、文章や質問に出てくる名前が、どの Q番号を指すか を決める作業(エンティティリンキング)が必要になります。「Salzburg で生まれた」の Salzburg は市で、「Salzburg の州都」の Salzburg は州です。人が問い合わせを書くときは、この作業を頭の中で行っています。
そのほかの限界
- 誤りや粒度の違い: 実験1の対象には、Wikipedia の導入部では画家と書かれている人物(Pietro Antonio Lorenzoni)も含まれていました。Wikidata の職業に、作曲家も登録されているためです。また、出生地を市で書くか、市内の地区で書くかは、人物によって違います(CoVe の記事の実験でも、この違いが正解の判定に影響しました)。ナレッジグラフの答えは、データの質以上には正確になりません。
- 関係にならない知識: 「なぜ Mozart はザルツブルクを離れたのか」のような理由や経緯、評価、ニュアンスは、トリプルにしにくい知識です。こうした知識は、文章のほうがよく表せます。
- 作るのに手間がかかる: Wikidata は、多くの人の編集と、既存のデータベースからの取り込みで作られています。自分の組織の文書からナレッジグラフを作るには、文章からエンティティと関係を抜き出し、同じものを指す名前をそろえる(名寄せ)必要があります。最近は、この抽出を LLM で行う方法が使われています。
ナレッジグラフと LLM
LLM は、文章を読んで答えるのは得意ですが、多くの事実を正確に集計したり、関係をいくつもたどったりする問いでは、誤りやすくなります。CoVe の記事では、LLM に「ボストンで生まれた政治家」のような人物を5人ずつ挙げさせると、4人に3人は、その都市の生まれではないか、Wikidata に見つからない人物でした。その正解を集めるのに使ったのが、本記事と同じ Wikidata への SPARQL の問い合わせです。
そこで、ナレッジグラフと LLM を組み合わせる方法が研究されています。
- ナレッジグラフを検索する RAG: RAG の記事の Modular RAG で触れた、ナレッジグラフを直接検索するモジュールのように、質問に関係するエンティティと関係をナレッジグラフから取り出して、LLM に渡します(GraphRAG の Local Search の記事で扱っています)。
- 質問を問い合わせに変換する: LLM に、質問を SPARQL などの問い合わせに書き換えさせ、答えはナレッジグラフから取り出します。集計や多段のたどりを、ナレッジグラフに任せられます。
- 文書からナレッジグラフを作る: LLM で文書からエンティティと関係を抜き出し、ナレッジグラフにします。グラフにしておけば、文書全体を見渡す問いや、関係をたどる問いに、グラフの上で答えられるようになります。
ナレッジグラフを使うときの注意点
- 問いに合ったプロパティとクラスを選ぶ: 実験1のように、「生まれた」「亡くなった」「活動した」は別のプロパティです。実験2のように、分類の粒度もまちまちなので、上位の分類をたどるかどうかで結果が大きく変わります。問い合わせを書く前に、対象の項目にどのプロパティとクラスが使われているかを確かめます。
- 数えた結果は「書かれている数」: 開世界仮説のとおり、登録されていない事実は数えられません。割合や順位を比べるときは、プロパティが登録されている割合も合わせて確かめます。
- 名前ではなく ID で指定する: 問い合わせでは、ラベルではなく Q番号・P番号で指定します。名前から ID を決めるときは、検索の候補を見て、説明で区別します。
- 公開のエンドポイントの制限を守る: Wikidata の SPARQL は、1回の問い合わせに時間の上限(60秒)があり、短時間に大量に送ると制限されます。大量のデータが必要なときは、Wikidata が公開しているダンプ(全データのファイル)を使います。
まとめ
本記事では、知識をトリプル(主語, 述語, 目的語)で持つナレッジグラフを、Wikipedia と Wikidata で確かめました。
「ザルツブルク生まれの作曲家は誰か」に Wikipedia の導入部で答えようとすると、「Salzburg が出てくる」規則では17人中8人しか拾えず、23人を誤って含め、「born … Salzburg」に絞ると誤りは1人に減る代わりに、拾えたのは4人だけでした。書き方の揺れと、書かれていない情報のためです。ナレッジグラフでは、出生地が決まった形のトリプルで持たれているので、1回の問い合わせで81人を生年の順に並べられました。
Wikidata は、エンティティを Q番号、関係を P番号で区別し、事実を修飾子や出典の付いた文として持っています。SPARQL では、変数を含んだトリプルのパターンでグラフの部分を探し、関係をたどる(父親も作曲家である6人)、集計する(オーストリアの出生地ごとの人数)、上位の分類をたどって推論する(都市で生まれた作曲家が182人から2,153人に)といった問いに答えられました。修飾子の持ち方は、RDF では文のノードを経由する3本のトリプル、プロパティグラフではエッジの属性になります。
一方で、ナレッジグラフは書かれていない関係を知らず(作曲家の約3割は出生地が不明)、名前からどの「もの」かを決める作業も別に必要です。文章の柔軟さと、ナレッジグラフの正確さを組み合わせることが、LLM とナレッジグラフを組み合わせる研究の出発点になっています。
参考文献
- S. Ji, S. Pan, E. Cambria, P. Marttinen, P. S. Yu (2022). A Survey on Knowledge Graphs: Representation, Acquisition and Applications. IEEE Transactions on Neural Networks and Learning Systems, 33(2).
- A. Hogan et al. (2021). Knowledge Graphs. ACM Computing Surveys, 54(4).
- A. Singhal (2012). Introducing the Knowledge Graph: things, not strings. Google Blog.
本記事の文章・構成の一部に生成AIを使用しています。