LightRAG とは? GraphRAG を軽くした2段階の検索
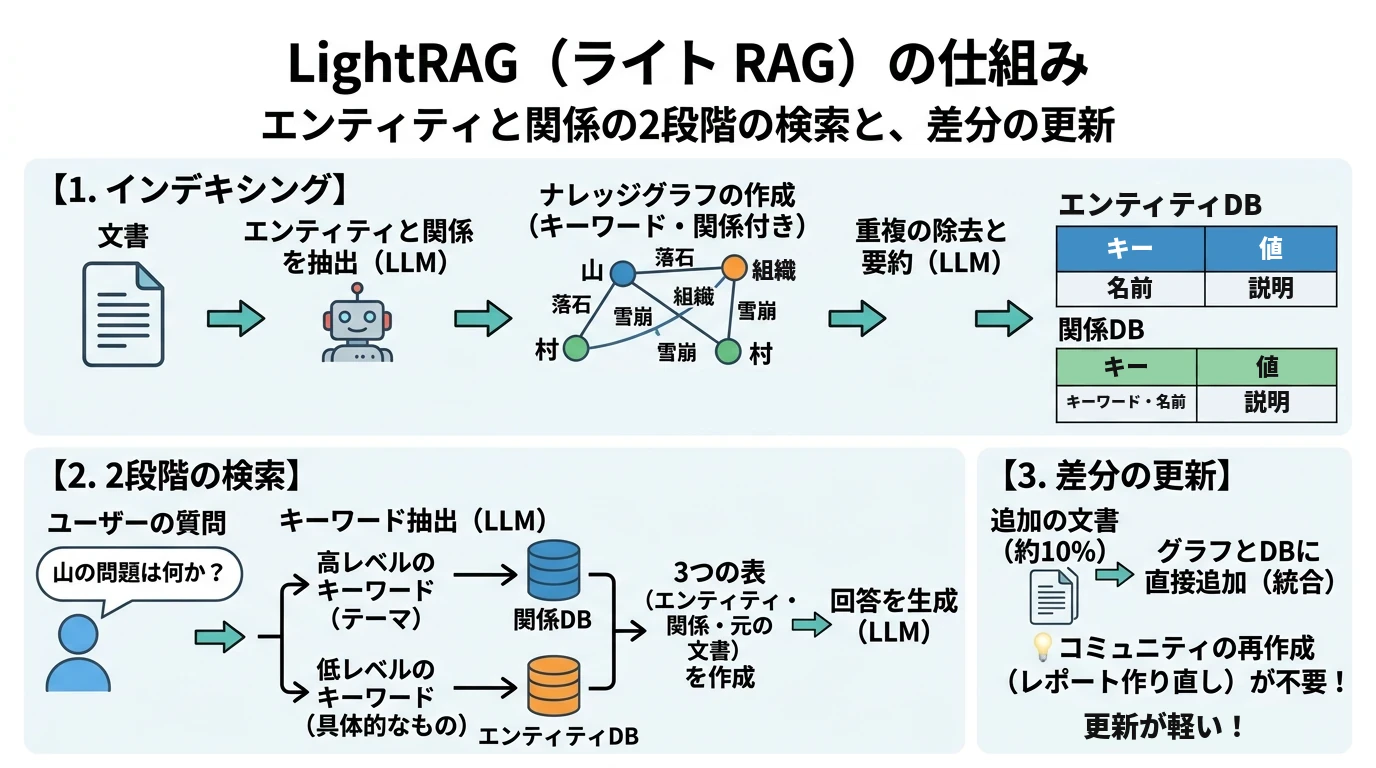 (画像は、Geminiで作成)
GraphRAG の2つの重さ(質問のたびにすべてのコミュニティのレポートを読むことと、文書を追加するたびにコミュニティとレポートを作り直すこと)を、LightRAG がどう避けるのかを、コードで理解すること。エンティティと関係のキー・値のインデックス、低レベル・高レベルのキーワードによる2段階の検索、差分の更新のそれぞれが、答えの質と手間にどう効くのかを、数値で説明できるようになること。
原著論文: LightRAG: Simple and Fast Retrieval-Augmented Generation (Guo, Xia, Yu, Ao, Huang, Findings of EMNLP 2025)
本記事のコードは、Google Colab の A100 GPU(40GB)で、Python 3.13、transformers 5.22.1、torch 2.14.1、sentence-transformers 5.7.0、networkx 3.7、igraph 1.0.0、leidenalg 0.12.0 を使って実行しました。LLM には Qwen2.5-7B-Instruct(bf16)、埋め込みには GraphRAG の記事と同じ SBERT のモデル(multi-qa-mpnet-base-cos-v1)を使います。全体の実行には約42分かかり、そのうち約24分は600件の文書からエンティティと関係を抽出する時間です。生成は貪欲法(do_sample=False)で、Leiden 法の乱数も固定しているので、同じ環境では同じ結果になります。
差分の更新の節で GraphRAG のコミュニティ検出と比べるために、igraph と leidenalg を使います。インストールされていない場合は、事前に次のコマンドを実行してください。
!pip install igraph leidenalg
概要
GraphRAG の記事では、文書からエンティティと関係のグラフを作り、コミュニティごとにレポートを書いておくことで、「これらの山の主な問題は何か」のような全体を俯瞰する問いに答えました。Local Search の記事では、同じグラフで、質問のエンティティの周りの関係と文書を集めました。GraphRAG には、2つの重さがあります。1つは、全体を俯瞰する問いに答える Global Search が、質問のたびにすべてのコミュニティのレポートを LLM に読ませる ことです。もう1つは、文書を追加するたびに、コミュニティの分け方とレポートを作り直す 必要があることです。
LightRAG(Guo et al., Findings of EMNLP 2025)は、コミュニティのレポートを作らずに、この2つを避けます。インデキシングでは、エンティティと関係を抽出するときに、関係ごとに「その関係が表すテーマ」のキーワードを書かせ、エンティティと関係のそれぞれを、検索に使うキーと、LLM に読ませる値(説明)の組にしてベクトル DB に入れます。質問が来たら、LLM で質問から 低レベルのキーワード(具体的なもの)と 高レベルのキーワード(テーマ)を書き出させ、前者でエンティティを、後者で関係を探します(2段階の検索)。文書を追加したときは、追加分だけを抽出して、同じ名前のノード・同じ組のエッジに統合します(差分の更新)。
本記事では、GraphRAG・Local Search の記事と同じ600件の架空の山の紹介文と、同じ LLM(Qwen2.5-7B-Instruct)で LightRAG をスクラッチ実装し、全体を俯瞰する問いと、特定のエンティティについての問いで、普通の RAG や、低レベル・高レベルの片方だけの検索と比べます。最後に、文書を60件追加して、差分の更新の手間と、GraphRAG ならコミュニティのレポートを何件書き直すことになるかを確かめます。
GraphRAG の2つの重さ
(図は、diagram-designで作成)
- 質問のたびに、すべてのレポートを読む: GraphRAG の記事の実験では、C1 の25件のレポートを読む Global Search で、LLM の呼び出しが26回、入力が7,987トークンでした。600件のコーパスでは小さな数ですが、レポートの数は文書の数とともに増えます。原著論文の Legal データセット(約508万トークン)では、検索に使う階層のコミュニティが610個あり、1回の質問で約61万トークンを読む計算になります。
- 文書を追加するたびに、作り直す: 抽出は追加した文書だけで済みます。しかし、コミュニティは、グラフ全体のつながりの密さで決まるので、ノードとエッジが増えると、分け方そのものが変わります。分け方が変わったコミュニティのレポートは、書き直す必要があります。
LightRAG の仕組み
(図は、diagram-designで作成)
LightRAG は、次の3つからなります。
- グラフを使ったインデキシング: 文書(原著論文では1,200トークンずつのチャンク)ごとに、LLM でエンティティ(名前・種類・説明)と関係(始点・終点・説明・キーワード・強さ)を抽出します。抽出のプロンプトは GraphRAG とほぼ同じですが、関係ごとに 関係のキーワード(「関係の性質を表す、具体的な細部ではなくテーマや概念の高レベルの語」)を書かせる点が違います。抽出の漏れを拾う gleaning(「漏れたエンティティを足せ」と続けて聞く)も1回行います。
- 重複の除去と、キー・値の組: 別々の文書から出てきた同じ名前のエンティティ、同じ組の関係を1つにまとめ、説明をつなぎます。つないだ説明が長くなりすぎたものだけ、LLM で1つの説明に要約します。原著論文はこれを LLM profiling と呼び、エンティティは名前を、関係はキーワードと両端の名前を キー、説明を 値 とする組にします。キーを埋め込みで検索し、値を LLM に読ませます。GraphRAG のようなコミュニティ検出とレポートは作りません。
- 2段階の検索: 質問から、LLM で低レベルと高レベルのキーワードを1回で書き出させます。
- 低レベルの検索: 低レベルのキーワードに近いエンティティを探し、そのエンティティの関係と、エンティティが出てきた元の文書を集めます。特定のものについての問いに向いています。
- 高レベルの検索: 高レベルのキーワードに近い関係を探し、その両端のエンティティと、関係が出てきた元の文書を集めます。テーマについての問いに向いています。
- 両方の結果を合わせて、エンティティ・関係・元の文書の3つの表にし、LLM に1回で答えさせます。検索そのものに LLM は使わないので、質問のたびの呼び出しは、キーワードと答えの2回です。
文書を追加したときは、同じ手順で追加分だけを抽出し、既存のグラフのノードとエッジに統合します(原著論文の言葉では、ノードの集合とエッジの集合の和集合を取る)。コミュニティがないので、作り直すものはありません。
ナレッジグラフの考え方はナレッジグラフの記事、抽出と名寄せはLLM によるナレッジグラフの構築の記事で解説しています。
実験の準備
架空の山岳コーパスと、追加の文書
GraphRAG の記事と同じ600件の架空の山の紹介文を使います。どの文書にも「山脈・標高・登山道の起点の村・登山の適期」があり、363件には6つの問題(落石150件、山小屋の管理人100件、高山植物の盗掘60件、ライチョウの減少30件、雪崩15件、ごみ8件)のどれか1つが1文で書かれています。差分の更新を確かめるために、後で足す60件も作っておきます。60件のうち20件には、600件にはない新しい問題(土砂崩れと、それを復旧する谷道路事務所)を、5件には雪崩を書きます。
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]

# 6つの問題(テーマ):文書の数、回答がそのテーマに触れたかを見つける正規表現、文書に足す文
THEMES = {
    "rockfall": (150, r"rock ?fall|falling rock|loose rock",
                 "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season."),
    "hut_keeper": (100, r"keeper|successor|caretaker|\bhuts?\b",
                   "The hut on Mount {n} may close because its keeper is retiring and no successor has been found."),
    "plant_poaching": (60, r"lil(y|ies)|poach",
                       "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}."),
    "ptarmigan": (30, r"ptarmigan",
                  "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago."),
    "avalanche": (15, r"avalanche",
                  "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter."),
    "litter": (8, r"trash|litter|garbage|rubbish",
               "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}."),
}
# 文の意味:rockfall「落石が続き、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した」
#   hut_keeper「管理人が引退し後継者が見つからないため、{n} 山の山小屋は閉鎖されるかもしれない」
#   plant_poaching「レンジャーは、{n} 山の草原でスノーリリーが掘り取られて持ち去られているのを見つけた」
#   ptarmigan「調査によると、{n} 山で巣を作るライチョウは10年前より少ない」
#   avalanche「雪崩監視班は、昨冬 {n} 山の北面で大きな雪崩があったと報告した」
#   litter「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた」


def build_corpus(themes, n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                      # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))                       # (b) 問題の文がない山
    rng.shuffle(labels)
    docs = []
    for name, theme in zip(names, labels):
        # 「{name} 山は {山脈} 山脈の峰で、標高 {高さ} メートル。主な登山道は {村} 村から始まる。登山の適期は {季節}。」
        mountain_range, height, village = rng.choice(RANGES), rng.randint(1500, 3999), rng.choice(VILLAGES)
        text = (f"Mount {name} is a peak in the {mountain_range} Range, rising {height:,} meters "
                f"above sea level. The main trail starts from the village of {village}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:                                              # (c) 問題の文を足し、どのテーマかを記録する
            text += " " + themes[theme][2].format(n=name)
        docs.append({"mountain": name, "range": mountain_range, "village": village, "text": text, "theme": theme})
    return docs


docs = build_corpus(THEMES)
print("文書の数:", len(docs), " 問題の文がある文書:", sum(d["theme"] is not None for d in docs))

# 後で差分の更新に使う、追加の60件:新しい問題(土砂崩れ)20件と、雪崩5件、問題のない35件
NEW_THEMES = {
    "landslide": (20, r"landslide|mudslide",
                  "Heavy rain caused a landslide that buried the approach road to Mount {n}, "
                  "and the Valley Road Office is repairing it."),
    "avalanche": (5, THEMES["avalanche"][1], THEMES["avalanche"][2]),
}
# 文の意味:landslide「大雨で土砂崩れが起き、{n} 山へのアプローチの道路が埋まった。谷道路事務所が復旧している」
ALL_THEMES = {**THEMES, "landslide": NEW_THEMES["landslide"]}


def build_new_docs(themes, existing, n=60, seed=1):
    """既存の山と名前が重ならない n 山の紹介文を、build_corpus と同じ形で作る"""
    rng = random.Random(seed)
    taken, names = {d["mountain"] for d in existing}, set()
    while len(names) < n:
        name = "".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize()
        if name not in taken:
            names.add(name)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))
    rng.shuffle(labels)
    new_docs = []
    for name, theme in zip(sorted(names), labels):
        mountain_range, height, village = rng.choice(RANGES), rng.randint(1500, 3999), rng.choice(VILLAGES)
        text = (f"Mount {name} is a peak in the {mountain_range} Range, rising {height:,} meters "
                f"above sea level. The main trail starts from the village of {village}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:
            text += " " + themes[theme][2].format(n=name)
        new_docs.append({"mountain": name, "range": mountain_range, "village": village, "text": text, "theme": theme})
    return new_docs


new_docs = build_new_docs(NEW_THEMES, docs)
print("追加の文書:", len(new_docs), " 土砂崩れ:", sum(d["theme"] == "landslide" for d in new_docs),
      " 雪崩:", sum(d["theme"] == "avalanche" for d in new_docs))
print("追加の例:", next(d["text"] for d in new_docs if d["theme"] == "landslide"))
600件の文書と、後で足す60件の文書を作るコードです。
- THEMES と build_corpus: GraphRAG・Local Search の記事と同じコードなので、同じ600件ができます。テーマごとに「文書の数、答えがそのテーマに触れたかを判定する正規表現、文書に足す文」を持ちます。
- NEW_THEMES: 追加の60件に入れる問題です。土砂崩れ(landslide)は、600件のどこにも出てこない新しい問題で、更新したあとに「主な問題」の答えに加わるかを確かめるために入れます。雪崩の5件は、既存の雪崩監視班(Avalanche Watch)のノードに、新しい山がつながるかを確かめるためです。
- ALL_THEMES: 更新後の採点に使う、7つのテーマの辞書です。
- build_new_docs(themes, existing, n=60, seed=1): build_corpus と同じ形の文書を作ります。600件の山と同じ名前を避けるのは、追加の文書が既存の山のノードに混ざって、更新の結果が読みにくくならないようにするためです。
実行結果
文書の数: 600  問題の文がある文書: 363
追加の文書: 60  土砂崩れ: 20  雪崩: 5
追加の例: Mount Fufuha is a peak in the Hoshimi Range, rising 2,832 meters above sea level. The main trail starts from the village of Sakaki. The best season to climb it is late summer. Heavy rain caused a landslide that buried the approach road to Mount Fufuha, and the Valley Road Office is repairing it.
英語の出力の日本語訳:
- 追加の例:「Fufuha 山は Hoshimi 山脈の峰で、標高2,832メートル。主な登山道は Sakaki 村から始まる。登山の適期は晩夏。大雨で土砂崩れが起き、Fufuha 山へのアプローチの道路が埋まった。谷道路事務所が復旧している。」
LLM と埋め込み
LLM と、使用量(呼び出し回数・入力と出力のトークン数・時間)を数えながら生成する関数は、GraphRAG の記事と同じです。LightRAG の抽出では、抽出の結果を見せたうえで「漏れを足せ」と続けて聞くので、会話の履歴(メッセージのリスト)も渡せるようにしています。
import time

import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()
# 埋め込み:GraphRAG・Local Search の記事と同じ SBERT のモデル
embedder = SentenceTransformer("sentence-transformers/multi-qa-mpnet-base-cos-v1", device="cuda")


def n_tokens(text):
    return len(tokenizer(text)["input_ids"])


def new_usage():
    """LLM の使用量を数える入れ物:呼び出し回数・入力と出力のトークン数・時間(秒)"""
    return {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}


@torch.no_grad()
def generate(prompts, usage, max_new_tokens=600, batch_size=16):
    """プロンプト(文字列、またはメッセージのリスト)をまとめて生成し、使用量を usage に足していく"""
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = []
        for p in prompts[i:i + batch_size]:
            messages = p if isinstance(p, list) else [{"role": "user", "content": p}]   # 文字列はユーザーの発言1つ
            texts.append(tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True))
        torch.cuda.empty_cache()                       # 長い文脈で、断片化した GPU のメモリが足りなくなるのを防ぐ
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += n_tokens(text)
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def embed(texts):
    """文のリストを、長さ1に正規化した埋め込みにする(内積がそのままコサイン類似度になる)"""
    return embedder.encode(texts, normalize_embeddings=True, batch_size=64, show_progress_bar=False)
LLM と埋め込みのモデルを読み込み、生成と埋め込みの関数を用意するコードです。
- generate(prompts, usage, max_new_tokens=600, batch_size=16): プロンプトを batch_size 個ずつまとめて生成し、使用量を usage に足していきます。プロンプトが文字列ならユーザーの発言1つ、メッセージのリストなら、そのまま会話として渡します。メッセージのリストは、gleaning(会話の続き)と、答えのプロンプト(システムのメッセージに文脈を入れる)で使います。
- torch.cuda.empty_cache(): 生成のたびに、使っていない GPU のメモリを解放します。LightRAG の答えの文脈は数万トークンになることがあり、最初の実行では、メモリの断片化で足りなくなって止まったためです。結果は変わりません。
- embed: ベクトルの長さを1にそろえるので、内積がそのままコサイン類似度になります。GraphRAG の記事と同じ SBERT のモデルにそろえ、結果を比べられるようにしています。原著論文の実装の既定は、OpenAI の埋め込みのモデルです。
インデックスを作る
エンティティと関係を、キーワード付きで抽出する
600件の文書のそれぞれから、公式の実装(2024年10月の版)のプロンプトで、エンティティと関係を抽出します。プロンプトの指示は公式のままで、例だけを、物語の文章から山の文書に置き換えています。公式の例は3つの物語(合わせて約2,000トークン)で、毎回の入力が長くなるためです。エンティティの種類は、GraphRAG の記事と同じく、山・山脈・村・組織・生物・その他にしています。
import re
from collections import defaultdict

TUPLE, RECORD, DONE = "<|>", "##", "<|COMPLETE|>"
ENTITY_TYPES = "mountain, range, village, organization, species, other"

# 公式の実装(2024年10月の版)の抽出のプロンプト。例だけを、山の文書に置き換えている
EXTRACT = """-Goal-
Given a text document that is potentially relevant to this activity and a list of entity types, identify all entities of those types from the text and all relationships among the identified entities.

-Steps-
1. Identify all entities. For each identified entity, extract the following information:
- entity_name: Name of the entity, capitalized
- entity_type: One of the following types: [{entity_types}]
- entity_description: Comprehensive description of the entity's attributes and activities
Format each entity as ("entity"{tuple}<entity_name>{tuple}<entity_type>{tuple}<entity_description>)

2. From the entities identified in step 1, identify all pairs of (source_entity, target_entity) that are *clearly related* to each other.
For each pair of related entities, extract the following information:
- source_entity: name of the source entity, as identified in step 1
- target_entity: name of the target entity, as identified in step 1
- relationship_description: explanation as to why you think the source entity and the target entity are related to each other
- relationship_strength: a numeric score indicating strength of the relationship between the source entity and target entity
- relationship_keywords: one or more high-level key words that summarize the overarching nature of the relationship, focusing on concepts or themes rather than specific details
Format each relationship as ("relationship"{tuple}<source_entity>{tuple}<target_entity>{tuple}<relationship_description>{tuple}<relationship_keywords>{tuple}<relationship_strength>)

3. Identify high-level key words that summarize the main concepts, themes, or topics of the entire text. These should capture the overarching ideas present in the document.
Format the content-level key words as ("content_keywords"{tuple}<high_level_keywords>)

4. Return output in English as a single list of all the entities and relationships identified in steps 1 and 2. Use **{record}** as the list delimiter.

5. When finished, output {done}

######################
-Examples-
######################
Example 1:

Entity_types: [{entity_types}]
Text:
Mount Taro is a peak in the Akatsuki Range. A bear was seen near its hut, and the Forest Office warned hikers.
################
Output:
("entity"{tuple}"Mount Taro"{tuple}"mountain"{tuple}"Mount Taro is a peak in the Akatsuki Range with a hut where a bear was seen."){record}
("entity"{tuple}"Akatsuki Range"{tuple}"range"{tuple}"The Akatsuki Range is a mountain range that includes Mount Taro."){record}
("entity"{tuple}"Bear"{tuple}"species"{tuple}"A bear was seen near the hut on Mount Taro."){record}
("entity"{tuple}"Forest Office"{tuple}"organization"{tuple}"The Forest Office warned hikers after a bear was seen on Mount Taro."){record}
("relationship"{tuple}"Mount Taro"{tuple}"Akatsuki Range"{tuple}"Mount Taro is a peak in the Akatsuki Range."{tuple}"geography, mountain range"{tuple}9){record}
("relationship"{tuple}"Bear"{tuple}"Mount Taro"{tuple}"A bear was seen near the hut on Mount Taro."{tuple}"wildlife sighting, hiker safety"{tuple}7){record}
("relationship"{tuple}"Forest Office"{tuple}"Mount Taro"{tuple}"The Forest Office warned hikers on Mount Taro about the bear."{tuple}"safety warning, wildlife risk"{tuple}8){record}
("content_keywords"{tuple}"wildlife, hiker safety, mountain geography"){done}
#############################
-Real Data-
######################
Entity_types: {entity_types}
Text: {input_text}
######################
Output:
"""
# EXTRACT の日本語訳:
# 「-目的-
#   この作業に関係するかもしれない文書と、エンティティの種類のリストが与えられます。文書から、それらの種類の
#   エンティティをすべて見つけ、見つけたエンティティどうしの関係をすべて見つけてください。
#  -手順-
#   1. エンティティをすべて見つけます。見つけたエンティティごとに、次の情報を抜き出します。
#      - entity_name:エンティティの名前(先頭を大文字にする)
#      - entity_type:次の種類のどれか 1 つ [{entity_types}]
#      - entity_description:エンティティの属性と活動を、漏れなく説明した文
#      各エンティティを ("entity"{tuple}<名前>{tuple}<種類>{tuple}<説明>) の形で書きます。
#   2. 手順 1 で見つけたエンティティから、*はっきりと関係している* (始点のエンティティ, 終点のエンティティ) の組を
#      すべて見つけます。関係している組ごとに、次の情報を抜き出します。
#      - source_entity:始点のエンティティの名前(手順 1 で見つけたもの)
#      - target_entity:終点のエンティティの名前(手順 1 で見つけたもの)
#      - relationship_description:始点と終点のエンティティが関係していると考える理由の説明
#      - relationship_strength:始点と終点のエンティティの関係の強さを表す数値
#      - relationship_keywords:関係の全体的な性質を要約する、1 つ以上の高レベルのキーワード。細かな事実ではなく、
#        概念やテーマに注目する
#      各関係を ("relationship"{tuple}<始点>{tuple}<終点>{tuple}<関係の説明>{tuple}<関係のキーワード>{tuple}<関係の強さ>)
#      の形で書きます。
#   3. 文書全体の主な概念・テーマ・話題を要約する、高レベルのキーワードを見つけます。文書にある全体的な考えを
#      とらえるものにします。この文書単位のキーワードを ("content_keywords"{tuple}<高レベルのキーワード>) の形で書きます。
#   4. 手順 1 と 2 で見つけたすべてのエンティティと関係を、英語で、1 つのリストとして出力します。リストの区切りには
#      **{record}** を使います。
#   5. 終わったら {done} を出力します。
#  -例-
#   例 1:
#   エンティティの種類:[{entity_types}]
#   文書:Taro 山は Akatsuki 山脈の峰である。山小屋の近くでクマが目撃され、森林事務所が登山者に注意を呼びかけた。
#   出力:
#   ("entity"{tuple}"Mount Taro"{tuple}"mountain"{tuple}"Taro 山は Akatsuki 山脈の峰で、山小屋の近くでクマが目撃された。"){record}
#   ("entity"{tuple}"Akatsuki Range"{tuple}"range"{tuple}"Akatsuki 山脈は、Taro 山を含む山脈である。"){record}
#   ("entity"{tuple}"Bear"{tuple}"species"{tuple}"Taro 山の山小屋の近くで、クマが目撃された。"){record}
#   ("entity"{tuple}"Forest Office"{tuple}"organization"{tuple}"Taro 山でクマが目撃されたあと、森林事務所が登山者に注意を呼びかけた。"){record}
#   ("relationship"{tuple}"Mount Taro"{tuple}"Akatsuki Range"{tuple}"Taro 山は Akatsuki 山脈の峰である。"{tuple}"地理, 山脈"{tuple}9){record}
#   ("relationship"{tuple}"Bear"{tuple}"Mount Taro"{tuple}"Taro 山の山小屋の近くで、クマが目撃された。"{tuple}"野生動物の目撃, 登山者の安全"{tuple}7){record}
#   ("relationship"{tuple}"Forest Office"{tuple}"Mount Taro"{tuple}"森林事務所が、Taro 山の登山者にクマへの注意を呼びかけた。"{tuple}"安全の警告, 野生動物の危険"{tuple}8){record}
#   ("content_keywords"{tuple}"野生動物, 登山者の安全, 山の地理"){done}
#  -実際のデータ-
#   エンティティの種類:{entity_types}
#   文書:{input_text}
#   出力:」
GLEAN = "MANY entities were missed in the last extraction.  Add them below using the same format:\n"
# 指示の意味:「多くのエンティティが前回の抽出で漏れた。同じ形で、下に追加せよ」


def clean(s):
    return s.strip().strip('"').strip()


def parse_records(text, chunk_id):
    """("entity"<|>名前<|>種類<|>説明) と ("relationship"<|>始点<|>終点<|>説明<|>キーワード<|>強さ) を取り出す"""
    entities, relations = [], []
    for record in re.split(re.escape(RECORD) + "|" + re.escape(DONE), text):
        m = re.search(r"\((.*)\)", record)
        if m is None:
            continue
        a = [clean(x) for x in m.group(1).split(TUPLE)]
        if a[0] == "entity" and len(a) >= 4 and a[1]:
            entities.append({"name": a[1].upper(), "type": a[2].upper(), "description": a[3], "source": chunk_id})
        elif a[0] == "relationship" and len(a) >= 5 and a[1] and a[2]:
            weight = float(a[-1]) if re.fullmatch(r"[-+]?\d*\.?\d+", a[-1]) else 1.0
            relations.append({"source": a[1].upper(), "target": a[2].upper(), "description": a[3],
                              "keywords": a[4], "weight": weight, "source_id": chunk_id})
    return entities, relations


def extract(texts, usage, gleaning=1):
    """文書ごとに抽出し、gleaning 回だけ「漏れを足せ」と続けて聞く(公式の既定は1回)"""
    prompts = [EXTRACT.format(tuple=TUPLE, record=RECORD, done=DONE, entity_types=ENTITY_TYPES, input_text=t)
               for t in texts]
    results = generate(prompts, usage, max_new_tokens=600, batch_size=32)      # (a) 1回目の抽出
    for _ in range(gleaning):                                                  # (b) 会話を続けて、漏れを足させる
        histories = [[{"role": "user", "content": p}, {"role": "assistant", "content": r},
                      {"role": "user", "content": GLEAN}] for p, r in zip(prompts, results)]
        more = generate(histories, usage, max_new_tokens=600, batch_size=32)
        results = [r + "\n" + m for r, m in zip(results, more)]
    return results


extract_usage = new_usage()
raw = extract([d["text"] for d in docs], extract_usage)
records = [parse_records(r, i) for i, r in enumerate(raw)]
print(f"抽出: 呼び出し {extract_usage['calls']}回  入力 {extract_usage['input_tokens']:,}  "
      f"出力 {extract_usage['output_tokens']:,}  時間 {extract_usage['seconds']:.0f} 秒")
print(f"エンティティ {sum(len(e) for e, _ in records)}  関係 {sum(len(r) for _, r in records)}(重複を含む)")
print("文書 1:", docs[1]["text"])
print(raw[1])
文書ごとに、エンティティと関係を区切り記号の形で書き出させ、gleaning で漏れを足させて、記録に読み取るコードです。
-
EXTRACT: 抽出のプロンプトです。日本語にすると、次の5つの手順を指示しています。
- エンティティを見つけ、名前(大文字で始める)・種類・属性と活動の包括的な説明を書く。
- はっきり関係のあるエンティティの組について、関係の説明・関係のキーワード(具体的な細部ではなく、テーマや概念を表す高レベルの語)・関係の強さ(数値)を書く。
- 文書全体のテーマを表す高レベルのキーワードを書く(content_keywords)。
- 英語で、すべてを ## で区切った1つのリストにする。
- 終わったら <|COMPLETE|> と書く。
GraphRAG の記事の抽出(エンティティは名前と種類、関係は短い説明)と比べると、エンティティにも説明を書かせる点と、関係にキーワードと強さを書かせる点が違います。関係のキーワードが、後で高レベルの検索のキーになります。
-
例: 架空の Mount Taro(太郎山)で、熊が出て森林事務所が登山者に警告した、という文と、その抽出の例です。問題(熊の出没)と、それに対応する組織の関係に、「wildlife sighting, hiker safety(野生動物の目撃、登山者の安全)」のようなテーマのキーワードを付ける形を見せています。
-
GLEAN: gleaning のプロンプトで、「多くのエンティティが前回の抽出で漏れた。同じ形で、下に追加せよ」という指示です。公式の実装と同じ文で、原著論文の実験と同じく1回だけ聞きます。
-
parse_records(text, chunk_id): 出力を ## と <|COMPLETE|> で区切り、かっこの中を <|> で分けます。先頭が entity ならエンティティ、relationship なら関係として読み、名前は公式の実装と同じく大文字にそろえます。大文字にするのは、「Ridge Safety Office」と「ridge safety office」を同じノードにするためです。強さが数値として読めないときは1にします。chunk_id は、そのエンティティや関係が出てきた文書の番号で、後で元の文書を集めるのに使います。
-
extract(texts, usage, gleaning=1): (a) 全文書の1回目の抽出をまとめて生成し、(b) 「抽出のプロンプト → 抽出の結果 → GLEAN」の会話の続きを生成して、1回目の結果の後ろにつなげます。公式の実装は、gleaning の結果を、1回目の結果と区別せずにつないで読みます。batch_size=32 は、抽出のプロンプトが短い(約800トークン)ので、A100 の40GB に収まる範囲で、まとめて生成する数を増やして時間を短くするためです。
実行結果
抽出: 呼び出し 1200回  入力 1,230,605  出力 425,022  時間 1450 秒
エンティティ 5454  関係 3927(重複を含む)
文書 1: Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level. The main trail starts from the village of Yanagi. The best season to climb it is early autumn. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhoha for the season.
("entity"<|>"Mount Fuhoha"<|>"mountain"<|>"Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level, and has an upper trail that was closed due to rockfall.")##
("entity"<|>"Kirisame Range"<|>"range"<|>"The Kirisame Range is a mountain range that includes Mount Fuhoha.")##
("entity"<|>"Yanagi"<|>"village"<|>"Yanagi is a village from which the main trail to Mount Fuhoha starts.")##
("entity"<|>"Ridge Safety Office"<|>"organization"<|>"The Ridge Safety Office is responsible for managing the trails and safety on Mount Fuhoha, and closed the upper trail due to rockfall.")##
("relationship"<|>"Mount Fuhoha"<|>"Kirisame Range"<|>"Mount Fuhoha is a peak in the Kirisame Range." <|>"mountain range, peak"<|>9)##
("relationship"<|>"Yanagi"<|>"Mount Fuhoha"<|>"The main trail to Mount Fuhoha starts from the village of Yanagi." <|>"trailhead, starting point"<|>8)##
("relationship"<|>"Ridge Safety Office"<|>"Mount Fuhoha"<|>"The Ridge Safety Office managed the trails and safety on Mount Fuhoha, and closed the upper trail due to rockfall." <|>"safety management, trail closure"<|>9)##
("content_keywords"<|>"mountain climbing, trail management, seasonal conditions")<|COMPLETE|>
Sure, let's add the missed entities and their relationships:

("entity"<|>"Mount Fuhoha"<|>"mountain"<|>"Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level, and has an upper trail that was closed due to rockfall.")##
("entity"<|>"Kirisame Range"<|>"range"<|>"The Kirisame Range is a mountain range that includes Mount Fuhoha.")##
("entity"<|>"Yanagi"<|>"village"<|>"Yanagi is a village from which the main trail to Mount Fuhoha starts.")##
("entity"<|>"Ridge Safety Office"<|>"organization"<|>"The Ridge Safety Office is responsible for managing the trails and safety on Mount Fuhoha, and closed the upper trail due to rockfall.")##
("entity"<|>"Rockfall"<|>"other"<|>"Rockfall occurred on Mount Fuhoha, leading to the closure of the upper trail.")##
("relationship"<|>"Mount Fuhoha"<|>"Kirisame Range"<|>"Mount Fuhoha is a peak in the Kirisame Range." <|>"mountain range, peak"<|>9)##
("relationship"<|>"Yanagi"<|>"Mount Fuhoha"<|>"The main trail to Mount Fuhoha starts from the village of Yanagi." <|>"trailhead, starting point"<|>8)##
("relationship"<|>"Ridge Safety Office"<|>"Mount Fuhoha"<|>"The Ridge Safety Office managed the trails and safety on Mount Fuhoha, and closed the upper trail due to rockfall." <|>"safety management, trail closure"<|>9)##
("relationship"<|>"Rockfall"<|>"Mount Fuhoha"<|>"Rockfall occurred on Mount Fuhoha, leading to the closure of the upper trail." <|>"trail closure, safety issue"<|>8)##
("content_keywords"<|>"mountain climbing, trail management, seasonal conditions, rockfall")<|COMPLETE|>
英語の出力の日本語訳(文書 1 の抽出の前半):
-
エンティティ:Fuhoha 山(山)「Kirisame 山脈の峰で、標高2,859メートル。上部の登山道が落石のために閉鎖された」、Kirisame 山脈(山脈)、Yanagi(村)、尾根安全事務所(組織)「Fuhoha 山の登山道と安全を管理し、落石のために上部の登山道を閉鎖した」
-
関係:Fuhoha 山 — Kirisame 山脈(キーワード「山脈、峰」、強さ9)、Yanagi — Fuhoha 山(「登山口、起点」、8)、尾根安全事務所 — Fuhoha 山(「安全管理、登山道の閉鎖」、9)
-
文書全体のキーワード:「登山、登山道の管理、季節の条件」
-
後半(gleaning):「漏れたエンティティと関係を足します」に続けて、前半と同じ記録を繰り返し、落石(Rockfall、その他) のエンティティと、落石 — Fuhoha 山の関係(「登山道の閉鎖、安全の問題」、8)を足している。
-
gleaning は、1回目の結果をほぼ繰り返した: 文書 1 では、gleaning の出力は「漏れたエンティティと関係を足します」と前置きしてから、1回目の7つの記録をそのまま繰り返し、落石(Rockfall)のエンティティと、落石と山の関係を1つずつ足しました。7B の LLM は、「漏れだけを足せ」という指示でも、全部を書き直すことが多く、出力のトークン数が42万5千と多くなりました。繰り返した記録は、次の統合で同じノード・同じエッジにまとまります。
-
説明に、原因まで書かれた: 山のエンティティの説明は「落石のために上部の登山道が閉鎖された」、関係の説明は「尾根安全事務所が、落石のために上部の登山道を閉鎖した」でした。GraphRAG の記事の抽出では、関係の説明が「上部の登山道を閉鎖した」だけになり、落石が消えていました。エンティティにも「属性と活動の包括的な説明」を書かせるプロンプトなので、文書の内容が説明に残りやすくなります。
-
関係のキーワードは、テーマの語になる: 尾根安全事務所と Fuhoha 山の関係のキーワードは「safety management, trail closure(安全管理、登山道の閉鎖)」でした。具体的な名前ではなく、関係の性質を表す語です。
-
抽出の入力は、GraphRAG の記事の約8.5倍: 600件で LLM を1,200回呼び、入力は約123万トークン、時間は1,450秒でした。GraphRAG の記事の抽出(600回、入力約14万5千トークン、228秒)と比べると、gleaning で呼び出しが2倍になり、プロンプトも長いので、入力は約8.5倍です。LightRAG が軽くするのは、インデキシングではなく、質問のときと、文書を追加したときの手間です。
重複の除去と、キー・値の組
抽出した記録を、同じ名前のノードと同じ組のエッジにまとめてグラフにし、エンティティと関係のベクトル DB を作ります。
import networkx as nx

SEP = "<SEP>"
SUMMARIZE = """You are a helpful assistant responsible for generating a comprehensive summary of the data provided below.
Given one or two entities, and a list of descriptions, all related to the same entity or group of entities.
Please concatenate all of these into a single, comprehensive description. Make sure to include information collected from all the descriptions.
If the provided descriptions are contradictory, please resolve the contradictions and provide a single, coherent summary.
Make sure it is written in third person, and include the entity names so we the have full context.

#######
-Data-
Entities: {name}
Description List: {descriptions}
#######
Output:
"""


def merge(G, records, usage, summary_tokens=500):
    """抽出した記録を、同じ名前のノード・同じ組のエッジにまとめて G に足す(既存のノードとも統合する)"""
    nodes, edges = defaultdict(list), defaultdict(list)
    for entities, relations in records:
        for e in entities:
            nodes[e["name"]].append(e)
        for r in relations:
            if r["source"] != r["target"]:
                edges[tuple(sorted((r["source"], r["target"])))].append(r)
    # (a) ノード:種類は多数決、説明は重複を除いて <SEP> でつなぐ。既にあるノードの説明も加える
    for name, items in nodes.items():
        old = G.nodes[name] if name in G else None
        types = [e["type"] for e in items] + ([old["type"]] if old else [])
        descriptions = {e["description"] for e in items} | ({old["description"]} if old else set())
        G.add_node(name, type=max(set(types), key=types.count), description=SEP.join(sorted(descriptions)),
                   source_ids={e["source"] for e in items} | (old["source_ids"] if old else set()))
    # (b) エッジ:重み(強さ)は足し、説明とキーワードは重複を除いてつなぐ
    for (s, t), items in edges.items():
        old = G.edges[s, t] if G.has_edge(s, t) else None
        for n in (s, t):
            if n not in G:      # 関係にだけ出てきた名前は、種類 UNKNOWN のノードにする
                G.add_node(n, type="UNKNOWN", description=items[0]["description"], source_ids=set())
        G.add_edge(s, t, weight=sum(r["weight"] for r in items) + (old["weight"] if old else 0),
                   description=SEP.join(sorted({r["description"] for r in items} | ({old["description"]} if old else set()))),
                   keywords=SEP.join(sorted({r["keywords"] for r in items} | ({old["keywords"]} if old else set()))),
                   source_ids={r["source_id"] for r in items} | (old["source_ids"] if old else set()))
    # (c) 説明が長くなりすぎたものだけ、LLM で1つの説明に要約する
    touched = [("node", n) for n in nodes] + [("edge", e) for e in edges]
    long = [(kind, k) for kind, k in touched
            if n_tokens((G.nodes[k] if kind == "node" else G.edges[k])["description"]) >= summary_tokens]
    prompts = [SUMMARIZE.format(name=k if kind == "node" else ", ".join(k),
                                descriptions=(G.nodes[k] if kind == "node" else G.edges[k])["description"].split(SEP))
               for kind, k in long]
    for (kind, k), summary in zip(long, generate(prompts, usage, max_new_tokens=summary_tokens, batch_size=4)):
        (G.nodes[k] if kind == "node" else G.edges[k])["description"] = summary
    return list(nodes), list(edges), len(long)


def update_vectors(index, G, node_names, edge_keys):
    """キー・値のベクトル DB:エンティティは「名前+説明」、関係は「キーワード+両端の名前+説明」を埋め込む"""
    for n, v in zip(node_names, embed([f"{n} {G.nodes[n]['description']}" for n in node_names])):
        index["entity_vecs"][n] = v
    texts = [f"{G.edges[e]['keywords']} {e[0]} {e[1]} {G.edges[e]['description']}" for e in edge_keys]
    for e, v in zip(edge_keys, embed(texts)):
        index["relation_vecs"][e] = v


G = nx.Graph()
index = {"G": G, "entity_vecs": {}, "relation_vecs": {}, "chunks": [d["text"] for d in docs]}
merge_usage = new_usage()
node_names, edge_keys, n_summaries = merge(G, records, merge_usage)
update_vectors(index, G, node_names, edge_keys)
print(f"ノード {G.number_of_nodes()}  エッジ {G.number_of_edges()}  要約した説明 {n_summaries}  "
      f"要約の呼び出し {merge_usage['calls']}回  入力 {merge_usage['input_tokens']:,}  時間 {merge_usage['seconds']:.0f} 秒")
print("次数の大きいノード:", sorted(G.degree, key=lambda x: -x[1])[:8])
for name in ["RIDGE SAFETY OFFICE", "AVALANCHE WATCH"]:
    if name in G:
        print(f"{name}({G.nodes[name]['type']}、次数 {G.degree[name]}): {G.nodes[name]['description'][:400]}")
e = next(e for e in G.edges("RIDGE SAFETY OFFICE")) if "RIDGE SAFETY OFFICE" in G else None
if e:
    print("エッジの例:", e, G.edges[e]["keywords"], "|", G.edges[e]["description"])
抽出した記録をグラフに統合し、長くなった説明を要約して、エンティティと関係をベクトル DB に入れるコードです。
- SUMMARIZE: 公式の実装の要約のプロンプトです。「1つか2つのエンティティについての説明のリストを、すべての情報を含む1つの包括的な説明にまとめよ。矛盾があれば解消し、三人称で、エンティティの名前を含めて書け」という指示です。
- merge(G, records, usage, summary_tokens=500): 公式の実装の重複の除去(Dedupe)と LLM profiling にあたります。最初の文書の追加にも、後の差分の更新にも、同じ関数を使います。
- (a) ノード: 同じ名前のエンティティの記録を集め、種類は多数決、説明は重複を除いて <SEP> でつなぎます。source_ids は、そのエンティティが出てきた文書の番号の集合です。すでにグラフにあるノードなら、その説明と文書の番号も加えます。差分の更新は、この「既にあるノードに足す」だけで済みます。
- (b) エッジ: 始点と終点の名前を並べ替えた組で集めます(向きのないグラフ)。重みは関係の強さの合計、説明とキーワードは重複を除いてつなぎます。関係にだけ出てきて、エンティティとして書かれなかった名前は、種類 UNKNOWN のノードにします。
- (c) 要約: つないだ説明が500トークン以上になったノードとエッジだけ、LLM で1つの説明に要約します。尾根安全事務所のように150件の文書に出てくるノードは、説明をつなぐと数千トークンになり、LLM に読ませる値として長すぎるためです。
- update_vectors(index, G, node_names, edge_keys): エンティティは「名前+説明」、関係は「キーワード+両端の名前+説明」を埋め込み、名前(関係は名前の組)をキーにした辞書に入れます。これがキー・値のベクトル DB です。値(説明)はグラフのノードとエッジに持たせています。追加や更新で触れたノードとエッジだけを埋め込み直します。
実行結果
ノード 669  エッジ 2259  要約した説明 30  要約の呼び出し 30回  入力 44,348  時間 145 秒
次数の大きいノード: [('RIDGE SAFETY OFFICE', 150), ('MIDSUMMER', 143), ('ROCKFALL', 133), ('LATE SUMMER', 111), ('HAYATE RANGE', 108), ('KIRISAME RANGE', 104), ('TSUKISHIRO RANGE', 101), ('SHIRANAMI RANGE', 101)]
RIDGE SAFETY OFFICE(ORGANIZATION、次数 150): The Ridge Safety Office is responsible for managing the trails and ensuring the safety of hikers on numerous mountains in the region. They have taken action to close the upper trails of many mountains due to rockfall, including Mount Waseki, Mount Hanemo, Mount Nakine, Mount Noriyo, Mount Shikine, Mount Rishiha, Mount Semifu, Mount Fuhoha, Mount Fuhomo, Mount Fukiri, Mount Funeto, Mount Funowa, Mo
AVALANCHE WATCH(ORGANIZATION、次数 15): Avalanche Watch reported a large avalanche on the north face of Mount Kakuyo last winter.<SEP>Avalanche Watch reported a large avalanche on the north face of Mount Kuhoshi last winter.<SEP>Avalanche Watch reported a large avalanche on the north face of Mount Mikaho last winter.<SEP>Avalanche Watch reported a large avalanche on the north face of Mount Miwaki last winter.<SEP>Avalanche Watch reporte
エッジの例: ('RIDGE SAFETY OFFICE', 'MOUNT FUHOHA') safety management, trail closure | The Ridge Safety Office managed the trails and safety on Mount Fuhoha, and closed the upper trail due to rockfall.
英語の出力の日本語訳:
- 尾根安全事務所の説明(要約):「尾根安全事務所は、この地域の多くの山で、登山道の管理と登山者の安全を担っている。落石のために、多くの山の上部の登山道を閉鎖した。Waseki 山、Hanemo 山、…」
- 雪崩監視班の説明:「雪崩監視班は、昨冬 Kakuyo 山の北面で大きな雪崩があったと報告した。」が、山の名前を変えて <SEP> でつながっている。
- エッジの例:キーワード「安全管理、登山道の閉鎖」、説明「尾根安全事務所は Fuhoha 山の登山道と安全を管理し、落石のために上部の登山道を閉鎖した。」
(図は、diagram-designで作成)
- ノード669・エッジ2,259のグラフ: GraphRAG の記事のグラフ(ノード728・エッジ1,725)よりエッジが多いのは、季節(MIDSUMMER など)や落石のような、文書の中の語もエンティティになり、それぞれの山とつながったためです。
- 要約は30個: 説明が500トークンを超えたのは、山脈・村・季節・尾根安全事務所・落石などのハブのノード30個で、要約に LLM を30回(入力約4万4千トークン、145秒)使いました。尾根安全事務所の説明は「多くの山で、落石のために上部の登山道を閉鎖した」と、問題の原因を含んだ1つの段落になりました。
- 雪崩監視班の説明は、要約されずにつながる: 15件の説明をつないでも500トークンに届かないので、「雪崩監視班は、昨冬 〇〇山の北面で大きな雪崩があったと報告した」が15個、<SEP> でつながったままです。
落石は、グラフのどこに残ったか
GraphRAG の記事では、落石が関係の説明に1回しか出てこず、Global Search の答えから消えました。同じことを確かめます。
# 落石は、グラフのどこに残ったか:エンティティの説明・関係の説明・関係のキーワード・ノードの名前
pattern = THEMES["rockfall"][1]
places = {
    "エンティティの説明": sum(bool(re.search(pattern, a["description"], re.I)) for _, a in G.nodes(data=True)),
    "関係の説明": sum(bool(re.search(pattern, a["description"], re.I)) for *_, a in G.edges(data=True)),
    "関係のキーワード": sum(bool(re.search(pattern, a["keywords"], re.I)) for *_, a in G.edges(data=True)),
    "ノードの名前": [n for n in G if re.search(pattern, n, re.I)],
}
for k, v in places.items():
    print(f"落石が出てくる {k}: {v}")
for t, (count, pat, _) in THEMES.items():
    n = sum(bool(re.search(pat, a["keywords"] + " " + a["description"], re.I)) for *_, a in G.edges(data=True))
    print(f"{t:15s} 文書 {count:3d}件  関係(説明かキーワード)に出てくる数 {n:3d}")
ノードの説明・エッジの説明・エッジのキーワード・ノードの名前のそれぞれに、落石の語が何回出てくるかと、テーマごとに、関係(説明かキーワード)に出てくる数を数えるコードです。G.edges(data=True) は「始点・終点・属性の辞書」の組を返すので、*_, a で属性の辞書だけを受け取っています。
実行結果
落石が出てくる エンティティの説明: 130
落石が出てくる 関係の説明: 277
落石が出てくる 関係のキーワード: 0
落石が出てくる ノードの名前: ['ROCKFALL']
rockfall        文書 150件  関係(説明かキーワード)に出てくる数 277
hut_keeper      文書 100件  関係(説明かキーワード)に出てくる数 116
plant_poaching  文書  60件  関係(説明かキーワード)に出てくる数 141
ptarmigan       文書  30件  関係(説明かキーワード)に出てくる数  38
avalanche       文書  15件  関係(説明かキーワード)に出てくる数  27
litter          文書   8件  関係(説明かキーワード)に出てくる数  12
- 落石は、説明に残った: 関係の説明に277回、エンティティの説明に130回出てきました。GraphRAG の記事(関係の説明に1回)とは大きな違いで、エンティティと関係の両方に包括的な説明を書かせる抽出のプロンプトの効果です。gleaning で、落石(ROCKFALL)そのものもノードになりました。
- 関係のキーワードには、落石が出てこない: キーワードは「safety management, trail closure」のような抽象的な語で、落石という具体的な語は入りませんでした。原著論文の指示どおり、キーワードはテーマを表す語になります。
- ほかのテーマも、文書の数以上に出てくる: 1つの文書から、同じ問題が、山・組織・生物などとの複数の関係の説明に書かれるためです。
2段階の検索
キーワードを書き出し、エンティティと関係を探す
質問から低レベル・高レベルのキーワードを書き出し、それぞれでエンティティと関係を探して、LLM に読ませる文脈を作ります。キーワード抽出と答えのプロンプトは、公式の実装(2024年10月の版)のままです。
import json

# 公式の実装(2024年10月の版)のキーワード抽出のプロンプト(例も公式のまま)
KEYWORDS = """---Role---

You are a helpful assistant tasked with identifying both high-level and low-level keywords in the user's query.

---Goal---

Given the query, list both high-level and low-level keywords. High-level keywords focus on overarching concepts or themes, while low-level keywords focus on specific entities, details, or concrete terms.

---Instructions---

- Output the keywords in JSON format.
- The JSON should have two keys:
  - "high_level_keywords" for overarching concepts or themes.
  - "low_level_keywords" for specific entities or details.

######################
-Examples-
######################
Example 1:

Query: "How does international trade influence global economic stability?"
################
Output:
{
  "high_level_keywords": ["International trade", "Global economic stability", "Economic impact"],
  "low_level_keywords": ["Trade agreements", "Tariffs", "Currency exchange", "Imports", "Exports"]
}
#############################
Example 2:

Query: "What are the environmental consequences of deforestation on biodiversity?"
################
Output:
{
  "high_level_keywords": ["Environmental consequences", "Deforestation", "Biodiversity loss"],
  "low_level_keywords": ["Species extinction", "Habitat destruction", "Carbon emissions", "Rainforest", "Ecosystem"]
}
#############################
Example 3:

Query: "What is the role of education in reducing poverty?"
################
Output:
{
  "high_level_keywords": ["Education", "Poverty reduction", "Socioeconomic development"],
  "low_level_keywords": ["School access", "Literacy rates", "Job training", "Income inequality"]
}
#############################
-Real Data-
######################
Query: {query}
######################
Output:

"""

RAG_RESPONSE = """---Role---

You are a helpful assistant responding to questions about data in the tables provided.


---Goal---

Generate a response of the target length and format that responds to the user's question, summarizing all information in the input data tables appropriate for the response length and format, and incorporating any relevant general knowledge.
If you don't know the answer, just say so. Do not make anything up.
Do not include information where the supporting evidence for it is not provided.

---Target response length and format---

{response_type}

---Data tables---

{context_data}

Add sections and commentary to the response as appropriate for the length and format. Style the response in markdown.
"""


def extract_keywords(queries, usage):
    """質問ごとに、高レベル(テーマ)と低レベル(具体的なもの)のキーワードを、1回の呼び出しで書き出させる"""
    texts = generate([KEYWORDS.replace("{query}", q) for q in queries], usage, max_new_tokens=200)
    keywords = []
    for text in texts:
        try:
            data = json.loads(re.search(r"\{.*\}", text, re.S).group(0))      # 最初の { から最後の } まで
        except (AttributeError, json.JSONDecodeError):
            data = {}                                                          # 読めなければ、キーワードなし
        keywords.append((data.get("high_level_keywords", []), data.get("low_level_keywords", [])))
    return keywords


def search(vecs, query_text, top_k=60, threshold=0.2):
    """ベクトル DB の検索:キーワードをつないだ文を埋め込み、コサイン類似度の上位 top_k 件(0.2 以上)"""
    keys = list(vecs)
    sims = np.stack([vecs[k] for k in keys]) @ embed([query_text])[0]
    return [keys[i] for i in np.argsort(-sims)[:top_k] if sims[i] > threshold]


def fill(items, text_of, max_tokens):
    """先頭から足していき、合計が max_tokens を超える手前で止める"""
    total = 0
    for i, item in enumerate(items):
        total += n_tokens(text_of(item))
        if total > max_tokens:
            return items[:i]
    return items


def low_level(index, keywords, max_tokens=4000):
    """低レベルの検索:キーワード → エンティティ → その関係と、元の文書"""
    G = index["G"]
    nodes = search(index["entity_vecs"], ", ".join(keywords))
    edges = list(dict.fromkeys(tuple(sorted(e)) for n in nodes for e in G.edges(n)))
    edges = sorted(edges, key=lambda e: (G.degree[e[0]] + G.degree[e[1]], G.edges[e]["weight"]), reverse=True)
    edges = fill(edges, lambda e: G.edges[e]["description"], max_tokens)
    chunks = {}
    for order, n in enumerate(nodes):          # ノードの順に、そのノードが出てきた文書。隣のノードとも共有する文書を先に
        for c in G.nodes[n]["source_ids"]:
            if c not in chunks:
                shared = sum(c in G.nodes[m]["source_ids"] for m in G.neighbors(n))
                chunks[c] = (order, -shared)
    chunks = fill(sorted(chunks, key=lambda c: chunks[c]), lambda c: index["chunks"][c], max_tokens)
    return nodes, edges, chunks


def high_level(index, keywords, max_tokens=4000):
    """高レベルの検索:キーワード → 関係(エッジ)→ その両端のエンティティと、元の文書"""
    G = index["G"]
    edges = search(index["relation_vecs"], ", ".join(keywords))
    edges = sorted(edges, key=lambda e: (G.degree[e[0]] + G.degree[e[1]], G.edges[e]["weight"]), reverse=True)
    edges = fill(edges, lambda e: G.edges[e]["description"], max_tokens)
    nodes = fill(list(dict.fromkeys(n for e in edges for n in e)), lambda n: G.nodes[n]["description"], max_tokens)
    chunks = list(dict.fromkeys(c for e in edges for c in sorted(G.edges[e]["source_ids"])))
    return nodes, edges, fill(chunks, lambda c: index["chunks"][c], max_tokens)


def build_context(index, parts, use_text=True):
    """エンティティ・関係・元の文書の3つの表にする(両方のレベルの結果は、重複を除いて合わせる)"""
    G = index["G"]
    nodes = list(dict.fromkeys(n for p in parts for n in p[0]))
    edges = list(dict.fromkeys(e for p in parts for e in p[1]))
    chunks = list(dict.fromkeys(c for p in parts for c in p[2])) if use_text else []
    rows = ["-----Entities-----", "id,\tentity,\ttype,\tdescription,\trank"]
    rows += [f"{i},\t{n},\t{G.nodes[n]['type']},\t{G.nodes[n]['description']},\t{G.degree[n]}" for i, n in enumerate(nodes)]
    rows += ["-----Relationships-----", "id,\tsource,\ttarget,\tdescription,\tkeywords,\tweight,\trank"]
    rows += [f"{i},\t{s},\t{t},\t{G.edges[s, t]['description']},\t{G.edges[s, t]['keywords']},\t"
             f"{G.edges[s, t]['weight']},\t{G.degree[s] + G.degree[t]}" for i, (s, t) in enumerate(edges)]
    rows += ["-----Sources-----", "id,\tcontent"] + [f"{i},\t{index['chunks'][c]}" for i, c in enumerate(chunks)]
    return "\n".join(rows), {"entities": len(nodes), "relations": len(edges), "chunks": len(chunks)}


def lightrag_query(index, queries, keywords, mode="hybrid", use_text=True, usage=None, max_new_tokens=600):
    """LightRAG の答え:キーワード(extract_keywords で LLM 1回)→ 検索(LLM なし)→ 答え(LLM 1回)"""
    usage = usage if usage is not None else new_usage()
    prompts, infos = [], []
    for query, (high, low) in zip(queries, keywords):
        parts = []
        if mode in ("hybrid", "high") and high:
            parts.append(high_level(index, high))                              # (a) 高レベル:関係から
        if mode in ("hybrid", "low") and low:
            parts.append(low_level(index, low))                                # (b) 低レベル:エンティティから
        context, sizes = build_context(index, parts, use_text)                 # (c) 3つの表にまとめる
        prompts.append([{"role": "system", "content": RAG_RESPONSE.format(response_type="Multiple Paragraphs",
                                                                          context_data=context)},
                        {"role": "user", "content": query}])
        infos.append({"context": context, "context_tokens": n_tokens(context), **sizes})
    answers = generate(prompts, usage, max_new_tokens=max_new_tokens, batch_size=1)   # (d) 答え(LLM 1回)
    return answers, infos


NAIVE_RESPONSE = """You're a helpful assistant
Below are the knowledge you know:
{content_data}
---
If you don't know the answer or if the provided knowledge do not contain sufficient information to provide an answer, just say so. Do not make anything up.
Generate a response of the target length and format that responds to the user's question, summarizing all information in the input data tables appropriate for the response length and format, and incorporating any relevant general knowledge.
If you don't know the answer, just say so. Do not make anything up.
Do not include information where the supporting evidence for it is not provided.
---Target response length and format---
{response_type}
"""


def naive_query(index, chunk_vecs, queries, usage=None, max_new_tokens=600, top_k=60, max_tokens=4000):
    """比べる普通の RAG(公式の naive モード):質問に似た文書の上位60件を、4,000トークンまで"""
    usage = usage if usage is not None else new_usage()
    prompts, infos = [], []
    for query in queries:
        top = np.argsort(-(chunk_vecs @ embed([query])[0]))[:top_k]
        chunks = fill([int(i) for i in top], lambda c: index["chunks"][c], max_tokens)
        context = "--New Chunk--\n".join(index["chunks"][c] for c in chunks)
        prompts.append([{"role": "system", "content": NAIVE_RESPONSE.format(content_data=context,
                                                                            response_type="Multiple Paragraphs")},
                        {"role": "user", "content": query}])
        infos.append({"context": context, "context_tokens": n_tokens(context), "chunks": len(chunks)})
    return generate(prompts, usage, max_new_tokens=max_new_tokens, batch_size=1), infos


chunk_vecs = embed(index["chunks"])
query = "List all mountains where Avalanche Watch reported an avalanche."
kw_usage = new_usage()
keywords = extract_keywords([query], kw_usage)
print("高レベルのキーワード:", keywords[0][0])
print("低レベルのキーワード:", keywords[0][1])
print(f"キーワード抽出: 入力 {kw_usage['input_tokens']}トークン  出力 {kw_usage['output_tokens']}トークン")
for mode in ["low", "high"]:
    part = (low_level if mode == "low" else high_level)(index, keywords[0][1] if mode == "low" else keywords[0][0])
    print(f"{mode}: エンティティ {len(part[0])}  関係 {len(part[1])}  文書 {len(part[2])}  "
          f"最初のエンティティ {part[0][:5]}  最初の関係 {part[1][:3]}")
キーワード抽出、2つのレベルの検索、文脈の組み立て、答えの生成と、比べる普通の RAG のコードです。
- KEYWORDS: キーワード抽出のプロンプトです。「質問から、高レベルのキーワード(全体の概念やテーマ)と低レベルのキーワード(具体的なもの・細部・具体的な語)を JSON で書き出せ」という指示で、国際貿易・森林破壊・教育の3つの例が付いています。
- extract_keywords(queries, usage): 質問ごとに LLM を1回呼び、出力の最初の { から最後の } までを JSON として読みます。読めないときは、キーワードなしにします。
- search(vecs, query_text, top_k=60, threshold=0.2): 公式の実装のベクトル DB(nano-vectordb)と同じく、キーワードを「, 」でつないだ1つの文を埋め込み、コサイン類似度の上位60件のうち、0.2より大きいものを返します。キーワードを1つずつ探すのではなく、つないだ1つの文で探す点に注意してください。
- fill(items, text_of, max_tokens): 先頭から足していき、合計が上限を超える手前で止めます。公式の実装と同じく、関係・エンティティ・元の文書のそれぞれに、4,000トークンの上限を設けます。
- low_level(index, keywords, max_tokens=4000): 低レベルの検索です。
- エンティティ: 低レベルのキーワードに近いエンティティを60個取ります。公式の実装では、ここで取ったエンティティの説明は切り詰めません。
- 関係: 取ったエンティティにつながるすべての関係を、rank(両端のノードの次数の和)と重みの大きい順に並べ、4,000トークンまで入れます。
- 元の文書: エンティティの順に、そのエンティティが出てきた文書を集めます。同じエンティティの中では、隣のノードとも共有している文書(関係の多い文書)を先にします。
- high_level(index, keywords, max_tokens=4000): 高レベルの検索です。高レベルのキーワードに近い関係を60本取り、rank と重みの順に並べて4,000トークンまで入れ、その両端のエンティティと、関係が出てきた文書を、それぞれ4,000トークンまで集めます。
- build_context(index, parts, use_text=True): 両方のレベルの結果を、重複を除いて合わせ、エンティティ・関係・元の文書の3つの表(公式の実装と同じ、コンマとタブで区切った形)にします。use_text=False は、元の文書を入れない比べ方(原著論文の -Origin)のためです。公式の実装は、2つのレベルの表の行を集合にして合わせるので、行の順番が実行のたびに変わります。ここでは、高レベル → 低レベルの順に並べ、順番を固定しています。
- lightrag_query(index, queries, keywords, mode="hybrid", use_text=True, usage=None, max_new_tokens=600): (a)・(b) mode に応じて高レベル・低レベルの検索をし、(c) 3つの表にまとめ、(d) システムのメッセージに表を入れて、質問に答えさせます。mode="low" と mode="high" は、原著論文の -High(低レベルだけ)と -Low(高レベルだけ)にあたります。キーワードは、同じ質問ならどのモードでも同じなので、先に1回だけ書き出して使い回しています(貪欲法なので、毎回書き出しても同じ結果です)。batch_size=1 は、文脈が数万トークンになることがあり、まとめて生成すると GPU のメモリが足りなくなるためです。
- RAG_RESPONSE: 答えのプロンプトで、「表のデータについての質問に答える。答えの形は Multiple Paragraphs(複数の段落)。分からなければそう言い、作り話をしない。根拠のないことは書かない」という指示です。
- naive_query: 比べる普通の RAG で、公式の実装の naive モードと同じく、質問に似た文書の上位60件を、4,000トークンまで読ませます。
実行結果
高レベルのキーワード: ['Avalanche Watch', 'Avalanche reports', 'Mountains']
低レベルのキーワード: ['Avalanche', 'Mountain locations', 'Watch reports']
キーワード抽出: 入力 378トークン  出力 47トークン
low: エンティティ 60  関係 186  文書 59  最初のエンティティ ['AVALANCHE WATCH', 'LARGE AVALANCHE', 'NORTH FACE', 'RIDGE SAFETY OFFICE', 'ROCKFALL']  最初の関係 [('MOUNT FUHOMO', 'RIDGE SAFETY OFFICE'), ('MOUNT HAKUSE', 'RIDGE SAFETY OFFICE'), ('MOUNT HANEMO', 'RIDGE SAFETY OFFICE')]
high: エンティティ 52  関係 60  文書 45  最初のエンティティ ['MOUNT NARANA', 'RIDGE SAFETY OFFICE', 'MOUNT KASHINO', 'MOUNT KAFUSHI', 'MOUNT SESHISE']  最初の関係 [('MOUNT NARANA', 'RIDGE SAFETY OFFICE'), ('MOUNT KASHINO', 'RIDGE SAFETY OFFICE'), ('MOUNT KAFUSHI', 'RIDGE SAFETY OFFICE')]
英語の出力の日本語訳:
- 高レベルのキーワード:「雪崩監視班、雪崩の報告、山」。低レベルのキーワード:「雪崩、山の位置、監視班の報告」
- 低レベルの検索の最初のエンティティ:雪崩監視班、大きな雪崩、北面、尾根安全事務所、落石
(図は、diagram-designで作成)
- キーワード抽出は、入力378トークン: 原著論文が「検索に使うトークンは100未満」と言っているのは、この段階のことです。公式の例が入っているので、本記事の計測では入力が378トークン、出力が47トークンでした。
- キーワードの分け方は、LLM 任せ: 雪崩監視班(Avalanche Watch)は、具体的な組織の名前ですが、高レベルのキーワードに入りました。低レベルのキーワードは「Avalanche, Mountain locations, Watch reports」です。それでも、つないだ文が雪崩監視班の説明に近いので、低レベルの検索の1位は AVALANCHE WATCH のエンティティになりました。
- 関係は、ハブのノードの関係から並ぶ: 低レベルの検索では、60個のエンティティにつながる関係のうち、4,000トークンに収まる186本を入れました。並べ方が rank(両端の次数の和)の大きい順なので、先頭は、150山とつながる尾根安全事務所の関係です。雪崩監視班は15山としかつながっていないので、その関係は後ろに回ります。高レベルの検索でも、先頭は尾根安全事務所の関係でした。
全体を俯瞰する問い
GraphRAG の記事と同じ「これらの山が抱えている主な問題は何か」に、5つの方法で答えさせます。原著論文の比べ方にならって、低レベルだけ(-High)、高レベルだけ(-Low)、元の文書なし(-Origin)も比べます。
QUESTION = ("What are the main problems facing these mountains? "
            "List every distinct problem, one short line each, without naming individual mountains.")


def covered_themes(text, themes):
    """答えが触れているテーマ(正規表現が見つかったテーマ)の一覧"""
    return [t for t, (_, pattern, _) in themes.items() if re.search(pattern, text, re.IGNORECASE)]


kw_usage = new_usage()
q_keywords = extract_keywords([QUESTION], kw_usage)
print("高レベルのキーワード:", q_keywords[0][0])
print("低レベルのキーワード:", q_keywords[0][1])
runs = {"普通の RAG(naive)": dict(), "低レベルだけ": dict(mode="low"), "高レベルだけ": dict(mode="high"),
        "LightRAG(hybrid)": dict(mode="hybrid"), "hybrid・元の文書なし": dict(mode="hybrid", use_text=False)}
global_results = {}
for name, kw in runs.items():
    usage = new_usage()
    if name.startswith("普通"):
        answers, infos = naive_query(index, chunk_vecs, [QUESTION], usage)
    else:
        answers, infos = lightrag_query(index, [QUESTION], q_keywords, usage=usage, **kw)
    found = covered_themes(answers[0], THEMES)
    in_context = covered_themes(infos[0]["context"], THEMES)
    global_results[name] = {"answer": answers[0], "themes": found, **infos[0]}
    print(f"{name:18s} 文脈 {infos[0]['context_tokens']:6,}トークン  文脈にあるテーマ {len(in_context)}  "
          f"答えが触れたテーマ {len(found)} / 6  見落とし {[t for t in THEMES if t not in found]}")
print("LightRAG(hybrid)の答え:\n" + global_results["LightRAG(hybrid)"]["answer"])
全体を俯瞰する問いのキーワードを書き出し、5つの方法で答えさせて、文脈と答えに6つのテーマのいくつが出てくるかを数えるコードです。
- QUESTION と covered_themes: GraphRAG の記事と同じ問いと採点です。答えが1つに決まらない問いなので、仕込んだ6つのテーマのうち、いくつに触れたかで測ります。
- runs: 方法の名前と、lightrag_query に渡す引数の辞書です。普通の RAG だけは naive_query で答えさせます。
- 文脈にあるテーマと、答えが触れたテーマ: 2つを比べると、テーマが落ちたのが検索の段階か、LLM が答える段階かが分かります。
実行結果
高レベルのキーワード: ['Main problems', 'Mountain challenges']
低レベルのキーワード: ['Erosion', 'Deforestation', 'Pollution', 'Climate change', 'Glacier melting', 'Wildlife habitat loss', 'Water scarcity', 'Soil degradation']
普通の RAG(naive)     文脈  4,113トークン  文脈にあるテーマ 6  答えが触れたテーマ 5 / 6  見落とし ['litter']
低レベルだけ             文脈 17,800トークン  文脈にあるテーマ 6  答えが触れたテーマ 5 / 6  見落とし ['litter']
高レベルだけ             文脈 11,487トークン  文脈にあるテーマ 6  答えが触れたテーマ 6 / 6  見落とし []
LightRAG(hybrid)   文脈 27,830トークン  文脈にあるテーマ 6  答えが触れたテーマ 6 / 6  見落とし []
hybrid・元の文書なし      文脈 20,675トークン  文脈にあるテーマ 6  答えが触れたテーマ 4 / 6  見落とし ['plant_poaching', 'ptarmigan']
LightRAG(hybrid)の答え:
- Rockfall leading to trail closures
- Closure of upper trails for safety reasons
- Retiring hut keepers causing potential closure of huts
- Illegal collection of snow lilies
- Declining nesting frequency of Rock Ptarmigans
- Large avalanches on north faces
- Trash left by hikers
- Seasonal climbing restrictions due to safety issues
英語の出力の日本語訳:
-
高レベルのキーワード:「主な問題、山の課題」。低レベルのキーワード:「浸食、森林破壊、汚染、気候変動、氷河の融解、野生生物の生息地の喪失、水不足、土壌の劣化」
-
LightRAG(hybrid)の答え:「落石による登山道の閉鎖/安全のための上部の登山道の閉鎖/管理人の引退による山小屋の閉鎖のおそれ/スノーリリーの違法な採取/ライチョウの営巣の減少/北面での大きな雪崩/登山者が残したごみ/安全上の理由による季節ごとの登山の制限」
-
hybrid と高レベルだけは、6つすべてに触れた: GraphRAG の記事の Global Search(C0・C1 とも5つ、落石を見落とし)と違い、LightRAG の答えの最初の行は「落石による登山道の閉鎖」でした。落石が関係とエンティティの説明に残っていたからです。LLM の呼び出しは、キーワードと答えの2回で、Global Search の14〜26回より少なく済みました。
-
低レベルのキーワードは、コーパスにない語になった: 「浸食、森林破壊、汚染、気候変動…」は、どれも文書に出てこない語です。キーワード抽出のプロンプトの例(森林破壊や生物多様性)に引きずられ、質問の文から一般的な環境問題を連想したと考えられます。それでも、近いエンティティ(落石・雪崩・スノーリリーなど)が見つかり、低レベルだけでも5つに触れました。
-
その代わり、文脈はとても長い: hybrid の文脈は27,830トークンで、普通の RAG(4,113トークン)の約7倍、GraphRAG の記事の Global Search(C1)が14回の呼び出しで読んだ合計(7,987トークン)の約3.5倍です。低レベルの検索で取った60個のエンティティの説明を切り詰めないので、要約した長い説明(山脈・村・季節など)がそのまま入るためです。呼び出しの回数は減っても、読むトークンは減っていません。
-
元の文書を外すと、盗掘とライチョウを落とした: 元の文書なしの文脈にも6つのテーマはありましたが、答えは4つでした。原著論文では、元の文書を外しても大きく下がりませんでしたが、本記事では、説明とキーワードの表だけでは、件数の少ない問題が埋もれました。
特定のエンティティについての問い
Local Search の記事と同じ2種類の問いで比べます。
- 1つのエンティティにつながるものを、もれなく挙げる: 「雪崩監視班が雪崩を報告した山をすべて挙げよ」(正解15山)。
- 1つの山の事実: 「〇〇山の登山道はどの村から始まり、どんな問題が報告されているか」を、Local Search の記事と同じ20山について聞きます。
def mountains_in(text):
    """文の中に出てくる山の名前(「Mount Kakuyo」と、グラフの表記「MOUNT KAKUYO」の両方)"""
    return {m.capitalize() for m in re.findall(r"mount ([a-z]+)", text, re.IGNORECASE)}


def score_names(text, docs, truth):
    """答えに出てくる山を、正解の山・正解でない山・存在しない山に分けて数える"""
    names, existing = mountains_in(text), {d["mountain"] for d in docs}
    return {"正しい": len(names & truth), "誤り": len(names & existing - truth), "存在しない": len(names - existing)}


# (a) 1つのエンティティにつながるものを、もれなく挙げる(Local Search の記事と同じ問い)
LIST_QUESTION = "List all mountains where Avalanche Watch reported an avalanche."
avalanche = {d["mountain"] for d in docs if d["theme"] == "avalanche"}
# (b) 1つの山の事実(Local Search の記事と同じ20山)
fact_docs = [docs[i] for i in np.random.default_rng(0).choice([i for i, d in enumerate(docs) if d["theme"]], 20,
                                                              replace=False)]
FACT = "From which village does the main trail of Mount {m} start, and what problem is reported there?"
fact_questions = [FACT.format(m=d["mountain"]) for d in fact_docs]

list_kw = extract_keywords([LIST_QUESTION], new_usage())
fact_kw = extract_keywords(fact_questions, new_usage())
specific_results = {}
for name, kw in runs.items():
    if name.startswith("普通"):
        list_ans, list_info = naive_query(index, chunk_vecs, [LIST_QUESTION])
        fact_ans, _ = naive_query(index, chunk_vecs, fact_questions, max_new_tokens=150)
    else:
        list_ans, list_info = lightrag_query(index, [LIST_QUESTION], list_kw, **kw)
        fact_ans, _ = lightrag_query(index, fact_questions, fact_kw, max_new_tokens=150, **kw)
    village = sum(d["village"] in a for d, a in zip(fact_docs, fact_ans))
    problem = sum(bool(re.search(THEMES[d["theme"]][1], a, re.IGNORECASE)) for d, a in zip(fact_docs, fact_ans))
    score = score_names(list_ans[0], docs, avalanche)
    specific_results[name] = {"village": village, "problem": problem, **score,
                              "context_tokens": list_info[0]["context_tokens"],
                              "in_context": len(mountains_in(list_info[0]["context"]) & avalanche)}
    print(f"{name:18s} 雪崩の15山: 文脈 {list_info[0]['context_tokens']:6,}トークン  文脈にある正解 "
          f"{specific_results[name]['in_context']:2d}  答え {score}   1つの山の事実(20問): 村 {village}  問題 {problem}")
print("低レベルのキーワード(雪崩):", list_kw[0][1], " 高レベル:", list_kw[0][0])
雪崩の山を挙げる問いと、1つの山の事実の問いを、5つの方法で答えさせて採点するコードです。
- mountains_in と score_names: Local Search の記事と同じ採点です。答えに出てくる山の名前を、正解・正解でない山・コーパスに存在しない山に分けて数えます。グラフのノードの名前は大文字(MOUNT KAKUYO)なので、大文字と小文字を区別せずに探します。
- fact_docs: Local Search の記事と同じ乱数で、問題のある363件から20件を選びます。
- 採点: 1つの山の事実は、答えに正しい村の名前が入っているかと、その山のテーマの正規表現が答えに見つかるかを、別々に数えます。max_new_tokens=150 は、答えが村と問題の1〜2段落で済むので、生成の時間を抑えるためです。
実行結果
普通の RAG(naive)     雪崩の15山: 文脈  3,968トークン  文脈にある正解 14  答え {'正しい': 6, '誤り': 0, '存在しない': 0}   1つの山の事実(20問): 村 20  問題 20
低レベルだけ             雪崩の15山: 文脈 20,168トークン  文脈にある正解 15  答え {'正しい': 12, '誤り': 0, '存在しない': 0}   1つの山の事実(20問): 村 9  問題 12
高レベルだけ             雪崩の15山: 文脈 10,862トークン  文脈にある正解 15  答え {'正しい': 12, '誤り': 0, '存在しない': 0}   1つの山の事実(20問): 村 20  問題 20
LightRAG(hybrid)   雪崩の15山: 文脈 26,234トークン  文脈にある正解 15  答え {'正しい': 11, '誤り': 0, '存在しない': 0}   1つの山の事実(20問): 村 20  問題 17
hybrid・元の文書なし      雪崩の15山: 文脈 20,097トークン  文脈にある正解 15  答え {'正しい': 11, '誤り': 0, '存在しない': 0}   1つの山の事実(20問): 村 15  問題 14
低レベルのキーワード(雪崩): ['Avalanche', 'Mountain locations', 'Watch reports']  高レベル: ['Avalanche Watch', 'Avalanche reports', 'Mountains']
- 雪崩の山を挙げる問いでは、普通の RAG の約2倍: LightRAG の4つの方法は、どれも文脈に15山すべてが入り、答えは11〜12山で、誤りはありませんでした。普通の RAG は、文脈に14山あったのに、6山しか挙げませんでした。ただし、Local Search の記事(1,502トークンの文脈から14山)と比べると、LightRAG の文脈は1万〜2万6千トークンと長く、挙げた数も少なくなりました。上の図のとおり、文脈の先頭が尾根安全事務所の関係で、雪崩監視班の関係が後ろに回ることも、挙げ漏れの一因と考えられます。
- 1つの山の事実では、低レベルだけが大きく崩れた: 普通の RAG と高レベルだけは20問すべてに正解し、hybrid も村は20問、問題は17問に正解しました。低レベルだけは、村9問・問題12問しか答えられませんでした。原因を次のコードで確かめます。
低レベルだけの検索が、山の事実を答えられなかった理由
# 1つの山の事実の問いで、文脈はどれだけ長くなり、何が入っているか
for name, kw in list(runs.items())[1:]:
    sizes = []
    for k in fact_kw:
        parts = []
        if kw.get("mode") in ("hybrid", "high") and k[0]:
            parts.append(high_level(index, k[0]))
        if kw.get("mode") in ("hybrid", "low") and k[1]:
            parts.append(low_level(index, k[1]))
        sizes.append(n_tokens(build_context(index, parts, kw.get("use_text", True))[0]))
    print(f"{name:18s} 1つの山の事実の文脈: 平均 {np.mean(sizes):7,.0f}  最大 {max(sizes):7,}トークン")
d0 = docs.index(fact_docs[0])
nodes, edges, chunks = low_level(index, fact_kw[0][1])
print("質問 0:", fact_questions[0])
print("低レベルのキーワード:", fact_kw[0][1], " 高レベル:", fact_kw[0][0])
print("見つかったエンティティ(先頭8):", nodes[:8])
print("山の文書が文脈に入ったか:", d0 in chunks, " 文書の順位:", chunks.index(d0) if d0 in chunks else None,
      " エンティティの説明の合計:", sum(n_tokens(G.nodes[n]["description"]) for n in nodes), "トークン")
1つの山の事実の問いで、方法ごとの文脈の長さと、質問 0 の低レベルの検索の中身を表示するコードです。list(runs.items())[1:] は、普通の RAG を除いた4つの方法です。
実行結果
低レベルだけ             1つの山の事実の文脈: 平均  23,180  最大  25,073トークン
高レベルだけ             1つの山の事実の文脈: 平均  11,253  最大  11,646トークン
LightRAG(hybrid)   1つの山の事実の文脈: 平均  30,963  最大  33,219トークン
hybrid・元の文書なし      1つの山の事実の文脈: 平均  23,911  最大  25,924トークン
質問 0: From which village does the main trail of Mount Toseto start, and what problem is reported there?
低レベルのキーワード: ['Starting point', 'Trailhead', 'Specific village name', 'Mountain', 'Local issue', 'Geographical location']  高レベル: ['Village', 'Main trail', 'Mount Toseto', 'Problem reporting']
見つかったエンティティ(先頭8): ['SAKAKI VILLAGE', 'KANBE VILLAGE', 'MINASE VILLAGE', 'VILLAGE OF ODA', 'ODA VILLAGE', 'VILLAGE OF HIRANO', 'MINASE', 'ISHIDA VILLAGE']
山の文書が文脈に入ったか: False  文書の順位: None  エンティティの説明の合計: 9100 トークン
(図は、diagram-designで作成)
英語の出力の日本語訳:
-
質問 0:「Toseto 山の主な登山道はどの村から始まり、どんな問題が報告されているか」
-
低レベルのキーワード:「起点、登山口、具体的な村の名前、山、地元の問題、地理的な位置」。高レベル:「村、主な登山道、Mount Toseto、問題の報告」
-
山の名前が、高レベルのキーワードに入った: 具体的なものの代表である山の名前「Mount Toseto」が、高レベルのキーワードに入り、低レベルのキーワードは一般的な語だけになりました。低レベルの検索は、これに近い村のエンティティを集め、Toseto 山の文書は文脈に入りませんでした。キーワードを2つのレベルに分けるのは LLM で、分け方が質問の意図とずれると、片方の検索は的を外します。
-
同じ村が、別のノードになっている: 見つかったエンティティには、SAKAKI VILLAGE、VILLAGE OF ODA と ODA VILLAGE、MINASE VILLAGE と MINASE のように、同じ村の別の表記が並んでいます。LightRAG の重複の除去は名前の完全一致なので、表記の揺れはまとまりません(LLM によるナレッジグラフの構築の記事で扱った名寄せの問題です)。
-
文脈は、Qwen2.5-7B の上限に近い: hybrid の文脈は平均約3万1千トークン、最大約3万3千トークンで、Qwen2.5-7B-Instruct の32,768トークンを超えるものもありました(実行中に、長さの上限を超えたという警告が出ました)。上限を超えた分は、モデルの性能が保証されません。hybrid の問題の正解が17問にとどまったのは、これも一因と考えられます。原著論文の GPT-4o-mini(12万8千トークン)では起きにくい問題で、小さなモデルで使うときは、エンティティの説明にも上限を設けるなどの調整が必要です。
(図は、diagram-designで作成)
文書を追加する:差分の更新
600件のインデックスに、追加の60件(土砂崩れ20件、雪崩5件を含む)を足します。LightRAG の差分の更新の手間と、同じグラフで GraphRAG のコミュニティとレポートを作り直す手間を比べます。
import igraph as ig
import leidenalg

# (a) LightRAG の差分の更新:追加の60件だけを抽出し、既存のグラフに統合する
G_before = G.copy()
update_usage = {"抽出": new_usage(), "統合(要約)": new_usage()}
start = len(index["chunks"])
index["chunks"] += [d["text"] for d in new_docs]
new_raw = extract([d["text"] for d in new_docs], update_usage["抽出"])
new_records = [parse_records(r, start + i) for i, r in enumerate(new_raw)]
node_names, edge_keys, n_summaries = merge(G, new_records, update_usage["統合(要約)"])
update_vectors(index, G, node_names, edge_keys)
chunk_vecs = embed(index["chunks"])
existing = sum(n in G_before for n in node_names)
print(f"更新: 触れたノード {len(node_names)}(うち既存 {existing})  触れたエッジ {len(edge_keys)}  "
      f"要約し直した説明 {n_summaries}  →  ノード {G.number_of_nodes()}  エッジ {G.number_of_edges()}")
for name, u in update_usage.items():
    print(f"  {name}: 呼び出し {u['calls']}回  入力 {u['input_tokens']:,}  時間 {u['seconds']:.0f} 秒")
print("VALLEY ROAD OFFICE:", G.nodes["VALLEY ROAD OFFICE"]["description"][:300] if "VALLEY ROAD OFFICE" in G else "なし")


# (b) GraphRAG なら:コミュニティを分け直し、中身が変わったコミュニティのレポートを書き直す
def leiden(G, seed=0):
    H = ig.Graph.from_networkx(G)
    partition = leidenalg.find_partition(H, leidenalg.ModularityVertexPartition, weights="weight", seed=seed)
    return [frozenset(H.vs[i]["_nx_name"] for i in c) for c in partition if len(c) >= 3]


REPORT = ("Below are relationships from one part of a knowledge graph about mountains.\n\n{relations}\n\n"
          "Write a short report about this group: a title, then three to five key findings, each one sentence. "
          "Mention specific problems, organizations, or species if they appear.")


def community_context(G, nodes, max_tokens=3000):
    lines = [f"- {s} -- {t}: {a['description'].split(SEP)[0]}" for s, t, a in
             sorted(G.subgraph(nodes).edges(data=True), key=lambda e: -(G.degree[e[0]] + G.degree[e[1]]))]
    return "\n".join(fill(lines, lambda x: x, max_tokens))


before, after = leiden(G_before), leiden(G)
changed = [c for c in after if c not in set(before)]
report_usage = {"初回(全部)": new_usage(), "更新(変わった分)": new_usage()}
generate([REPORT.format(relations=community_context(G_before, c)) for c in before], report_usage["初回(全部)"],
         max_new_tokens=300, batch_size=8)
generate([REPORT.format(relations=community_context(G, c)) for c in changed], report_usage["更新(変わった分)"],
         max_new_tokens=300, batch_size=8)
print(f"GraphRAG のコミュニティ: 更新前 {len(before)}個  更新後 {len(after)}個  中身が変わった {len(changed)}個")
for name, u in report_usage.items():
    print(f"  レポート {name}: 呼び出し {u['calls']}回  入力 {u['input_tokens']:,}  時間 {u['seconds']:.0f} 秒")
追加の60件を差分の更新で足し、更新の前後のグラフで GraphRAG のコミュニティを分けて、作り直すレポートの数と手間を数えるコードです。
- (a) LightRAG の差分の更新: 追加の60件に、最初と同じ extract と merge を使うだけです。start から始まる文書の番号を付けるので、元の文書を集めるときに、追加の文書も読めます。merge は、既にあるノードとエッジには説明と文書の番号を足し、長くなったものだけ要約し直します。触れたノードとエッジだけを埋め込み直し、普通の RAG のための文書の埋め込みも作り直します。
- G_before: 更新の前のグラフの写しです。GraphRAG のコミュニティを、更新の前後で比べるために取っておきます。
- (b) GraphRAG なら: GraphRAG の記事と同じく、Leiden 法(モジュラリティ、乱数のシード0)でグラフを分け、ノードが3個以上のまとまりをコミュニティにします。更新の後のコミュニティのうち、更新の前とノードの集合がまったく同じものは、レポートを書き直さずに済みます。それ以外(changed)は、レポートを書き直す必要があります。比べやすいように、GraphRAG の抽出ではなく、LightRAG のグラフをそのまま使っています。
- REPORT と community_context: GraphRAG の記事と同じレポートのプロンプトと、コミュニティの中の関係を、両端の次数の和の大きい順に3,000トークンまで並べる文脈です。最初に全部のレポートを書く手間と、更新で書き直す手間を、実際に生成して数えます。
実行結果
更新: 触れたノード 94(うち既存 29)  触れたエッジ 209  要約し直した説明 11  →  ノード 734  エッジ 2466
  抽出: 呼び出し 120回  入力 121,314  時間 134 秒
  統合(要約): 呼び出し 11回  入力 8,309  時間 58 秒
VALLEY ROAD OFFICE: The Valley Road Office is responsible for repairing the approach road to Mount Fufuha.<SEP>The Valley Road Office is responsible for repairing the approach road to Mount Fuwawa after a landslide.<SEP>The Valley Road Office is responsible for repairing the approach road to Mount Kakano after a landsl
GraphRAG のコミュニティ: 更新前 12個  更新後 9個  中身が変わった 9個
  レポート 初回(全部): 呼び出し 12回  入力 26,671  時間 26 秒
  レポート 更新(変わった分): 呼び出し 9回  入力 26,244  時間 23 秒
英語の出力の日本語訳:
- 谷道路事務所の説明:「谷道路事務所は、Fufuha 山へのアプローチの道路を復旧している。」「…土砂崩れのあと、Fuwawa 山への…」のように、山ごとの説明がつながっている。
(図は、diagram-designで作成)
- LightRAG の更新は、追加分の抽出と、少しの要約だけ: 追加の60件の抽出に120回(入力約12万1千トークン、134秒)、要約し直しに11回(入力8,309トークン、58秒)でした。触れたノードは94個で、そのうち29個は、既存の山脈・村・雪崩監視班などのノードです。新しい問題の谷道路事務所(VALLEY ROAD OFFICE)は、新しいノードとして入りました。
- GraphRAG では、すべてのレポートを書き直すことになった: 60件(約1割)を足しただけで、コミュニティは12個から9個に変わり、9個すべての中身が、更新の前と違うノードの集合になりました。Leiden 法は、グラフ全体のつながりの密さで分け方を決めるので、山脈や村のようなハブのノードに新しい山がつながると、分け方そのものが変わるためです。書き直しの手間(入力26,244トークン)は、最初に全部を書いた手間(26,671トークン)とほぼ同じでした。
- この規模では、差は抽出より小さい: 600件のコーパスでは、コミュニティが10個前後しかないので、レポートの書き直しは、追加分の抽出(約12万1千トークン)より小さな手間です。原著論文の Legal(約508万トークン)のように、コミュニティが1,399個になる規模では、この書き直しがインデキシングの手間の大部分を占めるようになります。
更新したインデックスで、もう一度聞く
追加した文書が答えに反映されるかを、全体を俯瞰する問いと、雪崩の山を挙げる問い(追加で20山になった)で確かめます。
# 更新したインデックスで、もう一度聞く:新しい問題(土砂崩れ)と、増えた雪崩(20山)
avalanche_all = {d["mountain"] for d in docs + new_docs if d["theme"] == "avalanche"}
all_docs = docs + new_docs
after_kw = extract_keywords([QUESTION, LIST_QUESTION], new_usage())
for name in ["普通の RAG(naive)", "LightRAG(hybrid)"]:
    if name.startswith("普通"):
        answers, infos = naive_query(index, chunk_vecs, [QUESTION, LIST_QUESTION])
    else:
        answers, infos = lightrag_query(index, [QUESTION, LIST_QUESTION], after_kw)
    found = covered_themes(answers[0], ALL_THEMES)
    print(f"{name:18s} 主な問題: 答えが触れたテーマ {len(found)} / 7  土砂崩れ {'landslide' in found}  "
          f"見落とし {[t for t in ALL_THEMES if t not in found]}")
    print(f"{'':18s} 雪崩の20山: 文脈にある正解 {len(mountains_in(infos[1]['context']) & avalanche_all):2d}  "
          f"答え {score_names(answers[1], all_docs, avalanche_all)}")
更新したインデックスで、全体を俯瞰する問いと雪崩の山の問いに、普通の RAG と LightRAG で答えさせるコードです。キーワードは、2つの質問について書き出し直します。採点には、土砂崩れを加えた7つのテーマ(ALL_THEMES)と、追加の5山を加えた20山を使います。
実行結果
普通の RAG(naive)     主な問題: 答えが触れたテーマ 5 / 7  土砂崩れ True  見落とし ['ptarmigan', 'litter']
                   雪崩の20山: 文脈にある正解 17  答え {'正しい': 9, '誤り': 4, '存在しない': 0}
LightRAG(hybrid)   主な問題: 答えが触れたテーマ 6 / 7  土砂崩れ True  見落とし ['ptarmigan']
                   雪崩の20山: 文脈にある正解 20  答え {'正しい': 17, '誤り': 0, '存在しない': 0}
- 新しい問題(土砂崩れ)が、答えに入った: 更新したあとの LightRAG の答えは、7つのテーマのうち、土砂崩れを含む6つに触れました。作り直したのは、触れたノードとエッジの説明と埋め込みだけです。
- 雪崩の山は、20山中17山を誤りなく挙げた: 追加の5山の雪崩の文書も、既存の雪崩監視班のノードにつながり、文脈には20山すべてが入りました。普通の RAG は、文脈にあった17山のうち9山を挙げ、雪崩ではない山を4つ混ぜました。
結果のまとめ
| 問い・手間 | 普通の RAG | LightRAG(hybrid) | 低レベルだけ | 高レベルだけ | GraphRAG・Local Search の記事 |
|---|---|---|---|---|---|
| 主な問題(6テーマ) | 5 | 6 | 5 | 6 | Global Search 5(落石を見落とし) |
| 主な問題の文脈 | 4,113トークン | 27,830トークン | 17,800トークン | 11,487トークン | Global Search(C1)26回・7,987トークン |
| 雪崩の15山(正しい・誤り) | 6・0 | 11・0 | 12・0 | 12・0 | Local Search 14・0(1,502トークン) |
| 1つの山の事実(村・問題、20問) | 20・20 | 20・17 | 9・12 | 20・20 | Local Search 20・20 |
| 質問のたびの LLM の呼び出し | 1回 | 2回 | 2回 | 2回 | Global Search 14〜26回、Local Search 2回 |
| インデキシング・更新 | LightRAG | GraphRAG(記事の値と、本記事のグラフでの見積もり) |
|---|---|---|
| 600件のインデキシング | 抽出1,200回(入力約123万トークン)+要約30回 | 抽出600回(入力約14万5千トークン)+レポート38回 |
| 60件の追加 | 抽出120回+要約し直し11回(入力8,309トークン) | 抽出は同じ+コミュニティ12個 → 9個、レポート9件をすべて書き直し(入力26,244トークン) |
原著論文の結果
原著論文は、大学の教科書からなる UltraDomain の4つのデータセット(Agriculture・CS・Legal・Mix。約62万〜508万トークン)で、データセットごとに LLM に125問の全体を俯瞰する問いを作らせ、2つの方法の答えを GPT-4o-mini に比べさせて、勝率を測っています。比べる観点は、網羅性(Comprehensiveness)・多様性(Diversity)・読み手が理解し判断できるか(Empowerment)と、それらを合わせた総合(Overall)です。
(図は、diagram-designで作成)
- チャンクを検索する方法には、大きく勝つ: NaiveRAG・RQ-RAG・HyDE に対する Overall の勝率は、57〜86%でした。いちばん大きい Legal(約508万トークン)で差が最も大きく、NaiveRAG に対して84.8%です。
- GraphRAG とは、ほぼ互角: GraphRAG に対する Overall の勝率は、49.6〜54.8%で、Mix では GraphRAG がわずかに勝っています。網羅性も49.6〜54.4%と互角で、差がはっきり出たのは多様性(59.2〜77.2%)です。LightRAG の主な利点は、答えの質より、質問のたびと更新のときの手間にあります。
- 手間の見積もり: Legal では、GraphRAG の Global Search が使う610個のコミュニティのレポート(各約1,000トークン)を読むと、1回の質問で約61万トークン、数百回の呼び出しになります。LightRAG は、キーワードの生成と検索に100トークン未満・1回の呼び出しです。ただし、この見積もりには、答えを書くときに読む文脈(本記事では1万〜3万トークン)は入っていません。文書の追加では、GraphRAG は1,399個のコミュニティのレポートを、元の分と新しい分の両方で作り直すので、約1,399 × 2 × 5,000トークンと見積もっています。
(図は、diagram-designで作成)
- どちらの検索を外しても、多くの場合で下がる: 高レベルの検索を外すと(-High)、4つのデータセットすべてで下がり、Legal では84.8%から78.0%になりました。低レベルの検索を外すと(-Low)、Mix 以外の3つで下がりました。原著論文は、低レベルだけでは特定のエンティティの周りに偏って全体を集めきれず、高レベルだけでは具体的な細部が浅くなると分析しています。
- 元の文書を外しても、大きくは下がらない: -Origin は、Agriculture では74.4%に上がり、ほかも CS・Legal は0.4ポイントの差でした。原著論文は、インデキシングで抽出した説明に必要な情報が入っていて、元の文書は余計な情報を足すこともあるためと考察しています。本記事では、元の文書を外すと2つのテーマを落としたので、コーパスや LLM によって結果は変わります。
原著論文と本記事の設定
| 原著論文 | 本記事 | 理由 | |
|---|---|---|---|
| 文書 | UltraDomain の4つのデータセット(約62万〜508万トークン) | 架空の山の紹介文600件(約3万5千トークン)+追加の60件 | GraphRAG・Local Search の記事と同じコーパスで比べるため |
| チャンク | 1,200トークン | 1件(約60トークン)をそのまま | 1件が1つの山の話なので、切ると意味が分かれるため |
| LLM | GPT-4o-mini(抽出・キーワード・答え・評価) | Qwen2.5-7B-Instruct | 手元の GPU で動かすため |
| 埋め込み | OpenAI の埋め込み(公式の実装の既定) | multi-qa-mpnet-base-cos-v1 | GraphRAG の記事とそろえるため |
| 抽出の例 | 公式の3つの物語の例 | 山の文書の例1つ | 毎回の入力を短くするため |
| エンティティの種類 | 組織・人・地名・出来事(既定) | 山・山脈・村・組織・生物・その他 | GraphRAG の記事とそろえるため |
| gleaning | 1回 | 1回 | 同じ |
| 検索 | 上位60件、関係・エンティティ・文書は各4,000トークン | 同じ | 同じ |
| 両方のレベルの結果の合わせ方 | 表の行を集合にして合わせる(順番が実行ごとに変わる) | 高レベル → 低レベルの順に並べる | 結果を再現できるようにするため |
| 評価 | GPT-4o-mini による2つの答えの比較(勝率) | 仕込んだテーマ・山・村の数を数える | 答えの分かっている問いで、数値で比べるため |
まとめ
本記事では、LightRAG のインデキシング(キーワード付きの抽出、重複の除去とキー・値の組)と、低レベル・高レベルの2段階の検索、差分の更新をスクラッチ実装し、GraphRAG・Local Search の記事と同じ600件の架空の山の紹介文と Qwen2.5-7B-Instruct で確かめました。
- 質問のたびの LLM の呼び出しは2回: キーワードの書き出し(入力378トークン)と答えの2回で、全体を俯瞰する問いに6つのテーマすべてで答えました。GraphRAG の記事の Global Search は、14〜26回の呼び出しで5つ(落石を見落とし)でした。
- ただし、読ませる文脈は長い: hybrid の文脈は、全体を俯瞰する問いで27,830トークン、1つの山の事実の問いで平均約3万1千トークンでした。切り詰めないエンティティの説明が長く、Qwen2.5-7B の上限(32,768トークン)を超えることもありました。
- キーワードの分け方が、検索の当たり外れを決める: 1つの山の事実の問いで、LLM が山の名前を高レベルのキーワードに入れたので、低レベルだけの検索は20問中9問しか村を答えられず、高レベルだけでは20問すべてに正解しました。2つのレベルを合わせる hybrid は、片方が外れても、もう片方で補えます。
- 差分の更新は、追加分の抽出と少しの要約だけ: 60件の追加は、抽出120回と要約し直し11回で済み、新しい問題(土砂崩れ)も答えに入りました。同じグラフで GraphRAG のコミュニティを分け直すと、12個が9個になって9個すべての中身が変わり、レポートをすべて書き直すことになりました。
- インデキシングは、GraphRAG より重い: gleaning と長いプロンプトのため、抽出の入力は約123万トークンで、GraphRAG の記事の抽出の約8.5倍でした。その代わり、エンティティと関係の説明に、GraphRAG では消えた落石のような原因まで残りました。
LightRAG は、GraphRAG のコミュニティとレポートをやめて、エンティティと関係そのものをキーワードで探せるようにした方法です。質問のたびの呼び出しを減らし、文書の追加を軽くする代わりに、答えの質は、抽出した説明の良さと、LLM がキーワードをどう分けるか、長い文脈をどこまで読めるかに左右されます。文書が頻繁に増えるコーパスや、Global Search の手間が重すぎる規模で、特に役立ちます。
参考文献
- Z. Guo, L. Xia, Y. Yu, T. Ao, C. Huang (2025). LightRAG: Simple and Fast Retrieval-Augmented Generation. Findings of EMNLP 2025, 10746–10761.
- HKUDS/LightRAG. 原著論文の公開コード(MIT License)。本記事のプロンプトと検索の手順は、2024年10月の版(
lightrag/prompt.py、lightrag/operate.py)にそろえています。 - D. Edge, H. Trinh, N. Cheng, J. Bradley, A. Chao, A. Mody, S. Truitt, J. Larson (2024). From Local to Global: A GraphRAG Approach to Query-Focused Summarization. arXiv:2404.16130.
- H. Qian, P. Zhang, Z. Liu, K. Mao, Z. Dou (2024). MemoRAG: Moving towards Next-Gen RAG via Memory-Inspired Knowledge Discovery. arXiv:2409.05591.(UltraDomain のデータセット)
- V. A. Traag, L. Waltman, N. J. van Eck (2019). From Louvain to Leiden: guaranteeing well-connected communities. Scientific Reports, 9, 5233.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。