尤度比スコアとは?
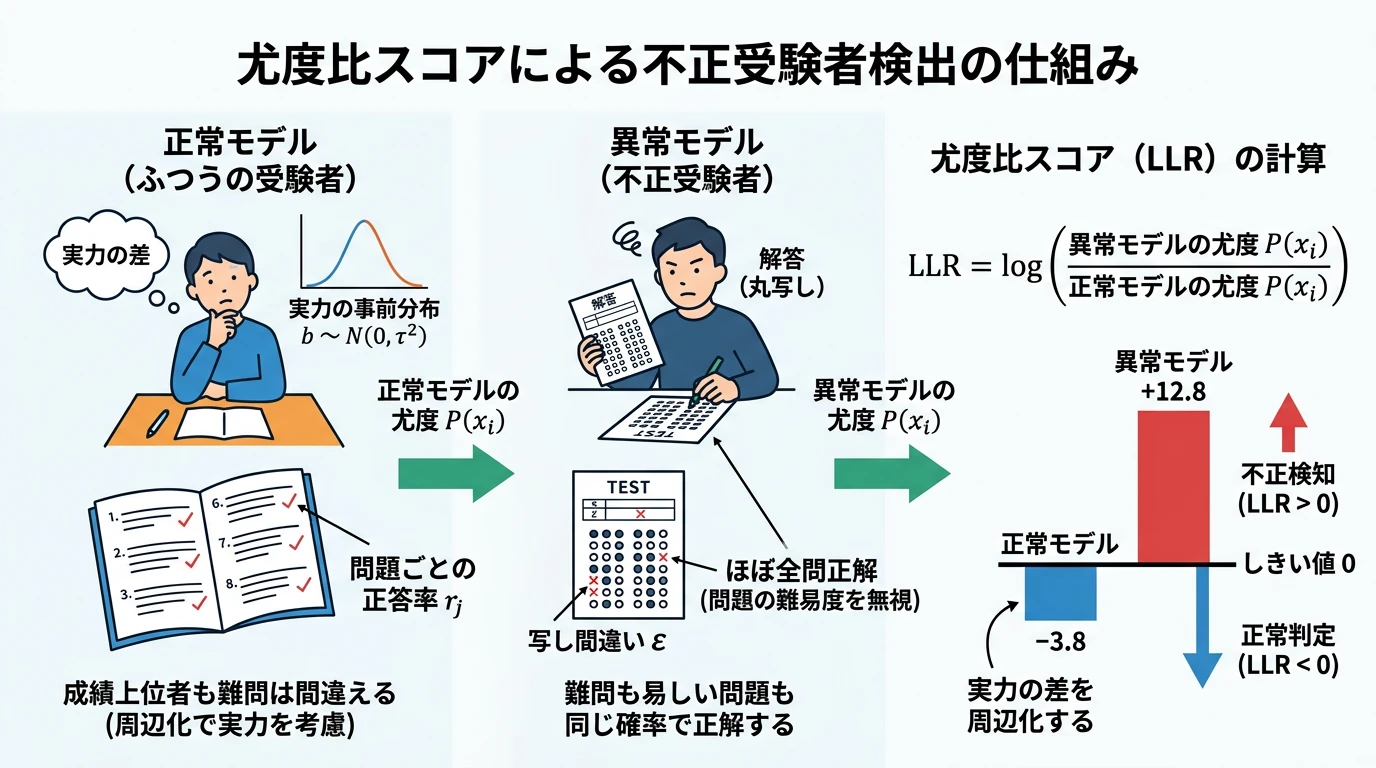 (画像は、Geminiで作成)
「尤度」と「尤度比」の意味を理解し、2つの仮説(モデル)のどちらがデータをよく説明できるかを数値で比べられるようになること。そのうえで、試験の解答データの中から不正受験者を見つけるスコアを自分で組み立てられるようになること。
この記事で扱う問題
100問の試験を3000人が受けたとします。手元にあるのは、受験者ごとに「各問題に正解した(1)/不正解だった(0)」を並べたデータです。
ところが、試験の前に解答が漏れていて、ごく一部の受験者が 解答を丸写ししてほぼ満点を取っていた としたらどうでしょうか。このような不正受験者を、解答データだけから見つけられるでしょうか。
「満点に近い人を疑えばよいのでは?」と思うかもしれません。しかし、受験者の中には実力で高得点を取る成績上位者もいます。95点の受験者と99点の受験者がいたとき、どちらが実力で、どちらが不正なのか。点数だけでは決められません。この線引きを、勘ではなく確率の言葉で行うための道具が、本記事で解説する 尤度比(ゆうどひ)スコア です。
ここでカギになるのが、問題ごとの正答率 です。正答率は「その問題に、ふつうの受験者がどのくらい正解しているか」を表すので、「正答率5%の超難問に正解した」ことがどれだけ珍しいかを教えてくれます。実力のある受験者でも難問はときどき落としますが、解答を丸写しした受験者は、難問も易しい問題も区別なく正解します。尤度比スコアは、この違いをうまく取り込むことができます。
尤度とは:コイン投げで考える
まずは試験から離れて、最も簡単な例で考えます。コインを10回投げたところ、表が7回、裏が3回出ました。このコインについて、次の2つの説明(仮説)があるとします。
- 仮説A: 表と裏が同じ確率で出る、ふつうのコイン(表の確率 )
- 仮説B: 表が出やすい、いびつなコイン(表の確率 )
どちらの説明のほうが、手元の結果「10回中7回が表」をうまく説明できるでしょうか。これを測るのが 尤度(likelihood) です。尤度とは、「その仮説が正しいとしたら、手元のデータが得られる確率」のことです。
表の確率が のコインで、ある特定の順番(例えば「表表裏表表表裏表裏表」)が出る確率は、1回ごとの確率の掛け算になります。表なら 、裏なら を掛けるので、表が7回、裏が3回なら次のようになります。
この を、 の関数とみなしたものが 尤度関数 です。2つの仮説の値を計算してみましょう。
仮説Bのほうが尤度が大きいので、「10回中7回が表」という結果は、仮説Bのほうがもっともらしく説明できる、ということになります。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。japanize-matplotlib は distutils を使うので、Python 3.12 以降で import エラーになる場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 観測データ:コインを10回投げて、表が7回出た
n_flips, n_heads = 10, 7

# 2. 尤度関数:表の出る確率が p のとき、この結果が得られる確率
def likelihood(p, n_heads=n_heads, n_flips=n_flips):
    return p**n_heads * (1 - p)**(n_flips - n_heads)

for p in [0.5, 0.7]:
    print(f"L({p}) = {likelihood(p):.6f}")
print(f"尤度比 L(0.7) / L(0.5) = {likelihood(0.7) / likelihood(0.5):.2f}")

# 3. 尤度関数を p の関数として描く
p_grid = np.linspace(0, 1, 201)
plt.figure(figsize=(8, 4.5))
plt.plot(p_grid, likelihood(p_grid), color='steelblue', label='尤度 L(p)')
for p, color in [(0.5, 'gray'), (0.7, 'red')]:
    plt.scatter(p, likelihood(p), color=color, zorder=3, s=60)
    plt.annotate(f'p = {p}\nL = {likelihood(p):.5f}', (p, likelihood(p)),
                 textcoords='offset points', xytext=(-90 if p == 0.5 else 10, 0))
plt.xlabel('表の出る確率 p')
plt.ylabel('尤度 L(p)')
plt.title('10回中7回が表だったときの尤度関数')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
「10回中7回が表」というデータに対して、2つの仮説の尤度を計算し、 を動かしたときに尤度がどこで最大になるかを確かめるコードです。
- 尤度関数 likelihood: 上の式 をそのまま計算します。データ(7回と10回)を既定の引数にして p だけを変えられるようにしているのは、尤度が「データを固定して、仮説()を動かして比べる」ものだからです。p に配列を渡すとすべての について一度に計算できるので、後のグラフにもそのまま使えます。
- 尤度比: 2つの仮説のどちらがデータをよく説明するかを1つの数で表すため、likelihood(0.7) / likelihood(0.5) で、仮説Bの尤度が仮説Aの尤度の何倍かを計算します。これが次の節で扱う尤度比です。
- 可視化: 2つの仮説だけでなく、どの で尤度が最大になるか(最尤推定)を見るため、p_grid で0〜1を201点に区切って尤度関数の形を描きます。2つの仮説の位置には点と値を書き込み、計算した値がグラフのどこにあたるかを示します。
実行結果
L(0.5) = 0.000977
L(0.7) = 0.002224
尤度比 L(0.7) / L(0.5) = 2.28
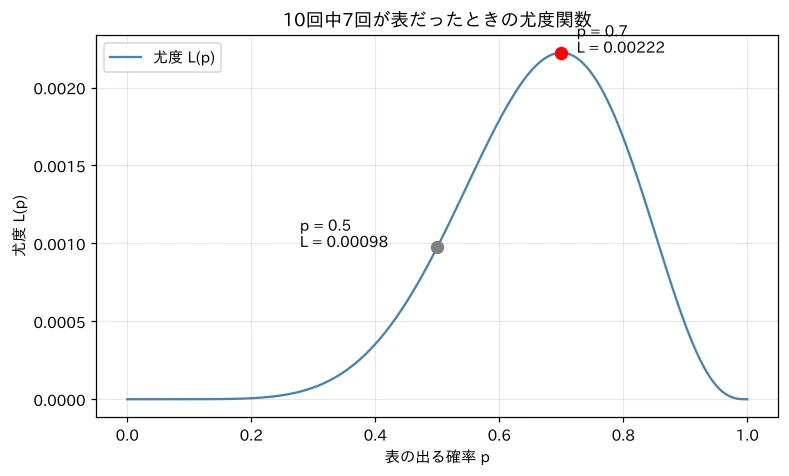
尤度関数は で最大になっています。10回中7回が表なら、「表の確率は0.7」とするのが最もデータに合う、というのは直感とも一致します。このように、尤度が最大になるパラメータを選ぶ方法を 最尤推定 と呼びます。
同じ という式でも、見方によって呼び方が変わります。
| 固定するもの | 動かすもの | 問い | |
|---|---|---|---|
| 確率 | パラメータ | データ | このコインを投げたら、どんな結果がどのくらい出やすいか |
| 尤度 | データ | パラメータ | この結果が出たのは、どんなコインだったからか |
なお、尤度の値は について足しても(積分しても)1にはなりません。尤度は確率分布ではなく、「仮説どうしを比べるための物差し」だと考えるとよいでしょう。
「10回中7回が表になる確率」を二項分布で計算するときは、表が出る順番の組み合わせの数 を掛けます。ここで掛けていないのは、観測した「特定の順番」の確率を計算しているためです。 は を含まない定数なので、尤度を比べたり最大化したりする目的では、掛けても掛けなくても結論は変わりません。
尤度比:2つの仮説を比べる
2つの仮説の尤度の比を 尤度比(likelihood ratio) と呼びます。
「手元のデータは、仮説Bのもとで仮説Aのもとより約2.28倍起こりやすい」という意味です。尤度比が1より大きければ仮説B、1より小さければ仮説Aのほうがデータをよく説明できます。
対数を取る理由1:掛け算は0に潰れる
データの数が増えると、尤度は小さな確率の掛け算になり、あっという間に0に近づきます。実際に、表の確率が0.7のコインを1000回投げたデータで確かめてみましょう。
# 1. 1000回投げたデータ(表の出る確率 0.7 のコイン)
rng = np.random.default_rng(0)
flips = rng.binomial(1, 0.7, size=1000)  # 1 = 表, 0 = 裏
print(f"表の回数: {flips.sum()} / {len(flips)}")

# 2. 1回ごとの確率:表なら p、裏なら 1 - p
def prob_each(p, flips):
    return np.where(flips == 1, p, 1 - p)

# 3. そのまま掛け算すると…
print("尤度(積)   :", np.prod(prob_each(0.7, flips)))
# 4. 対数を取って足し算すると…
print("対数尤度(和):", np.sum(np.log(prob_each(0.7, flips))))

# 5. 対数尤度比 = 1回ごとの「証拠」の足し算
contrib = np.log(prob_each(0.7, flips)) - np.log(prob_each(0.5, flips))
print(f"表1回の証拠: log(0.7/0.5) = {np.log(0.7 / 0.5):+.3f}")
print(f"裏1回の証拠: log(0.3/0.5) = {np.log(0.3 / 0.5):+.3f}")
print(f"対数尤度比(合計): {contrib.sum():.1f}")
データが増えると尤度の掛け算が0に近づいてしまうこと(アンダーフロー)と、対数を取ると「1回ごとの証拠の足し算」になることを、1000回分のデータで確かめるコードです。
- データの生成: 仮説B(表の確率0.7)が正しいと分かっているデータで確かめるため、rng.binomial(1, 0.7, size=1000) で、確率0.7で1(表)、0.3で0(裏)になる値を1000個作ります。シードを固定しているので、何度実行しても同じ1000回になります。
- 1回ごとの確率 prob_each: 尤度も対数尤度も1回ごとの確率から作るので、まずその配列を作る関数を用意します。np.where(flips == 1, p, 1 - p) で、表のところには 、裏のところには を並べます。尤度はこの配列の積、対数尤度は対数の和です。p を引数にしているのは、2つの仮説(0.7 と 0.5)で同じ関数を使い回すためです。
- 積と和の比較: 同じ尤度を2通りで計算し、そのまま掛け算すると値が極端に小さくなることを見せるため、np.prod(全要素の積)と np.sum(np.log(...))(対数の和)を並べて表示します。
- 1回ごとの証拠 contrib: 対数尤度比が「1回ごとの証拠の足し算」になることを確かめるため、2つの仮説での対数確率の差を1回ずつ計算して合計します。この合計が対数尤度比です。表1回・裏1回の証拠も表示しているのは、次の節の手計算(678 × 0.336 + 322 × (−0.511))と照らし合わせられるようにするためです。
実行結果
表の回数: 678 / 1000
尤度(積)   : 4.069257282609404e-274
対数尤度(和): -629.5048549834119
表1回の証拠: log(0.7/0.5) = +0.336
裏1回の証拠: log(0.3/0.5) = -0.511
対数尤度比(合計): 63.6
1000回分の尤度は という極端に小さな値になりました。コンピュータで扱える最小の数はおよそ なので、データがもう少し増えると0に潰れてしまいます(アンダーフロー)。対数を取れば、積は和に変わります。
のような、ふつうの大きさの数で計算できるようになります。対数は単調増加な関数なので、「尤度が大きいほうが、対数尤度も大きい」という大小関係は変わりません。
対数を取る理由2:証拠を足し算で積み上げられる
対数尤度比は、1回ごとの「証拠」の足し算に分解できます。ここが尤度比スコアを理解するうえで最も大切なポイントです。
コイン投げの場合、1回分の証拠は次の2通りしかありません。
- 表が出たとき: (仮説Bに有利な証拠)
- 裏が出たとき: (仮説Aに有利な証拠)
表が678回、裏が322回なので、対数尤度比は次のように計算できます。
コードの出力と一致しました。この足し算を図にすると、次のようになります。
(図は、diagram-designで作成)
対数尤度比が ということは、尤度比は 倍です。1000回も投げれば、「表の確率は0.7」という仮説Bのほうが圧倒的にもっともらしい、と判断できます。
対数尤度比が0より大きければ仮説B、0より小さければ仮説A というのが基本の読み方です。1つ1つの観測は小さな証拠でも、足し合わせることで確かな判断になります。
試験データへの応用:2つのモデルを用意する
コイン投げの「仮説A・B」を、試験の解答データの「ふつうの受験者のモデル」と「不正受験者のモデル」に置き換えます。
ダミーデータの生成
まず、不正受験者が混ざった解答データを作ります。ふつうの受験者が正解できるかどうかは、問題の難しさと、受験者の実力の両方で決まるようにします。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy.special import expit, logit

T = 100  # 問題数

# 1. 各問題の正答率の目安(1問目が最も易しく、後ろの問題ほど難しい)
rng = np.random.default_rng(0)
base_rate = np.sort(rng.uniform(0.03, 0.9, T))[::-1]

# 2. ふつうの受験者3000人(うち30人は成績上位者)と、解答を事前に入手した不正受験者60人
n_honest, n_cheat = 3000, 60
a = logit(base_rate) - 0.3                     # 問題の易しさ(ロジットで0.3引き、どの問題も目安より少し難しくする)
b = rng.normal(0, 1.0, n_honest)               # 受験者の実力
b[:30] += 2.5                                  # 成績上位者:不正受験者に近い点数を取る、ふつうの受験者を作る
X_honest = rng.binomial(1, expit(a[None, :] + b[:, None]))
X_cheat = rng.binomial(1, 0.99, size=(n_cheat, T))  # ほぼ全問正解(ごくまれに写し間違い)。難問も易しい問題も区別しない

X = np.vstack([X_honest, X_cheat]).astype(float)     # 1 = 正解, 0 = 不正解
y = np.r_[np.zeros(n_honest), np.ones(n_cheat)]      # 正解ラベル(評価にだけ使う)

# 3. 各問題の正答率(不正受験者も含めて集計されている)
r = X.mean(axis=0)
print(f"受験者数: {len(X)}(うち不正 {int(y.sum())} 人)")
print(f"正答率 最も易しい問題 {r.max():.3f} / 最も難しい問題 {r.min():.3f}")

# 4. 可視化:問題ごとの正答率と、3人の受験者の解答
top = int(np.argmax(X_honest.sum(1)))     # 最も点数の高いふつうの受験者
typical = 100                             # 平均的な受験者
cheat = n_honest                          # 不正受験者(先頭の1人)
fig, axes = plt.subplots(2, 1, figsize=(11, 6), gridspec_kw={'height_ratios': [1.3, 1]})
axes[0].bar(np.arange(1, T + 1), r, color='steelblue')
axes[0].set_xlim(0.5, T + 0.5)
axes[0].set_ylabel('正答率')
axes[0].set_title('問題ごとの正答率(後ろの問題ほど難しい)')
axes[0].grid(True, alpha=0.3)
axes[1].imshow(X[[typical, top, cheat]], aspect='auto', cmap='Greys', interpolation='nearest',
               extent=[0.5, T + 0.5, 2.5, -0.5])
axes[1].set_yticks([0, 1, 2])
axes[1].set_yticklabels([f'平均的な受験者({int(X[typical].sum())}点)',
                         f'成績上位者({int(X[top].sum())}点)',
                         f'不正受験者({int(X[cheat].sum())}点)'])
axes[1].set_xlabel('問題番号')
axes[1].set_title('解答(黒 = 正解、白 = 不正解)')
plt.tight_layout()
plt.show()
不正受験者を解答データだけから見つけられるかを試すために、誰が不正かが分かっている解答データを作り、問題ごとの正答率を集計するコードです。
- 問題の難しさ base_rate: 「正答率の低い難問に正解した」ことが不正の証拠になるかを確かめるため、難しさの違う問題をそろえます。各問題の正答率の目安を3%〜90%の範囲でランダムに決め、np.sort(...)[::-1] で易しい順に並べます。1問目が最も易しく、100問目が最も難しい試験になります。並べ替えるのは、図で「後ろの問題ほど難しい」と読み取れるようにするためです。
- ふつうの受験者の正解確率: 受験者 が問題 に正解する確率を としています。 はシグモイド関数 expit で、どんな実数も0〜1の確率に変換します。 は問題の易しさで、正答率の目安をシグモイドの逆関数 logit で変換し、0.3を引いたものです。ロジットで0.3引くと、どの問題も目安より少し難しくなり、ふつうの受験者の正答率の平均は、引かない場合の約50%から約45%に下がります。0.3を正答率から直接引くと、最も難しい問題(目安3.2%)では確率がマイナスになってしまいますが、ロジットで引けば、シグモイド関数を通した確率は必ず0〜1に収まります(その問題の正解の確率は、 のとき2.4%)。 は受験者の実力で、標準正規分布から引いています。実力を入れるのは、実力で高得点を取る受験者もいる、現実に近いデータにするためです。先頭30人に2.5を足すのは、不正受験者に近い点数(95点前後)を取るふつうの受験者をわざと作り、点数だけでは不正と区別できない状況にするためです。この受験者が、後の節の「成績上位者問題」を起こします。
- 不正受験者: rng.binomial(1, 0.99, ...) で、どの問題にも99%の確率で正解する受験者を60人作っています。完全に満点ではなく、解答の写し間違いなどで、まれに不正解が混ざる想定です。
- 正解ラベル y: 不正受験者を1としたラベルです。検出の 評価にだけ 使い、スコアの計算には使いません。
- 集計された正答率 r: 不正受験者も含めた全3060人で、問題ごとに正解した割合を計算しています。現実の試験でも、正答率は不正受験者を含んだまま集計されるためです。
- 3人の受験者: 点数だけでは不正と見分けにくいことを図で見せるため、平均的な受験者(100番目)、最も点数の高いふつうの受験者 top、不正受験者の先頭 cheat の3人を選び、解答を白黒で並べます。この3人は、後のコードでもスコアを比べるのに使います。
「正解の確率を、問題の易しさと受験者の実力の和をシグモイド関数に通して決める」というモデルは、テスト理論で ラッシュモデル(1パラメータ・ロジスティックモデル) と呼ばれるものです。TOEFL などの大規模な試験で使われる 項目反応理論(IRT) の最も基本的なモデルです。
実行結果
受験者数: 3060(うち不正 60 人)
正答率 最も易しい問題 0.833 / 最も難しい問題 0.059
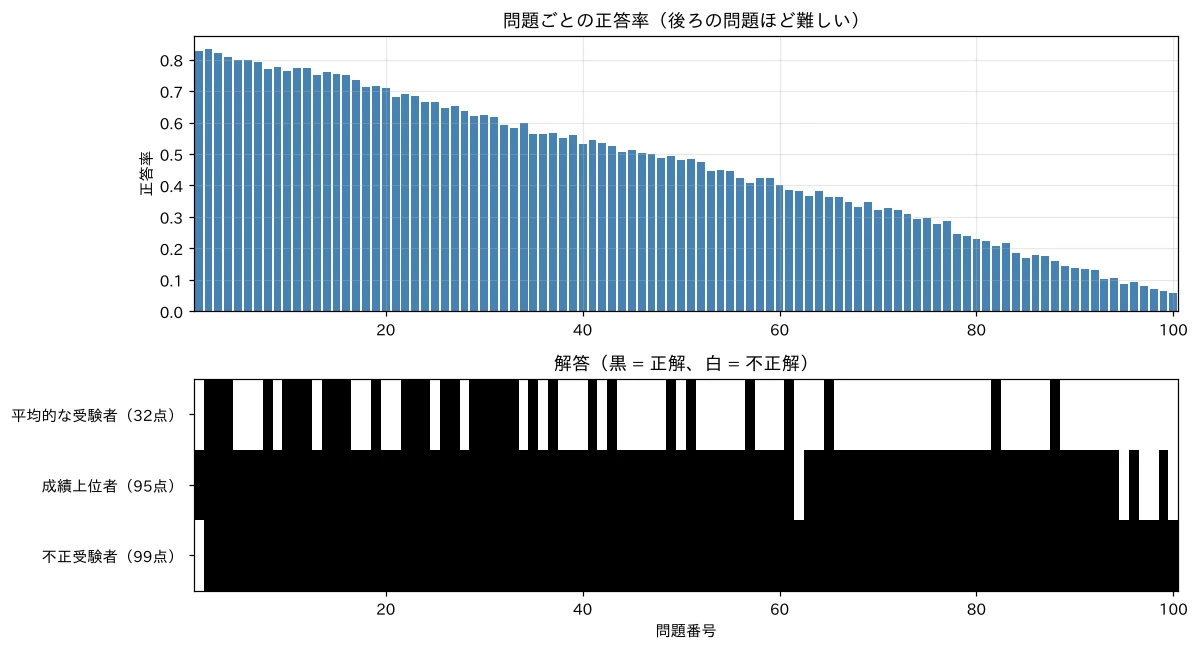
上段が問題ごとの正答率です。1問目の約83%から、100問目の約6%まで、後ろの問題ほど難しくなっています。下段は3人の受験者の解答です。平均的な受験者は前半の易しい問題を中心に32点、成績上位者は難問をいくつか落として95点です。不正受験者は、最も易しい1問目を写し間違えただけで、難問も含めてすべて正解し99点です。
正常モデルと異常モデル
コイン投げの2つの仮説に対応して、解答データについて2つのモデルを用意します。受験者 が問題 に正解したかどうかを とします。
正常モデル: ふつうの受験者は、その問題の正答率と同じ確率で正解する。
異常モデル: 不正受験者は、問題の難しさに関係なく、ほぼ必ず正解する。
異常モデルの は「不正受験者がたまに間違える確率」です。(絶対に間違えない)にすると、不正解が1つでも混ざった瞬間に異常モデルの尤度が0になり、対数が になってしまいます。小さな値にしておくことで、写し間違いのような「たまの不正解」を許容します。
コイン投げと同じように、1問ごとの証拠を足し合わせたものが 対数尤度比スコア です。
1問ごとの証拠は、正解したかどうかで2通りに分かれます。
この式に、正答率をうまく使う仕組みが入っています。
- 正解したとき: 分母が正答率 です。正答率の低い難問に正解していると、 は大きくなります。「ほとんど誰も解けない問題が解けている」ことが、不正の強い証拠になります。易しい問題に正解しても、みんなが正解している問題なので、証拠としては弱くなります。
- 不正解のとき: 分子が と小さいので、問題に関係なく 〜 程度の大きなマイナスの証拠になります。「不正受験者ならほとんど間違えないはずなのに、間違えた」からです。
下の図は、この後のコードで計算する4問分の証拠を並べたものです。正解の証拠(右)は難しい問題ほど長く、不正解の証拠(左)はどの問題でも大きなマイナスです。
(図は、diagram-designで作成)
eps = 0.01                       # 不正受験者が間違える確率(写し間違いなど)
p = np.clip(r, 1e-3, 1 - 1e-3)   # 正常モデル:正答率 = その問題に正解する確率(0や1だと対数が -∞ になるので端を避ける)

# 1. 1問ごとの証拠(対数尤度比への寄与)
def contrib(x, p, eps=eps):
    return np.where(x == 1, np.log((1 - eps) / p), np.log(eps / (1 - p)))

print("問題   正答率  正解したときの証拠  不正解のときの証拠")
for j in [0, 49, 89, 99]:
    print(f"{j + 1:3d}問目  {p[j]:.3f}       {np.log((1 - eps) / p[j]):+.2f}              {np.log(eps / (1 - p[j])):+.2f}")

# 2. 全受験者の対数尤度比スコア
llr_simple = contrib(X, p).sum(axis=1)
for name, idx in [('平均的な受験者', typical), ('成績上位者', top), ('不正受験者', cheat)]:
    print(f"{name}: {int(X[idx].sum())} 点, LLR = {llr_simple[idx]:+.1f}")

flag = llr_simple > 0
print(f"LLR > 0 で検出: {flag.sum()} 人(不正 {int((flag & (y == 1)).sum())} 人, ふつうの受験者 {int((flag & (y == 0)).sum())} 人)")

# 3. スコアの分布
plt.figure(figsize=(9, 4.5))
bins = np.linspace(llr_simple.min(), llr_simple.max(), 80)
plt.hist(llr_simple[y == 0], bins=bins, color='steelblue', alpha=0.7, label='ふつうの受験者')
plt.hist(llr_simple[y == 1], bins=bins, color='red', alpha=0.7, label='不正受験者')
plt.axvline(0, color='black', linestyle='--', label='LLR = 0')
plt.yscale('log')
plt.xlabel('対数尤度比スコア(大きいほど不正が疑われる)')
plt.ylabel('人数(対数目盛)')
plt.title('正答率だけを使った正常モデルでのスコア分布')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
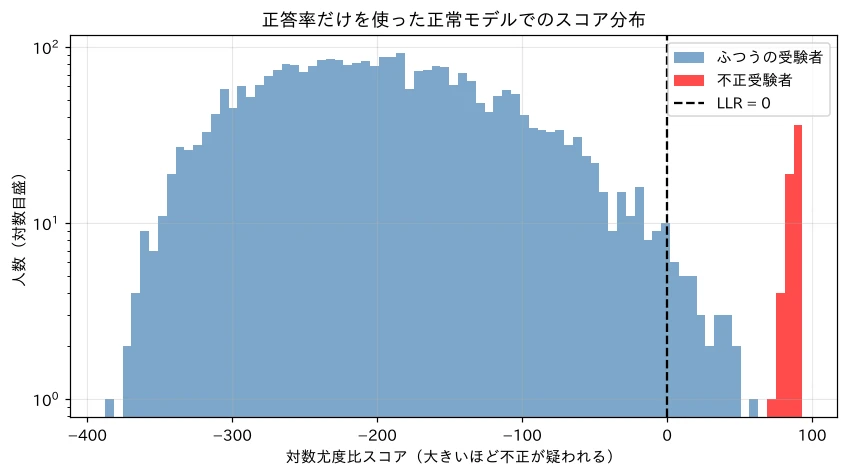
コイン投げの尤度比をそのまま試験データに当てはめ、正答率だけを使った正常モデルで不正受験者を見つけられるかを試すコードです。
- 確率のクリップ: np.clip(r, 1e-3, 1 - 1e-3) で、正答率がちょうど0や1にならないようにしています。0や1だと、対数を取ったときに になるためです。
- 1問ごとの証拠 contrib: 上の場合分けの式を np.where で書いたものです。x == 1 のところには 、それ以外には が入ります。np.where で書くのは、X(受験者数 × 100問の行列)をそのまま渡して、3060人 × 100問の証拠をループなしで一度に計算するためです。
- 証拠の表: 難しい問題ほど正解の証拠が大きくなることを数で確かめるため、易しい1問目から難しい100問目まで4問を選んで、正解したとき・不正解のときの証拠を表示します。
- スコアの合計: 受験者ごとに不正かどうかを1つの数で判定するため、.sum(axis=1) で問題の方向(列)に証拠を足し合わせます。
- しきい値0での検出: llr_simple > 0 は、「異常モデルのほうがデータをよく説明できる」受験者です。しきい値を0にするのは、「異常モデルの尤度が正常モデルを上回るか」という尤度比の基本の読み方そのものだからです。正解ラベル y と照らし合わせて、正しく検出できた数と誤検知の数を数えています。
- ヒストグラム: 2つのグループのスコアが、しきい値0でどれだけ分かれているかを見るため、ふつうの受験者と不正受験者のスコアを色分けして重ねます。縦軸を plt.yscale('log') で対数目盛にするのは、3000人と60人で人数の差が大きく、そのままでは不正受験者の棒が見えないためです。
実行結果
問題   正答率  正解したときの証拠  不正解のときの証拠
  1問目  0.827       +0.18              -2.85
 50問目  0.482       +0.72              -3.95
 90問目  0.139       +1.96              -4.46
100問目  0.059       +2.82              -4.54
平均的な受験者: 32 点, LLR = -256.5
成績上位者: 95 点, LLR = +59.8
不正受験者: 99 点, LLR = +90.3
LLR > 0 で検出: 93 人(不正 60 人, ふつうの受験者 33 人)
表を見ると、正答率5.9%の100問目に正解した証拠は で、正答率82.7%の1問目の の15倍以上です。難しい問題ほど、正解が「不正らしさ」の強い証拠になっています。
不正受験者60人は、すべてスコアが 〜 程度になり、検出できました。ところが、ふつうの受験者も33人がスコア0を超え、誤検知されています。95点の成績上位者のスコアは で、ふつうの受験者の中では最も高い値です。この受験者は5問を間違えているので、そのたびに約 以上の証拠が積み上がっているはずです。それでも不正と判定されたのはなぜでしょうか。
問題ごとの証拠と3人の LLR を並べると、次のようになります。
(図は、diagram-designで作成)
成績上位者問題:正常モデルが単純すぎる
原因は、正常モデルの側にあります。「すべての受験者が、正答率どおりの確率で正解する」というモデルでは、全員が同じ実力だと仮定していることになります。正答率の平均は約46%なので、このモデルのもとでの点数は平均46点程度で、95点を取る受験者はほとんど起こりえない存在です。
尤度比は「2つのモデルのうち、どちらがましか」しか比べません。正常モデルが成績上位者を説明できなければ、異常モデルのほうが「まし」と判定されてしまいます。尤度比で正しく判定するには、比べる2つのモデルが、それぞれのグループをきちんと説明できている必要があります。
実力の差を入れる
そこで、データ生成のときと同じように、正常モデルに受験者ごとの実力 を入れます。
はシグモイド関数、 はその逆関数です。 のときは となり、さきほどの単純なモデルに戻ります。 が大きいほど、すべての問題で正解しやすくなります。
ただし、「どの問題が難しいか」という順序()は全受験者で共通です。成績上位者でも、難問は易しい問題より間違えやすい、という構造が保たれます。ロジット(対数オッズ)の世界で足し算しているので、0〜1の範囲を超えることもありません。
を自由に選んではいけない
では、受験者ごとに を最尤推定すればよいのでしょうか。この方法を式で整理しておきます。
実力を と決めたときの正常モデルの対数尤度は、コイン投げと同じ形で、正解した問題では 、不正解の問題では を足し合わせたものです。
「 を自由に選ぶ」とは、受験者ごとにこの対数尤度が最も大きくなる を選ぶ(最尤推定する)ことです。そのときの対数尤度を、正常モデルの対数尤度として使います。
異常モデルの対数尤度は、これまでと同じく、正解の確率を とした場合です。
この2つの差が、 を自由に選んだ場合の対数尤度比です。判定のルールはこれまでと同じで、0より大きければ不正と判定します。
正常モデルは受験者ごとに最も都合のよい を選べるので、 に固定していたときより、どの受験者もうまく説明できるようになります。その分だけ は小さくなります。成績上位者の誤検知を防ぐにはよい方向ですが、不正受験者まで正常モデルで説明できてしまわないかが問題です。
成績上位者と不正受験者について、 をいくつか変えて対数尤度 を計算してみます。さらに、全受験者について を計算し、検出結果も確認します。
from scipy.special import logsumexp

a_hat = logit(p)                     # 問題の易しさ(正答率から計算)
b_values = [-2, 0, 2, 4, 6, 8]       # 受験者の実力の候補

# 1. 実力 b を固定したときの対数尤度 log P(x | b)
def loglik_given_b(x, b):
    q = np.clip(expit(a_hat + b), 1e-12, 1 - 1e-12)
    return np.sum(x * np.log(q) + (1 - x) * np.log(1 - q))

print("   b   成績上位者   不正受験者")
for bv in b_values:
    print(f"{bv:4d}   {loglik_given_b(X[top], bv):9.1f}   {loglik_given_b(X[cheat], bv):9.1f}")

# 2. 異常モデルでの対数尤度
def loglik_anom_model(x, eps=eps):
    return np.sum(x * np.log(1 - eps) + (1 - x) * np.log(eps))

# 3. 受験者ごとに b を自由に選んだ(最尤推定した)場合の対数尤度比
b_free = np.linspace(-6, 12, 181)   # b の候補。b を大きくすれば説明できてしまう場合も含めるよう、上側を広く取る
Q_free = np.clip(expit(a_hat[:, None] + b_free[None, :]), 1e-12, 1 - 1e-12)
loglik_free = (X @ np.log(Q_free) + (1 - X) @ np.log(1 - Q_free)).max(axis=1)   # b について最大化
llr_free = np.array([loglik_anom_model(x) for x in X]) - loglik_free
print(f"不正受験者: 異常モデル {loglik_anom_model(X[cheat]):.1f} / 正常モデル(b を自由に選んだ最大値){loglik_free[cheat]:.1f}")
flag = llr_free > 0
print(f"b を自由に選んだ場合の検出: {flag.sum()} 人(不正 {int((flag & (y == 1)).sum())} 人, ふつうの受験者 {int((flag & (y == 0)).sum())} 人)")
正常モデルに実力 を入れ、受験者ごとに を自由に選ぶ(最尤推定する)と、成績上位者の誤検知は防げるか、不正受験者まで説明できてしまわないかを確かめるコードです。
- 問題の易しさ a_hat: 正答率をロジットに変換したものです。こうしておくと、 のときに正解の確率が正答率に戻るので、前のコードの単純なモデルが の場合として含まれ、 を入れた効果だけを比べられます。
- loglik_given_b: 正解の確率 を計算し、正解した問題には 、不正解の問題には を足し合わせます。コイン投げの対数尤度と同じ形で、表の確率が問題ごとに違うだけです。成績上位者と不正受験者のそれぞれで、どの が最もよく説明するかを表で見るために使います。np.clip で確率を 1e-12〜1−1e-12 に収めるのは、 が極端なときに確率が0や1になり、対数が になるのを防ぐためです。
- loglik_anom_model: 比べる相手の異常モデル(正解の確率 )での対数尤度です。前のコードと同じ異常モデルを、受験者1人分の対数尤度として計算します。
- の最尤推定: b_free で の候補を 〜 の範囲に細かく並べ、全受験者 × 全候補の対数尤度を行列の掛け算で一度に計算しています。.max(axis=1) で、受験者ごとに対数尤度が最大になる候補の値を取り出しています。これが で、 を細かい候補の中から選ぶことで最大化を近似しています。最適化のライブラリを使わずに候補を並べて最大値を取るのは、 が1次元で、3060人分を行列の掛け算で一度に計算できるからです。範囲を 〜 と広く取るのは、不正受験者のように を大きくすれば説明できてしまう場合も含めて、最大値を見落とさないためです。
- 判定 llr_free: [loglik_anom_model(x) for x in X] で全受験者の を計算し、そこから loglik_free()を引いています。上の式 そのものです。llr_free > 0 の受験者を不正と判定し、正解ラベルと照らし合わせて検出数を数えています。
実行結果
   b   成績上位者   不正受験者
  -2      -216.8      -237.0
   0       -83.7       -95.9
   2       -23.4       -27.6
   4       -13.5        -9.7
   6       -20.0        -8.1
   8       -29.5        -9.6
不正受験者: 異常モデル -5.6 / 正常モデル(b を自由に選んだ最大値)-8.0
b を自由に選んだ場合の検出: 28 人(不正 28 人, ふつうの受験者 0 人)
成績上位者の対数尤度は 付近で最大になり、()より大幅に改善しています。実力の差を入れると、正常モデルで成績上位者を説明できるようになりました。
問題は不正受験者です。 前後まで大きくすると、対数尤度は まで上がり、異常モデルの との差はわずか になってしまいます。 を極端に大きくすれば「難問も含めてほぼ全問正解する超優秀な受験者」を作れるので、正常モデルでも不正受験者を説明できてしまうのです。実際、 を自由に選ぶと、不正受験者60人のうち28人しか検出できず、32人を見逃しました。
b ごとの対数尤度を表にすると、次のようになります。
(図は、diagram-designで作成)
解決策: を積分して消す(周辺化)
ここで使うのが 周辺化 という考え方です。 を1つの値に決めるのではなく、「受験者の実力 は、ふつうはこのくらいの範囲に分布している」という事前分布 を置き、あらゆる について平均を取ります。
この式は「ランダムに選んだ受験者が、このような解答をする確率」と読めます。 のような極端な実力の受験者は、事前分布のもとではめったにいないので、小さな重みしか付きません。標準正規分布()では、 の密度は の 倍です。対数でいえば のペナルティになり、不正受験者を「超優秀な受験者」として説明するのは割に合わなくなります。
一方、成績上位者の 前後は、ペナルティ()を払っても、 と比べた対数尤度の改善(上の表の の から の へ、約 )のほうがはるかに大きいので、正常モデルでうまく説明されます。
「自由に選ぶ」と「周辺化」の違い
ここで、前の節の「 を自由に選ぶ」方法との違いを整理しておきます。注意したいのは、どちらも「受験者ごとに実力 が異なる」という前提は同じだという点です。違うのは、「 がどんな値を取りやすいか」という前提を置くかどうかと、それに伴う の扱い方です。
| を自由に選ぶ | 周辺化 | |
|---|---|---|
| 受験者ごとに が異なるか | 異なる | 異なる |
| の取りやすさの前提 | なし( も も同じくらいありうる) | あり:(極端な実力の人はめったにいない) |
| の扱い | 尤度が最大になる1つの値を選ぶ(最尤推定) | すべての について、取りやすさで重み付けして平均する(積分) |
| 正常モデルの対数尤度 |
2つの関係は、周辺化の式を近似するとよく分かります。被積分関数 は、ほとんどの場合ある の付近に鋭い山を持つので、積分の値はその山の高さでおおよそ決まります。山の高さの対数を取ると、次のように書けます(ラプラス近似と呼ばれる考え方です)。
つまり周辺化は、「 を自由に選ぶ」方法に、「極端な を選ぶほど のペナルティを払う」という条件を付けたものと見ることができます。
(図は、diagram-designで作成)
図の右の値は、上の表の対数尤度からペナルティを引いたものです( なら 、 なら )。ペナルティを付けると、不正受験者を「超優秀な受験者」として説明しても、異常モデルの に届かなくなります。
- 自由に選ぶ場合: ペナルティがないので、不正受験者も を選べば「超優秀な受験者」として説明できてしまいます。これが32人の見逃しの原因でした。
- 周辺化の場合: には のペナルティが付くので、その説明は割に合いません。一方、成績上位者の は、ペナルティ を払っても尤度の改善(約 )のほうが大きいので、そのまま正常と説明されます。
2つの方法の違いは、「実力は、ふつうはこのくらいの範囲に分布している」という知識(事前分布)を使うかどうかにあるのです。
積分を足し算で近似する
この積分は手計算では求められないので、 を から まで 刻みの61個の点 に区切り、足し算で近似します。
は、正規分布の形をした重みを、合計が1になるように正規化したものです。範囲を にしたのは、 の正規分布の重みが、この外にはほとんど残らないためです。
この重み がどんな形をしているのか、実際に計算して描いてみましょう。
# 1. b の候補(-6〜6 を 0.2 刻みで61個)と、正規分布の形をした重み w_k
b_grid = np.linspace(-6, 6, 61)
tau = 1.0
w = np.exp(-b_grid**2 / (2 * tau**2))
w = w / w.sum()                                  # 合計が1になるように正規化
print(f"候補の数: {len(b_grid)}, 重みの合計: {w.sum():.3f}")
for bv in [0, 2, 4, 6]:
    k = np.argmin(np.abs(b_grid - bv))
    print(f"b = {bv}: 重み {w[k]:.2e}(b = 0 の {w[k] / w.max():.1e} 倍)")
print(f"-3 ≦ b ≦ 3 に入る重みの合計: {w[np.abs(b_grid) <= 3].sum():.4f}")

# 2. 重みの形を、通常の目盛りと対数目盛りで描く
fig, axes = plt.subplots(1, 2, figsize=(13, 4.5))
for ax, log_scale in [(axes[0], False), (axes[1], True)]:
    ax.bar(b_grid, w, width=0.15, color='steelblue', label='重み $w_k$(61個)')
    ax.axvline(4, color='orange', linestyle='--', label='成績上位者が必要な b ≈ 4')
    ax.axvline(6, color='red', linestyle='--', label='不正受験者を説明する b ≈ 6')
    ax.set_xlabel('受験者の実力 b')
    ax.grid(True, alpha=0.3)
    if log_scale:
        ax.set_yscale('log')
        ax.set_title('対数目盛り(裾の小ささが見える)')
    else:
        ax.set_title('通常の目盛り')
        ax.set_ylabel('重み $w_k$')
axes[0].legend(fontsize=9)
plt.tight_layout()
plt.show()
周辺化で使う重み を実際に計算し、極端な実力( = 4, 6)にどれだけ小さな重みしか付かないかを、数と図で確かめるコードです。
- 候補 b_grid: np.linspace(-6, 6, 61) で、 から までを0.2刻みで区切った61個の点を作っています。範囲を にした理由は直前の本文のとおりで、端の重みが十分小さいことを、このコードの出力でも確かめます。
- 重み w: np.exp(-b_grid2 / (2 * tau2)) が上の式の分子 で、w / w.sum() で全体の和(分母)で割り、合計を1にしています。合計を1にするのは、 の重み付きの平均にするためです。
- 代表的な の重み: 成績上位者が必要な と、不正受験者を説明する に、どれだけのペナルティが付くかを確かめるため、np.argmin(np.abs(b_grid - bv)) で指定した値に最も近い候補を探し、その重みと の重みとの比を表示します。比の対数が、本文のペナルティ(、)にあたります。 に入る重みの合計は、重みのほとんどがふつうの実力の範囲に集まっていることを確かめるためのものです。
- 2つの目盛り: 左は通常の目盛り、右は縦軸を ax.set_yscale('log') で対数目盛りにしています。対数目盛りにすると、通常の目盛りでは0にしか見えない裾の重みの大きさを比べられます。オレンジと赤の破線は、成績上位者と不正受験者を説明するのに必要な実力の目安です。
実行結果
候補の数: 61, 重みの合計: 1.000
b = 0: 重み 7.98e-02(b = 0 の 1.0e+00 倍)
b = 2: 重み 1.08e-02(b = 0 の 1.4e-01 倍)
b = 4: 重み 2.68e-05(b = 0 の 3.4e-04 倍)
b = 6: 重み 1.22e-09(b = 0 の 1.5e-08 倍)
-3 ≦ b ≦ 3 に入る重みの合計: 0.9981
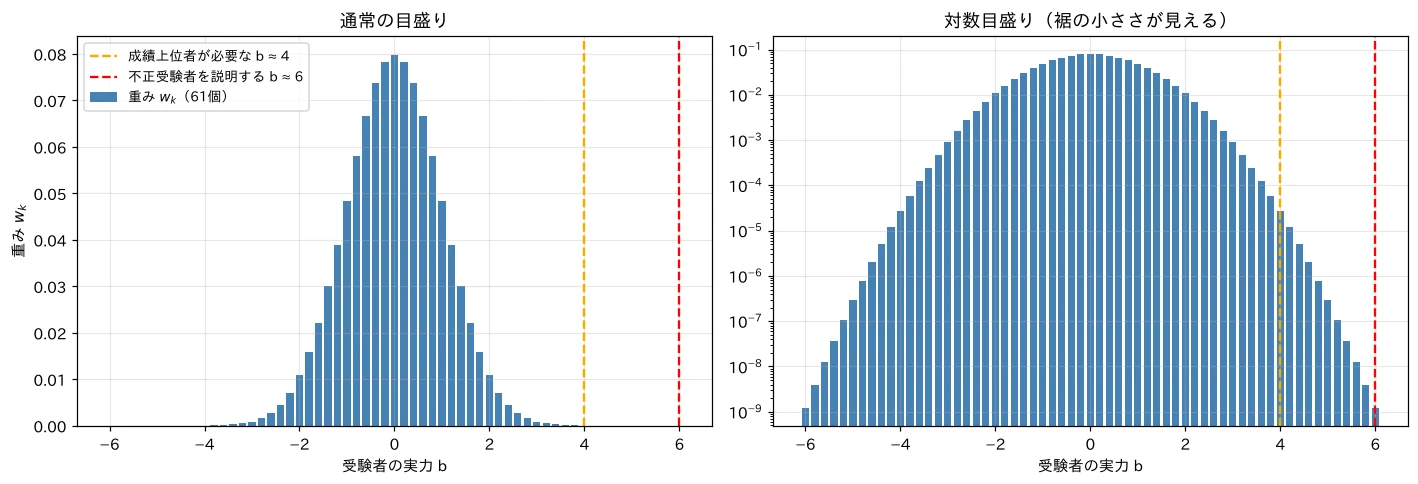
左の通常の目盛りでは、重みは を中心とした釣鐘型で、 の範囲に全体の99.8%が集まっています。 や の重みは、ほとんど0に見えます。
右の対数目盛りで見ると、重みは中心から離れるにつれて急激に小さくなっていることが分かります。 の重みは の 倍()、 の重みは 倍()です。上で見たペナルティ と は、この比の対数そのものです。範囲の端 での重みは約 しかないので、範囲をこれ以上広げても、計算結果はほとんど変わりません。
実際の計算は、アンダーフローを避けるために対数のまま行います。 は のような小さな値になるので、そのまま足せません。そこで、次の logsumexp という計算を使います。
最大値 を先にくくり出すと、 はどれも1以下で、少なくとも1つはちょうど1になるので、0に潰れません。ここで です。
# 1. b の候補を -6〜6 の範囲に 0.2 刻みで並べ、正規分布 N(0, 1) の重みを付ける
B_GRID = np.linspace(-6, 6, 61)
tau = 1.0
log_w = -0.5 * (B_GRID / tau) ** 2
log_w = log_w - logsumexp(log_w)            # 重みの合計を1にする(後で対数尤度と足すので、対数のまま持つ)

# 2. 全受験者 × 全候補の log P(x_i | b_k) を行列でまとめて計算
Q = np.clip(expit(a_hat[:, None] + B_GRID[None, :]), 1e-12, 1 - 1e-12)  # (問題, 候補)
G = X @ np.log(Q) + (1 - X) @ np.log(1 - Q)                              # (受験者, 候補)

# 3. 重み付きで足し合わせる(= b について積分する)
loglik_normal = logsumexp(G + log_w[None, :], axis=1)
loglik_anom = X.sum(1) * np.log(1 - eps) + (T - X.sum(1)) * np.log(eps)
llr_mixed = loglik_anom - loglik_normal

for name, idx in [('平均的な受験者', typical), ('成績上位者', top), ('不正受験者', cheat)]:
    print(f"{name}: LLR {llr_simple[idx]:+7.1f} → {llr_mixed[idx]:+7.1f}")
flag = llr_mixed > 0
print(f"LLR > 0 で検出: {flag.sum()} 人(不正 {int((flag & (y == 1)).sum())} 人, ふつうの受験者 {int((flag & (y == 0)).sum())} 人)")
print(f"ふつうの受験者の最大 {llr_mixed[y == 0].max():.1f} / 不正受験者の最小 {llr_mixed[y == 1].min():.1f}")

# 4. 2つのスコアの分布を並べる
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
for ax, s, title in [(axes[0], llr_simple, '実力の差を考えない'), (axes[1], llr_mixed, '実力の差を考える(周辺化)')]:
    bins = np.linspace(s.min(), s.max(), 80)
    ax.hist(s[y == 0], bins=bins, color='steelblue', alpha=0.7, label='ふつうの受験者')
    ax.hist(s[y == 1], bins=bins, color='red', alpha=0.7, label='不正受験者')
    ax.scatter(s[top], 1, marker='v', color='orange', s=80, zorder=3, label='成績上位者(95点)')
    ax.axvline(0, color='black', linestyle='--')
    ax.set_yscale('log')
    ax.set_title(title)
    ax.set_xlabel('対数尤度比スコア')
    ax.grid(True, alpha=0.3)
axes[0].set_ylabel('人数(対数目盛)')
axes[0].legend(loc='upper left')
plt.tight_layout()
plt.show()
実力の差を周辺化した正常モデルで、全受験者のスコアを計算し直し、成績上位者の誤検知と不正受験者の見逃しがどう変わるかを確かめるコードです。
- 重み log_w: -0.5 * (B_GRID / tau) ** 2 が正規分布の密度の指数部分 です。log_w - logsumexp(log_w) は、対数の世界で「全体の和で割る」操作で、重みの合計を1にしています。正規分布の係数 は、この正規化で打ち消されるので書いていません。重みを対数のまま持つのは、次の G と足し合わせて logsumexp に渡すためです( は のように小さく、確率のままでは0に潰れます)。
- 正解の確率の表 Q: 全受験者・全候補の対数尤度を一度に計算するために、まず正解の確率の表を作ります。a_hat[:, None] + B_GRID[None, :] は、100問 × 61候補の表を一度に作る書き方(ブロードキャスト)です。 番目の要素が になります。
- 対数尤度の行列 G: X @ np.log(Q) は、各受験者について「正解した問題の の和」を、61個の候補すべてについて行列の掛け算で一度に計算しています。不正解の問題の分 (1 - X) @ np.log(1 - Q) と合わせて、 になります。行列の掛け算にするのは、受験者と候補の組(3060 × 61)ごとにループを回さずに済ませるためです。
- 周辺化 logsumexp(G + log_w[None, :], axis=1): 上の近似式 を、対数のまま計算しています。axis=1 で候補の方向に足し合わせ、受験者ごとに1つの値にしています。対数のまま足すのは、直前の logsumexp の式のとおり、アンダーフローを避けるためです。
- 異常モデルの対数尤度 loglik_anom: 正解数 × と、不正解数 × の和です。異常モデルでは問題の難しさによる違いがないので、点数だけで決まります。ブロック5の loglik_anom_model と同じ値を、全受験者について一度に計算する書き方です。
- 比較の表示: 周辺化の効果を見るため、同じ3人のスコアを前の単純なモデル(llr_simple)と並べ、ふつうの受験者の最大値と不正受験者の最小値の隙間も表示します。2つの分布を左右に並べた図では、成績上位者の位置を ▼ で示し、しきい値0のどちら側に移ったかを見られるようにしています。
実行結果
平均的な受験者: LLR  -256.5 →  -260.1
成績上位者: LLR   +59.8 →    -3.8
不正受験者: LLR   +90.3 →   +12.8
LLR > 0 で検出: 60 人(不正 60 人, ふつうの受験者 0 人)
ふつうの受験者の最大 -3.8 / 不正受験者の最小 4.6
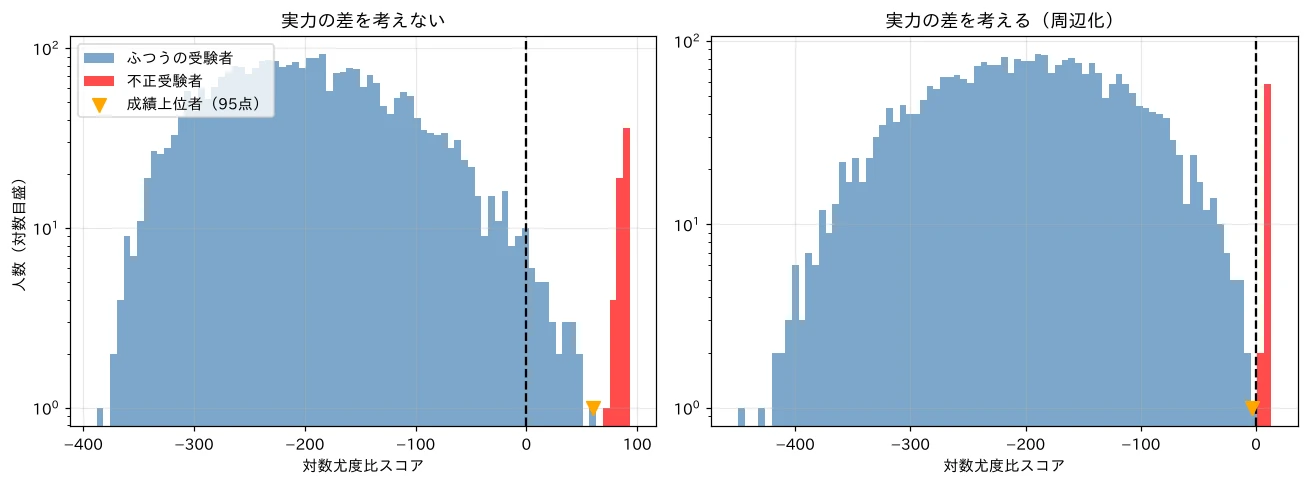
実力の差を周辺化したことで、成績上位者のスコアは から へと下がり、ふつうの受験者と判定されるようになりました。不正受験者60人はすべて検出され、誤検知は0人です。
一方で、不正受験者のスコアも から へと小さくなっています。正常モデルが「よくできる受験者」も説明できるようになったぶん、不正受験者との差が縮まったためです。ふつうの受験者の最大値()と不正受験者の最小値()の間の隙間は狭くなりましたが、しきい値0で正しく分けられています。
単純なモデルでも、しきい値を60〜75の間にすれば、うまく分けられたかもしれません。しかし、その数値には根拠がありません。2つのモデルがそれぞれのグループを正しく説明できていれば、しきい値0は「異常モデルのほうがもっともらしい」という明確な意味を持ちます。 これが、モデルをきちんと作る価値です。
の候補の範囲を狭くしすぎると(例えば )、範囲の端が「 はここまで」という上限として働いてしまいます。正常モデルが高得点の受験者を説明しにくくなり、スコアが不当に大きくなります。範囲は、事前分布の裾を十分に覆うように取ってください。 を大きくする場合は、範囲も に合わせて広げる必要があります。
周辺化の前後の LLR を表にすると、次のようになります。
(図は、diagram-designで作成)
残された課題
本記事のスコアは、1人ずつ「正常モデルと異常モデルのどちらがましか」を比べるものでした。実務で使うには、まだ2つの課題があります。
- 不正受験者がどのくらい混ざっているかを考慮していない: 不正受験者が全体の0.1%しかいないなら、スコアが少しプラスなだけでは、まだ不正でない可能性のほうが高いかもしれません。混入の割合を考慮して「不正である確率」を計算するには、2つのグループが混ざったデータ全体を1つのモデルで表す、混合モデルという考え方を使います(本記事では扱いません)。
- 正答率そのものが歪んでいる: 今回の正答率 は、不正受験者を含めたまま集計したものです。特に難問の正答率は、不正受験者のぶんだけ実際より高くなっています。正答率の補正と、混入の割合の推定を同時に行うには、EMアルゴリズムという方法を使います(本記事では扱いません)。
まとめ
- 尤度: 「その仮説が正しいとしたら、手元のデータが得られる確率」です。データを固定し、仮説(パラメータ)を動かして比べるための物差しです。
- 対数尤度: 掛け算を足し算に変えることで、アンダーフローを防げます。
- 対数尤度比: 1つ1つの観測が持つ「証拠」の足し算です。0より大きければ、比べた2つの仮説のうち分子側の仮説がもっともらしいと判断できます。
- 正答率の使い方: 正答率の低い難問への正解ほど、不正の強い証拠になります。正答率を正常モデルの確率として使うことで、この性質が自然に組み込まれます。
- モデルの質: 尤度比は2つのモデルの比較にすぎないので、正常モデルが単純すぎると、成績上位者のような正常なデータを誤検知します。実力の差を入れ、それを事前分布で周辺化することで、誤検知を防ぎつつ不正受験者を見分けられます。
参考文献
- J. Neyman, E. S. Pearson (1933). On the Problem of the Most Efficient Tests of Statistical Hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231, 289–337.
- G. Casella, R. L. Berger (2002). Statistical Inference (2nd ed.). Duxbury.
本記事の文章・構成の一部に生成AIを使用しています。