LLaVAとは?
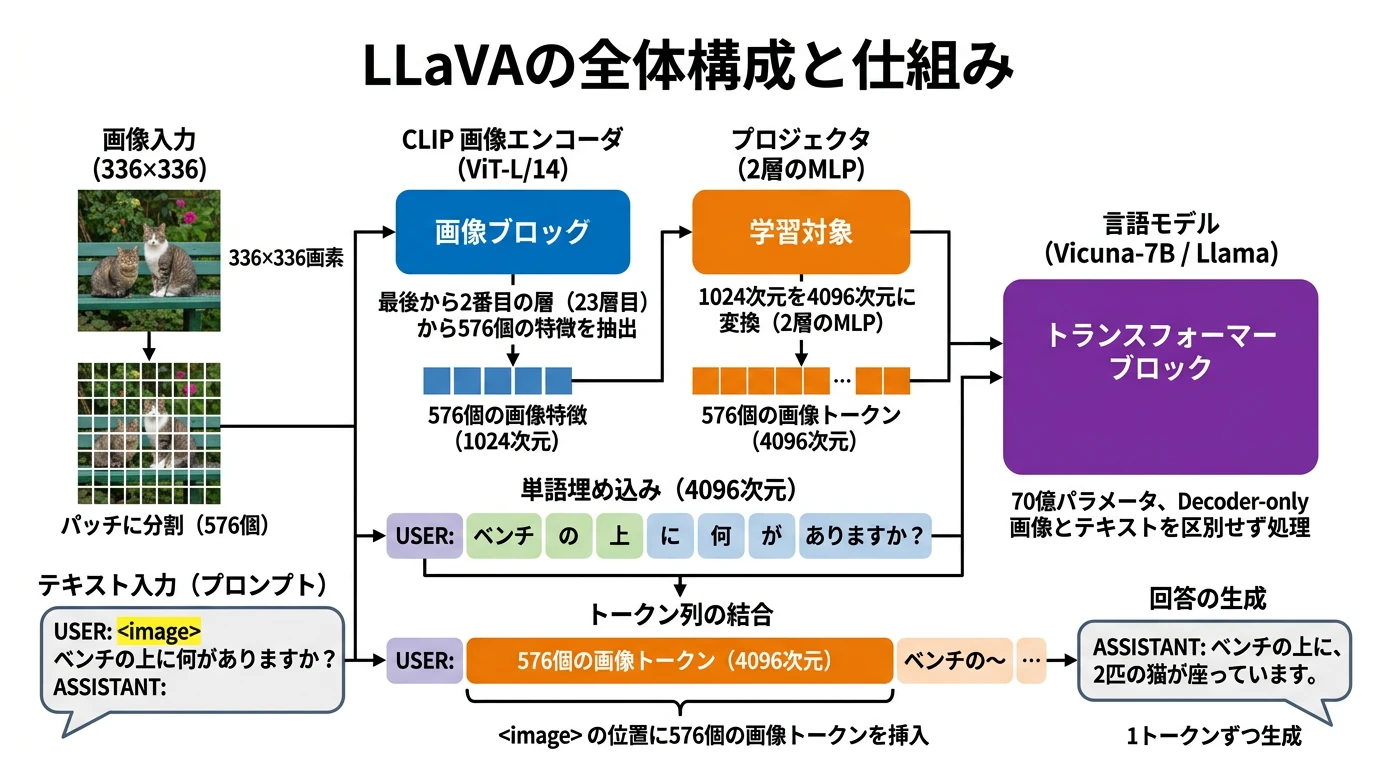 (画像は、Geminiで作成)
画像を見て質問に答える LLaVA-1.5 を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じトークン列を生成することを確かめること。画像の特徴を言語モデルに渡す仕組み(プロジェクタと埋め込みの置き換え)を理解し、プロジェクタの学習(第 1 段階)を自分で書いて動かせるようになること。
参考資料: Visual Instruction Tuning (Liu et al., 2023)、Improved Baselines with Visual Instruction Tuning (Liu et al., 2023、LLaVA-1.5)。公式の実装は haotian-liu/LLaVA(コードは Apache-2.0)、本記事で使う学習済みの重みは Hugging Face の llava-hf/llava-1.5-7b-hf です。重みのライセンスについては、記事の最後の注記を確認してください。
概要
ChatGPT のような大規模言語モデルは、テキストしか読めません。画像について質問に答えるには、画像の内容を、言語モデルが読める形にして渡す必要があります。
LLaVA(Large Language and Vision Assistant、ウィスコンシン大学マディソン校・Microsoft Research ほか、2023)は、この受け渡しをとても単純な方法で実現したモデルです。学習済みの画像エンコーダ CLIP で画像を特徴の列にし、小さな MLP(プロジェクタ)で、言語モデルの単語の埋め込みと同じ次元に変えます。その列を、プロンプトの中の <image> の位置に並べて、言語モデル(Vicuna)にそのまま入れます。言語モデルから見ると、画像は「576 個の単語」です。画像の特徴を言語モデルの入力の列に直接並べる点が、言語モデルの各層からクロス注意で画像を参照する Flamingo との違いです。
学習は 2 段階です。第 1 段階では、CLIP と言語モデルを固定し、画像とキャプションの組でプロジェクタだけを学習します。第 2 段階では、画像についての会話や質問応答のデータで、プロジェクタと言語モデルを学習します。改良版の LLaVA-1.5 は、プロジェクタを 1 層から 2 層の MLP にし、入力の画像を 336×336 に上げ、学習のデータに VQA などを加えたもので、その後の多くの画像と言語のモデル(VLM)の土台になりました。
本記事では、まず Hugging Face の実装で LLaVA-1.5(7B)に画像について質問し、仕組みを図で整理したうえで、CLIP・プロジェクタ・Llama をスクラッチで実装します。公式の重みで Hugging Face と同じトークン列を生成することを確かめ、物体の有無を問う質問(POPE)で、画像のトークンを減らしたときに答えがどう変わるかを調べます。最後に、第 1 段階の学習を COCO のキャプションで再現します。
LLaVA に画像について質問する
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。7B の言語モデルを float16 で GPU に載せるので、約 14 GB の GPU メモリを使います。最後の実験4の学習は、A100 で約 22 分かかります。
新しいセッションで、次を実行してください。pycocotools は COCO の注釈を読むライブラリ、pycocoevalcap はキャプションの評価指標 CIDEr を計算するライブラリです。transformers(比較用の LLaVA)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q pycocotools pycocoevalcap japanize-matplotlib setuptools
推論に利用する画像
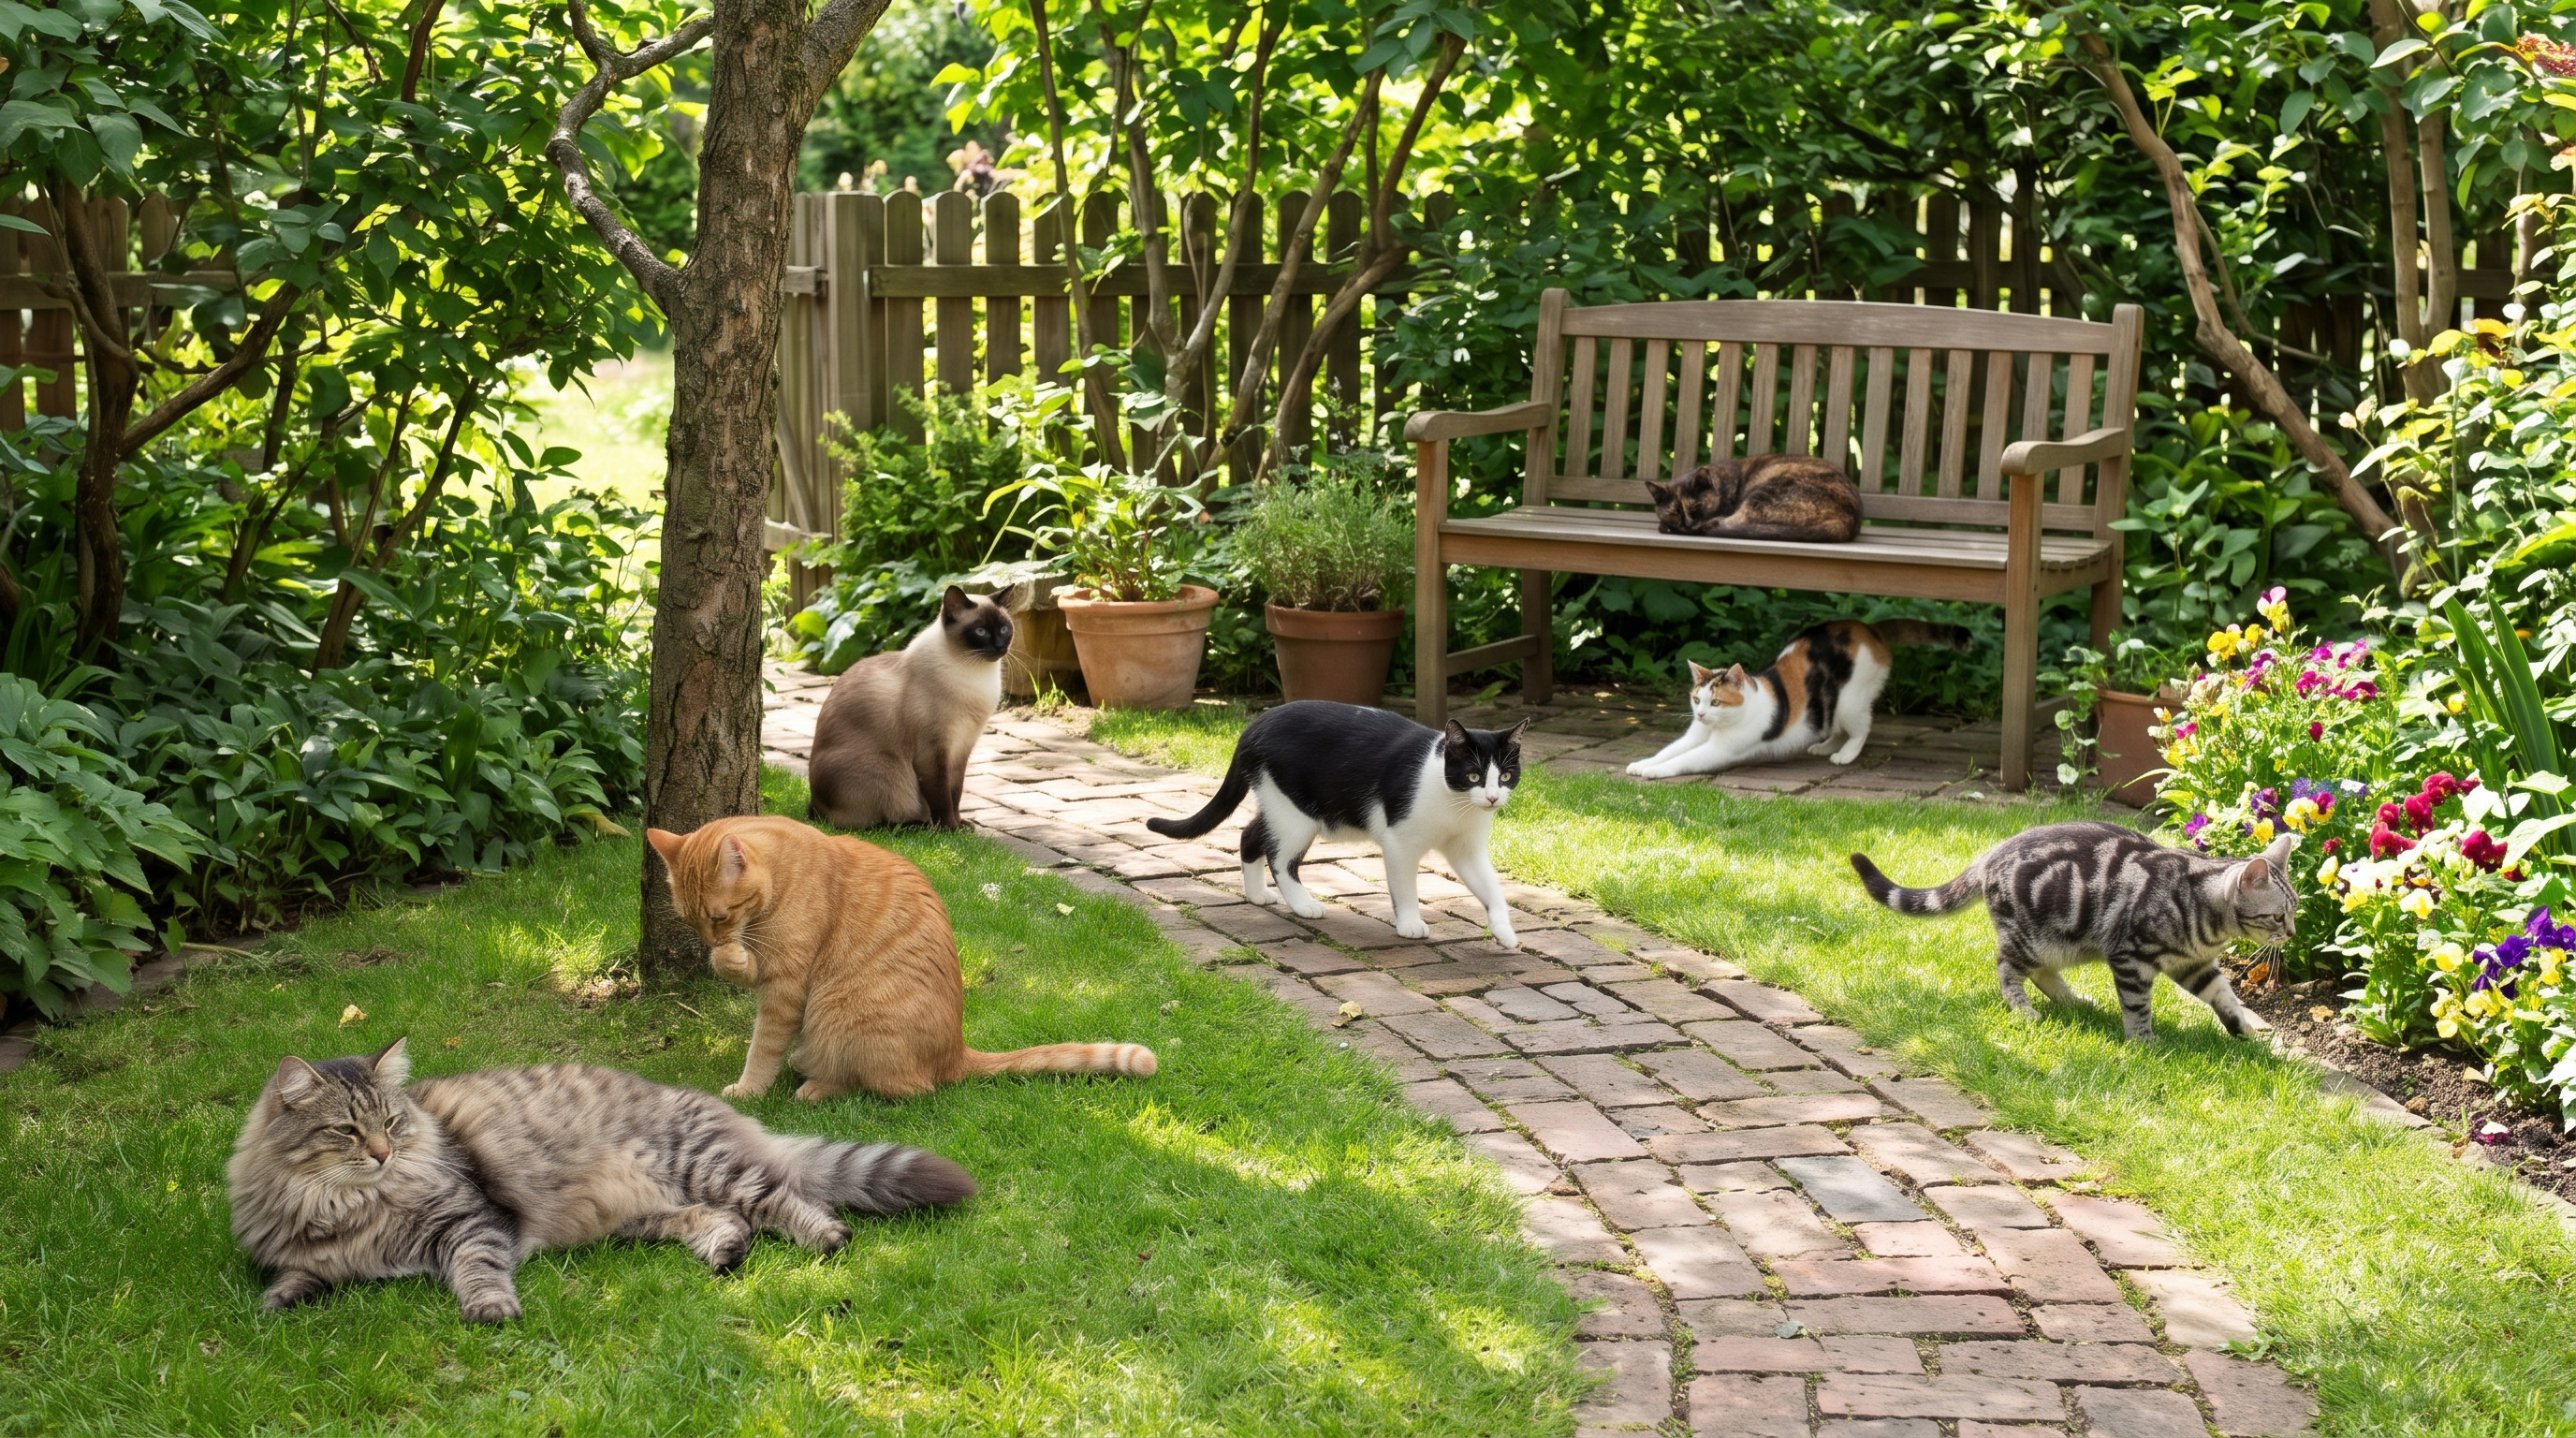
実験1と実験2では、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。
実験1:画像あり・なしで同じ質問をする
Hugging Face の実装で、3 つの質問を、画像ありと画像なしで LLaVA-1.5 に聞きます。画像なしの答えと比べると、モデルが画像を見て答えているかが分かります。
import os
import io
import json
import time
import random
import numpy as np
import torch
import torch.nn.functional as F
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image
from transformers import AutoProcessor, LlavaForConditionalGeneration

device = "cuda"
processor = AutoProcessor.from_pretrained("llava-hf/llava-1.5-7b-hf")
hf_model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", dtype=torch.float16).to(device).eval()
image = Image.open("cats.jpg").convert("RGB")

questions = ["Describe this image in two sentences.", "How many cats are in this image?", "What is on the bench?"]
for q in questions:
    for with_image in [True, False]:
        # LLaVA-1.5 の対話の形式。<image> の位置に画像の特徴が入る
        prompt = f"USER: <image>\n{q} ASSISTANT:" if with_image else f"USER: {q} ASSISTANT:"
        inputs = processor(images=image if with_image else None, text=prompt, return_tensors="pt").to(device, torch.float16)
        with torch.no_grad():
            out = hf_model.generate(**inputs, max_new_tokens=80, do_sample=False)
        answer = processor.decode(out[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True)
        print(f"[{'画像あり' if with_image else '画像なし'}] {q}\n  → {answer.strip()}")
    print()
print("入力のトークン数(画像あり、最初の質問):", processor(images=image, text=f"USER: <image>\n{questions[0]} ASSISTANT:", return_tensors="pt")["input_ids"].shape[1])
- プロンプトの形式: LLaVA-1.5 の学習と同じ USER: <image>\n質問 ASSISTANT: の形にします。<image> の位置に画像の特徴が入ります。画像なしでは <image> を書きません。
- float16: 7B のモデルを約 14 GB で GPU に載せるためです。
- 貪欲法: do_sample=False で、毎回確率が最大のトークンを選びます。後でスクラッチ実装の出力と 1 トークンずつ比べるためです。
- max_new_tokens=80: 2 文の説明が収まる長さです。
実行結果
[画像あり] Describe this image in two sentences.
  → A group of cats are sitting and laying on the grass in a yard.
[画像なし] Describe this image in two sentences.
  → A man is standing in front of a building, wearing a suit and tie.

[画像あり] How many cats are in this image?
  → There are nine cats in this image.
[画像なし] How many cats are in this image?
  → There are two cats in the image.

번역결과
이미지에는 두 마리의 고양이가 있습니다.

[画像あり] What is on the bench?
  → There are two cats on the bench.
[画像なし] What is on the bench?
  → There is a person sitting on the bench. (The person is sitting on the bench.)

入力のトークン数(画像あり、最初の質問): 596
- 画像あり: 3 つの質問とも、猫と庭・ベンチという画像の内容に沿って答えています。ただし「猫は何匹か」には「9 匹」と答えました。画像の猫は 7 匹で、数を数えるのは苦手です。
- 画像なし: 画像がないのに「スーツの男性が建物の前に立っている」「猫は 2 匹」「ベンチに人が座っている」と、ありそうな内容を作って答えています。2 つ目の質問では、答えのあとに韓国語の翻訳のような文まで続けて生成しました。言語モデルは、画像がなくても、もっともらしい文を続けてしまいます。
- 入力のトークン数: 画像ありの最初の質問は 596 トークンで、そのうち 576 個が画像です。プロンプトの文は 20 トークンしかなく、入力のほとんどが画像です。
LLaVA の仕組み
全体の構成
LLaVA-1.5 の全体は、次の図のとおりです(図は、後で実装する LLaVA クラスの構成です)。
(図は、diagram-designで作成)
- 画像エンコーダ: CLIP ViT-L/14(336 画素)です。ViT は、画像のパッチを並べて Transformer のエンコーダ(Transformer の記事)にかけるモデルです。画像を 14×14 画素のパッチ 576 個(24×24)に分け、各パッチを 1024 次元の特徴にします。重みは CLIP の学習済みのものを固定して使います。
- プロジェクタ: 1024 次元を 4096 次元にする 2 層の MLP(間に GELU)です。最初の LLaVA は 1 層の線形変換でしたが、LLaVA-1.5 で 2 層にして性能が上がりました。
- 言語モデル: Vicuna-7B(v1.5)です。Llama 2 を会話のデータで追加学習したモデルで、構造は Llama と同じです。
CLIP のどの層を使うか
(図は、diagram-designで作成)
LLaVA は、CLIP の最後の層ではなく、最後から 2 番目(23 層目)の出力を使います。論文の実験では、最後の層より 1 つ手前の層の方が性能がよく、論文は「最後の層は画像全体の抽象的な性質に寄り、手前の層の方が局所的な特徴を残すため」と推測しています。CLIP の学習で文と対応させるのに使う CLS(クラス)のトークンは除き、576 個のパッチの特徴だけを使います。
画像の特徴をテキストの中に入れる
(図は、diagram-designで作成)
Hugging Face のプロセッサは、プロンプトの <image> を 576 個の <image> のトークン(id 32000)に増やします。モデルは、テキストのトークンを単語の埋め込み(4096 次元)にしたあと、<image> の 576 個の位置を、プロジェクタの出力の 576 個で置き換えます。言語モデルの中では、画像とテキストを区別しません。テキストと同じく、左から順に因果的な注意(前のトークンだけを見る注意)で処理します。
2 段階の学習
(図は、diagram-designで作成)
- 第 1 段階(特徴のすり合わせ): CLIP と Vicuna を固定し、画像とキャプションの組 55.8 万件(LAION・CC・SBU から選んだ LCS-558K)でプロジェクタだけを学習します。入力は「[画像] キャプション」だけで、質問はありません。画像の特徴を、言語モデルが「その画像のキャプションを続けられる」埋め込みに変えるのが目的です。
- 第 2 段階(指示に従う学習): CLIP だけを固定し、GPT-4 で作った画像についての会話や、VQA・OCR などの質問応答の 66.5 万件で、プロジェクタと Vicuna を学習します。ここで、画像について質問に答える・指示に従う能力を身につけます。
本記事の実験4では、第 1 段階を小さな規模で再現します。第 2 段階は 7B の言語モデル全体の学習で、A100 1 枚では重すぎるので、公開済みの重みを使います。
LLaVA のスクラッチ実装
ここからは、LLaVA-1.5 を部品ごとに実装します。部品の構造・次元・計算の順番は、Hugging Face の LlavaForConditionalGeneration(CLIPVisionModel・LlavaMultiModalProjector・LlamaModel)と同じで、重みの名前も読み込みやすいように合わせています。
画像エンコーダ:CLIP ViT-L/14
import math
import torch.nn as nn
import torch.utils.checkpoint


# ===== 画像エンコーダ:CLIP ViT-L/14(336 画素) =====
class CLIPLayer(nn.Module):
    def __init__(self, dim=1024, heads=16, mlp=4096):
        super().__init__()
        self.heads = heads
        self.layer_norm1, self.layer_norm2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.q_proj, self.k_proj, self.v_proj, self.out_proj = (nn.Linear(dim, dim) for _ in range(4))
        self.fc1, self.fc2 = nn.Linear(dim, mlp), nn.Linear(mlp, dim)

    def forward(self, x):
        B, N, C = x.shape
        h = self.layer_norm1(x)
        split = lambda t: t.view(B, N, self.heads, -1).transpose(1, 2)
        a = F.scaled_dot_product_attention(split(self.q_proj(h)), split(self.k_proj(h)), split(self.v_proj(h)))
        x = x + self.out_proj(a.transpose(1, 2).reshape(B, N, C))
        h = self.fc1(self.layer_norm2(x))
        return x + self.fc2(h * torch.sigmoid(1.702 * h))       # quick GELU(CLIP の活性化関数)


class CLIPVision(nn.Module):
    """336×336 の画像を 14×14 のパッチ 576 個に分け、CLS を先頭に足して 24 層の Transformer にかける"""

    def __init__(self, dim=1024, layers=24, image=336, patch=14):
        super().__init__()
        self.patch_embedding = nn.Conv2d(3, dim, patch, patch, bias=False)
        self.class_embedding = nn.Parameter(torch.zeros(dim))
        self.position_embedding = nn.Embedding((image // patch) ** 2 + 1, dim)
        self.pre_layrnorm = nn.LayerNorm(dim)
        self.layers = nn.ModuleList(CLIPLayer(dim) for _ in range(layers))

    def forward(self, x, feature_layer=-2):
        """feature_layer=-2:最後から 2 番目の層の出力を返す(LLaVA の設定)。CLS は除く"""
        p = self.patch_embedding(x).flatten(2).transpose(1, 2)                  # (B, 576, 1024)
        cls = self.class_embedding.to(p.dtype).expand(p.shape[0], 1, -1)
        h = self.pre_layrnorm(torch.cat([cls, p], 1) + self.position_embedding.weight)
        for layer in self.layers[:len(self.layers) + 1 + feature_layer]:          # -2 なら 23 層まで
            h = layer(h)
        return h[:, 1:]                                                          # (B, 576, 1024)
- パッチの埋め込み: 14×14 画素・ストライド 14 の畳み込みで、336×336 の画像を 24×24 = 576 個の 1024 次元のベクトルにします。
- CLS と位置の埋め込み: 先頭に CLS のベクトルを足した 577 個に、学習済みの位置の埋め込みを足します。CLIP は、Transformer の前にも LayerNorm(pre_layrnorm、名前の綴りは Hugging Face に合わせています)をかけます。
- CLIPLayer: 注意(16 ヘッド)と MLP(4096 次元)の前に LayerNorm をかける、Pre-LN の Transformer の層です。活性化関数は、CLIP の学習と同じ quick GELU(x·sigmoid(1.702x))です。
- feature_layer=-2: 24 層のうち 23 層目までだけを計算します。24 層目の計算は使わないので省きます。
プロジェクタ
class Projector(nn.Module):
    """画像の特徴(1024 次元)を、言語モデルの単語の埋め込みと同じ 4096 次元にする 2 層の MLP"""

    def __init__(self, d_in=1024, d_out=4096):
        super().__init__()
        self.linear_1, self.linear_2 = nn.Linear(d_in, d_out), nn.Linear(d_out, d_out)

    def forward(self, x):
        return self.linear_2(F.gelu(self.linear_1(x)))
1024 次元から 4096 次元に上げ、GELU をはさんで、もう一度 4096 次元に変換します。パラメータは約 2,100 万個で、モデル全体(約 70 億)の 0.3% です。第 1 段階では、これだけを学習します。
言語モデル:Llama(Vicuna-7B)
# ===== 言語モデル:Llama(Vicuna-7B) =====
class RMSNorm(nn.Module):
    def __init__(self, dim, eps=1e-5):
        super().__init__()
        self.weight, self.eps = nn.Parameter(torch.ones(dim)), eps

    def forward(self, x):
        v = x.float()
        v = v * torch.rsqrt(v.pow(2).mean(-1, keepdim=True) + self.eps)
        return self.weight * v.to(x.dtype)


def rope(x, pos, theta=10000.0):
    """回転位置埋め込み:ベクトルの前半と後半を組にし、位置に比例した角度だけ回す"""
    d = x.shape[-1]
    inv = 1.0 / theta ** (torch.arange(0, d, 2, device=x.device, dtype=torch.float) / d)
    ang = pos[:, None].float() * inv[None]                                        # (L, d/2)
    cos, sin = torch.cat([ang, ang], -1).cos().to(x.dtype), torch.cat([ang, ang], -1).sin().to(x.dtype)
    x1, x2 = x[..., :d // 2], x[..., d // 2:]
    return x * cos + torch.cat([-x2, x1], -1) * sin


class LlamaLayer(nn.Module):
    def __init__(self, dim=4096, heads=32, mlp=11008):
        super().__init__()
        self.heads = heads
        self.input_layernorm, self.post_attention_layernorm = RMSNorm(dim), RMSNorm(dim)
        self.q_proj, self.k_proj, self.v_proj, self.o_proj = (nn.Linear(dim, dim, bias=False) for _ in range(4))
        self.gate_proj, self.up_proj = nn.Linear(dim, mlp, bias=False), nn.Linear(dim, mlp, bias=False)
        self.down_proj = nn.Linear(mlp, dim, bias=False)

    def forward(self, x, pos, cache=None):
        B, L, C = x.shape
        h = self.input_layernorm(x)
        split = lambda t: t.view(B, L, self.heads, -1).transpose(1, 2)
        q, k, v = rope(split(self.q_proj(h)), pos), rope(split(self.k_proj(h)), pos), split(self.v_proj(h))
        if cache is not None:                        # 生成中は、これまでのトークンの K・V を足して使い回す
            if "k" in cache:
                k, v = torch.cat([cache["k"], k], 2), torch.cat([cache["v"], v], 2)
            cache["k"], cache["v"] = k, v
        a = F.scaled_dot_product_attention(q, k, v, is_causal=L > 1)
        x = x + self.o_proj(a.transpose(1, 2).reshape(B, L, C))
        h = self.post_attention_layernorm(x)
        return x + self.down_proj(F.silu(self.gate_proj(h)) * self.up_proj(h))   # SwiGLU


class Llama(nn.Module):
    def __init__(self, vocab=32064, dim=4096, layers=32):
        super().__init__()
        self.embed_tokens = nn.Embedding(vocab, dim)
        self.layers = nn.ModuleList(LlamaLayer(dim) for _ in range(layers))
        self.norm = RMSNorm(dim)
        self.lm_head = nn.Linear(dim, vocab, bias=False)

    def forward(self, embeds, start=0, caches=None, checkpoint=False):
        pos = torch.arange(start, start + embeds.shape[1], device=embeds.device)
        x = embeds
        for i, layer in enumerate(self.layers):
            if checkpoint:                           # 学習でメモリを節約:層の中の値を保存せず、逆伝播で計算し直す
                x = torch.utils.checkpoint.checkpoint(layer, x, pos, use_reentrant=False)
            else:
                x = layer(x, pos, None if caches is None else caches[i])
        return self.lm_head(self.norm(x))
- RMSNorm: 平均を引かずに、2 乗平均の平方根で割る正規化です。float16 で 2 乗すると値があふれやすいので、計算だけ float32 で行います。
- rope(回転位置埋め込み): クエリとキーのベクトルの前半と後半を組にし、位置に比例した角度だけ回します。仕組みは RoPE の記事で説明しています。Llama 2 の設定と同じく、基数 theta は 10,000 です。
- LlamaLayer: 注意(32 ヘッド、128 次元ずつ)と SwiGLU の MLP(11,008 次元)の前に RMSNorm をかけます。線形層にバイアスはありません。
- KV キャッシュ: 生成中は、これまでのトークンのキーとバリューを cache にためて使い回し、新しいトークンの分だけを計算します。
- checkpoint=True: 実験4の学習で使います。各層の途中の値を保存せず、逆伝播のときに計算し直して、GPU メモリを減らします。
モデル全体と生成
# ===== LLaVA 全体 =====
class LLaVA(nn.Module):
    def __init__(self, image_token_id=32000, vocab=32064):
        super().__init__()
        self.image_token_id = image_token_id
        self.vision = CLIPVision()
        self.projector = Projector()
        self.llm = Llama(vocab)

    def embed(self, input_ids, pixel_values):
        """テキストの埋め込みを作り、<image> のトークンの位置を、画像の 576 個の特徴で置き換える"""
        mask = input_ids == self.image_token_id
        x = self.llm.embed_tokens(input_ids.masked_fill(mask, 0))   # <image> の番号は語彙の外のこともあるので、仮に 0 にする
        if pixel_values is not None:
            img = self.projector(self.vision(pixel_values.to(x.dtype)))          # (B, 576, 4096)
            x = x.masked_scatter(mask[..., None], img.to(x.dtype))
        return x

    def forward(self, input_ids, pixel_values=None):
        return self.llm(self.embed(input_ids, pixel_values))

    @torch.no_grad()
    def generate(self, input_ids=None, pixel_values=None, embeds=None, max_new_tokens=100, eos_id=2):
        """貪欲法:毎回、確率が最大のトークンを選んで足す(KV キャッシュで、新しいトークンだけを計算する)。1 件ずつ"""
        caches = [{} for _ in self.llm.layers]
        x = self.embed(input_ids, pixel_values) if embeds is None else embeds
        logits = self.llm(x, 0, caches)
        n, out = x.shape[1], []
        for _ in range(max_new_tokens):
            nxt = logits[:, -1].argmax(-1, keepdim=True)
            out.append(nxt)
            if (nxt == eos_id).all():
                break
            logits = self.llm(self.llm.embed_tokens(nxt), n + len(out) - 1, caches)
        return torch.cat(out, 1)


with torch.device("meta"):                           # 重みの領域を確保せずに、形だけ作る
    m = LLaVA()
count = lambda mod: sum(p.numel() for p in mod.parameters())
print(f"画像エンコーダ(CLIP ViT-L/14、24 層)       : {count(m.vision):>14,}")
print(f"プロジェクタ(2 層の MLP)                    : {count(m.projector):>14,}")
print(f"言語モデル(Llama 7B)                        : {count(m.llm):>14,}")
print(f"全体                                          : {count(m):>14,}")
- embed: 単語の埋め込みを作り、<image> の位置(mask)を、masked_scatter でプロジェクタの出力に置き換えます。実験4で使う Vicuna の語彙は 32,000 語で、id 32000 の行がないので、埋め込みを引く前に <image> の番号を仮に 0 にしています。
- 語彙 32,064 語: llava-hf の重みは、Vicuna の 32,000 語に <image> などを足し、計算の効率のため 64 の倍数にしています。
- generate: 貪欲法で 1 トークンずつ生成し、終わりのトークン </s>(id 2)で止めます。embeds を渡すと、埋め込みの列から直接生成します(実験3で画像のトークンの数を変えるときと、実験4で質問のない形式からキャプションを生成するときに使います)。
- torch.device("meta"): 重みの領域を確保せずに、形だけのモデルを作ります。パラメータの数を数えるのと、次の節で Hugging Face のテンソルを割り当てるのに使います。
実行結果
画像エンコーダ(CLIP ViT-L/14、24 層)       :    303,505,408
プロジェクタ(2 層の MLP)                    :     20,979,712
言語モデル(Llama 7B)                        :  6,738,939,904
全体                                          :  7,063,425,024
全体で約 70.6 億個のパラメータのうち、言語モデルが 95% を占めます。画像エンコーダは 3 億個、プロジェクタは 2,100 万個です。
学習済みの重みを読み込む
def load_hf_llava(model, sd):
    """Hugging Face の LlavaForConditionalGeneration の重みの名前を付け替えて、同じテンソルを割り当てる(コピーしない)"""
    out = {}
    for k, v in sd.items():
        n = k.replace("model.vision_tower.vision_model.", "model.vision_tower.")   # transformers の版による名前の違い
        n = n.replace("model.vision_tower.embeddings.", "vision.")
        n = n.replace("model.vision_tower.pre_layrnorm.", "vision.pre_layrnorm.")
        n = n.replace("model.vision_tower.encoder.layers.", "vision.layers.")
        n = n.replace(".self_attn.", ".").replace(".mlp.", ".")
        n = n.replace("model.multi_modal_projector.", "projector.")
        n = n.replace("model.language_model.", "llm.").replace("lm_head.", "llm.lm_head.")
        if "post_layernorm" in n or "position_ids" in n:
            continue                                 # LLaVA は最後の LayerNorm を使わない
        out[n] = v
    missing, unexpected = model.load_state_dict(out, strict=False, assign=True)
    assert not missing and not unexpected, (missing[:5], unexpected[:5])
    return model


def load_stage1(model, clip_sd, llama_sd):
    """第 1 段階の学習用:CLIP(openai/clip-vit-large-patch14-336)と Vicuna の重みを読み込む。プロジェクタは初期化のまま"""
    out = {}
    for k, v in clip_sd.items():
        if not k.startswith("vision_model.") or "post_layernorm" in k or "position_ids" in k:
            continue
        n = k.replace("vision_model.embeddings.", "vision.").replace("vision_model.pre_layrnorm.", "vision.pre_layrnorm.")
        out[n.replace("vision_model.encoder.layers.", "vision.layers.").replace(".self_attn.", ".").replace(".mlp.", ".")] = v
    for k, v in llama_sd.items():
        if "rotary_emb" in k:
            continue
        out[k.replace("model.", "llm.", 1).replace(".self_attn.", ".").replace(".mlp.", ".").replace("lm_head.", "llm.lm_head.")] = v
    missing, unexpected = model.load_state_dict(out, strict=False, assign=True)
    assert all(k.startswith("projector.") for k in missing) and not unexpected, (missing[:5], unexpected[:5])
    return model
- load_hf_llava: Hugging Face の LLaVA-1.5 の重みの名前を、本記事のモデルの名前に付け替えます。assign=True で、Hugging Face のモデルのテンソルをコピーせずにそのまま割り当てるので、GPU のメモリを 2 倍使いません。CLIP の最後の LayerNorm(post_layernorm)は、LLaVA では使わないので読み込みません。
- load_stage1: 実験4で使います。CLIP(openai/clip-vit-large-patch14-336)と Vicuna(lmsys/vicuna-7b-v1.5)の重みを別々に読み込み、プロジェクタは学習前のまま残します。
実験2:Hugging Face の実装と比べる
スクラッチ実装に公式の重みを読み込み、Hugging Face の実装と、CLIP の特徴・logit・生成したトークン列を比べます。
with torch.device("meta"):
    model = LLaVA()
model = load_hf_llava(model, hf_model.state_dict()).eval()   # Hugging Face のモデルと同じ重みのテンソルを使う

inputs = processor(images=image, text=f"USER: <image>\n{questions[1]} ASSISTANT:", return_tensors="pt").to(device, torch.float16)
ids, pv = inputs["input_ids"], inputs["pixel_values"]
print(f"入力 {ids.shape[1]} トークン(うち <image> が {(ids == 32000).sum().item()} 個)、画像 {tuple(pv.shape[2:])}")
with torch.no_grad():
    hs = hf_model.model.vision_tower(pv, output_hidden_states=True).hidden_states
    print(f"CLIP の最後から 2 番目の層(CLS を除く):差の最大値 {(hs[-2][:, 1:] - model.vision(pv)).abs().max().item():.2e}")
    logit_hf, logit_me = hf_model(**inputs).logits, model(ids, pv)
    print(f"logit の差の最大値 {(logit_hf - logit_me).abs().max().item():.2e}(logit の最大 {logit_hf.abs().max().item():.1f}、float16)")

    t_hf = t_me = 0.0
    for q in questions:
        inp = processor(images=image, text=f"USER: <image>\n{q} ASSISTANT:", return_tensors="pt").to(device, torch.float16)
        torch.cuda.synchronize(); t0 = time.time()
        a = hf_model.generate(**inp, max_new_tokens=80, do_sample=False)[:, inp["input_ids"].shape[1]:]
        torch.cuda.synchronize(); t1 = time.time()
        b = model.generate(inp["input_ids"], inp["pixel_values"], max_new_tokens=80)
        torch.cuda.synchronize(); t2 = time.time()
        t_hf, t_me = t_hf + t1 - t0, t_me + t2 - t1
        print(f"{q}:HF {a.shape[1]} 個・スクラッチ {b.shape[1]} 個、一致 {a.shape == b.shape and torch.equal(a, b)}")
print(f"3 つの質問の生成時間:HF {t_hf:.2f} 秒、スクラッチ {t_me:.2f} 秒")
- CLIP の特徴: Hugging Face の CLIP の、最後から 2 番目の層の出力(hidden_states[-2])から CLS を除いたものと比べます。
- logit: プロンプト全体(597 トークン)の、次のトークンのスコアを比べます。
- 生成: 実験1の 3 つの質問で、Hugging Face と同じトークン列を生成するかを比べます。
実行結果
入力 597 トークン(うち <image> が 576 個)、画像 (336, 336)
CLIP の最後から 2 番目の層(CLS を除く):差の最大値 0.00e+00
logit の差の最大値 5.47e-02(logit の最大 25.7、float16)
Describe this image in two sentences.:HF 18 個・スクラッチ 18 個、一致 True
How many cats are in this image?:HF 10 個・スクラッチ 10 個、一致 True
What is on the bench?:HF 11 個・スクラッチ 11 個、一致 True
3 つの質問の生成時間:HF 1.52 秒、スクラッチ 1.96 秒
- CLIP の特徴: 差は 0 で、Hugging Face の実装とビット単位で同じ値です。
- logit: 差の最大値は 5.47e-02 で、logit の最大値 25.7 に対して 0.2% です。7B のモデルを float16 で 32 層計算すると、計算の順番のわずかな違いで、この程度の丸めの誤差が積み重なります。
- 生成: 3 つの質問とも、Hugging Face と同じトークン列を生成しました。logit の小さな差は、確率が最大のトークンを変えるほどではありません。
- 時間: スクラッチ実装は、Hugging Face より 3 割ほど遅くなりました。生成の 1 トークンごとに、32 層のそれぞれで RoPE の cos と sin を計算し直しているのが主な理由と考えられます(Hugging Face は 1 度だけ計算して、全部の層で使い回します)。
実験3:物体の有無の質問と、画像のトークンの数
VLM は、画像に写っていない物を「ある」と答えてしまうこと(物体の幻覚、hallucination)があります。実験1の「猫は 9 匹」も、その一種です。POPE(Polling-based Object Probing Evaluation、Li et al., 2023)は、COCO の画像について「Is there a ○○ in the image?」と聞き、写っている物と写っていない物を同じ数だけ聞いて、はい・いいえの正しさを測る評価です。LLaVA-1.5 の論文の評価にも使われています(7B で F1 85.9、3 種類の分け方の平均)。
本記事では、POPE と同じ作り方の質問を COCO val2017 から作り、画像のトークンを 576 個のまま入れた場合と、隣どうしを平均して 144 個・36 個に減らした場合を比べます。画像のトークンの数は、言語モデルの計算量とメモリにそのまま効くので、その後の VLM では、トークンを減らす工夫が多く提案されています。何個まで減らしても答えられるのかを、実際に確かめます。
データを作る
import zipfile
import contextlib
import urllib.request
from concurrent.futures import ThreadPoolExecutor
from pycocotools.coco import COCO

# COCO val2017 の画像 ID の小さい順に 100 枚(RT-DETR の記事の 500 枚の先頭 100 枚)
os.makedirs("coco/val2017", exist_ok=True)
if not os.path.exists("coco/annotations/instances_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extractall("coco")
with contextlib.redirect_stdout(io.StringIO()):
    coco = COCO("coco/annotations/instances_val2017.json")
val_ids = sorted(coco.getImgIds())[:100]


def fetch(i, split="val2017"):
    path = f"coco/{split}/{i:012d}.jpg"
    if not os.path.exists(path):
        urllib.request.urlretrieve(f"http://images.cocodataset.org/{split}/{i:012d}.jpg", path)
    return path


with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, val_ids))

# POPE と同じく、写っている物体を 3 つと、写っていない物体を 3 つ、ランダムに選んで質問にする
rng = random.Random(0)
names = {c["id"]: c["name"] for c in coco.loadCats(coco.getCatIds())}
pope = []
for i in val_ids:
    present = sorted({a["category_id"] for a in coco.loadAnns(coco.getAnnIds(imgIds=i))})
    if len(present) < 3:
        continue
    absent = [c for c in names if c not in present]
    for c in rng.sample(present, 3):
        pope.append((i, names[c], "yes"))
    for c in rng.sample(absent, 3):
        pope.append((i, names[c], "no"))
print(f"画像 {len(set(p[0] for p in pope))} 枚、質問 {len(pope)} 個(はい {sum(p[2] == 'yes' for p in pope)}・いいえ {sum(p[2] == 'no' for p in pope)})")
print("例:", pope[:2], pope[3:5])
- 画像: COCO val2017 の画像 ID の小さい順に 100 枚から、写っている物体の種類が 3 つ以上の画像を使います。7B のモデルで 3 つの設定を比べるので、実行時間を数分に抑える枚数にしています。
- 質問: POPE の「random」の分け方と同じく、写っている物体を 3 つ(答えは yes)と、写っていない物体を 80 種類からランダムに 3 つ(答えは no)選びます。乱数の種は 0 に固定しています。
実行結果
画像 44 枚、質問 264 個(はい 132・いいえ 132)
例: [(139, 'refrigerator', 'yes'), (139, 'vase', 'yes')] [(139, 'baseball bat', 'no'), (139, 'sink', 'no')]
画像のトークンを減らして答えさせる
def splice(ids, img):
    """プロンプトの 576 個の <image> の位置に、画像の特徴(個数は自由)を差し込んだ埋め込みを作る"""
    pos = (ids[0] == model.image_token_id).nonzero()[:, 0]
    s, e = pos[0].item(), pos[-1].item() + 1
    emb = model.llm.embed_tokens
    return torch.cat([emb(ids[:, :s]), img.to(torch.float16), emb(ids[:, e:])], 1)


def pool(img, k):
    """24×24 の画像の特徴を、k×k ずつ平均して (24/k)^2 個にする"""
    g = img.view(1, 24, 24, -1).permute(0, 3, 1, 2)
    return F.avg_pool2d(g, k).flatten(2).transpose(1, 2)


results = {}
with torch.no_grad():
    for name, k in [("576 個(そのまま)", 1), ("144 個(2×2 で平均)", 2), ("36 個(4×4 で平均)", 4)]:
        pred = []
        for i, obj, gt in pope:
            q = f"USER: <image>\nIs there a {obj} in the image?\nAnswer the question using a single word or phrase. ASSISTANT:"
            inp = processor(images=Image.open(f"coco/val2017/{i:012d}.jpg").convert("RGB"), text=q, return_tensors="pt").to(device, torch.float16)
            img = model.projector(model.vision(inp["pixel_values"]))
            out = model.generate(embeds=splice(inp["input_ids"], pool(img, k) if k > 1 else img), max_new_tokens=3)
            pred.append("yes" if processor.decode(out[0], skip_special_tokens=True).strip().lower().startswith("yes") else "no")
        gts = [p[2] for p in pope]
        tp = sum(p == g == "yes" for p, g in zip(pred, gts))
        prec, rec = tp / max(1, pred.count("yes")), tp / gts.count("yes")
        acc = np.mean([p == g for p, g in zip(pred, gts)])
        results[name] = pred
        print(f"画像のトークン {name:<16s} 正解率 {acc:.1%}  適合率 {prec:.1%}  再現率 {rec:.1%}  "
              f"F1 {2 * prec * rec / (prec + rec):.1%}  「はい」の割合 {pred.count('yes') / len(pred):.1%}")
- splice: プロンプトの 576 個の <image> を取り除き、そこに任意の個数の画像の特徴を差し込んだ埋め込みを作ります。スクラッチ実装なので、モデルの中身を書き換えずにこうした実験ができます。
- pool: 24×24 に並んだ特徴を、2×2 または 4×4 ずつ平均して、12×12 = 144 個・6×6 = 36 個にします。位置の情報は、言語モデルの中ではトークンの順番(RoPE)だけなので、並びの順(左上から右下へ)は保ちます。
- プロンプト: LLaVA-1.5 の論文が POPE の評価に使った「Answer the question using a single word or phrase.」を付け、1 語で答えさせます。答えが yes で始まれば「はい」とします。
- 指標: 正解率・適合率(「はい」と答えたうち、本当に写っていた割合)・再現率(写っていた物のうち「はい」と答えた割合)・F1、「はい」と答えた割合を出します。正解の「はい」は半分なので、「はい」の割合が 50% より大きければ「ある」と答えすぎ、小さければ「ない」と答えすぎです。
実行結果
画像のトークン 576 個(そのまま)      正解率 87.1%  適合率 93.8%  再現率 79.5%  F1 86.1%  「はい」の割合 42.4%
画像のトークン 144 個(2×2 で平均)   正解率 84.5%  適合率 96.0%  再現率 72.0%  F1 82.3%  「はい」の割合 37.5%
画像のトークン 36 個(4×4 で平均)    正解率 78.4%  適合率 96.3%  再現率 59.1%  F1 73.2%  「はい」の割合 30.7%
画像のトークンの数ごとの結果を並べると、次のようになります。
(図は、diagram-designで作成)
- 576 個(そのまま): F1 は 86.1% で、LLaVA-1.5 の論文の POPE の値(7B で 85.9%)と近い値です(本記事は 44 枚・264 問で、random の作り方だけなので、厳密には比べられません)。適合率 93.8% に対して再現率は 79.5% で、「はい」の割合は 42.4% です。LLaVA-1.5 は、ない物を「ある」と答えるより、写っている物を「ない」と答える間違いの方が多いことが分かります。
- 144 個に減らす: トークンを 4 分の 1 にしても、正解率は 87.1% から 84.5% と 2.6 ポイントしか下がりません。
- 36 個に減らす: 正解率は 78.4%、再現率は 59.1% まで下がります。適合率は 96% 台のままなので、「ある」と答えた物はほとんど正しく、小さな物や目立たない物を「ない」と答えるようになっています。平均すると、小さな物の特徴が周りの特徴に埋もれてしまうためと考えられます。
- 学習なしで減らせる: LLaVA-1.5 は 576 個の特徴で学習していますが、学習し直さずに 144 個に減らしても大きくは崩れません。画像の 576 個の特徴には、隣どうしで似た情報が多く含まれていることが分かります。
実験4:第 1 段階の学習を再現する
最後に、LLaVA の第 1 段階の学習(プロジェクタだけの学習)を、COCO のキャプションで再現します。学習前のランダムなプロジェクタでは、言語モデルは画像の特徴を「意味のない単語の列」としか受け取れません。プロジェクタだけを学習すると、どこまでキャプションを生成できるようになるかを確かめます。
公式の第 1 段階の設定と、本記事の設定の違いは次のとおりです。
| 項目 | 論文・公式の第 1 段階(scripts/v1_5/pretrain.sh) | 本記事 |
|---|---|---|
| 出発点の重み | CLIP ViT-L/14-336 と Vicuna-7B v1.5(固定)、プロジェクタは初期化 | 同じ |
| 学習するもの | プロジェクタ(2 層の MLP)だけ | 同じ |
| データ | LCS-558K(LAION・CC・SBU から選んだ 55.8 万枚と、BLIP で作ったキャプション) | COCO train2017 の 1 万枚と、人が書いたキャプション(1 枚に約 5 つのうち、毎回 1 つをランダムに使う) |
| 入力の形式 | plain:[画像] キャプション 改行 | 同じ |
| 画像の前処理 | 短い辺を 336 に縮め、中央を 336×336 に切り出す | 同じ |
| 最適化・学習率 | AdamW、最大 1e-3、ウォームアップ 3%、cosine、weight decay 0 | 同じ |
| バッチ・エポック | 256(8 GPU × 32)、1 エポック(約 2,200 回の更新) | 32(GPU 1 枚)、1 エポック(312 回の更新)。1 万枚で 256 にすると更新が 39 回しかないため |
| 計算の精度・メモリ | bfloat16、勾配チェックポイント、DeepSpeed ZeRO-2 | bfloat16(重みも bfloat16)、勾配チェックポイント、CLIP の特徴は先に計算 |
| 学習の時間 | 論文によると、13B のモデルの 2 段階の学習の合計が、A100 8 枚で約 1 日 | A100 1 枚で約 22 分 |
CLIP と Vicuna を読み込み、特徴を先に計算する
del hf_model, model                                  # GPU のメモリを空ける
torch.cuda.empty_cache()
from transformers import CLIPModel, CLIPImageProcessor, AutoModelForCausalLM, AutoTokenizer

# 第 1 段階:CLIP と Vicuna-7B は固定し、新しいプロジェクタだけを学習する
clip = CLIPModel.from_pretrained("openai/clip-vit-large-patch14-336", dtype=torch.bfloat16)
vicuna = AutoModelForCausalLM.from_pretrained("lmsys/vicuna-7b-v1.5", dtype=torch.bfloat16)
tok = AutoTokenizer.from_pretrained("lmsys/vicuna-7b-v1.5")
clip_proc = CLIPImageProcessor.from_pretrained("openai/clip-vit-large-patch14-336")
with torch.device("meta"):
    s1 = LLaVA(image_token_id=32000, vocab=32000)    # <image> は Vicuna の語彙の外の番号にしておく
s1 = load_stage1(s1, clip.state_dict(), vicuna.state_dict())
del clip, vicuna
s1.projector.to_empty(device="cpu")
torch.manual_seed(0)
for layer in [s1.projector.linear_1, s1.projector.linear_2]:
    layer.reset_parameters()                         # PyTorch の既定の初期化
s1 = s1.to(device)
s1.projector.to(torch.bfloat16)
for p in s1.parameters():
    p.requires_grad_(p is not None and any(p is q for q in s1.projector.parameters()))

# COCO train2017 のキャプション。1 枚に 5 つあるうちの 1 つをランダムに使う
caps = json.load(open("coco/annotations/captions_train2017.json"))["annotations"]
by_img = {}
for c in caps:
    by_img.setdefault(c["image_id"], []).append(c["caption"].strip())
train_ids = sorted(by_img)[:10000]
os.makedirs("coco/train2017", exist_ok=True)
with ThreadPoolExecutor(32) as ex:
    list(ex.map(lambda i: fetch(i, "train2017"), train_ids))


@torch.no_grad()
def clip_features(ids_, split):
    """CLIP は固定なので、最後から 2 番目の層の 576 個の特徴を先に計算しておく(CPU に bfloat16 で置く)"""
    feats = []
    for k in range(0, len(ids_), 64):
        imgs = [Image.open(f"coco/{split}/{i:012d}.jpg").convert("RGB") for i in ids_[k:k + 64]]
        pv = clip_proc(images=imgs, return_tensors="pt")["pixel_values"].to(device, torch.bfloat16)
        feats.append(s1.vision(pv).cpu())
    return torch.cat(feats)


t0 = time.time()
train_feats = clip_features(train_ids, "train2017")
val_feats = clip_features(val_ids, "val2017")
print(f"学習用 {len(train_ids):,} 枚・評価用 {len(val_ids)} 枚の CLIP の特徴 {tuple(train_feats.shape[1:])}({time.time() - t0:.0f} 秒)")
- 出発点の重み: LLaVA-1.5 の第 1 段階と同じく、CLIP は openai/clip-vit-large-patch14-336、言語モデルは lmsys/vicuna-7b-v1.5 です。どちらも bfloat16 で読み込みます。float16 で学習すると、勾配が小さすぎて 0 になりやすいので、公式の学習と同じく bfloat16 を使います。
- プロジェクタの初期値: PyTorch の線形層の既定の初期化で、乱数の種は 0 です。
- 学習のデータ: COCO train2017 の画像 ID の小さい順に 1 万枚と、そのキャプション(1 枚に約 5 つ)です。A100 で 20 分ほどで 1 エポックを回せる量にしています。
- CLIP の特徴を先に計算する: CLIP は固定なので、各画像の 576 個の特徴は学習中に変わりません。最初に 1 度だけ計算して CPU に置き、毎回の CLIP の計算を省きます。
実行結果
学習用 10,000 枚・評価用 100 枚の CLIP の特徴 (576, 1024)(107 秒)
プロジェクタを学習する
import math

NL = tok("\n", add_special_tokens=False)["input_ids"][-1]   # 改行のトークン(plain の形式の区切り)


def make_batch(idx, rng):
    """plain の形式:[BOS] 画像の 576 個 キャプション 改行。損失はキャプションと改行だけにかける"""
    texts = [tok(rng.choice(by_img[train_ids[i]]) + "\n", add_special_tokens=False)["input_ids"] for i in idx]
    L = max(len(t) for t in texts)
    emb = s1.llm.embed_tokens
    img = s1.projector(train_feats[idx].to(device))                       # (B, 576, 4096)
    txt = torch.full((len(idx), L), tok.pad_token_id if tok.pad_token_id is not None else 0, device=device)
    labels = torch.full((len(idx), 1 + 576 + L), -100, device=device)
    for j, t in enumerate(texts):
        txt[j, :len(t)] = torch.tensor(t)
        labels[j, 1 + 576:1 + 576 + len(t)] = torch.tensor(t)
    bos = torch.full((len(idx), 1), tok.bos_token_id, device=device)
    x = torch.cat([emb(bos), img, emb(txt)], 1)
    return x, labels


def train_stage1(epochs=1, batch=32, lr=1e-3, warmup_ratio=0.03):
    rng = random.Random(0)
    opt = torch.optim.AdamW(s1.projector.parameters(), lr=lr, weight_decay=0.0)
    total = epochs * (len(train_ids) // batch)
    warm = int(total * warmup_ratio)
    lr_at = lambda s: lr * (s + 1) / warm if s < warm else lr * 0.5 * (1 + math.cos(math.pi * (s - warm) / (total - warm)))
    history, t0 = [], time.time()
    for ep in range(epochs):
        order = list(range(len(train_ids)))
        rng.shuffle(order)
        for step in range(len(order) // batch):
            for g in opt.param_groups:
                g["lr"] = lr_at(step)
            x, labels = make_batch(order[step * batch:(step + 1) * batch], rng)
            logits = s1.llm(x, checkpoint=True)
            loss = F.cross_entropy(logits[:, :-1].float().reshape(-1, logits.shape[-1]), labels[:, 1:].reshape(-1), ignore_index=-100)
            opt.zero_grad(set_to_none=True)
            loss.backward()
            opt.step()
            history.append(loss.item())
            if (step + 1) % 50 == 0:
                print(f"{step + 1:4d} 回  損失(最後の 50 回の平均){np.mean(history[-50:]):.3f}  ({time.time() - t0:.0f} 秒)", flush=True)
    return history


@torch.no_grad()
def caption_stage1(feats):
    out = []
    for f in feats:
        bos = torch.full((1, 1), tok.bos_token_id, device=device)
        x = torch.cat([s1.llm.embed_tokens(bos), s1.projector(f[None].to(device))], 1)
        out.append(tok.decode(s1.generate(embeds=x, max_new_tokens=40, eos_id=NL)[0], skip_special_tokens=True).strip())
    return out


caps_before = caption_stage1(val_feats)              # 学習の前(プロジェクタはランダムな初期値)
history = train_stage1()
caps_after = caption_stage1(val_feats)
- 入力の形式: 公式の第 1 段階の plain の形式と同じく、「[BOS] 画像の 576 個 キャプション 改行」です。質問の文はありません。
- 損失: キャプションと改行のトークンだけに交差エントロピーをかけます。画像とBOSの位置は -100 にして、損失に入れません。
- 学習するのはプロジェクタだけ: 最適化手法に渡すのはプロジェクタの重みだけです。言語モデルの中を勾配が流れる必要はあるので、checkpoint=True でメモリを抑えます。
- 学習率: 公式と同じく、最大 1e-3、最初の 3% で線形に上げ、そのあと cosine で 0 まで下げます。weight decay も公式と同じく 0 です。
- caption_stage1: 学習の前と後で、評価用の画像(実験3と同じ 100 枚)のキャプションを、改行が出るまで(最大 40 トークン)生成します。
実行結果
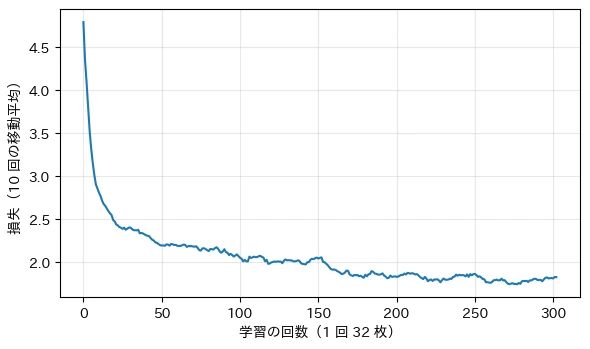
  50 回  損失(最後の 50 回の平均)2.954  (211 秒)
 100 回  損失(最後の 50 回の平均)2.167  (423 秒)
 150 回  損失(最後の 50 回の平均)2.020  (633 秒)
 200 回  損失(最後の 50 回の平均)1.904  (844 秒)
 250 回  損失(最後の 50 回の平均)1.828  (1054 秒)
 300 回  損失(最後の 50 回の平均)1.791  (1264 秒)
キャプションを評価する
import re
from pycocoevalcap.cider.cider import Cider

val_caps = json.load(open("coco/annotations/captions_val2017.json"))["annotations"]
refs = {}
for c in val_caps:
    if c["image_id"] in val_ids:
        refs.setdefault(c["image_id"], []).append(c["caption"])
norm = lambda s: " ".join(re.findall(r"[a-z0-9]+", s.lower()))

# 比べる相手:公式の LLaVA-1.5(第 1・第 2 段階を学習したモデル)に、1 文のキャプションを頼む
del s1
torch.cuda.empty_cache()
hf_model = LlavaForConditionalGeneration.from_pretrained("llava-hf/llava-1.5-7b-hf", dtype=torch.float16).to(device).eval()
caps_llava = []
with torch.no_grad():
    for i in val_ids:
        inp = processor(images=Image.open(f"coco/val2017/{i:012d}.jpg").convert("RGB"),
                        text="USER: <image>\nProvide a one-sentence caption for the provided image. ASSISTANT:", return_tensors="pt").to(device, torch.float16)
        out = hf_model.generate(**inp, max_new_tokens=40, do_sample=False)
        caps_llava.append(processor.decode(out[0, inp["input_ids"].shape[1]:], skip_special_tokens=True).strip())

for name, cs in [("学習の前(ランダムなプロジェクタ)", caps_before), ("第 1 段階を学習(本記事)", caps_after), ("公式の LLaVA-1.5", caps_llava)]:
    score, _ = Cider().compute_score({i: [norm(r) for r in refs[i]] for i in val_ids}, {i: [norm(c)] for i, c in zip(val_ids, cs)})
    print(f"{name:<22s} CIDEr {score:.3f}")
for k in [0, 1, 2]:
    print(f"\n画像 {val_ids[k]}\n  正解の例   : {refs[val_ids[k]][0].strip()}\n  学習の前   : {caps_before[k]}\n  本記事     : {caps_after[k]}\n  LLaVA-1.5 : {caps_llava[k]}")
- CIDEr: 生成したキャプションと、正解の 5 つのキャプションの、単語の n-gram の一致を測る指標です。ほかの画像にも出てくるありふれた語の一致は軽く数えます。0 に近いほど正解と似ていません。大文字と記号の違いを無視するため、小文字にして英数字の語だけを残してから計算します。
- 公式の LLaVA-1.5: 比べる相手として、2 段階の学習を終えた公式のモデルに「Provide a one-sentence caption for the provided image.」(LLaVA-1.5 の論文が、第 2 段階の学習データのうち TextCaps の短いキャプションに付けた指示)でキャプションを生成させます。第 2 段階のデータには COCO の画像を使ったものが含まれるので、本記事の第 1 段階だけのモデルと同じ条件の比較ではありません。
実行結果
学習の前(ランダムなプロジェクタ)      CIDEr 0.000
第 1 段階を学習(本記事)         CIDEr 1.101
公式の LLaVA-1.5          CIDEr 1.294

画像 139
  正解の例   : A woman stands in the dining area at the table.
  学習の前   :
  本記事     : A living room with a TV and a couch.
  LLaVA-1.5 : A woman is standing in a kitchen with a table and chairs.

画像 285
  正解の例   : A big burly grizzly bear is show with grass in the background.
  学習の前   : .Ъ...........................
  本記事     : A brown bear sitting on a grassy field.
  LLaVA-1.5 : A brown bear with a black nose sitting on the grass.

画像 632
  正解の例   : Bedroom scene with a bookcase, blue comforter and window.
  学習の前   :
  本記事     : A bedroom with a bed and a lamp on a table.
  LLaVA-1.5 : A bedroom with a blue bedspread and a window with a view of trees.
3つのモデルの CIDEr を並べると、次のようになります。
(図は、diagram-designで作成)
損失の推移
fig, ax = plt.subplots(figsize=(6, 3.6))
ax.plot(np.convolve(history, np.ones(10) / 10, mode="valid"))
ax.set_xlabel("学習の回数(1 回 32 枚)")
ax.set_ylabel("損失(10 回の移動平均)")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
- 学習の前: ランダムなプロジェクタでは、言語モデルは何も生成しないか、「.Ъ...」のような記号の列しか生成しません。CIDEr は 0.000 です。
- 損失: 最初の 50 回で 4.8 から 2.5 前後まで急に下がり、そのあとはゆっくり下がって、最後の 50 回の平均は 1.79 です。プロジェクタの 2,100 万個のパラメータだけで、画像の特徴を言語モデルが読める形に変えられることが分かります。
- 学習の後: 「草地に座る茶色のクマ」「ベッドとランプのある寝室」のように、画像に合ったキャプションを生成するようになりました。CIDEr は 1.101 で、公式の LLaVA-1.5(1.294)の 85% です。言語モデルは 1 つも変えていないので、キャプションを書く力は Vicuna がもともと持っていて、プロジェクタはそれに画像の情報を渡しているだけだと言えます。
- 間違いもある: 画像 139 では、台所の女性を「テレビとソファのある居間」と答えています。1 万枚・1 エポックの学習では、部屋の種類のような細かな区別までは身についていません。
- 比べ方の注意: 本記事のモデルは COCO のキャプションで学習したので、COCO の正解と書き方が似ていて、CIDEr では有利です。公式の LLaVA-1.5 は、COCO のキャプションの書き方に合わせて学習していません。CIDEr の差だけで、2 つのモデルの画像の理解の差は測れません。また、本記事のモデルは第 1 段階だけなので、質問に答えることはできません。
まとめ
本記事では、LLaVA-1.5 を CLIP ViT-L/14・2 層のプロジェクタ・Vicuna-7B(Llama)の部品に分けてスクラッチで実装し、次のことを確かめました。
- 画像は「576 個の単語」として入る: CLIP の最後から 2 番目の層の 576 個の特徴を、プロジェクタで 4096 次元にし、プロンプトの <image> の位置の埋め込みと置き換えるだけで、言語モデルは画像について答えられます。画像ありの入力 596 トークンのうち、576 個が画像でした。
- Hugging Face と同じ出力: 公式の重みを読み込んだスクラッチ実装は、CLIP の特徴が完全に一致し、logit の差は float16 の丸めの範囲(最大 5.47e-02)で、3 つの質問の生成したトークン列は Hugging Face と同じでした。
- 画像なしでも、もっともらしく答える: 画像を渡さないと、LLaVA は画像の内容を作って答えます。画像ありでも、猫の数を 7 匹ではなく 9 匹と答えました。
- 画像のトークンは減らせる: 物体の有無の質問(POPE と同じ作り方、264 問)で、F1 は 576 個のとき 86.1%(論文の 85.9% に近い値)、144 個で 82.3%、36 個で 73.2% でした。学習し直さずに 4 分の 1 にしても大きくは崩れず、減らしすぎると、写っている物を「ない」と答える間違いが増えます。
- 第 1 段階はプロジェクタだけで効く: CLIP と Vicuna を固定し、COCO のキャプション 1 万枚でプロジェクタだけを 1 エポック(A100 で約 22 分)学習すると、何も生成できなかったモデルが画像に合ったキャプションを書くようになり、CIDEr は 0.000 から 1.101 に上がりました。
LLaVA は、学習済みの画像エンコーダと言語モデルを、小さなプロジェクタでつなぐだけという単純な形で、その後の多くの VLM の土台になりました。画像のトークンの数を減らす工夫や、プロジェクタの形を変える工夫も、本記事の実装を土台に試せます。
ライセンスに関する注記
LLaVA の公式の実装(haotian-liu/LLaVA)のコードは Apache-2.0 です。学習済みの重み llava-hf/llava-1.5-7b-hf と、実験4で使った lmsys/vicuna-7b-v1.5 は、Llama 2 をもとにしたモデルで、Llama 2 Community License に従います(月間のアクティブユーザーが 7 億人を超えるサービスでの利用などに条件があります)。LLaVA-1.5 の重みは、学習データ(GPT-4 で作った会話など)の利用条件にも従うよう、公式のリポジトリが注意しています。CLIP の公式の実装(openai/CLIP)は MIT ライセンスで、本記事では Hugging Face の openai/clip-vit-large-patch14-336 の重みを使っています。
COCO の注釈は CC BY 4.0 です。COCO の画像は Flickr の画像で、それぞれの画像の著作権は撮影者にあり、Flickr の利用規約に従います。本記事では、COCO の画像を記事に載せていません。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- LLaVA の実装: 公式の haotian-liu/LLaVA(Apache-2.0)と Hugging Face の transformers(Apache-2.0)の構造を参考に、スクラッチで実装しています。第 1 段階の学習の設定は、論文の付録と公式の scripts/v1_5/pretrain.sh に合わせています。
- 学習済みのモデル: llava-hf/llava-1.5-7b-hf、lmsys/vicuna-7b-v1.5(Llama 2 Community License)、openai/clip-vit-large-patch14-336 を使用しています。
- データセット: COCO の val2017 と train2017 の画像・物体の注釈・キャプション(注釈は CC BY 4.0)。実験3の質問は、POPE(Li et al., 2023)の random の作り方に従って、本記事で作りました。
- 推論に利用した画像: 猫の画像は、Gemini で作成したものです。
@inproceedings{liu2023llava,
  title = {Visual Instruction Tuning},
  author = {Liu, Haotian and Li, Chunyuan and Wu, Qingyang and Lee, Yong Jae},
  booktitle = {NeurIPS},
  year = {2023}
}
@inproceedings{liu2024improved,
  title = {Improved Baselines with Visual Instruction Tuning},
  author = {Liu, Haotian and Li, Chunyuan and Li, Yuheng and Lee, Yong Jae},
  booktitle = {CVPR},
  year = {2024}
}
参考文献
- H. Liu, C. Li, Q. Wu, Y. J. Lee (2023). Visual Instruction Tuning. NeurIPS 2023.
- H. Liu, C. Li, Y. Li, Y. J. Lee (2024). Improved Baselines with Visual Instruction Tuning. CVPR 2024.
- H. Liu. haotian-liu/LLaVA. GitHub.
- llava-hf. llava-hf/llava-1.5-7b-hf. Hugging Face.
- LMSYS. lmsys/vicuna-7b-v1.5. Hugging Face.
- OpenAI. openai/clip-vit-large-patch14-336. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。