長い文書の要約(stuff・map-reduce・refine)とは?
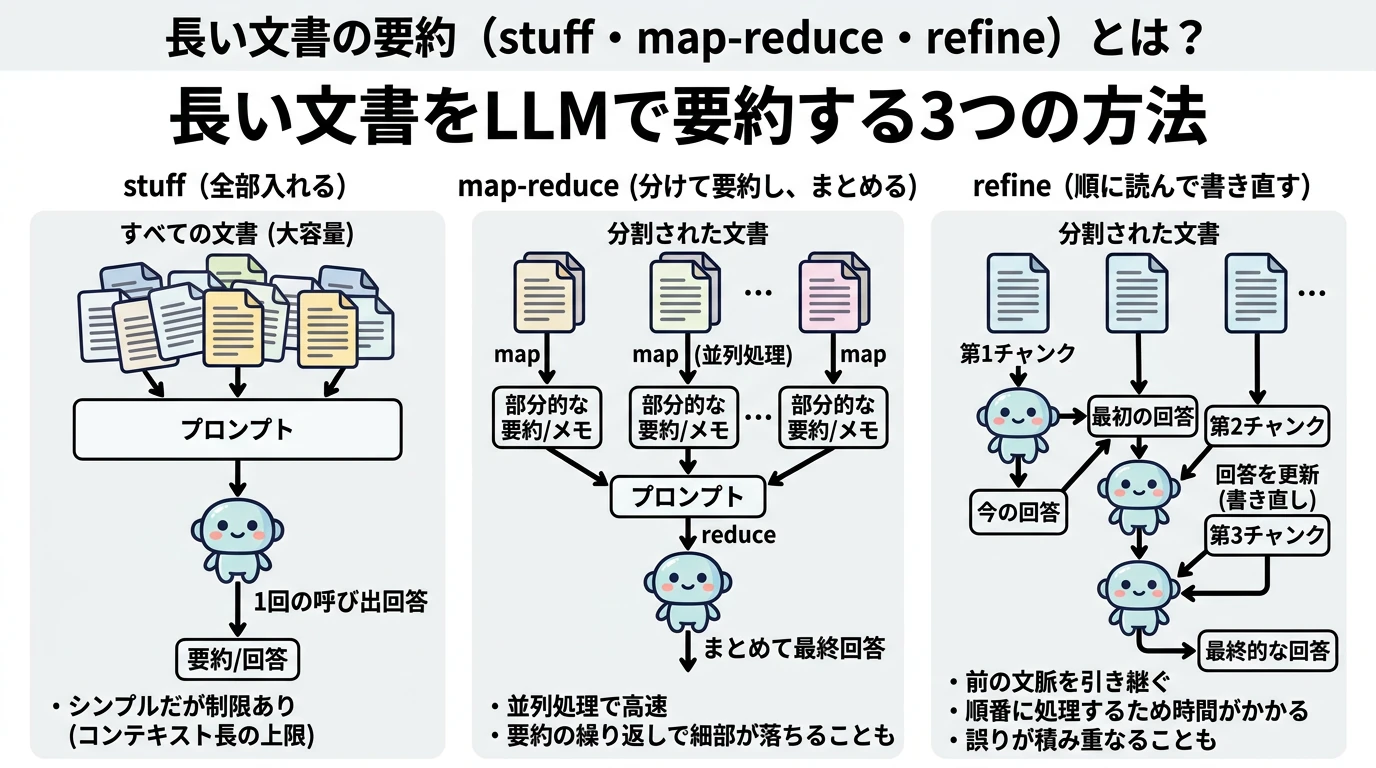 (画像は、Geminiで作成)
LLM のコンテキストに収まらない量の文書を、stuff・map-reduce・refine の3つの方法で要約し、どの方法で何が落ちるのかを、網羅できたテーマの数・細部の正しさ・LLM の呼び出し回数と時間で比べられるようになること。質問に合わせて要約する クエリ指向要約 と、map の出力に 重要度 を付ける工夫の効果と限界を、自分の言葉で説明できるようになること。
主な参考文献: From Local to Global: A Graph RAG Approach to Query-Focused Summarization (Edge et al., arXiv 2024)、BooookScore: A systematic exploration of book-length summarization in the era of LLMs (Chang et al., ICLR 2024)
本記事のコードは、Google Colab の A100 GPU(40GB)で、Python 3.13、transformers 5.22.1、torch 2.14.1 を使って実行しました。LLM には Qwen2.5-7B-Instruct(bf16、約15GB)を使います。モデルの読み込みのあとの実行には約6分かかり、そのうち3分半は refine の実験です。生成は貪欲法(do_sample=False)なので、同じ環境では同じ結果になります。GPU の種類やライブラリの版が違うと、生成される文が変わり、数値が少し変わることがあります。
グラフの日本語表示には japanize-matplotlib を使います。最初に、次のコマンドでインストールしてください(Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒に入れます)。
!pip install japanize-matplotlib setuptools
概要
RAG の記事では、質問に近い文書を上位 件だけ検索して LLM に読ませました。この方法は「〇〇山の登山口はどこか」のような、答えが1つの文書に書いてある質問には向いています。しかし、「これらの山が抱えている主な問題は何か」のように、文書の集まり全体を見渡さないと答えられない質問 には向きません。答えの材料が何百件もの文書に散らばっていて、上位 件にはその一部しか入らないからです。全部をプロンプトに入れようにも、文書の量は簡単に LLM のコンテキストの長さを超えます。
そこで、長い文書を LLM で要約する方法が使われます。代表的なのが、入るだけ全部入れる stuff、分けて要約してからまとめる map-reduce、順に読みながら答えを書き直していく refine の3つです。質問を最初から要約に組み込む クエリ指向要約(query-focused summarization) は、要約の評価会議 DUC 2005 で課題として取り上げられ(Dang, 2006)、GraphRAG の論文(Edge et al., 2024)が「文書全体についての問い」を扱う枠組みとして使った考え方でもあります。
本記事では、600件の架空の山の紹介文に6つの「問題」を仕込んだコーパスを作り、3つの方法で「主な問題は何か」と「雪崩が報告された山はどこか」に答えさせます。次の節で、まず3つの方法の違いを図で確かめます。
3つの方法
(図は、diagram-designで作成)
- stuff(全部入れる): 文書を全部つなげて1つのプロンプトに入れ、1回の呼び出しで答えさせます。いちばん単純ですが、コンテキストの長さを超える量は入りません。収まったとしても、長いコンテキストの中ほどにある情報は使われにくくなります(Lost in the Middle の記事)。
- map-reduce(分けて要約し、まとめる): 文書をコンテキストに収まる大きさのまとまり(チャンク)に分け、チャンクごとに要約させます(map)。最後に、すべての要約を1つのプロンプトに入れてまとめさせます(reduce)。map の呼び出しは互いに関係がないので、並列に(まとめて)実行できます。要約がまだ長すぎる場合は、要約の要約を作る、と段を重ねます(本記事のデータは1段で収まります)。
- refine(順に読んで書き直す): 1つ目のチャンクで答えを作り、「今の答え」と「次のチャンク」を入れて答えを書き直すことを、最後のチャンクまで繰り返します。前の答えを次の入力に使うので、1回ずつ順に呼ぶしかありません。
stuff・map_reduce・refine という呼び方は、LLM のアプリケーションを作るライブラリの LangChain が、要約の処理の種類(chain type)の名前として使って広まったものです。長い本の要約を調べた BooookScore の論文(Chang et al., 2024)では、map-reduce にあたる方法を hierarchical merging(階層的な統合)、refine にあたる方法を incremental updating(逐次的な更新) と呼んでいます。
実験の準備
架空の山岳コーパス
600件の架空の山の紹介文を作ります。すべての文書に「どの山脈の峰か・標高・登山道の起点の村・登山の適期」を書き、そのうち363件には、次の6つの「問題」のどれか1つを1文だけ書き加えます。テーマごとに文書の数に差をつけて、よく出る問題と、めったに出ない問題を作ります。
| テーマ | 文書の数 | 文書に足す文の意味 |
|---|---|---|
| 落石(rockfall) | 150 | 落石が続き、尾根安全事務所が上部の登山道を閉鎖した |
| 山小屋の管理人(hut_keeper) | 100 | 管理人が引退し、後継者がいないので山小屋が閉まるかもしれない |
| 高山植物の盗掘(plant_poaching) | 60 | 草原のスノーリリーが掘り取られて持ち去られた |
| ライチョウの減少(ptarmigan) | 30 | 巣を作るライチョウが10年前より少ない |
| 雪崩(avalanche) | 15 | 昨冬、北面で大きな雪崩があった |
| ごみ(litter) | 8 | 登山者が残したごみを、ボランティアが何袋も集めた |
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]

# 6つの問題(テーマ):文書の数、回答がそのテーマに触れたかを見つける正規表現、文書に足す文
THEMES = {
    "rockfall": (150, r"rock ?fall|falling rock|loose rock",
                 "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season."),
    "hut_keeper": (100, r"keeper|successor",
                   "The hut on Mount {n} may close because its keeper is retiring and no successor has been found."),
    "plant_poaching": (60, r"lil(y|ies)|poach",
                       "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}."),
    "ptarmigan": (30, r"ptarmigan",
                  "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago."),
    "avalanche": (15, r"avalanche",
                  "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter."),
    "litter": (8, r"trash|litter|garbage|rubbish",
               "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}."),
}
# 文の意味:rockfall「落石が続き、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した」
#   hut_keeper「管理人が引退し後継者が見つからないため、{n} 山の山小屋は閉鎖されるかもしれない」
#   plant_poaching「レンジャーは、{n} 山の草原でスノーリリーが掘り取られて持ち去られているのを見つけた」
#   ptarmigan「調査によると、{n} 山で巣を作るライチョウは10年前より少ない」
#   avalanche「雪崩監視班は、昨冬 {n} 山の北面で大きな雪崩があったと報告した」
#   litter「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた」


def build_corpus(themes, n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                      # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))                       # (b) 問題の文がない山
    rng.shuffle(labels)
    docs = []
    for name, theme in zip(names, labels):
        # 「{name} 山は {山脈} 山脈の峰で、標高 {高さ} メートル。主な登山道は {村} 村から始まる。登山の適期は {季節}。」
        text = (f"Mount {name} is a peak in the {rng.choice(RANGES)} Range, rising {rng.randint(1500, 3999):,} meters "
                f"above sea level. The main trail starts from the village of {rng.choice(VILLAGES)}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:                                              # (c) 問題の文を足し、どのテーマかを記録する
            text += " " + themes[theme][2].format(n=name)
        docs.append({"mountain": name, "text": text, "theme": theme})
    return docs


docs = build_corpus(THEMES)
print("文書の数:", len(docs), " 問題の文がある文書:", sum(d["theme"] is not None for d in docs))
print("例:", docs[1]["text"])
架空の山の紹介文を600件作り、どの文書にどのテーマの文を入れたかを、一緒に記録するコードです。
- 架空の山を使う理由: 実在の山なら、LLM は文書を読まなくても、事前学習で覚えた知識から「主な問題」を答えられてしまうかもしれません。架空の山なら、答えの材料は文書の中にしかありません。
- THEMES: テーマの名前をキー、「(文書の数, 正規表現, 文書に足す文)」を値にした辞書です。
- 文書の数: 150・100・60・30・15・8 と、大きく差をつけています。どの方法でも、よく出る落石や山小屋は拾えるはずで、差が出るのは、めったに出ない雪崩(15件)やごみ(8件)を拾えるかどうかだと考えたからです。
- 正規表現: 答えがそのテーマに触れたかを判定するのに使います(評価の節で説明します)。たとえば、ライチョウは「ptarmigan」という語が出てくれば触れたとみなします。
- 文書に足す文: {n} の部分に山の名前が入ります。テーマごとに1つの文にしているのは、言い回しの違いは今回比べたいことではないからです。
- build_corpus(themes, n=600, seed=0): テーマの辞書を引数で受け取り、文書のリストを返します。
- (a) 山の名前: 20個の音節から3つを選んでつなげ、「Fuhoha」のような架空の名前を、重複しないように600個作ります。
- (b) テーマの割り当て: テーマ名を文書の数だけ並べ(150 + 100 + 60 + 30 + 15 + 8 = 363個)、残りの237個を None(問題の文がない山)で埋めてから、シャッフルします。シャッフルするのは、どのテーマの文書もコーパス全体に散らばるようにするためです。
- (c) 正解の記録: 各文書に、山の名前 mountain と、足したテーマ theme を一緒に記録します。評価のときは、この記録と答えを比べるだけで済みます。
- 文書の数を600件にした理由: 全体で約3万5千トークンになり、次に読み込む Qwen2.5-7B-Instruct のコンテキストの長さ(32,768トークン)を少しだけ超えるようにするためです。
実行結果
文書の数: 600  問題の文がある文書: 363
例: Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level. The main trail starts from the village of Yanagi. The best season to climb it is early autumn. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhoha for the season.
英語の出力の日本語訳:
- 例:「Fuhoha 山は Kirisame 山脈の峰で、標高2,859メートル。主な登山道は Yanagi 村から始まる。登山の適期は初秋。落石が続いたため、尾根安全事務所は Fuhoha 山の上部の登山道を今シーズン閉鎖した。」
2件目の山(Fuhoha 山)には、落石の文が足されています。
LLM と、使用量を数える関数
LLM には Qwen2.5-7B-Instruct を使います。7B(70億パラメータ)の、手元の GPU で動かせる大きさのモデルで、コンテキストの長さは32,768トークンです。3つの方法の手間を比べるために、LLM を呼んだ回数・入力と出力のトークン数・かかった時間を数えながら生成します。
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()


def n_tokens(text):
    return len(tokenizer(text)["input_ids"])


def new_usage():
    """LLM の使用量を数える入れ物:呼び出し回数・入力と出力のトークン数・時間(秒)"""
    return {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}


@torch.no_grad()
def generate(prompts, usage, max_new_tokens=600, batch_size=16):
    """プロンプトのリストをまとめて生成し、使用量を usage に足していく"""
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = [tokenizer.apply_chat_template([{"role": "user", "content": p}], tokenize=False,
                                               add_generation_prompt=True) for p in prompts[i:i + batch_size]]
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += n_tokens(text)
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def pack(docs, max_tokens):
    """文書を順に詰めて、max_tokens 以下のまとまり(チャンク)に分ける"""
    chunks, current, size = [], [], 0
    for d in docs:
        n = n_tokens(d["text"]) + 1                  # 文書の間の改行の分を足す
        if current and size + n > max_tokens:
            chunks.append("\n".join(current))
            current, size = [], 0
        current.append(d["text"])
        size += n
    chunks.append("\n".join(current))
    return chunks


corpus_tokens = n_tokens("\n".join(d["text"] for d in docs))
print(f"コーパス全体のトークン数: {corpus_tokens:,}(コンテキストの長さ: {model.config.max_position_embeddings:,})")
モデルを読み込み、生成と、文書をチャンクに分ける関数を用意するコードです。
- new_usage(): 使用量を数える辞書を、0から作ります。方法ごとに新しく作って generate に渡し、その方法で使った量だけを数えます。
- generate(prompts, usage, max_new_tokens=600, batch_size=16): プロンプトのリストを受け取り、生成した文のリストを返します。
- チャットの形にする: apply_chat_template で、プロンプトを「ユーザーの発言」としてモデルが学習した会話の形に変えます。
- まとめて生成する: batch_size 個ずつ、パディングをそろえて一度に生成します。map のように、互いに関係のない呼び出しをまとめて実行できると、1つずつ呼ぶより速く終わります。padding_side="left" にしているのは、生成は文の右端から続けるので、短いプロンプトの空きを左側に詰めるためです。16は、A100(40GB)で3,000トークンのチャンクをまとめて処理できる数として選んでいます。
- max_new_tokens=600: 1回の出力の上限です。問題の一覧や山の名前の一覧なら十分に収まる長さで、これを超える答えは途中で切れます(refine の実験で、実際に切れる場面が出てきます)。
- 使用量: 呼ぶたびに、回数、入力のトークン数(パディングを除いた attention_mask の合計)、出力のトークン数を usage に足し、最後にかかった時間を足します。
- pack(docs, max_tokens): 文書を先頭から順に詰めていき、合計が max_tokens を超えそうになったら、新しいチャンクを始めます。文書の途中では切らないので、1つの文書が2つのチャンクに分かれることはありません。
- コーパス全体のトークン数: 600件を改行でつないだときのトークン数を数え、コンテキストの長さと比べます。
実行結果
コーパス全体のトークン数: 35,423(コンテキストの長さ: 32,768)
コーパス全体は35,423トークンで、コンテキストの長さ(32,768トークン)を超えています。全部を1回で読ませることはできません。
2つの質問と、答えの評価
3つの方法に、性質の違う2つの質問をします。
- 全体を俯瞰する問い: 「これらの山が抱えている主な問題は何か。異なる問題を、山の名前を挙げずに、1行ずつすべて挙げよ」。答えが6つのテーマのうちいくつに触れたかを数えます。答えが1つに決まらない問いなので、正解率ではなく、仕込んだテーマの 網羅数 で測ります。
- 細部を拾う問い: 「雪崩が報告されたのはどの山か。すべての山の名前を挙げよ」。正解は15山です。答えに挙がった山の名前を、正しい(雪崩の山)・誤り(実在するが雪崩の山ではない)・存在しない(コーパスにない名前)に分けて数えます。
# 2つの質問:全体を俯瞰する問いと、細部を拾う問い
QUESTION = ("What are the main problems facing these mountains? "
            "List every distinct problem, one short line each, without naming individual mountains.")
DETAIL_QUESTION = "On which mountains were avalanches reported? List the names of all such mountains."


def covered_themes(answer, themes):
    """回答が触れているテーマ(正規表現が見つかったテーマ)の一覧"""
    return [t for t, (_, pattern, _) in themes.items() if re.search(pattern, answer, re.IGNORECASE)]


def score_names(answer, docs, theme="avalanche"):
    """回答に出てくる山の名前を、正しい(そのテーマの山)・誤り(実在するが別の山)・存在しない、に数える"""
    truth = {d["mountain"] for d in docs if d["theme"] == theme}
    names = set(re.findall(r"Mount ([A-Z][a-z]+)", answer))
    existing = {d["mountain"] for d in docs}
    return {"正しい": len(names & truth), "誤り": len(names & existing - truth), "存在しない": len(names - existing)}


print("雪崩が報告された山(正解):", sum(d["theme"] == "avalanche" for d in docs))
2つの質問と、答えを採点する2つの関数を用意するコードです。
- covered_themes(answer, themes): テーマごとの正規表現で答えを検索し、見つかったテーマの一覧を返します。re.IGNORECASE で大文字と小文字を区別しません。たとえば落石は「rock fall」「rockfall」「falling rock」「loose rock」のどれか、山小屋は「keeper」か「successor」が出てくれば、触れたとみなします。
- LLM に判定させない理由: 最初は、テーマごとに「この答えは〇〇に触れているか」を LLM に yes / no で答えさせていました。ところが、「Rockfall」とだけ書いた行を「落石で登山道が壊れたり閉鎖されたりすることに触れていない」と判定するなど、短い答えほど判定がぶれました。テーマを表す語は決まっているので、正規表現で確かめる方が、単純で結果も安定します。
- 言い換えは数えない: ライチョウの減少を「野生動物の減少」と書いた答えは、ライチョウに触れたとはみなしません。どの動物が減っているのかという細部が落ちているからです。
- score_names(answer, docs, theme="avalanche"): 答えから「Mount +大文字で始まる語」を正規表現で取り出し、集合(set)にして、同じ山が2回挙がっても1つと数えます。正解の15山(truth)と、コーパスにある600山(existing)との集合の演算で、3つに分けて数えます。
- 正しい: names & truth(答えと正解の両方にある名前)
- 誤り: names & existing - truth(コーパスにはあるが、雪崩の山ではない名前)
- 存在しない: names - existing(コーパスにない、LLM が作った名前)
実行結果
雪崩が報告された山(正解): 15
stuff:入るだけ全部入れる
まず、いちばん単純な stuff を試します。コーパス全体はコンテキストに入らないので、先頭から入るだけの文書を入れます。入れる量を30,000・15,000・8,000トークンと変えて、入れた文書にあるテーマを、答えがどれだけ拾えるかを見ます。
STUFF = "Documents:\n{context}\n\nQuestion: {question}"


def stuff(docs, question, usage, budget, template=STUFF):
    """先頭から、budget トークンに収まるだけの文書を1つのプロンプトに入れて答えさせる"""
    included, size = [], 0
    for d in docs:
        n = n_tokens(d["text"]) + 1
        if size + n > budget:
            break
        included.append(d)
        size += n
    context = "\n".join(d["text"] for d in included)
    answer = generate([template.format(context=context, question=question)], usage, batch_size=1)[0]
    return answer, included


results = {}                       # 方法ごとの結果を、最後に表にまとめる
for budget in [30000, 15000, 8000]:
    usage = new_usage()
    answer, included = stuff(docs, QUESTION, usage, budget)
    present = [t for t in THEMES if any(d["theme"] == t for d in included)]
    found = covered_themes(answer, THEMES)
    print(f"stuff({budget:,}トークン): 入れた文書 {len(included)}件  入れた文書にあるテーマ {len(present)}  "
          f"回答が触れたテーマ {len(found)} / 6  見落とし {[t for t in present if t not in found]}  "
          f"時間 {usage['seconds']:.1f} 秒")
    if budget == 30000:
        print(answer)
        results["stuff(30,000トークン)"] = {"themes": len(found), **usage}

usage = new_usage()
answer, included = stuff(docs, DETAIL_QUESTION, usage, 30000)
print("入れた文書にある雪崩の山:", sum(d["theme"] == "avalanche" for d in included), " 回答:", score_names(answer, docs))
results["stuff(30,000トークン)"]["names"] = score_names(answer, docs)
print(answer)
先頭から決めた量までの文書を1つのプロンプトに入れて答えさせ、拾えたテーマを数えるコードです。
- stuff(docs, question, usage, budget, template=STUFF): 文書を先頭から1件ずつ足していき、合計が budget トークンを超える手前で止めます。入れた文書を改行でつないで STUFF のプロンプト(「文書:… 質問:…」)に入れ、1回だけ生成します。答えと一緒に、入れた文書のリストも返すのは、「入れた文書にあったのに、答えが拾えなかったテーマ」を数えるためです。
- プロンプトを引数にする理由: template を引数にして既定値を STUFF にしておくと、関数を別の言い回しのプロンプトで試すときに、関数の中を書き換えずに済みます。後の map-reduce と refine の関数も、同じ書き方にしています。
- 入れる量: 30,000トークンは、出力の600トークンと、チャットの形にするための数十トークンを足しても、コンテキストの32,768トークンに収まる、ほぼ上限の量です。15,000と8,000は、その半分と約4分の1で、入れる量を減らすと拾えるテーマがどう変わるかを見るためです。
- results: 方法ごとの結果(拾えたテーマの数と使用量)を記録する辞書で、最後の節で表にまとめます。
- 細部を拾う問い: 30,000トークンの場合だけ、雪崩の山を挙げさせます。入れた文書にあった雪崩の山の数と、答えの採点結果を表示します。
実行結果
stuff(30,000トークン): 入れた文書 500件  入れた文書にあるテーマ 6  回答が触れたテーマ 5 / 6  見落とし ['litter']  時間 4.9 秒
Rockfall is frequent.
Upper trails are closed.
Huts may close due to retirement of keepers.
Snow lilies are being dug up and taken.
Avalanches have occurred.
Fewer rock ptarmigans are nesting.
stuff(15,000トークン): 入れた文書 250件  入れた文書にあるテーマ 6  回答が触れたテーマ 6 / 6  見落とし []  時間 3.1 秒
stuff(8,000トークン): 入れた文書 135件  入れた文書にあるテーマ 6  回答が触れたテーマ 4 / 6  見落とし ['avalanche', 'litter']  時間 1.9 秒
入れた文書にある雪崩の山: 12  回答: {'正しい': 2, '誤り': 0, '存在しない': 0}
Based on the information provided, avalanches were reported on the following mountains:

1. Mount Kuhoshi - A large avalanche was reported on the north face of this mountain.
2. Mount Tamiho - A large avalanche was reported on the north face of this mountain.
英語の出力の日本語訳:
-
stuff(30,000トークン)の答え:「落石が多い。/上部の登山道が閉鎖されている。/管理人の引退で山小屋が閉まるかもしれない。/スノーリリーが掘り取られて持ち去られている。/雪崩が起きている。/巣を作るライチョウが減っている。」
-
雪崩の問いの答え:「提供された情報によると、雪崩が報告されたのは次の山です。1. Kuhoshi 山:この山の北面で大きな雪崩が報告された。2. Tamiho 山:この山の北面で大きな雪崩が報告された。」
-
入れた文書にあっても、拾えない: 30,000トークン(500件)の中には6つのテーマがすべてありましたが、答えはごみ(入れた文書の中に7件)に触れませんでした。8,000トークン(135件)でも6テーマすべてが入っていたのに、雪崩とごみを落としています。長いコンテキストの中の、数件にしか出てこない話題は、拾われにくいことが分かります。15,000トークンでは6テーマすべてを拾えましたが、量を変えると拾えたり拾えなかったりするので、たまたまと考える方がよいでしょう。
-
細部はほとんど拾えない: 入れた文書の中に雪崩の山は12あったのに、答えに挙がったのは2山だけでした。誤った名前はありませんでしたが、残りの10山は見落としています。
-
速い: 呼び出しは1回で、30,000トークンを読んでも約5秒で終わります。
map-reduce:分けて要約し、まとめる
普通の要約と、クエリ指向要約
map-reduce では、map でチャンクに何を書かせるかが大事です。ここでは2つの書かせ方を比べます。
(図は、diagram-designで作成)
- 普通の要約: 質問を見せずに、チャンクを短い1段落に要約させます。要約は質問と関係なく作れるので、一度作れば、いろいろな質問に使い回せます。その代わり、質問に関係のない内容(標高や季節)にも語を使います。
- クエリ指向要約: 質問を見せて、チャンクから質問に答えさせます。GraphRAG の論文の方法にならって、要点を1行ずつ書かせ、それぞれに「質問に答えるのにどれだけ重要か」を0〜100の点数で付けさせます。役立つ内容がなければ「none [0]」と書かせます。
reduce は、どちらの場合も同じプロンプトで、map の出力をすべてつないで入れ、質問への1つの答えにまとめさせます。
# map:チャンクごとに、普通に要約させるか、質問に答えさせるか
MAP_SUMMARY = "Summarize the following documents in one short paragraph.\n\nDocuments:\n{chunk}"
# 「次の文書を、短い1段落に要約してください。」
MAP_QUERY = ("Documents:\n{chunk}\n\nQuestion: {question}\n\n"
             "Answer the question using only the documents above. Write each distinct point on its own line as "
             "'- point [score]', where score (0-100) is how important the point is for answering the question. "
             "Write each point so that it can be understood without the documents. "
             "If the documents contain nothing that helps answer the question, write only '- none [0]'.")
# 「上の文書だけを使って質問に答えてください。異なる要点を1行ずつ『- 要点 [点数]』の形で書き、点数(0〜100)は、
#   その要点が質問に答えるのにどれだけ重要かを表します。要点は、文書を見なくても分かるように書いてください。
#   質問に答えるのに役立つ内容がなければ、『- none [0]』とだけ書いてください。」

# reduce:map の出力をまとめて、最終的な答えにする
REDUCE = ("Question: {question}\n\nBelow are notes, each written from a different part of a large set of documents."
          "\n\n{notes}\n\nCombine the notes into one final answer to the question.")
# 「質問:… 以下は、大きな文書の集まりの別々の部分から書いたメモです。… メモをまとめて、質問への1つの最終的な答えにしてください。」


def map_reduce(chunks, question, usage, map_template, reduce_template=REDUCE):
    """map:チャンクごとに LLM を呼ぶ(まとめて生成できる) → reduce:全部の出力を1回の呼び出しでまとめる"""
    notes = generate([map_template.format(chunk=c, question=question) for c in chunks], usage)       # (a) map
    joined = "\n\n".join(notes)
    answer = generate([reduce_template.format(notes=joined, question=question)], usage, batch_size=1)[0]  # (b) reduce
    return answer, notes


chunks = pack(docs, 3000)
print("チャンクの数:", len(chunks), " 1つのチャンクの文書の数(平均):", round(len(docs) / len(chunks), 1))
notes_by_method = {}
for name, map_template in {"普通の要約": MAP_SUMMARY, "質問に答える": MAP_QUERY}.items():
    usage = new_usage()
    answer, notes = map_reduce(chunks, QUESTION, usage, map_template)
    notes_by_method[name] = notes
    in_notes = covered_themes("\n".join(notes), THEMES)
    found = covered_themes(answer, THEMES)
    print(f"{name}: map の出力にあるテーマ {len(in_notes)}  回答が触れたテーマ {len(found)} / 6  "
          f"見落とし {[t for t in THEMES if t not in found]}  時間 {usage['seconds']:.1f} 秒")
    print(answer)
    results[f"map-reduce({name})"] = {"themes": len(found), **usage}
for name, notes in notes_by_method.items():
    print(f"map の出力の例({name}、1つ目のチャンク):\n" + notes[0])
print("ごみに触れた、普通の要約:", [note for note in notes_by_method["普通の要約"] if re.search("trash|litter", note, re.IGNORECASE)])
print("ライチョウ・野生動物に触れた要点:", [line for note in notes_by_method["質問に答える"] for line in note.splitlines()
                                  if re.search("ptarmigan|wildlife", line, re.IGNORECASE)])
map の書かせ方を2通りにして map-reduce を実行し、map の出力と最終的な答えのそれぞれで、拾えたテーマを数えるコードです。
- MAP_SUMMARY: 普通の要約のプロンプトです。{question} を含まないので、format に question を渡しても使われません。
- MAP_QUERY: クエリ指向要約のプロンプトです。最初に試したものから、2か所を直しています。
- 「文書を見なくても分かるように書く」: これがないと、雪崩の問いで「- Mount Kakuyo [100]」のように山の名前だけが書かれ、reduce が「このメモには雪崩のことが書いていない」と判断して、山を挙げませんでした。map の出力は、元の文書なしで reduce に読まれるので、それだけで意味の通る文にしておく必要があります。
- 質問を文書の後に置く: 質問を先に置き、「関係がなければ none」と書いたプロンプトでは、13チャンクのうち11で「none」と答え、問題の文があるチャンクまで捨ててしまいました。文書を読ませてから質問を示すと、この偏りはなくなりました。
- REDUCE: 質問と、map の出力(メモ)を並べ、「メモをまとめて、質問への1つの最終的な答えにする」よう指示します。
- map_reduce(chunks, question, usage, map_template, reduce_template=REDUCE):
- (a) map: チャンクの数だけプロンプトを作り、generate にまとめて渡します。13チャンクは、batch_size=16 の1回の生成で処理されます。
- (b) reduce: map の出力を空行でつなぎ、1回の呼び出しで答えさせます。答えと一緒に map の出力も返すのは、「map の時点では拾えていたのに、reduce で落ちた」テーマを調べるためです。
- チャンクの大きさ(3,000トークン): 1つのチャンクに約46件の文書が入り、13個のチャンクになります。チャンクの大きさを変えたときの違いは、後の節で調べます。
- notes_by_method: 書かせ方ごとの map の出力を残しておく辞書です。1つ目のチャンクの出力を表示して見比べ、後の節でも使います。
- 言い換えを調べる: クエリ指向要約の map の出力から、「ptarmigan(ライチョウ)」か「wildlife(野生動物)」を含む行を取り出し、普通の要約の map の出力から、ごみに触れたものを取り出して表示します。理由は実行結果で説明します。
実行結果
チャンクの数: 13  1つのチャンクの文書の数(平均): 46.2
普通の要約: map の出力にあるテーマ 6  回答が触れたテーマ 5 / 6  見落とし ['litter']  時間 16.6 秒
- Trails have been closed due to repeated rockfalls.
- Some huts may close due to retirements among keepers.
- Snow lilies have been dug up and taken from meadows.
- Rock ptarmigan nesting sites are declining.
- Upper trails are closed due to rockfalls.
- Environmental preservation concerns exist.
- Large avalanches have been reported.
- Specific peaks have closed sections or huts.
質問に答える: map の出力にあるテーマ 6  回答が触れたテーマ 5 / 6  見落とし ['ptarmigan']  時間 11.5 秒
- Repeated rockfall
- Retirement of keepers and lack of successors
- Closure of upper trails
- Digging and taking of snow lilies
- Declining wildlife populations
- Seasonal climbing restrictions
- Potential closure of huts
- Presence of large avalanches
- Littering by hikers
- Plant poaching
- Trash left by hikers
map の出力の例(普通の要約、1つ目のチャンク):
The documents describe various peaks in different ranges, including the Kirisame, Tsukishiro, Shiranami, Akatsuki, Hayate, and Hoshimi ranges, with elevations ranging from 1,558 meters to 3,946 meters. Most trails start from villages such as Minase, Yanagi, Sakaki, and Toyoura. The best climbing seasons vary but are primarily early or late summer, midsummer, and early autumn. Several peaks have closed sections due to repeated rockfalls, and some huts may close because of retirements among keepers. Additionally, there have been instances of snow lilies being dug up and taken from meadows on some mountains.
map の出力の例(質問に答える、1つ目のチャンク):
- repeated rockfall [80]
- retirement of keepers and lack of successors [70]
- closure of upper trails [60]
- digging and taking of snow lilies [50]
- none [0]
ごみに触れた、普通の要約: ['This summary covers various peaks across different ranges in Japan, including Mount Miramo, Mount Mirari, and others. Each mountain has a specific elevation, starting village, and recommended climbing season, which is generally midsummer or early/late summer depending on altitude. Notable issues include potential closure of huts due to retirement of keepers, damage from rockfalls leading to trail closures, and environmental concerns such as the digging of snow lilies and littering by hikers. Avalanche reports and declining wildlife populations, particularly rock ptarmigans, are also noted.']
ライチョウ・野生動物に触れた要点: ['- Declining wildlife populations [75]', '- reduction in wildlife populations [50]', '- wildlife population decline observed [50]', '- wildlife population decline [70]', '- Declining wildlife populations [40]', '- Fewer rock ptarmigans are nesting on some mountains [50]', '- surveys showing declining wildlife populations [40]', '- Decline in wildlife populations [40]', '- Decreased wildlife nesting [60]', '- Wildlife or plant damage [70]']
英語の出力の日本語訳:
-
普通の要約の答え:「落石が続いて登山道が閉鎖された。/管理人の引退で、いくつかの山小屋が閉まるかもしれない。/草原でスノーリリーが掘り取られて持ち去られた。/ライチョウの巣が減っている。/落石で上部の登山道が閉鎖されている。/環境保全の懸念がある。/大きな雪崩が報告されている。/一部の峰では区間や山小屋が閉鎖されている。」
-
質問に答える(クエリ指向要約)の答え:「落石が続いている/管理人の引退と後継者の不在/上部の登山道の閉鎖/スノーリリーの盗掘/野生動物の減少/登山の季節の制限/山小屋が閉まるおそれ/大きな雪崩/登山者によるごみの投棄/植物の盗掘/登山者が残したごみ」
-
map の出力の例(普通の要約):「文書は、Kirisame・Tsukishiro・Shiranami・Akatsuki・Hayate・Hoshimi の各山脈の、標高1,558〜3,946メートルのさまざまな峰について述べている。登山道の多くは Minase・Yanagi・Sakaki・Toyoura などの村から始まる。登山の適期はさまざまだが、主に初夏・晩夏・盛夏・初秋である。いくつかの峰では落石が続いて区間が閉鎖され、管理人の引退で閉まるかもしれない山小屋もある。さらに、いくつかの山の草原でスノーリリーが掘り取られて持ち去られた例がある。」
-
map の出力の例(質問に答える):「落石が続いている [80]/管理人の引退と後継者の不在 [70]/上部の登山道の閉鎖 [60]/スノーリリーの盗掘 [50]/なし [0]」
-
ごみに触れた普通の要約:「この要約は、Miramo 山・Mirari 山などを含む、日本の さまざまな山脈の峰を扱う。各山には標高・起点の村・登山の適期(標高に応じて、おおむね盛夏か初夏・晩夏)がある。主な問題は、管理人の引退による山小屋の閉鎖のおそれ、落石の被害による登山道の閉鎖、そしてスノーリリーの盗掘や登山者のごみといった環境の懸念である。雪崩の報告や、野生動物、特にライチョウの減少にも触れられている。」
-
ライチョウ・野生動物に触れた要点:「野生動物の減少 [75]/野生動物の減少 [50]/野生動物の減少が観察された [50]/野生動物の減少 [70]/野生動物の減少 [40]/いくつかの山で巣を作るライチョウが減っている [50]/調査で野生動物の減少が示された [40]/野生動物の減少 [40]/野生動物の巣の減少 [60]/野生動物や植物の被害 [70]」
-
map の時点では、6テーマすべてが拾えている: どちらの書かせ方でも、13個の map の出力を合わせると、6つのテーマがすべて出てきます。stuff のように1回で全部を読ませるより、約3,000トークンずつ読ませる方が、数件にしか出てこない話題も拾えています。
-
reduce で、言い換えによって消える: それでも、最終的な答えは5テーマでした。普通の要約では、ごみが「Environmental preservation concerns exist(環境保全の懸念がある)」という一般的な言い方に置き換わりました。map の要約では「スノーリリーの盗掘や、登山者のごみなどの環境の懸念」と書かれていたものが、まとめる途中で抽象化されたのです。クエリ指向要約では、ライチョウが「Declining wildlife populations(野生動物の減少)」に置き換わりました。map の出力でライチョウの話をしている10行のうち、「ptarmigan」と書いていたのは1行だけで、残りの9行はすでに「野生動物の減少」と書いていました。reduce は多数派の言い方に合わせてまとめています。
-
普通の要約は、質問に関係のない内容に語を使う: 普通の要約の1つ目のチャンクの出力は、山脈の名前、標高の範囲、起点の村、登山の季節の説明から始まり、問題に触れているのは後半の2文だけです。存在しない「in Japan(日本の)」という情報まで書いたものもありました。クエリ指向要約の出力は、4つの問題を重要度付きで並べただけで、出力のトークン数も少なく、時間も短くなっています(16.6秒と11.5秒)。
重要度で選ぶと、何が残るか
GraphRAG の論文では、map の出力の重要度を使って、reduce に渡す内容を選びます。重要度0の答えを捨て、残りを重要度の高い順に並べ、reduce のコンテキストの上限まで詰めます。map の出力が reduce のコンテキストに収まらないほど多いとき、重要なものから残すための工夫です。ここでは、reduce に渡す量を絞ったときに、どのテーマが残るかを確かめます。
def sorted_points(notes):
    """map の出力から「- 要点 [点数]」を取り出し、点数0を捨てて、点数の高い順に並べる"""
    points = [(int(score), point) for note in notes
              for point, score in re.findall(r"^- (.+?) \[(\d+)\]", note, re.MULTILINE)]
    return [f"- {point} [{score}]" for score, point in sorted(points, key=lambda p: -p[0]) if score > 0]


def take_budget(points, budget):
    """先頭から、合計 budget トークンまでの要点を取る"""
    selected, size = [], 0
    for p in points:
        if size + n_tokens(p) > budget:
            break
        selected.append(p)
        size += n_tokens(p)
    return selected


points = sorted_points(notes_by_method["質問に答える"])     # 上の map の出力(3,000トークンのチャンク)
print(f"要点の数: {len(points)}(点数0を除く)")
print("\n".join(points[:12]))
for budget in [None, 400, 200]:
    selected = points if budget is None else take_budget(points, budget)
    selected_text = "\n".join(selected)
    answer = generate([REDUCE.format(notes=selected_text, question=QUESTION)], new_usage(), batch_size=1)[0]
    label = "全部" if budget is None else f"{budget}トークン"
    print(f"reduce に渡す量 {label}: 要点 {len(selected)}個  要点にあるテーマ {len(covered_themes(selected_text, THEMES))}  "
          f"回答が触れたテーマ {len(covered_themes(answer, THEMES))} / 6")
クエリ指向要約の map の出力から要点を取り出して重要度の順に並べ、上から決めた量だけを reduce に渡すコードです。
- sorted_points(notes): 正規表現 ^- (.+?) [(\d+)] で、「- 要点 [点数]」の行から要点と点数を取り出します。re.MULTILINE は、^ を文字列の先頭だけでなく各行の先頭にも一致させる指定で、1つの出力に何行も書かれた要点を、すべて取り出すために使います。点数の高い順に並べ、点数0の要点(「none」など)を捨てます。
- take_budget(points, budget): 並べた要点を上から足していき、合計が budget トークンを超える手前で止めます。GraphRAG の論文の「コンテキストの上限まで詰める」を、小さな上限で再現しています。
- 渡す量: 全部(68個、約800トークン)、400トークン、200トークンの3通りです。今回のデータでは map の出力は全部でも reduce に収まりますが、文書がもっと多いと収まらなくなります。その状況をまねるために、上限を小さくしています。
実行結果
要点の数: 68(点数0を除く)
- trail closures due to rockfall [90]
- Rockfall leading to trail closures [85]
- repeated rockfall [80]
- Snow lilies being dug up and taken [80]
- trail closures due to rockfall [80]
- some trails may close due to maintenance or safety concerns [80]
- hut closure due to retirement [80]
- Upper trail closures due to rockfall [80]
- Rockfall [80]
- Rangers found that snow lilies have been dug up and taken from several mountain meadows [80]
- snow lily poaching [80]
- Upper trail closures due to rockfall [80]
reduce に渡す量 全部: 要点 68個  要点にあるテーマ 6  回答が触れたテーマ 5 / 6
reduce に渡す量 400トークン: 要点 35個  要点にあるテーマ 5  回答が触れたテーマ 5 / 6
reduce に渡す量 200トークン: 要点 17個  要点にあるテーマ 3  回答が触れたテーマ 3 / 6
英語の出力の日本語訳(上位12個の要点):
-
「落石による登山道の閉鎖 [90]/落石で登山道が閉鎖 [85]/落石が続いている [80]/スノーリリーの盗掘 [80]/落石による登山道の閉鎖 [80]/整備や安全上の理由で閉鎖される登山道がある [80]/引退による山小屋の閉鎖 [80]/落石による上部の登山道の閉鎖 [80]/落石 [80]/レンジャーが、いくつかの山の草原でスノーリリーが掘り取られて持ち去られたのを見つけた [80]/スノーリリーの盗掘 [80]/落石による上部の登山道の閉鎖 [80]」
-
上位は、落石と山小屋の要点が占める: 重要度の高い順に並べると、上位12個のうち、落石の要点が7個、スノーリリーが3個、山小屋が1個です。落石の文は150件の文書にあり、13個のチャンクのほとんどで「落石」の要点が書かれるので、同じ内容の要点が何度も上位に並びます。
-
枠を絞るほど、件数の少ない問題が落ちる: 400トークン(35個)に絞ると、要点に残るテーマは5つ、200トークン(17個)では3つまで減りました。重要度は「その要点が質問に答えるのに大事か」を表すもので、「ほかのチャンクにもう書いてあるか」は考えていません。よく出る問題の重複が枠を埋め、ライチョウや雪崩やごみが入らなくなります。
-
重要度の役割: 重要度は、関係のない内容(点数0)を捨てるのには役立ちます。一方で、網羅したいときに枠を絞る基準としては、重複をまとめてから使うなどの工夫が要ります。
チャンクの大きさを変える
チャンクの大きさを1,500・3,000・6,000・12,000トークンと変えて、クエリ指向要約の map-reduce を実行し、拾えたテーマと使用量を比べます。
for size in [1500, 3000, 6000, 12000]:
    usage = new_usage()
    size_chunks = pack(docs, size)
    answer, size_notes = map_reduce(size_chunks, QUESTION, usage, MAP_QUERY)
    in_notes = covered_themes("\n".join(size_notes), THEMES)
    print(f"チャンク {size:6,}トークン: チャンク {len(size_chunks):2d}個  map の出力にあるテーマ {len(in_notes)}  "
          f"回答が触れたテーマ {len(covered_themes(answer, THEMES))} / 6  呼び出し {usage['calls']}  "
          f"入力 {usage['input_tokens']:,}  出力 {usage['output_tokens']:,}  時間 {usage['seconds']:.1f} 秒")
チャンクの大きさだけを変えて、同じ map-reduce を繰り返すコードです。チャンクが小さいほど map の呼び出しが増え、大きいほど1回に読む量が増えます。12,000トークンは、コンテキストに余裕をもって収まり、コーパスが4つに分かれる大きさです。
実行結果
チャンク  1,500トークン: チャンク 25個  map の出力にあるテーマ 6  回答が触れたテーマ 6 / 6  呼び出し 26  入力 40,129  出力 1,450  時間 13.0 秒
チャンク  3,000トークン: チャンク 13個  map の出力にあるテーマ 6  回答が触れたテーマ 5 / 6  呼び出し 14  入力 38,010  出力 865  時間 11.5 秒
チャンク  6,000トークン: チャンク  7個  map の出力にあるテーマ 6  回答が触れたテーマ 5 / 6  呼び出し 8  入力 36,835  出力 488  時間 12.5 秒
チャンク 12,000トークン: チャンク  4個  map の出力にあるテーマ 6  回答が触れたテーマ 6 / 6  呼び出し 5  入力 36,259  出力 281  時間 14.4 秒
- 網羅数は、大きさではほとんど変わらない: どの大きさでも、map の出力には6テーマすべてが出てきました。最終的な答えは5か6で、大きさとの間に決まった傾向はありません。今回のデータでは、チャンクの大きさよりも、reduce で言い換えが起きるかどうかで結果が決まっています。
- 変わるのは、map の出力の量: チャンクが小さいほど、map の呼び出しと出力のトークン数が増えます(1,500トークンで出力1,450、12,000トークンで281)。チャンクごとに同じ問題(落石・山小屋)を書くので、チャンクが多いほど、reduce に渡す要点の重複が増えます。
- 入力のトークン数は、ほぼ同じ: どの大きさでも、コーパス全体(約3万5千トークン)を1回ずつ読むことに変わりはないので、入力は約3万6千〜4万トークンです。チャンクが小さいほど、プロンプトの指示文をくり返す分だけ少し増えます。
refine:順に読んで書き直す
最後に refine を試します。1つ目のチャンクで答えを作り、残りの12個のチャンクを順に読みながら、答えを書き直させます。答えがどう変わっていくかを、チャンクを読むごとに記録します。
FIRST = "Documents:\n{chunk}\n\nQuestion: {question}"
REFINE = ("Question: {question}\n\nCurrent answer (written from the documents read so far):\n{answer}\n\n"
          "New documents:\n{chunk}\n\n"
          "Update the current answer: keep every point in the current answer, and add any new points from the "
          "new documents that help answer the question. Write only the updated answer.")
# 「質問:… 今の答え(ここまでに読んだ文書から書いたもの):… 新しい文書:… 今の答えを更新してください。
#   今の答えの要点はすべて残し、新しい文書から、質問に答えるのに役立つ要点を足してください。更新した答えだけを書いてください。」


def refine(chunks, question, usage, first_template=FIRST, refine_template=REFINE):
    """1つ目のチャンクで答えを作り、残りのチャンクを順に読みながら、答えを書き直していく"""
    answer = generate([first_template.format(chunk=chunks[0], question=question)], usage, batch_size=1)[0]   # (a) 最初の答え
    history = [answer]
    for chunk in chunks[1:]:                                       # (b) 前の答えを入れて、1回ずつ順に呼ぶ
        answer = generate([refine_template.format(question=question, answer=answer, chunk=chunk)], usage, batch_size=1)[0]
        history.append(answer)
    return answer, history


usage = new_usage()
answer, history = refine(chunks, QUESTION, usage)
found = covered_themes(answer, THEMES)
print(f"refine: 回答が触れたテーマ {len(found)} / 6  呼び出し {usage['calls']}  時間 {usage['seconds']:.1f} 秒")
print("ステップごとのテーマの数:", [len(covered_themes(h, THEMES)) for h in history])
print("ステップごとの答えの長さ(トークン):", [n_tokens(h) for h in history])
print(answer)
results["refine"] = {"themes": len(found), **usage}
refine を実行し、チャンクを1つ読むごとに、答えが触れているテーマの数と、答えの長さを記録するコードです。
- FIRST と REFINE: 最初のチャンクは stuff と同じ形(「文書:… 質問:…」)で答えさせます。2つ目からは、質問、今の答え、新しい文書を並べ、「今の答えの要点はすべて残し、新しい文書から要点を足して、更新した答えだけを書く」よう指示します。「すべて残す」と書いたのは、最初に試した「まだ役立つものは残す」という指示では、新しいチャンクの内容だけで答えを書き直してしまうことがあったからです。
- refine(chunks, question, usage, first_template=FIRST, refine_template=REFINE):
- (a) 最初の答え: 1つ目のチャンクだけで答えを作ります。
- (b) 順に書き直す: 前の答えを次のプロンプトに入れるので、map のようにまとめて生成できず、batch_size=1 で1回ずつ呼びます。
- history: 各段階の答えを残したリストです。13個のチャンクなので13個の答えが入り、最後の要素が最終的な答えです。
- map-reduce と同じチャンク: map-reduce と比べられるように、同じ3,000トークンの13個のチャンクを使います。
実行結果
refine: 回答が触れたテーマ 6 / 6  呼び出し 13  時間 133.8 秒
ステップごとのテーマの数: [4, 4, 5, 5, 6, 6, 6, 6, 6, 6, 6, 6, 6]
ステップごとの答えの長さ(トークン): [29, 37, 55, 177, 423, 121, 130, 413, 598, 600, 600, 569, 171]
Rockfall
Hut closure due to retirement of keepers
Snow lilies being dug up and taken
Fewer nesting rock ptarmigans
Repeated rockfall leading to trail closures
Large avalanche
Avalanche Watch reporting
Trash left by hikers collected
Nest decline in rock ptarmigans on various mountains
Hut closure on various mountains
Trail closure on various mountains due to repeated rockfall
Large avalanche on various mountains
Avalanche Watch reporting on various mountains
Snow lilies being dug up and taken on various mountains
Keeper retirement with no successor on various mountains
Trail closure on Mount Yonose for the season due to repeated rockfall
Snow lilies being dug up and taken from the meadow on Mount Yorisu
Snow lilies being dug up and taken from the meadow on Mount Yosuse
英語の出力の日本語訳(refine の最終的な答え):
-
「落石/管理人の引退による山小屋の閉鎖/スノーリリーの盗掘/巣を作るライチョウの減少/落石が続いて登山道が閉鎖/大きな雪崩/雪崩監視班の報告/登山者が残したごみの回収/さまざまな山でのライチョウの巣の減少/さまざまな山での山小屋の閉鎖/さまざまな山で落石が続いて登山道が閉鎖/さまざまな山での大きな雪崩/さまざまな山での雪崩監視班の報告/さまざまな山でのスノーリリーの盗掘/さまざまな山で、後継者のいない管理人の引退/Yonose 山で、落石が続いて登山道が今シーズン閉鎖/Yorisu 山の草原でスノーリリーが盗掘/Yosuse 山の草原でスノーリリーが盗掘」
-
全体を俯瞰する問いでは、6テーマすべてを拾えた: チャンクを読むごとにテーマが増え、5つ目のチャンクで6テーマがそろい、その後も消えませんでした。「Fewer nesting rock ptarmigans」とライチョウを名指しで残しているのは、言い換えが起きた map-reduce との違いです。ライチョウを最初に見たときの具体的な書き方が、そのまま引き継がれています。
-
時間は約12倍: 呼び出しの回数は map-reduce とほぼ同じ13回ですが、1回ずつ順に呼ぶしかないので、133.8秒かかりました(map-reduce は11.5秒)。
-
答えが長くなり、出力の上限で切れる: 答えの長さは、29トークンから始まって増え、10・11個目のチャンクでは出力の上限(600トークン)に達しました。上限に達した答えは途中で切れていて、切れた答えがそのまま次の入力になります。最終的な答えには、同じ問題が「on various mountains」を付けて何度も繰り返され、最後に特定の山の話が混ざるなど、まとまりのない一覧になっています。
細部を拾う問い:雪崩の山を挙げる
全体を俯瞰する問いでは、refine が6テーマすべてを拾いました。では、雪崩が報告された15山を挙げる、細部を拾う問いではどうでしょうか。map-reduce(クエリ指向要約)と refine で比べます。
# 細部を拾う問い:雪崩が報告された15の山を、map-reduce と refine で挙げさせる
usage = new_usage()
answer, detail_notes = map_reduce(chunks, DETAIL_QUESTION, usage, MAP_QUERY)
print("map-reduce  map の出力:", score_names("\n".join(detail_notes), docs), " 回答:", score_names(answer, docs))
print(answer)
results["map-reduce(質問に答える)"]["names"] = score_names(answer, docs)

usage = new_usage()
answer, detail_history = refine(chunks, DETAIL_QUESTION, usage)
print("refine  回答:", score_names(answer, docs))
print("ステップごとの(正しい・誤り・存在しない):", [tuple(score_names(h, docs).values()) for h in detail_history])
print(answer)
results["refine"]["names"] = score_names(answer, docs)
細部を拾う問いを、map-reduce と refine で解かせ、挙がった山の名前を採点するコードです。map-reduce では、map の出力の時点で何山を拾えていたかも数えます。refine では、チャンクを1つ読むごとの「正しい・誤り・存在しない」の数を表示します。
実行結果
map-reduce  map の出力: {'正しい': 12, '誤り': 0, '存在しない': 0}  回答: {'正しい': 12, '誤り': 0, '存在しない': 0}
The mountains on which avalanches were reported are:

- Mount Kakuyo
- Mount Kuhoshi
- Mount Miyone
- Mount Miwaki
- Mount Mohone
- Mount Nesemo
- Mount Serane
- Mount Sewasu
- Mount Shineto
- Mount Tohaho
- Mount Yonamo
- Mount Yonewa
refine  回答: {'正しい': 9, '誤り': 19, '存在しない': 1}
ステップごとの(正しい・誤り・存在しない): [(0, 0, 0), (0, 0, 0), (1, 1, 0), (3, 1, 1), (3, 3, 1), (4, 3, 1), (4, 9, 1), (4, 10, 1), (6, 10, 1), (7, 10, 1), (7, 11, 1), (9, 12, 1), (9, 19, 1)]
Based on the information provided in both the original and new documents, avalanches were reported on the following mountains:

- Mount Miwaki in the Hayate Range
- Mount Miyone in the Hayate Range
- Mount Mohone in the Shiranami Range
- Mount Mohoshi in the Hayate Range
- Mount Mohowa in the Tsukishiro Range
- Mount Mohori in the Hayate Range
- Mount Mohoshi in the Hayate Range
- Mount Mohumi in the Shiranami Range
- Mount Nesemo in the Tsukishiro Range
- Mount Neyota in the Hayate Range
- Mount Neyoto in the Akatsuki Range
- Mount Neyoyo in the Hoshimi Range
- Mount Nofuri in the Hayate Range
- Mount Nohato in the Tsukishiro Range
- Mount Noriyo in the Hayate Range
- Mount Ririmo in the Hayate Range
- Mount Shikune in the Hayate Range
- Mount Shineto in the Hayate Range
- Mount Tarishi in the Hayate Range
- Mount Tohaho in the Hayate Range
- Mount Wamise in the Shiranami Range
- Mount Yonamo in the Shiranami Range
- Mount Yonewa in the Shiranami Range
- Mount Yotara in the Hayate Range

The documents mention no reports of avalanches on Mount Yonose, Mount Yorisu, Mount Yosuki, Mount Yosura, Mount Yosuse, or Mount Yoyoki.
英語の出力の日本語訳:
-
map-reduce の答え:「雪崩が報告された山は次のとおりです。」に続けて、12山の名前を挙げています。
-
refine の答え:「元の文書と新しい文書の両方の情報によると、雪崩が報告されたのは次の山です。」に続けて、「Hayate 山脈の Miwaki 山」のように、山脈の名前を付けた24行(Mohoshi 山が2回出てくるので23山)を挙げ、最後に「文書には、Yonose 山・Yorisu 山・Yosuki 山・Yosura 山・Yosuse 山・Yoyoki 山での雪崩の報告はない。」と書いています。
-
map-reduce は、正しい12山・誤り0: map の時点で12山を拾い、reduce はそれをそのまま残しました。拾えなかった3山は、map で各チャンクを読んだ時点で見落としたもので、reduce で落ちたものはありません。1つのチャンクに含まれる雪崩の山は数山しかないので、map は少ない候補を書き出すだけで済みます。
-
refine は、正しい9山・誤り19山・存在しない1山: 正しい山より、誤った山の方が多くなりました。答えの中の山には「in the Hayate Range」のように山脈の名前が付いていて、雪崩とは関係のない山の情報が混ざっています。コーパスにない名前も1つ挙がっています。なお、score_names は答えに出てくる山の名前をすべて数えるので、誤り19山には、答えの最後の文で「雪崩の報告はない」と書かれた6山も含まれています。雪崩の山として挙げた23山に限ると、正しいのは9山、誤りは13山、存在しない名前が1山です。それでも、正しい山より誤った山の方が多いことに変わりはありません。
refine の答えが、読み進めるにつれてどう変わったかを、グラフにします。
import matplotlib.pyplot as plt
import japanize_matplotlib

steps = range(1, len(history) + 1)
detail_scores = [score_names(h, docs) for h in detail_history]
fig, axes = plt.subplots(1, 2, figsize=(13, 4.2))
axes[0].plot(steps, [n_tokens(h) for h in history], marker="o")
axes[0].axhline(600, color="gray", linestyle="--", label="出力の上限(600トークン)")
axes[0].set_title("全体を俯瞰する問い:refine の答えの長さ")
axes[0].set_ylabel("トークン数")
axes[1].plot(steps, [s["正しい"] for s in detail_scores], marker="o", label="正しい山")
axes[1].plot(steps, [s["誤り"] + s["存在しない"] for s in detail_scores], marker="s", color="red", label="誤った山")
axes[1].axhline(15, color="gray", linestyle="--", label="正解(15山)")
axes[1].set_title("細部を拾う問い:refine の答えに挙がった山の数")
axes[1].set_ylabel("山の数")
for ax in axes:
    ax.set_xlabel("読んだチャンクの数")
    ax.grid(True, alpha=0.3)
    ax.legend()
plt.tight_layout()
plt.show()
refine の各段階の答えについて、左に答えの長さ(全体を俯瞰する問い)、右に挙がった山の数(細部を拾う問い)を描くコードです。誤った山は、「誤り」と「存在しない」を足した数にしています。点線は、出力の上限(600トークン)と、正解の山の数(15)です。
実行結果
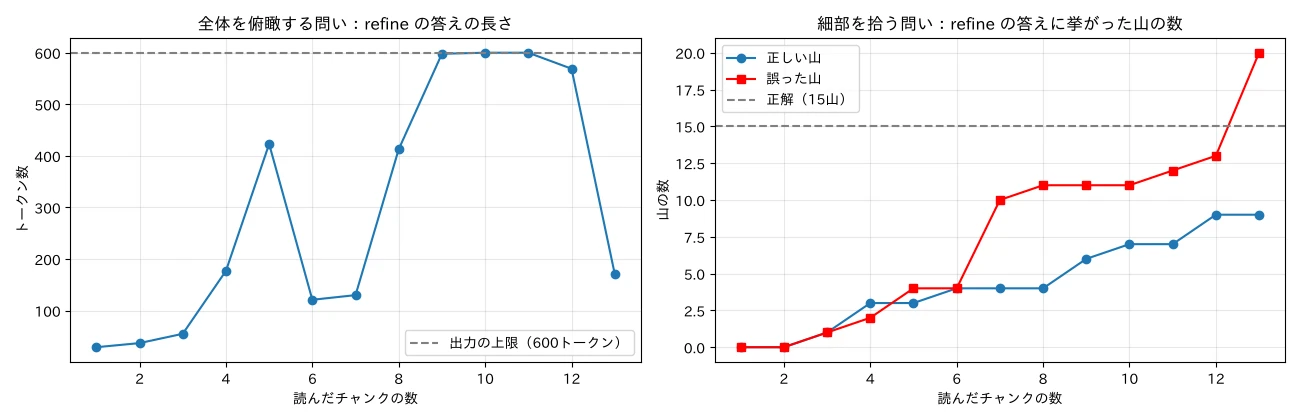
- 左(答えの長さ): 長さは単調には増えず、5つ目のチャンクで423トークンになった後、6つ目では121トークンに縮んでいます。「要点をすべて残す」と指示しても、LLM は答えを書き直すたびに、自分で要約し直しています。9〜11個目では上限の600トークン近くまで伸び、最後は171トークンまで縮みました。
- 右(挙がった山の数): 誤った山(赤)は、7つ目のチャンクで一気に増え、最後のチャンクでも7山増えました(最後の7山のうち6山は、「雪崩の報告はない」と書かれた山です)。正しい山(青)も少しずつ増えていますが、誤りの増え方の方が大きくなっています。一度答えに入った誤った山は、次の段階でも「今の答えの要点」として残されるので、誤りは減らずに積み上がります。refine では、前の答えが正しいかを、元の文書で確かめ直す機会がありません。
3つの方法の比較
ここまでの結果を、表にまとめます。
print(f"{'方法':40s} テーマ  呼び出し  入力トークン  時間(秒)  雪崩の山(正しい・誤り・存在しない)")
for name, r in results.items():
    names = r.get("names")
    names = f"{names['正しい']}・{names['誤り']}・{names['存在しない']}" if names else "-"
    print(f"{name:40s} {r['themes']} / 6  {r['calls']:4d}  {r['input_tokens']:10,}  {r['seconds']:8.1f}  {names}")
results に記録した、方法ごとのテーマの数と使用量、雪崩の山の採点結果を表示するコードです。使用量は、全体を俯瞰する問いのときの値です。
実行結果
方法                                       テーマ  呼び出し  入力トークン  時間(秒)  雪崩の山(正しい・誤り・存在しない)
stuff(30,000トークン)                        5 / 6     1      29,543       4.9  2・0・0
map-reduce(普通の要約)                        5 / 6    14      37,585      16.6  -
map-reduce(質問に答える)                       5 / 6    14      38,010      11.5  12・0・0
refine                                   6 / 6    13      40,480     133.8  9・19・1
| 方法 | 主な問題(6テーマ) | 雪崩の山(正しい・誤り・存在しない) | 呼び出し | 時間 | 落ちたもの・混ざったもの |
|---|---|---|---|---|---|
| stuff(30,000トークン) | 5 | 2・0・0 | 1 | 4.9秒 | 収まらない文書(100件)。入れた文書の中の、数件にしか出てこない話題(ごみ)と、雪崩の山の大半 |
| map-reduce(普通の要約) | 5 | — | 14 | 16.6秒 | まとめる途中で、ごみが「環境保全の懸念」に言い換えられた |
| map-reduce(クエリ指向要約) | 5 | 12・0・0 | 14 | 11.5秒 | ライチョウが「野生動物の減少」に言い換えられた。雪崩の山は map で3山を見落とした |
| refine | 6 | 9・19・1 | 13 | 133.8秒 | 答えが長くなって出力の上限で切れた。誤った山が積み上がった |
refine の誤り19山には、答えの中で「雪崩の報告はない」と書かれた6山も含まれます(雪崩の山として挙げたものに限ると、正しい9・誤り13・存在しない1)。
(図は、diagram-designで作成)
どの方法でも、元の文書には正しく書いてある内容が、要約を重ねる途中で落ちたり、混ざったりしました。
- 言い換え(抽象化): まとめる段階で、具体的な問題(ライチョウ、ごみ)が一般的な言葉(野生動物、環境保全)に置き換わります。読む人には「何か問題がある」ことは伝わりますが、何の問題かが分からなくなります。
- 重複による押し出し: よく出る話題ほど多くのチャンクで書かれ、まとめる段階の入力を埋めます。枠に限りがあると、めったに出ない話題が押し出されます。
- 誤りの引き継ぎ: refine では、ある段階で混ざった誤りが、次の段階の入力になり、確かめられないまま残ります。
これらは、BooookScore の論文が、本1冊の要約で報告していることとも合っています。論文では、階層的な統合(map-reduce)の方が筋の通った要約になる一方で、細部が少なくなりやすく、逐次的な更新(refine)の方が細部は多く残るものの、筋が通りにくいとされています。また、7B の LLaMA 2 では、逐次的な更新で要約を短くする指示に従わず、チャンクの文を写すだけになったと報告されています。今回の Qwen2.5-7B-Instruct でも、refine の答えは長くなって上限で切れ、まとまりのない一覧になりました。
使い分け
| 状況 | 向いている方法 | 理由(本記事の実験から) |
|---|---|---|
| 文書がコンテキストに十分な余裕をもって収まる | stuff | 1回の呼び出しで済み、最も速い。ただし、数件にしか出てこない話題は拾い漏れることがある |
| 文書の集まり全体についての質問に答える | map-reduce(クエリ指向要約) | map で6テーマすべてを拾い、並列に実行できて速い。細部の質問でも誤りがなかった |
| 一度作った要約を、いろいろな質問に使い回す | map-reduce(普通の要約) | 質問を見ずに要約を作れる。ただし、質問に関係のない内容にも語を使い、細部は落ちやすい |
| 話の流れが順番に意味を持つ(物語、議事録) | refine | 前の内容を踏まえて読み進められる。ただし、時間がかかり、誤りを引き継ぐ |
map-reduce を使うときは、次の点に気を付けると、細部が落ちにくくなります。
- map の出力は、それだけで意味が通るように書かせる: reduce は元の文書を読みません。山の名前だけのメモは、何のメモか分からなくなります。
- 重要度は、関係のないものを捨てるのに使う: 枠を絞るときは、よく出る話題の重複が枠を埋めないよう、似た要点をまとめてから選びます。
- まとめる段階の言い換えに注意する: 答えに「〇〇などの問題」「野生動物の減少」のような一般的な言葉が出てきたら、map の出力に戻って、具体的に何が書かれていたかを確かめます。
原著論文と本記事の設定
| GraphRAG の論文(TS) | BooookScore の論文 | 本記事 | |
|---|---|---|---|
| 対象 | ポッドキャストの書き起こし・ニュース記事(約100万トークン規模) | 出版された本(10万トークンを超えるもの) | 架空の山の紹介文600件(約3万5千トークン) |
| LLM | GPT-4 系 | GPT-4、Claude 2、LLaMA 2 など | Qwen2.5-7B-Instruct |
| 方法 | 元の文書をそのまま map-reduce(質問に答えさせる) | 階層的な統合(map-reduce)と逐次的な更新(refine) | stuff・map-reduce(普通の要約/クエリ指向要約)・refine |
| チャンク・コンテキスト | コンテキスト 8,000トークン | チャンク 2,048トークンなど | チャンク 3,000トークン(1,500〜12,000も比較) |
| 重要度 | 0〜100、0を捨てて高い順に詰める | 使わない | 0〜100、0を捨てて高い順に詰める(枠を絞って比較) |
| 評価 | LLM による答えの比較(網羅性・多様性など) | 要約の筋の通りやすさ(BooookScore) | 仕込んだテーマの網羅数、雪崩の山の正しさ |
本記事は、手元の GPU で動く 7B のモデルと小さなコーパスで、方法ごとに「何が落ちるか」を、答えの分かっているデータで数えることを目的にしています。そのため、論文の結果をそのまま再現したものではありません。GraphRAG の論文の TS は、本記事のクエリ指向要約の map-reduce にあたります。論文では、元の文書の代わりにグラフのコミュニティの要約を map-reduce する GraphRAG と比べ、中間から下の階層の要約(C1〜C3)が網羅性・多様性で TS をわずかに上回ったこと、最上位の要約(C0)は TS より97%以上少ないトークンで済んだことが報告されています。
まとめ
本記事では、LLM のコンテキストに収まらない文書の要約を、架空の山岳コーパス(600件、約3万5千トークン)と Qwen2.5-7B-Instruct で、3つの方法で比べました。
- stuff: 入るだけの30,000トークン(500件)を入れても、答えが拾えたのは6テーマのうち5つで、入れた文書の中に7件あったごみを落としました。雪崩の山は、入れた文書の中の12山のうち2山しか挙がりませんでした。
- map-reduce: map の出力には6テーマすべてが出てきましたが、reduce で具体的な問題が一般的な言葉に言い換えられ、答えは5テーマでした(普通の要約ではごみ、クエリ指向要約ではライチョウが消えた)。雪崩の山は、正しい12山・誤り0でした。
- クエリ指向要約と重要度: 質問に答えさせる map は、関係のない内容に語を使わず、時間も短くなりました(11.5秒、普通の要約は16.6秒)。重要度の高い順に reduce への枠を絞ると、よく出る問題の重複が枠を埋め、200トークンでは3テーマしか残りませんでした。
- refine: 全体を俯瞰する問いでは6テーマすべてを拾いましたが、順に呼ぶしかないので133.8秒かかりました。答えは長くなって出力の上限で切れ、雪崩の山の問いでは、雪崩の山として挙げた23山のうち正しいのは9山だけで、誤った山が13山、存在しない山が1山と、誤りが積み上がりました。
文書の集まり全体についての質問には、クエリ指向要約の map-reduce が、網羅性・正しさ・速さの釣り合いが最もよい方法でした。それでも、まとめる段階で細部が落ちることは避けられません。文書を要約してからさらに要約を重ねる RAPTOR や、文書からグラフを作ってコミュニティごとに要約する GraphRAG は、この map-reduce を発展させた方法と見ることができます。
参考文献
- D. Edge, H. Trinh, N. Cheng, J. Bradley, A. Chao, A. Mody, S. Truitt, D. Metropolitansky, R. O. Ness, J. Larson (2024). From Local to Global: A Graph RAG Approach to Query-Focused Summarization. arXiv:2404.16130.
- Y. Chang, K. Lo, T. Goyal, M. Iyyer (2024). BooookScore: A systematic exploration of book-length summarization in the era of LLMs. ICLR 2024.
- J. Wu, L. Ouyang, D. M. Ziegler, N. Stiennon, R. Lowe, J. Leike, P. Christiano (2021). Recursively Summarizing Books with Human Feedback. arXiv:2109.10862.
- H. T. Dang (2006). DUC 2005: Evaluation of Question-Focused Summarization Systems. Proceedings of the Workshop on Task-Focused Summarization and Question Answering.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。