LongRAG とは?
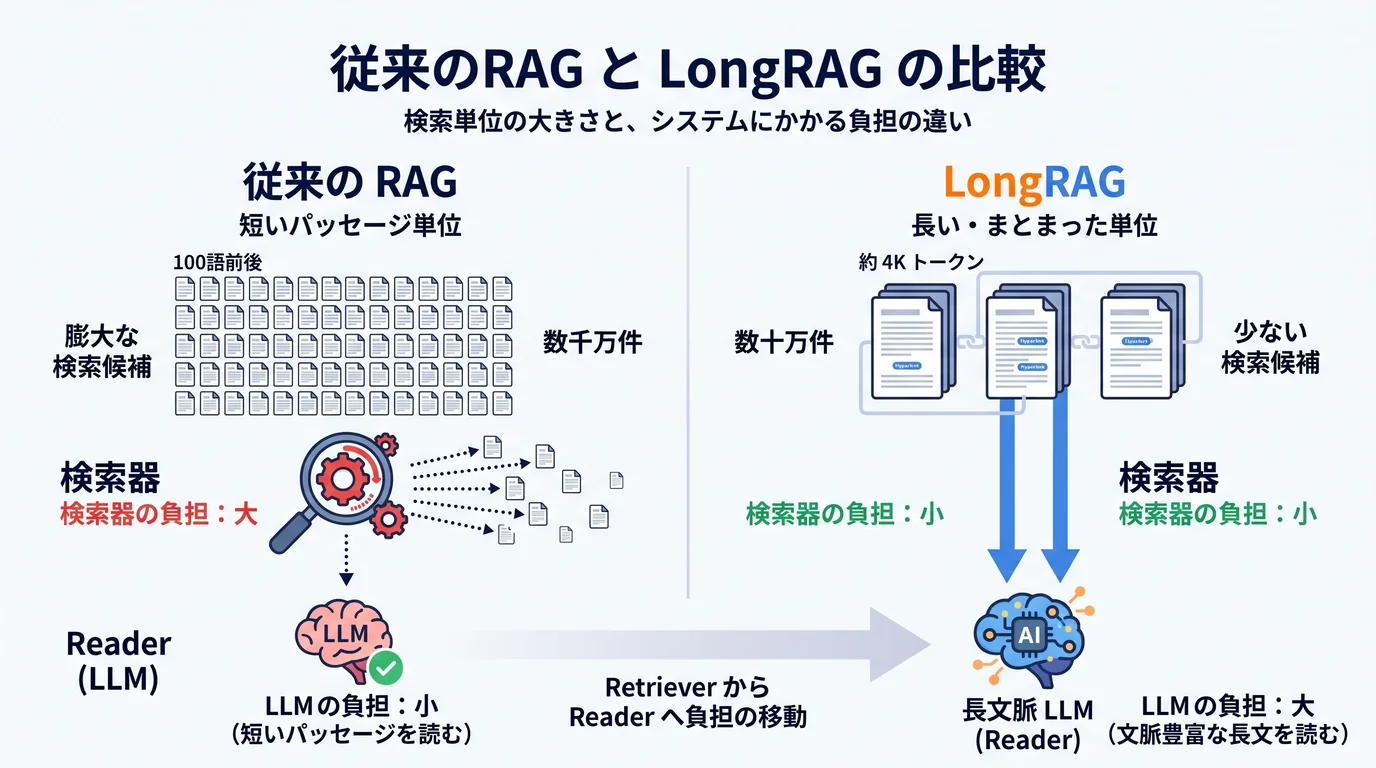 (画像は、Geminiで作成)
RAG の検索単位(retrieval unit)の長さが、検索と回答の精度をどう左右するかを、架空の百科事典を使った Python のコードで確かめること。100語の短いパッセージでは答えにたどり着けない質問が、関連する記事を数千トークンにまとめた長い単位なら上位1件で見つかり、長文を読める LLM がそこから答えを取り出せることを手元で再現し、「長文脈LLMがあれば RAG は不要か」という問いに自分の言葉で答えられるようになること。
原著論文: LongRAG: Enhancing Retrieval-Augmented Generation with Long-context LLMs (Jiang, Ma, Chen, arXiv 2024, arXiv:2406.15319)
同じ「LongRAG」という名前の別の論文(Zhao et al., EMNLP 2024)があります。本記事で扱うのは、上の arXiv:2406.15319 の手法です。
概要
RAG (Retrieval-Augmented Generation) とは? の記事で扱ったとおり、RAG は質問に関連する文書を検索し、上位 件をプロンプトに連結して大規模言語モデル(LLM)に回答させる仕組みです。その検索の部品として広く使われてきたのが DPR(Dense Passage Retrieval)で、Wikipedia の記事を 100語前後のパッセージ に切り、質問とパッセージを別々のエンコーダで埋め込み(エンベディング)にして、内積の大きいものを探します。100語という単位は、当時の生成側のモデル(BERT や BART など)が数百トークンしか読めなかったことに合わせた設計でした。Wikipedia 全体では、検索の候補は2,200万件にもなります。
LongRAG の論文は、この設計を「重い Retriever と軽い Reader」と呼んで問題にしました。Retriever(検索器)は2,200万件の中から答えを含む小さなパッセージをぴたりと当てなければならず、Reader(読み手の LLM)は短い文章から答えを抜き出すだけです。ところが今の LLM は数万トークンを読めます。それなら検索単位を 約4Kトークン に伸ばして候補を数十万件に減らし、Retriever の負担を軽くして、Reader に長い文章を読ませる方が合理的だ、というのが LongRAG の主張です。
次の節で、同じ文書の集まりを短く切った場合と長くまとめた場合で、答えを含む単位を検索できるかがどう変わるかを、実際に測ります。
100語のパッセージでは答えにたどり着けない
実験には、架空の町と人物だけでできた小さな百科事典を使います。次の図のように、同じ百科事典を3通りの長さの検索単位に分けて比べます。
(図は、diagram-designで作成)
百科事典と質問は、次のように作ります。
- 架空の名前だけを使う 実在の町や人物だと、LLM が事前学習で知っている知識(パラメトリック知識)で答えられてしまい、検索の良し悪しを測れません。町の名前(Falloka など)、創設者の名前、輸出品、生年はすべて乱数で作ります。
- 答えが記事の後半にある質問を作る 町の記事は4段落で、町の名前は冒頭の段落にしか出てきません。「主な輸出品」は最後の段落にあり、そこでは「the town」としか書かれていません。本物の Wikipedia でも、記事の名前を段落ごとに繰り返すことはまれです。この質問を 単一ホップ(single) と呼びます。
- 2つの記事をまたぐ質問を作る 「〇〇の創設者は何年生まれか」は、町の記事(創設者の名前)と創設者の記事(生年)の両方が必要です。創設者の記事には町の名前が出てきません。原著論文で使われた HotpotQA と同じ、複数ホップ(multi) の質問です。
地域が50あり、各地域に町の記事と創設者の記事が6組ずつあります。記事は全部で600件、質問は単一ホップと複数ホップが300問ずつです。
準備:Google Colab の GPU で動かす
Retriever には、原著論文と同じ埋め込みモデル BAAI/bge-large-en-v1.5 を使います。後半の Reader の実験では、7B の LLM も動かします。どちらも Google Colab の無料の T4 GPU(メモリ 15GB)で動くので、「ランタイム」→「ランタイムのタイプを変更」から T4 GPU を選んでください。
必要なパッケージは sentence-transformers・transformers・accelerate・bitsandbytes です。新しいセッションで、何も import する前に、Colab のセルで !pip install -U sentence-transformers transformers accelerate bitsandbytes を実行してください(transformers を読み込んだ後に bitsandbytes を入れると、セッションを再起動するまで認識されません)。記事の数値は、sentence-transformers 6.2.0・transformers 5.20.2・torch 2.11.0・bitsandbytes 0.50.2 で実行したものです。
- 実験1と実験2は、埋め込みモデルのダウンロード(約1.3GB)を含めて、それぞれ1〜2分で終わります。
- 実験3は、Reader のモデルのダウンロードと読み込み(約15GB)に約4分、300回の生成に約20分かかります(T4 の場合)。
- T4 のメモリでは、Reader に読ませられるのは数千トークンまでです。まとめた単位を2件(約6,600トークン)読ませようとしたところ、メモリ不足で止まりました。もっと長く読ませて試したい場合は、L4 や A100 の GPU を選んでください。
- 乱数のシードを固定し、Reader の生成も貪欲法(greedy)にしているので、同じ環境なら何度実行しても同じ数値になります。ただし、GPU の種類やライブラリのバージョンが違うと、数値が多少変わることがあります。
実験1:100語のパッセージで検索する
まず、従来の RAG と同じく、記事を100語ずつのパッセージに切って検索します。検索の良し悪しは、原著論文と同じ 答えの再現率(Answer Recall, AR) で測ります。質問の集合を 、質問 の正解の文字列を 、質問 に対して検索した上位 件の単位を とすると、
です。上位 件の中に答えの文字列が入っていれば、少なくとも Reader が答えを見つけられる可能性がある、という意味の指標です。 は k、 は q["answer"] にあたります。
質問とパッセージの類似度は、それぞれの埋め込み 、 の内積
で測ります(埋め込みは長さ1に正規化するので、内積はコサイン類似度と同じです)。質問の埋め込み が q_emb、パッセージの埋め込み が p_emb、類似度の行列が p_scores です。
import random
import numpy as np
from sentence_transformers import SentenceTransformer

# 1. 架空の固有名詞と、記事に入れる語彙
SYLLABLES = ["ka", "ve", "lo", "mir", "dan", "sel", "tor", "bri", "ne", "ash",
             "qu", "ren", "fal", "dor", "ith", "mo", "zan", "el", "gar", "vin"]
EXPORT_ADJ = ["dried", "smoked", "pickled", "woven", "polished", "salted", "carved", "glazed",
              "pressed", "spun", "cured", "painted", "forged", "roasted", "dyed", "braided",
              "candied", "hammered", "knitted", "lacquered", "bottled", "stitched", "baked", "tanned"]
EXPORT_NOUN = ["apricots", "copper wire", "wool blankets", "river pearls", "walnut oil", "clay tiles",
               "lavender soap", "pine resin", "goat cheese", "silver bells", "flax linen", "barley malt",
               "amber beads", "glass bottles", "cedar boxes", "plum brandy",
               "leather boots", "honey cakes", "iron nails", "reed baskets"]
# 輸出品は「形容詞 + 名詞」の組み合わせ(例:bottled leather boots = 瓶詰めの革のブーツ)
# EXPORT_ADJ:「干した・燻製の・酢漬けの・織った・磨いた・塩漬けの・彫った・釉薬をかけた・圧搾した・紡いだ・熟成させた・塗装した・
#             鍛造した・焙煎した・染めた・編み込んだ・砂糖漬けの・打ち出した・編んだ・漆塗りの・瓶詰めの・縫い合わせた・焼いた・なめした」
# EXPORT_NOUN:「アンズ・銅線・羊毛の毛布・川真珠・クルミ油・粘土瓦・ラベンダー石けん・松やに・ヤギのチーズ・銀の鈴・
#              亜麻のリネン・大麦麦芽・琥珀のビーズ・ガラス瓶・杉の箱・プラムブランデー・革のブーツ・蜂蜜のケーキ・鉄釘・葦のかご」
FESTIVALS = ["Lantern", "Harvest", "Kite", "Bell", "Ferry", "Snowmelt", "Weavers", "Fire",
             "Moonrise", "Orchard", "Stone", "River"]
# 祭りの名前:「ランタン・収穫・凧・鐘・渡し舟・雪解け・織り手・火・月の出・果樹園・石・川」の祭り
MONTHS = ["January", "February", "March", "April", "May", "June", "July", "August",
          "September", "October", "November", "December"]
# 「1月〜12月」
PROFESSIONS = ["surveyor", "merchant", "engineer", "botanist", "cartographer", "shipwright"]
# 「測量士・商人・技師・植物学者・地図製作者・船大工」
FIELDS = ["mathematics", "law", "medicine", "geology", "music", "astronomy"]
# 「数学・法学・医学・地質学・音楽・天文学」
FILLER = [
    "Local historians have published several studies on this period.",
    "Records from this time are kept in the regional archive.",
    "The details were later described in a guidebook for travelers.",
    "Visitors often mention this in letters and travel diaries.",
    "The topic is still discussed at meetings of the local historical society.",
    "A small exhibition about it can be seen in the municipal museum.",
    "Older residents remember the changes that followed.",
    "Several photographs from this era have survived.",
]
# 内容と関係の薄い、百科事典らしい文
# 「地元の歴史家が、この時代についていくつかの研究を発表しています。」
# 「この時代の記録は、地域の公文書館に保管されています。」
# 「その詳細は、後に旅行者向けのガイドブックに記されました。」
# 「訪れた人は、手紙や旅行記でよくこのことに触れています。」
# 「この話題は、今も地元の歴史協会の会合で語られています。」
# 「市立博物館では、これに関する小さな展示を見ることができます。」
# 「年配の住民は、その後に起きた変化を覚えています。」
# 「この時代の写真が何枚か残っています。」


def make_name(rng, n_syl):
    return "".join(rng.choice(SYLLABLES) for _ in range(n_syl)).capitalize()


def unique(rng, used, factory):
    """まだ使っていない値が出るまで作り直す(名前や輸出品の重複を防ぐ)"""
    while True:
        value = factory()
        if value not in used:
            used.add(value)
            return value


def paragraph(rng, sentences, n_filler=4):
    return " ".join(sentences + rng.sample(FILLER, n_filler))


# 2. 架空の百科事典を作る(地域ごとに、町の記事と創設者の記事を6組)
def build_corpus(n_regions=50, towns_per_region=6, seed=0):
    rng = random.Random(seed)
    used = set()
    docs, questions = [], []
    birth_years = rng.sample(range(1500, 1800), n_regions * towns_per_region)
    for r in range(n_regions):
        region = unique(rng, used, lambda: make_name(rng, 3))
        river = unique(rng, used, lambda: make_name(rng, 2))
        for t in range(towns_per_region):
            town = unique(rng, used, lambda: make_name(rng, 3))
            founder = unique(rng, used, lambda: make_name(rng, 2) + " " + make_name(rng, 3))
            export = unique(rng, used, lambda: f"{rng.choice(EXPORT_ADJ)} {rng.choice(EXPORT_NOUN)}")
            born = birth_years[r * towns_per_region + t]
            # 町の記事:町の名前は冒頭の段落にしか出てこない(輸出品は最後の段落)
            town_text = "\n\n".join([
                paragraph(rng, [
                    f"{town} is a town in the {region} region, on the banks of the {river} River.",
                    f"It was founded by {founder}, who laid out its first streets.",
                    "The town grew slowly during its first decades.",
                    # 「{town} は {region} 地方の、{river} 川のほとりにある町です。」
                    # 「{founder} によって創設され、最初の街路もこの人物が設計しました。」
                    # 「町は最初の数十年、ゆっくりと成長しました。」
                ]),
                paragraph(rng, [
                    f"Every {rng.choice(MONTHS)}, the town holds the {rng.choice(FESTIVALS)} Festival.",
                    "The festival includes a parade, music, and a market in the main square.",
                    "It is the largest public event of the year.",
                    # 「毎年(月)になると、町では(名前)祭りが開かれます。」
                    # 「祭りでは、パレードや音楽、中央広場の市場が催されます。」
                    # 「1年でいちばん大きな公共の行事です。」
                ]),
                paragraph(rng, [
                    f"As of the last census, the population was {rng.randint(2, 40)},{rng.randint(100, 999)}.",
                    "Most residents live within walking distance of the river.",
                    "The town is served by a regional bus line and a small ferry pier.",
                    # 「直近の国勢調査では、人口は(人数)人でした。」
                    # 「住民の多くは、川まで歩いて行ける範囲に住んでいます。」
                    # 「町には地域のバス路線と、小さなフェリー乗り場があります。」
                ]),
                paragraph(rng, [
                    "The town's economy has long depended on small workshops.",
                    f"Its main export is {export}, which is shipped downstream to the coast.",
                    "Trade fairs bring buyers from neighboring regions every year.",
                    # 「町の経済は、長く小さな工房に支えられてきました。」
                    # 「主な輸出品は {export} で、川を下って海岸まで運ばれます。」
                    # 「毎年の見本市には、近隣の地域から買い手が集まります。」
                ]),
            ])
            # 創設者の記事:生年はあるが、町の名前は出てこない
            pronoun = rng.choice(["He", "She"])
            # 「彼」「彼女」
            person_text = "\n\n".join([
                paragraph(rng, [
                    f"{founder} (born {born}) was a {rng.choice(PROFESSIONS)} "
                    "best known for founding a small river town.",
                    f"{pronoun} spent most of {'his' if pronoun == 'He' else 'her'} life in the {region} region.",
                    # 「{founder}({born}年生まれ)は(職業)で、小さな川沿いの町を創設したことで知られています。」
                    # 「生涯の大半を {region} 地方で過ごしました。」
                ]),
                paragraph(rng, [
                    f"{pronoun} studied {rng.choice(FIELDS)} before turning to practical work.",
                    "Friends described a careful and patient character.",
                    "Many of the surviving letters deal with everyday matters.",
                    # 「実務の仕事に就く前は、(分野)を学びました。」
                    # 「友人たちは、慎重で忍耐強い人柄だったと述べています。」
                    # 「残っている手紙の多くは、日々の出来事についてのものです。」
                ]),
                paragraph(rng, [
                    "A street and a small square were later named in this person's honor.",
                    "A portrait hangs in the town hall.",
                    # 「後に、この人物にちなんで通りと小さな広場が名付けられました。」
                    # 「町役場には肖像画が掛けられています。」
                ]),
            ])
            docs.append({"title": town, "region": r, "links": [founder], "text": town_text})
            docs.append({"title": founder, "region": r, "links": [], "text": person_text})
            questions.append({"type": "single", "question": f"What is the main export of {town}?",
                              "answer": export})
            questions.append({"type": "multi", "question": f"In what year was the founder of {town} born?",
                              "answer": str(born)})
            # 「{town} の主な輸出品は何ですか?」「{town} の創設者は何年に生まれましたか?」
    return docs, questions


docs, questions = build_corpus()


# 3. 従来の RAG:記事を100語ずつのパッセージに切る
def split_passages(docs, n_words=100):
    passages = []
    for doc in docs:
        words = doc["text"].split()
        for i in range(0, len(words), n_words):
            passages.append(" ".join(words[i:i + n_words]))
    return passages


passages = split_passages(docs)

# 4. 埋め込みで検索する(原著論文と同じ bge-large-en-v1.5)
encoder = SentenceTransformer("BAAI/bge-large-en-v1.5", device="cuda")
QUERY_PREFIX = "Represent this sentence for searching relevant passages: "
# 「関連するパッセージを検索するために、この文を表現してください:」(bge が推奨する、質問の前に付ける指示文)


def encode_queries(questions):
    return encoder.encode([QUERY_PREFIX + q["question"] for q in questions],
                          normalize_embeddings=True, batch_size=64)


def answer_recall(questions, scores, units, k):
    """上位 k 件の検索単位のどれかに、答えの文字列が含まれる質問の割合"""
    top_k = np.argsort(-scores, axis=1)[:, :k]
    hits = [any(q["answer"] in units[j] for j in top_k[i]) for i, q in enumerate(questions)]
    return np.mean(hits)


q_emb = encode_queries(questions)
p_emb = encoder.encode(passages, normalize_embeddings=True, batch_size=64)
p_scores = q_emb @ p_emb.T  # (質問数, パッセージ数) の内積

# 5. 上位 k 件の答えの再現率(Answer Recall)を、質問のタイプごとに求める
print(f"記事の数: {len(docs)}, パッセージの数: {len(passages)}")
for qtype in ["single", "multi"]:
    idx = [i for i, q in enumerate(questions) if q["type"] == qtype]
    qs = [questions[i] for i in idx]
    recalls = [answer_recall(qs, p_scores[idx], passages, k) for k in [1, 5, 20]]
    print(f"{qtype:6s}: AR@1={recalls[0]:.2f}  AR@5={recalls[1]:.2f}  AR@20={recalls[2]:.2f}")

# 6. 例:最初の質問で、上位1件に何が返ってきたか
q = questions[0]
top1 = int(np.argmax(p_scores[0]))
print(f"\n質問: {q['question']}(正解: {q['answer']})")
print(f"上位1件: {passages[top1][:160]} ...")
架空の百科事典を作り、100語のパッセージに切って、質問ごとに埋め込みの類似度で検索するコードです。
- 乱数の扱い: random.Random(seed) で乱数生成器を作り、名前・輸出品・生年などをすべてこの生成器から引いています。グローバルな乱数の状態に依存しないので、seed=0 なら何度実行しても同じ百科事典になります。
- 重複の防止: unique は、すでに使った名前や輸出品が出たら作り直します。答えの文字列が他の記事に偶然現れると、答えの再現率を正しく測れないためです。生年も rng.sample で重複なく選び、記事の中に他の4桁の年は書いていません。
- 町の記事: 4段落で、町の名前 town と創設者の名前 founder は冒頭の段落にだけ書きます。輸出品 export は最後の段落で、主語は「the town」です。各段落には、内容と関係の薄い文(FILLER)を4つずつ足し、百科事典らしい長さ(1段落70語前後)にしています。町の名前を冒頭の段落に、輸出品を最後の段落に分け、輸出品の文では町の名前を使わず「the town」とするのは、100語で切ったときに「この段落はどの町の話か」が失われる状況を再現するためです。
- 創設者の記事: 生年 born を冒頭の段落に書きますが、どの町を作ったかは書きません。町の名前から生年まで、2つの記事をたどらないと答えられない複数ホップの質問にするためです。町の記事の links には創設者の名前を入れ、Wikipedia のハイパーリンクの代わりにしています(実験2で使います)。
- 質問: 「1つの記事の中で文脈が切れる問題」と「記事をまたぐ問題」を分けて測るため、町ごとに単一ホップの「主な輸出品は?」と、複数ホップの「創設者は何年生まれ?」を作ります。type で質問の種類を区別します。
- パッセージへの分割: split_passages は、記事の本文を空白で単語に分け、100語ずつに区切ります。段落の切れ目は気にせず、機械的に切ります。100語で区切るのは、従来の RAG の代表である DPR が、Wikipedia を100語のパッセージに分けて検索しているのに合わせるためです。
- 埋め込み: SentenceTransformer で bge-large-en-v1.5 を読み込みます。このモデルは、質問の先頭に QUERY_PREFIX の指示文を付けて埋め込む使い方が推奨されています(文書側には付けません)。normalize_embeddings=True で長さ1に正規化するので、内積がコサイン類似度になります。
- 類似度の行列: q_emb は (600, 1024)、p_emb は (1500, 1024) の配列で、q_emb @ p_emb.T は全質問×全パッセージの類似度を一度に計算した (600, 1500) の行列です。質問を1つずつループで計算するより、行列の掛け算1回の方がずっと速いためです。
- 答えの再現率: answer_recall は、np.argsort(-scores, axis=1) で類似度の大きい順に並べた上位 k 件の中に、答えの文字列が入っているかを調べます。直前に示した の式をそのまま計算しています。Reader に答えさせる前に再現率を見るのは、失敗の原因が「検索で答えを取れなかった」ことにあるのか、「読んで答えを取り出せなかった」ことにあるのかを分けるためです。
- 例の表示: 再現率の数だけでは、なぜ外れたのかが分からないので、最初の質問について、上位1件のパッセージの冒頭160文字を表示し、何が返ってきたのかを見ます。
実行結果
記事の数: 600, パッセージの数: 1500
single: AR@1=0.00  AR@5=0.02  AR@20=0.05
multi : AR@1=0.00  AR@5=0.00  AR@20=0.03

質問: What is the main export of Falloka?(正解: bottled leather boots)
上位1件: Falloka is a town in the Ashnesel region, on the banks of the Mirmo River. It was founded by Neith Mirnedan, who laid out its first streets. The town grew slowl ...
答えを含むパッセージは、ほとんど検索できませんでした。上位20件まで広げても、単一ホップで5%、複数ホップで3%です。
例を見ると理由が分かります。「Falloka の主な輸出品は?」に対して、Retriever は Falloka の記事の 冒頭のパッセージ を正しく選んでいます。質問の「Falloka」と一致するのはこのパッセージだけだからです。しかし、輸出品は記事の最後の段落にあり、100語で切ると別のパッセージに入ります。そちらには「Falloka」の文字がなく、「Its main export is …(主な輸出品は…)」という段落は300の町すべてにあるので、どの町の輸出品の段落なのかを Retriever は区別できません。100語に切ったことで、「この段落はどの町の話か」という 文脈が失われた のです。
複数ホップの質問は、さらに厳しい状況です。答え(生年)は創設者の記事にありますが、そこには町の名前がありません。1件のパッセージに「町の名前」と「生年」の両方が入ることはないので、1件のパッセージだけでは、町の名前から生年までたどれません。生年を含むパッセージが上位に入るのは、質問とあまり似ていない創設者の記事が、たまたま上位に来たときだけです。
検索単位を長くする:LongRAG の Long Retriever
LongRAG は、検索単位を長くしてこの問題を解きます。原著論文の作り方は、次の2つです。
- 長い記事は、記事全体を1つの単位にする(4Kトークンを超えるような記事)
- 短い記事は、ハイパーリンクでつながった記事どうしをまとめて1つの単位にする(平均で約4Kトークン)
LongRAG 全体の流れは、次の図のとおりです。Long Retriever が長い単位を少数選び、Long Reader(長文脈 LLM)がそれを読んで答えを取り出します。
(図は、diagram-designで作成)
この記事の百科事典でも、同じように単位を作ります。町の記事から創設者の記事へのリンク(links)と、同じ地域の記事どうしのつながりをたどり、3,500語(約4,100トークン)を上限にまとめます。各地域の12記事は合わせて約2,800語なので、1地域が1つの単位になります。
長い単位の類似度:チャンクごとの類似度の最大値
単位を長くすると、もう1つ問題が出ます。埋め込みモデルの多くは、512トークン程度までしか一度に読めません。bge-large-en-v1.5 も最大512トークンで、それより長い文章は切り捨てられます。
そこで LongRAG は、長い単位 の類似度を、 を短く切ったチャンク との類似度の 最大値 で近似します。
- は質問、 は長い検索単位、 は を短く切ったチャンクの1つです( は「 に含まれるチャンク」を表します)。
- は質問を埋め込みに変える関数(質問側のエンコーダ)、 は文書(コンテキスト)を埋め込みに変える関数(文書側のエンコーダ)です。どちらも長さ1に正規化したベクトルを返すので、内積 は質問とチャンク のコサイン類似度になります。この記事では、どちらも bge-large-en-v1.5 で、質問にだけ指示文 QUERY_PREFIX を付けて埋め込みます(実験1と同じです)。
- は、質問 と単位 の類似度、つまり検索のスコアです。値が大きい単位ほど上位に来ます。
検索文書を段落に分けてスコアの最大値を取る、情報検索の MaxP という方法と同じ考え方です。原著論文では、長い単位全体を一度に埋め込める長文用のモデル(E5-Mistral-7B)より、512トークンのチャンクに切って bge-large-en-v1.5 で最大値を取る方が、答えの再現率がはるかに高い結果でした(上位1件で 71.7% 対 23.4%)。この記事でも、各単位を500トークンずつのチャンクに切り、最大値を取ります。チャンク が chunks の各要素、 が c_scores、最大値を取った が maxp_scores の戻り値です。
実験2:記事、まとめた単位で検索する
実験1のパッセージに加えて、記事を1つの単位にした場合と、地域ごとにまとめた単位にした場合で、答えの再現率を比べます。比較のため、DPR と同じように、各パッセージの先頭に記事のタイトルを付けた場合も測ります。実験1のコードを実行した後に、続けて実行してください。
# 1. 長い検索単位を作る:リンクでつながった記事を、上限の語数までまとめる
def group_documents(docs, max_words=3500):
    title_to_id = {d["title"]: i for i, d in enumerate(docs)}
    neighbors = []
    for i, d in enumerate(docs):
        linked = [title_to_id[t] for t in d["links"]]  # 本文に名前が出てくる記事
        same_region = [j for j, e in enumerate(docs) if e["region"] == d["region"] and j != i]
        neighbors.append(linked + [j for j in same_region if j not in linked])
    assigned, groups = set(), []
    for i in range(len(docs)):
        if i in assigned:
            continue
        group, n_words, queue = [i], len(docs[i]["text"].split()), list(neighbors[i])
        assigned.add(i)
        while queue:  # 幅優先でリンクをたどり、上限を超えない記事を足していく
            j = queue.pop(0)
            if j in assigned:
                continue
            w = len(docs[j]["text"].split())
            if n_words + w > max_words:
                continue
            group.append(j)
            assigned.add(j)
            n_words += w
            queue.extend(neighbors[j])
        groups.append(group)
    return groups


doc_units = [d["text"] for d in docs]
groups = group_documents(docs)
group_units = ["\n\n".join(docs[i]["text"] for i in g) for g in groups]


# 2. 長い単位の類似度:512トークン以下に切った各チャンクとの類似度の最大値
def split_by_tokens(text, max_tokens=500):
    ids = encoder.tokenizer(text, add_special_tokens=False)["input_ids"]
    return [encoder.tokenizer.decode(ids[i:i + max_tokens]) for i in range(0, len(ids), max_tokens)]


def maxp_scores(q_emb, units):
    chunks, owner = [], []
    for u, text in enumerate(units):
        for chunk in split_by_tokens(text):
            chunks.append(chunk)
            owner.append(u)
    c_emb = encoder.encode(chunks, normalize_embeddings=True, batch_size=32)
    c_scores = q_emb @ c_emb.T  # (質問数, チャンク数)
    owner = np.array(owner)
    return np.stack([c_scores[:, owner == u].max(axis=1) for u in range(len(units))], axis=1)


d_scores = maxp_scores(q_emb, doc_units)
g_scores = maxp_scores(q_emb, group_units)

# 3. 比較のため、DPR と同じく先頭に記事タイトルを付けたパッセージも作る
titled = []
for doc in docs:
    words = doc["text"].split()
    for i in range(0, len(words), 100):
        titled.append(doc["title"] + ". " + " ".join(words[i:i + 100]))
t_scores = q_emb @ encoder.encode(titled, normalize_embeddings=True, batch_size=64).T

# 4. 検索単位ごとに、上位1件・5件の答えの再現率を比べる
n_tokens = lambda units: np.mean([len(encoder.tokenizer(u, add_special_tokens=False)["input_ids"]) for u in units])
print("検索単位          単位の数  平均トークン数  single AR@1/@5  multi AR@1/@5")
for name, units, scores in [("passage", passages, p_scores), ("passage+title", titled, t_scores),
                            ("document", doc_units, d_scores), ("group", group_units, g_scores)]:
    ar = {}
    for qtype in ["single", "multi"]:
        idx = [i for i, q in enumerate(questions) if q["type"] == qtype]
        qs = [questions[i] for i in idx]
        ar[qtype] = [answer_recall(qs, scores[idx], units, k) for k in [1, 5]]
    print(f"{name:14s} {len(units):>8d} {n_tokens(units):>14.0f}"
          f"     {ar['single'][0]:.2f} / {ar['single'][1]:.2f}     {ar['multi'][0]:.2f} / {ar['multi'][1]:.2f}")
記事をリンクでまとめた長い単位を作り、チャンクごとの類似度の最大値で検索して、4種類の検索単位の答えの再現率を比べるコードです。
- リンクの表現: neighbors[i] は、記事 i からたどれる記事の番号のリストです。本文に名前が出てくる記事(町→創設者)を先に、同じ地域の記事を後に並べています。本文に名前が出てくる記事を先に並べるのは、語数の上限に達する前に、創設者の記事が必ず町と同じ単位に入るようにするためです。この記事の百科事典には地域の記事がないので、同じ地域に属することを、Wikipedia の地域の記事やカテゴリを介したリンクの代わりにしています。
- まとめ方: group_documents は、まだどの単位にも入っていない記事から始めて、queue を使った幅優先探索でリンクをたどり、合計の語数が max_words を超えない記事を足していきます。リンクの近い記事から順に入るので、町の記事とその創設者の記事は、必ず同じ単位に入ります。各記事はどれか1つの単位にだけ入ります(assigned)。max_words を3,500語(約4,100トークン)にしているのは、原著論文の単位の長さ(約4Kトークン)に合わせ、Reader が1件を読み切れる長さに収めるためです。
- 3種類の単位: doc_units は記事1件ずつ、group_units はまとめた記事の本文を空行でつないだものです。どちらも、実験1のパッセージと同じ本文から作っているので、含まれる情報は同じで、違うのは単位の長さだけです。
- トークン単位の分割: split_by_tokens は、埋め込みモデルのトークナイザで本文をトークン列にし、500トークンずつに切って文字列に戻します。特殊トークン([CLS] と [SEP])の分を残して、モデルの上限の512トークンに収めています。記事1件(約270トークン)は1つのチャンクのまま、まとめた単位(約3,300トークン)は7つほどのチャンクになります。
- 最大値による類似度: maxp_scores は、全単位のチャンクをまとめて埋め込み、owner にどの単位のチャンクかを記録します。c_scores[:, owner == u].max(axis=1) で、単位 u に属するチャンクの類似度の最大値を、全質問について一度に取ります。直前に示した の近似式です。最大値を取るのは、単位全体は埋め込みモデルの上限(512トークン)に収まらないうえ、どこか1つのチャンクが質問に合っていれば、その単位には答えがあると考えられるためです。
- タイトル付きパッセージ: titled は、実験1と同じ100語のパッセージの先頭に、記事のタイトル(町や人物の名前)を付けたものです。DPR も、Wikipedia のパッセージにタイトルを付けて埋め込んでいます。これを比べに入れるのは、単位を長くしなくても、タイトルを付けるだけで失われた文脈を補えるかを確かめるためです。
- 比較の表: 4種類の単位について、単位の数、平均トークン数、上位1件・5件の答えの再現率を、質問の種類ごとに表示します。
実行結果
検索単位          単位の数  平均トークン数  single AR@1/@5  multi AR@1/@5
passage            1500            109     0.00 / 0.02     0.00 / 0.00
passage+title      1500            115     0.98 / 1.00     0.00 / 0.00
document            600            273     1.00 / 1.00     0.00 / 0.00
group                50           3280     0.87 / 0.96     0.88 / 0.99
4種類の検索単位の、上位1件の答えの再現率を並べると、次のようになります。
(図は、diagram-designで作成)
検索単位を長くすると、答えの再現率がはっきり変わりました。
- 記事を単位にすると、単一ホップは解ける: 記事1件は約270トークンなので、1つのチャンクに町の名前と輸出品の両方が入ります。上位1件の再現率は 0.00 から 1.00 に上がりました。パッセージにタイトルを付けても(0.98)、ほぼ同じ効果があります。どちらも、「この段落はどの町の話か」という失われた文脈を取り戻しているわけです。
- 複数ホップは、記事単位でもタイトルを付けても解けない: 生年は創設者の記事にあり、そこには町の名前がないので、記事を単位にしても上位5件にすら入りません。0.00 のままです。
- まとめた単位なら、複数ホップも上位1件で解ける: 町の記事と創設者の記事が同じ単位に入るので、町の名前で単位を見つければ、その中に生年もあります。上位1件の再現率は 0.88、上位5件では 0.99 です。しかも、検索の候補は1,500件から50件に減っています。
- 単一ホップで記事単位にわずかに負ける: まとめた単位の単一ホップは 0.87 で、記事単位の 1.00 より下がりました。単位を500トークンずつ機械的に切っているので、町の名前の段落と輸出品の段落が別のチャンクに分かれる場合があるためです。それでも上位5件なら 0.96 で、パッセージの 0.02 とは比べものになりません。
短い単位で起きていた失敗は、2種類あったことになります。1つは、切ったことで段落の 文脈が失われる 失敗で、タイトルを付けたり記事単位にしたりすれば補えます。もう1つは、答えに必要な情報が 複数の記事にまたがる 失敗で、こちらは、関連する記事を1つの単位にまとめない限り、上位1件では解けません。
原著論文は何を示したか
原著論文は、この現象を Wikipedia 全体で確かめています。
検索単位を変えた結果
Natural Questions(NQ)での結果のうち、上位1件の答えの再現率を抜き出すと、次のとおりです。
| 検索単位 | 単位の数 | 単位の平均トークン数 | 上位1件の答えの再現率 |
|---|---|---|---|
| パッセージ(100語) | 2,200万 | 120 | 52.24% |
| 記事 | 300万 | 820 | 69.45% |
| まとめた記事 | 60万 | 4K | 71.69% |
上位1件の答えの再現率を並べると、次のようになります。
(図は、diagram-designで作成)
検索単位を約4Kトークンにまとめることで、候補の数は2,200万件から60万件に減り、上位1件の答えの再現率は 52% から 72% に上がりました。2つの記事をまたぐ質問の HotpotQA でも、候補は520万件から50万件に減り、上位2件の答えの再現率は 47.75% から 72.49% に上がっています。この記事の実験でも、NQ に近い単一ホップは記事単位で、HotpotQA に近い複数ホップはまとめた単位で大きく改善しました。原著論文の結果と同じ向きです。
重い Retriever と軽い Reader
原著論文の主張の中心は、この結果の解釈にあります。従来の RAG では、Reader は100語のパッセージを数件読めば済むので、仕事はほとんど Retriever に偏っていました。Retriever は、膨大な候補の中から、答えを含む小さな単位をぴたりと当てなければなりません。実験1で見たように、それが原理的に難しい質問もあります。
検索単位を長くすると、この負担の配分が変わります。候補が少なくなり、1件の中に答えとその文脈が入りやすくなるので、Retriever の仕事は楽になります。その代わり、Reader は数千トークンの単位を読み、その中から答えを探さなければなりません。100語の単位は、Reader が数百トークンしか読めなかった時代の制約に合わせたものでした。Reader が長文を読めるようになった今は、負担を Reader の側に移す方が合理的だ、というのが LongRAG の考え方です。
長い単位を読む:LongRAG の Long Reader
Retriever が長い単位を見つけても、Reader がその中から答えを取り出せなければ意味がありません。原著論文では、Reader に GPT-4o や Gemini-1.5-Pro などの長文脈 LLM を使い、上位の単位(NQ は4件、HotpotQA は8件、合わせて約3万トークン)を読ませました。学習はいっさい行わず、GPT-4o で NQ 62.7%、HotpotQA 64.3% の完全一致率(EM)を出しています。NQ では、そのデータで学習した当時の最先端の RAG(Atlas の 64.0%)と同程度で、HotpotQA でも学習済みの最先端の手法(68% 前後)に近い水準です。
この記事でも、検索した単位を LLM に読ませて、最終的な正答率を比べます。
実験3:従来の RAG と LongRAG を、最後の答えで比べる
Reader には、長いコンテキストを扱えるオープンモデル Qwen/Qwen2.5-7B-Instruct(最大32Kトークン)を、4bit に量子化して使います。比べる設定は、次の3つです。
- passage top-5:従来の RAG。100語のパッセージの上位5件(約580トークン)を読ませる
- passage top-30:パッセージの件数を増やし、まとめた単位1件と同じくらいの長さ(約3,300トークン)を読ませる
- group top-1:LongRAG。まとめた単位の上位1件を読ませる
正答率は、Reader の応答に正解の文字列が含まれる質問の割合です。原著論文の完全一致率も、予測が短い(5トークン未満の)場合は、予測と正解の一方がもう一方を含めば正解とする、ゆるめの基準で測っています。質問 に対する Reader の応答を とすると、
です。 は pred にあたります。時間を節約するため、単一ホップと複数ホップから50問ずつ、合わせて100問で測ります。実験1・2のコードを実行した後に、続けて実行してください。
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig

# 1. Reader:長いコンテキストを扱えるオープンモデルを4bitで読み込む
READER_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(READER_ID)
reader = AutoModelForCausalLM.from_pretrained(
    READER_ID,
    device_map="auto",
    quantization_config=BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype=torch.float16),
)
reader.eval()


@torch.no_grad()
def read(question, context, max_new_tokens=32):
    """検索した単位を読ませて、短い答えを貪欲法(greedy)で生成する"""
    messages = [{"role": "user", "content": (
        "Answer the question using only the context below. Reply with a short phrase.\n\n"
        f"Context:\n{context}\n\nQuestion: {question}")}]
    # 「以下のコンテキストだけを使って質問に答えてください。短い句で答えてください。コンテキスト:… 質問:…」
    inputs = tokenizer.apply_chat_template(messages, add_generation_prompt=True,
                                           return_tensors="pt", return_dict=True).to(reader.device)
    output = reader.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return tokenizer.decode(output[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True).strip()


# 2. 評価する質問:各タイプから50問ずつ
rng = random.Random(1)
sample = (rng.sample([i for i, q in enumerate(questions) if q["type"] == "single"], 50)
          + rng.sample([i for i, q in enumerate(questions) if q["type"] == "multi"], 50))


def evaluate(scores, units, k):
    """上位 k 件を連結して Reader に渡し、答えの文字列が応答に含まれる割合を求める"""
    correct = {"single": [], "multi": []}
    lengths = []
    for i in sample:
        top_k = np.argsort(-scores[i])[:k]
        context = "\n\n".join(units[j] for j in top_k)
        lengths.append(len(tokenizer(context)["input_ids"]))
        pred = read(questions[i]["question"], context)
        correct[questions[i]["type"]].append(questions[i]["answer"].lower() in pred.lower())
    return np.mean(lengths), np.mean(correct["single"]), np.mean(correct["multi"])


# 3. 従来の RAG(短いパッセージ)と LongRAG(まとめた単位)を比べる
print(f"{'設定':16s} {'平均トークン数':>8s} {'single':>7s} {'multi':>6s}")
for name, scores, units, k in [("passage top-5", p_scores, passages, 5),
                               ("passage top-30", p_scores, passages, 30),
                               ("group top-1", g_scores, group_units, 1)]:
    n_tok, acc_s, acc_m = evaluate(scores, units, k)
    print(f"{name:16s} {n_tok:>10.0f} {acc_s:>7.2f} {acc_m:>6.2f}")
検索した単位を Reader に読ませて答えを生成させ、3つの設定の正答率を比べるコードです。
- Reader の読み込み: BitsAndBytesConfig で load_in_4bit=True を指定し、7B のモデルを4bit に量子化して読み込みます。重みは約5GBになり、T4 の 15GB に、埋め込みモデルと一緒に載ります。計算は float16 で行います。
- プロンプト: read は、指示文(コンテキストだけを使い、短い句で答える)、検索した単位、質問の順に並べた1つのメッセージを作り、apply_chat_template でモデルの会話形式に変換します。「短い句で答える」と指示するのは、正解の文字列が応答に含まれるかで判定するため、また max_new_tokens の32トークンで答えが切れないようにするためです。return_dict=True で、トークン列と attention mask をまとめて受け取り、generate にそのまま渡しています。
- 生成: do_sample=False で、毎回いちばん確率の高いトークンを選ぶ貪欲法にしています。同じ入力なら同じ答えになります。答えは短い句なので、max_new_tokens は32で十分です。
- 評価する質問: random.Random(1) で、単一ホップと複数ホップの質問から50問ずつを選びます。600問すべてではなく100問にするのは、3つの設定で生成する時間を抑えるためです。3つの設定で同じ100問を使うので、設定の違いだけを比べられます。
- コンテキストの組み立て: evaluate は、質問ごとに類似度の上位 k 件を、類似度の高い順に空行でつないで Reader に渡します。lengths には、そのコンテキストのトークン数(Reader のトークナイザで数えたもの)を記録します。
- 正誤の判定: 応答 pred に正解の文字列が含まれていれば正解とします。大文字と小文字の違いは無視しています。直前に示した正答率の式です。
- 3つの設定: パッセージの上位5件と30件、まとめた単位の上位1件を比べます。パッセージの上位30件は、まとめた単位1件とほぼ同じ長さになるように選んだ件数です。生成は3 × 100 = 300回です。
実行結果
設定                平均トークン数  single  multi
passage top-5           577    0.04   0.00
passage top-30         3353    0.00   0.00
group top-1            3340    0.88   0.86
3つの設定の正答率を並べると、次のようになります。
(図は、diagram-designで作成)
最終的な正答率でも、検索単位の長さの違いがそのまま現れました。
- 従来の RAG はほとんど答えられない: パッセージの上位5件では、単一ホップで 0.04、複数ホップで 0.00 です。実験1で見たとおり、答えを含むパッセージがそもそも上位に入っていないので、Reader がどれだけ賢くても答えられません。
- パッセージを増やしても解決しない: 上位30件(約3,350トークン)まで増やしても、正答率は 0.00 のままでした。実験1の上位20件の再現率が 0.05 以下だったように、「Its main export is …」という段落はどの町の記事にもあるので、件数を増やしても、どの町の話か分からない段落が増えるだけです。上位5件で正解していた単一ホップの2問(0.04 = 2/50)も、30件では外れています。
- 同じ長さでも、長い単位1件なら答えられる: まとめた単位の上位1件(約3,340トークン)は、パッセージ30件とほぼ同じ長さです。それでも正答率は、単一ホップで 0.88、複数ホップで 0.86 に上がりました。実験2の上位1件の答えの再現率(0.87・0.88)とほぼ同じ水準で、答えを含む単位さえ渡せば、Reader(7B のモデル)は約3,300トークンの中から答えを正しく取り出せています。
Reader に渡す長さが同じでも、短い単位を寄せ集めるか、関連する記事をまとめた長い単位を渡すかで、結果は大きく変わります。長い単位には、答えだけでなく「どの町の話か」「創設者は誰か」という文脈が一緒に入っているからです。
長文脈LLMがあれば RAG は不要か
LongRAG は、長文を読める Reader を前提にした手法です。それなら、いっそ検索をやめて、すべての文書を LLM に読ませればよいのではないか、という疑問が浮かびます。これは、長文脈 LLM が登場してから繰り返し問われてきた問いです。答えは「規模によっては可能だが、多くの場合は RAG と組み合わせる方がよい」です。理由は3つあります。
- コーパスは、コンテキストウィンドウよりはるかに大きい この記事の百科事典は、まとめた単位が50件で、全体でも約16万トークンです。これでも、実験で使った Qwen2.5-7B の32Kトークンには収まりません。原著論文の Wikipedia は、約4Kトークンの単位が60万件あり、全体で数十億トークンになります。100万トークンを読めるモデルでも、まったく足りません。社内文書やWebのように、毎日増えていくコーパスならなおさらです。
- 長く読ませるほど、コストがかかる LLM の計算量と料金は、入力の長さにほぼ比例して増えます(注意機構の計算は、長さの2乗で増えます)。質問のたびに全文書を読ませるより、関係のありそうな数万トークンだけを読ませる方が、はるかに安く速く答えられます。Li らの比較(EMNLP 2024)では、十分な計算資源があれば、長文脈 LLM に全文を読ませる方が RAG より平均の精度は高い一方で、RAG の方がコストは大幅に低いことが示されています。両者の長所を生かすため、まず RAG で答えさせ、LLM が「答えられない」と判断した質問だけを長文脈で処理する Self-Route という方法も提案されています。
- 長く読ませれば読ませるほどよい、とは限らない 原著論文でも、Reader に渡す単位を増やしていくと、正答率はあるところまで上がった後に下がりました(NQ のまとめた単位では、4件から8件の間)。Reader に渡すのに最も適した長さは、約3万トークンでした。Jin らの研究(2024)も、多くの長文脈 LLM で、検索したパッセージを増やすと出力の質がいったん上がり、その後は下がることを報告しています。原因として挙げられているのは、関係がありそうに見えて答えを含まない文書(hard negatives)が増えることです。長いコンテキストの中央に置かれた情報が使われにくい現象については、Lost in the Middle の記事で扱いました。
つまり、長文脈 LLM は RAG を不要にするのではなく、RAG の設計の前提を変える ものだと言えます。Reader が数百トークンしか読めなかった時代は、Retriever が小さなパッセージを正確に当てるしかありませんでした。Reader が数万トークンを読める今は、Retriever には数千トークンの単位を少数選ばせ、その中から答えを探す仕事を Reader に任せられます。LongRAG は、この負担の配分を、検索単位の長さという1つの設計変数で調整する手法です。
実務上の指針
- 検索単位の長さを、Reader の読める長さから逆算する チャンクの長さを「とりあえず数百トークン」と決めるのではなく、Reader に渡せるコンテキストの長さ(原著論文では約3万トークン)と、渡したい件数から逆算します。長文を読める LLM を使うなら、数千トークンの単位を数件、という選択肢を検討してください。
- 短いチャンクを使うなら、文脈を補う チャンクの先頭に記事のタイトルや見出しを付けるだけでも、実験2のように単一ホップの検索は大きく改善します。チャンクだけを読んでも「何の話か」が分かるようにしておくことが大切です。
- 複数の文書にまたがる質問が多いなら、関連する文書をまとめる 社内 Wiki のリンク、同じ製品やプロジェクトの文書、同じフォルダの文書など、文書どうしのつながりを使って単位をまとめると、2つの文書をまたぐ質問でも上位数件で答えがそろいます。
- 長い単位の埋め込みは、チャンクに分けて最大値を取る 長い単位を丸ごと1つのベクトルにすると、多くの埋め込みモデルでは後半が切り捨てられ、精度も落ちます。単位を埋め込みモデルの上限以下のチャンクに切り、類似度の最大値を単位のスコアにします。
- 答えの再現率と最終的な正答率の両方を測る 検索単位を変えたときは、答えの再現率(Retriever の性能)と、Reader の正答率(最終的な性能)を分けて測ります。どちらがボトルネックかによって、次に手を入れる場所が変わります。
まとめ
本記事では、RAG の検索単位を長くする LongRAG を、架空の百科事典を使った実験で確かめました。
100語のパッセージに切った従来の RAG では、答えを含むパッセージをほとんど検索できませんでした。切ったことで段落の文脈が失われ、2つの記事にまたがる情報は1件のパッセージに入らないためです。記事を単位にしたりタイトルを付けたりすれば前者は補えますが、後者は、関連する記事を約3,300トークンの単位にまとめて初めて、上位1件で答えがそろいました。検索の候補は1,500件から50件に減り、Retriever の仕事は軽くなります。その代わり、Reader は長い単位を読んで答えを探す必要がありますが、今の長文脈 LLM はその仕事をこなせます。
原著論文の主張は、100語という検索単位が、Reader が弱かった時代の制約だったということです。Reader が長文を読めるなら、検索単位を伸ばして Retriever の負担を下げる方が合理的です。長文脈 LLM は RAG を不要にするのではなく、Retriever と Reader の負担の配分を変え、検索単位の長さを改めて設計し直すきっかけになっています。
発展:検索単位の長さ以外のアプローチ
本記事では、検索単位の長さという設計変数を扱いました。文書の表現の形式そのものを変え、文書からエンティティとその関係を取り出して、グラフとしてたどるアプローチもあります。全体を俯瞰する問いに答えるための方法で、検索単位を長くする LongRAG とは異なる方向の解決策です(GraphRAG の記事で扱っています)。
参考文献
- Z. Jiang, X. Ma, W. Chen (2024). LongRAG: Enhancing Retrieval-Augmented Generation with Long-context LLMs. arXiv:2406.15319.
- Z. Li, C. Li, M. Zhang, Q. Mei, M. Bendersky (2024). Retrieval Augmented Generation or Long-Context LLMs? A Comprehensive Study and Hybrid Approach. EMNLP 2024 Industry Track.
- B. Jin, J. Yoon, J. Han, S. O. Arik (2025). Long-Context LLMs Meet RAG: Overcoming Challenges for Long Inputs in RAG. ICLR 2025.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
- BAAI (2023). bge-large-en-v1.5. Hugging Face(MIT License).
本記事の文章・構成の一部に生成AIを使用しています。