Lost in the Middle とは?
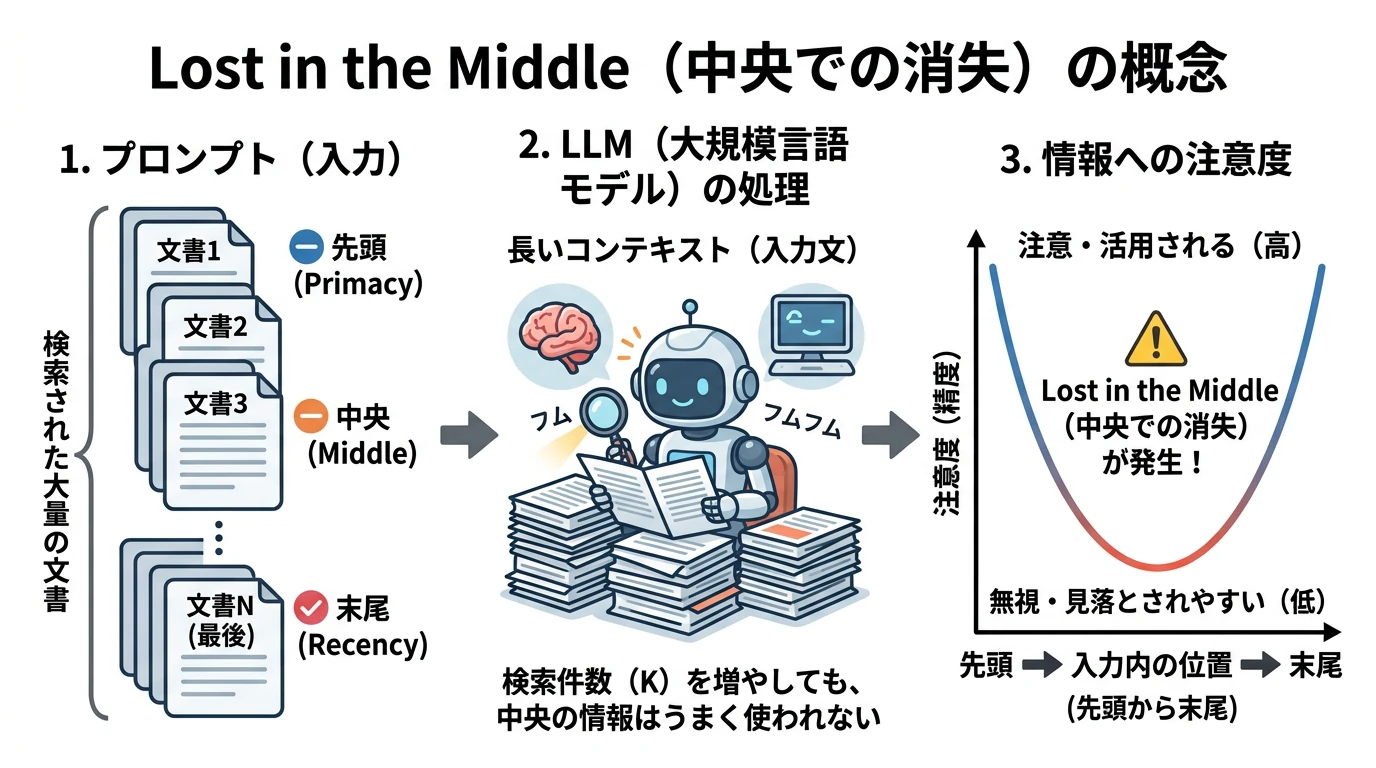 (画像は、Geminiで作成)
長いコンテキストの中央に置かれた情報を LLM が使いこなせなくなる「Lost in the Middle」現象を、まず架空のデータを使った Python のコードで手元で再現し、その上で原著論文の実験設計(Multi-document QA と Key-Value Retrieval)と結果を押さえること。最終的に、RAG で検索件数 を増やしても精度が伸びない理由を説明でき、検索結果の並べ方をどう設計すべきかの指針を持ち帰ること。
原著論文: Lost in the Middle: How Language Models Use Long Contexts (Liu et al., TACL 2024)
概要
RAG (Retrieval-Augmented Generation) とは? の記事で扱ったとおり、RAG は質問に関連する文書を検索し、上位 件をプロンプトに連結して大規模言語モデル(LLM)に回答させる仕組みです。近年の LLM は数万〜数百万トークンを入力できるので、「 を増やして情報をたくさん渡せば、正解が含まれる確率が上がり、精度も上がるはずだ」と考えたくなります。
ところが実際には、正解の文書をプロンプトに入れても、それが コンテキストの中央 にあるとモデルは答えを取りこぼします。先頭(primacy bias)と末尾(recency bias)の情報はよく使われる一方、中央の情報は使われにくい。この位置依存性が 「Lost in the Middle(中央での消失)」 です。検索が完璧に正解を拾ってきても、並べた結果その文書が中央に来れば読み落とされるので、誤答の原因が検索ではなく「並べ方」にある、という状況が生まれます。
次の節で、正解文書の位置だけを動かして、モデルの正答率がどう変わるかを実際に測ります。
正解文書を真ん中に置くと答えられなくなる
実験の構成は、次の図のとおりです。無関係な文書(ディストラクタ)の列に、答えを含む正解文書を1件だけ置き、その位置を先頭から末尾まで動かして正答率を測ります。RAG で検索結果を連結したプロンプトを、正解文書の順位だけ変えて作り直していることにあたります。
(図は、diagram-designで作成)
この実験では、3つの点に気をつけます。
- モデルが事前に知っている事実は使わない 「富士山の標高は?」のような質問だと、モデルは文書を読まなくても事前学習で得た知識(パラメトリック知識)で答えられてしまい、文書のどこを読んだかを測れません。そこで、架空の山「Karaseyama(標高2,847m)」を正解にします。
- ディストラクタも、質問に関係のある文書にする 原著論文の Multi-document QA では、ディストラクタも検索器が取ってきた「質問に関係はあるが答えを含まない」文書でした。ここでも、ディストラクタは Karaseyama に触れつつ、山小屋の標高や登山道の標高差など、山頂の標高ではない数値を含む文書にします。ディストラクタが無関係な別の山の文書だと、質問の「Karaseyama」を含むのが正解文書だけになり、モデルは名前を照合するだけで答えられてしまいます。実際、記事の作成時にそのような設定で試したところ、Gemini(gemini-3.8-flash)、Qwen2.5-1.5B-Instruct、TinyLlama-1.1B のいずれも、位置によらず正答率がほぼ100%になりました。
- 位置バイアスが見えるモデルを使う 原著論文によると、Flan-T5 などの Encoder-Decoder モデルは、学習時の系列長の範囲内なら位置の影響をほとんど受けません。また、関係のあるディストラクタにしたこの課題を、記事の作成時に Qwen2.5-1.5B-Instruct で試したところ、中央に置いても正答率は下がらず、U字は現れませんでした。最近のモデルは、長いコンテキストの扱いがかなり改善されています。そこで、原著論文でも評価された Decoder-only の長文脈モデル LongChat-7B-16k(lmsys/longchat-7b-16k、LLaMA ベース、最大16Kトークン)を使い、原著の時点のモデルで起きていた現象を手元で再現します。
準備:Google Colab の GPU で動かす
LongChat-7B-16k は Hugging Face で公開されていて、利用申請なしでダウンロードできます。7B のモデルを4bit に量子化して読み込むので、Google Colab の無料の T4 GPU(メモリ 15GB)で動きます。Colab で「ランタイム」→「ランタイムのタイプを変更」から T4 GPU を選び、必要なパッケージ transformers・accelerate・bitsandbytes を入れます(Colab のセルで !pip install -U transformers accelerate bitsandbytes)。記事の数値は、transformers 5.20.2・torch 2.11.0・bitsandbytes 0.50.2 で実行したものです。
- 実験1と実験3は、Colab の T4 GPU で、それぞれ15分ほどかかります。後半の、質問を文書群の前後に置くプロンプトの比較は45分ほどかかります。最初の実行では、モデルのダウンロード(約13.5GB)にさらに数分かかります。
- LongChat を使う実験(実験1・実験3・質問を前後に置く比較)は、生成が貪欲法(greedy)で、乱数のシードも固定しているので、同じ環境なら何度実行しても同じ数値になります。ただし、GPU の種類やライブラリのバージョンが違うと、数値が多少変わることがあります。
- 後半の、原著論文の基準線の確認(API の呼び出し2回)と実験2(300回)は Gemini API を使います。API キーの準備は、その直前で説明します。API の応答や実験2の UUID は毎回変わるので、こちらは実行するたびに結果が多少変わることがあります。
実験1:正解文書の位置を動かす(Multi-Document QA)
架空の正解文書1件と、19件のディストラクタを連結したプロンプトを作り、正解文書の位置を動かして正答率を測ります。原著論文で位置バイアスを示すのに使われた中心的なタスク(Multi-Document QA)を、手元で小さく再現したものです。
import random
import string
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig

# 原著論文でも評価された長文脈モデル(LLaMA ベース、最大16Kトークン)を4bitで読み込む
MODEL_ID = "lmsys/longchat-7b-16k"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, use_fast=False)
model = AutoModelForCausalLM.from_pretrained(
    MODEL_ID,
    device_map="auto",
    quantization_config=BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_compute_dtype=torch.float16),
)
model.eval()

# LongChat が学習時に使った会話形式(Vicuna 形式)
SYSTEM = (
    "A chat between a curious user and an artificial intelligence assistant. "
    "The assistant gives helpful, detailed, and polite answers to the user's questions."
)
# 「好奇心旺盛なユーザーと人工知能アシスタントの会話です。アシスタントは、ユーザーの質問に対して、役に立つ、詳しく丁寧な回答をします。」

@torch.no_grad()
def generate(prompt, max_new_tokens=64):
    """プロンプトを会話形式に包み、貪欲法(greedy)で回答を生成する"""
    text = f"{SYSTEM} USER: {prompt} ASSISTANT:"
    inputs = tokenizer(text, return_tensors="pt").to(model.device)
    output = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return tokenizer.decode(output[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True)

# 架空の正解データ(パラメトリック知識を排除)
GOLD_NAME = "Karaseyama"
GOLD_HEIGHT = "2,847"
GOLD_DOC = f"Mount {GOLD_NAME} is the highest peak in the Hoshimi Range, rising {GOLD_HEIGHT} meters above sea level."
QUESTION = f"How many meters tall is Mount {GOLD_NAME}?"
# 「唐瀬山(からせやま)は星見(ほしみ)山脈の最高峰で、標高は2,847メートルです。」
# 「唐瀬山の標高は何メートルですか?」

# ディストラクタ:同じ山に触れるが、山頂の標高ではない数値を含む文書
DISTRACTOR_TEMPLATES = [
    "The mountain hut on Mount Karaseyama stands at {height} meters, about two hours below the summit.",
    "From the trailhead, the main route up Mount Karaseyama gains {height} meters of elevation.",
    "Mount {name}, a neighbor of Mount Karaseyama in the Hoshimi Range, rises {height} meters above sea level.",
    "The tree line on Mount Karaseyama lies at about {height} meters.",
    "A weather station was built on the eastern ridge of Mount Karaseyama at {height} meters.",
    "The lake at the foot of Mount Karaseyama sits {height} meters above sea level.",
]
# 「唐瀬山(からせやま)の山小屋は標高{height}メートル地点にあり、山頂から2時間ほど下ったところに位置しています。」
# 「登山口から唐瀬山山頂へ至る主要ルートの標高差は{height}メートルです。」
# 「星見(ほしみ)山脈に属し、唐瀬山の隣に位置する{name}山は、標高{height}メートルです。」
# 「唐瀬山の森林限界は、標高およそ{height}メートル付近にあります。」
# 「唐瀬山の東稜、標高{height}メートルの地点には、気象観測所が設置されています。」
# 「唐瀬山の麓にある湖は、標高{height}メートルに位置しています。」

def random_name(length=8):
    return "".join(random.choices(string.ascii_lowercase, k=length)).capitalize()

def random_height():
    """正解(2,847)以外の、それらしい標高を作る"""
    while True:
        height = f"{random.randint(1, 3)},{random.randint(100, 999)}"
        if height != GOLD_HEIGHT:
            return height

def generate_distractors(num):
    return [
        random.choice(DISTRACTOR_TEMPLATES).format(name=random_name(), height=random_height())
        for _ in range(num)
    ]

def build_prompt(docs):
    """原著の Multi-Document QA に準拠したプロンプト"""
    context = "\n".join(f"Document [{i+1}] {doc}" for i, doc in enumerate(docs))
    return (
        "Write a high-quality answer for the given question using only the provided search results "
        "(some of which might be irrelevant).\n\n"
        f"{context}\n\n"
        f"Question: {QUESTION}\nAnswer:"
    )
    # 「与えられた検索結果(無関係なものも含まれている可能性があります)だけを使って、質問に対する質の高い回答を書いてください。」
    # 「文書 [1] …(文書を番号付きで並べる)」
    # 「質問:唐瀬山の標高は何メートルですか? 回答:」

def run_qa_trial(total_docs, target_idx, num_trials=30):
    """正解文書を指定した位置(target_idx)に挿入し、正答率を測る"""
    correct = 0
    for _ in range(num_trials):
        docs = generate_distractors(total_docs - 1)
        docs.insert(target_idx, GOLD_DOC)
        if GOLD_HEIGHT in generate(build_prompt(docs)):
            correct += 1
    return correct / num_trials

random.seed(0)  # ディストラクタの並びを毎回同じにして、結果を再現できるようにする

# 1. closed-book と oracle の基準線
closed_book = generate(f"Answer the question.\n\nQuestion: {QUESTION}\nAnswer:")
# 「質問に答えてください。質問:唐瀬山の標高は何メートルですか? 回答:」
print(f"Closed-book accuracy: {100 if GOLD_HEIGHT in closed_book else 0}%")
print(f"Oracle accuracy: {run_qa_trial(1, 0) * 100:.1f}%")
print("-" * 40)

# 2. 20件の文書の中で、正解文書の位置を動かして測定
N_DOCS = 20
for pos in [0, 5, 10, 15, 19]:
    acc = run_qa_trial(total_docs=N_DOCS, target_idx=pos)
    print(f"Position {pos:2d}: {acc * 100:>5.1f}%")
架空の山の標高を問う質問で、20件の文書の中の正解文書の位置を変えながら、正答率を測るコードです。
- モデルの読み込み: 7B のモデルを Colab の無料の T4 GPU(メモリ15GB)に載せるため、BitsAndBytesConfig で load_in_4bit=True を指定し、4bit に量子化して読み込みます。計算は float16 で行います。LongChat の設定ファイルには、位置埋め込み(RoPE)を8倍に引き伸ばして16Kトークンまで扱う設定が入っているので、こちらで指定する必要はありません。
- 会話形式: generate は、プロンプトを LongChat が学習時に使った形式(SYSTEM、USER:、ASSISTANT:)に包んでから生成します。形式が違うと指示に従いにくくなり、位置とは関係のない理由で正答率が下がるので、それを避けるためです。do_sample=False で、毎回いちばん確率の高いトークンを選ぶ貪欲法にしているので、同じ入力なら同じ出力になります。max_new_tokens は64で、このプロンプトの答えを書き切るのに十分な長さにしています(プロンプトの形によっては足りなくなることを、後の「クエリをもう一度置くと改善するか」で扱います)。
- 架空の正解: モデルが事前学習の知識(パラメトリック知識)では答えられず、文書を読んだときだけ正解できるようにするため、実在しない山 Karaseyama の標高を述べる文書 GOLD_DOC を正解にします。GOLD_HEIGHT が正解の文字列です。
- ディストラクタ: DISTRACTOR_TEMPLATES の6つの文型から1つを選び、random_height で作った標高を入れます。どれも Karaseyama に触れ、「〜メートル」という数値を含むので、名前や数値の有無では正解文書を見分けられません。「山頂の標高」を述べた文書を、意味で選ぶ必要があります。random_height は、たまたま正解と同じ 2,847 になった値を作り直しています。
- プロンプト: build_prompt は、原著論文の Multi-Document QA と同じ指示文(「検索結果の一部は無関係かもしれない」)で、文書に Document [1]、[2]… の番号を付けて並べ、最後に質問を置きます。原著論文と同じ指示文にするのは、原著の結果と比べられるようにするためです。
- 位置の操作: run_qa_trial は、docs.insert で正解文書を target_idx の位置に入れ、30回の正答率を返します。毎回ディストラクタを作り直すのは、特定の文書の並びに結果が左右されないようにするためです。応答に正解の標高が「含まれていれば」正解とするのは、モデルが前後に言葉を添えても正解と数えるためです。
- 基準線: 位置による差が「正解文書を読み落としたかどうか」だけで決まっていることを確かめるため、2つの基準線を測ります。closed-book は文書を与えずに質問だけを投げ、0%なら文書を読まずには答えられないことが分かります。oracle は run_qa_trial(1, 0) で正解文書だけを与え、100%なら正解文書1件なら確実に読めることが分かります。
- スイープ: 20件の文書の中で、正解文書を 0・5・10・15・19 番目(先頭・25%・中央・75%・末尾)に置きます。先頭から末尾まで5点を選ぶのは、両端と中央を比べて、U字の形かどうかを見るためです。生成の回数は、closed-book の1回、oracle の30回、位置ごとの 5 × 30 = 150 回で、全部で181回です。
- 乱数: random.seed(0) でシードを固定しているので、ディストラクタの並びも、実行するたびに同じになります。
実行結果
Closed-book accuracy: 0%
Oracle accuracy: 100.0%
----------------------------------------
Position  0: 100.0%
Position  5:  93.3%
Position 10:  56.7%
Position 15:  96.7%
Position 19:  80.0%
位置ごとの正答率を描くと、次のようになります。
(図は、diagram-designで作成)
正解の文書は、どの条件でも必ずプロンプトの中に入っています。変えたのは置き場所だけです。それでも、結果ははっきり分かれました。
- 先頭は読める: 正解文書が先頭(Position 0)にあると、30回すべて正解しています。末尾(Position 19)も80%と、比較的よく読めています。
- 中央で落ちる: 中央(Position 10)に置くと、正答率は56.7%まで下がります。先頭との差は40ポイント以上あり、両端が高く中央が窪む U字カーブ になっています。
- 少しずれれば戻る: 25%(Position 5)や75%(Position 15)の位置では90%以上を保っています。今回の LongChat では、ちょうど真ん中のあたりだけが特に読み落とされやすい、という形でした。
また、closed-book(文書を与えない設定)の正答率は0%、oracle(正解文書だけを与える設定)は100%でした。架空の山なので、モデルは文書を読まない限り答えられず、正解文書だけなら確実に読み取れます。つまり、上の正答率の違いは、20件の中で正解文書を読めたかどうかの違いだけを表しています。
Naive RAG のパイプラインでは、検索スコアの高い順に文書を先頭から並べるのが一般的です。しかし、本当に必要な情報が中間の順位(例えば20件中の10番目)に来てしまうと、モデルはそれをうまく拾えません。「プロンプトに正解が入っていること」と「モデルがそれを使えること」は別の問題なのです。
なお、谷の深さや位置は、モデルや文書の数・長さで変わります。今回の LongChat では、文書を40件に増やしても中央の正答率は下がらず、原著論文の図ほどきれいな U字にはなりませんでした(記事のコードで N_DOCS と、位置のリスト [0, 5, 10, 15, 19] を変えると確かめられます)。前述のとおり、最近のモデルではこの規模の課題で位置の影響がほとんど見えないこともあります。だからこそ、自分が使うモデルとプロンプトで、位置の影響を一度測っておくことが大切です。
ここからは、この現象を最初に体系的に示した原著論文が、どんな基準で、どんな実験をして、何を明らかにしたのかを見ていきます。
原著論文は何を示したか
比較の基準:closed-book と oracle
言語モデルがコンテキスト内の情報をどれだけうまく読み取れているかを評価するためには、絶対的な比較の基準が必要です。検索件数 を増やした結果の精度が「80%だった」と言われても、それが優れているのか劣っているのかは単独では判断できません。
そこで原著論文では、評価の枠組みを明確にするために closed-book(クローズドブック) と oracle(オラクル) という2つの極端な設定を基準線(ベースライン)として導入しています。
- closed-book(下限) 外部の文書を一切与えず、質問だけを投げる設定です。モデルは事前学習で獲得したパラメトリック知識(parametric knowledge)のみに頼って回答を生成します。RAGを用いない純粋な言語モデル単体の性能であり、これが評価の「下限」として機能します。
- oracle(上限) 正解を含む文書をただ1件だけ与える設定です。検索のノイズとなる無関係な文書(ディストラクタ)が一切存在しない理想的な状態であり、モデルがその文書の情報を正しく読み取れるかどうかの純粋なテストになります。これが評価の「上限」として機能します。
原著論文において、GPT-3.5-Turboを用いたMulti-document QAタスクでの基準線のスコアは以下の通りでした。
- closed-book: 56.1%
- oracle: 88.3%
この数値は、モデルが元々の知識だけで半分以上の質問に答えられる(56.1%)一方で、完璧な情報を1件だけ与えれば正答率が劇的に向上する(88.3%)ことを示しています。実際のRAGシステムに複数の検索結果を与えた場合の精度は、当然この上限と下限の間に収まることが期待されます。
2つの基準線がプロンプト上でどう違うのかを、コードで確認してみましょう。ここでは現実の知識を問うので、最新のモデルとして Gemini を API で呼びます(後の実験2も Gemini を使います)。プロジェクトのルートに .env ファイルを作成し、API キーを書きます。
GEMINI_API_KEY=your_api_key_here
Gemini APIキーは、Google AI Studioから無料で取得することができます。APIキーの取得・管理方法の詳細については、Googleの公式ドキュメントをご参照ください。 なお、無料枠(Free tier)を利用する場合、入力したデータはGoogleの製品改善やモデル学習のために利用される可能性がある点にご留意ください(機密情報の入力は避け、詳細は公式の利用規約をご確認ください)。
必要なパッケージは google-genai と python-dotenv です(pip install google-genai python-dotenv)。
from dotenv import load_dotenv
from google import genai

# .envファイルから環境変数を読み込む
load_dotenv()

# クライアントの初期化(環境変数 GEMINI_API_KEY が自動で読み込まれます)
client = genai.Client()

QUESTION = "Who got the first Nobel Prize in Physics?"
ORACLE_DOC = "The first Nobel Prize in Physics was awarded in 1901 to Wilhelm Conrad Röntgen, of Germany."
# 「最初のノーベル物理学賞を受賞したのは誰ですか?」
# 「最初のノーベル物理学賞は、1901年にドイツのヴィルヘルム・コンラート・レントゲンに授与されました。」

def ask_model(question: str, context: str = "") -> str:
    """コンテキストの有無に応じてプロンプトを切り替え、回答を生成する"""
    if context:
        # Oracle設定:与えられた文書のみに基づいて回答させる
        prompt = (
            "Write a high-quality answer for the given question using only "
            "the provided search results.\n\n"
            f"Document: {context}\n\n"
            f"Question: {question}\nAnswer:"
        )
        # 「与えられた検索結果だけを使って、質問に対する質の高い回答を書いてください。文書:… 質問:… 回答:」
    else:
        # Closed-book設定:質問のみを与え、モデル自身の知識で回答させる
        prompt = (
            "Write a high-quality answer for the given question.\n\n"
            f"Question: {question}\nAnswer:"
        )
        # 「質問に対する質の高い回答を書いてください。質問:… 回答:」

    response = client.models.generate_content(
        model="gemini-3.8-flash",
        contents=prompt,
        config={"temperature": 0.0}
    )
    return response.text.strip()

print("=== 基準線の測定 ===")
print("Closed-book :", ask_model(QUESTION))
print("Oracle      :", ask_model(QUESTION, ORACLE_DOC))
同じ質問を、文書なしの closed-book 設定と、正解文書を1件だけ与える oracle 設定で投げ分けるコードです。
- API キーの読み込み: load_dotenv が .env の内容を環境変数に読み込みます。genai.Client() は、環境変数 GEMINI_API_KEY を自動で読み取るので、キーをコードに直接書かずに済みます。
- 設定の切り替え: 2つの設定の違いを「文書を与えるかどうか」と指示文だけに絞るため、同じ関数 ask_model で、引数 context が空でなければ oracle 設定、空であれば closed-book 設定のプロンプトを作ります。
- 指示文の違い: oracle 設定では「与えた検索結果だけを使って答える」ように指示し、closed-book 設定では質問だけを与えます。oracle 設定で「与えた検索結果だけを使って」と指示するのは、モデル自身の知識ではなく、文書から答えたかを見るためです。
- 出力の安定化: temperature を 0.0 にして、同じ入力なら同じ出力になりやすくしています。
- 後処理: 2つの応答の表示をそろえるため、strip で前後の空白を取り除きます。
実行結果
=== 基準線の測定 ===
Closed-book : The first Nobel Prize in Physics was awarded to the German physicist **Wilhelm Conrad Röntgen** in **1901**.

He received the prize *"in recognition of the extraordinary services he has rendered by the discovery of the remarkable rays subsequently named after him"*—known today as **X-rays** (or Röntgen rays).

Röntgen made the groundbreaking discovery in November 1895, which revolutionized the fields of physics and medicine by making it possible to view the internal structures of the human body without surgery. Notably, Röntgen chose not to patent his discovery, believing that scientific advances should belong to the world and be used for the benefit of humanity.
Oracle      : The first Nobel Prize in Physics was awarded to Wilhelm Conrad Röntgen in 1901.
              (和訳:最初のノーベル物理学賞は、1901年にヴィルヘルム・コンラート・レントゲンに授与されました。)
この例のように、世界的に有名な事実であれば、モデルは closed-book 設定でも正解(Wilhelm Conrad Röntgen、1901年)を引き出すことができます。2つの設定の違いは、正誤よりも答え方に現れています。closed-book 設定では、モデルが自身の知識から受賞理由や発見の経緯まで補足して長く答えています。一方 oracle 設定では、「与えられた検索結果だけを使って答える」という指示と文書1件に従い、文書に書かれた内容だけを簡潔に答えています。
なお、この例の closed-book の正誤は、先頭の1文だけで判断できます。答えの正誤を機械的に判定するときは、後の実験のように、応答に正解の文字列が含まれるかどうかで見ます。
では、正解文書を含む複数の検索結果を与えたのに、精度が oracle を下回るだけでなく、何も情報を与えない closed-book のスコア(56.1%)すら下回ったら、それは何を意味するのでしょうか。
原著論文の GPT-3.5-Turbo を用いた Multi-document QA では、正解文書の位置を動かすだけで 20%以上 の性能差が生じ、20文書や30文書の設定で正解文書を中央付近に置くと、正答率が closed-book の 56.1% を下回るケースが報告されています。
正解を含む文書をわざわざ検索して渡したにもかかわらず、何も渡さないより結果が悪くなる。 これは「検索が足りない」問題ではなく、「渡し方」の問題である。
情報をたくさん与えたせいで、モデルが元々持っていた知識すら引き出せなくなった、ということです。この「下限割れ」を浮き彫りにするために、closed-book という基準線が欠かせません。実験1では架空の知識を使ったので closed-book は0%でしたが、現実の知識で同じことをすると、中央に置いた正解文書は「渡さない方がまし」になりうるのです。
U字は頑健である
ここでひとつの疑問が浮かびます。「RAGの検索結果は通常、関連度順(スコア順)に並んでいる。LLMは学習データを通じて『検索結果の後ろの方や真ん中あたりは重要ではない』というメタ的な意味を読み取っているだけではないか?」という反証です。
原著論文では、この仮説を棄却するための実験が行われています。
- ディストラクタ(無関係な文書)の順序を完全にランダム化する
- プロンプトの指示文に「提供された検索結果の順序はランダムです(The search results are ordered randomly.)」と明示する
これらの対策を施しても、U字カーブの窪みは消えませんでした。つまり、LLM が「順位の低い文書は重要ではない」という文脈上の意味を読み取って中央を無視しているわけではなく、並べ方や指示文の工夫では消えない、頑健な位置バイアスであることが分かります。原因の特定は論文でも仮説の段階にとどまっています。
コンテキストウィンドウを伸ばしても解決しない
近年、16Kや100K、さらには100万トークンといった巨大なコンテキストウィンドウを持つ大規模言語モデル(LLM)が次々と登場しています。これだけ長い文章を「入力できる」のであれば、真ん中に置かれた情報も問題なく読み取れるのではないか、と期待するのは自然なことです。
しかし結論から言えば、モデルのコンテキストウィンドウを拡張することは、位置バイアスの根本的な解決策にはなりません。「入力できる長さ(使える長さ)」と「情報を適切に処理できる長さ(使いこなせる長さ)」は全くの別物だからです。
原著論文では、GPT-3.5-Turbo の通常版(4K)と拡張コンテキスト版(16K)、および Claude-1.3 の通常版(8K)と拡張コンテキスト版(100K)を用いて、同じ文書数を与えた際の正答率の変化を比較しています。その結果、入力長が両方のモデルの制限内に収まる場合(例えば10文書や20文書の設定)、通常版と拡張版の性能カーブはほぼ完全に重なりました。
つまり、16Kの容量を持つモデルであっても、入力された情報が中央に配置された途端に読み落としてしまう性質は、4Kモデルと何ら変わらなかったのです。
重要なのは、この比較が「同じ入力を、容量だけが異なる2つのモデルに与えた」という統制された条件で行われている点です。入力内容もプロンプトも同一で、違うのはモデルが受け付けられる最大長だけ。それでも性能カーブが一致したということは、器の大きさを広げただけでは、モデルがコンテキストの中央に注意を向けるようにはならないことを意味します。
ただし、すべてのアーキテクチャが同じように位置バイアスに弱いわけではありません。Flan-T5 や Flan-UL2 といった Encoder-Decoder 型のモデルは、特定の条件下でこの問題に対して強い頑健性を示します。
具体的には、これらのモデルは「学習時に見た系列長の範囲内」であれば、正解文書がどこに置かれていても性能がほとんど低下しません。例えば、Flan-UL2 を学習時の最大系列長である2048トークン以内で評価した場合、正解が先頭にある場合と中央にある場合の正答率の差(最高精度と最低精度の差)はわずか1.9%に留まりました。
この違いは、アーキテクチャの構造に由来すると考えられています。現在主流の Decoder-only モデルは、各トークンが「過去のトークン」しか参照できない単方向の自己注意機構(Self-Attention)を持っています。一方、Encoder-Decoder モデルのエンコーダは、入力全体を双方向(bidirectional)に見渡すことができます。これにより、ある文書を読み込む際に「未来に出現する他の文書」との相対的な重要度を比較・評価しやすくなり、結果として中央の情報も適切に拾い上げることができるという仮説です。
しかし、この Encoder-Decoder モデルであっても万能ではありません。評価時の入力長が学習時の系列長(Flan-T5-XXL では512トークン、Flan-UL2 では2048トークン)を超えると、途端に中央の情報を読み落とすようになり、Decoder-only モデルと同様のU字カーブを描き始めます。
結局のところ、アーキテクチャやコンテキストウィンドウの拡張に頼るだけでは、長い入力の中から特定の情報を探し出す際の位置バイアスを完全に払拭することはできません。だからこそ、RAGのパイプラインを設計する側が「文書をどのような順序でモデルに渡すか」を意識的に制御する必要があるのです。
実験2:Key-Value Retrieval(知識を完全に排除した合成タスク)
原著論文では、Multi-document QA に加えて、もう1つのタスクを用意しています。ランダムに生成した UUID のペアを JSON 形式の辞書として与え、指定したキーに対応する値を抜き出させる Key-Value Retrieval です。
QA タスクだけでは、モデルが「コンテキストを読んで答えた」のか「事前学習で得た知識で答えた」のかを完全には区別できません。ランダムな UUID であれば、モデルが事前に知っている可能性はゼロです。知識を完全に排除し、純粋な「入力からの読み取り能力」だけを測るために、このタスクが設計されました。
以下のコードは、このタスクを手元で再現するための実装です。辞書の要素数 を増やしながら、ターゲットとなるキーの位置を「先頭(0%)」「25%」「中央(50%)」「75%」「末尾(100%)」へと動かし、それぞれ20回の試行で正答率を測定します。
import uuid
import json
from dotenv import load_dotenv
from google import genai

load_dotenv()
client = genai.Client()

def build_kv_prompt(n_pairs: int, target_index: int):
    """n_pairs 個のKVペアを作り、target_index 番目のキーを問うプロンプトを生成する"""
    # 完全にランダムなUUIDのペアを生成し、パラメトリック知識の関与を排除する
    pairs = [(str(uuid.uuid4()), str(uuid.uuid4())) for _ in range(n_pairs)]
    target_key, target_value = pairs[target_index]

    # JSON形式の文字列に変換
    kv_json = json.dumps(dict(pairs), indent=2)

    # 原著の実験設定に準拠したプロンプト構成
    prompt = (
        "Extract the value corresponding to the specified key "
        "in the JSON object below.\n\n"
        f"JSON data:\n{kv_json}\n\n"
        f"Key: \"{target_key}\"\n"
        "Corresponding value:"
    )
    # 「以下の JSON オブジェクトから、指定したキーに対応する値を取り出してください。JSON データ:… キー:「…」 対応する値:」
    return prompt, target_value

def run_trial(n_pairs: int, position_ratio: float, n_trials: int = 20):
    """指定した位置(割合)にターゲットを置き、正答率を測る"""
    target_index = int((n_pairs - 1) * position_ratio)
    correct = 0

    for _ in range(n_trials):
        prompt, expected = build_kv_prompt(n_pairs, target_index)

        # Gemini APIを呼び出して回答を生成
        response = client.models.generate_content(
            model="gemini-3.8-flash",
            contents=prompt,
        )

        # 出力に期待されるUUID(値)が含まれているかで正誤判定
        if response.text and expected in response.text:
            correct += 1

    return correct / n_trials

# N=50, 100, 150 のペア数で、5つの位置をスイープして正答率を測定
for n in [50, 100, 150]:
    scores = [run_trial(n, r) for r in [0.0, 0.25, 0.5, 0.75, 1.0]]
    print(f"N={n}: {scores}")
キーの位置と辞書の大きさを変えながら、Key-Value Retrieval の正答率を測るコードです。
- 位置の指定: position_ratio は 0.0 が先頭、1.0 が末尾を表します。target_index は、(n_pairs - 1) に position_ratio を掛けて整数にして求めています。(n_pairs - 1) に掛けるのは、position_ratio が 1.0 のときに、最後のペア(0から数えて n_pairs - 1 番目)を指すようにするためです。n_pairs に掛けると、範囲の外を指してしまいます。
- 試行ごとの再生成: ループのたびに build_kv_prompt を呼び、UUID を作り直しています。特定の UUID の並びに結果が左右されないようにするためです。
- 正誤の判定: 応答のテキストに、期待される値 expected が含まれていれば正解とします。完全一致ではなく「含まれるか」で見ているので、モデルが前後に言葉を添えても正解になります。
- スイープ: n を 50・100・150 と変え、それぞれ5つの位置を測ります。1条件につき20回試行するので、API の呼び出しは全部で 3 × 5 × 20 = 300 回です。
- 乱数: UUID は uuid.uuid4 で毎回ランダムに作り、シードは固定していません。Gemini の応答も毎回同じとは限らないので、実行するたびに数値は多少変わることがあります。
実行結果
N=50: [1.0, 1.0, 1.0, 1.0, 1.0]
N=100: [1.0, 1.0, 1.0, 1.0, 1.0]
N=150: [1.0, 1.0, 1.0, 1.0, 1.0]
最新のモデルである gemini-3.8-flash を用いて実験を行った結果、すべての位置・すべての条件で正答率 100%(1.0)に張り付くという結果が得られました。
実は、この「満点に張り付いた」という結果自体が、LLM の進化を示す非常に価値のある発見です。原著論文が発表された当時、GPT-3.5-Turbo などのモデルでは、(約 8K トークン)や (約 16K トークン)の設定において、先頭と末尾は高い精度を保つものの、中央にターゲットを配置すると正答率が 40% 台まで急落する明確な U字カーブが観察されていました。
つまり、JSON から特定のキーを完全一致で探し出すような「純粋な情報抽出(合成タスク)」においては、最新の長文脈モデルは位置バイアスをほぼ克服しつつあると言えます。現在のモデルで U字カーブを観察したい場合は、 や といったさらに長いコンテキストに広げて、限界点を探る必要があるかもしれません。
しかし、RAG の実運用で私たちが直面するのは、UUID のような無機質な文字列の完全一致検索ではありません。自然言語で書かれた複数の文書を読み、文脈を理解して答える、より複雑なタスクです。実験1の冒頭で触れたとおり、記事の作成時に試した最近のモデル(Gemini や Qwen2.5)では、架空の山の QA 形式でも U字は現れませんでした。一方、原著論文の時点の長文脈モデル(LongChat)では、関係のあるディストラクタを並べた QA 形式で、はっきりした U字が現れました。モデルの世代が進むにつれて位置バイアスは緩和されてきていますが、使うモデルや入力の長さ・内容によっては、今でも同じ問題が起こりえます。
クエリをもう一度置くと改善するか
コンテキストの中央に置かれた情報が使われにくいという位置バイアスの問題に対して、直感的に思いつく解決策があります。それは「プロンプトの工夫」です。具体的には、クエリ(質問)を文書群の前と後ろの両方に置くというシンプルなアプローチです。原著論文ではこれを Query-Aware Contextualization(クエリを意識したコンテキスト化)と呼んでいます。
なぜこのような工夫が考えられるのでしょうか。現在主流となっているGPTやLLaMAなどのデコーダオンリーモデルは、文章を左から右へ順番に処理する自己回帰(Autoregressive)の性質を持っています。つまり、各タイムステップにおいて「過去のトークン」にしかアテンション(注意)を向けることができません。
通常のRAGのプロンプトでは、大量の検索文書を並べた一番最後に「質問」を配置します。すると、モデルが文書群を読み込んでいる最中には、まだ質問のトークンが出現していないため、「何を探しながら読めばいいのか」を知らないまま文書を処理することになります。これが位置バイアスの一因になっているのではないか、という仮説です。
これを、実験1と同じ設定で確かめてみましょう。質問を文書群の前と後ろの両方に置くプロンプトと、実験1の通常のプロンプト(質問は後ろだけ)を、同じ文書の並びで比べます。実験1のコードを実行した後に、続けて実行してください。
# 1. 質問を文書群の前と後ろの両方に置くプロンプト(Query-Aware Contextualization)
def build_query_aware_prompt(docs):
    context = "\n".join(f"Document [{i+1}] {doc}" for i, doc in enumerate(docs))
    return (
        f"Question: {QUESTION}\n\n"
        "Write a high-quality answer for the given question using only the provided search results "
        "(some of which might be irrelevant).\n\n"
        f"{context}\n\n"
        f"Question: {QUESTION}\nAnswer:"
    )
    # 「質問:唐瀬山の標高は何メートルですか?」(冒頭にも質問を置く)
    # 「与えられた検索結果(無関係なものも含まれている可能性があります)だけを使って、質問に対する質の高い回答を書いてください。」
    # 「文書 [1] …(文書を番号付きで並べる)」
    # 「質問:唐瀬山の標高は何メートルですか? 回答:」


# 2. プロンプトの組み立て方を引数で受け取り、正答率を測る(答えが途中で切れないよう長めに生成する)
def run_qa_trial_with(build, total_docs, target_idx, num_trials=30, max_new_tokens=256):
    correct = 0
    for _ in range(num_trials):
        docs = generate_distractors(total_docs - 1)
        docs.insert(target_idx, GOLD_DOC)
        if GOLD_HEIGHT in generate(build(docs), max_new_tokens=max_new_tokens):
            correct += 1
    return correct / num_trials


# 3. 実験1と同じシードにして、2つのプロンプトを同じ文書の並びで比べる
positions = [0, 5, 10, 15, 19]
print("Position      " + "".join(f"{p:>8d}" for p in positions))
for name, build in [("standard", build_prompt), ("query-aware", build_query_aware_prompt)]:
    random.seed(0)
    accs = [run_qa_trial_with(build, 20, pos) for pos in positions]
    print(f"{name:12s}  " + "".join(f"{a * 100:>7.1f}%" for a in accs))

# 4. 例:正解文書を中央(10番目)に置いたときの、質問を前後に置いたプロンプトへの応答
random.seed(0)
docs = generate_distractors(19)
docs.insert(10, GOLD_DOC)
print("\n" + generate(build_query_aware_prompt(docs), max_new_tokens=256).strip())
実験1の通常のプロンプトと、質問を前後に置いたプロンプトで、正解文書の位置ごとの正答率を比べるコードです。
- 質問を前後に置くプロンプト: build_query_aware_prompt は、実験1の build_prompt の先頭に「Question: 質問」を1行足しただけのものです。指示文、文書の番号の付け方、最後の質問は同じなので、違いは質問を前にも置くかどうかだけです。
- プロンプトを引数で切り替える: run_qa_trial_with は、実験1の run_qa_trial と同じ処理で、プロンプトを組み立てる関数 build を引数で受け取ります。
- 生成の長さ: 実験1では max_new_tokens を64にしていましたが、ここでは256に広げています。質問を前に置くと、モデルが前置きの長い答え方をするようになり、64トークンでは標高を書く前に打ち切られることがあったためです。両方のプロンプトを同じ256トークンで比べています。
- 同じ文書の並びで比べる: どちらのプロンプトの前にも random.seed(0) を呼ぶので、実験1と同じ順番でディストラクタが作られます。2つのプロンプトは、まったく同じ文書の並びに対する応答を比べていることになります。
- 応答の例: 正答率の数だけでは、なぜ下がったのかが分からないので、正解文書を中央に置いたときの応答を1つ表示し、答え方がどう変わったかを見ます。
- 生成の回数: 2つのプロンプト × 5つの位置 × 30回 = 300回、それに例の1回です。質問を前後に置くと答えが長くなるので、T4 で45分ほどかかります。
実行結果
Position             0       5      10      15      19
standard        100.0%   93.3%   56.7%   96.7%   80.0%
query-aware      83.3%   80.0%   36.7%   70.0%   43.3%

The height of Mount Karaseyama is not a fixed number, as it varies depending on the source. However, we can gather information from various sources to estimate its height.

According to Document [1], the tree line on Mount Karaseyama lies at about 3,323 meters. This suggests that the mountain's base is around 3,323 meters tall.

Additionally, Document [15] states that the mountain hut on Mount Karaseyama stands at 1,162 meters, about two hours below the summit. This suggests that the summit of Mount Karaseyama is around 1,162 meters tall.

However, it's important to note that the height of a mountain can vary depending on the source. Therefore, we cannot provide an exact number for the height of Mount Karaseyama.
(応答の和訳:Karaseyama 山の高さは決まった数値ではなく、資料によって異なります。ただし、さまざまな資料から推測することはできます。文書 [1] によると、Karaseyama 山の森林限界は約3,323メートルにあります。このことから、山の基部は約3,323メートルだと考えられます。また、文書 [15] によると、山小屋は標高1,162メートルにあり、山頂から2時間ほど下った場所です。このことから、山頂は約1,162メートルだと考えられます。ただし、山の高さは資料によって異なることがあるので、正確な数値は示せません。)
2つのプロンプトの正答率を重ねて描くと、次のようになります。
(図は、diagram-designで作成)
質問を前にも置くと、正答率は改善するどころか、すべての位置で下がりました。
- 中央の谷はなくならない: 中央(Position 10)の正答率は 56.7% から 36.7% に下がり、U字の谷はむしろ深くなりました。
- 両端も下がる: 先頭は 100% から 83.3% に、末尾は 80.0% から 43.3% に下がっています。特に末尾の落ち込みが大きく、正解文書が後ろの質問の近くにあるという有利さも薄れています。
- 答え方そのものが変わる: 応答の例では、正解文書(11番目に置いた「標高2,847メートル」の文書)にはまったく触れず、森林限界や山小屋の標高から山の高さを「推測」し、「正確な数値は示せない」と結論づけています。質問を最初に見せたことで、モデルが「資料を集めて推測する」という答え方に切り替わり、山頂ではない数値を含むディストラクタに引きずられたと考えられます。
通常のプロンプトの行は、実験1とまったく同じ数値になりました。生成を256トークンに広げても、通常のプロンプトでは答えが切れていなかったことになります。一方、質問を前後に置いたプロンプトを64トークンで生成すると、前置きの長い答えが途中で切れて、正答率は 10〜30% まで下がりました(記事のコードでは確かめていない、作成時の追加の確認です)。プロンプトの形を変えると、答えの長さや書き方まで変わることがあるので、比べるときは生成の長さもそろえる必要があります。
つまり、少なくとも今回の LongChat-7B-16k では、「質問を先に見せれば、何を探しながら読むべきか分かるので、中央の情報も拾えるようになる」という期待どおりにはなりませんでした。
原著論文でも、この工夫の効果はタスクによって全く異なり、劇的な非対称性を示しました。
まず、純粋な位置効果を測る合成タスクである「Key-Value Retrieval(辞書からの値の抽出)」においては、この工夫は劇的な改善をもたらしました。GPT-3.5-Turbo (16K) を用いて300件のキーと値のペアを与えた場合、通常のプロンプトではターゲットが中央付近にあると正答率が 45.6% まで落ち込んでいました。しかし、クエリを前後両方に置いたプロンプトを使用すると、どの位置にターゲットがあっても 100%(完璧な精度) を達成したのです。
ところが、実際のRAGのユースケースに近い「Multi-document QA(複数文書からの質問応答)」においては、ほとんど効果がないという驚くべき結果が出ました。正解文書が先頭に置かれた場合の性能がわずかに向上するにとどまり、中央に置かれた際の性能低下(U字カーブ)はほとんど変わりませんでした。
なぜこのような違いが生まれるのでしょうか。Key-Value Retrieval は、指定されたUUID(キー)と完全に一致する文字列をコンテキスト内から探し出すだけの、純粋なパターンマッチングタスクです。この場合、冒頭でキーを提示しておけば、モデルはその文字列に対する強力なアテンションを維持したままスキャンを実行できます。
一方で Multi-document QA では、単なる文字列の完全一致ではなく、質問の意図を理解し、表現の揺れを吸収し、複数の情報から推論を行うという高度な意味的処理が求められます。このような複雑な推論タスクにおいては、単に「目的を先に教える」という表層的なプロンプトエンジニアリングだけでは、膨大なコンテキストの中央に埋もれた情報を適切に評価し引き出すことはできないのです。
手元の実験と原著論文の結果が示すのは、 「プロンプトの工夫といった簡単な対処法では、RAGにおける位置バイアスの問題は根本的には解決しない」 という事実です。原著論文の GPT-3.5-Turbo では QA にほとんど効果がなく、今回の LongChat ではかえって悪化しました。プロンプトの小さな変更でも、モデルによっては答え方が大きく変わるので、使う前に自分のモデルで確かめることが大切です。
検索件数 K を増やすと何が起きるか
RAG のパイプラインを改善するとき、誰もが一度は「検索件数 を増やせば、より多くの情報がプロンプトに入り、回答精度も上がるのではないか」と考えます。検索器(Retriever)の観点では、上位5件より上位50件を取得した方が、正解を含む文書を拾う確率(Recall)は確かに高くなります。
しかし、Lost in the Middle現象の存在を踏まえると、この直感的な想定は成り立ちません。原著論文では、実際のオープンドメインQA(NaturalQuestions-Open)のデータセットを用いて、検索件数 を増やしたときにシステム全体の性能がどう変化するかを検証するケーススタディを行っています。
結果として、検索器のRecallは を5件、10件、20件、50件と増やすにつれて単調に上昇し続けます。ところが、その検索結果を受け取って回答を生成する言語モデル(Reader)の精度は、早期に飽和してしまい、その後はほぼ横ばいになることが明らかになりました。
具体的には、検索件数を20件から50件へと大幅に増やしても、最終的な回答精度の向上は GPT-3.5-Turbo で約1.5%、Claude-1.3 に至っては約1%に留まりました。入力トークン数が劇的に増加し、計算コストやAPIのレイテンシが跳ね上がっているにもかかわらず、精度のリターンがほとんど得られていないのです。
なぜこのようなことが起きるのでしょうか。それは、検索件数を増やすことで正解文書がプロンプトに含まれたとしても、それが大量のディストラクタ(無関係な検索結果)に囲まれ、使われにくい「コンテキストの中央」付近に置かれることが増えるからです。言語モデルは中央に置かれた情報をうまく活用できないため、検索器がせっかく正解を見つけてきても、生成器がそれを見落としてしまいます。つまり、「プロンプトの中に正解のテキストが存在すること」と「モデルがその正解を読み取って回答できること」は全く別の問題なのです。
実験3:検索件数と精度のトレードオフ
この現象を、手元のコードで再現してみましょう。実際のRAGでは、正解文書が検索結果のどこにランクインするかはクエリに依存するため、常に先頭や末尾の有利な位置に来るとは限りません。そこで、正解文書をランダムな位置に配置し、入力する文書の総数 を増やしながら正答率の平均がどう変化するかを測ります。この実験では正解文書を必ずコンテキストに含めるので、再現率はどの でも100%です。それでも精度が変わるなら、その原因は検索の失敗ではなく、ノイズの増加と配置にあります。
実験1と同じく、LongChat-7B-16k と、架空の山 Karaseyama に関係するディストラクタを使います。コードは、実験1で定義したモデル・generate・generate_distractors・build_prompt などを、そのまま使います(実験1のコードを実行した後に続けて実行してください)。 は、正解文書のみをモデルに与える oracle(上限)設定に相当します。
def run_random_position_trial(n_docs, num_trials=30):
    """正解文書をランダムな位置に置き、正答率を測る"""
    correct = 0
    for _ in range(num_trials):
        docs = generate_distractors(n_docs - 1)
        # 実際のRAGを想定し、正解文書をランダムな位置に挿入
        insert_idx = random.randint(0, n_docs - 1)
        docs.insert(insert_idx, GOLD_DOC)
        if GOLD_HEIGHT in generate(build_prompt(docs)):
            correct += 1
    return correct / num_trials

random.seed(0)

# 文書数 N を増やしながら正答率を測定
for n in [1, 5, 10, 20, 40, 80]:
    print(f"N={n:2d}: Accuracy = {run_random_position_trial(n):.2f}")
正解文書をランダムな位置に置き、文書の総数 N を増やしたときの平均の正答率を測るコードです。
- 実験1の部品の再利用: ディストラクタ(generate_distractors)、プロンプト(build_prompt)、生成(generate)、正解の判定(GOLD_HEIGHT が応答に含まれるか)は、実験1と同じです。違うのは、正解文書の位置の決め方だけです。
- ランダムな位置: random.randint で正解文書の位置を毎回選び直します。実際の RAG では、正解文書の順位がクエリごとに変わることを想定しています。
- N = 1 の扱い: n_docs が 1 のときはディストラクタが 0 件になり、正解文書だけを与える oracle 設定になります。上限(oracle)と比べて、ディストラクタが加わるとどれだけ下がるかを見るために入れています。
- スイープ: N を 1・5・10・20・40・80 と変え、それぞれ30回試行します。80件まで増やすのは、文書を増やしても正答率が上がらない(頭打ちになる)ことを確かめるためです。生成は全部で 180 回です。 でもプロンプトは約2,700トークンで、LongChat の上限(16Kトークン)に収まります。
- 乱数: 実験1と同じく random.seed(0) でシードを固定しているので、何度実行しても同じ数値になります。
実行結果
N= 1: Accuracy = 1.00
N= 5: Accuracy = 0.87
N=10: Accuracy = 0.83
N=20: Accuracy = 0.70
N=40: Accuracy = 0.83
N=80: Accuracy = 0.73
文書の総数と正答率の関係を描くと、次のようになります。
(図は、diagram-designで作成)
正解文書だけを与えた では30回すべて正解しますが、ディストラクタが加わると正答率は下がり、 以降は0.7〜0.8前後で頭打ちになります。 で一度0.83に戻っているのは、30回の試行のばらつき(1回の正誤で約3ポイント動く)の範囲と考えられます。正解文書は確実にコンテキストの中にあるのに、文書が増えると、2〜3割の質問で正解を見つけられなくなるのです。
実験1で見たとおり、正解文書が中央付近に来ると読み落とされやすくなります。正解文書の位置がランダムだと、一定の割合でその苦手な位置に当たるため、平均の正答率は oracle を下回ったままになります。そして、文書数を4倍(20件→80件)に増やしても、正答率はまったく上がっていません。入力が長くなる分、計算コストだけが増えています。
この結果は、Naive RAG において「とりあえず検索件数 を増やす」というアプローチが、精度の改善には繋がらないことを示唆しています。コンテキストウィンドウに余裕があるからといって情報を詰め込んでも、モデルはそれを使いこなすことができません。
を無闇に増やす前に、確信度の高い文書をモデルが読みやすい位置(先頭や末尾)に配置する並べ方の工夫や、スコアの低い不要な文書を思い切って捨てる絞り込み(切り捨て)を検討することが、RAGの性能を正しく引き出すための鍵となります。
なぜ「並べ方」が効くのか:Naive RAG の定式化
ここまで、LLM が長いコンテキストの中央に置かれた情報を使いこなせない現象を見てきました。では、なぜ RAG において「文書をどこに置くか」がこれほど決定的な意味を持つのでしょうか。その理由は、現代の RAG の標準形である「Naive RAG」の構造にあります。
RAGの原典(Lewis et al., 2020)における定式化では、検索器が算出した文書の検索確率 が、生成器の確率計算に直接組み込まれていました。検索器が自信を持って提示した文書の意見ほど、生成される回答にソフトな「重み」として強く反映される構造です。一方、現代の Naive RAG は検索された上位 件を1本のコンテキストに連結して一度に入力するため、この が生成の式から消えます。導出の詳細は RAG (Retrieval-Augmented Generation) とは? を参照してください。
この記事にとって重要なのは、その帰結だけです。Naive RAG において検索確率が果たす役割は「上位 件の足切り」と「プロンプトに並べる順番の決定」の2つに限られ、生成モデルに情報が渡る頃には、検索器が緻密に計算した確率は次の指示関数に退化しています。
つまり「コンテキストに含まれている(1)か、含まれていない(0)か」という0/1の情報しか残りません。流れを図にすると、次のようになります。
(図は、diagram-designで作成)
この「重みが失われる」という現象がプログラム上でどのように起きているか、最小限のコードで確認してみましょう。
# 検索器が算出した文書とその確信度(スコア)
retrieved_docs = [
    {"doc": "文書A(富士山の標高は3,776m)", "score": 0.98}, # 非常に確信度が高い
    {"doc": "文書B(富士山は静岡県と山梨県にまたがる)", "score": 0.45}, # まあまあ
    {"doc": "文書C(エベレストの標高は8,849m)", "score": 0.12}, # ギリギリ拾ったノイズ
]

# Naive RAGのプロンプト構築
# ここでスコア情報が捨てられ、単なるテキストの羅列に退化する
context = "\n".join([item["doc"] for item in retrieved_docs])

print("LLMに渡されるコンテキスト:")
print(context)
検索スコアがプロンプトを作る過程でどうなるかを確かめるコードです。
- スコア付きの検索結果: retrieved_docs は、文書 doc と検索スコア score の組のリストです。連結の前後で何が失われるかをはっきり見せるため、0.98・0.45・0.12 と大きく違うスコアにしています。
- スコアの破棄: 連結では item["doc"] だけを取り出しているので、score は context に入りません。これが、数式で見た指示関数への退化にあたる、実装上の姿です。
- 出力の確認: LLM に渡るのは3つのテキストだけで、スコアの大小は伝わりません。
実行結果
LLMに渡されるコンテキスト:
文書A(富士山の標高は3,776m)
文書B(富士山は静岡県と山梨県にまたがる)
文書C(エベレストの標高は8,849m)
検索器は「文書Aが圧倒的に重要で、文書Cはほとんどノイズである」ということを と というスコアで知っていました。しかし、プロンプトとして文字列に連結された瞬間、その重みは完全に消滅します。LLMから見れば、文書Aも文書Cも「プロンプト内に存在する等価なテキストの塊」に過ぎません。
RAG の記事では、リランキングやコンテキスト圧縮が有効に機能する理由を「この重みが捨てられる前に文書集合そのものを整形しているため」と説明しました。本記事が示した位置依存性は、まさにこの「整形」が具体的に何を意味するかの実証にあたります。
スコアの重みが失われるということは、裏を返せば 「並び順」が、検索器の意図をLLMに伝えるための唯一残された制御手段である ということです。
LLMがコンテキストの先頭と末尾を重視し、中央を無視するという「位置バイアス」が存在する以上、この物理的な制御手段には絶大な効果があります。確信度の高い文書を先頭や末尾に配置し、ノイズである可能性が高い文書を中央に追いやる(あるいは切り捨てる)ことで、失われたスコアの重みを「LLMのアテンションの誘導」という形で擬似的に取り戻すことができるのです。
実務上の指針
ここまでの実験結果から明らかなように、LLMはプロンプトの中央に配置された情報をうまく活用できません。この「Lost in the Middle」現象を踏まえ、RAGシステムを構築・運用する際の実務的な対策を以下にまとめます。
-
検索件数 を増やす前に、並べ方を検討する 検索の網羅性を上げるために検索件数 を増やすことは、直感的には正しいアプローチに思えます。しかし、ReaderとなるLLMの精度は早期に飽和し、むしろ低下することさえあります。件数を増やすことで重要な情報がプロンプトの中央に押しやられてしまうリスクがあるため、まずは既存の検索結果の「並べ方」を見直すことが先決です。
-
最も確信度の高い文書は先頭か末尾に置く LLMには、入力の先頭(primacy bias)と末尾(recency bias)の情報を強く重視する傾向があります。この特性を逆手に取り、検索スコアが最も高い(正解を含んでいる可能性が高い)文書をプロンプトの先頭や末尾に配置し、スコアの低い文書を中央に配置するよう意図的に順序を制御することで、モデルが重要な情報を見落とす確率を下げることができます。
-
リランカーの導入を「位置制御」の手段として捉える 初期検索の後に文書を精緻に並べ替える「リランキング」という手法があります。リランカーの導入は、単に「より精度の高い文書を上位に持ってくる」ためだけのものではありません。Naive RAGの定式化で見たように、検索スコアの重みは生成時に失われてしまうため、リランカーが決定する「並び順」こそが、LLMに文書の重要度を伝える実質的かつ唯一の制御手段として機能します。
-
長いコンテキストウィンドウのモデルに乗り換えても解決しない コンテキストウィンドウが16Kや100Kといった長文脈対応のモデルを使用しても、入力がウィンドウ内に収まる範囲では、通常版のモデルとほぼ同一のU字カーブを描くことが確認されています。「長いテキストを入力できること」と「長いテキストの全域から均等に情報を引き出せること」は別物であると認識し、単なるモデルの乗り換えに頼らない設計が必要です。
-
自分のパイプラインで位置効果を測定する モデルのアーキテクチャや学習データ、さらにはプロンプトの記述方法によって、位置バイアスの現れ方は変化します。本記事で紹介したような、パラメトリック知識を排除した合成タスクや架空のデータを用いた実験を自身の環境で実行し、現在使用しているモデルがどの程度の位置バイアスを持っているのかを定量的に把握しておくことが推奨されます。
まとめ
本記事では、大規模言語モデルが長いコンテキストをどのように処理しているのかを明らかにする「Lost in the Middle」現象について解説しました。
モデルのコンテキストウィンドウが数万から数百万トークンへと劇的に拡大したことで、私たちは「検索した文書をすべてプロンプトに詰め込めば、モデルが勝手に必要な情報を探し出してくれるだろう」と期待しがちです。しかし実際のところ、LLMは与えられたテキストを均等に読んでいるわけではありません。コンテキストの先頭(Primacy bias)や末尾(Recency bias)に置かれた情報は高い精度で抽出・活用される一方で、中央に埋もれた情報は無視されやすく、場合によっては外部知識を一切与えない状態(closed-book)よりも性能が悪化するというU字カーブの特性が存在します。
手元の実験では、原著論文でも評価された LongChat-7B-16k で、正解文書を20件の中央に置くと正答率が 56.7% まで下がる U字を再現しました。質問を文書群の前後に置くプロンプトの工夫では解決せず、今回のモデルではかえって悪化しました。一方、最近のモデルでは同じ課題で位置の影響が見えないこともあり、位置バイアスの大きさはモデルや入力の長さ・内容によって変わります。
この事実は、RAG(検索拡張生成)のパイプライン設計に対して極めて重要な示唆を与えます。
第一に、「検索件数 を増やすこと」は、必ずしも生成精度の向上を意味しないということです。検索器(Retriever)の再現率(Recall)を上げるために文書を大量に取得しても、正解を含む文書がプロンプトの中央に押しやられてしまえば、生成器(Generator)はそれを見落としてしまいます。使える長さと、実際に情報を使いこなせる長さは別物であり、コンテキストウィンドウの拡張だけでこの問題は解決しません。
第二に、検索結果の「並び順」は、RAGにおける最も重要な設計変数のひとつであるということです。Naive RAGの定式化で見たように、検索器が算出した「どの文書がどれくらい信頼できるか」というスコアの重みは、プロンプトにテキストとして連結された時点で失われてしまいます。スコアという連続的な情報が切り捨てられる以上、私たちがモデルに重要度を伝えるために残された唯一の制御手段が「配置する場所」なのです。
実務においてRAGの精度向上を目指す際は、ただ漫然と検索スコア順に文書を上から並べるのではなく、確信度の高い文書を意図的に先頭や末尾に配置するなどの工夫が求められます。リランカー(Reranker)の導入も、単にノイズを弾くだけでなく、この「最適な位置への配置」を実現するための強力な手段となります。
LLMがどれほど長文脈を扱えるようになっても、「情報をどう渡すか」というアーキテクチャ上の工夫は不要になりません。Lost in the Middleの特性を理解し、モデルの認知バイアスに寄り添ったプロンプト構成を設計することが、信頼性の高いRAGシステムを構築するための鍵となります。
発展:並べ方以外のアプローチ
本記事では、検索結果をプロンプトに詰め込んでも中央の情報が使われにくいという「Lost in the Middle」現象を確認し、検索結果の「並べ方」が RAG の重要な設計変数であることを見てきました。ただし、この課題への対処は、順序の制御だけではありません。
RAG の各工程を見直すことで、異なる角度から取り組む技術も提案されています。ここでは、本記事が示した問題との関係を、考え方だけ紹介します。各工程の全体像は、RAG の記事の「Naive / Advanced / Modular」の整理が参考になります。
-
検索単位そのものを長くするアプローチ 細切れの短いチャンクを多数検索して並べるからこそ、コンテキストにノイズが混ざりやすく、重要な情報が中央に埋もれてしまいます。そこで、検索単位(チャンク)の粒度を数千トークン規模へと大幅に長くし、少数の長文だけを言語モデルに渡すことで、文脈の分断を防ぎつつ検索器の負担を下げるアプローチが存在します(LongRAG の記事で扱っています)。
-
取得した文書の品質を生成前に判定するアプローチ 検索された文書を無条件にすべてプロンプトに連結するのではなく、生成モデルに渡す前に「その文書が本当にクエリの答えを含んでいるか」を判定します。ノイズやディストラクタを事前に弾き、必要な情報だけを抽出・再構成することで、コンテキストの純度を高め、モデルが迷う余地を減らすアプローチです(CRAG の記事で扱っています)。
-
チャンクをやめて知識をグラフとして表現するアプローチ 文書をテキストの断片として並べる形式そのものを脱却し、コーパス全体のエンティティや関係性をナレッジグラフとして構造化します。検索結果の順序やスコアによる足切り(top-K)に依存せず、情報同士の繋がりを辿ることで、コーパス全体を俯瞰するような複雑な問いに答えることを可能にするアプローチです(GraphRAG の記事で扱っています)。
参考文献
- N. F. Liu et al. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, 12.
- Google. Gemini API ドキュメント.
本記事の文章・構成の一部に生成AIを使用しています。