モンテカルロ法(Monte Carlo Method)とは?
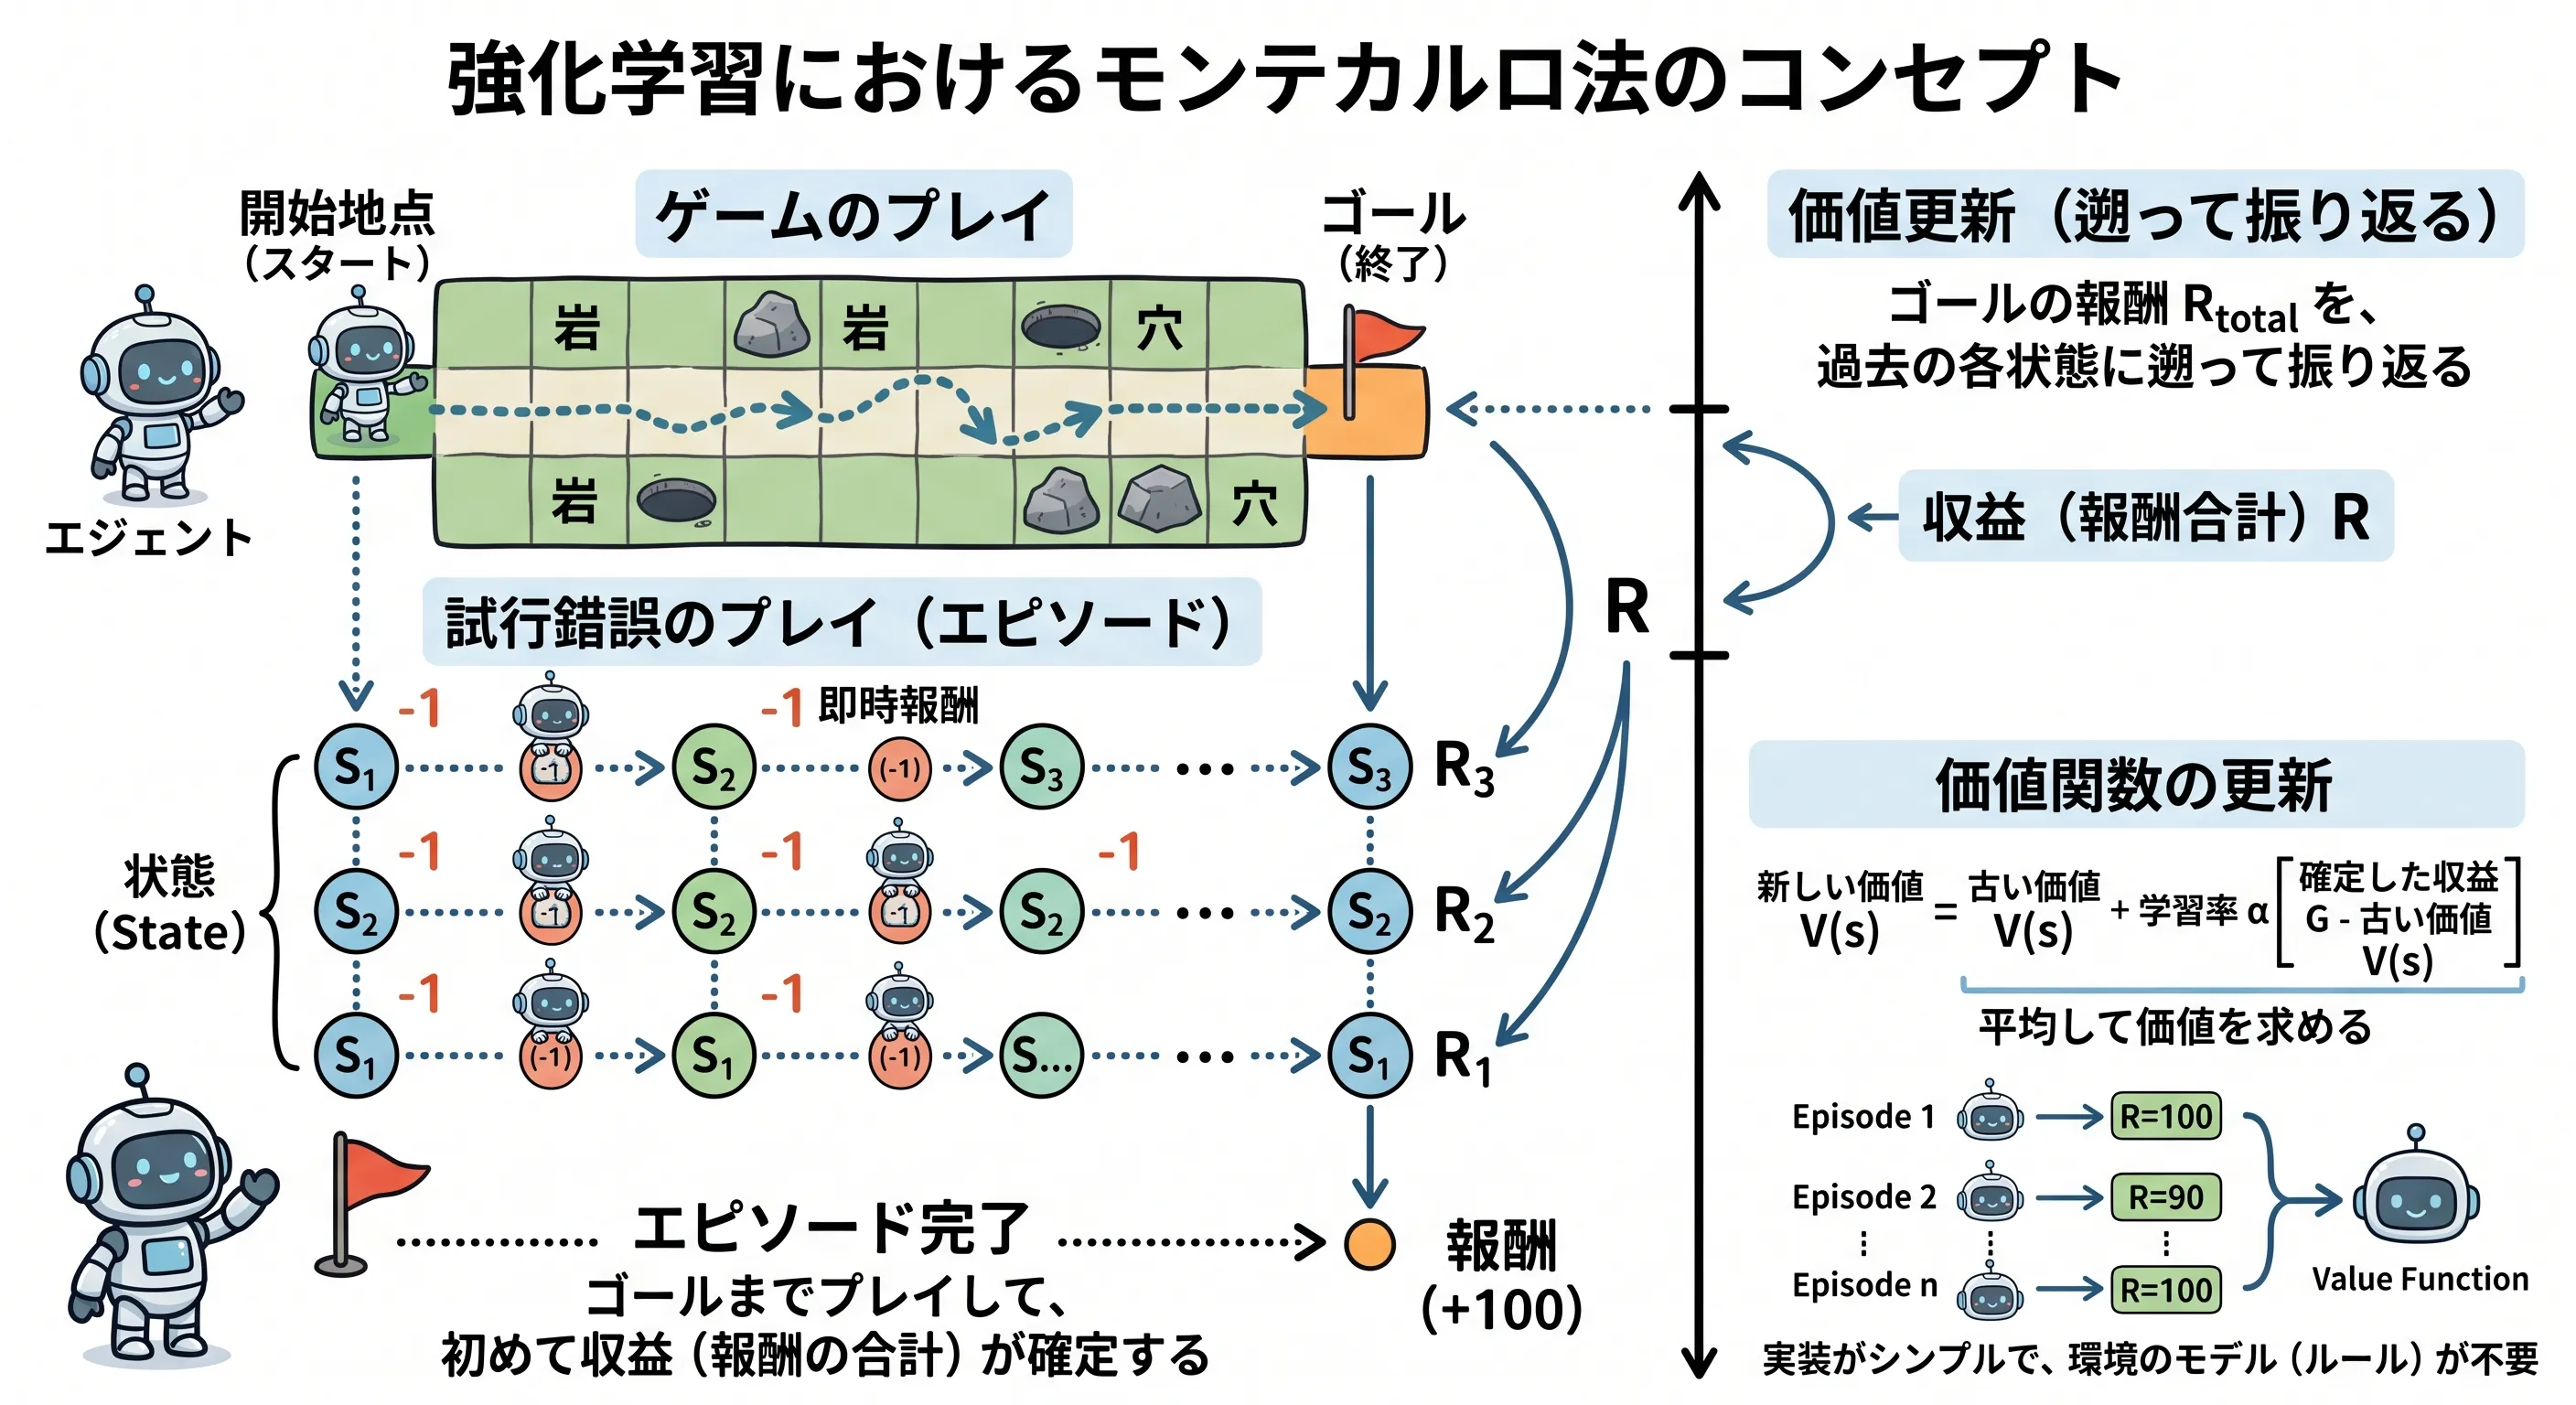 (画像は、Geminiで作成)
エピソードを最後まで終えてから、実際に得られた収益の平均で状態の価値を推定するモンテカルロ法の考え方を理解すること。FrozenLake でのスクラッチ実装で、推定した価値が真の価値に近づく様子を確かめ、次の TD 学習との違い(バイアスと分散)を説明できるようになること。
モンテカルロ法の概要
モンテカルロ法(Monte Carlo Method: MC法)は、強化学習においてエージェントが「経験から直接学習する」ための最も直感的で基礎的なアルゴリズムの一つです。(※一般的なモンテカルロ法自体は、1949年にNicholas MetropolisとStanislaw Ulamらによって発表された論文「The Monte Carlo Method」が起源とされていますが、強化学習の文脈においてはRichard S. Suttonらによる1998年の名著『Reinforcement Learning: An Introduction』で価値推定の基礎的な枠組みとして体系化されました。)
最大の特徴は、「エピソードが完全に終了するまで学習を待ち、最後までやり切って得られた実際の結果(合計報酬)を使って、途中の行動の良し悪しを評価する」 という点にあります。これは、例えるなら「テストを最後まで受けて、返ってきた合計点数を見てから、各科目の勉強法が正しかったかを振り返る」ようなアプローチです。
本記事では、強化学習における価値推定の基本となるモンテカルロ法の仕組みを解説し、Pythonを用いたシンプルなスクラッチ実装を通じてその挙動を学びます。この手法を理解することは、後に続くTD学習や、最新のアルゴリズムであるPPOにおける「バイアスと分散のトレードオフ」を理解するための重要な土台となります。
はじめに:強化学習における「価値」の推定
強化学習の目的は、環境の中でエージェントが得られる報酬の合計を最大化することです。そのためには、「ある状態 にいることが、将来的にどれくらい良いことなのか」という状態価値(State Value) を正確に予測する必要があります。
未知のゲーム(環境)に放り込まれたエージェントは、最初はどの状態が良いか悪いか全くわかりません。そこで、実際にゲームをプレイ(サンプリング)して、その結果から を少しずつ修正(学習)していく必要があります。モンテカルロ法は、この修正を「実際に得られた結果の平均をとる」というシンプルな方法で行います。
モンテカルロ法のコア技術
モンテカルロ法による価値の学習は、以下の3つのステップで成り立っています。
1. エピソードの完了(経験の蓄積)
まず、エージェントは現在の方策(ルール)に従って、ゲームの開始から終了(ゲームオーバーやクリア)までの1エピソードを完全にプレイし切ります。 その間に通った「状態 」と、その時に得た「即時報酬 」の履歴(軌跡)をすべて記録します。
2. 収益(Return)の計算
エピソードが終了したら、時間を遡るようにして収益 を計算します。 収益とは、ある時点 からエピソードの最後までにもらえた報酬の合計値(割引報酬和)のことです。REINFORCEやA2C、PPO等のアルゴリズムでも、「実際に得られた将来までの報酬の合計」として登場する強化学習において非常に重要な概念です。
(※ は将来の報酬をどれくらい重視するかを決める割引率です。)
3. 価値の更新(平均化)
過去にその状態 を訪れた際に得られたすべての収益 の平均値を計算し、それを新たな状態価値 とします。 プログラム上では、すべての履歴を保持して平均を計算し直すのはメモリの無駄になるため、以下のような「逐次更新式」を用いて、新しい結果が得られるたびに少しずつ予測値を修正します。
ここで、
- は学習率(新しく得た結果をどれくらい信用して予測を修正するか)
- は、「実際の結果」と「事前の予測」とのズレ(誤差)
を意味します。
特に、状態 の更新回数を として学習率を とおくと、この逐次更新式は「これまでに得られた収益の標本平均」と完全に一致します。これにより、更新を繰り返すほど予測値 は真の価値(収益の期待値)へと収束していきます。
一方、 を 0.1 などの固定値にすると、古い結果ほど影響が小さくなる指数移動平均になります。新しい結果を重視できるため、方策が変化していく場面(方策の改善を伴う学習)では有用ですが、推定値は真の値の周りで揺れ続け、厳密には収束しません。
3つのステップを、ゴールに着いた1回のエピソードの例で図にすると、次のようになります。
(図は、diagram-designで作成)
モンテカルロ法の実装(概念的な実装)
理論を理解したところで、実際にモンテカルロ法をPyTorchを用いずに純粋なPythonで実装してみましょう。環境には、滑る氷の床の上を歩いてゴールを目指すシンプルな迷路タスクである FrozenLake-v1 を使用します。
FrozenLakeのルール
FrozenLakeは4x4のグリッドで構成されており、S(スタート)から始まり、H(穴)を避けてG(ゴール)を目指します。
| 行 \ 列 | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | S (スタート) | F (氷) | F (氷) | F (氷) |
| 1 | F (氷) | H (穴) | F (氷) | H (穴) |
| 2 | F (氷) | F (氷) | F (氷) | H (穴) |
| 3 | H (穴) | F (氷) | F (氷) | G (ゴール) |
報酬のルール:
- ゴール(G)に到達した場合:報酬 +1 を得てエピソード終了。
- 穴(H)に落ちた場合:報酬 0 でエピソード終了(ペナルティ値はありませんが、ゴール報酬も得られません)。
- その他の氷(F)を移動中:報酬 0。
ライブラリのインストール
Gymnasiumなどの強化学習環境と、数値計算用のNumPy、プロット用のMatplotlibをインストールします。
!pip install gymnasium numpy matplotlib
ここでは、強化学習の標準的な環境を提供する gymnasium、配列計算を行う numpy、学習結果をヒートマップとして可視化するための matplotlib をインストールしています。Google Colab には、3 つとも最初から入っています。
MCAgentの定義
以下のコードでは、状態価値を推定するためのモンテカルロ法エージェントを定義します。 今回は行動の最適化(方策制御)ではなく、「ランダムに歩き回った場合、どのマスがどれくらい価値があるのか?」という状態価値の評価(予測)に焦点を当てます。
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from collections import defaultdict


# MCAgent: モンテカルロ法で状態価値 V(s) を学習するエージェント(状態ごとの値を表に持つ)
class MCAgent:
    def __init__(self, gamma=0.99):
        self.gamma = gamma    # 割引率:ゴールまで遠い状態ほど、価値を少し小さく見る
        # 状態価値 V(s) の表。まだ訪れていない状態は 0.0 から始まる
        self.V = defaultdict(float)
        # 各状態の更新回数 N(s)。学習率 α = 1/N(s) にして、V(s) を収益の標本平均と一致させるために使う
        self.N = defaultdict(int)

    def learn(self, episode):
        """
        1エピソード分の履歴を受け取り、状態価値を更新する
        episode: [(state, reward), (state, reward), ...] のリスト(reward はその状態で行動した後にもらった報酬)
        """
        G = 0  # 収益。終端から遡って足していく
        states = [s for s, _ in episode]  # エピソード中に訪れた状態の時系列(初回訪問の判定に使う)

        # 終端から開始地点に向かって逆順にたどる。G_t = R_{t+1} + γ G_{t+1} の漸化式で、各時刻の収益を 1 回の掃引で求められる
        for t in reversed(range(len(episode))):
            state, reward = episode[t]
            G = self.gamma * G + reward

            # 初回訪問 MC 法:S_t がそれより前(S_0〜S_{t-1})に現れていない=時刻 t が最初の訪問のときだけ更新する
            if state not in states[:t]:
                self.N[state] += 1
                alpha = 1.0 / self.N[state]
                # V(S_t) <- V(S_t) + α [G_t - V(S_t)]
                self.V[state] = self.V[state] + alpha * (G - self.V[state])
エピソード 1 回分の履歴から収益を遡って計算し、各状態の価値を、これまでの収益の平均に更新するエージェントです。
- 表で持つ価値: ニューラルネットワークのような関数近似は使わず、defaultdict(float) で状態ごとに価値を 1 つずつ記録します(テーブルベースの手法)。FrozenLake の状態は 16 個しかないので、表で十分です。まだ訪れていない状態は 0.0 から始まります。
- 割引率 gamma=0.99: 強化学習でよく使われる値です。この環境では報酬がゴールの 1 回だけなので、価値は「ゴールに着く確率」に、着くまでのステップ数ぶんの を掛けた値になり、ゴールから遠いマスほど少し小さくなります。
- 収益の逆順計算: 履歴を後ろ(終了時)から前(開始時)に reversed(range(len(episode))) でたどり、G = self.gamma * G + reward の漸化式 で収益を求めます。各時刻の を定義どおりに足し直すと、時刻ごとに残りの報酬を全部足すことになりますが、逆順なら 1 回の掃引ですべての時刻の収益が求まります。
- 初回訪問 MC 法: 1 つのエピソードの中で同じ状態を何度も訪れた場合、最初に訪れた時点の収益だけ を使います。逆順のループでは、最初に出会う訪問は時間の順では最後の訪問になってしまうので、状態の並び states を用意し、state not in states[:t](時刻 より前にその状態が現れていない)で、時刻 が本当に最初の訪問かを判定します。初回訪問だけを使うと、1 エピソードから 1 つの状態につき 1 つの収益が得られ、エピソードどうしは独立なので、その平均は真の価値の不偏推定量になります。
- 学習率 : self.N にその状態を更新した回数を数え、alpha = 1.0 / self.N[state] とします。こうすると、逐次更新した self.V[state] は、これまでに観測した収益 G の標本平均と常に一致します(前の節の説明)。
答え合わせ用の真の価値
FrozenLake は、行動するとどのマスに進むか(遷移の確率)がすべて公開されています。そこで、ランダムに歩くときの真の状態価値を計算で求めておき、モンテカルロ法の推定がそれにどれだけ近づくかを確かめます。
# 答え合わせ用:ランダム方策の「真の」状態価値を、環境の遷移の表から反復方策評価で求める
def true_values(env, gamma=0.99, tol=1e-10):
    P = env.unwrapped.P   # P[s][a] = [(確率, 次の状態, 報酬, 終了したか), ...]
    nS, nA = env.observation_space.n, env.action_space.n
    V = np.zeros(nS)
    while True:
        V_new = np.zeros(nS)
        for s in range(nS):
            for a in range(nA):   # ランダム方策なので、4 つの行動を 1/4 ずつの確率で選ぶ
                for p, s_next, r, done in P[s][a]:
                    V_new[s] += p / nA * (r + gamma * V[s_next] * (not done))
        if np.max(np.abs(V_new - V)) < tol:   # 値がほとんど変わらなくなったら終える
            return V_new
        V = V_new

env = gym.make('FrozenLake-v1', is_slippery=False)
V_true = true_values(env, gamma=0.99)
print("ランダム方策の真の状態価値")
print(np.round(V_true.reshape(4, 4), 3))
環境の遷移の表を使って、ランダムに歩くときの各マスの真の価値を求めるコードです。モンテカルロ法は遷移の表を使わずに、プレイした結果だけから価値を推定します。この答えと比べることで、推定がどれだけ正しいかを数値で確かめられます。
- 反復方策評価: ベルマン方程式 の右辺を計算して左辺に入れる、という更新を、値がほとんど変わらなくなるまで(変化が 未満になるまで)繰り返します。ランダム方策なので、 です。
- env.unwrapped.P: FrozenLake の遷移の表で、状態と行動ごとに「(確率, 次の状態, 報酬, 終了したか)」の一覧を持っています。is_slippery=False なので、どの行動も確率 1 で決まったマスに進みます。終了する遷移(穴かゴールに入る)では、その先の価値を足しません(not done)。
- 滑らない設定: is_slippery=False で、氷の上で滑らない(選んだ方向に必ず進む)設定にしています。結果を読み取りやすくするためです。
実行結果
ランダム方策の真の状態価値
[[0.012 0.01  0.019 0.009]
 [0.015 0.    0.039 0.   ]
 [0.033 0.084 0.138 0.   ]
 [0.    0.17  0.434 0.   ]]
ゴールの左隣のマス(右下から 2 番目)が 0.434 で最も高く、スタートは 0.012 です。ランダムに歩くと、スタートからゴールに着く確率はとても低い(穴に落ちる方がずっと多い)ことがわかります。
求めた真の価値を、FrozenLake のマップの上に並べると、次のようになります。
(図は、diagram-designで作成)
訓練ループ
エージェントに FrozenLake-v1 を何度もプレイさせ、価値を学習させます。途中で、真の価値との誤差を表示します。
env.action_space.seed(42)  # ランダム行動のシードを固定して結果を再現可能にする
agent = MCAgent(gamma=0.99)

EPISODES = 20000   # 推定の誤差がエピソード数とともにどう小さくなるかを見るため、2 万回までプレイする
CHECK = (10, 100, 500, 2000, 5000, 20000)   # 真の価値との誤差を表示するエピソード数
nonterminal = [s for s in range(16) if s not in (5, 7, 11, 12, 15)]   # 穴とゴール(終端状態)を除く 11 マス
n_goal, n_truncated = 0, 0

print("--- モンテカルロ法 学習開始 ---")
for episode_num in range(EPISODES):
    # 最初のエピソードのみ環境のシードを固定する
    state, _ = env.reset(seed=42 if episode_num == 0 else None)
    episode_history = []
    done = False

    # 1. エピソードが終了するまでデータを収集(サンプリング)する。この間は学習しない
    while not done:
        # 今回は価値評価のため、ランダムに行動を選択
        action = env.action_space.sample()
        next_state, reward, terminated, truncated, _ = env.step(action)
        done = terminated or truncated

        # 状態と「その状態で行動して得た報酬」のペアを履歴に保存
        episode_history.append((state, reward))
        state = next_state
    n_goal += int(reward == 1.0)
    n_truncated += int(truncated and not terminated)   # 100 ステップの上限で打ち切られたエピソード

    # 2. エピソード終了後、履歴を使って価値を更新(ここで初めて学習が行われる)
    agent.learn(episode_history)

    # 3. 途中経過:真の価値との誤差(11 マスの二乗平均平方根誤差)
    if episode_num + 1 in CHECK:
        rmse = np.sqrt(np.mean([(agent.V[s] - V_true[s]) ** 2 for s in nonterminal]))
        print(f"{episode_num + 1:6d} エピソード:真の価値との RMSE {rmse:.4f}(ゴールに着いたエピソード {n_goal} 回)")

print("--- モンテカルロ法 学習完了 ---")
print(f"打ち切られたエピソード {n_truncated} 回")
print("各マスの更新回数 N(s):", [agent.N[s] for s in range(16)])
ランダムに歩いて集めたエピソードで価値を学習し、エピソードが増えるにつれて真の価値に近づくかを確かめるコードです。
- ランダムなサンプリング: 今回の目的は方策の最適化(よい行動を見つけること)ではなく「価値の評価」なので、env.action_space.sample() で上下左右をランダムに選んで歩きます(ランダム方策)。
- 遅れて学習する(モンテカルロ法の特徴): while not done: のループの中では、一切学習しません。状態と報酬のペアを episode_history にためていき、エピソードが終わってループを抜けた後に、初めて agent.learn(episode_history) を呼びます。「最後までやり切った結果だけを使って学習する」というモンテカルロ法の特徴を、そのままコードにしたものです。
- 2 万エピソード: 推定の誤差がエピソード数とともにどう小さくなるかを見るため、2 万回までプレイします(CPU で 10 秒ほどです)。誤差は、穴とゴールを除く 11 マスの、真の価値との二乗平均平方根誤差(RMSE)で測ります。
- 打ち切りの数: FrozenLake-v1 は、100 ステップで打ち切ります(truncated)。打ち切られたエピソードは最後まで終わっていないので、収益が本当の値より小さくなります。そのようなエピソードがどれだけあったかを数えて表示します。
- シードの固定: env.action_space.seed(42) と最初の env.reset(seed=42) で乱数のシードを固定し、何度実行しても同じ結果が得られるようにしています。
実行結果
--- モンテカルロ法 学習開始 ---
    10 エピソード:真の価値との RMSE 0.1497(ゴールに着いたエピソード 0 回)
   100 エピソード:真の価値との RMSE 0.0410(ゴールに着いたエピソード 1 回)
   500 エピソード:真の価値との RMSE 0.0317(ゴールに着いたエピソード 7 回)
  2000 エピソード:真の価値との RMSE 0.0204(ゴールに着いたエピソード 27 回)
  5000 エピソード:真の価値との RMSE 0.0095(ゴールに着いたエピソード 73 回)
 20000 エピソード:真の価値との RMSE 0.0068(ゴールに着いたエピソード 285 回)
--- モンテカルロ法 学習完了 ---
打ち切られたエピソード 0 回
各マスの更新回数 N(s): [20000, 12361, 5220, 2263, 12417, 0, 2659, 0, 5290, 2245, 1438, 0, 0, 824, 667, 0]
- ゴールに着くのはごく一部: 2 万エピソードのうち、ゴールに着いたのは 285 回(約 1.4%)だけでした。ほとんどのエピソードは報酬 0 のまま穴に落ちるので、価値の推定は、まれに起きるゴールの回数に大きく左右されます。
- 誤差の減り方: RMSE は、2,000 エピソードで 0.0204、2 万エピソードで 0.0068 でした。エピソードを 10 倍にすると誤差がおよそ 3 分の 1()になるのは、標本平均の誤差が で小さくなることと合っています。
- 更新回数の偏り: スタートは毎回訪れるので 2 万回更新されますが、ゴールの手前の 2 マス(13・14 番)は 824 回と 667 回しか更新されていません。価値が大きいマスほど訪れにくく、推定に使える収益が少なくなります。
- 打ち切り: 100 ステップで打ち切られたエピソードは 0 回でした。滑らない 4×4 のマップでは、ランダムに歩いてもすぐに穴かゴールで終わるので、この実験では打ち切りによる偏りはありません。
エピソード数と真の価値との RMSE の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
実行結果と可視化
学習によって得られた各マスの状態価値 を、真の価値と並べて、マップの形のヒートマップにします。
# FrozenLakeのマップ配置 (S:スタート, F:氷, H:穴, G:ゴール)
lake_map = [
    ['S', 'F', 'F', 'F'],
    ['F', 'H', 'F', 'H'],
    ['F', 'F', 'F', 'H'],
    ['H', 'F', 'F', 'G']
]

# 状態の番号 0〜15 を、4×4 のマップの位置(行, 列)に並べ直す
V_grid = np.zeros((4, 4))
for state in range(16):
    row, col = divmod(state, 4)
    V_grid[row, col] = agent.V[state]

# 学習した価値と真の価値を、同じ色の範囲で並べて描く
fig, axes = plt.subplots(1, 2, figsize=(12, 5.5))
for ax, grid, title in [(axes[0], V_grid, f"Monte Carlo ({EPISODES} episodes)"), (axes[1], V_true.reshape(4, 4), "True value (random policy)")]:
    im = ax.imshow(grid, cmap='hot', interpolation='nearest', vmin=0, vmax=V_true.max())
    ax.set_title(title)
    # 各セルにマップ記号(S, G, Hなど)と数値を表示
    for i in range(4):
        for j in range(4):
            ax.text(j, i, f"{lake_map[i][j]}\n{grid[i, j]:.3f}", ha="center", va="center", color="cyan", fontweight="bold")
    # 軸のメモリ(数値)は不要なため非表示にする
    ax.set_xticks([])
    ax.set_yticks([])
fig.colorbar(im, ax=axes, label='State Value V(s)')
plt.show()
学習した価値の表(agent.V)と真の価値を、マップの形に並べて比べるコードです。
- 1 次元から 2 次元へ: FrozenLake の 16 個の状態(0〜15 の番号)を、divmod(state, 4) で 4 行 4 列の位置(row, col)に直し、V_grid に入れます。
- 同じ色の範囲で並べる: 2 つのヒートマップを、vmin=0, vmax=V_true.max() で同じ色の範囲にそろえます。範囲がそろっていないと、同じ色でも違う値を表すことになり、比べられないためです。
- 数値の重ね書き: ax.text で、各マスにマップの記号(S, F, H, G)と価値の数値を重ねて表示します。
実行結果
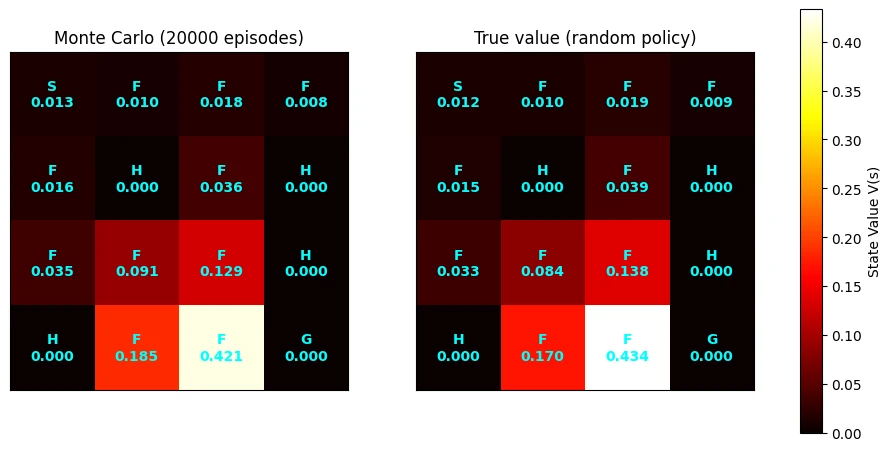
2 万エピソードで推定した価値(左)は、真の価値(右)とよく一致しています。ゴールに近いマスほど価値が高く(明るく)、スタートや、穴に囲まれたマスほど価値が低く(暗く)なっています。一番の差は、ゴールの左隣のマス(推定 0.421・真の値 0.434)と、その左のマス(0.185・0.170)で、更新回数の少ないマスほど推定が揺れることと合っています。
なお、ゴール(G)と穴(H)のマスは 0.000 になっています。これらはエピソードが終わる終端状態で、そこから先に得られる報酬はないため、価値は定義上 0 です(実装でも、終端状態は episode_history に記録されないので更新されません)。モンテカルロ法が、プレイした結果だけから、ランダム方策の各状態の価値を正しく推定できていることが確認できます。
モンテカルロ法のメリットと限界(バイアスと分散のジレンマ)
モンテカルロ法はシンプルで直感的ですが、強化学習における「バイアスと分散のトレードオフ」という永遠の課題を理解する上で重要な立ち位置にあります。
- メリット(バイアスがない):
途中の予測に頼らず、「実際に最後までプレイして得られた結果(事実)」だけを使って学習するため、予測の間違い(バイアス)による悪影響を受けません。 - デメリット(分散が非常に大きい・分散の爆発):
PPOの記事でも触れられるように、エピソードの最後まで待って得られる実際の収益 をそのまま使うと、「途中の様々なランダムな出来事」もすべて結果に含まれてしまうため、データのブレ(分散)が極めて大きくなります。一回まぐれでゴールできた時のデータと、不運で失敗した時のデータが極端に混ざるため、学習が安定するまでに膨大な回数のエピソードが必要になります。この問題は、モンテカルロ推定に依存するREINFORCE(モンテカルロ方策勾配法)などのアルゴリズムにおいて「分散の爆発」と呼ばれる致命的な課題として立ちはだかります。 - デメリット(学習が遅い):
ゲームオーバーになるまで学習を一切行えないため、1プレイが長いタスクや、永遠に終わらない(継続的な)タスクには適用できません。
TD(時間的差分)学習への橋渡し
モンテカルロ法の「最後まで待たないと学習できない」「分散が大きい」という弱点を克服するために考案されたのが、TD学習(時間的差分学習)です(TD学習の記事)。
TD学習は、エピソードの終了を待たず、1ステップ先の実際の報酬と「次の状態の予測価値」だけを見て学習を進めます。これは1ステップ先しか見ないため分散は小さい反面、もし予測価値自体が間違っていた場合、その間違い(バイアス)に強く影響されてしまう弱点を持っています。
事実のみを信じるモンテカルロ法(分散大・バイアス小)か、予測を信じて歩きながら学ぶTD学習(分散小・バイアス大)か。このジレンマをどのように解決していくかが、PPOなどの最新アルゴリズム(GAEの導入など)へと繋がる強化学習進化のメインストーリーとなります。
モンテカルロ法と TD 学習の違いを並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、強化学習の最も基礎的な価値推定アルゴリズムである「モンテカルロ法」について解説しました。
エピソードを最後までやり切り、得られた実際の収益を遡って各状態の価値を更新するという直感的なアプローチを学び、Pythonを用いたスクラッチ実装で、FrozenLake の各マスの価値を推定しました。遷移の表から求めた真の価値と比べると、誤差(RMSE)は 2,000 エピソードで 0.0204、2 万エピソードで 0.0068 と、エピソード数の平方根に反比例して小さくなりました。一方で、ゴールに着くのは全体の約 1.4% だけで、ゴールに近い価値の大きいマスほど訪れる回数が少なく、推定が揺れやすいことも確かめました。これが、次に説明するモンテカルロ法の「分散が大きい」という弱点です。
モンテカルロ法と対をなすもう一つの強力なアプローチ「TD学習」は、TD学習の記事で解説しています。
参考文献
- N. Metropolis, S. Ulam (1949). The Monte Carlo Method. Journal of the American Statistical Association, 44(247), 335–341.
- R. S. Sutton, A. G. Barto (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
本記事の文章・構成の一部に生成AIを使用しています。