MCMC(マルコフ連鎖モンテカルロ法)とは?
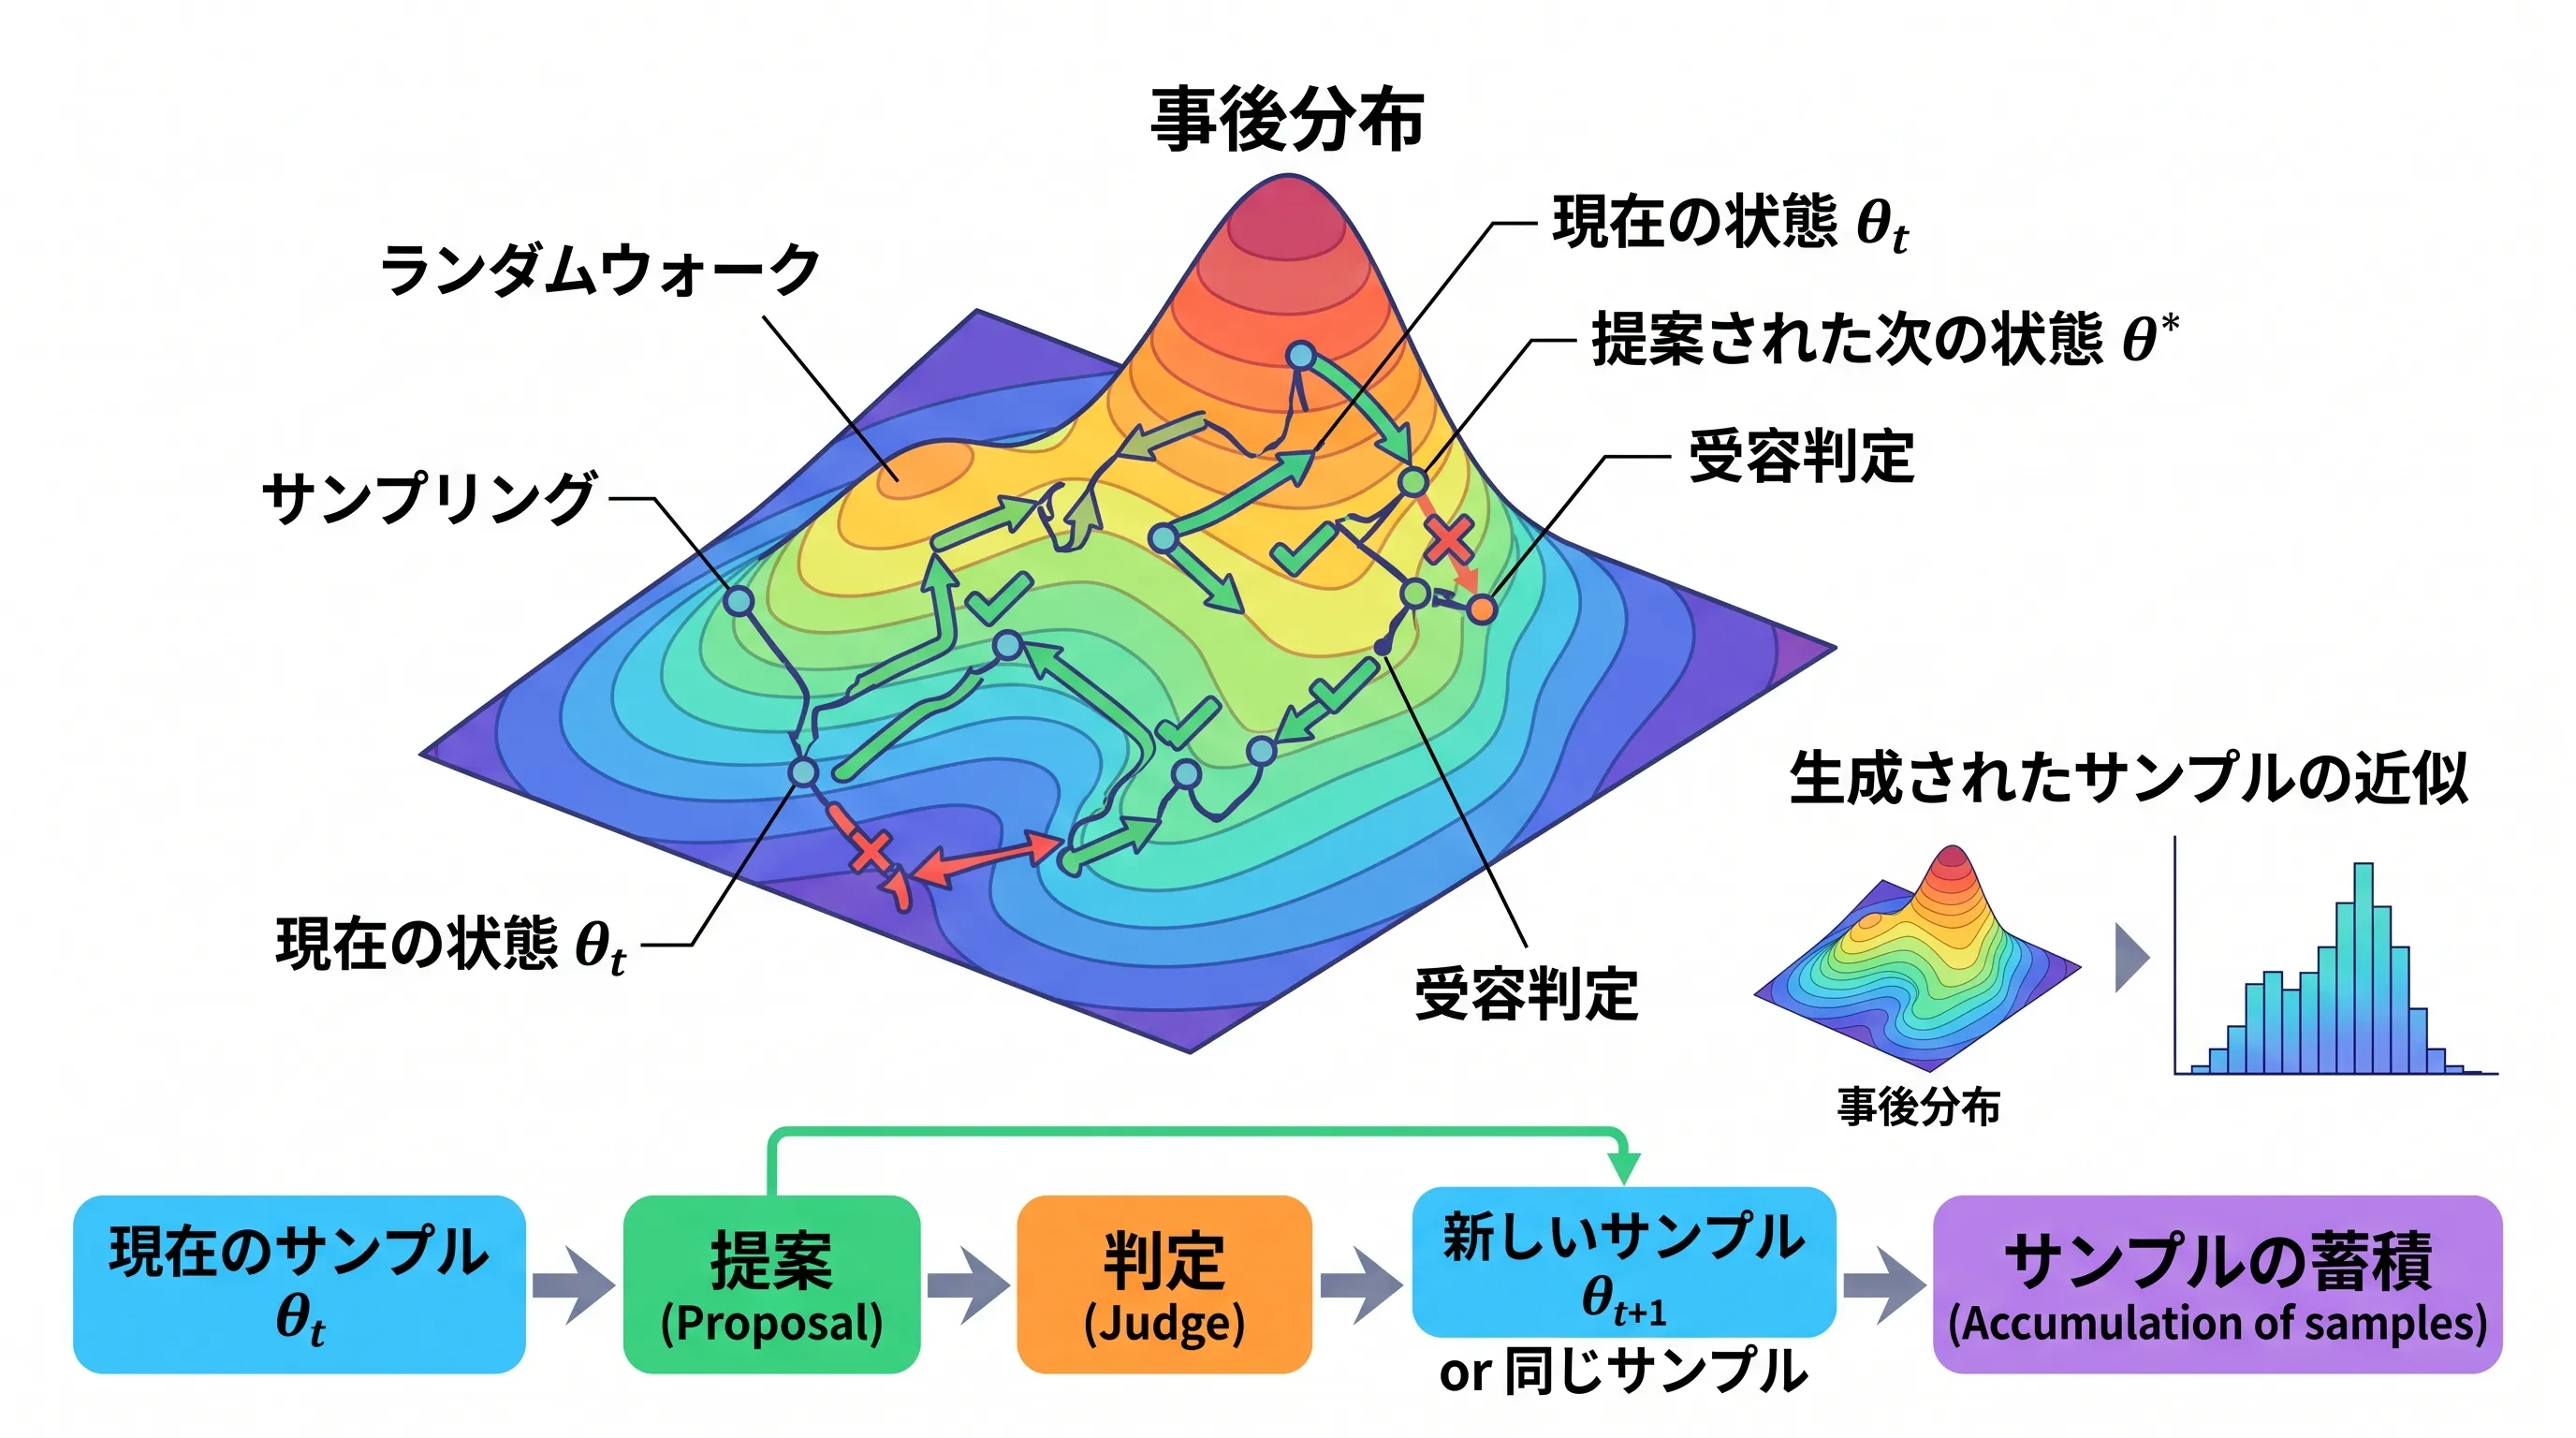 (画像は、Geminiで作成)
MCMCの仕組みを理解し、PyMC の出力(事後分布・収束診断)を正しく読めるようになること。
MCMC(マルコフ連鎖モンテカルロ法)とは?
MCMCは、ベイズ推定で求めたい事後分布から、難しい積分を計算せずにサンプル(乱数)を取り出す手法 です。パラメータの空間を、事後分布の高いところほど長く滞在するように歩き回り、その足跡を集めることで、事後分布の形・平均・信用区間を求めます。「推定値が1つ」ではなく、「その推定がどれくらい確かか」まで分布として分かるのが特徴です。
この記事の読み方
目的に合わせて、次の節から読み始めてください。
| 知りたいこと | 読む節 |
|---|---|
| すぐに動かしてみたい | 直後の「最短の使い方」(PyMC で平均と標準偏差を推定する) |
| なぜ MCMC が必要なのか | ベイズの定理とMCMCが必要な理由 |
| 最適化(焼きなまし法)との関係 | 焼きなまし法からMCMCへ |
| 仕組みを自分で実装して確かめたい | はじめの一歩とメトロポリス法のスクラッチ実装 |
| 結果が信頼できるかの見方(R-hat・ESS) | 収束診断:MCMCの結果は信頼できるか |
| PyMC での推定と、事前分布の影響 | PyMCによるモデル定義とHMC/NUTSと事前分布の影響 |
最短の使い方:PyMC で平均と標準偏差を推定する
Python のベイズ推定ライブラリ PyMC を使えば、モデルを書くだけで MCMC による推定ができます。ここでは、平均 5・標準偏差 2 の正規分布から作った 30 個のデータから、平均 と標準偏差 を推定します。真値を決めてデータを作っているので、推定がどれくらい真値に近いかを確かめられます。
import numpy as np
import pymc as pm
import arviz as az

# 平均 5、標準偏差 2 の正規分布から 30 個のデータを作る(真値と比べるため)
rng = np.random.default_rng(0)
y = rng.normal(loc=5.0, scale=2.0, size=30)

with pm.Model():
    # 事前分布:データを見る前の、幅の広い仮定
    mu = pm.Normal("mu", mu=0, sigma=10)
    sigma = pm.HalfNormal("sigma", sigma=5)
    # 尤度:データ y が、平均 mu・標準偏差 sigma の正規分布から出たとする
    pm.Normal("y", mu=mu, sigma=sigma, observed=y)
    # MCMC(NUTS)で事後分布からサンプルを取る
    trace = pm.sample(chains=4, random_seed=0)

print(az.summary(trace)[["mean", "sd", "ess_bulk", "ess_tail", "r_hat"]])
- データ: 30 個にしているのは、推定にある程度のばらつき(不確かさ)が残るようにするためです。データを増やすと、事後分布の幅(sd)は狭くなります。
- 事前分布: には標準偏差 10 の正規分布、 には負の値を取らない pm.HalfNormal を置いています。どちらもデータの値(5 前後)に比べて十分に広く、推定をほとんど邪魔しない「弱い事前分布」です。事前分布を強くしたときの影響は、事前分布の影響で確かめます。
- 尤度: observed=y を渡した確率変数は、推定の対象ではなく、データの当てはまりを表す尤度として扱われます。PyMC はこの事前分布と尤度から事後分布を組み立て、MCMC のアルゴリズムの一つ NUTS でサンプルを取ります。
- pm.sample(chains=4, random_seed=0): 4 本のチェーン(独立に走らせる MCMC)で、それぞれ 1,000 回の調整の後に 1,000 個のサンプルを取ります(回数は PyMC の既定値)。チェーンを複数にするのは、すべてのチェーンが同じ分布にたどり着いたかを で確かめるためです。
- az.summary: ArviZ で、サンプルの平均(mean)・標準偏差(sd)と、収束診断の指標を表にします。表示する列は、本文の PyMC の節とそろえています。
実行結果
        mean     sd ess_bulk ess_tail r_hat
mu      4.76   0.32     3854     2888  1.00
sigma  1.713  0.232     3900     2752  1.00
CPU で実行した結果です(数秒で終わります)。結果は次のように読みます。
- mean と sd: 平均 の推定は 4.76 で、事後分布の標準偏差は 0.32 です。真値の 5 はこの幅の中に入っています。30 個のデータの標本平均は 4.76、標本標準偏差から計算した標準誤差は 0.30 で、MCMC の結果とほぼ一致します。標準偏差 の推定は 1.71(真値 2)で、データの標本標準偏差 1.65 に近い値です。
- r_hat: 4 本のチェーンの結果が一致しているかの指標で、1.01 未満なら収束したとみなします。どちらも 1.00 です。
- ess_bulk と ess_tail: 有効サンプルサイズで、互いに似たサンプルを割り引いた「実質的なサンプル数」です。4,000 個のサンプルに対して 2,700〜3,900 あり、推定に十分な数です。
これらの指標の意味と、収束しないときに何が起きるかは、収束診断の節で、スクラッチ実装を使って詳しく確かめます。
ベイズの定理とMCMCが必要な理由
ベイズ推定の中心には「ベイズの定理」があります。
- : 事前分布(データを見る前の信念)
- : 尤度(そのパラメータのとき、手元のデータが得られる確率)
- : 事後分布(データを見た後のパラメータの確率分布)
私たちの目的は事後分布 を知ることですが、分母の (正規化定数)を計算するにはあらゆるパラメータの可能性について積分する必要があり、モデルが少し複雑になると計算が不可能になります。 しかし、MCMCを使えば「事後分布の形(分子である尤度 事前分布)に比例した確率で、パラメータの空間をランダムに歩き回る」ことができます。この歩き回った足跡(サンプル)を集めれば、積分を計算しなくても事後分布を再現できるのです。どのような規則で歩けばよいかを、次の節で、焼きなまし法のメトロポリス基準から説明します。
ベイズの定理と MCMC の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
焼きなまし法からMCMCへ
焼きなまし法(Simulated Annealing)の記事では、最適な解を見つけるために「温度 」を使って一時的な改悪を許容する最適化手法を見ました。実は、この焼きなまし法で使った「メトロポリス基準」は、もともと統計物理学で確率分布からのサンプリングを行うために作られたものです。
焼きなまし法の記事の最後で触れたように、温度 を固定してメトロポリス基準で移動を繰り返すと、十分に長く続けた後に解 を訪れる頻度は次の分布に従います。
ここで温度を に固定し、評価関数 を最適化問題のスコアから「対数事後確率 」に置き換えると、訪問頻度は事後分布そのものになります。つまり、探索の軌跡がそのままベイズ推定における事後分布からのサンプルになるのです。これが MCMC(マルコフ連鎖モンテカルロ法) の出発点です。
| 焼きなまし法(最適化) | メトロポリス法(MCMC) | |
|---|---|---|
| 評価関数 | 最大化したいスコア | 対数事後確率 |
| 温度 | 徐々に下げて に近づける | に固定する |
| 記録するもの | 最良解(1点) | 訪れた場所すべて(サンプル) |
| 得られるもの | 一番良いパラメータ | 「どのあたりがどれくらいありそうか」という分布全体 |
メトロポリス基準は、今いる点と移動先の候補の2点の事後確率の「比」(対数なら「差」)しか使いません。そのため、前の節で計算が難しいと述べたベイズの定理の分母 は打ち消し合い、計算する必要がなくなります。これが、MCMCで積分を計算せずに事後分布を扱える理由です。
表の対応を図にすると、次のようになります。
(図は、diagram-designで作成)
はじめの一歩:正規分布の平均を推定する
いきなり3つのパラメータを持つ回帰モデルに進む前に、パラメータが1つだけの最も簡単な例で、MCMCの動きを確認しておきましょう。
設定は次のとおりです。平均 、標準偏差 の正規分布から20個のデータを生成し、標準偏差は で既知として固定します。推定するのは平均 だけです。わざと真値から外れた からスタートし、メトロポリス法が平均 の付近へたどり着けるかを見ます。
事前分布には一様分布を置くので、事後分布は尤度に比例します。データ1件ごとの確率密度は正規分布の式で、20件分の積が尤度になります。
この例では事後分布を手計算でも求められ、平均が標本平均 、標準偏差が の正規分布になります。答えが分かっているので、MCMCのサンプルが本当に事後分布を再現できているかを確かめるのにちょうどよい題材です。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. データの生成(平均0、標準偏差1の正規分布から20個)
rng = np.random.default_rng(0)
true_mu = 0.0
sigma = 1.0  # 標準偏差は既知として固定
n_data = 20
data = rng.normal(true_mu, sigma, size=n_data)

# 2. 対数事後分布(事前分布は一様分布なので、対数尤度だけでよい)
def log_posterior_mu(mu, data, sigma=1.0):
    return -np.sum(0.5 * np.log(2 * np.pi * sigma**2) + (data - mu)**2 / (2 * sigma**2))

# 3. メトロポリス法(パラメータは mu の1つだけ)
def metropolis_mu(data, n_samples=2000, step_size=0.2, init=3.0, seed=1):
    rng = np.random.default_rng(seed)
    current_mu = init
    current_log_post = log_posterior_mu(current_mu, data)
    samples = []
    accepted = 0
    for _ in range(n_samples):
        prop_mu = current_mu + rng.normal(0, step_size)      # 近くの候補を提案
        prop_log_post = log_posterior_mu(prop_mu, data)
        log_accept_ratio = prop_log_post - current_log_post  # 対数事後確率の差
        if np.log(rng.uniform(0, 1)) < log_accept_ratio:     # メトロポリス基準
            current_mu, current_log_post = prop_mu, prop_log_post
            accepted += 1
        samples.append(current_mu)                           # 棄却されても現在地を記録
    return np.array(samples), accepted / n_samples

# 4. 実行(真値0から外れた mu = 3.0 からスタート)
samples_mu, accept_rate_mu = metropolis_mu(data, init=3.0)
burn_in_mu = 200
kept = samples_mu[burn_in_mu:]
print(f"受理率: {accept_rate_mu * 100:.1f}%")
print(f"データの標本平均: {data.mean():.3f}")
print(f"MCMCの事後平均: {kept.mean():.3f}, 事後標準偏差: {kept.std():.3f}")
print(f"理論上の事後標準偏差 (sigma / sqrt(n)): {sigma / np.sqrt(n_data):.3f}")

# 5. 可視化(左:推定の軌跡、右:サンプルのヒストグラムと理論上の事後分布)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5), gridspec_kw={'width_ratios': [2, 1]})

axes[0].plot(samples_mu, color='steelblue', linewidth=0.7)
axes[0].axhline(true_mu, color='red', linestyle='--', label='真値 (0)')
axes[0].axvspan(0, burn_in_mu, color='gray', alpha=0.2, label='バーンイン(捨てる区間)')
axes[0].set_xlabel('ステップ')
axes[0].set_ylabel('mu')
axes[0].set_title('推定の軌跡(初期値 mu = 3.0)')
axes[0].legend(loc='upper right')
axes[0].grid(True, alpha=0.3)

post_sd = sigma / np.sqrt(n_data)
mu_grid = np.linspace(kept.min() - 0.2, kept.max() + 0.2, 200)
post_pdf = np.exp(-(mu_grid - data.mean())**2 / (2 * post_sd**2)) / np.sqrt(2 * np.pi * post_sd**2)
axes[1].hist(kept, bins=40, density=True, color='steelblue', alpha=0.6, label='MCMCのサンプル')
axes[1].plot(mu_grid, post_pdf, color='black', label='理論上の事後分布')
axes[1].axvline(true_mu, color='red', linestyle='--', label='真値 (0)')
axes[1].set_xlabel('mu')
axes[1].set_title('バーンイン後のサンプルの分布')
axes[1].legend(loc='upper right', fontsize=9)
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
MCMCの基本的な流れは、「提案 → 評価 → 受理判定 → 記録」の4つの繰り返しです。この流れは、後の回帰モデルでもまったく同じなので、ここで1つずつ丁寧に見ておきます。
-
提案: 現在地 current_mu に rng.normal(0, step_size) の小さな揺らぎを加えて、次の候補 prop_mu を作ります。
-
評価(対数事後確率): log_posterior_mu は、上の事後分布の式の対数を計算しています。事前分布は一様分布なので定数となり、比較には影響しません。そのため、計算するのは尤度 の対数だけで済みます。尤度の式の両辺の対数を取ると、積 は和 に変わり、 は外れます。さらに なので、次の形になります。
最後の式が、コードの -np.sum(0.5 * np.log(2 * np.pi * sigma2) + (data - mu) 2 / (2 * sigma**2)) にそのまま対応しています(マイナスを の外にくくり出した形です)。data - mu は配列 data の全要素から一度に を引く計算(ベクトル化)で、np.sum が の役割を果たします。第2項は とデータのずれの2乗なので、 がデータの中心に近いほど対数事後確率は大きくなります。
-
受理判定: 対数を使わずに書くと、メトロポリス法の受理判定は本来「確率の比」で行います。まず、現在地と候補の事後確率の比を計算します。
ベイズの定理の分母 は、ここで打ち消し合います(今回は事前分布 も一様分布なので打ち消し合い、 は尤度の比になります)。次に、0〜1の一様乱数 を引き、 なら受理します。(候補のほうが確率が高い)なら は必ず より小さいので常に受理されます。(候補のほうが確率が低い)なら、ちょうど確率 で受理されます。つまり、対数を使わないコードは本来「一様乱数 rng.uniform(0, 1) が確率の比 prop_post / current_post より小さければ受理」という形になります。
ところが、事後確率そのものはデータ件数分の確率密度の積なので、非常に小さな値になります。この例でも、初期値 での対数事後確率は約 で、確率に直すと約 しかありません。データが増えたり、後の回帰モデルのように初期値で予測が大きく外れていたりすると、コンピュータで表せる最小の数を下回ります。そうなると np.exp で確率に戻した値が 0.0 になり(アンダーフロー)、比 が となって計算できなくなります。
そこで、不等式 の両辺の対数を取ります。対数は単調増加な関数なので、両辺に適用しても大小関係は変わりません。
右辺では「比の対数」が「対数の差」になるので、確率に戻さず、対数事後確率のまま引き算するだけで済みます。これがコードの log_accept_ratio = prop_log_post - current_log_post で、左辺が np.log(rng.uniform(0, 1)) です。判定の意味は元の「確率の比と一様乱数の比較」とまったく同じです。改善なら となり、 は常に0以下なので必ず受理されます。改悪なら確率 で受理されます。
-
記録: 受理・棄却にかかわらず、毎ステップ現在地を samples に追加します。棄却されたときに同じ値を重ねて記録するのは、「その場所に留まった回数」自体が確率の高さを表しているためです。確率の高い場所ほど長く留まり、多く記録されるので、サンプルの分布が事後分布の形になります。棄却時の記録を省くと、確率の高い場所が過小評価され、分布が歪みます。
最後に、初期値の影響が残る先頭の burn_in_mu = 200 ステップをバーンインとして捨て、残りのサンプルの平均と標準偏差を、理論上の値と比べています。
実行結果
受理率: 74.7%
データの標本平均: -0.183
MCMCの事後平均: -0.190, 事後標準偏差: 0.218
理論上の事後標準偏差 (sigma / sqrt(n)): 0.224
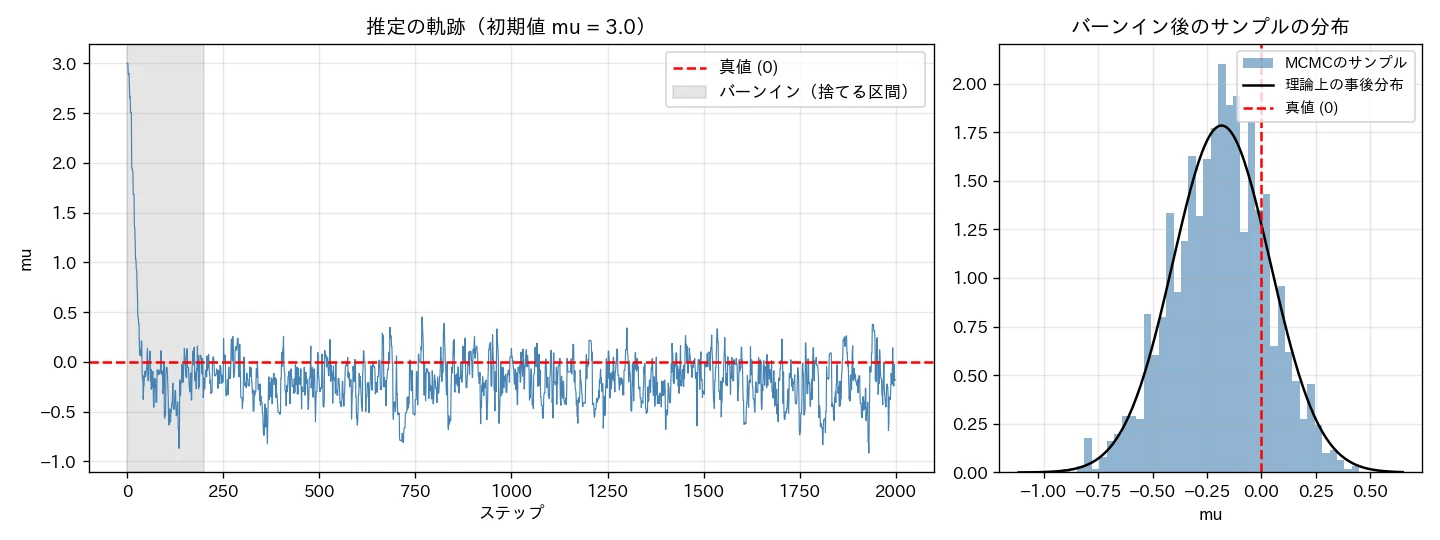
左の図が推定の軌跡です。 から出発したサンプルは、最初の数十ステップで一気に 付近まで下りてきて、その後は の周辺を細かく行ったり来たりしています。この「行ったり来たり」は推定の失敗ではなく、「 はこのくらいの範囲にありそうだ」という不確かさそのものを表しています。
右の図は、バーンイン後のサンプルをヒストグラムにしたものです。黒い線の理論上の事後分布とよく重なっており、提案と受理判定を繰り返すだけで、積分を一度も計算せずに事後分布を再現できていることが分かります。
事後平均が真値 ではなく 付近になっているのは、MCMCの誤りではありません。今回たまたま生成された20個のデータの標本平均が だったためで、MCMCは「このデータから言えること」を正しく捉えています。
次の節からは、同じ仕組みを、パラメータが3つ()ある回帰モデルに広げていきます。
ダミーデータの生成
1パラメータの例で仕組みをつかんだところで、次は単回帰モデル の簡単なダミーデータを生成し、MCMCで真値()を復元できるか試してみましょう。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 乱数シードを固定
rng = np.random.default_rng(42)

# 2. 真のパラメータ
true_alpha = 5.0
true_beta = 2.5
true_sigma = 1.5
n = 50

# 3. ダミーデータの生成
x = rng.uniform(0, 10, size=n)
epsilon = rng.normal(0, true_sigma, size=n)
y = true_alpha + true_beta * x + epsilon

# 4. データの可視化
x_line = np.linspace(0, 10, 100)
plt.figure(figsize=(8, 5))
plt.scatter(x, y, color='blue', alpha=0.7, label='観測データ')
plt.plot(x_line, true_alpha + true_beta * x_line, color='red', label='真の回帰直線', linestyle='--')
plt.xlabel("x")
plt.ylabel("y")
plt.legend()
plt.title("ダミーデータと真の回帰直線")
plt.grid(True, linestyle='--', alpha=0.6)
plt.show()
ここでは、真値を仕込んだ単回帰のダミーデータを生成しています。
- 乱数生成器の固定: np.random.default_rng(42) で乱数生成器を作成しています。グローバルな np.random.seed ではなく生成器オブジェクト rng から乱数を引くことで、後のコードで別の乱数を使っても、このデータの再現性が損なわれません。
- 真値の設定: true_alpha、true_beta、true_sigma は、MCMCで復元を目指す「答え」です。データ数 n = 50 は、後半の事前分布の比較でデータを5件に減らした版と対比するための基準になります。
- データの生成: rng.uniform(0, 10, size=n) で を0〜10の範囲から50個引き、rng.normal(0, true_sigma, size=n) で標準偏差1.5の観測ノイズを加えています。モデル をそのままコードにしたもので、推定に使うモデルと生成過程が一致しているため、推定結果を真値と直接比べられます。
- 可視化: 真の回帰直線は、ランダムな順序の x ではなく、等間隔に並べた x_line で描いています(x のまま plt.plot すると、点の並び順どおりに線が結ばれて乱れるため)。散布図の点が直線の周りにばらつく幅が、 に相当します。
実行結果
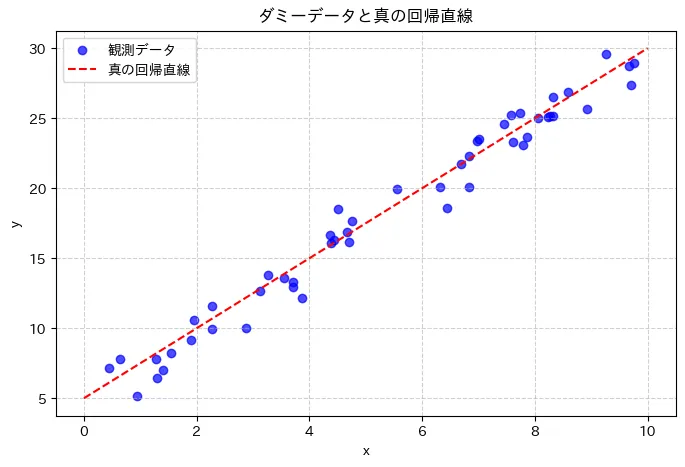
メトロポリス法の1ステップを図にすると、次のようになります。
(図は、diagram-designで作成)
メトロポリス法のスクラッチ実装
焼きなまし法のコードを改造し、最もシンプルなMCMCである「メトロポリス法」を実装します。焼きなまし法からの変更点は次の3つです。
- 温度の冷却を外す( に固定)
- 評価関数を対数事後確率に替える
- 最良解だけでなく、訪れた場所をすべて記録する
また、 は負にならないように対数変換()してから探索します。今回は簡単のため、、、 の事前分布には一様分布(どの値も同じくらいありうる、という事前分布)を置いています。
# 1. 事前分布、尤度、事後分布の定義
def log_prior(alpha, beta, log_sigma):
    """事前分布の対数(シンプルにするため一様分布を仮定)"""
    if log_sigma < -10 or log_sigma > 10:
        return -np.inf
    return 0.0

def log_likelihood(alpha, beta, log_sigma, x, y):
    """尤度の対数(正規分布)"""
    sigma = np.exp(log_sigma)
    mu = alpha + beta * x
    # 正規分布の対数確率密度関数の和
    return -np.sum(0.5 * np.log(2 * np.pi * sigma**2) + (y - mu)**2 / (2 * sigma**2))

def log_posterior(alpha, beta, log_sigma, x, y):
    """事後分布の対数(尤度 + 事前分布)"""
    lp = log_prior(alpha, beta, log_sigma)
    if not np.isfinite(lp):
        return -np.inf
    return lp + log_likelihood(alpha, beta, log_sigma, x, y)

# 2. メトロポリス法の実装
def metropolis_mcmc(x, y, n_samples=5000, step_size=0.1, seed=42, init=(0.0, 0.0, 0.0)):
    rng = np.random.default_rng(seed)

    # 初期値(alpha, beta, log_sigma)
    current_alpha, current_beta, current_log_sigma = init
    current_log_post = log_posterior(current_alpha, current_beta, current_log_sigma, x, y)

    samples = []
    accepted = 0

    for _ in range(n_samples):
        # 近傍への提案(3つのパラメータを同時に少しずつ動かす)
        prop_alpha = current_alpha + rng.normal(0, step_size)
        prop_beta = current_beta + rng.normal(0, step_size)
        prop_log_sigma = current_log_sigma + rng.normal(0, step_size)

        prop_log_post = log_posterior(prop_alpha, prop_beta, prop_log_sigma, x, y)

        # 遷移判定(メトロポリス基準)
        # T=1に固定し、評価値の差分(対数事後確率の差分)を計算
        log_accept_ratio = prop_log_post - current_log_post

        # 改善(log_accept_ratio > 0)なら確率は1より大きくなり必ず受理される
        # 改悪の場合でも、確率 np.exp(log_accept_ratio) で受理される
        if np.log(rng.uniform(0, 1)) < log_accept_ratio:
            current_alpha, current_beta, current_log_sigma = prop_alpha, prop_beta, prop_log_sigma
            current_log_post = prop_log_post
            accepted += 1

        # 最良解だけでなく、現在地を毎回すべて記録する(棄却されたときは同じ値が続く)
        samples.append((current_alpha, current_beta, np.exp(current_log_sigma)))

    return np.array(samples), accepted / n_samples

# 3. MCMCの実行
samples, accept_rate = metropolis_mcmc(x, y, n_samples=10000, step_size=0.1)
print(f"受理率: {accept_rate * 100:.1f}%")

# 4. 後半のサンプル(バーンイン後)を取り出して平均を計算
burn_in = 2000
post_burn_in_samples = samples[burn_in:]
alpha_mean = np.mean(post_burn_in_samples[:, 0])
beta_mean = np.mean(post_burn_in_samples[:, 1])
sigma_mean = np.mean(post_burn_in_samples[:, 2])

print(f"真値 -> alpha: {true_alpha}, beta: {true_beta}, sigma: {true_sigma}")
print(f"推定値 -> alpha: {alpha_mean:.2f}, beta: {beta_mean:.2f}, sigma: {sigma_mean:.2f}")

# 5. 参考:最小二乗法(OLS)による推定値
X_design = np.column_stack([np.ones(n), x])
ols_coef, *_ = np.linalg.lstsq(X_design, y, rcond=None)
ols_sigma = np.sqrt(np.sum((y - X_design @ ols_coef) ** 2) / (n - 2))
print(f"OLS    -> alpha: {ols_coef[0]:.2f}, beta: {ols_coef[1]:.2f}, sigma: {ols_sigma:.2f}")

# 6. トレースプロット(サンプルの軌跡)
fig, axes = plt.subplots(3, 1, figsize=(10, 8), sharex=True)
for ax, idx, name, true_val in zip(axes, [0, 1, 2], ['alpha', 'beta', 'sigma'],
                                   [true_alpha, true_beta, true_sigma]):
    ax.plot(samples[:, idx], color='steelblue', linewidth=0.6)
    ax.axhline(true_val, color='red', linestyle='--', label=f'真値 ({true_val})')
    ax.axvspan(0, burn_in, color='gray', alpha=0.2, label='バーンイン(捨てる区間)')
    ax.set_ylabel(name)
    ax.legend(loc='lower right')
    ax.grid(True, alpha=0.3)
axes[0].set_title('メトロポリス法のトレースプロット(step_size = 0.1)')
axes[-1].set_xlabel('ステップ')
plt.tight_layout()
plt.show()
提案・評価・受理判定・記録という流れと、対数で計算する理由は、先ほどの正規分布の平均の例とまったく同じです。ここでは、パラメータが の1つから の3つに増えたことで変わる点を中心に解説します。
-
事前分布 log_prior: 一様分布なので、定義域の中では定数(ここでは0)を返すだけです。log_sigma が ±10 を超える極端な値のときだけ -np.inf(確率0)を返し、 が極端に大きく・小さくなる方向へ迷い込むのを防いでいます。 には範囲の制限がないため、厳密には積分しても1にならない「非正則な事前分布」ですが、データが十分にあれば事後分布はきちんと定まります。
-
尤度 log_likelihood: 平均の例では、全データに共通の平均 の周りにデータがばらつくと考えていました。回帰モデルでは、その を、データごとに予測された直線 に置き換えます。つまり、「データ は、直線上の予測値 の周りに、標準偏差 の正規分布に従ってばらつく」というモデルです。対数尤度は、平均の例の式の を に替えただけの形になります。
コードの mu = alpha + beta * x が直線による予測値 で、配列 x 全体に対して一度に計算されます。y - mu が予測からのずれ(誤差 )です。直線がデータの近くを通るほど、第2項が小さくなり、対数尤度は大きくなります。今回は も推定するので、第1項の役割も重要になります。第1項は を大きくするほど対数尤度を小さくするため、「誤差を で割って小さく見せるために をむやみに大きくする」ことへのペナルティとして働きます。その結果、データのばらつきに見合った が選ばれます。
-
事後分布 log_posterior: ベイズの定理の分子(尤度 × 事前分布)の対数、つまり「対数尤度 + 対数事前分布」を返します。分母の は、受理判定で差を取ると打ち消し合うため計算していません。事前分布が -np.inf のときは、尤度を計算せずにそのまま打ち切っています。
-
提案(近傍の生成): 3つのパラメータそれぞれに rng.normal(0, step_size) の揺らぎを加えて、次の候補を作ります。焼きなまし法では一様分布で近傍を作っていましたが、ここでは正規分布を使っています。どちらも「AからBを提案する確率」と「BからAを提案する確率」が等しい(対称な)提案なので、メトロポリス基準をそのまま使えます。
-
受理判定: 平均の例と同じく、対数事後確率の差 log_accept_ratio と np.log(rng.uniform(0, 1)) を比べています。回帰モデルでは、対数を使うことが必須になります。初期値 での対数事後確率は約 で、 を np.exp で計算すると 0.0 になり、確率の比が計算できないためです。なお、この判定は、焼きなまし法の「一様乱数が math.exp(delta_f / T) より小さければ受理」において、 として両辺の対数を取ったものと見ることもできます。
-
全サンプルの記録: 平均の例と同じく、棄却されたときも現在地を記録しています。 は np.exp(current_log_sigma) で元のスケールに戻してから記録しています。
-
引数と戻り値: metropolis_mcmc は、init 引数で初期値を、seed 引数で乱数を切り替えられるようにしてあります。次の節で、ばらばらの初期値から複数のチェーンを走らせるための準備です。戻り値は、形状が (ステップ数, 3) のサンプル配列と受理率です。
-
バーンインと要約: 先頭の burn_in = 2000 ステップを捨て、残り8000個の平均を事後平均としています。比較用に np.linalg.lstsq で最小二乗法(OLS)の係数も計算し、 は残差平方和を自由度 で割って求めています。
-
トレースプロット: 各パラメータの値をステップ順に描き、真値(赤の破線)とバーンイン区間(灰色の帯)を重ねています。初期値から事後分布の中心へ移動していく様子と、その後の揺らぎ方を目で確認するための図です。
実行結果
受理率: 25.6%
真値 -> alpha: 5.0, beta: 2.5, sigma: 1.5
推定値 -> alpha: 4.66, beta: 2.52, sigma: 1.18
OLS    -> alpha: 4.65, beta: 2.52, sigma: 1.16
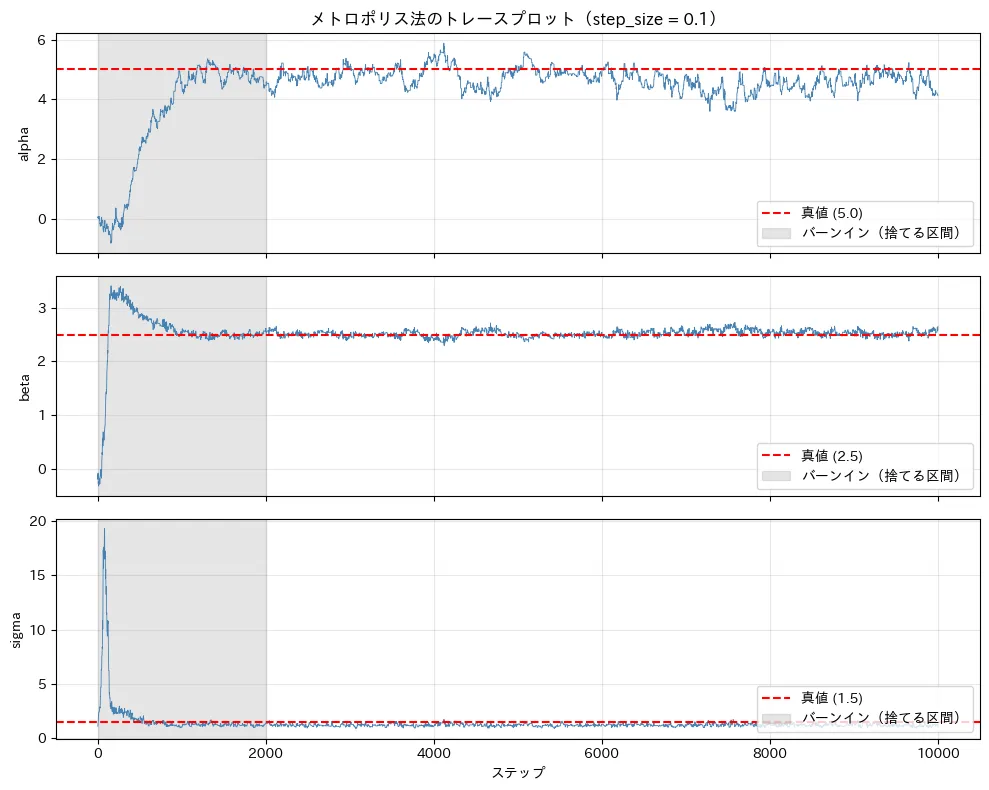
トレースプロットを見ると、初期値 から出発したサンプルが、最初の1000ステップほどで真値の周辺にたどり着き、その後はその周辺を行ったり来たりしていることが分かります。最初の区間(灰色)は初期値の影響が残っているため、バーンイン として捨ててから平均を計算しています。
推定値は 、、 となりました。 が真値 より小さいのは、MCMCの誤りではなく、今回たまたま生成された50個のデータのばらつきが小さかったためです。参考として計算した最小二乗法(OLS)の推定値ともほぼ一致しており、MCMCが「このデータから言えること」を正しく捉えていることが分かります。
ただし、この1本のチェーンだけで「正しく推定できた」と言い切るのは早計です。次の節で、その理由を確認します。
収束診断:MCMCの結果は信頼できるか
MCMCは「十分に長く歩けば事後分布に従う」という手法なので、実際に十分歩けたのか を確認する必要があります。そのための道具が収束診断です。
- バーンイン(Burn-in): 探索の初期は適当な初期値から始まるため、定常状態(事後分布)に達するまでの最初のサンプルを捨てます。
- 複数チェーン: 異なる初期値・乱数シードから始めた複数のチェーン(連鎖)が、同じ分布に収束しているかを確認します。
- トレースプロット: サンプルの軌跡を描き、複数のチェーンが同じ範囲で毛虫のようにきれいに混ざり合っているかを確認します。
- (R-hat): 「チェーン間のばらつき」と「チェーン内のばらつき」を比べ、チェーンが同じ分布に収束しているかを示す指標です。1に近いほど良く、現在は 1.01 未満 が目安とされています(Vehtari et al., 2021)。
- 有効サンプルサイズ (ESS): MCMCのサンプルは直前の値に似ている(自己相関がある)ため、8000個のサンプルがあっても、独立なサンプル8000個分の情報があるとは限りません。「実質的に独立なサンプルがいくつ分あるか」を示すのがESSで、大きいほど効率的にサンプリングできています。目安として、少なくとも数百以上は欲しいところです。
提案幅を変えて収束診断してみる
焼きなまし法の記事では、「近傍の幅(1回の移動の大きさ)」が探索性能を大きく左右することを確認しました。MCMCでも、この 提案幅 は重要です。ただし、問われることが少し違います。最適化では「谷を越えられるか」が重要でしたが、サンプリングでは「分布全体をいかに効率よく回れるか」が問われます。
- 狭すぎる: 受理率は高くなりますが、少しずつしか進まないため自己相関が強くなり、分布全体を覆うのに時間がかかります。
- 広すぎる: 事後確率の高い領域を飛び越えてしまい、受理率が極端に下がって同じ場所に留まり続けます。
実際に、提案幅を4通りに変え、ばらばらの初期値から4本のチェーンを走らせて比較してみましょう。
import arviz as az

# 1. 4本のチェーンを、ばらばらの初期値(alpha, beta, log_sigma)から走らせる
inits = [(0.0, 0.0, 0.0), (10.0, -2.0, 1.0), (-5.0, 5.0, -1.0), (8.0, 4.0, 0.5)]
step_sizes = [0.02, 0.1, 0.3, 1.0]
burn_in = 2000

results = {}
for step in step_sizes:
    chains, accept_rates = [], []
    for seed, init in enumerate(inits):
        s, a = metropolis_mcmc(x, y, n_samples=10000, step_size=step, seed=seed, init=init)
        chains.append(s)
        accept_rates.append(a)
    chains = np.array(chains)  # 形状: (チェーン数, ステップ数, パラメータ数)
    results[step] = chains

    # 2. バーンイン後のサンプルを ArviZ に渡して、R-hat と ESS を計算
    posterior = az.convert_to_dataset({
        'alpha': chains[:, burn_in:, 0],
        'beta': chains[:, burn_in:, 1],
        'sigma': chains[:, burn_in:, 2],
    })
    summary = az.summary(posterior)[['mean', 'sd', 'ess_bulk', 'r_hat']]
    print(f"=== step_size = {step}(受理率 {np.mean(accept_rates) * 100:.1f}%)===")
    print(summary, "\n")

# 3. beta のトレースプロットを提案幅ごとに比較(色がチェーンの違い)
fig, axes = plt.subplots(len(step_sizes), 1, figsize=(10, 10), sharex=True)
for ax, step in zip(axes, step_sizes):
    for c in range(len(inits)):
        ax.plot(results[step][c, :, 1], linewidth=0.6, alpha=0.8, label=f'チェーン{c + 1}')
    ax.axhline(true_beta, color='black', linestyle='--', linewidth=1)
    ax.axvspan(0, burn_in, color='gray', alpha=0.2)
    ax.set_ylim(1.5, 3.5)
    ax.set_ylabel('beta')
    ax.set_title(f'step_size = {step}')
    ax.grid(True, alpha=0.3)
axes[0].legend(loc='upper right', ncol=4)
axes[-1].set_xlabel('ステップ')
plt.tight_layout()
plt.show()
同じメトロポリス法を、提案幅と初期値を変えて何度も走らせ、ArviZ で収束診断の指標を計算しています。
- ばらばらの初期値: inits には、真値から離れた4つの初期値(alpha、beta、log_sigma の組)を用意しています。わざと離れた場所から出発させることで、「どこから始めても同じ分布にたどり着くか」を確かめられます。チェーンごとに seed も変えています。
- 二重ループ: 外側のループで提案幅 step_sizes を、内側のループで4本のチェーンを回しています。np.array(chains) で、形状が (チェーン数 4, ステップ数 10000, パラメータ数 3) の3次元配列にまとめています。
- ArviZ への受け渡し: az.convert_to_dataset に、(チェーン, ドロー) の2次元配列を変数ごとに辞書で渡すと、PyMC の出力と同じ形式のデータセットに変換されます。これにより、スクラッチ実装の結果にも PyMC と同じ az.summary で とESSを計算できます。バーンイン分は chains[:, burn_in:, 0] のように、ステップの軸(2番目の軸)で切り落としてから渡しています。
- 表示する列の指定: az.summary(posterior)[['mean', 'sd', 'ess_bulk', 'r_hat']] で列を絞っています。ArviZ のバージョンによって既定で表示される列が異なるためです。ここで見るべきは、平均・標準偏差に加えて、ess_bulk(分布の中心部分についての有効サンプルサイズ)と r_hat です。
- トレースプロットの比較: 提案幅ごとに1段ずつ、 の4本のチェーンを色分けして重ねています。縦軸を ax.set_ylim(1.5, 3.5) で揃えているので、段どうしで揺らぎ方を直接比べられます。4色が混ざり合って見分けられない状態が、収束している理想的な状態です。
実行結果
=== step_size = 0.02(受理率 77.6%)===
      mean   sd ess_bulk r_hat
alpha    4    2        5  2.20
beta   2.7  0.3        5  2.07
sigma  1.5  0.7        8  1.42

=== step_size = 0.1(受理率 25.9%)===
        mean     sd ess_bulk r_hat
alpha   4.62   0.35       93  1.04
beta    2.52  0.058      124  1.04
sigma  1.172   0.12     1497  1.00

=== step_size = 0.3(受理率 5.2%)===
        mean     sd ess_bulk r_hat
alpha   4.71   0.39      232  1.03
beta   2.509  0.063      278  1.02
sigma  1.188  0.135      742  1.01

=== step_size = 1.0(受理率 0.4%)===
       mean    sd ess_bulk r_hat
alpha   4.7   0.3       31  1.18
beta   2.51  0.06       20  1.13
sigma  1.14  0.14       28  1.35
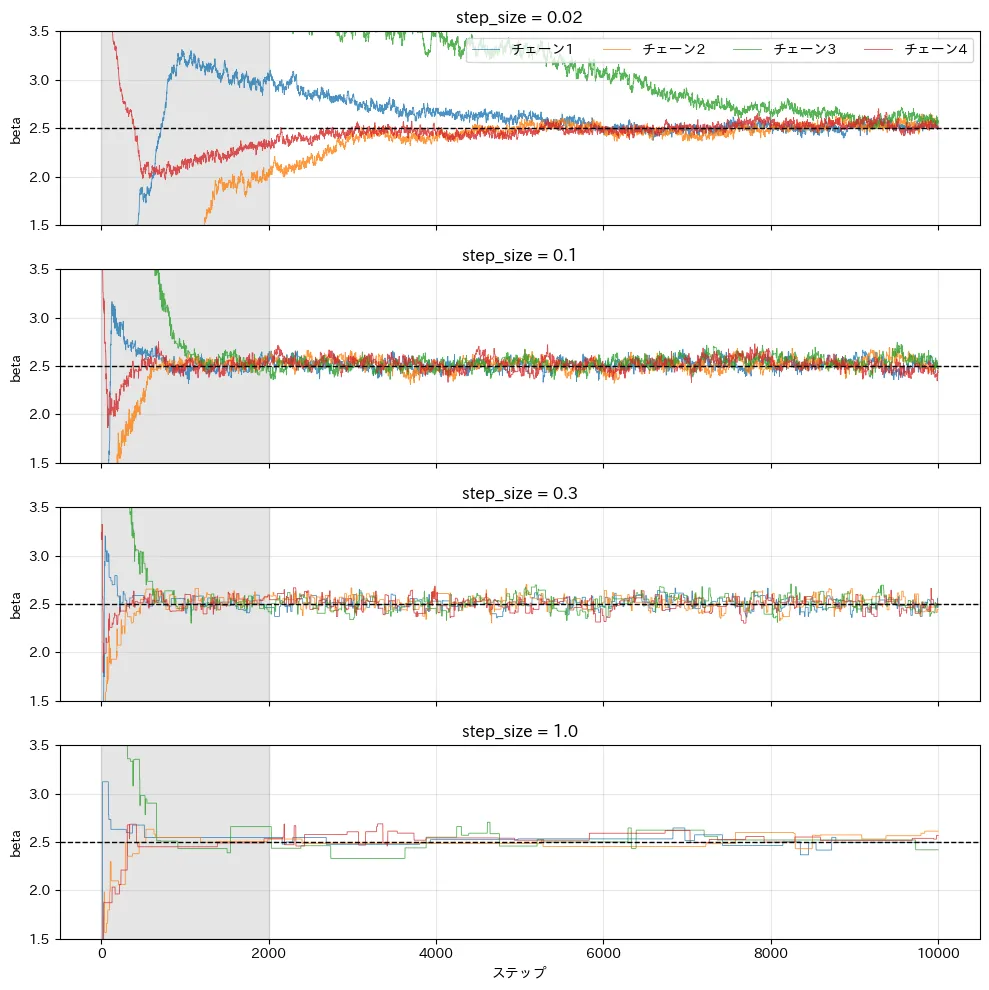
- step_size = 0.02(狭すぎる): 受理率は77.6%と高いものの、1歩が小さすぎて、10000ステップたってもチェーンが同じ場所に集まりきっていません。 は2を超え、ESSはわずか5です。この結果は信頼できません。
- step_size = 0.1(先ほどの設定): 平均値はOLSとほぼ一致しますが、 は1.04と目安の1.01を超え、 のESSは93しかありません。8000 × 4本 = 32000個のサンプルがあっても、実質的には100個分程度の情報しかないということです。先ほどの1本のチェーンで「うまくいった」ように見えたのは、この危うさに気づけていなかったからです。
- step_size = 0.3: 受理率は5.2%まで下がりますが、1回の移動が大きいぶん、 と のESSは今回の4通りで最も大きくなりました。
- step_size = 1.0(広すぎる): 受理率は0.4%。トレースプロットは階段状になり、同じ値に長く留まっています。 も1.1を超えています。
平均値だけを見ると、どの設定でも真値に近い値が出ているように見えます。しかし収束診断を見れば、信頼できる結果かどうかは一目瞭然 です。MCMCの結果を使うときは、平均値より先に とESSを確認する習慣をつけましょう。
4つの提案幅の結果を並べると、次のようになります。
(図は、diagram-designで作成)
PyMCによるモデル定義とHMC/NUTS
今回のスクラッチ実装は、どの提案幅でも満足のいく結果になりませんでした。原因の1つは、(切片)と (傾き)の事後分布が強く相関している(相関係数は約 )ことです。 が 0〜10 の範囲にあるため、「傾きを少し大きくしたら、切片を少し小さくする」という組み合わせでないとデータに合いません。事後分布は斜めに細長い形になり、全方向に同じ幅でランダムに提案するメトロポリス法では、細長い方向に効率よく進めないのです。パラメータの数(次元)が増えると、この問題はさらに深刻になります。
そこで、事後分布の 勾配情報 を使って、「分布の山の斜面に沿って勢いよく滑るように、遠くまで移動する」アルゴリズムが考案されました。これが HMC(ハミルトニアン・モンテカルロ) であり、その移動距離などを自動で調整してくれるのが NUTS(No-U-Turn Sampler) です。
Pythonのベイズ推定ライブラリである PyMC は、このNUTSをデフォルトで採用しています。同じモデルをPyMCで記述し、推定を行ってみましょう。スクラッチ実装とは異なり、事前分布には幅の広い正規分布を置いています(データが50個あるので、結果にはほとんど影響しません)。
import pymc as pm

with pm.Model() as model:
    # 1. 事前分布(データの情報を邪魔しない、幅の広い分布)
    alpha = pm.Normal('alpha', mu=0, sigma=10)
    beta = pm.Normal('beta', mu=0, sigma=10)
    sigma = pm.HalfNormal('sigma', sigma=5)

    # 2. 予測式
    mu = alpha + beta * x

    # 3. 尤度(データに適合させる)
    y_obs = pm.Normal('y_obs', mu=mu, sigma=sigma, observed=y)

    # 4. サンプリング(NUTSが自動的に使われます)
    trace = pm.sample(2000, tune=1000, chains=4, random_seed=42)

# 結果の要約
print(az.summary(trace)[['mean', 'sd', 'ess_bulk', 'ess_tail', 'r_hat']])
print("発散の数:", int(trace.sample_stats['diverging'].sum()))
スクラッチ実装と同じ単回帰モデルを、PyMC で定義して NUTS で推定しています。
- モデルの定義: with pm.Model() as model: のブロック内で定義した確率変数が、1つのモデルとして登録されます。PyMC はここから、対数事後確率とその勾配を自動で組み立てます。スクラッチ実装で手書きした log_posterior に相当する部分を、ライブラリが作ってくれるイメージです。
- 事前分布: alpha と beta には、標準偏差10の正規分布を置いています。データの値のスケール(数〜数十)に対して十分に広く、データの情報をほとんど邪魔しない「弱い事前分布」です。 には、負の値を取らない pm.HalfNormal を使っています。スクラッチ実装で手動で行った への変換は、PyMC が内部で自動的に行っています。
- 尤度: pm.Normal('y_obs', mu=mu, sigma=sigma, observed=y) のように observed 引数に観測データを渡すと、その確率変数は推定の対象ではなく、尤度として扱われます。スクラッチ実装の log_likelihood に対応する部分です。
- サンプリング: pm.sample(2000, tune=1000, chains=4, random_seed=42) は、4本のチェーンそれぞれで、1000ステップの調整期間の後に2000個のサンプルを取ります。tune の期間は単なるバーンインではなく、NUTS の1歩の大きさなどを自動で調整する期間でもあり、この期間のサンプルは結果から自動的に除外されます。スクラッチ実装で手動で行った「提案幅の調整」と「バーンイン」を、PyMC が自動でこなしてくれるわけです。
- 結果の要約と発散の確認: az.summary(trace) で、スクラッチ実装と同じ指標を表示しています。ess_tail は、分布の裾(信用区間の端)についての有効サンプルサイズです。trace.sample_stats['diverging'] には各サンプルで発散が起きたかどうかが真偽値で記録されており、その合計が発散の件数になります。
実行結果
        mean     sd ess_bulk ess_tail r_hat
alpha   4.63  0.362     2958     3655  1.00
beta   2.522   0.06     2931     3294  1.00
sigma  1.192  0.127     4486     3814  1.00
発散の数: 0
| スクラッチ(step_size = 0.3) | PyMC(NUTS) | |
|---|---|---|
| の平均 | 2.509 | 2.522 |
| のESS | 278 | 2931 |
| の | 1.02 | 1.00 |
| 総サンプル数 | 32000(8000 × 4本) | 8000(2000 × 4本) |
推定値はスクラッチ実装やOLSとほぼ一致しています。そのうえで、r_hat はすべて 1.00、ess_bulk は約3000〜4500 です。 で比べると、スクラッチ実装の約10倍の有効サンプルサイズを、4分の1のサンプル数で得られています。勾配を使うことで、斜めに細長い事後分布でも効率よく動けていることが分かります。
PyMC 6.3.2、ArviZ 1.3.0 で動作を確認しています。ArviZ のバージョンによって az.summary の既定の列(信用区間の列名など)が異なるため、本記事では表示する列を明示的に指定しています。また、実行環境によって推定値の下の桁やESSの値がわずかに異なる場合があります。
発散(Divergences)の意味
PyMCを実行した際、「Divergences(発散)」という警告が出ることがあります。これは、分布の形状が極端に急峻な谷(漏斗状のファンネルなど)になっており、HMCのシミュレーションの計算誤差が蓄積してサンプラーが軌道から外れてしまったことを意味します。
発散が起きたときの結果は信頼できないため、対処が必要です。主な対処法は次の2つです。
- サンプラーを慎重にする: pm.sample(..., target_accept=0.99) のように目標受理率を上げると、1歩を小さくして急な地形でも慎重に進むようになります。次の節で実際に使います。
- モデルを書き換える: 根本的な対処法は、サンプラーが歩きやすい形にモデルを書き換えることです。代表的な方法である 非中心化パラメータ化 については、CausalImpactの記事で詳しく解説しています。
事前分布の影響
最後に、事前分布の影響 を確認しておきましょう。3種類の事前分布と2通りのデータ数(5件と50件)を組み合わせて、推定結果を比較します。
- 弱い事前分布: 平均0、標準偏差10。データの情報をほとんど邪魔しない。
- 誤った強い事前分布: 平均0、標準偏差0.5。真値(、)から離れた0の周辺に強く引っ張る。
- 正しい強い事前分布: 平均が真値、標準偏差0.5。「確かな事前情報」がある状況を想定する。
# 1. 比較する3種類の事前分布(alpha, beta それぞれの 平均, 標準偏差)
priors = {
    '弱い事前分布 N(0, 10)':          {'alpha': (0, 10), 'beta': (0, 10)},
    '誤った強い事前分布 N(0, 0.5)':    {'alpha': (0, 0.5), 'beta': (0, 0.5)},
    '正しい強い事前分布 N(真値, 0.5)': {'alpha': (5, 0.5), 'beta': (2.5, 0.5)},
}

rows = []
for n_use in [5, 50]:
    # 2. 先頭 n_use 件だけを使う
    x_use, y_use = x[:n_use], y[:n_use]
    for prior_name, p in priors.items():
        with pm.Model():
            alpha = pm.Normal('alpha', mu=p['alpha'][0], sigma=p['alpha'][1])
            beta = pm.Normal('beta', mu=p['beta'][0], sigma=p['beta'][1])
            sigma = pm.HalfNormal('sigma', sigma=5)
            pm.Normal('y_obs', mu=alpha + beta * x_use, sigma=sigma, observed=y_use)
            # データが少ないと事後分布の形が歪みやすく発散が起きやすいため、
            # tune を増やし、target_accept を高めにして慎重に歩かせる
            tr = pm.sample(2000, tune=2000, chains=4, random_seed=42,
                           target_accept=0.99, progressbar=False)
        post = tr.posterior
        rows.append({
            'データ数': n_use,
            '事前分布': prior_name,
            'beta 平均': float(post['beta'].mean()),
            'beta 標準偏差': float(post['beta'].std()),
            'sigma 平均': float(post['sigma'].mean()),
            '発散': int(tr.sample_stats['diverging'].sum()),
        })

# 3. 結果の一覧(真値: beta = 2.5, sigma = 1.5)
import pandas as pd
print(pd.DataFrame(rows).round(2).to_string(index=False))
データ数と事前分布を組み合わせた6通りの設定で、同じモデルを推定し直しています。
- 事前分布の設定を辞書で管理: priors に3種類の事前分布の(平均, 標準偏差)をまとめ、同じモデル定義をループで使い回しています。モデルの構造を変えずに事前分布だけを入れ替えているので、結果の違いはすべて「事前分布とデータ数の違い」によるものと解釈できます。
- データ数の切り替え: x[:n_use] と y[:n_use] で、先頭の n_use 件だけを使っています。5件の版は50件の版の一部なので、「同じ状況でデータを追加で集めた」場合の変化として比べられます。
- ループ内でのモデルの作り直し: with pm.Model(): とモデルに名前を付けていないのは、ループのたびに新しいモデルを作り直して使い捨てるためです。確率変数の名前('alpha' など)がモデル間で重複しても問題ありません。
- 慎重なサンプリング設定: tune=2000 で調整期間を長くし、target_accept=0.99 で目標受理率を上げています。目標受理率を上げると NUTS の1歩が小さくなり、データが少なく形の歪んだ事後分布でも発散しにくくなります(その代わり、計算時間は増えます)。
- 結果の集約: 各設定の事後分布 tr.posterior から、 の平均と標準偏差、 の平均、発散の件数を取り出しています。post['beta'].mean() は、チェーンとドローの両方の軸にわたる平均を計算します。最後に pd.DataFrame にまとめ、6通りの結果を1つの表で比べられるようにしています。
実行結果
 データ数                 事前分布  beta 平均  beta 標準偏差  sigma 平均  発散
    5      弱い事前分布 N(0, 10)     2.88       0.22      1.14   0
    5  誤った強い事前分布 N(0, 0.5)     1.05       0.57     10.90   0
    5 正しい強い事前分布 N(真値, 0.5)     2.62       0.13      1.51   0
   50      弱い事前分布 N(0, 10)     2.52       0.06      1.19   0
   50  誤った強い事前分布 N(0, 0.5)     2.79       0.07      1.51   0
   50 正しい強い事前分布 N(真値, 0.5)     2.50       0.05      1.19   0
結果から、次のことが分かります。
- データが少ない(5件)と、事前分布の影響が大きい: 弱い事前分布では と真値から離れていますが、これは5件のデータだけで計算した最小二乗法の値(2.88)とほぼ同じで、少ないデータのばらつきがそのまま表れたものです。一方、誤った強い事前分布では まで0に引きずられています。このとき、事前分布とデータの食い違いを埋め合わせるために、ノイズの大きさ が10.9と極端に大きく推定されている点にも注目してください。
- 正しい事前情報は、少ないデータを補う: 正しい強い事前分布では、5件のデータでも と真値に近く、標準偏差も0.13と、弱い事前分布(0.22)より不確実性が小さくなっています。
- データが増えると事前分布の影響は弱まるが、ゼロにはならない: 50件のデータでは、弱い事前分布でも とOLSと一致します。一方で、誤った強い事前分布では とずれが残りました。 が0の周辺に強く押さえつけられた結果、その分を で補おうとしたためです。強すぎる事前分布の誤りは、データが増えてもすぐには消えず、別のパラメータにも波及する ことがあります。
なお、このコードでは target_accept=0.99 と tune=2000 を指定しています。データが5件しかないと事後分布の形が歪みやすく、既定の設定では発散が発生したためです。上の結果はいずれも発散0件で得られています。
事前分布は、データが少ないときの弱点にも、確かな知識を取り込むための強みにもなります。実験や過去の分析で得られた知見を事前分布として組み込めば、データだけでは不確実な推定を安定させることができます。ただしその分、事前分布そのものの妥当性が結果を左右することも忘れてはいけません。
beta の事後平均を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、事後分布からサンプリングを行うMCMCの仕組みと、PyMCを使った実践的な推論、および収束診断の見方を学びました。
- メトロポリス法: 焼きなまし法と同じメトロポリス基準を、温度 に固定して使うことで、事後分布に比例した頻度でパラメータ空間を探索するアルゴリズムです。正規化定数の計算が不要な点がポイントです。
- 収束診断: 平均値が真値に近く見えても、結果が信頼できるとは限りません。複数チェーンのトレースプロット、(1.01未満が目安)、有効サンプルサイズを必ず確認します。
- 提案幅: 狭すぎても広すぎても効率が落ちます。パラメータ同士が強く相関していると、メトロポリス法ではどの幅でも効率よく探索できません。
- HMC/NUTS: 勾配を使うことで、相関の強い分布や高次元でも効率よく探索でき、PyMCのデフォルトとして採用されています。発散の警告が出たときは、target_accept の引き上げやモデルの書き換えで対処します。
- 事前分布: データが少ないときほど結果を大きく左右します。正しい事前情報は少ないデータを補い、誤った強い事前情報は推定を歪めます。
MCMCは、パラメータの推定値だけでなく「その推定がどれくらい確かか」を分布として得られる、ベイズ推定の中核となる道具です。時系列の効果測定(CausalImpact)、広告効果のモデリング、顧客の購買行動のモデリングなど、さまざまなベイズモデルの推定の土台になります。例えば、マーケティングミックスモデル(MMM)でもベイズ推定が使われ、その推定にMCMCが活用されます。
参考文献
- A. Vehtari, A. Gelman, D. Simpson, B. Carpenter, P.-C. Bürkner (2021). Rank-Normalization, Folding, and Localization: An Improved Rˆ for Assessing Convergence of MCMC (with Discussion). Bayesian Analysis, 16(2), 667–718.
- O. Abril-Pla et al. (2023). PyMC: a modern, and comprehensive probabilistic programming framework in Python. PeerJ Computer Science, 9, e1516.
本記事の文章・構成の一部に生成AIを使用しています。