MCP(Model Context Protocol)とは?
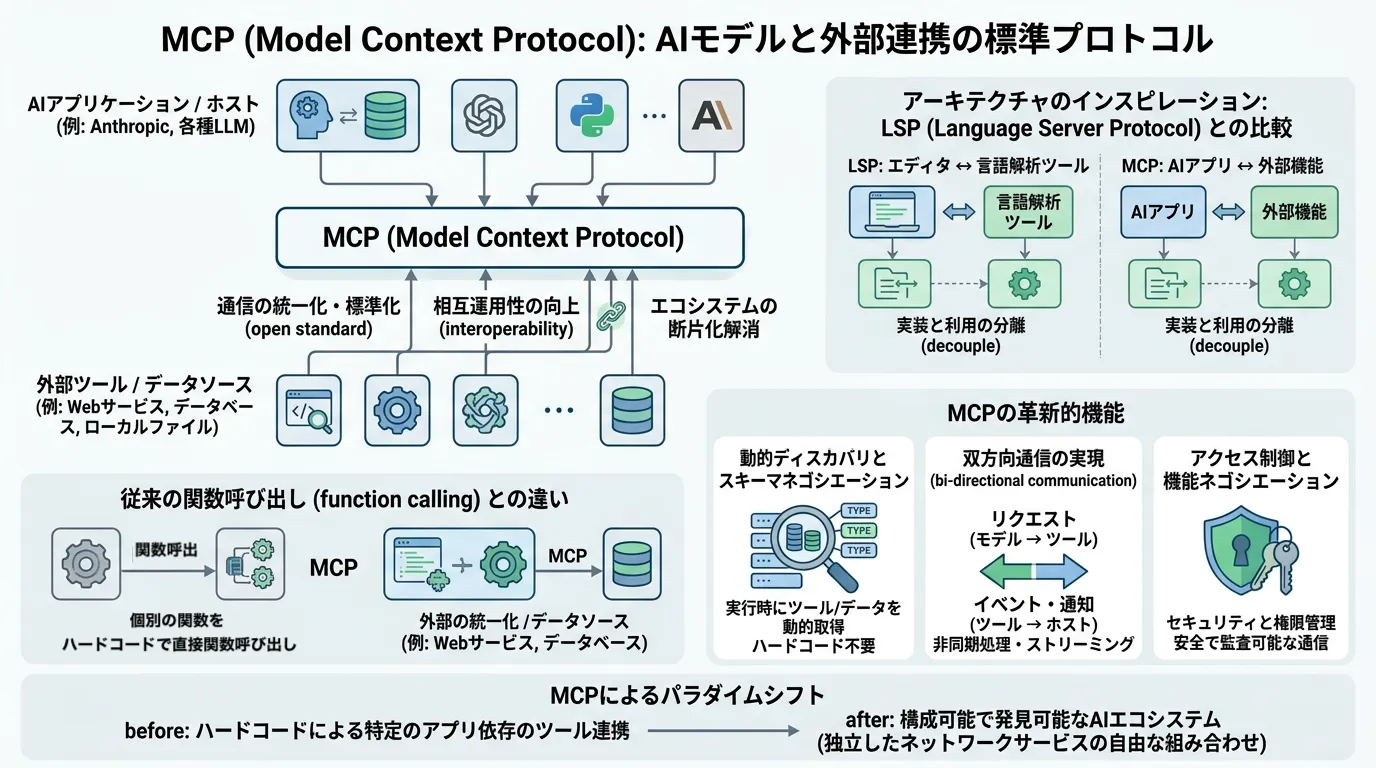
(画像は、Geminiで作成)
AI と外部のツールやデータの接続を標準化する MCP について、従来のツール統合の課題、ホスト・クライアント・サーバーからなるアーキテクチャ、通信と処理の流れを理解すること。LLM のツール選択を条件付き確率として定式化し、FastAPI と LLM によるスクラッチ実装と MCPServer(旧 FastMCP)でサーバーを動かして、MCP がもたらすセキュリティの課題の全体像を説明できるようになること。
MCP(Model Context Protocol)の概要
MCP(Model Context Protocol)は、AIモデルと外部ツールやデータソースとのやり取りを標準化するために、2024年後半にAnthropicによって提唱されたオープンな標準プロトコル(open standard)です。AIアプリケーションが外部の世界(Webサービス、データベース、ローカルファイルなど)とシームレスかつ安全に通信し、動的に情報を取得したり操作を実行したりするための統一されたインターフェースを提供します。
なお、本記事は論文「Model Context Protocol (MCP): Landscape, Security Threats, and Future Research Directions (arXiv:2503.23278v3, 2025年10月7日版)」に基づき構成しています(※版によってライフサイクルのフェーズ定義などが異なるため、v3を基準としています)。
近年、大規模言語モデル(LLM)は単なるテキスト生成にとどまらず、自律的にタスクをこなすAIエージェントとしての役割を期待されています。しかし、多様なシステム間でツールを連携させる仕組みはプラットフォームごとに異なり、開発者にとって大きな負担となっていました。MCPは、こうした多様なシステム間の相互運用性(interoperability)を高め、エコシステムの断片化(fragmentation)を解消することを目指して設計されています。
MCPのアーキテクチャは、ソフトウェア開発におけるLSP(Language Server Protocol)から強いインスピレーションを得ています。LSPが「エディタ」と「プログラミング言語の解析ツール」間の通信を統一したように、MCPは「AIアプリケーション」と「外部機能」の間の通信を統一します。これにより、ツールの実装とその利用を完全に分離(decouple)することが可能になります。
MCPは、従来の単純な関数呼び出し(function calling)のメカニズムを大きく拡張し、プロトコルレベルで以下のような革新的な機能を提供します。
- 動的ディスカバリ(dynamic discovery)とスキーマネゴシエーション クライアントは実行時にサーバーへ問い合わせることで、利用可能なツールやデータソースの一覧を動的に取得できます。これにより、事前にアプリケーション側へツールのアダプターをハードコードする必要がなくなります。
- 双方向通信(bi-directional communication)の実現 モデルからツールへの一方向のリクエストだけでなく、ツール側からホスト(AIアプリケーション)に向けた非同期のイベントや通知の送信をサポートしています。これにより、リアルタイムな状態更新やストリーミング処理など、よりリッチなインタラクションが可能になります。
- 機能ネゴシエーション(capability negotiation)による柔軟な構成 クライアントとサーバーが接続を確立する際に互いの機能を交渉(ネゴシエーション)し、双方がサポートする機能のみを有効化することで、柔軟で安定した通信チャネルを構築します。
MCPの登場は、AIツール統合のあり方を根本から変えるものです。特定のアプリケーションやフレームワークに依存してハードコードされていたこれまでのツール連携から、独立して開発されたネットワークサービスが自由に組み合わさる「構成可能で発見可能なAIエコシステム」へのパラダイムシフトをもたらす重要な基盤となっています。
MCP仕様・エコシステムの主な変遷
MCPの仕様や関連エコシステムは現在も急速に進化しています。MCPの関連記事を読み解く上で、以下の主要な改訂マイルストーンを把握しておくと今後の機能拡張の背景が理解しやすくなります。
- 2024年11月: Anthropicにより初期仕様(2024-11-05版)がオープンソースとして公開。
- 2025年3月: OAuth 2.1ベースの認可フローの導入、およびトランスポート層における SSE(Server-Sent Events)から Streamable HTTP への移行。
- 2025年6月: MCPサーバー(リソースサーバー)と外部IdP(認可サーバー)の役割分離の明確化。
- 2025年9月: 公式の MCP Registry がプレビュー公開され、サーバーの発見と検証が容易に。
- 2025年11月: OpenID Connect Discoveryによる認可サーバー探索、WWW-Authenticateを用いた段階的なスコープ同意、および
samplingへのツール呼び出し(tools/toolChoice)サポートの追加。 - 2026年7月: 2026-07-28 版の仕様で、プロトコルをステートレス化。
initializeによるハンドシェイクとプロトコルレベルのセッションを廃止し、各リクエストにプロトコルの版とクライアントの機能を載せる形に変更。Roots・Sampling・Logging の3つの機能は非推奨に。
各版の変更点は、公式仕様の changelog(2025-11-25 版、2026-07-28 版)で確かめられます。
主な変遷を時系列に並べると、次のようになります。
(図は、diagram-designで作成)
従来のAIツール統合の課題
(図は、diagram-designで作成)
AIアプリケーションが外部のツールやデータソースと連携し、より高度なタスクをこなすための試みは、MCPが登場する以前から様々な形で行われてきました。しかし、それぞれのアプローチには相互運用性や保守性の面で明確な限界が存在していました。ここでは、従来の主なツール統合手法と、それらが抱えていた課題について解説します。
手動のAPI連携(Manual API Wiring)
もっとも原始的かつ直接的なアプローチは、AIアプリケーションが対話する外部ツールやサービスごとに、開発者が手動でAPI接続を構築することです。この手法では、サービスごとに独自の認証メカニズム、データ変換処理、そしてエラーハンドリングをカスタムで実装する必要があります。
少数の外部サービスを利用するだけであれば機能しますが、利用するAPIの数が増えるにつれて保守の負担は飛躍的に増大します。結果として、システム全体が密結合(tightly coupled)で壊れやすいものになりがちであり、規模の拡大や仕様変更に対応することが極めて困難になるという課題を抱えていました。
標準化されたプラグインインターフェース(Standardized Plugin Interfaces)
手動連携の複雑さを軽減するため、OpenAPIのような標準化されたAPIスキーマを利用して外部ツールと接続するプラグインベースのインターフェースが登場しました。2023年3月に発表されたOpenAIのChatGPTプラグイン(ChatGPT Plugins)はその代表例であり、Zapierなどのプラグインを通じて、メールの送信やCRMレコードの更新といった事前定義されたアクションをモデルに実行させることが可能になりました。しかし、このプラグイン機能は2024年4月に提供を終了し、GPTsという別のプラットフォーム固有の仕組みへと移行してしまいました。こうした独自の仕組みの乱立と廃止は、開発者にとってエコシステムの断片化という大きな課題をもたらしました。
さらに、ByteDanceのCozeやTencentのYuanqiといったLLMアプリストアも、独自のWebサービスプラグインストアを提供し、利用可能なツールの数を大きく増やしました。
しかし、これらのプラグインを通じたやり取りは一方向(one-directional)であることが多く、状態を維持したり、タスク内の複数ステップを調整したりすることが困難でした。また、各プラットフォームが独自のプラグインエコシステムを形成してしまったため、プラグインがプラットフォーム固有(platform-specific)のものとなり、クロスプラットフォームの互換性が著しく制限されました。その結果、開発者はプラットフォームごとに重複した保守作業を強いられることになりました。
AIエージェントフレームワークにおけるツール統合(AI Agent Tool Integration)
LangChainのようなAIエージェントフレームワークやツールオーケストレーションフレームワークの台頭により、モデルが事前定義されたインターフェースを通じて外部ツールを呼び出すための構造化された方法が提供されました。これにより、タスクの自動化と適応性は大きく向上しました。
しかし、これらのフレームワークを利用した場合でも、ツールの統合や保守は依然として大部分が手動で行われていました。新しいツールを追加するたびにカスタム実装が必要となり、統合するツールの数が増加するにつれてシステムの複雑さが増大するという根本的な問題は解決されていませんでした。既存のフレームワークは、事前に定義された、あるいはハードコードされた統合の上で動作することが一般的であり、長期的な保守性や相互運用性に欠けていました。
RAGとベクトルデータベースの限界(Retrieval-Augmented Generation and Vector Database)
AIモデルの知識のカットオフ問題を解決するために広く普及したRAG(Retrieval-Augmented Generation:検索拡張生成)は、ベクトルベースの検索を活用してデータベースや知識ベースから関連情報を取得し、モデルの回答を最新の情報で補強します。
このアプローチはモデルの正確性を向上させる上で非常に有効でしたが、その機能は受動的な情報検索(passive retrieval of information)に限定されていました。たとえば、カスタマーサポートAIが製品ドキュメントのデータベースから関連するセクションを検索して回答することはできても、顧客レコードを更新したり、人間のサポートへ問題をエスカレーションしたりといった、データに対する能動的な操作(active operations)を本質的に行うことはできませんでした。テキストによる応答を超えたアクションを起こすための標準的な仕組みが欠けていたのです。
MCPのアーキテクチャと核心アイデア
(図は、diagram-designで作成)
MCP(Model Context Protocol)のアーキテクチャは、AIアプリケーションと外部システムを安全かつ標準化された方法で接続するために設計されています。この目的を達成するために、MCPは「MCP Host」「MCP Client」「MCP Server」という3つのコアコンポーネントによる構造を採用しています。
MCPを構成する3つのコアコンポーネント
MCPのワークフローにおいて、これら3つのコンポーネントはシームレスに連携し、ユーザーの意図解析から外部APIの呼び出し、そして結果の通知に至るまでの一連の処理を管理します。
-
MCP Host(ホスト) AIモデルを用いたタスク実行環境を提供するアプリケーション本体です。ホストはユーザーとのインターフェースを担い、AIモデルの推論プロセスを管理します。具体的な例としては、AIを活用したコンテンツ作成を支援する「Claude Desktop」、コード補完やソフトウェア開発を行うAI搭載IDEの「Cursor」、あるいは複雑なタスクを自律的に実行するAIエージェント(AI agents)などが挙げられます。ホストは後述するクライアントを内包し、外部のMCPサーバーとの通信を可能にします。
-
MCP Client(クライアント) ホスト環境内で動作し、MCPサーバーとの間で1対1(1:1)の通信リンクを維持する仲介コンポーネントです。ホストの代理として機能し、MCPサーバーに対してリクエストを開始して利用可能な機能を照会し、サーバーのツールやリソースに関する応答を取得します。また、クライアントはリクエストとレスポンスの管理だけでなく、サーバーからの通知(notifications)を処理してタスクの進捗やシステムステータスをリアルタイムでホストに伝達します。さらに、MCP特有の機能として「サンプリング(sampling)」と呼ばれる仕組みをサポートしています。これはテレメトリ収集ではなく、サーバー側からクライアントを経由してLLMにプロンプトを投げ、推論(AIの回答生成やツール呼び出しの決定)を依頼できるエージェント連携機能です。ただし、2026-07-28 版の仕様でサンプリングは非推奨になり、サーバーが LLM を使う場合は、LLM の提供元の API を直接使うことが勧められています。
-
MCP Server(サーバー) ホストおよびクライアントが外部システムにアクセスし、具体的な操作を実行できるようにするバックエンドコンポーネントです。Webサービス、データベース、ローカルファイルなどの外部データソースとの直接的なやり取りを担います。
MCPサーバーが提供する3つの主要機能(Capabilities)
MCPサーバーは、AIモデルが外部環境と相互作用するために、主に「Tools」「Resources」「Prompts」という3つのコア機能(Capabilities)を提供します。
Tools(ツール):外部操作の実行
AIモデルの代理として外部サービスやAPIを呼び出し、具体的な操作(アクション)を実行するための機能です。
AIアシスタントなどのホストアプリケーションが操作を実行する必要がある場合、まずクライアントを通じてMCPサーバーに照会を行い、利用可能なツールのリストとその機能を取得します。ホストはタスクの文脈に基づいて適切なツールを選択し、クライアント経由で呼び出しリクエストを発行します。サーバーは外部サービスを通じて該当する操作を実行し、その結果をクライアントに返します。例えば、AIモデルがリアルタイムの天気データや感情分析を必要とする場合、ホストはサーバーが提示した機能の中から対応するツールを特定し、サーバーがAPI呼び出しを行って結果のデータをホストに届けます。
単一のモデルやフレームワーク内に閉じ込められていた従来の関数呼び出し(function calling)インターフェースとは異なり、MCPのツールはモデルに依存しない標準化されたプロトコルを通じて記述およびアクセスされます。これにより、ツールは特定のプロバイダーに依存することなく、多様なAIシステム間で動的に発見・実行されるクロスプラットフォームの相互運用性が保証されます。さらに、MCPのツールはホストとサービス間の双方向通信(bi-directional communication)をサポートしており、非同期の更新やイベントストリーミングといったよりリッチなインタラクションを可能にします。
Resources(リソース):データへのアクセス
AIモデルに対して、構造化または非構造化データセットへのアクセスを提供する機能です。
データソースは、ローカルストレージ、データベース、またはクラウドプラットフォームなど多岐にわたります。AIモデルが特定のデータを要求すると、MCPサーバーが関連情報を取得・処理し、モデルに提示します。これにより、モデルは最新の情報に基づいたデータ駆動型の意思決定を行うことができます。具体的な活用例としては、推薦システムが顧客のインタラクションログにアクセスしたり、文書要約タスクにおいてテキストリポジトリを照会したりするケースが挙げられます。
Prompts(プロンプト):ワークフロー最適化のためのテンプレート
AIの応答を最適化し、反復的なタスクを効率化するためにサーバーが生成・維持する、事前定義されたテンプレートやワークフローです。
プロンプトを利用することで、AIモデルの応答の一貫性が保たれ、タスク実行の効率が向上します。例えば、カスタマーサポートのチャットボットが均一で正確な応答を提供するためにプロンプトテンプレートを使用したり、データアノテーションタスクにおいてラベリングの一貫性を維持するために事前定義されたプロンプトに依存したりといった使われ方をします。
これらのコンポーネントと機能により、MCPはツール実装を特定のAIアプリケーションから切り離し、動的に発見可能で構成可能なネットワークサービスのパラダイムを実現しています。
3つの主要機能を並べると、次のようになります。
(図は、diagram-designで作成)
MCPの通信と処理の流れ
MCP(Model Context Protocol)におけるAIモデルと外部システム間のメッセージ交換は、JSON-RPC 2.0 フォーマットを基盤として構築されており、トランスポート層(Transport Layer)を介したセキュアで双方向(bi-directional)な通信によって実現されます。このプロセスは、クライアントからの初期リクエストによる機能の発見から始まり、実行時の意図解析、そして実際のAPI呼び出しに至るまで、構造化されたフローに従って進行します。
トランスポート層による双方向通信の確立
MCPのトランスポート層は、リアルタイムな相互作用と効率的なデータ交換を管理し、AIモデルをホストする環境と外部リソースを同期させます。主に以下の2つのトランスポート方式が提供されています。
- stdio(標準入出力): 同一マシン内でローカルにサーバープロセスを起動し、
stdin/stdoutを介して高速に通信する方式です。 - Streamable HTTP: リモートサーバーとの通信に使用される方式です。初期のMCPでは「HTTP with SSE(Server-Sent Events)」が採用されていましたが、2025年3月26日の仕様改訂において、より柔軟な双方向ストリーミングを可能にする Streamable HTTP へと置き換えられました。このトランスポートの進化については、MCP-38の記事でも関連して触れています。
通信の確立と維持は、論文では以下のステップで説明されています。
- 初期リクエスト(Initial Request) 通信は、MCPクライアントからMCPサーバーに対する初期リクエストの送信から始まります。クライアントは、このリクエストを通じてサーバーがどのような機能を提供しているかを問い合わせます。
- 初期応答(Initial Response) リクエストを受け取ったMCPサーバーは、クライアントが利用可能なツール(Tools)、リソース(Resources)、およびプロンプト(Prompts)のリストを詳細に記述した初期応答を返します。この動的な機能の発見(Dynamic discovery)により、クライアントは事前にインターフェースをハードコーディングすることなく、サーバーの能力を把握できます。
- 通知の交換(Notification Exchange) 接続が確立された後、システムは継続的な通知の交換を維持します。これにより、サーバー側のステータス変更やタスクの進捗、データの更新などがリアルタイムにクライアントへ伝達され、AIアプリケーションは常に最新の情報を反映した状態で動作することが可能になります。
公式仕様(2025-11-25 版まで)のメッセージに当てはめると、次の図のようになります。論文の「初期リクエスト/初期応答」は、厳密には2段階に分かれています。まず initialize でプロトコルの版と、お互いが対応する機能(tools・resources・prompts など)を取り決め、そのあと tools/list などの一覧のリクエストで、ツールの名前・説明・入力のスキーマを受け取ります。ツールの実行は tools/call です。
(図は、diagram-designで作成)
なお、2026-07-28 版の仕様では initialize のハンドシェイクが廃止されました。各リクエストの _meta にプロトコルの版とクライアントの機能を入れて送り、事前に確かめたい場合は server/discover を呼びます。
実行時の処理フロー:意図解析からAPI呼び出しまで
運用フェーズ(Operation Phase)において、ユーザーからの入力がどのように処理され、外部ツールの実行と結果の返却に至るのか、その具体的な実行フローは以下の4つの段階で構成されます。
- 意図解析(Intent Analysis) ユーザーからの入力(プロンプト)は、MCPホストまたはクライアントからMCPサーバーに渡され、解析・コンテキスト化されます(論文の説明。実際の多くの実装では、次の節のように、ホスト側の LLM がツールを選びます)。この段階のロジックによって、ユーザーの要求を満たすために「ツールをトリガーするべきか」「リソースを取得するべきか」「プロンプトテンプレートを適用するべきか」が決定されます。正確な意図解析はシステムの使い勝手と有効性に直結しており、誤った解釈は不必要なリソース呼び出しや応答遅延、さらにはセキュリティリスクの拡大を引き起こす原因となります。
- 外部リソースへのアクセス(External Resource Access) 意図解析の結果、サードパーティのシステムや知識リポジトリから補足データ(Supplementary data)を取得する必要があると判断された場合、サーバーは事前に定義されたリソースインターフェースを通じてデータにアクセスします。このアクセスは、サーバーの作成フェーズで定義されたセキュリティ権限や認証・認可ポリシー、サンドボックス化のルールに厳密に従って行われ、データ漏洩や外部依存関係の侵害を防ぎます。
- ツールの呼び出し(Tool Invocation) 解析された意図に基づき、MCPサーバーまたはクライアントは登録されたツールを実行します。各ツールの呼び出しには、構造化されたパラメータの受け渡し、実行状態のモニタリング、および結果のシリアライズ(直列化)が含まれます。サーバーは指定された外部APIやサービスを通じて実際の操作を行い、その結果を構造化された出力としてユーザーセッションへ返却します。この段階での処理の信頼性と分離性が、システム全体の実行時の安定性を決定づけます。
- セッション管理(Session Management) これらの一連のやり取りの間、MCPはユーザーインターフェース、MCPクライアント、およびMCPサーバー間の論理的な連続性を維持するためのセッション管理を行います。セッションの確立、監視、および終了を適切に管理することで、AIモデルが複数のツールをまたいでマルチステップのタスクを実行する際にも文脈が途切れることなく、一貫した応答を提供することができます。
MCPにおけるツール選択と実行の定式化
MCP(Model Context Protocol)を介したAIモデルと外部ツールの連携は、単なるソフトウェア間の通信にとどまらず、大規模言語モデル(LLM)の言語生成プロセスを用いた条件付き確率の最大化問題として数学的に定式化することができます。本節では、LLMがユーザーのプロンプトとMCPサーバーから提供されたツール定義を受け取り、最適なツールとその引数を決定し、実行結果を踏まえて回答を生成するまでの一連のプロセスを数式を用いて厳密に表現します。
入力コンテキストの構成
まず、ユーザーからの自然言語による入力プロンプトを とします。 MCPクライアントは、接続されているMCPサーバーに問い合わせを行い、現在利用可能なツールの集合 を取得します。
各ツール は、ツールの名前、機能の説明、および要求される入力パラメータの構造(JSONスキーマなど)を含むメタデータを持っています。このメタデータを文字列として表現したものを とします。
LLMに与えられる入力コンテキスト は、システムの振る舞いを定義するシステムプロンプト、利用可能なすべてのツールの定義、そしてユーザーの入力 を結合()することによって構築されます。
このコンテキスト が、LLMがツールを選択するための前提条件(プロンプト空間)となります。
入力コンテキストの構成を図にすると、次のようになります。
(図は、diagram-designで作成)
ツール選択と引数生成の確率モデル
パラメータ を持つ自己回帰型のLLMは、コンテキスト を条件として、出力トークン列 を生成します。この生成確率は、各ステップのトークン予測確率の積として次のように表されます。
MCPを用いた関数呼び出し(Function Calling)において、モデルの出力 は、呼び出すべき特定のツール名 と、そのツールに渡す引数(パラメータ)の集合 を構造化されたテキスト(例:JSONフォーマット)で表現したものになります。
したがって、LLMがユーザーの入力 と利用可能なツール群 に基づいて、特定のツール と引数 を選択する結合確率は、それらを構成するトークン列 の生成確率として定式化できます。
推論時において、LLMの役割は、与えられたコンテキストの下でこの条件付き確率を最大化する最適なツール と、そのツールスキーマに適合する最適な引数 のペアを探索(デコーディング)することです。
ここで、 はツール の定義 によって許容される、有効な引数の探索空間を指します。意図解析とツール選択の精度は、この確率分布 がユーザーの真の意図をどれだけ正確にモデル化できているかに依存します。
実行結果の観測と最終応答の生成
最適なツール が決定されると、MCPクライアントはMCPサーバーに対してツール呼び出しのリクエストを送信します。MCPサーバーは外部システム(Web API、データベース、ローカルファイルなど)で実際の処理を実行し、その結果(観測値) をクライアントに返します。
結果 を受け取った後、LLMはこれまでの推論履歴と外部からの観測値を新たなコンテキストとして統合し、最終的なユーザーへの回答 を生成します。このプロセスもまた、拡張されたコンテキストに基づく条件付き言語生成として定式化されます。
複数のツールを連続して呼び出す必要がある複雑なタスク(エージェント的ワークフロー)の場合、このプロセスは再帰的に繰り返されます。ステップ における観測値を とすると、ステップ におけるツール選択の確率は、過去のすべての行動と観測の履歴 に依存して計算されます。
このように定式化することで、MCPのアーキテクチャが果たす本質的な役割が明確になります。従来のハードコードされたAPI連携やプラットフォーム固有のプラグインでは、ツール集合 やそのスキーマ の定義が分断されており、モデルの入力空間へマッピングする際の互換性が担保されていませんでした。MCPは、この の動的発見と の記述フォーマットをプロトコルレベルで完全に標準化することで、LLMの条件付き確率モデルに外部機能をシームレスかつ数学的に一貫した形で組み込むことを可能にしています。
スクラッチ実装:FastAPIとLLMを用いたMCPの基本動作
MCP(Model Context Protocol)の核心である「ツール定義の動的ディスカバリ」と「ツール実行」の双方向通信プロセスを深く理解するために、簡易的なMCPサーバーとクライアントをゼロから実装します。
ここでは、PythonのWebフレームワークであるFastAPIを用いてツールを提供するMCPサーバーを構築し、Hugging FaceのオープンソースLLM(大規模言語モデル)を用いてツールを選択・呼び出すMCPクライアントのロジックを実装します。ネットワーク設定の複雑さを避けるため、FastAPIの TestClient を活用し、単一のPythonスクリプト内で完結して実行できる構成とします。
実装の全体像
スクラッチ実装は、大きく以下の3つのコンポーネントで構成されます。
- MCPサーバー(FastAPI):
- ディスカバリエンドポイント (
/tools): サーバーが提供可能なツールの一覧と、それぞれの引数のJSONスキーマ(JSON Schema)をクライアントに提供します。 - 実行エンドポイント (
/execute): クライアントから送信されたツール名と引数を受け取り、実際のPython関数を実行して結果を返します。
- ディスカバリエンドポイント (
- MCPクライアント(LLMのセットアップ):
- Hugging Faceの
transformersライブラリを使用し、会話形式の指示に従うよう調整された軽量モデル(ここではQwen/Qwen2.5-0.5B-Instruct)をロードします。
- Hugging Faceの
- オーケストレーションロジック:
- クライアントがサーバーの
/toolsを呼び出してツール定義を取得します。 - 取得したツール定義とユーザーの自然言語プロンプトを組み合わせてシステムプロンプトを構築し、LLMに推論させます。
- LLMが出力したJSON形式のツール呼び出し要求をパースし、サーバーの
/executeエンドポイントに送信して最終的な結果を得ます。
- クライアントがサーバーの
このスクラッチ実装は、MCP の核心である「実行時にツールの定義を取得し、LLM がツールを選んで呼び出す」流れを理解するための簡略版です。公式の仕様・SDK とは、次の点が違います。
| 項目 | 公式の MCP(仕様・SDK) | 本記事のスクラッチ実装 | 簡略化した理由 |
|---|---|---|---|
| メッセージの形式 | JSON-RPC 2.0(method・params・id) | FastAPI の REST(GET /tools、POST /execute) | HTTP のエンドポイントのほうが、流れを追いやすいため |
| 初期化 | initialize で版と機能を取り決める(2026-07-28 版では各リクエストに載せる) | なし | ツールの発見と実行に絞るため |
| ツールの一覧 | tools/list(inputSchema は JSON Schema) | GET /tools(同じく JSON Schema 形式) | 形式は公式にそろえた |
| ツールの実行 | tools/call(結果は content の配列) | POST /execute(結果は辞書) | 同上 |
| トランスポート | stdio または Streamable HTTP | 同じプロセス内の TestClient | ネットワークの設定なしで1つのスクリプトで動かすため |
| ツールを選ぶ方法 | 規定なし(ホストの LLM の関数呼び出し機能に任せる) | ツール名の対数尤度を比べる(後の定式化の式をそのまま計算) | 選ぶ仕組みを数式と対応させて見せるため |
公式の SDK を使った実装は、後の節(MCPServer を用いたサーバー構築)で扱います。
実行可能なPythonコード
以下のコードは、必要なライブラリ(fastapi, httpx, transformers, torch, accelerate)がインストールされた環境であれば、そのまま実行可能な完全なスクリプトです。
記事の実行結果は、Google Colab の CPU ランタイムで、Python 3.13・torch 2.11.0・transformers 5.21.0・fastapi 0.141.1・httpx 0.28.1・mcp 2.3.0・langchain 1.4.7・langchain-google-genai 4.4.2・google-genai 2.34.0 を使って実行したものです。スクラッチ実装は、モデルのダウンロードを除いて CPU で1分ほどです。GPU は必要ありません。
pip install fastapi httpx transformers torch accelerate
以下のコードでは、FastAPIとHugging Faceのtransformersを用いて、MCP(Model Context Protocol)のサーバー・クライアント間の基本的な動作を実装・検証します。単一のスクリプト内でTestClientを用いてサーバーを擬似的に立ち上げ、小型LLM(Qwen2.5)が提供されたツール定義を動的に読み込み、ユーザーのプロンプトに応じて適切なツール呼び出し(JSON生成)を行う一連の流れをシミュレートします。
import json
import re

import torch
from fastapi import FastAPI, HTTPException
from fastapi.testclient import TestClient
from pydantic import BaseModel
from transformers import AutoModelForCausalLM, AutoTokenizer

# ==========================================
# 1. MCPサーバー(ここだけがツールを知っている)
# ==========================================
app = FastAPI(title="Simple MCP Server")

TOOLS = [
    {
        "name": "add_numbers",
        "description": "2つの数値を加算します。計算タスクに使用してください。",
        "parameters": {
            "type": "object",
            "properties": {
                "a": {"type": "integer", "description": "1つ目の数値"},
                "b": {"type": "integer", "description": "2つ目の数値"},
            },
            "required": ["a", "b"],
        },
    },
    {
        "name": "get_weather",
        "description": "指定された都市の現在の天気を取得します。",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "都市名(例: Tokyo, Osaka)"}
            },
            "required": ["location"],
        },
    },
    # ここに3つ目を足しても、以降のクライアントコードは一切変更不要
]


@app.get("/tools")
def list_tools():
    return {"tools": TOOLS}


class ExecuteRequest(BaseModel):
    name: str
    arguments: dict


@app.post("/execute")
def execute_tool(req: ExecuteRequest):
    if req.name == "add_numbers":
        try:
            return {"result": int(req.arguments["a"]) + int(req.arguments["b"]), "status": "success"}
        except (KeyError, TypeError, ValueError):
            raise HTTPException(status_code=400, detail="a/b は数値である必要があります")

    if req.name == "get_weather":
        loc = req.arguments.get("location")
        if not isinstance(loc, str) or not loc.strip():
            raise HTTPException(status_code=400, detail="location は文字列である必要があります")
        return {"result": f"{loc}の天気は晴れ、気温は22度です。", "status": "success"}

    raise HTTPException(status_code=404, detail=f"Tool '{req.name}' not found")


# ==========================================
# 2. クライアント側セットアップ
# ==========================================
client = TestClient(app)

# 会話形式の指示に従うよう調整された(Instruct)Qwen2.5 の最小のモデル。CPU でも1回の推論が数秒で済む
MODEL_ID = "Qwen/Qwen2.5-0.5B-Instruct"
print(f"Loading model {MODEL_ID}...")
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID)
# 公開されている重みの精度(bfloat16)のままロードする
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, device_map="auto", dtype=torch.bfloat16)
model.eval()


# ==========================================
# 3. スキーマからのプロンプト合成
# ==========================================
PLACEHOLDER = {
    "string": "<文字列>",
    "integer": 0,
    "number": 0.0,
    "boolean": True,
    "array": [],
    "object": {},
}


def schema_skeleton(tool: dict) -> str:
    """S(t_i) から、型定義ではなく「値の入った」出力例を機械的に合成する。"""
    props = tool["parameters"].get("properties", {})
    args = {k: PLACEHOLDER.get(v.get("type"), "<値>") for k, v in props.items()}
    return json.dumps({"name": tool["name"], "arguments": args}, ensure_ascii=False)


def build_system_prompt(tools: list) -> str:
    """全ツールを対称に列挙する。特定のツールを優遇する記述は一切入れない。"""
    blocks = []
    for t in tools:
        props = t["parameters"].get("properties", {})
        params = "\n".join(
            f"    - {k} ({v.get('type')}): {v.get('description', '')}" for k, v in props.items()
        )
        blocks.append(
            f"- {t['name']}: {t['description']}\n"
            f"  引数:\n{params}\n"
            f"  出力形: {schema_skeleton(t)}"
        )

    return (
        "あなたはツール呼び出し専用のアシスタントです。\n"
        "JSONオブジェクトを1つだけ出力してください。説明文やコードブロックは禁止です。\n"
        "引数には実際の値を入れてください。型名(\"string\" や \"integer\")を入れてはいけません。\n\n"
        "【利用可能なツール】\n" + "\n".join(blocks)
    )


# ==========================================
# 4. argmax_{t in T} P(t | X, T) の直接計算
# ==========================================
def _ids(text: str):
    return tokenizer(text, return_tensors="pt", add_special_tokens=False).input_ids.to(model.device)


@torch.no_grad()
def continuation_logprob(prefix_ids: torch.Tensor, cont_ids: torch.Tensor) -> float:
    """prefix に続けて cont が生成される平均対数尤度(トークン長で正規化)。"""
    ids = torch.cat([prefix_ids, cont_ids], dim=-1)
    logits = model(ids).logits
    logprobs = torch.log_softmax(logits[:, :-1].float(), dim=-1)
    target = ids[:, 1:]
    token_lp = logprobs.gather(-1, target.unsqueeze(-1)).squeeze(-1)
    n = cont_ids.shape[-1]
    return (token_lp[:, -n:].sum() / n).item()  # 名前の長さによる不公平を避けるため平均を取る


def select_tool(prompt_prefix: str, tools: list):
    """取得した T の各要素をスコアリングして t* を決める。候補は毎回サーバー由来。"""
    prefix_ids = _ids(prompt_prefix)
    scored = []
    for t in tools:
        # 名前の後の閉じ引用符まで採点する。名前の途中で終わる候補(例: get と get_weather)を区別するため
        lp = continuation_logprob(prefix_ids, _ids(t["name"] + '"'))
        scored.append((lp, t["name"]))
    scored.sort(reverse=True)
    return scored[0][1], scored


# ==========================================
# 5. 出力パース
# ==========================================
def extract_json_object(text: str):
    m = re.search(r"<tool_call>\s*(\{.*?\})\s*</tool_call>", text, re.S)
    candidate = m.group(1) if m else None
    if candidate is None:
        cleaned = re.sub(r"```(?:json)?", "", text).strip()
        start = cleaned.find("{")
        if start == -1:
            return None
        depth = 0
        for i, ch in enumerate(cleaned[start:], start):
            depth += (ch == "{") - (ch == "}")
            if depth == 0:
                candidate = cleaned[start : i + 1]
                break
        if candidate is None:
            return None
    try:
        return json.loads(candidate)
    except json.JSONDecodeError:
        try:
            return json.loads(re.sub(r",\s*([}\]])", r"\1", candidate))
        except json.JSONDecodeError:
            return None


def coerce_arguments(args, tool: dict):
    """スキーマ駆動で型を揃える。ツール固有の分岐は書かない。"""
    if isinstance(args, str):
        try:
            args = json.loads(args)
        except json.JSONDecodeError:
            return None, "arguments のパースに失敗"
    if not isinstance(args, dict):
        return None, "arguments が辞書ではない"

    props = tool["parameters"].get("properties", {})
    fixed = {}
    for key, value in args.items():
        if key not in props:
            continue
        if isinstance(value, dict) and "type" in value:
            return None, f"引数 '{key}' に値ではなく型定義が入っている"
        expected = props[key].get("type")
        if expected in ("integer", "number") and isinstance(value, str):
            digits = re.sub(r"[^\d.\-]", "", value)
            if digits:
                value = int(digits) if expected == "integer" else float(digits)
        fixed[key] = value

    missing = [k for k in tool["parameters"].get("required", []) if k not in fixed]
    if missing:
        return None, f"必須引数が不足: {missing}"
    return fixed, None


# ==========================================
# 6. オーケストレーション
# ==========================================
def run_mcp_workflow(user_prompt: str):
    print(f"\n--- ユーザー入力: '{user_prompt}' ---")

    # [Step 1] 動的ディスカバリ: T と S(t_i) を実行時に取得
    available_tools = client.get("/tools").json()["tools"]
    print(f"[Client] サーバーから {len(available_tools)} 個のツール定義を取得しました。")

    # [Step 2] コンテキスト C の構築(内容はすべて取得結果から合成)
    messages = [
        {"role": "system", "content": build_system_prompt(available_tools)},
        {"role": "user", "content": user_prompt},
    ]
    base = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)

    # [Step 3] t* の決定: T 上で対数尤度を実測して argmax を取る
    name_prefix = base + '{"name": "'
    tool_name, scored = select_tool(name_prefix, available_tools)
    print("[Client] ツール選択スコア: " + ", ".join(f"{n}={lp:.3f}" for lp, n in scored))
    tool = next(t for t in available_tools if t["name"] == tool_name)

    # [Step 4] A* の生成: 名前を確定させた状態で引数だけ生成させる
    arg_prefix = f'{{"name": "{tool_name}", "arguments": {{'
    inputs = tokenizer([base + arg_prefix], return_tensors="pt", add_special_tokens=False).to(model.device)
    with torch.no_grad():
        outputs = model.generate(
            # 引数の JSON は20トークンほどなので、96トークンあれば閉じかっこまで出し切れる。
            # 貪欲法(do_sample=False)にして、毎回同じ引数が出るようにする
            **inputs, max_new_tokens=96, do_sample=False, pad_token_id=tokenizer.eos_token_id
        )
    raw = arg_prefix + tokenizer.decode(outputs[0][inputs.input_ids.shape[1] :], skip_special_tokens=True)
    print(f"[LLM Output] {raw.strip()}")

    parsed = extract_json_object(raw)
    if parsed is None:
        print("[Client Error] JSONを抽出できませんでした。")
        return

    arguments, err = coerce_arguments(parsed.get("arguments", {}), tool)
    if arguments is None:
        print(f"[Client Error] 引数が不正です: {err}")
        return

    # [Step 5] ツール実行
    print(f"[Client] '{tool_name}' を引数 {arguments} で実行します...")
    res = client.post("/execute", json={"name": tool_name, "arguments": arguments})
    if res.status_code == 200:
        print(f"[Server Response] {res.json()}")
    else:
        print(f"[Server Error {res.status_code}] {res.text}")


if __name__ == "__main__":
    run_mcp_workflow("Tokyoの天気を教えてください。")
    run_mcp_workflow("1250と3845を足すといくつになりますか?")
ここでは、FastAPIとHugging Faceのtransformersを用いたMCPのスクラッチ実装について、各コンポーネントの役割と背後にある意図を解説します。
MCPサーバーの実装:
- ツールの動的ディスカバリの提供: @app.get("/tools")エンドポイントを通じて、利用可能なツール(add_numbersとget_weather)の仕様を定義したJSONスキーマ(TOOLS)をクライアントへ提供します。これによりクライアントは事前にツールをハードコードせずとも機能を発見できます。
- ツール呼び出しの処理: @app.post("/execute")エンドポイントで、クライアントから送信されたツール名と引数(ExecuteRequest)を受け取り、対応するPythonロジックを実行して結果を返却します。
MCPクライアントとLLMのセットアップ:
- サーバーのモック化: TestClient(app)を使用し、同一プロセス内でFastAPIのルーティングをシミュレートすることで、ネットワーク設定の複雑さを排除しつつAPI通信を再現しています。
- 推論モデルのロード: AutoModelForCausalLM.from_pretrained(MODEL_ID)により、会話形式の指示に従うよう調整された小規模なLLMであるQwen/Qwen2.5-0.5B-Instructを読み込みます。0.5B を選んだのは、CPU でも1回の推論が数秒で済むためです。重みは公開されている精度(bfloat16)のままロードします。
オーケストレーションの実行フロー (run_mcp_workflow):
- ツール定義の取得とプロンプト構築: client.get("/tools")でツール一覧を取得し、build_system_prompt(available_tools)関数を用いて型定義ではなく出力例(スケルトン)を含むシステムプロンプトを構築します。
- ツール選択スコアの計算(意図解析): 利用可能な各ツールの名前について、プロンプトに続くトークンの生成確率(対数尤度)をcontinuation_logprob()関数で直接計算し、最もスコアが高いツールを決定します。定式化の節の を、そのまま計算していることになります。名前の後の閉じ引用符(
")まで含めて採点するのは、getとget_weatherのように、ほかの名前の途中で終わる名前を区別するためです。また、トークンあたりの平均を取るのは、名前のトークン数が多いほど対数尤度の合計が小さくなり、長い名前が不利になるのを防ぐためです。 - 引数生成とツール実行: 選択したツール名を用いたプレフィックス(arg_prefix)を与えてmodel.generate()で引数部分のみを生成させ、パースと検証を行った後にclient.post("/execute")でサーバーのAPIを叩くことで、自然言語から外部API呼び出しへの変換を完了させます。max_new_tokens=96 は、引数の JSON(実行結果では7〜18トークン)を閉じかっこまで出し切るのに十分な長さです。足りないと JSON が途中で切れて、パースに失敗します。
スクラッチ実装の実行結果
前節で構築したFastAPIベースの簡易的なMCPサーバーと、LLMを組み込んだクライアントを実行した際の動作ログを確認します。ここでは、ユーザーから「Tokyoの天気を教えてください。」や「1250と3845を足すといくつになりますか?」という自然言語のプロンプトが与えられた際に、LLMが適切にツールを選択し、サーバー上で処理が実行されるまでの一連のプロセスを追います。
Loading model Qwen/Qwen2.5-0.5B-Instruct...

--- ユーザー入力: 'Tokyoの天気を教えてください。' ---
[Client] サーバーから 2 個のツール定義を取得しました。
[Client] ツール選択スコア: get_weather=-6.104, add_numbers=-9.729
[LLM Output] {"name": "get_weather", "arguments": { "location": "Tokyo"}}
[Client] 'get_weather' を引数 {'location': 'Tokyo'} で実行します...
[Server Response] {'result': 'Tokyoの天気は晴れ、気温は22度です。', 'status': 'success'}

--- ユーザー入力: '1250と3845を足すといくつになりますか?' ---
[Client] サーバーから 2 個のツール定義を取得しました。
[Client] ツール選択スコア: add_numbers=-5.585, get_weather=-6.828
[LLM Output] {"name": "add_numbers", "arguments": { "a": 1250, "b": 3845 }}
[Client] 'add_numbers' を引数 {'a': 1250, 'b': 3845} で実行します...
[Server Response] {'result': 5095, 'status': 'success'}
2つの入力のツール選択スコアを表にすると、次のようになります。
(図は、diagram-designで作成)
実行ログの解説
出力されたログから、MCP(Model Context Protocol)におけるクライアントとサーバー間の双方向通信と、LLMによる動的なツール実行のプロセスが意図通りに機能していることが読み取れます。
-
ツール定義の動的発見(Dynamic Discovery) 各テストケースの開始時に、クライアントはFastAPIサーバーの
/toolsエンドポイントへGETリクエストを送信し、利用可能なツールの一覧(add_numbersとget_weather)を動的に取得しています。これにより、クライアントは事前にツールをハードコーディングすることなく、実行時にサーバーの能力(Capabilities)を把握できます。 -
意図解析とツール選択(Intent Analysis and Tool Selection) 取得したツール定義とユーザーのプロンプトからコンテキストが構築されます。システムは利用可能な各ツールの名前に対して生成確率(対数尤度)を計算してスコアリングを行い、ユーザーの意図に最も合致するツールを選択します。その結果、「Tokyoの天気」に対しては
get_weatherを、「足し算」に対してはadd_numbersを選択し、その後決定されたツール名に基づいて指定されたスキーマに厳密に従ってJSONの引数を生成しています。このステップにより、自然言語の指示が構造化されたAPI呼び出しへと変換されます。 -
外部操作の実行(API Invocation) クライアントはLLMが生成した引数を用いて、FastAPIサーバーの
/executeエンドポイントへPOSTリクエストを送信します。サーバー側ではリクエストを受け取り、対応するPythonのロジック(天気取得のモック処理や実際の加算処理)を実行し、その結果(例:{'result': 5095, 'status': 'success'})をクライアントに返却しています。これがMCPにおけるツール実行の本体であり、モデルと外部システム間の安全なデータ交換を実現しています。
このように、スクラッチ実装を通じて、MCPが提唱する「ツール実装と利用の分離」および「プロトコルベースの標準化」の基礎的なメカニズムが確認できます。LLMは単なるテキスト生成器から、外部リソースを動的に操作するエージェントへと拡張されており、この一連のフローがMCPアーキテクチャの核心を成しています。なお、今回のスクラッチ版の実装例(run_mcp_workflow)は基礎理解を優先しているため単一のツール呼び出し(単発のFunction Calling)のみの対応となっていますが、後述するMCPServerとLangChainを用いた実践的な実装では、複数のツールを同時に指定・連鎖的に呼び出す処理もフレームワーク側で自動的にサポートされます。
実践的な実装例:MCPServer(旧 FastMCP)を用いたサーバー構築
前節までのスクラッチ実装では、プロトコルの仕様に沿って手動でルーティングやスキーマを定義するプロセスを確認しました。しかし、実際の開発現場では、より迅速かつ保守性の高い方法でサーバーを構築することが求められます。そこで本節では、公式のPython SDKに含まれるサーバーの実装「MCPServer」を利用した、実践的なMCPサーバーの構築と呼び出しの実装例を紹介します。
MCPServer は、SDK 1.x で「FastMCP」(mcp.server.fastmcp)と呼ばれていたもので、SDK 2.x で名前と場所(mcp.server.mcpserver)が変わりました。SDK 2.x で from mcp.server.fastmcp import FastMCP を実行すると ModuleNotFoundError になるので、古い記事のコードを動かすときは注意してください(詳しくは公式の移行ガイド)。
MCPServer は、WebフレームワークであるFastAPIにインスパイアされた設計となっており、デコレータベースで非常に簡潔にツールやリソースを定義できます。Pythonの型ヒント(Type Hints)とドックストリング(Docstrings)を解析し、LLMが解釈するためのJSONスキーマを自動生成するため、開発者はビジネスロジックの実装に集中することができます。
実行環境の準備
本実装を実行するためには、公式のMCP Python SDKが必要です。あらかじめ以下のコマンドでパッケージをインストールしてください。
pip install mcp
MCPServerを用いたサーバーの実装
以下は、MCPServerを用いて2つのツール(数値の加算ツールと、ダミーの天気取得ツール)を提供するサーバーの実装例です。このコードを server.py という名前で保存します。
# server.py
from mcp.server.mcpserver import MCPServer

# MCPServer(SDK 1.x の FastMCP)の初期化
# サーバー名を "DemoServer" としてインスタンスを作成します
mcp = MCPServer("DemoServer")

@mcp.tool()
def add_numbers(a: int, b: int) -> int:
    """
    2つの整数を加算して結果を返します。
    """
    return a + b

@mcp.tool()
def get_weather(location: str) -> str:
    """
    指定された都市の現在の天気を取得します。

    Args:
        location: 都市名(例: "Tokyo", "Osaka")
    """
    # 外部APIの代わりとなるダミーデータ
    weather_data = {
        "Tokyo": "晴れ、気温は22度です。",
        "Osaka": "曇り、気温は20度です。"
    }

    return f"{location}の天気は{weather_data.get(location, '不明です。')}"

if __name__ == "__main__":
    # サーバーを標準入出力(stdio)モードで起動します
    mcp.run(transport="stdio")
上記のコードでは、@mcp.tool() デコレータを関数に付与するだけで、その関数がMCPのツールとして公開されます。関数の引数の型(int や str)とドックストリングに記述された説明文が自動的に抽出され、クライアント(およびLLM)に対してツールの仕様(Capabilities)として提示されます。mcp.run(transport="stdio") は、標準入出力でクライアントとやり取りする設定です。SDK 2.x では、トランスポートの設定をコンストラクタではなく run() に渡します。
なお、docstring の先頭の改行は、そのままツールの description に入ります(実行結果のツール一覧で、名前の後に改行が入っているのはこのためです。各行の先頭のインデントは取り除かれます)。表示を整えたい場合は、docstring を1行にまとめて書きます。
実践:LangChainとGeminiを用いたMCPクライアント実装
次に、構築したMCPサーバーを外部アプリケーション(MCPクライアント)から呼び出す実装を作成します。ここでは、標準入出力(stdio)をトランスポート層として用いてサーバーをサブプロセスとして起動し、LangChainとGemini(gemini-3.8-flash)を用いて自然言語の指示から動的にツールを呼び出すオーケストレーションを実装します。
まず、APIキーを設定するためにプロジェクトのルートに .env ファイルを作成します。
GOOGLE_API_KEY=your_api_key_here
Gemini APIキーは、Google AI Studioから無料で取得することができます。APIキーの取得・管理方法の詳細については、Googleの公式ドキュメントをご参照ください。 なお、無料枠(Free tier)を利用する場合、入力したデータはGoogleの製品改善やモデル学習のために利用される可能性がある点にご留意ください(機密情報の入力は避け、詳細は公式の利用規約をご確認ください)。
続いて、以下のコードを client.py という名前で保存し、server.py と同じディレクトリに配置します。事前に以下のコマンドを実行して、必要なパッケージをインストールしておきます。
pip install mcp langchain langchain-google-genai python-dotenv
(※なお、.env から GOOGLE_API_KEY を自動で読み込む挙動は langchain-google-genai バージョン4.0.0以降を前提としています。)
# client.py
import os
os.environ["GRPC_VERBOSITY"] = "NONE"
os.environ["GLOG_minloglevel"] = "2"
import asyncio
from dotenv import load_dotenv
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client
from langchain_google_genai import ChatGoogleGenerativeAI
from langchain_core.messages import HumanMessage

# .envファイルから環境変数を読み込む
load_dotenv()

async def main():
    # サーバーの起動パラメータを設定
    # コマンドラインで `python server.py` を実行してサブプロセスを立ち上げる設定です
    server_params = StdioServerParameters(
        command="python",
        args=["server.py"]
    )

    # stdioを用いたクライアント接続の確立
    async with stdio_client(server_params) as (read, write):
        # クライアントセッションの初期化
        async with ClientSession(read, write) as session:
            # サーバーとの初期ハンドシェイク(Capabilityのネゴシエーション)を実行
            await session.initialize()

            # 1. サーバーが提供しているツールの一覧を取得
            tools_response = await session.list_tools()
            print("=== 利用可能なツール ===")
            for tool in tools_response.tools:
                print(f"- {tool.name}: {tool.description}")

            # 2. LangChainのツールフォーマット(JSON Schema)に変換
            lc_tools = []
            for t in tools_response.tools:
                lc_tools.append({
                    "type": "function",
                    "function": {
                        "name": t.name,
                        "description": t.description,
                        "parameters": t.input_schema
                    }
                })

            # Geminiモデルの初期化とツールのバインド
            llm = ChatGoogleGenerativeAI(
                model="gemini-3.8-flash",
                temperature=0.0
            )
            llm_with_tools = llm.bind_tools(lc_tools)

            # 3. ユーザーからの自然言語プロンプト
            user_prompt = "15と27を足して。それと、Tokyoの天気を教えて。"
            print(f"\nユーザー入力: '{user_prompt}'")

            # LLMに推論させる
            response = await llm_with_tools.ainvoke([HumanMessage(content=user_prompt)])

            # 4. LLMが選択したツールを実行
            for tool_call in response.tool_calls:
                print(f"\n=== ツール実行: {tool_call['name']} ===")
                print(f"引数: {tool_call['args']}")

                # MCPサーバーにツール実行をリクエスト
                result = await session.call_tool(tool_call["name"], arguments=tool_call["args"])
                print(f"結果: {result.content[0].text}")

if __name__ == "__main__":
    asyncio.run(main())
ここでは、LangChainとMCP公式SDKを組み合わせてAIクライアントを実装しています。
- サーバーの起動と接続の確立: StdioServerParametersで対象のサーバー(ここではpython server.py)を指定し、stdio_clientおよびClientSessionを用いて標準入出力を介したローカルサーバーとの通信チャネルを確立します。
- ツール定義の抽出と変換: session.list_tools()でサーバーから動的に提供されているツールのリストを取得し、それらをLangChainが解釈可能なフォーマット(OpenAI Functions互換のJSON Schema形式)に手動で変換してlc_toolsとしてリスト化します。入力のスキーマは t.input_schema で取り出します(SDK 1.x では
t.inputSchemaでしたが、SDK 2.x で snake_case に変わりました)。 - LLMの初期化とツールのバインド: ChatGoogleGenerativeAIを用いてGeminiモデルを初期化し、bind_tools(lc_tools)で変換したツール情報をLLMに紐付けます。temperature=0.0 は、実行のたびにツールの選び方や引数が変わらないようにするためです。
- 推論と動的なツール実行: ユーザープロンプトをHumanMessageとして渡し、LLMがainvokeでツール呼び出し(Function Calling)を決定します。その後、返されたtool_callsのリストに基づいて、session.call_tool()で実際にサーバー側のツールを実行し、結果を取得します。
実行結果
ターミナルで python client.py を実行すると、クライアントが背後で server.py を起動し、MCPプロトコルに従って通信を行います。実行結果は以下のようになります。
=== 利用可能なツール ===
- add_numbers:
2つの整数を加算して結果を返します。

- get_weather:
指定された都市の現在の天気を取得します。

Args:
    location: 都市名(例: "Tokyo", "Osaka")


ユーザー入力: '15と27を足して。それと、Tokyoの天気を教えて。'

=== ツール実行: add_numbers ===
引数: {'a': 15, 'b': 27}
結果: 42

=== ツール実行: get_weather ===
引数: {'location': 'Tokyo'}
結果: Tokyoの天気は晴れ、気温は22度です。
この実行ログからは、MCPにおける「動的な機能ディスカバリ」と「AIによる自律的なツール選択・実行」というプロセスが意図通りに動作していることが確認できます。
- 起動直後にクライアントがサーバーへ問い合わせを行い、add_numbersとget_weatherという2つのツールが利用可能であることを動的に把握しています。
- その後、ユーザーからの「15と27を足して。それと、Tokyoの天気を教えて。」という複合的なリクエストに対し、Geminiモデルが文脈を解析し、2つの異なるツールを連続して呼び出しています。
- 引数も適切にパースされ、ローカルで実行された計算とダミーデータの検索結果がそれぞれ正しく取得されています。
実践:Google公式SDK(google-genai)を用いた場合
LangChainのような抽象化フレームワークを使わず、Googleの新しい公式SDKである google-genai を使ってシンプルに実装することも可能です。以下のコマンドで必要なパッケージをインストールしてください。
pip install mcp google-genai python-dotenv
# client_sdk.py
import os
os.environ["GRPC_VERBOSITY"] = "NONE"
os.environ["GLOG_minloglevel"] = "2"
import asyncio
from dotenv import load_dotenv
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client
from google import genai
from google.genai import types

# .envファイルから環境変数を読み込む
load_dotenv()

async def main():
    # クライアントの初期化(環境変数 GOOGLE_API_KEY が自動で読み込まれます)
    client = genai.Client()

    server_params = StdioServerParameters(
        command="python",
        args=["server.py"]
    )

    async with stdio_client(server_params) as (read, write):
        async with ClientSession(read, write) as session:
            await session.initialize()

            tools_response = await session.list_tools()

            # Google SDKのツールフォーマットに変換
            sdk_tools = []
            for t in tools_response.tools:
                sdk_tools.append({
                    "name": t.name,
                    "description": t.description,
                    "parameters": t.input_schema
                })

            # ツール定義をモデルに渡す
            tool_config = types.Tool(function_declarations=sdk_tools)

            user_prompt = "15と27を足して。それと、Tokyoの天気を教えて。"
            print(f"ユーザー入力: '{user_prompt}'")

            # 生成を実行
            response = client.models.generate_content(
                model='gemini-3.8-flash',
                contents=user_prompt,
                config=types.GenerateContentConfig(
                    temperature=0.0,
                    tools=[tool_config]
                )
            )

            # LLMが選択したツールを実行
            if response.function_calls:
                for function_call in response.function_calls:
                    print(f"\n=== ツール実行: {function_call.name} ===")
                    # 引数を辞書として取得
                    args = {k: v for k, v in function_call.args.items()}
                    print(f"引数: {args}")

                    result = await session.call_tool(function_call.name, arguments=args)
                    print(f"結果: {result.content[0].text}")

if __name__ == "__main__":
    asyncio.run(main())
ここでは、Google公式の google-genai SDKを用いて、抽象化フレームワークに依存せずにMCPクライアントを実装しています。
- ツール定義の直接的な変換: サーバーから取得したツール定義を、Google SDK専用の google.genai.types.Tool 形式に変換し、function_declarations としてパッケージングしています。
- 設定の簡素化: GenerateContentConfig の引数として直接ツール情報を渡し、client.models.generate_content を呼び出すことで推論を実行します。
- レスポンスからのツール呼び出し: モデルの返答に含まれる response.function_calls をループ処理し、抽出した引数を辞書形式にパースした上で、直接 session.call_tool() に渡してサーバー側の機能を実行しています。LangChainを用いた場合と比較して、抽象化の層が薄いため、低レイヤーの挙動をコントロールしやすくなっています。
実行結果:
ユーザー入力: '15と27を足して。それと、Tokyoの天気を教えて。'

=== ツール実行: add_numbers ===
引数: {'b': 27, 'a': 15}
結果: 42

=== ツール実行: get_weather ===
引数: {'location': 'Tokyo'}
結果: Tokyoの天気は晴れ、気温は22度です。
LangChainを使用した場合の実行結果と同じ動作が、Google公式SDK単体でも実現できていることが確認できます。
- ユーザー入力に対して、LLMは適切に add_numbers と get_weather の2つのツール呼び出し(Function Calling)を生成しています。
- 引数の並び順が
{'b': 27, 'a': 15}と、LangChain の場合({'a': 15, 'b': 27})と逆になっています。引数は名前で渡す辞書なので、順番が変わっても結果は変わらず、最終的なツールの実行結果(42 と Tokyoの天気は晴れ、気温は22度です。)は正確に取得できています。
MCPのライフサイクルとセキュリティの考慮点
Model Context Protocol(MCP)は、AIモデルと外部ツールを接続するための強力な標準規格ですが、そのオープンで分散型の性質ゆえに新たなセキュリティリスクももたらします。本節では、論文に沿って、MCPサーバーが辿る4つのライフサイクルフェーズと、それに伴う16の主要なアクティビティを整理します。各フェーズの脅威は、論文の表3で「その脅威がどのフェーズのアクティビティから生じるか(Threat Origin)」として整理されている16の脅威から、代表的なものを挙げます。
MCPサーバーの4つのライフサイクルと16のアクティビティ
MCPサーバーのライフサイクルは、開発から運用、そして保守に至るまで、以下の4つのフェーズと16のキーアクティビティ(Key Activities)に分類されます。
-
作成フェーズ(Creation) 開発者がサーバーのデータ構造と機能を定義し、実装する段階です。
- メタデータ定義(Metadata Definition): サーバーの名前、バージョン、説明などを定義します。
- 機能宣言(Capability Declaration): ツール、リソース、プロンプトなどの提供機能と権限の境界を宣言します。
- コード実装(Code Implementation): 宣言された機能と、実際の入力処理やロジックを紐付けるコードを記述します。
- スラッシュコマンド定義(Slash Command Definition): ユーザーが特定のプロンプトを呼び出しやすくするためのコマンドを定義します。
- ※主なセキュリティ脅威: 論文の16の脅威のうち7つがこのフェーズから生じます。既存の有名なサーバーに似せた名前を付ける名前空間のタイポスクワッティング(Namespace Typosquatting)、別のサーバーと同じツール名で誤ったツールを呼ばせるツール名の衝突(Tool Name Conflict)、ツールの説明文に悪意のある指示を隠すツールポイズニング(Tool Poisoning)、コードの不備によるコマンドインジェクション(Command Injection) などです。
-
デプロイフェーズ(Deployment) 実装されたサーバーがパッケージ化され、ホスト環境にインストールされる段階です。
- MCPサーバーリリース(MCP Server Release): コードや設定ファイルを配布可能な形式にパッケージ化し、公開します。
- インストーラー展開(Installer Deployment): コンテナや自動スクリプトを用いて、ターゲットシステムにサーバーをインストールします。
- 環境セットアップ(Environment Setup): 環境変数、アクセス認証、ネットワーク権限などの実行環境を構成します。
- ツール登録(Tool Registration): デプロイされたサーバーの機能をMCPホストやクライアントに登録し、利用可能にします。
- ※主なセキュリティ脅威: このフェーズでは、配布経路を改ざんして不正なサーバーをインストールさせるインストーラーのスプーフィング(Installer Spoofing) が典型的な脅威です。
-
運用フェーズ(Operation) デプロイされたサーバーが、実際にユーザーやAIエージェントからのリクエストを処理する実行段階です。
- 意図解析(Intent Analysis): ユーザーの入力を解析し、適切なMCPの機能(ツールやリソース)にマッピングします。
- 外部リソースアクセス(External Resource Access): 事前定義された権限に基づき、外部のAPIやデータベースから情報を取得します。
- ツール呼び出し(Tool Invocation): パラメータを受け取り、実際にツールを実行して結果を返却します。
- セッション管理(Session Management): ホスト、クライアント、ユーザー間の論理的な接続状態を維持・監視します。
- ※主なセキュリティ脅威: このフェーズでは、外部のデータに紛れ込ませた指示で LLM を操る間接プロンプトインジェクション(Indirect Prompt Injection)、認証情報の窃取(Credential Theft)、実行環境の制限を突破するサンドボックスエスケープ(Sandbox Escape)、複数のツールを組み合わせてデータを持ち出すツールチェーンの悪用(Tool Chaining Abuse)、セッションの乗っ取りなどの不正アクセス(Unauthorized Access) が挙げられています。なお、ツールポイズニングは運用中に被害が出ますが、論文では、悪意のある説明文を宣言する作成フェーズの脅威に分類されています。
-
保守フェーズ(Maintenance) 運用中のサーバーの信頼性と安全性を維持するための継続的な管理段階です。
- バージョン管理(Version Control): バグ修正や機能追加の履歴を管理し、互換性を維持します。
- 設定変更(Configuration Change): 実行時のパラメータやアクセス権限の変更を安全に適用します。
- アクセス監査(Access Audit): 認証や権限昇格のイベントを記録し、最小権限の原則が守られているか確認します。
- ログ監査(Log Audit): サーバーやツールの実行ログを収集・分析し、異常な挙動を検知します。
- ※主なセキュリティ脅威: ここでは、既知の脆弱性が残る古い版を使い続ける脆弱なバージョン(Vulnerable Versions)、更新後も古い権限が残る権限の永続化(Privilege Persistence)、管理されない設定の変更で守りが崩れる設定のドリフト(Configuration Drift) に注意が必要です。
4つのフェーズと16のアクティビティを並べると、次のようになります。
(図は、diagram-designで作成)
MCPがもたらす新たなセキュリティ課題
MCPはツール統合を劇的に簡単にする一方で、「AIが自律的に外部システムを操作する」という性質上、これまでになかった新たな攻撃面(アタックサーフェス)を生み出します。
例えば、今回作成したようなMCPサーバーが悪意を持って作成されていた場合、AIは説明文を読んだだけで不正なコードを実行させられてしまうかもしれません。また、複数のツールをAIが自動で連鎖(チェーン)させることで、意図しないデータ漏洩が起きるリスクも指摘されています。
こうした 「MCPエコシステムに潜むセキュリティの脅威と、最新の対策仕様」 については、重要な論文を1本ずつ取り上げた関連記事で詳しく解説しています。レジストリ経由で侵入する攻撃はクロスエンティティ攻撃の記事、公開されているサーバーのコード品質はサーバーの実装リスクの記事、クライアント側の防御はツールポイズニング耐性の記事、脅威の体系と最新の仕様はMCP-38の記事で扱っています。
まとめと今後の展望
Model Context Protocol(MCP)は、AIモデルと外部ツールやデータソース間の双方向通信を統一するオープンな標準プロトコルとして、AIアプリケーションの開発と運用に根本的な変革をもたらしつつあります。従来の手動によるAPI連携やプラットフォームごとに分断されたプラグインの仕組みを単一のプロトコルで抽象化することにより、開発者は連携部分の摩擦を意識することなく、エージェントベースのワークフローや複雑な推論タスクの設計に集中できるようになりました。AnthropicやOpenAI、Cloudflareといった業界リーダーによる採用が急速に進んでいることは、MCPがツール拡張型AIシステム(Tool-Augmented AI Systems)の基盤インフラとして、業界全体の相互運用性と大規模なコラボレーションを促進する重要な役割を担っていることを示しています。
一方で、MCPの分散型かつオープンな設計は、持続可能な成長と運用上の信頼性を確保する上で、いくつかの重大な課題も浮き彫りにしています。今後のMCPエコシステムが乗り越えるべき主な課題は以下の通りです。
中央集権的なセキュリティ監視とガバナンスの欠如
初期のMCPアーキテクチャ(論文執筆時点:2025年3月〜10月頃)では、MCPサーバーの多くは独立した開発者やコミュニティによって管理されており、セキュリティのベースラインを監査したり、統一されたコンプライアンスを強制したりする中央権限が存在しませんでした。この分散化により、パッチ適用の不一致や脆弱性管理のばらつきが生じていました。悪意のある攻撃者がこの断片化を突いて、名前空間のタイポスクワッティング(Namespace Typosquatting)やツール名の衝突を引き起こし、不正なサーバーをインストールさせるリスクが存在していました。そのため、安全な発見と検証を促進する公式のサーバーレジストリ(Server Registry)の構築が急務とされていました。
認証・認可の標準化とマルチテナント環境でのスケーラビリティ
同じく論文執筆時点のMCPには、クライアントとサーバー間で信頼を確立するための標準化された認証・認可のフレームワークが不足していました。このギャップは、セッションハイジャックや権限の永続化(Privilege Persistence)といった脅威を招く要因となっていました。さらに、クラウドベースでのリモートホスティングやマルチテナント環境(Multi-Tenant Environments)へとMCPインフラが進化する中で、パフォーマンスとプライバシーを維持しながらテナントを分離(Tenant Isolation)することが困難になっていました。スケーラビリティとセキュリティを両立させるためには、標準化されたテナント分離モデルやランタイムのサンドボックス化(Sandboxing)をMCPサーバーの設計に不可欠な要素として組み込む必要がありました。
デバッグと監視メカニズムの不足
初期の仕様では、ログ記録、監査、またはランタイムのイントロスペクション(Introspection)機能が限られていました。統合されたテレメトリ(Telemetry)や監査証跡(Audit Trails)が存在しないため、開発者は実行中のエラーを追跡したり、異常な動作を調査したりすることが困難でした。この監視フレームワークの欠如により、クロスサーバーシャドウイング(Cross-Server Shadowing)やコマンドインジェクションといった攻撃が検知されずに進行する恐れがありました。今後は、リアルタイムの異常検知や、セッション状態の整合性を検証する堅牢な監視メカニズムの導入が求められていました。
スマート環境への組み込みにおける課題
MCPをスマートホーム、産業用IoTシステム、企業向け自動化システムへ統合することには、特有のリスクが伴っていました。これらの環境はリアルタイムの制約の下で稼働し、エージェントと異種デバイス間の継続的な通信を必要とします。エッジやオンプレミスのMCPサーバーが侵害された場合、重大な安全上の障害やコマンドのなりすましにつながる可能性が指摘されていました。安全なファームウェア更新チャネルの実装や、デバイスレベルでの厳格な認証の強制、MCPを認識できる侵入検知システムの統合が、接続された環境での安全な展開に向けた重要なステップとなっていました。
本記事の執筆時点(2026年9月)では、上記で指摘されていた課題の多くは既に対応が進んでいます。例えば、2025年9月には公式のMCP Registryがプレビュー公開され、認証・認可についてもOAuth 2.1をベースラインとした仕様が策定済みです。こうした最新のセキュリティ仕様や認可モデルの厳格化については、MCP-38の記事で詳しく解説しています。
MCPは、多様な外部サービスとの安全で効率的な連携を実現し、AIエコシステムを標準化するための強力な基盤です。しかし、その真の可能性を引き出すためには、プロトコルの利便性を損なうことなく、作成、デプロイ、運用、保守というライフサイクル全体にわたるセキュリティの強化とガバナンスの確立が不可欠です。コミュニティ全体での継続的な監査、透明性の維持、そして安全な設計原則(Secure-by-Design)の共有が、進化し続けるAIエコシステムにおけるMCPの信頼性と持続的な発展を支える鍵となるでしょう。
参考文献
- X. Hou, Y. Zhao, S. Wang, H. Wang (2025). Model Context Protocol (MCP): Landscape, Security Threats, and Future Research Directions. arXiv:2503.23278.
- Anthropic (2024). Introducing the Model Context Protocol.
- Model Context Protocol. Specification(2026-07-28): Key Changes.
- Qwen Team (2024). Qwen2.5-0.5B-Instruct. Hugging Face(Apache License 2.0).
- Google. Gemini API ドキュメント.
本記事の文章・構成の一部に生成AIを使用しています。