MCPサーバーの実装リスクとは?
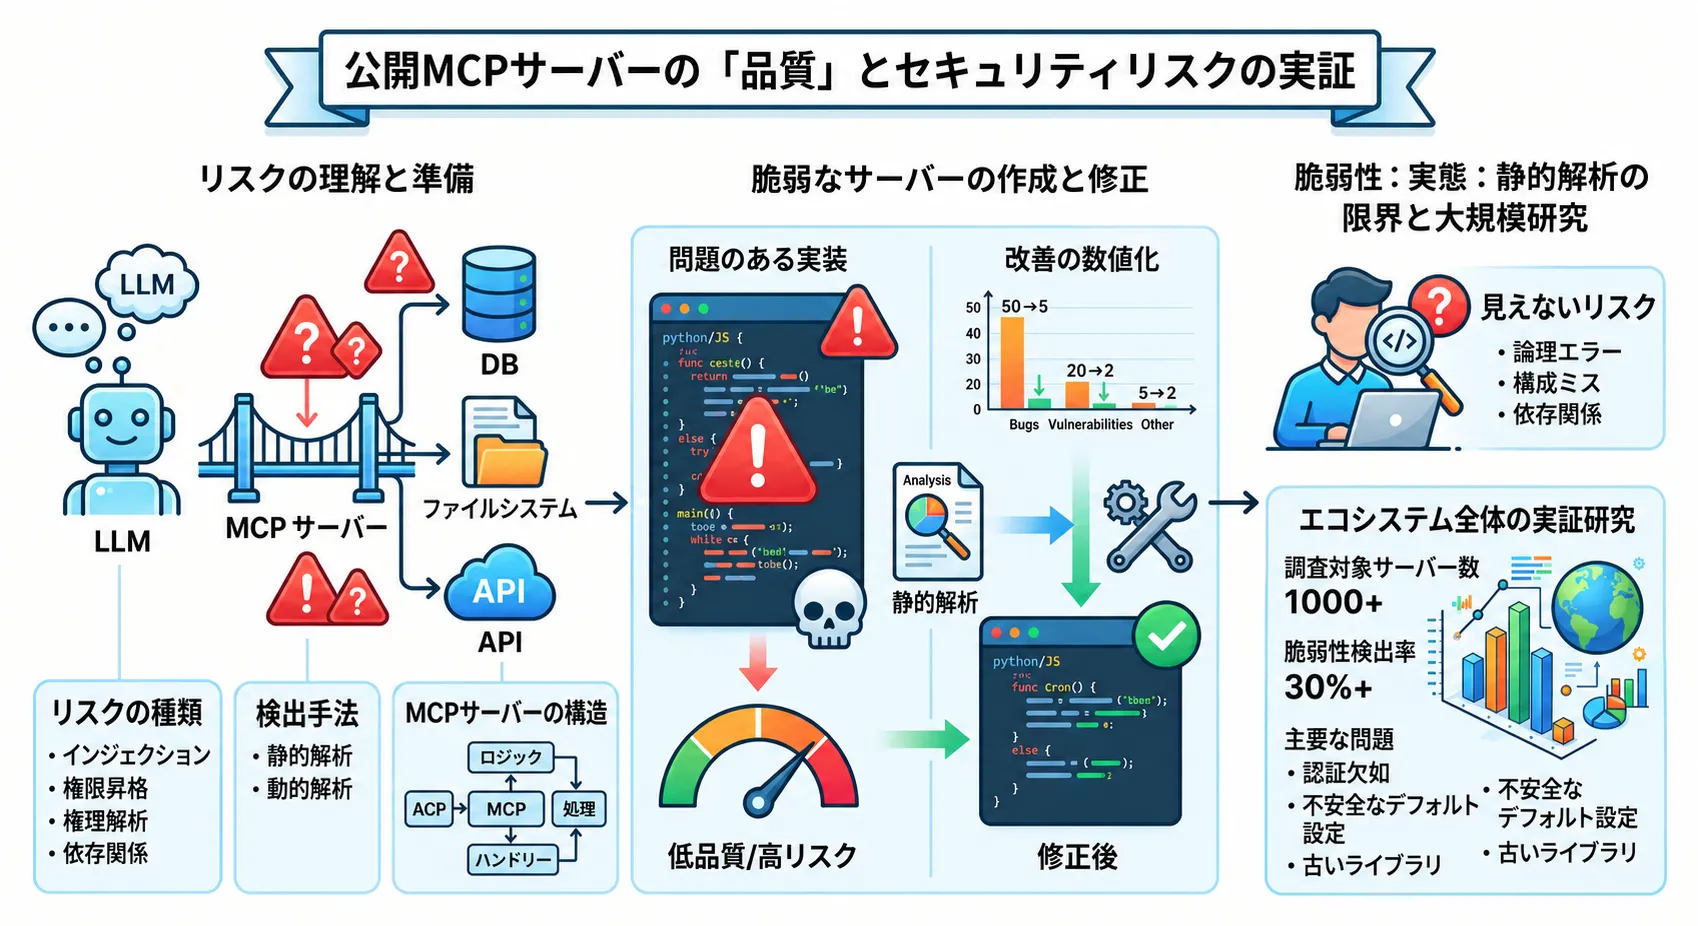
(画像は、Geminiで作成)
公開されている MCP サーバーが抱えるリスクを、一般的なソフトウェアの脆弱性・保守性の問題と、ツールポイズニングのような MCP に特有の問題に分けて理解すること。脆弱な MCP サーバーを書いて静的解析にかけ、FastMCP でリファクタリングして認知的複雑性や検出件数の改善を数値で確かめ、静的解析では見つからないリスクが残ることを説明できるようになること。
MCPサーバーの実装リスクの概要
本記事では、公開されているオープンソースMCPサーバーそのものの「品質」に焦点を当てます。MCPサーバーは、大規模言語モデル(LLM)と、データベースやファイルシステム、外部APIといった機密性の高いシステムとを直接結びつける橋渡し役です。つまりサーバーの実装品質が、そのままユーザーのシステムの安全性になります。
本記事では、実際に脆弱なMCPサーバーを書いて、静的解析にかけ、リファクタリングで直し、改善を数値で測るところまでを一通り体験します。そのうえで、公開されているサーバーが現実にどうなっているのかを、大規模実証研究の数字で確認します。
流れは次の通りです。前半でリスクの種類・検出手法・MCPサーバーの構造を押さえ、コードを読む準備をします。中盤で意図的に問題を抱えたサーバーを実装し、静的解析で検出させ、リファクタリングして改善を計測します。後半で、静的解析では原理的に見えないリスクと、エコシステム全体の実態を確認します。
記事中の実態データは、ACM TOSEMに採録された論文「Model Context Protocol (MCP) at First Glance: Studying the Security and Maintainability of MCP Servers (arXiv:2506.13538v5, Hasan, Li, Fallahzadeh, Rajbahadur, Adams, Hassan (Queen's University))」に基づいています。1,899台のOSSサーバーを収集し、健全性・セキュリティ・保守性を横断評価した初の大規模実証研究です。
数値の母数について 論文の数値は対象範囲が3層に分かれています。1,899件がデータセット全体、そこからスター数10未満のトイプロジェクトを除いた583件が静的解析(SonarQube)の対象、さらに動的解析(mcp-scan)が成功した73件という内訳です。本記事の「7.2%」「66%」は583件、「5.5%」は73件を母数としています(収集時点は2025年3月)。
MCPサーバーが抱える2種類のリスク
2種類のリスクと検出手法を並べると、次のようになります。
(図は、diagram-designで作成)
MCPサーバーの品質を考えるうえで厄介なのは、従来のソフトウェア開発におけるリスクと、AI駆動特有のリスクという、性質の異なる2つの脅威が混在している点です。
第一に、MCPサーバーは一般的なプログラミング言語で書かれたソフトウェアである以上、従来の実装リスクから逃れられません。認証情報の漏洩(Credential Exposure)、コードの可読性・拡張性を損なうコードスメル(Code Smell)、機能的な欠陥であるバグ。これらは目新しい脅威ではありませんが、前述の橋渡し役という立場上、そのまま機密データの漏洩やシステム侵害に直結します。
第二に、MCPは「AI駆動の非決定的な制御フロー」を持つため、プロトコル特有のリスクサーフェスを生みます。代表例が ツールポイズニング(Tool Poisoning) です。攻撃者はツールの実行ロジックを一切書き換えず、動的ディスカバリ(reflection)でLLMに読み込ませるツールの説明文(description)に悪意ある指示を紛れ込ませます。攻撃の仕組みはクロスエンティティ攻撃の記事で扱ったので、本記事では実態の側だけを見ます。
どちらも理論上の懸念ではありません。初の悪意あるPostmark-MCPサーバーは、ユーザーの気付かないうちに隠しBCCを追加して何千ものユーザーメールを外部に流出させました。デバッグツール「MCP Inspector」では、開発者が悪意あるウェブサイトを訪問するだけで任意のコマンドが実行されるRCE脆弱性(CVE-2025-49596)も見つかっています。
そして重要なのは、この2種類は検出手法がまったく異なるという点です。
リスクを検出する2つの目線:静的解析と動的解析
2つの解析の対象と検出できるものを図にすると、次のようになります。
(図は、diagram-designで作成)
論文が採用したのは、汎用的な静的解析ツールとMCP特有の動的スキャナーを組み合わせた「ハイブリッド解析フレームワーク」です。なぜ2つ必要なのかを、先に押さえておきます。
静的解析(SonarQube):ソースコードを読む
従来型のリスクは、ソースコードを読めば分かります。APIキーが文字列リテラルとして書かれていれば、そこにあると分かる。ネストが4段重なっていれば、それも構文を見れば分かる。プログラムを実行しなくても判定できるため、静的解析(Static Application Security Testing: SAST)の守備範囲です。
論文が使ったSonarQubeは、ソースコードをオフラインで解析し、MITRE CWE Top 25、OWASP Top 10、PCI DSSといった業界標準のベンチマークに準拠したルールベースの検査を行います。検出結果は3種類に分類されます。本記事でもこの分類をそのまま使います。
- 脆弱性(Vulnerability):セキュリティ上の欠陥。ハードコードされた認証情報、不適切なアクセス制御など。
- コードスメル(Code Smell):動作はするが、保守性を損なう構造的な問題。深いネスト、コードの重複など。
- バグ(Bug):機能的に誤った動作を引き起こす欠陥。
重要なのは、コードスメルは「動くけれど危ない」を検出するという点です。テストが全部通っても、スメルは残ります。この性質が、次節で実装するコードの厄介さに直結します。
動的解析(mcp-scan):稼働中のサーバーに話しかける
一方、ツールポイズニングはソースコードのどこにも「悪意あるコード」として存在しません。存在するのは、description フィールドに書かれた普通の日本語や英語の文章です。構文としては完全に正常な文字列リテラルなので、SonarQubeが何を検査しても「怪しい文字列がある」とは判定できません。
MCPサーバーは「リフレクション(reflection)」と呼ばれる仕組みで、実行時にツール名・説明文・パラメータのスキーマをクライアントに提供します。リスクはこの実行時に露出するメタデータの側にあります。そこで論文は、稼働中のサーバーインスタンスに実際に接続し、MCPクライアント(Claude Desktopなど)の挙動を模倣してメタデータを取得・検査する動的解析ツール mcp-scan(Invariant Labs製)を併用しました。
| 検査対象 | 検出できるもの | |
|---|---|---|
| 静的解析(SonarQube) | ソースコードという静的なアーティファクト | 認証情報漏洩、コードスメル、バグ |
| 動的解析(mcp-scan) | 実行時のリフレクションメタデータ | ツールポイズニング、プロンプトインジェクション |
この分業を覚えておいてください。 記事の後半で、片方だけでは攻撃面を覆えないことが数字で出てきます。
なお、SonarQubeは解析サーバーの構築が必要で手軽に試せるものではありません。本記事で実際に手を動かす際は、pip だけで導入できる detect-secrets とPython標準の ast を組み合わせ、同じ3種類のリスクを検出できる最小構成を自作します。
MCPサーバーの構造と、リスクが溜まる場所
次節でスクラッチ実装に入る前に、MCPサーバーがなぜこれらのリスクを抱えやすいのかを整理しておきます。コードの形がそのまま理由になっているためです。
MCPサーバーの責務は、煎じ詰めると2つだけです。
- どんなツールを提供できるかを申告する(ツール名・説明文・パラメータスキーマの一覧を返す)
- 指定されたツールを実行して結果を返す
本記事では、この2つをFastAPIの GET /tools と POST /execute という素朴な2エンドポイントとして実装します。実際のFastMCPはデコレータでこれを隠蔽しますが、中身はこの形です。あえて手で書くのは、リスクがどこに入り込むかを見えるようにするためです。フレームワークが隠してくれる部分にこそ、今回扱う問題が潜んでいます。
GET /tools が返すツールメタデータは、次のような構造をしています。次節のコードに出てくる TOOLS リストの各要素がこれです。
{
  "name": "calculate_duration",
  "description": "2つのタイムスタンプ間の期間(秒)を計算します。",
  "parameters": {
    "type": "object",
    "properties": {
      "start_time": {"type": "string", "description": "ISO format timestamp string."},
      "end_time":   {"type": "string", "description": "ISO format timestamp string."}
    },
    "required": ["start_time", "end_time"]
  }
}
注目してほしいのは、description フィールドが2箇所にあることです。ツール全体の説明と、各パラメータの説明。どちらもLLMがツールを選び引数を組み立てる際に読み込まれます。つまり自然言語のテキストが、構造化データの中に複数箇所に埋め込まれているのがMCPのツール定義の特徴です。この記事の後半で扱うツールポイズニングは、まさにこのフィールドを舞台にします。
この構造から、2つの傾向が生まれます。
第一に、認証情報がサーバーに集まります。 MCPサーバーは定義上、LLMと外部システムの橋渡し役です。データベースに繋ぐならDB接続情報を、外部APIを叩くならAPIキーを、必ず何らかの資格情報を保持することになります。「認証情報を持たないMCPサーバー」はほとんど存在しません。だからこそ、その管理方法がそのままリスクの大きさを決めます。
第二に、/execute が肥大化します。 ツールが増えるたび、素朴に書けば if req.name == "..." の分岐が1本ずつ増えていきます。各分岐の中には引数の検証、パース処理、エラーハンドリングが入るため、ネストは自然に深くなります。さらに、複数のツールが似たような前処理(日付のパースなど)を必要とすると、分岐をまたいだコピー&ペーストが発生します。
つまりMCPサーバーは、その責務の形からして「認証情報を持ち、単一の巨大な分岐関数を抱えやすい」構造をしています。論文の調査で認証情報漏洩と認知的複雑性が上位を占めたのは、偶然ではありません。
2つの責務とリスクが溜まる場所を図にすると、次のようになります。
(図は、diagram-designで作成)
数式による定式化:認知的複雑性はどう数えられるか
本記事では「認知的複雑性」を改善の指標として繰り返し使います。後半では実際にこの値を計測し、リファクタリング前後で比較します。その前に、この指標がどう算出されるのかを定式化しておきます。ルールが分かっていると、コードを読んだ時点でスコアの見当がつくようになります。
加算ルール
ある関数の中で、処理の流れを一直線でなくする構文(if、for、while、except など)の集合を とします。各構文 について、そのネストの深さを (最上位を )とすると、認知的複雑性 は次式で与えられます。
これは2つの成分に分解できます。
第1項は「分岐がいくつあるか」、第2項は「それがどれだけ深いところにあるか」です。循環的複雑度(Cyclomatic Complexity)が第1項だけを数えるのに対し、認知的複雑性は第2項を上乗せします。ここが両者の決定的な違いで、「分岐の数」ではなく「読みにくさ」を測る指標だと言われる理由です。
上式は本質をつかむための簡略化モデルです。SonarSourceの正式な仕様では、else や elif は されるがネスト加算は受けない、連続する論理演算子はまとめて とするなど、いくつかの例外が定められています。手計算した値がツールの出力と数点ずれることがあるのはこのためです。ネストが効くという骨格は変わりません。
平らな分岐と入れ子の分岐
同じ3つの分岐でも、配置によってスコアがどう変わるかを見てみましょう。
# 平らに並んだ3つの分岐:すべて d = 0
def flat(a, b, c):
    if a: pass        # 1 + 0 = 1
    if b: pass        # 1 + 0 = 1
    if c: pass        # 1 + 0 = 1
    # C = 3

# 入れ子になった3つの構文:d = 0, 1, 2
def nested(items, flag):
    if flag:                      # 1 + 0 = 1
        for x in items:           # 1 + 1 = 2
            try:                  # 1 + 2 = 3
                pass
            except Exception:
                pass
    # C = 6
構文の数は同じ3つなのに、スコアは3と6で2倍になります。循環的複雑度で測れば両者は同じ値です。
ネストの連鎖は二次関数的に重くなる
一般に、 段のネストが一直線に連鎖している場合、深さは と並ぶので、
となります。ネストの深さに対して二次関数的に増加するわけです。 なら3、 なら6、 なら10。1段深くするたびに、コストの増分そのものが大きくなっていきます。
リファクタリングが効く理由
この式は、なぜ「メソッドの抽出(Extract Method)」が有効なのかも説明してくれます。
入れ子の内側を別関数に切り出すと、切り出された側では深さが にリセットされます。 段の連鎖を 個の関数に分割した極端なケースを考えると、合計は になります。
二次から線形への低下です。処理の総量は1ミリも減っていないのに、スコアだけが下がります。これは指標の欠陥ではありません。人間が一度に頭に入れる制御フローの段数が減っているという事実を、そのまま数値化しているからです。
後半の計測セクションでは、この効果を実際のコードで確認します。
分岐の配置と認知的複雑性の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
再現する3つのアンチパターン
次節で実装するサーバーには、論文の調査で実際に上位を占めた3つのアンチパターンを意図的に埋め込みます。コードを読む際の着目点として、先に何を仕込むかを説明しておきます。
1. 認証情報漏洩(Credential Exposure)
APIキー・DBパスワード・秘密鍵IDを、ソースコードの先頭に文字列リテラルとして直接書きます。論文で最多の脆弱性であり、583件中3.6%(脆弱性が検出されたサーバーの半数)に存在しました。CWE-798(ハードコードされた認証情報の使用)に該当します。
一見「自分は書かないから関係ない」と思うかもしれませんが、動作確認のために一時的にベタ書きしたものがそのままコミットされる、というのが典型的な混入経路です。ローカルで動かす分には何の問題も起きないのが厄介なところです。
2. 高い認知的複雑性(High Cognitive Complexity)
/execute の中にすべてのツールのロジックを詰め込み、ネストを深くします。最頻出のコードスメルで59.7%、2位の3倍近い発生率です。
認知的複雑性は、行数ではなく 「読む人が制御フローを追うのにどれだけ頭を使うか」 を測る指標です。算出ルールは前節で定式化した通りで、平らに並んだ分岐は軽く、入れ子になった分岐は急激に重くなります。
次節のコードでは、ツール名の分岐 → 引数の有無チェック → ループ → try-except という4段のネストを作ります。前節の に照らせば、これだけで10点が確定します。読みながら、どこで何点加算されそうかを目で追ってみてください。
3. コードの重複(Code Duplication-Redundancy)
「ISOタイムスタンプの Z を +00:00 に置換してパースする」という同一処理を、2つのツールの分岐にコピー&ペーストします。発生率 21.4% で2位のスメルです。
これは論文のFigure 7で実例として挙げられているパターンをなぞったものです。害が出るのは仕様変更のときで、タイムゾーンの扱いを変える必要が生じた際に片方の修正を忘れると、同じサーバー内の2つのツールが異なる日付解釈をするという不整合(Change Misalignment)が生まれます。
スクラッチ実装:3つのリスクを埋め込んだMCPサーバー
以上を踏まえて、実際に書いてみましょう。提供するツールは期間計算(calculate_duration)と購入履歴フォーマット(format_purchase_history)の2つです。fastapi, httpx, pydantic が入っていれば、単一スクリプトとしてそのまま実行できます。
import json
from datetime import datetime
from fastapi import FastAPI, HTTPException
from fastapi.testclient import TestClient
from pydantic import BaseModel

app = FastAPI(title="Vulnerable MCP Server")

# 【脆弱性1: 認証情報漏洩(Credential Exposure)】
# 外部サービスのAPIキーやデータベースのパスワードをソースコードに直接ハードコードしています。
# ローカルでの動作確認では問題になりませんが、リポジトリにコミットされると流出につながる重大なセキュリティリスク(CWE-798)となります。
OPENAI_API_KEY = "sk-Wo********g5"
DB_PASSWORD = "super_secret_password_123"
PRIVATE_KEY_ID = "d4d****4a4"

TOOLS = [
    {
        "name": "calculate_duration",
        "description": "2つのタイムスタンプ間の期間(秒)を計算します。",
        "parameters": {
            "type": "object",
            "properties": {
                "start_time": {"type": "string", "description": "ISO format timestamp string."},
                "end_time": {"type": "string", "description": "ISO format timestamp string."}
            },
            "required": ["start_time", "end_time"]
        }
    },
    {
        "name": "format_purchase_history",
        "description": "購入履歴データを読みやすい文字列にフォーマットします。",
        "parameters": {
            "type": "object",
            "properties": {
                "history_data": {"type": "string", "description": "JSON string of purchase history"}
            },
            "required": ["history_data"]
        }
    }
]

@app.get("/tools")
def list_tools():
    return {"tools": TOOLS}

class ExecuteRequest(BaseModel):
    name: str
    arguments: dict

@app.post("/execute")
def execute_tool(req: ExecuteRequest):
    # 【脆弱性2: 巨大な実行関数による認知的複雑性の増大】
    # すべてのツールの処理を if req.name == ... の分岐で無理やり同居させています。
    # ツールが増えるたびにこの関数が肥大化し、分岐の中にループや try-except がネストすることで可読性が著しく悪化します。
    if req.name == "calculate_duration":
        start_time = req.arguments.get("start_time")
        end_time = req.arguments.get("end_time")

        if start_time and end_time:
            # 【脆弱性3: ロジックの重複(Change Misalignmentリスク)】
            # ISO 8601フォーマットのパース処理がコピペされています。
            # 仕様変更があった際に片方だけの修正が漏れるなど、一貫性を損なう保守上の大きなリスク要因となります。
            if "Z" in start_time:
                start_time = start_time.replace("Z", "+00:00")
            if "Z" in end_time:
                end_time = end_time.replace("Z", "+00:00")

            try:
                start = datetime.fromisoformat(start_time)
                end = datetime.fromisoformat(end_time)
                duration = end - start
                return {"result": duration.total_seconds(), "status": "success"}
            except Exception:
                raise HTTPException(status_code=400, detail="Invalid timestamp format")
        else:
            return {"result": 0.0, "status": "success"}

    elif req.name == "format_purchase_history":
        history_data = req.arguments.get("history_data")
        try:
            purchases = json.loads(history_data)
        except Exception:
            raise HTTPException(status_code=400, detail="Invalid JSON format")

        limit = 5
        if not purchases:
            return {"result": "No previous purchases found", "status": "success"}

        output = [f"Purchase History (showing {limit} most recent):"]
        # 深いネストによる高い認知的複雑性
        for purchase in purchases[:limit]:
            amount = float(purchase.get("amount", 0)) / 100
            timestamp = purchase.get("timestamp", "")

            if timestamp:
                # 【脆弱性3: ロジックの重複】ここでも全く同じタイムスタンプのパース処理が重複して実装されています。
                if "Z" in timestamp:
                    timestamp = timestamp.replace("Z", "+00:00")

                try:
                    dt = datetime.fromisoformat(timestamp)
                    formatted_date = dt.strftime("%B %d, %Y")
                    output.append(f"- ${amount:.2f} on {formatted_date}")
                except Exception:
                    continue

        return {"result": "\n".join(output), "status": "success"}

    raise HTTPException(status_code=404, detail=f"Tool '{req.name}' not found")

if __name__ == "__main__":
    client = TestClient(app)

    print("=== calculate_duration ツールの実行 ===")
    res1 = client.post("/execute", json={
        "name": "calculate_duration",
        "arguments": {
            "start_time": "2025-05-01T10:00:00Z",
            "end_time": "2025-05-01T12:30:00Z"
        }
    })
    print(json.dumps(res1.json(), indent=2, ensure_ascii=False))

    print("\n=== format_purchase_history ツールの実行 ===")
    res2 = client.post("/execute", json={
        "name": "format_purchase_history",
        "arguments": {
            "history_data": json.dumps([
                {"amount": 15000, "timestamp": "2025-05-01T10:00:00Z"},
                {"amount": 2500, "timestamp": "2025-05-02T15:30:00Z"}
            ])
        }
    })
    print(json.dumps(res2.json(), indent=2, ensure_ascii=False))
このコードは、FastAPIを用いて2つのツールを提供する意図的に脆弱なMCPサーバーのモックを実装しています。
- 認証情報の漏洩: コード冒頭で OPENAI_API_KEY などの秘匿情報をグローバル変数として直接ハードコードしています。ローカルでの動作確認では問題になりませんが、リポジトリにコミットされると流出につながる重大なセキュリティリスクとなります。
- 巨大な実行関数による認知的複雑性の増大: @app.post("/execute") で定義された execute_tool 関数の中で、すべてのツールの処理(calculate_duration と format_purchase_history)を if req.name == ... という分岐で無理やり同居させています。ツールが増えるたびにこの関数が肥大化し、分岐の中にさらにループや try-except ブロックがネストすることで、コードの可読性(認知的複雑性)が著しく悪化します。
- ロジックの重複(Change Misalignmentリスク): 2つのツールの分岐内で、ISO 8601フォーマットの末尾の "Z" を "+00:00" に置換し、datetime.fromisoformat() でパースする処理が完全にコピー&ペーストされています。仕様変更があった際に片方だけの修正が漏れるなど、一貫性を損なう保守上の大きなリスク要因となります。
実行すると、以下の通り正常な結果が返ります。深刻な脆弱性やコードスメルを抱えていても、機能要件自体は満たしてしまう——これが実装リスクの厄介なところです。テストがすべて通っても、リスクは残ります。
=== calculate_duration ツールの実行 ===
{
  "result": 9000.0,
  "status": "success"
}

=== format_purchase_history ツールの実行 ===
{
  "result": "Purchase History (showing 5 most recent):\n- $150.00 on May 01, 2025\n- $25.00 on May 02, 2025",
  "status": "success"
}
静的解析でリスクを顕在化させる
機能テストでは見えないものを見るのが静的解析です。論文が使ったSonarQubeはサーバーの構築が必要で手軽ではないので、ここでは pip だけで揃う同等のツールを組み合わせて、同じ3種類のリスクを実際に検出してみます。
環境の準備
使うのは以下の3つです。いずれもオフラインで動作し、外部サービスへの登録は不要です。
| ツール | 役割 | 対応するリスク |
|---|---|---|
| detect-secrets | Yelp製のシークレットスキャナ。キーワードとエントロピーで認証情報を検出 | 認証情報漏洩 |
| cognitive-complexity | 認知的複雑性の算出 | コードスメル(複雑性) |
| Python標準 ast | 構文木の比較による重複検出 | コードスメル(重複) |
pip install detect-secrets cognitive-complexity
前節のコードを vulnerable_server.py として保存してください。
解析スクリプト
3つのチェックをまとめて実行し、1つのレポートとして出力するスクリプトです。scan.py として保存します。
"""MCPサーバーの実装リスクを検出する簡易静的解析パイプライン。"""
import ast
import json
import re
import subprocess
import sys
from collections import defaultdict

from cognitive_complexity.api import get_cognitive_complexity

COMPLEXITY_THRESHOLD = 15


def scan_secrets(path: str) -> list[tuple[int, str]]:
    """detect-secrets を呼び出し、ハードコードされた認証情報を検出する。"""
    proc = subprocess.run(
        ["detect-secrets", "scan", path],
        capture_output=True, text=True, check=True,
    )
    results = json.loads(proc.stdout).get("results", {}).get(path, [])
    return sorted({(r["line_number"], r["type"]) for r in results})


def scan_complexity(tree: ast.AST) -> list[tuple[str, int]]:
    """関数ごとの認知的複雑性を算出する。"""
    return [
        (node.name, get_cognitive_complexity(node))
        for node in ast.walk(tree)
        if isinstance(node, ast.FunctionDef)
    ]


def scan_duplication(tree: ast.AST) -> list[tuple[str, list[int]]]:
    """変数名を伏せたうえで、同じ「処理の形」が複数箇所に現れる重複を検出する。"""
    # 同一ファイル内で定義済みの関数は「共通化の結果」なので重複とみなさない
    helpers = {n.name for n in ast.walk(tree) if isinstance(n, ast.FunctionDef)}

    seen = defaultdict(list)
    for func in ast.walk(tree):
        if not isinstance(func, ast.FunctionDef):
            continue
        for stmt in ast.walk(func):
            if not isinstance(stmt, ast.Assign):
                continue
            value = stmt.value
            if isinstance(value, ast.Call) and isinstance(value.func, ast.Name):
                if value.func.id in helpers:
                    continue
            # 変数名を '_' に置き換え、処理の構造だけを比較キーにする
            shape = re.sub(r"id='[^']*'", "id='_'", ast.dump(value))
            seen[shape].append((stmt.lineno, ast.unparse(value)))

    return [
        (occ[0][1], [n for n, _ in occ])
        for shape, occ in seen.items()
        if len(occ) > 1 and len(shape) > 60
    ]


def main(path: str) -> int:
    source = open(path, encoding="utf-8").read()
    tree = ast.parse(source)
    findings = 0

    print(f"=== 静的解析レポート: {path} ===\n")

    print("[1] 認証情報の漏洩 (Credential Exposure)")
    secrets = scan_secrets(path)
    lines = source.splitlines()
    for line_no, kind in secrets:
        findings += 1
        var = lines[line_no - 1].split("=")[0].strip()
        print(f"  NG  L{line_no:<4} {var:<18} 検出タイプ: {kind}")
    if not secrets:
        print("  OK  ハードコードされた認証情報は検出されませんでした")

    print("\n[2] 認知的複雑性 (Cognitive Complexity)")
    for name, score in scan_complexity(tree):
        over = score > COMPLEXITY_THRESHOLD
        findings += over
        mark = "NG " if over else "OK "
        note = f"  <- 閾値 {COMPLEXITY_THRESHOLD} 超過" if over else ""
        print(f"  {mark} {name:<28} C = {score:>2}{note}")

    print("\n[3] コードの重複 (Duplication)")
    dups = scan_duplication(tree)
    for snippet, locations in dups:
        findings += 1
        where = ", ".join(f"L{n}" for n in locations)
        print(f"  NG  {where} に同一の処理が重複")
        print(f"      {snippet[:64]}")
    if not dups:
        print("  OK  重複したロジックは検出されませんでした")

    print(f"\n--- 合計 {findings} 件の問題を検出しました ---")
    return 1 if findings else 0


if __name__ == "__main__":
    sys.exit(main(sys.argv[1] if len(sys.argv) > 1 else "vulnerable_server.py"))
このスクリプトは、MCPサーバーのソースコードに対して、認証情報漏洩、認知的複雑性、コードの重複という3つの実装リスクをオフラインで静的解析する簡易パイプラインです。
- 認証情報の漏洩検出: scan_secrets(path) では、外部ツールである detect-secrets を subprocess.run() で実行し、そのJSON出力をパースします。これにより、キーワードやエントロピーの高さに基づいてハードコードされたAPIキーやパスワードの流出リスクを検出します。
- 認知的複雑性の算出: scan_complexity(tree) は、標準ライブラリの ast (抽象構文木)モジュールを用いてコードを走査し、各関数定義(ast.FunctionDef)を取り出します。それぞれに対して get_cognitive_complexity(node) を適用することで、単なる行数ではなくネストの深さなどを考慮した「人間にとっての読みづらさ」をスコア化します。閾値の15は、SonarQube が認知的複雑性の既定の上限にしている値です。
- コードの重複検出: scan_duplication(tree) では、ASTに基づいた高度な構造比較を行います。単なるテキスト比較では変数名が違うだけで別物と判定されてしまうため、ast.dump(value) の出力に対して re.sub(r"id='[^']*'", "id='_'", ...) を適用し、変数名をすべて _ でマスクしています。これにより、「変数名が違うだけで処理の流れが全く同じロジック」をChange Misalignmentのリスクとして高精度に発見します。処理の形が60文字より長いものだけを比べるのは、x + 1 のような短い式が、偶然一致して重複と判定されるのを避けるためです。
- 解析レポートの統合: main(path) で対象のソースコードを読み込んでASTへ変換後、上記3つのスキャンを実行してターミナルに出力します。1件でも問題が見つかれば return 1 (終了コード1)を返す設計になっており、そのままCI/CDの自動チェックプロセスに組み込めるようになっています。 重複検出は少し工夫しています。単純に行を比較すると変数名の違いで取りこぼすため、構文木を走査したうえで変数名を _ に置き換え、「処理の形」だけを比較しています。これにより start_time.replace(...) と timestamp.replace(...) を同一の処理として検出できます。あわせて、同一ファイル内で定義済みの関数呼び出しは「共通化した結果」なので除外しています。
実行
python scan.py vulnerable_server.py
=== 静的解析レポート: vulnerable_server.py ===

[1] 認証情報の漏洩 (Credential Exposure)
  NG  L12   OPENAI_API_KEY     検出タイプ: Secret Keyword
  NG  L13   DB_PASSWORD        検出タイプ: Secret Keyword

[2] 認知的複雑性 (Cognitive Complexity)
  OK  list_tools                   C =  0
  NG  execute_tool                 C = 28  <- 閾値 15 超過

[3] コードの重複 (Duplication)
  NG  L64, L66, L98 に同一の処理が重複
      start_time.replace('Z', '+00:00')
  NG  L69, L70, L101 に同一の処理が重複
      datetime.fromisoformat(start_time)

--- 合計 5 件の問題を検出しました ---
仕込んだ3つのアンチパターンが、すべて検出されました。
結果の読み方
1. 認証情報漏洩 L12とL13が「Secret Keyword」として検出されています。detect-secrets は変数名に api_key、password、secret などのキーワードが含まれ、かつ値が文字列リテラルである箇所を拾います。ローカルで実行しても何のエラーも出ませんが、リポジトリを公開した瞬間に自動スキャンツールの収集対象になります。論文が最多の脆弱性として報告したCWE-798(ハードコードされた認証情報の使用)がこれです。
注意したいのは、クロスエンティティ攻撃の記事で扱った「レジストリの設定例に貼られたトークンの漏洩」と経路が違う点です。今回はサーバーのソースコードそのものが漏洩源になっています。
L14の PRIVATE_KEY_ID は検出されていません。本記事のサンプルでは値を d4d ****4a4 とマスクしているため、* を含む文字列をプレースホルダとみなす判定に引っかかったためです。実際の秘密鍵IDのような値を書くと、Hex High Entropy String として検出されます。** シークレットスキャナは万能ではなく、値の見た目に依存する**という点は覚えておいて損はありません。
2. 認知的複雑性 execute_tool が となり、閾値15を大きく超えました。前節で定式化した通り、ツール名の分岐 → 引数の有無チェック → ループ → try-except という4段のネストが、深さぶんの加算を繰り返した結果です。分岐の数自体は多くありませんが、入れ子になっているだけで閾値の1.8倍を超えます。
3. コードの重複 .replace('Z', '+00:00') が3箇所(L64、L66、L98)、datetime.fromisoformat(...) が3箇所(L69、L70、L101)に散っていることが検出されました。前節で予告したChange Misalignmentのリスクが、行番号付きで特定された形です。
ここで押さえておきたいのは、これら5件はいずれもプログラムを一度も実行せずに検出されているという点です。直前の機能テストは全部通っていました。動作確認だけでは、この層のリスクは一切見えません。
リファクタリング:FastMCPによるセキュアな実装
3つのリスクを、公式Python SDK同梱の軽量フレームワーク「FastMCP」を使って解消します。打ち手は2つだけです。
- 環境変数ベースの認証情報管理への切り替え(→ 認証情報漏洩の解消)
- メソッドの抽出(Extract Method) による重複ロジックの共通化(→ 重複と認知的複雑性の解消)
FastMCP自体の基本的な使い方はMCPの記事で扱っているため、差分に絞って説明します。
Python SDKの2.x系では FastMCP が MCPServer に改称され、インポートパスも from mcp.server.mcpserver import MCPServer に変更されています。本記事のコードは1.x系のAPI(from mcp.server.fastmcp import FastMCP)を前提としているため、後述の実行コマンドのように mcp<2 をピン留めするか、2.x系のマイグレーションガイドに沿って読み替えてください。
import os
import json
from datetime import datetime
from mcp.server.fastmcp import FastMCP

# サーバーの初期化
mcp = FastMCP("SecureServer")

# ==========================================
# 保守性の改善:重複ロジックの抽出(Extract Method)
# ==========================================
# 前段のコードで重複していたタイムスタンプのパース処理を一箇所に集約しています。
# これにより将来の仕様変更時の修正漏れ(Change Misalignment)を構造的に防ぎます。
def parse_iso_timestamp(timestamp_str: str) -> datetime:
    """
    ISO 8601形式のタイムスタンプ文字列を安全にパースするヘルパー関数。
    複数のツールで重複していた処理を共通化し、認知的複雑性を下げます。
    """
    if not timestamp_str:
        return datetime.now()
    if "Z" in timestamp_str:
        timestamp_str = timestamp_str.replace("Z", "+00:00")
    return datetime.fromisoformat(timestamp_str)


# ==========================================
# ツールの定義:アノテーションを活用した自動定義
# ==========================================
# @mcp.tool() デコレータと引数の型ヒントからJSONスキーマが自動生成されます。
# 巨大な if req.name == ... 分岐が不要になり、安全で可読性の高いコードが保たれます。
@mcp.tool()
def calculate_duration_seconds(start_time: str, end_time: str) -> float:
    """2つのタイムスタンプ間の期間を秒単位で計算します。"""
    # 抽出したヘルパー関数を利用することで、ロジックが簡素化される
    start = parse_iso_timestamp(start_time)
    end = parse_iso_timestamp(end_time)
    return (end - start).total_seconds()

@mcp.tool()
def format_purchase_history(purchases_json: str, limit: int = 5) -> str:
    """購入履歴を読みやすい文字列にフォーマットします。"""
    try:
        purchases = json.loads(purchases_json)
    except json.JSONDecodeError:
        return "エラー: 無効なJSONフォーマットです。"

    if not purchases:
        return "購入履歴が見つかりませんでした。"

    output = [f"購入履歴(最新 {limit} 件):"]
    for purchase in purchases[:limit]:
        amount = float(purchase.get("amount", 0)) / 100
        # 共通化されたパース処理を呼び出す
        timestamp = parse_iso_timestamp(purchase.get("timestamp", ""))
        formatted_date = timestamp.strftime("%Y年%m月%d日")
        output.append(f"- {formatted_date} に ${amount:.2f}")

    return "\n".join(output)

@mcp.tool()
def fetch_secure_data() -> str:
    """
    外部のセキュアなAPIからデータを取得します。
    APIキーはソースコードに含めず、環境変数から安全に読み込みます。
    """
    # ==========================================
    # セキュリティの改善:環境変数からの安全な読み込み
    # ==========================================
    # APIキーなどの機密情報を環境変数から動的に読み込む設計に変更しています。
    # ソースコードが公開されても認証情報が漏洩するリスク(CWE-798)を根本的に排除します。
    api_key = os.environ.get("SECURE_API_KEY")
    if not api_key:
        return "エラー: サーバーの構成エラー(APIキーが設定されていません)。"

    # 実際のAPI呼び出しのモック処理
    return f"APIキー(末尾4桁: ...{api_key[-4:]})を使用してデータを取得しました。"


if __name__ == "__main__":
    # 認証情報はコード内に一切書かない。
    # 実行前に <Highlight>export SECURE_API_KEY=...</Highlight> で環境変数に設定しておく。
    if not os.environ.get("SECURE_API_KEY"):
        raise SystemExit("環境変数 SECURE_API_KEY を設定してから実行してください。")

    print("=== セキュアなMCPサーバーの動作テスト ===\n")

    # 1. 環境変数を利用したセキュアなツール呼び出し
    print("[fetch_secure_data の実行結果]")
    print(fetch_secure_data())
    print("\n" + "-"*40 + "\n")

    # 2. リファクタリングされたフォーマットツールの呼び出し
    mock_purchases = json.dumps([
        {"amount": 1500, "timestamp": "2026-09-01T10:00:00Z"},
        {"amount": 3250, "timestamp": "2026-09-05T14:30:00Z"}
    ])
    print("[format_purchase_history の実行結果]")
    print(format_purchase_history(mock_purchases))

    # 本番環境では以下のコマンドでMCPサーバーとして起動します
    # mcp.run()
このコードは、公式のPython SDK(FastMCP)を活用し、意図的に埋め込んだ脆弱性やコードスメルを排除したセキュアなMCPサーバーの実装例です。
- ヘルパー関数の抽出によるコード重複の解消: parse_iso_timestamp 関数を新たに定義することで、前段のコードで重複していたタイムスタンプのパース処理を一箇所に集約(Extract Method)しています。これにより各ツールのネストが浅くなり、認知的複雑性が劇的に改善されるとともに、将来の仕様変更時の修正漏れ(Change Misalignment)を構造的に防いでいます。
- アノテーションを活用したツールの自動定義: @mcp.tool() デコレータを使用することで、関数の引数の型ヒント(start_time: str 等)とドックストリングから、LLMに提供するためのJSONスキーマが自動生成されます。これにより、手動での巨大な分岐処理(if req.name == ...)が不要となり、安全で可読性の高いコードが保たれます。
- 環境変数を通じた認証情報の安全な管理: APIキーなどの機密情報をコード内にハードコードするのではなく、os.environ.get("SECURE_API_KEY") のように環境変数から動的に読み込む設計に変更しています。これにより、ソースコードがGitリポジトリ等に公開されたとしても、認証情報が漏洩するリスク(CWE-798)を根本的に排除しています。
上記のコードを server_refactored.py として保存し、以下のコマンドで実行してください。APIキーはコードに含めないため、実行前にシェルで環境変数を設定します。
pip install "mcp<2"
export SECURE_API_KEY="sk-secure-mock-key-1234"
python server_refactored.py
実行結果は以下の通りです。
=== セキュアなMCPサーバーの動作テスト ===

[fetch_secure_data の実行結果]
APIキー(末尾4桁: ...1234)を使用してデータを取得しました。

----------------------------------------

[format_purchase_history の実行結果]
購入履歴(最新 5 件):
- 2026年09月01日 に $15.00
- 2026年09月05日 に $32.50
ハードコードの排除による脆弱性の解消 fetch_secure_data はAPIキーを文字列リテラルとして持たず、os.environ.get("SECURE_API_KEY") から取得します。リポジトリを公開してもシークレットが流出しないため、論文で最多だった認証情報漏洩の経路を断てます。運用環境では、CI/CDパイプラインやシークレットマネージャーから環境変数を注入する設計が推奨されます。
ロジックの分割によるコードスメルの排除 スクラッチ実装では calculate_duration 分岐と format_purchase_history 分岐の両方に、ISO 8601タイムスタンプをパースする処理が重複していました。これを parse_iso_timestamp として抽出(Extract Method)することで、修正箇所が1箇所に収まり、Change Misalignmentを構造的に防げます。加えて @mcp.tool() デコレータが型ヒントとドックストリングからJSONスキーマを自動生成するため、コード量そのものも減っています。
改善効果を測る:同じスキャンを流し直す
「読みやすくなった気がする」で終わらせず、先ほどと同じ scan.py を改善版に流して比較します。引数を変えて実行するだけです。
python scan.py server_refactored.py
=== 静的解析レポート: server_refactored.py ===

[1] 認証情報の漏洩 (Credential Exposure)
  OK  ハードコードされた認証情報は検出されませんでした

[2] 認知的複雑性 (Cognitive Complexity)
  OK  parse_iso_timestamp          C =  2
  OK  calculate_duration_seconds   C =  0
  OK  format_purchase_history      C =  3
  OK  fetch_secure_data            C =  1

[3] コードの重複 (Duplication)
  OK  重複したロジックは検出されませんでした

--- 合計 0 件の問題を検出しました ---
5件 → 0件。 3つのカテゴリすべてがクリアになりました。
| 改善前 | 改善後 | |
|---|---|---|
| 認証情報の漏洩 | 2件 | 0件 |
| 認知的複雑性(最大値) | 28 | 3 |
| コードの重複 | 2件 | 0件 |
認知的複雑性の変化は、定式化した がそのまま起きた結果です。すべてのロジックを抱え込んでいた execute_tool の28が、改善版では最も深い関数(format_purchase_history)でも にとどまっています。機能が減ったわけではありません。同じ処理を、ツールごとの関数と共通ヘルパーに配ったことで、1つの関数が抱えるネストの段数 が下がった——それだけで、二次関数的に効いていたコストが消えています。
この「測れる」という性質は重要です。scan.py は問題を検出すると終了コード1を返すので、そのままCIに組み込めます。
# GitHub Actions などで、問題が残っていればビルドを落とす
python scan.py server.py || exit 1
リファクタリングの必要性を主観ではなく数値で議論でき、一度直した状態が壊れていないことを自動で保証できるようになります。論文が「66%のサーバーに重大なコードスメルが存在する」と報告した状況は、裏を返せばこの種の閾値チェックがCIに入っていないということでもあります。
改善前後のスキャン結果を表にすると、次のようになります。
(図は、diagram-designで作成)
静的解析では見えないリスク:ツールポイズニング
ここまでで、従来型のリスクは静的解析で検出でき、リファクタリングで数値として改善できることを確認しました。ここからが、前半で予告したもう1つの目線の出番です。
ここまで実装したサーバーに、仮に悪意ある description が仕込まれていたとしても、scan.py は「合計 0 件」と報告し続けます。5件の問題を全部潰したクリーンなサーバーであっても、です。ツールポイズニングは構文上まったく正常な文字列リテラルの中にあるため、静的解析の検出対象ですらないからです。これを捉えられるのは、稼働中のサーバーに接続してリフレクションでメタデータを取得する mcp-scan の側だけです。
論文はこの動的解析を無作為抽出した73件の公開サーバーに対して実施し、5.5%(4件相当)からツールポイズニングを検出しました。標本サイズは割り引く必要がありますが、重要なのは件数ではありません。SonarQubeが1件も捉えられなかった類型の脅威が、無作為に選んだ公開サーバーから現に見つかったという事実のほうです。
クロスエンティティ攻撃の記事では、別の研究が別のツール(MCPInspect)で公開レジストリをスキャンし、不審なメタデータの検出数は数万件中18件(≒0.05%)だったと紹介しました。本節の5.5%とは100倍以上の開きがあります。
差の原因は、何を「不審」と判定するかの基準です。MCPInspectは <IMPORTANT> タグや定型フレーズを正規表現で拾う保守的な検出、mcp-scanはセマンティック解析を含むより広い検出で、後者のほうが網を大きく張ります。どちらが正しいというより、この種の脅威は「実態が何%か」を一意に言えない段階にあると理解しておくのが安全です。数字は手法とセットで読む必要があります。
ただし mcp-scan にも限界があります。検査対象は実行時のメタデータのみで、ソースコードや設定に起因する欠陥は見逃します。実際、手動検証ではmacOSのSQLiteに対する過剰なフルディスクアクセス要求や、機密操作に対する自動承認(auto-approval)の有効化といった重大な設定不備が、スキャナーをすり抜けて存在していました。
つまり静的・動的のどちらか一方では、MCPサーバーの攻撃面は覆えません。手元のCIにSASTを入れて満足していると、メタデータ側が丸ごと死角になります。
公開サーバーの実態
最後に、ここまで手を動かして見てきたリスクが、実際のエコシステムにどれだけ存在するのかを確認します。
静的解析の対象となった583件のうち、7.2%から脆弱性が検出され、その半数(全体の3.6%)を認証情報漏洩が占めました。保守性はさらに深刻で、66%のサーバーに重大(Critical)以上のコードスメルが存在します。内訳は高い認知的複雑性が59.7%、コードの重複が21.4%——まさに本記事で再現した2つです。加えて14.4%にはバグも検出されています。
もっとも示唆的なのは、Anthropicなどが管理する公式サーバーからは脆弱性が1件も検出されなかったという結果です。脆弱性が見つかったのは、すべてコミュニティ主導またはGitHubからマイニングされた非公式サーバーでした。両者を分けているのはコード規模と保守体制です。
| 脆弱性なし(公式) | 脆弱性あり | |
|---|---|---|
| コード行数(中央値) | 1,061行 | 4,529行 |
| 循環的複雑度(中央値) | 56 | 755 |
| 保守体制 | 複数人が頻繁に更新 | 単一コントリビューターで放置(最終コミットから中央値226.5日) |
MCPサーバー全体のコントリビュータ数の中央値は2.0人(従来のOSSは41.0人)です。コミット頻度やCI導入率では従来のOSSを上回る活発さを見せる一方で、担い手が抜けた瞬間に止まる属人性を構造的に抱えています。脆弱性が「巨大化したまま1人に放置されたサーバー」に集中していたのは、この弱点がそのまま表面化した結果と読めます。
同じ理由で、GitHubから独自に抽出されたサーバー群は開発が最も活発である反面、公式・コミュニティと比べてコードスメルが66%多く、バグも67%多いという結果でした。活発さと健全さは別物ということです。
論文の公開サーバーの調査結果を表にまとめると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、脆弱なMCPサーバーを書いて静的解析にかけ、リファクタリングで直し、改善を数値で確認するところまでを実際に手を動かして追いました。
ポイントは3つです。第一に、機能テストが通ることと安全であることは無関係でした。最初のサーバーは正常な結果を返しながら、CWE-798の脆弱性を3件抱えていました。第二に、リファクタリングの効果は測れます。認知的複雑性28が最大3に下がったことは主観ではなく数値で確認でき、CIに組み込んで閾値で落とすこともできます。第三に、静的解析だけでは足りません。ツールポイズニングはソースコードではなくツールの説明文というテキストの中にあるため、SASTを何回かけても原理的に検出できません。
実態としても、公開サーバーの7.2%に脆弱性、66%に重大なコードスメルが存在し、動的解析が成功した73件の5.5%からはツールポイズニングが検出されています。SonarQubeがこの類型を1件も検出できなかったことこそが、この研究の核心的な発見です。
開発者側の対策は基本の徹底に尽きます。認証情報を環境変数やシークレット管理サービスに逃がすこと、CI/CDにSASTとシークレットスキャンを組み込むこと、複雑化したロジックを分割すること。ここまでは、本記事で実際に手を動かして効果を確認した範囲です。
加えて、汎用SASTでは捕捉できないツールメタデータの検査を、別の工程として用意する必要があります。ただしこれは「用意すれば解決する」類のものではありません。クロスエンティティ攻撃の記事で静的なヒューリスティック検査を実装して測ったところ、検知率は44.4%にとどまりました。攻撃者は説明文を自由に書き換えられるのに対し、フィルタ側の辞書は固定されているためです。メタデータ検査はSASTが原理的に見ていない領域を埋める一層であって、それ自体が防御の完成形ではない、という位置づけで扱うのが実態に合っています。
エコシステム側には、より大きな宿題が残されています。CWEやOWASPといった既存の脆弱性データベースには、ツールポイズニングのようなMCP特有の脅威モデルがまだ定義されていません。これらを標準的な分類に組み込むこと、そしてレジストリ運営者が自動スキャンとコンプライアンスチェックを導入することが求められます。
この「ツールメタデータの検査」を担うべき最前線であるMCPクライアントについては、ツールポイズニング耐性の記事で扱っています。7つの主要クライアント実装がツールポイズニングに対してどこまで耐性を持つのかを比較した論文を取り上げ、防御側の現在地を確認しています。
参考文献
- M. M. Hasan, H. Li, E. Fallahzadeh, G. K. Rajbahadur, B. Adams, A. E. Hassan (2025). Model Context Protocol (MCP) at First Glance: Studying the Security and Maintainability of MCP Servers. arXiv:2506.13538.
- G. A. Campbell (2018). Cognitive Complexity: A new way of measuring understandability. SonarSource.
本記事の文章・構成の一部に生成AIを使用しています。