MCPの脅威モデルMCP-38とは?
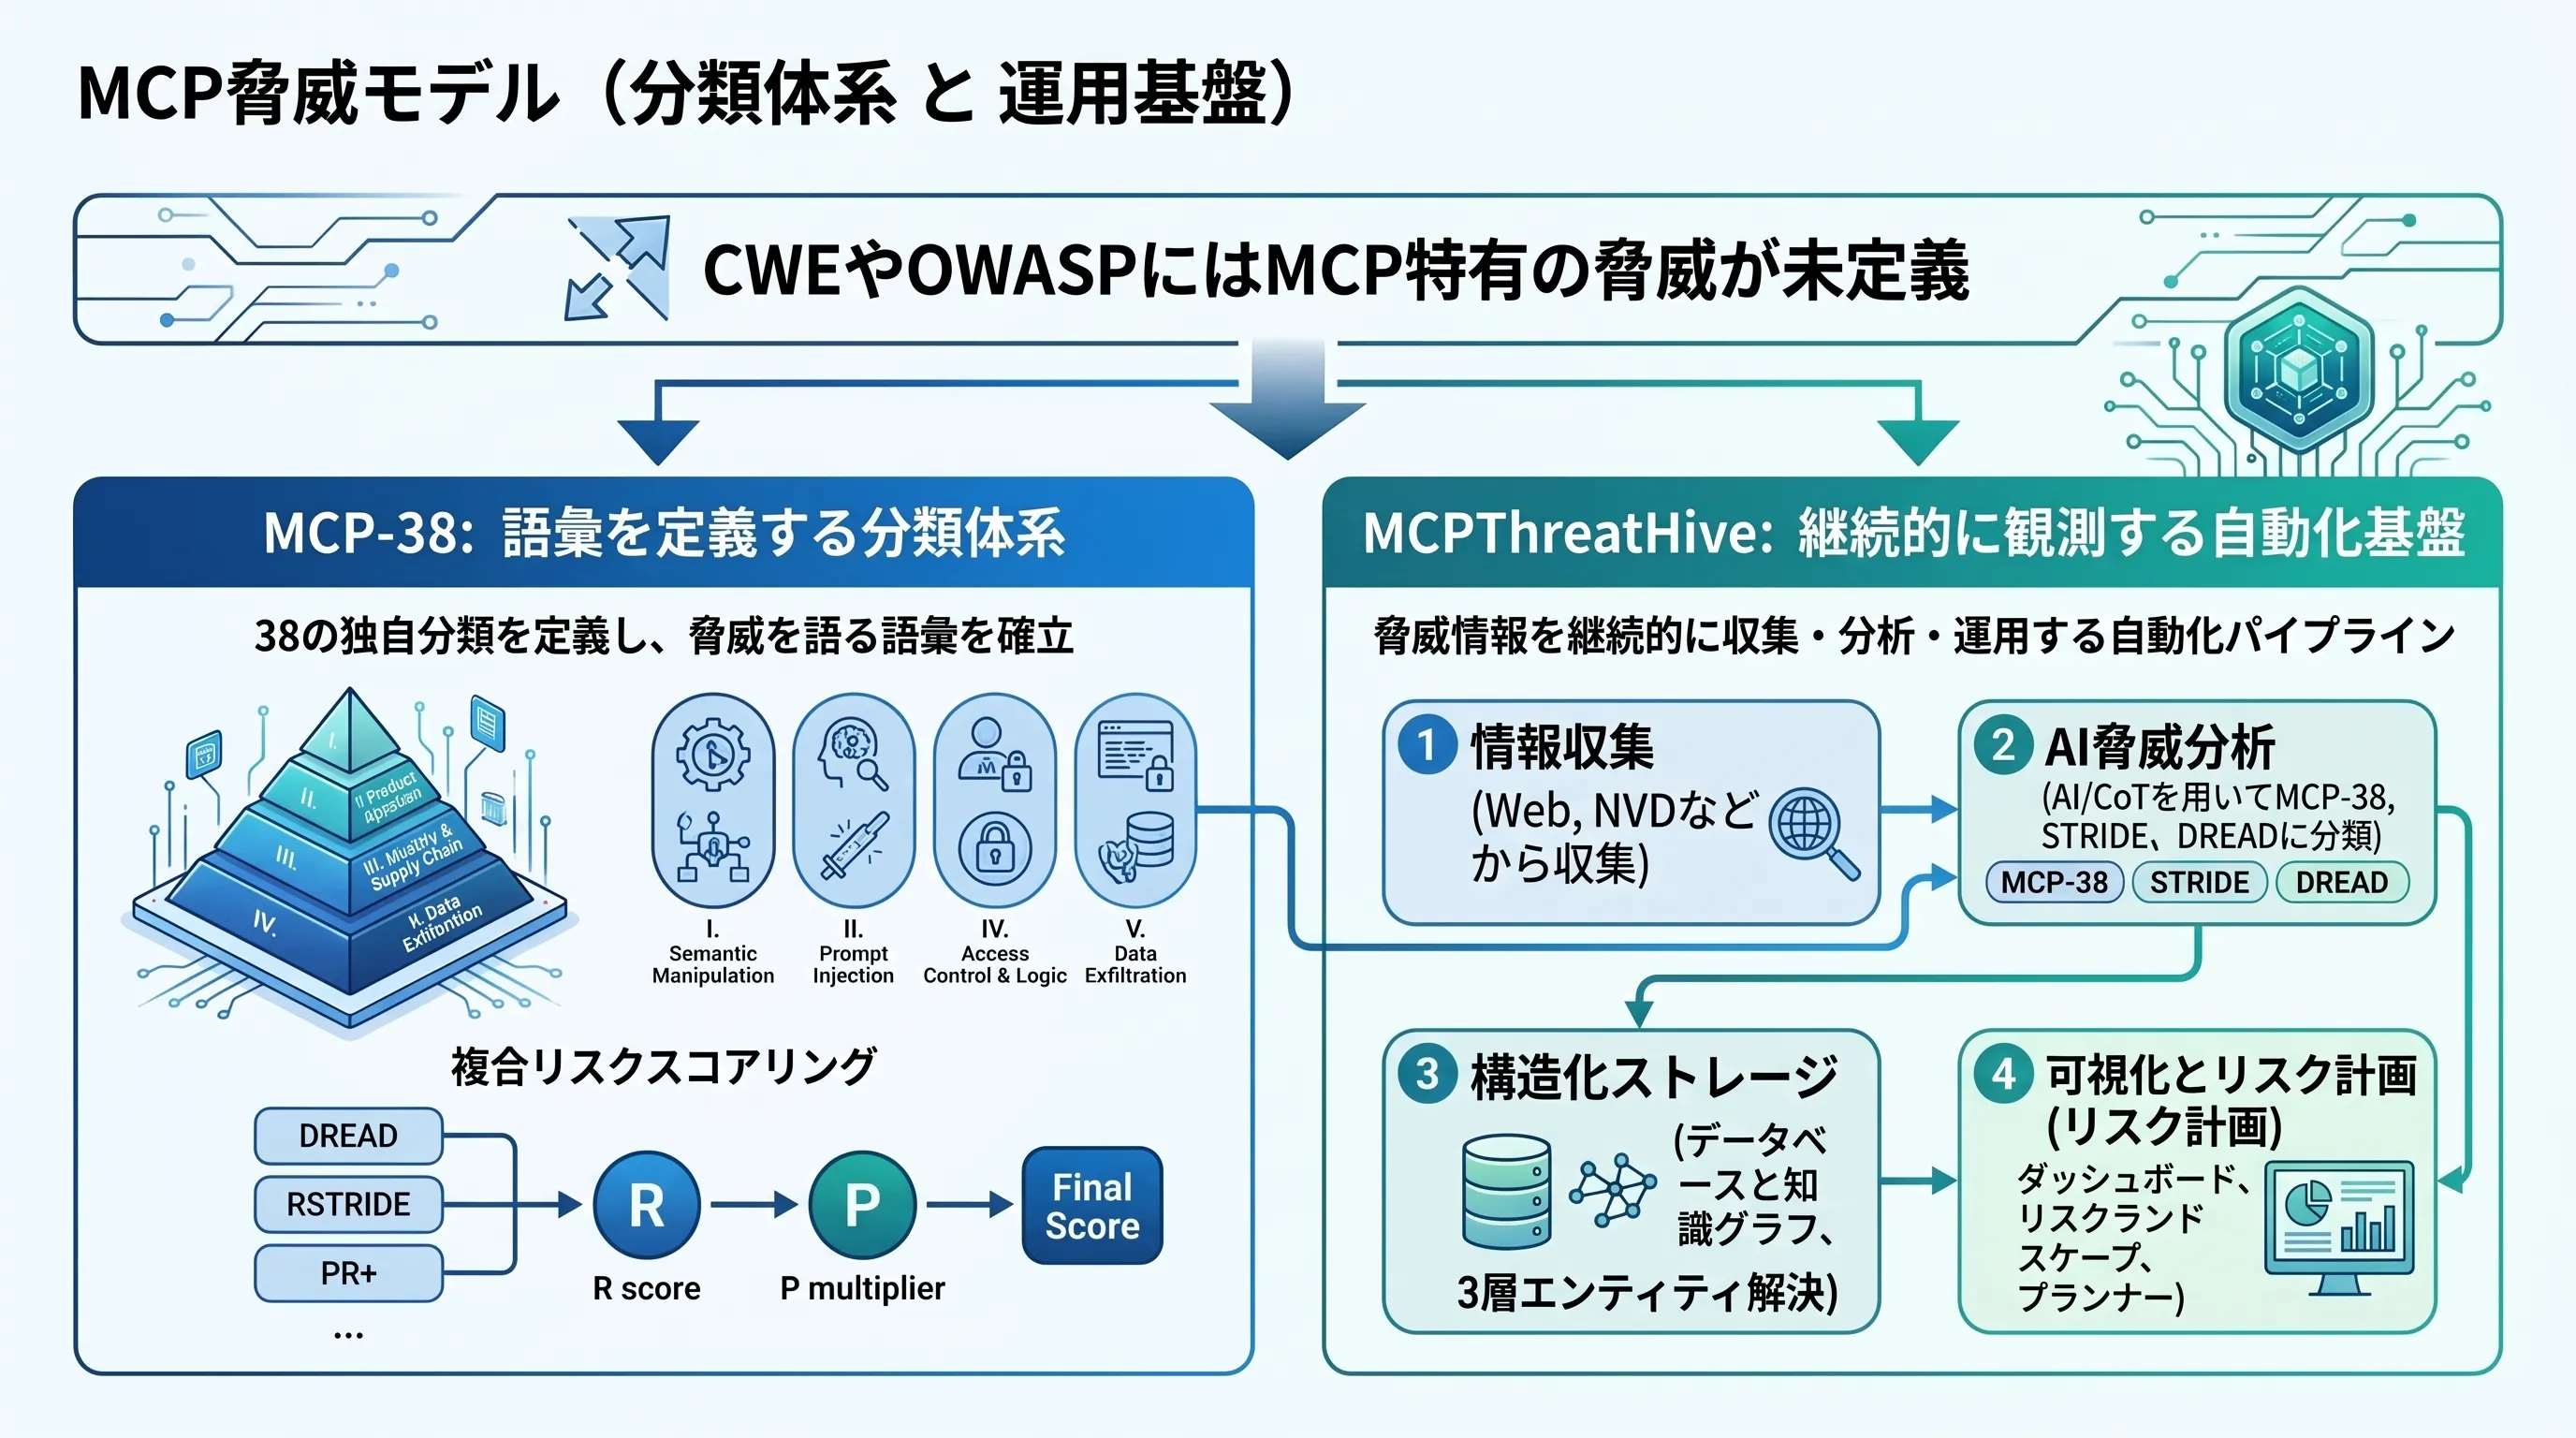
(画像は、Geminiで作成)
MCP に特有の脅威を38に分類した MCP-38 の導き方と構成を理解し、Tool Shadowing やツールポイズニングなど、MCP の各記事で扱ってきた脅威が分類のどこに位置づくかを説明できるようになること。複合リスクスコアリングと MCPThreatHive 型のパイプラインを実装して、意味論的な攻撃を補正する乗数が脅威の順位をどう入れ替えるかを確かめ、ステートレス化や認可の厳格化といった最新の仕様がどの脅威にどう答えているかを理解すること。
MCPの脅威モデルMCP-38の概要
本記事では、MCPの関連記事で個別に扱ってきた脅威を、ひとつの分類体系に載せて運用可能な形にするところまで進めます。
サーバーの実装リスクの記事の最後に、次の宿題を書きました。「CWEやOWASPといった既存の脆弱性データベースには、ツールポイズニングのようなMCP特有の脅威モデルがまだ定義されていない」。本記事で取り上げる2本の論文は、まさにこの宿題への直接的な回答にあたります。
- MCP-38: A Comprehensive Threat Taxonomy for Model Context Protocol Systems (v1.0) (arXiv:2603.18063) — MCP-01 から MCP-38 までの38分類を定義した分類体系の本体
- MCPThreatHive: Automated Threat Intelligence for Model Context Protocol Ecosystems (arXiv:2604.13849) — その分類体系を継続的な脅威インテリジェンスとして運用する自動化基盤
いずれも Yi Ting Shen, Kentaroh Toyoda, Alex Leung(Vulcan Research, AIFT)による研究で、前者が「語彙を定義する」論文、後者が「その語彙で世の中を観測し続ける」論文という関係にあります。
本記事の流れは次の通りです。前半で、なぜ38もの分類が必要になったのか、どう導出されたのかを押さえ、これまでの記事で扱ってきた Tool Shadowing や Tool Poisoning が体系上のどこに位置づくのかを対応表にまとめます。中盤で、脅威の優先度を決める複合リスクスコアリングを数式として定義し、そのままPythonに落としてこれまでの記事で扱った脅威を並べ替えます。さらに MCPThreatHive の4段パイプラインを縮小再現し、寄生的ツール連鎖の検出と知識グラフの構築まで動かします。後半で、既存ツールのカバレッジギャップを確認したうえで、公式仕様側の最新動向(ステートレス化・認可の厳格化・MCP Apps)が38分類のどこに効くのかを整理します。
背景と課題:脅威を語る語彙が足りていない
(図は、diagram-designで作成)
MCPの関連記事を通して、私たちは同じ現象に何度も別の名前を与えてきました。
クロスエンティティ攻撃の記事では、悪意あるツールの説明文が他の正常なツールの引数生成を歪める現象を Tool Shadowing と呼びました。ツールポイズニング耐性の記事では、ほぼ同じ仕組みで機密ファイルを読ませる攻撃を Tool Poisoning と呼びました。サーバーの実装リスクの記事で紹介した mcp-scan は、これをまとめて「ツールポイズニング」として検出します。一方、Invariant Labs のブログ、MCP Security Bench、MCPLib といった一次情報源では、それぞれ Tool Poisoning / Name Collision / Shadowing Attack と、微妙に異なる語が使われています。
同じ脅威に複数の名前があり、異なる脅威が同じ名前で呼ばれている、というのがMCPセキュリティの現状でした。これは単なる用語の揺れの問題ではありません。検知ルールを書く、優先度を決める、対策の実装状況を報告する——そのいずれもが「何を数えているのか」の合意を前提とするからです。
既存フレームワークはどこまでカバーしているのか
では、既存のセキュリティフレームワークをそのまま使えばよいのではないか、という疑問が出てきます。MCP-38 の論文は、代表的な4つのフレームワークを評価し、次のように整理しています。
| フレームワーク | 抽象度 | MCP特異性 | カバレッジ |
|---|---|---|---|
| OWASP Top 10 for LLM Applications (2025) | コンポーネント | 低 | 部分的 |
| OWASP Top 10 for Agentic Applications (2026) | エージェント | 中 | 部分的 |
| MITRE ATT&CK | システム | なし | 間接的 |
| NIST AI RMF 1.0 | ガバナンス | なし | なし |
| MCP-38(本論文) | プロトコル+意味論 | 完全 | 38分類 |
以下、LLM01 〜 LLM10 は OWASP Top 10 for LLM Applications (2025) の、ASI01 〜 ASI10 は OWASP Top 10 for Agentic Applications (2026) の項目番号です。OWASP の Web Application Top 10 が A01 〜 A10 で採番されているのと同じ流儀で、それぞれ独立した10項目のリストになっています。
本記事で頻出する「MCP-10 / LLM03 / ASI04」のような並記は、3つの異なるリストにおける同一脅威の住所を並べたものです。後述する決定論的タクソノミブリッジがやっているのは、この住所変換に他なりません。
論文が指摘する問題点は具体的です。OWASP LLM Top 10 はプロンプトインジェクション(LLM01)を定義していますが、複数のツール呼び出しが連鎖して初めて成立する攻撃経路を表現できません。OWASP Agentic (2026) はエージェント固有のリスクに踏み込んでいるものの、プロトコルレベルの粒度を欠くため、たとえば Rug Pull(監査通過後にツール定義が差し替わる攻撃)が複数のカテゴリにまたがってしまい、一意に対応づけられません。
MITRE ATT&CK にいたっては、より根本的なミスマッチがあります。ATT&CK はファイルアクセスやプロセスインジェクションといったシステムアクションの層で敵対行動を記述するため、推論時の意味論的な攻撃を表現できません。無理に当てはめると、ツール記述ポイズニングを「T1195 サプライチェーン侵害」にマップすることになりますが、機構がまったく違うため、そこから有効な検知ルールは導けません。
分類体系が必要だと示した2つの実インシデント
論文は、この語彙の欠落が実害につながった例として2件を挙げています。いずれもMCPの関連記事で断片的に触れてきたものです。
1件目は GitHub MCP Data Heist(2025年)です。攻撃者が公開リポジトリに細工したファイルを混ぜ、MCP対応アシスタントがそれを読んだ結果、別のプライベートリポジトリの機密データが外部へ持ち出されました。エージェント自身が特権実行エンジンとして振る舞ったため、従来のサンドボックス分離を素通りしています。
2件目は CVE-2025-6514 です。mcp-remote クライアントパッケージのコマンドインジェクション脆弱性で、悪意あるサーバーが OAuth ディスカバリ時に細工した authorization_endpoint URLを返すだけで、クライアントホスト上で任意コマンドが実行できました。論文によれば、影響は数十万規模の開発環境に及びました。
論文の主張は、どちらのインシデントも既存フレームワークの単一エントリでは記述しきれないという点にあります。前者は「プロンプトインジェクション」でも「データ漏洩」でもあり、後者は「コマンドインジェクション」でも「サンドボックスエスケープ」でもある。粗い分類のままでは、それぞれに必要な別々の対策が導けません。
核心アイデア:4フェーズで導出された38分類
(図は、diagram-designで作成)
MCP-38 の設計上の面白さは、分類の中身そのものより導出の手続きにあります。論文は、脅威分類には2つの失敗モードがあると述べています。既存フレームワークから出発すれば、そのフレームワークの盲点をそのまま受け継ぐ。逆にプロトコル分析だけから出発すれば、理屈の上では成立するが現実には起きない脅威が並ぶ。
この2つを避けるために採られたのが、以下の4フェーズです。
- プロトコル分解(Protocol Decomposition) MCP仕様の全ての規範的要素を4つの攻撃面(User Interaction / Client / Protocol / Server)に分解し、各層で「攻撃者は何を制御・注入・偽造・枯渇させられるか」を機械的に問います。ここでは網羅性だけを狙い、理論上の候補を大量に生成します。
- フレームワーク横断マッピング(Framework Cross-Mapping) 各候補を OWASP LLM Top 10、OWASP Agentic、MITRE ATT&CK に照合し、Covered(既存が完全に記述)/ Partial(既存カテゴリはあるがMCP固有の精度を欠く)/ Novel(記述が存在しない) に仕分けます。加えて MCP Security Bench の12攻撃ベクトルと既存のMCP脅威分類文献にも照合し、「Name Collision」と「Shadowing Attack」のような重複語彙を統合します。
- 実インシデント統合(Real-World Incident Synthesis) ここが実質的なフィルタです。CVE(NIST NVD)、公開されたセキュリティアドバイザリ、研究PoC、レジストリ観測の4つの異なる層の証拠のいずれにも紐づかない候補は削除されます。理論上の可能性だけでは残れません。
- カテゴリ化(Categorization) 残った38分類を、同じ種類の対策を必要とするもの同士で5つのリスクカテゴリにまとめます。グルーピングの基準が「攻撃の見た目」ではなく「修復面(remediation surface)」である点が重要です。
5つのリスクカテゴリ
| カテゴリ | 名称 | 悪用される構造的性質 | 必要な対策の型 |
|---|---|---|---|
| I | Semantic Manipulation & Poisoning | ツール選択が語彙駆動である | マニフェストの検証・サニタイズ |
| II | Prompt Injection & Boundary Breaking | 命令とデータの境界がプロトコル層で強制されない | ホスト層でのコンテキスト分離 |
| III | Identity, Trust & Supply Chain | 暗号学的なサーバー同一性・完全性が必須でない | 署名・content-addressing・相互認証 |
| IV | Access Control & Logic Drift | 自律的な意思決定に決定論的ガードレールがない | 強制層のポリシーとランタイムガードレール |
| V | Data Exfiltration & Resource Abuse | ツールをまたいだデータ集約が可能である | データフロー監視とクォータ強制 |
この分け方が効いてくるのは、対策を設計するときです。「カテゴリIの脅威が3件残っている」と分かれば、必要なのはマニフェスト検証の層であり、ネットワーク制御を強化しても動きません。逆に言えば、1つの対策で複数カテゴリを同時に潰そうとする設計は、たいてい破綻します。ツールポイズニング耐性の記事で実装した多層防御が、層ごとに検査対象を変えていたのと同じ発想です。
これまでの記事で扱った脅威をMCP-38に対応づける
ここが本記事の総括にあたる部分です。MCPの関連記事(MCPの記事・クロスエンティティ攻撃の記事・サーバーの実装リスクの記事・ツールポイズニング耐性の記事)で扱ってきた脅威が、38分類のどこに座るのかを整理します。
| 記事での呼称 | MCP-38 ID | 分類名 | Cat. | 主に扱った記事 |
|---|---|---|---|---|
| ツールポイズニング(説明文) | MCP-10 | Tool Description Poisoning | I | クロスエンティティ攻撃・ツールポイズニング耐性 |
| inputSchema への埋め込み | MCP-11 | Full Schema Poisoning | I | ツールポイズニング耐性 |
| Tool Confusion / 名前の衝突 | MCP-13 | Tool Shadowing / Name Spoofing | I | クロスエンティティ攻撃 |
| Tool Shadowing(サーバーをまたぐ) | MCP-14 | Cross-Server Tool Shadowing | I | クロスエンティティ攻撃 |
| 認証情報のハードコード(CWE-798) | MCP-02 | Credential Theft / Token Theft | III | サーバーの実装リスク |
| コマンドインジェクション | MCP-07 | Command Injection | II | サーバーの実装リスク |
| SSRF / XSS | MCP-09 | Traditional Web Vulnerabilities | II | サーバーの実装リスク |
| 自動更新による差し替え | MCP-16 | Rug Pull / Dynamic Behavior Change | III | クロスエンティティ攻撃 |
| レジストリ経由の混入 | MCP-26 | Supply Chain Compromise | III | クロスエンティティ攻撃 |
| メンテナハイジャック/接辞スクワッティング | MCP-01 | Identity Spoofing / Improper Authentication | III | クロスエンティティ攻撃 |
| 承認ダイアログの死角 | MCP-22 | Insecure Human-in-the-Loop Bypass | IV | ツールポイズニング耐性 |
| 承認疲れ | MCP-23 | Consent / Approval Fatigue | IV | ツールポイズニング耐性 |
| auto-run による不可視の実行 | MCP-38 | Invisible Agent Activity / No Observability | V | クロスエンティティ攻撃 |
いくつか、これまでの記事を書いてきた側として腑に落ちる点があります。
クロスエンティティ攻撃の記事の Tool Confusion と Tool Shadowing は、記事では「似た名前で誤選択させる」「他サーバーのツールの引数を歪める」と説明を分けていましたが、MCP-38 でも MCP-13 と MCP-14 として別IDが振られています。論文の方針では、機構が異なるか必要な緩和策が異なる候補は分割されるため、この2つは分かれます。前者は名前空間の予約と署名で対処でき、後者はサーバー間のコンテキスト分離が必要になる、という違いです。
一方、ツールポイズニング耐性の記事で扱った「パラメータ可視性の不足」と「承認疲れ」は、どちらもカテゴリIVに属し、MCP-22 と MCP-23 として並びます。攻撃者から見れば「ユーザーの承認を形骸化させる」という同じ目的の2手段であり、対策もどちらも承認UIの設計に帰着します。ツールポイズニング耐性の記事で Layer 4 の一点に集約できたのは、偶然ではなかったことになります。
これまでの記事で扱っていない脅威:寄生的ツール連鎖(MCP-17)
対応表を眺めると、これまでの記事が触れてこなかった大きな領域が1つあります。MCP-17: Parasitic Toolchain / Connector Chaining です。
ツールポイズニング耐性の記事で取り上げた論文は、クライアント実装のツールポイズニング耐性を評価したもので、ツール連鎖(Tool Chaining)の実証は含まれていません。MCPの関連記事でこの脅威を扱うのは本記事が初めてです。
寄生的ツール連鎖の厄介さは、個々のツールがどれも完全に正常である点にあります。ファイル読み取りツールは仕様通りにファイルを読み、HTTPクライアントは仕様通りにリクエストを送るだけです。どちらの説明文にも不審な文字列は含まれず、クロスエンティティ攻撃の記事で実装したヒューリスティック検査も、サーバーの実装リスクの記事の静的解析も、何も検出しません。
それでも、この2つが順番に呼ばれたとき、単体のツールでは到達し得ない情報漏洩経路が出来上がります。GitHub MCP Data Heist がまさにこれで、ファイルリーダーとネットワークツールの組み合わせによってプライベートリポジトリのデータが外部に出ました。
MCPThreatHive の論文は、この構造を Zhao らの MCP-UPD(MCP Unintended Privacy Disclosure) モデルに沿って3フェーズに分解しています。
- 寄生的取り込み(parasitic ingestion) — 攻撃者が外部データに悪意ある指示を埋め込み、エージェントがそれを読む
- プライバシー収集(privacy collection) — エージェントが正規のツールで機密データを集める
- プライバシー開示(privacy disclosure) — 収集したデータが外部へ持ち出される
そしてツール間の遷移を T2T(tool-to-tool)、最後の持ち出しを UPD とラベル付けします。
なぜ3つに分けるのか
この分解が効くのは、3つのフェーズがすべて、それ単独では正常な操作だからです。
公開リポジトリのファイルを読むのは、普段やっていることです。自分のプライベートリポジトリを読むのも、権限がある以上まったく正当です。Issue を立てて内容を書き込むのも、日常の作業です。どの1手を取り出しても、止める理由がありません。
にもかかわらず、この3つがこの順番で並んだ瞬間に、「攻撃者が置いたテキストが」「エージェントの権限で機密を集めさせ」「攻撃者が読める場所に出させた」という一本の経路が完成します。危険なのは各操作ではなく、操作と操作のあいだで受け渡されている「状態」のほうです。
したがって監視すべき対象も、ツールではなく状態になります。実装では次の2つのフラグを持ち回ることになります。
- tainted — 外部由来のテキストがエージェントのコンテキストに入ったか
- holds_secret — 機密データを保持している状態か
GitHub MCP Data Heist を、この目で追い直すとこうなります。
| # | ツール呼び出し | 呼び出し自体の妥当性 | tainted | holds_secret | フェーズ |
|---|---|---|---|---|---|
| — | (初期状態) | — | false | false | — |
| 1 | 公開リポジトリのファイルを読む | 正当 | true | false | 寄生的取り込み |
| 2 | プライベートリポジトリを読む | 正当(権限あり) | true | true | プライバシー収集 |
| 3 | 公開 Issue を作成する | 正当 | true | true | プライバシー開示 |
3行目だけを見ても、Issue の作成は何も悪くありません。しかし1行目と2行目の結果として tainted と holds_secret が両方立っている状態で Issue を作ると、それは外部への持ち出しになります。同じ操作が、直前までの経緯次第で安全にも危険にもなる——これが単体検査で捉えられない理由です。
言い換えれば、順序を見るというのは 「このツールは呼んでよいか」ではなく「いまの状態でこのツールを呼んでよいか」を問うことです。クロスエンティティ攻撃の記事の静的フィルタもツールポイズニング耐性の記事の引数検査も、1回の呼び出しを孤立させて見ていたため、この問いを立てられませんでした。
逆に言えば、3つのうちどれか1つでも断てば連鎖は成立しません。MCP-38 が MCP-17 の緩和策として挙げているのは、まさにこの考え方です。汚染データにマークを付けて追跡する(taint tracking)、「ファイル読み取りの結果をネットワーク送信ツールに渡してはならない」といったツールの組み合わせに対するポリシーを書く、「ファイル読み取り → ネットワーク送信」という系列パターンを監視する、漏洩に至る系列が成立しそうなときにチェーン全体をまとめてユーザーに確認する、といった対策です。いずれも個々のツールの良し悪しを判定していない点が共通しています。
T2T と UPD のラベルは何のためにあるのか
もう1つ、エッジに付けるラベルの役割にも触れておきます。
T2T と UPD を区別すると、攻撃の系列が有向グラフとして表現できます。MCPThreatHive はこれを知識グラフの CHAINS_INTO エッジとして格納し、「ある起点のツールから、文書化された攻撃チェーンを辿って到達可能なツールをすべて列挙する」というクエリを可能にしています。
ここが事後分析との分かれ目です。インシデントが起きてから系列を再構成するのではなく、接続中のツール群を眺めた時点で「この組み合わせには漏洩経路が存在する」と言えるようになります。UPD ラベルが付いたツール、つまり外部へ出口を持つツールが、どの取り込み口から到達可能か——それを接続時に数えられる、というのが有向グラフにする実利です。
後半の実装では、この判定を実際に書きます。
数式による定式化:複合リスクスコアリング
38分類を並べただけでは運用に載りません。「どれから対処するか」を決める必要があります。MCPThreatHive は DREAD を LLMエージェント向けに再解釈した複合リスクスコアリングを採用しています。
ツールポイズニング耐性の記事で扱った DREAD は という5項の単純和(最大50点)でした。本記事のスコアリングは、これを重み付き線形結合と乗数に分けた点が異なります。
基本スコア
まず、4つの因子の重み付き和として基本スコア を定義します。
| 因子 | 記号 | 重み | 定義 |
|---|---|---|---|
| セキュリティ影響度 | 0.35 | 7段階尺度の正規化値 | |
| 攻撃成功率 | 0.30 | 経験的な悪用成功確率 | |
| 永続性・スコープ | 0.20 | Transient = 0.5 / Session = 0.75 / Long-term = 1.0 | |
| 悪用容易性 | 0.15 | Insider-only = 0.33 / Moderate = 0.66 / Trivial = 1.0 |
の7段階は、論文が Table 1 で影響度を「7段階尺度の正規化値 」と定義していることによります。ただし論文が中身を明示しているのは が「リモートコード実行に至りうる」水準だという1点だけで、 から までの一覧は示されていません。
他の3因子が Transient / Session / Long-term のように取りうる値をすべて列挙しているのに対し、 だけが段数の指定にとどまっているのは、影響度の尺度を各組織の基準に委ねているためと読めます。論文は重みや因子そのものをリスク選好に応じて差し替えてよいと明記しており、 はその代表例にあたります。既に CVSS の深刻度基準や社内の障害レベル定義を運用しているなら、それを7段階に写して使うのが現実的です。
以下の説明と値の割り当ては、 が RCE であることから逆算した本記事の解釈です。
定義だけでは値の付け方が見えにくいので、これまでの記事で扱ってきた脅威を例に、各因子が何を測っているのかを確認します。
セキュリティ影響度 — 成功したとき何が起きるか。 の RCE を基準に置くと、おおよそ「情報が見えるだけ」から「システム全体の掌握」までを並べた尺度と読めます。サーバーの実装リスクの記事で再現した認証情報のハードコードは、漏れれば外部サービスの権限がまるごと渡るため上位に来ます。一方、クロスエンティティ攻撃の記事の Tool Shadowing でメールの宛先が書き換わるのは、深刻ではあってもホストを乗っ取られるわけではないので中位です。注意したいのは、この因子だけが従来型のセキュリティ評価軸そのものであり、コードを1行も実行しない攻撃はここで必ず低く出るという点です。
攻撃成功率 — 仕掛けたら実際に通るのか。 ここには実測値が入ります。クロスエンティティ攻撃の記事で紹介した実験では、検証された10通りのホスト・モデル組み合わせのうち8通りで、Tool Shadowing の ASR がおおむね100%に達していました。ツールポイズニング耐性の記事の7クライアント比較では、機密ファイル読み取りを Cursor が素通しさせる一方、Claude Desktop は止めています。つまり は環境によって変わる値で、自組織が使っているクライアントがあの表のどの行に近いかで調整すべき因子です。逆にサプライチェーン侵害のように、メンテナアカウントの奪取が前提となる攻撃は成立条件が重く、 は下がります。
永続性・スコープ — 一度きりか、居座り続けるか。 クロスエンティティ攻撃の記事の Tool Shadowing は、汚染されたメタデータがコンテキストに載っているあいだだけ効くため Session(0.75)です。対して Rug Pull や認証情報の漏洩は、気づいて対処するまで何ヶ月でも有効なので Long-term(1.0)になります。単発のインジェクションで1回だけ応答が歪むようなケースが Transient(0.5)です。サーバーの実装リスクの記事で見た「最終コミットから中央値226.5日」という放置されたサーバーの実態を踏まえると、MCPエコシステムでは Long-term に倒れる脅威が多くなります。
悪用容易性 — 誰が実行できるのか。 Trivial(1.0)は、攻撃者が外部から何の前提もなく仕掛けられる場合です。ツールポイズニング耐性の記事の汚染された add ツールは、公開レジストリにサーバーを1つ置くだけで成立するのでここに入ります。Moderate(0.66)は、特定のツールの組み合わせが読み込まれている、auto-run が有効になっているといった条件が要る場合。Insider-only(0.33)は、メンテナ権限やビルドパイプラインへのアクセスなど、内部に足場がなければ始まらない場合です。
この4つを性格の異なる3つの脅威に当てはめると、次のようになります( を含め、以下の値は本記事の仮定です)。
| 脅威 | 値の根拠 | ||||
|---|---|---|---|---|---|
| MCP-10 ツール記述ポイズニング | 5 | 0.75 | Long-term | Moderate | 説明文を置くだけで、審査を通れば消されるまで効き続ける |
| MCP-26 サプライチェーン侵害 | 7 | 0.40 | Long-term | Insider-only | 被害は最大だが、メンテナ権限の奪取という重い前提が要る |
| MCP-38 可観測性の欠如 | 3 | 0.70 | Long-term | Trivial | 単体では直接の被害を生まないが、ログがない状態は常に成立する |
MCP-26 は が最大の7でありながら と が低く、MCP-38 は が3と低いのに と が高い、という対照的な形をしています。4因子は互いに独立で、どれか1つが高いことは全体の高さを意味しません。単一の指標ではなく重み付き和にしている理由がここにあります。
MCP固有の優先度乗数
ここからが、汎用のDREADと決定的に違う部分です。エージェントシステム固有の性質を持つ脅威クラスにだけ、スコアを増幅する乗数 をかけます。
最終スコアは CVSS に合わせた0〜10のスケールに写します。
が Critical、 が High、 が Medium、それ未満が Low です。 論文が唯一具体値を挙げているのが MCP-19(直接プロンプトインジェクション)です。(RCEに至りうる)、、(セッションスコープ)、(自明に悪用可能)として計算します。 乗数を適用しない場合、 となり High 止まりです。しかし MCP-19 は意味論的攻撃なので が適用され、 となって Critical に分類されます。論文は、この結果が「直接プロンプトインジェクションは最も広く実証され普遍的に悪用可能なMCP脅威クラスである」という経験的知見と整合すると述べています。 言い換えれば、乗数は「従来型の尺度では過小評価されてしまう脅威」を補正するための装置です。従来のセキュリティ評価軸では、コードを1行も実行しない攻撃はどうしても影響度が低く見積もられます。この構造こそ、MCPの関連記事で繰り返し確認してきたMCPの特異性でした。 一方で注意も必要です。 による上限打ち切りがあるため、 が 1.0 を超える脅威はすべて 10.0 に張り付き、Critical内部での順位が失われます。本記事の実装でも MCP-19 がちょうどこの状態になります。詳細な式展開:なぜ乗数が必要なのか(MCP-19 の検算)
スコアの計算の流れを、MCP-19 の値で図にすると、次のようになります。
(図は、diagram-designで作成)
スクラッチ実装:スコアリングと多フレームワーク橋渡し
定義した式を、そのままPythonに落とします。同時に実装するのが、論文の言う決定論的タクソノミブリッジです。
MCPThreatHive の設計で興味深いのは、分類処理を意図的に2つに分けている点です。STRIDE と MCP-38 のラベル付けは意味論的な判断なのでLLMに任せ、そこから OWASP の各カテゴリへの対応づけは固定のルックアップ表で解決します。理由は単純で、LLMに「これは ASI04 ですか」と聞くと、存在しないカテゴリを自信満々に返しうるからです。決定した対応表を引くだけならハルシネーションは原理的に起こりません。
論文は MCPThreatHive をオープンソースとして公開していますが、以下のコードはそれをそのまま抜粋したものではありません。論文が本文中に記述しているスコアリング式・重み・乗数・分類の対応関係を、標準ライブラリのみで検算できる最小形に再構成した本記事独自の実装です。またスコアの因子値は、MCP-19 を除いて論文に記載がないため本記事の仮定値です。数値そのものより、式と対応表が何を生むかに注目してください。
実行環境の準備
標準ライブラリのみで動作します。APIキーもデータベースも不要です。以下を mcp38_risk.py として保存してください(次節のコードから import します)。本記事の実行結果は、Python 3.13 で実行したものです。
# =========================================================
# MCP-38 複合リスクスコアリングと多フレームワーク橋渡し
# =========================================================

# --- 重み(論文 Table 1 の既定値)---
W = {"L": 0.35, "S": 0.30, "I": 0.20, "D": 0.15}

# --- 順序尺度を [0,1] に写す辞書 ---
PERSISTENCE = {"transient": 0.5, "session": 0.75, "long_term": 1.0}
EASE = {"insider": 0.33, "moderate": 0.66, "trivial": 1.0}

# --- MCP固有の優先度乗数(複数該当時は積)---
MULTIPLIER = {"semantic": 1.20, "chaining": 1.15, "low_observability": 1.10}

# --- 決定論的タクソノミブリッジ(LLMではなくルックアップ表で解決する)---
BRIDGE = {
    "MCP-10": {"name": "Tool Description Poisoning", "stride": "T", "cat": "I",
               "llm": ["LLM03"], "asi": ["ASI04"]},
    "MCP-11": {"name": "Full Schema Poisoning", "stride": "T", "cat": "I",
               "llm": ["LLM04"], "asi": ["ASI06"]},
    "MCP-13": {"name": "Tool Shadowing / Name Spoofing", "stride": "S,E", "cat": "I",
               "llm": ["LLM03"], "asi": ["ASI04"]},
    "MCP-14": {"name": "Cross-Server Tool Shadowing", "stride": "S,E", "cat": "I",
               "llm": ["LLM03"], "asi": ["ASI04"]},
    "MCP-17": {"name": "Parasitic Toolchain / Connector Chaining", "stride": "T,D", "cat": "II",
               "llm": ["LLM05", "LLM06"], "asi": ["ASI02"]},
    "MCP-19": {"name": "Prompt Injection (Direct)", "stride": "I", "cat": "II",
               "llm": ["LLM01"], "asi": ["ASI01"]},
    "MCP-20": {"name": "Prompt Injection (Indirect via Data)", "stride": "I", "cat": "II",
               "llm": ["LLM01", "LLM04"], "asi": ["ASI01", "ASI06"]},
    "MCP-24": {"name": "Data Exfiltration via Tool Output", "stride": "I", "cat": "V",
               "llm": ["LLM02"], "asi": ["ASI02"]},
    "MCP-26": {"name": "Supply Chain Compromise", "stride": "T,S", "cat": "III",
               "llm": ["LLM03"], "asi": ["ASI04"]},
    "MCP-38": {"name": "Invisible Agent Activity / No Observability", "stride": "R", "cat": "V",
               "llm": ["LLM06"], "asi": ["ASI10"]},
}

# --- 評価対象の脅威(MCP-19 のみ論文記載値、他は本記事の仮定)---
ASSESSMENT = {
    "MCP-19": dict(L=6, S=0.85, I="session", D="trivial", tags=["semantic"]),
    "MCP-20": dict(L=6, S=0.80, I="session", D="moderate", tags=["semantic"]),
    "MCP-10": dict(L=5, S=0.75, I="long_term", D="moderate", tags=["semantic"]),
    "MCP-11": dict(L=5, S=0.70, I="long_term", D="moderate", tags=["semantic"]),
    "MCP-13": dict(L=5, S=0.65, I="long_term", D="moderate", tags=["semantic"]),
    "MCP-14": dict(L=5, S=0.60, I="session", D="moderate", tags=["semantic", "chaining"]),
    "MCP-17": dict(L=6, S=0.70, I="session", D="moderate", tags=["chaining"]),
    "MCP-24": dict(L=6, S=0.70, I="transient", D="moderate", tags=["chaining"]),
    "MCP-26": dict(L=7, S=0.40, I="long_term", D="insider", tags=[]),
    "MCP-38": dict(L=3, S=0.70, I="long_term", D="trivial", tags=["low_observability"]),
}


def base_score(L, S, I, D):
    """R = wL*Lnorm + wS*S + wI*I + wD*D  (R は [0,1])"""
    return (W["L"] * (L / 7) + W["S"] * S
            + W["I"] * PERSISTENCE[I] + W["D"] * EASE[D])


def priority(tags):
    p = 1.0
    for t in tags:
        p *= MULTIPLIER[t]
    return p


def final_score(params):
    R = base_score(params["L"], params["S"], params["I"], params["D"])
    P = priority(params["tags"])
    return min(10.0, (R * P) * 10), R, P


def level(score):
    if score >= 9.0:
        return "Critical"
    if score >= 7.0:
        return "High"
    if score >= 4.0:
        return "Medium"
    return "Low"


if __name__ == "__main__":
    rows = []
    for tid, params in ASSESSMENT.items():
        score, R, P = final_score(params)
        rows.append((score, tid, R, P))
    rows.sort(reverse=True)

    print(f"{'ID':<8}{'Threat':<44}{'R':>6}{'P':>6}{'Score':>7}  {'Level':<9}"
          f"{'STRIDE':<8}{'Cat':<5}{'OWASP LLM/ASI'}")
    print("-" * 118)
    for score, tid, R, P in rows:
        b = BRIDGE[tid]
        owasp = ",".join(b["llm"]) + " / " + ",".join(b["asi"])
        print(f"{tid:<8}{b['name']:<44}{R:6.3f}{P:6.2f}{score:7.2f}  {level(score):<9}"
              f"{b['stride']:<8}{b['cat']:<5}{owasp}")

    print("\n--- 論文記載の検算: MCP-19 ---")
    p = ASSESSMENT["MCP-19"]
    print(f"  wL*Lnorm = 0.35 * (6/7) = {W['L'] * (6/7):.3f}")
    print(f"  wS*S     = 0.30 * 0.85  = {W['S'] * 0.85:.3f}")
    print(f"  wI*I     = 0.20 * 0.75  = {W['I'] * 0.75:.3f}")
    print(f"  wD*D     = 0.15 * 1.00  = {W['D'] * 1.0:.3f}")
    s, R, P = final_score(p)
    print(f"  R = {R:.3f} / P = {P:.2f} -> R_final = min(10.0, {R*P*10:.2f}) = {s:.1f} ({level(s)})")
実装のポイント
- BRIDGE が決定論的タクソノミブリッジそのものです。MCP-38 の ID を受け取り、STRIDE・カテゴリ・OWASP LLM/Agentic の対応先を返すだけの純粋なルックアップ表です。ここに推論は一切入りません。表の中身は MCP-38 論文の Table 3(正準定義)と Table 4(フレームワーク横断マップ)から、これまでの記事で扱った10件を抜き出したものです。
- priority() が乗数を積で計算する点に注意してください。MCP-14(サーバー横断の Tool Shadowing)は意味論的であり、かつ他サーバーのツール呼び出しを巻き込むため、 が適用されます。複数の性質を併せ持つ脅威ほど強く増幅される設計です。
- 乗数のタグ(tags)は本記事の割り当てです。論文は3種類の乗数を定義していますが、38分類のどれにどの乗数をかけるかの一覧は示していません。本記事では、ツールの説明文や入力で LLM の推論を操るもの(MCP-10・11・13・14・19・20)に
semantic、複数のツールの組み合わせで成立するもの(MCP-14・17・24)にchaining、ログがないこと自体が問題のもの(MCP-38)にlow_observabilityを付けました。サプライチェーン侵害(MCP-26)は、コードの改ざんという従来型の攻撃なので、乗数をかけていません。 - final_score() は と も返します。最終スコアだけ見ても、それが「素の影響度が高いから」なのか「MCP固有性の乗数で押し上げられたから」なのか区別がつかないためです。運用上、この内訳は対策を選ぶ際の手がかりになります。
実行結果:これまでの記事で扱った脅威はどう並ぶのか
ID      Threat                                           R     P  Score  Level    STRIDE  Cat  OWASP LLM/ASI
----------------------------------------------------------------------------------------------------------------------
MCP-19  Prompt Injection (Direct)                    0.855  1.20  10.00  Critical I       II   LLM01 / ASI01
MCP-20  Prompt Injection (Indirect via Data)         0.789  1.20   9.47  Critical I       II   LLM01,LLM04 / ASI01,ASI06
MCP-14  Cross-Server Tool Shadowing                  0.679  1.38   9.37  Critical S,E     I    LLM03 / ASI04
MCP-10  Tool Description Poisoning                   0.774  1.20   9.29  Critical T       I    LLM03 / ASI04
MCP-11  Full Schema Poisoning                        0.759  1.20   9.11  Critical T       I    LLM04 / ASI06
MCP-13  Tool Shadowing / Name Spoofing               0.744  1.20   8.93  High     S,E     I    LLM03 / ASI04
MCP-17  Parasitic Toolchain / Connector Chaining     0.759  1.15   8.73  High     T,D     II   LLM05,LLM06 / ASI02
MCP-24  Data Exfiltration via Tool Output            0.709  1.15   8.15  High     I       V    LLM02 / ASI02
MCP-38  Invisible Agent Activity / No Observability  0.710  1.10   7.81  High     R       V    LLM06 / ASI10
MCP-26  Supply Chain Compromise                      0.719  1.00   7.19  High     T,S     III  LLM03 / ASI04

--- 論文記載の検算: MCP-19 ---
  wL*Lnorm = 0.35 * (6/7) = 0.300
  wS*S     = 0.30 * 0.85  = 0.255
  wI*I     = 0.20 * 0.75  = 0.150
  wD*D     = 0.15 * 1.00  = 0.150
  R = 0.855 / P = 1.20 -> R_final = min(10.0, 10.26) = 10.0 (Critical)
まず確認したいのは、MCP-19 が論文記載の 10.0 / Critical に一致したことです。式と重みの解釈は間違っていません。
そのうえで、この表には読み取るべき点が2つあります。
乗数が順位を入れ替えています。 MCP-14(サーバー横断の Tool Shadowing)は素の が 0.679 で、10件中最下位です。つまり従来型の評価軸では、この表の中で最も軽い脅威に見えます。ところが乗数 1.38 が効いて最終スコアは 9.37、MCP-10 や MCP-11 を追い越して3位に上がりました。これはクロスエンティティ攻撃の記事で確認した性質——悪意あるツールが一度も呼ばれないまま他の正常なツールの引数を書き換える——が、まさに「意味論的」かつ「マルチツール増幅」の両方に該当するためです。
サーバーの実装リスクの記事の発見が数値として再現されています。 MCP-26(サプライチェーン侵害)は と影響度が最大であるにもかかわらず、乗数が 1.00 のため最終スコアは 7.19 で最下位に沈みます。一方 MCP-10(ツール記述ポイズニング)は ながら 9.29 です。サーバーの実装リスクの記事で「SonarQube が1件も検出できなかった類型こそが核心的な発見だ」と書きましたが、従来型の重大脆弱性より、コードを1行も含まない脅威のほうが上位に来るという逆転が、スコアリングの設計そのものに組み込まれていることになります。
なお、MCP-19 は で上限に張り付いています。先ほど触れた通り、Critical 帯の内部では順位情報が失われる、という設計上の限界がここで実際に現れています。
10の脅威の最終スコアを並べると、次のようになります。
(図は、diagram-designで作成)
実践的な実装例:MCPThreatHive 型の4段パイプライン
スコアリング単体では、既知の脅威に点数を付けられるだけです。MCPThreatHive が解こうとしているのは、新しく公開された情報を継続的に取り込み、自動的にこの体系へ落とし込むという問題です。
論文が挙げる既存ツールの3つの欠落は次の通りです。
- 脅威を個別に扱い、個々には無害なツールの組み合わせから生じる複合攻撃を検出できない
- 継続監視ではなく、手動または特定時点のスキャンにとどまる
- 単一フレームワークでしか分類せず、STRIDE・OWASP LLM・OWASP Agentic・MCP-38 を横断できない
これに対する構成が、以下の4段パイプラインです。
- Intelligence Gathering — Web検索、RSS(arXiv cs.CR / cs.AI、セキュリティブログ)、NIST NVD、GitHub Security Advisories を統一スキーマ IntelItem に正規化
- AI Threat Analysis — 関連度しきい値 を超えた項目を、CoTで MCP-38 の ID・STRIDE・DREAD因子に分類し、そこから先は決定論的ブリッジで OWASP に写す
- Structured Storage — リレーショナルDBと知識グラフ(Neo4j)に保存。6種のノードと5種のエッジ(DESCRIBES / INSTANCES_OF / EXPLOITS / CHAINS_INTO / MITIGATED_BY)
- Visualization & Risk Planning — 脅威マトリクス、3Dランドスケープ、知識グラフビューア、リスクプランナー
以下では、この4段を標準ライブラリのみで縮小再現します。実システムがLLMで行っている判定は、決定論的なルールに置き換えてあります。目的は「LLMが賢いこと」の確認ではなく、パイプラインの各段が何を入力にして何を出力するかを目に見える形にすることだからです。論文の MCPThreatHive との違いは次のとおりです。
| 段 | 論文の MCPThreatHive | 本記事の縮小版 | 違う理由 |
|---|---|---|---|
| 1. 収集 | DuckDuckGo の検索、RSS(arXiv cs.CR / cs.AI、セキュリティブログ)、NVD、GitHub Security Advisories | 手で書いた2件の記事 | 外部の API を使わず、手元で同じ結果を再現できるようにするため |
| 1. 関連度 | LLM が付ける(GitHub の事案は 0.94) | 6つのキーワードのうち含まれる割合 | 同上。しきい値 θ = 0.70 は論文と同じ |
| 2. 分類 | LLM が CoT で MCP-38 の ID・STRIDE・DREAD の因子を出す | 本記事の例に合わせて書いた正規表現 | 同上 |
| 2. OWASP への写像 | 決定論的なルックアップ表 | 決定論的なルックアップ表(BRIDGE) | 論文と同じ考え方 |
| 3. MCP-UPD 解析 | 事案の記述からツール間の遷移を判定(GitHub の事案は「読み取り(T2T)→ 持ち出し(UPD)」の2手) | 3つのツールのトレースで、3フェーズを状態の遷移で判定 | Zhao らの3フェーズを1手ずつ見せるため |
| 4. 保存 | リレーショナル DB と Neo4j の知識グラフ(6種のノード、5種のエッジ) | Python の辞書とリスト | 同上 |
| 4. 名寄せの Tier 3 | LLM に YES / NO を問う | 同義語の表で応答を固定 | 同上 |
4段のパイプラインを図にすると、次のようになります。
(図は、diagram-designで作成)
3層エンティティ解決という地味だが効く仕組み
実装の中で1つだけ、事前に説明が要る部分があります。知識グラフに投入されるエンティティ名を正規化する3層エンティティ解決です。
同じ概念が「Prompt Injection」「Prompt Injections」「PI attack」と別々のノードになると、グラフは断片化して「この脅威に関連する攻撃チェーンをすべて取得する」というクエリが機能しなくなります。そこで次の3段で名寄せします。
Tier 1: 完全一致。大文字小文字を無視した文字列一致で、 のハッシュ参照です。
Tier 2: Jaccard 類似度による自動統合。文字列 , の 3-gram シングル集合を , として、
を計算し、 なら自動的に統合します。複数形・軽微なタイポ・ハイフン表記の揺れは、ここで吸収されます。
Tier 3: LLM検証。 の曖昧な帯に落ちた場合のみ、LLMに「この2つは同じセキュリティ概念か、YES か NO か」を問い合わせます。
を自動、 未満を別概念として切り捨て、間の帯だけをLLMに渡すという設計です。ここでもLLMは「判断が必要な箇所に限って」使われています。
4段パイプラインの実装
import re
from mcp38_risk import ASSESSMENT, BRIDGE, final_score, level

# =========================================================
# Stage 1: Intelligence Gathering(収集した記事を IntelItem に正規化)
# =========================================================
# 論文のケーススタディと同じ GitHub MCP の事案(関連あり)と、
# 無関係な記事(関連なし)を1件ずつ用意し、関連度のフィルタが両方を振り分けられるかを見る
INTEL_ITEMS = [
    {
        "id": "intel-001",
        "title": "GitHub MCP Vulnerability: Prompt Injection via Repository Content",
        "content": ("An attacker placed a crafted file in a public repository containing hidden "
                    "instructions. A Claude agent using the GitHub MCP server read the file, then "
                    "accessed tokens in a separate private repository and exfiltrated them through "
                    "a second tool call that created a public issue."),
        "source": "invariantlabs.ai",
    },
    {
        "id": "intel-002",
        "title": "New coffee machine firmware released",
        "content": "A minor firmware update improves espresso extraction stability.",
        "source": "example.com",
    },
]

# 関連度スコア(実システムではLLMが付与する。ここでは語彙一致で近似)
# MCP のセキュリティ記事に出てくる6語のうち、いくつが含まれるかの割合を関連度とする
RELEVANCE_VOCAB = ["mcp", "tool", "agent", "prompt injection", "exfiltrat", "server"]
THETA = 0.70  # 論文の既定値。6語では「5語以上(0.83)」で通り、「4語(0.67)」では落ちる

def relevance(item: dict) -> float:
    # タイトルと本文を小文字にして結合
    text = (item["title"] + " " + item["content"]).lower()
    # 定義したキーワードがいくつ含まれるかをカウント
    hit = sum(1 for w in RELEVANCE_VOCAB if w in text)
    # ヒットしたキーワードの割合をスコアとして返す
    return round(hit / len(RELEVANCE_VOCAB), 2)


# =========================================================
# Stage 2: AI Threat Analysis(LLMのCoT分類を決定論的ルールで代替)
# =========================================================
# 記事のテキストに含まれるパターンに基づいてMCP脅威モデルのIDを特定するルール群
# (本記事の例に合わせて手で書いたもの。実システムでは LLM が CoT で分類する)
CLASSIFY_RULES = [
    ("MCP-20", [r"crafted file", r"hidden instruction", r"repository content"]),
    ("MCP-24", [r"exfiltrat", r"created? a public issue"]),
    ("MCP-10", [r"tool description", r"description field"]),
    ("MCP-17", [r"second tool call", r"chain"]),
]

def classify(item: dict) -> list:
    # 記事のテキストに対して正規表現でマッチングを行う
    text = (item["title"] + " " + item["content"]).lower()
    return [tid for tid, pats in CLASSIFY_RULES
            if any(re.search(p, text) for p in pats)]


# =========================================================
# Stage 3: MCP-UPD 解析(寄生的ツール連鎖の3フェーズ判定)
# =========================================================
# ツールの読み書きの性質(コンテキスト、外部公開領域、機密領域)を定義するグラフ
TOOL_GRAPH = {
    "github_read_file":  {"reads": "external", "writes": "context"},
    "read_private_repo": {"reads": "private",  "writes": "context"},
    "create_issue":      {"reads": "context",  "writes": "public"},
}
# 実際に観測されたツール呼び出しの系列(トレース)
# MCP-UPD の3フェーズ(取り込み・収集・開示)が1つずつ現れるように、本記事で組み立てたもの
OBSERVED_TRACE = ["github_read_file", "read_private_repo", "create_issue"]

def analyze_upd(trace: list) -> dict:
    phases, edges = [], []
    tainted = False       # 外部由来の汚染データを取り込んだかのフラグ
    holds_secret = False  # 機密データを保持しているかのフラグ

    # ツールの呼び出し順(系列)を辿りながら状態遷移を追跡する(Taint Tracking)
    for i, tool in enumerate(trace):
        spec = TOOL_GRAPH[tool]
        # 1. 寄生的取り込み: 外部から汚染データを読み込む
        if spec["reads"] == "external" and not tainted:
            tainted = True
            phases.append((tool, "parasitic ingestion"))
        # 2. プライバシー収集: 汚染状態のまま機密情報を読み取る
        elif spec["reads"] == "private" and tainted:
            holds_secret = True
            phases.append((tool, "privacy collection"))
        # 3. プライバシー開示: 機密情報を保持したまま外部公開領域へ書き込む
        elif spec["writes"] == "public" and holds_secret:
            phases.append((tool, "privacy disclosure"))
        else:
            phases.append((tool, "-"))

        if i > 0:
            # 最後が情報漏洩(disclosure)であればUPD、それ以外はツール間連携(T2T)としてエッジを結ぶ
            label = "UPD" if phases[i][1] == "privacy disclosure" else "T2T"
            edges.append((trace[i - 1], tool, label))

    # 全てのフェーズが完了し、情報が漏洩したかを判定
    complete = any(p == "privacy disclosure" for _, p in phases)
    return {"phases": phases, "edges": edges, "upd_complete": complete}


# =========================================================
# Stage 4: 知識グラフ(3層エンティティ解決で重複ノードを防ぐ)
# =========================================================
def shingles(s: str, n: int = 3) -> set:
    # テキストからn-gram(今回は3文字ずつ)の部分文字列の集合を生成
    s = re.sub(r"\s+", " ", s.strip().lower())
    return {s[i:i + n] for i in range(max(len(s) - n + 1, 1))}

def jaccard(a: str, b: str) -> float:
    # 2つの集合のJaccard係数(共通部分 / 和集合)を計算し、類似度を測る
    sa, sb = shingles(a), shingles(b)
    return len(sa & sb) / len(sa | sb)


# Tier 3 で呼ばれるLLM検証。本記事では応答を同義語表で固定するモック実装
SYNONYM_ORACLE = {("tool poisoning attack", "tool poisoning"),
                  ("pi attack", "prompt injection")}

def llm_same_concept(a: str, b: str) -> bool:
    # 2つの用語が同じ概念を指しているかを判定(本来はLLMに問い合わせる箇所)
    pair = (a.strip().lower(), b.strip().lower())
    return pair in SYNONYM_ORACLE or pair[::-1] in SYNONYM_ORACLE


class KnowledgeGraph:
    def __init__(self):
        self.nodes, self.edges = {}, []
        self.verbose = False

    def resolve(self, name: str) -> str:
        # 新しいエンティティ(ノード)を追加する際の名寄せ処理
        key = name.strip().lower()

        # Tier 1: 既存ノードとの完全一致チェック
        for existing in self.nodes:
            if existing.strip().lower() == key:
                return existing

        # Tier 2: 既存ノードとのJaccard係数に基づく類似度評価
        best, score = None, 0.0
        for existing in self.nodes:
            j = jaccard(name, existing)
            if j > score:
                best, score = existing, j
        # 類似度が0.75以上であれば、自動的に同一ノードとして統合する
        if score >= 0.75:
            self.log(f"    [Tier2] '{name}' -> '{best}' に統合 (J={score:.2f})")
            return best

        # Tier 3: 類似度が中程度の曖昧な帯域 (0.50〜0.75) の場合のみLLMで検証する
        if 0.50 <= score < 0.75:
            if llm_same_concept(name, best):
                self.log(f"    [Tier3] '{name}' -> '{best}' に統合 (LLM検証: YES, J={score:.2f})")
                return best

        # どの条件も満たさなければ、独立した新しいノードとして扱う
        self.log(f"    [新規] '{name}' は別ノードとして登録 (最大 J={score:.2f})")
        return name

    def log(self, msg: str):
        if self.verbose:
            print(msg)

    def add_node(self, name: str, ntype: str) -> str:
        # 解決(名寄せ)済みの名前でノードを追加
        canonical = self.resolve(name)
        self.nodes.setdefault(canonical, ntype)
        return canonical

    def add_edge(self, src: str, rel: str, dst: str):
        self.edges.append((src, rel, dst))


# =========================================================
# パイプラインの実行
# =========================================================
if __name__ == "__main__":
    kg = KnowledgeGraph()

    print("=== Stage 1: Intelligence Gathering ===")
    passed = []
    for item in INTEL_ITEMS:
        r = relevance(item)
        verdict = "通過" if r > THETA else "除外"
        print(f"  {item['id']} relevance={r:.2f} (θ={THETA}) -> {verdict}")
        if r > THETA:
            passed.append(item)

    print("\n=== Stage 2: AI Threat Analysis ===")
    for item in passed:
        ids = classify(item)
        print(f"  {item['id']} -> {', '.join(ids)}")
        for tid in ids:
            b = BRIDGE[tid]
            score, _, _ = final_score(ASSESSMENT[tid])
            print(f"    {tid} {b['name']}")
            print(f"      STRIDE={b['stride']} / Cat={b['cat']} / "
                  f"OWASP {','.join(b['llm'])}+{','.join(b['asi'])} / "
                  f"risk={score:.2f} ({level(score)})")

    print("\n=== Stage 3: MCP-UPD Analyzer ===")
    result = analyze_upd(OBSERVED_TRACE)
    for tool, phase in result["phases"]:
        print(f"  {tool:<20} {phase}")
    chain = " -> ".join(f"{s}--[{lbl}]->{d}" for s, d, lbl in result["edges"])
    print(f"  連鎖: {chain}")
    print(f"  寄生的ツール連鎖の成立: {result['upd_complete']}")

    print("\n=== Stage 4: Knowledge Graph ===")
    incident = kg.add_node("GitHub MCP Data Heist", "IntelligenceItem")
    for tid in classify(passed[0]):
        node = kg.add_node(tid, "MCPThreatID")
        kg.add_edge(incident, "INSTANCES_OF", node)
    kg.verbose = True                                     # 以降の解決過程だけを表示する
    kg.add_node("Prompt Injection", "ThreatEntity")
    kg.add_node("Prompt Injections", "ThreatEntity")      # 単純な表記ゆれ
    kg.add_node("Tool Poisoning", "ThreatEntity")
    kg.add_node("Tool Poisoning Attack", "ThreatEntity")  # 語尾違い
    kg.add_node("PI Attack", "ThreatEntity")              # 略語
    kg.verbose = False
    for src, dst, lbl in result["edges"]:
        s = kg.add_node(src, "Tool")
        d = kg.add_node(dst, "Tool")
        kg.add_edge(s, "CHAINS_INTO" if lbl == "T2T" else "EXPLOITS", d)

    print(f"  ノード数: {len(kg.nodes)} / エッジ数: {len(kg.edges)}")
    for name, ntype in kg.nodes.items():
        print(f"    ({ntype}) {name}")
    for s, r, d in kg.edges:
        print(f"    {s} --[{r}]--> {d}")
ここでは、MCPThreatHiveの4段パイプラインについて、LLM推論を決定論的なルールベースで模倣した簡略版の実装について解説します。
- Stage 1: Intelligence Gathering(関連情報の収集): relevance() 関数は、入力された脅威情報(INTEL_ITEMS)に対して、RELEVANCE_VOCAB に定義されたキーワードが含まれている割合を計算し、しきい値 THETA を超える情報のみを後続のパイプラインに渡します。実運用ではLLMが文脈を解釈してスコア付けを行いますが、ここでは語彙の一致で近似しています。
- Stage 2: AI Threat Analysis(脅威の分類とスコアリング): classify() 関数は、CLASSIFY_RULES に設定された正規表現を用いて脅威を特定のMCP-38カテゴリにマッピングします。さらに外部モジュールから読み込んだ final_score() や BRIDGE テーブルを用いて、STRIDEやOWASPの基準に照らしたリスクレベルの算出や横断的な属性付与を自動的に実行します。
- Stage 3: MCP-UPD Analyzer(寄生的連鎖の検出): analyze_upd() 関数は、単体では無害なツールの呼び出し順序(trace)を解析し、複合的な攻撃(MCP-UPD)が成立しているかを判定します。外部データの読み込み(tainted = True)、機密データへのアクセス(holds_secret = True)、そして外部への送信(privacy disclosure)といった状態遷移(Taint Tracking)を追跡することで、ツール間連鎖(T2T)と最終的なプライバシー漏洩を検知します。
- Stage 4: Knowledge Graph(知識グラフとエンティティ解決): KnowledgeGraph クラスは脅威情報をグラフ構造として統合します。名寄せの閾値(自動で統合する 、LLM に問う )は論文の値です。T2T の遷移を CHAINS_INTO、持ち出し(UPD)の遷移を EXPLOITS のエッジにしているのは本記事の割り当てで、論文はエッジの種類(5種)を挙げていますが、UPD をどのエッジにするかまでは書いていません。resolve() メソッド内では、Tier 1(完全一致)、Tier 2(3-gramのJaccard係数による自動統合)、および Tier 3(llm_same_concept() を用いた同義語判定) の3段階のエンティティ解決プロセスを実行し、表記ゆれ(例: 「Prompt Injection」と「Prompt Injections」)を吸収して知識グラフの断片化を防ぎます。ただし後述するとおり、この仕組みが取りこぼす表記も存在します。
実行結果と解説
前節の mcp38_risk.py と同じフォルダに保存して実行すると、次のように出力されます。
=== Stage 1: Intelligence Gathering ===
  intel-001 relevance=1.00 (θ=0.7) -> 通過
  intel-002 relevance=0.00 (θ=0.7) -> 除外

=== Stage 2: AI Threat Analysis ===
  intel-001 -> MCP-20, MCP-24, MCP-17
    MCP-20 Prompt Injection (Indirect via Data)
      STRIDE=I / Cat=II / OWASP LLM01,LLM04+ASI01,ASI06 / risk=9.47 (Critical)
    MCP-24 Data Exfiltration via Tool Output
      STRIDE=I / Cat=V / OWASP LLM02+ASI02 / risk=8.15 (High)
    MCP-17 Parasitic Toolchain / Connector Chaining
      STRIDE=T,D / Cat=II / OWASP LLM05,LLM06+ASI02 / risk=8.73 (High)

=== Stage 3: MCP-UPD Analyzer ===
  github_read_file     parasitic ingestion
  read_private_repo    privacy collection
  create_issue         privacy disclosure
  連鎖: github_read_file--[T2T]->read_private_repo -> read_private_repo--[UPD]->create_issue
  寄生的ツール連鎖の成立: True

=== Stage 4: Knowledge Graph ===
    [新規] 'Prompt Injection' は別ノードとして登録 (最大 J=0.00)
    [Tier2] 'Prompt Injections' -> 'Prompt Injection' に統合 (J=0.93)
    [新規] 'Tool Poisoning' は別ノードとして登録 (最大 J=0.00)
    [Tier3] 'Tool Poisoning Attack' -> 'Tool Poisoning' に統合 (LLM検証: YES, J=0.63)
    [新規] 'PI Attack' は別ノードとして登録 (最大 J=0.00)
  ノード数: 10 / エッジ数: 5
    (IntelligenceItem) GitHub MCP Data Heist
    (MCPThreatID) MCP-20
    (MCPThreatID) MCP-24
    (MCPThreatID) MCP-17
    (ThreatEntity) Prompt Injection
    (ThreatEntity) Tool Poisoning
    (ThreatEntity) PI Attack
    (Tool) github_read_file
    (Tool) read_private_repo
    (Tool) create_issue
    GitHub MCP Data Heist --[INSTANCES_OF]--> MCP-20
    GitHub MCP Data Heist --[INSTANCES_OF]--> MCP-24
    GitHub MCP Data Heist --[INSTANCES_OF]--> MCP-17
    github_read_file --[CHAINS_INTO]--> read_private_repo
    read_private_repo --[EXPLOITS]--> create_issue
段ごとに何が起きたかを見ていきます。
Stage 1:関連度のフィルタが2件を振り分けました。 GitHub の事案の記事は6語すべてを含んで 1.00 となり、θ = 0.70 を超えて通過しました(論文では LLM が 0.94 を付けています)。無関係な記事は 0.00 で除外されました。
Stage 2:分類のルールは、この例に合わせて書いたものです。 MCPThreatHive の論文は、GitHub MCP プロンプトインジェクション事案を既知の正解ラベル付きデータとして投入し、パイプラインの各段が期待通りの出力を出すかを検証しています。論文の LLM が出した分類は MCP-20(間接プロンプトインジェクション)を主分類、MCP-24(ツール出力経由のデータ漏洩)を副分類とするもので、専門家のラベルと一致しました。本実装も MCP-20 と MCP-24 を出しますが、これは CLASSIFY_RULES の正規表現をこの記事の文面に合わせて書いたからで、分類の性能を確かめたことにはなりません。また、本実装は「second tool call」という語句から MCP-17(寄生的ツール連鎖)も出しています。論文の分類には MCP-17 はなく、ツールの連鎖は Stage 3 の MCP-UPD 解析が扱っています。
この段で見てほしいのは、ID が決まった後の横断マッピングです。BRIDGE を引くだけで、MCP-20 と MCP-24 から OWASP LLM01・LLM02・LLM04、OWASP Agentic ASI01・ASI02・ASI06 が出てきます。論文の出力(LLM01・LLM02、ASI01・ASI02)にない LLM04 と ASI06 は、MCP-38 論文の Table 4 で MCP-20 が「データとモデルのポイズニング(LLM04)」「記憶とコンテキストのポイズニング(ASI06)」にも対応づけられているためです。手作業でやるなら、MCP-38 の表を引き、OWASP LLM の表を引き、Agentic の表を引く、という3往復が必要でした。
Stage 3:個々に無害なツールの並びから、漏洩経路が検出されました。 github_read_file、read_private_repo、create_issue のいずれも、単体では完全に正常なツールです。説明文にも怪しい文字列はありません。それでも analyze_upd() は、外部データの読み込み(寄生的取り込み)→ 機密データの収集(プライバシー収集)→ 公開領域への書き込み(プライバシー開示)という順序を見て、寄生的ツール連鎖の成立を判定しました。なお、論文のケーススタディでは、この事案を「GitHub の読み取りツール(T2T)→ トークンを持ち出すツール(UPD)」の2手の連鎖として記録しています。本実装の3つのツール名とトレースは、3フェーズを1手ずつ見せるために本記事で組み立てたものです。
ここがクロスエンティティ攻撃の記事・ツールポイズニング耐性の記事の防御とは根本的に違う点です。クロスエンティティ攻撃の記事の静的フィルタはメタデータの文面を、ツールポイズニング耐性の記事の Layer 3 は引数の値を見ていました。どちらも1回のツール呼び出しの中で完結する検査です。対して MCP-UPD 解析が見ているのは呼び出しの系列であり、検査の単位がそもそも違います。ツールポイズニング耐性の記事で「多層防御が効くのはレイヤーごとに検査対象が異なるから」と書きましたが、系列という次元は、あのときの4層のどこにも含まれていませんでした。
Stage 4:エンティティ解決は3層のうち2層しか機能していません。 「Prompt Injections」は で Tier 2 が吸収し、「Tool Poisoning Attack」は と中間帯に落ちたため Tier 3 のLLM検証に回り、統合されました。ここまでは設計通りです。
問題は「PI Attack」です。「Prompt Injection」との 3-gram Jaccard は でした。文字列としての共通部分が事実上ないため、 の下限を下回り、Tier 3 のLLM検証にすら到達しません。結果として別ノードとして登録され、グラフは断片化します。
これは実装のバグではなく、設計そのものの限界です。Tier 3 に到達する条件が「ある程度は字面が似ていること」である以上、略語・頭字語・言語をまたぐ表記といった字面が似ていない同義語は原理的に拾えません。論文自身も限界として「非英語の脅威レポートや非標準の用語は誤分類されうる」と述べており、多言語プロンプティングが今後の緩和策として挙げられています。MCPThreatHive が「自動修復エンジンではなく、高信頼度の指標システムとして意図的に設計されており、出力は有資格のアナリストによるレビューを前提とする」と位置づけられているのは、こうした残存誤差があるからです。
Stage 3 で検出された連鎖を図にすると、次のようになります。
(図は、diagram-designで作成)
ツールのカバレッジギャップ:38分類中18
体系ができ、運用基盤ができたところで、既存のツール群が実際にどこまでカバーしているのかを確認します。MCP-38 の論文は、代表的な5つのOSSツールを38分類に対して評価しています。
| ツール | 主な手法 | カバー分類 | 未カバー |
|---|---|---|---|
| Enkrypt AI MCP Scanner | エージェント的静的解析 | MCP-07, 08, 10, 33 | 34 |
| MCP-Scan (Invariant) | 静的検査+ランタイムプロキシ | MCP-10, 13, 16, 25 | 34 |
| Akto MCP Proxy | リアルタイムのリクエストフィルタ+DLP | MCP-07, 08, 24, 25 | 34 |
| Promptfoo MCP Proxy | リアルタイム監視+RBAC | MCP-04, 24, 25 | 35 |
| AI-Infra-Guard (Tencent) | ReAct ベースの相関解析 | MCP-07, 37 | 36 |
5ツールすべてを足し合わせても、カバーされるのは38分類中18にとどまります。 そして、どのツールもカバーしていない分類が7つあります——MCP-15(選好操作)、MCP-20(間接プロンプトインジェクション)、MCP-22(Human-in-the-Loop のバイパス)、MCP-23(承認疲れ)、MCP-35(エージェントのロジックドリフト)、MCP-36(マルチエージェントのコンテキスト乗っ取り)、MCP-38(可観測性の欠如)。
この7つの顔ぶれには見覚えがあるはずです。MCP-22 と MCP-23 は、ツールポイズニング耐性の記事で扱ったパラメータ可視性と承認疲れそのものです。ツールポイズニング耐性の記事では、静的検査もランタイム監視もすり抜けた Tool Shadowing を最後に止めたのが Layer 4(全パラメータの強制展開)でした。ユーザーに見せる情報の設計でしか塞げない、という当時の結論が、分類体系のカバレッジ調査でも裏付けられた形になります。そして MCP-20 は、本節のパイプラインが Critical 9.47 と評価した脅威です。最も危険と評価された分類を、既存ツールが1つもカバーしていません。
サーバーの実装リスクの記事で「静的解析だけでは足りない」と書き、ツールポイズニング耐性の記事で「単一の防御機構は必ず突破される」と書きました。ツールカバレッジのデータが示しているのは、より厳しい現実です。現在流通しているツールを全部並べても、半分以上の分類は無防備のままであり、その中に最も重い脅威が含まれています。
ツールごとのカバー数を並べると、次のようになります。
(図は、diagram-designで作成)
仕様側の回答:ステートレス化・認可の厳格化・MCP Apps
ここまで見てきたのは研究側の動きです。では、プロトコル仕様そのものはどう応えているのでしょうか。
本節の内容は論文ではなく、MCP公式仕様の更新内容です。 前節までの MCP-38 / MCPThreatHive の記述とは出典が異なります。両者を混同しないよう、対応づけは「この仕様変更は結果としてこの分類に効く」という筆者の読み取りとして提示します。一次情報は公式の Key Changes をご確認ください。
ステートレス化(2026-07-28)
2026年7月28日に確定した仕様改訂の中心は、プロトコルレベルのセッションの廃止です。
- initialize / notifications/initialized のハンドシェイクが削除(SEP-2575)
- Streamable HTTP から Mcp-Session-Id ヘッダとプロトコルセッションが削除(SEP-2567)
- プロトコルバージョンとクライアント機能は、毎リクエストの _meta に載って移動する
- サーバーは server/discover の実装が必須となり、対応バージョン・機能・同一性をここで広告する
- 跨ぎの状態が必要な場合は、サーバーが発行する明示的なハンドルを通常のツール引数として受け渡す
MCPの記事で「2026年7月:トランスポート層からのプロトコルセッションの排除」として一行だけ触れた項目が、これにあたります。
セキュリティの観点から見ると、この変更は MCP-38 のいくつかの分類に直接効きます。MCP-03(リプレイ攻撃・セッションハイジャック)と MCP-29(セッションのコネクション束縛の欠如)は、セッションIDという攻撃対象そのものが消滅するため、プロトコル層では成立しなくなります。マルチテナント環境でセッション状態が混線する MCP-06(テナント分離の失敗) も、プロトコルが状態を持たなくなることで前提が変わります。
ただし、これはリスクの消滅ではなく移動です。状態管理の責務がトランスポート層からアプリケーション層に移った以上、ハンドルの発行と検証はサーバー実装者の仕事になります。推測可能なハンドルを発行すれば、それはサーバーの実装リスクの記事で見たような実装品質の問題として同じ脆弱性が再登場します。プロトコルが保証してくれていたものを、各実装が自前で用意し直すことになるからです。
同時に入った MRTR(Multi Round-Trip Requests) も、この文脈で読めます。従来はサーバーが sampling/createMessage などでクライアントに逆リクエストを投げていましたが、これが「サーバーが追加情報の要求を結果として返し、クライアントが再試行時に応答を添える」形に変わりました。サーバー起点の割り込みがなくなることで、承認フローの制御権がクライアント側に一本化されます。
認可の厳格化
認可まわりの変更は、いずれもクロスエンティティ攻撃の記事で扱った信頼境界の話に接続します。
| 変更 | 内容 | 関連する分類 |
|---|---|---|
| SEP-2468 | 認可応答の iss パラメータ(RFC 9207)をクライアントが検証必須 | MCP-01, MCP-03 |
| SEP-2352 | クライアント資格情報を発行元の issuer で鍵付けし、別の認可サーバーでの再利用を禁止 | MCP-01, MCP-04 |
| SEP-837 | 動的クライアント登録時に適切な application_type を指定必須 | MCP-04 |
| PR #2858 | 動的クライアント登録(RFC 7591)を非推奨とし、Client ID Metadata Documents へ移行 | MCP-04, MCP-26 |
特に重要なのが最後の行です。クロスエンティティ攻撃の記事では「レジストリが誰でもサーバーを登録でき、所有権の継続的な検証をしていない」ことが攻撃の入口だと確認しました。動的クライアント登録の非推奨化は、「登録できてしまうこと」自体を減らす方向の変更にあたります。MCP-04(Confused Deputy)の攻撃シナリオが、静的クライアントIDの使い回しと動的登録の組み合わせで成立していたことを思い出すと、この2つを同時に締めた意図が読み取れます。
iss 検証の必須化も、マルチサーバー環境ならではの対策です。複数の認可サーバーが並存する構成では、認可コードをどのサーバーが発行したかを確認しないと、リダイレクトベースの攻撃で別サーバー宛のコードを掴まされる余地が残ります。
MCP Apps
3つ目が、サーバーがインタラクティブなUIをホストに届ける拡張 MCP Apps(SEP-1865、拡張識別子 io.modelcontextprotocol/ui)です。仕様バージョン 2026-01-26 が Stable となり、MCP初の公式拡張として提供されています。
ツールが ui:// スキームのリソースをメタデータで宣言し、ホストがそれを取得してレンダリングする、という構成です。セキュリティ設計は次のようになっています。
- すべてのUIは権限を制限したサンドボックス化iframeでレンダリングされる。ホストのDOM・Cookie・ストレージには一切アクセスできない
- ホストとの通信は postMessage 上の JSON-RPC のみ。すべてのUI→ホスト通信が監査可能なMCPメッセージになる
- サーバーはUIが必要とするネットワークドメインをCSPメタデータで宣言し、ホストがそれを強制する。宣言がなければ外部接続は一切許可されない
- ホストは接続時にUIテンプレートを受け取るため、ツール実行の前に内容をレビューできる
この設計をツールポイズニング耐性の記事の議論に重ねると、意味が見えてきます。ツールポイズニング耐性の記事では、ユーザーが承認の判断に使う情報 と、実際に送信される引数 の食い違いが攻撃を成立させる、と定式化しました。MCP Apps は、この「ユーザーに何が見えるか」という部分をサーバー側が自由に設計できるようにする仕様です。
つまり、リッチなUIで引数を分かりやすく提示して に近づけることもできれば、逆に巧妙なレイアウトで危険な値を視覚的に埋没させることもできる、ということになります。宣言的CSPとサンドボックスは前者を後押ししますが、「表示された内容が実際の引数と一致しているか」を保証する仕組みではありません。UIの表現力が上がることは、MCP-22(Human-in-the-Loop のバイパス)の攻撃面が広がることでもあります。
もっとも、ホストによる事前レビューと監査可能な postMessage 通信という設計は、少なくとも何が起きたかを後から追えるようにはしています。MCP-38(可観測性の欠如)が5ツールすべての未カバー領域だったことを踏まえると、この方向は妥当です。
仕様では埋まらない領域
3つの動向を並べると、仕様側が手を打てている範囲がはっきりします。
セッション、トランスポート、認可——いずれもプロトコルが定義できる層です。ここに属する脅威(MCP-03, 04, 06, 28, 29, 31 など、主にカテゴリIIIとIV)は、仕様改訂で構造的に潰せます。
一方、カテゴリI(意味論的操作とポイズニング)は、仕様改訂ではほとんど動きません。ツールの description が自由テキストであり、LLMがそれを読んでツールを選ぶ、というMCPの中核的な設計は変わっていないからです。MCP-10(ツール記述ポイズニング)も MCP-13/14(Tool Shadowing)も、2026-07-28 の仕様で成立しなくなったわけではありません。
これは仕様の怠慢ではなく、トレードオフの帰結です。自然言語でツールを選べることがMCPの価値であり、その価値と意味論的攻撃面は同じ性質の裏表です。だからこそ、この層の防御はプロトコルではなく、クライアント実装(ツールポイズニング耐性の記事)と継続的な脅威インテリジェンス(本記事)が担うほかありません。
まとめ:MCPの関連記事を振り返って
本記事では、38分類からなる脅威分類体系 MCP-38 と、それを運用に載せる MCPThreatHive を取り上げ、これまでの記事で扱ってきた脅威を体系上に位置づけました。
手を動かして確認したことは3点です。第一に、複合リスクスコアリングの乗数が順位を入れ替えました。素の影響度では最下位だった MCP-14(サーバー横断の Tool Shadowing)が、意味論的攻撃と連鎖の両方に該当するため 9.37 / Critical で3位に上がり、影響度最大の MCP-26(サプライチェーン侵害)は 7.19 で最下位に沈みました。第二に、MCP-UPD 解析が、単体では無害なツールの並びから漏洩経路を検出しました。検査の単位が「1回の呼び出し」ではなく「呼び出しの系列」であり、これはクロスエンティティ攻撃の記事・ツールポイズニング耐性の記事の防御のどこにも含まれていなかった次元です。第三に、3層エンティティ解決は「PI Attack」を統合できませんでした。字面の類似がLLM検証への入場条件になっている以上、略語は原理的に拾えません。
MCPの関連記事全体を振り返ると、どの記事にも共通していたのは1つの問いでした。自然言語で書かれたテキストが実行の引き金を引くシステムを、どう検証するかという問いです。
MCPの記事では、LLMのツール選択を条件付き確率の最大化として定式化しました。クロスエンティティ攻撃の記事では、その確率分布が汚染されたコンテキストによって歪むことを確認し、静的ヒューリスティックの検知率が44.4%にとどまることを測りました。サーバーの実装リスクの記事では、そのメタデータが静的解析の検出対象ですらないことを確認しました。ツールポイズニング耐性の記事では、検査を担うべきクライアント7製品を横並びで見て、同じモデルで動く製品のあいだで結果が割れることを確認しました。そして本記事では、これらすべてに共通の語彙を与えたうえで、既存ツールを全部足しても38分類中18しかカバーできていないことを確認しました。
どの記事でも繰り返し現れたのは、単一の層では守れないという事実です。静的解析はメタデータを見ず、メタデータ検査は言い換えに弱く、ランタイム監視は系列を見ず、UIの可視化は人間の注意力に依存します。MCP-38 のカテゴリ分けが「攻撃の見た目」ではなく「修復面」を基準にしているのは、この事実に対する設計上の応答だと読めます。同じ対策で潰せるものを1つにまとめれば、どの層がまだ空いているかが数えられるようになるからです。
仕様側も進んでいます。ステートレス化はセッション由来の脅威を構造的に消し、認可の厳格化は登録と委譲の境界を締め、MCP Apps は表示層に監査可能性を持ち込みました。しかし、MCPの中核である「自然言語でのツール選択」という設計が変わらない限り、意味論的攻撃面は残り続けます。
だとすれば、これから必要になるのは、防御を1点に求めることではなく、空いている層を数え、埋まっていないところから埋めていくという地道な運用でしょう。そのための共通の物差しを提供すること——それが MCP-38 という分類体系の、おそらく最大の貢献です。
参考文献
- Y. T. Shen, K. Toyoda, A. Leung (2026). MCP-38: A Comprehensive Threat Taxonomy for Model Context Protocol Systems (v1.0). arXiv:2603.18063.
- Y. T. Shen, K. Toyoda, A. Leung (2026). MCPThreatHive: Automated Threat Intelligence for Model Context Protocol Ecosystems. arXiv:2604.13849.
- VulcanLab. MCPThreatHive. GitHub.
- Model Context Protocol. Specification(2026-07-28): Key Changes.
本記事の文章・構成の一部に生成AIを使用しています。