メタラーナー(Meta-Learners)とは?
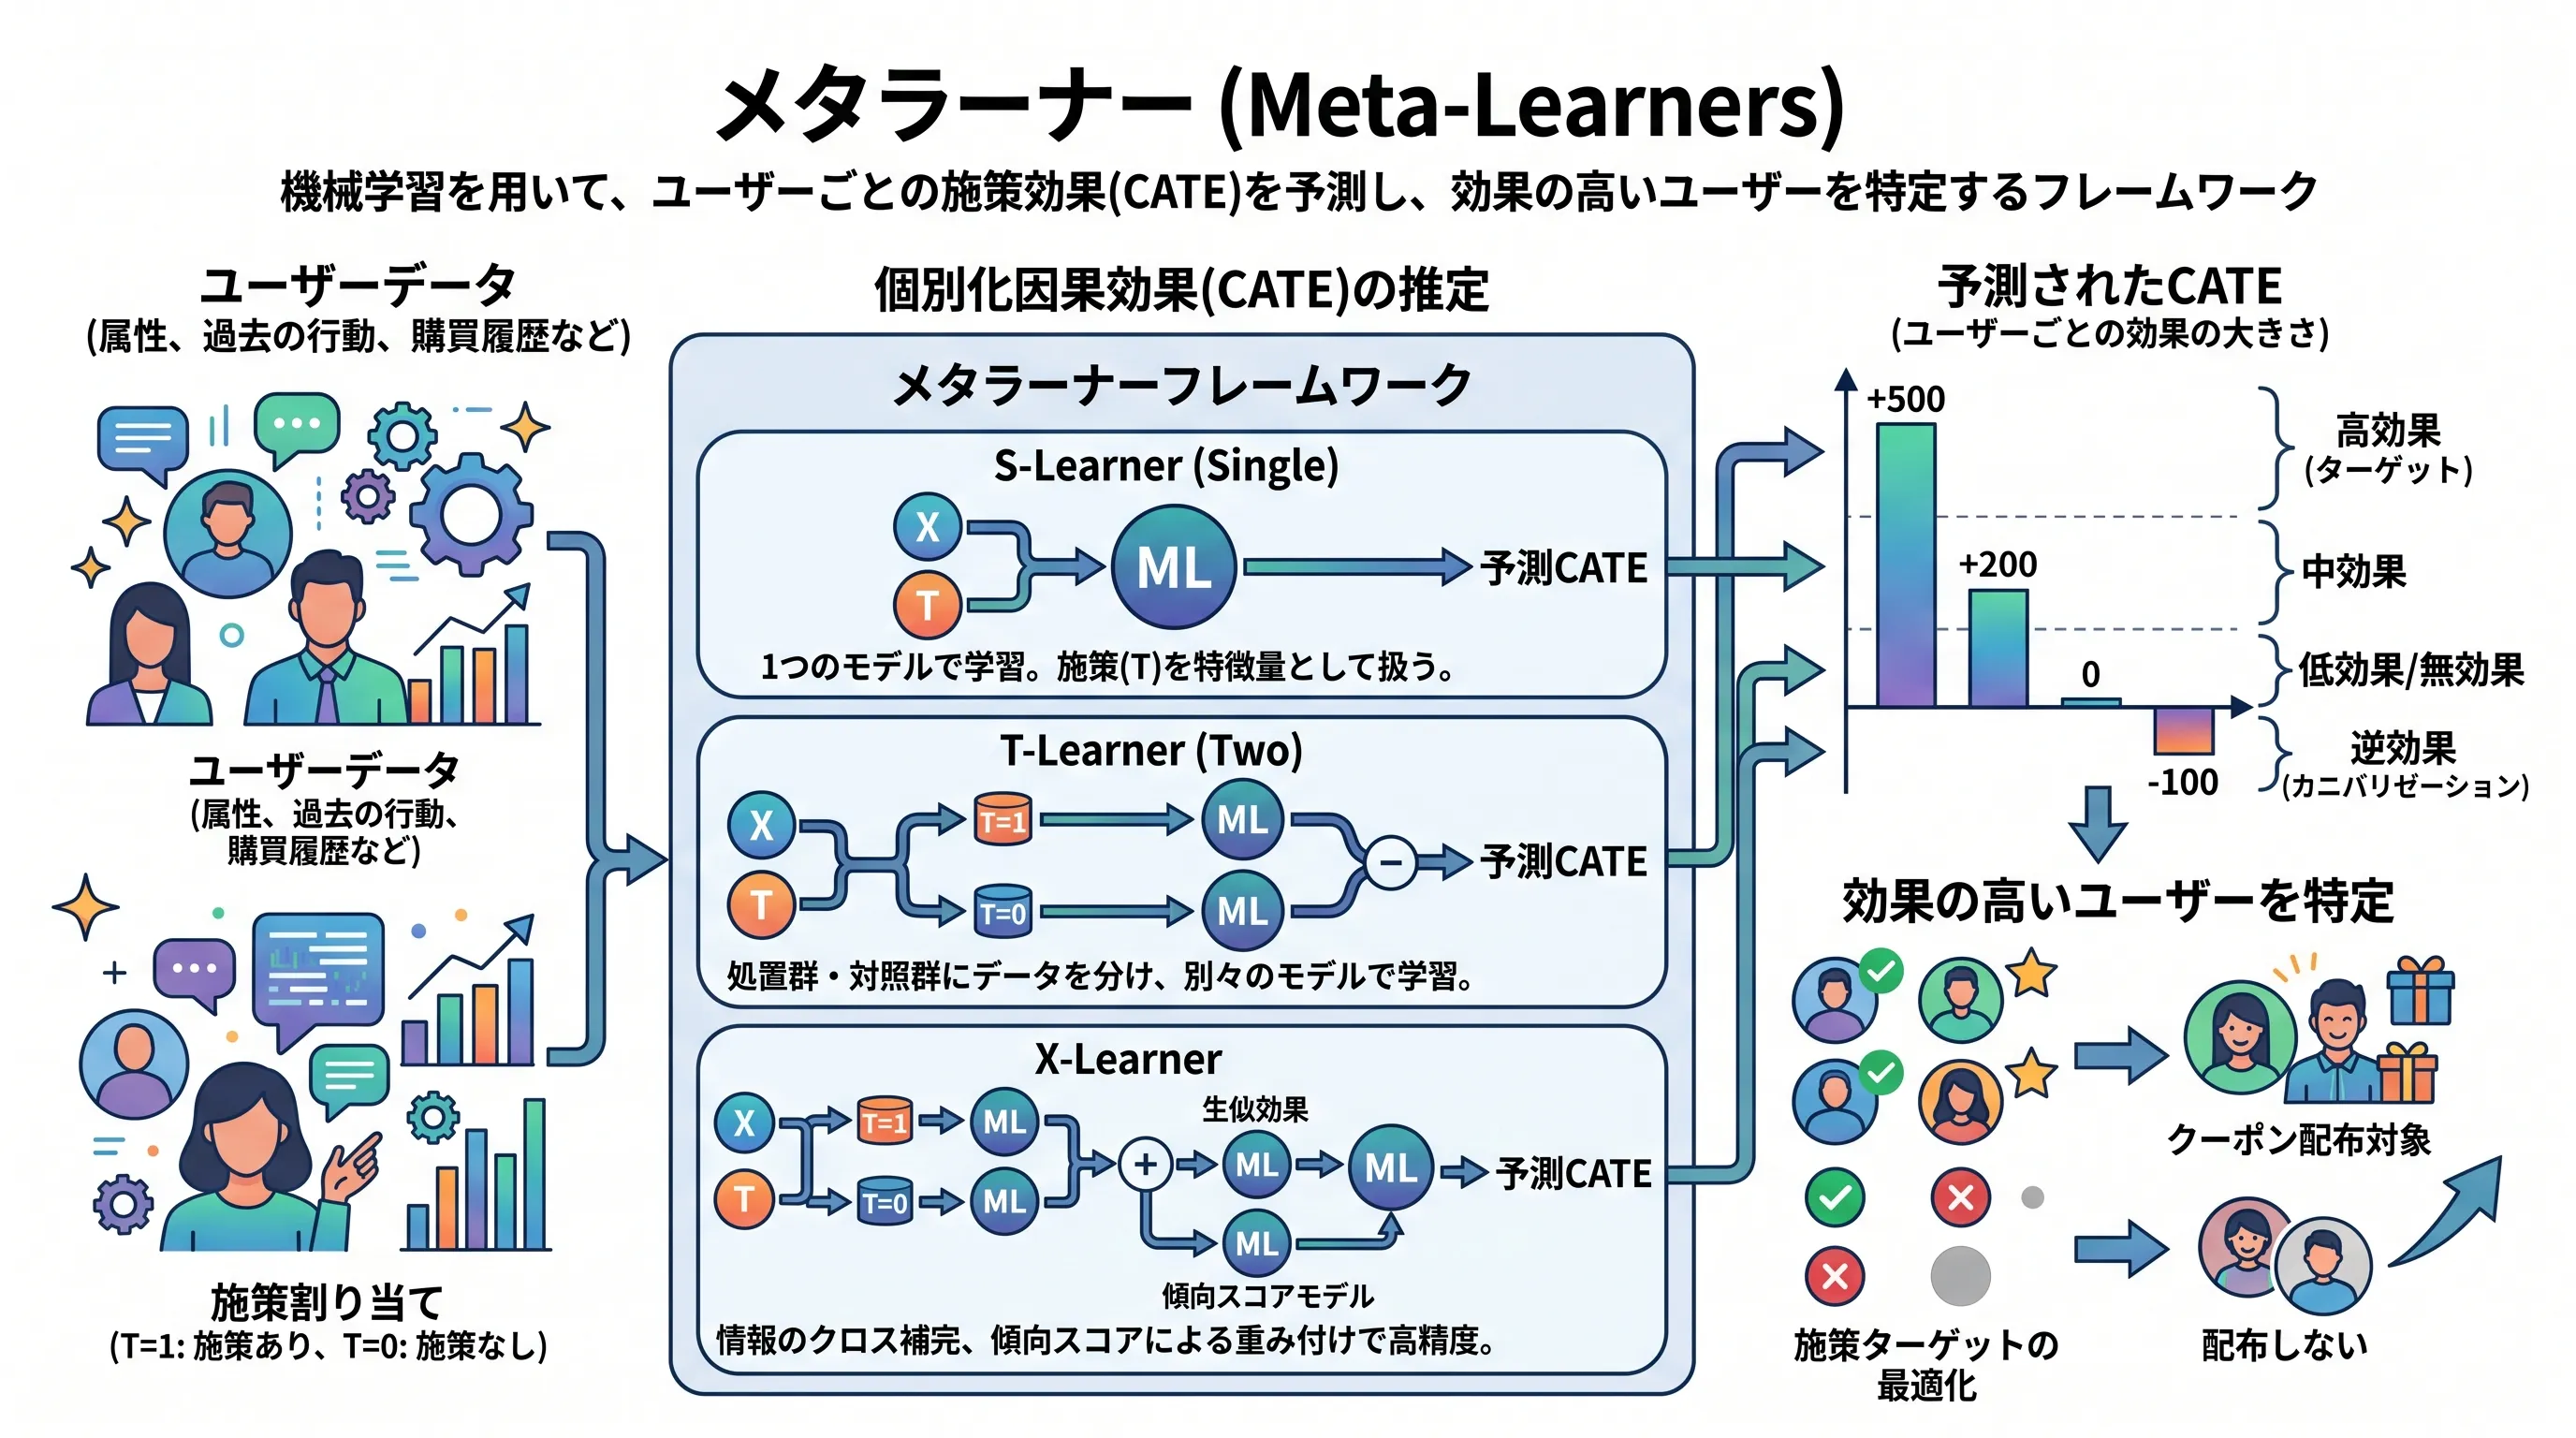 (画像は、Geminiで作成)
施策全体の平均の効果(ATE)ではなく、顧客の特徴ごとの効果(CATE)を推定するメタラーナーの考え方と、S-Learner・T-Learner・X-Learner の仕組みの違いを理解すること。LightGBM でのスクラッチ実装と EconML で3つの手法を比べ、真の効果が分からない中で十分位ごとのリフトや Uplift カーブで推定を検証し、推定した効果をもとに「誰にクーポンを配るか」を決められるようになること。
メタラーナー(Meta-Learners)の概要
RCT、PSM、IPTW、DiDなどでは、主に「施策全体として効果があったか?」を示す ATE(平均処置効果) や ATT(処置群における平均処置効果) を推定する方法を解説してきました。
しかし、これらの手法が返してくれるのは、あくまで 1つの平均値 です。実際のビジネスやマーケティングの現場では、次のような問いに直面することが多くあります。
- 「全体としては効果があったが、特に効果が高かったのはどんな顧客層か?」
- 「コストが限られているので、最もリターンが見込める人にだけクーポンを配りたい」
- 「逆に、クーポンを配らなくても買ってくれる人(あるいは配ると利益が減る人)を特定したい」
このように、「誰に施策を打てば最もリターンが大きいか(個別最適化)」を予測するアプローチを Uplift Modeling(アップリフトモデリング) と呼びます。そして、個々人の因果効果である CATE(条件付き平均処置効果:Conditional Average Treatment Effect) を、機械学習を用いて推定する強力な手法群が メタラーナー(Meta-Learners) です。
本記事では、代表的なメタラーナーである S-Learner, T-Learner, X-Learner の仕組みを解説し、3手法すべてをLightGBMでスクラッチ実装してライブラリ(EconML)の結果と突き合わせます。さらに、実務で最も見落とされやすい 「推定したCATEをどう検証するか」 までを一貫して扱います。
ATE から CATE へ:個別化因果効果とは
- ATE (Average Treatment Effect): 集団全体に対する平均的な施策効果。
- CATE (Conditional Average Treatment Effect): 特定の特徴量 (年齢、性別、過去の購買履歴など)を持つ個人の集団に対する平均的な施策効果。
数式で表すと、個人の特徴量を 、施策ありの潜在結果を 、施策なしの潜在結果を としたとき、CATEは以下のように定義されます。
ある特徴量 を持つユーザーに対して、施策を行った場合と行わなかった場合の「結果の差の期待値(リフト)」を予測することが目標になります。
ATEとCATEの違い(具体例)
簡単な例として、4人のユーザーに対するクーポンの効果(売上の増加分)を見てみましょう。
| ユーザー | 特徴量 (年齢層) | クーポンなしの売上 | クーポンありの売上 | 個別の因果効果 (リフト) |
|---|---|---|---|---|
| Aさん | 20代 | 1,000円 | 1,500円 | +500円 |
| Bさん | 20代 | 1,500円 | 2,000円 | +500円 |
| Cさん | 50代 | 3,000円 | 2,800円 | -200円 |
| Dさん | 50代 | 2,500円 | 2,300円 | -200円 |
- ATE (全体の平均効果):
(+500 + 500 - 200 - 200) / 4 = +150円 - CATE (20代の平均効果):
(+500 + 500) / 2 = +500円 - CATE (50代の平均効果):
(-200 - 200) / 2 = -200円
もし「ATE = +150円」という全体の結果だけを見て全員にクーポンを配ってしまうと、50代の顧客に対しては逆効果(売上減少)を招いてしまいます。このように、特定の特徴量ごとに効果を切り分けて算出(CATEを推定)し、「20代にだけクーポンを配る」といった個別最適化を行うのが、本記事の目的です。
似た用語が並ぶため、ここで整理しておきます。
-
ITE(Individual Treatment Effect:個別処置効果)
「Aさん個人にとっての効果」そのもの、つまり上の表の です。ただし現実には推定できません。Aさんに対して「クーポンを配った世界」と「配らなかった世界」を同時に観測することは原理的に不可能だからです(これを因果推論の根本問題と呼びます)。上の表は「もし両方の世界が見えたら」という架空の設定です。 -
CATE(条件付き平均処置効果)
そこで妥協案として、「Aさんと同じような特徴量を持つ人たちの集団での平均効果」を推定します。これがCATEです。個人そのものではなく「似た人の集団」に落とすことで、初めて推定可能になります。 -
Uplift(アップリフト)
マーケティング分野でCATEを指す実務用語です。本記事では両方の語が登場しますが、指しているものは同じです。
つまりメタラーナーが出力するのは「Aさん個人の効果」ではなく「Aさんによく似た人たちの平均効果」です。この区別は、後述する精度検証の方法を理解する上で重要になります。
メタラーナー(Meta-Learners)の仕組み
メタラーナーとは、「既存の機械学習アルゴリズム(Random ForestやLightGBM、ニューラルネットワークなど)を組み合わせて(メタ的に使って)因果効果を推定するフレームワーク」のことです。分類や回帰のアルゴリズムを自由に選べるのが特徴です。
代表的な3つの手法を紹介します。これらの手法(S-Learner, T-Learner, X-Learner)は、Künzelらの論文(Metalearners for estimating heterogeneous treatment effects using machine learning)で詳しく提案・議論されています。
1. S-Learner (Single-Learner)
S-Learnerは、施策変数 (例:クーポンの有無、0 or 1)を他の特徴量 (例:年齢や購買履歴など)と同じように「1つの特徴量」として扱い、1つの機械学習モデルで目的変数 (例:売上)を予測します。
- 特徴量 と施策変数 を入力として、目的変数 を予測するモデル を学習させる。
- 予測したいデータに対して、強制的に (クーポンあり)とした予測値 と、(クーポンなし)とした予測値 を算出する。
- その差分をCATEとして算出する。これにより、ある特定の年齢や購買履歴といった特徴量()に対して、施策ありと施策なしの比較を行うことになります。
メリット: 実装がシンプルで、全データを1つのモデルの学習に使えるためデータ効率が良い。
デメリット: 特徴量 の次元が大きい場合、施策変数 の影響が他の変数に埋もれてしまい、因果効果を過小評価しやすい傾向があります(正則化バイアス)。極端な場合、予測CATEが全員ほぼ同じ値に潰れてしまいます(後述の実例を参照)。
2. T-Learner (Two-Learner)
T-Learnerは、施策群(例:クーポンあり、)と対照群(例:クーポンなし、)で別々の機械学習モデルを作成します。
- 施策群のデータのみを使って、特徴量 (例:年齢や購買履歴)から目的変数を予測するモデル を学習させる。
- 対照群のデータのみを使って、同じく特徴量 から目的変数を予測するモデル を学習させる。
- 2つのモデルの予測値の差分をCATEとして算出する。これにより、特定の年齢や購買履歴()における施策ありと施策なしの比較を行います。
メリット: がモデル内で埋もれるS-Learnerの弱点を構造的に回避できる。
デメリット: 各モデルが使えるデータが半分以下になるうえ、2つのモデルの予測誤差がそのまま足し算されてCATEに乗ります。特に施策群と対照群でサンプルサイズに大きな偏りがある場合(例:対照群が圧倒的に多い)、少ない方のモデルの精度悪化がCATE全体を汚染します。
S-Learner と T-Learner の構造を並べると、次のようになります。
(図は、diagram-designで作成)
3. X-Learner
X-Learnerは、S-LearnerやT-Learnerの弱点を補うために考案された、より高度なメタラーナーです。情報の少ない群(例えば施策群)の推定を、情報の多い群(対照群)のデータを使って補完するようなクロス(X)した学習を行います。
- 第一段階: T-Learnerと同様に、施策群モデル と対照群モデル を別々に学習させます。
- 第二段階: それぞれの群において、「擬似的な因果効果(Imputed Treatment Effect)」を計算します。
- 施策群の疑似効果: (実際の値 - 対照群モデルの予測値)
- 対照群の疑似効果: (施策群モデルの予測値 - 実際の値)
- 第三段階: 疑似効果 を予測するモデル と、 を予測するモデル を学習させます。
- 最終段階: 2つのモデル と の予測値を、傾向スコア を用いて加重平均し、最終的なCATEとします。
最終段階で突然 傾向スコア が登場して戸惑うかもしれませんが、これは 「データが多い方の群から学んだモデルを信用する」 ための重み付けだと考えると分かりやすくなります。
まず、2つの疑似効果がそれぞれどちらのモデルに寄りかかっているかを確認してください。
- … 対照群モデル の精度に依存する
- … 施策群モデル の精度に依存する
いま、ある特徴量 を持つ層の傾向スコアが (10人に1人しか施策を受けていない層)だったとします。この層は対照群のデータが潤沢なので、 を正確に学習できます。ということは、 に寄りかかっている 、そしてそこから作った が信頼できる、ということです。実際に式を見ると、 には という大きな重みが掛かっています。
逆に (ほとんどの人が施策を受けている層)なら、 が正確に学習でき、 が信頼できる。その に重み が掛かります。
つまりこの式は、「少数派の群の推定を、多数派の群のデータで補う」 というX-Learnerの設計思想を、そのまま数式に落としたものです。
なお、RCTのように全員を50%で無作為に割り当てたデータでは がどこでも 0.5 に近づくため、この式は単に と の平均を取るだけになります。傾向スコアが本当に効いてくるのは、施策の受けやすさが人によって偏る観察データのときです。
X-Learner の4つの段階を図にすると、次のようになります。
(図は、diagram-designで作成)
3手法の比較
| S-Learner | T-Learner | X-Learner | |
|---|---|---|---|
| 学習するモデル数 | 1個 | 2個 | 4個 + 傾向スコアモデル |
| 各モデルが使うデータ | 全件 | 各群のみ(半分ずつ) | 各群 + クロス補完 |
| 傾向スコアの利用 | なし | なし | あり |
| 得意な場面 | 効果が小さく、全体に緩やかに効く場合 | 効果の構造が2群で大きく異なる場合 | 群のサイズが偏っている場合 |
| 主な弱点 | が埋もれてCATEが潰れる(正則化バイアス) | 2つのモデルの誤差が足し算される | 実装が複雑、傾向スコアの誤設定に影響される |
「どれが常に最強」ということはなく、データの性質に依存します。本記事では実際に3手法を同じデータで走らせ、精度を比較します。
検証用ダミーデータの生成
それでは、Pythonを使ってメタラーナーの実装を試してみましょう。ここでは PSMの記事と同じデータ生成プロセス(購買履歴と年齢が高い人ほどDMが送られやすい、というセレクションバイアス入りの観察データ)をベースに、施策効果に個人差を持たせたデータを作ります。
シナリオは次の通りです。
- 若い顧客ほどクーポンが効く:まだ購買習慣が固まっておらず、割引がきっかけになりやすい。
- 購買履歴が多い優良顧客ほど効かない:もともと定価で買ってくれる層なので、クーポンを配ると値引き分だけ売上が下がる(いわゆるカニバリゼーション)。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

np.random.seed(42)

# データサイズの指定(test 1,500人を十分位に分けても1グループ150人を確保するため)
N = 5000

# 1. 交絡因子(特徴量)の生成
age = np.random.normal(40, 10, N).clip(20, 65)
history = np.random.exponential(5000, N)

# 2. 施策割り当て(セレクションバイアスの導入)
# 年齢が高く、過去の購買金額が多いほどDMが送られやすい
logit_p = -3.0 + 0.05 * age + 0.0002 * history
propensity = 1 / (1 + np.exp(-logit_p))
treatment = np.random.binomial(1, propensity)

# 3. ベースの売上(施策を受けなかった場合の売上)
base_sales = 2000 + 30 * age + 0.5 * history

# ★ポイント★ 4. 個別化因果効果(CATE)の設定
# 平均効果は 1500 円だが、若いほど大きく、購買履歴が多いほど小さくなる
true_cate = 1500 - 40 * (age - 40) - 0.2 * (history - 5000)

# 5. 目的変数(売上)の生成(ノイズの標準偏差 1000 は PSM記事と同じ)
sales = base_sales + true_cate * treatment + np.random.normal(0, 1000, N)

df = pd.DataFrame({
    'age': age,
    'history': history,
    'treatment': treatment,
    'sales': sales,
    'true_cate': true_cate  # 答え合わせ用
})

print(df.head().round(1).to_string())
print("真のATE:", round(df['true_cate'].mean(), 1))
print("CATEが負の人の割合: %.1f%%" % ((df['true_cate'] < 0).mean() * 100))
print("単純比較での売上の差:",
      round(df[df.treatment == 1].sales.mean() - df[df.treatment == 0].sales.mean(), 1))
- 交絡因子の生成: np.random.normal(40, 10, N).clip(20, 65) と np.random.exponential(5000, N) で「年齢」と「過去の購買金額」を生成しています。年齢は現実的な範囲に収まるよう 20〜65 歳に丸めています。
- セレクションバイアスの導入: logit_p をシグモイド関数に通して「DMを受け取る確率(=傾向スコアの真値)」を作り、np.random.binomial(1, propensity) でコイントスを行っています。PSM記事と同一の設定で、優良顧客ほどDMが送られやすい状況を人工的に作り出しています。
- CATEに個人差を持たせる: ここが本記事の核心です。true_cate は定数ではなく age と history の関数になっており、人によって効果の大きさが変わります。基準点(40歳・履歴5,000円)でちょうど 1500 になるように定数を置いているため、PSM記事で推定した「平均 +1,500円」がそのまま平均効果として保たれる設計です。
- 目的変数の構築: ベース売上に true_cate * treatment を加えることで、「施策を受けた人だけが、その人固有の効果分だけ売上が増える」構造を表現しています。ノイズの標準偏差 1000 はPSM記事と同じ値で、後述の通り真のCATEの標準偏差(約 1,018円)とほぼ同じ大きさです。
- サンプルサイズ: PSM記事は N = 2000 でしたが、本記事では N = 5000 にしています。後半の検証では test データ(30%)を予測CATEで10グループに分け、各グループの中でさらに施策群と対照群を比べるためです。N = 2000 だと test は600人、1グループ60人になり、施策群が数人しかいないグループが出てしまいます。N = 5000 なら1グループ150人になり、最も偏った第10十分位でも施策群が38人残ります。
このダミーデータは、以下の数式(データ生成プロセス)に基づいています。
① 交絡因子の生成
② 施策割り当て(セレクションバイアスの導入)
③ 個別化因果効果(CATE)の設定
PSM記事では施策効果を「全員一律 1500 円」としていましたが、本記事ではここを の関数 に置き換えています。この1行が、ATEの世界からCATEの世界への入口です。
④ 目的変数(売上)の生成
実行結果
    age  history  treatment   sales  true_cate
0  45.0    921.0          0  2536.3     2117.1
1  38.6   1053.2          0  2367.3     2344.7
2  46.5   3087.5          1  4347.2     1623.4
3  55.2   1686.3          1  6871.1     1553.5
4  37.7   1421.5          0  4668.2     2309.4

真のATE: 1526.0
CATEが負の人の割合: 8.1%
単純比較での売上の差: 2818.4
このデータの構造を図で確認しておきましょう。
fig, axes = plt.subplots(1, 2, figsize=(13, 4.6))

# 左:CATEの分布
axes[0].hist(df['true_cate'], bins=50, color='#4C72B0', alpha=0.85)
axes[0].axvline(0, color='red', ls='--', lw=1.5, label='効果ゼロ')
axes[0].axvline(df['true_cate'].mean(), color='black', lw=1.5,
                label=f"ATE = {df['true_cate'].mean():.0f}円")
axes[0].set_xlabel('真の施策効果(CATE, 円)'); axes[0].set_ylabel('人数')
axes[0].set_title('個別化因果効果(CATE)の分布')
axes[0].legend(); axes[0].grid(alpha=0.3)

# 右:購買履歴との関係(色は年齢)
sc = axes[1].scatter(df['history'], df['true_cate'], c=df['age'],
                     cmap='viridis', s=8, alpha=0.6)
axes[1].axhline(0, color='red', ls='--', lw=1.5)
axes[1].set_xlabel('過去の購買金額 history(円)')
axes[1].set_ylabel('真の施策効果(CATE, 円)')
axes[1].set_title('購買履歴が多い顧客ほど効果が小さい')
axes[1].set_xlim(0, 25000)
plt.colorbar(sc, ax=axes[1], label='年齢 age')
axes[1].grid(alpha=0.3)

plt.tight_layout()
plt.show()
実行結果
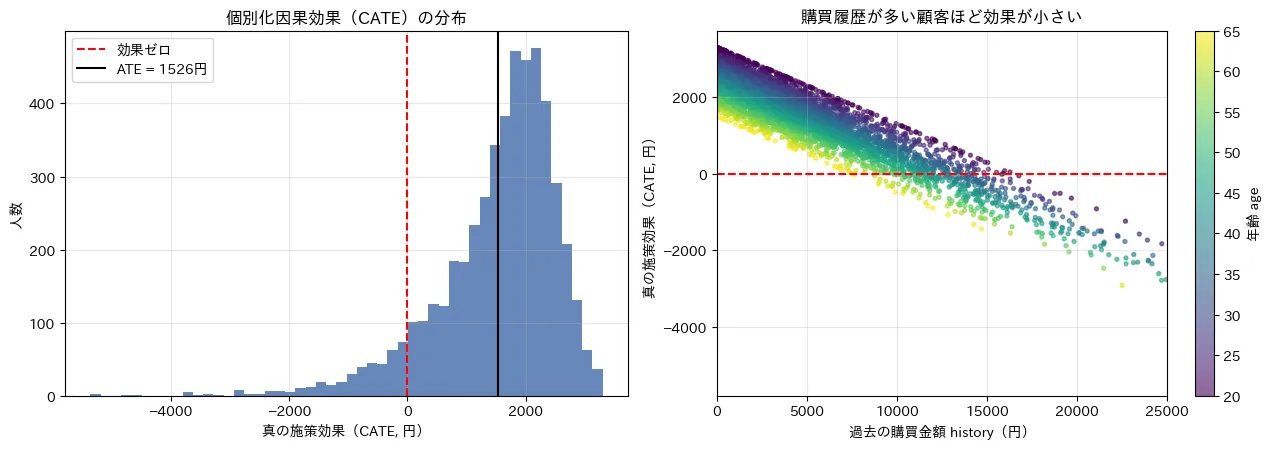
ここで注目すべきは、「平均 +1,526円」という1つの数字の裏側にある幅の広さです。左の図を見ると、効果が +3,000円を超える人がいる一方で、赤い破線(効果ゼロ)より左側、つまり クーポンを配ると売上が下がってしまう人が全体の 8.1%(405人) 存在します。右の図を見れば、その正体が「購買履歴の多い優良顧客」であることが分かります。
PSMやIPTWで「平均 +1,500円だった」と報告して終わりにしてしまうと、この構造は完全に見えません。平均値の内訳を開けにいくのが、メタラーナーの役割です。
このデータには、もう一段深い問題が埋め込まれています。真のATE(全員に配った場合の平均効果)は 1,526円 ですが、真のATT(実際にDMを受け取った人たちにとっての平均効果)を計算すると 1,133円 と、明確に下回ります。
print("真のATE (全員)       : %.1f" % df['true_cate'].mean())
print("真のATT (treatment=1): %.1f" % df.loc[df.treatment == 1, 'true_cate'].mean())
print("真のATC (treatment=0): %.1f" % df.loc[df.treatment == 0, 'true_cate'].mean())

print("処置群の平均 age %.1f / history %.1f"
      % (df.loc[df.treatment == 1, 'age'].mean(), df.loc[df.treatment == 1, 'history'].mean()))
print("対照群の平均 age %.1f / history %.1f"
      % (df.loc[df.treatment == 0, 'age'].mean(), df.loc[df.treatment == 0, 'history'].mean()))
真のATE (全員)       : 1526.0
真のATT (treatment=1): 1133.4
真のATC (treatment=0): 1896.4
処置群の平均 age 42.0 / history 6440.5
対照群の平均 age 38.4 / history 3341.5
理由は単純で、DMが送られやすいのは「購買履歴が多い優良顧客」=ちょうどクーポンが効かない層だからです。つまりこの企業は、効果の低い人を優先的にターゲティングしてしまっている状態にあります。
これはデータ生成の2つの式を並べると一目で分かります。
同じ2つの変数が、上の式では送られやすさを押し上げ、下の式では効き目を押し下げています。実際、処置群の平均値(42.0歳・6,440円)を効果の式に代入すると
となり、ATTの値と一致します(今回の効果は の線形関数なので、平均を代入した値と個別に計算した平均が厳密に一致します)。なお、この計算ができるのは true_cate を自分で作ったダミーデータだからであり、実データでは推定するほかありません。
このように、ATEとATTが乖離しているとき、その裏では「施策の受けやすさと効果の大きさが相関している」という現象が起きています。PSM記事やIPTW記事では「ATTなのかATEなのか」を手法選択の問題として扱いましたが、CATEを推定すると、その差がどこから来ているのかまで説明できるようになります。
真の CATE の式と、集団ごとの平均効果を並べると、次のようになります。
(図は、diagram-designで作成)
CATEを推定する前に:3つの前提条件
メタラーナーは機械学習の手法である前に因果推論の手法です。したがって、PSM記事で解説した3つの仮定が、そのまま(むしろより厳しい形で)必要になります。
1. 条件付き独立性(強く無視できる割り当て)
観測した共変量 で条件付ければ、施策の割り当て と潜在結果 が独立である、という仮定です。要するに「未観測の交絡因子は存在しない」という前提です。
CATEの推定では、この要求がATEのときより厳しくなります。ATEは集団全体で偏りが打ち消し合えばそれなりの値に落ち着くことがありますが、CATEは 「20代の層」「優良顧客の層」といったセグメントごとに、それぞれ交絡が除かれている必要があるためです。
2. 正値性(オーバーラップ / 共通サポート)
すべての人について、施策を受ける確率も受けない確率もゼロではない()という仮定です。
CATEの文脈では、これは非常に具体的な意味を持ちます。「ある特徴量の層で、施策群か対照群のどちらかが存在しない」場合、その層のCATEは推定できません。 例えば「購買履歴が20,000円を超える層では、全員にDMが送られている」なら、その層の (配らなかった場合の売上)を学習するためのデータが1件も存在せず、モデルは遠くの領域からの外挿で予測値を出すしかなくなります。
そこで、モデリングに入る前に傾向スコアの分布の重なりを確認します。
import seaborn as sns
from sklearn.linear_model import LogisticRegression

# 傾向スコアの推定(目的変数は treatment。売上 sales は一切使わない)
ps_model = LogisticRegression(max_iter=1000).fit(df[['age', 'history']], df['treatment'])
df['ps'] = ps_model.predict_proba(df[['age', 'history']])[:, 1]

fig, ax = plt.subplots(figsize=(8.5, 4.2))
sns.histplot(data=df, x='ps', hue='treatment', bins=40, kde=True, ax=ax,
             palette=['royalblue', 'darkorange'], alpha=0.6)
ax.set_xlabel('傾向スコア(DMを受け取る確率)')
ax.set_ylabel('人数')
ax.set_title('傾向スコアの分布(共通サポートの確認)')
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()

# 極端な領域の確認
print("history > 20000 の人数:", (df.history > 20000).sum())
print("  うち対照群:", ((df.history > 20000) & (df.treatment == 0)).sum(), "人")
- 傾向スコアの算出: PSM記事と同じく、LogisticRegression で「施策を受けたかどうか」を予測します。目的変数は treatment であり、売上 sales は一切使わない点が重要です。そのため、後段の評価に使う目的で全データから推定してもリークにはなりません。
- 分布の重なりを見る: 2つのヒストグラムが重なっている範囲が共通サポートです。ここが重なっていない領域については、「似た条件の比較相手」が存在しないため、何を推定しても外挿になります。
実行結果
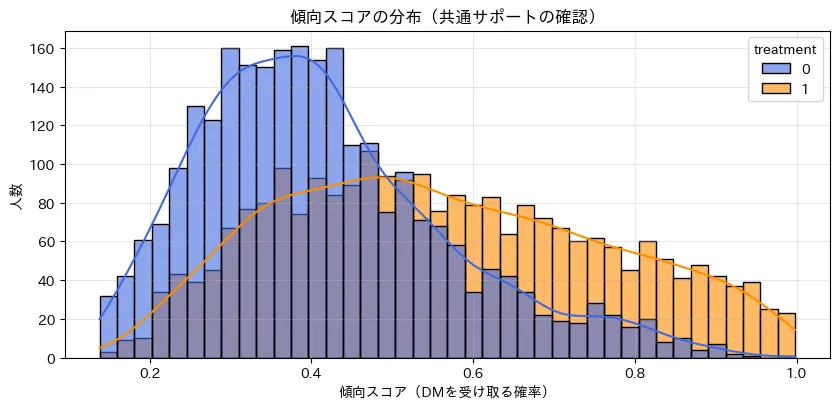
history > 20000 の人数: 66
  うち対照群: 1 人
図を見ると、中央付近(スコア 0.2〜0.8)では青と橙が十分に重なっており、この範囲のCATEは信頼して推定できそうです。一方、右端(スコア 0.9 以上)では対照群がほとんど存在しません。実際、購買履歴が 20,000円を超える 66人のうち、DMを受け取っていない人はたった1人です。
後ほど見るように、メタラーナーが最も大きく外すのは、まさにこの領域です。
3. SUTVA(安定単位処置値の仮定)
「あるユーザーへの施策が、他のユーザーの結果に影響を与えない(波及効果がない)」かつ「施策の内容は誰に対しても一定である」という仮定です。SNSの口コミキャンペーンや、紹介プログラムのようなネットワーク効果を持つ施策では崩れやすくなります。
RCTで取得したデータであれば、施策の割り当てが完全に無作為なので、条件付き独立性は設計上保証されており、傾向スコアもどこでも 0.5 で一定です。この場合、S-LearnerやT-Learnerをそのまま適用しても交絡の心配はありません。
問題は、実務で手に入るデータの多くが観察データだという点です。この場合、メタラーナーにも交絡調整の枠組みが必要になります。目安としては次のように整理できます。
- S-Learner / T-Learner: 傾向スコアを一切使わないため、交絡に対して無防備です。観察データにそのまま適用すると、「効果の個人差」ではなく「もともとの実力差」を学習してしまう危険があります。
- X-Learner / DR-Learner / DML: 傾向スコアを内部に組み込んでいるため、観察データにより適しています。
ただし重要な注意として、X-Learnerの傾向スコアは「群のサイズの偏りを補正する重み」であって、交絡そのものを取り除く仕組みではありません。X-Learnerも条件付き独立性の仮定に依存しています。本記事のダミーデータでは、交絡因子である「年齢(age)」や「過去の購入履歴(history)」をすべて機械学習モデルの特徴量(入力データ) として含めています。そのため、介入群と統制群の各予測モデル( と )が予測値を算出する過程で、すでに交絡因子の影響は考慮(調整)されているという状態になっています。
LightGBMを用いたスクラッチ実装(S-Learner / T-Learner)
ここでは理解を深めるため、LightGBMを使って S-Learner と T-Learner をスクラッチで実装します。まずはデータを学習用と評価用に分割します。
import lightgbm as lgb
from sklearn.model_selection import train_test_split

X = df[['age', 'history']]
T = df['treatment']
Y = df['sales']

X_train, X_test, T_train, T_test, Y_train, Y_test, cate_train, cate_test = train_test_split(
    X, T, Y, df['true_cate'], test_size=0.3, random_state=42
)

# 全モデル共通の設定(値の理由は下の解説を参照)
params = dict(random_state=42, n_estimators=100, max_depth=3, verbose=-1)

# --- S-Learner:T を特徴量の1つとして扱い、1つのモデルで学習 ---
XT_train = X_train.copy()
XT_train['T'] = T_train.values
s_model = lgb.LGBMRegressor(**params).fit(XT_train, Y_train)

# 全員を強制的に T=1 / T=0 にして予測し、その差を取る
X1 = X_test.copy(); X1['T'] = 1
X0 = X_test.copy(); X0['T'] = 0
s_cate = s_model.predict(X1) - s_model.predict(X0)

# --- T-Learner:施策群と対照群で別々のモデルを学習 ---
m1 = lgb.LGBMRegressor(**params).fit(X_train[T_train == 1], Y_train[T_train == 1])
m0 = lgb.LGBMRegressor(**params).fit(X_train[T_train == 0], Y_train[T_train == 0])
t_cate = m1.predict(X_test) - m0.predict(X_test)
- データ分割の比率: test_size=0.3 で 3,500人を学習に、1,500人を評価に回します。評価側は十分位で割ると150人ずつになり、グループ内の比較に必要な人数を確保できます。
- LightGBMの設定: n_estimators=100 はLightGBMの既定値です。max_depth=3 は、S-Learnerが「T・age・history」の3変数の交互作用を1本の木で表せる最小の深さです。実際に深さを変えて test のRMSEを比べると、S-Learnerは深さ2で 516.9、3で 436.5、5で 446.5 となり、3が最良でした。X-Learnerは深さ2で 374.3、3で 393.7、5で 435.6、制限なしで 516.7 と、深くするほど悪化します。後述する通り擬似効果にはノイズが多く、深い木はそのノイズを覚えてしまうためです。木の本数を300本に増やした場合も、X-Learnerは 442.3 に悪化しました。
- データ分割: train_test_split に df['true_cate'] も一緒に渡している点に注目してください。これはダミーデータだからできる答え合わせ用の列であり、学習には一切使いません。なお、以降の精度評価をすべて X_test に対して行う理由は、後述の検証パートにある「なぜ検証を test データだけで行うのか」で扱います。
- S-Learnerの「反実仮想の作り方」: コード内の s_model が、理論パートで説明した共通の予測モデル に該当します。X1 と X0 は、同じテストデータをコピーして T 列だけを 1 と 0 に書き換えたものです。つまり「この人がクーポンをもらった世界」と「もらわなかった世界」をモデルの中で人工的に作り、その差分をCATEとしています。
- T-Learnerのデータ分割: コード内の m1 と m0 が、それぞれ理論パートの (介入群モデル)と (統制群モデル)に該当します。X_train[T_train == 1] のように、学習データそのものを2つに割ってから別々に fit しています。各モデルが見られるデータが約半分になる点がT-Learnerのコストです。
S-Learnerの正則化バイアスは、抽象的な話ではありません。試しに、LightGBMの代わりに線形回帰をベースモデルにしてみましょう。
from sklearn.linear_model import LinearRegression

lr_s = LinearRegression().fit(XT_train, Y_train)
lin_s_cate = lr_s.predict(X1) - lr_s.predict(X0)

print("線形S-Learner: 最小 %.1f / 最大 %.1f / 標準偏差 %.4f"
      % (lin_s_cate.min(), lin_s_cate.max(), lin_s_cate.std()))
print("真のCATE     : 最小 %.1f / 最大 %.1f / 標準偏差 %.1f"
      % (cate_test.min(), cate_test.max(), cate_test.std()))
線形S-Learner: 最小 1692.9 / 最大 1692.9 / 標準偏差 0.0000
真のCATE     : 最小 -5353.0 / 最大 3290.7 / 標準偏差 1042.8
予測CATEが全員まったく同じ 1692.9 円になりました。 標準偏差はきっかり 0 です。
理由は式を書き下せば明らかです。線形回帰は という形なので、 と の差は常に 、つまり誰に対しても同じ定数にしかなりません。 と の交互作用項がモデルに存在しないため、そもそも個人差を表現する余地がないのです。
では、同じ線形回帰をベースモデルにしたまま、T-Learnerに切り替えるとどうなるでしょうか。
lr_1 = LinearRegression().fit(X_train[T_train == 1], Y_train[T_train == 1])
lr_0 = LinearRegression().fit(X_train[T_train == 0], Y_train[T_train == 0])
lin_t_cate = lr_1.predict(X_test) - lr_0.predict(X_test)

print("線形T-Learner: RMSE %.1f / 標準偏差 %.1f"
      % (np.sqrt(((lin_t_cate - cate_test.values) ** 2).mean()), lin_t_cate.std()))
線形T-Learner: RMSE 46.9 / 標準偏差 1020.0
RMSEはわずか 46.9、標準偏差も真のCATE(1042.8)とほぼ一致しており、極めて高精度です。(後述の比較表に示すLightGBM版T-LearnerのRMSE 717.8よりも、はるかに良い結果になっています。)
種明かしをすると、真のCATE 1500 - 40*(age-40) - 0.2*(history-5000) は展開すれば という完全な線形関数です。線形モデルを2本引き算した結果もまた線形関数なので、形が最初から一致しており、あとは係数の推定誤差しか残りません。データ生成過程を知っている出題者が、その形のモデルを当てにいった結果であり、実務でこの精度が出ることはまずない点には注意してください。
とはいえ、ここで重要なのは絶対的な精度ではありません。同じベースモデル(線形回帰)を使っているのに、S-Learnerでは効果が完全に消え、T-Learnerではほぼ完璧に復元されるという事実です。「どのメタラーナーを使うか」は「どのベースモデルを使うか」と切り離せないことがよく分かる例です。
LightGBMのような木モデルであれば分岐を通じて交互作用を表現できますが、それでも特徴量の次元が大きく効果が小さい場合、 が分岐にほとんど使われず、予測CATEが平坦に潰れる現象が起こります。S-Learnerを使ったら、まず予測CATEの分散を確認することを習慣にしてください。
2つの線形メタラーナーの結果を並べると、次のようになります。
(図は、diagram-designで作成)
X-Learnerのスクラッチ実装
X-Learnerは「4つのモデル + 傾向スコア」と聞くと複雑に見えますが、部品はすべてここまでに登場済みです。第一段階はT-Learnerそのものですし、傾向スコアはPSMやIPTWで使ったロジスティック回帰と同じものです。新しいアルゴリズムは1つも出てきません。
実装に入る前に、全体像を表で整理しておきます。
| 段階 | やること | 学習するモデル |
|---|---|---|
| 第一段階 | 群ごとに売上を予測する(T-Learnerと同一) | |
| 第二段階 | 擬似的な因果効果 を作る(学習は不要) | — |
| 第三段階 | 擬似効果 自体を目的変数として回帰する | |
| 最終段階 | 傾向スコアで加重平均する |
ポイントは、第二段階で「目的変数の作り替え」が起きていることです。第一段階までは売上 を予測していたのが、第三段階では効果 を直接予測する問題に変わっています。ここがX-Learnerの本質です。
実装
前節で学習した m1()と m0()をそのまま第一段階として流用し、第二段階以降を書き下します。
# === 第一段階:T-Learnerで学習済みの m1, m0 をそのまま使う ===

# === 第二段階:擬似的な因果効果(Imputed Treatment Effect)を計算 ===
is_treat = (T_train == 1).values
X_t, Y_t = X_train[is_treat],  Y_train[is_treat]   # 施策群
X_c, Y_c = X_train[~is_treat], Y_train[~is_treat]  # 対照群

D1 = Y_t.values - m0.predict(X_t)   # 実測値 −「配らなかったら」の予測
D0 = m1.predict(X_c) - Y_c.values   # 「配っていたら」の予測 − 実測値

# === 第三段階:擬似効果そのものを予測するモデルを学習 ===
tau1 = lgb.LGBMRegressor(**params).fit(X_t, D1)
tau0 = lgb.LGBMRegressor(**params).fit(X_c, D0)

# === 最終段階:傾向スコア g(x) で加重平均 ===
g_model = LogisticRegression(max_iter=1000).fit(X_train, T_train)
g = g_model.predict_proba(X_test)[:, 1]

x_cate_scratch = g * tau0.predict(X_test) + (1 - g) * tau1.predict(X_test)

print("施策群 %d人 / 対照群 %d人" % (len(X_t), len(X_c)))
print("擬似効果 D1: 平均 %7.1f / 標準偏差 %.1f" % (D1.mean(), D1.std()))
print("擬似効果 D0: 平均 %7.1f / 標準偏差 %.1f" % (D0.mean(), D0.std()))
print("傾向スコア g: 最小 %.3f / 最大 %.3f / 平均 %.3f" % (g.min(), g.max(), g.mean()))
print("推定ATE %.1f(真値 %.1f) / RMSE %.1f"
      % (x_cate_scratch.mean(), cate_test.mean(),
         np.sqrt(((x_cate_scratch - cate_test.values) ** 2).mean())))
# 答え合わせ用:学習データにおける真のATT(施策群)とATC(対照群)
print("学習データの真のATT %.1f / 真のATC %.1f"
      % (cate_train[is_treat].mean(), cate_train[~is_treat].mean()))
- 第二段階の D1 が意味するもの: 施策群の人について「実際に観測された売上」から「この人が配られなかった世界の売上( の予測)」を引いています。ITEの定義 のうち、観測できない側だけをモデルで埋めた形です。D0 は対照群について逆向きに同じことをしています。
- リークが起きない理由: m0.predict(X_t) は、 が学習時に一度も見ていない施策群の行に対する予測です。m1.predict(X_c) も同様に群をまたいでいます。つまり擬似効果は常に自分を学習に使っていないモデルで作られており、この構造自体がリーク防止になっています。
- 第三段階は「ただの回帰」: D1 は1人につき1つの数値なので、ここから先は から を予測する通常の教師あり学習です。目的変数が売上から効果に変わっただけで、特別なことは何もしていません。
- 答え合わせの行: 最後の print は、擬似効果 D1・D0 の平均と比べるために、学習データ内の真のATTとATCを出しています。cate_train はダミーデータだから持てる列で、学習には使っていません。
- 最終段階の g: 学習には X_train と T_train しか使わず、売上 Y は登場しません。 に 、 に を掛ける対応関係は、前掲の「3. X-Learner」の式と同じです。
実行結果
施策群 1681人 / 対照群 1819人
擬似効果 D1: 平均  1328.2 / 標準偏差 1408.6
擬似効果 D0: 平均  1947.0 / 標準偏差 1277.4
傾向スコア g: 最小 0.131 / 最大 0.998 / 平均 0.484
推定ATE 1574.5(真値 1509.6) / RMSE 393.7
学習データの真のATT 1131.4 / 真のATC 1904.2
ここで注目したいのが、D1 の平均(1,328円)と D0 の平均(1,947円)が 600円 以上ずれていることです。これはモデルの誤差ではありません。この学習データにおける真のATTは 1,131円、真のATC(対照群にとっての平均効果)は 1,904円(実行結果の最終行。前述の全データでの 1,133円 / 1,896円 とほぼ同じ)であり、擬似効果はそれぞれをほぼ正しく捉えています。
つまり「DMを受けた人たち」と「受けなかった人たち」は、そもそも効果の大きさが違う集団なのです(前述の通り、DMは効果の低い優良顧客に偏って送られています)。2つの擬似効果は別々の母集団の効果を推定しているため、単純に平均してよいものではありません。ここに最終段階の重み付けが効いてきます。
なぜ加重平均が効くのか:重みを変えて比べる
最終段階の意義を確かめるため、 と の混ぜ方だけを変えて精度を比較してみます。
p1, p0 = tau1.predict(X_test), tau0.predict(X_test)

def rmse(p):
    return np.sqrt(((p - cate_test.values) ** 2).mean())

for name, p in [('tau1 のみ使用', p1),
                ('tau0 のみ使用', p0),
                ('単純平均(0.5ずつ)', 0.5 * p1 + 0.5 * p0),
                ('傾向スコア加重(X-Learner)', g * p0 + (1 - g) * p1)]:
    print('%-22s 推定ATE %7.1f  RMSE %5.1f' % (name, p.mean(), rmse(p)))
実行結果
tau1 のみ使用              推定ATE  1625.0  RMSE 706.8
tau0 のみ使用              推定ATE  1569.4  RMSE 393.3
単純平均(0.5ずつ)            推定ATE  1597.2  RMSE 534.3
傾向スコア加重(X-Learner)     推定ATE  1574.5  RMSE 393.7
今回のデータでは 側が圧倒的に優秀(RMSE 393.3)で、 側は大きく劣ります(706.8)。もし何も考えず 単純平均を取ると RMSE 534.3 まで悪化しますが、傾向スコアで重み付けした X-Learner は 393.7 と、優秀な方にほぼ張り付いています。
重要なのは、どちらが優秀かを事前に知らなくてよいという点です。 は「その特徴量の層でどちらの群のデータが厚いか」を表しているので、それを重みにするだけで、自動的に信頼できる側が選ばれます。これがX-Learnerの設計思想そのものです。
混ぜ方ごとの RMSE を並べると、次のようになります。
(図は、diagram-designで作成)
なぜ τ1 に (1 − g) を掛けるのか
コードを読んでいて、g は「施策を受ける確率」なのだから tau1 に掛けるべきでは、と感じた方も多いはずです。ここで押さえておきたいのは、 の添字は「どの群のデータで学習したか」を表しているだけで、「どの群に対して使うか」ではないということです。
第二段階の式を、どのモデルに寄りかかっているかという目で見直してみましょう。
のうち は実測値なので誤差ゼロで手に入ります。誤差が入り込む余地があるのは の側だけです。つまり の品質、ひいてはそこから作った の品質は、対照群のデータがどれだけ厚いかで決まります。対照群が厚いのは施策を受ける確率が低い場所、すなわち が小さい場所なので、重みは になります。
「 の添字と、掛かる重みの添字は必ず食い違う」 — これがX-Learnerの「X(クロス)」の由来そのものです。
実際にそうなっているかを、 の水準で4分割して確認してみます。
# ① 重みを入れ替えたらどうなるか
print("正しい重み   g * tau0 + (1-g) * tau1 : RMSE %.1f" % rmse(g * p0 + (1 - g) * p1))
print("逆にした場合 g * tau1 + (1-g) * tau0 : RMSE %.1f" % rmse(g * p1 + (1 - g) * p0))

# ② g の水準ごとに tau1 / tau0 の精度を比べる
g_train = g_model.predict_proba(X_train)[:, 1]
q = pd.qcut(g, 4, labels=False)
c = cate_test.values

print("gの四分位        学習データ(施策/対照)   tau1 RMSE  tau0 RMSE")
for k in range(4):
    m = q == k
    lo, hi = g[m].min(), g[m].max()
    sel = (g_train >= lo) & (g_train <= hi)   # 同じg帯にいる学習データの内訳
    print("Q%d (%.2f-%.2f)   %4d人 / %4d人     %7.1f   %7.1f"
          % (k + 1, lo, hi, (sel & is_treat).sum(), (sel & ~is_treat).sum(),
             np.sqrt(((p1[m] - c[m]) ** 2).mean()),
             np.sqrt(((p0[m] - c[m]) ** 2).mean())))
実行結果
正しい重み   g * tau0 + (1-g) * tau1 : RMSE 393.7
逆にした場合 g * tau1 + (1-g) * tau0 : RMSE 692.6

gの四分位        学習データ(施策/対照)   tau1 RMSE  tau0 RMSE
Q1 (0.13-0.33)    249人 /  656人       249.6     255.2
Q2 (0.33-0.45)    306人 /  557人       253.9     238.7
Q3 (0.45-0.61)    459人 /  401人       226.9     228.6
Q4 (0.61-1.00)    667人 /  201人      1349.0     666.6
Q4( が高く、対照群が201人しかいない領域)で のRMSEが 1,349 と崩壊しています。 対照群が足りず がまともに学習できていないため、その差として作った が壊れているからです。ここでは に という大きな重みが掛かるので、崩壊した の寄与は 24% に抑えられます。
逆に Q1(対照群が656人と潤沢)では が をわずかに上回っており、重み が 側に掛かります。狙い通りの動きです。
そして重みを入れ替えると、RMSEは 393.7 から 692.6 へと約1.8倍に悪化し、 単独で使った場合(706.8)とほとんど変わらない水準まで落ちます。壊れているモデルに、よりによって壊れている場所で大きな重みを掛けてしまうためです。
原論文(Künzel et al., 2019)では、 は の値を取る重み関数とされ、本来は推定値 の分散が最小になるように選ぶものと位置づけられています。そのうえで、経験上は傾向スコアの推定値を使うとうまくいくこと、施策群と対照群の人数が極端に違う場合は や も選択肢になること、 と の共分散を推定できるなら分散最小の を計算してもよいことが述べられています。
| 項目 | 原論文 | 本記事 |
|---|---|---|
| ベースモデル | Random Forest、BART | LightGBM |
| 重み | 傾向スコアの推定値を推奨( / や分散最小の も可) | ロジスティック回帰の傾向スコア |
| データ | シミュレーションと、投票率向上の郵便(GOTV)・トランスフォビア低減の戸別訪問という2つのランダム化実験 | セレクションバイアスを入れた観察データ(ダミー) |
とはいえ傾向スコアは、交絡調整のためにどのみち推定していることが多く、しかも「どちらの群のデータが厚いか」という情報をそのまま持っています。わざわざ別の重みを設計する動機が薄いため、標準的な選択になっています。
上の実行結果で、傾向スコアの最大値が 0.998 になっている点に気づいたでしょうか。IPTWであれば という巨大な重みが発生し、たった1人が推定値全体を振り回す事態になります(そのため後述の検証パートでは .clip(0.05, 0.95) によるトリミングを行っています)。
しかしX-Learnerの最終段階では、傾向スコアは割り算の分母ではなく、0〜1の加重平均の重みとして登場します。 なら「 を 99.8%、 を 0.2% 使う」という意味にしかならず、値が発散することはありません。同じ傾向スコアでも、使い方によって安定性がまったく違うわけです。
ただし油断は禁物で、 の領域では対照群のデータがほとんど存在しないため、そこで採用される の中身(学習元である と少数の対照群データ)が信用できるとは限りません。重みが暴走しないことと、推定が当たることは別問題です。前述の正値性の議論がそのまま当てはまります。
- 擬似効果の向きを逆にしてしまう: は「予測 − 実測」であり、 とは引き算の順序が逆です。揃えてしまうと符号が反転し、CATEの大小が丸ごとひっくり返ります。
- 重みの対応を取り違える: に を掛けたくなりますが、正しくは です。前項の通り、 が信頼できるのは 対照群が厚い(= が小さい) 層だからです。入れ替えるとRMSEが約1.8倍に悪化します。
- 擬似効果のノイズを軽視する: 上の結果では の標準偏差が約 1,400円 で、真のCATEの標準偏差(約 1,000円)を上回っています。擬似効果には売上のノイズ がそのまま乗るためです。第三段階のモデルは過学習しやすいので、木の深さや正則化を控えめにするのが定石です。
- 傾向スコアに目的変数を混ぜる: の学習に を使ってはいけません。傾向スコアはあくまで「施策の受けやすさ」のモデルです。
四分位ごとの結果を図にすると、次のようになります。
(図は、diagram-designで作成)
EconMLによる実装と3手法の比較
仕組みが分かったところで、実務向けのライブラリ実装に切り替えます。ここでは Microsoft が開発する EconML を使います。
# !pip install econml
from econml.metalearners import XLearner
from sklearn.linear_model import LogisticRegression

x_learner = XLearner(
    models=lgb.LGBMRegressor(**params),                 # μ1, μ0, τ1, τ0 のベースモデル
    propensity_model=LogisticRegression(max_iter=1000)  # 重み付けに使う傾向スコア g(X)
)
x_learner.fit(Y_train.values, T_train.values, X=X_train.values)
x_cate = x_learner.effect(X_test.values)
- 2種類のモデルを渡す: models は結果予測(回帰)用、propensity_model は施策の受けやすさ予測(分類)用です。前節の式における と にそれぞれ対応しています。
- 引数の順番: EconMLの fit は (Y, T, X=X) の順です。目的変数・処置変数・共変量という因果推論の語順になっており、一般的な機械学習ライブラリの fit(X, y) とは異なる点に注意してください。
- effectメソッド: effect() が各行のCATE推定値を返します。4つのモデルの学習と傾向スコアによる加重平均は、すべてこの内部で処理されます。
前節のスクラッチ実装と突き合わせてみましょう。
print("スクラッチ版 先頭5件:", np.round(x_cate_scratch[:5], 1))
print("EconML版   先頭5件:", np.round(x_cate[:5], 1))
print("両者の最大差: %.2e" % np.abs(x_cate_scratch - x_cate).max())
実行結果
スクラッチ版 先頭5件: [1554.3 2073.6 1194.8 2874.7 1449.6]
EconML版   先頭5件: [1554.3 2073.6 1194.8 2874.7 1449.6]
両者の最大差: 1.36e-12
浮動小数点の誤差を除いて完全に一致しました。 EconMLの XLearner は、前節で30行ほど書いた処理をそのまま実行しているだけだと確認できます。ライブラリはブラックボックスではなく、中身を知った上で使えば「4つのモデルと1つの傾向スコアを、こう混ぜている」と説明できる道具です。
処理内容が同じなら自前で書いてもよさそうですが、EconMLには次の利点があります。
- 多値処置に対応: 処置が3水準以上(クーポンA / クーポンB / なし)でも、群ごとのモデル管理を自動で行ってくれます。
- ブートストラップ信頼区間: BootstrapInference を渡せば、CATEの区間推定が得られます。スクラッチ実装だと自前でリサンプリングのループを書く必要があります。
- 他手法との入れ替えが容易: XLearner を DRLearner や CausalForestDML に差し替えるだけで、後述の発展的手法をそのまま試せます。
理解はスクラッチで、運用はライブラリで、というのが現実的な使い分けです。
3手法の精度を比較してみましょう。
from scipy.stats import spearmanr

rows = []
for name, p in [('S-Learner', s_cate), ('T-Learner', t_cate), ('X-Learner', x_cate)]:
    rows.append({
        '手法': name,
        '推定ATE': round(p.mean(), 1),
        'RMSE': round(np.sqrt(((p - cate_test.values) ** 2).mean()), 1),
        '順位相関': round(spearmanr(p, cate_test.values).correlation, 3),
    })
print(pd.DataFrame(rows).to_string(index=False))
print("(testの真のATE = %.1f)" % cate_test.mean())
- RMSE: 予測CATEと真のCATEの二乗誤差の平方根です。「効果の大きさをどれだけ正確に当てられたか」を測ります。
- 順位相関(Spearman): 予測CATEの並び順が真のCATEの並び順とどれだけ一致しているかを測ります。「誰に配るか」を決めたいだけなら、実はRMSEよりこちらが重要です。
実行結果
       手法  推定ATE  RMSE  順位相関
S-Learner 1603.7 436.5 0.973
T-Learner 1612.7 717.8 0.907
X-Learner 1574.5 393.7 0.965
(testの真のATE = 1509.6)
fig, axes = plt.subplots(1, 3, figsize=(15, 4.8), sharex=True, sharey=True)
lo, hi = cate_test.min(), cate_test.max()

for ax, (name, p) in zip(axes, [('S-Learner', s_cate), ('T-Learner', t_cate), ('X-Learner', x_cate)]):
    ax.scatter(cate_test, p, alpha=0.35, s=12, color='#4C72B0')
    ax.plot([lo, hi], [lo, hi], 'r--', lw=1.5, label='理想(True = Pred)')
    ax.set_title('%s  (RMSE = %.0f)' % (name, np.sqrt(((p - cate_test.values) ** 2).mean())))
    ax.set_xlabel('真のCATE'); ax.grid(alpha=0.3); ax.legend(loc='upper left', fontsize=9)

axes[0].set_ylabel('予測CATE')
plt.tight_layout()
plt.show()
実行結果
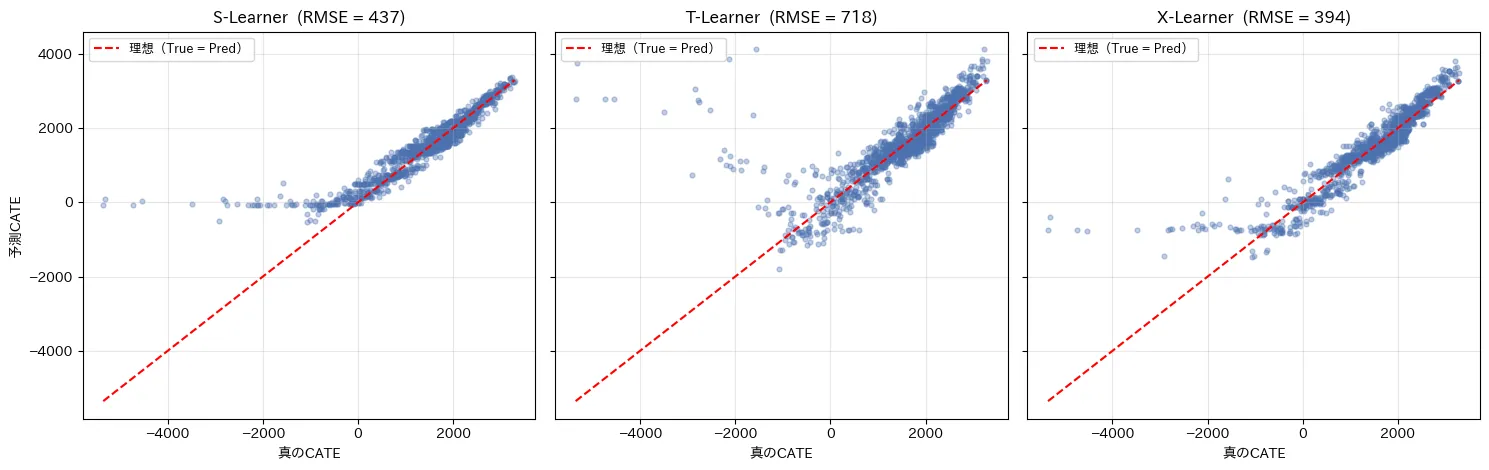
この結果からは、いくつか重要なことが読み取れます。
① 今回はS-LearnerとX-Learnerが優秀で、T-Learnerが劣る
「S-Learnerは弱い手法」というわけではありません。今回は効果の構造(age と history の単純な関数)が明快で、効果量もノイズに対して十分大きいため、全データを1つのモデルに使えるS-Learnerが有利に働きました。逆にT-Learnerは、 と という2つの予測誤差が足し算される構造がそのまま精度に表れています(散布図でも点の散らばりが最も大きい)。手法の優劣はデータ次第であり、必ず複数試して比較すべきです。
② どの手法も、右上(効果が大きい層)は正確に当てている
真のCATEが 0〜3,000円の範囲では、3手法とも赤い破線に沿って点が並んでいます。この範囲が、前節の図で確認した共通サポートが厚い領域です。
③ しかし左下(効果が大きくマイナスの層)では、全手法が揃って失敗している
真のCATEが −1,000円を下回る領域で、予測値が 0 付近に貼り付いて水平になっています。つまり 「配ると大きく損をする人」を、どの手法も見抜けていません。
上の散布図の左下で全手法が失敗しているのは、アルゴリズムの性能問題ではありません。データが存在しないからです。
ext = df['true_cate'] < -1000
print("真のCATEが -1000 未満の人:", ext.sum(), "人")
print("  うち対照群(DMを受け取っていない人):", (df.loc[ext, 'treatment'] == 0).sum(), "人")
真のCATEが -1000 未満の人: 124 人
  うち対照群(DMを受け取っていない人): 3 人
該当する124人のうち、DMを受け取っていない人はわずか3人です。(配らなかった場合の売上)を学習するための教師データが事実上存在せず、モデルは他の領域から外挿するしかありません。木モデルの予測は学習データの範囲外へ出ると平坦になるため、CATEが 0 付近に潰れたわけです。
これは、前節で確認した正値性(共通サポート)の破れがそのまま予測失敗として現れた例です。教訓は2つあります。
- 推定の前に共通サポートを確認する。傾向スコアが 0 または 1 に極端に近い領域は、そもそもCATEを推定できない領域です。
- その領域は「推定できない」と報告する。無理に予測値を出して意思決定に使うより、「この層については追加のデータ収集(小規模なRCTなど)が必要」と結論づける方が誠実です。
推定したCATEをどう検証するか
ここまでは散布図で「真のCATE」と突き合わせて精度を確認してきました。しかし、この答え合わせができるのはダミーデータだけです。
真値が観測できないという根本問題
true_cate という列が存在するのは、私たちが自分でデータを作ったからです。現実のデータには存在しません。ある人について「クーポンを配った場合の売上」と「配らなかった場合の売上」を同時に観測することは、原理的に不可能だからです。
では実務ではどう評価するのか。答えは、予測値そのものの当たり具合ではなく「並べ替えの精度」を見ることです。私たちの目的は「誰に配るか」を決めることなので、効果の高い人を上位に、低い人を下位に並べられていれば実務上は十分だからです。
十分位ごとの実測リフト
最も直感的な検証方法がこれです。手順は次の通りです。
- 予測CATEの高い順にユーザーを並べ、10個のグループ(十分位)に分割する。
- 各グループの中だけで、「施策を受けた人の平均売上 − 受けなかった人の平均売上」を計算する。
- モデルが正しく並べ替えられていれば、この実測値がグループ順に右肩上がりになるはず。
ただし、今回は観察データなので、同じグループの中にもセレクションバイアスが残っています。そこで各グループ内で IPTW(逆確率重みづけ) による調整を行います。
ここで2つの手法が登場するので、どちらが何を担当しているのかを整理しておきます。この検証の枠組みは、機械学習と因果推論のどちらか一方では成立しません。
手順1(順位付け)は X-Learner の仕事
「誰をどの十分位に入れるか」を決めるには、一人ひとりについて「Aさんは 3,000円、Bさんは −500円」という個人単位の効果を推定する必要があります。これはCATE推定そのものであり、メタラーナーにしかできません。
手順2(各グループの効果測定)は IPTW の仕事
一方、IPTW は集団の平均効果を推定する手法であり、原理的に個人単位の効果は出せません。IPWの推定量は「重み付き平均の差」という形をしているので、計算するには施策を受けた人と受けなかった人が両方いる集団が必要です。1人だけを取り出すと、その人は か のどちらか一方しか持たないため、片方の平均が空になり、式そのものが定義できません。
つまりこの2つは、得意分野がきれいに裏返しの関係にあります。
| 個人単位の効果 | 集団の平均効果 | 真値なしで検証できるか | |
|---|---|---|---|
| X-Learner(メタラーナー) | ○ | ○ | ✕(true_cate が要る) |
| IPTW | ✕ | ○ | ○(実測 , だけで済む) |
X-Learnerは個人単位の予測を出せますが、その予測が当たっているかを実データで直接確認する手段を持ちません。逆にIPTWは実測データだけで効果を測れますが、誰に配るべきかという順位は作れません。
十分位への分割は、この2つを橋渡しするための工夫です。 個人(1人)では平均効果を測れなくても、150人のグループ単位まで粒度を落とせばIPTWが機能します。そこで「X-Learnerに並べさせ、その並びが正しかったかをIPTWで採点する」という分業が成立します。手順2の計算に pred_cate が一切登場しないのはそのためで、採点する側が採点される側の予測値を使わないことが、この検証が成立する条件になっています。
機械学習で「誰に配るか」を決め、因果推論の基本手法で「その判断が正しかったか」を実績データから確かめる。これが実務における効果検証の王道パターンです。
test = X_test.copy()
test['T'] = T_test.values
test['Y'] = Y_test.values
test['true_cate'] = cate_test.values
test['pred_cate'] = x_cate

# 傾向スコア(重みの暴走を防ぐため 0.05〜0.95 に刈り込む)
test['ps'] = ps_model.predict_proba(X_test)[:, 1].clip(0.05, 0.95)

# 予測CATEの高い順に10グループへ分割
test['decile'] = pd.qcut(test['pred_cate'], 10, labels=False)

rows = []
for d, g in test.groupby('decile'):
    # ① 単純な群間差(バイアスが残る)
    naive = g.loc[g['T'] == 1, 'Y'].mean() - g.loc[g['T'] == 0, 'Y'].mean()
    # ② IPWで重み付けした群間差
    w1 = g['T'] / g['ps']
    w0 = (1 - g['T']) / (1 - g['ps'])
    ipw = (w1 * g['Y']).sum() / w1.sum() - (w0 * g['Y']).sum() / w0.sum()

    rows.append({'十分位': d + 1, '人数': len(g), '処置群': int(g['T'].sum()),
                 '予測CATE': round(g['pred_cate'].mean(), 1),
                 '実測リフト_単純': round(naive, 1),
                 '実測リフト_IPW': round(ipw, 1),
                 '真のCATE': round(g['true_cate'].mean(), 1)})

print(pd.DataFrame(rows).to_string(index=False))
true_cateを使っていない: 計算に使っているのは pred_cate、Y、T、ps だけです。最後の「真のCATE」列は答え合わせのために付けているだけで、実データでもこの表の左半分はそのまま作れます。- IPWによる調整: 各グループ内で、施策を受けた人を で、受けなかった人を で重み付けした平均を取ります。分母で重みの合計を割っている(Hájek推定量)ため、重みの合計が偏っても平均の水準がずれません。
- 十分位の数: 10グループにすると test 1,500人が150人ずつになります。グループを増やすほど右肩上がりかどうかは細かく見られますが、1グループの人数が減ってIPWの推定がぶれるため、標準的な10分割にしています。
- 傾向スコアの刈り込み: .clip(0.05, 0.95) は実務で広く使われる重みのトリミングです(今回の全データでは、0.05 未満か 0.95 超の人は 1.1% です)。スコアが 0.998 のような人がいると重みが 500 倍にもなり、たった1人の売上が推定値全体を振り回してしまうため、裾を切り落としています。
実行結果
 十分位  人数  処置群  予測CATE  実測リフト_単純  実測リフト_IPW  真のCATE
   1 150  123  -484.4     468.2     -316.4  -663.6
   2 150  108   482.7     774.6      554.3   470.4
   3 150   97  1146.1    1038.4      932.8  1059.6
   4 150   85  1385.9    1709.4     1632.5  1429.9
   5 150   67  1571.4    1519.9     1523.2  1649.6
   6 150   69  1722.1    2021.9     2032.0  1799.2
   7 150   57  2022.6    1837.3     1893.5  2012.6
   8 150   49  2295.2    2292.3     2281.3  2194.7
   9 150   53  2532.5    2297.0     2275.4  2360.9
  10 150   38  3070.9    2944.2     2911.2  2783.1
dec = pd.DataFrame(rows)
fig, ax = plt.subplots(figsize=(9.5, 4.6))
w = 0.27
xp = np.arange(len(dec))

ax.bar(xp - w, dec['予測CATE'],       w, label='予測CATEの平均',            color='#4C72B0')
ax.bar(xp,     dec['実測リフト_IPW'], w, label='実測リフト(IPW調整済み)', color='#DD8452')
ax.bar(xp + w, dec['真のCATE'],       w, label='真のCATEの平均(答え合わせ用)', color='#AAAAAA')

ax.axhline(0, color='black', lw=1)
ax.set_xticks(xp); ax.set_xticklabels(dec['十分位'])
ax.set_xlabel('予測CATEによる十分位(1 = 効果が低いと予測された層)')
ax.set_ylabel('施策効果(円)')
ax.set_title('十分位ごとの予測CATEと実測リフトの比較')
ax.legend(fontsize=9); ax.grid(axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
実行結果
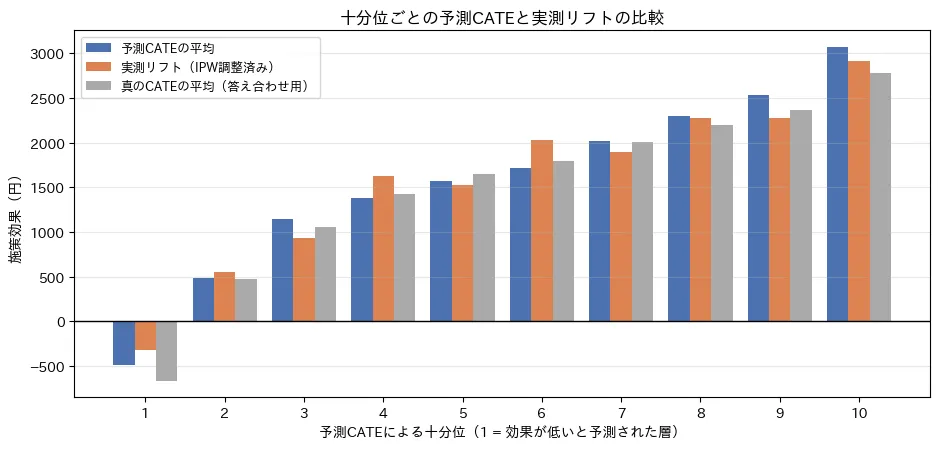
青(予測)と橙(実測)がほぼ同じ高さで、きれいに右肩上がりに並んでいます。真のCATE(灰色)を一切使わずにこの図が描けるという点が重要です。実データでも同じ手順で、モデルが機能しているかを確認できます。
そして第1十分位では、予測・実測ともにマイナスになっています。「この層に配ると売上が減る」というモデルの主張が、実測データでも裏付けられたことになります。
上の表で、第1十分位の2つの推定値を比べてみてください。
| 第1十分位の推定効果 | |
|---|---|
| 実測リフト(単純な群間差) | +468.2 |
| 実測リフト(IPW調整済み) | −316.4 |
| 真のCATE(答え) | −663.6 |
単純な群間差は プラス を返しています。真の答えはマイナスなので、符号が逆です。これをそのまま信じると「この層にも配った方がよい」という、まったく逆の意思決定に至ります。
原因は、第1十分位に含まれる150人のうち123人(82%)が処置群だという偏りです。この層は購買履歴が非常に多く、DMが送られやすい=もともと売上が高い人たちなので、単純な平均差にはセレクションバイアスが丸ごと残ります。
CATEモデルの検証工程そのものが、因果推論を必要とするというのがここでのポイントです。RCTデータであれば単純な群間差で問題ありませんが、観察データの場合はIPWなどの調整が必須になります。
なお、IPW調整後の推定(−316.4)も真の値(−663.6)からはまだ離れています。IPWは重みの分散が大きく、推定値が不安定になりやすい手法です。符号と大小関係は信頼できるが、水準の精度は過信しないという姿勢で読むのが適切です。
「せっかくデータがあるのに、なぜ学習に使った train を検証に含めないのか」は素朴かつ重要な疑問です。技術的には含められます(predict(X_train) は普通に動きます)。除いている理由は、train で測った検証結果が信用できないという一点にあります。
上の十分位リフトは、実測値として売上 を使っています。ところが学習済みモデルは、train の各行について に乗っていたノイズ を部分的に暗記しています。つまりモデルと検証データが同じノイズを共有しているため、「モデルが低いと予測した人」と「たまたま売上が低かった人」が一致し、検証が自動的に成功してしまいます。
あえて正則化を緩めた(過学習しやすい)T-Learnerで、第1十分位を train と test の両方で見てみましょう。
# あえて正則化を緩めた設定でT-Learnerを学習
over = dict(random_state=42, n_estimators=1000, num_leaves=255,
            min_child_samples=2, verbose=-1)
o1 = lgb.LGBMRegressor(**over).fit(X_train[T_train == 1], Y_train[T_train == 1])
o0 = lgb.LGBMRegressor(**over).fit(X_train[T_train == 0], Y_train[T_train == 0])

def first_decile(Xz, Tz, Yz, cz):
    """予測CATEが最も低い第1十分位の「予測・実測リフト・真値」を返す"""
    d = pd.DataFrame({'p': o1.predict(Xz) - o0.predict(Xz),
                      'T': Tz.values, 'Y': Yz.values, 'c': cz.values})
    d['ps'] = ps_model.predict_proba(Xz)[:, 1].clip(0.05, 0.95)
    g = d[pd.qcut(d['p'], 10, labels=False) == 0]
    w1 = g['T'] / g['ps']
    w0 = (1 - g['T']) / (1 - g['ps'])
    ipw = (w1 * g['Y']).sum() / w1.sum() - (w0 * g['Y']).sum() / w0.sum()
    return g['p'].mean(), ipw, g['c'].mean()

for name, a in [('train', (X_train, T_train, Y_train, cate_train)),
                ('test ', (X_test,  T_test,  Y_test,  cate_test))]:
    print('%s 第1十分位: 予測 %8.1f / 実測リフト(IPW) %8.1f / 真のCATE %7.1f'
          % (name, *first_decile(*a)))
train 第1十分位: 予測  -1207.9 / 実測リフト(IPW)  -1641.8 / 真のCATE   401.2
test  第1十分位: 予測  -1001.9 / 実測リフト(IPW)    111.0 / 真のCATE   298.9
train 側では、予測(−1,208円)と実測リフト(−1,642円)がきれいに一致し、検証工程を通過してしまいます。しかし真の値は +401円のプラスで、モデルの主張は完全に間違っています。一方 test 側の実測リフト(+111円)は、真値(+299円)と符号が一致しており、「この層はマイナスではない」という正しい判断ができます。
過学習用の設定は、木の本数を既定の100から1000に、葉の数(num_leaves)を既定の31から255に増やし、葉に必要な最小サンプル数(min_child_samples)を既定の20から2に減らしたものです。どれも「学習データに細かく合わせる」方向に振っています。
記事本文の設定(max_depth=3 の浅い木)であれば差はもっと穏やかです。3手法について、train と test でCATEのRMSEを比べてみます。
# train 側の予測CATE(test 側の s_cate / t_cate / x_cate と同じ手順)
XT1 = X_train.copy(); XT1['T'] = 1
XT0 = X_train.copy(); XT0['T'] = 0
train_pred = {'S-Learner': s_model.predict(XT1) - s_model.predict(XT0),
              'T-Learner': m1.predict(X_train) - m0.predict(X_train),
              'X-Learner': x_learner.effect(X_train.values)}
test_pred = {'S-Learner': s_cate, 'T-Learner': t_cate, 'X-Learner': x_cate}

for name in train_pred:
    print('%-10s train RMSE %6.1f / test RMSE %6.1f'
          % (name, np.sqrt(((train_pred[name] - cate_train.values) ** 2).mean()),
             np.sqrt(((test_pred[name] - cate_test.values) ** 2).mean())))
S-Learner  train RMSE  384.4 / test RMSE  436.5
T-Learner  train RMSE  672.8 / test RMSE  717.8
X-Learner  train RMSE  361.6 / test RMSE  393.7
差は30〜50程度に収まっています(train の方が常に小さいのは、学習に使ったデータだからです)。ただし、これは正則化が効いているから小さいだけです。そして実務では真のCATEが見えないため、「今どちらの状態なのか」を確認する術がありません。だからこそ、最初から test で測る必要があります。
なお、train/test分割はあくまで精度を測るための計測器であって、予測してよい範囲の制限ではありません。検証を通過してモデルを採用した後は、学習に使った顧客も含めて全員にスコアを付けて構いませんし、本番投入時に全データで再学習するのが一般的です。
例外は傾向スコアモデル ps_model で、これだけは全データで学習しています。目的変数が treatment であり、売上 sales を一切使わないため、結果側の情報が漏れないからです。
Upliftカーブと AUUC
十分位の図を「累積」で描き直したものが Upliftカーブ です。「予測CATEの高い順に上位 人へ配ったとき、売上が累計いくら増えるか」を の関数としてプロットします。
よく似たものに Qiniカーブ がありますが、両者は同じものではありません。Qiniカーブは上位 人の中で「施策群の結果の合計」から「対照群の結果の合計を施策群の人数に合わせて拡大したもの」を引く指標で、施策群の人数ぶんの増分を数えます。本記事のUpliftカーブは、上位 人の平均効果に を掛けて、 人全員に配ったときの増分を数えています。観察データなので、平均効果は単純な差ではなくIPWで推定しています。Qiniカーブを含む評価指標の違いは、アップリフトモデルの評価と方策価値の記事で扱っています。
def uplift_curve(score, d, n_points=120):
    """予測スコアの高い順に並べ、上位k人のIPW推定ATE × k を返す"""
    d = d.iloc[np.argsort(-score)].reset_index(drop=True)
    ks = np.unique(np.linspace(100, len(d), n_points).astype(int))
    gains = []
    for k in ks:
        g = d.iloc[:k]
        w1 = g['T'] / g['ps']
        w0 = (1 - g['T']) / (1 - g['ps'])
        ate_k = (w1 * g['Y']).sum() / w1.sum() - (w0 * g['Y']).sum() / w0.sum()
        gains.append(ate_k * k)
    return ks, np.array(gains)

fig, ax = plt.subplots(figsize=(8.5, 5))
for name, p, c in [('X-Learner', x_cate, '#DD8452'),
                   ('S-Learner', s_cate, '#4C72B0'),
                   ('T-Learner', t_cate, '#55A868')]:
    ks, g = uplift_curve(p, test)
    ax.plot(ks, g / 10000, label=name, lw=2, color=c)

# 理想(真のCATE順)とランダム(無作為配布)の基準線
ks, g = uplift_curve(test['true_cate'].values, test)
ax.plot(ks, g / 10000, label='理想(真のCATE順)', lw=1.6, color='black', ls=':')

w1 = test['T'] / test['ps']; w0 = (1 - test['T']) / (1 - test['ps'])
ate_all = (w1 * test['Y']).sum() / w1.sum() - (w0 * test['Y']).sum() / w0.sum()
ax.plot([0, len(test)], [0, ate_all * len(test) / 10000], 'r--', lw=1.5,
        label='ランダム(無作為に配布)')

ax.set_xlabel('配布人数(予測CATEの高い順)')
ax.set_ylabel('累積の売上増加額(万円)')
ax.set_title('Upliftカーブ:上位何人に配ると、どれだけ売上が増えるか')
ax.legend(fontsize=9); ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()

# AUUC(ランダム線との間の面積)
# ※ np.trapezoid は NumPy 2.0 以降の関数名です。1.x では np.trapz を使ってください
print("IPWで推定したtest全体のATE: %.1f" % ate_all)
print("\n(ランダム線との面積 = AUUC)")
for name, p in [('S-Learner', s_cate), ('T-Learner', t_cate),
                ('X-Learner', x_cate), ('理想', test['true_cate'].values)]:
    ks, g = uplift_curve(p, test)
    print('%-10s %.1f(百万円×人)' % (name, np.trapezoid(g - ate_all * ks, ks) / 1e6))
- 横軸の刻み: n_points=120 点で曲線を描きます。1,500人を120点で刻むと約12人おきになり、曲線の形を見るには十分な細かさです。開始を100人にしているのは、上位数十人だけでは対照群がほとんど含まれず、IPWの推定が定まらないためです。
- 縦軸の意味: 上位 人の平均効果に を掛けた「累積の売上増加額」です。全員に配る()と、どの手法も同じ点に収束します。順序の良し悪しは、そこに至るまでの膨らみ方に表れます。
- 2本の基準線: 赤い破線は「無作為に配った場合」で、これが最低ライン。黒い点線は「真のCATE順に配った場合」で、これが到達可能な上限です。モデルの良し悪しは、この2本の間のどこに位置するかで判断します。
- AUUC: 自分の曲線とランダム線の間の面積を AUUC(Area Under the Uplift Curve) と呼び、モデル比較の単一指標として使われます。
実行結果
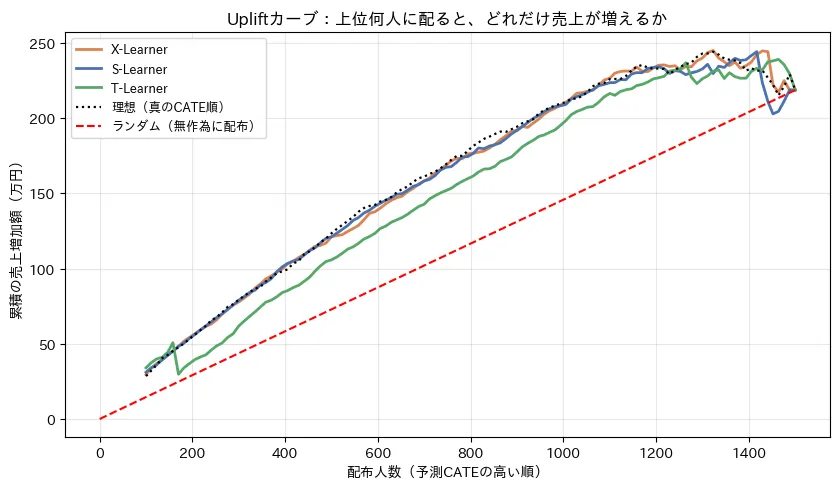
IPWで推定したtest全体のATE: 1458.1

(ランダム線との面積 = AUUC)
S-Learner  647.2(百万円×人)
T-Learner  501.0(百万円×人)
X-Learner  661.4(百万円×人)
理想       674.8(百万円×人)
X-Learner と S-Learner はほぼ黒い点線(理想)に重なっており、達成可能な上限の 96〜98% に到達しています。T-Learner は明確に下を通っており、散布図で見た精度の差がそのまま現れています。
さらに重要なのが曲線の形です。どの曲線も1,320〜1,470人あたりで頂点を迎え、その後は下向きに転じています。これは「効果がマイナスの人にまで配り続けると、増やした売上を自分で削り始める」ことを意味します。全員配布が最適ではないことが、この図1枚で示されています。
施策判断に落とす:誰にクーポンを配るか
最後に、推定したCATEをビジネスの意思決定に変換します。判断基準は極めてシンプルで、推定したCATEがクーポン1枚あたりのコスト を上回る人にだけ配る、というルールになります。
クーポンの原価を 1,500円 として(データ生成で決めた平均効果と同じ値にし、全員に配ると損益がほぼゼロになる状況を作っています)、配布戦略ごとの純利益を比較します。
cost = 1500
tc = test['true_cate'].values  # ※答え合わせ用。実務では推定値で評価する

for name, p in [('S-Learner', s_cate), ('T-Learner', t_cate), ('X-Learner', x_cate)]:
    sel = p > cost
    print('%-10s 配布 %4d人 (%.1f%%)  純利益 %10s 円'
          % (name, sel.sum(), sel.mean() * 100, format(int((tc[sel] - cost).sum()), ',')))

print('%-10s 配布 %4d人 (100.0%%)  純利益 %10s 円'
      % ('全員配布', len(tc), format(int((tc - cost).sum()), ',')))

b = tc - cost
print('%-10s 配布 %4d人 (%.1f%%)  純利益 %10s 円'
      % ('理論最大', (b > 0).sum(), (b > 0).mean() * 100, format(int(b[b > 0].sum()), ',')))
実行結果
S-Learner  配布  916人 (61.1%)  純利益    573,277 円
T-Learner  配布  869人 (57.9%)  純利益    499,228 円
X-Learner  配布  895人 (59.7%)  純利益    569,278 円
全員配布       配布 1500人 (100.0%)  純利益     14,461 円
理論最大       配布  902人 (60.1%)  純利益    587,457 円
全員に配った場合の純利益は 14,461円、つまりほぼ赤字ギリギリのトントンです。ATEが 1,526円 でコストが 1,500円 なのですから、平均だけ見れば当然の結果です。
ところが、X-Learnerの予測に基づいて上位59.7%(895人)に絞ると、純利益は 569,278円 まで跳ね上がります。約39倍です。しかもこれは、理論上の最大値 587,457円 の 97% に相当します。
配布人数と純利益の関係を曲線で見てみましょう。
fig, ax = plt.subplots(figsize=(8.5, 4.6))
order = np.argsort(-x_cate)
profit = np.cumsum(tc[order] - cost)
k_star = int((x_cate > cost).sum())

ax.plot(np.arange(1, len(tc) + 1), profit / 10000, lw=2.2, color='#DD8452',
        label='X-Learnerの予測順に配布')
ax.axvline(k_star, color='#4C72B0', ls='--', lw=1.5,
           label='予測CATE > %d円 の境界(%d人)' % (cost, k_star))
ax.axhline(0, color='black', lw=1)
ax.set_xlabel('配布人数(予測CATEの高い順)')
ax.set_ylabel('純利益(万円)')
ax.set_title('クーポン原価を%d円としたときの純利益カーブ' % cost)
ax.legend(loc='lower left', fontsize=9); ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
実行結果
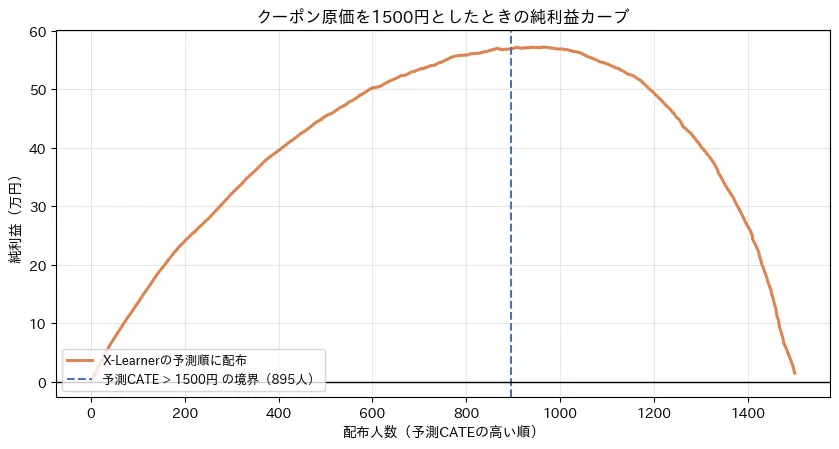
きれいな山型の曲線が現れます。左端から配布人数を増やしていくと利益は伸び続けますが、965人で頂点に達し、そこからは配れば配るほど利益が減っていきます。そして青い破線(予測CATE > コスト の境界、約895人)が、ほぼ山の頂点に一致しています。「CATEがコストを上回る人にだけ配る」という単純なルールが、実際に最適解を言い当てているわけです。
上のコードでは答え合わせのために true_cate を使って純利益を計算しましたが、実データではこれができません。代わりに、前節のUpliftカーブを使います。
Upliftカーブの縦軸は「上位 人に配ったときの累積売上増加額」なので、そこから を引けば、そのまま推定された純利益カーブになります。これは観測データだけで描けるため、実務ではこちらで最適な配布人数を決定します。
さらに厳密を期すなら、配布ルールを決めた後で小規模なRCTを実施し、「モデルが選んだ層」と「無作為に選んだ層」で実際に効果を比較するのが最も確実な検証になります。
メタラーナーのメリットとデメリット
メリット
-
既存の機械学習資産をそのまま使える
LightGBM、Random Forest、ニューラルネットなど、使い慣れたアルゴリズムをベースモデルとして流用できます。新しい理論を一から実装する必要がありません。 -
意思決定に直結する
ATEが「施策をやるかやらないか」の判断材料であるのに対し、CATEは「誰にやるか」という予算配分の判断に直接使えます。上で見たように、平均効果がトントンの施策でも、対象を絞れば大きな利益を生めます。 -
平均値の裏側を説明できる
「なぜATEとATTがずれているのか」「どの層が全体の平均を押し下げているのか」を、データに基づいて説明できるようになります。
デメリット
-
CATEの推定はATEの推定よりはるかに難しい
ATEは1つの数値を当てるだけですが、CATEは関数全体を当てる問題です。しかも今回のデータでは、CATEの標準偏差が約 1,018円 に対してノイズの標準偏差が 1,000円 と、信号とノイズが同程度です。ATEの推定に十分だったサンプルサイズが、CATEには全然足りないというのはよくあることです。 -
精度の検証が難しい
真のCATEが観測できないため、通常の機械学習のように「テストデータでのRMSE」を直接測れません。十分位リフトやUpliftカーブといった間接的な指標に頼る必要があります。 -
共通サポートの外では推定できない
傾向スコアが 0 や 1 に近い領域については、どんなに高性能なアルゴリズムを使っても答えは出ません。これはデータの問題であり、手法の問題ではありません。 -
未観測の交絡因子には無力
PSMやIPTWと同様、観測できていない交絡因子は調整できません。しかもCATEの場合、それがセグメントごとに異なる形で効いてくるため、影響がより読みにくくなります。
発展的な手法
本記事で扱った3つ以外にも、CATE推定の手法は活発に研究されています。
-
DR-Learner(Doubly Robust Learner)
結果モデルと傾向スコアモデルのどちらか一方が正しければ一致推定が得られる「二重頑健性」を持つ手法です。観察データでの標準的な選択肢の1つです。 -
R-Learner(Nie & Wager, 2021)
結果と処置の両方から「予測可能な部分」を除いた残差同士の関係としてCATEを定式化する手法です。ノイズの大きいデータで安定しやすいとされます。 -
Causal Forest(Wager & Athey, 2018)
ランダムフォレストを因果効果の推定用に改造した手法で、CATEの信頼区間を構成できる点が実務上の大きな利点です。メタラーナー自体は点推定の枠組みであり、区間推定にはブートストラップなどの計算コストの高い工夫が別途必要になりますが、Causal Forestは理論的裏付けのある信頼区間を直接算出できます。 -
Double Machine Learning(DML)(Chernozhukov et al., 2018)
クロスフィッティング(データを分割し、モデル学習と効果推定を別々のデータで行う)によって、機械学習モデルの過学習に由来するバイアスを取り除く枠組みです。
なお、メタラーナーの原論文は Künzel et al. (2019) であり、X-Learnerの設計思想や、群のサイズが偏っている場合の優位性はここで詳しく論じられています。
実装面では、以下の2つのライブラリを押さえておけば十分です。
- EconML(Microsoft): メタラーナー、DML、DR-Learner、Causal Forest を網羅。信頼区間の算出にも対応しています。
- CausalML(Uber): アップリフトモデリングに特化。Upliftカーブや AUUC の評価関数(
plot_gain、auuc_score)が標準で用意されており、本記事で手作りした評価指標をそのまま利用できます。
まとめ
本記事では、「施策全体の効果」ではなく「誰にどれだけ効いたか」を推定する手法として、メタラーナーを解説しました。
-
平均値には幅がある: 今回のデータでは、ATE は +1,526円 でしたが、その内訳は −5,353円 から +3,300円 まで大きく散らばっており、8.1% の顧客では効果がマイナスでした。ATEだけを見て全員に配る判断は、この構造を見落とします。
-
S / T / X に絶対的な優劣はない: 今回は S-Learner(RMSE 437)と X-Learner(RMSE 394)が優秀で、T-Learner(RMSE 718)が劣りました。一方、ベースモデルを線形回帰に変えると S-Learner の予測CATEは全員同じ値に潰れ、T-Learner が圧勝します。手法とベースモデルはセットで選び、必ず比較する必要があります。
-
X-Learnerの中身はブラックボックスではない: 30行ほどのスクラッチ実装が、EconMLの出力と浮動小数点誤差の範囲で一致しました。第二段階で「目的変数を売上から擬似効果へ作り替える」ことと、最終段階で「データが厚い側のモデルを傾向スコアで重く見る」ことの2点さえ押さえれば、挙動を説明できます。なお最終段階の傾向スコアは割り算の分母ではなく 0〜1 の重みなので、IPTWのように重みが発散することはありません。
-
検証工程を省略しない: 真のCATEは観測できないため、十分位ごとの実測リフトと Upliftカーブ で「並べ替えが機能しているか」を確認します。PSMにおけるSMDによるバランス確認と同じ位置づけの、報告前に必須の工程です。Qini曲線や方策価値を使った評価は、アップリフトモデルの評価と方策価値の記事で詳しく扱っています。
-
観察データでは検証にも因果推論が要る: 今回、第1十分位の効果を単純な群間差で測ると +468円(プラス)でしたが、IPW調整後は −316円(マイナス)と符号が逆転しました。真の値は −664円 です。検証方法を間違えると、モデルが正しくても結論を誤ります。
-
共通サポートの外は推定不能: 真のCATEが −1,000円を下回る124人のうち、対照群はわずか3人でした。この領域では全手法が予測を外しています。これは正値性の仮定が破れている領域であり、アルゴリズムの改善では解決しません。
-
意思決定に落として初めて価値が出る: クーポン原価を 1,500円 としたとき、全員配布の純利益は 14,461円 でしたが、予測CATEがコストを上回る 895人(59.7%)に絞ると 569,278円(理論最大の 97%)まで改善しました。
次回以降の施策検証では、「全体として効果があったか」だけでなく、「その平均の内訳はどうなっているか」を確認する視点を取り入れてみてください。多くの場合、平均値の裏側にこそ、改善の余地が残されています。
参考文献
- S. R. Künzel, J. S. Sekhon, P. J. Bickel, B. Yu (2019). Metalearners for estimating heterogeneous treatment effects using machine learning. Proceedings of the National Academy of Sciences, 116(10), 4156–4165.
- X. Nie, S. Wager (2021). Quasi-oracle estimation of heterogeneous treatment effects. Biometrika, 108(2), 299–319.
- S. Wager, S. Athey (2018). Estimation and Inference of Heterogeneous Treatment Effects using Random Forests. Journal of the American Statistical Association, 113(523), 1228–1242.
- V. Chernozhukov et al. (2018). Double/debiased machine learning for treatment and structural parameters. The Econometrics Journal, 21(1), C1–C68.
- Microsoft Research. EconML: A Python Package for ML-Based Heterogeneous Treatment Effects Estimation. GitHub.
- Uber. CausalML. 公式ドキュメント.
本記事の文章・構成の一部に生成AIを使用しています。