混合モデルとは?
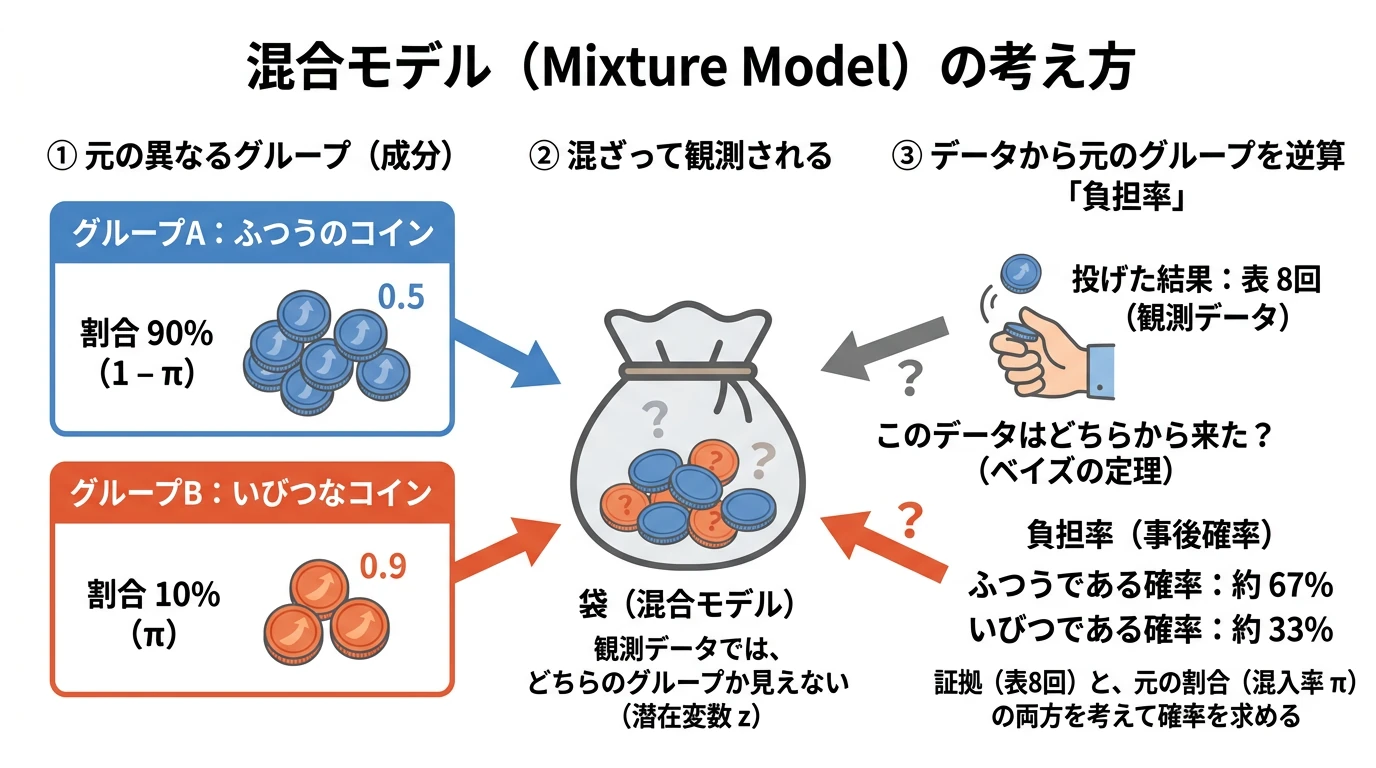 (画像は、Geminiで作成)
「複数のグループが混ざったデータ」を混合モデルとして表し、ベイズの定理を使って「このデータは、どのグループから来た確率が高いか」を計算できるようになること。
本記事のコードは、Python 3.13、NumPy 2.5.3、SciPy 1.18.1、matplotlib 3.11.2、scikit-learn 1.9.1 で動作を確認しました。どのコードも CPU で数秒で終わり、乱数のシードを固定しているので、同じ環境では同じ結果になります。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
混合モデルが必要になる問題
試験の解答データの中から、事前に解答を入手してほぼ満点を取った 不正受験者 を見つけたい、という問題を考えます。手元にあるのは全員の解答だけで、誰が不正受験者かは分かりません。データは「ふつうの受験者」と「不正受験者」という、性質の違う2つのグループが混ざったものですが、どの解答がどちらのグループのものかという印は付いていません。
この問題で知りたいのは、「この受験者が不正受験者である 確率 はいくつか」です。1人の解答を見て、「ふつうの受験者だとしたら、この解答はどのくらい起こりやすいか」と「不正受験者だとしたら、どのくらい起こりやすいか」を比べることはできます(この2つの起こりやすさの比を 尤度比 と呼びます。作り方は尤度比スコアの記事で詳しく扱いましたが、本記事を読むのに必要なことは、この後のコインの例で説明します)。しかし、尤度比だけでは確率は出せません。もう1つ、不正受験者が、そもそもどのくらいの割合で混ざっているか が必要だからです。
身近な例で考えてみましょう。ある病気の検査で「陽性」と出たとします。検査の精度がそれなりに高くても、その病気が1万人に1人しかかからない珍しいものなら、陽性と出た人の大半は実は病気ではない、ということが起こります。もともとの割合が小さいと、少しくらいの証拠では「やはり珍しいほうだ」とは言い切れないのです。
そこで、「どのグループが、どのくらいの割合で混ざっているか」と「それぞれのグループでは、データがどう生まれるか」をまとめて、データ全体を1つの確率モデルで表します。これが 混合モデル(mixture model) です。混合モデルがあると、次のような問題を扱えます。
- 1件ずつ、どのグループから来たかの確率を計算する: 印のないデータの1件ずつについて、各グループから来た確率(負担率)を計算します。本記事の中心です。
- 珍しいグループの割合を考えに入れて判定する: 不正受験者や病気のように珍しいグループを探すとき、割合を考えに入れて、見逃しと誤検知の釣り合いを決めます。
- 似たデータをまとまりに分ける: 連続の値に正規分布の成分を使うと、データをまとまりに分けるガウス混合(ソフトクラスタリング)になります。
2種類のコインが入った袋
試験のデータの前に、コインの例で考えます。袋の中に、次の100枚のコインが入っています。
- ふつうのコイン: 90枚。表の確率は
- いびつなコイン: 10枚。表の確率は
見た目では区別できません。袋から1枚を取り出して10回投げたところ、表が8回出ました。このコインが いびつなコインである確率 はいくつでしょうか。
この数字は、「尤度比ではいびつなコインのほうがもっともらしいのに、割合まで考えると逆の結論になる」例になるように選んでいます。いびつなコインを10枚に1枚と少なくし、表の回数を、いびつなコインでよく出る9〜10回ではなく、どちらのコインでも出うる8回にしています。
尤度比だけで考えると
それぞれのコインだとしたときの尤度は、二項分布の確率で計算できます。
尤度比は です。「表8回」という結果は、いびつなコインのほうが4.4倍起こりやすいので、尤度比だけで判断すれば「いびつなコインだ」となります。
割合まで考えると
ここで、袋の中のいびつなコインは10枚に1枚しかないことを思い出してください。取り出す前の時点では、いびつなコインである確率は しかありません。
この「データを見る前の確率」を 事前確率、データを見たあとの確率を 事後確率 と呼びます。事後確率は、ベイズの定理 で計算できます。
分母の は、「ふつうのコインを取り出して表が8回出る」場合と「いびつなコインを取り出して表が8回出る」場合の確率の合計です。
したがって、事後確率は次のようになります。
尤度比は4.4倍もあったのに、いびつなコインである確率は約33%にとどまりました。表8回という証拠は、「もともと10枚に1枚しかない」という不利な事前確率をひっくり返すほど強くはないのです。
いびつでなければふつうのコインなので、ふつうのコインである確率は、同じ分母でふつうのコインの分を割ったもので、残りの約67%です。
尤度比ではいびつなコインのほうが4.4倍もっともらしかったのに、割合まで考えると、ふつうのコインである確率のほうが約2倍高くなりました。
import numpy as np
from scipy.stats import binom

# 1. 袋の中身:ふつうのコイン90枚(表の確率0.5)、いびつなコイン10枚(表の確率0.9)
pi = 10 / 100          # いびつなコインの割合(混入率)
p_normal, p_biased = 0.5, 0.9

# 2. 1枚取り出して10回投げたら、表が8回出た
n, k = 10, 8

# 3. それぞれのコインだとしたときの尤度
L_normal = binom.pmf(k, n, p_normal)
L_biased = binom.pmf(k, n, p_biased)
print(f"尤度   ふつう: {L_normal:.4f}   いびつ: {L_biased:.4f}   尤度比: {L_biased / L_normal:.2f}")

# 4. 事前確率 × 尤度
joint_normal = (1 - pi) * L_normal
joint_biased = pi * L_biased
print(f"事前確率×尤度   ふつう: {joint_normal:.4f}   いびつ: {joint_biased:.4f}")

# 5. 正規化して事後確率にする(ベイズの定理)
gamma = joint_biased / (joint_normal + joint_biased)
print(f"いびつなコインである確率(事後確率): {gamma:.3f}")
上の手計算を、そのままコードにしています。
- 混入率 pi: いびつなコインの割合()です。取り出す前の、いびつなコインである事前確率でもあります。
- 尤度 binom.pmf(k, n, p): 表の確率が p のコインを n 回投げて、表がちょうど k 回出る確率(二項分布の確率)です。組み合わせの数 も含まれていますが、2つのコインで共通なので、事後確率の計算では分子と分母で打ち消し合います。
- 事前確率 × 尤度 joint_normal、joint_biased: 「そのコインを取り出し、かつ表が8回出る」確率です。
- 事後確率 gamma: いびつなコインの分を、2つの合計で割っています。ベイズの定理の分母は、この2つの合計そのものです。
- SciPy を使う理由: 二項分布の確率は式どおりに書くこともできますが、binom.pmf を使うと、後で表の回数 0〜10 をまとめて渡して、11通りの確率を一度に計算できます。
実行結果
尤度   ふつう: 0.0439   いびつ: 0.1937   尤度比: 4.41
事前確率×尤度   ふつう: 0.0396   いびつ: 0.0194
いびつなコインである確率(事後確率): 0.329
手計算と同じ結果になりました。
計算の流れを表にまとめると、次のようになります。
(図は、diagram-designで作成)
混合モデル:データが生まれる2段階の物語
このコインの袋の例を、データがどのように生まれるかという「物語」として整理してみます。
- グループを選ぶ: 確率 でいびつなコイン、確率 でふつうのコインを取り出す
- データを生む: 選んだコインを10回投げて、表の回数を記録する
ここで大事なのは、記録されるのは表の回数だけ で、どちらのコインを取り出したかは記録されない(観測できない)ことです。このように、データの生成に関わっているのに観測されない変数を 潜在変数(隠れ変数) と呼びます。ここでは、コインの種類を (いびつなら 、ふつうなら )で表します。
(図は、diagram-designで作成)
左から右へ進むのが、データが生まれる向きです。後で計算する 負担率 は、その逆向き、つまり「表8回」という見えている結果から、見えない がどちらだったかを推し量る計算です。
この物語から、表の回数 が観測される確率は、2つのグループの確率を混入率で重み付けして足したものになります。
これが 混合モデル です。2つの正規分布を混ぜたモデルでカニの計測データを説明した Pearson(1894)の研究が、最初期の例として知られています。「2つの分布を、割合 と で混ぜた分布」という意味で、それぞれの分布を混合モデルの 成分(component)、 を 混合比率(混入率) と呼びます。
実際に、この物語どおりにデータを生成して、混合モデルの式と比べてみましょう。
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 混合モデルからデータを生成する:まずコインの種類を選び、次に10回投げる
rng = np.random.default_rng(0)
n_coins = 2000
z = rng.binomial(1, pi, size=n_coins)                  # 1 = いびつなコイン(隠れた変数)
p_coin = np.where(z == 1, p_biased, p_normal)
heads = rng.binomial(n, p_coin)                         # 観測できるのは表の回数だけ

# 2. 混合モデルの確率:P(k) = (1 - π) P_ふつう(k) + π P_いびつ(k)
ks = np.arange(n + 1)
mix_pmf = (1 - pi) * binom.pmf(ks, n, p_normal) + pi * binom.pmf(ks, n, p_biased)

plt.figure(figsize=(9, 4.5))
plt.hist(heads, bins=np.arange(-0.5, n + 1.5), density=True, color='lightgray',
         edgecolor='gray', label='シミュレーション(2000枚)')
plt.plot(ks, (1 - pi) * binom.pmf(ks, n, p_normal), 'o--', color='steelblue', label='(1-π) × ふつうのコイン')
plt.plot(ks, pi * binom.pmf(ks, n, p_biased), 'o--', color='red', label='π × いびつなコイン')
plt.plot(ks, mix_pmf, 'k-', linewidth=2, label='混合モデル(2つの和)')
plt.xlabel('10回中の表の回数')
plt.ylabel('確率')
plt.title('2種類のコインが混ざった袋から取り出したときの、表の回数の分布')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
2段階の物語に沿って2000枚分のデータを生成し、その分布を混合モデルの式と重ねています。
- 潜在変数 z: rng.binomial(1, pi, size=n_coins) で、確率 で1(いびつなコイン)になる値を2000個作っています。物語の1段階目です。2000枚にしているのは、混入率が0.1でもいびつなコインが約200枚入り、表9〜10回の小さな山がヒストグラムで見えるようにするためです。
- 表の回数 heads: np.where でコインごとの表の確率を決め、rng.binomial(n, p_coin) で10回投げたときの表の回数を作っています。物語の2段階目です。現実のデータ分析で手に入るのは、この heads だけです。
- 混合モデルの確率 mix_pmf: 表の回数 0〜10 のそれぞれについて、2つの成分の確率を と で重み付けして足しています。
- 可視化: シミュレーションのヒストグラム(density=True で確率に揃えています)に、2つの成分(破線)と、その和である混合モデル(黒の実線)を重ねています。
実行結果
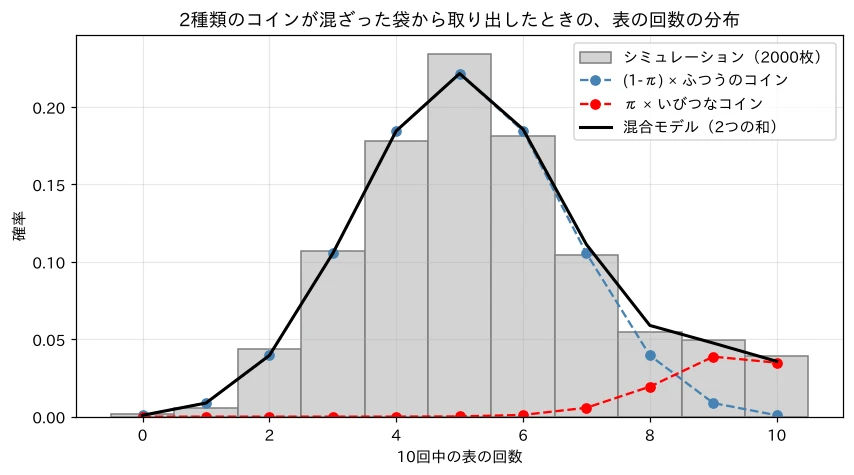
青の破線(ふつうのコイン)は表5回を中心とした山、赤の破線(いびつなコイン)は表9〜10回のあたりの小さな山です。その和である黒の線は、シミュレーションのヒストグラムとよく一致しています。表8回のところでは、青の高さ(0.0396)が赤(0.0194)の約2倍あり、どちらのコインからも生まれうることが分かります。表8回の確率のうち、いびつなコインの分は約3分の1()にすぎません。これが、事後確率が約33%にとどまった理由です。
負担率:どちらのグループから来たか
混合モデルでは、観測した がいびつなコイン(異常のグループ)から来た事後確率を、次のように書けます。
分母は混合モデルの確率 そのもので、分子はそのうち「いびつなコインの成分」が占める部分です。「観測された という結果を、どちらの成分がどれだけ受け持っているか」という意味で、この を 負担率(responsibility) と呼びます(Bishop の教科書『Pattern Recognition and Machine Learning』での呼び方です)。
負担率と対数尤度比の関係
負担率は、対数尤度比ととても簡単な関係で結ばれています。 と の比(オッズ)を取ると、分母が打ち消し合います。
両辺の対数を取ると、掛け算が足し算になります。
つまり、事後の対数オッズ = 事前の対数オッズ + 対数尤度比 です。対数オッズを確率に戻すにはシグモイド関数 を使うので、負担率は次のように計算できます。
コインの例で確かめてみましょう。対数尤度比は 、事前の対数オッズは なので、事後の対数オッズは です。 となり、さきほどの結果と一致します。
(図は、diagram-designで作成)
数直線で見ると、事前の対数オッズが「出発点」、対数尤度比が「証拠の分だけ進む距離」です。 では出発点が と左にあるので、 進んでも、確率0.5に当たる0には届きません。
この関係から、尤度比だけで判断する「対数尤度比が0より大きければ異常」という判定は、(正常と異常が半々)を暗黙のうちに仮定した判定 だったことが分かります。 のときだけ、事前の対数オッズが になるからです。
from scipy.special import expit

# 1. 表の回数ごとに、いびつなコインである事後確率を計算する
def posterior_biased(k, n, p_normal, p_biased, pi):
    llr = np.log(binom.pmf(k, n, p_biased)) - np.log(binom.pmf(k, n, p_normal))  # 対数尤度比
    prior_log_odds = np.log(pi / (1 - pi))                                       # 事前の対数オッズ
    return expit(llr + prior_log_odds)                                           # 事後確率

print("表の回数  対数尤度比   π=0.5   π=0.1   π=0.01")
for k_ in range(5, 11):
    llr = np.log(binom.pmf(k_, n, p_biased) / binom.pmf(k_, n, p_normal))
    print(f"   {k_:2d}       {llr:+6.2f}    " + "  ".join(f"{posterior_biased(k_, n, p_normal, p_biased, p_):.3f}" for p_ in [0.5, 0.1, 0.01]))

# 2. 可視化
plt.figure(figsize=(8, 4.5))
for p_, color in [(0.5, 'gray'), (0.1, 'red'), (0.01, 'purple')]:
    plt.plot(ks, posterior_biased(ks, n, p_normal, p_biased, p_), 'o-', color=color, label=f'π = {p_}')
plt.axhline(0.5, color='black', linestyle=':', linewidth=1)
plt.xlabel('10回中の表の回数')
plt.ylabel('いびつなコインである確率')
plt.title('混入率 π によって、同じ観測でも事後確率が変わる')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
表の回数と混入率 を変えながら、「事後の対数オッズ = 事前の対数オッズ + 対数尤度比」の式で負担率を計算しています。
- posterior_biased: 対数尤度比 llr に事前の対数オッズ prior_log_odds を足し、シグモイド関数 expit で確率に戻しています。上の最後の式をそのままコードにしたものです。投げる回数 n、2つのコインの表の確率 p_normal・p_biased、混入率 pi をすべて引数で受け取るので、別のコインや回数にも、関数をそのまま使えます。k には1つの値(8)も、配列(0〜10の ks)も渡せます。
- 表: 表の回数5〜10回について、対数尤度比と、3通りの での負担率を並べています。 は、半々(0.5)、この袋の実際の割合(0.1)、それより1桁少ない場合(0.01)の3つにして、割合が1桁変わると結論がどれだけ変わるかを見ます。表の回数が4回以下では、どの でも負担率がほぼ0なので省いています。
- 可視化: 横軸を表の回数、縦軸を負担率として、 ごとに線を描いています。点線は確率0.5の位置です。
実行結果
表の回数  対数尤度比   π=0.5   π=0.1   π=0.01
    5        -5.11    0.006  0.001  0.000
    6        -2.91    0.052  0.006  0.001
    7        -0.71    0.329  0.052  0.005
    8        +1.48    0.815  0.329  0.043
    9        +3.68    0.975  0.815  0.286
   10        +5.88    0.997  0.975  0.783
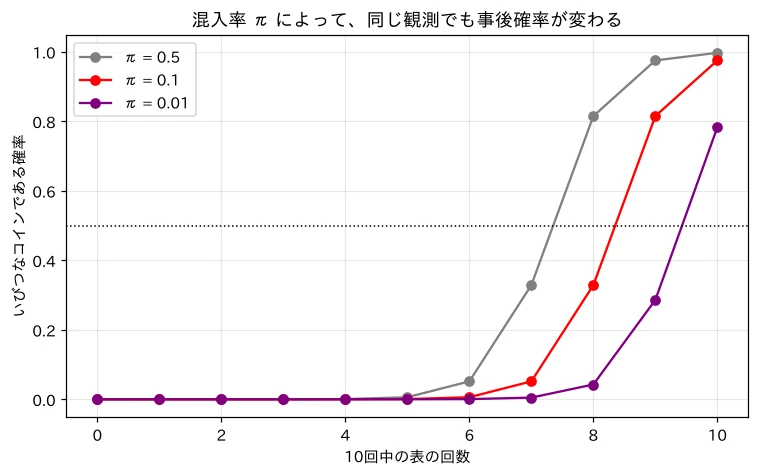
同じ「表8回」でも、混入率によって負担率は大きく変わります。
- (半々): 81.5%。対数尤度比だけで判断したのと同じ結論になります。
- (10枚に1枚): 32.9%。さきほど計算した値です。
- (100枚に1枚): わずか4.3%。表が10回すべて出ても78.3%にとどまり、確実とまでは言えません。
なお、表の回数が1回増えるごとに、対数尤度比はちょうど ずつ増えています。対数尤度比はコインの表の確率だけで決まり、 を含まないので、この増え方は がいくつでも同じです。 が変えるのは、事前の対数オッズ という出発点だけです。
ここで、 の出発点 の大きさも、ちょうど です。いびつなコインの割合()と、いびつなコインの表の確率()が、どちらも と の組み合わせになっているので、2つの値がそろいました。そのため、 の出発点は、(出発点0)より、ちょうど表1回分だけ左にあります。「 で表8回」と「 で表7回」の負担率が、どちらも0.329で一致するのはこのためです。珍しいグループだと認めてもらうには、表がもう1回分多く出る必要がある、というわけです。
試験データに混合モデルを当てはめる
コインの袋を、試験の解答データに置き換えます。
| コインの袋 | 試験の解答データ | |
|---|---|---|
| 1つのデータ | 1枚のコインの10回分の結果 | 1人の受験者の100問分の正誤 |
| ふつうの成分 | 表の確率0.5のコイン | ふつうの受験者(問題の難しさと実力に応じて正解する) |
| 異常の成分 | 表の確率0.9のコイン | 解答を事前に入手した不正受験者(ほぼ全問正解) |
| 混入率 | いびつなコインの割合 | 不正受験者の割合 |
| 負担率 | いびつなコインである確率 | 不正受験者である確率 |
ふつうの受験者と不正受験者の成分は、尤度比スコアの記事で作ったものをそのまま使います。ふつうの受験者の成分には、受験者ごとの実力の差を事前分布で周辺化したモデルを使います。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy.special import expit, logit, logsumexp

T = 100  # 問題数

# 1. 試験のダミーデータ(尤度比スコアの記事と同じ設定)
rng = np.random.default_rng(0)
base_rate = np.sort(rng.uniform(0.03, 0.9, T))[::-1]   # 後ろの問題ほど難しい
n_honest, n_cheat = 3000, 60
a = logit(base_rate) - 0.3
b = rng.normal(0, 1.0, n_honest)
b[:30] += 2.5                                           # 先頭30人は成績優秀者(不正をせず95点前後を取る)
X_honest = rng.binomial(1, expit(a[None, :] + b[:, None]))
X_cheat = rng.binomial(1, 0.99, size=(n_cheat, T))
X = np.vstack([X_honest, X_cheat]).astype(float)
y = np.r_[np.zeros(n_honest), np.ones(n_cheat)]   # 正解ラベル(評価にだけ使う)
r = X.mean(axis=0)                                 # 各問題の正答率

# 2. 対数尤度比スコア(実力の差を周辺化した正常モデル vs ほぼ全問正解の異常モデル)
def llr_score(X, r, eps=0.01, tau=1.0):
    a_hat = logit(np.clip(r, 1e-3, 1 - 1e-3))
    b_grid = np.linspace(-6, 6, 61)
    log_w = -0.5 * (b_grid / tau) ** 2
    log_w -= logsumexp(log_w)
    Q = np.clip(expit(a_hat[:, None] + b_grid[None, :]), 1e-12, 1 - 1e-12)
    G = X @ np.log(Q) + (1 - X) @ np.log(1 - Q)
    loglik_normal = logsumexp(G + log_w[None, :], axis=1)
    n_correct = X.sum(1)
    loglik_anom = n_correct * np.log(1 - eps) + (X.shape[1] - n_correct) * np.log(eps)
    return loglik_anom - loglik_normal

# 3. 混入率 π を考慮した、不正である事後確率
def posterior_cheat(llr, pi):
    return expit(llr + np.log(pi / (1 - pi)))

llr_all = llr_score(X, r)
pi_true = n_cheat / len(X)
gamma = posterior_cheat(llr_all, pi_true)
print(f"π = {pi_true:.4f}")
print(f"不正受験者の対数尤度比   最小 {llr_all[y == 1].min():+.2f}")
print(f"不正受験者の事後確率     最小 {gamma[y == 1].min():.4f}(0.99 を超えた人数: {int((gamma[y == 1] > 0.99).sum())} / {n_cheat})")
print(f"ふつうの受験者の事後確率 最大 {gamma[y == 0].max():.4f}")
試験のデータを生成し、100問分の解答で各受験者の負担率(不正である事後確率)を計算しています。
- データの生成: 尤度比スコアの記事と同じ設定です。後ろの問題ほど難しい100問の試験を、ふつうの受験者3000人(うち30人は成績上位者)と、どの問題にも99%の確率で正解する不正受験者60人が受けたデータを作り、全員で問題ごとの正答率 r を集計しています。値の意味は次のとおりです(詳しい理由は尤度比スコアの記事に書いています)。
- logit(base_rate) - 0.3:どの問題も目安の正答率より少し難しくし、ふつうの受験者の平均の正答率を約45%にする。ロジットで引くので、確率が0〜1の外に出ない
- b[:30] += 2.5:95点前後を取るふつうの受験者を30人作り、点数だけでは不正受験者と区別できない状況にする
- 0.99:不正受験者も、写し間違いなどでまれに不正解になる
- 60人(約2%):不正受験者が少数派で、混入率が判定に効く状況にする
- llr_score: 尤度比スコアの記事で1ステップずつ組み立てた計算を、1つの関数にまとめたものです。正常モデルは、受験者の実力 を 〜 の61点のグリッド上で正規分布 の重みを付けて周辺化しています。 は、データを作るときに実力 を標準正規分布から引いたのに合わせた値で、範囲を にしたのは、 の正規分布の重みがその外にはほとんど残らないためです。eps=0.01 は異常モデルで不正受験者が間違える確率で、データの 0.99 に合わせています。どの問題を使うか(X の列数)を変えても使えるように、問題数を X.shape[1] から取っています。
- posterior_cheat: 「事後の対数オッズ = 事前の対数オッズ + 対数尤度比」の式で、負担率を計算します。
- 混入率 pi_true: ここでは、真の混入率 が分かっているものとして使っています。実際には分からないので、その推定方法は本記事の最後で触れます。
実行結果
π = 0.0196
不正受験者の対数尤度比   最小 +4.60
不正受験者の事後確率     最小 0.6653(0.99 を超えた人数: 55 / 60)
ふつうの受験者の事後確率 最大 0.0004
100問分の解答があると、ふつうの受験者の負担率は最大でも0.0004と、ほぼ0になりました。不正受験者は60人中55人が0.99を超えましたが、最も低い人は0.665にとどまっています。
不正受験者の対数尤度比は、最も低い人で でした。ここに事前の対数オッズ を足すと、事後の対数オッズは約 になり、確率に直すと0.665です。対数尤度比だけを見れば「異常モデルのほうが約100倍()もっともらしい」受験者でも、不正受験者がもともと50人に1人しかいないことを考えると、「不正の可能性が高いが、確実とまでは言えない」という判断になるのです。
2つのグループの負担率を並べると、次のようになります。
(図は、diagram-designで作成)
問題数が少ないと、混入率が大きく効いてくる
証拠がもっと弱い場合はどうでしょうか。例えば、「100問すべての採点を待たずに、最も難しい8問(93〜100問目)の採点結果だけで、不正の疑いがある受験者を早めに見つけたい」という場面を考えます。問題が8問しかないと、1人あたりの証拠はずっと少なくなります。
# 1. 最も難しい8問(93〜100問目)だけで判定する場合
items = slice(92, 100)
llr_short = llr_score(X[:, items], r[items])
print(f"8問だけのスコア: ふつうの受験者の最大 {llr_short[y == 0].max():+.2f} / 不正受験者の最小 {llr_short[y == 1].min():+.2f}")

# 2. 混入率 π を変えて、事後確率 0.5 で判定する
print("    π     しきい値(LLR)  検出(不正)  誤検知(ふつう)")
for pi_ in [0.5, pi_true, 0.001]:
    g = posterior_cheat(llr_short, pi_)
    flag = g > 0.5
    print(f"{pi_:7.4f}      {np.log((1 - pi_) / pi_):+6.2f}         {int((flag & (y == 1)).sum()):3d}           {int((flag & (y == 0)).sum()):3d}")

# 3. 対数尤度比 → 事後確率 の変換を描く
s_grid = np.linspace(-15, 15, 301)
plt.figure(figsize=(9, 4.5))
for pi_, color in [(0.5, 'gray'), (pi_true, 'red'), (0.001, 'purple')]:
    plt.plot(s_grid, posterior_cheat(s_grid, pi_), color=color, label=f'π = {pi_:.4f}')
plt.scatter(llr_short[y == 0], np.full((y == 0).sum(), -0.05), marker='|', color='steelblue', alpha=0.3, label='ふつうの受験者のスコア')
plt.scatter(llr_short[y == 1], np.full((y == 1).sum(), -0.1), marker='|', color='red', label='不正受験者のスコア')
plt.axhline(0.5, color='black', linestyle=':', linewidth=1)
plt.xlim(-15, 15)
plt.xlabel('対数尤度比スコア(難問8問分)')
plt.ylabel('不正である事後確率')
plt.title('同じスコアでも、混入率 π によって事後確率が変わる')
plt.legend(loc='upper left', fontsize=9)
plt.grid(True, alpha=0.3)
plt.show()

# 4. スコアが最も近い2人の解答(1 = 正解)
i_h = np.where(y == 0)[0][np.argmax(llr_short[y == 0])]   # ふつうの受験者で最もスコアが高い人
i_c = np.where(y == 1)[0][np.argmin(llr_short[y == 1])]   # 不正受験者で最もスコアが低い人
for name, i in [('ふつうの受験者', i_h), ('不正受験者  ', i_c)]:
    print(f"{name}: 93〜100問目の解答 {X[i, items].astype(int)}, LLR = {llr_short[i]:+.2f}")
93〜100問目の8問分だけで対数尤度比を計算し、混入率を3通りに変えて判定しています。
- 問題の切り出し: slice(92, 100) で93〜100問目を指定し、解答 X[:, items] と正答率 r[items] の両方から同じ範囲を取り出しています(Python の番号は0から始まるので、92番目が93問目です)。
- 混入率の3通り: 半々を仮定した場合(0.5、尤度比スコアの記事の判定と同じ)、真の混入率(0.0196)、真の値の約20分の1に小さく見積もった場合(0.001)です。
- 判定の境目 0.5: 負担率が0.5を超えると、「不正である」ほうが「ふつうである」より確率が高いことになるので、この値で判定しています。
- しきい値(LLR): 負担率が0.5を超える条件 を書き直すと、 になります。表の2列目は、この「対数尤度比に換算したしきい値」です。
- 可視化: 3本の曲線は、対数尤度比を負担率に変換する関数です。曲線の下には、各受験者の実際のスコアを縦線で並べています(青がふつうの受験者、赤が不正受験者)。
- スコアが近い2人: ふつうの受験者で最もスコアが高い人と、不正受験者で最もスコアが低い人の、8問分の解答を表示しています。
実行結果
8問だけのスコア: ふつうの受験者の最大 +4.17 / 不正受験者の最小 +4.07
    π     しきい値(LLR)  検出(不正)  誤検知(ふつう)
 0.5000       +0.00          60             1
 0.0196       +3.91          60             1
 0.0010       +6.91          54             0
ふつうの受験者: 93〜100問目の解答 [1 1 1 1 1 0 1 1], LLR = +4.17
不正受験者  : 93〜100問目の解答 [1 1 1 1 1 1 0 1], LLR = +4.07
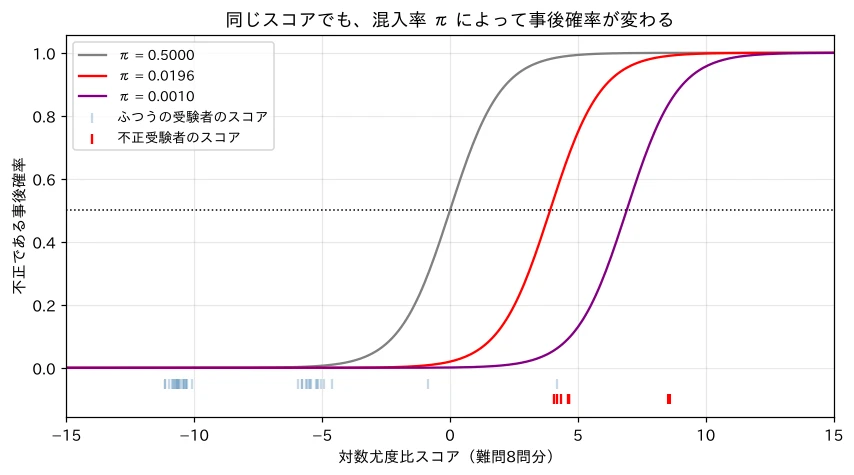
8問だけでは、ふつうの受験者の最大値()が不正受験者の最小値()を上回り、スコアだけでは完全には分けられなくなりました。最後の2行を見ると、この2人はどちらも「8問中7問正解」で、間違えた問題が1つずれているだけです。難問ばかり8問中7問も解ける実力者と、1問だけ写し間違えた不正受験者は、8問分の解答だけでは見分けがつかないのです。
図を見ると、3本の曲線は同じ形のまま左右にずれているだけです。混入率が小さいほど曲線は右にずれ、より大きな対数尤度比がないと「不正」と判定されなくなります。
- と : しきい値は0と3.91です。不正受験者60人をすべて検出しますが、ふつうの受験者を1人誤検知します。
- : しきい値は6.91まで上がります。誤検知は0人になりますが、不正受験者を6人見逃します。
混入率を小さく見積もると慎重な判定(見逃しが増える)になり、大きく見積もると積極的な判定(誤検知が増える)になります。正しい判定には、正しい混入率が必要 なのです。
負担率は「不正である確率」なので、しきい値を業務の言葉で決められます。例えば「追加の確認を行うのは、不正である確率が90%以上の受験者に限る」といった基準です。対数尤度比のままだと「スコア4.17は高いのか低いのか」を判断する物差しがありませんが、負担率なら混入率の情報も含めた確率として解釈できます。
尤度比より、混合モデルのほうが正確に見分けられるのか: 見分ける力そのものは同じです。 が同じなら、負担率 は対数尤度比が大きいほど大きくなるので、受験者を疑わしい順に並べた結果は変わりません。変わるのは、どこで線を引くかです。尤度比だけの「対数尤度比 > 0」は を仮定した線で、混合モデルでは線が に動きます。 が正しければ、誤りの数(見逃し+誤検知)が理論上最も少ない線になります。ただし、上の8問の例のように、線を動かしても結果が変わらないこともあり( と のどちらも、検出60人・誤検知1人)、 を誤って小さく見積もると見逃しが増えます。混合モデルで見分ける力そのものが上がりうるのは、混入率と問題ごとの正答率を、不正受験者の分を補正しながら一緒に推定し直す場合で、それが本記事の最後の節で触れる EM アルゴリズムの役割です。
混入率ごとの判定の結果を表にすると、次のようになります。
(図は、diagram-designで作成)
連続の値の混合:ガウス混合
ここまでの成分は、表の回数や正誤のような数えられる値の分布(二項分布)でした。解答時間や身長のような連続の値に、成分として 正規分布(ガウス分布) を使った混合モデルを ガウス混合(Gaussian Mixture Model, GMM)と呼びます。冒頭で触れた Pearson(1894)がカニの計測データに当てはめたのも、2つの正規分布の混合でした。
成分の分布が変わっても、負担率の式は同じです。
ここで は、平均 、標準偏差 の正規分布の確率密度です。例として、試験の「1問あたりの平均解答時間」を考えます。解答を事前に知っている不正受験者は、考えずに書き写すので、解答時間が短くなるはずです。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy.stats import norm
from sklearn.mixture import GaussianMixture


def responsibility(x, pi, mu0, sd0, mu1, sd1):
    """観測 x が成分1(不正受験者)から来た確率(負担率)"""
    p0 = (1 - pi) * norm.pdf(x, mu0, sd0)   # (a) ふつうの受験者の成分 × 割合
    p1 = pi * norm.pdf(x, mu1, sd1)         # (b) 不正受験者の成分 × 割合
    return p1 / (p0 + p1)


# 1. 1問あたりの平均解答時間(秒)のデータ:ふつう 平均60秒・標準偏差10秒、不正 平均25秒・標準偏差5秒、混入率0.1
rng = np.random.default_rng(0)
pi, (mu0, sd0), (mu1, sd1) = 0.1, (60, 10), (25, 5)
z = rng.binomial(1, pi, size=2000)
t = np.where(z == 1, rng.normal(mu1, sd1, size=2000), rng.normal(mu0, sd0, size=2000))

for x in [10, 25, 35, 40, 45, 60]:
    print(f"解答時間 {x:2d} 秒: 不正である確率 {responsibility(x, pi, mu0, sd0, mu1, sd1):.3f}")

# 2. 正解を知らないまま、scikit-learn のガウス混合で2つの成分を推定する
gmm = GaussianMixture(n_components=2, random_state=0).fit(t.reshape(-1, 1))
means, sds, weights = gmm.means_.ravel(), np.sqrt(gmm.covariances_.ravel()), gmm.weights_
c = int(np.argmin(means))                    # (c) 平均が小さいほうを「不正」の成分とみなす
print(f"推定した値  混入率 {weights[c]:.3f}  ふつう 平均 {means[1 - c]:.1f} 秒・標準偏差 {sds[1 - c]:.1f} 秒  "
      f"不正 平均 {means[c]:.1f} 秒・標準偏差 {sds[c]:.1f} 秒")
xs = np.array([25.0, 35.0, 40.0, 45.0])
print("scikit-learn の負担率      :", np.round(gmm.predict_proba(xs.reshape(-1, 1))[:, c], 3))
print("推定した値で計算した負担率:", np.round(responsibility(xs, weights[c], means[1 - c], sds[1 - c], means[c], sds[c]), 3))

# 3. 可視化:2つの成分と、負担率
grid = np.linspace(0, 110, 441)
fig, ax = plt.subplots(figsize=(9, 4.5))
ax.hist(t, bins=55, range=(0, 110), density=True, color="lightgray", edgecolor="gray", label="データ(2000人)")
ax.plot(grid, (1 - pi) * norm.pdf(grid, mu0, sd0), "--", color="steelblue", label="(1-π) × ふつうの受験者")
ax.plot(grid, pi * norm.pdf(grid, mu1, sd1), "--", color="red", label="π × 不正受験者")
ax.set_xlabel("1問あたりの平均解答時間(秒)")
ax.set_ylabel("確率密度")
ax2 = ax.twinx()
ax2.plot(grid, responsibility(grid, pi, mu0, sd0, mu1, sd1), color="black", linewidth=2, label="不正である確率(負担率)")
ax2.set_ylabel("不正である確率")
ax2.set_ylim(0, 1.05)
h1, l1 = ax.get_legend_handles_labels()
h2, l2 = ax2.get_legend_handles_labels()
ax.legend(h1 + h2, l1 + l2, loc="upper right", fontsize=9)
ax.grid(True, alpha=0.3)
plt.title("解答時間のガウス混合と、不正である確率")
plt.tight_layout()
plt.show()
正規分布の成分で負担率を計算し、scikit-learn のガウス混合と比べるコードです。
- responsibility: 上の式をそのままコードにした関数です。(a) ふつうの受験者の確率密度に を、(b) 不正受験者の確率密度に を掛け、(b) を2つの和で割ります。コインの例の joint_normal・joint_biased と同じ計算で、二項分布の binom.pmf を正規分布の norm.pdf に替えただけです。混入率と2つの成分の平均・標準偏差を、すべて引数で受け取ります。
- データの生成: コインの例と同じ2段階の物語で作っています。まず確率 で不正受験者かどうか(z)を決め、次に、ふつうの受験者なら平均60秒・標準偏差10秒、不正受験者なら平均25秒・標準偏差5秒の正規分布から解答時間を引きます。2つの成分の平均の差(35秒)を、ふつうの受験者の標準偏差の3.5倍にしているのは、ヒストグラムで2つの山が見分けられ、かつ30〜40秒のあたりで重なる部分が残るようにするためです。不正受験者の標準偏差を小さくしたのは、書き写すだけの解答時間は人によって差が出にくいと考えたためです。
- scikit-learn のガウス混合: GaussianMixture(n_components=2) に、正解(z)を渡さずに解答時間だけを渡し、混入率・平均・標準偏差を推定させます。(c) 推定した2つの成分のどちらが「不正」かは、モデルは知らないので、平均が小さいほうを不正の成分とみなします。predict_proba は、各データの負担率を返します。random_state=0 は、推定の初期値を固定して結果を再現するための値です。
- 2つの負担率の比較: 推定した値を responsibility に渡して計算した負担率と、predict_proba を並べます。xs を 25.0 のような小数で書いているのは、データ(t)と同じ浮動小数点数の型にそろえるためです。
- 可視化: ヒストグラムに、2つの成分(破線)を重ね、右の縦軸に負担率(黒の線)を描いています。
実行結果
解答時間 10 秒: 不正である確率 0.998
解答時間 25 秒: 不正である確率 0.990
解答時間 35 秒: 不正である確率 0.406
解答時間 40 秒: 不正である確率 0.018
解答時間 45 秒: 不正である確率 0.000
解答時間 60 秒: 不正である確率 0.000
推定した値  混入率 0.106  ふつう 平均 60.4 秒・標準偏差 9.6 秒  不正 平均 25.8 秒・標準偏差 5.9 秒
scikit-learn の負担率      : [0.994 0.65  0.09  0.003]
推定した値で計算した負担率: [0.994 0.65  0.09  0.003]
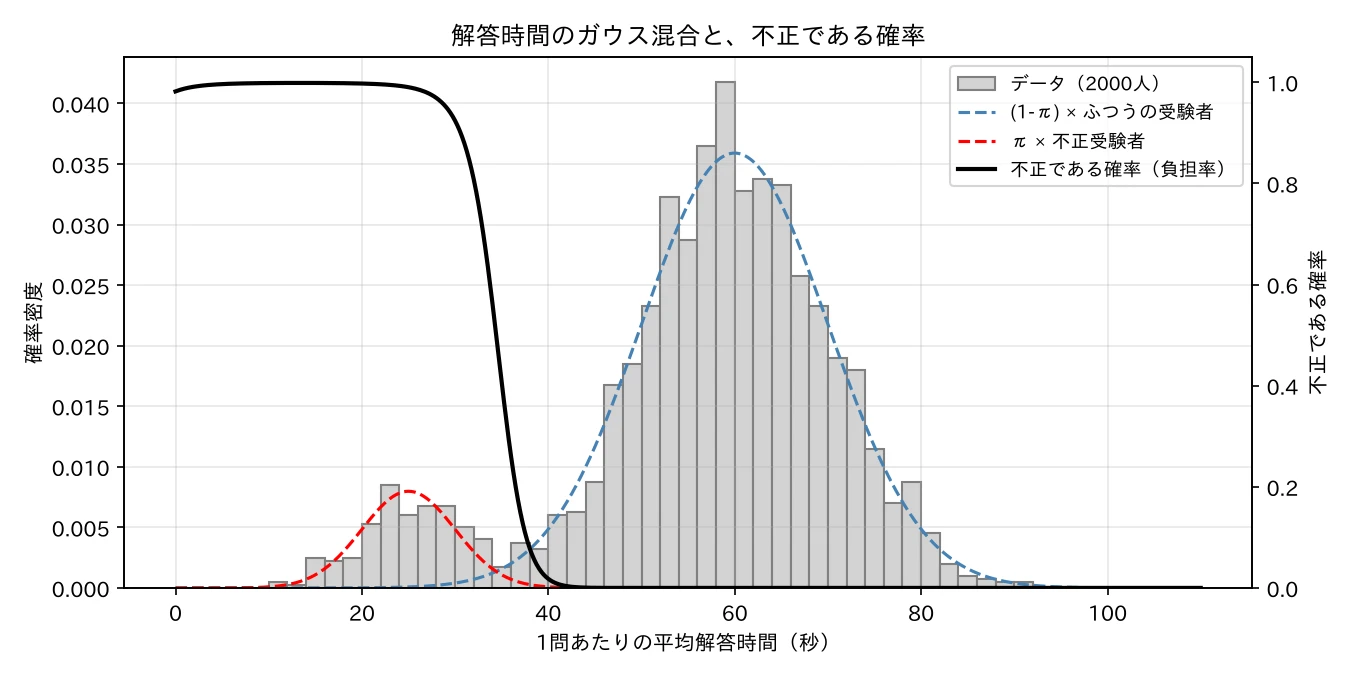
- 負担率は30〜40秒で急に変わる: 25秒なら0.990、35秒なら0.406、40秒なら0.018です。2つの成分が重なる30〜40秒のあたりで、負担率は1から0へ急に下がります。
- 短いほど不正とは限らない: 解答時間がとても短い場合(図の左端)、負担率はわずかに下がります。ふつうの受験者の成分のほうが広がりが大きい(標準偏差10秒と5秒)ので、平均から遠く離れたところでは、ふつうの受験者の確率密度のほうがゆっくり小さくなるためです。成分の広がりが違うと、負担率は「境目より左は全部不正」のような単純な形にならないことがあります。
- scikit-learn は同じ式を使っている: 正解を知らないまま推定した混入率は0.106(真の値0.1)、不正の成分は平均25.8秒・標準偏差5.9秒(真の値25秒・5秒)でした。推定した値を responsibility に渡すと、predict_proba と同じ負担率になります。ガウス混合でクラスタリングするときの「各クラスタに属する確率」は、この負担率です(クラスタリングの記事のソフトクラスタリングの節を参照)。
- 混入率も推定できている: 本記事では混入率を知っているものとして計算してきましたが、scikit-learn は混入率を、平均・標準偏差と一緒にデータから推定しました。この推定に使われているのが、次の節で触れる EM アルゴリズムです。
推定した値と真の値を並べると、次のようになります。
(図は、diagram-designで作成)
残された課題:混入率はどうやって知るのか
本記事では、真の混入率 を知っているものとして計算しました。しかし現実には、不正受験者が何人いるかは分かりません。分からないからこそ、見つけたいのです。
ここで、次のような「鶏と卵」の問題が生まれます。
- 混入率 が分かれば、各受験者の負担率 を計算できる
- 各受験者の負担率 が分かれば、それを平均して混入率 を見積もれる
さらに、問題ごとの正答率 も、不正受験者を含めたまま集計されているので、不正受験者が分かれば補正できるはずです。この「お互いがお互いに依存している」問題を、交互に更新しながら解いていく方法が、EMアルゴリズムです。
まとめ
- 混合モデル: 「まずグループを選び、次にそのグループのルールでデータを生む」という2段階の物語で、複数のグループが混ざったデータを表すモデルです。データの確率は、各グループの確率を混合比率 で重み付けした和 になります。
- 潜在変数: どのグループから来たかを表す変数で、データの生成に関わっているのに観測されません。
- 負担率: ベイズの定理で計算した「そのデータが、あるグループから来た確率」です。
- 対数尤度比との関係: 事後の対数オッズ = 事前の対数オッズ + 対数尤度比。対数尤度比 > 0 という判定は、 を仮定したのと同じです。
- ガウス混合: 成分に正規分布を使った混合モデルで、負担率の式は同じです。成分の広がりが違うと、負担率は単純な境目では分かれないことがあります。scikit-learn の predict_proba は、この負担率を返します。
- 混入率の影響: 証拠が強いとき(100問分の解答)は多くの受験者でほぼ確実な判定になりますが、証拠が弱いとき(8問分の解答)は、混入率の値が判定を大きく左右します。
参考文献
- K. Pearson (1894). Contributions to the Mathematical Theory of Evolution. Philosophical Transactions of the Royal Society of London. A, 185, 71–110.
- G. McLachlan, D. Peel (2000). Finite Mixture Models. Wiley.
- C. M. Bishop (2006). Pattern Recognition and Machine Learning. Springer(第9章「Mixture Models and EM」).
本記事の文章・構成の一部に生成AIを使用しています。