マーケティングミックスモデル(MMM)とは?
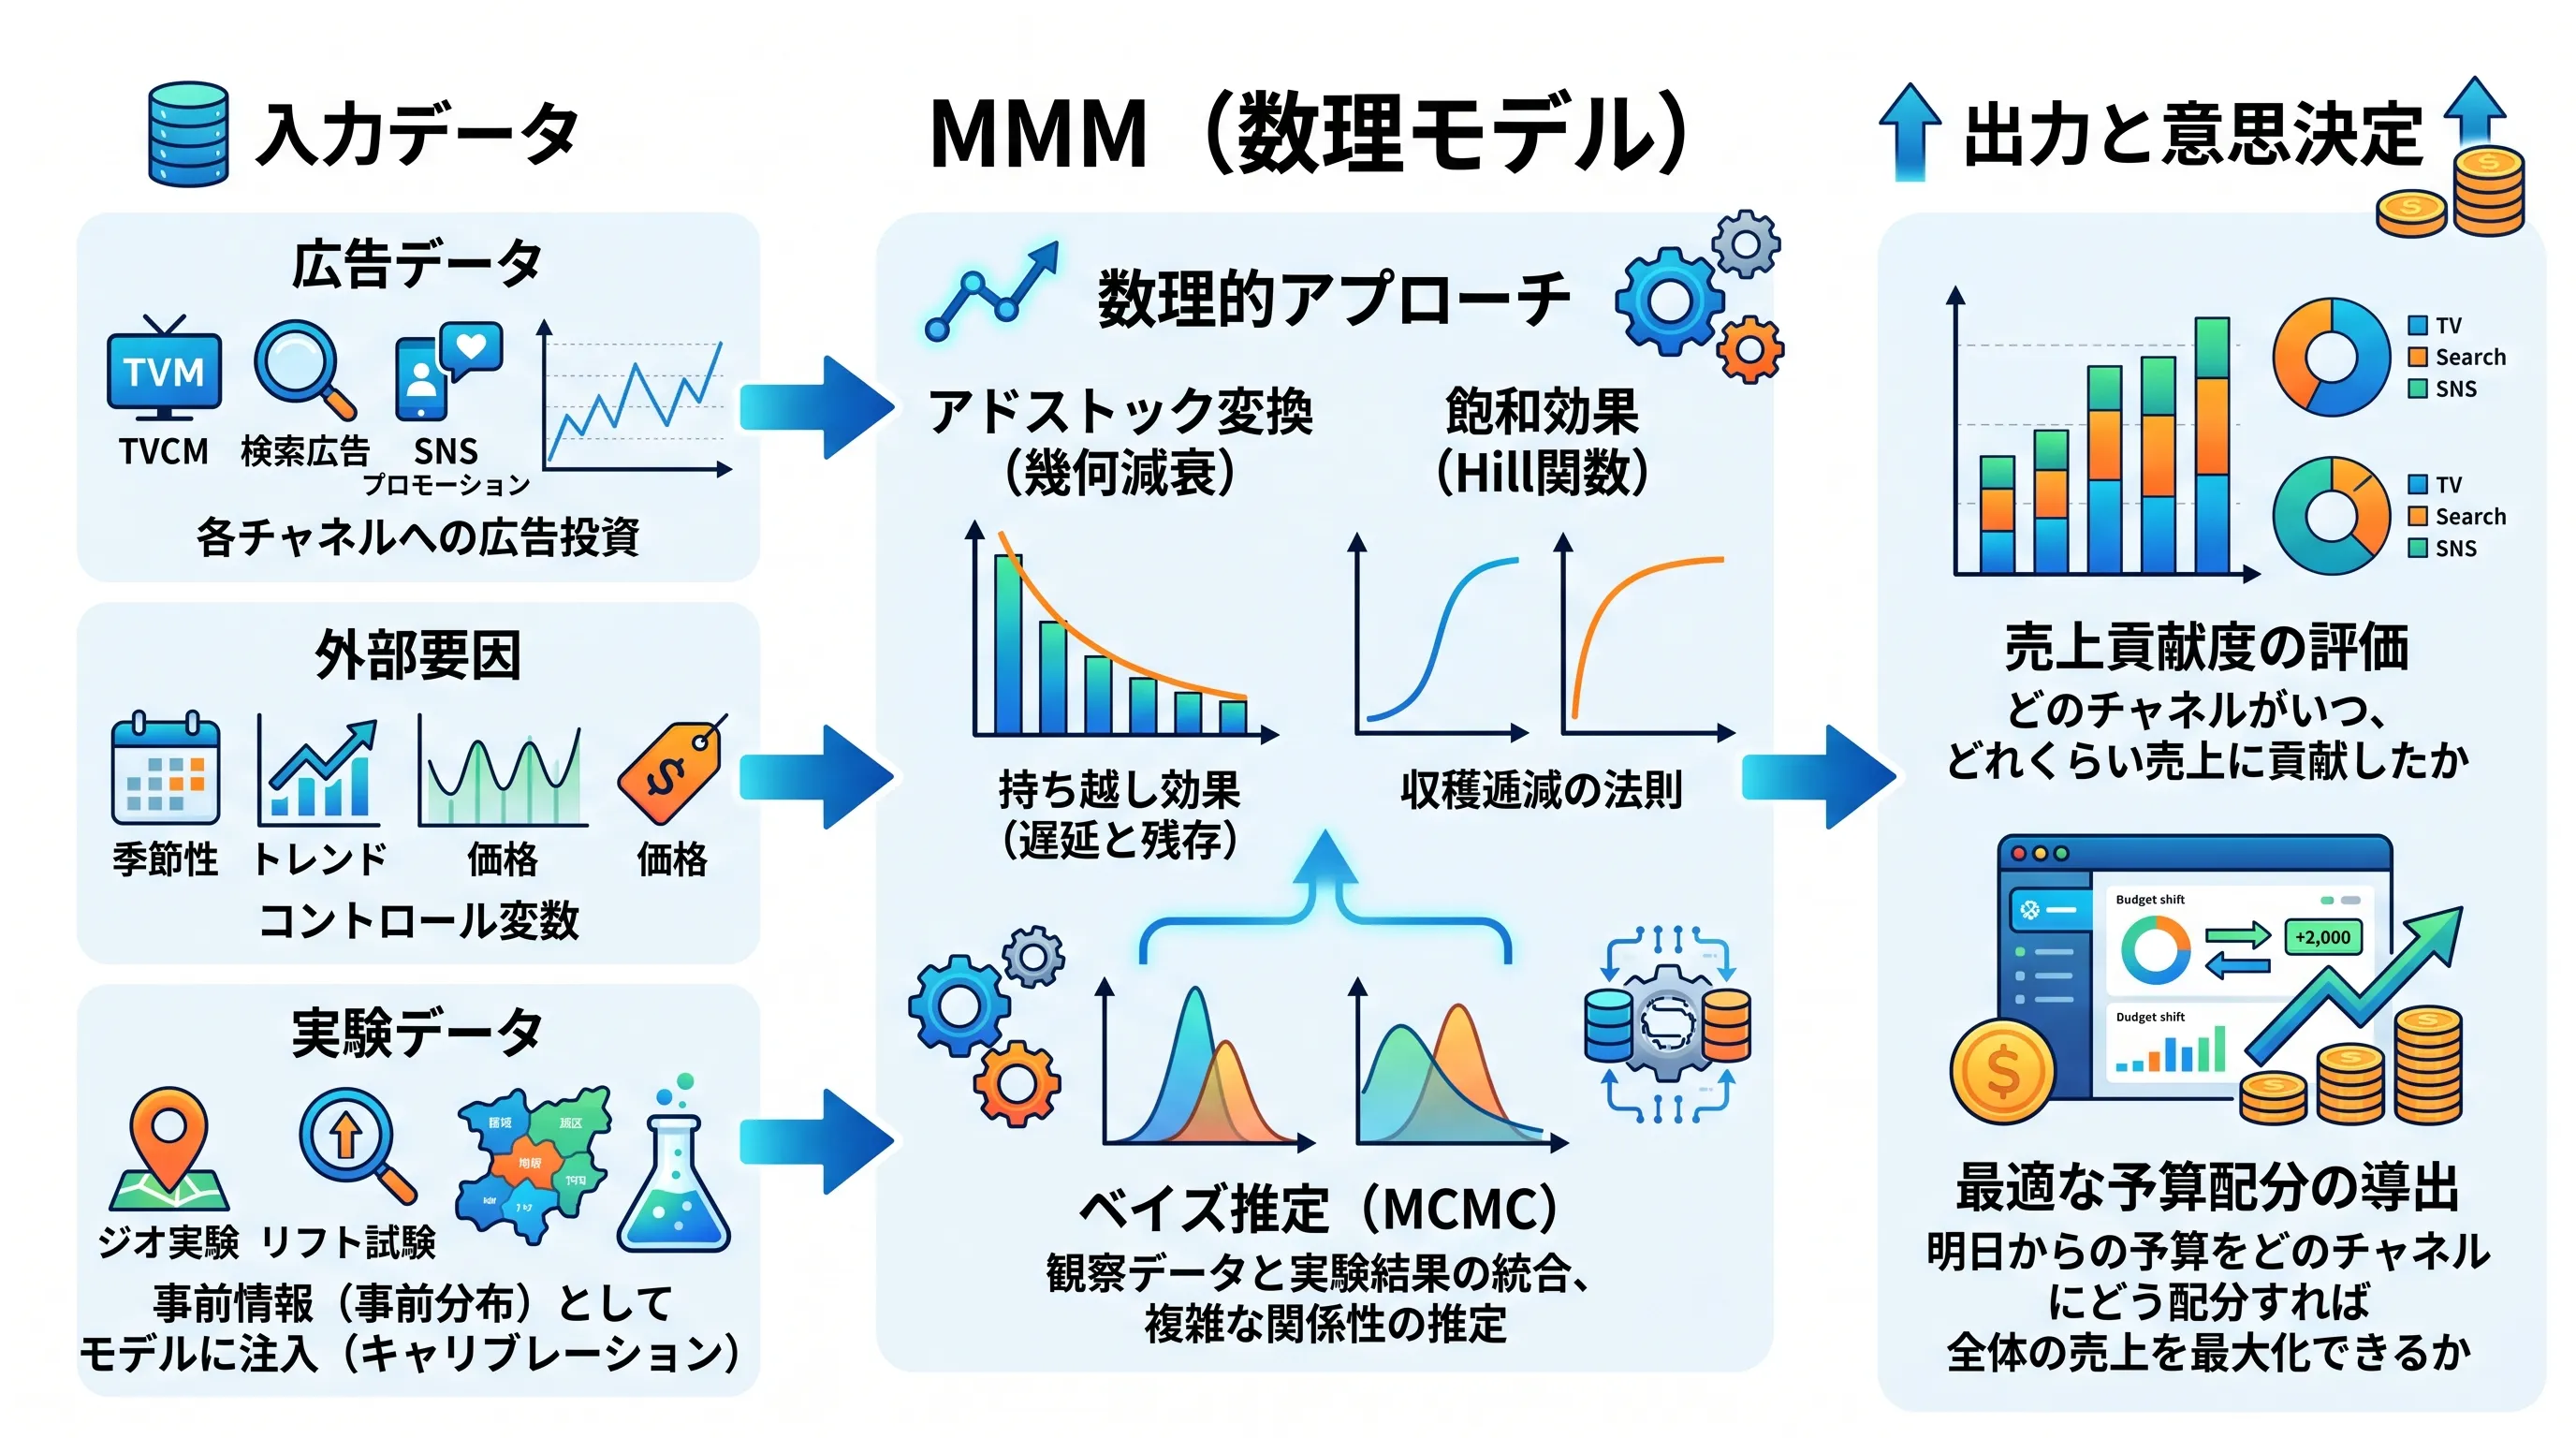 (画像は、Geminiで作成)
アドストックと飽和を組み込んだベイズMMMをPyMCでゼロから実装し、仕込んだ真値を復元できること、そして内生性や多重共線性によって復元できなくなる条件と、実験によるキャリブレーションの効果を理解すること。
概要
これまでの記事では、DiD(差の差法)やCausalImpact、地域単位で効果を測るジオ実験など、データから因果効果を測定する手法を見てきました。これらは「ある特定のキャンペーンを実施したことで、売上がどれだけ増えたか」という単一施策の検証において非常に強力な道具となります。
しかし実際のマーケティング現場では、テレビCM、検索広告、SNSプロモーションなど、複数のチャネルが同時に、かつ継続的に動いているのが普通です。経営層やマーケターが直面する最も重要な問いは、過去の振り返りだけでなく、「限られた予算を明日からどのチャネルにどう配分すれば全体の売上を最大化できるのか?」という未来に向けた意思決定です。
すべてのチャネルで常に実験を実施し続けることは現実的ではありません。かといって、単一施策の検証結果を単純に足し合わせても、市場トレンドや季節性を見落としてしまいます。そこで必要になるのが、マーケティングミックスモデル(MMM: Marketing Mix Modeling) です。
MMMは、過去の売上データと各チャネルへの広告投資額、価格変更や季節性といった外部要因(コントロール変数)の時系列データを統合し、「どのチャネルが、いつ、どれくらい売上に貢献したか」を同時に評価する統計モデルです。単純な重回帰分析とは異なり、広告という投資が持つ特有の性質を数理的に組み込んで構築されます。
近年では、MCMC(マルコフ連鎖モンテカルロ法)を用いたベイズ推定によるMMMが主流です。ベイズMMMの最大の強みは、観察データだけでは捉えきれない複雑な関係性に対し、ジオ実験などで得られた「信頼できる単一施策の検証結果」を 事前分布や尤度の形でモデルに組み込める(キャリブレーションできる) 点にあります。これにより、実験の正確さとモデリングによる網羅的な評価の「いいとこ取り」が可能になります。
本記事では、複数チャネルの投資対効果を同時に解き明かすベイズMMMの仕組みについて、背後にある数理からPyMCを用いたスクラッチ実装までを詳しく解説します。
背景と課題:複数チャネルの同時評価と広告の特性
「限られた予算をどのチャネルにどう配分すべきか」に答えるためには、全チャネルの効果を同時に評価するモデルが必要です。最も単純なアプローチは、ある週 の売上 を、各チャネルの広告費 の足し算(線形回帰)で説明することです。
しかし、この単純な回帰モデルは現実のマーケティングデータには歯が立ちません。広告が消費者の行動を変えて売上につながるプロセスには、単純な足し算では表現できない2つの重要な特性があるからです。
広告の特性1:持ち越し効果(遅延と残存)
広告の効果は投下した瞬間にすべて現れて消えるわけではありません。消費者の記憶にブランドが蓄積され、数週間経ってから購買に至ることも珍しくありません。
このように過去の広告費が現在に持ち越されて効いてくる現象を持ち越し効果(Carryover Effect)、あるいは アドストック(Adstock) と呼びます。「消費者の頭の中にどれくらい広告の記憶が蓄積されているか」をモデル化しなければ、効果を正しく測ることはできません。
広告の特性2:飽和効果(収穫逓減の法則)
広告費を2倍にしても売上は2倍にはなりません。同じターゲット層に広告を打ち続けると、反応しやすい人から順に刈り取られ、次第に追加で得られる効果は薄れていきます。
投資を増やすほど限界的な効果(追加の1円が生み出す売上)が小さくなる現象を 飽和効果(Saturation Effect) と呼びます。予算配分を最適化するには、「どのチャネルがまだ飽和しておらず、追加の投資余地があるか」を見極めることが不可欠です。
持ち越しと飽和の直感
持ち越し効果の直感的な挙動は、DiDの記事やCausalImpactの記事で、「施策の効果が少しずつ蓄積し、施策が終わった後もしばらく残る」様子として確認しました。また、飽和効果に近い「効果が逓減する」関係は、二重にロバストな推定法の記事のダミーデータにも登場しています。本記事では、これらを数式としてモデルに組み込みます。
チャネルごとの特性の違いと内生性
さらに厄介なのは、これらの特性がチャネルごとに異なることです。
テレビCMは消費者の記憶に長く残るため持ち越し効果が強い反面、ある程度の規模で打たなければ効果が出ないS字型の飽和カーブを描きがちです。一方、検索広告は即効性がありますが、検索ボリュームの上限に達するとすぐに飽和します。
加えて、検索広告は「需要が高まったから検索され、結果として広告費が消化される」という内生性を持っています。需要の変動をすべてモデルに取り込めない限り、単純な回帰分析ではこの内生性によって効果が過大に推定されてしまいます(詳しくは内生性の記事を参照してください)。
MMMの数式化
これら「持ち越し」「飽和」「チャネル間の性質の違い」「内生性」といった複雑な要因をすべて飲み込み、同時に評価する式が必要です。「持ち越し効果」と「飽和効果」という人間の認知メカニズムを数学的な関数として定義し、回帰モデルの中に組み込むことがMMMの核心です。本節では、それぞれの特性をどのように数式化し、最終的なMMMの基本式へと統合するのかを見ていきます。
1. 持ち越し効果:アドストック(幾何減衰)
MMMの世界では、効果の蓄積を アドストック(Adstock) と呼びます。再帰的な漸化式()は直感的ですが、モデルのパラメータとして推定する際には「過去の広告費の総和」の形(総和形)で書き直したほうが扱いやすくなります。総和形なら、過去の広告費を並べた行列と減衰重みの内積として一括で計算できるためです(実装の節で使います)。 再帰形の式 を、過去に向かって順番に展開していきます。 このように、再帰形は「過去のすべての時点の広告費 に、経過時間 に応じた減衰率 を掛けて足し合わせたもの」と完全に等価になります。 ただし、実務では無限の過去までさかのぼることはできません。そこで、展開を 段で止めると、次のように「残す部分」と「捨てる部分」に分けられます。 週より前の項 を切り捨てます。 なのでこの項は十分小さく(例:、 なら で約1%)、無視しても実用上問題ありません。最後に、チャネル ごとの添字を付け、Hill関数に入力する「変換後の広告費」であることを明示するために記号を から に変えると、下の定義になります。なお、データの開始時点より前の広告費は0とみなします(漸化式の初期条件 に相当します)。詳細な式展開
実務では影響が残る最大の期間(最大ラグ)を と置き、時点 におけるチャネル のアドストック変換後の広告費 を次のように定義します。
- : 週間前のチャネル の広告費
- : チャネル の減衰率()
- : アドストックの最大ラグ(例: なら、当週を含めて13週分を足し合わせます)
時間が経つにつれて重みが指数関数的に小さくなるため、これを 幾何減衰(Geometric decay) と呼びます。ワイブル型のアドストックや指数型の飽和、変換の順序の違いを含む詳細な数式と実装は、アドストックと飽和曲線の記事を参照してください。
2. 飽和効果:Hill関数
対数関数()は「最初から常に効果が逓減し続ける」ことしか表現できず、「ある程度の金額を投下して初めて効果が出始める」ようなS字カーブを描けません。
そこでMMMでは、薬学や生物学で受容体の反応を表すのに使われる Hill関数(Hill function) を応用します。アドストック変換された広告費 に対する飽和関数 は、次のように定義されます。
- : 半飽和点(Half-saturation point)。関数が取りうる最大値のちょうど半分(0.5)に達するときの入力の規模。入力はアドストック変換後の広告費 なので、 も「1週の広告費」ではなく「アドストック量」の単位で表されます(詳しくは後述の「3. 全体を統合したMMMの基本式」で補足します)。
- : 形状パラメータ(Shape parameter)。 なら最初から効果が逓減する「C字カーブ」になり、 なら最初は効果が加速し、途中から逓減に転じる「S字カーブ」になります。
この関数を通すことで出力は必ず から の間に収まり、そこに係数 (効果の大きさ)を掛けることで「最大でどれだけ売上を増やせるか」を表現できます。
コードによる挙動の確認
PythonコードでアドストックとHill関数の挙動を確認してみましょう。
import numpy as np

# --- 1. アドストック(幾何減衰)の挙動 ---
theta = 0.8  # 減衰率(前週の80%が残る)
L = 5        # 最大ラグ
spend = np.array([0, 100, 0, 0, 0, 0, 0])  # 1週目(インデックス1)のみ100出稿
adstocked = np.zeros(len(spend))

for t in range(len(spend)):
    # 過去L週分の広告費を減衰させて足し合わせる
    for l in range(min(t + 1, L + 1)):
        adstocked[t] += (theta ** l) * spend[t - l]

print("広告費   :", spend)
print("アドストック:", np.round(adstocked, 1))

# --- 2. Hill関数(飽和)の挙動 ---
def hill_function(x, K, S):
    return (x ** S) / (x ** S + K ** S)

# 広告費を 0〜150 まで 25 刻みで増やす(半飽和点はどちらも K=50 にそろえる)
x_test = np.arange(0, 151, 25)

# C字カーブ: 検索広告のように少額からすぐ効くが、すぐ頭打ちになる (S=1.0)
c_shape = hill_function(x_test, K=50, S=1.0)

# S字カーブ: テレビCMのように一定量を超えないと効き始めない (S=2.0)
s_shape = hill_function(x_test, K=50, S=2.0)

print("\n広告費 (x)    :", x_test)
print("C字カーブ (S=1.0):", np.round(c_shape, 2))
print("S字カーブ (S=2.0):", np.round(s_shape, 2))

# 広告費を25増やすごとの効果の増分(限界効果)
print("\n増分の区間    :", [f"{a}→{b}" for a, b in zip(x_test[:-1], x_test[1:])])
print("C字カーブの増分 :", np.round(np.diff(c_shape), 2))
print("S字カーブの増分 :", np.round(np.diff(s_shape), 2))
アドストックとHill関数を、小さな数値例で確認しています。
- アドストック(総和形)の計算: 二重ループで、各週 t について過去 L 週分の広告費に theta ** l の重みを掛けて足し合わせています。本文の総和形の式 をそのままコードにしたものです。序盤は過去のデータが存在しないため、min(t + 1, L + 1) でさかのぼる範囲を制限しています。減衰率0.8・出稿100は、翌週以降に残る量(80、64、51…)を暗算で確かめやすい値です。
- Hill関数: hill_function は、 を計算します。x_test に 0〜150 の広告量を25刻みで与え、出力(最大値1に対する割合)を比べています。
- C字カーブとS字カーブ: 形状 の違いだけを比べるため、半飽和点はどちらも K=50 にそろえ、S=1.0 と S=2.0 の2つの曲線を計算しています。
- 増分(限界効果): np.diff で、広告費を25増やすごとに効果がどれだけ増えたかを計算しています。C字とS字の違いは、出力の値そのものよりも、この増分の推移にはっきり現れます。
実行結果
広告費   : [  0 100   0   0   0   0   0]
アドストック: [  0.  100.   80.   64.   51.2  41.   32.8]

広告費 (x)    : [  0  25  50  75 100 125 150]
C字カーブ (S=1.0): [0.   0.33 0.5  0.6  0.67 0.71 0.75]
S字カーブ (S=2.0): [0.   0.2  0.5  0.69 0.8  0.86 0.9 ]

増分の区間    : ['0→25', '25→50', '50→75', '75→100', '100→125', '125→150']
C字カーブの増分 : [0.33 0.17 0.1  0.07 0.05 0.04]
S字カーブの増分 : [0.2  0.3  0.19 0.11 0.06 0.04]
アドストックの結果を見ると、1週目に投下された「100」が徐々に減衰しながら効果を持ち越していることが分かります。
Hill関数の結果からは、次のことが読み取れます。
- どちらも でちょうど0.5: 半飽和点 をそろえたため、2つの曲線は で同じ値(最大値の半分)を通ります。
- C字カーブ(): 増分は最初の区間(0→25)の0.33が最大で、そこから単調に小さくなります。最初の1円から効果が逓減していく形です。
- S字カーブ(): 増分は0.2 → 0.3と一度大きくなってから、0.19 → 0.11 … と小さくなります。少額では効きが弱く、ある量を超えると効き始め、さらに増やすと頭打ちになる、というS字の性質が増分の山として現れています。
このように、形状パラメータ を変えるだけで「少額から効くチャネル」と「まとまった投資が必要なチャネル」の違いを表現できます。
このコードでは、Hill関数そのものの挙動を見るために、入力 を直接動かしています。ただし、実際のMMMでHill関数に入るのは、その週の広告費ではなく、アドストックで積み上がった累積量 です。したがって「0.5を超えるかどうか」も、1回の出稿額ではなく、過去の出稿の減衰を含めた累積で決まります。この違いが何をもたらすかは、次の「3. 全体を統合したMMMの基本式」で説明します。
実行結果の値を図にすると、次のようになります。
(図は、diagram-designで作成)
3. 全体を統合したMMMの基本式
「アドストック」と「飽和」の部品を、ベースとなる売上のトレンドや季節性、価格などのコントロール変数と合体させることで、MMMの全体式が完成します。時点 における売上 は次のように定式化されます。
- : ベースライン(広告を一切しなくても売れる基礎体力)
- : 時系列のトレンドと季節性
- : 全チャネルの広告効果の総和。内訳は次のとおりです。
- : アドストック変換後の広告費(持ち越し効果)。生の広告費 ではなく、1. で定義した が入ります。
- : Hill関数(飽和効果)。 を0〜1の割合に変換します。
- : 効果の上限。チャネル が最大でどれだけ売上を増やせるかを表します。
- : コントロール変数(価格変更や祝日など )の影響
- : モデルで説明しきれない観測誤差
アドストックは式の中に独立した項として現れるのではなく、Hill関数に入力する広告費 の中に組み込まれている点に注意してください。1チャネル分の計算は、次の順番で進みます。
アドストックを略さずに書くと、広告効果の項は次のようになります。
私たちの目標は、手元にある過去の売上データ と広告費データ から、各チャネルの隠れた性質()を逆算して突き止めることになります。
本記事の実装では、 と を時間の一次項と1年周期のフーリエ項(, )で表し、これらをまとめてコントロール変数として扱います。
アドストックの累積に対して飽和がかかる
この式は、飽和が「その週の広告費」ではなく、アドストックで積み上がった累積量 に対してかかる、という仮定を置いています。直感的には、「消費者の頭の中に残っている広告の記憶の総量」が飽和していく、というイメージです。この仮定から、実務上重要な性質が2つ出てきます。
1. 半飽和点 を週の広告費に換算すると、 より小さくなる
毎週同じ額 を出し続けると、アドストックは ( が十分大きければ 程度)で頭打ちになります。したがって、毎週の広告費で見た半飽和点はおよそ です。後で作るダミーデータのTV(、、)なら、週600ではなく、週180程度を出し続ければ半飽和点に達します()。減衰率 が大きい(持ち越しが長い)チャネルほど、少ない週次予算で飽和に近づきます。
2. 同じ総額でも、出稿のタイミングで効果が変わる
1週ごとの金額が小さくても、連続して出稿すれば累積が積み上がり、飽和しやすくなります。逆に、S字カーブのチャネルでは、1週の大型出稿だけでなく数週間にわたる出稿の累積で「効き始める量」を超えることもできます。つまりこのモデルでは、予算を集中させるか分散させるかによって、同じ総額でも売上への効果が変わります。
なお、順番を逆にして「先に各週の広告費をHill関数で飽和させてから、その効果を持ち越す」()モデルも考えられます。こちらは「1回の出稿量そのものが飽和する」(同じ週に同じ人へ何度も広告が当たると無駄打ちになる)という仮定です。PyMC-Marketing などのライブラリでは両方の順序を選べますが、出稿が週をまたいで続くことが多い実務では、本記事のように アドストック → 飽和 の順が一般的です。
全体式の計算の流れを、本記事の3つのチャネルで図にすると、次のようになります。
(図は、diagram-designで作成)
検証用ダミーデータの生成:MMMワールド
数式化したアドストックとHill関数を組み合わせて、MMMの検証に使うダミーデータ「MMMワールド」を生成します。3年分(156週)の週次データを作成し、性質の異なる3つの広告チャネル(TV、検索広告、SNS)をシミュレーションします。
各チャネルには次のような特性(真のパラメータ)を持たせます。
| チャネル | (減衰率) | (半飽和点) | (形状) | (効果の上限) | 特性 |
|---|---|---|---|---|---|
| TV | 0.7 | 600 | 2.0 | 80 | 遅延が長く、少額だと効かない(S字カーブ)。数か月おきに大型キャンペーンを打つ |
| 検索広告 | 0.2 | 80 | 1.0 | 60 | 即効性がある(C字カーブ)。需要に反応して出稿される(内生性) |
| SNS | 0.4 | 150 | 1.0 | 60 | TVと検索広告の中間的な性質。月ごとに予算が大きく変わる |
このデータで特に重要なのは、分析者が観測できない需要の変動(需要ショック) を仕込んでいる点です。需要ショックは売上を直接押し上げると同時に、検索広告費も増やします(需要が高まると検索が増え、広告費が消化されるため)。一方で、推定に使えるデータには需要ショックは含まれません。これが、検索広告の内生性の正体です。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。
!pip install japanize-matplotlib
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 乱数と期間の設定(3年分の週次データ)
rng = np.random.default_rng(42)
T = 156
week = np.arange(T)

# 2. 広告がなくても生じる売上(ベースライン)
trend = 200 + 0.3 * week                      # 緩やかな成長
season = 20 * np.sin(2 * np.pi * week / 52)   # 1年周期の季節性
# 分析者が観測できない需要の変動(前週の8割が残るAR(1)過程)
demand_shock = np.zeros(T)
for t in range(1, T):
    demand_shock[t] = 0.8 * demand_shock[t - 1] + rng.normal(0, 6)
baseline = trend + season + demand_shock

# 3. 各チャネルの広告費
# TV: 普段は少額で、13週ごとに3週間の大型キャンペーンを打つ
tv_spend = rng.uniform(0, 30, size=T)
for start in range(5, T, 13):
    tv_spend[start:start + 3] += rng.uniform(250, 500)

# SNS: 4週(約1か月)ごとに予算が大きく変わる
sns_monthly = rng.uniform(10, 300, size=T // 4 + 1)
sns_spend = np.clip(np.repeat(sns_monthly, 4)[:T] + rng.normal(0, 10, size=T), 0, None)

# 検索広告(内生性の仕込み): 季節性と「観測できない需要」の両方に反応して増減する
search_spend = np.clip(60 + 1.5 * (season + demand_shock) + rng.normal(0, 12, size=T), 5, None)

spends = {'TV': tv_spend, 'Search': search_spend, 'SNS': sns_spend}

# 4. 真のパラメータ(分析者には分からない「答え」)
true_params = {
    'TV':     {'theta': 0.7, 'K': 600, 'S': 2.0, 'beta': 80},
    'Search': {'theta': 0.2, 'K': 80,  'S': 1.0, 'beta': 60},
    'SNS':    {'theta': 0.4, 'K': 150, 'S': 1.0, 'beta': 60},
}

# 5. アドストック(総和形)とHill関数
def geometric_adstock(x, theta, L=13):
    out = np.zeros(len(x))
    for t in range(len(x)):
        for l in range(min(t + 1, L)):
            out[t] += theta ** l * x[t - l]
    return out

def hill(x, K, S):
    return x ** S / (x ** S + K ** S)

# 6. 各チャネルの真の売上貢献
true_contrib = {
    c: p['beta'] * hill(geometric_adstock(spends[c], p['theta']), p['K'], p['S'])
    for c, p in true_params.items()
}

# 7. 売上 = ベースライン + 広告の貢献 + 観測ノイズ
noise = rng.normal(0, 5, size=T)
y = baseline + sum(true_contrib.values()) + noise

# 8. 分析者が観測できるデータ(需要ショックや真の貢献は含めない)
df = pd.DataFrame({'week': week, 'y': y, 'TV': tv_spend, 'Search': search_spend, 'SNS': sns_spend})

# 9. データの性質の確認
for c in true_params:
    print(f"{c:6s}: 平均広告費 {spends[c].mean():6.1f}  真の平均売上貢献 {true_contrib[c].mean():5.1f} /週")
print(f"検索広告費と観測できない需要ショックの相関: {np.corrcoef(search_spend, demand_shock)[0, 1]:.2f}")
print(f"TV広告費とSNS広告費の相関: {np.corrcoef(tv_spend, sns_spend)[0, 1]:.2f}")

# 10. 可視化
fig, axes = plt.subplots(3, 1, figsize=(11, 10), sharex=True)
axes[0].plot(week, y, label='売上 (y)', color='black')
axes[0].plot(week, baseline, label='ベースライン(トレンド + 季節性 + 需要ショック)', color='gray', linestyle='--')
axes[0].set_title('1. 売上とベースラインの推移')
axes[0].legend(loc='upper left')
axes[0].grid(True, alpha=0.3)
for c, color in zip(true_params, ['C0', 'C1', 'C2']):
    axes[1].plot(week, spends[c], label=f'{c} 広告費', color=color)
    axes[2].plot(week, true_contrib[c], label=f'{c} の売上貢献', color=color)
axes[1].set_title('2. 各チャネルの広告費')
axes[1].legend(loc='upper left')
axes[1].grid(True, alpha=0.3)
axes[2].set_title('3. 各チャネルの真の売上貢献(アドストック + 飽和 適用後)')
axes[2].set_xlabel('週')
axes[2].legend(loc='upper left')
axes[2].grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
MMMワールドの売上と広告費を生成しています。
- ベースライン: 緩やかな成長 trend、1年(52週)周期の季節性 season、観測できない需要ショック demand_shock の和です。需要ショックは「前週の8割が残り、そこに新しい揺らぎが加わる」AR(1)過程で作っており、良い時期・悪い時期が数週間続く、現実の需要の波を表しています。156週(3年分)にするのは、1年周期の季節性を3回含め、季節性と広告の効果を分けて推定できるようにするためです。
- TVの広告費: 普段は0〜30の少額で、13週ごとに3週間、250〜500の大型キャンペーンを上乗せしています。S字カーブの「少額では効かず、まとまった量で効く」性質を、データから読み取れるようにするための設計です。13週ごとにするのは、表の「数か月おきに大型キャンペーンを打つ」を、四半期に1回として置いたためです。
- SNSの広告費: 4週ごとに10〜300の範囲で予算を決め(np.repeat で4週分に引き延ばし)、週ごとの小さな揺らぎを加えています。広告費を広い範囲で動かすことで、飽和曲線の低い部分から高い部分までをデータに含めています。
- 検索広告の広告費(内生性): 60 + 1.5 * (season + demand_shock) のように、季節性と需要ショックの両方に比例させています。季節性はモデルでも調整できますが、需要ショックは観測できないため、調整しきれない交絡が残ります。
- 真の売上貢献: true_params の値を使い、geometric_adstock(総和形のアドストック。L=13 は当週を含む13週分、つまり を足し合わせる設定で、本文の式の上限 に当てはめると に相当します)と hill を順に適用して、効果の上限 beta を掛けています。true_contrib は答え合わせ用で、推定には使いません。true_params の値は、表のチャネルごとの特性を持たせた例です。
- 観測できるデータ: df には、週番号・売上・3チャネルの広告費だけを入れています。demand_shock や true_contrib を入れないことで、「現実の分析者が手にするデータ」を再現しています。
- データの性質の確認: 各チャネルの平均広告費と真の平均売上貢献に加えて、検索広告費と需要ショックの相関(内生性の強さ)と、TVとSNSの広告費の相関(多重共線性の有無)を表示しています。
実行結果
TV    : 平均広告費  104.7  真の平均売上貢献  19.5 /週
Search: 平均広告費   56.4  真の平均売上貢献  26.6 /週
SNS   : 平均広告費  164.3  真の平均売上貢献  36.5 /週
検索広告費と観測できない需要ショックの相関: 0.39
TV広告費とSNS広告費の相関: -0.00
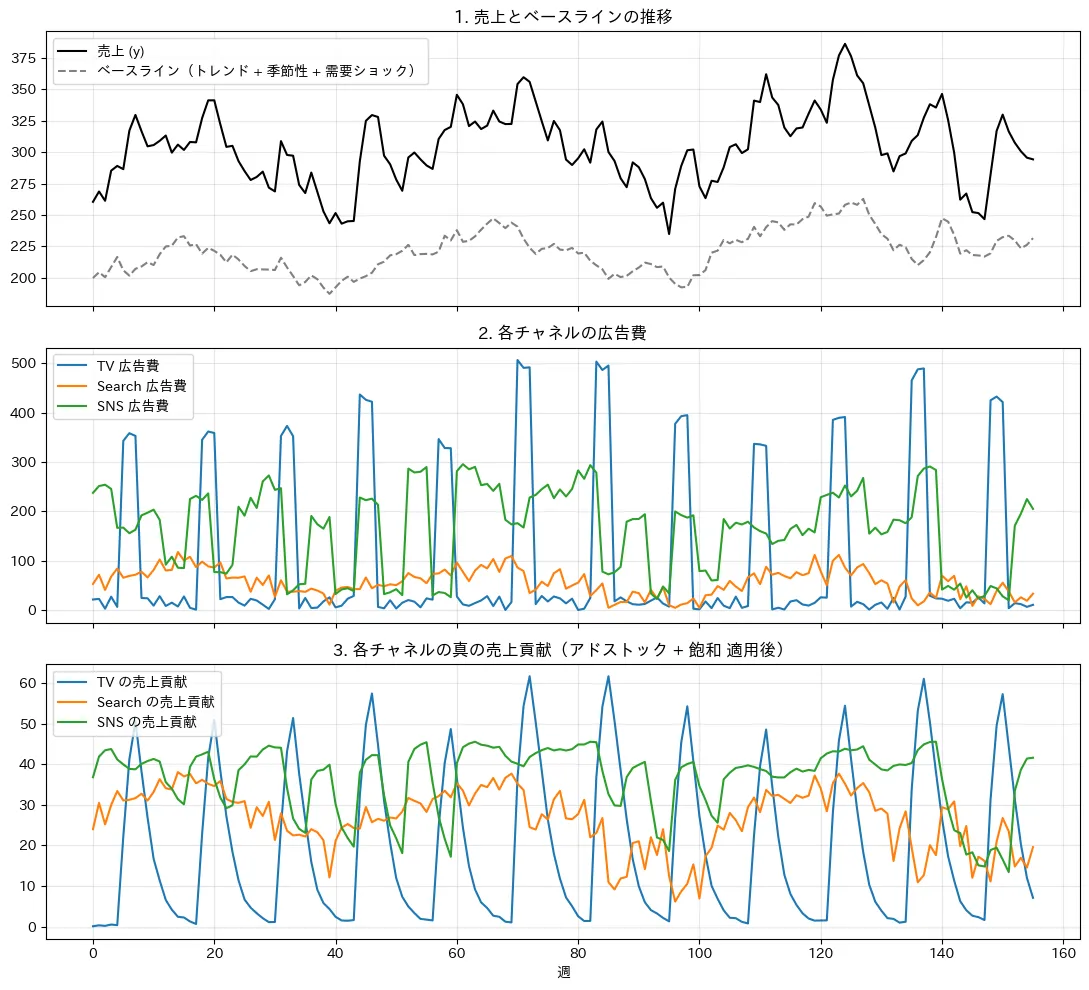
生成されたデータから、次のことが読み取れます。
- TVの遅延とS字効果: キャンペーンの3週間に出稿が集中し、売上貢献はキャンペーン終了後も数週間かけて減衰しています。普段の少額出稿の時期は、貢献がほぼ0になっています。
- 検索広告の内生性: 検索広告費と観測できない需要ショックの相関は0.39です。売上が高い時期に検索広告費も増えやすい、という交絡の関係が再現されています。
- 多重共線性はない: TVとSNSの広告費の相関はほぼ0で、互いに独立に動いています(多重共線性がある場合は、後の「落とし穴」の節で扱います)。
現実のデータ分析では、観測できるのは「売上 」と「各広告費」だけです。次節からは、この観測データだけを手掛かりに、PyMCを用いたベイズ推論で隠された真のパラメータを逆算します。
スクラッチ実装:PyMCによるベイズMMMの推定
ベイズ推定をMMMに用いる最大の利点は、マーケティングの業務知識を「事前分布」としてモデルに組み込めることです。単なる最小二乗法では係数の符号に制約がないため、ノイズや多重共線性の影響で「広告費を増やしたら売上が減る」といった結果が出ることがありますが、確率分布の形を選ぶことで、物理的にあり得ない結果を防げます。ただし、観測できない要因による交絡(内生性)の偏りは、事前分布だけでは解消できません。この点は、後の「内生性の補正」の節で扱います。MCMCの仕組みや収束診断の読み方については、MCMCの記事を参照してください。
本実装では、事前分布を次のように設計します。
- 減衰率 :0から1の間しか値を取らない 分布。
- 半飽和点 :正の値を取る 分布。 はアドストック量の単位で、本実装では広告費をチャネルごとの最大値で割って0〜1に揃えているため、そのスケーリング後の単位で考えます。
- 形状 :正の値を取る 分布(平均1.5)。C字カーブもS字カーブも取りうるように、1をまたぐ範囲に置きます。
- 効果の上限 :必ず正の値を取る (半正規分布)。
広告費をスケーリングするのは、チャネルによって広告費の桁が違っても同じ形の事前分布を使えるようにするためです。スケールを揃えずに事前分布を置くと、真の値が事前分布のほぼ外側に来てしまい、推定がうまくいきません。
本記事のMCMCによる推定は、1回あたり2〜3分程度かかります(CPU 1コアで実行した場合)。記事全体では6回推定するため、すべてのコードを通して実行すると15分前後かかります。
また、アドストックの総和計算をPyMCの内部でループ処理すると計算が遅くなるため、あらかじめ過去 期分の広告費を横に並べた「ラグ行列」を作成し、減衰重みのベクトルとの内積で一括計算します。ベースラインのトレンドと季節性は、時間の一次項と1年周期のフーリエ項(, )で表します。
import pymc as pm
import pytensor.tensor as pt
import arviz as az

L = 13
channels = ['TV', 'Search', 'SNS']

# 1. 広告費のスケーリングとラグ行列
spend_scale = {c: df[c].max() for c in channels}  # 各チャネルの最大値で割り、0〜1に揃える

def make_lag_matrix(x, L):
    """l列目に l週前の値を並べた行列(過去のない序盤は0埋め)"""
    X = np.zeros((len(x), L))
    for l in range(L):
        X[l:, l] = x[:len(x) - l]
    return X

X_lag = {c: make_lag_matrix(df[c].values / spend_scale[c], L) for c in channels}

# 2. コントロール変数(標準化した時間 + 1年周期のフーリエ項)
w = df['week'].values
controls = np.column_stack([
    (w - w.mean()) / w.std(),
    np.sin(2 * np.pi * w / 52),
    np.cos(2 * np.pi * w / 52),
])

# 3. ベイズMMMを組み立てる関数(後の節でも使い回す)
def build_mmm(X_lag, controls, y, lift_tests=None):
    with pm.Model() as model:
        # ベースライン: 切片 + コントロール変数
        intercept = pm.Normal('intercept', mu=y.mean(), sigma=50)
        gamma = pm.Normal('gamma', mu=0, sigma=20, shape=controls.shape[1])
        mu = intercept + pt.dot(controls, gamma)

        contribs = {}
        for c in channels:
            theta = pm.Beta(f'theta_{c}', alpha=2, beta=2)       # 減衰率: 0〜1
            K = pm.Gamma(f'K_{c}', alpha=2, beta=2)              # 半飽和点(スケーリング後の単位)
            S = pm.Gamma(f'S_{c}', alpha=3, beta=2)              # 形状: 平均1.5
            beta = pm.HalfNormal(f'beta_{c}', sigma=100)         # 効果の上限: 正の値

            adstock = pt.dot(X_lag[c], theta ** np.arange(L))    # アドストック(総和形)
            contribs[c] = pm.Deterministic(
                f'contrib_{c}', beta * adstock ** S / (adstock ** S + K ** S)
            )
            mu = mu + contribs[c]

        # 実験結果(リフト試験)があれば、尤度として追加する
        for i, test in enumerate(lift_tests or []):
            model_lift = pt.mean(contribs[test['channel']][test['start']:test['end']])
            pm.Normal(f'lift_test_{i}', mu=model_lift, sigma=test['se'], observed=test['lift'])

        sigma = pm.HalfNormal('sigma', sigma=20)
        pm.Normal('y_obs', mu=mu, sigma=sigma, observed=y)
    return model

# 4. 実験結果なしでMCMCサンプリング
with build_mmm(X_lag, controls, df['y'].values):
    trace_base = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)

# 5. 真値との比較(K はスケーリングを戻して元の広告費の単位で表示)
rows = []
for c in channels:
    post = trace_base.posterior
    for p in ['theta', 'K', 'S', 'beta']:
        s = post[f'{p}_{c}'].values.flatten() * (spend_scale[c] if p == 'K' else 1)
        rows.append({'パラメータ': f'{p}_{c}', '真値': true_params[c][p],
                     '推定(平均)': s.mean(), '95%区間': f"[{np.percentile(s, 2.5):.2f}, {np.percentile(s, 97.5):.2f}]"})
print(pd.DataFrame(rows).round(2).to_string(index=False))
print("r_hat の最大値:", float(az.summary(trace_base, var_names=['theta_TV', 'theta_Search', 'theta_SNS', 'K_TV', 'K_Search', 'K_SNS', 'S_TV', 'S_Search', 'S_SNS', 'beta_TV', 'beta_Search', 'beta_SNS'])['r_hat'].max()))
print("発散の数:", int(trace_base.sample_stats['diverging'].sum()))

# 6. 各チャネルの平均売上貢献(1週あたり)
def contrib_summary(trace, channel):
    # (チェーン, ドロー, 週) の配列を週方向に平均し、サンプルごとの平均貢献にする
    s = trace.posterior[f'contrib_{channel}'].values.mean(axis=-1).flatten()
    return s.mean(), np.percentile(s, 2.5), np.percentile(s, 97.5)

print("\n平均売上貢献(1週あたり)")
for c in channels:
    m, lo, hi = contrib_summary(trace_base, c)
    print(f"{c:6s}: 推定 {m:5.1f} [{lo:5.1f}, {hi:5.1f}]  真値 {true_contrib[c].mean():5.1f}")

# 7. 推定した売上貢献と真の売上貢献の推移を比較
fig, axes = plt.subplots(3, 1, figsize=(11, 9), sharex=True)
for ax, c, color in zip(axes, channels, ['C0', 'C1', 'C2']):
    samples = trace_base.posterior[f'contrib_{c}'].values.reshape(-1, T)
    ax.plot(week, true_contrib[c], color='black', linestyle='--', label='真の貢献')
    ax.plot(week, samples.mean(axis=0), color=color, label='推定(事後平均)')
    ax.fill_between(week, *np.percentile(samples, [2.5, 97.5], axis=0), color=color, alpha=0.2, label='95%信用区間')
    ax.set_title(f'{c} の売上貢献')
    ax.legend(loc='upper left')
    ax.grid(True, alpha=0.3)
axes[-1].set_xlabel('週')
plt.tight_layout()
plt.show()
広告費を整形し、ベイズMMMを定義してMCMCで推定しています。
- スケーリング: spend_scale に各チャネルの広告費の最大値を記録し、広告費をそれで割って0〜1の範囲に揃えています。推定後に を元の単位に戻すときにも使います。
- ラグ行列: make_lag_matrix は、 列目に 週前の広告費を並べた (週数, 13) の行列を作ります。これと重みベクトル の内積 pt.dot(X_lag[c], theta ** np.arange(L)) が、総和形のアドストックになります。
- コントロール変数: 標準化した週番号(トレンド)と、52週周期の ・(季節性)を並べています。 と の両方を使うのは、季節の山がどの時期に来るかをデータから推定できるようにするためです(詳しくは下の補足を参照してください)。観測できない需要ショックは、当然ここには入りません。
- ベースライン: pt.dot(controls, gamma) は、コントロール変数の各列(トレンド・・)に、係数 gamma の3つの要素をそれぞれ掛けて足し合わせたものです。これに切片を加えたものが、広告がなくても生じる売上になります。
- モデルを組み立てる関数: build_mmm は、ラグ行列・コントロール変数・売上を受け取ってモデルを返します。後の節で、実験結果を加えたり、学習期間を絞ったりしたモデルを同じ関数で作るためです。
- 売上貢献の記録: pm.Deterministic で、各チャネルの週ごとの売上貢献 contrib_TV などを事後サンプルとして保存しています。推定後に、真の貢献と直接比べられます。
- 事前分布: 減衰率 は、0〜1の範囲で、0や1の極端な値を避けるためです。半飽和点 は、広告費を最大値で割っているので、平均1(観測した広告費の範囲)の付近に来るようにするためです。形状 は、平均1.5で、C字()とS字()の両方を取れるようにするためです。効果の上限 は、週の売上(平均で約300)に比べて十分に広く、効果が正であることだけを仮定するためです。
- リフト試験の受け口: 引数 lift_tests に実験結果を渡すと、尤度が追加されます(次の節で使います)。この節では何も渡していません。
- サンプリング: 非線形なパラメータ同士の相関が強く、事後分布の形が複雑になりやすいため、tune=1500 で調整期間を長めに取り、target_accept=0.95 で慎重に歩かせています。4本の鎖を走らせるのは、鎖の間で結果が一致するか(収束したか)を確かめるためです。
- 真値との比較: ・・・ の事後平均と95%区間を、真値と並べて表示しています。 は spend_scale を掛けて元の広告費の単位に戻しています。
- 平均売上貢献: contrib_summary は、各事後サンプルについて週方向に平均した貢献を求め、その分布を要約します。 や は互いに補い合って動くため、個々のパラメータよりも「実際にどれだけ売上に貢献したか」の方が安定して比べられます。
- 可視化: チャネルごとに、真の貢献(黒の破線)と推定の事後平均・95%信用区間を重ねています。
補足:なぜ sin と cos の両方を入れると、季節の山の位置を推定できるのか
controls は (週数 × 3) の行列、gamma は長さ3のベクトルです。pt.dot(controls, gamma) は、週ごとに次の値を計算しています。
- gamma[0]: 標準化した週番号(線形トレンド)の係数です。売上全体が右肩上がりか下がりかを表します。
- gamma[1]・gamma[2]: と の係数です。この2つは個別に解釈するのではなく、セットで季節性の形を表します。
と の項は、三角関数の合成公式で1本の波にまとめられます(、。なお、ここでの は1年を1周とする角度で、アドストックの減衰率 とは別物です)。
振幅 (季節性の強さ)は係数の大きさで決まり、位相 (山がいつ来るか)は係数の比で決まります。つまり、 と をデータから推定すれば、山の位置も一緒に推定されることになります。山は のときに来るので、山の週は次の式で求まります。
たとえばMMMワールドの真の季節性は なので、、、 となり、山は第13週に来ます。
もし だけを入れると、係数を変えても動かせるのは振幅と符号だけで、山は第13週(係数が負なら第39週)に固定されてしまいます。 だけなら第0週か第26週です。かといって位相 を直接パラメータにすると、 が について非線形になり、扱いにくくなります。 と の2本の線形な項に分解すれば、位相を含めた季節性を、通常の回帰係数として推定できるのです。
なお、gamma はMCMCで推定される確率変数なので、事後サンプルごとに山の週を計算すれば、その不確実性も確認できます。
g = trace_base.posterior['gamma'].values.reshape(-1, 3)
phi = np.arctan2(g[:, 2], g[:, 1])
peak_week = (52 / (2 * np.pi) * (np.pi / 2 - phi)) % 52
この形(1次の調和成分)で表せるのは、年1回の山と谷が半年離れて現れる滑らかな波だけです。年に2回山がある場合(夏と年末など)や、山が鋭い場合は、・ のような高次の項(フーリエ項)を追加します。
実行結果
       パラメータ    真値  推定(平均)            95%区間
    theta_TV   0.7    0.74     [0.70, 0.77]
        K_TV 600.0  628.81 [484.76, 904.46]
        S_TV   2.0    2.25     [1.51, 3.12]
     beta_TV  80.0   73.55  [55.55, 107.51]
theta_Search   0.2    0.29     [0.20, 0.37]
    K_Search  80.0  154.31  [87.76, 281.83]
    S_Search   1.0    1.25     [0.88, 1.75]
 beta_Search  60.0  158.23 [100.64, 240.46]
   theta_SNS   0.4    0.41     [0.30, 0.51]
       K_SNS 150.0  210.46  [69.79, 549.09]
       S_SNS   1.0    1.06     [0.48, 2.03]
    beta_SNS  60.0   70.86  [36.69, 133.74]
r_hat の最大値: 1.0045023344319908
発散の数: 0

平均売上貢献(1週あたり)
TV    : 推定  19.2 [ 16.8,  22.3]  真値  19.5
Search: 推定  48.1 [ 38.0,  60.9]  真値  26.6
SNS   : 推定  39.6 [ 22.7,  69.3]  真値  36.5
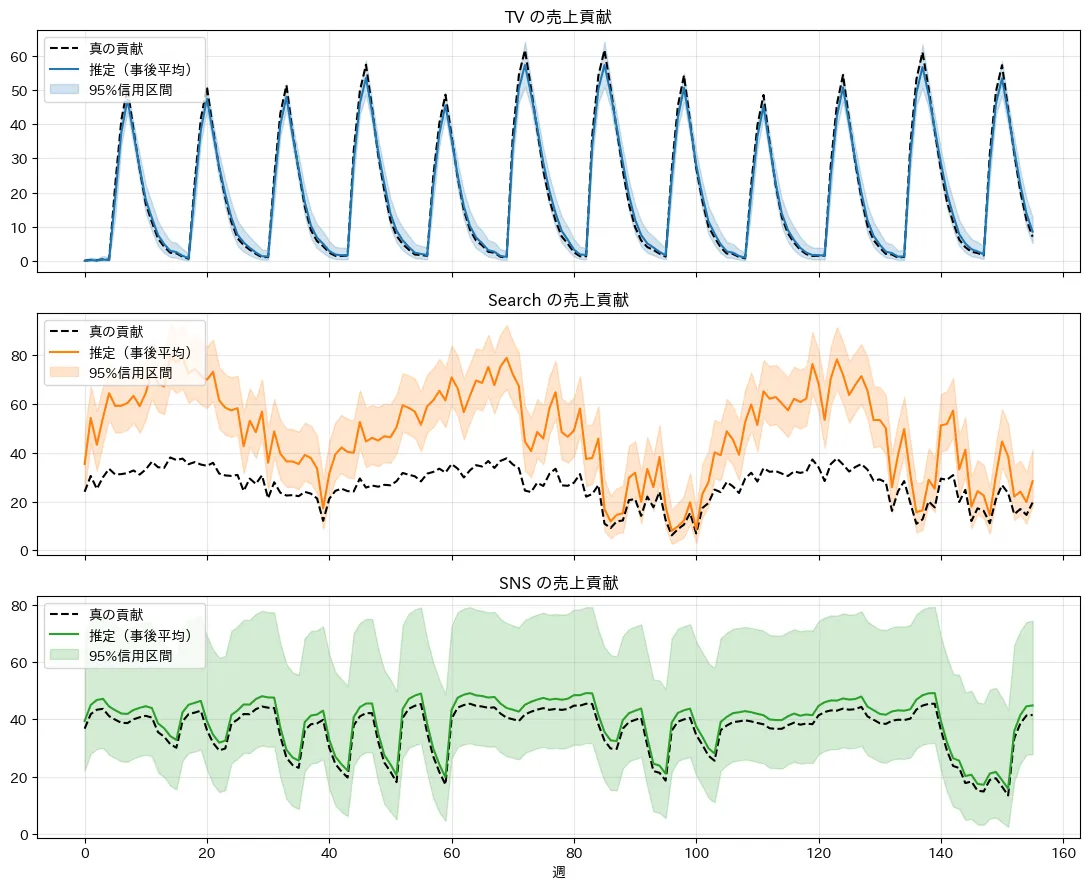
推定結果から、チャネルによって状況が大きく異なることが分かります。
- TV: 減衰率 は 0.74(真値0.7)、形状 は 2.25(真値2.0)と、S字カーブを含めて真の性質をよく捉えています。平均売上貢献も 19.2(真値19.5)で、95%区間が真値を含んでいます。キャンペーンによって広告費が大きく動くため、データから曲線全体を読み取れたのです。
- SNS: は真値に近いものの、 と の区間はかなり広くなっています。平均売上貢献の区間も [22.7, 69.3] と広く、真値36.5は含んでいますが、確信を持って言えることは多くありません。飽和の上限 と半飽和点 は、「上限が大きくて飽和しにくい」組み合わせと「上限が小さくて飽和しやすい」組み合わせでデータへの当てはまりが似てしまうため、互いに補い合って動きます。
- 検索広告: 効果の上限 は 158(真値60)、平均売上貢献は 48.1(真値26.6)と、約1.8倍に過大推定 されました。95%区間 [38.0, 60.9] も真値を含んでいません。観測できない需要ショックが売上と検索広告費を同時に押し上げているため、モデルは需要ショックによる売上の増加まで、検索広告の効果として取り込んでしまったのです。
ここで強調したいのは、 は1.00で発散も0件と、収束診断にはまったく問題がない ことです。収束診断が教えてくれるのは「このモデルとデータのもとで事後分布を正しく計算できたか」であり、「モデルが現実を正しく表しているか」ではありません。観測できない交絡がある限り、どれだけ正確に計算しても、答えは間違ったまま収束します。
内生性の補正:実験結果によるキャリブレーション
前節で見たように、観察データだけでは検索広告の効果が大きく過大推定されてしまいました。このままでは「検索広告の予算を増やすべき」という誤った結論を導いてしまいます。
そこで、ジオ実験などで検索広告の効果を直接測り、その結果をモデルに組み込みます(キャリブレーション)。このとき重要なのは、実験で測れるものは何か です。ジオ実験で測れるのは、「実験期間中の出稿水準で、検索広告が売上をどれだけ押し上げたか」というリフト(売上の増分)です。効果の上限 や半飽和点 を直接測れるわけではありません。
そこで、実験期間 における「モデルが予測する検索広告の平均貢献」が、実験で測定したリフトと一致するように、次の尤度を追加します。
- : 実験で測定された、1週あたりの平均リフト
- : 実験の測定誤差(標準誤差)
- : 実験を行った週の集合
こうすることで、実験結果は だけでなく、・・ を含めた「その出稿水準での貢献」を制約します。PyMC-Marketing などのライブラリにも、リフト試験の結果を尤度として加える機能が用意されています。ただし、尤度の与え方(持ち越し効果を含めるかどうかなど)はライブラリごとに異なるため、その違いはMMMライブラリの記事で扱います。
ここでは、検索広告費が少ない時期(第88〜99週)と多い時期(第8〜19週)に、それぞれ12週間の実験を行ったと想定します。まず実験1だけを組み込んだモデル、次に実験1と実験2の両方を組み込んだモデルを推定し、結果を比べます。
# 1. ジオ実験の結果を用意する
#    (ここでは、実験期間中の検索広告の真の貢献に、測定誤差を加えて模擬する)
rng_exp = np.random.default_rng(7)
experiments = [
    {'name': '実験1(検索広告費が少ない時期)', 'start': 88, 'end': 100},
    {'name': '実験2(検索広告費が多い時期)', 'start': 8, 'end': 20},
]
lift_tests = []
for e in experiments:
    measured = true_contrib['Search'][e['start']:e['end']].mean() + rng_exp.normal(0, 2)
    lift_tests.append({'channel': 'Search', 'start': e['start'], 'end': e['end'], 'lift': measured, 'se': 2.0})
    print(f"{e['name']}: 第{e['start']}〜{e['end'] - 1}週, 平均検索広告費 {search_spend[e['start']:e['end']].mean():5.1f}, "
          f"測定されたリフト {measured:4.1f} ± 2.0 /週")

# 2. 実験1だけを組み込んだモデルと、実験1・2の両方を組み込んだモデル
with build_mmm(X_lag, controls, df['y'].values, lift_tests=lift_tests[:1]):
    trace_calib1 = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)
with build_mmm(X_lag, controls, df['y'].values, lift_tests=lift_tests):
    trace_calib2 = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)

# 3. 検索広告の平均売上貢献を比較
traces = {'実験なし': trace_base, '実験1のみ': trace_calib1, '実験1 + 実験2': trace_calib2}
print(f"\n検索広告の平均売上貢献(真値 {true_contrib['Search'].mean():.1f} /週)")
for name, tr in traces.items():
    m, lo, hi = contrib_summary(tr, 'Search')
    print(f"{name:10s}: {m:5.1f} [{lo:5.1f}, {hi:5.1f}]")

# 4. 検索広告の応答曲線(アドストック量と売上貢献の関係)を比較
adstock_grid = np.linspace(0, 200, 100)          # 元の広告費の単位で表したアドストック量
x_scaled = adstock_grid / spend_scale['Search']   # モデル内のスケールに変換

plt.figure(figsize=(10, 6))
plt.plot(adstock_grid, true_params['Search']['beta'] * hill(adstock_grid, true_params['Search']['K'], 1.0),
         color='black', linestyle='--', linewidth=2, label='真の応答曲線')
for (name, tr), color in zip(traces.items(), ['C3', 'C1', 'C2']):
    post = tr.posterior
    K = post['K_Search'].values.reshape(-1, 1)
    S = post['S_Search'].values.reshape(-1, 1)
    b = post['beta_Search'].values.reshape(-1, 1)
    curves = b * x_scaled ** S / (x_scaled ** S + K ** S)   # 形状: (サンプル数, グリッド数)
    plt.plot(adstock_grid, curves.mean(axis=0), color=color, label=name)
    plt.fill_between(adstock_grid, *np.percentile(curves, [2.5, 97.5], axis=0), color=color, alpha=0.15)
plt.title('検索広告の応答曲線:実験によるキャリブレーションの効果')
plt.xlabel('検索広告のアドストック量')
plt.ylabel('1週あたりの売上貢献')
plt.legend(loc='upper left')
plt.grid(True, alpha=0.3)
plt.show()
実験結果を用意し、それを組み込んだ2つのモデルを推定して比較しています。
- 実験結果の模擬: 本来はジオ実験で測定する値ですが、ここでは実験期間中の検索広告の真の貢献 true_contrib の平均に、標準偏差2の測定誤差を加えて作っています。se は、その測定誤差の大きさ(2.0)です。測定誤差の乱数は、MMMワールドの乱数に影響しないよう、別の乱数生成器 rng_exp から引いています。
- 実験期間の選び方: 実験1は検索広告費が少ない時期、実験2は多い時期に設定しています。出稿水準の異なる2つの時点でリフトを測ることで、応答曲線の形に対する情報が増えます。
- 実験結果の組み込み: build_mmm の lift_tests に実験結果を渡すと、実験期間の貢献の平均 pt.mean(contribs[...][start:end]) を平均とする正規分布の尤度 lift_test_0 などが追加されます。lift_tests[:1] は実験1だけ、lift_tests は両方を渡しています。
- 応答曲線の計算: アドストック量の格子 adstock_grid をモデル内のスケールに変換し、各事後サンプルの ・・ で を計算しています。reshape(-1, 1) でパラメータを縦ベクトルにすることで、(サンプル数, 格子の数) の行列を一度に計算しています。
- 可視化: 真の応答曲線(黒の破線)と、3つのモデルの応答曲線の事後平均・95%信用区間を重ねています。なお、横軸のアドストック量は減衰率 の推定値によって少し変わるため、モデル間で厳密に同じ量ではありませんが、曲線の形の違いを見るには十分です。
実行結果
実験1(検索広告費が少ない時期): 第88〜99週, 平均検索広告費  23.6, 測定されたリフト 15.4 ± 2.0 /週
実験2(検索広告費が多い時期): 第8〜19週, 平均検索広告費  91.1, 測定されたリフト 35.6 ± 2.0 /週

検索広告の平均売上貢献(真値 26.6 /週)
実験なし      :  48.1 [ 38.0,  60.9]
実験1のみ     :  42.1 [ 37.1,  47.3]
実験1 + 実験2 :  27.5 [ 24.6,  30.4]
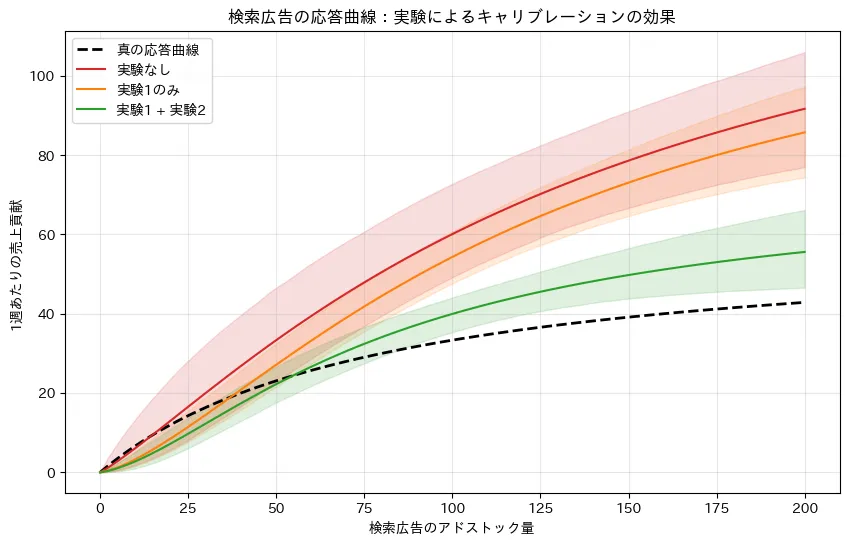
結果から、実験の組み込み方によって補正の度合いが大きく変わることが分かります。
- 実験1のみ: 平均売上貢献は48.1から42.1に下がりましたが、真値26.6にはまだ遠く、95%区間も真値を含みません。応答曲線を見ると、実験1を行った低い出稿水準の部分は真の曲線に近づいたものの、出稿量が多い部分は「実験なし」とほとんど変わっていません。1回の実験が教えてくれるのは、応答曲線上の1点の情報だけなのです。
- 実験1 + 実験2: 出稿水準の高い時期の実験を加えると、平均売上貢献は27.5(95%区間 [24.6, 30.4])となり、真値26.6を区間に含むところまで補正されました。応答曲線も、データのある範囲(アドストック量でおよそ130まで)では真の曲線に近づいています。
キャリブレーションは、観察データの弱点を実験で補う強力な方法です。ただし、実験は応答曲線の「測った場所」しか教えてくれません。実務では、出稿水準や時期を変えて実験を繰り返し、そのたびにモデルを更新していくことが重要です。
3つの条件の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
MMMの落とし穴:多重共線性と予測精度の罠
実務のデータにMMMを適用する際には、時系列の観察データ特有の「落とし穴」が存在します。ここでは、特に陥りやすい多重共線性と、予測精度で因果効果の正しさを判断する罠について解説します。
多重共線性(Multicollinearity)の罠
「夏の大型キャンペーンに合わせて、TVCMとSNS広告の予算を同時に増やす」といったように、複数のチャネルの出稿量が強く相関して動く状態を多重共線性と呼びます。
多重共線性があると、モデルは「どのチャネルが売上に貢献したのか」を切り分けられなくなります。直感的には、売上 がTVとSNSの出稿量で決まるとします。
もしTVとSNSの出稿量がほぼ同じ()であれば、式は次のように変形できます。
このとき、モデルから見れば「係数の和」さえ合っていれば、個別の がどう配分されていてもデータへの当てはまりはほとんど変わりません。その結果、個々のチャネルの効果の不確実性が極端に大きくなります。
実際に、MMMワールドのSNSの出稿をTVのキャンペーンに連動させたデータを作り、推定がどう変わるかを確認してみましょう。
# 1. SNSの出稿をTVのキャンペーンに連動させたデータを作る(他の条件はMMMワールドと同じ)
rng_c = np.random.default_rng(0)
sns_corr = np.clip(20 + 0.5 * tv_spend + rng_c.normal(0, 10, size=T), 0, None)
contrib_sns_corr = 60 * hill(geometric_adstock(sns_corr, 0.4), 150, 1.0)
y_corr = baseline + true_contrib['TV'] + true_contrib['Search'] + contrib_sns_corr + noise
print(f"TV広告費とSNS広告費の相関: {np.corrcoef(tv_spend, sns_corr)[0, 1]:.2f}")

# 2. SNSのラグ行列だけを差し替えて推定
X_lag_corr = dict(X_lag)
X_lag_corr['SNS'] = make_lag_matrix(sns_corr / sns_corr.max(), L)
with build_mmm(X_lag_corr, controls, y_corr):
    trace_corr = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)

# 3. TV・SNS・その合計の平均売上貢献を比較
tv_s = trace_corr.posterior['contrib_TV'].values.mean(axis=-1).flatten()
sns_s = trace_corr.posterior['contrib_SNS'].values.mean(axis=-1).flatten()
true_tv, true_sns = true_contrib['TV'].mean(), contrib_sns_corr.mean()
for name, s, true in [('TV', tv_s, true_tv), ('SNS', sns_s, true_sns), ('TV + SNS', tv_s + sns_s, true_tv + true_sns)]:
    print(f"{name:8s}: 推定 {s.mean():5.1f} [{np.percentile(s, 2.5):5.1f}, {np.percentile(s, 97.5):5.1f}]  真値 {true:5.1f}")
print(f"TVとSNSの推定貢献の相関(事後サンプル間): {np.corrcoef(tv_s, sns_s)[0, 1]:.2f}")

# 4. 事後サンプルの散布図
plt.figure(figsize=(7, 6))
plt.scatter(tv_s, sns_s, s=4, alpha=0.2, color='C0', label='事後サンプル')
plt.scatter([true_tv], [true_sns], marker='*', s=300, color='red', label='真値')
plt.xlabel('TV の平均売上貢献 /週')
plt.ylabel('SNS の平均売上貢献 /週')
plt.title('多重共線性があるときの事後分布')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
SNSの広告費だけを差し替えたデータで、同じモデルを推定しています。
- SNSの出稿をTVに連動させる: sns_corr は、TVの広告費の半分に一定額とノイズを加えたものです。TVのキャンペーン期間にSNSも増える、という状況を再現しています。SNSの真のパラメータ(、、、)と、ベースライン・観測ノイズは元のMMMワールドと同じです。TVの広告費の半分にするのは、TVのキャンペーン期間にSNSも大きく増え、2つのチャネルの広告費が強く相関する状況を作るためです。
- ラグ行列の差し替え: dict(X_lag) で元のラグ行列の辞書を複製し、SNSのラグ行列だけを新しいデータで作り直しています。TVと検索広告の入力は変わりません。
- 貢献の比較: TV・SNSそれぞれの平均売上貢献と、その合計を、真値と並べて表示しています。事後サンプルごとに計算しているので、合計の区間も正しく求められます。
- 事後サンプル間の相関: np.corrcoef(tv_s, sns_s) で、「TVの貢献が大きいサンプルほどSNSの貢献が小さいか」を確かめています。
- 可視化: 各事後サンプルの(TVの貢献, SNSの貢献)を散布図にし、真値を星印で重ねています。
実行結果
TV広告費とSNS広告費の相関: 0.99
TV      : 推定  13.9 [  1.7,  24.6]  真値  19.5
SNS     : 推定  23.3 [ 10.8,  37.3]  真値  22.5
TV + SNS: 推定  37.2 [ 29.8,  52.9]  真値  42.0
TVとSNSの推定貢献の相関(事後サンプル間): -0.56
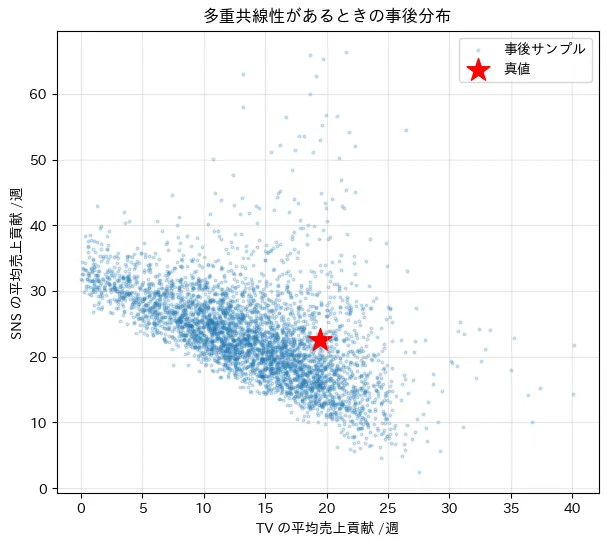
TVとSNSの広告費の相関は0.99と、ほぼ同じ動きになりました。
- 個々の貢献の不確実性が大きく広がる: TVの平均売上貢献の95%区間は [1.7, 24.6] です。元のMMMワールドでは [16.8, 22.3] だったので、区間の幅は4倍以上に広がりました。SNSも [10.8, 37.3] と広い区間になっています。
- 片方を多く見積もると、もう片方が少なくなる: 散布図の事後サンプルは右下がりに分布し、相関は -0.56 です。「TVの効果が大きく、SNSの効果が小さい」説明と、その逆の説明が、データからはどちらも同じくらいもっともらしく見えている状態です。
多重共線性は、データをどれだけ精密に分析しても解消できません。チャネルごとに出稿のタイミングをずらす、どちらか一方だけを止める期間やジオ実験を設けるなど、データの取り方そのものを工夫する 必要があります。
予測精度が高いモデルは、因果効果も正しいか?
機械学習の分野では、学習に使わなかったデータに対する予測精度(ホールドアウト検証)でモデルの良し悪しを判断するのが一般的です。MMMでも同じ考え方で良いのでしょうか。
MMMワールドのデータを使い、最初の130週で学習して残りの26週を予測してみます。比べるのは、実験を組み込んでいない(検索広告を過大推定する)モデルと、実験1・2を組み込んだモデルです。
# 1. 最初の130週で学習し、残りの26週を予測する
n_train = 130
train, test = slice(0, n_train), slice(n_train, T)
X_lag_train = {c: X_lag[c][train] for c in channels}
y_train = df['y'].values[train]

with build_mmm(X_lag_train, controls[train], y_train):
    trace_train_base = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)
with build_mmm(X_lag_train, controls[train], y_train, lift_tests=lift_tests):
    trace_train_calib = pm.sample(1000, tune=1500, chains=4, target_accept=0.95, random_seed=42)

# 2. 事後サンプルから、指定した週の売上を予測する
def predict(trace, rows):
    post = trace.posterior
    mu = post['intercept'].values.reshape(-1, 1) + post['gamma'].values.reshape(-1, controls.shape[1]) @ controls[rows].T
    for c in channels:
        theta = post[f'theta_{c}'].values.reshape(-1, 1)
        K = post[f'K_{c}'].values.reshape(-1, 1)
        S = post[f'S_{c}'].values.reshape(-1, 1)
        b = post[f'beta_{c}'].values.reshape(-1, 1)
        adstock = (theta ** np.arange(L)) @ X_lag[c][rows].T   # 形状: (サンプル数, 週数)
        mu = mu + b * adstock ** S / (adstock ** S + K ** S)
    return mu.mean(axis=0)

# 3. 検証期間の予測誤差と、学習期間での検索広告の貢献を比較
y_test = df['y'].values[test]
print(f"検索広告の真の平均売上貢献(学習期間): {true_contrib['Search'][train].mean():.1f} /週\n")
plt.figure(figsize=(11, 5))
plt.plot(week[test], y_test, color='black', marker='o', label='実際の売上')
for (name, tr), color in zip([('実験なし', trace_train_base), ('実験1 + 実験2', trace_train_calib)], ['C3', 'C2']):
    pred = predict(tr, test)
    mae = np.mean(np.abs(y_test - pred))
    m, lo, hi = contrib_summary(tr, 'Search')
    print(f"{name:10s}: 検証期間の予測誤差(MAE) {mae:5.2f}  |  検索広告の平均売上貢献 {m:5.1f} [{lo:5.1f}, {hi:5.1f}]")
    plt.plot(week[test], pred, color=color, marker='s', label=f'予測({name})')
plt.title('検証期間(第130〜155週)の予測')
plt.xlabel('週')
plt.ylabel('売上')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
学習期間と検証期間に分けて2つのモデルを推定し、検証期間の予測精度を比べています。
- 期間の分割: slice(0, n_train) で最初の130週を学習用、残りの26週を検証用にしています。時系列データなので、ランダムに分けるのではなく、「過去で学習して未来を予測する」順序で分けています。検証期間を最後の26週(半年)にするのは、季節の山(第13週・第65週・第117週)を学習期間に含めたまま、半年先の予測を確かめるためです。
- ラグ行列の切り出し: ラグ行列は全期間で作ったものから学習期間の行だけを取り出しています。検証期間の最初の週でも、学習期間の広告費がアドストックとして正しく反映されます。
- 2つのモデル: 実験なしのモデルと、実験1・2を組み込んだモデルを、どちらも学習期間のデータだけで推定しています。2つの実験はいずれも学習期間内(第8〜19週、第88〜99週)に行ったものです。
- 予測関数: predict は、事後サンプルごとにベースライン(切片 + コントロール変数)と3チャネルの貢献を計算し、その平均を予測値として返します。(theta ** np.arange(L)) @ X_lag[c][rows].T で、全サンプルのアドストックを一度に計算しています。
- 比較する指標: 検証期間の平均絶対誤差(MAE)と、学習期間における検索広告の平均売上貢献を並べて表示しています。
実行結果
検索広告の真の平均売上貢献(学習期間): 27.8 /週

実験なし      : 検証期間の予測誤差(MAE)  7.97  |  検索広告の平均売上貢献  52.1 [ 40.8,  66.7]
実験1 + 実験2 : 検証期間の予測誤差(MAE)  9.08  |  検索広告の平均売上貢献  29.0 [ 26.0,  32.1]
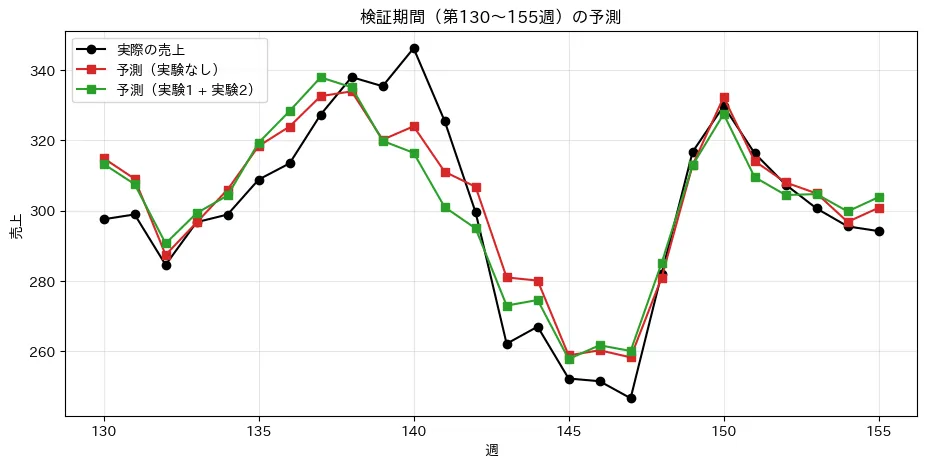
結果は、直感に反するものになりました。
- 予測誤差は、実験なしのモデルの方が小さい: 検証期間のMAEは、実験なしのモデルが7.97、実験を組み込んだモデルが9.08でした。
- しかし、検索広告の効果を正しく捉えているのは実験を組み込んだモデル: 実験なしのモデルは、検索広告の平均売上貢献を52.1(真値27.8)と約1.9倍に過大推定したままです。
なぜ、効果を間違えているモデルの方が予測は当たるのでしょうか。理由は、検索広告費が「観測できない需要ショック」と相関していることにあります。実験なしのモデルは、検索広告費を需要の代わりの指標 として使い、「検索広告費が多い週は需要も高い」という相関を売上の予測に活かしています。予測だけが目的なら、これは有効な戦略です。
しかし、その相関は「検索広告費を増やせば売上が増える」という因果関係ではありません。実験なしのモデルを信じて検索広告費を増やしても、需要ショックは増えないため、期待したほど売上は伸びません。MMMの目的は予測ではなく、「広告費を変えたら売上がどう変わるか」という因果効果を知ること です。予測精度はモデルの必要条件のチェックにはなりますが、因果効果の正しさを保証するものではありません。因果効果の正しさは、実験による検証でしか確かめられないのです。
なお、実験を組み込んだ学習期間のモデルでは、サンプリング時に発散が1件報告されました。件数はごくわずかですが、実務で結果を使う場合は、MCMCの記事で紹介したように target_accept を上げて再実行し、発散が0件になることを確認するのが安全です。
2つのモデルの予測精度と効果の推定を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、複数チャネルの広告効果を同時に評価し、マーケティング投資の全体最適化を導くための基盤となる マーケティングミックスモデル(MMM) の数理と実装を解説しました。
- 広告効果の数式化: 広告特有の「持ち越し効果(アドストック)」と「飽和効果(Hill関数)」を数式として定義し、MMMの基本式を構築しました。
- PyMCによるベイズ推定のスクラッチ実装: 広告費のスケーリングとラグ行列を用いてベイズMMMを実装し、TVのS字カーブを含む真の性質を復元できることを確認しました。
- 内生性による過大推定: 観測できない需要が検索広告費と売上を同時に動かすと、収束診断に問題がなくても、効果は大きく過大推定されることを確認しました。
- 実験結果によるキャリブレーション: 実験で測れるのはその出稿水準でのリフトであることを踏まえ、リフトを尤度としてモデルに組み込みました。出稿水準の異なる2つの実験を組み込むことで、過大推定を真値の近くまで補正できました。
- MMMの落とし穴: 多重共線性があると個々のチャネルの効果は切り分けられないこと、そして予測精度の高いモデルが因果効果を正しく捉えているとは限らないことを、シミュレーションで確認しました。
MMMは単なる回帰分析ではなく、マーケティングのドメイン知識と実験結果を統合するための「器」です。実験で得られた局所的な真実をモデルに流し込み、キャリブレーションを繰り返すことで、初めて信頼できる意思決定が可能になります。
「PyMC-Marketing・Meridian・RobynによるMMM実践」の記事では、本記事で学んだ理論をベースに、PyMC-Marketing、GoogleのMeridian、MetaのRobynといった主要なOSSライブラリの設計思想の違いと使い分けを、同じMMMワールドのデータを推定しながら解説します。さらにその先の記事「MMMによる予算配分の最適化とは?」では、推定したMMMが描き出す「応答曲線」と「限界ROAS」を用いて、限られた予算を各チャネルにどう配分すれば売上を最大化できるかという最適化問題にも取り組みます。「測る」フェーズから「配分する」フェーズへと、マーケティング意思決定のループを進めていきましょう。
参考文献
- Y. Jin, Y. Wang, Y. Sun, D. Chan, J. Koehler (2017). Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects. Google Research.
- D. Chan, M. Perry (2017). Challenges and Opportunities in Media Mix Modeling. Google Research.
- O. Abril-Pla et al. (2023). PyMC: a modern, and comprehensive probabilistic programming framework in Python. PeerJ Computer Science, 9, e1516.
本記事の文章・構成の一部に生成AIを使用しています。