PyMC-Marketing・Meridian・RobynによるMMM実践
 (画像は、Geminiで作成)
同じMMMワールドのデータを、PyMC-Marketing・Google Meridian・Meta Robynという3つの主要なOSSライブラリで推定し、それぞれの設計思想の違いと使い分けを理解すること。
概要
MMMの記事では、アドストックと飽和を組み込んだベイズMMMを、PyMCを用いてゼロから実装しました。スクラッチ実装は、モデルの中身(事前分布・尤度・アドストックの計算)を完全に把握できるという大きな利点があります。しかし実務でMMMを回すたびに、ラグ行列の作成やHill関数の実装、収束診断、応答曲線の描画までをすべて自前で書くのは現実的ではありません。
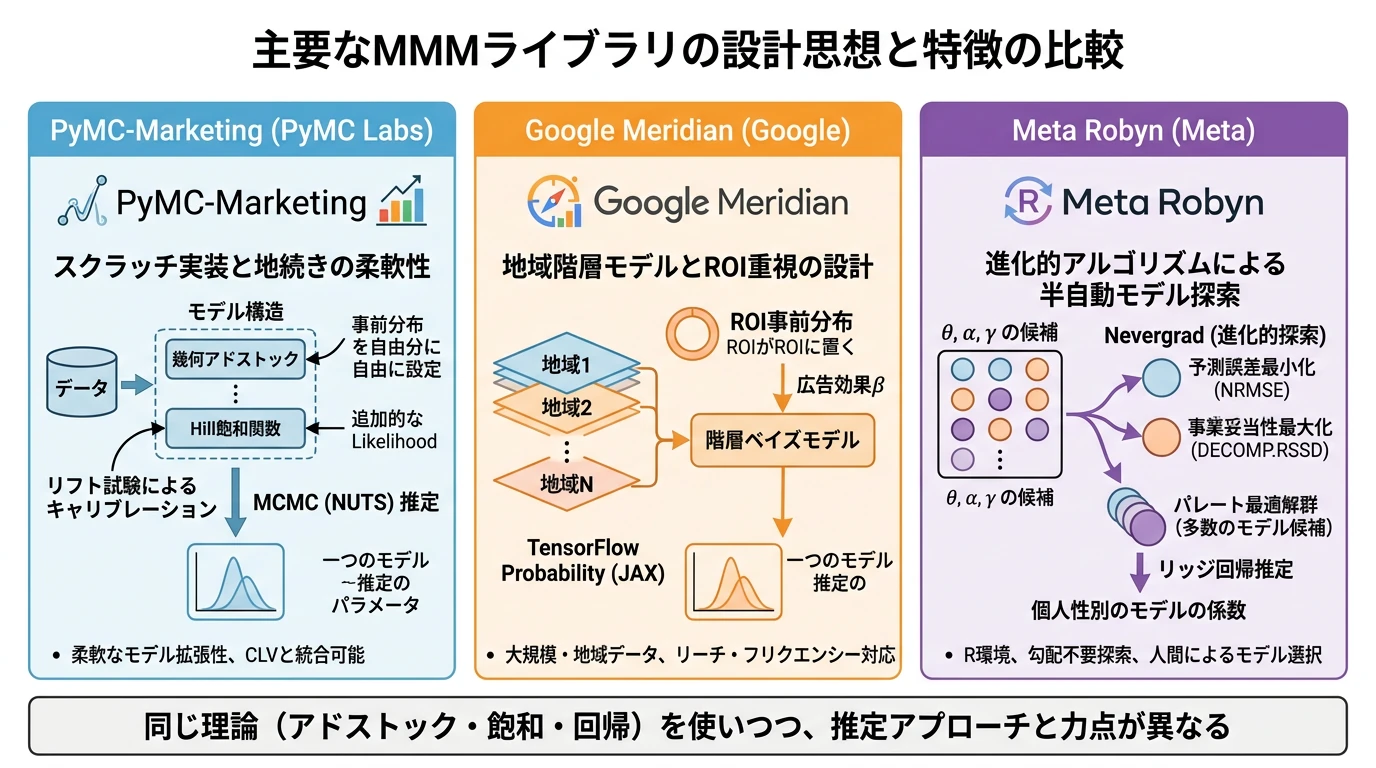
そこで登場するのが、MMMのためのOSSライブラリです。本記事では、現在広く使われている次の3つを取り上げます。
- PyMC-Marketing(PyMC Labs): PyMCの上に構築されたベイズMMMライブラリ。スクラッチ実装と地続きで、柔軟性が高い。
- Google Meridian: Googleが開発するベイズMMM。地域階層モデルやリーチ・フリクエンシー、ROIを事前分布に置く設計が特徴。
- Meta Robyn: Metaが開発するMMM。ベイズではなくリッジ回帰と進化的アルゴリズムを組み合わせた、独特のアプローチをとる。
アドストック・飽和・事前分布といったMMMの理論そのものはMMMの記事で扱ったため、本記事では繰り返しません。各ライブラリが採用している変換(幾何型・ワイブル型のアドストック、Hill関数などの飽和)の数式と違いは、アドストックと飽和曲線の記事で扱っています。ここでの主役は「同じ問題を、各ライブラリがどう解くのか」という設計思想の違いです。まずPyMC-MarketingでMMMワールドのデータを実際に推定してスクラッチ実装の結果と突き合わせ、そのうえでMeridianとRobynのコードと設計思想を見ていきます。
3つのライブラリの全体像
コードに入る前に、3つのライブラリがどのような思想で作られているかを俯瞰しておきます。同じ「アドストック+飽和+回帰」という骨格を持ちながら、推定の方法(ベイズか、リッジ回帰+最適化か)と、どこに力点を置くか(柔軟性か、地域階層か、自動化か)が大きく異なります。
PyMC-Marketing(PyMC Labs)
PyMC-Marketingは、ベイズ統計ライブラリ PyMC の上に構築されたマーケティング分析ライブラリです。MMMの記事で書いたスクラッチ実装と同じ「PyMC + MCMC(NUTS)」の道具立てをそのまま使うため、スクラッチ実装からの移行がもっとも自然です。
- 柔軟性: アドストックや飽和の関数を部品(クラス)として差し替えられ、事前分布も自由に設定できます。スクラッチ実装で書いたモデルを、ほぼそのままライブラリの語彙に翻訳できます。
- リフト試験の組み込み: MMMの記事で尤度として手書きした実験結果(キャリブレーション)を、専用のメソッドで追加できます。
- CLVモジュール: MMMだけでなく、顧客生涯価値(CLV)を推定するモジュール(BG/NBDやGamma-Gammaモデル)も同梱しています。これらは、「BG/NBDモデルとGamma-Gammaモデルとは?」の記事で使っています。
Google Meridian
Meridianは、Googleが開発するベイズMMMです。TensorFlow Probability を基盤とし、サンプリングにはNUTSを用います。かつてGoogleが公開していた LightweightMMM は現在メンテナンスが終了しており、公式にはMeridianが後継と位置づけられています(LightweightMMMのリポジトリにも「Meridianへの移行を強く推奨する」旨が明記されています)。
Meridianの設計の中心は、大規模な広告主が直面する次のような要件です。
- 地域階層モデル: 国全体を1本の時系列として扱うのではなく、地域(geo)ごとの時系列を階層ベイズでまとめて推定します。データ点が増えるため、パラメータをより安定して推定できます。
- ROIを事前分布に置く: 係数 に直接事前分布を置く代わりに、チャネルごとの ROI(投資対効果) に事前分布を置く設計を採ります。「このチャネルのROIはおおよそこれくらい」というジオ実験の結果を、そのまま事前情報として組み込めます。
- リーチ・フリクエンシー: 広告費だけでなく、到達人数(リーチ)と接触回数(フリクエンシー)を分けてモデル化できます。
Meta Robyn
Robynは、Metaが開発するMMMで、3つの中で唯一 ベイズを使いません。推定の骨格は次の2段構えです。
- リッジ回帰: アドストックと飽和で変換した広告費を説明変数に、売上を リッジ回帰(L2正則化つき線形回帰)で当てはめます。多重共線性に強く、係数が極端な値になるのを防ぎます。
- 進化的アルゴリズムによるハイパーパラメータ探索: アドストックの減衰率や飽和の形状、正則化の強さといった ハイパーパラメータ を、Metaの勾配を使わない最適化ライブラリ Nevergrad で探索します。予測誤差(NRMSE)と、各チャネルの「出稿シェアと効果シェアのズレ」(DECOMP.RSSD)を同時に小さくする、多目的最適化のパレート最適解を多数生成します。
このハイパーパラメータ探索は、局所探索(山登り法)や焼きなまし法の記事で扱った、勾配を使わない探索の一種です。山登り法が局所解に陥りやすいのに対し、Robynが使う進化的アルゴリズム(差分進化)は、複数の候補解を同時に保持しながら探索するため、広いハイパーパラメータ空間から多様な解を見つけ出せます。「良いモデルを1つ選ぶ」のではなく「もっともらしいモデルを多数提示し、人間が事業知識で選ぶ」という思想が、ベイズ的なライブラリとの大きな違いです。
3つのライブラリの関係を図にまとめると、次のようになります。
(図は、diagram-designで作成)
PyMC-MarketingでMMMワールドを推定する
まずは、スクラッチ実装と地続きのPyMC-Marketingから始めます。MMMの記事で作成したMMMワールドと同じデータを推定し、スクラッチ実装の結果と突き合わせます。
本記事のPyMC-Marketingのコードは、次のバージョンで動作を確認しています。
- pymc-marketing 1.1.0
- pymc 6.2.0
- pymc-extras 0.14.0
- arviz 1.3.0
- numpy 2.3.4 / pandas 2.3.3
ライブラリのAPIはバージョンによって変わりやすいため、実行時には公式ドキュメント(pymc-marketing.io)で最新のAPIを確認してください。
ライブラリのインストール(Google Colab)
本記事のコードはGoogle Colabで実行することを想定しています。Colabには PyMC-Marketing がプリインストールされていないため、最初のセルで次のコマンドを実行してライブラリをインストールします。
# Google Colab で最初に1回だけ実行する
!pip install -q pymc-marketing==1.1.0 pymc==6.2.0 pymc-extras==0.14.0 arviz==1.3.0
!pip install -q japanize-matplotlib setuptools
必要なライブラリをインストールしています。
- バージョンの固定: pymc-marketing・pymc・arviz は、本記事で動作確認したバージョンに固定しています。PyMC-MarketingのAPIはバージョンによって変わりやすいため、記事と同じ結果を得るには固定しておくのが安全です。
- pymc-extras: 事前分布を指定する Prior クラスは pymc_extras.prior から読み込みます。最新版の pymc-extras は新しい pymc(6.3以降)を要求して依存関係が衝突するため、pymc 6.2系に対応する 0.14.0 を指定しています。
- japanize-matplotlib と setuptools: グラフの日本語表示に使う japanize-matplotlib は、Python 3.12以降で削除された distutils に依存しています。setuptools を一緒にインストールすると distutils の代替が提供され、インポート時のエラー(ModuleNotFoundError: No module named 'distutils')を回避できます。
Colabにプリインストールされている numpy・pandas などのバージョンが入れ替わるため、インストール後に「ランタイム → セッションを再起動する」を実行してから、以降のセルを実行してください。再起動せずに進めると、古いバージョンのライブラリが読み込まれたままになり、インポート時にエラーが出ることがあります。
データの再生成
推定に使うMMMワールドのデータを生成します。このデータはMMMの記事で作成したものと同一で、3年分(156週)の週次データに、性質の異なる3つの広告チャネル(TV・検索広告・SNS)と、分析者には観測できない需要ショック を仕込んでいます。真のパラメータは次のとおりです(詳しい設計意図はMMMの記事を参照してください)。
| チャネル | (減衰率) | (半飽和点) | (形状) | (効果の上限) |
|---|---|---|---|---|
| TV | 0.7 | 600 | 2.0 | 80 |
| 検索広告 | 0.2 | 80 | 1.0 | 60 |
| SNS | 0.4 | 150 | 1.0 | 60 |
検索広告費は需要ショックと相関しており(内生性)、スクラッチ実装ではこの内生性によって効果が過大推定されました。同じ現象が、ライブラリを使っても起きることを確認します。
import numpy as np
import pandas as pd

# 1. 乱数と期間の設定(3年分の週次データ)
rng = np.random.default_rng(42)
T = 156
week = np.arange(T)

# 2. 広告がなくても生じる売上(ベースライン)
trend = 200 + 0.3 * week                      # 緩やかな成長
season = 20 * np.sin(2 * np.pi * week / 52)   # 1年周期の季節性
demand_shock = np.zeros(T)                     # 分析者が観測できない需要の変動(AR(1))
for t in range(1, T):
    demand_shock[t] = 0.8 * demand_shock[t - 1] + rng.normal(0, 6)
baseline = trend + season + demand_shock

# 3. 各チャネルの広告費
tv_spend = rng.uniform(0, 30, size=T)                        # TV: 普段は少額
for start in range(5, T, 13):
    tv_spend[start:start + 3] += rng.uniform(250, 500)       # 13週ごとに大型キャンペーン
sns_monthly = rng.uniform(10, 300, size=T // 4 + 1)         # SNS: 4週ごとに予算が変わる
sns_spend = np.clip(np.repeat(sns_monthly, 4)[:T] + rng.normal(0, 10, size=T), 0, None)
# 検索広告(内生性の仕込み): 季節性と観測できない需要の両方に反応して増減する
search_spend = np.clip(60 + 1.5 * (season + demand_shock) + rng.normal(0, 12, size=T), 5, None)

spends = {'TV': tv_spend, 'Search': search_spend, 'SNS': sns_spend}

# 4. 真のパラメータ(分析者には分からない「答え」)
true_params = {
    'TV':     {'theta': 0.7, 'K': 600, 'S': 2.0, 'beta': 80},
    'Search': {'theta': 0.2, 'K': 80,  'S': 1.0, 'beta': 60},
    'SNS':    {'theta': 0.4, 'K': 150, 'S': 1.0, 'beta': 60},
}

# 5. アドストック(総和形)とHill関数
def geometric_adstock(x, theta, L=13):
    out = np.zeros(len(x))
    for t in range(len(x)):
        for l in range(min(t + 1, L)):
            out[t] += theta ** l * x[t - l]
    return out

def hill(x, K, S):
    return x ** S / (x ** S + K ** S)

# 6. 各チャネルの真の売上貢献
true_contrib = {
    c: p['beta'] * hill(geometric_adstock(spends[c], p['theta']), p['K'], p['S'])
    for c, p in true_params.items()
}

# 7. 売上 = ベースライン + 広告の貢献 + 観測ノイズ
noise = rng.normal(0, 5, size=T)
y = baseline + sum(true_contrib.values()) + noise

# 8. 分析者が観測できるデータ(需要ショックや真の貢献は含めない)
df = pd.DataFrame({'week': week, 'y': y, 'TV': tv_spend, 'Search': search_spend, 'SNS': sns_spend})
for c in true_params:
    print(f"{c:6s}: 真の平均売上貢献 {true_contrib[c].mean():5.1f} /週")
MMMワールドのデータを再生成しています。生成過程の詳しい解説はMMMの記事にあるため、ここでは要点だけを述べます。
- ベースライン: トレンド・52週周期の季節性・観測できない需要ショック(AR(1))の和です。demand_shock は分析者が観測できず、df にも含めません。
- 検索広告の内生性: search_spend を season + demand_shock に比例させ、需要が高い週ほど検索広告費も増える構造を作っています。
- 観測できるデータ: df には週番号・売上・3チャネルの広告費だけを入れ、真の貢献 true_contrib は答え合わせにのみ使います。
実行結果
TV    : 真の平均売上貢献  19.5 /週
Search: 真の平均売上貢献  26.6 /週
SNS   : 真の平均売上貢献  36.5 /週
PyMC-Marketingでモデルを組み立てる
PyMC-Marketingでは、MMMの記事でラグ行列やHill関数を手書きした部分が、すべて部品(クラス)に置き換わります。アドストックは GeometricAdstock、飽和は HillSaturation というクラスで指定し、MMM クラスに渡すだけです。トレンドと季節性も、コントロール列と yearly_seasonality 引数で自動的に組み込まれます。
import arviz as az
from pymc_marketing.mmm import MMM, GeometricAdstock, HillSaturation
from pymc_extras.prior import Prior

# 1. PyMC-Marketing は日付列を要求するので、週次の日付を用意する
df['date'] = pd.date_range('2023-01-02', periods=T, freq='W-MON')
# 2. トレンドをコントロール変数として渡す(標準化した週番号)
df['t'] = (week - week.mean()) / week.std()

X = df[['date', 'TV', 'Search', 'SNS', 't']]
y_obs = df['y']

# 3. MMM の定義: アドストックと飽和を「部品」として渡す
#    θ と S の事前分布はスクラッチ実装(/mmm)と同じ。K と β はスケーリング後の単位で置く
mmm = MMM(
    date_column='date',
    channel_columns=['TV', 'Search', 'SNS'],
    control_columns=['t'],                                    # トレンド
    adstock=GeometricAdstock(                                 # 総和形アドストック(最大13週)
        l_max=13, normalize=False,
        priors={'alpha': Prior('Beta', alpha=2, beta=2)},    # 減衰率 θ: 0〜1
    ),
    saturation=HillSaturation(priors={                       # Hill関数による飽和
        'slope': Prior('Gamma', alpha=3, beta=2),            # 形状 S: 平均1.5
        'kappa': Prior('Gamma', alpha=2, beta=2),            # 半飽和点 K(広告費を最大値で割った単位)
        'beta':  Prior('HalfNormal', sigma=1.5),             # 効果の上限 β(売上を最大値で割った単位)
    }),
    yearly_seasonality=2,                                     # 1年周期のフーリエ項(2次まで)
)

# 4. MCMC サンプリング(スクラッチ実装より慎重な設定。理由は下の解説を参照)
idata = mmm.fit(X, y_obs, draws=1000, tune=2000, chains=4,
                target_accept=0.99, random_seed=42)
PyMC-MarketingでMMMを定義して推定しています。
- 日付列とスケーリング: PyMC-Marketingは date_column に実際の日付を要求します。広告費と売上のスケーリング(正規化)はライブラリが内部で自動的に行うため、スクラッチ実装で手書きした spend_scale の処理は不要です。
- アドストックと飽和の部品化: GeometricAdstock がMMMの記事の make_lag_matrix と総和形アドストックの計算に、HillSaturation が hill 関数に対応します。normalize=False は、アドストックの重みを の総和形(MMMの記事と同じ)にする指定です(既定の normalize=True は重みの和が1になるよう正規化します)。
- 事前分布の指定: priors に Prior オブジェクトを渡すと、事前分布を上書きできます。減衰率 の と形状 の (平均1.5)は、単位を持たないパラメータなので、MMMの記事のスクラッチ実装と同じ事前分布をそのまま置いています。既定の事前分布のままだと、特にSNSでパラメータが定まりにくく、収束が悪化しました()。
- スケーリング後の単位で置く事前分布: 一方、半飽和点 (kappa)と効果の上限 (beta)は、スクラッチ実装と同じ値をそのまま使えません。PyMC-Marketingは、広告費をチャネルごとの最大値で、売上を売上の最大値で割ってから推定するため、これらの事前分布は スケーリング後の単位 で指定することになるからです。たとえばMMMワールドの売上の最大値は約386なので、真の (60〜80)はスケーリング後には0.16〜0.21程度の値になります。スクラッチ実装の をそのまま渡すと、桁違いに広い事前分布になってしまいます。ここでは に を置いています。これは「効果の上限は、売上全体(スケーリング後の1)と同程度かそれ以下」という程度のゆるい事前分布で、元の単位に戻すと に相当します。スクラッチ実装の と厳密に揃えたい場合は、 を指定します。
- コントロールと季節性: control_columns に標準化した週番号を渡してトレンドを、yearly_seasonality=2 で52週周期のフーリエ項(・を2次まで)を組み込んでいます。スクラッチ実装で手で並べたコントロール変数が、引数1つで済みます。
- サンプリング: mmm.fit の内部で、スクラッチ実装と同じNUTSによるMCMCが走ります。draws・tune・target_accept といった引数の意味はMCMCの記事やMMMの記事と同じです。既定に近い設定(tune=1500・target_accept=0.95)では発散が数十件発生したため、MCMCの記事で紹介した対処に従い、tune=2000・target_accept=0.99 と慎重な設定にしています。推定には10分前後かかります。
推定結果とスクラッチ実装との比較
推定したパラメータと、各チャネルの平均売上貢献を確認します。PyMC-Marketingは広告費を内部でスケーリングしているため、 に相当するパラメータ(saturation_kappa)はスケーリング後の単位になっています。ここでは、単位に依存しない 減衰率 (adstock_alpha) と、元の広告費の単位に戻せる 平均売上貢献 を中心に比較します。
# 1. 推定した減衰率 θ(PyMC-Marketing では adstock_alpha)
post = idata.posterior
print("減衰率 θ(adstock_alpha)の事後平均")
alpha = post['adstock_alpha'].mean(dim=['chain', 'draw']).to_series()
for c in ['TV', 'Search', 'SNS']:
    print(f"  {c:6s}: 推定 {alpha[c]:.2f}  真値 {true_params[c]['theta']}")

# 2. 収束診断
summ = az.summary(idata, var_names=['adstock_alpha', 'saturation_kappa',
                                    'saturation_slope', 'saturation_beta'])
print("r_hat の最大値:", float(summ['r_hat'].max()))
print("発散の数:", int(idata.sample_stats['diverging'].sum()))

# 3. 各チャネルの平均売上貢献(元の売上の単位に戻して週平均)
scale = np.max(np.abs(y_obs))                                   # 売上の最大値でスケーリングされている
cc = idata.posterior['channel_contribution'] * scale           # 元スケールに戻す
per_sample = cc.mean(dim='date').stack(s=('chain', 'draw'))     # 週平均(サンプルごと)
print("\n平均売上貢献(1週あたり)")
for c in ['TV', 'Search', 'SNS']:
    v = per_sample.sel(channel=c).values
    print(f"  {c:6s}: 推定 {v.mean():5.1f} [{np.percentile(v, 2.5):5.1f}, "
          f"{np.percentile(v, 97.5):5.1f}]  真値 {true_contrib[c].mean():5.1f}")

# 4. 平均売上貢献の比較を可視化
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用

fig, ax = plt.subplots(figsize=(9, 5))
channels = ['TV', 'Search', 'SNS']
pos = np.arange(len(channels))
means, lows, highs, trues = [], [], [], []
for c in channels:
    v = per_sample.sel(channel=c).values
    means.append(v.mean())
    lows.append(v.mean() - np.percentile(v, 2.5))
    highs.append(np.percentile(v, 97.5) - v.mean())
    trues.append(true_contrib[c].mean())
ax.errorbar(pos, means, yerr=[lows, highs], fmt='o', color='C0', capsize=6,
            markersize=9, label='PyMC-Marketing の推定(95%区間)')
ax.scatter(pos, trues, marker='*', s=250, color='red', zorder=3, label='真値')
ax.set_xticks(pos)
ax.set_xticklabels(channels)
ax.set_ylabel('平均売上貢献 /週')
ax.set_title('PyMC-Marketing による平均売上貢献の推定と真値')
ax.legend()
ax.grid(True, axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
推定結果を、スクラッチ実装や真値と比べています。
- 減衰率の対応: PyMC-Marketingでは、アドストックの減衰率 が adstock_alpha という名前で保存されます。MMMの記事の記号 と、ライブラリのパラメータ名 alpha は同じものを指します(後述の対応表を参照)。
- 収束診断: az.summary の r_hat と sample_stats["diverging"] で、MCMCの記事で扱った収束診断を確認します。
- 元スケールへの復元: 売上貢献 channel_contribution は、PyMC-Marketingが売上を最大値で割ってスケーリングした単位で保存されています。そのため、売上の最大値 np.max(np.abs(y_obs)) を掛けて元の単位に戻します。サンプルごとに週平均を取り、その分布から事後平均と95%区間を求めています。
- 可視化: チャネルごとに、推定した平均売上貢献を95%区間つきの点(ax.errorbar)で、真値を赤い星(ax.scatter)で描いています。yerr には「事後平均から区間の下限・上限までの距離」を渡す必要があるため、区間の値をそのまま渡すのではなく差を計算しています。
実行結果
減衰率 θ(adstock_alpha)の事後平均
  TV    : 推定 0.73  真値 0.7
  Search: 推定 0.29  真値 0.2
  SNS   : 推定 0.43  真値 0.4
r_hat の最大値: 1.0049623069746847
発散の数: 0

平均売上貢献(1週あたり)
  TV    : 推定  19.2 [ 16.8,  22.4]  真値  19.5
  Search: 推定  59.1 [ 41.8,  89.5]  真値  26.6
  SNS   : 推定  81.8 [ 29.4, 220.5]  真値  36.5
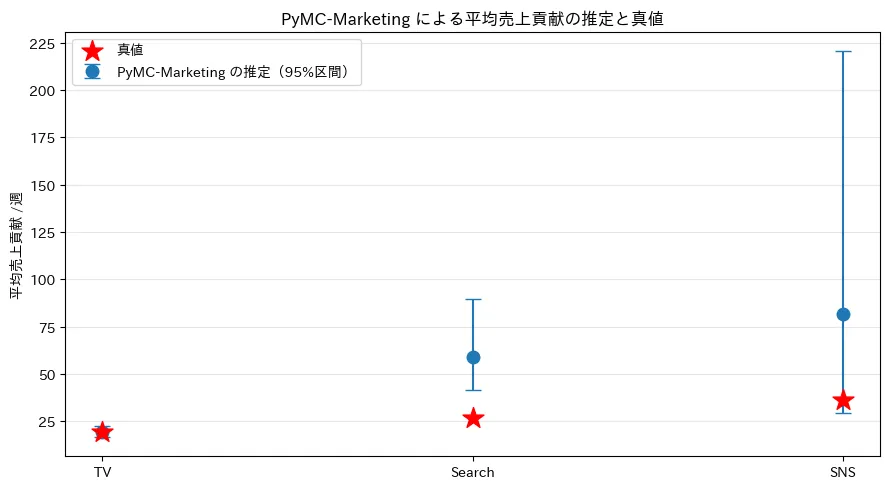
結果は、MMMの記事のスクラッチ実装と同じ傾向を示しました。数十行のスクラッチ実装が、ライブラリでは20行ほどのモデル定義に置き換わっています。
- 減衰率 はよく復元できている: TV 0.73(真値0.7)、検索 0.29(真値0.2)、SNS 0.43(真値0.4)と、スクラッチ実装と同程度の精度で減衰率を捉えています。 は1.005で、発散も0件でした。なお、既定に近い設定(tune=1500・target_accept=0.95)では発散が50件前後発生し、 も1.01をわずかに超えました。ライブラリを使う場合でも、収束診断の確認とサンプラーの設定の調整は欠かせません。
- TVの売上貢献は真値と一致: TVの平均売上貢献は19.2(真値19.5)で、95%区間 [16.8, 22.4] が真値を含みます。スクラッチ実装の19.2 [16.8, 22.3] ともほぼ一致します。
- 検索広告は過大推定: 検索広告の貢献は59.1(真値26.6)と、約2.2倍に過大推定されました。スクラッチ実装(48.1)と同様に、観測できない需要ショックとの内生性 が原因です。ライブラリを使っても、モデルに内生性への対処を組み込まない限り、この過大推定は避けられません。
- SNSは区間が広い: SNSの貢献は81.8で、95%区間は [29.4, 220.5] と非常に広くなりました(真値36.5は区間に含まれます)。飽和の上限 と半飽和点 が互いに補い合って動くため、事後分布が広がるのはスクラッチ実装と同じ現象です。ただし今回は、 の事前分布が元の単位でスクラッチ実装の約6倍広い( と )ため、大きな を許しやすく、この広がりがより顕著に出たと考えられます。
内生性による過大推定が収束診断ではまったく検知できない点も、MMMの記事と同じです。ライブラリは実装を楽にしてくれますが、因果効果の正しさそのものを保証してくれるわけではありません。次に、実験結果によるキャリブレーションで検索広告の過大推定を補正します。
実験結果によるキャリブレーション
MMMの記事では、検索広告のリフト試験の結果を尤度として手書きで追加しました。PyMC-Marketingには、この操作を行う add_lift_test_measurements というメソッドが用意されています。実験の結果を「チャネル」「基準の出稿量 」「出稿量の増分 」「売上の増分 」「測定誤差 」の表として渡すと、ライブラリが内部で対応する尤度を組み立てます。
# 1. 実験結果を表として用意する(検索広告の2つの実験)
#    MMMの記事と同じ、低出稿期・高出稿期のリフト(15.4, 35.6 /週, 測定誤差 2.0)
lift_df = pd.DataFrame({
    'channel': ['Search', 'Search'],
    'x':       [0.0, 0.0],                                    # 基準の出稿量
    'delta_x': [search_spend[88:100].mean(), search_spend[8:20].mean()],  # 出稿量の増分
    'delta_y': [15.4, 35.6],                                  # 売上の増分(測定リフト)
    'sigma':   [2.0, 2.0],                                    # 測定誤差
})

# 2. ベースモデルと同じ設定でモデルを構築してから、実験結果を尤度として追加する
mmm_calib = MMM(
    date_column='date', channel_columns=['TV', 'Search', 'SNS'],
    control_columns=['t'],
    adstock=GeometricAdstock(l_max=13, normalize=False,
                             priors={'alpha': Prior('Beta', alpha=2, beta=2)}),
    saturation=HillSaturation(priors={
        'slope': Prior('Gamma', alpha=3, beta=2),
        'kappa': Prior('Gamma', alpha=2, beta=2),
        'beta':  Prior('HalfNormal', sigma=1.5)}),
    yearly_seasonality=2,
)
mmm_calib.build_model(X, y_obs)
mmm_calib.add_lift_test_measurements(lift_df)   # ← 実験結果を組み込む

# 3. 再推定して、検索広告の平均売上貢献を比べる
idata_calib = mmm_calib.fit(X, y_obs, draws=1000, tune=2000, chains=4,
                            target_accept=0.99, random_seed=42)
cc2 = idata_calib.posterior['channel_contribution'] * scale
v = cc2.mean(dim='date').stack(s=('chain', 'draw')).sel(channel='Search').values
print(f"検索広告の平均売上貢献(キャリブレーション後): "
      f"{v.mean():.1f} [{np.percentile(v, 2.5):.1f}, {np.percentile(v, 97.5):.1f}]")
print(f"真値: {true_contrib['Search'].mean():.1f}")
print("発散の数:", int(idata_calib.sample_stats['diverging'].sum()))
実験結果を組み込んで再推定しています。
- 実験結果の表: add_lift_test_measurements は、各実験を1行とする表を受け取ります。公式ドキュメントによると、この尤度は「飽和曲線の観測」として追加され、モデル側の推定値は ( は飽和曲線)、観測値が delta_y という形で突き合わされます。分布は既定で が使われます。
- 実験の与え方: ここでは x = 0、delta_x を実験期間の平均出稿量として、「出稿ゼロから平均出稿量まで増やしたときの売上の増分」という形で実験結果を表現しています。delta_y はMMMの記事と同じ測定リフト(15.4・35.6 /週)、sigma は測定誤差2.0です。
- モデルの構築と追加の順序: build_model でモデルを組み立ててから add_lift_test_measurements を呼びます。この順序でないと、追加先のモデルが存在せずエラーになります。
- 効果: 内生性で過大推定されていた検索広告の貢献が、実験の情報によって真値の方向に補正されることを確認します。
実行結果
検索広告の平均売上貢献(キャリブレーション後): 36.4 [30.6, 42.4]
真値: 26.6
発散の数: 14
実験結果を組み込むことで、検索広告の平均売上貢献は 59.1から36.4へと大きく下がり、真値26.6の方向に補正されました。ただし、このモデルでは発散が14件残りました。実験の尤度を加えると事後分布の形がさらに歪みやすくなるためで、実務で使う場合は target_accept をさらに上げる、事前分布を見直すなどの対処が必要です。
スクラッチ実装で2つの実験を組み込んだとき(27.5)ほど真値には届いていません。これは、尤度の与え方がスクラッチ実装と異なるためです。MMMの記事では「実験期間中の平均貢献(持ち越しを含む)」を尤度にしましたが、PyMC-Marketingのリフト試験は飽和曲線そのものの観測であり、アドストック(持ち越し)を考慮しません。公式のジオリフト用のノートブックでも、リフト試験に渡す値は「その時点の瞬間的な飽和効果」であって、持ち越しを含む累積効果ではない点に注意するよう明記されています。アドストックの影響が大きいチャネルでは、実験で測ったリフトをどの量として渡すか(期間中の累積か、1週あたりの瞬間的な効果か)を慎重に決める必要があります。それでも、実験という外部の情報がなければ内生性による過大推定は補正できない という、MMMの記事の中心的なメッセージは、ライブラリでもそのまま成り立ちます。実務では、実験の測り方(出稿水準・期間)と、それをどう尤度に落とし込むかを、ライブラリのドキュメントで丁寧に確認することが重要です。
キャリブレーションの前後を並べると、次のようになります。
(図は、diagram-designで作成)
パラメータ名の対応表
同じMMMを扱っていても、ライブラリごとにパラメータの呼び名が異なります。MMMの記事で使った記号と、各ライブラリでの名前の対応をまとめます。ライブラリのドキュメントを読むときの「翻訳表」として使ってください。
| 概念 | 本記事の記号 | PyMC-Marketing | Meridian | Robyn |
|---|---|---|---|---|
| アドストックの減衰率 | adstock_alpha | alpha_m | thetas(geometric) | |
| アドストックの最大ラグ | l_max | max_lag | (adstockの種類で決まる) | |
| 飽和の半飽和点 | saturation_kappa | ec_m | gammas(変曲点) | |
| 飽和の形状 | saturation_slope | slope_m | alphas | |
| 効果の大きさ | saturation_beta | beta_m(ROI経由) | (リッジ回帰の係数) | |
| 推定方法 | ― | MCMC(NUTS) | MCMC(NUTS) | リッジ回帰+進化的探索 |
注意したいのは、Robynの飽和は同じHill関数でも、形状を alphas、変曲点を gammas と呼ぶ点です。本記事やPyMC-Marketingの (形状)とはアルファベットが逆になっているため、混同しやすい箇所です。またMeridianは、効果の大きさ に直接事前分布を置くのではなく、ROIの事前分布から を逆算する設計になっています。
Meridianのコード(Google製)
Meridianは、地域階層モデルやROI事前分布といった、大規模な広告主向けの機能を備えたベイズMMMです。ここでは、地域を分けない全国モデル(national model)の基本的な流れを見ます。
Meridianは TensorFlow Probability(バージョン2系ではJAXバックエンド)を基盤としており、本記事のコードは google-meridian 2.1.0(Python 3.13)で動作を確認しています。また、実用的な速度で推定するには GPUの利用が推奨 されています(macOSではGPUは公式にサポートされていません)。GPUを使わない場合でも推定はできますが、非常に時間がかかります。実際に動かす際は、公式ドキュメント(developers.google.com/meridian)で最新のAPIとハードウェア要件を確認してください。
Colabで試す場合は、「ランタイム → ランタイムのタイプを変更」でGPU(T4など)を選び、次のコマンドでMeridianをインストールします。記事と同じ結果を得られるよう、動作確認したバージョン(2.1.0)に固定しています。PyMC-Marketingとは依存ライブラリ(TensorFlow・JAXなど)が大きく異なるため、PyMC-Marketingとは別のノートブック(ランタイム)で実行する ことをおすすめします。
# Google Colab(GPUランタイム)で最初に1回だけ実行する
!pip install -q "google-meridian[colab,and-cuda]==2.1.0"
インストールでJAXやCUDA関連のライブラリが入れ替わるため、インストール後に「ランタイム → セッションを再起動する」を実行してから、GPUが認識されているかを確認します。
# セッションの再起動後に実行する
import jax
print(jax.devices())   # [CudaDevice(id=0)] と表示されればGPUが使われる
[CpuDevice(id=0)] と表示される場合や、以降の実行時に Jax plugin configuration error ... cuInit(0) failed というエラーが出る場合は、JAXがGPUを使えず、CPUで計算しています。推定自体は進みますが、非常に時間がかかります。ランタイムのタイプがGPUになっているか、インストール後にセッションを再起動したかを確認してください。
別のノートブックで実行する場合は、インストールの後にデータの再生成のコードを実行し、続けて次のコードで日付列とトレンド列を追加しておきます(PyMC-Marketingのモデル定義の冒頭で追加していたものと同じです)。
# 「データの再生成」のコードを実行した後に実行する
df['date'] = pd.date_range('2023-01-02', periods=T, freq='W-MON')   # 週次の日付
df['t'] = (week - week.mean()) / week.std()                        # トレンド(標準化した週番号)
Meridianのワークフローは、大きく「データの読み込み → 事前分布の設定 → サンプリング → 結果の要約」に分かれます。
import numpy as np
from meridian import constants
from meridian.data import data_frame_input_data_builder as dfb
from meridian.model import prior_distribution, spec, model
from meridian.analysis import analyzer
import tensorflow_probability.substrates.jax as tfp_jax

# 1. データの読み込み(全国モデル: geo・population を指定しない)
#    df は date / y / 各広告費 / トレンドを持つDataFrame
builder = dfb.DataFrameInputDataBuilder(
    kpi_type='revenue',                 # KPI は売上(金額)
    default_kpi_column='y',             # KPI の列名
    default_time_column='date',         # 日付の列名(既定は 'time')
    default_media_time_column='date',   # 広告データの日付の列名(既定は 'time')
)
builder = (builder
    .with_kpi(df)
    .with_controls(df, control_cols=['t'])
    .with_media(
        df,
        media_cols=['TV', 'Search', 'SNS'],        # 到達量(ここでは広告費で代用)
        media_spend_cols=['TV', 'Search', 'SNS'],  # 広告費
        media_channels=['TV', 'Search', 'SNS']))
data = builder.build()

# 2. ROI を事前分布に置く(β ではなく ROI に事前情報を入れる)
#    LogNormal の roi_mu は「ROI の対数」の平均。0.2・0.9 は Meridian の既定値で、ROI の中央値は e^0.2 ≈ 1.2
#    (実験で「ROI はおよそ 0.2」と分かっていれば roi_mu = np.log(0.2) とする)
roi_mu, roi_sigma = np.float64(0.2), np.float64(0.9)
prior = prior_distribution.PriorDistribution(
    roi_m=tfp_jax.distributions.LogNormal(roi_mu, roi_sigma, name=constants.ROI_M)
)
model_spec = spec.ModelSpec(prior=prior, max_lag=13)

# 3. モデルの構築とサンプリング(NUTS)
mmm = model.Meridian(input_data=data, model_spec=model_spec)
mmm.sample_prior(500)
mmm.sample_posterior(n_chains=4, n_adapt=1000, n_burnin=500, n_keep=1000, seed=42)

# 4. 結果の要約(ROI・貢献・応答曲線など)
an = analyzer.Analyzer(model_context=mmm.model_context, inference_data=mmm.inference_data)
summary = an.summary_metrics()
print(summary['roi'].sel(distribution='posterior').to_pandas().round(2))   # チャネル別の ROI

# 5. 答え合わせ: 真の ROI(真の売上貢献の合計 ÷ 広告費の合計)
for c in ['TV', 'Search', 'SNS']:
    print(f"{c:6s}: 真のROI {true_contrib[c].sum() / spends[c].sum():.2f}")
MeridianでMMMを組み立てるコードです。
-
データの読み込み: DataFrameInputDataBuilder に with_kpi・with_controls・with_media と連鎖させてデータを渡します。Meridianは既定で日付の列名を time、地域の列名を geo と想定しているため、MMMワールドのように日付の列名が date の場合は、default_time_column・default_media_time_column で列名を指定します(指定しないと、time 列がないというエラーになります)。また、MMMワールドのKPIは売上(金額)なので、kpi_type='revenue' としています。KPIが件数(コンバージョン数など)の場合は 'non_revenue' を指定します。geo と population を指定しないことで、地域を分けない全国モデルになります。地域階層モデルにする場合は、これらの列を追加します。
-
ROIを事前分布に置く: Meridianの最大の特徴です。効果の大きさ (beta_m)に直接事前分布を置くのではなく、チャネルごとの ROI(roi_m)に対数正規分布の事前分布を置きます。対数正規分布 は「ROIの対数が正規分布 に従う」分布なので、roi_mu はROIそのものではなく ROIの対数の平均 である点に注意が必要です。ここで使っている ・ はMeridianの既定値で、ROIの中央値は です。ジオ実験で「このチャネルのROIはおおよそ0.2」と分かっていれば、roi_mu = np.log(0.2) とし、実験の不確実性に応じて roi_sigma を小さくすることで、実験結果をキャリブレーションとして組み込めます。 は、このROIとアドストック・飽和のパラメータから内部で逆算されます。
-
サンプリング: sample_prior で事前予測を確認し、sample_posterior でNUTSによる事後サンプリングを行います。n_adapt・n_burnin はPyMCの tune に、n_keep は draws に相当します。
-
表示される警告: 実行すると、いくつかの警告が表示されますが、いずれも問題ありません。revenue_per_kpi is ignored はKPIが売上なので売上換算の係数を使わないこと、Hierarchical distribution parameters must be deterministically zero for national models は全国モデルでは地域間のばらつきのパラメータが不要なので自動で0に固定したこと、Setting use_kpi=True has no effect はKPIが売上なのでKPIベースと売上ベースの指標が一致することを知らせるものです。trace group is not defined in the InferenceData scheme もArviZ内部の形式に関するもので、結果には影響しません。
-
結果の要約: Analyzer を通じて、チャネル別のROIや売上貢献、応答曲線を取り出せます。summary_metrics の結果はxarrayのデータセットなので、ここではROIの事後分布の要約(平均・中央値・信用区間)を表の形に変換して表示しています。なお、最新版では Analyzer(mmm) のようにモデルを直接渡す書き方は非推奨になっており、model_context と inference_data を渡します。HTMLのレポートを自動生成する Summarizer も用意されています。
-
答え合わせ: MeridianのROIは「広告による売上の増分の合計 ÷ 広告費の合計」なので、真の売上貢献 true_contrib から同じ定義で真のROIを計算して比べます。
実行結果
metric        mean  median  ci_lo  ci_hi
channel
TV            0.31    0.31   0.28   0.35
Search        1.13    1.13   1.03   1.25
SNS           0.29    0.28   0.20   0.44
All Channels  0.44    0.44   0.39   0.52
TV    : 真のROI 0.19
Search: 真のROI 0.47
SNS   : 真のROI 0.22
Meridianの推定結果を、真のROIと比べます。
- 検索広告は過大推定: 検索広告のROIは1.13(95%区間 [1.03, 1.25])で、真値0.47の約2.4倍に過大推定されました。PyMC-Marketingで平均売上貢献が約2.2倍に過大推定されたのと同じく、観測できない需要ショックとの内生性 が原因です。区間が狭いにもかかわらず真値を大きく外しており、ライブラリを変えても、実験の情報なしには内生性を補正できないことがわかります。
- TVとSNSもやや高め: TVは0.31(真値0.19)、SNSは0.29(真値0.22)と、どちらもやや高めに推定されました。ここで使ったROIの事前分布(Meridianの既定値)は中央値が約1.2で、真のROI(0.2〜0.5)より高い値を想定しています。データだけでは効果を切り分けにくいチャネルほど、この事前分布に推定が引っ張られている可能性があります。
- ROI事前分布の効きどころ: 逆にいえば、ジオ実験などで「検索広告のROIはおよそ0.5」と分かっていれば、roi_mu = np.log(0.5) とし、roi_sigma を小さくすることで、内生性による過大推定を補正できます。PyMC-Marketingで add_lift_test_measurements が担っていた役割を、Meridianでは事前分布が担うわけです。
Meridianには、MMMをキャリブレーションするためのジオ実験を設計・分析する Meridian GeoX も用意されており、合成コントロール法とジオ実験の記事で扱った実験とMMMを、同じエコシステムの中でつなげられるようになっています。
Meridianの思想は、「実務家がもっとも解釈しやすいROIという指標を、モデルの入口(事前分布)と出口(要約)の両方で主役にする」ことにあります。MMMの記事で見たように、実験で測れるのは効果の大きさ そのものではなく「その出稿水準でのリフト(ひいてはROI)」でした。Meridianはこの事情に寄り添った設計になっているといえます。
Robynのコード(Meta製)
RobynはR言語のパッケージが主体です。Python版(パッケージ名 robynpy)も公開されていますが、公式リポジトリによれば、R版をLLMを活用して書き直したベータ版であり、不具合が残る可能性があると明記されています(Python版の現状は後述します)。そのため本記事では、R版の基本的な流れを示します。
本記事のRobynのコードは、R 4.3.3・Robyn 3.12.1(CRAN版)・reticulate 1.47.0、Python 3.12・Nevergrad 1.0.12 で動作を確認しています。Robynはハイパーパラメータの探索に Nevergrad(PythonのライブラリをRから呼び出す)を使うため、RとPythonの両方が必要です。最新のAPIは、公式ドキュメント(facebookexperimental.github.io/Robyn)で確認してください。
Colab(Rランタイム)でのインストール
Colabで試す場合は、新しいノートブックを開き、「ランタイム → ランタイムのタイプを変更」で言語に R を選びます。そのうえで、最初のセルで次のコードを実行し、RobynとNevergradをインストールします。
# Google Colab(Rランタイム)で最初に1回だけ実行する
# 1. Robyn 本体と、Python を呼び出すための reticulate をインストール
install.packages(c("Robyn", "reticulate"))

# 2. Colab に入っている Python に Nevergrad をインストール
system("python3 -m pip install -q nevergrad")

# 3. R から使う Python を、Nevergrad を入れた Python に固定する
library(reticulate)
use_python(Sys.which("python3"), required = TRUE)
py_module_available("nevergrad")   # TRUE と表示されれば準備完了
Rランタイムで、RobynとNevergradを使えるようにしています。
- Robynのインストール: RobynはCRANに登録されているため、install.packages でインストールできます。トレンド・季節性の分解に使う prophet など依存パッケージが多いため、インストールには時間がかかることがあります。また、Colabのランタイムを切断するとインストールしたパッケージは消えるため、再接続のたびにこのセルを実行し直す必要があります。
- reticulateも最新版にする: reticulate はRからPythonを呼び出すパッケージです。古いバージョンでは、Python 3.12と組み合わせたときにNevergradの呼び出しでエラー(TypeError: expected bytes, member_descriptor found)が出ることを確認しました。そのため、Robynと一緒に最新版をインストールしています。
- Nevergradのインストール: 公式のインストール手順では、reticulate で仮想環境を作ってNevergradを入れる方法が紹介されています。Colabにはあらかじめ Python が入っているため、ここでは system でその Python の pip を呼び出し、直接インストールしています。
- 使う Python の固定: use_python で、Nevergradをインストールしたのと同じ Python を reticulate に使わせます。ここがずれると、Robynの実行時に「Nevergradが見つからない」というエラーになります。py_module_available("nevergrad") が TRUE を返すことを確認してから先に進んでください。
データの受け渡し
MMMワールドのデータはPythonで生成したものなので、Rランタイムにはそのままでは存在しません。PyMC-Marketing側のノートブックで、日付列を追加した df をCSVに保存してダウンロードします。
# PyMC-Marketing 側(Python)のノートブックで実行する
df.to_csv('mmm_world.csv', index=False)
from google.colab import files
files.download('mmm_world.csv')
ダウンロードした mmm_world.csv を、Rランタイムのノートブックの左側のファイル欄にアップロードしてから、次のRコードを実行します。
RobynでMMMワールドを推定する
library(Robyn)

# 0. MMMワールドのデータを読み込む(date / y / TV / Search / SNS を持つデータ)
df <- read.csv("mmm_world.csv")
df$date <- as.Date(df$date)
data("dt_prophet_holidays")   # Robyn に同梱されている祝日データ

# 1. 入力の指定: 日付・売上・各広告費・コントロール変数と、アドストックの種類
InputCollect <- robyn_inputs(
  dt_input          = df,
  dt_holidays       = dt_prophet_holidays,
  date_var          = "date",
  dep_var           = "y",
  dep_var_type      = "revenue",
  prophet_vars      = c("trend", "season"),   # トレンド・季節性は Prophet が担当
  prophet_country   = "JP",
  paid_media_spends = c("TV", "Search", "SNS"),
  paid_media_vars   = c("TV", "Search", "SNS"),
  adstock           = "geometric"             # 幾何減衰アドストック
)

# 2. ハイパーパラメータの探索範囲を「範囲」で与える
#    thetas: アドストックの減衰率 θ, alphas: 飽和の形状, gammas: 飽和の変曲点
hyperparameters <- list(
  TV_thetas     = c(0.3, 0.8), TV_alphas     = c(0.5, 3), TV_gammas     = c(0.3, 1),
  Search_thetas = c(0.0, 0.3), Search_alphas = c(0.5, 3), Search_gammas = c(0.3, 1),
  SNS_thetas    = c(0.1, 0.4), SNS_alphas    = c(0.5, 3), SNS_gammas    = c(0.3, 1),
  train_size    = c(0.5, 0.8)
)
InputCollect <- robyn_inputs(InputCollect = InputCollect, hyperparameters = hyperparameters)

# 3. 実験結果(リフト試験)によるキャリブレーション
#    MMMの記事の実験1(検索広告の低出稿期、第88〜99週の12週間)のリフト 15.4 /週 × 12週 ≒ 185
calibration_input <- data.frame(
  channel       = "Search",
  liftStartDate = as.Date("2024-09-09"), liftEndDate = as.Date("2024-11-25"),
  liftAbs       = 185,        # 実験期間の売上リフトの総量(点推定)
  spend         = 283,        # 実験期間の検索広告費
  confidence    = 0.9, metric = "y", calibration_scope = "immediate"
)
InputCollect <- robyn_inputs(InputCollect = InputCollect,
                             calibration_input = calibration_input)

# 4. Nevergrad による多目的の進化的探索(多数のパレート最適モデルを生成)
OutputModels  <- robyn_run(InputCollect, iterations = 2000, trials = 5, cores = 2)
OutputCollect <- robyn_outputs(InputCollect, OutputModels, clusters = TRUE, export = FALSE)

# 5. 予算配分(応答曲線から、限界効果が等しくなる配分を求める)
select_model <- OutputCollect$allSolutions[1]   # パレート最適なモデルの1つ
AllocatorCollect <- robyn_allocator(
  InputCollect = InputCollect, OutputCollect = OutputCollect,
  select_model = select_model, scenario = "max_response",
  channel_constr_low = 0.7, channel_constr_up = 1.5,   # 各チャネルの予算は現状の0.7〜1.5倍
  export = FALSE
)

# 6. 選んだモデルの減衰率・実験とのズレ(MAPE)と、チャネル別の平均売上貢献・ROI
print(select_model)
hyp <- OutputCollect$resultHypParam
print(as.data.frame(hyp[hyp$solID == select_model,
                        c("TV_thetas", "Search_thetas", "SNS_thetas", "mape")]), digits = 2)
dec <- OutputCollect$xDecompAgg
print(as.data.frame(dec[dec$solID == select_model & dec$rn %in% c("TV", "Search", "SNS"),
                        c("rn", "xDecompMeanNon0", "roi_total")]), digits = 3)

# 7. 予算配分の結果(1週あたりの広告費と売上貢献の、現状と最適化後)
print(as.data.frame(AllocatorCollect$dt_optimOut[, c("channels", "initSpendUnit", "optmSpendUnit",
                                 "initResponseUnit", "optmResponseUnit")]), digits = 3)
RobynでMMMを構築するコードです。
- データの読み込み: Pythonで保存したCSVを read.csv で読み込み、日付列を as.Date で日付型に変換します。祝日データ dt_prophet_holidays はRobynに同梱されているものを使います。
- 入力とアドストックの指定: robyn_inputs に、売上・広告費・コントロール変数を渡します。トレンドと季節性は prophet_vars を通じてProphetが分解します。adstock では幾何減衰(geometric)のほか、Weibull型も選べます。祝日を使わないため、prophet_vars に holiday がないという警告が出ますが、問題ありません。
- ハイパーパラメータを「範囲」で与える: ベイズMMMが事前分布として不確実性を表すのに対し、Robynは各ハイパーパラメータの 探索範囲(下限・上限)を与えます。減衰率は thetas、飽和の形状は alphas、変曲点は gammas です。ここで指定した範囲の中から、進化的探索が良い組み合わせを見つけ出します。なお、train_size(学習に使う期間の割合)は、robyn_run で時系列の検証(ts_validation = TRUE)を有効にしたときだけ使われます。本記事では検証を行わず全期間で学習するため、train_size は使われず、その旨の警告(Time series validation inactive)が表示されます。
- キャリブレーション: calibration_input に実験結果(リフトの総量・期間・広告費)を渡すと、予測誤差に加えて「実験結果とのズレ(MAPE)」も最小化の目的に加わります。これがRobynにおける、実験によるキャリブレーションです。ここではMMMの記事の実験1(検索広告の低出稿期、第88〜99週 = 2024年9〜11月の12週間)のリフトを、期間の総量(15.4 /週 × 12週 ≒ 185)と期間中の広告費の合計(23.6 /週 × 12週 ≒ 283)に直して渡しています。MMMの記事やPyMC-Marketingでは2つの実験を使いましたが、ここでは1つだけです。
- 進化的探索: robyn_run の内部で、Nevergradによる多目的の進化的探索が走ります。iterations × trials 回の試行から、予測誤差(NRMSE)・事業的な妥当性(DECOMP.RSSD)・実験とのズレ(MAPE)を両立する パレート最適なモデル群 が得られます。cores は並列に使うCPUコア数で、既定では「全コア数 − 1」になるため、Colabの無料版(2コア)では明示的に2を指定しています。この設定で、推定には50分前後(1試行あたり約9〜10分)かかりました。キャリブレーションを行う場合、公式は「2000回 × 10試行」以上を推奨しており、5試行では推奨を下回る旨の警告が出ます。また、探索の終了時には、目的ごとに探索が収束したかどうかが表示されます。本記事の実行では、予測誤差(NRMSE)は収束した一方、事業的な妥当性(DECOMP.RSSD)と実験とのズレ(MAPE)は「NOT converged」(収束していない)と表示されました。これは試行数が足りず、良いモデルを探し切れていない可能性を示すサインで、実務では試行数や反復回数を増やして再実行します。
- 予算配分: robyn_allocator で、選んだモデルの応答曲線から最適な予算配分を求めます(配分の最適化の考え方は予算配分の最適化の記事で扱います)。select_model にはモデルのIDを指定します。IDは実行ごとに変わるため、ここではパレート最適なモデルの一覧(allSolutions)の先頭を選んでいますが、実務では出力されるレポートを見て、事業知識に照らして選びます。
- 結果の確認: resultHypParam には各モデルのハイパーパラメータと評価指標が、xDecompAgg には各モデルのチャネル別の売上貢献やROIが入っています。xDecompMeanNon0 は売上貢献の1週あたりの平均(広告費がゼロでない週の平均)、roi_total は期間全体のROIです。
実行結果
[1] "1_951_2"
  TV_thetas Search_thetas SNS_thetas  mape
1       0.8          0.08       0.34 0.059
      rn xDecompMeanNon0 roi_total
1     TV            12.5    0.1196
2 Search            30.7    0.5436
3    SNS            15.6    0.0951
       channels initSpendUnit optmSpendUnit initResponseUnit optmResponseUnit
Search   Search          56.4          84.7             30.7             42.0
SNS         SNS         164.3         167.5             15.6             16.6
TV           TV         104.7          73.3             12.5             10.8
Robynの推定結果を、真値と比べます。
- 検索広告はキャリブレーションで補正された: 検索広告の平均売上貢献は30.7(真値26.6)、ROIは0.54(真値0.47)で、PyMC-Marketing(キャリブレーション前で59.1)やMeridian(ROI 1.13)のような大きな過大推定は起きていません。実験とのズレ(MAPE)を目的に加えたことで、実験結果と整合するモデルが選ばれたためです。選んだモデルの実験とのズレは約6%(mape = 0.059)でした。
- TVとSNSは大きく過小推定: TVは12.5(真値19.5)、SNSは15.6(真値36.5)と、どちらも小さく推定されました。リッジ回帰の正則化は係数を小さく抑える方向に働くため、その分がトレンドなどに吸収されたと考えられます。特にSNSは真値の半分以下で、PyMC-Marketingでも区間が非常に広くなったチャネルであることから、データだけでは効果を特定しにくいことがわかります。
- 減衰率は一部が探索範囲の端に張り付いた: TVの減衰率は0.8(真値0.7)で、探索範囲(0.3〜0.8)の上限ちょうどでした。検索は0.08(真値0.2)とやや小さく、SNSは0.34(真値0.4)です。推定値が探索範囲の端に張り付くのは、範囲の設定が狭すぎる可能性を示すサインなので、実務では範囲を見直して再実行します。
- 予算配分: 最適化後は、検索広告の週あたりの予算を56.4から84.7へ上限(1.5倍)まで増やし、TVを104.7から73.3へ下限(0.7倍)まで減らす配分になりました。3チャネル合計の売上貢献は、1週あたり58.8から69.4へ増える見込みです。しかし、真のパラメータで計算すると、現状の配分ではTVの限界ROAS(追加の1円が生む売上、約0.29)が3チャネルの中で最も高く、TVは予算を増やすべきチャネルです(限界ROASの考え方は予算配分の最適化の記事を参照)。TVの効果を過小推定したモデルで配分を最適化すると、TVを削るという逆向きの結論になってしまいます。配分の結論は、それを導いたモデルの推定の正しさを超えられない という点に注意が必要です。
Robynの結果は、進化的探索の乱数と、パレート最適なモデル群からどのモデルを選ぶかによって変わります。たとえば、同じコードを別の機会に実行したときは、別のモデル(1_579_2)が先頭に選ばれ、TVの売上貢献は16.5、SNSは22.5、検索は28.7(MAPE 0.16)となり、配分ではTVを104.7から88.0に減らす結果でした。本記事のようにパレート最適なモデル群の先頭を機械的に選ぶのではなく、実務では複数のモデルの減衰率・売上貢献・配分を見比べ、事業知識と実験結果に照らして選ぶことが重要です。
Python版(robynpy 0.3.6)でも、データの入力・進化的探索・パレート最適なモデルの選択・予算配分までは実行できることを確認しました。ただし、現時点では次のような制約があります。
- 目的変数の列名が revenue であることを前提にした処理が残っており、別の列名ではモデルの評価時にエラーになる
- 実験結果によるキャリブレーションが機能しない(学習メソッドに実験結果を渡す引数がなく、内部でも実験とのズレ(MAPE)が常に0として計算される)
内生性の補正のように実験によるキャリブレーションが欠かせない分析では、現時点ではR版を使うのが確実です。
Robynのハイパーパラメータ探索は、局所探索(山登り法)や焼きなまし法の記事で扱った、評価関数の勾配を使わない探索 の一種です。山登り法が1つの解を少しずつ改善して局所解に陥りやすいのに対し、Robynの進化的アルゴリズム(差分進化)は、複数の候補解を同時に保持・交配させながら探索するため、広く多様な解を得られます。そのうえで「1つの正解」を機械的に選ばず、複数のもっともらしいモデルを人間に提示する点が、Robynの実務的な思想です。
Meridian と Robyn の ROI を真の値と並べると、次のようになります。
(図は、diagram-designで作成)
3つのライブラリの使い分け
3つのライブラリの特徴を整理します。どれが優れているというより、チームの技術スタックと、扱うデータの規模・種類 によって選ぶのが実務的です。
| 観点 | PyMC-Marketing | Meridian | Robyn |
|---|---|---|---|
| 開発元 | PyMC Labs | Meta | |
| 言語 | Python | Python | R(Python版はベータ) |
| 推定方法 | ベイズ(MCMC) | ベイズ(MCMC) | リッジ回帰+進化的探索 |
| 不確実性の表現 | 事後分布 | 事後分布 | パレート最適なモデル群 |
| 柔軟性・拡張性 | 高い | 中(機能は充実) | 中(半自動) |
| 地域階層モデル | 自分で実装 | 標準対応 | 非対応(全国モデルが基本) |
| リーチ・フリクエンシー | 自分で実装 | 標準対応 | 限定的(専用のベータ機能) |
| キャリブレーション | add_lift_test_measurements | ROI事前分布 | calibration_input(R版のみ) |
| CLVモジュール | あり | なし | なし |
| 向いている場面 | スクラッチからの拡張、CLVとの統合 | 大規模・地域データ、ROI重視 | R環境、自動化・多数モデルの比較 |
- PyMC-Marketing は、MMMの記事のスクラッチ実装から最も自然に移行でき、モデルの拡張やCLVとの統合まで見据えるチームに向いています。本記事とMMMの記事がPythonとPyMCで一貫しているのも、この地続きさが理由です。
- Meridian は、地域データを大量に持ち、ROIを軸に意思決定する大規模な広告主に向いています。ジオ実験の結果をROI事前分布として素直に組み込める点が強みです。
- Robyn は、R環境が整っているチームや、多数のモデル候補を機械的に生成して比較したい場合に向いています。Python版もありますが、現時点ではベータ版であり、実験によるキャリブレーションのように未対応の機能もあるため、本格的に使うならR版が第一の選択肢です。ベイズの事前分布に慣れていなくても扱いやすい反面、探索の再現性やモデル選択には注意が必要です。地域階層モデルやリーチ・フリクエンシーの本格的な対応は、開発チームの論文でも今後の拡張として挙げられている段階です。
まとめ
本記事では、MMMの主要な3つのOSSライブラリ——PyMC-Marketing・Google Meridian・Meta Robyn——の設計思想の違いと使い分けを解説しました。
- PyMC-Marketing: MMMの記事のスクラッチ実装と地続きのベイズMMM。同じMMMワールドのデータで、アドストックの減衰率や平均売上貢献がスクラッチ実装とよく一致し、内生性による検索広告の過大推定も、リフト試験のメソッド(add_lift_test_measurements)で真値の方向に補正できることを確認しました(尤度の定義の違いから、補正はスクラッチ実装ほど大きくありません)。
- Meridian: ROIを事前分布に置き、地域階層モデルやリーチ・フリクエンシーを標準で備えたGoogle製のベイズMMM。LightweightMMMの後継です。既定のROI事前分布のままでは、検索広告のROIが内生性によって約2.4倍に過大推定されました。
- Robyn: リッジ回帰と進化的アルゴリズム(Nevergrad)を組み合わせたMeta製のMMM。局所探索や焼きなまし法と同じ勾配を使わない探索で、パレート最適なモデル群を提示します。実験結果とのズレ(MAPE)を目的に加えるキャリブレーションによって、検索広告の売上貢献を真値の近くで推定できました。
- パラメータ名の対応: 同じ概念でもライブラリごとに呼び名が異なります(減衰率 = PyMC-Marketingの adstock_alpha = Meridianの alpha_m = Robynの thetas など)。
どのライブラリを使っても、MMMの目的は「広告費を変えたら売上がどう変わるか」という因果効果を推定し、意思決定に活かすことです。「MMMによる予算配分の最適化とは?」の記事では、推定したMMMが描き出す 応答曲線 と 限界ROAS を使い、限られた予算を各チャネルにどう配分すれば売上を最大化できるかという最適化問題に取り組みます。「モデル化する」フェーズから「配分する」フェーズへと、マーケティング意思決定のループを進めていきましょう。
参考文献
- PyMC Labs. PyMC-Marketing. GitHub.
- Google. Meridian. GitHub.
- Meta. Robyn. GitHub.
- Y. Jin, Y. Wang, Y. Sun, D. Chan, J. Koehler (2017). Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects. Google Research.
本記事の文章・構成の一部に生成AIを使用しています。