MRoPEとは?
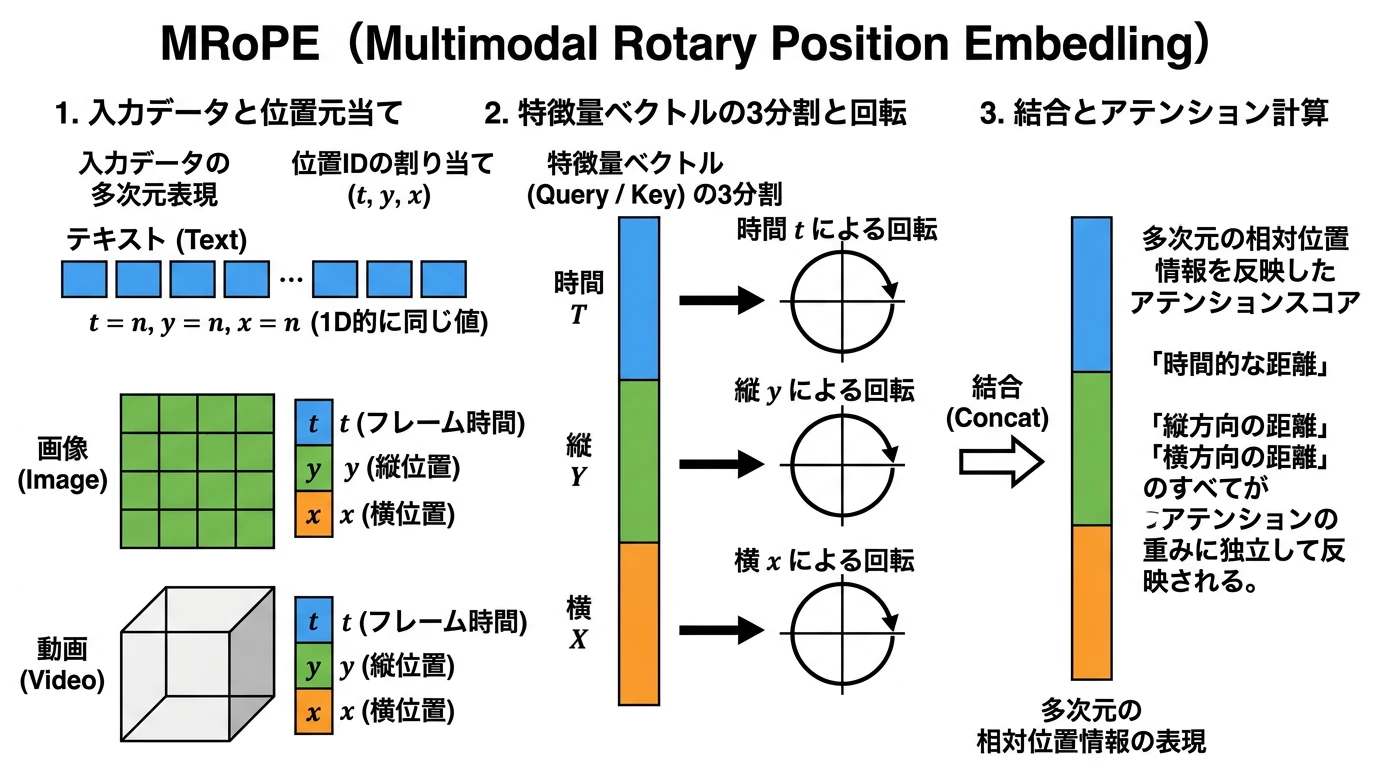 (画像は、Geminiで作成)
テキスト・画像・動画を1つの仕組みで扱うために、位置を時間・縦・横の3つの成分で表す MRoPE(Qwen2-VL)の考え方と、テキストと画像・動画への位置 ID の割り当て方を理解すること。NumPy でのシミュレーションで、1D RoPE・2D RoPE では表せない時空間の位置関係を MRoPE が捉えられることを確かめ、PyTorch で動画のパッチに MRoPE を適用してアテンションのスコアを計算できるようになること。
MRoPEの概要
MRoPE(Multimodal Rotary Position Embedding、M-RoPE) とは、トークンの特徴量ベクトルを「回転」させることで、時間や空間といった多次元の相対位置情報を表現する技術です。 Alibabaが開発したマルチモーダル大規模モデル(LMM)であるQwen2-VLで導入されました(論文は "Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution" です)。以下の特徴を持ちます。
- 多次元対応: テキストの並び順(1D)、画像の縦・横(2D)、動画の時間・縦・横(3D)の位置を、1つの仕組みで扱える
- 相対位置の学習: トークン同士の「距離感」を、時間・縦・横の軸ごとにモデルが捉えられる
- 長い入力への対応: 論文では、動画1本あたり最大16Kトークンで学習したモデルが、推論時に最大80Kトークンまで高い性能を保ったと報告されている
動画理解における位置表現の進化:2D RoPEから「MRoPE」へ
(図は、diagram-designで作成)
2次元の画像認識において、空間を縦(軸)と横(軸)に分解して処理する「2D RoPE」は、解像度やアスペクト比の変化に柔軟に対応できる位置エンコーディングです。 しかし、このアプローチをさらに「動画(Vision-Languageタスク)」へと拡張しようとすると、もう一つの壁にぶつかります。 それが「時間軸(軸)」という3つ目の次元の存在です。
従来の動画理解モデル(Video Transformerなど)では、動画データを処理する際、大きく分けて2つのアプローチが取られてきました。
1つ目は、「1Dへの平坦化(Flattening)」です。 これは、動画の各フレームをパッチに分割し、さらにそれらを時間順に並べた上で、全てのパッチを1列の長いシーケンスへと平坦化する方法です。 ここに1次元の位置埋め込みを付与します(1次元の位置エンコーディングの基本は、Transformer の記事で解説しています)。 しかし、この方法では、パッチ同士の距離が「平坦化したときの並び順」でしか表現されません。例えば、同じフレーム内で縦に隣り合うパッチや、次のフレームの同じ位置にあるパッチは、空間的・時間的には隣同士なのに、シーケンス上では大きく離れたものとして扱われます。 結果として、動画が持つ本質的な「3次元的な時空間構造」を、位置エンコーディングとして素直に表現できないというデメリットがありました。
2つ目は、「空間・時間分離型(Factorized / Separable)位置埋め込み」です。 空間(2D)の位置ベクトルと時間(1D)の位置ベクトルを別々に用意し、後から「足し算」または「結合」して3次元的な位置を表現します。 一見すると理にかなっていますが、学習可能な絶対位置ベクトルを使う場合、あらかじめ「16フレーム、224x224ピクセル」のように最大サイズを決めて位置ベクトルを学習するため、推論時にそれを超える「長い動画」や「高解像度な映像」が入力されると、対応する位置ベクトルが存在しません。 位置ベクトルを補間するなどの工夫が必要になり、性能の低下を招きやすいという弱点がありました。
この「時空間の構造維持」と「サイズ固定の壁」という2つの課題に対応したのが、Qwen2-VLで導入された「MRoPE(Multimodal Rotary Position Embedding:マルチモーダル回転位置埋め込み)」です。
MRoPEは、2D RoPEの「次元を分割して独立した回転を施す」という特性を、さらに「時間軸(軸)」、「縦方向(軸:Height)」、「横方向(軸:Width)」の3つの独立した回転へと拡張しました。 具体的には、QueryとKeyのベクトルを3つのブロックに分割します。
- 1つ目のブロックには、そのトークンが「何フレーム目か」に応じた時間軸の回転を施します。
- 2つ目のブロックには、フレーム内の縦方向の位置に応じた回転を施します。
- 3つ目のブロックには、フレーム内の横方向の位置に応じた回転を施します。
これらを1つのベクトルとして結合(Concat)することで、QueryとKeyの内積(アテンション・スコア)を計算する際、数学的に「時間的な距離」「縦方向の距離」「横方向の距離」のすべてがアテンションの重みに、それぞれ独立して反映されるようになります。
さらに、MRoPEはテキストにも同じ仕組みを使います。テキストのトークンには時間・縦・横の3つに同じ位置を割り当てることで、通常の1D RoPEと全く同じ計算になります。これにより、テキスト・画像・動画が混ざった入力を、1つの位置エンコーディングで一貫して扱えるようになりました(具体的な割り当て方は後述します)。
位置ベクトルの表を持たず、座標から回転角を計算するだけなので、学習時と異なる解像度の画像や長さの動画にもそのまま適用できます。 また、画像や動画の位置IDは縦・横・時間の座標で決まるため、パッチ数が多くても位置IDの値が大きくなりにくく、長い入力を扱いやすいという利点もあります。
なお、Qwen2-VLが任意の解像度の画像をそのまま処理できる「Naive Dynamic Resolution」は、MRoPEとは別の仕組みです。こちらは画像エンコーダ(ViT)の絶対位置埋め込みを取り除いて2D RoPEを導入し、画像の解像度に応じて異なる数の画像トークンを生成するものです。MRoPEは、そうして作られた画像・動画トークンとテキストを、言語モデル側でまとめて扱うための位置エンコーディングです。
1D RoPE, 2D RoPE, MRoPEの比較
以下では数式を用いて1D RoPE, 2D RoPE, MRoPEの比較を行います。
まずは行列による回転と複素数表現のつながりについて解説し、その後、それぞれの次元のRoPEについて解説していきます。
行列による回転と複素数表現のつながり
RoPEにおける位置エンコーディングの基本は、 と を用いた2次元の回転行列を対角線上に並べたブロック対角行列をベクトルに掛けることです。 ある特徴量ベクトルの隣り合う2つの要素 に対して、位置 と周波数 に基づく回転行列を掛けると、以下のようになります。
ここで、この2要素を複素数 ( は虚数単位)と見立ててみます。 オイラーの公式()を用いると、先ほどの行列による回転計算は、複素数の掛け算として次のように全く同じ結果として表現できます。
つまり、「ブロック対角行列を掛けること」と「複素数にして を掛けること」は数学的に等価です。次元数が増えてベクトルを分割する処理を数式で書く際、巨大な行列を書くよりも複素数表記を用いた方がスッキリするため、以下ではこの複素数表現 を用いて各次元のRoPEを比較します。
1. 1次元 RoPE (1D RoPE)
- 主な用途: テキスト(自然言語処理)などのシーケンスデータ
- 位置情報: 1つの座標 (シーケンス内のトークン位置)
1次元RoPEでは、次元 全体に対して、1つの位置座標 を用いて回転を適用します。 周波数パラメータを とすると、変換後の複素ベクトル は以下のようになります。
意味: 特徴量ベクトルのすべての次元ペアが、シーケンス上の位置 に応じた角度で一斉に回転します。
2. 2次元 RoPE (2D RoPE)
- 主な用途: 画像(Vision Transformer等)やグリッドデータ
- 位置情報: 2つの座標 (横と縦)
2次元RoPEでは、画像のように縦横の空間情報を持つため、次元 を前半の 次元(縦方向 )と後半の 次元(横方向 )に半分ずつ分割します。そして、それぞれの軸に対して独立した回転を適用します。
意味: 前半成分は縦の位置 に応じて回転し、後半成分は横の位置 に応じて回転します。これにより、2D空間の幾何学的な位置関係を別々に捉えることができます。
3. 3次元 RoPE (3D RoPE)
- 主な用途: 動画(時間・縦・横)や3D空間データ(深さ・縦・横)
- 位置情報: 3つの座標 (時間・縦・横など)
動画など3つの座標軸を持つデータを扱う場合、次元 を3つに分割し、それぞれに「時間(t)」「縦(y)」「横(x)」の位置情報を割り当てて回転させます。ここでは3等分した場合の式を示します(実際のQwen2-VLでは不均等に分割しています。後述)。
意味: ベクトルを3つの部分に分け、それぞれ「フレーム間の距離」「縦方向の距離」「横方向の距離」に対応する独立した回転を適用します。
3D RoPE の次元の分け方を図にすると、次のようになります。
(図は、diagram-designで作成)
Qwen2-VLにおける位置IDの割り当て
MRoPEでは、各トークンに時間・縦・横の3つの位置ID を割り当てます。Qwen2-VLの論文では、次のルールが説明されています。
- テキスト: 3つの成分に同じ位置IDを割り当てます。 なので、通常の1D RoPEと同じ計算になります。
- 画像: 時間成分は一定で、縦・横成分にはパッチの座標に応じた位置IDを割り当てます。
- 動画: 時間成分はフレームごとに1ずつ増やし、縦・横成分は画像と同じように割り当てます。
- 複数のモダリティが並ぶ場合: 次のモダリティの位置IDは、直前のモダリティの最大の位置ID + 1 から始めます。
以下のコードでは、このルールに従って「テキスト3トークン → 画像(縦2 × 横3パッチ) → テキスト2トークン」という入力に位置IDを割り当てます。
def get_mrope_position_ids(segments):
    """segments: ("text", トークン数) / ("image", 縦, 横) / ("video", フレーム数, 縦, 横) のリスト"""
    ids = []        # 各トークンの (t, y, x)
    start = 0       # 次のモダリティの開始位置
    for seg in segments:
        if seg[0] == "text":
            # テキスト: 3つの成分に同じ位置を割り当てる(1D RoPEと同じ)
            for i in range(seg[1]):
                ids.append(("text", start + i, start + i, start + i))
        elif seg[0] == "image":
            # 画像: 時間成分は一定、縦・横成分はパッチの座標
            _, h, w = seg
            for y in range(h):
                for x in range(w):
                    ids.append(("image", start, start + y, start + x))
        elif seg[0] == "video":
            # 動画: 時間成分はフレームごとに1ずつ増え、縦・横成分は画像と同じ
            _, f, h, w = seg
            for t in range(f):
                for y in range(h):
                    for x in range(w):
                        ids.append(("video", start + t, start + y, start + x))
        # 次のモダリティは、ここまでの最大の位置 + 1 から始める
        start = max(max(t, y, x) for _, t, y, x in ids) + 1
    return ids

segments = [("text", 3), ("image", 2, 3), ("text", 2)]
for kind, t, y, x in get_mrope_position_ids(segments):
    print(f"{kind:5s}  t={t}  y={y}  x={x}")
- 入力の表し方: segmentsは、テキスト・画像・動画の並びを表すリストです。("text", 3)はテキスト3トークン、("image", 2, 3)は縦2 × 横3パッチの画像を表します。テキスト3・画像(2×3)・テキスト2にするのは、画像の前後にテキストがある最小の並びで、画像の後のテキストの開始位置が、画像の最大の位置IDで決まることを確かめるためです。
- テキスト: ("text", start + i, start + i, start + i)のように、時間・縦・横に同じ位置IDを割り当てます。
- 画像: 時間成分はstartで一定にし、縦・横成分はパッチの座標y、xをstartに足した値にします。
- 動画: 時間成分をstart + tとしてフレームごとに1ずつ増やします。
- 次のモダリティの開始位置: 各モダリティを処理した後、start = max(...) + 1で、ここまでの最大の位置ID + 1を次の開始位置にします。
実行結果
text   t=0  y=0  x=0
text   t=1  y=1  x=1
text   t=2  y=2  x=2
image  t=3  y=3  x=3
image  t=3  y=3  x=4
image  t=3  y=3  x=5
image  t=3  y=4  x=3
image  t=3  y=4  x=4
image  t=3  y=4  x=5
text   t=6  y=6  x=6
text   t=7  y=7  x=7
- 結果: テキストは0〜2、画像は時間成分が3で一定、縦が3〜4、横が3〜5になっています。画像の後のテキストは、画像の最大の位置ID(5)+ 1 = 6から始まります。画像の6パッチに対して位置IDは3〜5の範囲に収まっており、1Dに平坦化して通し番号を振る場合よりも位置IDの値が小さく抑えられていることもわかります。
割り当てた位置 ID を表に並べると、次のようになります。
(図は、diagram-designで作成)
コードによるMRoPEのシミュレーション
コードからQuery V0H0T0に対するAttentionを可視化することで、上記の数式で説明した1D, 2D, MRoPEの挙動の違いを直感的に理解します。
の場合(時間48次元(24ペア)、縦48次元(24ペア)、横48次元(24ペア)の場合)
以下のコードでは、次元数 d が144の場合のMRoPEの挙動をシミュレートします。この設定では、時間(T)、縦(V)、横(H)の各軸に48次元(24ペア)ずつ均等に次元を割り当てます。numpy を用いて1D、2D、3D(MRoPE)の各方式でアテンションスコアを計算し、その結果を matplotlib で可視化することで、3次元の時空間情報を各方式がどのように捉えるかの違いを比較します。 にするのは、72ペアを3つの軸に24ペアずつ均等に分けられる次元数だからです。実際のモデル(128)では均等に分けられないので、まず均等な場合で3つの軸の働きを確かめます。4×4×4のグリッドは、3つの断面を並べて表示できる大きさです。 QueryとKeyはどちらも全要素1のベクトルとし、各ペアの内積が になることを利用してスコアを計算しています。
import numpy as np
import matplotlib.pyplot as plt

# --- 1. 基本設定 ---
# 時間(T), 縦(V), 横(H) のグリッドサイズ
T_size, V_size, H_size = 4, 4, 4

# 隠れ層の次元数 d と実際のRoPE周波数の計算
base = 10000
d = 144  # ★ 128から144に変更
k = np.arange(d // 2)  # ペアのインデックス (0 ~ 71 の計72ペア)

# 実際の逆周波数 (Inverse Frequency) の数式
thetas = 1.0 / (base ** (2 * k / d))

# アテンションスコアを格納する3Dテンソル
attn_1d = np.zeros((T_size, V_size, H_size))
attn_2d = np.zeros((T_size, V_size, H_size))
attn_3d = np.zeros((T_size, V_size, H_size))

# 内積を計算するヘルパー関数
def calc_score(delta_pos, theta_list):
    return sum(2 * np.cos(delta_pos * th) for th in theta_list)

# --- 2. Queryの位置設定 (V0, H0, T0) ---
q_T, q_V, q_H = 0, 0, 0
# 1Dシーケンスに平坦化した場合のインデックス
q_m = q_T * (V_size * H_size) + q_V * H_size + q_H

# --- 3. 全Key位置に対するAttention Scoreの計算 ---
# 周波数の均等配分(インターリーブ)
# 2D RoPE用: 72ペアを2分割 (36ペアずつ綺麗に分割)
thetas_2d_v = thetas[0::2]
thetas_2d_h = thetas[1::2]

# 3D RoPE用: 72ペアを3分割 (24ペアずつ綺麗に分割)
thetas_3d_t = thetas[0::3]
thetas_3d_v = thetas[1::3]
thetas_3d_h = thetas[2::3]

for t in range(T_size):
    for v in range(V_size):
        for h in range(H_size):
            # 1D RoPE用: 平坦化された1次元の相対距離
            m = t * (V_size * H_size) + v * H_size + h
            delta_m = m - q_m

            # 各軸の相対距離
            delta_t = t - q_T
            delta_v = v - q_V
            delta_h = h - q_H

            # ① 1D RoPE (全72ペアを使用)
            attn_1d[t, v, h] = calc_score(delta_m, thetas)

            # ② 2D RoPE (Tは無視してVとHのみ)
            score_2d_v = calc_score(delta_v, thetas_2d_v)
            score_2d_h = calc_score(delta_h, thetas_2d_h)
            attn_2d[t, v, h] = score_2d_v + score_2d_h

            # ③ 3D RoPE (T, V, Hのそれぞれに独立して適用)
            score_3d_t = calc_score(delta_t, thetas_3d_t)
            score_3d_v = calc_score(delta_v, thetas_3d_v)
            score_3d_h = calc_score(delta_h, thetas_3d_h)
            attn_3d[t, v, h] = score_3d_t + score_3d_v + score_3d_h

# --- 4. 可視化 (断面図のプロット) ---
fig, axes = plt.subplots(3, 3, figsize=(16, 16))
fig.suptitle("Attention Scores with Real RoPE Frequencies (d=144)", fontsize=20, y=0.95)

configs = [
    {"title": "V-H Slice (T=0)", "get_data": lambda a: a[0, :, :],   "xlabel": "Horizontal (H)", "ylabel": "Vertical (V)"},
    {"title": "H-T Slice (V=0)", "get_data": lambda a: a[:, 0, :].T, "xlabel": "Time (T)",       "ylabel": "Horizontal (H)"},
    {"title": "V-T Slice (H=0)", "get_data": lambda a: a[:, :, 0].T, "xlabel": "Time (T)",       "ylabel": "Vertical (V)"}
]

models = [
    {"name": "1D RoPE", "data": attn_1d},
    {"name": "2D RoPE", "data": attn_2d},
    {"name": "3D RoPE", "data": attn_3d}
]

for row, model in enumerate(models):
    for col, config in enumerate(configs):
        ax = axes[row, col]
        slice_data = config["get_data"](model["data"])

        # ★ d=144のため、スコアの最大値(vmax)を144に設定
        im = ax.imshow(slice_data, cmap='viridis', vmin=-10, vmax=144)

        ax.set_title(f'{model["name"]} : {config["title"]}', fontsize=14, pad=10)
        ax.set_xlabel(config["xlabel"])
        ax.set_ylabel(config["ylabel"])

        ax.set_xticks(range(4))
        ax.set_yticks(range(4))

        if col == 0:
            ax.set_xticklabels([f"H{i}" for i in range(4)])
            ax.set_yticklabels([f"V{i}" for i in range(4)])
        elif col == 1:
            ax.set_xticklabels([f"T{i}" for i in range(4)])
            ax.set_yticklabels([f"H{i}" for i in range(4)])
        elif col == 2:
            ax.set_xticklabels([f"T{i}" for i in range(4)])
            ax.set_yticklabels([f"V{i}" for i in range(4)])

        # スコアのテキスト描画 (見やすく整数表記に)
        for i in range(4):
            for j in range(4):
                val = slice_data[i, j]
                # ★ 背景色に合わせて文字色を変える閾値を90に調整
                color = "black" if val > 90 else "white"
                ax.text(j, i, f"{val:.0f}", ha="center", va="center", color=color, fontweight='bold')

plt.tight_layout(rect=[0, 0, 1, 0.93])
plt.show()
実行結果
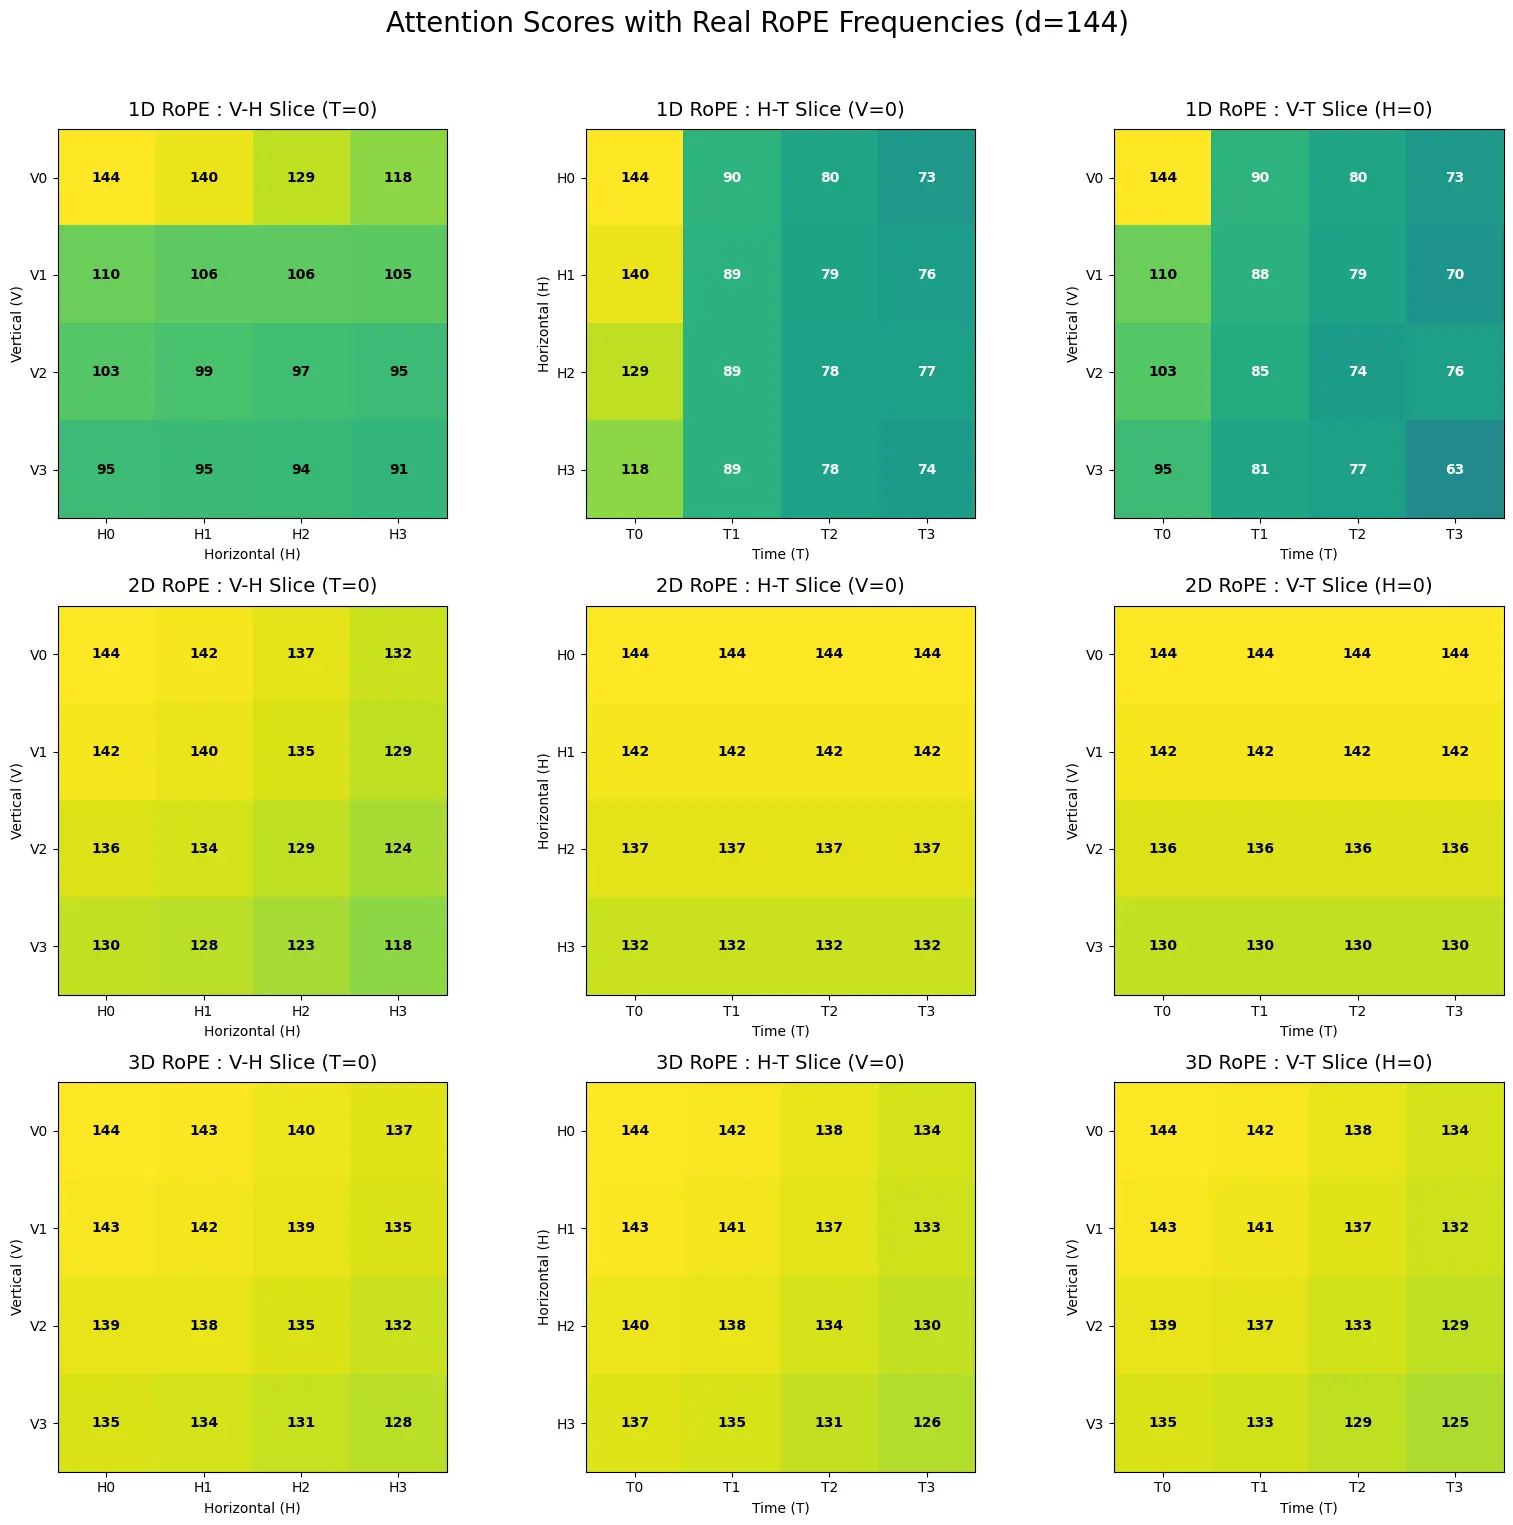
このコードは、1D RoPE、2D RoPE、そして 3D RoPE (MRoPE) が、4x4x4の時空間グリッド内で、原点 (T0, V0, H0) に置かれたQueryに対し、他のすべてのKeyトークンとの間でどのようなアテンションスコアを計算するかをシミュレーションしたものです。次元 d は144で、各軸に均等に48次元(24ペア)が割り当てられています。
-
1D RoPE: 動画の3Dグリッドを1次元のシーケンスに平坦化(m = t * (V_size * H_size) + v * H_size + h)して相対距離 delta_m を計算しています。シーケンス上で離れるほどスコアは下がりますが、その距離は平坦化の順番で決まります。例えば、縦に隣り合う (T=0, V=1, H=0) はシーケンス上の距離が4なので、同じ行で3つ右の (T=0, V=0, H=3)(距離3)よりもスコアが低くなります。さらに、次のフレームの同じ位置 (T=1, V=0, H=0) は距離16となり、スコアが大きく下がります。このように、時空間上の近さが正しく反映されません。
-
2D RoPE: 時間軸 t を無視し、縦 delta_v と横 delta_h の相対距離のみでスコアを計算します。そのため、「V-H Slice (T=0)」のグラフでは、原点から縦・横どちらに離れてもスコアが下がっており、空間的な距離を捉えられています。しかし、「H-T Slice」や「V-T Slice」を見ると、時間 t が変化してもスコアが全く変わっていません。これは、2D RoPEが時間(フレーム)の経過を全く測定できていないことを意味します。
-
3D RoPE (MRoPE): 次元を3分割し、時間 delta_t、縦 delta_v、横 delta_h のそれぞれに独立した周波数セット(thetas_3d_t, thetas_3d_v, thetas_3d_h)を割り当ててスコアを計算し、それらを合算しています。結果、すべての断面図で、原点から離れるほどスコアが下がる分布が確認できます。これは、時間・縦・横にそれぞれ独立した「定規」を適用することで、3次元の時空間構造を崩すことなく、すべての軸の相対的な距離を同時に測定できていることを示しています。
の場合(時間32次元(16ペア)、縦48次元(24ペア)、横48次元(24ペア)の場合)
続くコードは、より実際のモデルに近い設定として、次元数 d が128の場合を扱います。Qwen2-VLでは、Attentionの1ヘッドあたりの次元数が128(64ペア)で、MRoPEではこれを時間16ペア(32次元)、縦24ペア(48次元)、横24ペア(48次元)に割り当てています。ここでは、この16 : 24 : 24の配分でアテンションスコアを numpy で計算し、matplotlib を用いて可視化します。 なお、このシミュレーションでは周波数を各軸に交互(インターリーブ)に割り当てていますが、Qwen2-VLの実装では割り当て方が異なります(この違いは次の節で解説します)。
import numpy as np
import matplotlib.pyplot as plt

# --- 1. 基本設定 ---
# 時間(T), 縦(V), 横(H) のグリッドサイズ
T_size, V_size, H_size = 4, 4, 4

# 隠れ層の次元数 d と実際のRoPE周波数の計算
base = 10000
d = 128
k = np.arange(d // 2)  # ペアのインデックス (0 ~ 63 の計64ペア)

# 実際の逆周波数 (Inverse Frequency) の数式
thetas = 1.0 / (base ** (2 * k / d))

# アテンションスコアを格納する3Dテンソル
attn_1d = np.zeros((T_size, V_size, H_size))
attn_2d = np.zeros((T_size, V_size, H_size))
attn_3d = np.zeros((T_size, V_size, H_size))

# 内積を計算するヘルパー関数
def calc_score(delta_pos, theta_list):
    return sum(2 * np.cos(delta_pos * th) for th in theta_list)

# --- 2. Queryの位置設定 (V0, H0, T0) ---
q_T, q_V, q_H = 0, 0, 0
q_m = q_T * (V_size * H_size) + q_V * H_size + q_H

# --- 3. 全Key位置に対するAttention Scoreの計算 ---

# 2D RoPE用: 64ペアを2等分 (32ペアずつ)
thetas_2d_v = thetas[0::2]
thetas_2d_h = thetas[1::2]

# ★ 3D RoPE用: 64ペアを 不均等 (16 : 24 : 24) にインターリーブ配分
all_idx = np.arange(64)

# 時間(T)には全体の1/4(4つに1つ)を割り当て = 16ペア
t_idx = all_idx[::4]

# 残りの48ペアのインデックスを取得
rem_idx = np.setdiff1d(all_idx, t_idx)

# 残りを縦(V)と横(H)で交互に半分ずつ割り当て = 24ペアずつ
v_idx = rem_idx[0::2]
h_idx = rem_idx[1::2]

thetas_3d_t = thetas[t_idx]
thetas_3d_v = thetas[v_idx]
thetas_3d_h = thetas[h_idx]

for t in range(T_size):
    for v in range(V_size):
        for h in range(H_size):
            # 1Dの相対距離
            m = t * (V_size * H_size) + v * H_size + h
            delta_m = m - q_m

            # 各軸の相対距離
            delta_t = t - q_T
            delta_v = v - q_V
            delta_h = h - q_H

            # ① 1D RoPE
            attn_1d[t, v, h] = calc_score(delta_m, thetas)

            # ② 2D RoPE
            attn_2d[t, v, h] = calc_score(delta_v, thetas_2d_v) + calc_score(delta_h, thetas_2d_h)

            # ③ 3D RoPE (16, 24, 24のペアで計算)
            attn_3d[t, v, h] = calc_score(delta_t, thetas_3d_t) + \
                               calc_score(delta_v, thetas_3d_v) + \
                               calc_score(delta_h, thetas_3d_h)

# --- 4. 可視化 (断面図のプロット) ---
fig, axes = plt.subplots(3, 3, figsize=(16, 16))
fig.suptitle("Attention Scores (d=128) | 3D RoPE uses T:16, V:24, H:24", fontsize=20, y=0.95)

configs = [
    {"title": "V-H Slice (T=0)", "get_data": lambda a: a[0, :, :],   "xlabel": "Horizontal (H)", "ylabel": "Vertical (V)"},
    {"title": "H-T Slice (V=0)", "get_data": lambda a: a[:, 0, :].T, "xlabel": "Time (T)",       "ylabel": "Horizontal (H)"},
    {"title": "V-T Slice (H=0)", "get_data": lambda a: a[:, :, 0].T, "xlabel": "Time (T)",       "ylabel": "Vertical (V)"}
]

models = [
    {"name": "1D RoPE", "data": attn_1d},
    {"name": "2D RoPE", "data": attn_2d},
    {"name": "3D RoPE", "data": attn_3d}
]

for row, model in enumerate(models):
    for col, config in enumerate(configs):
        ax = axes[row, col]
        slice_data = config["get_data"](model["data"])

        # d=128のためスコアの最大値は128
        im = ax.imshow(slice_data, cmap='viridis', vmin=-10, vmax=128)

        ax.set_title(f'{model["name"]} : {config["title"]}', fontsize=14, pad=10)
        ax.set_xlabel(config["xlabel"])
        ax.set_ylabel(config["ylabel"])

        ax.set_xticks(range(4))
        ax.set_yticks(range(4))

        if col == 0:
            ax.set_xticklabels([f"H{i}" for i in range(4)])
            ax.set_yticklabels([f"V{i}" for i in range(4)])
        elif col == 1:
            ax.set_xticklabels([f"T{i}" for i in range(4)])
            ax.set_yticklabels([f"H{i}" for i in range(4)])
        elif col == 2:
            ax.set_xticklabels([f"T{i}" for i in range(4)])
            ax.set_yticklabels([f"V{i}" for i in range(4)])

        # スコアのテキスト描画
        for i in range(4):
            for j in range(4):
                val = slice_data[i, j]
                color = "black" if val > 80 else "white"
                ax.text(j, i, f"{val:.0f}", ha="center", va="center", color=color, fontweight='bold')

plt.tight_layout(rect=[0, 0, 1, 0.93])
plt.show()
実行結果
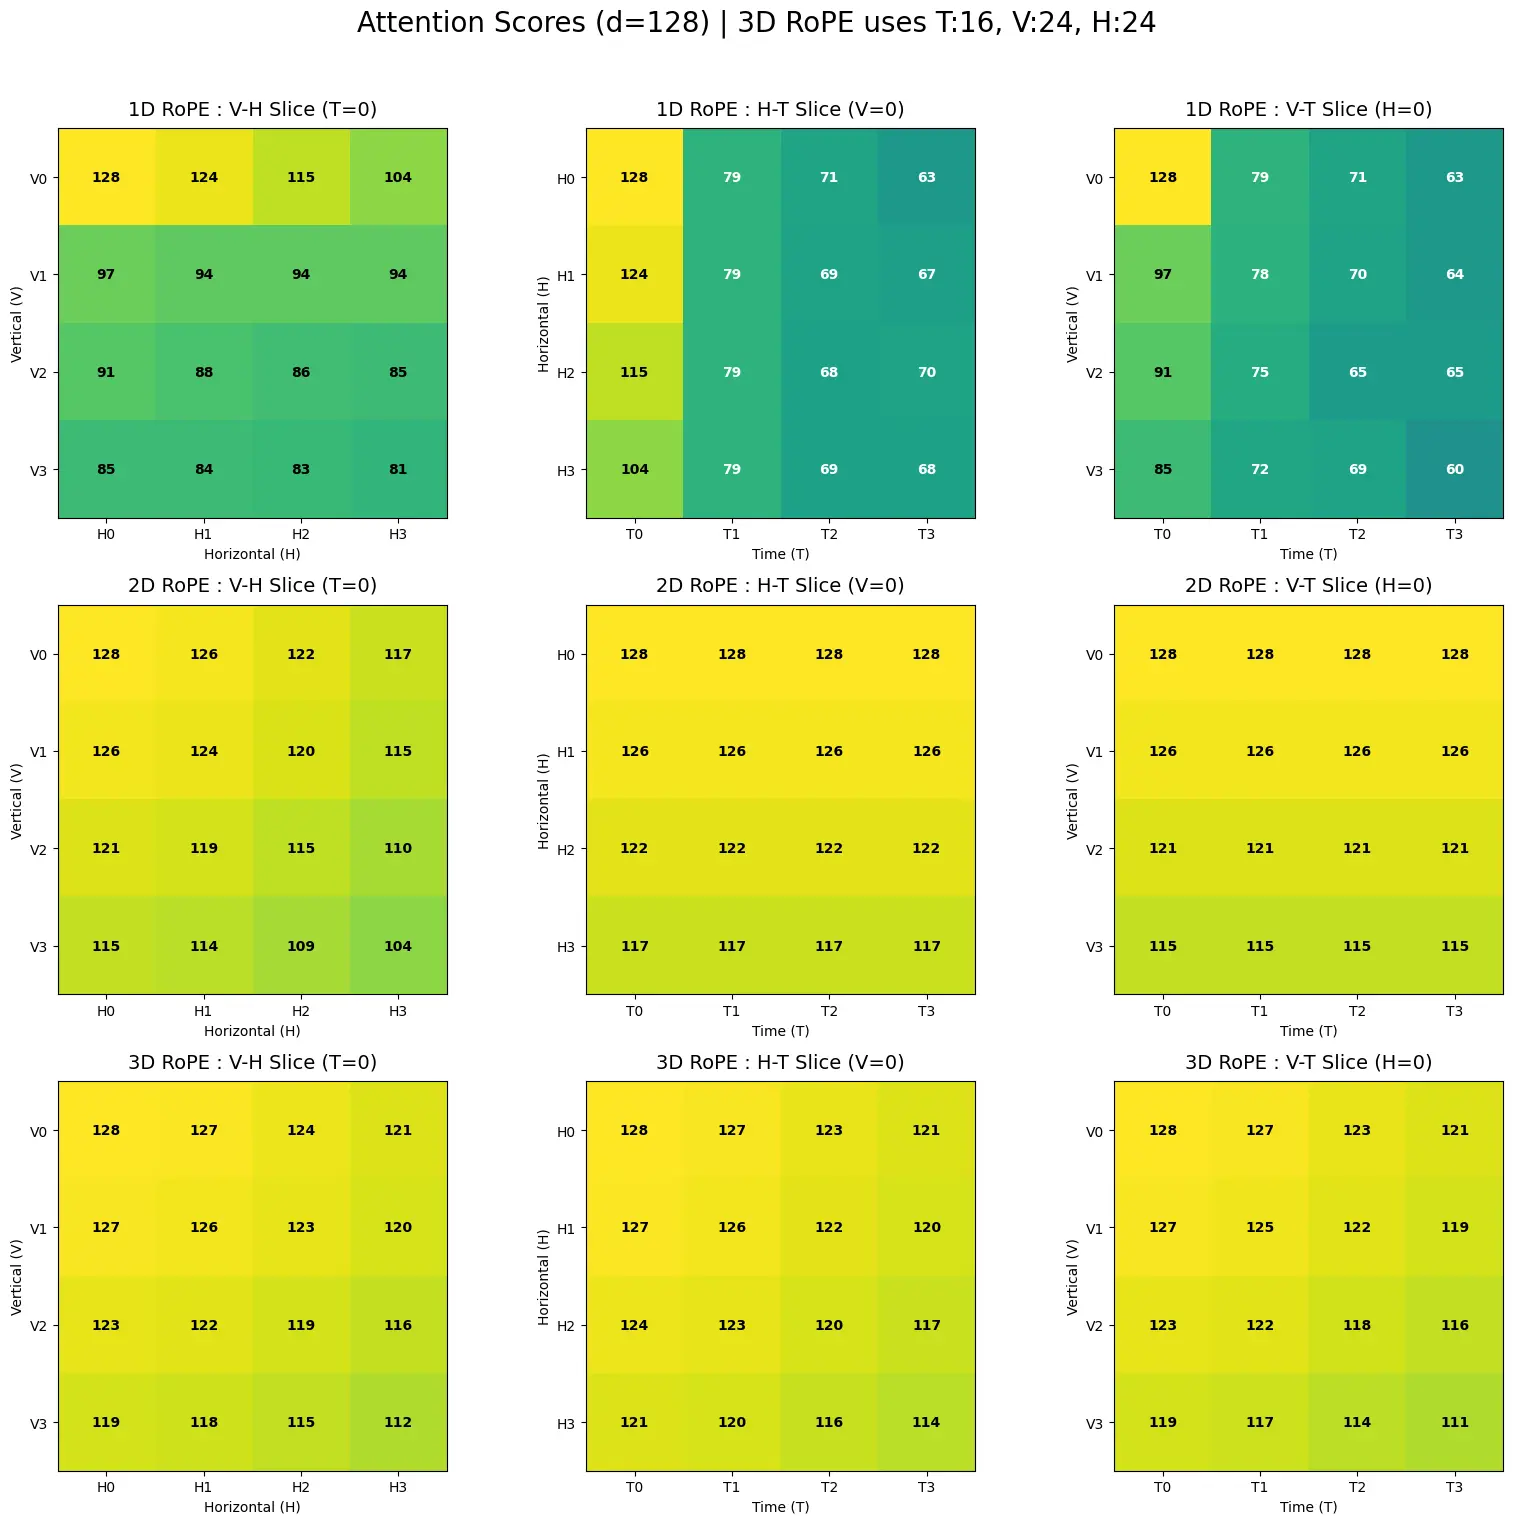 このシミュレーションでは、次元 d を128に設定し、合計64ペアの次元を、時間(T)に16ペア、縦(V)に24ペア、横(H)に24ペアという不均等な配分で割り当てています。
-
1D RoPE と 2D RoPE の挙動は、d=144のケースと本質的に同じです。1Dは時空間の構造を平坦化の順番でしか表現できず、2Dは時間構造を無視しています。スコアの最大値が128になっている点のみが異なります。
-
3D RoPE (MRoPE): ここでは、周波数ペアをインターリーブ方式で不均等に分割しています。まず全体の1/4にあたるインデックス(all_idx[::4])を時間 t_idx に割り当て、残りを縦 v_idx と横 h_idx で交互に分け合っています。 可視化結果を見ると、d=144の均等配分の場合と同様に、すべての断面で原点から離れるほどスコアが下がっています。各軸に割り当てる次元数が異なっていても、それぞれの軸の「定規」として独立して機能することがわかります。
周波数の割り当て方:連続ブロックとインターリーブ
上記のシミュレーションでは、周波数を各軸に交互に割り当てました。一方、Qwen2-VLの実装では、64ペアを先頭から連続して、時間に16ペア、縦に24ペア、横に24ペアずつ割り当てています。 RoPEでは前のペアほど速く回転する(周波数が高い)ため、連続して割り当てると、時間には高い周波数だけが、横には低い周波数だけが割り当てられることになります。 以下のコードでは、2つの割り当て方で、各軸の周波数の範囲と、距離が1・10離れたときにスコアがどれだけ下がるかを比較します。
import numpy as np

# d=128 (64ペア) の周波数
base = 10000
d = 128
thetas = 1.0 / (base ** (2 * np.arange(d // 2) / d))

def calc_score(delta_pos, theta_list):
    return sum(2 * np.cos(delta_pos * th) for th in theta_list)

# ① Qwen2-VL の実装: 先頭から連続して 16 : 24 : 24 ペアを割り当て
contiguous = {
    "T": thetas[0:16],
    "V": thetas[16:40],
    "H": thetas[40:64],
}

# ② 本記事のシミュレーション: インターリーブで 16 : 24 : 24 ペアを割り当て
all_idx = np.arange(64)
t_idx = all_idx[::4]
rem_idx = np.setdiff1d(all_idx, t_idx)
interleaved = {
    "T": thetas[t_idx],
    "V": thetas[rem_idx[0::2]],
    "H": thetas[rem_idx[1::2]],
}

for name, alloc in [("連続ブロック (Qwen2-VL)", contiguous), ("インターリーブ", interleaved)]:
    print(f"--- {name} ---")
    for axis, th in alloc.items():
        s0 = calc_score(0, th)
        drop_1 = s0 - calc_score(1, th)
        drop_10 = s0 - calc_score(10, th)
        print(f"{axis}: θの範囲 {th.min():.5f} ~ {th.max():.5f} | "
              f"距離1でのスコア低下 {drop_1:7.3f} | 距離10でのスコア低下 {drop_10:7.3f}")
- 連続ブロック: thetas[0:16]、thetas[16:40]、thetas[40:64]のように、先頭から順に時間・縦・横へ割り当てます。
- インターリーブ: all_idx[::4]で4つに1つを時間に、残りをrem_idx[0::2]とrem_idx[1::2]で縦と横に交互に割り当てます(前節のシミュレーションと同じ)。
- 比較の指標: 各軸について、周波数thの最小値と最大値、および距離0のスコアs0から距離1・10のスコアを引いた値(スコアの低下量)を表示します。全要素1のベクトルを想定した計算です。
実行結果
--- 連続ブロック (Qwen2-VL) ---
T: θの範囲 0.11548 ~ 1.00000 | 距離1でのスコア低下   3.773 | 距離10でのスコア低下  38.547
V: θの範囲 0.00365 ~ 0.10000 | 距離1でのスコア低下   0.040 | 距離10でのスコア低下   3.809
H: θの範囲 0.00012 ~ 0.00316 | 距離1でのスコア低下   0.000 | 距離10でのスコア低下   0.004
--- インターリーブ ---
T: θの範囲 0.00018 ~ 1.00000 | 距離1でのスコア低下   1.373 | 距離10でのスコア低下  11.882
V: θの範囲 0.00013 ~ 0.86596 | 距離1でのスコア低下   1.436 | 距離10でのスコア低下  16.171
H: θの範囲 0.00012 ~ 0.74989 | 距離1でのスコア低下   1.004 | 距離10でのスコア低下  14.307
- 結果: 連続ブロックでは、横(H)には0.00316以下の非常に遅い周波数しか割り当てられず、距離が1や10離れてもスコアがほとんど変わりません。つまり、近い距離の横方向の位置の違いを区別しにくくなります。一方、インターリーブでは、どの軸にも速い周波数から遅い周波数までがまんべんなく割り当てられ、各軸で距離に応じてスコアが下がっています。
このような周波数の偏りを解消するため、後継のQwen3-VLでは、周波数を時間・縦・横に交互に割り当てる「Interleaved-MRoPE」が採用されています。
距離 10 でのスコアの低下を軸ごとに並べると、次のようになります。
(図は、diagram-designで作成)
動画データへのMRoPEの適用
これまでの理論とシミュレーションを踏まえ、実際の動画データに対してMRoPE(3D RoPE)を適用する具体的なプロセスをコードで示します。 torch を用いて、ダミーの動画テンソル(時間、チャネル、縦、横の4次元)を作成し、パッチに分割して線形層で特徴量ベクトルに変換します。 RoPEは入力の特徴量ではなくAttention層の中でQueryとKeyに適用するものなので、特徴量からQueryとKeyを作り、各パッチの時空間座標(t, y, x)に応じた回転を施してから、アテンションスコアを計算するまでの流れを実装します。
import torch
import numpy as np

# --- 1. 入力動画の設定 (5フレーム x 10x10画像 x 3チャネル) ---
# Batch=1, Time=5, Channel=3, Height=10, Width=10
torch.manual_seed(42)
video = torch.randn(1, 5, 3, 10, 10)

# 空間方向のパッチサイズ (2x2ピクセル)
patch_size = 2
# 隠れ層の次元数 d=6 (時間:2, 高さ:2, 幅:2 に3分割するため6に設定)
hidden_dim = 6

# --- 2. 動画をパッチに分割してベクトル化 (Linear Projection) ---
# 5フレームの各10x10画像から、縦5個 × 横5個 = 25パッチ 作成されます
# 全体で 5フレーム × 25パッチ = 計125パッチ になります。
# 各パッチの元の画素数は 2 * 2 * 3(RGB) = 12次元 です

# ① まず縦方向(Dim 3)をサイズ2、ストライド2で切り出す
patches = video.unfold(3, patch_size, patch_size)
# 形状: [1, 5, 3, 5, 10, 2]

# ② 次に横方向(Dim 4)をサイズ2、ストライド2で切り出す
patches = patches.unfold(4, patch_size, patch_size)
# 形状: [1, 5, 3, 5, 5, 2, 2]

# 扱いやすいように次元の順序を入れ替える
# [Batch, Time, Channel, Grid_H, Grid_W, Patch_H, Patch_W]
# -> [Batch, Time, Grid_H, Grid_W, Channel, Patch_H, Patch_W]
patches = patches.permute(0, 1, 3, 4, 2, 5, 6)

# パッチ内の画素情報を1つのベクトルに平坦化
# 形状を [Batch(1), Time(5), Grid_H(5), Grid_W(5), パッチ内画素数(12)] に整理
patches = patches.flatten(4)

# 線形投影(Linear Projection)により、画素数12からモデルの隠れ層次元数6へ変換
projection_layer = torch.nn.Linear(patch_size * patch_size * 3, hidden_dim)
patch_features = projection_layer(patches)
# 形状: [1, 5, 5, 5, 6]

# --- 3. Attention層での Query と Key への変換 ---
# RoPEは入力に足すのではなく、Attention層の中で Query と Key に適用します
W_q = torch.nn.Linear(hidden_dim, hidden_dim, bias=False)
W_k = torch.nn.Linear(hidden_dim, hidden_dim, bias=False)
q = W_q(patch_features) # 形状: [1, 5, 5, 5, 6]
k = W_k(patch_features) # 形状: [1, 5, 5, 5, 6]

# --- 4. 3D RoPE の回転行列の生成 ---
# 時間(5) × 縦(5) × 横(5) のグリッド座標に対する回転行列を構築します
grid_t, grid_h, grid_w = patch_features.shape[1], patch_features.shape[2], patch_features.shape[3]
theta = 0.5

# 各座標用の回転行列を格納するテンソル [5, 5, 5, 6, 6]
R_3d_grid = torch.zeros(grid_t, grid_h, grid_w, hidden_dim, hidden_dim)

for t in range(grid_t):
    for y in range(grid_h):
        for x in range(grid_w):
            # 1/3部分 (インデックス 0, 1): 時間方向 t に応じた回転
            R_3d_grid[t, y, x, 0, 0] = np.cos(t * theta)
            R_3d_grid[t, y, x, 0, 1] = -np.sin(t * theta)
            R_3d_grid[t, y, x, 1, 0] = np.sin(t * theta)
            R_3d_grid[t, y, x, 1, 1] = np.cos(t * theta)

            # 2/3部分 (インデックス 2, 3): 縦方向 y に応じた回転
            R_3d_grid[t, y, x, 2, 2] = np.cos(y * theta)
            R_3d_grid[t, y, x, 2, 3] = -np.sin(y * theta)
            R_3d_grid[t, y, x, 3, 2] = np.sin(y * theta)
            R_3d_grid[t, y, x, 3, 3] = np.cos(y * theta)

            # 3/3部分 (インデックス 4, 5): 横方向 x に応じた回転
            R_3d_grid[t, y, x, 4, 4] = np.cos(x * theta)
            R_3d_grid[t, y, x, 4, 5] = -np.sin(x * theta)
            R_3d_grid[t, y, x, 5, 4] = np.sin(x * theta)
            R_3d_grid[t, y, x, 5, 5] = np.cos(x * theta)

# --- 5. 3D RoPE の適用 (Query と Key の回転) ---
q_rot = torch.zeros_like(q)
k_rot = torch.zeros_like(k)

for t in range(grid_t):
    for y in range(grid_h):
        for x in range(grid_w):
            R = R_3d_grid[t, y, x] # 対応する6x6の回転行列
            q_rot[0, t, y, x] = R @ q[0, t, y, x]
            k_rot[0, t, y, x] = R @ k[0, t, y, x]

# --- 6. 1列のシーケンスに平坦化してアテンションスコアを計算 ---
# [Batch=1, 全パッチ数=125, 次元数=6]
q_seq = q_rot.flatten(1, 3)
k_seq = k_rot.flatten(1, 3)
# 全パッチ同士の内積 [Batch=1, 125, 125]
attn_scores = q_seq @ k_seq.transpose(1, 2)

print("元の動画形状:", video.shape)
print("パッチ分割後のグリッド形状 (時間, 縦, 横, 次元):", patch_features.shape[1:])
print("回転後のQueryシーケンス形状:", q_seq.shape)
print("アテンションスコアの形状:", attn_scores.shape)

# --- 7. スコアが相対位置だけで決まることの確認 ---
# Query: (t=1, y=1, x=1)、Key: (t=3, y=2, x=4) → 相対位置 (Δt=2, Δy=1, Δx=3)
def flat_idx(t, y, x):
    return t * (grid_h * grid_w) + y * grid_w + x

score_rope = attn_scores[0, flat_idx(1, 1, 1), flat_idx(3, 2, 4)].item()
# 回転前の q, k の間に「相対位置 (2, 1, 3) の回転行列」を挟んだ値
score_rel = (q[0, 1, 1, 1] @ R_3d_grid[2, 1, 3] @ k[0, 3, 2, 4]).item()
print(f"回転後の内積                    : {score_rope:.4f}")
print(f"q^T R(Δt=2, Δy=1, Δx=3) k の値  : {score_rel:.4f}")
- 入力データ: torch.randn(1, 5, 3, 10, 10)で、(Batch, Time, Channel, Height, Width) の5次元を持つダミーの動画テンソルを生成します。「10x10ピクセルのRGB画像が5フレーム続く動画」を意味します。5フレーム・10×10ピクセルを2×2のパッチに切るのは、5×5×5 = 125パッチという、スコア行列を計算できる小さな大きさにするためです。
- パッチ化と線形射影: video.unfold()を縦・横方向に適用して2x2ピクセルのパッチを切り出し、patches.permute()とpatches.flatten(4)で各パッチを12次元(2x2x3)のベクトルにします。projection_layerで6次元のpatch_features(形状: [1, 5, 5, 5, 6])に変換します。
- QueryとKeyへの変換: Attention層の変換行列に相当するW_qとW_kで、特徴量からQueryqとKeykを作ります。Value(V)には回転を施しません。
- 回転行列の生成: R_3d_gridはブロック対角行列で、最初の2次元を時間t、次の2次元を縦y、最後の2次元を横xに応じて独立に回転させます。hidden_dim = 6 は、時間・縦・横にそれぞれ2次元ずつ(1組ずつ)割り当てられる、最小の次元数です。
- MRoPEの適用: 5x5x5のグリッド上のすべてのパッチについて、QueryとKeyにその座標(t, y, x)の回転行列Rを掛け(@は行列積)、q_rotとk_rotを作ります。
- アテンションスコアの計算: flatten(1, 3)で125パッチのシーケンス(形状: [1, 125, 6])に平坦化し、q_seq @ k_seq.transpose(1, 2)で全パッチ同士の内積(形状: [1, 125, 125])を計算します。
- 相対位置の確認: Query (t=1, y=1, x=1) とKey (t=3, y=2, x=4) の回転後の内積score_ropeと、回転前のqとkの間に相対位置 (Δt=2, Δy=1, Δx=3) の回転行列R_3d_grid[2, 1, 3]を挟んだ値score_relが、どちらも-0.2641で一致しています。回転後の内積が、時間・縦・横の相対位置だけで決まることが確認できます。3つの軸の距離が違う組(2・1・3)を選ぶのは、3つの方向が別々に効いていることを確かめるためです。
実行結果
元の動画形状: torch.Size([1, 5, 3, 10, 10])
パッチ分割後のグリッド形状 (時間, 縦, 横, 次元): torch.Size([5, 5, 5, 6])
回転後のQueryシーケンス形状: torch.Size([1, 125, 6])
アテンションスコアの形状: torch.Size([1, 125, 125])
回転後の内積                    : -0.2641
q^T R(Δt=2, Δy=1, Δx=3) k の値  : -0.2641
なお、実際のモデルではこの回転を、Transformerの各層のAttentionで毎回QueryとKeyに適用します。また、Qwen2-VLでは、テキストと画像・動画のトークンが1つのシーケンスに並び、前述の位置IDの割り当てルールに従ってMRoPEが適用されます。
ここまでの流れを図にまとめると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、動画などの多次元データを扱うための位置エンコーディング技術である MRoPE(Multimodal Rotary Position Embedding) について、その理論的背景から具体的な実装までを解説しました。
記事を通じて、以下のステップでMRoPEへの理解を深めました。
- RoPEの進化の学習: 1D RoPE、2D RoPEの限界点を学び、なぜ時間・空間を同時に扱うためにMRoPEが必要とされるのかを理解しました。
- 位置IDの割り当て: テキストには3成分に同じ位置IDを、画像・動画には時間・縦・横の座標に応じた位置IDを割り当てることで、テキストと画像・動画を1つの仕組みで扱えることを確認しました。
- 理論と実装による比較: numpyを用いたシミュレーションを通じて、1D/2D RoPEでは時空間情報を正しく表現できない一方、MRoPEはこれらを捉えられることを可視化して確認しました。また、周波数を連続ブロックで割り当てると軸ごとに周波数が偏ることと、インターリーブによる割り当てでそれが解消されることを学びました。
- PyTorchによる適用パイプラインの実装: 動画テンソルをパッチに分割し、QueryとKeyに各パッチの時空間座標に応じたMRoPEの回転を適用して、アテンションスコアを計算するまでの流れをコードで実践しました。
MRoPEは、Qwen2-VLのようなマルチモーダルモデルが、テキスト・画像・動画を1つの位置エンコーディングで扱うための根幹技術です。この「多次元回転」というアプローチを理解することは、今後のVision-Languageモデルの進化を読み解く上で重要となります。
参考文献
- P. Wang et al. (2024). Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution. arXiv:2409.12191.
本記事の文章・構成の一部に生成AIを使用しています。