Nougatとは?
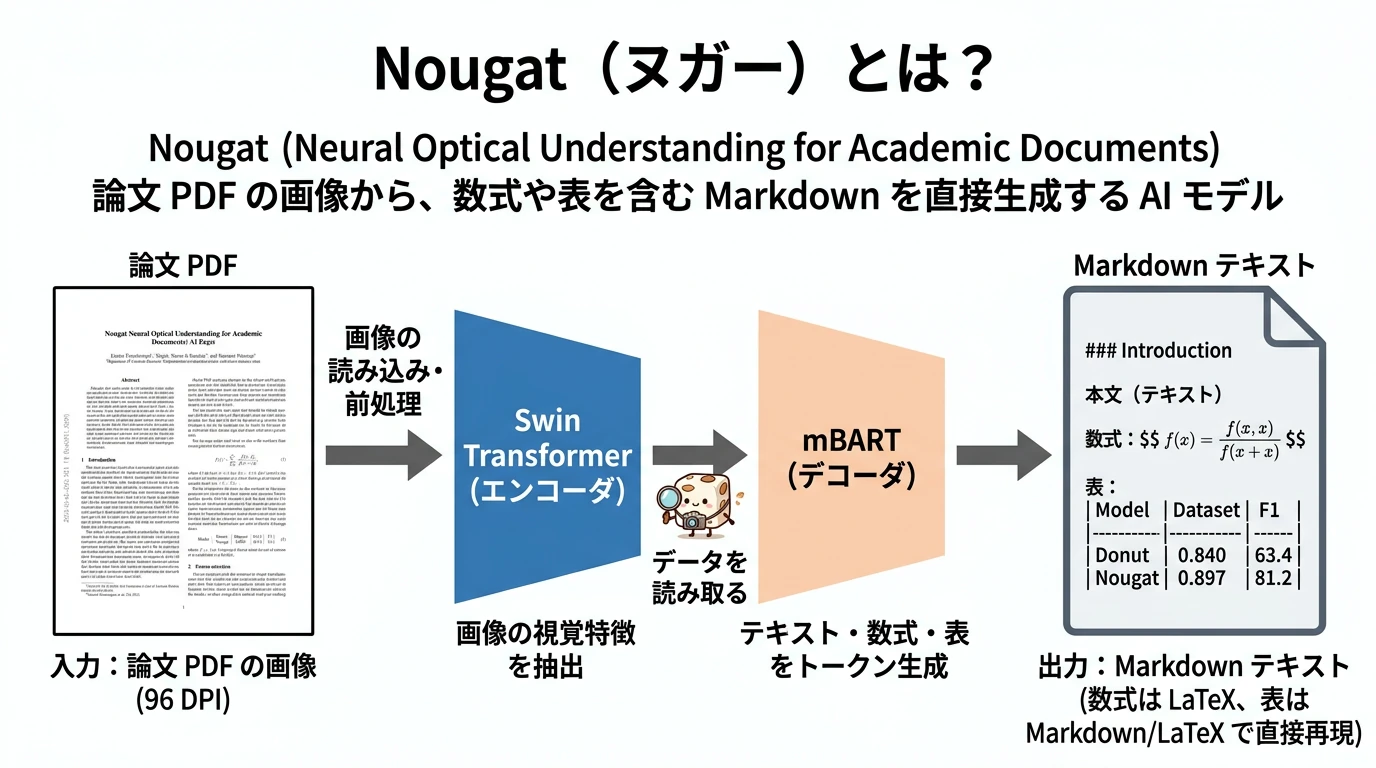 (画像は、Geminiで作成)
論文のページの画像から、数式と表を含む Markdown を直接生成する Nougat を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じトークン列を生成することを確かめること。生成が同じ文のくり返しに入る失敗と、それを止める仕組みを理解し、追加学習を自分で書いて出力の形式を変えられるようになること。
参考資料: Nougat: Neural Optical Understanding for Academic Documents (Blecher et al., 2023)。公式の実装は facebookresearch/nougat(コードは MIT)、本記事で使う学習済みの重みは Hugging Face の facebook/nougat-small です。重みのライセンスについては、記事の最後の注記を確認してください。
概要
論文は PDF で配られることがほとんどですが、PDF に埋め込まれた文字は「見た目の文字の並び」で、数式の構造や表の行と列は残っていません。スキャンした論文では、文字の情報すらありません。論文を検索したり、言語モデルに読ませたりするには、本文・数式・表を、構造の分かる形に戻す必要があります。
Nougat(Neural Optical Understanding for Academic Documents、Meta AI, 2023)は、論文のページの画像を入力し、Markdown を直接生成するモデルです。数式は LaTeX、表は LaTeX の tabular で書き出します。ページの画像だけを使うので、スキャンした論文も読めます。
Nougat の構造は、Donut の記事で実装した Donut と同じです。Swin Transformer のエンコーダがページの画像を特徴にし、mBART のデコーダが Markdown のトークンを 1 つずつ生成します(Encoder-Decoder と自己回帰生成の基本は、Transformer の記事で解説しています)。違うのは、入力の大きさ・語彙・最大のトークン数と、論文から作った大量のページと正解の組で学習していることです。
本記事では、まず Hugging Face の実装で Nougat の論文自身のページを読ませ、仕組みを図で整理したうえで、Nougat(small)を Donut の実装を土台にスクラッチで実装します。公式の重みで Hugging Face と同じトークン列を生成することを確かめ、生成が同じ文のくり返しに入る失敗と、それを止める仕組み、画質を落としたときの強さを調べます。最後に、合成の表の画像で追加学習し、表の出力の形式を LaTeX から Markdown に変えます。
Nougat で論文のページを読む
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。最後の実験4の追加学習は、A100 で約 5 分(3 エポック、更新 750 回)かかります。L4 GPU でも動きますが、時間はもっとかかります。
新しいセッションで、次を実行してください。pypdfium2 は PDF のページを画像にするライブラリです。python-Levenshtein と nltk は、Hugging Face の Nougat の後処理(post_process_generation)が使うライブラリで、編集距離の計算にも使います。transformers(比較用の Nougat)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q pypdfium2 python-Levenshtein nltk japanize-matplotlib setuptools
推論に利用する論文
本記事では、Nougat の論文自身(arXiv:2308.13418v1、CC BY-SA 4.0)の PDF を、Nougat に読ませます。数式・表・図を含む 17 ページの論文で、モデルの出力を、論文の内容と見比べながら確かめられます。PDF は、コードの中で arXiv からダウンロードします。
実験1:論文の 1 ページを Markdown にする
Hugging Face の実装で、論文の 3 ページ目(学習の設定が書かれたページ)を Markdown にします。
import os
import time
import urllib.request
import numpy as np
import torch
import matplotlib.pyplot as plt
import japanize_matplotlib
import pypdfium2 as pdfium
from transformers import NougatProcessor, VisionEncoderDecoderModel

device = "cuda"
# Nougat の論文(arXiv:2308.13418v1、CC BY-SA 4.0)の PDF を、Nougat 自身に読ませる
if not os.path.exists("nougat_paper.pdf"):
    urllib.request.urlretrieve("https://arxiv.org/pdf/2308.13418v1", "nougat_paper.pdf")
pdf = pdfium.PdfDocument("nougat_paper.pdf")
pages = [pdf[i].render(scale=96 / 72).to_pil() for i in range(len(pdf))]   # 論文と同じ 96 DPI で画像にする
print(f"{len(pages)} ページ、1 ページの画像 {pages[0].size}")

processor = NougatProcessor.from_pretrained("facebook/nougat-small")
hf_model = VisionEncoderDecoderModel.from_pretrained("facebook/nougat-small").to(device).eval()
tok = processor.tokenizer

page = pages[2]
pixel_values = processor(page, return_tensors="pt").pixel_values.to(device)
with torch.no_grad():
    out = hf_model.generate(pixel_values, min_length=1, max_length=3584,
                            bad_words_ids=[[tok.unk_token_id]], do_sample=False)
markdown = processor.post_process_generation(tok.decode(out[0], skip_special_tokens=True), fix_markdown=False)
print(f"入力 {tuple(pixel_values.shape[2:])}、生成したトークン {out.shape[1]} 個\n")
print(markdown[:1500])

plt.figure(figsize=(6, 8.5))
plt.imshow(page)
plt.axis("off")
plt.show()
- 96 DPI: 論文と同じ解像度で、PDF のページを画像にします(A4 の論文で 794×1123 画素)。
- 前処理: プロセッサが、ページの白い余白を切り取ってから、896×672 に収まるよう縮め、余白を埋めます。
- 生成: 公式の推論と同じく貪欲法で、未知語のトークン(unk)は出さないようにします。max_length=3584 は、nougat-small の位置埋め込みの数です。
- post_process_generation: 生成したテキストの細かな書式を整える、Hugging Face の後処理です。fix_markdown=False で、Markdown の修正はしません。
実行結果
17 ページ、1 ページの画像 (794, 1123)
入力 (896, 672)、生成したトークン 641 個


### Setup

We render the document images at a resolution of 96 DPI. Due to the restrictive possible input dimensions of the Swin Transformer we choose the input size \((H,\,W)=(896,\,672)\). The aspect ratio is in between the US letter and Din A4 format \(\frac{27}{17}<\frac{4}{3}<\sqrt{2}\). The document images are resized and then padded to achieve the desired input size. This input size allows us to use the Swin base model architecture [30]. We initialize the model with the pre-trained weights.

The Transformer decoder has a maximal sequence length of \(S=4096\). This relatively large sizing is due to the fact that the text of academic research papers can be dense and the syntax for tables in particular is token intensive. The BART decoder is a decoder-only transformer with 10 layers. The entire architecture has a total of 350M parameters.

We also test experiment with a smaller model (250M parameters) with a slightly smaller sequence length of \(S=3584\) and only 4 decoder layers, where we start from the pre-trained base model.

During inference the text is generated using greedy decoding.

**Training** We use an AdamW optimizer [34] to train for 3 epochs with an effective batch size of 192. Due to training instabilities, we choose a learning rate of \(\mathrm{lr}_{\mathrm{init}}=5\cdot 10^{-5}\) which is reduced by a factor of \(0.9996\) every 15 updates until it reaches \(\mathrm{lr}_{\mathrm{end}}=7.5\cdot 10^{-6}\).

### Data Augmentation

In image recognition tasks
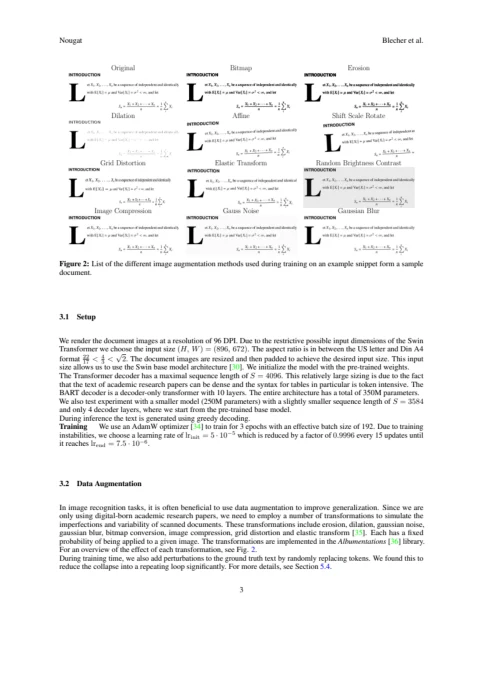
(画像は、Blecher et al.「Nougat: Neural Optical Understanding for Academic Documents」(arXiv:2308.13418v1、CC BY-SA 4.0)の 3 ページ目)
見出し(### Setup)、本文、太字(**Training**)が Markdown になり、本文の中の数式は \((H,\,W)=(896,\,672)\) や \(\frac{27}{17}<\frac{4}{3}<\sqrt{2}\) のように、LaTeX で書き出されました。PDF に埋め込まれた文字からは分からない、分数や平方根の構造も復元しています。
このページには、Nougat 自身の設定が書かれています。nougat-small は、デコーダが 4 層・最大のトークン数が 3,584 の小さいモデルで、学習済みの base のモデルから始めて学習したことが分かります(全体で約 2.5 億パラメータ)。学習は AdamW、学習率 5e-5 で、15 回の更新ごとに学習率を 0.9996 倍に下げています(公式の設定ファイルでは 16 回ごと)。実験4の追加学習では、この設定に合わせます。
Nougat の仕組み
全体の構成
Nougat の全体は、次の図のとおりです(図は、後で実装する Nougat クラスの構成です)。
(図は、diagram-designで作成)
- エンコーダ: Swin Transformer(Swin-B)で、896×672 のページの画像を、588 個(28×21)の 1024 次元の特徴にします。
- デコーダ: mBART のデコーダで、開始のトークン <s> から、Markdown のトークンを 1 つずつ生成します。nougat-small は 4 層、nougat-base は 10 層です。Donut のようなタスクのプロンプトはなく、タスクは「ページを Markdown にする」の 1 つだけです。
- 学習: arXiv などの論文の LaTeX のソースから正解の Markdown を作り、PDF のページの画像と組にして学習しています。
Donut との違い
(図は、diagram-designで作成)
部品の構造は同じなので、Donut の記事の実装の設定を変えるだけで、Nougat になります。Swin Transformer と mBART の仕組みは、Donut の記事で詳しく説明しています。
- 入力の大きさ 896×672: 論文によると、Swin の入力の大きさの制約に合い、縦横の比 4 : 3 が US レターと A4 の比の間にある大きさです。
- 窓 7: 画像分類の Swin と同じ大きさです。
- 語彙 50,000 語: 論文用の言語モデル Galactica と同じトークナイザで、LaTeX の数式を短いトークン列にできます。出力層は、単語の埋め込みと別の重みです。
- 最大のトークン数 3,584: 論文の 1 ページは文字も数式も多く、表の LaTeX は特に長くなるので、Donut(768)よりずっと長い列を生成します。
くり返しの検出
(図は、diagram-designで作成)
Nougat は、同じ文や同じ記号を延々と生成し続けて、最大のトークン数まで止まらないことがあります。論文は、これを「くり返し(repetition)」と呼んで、対策を論じています。公式の推論は、次の方法でくり返しを見つけて、生成を途中で止めます。
- 確信度のゆれ: 生成の各回で、次のトークンのスコア(logit)の最大値を記録します。直近 15 個の分散を 15 で割った値を、確信度のゆれの大きさとします。
- ゆれ方が一定か: そのゆれの大きさの、直近 200 個の分散を求めます。同じ文をくり返していると、確信度の並びも周期的にくり返すので、ゆれ方が一定になり、この分散が小さくなります。
- 止める: 200 回より後で、この分散が 0.015 未満になった状態が 2 回続いたら、生成を止めます。
Nougat のスクラッチ実装
ここからは、Nougat(small)を部品ごとに実装します。Donut の記事の実装を土台に、設定と生成の部分を変えます。部品の構造・次元・計算の順番は、Hugging Face の VisionEncoderDecoderModel(DonutSwinModel と MBartForCausalLM)と同じです。
エンコーダ
import math
import re
import torch.nn as nn
import torch.nn.functional as F


# ===== 画像エンコーダ:Swin Transformer(Nougat 版) =====
def window_partition(x, ws):
    """(B, H, W, C) を、ws×ws の窓を並べた (B*窓の数, ws*ws, C) にする"""
    B, H, W, C = x.shape
    x = x.view(B, H // ws, ws, W // ws, ws, C)
    return x.permute(0, 1, 3, 2, 4, 5).reshape(-1, ws * ws, C)


def window_reverse(windows, ws, H, W):
    """window_partition の逆"""
    C = windows.shape[-1]
    B = windows.shape[0] // ((H // ws) * (W // ws))
    x = windows.view(B, H // ws, W // ws, ws, ws, C)
    return x.permute(0, 1, 3, 2, 4, 5).reshape(B, H, W, C)


def shift_mask(H, W, ws, shift, device):
    """巡回シフトで貼り合わされた、元の画像では離れている位置の組に -100 を入れる (窓の数, N, N)"""
    h_reg = (torch.arange(H, device=device) >= H - ws).long() + (torch.arange(H, device=device) >= H - shift).long()
    w_reg = (torch.arange(W, device=device) >= W - ws).long() + (torch.arange(W, device=device) >= W - shift).long()
    region = (h_reg[:, None] * 3 + w_reg[None, :]).float()[None, :, :, None]   # 9 つの領域に番号を付ける
    mw = window_partition(region, ws).squeeze(-1)
    diff = mw[:, None, :] - mw[:, :, None]
    return diff.masked_fill(diff != 0, -100.0)


class WindowAttention(nn.Module):
    def __init__(self, dim, heads, ws):
        super().__init__()
        self.heads, self.ws = heads, ws
        self.qkv = nn.Linear(dim, dim * 3)
        self.proj = nn.Linear(dim, dim)
        self.relative_position_bias_table = nn.Parameter(torch.zeros((2 * ws - 1) ** 2, heads))
        c = torch.stack(torch.meshgrid(torch.arange(ws), torch.arange(ws), indexing="ij")).flatten(1)
        rel = (c[:, :, None] - c[:, None, :]).permute(1, 2, 0) + (ws - 1)       # (N, N, 2) の (dy, dx) を 0 始まりに
        self.register_buffer("rel_index", rel[..., 0] * (2 * ws - 1) + rel[..., 1], persistent=False)

    def forward(self, x, mask=None):                 # x: (B*窓の数, N, C)
        Bw, N, C = x.shape
        q, k, v = self.qkv(x).reshape(Bw, N, 3, self.heads, -1).permute(2, 0, 3, 1, 4)
        attn = (q * q.shape[-1] ** -0.5) @ k.transpose(-2, -1)
        attn = attn + self.relative_position_bias_table[self.rel_index].permute(2, 0, 1)[None]
        if mask is not None:
            nW = mask.shape[0]
            attn = (attn.view(Bw // nW, nW, self.heads, N, N) + mask[None, :, None]).view(Bw, self.heads, N, N)
        return self.proj((attn.softmax(-1) @ v).transpose(1, 2).reshape(Bw, N, C))


class SwinBlock(nn.Module):
    def __init__(self, dim, heads, ws=7, shift=0):
        super().__init__()
        self.ws, self.shift = ws, shift
        self.norm1, self.norm2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.attn = WindowAttention(dim, heads, ws)
        self.fc1, self.fc2 = nn.Linear(dim, 4 * dim), nn.Linear(4 * dim, dim)

    def forward(self, x):                            # x: (B, H, W, C)
        B, H, W, C = x.shape
        ws, shift = self.ws, self.shift
        if min(H, W) <= ws:                          # 特徴マップが窓より小さければ、全体を 1 つの窓にする
            ws, shift = min(H, W), 0
        h = self.norm1(x)
        ph, pw = (-H) % ws, (-W) % ws                # 窓の大きさで割り切れなければ、右と下を 0 で埋める
        h = F.pad(h, (0, 0, 0, pw, 0, ph))
        Hp, Wp = H + ph, W + pw
        if shift > 0:
            h = torch.roll(h, (-shift, -shift), (1, 2))
        mask = shift_mask(Hp, Wp, ws, shift, x.device).to(x.dtype) if shift > 0 else None
        h = window_reverse(self.attn(window_partition(h, ws), mask), ws, Hp, Wp)
        if shift > 0:
            h = torch.roll(h, (shift, shift), (1, 2))
        x = x + h[:, :H, :W]
        return x + self.fc2(F.gelu(self.fc1(self.norm2(x))))


class PatchMerging(nn.Module):
    def __init__(self, dim):
        super().__init__()
        self.norm = nn.LayerNorm(4 * dim)
        self.reduction = nn.Linear(4 * dim, 2 * dim, bias=False)

    def forward(self, x):
        x = F.pad(x, (0, 0, 0, x.shape[2] % 2, 0, x.shape[1] % 2))  # 奇数なら 1 行・1 列を埋める
        x = torch.cat([x[:, 0::2, 0::2], x[:, 1::2, 0::2], x[:, 0::2, 1::2], x[:, 1::2, 1::2]], -1)
        return self.reduction(self.norm(x))


class SwinEncoder(nn.Module):
    """Nougat のエンコーダ:Swin-B(窓 7、深さ 2・2・14・2)。最後の LayerNorm とプーリングはない"""

    def __init__(self, embed_dim=128, depths=(2, 2, 14, 2), heads=(4, 8, 16, 32), ws=7):
        super().__init__()
        self.patch_embed = nn.Conv2d(3, embed_dim, 4, 4)
        self.patch_norm = nn.LayerNorm(embed_dim)
        self.stages = nn.ModuleList()
        self.downsamples = nn.ModuleList()
        for i, (d, h) in enumerate(zip(depths, heads)):
            dim = embed_dim * 2 ** i
            self.stages.append(nn.Sequential(*[SwinBlock(dim, h, ws, 0 if j % 2 == 0 else ws // 2) for j in range(d)]))
            if i < len(depths) - 1:
                self.downsamples.append(PatchMerging(dim))

    def forward(self, x):                            # x: (B, 3, H, W)
        x = self.patch_norm(self.patch_embed(x).permute(0, 2, 3, 1))
        for i, stage in enumerate(self.stages):
            x = stage(x)
            if i < len(self.downsamples):
                x = self.downsamples[i](x)
        return x.flatten(1, 2)                       # (B, H/32 × W/32, 1024)
Donut の記事のエンコーダと同じで、窓の大きさの既定値を 7 にしています。各部分の説明は、Donut の記事を参照してください。896×672 の入力では、4 段のステージの特徴が 224×168・112×84・56×42・28×21 になり、どの段も窓 7 で割り切れます。
デコーダ
# ===== テキストデコーダ:mBART の 4 層 =====
class MHA(nn.Module):
    def __init__(self, dim=1024, heads=16):
        super().__init__()
        self.heads = heads
        self.q_proj, self.k_proj, self.v_proj, self.out_proj = (nn.Linear(dim, dim) for _ in range(4))

    def split(self, t):
        return t.view(t.shape[0], t.shape[1], self.heads, -1).transpose(1, 2)

    def forward(self, x, k, v, causal=False):        # k, v は split 済み (B, heads, L, d)
        q = self.split(self.q_proj(x))
        o = F.scaled_dot_product_attention(q, k, v, is_causal=causal)
        return self.out_proj(o.transpose(1, 2).reshape(x.shape[0], x.shape[1], -1))


class DecoderLayer(nn.Module):
    def __init__(self, dim=1024, heads=16, ffn=4096):
        super().__init__()
        self.self_attn, self.encoder_attn = MHA(dim, heads), MHA(dim, heads)
        self.self_attn_layer_norm, self.encoder_attn_layer_norm, self.final_layer_norm = (nn.LayerNorm(dim) for _ in range(3))
        self.fc1, self.fc2 = nn.Linear(dim, ffn), nn.Linear(ffn, dim)

    def forward(self, x, cross_kv, cache=None):
        h = self.self_attn_layer_norm(x)
        k, v = self.self_attn.split(self.self_attn.k_proj(h)), self.self_attn.split(self.self_attn.v_proj(h))
        if cache is not None:                        # 生成中は、これまでのトークンの K・V を足して使い回す
            if "k" in cache:
                k, v = torch.cat([cache["k"], k], 2), torch.cat([cache["v"], v], 2)
            cache["k"], cache["v"] = k, v
        x = x + self.self_attn(h, k, v, causal=(x.shape[1] > 1))
        x = x + self.encoder_attn(self.encoder_attn_layer_norm(x), *cross_kv)
        return x + self.fc2(F.gelu(self.fc1(self.final_layer_norm(x))))


class Decoder(nn.Module):
    def __init__(self, vocab=50000, dim=1024, layers=4, heads=16, ffn=4096, max_pos=3584):
        super().__init__()
        self.embed_scale = math.sqrt(dim)            # 単語の埋め込みに √d を掛ける(scale_embedding)
        self.embed_tokens = nn.Embedding(vocab, dim)
        self.embed_positions = nn.Embedding(max_pos + 2, dim)   # mBART は位置の番号を 2 ずらして使う
        self.layernorm_embedding = nn.LayerNorm(dim)
        self.layers = nn.ModuleList(DecoderLayer(dim, heads, ffn) for _ in range(layers))
        self.layer_norm = nn.LayerNorm(dim)
        self.lm_head = nn.Linear(dim, vocab, bias=False)

    def cross_kv(self, enc):
        """エンコーダの出力の K・V は、生成の最初に 1 回だけ計算する"""
        return [(l.encoder_attn.split(l.encoder_attn.k_proj(enc)), l.encoder_attn.split(l.encoder_attn.v_proj(enc))) for l in self.layers]

    def forward(self, ids, cross, caches=None, start=0):
        pos = torch.arange(start, start + ids.shape[1], device=ids.device) + 2
        x = self.layernorm_embedding(self.embed_tokens(ids) * self.embed_scale + self.embed_positions(pos))
        for i, layer in enumerate(self.layers):
            x = layer(x, cross[i], None if caches is None else caches[i])
        return self.lm_head(self.layer_norm(x))
Donut の記事のデコーダとの違いは、次の 2 点です。
- 出力層 lm_head: Nougat では、単語の埋め込みと別の重みです(Hugging Face の重みで、2 つの値が違うことを確かめています)。
- 既定値: 語彙 50,000 語、最大のトークン数 3,584 にしています。
モデル全体と生成
class Nougat(nn.Module):
    def __init__(self, vocab=50000, max_pos=3584):
        super().__init__()
        self.encoder = SwinEncoder()
        self.decoder = Decoder(vocab=vocab, max_pos=max_pos)

    def forward(self, pixel_values, ids):
        """学習用:正解のトークン列を入れて、次のトークンの logit を一度に出す(teacher forcing)"""
        return self.decoder(ids, self.decoder.cross_kv(self.encoder(pixel_values)))

    @torch.no_grad()
    def generate(self, pixel_values, bos_id=0, eos_id=2, unk_id=3, max_len=3584, stop_repetition=False, threshold=0.015, window=200):
        """貪欲法。stop_repetition=True なら、公式と同じ方法で、くり返しに入ったら途中で止める(1 枚ずつ)"""
        cross = self.decoder.cross_kv(self.encoder(pixel_values))
        caches = [{} for _ in self.decoder.layers]
        ids = torch.full((pixel_values.shape[0], 1), bos_id, device=pixel_values.device)
        logits = self.decoder(ids, cross, caches, 0)
        maxes, vars_, low = [], [], 0
        for step in range(1, max_len):
            last = logits[:, -1].clone()
            last[:, unk_id] = float("-inf")                      # 公式の推論と同じく、未知語のトークンは出さない
            nxt = last.argmax(-1, keepdim=True)
            ids = torch.cat([ids, nxt], 1)
            if (nxt == eos_id).all():
                break
            if stop_repetition:
                # 最大の logit の直近 15 個の分散(÷ 個数)を記録し、その直近 window 個の分散が小さければ、くり返しとみなす
                maxes.append(last.max(-1).values[0].float().item())
                m = torch.tensor(maxes[-15:])
                vars_.append((m.var() / len(m)).item() if len(m) > 1 else float("nan"))
                if step >= window:
                    v = torch.tensor(vars_[-window:])
                    low = low + 1 if v[~v.isnan()].var().item() < threshold else 0
                    if low >= 2:                                 # 公式の実装と同じく、2 回続けて条件を満たしたら止める
                        break
            logits = self.decoder(nxt, cross, caches, ids.shape[1] - 1)
        return ids


model = Nougat()
count = lambda m: sum(p.numel() for p in m.parameters())
print(f"エンコーダ(Swin-B)  : {count(model.encoder):>12,}")
print(f"デコーダ(mBART 4 層): {count(model.decoder):>12,}")
print(f"  うち単語の埋め込みと出力層: {model.decoder.embed_tokens.weight.numel() + model.decoder.lm_head.weight.numel():>12,}")
print(f"全体                  : {count(model):>12,}")
- 開始のトークン: <s>(id 0)だけを入れて生成を始めます。
- 未知語を出さない: 公式の推論と同じく、<unk>(id 3)の logit を にしてから、最大のトークンを選びます。
- stop_repetition: True なら、前の節のくり返しの検出で生成を止めます。公式の実装は、0.015 未満になった次の回で止まる書き方になっているので、同じく「2 回続いたら止める」にしています。分散の計算に CPU との受け渡しが毎回入るので、少し遅くなります。
実行結果
エンコーダ(Swin-B)  :   74,120,824
デコーダ(mBART 4 層):  173,262,848
  うち単語の埋め込みと出力層:  102,400,000
全体                  :  247,383,672
パラメータは約 2 億 4,738 万個で、論文の 3 ページ目にある small の大きさ(約 2.5 億)と合います。エンコーダ(Swin-B)は約 7,412 万個で、Donut(約 7,418 万個)とほぼ同じです。窓が小さい分、相対位置のバイアスの表が小さくなっています。デコーダの約 1 億 7,326 万個のうち、約 1 億 240 万個は、50,000 語の単語の埋め込みと、別の重みの出力層です。
実験2:公式の重みで、Hugging Face と同じトークン列を生成するか
公式の重みの読み込み
def load_hf_nougat(model, sd):
    """Hugging Face の VisionEncoderDecoderModel(Nougat)の重みを、スクラッチ実装の名前に付け替えて読み込む"""
    out = {}
    for k, v in sd.items():
        n = k
        n = n.replace("encoder.embeddings.patch_embeddings.projection.", "encoder.patch_embed.")
        n = n.replace("encoder.embeddings.norm.", "encoder.patch_norm.")
        n = re.sub(r"^encoder\.encoder\.layers\.(\d+)\.blocks\.(\d+)\.", r"encoder.stages.\1.\2.", n)
        n = re.sub(r"^encoder\.encoder\.layers\.(\d+)\.downsample\.", r"encoder.downsamples.\1.", n)
        n = n.replace("layernorm_before.", "norm1.").replace("layernorm_after.", "norm2.")
        n = n.replace("attention.output.dense.", "attn.proj.").replace("attention.self.relative_position_bias_table", "attn.relative_position_bias_table")
        n = n.replace("intermediate.dense.", "fc1.").replace("output.dense.", "fc2.")
        n = n.replace("decoder.model.decoder.", "decoder.")
        if "relative_position_index" in n:
            continue                                 # 窓の中の位置の組の番号は、計算で作る
        out[n] = v
    for k in list(out):                              # Hugging Face は Q・K・V を別々の層で持つので、1 つにまとめる
        m = re.match(r"(encoder\.stages\.\d+\.\d+\.)attention\.self\.query\.(weight|bias)", k)
        if m:
            p, t = m.groups()
            out[f"{p}attn.qkv.{t}"] = torch.cat([out.pop(f"{p}attention.self.{n}.{t}") for n in ("query", "key", "value")])
    missing, unexpected = model.load_state_dict(out, strict=False)
    assert not missing and not unexpected, (missing[:5], unexpected[:5])
    return model
Donut の記事の load_hf_donut と同じ付け替えで、出力層の重み(decoder.lm_head.weight)もそのまま読み込みます。
出力の一致を確かめる
model = load_hf_nougat(Nougat(), hf_model.state_dict()).to(device).eval()

with torch.no_grad():
    enc_hf = hf_model.encoder(pixel_values).last_hidden_state
    enc_me = model.encoder(pixel_values)
    print(f"エンコーダの出力 {tuple(enc_me.shape)}:差の最大値 {(enc_hf - enc_me).abs().max().item():.2e}(値の最大 {enc_hf.abs().max().item():.0f})")
    logit_hf = hf_model(pixel_values=pixel_values, decoder_input_ids=out).logits
    logit_me = model(pixel_values, out)
    print(f"同じトークン列を入れたときの logit の差の最大値 {(logit_hf - logit_me).abs().max().item():.2e}\n")

# 全 17 ページで、Hugging Face とスクラッチ実装が生成したトークン列を比べる
same, t_hf, t_me = 0, 0.0, 0.0
for i, pg in enumerate(pages):
    x = processor(pg, return_tensors="pt").pixel_values.to(device)
    with torch.no_grad():
        torch.cuda.synchronize(); t0 = time.time()
        a = hf_model.generate(x, min_length=1, max_length=3584, bad_words_ids=[[tok.unk_token_id]], do_sample=False)
        torch.cuda.synchronize(); t1 = time.time()
        b = model.generate(x)
        torch.cuda.synchronize(); t2 = time.time()
    t_hf, t_me = t_hf + t1 - t0, t_me + t2 - t1
    if a.shape == b.shape and torch.equal(a, b):
        same += 1
    else:                                            # 違うページは、何番目のトークンから違うかを調べる
        n = min(a.shape[1], b.shape[1])
        first = (a[0, :n] != b[0, :n]).nonzero()
        k = first[0].item() if len(first) else n
        print(f"ページ {i}:長さ HF {a.shape[1]}・スクラッチ {b.shape[1]}、最初に違うのは {k} 番目"
              f"(HF {tok.convert_ids_to_tokens(a[0, k].item())!r}、スクラッチ {tok.convert_ids_to_tokens(b[0, k].item())!r})")
print(f"{len(pages)} ページ中 {same} ページで、生成したトークン列が完全に一致")
print(f"全ページの生成時間:HF {t_hf:.1f} 秒、スクラッチ {t_me:.1f} 秒")
- エンコーダの出力と logit: 実験1のページで、エンコーダの出力と、同じトークン列を入れたときの logit を比べます。
- 全 17 ページ: Hugging Face の generate と、スクラッチ実装の generate(くり返しを止めない)で全ページを生成し、トークン列が一致するかを比べます。違うページは、何番目のトークンが何と何で違うかを表示します。
実行結果
エンコーダの出力 (1, 588, 1024):差の最大値 3.24e-05(値の最大 27)
同じトークン列を入れたときの logit の差の最大値 2.20e-04

ページ 12:長さ HF 3584・スクラッチ 3584、最初に違うのは 3583 番目(HF '</s>'、スクラッチ 'Ċ')
ページ 14:長さ HF 3584・スクラッチ 3584、最初に違うのは 3583 番目(HF '</s>'、スクラッチ '\\')
17 ページ中 15 ページで、生成したトークン列が完全に一致
全ページの生成時間:HF 102.1 秒、スクラッチ 62.2 秒
- エンコーダと logit: エンコーダの出力の差は最大 3.24e-05(値の最大は 27)、logit の差は最大 2.20e-04 で、計算の順番の違いによる誤差の大きさです。
- 生成したトークン列: 17 ページ中 15 ページで完全に一致しました。違った 2 ページ(12 と 14)は、どちらも上限の 3,584 個まで生成したページで、違うのは最後の 1 個(3,583 番目)だけです。Hugging Face の nougat-small の生成の設定には forced_eos_token_id=2 があり、上限に達する最後のトークンを </s> に置き換えます。スクラッチ実装はこの置き換えをしないので、くり返しの途中のトークン(改行を表す
Ċと、バックスラッシュ\)のままです。それより前の 3,582 個は一致しています。
スクラッチ実装の計算は、Hugging Face と同じです。全ページの生成時間は、スクラッチ実装(62.2 秒)の方が Hugging Face(102.1 秒)より短くなりました。Donut の記事と同じく、貪欲法だけに絞った短い生成のループのためと考えられます。
実験3:くり返しの対策と、画質への強さ
くり返しを止める
# くり返しを止める仕組みの有無で、全ページを生成し直す
rows = []
for i, pg in enumerate(pages):
    x = processor(pg, return_tensors="pt").pixel_values.to(device)
    res = []
    for stop in [False, True]:
        torch.cuda.synchronize(); t0 = time.time()
        ids = model.generate(x, stop_repetition=stop)
        torch.cuda.synchronize()
        res += [ids.shape[1], time.time() - t0, (ids[0, -1] == tok.eos_token_id).item()]
    rows.append((i, *res))
    if res[0] >= 3584 or res[3] < res[0]:
        print(f"ページ {i:2d}:止めない {res[0]:4d} 個({res[1]:4.1f} 秒)→ 止める {res[3]:4d} 個({res[4]:4.1f} 秒)")
print(f"\n上限(3,584 個)まで生成したページ:{sum(r[1] >= 3584 for r in rows)} ページ")
print(f"全ページの合計:止めない {sum(r[2] for r in rows):.1f} 秒、止める {sum(r[5] for r in rows):.1f} 秒")

# くり返しに入ったページの、止めないときの出力の終わりの部分を見る
worst = max(rows, key=lambda r: r[1])[0]
x = processor(pages[worst], return_tensors="pt").pixel_values.to(device)
text = tok.decode(model.generate(x)[0], skip_special_tokens=True)
body = text.rstrip("\n")
print(f"\nページ {worst} の出力(止めない):{len(text):,} 文字のうち、最後の {len(text) - len(body):,} 文字が改行のくり返し")
print("改行の前の最後の 300 文字:\n" + body[-300:])
- 全ページを、くり返しを止める仕組みなし・ありの 2 通りで生成し、生成したトークンの数と時間を比べます。
- 最も長く生成したページについて、止めないときの出力の終わりの部分を確かめます。
実行結果
ページ 12:止めない 3584 個(11.1 秒)→ 止める  579 個( 1.9 秒)
ページ 14:止めない 3584 個(11.1 秒)→ 止める  206 個( 0.7 秒)

上限(3,584 個)まで生成したページ:2 ページ
全ページの合計:止めない 62.1 秒、止める 45.8 秒

ページ 12 の出力(止めない):4,694 文字のうち、最後の 3,217 文字が改行のくり返し
改行の前の最後の 300 文字:
. B.2.

In Fig. B.3 we present pages, scanned with a mobile device, from a printed master thesis and the Nougat output. The model is robust to the artifacts that arise when hand-scanning a document.

Explore the examples in this section on the project page: https://facebookresearch.github.io/nougat.
- くり返しに入ったページ: 17 ページ中 2 ページ(12 と 14)で、止めなければ上限の 3,584 個まで生成しました。12 ページ目は、付録の本文を正しく読んだ後、改行だけを 3,217 文字くり返していました。14 ページ目は、付録の、古い論文をスキャンした例を載せたページです。
- 止める仕組み: くり返しを検出すると、12 ページ目は 579 個、14 ページ目は 206 個で生成を止めました。1 ページに 11 秒かかっていた生成が、1.9 秒と 0.7 秒になり、全ページの合計の時間は 62.1 秒から 45.8 秒に減りました。
12 ページ目では、本文を読み終えた後のくり返しだけを切り落とせています。14 ページ目は 206 個で止まったので、ページの最初の方でくり返しに入ったと考えられ、止めても読めた部分は少ししかありません。止める仕組みは、くり返しによる時間のむだと、出力の終わりのごみを防ぎますが、くり返しに入る前に読めなかった部分を取り戻すことはできません。
画質を落とす
スキャンした論文やスマートフォンで撮った論文を想定し、ページの画像を劣化させて、出力がどう変わるかを調べます。
import io
import re
import Levenshtein
from PIL import Image, ImageFilter


def degrade(img, kind):
    """スキャンを模した劣化:ぼかし、低い解像度、JPEG の強い圧縮とノイズ"""
    if kind == "ぼかし":
        return img.filter(ImageFilter.GaussianBlur(1.5))
    if kind == "低い解像度(48 DPI)":
        return img.resize((img.width // 2, img.height // 2), Image.BILINEAR).resize(img.size, Image.BILINEAR)
    if kind == "JPEG 圧縮+ノイズ":
        a = np.array(img).astype(np.float32) + np.random.default_rng(0).normal(0, 20, (img.height, img.width, 3))
        buf = io.BytesIO()
        Image.fromarray(np.clip(a, 0, 255).astype(np.uint8)).save(buf, "JPEG", quality=20)
        return Image.open(buf).convert("RGB")
    return img


def norm(s):
    """数式・記号の書き方の違いを減らすため、英数字だけを小文字で残す"""
    return re.sub(r"[^a-z0-9]", "", s.lower())


# 本文が中心の 0〜4 ページで、PDF に埋め込まれた文字(テキスト層)と出力の正規化した編集距離を測る
refs = [norm(pdf[i].get_textpage().get_text_range()) for i in range(5)]
for kind in ["元の画像", "ぼかし", "低い解像度(48 DPI)", "JPEG 圧縮+ノイズ"]:
    dists = []
    for i in range(5):
        x = processor(degrade(pages[i], kind), return_tensors="pt").pixel_values.to(device)
        hyp = norm(tok.decode(model.generate(x, stop_repetition=True)[0], skip_special_tokens=True))
        dists.append(Levenshtein.distance(hyp, refs[i]) / max(len(hyp), len(refs[i])))
    print(f"{kind:<20s} 正規化した編集距離 {np.mean(dists):.3f}(ページごと {' '.join(f'{d:.3f}' for d in dists)})")

# 劣化させた画像の一部(pages[2]、つまり 3 ページ目の左上)を並べる
fig, axes = plt.subplots(1, 4, figsize=(16, 4.6))
for ax, kind in zip(axes, ["元の画像", "ぼかし", "低い解像度(48 DPI)", "JPEG 圧縮+ノイズ"]):
    ax.imshow(degrade(pages[2], kind).crop((60, 60, 460, 330)))
    ax.set_title(kind)
    ax.axis("off")
plt.tight_layout()
plt.show()
- 劣化の種類: ぼかし(ガウシアン、半径 1.5 画素)、低い解像度(縦横を半分にしてから戻す、48 DPI 相当)、JPEG の強い圧縮(品質 20)とノイズ(標準偏差 20)です。
- 正解の代わり: このページの正解の Markdown はないので、PDF に埋め込まれた文字(テキスト層)を正解の代わりにします。数式や記号の書き方の違いで差が出ないよう、どちらも英数字だけを小文字で残してから、文字の編集距離を長い方の長さで割ります(0 なら一致、1 に近いほど違う)。テキスト層にはページ番号や図の中の文字も含まれるので、元の画像でも 0 にはなりません。値の大きさより、劣化させたときの増え方を見ます。
- 対象: 図や表が少なく本文が中心の、最初の 5 ページです。
実行結果
元の画像                 正規化した編集距離 0.203(ページごと 0.182 0.203 0.204 0.253 0.172)
ぼかし                  正規化した編集距離 0.587(ページごと 0.817 0.927 0.704 0.269 0.217)
低い解像度(48 DPI)        正規化した編集距離 0.203(ページごと 0.151 0.202 0.212 0.262 0.189)
JPEG 圧縮+ノイズ          正規化した編集距離 0.339(ページごと 0.150 0.897 0.206 0.258 0.183)
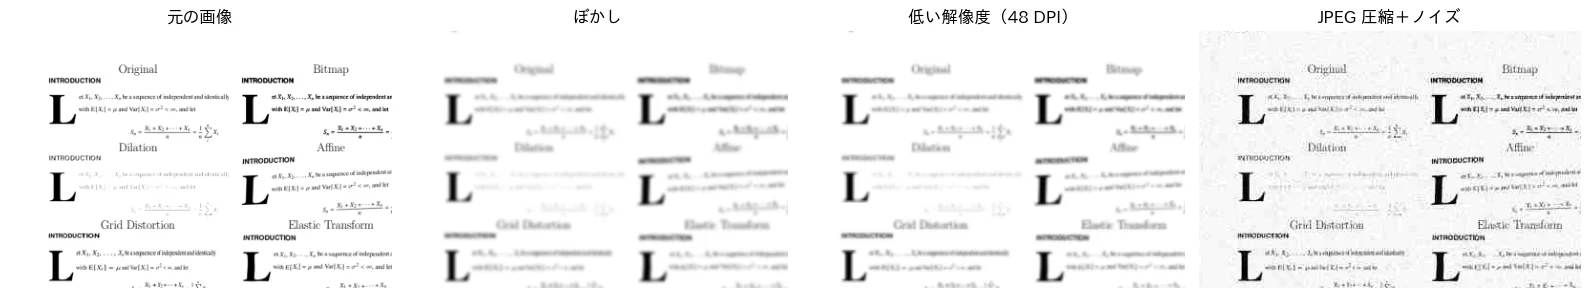
(画像は、Blecher et al.「Nougat: Neural Optical Understanding for Academic Documents」(arXiv:2308.13418v1、CC BY-SA 4.0)の 3 ページ目の一部を劣化させたもの)
- 元の画像: 正規化した編集距離は平均 0.203 でした。テキスト層との書き方の違い(ページ番号、図の中の文字、数式の書き方など)によるもので、この値を基準にします。
- 低い解像度(48 DPI): 平均 0.203 で、元の画像と変わりませんでした。入力は 896×672 に縮めるので、元のページの解像度が半分になっても、モデルが見る画像はあまり変わりません。
- ぼかし: 平均 0.587 で、大きく悪くなりました。特に 0〜2 ページ目は 0.70〜0.93 で、出力のほとんどが正解の文字と合いませんでした。一方、3・4 ページ目は 0.27・0.22 で、元の画像に近い値です。
- JPEG 圧縮+ノイズ: 平均 0.339 で、1 ページ目だけが 0.897 と大きく崩れ、残りのページは元の画像とほぼ同じでした。
Nougat は、ページによっては劣化に強い一方で、同じ劣化でも、あるページでは読めて別のページでは崩れる、という不安定さがあります。論文は、学習でぼかしやノイズなどの画像の劣化を加えていると述べていますが、強い劣化では読めなくなることがあります。
実験4:合成の表で、出力の形式を変える
Nougat は、表を LaTeX の tabular で出力します。Markdown の表(| 区切り)で出力したい場合に、追加学習で出力の形式を変えられるかを確かめます。
(図は、diagram-designで作成)
実装方針:論文の学習との違い
| 項目 | 論文・公式の学習(config/train_nougat.yaml) | 本記事(合成の表) |
|---|---|---|
| 初期の重み | base は事前学習の重みから、small は学習した base の重みから始める | 公開されている nougat-small |
| データ | arXiv・PubMed Central・IDL の文書から作った、ページと正解の組(数百万ページ) | 合成の表の画像 2,000 枚(出力の形式を変えることだけを確かめるため) |
| 正解の形式 | 表は LaTeX の tabular | Markdown の表(| 区切り) |
| 最適化 | AdamW、学習率 5e-5、勾配のクリップ 0.5 | 同じ |
| 学習率の変化 | 250 回(設定ファイルの単位で、16 回の更新が 1 回)のウォームアップの後、16 回の更新ごとに 0.9996 倍、7.5e-6 で止める | ウォームアップを更新 250 回にし(学習が短いため)、その後は同じ |
| バッチ・エポック | 実効のバッチ 192、3 エポック | バッチ 8、3 エポック(A100 で数分で終わる大きさ) |
| データ拡張 | 画像の劣化(ぼかし・ノイズ・圧縮など)と、くり返しを減らすための正解のトークンのランダムな入れ替え | なし |
| 計算の精度 | bfloat16 の混合精度 | 同じ |
合成の表
import random
from PIL import Image, ImageDraw, ImageFont
from matplotlib import font_manager

FONT = font_manager.findfont("DejaVu Sans")
HEADS = ["Model", "Method", "Dataset", "Params", "Accuracy", "F1", "BLEU", "Time", "Loss", "Size", "Epochs", "Score"]
WORDS = ["Swin", "BERT", "ViT", "ResNet", "Donut", "Nougat", "GPT", "CNN", "LSTM", "mBART", "base", "large", "small"]


def cell(rng):
    """セルの中身:小数・整数・カンマ区切り・単語のどれか"""
    r = rng.random()
    if r < 0.3:
        return f"{rng.uniform(0, 100):.1f}"
    if r < 0.5:
        return f"{rng.uniform(0, 1):.3f}"
    if r < 0.7:
        return f"{rng.randint(1, 99999):,}"
    return rng.choice(WORDS)


def make_table(seed):
    """白いページに表を 1 つ描き、(画像, Markdown の表) を返す"""
    rng = random.Random(seed)
    n_rows, n_cols = rng.randint(3, 6), rng.randint(3, 5)
    rows = [rng.sample(HEADS, n_cols)] + [[cell(rng) for _ in range(n_cols)] for _ in range(n_rows - 1)]
    font = ImageFont.truetype(FONT, rng.randint(13, 19))
    pad = rng.randint(10, 18)
    col_w = [max(font.getlength(r[c]) for r in rows) + 2 * pad for c in range(n_cols)]
    row_h = font.size + pad
    img = Image.new("RGB", (672, 896), "white")
    d = ImageDraw.Draw(img)
    x0 = rng.randint(30, max(31, int(672 - sum(col_w)) - 30))
    y0 = rng.randint(40, 896 - row_h * n_rows - 40)
    vertical = rng.random() < 0.5                    # 縦の罫線を引くかどうか
    for r, row in enumerate(rows):
        x = x0
        for c, txt in enumerate(row):
            d.text((x + pad, y0 + r * row_h + pad // 2), txt, font=font, fill="black")
            x += col_w[c]
    W, H = sum(col_w), row_h * n_rows
    for y in [y0, y0 + row_h, y0 + H]:              # 上・見出しの下・下の横線
        d.line([(x0, y), (x0 + W, y)], fill="black", width=1)
    if vertical:
        for xv in np.cumsum([0] + col_w):
            d.line([(x0 + xv, y0), (x0 + xv, y0 + H)], fill="black", width=1)
    md = "\n".join(["| " + " | ".join(rows[0]) + " |", "|" + "---|" * n_cols] + ["| " + " | ".join(r) + " |" for r in rows[1:]])
    return img, md


train_tables = [make_table(s) for s in range(2000)]
test_tables = [make_table(s) for s in range(10**6, 10**6 + 100)]
print("正解の例:\n" + test_tables[0][1])

fig, axes = plt.subplots(1, 3, figsize=(12, 5.4))
for ax, (img, _) in zip(axes, test_tables[:3]):
    ax.imshow(img)
    ax.axis("off")
plt.tight_layout()
plt.show()
- 表の中身: 見出しの行は、モデルの評価の表によく出る語(Model・Accuracy など)から選び、残りの行は小数・整数・カンマ区切りの数・モデルの名前のどれかにします。
- 見た目: 文字の大きさ(13〜19 ポイント)・セルの余白・表の位置をランダムにし、縦の罫線は半分の表にだけ引きます。論文の表によくある、上・見出しの下・下の 3 本の横線は、すべての表に引きます。
- 枚数: 学習用 2,000 枚、テスト用 100 枚です。出力の形式を覚えるのに十分な数を、A100 で数分で学習できる量にしています。
実行結果
正解の例:
| Model | Dataset | F1 |
|---|---|---|
| 42,304 | ViT | 63.4 |
| BERT | 0.840 | ViT |

評価の方法
def parse_table(text):
    """Markdown の表(| 区切り)か、LaTeX の tabular(& と \\\\ 区切り)を、セルの 2 次元のリストにする"""
    m = re.search(r"\\begin\{tabular\}\{[^}]*\}(.*?)\\end\{tabular\}", text, re.S)
    if m:                                            # LaTeX の表
        body = re.sub(r"\\(hline|toprule|midrule|bottomrule)", "", m.group(1))
        return [[c.strip() for c in r.split("&")] for r in body.split("\\\\") if r.strip()]
    rows = [l.strip() for l in text.splitlines() if l.strip().startswith("|")]
    rows = [r for r in rows if not re.fullmatch(r"\|[\s:\-|]*\|", r)]   # 区切りの行 |---|---| を除く
    return [[c.strip() for c in r.strip("|").split("|")] for r in rows]


def score(pred_text, gt_md):
    """形式(Markdown の表か)・表の大きさが合うか・セルの正解率"""
    gt, pr = parse_table(gt_md), parse_table(pred_text)
    is_md = pred_text.strip().startswith("|")
    same_shape = len(pr) == len(gt) and all(len(a) == len(b) for a, b in zip(pr, gt))
    hit = sum(1 for i, row in enumerate(gt) for j, c in enumerate(row) if i < len(pr) and j < len(pr[i]) and pr[i][j] == c)
    return is_md, same_shape, hit / sum(len(r) for r in gt)


def evaluate(m, tables):
    res = []
    for img, md in tables:
        x = processor(img, return_tensors="pt").pixel_values.to(device)
        text = tok.decode(m.generate(x, stop_repetition=True)[0], skip_special_tokens=True)
        res.append((text, *score(text, md)))
    return res
- parse_table: LaTeX の tabular(
&で列、\\で行を区切る)と Markdown の表(| で区切る)の両方を、セルの 2 次元のリストにします。出力の形式が違っても、セルを読めているかを同じ基準で比べるためです。 - 指標: Markdown の表で出力した割合、表の大きさ(行と列の数)が正解と一致した割合、セルの正解率(正解の各セルと、同じ位置の予測のセルが完全に一致した割合)です。
追加学習
del hf_model                                         # 学習の GPU のメモリを空ける
torch.cuda.empty_cache()
train_ids = [[tok.bos_token_id] + tok(md, add_special_tokens=False).input_ids + [tok.eos_token_id] for _, md in train_tables]
print(f"正解のトークン列の長さ:中央値 {int(np.median([len(t) for t in train_ids]))}、最大 {max(len(t) for t in train_ids)}")


def make_batch(idx):
    x = processor([train_tables[i][0] for i in idx], return_tensors="pt").pixel_values.to(device)
    L = max(len(train_ids[i]) for i in idx)
    ids = torch.full((len(idx), L), tok.pad_token_id)
    for j, i in enumerate(idx):
        ids[j, :len(train_ids[i])] = torch.tensor(train_ids[i])
    labels = ids[:, 1:].clone()
    labels[labels == tok.pad_token_id] = -100
    return x, ids[:, :-1].to(device), labels.to(device)


def train(m, epochs=3, batch=8, lr=5e-5, warmup=250, gamma=0.9996, lr_step=16, min_lr=7.5e-6):
    """公式と同じ学習率:ウォームアップの後、16 回ごとに 0.9996 倍にし、7.5e-6 より下げない"""
    torch.manual_seed(25)
    random.seed(25)
    m.train()
    opt = torch.optim.AdamW(m.parameters(), lr=lr)
    lr_at = lambda s: lr * s / warmup if s < warmup else max(min_lr, lr * gamma ** ((s - warmup) // lr_step))
    step, history, t0 = 0, [], time.time()
    for ep in range(1, epochs + 1):
        order = list(range(len(train_ids)))
        random.shuffle(order)
        for k in range(0, len(order), batch):
            for g in opt.param_groups:
                g["lr"] = lr_at(step)
            x, inp, labels = make_batch(order[k:k + batch])
            with torch.autocast("cuda", dtype=torch.bfloat16):
                logits = m(x, inp)
            loss = F.cross_entropy(logits.float().reshape(-1, logits.shape[-1]), labels.reshape(-1), ignore_index=-100)
            opt.zero_grad(set_to_none=True)
            loss.backward()
            torch.nn.utils.clip_grad_norm_(m.parameters(), 0.5)
            opt.step()
            step += 1
            history.append(loss.item())
        print(f"エポック {ep}  損失(最後の 50 回の平均){np.mean(history[-50:]):.4f}  ({time.time() - t0:.0f} 秒)", flush=True)
    return m.eval(), history


before = evaluate(model, test_tables)                # 追加学習の前に評価しておく
model, history = train(model)
after = evaluate(model, test_tables)
for name, res in [("追加学習の前", before), ("追加学習の後", after)]:
    print(f"{name}:Markdown の表 {np.mean([r[1] for r in res]):.0%}、表の大きさが一致 {np.mean([r[2] for r in res]):.0%}、"
          f"セルの正解率 {np.mean([r[3] for r in res]):.1%}")
- トークン列: <s> から始め、Markdown の表、</s> の順に並べます。
- 損失: Donut の記事と同じ、1 つ先のトークンを予測するクロスエントロピーです。埋めた部分は損失に入れません。
- 学習率: 公式と同じく、ウォームアップの後に 16 回の更新ごとに 0.9996 倍にし、7.5e-6 より下げません。勾配のノルムは 0.5 で切ります(公式の設定)。
- 乱数の種 25: 公式の設定(seed: 25)と同じ値です。
実行結果
正解のトークン列の長さ:中央値 120、最大 230
エポック 1  損失(最後の 50 回の平均)0.0081  (87 秒)
エポック 2  損失(最後の 50 回の平均)0.0069  (174 秒)
エポック 3  損失(最後の 50 回の平均)0.0026  (262 秒)
追加学習の前:Markdown の表 0%、表の大きさが一致 58%、セルの正解率 56.8%
追加学習の後:Markdown の表 100%、表の大きさが一致 97%、セルの正解率 98.6%
- 追加学習の前: すべての表を LaTeX の tabular で出力し、Markdown の表は 0% でした。セルを取り出して比べると、表の大きさが正解と一致したのは 58%、セルの正解率は 56.8% でした。
- 追加学習の後: すべての表を Markdown の表で出力し(100%)、表の大きさの一致は 97%、セルの正解率は 98.6% に上がりました。
3 エポック(約 4 分半)の追加学習で、出力の形式を LaTeX から Markdown に変えられました。セルの正解率も上がったのは、学習の画像と同じ種類の表(同じフォントと罫線)を、テストでも使っているためです。実際の論文の表で同じ精度が出るとは限りません。
出力と損失の推移
print("[追加学習の前]\n" + before[0][0][:400] + "\n")
print("[追加学習の後]\n" + after[0][0] + "\n")
print("[正解]\n" + test_tables[0][1])

fig, ax = plt.subplots(figsize=(6, 3.6))
ax.plot(np.convolve(history, np.ones(20) / 20, mode="valid"))
ax.set_xlabel("学習の回数")
ax.set_ylabel("損失(20 回の移動平均)")
ax.set_yscale("log")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
実行結果
[追加学習の前]
\begin{tabular}{|c|c|c|} \hline Model & Dataset & F1 \\ \hline
42,304 & WIT & 63.4 \\ BERT & 0.840 & WIT \\ \hline \end{tabular}

[追加学習の後]
| Model | Dataset | F1 |
|---|---|---|
| 42,304 | ViT | 63.4 |
| BERT | 0.840 | ViT |

[正解]
| Model | Dataset | F1 |
|---|---|---|
| 42,304 | ViT | 63.4 |
| BERT | 0.840 | ViT |
The following objects are still open and will now be closed: [<PdfDocument 0x7f6759c5f4d0 from '/content/nougat/nougat_paper.pdf'>]
テスト用の 1 枚目の表では、追加学習の前は LaTeX の tabular で、「ViT」を「WIT」と読み間違えていました。追加学習の後は、Markdown の表で、正解と完全に一致しました。
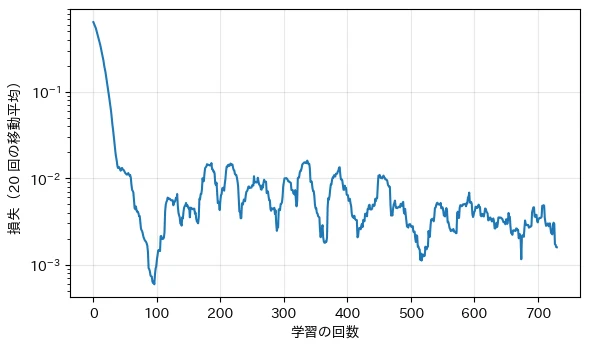
学習の損失(20 回の移動平均、縦軸は対数)は、最初の 100 回ほどで 0.6 から 0.001 ほどまで下がりました。その後、ウォームアップで学習率が上がる 250 回目までは 0.01 前後まで上がり、学習率が最大になってからは、ゆれながらゆっくり下がっています。出力の形式を変えるだけなら、学習率がまだ小さいうちに、ほとんど覚えてしまいます。
まとめ
本記事では、Nougat(small)を、Donut と同じ Swin エンコーダと mBART デコーダの構造で PyTorch で実装し、次のことを確かめました。
- 論文のページを Markdown にする: Nougat の論文自身の 3 ページ目から、見出し・本文・太字を Markdown で、数式を LaTeX で書き出しました。分数や平方根など、PDF の文字からは分からない数式の構造も復元しています。
- Hugging Face との一致: エンコーダの出力の差は最大 3.24e-05、logit の差は最大 2.20e-04 でした。全 17 ページのうち 15 ページで生成したトークン列が完全に一致し、残りの 2 ページも、Hugging Face が上限で最後のトークンを </s> に置き換える設定の違いだけでした。
- くり返し: 17 ページ中 2 ページでくり返しに入り、上限の 3,584 個まで生成しました。公式と同じ「確信度のゆれ方が一定になったら止める」仕組みで、12 ページ目は 579 個、14 ページ目は 206 個で止まり、全ページの生成時間は 62.1 秒から 45.8 秒に減りました。
- 画質への強さ: 解像度を半分にしても読めましたが、ぼかしや JPEG の強い圧縮では、ページによって出力が大きく崩れました(正規化した編集距離が 0.2 から 0.9 近くまで)。
- 出力の形式を変える追加学習: 合成の表 2,000 枚で約 4 分半の追加学習をすると、表の出力が LaTeX から Markdown に変わり、合成の表のセルの正解率は 56.8% から 98.6% になりました。
Nougat は、Donut の「画像から直接テキストを生成する」形を、論文という長く数式の多い文書に広げたモデルです。長い生成ではくり返しが避けられないので、それを止める仕組みも合わせて使います。
ライセンスに関する注記
Nougat の公式の実装(facebookresearch/nougat)のコードは MIT ライセンスです。一方、学習済みの重みについては、公式のリポジトリの README と LICENSE-MODEL.md が「CC BY-NC 4.0(非営利に限る)」としています。Hugging Face の facebook/nougat-small のモデルカードは CC BY 4.0、facebook/nougat-base のモデルカードは CC BY-NC 4.0 と表示しており、small のライセンスは公式のリポジトリの記載と食い違っています。本記事では、公式のリポジトリの記載に従い、重みは非営利の範囲で使うものとして扱っています。商用で使う場合は、権利者に確認してください。
実験に使った Nougat の論文(arXiv:2308.13418v1)は CC BY-SA 4.0 で公開されており、ページの画像を載せるときは、出典とライセンスの表示が必要です。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- Nougat の実装: 公式の facebookresearch/nougat(コードは MIT)と Hugging Face の transformers(Apache-2.0)の構造を参考に、スクラッチで実装しています。くり返しの検出と学習率の設定は、公式の実装(nougat/model.py、config/train_nougat.yaml)に合わせています。
- 学習済みのモデル: facebook/nougat-small を、非営利の範囲で使用しています(上の注記を参照)。
- 推論に利用した論文: Blecher, L., Cucurull, G., Scialom, T., Stojnic, R.「Nougat: Neural Optical Understanding for Academic Documents」(arXiv:2308.13418v1、CC BY-SA 4.0)。ページの画像は、PDF を 96 DPI で画像にしたもの(実験3では、劣化させたものの一部)です。
@article{blecher2023nougat,
  title = {Nougat: Neural Optical Understanding for Academic Documents},
  author = {Blecher, Lukas and Cucurull, Guillem and Scialom, Thomas and Stojnic, Robert},
  journal = {arXiv preprint arXiv:2308.13418},
  year = {2023}
}
参考文献
- L. Blecher, G. Cucurull, T. Scialom, R. Stojnic (2024). Nougat: Neural Optical Understanding for Academic Documents. ICLR 2024.
- Meta AI. facebookresearch/nougat. GitHub.
- Meta AI. facebook/nougat-small. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。