中心性と PageRank とは?
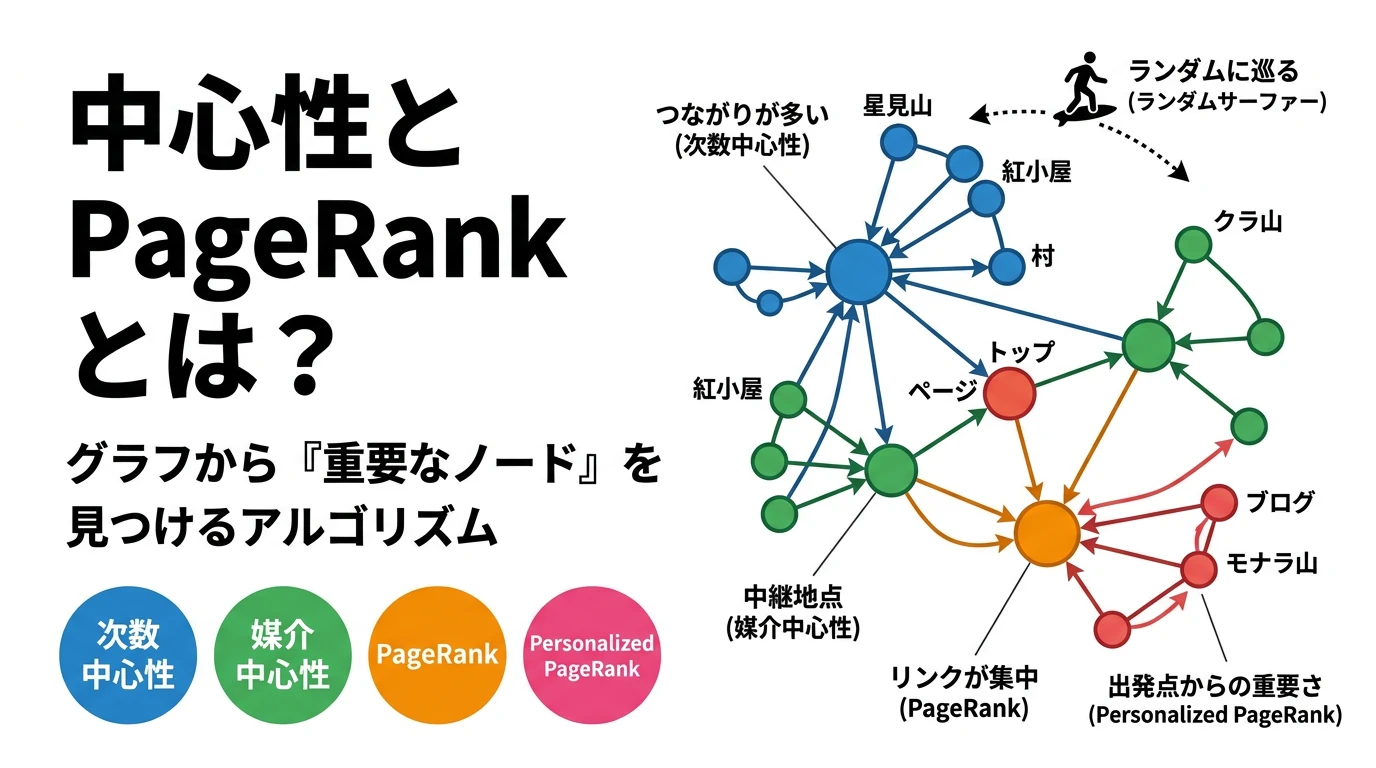 (画像は、Geminiで作成)
グラフの中で「どのノードが重要か」を測る 中心性 が、測り方によって違う答えを出すことを理解すること。次数中心性・媒介中心性・PageRank の定義と使い分けを説明でき、PageRank をべき乗法でスクラッチ実装して networkx の結果と一致させられるようになること。PageRank を「リンクをたどり続けるランダムサーファーが、各ページにいる時間の割合」として理解し、テレポートが必要な理由と、出発点から見た重要さを測る Personalized PageRank を説明できるようになること。
原著論文: The PageRank Citation Ranking: Bringing Order to the Web (Page, Brin, Motwani, Winograd, Stanford InfoLab Technical Report 1999)
概要
グラフ(ネットワーク)では、ノードによって、つながり方がまったく違います。たくさんの道が集まる地点もあれば、2つの山脈をつなぐ唯一の峠もあります。「どのノードが重要か」を数値で表したものを 中心性 と呼びます。重要なノードが分かれば、Web ページの検索結果の順位付け、交通網の弱点探し、論文や人物の影響力の評価、文書から作ったグラフの中で LLM に渡す情報の選択などに使えます。
ただし、「重要」の意味は1つではありません。つながっている数が多いノードが重要なのか、多くの経路が通るノードが重要なのか、重要なノードからつながっているノードが重要なのか。測り方を変えると、上位に来るノードが入れ替わります。
本記事では、グラフの記事で作った架空の山域の登山道のデータで、3つの中心性が違う地点を選ぶことを確かめます。そのうえで、Google の検索の順位付けのために考案された PageRank を、べき乗法でスクラッチ実装し、ランダムウォークとしての意味、テレポートが必要な理由、出発点から見た重要さを測る Personalized PageRank までを扱います。
「重要な地点」は、測り方で変わる
実験には、グラフの記事と同じ、架空の山域の登山道のデータを使います。
- 地点: 3つの山脈(Hoshimi・Akatsuki・Shiranami)に、それぞれ村3つ・山小屋12軒・山頂25座、合わせて120の地点があります。
- 登山道: 山脈の中では、すべての地点がつながるように道が引かれ、回り道ができるように、各地点から近い2地点へも道があります。Hoshimi 山脈と Akatsuki 山脈の間には峠越えの道が1本だけあり、Shiranami 山脈にはほかの山脈からの道がありません。登山道は170本です。
このグラフで、「重要な地点」を3つの方法で選び、上位の地点を比べます。
準備:Python の環境
NumPy・pandas・networkx を使います(networkx の PageRank は、内部で SciPy を使います)。Google Colab ならインストール済みです。GPU は使いません。記事の数値は、Python 3.13・NumPy 2.5.3・pandas 3.0.5・networkx 3.7・SciPy 1.18.1 で実行したものです。実行時間(秒)は、環境によって変わります。
実験1:登山道のグラフで、3つの中心性を比べる
import time
import numpy as np
import pandas as pd
import networkx as nx

# 1. 架空の山域:3つの山脈に、村・山小屋・山頂の地点を置く
SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = {"Hoshimi": (0, 0), "Akatsuki": (14, 2), "Shiranami": (40, 0)}   # 山脈の中心の座標(km)
KINDS = {"village": 3, "hut": 12, "summit": 25}                          # 山脈ごとの地点の数


def build_trails(seed=0):
    rng = np.random.default_rng(seed)
    used, rows = set(), []
    for rng_name, (cx, cy) in RANGES.items():
        for kind, count in KINDS.items():
            for _ in range(count):
                while True:
                    name = "".join(rng.choice(SYLLABLES, 3)).capitalize()
                    if name not in used:
                        used.add(name)
                        break
                label = {"village": f"{name} Village", "hut": f"{name} Hut", "summit": f"Mount {name}"}[kind]
                # 「{name} 村」「{name} 小屋(山小屋)」「{name} 山」
                rows.append((label, kind, rng_name, cx + rng.uniform(-6, 6), cy + rng.uniform(-6, 6)))
    points = pd.DataFrame(rows, columns=["name", "kind", "range", "x", "y"])

    # 2. 登山道:山脈ごとに、役割の違う2種類の道を引く
    #    (a) 最小全域木の道:山脈の中のどの地点にもたどり着けるようにする(これだけだと、経路が1通りしかない木になる)
    #    (b) 各地点から近い2地点への道:回り道(閉路)を作る(これだけだと、山脈の中が2〜3個に分かれてしまう)
    #    (a) と (b) は同じ道を選ぶことが多い。道は集合 pairs に (小さい番号, 大きい番号) で入れるので、重なった道は1本になる
    pairs = set()
    for _, g in points.groupby("range"):
        xy, idx = g[["x", "y"]].values, g.index.values                    # idx:山脈の中の番号 0〜39 → 全体の番号
        dist = np.linalg.norm(xy[:, None] - xy[None], axis=-1)          # 山脈の40地点どうしの距離(km)の表(40 × 40)
        # (a) 距離の表を「全地点どうしを、距離を重みにしたエッジで結んだグラフ」とみなし、その最小全域木
        #     (全地点をつなぐ、距離の合計が最小の39本のエッジ)の各エッジ (a, b) を道にする
        for a, b in nx.minimum_spanning_tree(nx.from_numpy_array(dist)).edges():
            pairs.add(tuple(sorted((idx[a], idx[b]))))
        # (b) 各地点から、近い順に1番目と2番目の地点へ道を引く(0番目は距離0の自分自身なので除く)
        for a in range(len(idx)):
            for b in np.argsort(dist[a])[1:3]:
                pairs.add(tuple(sorted((idx[a], idx[b]))))
    # Hoshimi と Akatsuki の間に、峠越えの道を1本だけ引く(Shiranami にはつながない)
    h, k = points[points["range"] == "Hoshimi"], points[points["range"] == "Akatsuki"]
    dist = np.linalg.norm(h[["x", "y"]].values[:, None] - k[["x", "y"]].values[None], axis=-1)
    i, j = np.unravel_index(dist.argmin(), dist.shape)
    pairs.add(tuple(sorted((h.index[i], k.index[j]))))

    # 3. 所要時間(分)= 25 × 距離(km)+ 休憩などのばらつき(5〜19分)
    trails = []
    for u, v in sorted(pairs):
        d = np.hypot(points.x[u] - points.x[v], points.y[u] - points.y[v])
        trails.append((points.name[u], points.name[v], int(round(25 * d + rng.integers(5, 20)))))
    return points, pd.DataFrame(trails, columns=["a", "b", "minutes"])


points, trails = build_trails()
G = nx.Graph()
G.add_weighted_edges_from(trails.values, weight="minutes")

# 4. 3つの「重要さ」で地点を並べる(どれも networkx の関数で求める)
score = pd.DataFrame({
    "range": points.set_index("name")["range"],
    "degree": pd.Series(dict(G.degree())),                     # 次数:つながっている道の数
    "betweenness": pd.Series(nx.betweenness_centrality(G)),    # 媒介中心性:最短経路が通る割合
    "pagerank": pd.Series(nx.pagerank(G, alpha=0.85, weight=None)),   # PageRank
})
for col in ["degree", "betweenness", "pagerank"]:
    print(f"--- {col} の上位5地点 ---")
    print(score.sort_values(col, ascending=False).head(5).round(4).to_string())

# 5. 山脈をまたぐ道
cross = trails[trails.a.map(score["range"]) != trails.b.map(score["range"])]
print("\n山脈をまたぐ道:", cross.values.tolist())
print("順位の相関(スピアマン)  次数と PageRank:",
      round(score["degree"].corr(score["pagerank"], method="spearman"), 3),
      " 次数と媒介中心性:", round(score["degree"].corr(score["betweenness"], method="spearman"), 3))
グラフの記事と同じ登山道のデータを作り、地点ごとに3つの中心性を networkx で求めて、上位の地点を比べるコードです。
- 地点と登山道: build_trails は、グラフの記事のコードと同じです。3つの山脈に120の地点を置き、山脈の中の道(最小全域木と、近い2地点への道)と、峠越えの道1本を引きます。
- 登山道を引く理由: 道は、役割の違う2種類を引きます。1つ目の最小全域木の道は、山脈の中のどの地点にもたどり着けるようにするためのものです。ただし、最小全域木は閉路のない木なので、これだけだと、どの2地点の間も経路が1通りしかなく、最短経路を探す意味がなくなります。2つ目の「各地点から近い2地点への道」は、回り道(閉路)を作るためのものです。ただし、地点ごとに近い相手を選ぶだけなので、これだけだと、近い地点どうしで固まったまとまりの間に道ができず、この登山道では、山脈の中が2〜3個のまとまりに分かれてしまいます。2つを合わせて、「どの地点にもたどり着けて、回り道もある」登山道にしています。
- 最小全域木の道: dist は、山脈の40地点どうしの距離の表(40 × 40)です。nx.from_numpy_array(dist) は、この表を隣接行列とみなし、40地点のすべての組を、距離を重みにしたエッジで結んだグラフ(対角の0はエッジにしません)を作ります。nx.minimum_spanning_tree は、そのグラフから、すべての地点をつなぎ、閉路を作らず(エッジは 40 − 1 = 39 本)、重みの合計が最小になるエッジの組(最小全域木)を取り出します。networkx は既定でクラスカル法(短いエッジから順に、閉路ができない限り採用する方法)を使います。.edges() が返す (a, b) は山脈の中での番号(0〜39)なので、idx[a] で地点の表全体の番号に直します。
- 近い2地点への道: np.argsort(dist[a]) は、地点 a から近い順に地点の番号を並べたものです。0番目は距離0の自分自身なので、[1:3] で1番目と2番目に近い地点を選びます。40地点 × 2 で80回道を加えますが、増える道はずっと少なくなります。A と B が互いを近い2地点に選ぶと同じ道になり、また、各地点から1番近い地点への道は、必ず最小全域木に含まれているからです。
- 重なった道を1本にまとめる: 道は、両端の番号を sorted で (小さい番号, 大きい番号) の組にして、集合 pairs に入れます。(A, B) と (B, A) が同じ組になり、集合は同じ組を1つしか持たないので、2種類の道で重なった道や、互いに選び合った道は1本になります。この登山道では、山脈ごとに最小全域木の39本に、新しい道が15〜19本加わり、山脈の中の道は合わせて169本になります(峠越えの1本を足して170本)。
- 峠越えの道: Hoshimi 山脈の地点と Akatsuki 山脈の地点の組のうち、直線距離がいちばん近い2地点を探し、その間に道を1本引きます。
- 地点を山脈ごとに取り出す: h は Hoshimi の40地点、k は Akatsuki の40地点です。
- 全組の距離をまとめて求める: 座標の配列はどちらも形が (40, 2) です。[:, None] で h 側を (40, 1, 2)、[None] で k 側を (1, 40, 2) にしてから引き算すると、NumPy のブロードキャストで (40, 40, 2) の配列になり、[i, j] に「Hoshimi の i 番目と Akatsuki の j 番目の座標の差 」が入ります。np.linalg.norm(..., axis=-1) で最後の軸(長さ2)の長さ を求めると、40 × 40 = 1,600 組の距離の表 dist(40 × 40)が、ループを書かずに1行で得られます。山脈の中の距離の表と同じ書き方で、違いは、同じ地点どうしではなく、2つの山脈の地点どうしを組にしている点です。
- いちばん近い組を探す: dist.argmin() は、表を1列(長さ1,600)に並べたときの最小値の位置(0〜1,599)を返します。np.unravel_index は、その位置を、元の (40, 40) の表での (行, 列) の番号 (i, j) に戻します。
- 全体の番号に直して道にする: i と j は、取り出した h と k の中での順番(0〜39)にすぎないので、h.index[i] と k.index[j] で、地点の表全体での番号(0〜119)に直します。あとは山脈の中の道と同じく、(小さい番号, 大きい番号) の組にして pairs に入れます。
- 所要時間: minutes(分)は、地点の間の距離(km)の25倍に、休憩などのばらつき(5〜19分の整数)を足して決めます。乱数のシードを固定しているので、何度実行しても同じデータになります。
- グラフ: networkx の無向グラフ G に、登山道を所要時間の重み付きのエッジとして入れます。本記事の中心性は、道の本数だけを見るもの(重みを使わないもの)にそろえます。
- 3つの中心性: G.degree() は次数(つながっている道の数)、nx.betweenness_centrality は媒介中心性(最短経路がその地点を通る割合)、nx.pagerank は PageRank です。PageRank の alpha=0.85 は、後の節で説明する減衰係数 で、weight=None で所要時間を使わないことを指定します。どれも次の節以降で、定義から計算し直します。
- 表示: 3つの中心性を score の表にまとめ、それぞれの値の大きい順に上位5地点を表示します。最後に、山脈をまたぐ道(両端の地点の山脈が違う道)と、中心性どうしの順位の相関(スピアマンの順位相関係数。1に近いほど、順位が似ている)を表示します。
実行結果
--- degree の上位5地点 ---
                    range  degree  betweenness  pagerank
Mount Horara      Hoshimi       6       0.0735    0.0169
Horino Village  Shiranami       5       0.0131    0.0139
Yokana Hut       Akatsuki       5       0.0181    0.0131
Kuseshi Hut      Akatsuki       4       0.1847    0.0102
Mount Hosuri     Akatsuki       4       0.0986    0.0102
--- betweenness の上位5地点 ---
                 range  degree  betweenness  pagerank
Mihoshi Hut    Hoshimi       4       0.2248    0.0106
Mount Namomi  Akatsuki       3       0.2222    0.0079
Mount Mifuno   Hoshimi       4       0.2205    0.0107
Mount Rakuto   Hoshimi       3       0.2179    0.0084
Mount Rikine   Hoshimi       3       0.2162    0.0083
--- pagerank の上位5地点 ---
                    range  degree  betweenness  pagerank
Mount Horara      Hoshimi       6       0.0735    0.0169
Horino Village  Shiranami       5       0.0131    0.0139
Yokana Hut       Akatsuki       5       0.0181    0.0131
Suneha Hut        Hoshimi       4       0.0536    0.0125
Tokito Hut       Akatsuki       4       0.0627    0.0118

山脈をまたぐ道: [['Mihoshi Hut', 'Mount Namomi', 81]]
順位の相関(スピアマン)  次数と PageRank: 0.932  次数と媒介中心性: 0.575
(和訳)
- 地点の名前:Village は村、Hut は山小屋、Mount は山です。range は地点のある山脈です。
次数 の上位は、6本の道が集まる Horara 山(Hoshimi 山脈)や、5本の道が集まる Horino 村(Shiranami 山脈)でした。一方、媒介中心性 の上位は、Mihoshi 小屋と Namomi 山です。この2地点は、山脈をまたぐ唯一の道(峠越えの道)の両端です。次数は4と3で、次数の上位5地点には入っていません。媒介中心性の3〜5位の Mifuno 山・Rakuto 山・Rikine 山も、峠へ向かう道の途中にある地点です。
PageRank の上位は、次数の上位とほとんど同じでした。順位の相関も、次数と PageRank は0.932と高く、次数と媒介中心性は0.575にとどまります。
同じグラフでも、「つながっている数」で測るか「経路が通るか」で測るかで、重要な地点がまったく違います。また、PageRank は次数とほとんど同じ順位になりましたが、これは登山道が 無向グラフ だからです。PageRank が次数と違う答えを出すのは、Web ページのリンクのような 有向グラフ の場合です(後の節)。以降の節で、それぞれの定義を見ていきます。
次数中心性と媒介中心性
次数中心性:つながっている数
次数中心性 は、ノード の次数 (つながっているエッジの数)そのものです。ノードの数 が違うグラフどうしで比べるときは、つながりうる最大の数 で割って0〜1にそろえます。
計算は簡単ですが、見ているのは 自分の隣だけ です。隣のノードがどれだけ重要か、グラフ全体の中でどんな位置にあるかは考えません。
計算例
6つの地点 A〜F と、次の6本の道からなる小さなグラフで計算してみます。A・B・D・C が四角形の周りの道でつながり(A–B、B–D、D–C、C–A)、D から E を通って F まで、1本道が延びています(D–E、E–F)。図の左が次数中心性、右が後の節で計算する媒介中心性で、各地点の数字は「計算の途中の値 → 中心性」です。
(図は、diagram-designで作成)
なので、次数を で割ります。
| 地点 | つながっている地点 | 次数 | 次数中心性 |
|---|---|---|---|
| A | B, C | 2 | 0.4 |
| B | A, D | 2 | 0.4 |
| C | A, D | 2 | 0.4 |
| D | B, C, E | 3 | 0.6 |
| E | D, F | 2 | 0.4 |
| F | E | 1 | 0.2 |
道が3本集まる D がいちばん大きく、行き止まりの F がいちばん小さくなります。A・B・C・E は、どれも道が2本で、次数中心性では区別がつきません。このうち E は、F へ行くための唯一の中継地点ですが、次数中心性にはその違いが表れません。
媒介中心性:多くの最短経路が通るか
媒介中心性(betweenness centrality)は、グラフの中のノードの組 を結ぶ最短経路のうち、ノード を通るものの割合を、すべての組について足したものです(Freeman, 1977)。
- : から への最短経路の本数(同じ長さの最短経路が複数ある場合があります)
- :そのうち、途中で を通るものの本数
- : 以外のノードの組の数 で割って、0〜1にそろえるための係数(無向グラフの場合)
最短経路は、ここでは道の本数(ホップ数)で測ります。 から へ行くのに、必ず を通らなければならないなら です。媒介中心性が大きいノードは、ほかのノードどうしの行き来の 中継地点 で、そのノードがなくなると、多くの組の行き来が遠回りになるか、できなくなります。
計算例
次数中心性の計算例と同じグラフ(A・B・D・C の四角形と、D–E–F の1本道。前の図の右)で計算します。 ごとに、 以外の地点の組 を1つずつ見て、最短経路のうち を通る割合 を足します。
ポイントは、最短経路が2本ある組です。たとえば B から C へは、B–A–C と B–D–C の2本が、どちらも道2本で最短です()。このうち A を通るのは1本なので、A には を足します。D にも同じく を足します。同じように、A から D へは A–B–D と A–C–D の2本があり、B と C に ずつ足します。A から E・F へ行く経路も、B 経由と C 経由の2本に分かれます。
| 地点 | を通る組と、その割合 | 合計 | 媒介中心性 (合計 × ) |
|---|---|---|---|
| A | (B, C): | 0.5 | 0.05 |
| B | (A, D)・(A, E)・(A, F):それぞれ | 1.5 | 0.15 |
| C | (A, D)・(A, E)・(A, F):それぞれ | 1.5 | 0.15 |
| D | と の6組:それぞれ1、(B, C): | 6.5 | 0.65 |
| E | F と の4組:それぞれ1 | 4 | 0.4 |
| F | なし(行き止まりで、どの経路も途中で通らない) | 0 | 0 |
なので、 以外の地点の組は 組で、合計を10で割ります。次数中心性ではどれも0.4で並んでいた A・B・C・E のうち、媒介中心性は E が0.4と、A・B・C(0.05〜0.15)よりはっきり大きくなりました。F へ行く経路は、必ず E を通るからです。一方、A は B と C の間の2本の最短経路のうち1本に乗るだけなので、0.05にとどまります。次数が同じでも、グラフ全体の行き来の中での位置によって、媒介中心性は大きく変わります。networkx の nx.betweenness_centrality で計算しても、同じ値になります。
次のコードでは、媒介中心性を定義どおりに数えて networkx と一致させ、実際に地点を通れなくしたときの影響を数えます。
from itertools import combinations

# 1. 媒介中心性を定義どおりに数える:地点の組 (s, t) ごとに、最短経路のうち v を通るものの割合を足す
def betweenness(G):
    nodes = list(G)
    C = dict.fromkeys(nodes, 0.0)
    for s, t in combinations(nodes, 2):
        if not nx.has_path(G, s, t):
            continue                                       # たどり着けない組は数えない
        paths = list(nx.all_shortest_paths(G, s, t))       # 道の本数が最少の経路を、すべて列挙する
        for p in paths:
            for v in p[1:-1]:                              # 両端を除く、途中の地点
                C[v] += 1 / len(paths)                     # σ_st(v) / σ_st
    n = len(nodes)
    return {v: c * 2 / ((n - 1) * (n - 2)) for v, c in C.items()}   # 0〜1 に正規化する


t0 = time.time()
bc = betweenness(G)
print(f"計算時間: {time.time() - t0:.1f} 秒")
print("networkx と一致:", all(abs(bc[v] - score.loc[v, "betweenness"]) < 1e-12 for v in G))

# 2. その地点を通れなくすると、行き来できなくなる地点の組はいくつか
def reachable_pairs(g):
    return sum(len(c) * (len(c) - 1) // 2 for c in nx.connected_components(g))


print()
for v in ["Mount Horara", "Horino Village", "Yokana Hut", "Mihoshi Hut", "Mount Namomi"]:
    H = G.copy()
    H.remove_node(v)
    lost = reachable_pairs(G) - (len(nx.node_connected_component(G, v)) - 1) - reachable_pairs(H)
    print(f"{v:15s} 次数: {G.degree(v)}  通れないと行き来できなくなる地点の組: {lost:5,d}")
媒介中心性を、直前の式のとおりに数えるコードと、地点を通れなくしたときに行き来できなくなる地点の組を数えるコードです。
- 定義どおりに数える: betweenness は、combinations(nodes, 2) で地点の組 を1つずつ取り出し、nx.all_shortest_paths で道の本数が最少の経路をすべて列挙します。経路の本数が (len(paths))で、各経路の途中の地点 p[1:-1] に ずつ足すと、地点 には が足されます。nx.has_path でたどり着けない組(違う連結成分の地点の組)は数えません。最後に、式の係数 を掛けます。
- networkx との比較: 実験1で求めた score の媒介中心性と、すべての地点で一致するかを確かめます。networkx は、Brandes のアルゴリズム(BFS を各ノードから1回ずつ行い、経路を列挙せずに の和を求める方法。計算量は )を使っていて、大きなグラフでも速く計算できます。
- 通れなくしたときの影響: reachable_pairs は、連結成分ごとに、その中の地点の組の数 ( は成分の大きさ)を足して、行き来できる地点の組を数えます。H.remove_node(v) で地点 を除いたグラフで数え直し、元のグラフとの差から、 自身を含む組( と同じ成分の地点の数 − 1 個)を除いたものを、「 を通れないと行き来できなくなる組」とします。次数の上位3地点と、媒介中心性の上位2地点を比べます。
実行結果
計算時間: 0.4 秒
networkx と一致: True

Mount Horara    次数: 6  通れないと行き来できなくなる地点の組:   514
Horino Village  次数: 5  通れないと行き来できなくなる地点の組:    74
Yokana Hut      次数: 5  通れないと行き来できなくなる地点の組:     0
Mihoshi Hut     次数: 4  通れないと行き来できなくなる地点の組: 1,560
Mount Namomi    次数: 3  通れないと行き来できなくなる地点の組: 1,560
定義どおりに数えた媒介中心性は、networkx の結果とすべての地点で一致しました。
峠越えの道の両端(Mihoshi 小屋と Namomi 山)は、通れなくすると、1,560組の地点が行き来できなくなります。Hoshimi 山脈の残りの39地点と、Akatsuki 山脈の40地点のすべての組()です。一方、次数が最大の Horara 山を通れなくしても、行き来できなくなるのは514組で、次数5の Yokana 小屋にいたっては0組(ほかの道で迂回できる)でした。
次数は「自分の周りがにぎやかか」を、媒介中心性は「グラフ全体の行き来を支えているか」を測っています。交通網や通信網の弱点(そこが止まると全体が分断される場所)を探すなら媒介中心性、局所的なハブを探すなら次数が向いています。
PageRank:重要なページからリンクされるページは重要
次数と媒介中心性は、どちらも ほかのノードの重要さ を考えていません。Web ページの重要さを、リンクされている数(被リンク数、有向グラフの入次数)で測ると、だれにも読まれていないページからのリンクも、多くの人が訪れるページからのリンクも、同じ1本として数えてしまいます。
PageRank は、この問題を「重要なページからリンクされているページは重要である」という再帰的な定義で解決します。Google の創業者の Larry Page と Sergey Brin らが、Web 検索の順位付けのために考案しました(Page et al., 1999、Brin & Page, 1998)。
実験には、架空の山域の情報サイトの、9ページのリンクを使います。
(図は、diagram-designで作成)
トップページと Monara 山のページは、どちらも3本のリンクを受けています。違いは、リンク元です。トップページは、互いにリンクし合う山脈のページからリンクされ、Monara 山のページは、どこからもリンクされていない個人のブログからリンクされています。被リンク数では区別できない、この違いを PageRank で測ります。
PageRank の式
ページ の PageRank を、次の式で定めます。
- :ページの数(この例では9)
- :ページ にリンクしているページ のすべて
- :ページ から出ているリンクの数(出次数)
- :減衰係数(damping factor)。0〜1の値で、Brin & Page は0.85を使いました
右辺の第2項は、「ページ は、自分の PageRank を、リンク先の ページに等分して配る」ことを表しています。重要なページ( が大きい)からのリンクほど、多くを受け取れます。ただし、リンクの多いページ( が大きい)からのリンクは、1本あたりの取り分が小さくなります。第1項 は、すべてのページが最低限受け取る分で、その意味は後の節(ランダムサーファー、テレポート)で説明します。
どこにもリンクしていないページ(Monara 山のページのような ダングリングノード)は、配り先がないので、自分の PageRank をすべてのページに等分して配ることにします。こうすると、PageRank の合計はいつも1に保たれます。
計算例
3つのページ A・B・C と、4本のリンク A → B、A → C、B → C、C → A で計算してみます。
(図は、diagram-designで作成)
出ているリンクの数は 、、 です。、 とすると、第1項は なので、3つのページの式は次のようになります。
A は、自分の PageRank を B と C に半分ずつ配ります。B と C は、リンク先が1つなので、すべてをリンク先に渡します。
この3つの式を連立方程式として解くと、次の値になります(合計は1)。
| ページ | リンク元 | 被リンク数 | PageRank |
|---|---|---|---|
| A | C | 1 | 0.388 |
| B | A | 1 | 0.215 |
| C | A、B | 2 | 0.397 |
A と B は、どちらも1本しかリンクを受けていませんが、PageRank は A が B の約1.8倍です。A は、PageRank の大きい C から、C の分を まるごと 受け取ります。一方、B は A から、A の分の 半分 しか受け取りません。被リンク数が2の C とほぼ同じ値になるのは A で、リンクの本数ではなく、リンク元の重要さと、リンク元が何ページに配っているかで決まることがわかります。
連立方程式を解く代わりに、後で説明するべき乗法のように、すべてのページを から始めて右辺で更新することを繰り返しても、同じ値に近づきます。1回目の更新では、たとえば となり、(A, B, C) は (0.333, 0.192, 0.475)、2回目は (0.454, 0.192, 0.355)、3回目は (0.351, 0.243, 0.406) と、値が行き来しながら上の値に近づいていきます。networkx の nx.pagerank(alpha=0.85)で計算しても、同じ値になります。
すべてのページの式をまとめて、行列で書きます。ページ から へ進む確率を並べた 遷移行列 (、ダングリングノードの行はすべて )と、すべての要素が のベクトル を使うと、
詳細な式展開(ページごとの式から、行列の式へ)
1. 遷移行列 の作り方: は、行が「リンク元」、列が「リンク先」の の行列です。ページ の行には、リンク先の列に を、それ以外の列に0を入れます。計算例の3ページ(A → B、A → C、B → C、C → A)では、行と列を A・B・C の順に並べて、
となります。1行目は「A から、B と C へ ずつ進む」、3行目は「C から、A へ必ず進む」を表します。どの行も、合計は1です。
2. なぜ転置 を掛けるのか:ページ の式の第2項は、 に 入ってくる リンクについての和です。 の行は「 から出ていくリンク」なので、 に入ってくるリンクは、 の 第 列 に並んでいます。行列とベクトルの積は行ごとに計算するので、列を行に入れ替えた を掛けます。 の第 成分は、
です。最後の等号は、 が「 が にリンクしていれば 、していなければ0」であることから、0の項を除いたものです。計算例では、
となり、計算例の3つの式の第2項( を掛ける前)と一致します。
3. 第1項をベクトルにする:第1項 は、どのページでも同じ値です。すべての要素が のベクトル を使うと、 ページ分をまとめて と書けます。2と合わせると、ページ の式 を、 について縦に並べたものが、
です。
4. ダングリングノードの扱い:どこにもリンクしていないページ の行を、すべて にしておくと、 がすべての に入るので、 は自分の を ページに ずつ配ることになります。ページごとの式では別に書いた「すべてのページに等分して配る」というルールが、行列の式では の中に含まれます。これで、どの行の合計も1になります。
5. 合計が1に保たれる理由:すべての要素が1のベクトルを とすると、 のどの行の合計も1なので です。両辺の要素を足し合わせる( を左から掛ける)と、
となります()。 のとき、右辺も になるので、合計が1のベクトルから始めれば、更新しても合計は1のままです。
6. 固有ベクトルとしての PageRank:PageRank の合計は1なので、 と書き換えられ、
となります。PageRank は、行列 の 固有値1の固有ベクトル です( の転置 は「Google 行列」と呼ばれます)。 は、すべての要素が 以上の正の行列です。正の行列には、合計が1で要素がすべて正の固有ベクトルがただ1つあり(ペロン=フロベニウスの定理)、 を繰り返し掛けると、どのベクトルから始めてもそこに近づきます。行列を何度も掛ける(べき乗する)ことで求めるので、次のやり方を べき乗法 と呼びます。
べき乗法は、行列を繰り返し掛けて、絶対値が最大の固有値(ここでは1)の固有ベクトルを求める、固有ベクトルの計算方法の1つです。収束の速さは、2番目に大きい固有値の絶対値で決まり、 ではそれが 以下になるので、誤差が1回ごとに 倍以下に縮みます(次のコードの実行結果で確かめます)。
となります。 が両辺に現れるので、このままでは計算できません。そこで、適当な から始めて、右辺で を更新することを、変わらなくなるまで繰り返します。これを べき乗法(power iteration)と呼びます。
べき乗法で PageRank を求める
# 1. 架空の山域の情報サイト:ページごとに、リンク先のページを並べる
links = {
    "Portal":          ["Hoshimi Range", "Akatsuki Range", "Shiranami Range"],
    "Hoshimi Range":   ["Portal", "Mount Horara"],
    "Akatsuki Range":  ["Portal", "Mount Horara"],
    "Shiranami Range": ["Portal"],
    "Mount Horara":    ["Hoshimi Range"],
    "Blog A":          ["Mount Monara"],
    "Blog B":          ["Mount Monara"],
    "Blog C":          ["Mount Monara"],
    "Mount Monara":    [],                     # どこにもリンクしていないページ
}
# 「山域のトップページ」「Hoshimi 山脈のページ」「Akatsuki 山脈のページ」「Shiranami 山脈のページ」
# 「Horara 山のページ」「個人のブログ A・B・C」「Monara 山のページ」


# 2. PageRank をべき乗法で求める:r ← d Pᵀ r + (1 − d) v を、r が変わらなくなるまで繰り返す
def pagerank(links, d=0.85, seeds=None, n_iter=200, fix_dangling=True):
    pages = list(links)
    N = len(pages)
    idx = {p: i for i, p in enumerate(pages)}

    # テレポート先の分布 v:seeds がなければ全ページに一様、あれば seeds のページだけ
    v = np.zeros(N)
    for p in (seeds or pages):
        v[idx[p]] = 1
    v /= v.sum()

    # 遷移行列 P:P[i, j] = ページ i から j へ進む確率
    P = np.zeros((N, N))
    for p, outs in links.items():
        if outs:
            for q in outs:
                P[idx[p], idx[q]] = 1 / len(outs)   # リンク先から一様に1つ選ぶ
        elif fix_dangling:
            P[idx[p]] = v                          # リンクのないページからは、v に従って移る

    r = v.copy()
    diffs = []
    for _ in range(n_iter):
        r_new = d * P.T @ r + (1 - d) * v
        diffs.append(np.abs(r_new - r).sum())    # 前の反復からの変化(L1 距離)
        r = r_new
    return pd.Series(r, index=pages), diffs


pr, diffs = pagerank(links)
DG = nx.DiGraph(links)
table = pd.DataFrame({"in_links": pd.Series(dict(DG.in_degree())),
                      "pagerank": pr,
                      "networkx": pd.Series(nx.pagerank(DG, alpha=0.85, tol=1e-12, max_iter=1000))})
print(table.round(4).to_string())
print("\n合計:", round(pr.sum(), 6), " networkx との差の最大:", f"{(table.pagerank - table.networkx).abs().max():.1e}")
for k in [1, 10, 20, 50, 100, 200]:
    print(f"{k:3d} 回目の反復  変化: {diffs[k - 1]:.1e}")
図のリンクを辞書で表し、PageRank をべき乗法で求めて、被リンク数・networkx の結果と並べるコードです。
- リンクの辞書: links は、ページの名前をキーに、リンク先のページの名前を並べたリストを値にした辞書です(グラフの記事の隣接リストを、有向グラフにしたものです)。Mount Monara はリンク先が空のリストで、ダングリングノードです。
- テレポート先の分布: v は、式の です。seeds を指定しないときは、すべてのページに を入れます。seeds は、後の節の Personalized PageRank で使います。
- 遷移行列: P は の行列で、ページ の行には、リンク先の列に を入れます。ダングリングノードの行には を入れ、すべてのページに等分して移るようにします。fix_dangling=False にすると、ダングリングノードの行が0のままになります(後の節で、この場合に何が起きるかを確かめます)。
- べき乗法: r_new = d * P.T @ r + (1 - d) * v が、直前の更新式そのものです。P.T @ r の 番目の要素は で、ページ にリンクしているページから受け取る量の合計です。r の初期値は v で、n_iter 回(200回)更新します。反復ごとに、前の との差の絶対値の和(L1 距離)を diffs に記録し、収束の様子を見ます。
- 比較: nx.DiGraph(links) は、辞書から有向グラフを作ります。DG.in_degree() が被リンク数で、nx.pagerank の結果と、スクラッチ実装の結果を並べます。networkx は、収束の判定を tol で行うので、比較のために厳しい値()にしています。
実行結果
                 in_links  pagerank  networkx
Portal                  3    0.2458    0.2458
Hoshimi Range           2    0.2352    0.2352
Akatsuki Range          1    0.0947    0.0947
Shiranami Range         1    0.0947    0.0947
Mount Horara            2    0.1653    0.1653
Blog A                  0    0.0251    0.0251
Blog B                  0    0.0251    0.0251
Blog C                  0    0.0251    0.0251
Mount Monara            3    0.0890    0.0890

合計: 1.0  networkx との差の最大: 1.2e-12
  1 回目の反復  変化: 7.1e-01
 10 回目の反復  変化: 5.7e-02
 20 回目の反復  変化: 1.1e-02
 50 回目の反復  変化: 8.5e-05
100 回目の反復  変化: 2.5e-08
200 回目の反復  変化: 2.2e-15
(和訳)
- ページ名:Portal はトップページ、Range は山脈のページ、Mount は山のページ、Blog はブログです。in_links は被リンク数です。
スクラッチ実装の PageRank は、networkx の結果と の精度で一致し、合計は1になりました。
被リンク数が3で同じトップページ(Portal)と Monara 山のページは、PageRank が0.2458と0.0890で、約2.8倍の差がつきました。Monara 山のページは、被リンク数が2の Horara 山のページ(0.1653)だけでなく、被リンク数が1の Akatsuki 山脈・Shiranami 山脈のページ(0.0947)よりも下です。リンク元のブログは、どこからもリンクされていないので、テレポートで受け取る分()と、Monara 山のページが全ページに配る分を合わせた0.0251しか持っておらず、3本のリンクで渡せる量も小さいからです。
式のとおりになっているか、Monara 山のページで確かめます。受け取る量は、3つのブログからのリンク()、全ページが受け取る 、ダングリングノードである自分自身が全ページに配る分の3つです。
丸めの誤差を除いて、実行結果の0.0890と一致します。
収束の様子を見ると、反復ごとの変化は、10回目の から100回目の まで、90回で約 倍に小さくなりました。1回あたりでは 倍で、減衰係数 と同じです。べき乗法の誤差は、1回の反復で 倍以下に縮むことが知られていて(前の「詳細な式展開」の6)、 なら、100回ほどで実用上十分な精度になります。ページの数 には、ほとんどよりません。Web 全体のような何十億ページのグラフでも、疎な行列とベクトルの積を100回ほど繰り返すだけで計算できるのが、べき乗法の強みです。
ランダムサーファーとしての PageRank
PageRank の式には、わかりやすい解釈があります。Web を、次のように歩き回る ランダムサーファー を考えます。
- 確率 で、今いるページのリンクを1つ一様に選んで、リンク先へ進む
- 確率 で(または、今いるページにリンクがないとき)、すべてのページから1つ一様に選んで、そこへ移る(テレポート)
これを何度も繰り返したとき、サーファーが ページ にいる時間の割合 が、PageRank です。ページ にいる割合が なら、次の1歩でページ からページ へ進む割合は で、テレポートでページ に来る割合は です。これを足したものが、PageRank の式の右辺そのものです。
サーファーの位置は、今いるページだけで次の位置の確率が決まる マルコフ連鎖 で、PageRank はその 定常分布(十分長く歩いたときに、各ページにいる割合)です。MCMC の記事で、「探索の軌跡の訪問頻度が、事後分布になる」ように設計した仕組みと、同じ考え方です。次のコードで、サーファーを実際に100万歩歩かせて、各ページにいた割合を数えます。
# 1. ランダムサーファー:リンクを1つ選んで進むことを繰り返し、各ページにいた回数を数える
def random_surfer(links, d=0.85, n_steps=1_000_000, seed=0):
    rng = np.random.default_rng(seed)
    pages = list(links)
    counts = dict.fromkeys(pages, 0)
    page = pages[0]
    for _ in range(n_steps):
        outs = links[page]
        if outs and rng.random() < d:
            page = outs[rng.integers(len(outs))]      # 確率 d:今のページのリンクを、一様に1つ選んで進む
        else:
            page = pages[rng.integers(len(pages))]    # 確率 1 − d(またはリンクがないとき):ランダムなページへ移る
        counts[page] += 1
    return pd.Series(counts) / n_steps


t0 = time.time()
visits = random_surfer(links)
print(f"計算時間: {time.time() - t0:.1f} 秒")
print(pd.DataFrame({"visit_ratio": visits, "pagerank": pr}).round(4).to_string())
ランダムサーファーを100万歩歩かせて、各ページにいた割合を数え、べき乗法で求めた PageRank と比べるコードです。
- 1歩の動き: random_surfer は、今いるページ page にリンクがあり、かつ rng.random()(0〜1の一様乱数)が より小さいときに、リンク先 outs から rng.integers(len(outs)) で1つ選んで進みます。それ以外のとき(確率 、またはダングリングノードにいるとき)は、全ページから一様に1つ選んで移ります。直前の手順1・2をそのまま書いたものです。
- 数える: 1歩ごとに、移った先のページの回数 counts を1増やし、最後に歩数 n_steps で割って、ページにいた割合にします。乱数のシードを固定しているので、何度実行しても同じ結果になります。最初のページ(pages[0]、トップページ)の影響は、100万歩の中ではほとんど残りません。
- 比較: べき乗法で求めた pr と並べて表示します。
実行結果
計算時間: 1.4 秒
                 visit_ratio  pagerank
Portal                0.2457    0.2458
Hoshimi Range         0.2349    0.2352
Akatsuki Range        0.0945    0.0947
Shiranami Range       0.0950    0.0947
Mount Horara          0.1653    0.1653
Blog A                0.0251    0.0251
Blog B                0.0255    0.0251
Blog C                0.0249    0.0251
Mount Monara          0.0891    0.0890
100万歩のシミュレーションで数えた、各ページにいた割合は、べき乗法の PageRank と小数第3位まで一致しました(ずれは、乱数による誤差です)。
この解釈から、PageRank が大きいページは「リンクをたどって歩いていると、よく行き着くページ」だとわかります。トップページは、山脈のページから戻ってくるリンクが多く、サーファーが何度も通ります。Monara 山のページに来るには、まずブログにテレポートし、そこからリンクをたどるしかないので、訪れる回数が少なくなります。
テレポートが必要な理由
テレポート( の項)と、ダングリングノードの扱いは、何のためにあるのでしょうか。どちらかを外した場合を比べます。
# 1. テレポートしない(d = 1)場合
pr_no_jump, diffs_no_jump = pagerank(links, d=1.0)
# 2. リンクのないページの扱いを入れない場合
pr_leak, _ = pagerank(links, fix_dangling=False)

print(pd.DataFrame({"d=0.85": pr, "d=1.0": pr_no_jump, "no_fix": pr_leak}).round(4).to_string())
print("\n合計  d=0.85:", round(pr.sum(), 4), " d=1.0:", round(pr_no_jump.sum(), 4), " no_fix:", round(pr_leak.sum(), 4))
print("最後の3回の変化(d=1.0):", [f"{x:.4f}" for x in diffs_no_jump[-3:]])
for n in [200, 201, 202, 203]:
    print(f"{n} 回の反復  Portal の値(d=1.0): {pagerank(links, d=1.0, n_iter=n)[0]['Portal']:.4f}")
べき乗法の pagerank の設定を変えて、テレポートを外した場合と、ダングリングノードの扱いを外した場合の結果を、元の PageRank と並べるコードです。
- テレポートなし: d=1.0 にすると、 の項が0になり、サーファーはリンクをたどるだけになります(ダングリングノードからの移動は残ります)。
- ダングリングノードの扱いなし: fix_dangling=False にすると、Monara 山のページの行が0のままの遷移行列で計算します。サーファーが Monara 山のページに着くと、行き先がなくなる状態です。
- 表示: 3つの結果と合計を並べ、テレポートなしの場合の、最後の3回の反復での変化と、200〜203回目のトップページの値を表示します。
実行結果
                 d=0.85   d=1.0  no_fix
Portal           0.2458  0.2571  0.1634
Hoshimi Range    0.2352  0.3429  0.1564
Akatsuki Range   0.0947  0.1143  0.0630
Shiranami Range  0.0947  0.1143  0.0630
Mount Horara     0.1653  0.1714  0.1099
Blog A           0.0251  0.0000  0.0167
Blog B           0.0251  0.0000  0.0167
Blog C           0.0251  0.0000  0.0167
Mount Monara     0.0890  0.0000  0.0592

合計  d=0.85: 1.0  d=1.0: 1.0  no_fix: 0.6647
最後の3回の変化(d=1.0): ['0.2857', '0.2857', '0.2857']
200 回の反復  Portal の値(d=1.0): 0.2571
201 回の反復  Portal の値(d=1.0): 0.3429
202 回の反復  Portal の値(d=1.0): 0.2571
203 回の反復  Portal の値(d=1.0): 0.3429
テレポートを外すと(d=1.0)、2つの問題が起きました。
- リンクされていないページの値が0になる: ブログ A・B・C と Monara 山のページが0になりました。ブログにたどり着くリンクはなく、Monara 山のページから全ページへ移ったサーファーも、いずれ左のまとまりに入ります。左のまとまりからは外へ出るリンクがないので、サーファーは二度と戻ってきません。左のまとまりのように、入ることはできても出るリンクがないページの集まりは ランクシンク(rank sink)と呼ばれ、PageRank をすべて吸い込んでしまいます。
- 収束しない: 反復ごとの変化が0.2857のまま減らず、トップページの値が0.2571と0.3429の間で、1回ごとに入れ替わり続けました。左のまとまりの中の行き来は、トップページ → 山脈のページ → トップページ、トップページ → 山脈のページ → Horara 山 → Hoshimi 山脈 → トップページ のように、すべて偶数歩でトップページに戻ってきます。そのため、サーファーの位置が偶数歩目と奇数歩目で入れ替わり、1つの分布に落ち着きません(周期的なマルコフ連鎖)。
テレポートがあると、どのページからどのページへも、確率 で1歩で移れます。そのため、どこかに閉じ込められることも、周期的に振動することもなく、べき乗法がいつも1つの答えに収束します。これが、PageRank の式に の項がある理由です。
ダングリングノードの扱いを外すと(no_fix)、PageRank の合計が0.6647に減りました。サーファーが Monara 山のページに着くたびに、行き先がないまま消えてしまうためです。順位は元とほぼ同じですが、合計が1でなくなり、確率としての解釈ができなくなります。Web には、リンクのない PDF や画像のようなページが大量にあるので、この扱いは欠かせません。
の値は、テレポートの頻度を決めます。 を1に近づけるほどリンク構造をよく反映しますが、収束が遅くなり(誤差が1回あたり 倍にしか縮まない)、ランクシンクの影響も強く受けます。0.85は、その折り合いとして広く使われている値です。
無向グラフの PageRank は、次数に近くなる
実験1では、登山道のグラフの PageRank が、次数とほとんど同じ順位になりました。その理由は、無向グラフのランダムウォークの性質にあります。
無向グラフでは、ノード から隣のノードへ、それぞれ確率 で進みます。テレポートがない場合()、各ノードにいる割合が次数に比例する分布 ( はエッジの数)は、PageRank の式を満たします。実際、右辺に代入すると、
となり、左辺と一致します。ノード の隣は 個あり、どの隣からも ずつ受け取るからです。無向グラフでは、「重要なノードからつながっている」効果が、「つながっている数」に吸収されてしまうのです。テレポートがある場合()は、この分布から少しずれるので、次数が同じ4の地点でも PageRank に差がつきますが、順位はほぼ次数で決まります(実験1の順位相関0.932)。
PageRank が次数と違う情報を持つのは、リンクに向きがあり、「だれが、だれを指しているか」が非対称な 有向グラフ の場合です。Web のリンク、論文の引用、SNS のフォローなどが、その典型です。
Personalized PageRank:出発点から見た重要さ
PageRank は、グラフ全体から見た重要さです。しかし、「Notaha 村から見て、重要な地点はどこか」「この質問に出てくる人物に関係の深い人物はだれか」のように、ある出発点から見た重要さ を知りたいことがあります。
Personalized PageRank(PPR)は、テレポート先を、全ページへの一様な分布 から、出発点 だけに集中した分布 ( の要素だけが1、ほかは0のベクトル)に変えたものです(Haveliwala, 2002、Jeh & Widom, 2003)。
ランダムサーファーで言えば、「確率 で、出発点に戻ってやり直す」歩き方です。サーファーは出発点の周りを歩き回り、ときどき出発点に戻るので、出発点から近く、しかもつながりの多いノードに長くいることになります。リスタート付きランダムウォーク(random walk with restart)とも呼ばれます。出発点は複数でもよく、その場合は、出発点のノードに重みを分けた分布を にします。
計算例
PageRank の計算例と同じ3ページ(A → B、A → C、B → C、C → A、)で、出発点を B にした PPR を計算します。PageRank の式との違いは第1項だけです。PageRank では全ページが ずつ受け取りましたが、PPR では出発点の B だけが を受け取り、A と C は0になります。
この連立方程式を解くと、 になります(合計は1)。出発点を A・C にした場合も同じように解いて、PageRank と並べます。
| A | B | C | |
|---|---|---|---|
| PageRank | 0.388 | 0.215 | 0.397 |
| PPR(出発点 A) | 0.452 | 0.192 | 0.356 |
| PPR(出発点 B) | 0.327 | 0.289 | 0.384 |
| PPR(出発点 C) | 0.384 | 0.163 | 0.452 |
- 出発点の値が上がる: B の値は、PageRank では0.215ですが、B を出発点にすると0.289に上がります。サーファーが確率0.15で B に戻ってくるからです。
- 出発点がいちばん上とは限らない: 出発点を B にしても、最大は C(0.384)です。B は、受け取った分をすべて C に渡すからです。PPR は、出発点そのものではなく、出発点から流れ込みやすいページ を高く評価します。
- 出発点から遠いページは下がる: 出発点を C にすると、B は0.163と、PageRank の0.215より下がります。C から B へは、C → A → B と2本のリンクをたどる必要があり、A では流れが半分に分かれるからです。出発点を A にした場合(A → B は1本)の0.192より小さくなります。
3つの PPR を平均すると (0.388, 0.215, 0.397) となり、PageRank と一致します。PageRank のテレポート先 は、・・ の平均で、式が について線形なので、解も平均になるからです。PageRank は、「すべてのページを出発点にした PPR の平均」と見ることもできます。networkx でも、nx.pagerank の personalization に {"B": 1} を渡すと、出発点を B にした PPR が同じ値になります。
べき乗法の pagerank は、seeds に出発点を渡すと、 を出発点だけに集中した分布にするので、そのまま PPR を計算できます。登山道のグラフで、Notaha 村(Hoshimi 山脈の村)を出発点にした PPR を求めます。
# 1. 登山道のグラフを、地点ごとの隣の地点のリストにする(無向グラフなので、道は両向きのリンク)
trail_links = {v: list(G.neighbors(v)) for v in points["name"]}
start = "Notaha Village"
hops = pd.Series(nx.single_source_shortest_path_length(G, start)).reindex(points["name"]).astype("Int64")

# 2. PageRank と Personalized PageRank(出発点を Notaha Village にしたもの)
pr_all, _ = pagerank(trail_links)
ppr, _ = pagerank(trail_links, seeds=[start])
print("networkx と一致:",
      np.allclose(pr_all, pd.Series(nx.pagerank(G, alpha=0.85, weight=None, tol=1e-12, max_iter=1000))[pr_all.index]),
      np.allclose(ppr, pd.Series(nx.pagerank(G, alpha=0.85, weight=None, personalization={start: 1},
                                            tol=1e-12, max_iter=1000))[ppr.index], atol=1e-10))

result = pd.DataFrame({"range": score["range"], "degree": score["degree"], "hops": hops,
                       "pagerank": pr_all, "ppr": ppr})
print("\n--- PageRank の上位5地点 ---")
print(result.sort_values("pagerank", ascending=False).head(5).round(4).to_string())
print(f"\n--- Personalized PageRank(出発点: {start})の上位8地点 ---")
print(result.sort_values("ppr", ascending=False).head(8).round(4).to_string())
print("\n山脈ごとの合計:", {k: float(f"{v:.2g}") for k, v in result.groupby("range")["ppr"].sum().items()})

# 3. d を変えると、出発点からどれだけ遠くまで広がるか
for d in [0.5, 0.85, 0.95]:
    p, _ = pagerank(trail_links, d=d, seeds=[start], n_iter=1000)
    near = [p[hops[hops <= h].index].sum() for h in [0, 1, 2, 3]]
    print(f"d={d:.2f}  出発点からのホップ数ごとの累積  0: {near[0]:.3f}  1以内: {near[1]:.3f}"
          f"  2以内: {near[2]:.3f}  3以内: {near[3]:.3f}  Akatsuki 山脈: {p[score['range'] == 'Akatsuki'].sum():.1e}")
登山道のグラフで、PageRank と、Notaha 村を出発点にした Personalized PageRank を、べき乗法で求めて比べるコードです。
- リンクの辞書: trail_links は、地点ごとに、道でつながっている隣の地点を並べた辞書です。無向グラフなので、1本の道が両向きのリンクになります。hops は、Notaha 村から各地点まで何本の道をたどるか(ホップ数)で、nx.single_source_shortest_path_length(BFS)で求めます。たどり着けない地点(Shiranami 山脈)は reindex で欠損値(NA)にします。
- PageRank と PPR: 同じ pagerank 関数で、seeds なし(PageRank)と、seeds=[start](PPR)の2通りを計算します。PPR では、べき乗法の初期値も出発点に集中した分布になります。どちらも、networkx の nx.pagerank の結果(PPR は personalization に出発点を指定したもの)と、np.allclose で一致するかを確かめます。
- 表示: PageRank の上位5地点と、PPR の上位8地点を、山脈・次数・ホップ数と並べて表示し、PPR の値を山脈ごとに合計します。
- d を変える: を0.5・0.85・0.95に変えて PPR を求め(収束が遅い のために、反復を1,000回にしています)、出発点から0・1・2・3ホップ以内の地点の PPR の合計と、Akatsuki 山脈の地点の合計を表示します。
実行結果
networkx と一致: True True

--- PageRank の上位5地点 ---
                    range  degree  hops  pagerank     ppr
Mount Horara      Hoshimi       6     2    0.0169  0.1503
Horino Village  Shiranami       5  <NA>    0.0139  0.0000
Yokana Hut       Akatsuki       5    17    0.0131  0.0000
Suneha Hut        Hoshimi       4    11    0.0125  0.0001
Tokito Hut       Akatsuki       4    22    0.0118  0.0000

--- Personalized PageRank(出発点: Notaha Village)の上位8地点 ---
                  range  degree  hops  pagerank     ppr
Notaha Village  Hoshimi       2     0    0.0061  0.2379
Mount Honeku    Hoshimi       4     1    0.0114  0.1950
Mount Noyono    Hoshimi       3     1    0.0087  0.1638
Mount Horara    Hoshimi       6     2    0.0169  0.1503
Mount Rinori    Hoshimi       2     2    0.0064  0.0616
Mount Nasene    Hoshimi       2     3    0.0064  0.0475
Morato Hut      Hoshimi       2     3    0.0063  0.0370
Mount Tohowa    Hoshimi       2     3    0.0063  0.0370

山脈ごとの合計: {'Akatsuki': 1.8e-05, 'Hoshimi': 1.0, 'Shiranami': 0.0}
d=0.50  出発点からのホップ数ごとの累積  0: 0.549  1以内: 0.889  2以内: 0.970  3以内: 0.998  Akatsuki 山脈: 4.8e-10
d=0.85  出発点からのホップ数ごとの累積  0: 0.238  1以内: 0.597  2以内: 0.809  3以内: 0.956  Akatsuki 山脈: 1.8e-05
d=0.95  出発点からのホップ数ごとの累積  0: 0.127  1以内: 0.409  2以内: 0.644  3以内: 0.840  Akatsuki 山脈: 1.4e-03
(和訳)
- hops は Notaha 村からのホップ数で、NA(欠損値)はたどり着けない地点です。
PageRank(グラフ全体から見た重要さ)の上位には、Shiranami 山脈の Horino 村や、Notaha 村から17〜22ホップも離れた Akatsuki 山脈の山小屋が並びました。Notaha 村から歩いて行く人にとっては、ほとんど関係のない地点です。
PPR の上位は、Notaha 村の周り(3ホップ以内)の地点だけになりました。Shiranami 山脈の合計はちょうど0で、Akatsuki 山脈も しかありません。出発点からたどり着けないノードには、PPR は一切配られません。
PPR は、単に近い順に並べたものではありません。2ホップ先の Horara 山(次数6)の PPR は0.1503で、同じ2ホップ先の Rinori 山(次数2)の0.0616の約2.4倍あり、1ホップ先の Noyono 山(0.1638)に迫っています。出発点からの 近さ と、その地点の つながりの多さ の両方が反映されます。
を変えると、PPR がどこまで広がるかが変わります。 では、PPR の97%が2ホップ以内に集まりました。 では2ホップ以内は64%にとどまり、Akatsuki 山脈にも が届きました。サーファーが出発点に戻るまでに歩く歩数の平均は 歩( で1歩、 で約5.7歩、 で19歩)なので、 は「出発点からどのくらいの範囲を見るか」を決めるパラメータになります。
文書の検索への応用
PPR は、Web 検索の個人化(ユーザーがよく見るページを出発点にする)のほか、SNS の「おすすめのユーザー」、推薦システム、そして LLM を使った検索に使われています。
たとえば、文書から人物・組織・場所などの「もの」と、その間の関係を抜き出してグラフ(ナレッジグラフ)にしておき、質問に出てくる「もの」を出発点にして PPR を計算すると、質問に直接は書かれていないが、出発点と強くつながっている「もの」と、それが登場する文書を見つけられます。複数の文書をたどらないと答えられない質問(マルチホップの質問)に対して、この方法で文書を検索するのが、HippoRAG(Gutiérrez et al., NeurIPS 2024)です(HippoRAG の記事で、スクラッチ実装して確かめています)。また、GraphRAG のように、文書から作ったグラフの情報を LLM に渡す方法では、次数のような中心性を、どの関係を優先して渡すかの目安に使います。
ほかの中心性
本記事で扱った以外にも、中心性にはいくつもの種類があります。代表的なものを、問いの違いで整理します。
| 中心性 | 何を重要とみなすか | 向いている問い |
|---|---|---|
| 次数中心性 | つながっている数が多い | 局所的なハブ、人気のノード |
| 近接中心性 | ほかのすべてのノードへの距離の平均が短い | どこへでも早く届く場所(拠点の配置など) |
| 媒介中心性 | 多くの最短経路が通る | 行き来の中継地点、ネットワークの弱点 |
| 固有ベクトル中心性 | 重要なノードとつながっている | 影響力(PageRank の、テレポートと出次数での割り算がない版) |
| PageRank | 重要なページから、リンクを独占的に受けている | 有向グラフでの重要さ(Web、引用) |
| Personalized PageRank | 出発点から近く、つながりが多い | 出発点に関係の深いノード(推薦、検索) |
なお、近接中心性は、連結成分が複数あるグラフでは定義に工夫が必要です(登山道のグラフのように、たどり着けない地点があると、距離が無限大になるため)。networkx の nx.closeness_centrality は、たどり着ける範囲の大きさで補正した値を返します。
中心性を使うときの注意点
- 問いに合った中心性を選ぶ: 実験1のとおり、次数・媒介中心性・PageRank は、同じグラフで違う地点を選びます。「何のための重要さか」を先に決め、それに合う中心性を選びます。1つの中心性の順位を、そのまま「重要度」と呼ばないようにします。
- 無向グラフの PageRank は、ほぼ次数: 無向グラフでは、PageRank は次数とほとんど同じ順位になります。計算の手間に見合う情報が得られるのは、主に有向グラフです。
- グラフの作り方で、値が大きく変わる: 名寄せの漏れで同じものが2つのノードに分かれると、次数も PageRank も半分ずつになります。どの関係をエッジにするかでも、中心性は変わります。文書から作ったグラフでは、多くの文書に出てくる一般的な「もの」が、内容と関係なく高い中心性を持つことにも注意します。
- PageRank は操作されうる: リンクを大量に作るページ群(リンクファーム)を用意すると、特定のページの PageRank を押し上げられます。実際の検索エンジンは、信頼できるページを出発点にした PPR(TrustRank など)や、ほかの多くの信号を組み合わせて対策しています。
- 計算量: 次数は 、PageRank は1回の反復が で100回程度、媒介中心性は Brandes のアルゴリズムでも かかります。数百万ノードのグラフでは、媒介中心性は一部のノードから求める近似を使います。
まとめ
本記事では、グラフの中で「どのノードが重要か」を測る中心性を、架空の山域の登山道と情報サイトのリンクで確かめました。
登山道のグラフでは、次数の上位は6本の道が集まる Horara 山でしたが、媒介中心性の上位は、山脈をまたぐ唯一の道の両端(Mihoshi 小屋と Namomi 山)でした。この2地点を通れなくすると1,560組の地点が行き来できなくなり、次数では見えない「全体の行き来を支える地点」を、媒介中心性で見つけられました。
PageRank は、「重要なページからリンクされているページは重要」という再帰的な定義で、被リンク数が同じ3でも、リンク元によって約2.8倍の差をつけました。べき乗法で求めた値は、networkx と一致し、ランダムサーファーを100万歩歩かせて数えた、各ページにいた割合とも一致しました。テレポートがないと、リンクされていないページの値が0になり、計算も振動して収束しませんでした。
Personalized PageRank は、テレポート先を出発点に限ることで、出発点から見た重要さを測ります。Notaha 村を出発点にすると、上位は3ホップ以内の地点だけになり、同じ距離でもつながりの多い地点が高くなりました。この性質は、質問に出てくる「もの」から関係をたどる文書の検索にも使われています。
参考文献
- B. Jiménez Gutiérrez, Y. Shu, Y. Gu, M. Yasunaga, Y. Su (2024). HippoRAG: Neurobiologically Inspired Long-Term Memory for Large Language Models. NeurIPS 2024.
- L. Page, S. Brin, R. Motwani, T. Winograd (1999). The PageRank Citation Ranking: Bringing Order to the Web. Technical Report, Stanford InfoLab.
本記事の文章・構成の一部に生成AIを使用しています。