PPOとは?
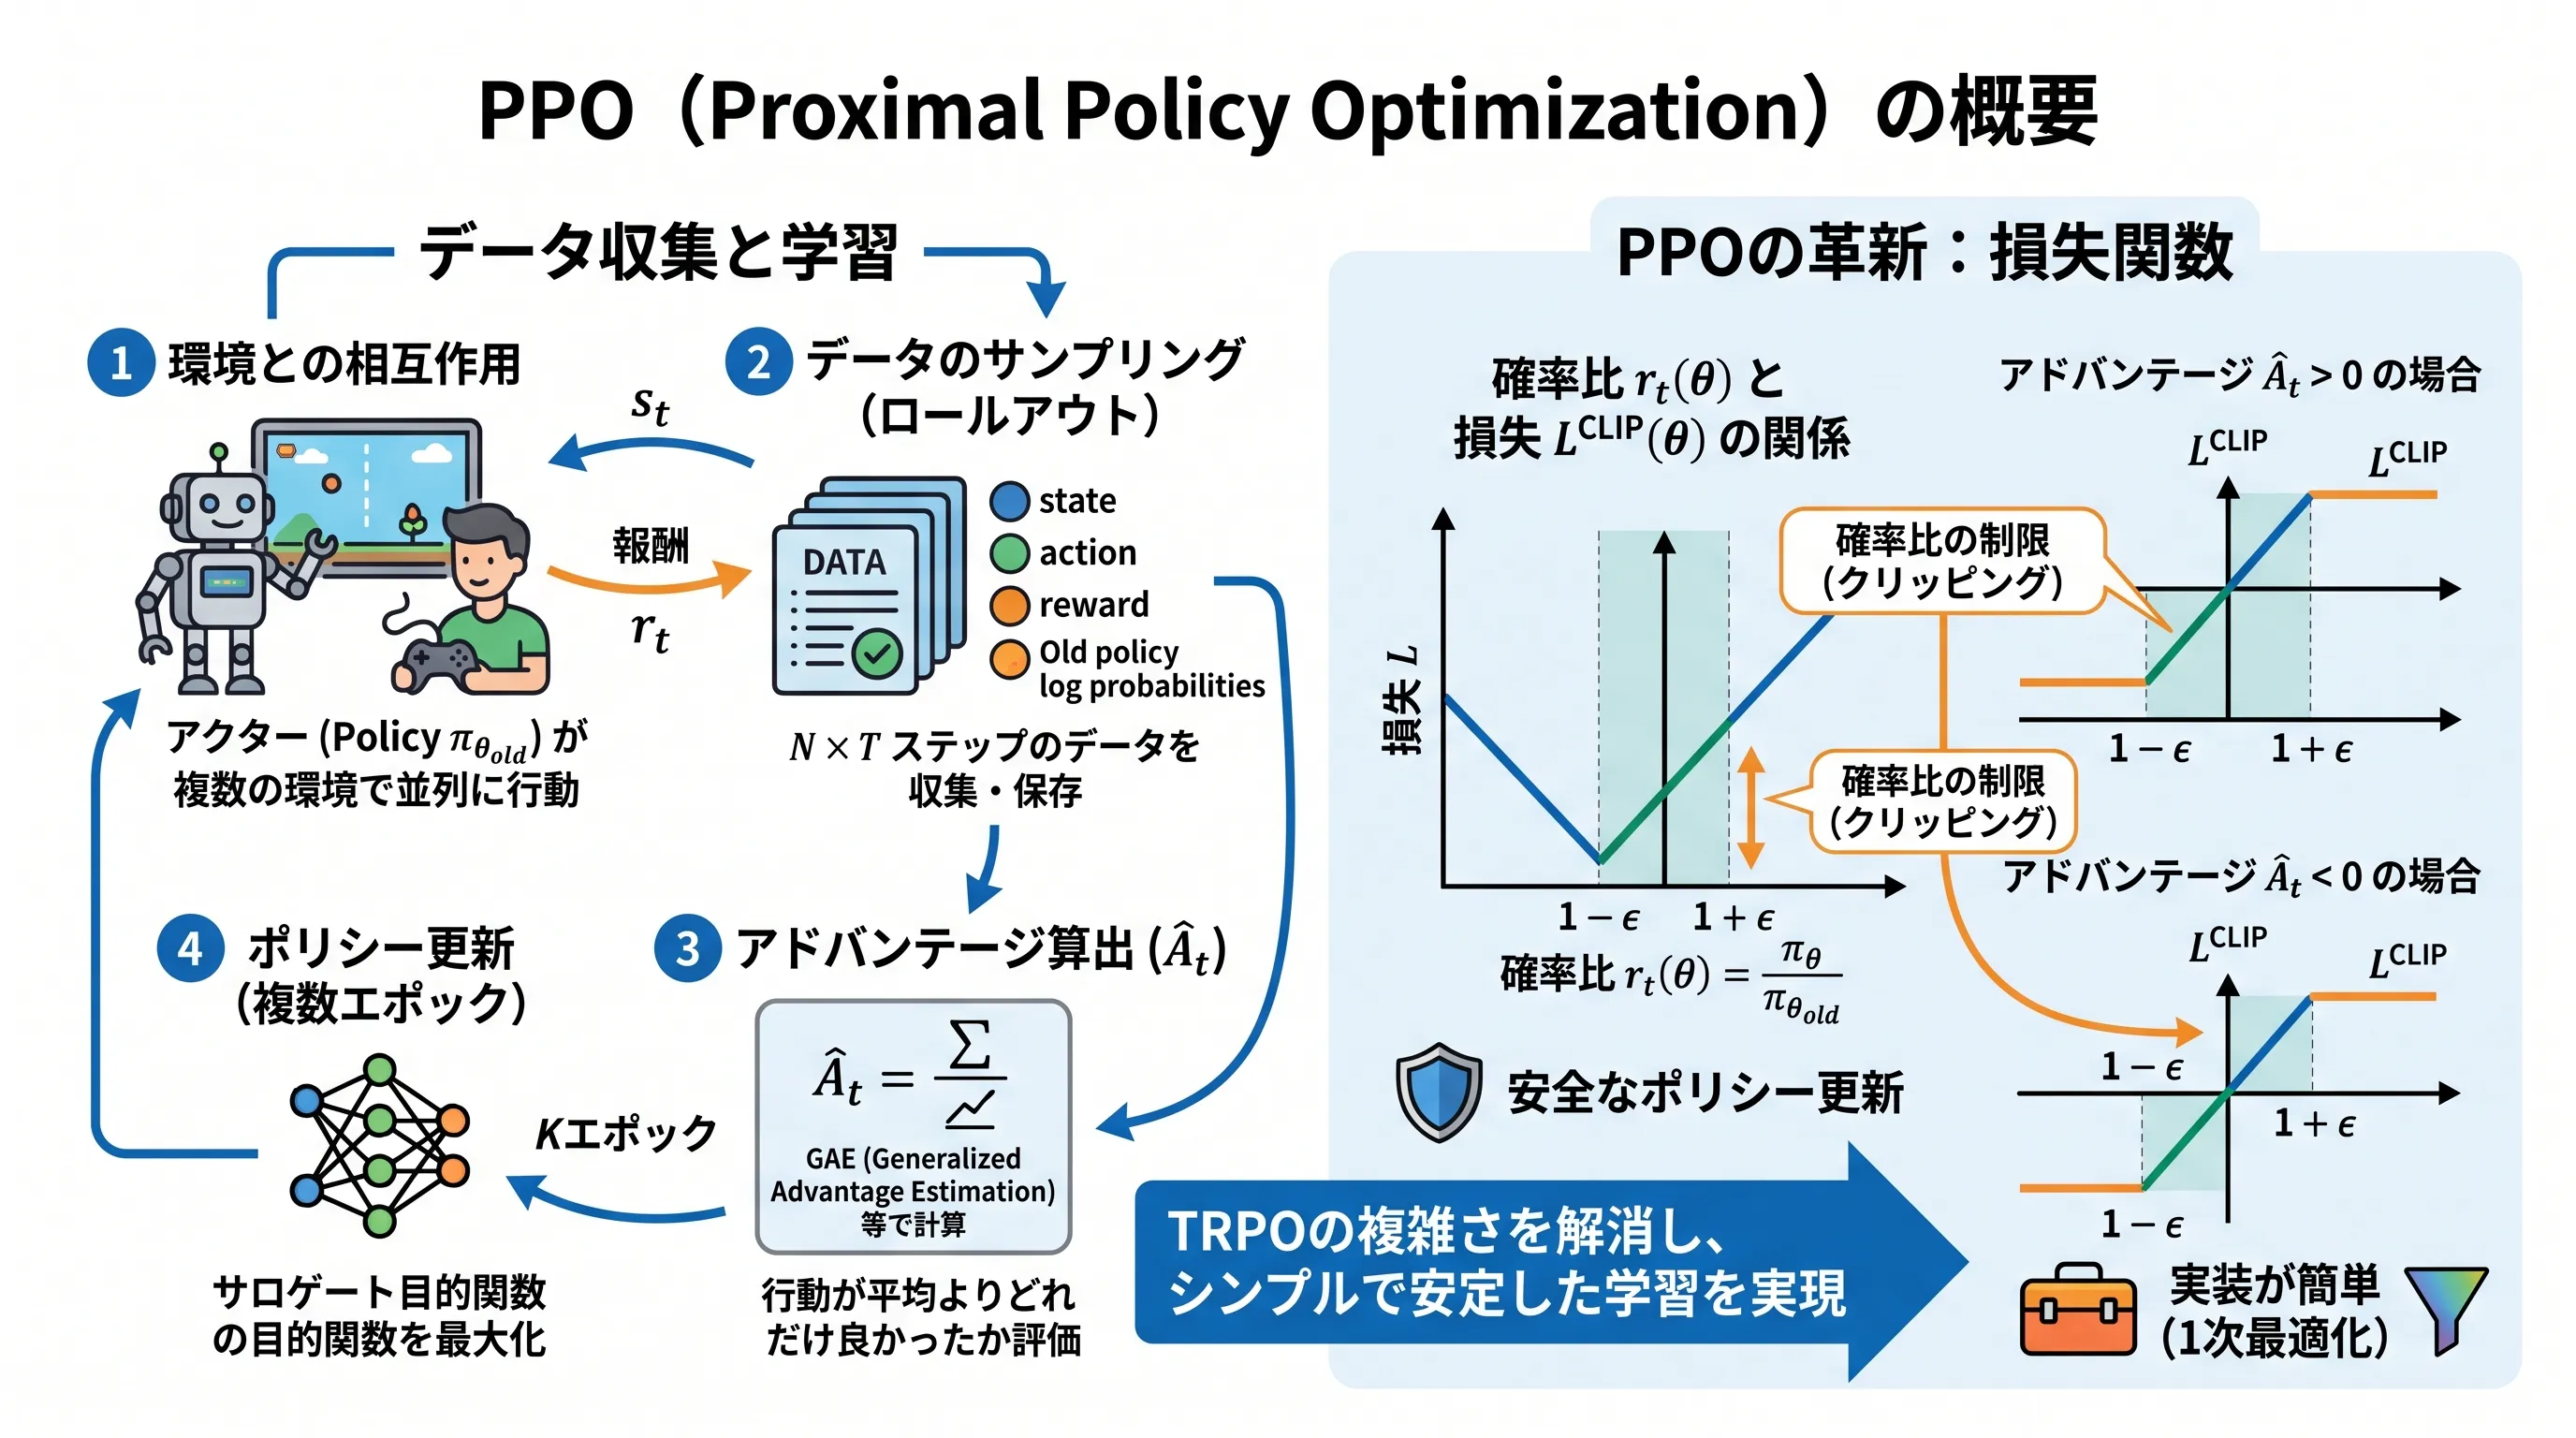
(画像は、Geminiで作成)
TRPO の「方策を変えすぎない」という考え方を、確率比のクリップというシンプルな目的関数で実現する PPO の仕組みと、アドバンテージを推定する GAE を理解すること。PyTorch でのスクラッチ実装と Stable Baselines3 で CartPole を学習し、5つのシードで TRPO と比べて、PPO の利点がデータ効率よりも実装の簡単さにあることを確かめること。
PPOの概要
PPO(Proximal Policy Optimization)は、強化学習における方策勾配法(Policy Gradient Methods)の新しいファミリです。環境との相互作用によるデータのサンプリングと、確率的勾配上昇法を用いた「サロゲート(代替)」目的関数の最適化を交互に行うアルゴリズムです。
標準的な方策勾配法がデータサンプルごとに1回の勾配更新を行うのに対し、PPOはミニバッチ更新による複数エポックの学習を可能にする斬新な目的関数(Clipped probability ratios)を提案しています。これにより、TRPO(Trust Region Policy Optimization)が持つデータ効率や信頼性といった利点を維持しつつ、実装がはるかに簡単で汎用性が高く、経験的に優れたサンプル効率を実現しています。
OpenAIによって発表されて以来、シミュレートされたロボットの移動やAtariのゲームプレイなど、様々なベンチマークタスクにおいて他のオンライン方策勾配法を上回る性能を示し、現在では強化学習のデファクトスタンダードとして広く活用されています。
これまでのアルゴリズムの課題とPPOの位置づけ
(図は、diagram-designで作成)
ニューラルネットワークを関数近似器として用いる強化学習において、PPOに至るまでに以下のアルゴリズムが発展してきました。しかし、それぞれに課題がありました。
- 価値ベースの手法(DQN など): 経験再生(Experience Replay)や固定ターゲットネットワークにより、離散的な行動空間ではうまく機能しますが、連続制御問題への適用が難しく、方策を直接最適化できないという限界がありました。
- 方策勾配法(REINFORCE、A2C など): 方策を直接学習でき、連続値制御も可能ですが、更新のステップサイズ(学習率)に非常に敏感です。一度でも方策を大きく更新しすぎると性能が致命的に崩壊してしまうという不安定性がありました。
- 信頼領域法(TRPO): 方策勾配法の弱点を克服するため、「KLダイバージェンス」を用いた制約付き最適化を導入し、単調な改善(性能崩壊の防止)を数学的に保証しました。しかし、逆行列やヘッセ行列の計算(共役勾配法)が必要であり、実装が複雑で計算コストが高いことや、Dropoutなどのノイズを伴うネットワーク構造と相性が悪いという欠点がありました。
PPOは、これらの課題を解決し、TRPOの持つ「データ効率と安定した性能」を保ちながら、DQNやA2Cのように「1次最適化(通常の勾配降下法)のみで実装できるシンプルさ」 を実現したアルゴリズムです。ただし、TRPOの理論が与える単調改善の保証は、クリップした目的関数には引き継がれていません。論文も、PPOの良さは理論ではなく実験で示しています。
PPOの処理概要
(図は、diagram-designで作成)
PPO(Actor-Criticスタイル)のアルゴリズムは、環境と相互作用してデータを収集するフェーズと、収集したデータを使ってネットワークを最適化するフェーズを繰り返します。固定長の軌跡(Trajectory)セグメントを使用する学習の流れは以下のようになります。
-
データのサンプリング (Data Collection): まず、現在のAIの方策(ポリシー、)を使って、これから学習するためのデータを集めます。このプロセスは、以下のステップで進められます。
-
基本的な流れ(1人プレイ): まず、1人の「アクター」(行動者)が環境の中で行動します。アクターは、現在の状態 を見て、方策 に従って次に行うべき行動 を決定します。行動した結果、環境から新しい状態 、報酬 、そして「ゲーム終了」かどうかを示す情報を受け取ります。この1ステップの遷移 を 回(論文のMuJoCoの実験では2048ステップ、Atariの実験では128ステップ)繰り返して、一続きのプレイデータ(「軌跡」や「エピソード」)として保存します。
-
効率化のための並列化(N人での同時プレイ): 1人分のプレイデータだけでは、内容に偏りが生じたり、学習に必要なデータ量を集めるのに時間がかかったりします。そこでPPOでは、
N人のアクター(論文のAtariの実験では8人)を用意し、それぞれが同時に(並列で) 異なる環境や初期状態でプレイを開始します。各アクターがそれぞれTステップ分のデータを集めることで、多様で大量のデータを一度に効率よく収集できます。最終的に、このフェーズでは合計N × Tステップ分のデータが集まります。
-
-
アドバンテージの計算 (Advantage Estimation): 次に、集めた
N × T個のデータ一つひとつに対して、「その行動が平均と比べてどれだけ良かったか」を評価する指標であるアドバンテージ(Advantage) を計算します。(※この計算は全データを混ぜて行うのではなく、 人のアクターがそれぞれ集めた「長さ の軌跡」ごとに独立して行われます。)
アドバンテージは、基本的には「実際に得られた将来までの報酬の合計(収益 )」から「あらかじめ予測していたその状態の平均的な価値(ベースライン )」を引くことで計算されます。
つまり、単純な即時報酬を見るのではなく、長期的な視点で「その状況でその行動を選択したことが、事前の予測よりも本当に良い結果をもたらしたか」を測ります。
なぜ「未来」を足し合わせるのか?(GAEの導入)
アドバンテージを計算する際、以下の2つの極端な方法にはそれぞれ弱点があります。
- 最後までやり切った結果(収益 :モンテカルロ法)を使う: 正確(バイアス小)ですが、途中のまぐれや不運が混ざりすぎてデータがブレブレ(分散大)になります。
- 1歩先だけの予測(TD誤差 )を使う: データのブレは少ない(分散小)ですが、そもそもの「予測」である が間違っていたら元も子もありません(バイアス大)。
そこで GAE (Generalized Advantage Estimation: 一般化アドバンテージ推定) は、「1歩先の予測()」「2歩先の予測()」「3歩先の予測…」と、未来に向かって発生するTD誤差を全部足し合わせることで、両者のいいとこ取り(バランス)をしようと考えました。
バイアスと分散のトレードオフについてここで説明されている「モンテカルロ法」と「TD学習」の両極端な性質(バイアスと分散のジレンマ)は、強化学習における永遠のテーマです。GAEがどのようにこのジレンマを解決しようとしているのか、その前提知識をより深く理解したい方は、ぜひモンテカルロ法(Monte Carlo Method)とは? および TD学習(時間的差分学習)とは? の記事もあわせてご覧ください。
の役割:未来の「不確実性」を割り引く
ここで登場するのが です。未来のTD誤差を足していく際、1歩先の誤差()は今の状況に近いので比較的信用できますが、10歩先の誤差()となると、その間にどんなランダムな出来事が起こるか分からないため、非常に不確実になります。
そこで、足し合わせる式にパラメータ ( の値)を掛け合わせます。
例えば とすると、
- 現在のTD誤差: 倍の重み
- 1歩先のTD誤差: 倍に重みを下げる
- 2歩先のTD誤差: 倍に重みを下げる
- 3歩先のTD誤差: 倍に重みを下げる...
このように、 を何度も掛け合わせることで、「遠い未来の不確実な情報ほど、影響力(重み)を徐々に小さくしていく」という操作を行っているのです。
極端な例で考えてみると…
を極端な値に設定すると、このダイヤルの意味がよりハッキリします。
- に設定した場合: 未来の項がすべて になるため、 となります。つまり「1歩先の情報しか見ない(バイアス大・分散小)」という状態に戻ります。
- に設定した場合: 未来の項が全く減衰しません。これは数学的に計算していくと、最終的に「最後までやり切った結果(収益 )をそのまま使う(バイアス小・分散大)」のと同じことになります。
つまり は、この「両極端な手法の間をシームレスに繋ぎ、一番ちょうどいいバランス(バイアスと分散のトレードオフの最適化)を見つけるために、後から数学的に導入された便利なパラメータ」だったというわけです。
GAEの計算イメージ(3ステップの例)
計算のイメージを掴むために、あえて非常に短い3ステップ()の軌跡を例に、現在()のアドバンテージ を計算してみましょう。
1. 前提となる数値を設定する 計算をシンプルにするため、割引率 は 1.0(減衰なし)とし、今回は未来の不確実性を調整する の効果だけに注目します。
- (割引率): 1.0
- (GAEの減衰パラメータ): 0.5
- 各ステップで発生した「1歩先の予測とのズレ(TD誤差)」:
- 現在()のTD誤差 = 10 (予想よりかなり良かった)
- 1歩先()のTD誤差 = 8 (予想より良かった)
- 2歩先()のTD誤差 = -4 (予想より悪かった)
2. GAEの公式に当てはめる 今()のアドバンテージ です。 なので、式は以下のようになります。
ここに数値を代入して計算します。
- 現在のTD誤差: (そのまま 100% 信用する)
- 1歩先のTD誤差: (半分だけ信用する)
- 2歩先のTD誤差: (かなり不確実なので 25% だけ信用する)
すべて足し合わせます。
現在のアドバンテージは 13 と計算されました。
3. を変えるとどうなるか?(比較) ここからが の面白いところです。もし を両極端な値(0 または 1)に設定していたら、計算結果はどう変わっていたかを比較してみましょう。
の設定値 計算式 算出されるアドバンテージ 特徴 10 目の前の結果のみを信じる(バイアス大・分散小)。未来の情報は完全に無視されます。 13 バランス型。未来の情報を少しずつ割り引きながら取り入れます。 14 未来の結果も100%信じる(バイアス小・分散大)。最後までやり切った実際の収益をそのまま評価に使うことになります。 このように、 を 0.5 に設定したことで、「目の前の確実な大成功(10)」を一番重視しつつも、「未来もそこそこ良かった(8)」「でも最後はちょっと失敗した(-4)」という未来の情報を、不確実性に合わせて適度にトッピングすることができました。
この式を 人分の軌跡それぞれに適用することで、最終的に 個すべてのデータに対して高精度なアドバンテージ が割り当てられます。
-
複数エポックの最適化 (Optimization): 最後に、方策を更新する学習(最適化)のフェーズです。PPOの核心部分であり、以下の特徴があります。
- サロゲート損失の利用: PPOでは、方策を更新しすぎないように「ブレーキ」をかける仕組みを持つ特別な目的関数(サロゲート損失)を計算します。これにより、学習が一歩進むごとに方策が急激に変化して性能が不安定になるのを防ぎます。(※サロゲート損失の具体的な仕組みについては、後述の「TRPOの複雑な制約をシンプルに実現するクリッピング (Clipped Surrogate Objective)」で詳しく解説します)
- データの再利用(複数エポック学習): 一度集めた
N × T個の貴重なデータを一度の学習で使い捨てるのは非効率です。PPOでは、同じデータセットを使ってKエポック(K回)繰り返し学習します。 - ミニバッチ学習: さらに、
N × T個のデータをいくつかの小さな塊(ミニバッチ)に分割し、ミニバッチごとに勾配を計算してパラメータを更新します。これにより、学習プロセスがさらに安定し、効率化されます。
この3つのステップを何度も繰り返すことで、PPOは方策を徐々に改善していきます。
TRPOの複雑な制約をシンプルに実現するクリッピング (Clipped Surrogate Objective)
PPOの最も重要なイノベーションである 「クリップされたサロゲート目的関数 (Clipped Surrogate Objective)」 を理解するために、まずはこれまでのアルゴリズムの目的関数を少し振り返ってみましょう。
REINFORCE や A2C のような標準的な方策勾配法では、以下のような目的関数を最大化することで方策を更新していました。
これはシンプルに「アドバンテージ が高い(良かった)行動の確率を高める」という直感的な式ですが、この関数をそのまま最適化し続けると、1回の更新で方策が急激に変化しすぎ、学習が崩壊してしまうという問題がありました。(※この現象については、A2Cの記事における「方策の崩壊(Policy Collapse)のシミュレーション」で実演しています)
これを防ぐため、TRPO では更新前(古い方策)と更新後(新しい方策)の確率比に注目しました。 新しいポリシー と古いポリシー の行動確率の比を と定義します。
(※更新前は方策が同じなので となります)
TRPOは、この確率比を用いた目的関数 を、KLダイバージェンスを用いた厳密な制約の下で最大化することで、方策の崩壊を防ぎました。しかし、その計算プロセスは非常に複雑なものでした。
この は、TRPOの記事における「ペナルティからハード制約へ」 で解説した以下の「サロゲート目的関数」と全く同じ数式です。
PPO論文では、この方策勾配法と重要度サンプリングを組み合わせた式を "Conservative Policy Iteration (CPI)" に由来して と呼んでいます。
PPOは、TRPOの「確率比 を用いる」という良いアイデアを引き継ぎつつ、複雑な制約計算の代わりに、「確率比 の値そのものを一定範囲内にクリッピング(制限)してしまえば、安全に更新できるのではないか?」 という極めてシンプルなアプローチを採用しました。
このアイデアを数式で表した、PPOのメインの目的関数は以下の式になります。
ここで、 はハイパーパラメータ(例:)です。この目的関数の設計には以下のようなモチベーションがあります。
- の中の最初の項 は、TRPOでもベースとなっているConservative Policy Iteration (CPI) の目的関数です。制約なしにこれを最大化すると、ポリシーの過度な更新を招いてしまいます。
- の中の2つ目の項 は、確率比をクリップすることで、 が区間 の外へ移動するインセンティブを取り除きます。
- これら2つの項の最小値()をとることで、最終的な目的関数はクリップされていない目的関数の下限(つまり悲観的なバウンド)となります。
このスキームの巧妙な点は、「目的関数を改善させるような確率比の変更(大きすぎる更新)のみを無視し、目的関数を悪化させるような変更はそのまま含める」 という点にあります。これにより、大きすぎるポリシーの更新(学習の崩壊)を防ぎつつ、安全な範囲内で最大限の改善を行うことができます。
具体例:クリッピングはどのように働くのか?
この数式が実際にどのように「行き過ぎた更新だけを無視し、悪化にはペナルティを与える」のか、 (クリップ範囲 )とした時の具体的な数値例で確認してみましょう。
【ケース1】 アドバンテージがプラス():良かった行動なので確率を上げたい場合
| 新しい確率比 | 本来のスコア | クリップされたスコア | 最小値 の結果 | 勾配(学習の挙動) |
|---|---|---|---|---|
| (適度に上げた) | 学習する(そのままスコアが伸びる) | |||
| (上げすぎた) | 学習ストップ(12で頭打ちになり、これ以上確率を上げても勾配が0になる) | |||
| (なぜか下げた) | ペナルティ(悪化する方向への更新はそのまま反映される) |
【ケース2】 アドバンテージがマイナス():悪かった行動なので確率を下げたい場合
| 新しい確率比 | 本来のスコア | クリップされたスコア | 最小値 の結果 | 勾配(学習の挙動) |
|---|---|---|---|---|
| (適度に下げた) | 学習する(そのままスコアが伸びる) | |||
| (下げすぎた) | 学習ストップ(-8で頭打ちになり、これ以上確率を下げても勾配が0になる) | |||
| (なぜか上げた) | ペナルティ(悪化する方向への更新はそのまま反映される) |
このように、単なるハードクリッピング(上限・下限を強制的にカットするだけ)ではなく 関数を組み合わせることで、「安全な範囲()での更新は許可し、それを超えてさらに良くしようとする欲張った更新は無視する。ただし、状況を悪化させるような更新に対しては一切容赦せずペナルティ(マイナスの勾配)を与える」という非常に賢い非対称な挙動を実現しているのです。
2つの表の数値を、確率比 に対する目的関数のグラフに置くと、次のようになります。
(図は、diagram-designで作成)
Adaptive KL Penalty Coefficientについて
PPOの論文では、クリッピングの代替として、TRPOのようにKLダイバージェンスへのペナルティを目的関数(方策勾配)から直接差し引く手法(Adaptive KL Penalty)も提案されています。数式にすると以下のようになります(論文の式(8))。
ここで問題となるのが、ペナルティの強さを決める係数 をいくつに設定すべきかです。この手法(Adaptive KL Penalty)では、 を固定せず、更新による実際のKLダイバージェンスの大きさ()が、人間があらかじめ設定した「方策の変化をこれくらいに抑えたい」という目標値となるハイパーパラメータ() に収まるように、 を適応的(Adaptive)に調整します。 具体的には、数エポックの学習の直後に実際のKLダイバージェンスの平均値 を計算し、 と を比較して以下のルールで次回の を更新します。
- の場合(方策が全然変化していない): ペナルティが強すぎるので を半分にする。
- の場合(方策が変化しすぎている): ペナルティが弱すぎるので を2倍にする。
このように動的に を調整して を達成しようと試みますが、実験の結果、このKLペナルティを用いた手法はクリップされたサロゲート目的関数(CLIP)よりもパフォーマンスが劣ることが分かっています。そのため、現在広く使われているPPOの実装のほとんどはCLIPを採用しています。
β を調整するルールを図にすると、次のようになります。
(図は、diagram-designで作成)
ここで提案されている「Adaptive KL Penalty」は、PPO単体で方策の更新幅を制限する(TRPOの信頼領域制約をペナルティ項で代替する)ためのものであり、CLIPに劣るため現在ではほぼ使われません。
しかし、大規模言語モデル(LLM)を人間からのフィードバック(RLHF)で学習させる文脈(InstructGPT など)においては、これとは異なる目的で「KLペナルティ」が極めて重要な役割を果たします。 RLHFにおけるKLペナルティは、学習中のモデル(方策)が初期の教師あり微調整(SFT)モデルから離れすぎて、言語能力が破綻したり(言語の崩壊)、報酬モデルの弱点を突く「報酬ハッキング(Reward Hacking)」を起こしたりするのを防ぐために、報酬関数(目的関数)に直接差し引くペナルティとして追加されます。
PPO単体での「方策更新制限」としてのKLペナルティ(本論文)と、RLHFにおける「初期モデルからの逸脱抑制」としてのKLペナルティは、目的も数式上の組み込み位置も異なるため、混同しないよう注意が必要です。詳しくは後述の補足セクションで解説します。
PPOの構成技術要素(詳細)
PPOをActor-Criticアーキテクチャで実装し、ポリシーと価値関数でニューラルネットワークのパラメータを共有する場合、単一の損失関数を構成して最適化を行います。この目的関数は以下の3つの要素を結合したものです。
- ポリシーサロゲート損失 (): 前述のクリップされた目的関数です。行動の良し悪し(アドバンテージ)に基づいてポリシーを更新します。
- 価値関数の誤差 (): 状態価値関数の予測精度を高めるための二乗誤差損失です。 として計算されます。係数 によって重み付けされます。(※この式は、A2Cの記事における と全く同じものです。論文上の表記として「実際に得られた収益()」を「予測ターゲット()」と呼んでいるだけで、中身は同じ平均二乗誤差です)
- エントロピーボーナス (): 十分な探索を確保するために追加される項です。ポリシーの出力する確率分布のエントロピー を加算し、係数 で重み付けします。これにより、ポリシーが早すぎる段階で決定論的になる(局所解に陥る)のを防ぎます。(※これも、A2Cの記事で解説した「エントロピー正則化」と全く同じ仕組みです。PPO論文ではエントロピーの記号として の代わりに を用い、重み係数を の代わりに と表記しているだけです)
大規模言語モデル(LLM)アライメントへの応用:InstructGPTへの橋渡し
PPOは元々、ロボット制御やAtariのゲームプレイなど、一般的な強化学習タスクのために開発されましたが、現在では大規模言語モデル(LLM)を人間にアライメントさせる「RLHF(人間からのフィードバックによる強化学習)」の基盤技術として広く知られています(例:ChatGPTのベースとなったInstructGPT)。
PPOがLLMの学習で選ばれる理由
LLMのテキスト生成における行動空間(語彙サイズ)は数万に及びます。この巨大な空間で方策勾配法を行うと、わずかな更新でモデルが全く意味不明な言語を生成する「言語崩壊」に陥る危険性が極めて高くなります。PPOの 「クリップされたサロゲート目的関数」 は、この巨大な行動空間においても方策の急激な変化に強力なブレーキをかけるため、極めて安全で安定した学習(ファインチューニング)を可能にします。
LLMへの適用時の対応関係
LLMにPPOを適用する場合、強化学習の各要素は以下のように対応します。
| 強化学習の用語 | 言語モデル(LLM)における対応 |
|---|---|
| 状態 | プロンプトと、そこまでに生成したトークン列 |
| 行動 | 次に選択する1つのトークン |
| 方策 | 言語モデルそのもの(次トークンの出力確率分布) |
| 報酬 | 報酬モデルのスコア + ペナルティ項(後述) |
| エピソード | 1つの応答文が完成する(EOSトークンの生成や最大長到達)まで |
InstructGPTに向けた重要な注意点(KLペナルティの意味合い)
PPO単体の理論では、本記事で解説したように、方策の更新幅を制限するために「Adaptive KL Penalty」という手法も提案されていましたが、CLIP(クリッピング)の方が優秀であると結論づけられました。
しかし、InstructGPTなどのRLHFにおいては、「KLペナルティ」が全く別の重要な目的で復活します。 RLHFでは、不完全な報酬モデルを最適化しようとするため、言語モデルが報酬モデルの裏をかいて異常な文章で高得点を稼ごうとする 「報酬ハッキング」 が発生します。これを防ぐため、学習前の初期モデル(SFTモデル)から出力分布が離れすぎないように、報酬そのものからKLダイバージェンスを差し引くという処理を行います。
PPOはこの「ペナルティ付きの報酬」を最大化するように、通常のクリッピング目的関数を用いて安全にモデルを更新します。このように、PPOの強固な最適化能力は、最新のLLM開発において不可欠なエンジンとなっています。
PPO 論文の KL ペナルティと RLHF の KL ペナルティの違いを並べると、次のようになります。
(図は、diagram-designで作成)
このRLHFの具体的な枠組みと、PPOがどのように人間の意図を反映させるのかについては、InstructGPTの記事で解説しています。
実装における重要ノウハウ:直交重み初期化(Orthogonal Initialization)
後述するPPOのシンプルな実装例にも組み込まれていますが、PPOを実際に安定して動作させるための重要なノウハウとして「直交重み初期化(Orthogonal Initialization)」があります。
PPOの原論文自体には詳細な記載はありませんが、後年に公開されたOpenAI Baselinesの実装などを通じて、PPOの性能を引き出すためのデファクトスタンダードとして広く認知されるようになりました。
直交初期化の理論的背景
直交行列とは、転置行列が逆行列になる()ような行列のことです。ニューラルネットワークの重み行列 を直交行列で初期化することには、以下のような数学的な利点があります。
- ノルムの保存(勾配消失・爆発の防止): 直交行列をベクトルに掛けても、そのベクトルの長さ(ノルム)は変化しません。つまり、深い層を経由しても信号が減衰したり発散したりするのを防ぐことができます。これにより、学習の初期段階から安定した勾配がネットワーク全体に伝わります。
- 特徴量の独立性: 直交する重みベクトルは、入力に対して互いに無相関な(独立した)特徴を抽出するように機能します。これにより、ネットワークの表現力を効率よく活用し、学習の効率を高めることができます。
PPOにおける具体的な活用
PPOの実装では、単に直交行列で初期化するだけでなく、層の役割(ActorかCriticか、隠れ層か出力層か)に応じて出力のスケール(標準偏差 std)を適切に調整する手法が一般的に用いられます。
- 隠れ層: 通常のスケール(例:活性化関数が の場合は など)で直交初期化を行い、安定した特徴抽出を促します。
- Actorの出力層(方策): スケールを非常に小さく(例:
std=0.01)して初期化します。これにより、学習開始時の各行動の選択確率がほぼ均等(一様分布に近い状態)になり、方策のエントロピーが最大化されます。初期段階で特定の行動に偏ることなく、幅広い探索を行うために極めて重要です。 - Criticの出力層(状態価値): スケールを
std=1.0などとし、予測価値の初期スケールを維持します。
本記事の ActorCritic で、層ごとの倍率を図にすると次のようになります。
(図は、diagram-designで作成)
これらの工夫は、PPOのアルゴリズム自体の数式(目的関数のクリッピング等)と同じくらい、最終的なパフォーマンスと学習の安定性に大きな影響を与えることが経験的に分かっています。実際、Engstrom et al. (2020) の "Implementation Matters in Deep Policy Gradients" などの研究により、直交初期化をはじめとするコードレベルの実装詳細がPPOの性能に極めて大きな影響を与えていることが実証されています。
PPOの実装(概念的なシンプルな実装)
ここでは、論文に記載されている Algorithm 1 (Actor-Critic Style) に基づく、PyTorchを用いたPPOのシンプルな概念実装を示します。
ライブラリのインストール
Gymnasiumなどの強化学習環境とPyTorchをインストールします。
!pip install torch numpy gymnasium
!pip install stable-baselines3[extra] sb3-contrib matplotlib # 比較のTRPOの利用に必要
モデルの定義 (Actor-Critic Network)
以下のコードでは、PyTorchを用いてPPOのActor-Criticネットワークを実装します。方策(行動の確率分布)を出力するActorと、状態価値を出力するCriticを、同じ構造の独立したネットワークとして定義しています。 ネットワークの層構成(64ユニットの2層隠れ層とtanh活性化関数)と、ActorとCriticでパラメータを共有しない作りは、PPO原論文のMuJoCoの実験の設定に合わせています。それに加えて、後年のOpenAI Baselines実装等で広く知られるようになった直交重み初期化(Orthogonal Initialization) も組み込んでいます。
import torch
import torch.nn as nn
from torch.distributions import Categorical
import gymnasium as gym
import numpy as np

# --- 1. デバイス設定 ---
# ネットワークが小さく(64 ユニット × 2 層)、1 ステップずつ環境とやり取りするので、GPU に送る手間の方が大きい。CPU で計算する
device = torch.device('cpu')

# --- 2. 直交重み初期化関数 ---
# 重みを直交行列で初期化し、std 倍する。バイアスは 0 にする
def layer_init(layer, std=np.sqrt(2), bias_const=0.0):
    torch.nn.init.orthogonal_(layer.weight, std)
    torch.nn.init.constant_(layer.bias, bias_const)
    return layer

# --- 3. クラス定義 ---
# 論文の MuJoCo の実験と同じく、方策(Actor)と価値(Critic)を別々のネットワークにする(隠れ層は 64 ユニット × 2 層、tanh)
class ActorCritic(nn.Module):
    def __init__(self, state_dim, action_dim):
        super(ActorCritic, self).__init__()
        # 隠れ層は std=√2(tanh の層でよく使われる値)。Actor の出力層は std=0.01 にして、最初は各行動の確率をほぼ等しくする
        self.actor = nn.Sequential(
            layer_init(nn.Linear(state_dim, 64)),
            nn.Tanh(),
            layer_init(nn.Linear(64, 64)),
            nn.Tanh(),
            layer_init(nn.Linear(64, action_dim), std=0.01),
            nn.Softmax(dim=-1)
        )
        # Critic の出力層は std=1.0(価値の予測を小さくしすぎない)
        self.critic = nn.Sequential(
            layer_init(nn.Linear(state_dim, 64)),
            nn.Tanh(),
            layer_init(nn.Linear(64, 64)),
            nn.Tanh(),
            layer_init(nn.Linear(64, 1), std=1.0)
        )

    def act(self, state):
        """データを集めるときに使う:行動をサンプリングし、その対数確率と状態価値も返す"""
        action_probs = self.actor(state)
        dist = Categorical(action_probs)
        action = dist.sample()
        return action.detach(), dist.log_prob(action).detach(), self.critic(state).detach()

    def evaluate(self, state, action):
        """更新するときに使う:集めた状態と行動について、今のネットワークでの対数確率・価値・エントロピーを計算し直す"""
        action_probs = self.actor(state)
        dist = Categorical(action_probs)
        return dist.log_prob(action), self.critic(state), dist.entropy()
- ActorとCriticを分ける:論文のMuJoCoの実験では、方策と価値関数でパラメータを共有していません。共有しない場合、損失を足し合わせても、Actorの重みには方策の損失とエントロピーの勾配だけが、Criticの重みには価値の損失の勾配だけが流れます。
- 直交初期化と出力層の大きさ:layer_init で、すべての線形層を直交初期化します。Actorの出力層を std=0.01 と小さくするのは、学習の最初に各行動の確率をほぼ等しくして(エントロピーがほぼ最大の状態)、特定の行動に偏らずに探索させるためです。Criticの出力層は std=1.0 にして、予測する価値の大きさを小さくしすぎないようにします。
- act と evaluate を分ける:act はデータを集めるときに使い、行動と一緒に、その時点の方策での対数確率と状態価値を、勾配を切って(detach())返します。これが確率比の分母 とGAEの になります。evaluate は更新のときに使い、同じ状態と行動について、更新中のネットワークでの対数確率・価値・エントロピー(dist.entropy())を計算し直します。
- CPUで計算する:ネットワークが小さく、環境とは1ステップずつやり取りするので、GPUに送る手間の方が大きくなります。
Rollout Bufferの定義
環境との相互作用で得られたタイムステップのデータを一時的に保存するためのバッファクラスです。
class RolloutBuffer:
    def __init__(self):
        # 1 回の更新に使う T ステップ分の遷移を、ステップの順に並べて持つ
        # is_terminals はエピソードの区切り(ポールが倒れた、または 500 ステップで打ち切られた)を表す
        self.states, self.actions, self.logprobs, self.rewards, self.is_terminals, self.values = [], [], [], [], [], []

    def clear(self):
        # PPO はオンポリシーなので、更新に使ったデータは捨てる(次は更新後の方策でデータを集め直す)
        self.states.clear(); self.actions.clear(); self.logprobs.clear(); self.rewards.clear(); self.is_terminals.clear(); self.values.clear()
- 集めた時点の値を保存する:状態(states)・行動(actions)に加えて、集めた時点の方策での対数確率(logprobs)と状態価値(values)も保存します。更新中にネットワークが変わっても、確率比の分母とGAEには、データを集めた方策の値を使う必要があるためです。
- 使い終わったら捨てる:PPOはオンポリシーのアルゴリズムなので、K_epochs 回の更新に使ったデータは clear で捨て、更新後の方策でデータを集め直します。
PPOアルゴリズムのコア実装 (Algorithm 1)
クリップされた目的関数、価値関数の損失、エントロピーボーナスを組み合わせた最適化ステップを定義します。
以下のコードでは、データのサンプリングに伴う行動選択処理、一般化アドバンテージ推定(GAE)による目標リターンとアドバンテージの計算、およびクリップされた目的関数・価値関数損失・エントロピーボーナスを組み合わせた損失の最小化を、PPO クラスにまとめます。
class PPO:
    # lr・gamma・lam・K_epochs・batch_size は論文の MuJoCo の実験(Table 3)、eps_clip=0.2 は論文の Table 1 で最もよかった値
    def __init__(self, state_dim, action_dim, lr=3e-4, gamma=0.99, lam=0.95, K_epochs=10, eps_clip=0.2, batch_size=64):
        self.gamma = gamma
        self.lam = lam
        self.eps_clip = eps_clip
        self.K_epochs = K_epochs
        self.batch_size = batch_size

        self.buffer = RolloutBuffer()

        self.policy = ActorCritic(state_dim, action_dim).to(device)
        # eps=1e-5 は OpenAI Baselines と Stable Baselines3 の PPO の設定(PyTorch の既定は 1e-8)
        self.optimizer = torch.optim.Adam(self.policy.parameters(), lr=lr, eps=1e-5)

        # データを集める方策 π_θold。更新のあいだは固定し、確率比の分母に使う
        self.policy_old = ActorCritic(state_dim, action_dim).to(device)
        self.policy_old.load_state_dict(self.policy.state_dict())
        self.MseLoss = nn.MSELoss()

    def select_action(self, state):
        with torch.no_grad():
            state = torch.FloatTensor(state).to(device)
            action, action_logprob, state_value = self.policy_old.act(state)

        # 更新のときに必要になる値(状態・行動・π_θold の対数確率・状態価値)を、集めた時点の方策で保存しておく
        self.buffer.states.append(state)
        self.buffer.actions.append(action)
        self.buffer.logprobs.append(action_logprob)
        self.buffer.values.append(state_value)
        return action.item()

    def update(self, next_state, next_done):
        # テンソル化
        old_states = torch.squeeze(torch.stack(self.buffer.states)).to(device)
        old_actions = torch.squeeze(torch.stack(self.buffer.actions)).to(device)
        old_logprobs = torch.squeeze(torch.stack(self.buffer.logprobs)).to(device)
        values = torch.squeeze(torch.stack(self.buffer.values)).to(device)
        rewards = torch.tensor(self.buffer.rewards, dtype=torch.float32).to(device)
        dones = torch.tensor(self.buffer.is_terminals, dtype=torch.float32).to(device)

        # 最後のステップの次の状態の価値(T ステップ目で区切ったエピソードの続きを、V で見積もるため)
        with torch.no_grad():
            next_state = torch.FloatTensor(next_state).to(device)
            next_value = self.policy_old.critic(next_state).squeeze()

        # --- GAE (Generalized Advantage Estimation) の計算 ---
        # 後ろから A_t = δ_t + γλ A_{t+1} を順に求める。エピソードの区切りでは、次のエピソードの値を足さない(nextnonterminal = 0)
        advantages = torch.zeros_like(rewards).to(device)
        lastgaelam = 0
        for t in reversed(range(len(rewards))):
            if t == len(rewards) - 1:
                nextnonterminal = 1.0 - next_done
                nextvalues = next_value
            else:
                # dones[t] は、ステップ t の行動でエピソードが終わったかどうか
                nextnonterminal = 1.0 - dones[t]
                nextvalues = values[t+1]
            delta = rewards[t] + self.gamma * nextvalues * nextnonterminal - values[t]
            advantages[t] = lastgaelam = delta + self.gamma * self.lam * nextnonterminal * lastgaelam
        # 価値関数の学習の目標 V_t^targ = A_t + V(s_t)
        returns = advantages + values

        b_inds = np.arange(len(old_states))

        # --- シャッフルを伴うミニバッチ学習 ---
        # 同じ T ステップのデータを K_epochs 回使う。毎回並べ替えて、batch_size ずつに分けて更新する
        for _ in range(self.K_epochs):
            np.random.shuffle(b_inds)
            for start in range(0, len(old_states), self.batch_size):
                end = start + self.batch_size
                mb_inds = b_inds[start:end]

                logprobs, state_values, dist_entropy = self.policy.evaluate(old_states[mb_inds], old_actions[mb_inds])
                state_values = torch.squeeze(state_values)

                mb_advantages = advantages[mb_inds]
                # ミニバッチ単位でのアドバンテージ正規化(報酬の大きさによらず、更新の大きさをそろえる。Baselines・SB3 と同じ)
                mb_advantages = (mb_advantages - mb_advantages.mean()) / (mb_advantages.std() + 1e-8)

                # --- 1. ポリシーサロゲート損失 (L^{CLIP}) の計算 ---
                # 確率比 r_t(θ) = π_θ(a|s) / π_θold(a|s) を計算
                # 対数の引き算は割り算と同値: exp(log(a) - log(b)) = a / b
                ratios = torch.exp(logprobs - old_logprobs[mb_inds])

                # クリップ前の本来の目的関数 (CPI)
                surr1 = ratios * mb_advantages
                # クリップ後の目的関数(epsilon = eps_clip で制限)
                surr2 = torch.clamp(ratios, 1 - self.eps_clip, 1 + self.eps_clip) * mb_advantages

                # PyTorchのオプティマイザは「最小化」を行うため、符号を反転して負の損失にする
                loss_pi = -torch.min(surr1, surr2).mean()

                # --- 2. 価値関数の二乗誤差損失 (L^{VF}) の計算 ---
                # 予測価値(state_values)をターゲット(returns)に近づける MSE
                # 係数 c_1 = 0.5 は Baselines・SB3 の既定値(論文の Atari の実験は c_1 = 1)
                loss_v = 0.5 * self.MseLoss(state_values, returns[mb_inds])

                # --- 3. エントロピーボーナス (S) の計算 ---
                # 方策が早く決定的になりすぎないようにするボーナス。最小化する損失なのでマイナスをつける
                # 係数 c_2 = 0.01 は論文の Atari の実験の値
                loss_ent = -0.01 * dist_entropy.mean()

                # --- 損失の結合と最適化 ---
                # L^{CLIP+VF+S} の最大化 = (-L^{CLIP}) + c_1 * L^{VF} - c_2 * S の最小化
                loss = loss_pi + loss_v + loss_ent

                self.optimizer.zero_grad()
                loss.backward()
                # 勾配のノルムを 0.5 までに抑える(目的関数のクリッピングとは別物。0.5 は Baselines・SB3 の既定値)
                nn.utils.clip_grad_norm_(self.policy.parameters(), 0.5)
                self.optimizer.step()

        # 更新が終わったら、次にデータを集める方策を新しい方策にそろえる
        self.policy_old.load_state_dict(self.policy.state_dict())
        self.buffer.clear()
PPO クラスは、PPOアルゴリズムにおける「行動の選択」と「方策および価値ネットワークのパラメータ更新」のコアプロセスを担当します。
1. 行動の選択 (select_action)
エージェントが環境の中で探索を行う際、古い方策(policy_old)を用いて行動を決定します。with torch.no_grad() で勾配計算を無効にし、サンプリングされた行動や対数確率、状態価値予測を RolloutBuffer(self.buffer)に保存してから、ゲーム環境に渡すためにスカラ値に変換して返します。
2. GAE (Generalized Advantage Estimation) によるアドバンテージの計算
update メソッドでは、バッファに溜まった ステップ分のデータをテンソルに変換した後、一般化アドバンテージ推定(GAE)を用いて各ステップのアドバンテージ と目標状態価値(予測ターゲット)である収益(Returns)を計算します。 数式で定義された以下の関係式:
は、コード内で reversed(range(len(rewards))) のループを用いて時系列の逆順から動的に計算されています。変数 delta が に対応し、累積された lastgaelam が を表します。この時系列の逆順による実装は、二重ループを避けて計算を効率化する定石です。
3. ミニバッチを用いた複数エポックの最適化
PPOの特徴的な要素として、1回に集めた ステップ分のデータを複数回(K_epochs 回)再利用して学習を繰り返す点が挙げられます。バッファ内のデータインデックスをシャッフルした上で、指定した batch_size ごとに以下の損失(目的関数)を計算します。
- 確率比(Probability Ratio)の算出: は、対数確率の差の指数をとる形で計算されます: ratios = torch.exp(logprobs - old_logprobs[mb_inds]) 対数における引き算 の性質を利用し、 となるため、この計算は数学的に確率比 と等価です。
- ポリシー損失(サロゲート損失 ): に対応するコードは以下のように実装されています。 surr1 = ratios * mb_advantages surr2 = torch.clamp(ratios, 1 - self.eps_clip, 1 + self.eps_clip) * mb_advantages loss_pi = -torch.min(surr1, surr2).mean() 最適化(Adam)は最小化を目指すため、最大化を目的とする にマイナスを掛け合わせて損失 loss_pi としています。これにより、確率比 の極端な変動による方策の急激な変化にブレーキがかけられます。
- 価値関数の二乗誤差損失 (): loss_v = 0.5 * self.MseLoss(state_values, returns[mb_inds]) これは Critic ネットワークの予測精度を向上させ、収益目標に近づけるためのMSE(平均二乗誤差)です。係数 に相当する 0.5 が掛けられています。
- エントロピーボーナス (): loss_ent = -0.01 * dist_entropy.mean() これは方策のランダム性を確保し、早期の局所解への収束(探索の枯渇)を防ぐ役割を持ちます。係数 は 0.01 としています。
- 総合損失(統合目的関数 ): の最大化を最小化に変換した: loss = loss_pi + loss_v + loss_ent を計算し、誤差逆伝播(loss.backward())を実行します。この際、nn.utils.clip_grad_norm_ を用いて勾配のL2ノルムが を超えないようクリッピング(Gradient Clipping)を施し、勾配爆発を抑止しています。
1回の更新で、3つの項の損失を計算して重みを更新するまでの流れを図にまとめます。
(図は、diagram-designで作成)
4. 本来のPPO(実用的実装)との異なる箇所
このシンプルなスクラッチ実装は、PPOのアルゴリズムを原理から理解するために設計された「概念モデル」であり、Stable Baselines3などの実用的なプロダクション用ライブラリで採用されている本来のPPOとは、主に以下の点で異なります。
- 並列環境(Vectorized Environments)の非対応: 本来のPPOは、複数の独立した環境(アクター)を並列で実行し、それぞれからデータを同時に収集(マルチスレッドやマルチプロセス処理)することでデータの多様性を確保します。本スクラッチ実装では、シングルプロセスで1つの環境から逐次的にデータを収集しています。
- 状態(Observation)と報酬(Reward)の正規化・スケーリング: OpenAI BaselinesのMuJoCo用の設定などでは、状態ベクトルを平均 、分散 に正規化したり、報酬のスケールを調整したりします(Stable Baselines3では VecNormalize を使うと有効になり、既定では使いません)。本コードではこれらを使わず、生の環境データをそのまま流しています。
- 価値関数(Critic)のクリッピング: 方策(Actor)の確率比のクリッピングと同様に、価値関数(Critic)の予測値 に対しても、更新前の予測値から大きく逸脱しないようにクリッピングを適用する仕組み(Value Function Clipping)があります。OpenAI Baselinesでは使われていますが、Stable Baselines3では既定で使いません(clip_range_vf=None)。本実装でも使わず、単純な MSE で最適化しています。
- 学習率の線形減衰(Learning Rate Decay): 論文のAtariの実験では、学習率とクリップの幅 を、学習の進み具合に応じて に向けて線形に小さくしています。MuJoCoの実験の設定(Table 3)とStable Baselines3の既定は固定値なので、本実装も固定値の lr=3e-4 を最後まで使います。
5. 値の決め方(論文・Stable Baselines3との対応)
コードの値は、論文のMuJoCoの実験の設定を基本にし、論文にない値はOpenAI BaselinesとStable Baselines3の既定値に合わせています。
| 値 | 論文:MuJoCo(Table 3) | 論文:Atari(Table 5) | 本記事のスクラッチ実装 | Stable Baselines3 の既定値 |
|---|---|---|---|---|
| 1回に集めるステップ数 | 2048 | 128(× 8アクター) | 2048 | 2048 |
| 学習率 | ||||
| エポック数 | 10 | 3 | 10 | 10 |
| ミニバッチの大きさ | 64 | 32 × 8 | 64 | 64 |
| / | 0.99 / 0.95 | 0.99 / 0.95 | 0.99 / 0.95 | 0.99 / 0.95 |
| クリップの幅 | 0.2 | 0.2 | 0.2 | |
| 価値の損失の係数 | (共有しないので不要) | 1 | 0.5 | 0.5 |
| エントロピーの係数 | (使わない) | 0.01 | 0.01 | 0.0 |
| 勾配のノルムの上限 | 記載なし | 記載なし | 0.5 | 0.5 |
は、学習の進み具合に応じて1から0に下げる係数です。エントロピーボーナスはSB3の既定(0.0)と違いますが、損失の3つの項をすべてコードで示すため、論文のAtariの実験の値を入れています。
訓練ループ
以下のコードでは、これまでに定義した PPO エージェントを、Gymnasiumの CartPole-v1 環境で学習させます。
def train_ppo_scratch(seed, total_timesteps=100_000, update_timestep=2048, log=True):
    """スクラッチの PPO を CartPole-v1 で学習し、エピソードが終わった時点の (累計ステップ数, スコア) のリストを返す"""
    # 乱数を固定する(ネットワークの初期値・行動のサンプリング・ミニバッチの並べ替え・環境の初期状態)
    torch.manual_seed(seed)
    np.random.seed(seed)
    env = gym.make("CartPole-v1")
    state_dim = env.observation_space.shape[0]   # 4(カートの位置・速度、ポールの角度・角速度)
    action_dim = env.action_space.n              # 2(左に押す・右に押す)
    ppo_agent = PPO(state_dim, action_dim)

    state, _ = env.reset(seed=seed)
    episode_score, episode_count = 0, 0
    history = []

    for time_step in range(1, total_timesteps + 1):
        action = ppo_agent.select_action(state)
        next_state, reward, terminated, truncated, _ = env.step(action)
        episode_score += reward

        if truncated and not terminated:
            # 500 ステップで打ち切られただけで、ポールはまだ立っている。続きの価値 γV(s_{t+1}) を報酬に足して、
            # 「ここで終わり(その先の価値は 0)」と扱わないようにする(Stable Baselines3 と同じ扱い)
            with torch.no_grad():
                reward += ppo_agent.gamma * ppo_agent.policy_old.critic(torch.FloatTensor(next_state)).item()
        ppo_agent.buffer.rewards.append(reward)
        ppo_agent.buffer.is_terminals.append(terminated or truncated)

        if time_step % update_timestep == 0:
            # T ステップたまったら更新する。GAE の計算に、次の状態とエピソードの区切りを渡す
            ppo_agent.update(next_state, terminated or truncated)

        state = next_state
        if terminated or truncated:
            episode_count += 1
            history.append((time_step, episode_score))
            if log and episode_count % 50 == 0:
                print(f"PPO エピソード {episode_count}({time_step:,} ステップ): スコア {episode_score}")
            state, _ = env.reset()
            episode_score = 0
    return history


print("--- PPO (スクラッチ) 学習開始 ---")
# 10 万ステップは、Stable Baselines3 の調整済み設定(RL Zoo)の CartPole-v1 の学習ステップ数
ppo_history = train_ppo_scratch(seed=0)
print("--- PPO (スクラッチ) 学習完了 ---")
この訓練ループでは、Gymnasiumの代表的なタスクである CartPole-v1 環境で、これまでに定義した PPO エージェントを学習させます。あとでシードを変えて何度も学習させるので、1回の学習を関数 train_ppo_scratch にまとめています。
- 乱数を固定する:ネットワークの初期値、行動のサンプリング、ミニバッチの並べ替え、環境の初期状態がすべて乱数で決まります。シードを固定しないと、同じコードでも実行のたびに学習の進み方が変わり、手法の違いなのか運なのかを区別できません。
- ステップごとに更新する:update_timestep=2048 は、論文のMuJoCoの実験の (Table 3)と同じ値です。Stable Baselines3のPPOの既定値(n_steps=2048)とも同じなので、後半のSB3との比較でもデータの集め方がそろいます。
- 500ステップの打ち切りを、ポールが倒れた終わりと区別する:CartPole-v1は、ポールが倒れると terminated、倒れずに500ステップ続くと truncated になります。打ち切りは時間切れにすぎず、その先もポールは立っていられるので、続きの価値は0ではありません。そこで、打ち切られたステップでは、報酬に を足してから保存します(Stable Baselines3と同じ扱い)。これをしないと、上手になって500ステップ続くほど「最後の状態の価値は0」という誤った目標を学ぶことになります。
- エピソードの区切りを保存する:is_terminals には、倒れた場合と打ち切られた場合のどちらでも True を入れます。GAEの計算で、次のエピソードの最初の状態の価値を、前のエピソードの続きとして足さないようにするためです(打ち切りの続きの価値は、上で報酬に入れてあります)。
- 記録はステップ数と組にする:エピソードが終わるたびに、それまでの累計ステップ数とスコアを history に入れます。上手な方策ほど1エピソードが長いので、エピソード数ではなく、環境とやり取りした回数(ステップ数)で手法を比べるためです。
- 学習するステップ数は10万:Stable Baselines3の調整済みの設定集(RL Zoo)が、CartPole-v1のPPOに使っているステップ数です。
PPO(スクラッチ)の実行結果
--- PPO (スクラッチ) 学習開始 ---
PPO エピソード 50(1,120 ステップ): スコア 23.0
PPO エピソード 100(2,114 ステップ): スコア 14.0
PPO エピソード 150(3,482 ステップ): スコア 22.0
PPO エピソード 200(4,796 ステップ): スコア 12.0
PPO エピソード 250(7,088 ステップ): スコア 17.0
PPO エピソード 300(11,878 ステップ): スコア 127.0
PPO エピソード 350(24,921 ステップ): スコア 254.0
PPO エピソード 400(48,306 ステップ): スコア 500.0
PPO エピソード 450(73,306 ステップ): スコア 500.0
PPO エピソード 500(98,306 ステップ): スコア 500.0
--- PPO (スクラッチ) 学習完了 ---
最初の250エピソード(約7,000ステップ)はスコアが数十にとどまっています。その後スコアが伸び、400エピソード目(約48,000ステップ)以降は、CartPole-v1の上限である500を出し続けています。エピソード数で見ると最初の250エピソードが長く見えますが、使ったステップ数では全体の1割にもなりません。うまくなるほど1エピソードが長くなるためで、後で手法を比べるときに横軸をステップ数にする理由です。
エピソードの区切りを累計ステップ数の上に置くと、次のようになります。
(図は、diagram-designで作成)
比較のTRPOの実装
以下のコードでは、PPOの先行研究であり、より厳密な信頼領域(Trust Region)の制約を課すTRPO(Trust Region Policy Optimization)を、強化学習ライブラリの拡張パッケージである sb3-contrib から使い、同じ CartPole-v1 で学習させます。
from sb3_contrib import TRPO
from stable_baselines3.common.callbacks import BaseCallback

# エピソードが終わるたびに (累計ステップ数, スコア) を記録するコールバック(スクラッチの PPO と同じ形の記録にする)
class ScoreCallback(BaseCallback):
    def __init__(self, algo_name, print_freq=50, log=True, verbose=0):
        super().__init__(verbose)
        self.algo_name = algo_name
        self.print_freq = print_freq
        self.log = log
        self.history = []
        self.current_score = 0

    def _on_step(self) -> bool:
        # SB3 は環境をベクトル化環境(ここでは 1 つ)として扱うので、[0] で取り出す
        self.current_score += float(self.locals["rewards"][0])
        # dones は、ポールが倒れた場合と 500 ステップで打ち切られた場合のどちらでも True になる
        if self.locals["dones"][0]:
            self.history.append((self.num_timesteps, self.current_score))
            if self.log and len(self.history) % self.print_freq == 0:
                print(f"{self.algo_name} エピソード {len(self.history)}({self.num_timesteps:,} ステップ): スコア {self.current_score}")
            self.current_score = 0
        return True


def train_sb3(algo_cls, algo_name, seed, total_timesteps=100_000, log=True, **kwargs):
    """Stable Baselines3 のアルゴリズムを CartPole-v1 で学習し、(累計ステップ数, スコア) のリストを返す"""
    # 小さなネットワークなので、スクラッチの PPO と同じく CPU で計算する(SB3 も MLP の方策では CPU を勧めている)
    model = algo_cls("MlpPolicy", gym.make("CartPole-v1"), seed=seed, device="cpu", verbose=0, **kwargs)
    callback = ScoreCallback(algo_name, log=log)
    model.learn(total_timesteps=total_timesteps, callback=callback)
    return callback.history


print("--- TRPO (sb3-contrib) 学習開始 ---")
# TRPO の設定は sb3-contrib の既定値のまま。ステップ数は PPO と同じ 10 万
trpo_history = train_sb3(TRPO, "TRPO", seed=0)
print("--- TRPO (sb3-contrib) 学習完了 ---")
このコードでは、Stable Baselines3の拡張パッケージ(sb3-contrib)にある TRPO を、PPOと同じ CartPole-v1 で学習させます。
- 記録の形をスクラッチのPPOとそろえる:ScoreCallback は、エピソードが終わるたびに(累計ステップ数, スコア)を記録します。_on_step は1ステップ進むごとに呼ばれるので、報酬を足し合わせ、dones が True になったところで1エピソード分として記録します。SB3は環境を並列化された形(ここでは1つ)で扱うので、[0] で取り出しています。
- TRPOの設定は既定値のまま:TRPOの性能を引き出すように調整することはしていません。PPOの記事なので、TRPOは「手を加えずに使ったときの比較の相手」にします。ステップ数だけPPOと同じ10万にそろえます。
- CPUで計算する:スクラッチのPPOと同じく、小さなネットワークではGPUに送る手間の方が大きいため、device="cpu" を指定します。SB3も、MLPの方策ではCPUを勧める警告を出します。
TRPO(sb3-contrib)の実行結果
--- TRPO (sb3-contrib) 学習開始 ---
TRPO エピソード 50(1,369 ステップ): スコア 51.0
TRPO エピソード 100(2,607 ステップ): スコア 12.0
TRPO エピソード 150(4,357 ステップ): スコア 46.0
TRPO エピソード 200(6,197 ステップ): スコア 35.0
TRPO エピソード 250(9,996 ステップ): スコア 85.0
TRPO エピソード 300(21,434 ステップ): スコア 460.0
TRPO エピソード 350(44,521 ステップ): スコア 500.0
TRPO エピソード 400(69,521 ステップ): スコア 500.0
TRPO エピソード 450(94,521 ステップ): スコア 500.0
--- TRPO (sb3-contrib) 学習完了 ---
TRPOも、300エピソード目(約21,000ステップ)ごろにスコアが大きく伸び、350エピソード目以降は500を出し続けています。
スコアの可視化と比較
以下のコードでは、スクラッチで実装したPPOとTRPOのスコアの推移を、横軸を累計ステップ数にして重ねて描きます。
import matplotlib.pyplot as plt

plt.figure(figsize=(10, 6))

# 横軸はエピソード数ではなく累計ステップ数にする。上手な方策ほど 1 エピソードが長いので、
# エピソード数でそろえると、使ったデータ量(環境とのやり取りの回数)が方法ごとに違ってしまうため
for history, label in [(ppo_history, "PPO (Scratch)"), (trpo_history, "TRPO (sb3-contrib)")]:
    steps, scores = zip(*history)
    plt.plot(steps, scores, label=label, alpha=0.7)

plt.title("CartPole-v1: PPO vs TRPO Training Scores (seed 0)")
plt.xlabel("Timesteps")
plt.ylabel("Score (Reward Sum)")
plt.legend()
plt.grid(True)
plt.show()
- 横軸を累計ステップ数にする:上手な方策ほど1エピソードが長いので、エピソード数で横軸をそろえると、同じ位置でも使ったデータの量が手法ごとに違ってしまいます。データ効率を比べたいので、環境とやり取りした回数(ステップ数)でそろえます。
- 線を半透明にする:alpha=0.7 にして、2本の線が重なったところも見えるようにします。
上記のコードを実行すると、以下の結果が得られます。
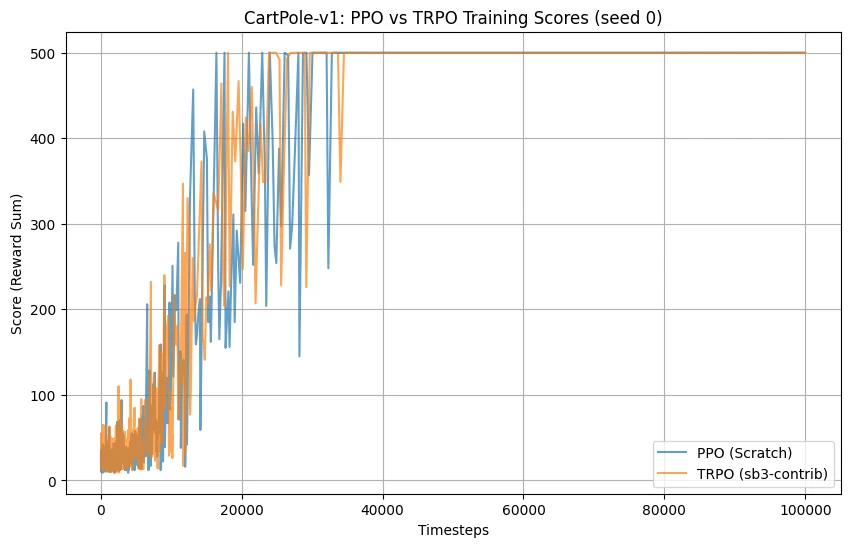
シード0では、どちらも2万〜3万ステップのあたりで500に届き、その後は500を保っています。この1回の学習だけでは、どちらが早いかは言えません。スコアは1エピソードごとに大きく上下するうえ、シードを変えると学習の進み方も変わるからです。そこで、後の節でシードを変えて比べます。
Stable Baselines3による実装
強化学習の分野にも強力で使いやすいライブラリが存在します。その代表格が Stable Baselines3 (SB3) です。 SB3を使用すれば、何百行にも及ぶ実装を数行のコードに抽象化し、整備されたPPOをすぐに利用できます。ライブラリは最初の節でインストールしています。
以下のコードでは、SB3のPPOを、スクラッチの実装と同じ条件(同じ記録の関数・同じステップ数)で学習させます。
from stable_baselines3 import PPO as SB3_PPO   # スクラッチの PPO クラスと名前がぶつからないように別名にする

print("--- PPO (Stable Baselines3) 学習開始 ---")
# 値はどれも SB3 の既定値で、論文の MuJoCo の実験(Table 3)と同じ。何を設定しているかが見えるように、あえて書いている
sb3_ppo_history = train_sb3(
    SB3_PPO, "PPO (SB3)", seed=0,
    learning_rate=3e-4,
    n_steps=2048,
    batch_size=64,
    n_epochs=10,
    clip_range=0.2,
)
print("--- PPO (Stable Baselines3) 学習完了 ---")
- 前の節の関数をそのまま使う:TRPOで使った train_sb3 にPPOのクラスを渡すだけで、記録の形もステップ数もそろいます。
- 値はSB3の既定値:learning_rate=3e-4・n_steps=2048・batch_size=64・n_epochs=10・clip_range=0.2 は、どれもSB3の既定値で、論文のMuJoCoの実験の設定と同じです。書かなくても同じ動きになりますが、スクラッチの実装と同じ設定であることが見えるように書いています。スクラッチの実装との主な違いは、エントロピーボーナスを使わないこと(ent_coef=0.0)です。
実行結果
--- PPO (Stable Baselines3) 学習開始 ---
PPO (SB3) エピソード 50(1,369 ステップ): スコア 51.0
PPO (SB3) エピソード 100(2,756 ステップ): スコア 26.0
PPO (SB3) エピソード 150(4,361 ステップ): スコア 19.0
PPO (SB3) エピソード 200(6,922 ステップ): スコア 161.0
PPO (SB3) エピソード 250(13,603 ステップ): スコア 383.0
PPO (SB3) エピソード 300(29,371 ステップ): スコア 500.0
PPO (SB3) エピソード 350(54,147 ステップ): スコア 500.0
PPO (SB3) エピソード 400(79,147 ステップ): スコア 500.0
--- PPO (Stable Baselines3) 学習完了 ---
SB3のPPOも、300エピソード目(約29,000ステップ)以降は500を出し続けています。
シードを変えて比べる
ここまでの比較は、どれもシード0の1回だけです。強化学習の結果は乱数で大きく変わるので、シードを0〜4の5つに変えて、スクラッチのPPO・SB3のPPO・TRPOを学習させます。
SEEDS = [0, 1, 2, 3, 4]   # 強化学習の結果は乱数で大きく変わるので、5 つのシードで比べる(論文の MuJoCo の実験は 3 シード)
WINDOW = 10               # 直近 10 エピソードの平均スコアで、学習の進み具合を見る
THRESHOLD = 475           # CartPole-v1 の「解けた」とみなす基準(gym.make("CartPole-v1").spec.reward_threshold)
GRID = np.arange(500, 100_001, 500)   # シードごとに記録の時点が違うので、500 ステップおきの共通の時点にそろえる

methods = {
    "PPO (Scratch)": lambda s: train_ppo_scratch(s, log=False),
    "PPO (SB3)": lambda s: train_sb3(SB3_PPO, "PPO (SB3)", s, log=False),
    "TRPO (sb3-contrib)": lambda s: train_sb3(TRPO, "TRPO", s, log=False),
}


def moving_average_curve(history):
    """直近 WINDOW エピソードの平均スコアを、GRID の各時点で読み取る(その時点までに終わったエピソードを使う)"""
    steps = np.array([h[0] for h in history])
    scores = np.array([h[1] for h in history])
    ma = np.array([scores[max(0, i - WINDOW + 1): i + 1].mean() for i in range(len(scores))])
    idx = np.searchsorted(steps, GRID, side="right") - 1   # 各時点で、最後に終わったエピソードの番号
    return np.where(idx >= 0, ma[np.clip(idx, 0, None)], np.nan), steps, ma


results = {}
for name, train in methods.items():
    curves, solved, finals = [], [], []
    for seed in SEEDS:
        curve, steps, ma = moving_average_curve(train(seed))
        curves.append(curve)
        hit = np.nonzero(ma >= THRESHOLD)[0]
        solved.append(steps[hit[0]] if len(hit) else None)   # 直近 10 エピソードの平均が初めて 475 以上になったステップ
        finals.append(round(float(ma[-1]), 1))
    results[name] = np.array(curves)
    s = [f"{x:,}" if x is not None else "未達" for x in solved]
    print(f"{name:<19}: 475 以上になったステップ {s}、最後の 10 エピソードの平均 {finals}")

plt.figure(figsize=(10, 6))
for name, curves in results.items():
    mean = np.nanmean(curves, axis=0)
    line, = plt.plot(GRID, mean, label=name)
    plt.fill_between(GRID, np.nanmin(curves, axis=0), np.nanmax(curves, axis=0), color=line.get_color(), alpha=0.15)
plt.axhline(THRESHOLD, color="gray", linestyle="--", linewidth=1)
plt.title("CartPole-v1: mean of 5 seeds (band: min-max), 10-episode moving average")
plt.xlabel("Timesteps")
plt.ylabel("Score (Reward Sum)")
plt.legend()
plt.grid(True)
plt.show()
- 5つのシード:論文のMuJoCoの実験は3つのシードの平均ですが、手法の差がシードによるばらつきより大きいかを見たいので、5つにしています。
- 直近10エピソードの平均で見る:1エピソードごとのスコアは大きく上下するので、直近10エピソードの平均で学習の進み具合を見ます。
- 475を基準にする:CartPole-v1が「解けた」とみなす基準(reward_threshold)です。直近10エピソードの平均が初めて475以上になったステップ数を、手法ごとのデータ効率の目安にします。
- 共通の時点にそろえる:エピソードが終わる時点はシードごとに違うので、500ステップおきの時点で、その時点までに終わったエピソードの移動平均を読み取ってから、5つのシードの平均と最小・最大を求めます。
実行結果
PPO (Scratch)      : 475 以上になったステップ ['37,306', '22,180', '33,382', '23,973', '32,568']、最後の 10 エピソードの平均 [500.0, 500.0, 500.0, 500.0, 500.0]
PPO (SB3)          : 475 以上になったステップ ['30,871', '26,919', '31,259', '30,136', '25,506']、最後の 10 エピソードの平均 [500.0, 500.0, 500.0, 500.0, 500.0]
TRPO (sb3-contrib) : 475 以上になったステップ ['34,021', '25,996', '24,189', '26,238', '26,497']、最後の 10 エピソードの平均 [500.0, 500.0, 500.0, 500.0, 500.0]
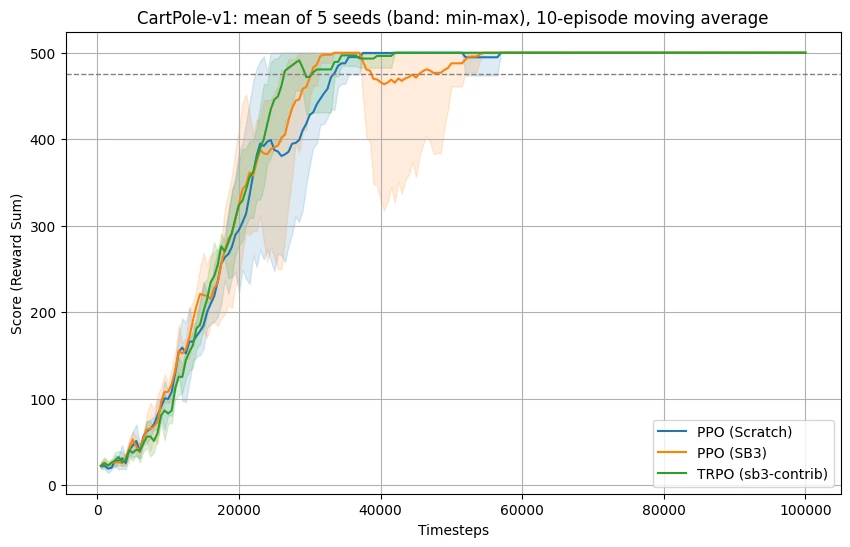
5つのシードのすべてで、3つの手法とも10万ステップのうちに475に届き、最後の10エピソードの平均は500でした。475に届いたステップ数の平均は、スクラッチのPPOが約29,900、SB3のPPOが約28,900、TRPOが約27,400です。シードによる幅(スクラッチのPPOで22,000〜37,000)の方が手法の差より大きく、CartPoleでは、PPOとTRPOのデータ効率にはっきりした差は見られませんでした。SB3のPPOでは、あるシードで、一度475に届いた後に移動平均が一時的に320ほどまで下がっています(グラフの帯)。
これは、論文の主張とも矛盾しません。論文がPPOについて示したのは、TRPOと同じくらいのデータ効率と安定した性能を、1次の最適化だけのずっと簡単な実装で得られることでした。CartPoleのように簡単な課題では、どの手法でもすぐに解けてしまうので、差が出にくくなります。論文で差が出たのは、MuJoCoの連続値の制御やAtariのゲームです。本記事で確かめられたのは、数十行の目的関数の工夫だけで、TRPOと同じ程度に学習できるという点です。
まとめ
本記事では、現代の強化学習(DRL)におけるデファクトスタンダードである PPO (Proximal Policy Optimization) について、その理論から実装まで詳しく解説しました。
PPOは、TRPOの「1回の更新で方策を変えすぎない」という考え方を残しつつ、KLダイバージェンスの制約と二次の最適化を「クリップされたサロゲート目的関数」に置き換えることで、TRPOと同程度のデータ効率を、はるかに簡単な実装で得たアルゴリズムです。
本記事を通じて、以下の内容を学習・実践しました:
- PPOのコア理論の理解:ポリシー更新の急激な変化にブレーキをかける「クリッピング」の数式や、アドバンテージを安定して推定する GAE(Generalized Advantage Estimation) の仕組みを学びました。
- Actor-Criticのスクラッチ実装:PyTorchを用いて、直交重み初期化を適用した ActorCritic ネットワークから、バッファ管理の RolloutBuffer、GAEやサロゲート損失の最小化ステップを担う PPO クラスまでを自力で構築しました。500ステップの打ち切りを、ポールが倒れた終わりと区別して扱うことも確かめました。
- TRPO・Stable Baselines3との比較:5つのシードで、スクラッチのPPO・SB3のPPO・TRPOのすべてが10万ステップのうちにCartPole-v1の基準(475)に届きました。届くまでのステップ数の平均は約27,000〜30,000で、シードによる幅(約22,000〜37,000)の方が大きく、CartPoleではPPOとTRPOのデータ効率にはっきりした差はありませんでした。PPOの利点は、TRPOと同程度の結果を、1次の最適化だけの簡単な実装で得られる点にあります。
PPOは、ゲームAIの開発からロボット制御、さらには大規模言語モデル(LLM)の人間フィードバックによる強化学習(RLHF)の基盤技術に至るまで、極めて幅広い領域で活用されています。本記事をきっかけに、ぜひご自身の強化学習プロジェクトやモデルのチューニングにPPOを活用してみてください。
参考文献
- J. Schulman, F. Wolski, P. Dhariwal, A. Radford, O. Klimov (2017). Proximal Policy Optimization Algorithms. arXiv:1707.06347.
- L. Engstrom et al. (2020). Implementation Matters in Deep Policy Gradients: A Case Study on PPO and TRPO. ICLR 2020.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
- A. Raffin, A. Hill, A. Gleave, A. Kanervisto, M. Ernestus, N. Dormann (2021). Stable-Baselines3: Reliable Reinforcement Learning Implementations. Journal of Machine Learning Research, 22(268), 1–8.
本記事の文章・構成の一部に生成AIを使用しています。