傾向スコアとは? ロジスティック回帰と共変量のバランス
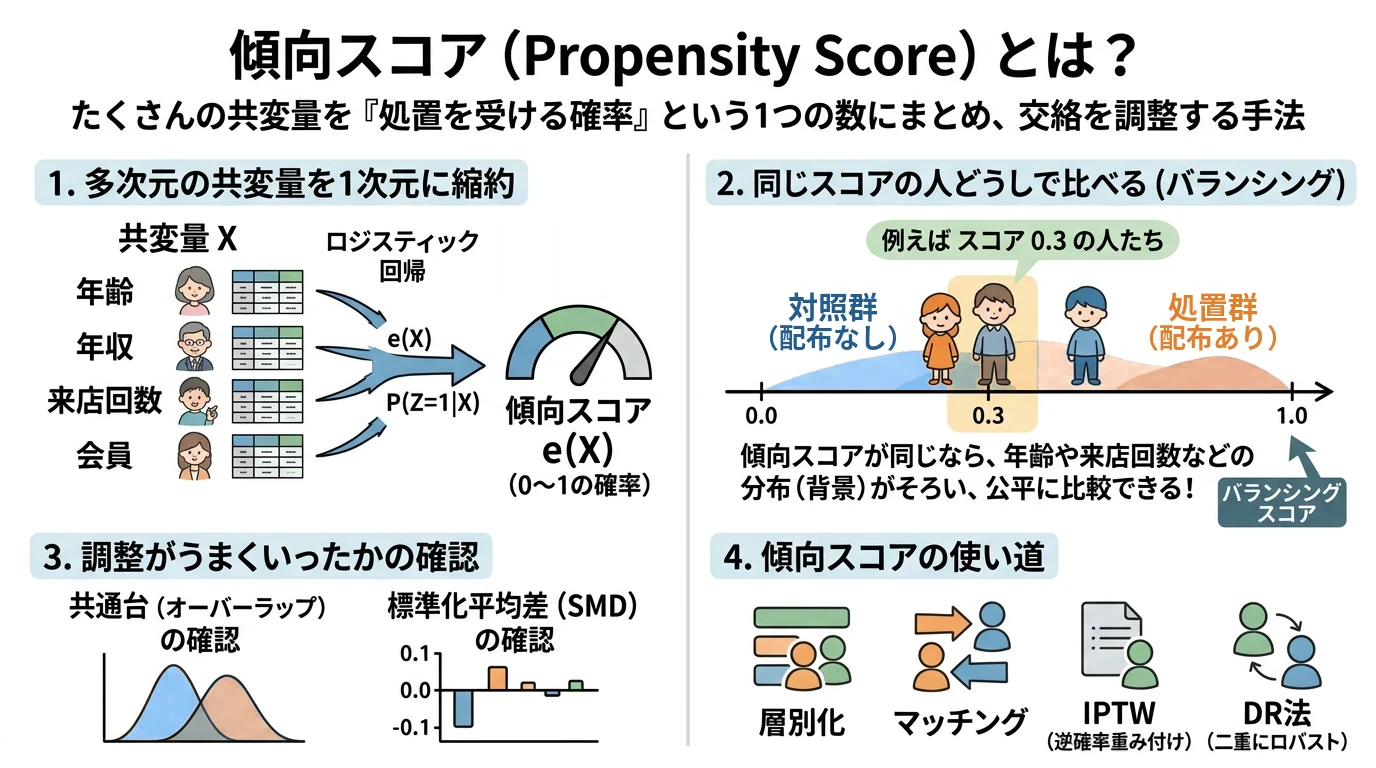 (画像は、Geminiで作成)
多くの共変量を「処置を受ける確率」という1つの数にまとめる傾向スコアが、なぜ交絡の調整に使えるのか(バランシングスコア)を理解すること。ロジスティック回帰をスクラッチ実装してスコアを推定し、共通台(オーバーラップ)と標準化平均差(SMD)で、調整がうまくいったかを自分で確かめられるようになること。推定したスコアを、層別化・マッチング・IPTW・DR 法のどれに使うかを説明できるようになること。
原著論文: The central role of the propensity score in observational studies for causal effects (Rosenbaum, Rubin, Biometrika 1983)
本記事のコードは、CPU だけの環境で、Python 3.13、numpy 2.5.3、pandas 3.0.5、scikit-learn 1.9.1、matplotlib 3.11.2 を使って実行しました。GPU は使いません。200回のシミュレーションを含めて、全体の実行は約10秒です。乱数のシードを固定しているので、同じ環境では同じ結果になります。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google Colab や Jupyter では先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
概要
クーポンを配った人と配らなかった人の購入金額を比べても、クーポンの効果はわかりません。よく来店する人や会員ほどクーポンを配られやすく、そもそも多く買う人だからです。このように、処置(クーポンの配布)と結果(購入金額)の両方に影響する変数を 交絡因子 と呼びます。ランダム化比較試験(RCT)なら、配る人をくじで決めるので交絡は起きませんが、すでにあるデータ(観察データ)では、そうはいきません。
交絡を取り除く素直な方法は、年齢・年収・来店回数・会員の値が同じ人どうしで比べることです。しかし、共変量が増えると、値の組み合わせの数が爆発的に増え、同じ組み合わせに配った人と配らなかった人の両方がいる層は、すぐになくなります。傾向スコア(Rosenbaum & Rubin, 1983)は、共変量 のもとで処置を受ける確率 です。傾向スコアが同じ人どうしでは、共変量の分布が処置群と対照群で同じになる(バランシングスコア)ので、多くの共変量の代わりに、この1つの数で比べれば済みます。
本記事では、4つの交絡因子でクーポンの配りやすさが決まる架空の1,000人のデータを作り、ロジスティック回帰をニュートン法と最急降下法でスクラッチ実装して、傾向スコアを推定します。推定したスコアで、両群のスコアが重なる範囲(共通台)を確かめ、スコアの五分位で層に分けたあとに、共変量ごとの 標準化平均差(SMD) が目安の0.1を下回るかを確かめます。最後に、同じスコアを層別化・マッチング・IPTW・DR 法に使い、200個のデータで推定値の偏りとばらつきを比べます。
傾向スコアとは?
定義:処置を受ける確率
処置を受けたかどうかを (受けたら1、受けなければ0)、処置の前に決まっている共変量を とします。傾向スコアは、共変量が の人が処置を受ける確率です。
RCT では、全員が同じ確率(たとえば0.5)で処置を受けるので、傾向スコアは全員で同じです。観察データでは、来店回数の多い人ほど配られやすいというように、人によって傾向スコアが違います。この違いが、処置群と対照群の共変量の偏り(セレクションバイアス)を生みます。
バランシングスコア:同じスコアの人どうしなら、共変量がそろう
Rosenbaum & Rubin(1983)は、次の性質を示しました。
(1) 傾向スコアはバランシングスコアである: 傾向スコアが同じ人どうしでは、処置を受けたかどうかと共変量が独立になります。
たとえば、傾向スコアが0.3の人だけを集めると、その中で処置を受けた人と受けなかった人の、年齢・年収・来店回数・会員の分布は同じです。来店回数が多く会員でない人も、来店回数が少なく会員の人も、スコアが0.3なら「処置の受けやすさ」は同じで、どちらが処置群に入るかは、共変量とは関係のない偶然で決まるからです。この性質は、データの作られ方に関係なく、定義から成り立ちます。
(2) 傾向スコアは、最も粗いバランシングスコアである: 関数 がバランシングスコアになるのは、 と、 から が計算できるときだけです。共変量 そのものが最も細かいバランシングスコアで、 は1次元に縮約した最も粗いバランシングスコアです。
(3) 強い無視可能性は、傾向スコアに引き継がれる: 処置を受けたときと受けなかったときの結果を として、次の2つが成り立つ(強い無視可能性)とします。
1つ目は「交絡因子をすべて に入れている」、2つ目は「どの の人にも、処置を受ける人と受けない人がいる」という仮定です。このとき、 の代わりに で条件付けても同じことが成り立ち、傾向スコアが同じ人どうしの結果の差の平均が、その人たちへの効果の偏りのない推定になります。
つまり、交絡因子をすべて測っていれば、4つの共変量の組み合わせで比べる代わりに、傾向スコアという1つの数で比べればよい、ということです。ただし、測っていない交絡因子があれば、傾向スコアでは取り除けません(後の節で確かめます)。
実験の準備
交絡のある観察データを作る
架空の小売店の1,000人のデータを作ります。年齢・年収・過去30日の来店回数・会員かどうかの4つが、クーポンの配られやすさと、その後1か月の購入金額の両方を押し上げます(交絡因子)。配られる確率は、4つの共変量の線形結合をシグモイド関数に通したもの(ロジスティックモデル)です。
購入金額は、共変量の線形結合に、クーポンの効果(全員 +1,000円)と正規分布のノイズ(標準偏差1,000円)を足したものです。
import numpy as np
import pandas as pd

covariates = ["age", "income", "visits", "member"]
TRUE_EFFECT = 1000                      # クーポンの効果は、全員 +1,000円


def make_data(n=1000, seed=0):
    """交絡のある観察データ:同じ共変量が、クーポンの配られやすさと購入金額の両方を押し上げる"""
    rng = np.random.default_rng(seed)
    # (a) 交絡因子:年齢・年収(万円)・過去30日の来店回数・会員かどうか
    age = rng.normal(40, 10, n).round()
    income = rng.lognormal(np.log(450), 0.4, n).round()
    visits = rng.poisson(4, n)
    member = rng.binomial(1, 0.4, n)
    # (b) 処置(クーポンの配布):来店が多い・会員・年収が高い・年齢が高い人ほど配られやすい
    logit = -5.0 + 0.03 * age + 0.002 * income + 0.35 * visits + 1.0 * member
    e_true = 1 / (1 + np.exp(-logit))
    z = rng.binomial(1, e_true)
    # (c) 結果(その後1か月の購入金額、円)
    y = (2000 + 30 * age + 3 * income + 400 * visits + 800 * member + TRUE_EFFECT * z
         + rng.normal(0, 1000, n)).round()
    return pd.DataFrame({"age": age, "income": income, "visits": visits, "member": member,
                         "z": z, "y": y, "e_true": e_true})


df = make_data(seed=5)
print(df.head())
print(f"処置群 {df.z.sum()}人  対照群 {(1 - df.z).sum()}人  真の傾向スコアの範囲 {df.e_true.min():.3f}〜{df.e_true.max():.3f}")
naive = df.y[df.z == 1].mean() - df.y[df.z == 0].mean()
print(f"単純な平均の差: {naive:,.0f}円  (真の効果 {TRUE_EFFECT:,}円)")
print(df.groupby("z")[covariates].mean().round(2))
交絡のある1,000人のデータを作り、配った人と配らなかった人の購入金額の平均を、そのまま比べるコードです。
- make_data(n=1000, seed=0): 乱数のシードを引数で受け取り、同じ作り方のデータを作る関数です。最後の節で、シードだけを変えた200個のデータで推定を繰り返すために、関数にしています。
- (a) 交絡因子: 年齢は平均40歳・標準偏差10歳の正規分布、年収は中央値450万円の対数正規分布(右に裾の長い、年収らしい分布)、来店回数は平均4回のポアソン分布、会員は40%が1のベルヌーイ分布です。
- (b) 処置: 上の式で配られる確率 e_true(真の傾向スコア)を計算し、その確率で配るかどうかを決めます。切片の −5.0 は、配られる人が全体の約3割になるように選んだ値です。分析する側には e_true はわかりませんが、推定の答え合わせのために列に残しています。
- (c) 結果: 来店回数の係数(1回あたり400円)が大きいので、来店回数の偏りが、単純な比較を最も大きく狂わせます。
- covariates と TRUE_EFFECT: 共変量の列名と、真の効果(1,000円)です。以降のコードは、この2つを使います。
- df = make_data(seed=5): 本文で使う1つのデータです。最後の節の200個のデータと比べて、偏りの大きさが平均的なデータ(シード5)を選んでいます。
実行結果
    age  income  visits  member  z       y    e_true
0  32.0   451.0       3       1  0  5419.0  0.251995
1  27.0   577.0       5       1  0  7455.0  0.428983
2  38.0   468.0       6       0  0  8101.0  0.304915
3  44.0   930.0       4       0  1  9517.0  0.396517
4  51.0   410.0       5       0  0  7534.0  0.289050
処置群 301人  対照群 699人  真の傾向スコアの範囲 0.033〜0.963
単純な平均の差: 1,973円  (真の効果 1,000円)
     age  income  visits  member
z
0  39.19  472.16    3.62    0.34
1  41.91  543.68    4.90    0.56
- 単純な比較は、真の効果の約2倍: 配った人(処置群)301人と配らなかった人(対照群)699人の購入金額の差は1,973円で、真の効果1,000円の約2倍でした。差の残りの約973円は、クーポンではなく、もともとの客層の違いによるものです。
- 処置群は、どの共変量も大きい: 処置群は、平均の来店回数が4.90回(対照群3.62回)、会員の割合が56%(34%)、年収が544万円(472万円)、年齢が41.9歳(39.2歳)でした。配られやすい人ほど、もともと多く買う人です。
- 真の傾向スコアは0.033〜0.963: 配られる確率がほぼ0の人から、ほぼ1の人までいます。
偏りを測る:標準化平均差(SMD)
共変量の偏りの大きさを、標準化平均差(SMD: Standardized Mean Difference) で測ります。処置群と対照群の平均の差を、両群の標準偏差の平均で割った値です(Austin, 2011)。
は処置群と対照群の平均(m1、m0)、 は分散です。単位のない量なので、年齢(歳)と年収(万円)のように単位の違う共変量どうしでも比べられます。絶対値が0.1未満なら、偏りは無視できるほど小さいとみなすのが、よく使われる目安です。調整した後の SMD は、平均を重み (w)付きの平均 に置き換えて計算します。
def smd(x, z, w=None):
    """標準化平均差:重み付きの群の平均の差を、調整前の2群の標準偏差の平均で割る"""
    w = np.ones(len(x)) if w is None else w
    m1 = np.average(x[z == 1], weights=w[z == 1])
    m0 = np.average(x[z == 0], weights=w[z == 0])
    sd = np.sqrt((x[z == 1].var(ddof=1) + x[z == 0].var(ddof=1)) / 2)   # 分母は調整前のばらつきに固定
    return (m1 - m0) / sd


smd_before = {c: smd(df[c].to_numpy(), df.z.to_numpy()) for c in covariates}
for c, v in smd_before.items():
    print(f"{c:7s} SMD {v:+.3f}  {'偏りあり' if abs(v) > 0.1 else ''}")
共変量ごとに、調整前の SMD を計算するコードです。
- smd(x, z, w=None): 1つの共変量 x と処置 z、重み w を受け取り、SMD を返す関数です。重みを省くと、全員の重みを1にして、ふつうの平均の差になります。後の節で、層別化の重みを渡して、調整した後の SMD も同じ関数で計算します。
- 分母は、調整前のばらつきに固定: 分母の標準偏差は、重みを付けずに計算します。調整の前後で分母が同じなので、SMD の変化が、そのまま平均の差の変化になります。分母まで重み付きにすると、平均の差が同じでも、ばらつきが変わっただけで SMD が変わってしまいます。
- 会員(0か1)にも、同じ式を使う: 0か1の変数の分散 var(ddof=1) は、割合 のときにほぼ になるので、Austin(2011)の2値の変数の SMD の式と、ほぼ同じ値になります。
実行結果
age     SMD +0.276  偏りあり
income  SMD +0.360  偏りあり
visits  SMD +0.662  偏りあり
member  SMD +0.438  偏りあり
- 4つの共変量すべてで、偏りがある: SMD は来店回数が +0.662 で最も大きく、会員 +0.438、年収 +0.360、年齢 +0.276 と、すべて目安の0.1を大きく超えました。来店回数の偏りは、両群の平均の差が、標準偏差の約3分の2もあるということです。
共変量で直接層に分けると、比べる相手がいなくなる
傾向スコアを使わずに、共変量の値で層に分けて、層の中で比べる方法を試します。年齢・年収・来店回数は五分位で5つに、会員は2つに分け、使う共変量を1つずつ増やしたときに、処置群と対照群の両方がいる層がいくつ残るかを数えます。
def strata_overlap(strata, z):
    """層ごとに処置群と対照群が両方いるかを調べ、層の数・両群がいる層の数・そこに入る人の割合を返す"""
    g = pd.DataFrame({"s": strata, "z": z}).groupby("s")["z"]
    both = (g.min() == 0) & (g.max() == 1)              # 両群がいる層:z の最小が0、最大が1
    return len(both), int(both.sum()), g.size()[both].sum() / len(z)


# 連続の共変量は5つ(五分位)、会員は2つに区切り、その組み合わせを層にする
binned = df[covariates].copy()
for c in ["age", "income", "visits"]:
    binned[c] = pd.qcut(df[c].rank(method="first"), 5, labels=False)
for k in range(1, 5):
    strata = binned[covariates[:k]].astype(str).agg("-".join, axis=1)
    n_strata, n_both, share = strata_overlap(strata, df.z)
    print(f"共変量 {k}個: 層 {n_strata:3d}個  両群がいる層 {n_both:3d}個  比べられる人 {share:6.1%}  "
          f"1層あたり平均 {len(df) / n_strata:5.1f}人")
共変量の組み合わせで層に分け、両群がいる層の数と、そこに入る人の割合を数えるコードです。
- strata_overlap(strata, z): 各人の層の名前と処置を受け取り、層の数・両群がいる層の数・両群がいる層に入る人の割合を返します。層ごとの z の最小が0で最大が1なら、その層には両群がいます。
- 五分位の区切り: pd.qcut で、人数が同じ5つの区間に分けます。来店回数は0〜12回の整数で同じ値の人が多く、そのままでは区切りが重なって5つに分けられないので、rank(method="first") で同じ値の人にも別々の順位を付けてから分けています。
- 層の名前: 使う共変量の区間の番号を「2-4-1」のように文字列でつなぎ、組み合わせごとに1つの層にします。
実行結果
共変量 1個: 層   5個  両群がいる層   5個  比べられる人 100.0%  1層あたり平均 200.0人
共変量 2個: 層  25個  両群がいる層  25個  比べられる人 100.0%  1層あたり平均  40.0人
共変量 3個: 層 125個  両群がいる層 101個  比べられる人  85.5%  1層あたり平均   8.0人
共変量 4個: 層 240個  両群がいる層 135個  比べられる人  66.2%  1層あたり平均   4.2人
- 共変量が3個で、比べられない層が出る: 1個(5層)・2個(25層)では、すべての層に両群がいました。3個で125層になると、両群がいるのは101層で、比べられるのは85.5%の人になりました。
- 4個では、3分の1の人を捨てることになる: 4個(240層。1人もいない組み合わせがあるので、5 × 5 × 5 × 2 = 250 より少ない)では、両群がいる層は135層で、比べられるのは66.2%でした。1層あたりの人数は平均4.2人で、残った層でも、層の中の差は数人の平均にすぎません。
(図は、diagram-designで作成)
共変量が増えるほど層の数は掛け算で増え、1,000人のデータでも、4つの共変量で層の中に比べる相手がいなくなります(次元の呪い)。傾向スコアは、4つの共変量を1つの数にまとめるので、スコアの五分位で5層に分ければ、どの層にも両群の人が十分にいます。
ロジスティック回帰で傾向スコアを推定する
(図は、diagram-designで作成)
実際のデータでは、真の傾向スコアはわかりません。処置を受けたかどうか(0か1)を共変量から予測するモデルを作り、その予測確率を傾向スコアとして使います。最もよく使われるのは、ロジスティック回帰です(Austin, 2011)。
対数尤度と、ニュートン法・最急降下法
各人の共変量 (先頭に切片の1を足したベクトル。全員分を並べた行列が 、コードの X)と係数 (beta)から、処置を受ける確率を次のように表します。
実際に処置を受けた人()では が、受けなかった人では が大きいほど、データをよく説明しています。そこで、次の対数尤度を最大にする を求めます。
対数尤度の勾配は (grad)(実際の処置と予測確率の差を、共変量で重み付けして足したもの)、ヘッセ行列は ()です。ニュートン・ラフソン法 は、対数尤度を2次式で近似し、その頂点に一気に動く更新を繰り返します。
最急降下法(最大化なので勾配上昇法)は、勾配の向きに学習率 だけ動く更新を繰り返します。
def sigmoid(t):
    return 1 / (1 + np.exp(-t))


def log_likelihood(beta, X, z):
    e = sigmoid(X @ beta)
    return np.sum(z * np.log(e) + (1 - z) * np.log(1 - e))


def fit_logistic_newton(X, z, n_iter=10, tol=1e-10):
    """ニュートン・ラフソン法:β ← β + (XᵀWX)⁻¹ Xᵀ(z − e)、W = diag(e(1 − e))"""
    beta = np.zeros(X.shape[1])
    history = [log_likelihood(beta, X, z)]                    # β = 0(全員 e = 0.5)から始める
    for _ in range(n_iter):
        e = sigmoid(X @ beta)
        grad = X.T @ (z - e)                                  # 対数尤度の勾配
        hess = X.T @ (X * (e * (1 - e))[:, None])            # 対数尤度のヘッセ行列の符号を反転したもの
        step = np.linalg.solve(hess, grad)
        beta = beta + step
        history.append(log_likelihood(beta, X, z))
        if np.max(np.abs(step)) < tol:                        # 更新がほぼ0になったら止める
            break
    return beta, history


def fit_logistic_gd(X, z, lr=0.5, n_iter=1000):
    """最急降下法(勾配上昇法):β ← β + η · Xᵀ(z − e) / n"""
    beta, history = np.zeros(X.shape[1]), {}
    for t in range(1, n_iter + 1):
        beta = beta + lr * X.T @ (z - sigmoid(X @ beta)) / len(z)
        if t in (10, 100, 1000):
            history[t] = log_likelihood(beta, X, z)
    return beta, history


# 共変量を標準化し、先頭に切片の列(すべて1)を足す
raw = df[covariates].to_numpy(float)
mu, sd = raw.mean(axis=0), raw.std(axis=0)
X = np.column_stack([np.ones(len(df)), (raw - mu) / sd])
zv = df.z.to_numpy()

beta_nr, hist_nr = fit_logistic_newton(X, zv)
beta_gd, hist_gd = fit_logistic_gd(X, zv)
print("ニュートン法の対数尤度:", " → ".join(f"{v:.3f}" for v in hist_nr))
print("最急降下法の対数尤度:", "  ".join(f"{t}回 {v:.3f}" for t, v in hist_gd.items()))

# 標準化した係数を元の単位に戻して、データを作ったときの係数と比べる
coef = beta_nr[1:] / sd
intercept = beta_nr[0] - np.sum(beta_nr[1:] * mu / sd)
true = {"切片": -5.0, "age": 0.03, "income": 0.002, "visits": 0.35, "member": 1.0}
for (name, t), b in zip(true.items(), [intercept, *coef]):
    print(f"{name:7s} 推定 {b:+.4f}  真の値 {t:+.4f}")

from sklearn.linear_model import LogisticRegression
sk = LogisticRegression(C=np.inf, max_iter=1000).fit(X[:, 1:], zv)
print(f"scikit-learn との係数の差の最大: {np.max(np.abs(np.r_[sk.intercept_, sk.coef_[0]] - beta_nr)):.1e}")
df["ps"] = sigmoid(X @ beta_nr)
print(f"傾向スコア:処置群 {df.ps[df.z == 1].min():.3f}〜{df.ps[df.z == 1].max():.3f}  "
      f"対照群 {df.ps[df.z == 0].min():.3f}〜{df.ps[df.z == 0].max():.3f}")
ロジスティック回帰を、ニュートン法と最急降下法の2通りでスクラッチ実装し、対数尤度の増え方と、推定した係数を確かめるコードです。
- sigmoid と log_likelihood(beta, X, z): 上の式の と です。
- fit_logistic_newton(X, z, n_iter=10, tol=1e-10): ニュートン法で係数を求め、係数と、各更新のあとの対数尤度のリストを返します。
- hess: です。X * (e * (1 - e))[:, None] は、 の各行に を掛けることで、1,000 × 1,000 の対角行列 を作らずに を計算しています。
- np.linalg.solve(hess, grad): 逆行列 を作らずに、連立方程式 を解いて更新量 を求めます。逆行列を作るより、計算が速く、数値の誤差も小さくなります。
- β = 0 から始める: 全員の予測確率が0.5の状態です。このときの対数尤度は になります。更新量がすべて tol より小さくなったら止めます。
- fit_logistic_gd(X, z, lr=0.5, n_iter=1000): 最急降下法で係数を求め、10回・100回・1,000回の更新のあとの対数尤度を記録します。勾配を人数 で割って平均にしているので、学習率 lr=0.5 は、データの人数によらず使える大きさです。
- 共変量を標準化する: 年収(中央値450万円)と会員(0か1)のように桁の違う共変量をそのまま使うと、最急降下法では、桁の大きい年収の係数だけが大きく動き、ほかの係数がなかなか動きません。平均0・標準偏差1にそろえると、1つの学習率ですべての係数がそろって動きます。ニュートン法は桁の違いの影響を受けにくいですが、2つの方法を同じ で比べるために、どちらにも標準化した を使います。
- 係数を元の単位に戻す: 標準化した の係数 は、元の単位の係数 にあたり、切片は になります。データを作ったときの係数と比べるために戻しています。
- scikit-learn との比較: LogisticRegression(C=np.inf) は、正則化なし(ペナルティの強さが0)のロジスティック回帰です。scikit-learn の既定は L2 の正則化付き(C=1.0)なので、そのままでは係数が少し0に寄り、スクラッチ実装と一致しません。
- df["ps"]: ニュートン法の係数で計算した、各人の傾向スコアです。以降の節は、この列を使います。
実行結果
ニュートン法の対数尤度: -693.147 → -525.725 → -518.024 → -517.887 → -517.887 → -517.887 → -517.887
最急降下法の対数尤度: 10回 -544.017  100回 -517.888  1000回 -517.887
切片      推定 -5.7172  真の値 -5.0000
age     推定 +0.0400  真の値 +0.0300
income  推定 +0.0024  真の値 +0.0020
visits  推定 +0.3799  真の値 +0.3500
member  推定 +0.9853  真の値 +1.0000
scikit-learn との係数の差の最大: 3.5e-05
傾向スコア:処置群 0.061〜0.980  対照群 0.026〜0.880
- ニュートン法は3回でほぼ収束した: 対数尤度は −693.147 から、1回目の更新で −525.725、3回目で −517.887 になり、その後は変わりませんでした。2次式の近似で一気に動くので、少ない回数で済みます。
- 最急降下法は100回かかった: 10回では −544.017 で、100回で −517.888 とニュートン法にほぼ追いつきました。1回の計算は軽いですが、勾配の向きに少しずつしか動かないので、回数が必要です。
- 係数は、真の値の近くに推定された: 来店回数の係数は 0.380(真の値0.35)、会員は 0.985(1.0)でした。切片は −5.72(−5.0)と少し離れましたが、切片と年齢の係数(0.040、真の値0.03)は、年齢が高いほど切片が下がる関係にあり、1,000人のデータでは一緒にずれやすいためです。scikit-learn の係数との差は最大でも 3.5e-05 で、実装が正しいことを確かめられました。
- 推定した傾向スコアは、処置群が0.061〜0.980、対照群が0.026〜0.880: 処置群のスコアは高い側に、対照群は低い側に寄っています。
傾向スコアのモデルは、係数を正しく推定することや、処置を正確に予測することが目的ではありません。目的は、スコアで調整したあとに、共変量のバランスが取れることです。モデルの良し悪しは、当てはまりの良さや予測の精度(c統計量など)ではなく、後の節の SMD で判断します(Austin, 2011)。
共通台(オーバーラップ)を確かめる
(図は、diagram-designで作成)
強い無視可能性の2つ目の仮定 は、データで確かめられます。両群の傾向スコアが重なる範囲を 共通台(Common Support)と呼び、次のように求めます。
共通台の外の人には、傾向スコアの近い相手がもう一方の群にいないので、比べる相手がいません。また、傾向スコアを重みに使う IPTW では、処置群の人に 、対照群の人に の重みを付けるので、0や1に近いスコアの人の重みが大きくなります。
import matplotlib.pyplot as plt
import japanize_matplotlib


def common_support(ps, z):
    """共通台:両群の傾向スコアが重なる範囲 [両群の最小値の大きい方, 両群の最大値の小さい方]"""
    lo = max(ps[z == 1].min(), ps[z == 0].min())
    hi = min(ps[z == 1].max(), ps[z == 0].max())
    return lo, hi, int(((ps < lo) | (ps > hi)).sum())


def plot_overlap(ps, z, title, path):
    fig, ax = plt.subplots(figsize=(8, 3.5))
    bins = np.linspace(0, 1, 41)
    ax.hist(ps[z == 0], bins=bins, alpha=0.6, density=True, label="対照群(配布なし)", color="#4C72B0")
    ax.hist(ps[z == 1], bins=bins, alpha=0.6, density=True, label="処置群(配布あり)", color="#DD8452")
    lo, hi, _ = common_support(ps, z)
    ax.axvspan(lo, hi, color="gray", alpha=0.12, label="共通台")
    ax.set_xlabel("傾向スコア e(X)"); ax.set_ylabel("密度"); ax.set_title(title); ax.legend()
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


ps, zv = df.ps.to_numpy(), df.z.to_numpy()
lo, hi, n_out = common_support(ps, zv)
print(f"共通台 {lo:.3f}〜{hi:.3f}  外れる人 {n_out}人")
w = np.where(zv == 1, 1 / ps, 1 / (1 - ps))                 # IPTW の重み(ATE)
print(f"重みの最大 {w.max():.1f}  (傾向スコア {ps[np.argmax(w)]:.3f} の{'処置群' if zv[np.argmax(w)] else '対照群'})"
      f"  重み10以上 {(w >= 10).sum()}人")
plot_overlap(ps, zv, "推定した傾向スコアの分布", "propensity_score_5.png")
共通台の範囲と、その外の人数を求め、IPTW の重みの大きさを確かめて、両群の傾向スコアの分布を描くコードです。
- common_support(ps, z): 上の式の範囲と、その外の人数を返します。
- plot_overlap(ps, z, title, path): 両群の傾向スコアのヒストグラムを重ね、共通台を灰色の帯で示します。density=True で面積を1にそろえるのは、処置群(301人)と対照群(699人)の人数が違っても、分布の形を比べられるようにするためです。0〜1を40の区間(幅0.025)に分けています。
- w: IPTW の重みです。重みの最大と、10以上の人数を数えます。重み10は、その1人が10人分として数えられるということです。
実行結果
共通台 0.061〜0.880  外れる人 34人
重みの最大 16.4  (傾向スコア 0.061 の処置群)  重み10以上 10人
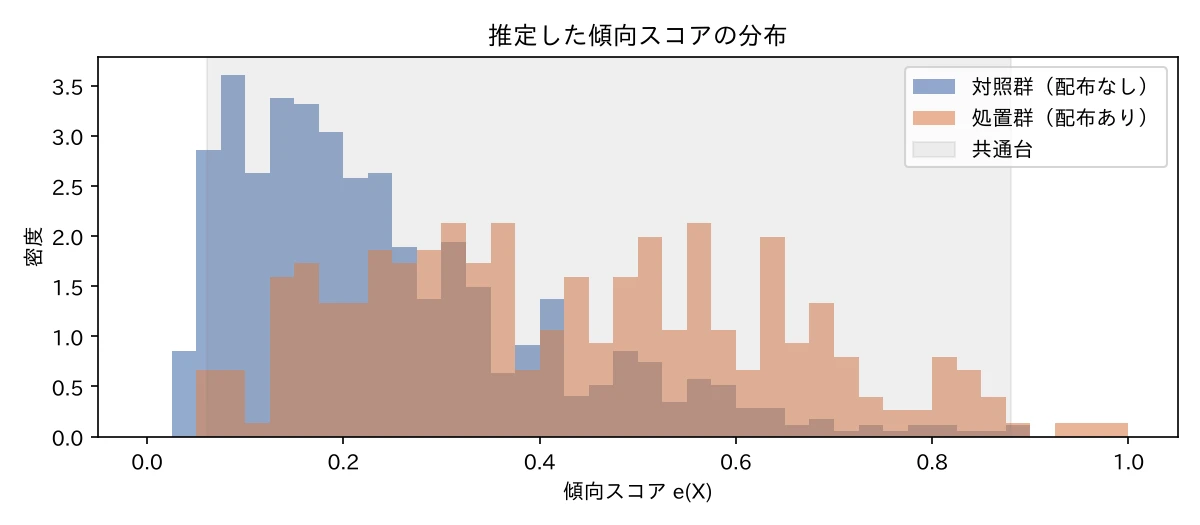
- 対照群は0.1〜0.3に、処置群は0.3〜0.7に多い: 2つの分布は重なりながらも、ずれています。このずれが、共変量の偏り(SMD)を1つの数にまとめたものです。
- 共通台は0.061〜0.880で、外れる人は34人: 0.880より高いスコアには処置群しかいません(処置群の最大は0.980)。全体の3.4%の人には、比べる相手がいません。
- 重みの最大は16.4: 傾向スコア0.061の処置群の人の重みは で、この1人が、16人分の「配られなかった、似た人」の代わりになります。重みが10以上の人は10人でした。
配布が共変量でほぼ決まると
配布の決まり方がもっと偏っていたら、共通台はどうなるかを確かめます。真の傾向スコアのロジットを、平均を引いてから3倍にして、配られる確率を0か1に近づけたデータを作ります。
# 配布の決まり方がもっと偏っていたら:ロジットを3倍にして、配布が共変量でほぼ決まるデータを作る
logit = -5.0 + 0.03 * df.age + 0.002 * df.income + 0.35 * df.visits + 1.0 * df.member
rng_s = np.random.default_rng(1)
z_s = rng_s.binomial(1, 1 / (1 + np.exp(-3 * (logit - logit.mean())).to_numpy()))
beta_s, _ = fit_logistic_newton(X, z_s)
ps_s = sigmoid(X @ beta_s)
lo_s, hi_s, n_out_s = common_support(ps_s, z_s)
w_s = np.where(z_s == 1, 1 / ps_s, 1 / (1 - ps_s))
print(f"偏りの強いデータ:共通台 {lo_s:.3f}〜{hi_s:.3f}  外れる人 {n_out_s}人  "
      f"0.05未満か0.95超 {((ps_s < 0.05) | (ps_s > 0.95)).sum()}人  重みの最大 {w_s.max():.1f}  重み10以上 {(w_s >= 10).sum()}人")
plot_overlap(ps_s, z_s, "配布がほぼ共変量で決まる場合の傾向スコアの分布", "propensity_score_6.png")
配布が共変量でほぼ決まるデータで、同じ から傾向スコアを推定し直し、共通台と重みを確かめるコードです。logit は上の式の で、データを作ったときと同じ係数で計算します。平均を引いてから3倍にするのは、配られる人の割合を変えずに、確率だけを0と1の側に広げるためです。
実行結果
偏りの強いデータ:共通台 0.021〜0.972 外れる人 170人 0.05未満か0.95超 282人 重みの最大 47.7 重み10以上 17人
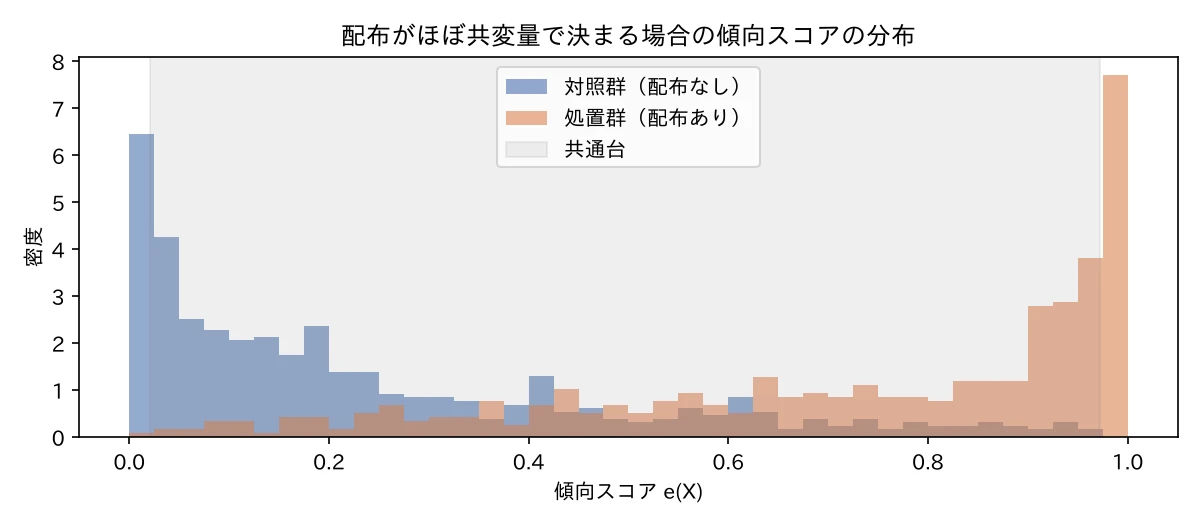
- 0.05未満か0.95超の人が282人: 対照群は0の近くに、処置群は1の近くに集まり、真ん中で重なる人が少なくなりました。
- 共通台の外の人は170人、重みの最大は47.7: 共通台(0.021〜0.972)の外の人は、元のデータの34人から170人に増えました。重みが最大の人は1人で約48人分になり、この人の購入金額のノイズが、推定をそのまま揺らします。
このようなデータでは、共通台の外の人を除く(トリミング)か、0.05〜0.95のような範囲の外のスコアを除くなどの対処が必要です。除くと、推定する効果は「全員への効果」ではなく「両群の人がいる範囲の人への効果」に変わります。重みを安定させる方法は、IPTW の記事で扱います。
共変量のバランスを確かめる
傾向スコアで層に分ける
推定した傾向スコアの五分位で5層に分け、層の中で処置群と対照群を比べます(層別化、サブクラス化)。傾向スコアが近い人どうしなので、バランシングスコアの性質から、層の中では共変量がほぼそろうはずです。
層別化した後の共変量のバランスは、層ごとに両群の人数をそろえる重みを付けて、SMD で確かめます。層 の人数を (n_s)、層 の群 の人数を (表 t の値)として、各人の重みを次のようにします。
この重みを付けると、処置群も対照群も、各層の人数が全体の層の人数 と同じになり、層の中の両群の平均の差を、層の人数の割合で平均したものになります。効果も、同じ考え方で、層の中の平均の差を、層の人数で重み付けして平均します。
def subclass_weights(ps, z, n_strata=5):
    """傾向スコアの分位で層に分け、層ごとに両群の人数をそろえる重み n_s / n_{s,z} を返す"""
    strata = pd.qcut(ps, n_strata, labels=False)
    t = pd.crosstab(strata, z)                                  # 層 × 群 の人数
    n_s = t.sum(axis=1)
    w = np.array([n_s[s] / t.loc[s, g] for s, g in zip(strata, z)])
    return strata, w, t


def subclass_ate(y, z, strata):
    """層ごとの平均の差を、層の人数で重み付けして平均する"""
    d = pd.DataFrame({"y": y, "z": z, "s": strata})
    m = d.groupby(["s", "z"])["y"].mean().unstack()
    n_s = d.groupby("s").size()
    return float(np.sum((m[1] - m[0]) * n_s) / n_s.sum())


strata, w_sub, table = subclass_weights(ps, zv)
print(table.rename(columns={0: "対照群", 1: "処置群"}).rename_axis(index="層", columns=None).T)
smd_after = {c: smd(df[c].to_numpy(), zv, w_sub) for c in covariates}
for c in covariates:
    print(f"{c:7s} SMD 調整前 {smd_before[c]:+.3f}  →  層別化の後 {smd_after[c]:+.3f}")
for k in (5, 10):
    s_k, w_k, _ = subclass_weights(ps, zv, k)
    print(f"{k:2d}層:ATE の推定 {subclass_ate(df.y.to_numpy(), zv, s_k):,.0f}円  "
          f"|SMD| の最大 {max(abs(smd(df[c].to_numpy(), zv, w_k)) for c in covariates):.3f}")
傾向スコアの五分位で層に分け、層ごとの両群の人数、層別化した後の SMD、効果の推定を確かめるコードです。
- subclass_weights(ps, z, n_strata=5): 傾向スコアを n_strata 個の分位で層に分け、各人の層、上の式の重み、層 × 群の人数の表を返します。pd.crosstab で層 × 群の人数を数え、各人の層と群から を引いています。
- subclass_ate(y, z, strata): 層 × 群ごとの結果の平均を計算し、層ごとの差を層の人数で重み付けして平均します。この値は、上の重みを付けた両群の平均の差と同じ値になります。
- 5層と10層: Cochran(1968)は、1つの共変量で5層に分ければ、その共変量による偏りの約90%を取り除けることを示しました。Austin(2011)は、傾向スコアの五分位で層に分けても、測った交絡因子による偏りの約90%を取り除けると紹介しています。層を細かくすると、層の中に残る偏りは減りますが、層の中の人数が減ってばらつきが増えます。
実行結果
層      0    1    2    3    4
対照群  188  166  146  123   76
処置群   12   34   54   77  124
age     SMD 調整前 +0.276  →  層別化の後 -0.046
income  SMD 調整前 +0.360  →  層別化の後 +0.034
visits  SMD 調整前 +0.662  →  層別化の後 +0.087
member  SMD 調整前 +0.438  →  層別化の後 -0.011
 5層:ATE の推定 1,085円  |SMD| の最大 0.087
10層:ATE の推定 1,043円  |SMD| の最大 0.044
- どの層にも、両群がいる: スコアの低い層1は対照群188人・処置群12人、高い層5は対照群76人・処置群124人でした。層の中の人数の比は違いますが、どの層でも比べる相手がいます。
- 層別化した後、すべての共変量で |SMD| が0.1未満になった: 来店回数は +0.662 から +0.087 に、年収は +0.360 から +0.034 に、会員は +0.438 から −0.011 に、年齢は +0.276 から −0.046 になりました。
- 来店回数の偏りは、5層では少し残る: 来店回数の SMD は +0.087 で、目安の0.1は下回りましたが、ほかより大きく残りました。層の中にも、スコアの高い人と低い人の幅があるためです。10層にすると、|SMD| の最大は0.044になり、効果の推定も 1,085円から1,043円と、真の効果1,000円に近づきました。
調整前と、5層の層別化の後の |SMD| を、Love plot で並べます。共変量ごとに、調整前後の点を横に並べ、目安の0.1の線と比べる図です。
def love_plot(before, after, path):
    """共変量ごとの |SMD| を、調整前と調整後で並べる(Love plot)"""
    names = list(before)
    fig, ax = plt.subplots(figsize=(7, 3))
    ax.scatter([abs(before[c]) for c in names], names, s=90, color="#C44E52", label="調整前", zorder=3)
    ax.scatter([abs(after[c]) for c in names], names, s=90, color="#4C72B0", marker="D", label="層別化の後", zorder=3)
    ax.axvline(0.1, color="gray", ls="--", label="目安 0.1")
    ax.set_xlabel("標準化平均差の絶対値 |SMD|"); ax.set_xlim(0, 0.6); ax.legend(loc="lower right")
    ax.grid(axis="x", alpha=0.3); fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


love_plot(smd_before, smd_after, "propensity_score_7.png")
共変量ごとの |SMD| を、調整前(丸)と層別化の後(ひし形)で並べるコードです。符号ではなく大きさで比べるので、絶対値を描き、目安の0.1に破線を引いています。
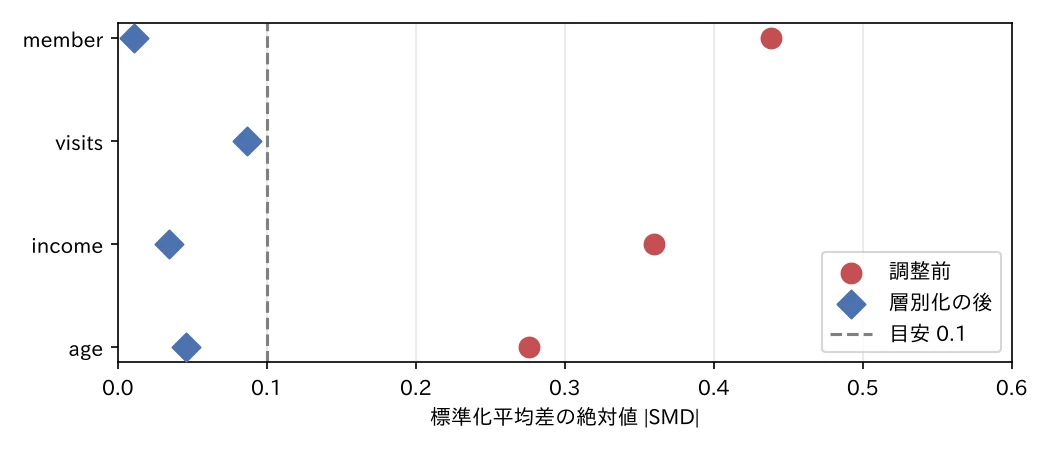
4つの共変量すべてで、ひし形が0.1の破線の左に入りました。どの共変量の偏りが大きかったか、調整でどこまで縮んだかが一目でわかるので、論文やレポートでは、この図を表と一緒に示すことが多くあります。
交絡因子をモデルから落とすと
傾向スコアで調整できるのは、モデルに入れた共変量だけです。来店回数を測っていなかったとして、残りの3つの共変量で傾向スコアを推定し直し、同じように層別化します。
# 来店回数を測っていなかったら:来店回数を除いた3つの共変量で傾向スコアを推定する
cols_obs = ["age", "income", "member"]
idx = [covariates.index(c) + 1 for c in cols_obs]
X_obs = X[:, [0] + idx]
ps_obs = sigmoid(X_obs @ fit_logistic_newton(X_obs, zv)[0])
strata_obs, w_obs, _ = subclass_weights(ps_obs, zv)
for c in covariates:
    print(f"{c:7s} SMD 調整前 {smd_before[c]:+.3f}  →  層別化の後 {smd(df[c].to_numpy(), zv, w_obs):+.3f}"
          f"{'  (モデルに入れていない)' if c not in cols_obs else ''}")
print(f"ATE の推定 {subclass_ate(df.y.to_numpy(), zv, strata_obs):,.0f}円  (真の効果 {TRUE_EFFECT:,}円)")
来店回数を除いた3つの共変量で傾向スコアを推定し、層別化した後の4つの共変量の SMD と、効果の推定を確かめるコードです。idx は、3つの共変量の での列の番号(切片が0列目なので +1)で、標準化した から、切片と3つの列だけを取り出しています。
実行結果
age     SMD 調整前 +0.276  →  層別化の後 +0.048
income  SMD 調整前 +0.360  →  層別化の後 +0.098
visits  SMD 調整前 +0.662  →  層別化の後 +0.734  (モデルに入れていない)
member  SMD 調整前 +0.438  →  層別化の後 +0.004
ATE の推定 1,630円  (真の効果 1,000円)
- モデルに入れた3つの共変量は、バランスが取れた: 年齢・年収・会員の |SMD| は、すべて0.1未満になりました。
- 来店回数の偏りは、むしろ大きくなった: 来店回数の SMD は +0.662 から +0.734 になりました。モデルに入れていない共変量は、傾向スコアでそろう保証がありません。
- 効果の推定は1,630円で、偏りが残った: 真の効果1,000円に対して、630円も大きく推定しました。単純な比較の1,973円から、取り除けたのは約3分の1だけです。
この実験では、来店回数を持っているので SMD で偏りに気づけましたが、実際に測っていない交絡因子は、SMD でも確かめられません。強い無視可能性の1つ目の仮定(交絡因子をすべて測っている)は、データでは確かめられない仮定で、どの変数が処置と結果の両方に影響するかを、分野の知識で考えて選ぶ必要があります。
傾向スコアの使い道
(図は、diagram-designで作成)
推定した傾向スコアは、層別化のほかに、次の3つの方法でも効果の推定に使います。
マッチング は、処置群の各人に、傾向スコアが最も近い対照群の人を組にして、組ごとの差を平均します。処置群の人への効果(ATT)を推定します。詳しくは傾向スコアマッチング(PSM)の記事で扱います。
IPTW(逆確率重み付け)は、処置群を 、対照群を で重み付けした平均の差を取ります。全員への効果(ATE)を推定します。
詳しくはIPTW の記事で扱います。
DR 法(AIPW)は、処置群と対照群のそれぞれで、結果を共変量で予測する回帰モデル を作り、その予測を、傾向スコアの重みを付けた残差で補正します。結果のモデルと傾向スコアのモデルのどちらか一方が正しければ、偏りなく推定できます。
詳しくはDR 法の記事で扱います。
傾向スコアを使わずに、結果を共変量と処置で回帰して調整する方法もあります。こちらは回帰による効果推定の記事で扱います。
4つの方法で効果を推定する
本文のデータで、同じ傾向スコアを4つの方法に使います。
yv = df.y.to_numpy()
# (a) 層別化(サブクラス化):上で計算した5層
est = {"層別化(5層)": subclass_ate(yv, zv, strata)}
# (b) IPTW:処置群は 1/e、対照群は 1/(1 − e) で重み付けした平均の差
est["IPTW"] = np.average(yv[zv == 1], weights=1 / ps[zv == 1]) - np.average(yv[zv == 0], weights=1 / (1 - ps[zv == 0]))
# (c) マッチング:処置群の各人に、傾向スコアが最も近い対照群の人を1人選ぶ(復元あり、ATT)
ctrl = np.where(zv == 0)[0]
nearest = ctrl[np.abs(ps[ctrl][None, :] - ps[zv == 1][:, None]).argmin(axis=1)]
est["マッチング(1対1)"] = np.mean(yv[zv == 1] - yv[nearest])
# (d) DR 法(AIPW):結果の線形回帰の予測を、傾向スコアの重みで補正する
from sklearn.linear_model import LinearRegression
m1 = LinearRegression().fit(raw[zv == 1], yv[zv == 1]).predict(raw)
m0 = LinearRegression().fit(raw[zv == 0], yv[zv == 0]).predict(raw)
est["DR 法(AIPW)"] = np.mean(m1 - m0 + zv * (yv - m1) / ps - (1 - zv) * (yv - m0) / (1 - ps))
print(f"単純な平均の差     {naive:6,.0f}円")
for k, v in est.items():
    print(f"{k:12s} {v:6,.0f}円")
print(f"真の効果           {TRUE_EFFECT:6,}円")
推定した傾向スコアを、層別化・IPTW・マッチング・DR 法に使って、効果を推定するコードです。
- (a) 層別化: 前の節で作った5層の strata を、そのまま使います。
- (b) IPTW: np.average の weights に重みを渡すと、上の式の重み付き平均になります。
- (c) マッチング: 処置群の人(301人)× 対照群の人(699人)の傾向スコアの差の絶対値を表にし、行ごとに最小の列を選びます。同じ対照群の人を何度選んでもよい(復元あり)ので、一番近い人を必ず選べます。キャリパー(組にしてよいスコアの差の上限)は、ここでは使いません。
- (d) DR 法: 結果のモデルには、処置群と対照群で別々の線形回帰(元の単位の4つの共変量)を使います。このデータの購入金額は共変量の線形の式で作っているので、結果のモデルも正しく指定されています。
実行結果
単純な平均の差      1,973円
層別化(5層)       1,085円
IPTW          1,027円
マッチング(1対1)    1,049円
DR 法(AIPW)    1,008円
真の効果            1,000円
- 4つの方法とも、単純な比較の偏りの大部分を取り除いた: 単純な比較の1,973円に対して、DR 法が1,008円、IPTW が1,027円、マッチングが1,049円、層別化(5層)が1,085円でした。
- 1つのデータでは、どの方法が良いかはわからない: 1,000人のデータには、購入金額のノイズ(標準偏差1,000円)があるので、推定値は真の効果の周りでばらつきます。1つのデータの推定値の順番は、たまたまの結果かもしれません。
200個のデータで、偏りとばらつきを比べる
推定値のばらつきと、方法そのものの偏りを分けて見るために、乱数のシードだけを変えた200個のデータで、推定を繰り返します。推定値の平均が真の効果1,000円からどれだけずれるか(偏り)と、標準偏差(ばらつき)を比べます。
def estimate_all(df, covariates):
    """1つのデータから、単純な差と、傾向スコアを使う4つの方法で効果を推定する"""
    raw = df[covariates].to_numpy(float)
    X = np.column_stack([np.ones(len(df)), (raw - raw.mean(axis=0)) / raw.std(axis=0)])
    z, y = df.z.to_numpy(), df.y.to_numpy()
    ps = sigmoid(X @ fit_logistic_newton(X, z)[0])
    est = {"単純な差": y[z == 1].mean() - y[z == 0].mean()}
    for k in (5, 10):
        est[f"層別化({k}層)"] = subclass_ate(y, z, subclass_weights(ps, z, k)[0])
    est["IPTW"] = np.average(y[z == 1], weights=1 / ps[z == 1]) - np.average(y[z == 0], weights=1 / (1 - ps[z == 0]))
    ctrl = np.where(z == 0)[0]
    nearest = ctrl[np.abs(ps[ctrl][None, :] - ps[z == 1][:, None]).argmin(axis=1)]
    est["マッチング(1対1)"] = np.mean(y[z == 1] - y[nearest])
    m1 = LinearRegression().fit(raw[z == 1], y[z == 1]).predict(raw)
    m0 = LinearRegression().fit(raw[z == 0], y[z == 0]).predict(raw)
    est["DR 法(AIPW)"] = np.mean(m1 - m0 + z * (y - m1) / ps - (1 - z) * (y - m0) / (1 - ps))
    return est


# 乱数のシードだけを変えて、同じ作り方のデータを200個作り、推定を繰り返す
sims = pd.DataFrame([estimate_all(make_data(seed=s), covariates) for s in range(100, 300)])
print(sims.agg(["mean", "std"]).T.round(0).rename(columns={"mean": "平均(円)", "std": "標準偏差(円)"}))


def plot_estimates(sims, true_effect, path):
    """方法ごとに、200回の推定値のばらつきを箱ひげ図で並べる"""
    fig, ax = plt.subplots(figsize=(8, 3.8))
    names = list(sims.columns)[::-1]                          # 上から「単純な差」の順に並べる
    ax.boxplot([sims[c] for c in names], vert=False, widths=0.5)
    ax.set_yticks(range(1, len(names) + 1), names)
    ax.axvline(true_effect, color="#C44E52", ls="--", label=f"真の効果 {true_effect:,}円")
    ax.set_xlabel("効果の推定値(円)"); ax.legend(loc="lower right"); ax.grid(axis="x", alpha=0.3)
    fig.tight_layout(); fig.savefig(path, dpi=150); plt.close(fig)


plot_estimates(sims, TRUE_EFFECT, "propensity_score_9.png")
同じ作り方の200個のデータで、傾向スコアの推定から4つの方法の推定までを繰り返し、推定値の平均と標準偏差を計算して、箱ひげ図で並べるコードです。
- estimate_all(df, covariates): 1つのデータを受け取り、共変量の標準化、ニュートン法による傾向スコアの推定、単純な差と5つの推定(層別化は5層と10層)までを行って、辞書で返します。これまでの節の関数を、そのまま組み合わせています。
- range(100, 300): シード100〜299の200個のデータです。本文のデータ(シード5)とは別のデータにしています。
- plot_estimates(sims, true_effect, path): 方法ごとの200個の推定値を、横向きの箱ひげ図で並べ、真の効果に破線を引きます。箱は推定値の中央の半分(25〜75%点)、中の線は中央値です。
実行結果
             平均(円)  標準偏差(円)
単純な差        1968.0     93.0
層別化(5層)     1104.0     85.0
層別化(10層)    1044.0     86.0
IPTW        1009.0    108.0
マッチング(1対1)  1009.0    105.0
DR 法(AIPW)  1005.0     86.0
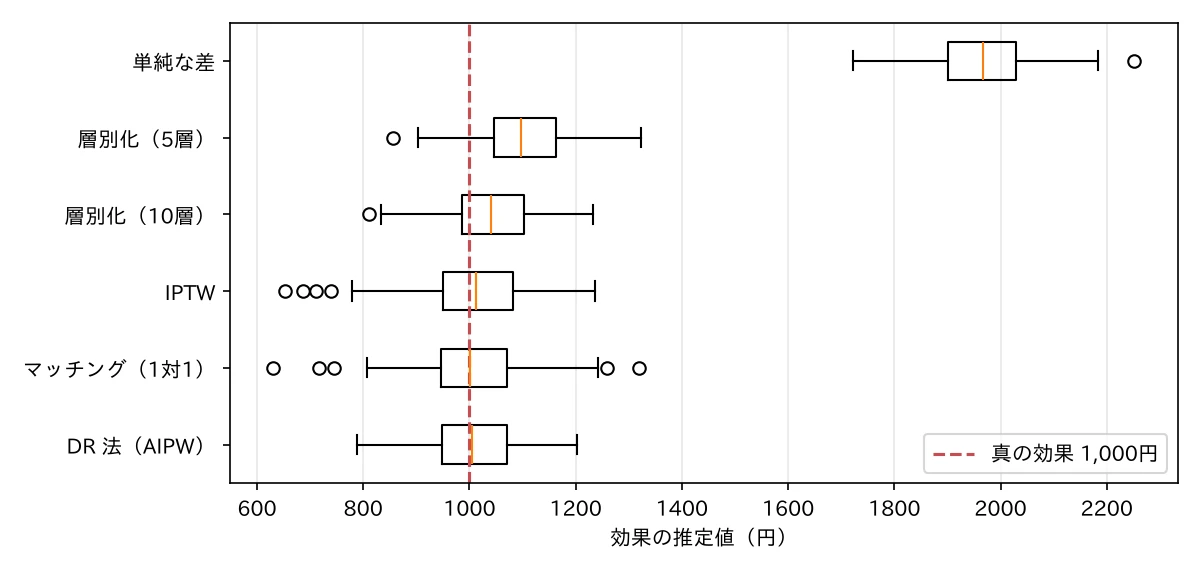
- 単純な差は、平均1,968円で、つねに大きく外れる: 標準偏差は93円で、200個のどのデータでも1,700円を超えました(最小1,722円)。データを増やしても、交絡による偏りは消えません。
- 層別化(5層)には、約100円の偏りが残った: 平均は1,104円で、単純な差の偏り968円のうち、約89%を取り除き、約11%が残りました。「5層で約90%」という Cochran(1968)の目安とよく合います。10層にすると平均1,044円で、偏りは44円に減りました。
- IPTW・マッチング・DR 法は、平均がほぼ1,000円: 平均は IPTW が1,009円、マッチングが1,009円、DR 法が1,005円で、偏りはほぼありませんでした。
- 偏りのない3つの方法では、DR 法のばらつきが最も小さい: 標準偏差は DR 法が86円、マッチングが105円、IPTW が108円でした。DR 法は、結果のモデルで購入金額のばらつきの大部分を説明してから補正するので、ばらつきが小さくなります。IPTW は少数の大きな重みの人に、マッチングは組にした1人の対照群の人に、推定が左右されやすくなります。
まとめ
本記事では、架空の1,000人のクーポンのデータで、傾向スコアをロジスティック回帰でスクラッチ推定し、共通台と標準化平均差(SMD)で調整を確かめて、4つの方法で効果を推定しました。
- 単純な比較は、真の効果の約2倍: 来店回数・会員などの交絡で、配った人と配らなかった人の差は1,973円(真の効果1,000円)になり、4つの共変量の SMD は +0.276〜+0.662でした。
- 共変量で直接層に分けると、比べる相手がいなくなる: 4つの共変量の組み合わせでは240層になり、比べられるのは66.2%の人でした。傾向スコアの五分位なら、5層すべてに両群がいました。
- ニュートン法は3回、最急降下法は100回で収束: どちらも対数尤度 −517.887 に達し、scikit-learn との係数の差は最大 3.5e-05 でした。
- 層別化で、すべての共変量の |SMD| が0.1未満になった: 来店回数は +0.662 から +0.087 になりました。一方、来店回数をモデルから落とすと、その SMD は +0.734 のまま残り、推定は1,630円と偏りました。
- 200個のデータでは、IPTW・マッチング・DR 法の平均がほぼ1,000円: 層別化(5層)には約100円(偏りの約11%)が残りました。3つの方法の標準偏差は、DR 法が86円で最も小さくなりました。
傾向スコアは、多くの共変量を「処置を受ける確率」という1つの数にまとめ、観察データの中に、共変量のそろった比較を作る道具です。うまくいったかは、モデルの当てはまりではなく、共通台と SMD で確かめます。ただし、取り除けるのはモデルに入れた交絡因子だけなので、測っていない交絡因子がないかは、データではなく分野の知識で考える必要があります。スコアを推定したあとは、知りたい効果(ATE か ATT か)と、極端なスコアの有無に応じて、マッチング・IPTW・DR 法を選びます。
参考文献
- P. R. Rosenbaum, D. B. Rubin (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55.
- P. C. Austin (2011). An Introduction to Propensity Score Methods for Reducing the Effects of Confounding in Observational Studies. Multivariate Behavioral Research, 46(3), 399–424.
- W. G. Cochran (1968). The effectiveness of adjustment by subclassification in removing bias in observational studies. Biometrics, 24(2), 295–313.
本記事の文章・構成の一部に生成AIを使用しています。