Q学習(Q-Learning)とは?
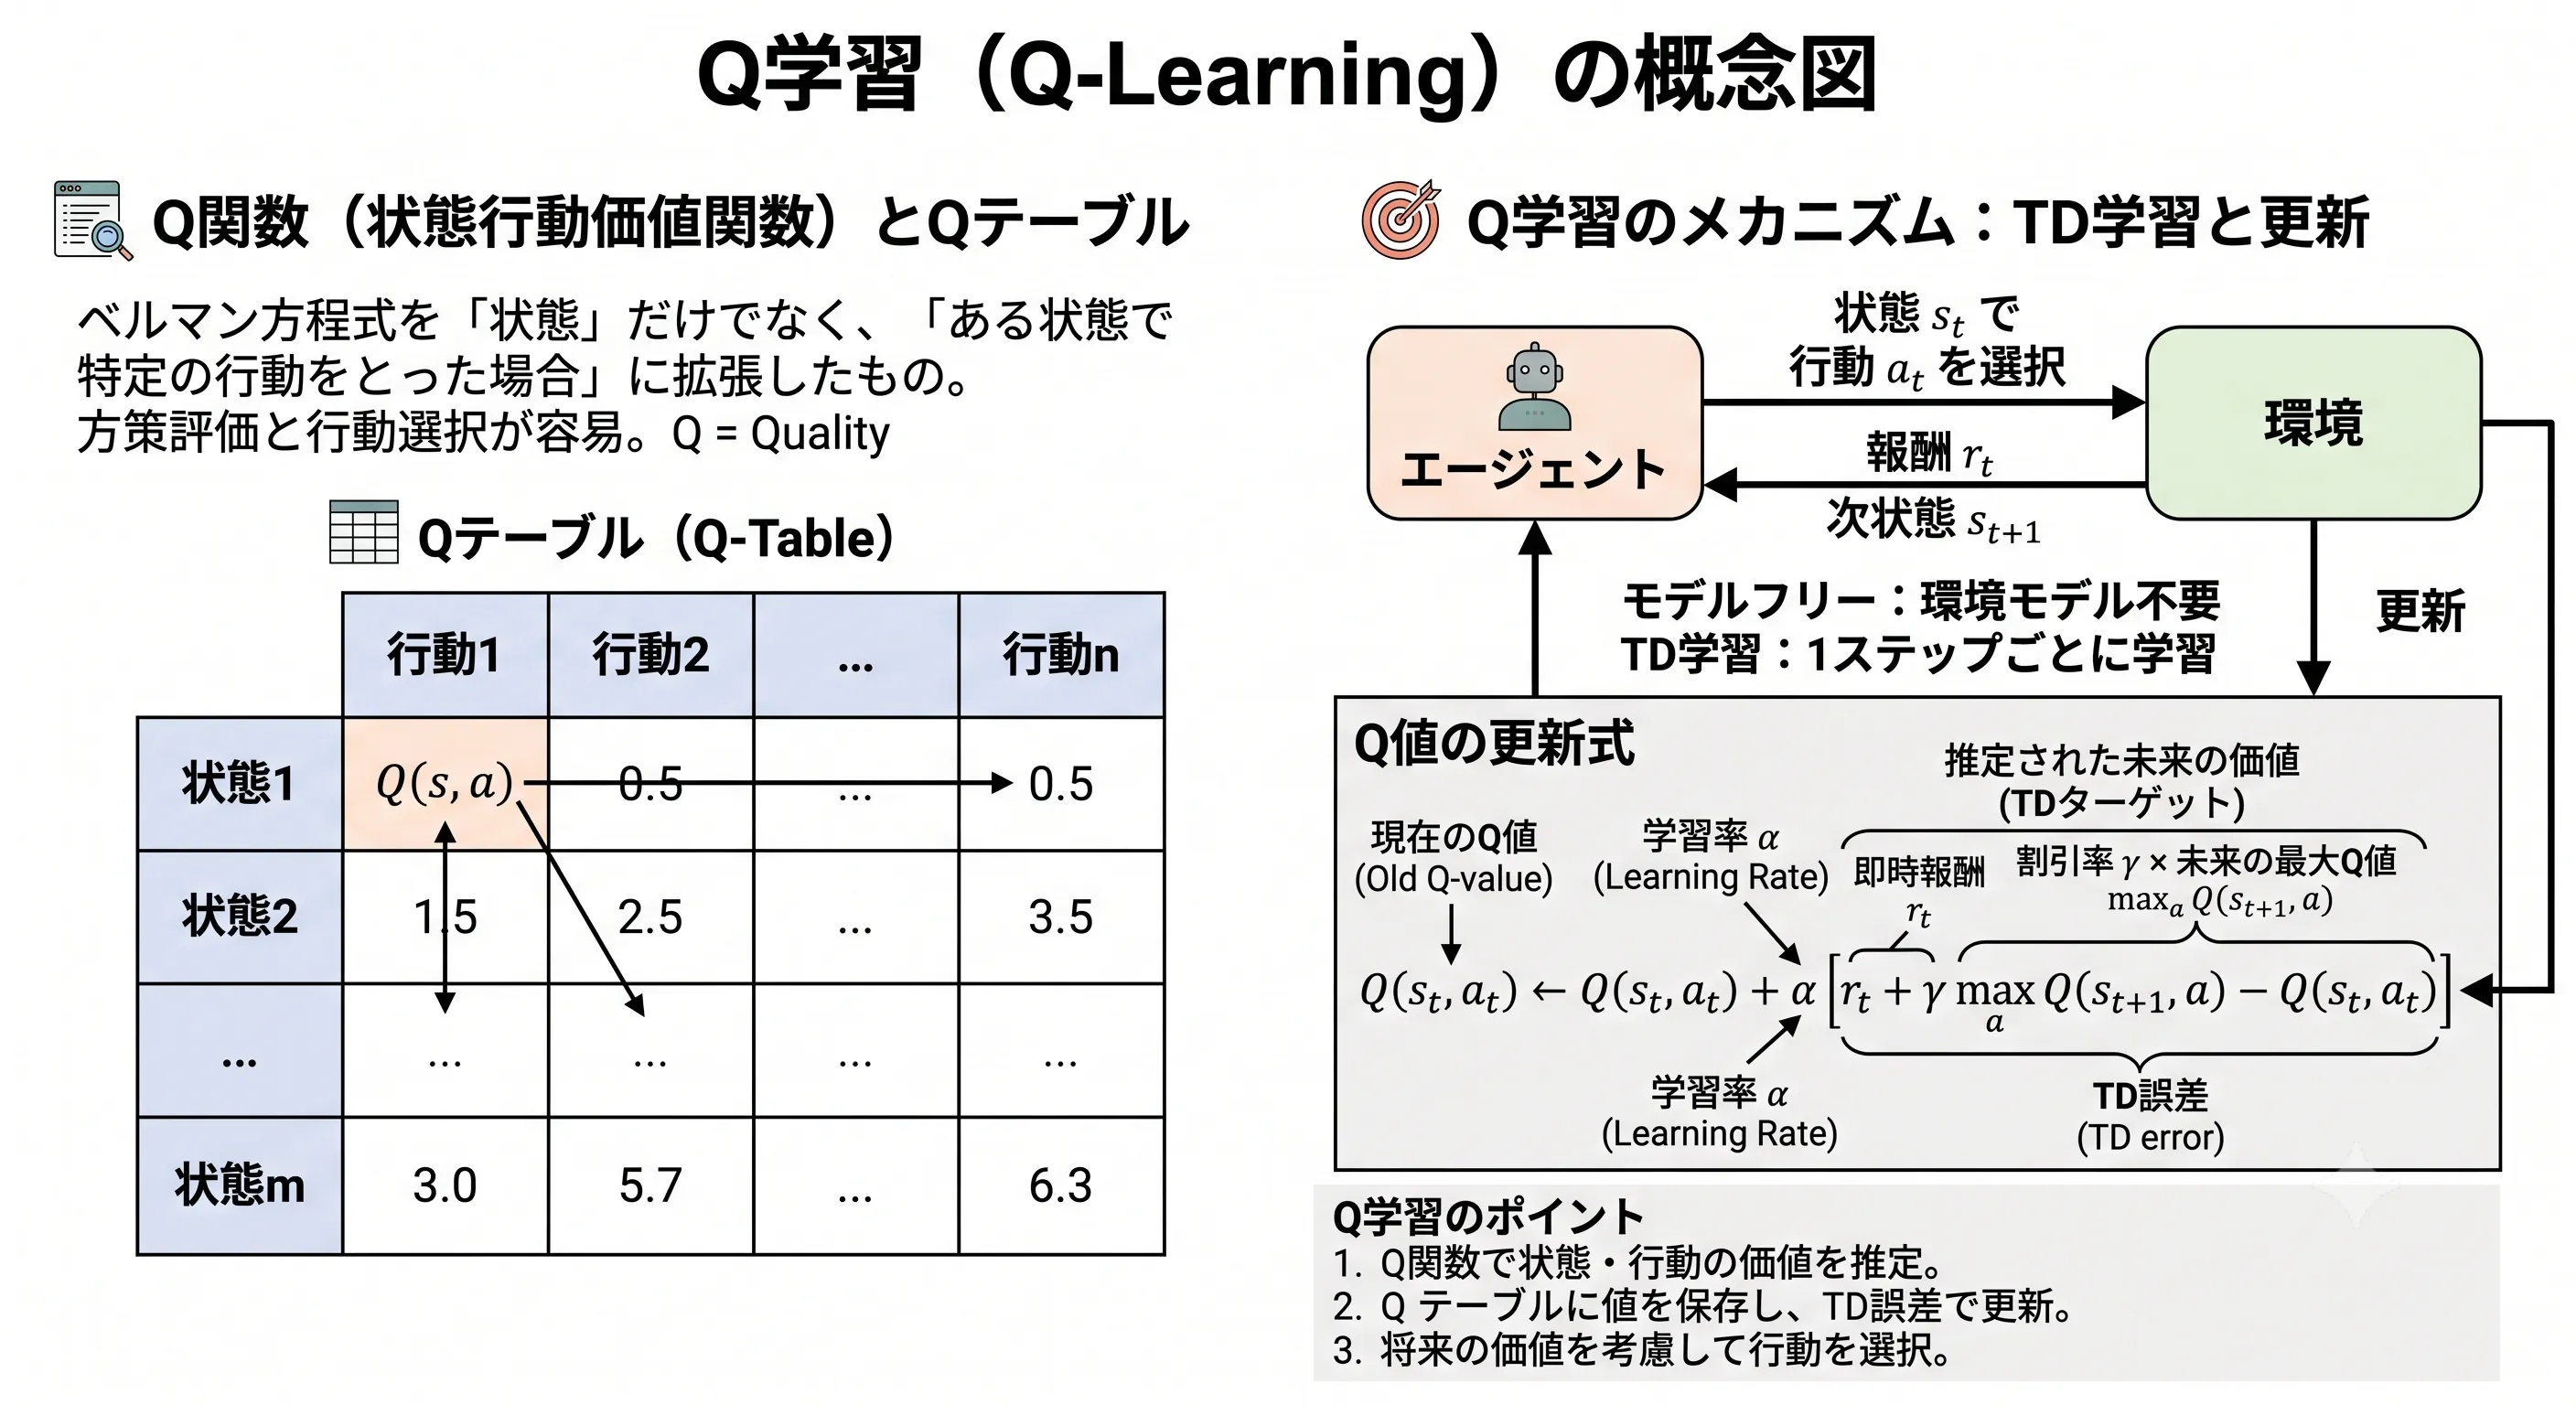 (画像は、Geminiで作成)
ベルマン方程式と Q 関数の意味を理解し、TD 誤差で Q テーブルを更新する Q 学習の仕組みと、オフポリシーであることを説明できるようになること。CartPole で連続的な状態を離散化して Q 学習を実装し、離散化の設計や終端状態の扱いが学習の成否を左右することを確かめること。
Q学習(Q-Learning)の概要
Q学習(Q-Learning)は、1989年にChristopher Watkinsが博士論文で提唱した、強化学習(Reinforcement Learning: RL)における最も基礎的で有名なアルゴリズムの一つです。その後、1992年にWatkinsとPeter Dayanによる論文「Q-learning」で、一定の条件のもとで最適な行動価値へ確率1で収束することが証明されました(条件は後述します)。 この記事では、Deep Q-Network(DQN)のような高度な深層強化学習アルゴリズムを学ぶ前の基礎として、 Q学習の基本的な仕組み、ベルマン方程式の詳細な解説、そして「Cart Pole(倒立振子)」を用いた具体的なPythonコード(可視化を含む)について解説します。
強化学習の基本パイプライン
Q学習の詳細に入る前に、強化学習の基本的な枠組みをおさらいしましょう。
強化学習の環境は、以下のような要素で構成されます。
- エージェント(Agent): 環境内で行動を起こし、学習を行う主体です。
- 環境(Environment): エージェントが相互作用する世界やシミュレーションのことです。
- エージェントは環境から状態(State, ) を受け取ります。
- その状態に基づいて行動(Action, ) を決定し、環境に働きかけます。
- 環境は行動に応じて状態を変化させ、エージェントに報酬(Reward, ) と次の状態(Next State, ) を返します。
エージェントの目的は、時間の経過とともに得られる報酬の合計(長期的な収益)を最大化するような「方策(Policy)」を学習することです。また、強化学習では「探索(Exploration)」と「利用(Exploitation)」のバランスを最適に保つことが重要になります。
強化学習の基本的な枠組みや用語についてさらに詳しく知りたい方、事前知識に不安がある方は、先に 強化学習超入門 の記事をお読みいただくことをおすすめします。
エージェントと環境のやり取りを図にすると、次のようになります。
(図は、diagram-designで作成)
ベルマン方程式とQ関数(詳細解説)
強化学習において、エージェントが将来どれくらいの報酬を得られるかを示す指標を収益(Return, ) と呼びます。
(エピソードが時刻 で終了するタスクでは、終了後の報酬をすべて0とみなします。)
ここで、(ガンマ)は 割引率(Discount Factor) と呼ばれ、 の値を取ります。これは経済学の考え方を借りたもので、遠い未来の報酬よりも目先の報酬を高く評価するためのパラメータであり、同時に数学的な収束を保証する役割も果たします。
価値関数(Value Function)と無限期間問題の回避
現実の環境は確率的(Stochastic)であるため、収益 そのものは毎回ばらつきます。そこで、ある方策 に従って行動したときの、状態 から得られる収益の期待値を状態価値関数(State Value Function) と定義します。
もしゲームが無限に続くタスク()の場合、割引率が だと、毎ステップ +1 の報酬を得続けた場合の収益が と無限大に発散してしまい、状態の良し悪しを比較できなくなります。
しかし、 のように 未満に設定すると、収益は という無限等比級数になります。高校数学の等比級数の和の公式 を当てはめると、 となり、未来永劫の報酬を足し合わせても「10」という有限の値に綺麗に収束します。割引率には、このような数学的な破綻を防ぐ重要な役割があります。
しかし、この期待値の式をそのまま計算しようとすると、未来永劫にわたるすべての状態遷移と報酬を追跡しなければならない「無限期間問題(Infinite horizon problem)」に陥ってしまいます。これを解決するのがベルマン方程式(Bellman Equation) です。1950年代にRichard Bellmanが動的計画法の研究の中で導いたこの式は、収益を「即時報酬」と「割引された次の状態の価値」に再帰的に分解します。
収益が と再帰的に書けることから、この関係が導かれます。次の状態 や報酬 は確率的に決まるため、右辺全体に期待値がかかっている点に注意してください。この再帰的な表現によって、無限に続く問題を「1ステップ先」という解ける部分問題に分割することができます。
Q関数(状態行動価値関数)
ベルマン方程式の考え方を状態だけでなく、「ある状態で特定の行動をとった場合」に拡張したものがQ関数(Q-function) です。Qは「Quality(品質)」を表します。
状態価値関数 と違い、Q関数は状態と行動の両方に条件付けられているため、エージェントの方策を評価し、具体的な行動を選択することが容易になります。ある状態 で が最も大きい行動 を選べばよいからです。
ベルマン最適方程式
ここまでの式は「ある方策 に従ったときの価値」でした。強化学習の最終目標は、価値を最大にする最適方策を見つけることです。最適方策のもとでのQ関数(最適行動価値関数) は、次のベルマン最適方程式(Bellman Optimality Equation) を満たします。
「今の行動 をとって報酬を受け取り、その後は常に最善の行動()をとり続ける」と考えたときの価値が である、という意味です。次に解説するQ学習の更新式に が登場するのは、Q学習がこのベルマン最適方程式を満たす を、経験から近似的に求めようとしているためです。
Q学習のメカニズム:TD学習とQテーブル
Q学習は、このQ関数を表形式(Qテーブル)で保存し、更新していくアルゴリズムです。動的計画法(Dynamic Programming)のように環境の完全なモデル(遷移確率など)を必要としないモデルフリー(Model-free) な手法であり、1ステップごとに学習を行う TD(Temporal-Difference)学習 の一種です。
Q学習のベースとなっている「1ステップごとに予測を更新する」仕組みについてより深く学びたい方は、TD学習(時間的差分学習)とは?の記事をあわせてご覧ください。TD誤差やベルマン方程式に基づく価値更新の概念を、Pythonによるスクラッチ実装とともに詳しく解説しています。
Q学習の更新式は以下のようになります。
- : 学習率(Learning Rate)
- : 推定された未来の価値(TDターゲット)。ベルマン最適方程式の右辺を、実際に観測した1ステップ分の経験で置き換えたものです。
- : 現在のQ値(Old Q-value)。
- 大カッコの中身全体(TDターゲットと現在のQ値の差)がTD誤差(TD error) と呼ばれます。
なお、 がエピソードの終端状態(ゲームオーバーなど)の場合、その先に得られる報酬はないため、 は0として扱い、TDターゲットは だけになります。実装ではこの扱いを忘れやすいので注意が必要です(後述のコードでも明示的に処理しています)。
Watkins & Dayan(1992)の論文「Technical Note: Q-Learning」では、次の条件がそろえば、Q値がすべての状態と行動の組について最適なQ値 に確率1で収束することが示されています。
- 状態と行動の数が有限で、Q値を表(Qテーブル)で正確に表せる
- 報酬の大きさが有界である
- すべての状態と行動の組を無限回試す
- 学習率 を、合計が無限大()で、2乗の合計が有限()になるように小さくしていく(例:。 はその組を更新した回数)
後半で実装するCartPoleの例は、次の表のように、この条件を満たしていません。
| 項目 | 収束定理の条件 | 本記事の実装 |
|---|---|---|
| 状態 | 有限個で、表で正確に表せる | 連続値を648個のビンに離散化する(違う状態が同じビンにまとまる) |
| 学習率 | 更新のたびに小さくしていく | 0.1 で固定 |
| 試行の回数 | すべての組を無限回 | 1,000エピソード |
| 報酬 | 有界 | 1ステップごとに +1(有界) |
状態をまとめてしまうことと、学習率を固定していることから、収束の保証はなく、Q値は揺れ続けます。実行結果で平均スコアが上下するのはこのためです。それでも学習率を固定しているのは、学習率を小さくしていくと、少ない試行では更新がすぐに止まってしまい、1,000エピソードでは学習が進まないためです。
数式の中にある は、「次の状態 に移動したあと、そこから最も賢い行動(最大のQ値を持つ行動)を選んだ場合に得られるであろう将来の価値」を意味しています。
- グリッドワールド(迷路)の例: 現在地から「一歩右に動く」という行動をとった結果、次のマス() が「ゴールのすぐ隣のマス」だったとします。まだゴールに到達していませんが、次のマスにおいては「さらに右へ動く(ゴールに入る)」という行動のQ値が非常に高く設定されているはずです()。そのため、現在のマスのQ値も「次へ進めば高得点が確定している」という理由で高く更新されます。
- Cart Pole(倒立振子)の例: 現在カートを「右に押す」という行動をとった結果、次の状態() が「ポールが垂直にピンと立って安定している状態」になったとします。この次状態からは、一番安全な行動(例えば少し左に押して微調整するなど)を選んだときの価値 が高いはずです。したがって、「そもそも現在カートを右に押した行動は正解だった」として現在のQ値が引き上げられます。
つまり、「次の場所から一番良い選択をした場合のポテンシャル」を逆算し、現在の行動の評価(Q値)に組み込んでいるのがこの数式の核心(コア)です。
エージェントはQテーブルを用いて、特定の状態で取るべき行動のQ値を保存します。そして、観測された報酬と推定された将来の価値に基づいてQ値を更新します。
更新式の各項の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
探索と利用(-greedy法)
強化学習超入門で解説した通り、強化学習では「今わかっている一番良い行動をとる(利用)」と「まだ試していない行動をとって新しい知識を得る(探索)」のバランスが重要です。
Q学習では、このバランスをとるために -greedy法(イプシロン・グリーディ法) を用いるのが一般的です。
- (小さな値、例: 0.1)の確率であえてランダムな行動を選び、新しい可能性を探索します。
- 残りの の確率で、現在のQテーブルの中で最大のQ値を持つ行動を選び、既存の知識を利用します。
オフポリシー(Off-policy)という特徴
Q学習の大きな特徴は、オフポリシー(Off-policy) な手法であることです。
- 実際に行動を選ぶ方策(行動方策): ランダムな探索を含む -greedy法
- 更新式で評価している方策(目標方策): 常にQ値が最大の行動を選ぶ貪欲(greedy)な方策(更新式の の部分)
このように、Q学習は「探索しながら行動しているにもかかわらず、学習しているのは『探索をやめて常に最善を選んだ場合』の価値」になっています。行動方策と目標方策が異なるため「オフポリシー」と呼ばれます。これに対し、実際に次にとった行動 のQ値 を使って更新する手法は SARSA と呼ばれ、行動方策と目標方策が一致するオンポリシー(On-policy) な手法です。
オフポリシーであることから、Q学習は「過去の古い方策で集めた経験」からも学習できます。この性質は、後述するDQNの「経験再生(Experience Replay)」を可能にする重要な土台となっています。
Q学習と SARSA の違いを並べると、次のようになります。
(図は、diagram-designで作成)
Q学習の実装:Cart Poleの学習と可視化
理論を理解したところで、Pythonと gymnasium を用いてCart PoleのQ学習を実装してみましょう。 Cart Poleの環境において、カートの位置や速度などの「状態」は連続値(Continuous states)を取ります。しかし、Q学習は有限サイズのテーブル(Finite-size tables)を脳として使用するため、連続的な状態や行動を持つ環境で直接学習することはできません。 そこで、連続値をいくつかの「ビン(箱)」に分割して離散化(Discretize)する処理を行います。
1. ライブラリのインストール
!pip install "gymnasium[classic-control]" numpy matplotlib japanize-matplotlib setuptools
強化学習環境の gymnasium、数値計算用の numpy、そして可視化のための matplotlib をインストールします。CartPoleの描画(アニメーション作成)には pygame が必要なため、gymnasium[classic-control] と指定して一緒にインストールしています。学習曲線のグラフに日本語を表示するため japanize-matplotlib も入れます。setuptools は、Python 3.12 以降で japanize-matplotlib が使う distutils を補うために入れています。
本記事のコードは、gymnasium 1.4.0 で実行した結果を載せています。どれもCPUで動き、学習は1回あたり約10秒です。
CartPole の4つの連続値をビンに分ける様子を図にすると、次のようになります。
(図は、diagram-designで作成)
2. 学習コードの実装
以下のコードは、連続値の状態を離散化し、Qテーブルを用いてCart Poleを学習させるスクリプトです。
CartPoleの状態は「カートの位置」「カートの速度」「ポールの角度」「ポールの角速度」の4次元の連続値です。これらをそれぞれ 個のビン(区間)に分割し、 個の離散的な状態として扱います。 ポールを立て続けるうえで最も重要なのは「ポールがどちらにどれくらい傾いていて、どちらに倒れつつあるか」なので、ポールの角度と角速度は細かく、カートの位置と速度は粗く分割しています。また、離散化する範囲はエピソードの終了条件(カート位置 ±2.4、ポール角度 ±12度 ≒ ±0.2095ラジアン)や実際に取りうる速度の範囲に合わせて設定しています。範囲を広くとりすぎると、実際には使われないビンが増えて状態の区別が粗くなり、学習がうまく進みません。
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt

# 再現性のための乱数シード
SEED = 42
rng = np.random.default_rng(SEED)

# 環境の初期化
env = gym.make('CartPole-v1')
env.action_space.seed(SEED)

# ハイパーパラメータの設定(値の理由は下の解説と「値の決め方」を参照)
EPISODES = 1000       # ε が下限 0.01 に届く約919エピソードの後も、少し利用を続けて確かめる長さ
LEARNING_RATE = 0.1   # α:0.2 にすると学習の終盤でスコアが大きく揺れる
DISCOUNT = 0.99       # γ:最大500ステップ続くので、約100ステップ先まで見通せる値にする
EPSILON = 1.0         # 探索率の初期値(最初は Q テーブルに知識がないので、すべてランダムに動く)
EPSILON_DECAY = 0.995 # 1エピソードごとに掛ける減衰率
EPSILON_MIN = 0.01    # 探索率の下限(探索をゼロにせず、まれに別の行動も試す)

# 連続状態を離散化するためのビンの数(カート位置, カート速度, ポール角度, ポール角速度)
NUM_BINS = [3, 3, 6, 12]

# 離散化する範囲(この範囲外の値は両端のビンにまとめる)
# 位置と角度は終了条件の値、速度と角速度は学習中に観測した値の範囲から決めた
upper_bounds = [2.4, 3.0, 0.2095, 3.5]
lower_bounds = [-2.4, -3.0, -0.2095, -3.5]

# Qテーブルの初期化(状態の各次元のビン数 × 行動数)
q_table = rng.uniform(low=-1, high=1, size=(NUM_BINS + [env.action_space.n]))

# 状態を離散化(インデックス化)する関数
def discretize_state(state):
    discrete_state = []
    for i in range(len(state)):
        # 最小値・最大値の範囲内にクリップ
        val = np.clip(state[i], lower_bounds[i], upper_bounds[i])
        # 範囲を0〜1に正規化し、ビン数に掛けてインデックスを取得
        ratio = (val - lower_bounds[i]) / (upper_bounds[i] - lower_bounds[i])
        bin_idx = int(round((NUM_BINS[i] - 1) * ratio))
        discrete_state.append(bin_idx)
    return tuple(discrete_state)

# 学習ループ
scores = []
observed = []                 # 離散化の範囲が妥当かを後で確かめるため、観測した状態を記録する
best_avg = -np.inf            # 直近100エピソードの平均スコアの最高値
best_episode = 0              # その最高値を記録したエピソード
best_q_table = q_table.copy() # その時点のQテーブルを保存しておく
for episode in range(EPISODES):
    state, _ = env.reset(seed=SEED if episode == 0 else None)
    discrete_state = discretize_state(state)
    done = False
    score = 0

    while not done:
        # epsilon-greedy法による行動選択
        if rng.random() < EPSILON:
            action = env.action_space.sample()  # 探索
        else:
            action = int(np.argmax(q_table[discrete_state]))  # 利用

        next_state, reward, terminated, truncated, _ = env.step(action)
        done = terminated or truncated
        observed.append(next_state)
        next_discrete_state = discretize_state(next_state)

        # TDターゲットの計算
        if terminated:
            # ポールが倒れた(終端状態):その先に未来はないので報酬のみ
            td_target = reward
        else:
            # それ以外(時間切れの打ち切りを含む):報酬 + 割引された次状態の最大Q値
            next_max = np.max(q_table[next_discrete_state])
            td_target = reward + DISCOUNT * next_max

        # Q値の更新: Q(s,a) <- Q(s,a) + α [TDターゲット - Q(s,a)]
        old_q_value = q_table[discrete_state + (action,)]
        q_table[discrete_state + (action,)] = old_q_value + LEARNING_RATE * (td_target - old_q_value)

        discrete_state = next_discrete_state
        score += reward

    # epsilonの減衰(下限 EPSILON_MIN を下回らないようにする)
    EPSILON = max(EPSILON_MIN, EPSILON * EPSILON_DECAY)

    scores.append(score)

    # 直近100エピソードの平均スコアが過去最高を更新したら、Qテーブルを保存する
    if len(scores) >= 100 and np.mean(scores[-100:]) > best_avg:
        best_avg = np.mean(scores[-100:])
        best_episode = episode + 1
        best_q_table = q_table.copy()

    if (episode + 1) % 100 == 0:
        print(f"Episode {episode + 1}: Average Score (last 100): {np.mean(scores[-100:]):.1f}, EPSILON: {EPSILON:.3f}")

print(f"学習完了! 直近100エピソード平均スコアの最高値: {best_avg:.1f}({best_episode}エピソード目)")
env.close()
- 乱数シードの固定: SEED = 42 として、Qテーブルの初期化と -greedy法の判定に使う乱数生成器 rng、ランダム行動を選ぶ env.action_space.seed(SEED)、環境の初期状態を決める env.reset(seed=SEED) のシードを固定し、実行結果を再現できるようにしています。
- 状態の離散化(discretize_state): gymnasium から返される連続値のリストを、lower_bounds と upper_bounds の範囲で0〜1に正規化し、各次元のビン数 NUM_BINS に応じた整数のインデックスに変換しています。範囲外の値は np.clip で両端のビンにまとめます。
- 行動選択: rng.random() < EPSILON の場合はランダムに行動し(探索)、それ以外は np.argmax(q_table[discrete_state]) で現在の最大Q値の行動(利用)を選びます。
- TDターゲットの計算(終端状態の扱い): ポールが倒れて terminated が True になった場合、その先に未来はないため、TDターゲットは reward のみとします。一方、500ステップに達して打ち切られた(truncated)場合は、失敗したわけではなく「時間切れ」で止められただけなので、通常どおり reward + DISCOUNT * next_max を使います。この区別をしないと、「ポールが倒れると損をする」ことをうまく学習できません。
- Q値の更新: 先ほど解説した更新式 を、old_q_value + LEARNING_RATE * (td_target - old_q_value) としてそのままコードに落とし込んでいます。
- の減衰: エピソードごとに EPSILON に EPSILON_DECAY を掛けて探索の割合を徐々に減らし、max(EPSILON_MIN, ...) で下限 0.01 を下回らないようにしています。 を解くと なので、ε は約919エピソード目で下限に届きます。EPISODES = 1000 は、探索がほぼ終わった後のエージェントの成績を、残りの約80エピソードで確かめられる長さです。
- ハイパーパラメータの値: 割引率 DISCOUNT = 0.99 は、 ステップ程度先の報酬まで考慮する値です。1エピソードは最大500ステップ続くので、目先の数十ステップだけでなく、ポールが倒れるかなり前から「倒れそうな状態」を避けられるようにしています。学習率 LEARNING_RATE = 0.1、ビン数、離散化の範囲、Qテーブルの初期値も含め、値を変えた場合の比較は、後の「値の決め方」で示します。
- 観測した状態の記録: observed は学習には使いません。速度と角速度の範囲が、実際に観測した値をどれだけカバーしているかを、学習後に確かめるために記録しています。
- 最良のQテーブルの保存: 直近100エピソードの平均スコアが過去最高を更新するたびに、その時点のQテーブルを q_table.copy() で best_q_table に保存し、そのエピソード番号を best_episode に記録しています。copy() を使うのは、代入だけでは学習を続けるQテーブルと同じ配列を指してしまい、保存したことにならないためです。理由は実行結果のところで説明します。
学習コードの実行結果
Episode 100: Average Score (last 100): 28.2, EPSILON: 0.606
Episode 200: Average Score (last 100): 70.4, EPSILON: 0.367
Episode 300: Average Score (last 100): 111.1, EPSILON: 0.222
Episode 400: Average Score (last 100): 162.7, EPSILON: 0.135
Episode 500: Average Score (last 100): 226.8, EPSILON: 0.082
Episode 600: Average Score (last 100): 187.1, EPSILON: 0.049
Episode 700: Average Score (last 100): 337.4, EPSILON: 0.030
Episode 800: Average Score (last 100): 287.4, EPSILON: 0.018
Episode 900: Average Score (last 100): 247.8, EPSILON: 0.011
Episode 1000: Average Score (last 100): 340.6, EPSILON: 0.010
学習完了! 直近100エピソード平均スコアの最高値: 371.4(757エピソード目)
エピソードが進むごとに (探索率)が減衰し、エージェントが徐々に「利用(学習した知識の活用)」にシフトしていることがわかります。それに伴い、直近100エピソードの平均スコアは最初の28.2から300台まで大きく上昇しています。
一方で、平均スコアは単調には増えておらず、600エピソード目や800〜900エピソード目のように一時的に下がることもあります。この揺れは、エピソードごとのスコアを図にするとよく分かります。
import japanize_matplotlib  # グラフの日本語表示のため

# 直近100エピソードの移動平均(最初の99エピソードは、それまでのエピソードの平均)
rolling = [np.mean(scores[max(0, i - 99):i + 1]) for i in range(len(scores))]
episodes = np.arange(1, len(scores) + 1)

fig, ax = plt.subplots(figsize=(10, 4.8))
ax.plot(episodes, scores, color='#9DB4D8', lw=0.8, label='各エピソードのスコア')
ax.plot(episodes, rolling, color='#DD8452', lw=2.2, label='直近100エピソードの平均')
ax.axhline(500, color='gray', ls='--', lw=1, label='上限(500ステップ)')
ax.axvline(best_episode, color='#55A868', ls=':', lw=1.8,
           label=f'best_q_table を保存した時点({best_episode}エピソード目)')
ax.set_xlabel('エピソード')
ax.set_ylabel('スコア(ポールを立てていたステップ数)')
ax.set_title('Q学習によるCartPoleの学習曲線')
ax.legend(loc='upper left', fontsize=9)
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
- 移動平均: 1エピソードごとのスコアは0〜500の間で大きくばらつくため、そのままでは傾向が読めません。学習コードの出力と同じ「直近100エピソードの平均」を重ねて描いています。
- 保存した時点の線: 学習コードで記録した best_episode に縦線を引き、best_q_table がどの時点のQテーブルかを示しています。
実行結果
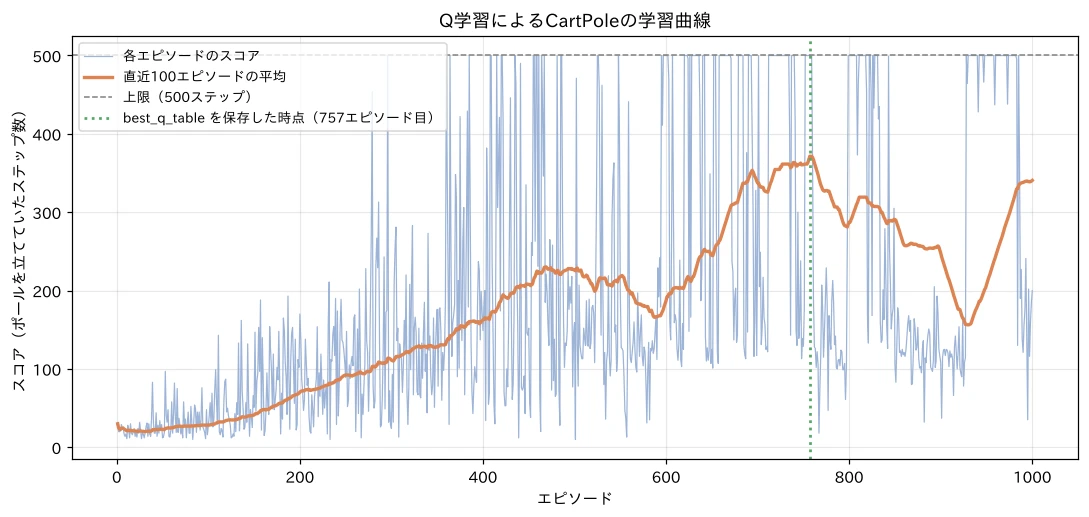
平均スコア(橙)は757エピソード目に371.4で最高になった後、930エピソード目付近では約160まで下がり、その後また340前後まで戻っています。個々のエピソード(青)を見ると、上限の500に届くエピソードと、100前後で倒れるエピソードが学習の後半でも入り混じっています。
これは、前述の収束の条件を満たしていないためです。離散化によって「実際には異なる状態」が同じビンにまとめられ、さらに学習率を固定して更新を続けるため、Q値が揺れ続けます。表形式のQ学習ではよく見られる現象です。そのため、学習を最後まで続けたQテーブルが最も良いとは限りません。今回は、学習中に最も成績の良かった時点のQテーブル(best_q_table)を保存しておき、次の可視化ではそれを使います。
離散化の範囲の確認
学習コードで記録した状態を使って、離散化の範囲(upper_bounds)が実際の値をどれだけカバーしているかを確かめます。
# 学習中に観測した状態の絶対値が、離散化の範囲に収まっているかを確かめる
obs = np.abs(np.array(observed))
names = ['カート位置', 'カート速度', 'ポール角度', 'ポール角速度']
print(f"観測した状態の数: {len(obs)}")
for i, name in enumerate(names):
    inside = (obs[:, i] <= upper_bounds[i]).mean() * 100
    print(f"{name:8s} 範囲 ±{upper_bounds[i]:<6} 99.9%点 {np.percentile(obs[:, i], 99.9):.2f}  "
          f"最大 {obs[:, i].max():.2f}  範囲内の割合 {inside:.2f}%")
- 確かめる理由: 範囲の外の値は両端のビンにまとめられるため、範囲が狭すぎると、性質の違う状態が端のビンに集まってしまいます。逆に広すぎると、実際には使われないビンが増え、使われるビンが粗くなります。
- 99.9%点と最大値: ごく一部の外れた値に引きずられないよう、最大値だけでなく、99.9%の値が収まる点も出しています。
観測した状態の数: 199933
カート位置    範囲 ±2.4    99.9%点 2.40  最大 2.45  範囲内の割合 99.91%
カート速度    範囲 ±3.0    99.9%点 3.01  最大 3.78  範囲内の割合 99.89%
ポール角度    範囲 ±0.2095 99.9%点 0.22  最大 0.26  範囲内の割合 99.68%
ポール角速度   範囲 ±3.5    99.9%点 2.09  最大 3.17  範囲内の割合 100.00%
カート速度の範囲 ±3.0 は、観測した値の99.89%をカバーしています。ポール角速度の範囲 ±3.5 は、観測した最大値(3.17)も含めてすべてをカバーしています。カート位置とポール角度は終了条件の値(±2.4、±12度)なので、範囲を少し超える値は、その1ステップでエピソードが終わる状態です。
学習率やビン数などの値が、結果をどれだけ左右するかを確かめるため、値を1つずつ変えて学習し直しました。1つのシードの結果だけでは、たまたまの当たり外れで順位が入れ替わるため、5つのシードで学習した結果の平均で比べています。「最高値」は学習中の直近100エピソード平均の最高値、「最後の値」は最後の100エピソードの平均です。
def train(seed, lr=0.1, discount=0.99, eps_decay=0.995, num_bins=(3, 3, 6, 12),
          v_bound=3.0, w_bound=3.5, init='uniform', episodes=1000):
    """学習コードと同じ手順で学習し、直近100エピソード平均の「最高値」と「最後の値」を返す"""
    rng = np.random.default_rng(seed)
    env = gym.make('CartPole-v1')
    env.action_space.seed(seed)
    ub = np.array([2.4, v_bound, 0.2095, w_bound])
    lb = -ub
    bins = list(num_bins)
    if init == 'uniform':
        q = rng.uniform(low=-1, high=1, size=bins + [env.action_space.n])
    else:
        q = np.zeros(bins + [env.action_space.n])

    def disc(s):
        ratio = (np.clip(s, lb, ub) - lb) / (ub - lb)
        return tuple(int(round((bins[i] - 1) * ratio[i])) for i in range(4))

    eps, sc_list, best = 1.0, [], -np.inf
    for ep in range(episodes):
        s, _ = env.reset(seed=seed if ep == 0 else None)
        d, done, sc = disc(s), False, 0
        while not done:
            a = env.action_space.sample() if rng.random() < eps else int(np.argmax(q[d]))
            ns, r, term, trunc, _ = env.step(a)
            done = term or trunc
            nd = disc(ns)
            target = r if term else r + discount * np.max(q[nd])
            q[d + (a,)] += lr * (target - q[d + (a,)])
            d, sc = nd, sc + r
        eps = max(0.01, eps * eps_decay)
        sc_list.append(sc)
        if len(sc_list) >= 100:
            best = max(best, np.mean(sc_list[-100:]))
    env.close()
    return best, np.mean(sc_list[-100:])

# 1つずつ値を変えた設定(それ以外は記事の設定のまま)
configs = [
    ('記事の設定',                {}),
    ('α = 0.05',                  dict(lr=0.05)),
    ('α = 0.2',                   dict(lr=0.2)),
    ('γ = 0.95',                  dict(discount=0.95)),
    ('ε の減衰 0.99',             dict(eps_decay=0.99)),
    ('ε の減衰 0.998',            dict(eps_decay=0.998)),
    ('Q の初期値を 0',            dict(init='zeros')),
    ('ビン数 [6, 6, 6, 6]',       dict(num_bins=(6, 6, 6, 6))),
    ('ビン数 [3, 3, 3, 6]',       dict(num_bins=(3, 3, 3, 6))),
    ('ビン数 [1, 1, 6, 12]',      dict(num_bins=(1, 1, 6, 12))),
    ('速度 ±1.5 / 角速度 ±2.0',   dict(v_bound=1.5, w_bound=2.0)),
    ('速度 ±5.0 / 角速度 ±5.0',   dict(v_bound=5.0, w_bound=5.0)),
]
SEEDS = [0, 1, 2, 3, 4]  # 1つのシードだけだと、たまたまの当たり外れで順位が入れ替わるため5回の平均で比べる

print('%-24s %16s %16s' % ('設定', '最高値の平均', '最後の値の平均'))
for name, kw in configs:
    res = np.array([train(s, **kw) for s in SEEDS])
    print('%-24s %16.1f %16.1f' % (name, res[:, 0].mean(), res[:, 1].mean()))
- train 関数: 学習コードと同じ手順を、値を引数で変えられるようにまとめたものです。ここでは比べるのが目的なので、Qテーブルの保存やログの出力は省いています。
- 比べ方: 1回に変える値は1つだけにして、それ以外は記事の設定のままにしています。複数の値を同時に変えると、どの値が結果を変えたのか分からなくなるためです。
- 実行時間: 12通り × 5シードで60回学習するため、手元のCPUで約5分半かかりました。
設定                                 最高値の平均          最後の値の平均
記事の設定                               422.8            374.0
α = 0.05                            414.8            388.2
α = 0.2                             371.1            298.8
γ = 0.95                            313.8            233.2
ε の減衰 0.99                          460.9            374.2
ε の減衰 0.998                         172.0            142.2
Q の初期値を 0                           416.8            362.2
ビン数 [6, 6, 6, 6]                    151.0            145.6
ビン数 [3, 3, 3, 6]                    179.2            175.2
ビン数 [1, 1, 6, 12]                   454.2            292.5
速度 ±1.5 / 角速度 ±2.0                  370.3            240.7
速度 ±5.0 / 角速度 ±5.0                  363.4            227.1
この結果から、記事の値は次のように決めています。
- 学習率 0.1: 0.05 でもほぼ同じ成績(最後の値 388.2)で、結果は大きく左右されません。0.2 にすると最後の値が 298.8 に下がり、学習の終盤でQ値が揺れやすくなります。
- 割引率 0.99: 0.95 にすると最後の値が 233.2 まで下がります。 ステップ程度先までしか考慮しなくなり、ポールが倒れる手前の状態を避けにくくなるためです。
- ε の減衰 0.995: 0.99(約459エピソード目で下限に届く)でも最後の値は同じ 374.2 で、学習中の最高値はむしろ高くなりました。一方、0.998 では1,000エピソード後も ε が0.135残り、探索が終わらないため 142.2 にとどまります。0.995 は、1,000エピソードの中で探索を終えられる減衰率の1つです。
- Qテーブルの初期値: 0 で初期化しても、ほぼ同じ成績(最後の値 362.2)です。結果は初期値に大きく左右されないので、記事ではQ値に小さなばらつきを持たせる一様乱数(−1〜1)のままにしています。
- ビン数 [3, 3, 6, 12]: すべての次元を6個ずつに分けると 145.6、角度と角速度を [3, 6] に粗くすると 175.2 と、大きく下がります。ポールの状態を細かく見分けることが重要だと分かります。一方、カートの位置と速度を1個(区別しない)にすると、最高値は 454.2 と高いのに、最後の値は 292.5 に下がります。カートが端に寄っても気づけず、場外に出て終わるエピソードが残るためです。
- 速度と角速度の範囲: 狭くしても(±1.5 / ±2.0)、広くしても(±5.0 / ±5.0)、最後の値は 240.7 と 227.1 に下がります。狭すぎると端のビンに違う状態が集まり、広すぎると使われるビンが粗くなるためです。
設定ごとの最後の100エピソードの平均スコアを並べると、次のようになります。
(図は、diagram-designで作成)
3. 可視化(エージェントの動きを見る)
学習中に保存した最良のQテーブルを用いて、実際にCart Poleがどのようにバランスを取るのかをアニメーション(レンダリング)で確認するコードです。 ここではGoogle Colabなどのクラウド環境でも動作するように、画像を配列として取得し、Matplotlibを使ってアニメーションとして表示します。
from matplotlib import animation
from IPython.display import HTML

# 可視化用の環境を再作成(Colab用にrgb_arrayを指定)
env = gym.make('CartPole-v1', render_mode='rgb_array')

state, _ = env.reset(seed=SEED)
discrete_state = discretize_state(state)
done = False
total_reward = 0
frames = []  # 動画用のアニメーションフレームを保存するリスト

print("--- 学習済みエージェントのテスト開始 ---")
while not done:
    # 現在の環境の描画データを配列として取得し、リストに追加
    frames.append(env.render())

    # テスト時は探索(epsilon)を行わず、学習中に保存した最良のQテーブルから最適な行動を常に選ぶ
    action = int(np.argmax(best_q_table[discrete_state]))
    next_state, reward, terminated, truncated, _ = env.step(action)
    done = terminated or truncated

    discrete_state = discretize_state(next_state)
    total_reward += reward

# エピソード終了時の描画も保存する
frames.append(env.render())

print(f"テスト完了: 合計スコア = {total_reward}")
env.close()

# アニメーションを作成し、Colab上に表示する
print("アニメーションを生成中...")
fig = plt.figure(figsize=(frames[0].shape[1] / 72.0, frames[0].shape[0] / 72.0), dpi=72)
ax = fig.add_subplot(111)
ax.axis('off')

patch = ax.imshow(frames[0])

def animate(i):
    patch.set_data(frames[i])

anim = animation.FuncAnimation(fig, animate, frames=len(frames), interval=50)
plt.close(fig)

HTML(anim.to_jshtml())
- 探索なしでのテスト: 学習時と異なり epsilon-greedy 法によるランダムな「探索」を一切行わず、常に np.argmax(best_q_table[discrete_state]) によって「利用(もっともQ値が高い行動の選択)」を行っています。
- 描画データの保存: render_mode='rgb_array' で作成した環境から、各ステップの行動前に env.render() で画像配列を取得して frames に保存しています。ループの中では行動前に描画しているため、エピソード終了時の状態はループを抜けた後に frames.append(env.render()) で追加しています。
- アニメーションの表示: 保存したフレームから animation.FuncAnimation でアニメーションを作成し、HTML(anim.to_jshtml()) でColabの出力セル上に表示しています。
本記事の実装コードでは、Google Colabなどのブラウザ・クラウド環境でもエラーなく動作し、その場でアニメーションを確認できるように、render_mode='rgb_array' と matplotlib を組み合わせた動画再生方式を採用しています。
もし、ご自身のローカルPC(GUIが利用できる環境)で直接ポップアップウィンドウを開いてリアルタイム描画を確認したい場合は、以下のように変更して実行することも可能です。
- 変更点1: 環境作成時に render_mode='human' を指定する。
env = gym.make('CartPole-v1', render_mode='human') - 変更点2: frames.append(env.render()) や、Matplotlibによるアニメーション生成・再生用のコードをすべて削除する。
どちらの方法でも描画には pygame が必要なため、gymnasium[classic-control] でインストールしておいてください。
可視化コードの実行結果
--- 学習済みエージェントのテスト開始 ---
テスト完了: 合計スコア = 500.0
アニメーションを生成中...
学習したエージェントは、カートを小刻みに左右へ動かしながらポールのバランスを取り続け、CartPole-v1の上限である500ステップまでポールを立て続けることができました。ランダムに行動するだけのエージェント(強化学習超入門では、1,000エピソードの平均スコアが22.6)と比べると、Q学習によって行動が大きく改善されていることがわかります。
Qテーブルの限界とDQNへの橋渡し
上記のコードで見たように、Q学習はシンプルでありながら強力なアルゴリズムです。しかし、状態を離散化したことにお気づきでしょうか。今回のCartPoleでも、ビンの数や範囲の決め方ひとつで学習の成否が大きく変わりました(すべての次元を6個ずつに分けると、最後の100エピソードの平均は 374.0 から 145.6 に下がりました)。
状態空間や行動空間が巨大な問題(例えば、Atariのゲーム画面のような高次元のピクセルデータ)では、すべての状態を網羅する有限サイズのテーブルを作成することは不可能です。この問題は「次元の呪い」と呼ばれます。
この限界を突破するために、Qテーブルという「表」の代わりに、「ニューラルネットワーク(NN)」を関数近似器として用いたのがDeep Q-Network (DQN)です。DQNの登場により、強化学習は連続的な状態空間や複雑な画像入力を持つタスクでも、人間を超えるパフォーマンスを発揮できるようになりました。また、今回見られたような学習の不安定さは関数近似を使うとさらに顕著になるため、DQNでは「経験再生(Experience Replay)」や「ターゲットネットワーク(Target Network)」といった安定化の工夫が導入されています。
ここまでのQ学習の基礎とベルマン方程式の仕組みを理解していれば、DQNにおけるニューラルネットワークの損失関数が「なぜあの形(TD誤差の最小化)をしているのか」がはっきりと理解できるはずです。
まとめ
この記事では、強化学習の根幹をなす「Q学習」の基本的な仕組みとベルマン方程式の意味について解説し、Pythonを用いたCart Poleの実装を行いました。
- 強化学習の目的 は、累積報酬(収益)を最大化する方策を見つけることです。
- ベルマン方程式 は、無限に続く未来の価値の計算を、再帰的な部分問題(即時報酬+割引された次の状態の価値)に落とし込みます。
- Q学習 は、ベルマン最適方程式を満たす最適なQ値を、経験を通じてTD誤差を修正しながら近似的に求めるモデルフリーな手法です。行動は探索を含む方策でとりつつ、最善の行動の価値を学習するオフポリシーな手法でもあります。
- 実装では、終端状態ではTDターゲットを報酬のみにすることが重要です。
- 連続的な状態空間では 離散化(ビン分割) が必要になり、その設計が学習の成否を大きく左右します。今回の比較では、ポールの角度と角速度を細かく分けることが特に重要でした。
- 離散化と固定の学習率のため、収束の条件を満たさず、平均スコアは学習の後半でも上下に揺れます。そのため、学習中に最も成績の良かったQテーブルを保存して使い、CartPole-v1 の上限である500ステップまでポールを立て続けられました。
Q学習のアルゴリズムは非常にシンプルですが、これをニューラルネットワークに置き換えた「DQN」などの深層強化学習(Deep RL)を理解するための重要な土台となります。
参考文献
- C. J. C. H. Watkins, P. Dayan (1992). Q-learning. Machine Learning, 8(3-4), 279–292.
- R. S. Sutton, A. G. Barto (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
本記事の文章・構成の一部に生成AIを使用しています。