制約付き2次計画問題(Quadratic Programming)とは?
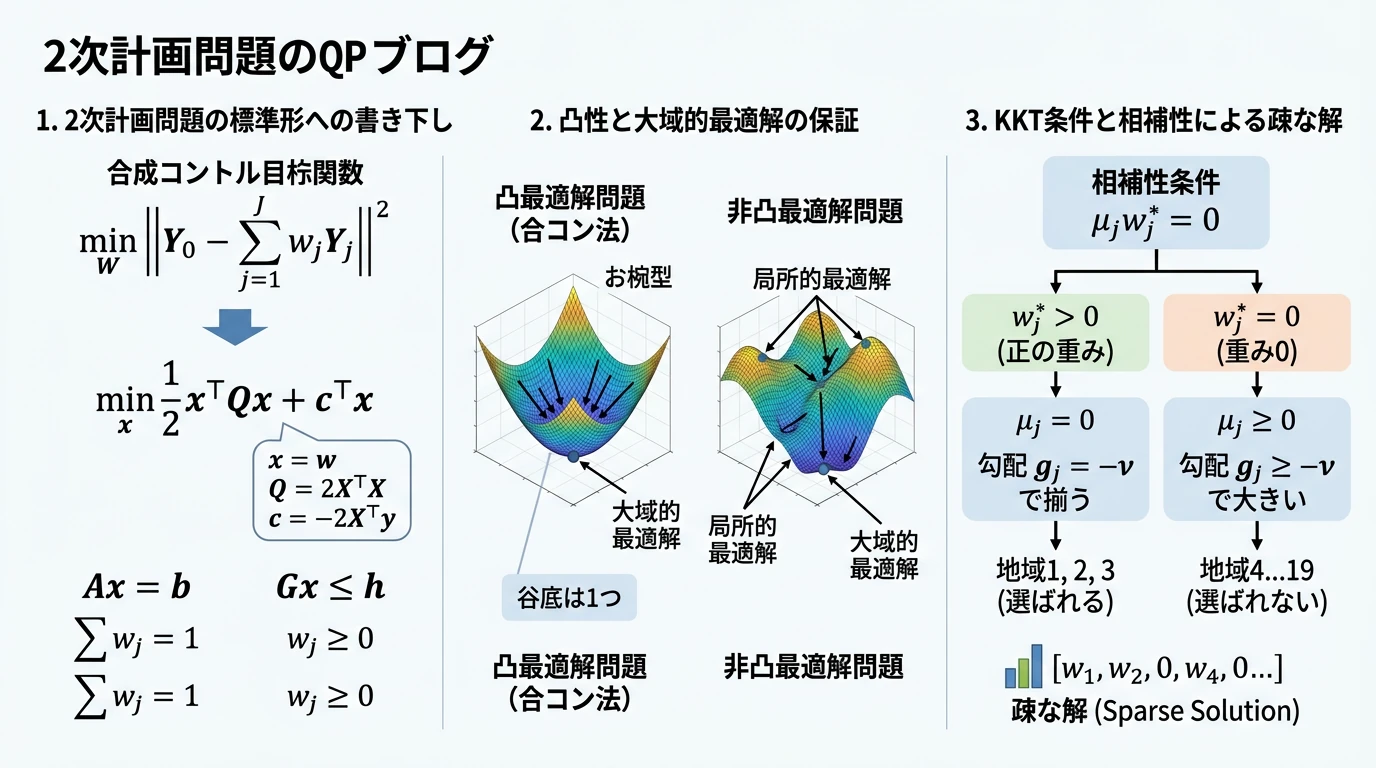 (画像は、Geminiで作成)
はじめに ── 合成コントロール法の「1行」の裏側
合成コントロール法とジオ実験の記事では、介入地域の反事実を、複数のドナー地域の重み付き平均(合成コントロール)として再構成しました。その重み は、次の最適化問題を解いて求めました。
記事では、これを「制約付き2次計画問題(Quadratic Programming: QP) であり、大域的最適解を高速に計算できる」と1行で済ませ、実装も SciPy の minimize(method='SLSQP') に任せていました。しかし、この1行には次のような疑問が隠れています。
- なぜ「2次計画問題」と呼べるのか? どんな形をしていれば2次計画問題なのか?
- 山登り法や焼きなまし法の記事では「局所的最適解の罠」に苦しみました。なぜ合成コントロール法では、その心配がないと言い切れるのか?
- 凸結合の制約を課すと、なぜ多くのドナーの重みがちょうど0になる(疎な解になる)のか?
- ソルバーの内部では、制約をどのように扱っているのか?
本記事では、これらの疑問に答えながら、制約付き2次計画問題の考え方を掘り下げます。理論の参考文献としては、凸最適化の定番教科書である Boyd & Vandenberghe の Convex Optimization(無料公開)の第4・5章が対応しています。
- 2次計画問題の標準形を理解し、合成コントロール法の重み推定をその形に書き下せるようになる
- 「凸」であることが、なぜ局所的最適解の罠をなくすのかを理解する
- KKT条件(とくに相補性条件)から、疎な解が生まれる仕組みを数値で確かめる
- 射影勾配法をゼロから実装し、データの前処理が収束速度を大きく変えることを体験する
- cvxpy で制約を自由に組み替えて解く方法を身につける
2次計画問題とは
標準形
2次計画問題 とは、目的関数が変数の 2次式 で、制約がすべて 1次式(線形) の等式・不等式で書ける最適化問題のことです。一般に次の 標準形 で表されます。
| 記号 | 意味 |
|---|---|
| 最適化する変数( 次元ベクトル) | |
| 2次の項を決める の対称行列 | |
| 1次の項を決める 次元ベクトル | |
| 線形の等式制約 | |
| 線形の不等式制約(各成分ごとの不等式) |
目的関数が1次式()なら、よく知られた 線形計画問題(Linear Programming: LP) になります。2次計画問題は、線形計画問題の目的関数に「2次の項」を足したものと言えます。
合成コントロール法を標準形に書き下す
事前期間の介入地域の売上を並べたベクトルを (長さ )、ドナー地域の売上を並べた行列を ()とすると、合成コントロール法の目的関数は次のように展開できます。
最後の は に関係しない定数なので、最適化には影響しません。標準形と見比べると、次の対応がわかります。
制約も、すべて1次式で書けます。
このように、合成コントロール法の重み推定は、正真正銘の2次計画問題です。
「凸」であることの意味 ── 局所的最適解の罠がない
山登り法の記事では、 のように山が複数ある関数を扱い、探索が小さな山の頂上(局所的最適解)で止まってしまう問題を見ました。
合成コントロール法の2次計画問題には、この心配がありません。その理由が 凸性(convexity) です。
- 目的関数が凸: は、任意のベクトル に対して を満たします(半正定値)。これは、目的関数が「お椀型」で、山や谷が1つしかないことを意味します。
- 実行可能領域が凸: 「非負かつ和が1」を満たす の集合(単体: simplex)は、どの2点を結ぶ線分も集合の中に収まる凸集合です。
凸な関数を凸な集合の上で最小化する問題(凸最適化問題)では、局所的最適解は必ず大域的最適解 になります。どこから探索を始めても、谷底は1つしかないので、行き着く先は同じです。さらに、 の列が一次独立なら は 正定値 になり、最適解は ただ1つ に定まります。
が半正定値でない(負の固有値を持つ)2次計画問題は 非凸 になり、局所的最適解が複数生じて、一般に解くのが非常に難しくなります(NP困難)。最小二乗法から来る は必ず半正定値なので、合成コントロール法は「易しい側」の2次計画問題です。
図で見る2次計画問題:3地域のトイ問題
抽象的な話が続いたので、変数が少ないトイ問題で、2次計画問題を目で見てみましょう。
ドナー地域を3つに絞ると、重みは の3つです。和が1の制約から と消去できるので、問題は の2次元平面上で描けます。ここでは、介入地域の売上が「地域3に 負の重み を持つ構造」になっている、つまりドナーの凸結合では完全には再現できないデータを作ります。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用
from scipy.optimize import minimize

# 1. トイデータ:3つのドナー地域と、それらより売上規模が大きい介入地域
rng_toy = np.random.default_rng(0)
T_toy = 30
t_toy = np.arange(T_toy)
d1 = 60 + 0.5 * t_toy + 3 * np.sin(2 * np.pi * t_toy / 7) + rng_toy.normal(0, 1, T_toy)
d2 = 45 + 0.2 * t_toy + 3 * np.sin(2 * np.pi * t_toy / 7) + rng_toy.normal(0, 1, T_toy)
d3 = 30 + 0.4 * t_toy + 3 * np.sin(2 * np.pi * t_toy / 7) + rng_toy.normal(0, 1, T_toy)
X_toy = np.column_stack([d1, d2, d3])                                  # (30, 3)
y_toy = 0.8 * d1 + 0.4 * d2 - 0.2 * d3 + rng_toy.normal(0, 1, T_toy)  # 地域3に負の重みを持つ構造

# 2. QPの標準形の材料: f(w) = 1/2 w^T Q w + c^T w + 定数
Q_toy = 2 * X_toy.T @ X_toy
c_toy = -2 * X_toy.T @ y_toy

# 3. 等式制約(和=1)だけの場合:KKT条件の連立一次方程式を直接解く
K = np.block([[Q_toy, np.ones((3, 1))],
              [np.ones((1, 3)), np.zeros((1, 1))]])
rhs = np.concatenate([-c_toy, [1.0]])
w_eq_toy = np.linalg.solve(K, rhs)[:3]

# 4. 凸結合制約(非負 + 和=1)の場合:SLSQPで解く
res_toy = minimize(lambda w: np.sum((y_toy - X_toy @ w) ** 2), np.ones(3) / 3,
                   method='SLSQP', bounds=[(0, 1)] * 3,
                   constraints={'type': 'eq', 'fun': lambda w: np.sum(w) - 1.0})
w_cvx_toy = res_toy.x

print(f"和=1のみ   : w = {np.round(w_eq_toy, 4)},  二乗誤差 = {np.sum((y_toy - X_toy @ w_eq_toy) ** 2):.2f}")
print(f"凸結合制約 : w = {np.round(w_cvx_toy, 4)},  二乗誤差 = {np.sum((y_toy - X_toy @ w_cvx_toy) ** 2):.2f}")
- トイデータの構造: 3つのドナー系列 d1, d2, d3 は、水準とトレンドが異なり、曜日周期を共有しています。介入地域 y_toy は 0.8 * d1 + 0.4 * d2 - 0.2 * d3 にノイズを加えたもので、地域3に負の重みが掛かっています。地域3に負の重みを置くのは、和=1だけの解では重みが負になり、凸結合の制約を入れると0に張り付く、という制約の効き方の違いを見せるためです。
- QPの材料: 標準形の Q_toy = 2 * X_toy.T @ X_toy と c_toy = -2 * X_toy.T @ y_toy を、前節の書き下しのとおりに作っています。
- 和=1のみの場合: 不等式制約がなく等式制約だけなら、最適解は後で説明するKKT条件の連立一次方程式 K を np.linalg.solve で解くだけで求まります。[:3] で、解のうち重みの部分だけを取り出しています(残りの1つはラグランジュ乗数です)。
- 凸結合制約の場合: 合成コントロール法の記事と同じく、bounds で非負、constraints で和が1を指定して SLSQP で解いています。
実行結果
和=1のみ   : w = [ 0.8511  0.2685 -0.1196],  二乗誤差 = 22.47
凸結合制約 : w = [0.9244 0.0756 0.    ],  二乗誤差 = 29.18
和が1の制約だけなら、地域3に という負の重みが付きます。非負制約を加えると、地域3の重みはちょうど になり、その代わりに二乗誤差は 22.47 から 29.18 に増えています。これを図で確認しましょう。
# 1. 和=1の制約で w3 = 1 - w1 - w2 と消去し、(w1, w2) 平面上で目的関数を計算
g1, g2 = np.meshgrid(np.linspace(-0.2, 1.3, 400), np.linspace(-0.3, 1.1, 400))
W_grid = np.stack([g1.ravel(), g2.ravel(), 1 - g1.ravel() - g2.ravel()], axis=1)   # (160000, 3)
F_grid = np.sum((y_toy[None, :] - W_grid @ X_toy.T) ** 2, axis=1).reshape(g1.shape)

# 2. 等高線(対数間隔)と実行可能領域(三角形 = 単体)を描画
fig, ax = plt.subplots(figsize=(8, 7))
levels = np.geomspace(F_grid.min() * 1.05, F_grid.max(), 25)
cs = ax.contour(g1, g2, F_grid, levels=levels, cmap='viridis', linewidths=1)
ax.fill([0, 1, 0], [0, 0, 1], color='orange', alpha=0.2, label='実行可能領域(w は非負かつ和が1)')
ax.plot([0, 1, 0, 0], [0, 0, 1, 0], color='orange', linewidth=2)

# 3. 2つの解をプロット
ax.plot(w_eq_toy[0], w_eq_toy[1], 'bs', markersize=10, label=f'和=1のみの解 (w3 = {w_eq_toy[2]:.3f})')
ax.plot(w_cvx_toy[0], w_cvx_toy[1], 'r*', markersize=18, label=f'凸結合制約の解 (w3 = {w_cvx_toy[2]:.3f})')
ax.annotate('', xy=(w_cvx_toy[0], w_cvx_toy[1]), xytext=(w_eq_toy[0], w_eq_toy[1]),
            arrowprops=dict(arrowstyle='->', color='black', linewidth=1.5))

ax.set_xlabel('地域1の重み w1')
ax.set_ylabel('地域2の重み w2')
ax.set_title('目的関数の等高線と実行可能領域(w3 = 1 − w1 − w2)')
ax.set_aspect('equal')
ax.legend(loc='upper right')
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
- 変数の消去: W_grid の3列目を 1 - g1 - g2 とすることで、和が1の制約を満たす重みだけを格子状に並べ、それぞれの二乗誤差 F_grid を計算しています。
- 等高線: 目的関数は最小値付近で値が急に小さくなるため、np.geomspace で対数間隔の等高線を引いています。
- 実行可能領域: 、、 を満たす領域は、頂点 、、 の三角形になります。これを ax.fill でオレンジに塗っています。
- 2つの解: 和=1のみの解を青い四角、凸結合制約の解を赤い星で示し、矢印で結んでいます。
実行結果
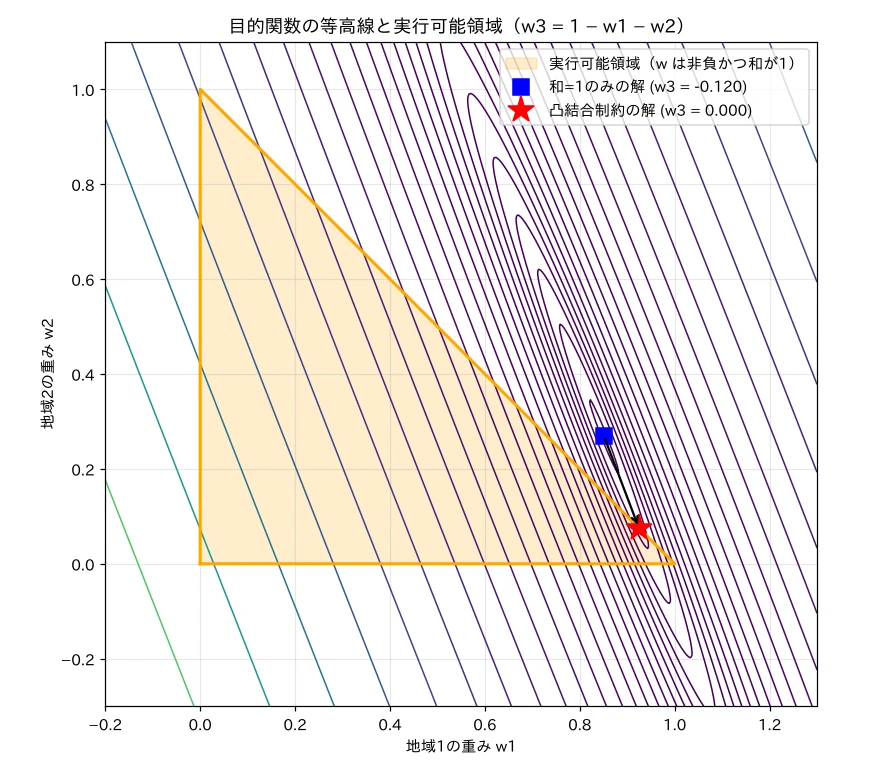
この図から、2次計画問題の本質が見えてきます。
- 目的関数は楕円形のお椀: 等高線はすべて同じ中心を持つ楕円で、谷底(青い四角)は1つしかありません。これが「凸」の姿です。
- 制約がなければ谷底へ、あれば境界へ: 谷底は三角形の外( の側)にあるため、使うことができません。凸結合制約の解(赤い星)は、三角形の中で最も内側の等高線に 接する点 であり、三角形の斜辺( の辺)の上にあります。これが「地域3の重みがちょうど0になる」理由です。
- 楕円がとても細長い: 等高線は、左上から右下へ細長く伸びています。この方向に重みを動かしても誤差がほとんど変わらないため、「地域1と地域2の配分」はデータからあまりはっきりとは決まりません。合成コントロール法の記事で「個々の重みを解釈しすぎないことが大切」と述べたのは、この細長さが原因です。この細長さは、後で見るように最適化アルゴリズムの収束速度にも影響します。
なお、赤い星は青い四角から三角形への「最短距離の点」ではありません。楕円が細長いため、ユークリッド距離で最も近い点ではなく、目的関数の等高線が三角形に接する点 が最適解になります。
KKT条件 ── 最適解が満たす条件
ラグランジュ関数とKKT条件
制約付き最適化問題の最適解を特徴付けるのが KKT条件(Karush–Kuhn–Tucker条件) です。目的関数を として、各制約にラグランジュ乗数(等式制約に 、不等式制約 に )を割り当てたラグランジュ関数を作ります。
このとき、最適解 は次の4つの条件を満たします。
| 条件 | 数式 | 意味 |
|---|---|---|
| ① 停留条件 | ラグランジュ関数の勾配が0 | |
| ② 主実行可能性 | 制約を満たしている | |
| ③ 双対実行可能性 | 不等式制約の乗数は非負 | |
| ④ 相補性条件 | と の少なくとも一方は0 |
一般の最適化問題では、KKT条件は「最適解であるための必要条件」にすぎません。しかし、合成コントロール法のような 凸な2次計画問題では、KKT条件は必要十分条件 です。つまり、KKT条件を満たす点を見つければ、それが大域的最適解であると保証されます。
等式制約だけなら連立一次方程式で解ける
不等式制約がない場合()、条件①と②の等式部分は、 と についての連立一次方程式になります。
トイ問題で「和=1のみの解」を np.linalg.solve の1行で求められたのは、このためです。
相補性条件が「疎な解」を生む
難しいのは不等式制約です。どの が0になるか(どの不等式制約が アクティブ になるか)が事前にわからないからです。もし「0になる重みの集合」がわかっていれば、それらを0に固定して残りを上の連立一次方程式で解けば済みます。アクティブセット法 と呼ばれる古典的なアルゴリズムは、まさにこの「0になる重みの集合」を推測して更新することを繰り返して解に到達します。
ここで、目的関数の勾配を と書くと、条件①より です。これと相補性条件④を組み合わせると、次の性質が導かれます。
つまり、正の重みを持つドナーは、すべて勾配の値が等しく揃い、重みが0のドナーの勾配はそれ以上になります。
この性質は、次のように直感的に理解できます。勾配 は「ドナー の重みを少し増やしたときの誤差の増え方」です。重みが正のドナー から、重みが0のドナー へ、ごくわずかな重み を付け替えると、誤差はおよそ だけ変化します。つまり、重みが0のドナーにいくら重みを移しても誤差は減らない ため、最適解ではそのドナーの重みがちょうど0のまま残るのです。合成コントロール法の記事で「無関係なドナーの重みは自然と厳密に0になる」と述べた疎な解は、この相補性条件から生まれています。
ジオワールドで確かめる:制約は何をしているのか
ここからは、合成コントロール法の記事と同じ「ジオワールド」のデータを使って、2次計画問題の性質を数値で確かめます。
検証用ダミーデータの生成
データの生成方法は、合成コントロール法の記事とまったく同じです(乱数シードも同じなので、同じデータが得られます)。最後に、2次計画問題の材料となる と を取り出しています。
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用
from scipy.optimize import minimize

# 1. 乱数シードの固定とパラメータ設定(合成コントロール法の記事と同一)
rng = np.random.default_rng(42)
n_regions = 20
n_days = 120
pre_days = 70
treat_start = 70
treat_end = 100

time = np.arange(n_days)

# 2. 共通トレンドと曜日周期(7日周期)
common_trend = 0.2 * time
weekday_effect = 3.0 * np.sin(2 * np.pi * time / 7)

# 3. ドナー地域(地域1〜19)のデータ生成
Y_all = np.zeros((n_days, n_regions))
for j in range(1, n_regions):
    base = 50.0 + rng.uniform(-15, 15)
    trend_factor = rng.uniform(0.7, 1.3)
    noise = rng.normal(0, 1.5, n_days)
    ar_noise = np.zeros(n_days)
    for t in range(1, n_days):
        ar_noise[t] = 0.5 * ar_noise[t-1] + rng.normal(0, 1.0)
    Y_all[:, j] = base + trend_factor * common_trend + weekday_effect + noise + ar_noise

# 4. 介入地域(地域0)の真の反事実(地域1, 2, 3の凸結合 + 微小ノイズ)
true_weights = np.zeros(n_regions - 1)
true_weights[0], true_weights[1], true_weights[2] = 0.5, 0.3, 0.2
Y_target_counterfactual = Y_all[:, 1:] @ true_weights + rng.normal(0, 0.8, n_days)

# 5. 施策効果の生成(持ち越し効果 theta=0.8, 最大約15)
theta, scale = 0.8, 15.0
c = np.zeros(n_days)
s = np.zeros(n_days)
s[treat_start:treat_end] = 1.0
for t in range(1, n_days):
    c[t] = s[t] + theta * c[t-1]
true_effect = scale * (1 - theta) * c
Y_all[:, 0] = Y_target_counterfactual + true_effect
true_cum_total = np.sum(true_effect[treat_start:])

# 6. 2次計画問題の材料(事前期間の行列とベクトル)
y = Y_all[:pre_days, 0]       # 介入地域の事前データ (70,)
X = Y_all[:pre_days, 1:]      # ドナー地域の事前データ (70, 19)
n_donors = X.shape[1]

print(f"y の形状: {y.shape}, X の形状: {X.shape}")
print(f"真の累積効果(全期間 70〜119日): {true_cum_total:.2f}")
- データの仕様: 20地域・120日間で、事前期間70日、施策期間30日、施策後20日です。介入地域(地域0)の真の反事実は、地域1〜3を重み 0.5、0.3、0.2 で凸結合したものです。詳細は合成コントロール法の記事を参照してください。値は合成コントロール法の記事と同じで、理由もそちらに書いています。
- QPの材料: y は介入地域の事前期間の売上(長さ70)、X は19のドナー地域の事前期間の売上(70行19列)です。2次計画問題の変数は、19個の重み です。
実行結果
y の形状: (70,), X の形状: (70, 19)
真の累積効果(全期間 70〜119日): 449.31
4通りの制約で解き比べる
制約の効果を切り分けるため、次の4通りで重みを推定して比べます。
| 手法 | 制約 | 解き方 |
|---|---|---|
| 制約なし | なし | 通常の最小二乗法(OLS) |
| 和=1のみ | KKT条件の連立一次方程式 | |
| 非負のみ | 非負最小二乗法(NNLS) | |
| 凸結合(SCM) | SLSQP |
from scipy.optimize import nnls

# 1. 4通りの制約で重みを推定
# (a) 制約なし(通常の最小二乗法)
w_ols = np.linalg.lstsq(X, y, rcond=None)[0]

# (b) 和=1のみ:KKT条件の連立一次方程式を直接解く
Q = 2 * X.T @ X
c_vec = -2 * X.T @ y
K = np.block([[Q, np.ones((n_donors, 1))],
              [np.ones((1, n_donors)), np.zeros((1, 1))]])
w_sum1 = np.linalg.solve(K, np.concatenate([-c_vec, [1.0]]))[:n_donors]

# (c) 非負のみ:非負最小二乗法(NNLS)
w_nnls, _ = nnls(X, y)

# (d) 非負 + 和=1(合成コントロール法):SLSQP
res = minimize(lambda w: np.sum((y - X @ w) ** 2), np.ones(n_donors) / n_donors,
               method='SLSQP', bounds=[(0.0, 1.0)] * n_donors,
               constraints={'type': 'eq', 'fun': lambda w: np.sum(w) - 1.0})
w_scm = res.x

# 2. 各手法の評価
results = {'制約なし': w_ols, '和=1のみ': w_sum1, '非負のみ': w_nnls, '凸結合(SCM)': w_scm}
rows = []
for name, w in results.items():
    pre_rmse = np.sqrt(np.mean((y - X @ w) ** 2))
    est_effect = Y_all[:, 0] - Y_all[:, 1:] @ w
    cum_lift = np.sum(est_effect[treat_start:])
    rows.append({
        '手法': name,
        '重みの和': round(w.sum(), 3),
        '最小の重み': round(w.min(), 3),
        '非ゼロ数': int(np.sum(np.abs(w) > 1e-4)),
        '事前RMSE': round(pre_rmse, 4),
        '累積リフト': round(cum_lift, 2),
        '誤差': round(cum_lift - true_cum_total, 2),
    })
pd.set_option('display.unicode.east_asian_width', True)  # 日本語の列幅を揃える
print(pd.DataFrame(rows).to_string(index=False))
- 制約なし: np.linalg.lstsq で、普通の最小二乗法を解いています。
- 和=1のみ: トイ問題と同じく、KKT条件の行列 K を組み立てて np.linalg.solve で解いています。ここで作った Q と c_vec は、後のKKT条件の検証や射影勾配法でも使います。
- 非負のみ: SciPy の nnls は、非負制約だけを持つ最小二乗法(これも2次計画問題の一種)を、アクティブセット法の一種で解く関数です。
- 凸結合(SCM): 合成コントロール法の記事と同じ SLSQP による解です。
- 評価指標: 事前期間の当てはまり(pre_rmse)と、施策開始日以降の累積リフト(cum_lift)、およびその真値 true_cum_total との誤差を表にしています。display.unicode.east_asian_width は、日本語の列幅を揃えるための pandas の設定です。
実行結果
         手法  重みの和  最小の重み  非ゼロ数  事前RMSE  累積リフト  誤差
     制約なし     1.003      -0.145        19    0.7529      472.69 23.38
     和=1のみ     1.000      -0.147        19    0.7529      473.01 23.70
     非負のみ     1.027       0.000         7    0.8556      449.23 -0.08
凸結合(SCM)     1.000       0.000         5    0.8653      448.95 -0.36
この表から、次のことがわかります。
- 事前期間の当てはまりは、制約がないほど良い: 制約なしの事前RMSE(0.7529)は、凸結合(0.8653)より小さくなっています。制約を課すと、使える重みの範囲が狭まるので、事前期間の誤差は必ず同じか大きくなります。
- それでも効果の推定は、制約がある方が正確: 制約なしの累積リフトは 472.69 で、真値(449.31)より +23.38 もずれています。一方、凸結合では誤差 -0.36 です。制約なしの解は、19地域すべてに重みを配り、地域11()や地域18 のように負の重みも使って、事前期間のノイズまで再現しようとしています。この 過学習 が、施策期間以降の予測(外挿)を狂わせています。
- 和=1の制約だけでは外挿を防げない: 和=1のみの解は、制約なしとほとんど同じです(もともと重みの和が 1.003 とほぼ1だったため)。負の重みを禁止する 非負制約 が、過学習を抑えて疎な解を生む主役になっています。
- 非負のみでも今回は十分良い: 非負のみの解は、重みの和が 1.027 とわずかに1を超えますが、誤差は -0.08 と小さくなりました。今回のデータは介入地域とドナーの売上水準が近いためです。介入地域の水準がドナーと大きく異なる場合、和が1を超える(あるいは下回る)重みは「ドナー全体を拡大・縮小する」という水準方向の外挿になります。和=1の制約は、この水準方向の外挿を禁止する役割を担っています。
なお、凸結合の解の非ゼロ数は5で、合成コントロール法の記事で「0.01以上」として表示した4地域(地域1、2、3、12)に加え、地域9にも 0.0026 というごく小さな重みが付いています。
重みと累積効果の可視化
制約なしと凸結合の違いを、グラフで確認しましょう。
# 1. 可視化の準備
fig, axes = plt.subplots(1, 2, figsize=(15, 5.5))
donor_labels = [f'{j}' for j in range(1, n_donors + 1)]
x_pos = np.arange(n_donors)

# 2. 左:制約なし と 凸結合 の重みの比較
axes[0].bar(x_pos - 0.2, w_ols, width=0.4, color='gray', label='制約なし(OLS)')
axes[0].bar(x_pos + 0.2, w_scm, width=0.4, color='red', label='凸結合(SCM)')
nz = true_weights > 0  # 真の重みが正のドナー(地域1〜3)だけ印を付ける
axes[0].scatter(x_pos[nz], true_weights[nz], marker='_', s=300, color='black', linewidths=2, label='真の重み', zorder=3)
axes[0].axhline(0, color='black', linewidth=1)
axes[0].set_xticks(x_pos)
axes[0].set_xticklabels(donor_labels)
axes[0].set_xlabel('ドナー地域')
axes[0].set_ylabel('重み')
axes[0].set_title('推定されたドナー重み')
axes[0].legend(loc='upper right')
axes[0].grid(True, axis='y', alpha=0.3)

# 3. 右:施策開始日(70日目)からの累積効果の比較
days = np.arange(treat_start, n_days)
for name, w, color in [('制約なし(OLS)', w_ols, 'gray'), ('凸結合(SCM)', w_scm, 'red')]:
    effect = Y_all[:, 0] - Y_all[:, 1:] @ w
    axes[1].plot(days, np.cumsum(effect[treat_start:]), color=color, linewidth=2, label=name)
axes[1].plot(days, np.cumsum(true_effect[treat_start:]), color='black', linestyle=':', linewidth=2, label='真の累積効果')
axes[1].axvspan(treat_start, treat_end, color='orange', alpha=0.15, label='施策期間')
axes[1].set_xlabel('日')
axes[1].set_ylabel('累積効果')
axes[1].set_title('累積効果(施策開始日から)')
axes[1].legend(loc='upper left')
axes[1].grid(True, alpha=0.3)

plt.tight_layout()
plt.show()
- 左図(重みの比較): 19のドナー地域それぞれについて、制約なし(灰色)と凸結合(赤)の重みを並べた棒グラフです。真の重みが正の地域1〜3にだけ、黒い横線で真値を示しています(nz = true_weights > 0)。
- 右図(累積効果の比較): 実績から合成コントロールを引いた日ごとの効果を、施策開始日(70日目)から np.cumsum で足し上げた累積効果です。日ごとの効果の小さなずれも、累積すると差がはっきり見えます。
実行結果
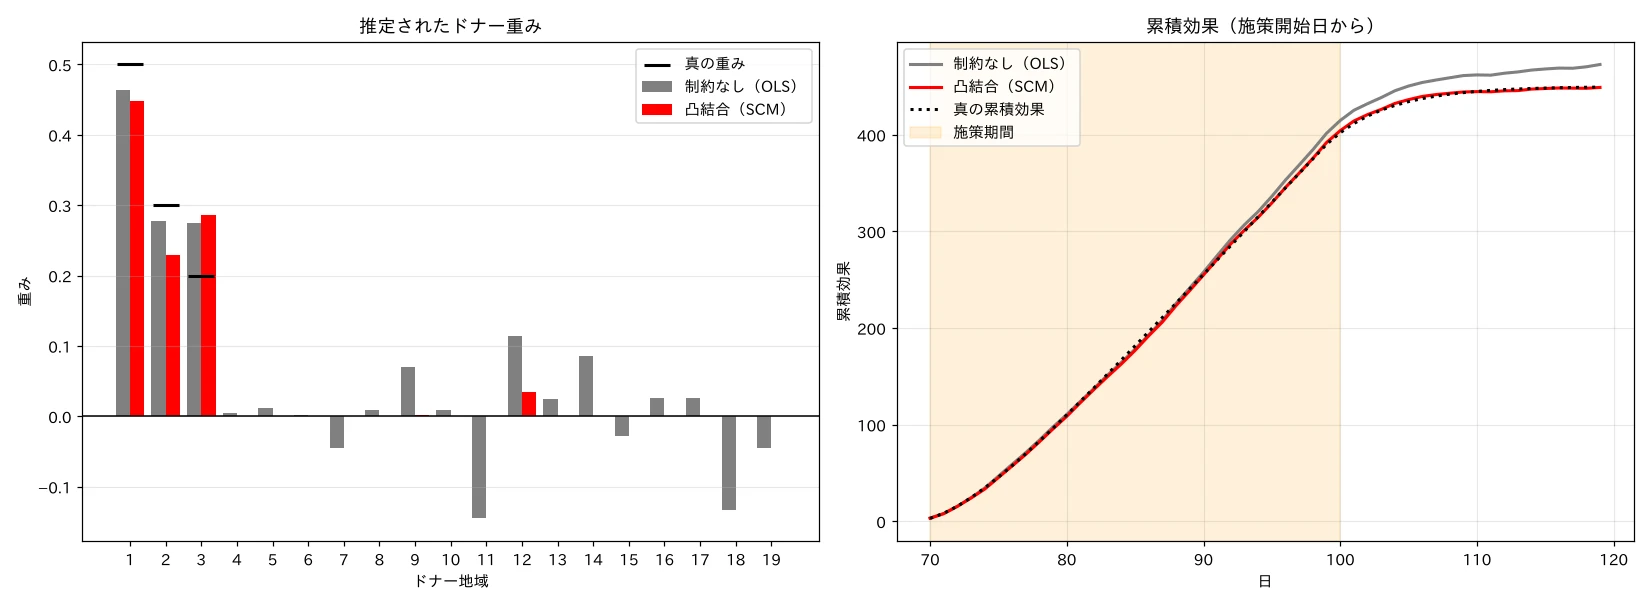
- 左図: 制約なしの解(灰色)は、地域9、11、14、18 などの無関係な地域にも正負の重みをばらまいています。凸結合の解(赤)は、地域1〜3と地域12にだけ重みが集中しています。
- 右図: 施策期間の前半は3つの線がほとんど重なっていますが、制約なしの線(灰色)は徐々に真値(黒の点線)から上にずれていき、最終的に約23の過大推定になります。凸結合の線(赤)は、最後まで真値にほぼ重なっています。
KKT条件を数値で確かめる
次に、SLSQP で得た凸結合の解が、本当にKKT条件を満たしているかを確かめます。
# 1. 最適解における目的関数の勾配 g = Qw + c
grad = Q @ w_scm + c_vec

# 2. 正の重みを持つドナー(アクティブでない不等式制約)から、等式制約の乗数 ν を求める
support = w_scm > 1e-6
nu = -np.mean(grad[support])

# 3. 不等式制約の乗数 μ = g + ν(停留条件から)
mu = grad + nu

print(f"等式制約の乗数 ν = {nu:.3f}\n")
print(" 地域 |   重み w_j | 勾配 g_j  |  乗数 μ_j | μ_j × w_j")
print("-" * 58)
for j in range(n_donors):
    print(f"  {j+1:2d}  | {w_scm[j]:9.4f}  | {grad[j]:8.3f}  | {mu[j]:8.3f}  | {mu[j] * w_scm[j]:8.4f}")
print("-" * 58)
print(f"双対実行可能性  min(μ) = {mu.min():.4f}")
print(f"相補性条件      max|μ_j × w_j| = {np.max(np.abs(mu * w_scm)):.4f}")
- 勾配の計算: 最適解 w_scm での目的関数の勾配 grad = Q @ w_scm + c_vec を計算しています。
- 乗数 ν の推定: 正の重みを持つドナーでは が成り立つはずなので、それらの勾配の平均の符号を反転させて nu としています。重みが正かどうかは、数値誤差を考えて w_scm > 1e-6 で判定しています。
- 乗数 μ の計算: 停留条件 から、各ドナーの mu を求めています。
- 条件の確認: 双対実行可能性()は mu.min()、相補性条件()は mu * w_scm の絶対値の最大で確認しています。
実行結果
等式制約の乗数 ν = 99.805

 地域 |   重み w_j | 勾配 g_j  |  乗数 μ_j | μ_j × w_j
----------------------------------------------------------
   1  |    0.4474  |  -99.805  |    0.000  |   0.0000
   2  |    0.2294  |  -99.804  |    0.001  |   0.0001
   3  |    0.2865  |  -99.804  |    0.000  |   0.0000
   4  |    0.0000  |  -57.172  |   42.633  |   0.0000
   5  |    0.0000  |  -54.859  |   44.945  |   0.0000
   6  |    0.0000  |  -61.491  |   38.313  |   0.0000
   7  |    0.0000  |  -57.846  |   41.959  |   0.0000
   8  |    0.0000  |  -39.670  |   60.135  |   0.0000
   9  |    0.0026  |  -99.804  |    0.000  |   0.0000
  10  |    0.0000  |  -81.894  |   17.911  |   0.0000
  11  |    0.0000  |   22.907  |  122.712  |   0.0000
  12  |    0.0341  |  -99.806  |   -0.001  |  -0.0000
  13  |    0.0000  |  -79.924  |   19.881  |   0.0000
  14  |    0.0000  |  -76.380  |   23.424  |   0.0000
  15  |    0.0000  |  -94.463  |    5.341  |   0.0000
  16  |    0.0000  |  -40.939  |   58.866  |   0.0000
  17  |    0.0000  |  -44.528  |   55.276  |   0.0000
  18  |    0.0000  |  -21.600  |   78.205  |   0.0000
  19  |    0.0000  |  -59.064  |   40.741  |   0.0000
----------------------------------------------------------
双対実行可能性  min(μ) = -0.0011
相補性条件      max|μ_j × w_j| = 0.0001
理論どおりの結果が得られています。
- 正の重みを持つ5地域(1、2、3、9、12)の勾配は、すべて約 -99.80 で揃っています。重みが 0.0026 しかない地域9も、重みが 0.447 の地域1も、勾配の値は同じです。
- 重みが0の14地域の勾配は、すべて -99.80 より大きく、乗数 は正になっています。 は「その地域に重みを移すと誤差がどれだけ増えるか」の度合いです。例えば地域15()は「もう少しで選ばれそうだった地域」、地域11()は「最も合成に向かない地域」と読めます。
- 相補性条件 も、すべての地域で成り立っています。 が とわずかに負なのは、SLSQP の数値誤差(収束の許容誤差)によるもので、実質的には0です。
スクラッチ実装:射影勾配法
SLSQP の中身は複雑なので、ここでは2次計画問題を解く最もシンプルなアルゴリズムの1つである 射影勾配法(Projected Gradient Descent) をゼロから実装してみましょう。アイデアは次の2ステップの繰り返しです。
- 勾配降下: 制約を無視して、勾配の逆方向に1歩進む()
- 射影: 制約からはみ出した点を、実行可能領域の中で 最も近い点 に引き戻す
ここで は単体(非負かつ和が1の集合)への射影、 は の最大固有値です。ステップ幅を にすると、目的関数が毎回必ず減少することが知られています。
単体への射影
単体への射影は、次のような簡単な形で求まることが知られています(Duchi et al., 2008)。
つまり、全要素から同じしきい値 を引き、負になった要素を0に切り上げる だけです。 は、結果の和がちょうど1になるように選びます。この「しきい値より小さい要素を0にする」操作によって、射影勾配法でも重みがちょうど0になる疎な解が自然に得られます。
データの前処理という工夫
射影勾配法の収束の速さは、 の固有値の 最大と最小の比(条件数) に大きく左右されます。トイ問題の図で見た「細長い楕円」は、この比が大きいことを表しており、勾配降下は細長い谷をジグザグに進むことになって、なかなか谷底にたどり着きません。
ジオワールドのデータでは、すべての地域が共通のトレンドと曜日周期を持ち、売上の水準も似ているため、 の列同士が強く相関しています。そこで、次の工夫を考えます。
各時点のドナー平均 を、介入地域とドナーの両方から引きます。一見、問題を変えてしまうように見えますが、重みの和が1である限り、目的関数の値は変わりません。
和=1の制約のおかげで、共通成分を取り除いても同じ問題のまま、 の形だけを解きやすくできるのです。
Pythonでの実装
# 1. 単体(非負かつ和が1の集合)への射影
def project_simplex(v):
    """ベクトル v に最も近い(ユークリッド距離で)単体上の点を返す"""
    u = np.sort(v)[::-1]                        # 大きい順に並べる
    css = np.cumsum(u)                          # 累積和
    k = np.arange(1, len(v) + 1)
    rho = np.nonzero(u - (css - 1) / k > 0)[0][-1]  # 正のまま残る要素の個数 - 1
    tau = (css[rho] - 1) / (rho + 1)            # 全要素から引くしきい値
    return np.maximum(v - tau, 0.0)

# 2. 射影勾配法
def projected_gradient(Q, c, w0, n_iter):
    """勾配で1歩進み、単体へ射影し直す操作を n_iter 回繰り返す"""
    L = np.linalg.eigvalsh(Q).max()             # 勾配のリプシッツ定数(Qの最大固有値)
    w = w0.copy()
    history = []
    for _ in range(n_iter):
        w = project_simplex(w - (Q @ w + c) / L)  # ステップ幅 1/L で勾配降下 → 射影
        history.append(np.sum((y - X @ w) ** 2))
    return w, np.array(history)

f_opt = np.sum((y - X @ w_scm) ** 2)            # SLSQPで得た最適値(基準)
n_iter = 5000

# 3. (A) 元のデータのまま解く
w_pg_raw, hist_raw = projected_gradient(Q, c_vec, np.ones(n_donors) / n_donors, n_iter)

# 4. (B) 各時点のドナー平均を y と X の両方から引いてから解く
m = X.mean(axis=1, keepdims=True)
Xc, yc = X - m, y - m.ravel()
Qc, cc = 2 * Xc.T @ Xc, -2 * Xc.T @ yc
w_pg, hist_c = projected_gradient(Qc, cc, np.ones(n_donors) / n_donors, n_iter)

eig_raw = np.linalg.eigvalsh(Q)
print(f"(A) Qの固有値   最小: {eig_raw.min():,.1f}   最大: {eig_raw.max():,.0f}   (比: {eig_raw.max() / eig_raw.min():,.0f})")
print(f"(B) Qの最大固有値: {np.linalg.eigvalsh(Qc).max():,.0f}")
print(f"{n_iter}回後の最適値との差   (A) {hist_raw[-1] - f_opt:.4f}   (B) {hist_c[-1] - f_opt:.6f}")
print(f"(B) の重み(0.001以上): " + ", ".join(f"地域{j+1}={w_pg[j]:.4f}" for j in range(n_donors) if w_pg[j] > 1e-3))

# 5. (B) の方法で、ランダムな5つの初期値から解く
rng_init = np.random.default_rng(0)
print("\nランダムな初期値からの到達点((B) の方法)")
hist_starts = []
for i in range(5):
    w_init = rng_init.dirichlet(np.ones(n_donors))   # 単体上のランダムな点
    w_i, h_i = projected_gradient(Qc, cc, w_init, n_iter)
    hist_starts.append(h_i)
    print(f"  初期値{i+1}: 目的関数 = {h_i[-1]:.4f},  地域1〜3の重み = {np.round(w_i[:3], 4)}")
- 単体への射影: project_simplex は、Duchi et al. のアルゴリズムの実装です。要素を大きい順に並べた u と累積和 css から、正のまま残る要素の個数を rho で求め、その要素の和が1になるようにしきい値 tau を決めます。最後に np.maximum(v - tau, 0.0) で、しきい値を引いて負の要素を0にしています。
- 射影勾配法: projected_gradient は、ステップ幅 1 / L の勾配降下と射影を n_iter 回繰り返します。収束の様子を見るため、各反復での目的関数の値を、元のデータ y、X で計算して history に記録しています(前処理の有無にかかわらず、同じ物差しで比べるためです)。
- (A) と (B) の比較: (A) は元のデータの Q、c_vec をそのまま使い、(B) は各時点のドナー平均 m を引いた Qc、cc を使います。どちらも等配分の重みから出発し、5000回反復します。5000回にするのは、(B) が最適値に収束しきる一方で、(A) にはまだ大きな誤差が残り、2つの収束の速さの違いがはっきり見える回数だからです。
- ランダムな初期値: rng_init.dirichlet は、単体上のランダムな点(非負かつ和が1のランダムなベクトル)を生成します。5通りの初期値から (B) の方法で解き、到達点を比べています。5通りの初期値を試すのは、凸な2次計画問題では、初期値によらず同じ解に着くことを確かめるためです。
実行結果
(A) Qの固有値   最小: 170.7   最大: 7,617,815   (比: 44,629)
(B) Qの最大固有値: 211,791
5000回後の最適値との差   (A) 26.8626   (B) 0.000001
(B) の重み(0.001以上): 地域1=0.4474, 地域2=0.2294, 地域3=0.2865, 地域9=0.0026, 地域12=0.0341

ランダムな初期値からの到達点((B) の方法)
  初期値1: 目的関数 = 52.4134,  地域1〜3の重み = [0.4474 0.2294 0.2865]
  初期値2: 目的関数 = 52.4134,  地域1〜3の重み = [0.4474 0.2294 0.2865]
  初期値3: 目的関数 = 52.4134,  地域1〜3の重み = [0.4474 0.2294 0.2865]
  初期値4: 目的関数 = 52.4134,  地域1〜3の重み = [0.4474 0.2294 0.2865]
  初期値5: 目的関数 = 52.4134,  地域1〜3の重み = [0.4474 0.2294 0.2865]
- 前処理の効果は劇的: 元のデータの は、最大固有値が約762万、最小固有値が約171で、その比は約4.5万に達します。前処理で最大固有値は約21万(約36分の1)に下がり、ステップ幅をそのぶん大きく取れるようになりました。その結果、5000回反復後の最適値との差は、(A) では 26.86 も残っているのに対し、(B) では 0.000001 まで縮まっています。
- SLSQP と同じ解に到達: (B) の重み(地域1 = 0.4474、地域2 = 0.2294、地域3 = 0.2865、地域9 = 0.0026、地域12 = 0.0341)は、SLSQP の解と小数点以下4桁まで一致しています。射影のしきい値処理によって、残りの14地域の重みもちょうど0になっています。
- どこから始めても同じ答え: 5つのランダムな初期値から出発しても、すべて同じ目的関数値 52.4134 と同じ重みに到達しました。山登り法では初期値によって行き着く山が変わりましたが、凸な2次計画問題では、初期値に関係なく同じ大域的最適解にたどり着きます。最小固有値が約171と正なので、 は正定値であり、最適解はただ1つです。
収束の様子の可視化
fig, ax = plt.subplots(figsize=(10, 5.5))
iters = np.arange(1, n_iter + 1)
eps = 1e-10  # 対数目盛りで 0 を描けないための下限

for i, h in enumerate(hist_starts):
    ax.plot(iters, np.maximum(h - f_opt, eps), color='tab:blue', alpha=0.4, linewidth=1,
            label='(B) 平均除去後・ランダム初期値' if i == 0 else None)
ax.plot(iters, np.maximum(hist_c - f_opt, eps), color='tab:blue', linewidth=2.5, label='(B) 平均除去後・等配分の初期値')
ax.plot(iters, np.maximum(hist_raw - f_opt, eps), color='gray', linewidth=2.5, label='(A) 元データ・等配分の初期値')

ax.set_yscale('log')
ax.set_xlabel('反復回数')
ax.set_ylabel('目的関数 − 最適値(対数目盛り)')
ax.set_title('射影勾配法の収束の様子')
ax.legend(loc='upper right')
ax.grid(True, which='both', alpha=0.3)
plt.tight_layout()
plt.show()
- 縦軸: 各反復での目的関数の値から最適値 f_opt を引いた「残りの誤差」を、対数目盛りで描いています。0は対数目盛りで描けないので、np.maximum(..., eps) で下限を設けています。
- 描いている線: (A) 元データ(灰色の太線)、(B) 前処理後の等配分の初期値(青の太線)、(B) 前処理後の5つのランダムな初期値(青の細線)です。
実行結果
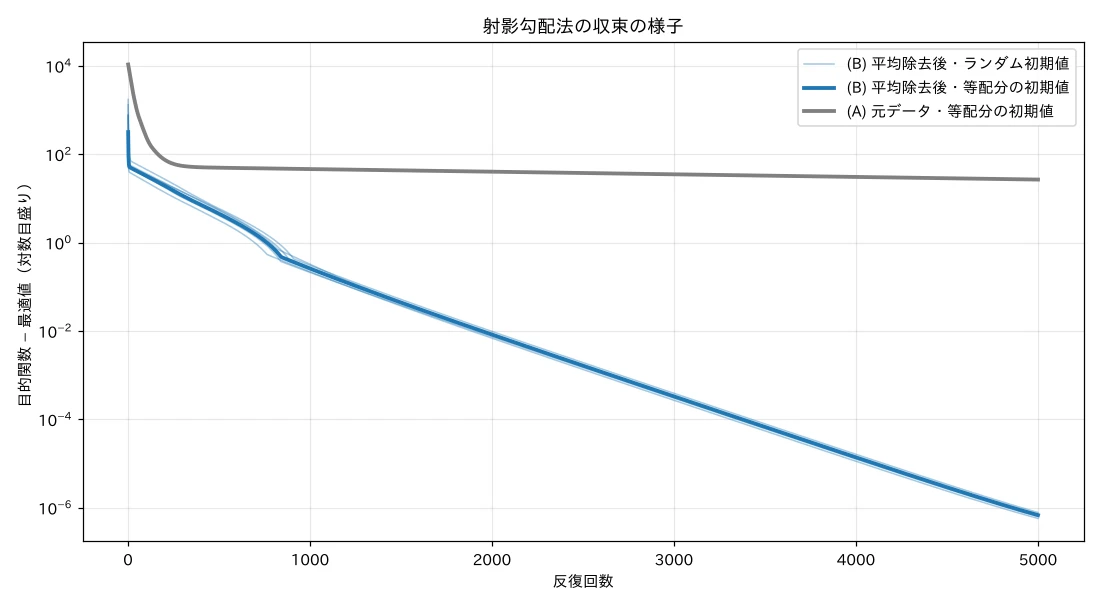
- (A) 元データ: 最初の数百回で急速に誤差が減ったあと、ほとんど横ばいになっています。これが、細長い谷の中をジグザグに進んでなかなか谷底にたどり着けない状態です。
- (B) 前処理後: 対数目盛りの上でほぼ直線的に誤差が減っています。これは誤差が反復ごとに一定の割合で縮む「線形収束」を表しています。約800回付近で傾きが変わるのは、0になるべき重みが次々と0に固定され、アクティブな制約の組み合わせが確定したためと考えられます。
- ランダムな初期値(細線): 出発点は違っても、すべて同じ速さで同じ最適値に収束しています。
射影勾配法は仕組みを理解するには最適ですが、条件数の影響を強く受けるため、実務では専用のソルバー(次節)を使うのが基本です。それでも、「データの前処理で問題の形を整えるとソルバーが速く・安定に解ける」という知見は、どのソルバーを使う場合にも役立ちます。
cvxpy による実装 ── 制約を自由に組み替える
合成コントロール法の記事の最後で触れた cvxpy は、凸最適化問題を数式に近い書き方で記述し、適切なソルバーに自動で渡してくれる Python ライブラリです。同じ問題を cvxpy で解き、さらに制約を追加してみましょう(事前に pip install cvxpy が必要です)。
import cvxpy as cp

# 1. 変数・目的関数・制約を数式に近い形で書く
w = cp.Variable(n_donors)
objective = cp.Minimize(cp.sum_squares(y - X @ w))
constraints = [w >= 0, cp.sum(w) == 1]
problem = cp.Problem(objective, constraints)

# 2. 求解(ソルバーは問題の種類から自動で選ばれる)
problem.solve()
w_cvx = w.value

print(f"ステータス: {problem.status}  (使用ソルバー: {problem.solver_stats.solver_name})")
print(f"目的関数値: cvxpy = {problem.value:.4f},  SLSQP = {f_opt:.4f}")
print(f"重みの最大差(cvxpy と SLSQP): {np.max(np.abs(w_cvx - w_scm)):.1e}")
print(f"等式制約の乗数 ν(cvxpy): {constraints[1].dual_value:.3f}")

# 3. 制約を差し替えるのも1行:重みの上限を0.4にした場合
problem_cap = cp.Problem(objective, [w >= 0, cp.sum(w) == 1, w <= 0.4])
problem_cap.solve()
w_cap = w.value
cum_lift_cap = np.sum(Y_all[treat_start:, 0] - Y_all[treat_start:, 1:] @ w_cap)
print(f"\n【上限0.4を追加】目的関数値 = {problem_cap.value:.4f}, 累積リフト = {cum_lift_cap:.2f}(真値 {true_cum_total:.2f})")
print("  重み(0.001以上): " + ", ".join(f"地域{j+1}={w_cap[j]:.4f}" for j in range(n_donors) if w_cap[j] > 1e-3))
- 問題の記述: cp.Variable で19個の重みを変数として宣言し、cp.sum_squares で二乗誤差の和を目的関数にしています。制約は w >= 0 と cp.sum(w) == 1 のように、数式そのままのリストで渡します。
- 求解: problem.solve() を呼ぶと、cvxpy が問題を2次計画問題と認識し、適切なソルバーを選んで解きます。使われたソルバー名は problem.solver_stats.solver_name で確認できます(インストールされているソルバーやバージョンによって変わることがあります)。
- ラグランジュ乗数: 各制約の dual_value で、KKT条件のラグランジュ乗数を取り出せます。constraints[1] は和=1の等式制約なので、前節で求めた に対応します。
- 制約の追加: w <= 0.4 を制約のリストに加えるだけで、「1つの地域に重みを集中させすぎない」という新しい問題を解けます。上限を0.4にするのは、真の最大の重み(地域1の0.5)より小さくして、制約が実際に効く(重みが上限に張り付く)場合を見せるためです。
実行結果
ステータス: optimal  (使用ソルバー: OSQP)
目的関数値: cvxpy = 52.4134,  SLSQP = 52.4134
重みの最大差(cvxpy と SLSQP): 1.9e-06
等式制約の乗数 ν(cvxpy): 99.807

【上限0.4を追加】目的関数値 = 53.1591, 累積リフト = 441.97(真値 449.31)
  重み(0.001以上): 地域1=0.4000, 地域2=0.2410, 地域3=0.3126, 地域9=0.0166, 地域12=0.0290
- SLSQP と一致: cvxpy(今回はソルバーとして OSQP が選ばれました)の解は、目的関数値・重みともに SLSQP の解と一致しています。等式制約の乗数 も 99.807 で、前節で勾配から逆算した値(99.805)とほぼ同じです。
- 制約の追加: 重みの上限を0.4にすると、地域1の重みがちょうど上限の0.4に張り付き、その分が地域3や地域9に再配分されました。今回のデータでは真の重みが0.5なので、この制約はかえって推定を悪化させています(累積リフト 441.97、真値 449.31)。制約は「正しい知識」を加えれば推定を安定させますが、誤った制約は偏りを生むという点に注意が必要です。
2次計画問題の主なアルゴリズム
最後に、2次計画問題を解く代表的なアルゴリズムを整理しておきます。
| アルゴリズム | 考え方 | 代表的な実装 |
|---|---|---|
| アクティブセット法 | 「0になる変数(アクティブな制約)の集合」を推測・更新しながら、等式制約付きの問題(連立一次方程式)を繰り返し解く | SciPy の nnls、SLSQP(逐次2次計画法の部分問題で使用) |
| 内点法 | 実行可能領域の内側を通りながら、制約の境界に少しずつ近づいて解く。大規模でも反復回数が少ない | Clarabel、MOSEK など |
| ADMM(交互方向乗数法) | 問題を「目的関数の部分」と「制約の部分」に分け、交互に解いて合意させる。1反復が軽く、大規模・疎な問題に強い | OSQP |
| 射影勾配法 | 勾配降下と制約への射影を繰り返す。射影が簡単な制約(単体や箱型制約)なら実装が非常に簡単 | 本記事のスクラッチ実装 |
まとめ
本記事では、合成コントロール法の重み推定の裏側にある 制約付き2次計画問題 について掘り下げました。
- 2次計画問題の標準形: 目的関数が2次式、制約が1次式の最適化問題です。合成コントロール法の重み推定は、、 とおいた2次計画問題そのものです。
- 凸性による保証: は半正定値で、単体は凸集合なので、問題全体が凸になります。そのため、山登り法や焼きなまし法で問題になった局所的最適解の罠がなく、どこから解き始めても同じ大域的最適解に到達します。
- KKT条件と疎な解: 凸な2次計画問題では、KKT条件が最適性の必要十分条件です。相補性条件から、正の重みを持つドナーの勾配は1つの値に揃い、重みを移しても誤差が減らないドナーの重みはちょうど0になります。
- 制約の役割: 非負制約は負の重みによる過学習と外挿を防ぎ、和=1の制約は水準方向の外挿を防ぎます。事前期間の当てはまりは制約なしより悪くなりますが、施策効果の推定は大幅に正確になりました(誤差 +23.38 → -0.36)。
- アルゴリズムと前処理: 射影勾配法はシンプルですが、条件数に強く影響されます。和=1の制約を利用して共通成分を取り除くと、問題を変えずに収束を劇的に速められます。実務では cvxpy などを使えば、制約を自由に組み替えて解けます。
2次計画問題は、合成コントロール法に限らず、ポートフォリオ最適化(平均分散モデル)、サポートベクターマシン、Lasso回帰など、データサイエンスのさまざまな場面に登場します。今回の「凸性」「KKT条件」「相補性による疎な解」という見方は、それらの手法を理解するうえでも共通の土台になります。
本記事の文章・構成の一部に生成AIを使用しています。