Qwen2-VLとは?
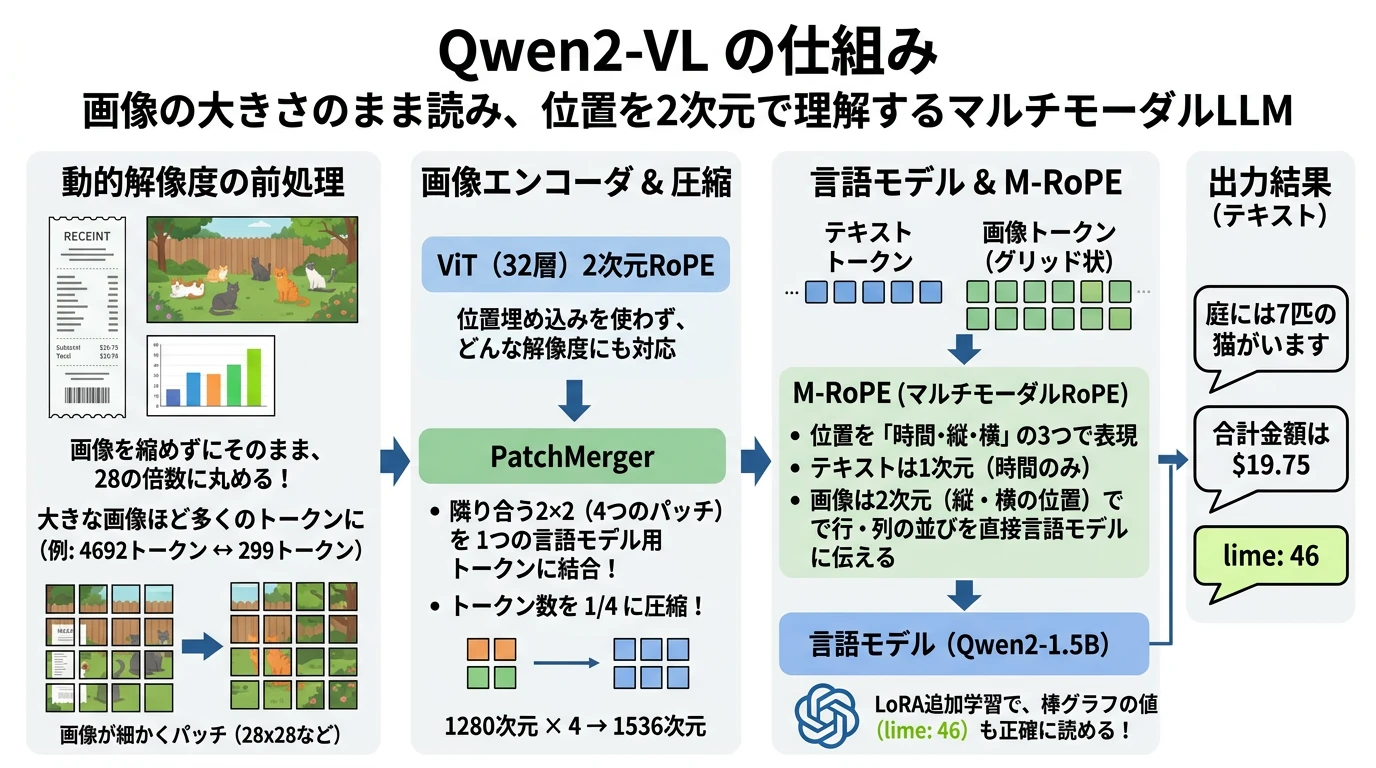 (画像は、Geminiで作成)
画像の大きさに応じた数のトークンで画像を読む Qwen2-VL を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じトークン列を生成することを確かめること。動的解像度と M-RoPE が、文字や位置の読み取りにどう効くかを理解し、LoRA の追加学習を自分で書いて動かせるようになること。
参考資料: Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution (Wang et al., 2024)。公式の実装は QwenLM/Qwen2.5-VL(Qwen2-VL のリポジトリ、Apache-2.0)、本記事で使う学習済みの重みは Hugging Face の Qwen/Qwen2-VL-2B-Instruct(Apache-2.0)です。
概要
LLaVA などの多くの画像と言語のモデル(VLM)は、画像を 336×336 のような決まった大きさに縮めてから読みます。縦長の書類や横長のスクリーンショットも同じ大きさに押し込むので、小さな文字はつぶれ、縦横の比もゆがみます。
Qwen2-VL(Alibaba の Qwen チーム、2024)は、画像を大きさのまま読むモデルです。縦横を 28 画素の倍数に合わせるだけで、大きな画像ほど多くのトークンにします(動的解像度)。画像のトークンの位置は、テキストのように 1 列の番号ではなく、縦と横の 2 次元で言語モデルに伝えます(M-RoPE)。動画では、時間の位置も加えます。
本記事では、まず Hugging Face の実装で Qwen2-VL-2B-Instruct に画像の説明と文字の読み取りをさせ、仕組みを図で整理したうえで、前処理・画像エンコーダ・PatchMerger・言語モデルをスクラッチで実装します。公式の重みで Hugging Face と同じトークン列を生成することを確かめ、画像のトークンの数を変えたときの文字の読み取りの正解率と、M-RoPE を 1 列の位置に変えたときの変化を調べます。最後に、LoRA で言語モデルを追加学習し、棒グラフの値を読めるようにします。
Qwen2-VL で画像を読む
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。最後の実験5の追加学習は、A100 で約 10 分かかります。
新しいセッションで、次を実行してください。transformers(比較用の Qwen2-VL)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q japanize-matplotlib setuptools
推論に利用する画像
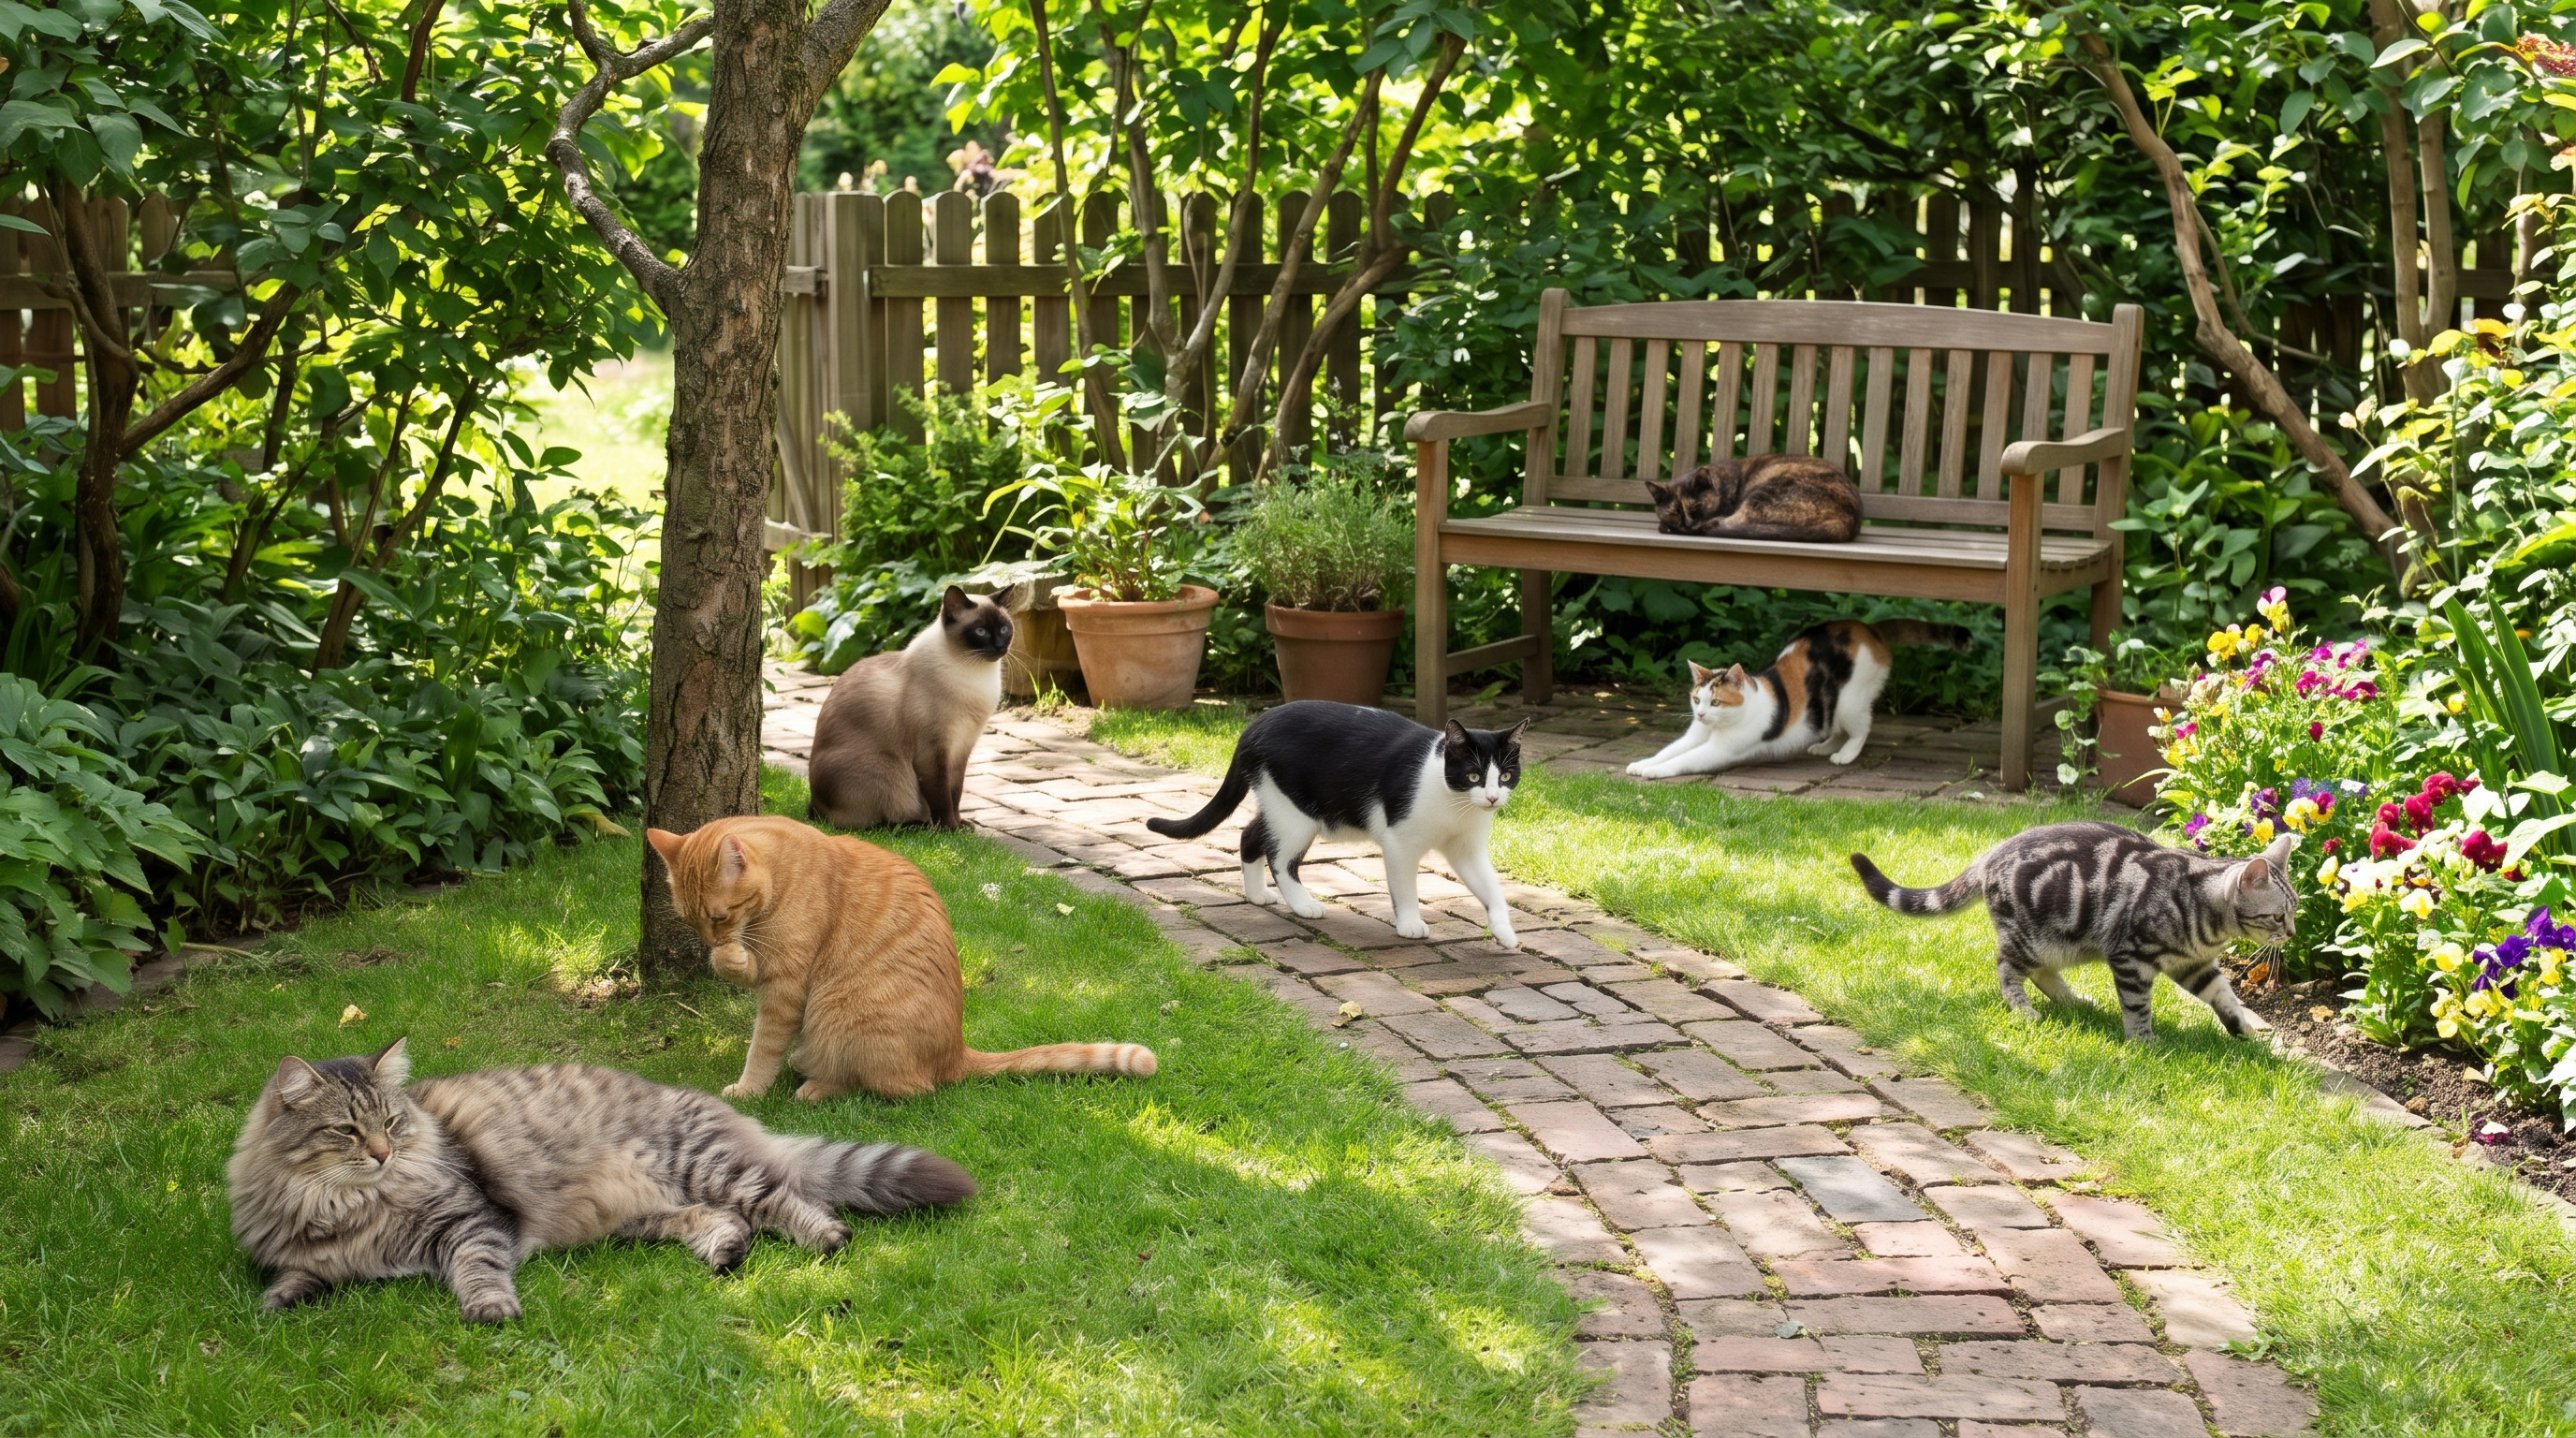
実験1と実験2では、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。文字の画像・表のような画像・棒グラフは、コードの中で作ります。
実験1:画像の説明と、文字の読み取り
Hugging Face の実装で、猫の画像と、コードで作った架空のレシートの画像に質問します。
import os
import re
import io
import math
import time
import random
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt
import japanize_matplotlib
from matplotlib import font_manager
from PIL import Image, ImageDraw, ImageFont
from transformers import AutoProcessor, Qwen2VLForConditionalGeneration

device = "cuda"
MID = "Qwen/Qwen2-VL-2B-Instruct"
processor = AutoProcessor.from_pretrained(MID)
hf_model = Qwen2VLForConditionalGeneration.from_pretrained(MID, dtype=torch.bfloat16).to(device).eval()
FONT = font_manager.findfont("DejaVu Sans")          # matplotlib に入っているフォント


def chat_text(question):
    """Qwen2-VL の対話の形式。画像は <|vision_start|><|image_pad|><|vision_end|> の位置に入る"""
    msgs = [{"role": "user", "content": [{"type": "image"}, {"type": "text", "text": question}]}]
    return processor.apply_chat_template(msgs, add_generation_prompt=True)


def ask_hf(image, question, max_new_tokens=128, **kw):
    inputs = processor(images=[image], text=[chat_text(question)], return_tensors="pt", **kw).to(device)
    with torch.no_grad():
        out = hf_model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return processor.decode(out[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True), inputs


# 文字の入った画像:架空のレシート
receipt = Image.new("RGB", (640, 360), "white")
d = ImageDraw.Draw(receipt)
lines = ["GREEN LEAF CAFE", "Order No. 4821", "Latte x2      9.00", "Bagel x1      3.25", "Muffin x3     7.50", "TOTAL        19.75"]
for i, line in enumerate(lines):
    d.text((60, 30 + i * 52), line, fill="black", font=ImageFont.truetype(FONT, 30))
receipt.save("receipt.png")

cats = Image.open("cats.jpg").convert("RGB")
for image, q in [(cats, "Describe this image in two sentences."), (cats, "How many cats are in this image?"),
                 (receipt, "Read all the text in the image."), (receipt, "What is the total amount?")]:
    answer, inputs = ask_hf(image, q)
    n_img = (inputs["input_ids"] == 151655).sum().item()
    print(f"[{image.size[0]}×{image.size[1]} → 画像のトークン {n_img} 個] {q}\n  → {answer}\n")
- 対話の形式: apply_chat_template で、Qwen2-VL の学習と同じ形式(システムの文、ユーザーの発言、アシスタントの発言の始まり)にします。画像は <|vision_start|><|image_pad|><|vision_end|> の位置に入ります。
- bfloat16: Qwen2-VL の公式の重みの型です。
- 貪欲法: do_sample=False で、毎回確率が最大のトークンを選びます。後でスクラッチ実装の出力と比べるためです。
- フォント: matplotlib に入っている DejaVu Sans を使い、どの環境でも同じ画像になるようにしています。
実行結果
[2576×1438 → 画像のトークン 4692 個] Describe this image in two sentences.
  → The image depicts a garden scene with a variety of cats scattered across a brick pathway. There is a wooden bench in the background, surrounded by lush greenery and potted plants. The cats are of different breeds and colors, including black and white, calico, and tabby. The garden is well-maintained, with a wooden fence and a tree providing shade.

[2576×1438 → 画像のトークン 4692 個] How many cats are in this image?
  → There are seven cats in the image.

[640×360 → 画像のトークン 299 個] Read all the text in the image.
  → Green Leaf Cafe
Order No. 4821
Latte x2     9.00
Bagel x1     3.25
Muffin x3     7.50
TOTAL        19.75

[640×360 → 画像のトークン 299 個] What is the total amount?
  → The total amount for the order is $19.75.
- 画像の説明: 庭・レンガの道・ベンチ・猫の毛の色まで説明しました。「2 文で」という指示は守らず、4 文になっています。
- 猫の数: 7 匹と正しく答えました(LLaVA の記事の LLaVA-1.5 は 9 匹と答えました)。
- レシートの読み取り: 6 行の文字と数字をすべて読み、合計の金額の質問にも答えました。大文字の「GREEN LEAF CAFE」だけは「Green Leaf Cafe」と書いています。
- 画像のトークンの数: 2576×1438 の猫の画像は 4,692 トークン、640×360 のレシートは 299 トークンです。画像の大きさに応じて、トークンの数が大きく変わります。
Qwen2-VL の仕組み
全体の構成
Qwen2-VL の全体は、次の図のとおりです(図は、後で実装する Qwen2VL クラスの構成です)。
(図は、diagram-designで作成)
- 画像エンコーダ: 約 6.3 億個のパラメータの ViT(32 層、1280 次元。Transformer のエンコーダの構成はTransformer の記事)です。位置の埋め込みの表を持たず、パッチの縦と横の位置で回す 2 次元の RoPE を使うので、どんな大きさの画像にも同じ重みで対応できます。
- PatchMerger: 隣り合う 2×2 のパッチの特徴をつなげて MLP にかけ、言語モデルの 1 トークン(1536 次元)にします。トークンの数は、パッチの 4 分の 1 になります。
- 言語モデル: Qwen2-1.5B(28 層)です。位置の情報に M-RoPE を使います。
動的解像度と PatchMerger
(図は、diagram-designで作成)
前処理では、画像の縦横を、最も近い 28 の倍数に丸めるだけです。画素数が上限(max_pixels)を超えるときだけ、縦横比を保ったまま縮めます。28×28 画素が言語モデルの 1 トークンになるので、1120×560 の画像は 40×20 = 800 トークン、448×224 の画像は 128 トークンです。大きな画像の細かい文字まで読める代わりに、トークンが多いほど計算量とメモリが増えます。max_pixels は、その釣り合いを決める設定です。
M-RoPE:時間・縦・横の 3 つの位置
(図は、diagram-designで作成)
RoPE は、クエリとキーのベクトルを、トークンの位置に比例した角度だけ回して、位置を伝えます。M-RoPE(Multimodal RoPE)は、位置を「時間・縦・横」の 3 つにし、1 ヘッド 128 次元を回す 64 組の周波数を 16・24・24 組に分けて、それぞれの位置で回します。
- テキスト: 3 つの位置がすべて同じ値なので、ふつうの RoPE とまったく同じになります。
- 画像: 時間の位置は画像の開始の位置のまま、縦と横の位置は「開始の位置 + 行・列の番号」にします。同じ行のトークンは縦の位置が同じ、同じ列のトークンは横の位置が同じになり、言語モデルは 2 次元の並びを直接知ることができます。
- 画像の後ろのテキスト: 「開始の位置 + max(行の数, 列の数)」から続けます。800 トークンの画像でも、位置は 40 しか進みません。
詳しくは MRoPE の記事で説明しています。
3 段階の学習
(図は、diagram-designで作成)
論文によると、Qwen2-VL は 3 段階で学習しています。第 1 段階は画像とテキストの組で ViT だけを、第 2 段階はより多様なデータですべての重みを、第 3 段階は ViT を固定して、指示に従う対話のデータで言語モデルを学習します。本記事の実験5では、第 3 段階のように ViT を固定し、言語モデルだけを LoRA で小さく追加学習します。
Qwen2-VL のスクラッチ実装
ここからは、Qwen2-VL を部品ごとに実装します。部品の構造・次元・計算の順番は、Hugging Face の Qwen2VLForConditionalGeneration(Qwen2VisionTransformerPretrainedModel と Qwen2VLTextModel)と同じで、重みの名前も読み込みやすいように合わせています。
前処理:動的解像度
def smart_resize(h, w, factor=28, min_pixels=56 * 56, max_pixels=28 * 28 * 1280):
    """縦横を 28(パッチ 14 × まとめる 2)の倍数に丸め、画素数を min_pixels〜max_pixels に収める"""
    hb, wb = round(h / factor) * factor, round(w / factor) * factor
    if hb * wb > max_pixels:                           # 大きすぎる:縦横比を保ったまま縮める
        beta = math.sqrt(h * w / max_pixels)
        hb, wb = max(factor, math.floor(h / beta / factor) * factor), max(factor, math.floor(w / beta / factor) * factor)
    elif hb * wb < min_pixels:                         # 小さすぎる:縦横比を保ったまま広げる
        beta = math.sqrt(min_pixels / (h * w))
        hb, wb = math.ceil(h * beta / factor) * factor, math.ceil(w * beta / factor) * factor
    return hb, wb


MEAN = torch.tensor([0.48145466, 0.4578275, 0.40821073])
STD = torch.tensor([0.26862954, 0.26130258, 0.27577711])


def preprocess(img, max_pixels=12845056, min_pixels=56 * 56, patch=14, merge=2, tp=2):
    """PIL 画像 → パッチの列 (パッチの数, 3×2×14×14) と grid (1, 縦のパッチ数, 横のパッチ数)"""
    img = img.convert("RGB")
    H, W = smart_resize(img.height, img.width, patch * merge, min_pixels, max_pixels)
    x = torch.tensor(np.array(img.resize((W, H), Image.BICUBIC))).permute(2, 0, 1).float()
    x = (x / 255 - MEAN[:, None, None]) / STD[:, None, None]
    gh, gw = H // patch, W // patch
    # 2×2 のまとまりごとにパッチを並べる(あとで隣の 4 つを 1 トークンにまとめるため)
    x = x.view(3, gh // merge, merge, patch, gw // merge, merge, patch).permute(1, 4, 2, 5, 0, 3, 6)
    x = x[:, :, :, :, :, None].expand(-1, -1, -1, -1, -1, tp, -1, -1)       # 静止画は同じ画像を 2 フレーム分並べる
    return x.reshape(gh * gw, 3 * tp * patch * patch), torch.tensor([[1, gh, gw]])


for name, image in [("cats.jpg", cats), ("receipt.png", receipt)]:
    for mp in [None, 256 * 28 * 28]:
        kw = {} if mp is None else {"max_pixels": mp}
        hf_in = processor(images=[image], text=[chat_text("x")], return_tensors="pt", **kw)
        pv, grid = preprocess(image, **kw)
        print(f"{name} {image.size[0]}×{image.size[1]}  max_pixels={mp}: grid {grid[0].tolist()} (HF {hf_in['image_grid_thw'][0].tolist()})"
              f" → パッチ {pv.shape[0]:,} 個・トークン {pv.shape[0] // 4:,} 個、HF との差の最大値 {(pv - hf_in['pixel_values']).abs().max():.3f}")
- smart_resize: Hugging Face の前処理と同じ計算で、縦横を 28 の倍数に丸め、画素数を min_pixels〜max_pixels に収めます。公式の設定の max_pixels は 12,845,056(約 1,600 万画素、16,384 トークン)で、ふつうの画像はほぼ縮めません。
- パッチの並べ方: 14×14 のパッチを、左上から 1 つずつではなく、2×2 のまとまりごとに並べます。PatchMerger が、続けて並んだ 4 つのパッチを 1 トークンにまとめられるようにするためです。
- 2 フレーム分: 画像エンコーダは動画と同じ形(2 フレームを 1 つにまとめるパッチ)で作られているので、静止画は同じ画像を 2 回並べます。
- 画素の値: Hugging Face の前処理と、ごく一部の画素で 1〜2 階調の違いがあります(縮小の計算の細かな違い)。実験2では、比べやすいよう Hugging Face の前処理の結果を両方に入れます。
実行結果
cats.jpg 2576×1438  max_pixels=None: grid [1, 102, 184] (HF [1, 102, 184]) → パッチ 18,768 個・トークン 4,692 個、HF との差の最大値 0.015
cats.jpg 2576×1438  max_pixels=200704: grid [1, 22, 42] (HF [1, 22, 42]) → パッチ 924 個・トークン 231 個、HF との差の最大値 0.015
receipt.png 640×360  max_pixels=None: grid [1, 26, 46] (HF [1, 26, 46]) → パッチ 1,196 個・トークン 299 個、HF との差の最大値 0.015
receipt.png 640×360  max_pixels=200704: grid [1, 24, 42] (HF [1, 24, 42]) → パッチ 1,008 個・トークン 252 個、HF との差の最大値 0.030
画像エンコーダと PatchMerger
# ===== 画像エンコーダ:ViT(675M、2 次元の RoPE) =====
def rotate_half(x):
    x1, x2 = x[..., :x.shape[-1] // 2], x[..., x.shape[-1] // 2:]
    return torch.cat([-x2, x1], -1)


def vision_rope(grid, merge=2, head_dim=80, theta=10000.0):
    """各パッチの (縦, 横) の位置。並びは 2×2 のまとまりごと。head_dim の前半を縦、後半を横の回転に使う"""
    pos = []
    for t, h, w in grid.tolist():
        hp, wp = torch.meshgrid(torch.arange(h), torch.arange(w), indexing="ij")
        shape = (h // merge, merge, w // merge, merge)
        pos.append(torch.stack([hp.reshape(shape).transpose(1, 2).flatten(), wp.reshape(shape).transpose(1, 2).flatten()], -1).repeat(t, 1))
    pos = torch.cat(pos).float()                                                  # (N, 2)
    inv = 1.0 / theta ** (torch.arange(0, head_dim // 2, 2).float() / (head_dim // 2))   # 20 個の周波数
    f = torch.cat([pos[:, :1] * inv, pos[:, 1:] * inv], -1)                       # (N, 40):縦 20 + 横 20
    f = torch.cat([f, f], -1)
    return f.cos(), f.sin()


class VisionBlock(nn.Module):
    def __init__(self, dim=1280, heads=16):
        super().__init__()
        self.heads = heads
        self.norm1, self.norm2 = nn.LayerNorm(dim, eps=1e-6), nn.LayerNorm(dim, eps=1e-6)
        self.qkv, self.proj = nn.Linear(dim, 3 * dim), nn.Linear(dim, dim)
        self.fc1, self.fc2 = nn.Linear(dim, 4 * dim), nn.Linear(4 * dim, dim)

    def forward(self, x, cos, sin, cu):
        N, C = x.shape
        q, k, v = self.qkv(self.norm1(x)).view(N, 3, self.heads, -1).unbind(1)
        rot = lambda t: ((t.float() * cos[:, None] + rotate_half(t.float()) * sin[:, None])).to(t.dtype)
        q, k = rot(q), rot(k)
        out = []
        for s, e in zip(cu[:-1], cu[1:]):                                         # 画像ごとに、その画像の中だけで注意をとる
            a = F.scaled_dot_product_attention(*(t[s:e].transpose(0, 1)[None] for t in (q, k, v)))
            out.append(a[0].transpose(0, 1).reshape(e - s, C))
        x = x + self.proj(torch.cat(out))
        h = self.fc1(self.norm2(x))
        return x + self.fc2(h * torch.sigmoid(1.702 * h))                         # quick GELU


class PatchMerger(nn.Module):
    """隣り合う 2×2 のパッチ(4 × 1280 次元)をつなげて、言語モデルの 1536 次元の 1 トークンにする"""

    def __init__(self, dim=1280, out=1536, merge=2):
        super().__init__()
        self.ln_q = nn.LayerNorm(dim, eps=1e-6)
        self.mlp = nn.Sequential(nn.Linear(dim * merge ** 2, dim * merge ** 2), nn.GELU(), nn.Linear(dim * merge ** 2, out))

    def forward(self, x):
        return self.mlp(self.ln_q(x).view(-1, self.mlp[0].in_features))


class VisionEncoder(nn.Module):
    def __init__(self, dim=1280, depth=32):
        super().__init__()
        self.patch_embed = nn.Conv3d(3, dim, (2, 14, 14), (2, 14, 14), bias=False)
        self.blocks = nn.ModuleList(VisionBlock(dim) for _ in range(depth))
        self.merger = PatchMerger(dim)

    def forward(self, pixels, grid):
        x = self.patch_embed(pixels.view(-1, 3, 2, 14, 14).to(self.patch_embed.weight.dtype)).flatten(1)   # (N, 1280)
        cos, sin = (t.to(x.device) for t in vision_rope(grid))
        cu = [0] + torch.cumsum(grid.prod(-1), 0).tolist()
        for blk in self.blocks:
            x = blk(x, cos, sin, cu)
        return self.merger(x)                                                     # (N/4, 1536)
- vision_rope: 各パッチの (縦, 横) の位置から、2 次元の RoPE の角度を作ります。1 ヘッド 80 次元のうち、前半の回転を縦の位置、後半を横の位置で決めます。
- VisionBlock: LayerNorm・注意(16 ヘッド)・MLP(5120 次元、quick GELU)の、Pre-LN の Transformer の層です。複数の画像を一度に入れたときは、cu(各画像のパッチの区切り)で、画像ごとに注意をとります。
- patch_embed: 2 フレーム × 14×14 画素 × 3 色を 1280 次元にする 3 次元の畳み込みです。
言語モデル:Qwen2-1.5B と M-RoPE
# ===== 言語モデル:Qwen2-1.5B と M-RoPE =====
class RMSNorm(nn.Module):
    def __init__(self, dim, eps=1e-6):
        super().__init__()
        self.weight, self.eps = nn.Parameter(torch.ones(dim)), eps

    def forward(self, x):
        v = x.float()
        return self.weight * (v * torch.rsqrt(v.pow(2).mean(-1, keepdim=True) + self.eps)).to(x.dtype)


def mrope(pos, head_dim=128, theta=1e6, section=(16, 24, 24)):
    """M-RoPE:位置を (時間, 縦, 横) の 3 つにし、64 個の周波数を 16・24・24 に分けて、それぞれの位置で回す"""
    inv = 1.0 / theta ** (torch.arange(0, head_dim, 2, device=pos.device).float() / head_dim)   # 64 個
    f = pos[..., None].float() * inv                                              # (3, L, 64)
    f = torch.cat([chunk[i] for i, chunk in enumerate(f.split(list(section), -1))], -1)   # (L, 64)
    f = torch.cat([f, f], -1)
    return f.cos(), f.sin()


class LMLayer(nn.Module):
    def __init__(self, dim=1536, heads=12, kv_heads=2, mlp=8960):
        super().__init__()
        self.heads, self.kv_heads, self.hd = heads, kv_heads, dim // heads
        self.input_layernorm, self.post_attention_layernorm = RMSNorm(dim), RMSNorm(dim)
        self.q_proj = nn.Linear(dim, heads * self.hd)
        self.k_proj, self.v_proj = nn.Linear(dim, kv_heads * self.hd), nn.Linear(dim, kv_heads * self.hd)
        self.o_proj = nn.Linear(heads * self.hd, dim, bias=False)
        self.gate_proj, self.up_proj = nn.Linear(dim, mlp, bias=False), nn.Linear(dim, mlp, bias=False)
        self.down_proj = nn.Linear(mlp, dim, bias=False)

    def forward(self, x, cos, sin, cache=None):
        B, L, C = x.shape
        h = self.input_layernorm(x)
        q = self.q_proj(h).view(B, L, self.heads, self.hd).transpose(1, 2)
        k = self.k_proj(h).view(B, L, self.kv_heads, self.hd).transpose(1, 2)
        v = self.v_proj(h).view(B, L, self.kv_heads, self.hd).transpose(1, 2)
        cos, sin = cos.to(q.dtype), sin.to(q.dtype)                              # (L, 128) を全ヘッドに使う
        q, k = q * cos + rotate_half(q) * sin, k * cos + rotate_half(k) * sin
        if cache is not None:
            if "k" in cache:
                k, v = torch.cat([cache["k"], k], 2), torch.cat([cache["v"], v], 2)
            cache["k"], cache["v"] = k, v
        a = F.scaled_dot_product_attention(q, k, v, is_causal=L > 1, enable_gqa=True)   # キーとバリューは 2 ヘッドを 6 回ずつ使う
        x = x + self.o_proj(a.transpose(1, 2).reshape(B, L, C))
        h = self.post_attention_layernorm(x)
        return x + self.down_proj(F.silu(self.gate_proj(h)) * self.up_proj(h))


class LM(nn.Module):
    def __init__(self, vocab=151936, dim=1536, layers=28):
        super().__init__()
        self.embed_tokens = nn.Embedding(vocab, dim)
        self.layers = nn.ModuleList(LMLayer(dim) for _ in range(layers))
        self.norm = RMSNorm(dim)

    def forward(self, x, pos, caches=None, checkpoint=False):
        cos, sin = mrope(pos)
        for i, layer in enumerate(self.layers):
            if checkpoint:
                x = torch.utils.checkpoint.checkpoint(layer, x, cos, sin, use_reentrant=False)
            else:
                x = layer(x, cos, sin, None if caches is None else caches[i])
        return F.linear(self.norm(x), self.embed_tokens.weight)                   # 出力層は埋め込みと同じ重み
- mrope: 位置 (3, L) から、64 組の周波数のうち最初の 16 組を時間の位置、次の 24 組を縦、最後の 24 組を横の位置で回す角度を作ります。基数は Qwen2 と同じ 1,000,000 です。
- LMLayer: Llama と同じ形の層ですが、クエリ・キー・バリューの線形層にバイアスがあります。キーとバリューは 2 ヘッドだけで、12 ヘッドのクエリで 6 回ずつ使います(GQA)。KV キャッシュの大きさが 6 分の 1 になります。
- 出力層: 2B のモデルは、単語の埋め込みと同じ重みを使います。
モデル全体と生成
# ===== Qwen2-VL 全体 =====
class Qwen2VL(nn.Module):
    IMAGE = 151655

    def __init__(self):
        super().__init__()
        self.visual = VisionEncoder()
        self.model = LM()

    @staticmethod
    def position_ids(ids, grids, flat_image=False):
        """テキストは 1 ずつ進む位置、画像は (開始位置, 開始+行, 開始+列) の 3 次元の位置。flat_image=True なら画像も 1 列に並べる"""
        pos, cur, i, g = [], 0, 0, iter(grids.tolist())
        ids = ids[0].tolist()
        while i < len(ids):
            if ids[i] != Qwen2VL.IMAGE:
                pos.append(torch.full((3, 1), cur)); cur += 1; i += 1
                continue
            t, h, w = next(g)
            h, w = h // 2, w // 2
            if flat_image:
                pos.append(torch.arange(cur, cur + t * h * w).expand(3, -1)); cur += t * h * w
            else:
                tt, hh, ww = torch.meshgrid(torch.arange(t), torch.arange(h), torch.arange(w), indexing="ij")
                pos.append(torch.stack([tt, hh, ww]).reshape(3, -1) + cur); cur += max(h, w)
            i += t * h * w
        return torch.cat(pos, 1)                                                  # (3, L)

    def embed(self, ids, pixels, grids):
        x = self.model.embed_tokens(ids)
        if pixels is not None:
            img = self.visual(pixels, grids).to(x.dtype)
            x = x.masked_scatter((ids == self.IMAGE)[..., None], img)               # <|image_pad|> の位置に画像のトークンを入れる
        return x

    def forward(self, ids, pixels=None, grids=None, flat_image=False, checkpoint=False):
        pos = self.position_ids(ids, grids, flat_image).to(ids.device) if pixels is not None else torch.arange(ids.shape[1], device=ids.device).expand(3, -1)
        return self.model(self.embed(ids, pixels, grids), pos, checkpoint=checkpoint)

    @torch.no_grad()
    def generate(self, ids, pixels=None, grids=None, max_new_tokens=128, eos=(151645, 151643), flat_image=False):
        pos = self.position_ids(ids, grids, flat_image).to(ids.device) if pixels is not None else torch.arange(ids.shape[1], device=ids.device).expand(3, -1)
        caches = [{} for _ in self.model.layers]
        logits = self.model(self.embed(ids, pixels, grids), pos, caches)
        nxt_pos, out = pos.max().item() + 1, []                                   # 生成するトークンは、最大の位置の次から 1 ずつ進む
        for _ in range(max_new_tokens):
            nxt = logits[:, -1].argmax(-1, keepdim=True)
            out.append(nxt)
            if nxt.item() in eos:
                break
            p = torch.full((3, 1), nxt_pos + len(out) - 1, device=ids.device)
            logits = self.model(self.model.embed_tokens(nxt), p, caches)
        return torch.cat(out, 1)


with torch.device("meta"):
    m = Qwen2VL()
count = lambda mod: sum(p.numel() for p in mod.parameters())
print(f"画像エンコーダ(ViT 32 層)     : {count(m.visual) - count(m.visual.merger):>14,}")
print(f"PatchMerger                     : {count(m.visual.merger):>14,}")
print(f"言語モデル(Qwen2-1.5B)        : {count(m.model):>14,}")
print(f"全体                            : {count(m):>14,}")

ids = torch.tensor([[1, 2, 3] + [Qwen2VL.IMAGE] * 6 + [4, 5]])              # テキスト 3 個、画像(縦 2×横 3 トークン)、テキスト 2 個
print("M-RoPE の位置(時間・縦・横):\n", Qwen2VL.position_ids(ids, torch.tensor([[1, 4, 6]])))
- position_ids: 入力のトークンを前から見て、テキストは 1 ずつ、画像は図のとおり (開始, 開始+行, 開始+列) の位置を作ります。flat_image=True にすると、画像のトークンにも 1 列の番号を振ります(実験4で使います)。
- embed: <|image_pad|>(id 151655)の位置を、画像エンコーダの出力で置き換えます。
- generate: 生成するトークンの位置は、プロンプトの最大の位置の次から 1 ずつ進めます。画像があると、位置の番号はトークンの数より小さくなります。
実行結果
画像エンコーダ(ViT 32 層)     :    631,183,360
PatchMerger                     :     34,087,936
言語モデル(Qwen2-1.5B)        :  1,543,714,304
全体                            :  2,208,985,600
M-RoPE の位置(時間・縦・横):
 tensor([[0, 1, 2, 3, 3, 3, 3, 3, 3, 6, 7],
        [0, 1, 2, 3, 3, 3, 4, 4, 4, 6, 7],
        [0, 1, 2, 3, 4, 5, 3, 4, 5, 6, 7]])
- パラメータの数: 全体で約 22 億個で、ViT が 6.3 億個、PatchMerger が 3,400 万個、言語モデルが 15.4 億個です(名前の 2B は、この合計です)。
- M-RoPE の位置: テキスト 3 個(位置 0〜2)のあとの、2 行 × 3 列の画像のトークンは、時間の位置がすべて 3、縦の位置が 3・3・3・4・4・4、横の位置が 3・4・5・3・4・5 です。画像の後ろのテキストは、3 + max(2, 3) = 6 から続きます。
学習済みの重みを読み込む
def load_hf_qwen2vl(model, sd):
    """Hugging Face の Qwen2VLForConditionalGeneration の重みの名前を付け替えて、同じテンソルを割り当てる"""
    out = {}
    for k, v in sd.items():
        n = k.replace("model.visual.", "visual.").replace("model.language_model.", "model.")
        n = n.replace("visual.patch_embed.proj.", "visual.patch_embed.").replace(".attn.", ".").replace(".mlp.fc", ".fc")
        n = n.replace(".self_attn.", ".").replace(".mlp.gate_proj", ".gate_proj").replace(".mlp.up_proj", ".up_proj").replace(".mlp.down_proj", ".down_proj")
        if n.startswith("lm_head."):
            continue                                                              # 埋め込みと同じ重み
        out[n] = v
    missing, unexpected = model.load_state_dict(out, strict=False, assign=True)
    assert not missing and not unexpected, (missing[:5], unexpected[:5])
    return model
Hugging Face の重みの名前を付け替えて、同じテンソルを割り当てます(assign=True)。出力層(lm_head)は単語の埋め込みと同じ重みなので読み込みません。
実験2:Hugging Face の実装と比べる
3 つの質問で、画像エンコーダの出力・logit・生成したトークン列を比べます。
# float32 で比べる(bfloat16 では、32 層の画像エンコーダと 28 層の言語モデルで丸めの誤差が大きくなるため)
del hf_model
torch.cuda.empty_cache()
hf32 = Qwen2VLForConditionalGeneration.from_pretrained(MID, dtype=torch.float32).to(device).eval()
with torch.device("meta"):
    model = Qwen2VL()
model = load_hf_qwen2vl(model, hf32.state_dict()).eval()

for image, q in [(cats, "How many cats are in this image?"), (receipt, "Read all the text in the image."), (cats, "Describe this image in two sentences.")]:
    inputs = processor(images=[image], text=[chat_text(q)], return_tensors="pt").to(device)
    ids, pv, grid = inputs["input_ids"], inputs["pixel_values"], inputs["image_grid_thw"].cpu()
    with torch.no_grad():
        v_hf = hf32.model.visual(pv, grid_thw=inputs["image_grid_thw"]).pooler_output
        v_me = model.visual(pv, grid)
        l_hf, l_me = hf32(**inputs).logits, model(ids, pv, grid)
        torch.cuda.synchronize(); t0 = time.time()
        g_hf = hf32.generate(**inputs, max_new_tokens=128, do_sample=False)[0, ids.shape[1]:]
        torch.cuda.synchronize(); t1 = time.time()
        g_me = model.generate(ids, pv, grid, max_new_tokens=128)[0]
        torch.cuda.synchronize(); t2 = time.time()
    print(f"{q}(入力 {ids.shape[1]} トークン)\n  画像の特徴の差の最大値 {(v_hf - v_me).abs().max().item():.2e}(最大 {v_hf.abs().max().item():.0f})"
          f"、logit の差の最大値 {(l_hf - l_me).abs().max().item():.2e}(最大 {l_hf.abs().max().item():.0f})\n"
          f"  生成:HF {len(g_hf)} 個・スクラッチ {len(g_me)} 個、一致 {len(g_hf) == len(g_me) and torch.equal(g_hf, g_me)}"
          f"(HF {t1 - t0:.2f} 秒、スクラッチ {t2 - t1:.2f} 秒)")

# 以降の実験は bfloat16 で動かす
model = model.to(torch.bfloat16)
del hf32
torch.cuda.empty_cache()
実行結果
How many cats are in this image?(入力 4721 トークン)
  画像の特徴の差の最大値 2.62e-03(最大 74)、logit の差の最大値 5.00e-02(最大 32)
  生成:HF 9 個・スクラッチ 9 個、一致 True(HF 6.06 秒、スクラッチ 6.10 秒)
Read all the text in the image.(入力 328 トークン)
  画像の特徴の差の最大値 7.86e-04(最大 51)、logit の差の最大値 5.38e-02(最大 31)
  生成:HF 56 個・スクラッチ 56 個、一致 True(HF 2.10 秒、スクラッチ 1.96 秒)
Describe this image in two sentences.(入力 4720 トークン)
  画像の特徴の差の最大値 2.62e-03(最大 74)、logit の差の最大値 5.00e-02(最大 33)
  生成:HF 64 個・スクラッチ 64 個、一致 True(HF 7.97 秒、スクラッチ 7.84 秒)
- 画像の特徴: 差の最大値は 2.6e-03 で、値の大きさ(最大 74)に対してごくわずかです。float32 で 32 層を計算したときの、計算の順番の違いによる丸めの誤差の範囲です。
- logit: 差の最大値は 5e-02(値の最大は約 32)です。入力が 4,721 トークンと長く、28 層を通るので、丸めの誤差が積み重なります。
- 生成: 3 つの質問とも、Hugging Face と同じトークン列を生成しました(56 トークン・64 トークンの長い回答も一致)。時間もほぼ同じです。
実験3:画像のトークンの数と、文字の読み取り
max_pixels を変えて、同じ画像を 55〜800 トークンで読ませ、文字の読み取りの正解率を比べます。
IMAGE_PAD = "<|image_pad|>"


def build_inputs(image, question, max_pixels=12845056, answer=None):
    """スクラッチ実装用の入力:<|image_pad|> を画像のトークンの数だけ並べる"""
    pv, grid = preprocess(image, max_pixels=max_pixels)
    text = chat_text(question).replace(IMAGE_PAD, IMAGE_PAD * (pv.shape[0] // 4))
    if answer is not None:
        text += answer + "<|im_end|>"
    ids = processor.tokenizer(text, return_tensors="pt")["input_ids"]
    return ids.to(device), pv.to(device, torch.bfloat16), grid


def ask(image, question, max_pixels=12845056, max_new_tokens=128, flat_image=False):
    ids, pv, grid = build_inputs(image, question, max_pixels)
    out = model.generate(ids, pv, grid, max_new_tokens=max_new_tokens, flat_image=flat_image)
    return processor.tokenizer.decode(out[0], skip_special_tokens=True).strip()


def edit_distance(a, b):
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1]


def char_accuracy(pred, gt):
    """1 − 編集距離 / 正解の文字数(空白と改行は 1 つの空白にそろえる)。0 未満は 0 にする"""
    p, g = " ".join(pred.split()), " ".join(gt.split())
    return max(0.0, 1 - edit_distance(p, g) / len(g))


print(ask(cats, "How many cats are in this image?"))
- build_inputs: 自分の前処理で画像をパッチにし、<|image_pad|> を画像のトークンの数だけ並べた入力を作ります。answer を渡すと、回答まで含めた入力にします(実験5の学習で使います)。
- char_accuracy: 1 −(編集距離 ÷ 正解の文字数)です。編集距離は、生成した文を正解に直すのに必要な、文字の追加・削除・置き換えの回数です。
実行結果
There are seven cats in the image.
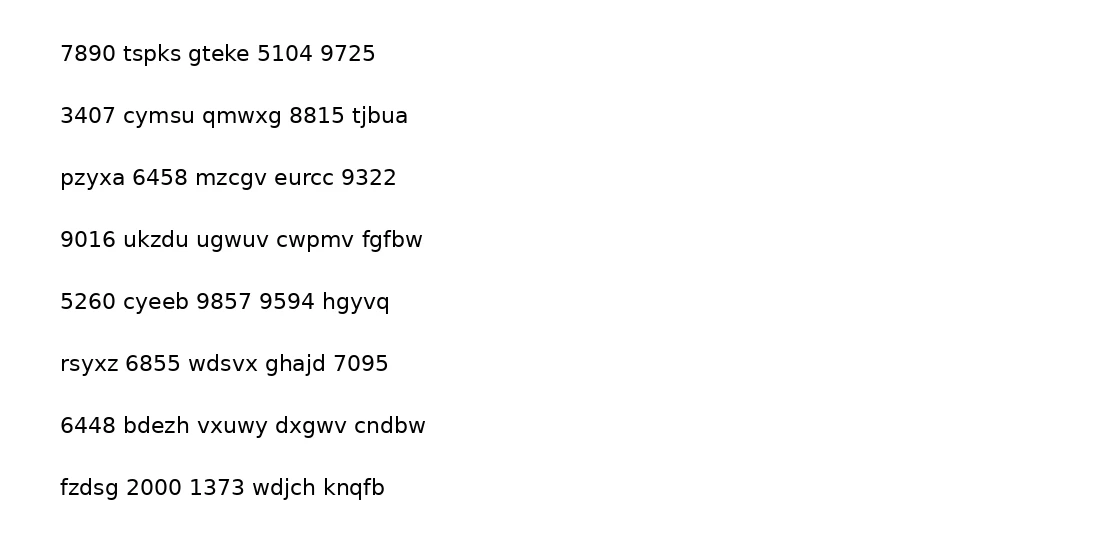
# 文字の読み取りのテスト画像:1120×560 に、ランダムな語を 8 行 × 5 語ずつ書く(l・i・o は数字や大文字と紛らわしいので使わない)
rng = random.Random(0)
letters = "abcdefghjkmnpqrstuvwxyz"


def random_word():
    return "".join(rng.choice(letters) for _ in range(5)) if rng.random() < 0.6 else str(rng.randint(1000, 9999))


def make_text_image():
    img = Image.new("RGB", (1120, 560), "white")
    d = ImageDraw.Draw(img)
    rows = [" ".join(random_word() for _ in range(5)) for _ in range(8)]
    for i, r in enumerate(rows):
        d.text((60, 40 + i * 62), r, fill="black", font=ImageFont.truetype(FONT, 22))
    return img, "\n".join(rows)


ocr_set = [make_text_image() for _ in range(30)]
ocr_set[0][0].save("ocr_example.png")
Q_OCR = "Read all the text in the image. Output only the text."
ocr_results = {}
for n_tok in [64, 144, 256, 400, 800]:
    torch.cuda.synchronize(); t0 = time.time()
    preds = [ask(img, Q_OCR, max_pixels=n_tok * 28 * 28, max_new_tokens=200) for img, _ in ocr_set]
    torch.cuda.synchronize()
    acc = np.mean([char_accuracy(p, gt) for p, (_, gt) in zip(preds, ocr_set)])
    H, W = smart_resize(560, 1120, max_pixels=n_tok * 28 * 28)
    ocr_results[n_tok] = acc
    print(f"max_pixels = {n_tok:>3d}×28×28 → {W}×{H}・画像のトークン {H * W // 784:>3d} 個  文字の正解率 {acc:.1%}  (1 枚 {(time.time() - t0) / len(ocr_set):.2f} 秒)")
    print(f"    例: {preds[0][:60]!r}")
print("    正解:", repr(ocr_set[0][1][:60]))
- テスト画像: 1120×560 の白い画像に、5 文字のランダムな英字か 4 桁の数字を、8 行 × 5 語ずつ書きます。意味のない語なので、言語モデルが文脈から推測することはできません。30 枚です。
- max_pixels: 64・144・256・400・800 トークン分の画素数にします。800 トークンは、この画像を縮めない大きさです。
実行結果
max_pixels =  64×28×28 → 308×140・画像のトークン  55 個  文字の正解率 77.4%  (1 枚 4.48 秒)
    例: '7890 tpski gteke 5104 9725\n3407 cymus mqwq 8815 ibua\npzyka 6'
max_pixels = 144×28×28 → 448×224・画像のトークン 128 個  文字の正解率 97.6%  (1 枚 4.68 秒)
    例: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbua\npyxa '
max_pixels = 256×28×28 → 616×308・画像のトークン 242 個  文字の正解率 98.1%  (1 枚 4.69 秒)
    例: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbaa\npzyxa'
max_pixels = 400×28×28 → 784×392・画像のトークン 392 個  文字の正解率 99.5%  (1 枚 4.73 秒)
    例: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbua\npzyxa'
max_pixels = 800×28×28 → 1120×560・画像のトークン 800 個  文字の正解率 99.5%  (1 枚 4.78 秒)
    例: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbua\npzyxa'
    正解: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbua\npzyxa'
画像のトークンの数と文字の正解率の関係を描くと、次のようになります。
(図は、diagram-designで作成)
- トークンが少ないと読めない: 55 トークン(308×140 に縮小)では、文字の正解率は 77.4% で、「tspks」を「tpski」と読むなど、文字の取り違えや抜けが増えます。
- 128 トークンでほぼ読める: 448×224 に縮めた 128 トークンで 97.6%、392 トークン以上では 99.5% になりました。この大きさの文字なら、画像を縮めずに読む 800 トークンと、半分の 392 トークンで正解率は変わりません。
- 時間: 1 枚あたりの時間は 4.5〜4.8 秒で、トークンの数ではほとんど変わりません。この大きさでは、時間のほとんどが回答(約 60 トークン)の生成にかかっているためです。画像のトークンが数千個になると、入力の計算とメモリが効いてきます。
- 使い分け: 細かい文字を読むときは max_pixels を大きく、ざっくりした内容を聞くときは小さくすると、計算量を抑えられます。
実験4:M-RoPE の役割
画像のトークンの位置を、M-RoPE の 2 次元の位置から、1 列の通し番号(ふつうの RoPE と同じ)に変えて、2 つのテストの正解率を比べます。
# 位置の質問のテスト画像:3×3 のマスを 9 色で塗り、指定したマスの色を聞く
colors = {"red": (220, 40, 40), "green": (40, 170, 60), "blue": (40, 80, 220), "yellow": (240, 200, 0), "purple": (140, 60, 180),
          "orange": (250, 140, 20), "black": (20, 20, 20), "pink": (250, 150, 200), "gray": (150, 150, 150)}
row_names, col_names = ["top", "middle", "bottom"], ["left", "center", "right"]
pos_set = []
for _ in range(20):
    names = rng.sample(list(colors), 9)
    img = Image.new("RGB", (448, 448), "white")
    d = ImageDraw.Draw(img)
    for k, c in enumerate(names):
        r, col = divmod(k, 3)
        d.rectangle([20 + col * 140, 20 + r * 140, 150 + col * 140, 150 + r * 140], fill=colors[c])
    for k in rng.sample(range(9), 5):
        r, col = divmod(k, 3)
        pos_set.append((img, f"What color is the square in the {row_names[r]} row and the {col_names[col]} column? Answer with one word.", names[k]))
pos_set[0][0].save("grid_example.png")

for flat in [False, True]:
    name = "1 列の位置(ふつうの RoPE と同じ)" if flat else "M-RoPE(縦・横の位置)"
    acc_pos = np.mean([ask(img, q, max_new_tokens=4, flat_image=flat).lower().startswith(c) for img, q, c in pos_set])
    preds = [ask(img, Q_OCR, max_pixels=400 * 28 * 28, max_new_tokens=200, flat_image=flat) for img, _ in ocr_set]
    acc_ocr = np.mean([char_accuracy(p, gt) for p, (_, gt) in zip(preds, ocr_set)])
    print(f"{name:<24s} マスの色の正解率 {acc_pos:.1%}({len(pos_set)} 問)  文字の正解率 {acc_ocr:.1%}")
    print(f"    例: {preds[0][:60]!r}")
- マスの色のテスト: 3×3 のマスを 9 色で塗り、「上の行・右の列のマスの色は?」のように、指定したマスの色を聞きます。色の名前を答えるには、マスの縦と横の位置が分かる必要があります。20 枚 × 5 問です。
- 文字の読み取り: 実験3と同じ 30 枚を、400 トークンで読ませます。
実行結果
M-RoPE(縦・横の位置)           マスの色の正解率 69.0%(100 問)  文字の正解率 99.5%
    例: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbua\npzyxa'
1 列の位置(ふつうの RoPE と同じ)    マスの色の正解率 65.0%(100 問)  文字の正解率 52.1%
    例: '7890 tspks gteke 5104 9725\n3407 cymsu qmwxg 8815 tjbua\n3407 '
2つの位置の与え方の結果を並べると、次のようになります。
(図は、diagram-designで作成)
- 文字の読み取り: 画像のトークンを 1 列の位置にすると、正解率は 99.5% から 52.1% に下がりました。例の出力では、3 行目を読むはずのところで 2 行目の「3407」をくり返しています。行の区切りが位置から分からなくなり、どこまで読んだかを見失っていると考えられます。
- マスの色: M-RoPE でも正解率は 69.0% で、1 列の位置では 65.0% でした。差は 4 ポイントで、100 問では偶然の差と区別できません。2B のモデルは、そもそも「上の行・右の列」のような位置の言葉と、マスの対応をつけるのが得意ではないようです。
- 学習した位置で読む: モデルは M-RoPE の位置で学習しているので、別の位置を与えると、特に文字の並び順のような細かい 2 次元の情報が崩れます。
実験5:LoRA で棒グラフを読めるようにする
最後に、言語モデルを LoRA で追加学習して、棒グラフの棒の値を読めるようにします。値は棒の上に書かず、縦軸の目盛りから読み取る必要があります。公式の学習と、本記事の追加学習の違いは次のとおりです。
| 項目 | Qwen2-VL の公式の第 3 段階(論文) | 本記事の追加学習 |
|---|---|---|
| 固定する部品 | ViT | ViT と PatchMerger |
| 学習する重み | 言語モデルのすべての重み | 言語モデルの注意の 4 つの線形層に足した LoRA(ランク 16)だけ(約 436 万個、全体の 0.2%)。A100 1 枚で短く学習するため |
| データ | 指示に従う対話のデータ(画像の質問応答・文書の読み取り・動画など、多くの種類) | 棒グラフの画像と値の組 2,000 件(コードで作ったもの、1 種類のタスク) |
| 学習の量 | 論文に詳しい記載なし | バッチ 8、1 エポック(250 回の更新) |
| 学習率 | 論文に詳しい記載なし | 最大 2e-4(LoRA でよく使われる値)、10 回で上げてから線形に下げる |
| 計算の精度 | bfloat16 | 重みは bfloat16、LoRA の重みと計算は float32 |
データを作り、追加学習の前の正解率を測る
# 棒グラフの画像と、正解の値を作る。値は棒の上に書かず、縦軸の目盛りから読み取らせる
labels_pool = ["apple", "lemon", "grape", "melon", "peach", "plum", "kiwi", "mango", "pear", "lime"]


def make_chart(rng):
    labels = rng.sample(labels_pool, rng.randint(3, 6))
    values = [rng.randint(5, 95) for _ in labels]
    fig, ax = plt.subplots(figsize=(4.8, 3.2), dpi=100)
    ax.bar(labels, values, color=rng.choice(["tab:blue", "tab:orange", "tab:green", "tab:red", "tab:purple"]))
    ax.set_ylim(0, 100)
    ax.set_yticks(range(0, 101, 20))
    ax.grid(axis="y", alpha=0.4)
    fig.tight_layout()
    buf = io.BytesIO()
    fig.savefig(buf, format="png")
    plt.close(fig)
    return Image.open(buf).convert("RGB"), ", ".join(f"{l}: {v}" for l, v in zip(labels, values))


def parse_values(text):
    return {m.group(1): int(m.group(2)) for m in re.finditer(r"([a-z]+)\s*:\s*(\d+)", text.lower())}


def chart_scores(preds, data):
    """書式どおりに全部の棒を答えた割合と、値の誤差の平均(答えなかった棒は誤差 100 とする)、±2 以内の割合"""
    ok, errs = [], []
    for p, (_, gt) in zip(preds, data):
        P, G = parse_values(p), parse_values(gt)
        ok.append(set(P) == set(G))
        errs += [abs(P[k] - v) if k in P else 100 for k, v in G.items()]
    errs = np.array(errs)
    return np.mean(ok), errs.mean(), np.mean(errs <= 2)


rng_c = random.Random(1)
train_charts = [make_chart(rng_c) for _ in range(2000)]
test_charts = [make_chart(rng_c) for _ in range(100)]
test_charts[0][0].save("chart_example.png")
Q_CHART = "Read the value of each bar. Answer in the form 'label: value, label: value'."
print(f"学習 {len(train_charts)} 枚、評価 {len(test_charts)} 枚。例の正解: {test_charts[0][1]}")

base_preds = [ask(img, Q_CHART, max_new_tokens=64) for img, _ in test_charts]
fmt, mae, within2 = chart_scores(base_preds, test_charts)
print(f"\n追加学習の前:書式どおり {fmt:.0%}、値の誤差の平均 {mae:.1f}、±2 以内 {within2:.1%}\n例の出力: {base_preds[0]}")
- 棒グラフ: 果物の名前の棒を 3〜6 本、値は 5〜95 の整数、縦軸は 0〜100 で 20 ごとに目盛りと補助線を引きます。学習 2,000 枚、評価 100 枚です。
- 指標: 書式どおりに全部の棒を答えた割合、値の誤差の平均(答えなかった棒は誤差 100)、誤差が ±2 以内の割合です。
実行結果

学習 2000 枚、評価 100 枚。例の正解: lime: 46, plum: 57, kiwi: 75, grape: 27, melon: 6, lemon: 73

追加学習の前:書式どおり 81%、値の誤差の平均 10.6、±2 以内 36.5%
例の出力: lime: 40, plum: 50, kiwi: 70, grape: 30, melon: 10
LoRA で追加学習する
class LoRALinear(nn.Module):
    """元の重み W は固定し、小さな行列 B·A(ランク r)だけを学習して W + (α/r)·B·A として使う"""

    def __init__(self, base, r=16, alpha=32):
        super().__init__()
        self.base, self.scale = base, alpha / r
        self.A = nn.Parameter(torch.randn(r, base.in_features, device=base.weight.device) / math.sqrt(base.in_features))
        self.B = nn.Parameter(torch.zeros(base.out_features, r, device=base.weight.device))   # 0 から始めるので、最初は元のモデルと同じ

    def forward(self, x):
        return self.base(x) + ((x.float() @ self.A.T) @ self.B.T * self.scale).to(x.dtype)


for p in model.parameters():
    p.requires_grad_(False)
for layer in model.model.layers:
    for name in ["q_proj", "k_proj", "v_proj", "o_proj"]:
        setattr(layer, name, LoRALinear(getattr(layer, name)))
lora_params = [p for n, p in model.named_parameters() if n.endswith(".A") or n.endswith(".B")]
print(f"学習するパラメータ {sum(p.numel() for p in lora_params):,} 個(全体の {sum(p.numel() for p in lora_params) / sum(p.numel() for p in model.parameters()):.2%})")


def train_batch(batch):
    """回答(値の列と <|im_end|>)のトークンだけに損失をかける"""
    loss_sum, n_tok = 0.0, 0
    for img, ans in batch:
        ids, pv, grid = build_inputs(img, Q_CHART, answer=ans)
        prompt_len = build_inputs(img, Q_CHART)[0].shape[1]            # 質問の部分(「<|im_start|>assistant\n」まで)の長さ
        with torch.no_grad():
            img_feat = model.visual(pv, grid)                        # 画像エンコーダは固定
        x = model.model.embed_tokens(ids).masked_scatter((ids == Qwen2VL.IMAGE)[..., None], img_feat)
        logits = model.model(x, Qwen2VL.position_ids(ids, grid).to(device), checkpoint=True)
        labels = ids[0, prompt_len:]
        loss = F.cross_entropy(logits[0, prompt_len - 1:-1].float(), labels, reduction="sum")
        (loss / 300).backward()                                       # 1 バッチの回答のトークン数がおよそ 300 なので、その程度で割る
        loss_sum, n_tok = loss_sum + loss.item(), n_tok + len(labels)
    return loss_sum / n_tok


opt = torch.optim.AdamW(lora_params, lr=2e-4, weight_decay=0.0)
steps, bs, history, t0 = len(train_charts) // 8, 8, [], time.time()
model.train()
for step in range(steps):
    for g in opt.param_groups:
        g["lr"] = 2e-4 * min(1.0, (step + 1) / 10) * (1 - step / steps)   # 10 回で上げてから線形に下げる
    history.append(train_batch(train_charts[step * bs:(step + 1) * bs]))
    torch.nn.utils.clip_grad_norm_(lora_params, 1.0)
    opt.step()
    opt.zero_grad(set_to_none=True)
    if (step + 1) % 50 == 0:
        print(f"{step + 1:4d} 回  損失(最後の 50 回の平均){np.mean(history[-50:]):.4f}  ({time.time() - t0:.0f} 秒)", flush=True)
model.eval()
- LoRALinear: 元の重み W(1536 次元など)は固定し、ランク 16 の小さな行列 A と B だけを学習して、W + (α/r)·B·A の線形層として使います。B は 0 から始めるので、学習の最初は元のモデルとまったく同じ出力です。α = 32、r = 16 は、LoRA でよく使われる組み合わせです。
- 入れる場所: 言語モデルの 28 層の、クエリ・キー・バリュー・出力の 4 つの線形層です。画像エンコーダと PatchMerger は固定します。
- 損失: 回答(値の列と <|im_end|>)のトークンだけにかけます。
- 最適化: AdamW、学習率は最大 2e-4(LoRA でよく使われる値)で、最初の 10 回で上げてから線形に下げます。バッチ 8 で 2,000 枚を 1 エポック(250 回)学習します。
- メモリ: 言語モデルは勾配チェックポイント(checkpoint=True)で、層の中の値を保存せずに逆伝播で計算し直します。
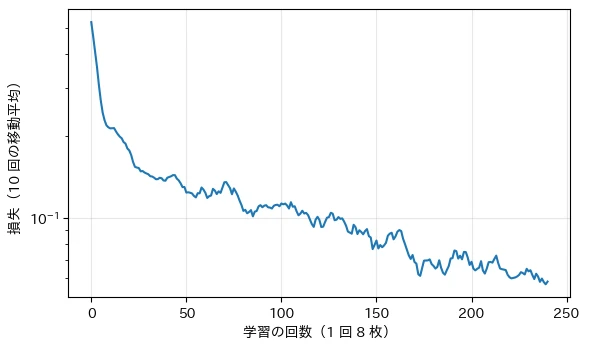
実行結果
学習するパラメータ 4,358,144 個(全体の 0.20%)
  50 回  損失(最後の 50 回の平均)0.2396  (124 秒)
 100 回  損失(最後の 50 回の平均)0.1195  (248 秒)
 150 回  損失(最後の 50 回の平均)0.1004  (372 秒)
 200 回  損失(最後の 50 回の平均)0.0748  (496 秒)
 250 回  損失(最後の 50 回の平均)0.0640  (621 秒)
評価する
with torch.no_grad():
    tuned_preds = [ask(img, Q_CHART, max_new_tokens=64) for img, _ in test_charts]
fmt2, mae2, within2_2 = chart_scores(tuned_preds, test_charts)
print(f"追加学習の前:書式どおり {fmt:.0%}、値の誤差の平均 {mae:.1f}、±2 以内 {within2:.1%}")
print(f"追加学習の後:書式どおり {fmt2:.0%}、値の誤差の平均 {mae2:.1f}、±2 以内 {within2_2:.1%}")
for k in range(3):
    print(f"\n正解   : {test_charts[k][1]}\n学習前 : {base_preds[k]}\n学習後 : {tuned_preds[k]}")
print("\n追加学習の後の、ほかの質問への回答:", ask(cats, "How many cats are in this image?"), "/", ask(receipt, "What is the total amount?"))

fig, ax = plt.subplots(figsize=(6, 3.6))
ax.plot(np.convolve(history, np.ones(10) / 10, mode="valid"))
ax.set_xlabel("学習の回数(1 回 8 枚)")
ax.set_ylabel("損失(10 回の移動平均)")
ax.set_yscale("log")
ax.grid(alpha=0.3)
plt.tight_layout()
plt.show()
実行結果
追加学習の前:書式どおり 81%、値の誤差の平均 10.6、±2 以内 36.5%
追加学習の後:書式どおり 100%、値の誤差の平均 0.1、±2 以内 100.0%

正解   : lime: 46, plum: 57, kiwi: 75, grape: 27, melon: 6, lemon: 73
学習前 : lime: 40, plum: 50, kiwi: 70, grape: 30, melon: 10
学習後 : lime: 46, plum: 57, kiwi: 75, grape: 27, melon: 6, lemon: 73

正解   : peach: 85, apple: 24, plum: 36
学習前 : peach: 80, apple: 20, plum: 30
学習後 : peach: 85, apple: 24, plum: 36

正解   : lime: 91, kiwi: 56, grape: 66, peach: 41, melon: 17, plum: 50
学習前 : lime: 90, kiwi: 50, grape: 60, peach: 40, melon: 20
学習後 : lime: 91, kiwi: 56, grape: 66, peach: 41, melon: 17, plum: 50

追加学習の後の、ほかの質問への回答: There are seven cats in the image. / The total amount for the order is $19.75.
追加学習の前後の結果を並べると、次のようになります。
(図は、diagram-designで作成)
- 追加学習の前: 値をほとんど 10 の倍数に丸めて答え(46 を 40、57 を 50)、誤差 ±2 以内は 36.5% でした。6 本の棒のうち 5 本しか答えないこともあり、書式どおりにすべての棒を答えたのは 81% です。
- 追加学習の後: 値の誤差の平均は 10.6 から 0.1 に、±2 以内は 100% になりました。例の 3 枚は、すべての値がぴったり正解です。補助線は 20 ごとにしかないので、モデルは棒の高さと目盛りの位置から、1 刻みの値を読むことを学んでいます。
- 学習の量: LoRA の約 436 万個(全体の 0.2%)を、A100 で約 10 分学習しただけです。損失は 0.24 から 0.06 まで下がりました。
- ほかの質問: 追加学習の後も、猫の数(7 匹)とレシートの合計金額には、学習前と同じく正しく答えました。この範囲では、元の能力は壊れていません。
- 注意: 学習と評価のグラフは、同じ作り方(同じ色の候補・同じ目盛り・同じフォント)の合成のグラフです。実際のさまざまなグラフで同じように読めるとは限りません。
まとめ
本記事では、Qwen2-VL-2B を、動的解像度の前処理・2 次元の RoPE の ViT・PatchMerger・M-RoPE の言語モデルに分けてスクラッチで実装し、次のことを確かめました。
- 画像を大きさのまま読む: 縦横を 28 の倍数に合わせ、28×28 画素を 1 トークンにするので、2576×1438 の画像は 4,692 トークン、640×360 の画像は 299 トークンになります。
- Hugging Face と同じ出力: 公式の重みを読み込んだスクラッチ実装は、float32 で画像の特徴の差が 2.6e-03、logit の差が 5e-02 以内で、3 つの質問で生成したトークン列が Hugging Face と同じでした。
- トークンの数と文字の読み取り: 1120×560 の文字の画像は、55 トークンでは正解率 77.4%、128 トークンで 97.6%、392 トークン以上で 99.5% でした。max_pixels で、精度と計算量の釣り合いを選べます。
- M-RoPE が文字の並びを支える: 画像のトークンを 1 列の位置にすると、文字の正解率は 99.5% から 52.1% に下がり、行をくり返すようになりました。
- LoRA で新しい読み取りを覚える: 元のモデルは棒グラフの値を 10 の倍数に丸めて答えました(±2 以内 36.5%)。LoRA(全体の 0.2%)を約 10 分学習すると、±2 以内が 100% になり、ほかの質問への回答は変わりませんでした。
Qwen2-VL は、画像を縮めずにトークンの数を変える動的解像度と、画像の 2 次元の位置を言語モデルに伝える M-RoPE で、文書や画面のような細かい画像を読む力を高めました。この 2 つは、後継の Qwen2.5-VL などにも引き継がれています。
ライセンスに関する注記
Qwen2-VL-2B-Instruct の重み(Qwen/Qwen2-VL-2B-Instruct)は Apache-2.0 で公開されていて、商用でも使えます。公式の実装(QwenLM/Qwen2.5-VL)も Apache-2.0 です。なお、Qwen2-VL の 72B のモデルは、別の Qwen のライセンスです。本記事で使った画像は、Gemini で作成した猫の画像と、コードで作った画像だけです。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- Qwen2-VL の実装: Hugging Face の transformers(Apache-2.0)の modeling_qwen2_vl.py と image_processing_qwen2_vl.py の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: Qwen/Qwen2-VL-2B-Instruct(Apache-2.0)を使用しています。
- 推論に利用した画像: 猫の画像は、Gemini で作成したものです。レシート・文字・マス・棒グラフの画像は、本記事のコードで作成したものです。
@article{wang2024qwen2vl,
  title = {Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution},
  author = {Wang, Peng and Bai, Shuai and Tan, Sinan and Wang, Shijie and Fan, Zhihao and others},
  journal = {arXiv preprint arXiv:2409.12191},
  year = {2024}
}
参考文献
- P. Wang et al. (2024). Qwen2-VL: Enhancing Vision-Language Model's Perception of the World at Any Resolution. arXiv:2409.12191.
- Qwen Team. QwenLM/Qwen2.5-VL. GitHub.
- Qwen Team. Qwen/Qwen2-VL-2B-Instruct. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。