RAPTOR とは?
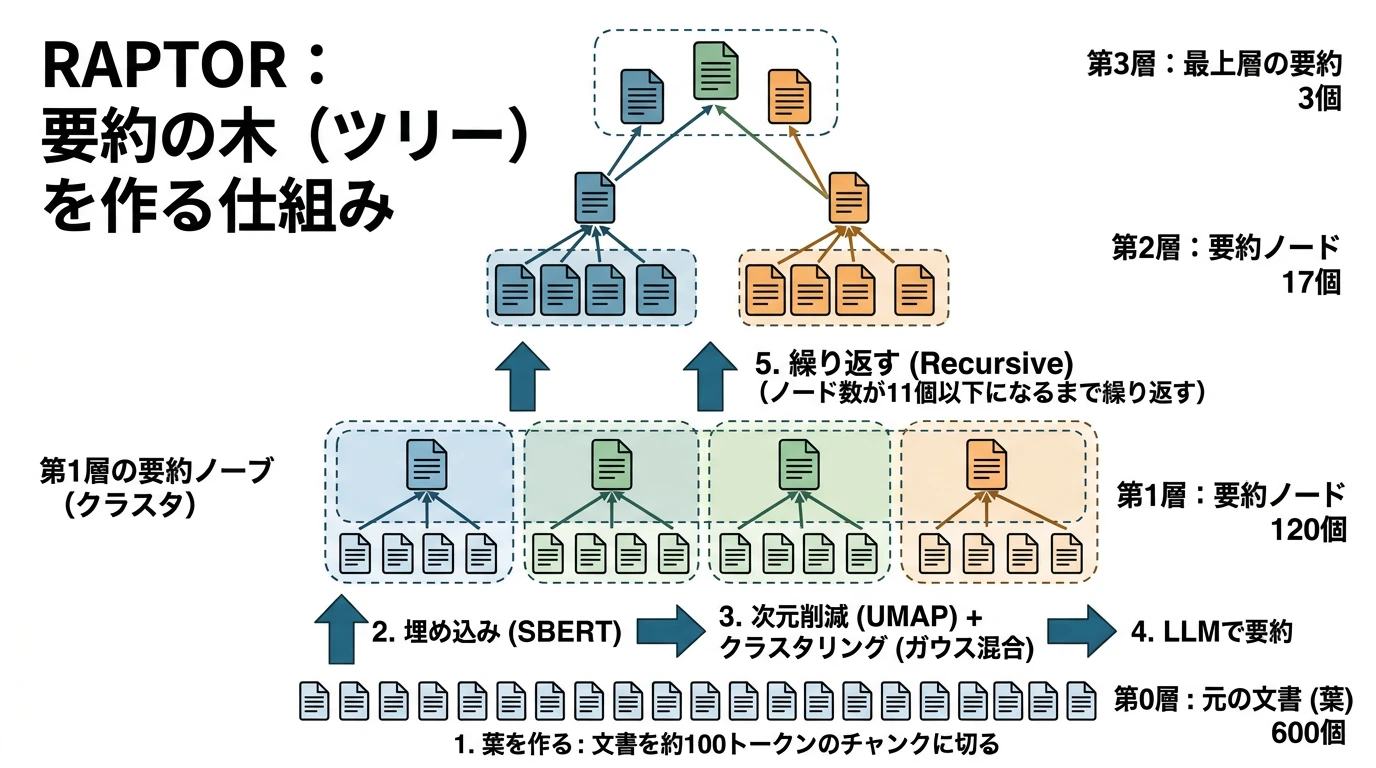 (画像は、Geminiで作成)
RAPTOR が、文書のクラスタリングと要約を繰り返して 要約の木 を作り、質問に合わせて木のいろいろな高さから情報を取り出す仕組みを理解すること。手元の実験で、どんな質問に強く、どんな質問に弱いのか、木の出来がクラスタリングと要約の質にどう左右されるのかを、数値で説明できるようになること。
原著論文: RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval (Sarthi et al., ICLR 2024)
本記事のコードは、Google Colab の A100 GPU(40GB)で、Python 3.13、transformers 5.22.1、torch 2.14.1、sentence-transformers、umap-learn を使って実行しました。LLM には Qwen2.5-7B-Instruct(bf16)、埋め込みには原著論文と同じ SBERT のモデル(multi-qa-mpnet-base-cos-v1)を使います。モデルの読み込みのあとの実行には約10分かかり、そのほとんどは要約の木を作る時間です。生成は貪欲法(do_sample=False)で、UMAP とガウス混合の乱数も固定しているので、同じ環境では同じ結果になります。
UMAP には umap-learn を使います。インストールされていない場合は、事前に次のコマンドを実行してください。
!pip install umap-learn
概要
RAG の記事の方法(普通の RAG)は、文書を短く切ったチャンクから、質問に似たものを上位 件だけ取り出して LLM に読ませます。答えが1つのチャンクに書いてある質問には強い一方で、「これらの山が抱えている主な問題は何か」のように、たくさんのチャンクにまたがる質問には弱くなります。上位 件には、全体の一部しか入らないからです。
長い文書の要約の記事では、質問のたびに全部の文書を map-reduce で要約する方法を試しました。全体を見渡せますが、質問のたびに全部を読むので、LLM の呼び出しが多くなります。RAPTOR(Recursive Abstractive Processing for Tree-Organized Retrieval)は、その中間を狙う方法です。質問が来る前に、似たチャンクをまとめて要約し、その要約をさらにまとめて要約する、を繰り返して 要約の木 を作っておきます。質問が来たら、細かい事実なら葉(元のチャンク)、全体の傾向なら上の層の要約、というように、木のいろいろな高さから似ているノードを検索します。
原著論文は、長い物語や論文についての質問応答(NarrativeQA、QASPER、QuALITY)で、普通の RAG より高い正答率を報告しました。本記事では、600件の架空の山の紹介文で木を作り、普通の RAG と比べます。次の節で、まず木の作り方と検索の仕方を図で確かめます。
RAPTOR の仕組み
要約の木を作る
(図は、diagram-designで作成)
- 葉を作る: 文書を約100トークンのチャンクに切ります。これが木の葉(第0層のノード)です。
- 埋め込み: 各ノードの文を、SBERT で埋め込みのベクトルにします。
- クラスタリング: 埋め込みを UMAP で10次元に減らしてから、ガウス混合で似たノードのまとまり(クラスタ)に分けます。
- クラスタの数: BIC(ベイズ情報量規準)が最小になる数を選びます。BIC は「当てはまりのよさ」から「パラメータの多さの罰」を引いた量で、クラスタを増やしすぎると罰が大きくなります。
- ソフトクラスタリング: ガウス混合は、ノードが各クラスタに属する確率(負担率)を出します。RAPTOR は、負担率がしきい値(0.1)を超えるクラスタすべてにノードを入れます。1つの文書が複数の話題にまたがっていれば、複数のクラスタの要約に使われます。
- 2段のクラスタリング: まず UMAP の近所を広く取って大きなまとまりに分け(global)、そのそれぞれを、近所を狭く取って細かく分けます(local)。
- 要約: クラスタごとに、入っているノードの文をつないで LLM に要約させます。要約が、1つ上の層のノードになります。
- 繰り返す: 新しい層のノードに、2〜4をくり返します。ノードの数が、UMAP で減らす次元(10)+1以下になったら止めます。
クラスタリングの考え方はクラスタリングの記事、UMAP は次元削減の記事、ガウス混合と負担率は混合モデルの記事で解説しています。
木から検索する:tree traversal と collapsed tree
(図は、diagram-designで作成)
- tree traversal: 最上層のノードのうち、質問の埋め込みと似ている 個を選び、その子ノードの中からまた 個を選ぶ、を葉まで繰り返します。各層で選んだノードを全部つないで LLM に読ませます。木を上から下へ、大まかな話題から細部へと絞り込んでいく方法です。
- collapsed tree: 層を気にせず、全部のノード(葉も要約も)を1つの集まりにして、質問に似ている順に、トークンの予算(原著論文では2,000トークン)まで取ります。質問が細かければ葉が、全体的なら要約が、自然に上位に来ることを期待する方法です。
原著論文では、collapsed tree の方が一貫して良い結果だったので、主な実験には collapsed tree が使われています。
実験の準備
架空の山岳コーパス
長い文書の要約の記事と同じ、600件の架空の山の紹介文を使います。どの文書にも「山脈・標高・登山道の起点の村・登山の適期」があり、363件には6つの問題(落石150件、山小屋の管理人100件、高山植物の盗掘60件、ライチョウの減少30件、雪崩15件、ごみ8件)のどれか1つが書かれています。1件は約60トークンで、原著論文の約100トークンのチャンクに近い大きさなので、1件をそのまま葉にします。今回は、個別の事実の問いで使うために、山脈と登山口の村も一緒に記録します。
import random
import re

SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]
SEASONS = ["early summer", "midsummer", "late summer", "early autumn"]

# 6つの問題(テーマ):文書の数、回答がそのテーマに触れたかを見つける正規表現、文書に足す文
THEMES = {
    "rockfall": (150, r"rock ?fall|falling rock|loose rock",
                 "After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount {n} for the season."),
    "hut_keeper": (100, r"keeper|successor|caretaker|\bhuts?\b",
                   "The hut on Mount {n} may close because its keeper is retiring and no successor has been found."),
    "plant_poaching": (60, r"lil(y|ies)|poach",
                       "Rangers found that snow lilies had been dug up and taken from the meadow on Mount {n}."),
    "ptarmigan": (30, r"ptarmigan",
                  "Surveys show that fewer rock ptarmigans nest on Mount {n} than ten years ago."),
    "avalanche": (15, r"avalanche",
                  "Avalanche Watch reported a large avalanche on the north face of Mount {n} last winter."),
    "litter": (8, r"trash|litter|garbage|rubbish",
               "Clean Summit Volunteers collected bags of trash left by hikers on Mount {n}."),
}
# 文の意味:rockfall「落石が続き、尾根安全事務所は {n} 山の上部の登山道を今シーズン閉鎖した」
#   hut_keeper「管理人が引退し後継者が見つからないため、{n} 山の山小屋は閉鎖されるかもしれない」
#   plant_poaching「レンジャーは、{n} 山の草原でスノーリリーが掘り取られて持ち去られているのを見つけた」
#   ptarmigan「調査によると、{n} 山で巣を作るライチョウは10年前より少ない」
#   avalanche「雪崩監視班は、昨冬 {n} 山の北面で大きな雪崩があったと報告した」
#   litter「クリーン・サミット・ボランティアは、{n} 山で登山者が残したごみを何袋も集めた」


def build_corpus(themes, n=600, seed=0):
    rng = random.Random(seed)
    names = set()
    while len(names) < n:                                      # (a) 音節3つの架空の山の名前
        names.add("".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize())
    names = sorted(names)
    labels = [t for t, (count, _, _) in themes.items() for _ in range(count)]
    labels += [None] * (n - len(labels))                       # (b) 問題の文がない山
    rng.shuffle(labels)
    docs = []
    for name, theme in zip(names, labels):
        # 「{name} 山は {山脈} 山脈の峰で、標高 {高さ} メートル。主な登山道は {村} 村から始まる。登山の適期は {季節}。」
        mountain_range, height, village = rng.choice(RANGES), rng.randint(1500, 3999), rng.choice(VILLAGES)
        text = (f"Mount {name} is a peak in the {mountain_range} Range, rising {height:,} meters "
                f"above sea level. The main trail starts from the village of {village}. "
                f"The best season to climb it is {rng.choice(SEASONS)}.")
        if theme:                                              # (c) 問題の文を足し、どのテーマかを記録する
            text += " " + themes[theme][2].format(n=name)
        docs.append({"mountain": name, "range": mountain_range, "village": village, "text": text, "theme": theme})
    return docs


docs = build_corpus(THEMES)
print("文書の数:", len(docs), " 問題の文がある文書:", sum(d["theme"] is not None for d in docs))
print("例:", docs[1]["text"])
架空の山の紹介文を600件作り、問題のテーマ・山脈・登山口の村を、正解として一緒に記録するコードです。作り方は長い文書の要約の記事と同じで、乱数の使い方も同じなので、同じ600件ができます。
- 山脈・高さ・村を変数に取り出す: mountain_range, height, village を先に決めてから文に入れ、docs にも記録します。乱数を引く順番は文の中に直接書いた場合と同じなので、できる文書は変わりません。
- 山小屋のテーマの正規表現: 長い文書の要約の記事の「keeper(管理人)・successor(後継者)」に、「caretaker(管理人)」と「hut / huts(山小屋)」を足しています。上の層の要約では、「管理人の引退で山小屋が閉まるかもしれない」が「caretaker の引退」「山小屋の人手不足」などと言い換えられることがあり、これも山小屋の問題に触れたとみなすためです。山小屋という語は、コーパスでは山小屋の問題の文にしか出てきません。
実行結果
文書の数: 600  問題の文がある文書: 363
例: Mount Fuhoha is a peak in the Kirisame Range, rising 2,859 meters above sea level. The main trail starts from the village of Yanagi. The best season to climb it is early autumn. After repeated rockfall, the Ridge Safety Office closed the upper trail of Mount Fuhoha for the season.
英語の出力の日本語訳:
- 例:「Fuhoha 山は Kirisame 山脈の峰で、標高2,859メートル。主な登山道は Yanagi 村から始まる。登山の適期は初秋。落石が続いたため、尾根安全事務所は Fuhoha 山の上部の登山道を今シーズン閉鎖した。」
LLM と埋め込み
LLM と、使用量を数えながら生成する関数は、長い文書の要約の記事と同じです。埋め込みには、原著論文と同じ SBERT のモデルを使います。
import time

import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_ID = "Qwen/Qwen2.5-7B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.bfloat16, device_map="cuda")
model.eval()
# 埋め込み:原著論文と同じ SBERT のモデル
embedder = SentenceTransformer("sentence-transformers/multi-qa-mpnet-base-cos-v1", device="cuda")


def n_tokens(text):
    return len(tokenizer(text)["input_ids"])


def new_usage():
    """LLM の使用量を数える入れ物:呼び出し回数・入力と出力のトークン数・時間(秒)"""
    return {"calls": 0, "input_tokens": 0, "output_tokens": 0, "seconds": 0.0}


@torch.no_grad()
def generate(prompts, usage, max_new_tokens=600, batch_size=16):
    """プロンプトのリストをまとめて生成し、使用量を usage に足していく"""
    outputs, start = [], time.time()
    for i in range(0, len(prompts), batch_size):
        texts = [tokenizer.apply_chat_template([{"role": "user", "content": p}], tokenize=False,
                                               add_generation_prompt=True) for p in prompts[i:i + batch_size]]
        inputs = tokenizer(texts, return_tensors="pt", padding=True).to(model.device)
        out = model.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
        for row, mask in zip(out[:, inputs["input_ids"].shape[1]:], inputs["attention_mask"]):
            text = tokenizer.decode(row, skip_special_tokens=True).strip()
            usage["calls"] += 1
            usage["input_tokens"] += int(mask.sum())
            usage["output_tokens"] += n_tokens(text)
            outputs.append(text)
    usage["seconds"] += time.time() - start
    return outputs


def embed(texts):
    """文のリストを、長さ1に正規化した埋め込みにする(内積がそのままコサイン類似度になる)"""
    return embedder.encode(texts, normalize_embeddings=True, batch_size=64)
LLM と埋め込みのモデルを読み込み、生成と埋め込みの関数を用意するコードです。
- generate: プロンプトのリストを batch_size 個ずつまとめて生成し、呼び出し回数・入力と出力のトークン数・時間を usage に足していきます。木を作るときの要約の手間を数えるのに使います。
- embed: normalize_embeddings=True で、ベクトルの長さを1にそろえます。長さが1なら、2つのベクトルの内積がそのままコサイン類似度になるので、検索のときに vecs @ q と内積を計算するだけで、似ている順に並べられます。
- multi-qa-mpnet-base-cos-v1: 質問と、その答えを含む文が近くなるように学習された SBERT のモデルです。原著論文と同じものにそろえ、埋め込みの違いが結果に入らないようにしています。
クラスタリング
UMAP で次元を減らし、ガウス混合で、重なりを許してクラスタに分ける関数です。原著論文の公開コードの手順と、値(10次元、しきい値0.1、クラスタ数の上限50、local の近所の数10)に合わせています。
import warnings

import umap
from sklearn.mixture import GaussianMixture

warnings.filterwarnings("ignore", message="n_jobs value")   # 乱数を固定すると並列化できない、という UMAP の注意


def reduce_dim(X, n_neighbors, dim=10, seed=0):
    """UMAP で dim 次元に減らす(コサイン類似度で近所を決める)"""
    return umap.UMAP(n_neighbors=n_neighbors, n_components=dim, metric="cosine",
                     random_state=seed).fit_transform(X)


def gmm_soft(Z, threshold=0.1, max_clusters=50, seed=0):
    """BIC が最小になる数でガウス混合を当てはめ、負担率が threshold を超えるクラスタすべてに入れる"""
    ks = list(range(1, min(max_clusters, len(Z))))
    bics = [GaussianMixture(k, random_state=seed).fit(Z).bic(Z) for k in ks]   # (a) クラスタ数ごとの BIC
    k = ks[int(np.argmin(bics))]
    probs = GaussianMixture(k, random_state=seed).fit(Z).predict_proba(Z)      # (b) 負担率
    return [np.where(p > threshold)[0] for p in probs], k                     # (c) 1つのノードが複数に入れる


def cluster_layer(X, dim=10, threshold=0.1):
    """広い近所で大きく分け(global)、その中を狭い近所で細かく分ける(local)。クラスタごとのノード番号を返す"""
    Z = reduce_dim(X, n_neighbors=int((len(X) - 1) ** 0.5), dim=min(dim, len(X) - 2))
    global_labels, n_global = gmm_soft(Z, threshold)
    clusters = []
    for g in range(n_global):
        members = np.array([i for i, labels in enumerate(global_labels) if g in labels])
        if len(members) <= dim + 1:                   # 少なすぎて、さらに分けられない
            clusters.append([int(i) for i in members])
            continue
        local_labels, n_local = gmm_soft(reduce_dim(X[members], n_neighbors=10, dim=dim), threshold)
        for l in range(n_local):
            clusters.append([int(members[i]) for i, labels in enumerate(local_labels) if l in labels])
    return [c for c in clusters if c]
- reduce_dim(X, n_neighbors, dim=10, seed=0): UMAP で dim 次元に減らします。metric="cosine" で、コサイン類似度で近所を決めます。埋め込みは、方向(内積)で似ているかを測るように学習されているからです。768次元のままガウス混合を当てはめると、平均と共分散のパラメータが多すぎて推定が不安定になるので、先に次元を減らします。
- gmm_soft(Z, threshold=0.1, max_clusters=50, seed=0):
- (a) BIC: クラスタの数を1から49まで変えてガウス混合を当てはめ、それぞれの BIC を計算します。
- (b) 負担率: BIC が最小の数で当てはめ直し、predict_proba で、各ノードが各クラスタに属する確率(負担率)を求めます。
- (c) ソフトクラスタリング: 負担率が threshold(0.1)を超えるクラスタの番号を、ノードごとにすべて返します。1つのノードが複数のクラスタに入ることがあります。
- cluster_layer(X, dim=10, threshold=0.1):
-
global: UMAP の近所の数を「ノード数 − 1」の平方根(600ノードなら24)と広めに取って、大きなまとまりに分けます。近所を広く取ると、UMAP は全体の大まかな配置を保つようになります(次元削減の記事の n_neighbors の説明)。
-
local: 大きなまとまりの中を、近所の数10で細かく分けます。まとまりの中のノードが dim + 1 個以下なら、UMAP で10次元に減らせないので、そのまま1つのクラスタにします。
-
返り値: クラスタごとに、そのクラスタに入るノードの番号をリストにし、それを並べたリスト(リストのリスト)を返します。たとえば次のような形です。
clusters = [[0, 3, 15], # 1つ目のクラスタに入るノードの番号[2, 7, 12, 18], # 2つ目のクラスタに入るノードの番号[3, 9, 21], # 3つ目のクラスタ(ノード3は、1つ目のクラスタにも入っている)...]番号は、X の行の番号(今の層のノードの順番)です。ソフトクラスタリングなので、ノード3のように、負担率が0.1を超えた複数のクラスタに同じ番号が入ることがあります。build_tree は、このリストの1つ1つについて、番号のノードの文をつないで要約し、その要約を1つ上の層のノードにします。
-
- 警告を消す: UMAP は、乱数を固定すると並列計算ができないという警告を出します。結果には関係がないので、warnings.filterwarnings で表示しないようにしています。
要約の木を作る
クラスタリングと要約を繰り返して木を作ります。要約のプロンプトは2通り試します。1つは原著論文の公開コードのプロンプトそのもの、もう1つは長さと書き方を指定したプロンプトです。最初に原著のプロンプトで作ったところ、7B のモデルでは要約が元より長くなってしまったので、2つを比べられるようにしています。
# 原著論文のコードの要約プロンプト:「次の文を、重要な細部をできるだけ多く含めて要約してください:…」
SUMMARIZE_PAPER = "Write a summary of the following, including as many key details as possible: {context}:"
# 長さと書き方を指定したプロンプト:「…を、100語以内の1段落で要約してください。…1つずつ説明しないでください」
SUMMARIZE_SHORT = ("Write a summary of the following in one paragraph of at most 100 words, "
                   "including as many key details as possible. Do not describe the items one by one: {context}")


def build_tree(docs, usage, template, dim=10, max_summary_tokens=200):
    """葉(文書)から始めて、クラスタリングと要約を、ノードが dim + 1 個以下になるまで繰り返す"""
    layers = [[{"text": d["text"], "children": []} for d in docs]]                  # (a) 第0層 = 文書
    while len(layers[-1]) > dim + 1:
        nodes = layers[-1]
        clusters = cluster_layer(embed([n["text"] for n in nodes]), dim=dim)        # (b) クラスタリング
        contexts = ["\n\n".join(nodes[i]["text"] for i in c) for c in clusters]
        summaries = generate([template.format(context=c) for c in contexts], usage,  # (c) クラスタごとに要約
                             max_new_tokens=max_summary_tokens, batch_size=8)
        layers.append([{"text": s, "children": c} for s, c in zip(summaries, clusters)])
        if len(layers[-1]) >= len(nodes):            # (d) 数が減らなければ、それ以上は重ねない
            break
    return layers


def describe(tree, max_summary_tokens):
    """層ごとのノード数・平均の長さ・上限で切れた要約の数・圧縮率(要約 ÷ 子ノードの合計)"""
    for l, nodes in enumerate(tree):
        lengths = [n_tokens(n["text"]) for n in nodes]
        line = f"  第{l}層: ノード {len(nodes):3d}個  平均 {np.mean(lengths):5.1f}トークン"
        if l > 0:
            ratio = np.mean([n_tokens(n["text"]) / sum(n_tokens(tree[l - 1][c]["text"]) for c in n["children"])
                             for n in nodes])
            cut = sum(t >= max_summary_tokens - 1 for t in lengths)
            line += f"  上限で切れた要約 {cut}個  圧縮率 {ratio:.2f}"
        print(line)


trees, build_usage = {}, {}
for name, template, max_tokens in [("原著のプロンプト", SUMMARIZE_PAPER, 500), ("100語以内のプロンプト", SUMMARIZE_SHORT, 200)]:
    build_usage[name] = new_usage()
    trees[name] = build_tree(docs, build_usage[name], template, max_summary_tokens=max_tokens)
    u = build_usage[name]
    print(f"{name}(要約の上限 {max_tokens}トークン): 要約 {u['calls']}回  入力 {u['input_tokens']:,}  "
          f"出力 {u['output_tokens']:,}  時間 {u['seconds']:.0f} 秒")
    describe(trees[name], max_tokens)
print("第1層の要約の例(原著のプロンプト):\n" + trees["原著のプロンプト"][1][0]["text"][:700])
print("第1層の要約の例(100語以内のプロンプト):\n" + trees["100語以内のプロンプト"][1][0]["text"])
print("その子ノードの山:", [docs[i]["mountain"] for i in trees["100語以内のプロンプト"][1][0]["children"]])
要約のプロンプトを変えて木を2つ作り、層ごとの大きさと、要約の手間を表示するコードです。
- SUMMARIZE_PAPER: 原著論文の公開コードの要約プロンプトで、「重要な細部をできるだけ多く含めて要約せよ」という指示です。原著論文では gpt-3.5-turbo で要約していて、要約の平均の長さは131トークン、子ノードの合計に対する比(圧縮率)は平均0.28でした。
- SUMMARIZE_SHORT: 同じ指示に、「100語以内の1段落で」と「1つずつ説明しない」を足したものです。100語は約130トークンで、原著論文の要約の平均の長さに合わせています。
- build_tree(docs, usage, template, dim=10, max_summary_tokens=200):
- (a) 第0層: 文書をそのまま葉のノードにします。ノードは、文 text と、子ノードの番号のリスト children を持つ辞書です。葉には子がありません。
- (b) クラスタリング: 今の層のノードの文を埋め込み、cluster_layer でクラスタに分けます。
- (c) 要約: クラスタごとに子ノードの文を空行でつなぎ、まとめて生成します。1つのクラスタの文は長くて数千トークンになるので、batch_size=8 と少なめにして、GPU のメモリに収まるようにしています。
- (d) 止める条件: ノードが dim + 1(11)個以下になったら止めます。UMAP で10次元に減らすには、それより多いノードが要るからです。クラスタの数が前の層から減らなかった場合も、それ以上重ねても木が高くならないので止めます。
- 要約の上限: 原著のプロンプトでは、要約が長くなることが分かっていたので、上限を500トークンにしています。100語以内のプロンプトは200トークンです(100語に十分な余裕がある長さ)。
- describe(tree, max_summary_tokens): 層ごとに、ノードの数、平均の長さ、上限で切れた要約の数、圧縮率(要約の長さ ÷ 子ノードの長さの合計)を表示します。
実行結果
原著のプロンプト(要約の上限 500トークン): 要約 144回  入力 96,086  出力 56,296  時間 377 秒
  第0層: ノード 600個  平均  59.0トークン
  第1層: ノード 120個  平均 369.3トークン  上限で切れた要約 10個  圧縮率 1.30
  第2層: ノード  20個  平均 499.0トークン  上限で切れた要約 18個  圧縮率 0.27
  第3層: ノード   4個  平均 499.8トークン  上限で切れた要約 4個  圧縮率 0.22
100語以内のプロンプト(要約の上限 200トークン): 要約 140回  入力 64,754  出力 20,898  時間 143 秒
  第0層: ノード 600個  平均  59.0トークン
  第1層: ノード 120個  平均 143.9トークン  上限で切れた要約 5個  圧縮率 0.52
  第2層: ノード  17個  平均 182.1トークン  上限で切れた要約 10個  圧縮率 0.21
  第3層: ノード   3個  平均 179.7トークン  上限で切れた要約 0個  圧縮率 0.18
第1層の要約の例(原著のプロンプト):
Here is a summary of the information provided about the mountains in the specified ranges:

### Mount Nohato
- **Location**: Tsukishiro Range
- **Elevation**: 3,018 meters above sea level
- **Starting Point**: Village of Oda
- **Best Climbing Season**: Late summer
- **Current Status**: Upper trail closed due to repeated rockfall

### Mount Noneto
- **Location**: Akatsuki Range
- **Elevation**: 3,404 meters above sea level
- **Starting Point**: Village of Yanagi
- **Best Climbing Season**: Late summer
- **Current Status**: Hut may close due to retirement of the keeper and lack of a successor

### Mount Norira
- **Location**: Akatsuki Range
- **Elevation**: 3,388 meters above sea level
- **Sta
第1層の要約の例(100語以内のプロンプト):
Mount Nohato in the Tsukishiro Range (3,018m) and Mount Noriyo in the Hayate Range (3,901m) are both best climbed in late summer, though the upper trails of both have been closed due to rockfall. Mount Noneto (3,404m) and Mount Norito (3,536m), both in the Akatsuki Range, also offer their best climbs in late summer, but the hut on Mount Noneto may close as its keeper retires, and rangers have noted snow lilies being dug up on Mount Norira (3,388m).
その子ノードの山: ['Nohato', 'Noneto', 'Norira', 'Norito', 'Noriyo']
英語の出力の日本語訳:
-
第1層の要約の例(原著のプロンプト):「指定された山脈の山々について、提供された情報の要約は次のとおりです。」に続けて、「### Nohato 山」「場所:Tsukishiro 山脈」「標高:海抜3,018メートル」「起点:Oda 村」「登山の適期:晩夏」「現在の状況:落石が続いて上部の登山道が閉鎖」のように、山ごとに見出しと箇条書きを並べています(Noneto 山の現在の状況は「管理人の引退と後継者の不在で、山小屋が閉まるかもしれない」)。3山目の途中で、表示を700文字で切っています。
-
第1層の要約の例(100語以内のプロンプト):「Tsukishiro 山脈の Nohato 山(3,018m)と Hayate 山脈の Noriyo 山(3,901m)は、どちらも晩夏が登山の適期だが、どちらも落石で上部の登山道が閉鎖されている。Akatsuki 山脈の Noneto 山(3,404m)と Norito 山(3,536m)も晩夏が適期だが、Noneto 山の山小屋は管理人の引退で閉まるかもしれず、Norira 山(3,388m)ではスノーリリーが掘り取られているのをレンジャーが確認している。」
-
原著のプロンプトでは、要約が元より長くなる: 第1層の圧縮率は1.30で、5個前後の文書(約300トークン)から、平均369トークンの「要約」ができました。例を見ると、山ごとに見出しを立て、場所・標高・登山口・季節・状況を箇条書きにしたもので、要約というより表の書き直しです。第2層・第3層では、ほとんどの要約が500トークンの上限で切れていて、木の上の方ほど、最初の数山の箇条書きしか残っていません。gpt-3.5-turbo では131トークンにまとまった指示でも、7B のモデルは「細部をできるだけ多く」を文字どおりに受け取り、すべてを書き写そうとします。
-
長さを指定すると、要約らしくなる: 100語以内のプロンプトでは、圧縮率が第1層0.52、第2層0.21、第3層0.18と、上の層ほど強くまとめられました。第2層・第3層の圧縮率は、原著論文の0.28に近い値です。要約の手間も、呼び出し140回・出力20,898トークン・143秒と、原著のプロンプト(出力56,296トークン・377秒)の半分以下で済みました。
-
木の形: 600個の葉から、120 → 17 → 3 と、3段の木になりました。
以降の実験では、100語以内のプロンプトで作った木を使います。
クラスタは何でまとまったか
上の要約の例で、第1層の1つ目のクラスタに入っていたのは、Nohato・Noneto・Norira・Norito・Noriyo と、名前がどれも「No」で始まる5山でした。クラスタが、問題のテーマでも山脈でもなく、名前の綴り でまとまっているように見えます。第1層の120個のクラスタについて、確かめます。
from collections import Counter


def purity(clusters, labels):
    """クラスタごとに、いちばん多いラベルが占める割合を平均する(1なら、どのクラスタも1種類だけ)"""
    return np.mean([Counter(labels[i] for i in c).most_common(1)[0][1] / len(c) for c in clusters])


tree = trees["100語以内のプロンプト"]
layer1 = [n["children"] for n in tree[1]]
shuffled = np.random.default_rng(0).permutation(len(docs))            # 文書をでたらめに並べ替えた比較用
for key, label in [("theme", "問題のテーマ"), ("range", "山脈"), ("village", "登山口の村")]:
    labels = [d[key] for d in docs]
    print(f"{label}: 純度 {purity(layer1, labels):.3f}(でたらめに分けた場合 {purity(layer1, [labels[i] for i in shuffled]):.3f})")
print("名前の先頭2文字がそろうクラスタの割合:",
      round(purity(layer1, [d["mountain"][:2] for d in docs]), 3))

# 埋め込みの類似度:名前の先頭2文字が同じ組・テーマが同じ組と、そうでない組の平均
E = embed([d["text"] for d in docs])
S = E @ E.T
off = ~np.eye(len(docs), dtype=bool)
for key, label in [(lambda d: d["mountain"][:2], "名前の先頭2文字"), (lambda d: d["theme"], "問題のテーマ")]:
    v = np.array([key(d) for d in docs], dtype=object)
    same = (v[:, None] == v[None, :]) & off
    print(f"{label}が同じ組 {S[same].mean():.3f}  違う組 {S[~same & off].mean():.3f}")
第1層のクラスタがどれだけ「そろっているか」を、いくつかのラベルで測り、埋め込みの類似度も比べるコードです。
- purity(clusters, labels): クラスタごとに、いちばん多いラベルが占める割合を求めて平均します。どのクラスタも1種類のラベルだけなら1、ばらばらなら小さくなります。
- でたらめに分けた場合: 同じ大きさのクラスタに、文書をでたらめに入れた場合の純度です。ラベルの文書を permutation で並べ替えてから同じクラスタで計算すると、「クラスタの分け方とラベルが無関係なとき」の値になります。問題のテーマは「問題なし(None)」が237件と多いので、でたらめでも0.5くらいになります。
- 名前の先頭2文字: 山の名前の先頭2文字(「No」「Wa」など)をラベルにした純度です。
- 類似度: 600件の文書の埋め込みどうしの内積(コサイン類似度)を全部の組で計算し、「名前の先頭2文字が同じ組とそうでない組」「問題のテーマが同じ組とそうでない組」で平均を比べます。off は、文書自身との組(対角)を除くための印です。
実行結果
問題のテーマ: 純度 0.539(でたらめに分けた場合 0.509)
山脈: 純度 0.555(でたらめに分けた場合 0.427)
登山口の村: 純度 0.406(でたらめに分けた場合 0.388)
名前の先頭2文字がそろうクラスタの割合: 0.843
名前の先頭2文字が同じ組 0.704  違う組 0.628
問題のテーマが同じ組 0.637  違う組 0.630
(図は、diagram-designで作成)
- 名前の綴りでまとまっている: 名前の先頭2文字の純度は0.843で、ほとんどのクラスタが、同じ2文字で始まる山の集まりでした。問題のテーマの純度は0.539で、でたらめに分けた場合(0.509)とほとんど変わりません。山脈は0.555と、でたらめ(0.427)よりは少しそろっています。
- 原因は埋め込み: 名前の先頭2文字が同じ組の類似度は0.704で、違う組(0.628)より0.08高くなりました。問題のテーマが同じ組と違う組の差は0.007しかありません。どの文書も「山脈・標高・村・季節」の同じ型の文で、違いは名前と数語だけなので、架空の名前の綴り(トークンの重なり)が、埋め込みの近さを大きく左右しています。ナレッジグラフの構築の記事で、架空の固有名詞では埋め込みが文字の重なりで近さを決めていたのと同じ現象です。
- 要約への影響: クラスタが話題でまとまっていないので、第1層の要約は「名前の似た5山の、ばらばらの情報」を1段落に詰め込んだものになります。上の層の要約も、その寄せ集めです。RAPTOR の木は、似た話題をまとめて要約することを前提にしているので、この前提は崩れています。それでも、上の層の要約には、600件のあちこちに散らばった問題が少しずつ書き込まれています。次の節で、これが検索にどう効くかを確かめます。
木から検索して答える
普通の RAG(葉だけから検索)と、RAPTOR の2つの検索方法を、どれも2,000トークンの予算で比べます。
def make_index(tree):
    """木の全ノードを1列に並べ、層の番号・埋め込み・トークン数と一緒にまとめる"""
    nodes = [n for layer in tree for n in layer]
    offsets = np.cumsum([0] + [len(layer) for layer in tree])     # 第 l 層のノードが始まる位置
    return {"tree": tree, "nodes": nodes, "offsets": offsets,
            "layer": np.repeat(np.arange(len(tree)), [len(layer) for layer in tree]),
            "vecs": embed([n["text"] for n in nodes]), "tokens": [n_tokens(n["text"]) for n in nodes]}


def take_budget(index, ranked, budget):
    """似ている順のノードを、合計 budget トークンまで取る"""
    selected, size = [], 0
    for i in ranked:
        if size + index["tokens"][i] > budget:
            break
        selected.append(int(i))
        size += index["tokens"][i]
    return selected


def retrieve_leaves(index, question, budget=2000):
    """普通の RAG:葉(元の文書)だけから、似ている順に取る"""
    q = embed([question])[0]
    leaves = np.where(index["layer"] == 0)[0]
    return take_budget(index, leaves[np.argsort(-(index["vecs"][leaves] @ q))], budget)


def retrieve_collapsed(index, question, budget=2000):
    """collapsed tree:全層のノードを1つにまとめ、似ている順に取る"""
    q = embed([question])[0]
    return take_budget(index, np.argsort(-(index["vecs"] @ q)), budget)


def retrieve_traversal(index, question, k=3, budget=2000):
    """tree traversal:最上層で似ている k 個を選び、その子ノードの中から k 個を選ぶ、を葉まで繰り返す"""
    q = embed([question])[0]
    tree, offsets = index["tree"], index["offsets"]
    candidates = np.arange(offsets[-2], offsets[-1])               # 最上層の全ノード
    selected = []
    for l in range(len(tree) - 1, -1, -1):
        top = candidates[np.argsort(-(index["vecs"][candidates] @ q))[:k]]
        selected += list(top)
        if l == 0:
            break
        candidates = np.array(sorted({offsets[l - 1] + c for i in top for c in index["nodes"][i]["children"]}))
    return take_budget(index, selected, budget)


QA = "Documents:\n{context}\n\nQuestion: {question}"


def ask(index, retrieve, questions, max_new_tokens=600):
    """質問ごとに検索して文脈を作り、まとめて答えさせる。答えと、選んだノードを返す"""
    selected = [retrieve(index, q) for q in questions]
    prompts = [QA.format(context="\n\n".join(index["nodes"][i]["text"] for i in s), question=q)
               for s, q in zip(selected, questions)]
    return generate(prompts, new_usage(), max_new_tokens=max_new_tokens, batch_size=8), selected


index = make_index(tree)
retrievers = {"普通の RAG(葉だけ)": retrieve_leaves, "RAPTOR(collapsed tree)": retrieve_collapsed,
              "RAPTOR(tree traversal)": retrieve_traversal}
print("全ノード:", len(index["nodes"]), " 層ごと:", [len(layer) for layer in tree])
木から検索する3つの関数と、検索して答えさせる関数を用意するコードです。
- make_index(tree): 木の全ノードを1列に並べ、層の番号、埋め込み、トークン数を一緒に持つ辞書を返します。検索の関数は、この辞書を引数で受け取ります。offsets は、1列に並べたときに第 層のノードが何番目から始まるかで、子ノードの番号(層の中での番号)を、1列の中の番号に直すのに使います。
- take_budget(index, ranked, budget): 似ている順に並べたノードを先頭から足していき、合計が budget トークンを超える手前で止めます。原著論文の公開コードの collapsed tree と同じ止め方です。
- retrieve_leaves: 普通の RAG です。葉(第0層)だけを、質問との内積の大きい順に並べて取ります。1件約60トークンなので、2,000トークンで約30件になります。
- retrieve_collapsed: collapsed tree です。全層のノードを、内積の大きい順に並べて取ります。
- retrieve_traversal(index, question, k=3, budget=2000): tree traversal です。最上層の全ノードから似ている 個を選び、その子ノードを次の候補にする、を葉まで繰り返します。選んだノードは上の層から順に並べ、最後に予算で切ります。
- k = 3 にした理由: 最初に原著論文の公開コードの既定値 で試したところ、上の層の要約(約180トークン)を5個ずつ選ぶだけで2,000トークンの予算を使い切り、葉まで届きませんでした。 なら、3層の要約9個と葉3個が予算に収まります。
- ask(index, retrieve, questions, max_new_tokens=600): 質問ごとに検索し、選んだノードの文を空行でつないで、「文書:… 質問:…」の形で答えさせます。答えと、選んだノードの番号を返します。
実行結果
全ノード: 740 層ごと: [600, 120, 17, 3]
木のノードは、葉600個と要約140個の、合わせて740個です。
3種類の問い
次の3種類の問いで比べます。
- 全体を俯瞰する問い: 「これらの山の主な問題は何か」。答えが6テーマのうちいくつに触れたかを数えます。
- 細部の問い: 「雪崩が報告された山はどこか」。正解の15山について、答えに挙がった山を正しい・誤り・存在しないに分けて数えます。
- 個別の事実の問い: 「Mount 〇〇 の登山道は、どの村から始まるか」。でたらめに選んだ40山について聞き、その山の文書を検索で取れたか、答えに正しい村の名前が入っているかを数えます。
QUESTION = ("What are the main problems facing these mountains? "
            "List every distinct problem, one short line each, without naming individual mountains.")
DETAIL_QUESTION = "On which mountains were avalanches reported? List the names of all such mountains."
FACT_QUESTION = "From which village does the main trail of Mount {m} start?"
fact_docs = [docs[i] for i in np.random.default_rng(0).choice(len(docs), 40, replace=False)]


def covered_themes(text, themes):
    return [t for t, (_, pattern, _) in themes.items() if re.search(pattern, text, re.IGNORECASE)]


def score_names(text, docs, theme="avalanche"):
    truth = {d["mountain"] for d in docs if d["theme"] == theme}
    names = set(re.findall(r"Mount ([A-Z][a-z]+)", text))
    existing = {d["mountain"] for d in docs}
    return {"正しい": len(names & truth), "誤り": len(names & existing - truth), "存在しない": len(names - existing)}


for name, retrieve in retrievers.items():
    (overview,), (sel,) = ask(index, retrieve, [QUESTION])
    context = "\n".join(index["nodes"][i]["text"] for i in sel)
    by_layer = dict(sorted(Counter(int(index["layer"][i]) for i in sel).items()))
    print(f"{name}  選んだノード(層: 個数) {by_layer}")
    print(f"  全体の問い: 文脈にあるテーマ {len(covered_themes(context, THEMES))}  回答が触れたテーマ "
          f"{len(covered_themes(overview, THEMES))} / 6  見落とし {[t for t in THEMES if t not in covered_themes(overview, THEMES)]}")
    (detail,), (sel,) = ask(index, retrieve, [DETAIL_QUESTION])
    context = "\n".join(index["nodes"][i]["text"] for i in sel)
    print(f"  雪崩の問い: 文脈 {score_names(context, docs)}  回答 {score_names(detail, docs)}")
    answers, selected = ask(index, retrieve, [FACT_QUESTION.format(m=d["mountain"]) for d in fact_docs], max_new_tokens=60)
    found = sum(any(index["nodes"][i]["text"] == d["text"] for i in s) for d, s in zip(fact_docs, selected))
    correct = sum(d["village"] in a for d, a in zip(fact_docs, answers))
    print(f"  個別の事実の問い: その山の文書を取れた {found} / 40  正解 {correct} / 40")
    if name != "普通の RAG(葉だけ)":
        print("  全体の問いの回答:\n" + overview)
3種類の問いを、3つの検索方法で解かせて採点するコードです。
- covered_themes と score_names: 長い文書の要約の記事と同じ採点の関数です。答えをテーマごとの正規表現で検索し、答えに出てくる「Mount +名前」を正解の15山と比べます。
- 文脈の採点: 回答だけでなく、検索で選んだノードの文(文脈)も同じ関数で採点します。文脈にあるテーマや山の数と比べると、落ちたのが検索の段階か、LLM が答える段階かが分かります。雪崩の問いの文脈の「誤り」は、文脈に出てくる雪崩以外の山の数で、文脈に雪崩と関係のない山がどれだけ混ざっているかを表します。
- fact_docs: 乱数を固定して、600件からでたらめに40件を選びます。どの方法にも同じ40問を聞きます。
- 個別の事実の採点: 選んだノードの中に、その山の文書と同じ文があれば「取れた」とします。答えに、その山の登山口の村の名前(d["village"])が入っていれば正解とします。
- max_new_tokens=60: 個別の事実の答えは村の名前だけなので、短い上限にして生成の時間を減らしています。
実行結果
普通の RAG(葉だけ)  選んだノード(層: 個数) {0: 30}
  全体の問い: 文脈にあるテーマ 5  回答が触れたテーマ 4 / 6  見落とし ['ptarmigan', 'litter']
  雪崩の問い: 文脈 {'正しい': 11, '誤り': 20, '存在しない': 0}  回答 {'正しい': 8, '誤り': 0, '存在しない': 0}
  個別の事実の問い: その山の文書を取れた 40 / 40  正解 40 / 40
RAPTOR(collapsed tree)  選んだノード(層: 個数) {1: 5, 2: 6, 3: 1}
  全体の問い: 文脈にあるテーマ 6  回答が触れたテーマ 5 / 6  見落とし ['avalanche']
  雪崩の問い: 文脈 {'正しい': 4, '誤り': 65, '存在しない': 1}  回答 {'正しい': 2, '誤り': 4, '存在しない': 1}
  個別の事実の問い: その山の文書を取れた 40 / 40  正解 40 / 40
  全体の問いの回答:
- Trail closures due to rockfalls
- Potential closure of huts due to caretaker retirements
- Illegal collection of snow lilies
- Declining rock ptarmigan nesting sites
- Litter collection efforts
- Closed upper trails for safety reasons
RAPTOR(tree traversal)  選んだノード(層: 個数) {0: 3, 1: 3, 2: 3, 3: 3}
  全体の問い: 文脈にあるテーマ 6  回答が触れたテーマ 5 / 6  見落とし ['avalanche']
  雪崩の問い: 文脈 {'正しい': 3, '誤り': 59, '存在しない': 1}  回答 {'正しい': 3, '誤り': 0, '存在しない': 0}
  個別の事実の問い: その山の文書を取れた 24 / 40  正解 25 / 40
  全体の問いの回答:
- Rockfalls causing trail closures
- Upper trail closures for safety reasons
- Potential hut closures due to staffing issues
- Illegal snow lily digging
- Declining rock ptarmigan nesting sites
- Litter cleanup efforts needed
- Snow lily poaching
- Staff retirements affecting hut operations
英語の出力の日本語訳:
- collapsed tree の全体の問いの答え:「落石による登山道の閉鎖/管理人(caretaker)の引退 による山小屋の閉鎖のおそれ/スノーリリーの違法な採取/ライチョウの巣の減少/ごみの回収の取り組み/安全のための上部の登山道の閉鎖」
- tree traversal の全体の問いの答え:「落石による登山道の閉鎖/安全のための上部の登山道の閉鎖/人手不足 による山小屋の閉鎖のおそれ/スノーリリーの違法な掘り取り/ライチョウの巣の減少/ごみの清掃が必要/スノーリリーの盗掘/職員の引退 が山小屋の運営に影響」
| 方法 | 選んだノード | 全体の問い(6テーマ) | 雪崩の15山(正しい・誤り・存在しない) | 個別の事実(40問) |
|---|---|---|---|---|
| 普通の RAG(葉だけ) | 葉30個 | 4(ライチョウ・ごみを見落とし) | 8・0・0 | 40 |
| RAPTOR(collapsed tree) | 第1層5・第2層6・第3層1 | 5(雪崩を見落とし) | 2・4・1 | 40 |
| RAPTOR(tree traversal) | 各層3個 | 5(雪崩を見落とし) | 3・0・0 | 25 |
- 全体を俯瞰する問いでは、RAPTOR が上回った: 普通の RAG は、似ている30件の文書を読んだだけなので、文脈には5テーマしか入らず、答えはライチョウとごみを見落としました。RAPTOR の2つの方法は、上の層の要約を読んだことで、文脈に6テーマすべてが入り、回答は5テーマに触れました。要約の木が、600件に散らばった問題を、少ないトークンに集めてくれたためです。ただし、どちらも雪崩を見落としました。15件しかない雪崩は、要約を重ねる途中で落ちやすく、また回答の段階でも拾われませんでした。
- 細部の問いでは、普通の RAG が上回った: 雪崩の山の名前は、文書の「雪崩」の文と似ているので、普通の RAG は雪崩の文書を直接取れます。文脈に雪崩の山が11山入り、答えは8山、誤り0でした。collapsed tree は、雪崩の問いでも要約ばかり(第1層・第2層)を選び、文脈に雪崩の山は4山しか入りませんでした。答えには、雪崩とは関係のない山が4山混ざり、存在しない名前も1つありました。要約では、どの山にどの問題があったかの対応が崩れやすいためです。
- 個別の事実の問いでは、collapsed tree は普通の RAG と同じ: collapsed tree は、山の名前を含む質問では、その山の文書(葉)がいちばん似ているので、40問すべてで葉を取れ、40問とも正解しました。全体の問いでは要約を、個別の問いでは葉を、質問に応じて自然に選べています。
- tree traversal は、枝を外すと戻れない: tree traversal は、最上層の3個の要約から枝を選ぶので、その山の文書が選んだ枝の外にあると、どんなに似ていても取れません。その山の文書を取れたのは40問中24問で、正解は25問でした。原著論文が collapsed tree を主に使ったのと同じ結論です。
原著論文と本記事の設定
| 原著論文 | 本記事 | 理由 | |
|---|---|---|---|
| 文書 | 物語・論文(NarrativeQA、QASPER、QuALITY) | 架空の山の紹介文600件 | 答えの分かっている問いを、テーマ・細部・個別の事実の3種類で作るため |
| 葉の大きさ | 約100トークンのチャンク | 1件(約60トークン)をそのまま葉に | 1件が1つの山についての話なので、切ると意味が分かれるため |
| 埋め込み | SBERT(multi-qa-mpnet-base-cos-v1) | 同じ | 埋め込みの違いを結果に入れないため |
| クラスタリング | UMAP(10次元)+ガウス混合(BIC、しきい値0.1) | 同じ(公開コードの手順と値) | |
| 要約の LLM | gpt-3.5-turbo(要約の平均131トークン、圧縮率0.28) | Qwen2.5-7B-Instruct(100語以内の指定。圧縮率0.52・0.21・0.18) | 手元の GPU で動かすため。原著のプロンプトでは要約が長くなったので、長さを指定した |
| 検索 | collapsed tree(2,000トークン)が主。tree traversal も比較 | 同じ予算で両方と、普通の RAG | |
| 回答の LLM | GPT-4、GPT-3、UnifiedQA | Qwen2.5-7B-Instruct |
原著論文は、QuALITY で GPT-4 と組み合わせて正答率82.6%(それまでの最高は62.3%)を報告しています。また、要約の中に元の文書にない内容(ハルシネーション)が混ざっていたのは、調べた150ノードのうち約4%で、質問応答の性能への影響は見られなかったとしています。本記事の実験では、クラスタが名前の綴りでまとまったことで、要約が「似た名前の山の寄せ集め」になり、山と問題の対応が崩れる誤りが答えに出ました。原著論文の物語や論文では、近いチャンクは話の流れでも近く、埋め込みのクラスタが話題のまとまりに近くなりやすいと考えられます。同じ型の文書がたくさん並ぶコーパスでは、クラスタが何でまとまったかを確かめてから使うことが大切です。
使い分け
| 問いの種類 | 向いている方法 | 理由(本記事の実験から) |
|---|---|---|
| 答えが1つの文書に書いてある | 普通の RAG、collapsed tree | どちらも40問すべてで、その山の文書を取れた |
| 特定のテーマに当てはまるものを全部挙げる | 普通の RAG(+件数が多ければ map-reduce) | 要約では、どの山にどの問題があったかの対応が崩れ、誤りが混ざった |
| 全体の傾向・主な問題をまとめる | RAPTOR(collapsed tree) | 上の層の要約が、散らばった話題を少ないトークンに集めた。ただし件数の少ない話題は落ちることがある |
- collapsed tree を使う: tree traversal は、上の層で枝を外すと、葉に正解があっても取れません。
- クラスタを確かめる: 木を作ったら、いくつかのクラスタの中身と要約を読み、話題でまとまっているかを確かめます。名前や書式でまとまっている場合は、埋め込みの前に固有名詞を外す、話題の違いが出る埋め込みのモデルを選ぶ、などの工夫が要ります。
- 要約の長さを指定する: 小さな LLM では、原著のプロンプトのままだと要約が元より長くなりました。長さを指定し、上限で切れていないか、圧縮率を確かめます。
- 木を作る手間: 本記事の木は、要約140回・入力約6万5千トークン・約2.5分でした。質問のたびに全部を map-reduce するより安く済みますが、文書が増えたら作り直す必要があります。原著論文は、木を作る手間(トークン数と時間)が文書の長さにほぼ比例して増えると報告しています。
まとめ
本記事では、要約の木を作って検索する RAPTOR を、架空の山岳コーパス(600件)と Qwen2.5-7B-Instruct で、普通の RAG と比べました。
- 木を作る: UMAP とガウス混合によるクラスタリングと要約を繰り返し、600 → 120 → 17 → 3 の木ができました。原著のプロンプトのままでは、7B のモデルの要約は元より長くなり(第1層の圧縮率1.30)、長さを指定すると圧縮率は0.52・0.21・0.18になりました。
- クラスタは名前の綴りでまとまった: 名前の先頭2文字の純度は0.843で、問題のテーマの純度(0.539)は、でたらめに分けた場合(0.509)とほとんど変わりませんでした。同じ型の文書では、架空の名前の綴りが埋め込みの近さを左右しました。
- 全体を俯瞰する問いでは RAPTOR が上回った: 普通の RAG は6テーマ中4、RAPTOR は collapsed tree・tree traversal とも5テーマに触れました。
- 細部と個別の事実では、葉が大事: 雪崩の15山の問いでは、普通の RAG が正しい8山・誤り0で、RAPTOR の collapsed tree は正しい2山・誤り4山・存在しない1山でした。個別の事実の問いでは、普通の RAG と collapsed tree が40問すべてに正解し、tree traversal は25問でした。
RAPTOR は、文書の集まり全体についての問いと、個別の事実の問いを、1つの仕組みで扱える方法です。ただし、その力は、クラスタが話題でまとまり、要約が短く正確であることに支えられています。文書からエンティティと関係のグラフを作り、グラフのコミュニティごとに要約する GraphRAG は、この「何でまとめるか」を、埋め込みの近さではなく、文書に書かれた関係で決める方法です。
参考文献
- P. Sarthi, S. Abdullah, A. Tuli, S. Khanna, A. Goldie, C. D. Manning (2024). RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval. ICLR 2024.
- parthsarthi03/raptor. 原著論文の公開コード(MIT License).
- L. McInnes, J. Healy, J. Melville (2018). UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction. arXiv:1802.03426.
- N. Reimers, I. Gurevych (2019). Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks. EMNLP-IJCNLP 2019.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
本記事の文章・構成の一部に生成AIを使用しています。