ランダム化比較試験(RCT)とは?
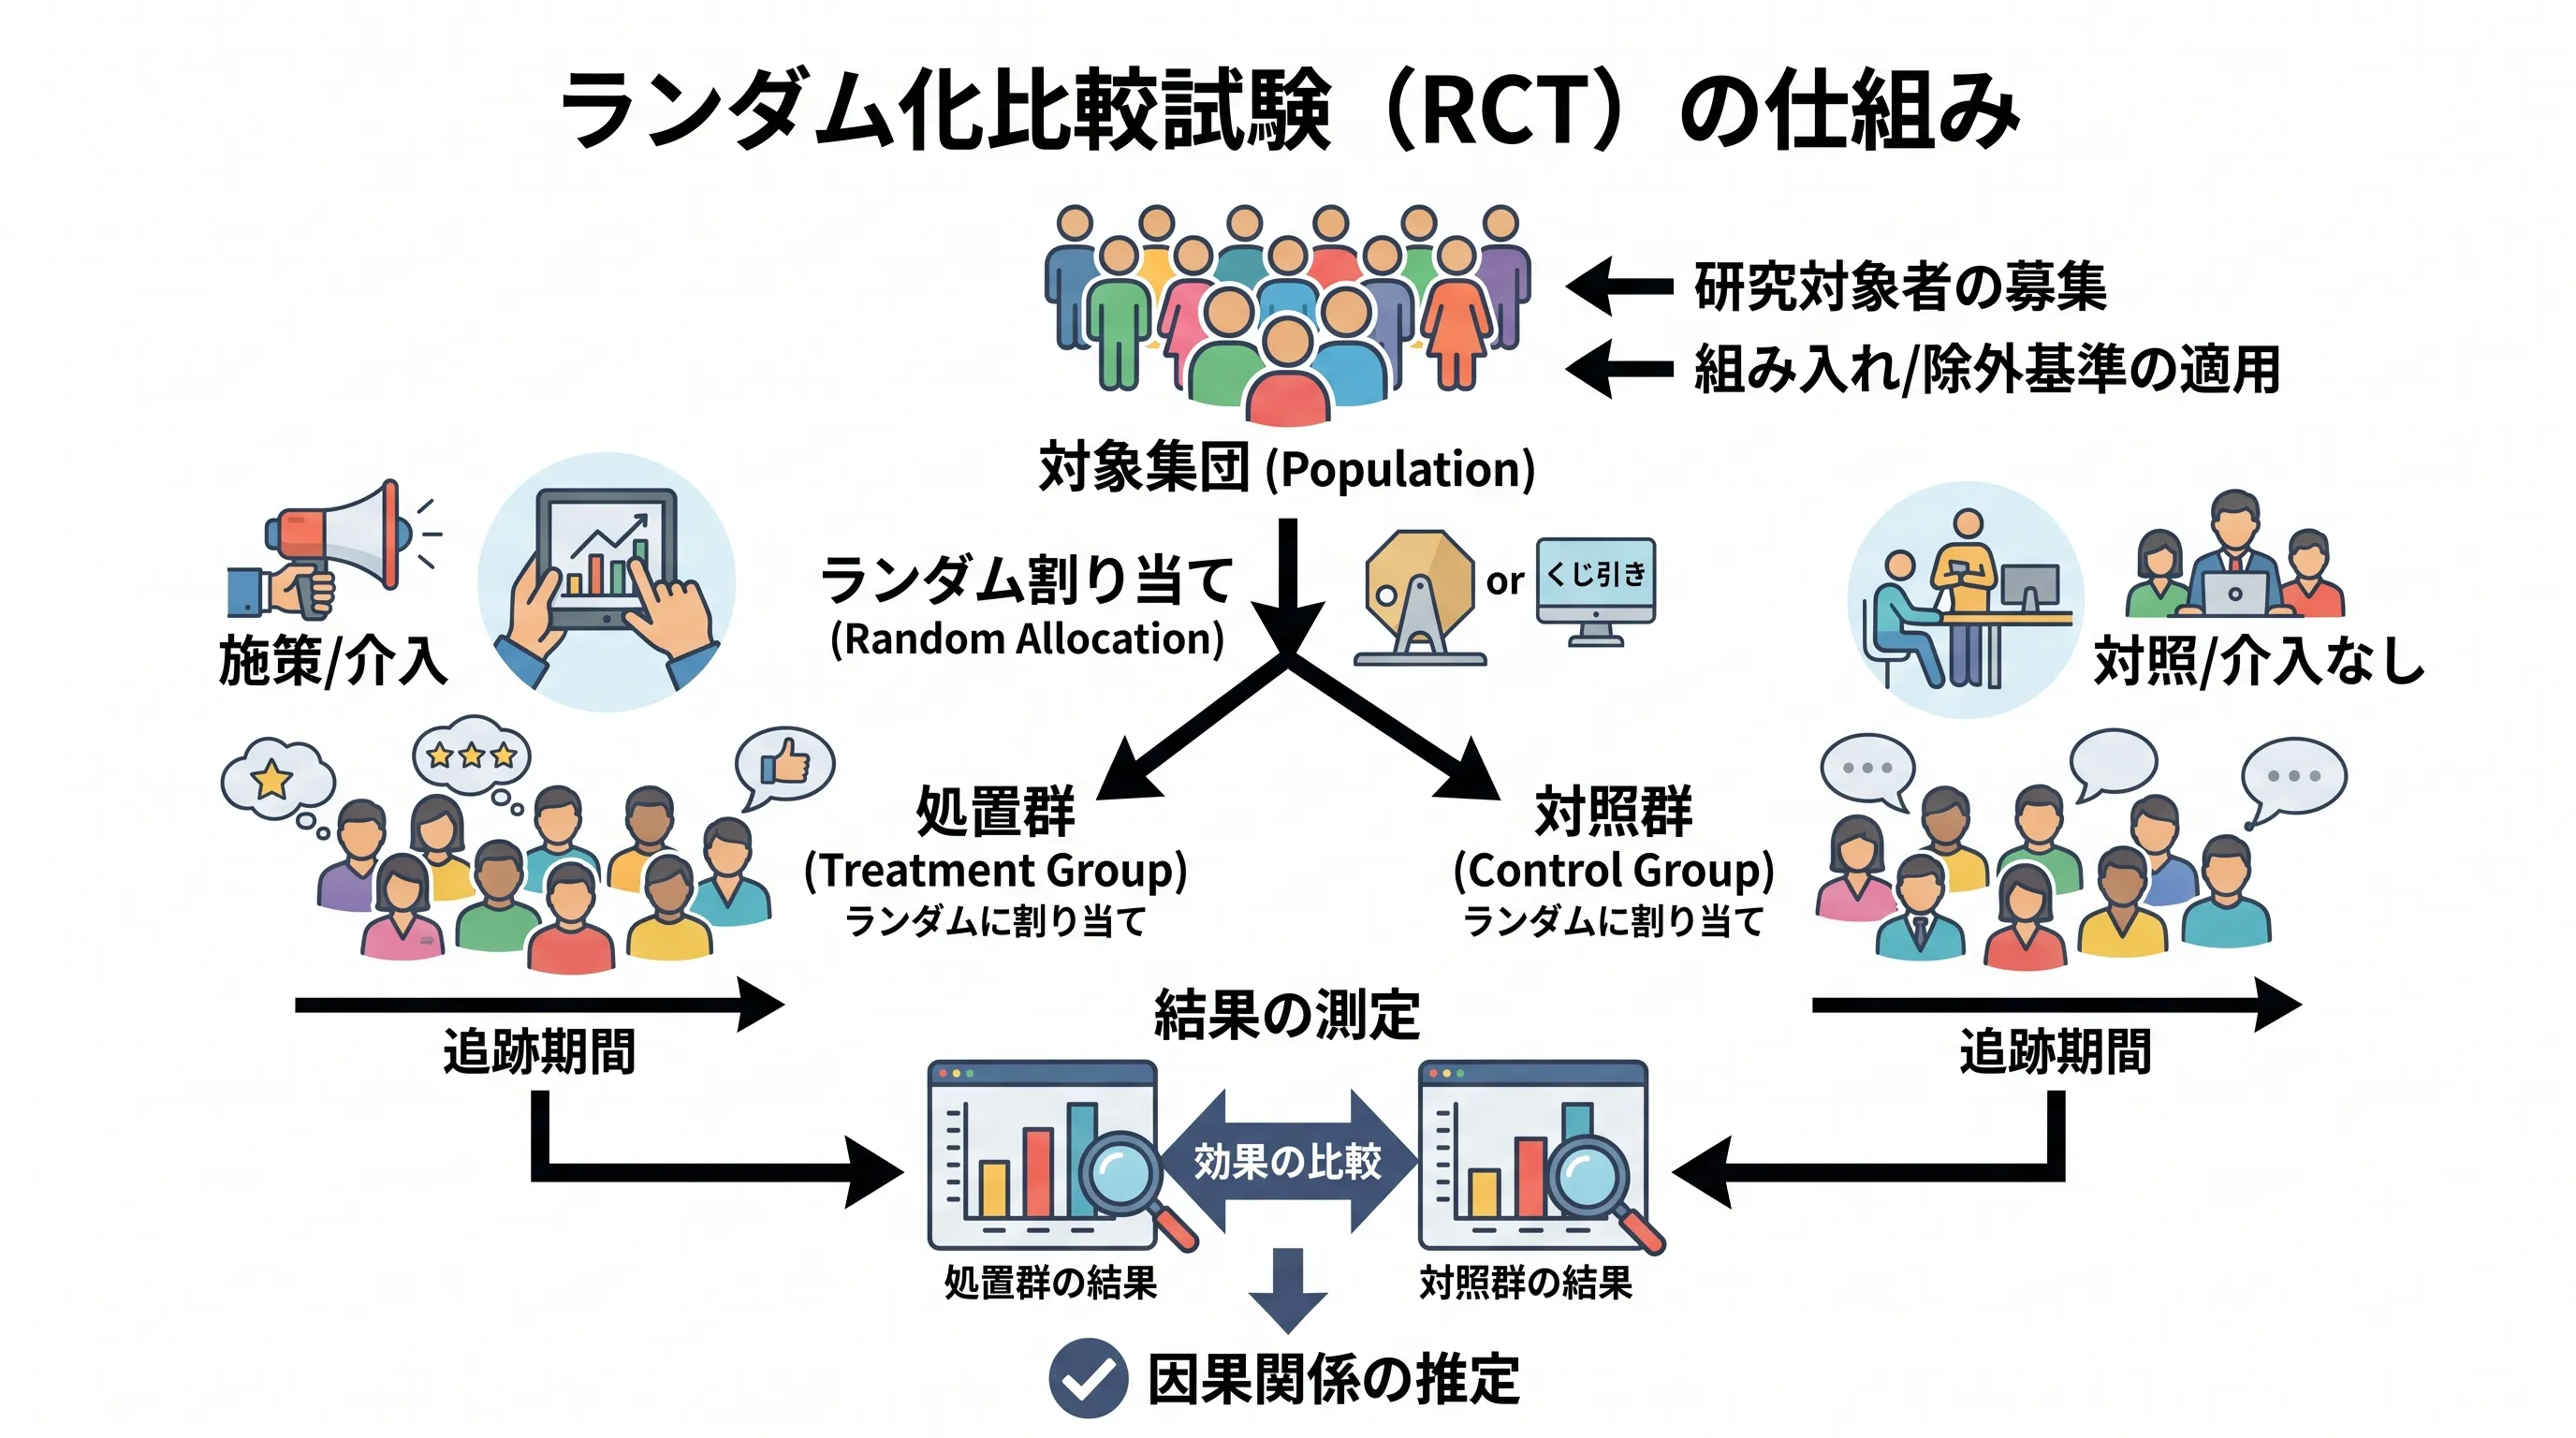 (画像は、Geminiで作成)
施策を受けるグループと受けないグループをランダムに分けると、なぜセレクションバイアスがなくなり、平均の差がそのまま施策の効果になるのかを理解すること。ダミーデータで、共変量のバランスを分布の可視化と標準化平均差(SMD)で確かめ、効果を検定と信頼区間で評価し、実験を繰り返して推定が真の効果のまわりに分布することを確かめること。
RCTの概要
ビジネスや医療の現場において、「この施策(や新薬)は本当に効果があったのか?」を正しく評価することは至上命題です。この「真の効果」を検証するための最強の手法であり、因果推論における「ゴールドスタンダード(最高峰の基準)」と呼ばれているのが ランダム化比較試験(RCT:Randomized Controlled Trial) です。
WEBマーケティングの文脈でよく耳にする「A/Bテスト」も、本質的にはこのRCTと同じ考え方に基づいています。
RCTの仕組みは非常にシンプルです。対象となるユーザーを「施策を受けるグループ(処置群)」と「施策を受けないグループ(対照群)」に完全にランダム(無作為) に割り振ります。そして、一定期間経過後に両グループの平均値(売上やコンバージョン率など)を比較します。
なぜ「ランダム」が必要なのか?(セレクションバイアス)
なぜわざわざサイコロを振るようにランダムに分ける必要があるのでしょうか?それは、人間の行動履歴や意思決定が絡むデータには、多くの場合セレクションバイアス(選択バイアス) が潜んでいるからです。
例えば、「新しいダイレクトメール(DM)を送った顧客」と「送らなかった顧客」の購買金額を比較するとします。実務においては、予算の都合上「元々よく買ってくれる優良顧客」や「最近アクセスがあった顧客」に優先してDMを送る傾向があります。 この場合、DMを受け取ったグループは 「DMの効果がなくても、元々よく買う人たち」 の集まりになります。これを単純に比較してしまうと、「DMのおかげで売上が上がったのか」、それとも「元々買う人にDMを送っただけなのか」が区別できず、DMの効果を過大評価してしまいます。このように、結果に影響を与える背景要因のことを 交絡因子(Confounding factor) と呼びます。
ランダム化の魔法
ここで「ランダム割り当て」を行うとどうなるでしょうか。完全にランダムにグループ分けをすれば、「元々よく買う人」も「全く買わない人」も、「男性」も「女性」も、処置群と対照群に均等に分散されます。
つまり、データとして観測できている交絡因子(年齢、性別、購買履歴など)だけでなく、観測できていない未知の交絡因子(その人のその日の気分、潜在的なブランドへの愛着など)までもが、大数の法則によって両グループでバランスするのです。 この「比較可能性(Comparability)」が完全に担保された状態であれば、両グループの違いは「DMを受け取ったか、受け取らなかったか」だけになります。したがって、グループ間の平均値の差を計算するだけで、期待値としてはバイアスのない「真の効果」を推定することができます(ただし、実際のデータは有限であるため、偶然のばらつきによる誤差は生じます)。
偏った割り当てと RCT の違いを図にすると、次のようになります(数値は後の「実験を繰り返して確かめる」の結果です)。
(図は、diagram-designで作成)
検証用ダミーデータの生成と効果検証
実際にPythonを用いて、ランダム割り当てが行われたダミーデータを作成し、効果検証を行ってみましょう。
ここでは、「年齢(age)」と「過去の購買金額(history)」という特徴量を持つユーザーがいるとします。通常の実務データであれば、これらの特徴量が高い人ほどDMが送られやすくなりますが、今回はRCTなので、これらの特徴量を完全に無視して50%の確率でDM(施策)を割り当てます。
ダミーデータの作成
import numpy as np
import pandas as pd

np.random.seed(42)

# データサイズの指定(効果 1500 を、1 回の実験で誤差と見分けられる人数)
N = 2000

# 1. 特徴量(実務データでは交絡因子になりうる変数)の生成
# age: 年齢(平均 40 歳、標準偏差 10 歳。95% の人が 20〜60 歳に入る)
# history: 過去の購買金額(平均 5000 円の指数分布。少数の人が大きな金額を持つ、裾の長い分布)
age = np.random.normal(40, 10, N)
history = np.random.exponential(5000, N)

# 2. 施策割り当て(RCT:特徴量に依存せずランダムに50%ずつ割り当て)
# np.random.binomialを用いて、成功確率0.5のベルヌーイ試行を行う
treatment = np.random.binomial(1, 0.5, N)

# 3. 目標変数(売上)の生成
# 真の施策効果(ATE)を +1500 と設定
# ただし、年齢が高いほど、過去の購買金額が高いほど、元々の売上も高くなる
# (割り当てがこれらに偏ると、効果を見誤る状況を作るため。ノイズの標準偏差は 1000)
true_effect = 1500
sales = 2000 + 30 * age + 0.5 * history + true_effect * treatment + np.random.normal(0, 1000, N)

# データフレームの作成
df = pd.DataFrame({
    'age': age,
    'history': history,
    'treatment': treatment,
    'sales': sales
})

# データの確認
print(df.head())
ここでは NumPy と pandas を用いて、因果推論の検証に使うダミーデータをシミュレーションしています。
- 特徴量(共変量)の生成: np.random.normal で正規分布に従う年齢(age)を、np.random.exponential で指数分布に従う過去の購買金額(history)を生成しています。これらは売上に影響を与える要素ですが、RCTの環境下では施策の割り当てには影響しません。購買金額を裾の長い指数分布にしたのは、実際の購買金額のように一部の顧客が大きな値を持つ変数でも、ランダム化で両群がそろうことを後で確かめるためです。
- 施策のランダム割り当て(RCT): np.random.binomial(1, 0.5, N) を使用して、ユーザーの特徴量に一切依存せず、コイントスのように50%の確率で完全にランダムに処置群(1)と対照群(0)を割り当てています。
- 目標変数(売上)の計算: sales は、ベース金額に対して年齢・購買履歴の影響と、施策による効果(true_effect * treatment)、そしてランダムな誤差(ノイズ)を足し合わせて計算しています。真の施策効果が明確に +1500 としてデータ内に埋め込まれています。年齢と購買金額を売上に効かせているのは、これらが交絡因子になりうる状況を作るためです。割り当てがこれらに偏ると、効果を見誤ります(後半のシミュレーションで確かめます)。
- 値の決め方: 係数は、購買金額が売上のばらつきの大部分を占めるようにしています(売上の標準偏差は約2800で、そのうち購買金額の項 0.5 * history の標準偏差が約2400、年齢の項 30 * age が約300)。購買金額で割り当てが偏ったときの影響を、はっきり見せるためです。人数 N = 2000 とノイズの標準偏差1000は、効果1500が1回の実験で偶然の誤差と見分けられる大きさにしています(後の信頼区間の幅は約±230です)。ベース金額2000は売上を正の値にするための値で、結果には影響しません。
- データセットの構築: pd.DataFrame によって配列を結合し、後続の集計や検定で扱いやすい表形式のデータセット df を構築しています。
このダミーデータは、以下の数式(データ生成プロセス)に基づいています。
① 目的変数(売上)の生成
私たちが最終的に知りたいのは、この式にある (施策による真の効果)です。売上には「年齢」や「購買金額」といった要素(実務データでは交絡因子になりうる変数)も同時に影響を与えていますが、今回はRCTのため割り当て はこれらと独立しています。
② 特徴量の生成とランダム割り当て
(※ 数学的な慣例では指数分布を と率パラメータ で表記しますが、本記事ではPython(numpy)の実装パラメータと対応させるため、平均値を示す scale=5000( に相当)として明記しています。)
このデータの作り方を図にすると、次のようになります。
(図は、diagram-designで作成)
実行結果
         age      history  treatment        sales
0  44.967142  2613.702365          1  5971.719613
1  38.617357   341.446903          1  3699.065432
2  46.476885  2144.849986          1  6239.742272
3  55.230299   588.279524          0  1876.408682
4  37.658466  8257.428550          0  7166.511480
共変量バランスの確認(バランスチェック)
「ランダム化によって特徴量(交絡因子)がバランスする」という記事の核となる主張を、実際に数字で確認してみましょう。実務でも、A/Bテストの割り当てが正しく機能しているかを検証するために必ず行われる定番の手続きです。
from scipy import stats

# 処置群と対照群で特徴量の平均を比較
print(df.groupby('treatment')[['age', 'history']].mean())

# ageとhistoryの平均の差の検定(equal_var=False でウェルチのt検定)
_, p_age = stats.ttest_ind(df[df['treatment']==1]['age'], df[df['treatment']==0]['age'],
                           equal_var=False)
_, p_hist = stats.ttest_ind(df[df['treatment']==1]['history'], df[df['treatment']==0]['history'],
                            equal_var=False)

print(f"ageのp値: {p_age:.3f}")
print(f"historyのp値: {p_hist:.3f}")
SciPy の stats モジュールを用いて、特徴量(共変量)が処置群と対照群の間で偏りなく分布しているかを統計的に確認(バランスチェック)しています。
- グループごとの平均値の集計: df.groupby('treatment')[['age', 'history']].mean() を用いて、処置群(1)と対照群(0)のそれぞれにおける年齢(age)と過去の購買金額(history)の平均値を一括で計算・出力しています。
- 平均値の差の検定(t検定): stats.ttest_ind を使用して、各特徴量について「両グループの平均値に有意な差があるか」という仮説検定(独立2群のt検定)を実行しています。equal_var=False は等分散を仮定しないウェルチのt検定を指定する引数です(省略するとスチューデントのt検定になります)。検定の中身についてはt検定の記事で解説しています。
- p値による評価: 検定結果として得られた p_age と p_hist を出力します。このp値が有意水準(例えば0.05)よりも十分に大きければ、「グループ間に有意な差は見られず、交絡因子が適切にバランス(ランダム化)されている」と判断する根拠になります。
実行結果
                 age      history
treatment
0          40.353762  4705.510110
1          40.549684  4948.128756
ageのp値: 0.658
historyのp値: 0.262
ageの平均は 40.5 vs 40.4(p=0.658)、historyの平均は 4948 vs 4706(p=0.262)となり、両グループ間で統計的に有意な差は見られません。特徴量を一切見ずにコインを投げただけなのに、2つのグループの中身が揃っているわけです。これが「ランダム化の魔法」の正体です。
分布の可視化によるバランスの確認
とはいえ、ここまで確認したのは「平均値」という代表値だけです。平均が一致していても、片方のグループにだけ若年層と高齢層が偏っている、といった可能性は残ります。ランダム化が本当に効いているなら、平均だけでなく分布の形そのものが両群で一致しているはずです。実際に描いて確かめてみましょう。
import matplotlib.pyplot as plt
import japanize_matplotlib

fig, axes = plt.subplots(2, 2, figsize=(12, 8))
features = [('age', '年齢'), ('history', '過去の購買金額')]
colors = {0: '#4C72B0', 1: '#DD8452'}
labels = {0: '対照群 (treatment=0)', 1: '処置群 (treatment=1)'}

for j, (col, jp) in enumerate(features):
    # 上段:ヒストグラムの重ね描き
    ax = axes[0, j]
    bins = np.histogram_bin_edges(df[col], bins=30)  # 両群で共通のビンを使う
    for t in [0, 1]:
        ax.hist(df[df['treatment'] == t][col], bins=bins, alpha=0.5,
                color=colors[t], label=labels[t], density=True)
    ax.set_title(f'{jp}({col})の分布')
    ax.set_xlabel(jp)
    ax.set_ylabel('密度')
    ax.legend()

    # 下段:累積分布関数(ECDF)
    ax = axes[1, j]
    for t in [0, 1]:
        x = np.sort(df[df['treatment'] == t][col].values)
        y = np.arange(1, len(x) + 1) / len(x)
        ax.plot(x, y, color=colors[t], label=labels[t], lw=2)
    ax.set_title(f'{jp}({col})の累積分布')
    ax.set_xlabel(jp)
    ax.set_ylabel('累積割合')
    ax.legend()

plt.tight_layout()
plt.show()
Matplotlib を用いて、処置群と対照群それぞれの特徴量の分布を重ね合わせて描画しています。
- 共通ビンの指定: np.histogram_bin_edges でデータ全体から先にビンの区切りを決め、両群に同じ bins を渡しています。これをせずに群ごとに hist を呼ぶと区切り位置がずれてしまい、正しく比較できません。
- 密度への正規化: density=True を指定しています。ランダム割り当てでは両群の人数が完全に同数にはならない(今回は対照群が1009人、処置群が991人)ため、度数のままだと僅かな高さの差が「人数の差」なのか「分布の差」なのか区別できなくなります。
- 累積分布(ECDF)の描画: 値をソートし、「その値以下が全体の何割か」を np.arange(1, len(x)+1) / len(x) で計算して折れ線にしています。ヒストグラムはビン幅の取り方次第で見え方が変わりますが、ECDFにはその任意性がなく、2本の線の重なり具合で分布の一致をそのまま判断できます。裾の長い history のような変数では特に有効です。
実行結果
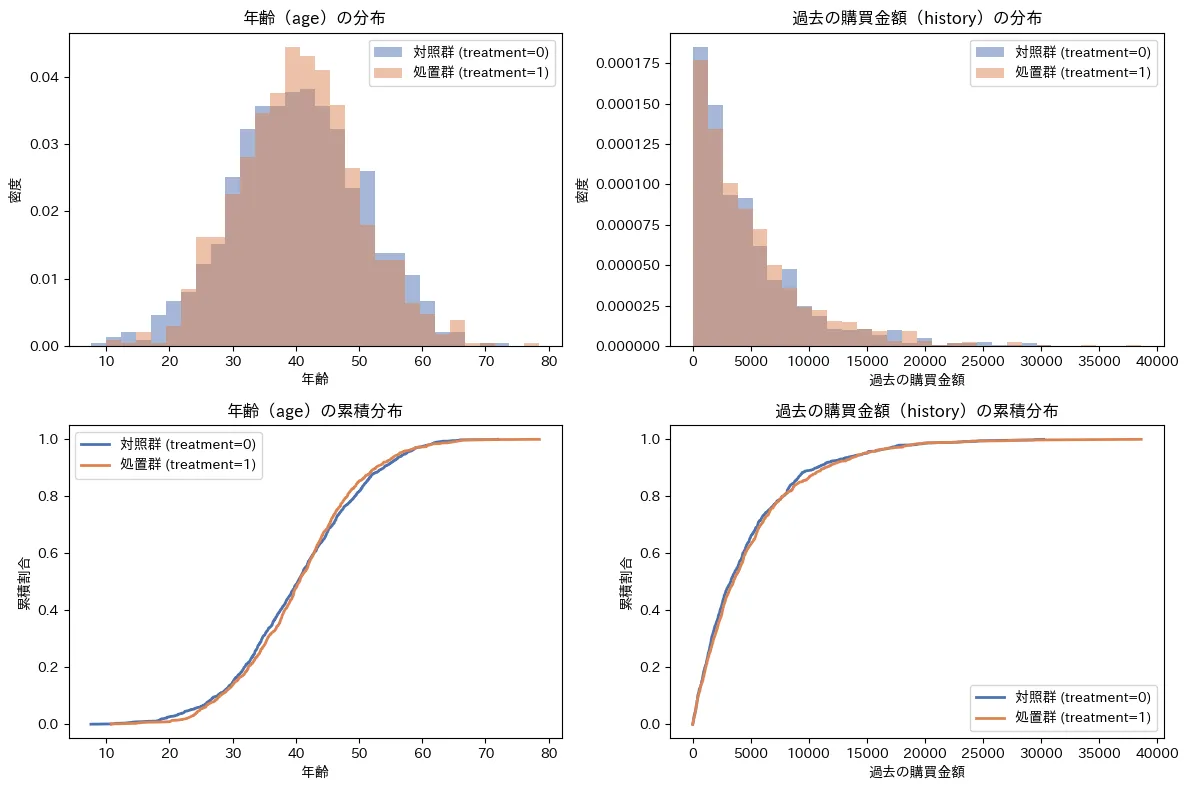
正規分布に従う年齢も、裾の長い指数分布に従う購買金額も、処置群と対照群のヒストグラムがほぼ完全に重なっています。累積分布に至っては、2本の線がほとんど見分けられません。ランダム化によって作られた2つのグループは、「平均値がたまたま近い集団」ではなく「同じ分布から取り出された双子のような集団」であることが、直感的に確認できます。
なお、分布全体の一致を統計的に検定したい場合は、平均を比較するt検定ではなく、コルモゴロフ・スミルノフ検定(stats.ks_2samp)を用います。
# コルモゴロフ・スミルノフ検定による分布の一致の確認
ks_age = stats.ks_2samp(df[df['treatment']==1]['age'], df[df['treatment']==0]['age'])
ks_hist = stats.ks_2samp(df[df['treatment']==1]['history'], df[df['treatment']==0]['history'])

print(f"ageのKS検定 p値: {ks_age.pvalue:.3f}")
print(f"historyのKS検定 p値: {ks_hist.pvalue:.3f}")
実行結果
ageのKS検定 p値: 0.310
historyのKS検定 p値: 0.556
今回のデータではageがp=0.310、historyがp=0.556となり、いずれも一般的な有意水準である0.05を大きく上回っているため、こちらでも分布に差があるとは言えないという結論になります(p値が大きいことは、分布が一致することの証明ではありません。差が見つからなかった、という意味です)。
標準化平均差(SMD)による評価
前2節で紹介したt検定やKS検定は「ランダム割り当てが正しく機能しているか」の動作確認としては有用ですが、実務において共変量が数十個に及ぶと「多重比較の問題(どれか1つは偶然有意になってしまう)」が生じ、またp値自体もサンプルサイズに引きずられてしまうという弱点があります。 そこで、実務におけるバランス評価の定番指標となるのが、標準化平均差(SMD:Standardized Mean Difference) を全変数について計算し、1枚の図にまとめる方法です。この図は慣例的に Loveプロット と呼ばれます。
SMDの定義
SMDは、処置群と対照群における共変量の平均の差を、2群の分散をプールした標準偏差で割った値として定義されます。
( は処置群・対照群における共変量の平均、 はそれぞれの分散)
分子は「2群でどれだけ平均がずれているか」、分母は「その変数がそもそも持っているばらつきの大きさ」です。つまりSMDは、群間のズレを、その変数自身のばらつきを物差しとして測った値ということになります。この単純な式が共変量バランスの標準的な指標として定着しているのは、次の3つの性質によります。
- 標準化による無次元化: 平均の差をそのまま眺めると、年齢(数十)と購買金額(数千)のようにスケールの異なる変数を横並びで比較できませんが、標準偏差で割ることで同じ物差しに乗せることができます。分子と分母が同じ単位を持つため、SMDは単位を持たない(無次元の)量になります。
- 点推定値がサンプルサイズに引きずられない: p値はサンプルサイズが大きいほど小さくなる性質があり、実質的に無視できるような微小な差でも「有意差あり」と判定されてしまう問題があります。一方でSMDの定義式にはサンプルサイズ が直接現れないため、推定値の大きさが系統的に の影響を受けません(※標本から計算される以上、値のばらつき自体は に依存します)。バランスの評価指標としてp値よりも適切だとされているのはこのためです(この論点はt検定の記事でも扱っています)。
- 0.1という共通の基準: 慣例的に であれば、その変数はバランスが取れていると判断します。無次元でサンプルサイズにも依存しないので、変数が違っても、データセットが違っても、同じ基準線を引いて比較できます。
このデータの値で SMD を計算すると、次のようになります(標準偏差は SMD から逆算した概数です)。
(図は、diagram-designで作成)
Pythonによる計算とLoveプロット
# 標準化平均差:平均の差を、2群の分散をプールした標準偏差で割った値
def smd(x1, x0):
    return (x1.mean() - x0.mean()) / np.sqrt((x1.var(ddof=1) + x0.var(ddof=1)) / 2)

cols = ['age', 'history']
smds = [smd(df[df['treatment'] == 1][c], df[df['treatment'] == 0][c]) for c in cols]

fig, ax = plt.subplots(figsize=(7, 3))
ax.scatter(np.abs(smds), cols, s=110, color='#DD8452', zorder=3)
ax.axvline(0.1, color='red', ls='--', label='目安となる基準 (0.1)')
ax.set_xlim(0, 0.3)
ax.set_xlabel('標準化平均差の絶対値 |SMD|')
ax.set_title('共変量バランス(Loveプロット)')
ax.grid(axis='x', alpha=0.3)
ax.legend()
plt.tight_layout()
plt.show()

for c, s in zip(cols, smds):
    print(f"{c} の標準化平均差(SMD): {s:.3f}")
共変量ごとの偏りの大きさを、単位に依存しない共通の指標に変換して可視化しています。
- 定義式の実装: 関数 smd は、上で示した定義式をそのまま書き下したものです。分母のプールした分散は不偏分散(ddof=1)で計算しています。
- 絶対値でのプロット: np.abs(smds) として絶対値を横軸に取っています。バランスの評価で関心があるのは「どちらの群が大きいか」ではなく「どれだけずれているか」だけなので、符号を落として比較します。
- 基準線の描画: ax.axvline(0.1) で慣例的な基準 を引いています。共変量が数十個あっても、この線の内側に点が収まっているかどうかを見るだけでバランスを一覧で判断できるのがLoveプロットの利点です。
実行結果

age の標準化平均差(SMD): 0.020
history の標準化平均差(SMD): 0.050
いずれも基準の0.1を大きく下回っており、ランダム化が正しく機能していることが確認できました。両グループが「比較可能」であることが、平均・分布・SMDの3つの角度から保証されたことになります。
そして、この Loveプロットは、PSM(傾向スコアマッチング)の記事で主役になります。そこでは「マッチング前は基準線を大きく超えていた点が、マッチング後にどれだけ基準線の内側に入ったか」を評価することになります。つまり、いま見ているRCTのこの状態こそが、観察データで再現を目指す「お手本」なのです。
本記事で示したSMDは、重みなし・全データに対する最も基本的な形です。観察データを扱う記事(PSM・IPTW など)では、この式の平均と分散を目的に応じて置き換えながら、同じ指標でバランスを評価していきます。
- 傾向スコアマッチング(PSM): 上とまったく同じ式を「マッチング後に残ったデータセット」に適用し、マッチング前後のSMDを比較します。
- 逆確率重みづけ(IPTW): 式中の平均と分散を、逆確率重みで加重したもの(重み付き平均・重み付き分散)に置き換えます。
置き換わるのは平均と分散の計算方法だけで、「群間のズレを、その変数のばらつきで割って無次元化する」という考え方と、 という基準は共通です。以降の記事でSMDが登場した際は、本セクションが定義の参照元になります。
結果の確認(単純な平均の差)
ランダム割り当てを行っているため、複雑な統計モデルや機械学習を使わなくても、単に処置群(treatment = 1)と対照群(treatment = 0)の売上平均の差分を計算するだけで、「真の効果(+1500)」に近い値が算出できるはずです。
# 処置群と対照群の平均売上を計算
mean_sales_treated = df[df['treatment'] == 1]['sales'].mean()
mean_sales_control = df[df['treatment'] == 0]['sales'].mean()

# 平均の差(効果の推定値)
estimated_effect = mean_sales_treated - mean_sales_control

print(f"処置群の平均売上: {mean_sales_treated:.1f}")
print(f"対照群の平均売上: {mean_sales_control:.1f}")
print(f"推定された施策効果: {estimated_effect:.1f} (真の効果は {true_effect})")
ここでは、ランダム化が行われたデータに対し、最もシンプルに「単純な平均の差」を計算することで施策効果を推定しています。
- グループ別平均売上の計算: pandas の条件抽出機能(df['treatment'] == 1 および 0)を用いてデータを処置群と対照群に分割し、それぞれの sales 列に対して .mean() メソッドを適用して平均値を算出しています。
- ATE(平均処置効果)の推定: 処置群の平均売上から対照群の平均売上を引くこと(mean_sales_treated - mean_sales_control)で、施策による効果(ATE)を推定しています。完全にランダム化されて交絡因子の影響が相殺されているため、重回帰分析のような複雑なモデリングを行わなくとも、単なる引き算だけでバイアスのない推定値が得られます。
実行結果
処置群の平均売上: 7173.0
対照群の平均売上: 5494.9
推定された施策効果: 1678.1 (真の効果は 1500)
このように、ランダムに割り振られたデータにおいては、単純集計だけで「期待値としてバイアスのない」効果測定(ATE:Average Treatment Effect の推定)が可能となります。
ただし、上記で計算された推定値(今回の乱数シードでの実行結果は約1678になります)と真の効果(1500)にはズレが生じます。これは、ランダム化によって交絡因子の偏りは解消されても、有限のサンプルサイズでは「偶然のばらつき(誤差)」が生じるためです。 そのため、実務のA/Bテストでは「単に平均に差が出たか」だけで判断するのではなく、統計的仮説検定(p値)や信頼区間を併せて確認することが不可欠です。
統計的仮説検定と信頼区間の確認
SciPyを用いて、2群の平均値の差の検定(t検定)を行ってみましょう。
from scipy import stats

# equal_var=False でウェルチのt検定(等分散を仮定しない)
res = stats.ttest_ind(
    df[df['treatment'] == 1]['sales'],
    df[df['treatment'] == 0]['sales'],
    equal_var=False
)
print(f"t値: {res.statistic:.2f}")
print(f"p値: {res.pvalue:.4f}")

ci = res.confidence_interval(confidence_level=0.95)
print(f"95%信頼区間: [{ci.low:.1f}, {ci.high:.1f}]")
ここでは、先ほど計算した「平均売上の差(効果の推定値)」が偶然のばらつきによるものではないかを統計的に検証しています。
- 効果の有意差検定(t検定): バランスチェック時と同様に、SciPy の stats.ttest_ind を用いて独立2群のt検定を実行しています。今回は特徴量ではなく、目標変数である sales の配列(処置群と対照群)を直接渡しています。t値やp値がどのような計算で導かれているかはt検定の記事を参照してください。
- t値・p値・信頼区間の出力: 返り値であるオブジェクトからt値(res.statistic)とp値(res.pvalue)を取得し、さらに res.confidence_interval() メソッドを呼ぶことで95%信頼区間を算出・出力しています。このp値が非常に小さい(通常0.05未満)場合、「両グループの売上に差はない(施策効果ゼロ)」という帰無仮説を棄却し、「得られた売上の差は偶然ではなく、統計的に意味のある差(有意差)である」と結論付けることができます。有限サンプルの実験において、単なる偶然による見逃しや誤認を防ぐための重要なステップです。
実行結果
t値: 14.02
p値: 0.0000
95%信頼区間: [1443.3, 1912.9]
これを実行すると となり、「施策効果はゼロである」という帰無仮説は棄却されます。さらに95%信頼区間を計算すると [1443.3, 1912.9] となり、「点推定値は1678と上振れしたが、区間で見れば真の効果である1500が十分にありうる範囲に含まれている」ことが確認できます。このように、信頼区間を含めて評価することで、意思決定のミス(偶然の誤差を真の効果と誤認すること)を防ぐことができます。
1回目の推定値と信頼区間を、後で行う1,000回の実験の結果と並べると、次のようになります。
(図は、diagram-designで作成)
実験を繰り返して確かめる
ここまでの結果は、乱数のシードを1つに決めた1回の実験です。本記事の主張は「ランダム化すれば、平均の差は期待値として真の効果に一致する」「特徴量で割り当てを偏らせると、効果を見誤る」の2つでした。1回の実験では、どちらも確かめきれません。そこで、同じ作り方のデータで実験を1,000回繰り返し、推定値の分布を見てみましょう。比べるのは、RCTのようにランダムに割り当てた場合と、冒頭の例のように「よく買う顧客に優先してDMを送った」場合です。
def simulate(assign, n_rep=1000, N=2000, true_effect=1500, seed=0):
    """同じデータの作り方で n_rep 回実験し、毎回の効果の推定値と、95% 信頼区間が真の効果を含んだかを返す"""
    rng = np.random.default_rng(seed)
    estimates, covered = [], []
    for _ in range(n_rep):
        # 毎回、新しい顧客を作る(作り方は記事の最初のダミーデータと同じ)
        age = rng.normal(40, 10, N)
        history = rng.exponential(5000, N)
        treatment = assign(history, rng)
        sales = 2000 + 30 * age + 0.5 * history + true_effect * treatment + rng.normal(0, 1000, N)

        res = stats.ttest_ind(sales[treatment == 1], sales[treatment == 0], equal_var=False)
        ci = res.confidence_interval(confidence_level=0.95)
        estimates.append(sales[treatment == 1].mean() - sales[treatment == 0].mean())
        covered.append(ci.low <= true_effect <= ci.high)
    return np.array(estimates), np.array(covered)


# (a) RCT:特徴量を見ずに、全員 50% の確率で DM を送る
def random_assign(history, rng):
    return rng.binomial(1, 0.5, len(history))

# (b) 偏った割り当て:購買金額が上位半分の顧客には 80%、下位半分には 20% の確率で送る
#     (全体ではおよそ半数に送る点は RCT と同じ。予算の都合で優良顧客を優先した状況)
def biased_assign(history, rng):
    p = np.where(history > np.median(history), 0.8, 0.2)
    return rng.binomial(1, p)


results = {"ランダムな割り当て(RCT)": simulate(random_assign),
           "購買金額で偏った割り当て": simulate(biased_assign)}

for name, (est, cov) in results.items():
    print(f"{name}: 推定値の平均 {est.mean():.1f}、標準偏差 {est.std():.1f}、"
          f"95%信頼区間が真の効果を含んだ割合 {cov.mean():.1%}")

fig, ax = plt.subplots(figsize=(10, 4.5))
bins = np.linspace(1000, 4500, 71)   # 両方の推定値が収まる範囲に、共通のビンを取る
for (name, (est, _)), color in zip(results.items(), ['#4C72B0', '#DD8452']):
    ax.hist(est, bins=bins, alpha=0.6, color=color, label=name)
ax.axvline(1500, color='red', ls='--', label='真の効果 (1500)')
ax.set_xlabel('効果の推定値(処置群の平均売上 − 対照群の平均売上)')
ax.set_ylabel('回数(1,000回のうち)')
ax.set_title('実験を1,000回繰り返したときの推定値の分布')
ax.legend()
plt.tight_layout()
plt.show()
- 毎回新しい顧客を作る:simulate は、記事の最初と同じ作り方で毎回新しい2,000人を作り、割り当て・売上の生成・平均の差・95%信頼区間の計算を1,000回繰り返します。「同じ実験を何度もやり直したら、推定値はどう散らばるか」を見るためです。
- 偏った割り当ての作り方:購買金額が中央値より多い顧客には80%、少ない顧客には20%の確率でDMを送ります。全体ではおよそ半数に送る点はRCTと同じにして、違いを「誰に送ったか」だけにしています。
- 1,000回:信頼区間が真の値を含む割合(本来は95%)を、±1.4ポイントほどの誤差で確かめられる回数です。計算は数秒で終わります。
- 共通のビン:2つのヒストグラムが同じ区切りで比べられるように、両方の推定値が収まる範囲(1000〜4500)に共通のビンを取っています。
実行結果
ランダムな割り当て(RCT): 推定値の平均 1499.0、標準偏差 118.2、95%信頼区間が真の効果を含んだ割合 95.2%
購買金額で偏った割り当て: 推定値の平均 3586.4、標準偏差 112.9、95%信頼区間が真の効果を含んだ割合 0.0%
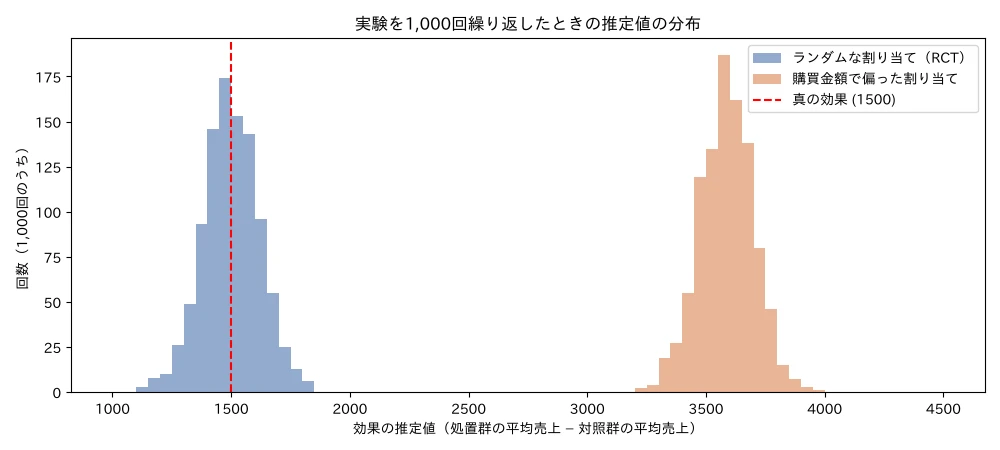
ランダムに割り当てた場合、推定値は1回ごとに1100〜1850ほどの範囲でばらつきますが、その平均は1499.0で、真の効果1500とほぼ一致しました。最初の実験の1678は、この分布の中でやや上振れした1回だったことになります。95%信頼区間が真の効果を含んだのは1,000回中95.2%で、名前のとおり約95%です。
一方、購買金額で偏らせた場合、推定値の平均は3586.4で、真の効果の2倍以上になりました。1,000回のうち、信頼区間が1500を含んだことは一度もありません。DMを受け取った群には購買金額の多い顧客が集まるため、「元々よく買う」分の売上の差(購買金額の差 × 0.5、約2,100)が、DMの効果に上乗せされてしまうからです。標準偏差はRCTとほとんど変わらないので、人数を増やして誤差を小さくしても、このずれは消えません。冒頭で述べたセレクションバイアスが、実際の数字としてこれだけの大きさになります。
RCTの限界と「観察データ」の課題
ここまで見ると、「常にRCTを行えばよいのではないか?」と思われるかもしれません。しかし、現実のビジネスや医療においてRCTを実施することには、高いハードルが存在します。
- コストと時間: 完璧なA/Bテスト環境(システム基盤)を構築するには、開発コストや期間がかかります。
- 倫理的・ビジネス的な制約: 「一部の顧客だけに有利な割引キャンペーンをする(不公平感)」、「すでに全社的に導入してしまった有効な施策を、テストのために一部の店舗だけ取りやめる」といったことは、クレームや機会損失に直結するため実務上不可能なケースが多々あります。
- 過去に遡れない: 「先月実施した施策の効果を今から知りたい」といった場合、時間を遡ってRCTをやり直すことは原理的に不可能です。
- サンプルサイズと検出力: 小さな効果を統計的に有意に検出するには大量のサンプルが必要になるため、母数の少ないBtoBビジネスなどでは実施が困難な場合があります。
- 外的妥当性の懸念: 一部の限定的なユーザー層や環境で検証した結果が、そのまま本番環境や全体に当てはまるとは限りません。
結果として、データサイエンティストやマーケターの手元に残るのは、 「意図的にランダム化されておらず、すでにバイアスがかかった状態で収集された過去の履歴データ(=観察データ:Observational Data)」 であることが大半です。
まとめ
ランダム化比較試験(RCT)は、割り当て時点のセレクションバイアスを排除できるため、効果検証における最も強力で確実なアプローチです(※ただし、実験開始後のユーザーの脱落や非遵守などによるバイアスは残るため、厳密には「完全に排除できる」わけではありません)。本記事のシミュレーションでも、ランダムに割り当てた場合は1,000回の実験の推定値の平均が1499.0と真の効果1500にほぼ一致したのに対し、購買金額の多い顧客を優先した場合は3586.4と2倍以上に膨らみました。しかし、前述した実務上の制約から、すべての施策でRCTを実施することはできません。
そこで、次なる課題は 「ランダム化されていない観察データを使って、いかにしてRCTに近い状態を仮想的に作り出し、真の効果を測るか?」 となります。
そのための代表的なアプローチの1つが「傾向スコアマッチング(PSM)」で、その記事で解説しています。
参考文献
- R. A. Fisher (1935). The Design of Experiments. Oliver and Boyd.
- G. W. Imbens, D. B. Rubin (2015). Causal Inference for Statistics, Social, and Biomedical Sciences: An Introduction. Cambridge University Press.
- R. Kohavi, D. Tang, Y. Xu (2020). Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press.
本記事の文章・構成の一部に生成AIを使用しています。