推論の蒸留(Reasoning Distillation)とは?
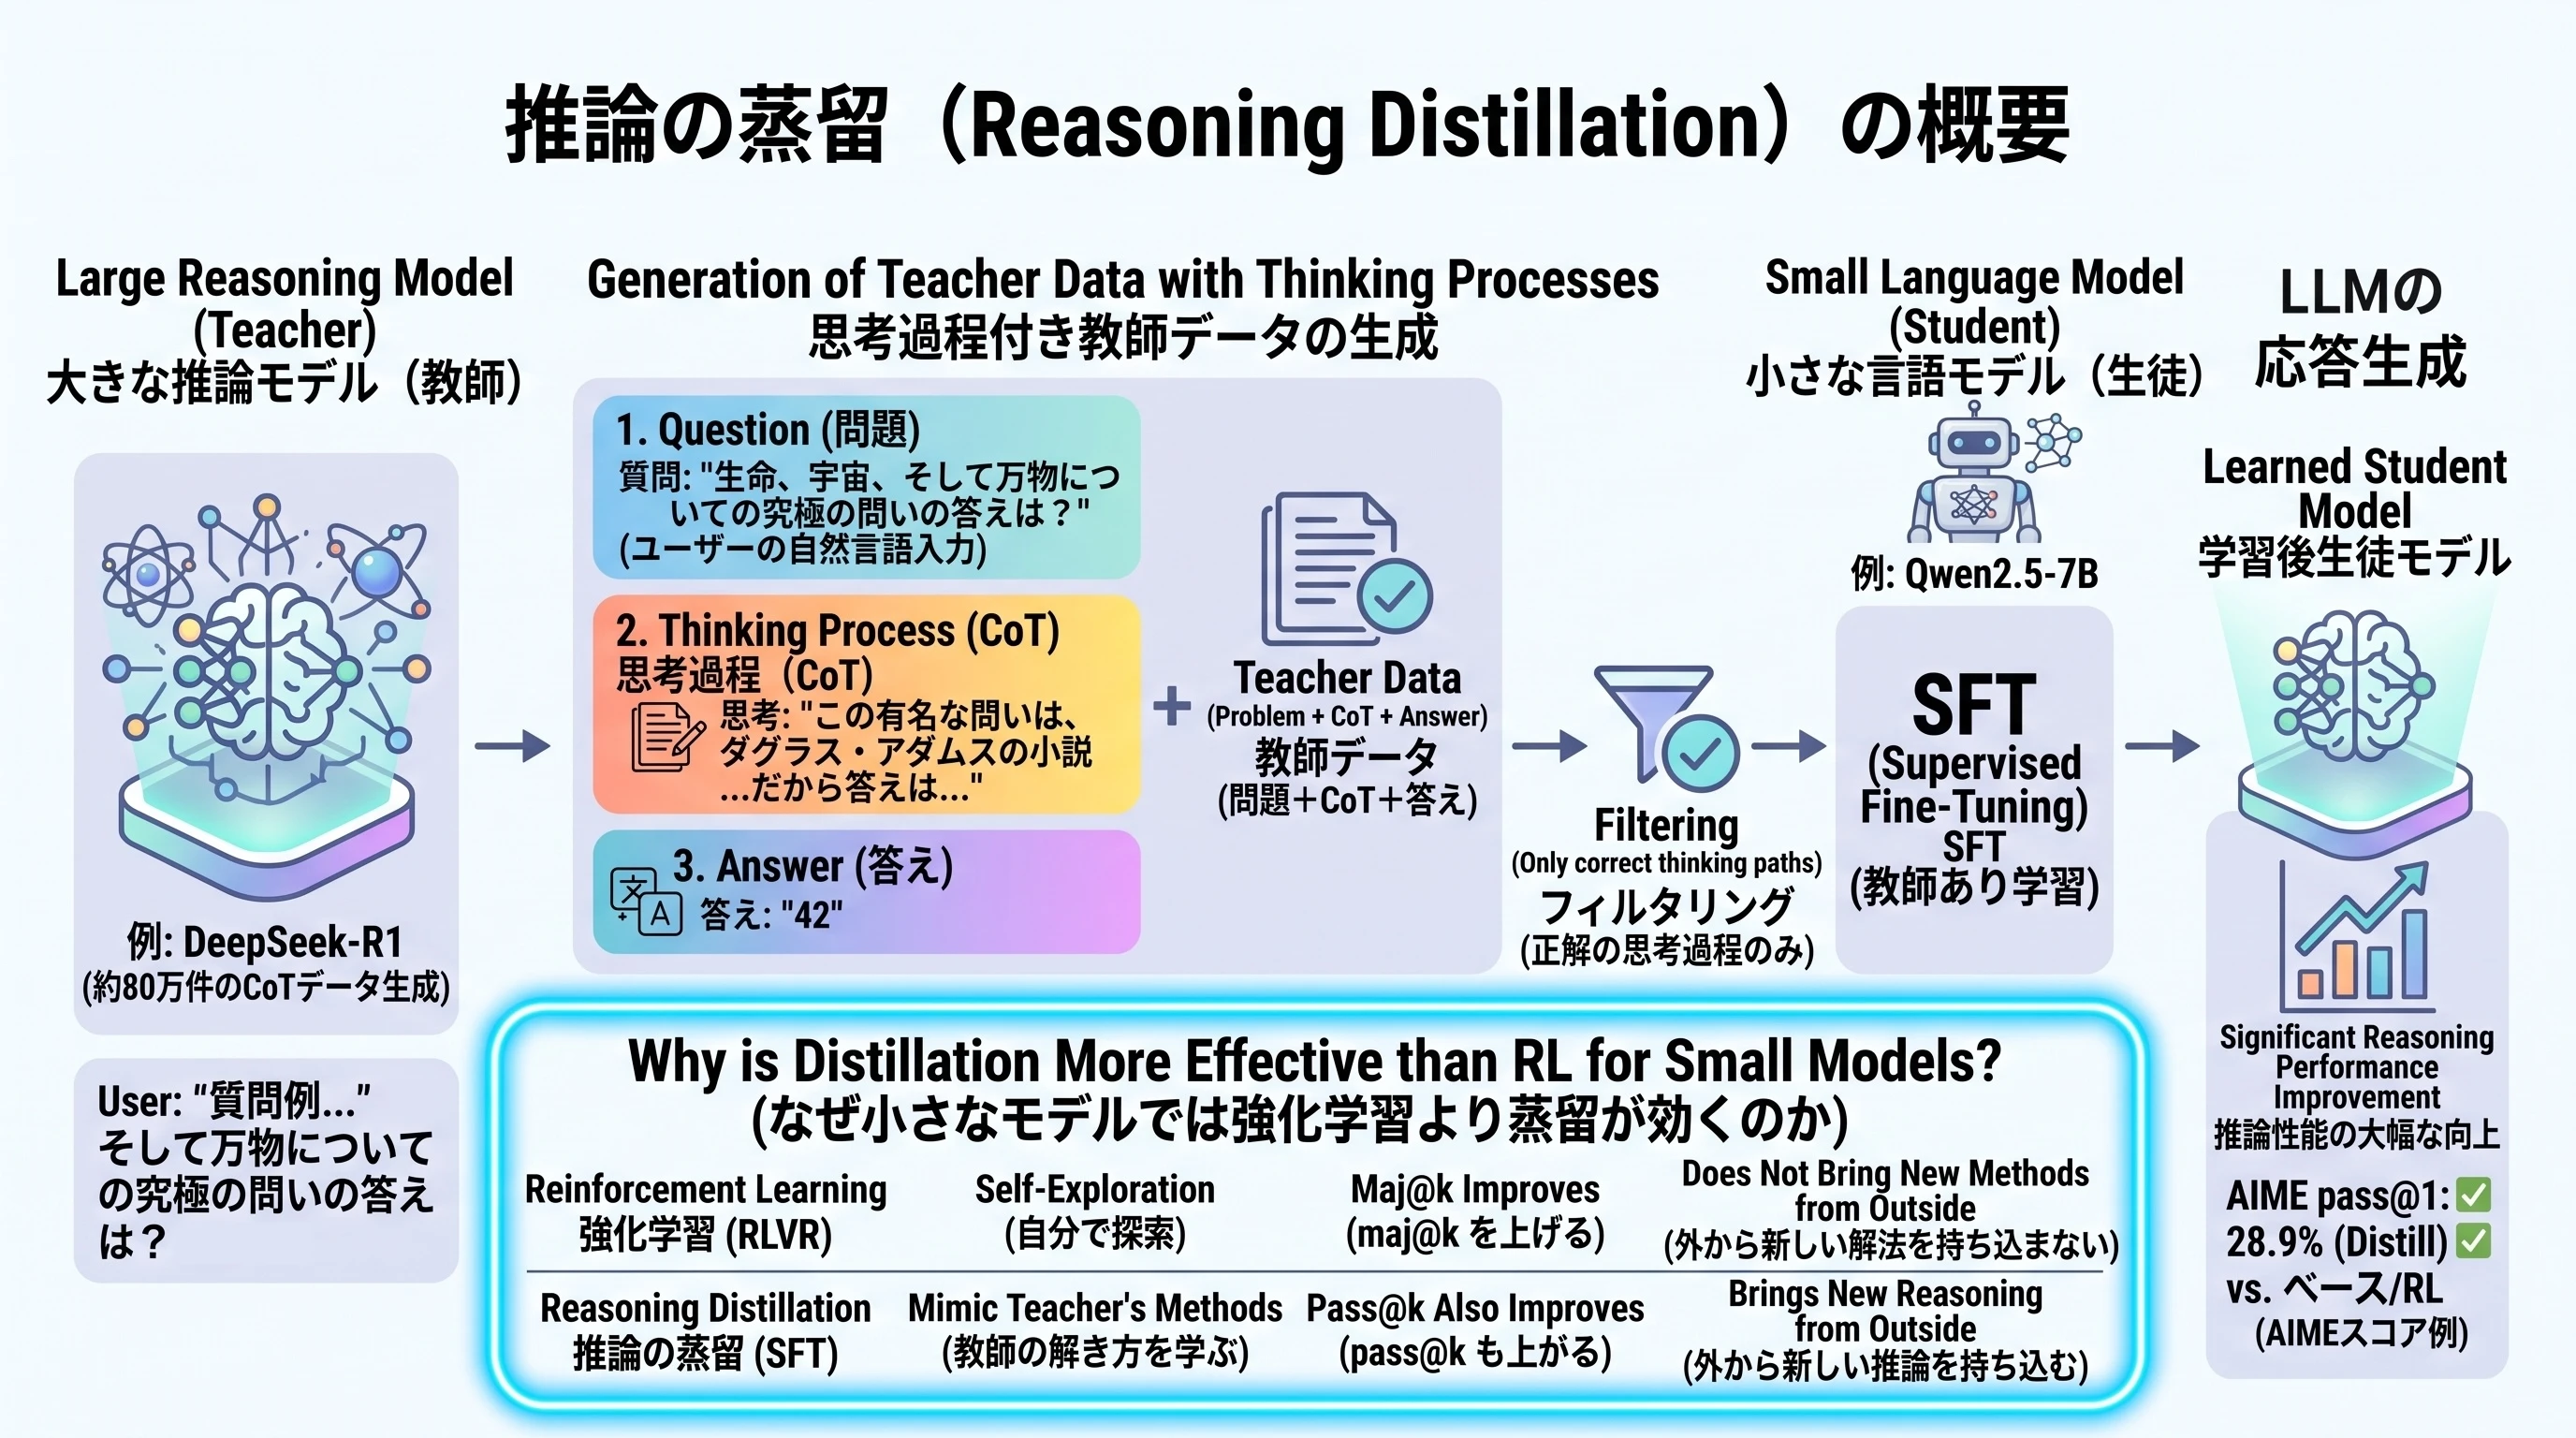 (画像は、Geminiで作成)
大きなモデルが生成した推論過程で小さなモデルを SFT する推論の蒸留について、知識蒸留からの系譜、強化学習との違い、教師データの作り方(正解だけを残すフィルタリングとデータの量)を理解すること。DeepSeek-R1-Distill-Qwen-7B を教師、Qwen2.5-1.5B を生徒として、蒸留・GRPO・蒸留のあとの GRPO を比べ、どの条件で蒸留と強化学習のどちらが有利になるか、データの質と量がどう効くかを確かめること。
推論の蒸留(Reasoning Distillation)とは?
推論の蒸留は、大きな推論モデル(教師)に問題を解かせて思考過程を書かせ、正解したものだけを教師データにして、小さなモデル(生徒)を SFT する手法 です。小さなモデルは、自分で強化学習をして解き方を見つけるより、強いモデルの解き方を真似するほうが、少ない計算で推論能力を伸ばせることが知られています。DeepSeek-R1 の蒸留モデル(DeepSeek-R1-Distill-Qwen など)は、この方法で作られています。
この記事の読み方
目的に合わせて、次の節から読み始めてください。
| 知りたいこと | 読む節 |
|---|---|
| すぐに手順を動かしてみたい | 直後の「最短の使い方」(教師の生成 → 正解だけ残す → SFT) |
| 知識蒸留との違い | 知識蒸留の系譜 |
| なぜ小さなモデルでは強化学習より蒸留が効くのか | なぜ小さなモデルでは蒸留が効くのか |
| 教師データの質と量の決め方 | 教師データの作り方 |
| 蒸留と GRPO を実際に比べた結果 | 実装と比較実験(結果の一覧は実装8) |
| 蒸留の弱点 | 推論の蒸留の限界 |
最短の使い方:教師の推論過程で生徒を SFT する
蒸留の3つの手順を、8問だけの小さな規模で通して実行します。本文の実験より小さな教師(DeepSeek-R1-Distill-Qwen-1.5B、MIT License)と生徒(Qwen2.5-0.5B、Apache-2.0)を使うので、GPU がなくても動きます。
!pip install transformers trl datasets
import re
import torch
from datasets import Dataset
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
from trl import SFTConfig, SFTTrainer

set_seed(0)
# 教師:推論モデル、生徒:小さなベースモデル
TEACHER_ID = "deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B"
STUDENT_ID = "Qwen/Qwen2.5-0.5B"

# 算数の文章題(本文の算数ワールドと同じ形式で、2〜3回の計算が必要な問題)
problems = [
    ("りんごが24個あります。13個もらいました。3個使いました。いまりんごは何個ありますか。", 34),
    ("みかんが15個あります。みかんの数が4倍になりました。20個使いました。いまみかんは何個ありますか。", 40),
    ("クッキーが36個あります。6等分して、そのうち1つ分だけを残しました。9個もらいました。いまクッキーは何個ありますか。", 15),
    ("ノートが42個あります。7個使いました。ノートの数が3倍になりました。いまノートは何個ありますか。", 105),
    ("シールが18個あります。27個もらいました。5等分して、そのうち1つ分だけを残しました。いまシールは何個ありますか。", 9),
    ("えんぴつが50個あります。14個使いました。4等分して、そのうち1つ分だけを残しました。いまえんぴつは何個ありますか。", 9),
    ("りんごが11個あります。りんごの数が5倍になりました。8個使いました。12個もらいました。いまりんごは何個ありますか。", 59),
    ("みかんが30個あります。15個もらいました。9等分して、そのうち1つ分だけを残しました。みかんの数が2倍になりました。いまみかんは何個ありますか。", 10),
]

# (1) 教師に推論過程を書かせる(DeepSeek の推奨どおり、答えは \boxed{} に書かせる)
t_tok = AutoTokenizer.from_pretrained(TEACHER_ID, padding_side="left")
teacher = AutoModelForCausalLM.from_pretrained(TEACHER_ID)
INSTRUCTION = "\n最後に、答えの整数を \\boxed{} の中に書いてください。"
prompts = [
    t_tok.apply_chat_template([{"role": "user", "content": q + INSTRUCTION}],
                              tokenize=False, add_generation_prompt=True)
    for q, _ in problems
]
inputs = t_tok(prompts, return_tensors="pt", padding=True,
               add_special_tokens=False)
with torch.no_grad():
    # 温度 0.6・top-p 0.95 は DeepSeek-AI の推奨設定
    out = teacher.generate(**inputs, max_new_tokens=1024, do_sample=True,
                           temperature=0.6, top_p=0.95)
new_tokens = out[:, inputs["input_ids"].shape[1]:]   # 問題文の後ろの生成部分
texts = t_tok.batch_decode(new_tokens, skip_special_tokens=True)

# (2) 思考が閉じていて、\boxed{} の答えが正解のものだけを残す(リジェクションサンプリング)
data = []
for (q, gold), text in zip(problems, texts):
    if "</think>" not in text:
        continue                     # 上限で途中で切れた出力は捨てる
    think, rest = text.split("</think>", 1)
    boxed = re.findall(r"\\boxed\{(-?\d+)\}", rest)
    if boxed and int(boxed[-1]) == gold:
        completion = f"\n{think.strip()}\n</think>\n<answer>{gold}</answer>"
        data.append({"prompt": f"User: {q} Assistant: <think>",
                     "completion": completion})
print(f"教師が正解した推論過程: {len(data)} / {len(problems)} 件")
print("例:", data[0]["completion"][:120].replace("\n", " / "), "...")

# (3) 残した推論過程で生徒を SFT する(応答部分だけを損失にする=系列レベルの蒸留)
s_tok = AutoTokenizer.from_pretrained(STUDENT_ID)
student = AutoModelForCausalLM.from_pretrained(STUDENT_ID)
trainer = SFTTrainer(
    model=student,
    args=SFTConfig(
        output_dir="distill_demo",
        num_train_epochs=1,
        per_device_train_batch_size=2,
        learning_rate=1e-5,
        completion_only_loss=True,
        bf16=torch.cuda.is_available(),  # GPU なら bf16、CPU なら fp32
        logging_steps=1,
        save_strategy="no",
        report_to="none",
    ),
    train_dataset=Dataset.from_list(data),
    processing_class=s_tok,
)
trainer.train()
losses = [round(h["loss"], 3) for h in trainer.state.log_history if "loss" in h]
print("学習の損失:", losses)
- (1) 教師の生成: 教師は DeepSeek-R1 の出力で SFT された推論モデルで、チャットテンプレートで質問を渡すと、思考を書いて </think> で閉じてから答えを書きます。答えを
\boxed{}に書かせる指示と、温度 0.6・top-p 0.95 は、DeepSeek-AI が推奨する設定です。max_new_tokens=1024 は、2〜3回の計算の問題なら思考がこの長さに収まることが多いので、この値にしています。 - (2) 正解だけを残す: 思考が閉じていない(上限で切れた)出力と、
\boxed{}の答えが正解と違う出力を捨てます。教師の誤った推論で SFT すると、生徒は誤りも真似するからです。これを、教師の出力から条件に合うものだけを選ぶ「リジェクションサンプリング」と呼びます。 - (3) SFT: 残った思考と答えを、生徒の形式(<think> 思考 </think> <answer>答え</answer>)にして学習します。completion_only_loss=True で、問題文(prompt)を損失から除き、応答(completion)だけを学ばせます。教師の応答の負の対数尤度を下げることが、系列レベルの蒸留そのものです。
- 規模: 8問・1エポックでは、生徒の正解率はほとんど変わりません。ここでは手順の全体像を示すことを目的にしています。本文の実験では、7B の教師に1,500問を解かせ、正解した推論過程(546件)で 1.5B の生徒を SFT して、正解率が 0.036 から 0.710 に上がることを確かめます。
実行結果
教師が正解した推論過程: 3 / 8 件
例:  / まず、みかんの数が15個あります。その数が4倍ened後、20個を使用しました。 remainder后、 remainingは20個を使用了多少個を求めるため、15の4倍是多少を求める? /  / 15の4倍は、15×4=60個です。 /  /  aft ...
学習の損失: [1.739, 1.118]
例の日本語訳:
- まず、みかんは15個あります。その数が4倍になった後、20個を使いました。残りがいくつかを求めるために、まず15の4倍がいくつかを求めます。15の4倍は、15×4=60個です。(このあとも続く)
CPU で実行した結果です(教師の生成と SFT を合わせて約5分半)。
- 残ったのは8件中3件: 残りの5件は、思考が1,024トークンで閉じなかったか、答えが間違っていました。1.5B の教師は、本文で使う 7B の教師より弱く、捨てる出力が多くなります。教師の強さが、使える教師データの量と、生徒が学べる上限を決めます。
- 教師の癖も写る: 例の思考には、日本語の中に英語(ened、remainder、remaining)や中国語(后、使用了多少、是多少)が混ざっています。答えが正解なので、この思考も教師データに残ります。答えだけで選ぶと、こうした言語の混在も生徒に写ります(詳しくは推論の蒸留の限界)。
- 学習の損失: 3件をバッチサイズ 2 で学習したので、更新は2回です。損失は 1.739 から 1.118 に下がり、生徒が教師の応答に近づいたことが分かります。
DeepSeek-R1 の論文で示された蒸留の効果
DeepSeek-R1の記事で見たように、DeepSeek-R1 の論文(DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning)には、もう1つ重要な結果がありました。R1 が生成した約80万件のデータで Qwen2.5 系や Llama 系の小さなモデル(1.5B〜70B)を SFT するだけで、小さなモデルの推論性能が大きく上がったのです。たとえば DeepSeek-R1-Distill-Qwen-1.5B は、AIME 2024 の pass@1 で 28.9%、MATH-500 で 83.9% を記録しました。
さらに、Qwen2.5-32B のベースモデルに1万ステップ以上の強化学習を行ったモデル(AIME 2024 の pass@1 が 47.0%)より、R1 のデータで SFT したモデル(同 72.6%)の方がはるかに高い性能を示しました。論文は、小さなモデルでは、自分で大規模な強化学習をするより、強いモデルの推論過程を真似させる(蒸留する)方が効果的 だと結論づけています。
このように、大きなモデルが生成した推論過程を教師データにして小さなモデルを SFT することを、本記事では 推論の蒸留(reasoning distillation) と呼びます。本記事では、次の順に解説します。
- 知識蒸留の系譜: Hinton の知識蒸留、系列レベル蒸留、推論過程の蒸留の違い
- なぜ小さなモデルでは蒸留が効くのか: 強化学習との違いを、pass@k・maj@k の観点から考える
- 教師データの作り方: 正解した推論過程だけを残すフィルタリングと、データの量(s1 の知見)
- 実装と比較実験: 算数ワールドで、教師モデルの推論過程の生成、フィルタリング、SFT、GRPO を実装し、4つの条件と、データの質・量を変えた条件を比べる(結果が出たところで順に考察します)
- 蒸留の限界と、関連する手法との関係
プロンプト(問題)を 、応答を 、学習する生徒モデルの方策を 、教師モデルを と書きます。R1 形式の応答は、思考過程と最終的な答えからなります。ルールベースの報酬は です。
知識蒸留の系譜
蒸留(distillation) は、大きなモデル(教師)の知識を小さなモデル(生徒)に移す手法の総称です。教師から何を受け取るかによって、次の3つに整理できます。
1. 知識蒸留(Hinton et al., 2015)
   教師の出力の確率分布を、生徒が真似る
   入力 x → 教師 → 確率分布 q ─┐
   入力 x → 生徒 → 確率分布 p ─┴→ 分布の近さ(KL ダイバージェンス)を損失にする

2. 系列レベル蒸留(Kim & Rush, 2016)
   教師が生成した出力の文章を、生徒が正解として学ぶ(SFT)
   入力 x → 教師 → 出力文 ŷ → 生徒を ŷ で SFT

3. 推論過程の蒸留(Ho et al., 2023 など / DeepSeek-R1, 2025)
   教師が生成した「思考過程 + 答え」を、生徒が正解として学ぶ(SFT)
   入力 x → 教師 → 思考過程と答え → 生徒をそれで SFT
3つの違いを図にすると、次のようになります。
(図は、diagram-designで作成)
1. 知識蒸留(Hinton et al., 2015)
知識蒸留の原点は、Distilling the Knowledge in a Neural Network(Hinton et al., 2015)です。
分類モデルの出力には、正解のクラスだけでなく、不正解のクラスにどれだけの確率を割り当てたか という情報も含まれています。論文の例では、BMW の画像をごみ収集車と間違える確率は小さいものの、にんじんと間違える確率よりはずっと大きくなります。こうした確率の比には「何と何が似ているか」という教師の知識が表れていて、正解ラベル(ハードターゲット)だけを使う学習では失われてしまいます。
そこで、教師のロジット を温度 で割ってソフトマックスをとり、なめらかにした確率分布(ソフトターゲット)を作ります。
生徒の確率分布 も同じ温度で計算し、教師の分布 に近づくように学習します。実際には、正解ラベルに対する通常の交差エントロピーと組み合わせて使います。
を掛けるのは、温度を上げると勾配が に小さくなるのを打ち消し、2つの項の大きさを揃えるためです。
2. 系列レベル蒸留(Kim & Rush, 2016)
機械翻訳のような文章を生成するタスクで、知識蒸留を各トークンの確率分布に適用する(単語レベルの蒸留)と、教師の分布を各時点で保持・計算する必要があります。Sequence-Level Knowledge Distillation(Kim & Rush, 2016)は、代わりに 教師がビームサーチで生成した出力文 を正解として、生徒を通常の負の対数尤度で学習する 系列レベルの蒸留を提案しました。
生徒は教師の確率分布を見る必要がなく、教師が生成した文章で SFT するだけです。教師のロジットを使えない API 経由のモデルからも蒸留できるので、現在の LLM の蒸留の多くはこの形をとります。
3. 推論過程の蒸留
系列レベルの蒸留で、教師の出力として 思考過程(CoT)を含む応答 を使うのが、推論過程の蒸留です。答えだけを学ばせると、生徒は途中の計算を飛ばして答えを当てようとするので、多段階の推論が必要な問題では伸びにくくなります(Chain-of-Thoughtの記事の標準 Few-shot と同じ問題です)。
- Large Language Models Are Reasoning Teachers(Ho et al., ACL 2023)は、GPT-3(175B)に Zero-shot CoT で推論過程を書かせ、それで小さな GPT-3 系のモデルを SFT しました。1問あたり複数の推論過程を生成して学習データを増やす(diverse reasoning)と、さらに性能が上がることも示しています。
- Teaching Small Language Models to Reason(Magister et al., ACL 2023)は、PaLM や GPT-3 に Few-shot CoT で推論過程を書かせ、最終的な答えが正しいものだけを残して T5 を SFT し、算数の文章題などで正解率が大きく上がることを示しました。
- Distilling Step-by-Step!(Hsieh et al., Findings of ACL 2023)は、LLM が書いた推論の根拠(rationale)を使い、生徒に「答えの予測」と「根拠の生成」を別々のタスクとして同時に学習させる方法を提案しました。770M の T5 が、学習データの一部だけを使って 540B の PaLM の Few-shot の性能を上回る例を報告しています。
- DeepSeek-R1 の蒸留は、強化学習で長い思考過程を書くようになった R1 の出力で SFT する、系列レベルの推論過程の蒸留です。
| 手法 | 教師から受け取るもの | 生徒の損失 | 特徴 |
|---|---|---|---|
| 知識蒸留(Hinton) | 各出力の確率分布 | KL ダイバージェンス(+正解ラベルの交差エントロピー) | 不正解のクラスの確率の比という細かい情報を学べる。教師の確率分布が必要 |
| 系列レベル蒸留(Kim & Rush) | 教師が生成した出力文 | 負の対数尤度(通常の SFT) | 教師の出力文だけで学べ、実装が簡単 |
| 推論過程の蒸留 | 思考過程と答えを含む出力文 | 負の対数尤度(通常の SFT)。Distilling Step-by-Step は答えと根拠のマルチタスク | 答えだけでなく、問題の分け方や計算の手順も学べる |
なぜ小さなモデルでは蒸留が効くのか
GRPOの記事やDeepSeek-R1の記事で見たように、正解かどうかだけを報酬にする強化学習(RLVR)でも推論能力は伸びます。それでも、小さなモデルでは蒸留の方が強いと報告されているのはなぜでしょうか。
強化学習は「もともと出せる正解」を強化する
GRPO では、グループ内の応答の報酬がすべて同じだと学習信号が得られません(GRPOの記事の「グループ内の報酬がすべて同じ問題」を参照)。ある問題について、モデルが何度サンプリングしても正解を出せないなら、その問題からは学習できません。強化学習が強化できるのは、モデルがときどきでも出せる正解 です。
GRPOの記事で紹介した DeepSeekMath の「RL は maj@k を上げるが pass@k はあまり上げない」という結果も、この見方と一致します。さらに Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?(Yue et al., 2025)は、RLVR で学習したモデルは小さな の pass@k ではベースモデルを上回るものの、 を大きくするとベースモデルの pass@k が追いつき、逆転することもあると報告しています。強化学習は、ベースモデルが持っていた正解の出し方の中から、よく当たるものに確率を集める働きが大きい、という解釈です。同じ論文は、蒸留では、ベースモデルにはなかった推論の仕方を持ち込めることも示しています。
蒸留は外から新しい解き方を持ち込む
蒸留では、生徒が自分では生成できない推論過程でも、教師が生成したものを正解として直接学べます。探索に頼らないので、「一度も正解できない問題からは学べない」という強化学習の制約を受けません。
pass@k と maj@k(定義は Chain-of-Thoughtの記事)で整理すると、次のような違いが予想されます。
- 強化学習: pass@1 や maj@k は上がるが、pass@k(大きな で1本でも正解できるか)はあまり上がらない。
- 蒸留: 教師の解き方を学ぶので、pass@k も上がりうる。
- 蒸留 → 強化学習: 蒸留で出せるようになった解き方を、強化学習でさらに確実にする。R1 の論文も、蒸留したモデルにさらに強化学習を行うと性能が上がると述べています。
本記事の実験では、この予想が算数ワールドの小さなモデルでも成り立つかを確かめます。
強化学習と蒸留の違いを図にまとめます。
(図は、diagram-designで作成)
計算コストの違い
GRPO は、学習のたびに各問題で 本の応答を生成する必要があり、この生成が学習時間の大部分を占めます。SFT は、用意したデータで順伝播と逆伝播を行うだけなので、生徒の学習そのものはずっと軽く済みます。
ただし、蒸留には 教師の推論過程を生成するコスト がかかります。さらに、その教師を作るために大規模な強化学習が行われています。「蒸留の方が安い」と言えるのは、強い教師がすでに存在し、その出力を使える場合です。本記事の実験では、教師の生成にかかった時間も別に記録します。
教師データの作り方
正解した推論過程だけを残す
教師モデルも、ときどき計算を誤ったり、途中で推論が破綻したりします。誤った推論過程で SFT すると、生徒はその誤りも真似てしまいます。そこで、DeepSeek-R1の記事で扱った リジェクションサンプリング と同じく、教師の出力のうち 最終的な答えが正解で、形式が崩れていないもの だけを残します。
問題 x → 教師が生成 ─┬→ 候補1:思考過程を閉じて答え 42(正解)→ 採用
                     ├→ 候補2:思考過程を閉じて答え 35(不正解)→ 捨てる
                     └→ 候補3:生成長の上限で思考が途中で切れた → 捨てる
1問あたり何本を残すかも設計の選択です。Ho et al. のように、1問から複数の正しい推論過程を残すとデータが増え、解き方の多様性も学べます。本記事では、問題の多様性を優先して 1問1本 とします。
答えが正しくても、思考過程に誤りが含まれている可能性は残ります(たとえば、途中で間違えた計算が後で打ち消し合う場合)。答えの正誤だけのフィルタリングは、あくまで最低限の品質保証です。
データの量:少数の精選データ(s1)
R1 の蒸留では約80万件のデータを使いましたが、s1: Simple test-time scaling(Muennighoff et al., 2025)は、わずか1,000件 のデータでも推論能力を大きく引き出せることを示しました。
- 約5.9万件の問題から、難しさ・多様性・質の基準で1,000問を選び、Gemini の推論モデルが生成した思考過程と組み合わせたデータ(s1K)を作りました。
- このデータで Qwen2.5-32B-Instruct を SFT し、生成時に思考の長さを制御する方法(budget forcing)と組み合わせると、数学の競技問題で OpenAI の o1-preview を上回りました。
- 5.9万件すべてで学習しても、選び抜いた1,000件での学習と比べて性能はほとんど変わりませんでした。
s1 の結果は、データの件数よりも、どの問題と推論過程を選ぶかが重要 であることを示しています。ただし、s1 のベースモデルは 32B の指示追従モデルで、もともと高い能力を持っています。小さなモデルで同じように少数のデータで足りるかは別の問題なので、本記事では件数を変えて確かめます。
実装と比較実験
算数ワールドで、推論の蒸留と GRPO を比べます。
実験の設計
- 生徒モデル:
Qwen/Qwen2.5-1.5B(ベースモデル)。DeepSeek-R1の記事の追試と同じモデルと、同じ R1-Zero 形式のテンプレート・報酬を使います。 - 教師モデル:
deepseek-ai/DeepSeek-R1-Distill-Qwen-7B。R1 の出力で SFT された推論モデルで、長い思考過程を書いてから答えます。 - データ: 算数ワールドの学習用5,000問から教師に解かせる問題を選び、評価は Chain-of-Thought・GRPO・DeepSeek-R1 の記事と共通の500問で行います。
- 実行環境: 7B の教師を bf16 で動かすため、L4 や A100 などの GPU を想定しています。教師の生成に最も時間がかかるので、生成した結果は保存して再利用します。
比べる条件は次のとおりです。
| 条件 | 学習 | 目的 |
|---|---|---|
| (a) ベースモデル | なし | 比較の基準 |
| (b) 蒸留 | 教師の正しい推論過程(最大1,000件)で SFT | 外から解き方を持ち込む効果 |
| (c) GRPO のみ | ベースモデルから GRPO(600ステップ) | 自分で探索する効果 |
| (d) 蒸留 → GRPO | (b) から GRPO(600ステップ) | 蒸留と強化学習の組み合わせ |
| (e) 蒸留(100件) | 教師の正しい推論過程100件で SFT | データの量の影響(s1 の観点) |
| (f) 蒸留(フィルタなし) | 教師の推論過程1,000件(誤答を含む)で SFT | データの質(正解のみに絞る)の影響 |
評価では、ステップ数ごとの正解率、pass@1・maj@8・pass@8、形式の遵守率、生成長、思考の言語、学習にかかった時間を比べます。
6つの条件の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
実装は次の順に進みます。実装4以降は、実行結果が出たところでその場で考察します。
| 何をするか | そこで分かること | |
|---|---|---|
| 実装1〜2 | 算数ワールド・R1 形式のテンプレートと報酬の準備 | (準備) |
| 実装3 | 教師(7B の推論モデル)に1,500問を解かせる | (教師データの作成) |
| 実装4 | 教師の正解率・思考の長さ・言語の確認と、3種類の SFT データの作成 | 教師がどれだけ強く、どんな思考を書くか(=生徒の上限) |
| 実装5〜6 | 蒸留(SFT)と GRPO で、条件 (b)〜(f) を学習 | (学習) |
| 実装7 | 6条件を同じ500問で評価 | (評価結果の作成) |
| 実装8 | 全体の指標と学習時間の集計 | 蒸留と GRPO のどちらが強いか、データの質と量はどう効くか |
| 実装9 | ステップ数ごとの正解率 | 難易度が上がると条件ごとに何が起きるか |
ライブラリのインストールとGoogleドライブのマウント
!pip install --upgrade transformers accelerate peft datasets trl
!pip install matplotlib-fontja
!pip uninstall -y torchao
- ライブラリ: trl の SFTTrainer(蒸留)と GRPOTrainer(強化学習)、peft(LoRA)を使います。教師の生成を速くしたい場合は、vLLM などの推論ライブラリを使うこともできます(本記事では Transformers だけで実装します)。
- torchao の削除: 新しい peft は、環境に torchao があると、そのバージョンを確認して量子化関連の機能を読み込もうとします。Colab にあらかじめ入っている古い torchao だと、LoRA を付けるときに「互換性のないバージョン」というエラーになります。本記事は量子化を使わないので、あらかじめ削除しておきます(削除した後は、ランタイムを再起動してから以降のセルを実行してください)。
- matplotlib-fontja: matplotlib のグラフに日本語を表示するためのライブラリです。import matplotlib_fontja とするだけで、日本語フォントが設定されます。同じ目的の japanize_matplotlib は、Python 3.12 以降で削除された distutils を使っているため、新しい Colab ではそのままでは読み込めません。
import os
from google.colab import drive

drive.mount("/content/drive")

SAVE_ROOT = "/content/drive/MyDrive/reasoning_distillation"
os.makedirs(SAVE_ROOT, exist_ok=True)
- 保存先: 教師の生成結果、学習したモデル、評価結果、学習時間を SAVE_ROOT 以下に保存します。教師の生成と各条件の学習は時間がかかるので、セッションを分けて実行できるようにします。
実装1:算数ワールドと答えの抽出
Chain-of-Thoughtの記事と同じ算数ワールドの生成器と、評価用の抽出関数・指標です。設計の説明はそちらを参照してください。
import numpy as np

ITEMS = ["りんご", "みかん", "クッキー", "ノート", "シール", "えんぴつ"]
MAX_VALUE = 10_000
OP_SYMBOL = {"add": "+", "sub": "-", "mul": "×", "div": "÷"}

def sample_operation(rng, current):
    """現在の値に適用できる演算を1つ選ぶ(条件を満たさなければ選び直す=棄却サンプリング)"""
    while True:                              # 条件を満たす組み合わせが出るまで繰り返す
        # rng.choice は NumPy の文字列型で返るので、str() で Python の文字列に戻す
        op = str(rng.choice(["add", "sub", "mul", "div"]))
        if op in ("add", "sub"):
            val = int(rng.integers(2, 51))   # 2〜50
        elif op == "mul":
            val = int(rng.integers(2, 6))    # 2〜5倍
        else:
            val = int(rng.integers(2, 10))   # 2〜9等分

        if op == "add":
            new = current + val
        elif op == "sub":
            new = current - val
        elif op == "mul":
            new = current * val
        else:
            if current % val != 0:
                continue                     # 割り切れない除算は棄却
            new = current // val

        if 1 <= new <= MAX_VALUE:            # 中間結果は 1 以上 10,000 以下
            return op, val, new

def make_problem(rng, n_steps):
    """ステップ数 n_steps(=四則演算の回数)の算数文章題を1問生成する"""
    item = str(rng.choice(ITEMS))
    current = int(rng.integers(10, 51))
    story = [f"{item}が{current}個あります。"]
    steps = []
    for _ in range(n_steps):
        op, val, new = sample_operation(rng, current)
        if op == "add":
            story.append(f"{val}個もらいました。")
        elif op == "sub":
            story.append(f"{val}個使いました。")
        elif op == "mul":
            story.append(f"{item}の数が{val}倍になりました。")
        else:
            story.append(f"{val}等分して、そのうち1つ分だけを残しました。")
        steps.append(f"{current} {OP_SYMBOL[op]} {val} = {new}")
        current = new
    question = "".join(story) + f"いま{item}は何個ありますか。"
    gold_steps = "。".join(steps) + f"。答え: {current}"
    return {"question": question, "answer": current, "gold_steps": gold_steps, "n_steps": n_steps}

def make_dataset(n_per_step, seed, exclude=None):
    """ステップ数1〜5の問題を n_per_step 問ずつ生成する。exclude に含まれる問題文と重複は除外する"""
    rng = np.random.default_rng(seed)
    seen = set(exclude) if exclude else set()
    dataset = []
    for s in [1, 2, 3, 4, 5]:
        count = 0
        while count < n_per_step:
            prob = make_problem(rng, s)
            if prob["question"] in seen:
                continue
            seen.add(prob["question"])
            dataset.append(prob)
            count += 1
    return dataset


import re
import unicodedata
from collections import Counter
import numpy as np

def _last_integer(s):
    """文字列中の最後の整数を返す(引き算の式の「-」は符号として扱わない)"""
    # (?<!\d) は「直前が数字でない」という条件(否定後読み)。
    # これがないと「12-5」の「-5」を負の数として拾ってしまう
    nums = re.findall(r"(?<!\d)-?\d+", s)
    return int(nums[-1]) if nums else None

def extract_answer(text):
    """生成テキストから最終回答の整数を抽出する(抽出できなければ None)"""
    if not text:
        return None
    text = unicodedata.normalize("NFKC", text).replace(",", "")   # 全角→半角、カンマ除去

    # 1. <answer> タグ
    m = re.search(r"<answer>(.*?)</answer>", text, re.DOTALL)
    if m and _last_integer(m.group(1)) is not None:
        return _last_integer(m.group(1))

    # 2. 「答え:」の行(複数あれば最後の行)
    lines = re.findall(r"(?:答え|Answer)\s*[::]\s*([^\n]*)", text, re.IGNORECASE)
    for line in reversed(lines):
        if _last_integer(line) is not None:
            return _last_integer(line)

    # 3. テキスト中の最後の数値
    return _last_integer(text)

def pass_at_k(n, c, k):
    """Codex 論文の pass@k の不偏推定量:n 本中 c 本正解のとき、k 本に1本以上正解が含まれる確率"""
    if n - c < k:
        return 1.0                           # 不正解が k 本より少ない → 必ず正解が混ざる
    # 「k 本すべてが不正解」の確率を、1本ずつ引いていく積の形で計算する
    # (二項係数を直接計算すると値が大きくなりすぎるため)
    prob_all_wrong = 1.0
    for i in range(1, k + 1):
        prob_all_wrong *= (n - c - i + 1) / (n - i + 1)
    return 1.0 - prob_all_wrong

def majority_vote(preds):
    """None を除いた答えの最頻値(同数なら先に出た答え)"""
    valid = [p for p in preds if p is not None]
    if not valid:
        return None
    return Counter(valid).most_common(1)[0][0]

def maj_at_k(preds, target, k, n_perm=1000, seed=0):
    """n 本から k 本を無作為に選んで多数決をとったときの正解率(並べ替えを変えて平均する)"""
    rng = np.random.default_rng(seed)
    hits = 0
    for _ in range(n_perm):
        # n 本を並べ替えて先頭 k 本を取る=k 本の無作為な選び方を1通り作る
        subset = [preds[i] for i in rng.permutation(len(preds))[:k]]
        hits += majority_vote(subset) == target     # True は 1 として足される
    return hits / n_perm                            # 選び方を変えた平均が maj@k の推定値

eval_dataset = make_dataset(n_per_step=100, seed=2026)          # 評価用:CoT・GRPO・R1 の記事と共通の500問
eval_questions = {p["question"] for p in eval_dataset}         # 重複判定用の集合(set)
train_dataset = make_dataset(n_per_step=1000, seed=0, exclude=eval_questions)  # 学習用5,000問
print(f"評価用: {len(eval_dataset)} 問 / 学習用: {len(train_dataset)} 問")
- データ: 評価用は CoT・GRPO・DeepSeek-R1 の記事と共通の500問(seed=2026)、学習用は評価用と重複しない5,000問(seed=0)です。
- 指標: pass_at_k・majority_vote で、pass@8 と maj@8 を計算します。
実行結果
評価用: 500 問 / 学習用: 5000 問
実装2:R1形式のテンプレートと報酬
生徒のプロンプトと報酬は、DeepSeek-R1の記事と同じものを使います。
R1_ZERO_TEMPLATE = (
    "A conversation between User and Assistant. The user asks a question, and the Assistant solves it. "
    "The assistant first thinks about the reasoning process in the mind and then provides the user with the answer. "
    "The reasoning process and answer are enclosed within <think> </think> and <answer> </answer> tags, "
    "respectively, i.e., <think> reasoning process here </think> <answer> answer here </answer>. "
    "User: {question} Assistant: <think>"     # 末尾に <think> を置いて思考から書き始めさせる
)

def build_r1_zero_prompt(question):
    # format で {question} の部分を実際の問題文に差し替える
    return R1_ZERO_TEMPLATE.format(question=question)

import re
import unicodedata

CORRECT_REWARD = 1.0
FORMAT_REWARD = 0.2
LANG_REWARD = 0.2

THINK_ANSWER = re.compile(r"^(.*?)</think>\s*<answer>(.*?)</answer>\s*$", re.DOTALL)
TAGS = ["<think>", "</think>", "<answer>", "</answer>"]
KANA = re.compile(r"[\u3040-\u30ff]")      # ひらがな・カタカナ
HAN = re.compile(r"[\u4e00-\u9fff]")       # 漢字(日本語と中国語で共通)
LATIN = re.compile(r"[A-Za-z]")

def parse_r1_output(completion):
    """プリフィルした <think> に続く生成を、思考と回答に分ける。形式が崩れていれば None"""
    text = completion.lstrip()
    if text.startswith("<think>"):
        text = text[len("<think>"):]               # モデルが <think> を重ねて書いた場合は取り除く
    m = THINK_ANSWER.match(text)
    if m is None:
        return None                                # 形式違反(タグが閉じない、後ろに続きがある など)
    think, answer = m.group(1), m.group(2)         # 丸かっこの1つ目が思考、2つ目が答え
    if any(tag in think or tag in answer for tag in TAGS):
        return None                                # タグが2組以上ある
    return think, answer

def extract_tag_answer(answer_part):
    """<answer> の中に整数がちょうど1つあるときだけ、その整数を返す"""
    text = unicodedata.normalize("NFKC", answer_part).replace(",", "")   # 全角→半角、カンマ除去
    # (?<!\d) は「直前が数字でない」条件(否定後読み)。「12-5」の「-5」を負の数として拾わないため
    nums = re.findall(r"(?<!\d)-?\d+", text)
    return int(nums[0]) if len(nums) == 1 else None   # 2つ以上あればハッキングとみなして None

def sentence_languages(text):
    """思考を文に分け、各文を ja(かなを含む)/ zh(漢字のみ)/ en(ラテン文字のみ)に分類して数える"""
    counts = {"ja": 0, "zh": 0, "en": 0}
    # 句点・ピリオド・感嘆符・改行のいずれかで区切って文に分ける
    for sent in re.split(r"[。..!?!?\n]+", unicodedata.normalize("NFKC", text)):
        # 判定の順番が重要:かなを先に見ることで、漢字かな交じりの文を日本語と判定できる
        if KANA.search(sent):
            counts["ja"] += 1
        elif HAN.search(sent):
            counts["zh"] += 1
        elif LATIN.search(sent):
            counts["en"] += 1                      # 数式だけの文はどれにも数えない
    return counts

def japanese_ratio(think):
    counts = sentence_languages(think)
    total = sum(counts.values())
    # 文が1つもない(数式だけの思考)場合は 0 を返す
    return counts["ja"] / total if total > 0 else 0.0

def r1_reward(completion, target, use_lang_reward=True):
    """形式報酬 0.2 + 正解報酬 1.0 + 言語一貫性報酬(最大 0.2)"""
    parsed = parse_r1_output(completion)
    if parsed is None:
        return 0.0                                 # 形式違反は報酬0(他の報酬も与えない)
    think, answer = parsed
    reward = FORMAT_REWARD                         # ここまで来たら形式は守っている
    if extract_tag_answer(answer) == target:
        reward += CORRECT_REWARD
    if use_lang_reward:
        reward += LANG_REWARD * japanese_ratio(think)   # 日本語の文の割合に比例(0〜0.2)
    return reward
- テンプレート: build_r1_zero_prompt は R1-Zero 形式のプロンプトを作り、末尾に <think> を置きます。蒸留のデータも GRPO の生成も、この続きとして書かれます。
- 厳しい形式の判定: parse_r1_output は、「思考 → </think> → <answer>答え</answer>」の形で、その後に何も続かない出力だけを受け付けます。extract_tag_answer は、<answer> の中の整数がちょうど1つのときだけ答えを返します。
- 正規表現の読み方: THINK_ANSWER の ^ と $ は文字列の先頭と末尾で、全体がこの形に一致することを要求します。末尾が </answer>\s*$ なので、「</answer> の後ろは空白か改行だけ」という条件になります。(.*?) の ? は最短一致、re.DOTALL は . を改行にも一致させる指定です(思考は複数行にわたるため必要です)。詳しくは DeepSeek-R1の記事の実装3を参照してください。
- 報酬: r1_reward は形式報酬 0.2 と正解報酬 1.0 の和です。本記事では言語一貫性報酬は使いません(use_lang_reward=False)。
- 思考の言語: sentence_languages は、思考を文に分けて日本語・中国語・英語の文を数えます。教師の思考の言語が生徒にどう写るかを調べるために使います。かな → 漢字 → ラテン文字の順に判定するのは、漢字かな交じりの日本語の文を中国語と誤判定しないためです。数式だけの文はどの言語にも数えないので、思考が式だけになると割合が計算できず NaN になります。
実装3:教師の推論過程の生成
教師モデルに学習用の問題を解かせ、思考過程と答えを保存します。まず、教師の出力を生徒の R1 形式に変換する関数を用意します。
import json
import re
import time
import unicodedata
import numpy as np
import pandas as pd
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed

SEED = 42
TEACHER_ID = "deepseek-ai/DeepSeek-R1-Distill-Qwen-7B"
STUDENT_ID = "Qwen/Qwen2.5-1.5B"
TEACHER_INSTRUCTION = "\n最後に、答えの整数を \\boxed{} の中に書いてください。"
# \boxed{...} の中身を取り出す正規表現。\\ は「バックスラッシュ1文字」、
# \{ \} は波かっこそのもの、[^{}]* は「波かっこ以外の文字の並び」
BOXED = re.compile(r"\\boxed\{([^{}]*)\}")
MAX_THINK_TOKENS = 900      # 生徒の生成長の上限(1,024)に答えの部分を足しても収まる長さ

student_tokenizer = AutoTokenizer.from_pretrained(STUDENT_ID)

def split_teacher_output(text):
    """教師の出力を思考と答えに分ける。思考が閉じていない(途中で切れた)ときは None"""
    if "</think>" not in text:
        return None                              # 上限に達して思考の途中で切れた出力
    think, rest = text.split("</think>", 1)      # 第2引数の 1 は「最初の1回だけで分割する」
    think = think.replace("<think>", "").strip()
    # 答えは </think> より後ろにある。\boxed{} が複数あれば最後のものを使う
    boxed = BOXED.findall(unicodedata.normalize("NFKC", rest).replace(",", ""))
    answer = _last_integer(boxed[-1]) if boxed else None
    return think, answer

def to_r1_completion(think, answer):
    """教師の思考と答えを、生徒の R1 形式(プロンプト末尾の <think> の続き)に書き換える"""
    # 先頭の改行は、プロンプトが <think> で終わっていてその直後に続くため
    return f"\n{think}\n</think>\n<answer>{answer}</answer>"

def log_time(name, seconds):
    """学習・生成にかかった時間(秒)を記録する。中断して再開した場合は足し合わせる"""
    path = f"{SAVE_ROOT}/timing.json"
    times = json.load(open(path)) if os.path.exists(path) else {}   # 既存の記録を読む
    times[name] = times.get(name, 0.0) + seconds                    # 無ければ0から足す
    with open(path, "w") as f:
        json.dump(times, f)
- 教師の出力形式: DeepSeek-R1-Distill 系のモデルは、チャットテンプレートで質問を渡すと、思考を書いて </think> で閉じ、その後に答えを書きます。DeepSeek-AI の推奨に従い、答えを
\boxed{}の中に書くよう質問の末尾で指示します。 - 形式の変換: split_teacher_output は、</think> の前を思考、後ろの最後の
\boxed{}の中の整数を答えとして取り出します。to_r1_completion で、それを生徒の R1 形式(思考 → </think> → <answer>答え</answer>)に書き換えます。教師と生徒で出力の形式が違っても、中身(思考過程と答え)だけを受け渡せます。 splitの第2引数: text.split("</think>", 1) の 1 は「最初の1回だけで分割する」という指定です。思考の中に </think> が現れた場合でも、前半を思考、残り全部を答えの部分として扱えます。- 時間の記録: log_time は、経過時間を JSON に足し込んでいきます。times.get(name, 0.0) は「記録があればその値、なければ0」という書き方で、中断して再開したときに時間を通算できます。教師の生成にかかる時間は蒸留の実質的なコストなので、後で GRPO の学習時間と比べます。
- 思考の長さの上限: 生徒は最大1,024トークンまで生成する設定にするので、それを超える推論過程を学ぶと、評価時に途中で切れてしまいます。MAX_THINK_TOKENS を超える思考は、後で学習データから除きます。長さは生徒のトークナイザーで数えます。
- 時間の記録: log_time で、教師の生成・SFT・GRPO にかかった時間を記録し、最後に比較します。
変換の動作を確認します。
sample = "<think>\nまず 28 + 14 = 42 です。次に 42 × 3 = 126 です。\n</think>\n\n答えは $\\boxed{126}$ です。"
think, answer = split_teacher_output(sample)
completion = to_r1_completion(think, answer)
print("思考:", think.replace("\n", " / "))
print("答え:", answer)
print("生徒の形式での報酬:", r1_reward(completion, 126, use_lang_reward=False))
print("途中で切れた出力:", split_teacher_output("<think>\nまず 28 + 14 = 42"))
- テストの内容: 教師の出力を模した文字列を変換し、生徒の R1 形式にしたものが r1_reward で満点(形式 0.2 + 正解 1.0)になることを確かめます。また、思考が閉じていない出力は None(使えない)になることを確認します。
実行結果
思考: まず 28 + 14 = 42 です。次に 42 × 3 = 126 です。
答え: 126
生徒の形式での報酬: 1.2
途中で切れた出力: None
続いて、教師に学習用の問題を解かせます。
N_TEACHER = 1500            # 教師に解かせる問題数
TEACHER_BATCH = 16
teacher_path = f"{SAVE_ROOT}/teacher_records.json"

teacher_tokenizer = AutoTokenizer.from_pretrained(TEACHER_ID)
teacher_tokenizer.padding_side = "left"
if teacher_tokenizer.pad_token is None:
    teacher_tokenizer.pad_token = teacher_tokenizer.eos_token
teacher = AutoModelForCausalLM.from_pretrained(TEACHER_ID, torch_dtype=torch.bfloat16).to("cuda")
teacher.eval()

rng = np.random.default_rng(SEED)
# 学習用データはステップ数の順に並んでいるので、並べ替えてから先頭 N_TEACHER 問を取る
teacher_problems = [train_dataset[i] for i in rng.permutation(len(train_dataset))[:N_TEACHER]]

def build_teacher_prompt(question):
    """教師(チャット形式のモデル)用に、質問+答えの書き方の指示を1往復の会話にする"""
    messages = [{"role": "user", "content": question + TEACHER_INSTRUCTION}]
    return teacher_tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)

records = json.load(open(teacher_path, encoding="utf-8")) if os.path.exists(teacher_path) else []
# 保存済みの件数から始めることで、中断しても続きから生成できる
for b in range(len(records), N_TEACHER, TEACHER_BATCH):
    start = time.time()
    batch = teacher_problems[b:b + TEACHER_BATCH]
    enc = teacher_tokenizer([build_teacher_prompt(p["question"]) for p in batch], return_tensors="pt",
                            padding=True, add_special_tokens=False).to("cuda")
    with torch.no_grad():
        out = teacher.generate(**enc, max_new_tokens=2048, do_sample=True, temperature=0.6, top_p=0.95,
                               pad_token_id=teacher_tokenizer.pad_token_id)
    for p, ids in zip(batch, out[:, enc["input_ids"].shape[1]:]):
        text = teacher_tokenizer.decode(ids, skip_special_tokens=False)
        for tok in {teacher_tokenizer.eos_token, teacher_tokenizer.pad_token}:
            text = text.replace(tok, "")              # 終了・パディングのトークンだけを取り除く
        parsed = split_teacher_output(text)
        think, pred = parsed if parsed else (None, None)   # 失敗時は2つとも None にする
        # {**p, ...} は、問題の辞書をそのまま展開して結果の列を足す書き方。
        # 思考の長さは「生徒のトークナイザー」で測る(生徒の生成長の上限と比べるため)
        records.append({**p, "think": think, "teacher_pred": pred, "closed": parsed is not None,
                        "correct": pred == p["answer"],
                        "think_tokens": len(student_tokenizer(think)["input_ids"]) if think else None})
    with open(teacher_path, "w", encoding="utf-8") as f:
        json.dump(records, f, ensure_ascii=False)
    log_time("teacher_generation", time.time() - start)

del teacher
torch.cuda.empty_cache()
- 問題の選び方: 学習用データはステップ数の順に並んでいるので、rng.permutation で並べ替えてから先頭の1,500問を使います。ステップ数1〜5の問題がほぼ均等に含まれます。
- 生成の設定: DeepSeek-AI が R1-Distill 系のモデルに推奨している温度 0.6・top_p=0.95 でサンプリングします。思考が長くなることがあるので、max_new_tokens は 2,048 にしています。
- チャットテンプレート: apply_chat_template で作ったプロンプトには開始トークンが含まれているので、トークナイズ時に add_special_tokens=False にして二重に付かないようにします。
- デコードの注意: <think> と </think> がトークナイザーの特殊トークンとして登録されていると、skip_special_tokens=True でデコードしたときに消えてしまい、思考と答えを分けられなくなります。そこで特殊トークンを残したままデコードし、終了とパディングのトークンだけを取り除きます。for tok in {...} が集合になっているのは、終了トークンとパディングトークンが同じ文字列のことがあり、その場合に2回置換しないためです。
- 記録の作り方: {**p, "think": think, ...} は、問題の辞書 p の中身をそのまま展開して、そこに結果の列を足す書き方です。問題文・正解・ステップ数と、教師の出力を1つの辞書にまとめられます。思考の長さを 生徒の トークナイザーで測っているのは、生徒の生成長の上限(MAX_THINK_TOKENS)と比べるためです。
- 記録する内容: 問題ごとに、思考、教師の答え、思考が閉じたか、正解か、思考の長さ(生徒のトークン数)を保存します。フィルタの条件を後から変えて試せるよう、誤答や途中で切れた出力も捨てずに記録 します。
- 再開できる設計: バッチごとに JSON に保存し、再実行時は続きから生成します。
実装4:教師データの確認と学習データの作成
教師の正解率や思考の長さ・言語を確認し、3種類の SFT データを作ります。
records = json.load(open(teacher_path, encoding="utf-8"))
df_t = pd.DataFrame(records)                    # 集計しやすいように表にする
# 使える記録:思考が閉じている・答えが取り出せた・生徒の生成長の上限に収まる
usable = [r for r in records if r["closed"] and r["teacher_pred"] is not None
          and r["think_tokens"] <= MAX_THINK_TOKENS]
usable_correct = [r for r in usable if r["correct"]]   # さらに正解だけに絞ったもの

print(f"教師が解いた問題: {len(records)} 問")
print(f"思考が閉じた割合: {df_t['closed'].mean():.3f} / 正解率: {df_t['correct'].mean():.3f}")
print(f"長さの条件を満たす: {len(usable)} 件(うち正解 {len(usable_correct)} 件)")
print("ステップ数ごとの教師の正解率:")
print(df_t.groupby("n_steps")["correct"].mean().round(3))
print("思考の長さ(生徒のトークン数):")
print(df_t["think_tokens"].describe().round(1))
# 記録ごとの言語の内訳(辞書)を表にして列ごとに合計し、割合に直す
lang_counts = pd.DataFrame([sentence_languages(r["think"]) for r in usable]).sum()
print("思考の文の言語の内訳:", (lang_counts / lang_counts.sum()).round(3).to_dict())

# 3種類の SFT データ((記録, 学習に使う答え) の組)
sft_sets = {
    # 正解した記録だけ。「学習に使う答え」は正解(r["answer"])
    "distill_1000": [(r, r["answer"]) for r in usable_correct[:1000]],
    "distill_100": [(r, r["answer"]) for r in usable_correct[:100]],     # その先頭100件
    # 正誤を問わない記録。答えは「教師が出した答え」なので、誤りもそのまま学ばせる
    "unfiltered_1000": [(r, r["teacher_pred"]) for r in usable[:1000]],
}
for name, pairs in sft_sets.items():
    wrong = np.mean([r["teacher_pred"] != r["answer"] for r, _ in pairs])   # 誤答の割合
    print(f"{name}: {len(pairs)} 件(教師の誤答の割合 {wrong:.3f})")
【教師の確認】
- 教師の正解率: 教師がどれくらい正しく解けるか、ステップ数が増えると下がるかを確認します。教師が解けない難易度の問題は、蒸留でも生徒に教えられません。
- 思考の長さ: describe() で思考の長さの分布を見ます。MAX_THINK_TOKENS を超えて除かれる割合が大きい場合、学習データが「教師の短い思考」に偏る点に注意が必要です。
- 思考の言語: DeepSeek-R1-Distill 系のモデルは、日本語の質問にも英語や中国語で考えることがあります。教師の思考の言語は、そのまま生徒に写ります。
【3種類のデータ】
- distill_1000: 正解した推論過程1,000件。本記事の基本の蒸留データです。
- distill_100: その先頭100件。データの量の影響を見ます。
- unfiltered_1000: 正誤を問わない推論過程1,000件。学習に使う答えは 教師の答え(誤りを含む)です。正解だけに絞ることの効果を見ます。思考が途中で切れたものは、答えがないので R1 形式にできず、こちらからも除いています。
- 組(タプル)で持つ理由: sft_sets の各要素が (記録, 学習に使う答え) の組になっているのは、3つのデータで 答えの出どころが違う ためです。distill_* は正解(r["answer"])、unfiltered_1000 は教師の答え(r["teacher_pred"])を使います。思考は同じ記録から取るので、変わるのは <answer> に書く数字だけです。
- 件数が足りない場合: 正解した推論過程が1,000件に満たない場合は、N_TEACHER を増やして実装3を再実行すると、続きから生成されます。
実行結果
教師が解いた問題: 1500 問
思考が閉じた割合: 0.939 / 正解率: 0.364
長さの条件を満たす: 1362 件(うち正解 546 件)
ステップ数ごとの教師の正解率:
n_steps
1    0.726
2    0.405
3    0.290
4    0.236
5    0.184
Name: correct, dtype: float64
思考の長さ(生徒のトークン数):
count    1408.0
mean      134.9
std       121.1
min        24.0
25%        82.0
50%       113.0
75%       150.0
max      1966.0
Name: think_tokens, dtype: float64
思考の文の言語の内訳: {'ja': 0.905, 'zh': 0.053, 'en': 0.042}
distill_1000: 546 件(教師の誤答の割合 0.000)
distill_100: 100 件(教師の誤答の割合 0.000)
unfiltered_1000: 1000 件(教師の誤答の割合 0.610)
考察:教師データの質(=蒸留の上限)
教師(DeepSeek-R1-Distill-Qwen-7B)の1,500問に対する結果は、次のとおりでした。
- 思考が閉じた割合: 0.939(残りは2,048トークンの上限で途中のまま切れたもの)
- 正解率: 0.364(ステップ数1で 0.726、ステップ数5で 0.184)
- 思考の長さ: 中央値113トークン、平均134.9トークン、最大1,966トークン
- 思考の言語: 日本語 0.905、中国語 0.053、英語 0.042
正解率が 0.364 と低かったため、条件 (b) に使える「正解した推論過程」は546件にとどまり、目標の1,000件には届きませんでした(コード上の名前は distill_1000 のままです)。7B の推論モデルでも、日本語の多段階の算数の文章題は簡単ではなかったことになります。教師の生成を増やすか、より強い教師を使えば、蒸留の条件の結果は変わる可能性があります。
思考の言語は9割が日本語で、中国語と英語も1割弱混ざっていました。後で見るように、蒸留した生徒の日本語の文の割合は 0.950 になります。この教師の性質を受け継いだものです。
教師データの絞り込みと、3種類の SFT データを図にすると、次のようになります。
(図は、diagram-designで作成)
実装5:蒸留(SFT)
3種類のデータで、生徒モデルをそれぞれ SFT します。SFT の仕組み(プロンプト部分を損失から除くなど)は Instruction Tuningの記事 を参照してください。
from datasets import Dataset
from peft import LoraConfig
from trl import SFTConfig, SFTTrainer

def lora_config():
    """LoRA の設定。毎回同じ設定を使うので、関数にして呼び出すたびに新しく作る"""
    return LoraConfig(r=16, lora_alpha=32, lora_dropout=0.0, bias="none", task_type="CAUSAL_LM",
                      target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"])

def train_sft(name, pairs):
    """(記録, 学習に使う答え) の組から SFT を行い、統合したモデルの保存先を返す"""
    merged_dir = f"{SAVE_ROOT}/{name}/merged"
    if os.path.exists(merged_dir):
        return merged_dir                     # 学習済みならスキップする
    set_seed(SEED)
    # 教師の思考と「学習に使う答え」を組み合わせて、生徒の R1 形式の応答にする
    data = Dataset.from_list([{"prompt": build_r1_zero_prompt(r["question"]),
                               "completion": to_r1_completion(r["think"], ans)} for r, ans in pairs])
    model = AutoModelForCausalLM.from_pretrained(STUDENT_ID, torch_dtype=torch.bfloat16)
    trainer = SFTTrainer(
        model=model,
        args=SFTConfig(
            output_dir=f"{SAVE_ROOT}/{name}",
            learning_rate=1e-4,
            num_train_epochs=2,
            per_device_train_batch_size=4,
            gradient_accumulation_steps=4,
            max_length=1280,
            completion_only_loss=True,
            gradient_checkpointing=True,
            bf16=True,
            logging_steps=10,
            save_strategy="no",
            seed=SEED,
            report_to="none",
        ),
        train_dataset=data,
        processing_class=student_tokenizer,
        peft_config=lora_config(),
    )
    # トークナイズ済みの1件目の最後のトークンが EOS かを確かめる
    print("学習データの末尾が EOS か:", trainer.train_dataset[0]["input_ids"][-1] == student_tokenizer.eos_token_id)
    start = time.time()
    trainer.train()
    log_time(name, time.time() - start)       # 蒸留と GRPO の計算コストを比べるために記録する
    pd.DataFrame(trainer.state.log_history).to_csv(f"{SAVE_ROOT}/{name}/log_history.csv", index=False)
    # LoRA の差分を元の重みに足し込み、LoRA の付いていないモデルとして保存する
    trainer.model.merge_and_unload().save_pretrained(merged_dir)
    student_tokenizer.save_pretrained(merged_dir)   # 読み込み時に必要なので一緒に保存する
    del model, trainer
    torch.cuda.empty_cache()
    return merged_dir

# 3種類のデータそれぞれで SFT し、条件名 → モデルの保存先の辞書にする
SFT_DIRS = {name: train_sft(name, pairs) for name, pairs in sft_sets.items()}
- データの形式: prompt は生徒の R1-Zero 形式のプロンプト、completion は教師の思考と答えを R1 形式にしたものです。completion_only_loss=True で、応答部分だけを損失の対象にします。この応答の負の対数尤度を最小化することが、系列レベルの蒸留そのものです。
- EOS の確認: 答えの後で生成を止めることを学ばせるため、応答の末尾に EOS が付いている必要があります。TRL は応答の末尾に EOS を付けますが、バージョンによって挙動が異なるので確認します。False の場合は、completion の末尾に EOS トークンを足してください。
- ハイパーパラメータ: 3種類のデータで同じ設定(2エポック、学習率 1e-4)を使います。そのため、100件のデータでは更新回数が1,000件の10分の1になります。「同じエポック数での比較」である点に注意してください。
- 条件ごとに変わるステップ数: max_steps を指定していないので、総ステップ数は「件数 ÷ バッチサイズ ÷ 勾配累積数 × エポック数」で自動的に決まります。per_device_train_batch_size=4・gradient_accumulation_steps=4・2エポックなので、条件ごとに次のようになります(端数も1ステップとして数えられます)。
| 条件 | 件数 | バッチ数 | 更新ステップ/エポック | 総ステップ数 | ログの最後 |
|---|---|---|---|---|---|
| distill_1000 | 546 | 70 | 70 | ||
| distill_100 | 100 | 14 | 10 | ||
| unfiltered_1000 | 1,000 | 126 | 120 |
下の実行結果で3つのログの長さが違うのはこのためです。logging_steps=10 により10の倍数しかログに出ないので、最後の数ステップは表示されません(distill_100 は step 10 の1行だけですが、実際には14ステップ走っています)。実際の値は trainer.state.max_steps で確認できます。なお、端数の扱いは Transformers のバージョンによって変わることがあり、古い版では端数を切り捨てるためステップ数が少し小さくなります。
- 統合して保存: LoRA を重みに統合して保存します(merge_and_unload())。LoRA は「元の重み + 低ランクの差分」という形なので、差分を足し込めば LoRA の付いていない普通のモデルになります。(d) の GRPO では、このモデルに新しい LoRA を付けて学習するので、参照モデルは蒸留後のモデルになります。
- 辞書内包表記でまとめて学習: SFT_DIRS = {name: train_sft(name, pairs) for name, pairs in sft_sets.items()} は、3種類のデータを順に学習して「条件名 → 保存先」の辞書を作ります。train_sft は学習済みならスキップして保存先だけを返すので、途中で中断しても同じ行を再実行できます。
- 再開できる設計: 統合済みのモデルが既にあれば学習をスキップします。学習ログは CSV に保存するので、セッションが切れても後から損失の推移を取り出せます。
実行結果
学習データの末尾が EOS か: True
Step	Training Loss
10	0.888519
20	0.673533
30	0.624578
40	0.564414
50	0.534927
60	0.503761
70	0.484712
学習データの末尾が EOS か: True
Step	Training Loss
10	0.878288
学習データの末尾が EOS か: True
Step	Training Loss
10	0.908260
20	0.843216
30	0.689784
40	0.681439
50	0.637103
60	0.593532
70	0.615574
80	0.531283
90	0.566954
100	0.531353
110	0.498012
120	0.540225
実装6:GRPO
ベースモデルからの GRPO(条件 c)と、蒸留後のモデルからの GRPO(条件 d)を、同じ設定で学習します。GRPO の仕組みは GRPOの記事、設定の意味は DeepSeek-R1の記事 を参照してください。
from trl import GRPOConfig, GRPOTrainer

grpo_train = Dataset.from_list(
    [{"prompt": build_r1_zero_prompt(p["question"]), "answer": p["answer"]} for p in train_dataset])

def reward_fn(completions, answer, **kwargs):
    # 引数名 answer をデータセットの列名と一致させると、TRL がその列を渡してくれる。
    # **kwargs は、TRL が渡す他の引数を受け取って無視するための書き方
    return [r1_reward(c, a, use_lang_reward=False) for c, a in zip(completions, answer)]

def train_grpo(name, init_model):
    """init_model から GRPO を行い、学習した LoRA アダプターの保存先を返す"""
    final_dir = f"{SAVE_ROOT}/{name}/final"
    if os.path.exists(final_dir):
        return final_dir                      # 学習済みならスキップする
    set_seed(SEED)
    tokenizer = AutoTokenizer.from_pretrained(STUDENT_ID)
    tokenizer.padding_side = "left"           # 生成時は左側にパディングする
    trainer = GRPOTrainer(
        model=AutoModelForCausalLM.from_pretrained(init_model, torch_dtype=torch.bfloat16),
        reward_funcs=reward_fn,
        args=GRPOConfig(
            output_dir=f"{SAVE_ROOT}/{name}",
            learning_rate=2e-5,
            lr_scheduler_type="constant",       # TRL の既定(線形減衰)ではなく、一定にする
            per_device_train_batch_size=16,     # 応答の数(2問 × G=8)
            gradient_accumulation_steps=2,
            num_generations=8,
            max_completion_length=1024,
            temperature=1.0, top_p=1.0, top_k=0, repetition_penalty=1.0,
            beta=0.001, epsilon=0.2, num_iterations=1,
            loss_type="grpo", scale_rewards=True,
            max_steps=600,
            logging_steps=10,
            save_strategy="no",
            gradient_checkpointing=True,
            bf16=True,
            seed=SEED,
            report_to="none",
        ),
        train_dataset=grpo_train,
        processing_class=tokenizer,
        peft_config=lora_config(),
    )
    start = time.time()
    trainer.train()
    log_time(name, time.time() - start)
    pd.DataFrame(trainer.state.log_history).to_csv(f"{SAVE_ROOT}/{name}/log_history.csv", index=False)
    trainer.save_model(final_dir)
    del trainer
    torch.cuda.empty_cache()
    return final_dir

GRPO_DIRS = {
    "grpo_only": train_grpo("grpo_only", STUDENT_ID),                      # (c) ベースモデルから
    "distill_grpo": train_grpo("distill_grpo", SFT_DIRS["distill_1000"]),  # (d) 蒸留後のモデルから
}
- 学習率のスケジュール: Transformers の Trainer(TRL を含む)の既定は線形減衰です。学習の後半ほど学習率が小さくなるので、lr_scheduler_type="constant" で一定にします(GRPOの記事と同じ設定です)。
- 学習ログの保存: 報酬や KL の推移を後から見られるように、学習ログを CSV に保存します。
- 2つの条件の違い: init_model だけが違い、報酬・ハイパーパラメータ・ステップ数は同じです。(c) はベースモデルから、(d) は distill_1000 を統合したモデルから始めます。
- 参照モデル: どちらも、学習を始めたモデルに新しい LoRA を付けて学習するので、参照モデル(LoRA を外した状態)は (c) ではベースモデル、(d) では蒸留後のモデルになります。蒸留の LoRA をそのまま GRPO で学習し続けると、参照モデルがベースモデルになり、KL の項が蒸留前の状態に引き戻そうとしてしまうので、統合してから新しい LoRA を付けています。
- 生成長: 蒸留した生徒は教師の長い思考を真似るので、max_completion_length を DeepSeek-R1の記事(512)より長い 1,024 にしています。公平に比べるため、(c) も同じ長さにしています。
- 報酬: 形式報酬と正解報酬だけで、言語一貫性報酬は使いません。
- 学習時間: log_time で、各条件の学習時間を記録します。
実行結果
Step	Training Loss
10	0.000005
20	0.000044
30	0.000085
40	0.000165
50	0.000231
60	0.000227
70	0.000239
80	0.000286
90	0.000622
100	0.000222
110	0.000255
120	0.000204
130	0.000262
140	0.000198
150	0.000240
160	0.000319
170	0.000235
180	0.000329
190	0.000245
200	0.000260
210	0.000213
220	0.000202
230	0.000173
240	0.000288
250	0.000211
260	0.000200
270	0.000192
280	0.000196
290	0.000187
300	0.000185
310	0.000181
320	0.000183
330	0.000193
340	0.000214
350	0.000189
360	0.000197
370	0.000290
380	0.000171
390	0.000177
400	0.000195
410	0.000177
420	0.000180
430	0.000186
440	0.000175
450	0.000191
460	0.000196
470	0.000195
480	0.000174
490	0.000190
500	0.000185
510	0.000197
520	0.000189
530	0.000205
540	0.000196
550	0.000284
560	0.000188
570	0.000187
580	0.000431
590	0.000199
600	0.000346
Step	Training Loss
10	0.000001
20	0.000003
30	0.000008
40	0.000018
50	0.000031
60	0.000044
70	0.000084
80	0.000150
90	0.000185
100	0.000216
110	0.000211
120	0.000226
130	0.000249
140	0.000246
150	0.000245
160	0.000267
170	0.000247
180	0.000256
190	0.000219
200	0.000192
210	0.000221
220	0.000218
230	0.000264
240	0.000202
250	0.000187
260	0.000180
270	0.000211
280	0.000228
290	0.000184
300	0.000184
310	0.000172
320	0.000409
330	0.000213
340	0.000220
350	0.000647
360	0.000201
370	0.000223
380	0.000173
390	0.000219
400	0.000195
410	0.000164
420	0.000177
430	0.000179
440	0.000184
450	0.000186
460	0.000177
470	0.000171
480	0.000200
490	0.000180
500	0.000181
510	0.000246
520	0.000296
530	0.000244
540	0.000175
550	0.000177
560	0.000387
570	0.000192
580	0.000197
590	0.000200
600	0.000229
実装7:評価
6つの条件を、評価用500問で評価します。
from peft import PeftModel

EVAL_MODELS = {                       # 条件名: (学習開始時のモデル, GRPO の LoRA アダプター)
    "base": (STUDENT_ID, None),
    "distill_1000": (SFT_DIRS["distill_1000"], None),
    "distill_100": (SFT_DIRS["distill_100"], None),
    "unfiltered_1000": (SFT_DIRS["unfiltered_1000"], None),
    "grpo_only": (STUDENT_ID, GRPO_DIRS["grpo_only"]),
    "distill_grpo": (SFT_DIRS["distill_1000"], GRPO_DIRS["distill_grpo"]),
}
N_SAMPLES = 8
EVAL_MAX_NEW_TOKENS = 1024
# maj@8・pass@8 まで測る条件(データの質と量の比較は pass@1 と形式だけでよい)
SAMPLED_CONDITIONS = ["base", "distill_1000", "grpo_only", "distill_grpo"]

def lenient_answer(text):
    """最初の </answer> までを切り出し、共通の extract_answer で答えを取り出す(形式が崩れていても答えを見る)"""
    head = text.split("</answer>")[0] + "</answer>" if "</answer>" in text else text
    return extract_answer(head)

@torch.no_grad()       # 評価に勾配は不要なので、計算グラフを作らずメモリを節約する
def evaluate_student(model, tokenizer, data, batch_size=16, n_samples=N_SAMPLES):
    """貪欲探索で1本、n_samples が正なら温度付きサンプリングでその本数も生成して採点する"""
    model.eval()                              # ドロップアウトなどを評価用の動作にする
    rows = []
    for b in range(0, len(data), batch_size):
        batch = data[b:b + batch_size]
        enc = tokenizer([build_r1_zero_prompt(p["question"]) for p in batch],
                        return_tensors="pt", padding=True).to(model.device)
        # 2回の generate で共通の設定を dict にまとめ、** で展開して渡す
        common = dict(max_new_tokens=EVAL_MAX_NEW_TOKENS, pad_token_id=tokenizer.pad_token_id, repetition_penalty=1.0)
        greedy = model.generate(**enc, do_sample=False, **common)      # pass@1 用の1本
        n_prompt = enc["input_ids"].shape[1]
        # [:, n_prompt:] で、プロンプトの後ろ=生成した部分だけを取り出してから文字列に戻す
        g_texts = tokenizer.batch_decode(greedy[:, n_prompt:], skip_special_tokens=True)
        s_texts = []
        if n_samples > 0:
            # maj@8・pass@8 用に、同じプロンプトから n_samples 本をサンプリングする
            sampled = model.generate(**enc, do_sample=True, temperature=0.7, top_p=1.0, top_k=0,
                                     num_return_sequences=n_samples, **common)
            s_texts = tokenizer.batch_decode(sampled[:, n_prompt:], skip_special_tokens=True)
        for j, p in enumerate(batch):
            parsed = parse_r1_output(g_texts[j])
            langs = sentence_languages(parsed[0] if parsed else g_texts[j].split("</think>")[0])
            n_sent = sum(langs.values())
            row = {
                "n_steps": p["n_steps"],
                "pass@1": parsed is not None and extract_tag_answer(parsed[1]) == p["answer"],
                "pass@1_lenient": lenient_answer(g_texts[j]) == p["answer"],
                "format": parsed is not None,
                "length": len(tokenizer(g_texts[j])["input_ids"]),
                "ja_ratio": langs["ja"] / n_sent if n_sent else float("nan"),
            }
            if n_samples > 0:
                # s_texts は「問題ごとに n_samples 本が連続」の順なので、問題 j の分を切り出す
                group = s_texts[j * n_samples:(j + 1) * n_samples]
                # := は代入式(セイウチ演算子)。parse_r1_output の結果を x に入れ、
                # その場で真偽も判定する(None なら答えなし)
                strict = [extract_tag_answer(x[1]) if (x := parse_r1_output(t)) else None for t in group]
                lenient = [lenient_answer(t) for t in group]
                c_strict = sum(a == p["answer"] for a in strict)      # 厳しい判定での正解数
                c_lenient = sum(a == p["answer"] for a in lenient)    # 緩い判定での正解数
                row.update({
                    f"maj@{n_samples}": majority_vote(strict) == p["answer"],
                    f"pass@{n_samples}": pass_at_k(n_samples, c_strict, n_samples),
                    f"pass@{n_samples}_lenient": pass_at_k(n_samples, c_lenient, n_samples),
                })
            rows.append(row)
    return pd.DataFrame(rows)

tokenizer = AutoTokenizer.from_pretrained(STUDENT_ID)
tokenizer.padding_side = "left"
for name, (init_model, adapter) in EVAL_MODELS.items():   # タプルを2つの変数に展開して受け取る
    path = f"{SAVE_ROOT}/eval_{name}.csv"
    if os.path.exists(path):
        continue                              # 評価済みならスキップする
    model = AutoModelForCausalLM.from_pretrained(init_model, torch_dtype=torch.bfloat16).to("cuda")
    if adapter is not None:
        model = PeftModel.from_pretrained(model, adapter)   # GRPO の条件だけ LoRA を読み込む
    # サンプリングは時間がかかるので、主な4条件だけ8本を生成する
    n_samples = N_SAMPLES if name in SAMPLED_CONDITIONS else 0
    evaluate_student(model, tokenizer, eval_dataset, n_samples=n_samples).to_csv(path, index=False)
    del model                                 # 次の条件を読み込む前に解放する
    torch.cuda.empty_cache()
【評価する量】
- pass@1(2種類): pass@1 は貪欲探索の1本を報酬と同じ厳しい判定で採点したもの、pass@1_lenient は最初の </answer> までを共通の extract_answer で採点したものです。ベースモデルは形式を守れないことが多いので、「答えは合っているが形式が崩れている」分を緩い判定で確認します。
- maj@8・pass@8: 温度 0.7 で8本サンプリングし、厳しい判定での多数決の正解率と、8本のうち1本でも正解する割合を計算します。pass@8 は緩い判定でも計算し、形式の影響を除いた「解ける問題の範囲」を見ます。
- 形式・生成長・思考の言語: 貪欲探索の応答について、形式を守ったか、生成トークン数、思考の文のうち日本語の文の割合を記録します。
- 代入式(セイウチ演算子): 8本の答えを取り出す行の if (x := parse_r1_output(t)) は、parse_r1_output(t) の結果を x に代入しつつ、その場で真偽も判定する書き方です(None は偽になります)。同じ関数を2回呼ばずに、「形式が通ったときだけ x[1](答えの部分)を使う」と書けます。
- 打ち切り: 生成が EVAL_MAX_NEW_TOKENS に達して </answer> で終われなかった応答は、厳しい判定では形式違反として不正解になります。
【評価の進め方】
- 条件ごとのモデル: EVAL_MODELS に、学習開始時のモデルと GRPO の LoRA アダプターの組を並べます。蒸留の条件は統合済みのモデル、GRPO の条件はその上にアダプターを読み込んだモデルです。
- サンプリングする条件を絞る: 8本のサンプリングは、1本の貪欲探索の8倍の時間がかかります。maj@8 と pass@8 を使うのは4条件の比較だけなので、データの質と量を比べる2条件(distill_100・unfiltered_1000)では貪欲探索だけにします(SAMPLED_CONDITIONS)。
- 再開できる設計: 条件ごとに CSV に保存し、既にあればスキップします。
実装8:全体の指標と学習時間の集計
6つの条件の評価結果を読み込み、正解率・形式の遵守率・生成長・思考の言語と、学習にかかった時間を1つの表にまとめます。ここで「蒸留と GRPO のどちらが強いか」「蒸留データの質と量はどれだけ効くか」が見えます。
# 条件名 → 評価結果の表 の辞書にまとめて読み込む
results = {name: pd.read_csv(f"{SAVE_ROOT}/eval_{name}.csv") for name in EVAL_MODELS}
cols = ["pass@1", "pass@1_lenient", "maj@8", "pass@8", "pass@8_lenient", "format", "length", "ja_ratio"]
# reindex(columns=cols) で列を cols に揃える。存在しない列(サンプリングしなかった条件の
# maj@8 など)は NaN で埋まる。.T で行と列を入れ替えて「行=条件」にする
summary = pd.DataFrame({name: df.reindex(columns=cols).mean() for name, df in results.items()}).T
summary["se(pass@1)"] = np.sqrt(summary["pass@1"] * (1 - summary["pass@1"]) / len(eval_dataset))
print(summary.round(3))

with open(f"{SAVE_ROOT}/timing.json") as f:
    times = json.load(f)
print({k: f"{v / 60:.1f} 分" for k, v in times.items()})    # 秒を分に直して表示する
- 全体の表: 条件ごとに、評価の指標の平均と、pass@1 の標準誤差を表示します。reindex を使うので、サンプリングをしなかった条件の maj@8・pass@8 は NaN として表示されます。
- 学習時間: timing.json に記録した、教師の生成と各条件の学習にかかった時間(分)です。蒸留の条件の実質的なコストは、SFT の時間に教師の生成時間を足したものです。
実行結果
                 pass@1  pass@1_lenient  maj@8  pass@8  pass@8_lenient  \
base              0.036           0.288  0.102   0.118           0.506
distill_1000      0.710           0.738  0.832   0.932           0.942
distill_100       0.336           0.478    NaN     NaN             NaN
unfiltered_1000   0.426           0.434    NaN     NaN             NaN
grpo_only         0.984           0.984  0.984   0.990           0.990
distill_grpo      0.998           0.998  1.000   1.000           1.000

                 format   length  ja_ratio  se(pass@1)
base              0.208  758.372     0.332       0.008
distill_1000      0.922  143.164     0.950       0.020
distill_100       0.660  149.548     0.959       0.021
unfiltered_1000   0.868  220.022     0.959       0.022
grpo_only         1.000   40.066     0.021       0.006
distill_grpo      1.000   83.508     0.722       0.002
{'teacher_generation': '121.6 分', 'distill_1000': '2.0 分', 'distill_100': '0.4 分', 'unfiltered_1000': '3.9 分', 'grpo_only': '90.7 分', 'distill_grpo': '139.7 分'}
考察:4つの条件の比較
| 条件 | pass@1 | maj@8 | pass@8 | pass@8(緩い判定) | 形式の遵守率 | 平均生成長 | 学習時間 |
|---|---|---|---|---|---|---|---|
| (a) ベースモデル | 0.036 | 0.102 | 0.118 | 0.506 | 0.208 | 758.4 | ― |
| (b) 蒸留(546件) | 0.710 | 0.832 | 0.932 | 0.942 | 0.922 | 143.2 | 2.0分(+教師の生成 121.6分) |
| (c) GRPO のみ | 0.984 | 0.984 | 0.990 | 0.990 | 1.000 | 40.1 | 90.7分 |
| (d) 蒸留 → GRPO | 0.998 | 1.000 | 1.000 | 1.000 | 1.000 | 83.5 | 139.7分(+教師の生成と蒸留 123.6分) |
500問の pass@1 の標準誤差は、最大で約 です。
- この実験では GRPO の方が強かった: 蒸留(0.710)より、GRPO のみ(0.984)の方が高い正解率でした。R1 の論文が報告した「小さなモデルでは蒸留の方が強い」とは逆の結果です。理由は2つ考えられます。1つは、算数ワールドが四則演算の組み合わせで、正解を機械的に判定でき、ベースモデルでもときどきは正解を引ける(緩い判定の pass@8 が 0.506)タスクだということです。強化学習が働くための条件がそろっています。もう1つは、教師が弱かったことです(実装4の考察)。R1 の実験は、小さなモデルでは正解をほとんど引けないような難しいベンチマークでのものなので、タスクの難しさが結論を分けたと考えられます。
- 組み合わせが最も強い: 蒸留 → GRPO(0.998)は、GRPO のみ(0.984)をさらに上回りました。maj@8 と pass@8 も 1.000 です。蒸留で「途中の計算を書いて答える」書き方を先に与えておくと、強化学習がそこから始められるので、R1 が蒸留モデルにさらに強化学習を行うと性能が上がると述べていることと合います。
- pass@8 はどちらの方法でも上がった: ベースモデルの pass@8 は 0.118(緩い判定で 0.506)でしたが、蒸留で 0.932、GRPO で 0.990 になりました。「強化学習はもともと出せる正解を強化するだけで、pass@k はあまり上げない」という見方は、この実験では当てはまりません。ベースモデルの pass@8 が低いのは主に形式(遵守率 0.208)のためで、緩い判定では 0.506 あります。形式を覚えるだけで大きく上がる余地があった、という事情があります。
- 生成長と思考の言語: GRPO のみの条件は、生成長が40.1トークンと最も短く、日本語の文の割合も 0.021 まで下がりました。DeepSeek-R1の記事の言語一貫性報酬なしの条件と同じく、思考が式だけの表記に変わっています。一方、蒸留を経た条件は日本語の文が残り((b) 0.950、(d) 0.722)、生成長も長めです。蒸留は、R1 のコールドスタート SFT と同じように、読みやすい思考の書き方を残す働き をしたことになります。
- 計算コスト: 蒸留は、生徒の SFT 自体は2.0分と非常に軽い一方、教師の生成に121.6分かかりました。GRPO のみ(90.7分)より合計では長くなっています。「蒸留は軽い」と言えるのは、教師の出力がすでに手元にある場合だけだという点が、数字にも表れました。
4つの条件の pass@1・maj@8・pass@8 を並べると、次のようになります。
(図は、diagram-designで作成)
考察:データの質と量
| 条件 | データ数 | フィルタ | pass@1 | 形式の遵守率 |
|---|---|---|---|---|
| (e) 蒸留(100件) | 100 | 正解のみ | 0.336 | 0.660 |
| (b) 蒸留 | 546 | 正解のみ | 0.710 | 0.922 |
| (f) 蒸留(フィルタなし) | 1,000 | なし(教師の誤答が61%) | 0.426 | 0.868 |
- 正解だけに絞る効果は大きい: フィルタなしの1,000件(0.426)は、正解だけの546件(0.710)に大きく負けました。データが約2倍あっても、6割が誤答だと性能は下がります。教師の正解率が 0.364 と低かったため、フィルタの有無の差がはっきり出ました。答えの正誤という単純な基準でも、教師データの質を保つ効果が大きいことが分かります。
- 件数は効いた: 100件(0.336)と546件(0.710)では大きな差がありました。s1 の「1,000件の精選データで十分」という結果は、32B の指示追従モデルを出発点にしたものです。ベースモデルから始める1.5B のモデルでは、この規模のデータでもまだ件数が効いています。形式の遵守率も、100件では 0.660 にとどまりました(同じエポック数なので、更新回数も5分の1程度である点には注意が必要です)。
データの質と量を変えた3つの条件を並べると、次のようになります。
(図は、diagram-designで作成)
実装9:ステップ数ごとの正解率
全体の正解率だけでは、条件ごとの弱点が見えません。ステップ数(=四則演算の回数)ごとに正解率を並べ、難易度が上がったときにどの条件が崩れるかを確かめます。
import matplotlib.pyplot as plt
import matplotlib_fontja   # グラフに日本語を表示する

# 条件ごとに、ステップ数別の pass@1 の平均をとって列にする(行=ステップ数)
by_step = pd.DataFrame({name: df.groupby("n_steps")["pass@1"].mean() for name, df in results.items()})
print(by_step.round(3))

PLOT_LABELS = {"base": "(a) ベースモデル", "distill_1000": "(b) 蒸留",
               "grpo_only": "(c) GRPO のみ", "distill_grpo": "(d) 蒸留 → GRPO"}
fig, ax = plt.subplots(figsize=(7, 4))
for name, label in PLOT_LABELS.items():
    ax.plot(by_step.index, by_step[name], marker="o", label=label)
ax.set(xlabel="ステップ数 s", ylabel="pass@1(貪欲探索・厳しい判定)", ylim=(0, 1))
ax.legend()
plt.show()
- ステップ数ごとの正解率: 難易度ごとに、どの条件がどれだけ解けるかを比べます。
- 図: 主な4条件について、ステップ数ごとの pass@1 を描きます。凡例には、PLOT_LABELS で考察の表と同じ条件名を表示します。
実行結果
         base  distill_1000  distill_100  unfiltered_1000  grpo_only  \
n_steps
1        0.12          0.96         0.73             0.71       1.00
2        0.02          0.86         0.37             0.55       1.00
3        0.02          0.67         0.25             0.43       1.00
4        0.01          0.69         0.22             0.31       0.97
5        0.01          0.37         0.11             0.13       0.95

         distill_grpo
n_steps
1                1.00
2                1.00
3                1.00
4                1.00
5                0.99
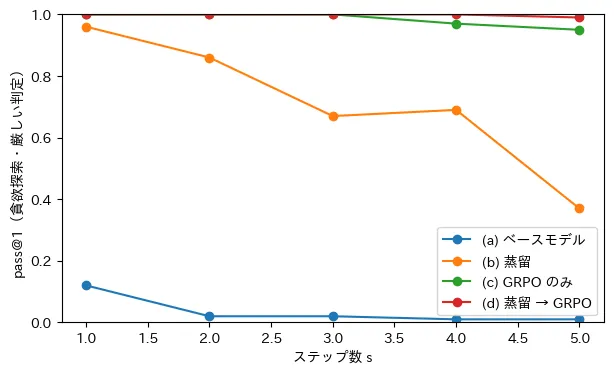
考察:難易度ごとの比較
| ステップ数 | (a) ベース | (b) 蒸留 | (c) GRPO のみ | (d) 蒸留 → GRPO | 教師 |
|---|---|---|---|---|---|
| 1 | 0.12 | 0.96 | 1.00 | 1.00 | 0.73 |
| 2 | 0.02 | 0.86 | 1.00 | 1.00 | 0.41 |
| 3 | 0.02 | 0.67 | 1.00 | 1.00 | 0.29 |
| 4 | 0.01 | 0.69 | 0.97 | 1.00 | 0.24 |
| 5 | 0.01 | 0.37 | 0.95 | 0.99 | 0.18 |
(教師の列は、実装4で表示した学習用の問題での正解率です。評価用の問題ではない点に注意してください。)
- 蒸留は難しい問題で崩れる: 蒸留した生徒は、ステップ数1で 0.96 ですが、ステップ数5では 0.37 まで下がります。一方、GRPO を行った条件は、ステップ数5でも 0.95〜0.99 を保っています。強化学習は、自分で解いて正誤の判定を受けながら、1回ずつの演算を確実にしていくので、演算の回数が増えても崩れにくくなったと考えられます。
- 生徒は教師の1回あたりの正解率を超えた: 教師の正解率は、ステップ数1で 0.73、ステップ数5で 0.18 です。蒸留した生徒は、どのステップ数でも教師を上回りました。教師の出力から 正解したものだけ を残して学習したので、教師の平均的な出来ではなく「教師がうまくいったときの解き方」を学べたためです(リジェクションサンプリングの効果)。ただし、教師がほとんど正解できないステップ数5では学習データも少なく、生徒の正解率も最も低くなっています。教師の弱さが、そのまま生徒の弱点になっています。
教師と生徒の正解率をステップ数ごとに並べると、次のようになります。
(図は、diagram-designで作成)
推論の蒸留の限界
教師を超えにくい
蒸留は教師の出力を真似る学習なので、生徒の能力は教師の能力を超えにくくなります。R1 の論文も、蒸留は強いモデルの能力を小さなモデルに移すには効果的でも、推論能力の限界そのものを押し広げるには、より強いベースモデルと大規模な強化学習が必要かもしれないと述べています。教師が解けない問題は、蒸留では教えられません。ただし、正解した出力だけを残して学習するので、教師の1回あたりの正解率を超えることはあります(本実験では、教師の正解率 0.364 に対し、蒸留した生徒は 0.710 でした)。超えられないのは「教師が一度も解けない問題」です。
教師の癖や誤りも写る
生徒は、教師の推論の良い部分だけでなく、望ましくない癖も真似ます。
- 長すぎる思考: 教師が簡単な問題でも長く考える場合、生徒も長い思考を真似て、推論のコストが増えます。
- 言語の混在: 教師が日本語の問題を英語や中国語で考える場合、生徒も同じように考えるようになります(実装4の思考の言語の内訳と、評価の日本語の文の割合で確認できます)。
- 誤った推論: 答えが正しくても、途中の推論に誤りが含まれる場合があり、答えの正誤だけのフィルタではそれを除けません。
結論はタスクに左右される
本実験では GRPO の方が蒸留より強い結果になりましたが、これは算数ワールドが「正解を機械的に判定でき、ベースモデルでもときどきは正解を引ける」タスクだからです。小さなモデルが正解をほとんど引けない難しいタスクでは、強化学習の学習信号が得られず、R1 の論文のように蒸留が有利になると考えられます。また、本実験の教師は正解率 0.364 と弱く、蒸留の条件に不利でした。より強い教師を使えば、結果は変わる可能性があります。
ライセンスと利用規約
蒸留には、教師モデルの出力を学習に使うことについての権利と規約の問題があります。
- 多くの商用の API は、利用規約で、出力を競合するモデルの開発に使うことを禁止しています。
- オープンウェイトのモデルも、ライセンスはモデルごとに異なります。DeepSeek-R1 は MIT ライセンスで公開されていますが、R1-Distill 系のモデルは Qwen2.5 や Llama をもとにしているので、元のモデルのライセンスも関係します。蒸留したモデルを公開・商用利用する場合は、教師と生徒の両方のモデルカードを確認する必要があります。
関連する手法との関係
推論の蒸留は、In-Context Learning から続く、次の手法の流れの上にあります。
事前学習済みモデル
 ├─ In-Context Learning ……… プロンプトの例示だけでタスクに適応する
 │    └─ Chain-of-Thought …… 思考過程を書かせて推論を引き出す(Self-Consistency、pass@k・maj@k)
 └─ Instruction Tuning(SFT)… 指示に従う形式を学ぶ
      └─ InstructGPT(RLHF・PPO)… 報酬モデルで人の好みに合わせる(報酬ハッキング・長さの崩壊)
           └─ DPO …………………… 報酬モデルと強化学習を1つの損失に置き換える(オフライン)
                └─ GRPO ………… 価値関数をなくし、正解判定を報酬にしてオンラインで学ぶ
                     └─ DeepSeek-R1 … ベースモデルからの強化学習、コールドスタートと多段階の学習
                          └─ 推論の蒸留 … 強いモデルの推論過程で小さなモデルを SFT する
人の好みに合わせる方法は、報酬モデルと PPO を使う InstructGPT から、報酬モデルを使わない DPO へと発展しました。推論能力を引き出す方法は、プロンプトで推論を引き出す Chain-of-Thought から、正解判定を報酬にするオンラインの強化学習(GRPO、DeepSeek-R1)、そしてそれを小さなモデルに移す推論の蒸留へと進みました。Chain-of-Thought・GRPO・DeepSeek-R1 の記事と本記事は、同じ算数ワールドと評価の方法を使っているので、手法ごとの結果を並べて比べられます。
今後の発展
最後に、本記事で扱わなかった発展の方向を紹介します。
- テスト時計算のスケーリング: 推論時に、サンプリングの本数や思考の長さを増やして性能を上げる方向です(Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters、Snell et al., 2024 など)。s1 の budget forcing も、思考の長さを制御する方法の1つです。
- 過程報酬の再評価: R1 は結果報酬だけを使いましたが、定理証明のように途中の各ステップを厳密に検証できる分野では、形式検証ツール(Lean など)を使った過程の検証と強化学習の組み合わせが研究されています。
- ツールを使う推論: 思考の途中でプログラムを実行したり検索したりして、その結果を使いながら推論する、エージェント的な推論です。
まとめ
記事を通じて、以下の内容を学習・実践しました。
- 知識蒸留の系譜: 教師の確率分布を真似る知識蒸留(Hinton)、教師の出力文で SFT する系列レベル蒸留(Kim & Rush)、思考過程を含む出力で SFT する推論過程の蒸留(Reasoning Teachers、Distilling Step-by-Step、DeepSeek-R1)の違いを整理しました。
- 蒸留と強化学習の違い: 強化学習はモデルがもともと出せる正解を強化するのに対し、蒸留は教師の解き方を外から持ち込めます。そのため、小さなモデルでは蒸留が効きやすいと考えられています。ただし、蒸留には教師の生成と、教師自体を作るコストがかかります。
- 教師データの作り方: 教師の出力から、正解で形式の崩れていないものだけを残すリジェクションサンプリングと、少数の精選データで推論能力を引き出した s1 の知見を見ました。
- 実装: DeepSeek-R1-Distill-Qwen-7B を教師、Qwen2.5-1.5B を生徒として、教師の出力の変換とフィルタリング、SFT による蒸留、GRPO、蒸留 → GRPO を実装し、データの質と量を変えた条件も含めて、pass@1・maj@8・pass@8・生成長・思考の言語・学習時間を比べました。
- 蒸留の限界: 生徒は教師を超えにくく、教師の癖や誤り、言語の混在も写ります。教師と生徒のライセンスや利用規約の確認も必要になります。
- 実験の結果:
- 算数ワールドでは、蒸留(pass@1 0.710)より GRPO のみ(0.984)の方が強く、蒸留 → GRPO(0.998)が最も強くなりました。正解を判定でき、ベースモデルでもときどき正解を引けるタスクでは、R1 の論文とは逆に強化学習が有利になりました。
- 教師データの質と量はどちらも効きました。正解だけに絞った546件(0.710)は、誤答を6割含む1,000件(0.426)を大きく上回り、100件(0.336)とも差がつきました。
- 蒸留を経た条件は、思考に日本語の文が残りました((b) 0.950、(d) 0.722)。GRPO のみの条件は式だけの短い思考(40.1トークン、日本語の文の割合 0.021)に変わり、R1 の記事の言語一貫性報酬なしの条件と同じ現象が見られました。
※ライセンスに関する注記 本記事の実験で利用したモデルのうち、Qwen/Qwen2.5-1.5B は Apache License 2.0、deepseek-ai/DeepSeek-R1-Distill-Qwen-7B は MIT License で公開されています(ベースとなった Qwen2.5 のライセンスも併せて確認してください)。各提供元のライセンスに準拠して利用しています。論文の数値は、各原典から引用しています。
参考文献
- DeepSeek-AI et al. (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. arXiv:2501.12948.
- G. Hinton, O. Vinyals, J. Dean (2014). Distilling the Knowledge in a Neural Network. NIPS 2014 Deep Learning Workshop.
- Y. Kim, A. M. Rush (2016). Sequence-Level Knowledge Distillation. EMNLP 2016.
- N. Ho, L. Schmid, S.-Y. Yun (2023). Large Language Models Are Reasoning Teachers. ACL 2023.
- L. C. Magister, J. Mallinson, J. Adamek, E. Malmi, A. Severyn (2023). Teaching Small Language Models to Reason. ACL 2023.
- C.-Y. Hsieh et al. (2023). Distilling Step-by-Step! Outperforming Larger Language Models with Less Training Data and Smaller Model Sizes. Findings of ACL 2023.
- Y. Yue et al. (2025). Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?. NeurIPS 2025.
- N. Muennighoff et al. (2025). s1: Simple test-time scaling. EMNLP 2025.
- C. Snell, J. Lee, K. Xu, A. Kumar (2025). Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters. ICLR 2025.
- Qwen Team (2024). Qwen2.5-0.5B. Hugging Face(Apache License 2.0).
- Qwen Team (2024). Qwen2.5-1.5B. Hugging Face(Apache License 2.0).
- DeepSeek-AI (2025). DeepSeek-R1-Distill-Qwen-1.5B. Hugging Face(MIT License).
- DeepSeek-AI (2025). DeepSeek-R1-Distill-Qwen-7B. Hugging Face(MIT License).
本記事の文章・構成の一部に生成AIを使用しています。