回帰による効果推定(共分散分析・G-computation)とは?
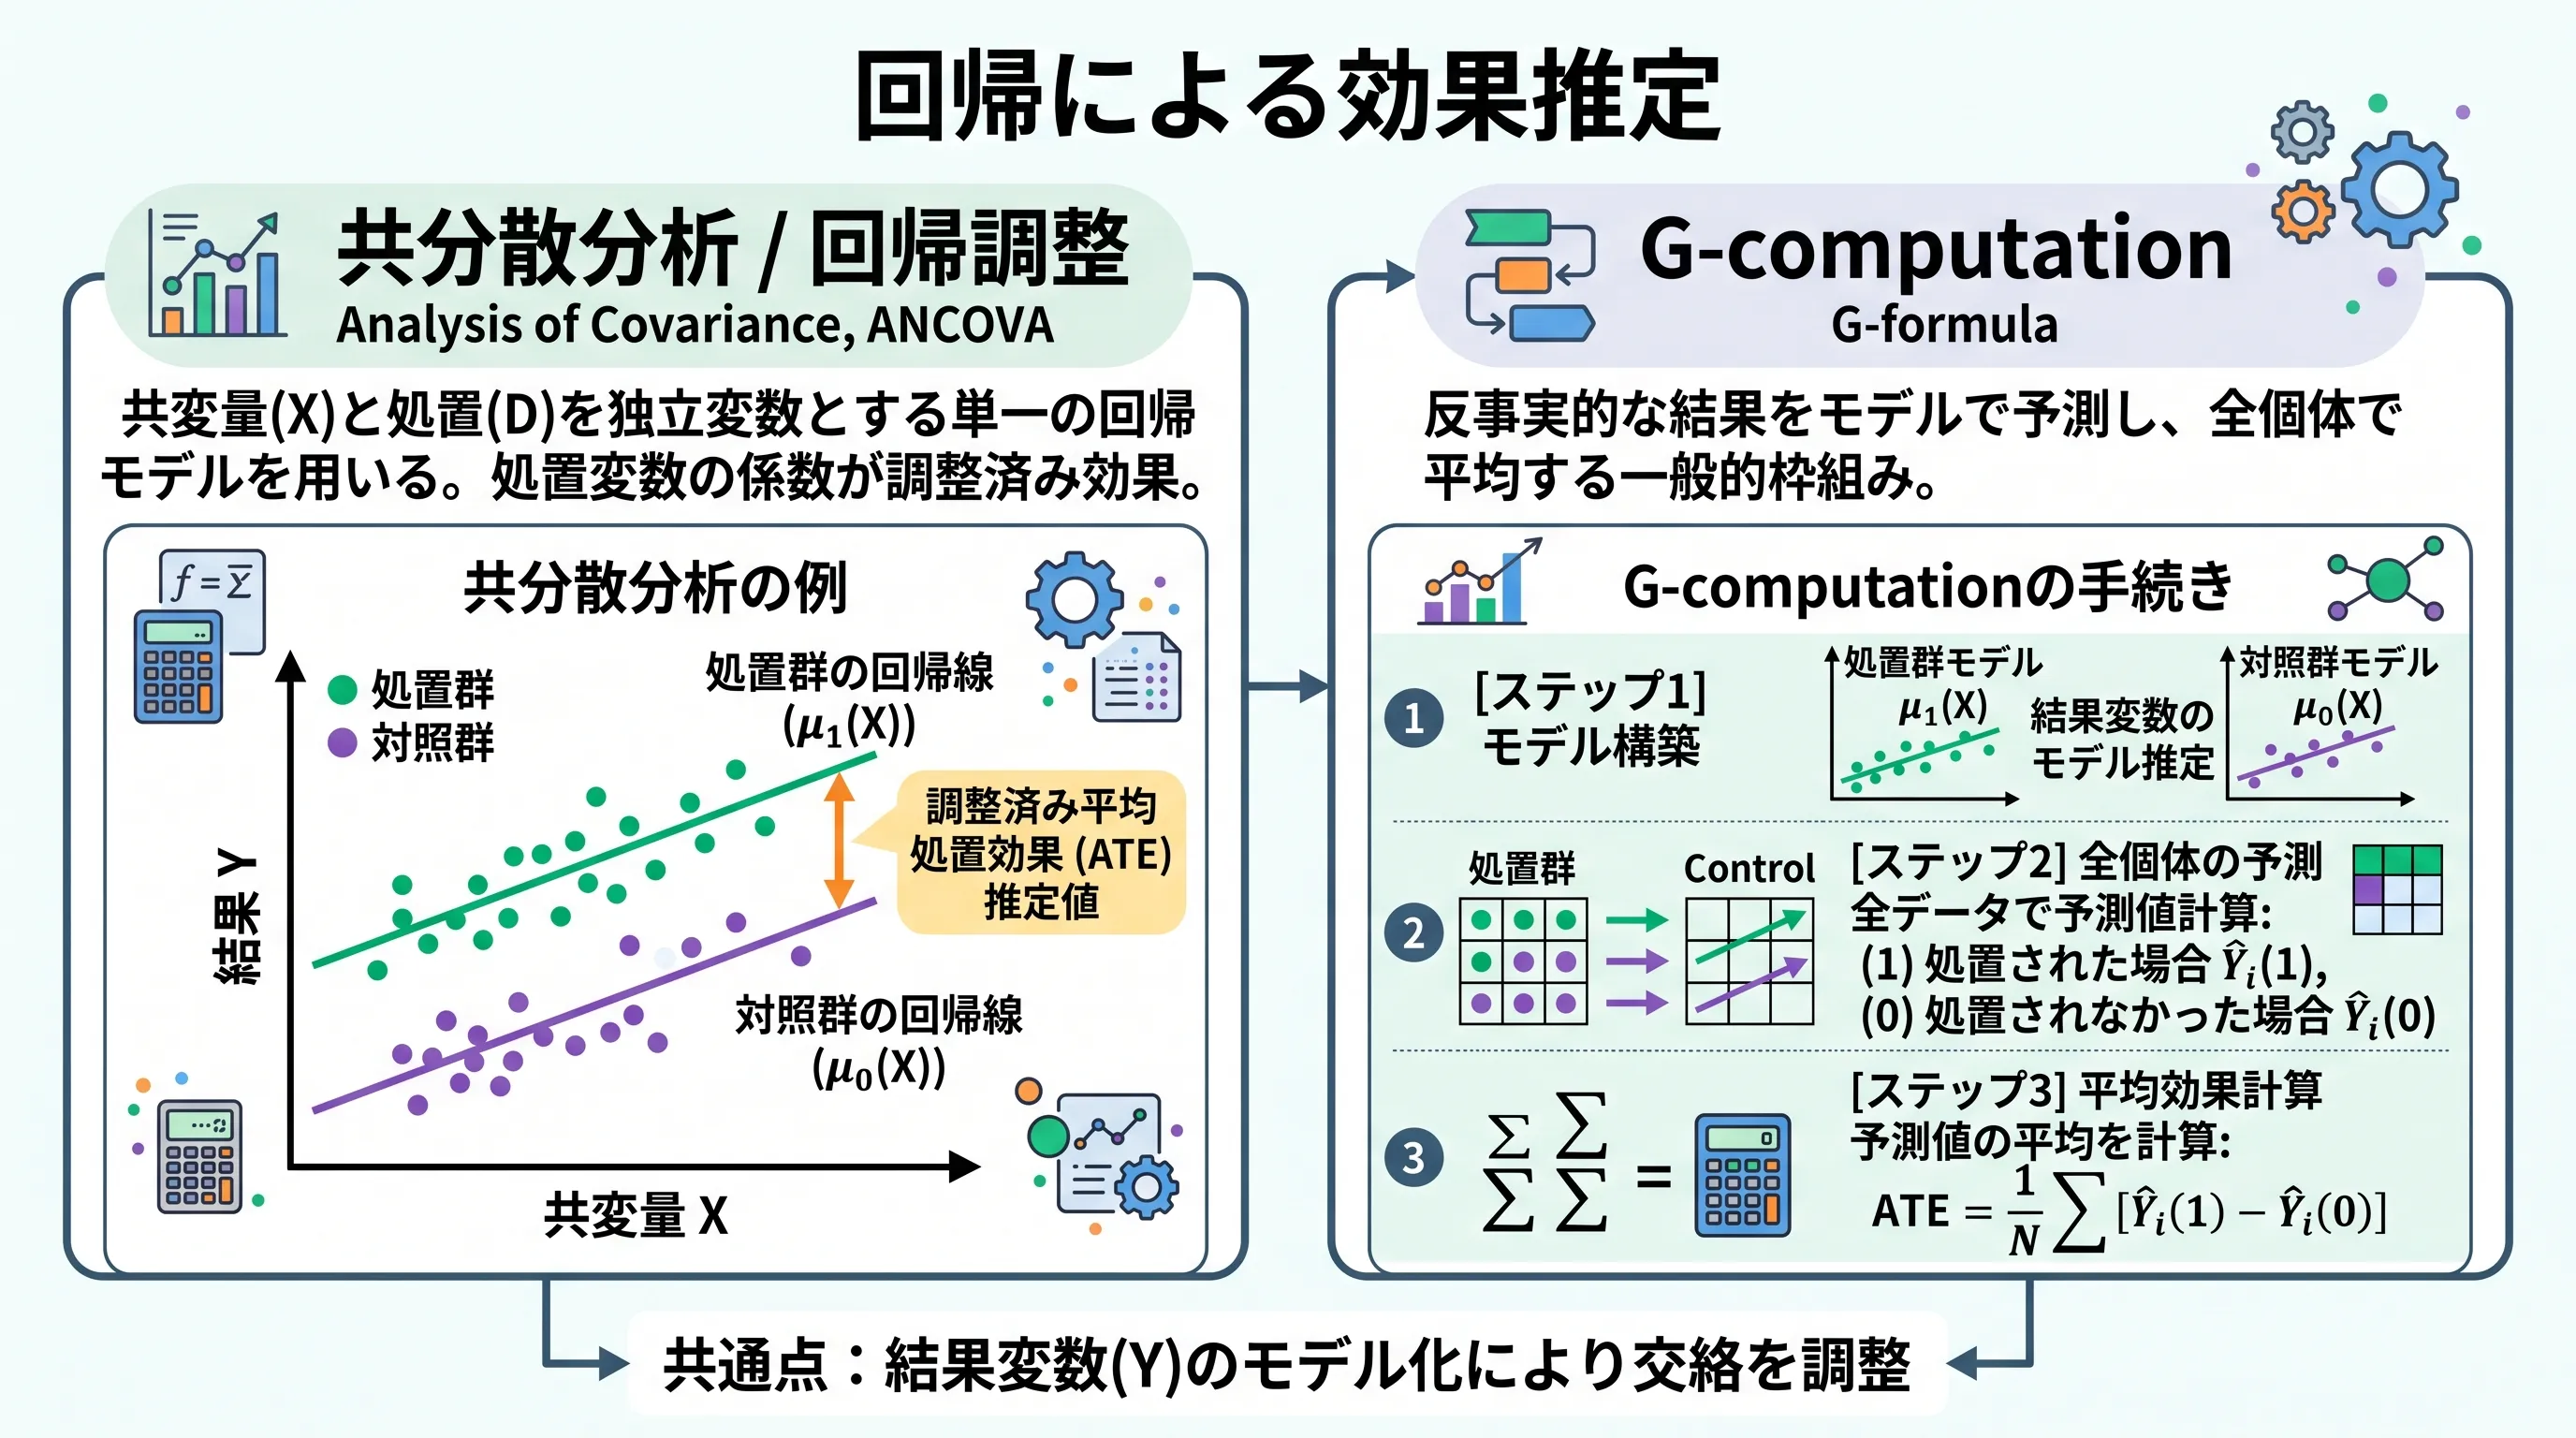 (画像は、Geminiで作成)
回帰による効果推定の概要
施策の効果を測りたいとき、多くの人が最初に思いつくのは「売上を目的変数にして、施策の有無を説明変数に入れた回帰分析を回す」という方法ではないでしょうか。
売上 ~ 施策の有無 + 年齢 + 過去の購買金額
この式を書いて、「施策の有無」の係数を効果として報告する。統計解析ツールで数行、非常に手軽で、実務で最も頻繁に使われているアプローチです。
RCT、傾向スコアマッチング(PSM)、逆確率重みづけ(IPTW)の記事では、主に「施策の受けやすさ(傾向スコア)」をモデル化する系譜を扱いました。本記事で扱うのは、それとは対照的な、もう1つの系譜です。
- 傾向スコア系:「その人が施策を受ける確率」をモデル化し、割り当ての偏りを打ち消す(傾向スコアの記事)
- 回帰(アウトカム)系:「その人の結果(売上)がどう決まるか」をモデル化し、施策以外の要因を差し引く
この回帰系のアプローチは、文脈によって呼び名が変わります。
- RCTのデータに共変量を入れて精度を上げる使い方 → 共分散分析(ANCOVA: Analysis of Covariance)
- 観察データに対して交絡を取り除く使い方 → 回帰調整(Regression Adjustment)
- 群ごとにモデルを作り、全員分の反事実を予測して平均する手続き → G-computation(g-formula)
数式の見た目はほとんど同じなのに、前提条件も、推定している中身も、必要な注意点も違います。「回帰を回すだけ」という手軽さの裏で、実はいくつもの落とし穴が待ち構えています。
本記事では、次の点をPythonで確認しながら整理していきます。
- RCTでのANCOVA:点推定はほぼ変わらないが、標準誤差が大きく縮む(精度の話)
- 観察データでの回帰調整:同じ式でも目的が変わり、必要な前提が跳ね上がる(バイアスの話)
- 処置ダミーの係数はATEとは限らない:効果に異質性があると係数はATEからずれる。だからG-computationが要る
- 回帰は平気で外挿する:共通サポートがなくても、モデルは自信満々に答えを返してくる
- ベースラインを共変量に入れるか、差を取るか:DiDとの使い分けは、技術的な好みではなく仮定の選択である
同じ式でも、目的が違う
まず、いちばん混乱しやすいところから整理します。以下の2つは書いている式が同じでも、やっていることがまったく違います。
| RCTでのANCOVA | 観察データでの回帰調整 | |
|---|---|---|
| 割り当て | ランダム(設計で保証) | 交絡因子に依存(偏っている) |
| 共変量を入れる目的 | 精度を上げる(分散削減) | バイアスを取る(交絡調整) |
| 共変量を入れないと | 推定値は正しいが、区間が広い | 推定値そのものが誤る |
| 必要な前提 | ランダム化されていること | 交絡因子がすべて観測されていること+モデルが正しいこと |
| 共変量の選び方を間違えると | 精度が上がらないだけ | 結論が変わる |
RCTでは、RCTの記事で確認した通り、単純な平均の差だけで期待値としてバイアスのない推定ができます。ではなぜ共変量を入れるのか。答えは「より狭い信頼区間で同じ答えを出すため」です。
一方、観察データでは単純な平均の差はバイアスを含みます。ここでの共変量は精度のためではなく、バイアスを取り除くために必須の部品です。
この区別を曖昧にしたまま「とりあえず共変量を入れておけば安心」と考えるのが、実務でいちばんよくある誤解です。
表の内容を図にまとめると、次のようになります。
(図は、diagram-designで作成)
検証①:RCTデータでのANCOVA(分散削減)
まずはRCTのケースから見ていきましょう。「年齢(age)」と「過去の購買金額(history)」という特徴量を持つユーザーに対し、これらを完全に無視して50%の確率でDM(施策)を割り当てたデータを作ります。
検証用ダミーデータの生成(RCT)
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf

np.random.seed(42)

# データサイズの指定
N = 2000

# 1. 特徴量の生成(RCTでは割り当てに影響しないが、売上には影響する)
# age: 年齢, history: 過去の購買金額
age = np.random.normal(40, 10, N)
history = np.random.exponential(5000, N)

# 2. 施策割り当て(RCT:特徴量に依存せずランダムに50%ずつ)
treatment = np.random.binomial(1, 0.5, N)

# 3. 目的変数(売上)の生成。真の効果(ATE)は +1500
true_effect = 1500
sales = (2000
         + 30 * age
         + 0.5 * history
         + true_effect * treatment
         + np.random.normal(0, 1000, N))

rct = pd.DataFrame({'age': age, 'history': history,
                    'treatment': treatment, 'sales': sales})

print(rct.head())
print()
print(f"処置群: {rct['treatment'].sum()} 件 / 対照群: {(1 - rct['treatment']).sum()} 件")
- 特徴量の生成: np.random.normal で正規分布に従う年齢を、np.random.exponential で指数分布に従う過去の購買金額を生成しています。どちらも売上には影響しますが、RCTなので割り当てには影響しません。
- ランダム割り当て: np.random.binomial(1, 0.5, N) により、特徴量を一切見ずにコイントスで処置群(1)と対照群(0)を決めています。年齢・購買金額・売上の式は、PSMとIPTWの記事と同じです。割り当てだけをコイントスにして、交絡のない状態から始めるためです。
- 売上の計算: ベース金額に年齢・購買履歴の影響、施策効果(true_effect * treatment)、ランダムな誤差を足し合わせています。真の効果 +1500 がデータ内に埋め込まれています。
このダミーデータは、以下のデータ生成プロセスに基づいています。
① 特徴量の生成とランダム割り当て
(※ 指数分布は数学的な慣例では率パラメータ で表記しますが、本記事ではPython(numpy)の実装パラメータに合わせ、平均値を示す scale=5000( に相当)として明記しています。)
② 目的変数(売上)の生成
割り当て が ・ と独立であることが、この節の議論の出発点になります。
実行結果
         age      history  treatment        sales
0  44.967142  2613.702365          1  5971.719613
1  38.617357   341.446903          1  3699.065432
2  46.476885  2144.849986          1  6239.742272
3  55.230299   588.279524          0  1876.408682
4  37.658466  8257.428550          0  7166.511480

処置群: 991 件 / 対照群: 1009 件
共変量バランスの確認
ランダム割り当てなので、処置群と対照群で特徴量が揃っているはずです。後の議論で使うので、t検定で確認しておきます。
from scipy import stats

print(rct.groupby('treatment')[['age', 'history']].mean())

# equal_var=False でウェルチのt検定(等分散を仮定しない)
_, p_age = stats.ttest_ind(rct[rct['treatment'] == 1]['age'],
                           rct[rct['treatment'] == 0]['age'], equal_var=False)
_, p_hist = stats.ttest_ind(rct[rct['treatment'] == 1]['history'],
                            rct[rct['treatment'] == 0]['history'], equal_var=False)
print(f"ageのp値: {p_age:.3f}")
print(f"historyのp値: {p_hist:.3f}")
- グループ別平均の集計: groupby('treatment') で処置群・対照群それぞれの特徴量の平均を比較しています。
- 平均の差の検定: stats.ttest_ind で独立2群のt検定を行い、偏りが統計的に有意かどうかを確認しています。equal_var=False は等分散を仮定しないウェルチのt検定の指定です(詳しくはt検定の記事を参照)。
実行結果
                 age      history
treatment
0          40.353762  4705.510110
1          40.549684  4948.128756
ageのp値: 0.658
historyのp値: 0.262
年齢はほぼ一致(p=0.658)、購買履歴も有意差なし(p=0.262)です。ランダム化は正しく機能しています。ただし購買履歴は 4948 vs 4706 と、わずかに処置群の方が高くなっています。この「有意ではないが確かに存在する偏り」が、後で効いてきます。
共変量を入れない回帰(単純な平均の差)
# 共変量を入れない回帰(=単純な平均の差とまったく同じ)
m_simple = smf.ols('sales ~ treatment', data=rct).fit()
print(m_simple.summary().tables[1])
- statsmodelsの利用: smf.ols に 'sales ~ treatment' という式(formula)を渡すだけで、最小二乗法による回帰が実行できます。DiDの記事と同じ書き方です。
- 単純差との等価性: 説明変数が処置ダミーだけの回帰は、数学的に「2群の平均の差」と完全に一致します。わざわざ回帰にしているのは、次のANCOVAと同じ土俵で標準誤差を比較するためです。
- 信頼区間の種類: OLSは誤差の等分散を仮定するため、ここで出力される区間はスチューデントのt検定の区間と一致します。等分散を仮定しないウェルチのt検定(equal_var=False)ではわずかに異なる区間になります。
実行結果
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept   5494.9444     84.247     65.224      0.000    5329.724    5660.165
treatment   1678.1023    119.683     14.021      0.000    1443.387    1912.818
==============================================================================
推定値は 1678.10(95%信頼区間 [1443.4, 1912.8])。真の効果 1500 は区間に含まれていますが、区間の幅は約 470 もあります。
共変量を入れる(ANCOVA)
ここに、割り当てとは無関係な「年齢」と「過去の購買金額」を説明変数として追加します。
# 共変量を追加した回帰(ANCOVA)
m_ancova = smf.ols('sales ~ treatment + age + history', data=rct).fit()
print(m_ancova.summary().tables[1])

print()
print(f"残差の標準偏差 単純差 : {np.sqrt(m_simple.scale):.1f}")
print(f"残差の標準偏差 ANCOVA : {np.sqrt(m_ancova.scale):.1f}")
print(f"標準誤差の比           : {m_ancova.bse['treatment'] / m_simple.bse['treatment']:.3f}")
- 共変量の追加: 式に + age + history を足しただけです。ランダム割り当てなので、これらは処置変数と(期待的に)無相関です。
- 残差の比較: np.sqrt(model.scale) で残差の標準偏差を取り出しています。共変量が売上のばらつきをどれだけ説明できたかを示す指標です。
実行結果
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept   1973.8918    100.799     19.582      0.000    1776.209    2171.575
treatment   1549.7707     45.821     33.822      0.000    1459.909    1639.633
age           28.2351      2.319     12.177      0.000      23.688      32.782
history        0.5061      0.005    106.784      0.000       0.497       0.515
==============================================================================

残差の標準偏差 単純差 : 2676.1
残差の標準偏差 ANCOVA : 1024.2
標準誤差の比           : 0.383
注目すべきは標準誤差です。119.68 → 45.82 と、約 38% にまで縮みました。信頼区間も [1443.4, 1912.8](幅469)から [1459.9, 1639.6](幅180)へと、劇的に狭くなっています。
理由は残差の標準偏差を見れば明らかです。共変量を入れない場合、売上のばらつきには「年齢の違い」「購買履歴の違い」がすべて雑音として含まれており、残差SDは 2676 もありました。年齢と購買履歴を説明変数に入れると、そのばらつきが説明されて残差SDは 1024(=データ生成時のノイズ にほぼ一致)まで下がります。雑音を減らせば、同じサンプルサイズでもより精密に効果を測れる、という単純な話です。
Web系のA/Bテストで用いられる CUPED(Controlled-experiment Using Pre-Experiment Data) は、実験前の指標(前期の購買金額など)を共変量として使い、検定の分散を削減する手法です。名前は違いますが、やっていることはここで見たANCOVAとほぼ同じで、「事前データで説明できるばらつきを先に除いてから比べる」という発想です。
サンプルサイズを増やすのはコストがかかりますが、すでに手元にある事前データを使うだけで検出力が上がるため、実務上のコストパフォーマンスは非常に高い工夫だと言えます。
点推定値が 1678 → 1550 に動いたのはなぜか
標準誤差だけでなく、点推定値も 1678.10 から 1549.77 へ変化しました。「共変量を入れたら効果が変わってしまった。どちらが正しいのか」と不安になるところです。
これはランダム化のもとでも偶然生じる、共変量のわずかな偏りを調整した結果です。先ほどのバランスチェックで、処置群の方がわずかに購買履歴が高いことを確認しました(4948 vs 4706、p=0.262)。有意ではないものの、購買履歴は売上に強く効くため、この偏りが単純差を押し上げていたわけです。
実際、ズレはきれいに分解できます。ANCOVAが推定した係数(age: 28.2351、history: 0.5061)を、群間の偏り(事前の「共変量バランスの確認」で出力された、処置群と対照群の平均値の差)に掛けてみます。
単純差 1678.10 と ANCOVA 1549.77 の差は 128.33 です。共変量の偶然の偏りが売上に与えていた分を、ANCOVAがちょうど差し引いたことが分かります。
重要なのは、どちらも「期待値としては」正しいという点です。500回シミュレーションして確認してみましょう。
def sim_rct(seed, n=2000):
    r = np.random.RandomState(seed)
    a = r.normal(40, 10, n)
    h = r.exponential(5000, n)
    t = r.binomial(1, 0.5, n)
    y = 2000 + 30 * a + 0.5 * h + 1500 * t + r.normal(0, 1000, n)
    d = pd.DataFrame({'age': a, 'history': h, 'treatment': t, 'sales': y})
    return {
        '単純差': smf.ols('sales ~ treatment', data=d).fit().params['treatment'],
        'ANCOVA': smf.ols('sales ~ treatment + age + history', data=d).fit().params['treatment'],
    }

sims = pd.DataFrame([sim_rct(s) for s in range(500)])
print(pd.DataFrame({
    '平均推定値': sims.mean().round(1),
    'バイアス': (sims.mean() - 1500).round(1),
    '標準偏差': sims.std().round(1),
}).to_string())
- データ生成の再現: sim_rct の中身は、先ほどの生成コードとまったく同じ式です。違うのは np.random.RandomState(seed) でシードを差し替えている点だけで、500種類の異なるデータセットを作っています。
- 2手法の同時推定: 同じデータに対して「単純差」と「ANCOVA」の両方を推定し、辞書で返しています。同一データでの比較なので、差は純粋に手法の違いによるものです。
- バイアスとばらつきの分離: 平均推定値からバイアスを、標準偏差から推定値のばらつきを読み取ります。500回にするのは、推定値の平均(バイアス)と標準偏差を、1回ごとの偶然に左右されずに読み取れる回数だからです。
実行結果
         平均推定値  バイアス   標準偏差
単純差     1492.8  -7.2  112.5
ANCOVA  1500.1   0.1   44.4
500回の平均はどちらも 1500 付近(−7.2 と +0.1)で、バイアスはありません。違うのは標準偏差で、単純差の 112.5 に対してANCOVAは 44.4 です。
つまり、ANCOVAがやっているのは「推定値を正しい方向へ動かす」ことではなく、「当たり外れの幅を狭める」ことです。1回の実験で得られた 1678 と 1550 のどちらが真値に近いかは事前には分かりませんが、ANCOVAの方が平均的に外れにくいというのが正しい理解になります。
「RCTなら共変量を入れるだけで無条件に良くなる」わけではありません。統計学の側から、いくつかの注意が指摘されています。
- 共変量は事前に決める:割り当て後に「どの共変量を入れると有意になるか」を探すのは、結果を見て解析方法を選ぶ行為(specification search)にあたります。事前登録された解析計画で共変量を固定しておくのが原則です。
- 処置後に決まる変数は入れない:施策の影響を受けて変化する変数(施策後のサイト訪問回数など)を共変量にすると、効果の一部を打ち消してしまいます。共変量は「割り当て前に確定している変数」に限ります。
- 小標本ではバイアスが出うる:Freedman (2008) は、ランダム化推論の枠組みでは回帰調整が小標本バイアスや誤った分散推定を生みうると指摘しました。これに対し Lin (2013) は、処置と共変量の交互作用をすべて入れ、共変量を中心化し、ロバスト標準誤差(Huber-White)を使えば、これらの問題は大きなサンプルではほぼ解消すると示しています。
実務的には、sales ~ treatment * (中心化した共変量) の形で推定し、cov_type='HC1' などのロバスト標準誤差を指定しておくのが安全です。
単純な平均の差と ANCOVA の推定値・信頼区間・500回の結果を並べると、次のようになります。
(図は、diagram-designで作成)
検証②:観察データでの回帰調整(交絡調整)
ここからが本題です。ランダム化されていない観察データに、同じ式を当てはめてみます。売上の式はRCTのときと同じにしたまま、割り当てだけを特徴量に依存させるのがポイントです。
検証用ダミーデータの生成(観察データ)
np.random.seed(42)

# 1. 特徴量の生成(ここまではRCTと同じ)
age = np.random.normal(40, 10, N)
history = np.random.exponential(5000, N)

# 2. 施策割り当て(★セレクションバイアスの導入★)
# 年齢が高く、過去の購買金額が多いほどDMが送られやすい
logit_p = -3.0 + 0.05 * age + 0.0002 * history
propensity = 1 / (1 + np.exp(-logit_p))
treatment = np.random.binomial(1, propensity)

# 3. 目的変数(売上)の生成。真の効果は +1500(RCTのときと同じ式)
sales = (2000
         + 30 * age
         + 0.5 * history
         + 1500 * treatment
         + np.random.normal(0, 1000, N))

obs = pd.DataFrame({'age': age, 'history': history,
                    'treatment': treatment, 'sales': sales})

naive = obs[obs.treatment == 1].sales.mean() - obs[obs.treatment == 0].sales.mean()
print(f"処置群: {obs.treatment.sum()} 件 / 対照群: {(1 - obs.treatment).sum()} 件")
print(obs.groupby('treatment')[['age', 'history']].mean())
print(f"単純比較での売上の差: {naive:.2f}")
- 割り当て確率の計算: logit_p を特徴量の線形結合で作り、シグモイド関数 1 / (1 + np.exp(-logit_p)) で 0〜1 の確率に変換しています。これが真の傾向スコアです。
- 確率的な割り当て: np.random.binomial(1, propensity) では、RCTのときの固定値 0.5 と違い、人によって異なる確率で処置が割り当てられます。ここがセレクションバイアスの発生源です。
- 売上の式は不変: RCTのケースと係数はまったく同じです。違うのは「誰が処置を受けたか」だけなので、単純比較がずれたらそれはすべて割り当ての偏りによるものです。
このダミーデータは、以下のデータ生成プロセスに基づいています。
① 特徴量の生成
② 施策割り当て(セレクションバイアスの導入)
③ 目的変数(売上)の生成
RCTのケースとの違いは ②だけです。 が ・ に依存するようになった結果、③の売上式に含まれる と の影響が、施策効果と混ざって観測されてしまいます。これが交絡です。
実行結果
処置群: 961 件 / 対照群: 1039 件
                 age      history
treatment
0          38.547778  3177.053565
1          42.508368  6608.217111
単純比較での売上の差: 3303.11
RCTのときは両群の特徴量がほぼ一致していましたが、今回は年齢が 42.5 vs 38.5、購買履歴に至っては 6608 vs 3177 と、はっきり偏っています。
真の効果 1500 に対し、単純比較は 3303 と2倍以上に膨らんでいます。ここに共変量を入れます。
m_obs = smf.ols('sales ~ treatment + age + history', data=obs).fit()
print(m_obs.summary().tables[1])
- 式はANCOVAと同一: 検証①で書いた式と1文字も変わりません。変わったのは、この共変量が「精度を上げるためのオプション」から「バイアスを取るための必須部品」になったという意味づけだけです。
- 係数の読み方: treatment の係数が効果の推定値、age と history の係数は交絡の影響を吸収する役割を担っています。
実行結果
==============================================================================
                 coef    std err          t      P>|t|      [0.025      0.975]
------------------------------------------------------------------------------
Intercept   1992.6224     98.608     20.207      0.000    1799.236    2186.009
treatment   1445.2608     50.055     28.873      0.000    1347.094    1543.427
age           28.7816      2.368     12.157      0.000      24.139      33.425
history        0.5082      0.005    100.252      0.000       0.498       0.518
==============================================================================
1445.26(95%信頼区間 [1347.1, 1543.4])と、真の効果 1500 をしっかり捉えました。同じデータに対する他手法の結果と並べると、次のようになります。
| 手法 | 推定値 | 備考 |
|---|---|---|
| 単純比較 | 3303.11 | バイアスあり |
| PSM(傾向スコアマッチング) | 約1500 | ATTを推定 |
| IPTW(逆確率重みづけ) | 1451.11 | データを捨てない |
| 回帰調整(本記事) | 1445.26 | 最も標準誤差が小さい |
注目すべきは、回帰調整が最もシンプルで、かつ標準誤差も小さいという点です。今回のデータは「売上=年齢と購買履歴の線形結合+効果」という構造でデータを作っており、回帰モデルの仮定がぴったり当たっているためです。
ここで強調したいのは、この好成績は「モデルが正しかったから」得られたものだということです。傾向スコア系の手法は結果の構造を仮定しませんが、回帰調整は結果の構造そのものに賭けています。次節以降で見るのは、この賭けが外れたときに何が起きるかです。
上のコードでは処置ダミーの係数をそのまま効果として読みました。これは実は、 効果が全員同じ(均一) という強い仮定を置いた形です。
もっと一般的な手続きが G-computation(g-formula) で、次の手順を踏みます。
- 処置群のデータだけで、共変量から売上を予測するモデル を学習する
- 対照群のデータだけで、同じくモデル を学習する
- 全員分の共変量を両方のモデルに入れ、「もし受けていたら」「もし受けていなかったら」の予測値を出す
- その差の平均をATEとする
群ごとにモデルを分けるため、効果が人によって違っていても対応できます。この手続きは Künzel et al. (2019) らが整理した T-Learner と計算上は同じもので、違いは「個人ごとの効果(CATE)を見るか、平均して集団全体の効果(ATE)を見るか」という目的だけです(メタラーナーの記事を参照)。
なぜわざわざ手順を分けるのか。その理由を、次節で数値とともに確認します。
単純比較と各手法の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
落とし穴①:処置ダミーの係数はATEとは限らない
ここまでのデータは「施策の効果は誰に対しても +1500 で一定」という設定でした。しかし現実には、効果は人によって違います。若い顧客にはよく効くが高齢顧客には効かない、といったことは日常的に起こります。
このとき、sales ~ treatment + age + history の treatment 係数は何を推定しているのでしょうか。
効果に異質性のあるデータを作る
from sklearn.linear_model import LinearRegression

def make_het(seed=42, n=2000):
    r = np.random.RandomState(seed)
    a = r.normal(40, 10, n)
    h = r.exponential(5000, n)
    # 年齢が高いほどDMが送られやすい(選択がかなり強い設定)
    p = 1 / (1 + np.exp(-(-2.0 + 0.25 * (a - 40) + 0.0002 * h)))
    z = r.binomial(1, p)
    # ★効果そのものが年齢によって変わる(異質性)
    tau = 1500 + 80 * (a - 40)
    y = 2000 + 30 * a + 0.5 * h + tau * z + r.normal(0, 1000, n)
    return pd.DataFrame({'age': a, 'history': h, 'treatment': z,
                         'sales': y, 'tau': tau, 'ps': p})

het = make_het()
t_h = het.treatment == 1

print(f"真のATE(tauの平均)  : {het.tau.mean():.2f}")
print(f"真のATT(処置群でのtau): {het.tau[t_h].mean():.2f}")
print(f"真のATU(対照群でのtau): {het.tau[~t_h].mean():.2f}")
print(f"処置群の平均年齢: {het.age[t_h].mean():.2f} / 対照群の平均年齢: {het.age[~t_h].mean():.2f}")
print(f"処置群の割合: {het.treatment.mean():.3f}")
- 効果の異質性: tau = 1500 + 80 * (a - 40) により、40歳の人には +1500、50歳の人には +2300、30歳の人には +700 の効果、という設定にしています。
- 割り当てと効果の相関: 年齢が高いほど施策を受けやすく、かつ効果も大きい、という現実によくある構造です。年齢の係数を0.25と、検証②(0.05)より強くするのは、年齢による割り当ての偏りを大きくして、処置ダミーの係数とATEのずれをはっきり見せるためです。効果の傾き80は、30歳と50歳で効果が約3倍違う(700と2300)大きさです。施策を受ける割合は38%です。
このダミーデータは、以下のデータ生成プロセスに基づいています。基本構造は検証②と同じで、変えたのは 割り当ての強さと効果の異質性の2点だけです。
① 特徴量の生成(検証②と同じ)
② 施策割り当て(★年齢への依存を強めている★)
③ 効果の異質性(★今回の主役★)
④ 目的変数(売上)の生成
これまでの検証では施策効果が定数 でしたが、今回は人によって値が変わる関数 になっています。そして②により、 が大きい人(年齢が高い人)ほど施策を受けやすい、という構造です。
実行結果
真のATE(tauの平均)  : 1536.07
真のATT(処置群でのtau): 2146.74
真のATU(対照群でのtau): 1166.52
処置群の平均年齢: 48.08 / 対照群の平均年齢: 35.83
処置群の割合: 0.377
処置群は平均48歳、対照群は平均36歳と大きく分かれました。そのため、実際に施策を受けた人への効果(ATT = 2147)と、受けなかった人への効果(ATU = 1167)は倍近く違います。集団全体の平均効果(ATE)は 1536 です。
単一モデルの係数 vs G-computation
# ① 処置ダミーを1本入れただけの単一モデル
m_het = smf.ols('sales ~ treatment + age + history', data=het).fit()
ci = m_het.conf_int().loc['treatment']
print(f"単一モデルのtreatment係数: {m_het.params['treatment']:.2f} "
      f"(95%CI: [{ci[0]:.1f}, {ci[1]:.1f}])")

# ② G-computation(群ごとにモデルを作り、全員分を予測して平均)
Xh = het[['age', 'history']]
mu1 = LinearRegression().fit(Xh[t_h], het.sales[t_h]).predict(Xh)
mu0 = LinearRegression().fit(Xh[~t_h], het.sales[~t_h]).predict(Xh)
print(f"G-computation: {np.mean(mu1 - mu0):.2f}")
- 単一モデル: 処置ダミーの係数は1つしかないため、「効果は全員同じ」という制約が暗黙に課されています。
- G-computation: 群ごとに別々の回帰式を推定するため、年齢による効果の違いが自動的に反映されます。
実行結果
単一モデルのtreatment係数: 1891.61 (95%CI: [1765.2, 2018.0])
G-computation: 1630.10
真のATEは 1536.07 です。単一モデルの係数 1891.61 は、それを 355 も上回っており、しかも 95%信頼区間 [1765.2, 2018.0] は真のATEを含んでいません。統計的にはっきりと「別のもの」を推定してしまっています。
一方、G-computationは 1630.10 とATEに近い値を返しました(後述するブートストラップ信頼区間には真値が含まれます)。
なぜ係数はATEからずれるのか
Słoczyński (2022) によれば、処置ダミーを1本だけ入れた線形モデルの係数は、ATTとATUの加重平均として表せます。そして驚くべきことに、その重みはグループの大きさと逆向きにつきます。つまり「少数派のグループほど大きな重みを持つ」という性質があります。
今回のデータで確認してみましょう。処置群は全体の 37.7% と少数派です。
これを解くと となります。処置群は 37.7% しかいないのに、その効果(ATT)に74%もの重みが置かれているわけです。ATTがATEより大きいので、係数はATEより上振れします。
この重みは、分析者が選んだものではありません。OLSの計算過程で自動的に決まってしまう「暗黙の重み」です。「どんな推定対象を知りたいか」ではなく「たまたまどちらの群が少数派か」で答えが変わるというのは、意思決定に使う数値としては危うい性質です。
ATU・ATE・ATT と2つの推定値を1本の軸に並べると、係数がどこに引き寄せられているかがわかります。
(図は、diagram-designで作成)
シミュレーションで確認する
def sim_het(seed):
    d = make_het(seed=seed)
    td = d.treatment == 1
    Xd = d[['age', 'history']]
    g1 = LinearRegression().fit(Xd[td], d.sales[td]).predict(Xd)
    g0 = LinearRegression().fit(Xd[~td], d.sales[~td]).predict(Xd)
    return {
        '真のATE': d.tau.mean(),
        '単一モデルの係数': smf.ols('sales ~ treatment + age + history', data=d).fit().params['treatment'],
        'G-computation': np.mean(g1 - g0),
    }

S = pd.DataFrame([sim_het(s) for s in range(300)])
print(pd.DataFrame({'平均推定値': S.mean().round(1),
                    '標準偏差': S.std().round(1)}).to_string())
- 真のATEも一緒に記録: d.tau.mean() はデータごとに微妙に変わるため(年齢の実現値に依存します)、比較対象としてシミュレーションごとに記録しています。
- 同一データでの比較: 各シードで同じデータに対して2つの推定量を計算しているので、差は手法の違いのみを反映します。300回にするのは、2つの推定量の平均を真のATEと比べるのに十分な回数で、計算時間を抑えるためです。
実行結果
                平均推定値  標準偏差
真のATE          1500.7  18.7
単一モデルの係数       1805.2  66.5
G-computation  1501.7  68.0
300回の平均で見ると、G-computationは 1501.7 と真のATE(1500.7)をほぼ正確に捉えているのに対し、単一モデルの係数は 1805.2 と約 300 上振れし続けています。これは偶然ではなく、 構造的なズレ(バイアス) です。
G-computationの信頼区間
G-computationは「モデルの予測値を平均する」という2段構えの手続きなので、回帰の標準誤差がそのまま使えません。IPTWやDR法と同様、ブートストラップ法で求めます。
def gcomp(data):
    td = data.treatment == 1
    Xd = data[['age', 'history']]
    g1 = LinearRegression().fit(Xd[td], data.sales[td]).predict(Xd)
    g0 = LinearRegression().fit(Xd[~td], data.sales[~td]).predict(Xd)
    return np.mean(g1 - g0)

rng = np.random.default_rng(0)
boot = np.array([gcomp(het.iloc[rng.integers(0, len(het), len(het))]) for _ in range(500)])

lo, hi = np.percentile(boot, [2.5, 97.5])
print(f"G-computation: {gcomp(het):.2f} / SE: {boot.std(ddof=1):.2f} / 95%CI: [{lo:.2f}, {hi:.2f}]")
- モデルの再学習: gcomp はリサンプルされたデータを受け取り、その中で回帰モデルを学習し直します。モデルを固定してしまうと、モデル推定そのものの不確実性が標準誤差に反映されません。
- 復元抽出: rng.integers(0, len(het), len(het)) で同じサイズのインデックスを重複ありで抽出し、.iloc でデータを作り直しています。
- パーセンタイル法: 500個の推定値の 2.5% 点と 97.5% 点を信頼区間の端点としています。
実行結果
G-computation: 1630.10 / SE: 70.92 / 95%CI: [1504.61, 1766.24]
真のATE 1536.07 が区間に含まれています。単一モデルの区間 [1765.2, 2018.0] が真値を外していたのと対照的です。
「では単一モデルに交互作用を入れればよいのでは」と考えた方は正しいです。ただし、そのまま入れると treatment の係数は意味不明な値になります。
het['age_c'] = het.age - het.age.mean()
het['history_c'] = het.history - het.history.mean()

m_raw = smf.ols('sales ~ treatment * (age + history)', data=het).fit()
m_c = smf.ols('sales ~ treatment * (age_c + history_c)', data=het).fit()

print(f"中心化なし treatment係数: {m_raw.params['treatment']:.2f}")
print(f"中心化あり treatment係数: {m_c.params['treatment']:.2f}")
print(f"treatment:age_c の係数  : {m_c.params['treatment:age_c']:.2f}  (真の値: 80)")
実行結果
中心化なし treatment係数: -1565.48
中心化あり treatment係数: 1630.10
treatment:age_c の係数  : 78.55  (真の値: 80)
交互作用を入れたモデルの treatment 係数は「すべての共変量が0のときの効果」を意味します。年齢0歳・購買履歴0円という存在しない人の効果なので、−1565 という無意味な値になりました。共変量を平均で中心化すれば、係数は「平均的な人の効果」=ATEの推定値になり、G-computationの 1630.10 と完全に一致します。
交互作用の係数 78.55 は真の値 80 をよく捉えており、「年齢が1歳上がるごとに効果が約79円大きくなる」という、施策のターゲティングに直結する情報まで得られています。効果の異質性そのものに関心があるなら、メタラーナーの枠組みに進むことになります。
落とし穴②:回帰は平気で外挿する
傾向スコア系の手法では、正値性(共通サポート)が破れているとマッチング相手が見つからなかったり、重みが爆発したりして、問題が目に見える形で表面化します。
ところが回帰調整では、そうした警告はいっさい出ません。共変量の値を入れれば、モデルは必ず何らかの予測値を返します。比較対象が1人もいない領域でも、直線を伸ばして答えを作ってしまうのです。
重なりのないデータを作る
def make_nooverlap(seed=42, n=2000):
    r = np.random.RandomState(seed)
    a = np.clip(r.normal(40, 10, n), 20, 60)
    # 年齢42歳を境に、施策の受けやすさが急激に変わる
    p = 1 / (1 + np.exp(-(0.4 * (a - 42))))
    z = r.binomial(1, p)
    # 真の売上は年齢に対してU字型(2次関数)
    y = 2000 + 30 * a + 10 * (a - 40) ** 2 + 1500 * z + r.normal(0, 1000, n)
    return pd.DataFrame({'age': a, 'treatment': z, 'sales': y, 'ps': p})

nd = make_nooverlap()
tn = nd.treatment == 1

print(f"処置群の年齢: {nd.age[tn].min():.1f} 〜 {nd.age[tn].max():.1f} (n={tn.sum()})")
print(f"対照群の年齢: {nd.age[~tn].min():.1f} 〜 {nd.age[~tn].max():.1f} (n={(~tn).sum()})")
for lo_, hi_ in [(20, 30), (30, 35), (35, 40), (40, 45), (45, 50), (50, 60)]:
    sel = (nd.age >= lo_) & (nd.age < hi_)
    print(f"  年齢{lo_}〜{hi_}歳: 処置群 {int((sel & tn).sum()):4d} 人 / 対照群 {int((sel & ~tn).sum()):4d} 人")
- 年齢の範囲制限: np.clip(..., 20, 60) で年齢を現実的な範囲に収めています。
- 急峻な割り当て: シグモイドの係数を 0.4 と大きくすることで、42歳を境に処置確率が 0 から 1 へ急激に変化します。これが共通サポートの欠如を生みます。境目を42歳と平均(40歳)より少し上にしたのは、施策群が年齢の高い側に偏るようにするためです(施策を受ける割合は44%)。
- 非線形な売上: 10 * (a - 40) ** 2 により、売上は年齢に対してU字を描きます。分析者はこの2次項の存在を知らない、という設定です。係数10は、20歳と60歳で売上が4,000上がる大きさで、真の効果1500より大きいので、直線を当てはめたときのずれがはっきり出ます。
- 年齢帯ごとの内訳: ループで年齢帯を区切り、各帯に処置群・対照群が何人いるかを数えています。共通サポートの有無を目視するための確認です。
このダミーデータは、以下のデータ生成プロセスに基づいています。
① 特徴量の生成
② 施策割り当て(★共通サポートを壊す★)
③ 目的変数(売上)の生成(★年齢に対してU字★)
②のシグモイドの傾きが急なため、30歳では 、55歳では となり、年齢の両端では片方の群がほぼ存在しなくなります。
実行結果
処置群の年齢: 31.5 〜 60.0 (n=869)
対照群の年齢: 20.0 〜 54.2 (n=1131)
  年齢20〜30歳: 処置群    0 人 / 対照群  286 人
  年齢30〜35歳: 処置群    9 人 / 対照群  296 人
  年齢35〜40歳: 処置群   60 人 / 対照群  316 人
  年齢40〜45歳: 処置群  195 人 / 対照群  200 人
  年齢45〜50歳: 処置群  278 人 / 対照群   29 人
  年齢50〜60歳: 処置群  273 人 / 対照群    4 人
20代には処置群が1人もいません。50代以上の対照群も 4人だけです。つまり、これらの年齢層について「もし施策を受けていたら / 受けていなかったら」を比較で知る方法は、データ上存在しません。
年齢帯ごとの人数を左右に並べると、重なりのなさがはっきりします。
(図は、diagram-designで作成)
それでもモデルは答えを返す
def report(label, model):
    """処置効果の推定値・信頼区間・p値・決定係数をまとめて出力する"""
    lo, hi = model.conf_int().loc['treatment']
    print(f"{label}: {model.params['treatment']:7.1f} "
          f"(95%CI: [{lo:.1f}, {hi:.1f}], p={model.pvalues['treatment']:.3f}, "
          f"R2={model.rsquared:.3f})")

print(f"単純比較        : {nd.sales[tn].mean() - nd.sales[~tn].mean():.1f}")

m_lin = smf.ols('sales ~ treatment + age', data=nd).fit()
report("回帰調整(線形・誤設定)", m_lin)

m_quad = smf.ols('sales ~ treatment + age + I((age - 40)**2)', data=nd).fit()
report("回帰調整(2次項あり)  ", m_quad)

sub = nd[(nd.age >= 35) & (nd.age <= 50)]
m_sub = smf.ols('sales ~ treatment + age', data=sub).fit()
report(f"共通サポート(35-50歳, n={len(sub)})・線形", m_sub)
- 誤設定モデル: 真の関係は年齢の2次関数なのに、sales ~ treatment + age と直線を当てはめています。
- 正しい仕様: I((age - 40)**2) で2次項を追加します。statsmodelsのformulaでは、I() で囲むことで式をそのまま計算式として解釈させられます。
- トリミング: 処置群と対照群の両方が十分に存在する 35〜50歳に限定して推定し直しています。
- p値と決定係数の併記: model.pvalues と model.rsquared を一緒に出力しています。誤った推定値が、統計指標の上ではどう見えるのかを確認するためです。
実行結果
単純比較        : 2226.6
回帰調整(線形・誤設定):  1891.3 (95%CI: [1698.8, 2083.8], p=0.000, R2=0.366)
回帰調整(2次項あり)  :  1458.3 (95%CI: [1327.6, 1589.1], p=0.000, R2=0.713)
共通サポート(35-50歳, n=1078)・線形:  1419.0 (95%CI: [1270.5, 1567.5], p=0.000, R2=0.486)
真の効果は 1500 です。線形モデルは 1891.3 と大きく外し、しかも 95%信頼区間 [1698.8, 2083.8] は真値を含んでいません。それでも p値は 0.000(実際には )であり、出力だけを見れば「極めて精度よく推定できている」ようにしか見えません。
そして決定係数 は 0.366 と、2次項を入れたモデルの 0.713 に大きく劣っています。当てはまりの悪さは指標に出ているのに、それが「効果の推定値が 391 もずれている」という事実とは結びつかないのが厄介な点です。仮に共変量をもっと増やして を 0.9 まで引き上げたとしても、関数形の誤りが残っていれば推定値のズレは消えません。
何が起きているのかを図で見る
なぜこうなるのか、モデルが引いた線を実際に描いてみましょう。真の関係(U字)と、モデルの予測線を重ねます。
import matplotlib.pyplot as plt
import japanize_matplotlib

grid = np.linspace(20, 60, 200)

# 真の関係(データ生成式そのもの。ノイズと処置効果を除いたもの)
true_0 = 2000 + 30 * grid + 10 * (grid - 40) ** 2   # 施策を受けなかった場合
true_1 = true_0 + 1500                              # 施策を受けた場合

C_T, C_C = '#C44E52', '#4C72B0'
fig, axes = plt.subplots(1, 2, figsize=(13, 5), sharey=True)

for ax, model, title in [(axes[0], m_lin,  '誤設定:直線を当てはめた場合'),
                         (axes[1], m_quad, '正しい仕様:2次項を入れた場合')]:
    # 片方の群がほとんど存在しない領域を灰色で示す
    ax.axvspan(20, 35, color='gray', alpha=0.10)
    ax.axvspan(50, 60, color='gray', alpha=0.10)

    ax.scatter(nd.age[~tn], nd.sales[~tn], s=6, alpha=0.18, color=C_C)
    ax.scatter(nd.age[tn],  nd.sales[tn],  s=6, alpha=0.18, color=C_T)

    ax.plot(grid, true_0, color='k', lw=2, ls=':',  label='真の関係(対照群)')
    ax.plot(grid, true_1, color='k', lw=2, ls='--', label='真の関係(処置群)')

    # モデルが考える「もし施策を受けなかったら / 受けたら」
    pred_0 = model.predict(pd.DataFrame({'age': grid, 'treatment': 0}))
    pred_1 = model.predict(pd.DataFrame({'age': grid, 'treatment': 1}))
    ax.plot(grid, pred_0, color=C_C, lw=2.5, label='モデルの予測(対照群)')
    ax.plot(grid, pred_1, color=C_T, lw=2.5, label='モデルの予測(処置群)')

    # 2本の予測線の縦の差が、そのまま推定された処置効果になる
    xa = 42
    y0 = float(model.predict(pd.DataFrame({'age': [xa], 'treatment': [0]})).iloc[0])
    y1 = float(model.predict(pd.DataFrame({'age': [xa], 'treatment': [1]})).iloc[0])
    ax.annotate('', xy=(xa, y1), xytext=(xa, y0),
                arrowprops=dict(arrowstyle='<->', color='#55A868', lw=2))
    ax.text(xa + 1.0, (y0 + y1) / 2, f'推定効果\n{model.params["treatment"]:.0f}',
            color='#2f6b48', fontsize=11, va='center',
            bbox=dict(boxstyle='round,pad=0.3', fc='white', ec='#55A868', alpha=0.9))

    ax.set_title(title)
    ax.set_xlabel('年齢')
    ax.set_xlim(20, 60)
    ax.set_ylim(0, 12500)
    ax.text(27.5, 11300, '処置群がほぼ\nいない領域', ha='center', fontsize=9, color='dimgray')
    ax.text(55.0, 11300, '対照群がほぼ\nいない領域', ha='center', fontsize=9, color='dimgray')

axes[0].set_ylabel('売上')
handles, labels = axes[0].get_legend_handles_labels()
fig.legend(handles, labels, loc='lower center', ncol=4, fontsize=10, frameon=False)
plt.tight_layout(rect=[0, 0.07, 1, 1])
plt.show()
- 真の関係の描画: true_0 と true_1 は、データ生成式からノイズを除いたものです。分析者には見えない「正解」として重ねています。
- 反事実の予測線: model.predict に treatment=0 と 1 を渡し、全年齢について両方のケースを予測させています。データが存在しない年齢帯についても、モデルは平然と値を返します。
- 推定効果の可視化: 2本の予測線の縦方向の距離が、そのまま model.params['treatment'] になります。矢印でその幅を示しています。
- 外挿領域の明示: ax.axvspan で、片方の群がほとんど存在しない 35歳未満・50歳超を灰色に塗っています。
実行結果
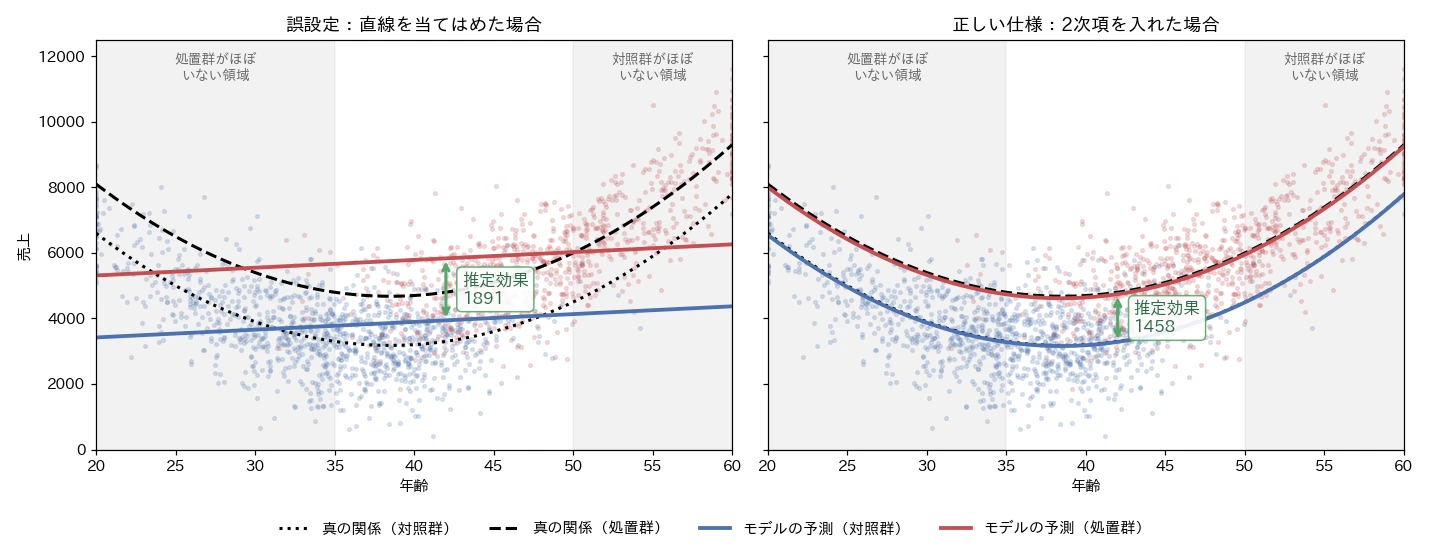
左のグラフが答えです。真の関係は下に凸のU字(黒の点線・破線)ですが、モデルは直線しか引けません。その結果、次のことが起きています。
- 対照群のデータは左側(若年層)に偏っているため、青い予測線はU字の左半分(下り坂)に引きずられ、右上がりが緩やかになります。
- 処置群のデータは右側(高年齢層)に偏っているため、赤い予測線はU字の右半分(上り坂)に合わせて持ち上がります。
- 2本の直線は、ほとんど重ならない別々の年齢帯から引かれているにもかかわらず、モデルはその縦の差を「処置効果」として報告します。
特に灰色の領域を見てください。20代の赤い線は、そこに処置群のデータが1人もいないのに引かれています。50代の青い線も同様です。これが外挿です。真の破線・点線から大きく離れているのが一目でわかりますが、推定値と信頼区間だけを見ている限り、この乖離には決して気づけません。
右のグラフでは、2次項を入れたことで予測線が真の曲線にぴたりと重なり、2本の間隔(=推定効果 1458)も真値 1500 に近づいています。
なお、共通サポートのある 35〜50歳に絞れば、誤設定の線形モデルのままでも 1419.0 と真値に近づきます。左のグラフの白い領域だけを見れば、U字はほぼ直線で近似できるためです。関数形を正しく当てるか、外挿しなくて済む範囲に限定するか、という2つの対処法があることがわかります。
今回のデータでIPTWを使えば、傾向スコアが 0 や 1 に貼り付くサンプルの重みが爆発し、有効サンプルサイズ(ESS)が激減するという形で問題が可視化されます。PSMならキャリパー内にペアが見つからず、マッチング率の低下として現れます。
回帰調整には、この安全装置がありません。分析者が意識的に確認しない限り、外挿していることに気づけないまま結果が出てしまいます。
実務では、回帰調整を使う場合でも次の診断を並行して行うことを強く推奨します。
- 処置群・対照群それぞれで、共変量の分布を重ねて可視化する
- 傾向スコアを推定して、その分布の重なり(共通サポート)を確認する
- SMD(標準化平均差)で、調整前の偏りの大きさを把握する
- 重なりが乏しい領域があれば、そこを除外した(トリミングした)結果も併記する
「回帰なら全データを使える」というのは、使えているように見えるだけの場合があります。
落とし穴③:ベースラインを入れるか、差を取るか(Lordのパラドックス)
実務で頻出するのが、「施策前後の売上データがあるとき、前期売上をどう扱うか」という問題です。選択肢は2つあります。
- ANCOVA:後期売上 ~ 施策 + 前期売上 として、前期売上を共変量に入れる
- DiD(差の差法):(後期 − 前期) の変化量を2群で比較する
どちらも自然な発想ですが、同じデータに対して違う答えを返すことがあります。これは統計学で Lordのパラドックス(Lord, 1967)として知られる現象です。
重要なのは、どちらか一方が常に正しいわけではないということです。答えは「前期売上の差が、なぜ生じたのか」によって決まります。2つのシナリオで確認してみましょう。
2つのシナリオ
以下のコードでは、2つの異なる割り当てルールでパネルデータを生成します。このうちシナリオBは、実務で極めて頻繁に登場する「平均回帰」という現象を含んでいます。
平均回帰(Regression to the Mean) とは、観測データに「たまたまの上下動(一時的な運や測定ノイズ)」が含まれるとき、1回目の測定で極端な値(極端に高い、または低い値)をとった個体は、2回目の測定では何もしなくても自然と全体の平均値へと近づく(回帰する) という統計的な現象です。
-
よくある具体例:
- 学力: 「直近のテストで赤点を取った生徒を集めて補習を行ったら、次のテストの点数が伸びた」
- マーケティング: 「直近1か月の購入金額が激減した顧客にテコ入れクーポンを配布したら、翌月の購入額が持ち直した」
これらは「補習」や「クーポン」が劇的に効いた可能性もありますが、単に 「普段の実力は人並みなのに、たまたま運悪く一時的に下振れしていた生徒・顧客が、通常の状態に戻っただけ(自然回復)」 という要素が大きく混ざっています。
-
因果推論における注意点: 「過去の観測値が低かった層」をターゲットにする施策では、必ずこの平均回帰が発生します。変化量(差)をそのまま比較する DiD を使うと、この自然回復分まで施策の成果としてカウントしてしまい、効果を大幅に過大評価してしまいます。
一方、判定基準となった前期の観測値そのものを共変量としてモデルに投入する ANCOVA であれば、平均回帰による影響をコントロールして純粋な施策効果を取り出すことができます。
def make_panel(scenario, seed=42, n=2000):
    r = np.random.RandomState(seed)
    u = r.normal(5000, 2000, n)          # 個体の「真の購買力」(観測できない)

    if scenario == 'A':
        # シナリオA: 真の購買力が高い人ほどDMが送られる(恒常的な差)
        z = r.binomial(1, 1 / (1 + np.exp(-(u - 5000) / 2000)))
        pre = u + r.normal(0, 2000, n)
    else:
        # シナリオB: 観測された前期売上が低かった人にDMを送る(平均回帰が起きる)
        pre = u + r.normal(0, 2000, n)
        z = r.binomial(1, 1 / (1 + np.exp((pre - 5000) / 2000)))

    # 真の効果は +1000、共通トレンドは +300
    post = u + 300 + 1000 * z + r.normal(0, 2000, n)
    return pd.DataFrame({'pre': pre, 'post': post, 'treatment': z})

rows = []
for sc in ['A', 'B']:
    d = make_panel(sc)
    tz = d.treatment == 1
    rows.append({
        'シナリオ': sc,
        '前期の平均(処置群)': round(d.pre[tz].mean(), 1),
        '前期の平均(対照群)': round(d.pre[~tz].mean(), 1),
        '単純比較': round(d.post[tz].mean() - d.post[~tz].mean(), 1),
        'DiD': round((d.post - d.pre)[tz].mean() - (d.post - d.pre)[~tz].mean(), 1),
        'ANCOVA': round(smf.ols('post ~ treatment + pre', data=d).fit().params['treatment'], 1),
    })
print(pd.DataFrame(rows).to_string(index=False))
- シナリオA: 割り当てが「観測できない真の購買力 」に依存します。前期売上の差は恒常的な個体差を反映しています。
- シナリオB: 割り当てが「観測された前期売上」に依存します。前期売上の差には たまたまの上下動(測定ノイズ) が含まれており、平均回帰が起きます。前期売上のノイズの標準偏差を、個体差 と同じ2000にするのは、前期売上のうち個体差の占める割合が半分(後の )になり、平均回帰がはっきり出るためです。
- 真の効果はどちらも +1000、共通トレンドも +300 で同じです。違いは「なぜ前期に差がついたか」だけです。
このダミーデータは、以下のデータ生成プロセスに基づいています。
① 共通部分
② 割り当てのしかた(ここだけがシナリオ間の違い)
シナリオAは が高い人ほど処置を受け、シナリオBは が低い人ほど処置を受けます(指数部の符号が反転している点に注意してください)。 には測定ノイズ が乗っているため、シナリオBの処置群には「たまたま前期に落ち込んだだけの人」が多く含まれ、平均回帰が発生します。
実行結果
シナリオ  前期の平均(処置群)  前期の平均(対照群)   単純比較    DiD  ANCOVA
   A      5875.0      4154.0 2726.0 1005.0  1950.5
   B      3690.1      6509.6 -476.6 2342.9   927.3
見事に結果が割れました。
- シナリオA:DiDが 1005.0 とほぼ正解。ANCOVAは 1950.5 と約2倍に過大評価。
- シナリオB:ANCOVAが 927.3 と正解に近い。DiDは 2342.9 と2倍以上に過大評価。
なぜこうなるのか
シナリオA(恒常的な個体差) では、処置群はもともと購買力が高い集団です。この差は前期も後期も同じように効き続けるので、差を取れば消えます。DiDが機能する理由です。
一方、ANCOVAは「前期売上が同じ人同士を比べる」という調整をしますが、前期売上には測定ノイズが混じっています。前期売上が同じ 5000円 でも、処置群の人は「真の購買力 4500 + 上振れ 500」、対照群の人は「真の購買力 5500 + 下振れ 500」かもしれません。前期売上で条件付けても、観測できない購買力の差は残ってしまうのです(測定誤差による過少調整)。
シナリオB(平均回帰) では話が逆転します。処置群は「たまたま前期に落ち込んだ人」です。彼らは施策がなくても、後期には平均へ戻って(=回復して)きます。DiDはこの自然な回復分まで「施策の効果」として計上してしまうため、大幅に過大評価します。「売上が落ちた顧客にテコ入れする」という、実務で極めてよくある施策設計で必ず起きる問題です。
ANCOVAは前期売上そのもので条件付けるため、この平均回帰を正しく差し引けます。
数式で確かめる
直感的な説明を、データ生成プロセスの式に戻って確認します。もう一度、共通部分の式を並べます。
真に知りたいのは という係数です。邪魔をするのは、観測できない (真の購買力)、(前期のたまたまの上下動)、(後期のたまたまの上下動)の3つです。2つの手法は、このうち何を消し、何を残すのかが違います。
DiDが消すもの:
変化量を取ると、 が引き算で消えます。
この差を2群(処置群 と 対照群 )で比較するので、DiD推定量は次のように分解できます。
は完全に消えているので、 が とどれだけ強く相関していても構いません。逆に、 が と相関していたら(=割り当てがノイズに依存して となったら)アウトです。
ANCOVAが消すもの: で説明できる範囲の
ANCOVAは を共変量に入れます。 と がともに標準偏差 の正規分布なので、 から を予測すると次のようになります。
数式の導出過程(2変量正規分布の条件付き期待値)
の導出は、正規分布の線形結合から得られる「2変量正規分布の条件付き期待値の公式」に基づいています。
① 各変数の期待値・分散・共分散
- 、 であり、 と は互いに独立です()。
- より、
- 期待値:
- 分散:
- 共分散:
② 2変量正規分布の条件付き期待値 と はともに正規分布に従うため、ベクトル は2変量正規分布に従います。一般に、 が与えられたときの の条件付き期待値は、回帰係数を として以下のように表されます。
ここに 、 を代入すると、
③ パラメータの代入 、 なので、
となり、 が得られます。この は計量経済学や心理統計学で「信頼性係数(Reliability Ratio)」と呼ばれ、「観測された分散のうち真のシグナルが占める割合」を表します。
この という数字が、ANCOVAの命運を分けます。意味するところは 「前期売上()を見ても、その人の真の実力()のばらつきのうち半分しか見通せず、残り半分は霧の中に隠れたままになる」 ということです。3つの角度から確認します。
① 具体例:前期売上が平均より1,000円高かった人
ある人の前期売上が、平均の 5,000円 より 1,000円 高い 6,000円 だったとします。この人の真の実力 はいくらと見積もるべきでしょうか。
売上は「真の実力 」と「たまたまの運 」の足し算()です。そして今回の設定では、実力のばらつき()と運のばらつき()が 1対1の五分五分です。
となれば、1,000円 高かった理由の内訳として最も尤もらしいのは、
- +500円:本人の実力 が高かったから
- +500円:たまたま運 が良かったから
という半々の配分です。これを式にしたものが、まさに先ほどの条件付き期待値です。
観測された売上が平均からどれだけ離れていようと、そのズレのうち半分しか実力に起因するものとして説明できないわけです。
② 分散で見る: から を予測したときの は 0.5
同じことを、ばらつき(分散)の分解として見てみます。
| 分散 | 全体に占める割合 | |
|---|---|---|
| 実力 全体のばらつき | 100% | |
| で説明できたばらつき | 50% | |
| 説明できずに残ったばらつき | 50% |
回帰分析の言葉にすれば、「 から を予測する回帰モデルの決定係数 が、ちょうど 0.5 にしかならない」 ということです。残差 の標準偏差は 円で、依然として無視できない大きさです。
③ なぜこれがANCOVAで問題になるのか:過少調整
ここが核心です。ANCOVAで を共変量に入れた目的は、グループ間の実力差 を打ち消すことでした。
- もし測定ノイズがまったくなければ(、つまり ): なので、 を入れれば実力差は 100% 消し去れます。
- 今回のようにノイズがあると(): を入れても、実力差は 半分しか 打ち消せません。
消しきれなかった残り半分の実力差 は、データの中にそのまま生き残ります。そしてシナリオAのように「もともと実力が高い層に施策を打った」場合、調整したつもりでも実力差の半分しか相殺できておらず、残った差がそのまま「施策の効果」として計上されてしまいます。
これは統計学で 測定誤差による過少調整(under-adjustment due to measurement error) と呼ばれる現象です。共変量に測定誤差が含まれるとき、回帰による調整は常に「効きが甘くなる」方向に働きます。
本記事はシミュレーションなので と分かっており、 と計算できました。しかし実務では、観測された前期売上のうちどこまでが実力でどこからが運なのかを知る手立てはありません。
つまり 「ANCOVAがどの程度過少調整になっているか」は、原理的に確かめられない ということです。だからこそ、次に述べるように「施策の対象を何を見て選んだか」というデータの外側の知識が判断の決め手になります。
説明しきれずに残る成分を と置き、 を の式に代入すると、次のように整理できます。
ここで、ANCOVAで推定している回帰式は「後期売上 ~ 施策 + 前期売上」でした。
この回帰モデルにおいて、関心のある施策効果を表す係数が (前期売上の係数が )です。上の展開式をこの回帰モデルに当てはめると、施策効果の推定量 は次のように分解できます。
は の一部として制御されるので、 が と相関していても問題ありません。逆に、 で条件付けた後も が と相関していたらアウトです。
シナリオごとに当てはめる
2つの手法の「アウトになる条件」が、ちょうど裏返しになっている点に注目してください。
| の生成元 | と | と | DiD | ANCOVA | |
|---|---|---|---|---|---|
| シナリオA | 無相関 ✓ | 相関あり ✗ | 正しい | 過大評価 | |
| シナリオB | 相関あり ✗ | 無相関 ✓ | 過大評価 | 正しい |
- シナリオA: は だけから決まり、 とは独立なのでDiDは無傷です。一方 は「 で説明しきれなかった の残り」なので、 で選ばれた とはどうしても相関します。
- シナリオB: は だけの関数なので、 で条件付ければ は とも とも独立になり、ANCOVAは正しく働きます。一方 を通じて は と強く相関するため、DiDが壊れます。
分解を数値で確認する
通常は観測できない ・・ を取り出して、上の分解が実際に成り立つかを確かめます。
def make_panel_detail(scenario, seed=42, n=2000):
    # 隠れた成分(U, η, ε)も一緒に返すバージョン
    r = np.random.RandomState(seed)
    u = r.normal(5000, 2000, n)

    if scenario == 'A':
        z = r.binomial(1, 1 / (1 + np.exp(-(u - 5000) / 2000)))
        eta = r.normal(0, 2000, n)
        pre = u + eta
    else:
        eta = r.normal(0, 2000, n)
        pre = u + eta
        z = r.binomial(1, 1 / (1 + np.exp((pre - 5000) / 2000)))

    eps = r.normal(0, 2000, n)
    post = u + 300 + 1000 * z + eps
    return pd.DataFrame({'u': u, 'eta': eta, 'eps': eps,
                         'pre': pre, 'post': post, 'treatment': z})

for sc in ['A', 'B']:
    d = make_panel_detail(sc)
    tz = d.treatment == 1

    # Pre で説明しきれなかった U の残り(λ = 0.5)
    d['v'] = d.u - (5000 + 0.5 * (d.pre - 5000))

    # DiD の分解
    did = (d.post - d.pre)[tz].mean() - (d.post - d.pre)[~tz].mean()
    d_eps = d.eps[tz].mean() - d.eps[~tz].mean()
    d_eta = d.eta[tz].mean() - d.eta[~tz].mean()

    # ANCOVA の分解(OLSは目的変数について線形なので、成分ごとの係数が足し合わさる)
    anc = smf.ols('post ~ treatment + pre', data=d).fit().params['treatment']
    c_v = smf.ols('v ~ treatment + pre', data=d).fit().params['treatment']
    c_eps = smf.ols('eps ~ treatment + pre', data=d).fit().params['treatment']

    print(f"--- シナリオ{sc} ---")
    print(f"DiD    = {did:7.1f} = 1000 + ε差({d_eps:7.1f}) - η差({d_eta:8.1f})")
    print(f"ANCOVA = {anc:7.1f} = 1000 + Vの寄与({c_v:6.1f}) + εの寄与({c_eps:7.1f})")
- 隠れた成分の取り出し: 乱数の生成順序は元の make_panel と同一なので、生成されるデータもまったく同じです。違いは ・・ を返すかどうかだけです。
- 残差成分 の計算: d.u - (5000 + 0.5 * (d.pre - 5000)) で、 から予測できる分を引いた「残り」を求めています。 は上で導出した です。
- ANCOVAの分解: OLSは目的変数について線形なので、post を成分に分けてそれぞれ同じ説明変数で回帰すると、各係数の合計が元の係数に一致します。
実行結果
--- シナリオA ---
DiD    =  1005.0 = 1000 + ε差(   10.3) - η差(     5.3)
ANCOVA =  1950.5 = 1000 + Vの寄与( 945.0) + εの寄与(    5.5)
--- シナリオB ---
DiD    =  2342.9 = 1000 + ε差( -174.6) - η差( -1517.5)
ANCOVA =   927.3 = 1000 + Vの寄与( 111.9) + εの寄与( -184.6)
分解がぴったり足し合わさっていることが確認できます。そして、バイアスの正体もはっきりしました。
- シナリオAのANCOVA: の寄与が +945.0。 で条件付けても消しきれなかった購買力の差が、そのまま効果に上乗せされています。一方 の群間差は とほぼゼロなので、DiDは無傷です。
- シナリオBのDiD: の群間差が −1517.5。処置群は前期にたまたま 1517円 も落ち込んでいた集団であり、その分が自然に回復するだけで効果として計上されます。式の上では の上乗せです。一方 の寄与は と小さく、ANCOVAはほぼ正しい値を返しています。
2つのシナリオの結果を並べると、次のようになります。
(図は、diagram-designで作成)
どちらを選ぶか
| ANCOVA(前期を共変量に) | DiD(差を取る) | |
|---|---|---|
| 暗黙の仮定 | 前期売上で条件付ければ割り当てが無視できる | 施策がなければ2群の変化量が等しい(平行トレンド) |
| 得意なケース | 観測された前期の値で対象を選んだ(平均回帰がある) | 恒常的な群間差がある(時間不変の交絡) |
| 苦手なケース | ベースラインに測定ノイズが大きいと過少調整になる | 平均回帰があると効果を過大評価する |
実務での判断基準はシンプルです。
「施策の対象を、何を見て選んだか」を思い出す。
- 「前期の売上が落ちた顧客リストを抽出してDMを送った」→ 選択基準は観測された前期の値。ANCOVAが適切。
- 「もともと優良顧客の層に継続的にDMを送っている」→ 選択基準は恒常的な属性。DiDが適切。
- どちらか判断がつかない場合は、両方を報告する。結果が大きく食い違うなら、それ自体が「割り当ての仕組みを調べ直すべき」というシグナルです。
平行トレンドの仮定についてはDiDの記事で詳しく解説しています。
落とし穴④:モデルの誤設定
最後に、回帰調整の根本的な弱点に触れておきます。落とし穴②で既に片鱗が見えていましたが、回帰調整は「結果の構造を正しくモデル化できている」ことに全面的に依存します。
厄介なのは、この誤設定が予測精度の指標では検出できないことです。 が 0.9 を超えていても、処置群と対照群で当てはめられる曲線の形が少しずれていれば、その差はそのまま効果の推定バイアスになります。 は「売上全体のばらつきをどれだけ説明できたか」を測る指標であって、「処置群と対照群の比較が妥当か」はまったく測っていないためです。
落とし穴②で見た通り、p値が という水準でも推定値は 391 ずれていました。統計ソフトの出力に並ぶ指標のどれを見ても、この誤りは警告として現れません。
この問題への対処として、大きく3つの方向があります。
- 柔軟なモデルを使う:多項式項、スプライン、あるいは勾配ブースティングなどの機械学習モデルを に用いる。ただし過学習による新たなバイアスに注意が必要です。
- 傾向スコア系の手法と併用する:PSMやIPTWは結果の構造を仮定しないため、回帰調整と結果を突き合わせることで相互チェックになります。
- 両方を組み合わせる:アウトカム回帰と傾向スコアを1つの推定量に統合し、どちらか一方さえ正しければよいという性質を持たせる。
3番目のアプローチが、DR法の記事で解説する 二重にロバストな推定法(DR法 / AIPW) です。本記事で組み立てたG-computationは、その推定量の「半分」にあたる重要な部品になります。
回帰による効果推定を成立させる前提条件
観察データに回帰調整を適用する場合、PSMの記事で整理した3つの前提条件がそのまま必要です。加えて、回帰特有の条件が加わります。
- 強く無視できる割り当て:交絡因子がすべて観測されていること。傾向スコア系と共通の、最も重要かつ検証不能な仮定です。
- 正値性(共通サポート):落とし穴②で見た通り、回帰では破れていても表面化しません。自分で確認しに行く必要があります。
- SUTVA:他のユーザーへの波及効果がないこと。
- モデルの正しい設定(回帰特有):共変量と結果の関係を、関数形まで含めて正しく表現できていること。
- 処置後の変数を共変量に入れないこと:施策の影響を受けて変化する変数を調整すると、効果の一部を消してしまったり、新たなバイアス(コライダーバイアス)を生んだりします。「割り当て前に確定している変数だけを使う」が原則です。
メリットとデメリット
メリット
- 手軽で高速:ライブラリ1行で実行でき、計算コストも低い。統計ツールを問わず実装できます。
- 精度(分散)が高い:モデルが当たっていれば、傾向スコア系より標準誤差が小さくなります。RCTでのANCOVAは、コストゼロで検出力を上げる定番の手法です。
- 共変量が多くても扱いやすい:マッチングのように次元の呪いに直面しにくい構造です。
- 解釈が明快:「年齢の影響を差し引いた上での効果」という説明が通じやすく、他の分析とも接続しやすい。
デメリット
- モデルの誤設定に弱い:関数形を間違えれば、そのままバイアスになります。しかも予測精度の指標では気づけません。
- 外挿の危険が見えない:共通サポートが乏しくても警告が出ず、自信満々に誤った答えを返します。
- 処置ダミーの係数はATEとは限らない:効果に異質性があると、意図しない推定対象(ATTとATUの奇妙な加重平均)を推定してしまいます。
- ステークホルダーが「係数」を効果だと思い込みやすい:出力表の1行を見れば済むという手軽さが、かえって上記の落とし穴を見えなくします。
まとめ
本記事では、因果推論におけるもう1つの系譜である「回帰によるアウトカムのモデル化」を整理しました。
- RCTでのANCOVAは「精度」の話:500回シミュレーションの結果、単純差もANCOVAもバイアスはゼロでしたが、標準偏差は 112.5 → 44.4 と大きく改善しました。共変量は推定値を正す道具ではなく、当たり外れの幅を狭める道具です。
- 観察データでの回帰調整は「バイアス」の話:単純比較 3303 に対し、回帰調整は 1445 と真の効果 1500 を捉えました。ただしこれは、モデルの仮定がデータ生成プロセスと一致していたからこその成績です。
- 処置ダミーの係数はATEではない:効果に異質性があるデータでは、係数 1891.6 に対し真のATEは 1536.1 でした。OLSはATTとATUを「少数派に大きな重みを置く」形で混ぜてしまいます。群ごとにモデルを作り、全員分を予測して平均するG-computation(1630.1、ブートストラップ95%CIに真値を含む)が正しい手続きです。
- 回帰は共通サポートの外へ平気で外挿する:重なりのないデータで、線形モデルは 1891.3(95%CI [1698.8, 2083.8])と真値 1500 を区間ごと外しました。診断は手法に組み込まれていないので、分析者が自分で行う必要があります。
- ANCOVAとDiDの選択は仮定の選択:同じ真の効果 +1000 のデータでも、シナリオAではDiDが正解(1005.0)でANCOVAが誤り(1950.5)、シナリオBでは逆に ANCOVA が正解(927.3)でDiDが誤り(2342.9)でした。 「施策の対象を何を見て選んだか」 が判断の起点になります。
「回帰を回すだけ」という手軽さの裏側には、これだけの判断が潜んでいます。逆に言えば、これらを意識して使えば、回帰調整は最もコストパフォーマンスの高い効果測定手法の1つです。
関連する手法
回帰調整は「結果の構造」に賭け、IPTWは「割り当ての構造」に賭けます。どちらも、賭けが外れれば推定値は壊れます。そして実務では、どちらのモデルが正しいかを事前に知る方法はありません。
この2つを組み合わせることで「どちらか一方さえ正しければよい」という性質を手に入れる手法、二重にロバストな推定法(DR法 / AIPW)は、DR法の記事で解説しています。本記事で組み立てたG-computationが、そのまま推定量の骨格として使われます。
参考文献
- D. A. Freedman (2008). On regression adjustments in experiments with several treatments. The Annals of Applied Statistics, 2(1), 176–196.
- W. Lin (2013). Agnostic notes on regression adjustments to experimental data: Reexamining Freedman’s critique. The Annals of Applied Statistics, 7(1), 295–318.
- S. R. Künzel, J. S. Sekhon, P. J. Bickel, B. Yu (2019). Metalearners for estimating heterogeneous treatment effects using machine learning. Proceedings of the National Academy of Sciences, 116(10), 4156–4165.
- T. Słoczyński (2022). Interpreting OLS Estimands When Treatment Effects Are Heterogeneous: Smaller Groups Get Larger Weights. The Review of Economics and Statistics, 104(3), 501–509.
本記事の文章・構成の一部に生成AIを使用しています。