REINFORCEアルゴリズムとは?
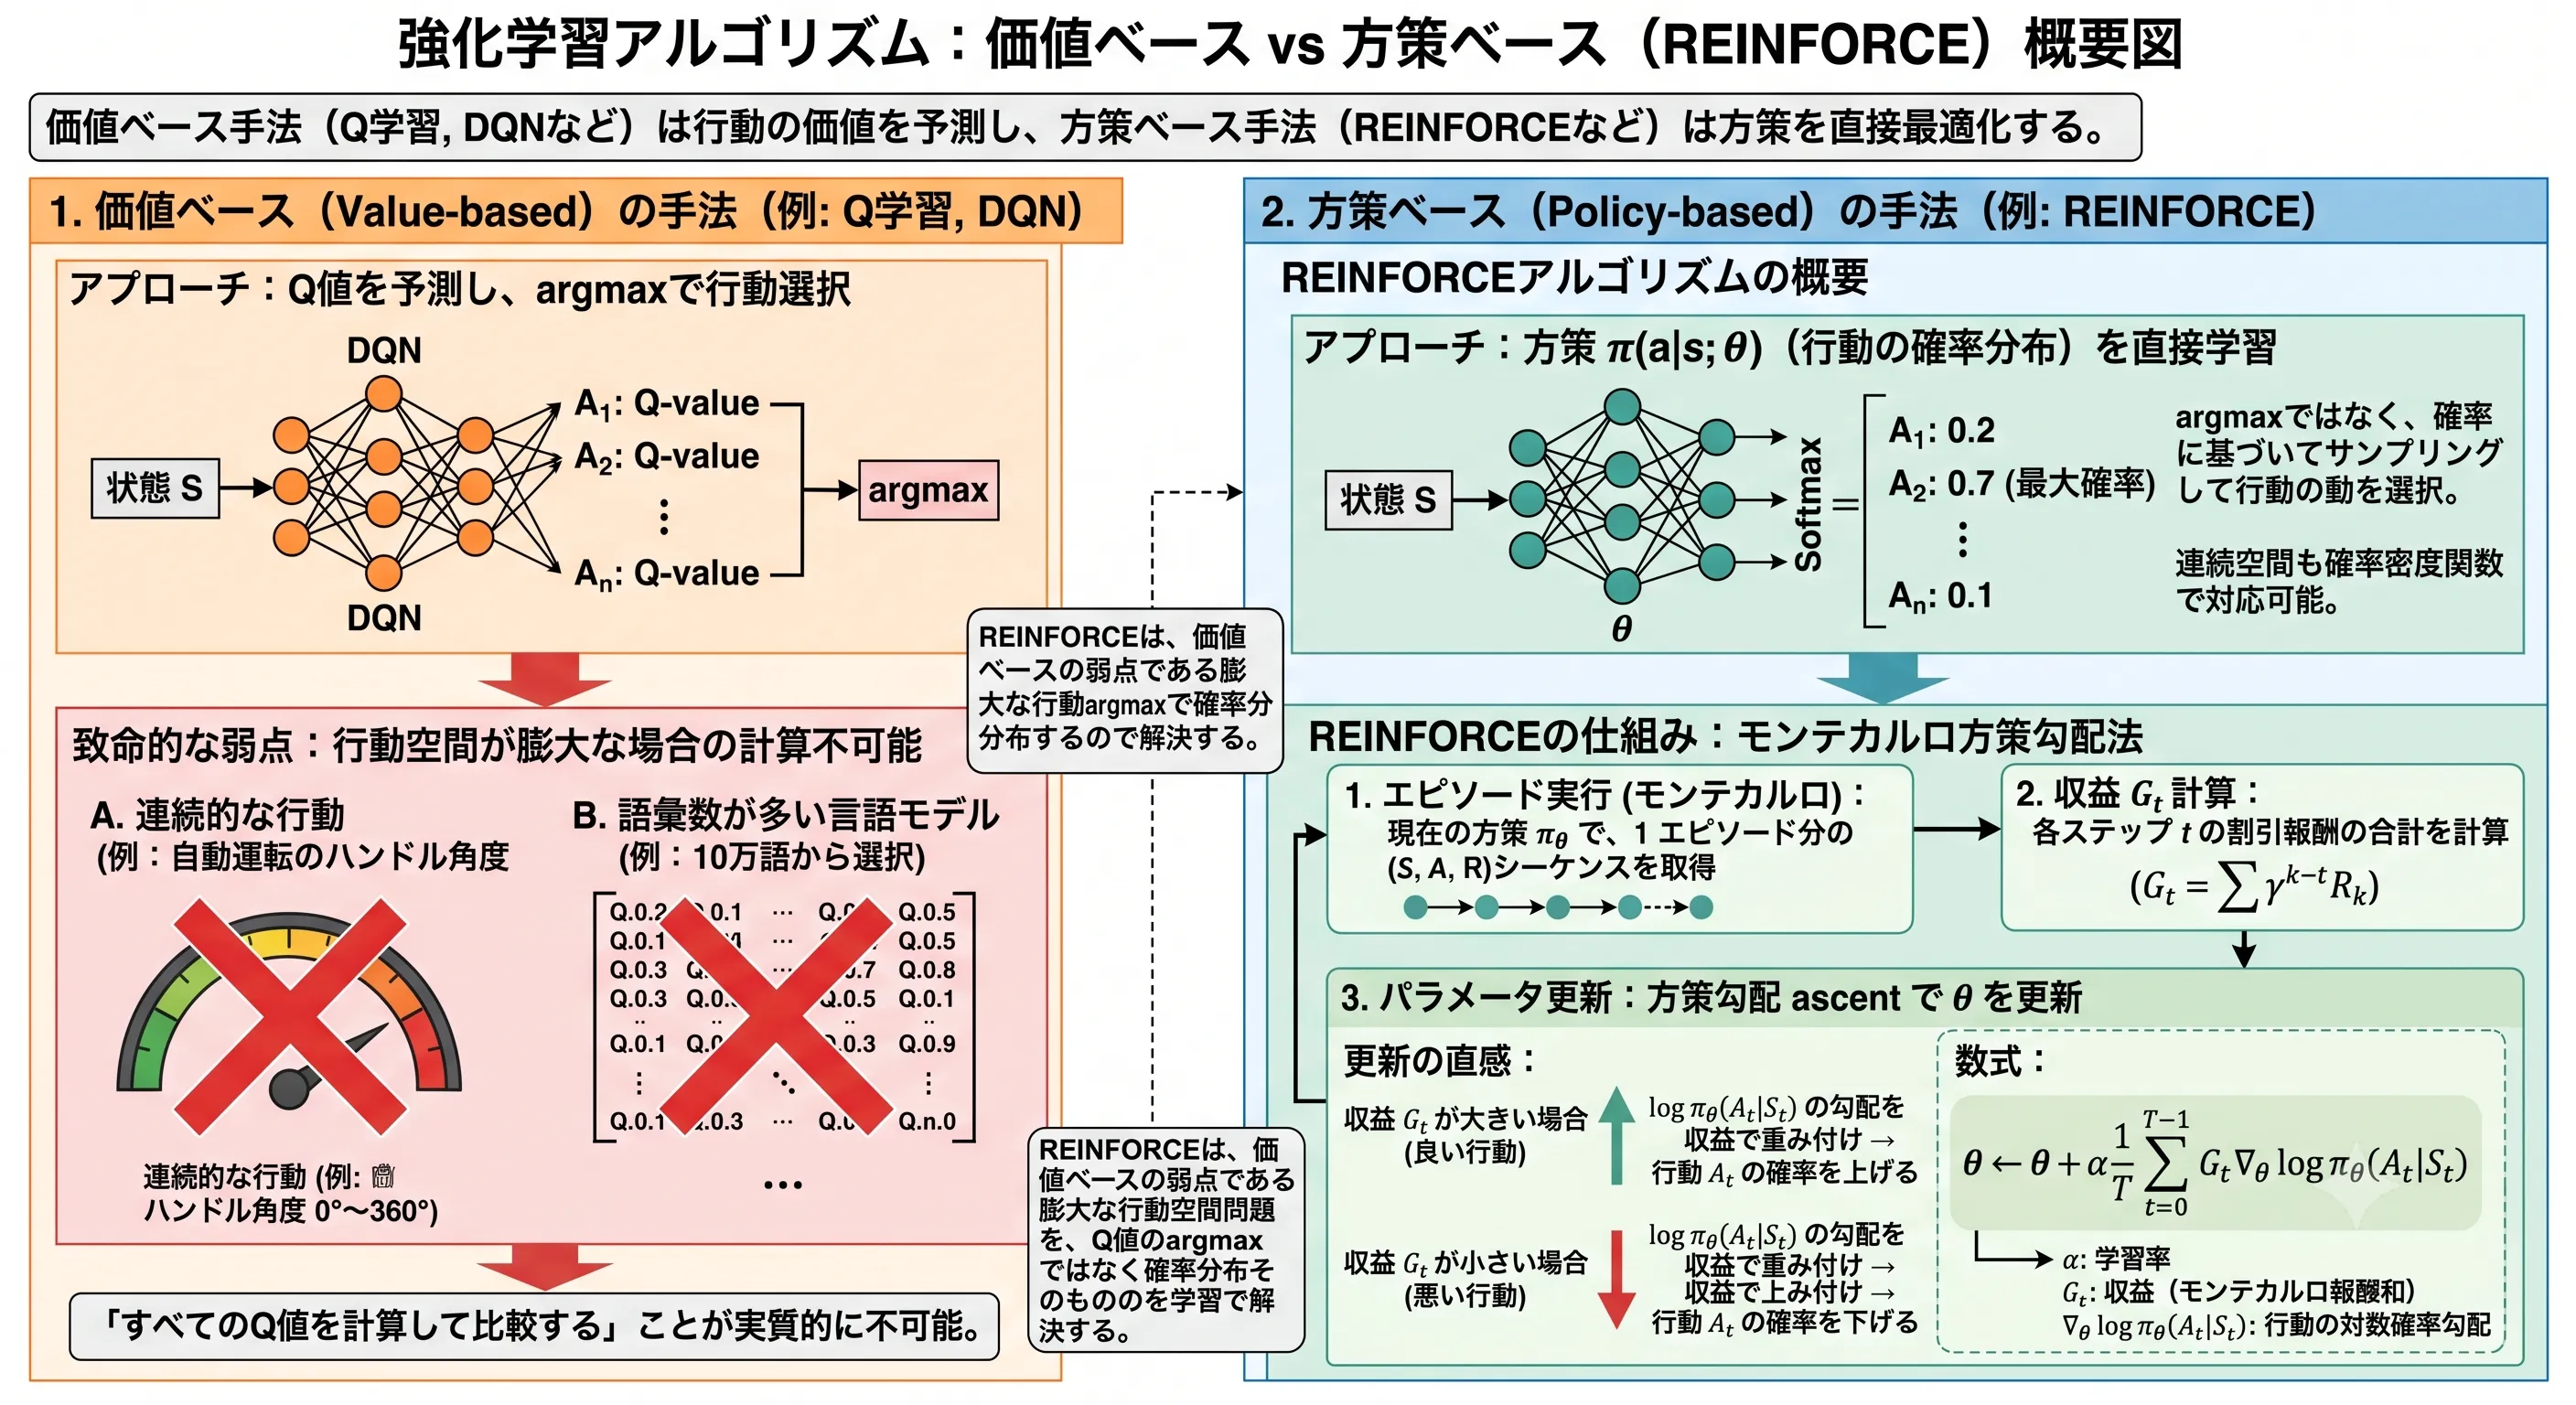
(画像は、Geminiで作成)
Q 値ではなく方策(行動の確率)を直接最適化する方策勾配法の考え方と、その原点である REINFORCE の更新式を理解すること。CartPole でのスクラッチ実装で、REINFORCE で学習できる一方、収益のばらつき(分散)が大きいために学習が崩れることを確かめ、A2C・PPO へ発展した理由を説明できるようになること。
REINFORCEアルゴリズムの概要
これまで「Q学習」や「DQN」といった、行動の価値(Q値)を予測する価値ベース(Value-based) の強化学習アルゴリズムを見てきました。価値ベースの手法は「すべての行動のQ値を計算し、その中から最もQ値が高い行動を選ぶ(argmax)」というアプローチをとります。
しかし、このアプローチには弱点があります。1 つは、連続的な行動空間(例: 自動運転のハンドルの角度)では、行動が無数にあるので、「すべての行動の Q 値を計算して比較する」ことができず、Q 値が最大になる行動を探すこと自体が別の最適化問題になってしまう点です。もう 1 つは、argmax で選ぶ方策は決定的で、「状況によって確率的に行動を選ぶ」方策を直接表せない点です。
そこで登場するのが、すべての行動の価値を調べるのではなく、方策(行動をとる確率分布)そのものを直接最適化する方策ベース(Policy-based) の手法です。本記事では、その原点であるアルゴリズムREINFORCEについて解説します。
REINFORCEの処理概要
REINFORCE(モンテカルロ方策勾配法)は、ニューラルネットワークを用いて「ある状態 で特定の行動 をとる確率 」を出力し、それが良い結果をもたらしたならその確率を上げ、悪い結果なら下げるという直感的なアプローチをとります。
方策勾配定理 (Policy Gradient Theorem) とその導出
方策ベースの目標は、「得られる総報酬の期待値」を最大化するように、ネットワークのパラメータ を更新することです。 いきなり最終的な数式を見ると難しく見えますが、順を追って考えると非常に直感的です。
1. 目的関数の定義(何を最大化したいか?)
まず、ある方策 に従ってゲームを最初から最後までプレイしたときの「状態と行動の連続(軌跡)」を (タウ)とし、そのプレイで得られた最終的な総報酬を とします。 目的関数 は、方策 によって得られる総報酬の期待値(平均スコア) として定義されます。
(※連続値の場合は和の代わりに積分になります) ここで は、パラメータ の方策に従ったときに、その特定のプレイ履歴 が発生する確率です。
2. パラメータの更新方向(勾配)を求める
スコアの期待値 を最大化したいので、これを で微分(勾配を計算)します。報酬 自体はパラメータ に依存しない(ただのゲームの得点)ため、微分は確率 にのみかかります。
しかし、このままでは計算ができません。私たちが知りたいのは期待値(実際にプレイして得られたデータの平均)として計算できる形です。
3. 「対数微分のトリック(Log-derivative trick)」の活用
ここで、対数関数の微分と合成関数の微分から得られる関係 (つまり )を利用します。これを先ほどの式に当てはめます。
式の中に再び (確率)が現れました。確率を掛けてすべてのパターンを足し合わせることは、すなわち期待値を取ることと同じです。これにより、数式が「実際にプレイした結果()から計算できる期待値」の形に変わります!()
4. 軌跡の確率をステップごとに分解する
軌跡の確率 は、各ステップでの「方策による行動確率」と「環境の遷移確率(初期状態 や状態遷移 )」の掛け算で表されます。
対数(log)をとると、掛け算はすべて足し算に変わります。 さらに、「環境の遷移確率( および )」は私たちのパラメータ には依存しない(ゲームのルール自体は変えられない)ため、 で微分するとすべてゼロになって消えます。 残るのは「自分の方策がその行動を選んだ確率」の対数微分だけになります。
5. 最終的な方策勾配定理
さらに因果関係(過去の行動は未来の報酬にしか影響しない)を考慮し、 を「時刻 以降の割引報酬和 ()」に置き換えます。これにより、最終的な方策勾配定理の数式が導出されます。
(厳密には、過去の報酬を除いても期待値は変わりませんが、割引率 を掛けた を使うと、割引しない総報酬の勾配からは少しずれます。実装では、遠い将来の報酬ほど行動との関係が薄いので、このずれを許して のような値を使うのが一般的です。)
エピソードを最後までやり切って実際の収益 を計算し、学習の評価指標として用いるこのアプローチは、まさにモンテカルロ法の考え方そのものです。REINFORCEが別名「モンテカルロ方策勾配法」と呼ばれる理由はここにあります。基礎となる収益の計算やモンテカルロ推定の仕組みを復習したい方は、モンテカルロ法(Monte Carlo Method)とは?の記事もあわせてご覧ください。
【数式の意味(直感的な理解)】 この式は非常にシンプルで強力なメッセージを持っています。
- は、「その行動をとる確率を上げるためのパラメータの更新方向」を指します。
- は、その行動をとった結果として将来得られた報酬です。
つまり、「結果()が良かった行動は、その確率を上げる方向にパラメータを大きく更新し、結果が悪かった(マイナスだった)行動は、その確率を下げる」 という、極めて直感的な学習の仕組みが数式として証明されているのです。
ここまでの導出の流れを図にまとめると、次のようになります。
(図は、diagram-designで作成)
アルゴリズムの流れ
- 現在の方策 に従ってエピソードを最後まで実行し、状態・行動・報酬の軌跡(Trajectory)を収集する。
- 各ステップ における割引報酬和 を計算する。
- を計算し、勾配上昇(Gradient Ascent)によってパラメータ を更新する。
REINFORCEの実装(概念的なシンプルな実装)
以下では、REINFORCEのシンプルなPyTorch実装を示します。
方策ネットワークとREINFORCEの更新ステップ関数の定義
ここでは、ニューラルネットワークを用いて「状態から各行動の選択確率を出力する」ための 方策ネットワーク(PolicyNetwork) と、集めたプレイ結果(対数確率と報酬)をもとに方策勾配定理の数式に従ってパラメータを更新する 学習用関数(update_policy) を定義します。
import torch
import torch.nn as nn
import torch.optim as optim
from torch.distributions import Categorical

# 方策ネットワークの定義
class PolicyNetwork(nn.Module):
    def __init__(self, state_dim, action_dim):
        super(PolicyNetwork, self).__init__()
        self.fc = nn.Sequential(
            nn.Linear(state_dim, 128),
            nn.ReLU(),
            nn.Linear(128, action_dim),
            nn.Softmax(dim=-1) # 行動の確率分布を出力
        )

    def forward(self, x):
        return self.fc(x)

# REINFORCEの更新ステップ
def update_policy(policy_net, optimizer, log_probs, rewards, gamma=0.99):
    discounted_rewards = []
    R = 0
    # 後ろから割引報酬和 G_t を計算
    for r in reversed(rewards):
        R = r + gamma * R
        discounted_rewards.insert(0, R)

    discounted_rewards = torch.tensor(discounted_rewards)
    # ベースラインの導入(平均0、分散1に正規化することで分散の爆発を抑え、学習を安定化させる)
    if len(discounted_rewards) > 1:
        discounted_rewards = (discounted_rewards - discounted_rewards.mean()) / (discounted_rewards.std() + 1e-9)

    policy_loss = []
    for log_prob, G_t in zip(log_probs, discounted_rewards):
        # 勾配上昇を行うため、マイナスをつけて最小化問題にする
        policy_loss.append(-log_prob * G_t)

    optimizer.zero_grad()
    loss = torch.stack(policy_loss).sum()
    loss.backward()
    optimizer.step()
方策勾配定理の式を、方策ネットワークと 1 回分の更新の関数にしたコードです。この 2 つは、次の CartPole の学習でそのまま使います。
- 方策ネットワーク(PolicyNetwork): 状態(CartPole では 4 次元)を受け取り、隠れ層 128 を通して、最後に nn.Softmax(dim=-1) で合計が 1 になる行動の確率 を出力します。確率を出力するのは、方策勾配定理が「行動の確率をどちらに動かすか」で書かれているからで、DQN のように価値を出力して argmax で選ぶのとは違います。隠れ層の 128 は、PyTorch の公式のサンプル(pytorch/examples の reinforce.py)と同じ大きさです。公式のサンプルは Dropout(0.6)も入れていますが、ここでは方策勾配の仕組みだけを見るために省いています。
- 割引報酬和 : for r in reversed(rewards) でエピソードの最後から逆向きにたどり、 で各時刻の を求めます。前から計算すると時刻ごとに未来の報酬を足し直すことになりますが、後ろからなら 1 回のループで済みます。gamma=0.99 は、公式のサンプルと同じ値です。
- の正規化: discounted_rewards を、エピソードの中で平均 0・標準偏差 1 にそろえます(公式のサンプルと同じ処理です)。CartPole の報酬は毎ステップ +1 なので、正規化しないと はすべて正になり、どの行動の確率も上げる方向に更新されます。平均を引くと、エピソードの中で「後に続く報酬が平均より多かった行動」の確率を上げ、「少なかった行動」の確率を下げるようになります。標準偏差で割るのは、エピソードの長さによって の大きさ(最大で約 100)が変わっても、更新の大きさがそろうようにするためです。なお、これは状態ごとの価値を引く本来のベースライン(A2C の Critic)とは違い、エピソードの中の平均を引くだけの簡易な方法です。
- 損失と勾配上昇: PyTorch の最適化手法は損失を最小化するので、最大化したい にマイナスを付けた -log_prob * G_t を足して損失にします。loss.backward() で が計算され、optimizer.step() で が勾配上昇の向きに動きます。対数確率 は、次のコードでプレイしながら m.log_prob(action) で計算し、log_probs にためておいたものです。
CartPoleでの性能評価
実際に gymnasium ライブラリの CartPole-v1 環境(カートを左右に動かして棒を倒さないようにする課題。1 ステップ立てるごとに報酬 +1、500 ステップで打ち切り)を用いて、REINFORCEアルゴリズムでエージェントを学習させる完全なコードを紹介します。
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt

def train_reinforce():
    env = gym.make('CartPole-v1')
    # 前のセルで定義したネットワークを利用
    policy_net = PolicyNetwork(env.observation_space.shape[0], env.action_space.n)
    optimizer = optim.Adam(policy_net.parameters(), lr=1e-2)
    scores = []  # 各エピソードのスコア(立っていたステップ数)

    for episode in range(500):
        # 最初のエピソードだけ seed を渡すと、以降のエピソードの初期状態も決まる
        state, _ = env.reset(seed=0 if episode == 0 else None)
        log_probs = []
        rewards = []

        # 1エピソードのプレイ
        for t in range(1000):  # CartPole-v1 は 500 ステップで打ち切られるので、実際は 500 回まで
            state_tensor = torch.FloatTensor(state).unsqueeze(0)
            probs = policy_net(state_tensor)
            m = Categorical(probs)
            action = m.sample() # 確率分布に従って行動をサンプリング

            # 選んだ行動の対数確率を保存
            log_probs.append(m.log_prob(action))

            # 環境を1ステップ進める (gymnasiumのAPIに対応)
            state, reward, terminated, truncated, _ = env.step(action.item())
            rewards.append(reward)

            if terminated or truncated:
                break

        # 先ほど定義した関数を呼び出してパラメータを更新
        update_policy(policy_net, optimizer, log_probs, rewards)

        # 進捗の表示:そのエピソードのスコアと、直近 50 エピソードの平均
        scores.append(sum(rewards))
        if (episode+1) % 50 == 0:
            print(f"Episode {episode+1}\tScore: {scores[-1]:.0f}\tAverage(50): {np.mean(scores[-50:]):.1f}")

    env.close()
    return scores

# 学習の実行(ネットワークの初期値と行動のサンプリングを、実行ごとに同じにする)
torch.manual_seed(0)
scores = train_reinforce()

# エピソードごとのスコアと、直近 20 エピソードの移動平均
plt.figure(figsize=(10, 4.5))
plt.plot(scores, color="lightgray", label="Score")
plt.plot(np.arange(19, len(scores)), np.convolve(scores, np.ones(20) / 20, mode="valid"), color="tab:blue", label="Moving average (20)")
plt.xlabel("Episode"); plt.ylabel("Score"); plt.ylim(0, 520); plt.grid(True); plt.legend()
plt.title("REINFORCE on CartPole-v1")
plt.show()
1 エピソードをプレイしては 1 回更新することを 500 回繰り返し、REINFORCE で CartPole の棒を立て続けられるようになるか、なった後も保てるかを確かめるコードです。
- 行動の選び方: probs = policy_net(state_tensor) で行動の確率を出し、Categorical(probs) と m.sample() で、その確率に従って行動を選びます。確率が最大の行動だけを選ぶと、ほかの行動を試さなくなり、どちらが良いかを学べないため、サンプリングで選びます。
- 対数確率の保存: m.log_prob(action) が、方策勾配定理の です。計算グラフをつないだまま保存しておくので、エピソードの後の loss.backward() で、プレイ中のすべてのステップに勾配が流れます。
- 1 エピソードで 1 回の更新: エピソードが終わる(棒が倒れる terminated か、500 ステップで打ち切られる truncated)まで待ってから、update_policy を 1 回呼びます。 にはエピソードの最後までの報酬が必要なので、途中では更新できません。
- 学習率と回数: Adam の学習率 1e-2 は、PyTorch の公式のサンプルと同じ値です。500 エピソードは、スコアが上限の 500 に届くことと、その後に保てるかを見るための長さです(この実行では 100 エピソード前後で 500 に届きます)。
- 乱数の固定: torch.manual_seed(0) でネットワークの初期値と行動のサンプリングを、最初の env.reset(seed=0) で各エピソードの初期状態を固定し、実行結果を再現できるようにします。
- 記録と図: 1 エピソードごとのスコアはばらつきが大きいので、50 エピソードごとに、そのエピソードのスコアと直近 50 エピソードの平均を表示します。図は、全エピソードのスコア(灰色)と直近 20 エピソードの移動平均(青)です。
実行結果
Episode 50	Score: 128	Average(50): 43.0
Episode 100	Score: 500	Average(50): 292.0
Episode 150	Score: 500	Average(50): 490.2
Episode 200	Score: 37	Average(50): 131.5
Episode 250	Score: 43	Average(50): 33.2
Episode 300	Score: 47	Average(50): 41.7
Episode 350	Score: 64	Average(50): 61.4
Episode 400	Score: 65	Average(50): 116.1
Episode 450	Score: 114	Average(50): 87.2
Episode 500	Score: 88	Average(50): 106.0
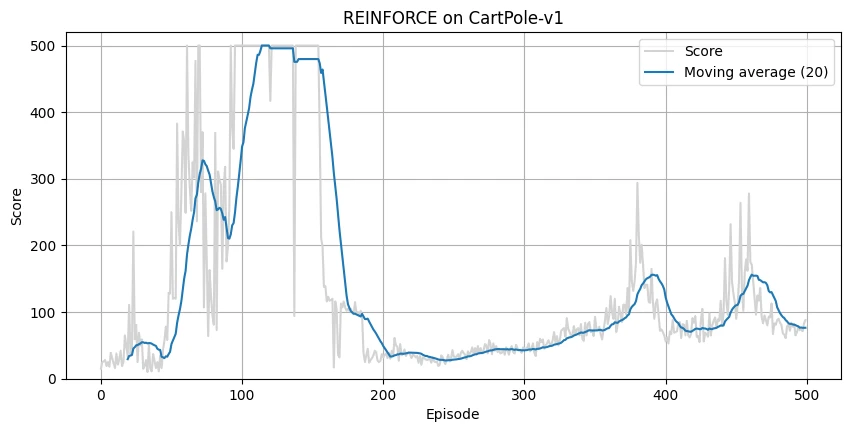
- 500 に届くまで: 最初の 50 エピソードの平均は 43.0 ですが、50〜100 エピソードで急に伸び、101〜150 エピソードの平均は 490.2 と、ほぼ毎回 500 ステップ立ち続けました。REINFORCE の単純な仕組みでも、CartPole を解ける方策にたどり着けます。
- 500 に届いた後: 155 エピソード目あたりから急にスコアが下がり、201〜250 エピソードの平均は 33.2 と、学習を始めたころと同じ水準に戻りました。その後の 250 エピソードでも、移動平均は 160 を超えず、500 には戻りません。一度覚えた方策を、その後の更新で壊してしまっています。
- 崩れる理由: REINFORCE は、1 エピソードの結果だけで方策を更新します。500 ステップ立ち続けたエピソードでも、 は後半ほど小さいので、正規化すると後半のステップは負になり、毎回「後半の行動の確率を下げる」更新が入ります。1 回の更新の大きさを制限する仕組みもないため、こうした更新が重なって方策が良い状態からずれ、その後は 1 エピソードごとの結果に振り回されて戻れなくなったと考えられます。この「1 回の結果による更新のばらつき」が、次項で解説する分散の問題です。
Stable Baselines3での実装について
DQNの解説記事などでは、実践的なライブラリとして「Stable Baselines3 (SB3)」による実装例を紹介してきましたが、Stable Baselines3にはREINFORCE(Vanilla Policy Gradient)は実装されていません。 方策ベースの手法としては、次項の分散の問題に Critic(価値の予測)で対処した A2C や PPO などが実装されているので、実務で方策ベースの手法を使う場合は、それらを使うことになります。
REINFORCEの限界(最大の弱点)
REINFORCEは方策勾配法の中でも最もシンプルで直感的ですが、いくつかの致命的な弱点があります。
1. 分散の爆発(モンテカルロ推定の限界)
方策の評価にエピソードの最後までプレイした「総収益(モンテカルロ推定)」を使っているためです。同じ状態から同じ行動をとっても、その後の展開によって最終的な総収益 は毎回大きくブレるため、勾配の分散が極めて大きくなり、学習が著しく不安定になります。
実際に、全く同じ初期状態から同じ最初の一手をとった場合でも、その後の展開によって総報酬がどれほどブレるか(分散するか)を確認するコードを以下に示します。
import gymnasium as gym
import numpy as np

def demonstrate_variance():
    env = gym.make('CartPole-v1')
    env.action_space.seed(0)  # ランダムな行動の列を、実行ごとに同じにする
    returns = []

    # 100回、全く同じ初期状態からシミュレーションを行う
    for _ in range(100):
        # seedを固定して、CartPoleの初期状態を完全に同一にする
        state, _ = env.reset(seed=42)

        # 最初の行動を「右に移動(1)」で完全に固定する
        state, reward, terminated, truncated, _ = env.step(1)

        G_t = reward
        gamma = 0.99
        discount = gamma

        # その後はランダムに行動し続ける(未学習の方策を想定)
        while not (terminated or truncated):
            action = env.action_space.sample()
            _, r, terminated, truncated, _ = env.step(action)
            G_t += discount * r
            discount *= gamma

        returns.append(G_t)

    returns = np.array(returns)
    print(f"報酬和の平均: {returns.mean():.2f}")
    print(f"報酬和の標準偏差(ブレの大きさ): {returns.std():.2f}")
    print(f"最大報酬: {returns.max():.2f}, 最小報酬: {returns.min():.2f}")

    env.close()

# 実行
demonstrate_variance()
同じ状態から同じ行動を取ったときの を 100 回測り、その後の展開だけでどれだけばらつくかを確かめるコードです。
- 条件をそろえる: 毎回 env.reset(seed=42) で同じ初期状態に戻し、最初の行動も「右に移動」(env.step(1))に固定します。方策勾配定理の は「状態 で行動 を取った後の収益」なので、 と をそろえたうえで、残るばらつきを見ます。
- その後の行動: env.action_space.sample() で、左右を等確率で選びます。学習を始めたばかりの方策(どちらの行動もほぼ 50%)を想定しています。env.action_space.seed(0) でこの乱数を固定し、実行結果を再現できるようにします。
- 割引報酬和: 学習のコードと同じ gamma = 0.99 で を計算します。100 回は、平均と標準偏差がおおよそ安定する回数として選んでいます。
実行結果
報酬和の平均: 20.36
報酬和の標準偏差(ブレの大きさ): 7.53
最大報酬: 41.88, 最小報酬: 10.47
100 回の Gₜ の散らばりを1本の軸に描くと、次のようになります。
(図は、diagram-designで作成)
実行結果からの考察
この結果から、「全く同じ初期状態」から「全く同じ最初の一手」を取ったにもかかわらず、最終的な報酬和は 約10〜42 まで、4 倍の幅でばらついていることがわかります。 標準偏差(7.53)は平均(20.36)の 4 割近くあり、これは「その行動自体が良かったかどうか」よりも「その後のランダムな展開(運)」によって最終スコアが大きく左右されてしまうことを意味しています。
このように、1回のプレイ結果(モンテカルロ推定)をそのまま使って方策を更新しようとすると、たまたま運が良かっただけの行動を過大評価したり、運が悪かっただけの良い行動を過小評価したりしてしまい、学習が正しく進みません。これが方策勾配法における最大の課題である「分散の爆発」です。
この問題を根本から解決するために、後の研究で「価値ネットワーク(Critic)」を導入し、安定したベースラインを引く手法(A2C / Actor-Critic)が誕生しました。
2. オンポリシー(On-policy)によるサンプル効率の悪さ
強化学習アルゴリズムは、データを収集する方策と学習する方策の関係性によって分類されます。
- オフポリシー(Off-policy): Q学習やDQNのように、過去の古い方策で集めたデータ(経験再生バッファ)を再利用して学習できる手法。
- オンポリシー(On-policy): REINFORCEのように、「今まさに学習中の最新の方策」が直接収集したデータでしか学習できない手法。
REINFORCEはオンポリシー手法であるため、1回学習に使ったデータ(エピソード)は直ちに捨てなければならず、DQNのように過去の経験を何度も再利用(Experience Replay)することができません。そのため、膨大なデータ収集が必要となり、非常にサンプル効率が悪いという問題があります。
オンポリシーとオフポリシーのデータの使い方を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
- REINFORCEは、状態から行動確率を直接出力する方策ベースの強化学習の原点です。
- 良い結果をもたらした行動の確率を上げるように、対数確率勾配を使ってパラメータを更新します。
- エピソード全体の報酬和に基づくため、勾配の分散が大きく学習が不安定になりやすいという課題があります。CartPole では約 100 エピソードで 500 に届いた後、155 エピソード目あたりから崩れ、500 エピソードまで戻りませんでした。これが次の A2C や PPO の発展に直結します。
参考文献
- R. J. Williams (1992). Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning, 8(3-4), 229–256.
- R. S. Sutton, D. McAllester, S. Singh, Y. Mansour (2000). Policy Gradient Methods for Reinforcement Learning with Function Approximation. Advances in Neural Information Processing Systems 12.
- R. S. Sutton, A. G. Barto (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- PyTorch. pytorch/examples: reinforcement_learning. GitHub.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
本記事の文章・構成の一部に生成AIを使用しています。