RFM分析とは?
 (画像は、Geminiで作成)
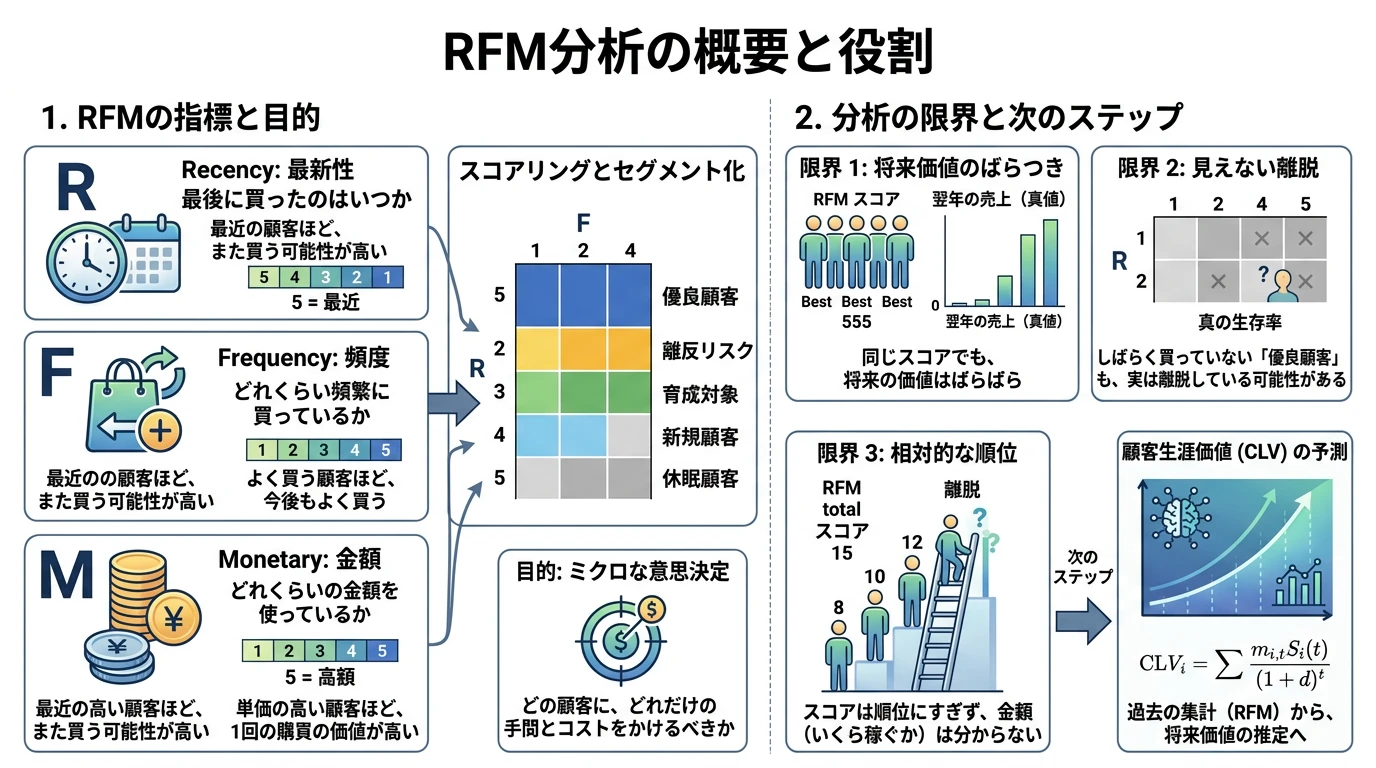
RFM分析で顧客をスコアリング・セグメント化できるようになること。あわせて、顧客生涯価値(CLV)の定義と、契約型・非契約型というビジネスの区別を理解し、「過去の行動の集計だけでは、顧客の将来の価値は予測できない」というRFM分析の限界を、真値を仕込んだダミーデータで確かめること。
概要
マーケティングミックスモデル(MMM)の記事では、「どの広告チャネルにいくら配分するか」というマクロな意思決定を扱いました。しかし、マーケティングにはもう1つの重要な問いがあります。それは「どの顧客に、どれだけの手間とコストをかけるべきか」というミクロな意思決定です。
すべての顧客が同じ価値を持つわけではありません。EC(ネット通販)の多くでは、売上の大半を一部の顧客が生み出しています。限られた販促予算を、すでに離れてしまった顧客や、放っておいても買い続けてくれる顧客に使ってしまえば、費用に見合う効果は得られません。施策の対象を決めるには、まず顧客を「価値」で見分ける必要があります。
顧客の将来の価値を予測し、施策によって価値が大きく伸びる顧客 ── HVA(High Value Audience) ── を見つけ出すための出発点になるのが、古くからダイレクトマーケティングで使われてきた RFM分析 です。RFM分析は、購買履歴という手元のデータだけで顧客を分類できる、シンプルで強力な方法です。
一方で、RFM分析は「過去の行動の集計」にすぎず、「この顧客が今後どれだけ買ってくれるか」を直接は教えてくれません。本記事では、RFM分析の実装に加えて、HVA 関連の記事で予測の対象にする顧客生涯価値(CLV: Customer Lifetime Value) を定義し、真値を仕込んだダミーデータを使って、RFM分析で分かることと分からないことの境界線を確かめます。
RFM分析の基本
3つの指標
RFM分析では、顧客ごとの購買履歴を、次の3つの指標に集約します。
| 指標 | 意味 | 計算方法の例 | 直感 |
|---|---|---|---|
| R(Recency:最新性) | 最後に買ったのはいつか | 基準日から最終購買日までの日数 | 最近買った顧客ほど、また買う可能性が高い |
| F(Frequency:頻度) | どれくらい頻繁に買っているか | 分析期間中の購買回数 | よく買う顧客ほど、今後もよく買う |
| M(Monetary:金額) | どれくらいの金額を使っているか | 1回あたりの平均購買金額(または合計金額) | 単価の高い顧客ほど、1回の購買の価値が高い |
R は「値が小さいほど良い」(最近買っている)指標で、F と M は「値が大きいほど良い」指標である点に注意してください。
M には「合計金額」を使う流儀と、「1回あたりの平均金額」を使う流儀があります。合計金額は「購買回数 × 平均金額」なので、F の情報と重複してしまいます。本記事では、F と M が別々の情報を表すように、M に1回あたりの平均購買金額を使います。
3つの指標を1人の購買履歴の上に置くと、次のようになります。
(図は、diagram-designで作成)
スコアリングとセグメント化
R・F・M は単位も分布もばらばらなので、そのままでは比較しにくい値です。そこで、それぞれを 1〜5の5段階のスコア に変換するのが一般的です。代表的な方法は、顧客を指標の順に並べて人数が均等になるように5つに分ける 五分位(quintile) によるスコアリングです。R は最近の顧客ほど高いスコアに、F と M は大きい顧客ほど高いスコアにします。
3つのスコアの組み合わせは 通りになりますが、125のグループを個別に運用するのは現実的ではありません。実務では、次のどちらかでまとめて扱います。
- スコアの合計:R + F + M(3〜15点)で顧客を順位付けする。単純ですが、「最近は来ていないが昔はよく買っていた顧客」と「最近初めて買った顧客」が同じ点数になるなど、性質の違う顧客が混ざります。
- 名前付きのセグメント:R と F の組み合わせを、「優良顧客」「離反リスク」「新規顧客」のような、施策と結びつけやすいグループにまとめる。
本記事では、R と F の2軸で次の5つのセグメントを定義します(M はセグメントの定義には使わず、後で単価の違いを見るために使います)。
| セグメント | 条件 | 想定する施策の例 |
|---|---|---|
| 優良顧客 | F が4以上、R が3以上 | 特典やロイヤルティプログラムで関係を維持する |
| 離反リスク | F が4以上、R が2以下 | 以前はよく買っていたので、離脱を防ぐ働きかけ |
| 育成対象 | F が2〜3、R が3以上 | 購買頻度を上げるためのクロスセル |
| 新規顧客 | F が1、R が4以上 | 2回目の購買を促すフォローアップ |
| 休眠顧客 | 上記以外(R が低く F も低い) | 費用をかけすぎない掘り起こし |
これらのセグメント名や境界は一例で、業種や商材によって調整します。
顧客生涯価値(CLV)の定義
RFM分析は顧客を分類するための道具ですが、私たちが本当に知りたいのは「この顧客は、これから先どれだけの価値をもたらしてくれるのか」です。これを表す指標が 顧客生涯価値(CLV: Customer Lifetime Value) です。
CLVの一般式
顧客 の CLV は、将来の各期間に顧客がもたらす利益を、現在の価値に割り引いて足し合わせたものとして定義します(Gupta et al., 2006)。
- : 期間(月や年)。 は現在の期間
- : 顧客 が期間 に取引を続けていた場合にもたらす利益(粗利)
- : 顧客 が期間 まで取引を続けている(離脱していない)確率
- : 割引率(1期間あたり)
- : 考慮する期間の長さ( とすることもある)
この式には、実務で見落とされがちな4つのポイントが含まれています。
- 売上ではなく利益:CLV は「顧客を獲得・維持するためにいくらまで使ってよいか」を判断するための指標なので、売上ではなく、原価などを差し引いた粗利で計算します。ただし、粗利率が顧客によらず一定とみなせる場合は、売上で計算してから最後に粗利率を掛けても同じです。
- 割引:来年の1万円は、今日の1万円より価値が低いと考えます。割引率 は、資本コストや、将来の不確実さを反映して決めます。
- 生存確率:顧客はいつか離れていきます。将来の利益は、その時点まで顧客が残っている確率 で重み付けします。
- 期待値:将来の や は観測できないので、CLV は予測値(期待値) です。過去の実績を合計した「過去のCLV(Historical CLV)」と区別して、予測CLV(pCLV: predicted CLV) と呼ぶこともあります。また、既存顧客の CLV を考えるときは、すでに支払われた過去の利益は含めず、これから先の分だけを数えます(残存CLV)。
HVA 関連の記事で CLV と書くときは、すべてこの式を指します。それらの記事で使う確率モデルや機械学習は、いずれも と をどう予測するか、という問題に取り組むものです。
契約型の単純な例
式の意味を確かめるために、最も単純なケースを考えます。毎年の会費(利益 )が一定で、毎年一定の確率 で契約を更新するサブスクリプションです( を継続率と呼びます)。 年後まで契約が続いている確率は なので、期間を無限大にすると、CLV は無限等比級数の和として計算できます。
詳細な式展開(無限等比級数の和)
各項は、初項 、公比 の等比数列になっています。
、 なら公比は1未満なので、無限等比級数の和の公式 が使えます。
割引をしない場合()は、 となります。 は、顧客が契約を続ける年数の期待値(初年度を含む)です。
Pythonで、定義どおりに足し合わせた値と公式の値を比べてみましょう。
import numpy as np

# 1. 契約型の単純な例の設定(1期間 = 1年)
m = 10_000   # 1年あたりの利益(円)
rho = 0.8    # 継続率(翌年も契約を更新する確率)
d = 0.1      # 割引率(年10%)

# 2. 定義どおりに足し合わせる(t = 0, 1, ..., 199年)
t = np.arange(200)
clv_sum = np.sum(m * rho ** t / (1 + d) ** t)

# 3. 無限等比級数の公式
clv_formula = m * (1 + d) / (1 + d - rho)

# 4. 比較:期間を3年で区切った場合と、割引をしない場合
clv_3years = np.sum(m * rho ** t[:3] / (1 + d) ** t[:3])
clv_no_discount = m / (1 - rho)

print(f"定義どおりの和(200年分): {clv_sum:,.0f} 円")
print(f"公式による値      : {clv_formula:,.0f} 円")
print(f"3年間で区切った場合   : {clv_3years:,.0f} 円")
print(f"割引をしない場合    : {clv_no_discount:,.0f} 円")
CLV の定義式を、契約型の単純な例で数値として確かめています。
- 設定: 1年あたりの利益 m を1万円、継続率 rho を0.8、割引率 d を10%としています。継続率0.8は「毎年2割の顧客が解約する」ことを意味します。これらの値は、式どおりに計算できるかを確かめるための例です。継続率 0.8 なら、平均の継続年数が 年と暗算でき、結果を「1万円 × 5年」と比べやすいので選んでいます。
- 定義どおりの和: t = np.arange(200) で0〜199年目を並べ、各年の「利益 × 生存確率 ÷ 割引 」をベクトル演算でまとめて計算し、np.sum で足し合わせています。rho ** t や (1 + d) ** t は、配列 t の各要素についてべき乗を計算するので、200年分の項を1行で作れます。無限に足すことはできませんが、200年後の項は事実上0なので、無限和とみなせます。
- 公式: clv_formula は、上の式展開で導いた です。
- 比較: t[:3] で最初の3年分()だけを足した値と、割引をしない場合の を計算し、期間 と割引率 の設定で CLV がどれだけ変わるかを確認しています。
- 表示: f-string の :,.0f は、3桁ごとにカンマを入れ、小数点以下を四捨五入して表示する書式です。
実行結果
定義どおりの和(200年分): 36,667 円
公式による値      : 36,667 円
3年間で区切った場合   : 22,562 円
割引をしない場合    : 50,000 円
定義どおりに足し合わせた値と公式の値は、どちらも36,667円で一致しました。一方で、同じ顧客でも、計算の前提によって CLV は大きく変わります。
- 割引をしない場合は50,000円: 継続率0.8の顧客は、平均して 年間契約を続けるので、単純に「1万円 × 5年」になります。割引を入れると、遠い将来の利益ほど小さく評価されるため、約3.7万円に下がります。
- 3年間で区切ると22,562円: 「今後3年間の CLV」のように期間を区切ると、それより先の利益は数えません。
CLV という1つの言葉でも、期間 ・割引率 ・利益の定義(売上か粗利か) が違えば、値はまったく別物になります。CLV を報告したり、記事やツールの数字を比べたりするときは、これらの前提を必ず確認してください。
3つの計算方法の値を並べると、次のようになります。
(図は、diagram-designで作成)
RFMとCLVの関係
RFM と CLV の違いは、過去の集計か、将来の予測か にあります。RFM は過去に起きたことを要約した3つの数字にすぎませんが、CLV は「これから先」の利益の期待値です。
それでも RFM が実務で長く使われてきたのは、R・F・M が将来の購買と強く関係していると経験的に知られているからです。実は、BG/NBDモデルの記事で扱う確率モデルを使うと、R と F(と顧客の在籍期間)から将来の購買回数の期待値を計算でき、RFM と CLV を数式でつなぐことができます(Fader, Hardie & Lee, 2005)。本記事では、その準備として、RFM の集計だけでどこまで将来を言い当てられるかを確かめます。
契約型と非契約型 ── どのモデルを使うか
CLV を予測する方法は、ビジネスの形態によって大きく変わります。その分かれ目は、顧客の離脱が観測できるかどうか です。
離脱が「見える」かどうか
- 契約型(Contractual):サブスクリプション、携帯電話、保険、ジムの会員など。顧客は解約の手続きをするので、いつ離脱したかが記録に残ります。
- 非契約型(Non-contractual):EC、小売店、飲食店など。顧客は「もう買わない」と宣言せずに、ただ来なくなります。離脱は観測できず、「しばらく買っていない」顧客が、離脱したのか、たまたま間が空いているだけなのかは区別できません。
契約型なら、「何か月で解約したか」のデータから生存確率 を直接推定できます。一方、非契約型では、生存しているかどうか自体が隠れた状態なので、購買のパターンから「まだ生存している確率」を推定するところから始めなければなりません。RFM分析が主に使われてきたのは、この非契約型のビジネスです。
4つのビジネス形態とモデルの地図
さらに、購買の機会がいつでもあるのか(連続的)、決まったタイミングにしかないのか(離散的)でも分けると、ビジネスは次の4つに整理できます(Fader & Hardie, 2009)。
| 契約型(離脱が観測できる) | 非契約型(離脱が観測できない) | |
|---|---|---|
| 連続的(いつでも購買できる) | クレジットカード、携帯電話の利用 | EC、小売店での購買、ホテルの宿泊 |
| 離散的(購買の機会が決まっている) | 雑誌の定期購読、保険、ジムの会員 | 年1回のイベントへの参加、定期的な寄付 |
このうち代表的なケースは、次の表の記事で扱っています。
| 対象 | 主なモデル | 担当する記事 |
|---|---|---|
| 契約型 | カプラン・マイヤー推定、Cox比例ハザードモデル、sBGモデル | 生存時間分析の記事 |
| 非契約型・連続的 | BG/NBDモデル(購買回数と離脱)、Gamma-Gammaモデル(購買金額) | BG/NBDモデルの記事 |
| 非契約型(購買履歴以外の情報も使う) | 機械学習(LightGBM、ゼロ過剰な分布に合わせた損失関数など) | 機械学習によるCLV予測の記事 |
本記事のダミーデータは、ECを想定した非契約型・連続的なビジネスです。
4つの形態と担当する記事を図にすると、次のようになります。
(図は、diagram-designで作成)
検証用ダミーデータの生成:顧客ワールド
RFM分析で何が分かり、何が分からないのかを確かめるために、10,000人の顧客の2年分の購買ログを生成します。このデータを「顧客ワールド」と呼び、HVA 関連の記事でも同じデータを使います。
購買ログは、次のような「ある確率モデル」に従って生成します。
- 購買ペースは顧客ごとに違う:顧客はそれぞれ自分のペース(1日あたりの平均購買回数)でランダムに買い物をします。ペースは顧客によって大きくばらつき、年に1回も買わない人もいれば、毎週のように買う人もいます。
- 購買の直後に、一定の確率で離脱する:2回目以降の購買の直後に、顧客は一定の確率で「もうこの店では買わない」状態になります(離脱)。離脱のしやすさも顧客ごとに違います。離脱した顧客は二度と買いませんが、そのことは記録に残りません。
- 購買金額は、顧客ごとの平均の周りでばらつく:1回あたりの購買金額は、顧客ごとの平均金額を中心にばらつきます。平均金額も顧客ごとに違います。
- 新規顧客は少しずつ獲得される:最初の1年の間に、顧客が少しずつ初回購買をします。
このモデルの正式な名前と、購買ログからパラメータを推定する方法は、後続のBG/NBDモデルの記事で解説します。ここでは、分析者が観測できるのは購買ログ(顧客ID・購買日・金額)だけで、購買ペース・離脱のしやすさ・平均金額・離脱したかどうかは観測できない、という点だけ押さえてください。
2年間のうち、前半の1年を分析に使う期間、後半の1年を答え合わせ用のホールドアウト期間とします。前半の1年のデータだけで RFM分析を行い、その結果が後半の1年の実際の購買をどれだけ言い当てているかを確かめます。 次のコードが何をしているかを式で確かめたい人のために、生成の規則をまとめておきます。 顧客 の隠れた性質は、次の分布から1つずつ引きます(ガンマ分布は形状とレートで書きます。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、コードではレートの逆数を渡しています)。 (lam)は1日あたりの購買ペース、(p_drop)は繰り返し購買の直後に離脱する確率、(nu)は購買金額の尺度、(first_day)は初回購買日です。 購買ログは、初回購買日 から、次の規則で730日目まで作ります。 は 回目の購買から次の購買までの日数(平均 日)、 は1回ごとの購買金額です(形状6は p_gg)。2回目以降の購買(繰り返し購買)の直後には、確率 で離脱し、それ以降は買いません。初回購買の直後には離脱の判定をしません。1回あたりの平均購買金額は (truth['mean_amount'])で、離脱した日(death_day)が365日目以降なら、基準日に生存している(truth['alive'])とします。顧客ワールドの生成式
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は日)
rng = np.random.default_rng(42)
N = 10_000          # 顧客数
CALIB_END = 365     # 0〜364日目: 分析に使う期間(前半1年)
OBS_END = 730       # 365〜729日目: 答え合わせ用のホールドアウト期間(後半1年)

# 2. 顧客ごとの隠れた性質(分析者には観測できない「答え」)
r, alpha = 0.6, 25.0                         # 購買ペースのばらつきを決めるパラメータ
a, b = 0.8, 3.0                              # 離脱のしやすさのばらつきを決めるパラメータ
p_gg, q_gg, gamma_gg = 6.0, 4.0, 1500.0      # 購買金額のばらつきを決めるパラメータ
lam = rng.gamma(r, 1 / alpha, size=N)        # 購買ペース(1日あたりの平均購買回数)
p_drop = rng.beta(a, b, size=N)              # 2回目以降の購買の直後に離脱する確率
nu = rng.gamma(q_gg, 1 / gamma_gg, size=N)   # 購買金額の尺度(平均購買金額は p_gg / nu)
first_day = rng.uniform(0, CALIB_END, size=N)  # 初回購買日(最初の1年で少しずつ獲得)

# 3. 購買ログの生成
records = []
death_day = np.full(N, np.inf)   # 離脱した日(観測期間内に離脱しなければ inf)
for i in range(N):
    t = first_day[i]
    records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))   # 初回購買
    while True:
        t += rng.exponential(1 / lam[i])   # 次の購買までの待ち時間
        if t >= OBS_END:
            break
        records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))
        if rng.uniform() < p_drop[i]:      # 購買の直後に、一定の確率で離脱する
            death_day[i] = t
            break

# 4. 分析者が観測できる購買ログ(購買日は整数の日付、金額は10円単位)
log = pd.DataFrame(records, columns=['customer_id', 'day', 'amount'])
log['day'] = np.floor(log['day']).astype(int)
log['amount'] = log['amount'].round(-1).astype(int)

# 5. 答え合わせ用の真値(分析には使わない)
truth = pd.DataFrame({
    'lam': lam,                          # 購買ペース
    'p_drop': p_drop,                    # 購買の直後に離脱する確率
    'mean_amount': p_gg / nu,            # 平均購買金額
    'alive': death_day >= CALIB_END,     # ホールドアウト期間の開始時点で生存しているか
})

# 6. データの性質の確認
print(log.head())
print(f"\n購買ログの件数: {len(log):,} 件(前半 {(log['day'] < CALIB_END).sum():,} 件、後半 {(log['day'] >= CALIB_END).sum():,} 件)")
print(f"1回あたりの購買金額: 平均 {log['amount'].mean():,.0f} 円、中央値 {log['amount'].median():,.0f} 円")
print(f"年間の購買ペースの中央値: {np.median(lam * 365):.1f} 回、平均: {np.mean(lam * 365):.1f} 回")
print(f"ホールドアウト期間の開始時点で生存している顧客: {truth['alive'].mean():.1%}")
顧客ワールドの購買ログを生成しています。
- 観測期間: 時間の単位は日で、CALIB_END = 365 より前を分析に使う期間、OBS_END = 730 までをホールドアウト期間としています。乱数は default_rng(42) で固定しているので、何度実行しても同じデータになります。顧客数を10,000人にするのは、5つのセグメントに分けても、最も小さいセグメント(離反リスク、644人)にも数百人が残り、翌年の購買率や売上の平均が安定するためです。
- 顧客ごとの隠れた性質: 購買ペース lam はガンマ分布、離脱確率 p_drop はベータ分布、購買金額の尺度 nu はガンマ分布から、size=N で顧客ごとに1つずつ引いています。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、rng.gamma(r, 1 / alpha, size=N) のようにレートの逆数を渡しています。初回購買日 first_day は、rng.uniform(0, CALIB_END, size=N) で最初の1年の一様分布から引きます。r・alpha などの7つのパラメータは、これらの分布の形(顧客の間でどれくらいばらつくか)を決める「答え」で、BG/NBDモデルの記事などで推定の対象になります。購買ペースのガンマ分布は形状 r = 0.6 と1より小さく、「ほとんど買わない顧客が多く、ごく一部に非常によく買う顧客がいる」という偏った分布にしています。離脱の a = 0.8・b = 3.0 と、金額の形状 p_gg = 6.0・q_gg = 4.0 は、BG/NBD モデルと Gamma-Gamma モデルの原著論文で、CDNOW のデータから推定された値(、、、)を参考にしています。購買ペースの alpha = 25 と金額の gamma_gg = 1500 は、時間の単位を日に、金額の単位を円にするために、スケールを合わせた値です。
- 購買ログの生成: records は(顧客ID, 購買日, 金額)のタプルをためるリスト、death_day は np.full(N, np.inf) で全員を無限大(離脱しない)に初期化した配列です。for i in range(N) で1人ずつ、まず初回購買を records.append で記録し、続く while True のループで、初回購買日 first_day から、指数分布に従う待ち時間 rng.exponential(1 / lam[i]) だけ時間を進めて次の購買を記録する、という処理を観測期間の終わりまで繰り返しています。待ち時間が指数分布に従うと、購買はランダムなタイミングで起き、平均すると1日に lam[i] 回のペースになります。次の購買日が OBS_END 以上になったら break でループを抜けます。2回目以降の購買の直後に rng.uniform() < p_drop[i] なら(0〜1の一様乱数が確率より小さい、つまり確率 p_drop[i] で)離脱としてループを抜け、その日を death_day[i] に記録します。初回購買は while の前に記録するので、初回購買の直後には離脱の判定をしません。
- 購買金額: 購買のたびに、形状 p_gg・尺度 1 / nu[i] のガンマ分布から金額を引いています。顧客 の平均購買金額は p_gg / nu[i] です。
- 観測できるデータ: log には顧客ID・購買日・金額だけを入れ、購買日は整数の日付に、金額は round(-1) で10円単位に丸めています。pd.DataFrame(records, columns=[...]) でタプルのリストを表にし、np.floor で小数の購買日を切り捨ててから astype(int) で整数にしています。
- 答え合わせ用の真値: truth には、購買ペース・離脱確率・平均購買金額と、ホールドアウト期間の開始時点(365日目)で生存しているかどうか alive を保存しています。death_day >= CALIB_END は、離脱した日が365日目以降(離脱しなかった顧客は無限大)なら True です。分析には使わず、RFM分析の結果を評価するときだけ参照します。
- 確認: 購買ログの先頭5行(log.head())、前半・後半の購買件数、1回あたりの購買金額の平均と中央値、年間の購買ペース(lam * 365)の中央値と平均、ホールドアウト期間の開始時点で生存している顧客の割合(truth['alive'].mean()。True/False の平均は True の割合)を表示しています。
実行結果
   customer_id  day  amount
0            0  218    1150
1            0  234     640
2            0  247    1110
3            0  259    2480
4            0  315     700

購買ログの件数: 57,667 件(前半 33,288 件、後半 24,379 件)
1回あたりの購買金額: 平均 3,012 円、中央値 2,320 円
年間の購買ペースの中央値: 4.8 回、平均: 8.9 回
ホールドアウト期間の開始時点で生存している顧客: 67.8%
生成されたデータから、次のことが読み取れます。
- 購買ログ: 10,000人分で約5.8万件の購買が記録されました。後半の件数が前半より少ないのは、新規顧客の獲得が前半の1年だけで、後半には離脱した顧客が増えているためです。
- 購買ペースの偏り: 年間の購買ペースは、中央値4.8回に対して平均8.9回です。平均が中央値の約2倍になっているのは、ごく一部のヘビーユーザーが平均を押し上げているためです。
- 見えない離脱: ホールドアウト期間の開始時点で生存している顧客は67.8%です。つまり、約3割の顧客はすでに離脱していますが、購買ログにはその記録はどこにも残っていません。
RFMの計算
前半1年(0〜364日目)の購買ログだけを使って、顧客ごとに R・F・M を集計します。基準日は、ホールドアウト期間が始まる365日目です。
# 1. 分析に使う期間と、答え合わせ用のホールドアウト期間に分ける
calib = log[log['day'] < CALIB_END]
holdout = log[log['day'] >= CALIB_END]

# 2. 顧客ごとに R・F・M を集計する
rfm = calib.groupby('customer_id').agg(
    last_day=('day', 'max'),          # 最終購買日
    frequency=('day', 'size'),        # 購買回数
    monetary=('amount', 'mean'),      # 1回あたりの平均購買金額
)
rfm['recency'] = CALIB_END - rfm['last_day']   # 基準日(365日目)から最終購買日までの日数
rfm = rfm[['recency', 'frequency', 'monetary']]

# 3. 答え合わせ用: ホールドアウト期間(翌1年)の売上(購買がなければ0)
rfm['future_sales'] = holdout.groupby('customer_id')['amount'].sum().reindex(rfm.index, fill_value=0)

print(rfm.head())
print()
print(rfm[['recency', 'frequency', 'monetary']].describe().round(1))
print(f"\n翌1年に1回も購買しなかった顧客: {(rfm['future_sales'] == 0).mean():.1%}")
top10 = rfm['future_sales'].sort_values(ascending=False).head(len(rfm) // 10)
print(f"翌1年の売上のうち、上位10%の顧客が占める割合: {top10.sum() / rfm['future_sales'].sum():.1%}")
前半1年の購買ログから、顧客ごとの R・F・M を集計しています。
- 期間の分割: log[log['day'] < CALIB_END] のように、条件を満たす行だけを取り出しています。calib は365日目より前の購買、holdout は365日目以降の購買です。RFM の計算には calib だけを使います。
- 集計: groupby('customer_id').agg(...) で、顧客ごとに最終購買日(max)、購買回数(size)、1回あたりの平均購買金額(mean)を一度に計算しています。last_day=('day', 'max') は「day 列の最大値を last_day という列名で出す」という書き方(名前付き集計)です。購買回数には初回購買も含めています。
- Recency: 基準日(365日目)から最終購買日を引いた日数です。364日目に買った顧客は1、前半の初日に1回だけ買った顧客は365になります。全員が前半に初回購買をしているので、集計の対象は10,000人全員です。rfm[['recency', 'frequency', 'monetary']] で、列の順番を R・F・M にそろえています。
- 答え合わせ用の列: future_sales は、ホールドアウト期間の売上の合計です。購買のなかった顧客は集計結果に現れないので、reindex(rfm.index, fill_value=0) で0を埋めています。現実の分析では、この列は分析の時点では手に入りません。
- 集計の確認: describe() は、各列の件数・平均・標準偏差・最小値・四分位点・最大値をまとめて表示します。(rfm['future_sales'] == 0).mean() は、翌1年に1回も買わなかった顧客の割合です。
- 売上の集中度: sort_values(ascending=False).head(len(rfm) // 10) で、翌1年の売上が多い順に顧客を並べて上位10%(1,000人)を取り出し、その売上の合計が全体に占める割合を計算しています。
実行結果
             recency  frequency     monetary  future_sales
customer_id
0                 33          7  1348.571429         19080
1                212          5  3708.000000             0
2                139          1  1630.000000             0
3                 11          3  3146.666667         18330
4                338          1  2180.000000             0

       recency  frequency  monetary
count  10000.0    10000.0   10000.0
mean     113.9        3.3    3019.0
std       98.3        3.9    2418.5
min        1.0        1.0     280.0
25%       30.0        1.0    1610.0
50%       85.0        2.0    2376.5
75%      180.0        4.0    3625.0
max      365.0       53.0   43905.6

翌1年に1回も購買しなかった顧客: 50.5%
翌1年の売上のうち、上位10%の顧客が占める割合: 64.0%
集計結果から、ECの顧客データによく見られる特徴が読み取れます。
- F の偏り: 購買回数の中央値は2回、25%点は1回です。多くの顧客は1〜2回しか買っておらず、最大は53回と、ごく一部の顧客が突出しています。
- 翌年の売上の偏り: 翌1年に1回も買わなかった顧客が約半分(50.5%)を占める一方、上位10%の顧客が翌年の売上の64.0%を生み出しています。「誰が上位10%に入るか」を事前に言い当てられれば、施策の費用対効果は大きく変わります。
スコアリングとセグメント化の実装
5段階のスコアに変換する
R と M は五分位でスコアにします。一方、F は「1回」しか買っていない顧客が3割以上を占めるため、五分位の境界が同じ値に重なってしまいます。そこで、F は購買回数の閾値で5段階に分けます。
# 1. F の分布を確認する(五分位の境界が重なってしまう)
print("F(購買回数)の分位点:")
print(rfm['frequency'].quantile([0.2, 0.4, 0.6, 0.8]).to_string())

# 2. R と M は五分位(人数が均等になるように5段階に分ける)
rfm['R'] = pd.qcut(rfm['recency'], 5, labels=[5, 4, 3, 2, 1]).astype(int)   # 最近ほど高いスコア
rfm['M'] = pd.qcut(rfm['monetary'], 5, labels=[1, 2, 3, 4, 5]).astype(int)

# 3. F は購買回数の閾値で5段階に分ける(1回 / 2回 / 3回 / 4〜6回 / 7回以上)
rfm['F'] = pd.cut(rfm['frequency'], bins=[0, 1, 2, 3, 6, np.inf], labels=[1, 2, 3, 4, 5]).astype(int)

# 4. 各スコアの境界と人数を確認する
print("\nR スコアの境界(最終購買からの日数):")
for score, interval in zip([5, 4, 3, 2, 1], pd.qcut(rfm['recency'], 5).cat.categories):
    print(f"  R={score}: {interval}")
print("\nM スコアの境界(平均購買金額):")
for score, interval in zip([1, 2, 3, 4, 5], pd.qcut(rfm['monetary'], 5).cat.categories):
    print(f"  M={score}: {interval}")
print("\nF スコアごとの人数:")
print(rfm['F'].value_counts().sort_index().to_string())
R・F・M を1〜5のスコアに変換しています。
- F の分位点の確認: quantile([0.2, 0.4, 0.6, 0.8]) で、五分位の境界になる値を表示しています。最小値も20%点も「1回」なので、五分位で区切ろうとすると境界が重なり、pd.qcut はエラーになります(重なった境界を捨てる duplicates='drop' を指定すると、5段階ではなくなります)。
- R と M の五分位: pd.qcut(..., 5, labels=...) は、値の小さい順に顧客を人数が均等な5グループに分けます。R は日数が小さいほど良いので、labels=[5, 4, 3, 2, 1] と逆順のラベルを付け、最近購買した顧客ほど高いスコアにしています。pd.qcut の結果はカテゴリ型なので、astype(int) で整数に変換し、後で足し算や比較ができるようにしています。
- F の閾値: pd.cut で、購買回数を「1回」「2回」「3回」「4〜6回」「7回以上」の5段階に分けています。bins=[0, 1, 2, 3, 6, np.inf] は右端を含む区間(0より大きく1以下、など)を表します。閾値は、各スコアの人数がおおむね1,000〜3,000人になるように決めました。
- 境界の確認: pd.qcut(...).cat.categories で、各スコアに対応する値の範囲(区間)を取り出し、zip でスコアと組にして表示しています。F は value_counts().sort_index() で、スコアごとの人数をスコアの順に表示しています。
実行結果
F(購買回数)の分位点:
0.2    1.0
0.4    2.0
0.6    3.0
0.8    4.0

R スコアの境界(最終購買からの日数):
  R=5: (0.999, 22.0]
  R=4: (22.0, 59.0]
  R=3: (59.0, 118.0]
  R=2: (118.0, 206.0]
  R=1: (206.0, 365.0]

M スコアの境界(平均購買金額):
  M=1: (279.999, 1467.5]
  M=2: (1467.5, 2050.0]
  M=3: (2050.0, 2790.0]
  M=4: (2790.0, 4040.0]
  M=5: (4040.0, 43905.556]

F スコアごとの人数:
F
1    3413
2    2573
3    1276
4    1603
5    1135
- R スコア: 最終購買が22日以内なら5、59日以内なら4、…、206日より前なら1です。五分位なので、各スコアはほぼ2,000人ずつになります。
- M スコア: 平均購買金額が約1,470円以下なら1、約4,040円を超えると5です。
- F スコア: 1回だけの顧客(F=1)が3,413人と最も多く、閾値で区切っても人数は均等になりません。F のように同じ値に顧客が集中する指標では、五分位がそのまま使えないことは、実務でRFM分析を行うときに最初につまずく点の1つです。
なお、五分位の境界は「このデータの中での相対的な位置」で決まります。同じ顧客でも、比べる相手(期間や顧客層)が変われば、スコアも変わる点に注意してください。
セグメントに分けて、翌年の実績と照らし合わせる
R と F のスコアから5つのセグメントを作り、ホールドアウト期間(翌1年)の実績と照らし合わせます。現実の分析では翌年の実績は分かりませんが、ここでは答え合わせのために使います。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. R と F のスコアからセグメントを決める(上の条件から順に判定)
conditions = [
    (rfm['F'] >= 4) & (rfm['R'] >= 3),
    (rfm['F'] >= 4),
    (rfm['F'] >= 2) & (rfm['R'] >= 3),
    (rfm['F'] == 1) & (rfm['R'] >= 4),
]
choices = ['優良顧客', '離反リスク', '育成対象', '新規顧客']
rfm['segment'] = np.select(conditions, choices, default='休眠顧客')

# 2. セグメントごとの集計(翌年の購買率・売上は答え合わせ用)
summary = rfm.groupby('segment').agg(
    人数=('recency', 'size'),
    R_日数=('recency', 'mean'),
    F_回数=('frequency', 'mean'),
    M_円=('monetary', 'mean'),
    翌年の購買率=('future_sales', lambda s: (s > 0).mean()),
    翌年の売上_円=('future_sales', 'mean'),
).reindex(['優良顧客', '離反リスク', '育成対象', '新規顧客', '休眠顧客'])
print(summary.round(2).to_string())

# 3. R × F のマトリクスで、人数と翌年の平均売上を可視化
count_mat = pd.crosstab(rfm['R'], rfm['F']).sort_index(ascending=False)
sales_mat = pd.crosstab(rfm['R'], rfm['F'], values=rfm['future_sales'], aggfunc='mean').sort_index(ascending=False)

fig, axes = plt.subplots(1, 2, figsize=(13, 5))
for ax, mat, title, fmt in [
    (axes[0], count_mat, '人数', '{:.0f}'),
    (axes[1], sales_mat, '翌年の平均売上(円)', '{:,.0f}'),
]:
    im = ax.imshow(mat.values, cmap='Blues')
    for i in range(mat.shape[0]):
        for j in range(mat.shape[1]):
            value = mat.values[i, j]
            color = 'white' if value > mat.values.max() * 0.6 else 'black'
            ax.text(j, i, fmt.format(value), ha='center', va='center', color=color, fontsize=9)
    ax.set_xticks(range(mat.shape[1]), labels=mat.columns)
    ax.set_yticks(range(mat.shape[0]), labels=mat.index)
    ax.set_xlabel('F スコア(右ほど購買回数が多い)')
    ax.set_ylabel('R スコア(上ほど最近購買)')
    ax.set_title(title)
    fig.colorbar(im, ax=ax, shrink=0.8)
plt.tight_layout()
plt.show()
R と F のスコアから5つのセグメントを作り、翌年の実績と照らし合わせています。
- セグメントの判定: np.select は、conditions の条件を上から順に調べ、最初に当てはまった条件に対応する choices の名前を返します。どれにも当てはまらない顧客は default='休眠顧客' になります。2番目の条件 rfm['F'] >= 4 は「F が4以上だが、1番目(R が3以上)には当てはまらなかった」顧客、つまり R が2以下の顧客を表しています。F が4以上・R が3以上という区切りは、一般的な RFM のセグメントの定義に合わせたものです。
- セグメントごとの集計: 人数と、R・F・M の平均(日数・回数・円)に加えて、答え合わせ用に「翌年に1回以上購買した割合」と「翌年の売上の平均」を計算しています。翌年の購買率=('future_sales', lambda s: (s > 0).mean()) のように、集計の関数には lambda で書いた自前の関数も渡せます。ここでは「翌年の売上が0より大きい顧客の割合」です。reindex で、表の行の順番を本文の表と同じにしています。
- R × F のマトリクス: pd.crosstab で、R スコア(行)× F スコア(列)の25マスそれぞれの人数と、翌年の平均売上を計算しています。平均売上は、values=rfm['future_sales'] と aggfunc='mean' を指定して、各マスの顧客の翌年の売上の平均をとっています。sort_index(ascending=False) で、R=5 が上に来るように並べ替えています。
- 可視化: 2つのマトリクスを imshow でヒートマップにし、各マスに値を書き込んでいます。色の濃いマスで文字が読みにくくならないよう、値が最大値の6割を超えるマスでは文字を白にしています。ax.text(j, i, ...) の j は列(横方向)、i は行(縦方向)の位置で、ha='center', va='center' でマスの中央にそろえています。fig.colorbar で色と値の対応を示すカラーバーを付けています。
実行結果
           人数    R_日数  F_回数      M_円  翌年の購買率   翌年の売上_円
segment
優良顧客     2094   38.06  8.09  2969.55    0.69  18063.38
離反リスク     644  193.04  6.14  3055.12    0.10   1236.60
育成対象     2223   49.56  2.36  3074.78    0.56   7346.79
新規顧客     1077   26.73  1.00  3115.78    0.73   7864.80
休眠顧客     3962  200.88  1.53  2981.73    0.36   2297.03
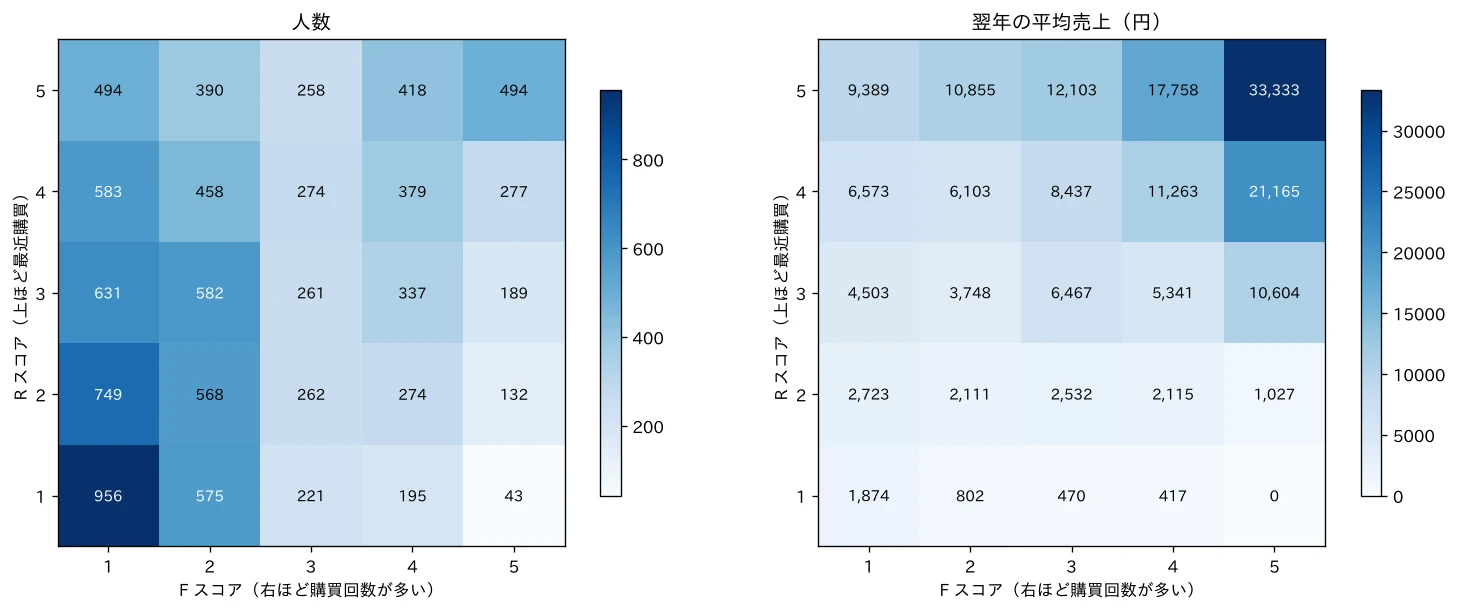
セグメントごとの結果を見ると、RFM分析は大まかには「将来の価値」をうまく分けられています。
- 優良顧客: 翌年の購買率は69%、翌年の売上の平均は約1.8万円で、全セグメントの中で最も高くなりました。
- 離反リスク: 以前は平均6回以上買っていたにもかかわらず、翌年に購買したのはわずか10%で、売上の平均も約1,200円と最も低くなっています。
- 新規顧客: 購買回数は1回だけですが、翌年の購買率は73%と最も高く、売上の平均は育成対象と同じ程度(約7,900円)です。購買回数の少なさだけで判断すると、見落としてしまう層です。
- M はどのセグメントでもほぼ同じ: 平均購買金額は、どのセグメントでも約3,000円です。このデータでは、購買の頻度と1回あたりの金額を互いに無関係に生成しているためです(現実のデータでは、両者に関係があることもあります)。
右のヒートマップを見ると、翌年の平均売上は右上(R も F も高い)のマスほど大きく、R=5・F=5 のマスでは約3.3万円に達しています。ところが、下の2行(R が1〜2)では、F が高いほど翌年の売上が小さくなるという逆転が起きています。R=1 の行では、F=1 の顧客の1,874円に対して、F=5 の顧客は0円です。「よく買う顧客ほど良い顧客」という RFM の前提が、ここでは成り立っていません。この理由は、後の「限界2」で明らかになります。
セグメントごとの翌年の実績を並べると、次のようになります。
(図は、diagram-designで作成)
RFM分析の限界
ここまで見たように、RFM分析は顧客を大まかに「将来買ってくれそうな順」に並べることができます。しかし、真値を知っているダミーデータで細かく見ていくと、RFM分析には3つの限界があることが分かります。
限界1:同じスコアでも、将来の価値はばらばら
まず、R・F・M のすべてが最高の5点(「555」)の顧客を取り出して、翌年の売上と、隠れた真値(購買ペース・生存)を確認します。
# 1. R・F・M がすべて5点の顧客を取り出す
best = rfm[(rfm['R'] == 5) & (rfm['F'] == 5) & (rfm['M'] == 5)]
best_truth = truth.loc[best.index]

# 2. 翌年の売上のばらつき
print(f"RFMスコア 555 の顧客: {len(best)} 人")
print(f"翌年に1回も購買しなかった顧客: {(best['future_sales'] == 0).mean():.1%}")
print("翌年の売上の分位点(円):")
print(best['future_sales'].quantile([0.1, 0.25, 0.5, 0.75, 0.9]).round(0).to_string())

# 3. 隠れた真値のばらつき(現実には観測できない)
print(f"\n基準日の時点ですでに離脱していた顧客: {1 - best_truth['alive'].mean():.1%}")
print("年間の購買ペース(真値)の分位点(回/年):")
print((best_truth['lam'] * 365).quantile([0.1, 0.25, 0.5, 0.75, 0.9]).round(1).to_string())

# 4. 翌年の売上の分布を可視化
plt.figure(figsize=(10, 5))
plt.hist(best['future_sales'] / 1000, bins=30, color='C0', edgecolor='white')
plt.axvline(best['future_sales'].median() / 1000, color='black', linestyle='--', label='中央値')
plt.title('RFMスコア 555 の顧客の翌年の売上')
plt.xlabel('翌年の売上(千円)')
plt.ylabel('人数')
plt.legend()
plt.grid(True, alpha=0.3)
plt.show()
最高スコアの顧客の中で、翌年の売上と隠れた真値がどれだけばらついているかを確認しています。
- 顧客の抽出: R・F・M のスコアがすべて5の顧客を best に取り出し、同じ顧客の真値を truth.loc[best.index] で取り出しています。customer_id が truth の行番号と一致するように作っているので、インデックスで対応づけられます。
- 翌年の売上の分位点: quantile([0.1, 0.25, 0.5, 0.75, 0.9]) で10%・25%・50%・75%・90%点を表示し、同じスコアの顧客の間で、翌年の売上がどれくらい違うかを見ています。
- 真値のばらつき: 基準日の時点ですでに離脱していた顧客の割合と、購買ペース lam を年間の回数(× 365)に直した値の分位点を表示しています。どちらも、現実の分析では観測できない値です。
- 可視化: plt.hist(best['future_sales'] / 1000, bins=30) で、翌年の売上を千円単位にして30本の棒のヒストグラムにし、plt.axvline で中央値を破線で示しています。
実行結果
RFMスコア 555 の顧客: 93 人
翌年に1回も購買しなかった顧客: 9.7%
翌年の売上の分位点(円):
0.10      4328.0
0.25     10300.0
0.50     40820.0
0.75     90540.0
0.90    140556.0

基準日の時点ですでに離脱していた顧客: 9.7%
年間の購買ペース(真値)の分位点(回/年):
0.10     7.5
0.25    11.5
0.50    16.9
0.75    24.4
0.90    35.7
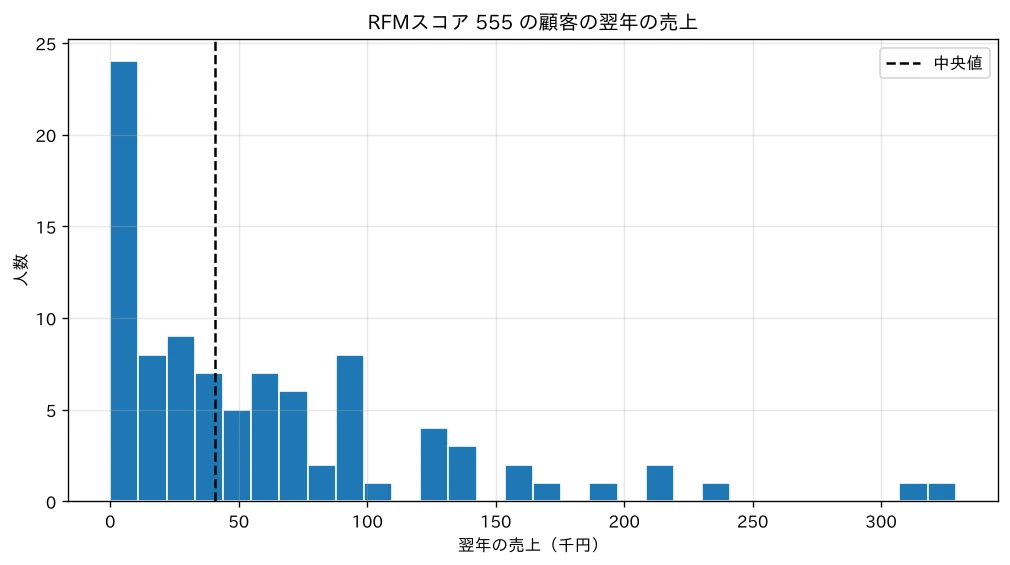
RFMの上では「まったく同じ最高の顧客」である93人の中に、大きな違いが隠れています。
- 翌年の売上は数十倍の差: 翌年の売上の中央値は約4.1万円ですが、10%点は約4,300円、90%点は約14万円です。ヒストグラムを見ても、0付近に山がある一方、30万円を超える顧客もいます。
- 約1割はすでに離脱している: 翌年に1回も購買しなかった顧客は9.7%で、基準日の時点ですでに離脱していた顧客の割合(9.7%)と同じです(このデータでは、両者は同じ9人でした)。最近まで頻繁に高額の買い物をしていた顧客でも、離脱は起こります。そして、それは購買ログからは分かりません。
- 購買ペースの違い: 生存している顧客の間でも、真の購買ペースは年7.5回(10%点)から年35.7回(90%点)まで、5倍近く違います。F スコアの5は「7回以上」をすべて同じ扱いにするため、この違いがスコアから消えてしまいます。
スコアを5段階に丸めた時点で、顧客の違いの多くは失われます。そのうえ、離脱しているかどうかという、将来の価値を最も大きく左右する情報は、そもそも R・F・M のどれにも直接は現れません。
限界2:離脱が観測できない
非契約型のビジネスでは、顧客が離脱したかどうかは観測できません。ダミーデータでは真値が分かるので、R × F のマトリクスの各マスで、基準日の時点で実際に生存していた顧客の割合を見てみます。
# 1. R × F の各マスで、基準日の時点で生存している顧客の割合(真値)
alive_mat = pd.crosstab(rfm['R'], rfm['F'], values=truth.loc[rfm.index, 'alive'], aggfunc='mean').sort_index(ascending=False)
print("基準日の時点で生存している顧客の割合(行: R スコア、列: F スコア)")
print(alive_mat.round(2).to_string())

# 2. R スコアが低い(しばらく買っていない)顧客に絞って、F スコアごとに比較
low_r = rfm[rfm['R'] <= 2]
compare = low_r.groupby('F').agg(
    人数=('recency', 'size'),
    生存率_真値=('recency', lambda s: truth.loc[s.index, 'alive'].mean()),
    翌年の購買率=('future_sales', lambda s: (s > 0).mean()),
    翌年の売上_円=('future_sales', 'mean'),
)
print("\nR スコアが2以下の顧客(F スコア別)")
print(compare.round(2).to_string())

# 3. セグメントごとの生存率(真値)
seg_alive = truth.loc[rfm.index, 'alive'].groupby(rfm['segment']).mean()
print("\nセグメントごとの生存率(真値)")
print(seg_alive.reindex(['優良顧客', '離反リスク', '育成対象', '新規顧客', '休眠顧客']).round(2).to_string())

# 4. 生存率のマトリクスを可視化
fig, ax = plt.subplots(figsize=(7, 5))
im = ax.imshow(alive_mat.values, cmap='RdYlGn', vmin=0, vmax=1)
for i in range(alive_mat.shape[0]):
    for j in range(alive_mat.shape[1]):
        ax.text(j, i, f"{alive_mat.values[i, j]:.2f}", ha='center', va='center', fontsize=10)
ax.set_xticks(range(alive_mat.shape[1]), labels=alive_mat.columns)
ax.set_yticks(range(alive_mat.shape[0]), labels=alive_mat.index)
ax.set_xlabel('F スコア(右ほど購買回数が多い)')
ax.set_ylabel('R スコア(上ほど最近購買)')
ax.set_title('基準日の時点で生存している顧客の割合(真値)')
fig.colorbar(im, ax=ax, shrink=0.8)
plt.tight_layout()
plt.show()
R × F のマトリクスの各マスで、真の生存率と翌年の実績を比べています。
- 生存率のマトリクス: pd.crosstab の values に真値の alive(True / False)を渡し、aggfunc='mean' で平均を取ることで、各マスの生存している顧客の割合を計算しています。True は1、False は0として平均されます。
- R スコアが低い顧客の比較: R スコアが2以下(最終購買から119日以上たっている)顧客に絞り、F スコアごとに、人数・真の生存率・翌年の購買率・翌年の売上の平均を並べています。真の生存率は、各グループの顧客ID(s.index)で truth を引いて計算しています。
- セグメントごとの生存率: truth.loc[rfm.index, 'alive'].groupby(rfm['segment']).mean() で、真の生存の有無を、前の節で作った5つのセグメントごとに平均しています。
- 可視化: 生存率のマトリクスを、cmap='RdYlGn', vmin=0, vmax=1 で0(赤)〜1(緑)の色に対応させたヒートマップにしています。vmin・vmax を固定しているので、色が生存率の値そのものを表します。
実行結果
基準日の時点で生存している顧客の割合(行: R スコア、列: F スコア)
F    1     2     3     4     5
R
5  1.0  0.73  0.81  0.85  0.89
4  1.0  0.66  0.69  0.70  0.73
3  1.0  0.51  0.46  0.43  0.33
2  1.0  0.40  0.33  0.19  0.06
1  1.0  0.18  0.08  0.04  0.00

R スコアが2以下の顧客(F スコア別)
     人数  生存率_真値  翌年の購買率  翌年の売上_円
F
1  1705    1.00    0.41  2247.20
2  1143    0.29    0.22  1452.83
3   483    0.21    0.18  1588.53
4   469    0.13    0.12  1409.06
5   175    0.05    0.05   774.40

セグメントごとの生存率(真値)
segment
優良顧客     0.70
離反リスク    0.11
育成対象     0.63
新規顧客     1.00
休眠顧客     0.70
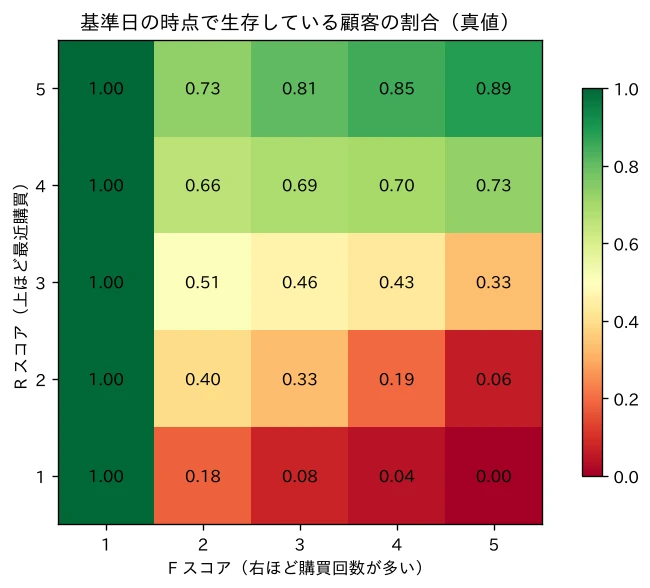
まず、ヒートマップの F=1 の列がすべて1.00になっている点について補足します。このデータの生成モデルでは、離脱は「2回目以降の購買の直後」にしか起こりません。そのため、1回しか買っていない顧客は、形式上は全員が「生存」として扱われます。ただし、R が2以下で F=1 の顧客の翌年の購買率は41%にとどまっており、生存していても購買ペースが非常に遅い顧客が多く含まれています。この「1回しか買っていない顧客は離脱しない」という性質は、生成に使ったモデルの特徴(そして弱点)の1つで、BG/NBDモデルの記事で改めて取り上げます。
そのうえで、F が2以上の列を見ると、R と F の関係について重要なことが分かります。
- 上の行(最近購買した顧客)では、F が高いほど生存率が高い: R=5 の行では、生存率は F=2 の0.73から F=5 の0.89まで上がります。最近も買っていて、購買回数も多い顧客は、まさに活発な顧客です。
- 下の行(しばらく買っていない顧客)では、F が高いほど生存率が低い: R=1 の行では、生存率は F=2 の0.18から F=5 の0.00まで下がります。以前は毎月のように買っていた顧客が200日以上も買っていないのは、「たまたま間が空いた」と考えるには不自然で、離脱した可能性が高いのです。一方、もともと年に1〜2回しか買わない顧客なら、200日買っていなくても普通のことです。
- 翌年の売上も同じ傾向: R スコアが2以下の顧客では、翌年の売上の平均は F=1 で約2,200円、F=5 で約770円です。RFM のスコアの合計では F=5 の顧客の方が4点も高くなりますが、将来の価値は逆になっています。
つまり、「しばらく買っていない」という同じ事実が、購買回数によってまったく違う意味を持つ のです。R と F を別々の点数として足し合わせる RFM のスコアリングでは、この関係を表現できません。
セグメントで見ると、「離反リスク」の生存率はわずか0.11で、名前に反して、ほとんどの顧客はすでに離脱しています。また、「優良顧客」でも3割はすでに離脱しています。RFMのセグメントには、生存している顧客と離脱した顧客が混ざっており、購買ログだけからそれを見分けることはできません。
限界3:順位は付けられても、価値の金額は分からない
RFM のスコアは、あくまで顧客の相対的な順位です。「R・F・M の合計が12点の顧客は、来年いくら買ってくれるのか」には答えられません。そのため、「この顧客に1,000円のクーポンを配る価値があるか」のような、金額で比べる判断には直接使えません。
では、順位付けの道具としてはどれくらい優秀なのでしょうか。翌年の売上の上位顧客を、RFMスコアでどれだけ取りこぼさずに見つけられるかを確かめます。比較のために、隠れた真値(購買ペース・離脱確率・平均購買金額・生存しているか)を知っている「神の視点」から計算した、翌年の売上の期待値でも順位付けしてみます。 基準日の時点で生存している顧客は、購買ペース でランダムに買い物を続け、2回目以降の購買の直後に確率 で離脱します。このとき、翌1年( 日)の間に 回目の購買が起きるのは、次の2つが両方とも成り立つときです。 したがって、翌1年の購買回数の期待値は、各 について「 回目の購買が起きる確率」を足し合わせたものになります。 これに平均購買金額を掛けたものが、翌1年の売上の期待値です。基準日の時点で離脱している顧客の期待値は0です。 なお、このデータの購買は「いつ起きるかが過去に左右されない」ランダムな過程(ポアソン過程)なので、最後の購買から何日たっていても、基準日からの1年間の購買の機会の回数は、同じ に従います。 数値例:基準日の時点で生存している、次の2人の顧客で計算してみます。どちらも離脱確率 、平均購買金額は3,000円とします。 本文の式を、2人の顧客について計算しています。補足:真値から翌年の売上の期待値を計算する方法
実行結果
from scipy.stats import poisson

# 1. 神の視点:真値から計算した翌1年の売上の期待値(現実には計算できない)
tau = OBS_END - CALIB_END
k = np.arange(1, 300)[None, :]                       # k 回目の購買(横方向)
lam_tau = truth['lam'].values[:, None] * tau          # 1年間の購買の機会の平均回数(縦方向)
p = truth['p_drop'].values[:, None]
expected_count = ((1 - p) ** (k - 1) * poisson.sf(k - 1, lam_tau)).sum(axis=1)
truth['expected_sales'] = truth['alive'] * expected_count * truth['mean_amount']
rfm['oracle'] = truth.loc[rfm.index, 'expected_sales']
print(f"翌年の売上の平均: 実績 {rfm['future_sales'].mean():,.0f} 円 / 神の視点の期待値 {rfm['oracle'].mean():,.0f} 円")

# 2. 3通りの順位付けで上位20%の顧客を選び、翌年の売上の何%をカバーできるかを比べる
rfm['rfm_total'] = rfm['R'] + rfm['F'] + rfm['M']
n_top = len(rfm) // 5
total_sales = rfm['future_sales'].sum()
rankings = {
    'RFMスコアの合計': 'rfm_total',
    '神の視点の期待値': 'oracle',
    '翌年の実績(理想)': 'future_sales',
}
print(f"\n上位20%({n_top:,}人)に選ばれた顧客が、翌年の売上の何%を占めるか")
for name, col in rankings.items():
    top = rfm.sort_values(col, ascending=False, kind='stable').head(n_top)
    print(f"  {name:12s}: {top['future_sales'].sum() / total_sales:.1%}")
3通りの方法で顧客を順位付けし、上位20%が翌年の売上をどれだけカバーするかを比べています。
- 神の視点の期待値: 上の補足の式を、全顧客について一度に計算しています。k を横方向(1〜299回目の購買)、lam_tau と p を縦方向(顧客)に並べ、NumPy のブロードキャストで (顧客数, 299) の行列を作ってから、sum(axis=1) で顧客ごとに足し合わせています。poisson.sf(k - 1, lam_tau) は、ポアソン分布で値が を超える確率、つまり です。299回目までで打ち切っても、それより先の項は事実上0です。
- 期待値の検算: 期待値の平均と、翌年の実績の平均がほぼ一致することを確認しています。一致すれば、期待値の計算が生成過程と整合していることの確認になります。
- RFMスコアの合計: rfm_total は R + F + M(3〜15点)です。同じ点数の顧客が多いため、kind='stable' で並べ替え、同点の顧客は顧客IDの順に選ばれるようにしています。同点の顧客の順番を固定するのは、実行するたびに選ばれる顧客が変わって、カバー率が変わらないようにするためです。
- 上位20%のカバー率: n_top(2,000人)を各方法の上位から選び、その顧客の翌年の売上の合計を、全体の売上で割っています。「翌年の実績」で選んだ場合は、後から答えを見て選んだ理想的な上限です。上位20%にするのは、施策の対象を顧客の2割に絞る、という実務でよくある設定に合わせるためです。
実行結果
翌年の売上の平均: 実績 7,252 円 / 神の視点の期待値 7,199 円

上位20%(2,000人)に選ばれた顧客が、翌年の売上の何%を占めるか
  RFMスコアの合計   : 57.1%
  神の視点の期待値    : 78.0%
  翌年の実績(理想)   : 83.2%
まず、神の視点の期待値の平均(7,199円)は実績の平均(7,252円)とほぼ一致しており、期待値を正しく計算できています。
そのうえで、上位20%の顧客が翌年の売上に占める割合を比べると、次のことが分かります。
- RFMスコアの合計は57.1%: ランダムに20%を選んだ場合(期待値20%)よりははるかに良く、RFM分析が有用な情報を持っていることは確かです。
- 神の視点なら78.0%: 購買ペース・離脱確率・平均金額・生存しているかを知っていれば、同じ2,000人の枠で、翌年の売上の約8割をカバーできます。RFMスコアとの差の約21ポイントは、RFMの集計では捉えきれていない情報の大きさを表しています。
- 神の視点でも理想(83.2%)には届かない: 真の性質をすべて知っていても、来年いつ何回買うかには偶然の要素が残るため、実績を完全には言い当てられません。どんなに優れた予測モデルでも超えられない壁です。
現実には「神の視点」は手に入りません。しかし、購買ペースや離脱のしやすさを購買ログから推定するモデルを作れば、RFMスコアの57%から、神の視点の78%へと近づける余地があります。それが、生存時間分析やBG/NBDモデルの記事で取り組む CLV の予測です。なお、予測の良し悪しをどう評価するか(評価指標)は、機械学習による CLV 予測の記事で詳しく扱います。
上位20%が占める翌年の売上の割合を並べると、次のようになります。
(図は、diagram-designで作成)
RFMから将来価値の予測へ
3つの限界から見えてきたのは、RFM分析の弱点が「R・F・M を別々の軸として扱い、足し算や機械的な区切りでまとめている」ことにある、という点です。限界2で見たように、同じ R スコアでも、F が高い顧客と低い顧客では「しばらく買っていない」ことの意味がまったく違います。R と F は、組み合わせて解釈して初めて、顧客が生存しているかどうかの手がかりになるのです。
さらに、RFM は顧客の在籍期間(初回購買からの経過日数)を使っていません。購買回数が2回の顧客でも、1か月前に獲得した顧客と、1年前に獲得した顧客では、購買ペースの見積もりが大きく変わるはずです。
これらの情報を正しく組み合わせるには、「顧客がどのように購買し、どのように離脱するか」という購買の生成過程そのものをモデル化する必要があります。BG/NBDモデルの記事で扱う確率モデルを使うと、顧客ごとの「まだ生存している確率」や「将来の購買回数の期待値」を、R・F・在籍期間から計算できます。さらに、R と F の組み合わせごとに CLV の等しい点を結んだ 等価値曲線(iso-value curve) を描くことで、RFMのマトリクスに CLV という「金額の物差し」を入れることもできます。
まとめ
本記事では、HVA分析の出発点として、RFM分析の実装と、その限界を解説しました。
- RFM分析の実装:購買ログを R(最新性)・F(頻度)・M(金額)の3つの指標に集約し、5段階のスコアと名前付きのセグメントに変換しました。購買回数のように同じ値が多い指標は、五分位ではなく閾値で区切る必要があることも確認しました。
- CLVの定義:顧客生涯価値を、将来の利益を生存確率で重み付けし、割引率で現在価値に直したものとして定義しました。HVA 関連の記事では、この式を CLV の定義として使います。
- 契約型と非契約型:離脱が観測できるかどうかでビジネスを分け、それぞれに使うモデルの地図を示しました。
- RFM分析の限界:真値を仕込んだダミーデータで、(1) 同じスコアの顧客でも将来の価値は大きくばらつくこと、(2) 離脱は観測できず、しばらく買っていない顧客の中では、以前よく買っていた顧客ほどすでに離脱している可能性が高いこと、(3) スコアは順位にすぎず、金額で比べる判断には使えないことを確認しました。
RFM分析は、顧客を大まかに把握するための入り口としては今でも有用です。しかし、「この顧客に、いくらまでかけてよいか」という問いに答えるには、CLV を予測するモデルが必要です。
「生存時間分析とは?」の記事では、まず離脱が観測できる契約型のビジネスを対象に、「いつ離脱するか」をモデル化する 生存時間分析 を扱います。CLV の式の (生存確率)を、打ち切りのあるデータからどう推定するかを見ていきます。
参考文献
- S. Gupta et al. (2006). Modeling Customer Lifetime Value. Journal of Service Research, 9(2), 139–155.
- P. S. Fader, B. G. Hardie, K. L. Lee (2005). RFM and CLV: Using Iso-Value Curves for Customer Base Analysis. Journal of Marketing Research, 42(4), 415–430.
- P. S. Fader, B. G. Hardie (2009). Probability Models for Customer-Base Analysis. Journal of Interactive Marketing, 23(1), 61–69.
本記事の文章・構成の一部に生成AIを使用しています。