強化学習(Reinforcement Learning)とは?:ゼロから学ぶ基礎と全体像
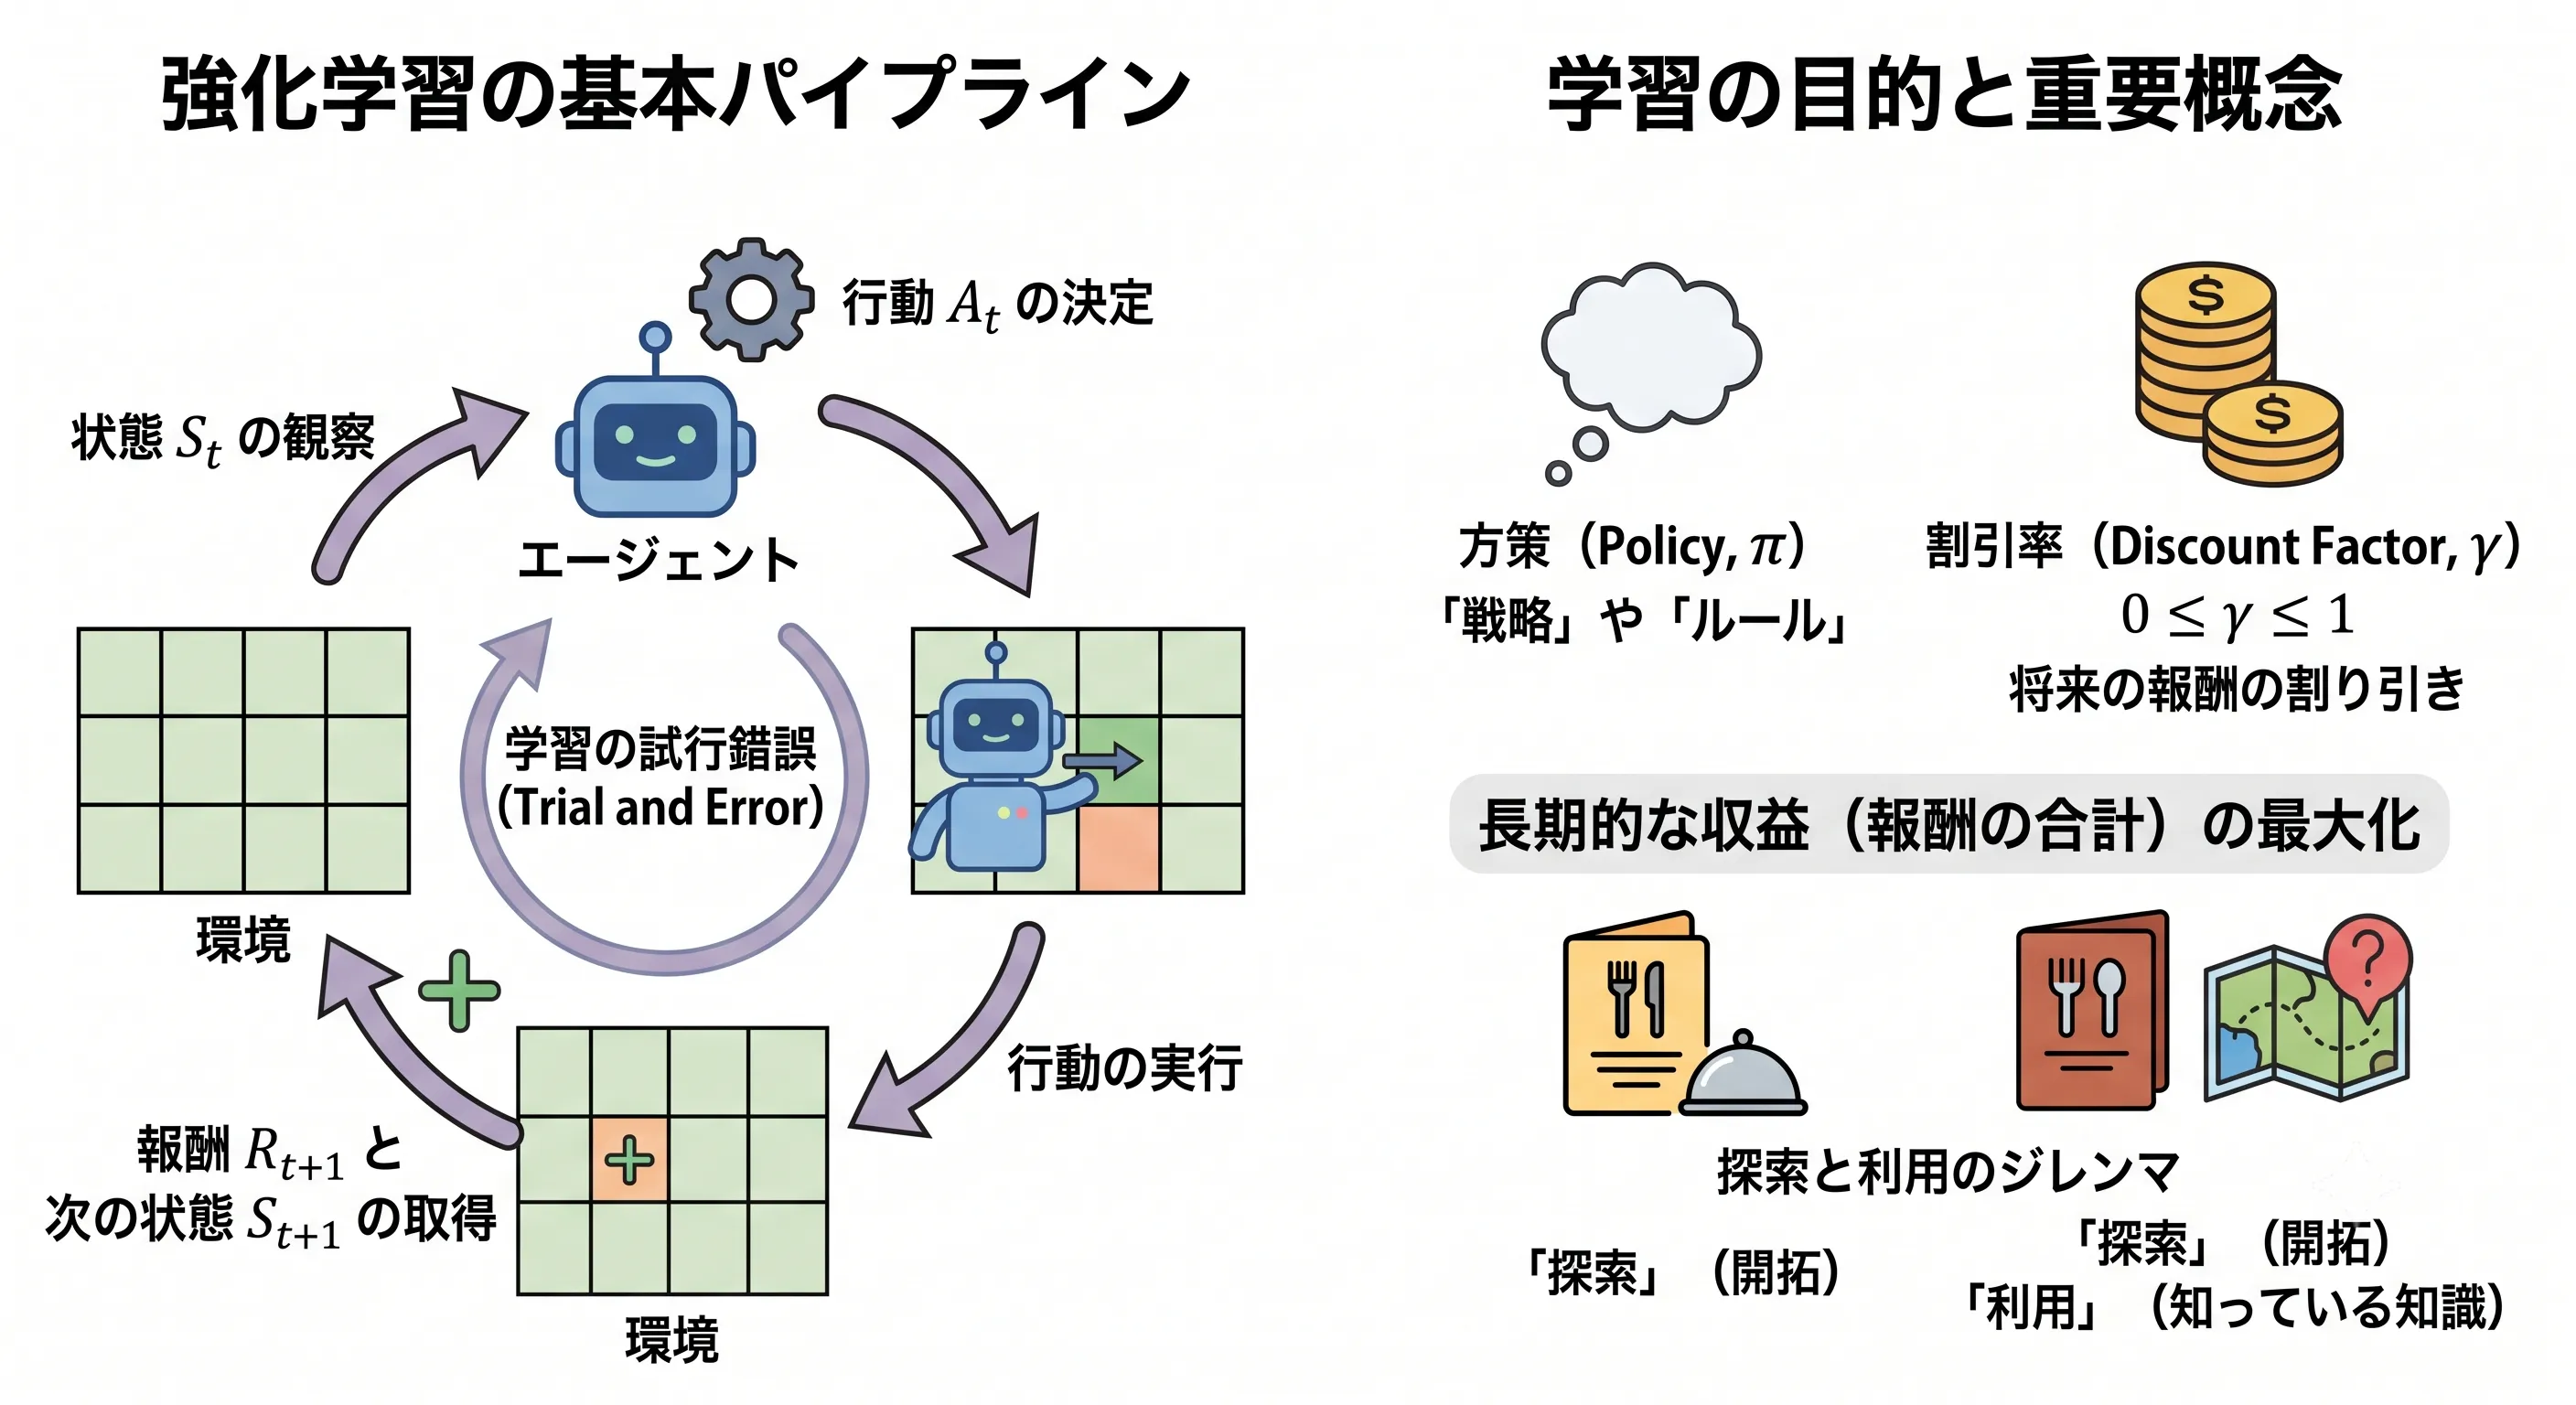 (画像は、Geminiで作成)
強化学習が、正解のラベルではなく報酬を手がかりに試行錯誤で学ぶ仕組みであることを理解し、MDP の構成要素(状態・行動・遷移確率・報酬・割引率)と、方策・割引率・探索と利用という3つの基本概念を説明できるようになること。そして、Gymnasium で CartPole を動かし、ランダムに行動するエージェントのスコアを、後の記事で学ぶアルゴリズムと比べる基準として確かめること。
機械学習には大きく分けて「教師あり学習」「教師なし学習」、そして「強化学習(Reinforcement Learning: RL)」の3つがあります。強化学習は、正解データ(ラベル)が与えられるのではなく、エージェントが環境内で意思決定を行い、得られる「報酬(Reward)」を最大化するように試行錯誤を通じて学習するアプローチです。
自転車の乗り方を覚える子供や、犬のしつけをイメージしてみてください。最初はうまくいかなくても、「うまく進めた」「褒められた」という結果(報酬)を手がかりに、徐々に最適な行動を身につけていきます。この記事では、アルゴリズムの解説に入る前に、強化学習の基本的な考え方と専門用語、そしてPythonを使って実際に「環境」を動かしてみるまでの基礎を解説します。
1. 強化学習の基本パイプライン
強化学習には、行動を決めて学習する エージェント(Agent) と、エージェントが相互作用する世界である 環境(Environment) が登場します。環境はゲームやロボットのシミュレーションなどです。
両者のやり取りは、マルコフ決定過程(Markov Decision Process: MDP) という枠組みで表されます。MDPを構成するのは次の要素です。
- 状態(State, ): 時刻 における環境の状況です。
- 行動(Action, ): エージェントが状態に基づいて選ぶアクションです。
- 遷移確率: 状態 で行動 をとったときに、次の状態 がどうなるかの確率です。
- 報酬(Reward, ): 行動の結果として環境から与えられるフィードバック(点数やペナルティ)です。行動の後にもらうので、添字は と書きます。
- 割引率(): 将来の報酬をどれだけ割り引いて評価するかを決める値です(後述)。
「マルコフ」は、次の状態と報酬が、今の状態と行動だけで決まり、それより前の履歴には左右されないという性質(マルコフ性)を指します。この性質があるので、エージェントは「今の状態」だけを見て行動を決めればよくなります。
(図は、diagram-designで作成)
学習のサイクルは以下のようになります。
- エージェントが現在の状態を観察します。
- その状態に基づいて行動を決定します。
- 環境がその行動を受け取り、遷移確率にしたがって次の状態と報酬をエージェントに返します。
- エージェントはこの結果をもとに、次からもっと多くの報酬をもらえるように自分の戦略をアップデートします。
2. 絶対に知っておくべき3つのキーワード
強化学習の目的は、長期的に見て最も多くの報酬を得られるような行動ルールを見つけることです。そのために重要な3つの概念を紹介します。
方策(Policy, )
方策とは、エージェントの「行動ルール」や「戦略」のことです。「もし状態Aなら、行動Bをとる」というマッピングを指します。強化学習の最終的な目標は、この「方策」を最適なもの(最も報酬がもらえるルール)にすることです。
割引率(Discount Factor, )
エージェントは、すぐにもらえる目先の報酬だけでなく、将来もらえる報酬も考慮して行動する必要があります。しかし、無限に先の未来を予測することは不可能です。そこで、遠い未来の報酬ほど少し割り引いて評価するために使われるのが 割引率 (0から1の間の値) です。これにより、エージェントは「なるべく早く報酬を得る」ことと「計算の安定性」の両立が可能になります。
2つの割引率で、報酬の重みがどう減っていくかを図にすると、次のようになります。
(図は、diagram-designで作成)
探索と利用のトレードオフ(Exploration-Exploitation Trade-off)
強化学習における最大のジレンマです。
- 利用(Exploitation): 今知っている知識の中で、一番良いと思われる行動をとること。
- 探索(Exploration): まだ試していない行動をとり、新しい知識を得ること。
例えば、お気に入りのおいしいレストランに行く(利用)か、まだ行ったことのない新しいレストランを開拓する(探索)か、という状況と同じです。最初から「利用」ばかりしていると、もっと良い選択肢を見逃してしまうため、このバランスを最適に保つことが学習成功の鍵となります。
探索と利用の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
3. まずはPythonで「環境」を動かしてみよう
アルゴリズム(Q学習など)を実装してエージェントを賢くする前に、まずはPythonで強化学習の「環境」を用意し、エージェントに完全にランダムな行動をとらせてみましょう。 強化学習の標準的な環境を提供するライブラリ gymnasium を使用して、「Cart Pole(倒立振子)」という環境を動かします。
ライブラリのインストール
!pip install "gymnasium[classic-control]" matplotlib japanize-matplotlib setuptools
CartPoleなどの古典的な制御タスクを描画するには、描画ライブラリの pygame が必要です。gymnasium[classic-control] と指定すると、gymnasium 本体と一緒に pygame もインストールされます。また、アニメーションの作成に使う matplotlib と、フレームを並べた図のタイトルを日本語で表示するための japanize-matplotlib もインストールしています。setuptools は、Python 3.12 以降で japanize-matplotlib が使う distutils を補うために入れています。
本記事のコードは、gymnasium 1.4.0 で実行した結果を載せています。
ランダムエージェントの実装
以下のコードでは、強化学習環境のデファクトスタンダードである gymnasium ライブラリを使用して「CartPole(倒立振子)」環境を構築し、完全にランダムに行動を選択するエージェントを実行します。 学習を一切行わないランダムエージェントの挙動を通じて、強化学習における基本的な実行サイクル(状態の取得、行動の決定、環境への適用、報酬と次状態の獲得)がPythonでどのようにループ処理として記述されるか、そのマクロな流れを確認してください。
import gymnasium as gym
import matplotlib.pyplot as plt
from matplotlib import animation
from IPython.display import HTML

# 1. 環境の作成(レンダリングモードを 'rgb_array' にして画像配列として取得する)
env = gym.make('CartPole-v1', render_mode='rgb_array')

# 2. 環境の初期化(最初の状態を取得)
# 実行結果を再現できるように、環境と行動選択の乱数シードを固定する
state, _ = env.reset(seed=42)
env.action_space.seed(42)
done = False
total_reward = 0
frames = []  # 動画用のアニメーションフレームを保存するリスト
angles = [state[2]]  # ポールの角度(ラジアン)の記録。後で、どのくらい傾いて終わったかを確かめる

print("--- ランダムエージェントの実行開始 ---")

# 3. エピソードが終了するまでループ
while not done:
    # 現在の環境の描画データを配列として取得し、リストに追加
    frames.append(env.render())

    # ランダムに行動を1つ選ぶ
    action = env.action_space.sample()

    # 4. 環境に行動を適用し、結果を受け取る
    next_state, reward, terminated, truncated, _ = env.step(action)

    # 終了条件の更新
    done = terminated or truncated
    total_reward += reward

    # 次のステップに向けて状態を更新する
    state = next_state
    angles.append(state[2])

# エピソード終了時(ポールが倒れた瞬間)の描画も保存する
frames.append(env.render())

print(f"エピソード終了: 獲得した合計報酬(スコア) = {total_reward}")

# 5. 環境を閉じる
env.close()

# 6. 保存したフレームを使ってアニメーションを作成し、Colab上に表示する
print("アニメーションを生成中...")
fig = plt.figure(figsize=(frames[0].shape[1] / 72.0, frames[0].shape[0] / 72.0), dpi=72)
ax = fig.add_subplot(111)
ax.axis('off')  # 軸を非表示にする

patch = ax.imshow(frames[0])

# アニメーション更新用の関数
def animate(i):
    patch.set_data(frames[i])

# FuncAnimationで動画を作成
anim = animation.FuncAnimation(fig, animate, frames=len(frames), interval=50)
plt.close(fig)  # 余分な静止画プロットを防ぐ

# HTMLとしてColabの出力セルにアニメーションを表示
HTML(anim.to_jshtml())
ランダムエージェントを動かすための一連の処理について詳しく解説します。
- ライブラリのインポート: 強化学習シミュレータの gymnasium(OpenAI Gym の後継ライブラリ)に加え、Google Colab上で描画結果をアニメーションとして可視化するために matplotlib.pyplot、matplotlib.animation、および IPython.display.HTML をインポートしています。
- 環境の構築: gym.make('CartPole-v1', render_mode='rgb_array') で、定番タスク「CartPole-v1」を初期化しています。クラウド環境(Colab等)ではGUIウィンドウをポップアップさせることができないため、ここでは render_mode='rgb_array' を指定して、描画結果を数値配列(画像データ)として取得できるように設定します。
- 環境の初期化とシードの固定: env.reset(seed=42) で環境を初期化して最初の状態を受け取ります。あわせて env.action_space.seed(42) でランダムな行動選択の乱数シードも固定し、何度実行しても同じ結果になるようにしています。シードの値(42)そのものに意味はなく、固定することが目的です。また、各ステップでの描画結果(画像)を溜めておくための空リスト frames と、ポールの角度を記録するリスト angles を用意します。角度は、後でポールがどのくらい傾いて終わったかを確かめるために記録しています。
- 実行ループと描画データの保存: while not done ループ内で、行動を決定する前に env.render() を呼び出しています。これにより現在の環境の状況を画像配列として取得し、frames.append() でリストに保存していきます。なお、このループでは学習は一切行っていません。
- ランダムな行動選択: env.action_space.sample() を使用して、エージェントがその環境内で選択可能な行動(CartPoleでは「0: カートを左に押す」「1: カートを右に押す」の2通り)の中から、完全にランダムに1つを決定します。
- 環境のステップ更新とフィードバックの獲得: 決定した行動を env.step(action) に渡し、環境を1ステップ進めます。ここで得られる戻り値は以下の通りです。
- next_state: 行動適用後の新しい状態(カートの位置、速度、ポールの角度、角速度)。
- reward: このステップで得られた報酬。CartPoleでは、終了したステップも含めて、1ステップごとに
1が与えられます。そのため、合計報酬はポールを立てていたステップ数と同じになります。 - terminated: ポールが大きく傾く、またはカートが画面外に出るなどの理由でエピソードが失敗・終了したかどうか。
- truncated: 最大ステップ制限(CartPole-v1では500ステップ)に達して打ち切られたかどうか。
- 終了判定・報酬加算・状態の更新: terminated or truncated によってエピソードの終了判定を更新し、得られた報酬を total_reward に加算します。最後に state = next_state で現在の状態を次の状態に置き換え、次のステップに進みます。今回はランダムに行動するため state を使っていませんが、Q学習などのアルゴリズムでは、この現在の状態をもとに行動を決めます。
- 最終フレームの保存: ループ内では行動前に描画しているため、エピソードが終了した瞬間(ポールが倒れた状態)の画像はループの中では保存されません。そこで、ループを抜けた後に frames.append(env.render()) をもう一度呼び、最後の状態もアニメーションに含めています。
- 環境のクリーンアップ: 最後に env.close() を呼び出して環境のリソースを解放します。
- アニメーションの生成とColab表示: 保存した画像フレーム(frames)をもとに、Matplotlibの animation.FuncAnimation を使用してアニメーションを作成します。これを HTML(anim.to_jshtml()) で変換してColabの出力セル上に埋め込むことで、GUI非対応のクラウド環境でも、エージェントの動く様子をインタラクティブなアニメーション動画として再生可能にしています。
- アニメーションの大きさと速さ: figsize を画像の幅と高さ(600×400ピクセル)を 72 で割った値にし、dpi=72 と組み合わせることで、画像を拡大も縮小もせずに表示しています。interval=50 は1フレームを50ミリ秒表示する設定です。CartPoleの1ステップは0.02秒(描画の設定は毎秒50フレーム)なので、実際の2.5倍の遅さで再生され、ポールが傾いていく様子を目で追いやすくなります。
Gymnasiumの CartPole-v1 環境では、ポールが地面にバタンと倒れるまでゲームが続くわけではありません。以下のいずれかの条件を満たすと、その時点で「ポールが倒れた(失敗した)」とみなされ、強制終了(terminated = True または done = True)になります。
- ポールの傾きが ±12度 を超えたとき
- カートの位置が中心から ±2.4(画面の端)を超えたとき
±12度というのは、人間の目から見ると「少し傾いたかな?」という程度です。そのため、完全に倒れるずっと前の段階でシミュレーションがストップしてしまいます。
本記事の実装コードでは、Google Colabなどのブラウザ・クラウド環境でもエラーなく動作し、その場でアニメーションを確認できるように、render_mode='rgb_array' と matplotlib を組み合わせた動画再生方式を採用しています。
もし、ご自身のローカルPC(GUIが利用できる環境)で直接ポップアップウィンドウを開いてリアルタイム描画を確認したい場合は、以下のように変更して実行することも可能です。
- 変更点1: 環境作成時に render_mode='human' を指定する。
env = gym.make('CartPole-v1', render_mode='human') - 変更点2: frames.append(env.render()) や、Matplotlibによるアニメーション生成・再生用のコード(コード中の「6.」以降の処理)をすべて削除する。
どちらの方法でも描画には pygame が必要なため、gymnasium[classic-control] でインストールしておいてください。
実行結果
--- ランダムエージェントの実行開始 ---
エピソード終了: 獲得した合計報酬(スコア) = 30.0
アニメーションを生成中...
アニメーションでは、カートが左右にランダムに動き、ポールがすぐに傾いて終了する様子が確認できます。合計報酬(スコア)は30でした(最大スコアは500)。
アニメーションは記事上では再生できないため、途中のフレームを横に並べて、ポールがどう傾いていったかを確かめます。
import numpy as np
import japanize_matplotlib  # グラフのタイトルを日本語で表示するため

# 開始時・途中・終了した瞬間のフレームを横に並べ、ポールが傾いていく様子を1枚で見る
# 角度の記録を見て、右に最も傾いた13ステップ目と、いったん垂直近くに戻った20ステップ目を選んだ
steps = [0, 13, 20, len(frames) - 1]  # frames[i] は i ステップ後の画面(最後は終了した瞬間)
fig, axes = plt.subplots(1, len(steps), figsize=(16, 3.4))
for ax, i in zip(axes, steps):
    ax.imshow(frames[i][120:330])  # 上下の余白(空と地面の下)を切り落とし、カートとポールを大きく見せる
    label = f'{i}ステップ目  角度 {np.degrees(angles[i]):+.1f}度' + ('(終了)' if i == len(frames) - 1 else '')
    ax.set_title(label, fontsize=13)
    ax.axis('off')
plt.tight_layout()
plt.show()
- フレームの選び方: angles の記録を見ると、ポールは最初に右へ傾き(13ステップ目に +5.6度)、いったん垂直近くに戻った後(20ステップ目)、左へ倒れていきます。この動きが分かる4つのフレームを選んでいます。
- 角度の符号: CartPoleの角度は、右に傾くとプラス、左に傾くとマイナスです。np.degrees でラジアンを度に直して表示しています。
- 切り落とし: 描画は600×400ピクセルで、上半分はほとんど空白です。frames[i][120:330] で上下の余白を切り落とし、4枚を並べてもカートとポールが小さくなりすぎないようにしています。
実行結果
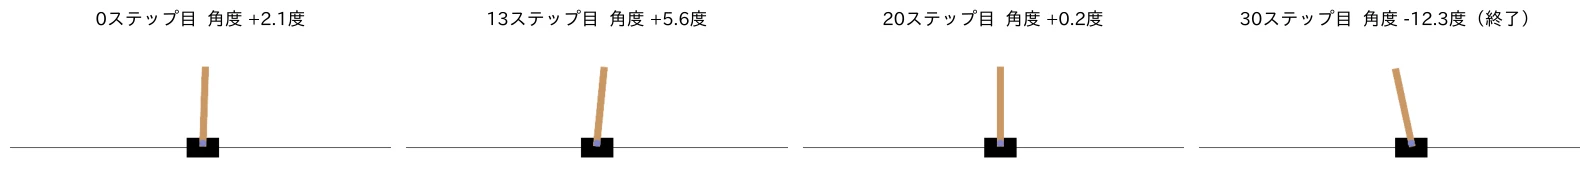
ランダムに左右に押すだけなので、ポールは右に傾いたり戻ったりを繰り返し、最後は左へ倒れて、30ステップ目に −12.3度となり、±12度の終了条件を超えて終了しました。
ランダムエージェントのスコアの分布
スコア30は、シード42の1エピソードだけの結果です。ランダムエージェントの実力を知るには、多くのエピソードで平均を見る必要があります。
import numpy as np

# ランダムエージェントを1,000エピソード動かし、スコアの分布を調べる
scores = []
for seed in range(1000):
    env = gym.make('CartPole-v1')   # 描画しないので render_mode は指定しない(速く動く)
    env.reset(seed=seed)            # エピソードごとに別のシードで、初期状態を変える
    env.action_space.seed(seed)     # ランダムな行動も、エピソードごとに変える
    done, total = False, 0
    while not done:
        _, reward, terminated, truncated, _ = env.step(env.action_space.sample())
        done = terminated or truncated
        total += reward
    scores.append(total)
    env.close()

scores = np.array(scores)
print(f"平均 {scores.mean():.1f} / 中央値 {np.median(scores):.0f} / 最小 {scores.min():.0f} / 最大 {scores.max():.0f}")
print(f"平均の標準誤差 {scores.std(ddof=1) / np.sqrt(len(scores)):.2f}")
print(f"スコア30以上のエピソード: {(scores >= 30).mean() * 100:.1f}%")
- 1,000エピソードにした理由: 平均の標準誤差(平均がどのくらいぶれるか)が0.4程度になり、平均を小数第1位まで比べるのに十分な回数だからです。描画をしないので、1,000エピソードでも数秒で終わります。
- エピソードごとにシードを変える: シードを固定したままだと、毎回同じ初期状態・同じ行動になり、1,000回動かしても同じ結果が並ぶだけです。range(1000) の番号をシードに使い、再現できる形で毎回違うエピソードにしています。
実行結果
平均 22.6 / 中央値 19 / 最小 9 / 最大 100
平均の標準誤差 0.37
スコア30以上のエピソード: 19.5%
ランダムエージェントの平均スコアは22.6で、上限の500に遠く及びません。シード42のスコア30は、1,000エピソードの中では上位約20%に入る、少し運の良い結果でした。
1,000エピソードのスコアを1本の軸に並べると、次のようになります。
(図は、diagram-designで作成)
次のステップへ
このランダムに行動するだけのエージェントを、「過去の経験から学び、ポールを落とさないように賢く動くエージェント」に進化させるのが強化学習アルゴリズムの役割です。
Q学習(Q-Learning)の記事では、最も基礎的で有名なアルゴリズムである Q学習を用いて、このCart Poleを実際に学習させます。
まとめ
本記事では、強化学習(Reinforcement Learning)のコアコンセプトから、専門用語、そしてシミュレーション環境をPythonで実際に動かすまでの一連の流れを学習しました。
本記事を通じて、以下の重要なポイントを理解しました。
- 強化学習の定義: 教師ラベルを必要とせず、エージェントが環境の中で行動と「報酬」を通じた試行錯誤から最適な意思決定ルール(方策)を学習する仕組み。
- MDPの構成要素: 状態・行動・遷移確率・報酬・割引率と、次の状態が今の状態と行動だけで決まるマルコフ性。エージェントと環境が、行動と「次の状態・報酬」をやり取りするサイクル。
- 3つの基本概念: 最適なルールを指す「方策(Policy)」、将来の報酬を評価する「割引率(Discount Factor)」、そして新しい行動を開拓する「探索と利用のトレードオフ」の重要性とバランス。
- Gymnasium環境の実装: gymnasium ライブラリを使用したCartPoleの動かし方と、強化学習の基本的な実行ループの記述方法。ランダムエージェントのスコアは、1,000エピソードの平均で22.6でした。
ランダムに行動するだけのエージェントでは、すぐにポールが倒れてしまい、高いスコアを獲得することができませんでした。エージェントが過去の経験から賢い行動ルールを自律的に獲得するアルゴリズムである Q学習(Q-Learning) は、その記事で詳しく解説しています。
参考文献
- R. S. Sutton, A. G. Barto (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
本記事の文章・構成の一部に生成AIを使用しています。