RoPEとは?
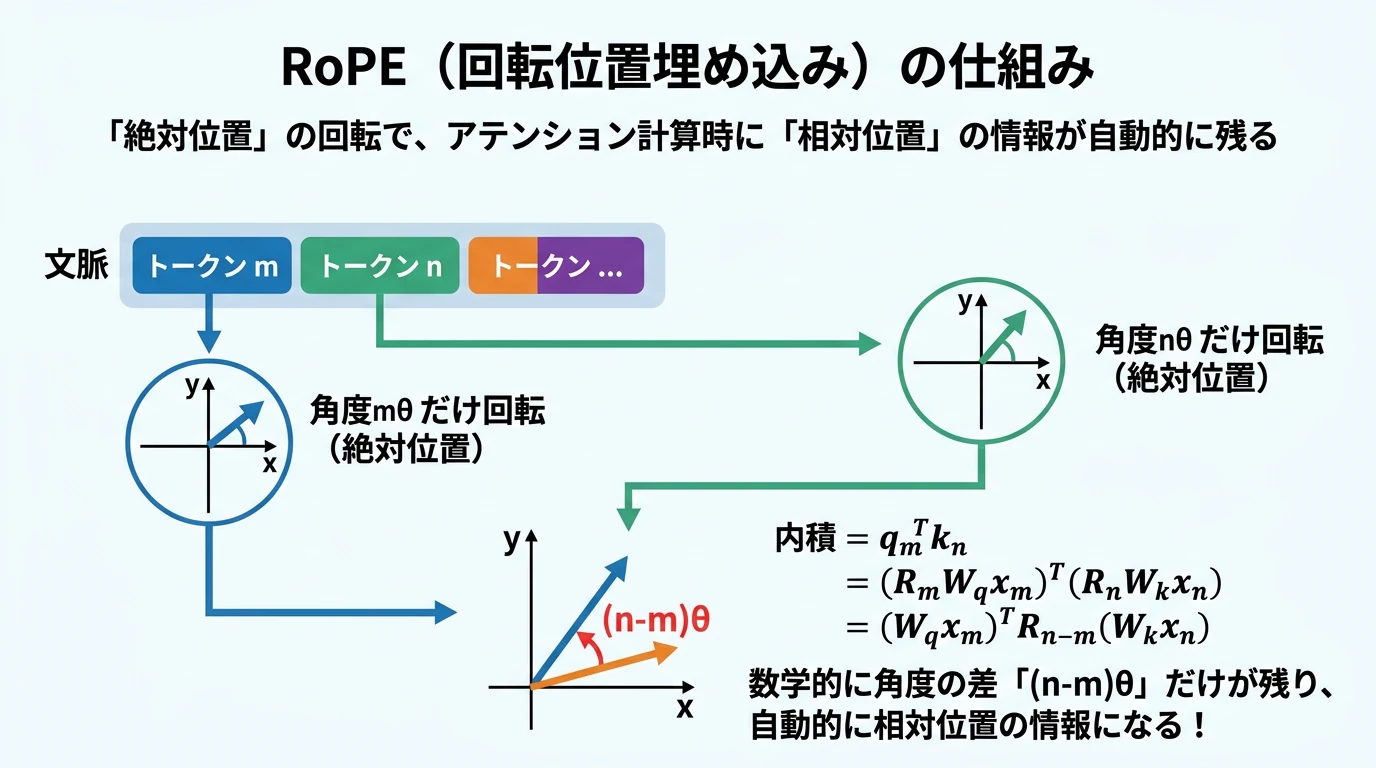 (画像は、Geminiで作成)
絶対位置埋め込みや相対位置埋め込みの課題と、Query と Key のベクトルを位置に応じて回転させることで、アテンションのスコアに相対的な距離だけを反映させる RoPE の仕組みを理解すること。PyTorch で各方式を比べ、同じ距離なら同じスコアになること、距離が離れるとスコアが減衰すること(とその条件)を確かめ、学習時より長い文章への拡張(Position Interpolation・YaRN)の考え方を説明できるようになること。
RoPEの概要
RoPE(Rotary Position Embedding) は、Jianlin Su氏(追一科技:Zhuiyi Technology)らの研究チームによって開発され、2021年に論文 "RoFormer: Enhanced Transformer with Rotary Position Embedding" として発表されました。 その後、GPT-J、GPT-NeoX、PaLMなどで採用され、MetaのLLaMAシリーズへの採用をきっかけに、現在の主要な大規模言語モデル(LLM)における事実上の標準となりました。
自然言語処理の基盤となったTransformerは、単語の並び順(位置情報)を認識できないため、何らかの方法で位置情報を付与する必要があります。Transformer の構成と、原著論文のサイン・コサインの位置エンコーディング(Sinusoidal Positional Encoding)は、Transformer の記事でスクラッチ実装しています。 初期のTransformerでは、各位置に対応するベクトルを単語ベクトルに足し算する「絶対位置埋め込み(Absolute Position Embedding)」が採用されました。元祖Transformer(Vaswani et al., 2017)ではsin/cosで作った固定のベクトルを、BERTやGPT-2では位置ごとに学習可能なベクトルを足し算しています。 この方式は計算がシンプルで高速というメリットがあるものの、単語同士の「相対的な距離(2つの単語がどれくらい離れているか)」をモデルが直接捉えるのが苦手でした。 また、学習可能な位置ベクトルを使う場合、モデルの学習時よりも長い文章が与えられると、対応する位置ベクトルがそもそも存在しないという問題もありました。
この課題を解決するため、単語間の距離に注目して計算する「相対位置埋め込み(Relative Position Embedding)」も提案されました。 しかし、この方式はアテンションスコアの行列そのものに「距離ごとの項」を後から加える必要があり、QueryとKeyの行列積だけでは計算が完結しません。 そのため実装が複雑になりやすく、方式によっては計算量やメモリ消費量が増えたり、アテンション行列を明示的に作らない線形アテンションのような高速化手法と組み合わせられなかったりするというデメリットがありました。
RoPEは、単語ベクトルを位置に応じた角度だけ回転させる「回転位置埋め込み」を取り入れることで、これらの課題を解決しました。 実装上は各単語を個別に回転させる「絶対位置」の手軽さを保ちながら、アテンション(内積)を計算する段階になると、数学的に自動で単語間の「相対位置」だけが残る仕組みを実現したのです。 これにより、通常の行列積によるアテンション計算をそのまま使いつつ、相対位置の情報をモデルに与えることが可能になりました。 さらに、QueryとKeyがともに全要素1のベクトルのような条件では、「距離が離れるほど内積が小さくなる」という長期減衰(Long-term Decay)の性質を持つことも示されています(詳しくは後述します)。
なお、RoPEを使えば学習時より長い文章をそのまま扱えるわけではありません。RoPE単体では、学習時の長さを超えると精度が大きく低下します。 ただし、回転角を調整するだけで扱える長さを拡張できる(Position Interpolation、YaRNなど)という扱いやすさがあり、これが現在のLLMにおけるコンテキストウィンドウ(扱える文脈長)の長大化を支えています(「RoPEと長文への拡張」の節で後述します)。
3つの方式で位置の情報を入れる場所を並べると、次のようになります。
(図は、diagram-designで作成)
各位置埋め込み方式の比較
単語ベクトルを (位置 )、(位置 )とし、Queryへの変換行列を 、Keyへの変換行列を とします。ベクトルはすべて列ベクトルとして扱います。 Attentionで最も重要なQueryとKeyの内積()が、各方式でどのように変化するかを見ていきます。
① 絶対位置埋め込み (Absolute Position Embedding)
単語ベクトル に位置ベクトル を足し算してから、Query・Keyへ変換します。原著の Transformer のサイン・コサインの位置エンコーディングも、この方式です(Transformer の記事)。
- QueryベクトルとKeyベクトルへの位置ベクトルの加算:
- AttentionによるQueryベクトルとKeyベクトルの内積:
内積を展開すると「単語×単語」「単語×位置」「位置×単語」「位置×位置」の4つの項が出現します。 位置 と はそれぞれ別々の位置ベクトルとして計算に入るため、「 と の距離(相対位置)」が直接計算に現れることはありません。
② 相対位置埋め込み (Relative Position Embedding)
位置の「差」に応じた埋め込みベクトル を用意し、アテンションスコアの計算に組み込みます。代表的な手法である Shaw et al.(Self-Attention with Relative Position Representations)では、Keyに相対位置ベクトルを足し算します。
- アテンションスコア(内積)への相対位置ベクトルの加算:
また、T5(Raffel et al.)では、さらに簡略化して、距離ごとに学習したスカラーのバイアス をスコアに足し算します。
相対距離 に対応する値をルックアップテーブルから取得して足すため、距離の情報を直接扱えます。 一方で、いずれの方式もQueryとKeyの行列積とは別に、全トークンペアについて「距離ごとの項」を計算してアテンション行列に加える必要があります。特にShaw方式では、ペアごとに異なる相対位置ベクトル とQueryの内積が必要になるため、計算効率が悪化しやすくなります。
③ RoPE (Rotary Position Embedding)
ベクトルを2次元ずつのペアに分け、位置 に応じた角度で回転(回転行列の掛け算)させます。 位置 における回転行列 は、2次元の回転行列を対角線上に並べたブロック対角行列です( はベクトルの次元数)。
各ペアの回転の速さ(周波数) は、論文では次のように定義されています。後ろのペアほど が小さくなり、ゆっくり回転します。
- QueryベクトルとKeyベクトルの回転:
- AttentionによるQueryベクトルとKeyベクトルの内積:
転置の基本性質 より、
ここで、 は「角度 だけ逆向きに回転する」行列なので、続けて で回転させると、差し引き「角度 の回転」だけが残ります()。
回転前のQueryベクトルとKeyベクトルを 、 とすると、
回転行列の性質により、内積を計算すると自動的に角度の差(相対距離 )の回転だけが残ります。
個々の単語をそれぞれの位置で回転させるだけ(絶対位置の実装)で、内積の結果は相対位置だけで決まるという美しい数式です。
また、絶対位置埋め込みのように足し算ではなく回転(掛け算)なので、ベクトルの長さ(ノルム)は変わらず、単語自体の情報を壊さずに位置情報を付与できます。
1つのペアの回転を図にすると、次のようになります。
(図は、diagram-designで作成)
コードによる挙動の確認
PyTorchのコードを使って、それぞれの位置埋め込みがベクトルの内積(アテンションスコア)にどのような影響を与えるのか、実際に見ていきましょう。 ここでは、位置埋め込みそのものの影響だけを見るため、QueryとKeyの変換行列(, )は省略し、単語ベクトルをそのままQuery・Keyとして扱います。
まずはQueryベクトルとKeyベクトルを定義します。
import torch
import torch.nn as nn
import math

# 実験設定
dim = 64  # 64次元ベクトル
pos_m = 2  # Queryの位置
pos_n1 = 3 # Key位置1 (距離 1)
pos_n2 = 5 # Key位置2 (距離 3)
pos_n3 = 20 # Key位置3 (距離 18)

# テスト用のクエリとキー(全く同じベクトルにする)
x_q = torch.ones(dim)
x_k = torch.ones(dim)

print("--- 準備 ---")
print(f"Queryベクトル: {x_q}")
print(f"Keyベクトル  : {x_k}\n")
- 実験設定: ベクトルの次元数をdim = 64とし、Queryの位置pos_mを2、Keyの位置を3・5・20(Queryからの距離が1・3・18)に設定します。Key の位置を3・5・20にするのは、距離が近い(1)・中くらい(3)・遠い(18)の3段階で、スコアが距離とどう関係するかを見るためです。64次元は、RoPE の回転の速さが次元ごとに大きく違う様子が出る、小さめの次元数の例です。
- QueryとKey: torch.ones(dim)で、全要素が1の同じベクトルをx_qとx_kとして用意します。単語の中身を同じにすることで、スコアの違いが位置埋め込みだけから生じるようにしています。
実行結果
--- 準備 ---
Queryベクトル: tensor([1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1.])
Keyベクトル  : tensor([1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1., 1.,
        1., 1., 1., 1., 1., 1., 1., 1., 1., 1.])
以降の3つの実験では、距離1・3・18のスコアに加えて、位置10と位置11(同じ距離1) のスコアも計算します。相対位置を捉えられる方式なら、位置2と位置3のペアと同じスコアになるはずです。
絶対位置埋め込み (Absolute Position Embedding)
以下のコードでは、PyTorchのnn.Embeddingを用いて、BERTやGPT-2のような学習可能な「絶対位置埋め込み」をシミュレートします。各位置に対応するベクトルを生成し、それをQueryおよびKeyベクトルに直接加算してから内積(アテンションスコア)を計算します。
torch.manual_seed(0)
pos_emb_abs = nn.Embedding(21, dim)
nn.init.normal_(pos_emb_abs.weight)

# 位置ベクトルをそのまま足し算してから内積を計算
def get_abs_score(m, n):
    q_abs = x_q + pos_emb_abs(torch.tensor(m))
    k_abs = x_k + pos_emb_abs(torch.tensor(n))
    return torch.dot(q_abs, k_abs).item()

print(f"距離1  (位置 {pos_m}x{pos_n1}) のスコア: {get_abs_score(pos_m, pos_n1):.4f}")
print(f"距離3  (位置 {pos_m}x{pos_n2}) のスコア: {get_abs_score(pos_m, pos_n2):.4f}")
print(f"距離18 (位置 {pos_m}x{pos_n3}) のスコア: {get_abs_score(pos_m, pos_n3):.4f}")
print(f"距離1  (位置 10x11) のスコア: {get_abs_score(10, 11):.4f}")
print("❌ 課題: 距離とスコアに規則的な関係がなく、同じ距離1でも位置が変わるとスコアが変わる。")
- シードの固定: torch.manual_seed(0)で乱数のシードを固定し、再現性を確保します。
- 位置埋め込み層: nn.Embedding(21, dim)で、位置番号0〜20をそれぞれdim次元のベクトルに変換する埋め込み層を作成し、nn.init.normal_で正規分布の乱数により初期化します。各位置にユニークなベクトルを割り当てる辞書のようなものです。21個にするのは、実験で使う位置(最大20)をすべて含めるためです。
- スコアの計算: get_abs_score関数では、x_qとx_kに、それぞれの位置mとnに対応する位置ベクトルを足し算し、torch.dotで内積を計算します。
実行結果
距離1  (位置 2x3) のスコア: 67.7718
距離3  (位置 2x5) のスコア: 75.1215
距離18 (位置 2x20) のスコア: 76.9451
距離1  (位置 10x11) のスコア: 57.5439
❌ 課題: 距離とスコアに規則的な関係がなく、同じ距離1でも位置が変わるとスコアが変わる。
- 結果: 距離が1, 3, 18と離れるにつれてスコアがむしろ大きくなっており、距離との規則的な関係は見られません(シードを変えると、増えたり減ったりと結果も変わります)。また、位置2と位置3、位置10と位置11はどちらも距離1ですが、スコアが異なります。2つの位置ベクトルの内積は「位置の組み合わせ」で決まり、相対的な距離が直接考慮されないためです。
なお、これはランダムに初期化した位置ベクトルでの結果です。元祖Transformerのsin/cosによる固定の位置ベクトルであれば、位置ベクトル同士の内積(「位置×位置」の項)は距離に応じて規則的に変化します。ただし、「単語×位置」の項には絶対位置が残るため、相対位置だけでスコアが決まるわけではありません。
相対位置埋め込み (Relative Position Embedding)
以下のコードでは、T5のような「距離ごとのスカラーのバイアスを足す」相対位置埋め込みを簡易的に実装します。単語同士の内積に対して、QueryとKeyの相対距離に応じた学習可能なバイアスをnn.Embeddingから取得して加算します。
# 相対距離(-20 から +20)ごとにスカラーのバイアスを持つ埋め込み辞書を用意
# 本来は距離の上限(clip)を設けますが、簡易化のためそのまま保持
rel_emb = nn.Embedding(41, 1) # 出力はスコアに足すためのスカラー(1次元)
nn.init.normal_(rel_emb.weight)

# ベースとなる単語同士の内積(位置なし)
base_score = torch.dot(x_q, x_k).item()

# 相対距離 (n - m) をインデックスに変換して、対応するバイアスを足し算する
# 例: 距離0をインデックス20とする
def get_rel_score(base, m, n):
    dist = n - m
    idx = torch.tensor(dist + 20) # 負の数を防ぐオフセット
    bias = rel_emb(idx).item()
    return base + bias

print(f"距離1  (位置 {pos_m}x{pos_n1}) のスコア: {get_rel_score(base_score, pos_m, pos_n1):.4f}")
print(f"距離3  (位置 {pos_m}x{pos_n2}) のスコア: {get_rel_score(base_score, pos_m, pos_n2):.4f}")
print(f"距離18 (位置 {pos_m}x{pos_n3}) のスコア: {get_rel_score(base_score, pos_m, pos_n3):.4f}")
print(f"距離1  (位置 10x11) のスコア: {get_rel_score(base_score, 10, 11):.4f}")
print("⭕ 利点: 同じ距離なら位置が変わっても同じスコアになる。")
print("❌ 課題: Attention行列(全トークンペア)に、距離ごとの項を後から加える処理が必要になる。")
- 相対位置バイアスの辞書: nn.Embedding(41, 1)で、相対距離-20〜+20の41通りそれぞれに1つのスカラー値(バイアス)を持つ埋め込み層を作成し、nn.init.normal_で初期化します。前述のT5方式の に相当します。41通りにするのは、位置0〜20の間で起こりうる相対距離(−20〜+20)をすべて含めるためです。
- ベーススコア: base_score = torch.dot(x_q, x_k).item()で、位置情報を考慮しない単語ベクトル同士の内積(64)を計算します。
- バイアスの加算: get_rel_score関数で相対距離dist = n - mを計算し、負の値にならないようdist + 20でインデックスに変換して、rel_emb(idx)から取り出したバイアスをbaseに加算します。
実行結果
距離1  (位置 2x3) のスコア: 63.6351
距離3  (位置 2x5) のスコア: 65.0246
距離18 (位置 2x20) のスコア: 65.2191
距離1  (位置 10x11) のスコア: 63.6351
⭕ 利点: 同じ距離なら位置が変わっても同じスコアになる。
❌ 課題: Attention行列(全トークンペア)に、距離ごとの項を後から加える処理が必要になる。
- 結果: 位置2と位置3、位置10と位置11はどちらも距離1なので、同じスコア(63.6351)になっています。スコアが相対距離だけで決まることがわかります。一方で、この計算はQueryとKeyの内積とは別に、全トークンペアについて行う必要があります。なお、バイアスはランダムに初期化しているため、距離とスコアの大小関係(距離が離れるほどスコアが大きい)には意味がありません。実際のモデルでは学習によって決まります。
回転位置埋め込み (Rotary Position Embedding)
以下のコードでは、RoPEのコアロジックを実装します。ベクトルを2次元ずつのペアに分割し、位置に応じて異なる速度で回転させる関数を定義して、QueryとKeyをそれぞれの位置で回転させてから内積(アテンションスコア)を計算します。
def apply_rope(v, pos, dim):
    rotated_v = torch.zeros_like(v)

    # 2次元(1ペア)ずつループ
    for i in range(0, dim, 2):
        # 論文の定義に基づく、このペアの回転スピード(theta_i)の計算
        # インデックスはペア単位なので i ではなく i // 2
        pair_idx = i // 2
        theta_i = 10000 ** (- (2 * pair_idx) / dim)

        # 現在の位置(pos)に応じた最終的な回転角度
        m_theta = pos * theta_i

        # 回転処理
        x = v[i]
        y = v[i+1]
        rotated_v[i]   = x * math.cos(m_theta) - y * math.sin(m_theta)
        rotated_v[i+1] = x * math.sin(m_theta) + y * math.cos(m_theta)

    return rotated_v

# QueryとKeyをそれぞれの位置で回転させてから内積を計算
def get_rope_score(m, n):
    q_rope = apply_rope(x_q, m, dim)
    k_rope = apply_rope(x_k, n, dim)
    return torch.dot(q_rope, k_rope).item()

print(f"距離1  (位置 {pos_m}x{pos_n1}) のスコア: {get_rope_score(pos_m, pos_n1):.4f}")
print(f"距離3  (位置 {pos_m}x{pos_n2}) のスコア: {get_rope_score(pos_m, pos_n2):.4f}")
print(f"距離18 (位置 {pos_m}x{pos_n3}) のスコア: {get_rope_score(pos_m, pos_n3):.4f}")
print(f"距離1  (位置 10x11) のスコア: {get_rope_score(10, 11):.4f}")
print("⭕ 利点: 各トークンを個別に回転させただけなのに、同じ距離なら同じスコアになり、距離が開くほどスコアが小さくなる。")
- ペアごとのループ: apply_rope関数は、入力ベクトルvをfor i in range(0, dim, 2):で2次元ずつのペアに分けて処理します。
- 回転の速さ: theta_i = 10000 ** (- (2 * pair_idx) / dim)は、前述の に対応します(pair_idxは0始まりなので に相当)。後ろのペアほどtheta_iが小さくなり、ゆっくり回転します。速い回転(高周波)と遅い回転(低周波)を組み合わせることで、近い距離から遠い距離までを区別できるようにしています。底の10000は、原論文(と元祖 Transformer の正弦波の位置埋め込み)と同じ値です。
- 回転角度: m_theta = pos * theta_iで、単語の位置posに応じた回転角度を決めます。
- 回転処理: rotated_v[i] = x * math.cos(m_theta) - y * math.sin(m_theta)とrotated_v[i+1] = x * math.sin(m_theta) + y * math.cos(m_theta)は、2次元の回転行列をペア に掛ける操作と同じです。
- スコアの計算: get_rope_score関数で、Queryを位置m、Keyを位置nでそれぞれ回転させ、torch.dotで内積を計算します。
実行結果
距離1  (位置 2x3) のスコア: 61.8337
距離3  (位置 2x5) のスコア: 51.1741
距離18 (位置 2x20) のスコア: 40.5986
距離1  (位置 10x11) のスコア: 61.8337
⭕ 利点: 各トークンを個別に回転させただけなのに、同じ距離なら同じスコアになり、距離が開くほどスコアが小さくなる。
- 結果: 位置2と位置3、位置10と位置11はどちらも距離1で、同じスコア(61.8337)になっています。個々のベクトルを絶対位置で回転させただけなのに、内積は相対距離だけで決まることが確認できます。また、距離が1, 3, 18と離れるにつれてスコアが61.8から51.2、40.6へと小さくなっています。
なお、このコードでは論文と同じく、隣り合う次元(v[i]とv[i+1])をペアにしています。Hugging FaceのLLaMA実装などでは、ベクトルを前半と後半に分け、v[i]とv[i + dim // 2]をペアにする方式(rotate_half)が使われています。ペアの組み方が違うだけで、内積が相対位置だけで決まるという性質は同じです。
3つの方式のスコアを並べると、次のようになります。
(図は、diagram-designで作成)
RoPEの長期減衰
上記のコードでは、距離が1, 3, 18の場合のAttentionスコアを確認しましたが、以下のコードでは位置0のQueryに対して、Keyの位置を0〜100まで変化させた時のスコアの変化を確認します。
import torch
import math
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. RoPE関数の定義
def apply_rope(v, pos, dim):
    rotated_v = torch.zeros_like(v)
    for i in range(0, dim, 2):
        pair_idx = i // 2
        # 論文の定義: 後ろの次元ほど回転スピードが遅くなる
        theta_i = 10000 ** (- (2 * pair_idx) / dim)
        m_theta = pos * theta_i

        x = v[i]
        y = v[i+1]
        rotated_v[i]   = x * math.cos(m_theta) - y * math.sin(m_theta)
        rotated_v[i+1] = x * math.sin(m_theta) + y * math.cos(m_theta)
    return rotated_v

# 2. 実験設定
dim = 64            # 64次元ベクトル
max_distance = 100  # 距離0から100まで離していく

# トークンの初期ベクトル (すべて1.0の同一ベクトルと仮定)
x_q = torch.ones(dim)
x_k = torch.ones(dim)

# 3. 位置m=0におけるQueryのRoPE適用
# (位置0なので回転角度は0となり、実質回転しない)
q_rope = apply_rope(x_q, pos=0, dim=dim)

# 4. Keyの位置 n を 0 から max_distance まで変化させて内積を計算
distances = list(range(max_distance + 1))
scores = []

for n in distances:
    # 位置 n のKeyにRoPEを適用
    k_rope = apply_rope(x_k, pos=n, dim=dim)

    # 内積(アテンションスコア)を計算
    score = torch.dot(q_rope, k_rope).item()
    scores.append(score)

# 5. グラフの描画
plt.figure(figsize=(10, 6))
plt.plot(distances, scores, marker='o', markersize=3, color='#1f77b4', linewidth=2)
plt.title("RoPEにおけるトークン間距離とアテンションスコアの長期減衰 (m = 0)", fontsize=14, fontweight='bold')
plt.xlabel("Keyの位置 n (Queryの位置 m=0 からの距離)", fontsize=12)
plt.ylabel("Attention スコア (内積)", fontsize=12)
plt.grid(True, linestyle='--', alpha=0.6)

# グラフにRoPEの特徴的な挙動の注釈を追加
plt.annotate('近くのトークンとは\n高いスコアで結合', xy=(2, scores[2]), xytext=(15, scores[0]*0.9),
             arrowprops=dict(facecolor='black', shrink=0.05, width=1, headwidth=6))
plt.annotate('距離が離れるにつれて\nスコアが自然に減衰', xy=(50, scores[50]), xytext=(55, scores[0]*0.5),
             arrowprops=dict(facecolor='black', shrink=0.05, width=1, headwidth=6))

plt.show()
- RoPE関数: apply_ropeは、前のコードと同じ回転処理です。
- 実験設定: 次元数をdim = 64、最大距離をmax_distance = 100とし、全要素が1のx_qとx_kを用意します。距離を100まで延ばすのは、波打ちながらも全体として減っていく様子を、十分な長さで見るためです。
- Queryの回転: apply_rope(x_q, pos=0, dim=dim)でQueryを位置0で回転させます。位置0なので回転角度は常に0となり、実質的に回転しません。
- スコアの記録: Keyの位置nを0から100まで1ずつ変えながら、apply_rope(x_k, pos=n, dim=dim)でKeyを回転させ、torch.dot(q_rope, k_rope).item()で内積を計算してscoresに格納します。
- グラフの描画: matplotlib.pyplotと日本語化のためのjapanize_matplotlibで、横軸を距離、縦軸をスコアとした折れ線グラフを描画し、plt.annotateで矢印付きの注釈を加えています。
実行結果
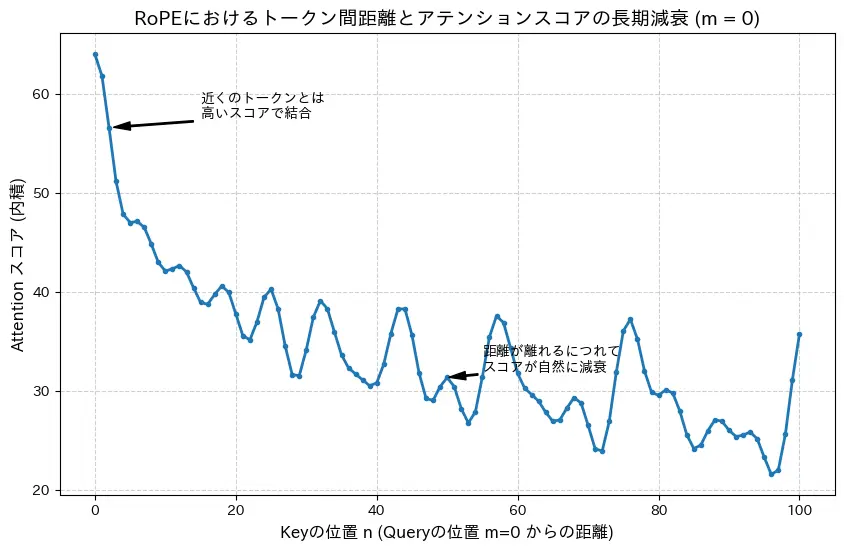
グラフからは、次のような特徴が読み取れます。
- 距離に応じた減衰
距離()が0のときにスコアが最も高く、離れるにつれて、波打ちながらも全体として右肩下がりにスコアが小さくなっていきます。これがRoPEの論文で「長期減衰(Long-term Decay)」と呼ばれている性質です。 - なぜ波打つのか(オシレーション)
スコアは直線的に減るのではなく、波打ちながら減っていきます。各ペアの寄与は で、速く回転するペア(前の次元)は距離が少し変わるだけで何周も回り、プラスとマイナスを行き来します。一方、ゆっくり回転するペア(後ろの次元)は角度がなかなか大きくならず、遠くまで高い値を保ちます。この足し合わせによって、波打ちながら減衰する形になります。今回の設定(距離0〜100)では、元の高いスコアまで戻ることはありません。 - 明示的なルールなしでの減衰
「距離が○以上ならスコアを引く」といった条件分岐(if文)や上限の設定を一切していないにもかかわらず、ベクトルの回転と内積という数学的な性質だけで、この減衰が生まれています。
ただし、この減衰がきれいに見えるのは、QueryとKeyがともに全要素1のベクトルだからです。一般のQueryとKeyでは、スコアは距離に対して必ずしも単調には減りません。 論文が示しているのは、「スコアの上界(取りうる値の上限)が、距離が離れるにつれて小さくなる」という性質です。実際のモデルでは、学習によってQueryとKeyのベクトルが決まり、どの距離のトークンに注目するかもデータから学習されます。
RoPEと長文への拡張
冒頭で触れたように、RoPEを使えば学習時より長い文章をそのまま扱えるわけではありません。 学習時に見たことのない大きな位置では、回転角度もモデルにとって未知の値になるため、RoPE単体では学習時の長さを超えると精度が大きく低下します。
一方で、RoPEは位置情報が「回転角度」というシンプルな形で表現されているため、回転角度を調整するだけで、扱える長さを拡張しやすいという利点があります。代表的な手法には次のようなものがあります。
- Position Interpolation(PI): 位置 を縮小して(例:)、長い文章の位置を学習時の範囲内に収める手法です(Chen et al., 2023)。少量の追加学習で、コンテキスト長を大きく伸ばせることが示されました。
- NTK-aware scaling / YaRN: すべてのペアを一律に縮小するのではなく、周波数ごとに調整の度合いを変える手法です。速く回転するペア(近い距離の区別に使われる)はそのまま残し、ゆっくり回転するペアを中心に調整します(YaRN:Peng et al., 2023)。
- base(10000)の拡大: の式にある10000(base)を大きくして、全体の回転をゆっくりにする方法です。長いコンテキストに対応したモデルでは、学習時からbaseを大きく設定することもあります。
このように、RoPE自体の外挿性が高いわけではありませんが、「回転角度を調整するだけで長さを拡張できる」という扱いやすさが、現在のLLMにおけるコンテキストウィンドウの長大化を支えています。
長さを伸ばす3つの方法を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、大規模言語モデル(LLM)で広く使われている位置埋め込み技術であるRoPE(Rotary Position Embedding) について、その理論的背景から具体的な挙動までを解説しました。
本記事では、以下の点について解説しました。
- RoPEのコアコンセプト: 従来の絶対位置埋め込みや相対位置埋め込みが抱えていた課題を、ベクトルを回転させるというシンプルなアイデアでどのように解決したかを、数式で確認しました。
- PyTorchによる挙動の比較検証: 各位置埋め込み方式をコードでシミュレートし、RoPEが事前のベクトル回転だけで、Attention計算時に単語間の相対的な距離を反映できる(同じ距離なら同じスコアになる)ことを確認しました。
- 長期減衰の可視化: QueryとKeyの距離が離れるほどAttentionスコアが減衰する様子をグラフで確認し、その仕組みと、全要素1のベクトルという条件付きの結果であることを解説しました。
- 長文への拡張: RoPE単体では学習時より長い文章に対応できないこと、そしてPosition InterpolationやYaRNのように回転角度を調整することで長文に拡張できることを解説しました。
RoPEは、実装の手軽さと計算効率を維持しながら相対位置の情報をモデルに与えられる、非常にエレガントな技術です。画像向けの2D RoPEや、動画向けのMRoPEのように多次元への拡張も進んでいます。現在のLLMの基盤となっているこの重要な概念を理解することは、Transformerベースのモデルをより深く知る上で不可欠と言えるでしょう。
参考文献
- J. Su, Y. Lu, S. Pan, A. Murtadha, B. Wen, Y. Liu (2024). RoFormer: Enhanced Transformer with Rotary Position Embedding. Neurocomputing, 568.
- P. Shaw, J. Uszkoreit, A. Vaswani (2018). Self-Attention with Relative Position Representations. NAACL 2018.
- C. Raffel et al. (2020). Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer. Journal of Machine Learning Research, 21(140).
- S. Chen, S. Wong, L. Chen, Y. Tian (2023). Extending Context Window of Large Language Models via Positional Interpolation. arXiv:2306.15595.
- B. Peng, J. Quesnelle, H. Fan, E. Shippole (2024). YaRN: Efficient Context Window Extension of Large Language Models. ICLR 2024.
本記事の文章・構成の一部に生成AIを使用しています。