RT-DETRとは?
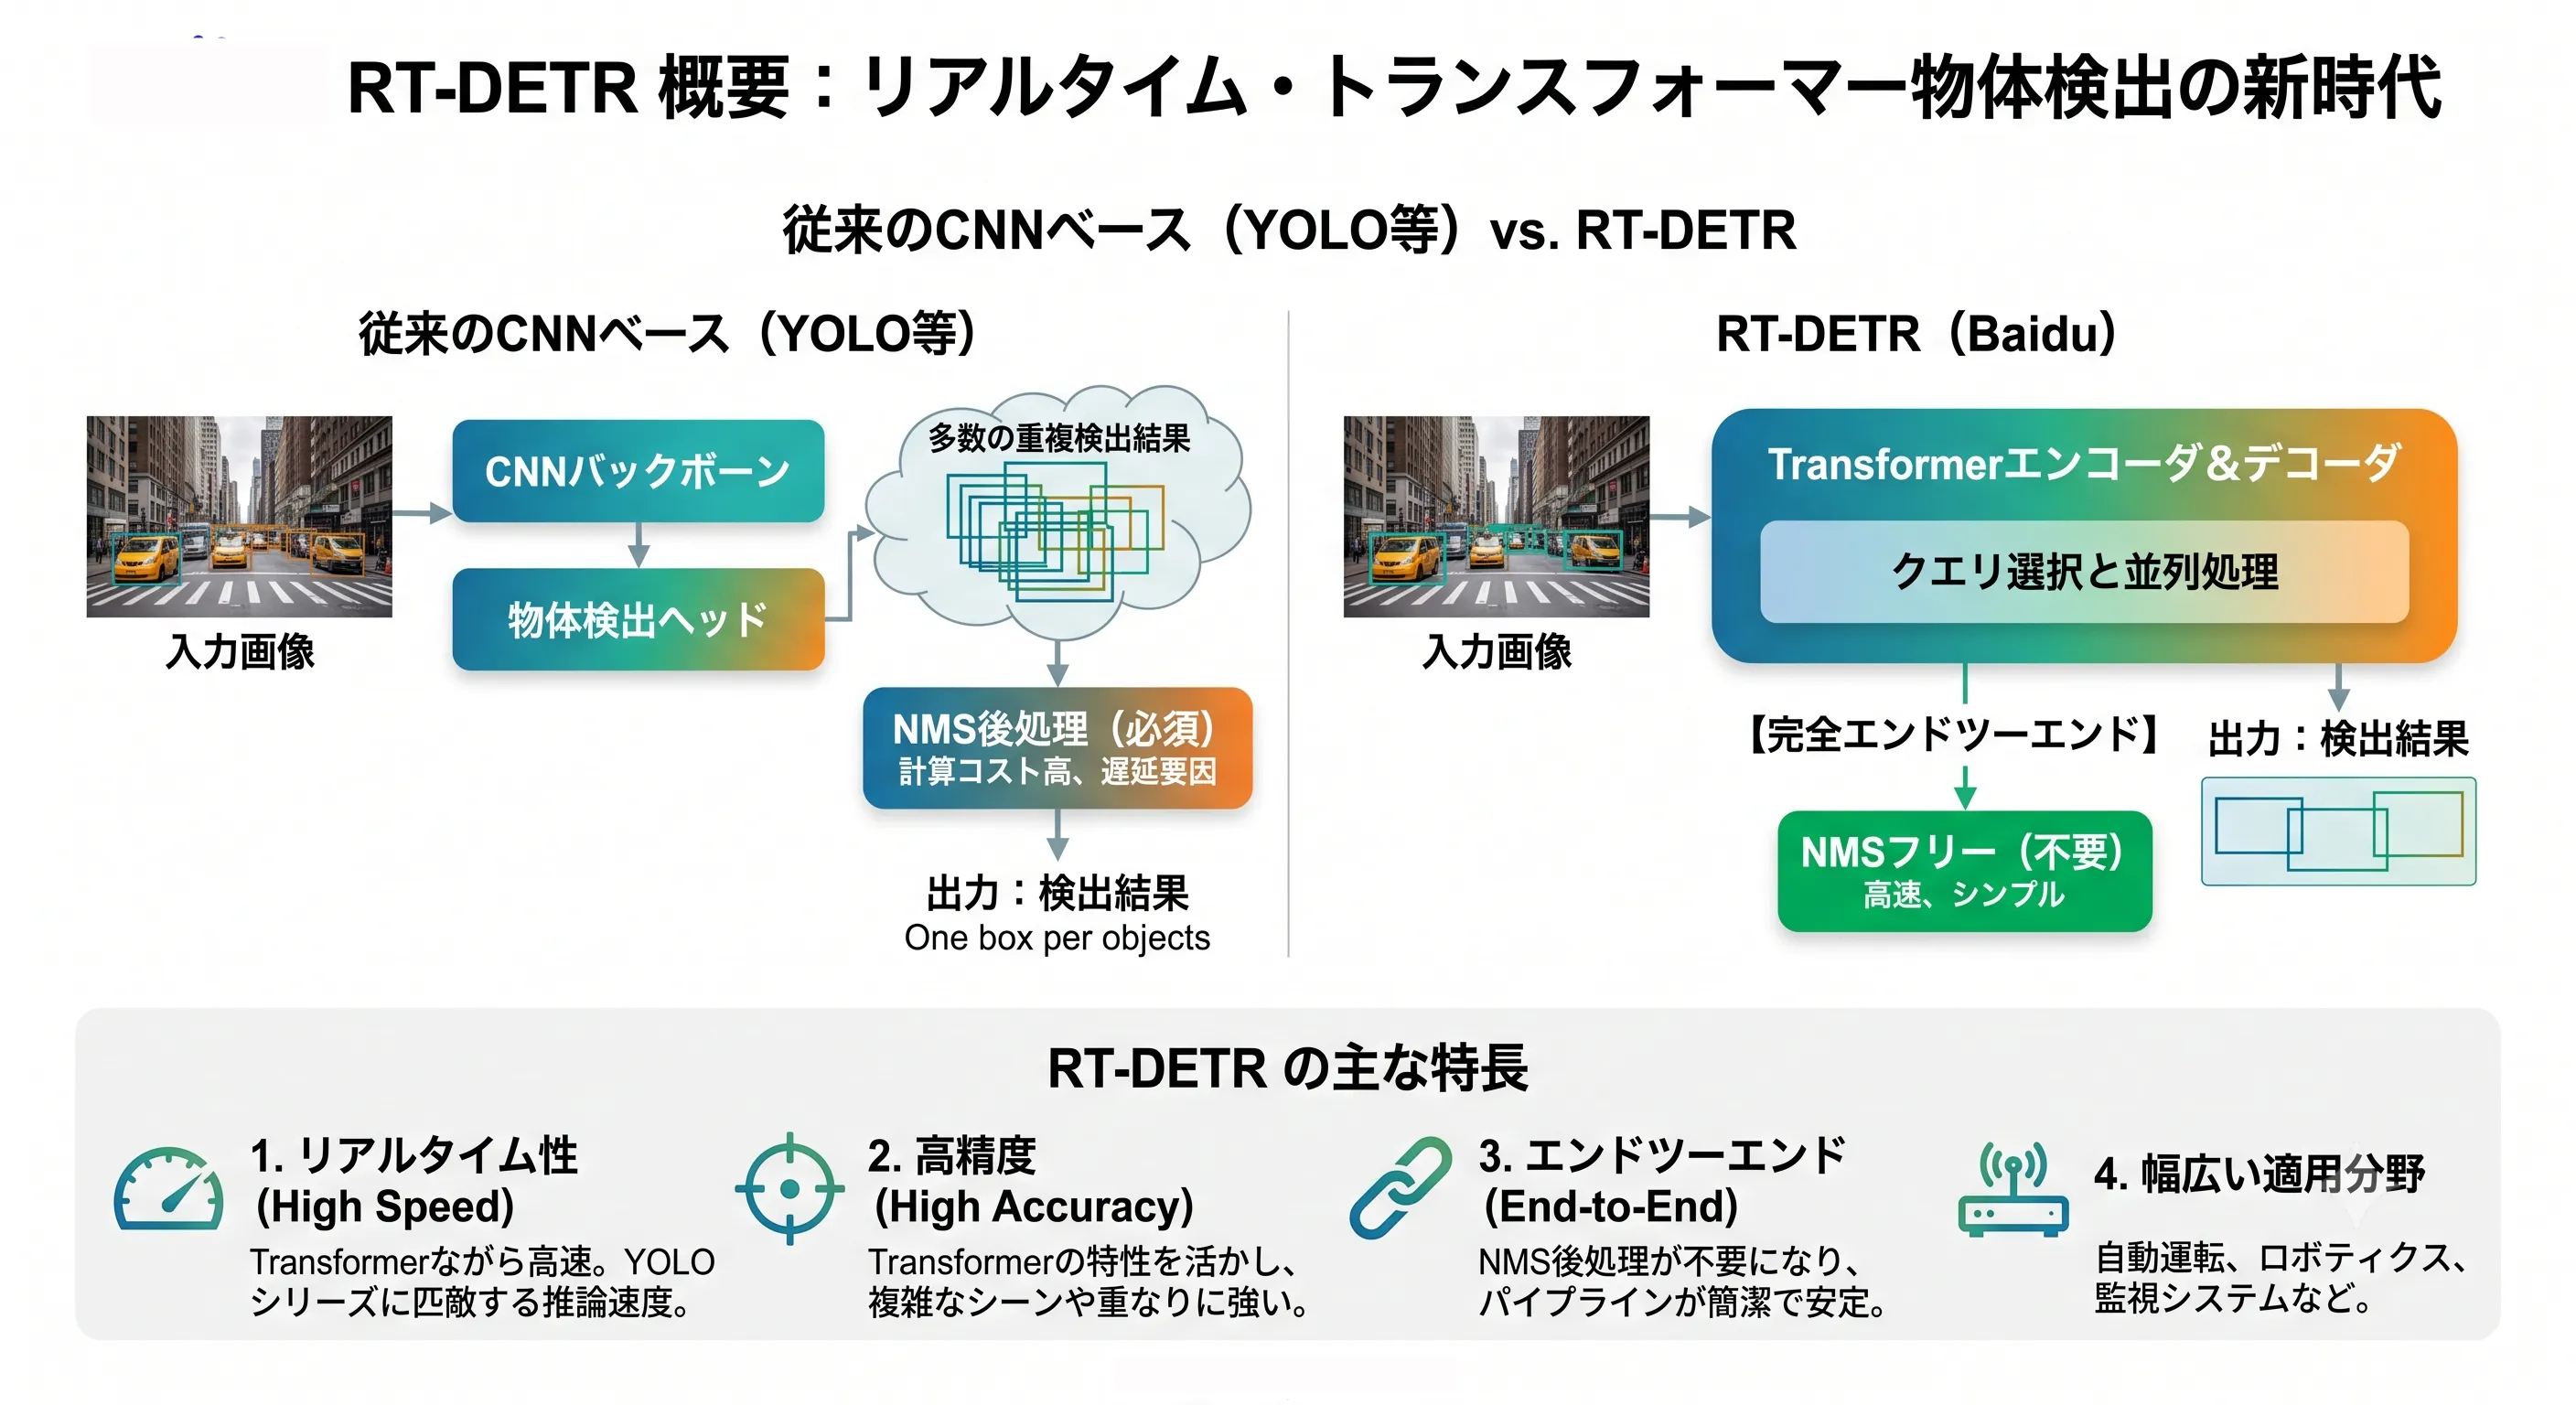 (画像は、Geminiで作成)
NMS を使わないリアルタイム物体検出モデル RT-DETR を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じ出力になることを確かめること。Hybrid Encoder・クエリの選択・Deformable Attention の役割を理解し、ハンガリアンマッチングと損失を自分で書いて追加学習し、1 対 1 のマッチングがなぜ NMS を不要にするのかを実験で確かめること。
参考資料: DETRs Beat YOLOs on Real-time Object Detection (Zhao et al., CVPR 2024)。公式の実装は lyuwenyu/RT-DETR(Apache-2.0)、本記事で使う学習済みの重みは Hugging Face の PekingU/rtdetr_r18vd(Apache-2.0)です。
概要
物体検出は、画像の中の物体を囲む箱(バウンディングボックス)とそのクラスを当てるタスクです。YOLO のような CNN の検出器は、画像の各位置が箱の候補を出すので、1 つの物体の周りに同じ物体を指す箱がいくつも出ます。そこで、重なった箱のうち確率の低い方を消す NMS(Non-Maximum Suppression) という後処理が欠かせません。NMS には重なりの閾値という調整の必要な値があり、処理時間も箱の数によって変わります。
DETR(Carion et al., 2020)は、Transformer のデコーダ(Cross-Attention で画像の特徴を見るデコーダ。Transformer の記事で実装しています)で決まった数のクエリから箱を出し、学習で 1 つの物体に 1 つのクエリだけを対応づける(ハンガリアンマッチング)ことで、NMS を使わない検出器を作りました。ただし、DETR は学習に時間がかかり、推論も遅く、リアルタイムの用途には向きませんでした。
RT-DETR(Real-Time DEtection TRansformer) は、Baidu が 2023 年に発表した、NMS を使わないままリアルタイムで動く DETR です。次の 3 つの工夫で、同じくらいの速さの YOLO より高い精度を出しました。
- Hybrid Encoder: 解像度のいちばん低い特徴にだけ自己注意をかけ(AIFI)、解像度の違う特徴どうしは CNN で混ぜる(CCFM)ことで、エンコーダの計算を大きく減らします。
- クエリの選択: エンコーダの全位置でクラスと箱を予測し、確率の高い位置をデコーダのクエリにします。学習では、分類の目標を「箱の当たり具合(IoU)」にする損失(VFL)を使うので、確率の高い位置は箱も正確になります(IoU-aware query selection)。
- 少ない点だけを見るデコーダ: デコーダは、参照する箱の周りの少数の点だけを見る Deformable Attention で、画像の特徴を読み取ります。デコーダの層の数を推論のときに減らせば、学習し直さずに速さを調整できます。
本記事では、まず YOLO11n の NMS の振る舞いを確かめ、RT-DETR の仕組みを図で整理したうえで、RT-DETR-R18 をスクラッチで実装します。
YOLO11n の NMS を確かめる
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。後半の追加学習は、A100 で約 85 分かかります。L4 GPU でも動きますが、時間はもっとかかります。
新しいセッションで、次を実行してください。ultralytics は実験1の YOLO11n に、pycocotools は実験3の COCO の評価に使います。transformers(実験2の比較用の RT-DETR)と scipy(ハンガリアン法)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q ultralytics pycocotools japanize-matplotlib setuptools
推論に利用する画像
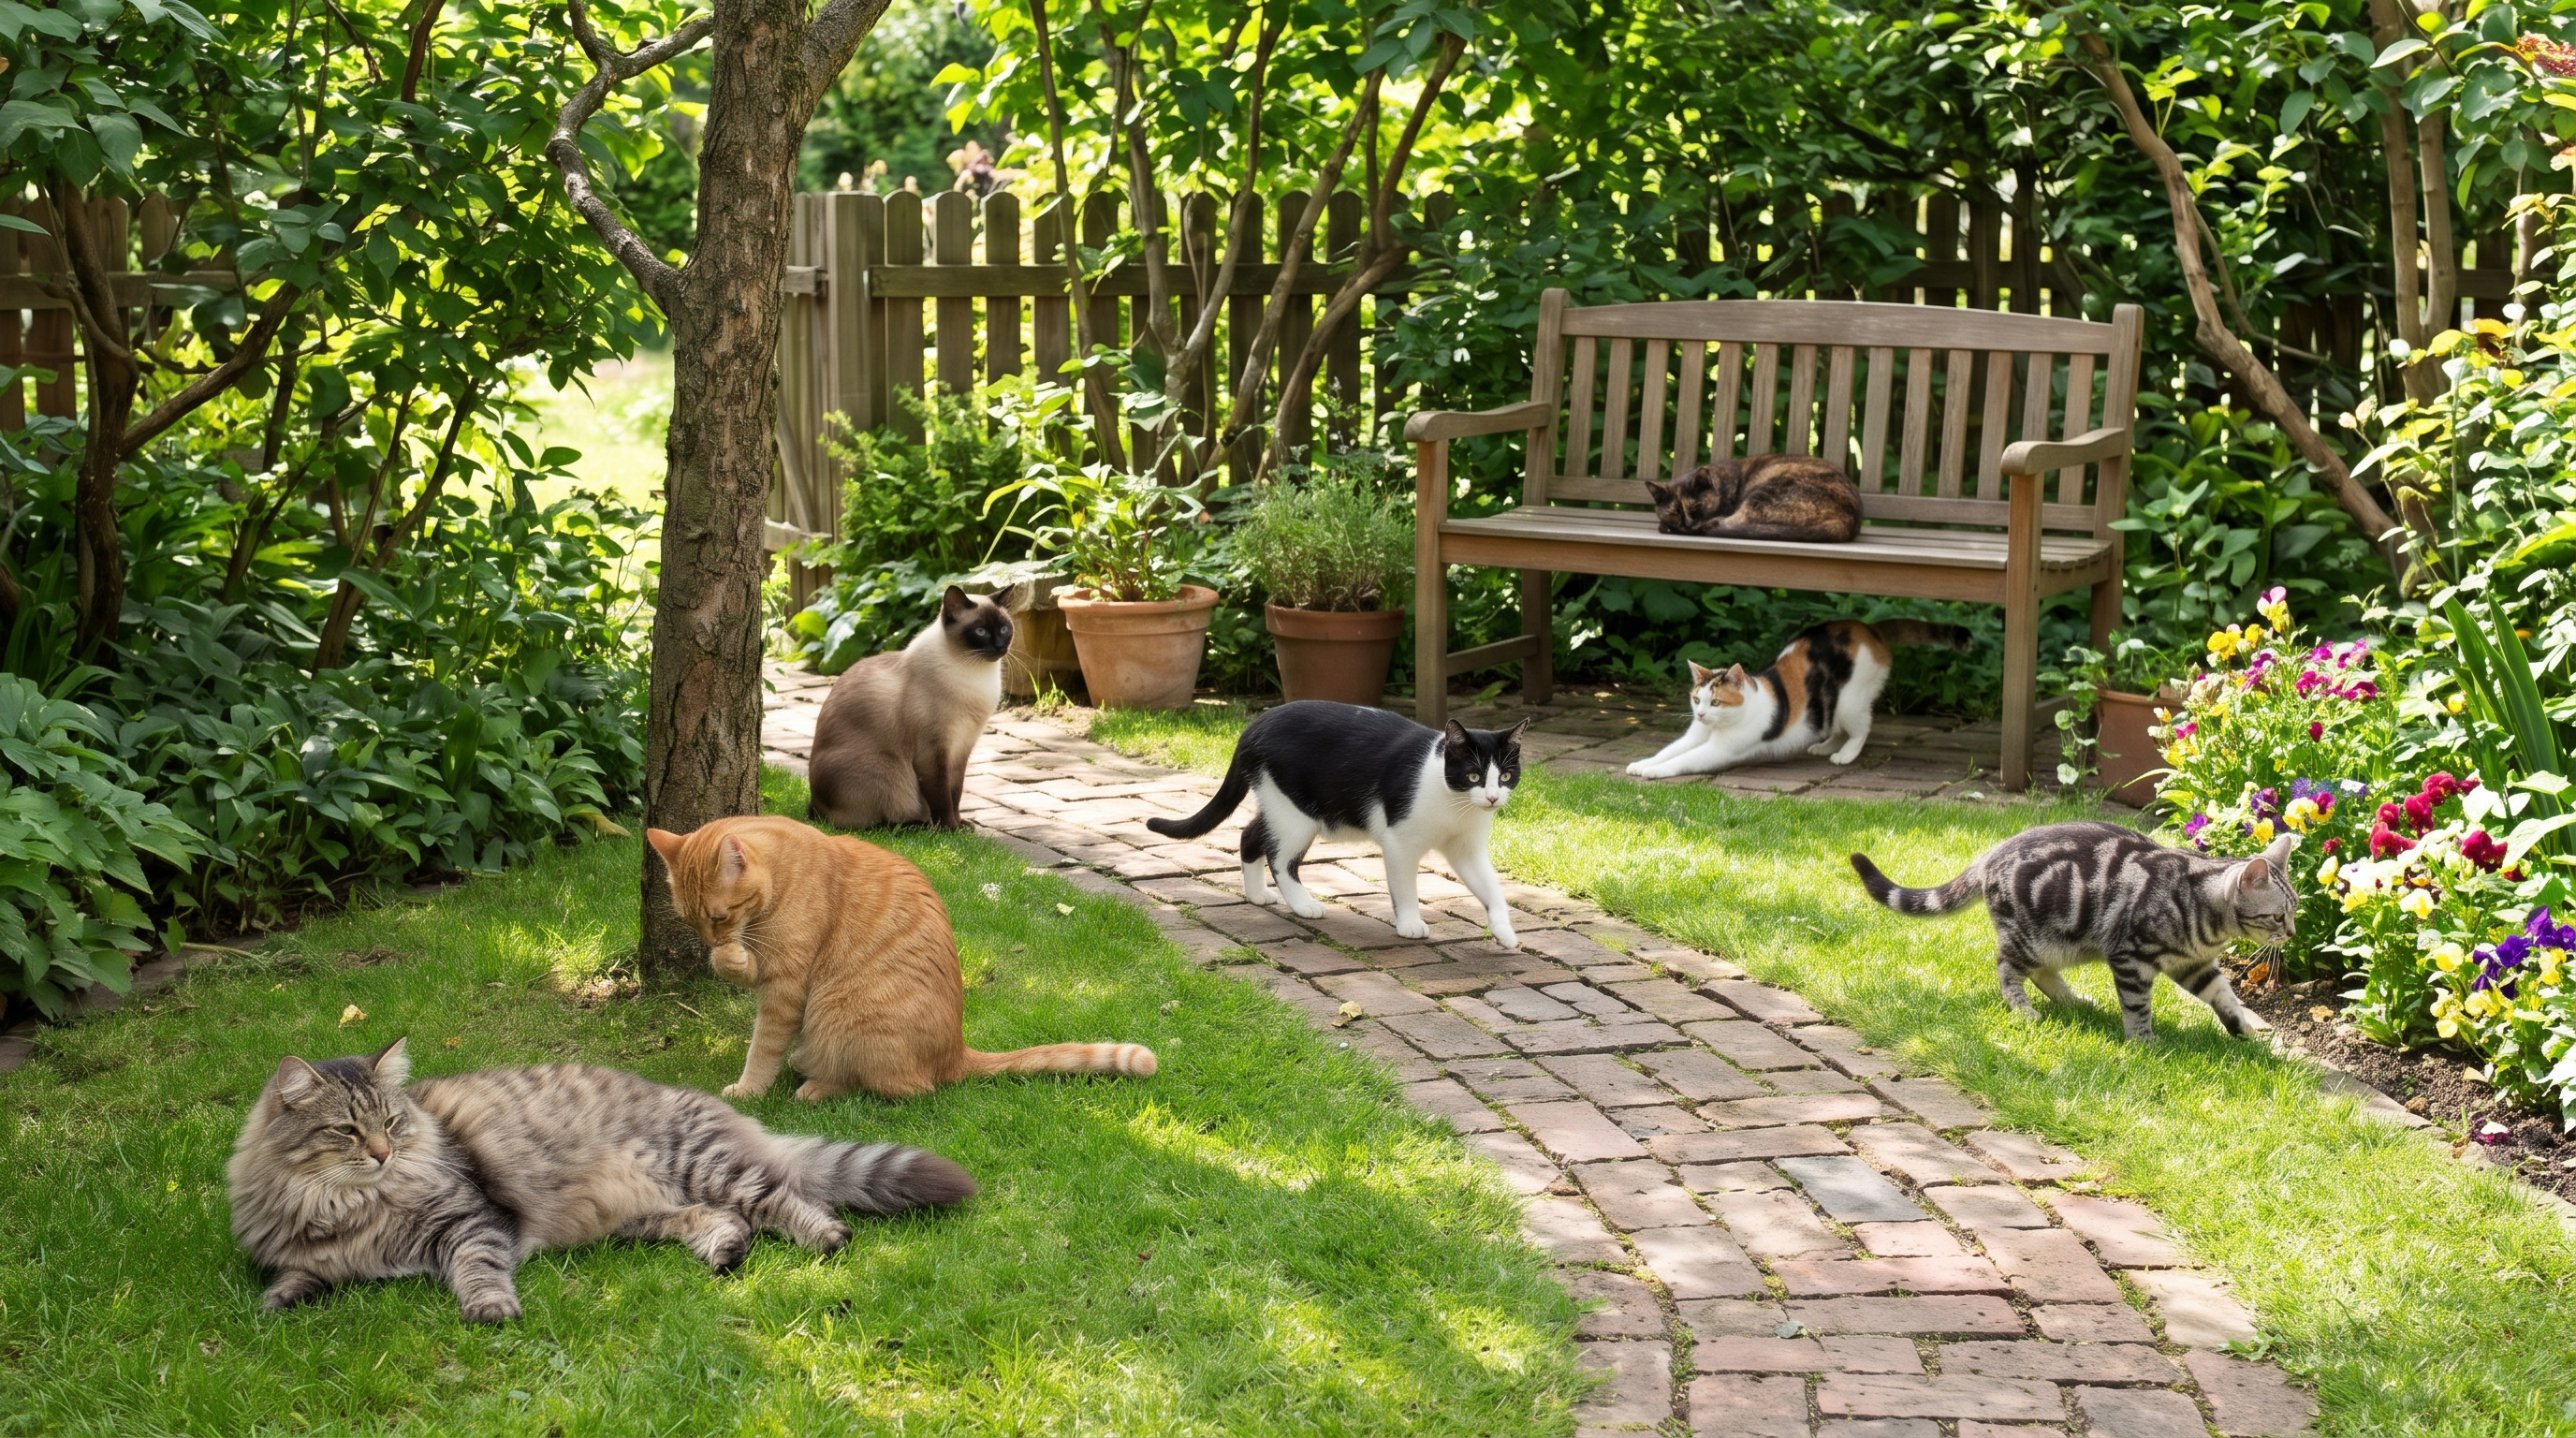
実験1と実験2では、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。
実験1:NMS の閾値で検出の数が変わる
YOLO11n の NMS をかける前の出力を取り出し、NMS の重なりの閾値(IoU の閾値)を変えて、残る箱の数を比べます。前処理は、YOLO11の記事と同じ letterbox(縦横比を保って 640×640 に収める)です。
import time
import numpy as np
import cv2
import torch
import torchvision
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image
from ultralytics import YOLO

# 1. YOLO11n の NMS をかける前の出力を取り出す(前処理は YOLO11 の記事と同じ letterbox)
img = np.array(Image.open("cats.jpg").convert("RGB"))
h, w = img.shape[:2]
r = 640 / max(h, w)
nh, nw = round(h * r), round(w * r)
canvas = np.full((640, 640, 3), 114, dtype=np.uint8)
top, left = (640 - nh) // 2, (640 - nw) // 2
canvas[top:top + nh, left:left + nw] = cv2.resize(img, (nw, nh), interpolation=cv2.INTER_LINEAR)
x = torch.from_numpy(canvas).permute(2, 0, 1)[None].float() / 255

yolo = YOLO("yolo11n.pt").model.float().eval()
with torch.no_grad():
    pred = yolo(x)[0][0]                                  # (84, 8400):格子点ごとの箱 (cx, cy, w, h) と 80 クラスの確率
score, label = pred[4:].max(0)
keep = score > 0.25
boxes = pred[:4, keep].T
xyxy = torch.cat([boxes[:, :2] - boxes[:, 2:] / 2, boxes[:, :2] + boxes[:, 2:] / 2], 1)
score, label = score[keep], label[keep]
print(f"8,400 個の格子点のうち、確率 0.25 以上の候補: {len(xyxy)} 個")

# 2. NMS の IoU の閾値を変えて、残る箱の数と時間を比べる
for thr in [0.3, 0.5, 0.7, 0.9]:
    t0 = time.perf_counter()
    for _ in range(100):
        kept = torchvision.ops.batched_nms(xyxy, score, label, thr)
    ms = (time.perf_counter() - t0) / 100 * 1000
    print(f"NMS の閾値 {thr}: 残った箱 {len(kept):2d} 個({ms:.2f} ms)")

# 3. NMS 前の候補と、NMS(閾値 0.7)の後の箱を並べて描く
fig, axes = plt.subplots(1, 2, figsize=(16, 5))
for ax, idx, title in [(axes[0], torch.arange(len(xyxy)), f"NMS の前({len(xyxy)} 個)"),
                       (axes[1], torchvision.ops.batched_nms(xyxy, score, label, 0.7), "NMS の後(閾値 0.7)")]:
    ax.imshow(canvas[top:top + nh])
    for x0, y0, x1, y1 in xyxy[idx].tolist():
        ax.add_patch(plt.Rectangle((x0, y0 - top), x1 - x0, y1 - y0, fill=False, color="red", lw=1))
    ax.set_title(title)
    ax.axis("off")
plt.tight_layout()
plt.show()
- NMS の前の出力: YOLO("yolo11n.pt").model で、後処理を含まない PyTorch のモデルを取り出します。出力 pred は (84, 8400) で、640×640 の画像の 8,400 個の格子点ごとに、箱の (cx, cy, w, h) と 80 クラスの確率を持ちます。確率 0.25 以上の候補だけを残すのは、Ultralytics の推論の既定値(conf=0.25)に合わせたためです。
- 閾値の比較: torchvision.ops.batched_nms は、同じクラスの箱のうち、確率の高い箱との IoU が閾値を超える箱を消します。0.7 は Ultralytics の既定値で、0.3〜0.9 はその前後を広く見るための値です。時間は 100 回の平均です。
- 図: 左に NMS の前の候補(確率 0.25 以上)、右に NMS(閾値 0.7)の後の箱を描きます。
実行結果
8,400 個の格子点のうち、確率 0.25 以上の候補: 77 個
NMS の閾値 0.3: 残った箱  9 個(0.05 ms)
NMS の閾値 0.5: 残った箱  9 個(0.04 ms)
NMS の閾値 0.7: 残った箱  9 個(0.04 ms)
NMS の閾値 0.9: 残った箱 15 個(0.04 ms)
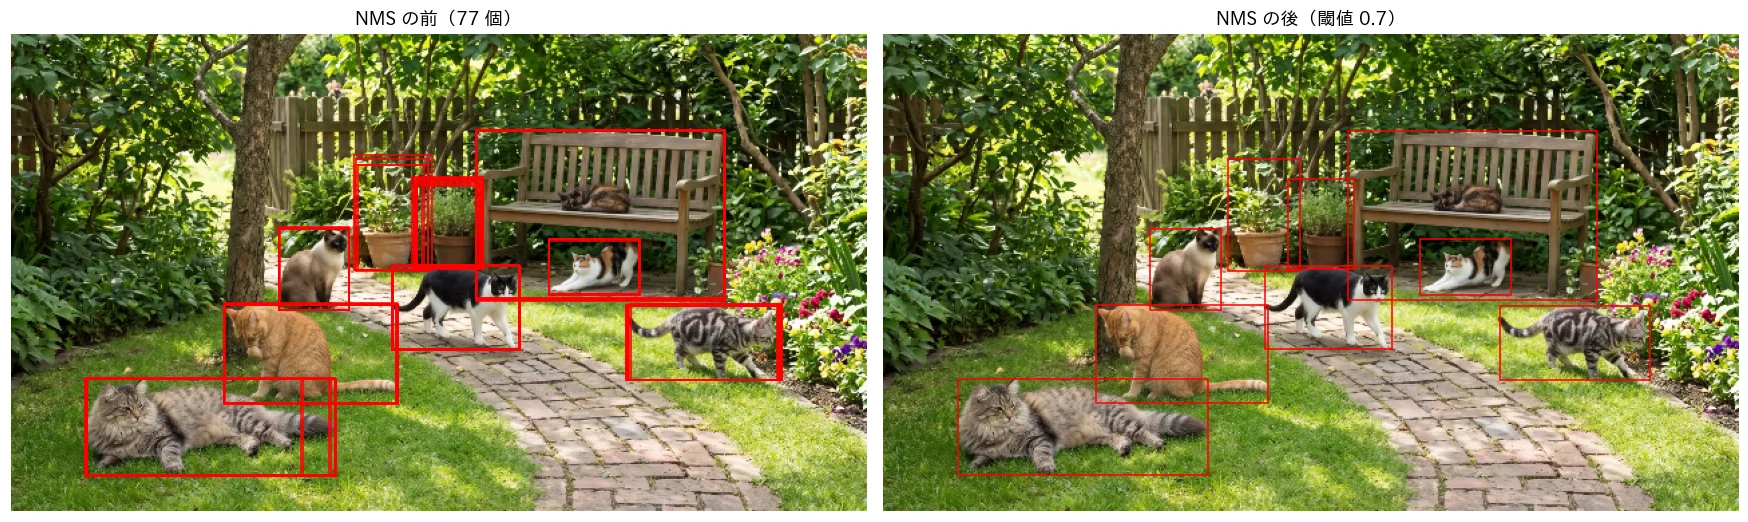
8,400 個の格子点のうち 77 個が確率 0.25 以上の候補になり、左の図のように 1 匹の猫に何重にも箱が重なっています。NMS の後は 9 個に減りますが、閾値を 0.9 に緩めると、消しきれない重複が残って 15 個になりました。この画像では 0.3〜0.7 で結果が変わりませんでしたが、物体どうしが重なる画像では、閾値を下げると隣の物体の正しい箱まで消え、上げると重複が残ります。NMS の時間はこの画像では 0.1 ms 未満でしたが、候補の数が多い画像ほど長くなります。RT-DETR の論文は、NMS のこの 2 つの性質(閾値で精度が変わること、処理時間が一定でないこと)を、YOLO の速さを測るうえでの問題として挙げています。
RT-DETR の仕組み
全体の構成
RT-DETR の全体は、次の図のとおりです(図は、後で実装する RTDETR クラスの構成です)。
(図は、diagram-designで作成)
- Backbone: ResNet18-vd で、1/8・1/16・1/32 の解像度の特徴(S3・S4・S5)を取り出します。vd は、最初の 7×7 の畳み込みを 3×3 の 3 つに替え、縮小する残差の経路で平均プーリングを使う ResNet の改良版です。
- Hybrid Encoder: S5 に自己注意をかけ(AIFI)、3 段の特徴を CNN で混ぜます(CCFM)。
- クエリの選択: 3 段の全位置(640×640 の画像なら 80×80 + 40×40 + 20×20 = 8,400 位置)でクラスと箱を予測し、確率の高い 300 位置をデコーダのクエリにします。
- Decoder: 3 層のデコーダで、300 個のクエリの箱を少しずつ直します。最後の層の 300 個の箱とクラスの確率が、そのまま検出結果になります。
Hybrid Encoder:AIFI と CCFM
(図は、diagram-designで作成)
それまでの DETR の改良版(Deformable DETR など)は、3 段すべての位置(8,400 位置)にエンコーダの注意をかけていて、エンコーダが計算の大半を占めていました。RT-DETR の論文は、意味をよく表す深い特徴(S5)の中で位置どうしの関係を取れば十分で、浅い特徴にまで注意をかけても精度はあまり上がらないことを実験で示し、エンコーダを次の 2 つに分けました。
- AIFI(Attention-based Intra-scale Feature Interaction): S5(20×20 = 400 位置)にだけ、Transformer のエンコーダの層を 1 つかけます。位置は、縦と横の座標の sin・cos で表す 2 次元の位置埋め込みで与えます。注意の計算量は位置の数の 2 乗に比例するので、8,400 位置ではなく 400 位置にかけることで、計算が大きく減ります。
- CCFM(CNN-based Cross-scale Feature Fusion): YOLO の Neck と同じように、深い特徴を拡大して浅い特徴と連結する経路(上から下へ)と、浅い特徴を縮小して深い特徴と連結する経路(下から上へ)で、3 段を混ぜます。連結した特徴は、RepVGG のブロックを使った CSP の層(CSPRep)でまとめます。
クエリの選択とデコーダ
(図は、diagram-designで作成)
DETR は、学習で決まる固定のクエリから始めるので、どのクエリがどの物体を担当するかが学習の初めに定まらず、学習に時間がかかりました。RT-DETR は、エンコーダの出力の全位置で一度クラスと箱を予測し、確率の高い 300 位置の特徴と箱を、デコーダのクエリ(内容)と参照箱(位置)の初期値にします。
デコーダの各層は、クエリどうしの自己注意で「同じ物体を担当するクエリがほかにあるか」を見たうえで、Deformable Attention(Zhu et al., 2021)で画像の特徴を読みます。通常の cross attention は全 8,400 位置を見ますが、Deformable Attention は、クエリごとに参照箱の周りの少数の点(8 ヘッド × 3 段 × 4 点)の値だけを、双線形補間で取り出して重み付きで足します。
はクエリ、 は参照箱(中心 、幅と高さ 、どれも 0〜1)、 はクエリから予測するずれ、 はクエリから予測する重み(ヘッドごとに 12 点で合計 1)、 はヘッド の段 の特徴、 は出力の変換です。ずれを箱の大きさに比例させるので、大きな物体では広く、小さな物体では狭く点を置きます。
各層の最後に、箱の修正量を予測し、参照箱の logit(sigmoid の逆関数の値)に足してから sigmoid で 0〜1 に戻します。新しい箱は次の層の参照箱になり、3 層で少しずつ箱を直します。
1 対 1 のマッチングと損失
(図は、diagram-designで作成)
NMS が不要になる理由は、モデルの構造ではなく学習のしかたにあります。学習では、画像ごとに 300 個のクエリの予測と正解の物体の間のコストを計算し、コストの合計が最小になる 1 対 1 の組をハンガリアン法で求めます。組になったクエリには正解のクラスと箱を、残りのクエリには「物体なし」(どのクラスの確率も 0)を学ばせます。1 つの物体を担当するクエリが 1 つだけになるよう学習するので、デコーダの自己注意を通して、同じ物体を指すほかのクエリは確率を下げるようになります。
クエリ と正解 のコストは、クラス・箱の L1 距離・GIoU の重み付きの和です(重みは公式の実装の値)。
はクエリ の正解クラス の確率、 と は予測と正解の箱(0〜1 の cx, cy, w, h)です。 は Focal Loss の形のコストで、確率が高いほど小さくなります。
組が決まったら、分類に VFL(Varifocal Loss)、箱に L1 と GIoU の損失をかけます。VFL は、正解クラスの目標を 1 ではなく、予測の箱と正解の箱の IoU にする 2 値交差エントロピーです。
は目標(組になったクエリの正解クラスでは IoU、それ以外は 0)です。確率が IoU に近づくよう学習するので、確率の高いクエリほど箱も正確になります。これが、クエリの選択で確率の高い位置を選ぶと箱も正確になる理由(IoU-aware query selection)です。この損失を、デコーダの全層の出力と、クエリの選択の予測にかけて足します。
RT-DETR のスクラッチ実装
ここからは、RT-DETR-R18 を部品ごとに実装します。部品の構造・チャンネル数・計算の順番は、Hugging Face の RTDetrForObjectDetection(公式の実装を移植したもの)と同じにしています。実験2で、学習済みの重みを読み込み、同じ出力になることを確かめます。
Backbone:ResNet18-vd
import math
import torch
import torch.nn as nn
import torch.nn.functional as F


class ConvBN(nn.Module):
    """畳み込み → バッチ正規化 →(活性化)"""

    def __init__(self, c1, c2, k, s=1, act=None):
        super().__init__()
        self.conv = nn.Conv2d(c1, c2, k, s, (k - 1) // 2, bias=False)
        self.norm = nn.BatchNorm2d(c2)
        self.act = {"relu": nn.ReLU(), "silu": nn.SiLU(), None: nn.Identity()}[act]

    def forward(self, x):
        return self.act(self.norm(self.conv(x)))


class BasicBlock(nn.Module):
    """ResNet の基本ブロック(3×3 の畳み込み 2 つと残差接続)。vd 型は、縮小する近道を平均プーリング → 1×1 にする"""

    def __init__(self, c1, c2, stride, first):
        super().__init__()
        self.layer = nn.Sequential(ConvBN(c1, c2, 3, stride, "relu"), ConvBN(c2, c2, 3, 1))
        if not first:
            self.shortcut = nn.Identity()
        elif c1 != c2:
            self.shortcut = nn.Sequential(nn.AvgPool2d(2, 2, 0, ceil_mode=True), ConvBN(c1, c2, 1))
        else:
            self.shortcut = ConvBN(c1, c2, 1, stride)

    def forward(self, x):
        return F.relu(self.layer(x) + self.shortcut(x))


class ResNet18vd(nn.Module):
    """3×3 の畳み込み 3 つの入口と 4 つの段。1/8・1/16・1/32 の 3 つの特徴(128・256・512 チャンネル)を返す"""

    def __init__(self):
        super().__init__()
        self.stem = nn.Sequential(ConvBN(3, 32, 3, 2, "relu"), ConvBN(32, 32, 3, 1, "relu"),
                                  ConvBN(32, 64, 3, 1, "relu"), nn.MaxPool2d(3, 2, 1))
        chans = [64, 64, 128, 256, 512]
        self.stages = nn.ModuleList(
            nn.Sequential(BasicBlock(chans[i], chans[i + 1], 1 if i == 0 else 2, True),
                          BasicBlock(chans[i + 1], chans[i + 1], 1, False)) for i in range(4))

    def forward(self, x):
        x = self.stem(x)
        outs = []
        for i, stage in enumerate(self.stages):
            x = stage(x)
            if i >= 1:
                outs.append(x)
        return outs                                   # [S3 (1/8), S4 (1/16), S5 (1/32)]
- ConvBN: 畳み込み・バッチ正規化・活性化の組です。畳み込みの直後にバッチ正規化があるので、畳み込みのバイアスは使いません。
- BasicBlock: 3×3 の畳み込み 2 つと残差接続からなる ResNet18 のブロックです。段の最初のブロックで解像度を半分にするときは、残差の経路を「2×2 の平均プーリング → 1×1 の畳み込み」にします(vd の改良)。ストライド 2 の 1×1 の畳み込みで縮小すると、4 画素のうち 1 画素しか使わず情報を捨てるためです。
- ResNet18vd: 最初の 7×7 の畳み込みを、3×3 の畳み込み 3 つ(32・32・64 チャンネル)に替えた stem と、2 ブロックずつの 4 段からなります。2〜4 段目の出力(128・256・512 チャンネル、1/8・1/16・1/32)を S3・S4・S5 として返します。
Hybrid Encoder
class Attention(nn.Module):
    """Multi-Head Attention。位置埋め込みは Q と K にだけ足す"""

    def __init__(self, d=256, heads=8):
        super().__init__()
        self.heads = heads
        self.q_proj, self.k_proj = nn.Linear(d, d), nn.Linear(d, d)
        self.v_proj, self.o_proj = nn.Linear(d, d), nn.Linear(d, d)

    def forward(self, x, pos=None, mask=None):
        B, N, D = x.shape
        qk = x if pos is None else x + pos
        split = lambda t: t.view(B, N, self.heads, D // self.heads).transpose(1, 2)
        q, k, v = split(self.q_proj(qk)), split(self.k_proj(qk)), split(self.v_proj(x))
        attn = (q @ k.transpose(-2, -1)) / math.sqrt(D // self.heads)
        if mask is not None:
            attn = attn + mask
        out = (attn.softmax(-1) @ v).transpose(1, 2).reshape(B, N, D)
        return self.o_proj(out)


class MLP(nn.Module):
    def __init__(self, d, hidden, act):
        super().__init__()
        self.fc1, self.fc2 = nn.Linear(d, hidden), nn.Linear(hidden, d)
        self.act = nn.GELU() if act == "gelu" else nn.ReLU()

    def forward(self, x):
        return self.fc2(self.act(self.fc1(x)))


def sincos_2d(h, w, dim=256, temperature=10000.0):
    """2 次元の位置埋め込み:縦と横の位置を、それぞれ dim/4 個の周波数の sin・cos で表す"""
    omega = 1.0 / temperature ** (torch.arange(dim // 4, dtype=torch.float64) / (dim // 4))
    gy, gx = torch.meshgrid(torch.arange(h, dtype=torch.float64), torch.arange(w, dtype=torch.float64), indexing="ij")
    ey, ex = gy.flatten().outer(omega), gx.flatten().outer(omega)
    return torch.cat([ey.sin(), ey.cos(), ex.sin(), ex.cos()], 1).float()[None]   # (1, h*w, dim)


class AIFI(nn.Module):
    """S5 だけにかける Transformer エンコーダの 1 層(後置の LayerNorm)"""

    def __init__(self, d=256, heads=8, ffn=1024):
        super().__init__()
        self.self_attn = Attention(d, heads)
        self.self_attn_layer_norm = nn.LayerNorm(d)
        self.mlp = MLP(d, ffn, "gelu")
        self.final_layer_norm = nn.LayerNorm(d)

    def forward(self, x):                             # x: (B, C, H, W)
        B, C, H, W = x.shape
        t = x.flatten(2).transpose(1, 2)              # (B, H*W, C)
        pos = sincos_2d(H, W, C).to(x.device, x.dtype)
        t = self.self_attn_layer_norm(t + self.self_attn(t, pos))
        t = self.final_layer_norm(t + self.mlp(t))
        return t.transpose(1, 2).reshape(B, C, H, W)


class RepVggBlock(nn.Module):
    """3×3 と 1×1 の畳み込みを並べて足す(推論時は 1 つの 3×3 にまとめられる)"""

    def __init__(self, c):
        super().__init__()
        self.conv1, self.conv2 = ConvBN(c, c, 3), ConvBN(c, c, 1)

    def forward(self, x):
        return F.silu(self.conv1(x) + self.conv2(x))


class CSPRepLayer(nn.Module):
    """2 つの特徴を連結した 512 チャンネルを、CSP の形(片方だけ RepVgg を 3 つ通して足す)で 256 チャンネルにまとめる"""

    def __init__(self, c_in=512, c_out=256, expansion=0.5):
        super().__init__()
        h = int(c_out * expansion)
        self.conv1, self.conv2 = ConvBN(c_in, h, 1, act="silu"), ConvBN(c_in, h, 1, act="silu")
        self.bottlenecks = nn.Sequential(*[RepVggBlock(h) for _ in range(3)])
        self.conv3 = ConvBN(h, c_out, 1, act="silu") if h != c_out else nn.Identity()

    def forward(self, x):
        return self.conv3(self.bottlenecks(self.conv1(x)) + self.conv2(x))


class HybridEncoder(nn.Module):
    """AIFI(S5 の自己注意)と CCFM(上から下・下から上に特徴を混ぜる畳み込み)"""

    def __init__(self, d=256):
        super().__init__()
        self.aifi = AIFI(d)
        self.lateral_convs = nn.ModuleList(ConvBN(d, d, 1, act="silu") for _ in range(2))
        self.fpn_blocks = nn.ModuleList(CSPRepLayer(2 * d, d) for _ in range(2))
        self.downsample_convs = nn.ModuleList(ConvBN(d, d, 3, 2, act="silu") for _ in range(2))
        self.pan_blocks = nn.ModuleList(CSPRepLayer(2 * d, d) for _ in range(2))

    def forward(self, feats):                         # feats: [S3, S4, S5](どれも 256 チャンネル)
        s3, s4, s5 = feats
        f5 = self.aifi(s5)
        # 上から下へ(FPN):深い特徴を拡大して、浅い特徴と混ぜる
        inner = [f5]
        for i, lower in enumerate([s4, s3]):
            top = self.lateral_convs[i](inner[-1])
            inner[-1] = top
            up = F.interpolate(top, scale_factor=2.0, mode="nearest")
            inner.append(self.fpn_blocks[i](torch.cat([up, lower], 1)))
        inner.reverse()                               # [1/8, 1/16, 1/32]
        # 下から上へ(PAN):浅い特徴を縮小して、深い特徴と混ぜる
        outs = [inner[0]]
        for i in range(2):
            down = self.downsample_convs[i](outs[-1])
            outs.append(self.pan_blocks[i](torch.cat([down, inner[i + 1]], 1)))
        return outs
- Attention: 8 ヘッドの Multi-Head Attention です。位置埋め込み pos は、Q と K にだけ足し、V には足しません。注意の重みは位置を見て決め、取り出す値は特徴そのものにするためです。mask は、学習でノイズ除去のクエリを使うときに注意を遮るためのもので、本記事では使いません。
- sincos_2d: 2 次元の位置埋め込みです。256 次元を 4 つに分け、縦の位置の sin・cos と横の位置の sin・cos を、それぞれ 64 個の周波数で並べます。温度 10000 は、公式の実装の値(Transformer の元の論文と同じ)です。
- AIFI: S5 を (B, 400, 256) の並びにし、自己注意と FFN(GELU、1024 次元)を 1 回ずつかけます。どちらも残差接続の後に LayerNorm をかける後置の正規化で、公式の実装に合わせています。
- RepVggBlock・CSPRepLayer: RepVggBlock は、3×3 と 1×1 の畳み込みを並べて足すブロックです。学習の後は 2 つを 1 つの 3×3 の畳み込みにまとめられるので、推論が速くなります(本記事ではまとめずに計算します)。CSPRepLayer は、連結した 512 チャンネルを 1×1 の畳み込みで 128 チャンネルずつの 2 つにし、片方にだけ RepVggBlock を 3 つ通して足し、256 チャンネルに戻します。128 チャンネル(256 の半分)は、R18 の公式の設定(expansion=0.5)です。
- HybridEncoder: S5 に AIFI をかけた後、上から下への経路で、1×1 の畳み込み(lateral_convs)→ 2 倍に拡大 → 1 つ浅い特徴と連結 → CSPRepLayer をくり返します。下から上への経路で、ストライド 2 の 3×3 の畳み込みで縮小 → 1 つ深い特徴と連結 → CSPRepLayer をくり返し、1/8・1/16・1/32 の 3 つを返します。
Deformable Attention
class DeformableAttention(nn.Module):
    """各クエリが、参照点の周りの少数の点(3 段 × 4 点 × 8 ヘッド)だけを見る cross attention"""

    def __init__(self, d=256, heads=8, levels=3, points=4):
        super().__init__()
        self.heads, self.levels, self.points = heads, levels, points
        self.sampling_offsets = nn.Linear(d, heads * levels * points * 2)
        self.attention_weights = nn.Linear(d, heads * levels * points)
        self.value_proj = nn.Linear(d, d)
        self.output_proj = nn.Linear(d, d)

    def forward(self, query, ref_boxes, value, shapes):
        """query: (B, Q, D)、ref_boxes: (B, Q, 4) の (cx, cy, w, h)(0〜1)、value: (B, S, D)、shapes: 各段の (H, W)"""
        B, Q, D = query.shape
        Hd, L, P = self.heads, self.levels, self.points
        v = self.value_proj(value).view(B, -1, Hd, D // Hd)
        off = self.sampling_offsets(query).view(B, Q, Hd, L, P, 2)
        w = self.attention_weights(query).view(B, Q, Hd, L * P).softmax(-1).view(B, Q, Hd, L, P)
        # 点の位置 = 参照の箱の中心 + ずれ。ずれは箱の大きさに比例させる
        loc = ref_boxes[:, :, None, None, None, :2] + off / P * ref_boxes[:, :, None, None, None, 2:] * 0.5
        grid = 2 * loc - 1                            # grid_sample は -1〜1 の座標を使う
        out, start = 0, 0
        for l, (h, wd) in enumerate(shapes):
            v_l = v[:, start:start + h * wd].permute(0, 2, 3, 1).reshape(B * Hd, D // Hd, h, wd)
            g_l = grid[:, :, :, l].transpose(1, 2).reshape(B * Hd, Q, P, 2)
            s = F.grid_sample(v_l, g_l, mode="bilinear", padding_mode="zeros", align_corners=False)   # (B*Hd, D/Hd, Q, P)
            out = out + (s * w[:, :, :, l].transpose(1, 2).reshape(B * Hd, 1, Q, P)).sum(-1)
            start += h * wd
        out = out.view(B, Hd, D // Hd, Q).permute(0, 3, 1, 2).reshape(B, Q, D)
        return self.output_proj(out)
- ずれと重みの予測: クエリから、ヘッド・段・点ごとの 2 次元のずれ(8 × 3 × 4 × 2 = 192 個)と重み(8 × 3 × 4 = 96 個)を線形層で予測します。重みは、ヘッドごとに 12 点で softmax をとり、合計を 1 にします。
- 点の位置: 参照箱の中心に、ずれを「点の数 4 で割り、箱の幅・高さの半分を掛けた」値を足します。前の節の式のとおりです。
- 値の取り出し: F.grid_sample は、-1〜1 の座標で指定した位置の値を、周りの 4 画素から双線形補間で取り出します。そこで、0〜1 の位置を 2 * loc - 1 に直します。段ごとに、エンコーダの出力の該当する部分を (B × 8, 32, H, W) の画像の形に戻してから取り出し、重みを掛けて足します。
モデル全体
class PredHead(nn.Module):
    """全結合層を重ねた小さな MLP(最後の層以外は ReLU)"""

    def __init__(self, d_in, d_hidden, d_out, n):
        super().__init__()
        dims = [d_in] + [d_hidden] * (n - 1) + [d_out]
        self.layers = nn.ModuleList(nn.Linear(a, b) for a, b in zip(dims[:-1], dims[1:]))

    def forward(self, x):
        for i, layer in enumerate(self.layers):
            x = layer(x) if i == len(self.layers) - 1 else F.relu(layer(x))
        return x


class DecoderLayer(nn.Module):
    """クエリどうしの自己注意 → 画像の特徴への Deformable Attention → MLP(それぞれ残差接続と LayerNorm)"""

    def __init__(self, d=256, heads=8, ffn=1024):
        super().__init__()
        self.self_attn = Attention(d, heads)
        self.self_attn_layer_norm = nn.LayerNorm(d)
        self.encoder_attn = DeformableAttention(d, heads)
        self.encoder_attn_layer_norm = nn.LayerNorm(d)
        self.mlp = MLP(d, ffn, "relu")
        self.final_layer_norm = nn.LayerNorm(d)

    def forward(self, x, pos, ref_boxes, memory, shapes, mask=None):
        x = self.self_attn_layer_norm(x + self.self_attn(x, pos, mask))
        x = self.encoder_attn_layer_norm(x + self.encoder_attn(x + pos, ref_boxes, memory, shapes))
        return self.final_layer_norm(x + self.mlp(x))


def inverse_sigmoid(x, eps=1e-5):
    x = x.clamp(0, 1)
    return torch.log(x.clamp(min=eps) / (1 - x).clamp(min=eps))


class RTDETR(nn.Module):
    def __init__(self, num_classes=80, num_queries=300, d=256, num_decoder_layers=3):
        super().__init__()
        self.num_queries = num_queries
        self.backbone = ResNet18vd()
        self.encoder_input_proj = nn.ModuleList(
            nn.Sequential(nn.Conv2d(c, d, 1, bias=False), nn.BatchNorm2d(d)) for c in (128, 256, 512))
        self.encoder = HybridEncoder(d)
        self.decoder_input_proj = nn.ModuleList(
            nn.Sequential(nn.Conv2d(d, d, 1, bias=False), nn.BatchNorm2d(d)) for _ in range(3))
        # クエリの選択:エンコーダの全位置でクラスと箱を予測し、スコアの高い位置をクエリにする
        self.enc_output = nn.Sequential(nn.Linear(d, d), nn.LayerNorm(d))
        self.enc_score_head = nn.Linear(d, num_classes)
        self.enc_bbox_head = PredHead(d, d, 4, 3)
        # デコーダ:層ごとに、クラスと箱の修正量を出すヘッドを持つ
        self.decoder_layers = nn.ModuleList(DecoderLayer(d) for _ in range(num_decoder_layers))
        self.query_pos_head = PredHead(4, 2 * d, d, 2)
        self.class_embed = nn.ModuleList(nn.Linear(d, num_classes) for _ in range(num_decoder_layers))
        self.bbox_embed = nn.ModuleList(PredHead(d, d, 4, 3) for _ in range(num_decoder_layers))

    @staticmethod
    def make_anchors(shapes, device, grid_size=0.05):
        """各段の格子の中心を (cx, cy)、大きさを 0.05 × 2^段 にした箱を、sigmoid の前の値(logit)で返す"""
        anchors = []
        for l, (h, w) in enumerate(shapes):
            gy, gx = torch.meshgrid(torch.arange(h, device=device, dtype=torch.float32),
                                    torch.arange(w, device=device, dtype=torch.float32), indexing="ij")
            xy = torch.stack([(gx + 0.5) / w, (gy + 0.5) / h], -1)
            wh = torch.full_like(xy, grid_size * 2.0 ** l)
            anchors.append(torch.cat([xy, wh], -1).view(-1, 4))
        anchors = torch.cat(anchors)[None]
        valid = ((anchors > 0.01) & (anchors < 0.99)).all(-1, keepdim=True)   # 画像の端に近すぎる箱は使わない
        logits = torch.log(anchors / (1 - anchors))
        return torch.where(valid, logits, torch.full_like(logits, torch.finfo(torch.float32).max)), valid

    def forward(self, x, num_layers=None, dn_queries=None):
        # (1) Backbone と Hybrid Encoder
        feats = [p(f) for p, f in zip(self.encoder_input_proj, self.backbone(x))]
        feats = [p(f) for p, f in zip(self.decoder_input_proj, self.encoder(feats))]
        shapes = [f.shape[-2:] for f in feats]
        memory = torch.cat([f.flatten(2).transpose(1, 2) for f in feats], 1)      # (B, 8400, 256)
        # (2) クエリの選択
        anchors, valid = self.make_anchors(shapes, x.device)
        out_memory = self.enc_output(valid.to(memory.dtype) * memory)
        enc_logits = self.enc_score_head(out_memory)                              # (B, 8400, C)
        enc_boxes_unact = self.enc_bbox_head(out_memory) + anchors                 # (B, 8400, 4)
        topk = enc_logits.max(-1).values.topk(self.num_queries, dim=1).indices    # (B, 300)
        gather = lambda t: t.gather(1, topk[..., None].expand(-1, -1, t.shape[-1]))
        ref_unact = gather(enc_boxes_unact)
        enc_topk = (gather(enc_logits), ref_unact.sigmoid())                      # 学習でエンコーダにも損失をかける
        query = gather(out_memory).detach()
        mask = None
        if dn_queries is not None:                    # 学習時のノイズ除去クエリ(本記事では使わない)
            query, ref_unact, mask = dn_queries(query, ref_unact)
        # (3) デコーダ:層ごとに箱を少しずつ直す
        ref = ref_unact.detach().sigmoid()
        logits_all, boxes_all = [], []
        for i, layer in enumerate(self.decoder_layers[:num_layers]):
            pos = self.query_pos_head(ref)
            query = layer(query, pos, ref, memory, shapes, mask)
            new_ref = (self.bbox_embed[i](query) + inverse_sigmoid(ref)).sigmoid()
            logits_all.append(self.class_embed[i](query))
            boxes_all.append(new_ref)
            ref = new_ref.detach()
        return torch.stack(logits_all, 1), torch.stack(boxes_all, 1), enc_topk   # (B, 層, 300, C)・(B, 層, 300, 4)


model = RTDETR().eval()
x = torch.rand(1, 3, 640, 640)
with torch.no_grad():
    feats = model.backbone(x)
    print("Backbone:", [tuple(f.shape) for f in feats])
    logits, boxes, _ = model(x)
print("クラスの出力:", tuple(logits.shape), " 箱の出力:", tuple(boxes.shape), "(バッチ, デコーダの層, クエリ, …)")
print(f"パラメータ数: {sum(p.numel() for p in model.parameters()):,}")
- 入力の変換: Backbone の 128・256・512 チャンネルの出力を、1×1 の畳み込みとバッチ正規化(encoder_input_proj)で 256 チャンネルにそろえてから Hybrid Encoder に入れます。エンコーダの出力も、同じ形の変換(decoder_input_proj)を通してから、3 段を (B, 8400, 256) の 1 つの並びにします。
- make_anchors: 各段の格子の中心を箱の中心、0.05 × 2^段(1/8 の段で幅・高さが画像の 5%)を箱の大きさにしたアンカーの箱を作ります。箱の予測は、このアンカーの logit に修正量を足して求めます。画像の端に近すぎる位置(座標が 0.01〜0.99 の外)は、valid で特徴を 0 にし、選ばれないようにします。0.05 と 0.01・0.99 は、公式の実装の値です。
- クエリの選択: 全位置のクラスの予測(enc_score_head)の最大値の上位 300 位置を選び、その位置の特徴を内容クエリ、箱の予測を参照箱にします。300 は、公式の実装のクエリの数です。内容クエリと参照箱は detach で勾配を止めます。クエリの選択の予測には、学習で直接損失をかけるので(enc_topk として返します)、デコーダからの勾配を流さなくても学習できます。
- デコーダ: 各層で、参照箱から MLP(query_pos_head)で作った位置埋め込みをクエリに足して自己注意をかけ、Deformable Attention と FFN を通します。層ごとのヘッドで、クラスの logit と箱の修正量を出します。新しい箱は、次の層の参照箱として勾配を止めて渡します。num_layers を指定すると、前から何層だけを使うかを選べます(実験3で使います)。
- 出力: 全層のクラスの logit (B, 層, 300, クラス数) と箱 (B, 層, 300, 4) を返します。推論では最後の層だけを使い、学習では全層に損失をかけます(補助損失)。
実行結果
Backbone: [(1, 128, 80, 80), (1, 256, 40, 40), (1, 512, 20, 20)]
クラスの出力: (1, 3, 300, 80)  箱の出力: (1, 3, 300, 4) (バッチ, デコーダの層, クエリ, …)
パラメータ数: 20,163,728
Backbone の出力は、640×640 の入力に対して 80×80・40×40・20×20 の 3 段です。出力は、デコーダの 3 層それぞれに 300 個のクエリの、80 クラスの logit と 4 つの箱の値です。パラメータ数は約 2,016 万個で、論文の RT-DETR-R18 の 20M と一致します。
実験2:公式の重みで、Hugging Face と同じ出力になるか
公式の重みの読み込み
def load_hf_rtdetr(model, sd):
    """Hugging Face の RTDetrForObjectDetection の重みを、スクラッチ実装の名前に付け替えて読み込む"""
    import re
    out = {}
    for k, v in sd.items():
        if not k.startswith("model.") or "denoising_class_embed" in k:
            continue                                  # 先頭に model. のない class_embed・bbox_embed は、同じ重みの別名
        k = k[len("model."):]
        k = k.replace("backbone.model.embedder.embedder.", "backbone.stem.")
        k = re.sub(r"backbone\.model\.encoder\.stages\.(\d+)\.layers\.(\d+)\.", r"backbone.stages.\1.\2.", k)
        k = k.replace(".convolution.", ".conv.").replace(".normalization.", ".norm.")
        k = k.replace("encoder.aifi.0.layers.0.", "encoder.aifi.")
        k = k.replace("decoder.layers.", "decoder_layers.").replace("decoder.query_pos_head.", "query_pos_head.")
        k = k.replace("decoder.class_embed.", "class_embed.").replace("decoder.bbox_embed.", "bbox_embed.")
        out[k] = v
    missing, unexpected = model.load_state_dict(out, strict=False)
    missing = [m for m in missing if not m.endswith("num_batches_tracked")]
    assert not missing and not unexpected, (missing[:10], unexpected[:10])
    return model
Hugging Face の RTDetrForObjectDetection の重みの名前を、スクラッチ実装の名前に付け替えて読み込みます。
- 読み飛ばす重み: 先頭に model. の付かない class_embed・bbox_embed は、model.decoder の中の同じ重みを別の名前で指したものなので読み飛ばします。denoising_class_embed は、学習のノイズ除去のクエリにだけ使う重みで、推論では使いません。
- 名前の付け替え: Backbone の段・ブロック、AIFI、デコーダの層などの名前を、正規表現と文字列の置き換えで対応させます。
- 確認: strict=False で読み込んだ後、足りない重みがバッチ正規化の num_batches_tracked(推論では使わない回数の記録)だけであることを assert で確かめます。名前の付け替えに漏れがあれば、ここで止まります。
出力の一致を確かめる
from transformers import RTDetrForObjectDetection

hf_model = RTDetrForObjectDetection.from_pretrained("PekingU/rtdetr_r18vd").eval()
ours = load_hf_rtdetr(RTDETR(), hf_model.state_dict()).eval()

image = Image.open("cats.jpg").convert("RGB")
x = torch.from_numpy(np.array(image.resize((640, 640), Image.BILINEAR))).permute(2, 0, 1)[None].float() / 255
with torch.no_grad():
    out_hf = hf_model(pixel_values=x)
    logits, boxes, _ = ours(x)
print("クラスの出力の差の最大値:", f"{(out_hf.logits - logits[:, -1]).abs().max().item():.2e}")
print("箱の出力の差の最大値    :", f"{(out_hf.pred_boxes - boxes[:, -1]).abs().max().item():.2e}")
- 前処理: 公式の前処理(RTDetrImageProcessor)と同じく、縦横比を変えて 640×640 に縮小し(双線形補間)、画素の値を 255 で割って 0〜1 にします。平均と標準偏差による正規化はしません。YOLO の letterbox と違い、縦横比を保たないので、余白の処理はいりません。
- 比較: 同じ入力で、Hugging Face のモデルの logits・pred_boxes と、スクラッチ実装の最後の層の出力の差の最大値を求めます。
実行結果
クラスの出力の差の最大値: 1.03e-04
箱の出力の差の最大値    : 1.88e-05
クラスの logit の差は最大 1.03e-04、箱の差は最大 1.88e-05 で、float32 の計算の順番の違いによる誤差の範囲です。スクラッチ実装が、公式の学習済みの重みを読み込んで同じ計算をしていることが確かめられました。
NMS なしで検出する
def postprocess(logits, boxes, size, top_k=300):
    """NMS は使わない。全クエリ × 全クラスの確率から上位を取り、箱を画像の座標 (x1, y1, x2, y2) に直す"""
    W, H = size
    prob = logits.sigmoid().flatten()                     # (300 × クラス数,)
    score, idx = prob.topk(top_k)
    label, q = idx % logits.shape[-1], idx // logits.shape[-1]
    cx, cy, bw, bh = boxes[q].unbind(-1)
    xyxy = torch.stack([(cx - bw / 2) * W, (cy - bh / 2) * H, (cx + bw / 2) * W, (cy + bh / 2) * H], -1)
    return xyxy, score, label


names = hf_model.config.id2label
xyxy, score, label = postprocess(logits[0, -1], boxes[0, -1], image.size)
sel = score > 0.5
for b, s, l in zip(xyxy[sel], score[sel], label[sel]):
    print(f"{names[int(l)]:<13s} {s:.3f}  箱 {[round(v) for v in b.tolist()]}")

# 同じクラスで大きく重なった(IoU 0.5 以上の)検出の組がいくつあるか = NMS が消すはずの重複
for th in [0.5, 0.3]:
    m = score > th
    iou = torchvision.ops.box_iou(xyxy[m], xyxy[m])
    same = label[m][:, None] == label[m][None, :]
    print(f"確率 {th} 以上の検出 {int(m.sum()):2d} 個のうち、同じクラスで IoU 0.5 以上重なる組: {int(((iou > 0.5) & same).triu(1).sum())} 組")

fig, ax = plt.subplots(figsize=(12, 7))
ax.imshow(image)
for b, s, l in zip(xyxy[sel], score[sel], label[sel]):
    x0, y0, x1, y1 = b.tolist()
    ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color="red", lw=2))
    ax.text(x0, y0 - 8, f"{names[int(l)]} {s:.2f}", color="white", fontsize=11, backgroundcolor="red")
ax.axis("off")
plt.tight_layout()
plt.show()
- postprocess: NMS は使いません。300 個のクエリ × 80 クラスの確率(sigmoid)を 1 列に並べ、上位 300 個を取ります。番号をクラスの数で割った商がクエリ、余りがクラスです。箱は (cx, cy, w, h) の 0〜1 の値なので、画像の幅・高さを掛けて (x1, y1, x2, y2) の画素の座標にします。公式の後処理(post_process_object_detection)と同じ手順です。
- 表示: 確率 0.5 以上の検出を表示します。確率が五分五分より高い、モデルが物体だと判断した検出に絞るための値です。
- 重複の数え上げ: 確率が閾値以上の検出の中で、同じクラスで IoU が 0.5 以上重なる組を数えます。NMS がないので、重複があればそのまま残ります。閾値は、表示に使った 0.5 と、Hugging Face のモデルカードの使用例の 0.3 の 2 つです。
実行結果
cat           0.945  箱 [225, 1034, 978, 1326]
bench         0.936  箱 [1399, 287, 2149, 792]
cat           0.923  箱 [641, 812, 1161, 1109]
cat           0.905  箱 [1845, 820, 2305, 1046]
cat           0.897  箱 [1617, 619, 1898, 781]
cat           0.847  箱 [804, 564, 1046, 832]
cat           0.846  箱 [1142, 698, 1530, 952]
cat           0.827  箱 [1647, 448, 1866, 541]
pottedplant   0.801  箱 [1043, 460, 1241, 712]
pottedplant   0.793  箱 [1228, 441, 1419, 706]
pottedplant   0.555  箱 [767, 357, 1091, 685]
確率 0.5 以上の検出 11 個のうち、同じクラスで IoU 0.5 以上重なる組: 0 組
確率 0.3 以上の検出 21 個のうち、同じクラスで IoU 0.5 以上重なる組: 1 組
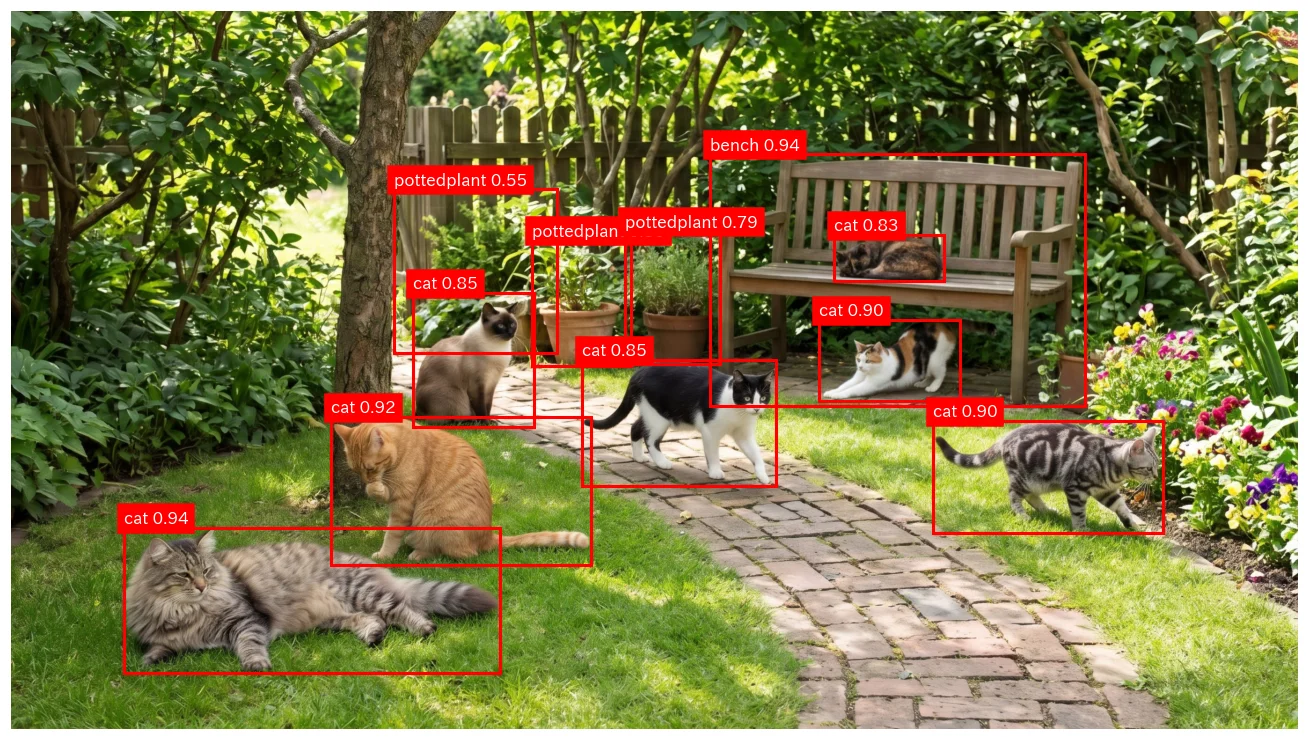
NMS を使っていないのに、確率 0.5 以上の 11 個の検出の中に、同じ物体を指す重複は 1 組もありません。7 匹の猫(ベンチの上で丸まっている猫を含む)、ベンチ、鉢植えを、それぞれ 1 つの箱で検出しています。YOLO11の記事の YOLO11n は、同じ画像でベンチの上の猫を見逃し、白黒の猫を犬と判定していました。ただし、RT-DETR-R18(約 2,016 万個のパラメータ)は YOLO11n(約 262 万個)より大きなモデルなので、この差は NMS の有無だけによるものではありません。
閾値を 0.3 に下げると検出は 21 個に増え、重なる組が 1 組出ました。増えた 10 個は、どれも確率 0.30〜0.41 の鉢植えの検出です。1 対 1 のマッチングで学習しても、確率の低い検出どうしの重複まで完全になくなるわけではないので、閾値は低くしすぎない方が安全です。
実験3:COCO val2017 の 500 枚で、精度と速度を測る
論文は、RT-DETR の利点として、デコーダの層の数を推論のときに減らせば、学習し直さずに速さを調整できることを挙げています。COCO val2017 の先頭の 500 枚で、使うデコーダの層の数を 1〜3 に変えて、精度(AP)と推論時間を測ります。
COCO val2017 の準備
import os
import json
import zipfile
import urllib.request
from concurrent.futures import ThreadPoolExecutor

# COCO val2017 のアノテーションと、先頭 500 枚の画像をダウンロードする
os.makedirs("coco/val2017", exist_ok=True)
if not os.path.exists("coco/annotations/instances_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extract("annotations/instances_val2017.json", "coco")

ann = json.load(open("coco/annotations/instances_val2017.json"))
img_ids = sorted(im["id"] for im in ann["images"])[:500]

def fetch(i):
    path = f"coco/val2017/{i:012d}.jpg"
    if not os.path.exists(path):
        urllib.request.urlretrieve(f"http://images.cocodataset.org/val2017/{i:012d}.jpg", path)

with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, img_ids))
print(f"画像 {len(os.listdir('coco/val2017'))} 枚、物体 {sum(a['image_id'] in set(img_ids) for a in ann['annotations'])} 個")
COCO の公式サイトから、val2017 のアノテーション(約 240 MB の zip の中の instances_val2017.json)と、画像 ID の小さい順に 500 枚の画像をダウンロードします。val2017 の全 5,000 枚では評価に時間がかかるので、500 枚に絞りました。画像は、16 のスレッドで並行してダウンロードします。
実行結果
画像 500 枚、物体 3541 個
デコーダの層の数を変えて評価する
import io
import contextlib
from pycocotools.coco import COCO
from pycocotools.cocoeval import COCOeval

device = "cuda"
ours = ours.to(device).eval()
with contextlib.redirect_stdout(io.StringIO()):
    coco = COCO("coco/annotations/instances_val2017.json")
cat_ids = sorted(coco.getCatIds())                        # モデルのクラス番号 0〜79 → COCO のカテゴリ ID

def evaluate(num_layers):
    results = []
    for i in img_ids:
        image = Image.open(f"coco/val2017/{i:012d}.jpg").convert("RGB")
        x = torch.from_numpy(np.array(image.resize((640, 640), Image.BILINEAR))).permute(2, 0, 1)[None].float().div(255).to(device)
        with torch.no_grad():
            logits, boxes, _ = ours(x, num_layers=num_layers)
        xyxy, score, label = postprocess(logits[0, -1].cpu(), boxes[0, -1].cpu(), image.size, top_k=100)
        for (x0, y0, x1, y1), s, l in zip(xyxy.tolist(), score.tolist(), label.tolist()):
            results.append({"image_id": i, "category_id": cat_ids[l], "bbox": [x0, y0, x1 - x0, y1 - y0], "score": s})
    with contextlib.redirect_stdout(io.StringIO()):
        E = COCOeval(coco, coco.loadRes(results), "bbox")
        E.params.imgIds = img_ids
        E.evaluate(); E.accumulate(); E.summarize()
    return E.stats[0], E.stats[1]                         # AP(IoU 0.5〜0.95 の平均)、AP50

def latency(num_layers, n=200):
    x = torch.rand(1, 3, 640, 640, device=device)
    with torch.no_grad():
        for _ in range(20):
            ours(x, num_layers=num_layers)
        torch.cuda.synchronize()
        t0 = time.perf_counter()
        for _ in range(n):
            ours(x, num_layers=num_layers)
        torch.cuda.synchronize()
    return (time.perf_counter() - t0) / n * 1000

for L in [1, 2, 3]:
    ap, ap50 = evaluate(L)
    print(f"デコーダ {L} 層: AP {ap:.3f}  AP50 {ap50:.3f}  推論 {latency(L):.2f} ms")
- クラスの番号: モデルの出力のクラスは 0〜79 の番号ですが、COCO のカテゴリ ID は 1〜90 の飛び飛びの番号です。カテゴリ ID を小さい順に並べた cat_ids で対応させます。
- evaluate: 画像ごとに、実験2と同じ前処理でモデルに入れ、num_layers 層目の出力から上位 100 個の検出を取ります。100 は、COCO の評価で 1 枚あたりに数える検出の数の上限(maxDets=100)です。検出を COCO の形式(左上の座標と幅・高さ)にして COCOeval に渡し、500 枚に絞って評価します。AP は IoU の閾値 0.5〜0.95 の平均、AP50 は IoU 0.5 での AP です。
- latency: GPU で、ウォームアップの 20 回の後、640×640 の画像 1 枚の推論を 200 回くり返した平均の時間を測ります。GPU の処理は非同期なので、torch.cuda.synchronize で処理の終わりを待ってから時刻を取ります。
実行結果
デコーダ 1 層: AP 0.458  AP50 0.623  推論 14.85 ms
デコーダ 2 層: AP 0.486  AP50 0.653  推論 16.99 ms
デコーダ 3 層: AP 0.496  AP50 0.661  推論 18.54 ms
デコーダの層の数ごとの結果を並べると、次のようになります。
(図は、diagram-designで作成)
3 層すべてを使うと AP 0.496 で、論文の RT-DETR-R18 の COCO val2017 全体での AP 46.5 と近い値です(500 枚に絞ったので、全体の値とは少し違います)。デコーダを 2 層にすると AP は 0.010 下がり、推論は 1.6 ms 速くなります。1 層にすると AP は 0.038 下がり、3.7 ms 速くなります。学習し直さずに、層を減らすだけで精度と速さを選べることが確かめられました。
推論時間は、A100 で PyTorch のまま float32 で測った値です。論文の 217 FPS(約 4.6 ms)は、T4 GPU で TensorRT の float16 を使った値なので、本記事の値と直接は比べられません。
実験4:ハンガリアンマッチングと損失を実装して追加学習する
最後に、ハンガリアンマッチングと損失を実装し、COCO で学習済みの RT-DETR-R18 を、丸・四角・三角の 3 クラスの合成データで追加学習します。さらに、正解を 4 つに複製してマッチングする「1 対 4」の学習と比べ、1 対 1 のマッチングが NMS を不要にしていることを確かめます。
実装方針:公式の学習との違い
| 項目 | 公式の学習(COCO、RT-DETR-R18) | 本記事(合成データ) |
|---|---|---|
| 初期の重み | ImageNet で学習した Backbone | COCO で学習済みの RT-DETR-R18 全体(追加学習の例として。クラスの層だけ新しくする) |
| データ | COCO(80 クラス) | 丸・四角・三角の合成画像 2 万枚(3 クラス。物体を重ならないように置ける) |
| 入力画像 | 640×640(学習では 480〜800 の複数の大きさ) | 256×256 の 1 つの大きさ(合成画像の大きさに合わせる) |
| エポック | 72 | 12(2 つの設定を A100 で合わせて約 85 分で学習するため) |
| バッチ | 16(4 GPU × 4 枚) | 32(GPU 1 枚で、画像が小さいため) |
| 最適化 | AdamW、学習率 1e-4(Backbone は 1e-5)、重み減衰 1e-4、勾配のクリップ 0.1 | 同じ |
| Backbone のバッチ正規化 | 学習する(R18 の設定) | 固定(R50 の設定と同じ。学習済みの統計量を保つため) |
| マッチングと損失 | ハンガリアン法(クラス 2・L1 5・GIoU 2)、VFL 1・L1 5・GIoU 2、補助損失 | 同じ |
| ノイズ除去のクエリ | 100 個(正解の箱にノイズを加えたクエリを足し、学習を速める) | なし(実装を短くするため。マッチングの効果だけを見る) |
| データの水増し | 色の変化・縮小・切り抜き・左右反転 | なし(毎回違う配置の合成画像を作るため) |
| 重みの平滑化 | EMA | なし(比較を単純にするため) |
| 混合精度 | float32 | bfloat16(A100 で学習を速くするため) |
合成データ
import math
import cv2

IMG, NC = 256, 3
CLASSES = ["丸", "四角", "三角"]


def overlap(a, b, gap=2):
    """2 つの箱が、gap 画素より近づいているか(重なっているか)"""
    return not (a[2] + gap <= b[0] or b[2] + gap <= a[0] or a[3] + gap <= b[1] or b[3] + gap <= a[1])


def make_shapes(seed, size=IMG):
    """背景のグラデーションとノイズの上に、丸・四角・三角を大きさをばらつかせて、重ならないように描く"""
    rng = np.random.default_rng(seed)
    c0, c1 = rng.integers(0, 256, 3), rng.integers(0, 256, 3)
    t = np.linspace(0, 1, size)[None, :, None]
    img = (c0 * (1 - t) + c1 * t).repeat(size, 0)
    img = np.clip(img + rng.normal(0, 12, img.shape), 0, 255).astype(np.uint8).copy()
    boxes, labels = [], []
    for _ in range(rng.integers(1, 10)):
        for _try in range(20):
            s = math.exp(rng.uniform(math.log(6), math.log(96)))      # 一辺 6〜96 画素(対数で一様)
            x0, y0 = rng.uniform(0, size - s, 2)
            b = np.array([x0, y0, x0 + s, y0 + s])
            if not any(overlap(b, o) for o in boxes):
                break
        else:
            continue
        k = int(rng.integers(0, NC))
        color = tuple(int(v) for v in rng.integers(0, 256, 3))
        x0, y0, x1, y1 = b
        if k == 0:
            cv2.circle(img, (int(round((x0 + x1) / 2)), int(round((y0 + y1) / 2))), int(round(s / 2)), color, -1, cv2.LINE_AA)
        elif k == 1:
            cv2.rectangle(img, (int(round(x0)), int(round(y0))), (int(round(x1)), int(round(y1))), color, -1)
        else:
            pts = np.array([[(x0 + x1) / 2, y0], [x0, y1], [x1, y1]]).round().astype(np.int32)
            cv2.fillPoly(img, [pts], color, cv2.LINE_AA)
        boxes.append(b)
        labels.append(k)
    return img, np.array(boxes, dtype=np.float32).reshape(-1, 4), np.array(labels, dtype=np.int64)


class Shapes(torch.utils.data.Dataset):
    def __init__(self, n, offset):
        self.n, self.offset = n, offset

    def __len__(self):
        return self.n

    def __getitem__(self, i):
        img, boxes, labels = make_shapes(self.offset + i)
        b = torch.from_numpy(boxes) / IMG
        cxcywh = torch.cat([(b[:, :2] + b[:, 2:]) / 2, b[:, 2:] - b[:, :2]], 1)          # 0〜1 の (cx, cy, w, h)
        return torch.from_numpy(img).permute(2, 0, 1).float() / 255, {"labels": torch.from_numpy(labels), "boxes": cxcywh}


def collate(batch):
    return torch.stack([b[0] for b in batch]), [b[1] for b in batch]
YOLO11の記事の実験3と同じ合成データです。
- make_shapes: 256×256 の画像に、ランダムな色のグラデーションとノイズの背景を描き、1〜9 個の丸・四角・三角を、一辺 6〜96 画素の大きさで描きます。大きさは対数で一様に選ぶので、小さな物体と大きな物体が同じくらいの数になります。物体どうしは 2 画素以上離して置き、隠れて見えない物体が正解に入らないようにします。
- Shapes: 画像の番号を乱数の種にして、その場で画像を作ります。正解の箱は、RT-DETR の出力に合わせて 0〜1 の (cx, cy, w, h) にします。
- collate: 画像ごとに物体の数が違うので、正解は画像ごとの辞書のリストのまま渡します。
ハンガリアンマッチング
from scipy.optimize import linear_sum_assignment


def cxcywh_to_xyxy(b):
    cx, cy, w, h = b.unbind(-1)
    return torch.stack([cx - w / 2, cy - h / 2, cx + w / 2, cy + h / 2], -1)


def generalized_box_iou(a, b):
    """GIoU = IoU - (2 つの箱を囲む最小の箱のうち、どちらにも含まれない部分の割合)。a (N, 4)・b (M, 4) は x1y1x2y2"""
    area_a = (a[:, 2:] - a[:, :2]).prod(-1)
    area_b = (b[:, 2:] - b[:, :2]).prod(-1)
    inter = (torch.min(a[:, None, 2:], b[None, :, 2:]) - torch.max(a[:, None, :2], b[None, :, :2])).clamp(0).prod(-1)
    union = area_a[:, None] + area_b[None] - inter
    iou = inter / union
    hull = (torch.max(a[:, None, 2:], b[None, :, 2:]) - torch.min(a[:, None, :2], b[None, :, :2])).clamp(0).prod(-1)
    return iou - (hull - union) / hull, iou


@torch.no_grad()
def hungarian_match(logits, boxes, targets, copies=1, w_class=2.0, w_bbox=5.0, w_giou=2.0, alpha=0.25, gamma=2.0):
    """画像ごとに「クエリ × 正解」のコストを作り、合計コストが最小になる 1 対 1 の組をハンガリアン法で求める
    logits (B, Q, C)・boxes (B, Q, 4) は予測、targets は画像ごとの {"labels": (M,), "boxes": (M, 4) cxcywh}
    copies > 1 のときは正解を copies 回複製し、1 つの正解に copies 個のクエリを割り当てる(1 対多の比較用)"""
    out = []
    for lg, bx, t in zip(logits, boxes, targets):
        labels, tboxes = t["labels"].repeat(copies), t["boxes"].repeat(copies, 1)
        if len(labels) == 0:
            out.append((torch.zeros(0, dtype=torch.long), torch.zeros(0, dtype=torch.long)))
            continue
        p = lg.sigmoid()[:, labels]                                                     # (Q, M)
        neg = (1 - alpha) * p ** gamma * -(1 - p + 1e-8).log()
        pos = alpha * (1 - p) ** gamma * -(p + 1e-8).log()
        cost_class = pos - neg                                                          # Focal Loss の形のクラスのコスト
        cost_bbox = torch.cdist(bx, tboxes, p=1)                                        # 箱の L1 距離
        cost_giou = -generalized_box_iou(cxcywh_to_xyxy(bx), cxcywh_to_xyxy(tboxes))[0]
        C = w_bbox * cost_bbox + w_class * cost_class + w_giou * cost_giou
        q, g = linear_sum_assignment(C.float().cpu().numpy())
        out.append((torch.as_tensor(q, dtype=torch.long), torch.as_tensor(g % len(t["labels"]), dtype=torch.long)))
    return out
- generalized_box_iou: GIoU は、IoU から「2 つの箱を囲む最小の箱のうち、どちらの箱にも含まれない部分の割合」を引いた値です。箱が重なっていないと IoU はどれも 0 で区別できませんが、GIoU は離れているほど小さくなるので、離れた箱にも近づく方向の勾配がかかります。
- hungarian_match: 画像ごとに、300 個のクエリ × 正解の物体のコスト行列を作り、scipy.optimize.linear_sum_assignment(ハンガリアン法)で、コストの合計が最小になる 1 対 1 の組を求めます。クラスのコストは Focal Loss の形(alpha=0.25・gamma=2)で、正解クラスの確率が高いほど小さくなります。重み(クラス 2・L1 5・GIoU 2)と alpha・gamma は、公式の実装の値です。
- copies: 比較用に、正解を copies 回複製してマッチングします。複製した正解はそれぞれ別のクエリと組になるので、1 つの物体を copies 個のクエリが担当します。組の正解の番号は、複製前の番号に戻して返します。
損失:VFL・L1・GIoU
def detr_loss(logits, boxes, targets, matches, w_vfl=1.0, w_bbox=5.0, w_giou=2.0, alpha=0.75, gamma=2.0):
    """マッチした組に VFL(分類)・L1・GIoU の損失をかける。マッチしなかったクエリは「物体なし」として VFL だけかかる"""
    B, Q, C = logits.shape
    bi = torch.cat([torch.full_like(q, i) for i, (q, _) in enumerate(matches)])
    qi = torch.cat([q for q, _ in matches])
    src = boxes[bi, qi]                                                                 # マッチしたクエリの箱
    tgt = torch.cat([t["boxes"][g] for t, (_, g) in zip(targets, matches)])
    tlab = torch.cat([t["labels"][g] for t, (_, g) in zip(targets, matches)])
    num = max(sum(len(t["labels"]) for t in targets), 1)                                # 正解の箱の数で割る
    giou, iou = generalized_box_iou(cxcywh_to_xyxy(src), cxcywh_to_xyxy(tgt))
    giou, iou = giou.diagonal(), iou.diagonal()
    loss_bbox = F.l1_loss(src, tgt, reduction="none").sum() / num
    loss_giou = (1 - giou).sum() / num
    # VFL:正解クラスの目標を 1 ではなく IoU にする。負例は確率が高いものほど重くする(Focal Loss と同じ考え方)
    target = torch.zeros(B, Q, C, device=logits.device)
    target[bi, qi, tlab] = 1.0
    score = target.clone()
    score[bi, qi, tlab] = iou.detach().to(score.dtype)
    p = logits.sigmoid().detach()
    weight = alpha * p ** gamma * (1 - target) + score
    loss_vfl = F.binary_cross_entropy_with_logits(logits, score, weight=weight, reduction="none").mean(1).sum() * Q / num
    return w_vfl * loss_vfl + w_bbox * loss_bbox + w_giou * loss_giou


def total_loss(logits_all, boxes_all, enc_topk, targets, copies=1):
    """デコーダの全層(補助損失)と、エンコーダが選んだクエリの予測に、同じ損失をかけて足す"""
    outs = [(logits_all[:, l], boxes_all[:, l]) for l in range(logits_all.shape[1])] + [enc_topk]
    loss = 0
    for lg, bx in outs:
        matches = hungarian_match(lg.float(), bx.float(), targets, copies)
        loss = loss + detr_loss(lg.float(), bx.float(), targets, matches)
    return loss
- detr_loss: マッチした組の箱に、L1 の損失(重み 5)と、1 − GIoU の損失(重み 2)をかけます。分類には VFL(重み 1)をかけます。目標 score は、マッチしたクエリの正解クラスだけを予測と正解の IoU にし、ほかは 0 です。IoU は detach で目標として固定し、分類の損失から箱に勾配が流れないようにします。重み weight は、負例では 0.75 × 確率の 2 乗、正例では目標の IoU で、確率の高い負例ほど強く罰します。どの損失も、バッチの正解の箱の数で割ります。重みと alpha・gamma は、公式の実装の値です。
- total_loss: デコーダの 3 層それぞれの出力と、クエリの選択の予測(enc_topk)に、それぞれマッチングをし直して同じ損失をかけ、足し合わせます。途中の層にも損失をかける(補助損失)と、深い層まで勾配が届きやすくなり、学習が速くなります。
学習の関数
def new_head_model():
    """COCO で学習済みの重みを読み込み、クラスの出力(80 クラス)だけを 3 クラスの新しい層に取り替える"""
    model = load_hf_rtdetr(RTDETR(), hf_model.state_dict())
    bias = -math.log((1 - 0.01) / 0.01)                    # 最初はどのクラスの確率も 0.01 にする(論文と同じ初期化)
    model.enc_score_head = nn.Linear(256, NC)
    model.class_embed = nn.ModuleList(nn.Linear(256, NC) for _ in range(3))
    for head in [model.enc_score_head, *model.class_embed]:
        nn.init.constant_(head.bias, bias)
    return model.to(device)


def freeze_bn(model):
    """Backbone のバッチ正規化は、学習済みの統計量のまま固定する(公式の実装と同じ)"""
    for m in model.backbone.modules():
        if isinstance(m, nn.BatchNorm2d):
            m.eval()


def train(copies, epochs=12, n_train=20000, batch=32):
    torch.manual_seed(0)
    loader = torch.utils.data.DataLoader(Shapes(n_train, 0), batch_size=batch, shuffle=True, num_workers=8,
                                         collate_fn=collate, drop_last=True, persistent_workers=True)
    model = new_head_model()
    backbone = [p for n, p in model.named_parameters() if n.startswith("backbone.")]
    others = [p for n, p in model.named_parameters() if not n.startswith("backbone.")]
    opt = torch.optim.AdamW([{"params": backbone, "lr": 1e-5}, {"params": others, "lr": 1e-4}], weight_decay=1e-4)
    for epoch in range(1, epochs + 1):
        model.train()
        freeze_bn(model)
        t0, tot = time.time(), 0.0
        for imgs, targets in loader:
            imgs = imgs.to(device)
            targets = [{k: v.to(device) for k, v in t.items()} for t in targets]
            with torch.autocast("cuda", dtype=torch.bfloat16):
                logits_all, boxes_all, enc_topk = model(imgs)
            loss = total_loss(logits_all, boxes_all, enc_topk, targets, copies)
            opt.zero_grad(set_to_none=True)
            loss.backward()
            torch.nn.utils.clip_grad_norm_(model.parameters(), 0.1)
            opt.step()
            tot += loss.item()
        print(f"[{'1 対 1' if copies == 1 else f'1 対 {copies}'}] エポック {epoch:2d}  損失 {tot / len(loader):.3f}  ({time.time() - t0:.0f} 秒)", flush=True)
    return model
- new_head_model: 実験2の Hugging Face のモデルから COCO で学習済みの重みを読み込み、クラスを出す層(enc_score_head と、デコーダの 3 層の class_embed)だけを 3 クラスの新しい層に替えます。新しい層のバイアスは、最初の確率が 0.01 になる値にします。学習の初めに、ほとんどのクエリが「物体なし」になる状態から始めて、負例の損失が大きくなりすぎないようにするためです(RetinaNet 以来の初期化で、公式の実装と同じ)。
- freeze_bn: Backbone のバッチ正規化は、COCO で学習した統計量のまま固定します。公式の R50 の設定(freeze_norm=True)と同じ扱いです。
- train: AdamW で、Backbone の学習率を 1e-5、それ以外を 1e-4、重み減衰を 1e-4、勾配のクリップを 0.1 にします。どれも公式の実装の値です。順伝播は bfloat16 の混合精度で計算し、損失は float32 で計算します。
1 対 1 と 1 対 4 を学習して比べる
@torch.no_grad()
def evaluate_shapes(model, n_test=1000, use_nms=False):
    """mAP50(IoU 0.5 以上で正解)と、確率 0.5 以上の検出のうち、同じクラスで IoU 0.5 以上重なる組(重複)の数"""
    model.eval()
    loader = torch.utils.data.DataLoader(Shapes(n_test, 10**6), batch_size=100, num_workers=8, collate_fn=collate)
    dets, n_gt, dup, n_det = {c: [] for c in range(NC)}, np.zeros(NC), 0, 0
    for imgs, targets in loader:
        logits, boxes, _ = model(imgs.to(device))
        for i, t in enumerate(targets):
            xyxy, score, label = postprocess(logits[i, -1].float().cpu(), boxes[i, -1].float().cpu(), (IMG, IMG), top_k=100)
            if use_nms:
                keep = torchvision.ops.batched_nms(xyxy, score, label, 0.7)
                xyxy, score, label = xyxy[keep], score[keep], label[keep]
            g = cxcywh_to_xyxy(t["boxes"]) * IMG
            gl = t["labels"]
            sel = score > 0.5
            iou = torchvision.ops.box_iou(xyxy[sel], xyxy[sel])
            dup += int(((iou > 0.5) & (label[sel][:, None] == label[sel][None])).triu(1).sum())
            n_det += int(sel.sum())
            for c in range(NC):
                n_gt[c] += int((gl == c).sum())
            used = torch.zeros(len(g), dtype=torch.bool)
            ious = torchvision.ops.box_iou(xyxy, g) if len(g) else torch.zeros(len(xyxy), 0)
            for j in score.argsort(descending=True).tolist():          # 確率の高い順に、まだ使っていない同じクラスの正解と対応づける
                ok = (gl == label[j]) & ~used
                if ok.any():
                    v, k = (ious[j] * ok).max(0)
                    if v >= 0.5:
                        used[k] = True
                        dets[int(label[j])].append((score[j].item(), 1))
                        continue
                dets[int(label[j])].append((score[j].item(), 0))
    aps = []
    for c in range(NC):
        d = sorted(dets[c], key=lambda x: -x[0])
        tp = np.cumsum([x[1] for x in d])
        fp = np.cumsum([1 - x[1] for x in d])
        rec, prec = tp / max(n_gt[c], 1), tp / np.maximum(tp + fp, 1e-9)
        mrec, mpre = np.concatenate(([0], rec, [1])), np.concatenate(([1], prec, [0]))
        mpre = np.flip(np.maximum.accumulate(np.flip(mpre)))
        idx = np.where(mrec[1:] != mrec[:-1])[0]
        aps.append(np.sum((mrec[idx + 1] - mrec[idx]) * mpre[idx + 1]))
    return float(np.mean(aps)), dup, n_det, int(n_gt.sum())


results = {}
for copies in [1, 4]:
    m = train(copies)
    for use_nms in [False, True]:
        results[(copies, use_nms)] = evaluate_shapes(m, use_nms=use_nms)
    torch.save(m.state_dict(), f"shapes_copies{copies}.pt")
for (copies, use_nms), (ap, dup, n_det, n_gt) in results.items():
    print(f"{'1 対 1' if copies == 1 else '1 対 4'}・NMS {'あり' if use_nms else 'なし'}: mAP50 {ap:.3f}  確率 0.5 以上の検出 {n_det} 個(正解 {n_gt} 個)  重複 {dup} 組")
- evaluate_shapes: 学習に使わない 1,000 枚(乱数の種 100 万から)で評価します。各画像の上位 100 個の検出について、確率の高い順に、まだ使っていない同じクラスの正解と IoU 0.5 以上で対応づけ、クラスごとの AP50 の平均(mAP50)を求めます。use_nms=True のときは、閾値 0.7(YOLO11 の既定値)の NMS をかけてから評価します。あわせて、確率 0.5 以上の検出の数と、その中の同じクラスで IoU 0.5 以上重なる組(重複)を数えます。
- 学習: 1 対 1(copies=1、RT-DETR の学習)と 1 対 4(copies=4)を、同じ設定で 12 エポックずつ学習し、それぞれ NMS なしとありで評価します。
実行結果
[1 対 1] エポック  1  損失 2.891  (192 秒)
[1 対 1] エポック  2  損失 2.042  (196 秒)
[1 対 1] エポック  3  損失 1.913  (192 秒)
[1 対 1] エポック  4  損失 1.735  (190 秒)
[1 対 1] エポック  5  損失 1.701  (190 秒)
[1 対 1] エポック  6  損失 1.653  (191 秒)
[1 対 1] エポック  7  損失 1.581  (191 秒)
[1 対 1] エポック  8  損失 1.549  (191 秒)
[1 対 1] エポック  9  損失 1.527  (191 秒)
[1 対 1] エポック 10  損失 1.516  (190 秒)
[1 対 1] エポック 11  損失 1.500  (189 秒)
[1 対 1] エポック 12  損失 1.479  (189 秒)
[1 対 4] エポック  1  損失 12.179  (217 秒)
[1 対 4] エポック  2  損失 8.004  (216 秒)
[1 対 4] エポック  3  損失 7.288  (215 秒)
[1 対 4] エポック  4  損失 6.922  (216 秒)
[1 対 4] エポック  5  損失 6.697  (216 秒)
[1 対 4] エポック  6  損失 6.545  (215 秒)
[1 対 4] エポック  7  損失 6.401  (215 秒)
[1 対 4] エポック  8  損失 6.309  (216 秒)
[1 対 4] エポック  9  損失 6.201  (214 秒)
[1 対 4] エポック 10  損失 6.146  (214 秒)
[1 対 4] エポック 11  損失 6.062  (220 秒)
[1 対 4] エポック 12  損失 5.998  (218 秒)
1 対 1・NMS なし: mAP50 1.000  確率 0.5 以上の検出 5096 個(正解 5084 個)  重複 11 組
1 対 1・NMS あり: mAP50 1.000  確率 0.5 以上の検出 5085 個(正解 5084 個)  重複 0 組
1 対 4・NMS なし: mAP50 0.263  確率 0.5 以上の検出 20400 個(正解 5084 個)  重複 30765 組
1 対 4・NMS あり: mAP50 1.000  確率 0.5 以上の検出 5086 個(正解 5084 個)  重複 1 組
4つの組み合わせの結果を並べると、次のようになります。
(図は、diagram-designで作成)
1 対 1 のマッチングで学習したモデルは、NMS なしで mAP50 1.000 になり、NMS をかけても変わりません。確率 0.5 以上の検出は 5,096 個で、正解の 5,084 個とほぼ同じ数です。1,000 枚全体で重複は 11 組だけ残りましたが、これを NMS で消しても mAP50 は変わりませんでした。
1 対 4 のマッチングで学習したモデルは、NMS なしでは確率 0.5 以上の検出が 20,400 個(正解の約 4 倍)になり、重複は 30,765 組、mAP50 は 0.263 まで下がりました。1 つの物体に 4 つのクエリが高い確率を出すよう学習したので、同じ物体の箱が 4 つずつ出て、2 つ目以降はすべて誤検出として数えられるためです。NMS をかけると重複が消え、mAP50 は 1.000 に戻ります。
モデルの構造は 2 つとも同じで、違うのはマッチングだけです。RT-DETR が NMS を使わずに済むのは、Transformer を使っているからではなく、1 対 1 のマッチングで学習しているからだと分かります。損失の値は、1 対 4 の方が正解の数が 4 倍になり、マッチした組の損失が増えるので大きくなっています(損失は複製前の正解の数で割っています)。
検出結果を見る
# 学習した 2 つのモデルで、同じテスト画像を NMS なしで検出する
models = {}
for copies in [1, 4]:
    models[copies] = new_head_model()
    models[copies].load_state_dict(torch.load(f"shapes_copies{copies}.pt"))
    models[copies].eval()

fig, axes = plt.subplots(2, 4, figsize=(16, 8.4))
for col in range(4):
    img, t = Shapes(1, 10**6 + col)[0]
    for row, copies in enumerate([1, 4]):
        with torch.no_grad():
            logits, boxes, _ = models[copies](img[None].to(device))
        xyxy, score, label = postprocess(logits[0, -1].float().cpu(), boxes[0, -1].float().cpu(), (IMG, IMG), top_k=100)
        ax = axes[row, col]
        ax.imshow(img.permute(1, 2, 0))
        sel = score > 0.5
        for (x0, y0, x1, y1), s, l in zip(xyxy[sel].tolist(), score[sel].tolist(), label[sel].tolist()):
            ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color="red", lw=1.5))
            ax.text(x0, y0 - 2, f"{CLASSES[l]} {s:.2f}", color="white", fontsize=8, backgroundcolor="red")
        ax.set_title(f"{'1 対 1' if copies == 1 else '1 対 4'}・NMS なし({int(sel.sum())} 個、正解 {len(t['labels'])} 個)", fontsize=11)
        ax.axis("off")
plt.tight_layout()
plt.show()
学習した 2 つのモデルを読み込み、テスト用の 4 枚の画像を NMS なしで検出して、確率 0.5 以上の箱を描きます。上の段が 1 対 1、下の段が 1 対 4 です。
実行結果
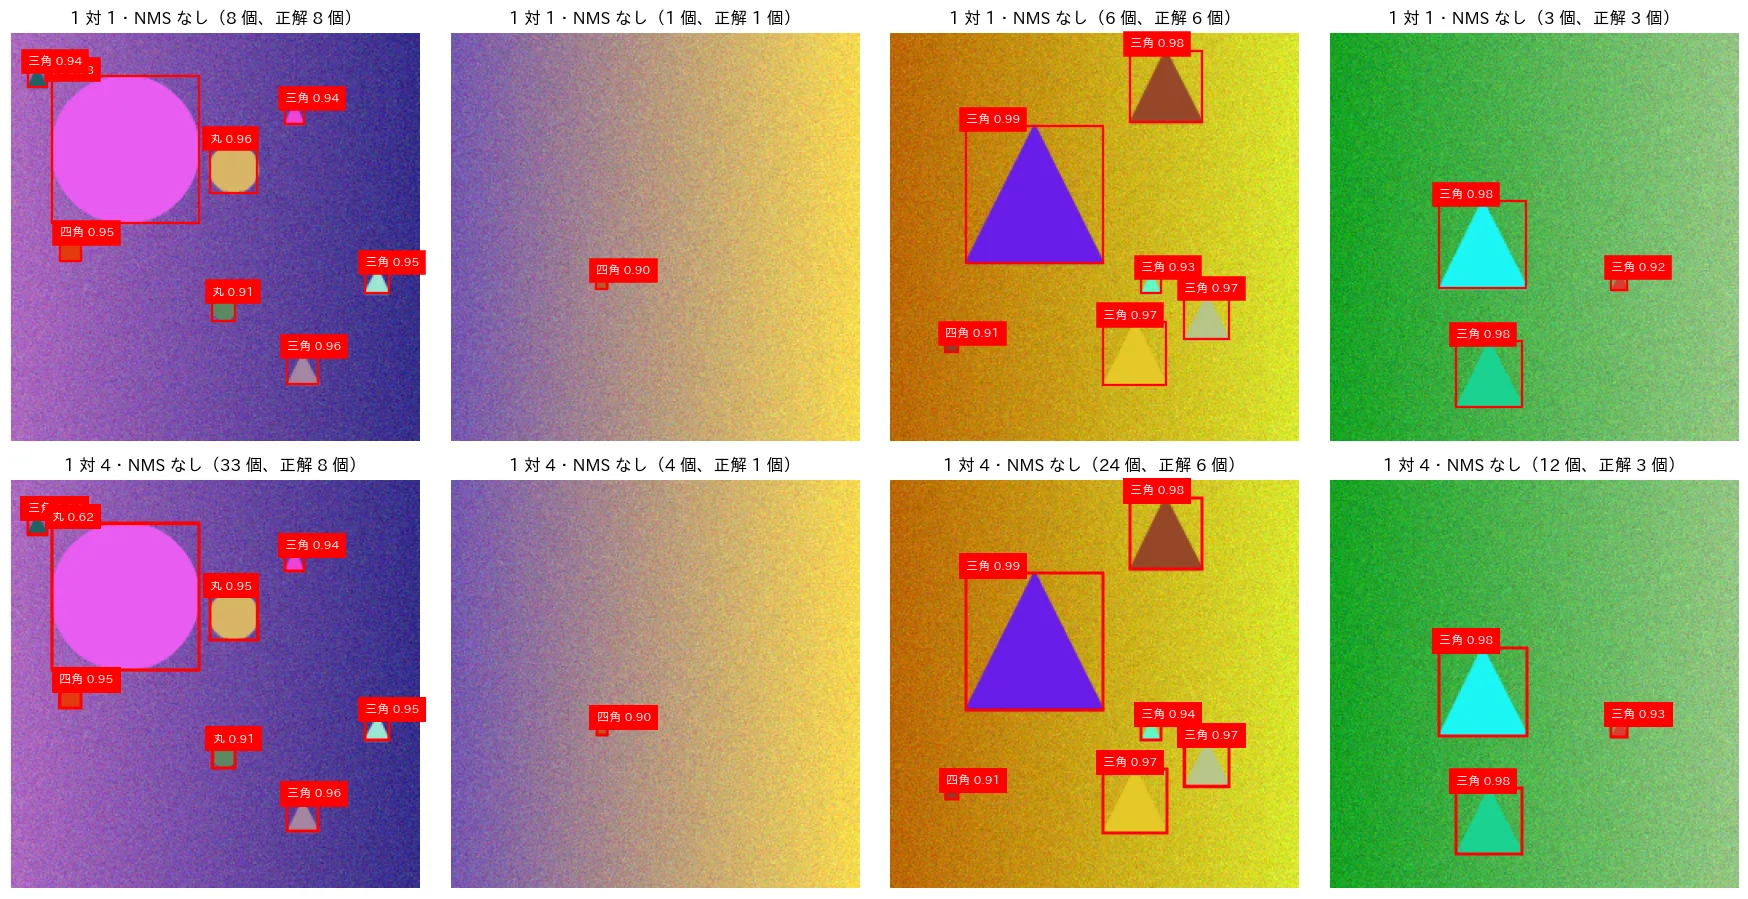
上の段の 1 対 1 のモデルは、どの画像でも、検出の数が正解の数と同じです。下の段の 1 対 4 のモデルは、正解の約 4 倍の箱を出しています。ほとんど同じ位置に重なっているので図では 1 つに見えますが、題の検出の数が示すとおり、同じ物体に箱が何重にも出ています。YOLO11n の NMS の前の出力(実験1)と同じ状態で、NMS が欠かせなくなります。
まとめ
本記事では、NMS を使わないリアルタイム物体検出モデル RT-DETR を、PyTorch のスクラッチ実装で確かめました。
- NMS の問題(実験1): YOLO11n は、NMS の前に 77 個の候補を出し、1 匹の猫に何重にも箱が重なっていました。NMS の閾値を 0.9 に緩めると、9 個のはずの検出が 15 個に増え、結果が閾値に左右されることを確かめました。
- スクラッチ実装(実験2): ResNet18-vd の Backbone、AIFI と CCFM の Hybrid Encoder、クエリの選択、Deformable Attention のデコーダを実装し、公式の学習済みの重みを読み込みました。Hugging Face の実装との差は logit で最大 1.03e-04、箱で最大 1.88e-05 でした。NMS なしで、確率 0.5 以上の 11 個の検出に重複はありませんでした。
- 精度と速度(実験3): COCO val2017 の 500 枚で AP 0.496 でした。デコーダを 3 層から 1 層に減らすと、学習し直さずに AP 0.458・推論 14.85 ms(3 層は 18.54 ms)になり、層の数で精度と速さを選べることを確かめました。
- 1 対 1 のマッチング(実験4): ハンガリアンマッチングと VFL・L1・GIoU の損失を実装し、合成データで追加学習しました。1 対 1 で学習したモデルは NMS なしで mAP50 1.000 でしたが、正解を 4 つに複製して学習したモデルは、NMS なしでは重複が 30,765 組出て mAP50 0.263 に下がりました。NMS が不要になるのは、モデルの構造ではなく 1 対 1 のマッチングによることを確かめました。
本記事では省いた学習の工夫に、正解の箱にノイズを加えたクエリで学習を速めるノイズ除去の学習があります。後継の RT-DETRv2 は、デコーダの段ごとにサンプリングの点の数を変えるなどの改良を加えています。
ライセンスに関する注記
RT-DETR の公式の実装(lyuwenyu/RT-DETR)と、Hugging Face の学習済みの重み(PekingU/rtdetr_r18vd)は、Apache-2.0 で公開されています。Apache-2.0 は、商用利用・改変・再配布ができるライセンスです。再配布するときは、ライセンスの全文と著作権の表示を含め、改変したファイルには改変したことを明記してください。実験1で使った YOLO11n(Ultralytics)は AGPL-3.0 なので、扱いが異なります(YOLO11の記事を参照してください)。COCO のアノテーションは CC BY 4.0 で、画像はそれぞれの撮影者の Flickr のライセンスに従います。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- RT-DETR の実装: 公式の lyuwenyu/RT-DETR と Hugging Face の transformers(どちらも Apache-2.0)の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: PekingU/rtdetr_r18vd(Apache-2.0)、Ultralytics の yolo11n.pt(AGPL-3.0)を使用しています。
- 評価データ: COCO val2017(アノテーションは CC BY 4.0)の一部を使用しています。
- 推論に利用した画像: Gemini で作成した画像です。
@inproceedings{zhao2024detrs,
  title = {DETRs Beat YOLOs on Real-time Object Detection},
  author = {Zhao, Yian and Lv, Wenyu and Xu, Shangliang and Wei, Jinman and Wang, Guanzhong and Dang, Qingqing and Liu, Yi and Chen, Jie},
  booktitle = {Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR)},
  pages = {16965--16974},
  year = {2024}
}
参考文献
- Y. Zhao et al. (2024). DETRs Beat YOLOs on Real-time Object Detection. CVPR 2024.
- W. Lyu. lyuwenyu/RT-DETR. GitHub.
- PekingU. PekingU/rtdetr_r18vd. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。