SAMとは?
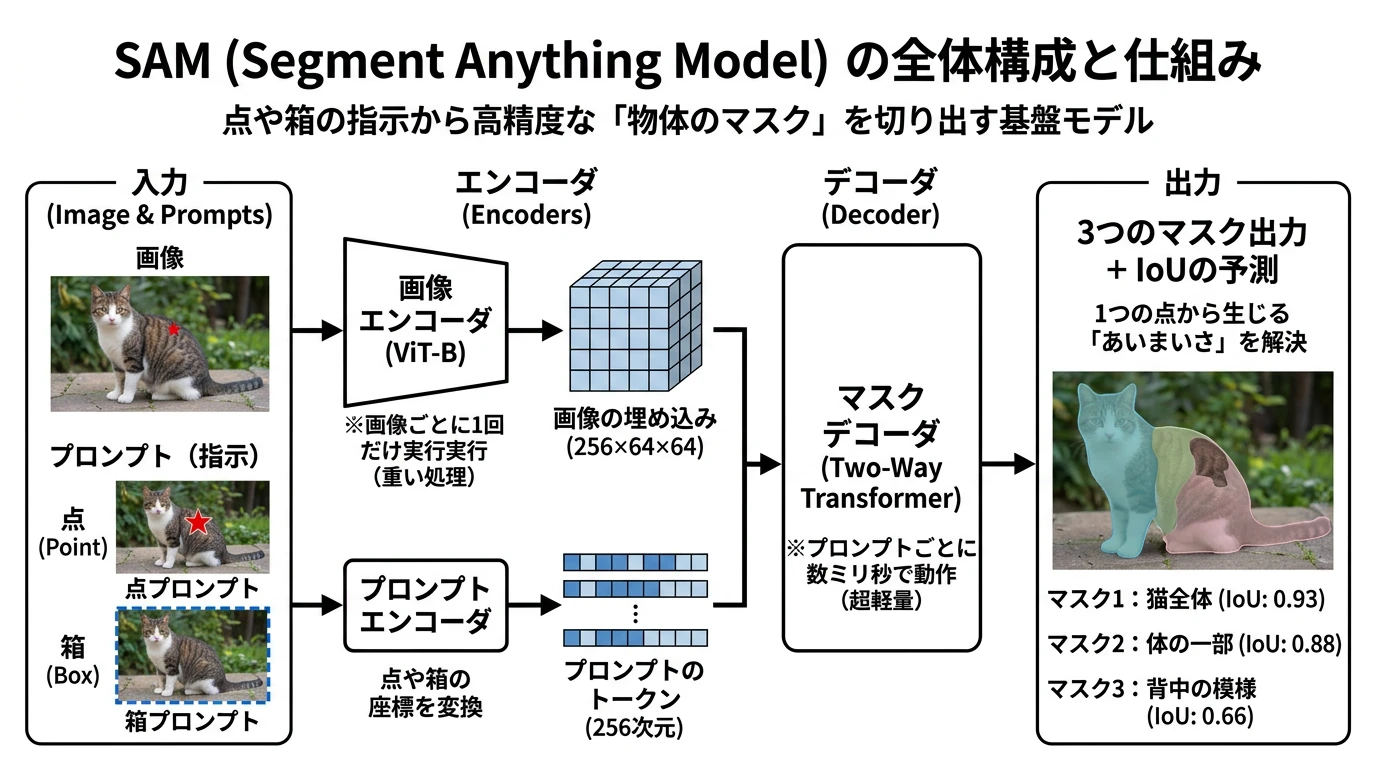 (画像は、Geminiで作成)
点や箱で指示した物体のマスクを出す SAM を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで Hugging Face の実装と同じマスクになることを確かめること。重い画像エンコーダを 1 回だけ動かし、軽いデコーダでプロンプトごとにマスクを出す仕組みと、1 つの点から 3 つのマスクを出してあいまいさを扱う仕組みを理解し、損失を自分で書いて学習させられるようになること。
参考資料: Segment Anything (Kirillov et al., ICCV 2023)。公式の実装は facebookresearch/segment-anything(Apache-2.0)、本記事で使う学習済みの重みは Hugging Face の facebook/sam-vit-base(Apache-2.0)です。
概要
画像のセグメンテーションは、画像のどの画素がどの物体に当たるかを求める処理です。これまでのセグメンテーションのモデルは、学習で決めたクラス(COCO なら 80 クラス)の物体しか切り出せず、新しい種類の物体を切り出すには、その物体のマスクを集めて学習し直す必要がありました。
SAM(Segment Anything Model、Meta, 2023)は、画像の上の点や箱(プロンプト)を入力し、指示した物体のマスクを出すモデルです。1,100 万枚の画像と 11 億個のマスクからなるデータセット SA-1B で学習しており、クラスを決めずに「物体のまとまり」を切り出します。学習で見ていない種類の物体でも、点や箱を与えればマスクを出せます。
SAM は、次の 3 つの部品からなります。
- 画像エンコーダ: ViT(画像のパッチを並べて Transformer のエンコーダにかけるモデル。Transformer はTransformer の記事)で画像を 256×64×64 の特徴(画像の埋め込み)にします。重い処理ですが、画像ごとに 1 回だけ動かします。
- プロンプトエンコーダ: 点や箱の座標を、256 次元のトークンにします。
- マスクデコーダ: 画像の埋め込みとプロンプトのトークンから、マスクを出します。軽いので、点や箱を変えるたびに動かしても数ミリ秒で終わります。
また、1 つの点は「猫の背中の模様」「猫」「猫の群れ」のように、何を指すかがあいまいです。SAM は 1 つの点から 3 つのマスクと、それぞれのマスクの良さの予測(IoU の予測)を出して、このあいまいさを扱います。
本記事では、まず Hugging Face の実装で 1 つの点から出る 3 つのマスクを確かめ、仕組みを図で整理したうえで、SAM(ViT-B)をスクラッチで実装します。公式の重みで Hugging Face と同じマスクになることを確かめ、Grounding DINO の記事で検出した箱をプロンプトにして、テキストで指定した物体を切り出します。最後に、COCO val2017 の一部で箱と点のプロンプトの精度を測り、3 つのマスクを出す学習が、あいまいな点を扱えることを合成データで確かめます。
1 つの点から 3 つのマスクを出す
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。最後の実験4の学習は、A100 で約 25 分(特徴の計算に約 4 分、2 つのモデルの学習にそれぞれ約 10 分)かかります。L4 GPU でも動きますが、時間はもっとかかります。
新しいセッションで、次を実行してください。pycocotools は実験3の COCO の読み込みに使います。transformers(比較用の SAM)と scipy・opencv-python(マスクの距離の計算と、合成画像の描画)は Colab に最初から入っています。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q pycocotools japanize-matplotlib setuptools
推論に利用する画像
実験1と実験2では、Grounding DINO の記事と同じ、庭にいる複数の猫の画像を使います。次の画像を保存し、cats.jpg という名前で Colab にアップロードしてください(画像は、Geminiで作成)。
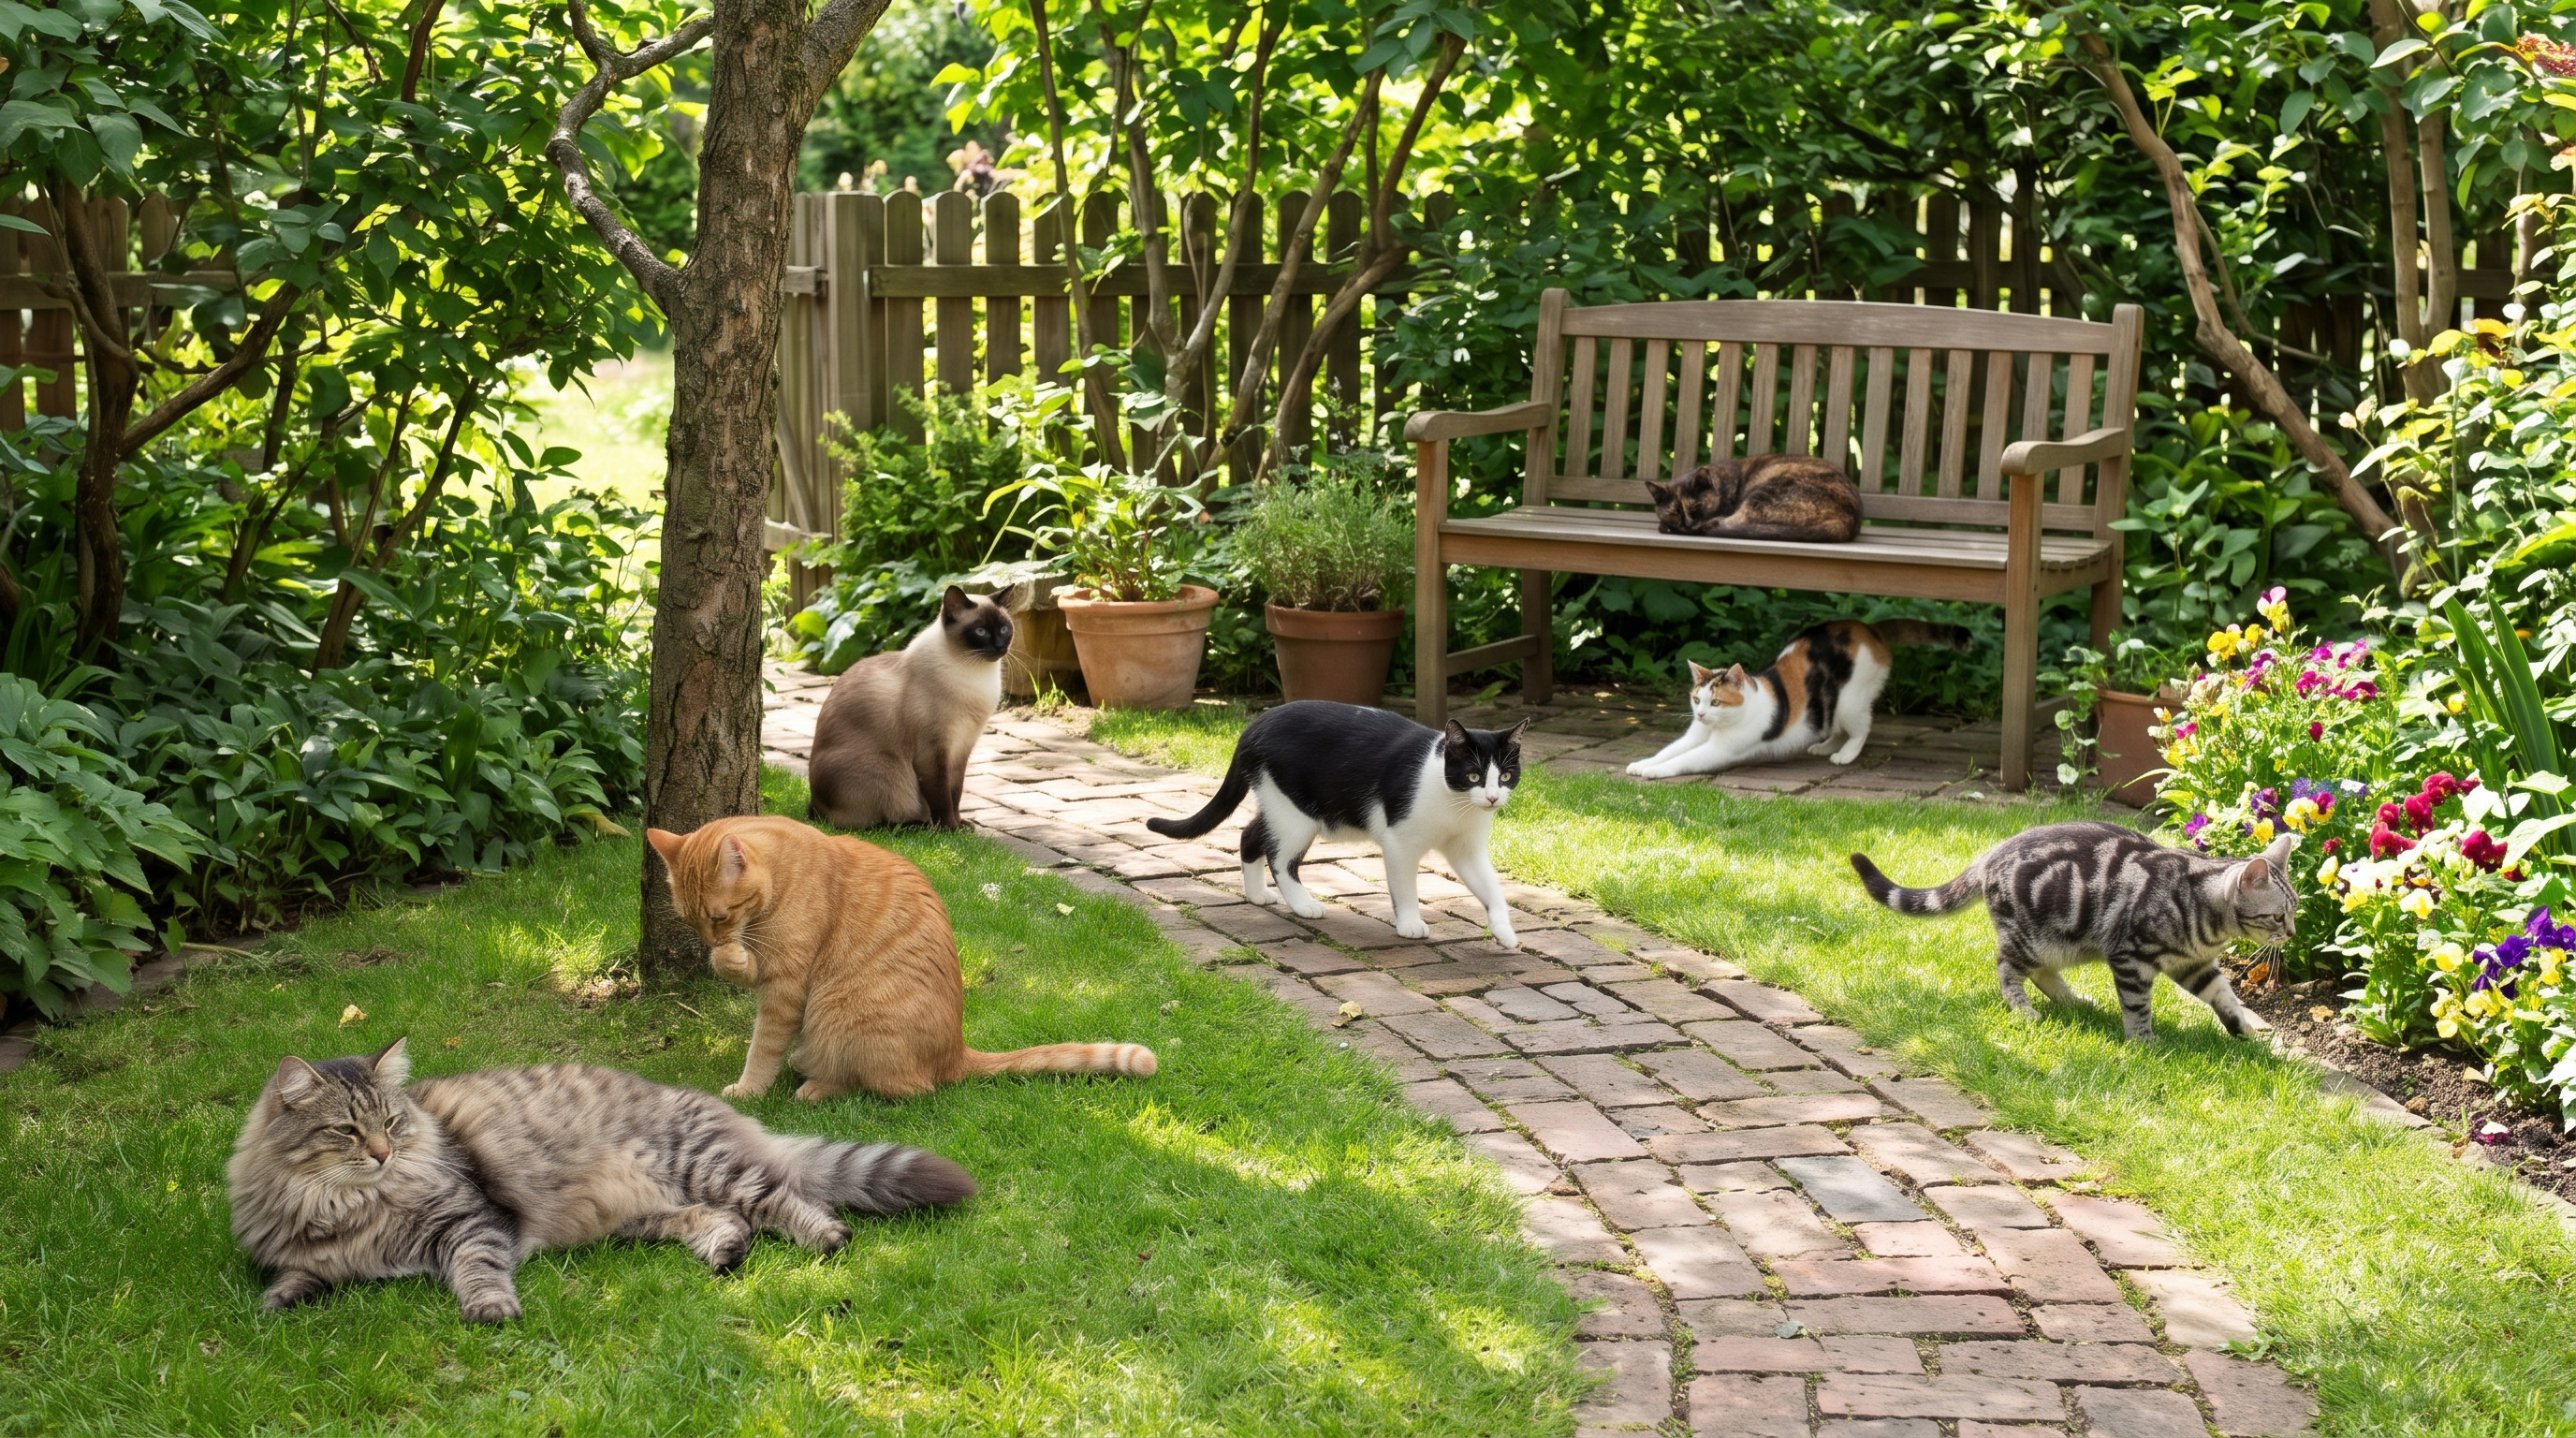
実験1:1 つの点から出る 3 つのマスク
Hugging Face の実装で、1 つの点を与えて、3 つのマスクとそれぞれの IoU の予測を出します。
import time
import numpy as np
import torch
import matplotlib.pyplot as plt
import japanize_matplotlib
from PIL import Image
from transformers import SamModel, SamProcessor

device = "cuda"
hf_model = SamModel.from_pretrained("facebook/sam-vit-base").to(device).eval()
processor = SamProcessor.from_pretrained("facebook/sam-vit-base")
image = Image.open("cats.jpg").convert("RGB")

# 1 つの点だけを与えて、3 つのマスクと、それぞれの IoU の予測を出す
points = {"白黒の猫の背中": (1300, 790), "ベンチの背もたれ": (1700, 330)}
fig, axes = plt.subplots(2, 4, figsize=(18, 6.4))
for row, (name, (x, y)) in enumerate(points.items()):
    inputs = processor(images=image, input_points=[[[[x, y]]]], return_tensors="pt").to(device)
    with torch.no_grad():
        out = hf_model(**inputs)
    masks = processor.post_process_masks(out.pred_masks.cpu(), inputs["original_sizes"].cpu(),
                                         inputs["reshaped_input_sizes"].cpu())[0][0]        # (3, H, W) の True/False
    scores = out.iou_scores[0, 0].cpu()
    print(f"{name}: IoU の予測 {[round(s, 3) for s in scores.tolist()]}  マスクの面積 {[int(m.sum()) for m in masks]} 画素")
    axes[row, 0].imshow(image)
    axes[row, 0].plot(x, y, "r*", ms=18)
    axes[row, 0].set_title(f"入力の点({name})")
    for i in range(3):
        axes[row, i + 1].imshow(image)
        axes[row, i + 1].imshow(np.ma.masked_where(~masks[i].numpy(), masks[i].numpy()), alpha=0.6, cmap="autumn")
        axes[row, i + 1].plot(x, y, "c*", ms=14)
        axes[row, i + 1].set_title(f"マスク {i + 1}(IoU の予測 {scores[i]:.3f})")
for ax in axes.flat:
    ax.axis("off")
plt.tight_layout()
plt.show()
- 点の選び方: 白黒の猫の背中(黒い模様の上)と、ベンチの背もたれの上の 2 点です。どちらも「模様だけ」「物体の一部」「物体の全体」のように、点が指すものが何通りにも考えられる位置を選びました。
- input_points: 元の画像の画素の座標で渡します。入れ子は「画像・プロンプト・点・座標」の順で、ここでは 1 枚の画像に 1 つのプロンプト(1 点)です。プロセッサが、画像を 1024 画素にした大きさに座標を合わせます。
- iou_scores: 3 つのマスクのそれぞれについて、モデルが予測した「正解との IoU」です。点だけでは正解が決まらないので、SAM は 3 つのマスクを出し、どれがもっともらしいかを自分で採点します。
- post_process_masks: 256×256 のマスクの logit を元の画像の大きさに戻し、0 を境に True と False にします。
実行結果
白黒の猫の背中: IoU の予測 [0.912, 0.926, 0.665]  マスクの面積 [47119, 45675, 19993] 画素
ベンチの背もたれ: IoU の予測 [0.924, 0.886, 0.832]  マスクの面積 [183114, 126239, 48993] 画素
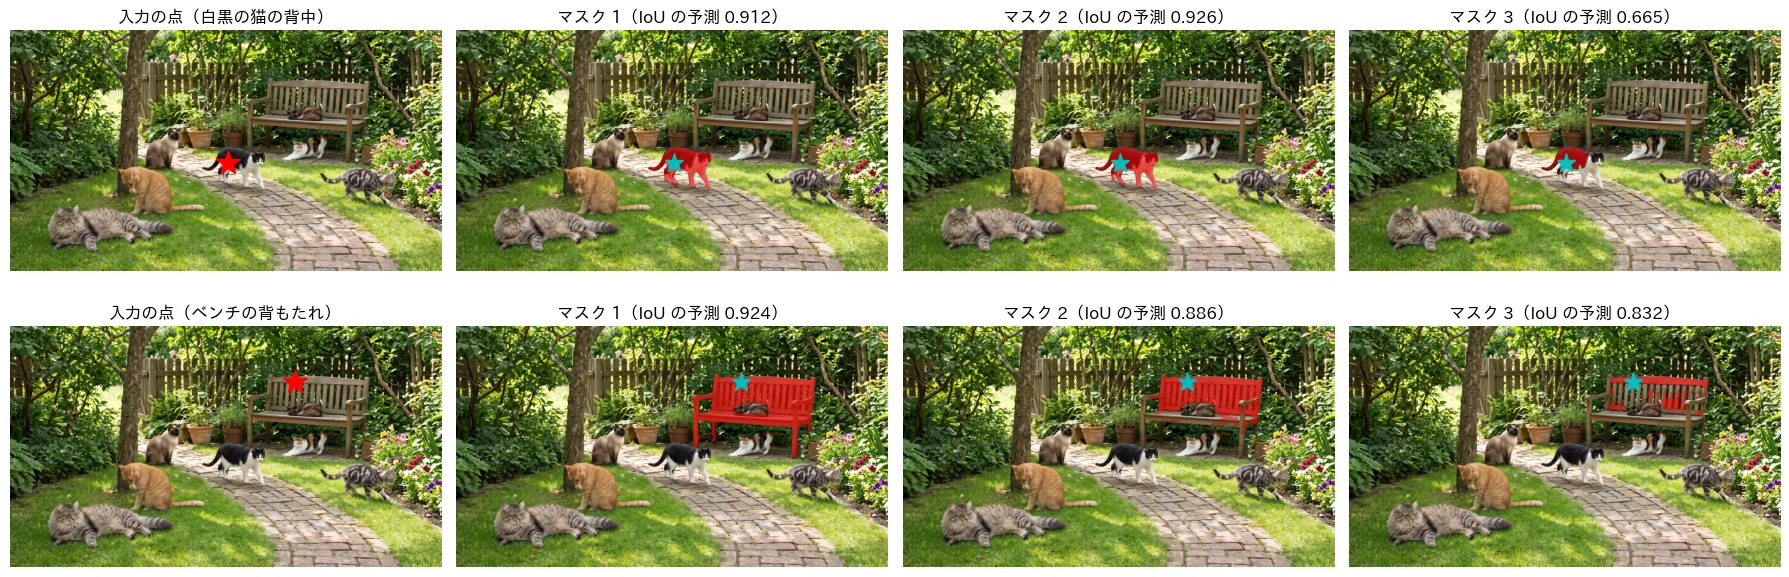
白黒の猫の背中の点では、マスク 1 とマスク 2(IoU の予測 0.912・0.926)が猫の全体を、マスク 3(0.665)が点の下の黒い模様だけを切り出しました。ベンチの背もたれの点では、マスク 1(0.924)がベンチの全体を、マスク 2(0.886)が脚を除いた座面と背もたれを、マスク 3(0.832)が背もたれだけを切り出しました。
同じ 1 つの点から、「模様」「部品」「物体の全体」のように大きさの違うマスクが出ています。IoU の予測は、物体の全体のマスクで高く、模様だけのマスクで低くなりました。1 つだけ選ぶなら IoU の予測が最大のマスクを使い、違う解釈が欲しければほかのマスクを選べます。
SAM の仕組み
全体の構成
SAM の全体は、次の図のとおりです(図は、後で実装する SAM クラスの構成です)。
(図は、diagram-designで作成)
- 前処理: 画像の長い辺を 1024 画素にし、右と下を 0 で埋めて 1024×1024 にします。
- 画像エンコーダ: ViT-B で、画像を 256×64×64 の埋め込みにします。パラメータの 96% がここにあり、計算もいちばん重い部分です。画像が同じなら、点や箱を変えても計算し直す必要はありません。
- プロンプトエンコーダ: 点や箱の角の座標を、それぞれ 256 次元のトークンにします。
- マスクデコーダ: 画像の埋め込みとプロンプトのトークンから、256×256 のマスクの logit と、IoU の予測を出します。マスクは、元の画像の大きさに拡大して使います。
論文では、ViT-H の画像エンコーダ(約 6 億パラメータ)が中心ですが、本記事では、Colab で軽く動かせる ViT-B(約 9,000 万パラメータ)を使います。プロンプトエンコーダとマスクデコーダの構造は、ViT-B と ViT-H で同じです。
画像エンコーダ
(図は、diagram-designで作成)
- パッチ埋め込み: 1024×1024 の画像を 16×16 画素のパッチに分け、64×64 = 4,096 個のトークンにします。MAE(画像の一部を隠して復元する自己教師あり学習)で事前学習した ViT を、1024 画素の入力で使います。
- 窓の注意と全体の注意: 4,096 個のトークンのすべての組に注意をかけると、計算が重くなります。そこで、12 個のブロックのうち 8 個は、14×14 の窓の中だけを見る注意にします(ViTDet と同じ方法)。全体を見る注意は、3・6・9・12 番目の 4 個だけです。
- 相対位置のバイアス: 注意の重みに、縦の距離と横の距離ごとに学習した埋め込みとクエリの内積を足します(MViTv2 の分解した相対位置)。
- ネック: 1×1 と 3×3 の畳み込みで 256 チャンネルにし、プロンプトのトークンと同じ次元にそろえます。
プロンプトエンコーダ
(図は、diagram-designで作成)
点の座標 (0〜1 に正規化)は、学習しない乱数の行列 (2×128)を使って、次の 256 次元のベクトルにします(ランダムなフーリエ特徴)。
- 点のトークン: に、前景の点か背景の点かを表す学習した埋め込みを足します。
- 箱のトークン: 箱の左上と右下の角を 2 つの点として にし、それぞれ「左上」「右下」の埋め込みを足します。
- 画像の位置の埋め込み: 64×64 の格子の各位置の中心の座標も、同じ で 256 次元にします。点のトークンと画像の位置の埋め込みが同じ式で作られるので、デコーダの注意で「点の近くの画像の位置」を見つけやすくなります。
マスクデコーダ
(図は、diagram-designで作成)
- 出力のトークン: 学習した IoU トークン 1 個とマスクトークン 4 個を、プロンプトのトークンの前に並べます。マスクトークンの 1 個目は「マスクを 1 つだけ出す」とき、残りの 3 個は「3 つのマスクを出す」ときに使います。
- Two-Way Transformer: 各層で、トークンの自己注意 → トークンから画像への注意 → MLP → 画像からトークンへの注意 の順に計算します。普通の Transformer のデコーダはトークンだけを更新しますが、SAM は画像の特徴もトークンを見て更新します(双方向)。注意のたびに、トークンにはプロンプトのトークン、画像には位置の埋め込みを足し直します。
- マスクの計算: 画像の特徴を転置畳み込みで 4 倍の 256×256 に拡大し、32 チャンネルにします。マスクトークンごとに、MLP(ハイパーネットワーク)で 32 次元の重みを作り、拡大した特徴との内積をマスクの logit にします。
- IoU の予測: IoU トークンから、MLP で各マスクの IoU の予測を出します。
学習では、3 つのマスクのうち、正解との損失が最も小さいマスクの損失だけを使います。点が「模様」を指す場合も「猫全体」を指す場合も学習データにあると、3 つのマスクが別々の解釈を受け持つようになります。マスクを 1 つしか出さないと、2 つの解釈を平均したようなぼやけたマスクになります。これを実験4で確かめます。
SAM のスクラッチ実装
ここからは、SAM(ViT-B)を部品ごとに実装します。部品の構造・次元・計算の順番は、Hugging Face の SamModel(公式の実装を移植したもの)と同じにしています。実験2で、学習済みの重みを読み込み、同じマスクになることを確かめます。
画像エンコーダ
import math
import torch.nn as nn
import torch.nn.functional as F


class LayerNorm2d(nn.LayerNorm):
    """チャンネルが 2 番目の軸にある (B, C, H, W) の特徴に、チャンネル方向の LayerNorm をかける"""

    def forward(self, x):
        return super().forward(x.permute(0, 2, 3, 1)).permute(0, 3, 1, 2)


def get_rel_pos(q_size, k_size, rel_pos):
    """2 つの位置の差(-(k-1)〜q-1)ごとの埋め込みを、表から取り出す (q_size, k_size, C)"""
    max_dist = 2 * max(q_size, k_size) - 1
    if rel_pos.shape[0] != max_dist:                  # 表の長さが違えば、線形補間で伸ばす
        rel_pos = F.interpolate(rel_pos.T[None], size=max_dist, mode="linear")[0].T
    q = torch.arange(q_size)[:, None] * max(k_size / q_size, 1.0)
    k = torch.arange(k_size)[None, :] * max(q_size / k_size, 1.0)
    return rel_pos[((q - k) + (k_size - 1) * max(q_size / k_size, 1.0)).long()]


class ViTAttention(nn.Module):
    def __init__(self, dim, heads, input_size):
        super().__init__()
        self.heads = heads
        self.qkv = nn.Linear(dim, dim * 3)
        self.proj = nn.Linear(dim, dim)
        # 縦と横の相対位置ごとの埋め込み(分解した相対位置バイアス、MViTv2 の方法)
        self.rel_pos_h = nn.Parameter(torch.zeros(2 * input_size - 1, dim // heads))
        self.rel_pos_w = nn.Parameter(torch.zeros(2 * input_size - 1, dim // heads))

    def forward(self, x):                             # x: (B, H, W, C)
        B, H, W, C = x.shape
        hd = C // self.heads
        qkv = self.qkv(x).reshape(B, H * W, 3, self.heads, hd).permute(2, 0, 3, 1, 4).reshape(3, B * self.heads, H * W, hd)
        q, k, v = qkv.unbind(0)
        attn = (q * hd ** -0.5) @ k.transpose(-2, -1)
        # 相対位置バイアス:q と、縦の距離の埋め込み・横の距離の埋め込みの内積を足す
        Rh, Rw = get_rel_pos(H, H, self.rel_pos_h).to(x.device), get_rel_pos(W, W, self.rel_pos_w).to(x.device)
        rq = q.reshape(B * self.heads, H, W, hd)
        rel_h = torch.einsum("bhwc,hkc->bhwk", rq, Rh)
        rel_w = torch.einsum("bhwc,wkc->bhwk", rq, Rw)
        # (H*W)×(H*W) の行列は大きい(全体の注意で 1 ヘッドあたり 4096×4096)ので、新しい行列を作らずにその場で足す
        attn.view(B * self.heads, H, W, H, W).add_(rel_h[:, :, :, :, None]).add_(rel_w[:, :, :, None, :])
        out = (attn.softmax(-1) @ v).reshape(B, self.heads, H, W, hd).permute(0, 2, 3, 1, 4).reshape(B, H, W, C)
        return self.proj(out)


class ViTBlock(nn.Module):
    def __init__(self, dim=768, heads=12, window=14, grid=64):
        super().__init__()
        self.window = window                          # 0 なら画像全体(64×64)に注意をかける
        self.norm1, self.norm2 = nn.LayerNorm(dim, eps=1e-6), nn.LayerNorm(dim, eps=1e-6)
        self.attn = ViTAttention(dim, heads, window if window > 0 else grid)
        self.lin1, self.lin2 = nn.Linear(dim, 4 * dim), nn.Linear(4 * dim, dim)

    def forward(self, x):
        h = self.norm1(x)
        if self.window > 0:                           # 14×14 の窓に分けて注意をかける(64 は 14 で割れないので埋める)
            B, H, W, C = h.shape
            w = self.window
            ph, pw = (-H) % w, (-W) % w
            h = F.pad(h, (0, 0, 0, pw, 0, ph))
            Hp, Wp = H + ph, W + pw
            h = h.reshape(B, Hp // w, w, Wp // w, w, C).permute(0, 1, 3, 2, 4, 5).reshape(-1, w, w, C)
            h = self.attn(h)
            h = h.reshape(B, Hp // w, Wp // w, w, w, C).permute(0, 1, 3, 2, 4, 5).reshape(B, Hp, Wp, C)[:, :H, :W]
        else:
            h = self.attn(h)
        x = x + h
        return x + self.lin2(F.gelu(self.lin1(self.norm2(x))))


class ImageEncoder(nn.Module):
    """1024×1024 の画像を 16×16 のパッチに分け(64×64 個)、12 層の ViT と Neck で 256 チャンネルの特徴にする"""

    def __init__(self, dim=768, depth=12, heads=12, global_layers=(2, 5, 8, 11), out_dim=256):
        super().__init__()
        self.patch_embed = nn.Conv2d(3, dim, 16, 16)
        self.pos_embed = nn.Parameter(torch.zeros(1, 64, 64, dim))     # 学習した絶対位置の埋め込み
        self.blocks = nn.ModuleList(ViTBlock(dim, heads, 0 if i in global_layers else 14) for i in range(depth))
        self.neck = nn.Sequential(nn.Conv2d(dim, out_dim, 1, bias=False), LayerNorm2d(out_dim, eps=1e-6),
                                  nn.Conv2d(out_dim, out_dim, 3, padding=1, bias=False), LayerNorm2d(out_dim, eps=1e-6))

    def forward(self, x):                             # x: (B, 3, 1024, 1024)
        x = self.patch_embed(x).permute(0, 2, 3, 1) + self.pos_embed
        for blk in self.blocks:
            x = blk(x)
        return self.neck(x.permute(0, 3, 1, 2))       # (B, 256, 64, 64)
- get_rel_pos: クエリの位置とキーの位置の差( から まで)ごとの埋め込みを、表から取り出します。窓の注意では 14×14、全体の注意では 64×64 の表を持ちます。
- 相対位置のバイアス: クエリと「縦の距離の埋め込み」「横の距離の埋め込み」の内積を、注意の重みに足します。2 次元の距離ごとに埋め込みを持つ代わりに、縦と横に分けて表を小さくしています。
- その場で足す(add_): 全体の注意の重みは 12 ヘッド × 4,096 × 4,096 で、float32 で約 800 MB あります。バイアスを足した新しい行列を作らずに、同じ行列に足して、メモリを節約します。
- 窓の分割: 64×64 は 14 で割り切れないので、0 で埋めて 70×70 にし、5×5 = 25 個の窓に分けます。注意の後で元の並びに戻し、埋めた部分を切り落とします。
- global_layers=(2, 5, 8, 11): 全体を見る注意を置くブロックの番号(0 から数える)で、公式の ViT-B の設定です。
- LayerNorm の eps: ブロックの中は 1e-6 です。公式の実装と同じ値にしないと、出力がわずかにずれます。
プロンプトエンコーダ
class RandomFourierPE(nn.Module):
    """0〜1 の座標 (x, y) を、学習しないランダムな 2×128 の行列で射影し、sin・cos の 256 次元にする"""

    def __init__(self, num_feats=128):
        super().__init__()
        self.positional_embedding = nn.Parameter(torch.randn(2, num_feats))

    def forward(self, coords):                        # coords: (..., 2)、0〜1
        c = (2 * coords.to(self.positional_embedding.dtype) - 1) @ self.positional_embedding * 2 * math.pi
        return torch.cat([c.sin(), c.cos()], -1)


class PromptEncoder(nn.Module):
    def __init__(self, dim=256, image_size=1024, embed_size=64):
        super().__init__()
        self.image_size, self.embed_size = image_size, embed_size
        self.pe = RandomFourierPE(dim // 2)
        # 0:負例の点、1:正例の点、2:箱の左上、3:箱の右下
        self.point_embed = nn.ParameterList(nn.Parameter(torch.zeros(1, dim)) for _ in range(4))
        self.not_a_point_embed = nn.Parameter(torch.zeros(1, dim))      # 点がないことを表す(箱がないときの埋め草)
        self.no_mask_embed = nn.Parameter(torch.zeros(1, dim))

    def image_pe(self):
        """64×64 の各位置の中心の座標を、点と同じ位置埋め込みにする (1, 256, 64, 64)"""
        g = (torch.arange(self.embed_size, device=self.pe.positional_embedding.device) + 0.5) / self.embed_size
        y, x = torch.meshgrid(g, g, indexing="ij")
        return self.pe(torch.stack([x, y], -1)).permute(2, 0, 1)[None]

    def forward(self, points=None, labels=None, boxes=None):
        """points: (B, N, 2) 画素の座標(1024 の画像上)、labels: (B, N) 1 が正例・0 が負例、boxes: (B, 4) の (x1, y1, x2, y2)"""
        tokens = []
        if points is not None:
            pts, lab = points + 0.5, labels           # 画素の中心に合わせる
            if boxes is None:                         # 箱がなければ、「点ではない」埋め草の点を 1 つ足す
                pts = torch.cat([pts, torch.zeros_like(pts[:, :1])], 1)
                lab = torch.cat([lab, -torch.ones_like(lab[:, :1])], 1)
            e = self.pe(pts / self.image_size)
            e = torch.where(lab[..., None] == -1, self.not_a_point_embed, e)
            e = e + (lab[..., None] == 0) * self.point_embed[0] + (lab[..., None] == 1) * self.point_embed[1]
            tokens.append(e)
        if boxes is not None:
            corners = (boxes.reshape(-1, 2, 2) + 0.5) / self.image_size
            e = self.pe(corners)
            tokens.append(torch.stack([e[:, 0] + self.point_embed[2], e[:, 1] + self.point_embed[3]], 1))
        sparse = torch.cat(tokens, 1)                 # (B, トークン数, 256)
        dense = self.no_mask_embed.reshape(1, -1, 1, 1).expand(sparse.shape[0], -1, self.embed_size, self.embed_size)
        return sparse, dense
- RandomFourierPE: 座標を で 〜 にしてから、乱数の行列を掛けて sin と cos にします。行列は学習しませんが、公式の重みに含まれているので、読み込んで同じ値を使います。
- 画素の中心(+0.5): 画素の座標 の点は、その画素の中心 として扱います。
- 「点ではない」トークン: 点だけを与えるときは、座標が 0 の点を 1 つ足し、その埋め込みを not_a_point_embed に置き換えます(公式の実装と同じ)。箱があるときは足しません。
- no_mask_embed: SAM は前の予測のマスクもプロンプトにできますが、本記事では使いません。マスクがないときは、この 256 次元の埋め込みを 64×64 の全位置に足します。
マスクデコーダ
class Attention(nn.Module):
    """Q・K・V を downsample 分の 1 の次元に落としてから注意をかける"""

    def __init__(self, dim=256, heads=8, downsample=1):
        super().__init__()
        self.heads, inner = heads, dim // downsample
        self.q_proj, self.k_proj, self.v_proj = nn.Linear(dim, inner), nn.Linear(dim, inner), nn.Linear(dim, inner)
        self.out_proj = nn.Linear(inner, dim)

    def forward(self, q, k, v):
        B = q.shape[0]
        split = lambda t: t.reshape(B, t.shape[1], self.heads, -1).transpose(1, 2)
        q, k, v = split(self.q_proj(q)), split(self.k_proj(k)), split(self.v_proj(v))
        a = (q @ k.transpose(-2, -1)) * q.shape[-1] ** -0.5
        return self.out_proj((a.softmax(-1) @ v).transpose(1, 2).reshape(B, -1, self.heads * q.shape[-1]))


class TwoWayBlock(nn.Module):
    """(1) トークンの自己注意 (2) トークン→画像の注意 (3) トークンの MLP (4) 画像→トークンの注意"""

    def __init__(self, dim=256, heads=8, mlp_dim=2048, skip_first_pe=False):
        super().__init__()
        self.skip_first_pe = skip_first_pe
        self.self_attn = Attention(dim, heads)
        self.cross_token_to_image = Attention(dim, heads, 2)
        self.cross_image_to_token = Attention(dim, heads, 2)
        self.lin1, self.lin2 = nn.Linear(dim, mlp_dim), nn.Linear(mlp_dim, dim)
        self.norm1, self.norm2, self.norm3, self.norm4 = (nn.LayerNorm(dim, eps=1e-6) for _ in range(4))

    def forward(self, tokens, image, token_pe, image_pe):
        if self.skip_first_pe:                        # 1 層目は、位置埋め込みを足さず、残差もとらない(公式の実装と同じ)
            tokens = self.self_attn(tokens, tokens, tokens)
        else:
            q = tokens + token_pe
            tokens = tokens + self.self_attn(q, q, tokens)
        tokens = self.norm1(tokens)
        tokens = self.norm2(tokens + self.cross_token_to_image(tokens + token_pe, image + image_pe, image))
        tokens = self.norm3(tokens + self.lin2(F.relu(self.lin1(tokens))))
        image = self.norm4(image + self.cross_image_to_token(image + image_pe, tokens + token_pe, tokens))
        return tokens, image


class MLP(nn.Module):
    def __init__(self, d_in, d_hidden, d_out, n):
        super().__init__()
        self.proj_in, self.proj_out = nn.Linear(d_in, d_hidden), nn.Linear(d_hidden, d_out)
        self.layers = nn.ModuleList(nn.Linear(d_hidden, d_hidden) for _ in range(n - 2))

    def forward(self, x):
        x = F.relu(self.proj_in(x))
        for layer in self.layers:
            x = F.relu(layer(x))
        return self.proj_out(x)


class MaskDecoder(nn.Module):
    def __init__(self, dim=256, num_masks=4):
        super().__init__()
        self.num_masks = num_masks                    # 1 つ(あいまいでないとき)+ 3 つ(あいまいなとき)
        self.iou_token = nn.Parameter(torch.zeros(1, dim))
        self.mask_tokens = nn.Parameter(torch.zeros(num_masks, dim))
        self.blocks = nn.ModuleList(TwoWayBlock(dim, skip_first_pe=(i == 0)) for i in range(2))
        self.final_attn = Attention(dim, 8, 2)
        self.final_norm = nn.LayerNorm(dim)
        self.upscale_conv1 = nn.ConvTranspose2d(dim, dim // 4, 2, 2)
        self.upscale_norm = LayerNorm2d(dim // 4, eps=1e-6)
        self.upscale_conv2 = nn.ConvTranspose2d(dim // 4, dim // 8, 2, 2)
        self.hyper_mlps = nn.ModuleList(MLP(dim, dim, dim // 8, 3) for _ in range(num_masks))
        self.iou_head = MLP(dim, 256, num_masks, 3)

    def forward(self, image_emb, image_pe, sparse, dense, multimask=True):
        B = sparse.shape[0]
        tokens = torch.cat([self.iou_token, self.mask_tokens], 0)[None].expand(B, -1, -1)
        tokens = torch.cat([tokens, sparse], 1)       # 出力用の 5 トークン + プロンプトのトークン
        image = (image_emb + dense).flatten(2).transpose(1, 2)            # (B, 4096, 256)
        pe = image_pe.flatten(2).transpose(1, 2).expand(B, -1, -1)
        t = tokens
        for blk in self.blocks:
            t, image = blk(t, image, tokens, pe)
        t = self.final_norm(t + self.final_attn(t + tokens, image + pe, image))
        iou_out, mask_out = t[:, 0], t[:, 1:1 + self.num_masks]
        # 画像の特徴を 64×64 → 256×256 に拡大し、マスクのトークンから作った重みとの内積をマスクにする
        x = image.transpose(1, 2).reshape(B, -1, 64, 64)
        x = F.gelu(self.upscale_conv2(F.gelu(self.upscale_norm(self.upscale_conv1(x)))))   # (B, 32, 256, 256)
        w = torch.stack([mlp(mask_out[:, i]) for i, mlp in enumerate(self.hyper_mlps)], 1)  # (B, 4, 32)
        masks = (w @ x.flatten(2)).reshape(B, -1, 256, 256)
        iou = self.iou_head(iou_out)
        sl = slice(1, None) if multimask else slice(0, 1)
        return masks[:, sl], iou[:, sl]
- Attention(downsample=2): トークンと画像の間の注意は、Q・K・V を 128 次元に落としてから計算します。4,096 個の画像の位置との注意の計算を軽くするためで、公式の設定です。
- 1 層目の自己注意: 1 層目だけは、位置埋め込みを足さず、残差もとりません。公式の実装と同じです。
- final_attn: 2 層の後に、もう 1 回トークンから画像への注意をかけてから、出力のトークンを取り出します。
- multimask: True なら 2〜4 番目のマスクトークン(3 つのマスク)を、False なら 1 番目(1 つのマスク)を出します。
モデル全体
class SAM(nn.Module):
    def __init__(self):
        super().__init__()
        self.image_encoder = ImageEncoder()
        self.prompt_encoder = PromptEncoder()
        self.mask_decoder = MaskDecoder()

    def forward(self, pixel_values=None, points=None, labels=None, boxes=None, image_emb=None, multimask=True):
        if image_emb is None:                         # 画像エンコーダは重いので、同じ画像なら 1 回だけ計算して使い回す
            image_emb = self.image_encoder(pixel_values)
        sparse, dense = self.prompt_encoder(points, labels, boxes)
        if image_emb.shape[0] != sparse.shape[0]:     # 1 枚の画像に複数のプロンプトを与えるとき
            image_emb = image_emb.expand(sparse.shape[0], -1, -1, -1)
        return self.mask_decoder(image_emb, self.prompt_encoder.image_pe(), sparse, dense, multimask)


model = SAM()
count = lambda m: sum(p.numel() for p in m.parameters())
print(f"画像エンコーダ(ViT-B)    : {count(model.image_encoder):>11,}")
print(f"プロンプトエンコーダ        : {count(model.prompt_encoder):>11,}")
print(f"マスクデコーダ              : {count(model.mask_decoder):>11,}")
print(f"全体                        : {count(model):>11,}")
- image_emb: 画像の埋め込みを外から渡せるようにしています。画像エンコーダを 1 回だけ動かし、点や箱を変えながらプロンプトエンコーダとマスクデコーダだけを動かすためです。
- expand: 1 枚の画像に複数のプロンプトを与えるとき、画像の埋め込みをプロンプトの数だけ並べます(コピーはしません)。
実行結果
画像エンコーダ(ViT-B)    :  89,670,912
プロンプトエンコーダ        :       1,792
マスクデコーダ              :   4,058,340
全体                        :  93,731,044
パラメータは約 9,373 万個で、そのうち 96% が画像エンコーダです。マスクデコーダは約 406 万個、プロンプトエンコーダは 1,792 個(256 次元の埋め込み 6 個と、2×128 の乱数の行列)しかありません。Hugging Face の SamModel(93,735,728 個)との差の 4,684 個は、本記事で使わないマスクのプロンプトの部品です。
実験2:公式の重みで、Hugging Face と同じマスクになるか
公式の重みの読み込み
def load_hf_sam(model, sd):
    """Hugging Face の SamModel の重みを、スクラッチ実装の名前に付け替えて読み込む"""
    import re
    rules = [
        (r"^vision_encoder\.patch_embed\.projection\.", "image_encoder.patch_embed."),
        (r"^vision_encoder\.pos_embed$", "image_encoder.pos_embed"),
        (r"^vision_encoder\.layers\.(\d+)\.layer_norm(\d)\.", r"image_encoder.blocks.\1.norm\2."),
        (r"^vision_encoder\.layers\.(\d+)\.attn\.", r"image_encoder.blocks.\1.attn."),
        (r"^vision_encoder\.layers\.(\d+)\.mlp\.(lin\d)\.", r"image_encoder.blocks.\1.\2."),
        (r"^vision_encoder\.neck\.conv1\.", "image_encoder.neck.0."), (r"^vision_encoder\.neck\.layer_norm1\.", "image_encoder.neck.1."),
        (r"^vision_encoder\.neck\.conv2\.", "image_encoder.neck.2."), (r"^vision_encoder\.neck\.layer_norm2\.", "image_encoder.neck.3."),
        (r"^shared_image_embedding\.", "prompt_encoder.pe."),
        (r"^prompt_encoder\.point_embed\.(\d)\.weight$", r"prompt_encoder.point_embed.\1"),
        (r"^prompt_encoder\.not_a_point_embed\.weight$", "prompt_encoder.not_a_point_embed"),
        (r"^prompt_encoder\.no_mask_embed\.weight$", "prompt_encoder.no_mask_embed"),
        (r"^mask_decoder\.iou_token\.weight$", "mask_decoder.iou_token"),
        (r"^mask_decoder\.mask_tokens\.weight$", "mask_decoder.mask_tokens"),
        (r"^mask_decoder\.transformer\.layers\.(\d)\.cross_attn_token_to_image\.", r"mask_decoder.blocks.\1.cross_token_to_image."),
        (r"^mask_decoder\.transformer\.layers\.(\d)\.cross_attn_image_to_token\.", r"mask_decoder.blocks.\1.cross_image_to_token."),
        (r"^mask_decoder\.transformer\.layers\.(\d)\.self_attn\.", r"mask_decoder.blocks.\1.self_attn."),
        (r"^mask_decoder\.transformer\.layers\.(\d)\.layer_norm(\d)\.", r"mask_decoder.blocks.\1.norm\2."),
        (r"^mask_decoder\.transformer\.layers\.(\d)\.mlp\.(lin\d)\.", r"mask_decoder.blocks.\1.\2."),
        (r"^mask_decoder\.transformer\.final_attn_token_to_image\.", "mask_decoder.final_attn."),
        (r"^mask_decoder\.transformer\.layer_norm_final_attn\.", "mask_decoder.final_norm."),
        (r"^mask_decoder\.upscale_layer_norm\.", "mask_decoder.upscale_norm."),
        (r"^mask_decoder\.output_hypernetworks_mlps\.", "mask_decoder.hyper_mlps."),
        (r"^mask_decoder\.iou_prediction_head\.", "mask_decoder.iou_head."),
    ]
    out = {}
    for k, v in sd.items():
        if k.startswith("prompt_encoder.mask_embed") or k.startswith("prompt_encoder.shared_embedding"):
            continue                                  # マスクのプロンプトは使わない/位置埋め込みは shared_image_embedding と同じ重み
        new = k
        for pat, rep in rules:
            new = re.sub(pat, rep, new)
        out[new] = v.reshape(1, -1) if new.startswith("prompt_encoder.point_embed") else v
    missing, unexpected = model.load_state_dict(out, strict=False)
    assert not missing and not unexpected, (missing[:5], unexpected[:5])
    return model
- 名前の付け替え: Hugging Face の重みの名前を、正規表現でスクラッチ実装の名前に置き換えます。shared_image_embedding が、プロンプトエンコーダの乱数の行列 です。
- 読み込まない重み: マスクのプロンプトの部品(mask_embed)は使わないので読み込みません。prompt_encoder.shared_embedding は shared_image_embedding と同じ重みです。
- 確認: 足りない重みと余った重みがないことを assert で確かめます。
出力の一致を確かめる
前処理と後処理を自分で書き、実験1の 1 つ目の点で、Hugging Face の出力と比べます。
MEAN = torch.tensor([123.675, 116.28, 103.53]).view(3, 1, 1)
STD = torch.tensor([58.395, 57.12, 57.375]).view(3, 1, 1)


def preprocess(image):
    """長い辺を 1024 画素にし(PIL の bilinear で縮める)、ImageNet の平均と標準偏差で正規化して、右と下を 0 で埋めて 1024×1024 にする"""
    W, H = image.size
    w, h = int(W * 1024 / max(W, H) + 0.5), int(H * 1024 / max(W, H) + 0.5)
    scale = torch.tensor([w / W, h / H])                # 点や箱の座標に掛ける、横と縦の倍率
    x = torch.from_numpy(np.array(image.resize((w, h), Image.BILINEAR))).permute(2, 0, 1).float()
    x = F.pad((x - MEAN) / STD, (0, 1024 - w, 0, 1024 - h))
    return x[None], scale, (h, w)


def postprocess(masks, size_resized, size_original):
    """256×256 のマスクの logit を 1024×1024 に拡大し、余白を切り落として、元の画像の大きさに戻す"""
    m = F.interpolate(masks, (1024, 1024), mode="bilinear", align_corners=False)
    m = m[..., :size_resized[0], :size_resized[1]]
    return F.interpolate(m, size_original, mode="bilinear", align_corners=False) > 0


sam = load_hf_sam(model, hf_model.state_dict()).to(device).eval()
x, scale, size_resized = preprocess(image)
inputs = processor(images=image, input_points=[[[[1300, 790]]]], return_tensors="pt").to(device)
diff = (inputs["pixel_values"].cpu() - x).abs() * STD                 # 正規化の前の 0〜255 の値に戻して比べる
print(f"前処理の差:最大 {diff.max().item():.2f} 階調、違う値の割合 {(diff > 0.5).float().mean().item():.2%}")
pts = (torch.tensor([[[1300.0, 790.0]]]) * scale).to(device)          # 点の座標も 1024 の画像に合わせる
with torch.no_grad():
    out_hf = hf_model(**inputs)
    # (1) HF と同じ前処理の画像を入れて、モデルの計算が同じかを確かめる
    masks, iou = sam(pixel_values=inputs["pixel_values"], points=pts, labels=torch.ones(1, 1, device=device))
    print(f"同じ入力:マスクの logit の差の最大値 {(out_hf.pred_masks[:, 0] - masks).abs().max().item():.2e}、"
          f"IoU の予測の差の最大値 {(out_hf.iou_scores[:, 0] - iou).abs().max().item():.2e}")
    # (2) 自前の前処理の画像を入れる。画像エンコーダは 1 回だけ計算し、後で使い回す
    image_emb = sam.image_encoder(x.to(device))
    masks, iou = sam(points=pts, labels=torch.ones(1, 1, device=device), image_emb=image_emb)
mine = postprocess(masks.cpu(), size_resized, image.size[::-1])[0]
ref = processor.post_process_masks(out_hf.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu())[0][0]
print(f"自前の前処理:IoU の予測 {[round(v, 3) for v in iou[0].tolist()]}(HF {[round(v, 3) for v in out_hf.iou_scores[0, 0].tolist()]})")
print(f"自前の前処理:元の画像の大きさのマスクで、HF と違う画素の割合 {(mine != ref).float().mean().item():.2e}")
- 前処理: 公式の実装と同じく、長い辺を 1024 画素にする縮小に PIL の bilinear を使います。正規化の平均と標準偏差は、ImageNet の値を 0〜255 の目盛りにしたもので、公式の設定です。
- 座標の倍率: 点や箱の座標には、縮めた後の画像の幅と高さの比を、横と縦で別々に掛けます(公式の実装と同じ)。幅と高さを整数に丸めるので、横と縦の倍率はわずかに違います。
- 2 つの比べ方: (1) Hugging Face の前処理の画像をそのまま入れて、モデルの計算が同じかを確かめます。(2) 自前の前処理の画像を入れて、元の画像の大きさのマスクで比べます。
- 後処理: 256×256 の logit を 1024×1024 に拡大し、埋めた部分を切り落としてから、元の画像の大きさに拡大します。
実行結果
前処理の差:最大 1.00 階調、違う値の割合 0.06%
同じ入力:マスクの logit の差の最大値 1.82e-03、IoU の予測の差の最大値 1.28e-05
自前の前処理:IoU の予測 [0.912, 0.926, 0.665](HF [0.912, 0.926, 0.665])
自前の前処理:元の画像の大きさのマスクで、HF と違う画素の割合 1.26e-06
- 同じ入力: Hugging Face の前処理の画像を入れると、マスクの logit の差は最大 1.82e-03、IoU の予測の差は最大 1.28e-05 でした。float32 の計算で、足し算の順番などが違うことによる誤差の大きさです。スクラッチ実装のモデルの計算は、Hugging Face と同じです。
- 前処理の差: Hugging Face のプロセッサ(transformers 5 の SamImageProcessor)は、画像を torchvision の tensor にしてから縮めます。PIL で縮める公式の実装や本記事の前処理とは、0.06% の値で 1 階調だけずれます。
- 自前の前処理: この 1 階調の差があっても、IoU の予測は 3 桁まで同じで、元の画像の大きさ(約 370 万画素)のマスクで違う画素は 1.26e-06(5 画素ほど)でした。
なお、点の座標の倍率を横と縦で分けずに、1024 ÷ 長い辺の 1 つの値にすると、座標が 1 画素未満ずれて、logit の差が 0.1 ほどに広がりました。前処理の細かな決まりも、公式の実装に合わせる必要があります。
Grounding DINO の箱で、テキストで指定した物体を切り出す
SAM は点や箱で物体を指定しますが、テキストでは指定できません。Grounding DINO の記事で「cat. bench. potted plant.」から検出した 11 個の箱を SAM の箱のプロンプトにすると、テキストで指定した物体のマスクが得られます(Grounded-SAM と呼ばれる組み合わせ方です)。
# Grounding DINO の記事で「cat. bench. potted plant.」から検出した 11 個の箱を、SAM の箱のプロンプトにする
boxes = {"cat": [[225, 1035, 978, 1327], [644, 813, 1157, 1107], [1145, 699, 1532, 953], [1850, 819, 2305, 1048],
                 [1623, 616, 1974, 782], [1644, 453, 1865, 544], [805, 581, 1028, 833]],
         "bench": [[1404, 288, 2145, 794]],
         "potted plant": [[1227, 461, 1418, 707], [980, 455, 1225, 712], [2053, 631, 2207, 810]]}
all_boxes = torch.tensor([b for bs in boxes.values() for b in bs], dtype=torch.float32)
names = [n for n, bs in boxes.items() for _ in bs]
with torch.no_grad():
    masks, iou = sam(boxes=(all_boxes * scale.repeat(2)).to(device), image_emb=image_emb, multimask=False)   # 11 個をまとめて
masks = postprocess(masks.cpu(), size_resized, image.size[::-1])[:, 0]
for n, b, m, s in zip(names, all_boxes.tolist(), masks, iou[:, 0].tolist()):
    box_area = (b[2] - b[0]) * (b[3] - b[1])
    print(f"{n:<13s} IoU の予測 {s:.3f}  マスクの面積は箱の {m.sum().item() / box_area:.0%}")

colors = plt.cm.hsv(np.linspace(0, 0.9, len(names)))     # 灰色を使わず、はっきり違う色にする
overlay = np.array(image).astype(float) / 255
for m, c in zip(masks.numpy(), colors):
    overlay[m] = overlay[m] * 0.4 + c[:3] * 0.6
fig, ax = plt.subplots(figsize=(12, 7))
ax.imshow(overlay)
for (x0, y0, x1, y1), c in zip(all_boxes.tolist(), colors):
    ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color=c, lw=2))
ax.axis("off")
plt.tight_layout()
plt.show()
- 箱の座標: Grounding DINO の記事の実験2で、スクラッチ実装が出した箱(元の画像の画素の座標)です。
- multimask=False: 箱は点よりあいまいさが小さいので、マスクを 1 つだけ出します。公式のノートブックでも、箱だけを与える例では 1 つのマスクを出しています。
- まとめて計算: 画像の埋め込みは実験2で計算したものを使い回し、11 個の箱を 1 回のデコーダの計算でまとめて処理します。
実行結果
cat           IoU の予測 0.978  マスクの面積は箱の 54%
cat           IoU の予測 0.976  マスクの面積は箱の 44%
cat           IoU の予測 0.957  マスクの面積は箱の 46%
cat           IoU の予測 0.955  マスクの面積は箱の 47%
cat           IoU の予測 0.952  マスクの面積は箱の 43%
cat           IoU の予測 0.961  マスクの面積は箱の 76%
cat           IoU の予測 0.967  マスクの面積は箱の 56%
bench         IoU の予測 0.960  マスクの面積は箱の 48%
potted plant  IoU の予測 0.949  マスクの面積は箱の 64%
potted plant  IoU の予測 0.869  マスクの面積は箱の 52%
potted plant  IoU の予測 0.835  マスクの面積は箱の 54%
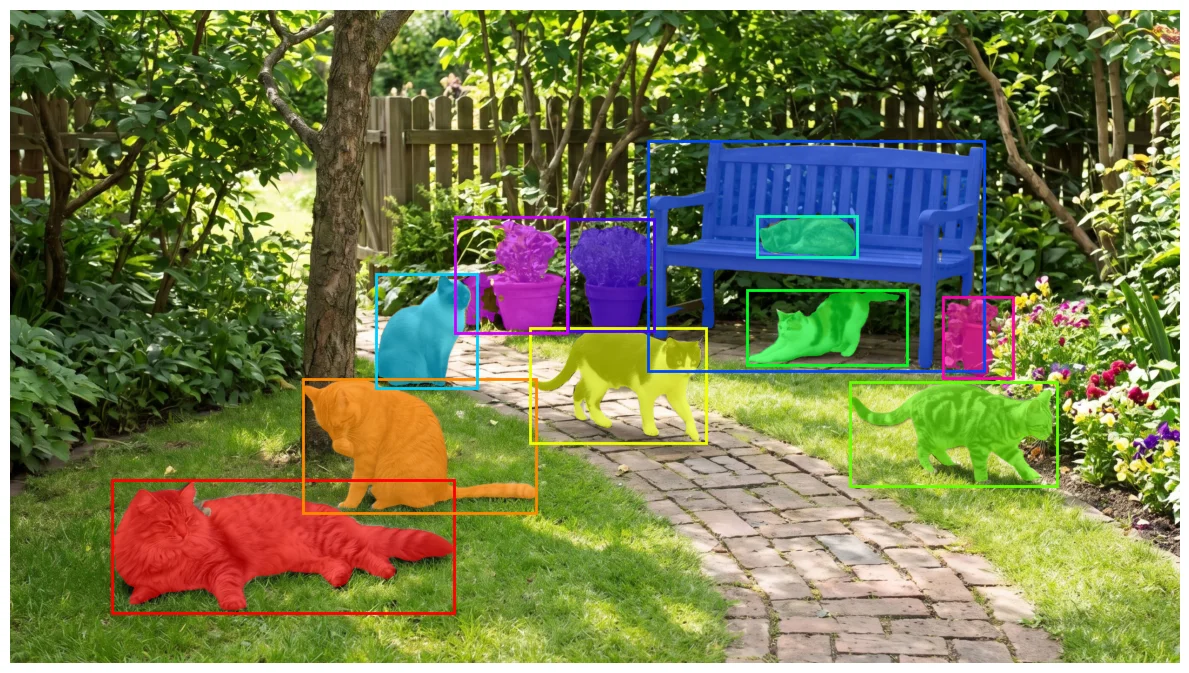
11 個の箱のすべてで、物体の輪郭に沿ったマスクが出ました。IoU の予測は 0.835〜0.978 で、猫とベンチでは 0.95 以上、葉が細かく背景が透けて見える鉢植えでは低めです。マスクの面積は箱の 43〜76% で、箱の中から物体の画素だけを取り出しています。ベンチの箱の中にいる 2 匹の猫は、ベンチのマスクに含まれていません。
Grounding DINO で「何を」、SAM で「どの画素か」を求めることで、テキストで指定した物体のマスクが、追加の学習なしで得られます。
実験3:COCO val2017 の 500 枚で、箱と点のプロンプトの精度を測る
SAM は、学習で COCO を使っていません。COCO val2017 の正解のマスクからプロンプトを作り、SAM が出したマスクと正解の IoU の平均(mIoU)を測ります。
COCO val2017 の準備
import os
import io
import zipfile
import contextlib
import urllib.request
from concurrent.futures import ThreadPoolExecutor
from pycocotools.coco import COCO
from scipy.ndimage import distance_transform_edt

# COCO val2017 のアノテーションと、画像 ID の小さい順に 500 枚の画像をダウンロードする(RT-DETR の記事と同じ 500 枚)
os.makedirs("coco/val2017", exist_ok=True)
if not os.path.exists("coco/annotations/instances_val2017.json"):
    urllib.request.urlretrieve("http://images.cocodataset.org/annotations/annotations_trainval2017.zip", "coco/ann.zip")
    zipfile.ZipFile("coco/ann.zip").extract("annotations/instances_val2017.json", "coco")
with contextlib.redirect_stdout(io.StringIO()):
    coco = COCO("coco/annotations/instances_val2017.json")
img_ids = sorted(coco.getImgIds())[:500]


def fetch(i):
    path = f"coco/val2017/{i:012d}.jpg"
    if not os.path.exists(path):
        urllib.request.urlretrieve(f"http://images.cocodataset.org/val2017/{i:012d}.jpg", path)


with ThreadPoolExecutor(16) as ex:
    list(ex.map(fetch, img_ids))


def make_prompts(gt, rng):
    """正解のマスクから、箱・境界から最も遠い 1 点・その点に物体の中のランダムな 2 点を足した 3 点を作る"""
    ys, xs = np.nonzero(gt)
    box = [xs.min(), ys.min(), xs.max() + 1, ys.max() + 1]
    dist = distance_transform_edt(np.pad(gt, 1))[1:-1, 1:-1]
    cy, cx = np.unravel_index(dist.argmax(), dist.shape)
    k = rng.choice(len(xs), 2)
    return box, [[cx, cy]], [[cx, cy], [xs[k[0]], ys[k[0]]], [xs[k[1]], ys[k[1]]]]


n_obj = sum(1 for i in img_ids for a in coco.loadAnns(coco.getAnnIds(imgIds=i, iscrowd=False)) if a["area"] > 0)
print(f"画像 {len(img_ids)} 枚、物体(群衆の領域を除く){n_obj} 個")
- 500 枚: 画像 ID の小さい順に 500 枚で、RT-DETR の記事と同じ画像です。全 5,000 枚では時間がかかるので、一部で比べます。
- 群衆の領域: iscrowd の領域(人の群れなどをまとめて塗った領域)は、1 つの物体ではないので除きます。
- 箱: 正解のマスクを囲む最小の箱です。
- 1 点: 正解のマスクの中で、境界から最も遠い点です。論文の 1 点の評価と同じ選び方で、物体の「中心」に当たります。
- 3 点: 1 点に、物体の中からランダムに選んだ 2 点を足します。論文では、前の予測の誤りの領域から次の点を選びますが、本記事では実装を短くするため、ランダムに選びます。
実行結果
画像 500 枚、物体(群衆の領域を除く)3504 個
5 つの設定で評価する
def iou_mask(a, b):
    return (a & b).sum().item() / max((a | b).sum().item(), 1)


rng = np.random.default_rng(0)
res = {k: [] for k in ["箱", "1 点(IoU の予測が最大のマスク)", "1 点(正解に最も近いマスク)", "1 点(マスクを 1 つだけ出す)", "3 点"]}
with torch.no_grad():
    for i in img_ids:
        img = Image.open(f"coco/val2017/{i:012d}.jpg").convert("RGB")
        anns = [a for a in coco.loadAnns(coco.getAnnIds(imgIds=i, iscrowd=False)) if a["area"] > 0]
        if not anns:
            continue
        x, s, size_r = preprocess(img)
        emb = sam.image_encoder(x.to(device))
        gts = [torch.from_numpy(coco.annToMask(a)).bool() for a in anns]
        pr = [make_prompts(g.numpy(), rng) for g in gts]
        sp, sb = s.to(device), s.repeat(2).to(device)            # 点 (x, y) と箱 (x0, y0, x1, y1) の倍率
        to_t = lambda v: torch.tensor(np.array(v, dtype=np.float32), device=device)
        n = len(gts)
        ones = lambda k: torch.ones(n, k, device=device)
        m_box, _ = sam(boxes=to_t([p[0] for p in pr]) * sb, image_emb=emb, multimask=False)
        m_1, iou_1 = sam(points=to_t([p[1] for p in pr]) * sp, labels=ones(1), image_emb=emb, multimask=True)
        m_1s, _ = sam(points=to_t([p[1] for p in pr]) * sp, labels=ones(1), image_emb=emb, multimask=False)
        m_3, _ = sam(points=to_t([p[2] for p in pr]) * sp, labels=ones(3), image_emb=emb, multimask=False)
        up = lambda m: postprocess(m.cpu(), size_r, img.size[::-1])
        m_box, m_1, m_1s, m_3 = up(m_box), up(m_1), up(m_1s), up(m_3)
        for j, g in enumerate(gts):
            ious3 = [iou_mask(m_1[j, k], g) for k in range(3)]
            res["箱"].append(iou_mask(m_box[j, 0], g))
            res["1 点(IoU の予測が最大のマスク)"].append(ious3[iou_1[j].argmax().item()])
            res["1 点(正解に最も近いマスク)"].append(max(ious3))
            res["1 点(マスクを 1 つだけ出す)"].append(iou_mask(m_1s[j, 0], g))
            res["3 点"].append(iou_mask(m_3[j, 0], g))
for k, v in res.items():
    print(f"{k:<28s}: mIoU {np.mean(v):.3f}")

# 処理時間:画像エンコーダ(画像ごとに 1 回)と、プロンプトエンコーダ+マスクデコーダ(プロンプトごと)
def timeit(fn, n):
    with torch.no_grad():
        for _ in range(5):
            fn()
        torch.cuda.synchronize()
        t0 = time.perf_counter()
        for _ in range(n):
            fn()
        torch.cuda.synchronize()
    return (time.perf_counter() - t0) / n * 1000


x = torch.rand(1, 3, 1024, 1024, device=device)
pts = torch.tensor([[[500.0, 500.0]]], device=device)
print(f"\n画像エンコーダ          : {timeit(lambda: sam.image_encoder(x), 20):.1f} ms")
print(f"プロンプト+マスクデコーダ: {timeit(lambda: sam(points=pts, labels=torch.ones(1, 1, device=device), image_emb=emb[:1]), 100):.1f} ms")
- 箱: 箱を与え、マスクを 1 つだけ出します。
- 1 点(IoU の予測が最大のマスク): 3 つのマスクを出し、IoU の予測が最も大きいマスクを選びます。正解を見ずに選べるので、実際の使い方と同じです。
- 1 点(正解に最も近いマスク): 3 つのマスクのうち、正解との IoU が最も大きいマスクを選びます(オラクル)。論文の評価と同じで、「3 つの中に正解があるか」を測ります。
- 1 点(マスクを 1 つだけ出す): 1 番目のマスクトークンで、マスクを 1 つだけ出します。
- 3 点: 3 点を与え、マスクを 1 つだけ出します。点が増えるとあいまいさが減るので、公式のノートブックでも、点が複数のときは 1 つのマスクを出す例になっています。
- 処理時間: 画像エンコーダ(画像ごとに 1 回)と、プロンプトエンコーダ+マスクデコーダ(プロンプトごと)の時間を、GPU の同期をとって測ります。
実行結果
箱                           : mIoU 0.757
1 点(IoU の予測が最大のマスク)         : mIoU 0.530
1 点(正解に最も近いマスク)             : mIoU 0.712
1 点(マスクを 1 つだけ出す)           : mIoU 0.506
3 点                         : mIoU 0.640

画像エンコーダ          : 91.5 ms
プロンプト+マスクデコーダ: 5.2 ms
5つの設定の mIoU を並べると、次のようになります。
(図は、diagram-designで作成)
- 箱: mIoU 0.757 で、5 つの設定で最も高くなりました。箱は物体の範囲を決めるので、あいまいさが小さいためです。
- 1 点: IoU の予測で選んだマスクは 0.530 でしたが、3 つのうち正解に最も近いマスクを選ぶと 0.712 に上がりました。3 つのマスクのどれかは正解に近いものの、IoU の予測で選んだマスクが、COCO の正解(物体の全体)と合わないことが多いということです。実験1の猫の模様のように、点が物体の一部分の上にあると、部分のマスクも同じくらいもっともらしいためと考えられます。
- マスクを 1 つだけ出す: 0.506 で、3 つのマスクから IoU の予測で選ぶ(0.530)より低くなりました。1 点からは、3 つのマスクを出して選ぶ方が良い結果になります。
- 3 点: 0.640 で、1 点で IoU の予測で選ぶより 0.11 高くなりました。点を足すほど、どの物体を指しているかがはっきりします。
- 処理時間: 画像エンコーダは 1 枚 91.5 ms、プロンプトエンコーダとマスクデコーダは 1 回 5.2 ms でした(A100、float32)。画像エンコーダを 1 回だけ動かせば、点や箱を変えるたびに約 5 ms でマスクを出せます。
論文の 1 点の評価(23 個のデータセット)は ViT-H の結果が中心で、評価の方法も違うので、数値は直接は比べられません。ただし、「1 点では正解に最も近いマスクの mIoU が大きく上がる」「点を足すと精度が上がる」という傾向は、論文と同じです。
実験4:3 つのマスクを出す学習で、あいまいな点を扱う
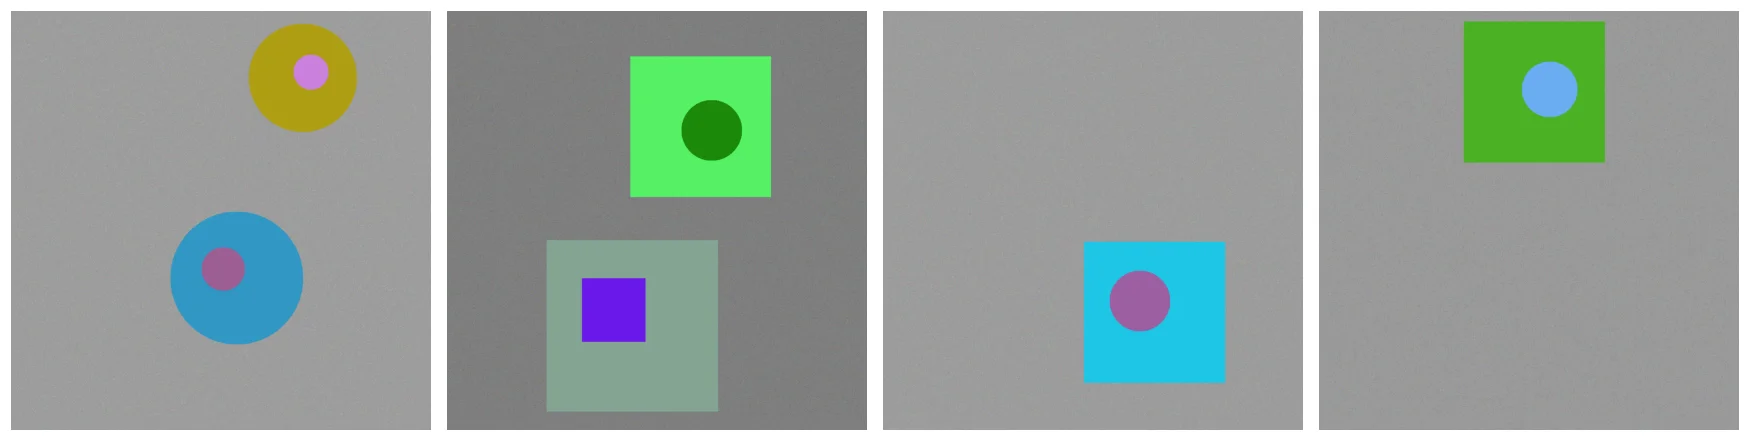
SAM の学習の工夫は「3 つのマスクを出し、損失が最小のマスクだけで学習する」ことです。これがあいまいな点をどう扱うかを、合成データで確かめます。正解が 2 通りある点を自由に作れるよう、外側の図形の中に内側の図形がある物体を描き、内側の図形の上の点に「内側の図形」と「物体全体」の 2 通りの正解を、半々の確率で与えます。同じ点に 2 通りの正解があるので、マスクを 1 つしか出さないモデルは、どちらにも合わせられません。
実装方針:論文の学習との違い
| 項目 | 論文の学習(SA-1B) | 本記事(合成データ) |
|---|---|---|
| データ | SA-1B(1,100 万枚の画像と 11 億個のマスク) | 合成画像 1,200 枚(外側の図形の中に内側の図形がある物体。正解が 2 通りある点を自由に作れる) |
| 画像エンコーダ | MAE で事前学習した ViT-H を初期値に、全体を学習 | 公開されている SAM(ViT-B)の画像エンコーダを固定(特徴を先に計算して、学習を軽くする) |
| 学習する部分 | 画像エンコーダ・プロンプトエンコーダ・マスクデコーダの全体 | プロンプトエンコーダとマスクデコーダを初期化して学習(位置埋め込みの乱数の行列は学習しないので、公開されているものを使う) |
| プロンプト | 点か箱を等しい確率で選び、誤りの領域から点を足す操作を 11 回くり返す(前の予測のマスクも入力にする) | 正例の 1 点だけ(1 点のあいまいさだけを確かめるため) |
| 出力と損失 | 3 つのマスクのうち損失が最小のものだけで学習。Focal Loss と Dice Loss を 20 : 1、IoU の予測は MSE | 同じ |
| 最適化 | AdamW(β 0.9・0.999)、学習率 8e-4、重み減衰 0.1、最初の 250 回はウォームアップ、6 万回と 86,666 回で学習率を 1/10 | AdamW、学習率 1e-4(論文の 8e-4 をバッチの大きさの比 32/256 で小さくした値)、重み減衰 0.1、250 回のウォームアップ、学習率の減衰なし(学習が短いため) |
| 回数・バッチ | 9 万回、バッチ 256(256 個の GPU) | 4,000 回、バッチ 32(A100 で 1 つのモデルを約 10 分で学習するため) |
合成データ
import cv2
import copy
import random


def make_scene(seed):
    """灰色の背景に、外側の図形(四角か丸)の中に内側の図形がある物体を 1〜2 個描く。物体ごとに (内側のマスク, 全体のマスク) を返す"""
    rng = np.random.default_rng(seed)
    img = np.clip(rng.integers(90, 170) + rng.normal(0, 10, (1024, 1024, 3)), 0, 255).astype(np.uint8)
    objs, placed = [], []
    for _ in range(rng.integers(1, 3)):
        for _try in range(30):
            s = int(rng.integers(260, 460))                     # 外側の図形の一辺
            x0, y0 = rng.integers(20, 1024 - s - 20, 2)
            if all(x0 + s + 20 < a or a + b + 20 < x0 or y0 + s + 20 < c or c + b + 20 < y0 for a, c, b in placed):
                break
        else:
            continue
        placed.append((x0, y0, s))
        c_out, c_in = rng.integers(0, 256, 3), rng.integers(0, 256, 3)
        while np.abs(c_out - c_in).sum() < 200:                 # 内側と外側の色をはっきり違えるため
            c_in = rng.integers(0, 256, 3)
        whole, inner = np.zeros((1024, 1024), np.uint8), np.zeros((1024, 1024), np.uint8)
        if rng.random() < 0.5:
            cv2.rectangle(whole, (int(x0), int(y0)), (int(x0 + s), int(y0 + s)), 1, -1)
        else:
            cv2.circle(whole, (int(x0 + s / 2), int(y0 + s / 2)), s // 2, 1, -1)
        r = int(s * rng.uniform(0.15, 0.22))                    # 内側の図形の半径(外側の一辺の 15〜22%)
        cx, cy = x0 + s / 2 + rng.uniform(-0.12, 0.12) * s, y0 + s / 2 + rng.uniform(-0.12, 0.12) * s
        if rng.random() < 0.5:
            cv2.circle(inner, (int(cx), int(cy)), r, 1, -1)
        else:
            cv2.rectangle(inner, (int(cx - r), int(cy - r)), (int(cx + r), int(cy + r)), 1, -1)
        img[whole > 0] = c_out
        img[inner > 0] = c_in
        objs.append((inner.astype(bool), whole.astype(bool)))
    return img, objs


def sample_prompt(objs, rng, ambiguous):
    """ambiguous なら内側の図形の上の点(正解は内側か全体のどちらか)、そうでなければ外側だけの部分の点(正解は全体)"""
    inner, whole = objs[rng.integers(len(objs))]
    region = inner if ambiguous else (whole & ~inner)
    ys, xs = np.nonzero(region)
    k = rng.integers(len(xs))
    target = (inner if rng.random() < 0.5 else whole) if ambiguous else whole
    return (xs[k], ys[k]), target, inner, whole


fig, axes = plt.subplots(1, 4, figsize=(16, 4.2))
for ax, seed in zip(axes, range(4)):
    ax.imshow(make_scene(seed)[0])
    ax.axis("off")
plt.tight_layout()
plt.show()
- 外側の図形: 一辺 260〜460 画素の四角か丸で、1 枚に 1〜2 個描きます。64×64 の画像の埋め込みでも、内側と外側の両方が十分な数の位置(16 画素のパッチ)にまたがる大きさにしています。
- 内側の図形: 半径が外側の一辺の 15〜22% の丸か四角で、外側の中心の近くに描きます。内側と外側の色は、RGB の差の合計が 200 以上になるようにして、境界をはっきりさせます。
- sample_prompt: あいまいな点は内側の図形の上の点で、正解を内側か全体かのどちらかに半々で決めます。あいまいでない点は、外側だけの部分(内側を除く部分)の点で、正解は全体です。
実行結果
画像の特徴を先に計算する
# 画像エンコーダは固定するので、学習用 1,200 枚とテスト用 100 枚の特徴を先に計算しておく(float16 で GPU に置く)
def encode_scenes(seeds):
    embs, objs = [], []
    with torch.no_grad():
        for k in range(0, len(seeds), 8):
            imgs = [make_scene(s) for s in seeds[k:k + 8]]
            x = torch.stack([(torch.from_numpy(im).permute(2, 0, 1).float() - MEAN) / STD for im, _ in imgs]).to(device)
            embs.append(sam.image_encoder(x).half())
            objs += [o for _, o in imgs]
    return torch.cat(embs), objs


t0 = time.time()
train_emb, train_objs = encode_scenes(list(range(1200)))
test_emb, test_objs = encode_scenes(list(range(10**6, 10**6 + 100)))
print(f"学習用 {len(train_objs)} 枚・テスト用 {len(test_objs)} 枚の特徴: {tuple(train_emb.shape[1:])}({time.time() - t0:.0f} 秒)")
- 画像エンコーダを固定: 公開されている SAM の画像エンコーダは学習しないので、学習用 1,200 枚とテスト用 100 枚の画像の埋め込みを先に計算しておきます。学習では、軽いプロンプトエンコーダとマスクデコーダだけを動かします。
- 1,200 枚: 1 枚に 1〜2 個の物体があり、点の位置も毎回ランダムに選ぶので、4,000 回 × 32 個の学習でも同じ組み合わせはほとんど出ません。float16 の埋め込み(1 枚 2 MB)が A100 のメモリに収まる枚数にしています。
- テスト用の画像: 学習に使わない乱数の種(100 万以降)で作ります。
実行結果
学習用 1200 枚・テスト用 100 枚の特徴: (256, 64, 64)(213 秒)
損失
def mask_loss(logits, target):
    """論文と同じく、Focal Loss と Dice Loss を 20 : 1 で足す。logits・target: (N, 256, 256)"""
    p = logits.sigmoid()
    ce = F.binary_cross_entropy_with_logits(logits, target, reduction="none")
    p_t = p * target + (1 - p) * (1 - target)
    focal = ((0.25 * target + 0.75 * (1 - target)) * (1 - p_t) ** 2 * ce).mean((1, 2))
    dice = 1 - (2 * (p * target).sum((1, 2)) + 1) / (p.sum((1, 2)) + target.sum((1, 2)) + 1)
    return 20 * focal + dice


def compute_loss(masks, iou_pred, target):
    """masks: (N, K, 256, 256)。K = 3 なら、損失が最小のマスクだけで学習する(SAM の方法)"""
    N, K = masks.shape[:2]
    losses = torch.stack([mask_loss(masks[:, k], target) for k in range(K)], 1)   # (N, K)
    loss_mask = losses.min(1).values.mean()
    with torch.no_grad():                             # 予測したマスクと正解の実際の IoU を、IoU の予測の目標にする
        pm = masks > 0
        inter = (pm & (target[:, None] > 0.5)).sum((2, 3)).float()
        union = (pm | (target[:, None] > 0.5)).sum((2, 3)).float()
        iou_true = inter / union.clamp(min=1)
    return loss_mask + F.mse_loss(iou_pred, iou_true)
- Focal Loss と Dice Loss: 論文と同じく 20 : 1 で足します。Focal Loss(、)は画素ごとの分類の損失で、見分けやすい画素の重みを下げます。Dice Loss はマスク全体の重なりの損失で、物体の大きさによらず効きます。
- 損失が最小のマスクだけ: 3 つのマスクのそれぞれで損失を計算し、最小の損失だけを使います(losses.min(1))。1 つのマスクのモデルでは、そのまま 1 つの損失です。
- IoU の予測の損失: 予測したマスクと正解の実際の IoU を目標に、IoU の予測に平均二乗誤差をかけます。3 つのマスクすべてで学習します。
学習
def new_decoder_model():
    """画像エンコーダは公開されている SAM のものを固定して使い、プロンプトエンコーダとマスクデコーダを初期化する"""
    m = SAM()
    m.image_encoder = None
    for p in [*m.prompt_encoder.point_embed, m.prompt_encoder.not_a_point_embed, m.prompt_encoder.no_mask_embed, m.mask_decoder.iou_token, m.mask_decoder.mask_tokens]:
        torch.nn.init.normal_(p, std=1.0)                                     # 学習する埋め込みは標準正規分布で初期化(nn.Embedding と同じ)
    # 位置埋め込みの行列は、学習しないランダムな行列(公式の実装でも学習しない)なので、公開されている SAM のものを使う
    m.prompt_encoder.pe.positional_embedding.data.copy_(sam.prompt_encoder.pe.positional_embedding.data)
    m.prompt_encoder.pe.positional_embedding.requires_grad_(False)
    return m.to(device)


def make_batch(emb, objs, rng, n, ambiguous_ratio=0.7):
    idx = rng.integers(len(objs), size=n)
    pts, tgts = [], []
    for i in idx:
        (x, y), target, _, _ = sample_prompt(objs[i], rng, rng.random() < ambiguous_ratio)
        pts.append([[x, y]])
        tgts.append(torch.from_numpy(cv2.resize(target.astype(np.float32), (256, 256), interpolation=cv2.INTER_AREA)))
    return emb[idx].float(), torch.tensor(pts, dtype=torch.float32, device=device), torch.stack(tgts).to(device)


def train(multimask, steps=4000, batch=32):
    """multimask=True:3 つのマスクを出し、損失が最小のものだけで学習する。False:マスクを 1 つだけ出す"""
    torch.manual_seed(0)
    rng = np.random.default_rng(0)
    m = new_decoder_model()
    params = [p for p in m.parameters() if p.requires_grad]
    opt = torch.optim.AdamW(params, lr=1e-4, weight_decay=0.1)
    sched = torch.optim.lr_scheduler.LambdaLR(opt, lambda s: min(1.0, (s + 1) / 250))   # 論文と同じく、最初の 250 回はウォームアップ
    t0 = time.time()
    for step in range(1, steps + 1):
        emb, pts, tgt = make_batch(train_emb, train_objs, rng, batch)
        sparse, dense = m.prompt_encoder(pts, torch.ones(batch, 1, device=device))
        masks, iou = m.mask_decoder(emb, m.prompt_encoder.image_pe(), sparse, dense, multimask)
        loss = compute_loss(masks, iou, tgt)
        opt.zero_grad(set_to_none=True)
        loss.backward()
        opt.step()
        sched.step()
        if step % 1000 == 0:
            print(f"[{'3 つ' if multimask else '1 つ'}] {step} 回  損失 {loss.item():.3f}  ({time.time() - t0:.0f} 秒)", flush=True)
    return m.eval()


models = {k: train(k) for k in [False, True]}
- 初期化: 学習する埋め込み(点の種類、IoU トークン、マスクトークンなど)は、標準正規分布で初期化します。公式の実装は nn.Embedding を使っており、その初期値と同じです。線形層は PyTorch の既定の初期化です。
- 位置埋め込みの行列 : 学習しない乱数の行列なので、公開されている SAM のものをそのまま使います。
- あいまいな点の割合 70%: あいまいな点の学習を多めにしつつ、外側だけの部分の点(正解は全体)も入れて、「点が外側にあれば全体」も学ばせるための割合です。
- 学習率 1e-4: 論文の学習率 8e-4(バッチ 256)を、バッチの大きさの比(32/256)で小さくした値です。重み減衰 0.1 と、最初の 250 回のウォームアップは論文と同じです。
- 2 つのモデル: 同じ乱数の種・同じデータの順番で、マスクを 1 つ出すモデルと、3 つ出すモデルを学習します。違いは multimask だけです。
実行結果
[1 つ] 1000 回  損失 0.688  (153 秒)
[1 つ] 2000 回  損失 0.658  (307 秒)
[1 つ] 3000 回  損失 0.597  (460 秒)
[1 つ] 4000 回  損失 0.746  (613 秒)
[3 つ] 1000 回  損失 0.207  (156 秒)
[3 つ] 2000 回  損失 0.182  (311 秒)
[3 つ] 3000 回  損失 0.163  (467 秒)
[3 つ] 4000 回  損失 0.189  (622 秒)
表示した損失は、その回のバッチ(32 個)の損失です。マスクを 1 つ出すモデルの損失は 0.6〜0.75 ほどで下がりきらず、3 つ出すモデルは 0.16〜0.21 ほどまで下がりました。同じ点に 2 通りの正解があるので、マスクが 1 つだと、どちらかの正解には必ず外れるためです。
あいまいな点で比べる
def to_low(mask):
    return torch.from_numpy(cv2.resize(mask.astype(np.float32), (256, 256), interpolation=cv2.INTER_AREA) > 0.5)


def iou_low(pred, gt):
    return ((pred & gt).sum() / (pred | gt).sum().clamp(min=1)).item()


# テスト用の 100 枚の、すべての物体の内側の図形の中心(境界から最も遠い点)をプロンプトにする
results = {False: [], True: []}
with torch.no_grad():
    for e, objs in zip(test_emb, test_objs):
        for inner, whole in objs:
            dist = distance_transform_edt(inner)
            cy, cx = np.unravel_index(dist.argmax(), dist.shape)
            pts = torch.tensor([[[cx, cy]]], dtype=torch.float32, device=device)
            gi, gw = to_low(inner), to_low(whole)
            for k, m in models.items():
                sparse, dense = m.prompt_encoder(pts, torch.ones(1, 1, device=device))
                masks, iou = m.mask_decoder(e[None].float(), m.prompt_encoder.image_pe(), sparse, dense, k)
                pm = (masks[0] > 0).cpu()
                results[k].append(([iou_low(p, gi) for p in pm], [iou_low(p, gw) for p in pm], iou[0].tolist()))

for k, r in results.items():
    name = "3 つのマスク(損失が最小のものだけで学習)" if k else "1 つのマスク"
    print(f"{name}: 物体 {len(r)} 個")
    if not k:
        print(f"    内側の図形との IoU {np.mean([a[0] for a, b, c in r]):.3f}  全体との IoU {np.mean([b[0] for a, b, c in r]):.3f}")
    else:
        print(f"    3 つのうち内側の図形に最も近いマスクの IoU {np.mean([max(a) for a, b, c in r]):.3f}  "
              f"全体に最も近いマスクの IoU {np.mean([max(b) for a, b, c in r]):.3f}")
        same = np.mean([np.argmax(a) == np.argmax(b) for a, b, c in r])
        print(f"    内側に最も近いマスクと全体に最も近いマスクが同じ出力だった割合 {same:.0%}")
        for j in range(3):
            print(f"    マスク {j + 1}: 内側との IoU {np.mean([a[j] for a, b, c in r]):.3f}  全体との IoU {np.mean([b[j] for a, b, c in r]):.3f}  "
                  f"IoU の予測 {np.mean([c[j] for a, b, c in r]):.3f}")
- テストの点: テスト用の 100 枚のすべての物体について、内側の図形の中心(境界から最も遠い点)を点にします。正解は「内側の図形」と「全体」の 2 通りです。
- 評価: 1 つのマスクのモデルは、出したマスクと内側・全体それぞれの IoU を測ります。3 つのマスクのモデルは、3 つのうち内側に最も近いマスクと、全体に最も近いマスクの IoU を測ります。2 通りの正解の両方を出せているかを確かめるためです。
実行結果
1 つのマスク: 物体 147 個
    内側の図形との IoU 0.702  全体との IoU 0.231
3 つのマスク(損失が最小のものだけで学習): 物体 147 個
    3 つのうち内側の図形に最も近いマスクの IoU 0.980  全体に最も近いマスクの IoU 0.993
    内側に最も近いマスクと全体に最も近いマスクが同じ出力だった割合 0%
    マスク 1: 内側との IoU 0.980  全体との IoU 0.138  IoU の予測 0.517
    マスク 2: 内側との IoU 0.138  全体との IoU 0.993  IoU の予測 0.596
    マスク 3: 内側との IoU 0.148  全体との IoU 0.941  IoU の予測 0.573
2つのモデルの IoU を並べると、次のようになります。
(図は、diagram-designで作成)
- 1 つのマスクのモデル: 内側の図形との IoU は 0.702、全体との IoU は 0.231 でした。正解が半々で 2 通りあるので、0 を境に 2 値にしたマスクは内側の図形に寄り、全体を指したい場合には合いません。
- 3 つのマスクのモデル: 3 つのうち内側に最も近いマスクの IoU は 0.980、全体に最も近いマスクの IoU は 0.993 でした。147 個のすべての物体で、内側に最も近いマスクと全体に最も近いマスクは別の出力で、マスク 1 が内側の図形を、マスク 2 とマスク 3 が全体を受け持つように分かれました。
- IoU の予測: どのマスクも 0.5〜0.6 でした。同じ点の正解が半々で内側か全体なので、内側のマスクの実際の IoU は「1 か 0.14 ほど」を半々でとり、平均は 0.57 ほどになります。IoU の予測は、このあいまいさをそのまま表しています。
同じモデルの構造・同じデータで、違いは「3 つのマスクを出し、損失が最小のものだけで学習する」ことだけです。それだけで、あいまいな点に対して、2 通りの解釈の両方を出せるようになりました。
マスクを見る
# テスト画像の 1 つの物体について、内側の図形の中心の点から出したマスクを並べる
e, objs = test_emb[0], test_objs[0]
img, _ = make_scene(10**6)
inner, whole = objs[0]
dist = distance_transform_edt(inner)
cy, cx = np.unravel_index(dist.argmax(), dist.shape)
pts = torch.tensor([[[cx, cy]]], dtype=torch.float32, device=device)
fig, axes = plt.subplots(1, 5, figsize=(20, 4.4))
axes[0].imshow(img)
axes[0].plot(cx, cy, "r*", ms=16)
axes[0].set_title("入力の点")
with torch.no_grad():
    for k, cols in [(False, [1]), (True, [2, 3, 4])]:
        m = models[k]
        sparse, dense = m.prompt_encoder(pts, torch.ones(1, 1, device=device))
        masks, iou = m.mask_decoder(e[None].float(), m.prompt_encoder.image_pe(), sparse, dense, k)
        for j, c in enumerate(cols):
            prob = F.interpolate(masks[:, j:j + 1], (1024, 1024), mode="bilinear")[0, 0].sigmoid().cpu()
            axes[c].imshow(prob, cmap="gray", vmin=0, vmax=1)
            axes[c].plot(cx, cy, "r*", ms=12)
            axes[c].set_title(("1 つのマスク" if not k else f"3 つのうちマスク {j + 1}") + f"(IoU の予測 {iou[0, j]:.2f})")
for ax in axes:
    ax.axis("off")
plt.tight_layout()
plt.show()
実行結果
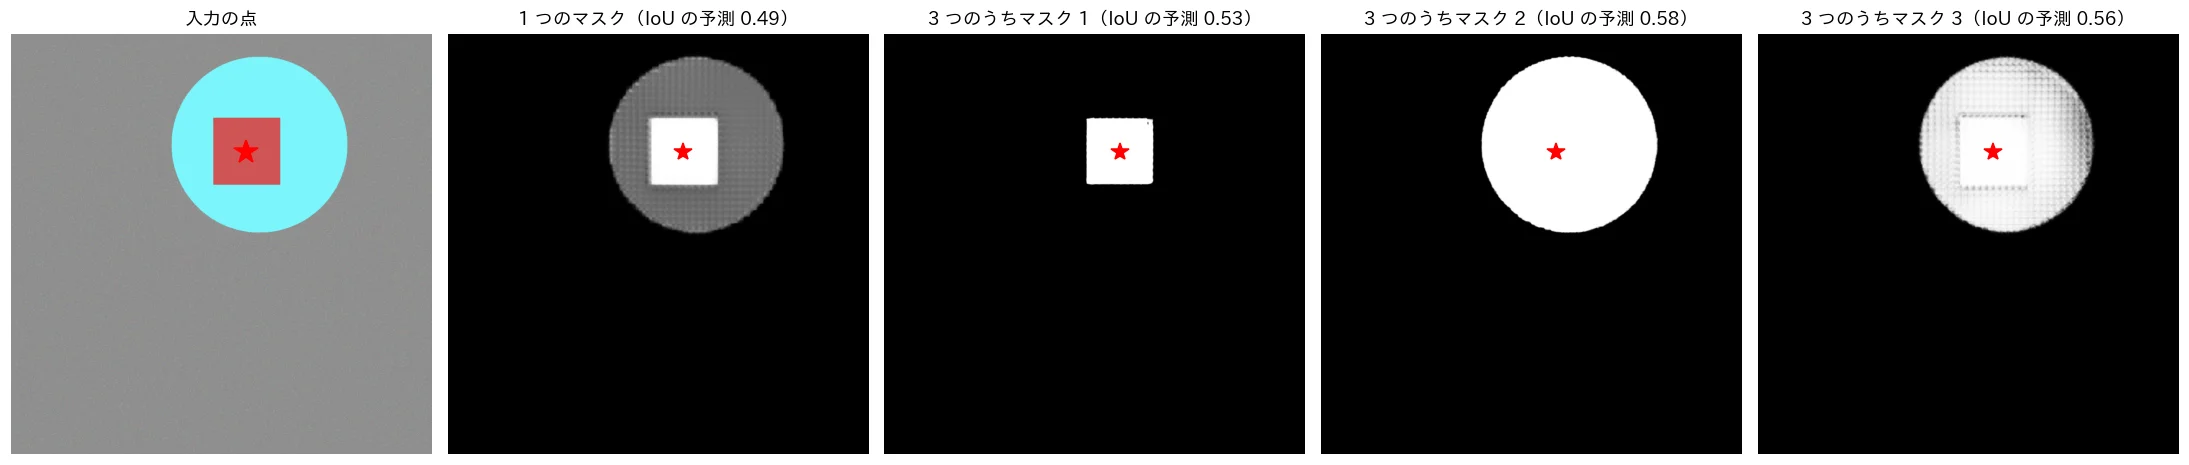
図は、マスクの logit を sigmoid で確率にした値です(白が 1、黒が 0)。1 つのマスクのモデルは、内側の図形を確率 1 に近く、外側の部分を 0.4〜0.5 ほどの灰色にしています。「内側だけ」と「全体」の 2 通りの正解を平均したような、どっちつかずのマスクです。3 つのマスクのモデルは、マスク 1 が内側の四角だけを、マスク 2 が丸の全体を、はっきりした境界で出しています。マスク 3 も全体を指していますが、外側の部分の確率がやや低く、マスク 2 ほどはっきりしていません。
まとめ
本記事では、SAM(ViT-B)を部品ごとに PyTorch で実装し、次のことを確かめました。
- 1 つの点から 3 つのマスク: 猫の背中の点から「猫の全体」と「黒い模様」、ベンチの背もたれの点から「ベンチの全体」「座面と背もたれ」「背もたれ」のマスクが出ました。SAM は点のあいまいさを、大きさの違う 3 つのマスクと IoU の予測で表します。
- Hugging Face との一致: 同じ入力で、マスクの logit の差は最大 1.82e-03、IoU の予測の差は最大 1.28e-05 でした。前処理は Hugging Face と 1 階調ずれますが、元の画像の大きさのマスクで違う画素は 1.26e-06 でした。
- Grounding DINO との組み合わせ: Grounding DINO が検出した 11 個の箱を SAM に与えると、テキストで指定した猫・ベンチ・鉢植えのマスクが、追加の学習なしで得られました。
- COCO val2017 の 500 枚: 箱のプロンプトで mIoU 0.757、1 点では IoU の予測で選ぶと 0.530、3 つのうち正解に最も近いマスクなら 0.712、3 点で 0.640 でした。画像エンコーダは 1 枚 91.5 ms、プロンプトごとのデコーダは 5.2 ms(A100)です。
- 3 つのマスクの学習: 正解が 2 通りある点で学習すると、マスクを 1 つ出すモデルは 2 通りの正解の間のどっちつかずのマスクになり、全体との IoU は 0.231 でした。3 つのマスクを出して損失が最小のものだけで学習すると、内側の図形(IoU 0.980)と全体(IoU 0.993)を別々のマスクが受け持つようになりました。
SAM の強さは、大量のマスクで学習した画像エンコーダに加えて、「重い処理を 1 回にし、軽いデコーダでプロンプトごとにマスクを出す」構成と、「あいまいさを 3 つのマスクで表す」学習の工夫にあります。
ライセンスに関する注記
SAM の公式の実装(facebookresearch/segment-anything)と、Hugging Face の学習済みの重み(facebook/sam-vit-base)は、Apache-2.0 で公開されています。Apache-2.0 は、商用利用・改変・再配布ができるライセンスです。再配布するときは、ライセンスの全文と著作権の表示を含め、改変したファイルには改変したことを明記してください。SA-1B データセットは、研究目的に限った独自のライセンスで公開されており、本記事では使っていません。COCO のアノテーションは CC BY 4.0 で、画像はそれぞれの撮影者の Flickr のライセンスに従います。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認してください。
出典・ライセンスについて
- SAM の実装: 公式の facebookresearch/segment-anything と Hugging Face の transformers(どちらも Apache-2.0)の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: facebook/sam-vit-base(Apache-2.0)を使用しています。
- 評価データ: COCO val2017(アノテーションは CC BY 4.0)の一部を使用しています。
- 推論に利用した画像: Gemini で作成した画像です。
@inproceedings{kirillov2023segment,
  title = {Segment Anything},
  author = {Kirillov, Alexander and Mintun, Eric and Ravi, Nikhila and Mao, Hanzi and Rolland, Chloe and Gustafson, Laura and Xiao, Tete and Whitehead, Spencer and Berg, Alexander C. and Lo, Wan-Yen and Doll{\'a}r, Piotr and Girshick, Ross},
  booktitle = {Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV)},
  year = {2023}
}
参考文献
- A. Kirillov et al. (2023). Segment Anything. ICCV 2023.
- Meta AI. facebookresearch/segment-anything. GitHub.
- Meta AI. facebook/sam-vit-base. Hugging Face.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。