Self-RAG とは?
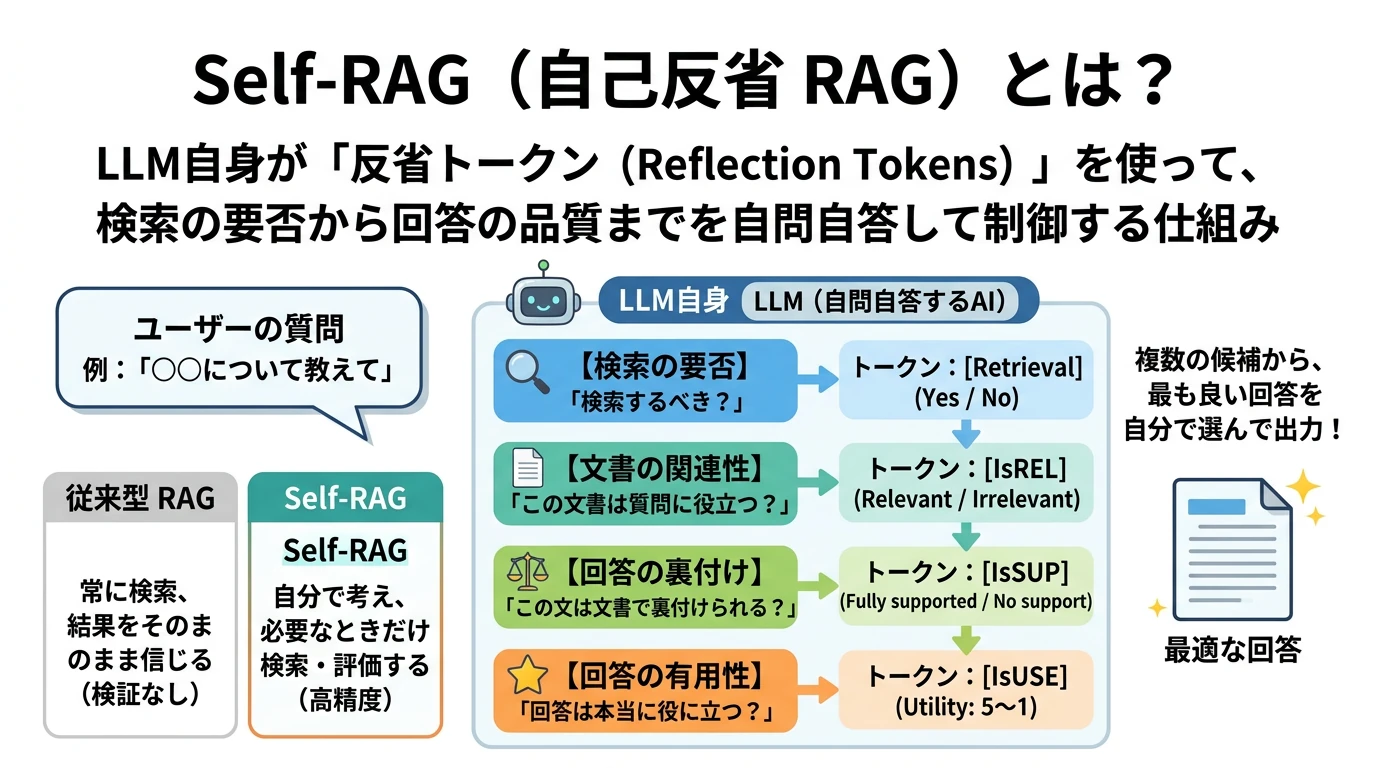 (画像は、Geminiで作成)
検索の要否、文書の関連、回答の裏付けを、特殊なトークン(反省トークン)として LLM 自身に生成させる Self-RAG の仕組みを、公開されている学習済みモデルと Python のコードで確かめること。反省トークンの確率を読んで、検索するかを決め、複数の回答の候補から選ぶ推論を手元で動かし、外付けの評価器を使う CRAG との違いと、それぞれが得意な場面を説明できるようになること。
原著論文: Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection (Asai, Wu, Wang, Sil, Hajishirzi, ICLR 2024)
概要
RAG (Retrieval-Augmented Generation) とは? の記事で扱った従来の RAG は、どんな質問にも決まった件数の文書を検索し、そのまま LLM に読ませます。検索が要らない質問にも検索し、検索した文書が役に立つか、回答が文書で裏付けられているかを、だれも確かめません。CRAG の記事では、この確認を、生成の前に 外付けの小さな評価器 に任せる方法を扱いました。
Self-RAG は、同じ確認を LLM 自身に学習させる 方法です。語彙に「反省トークン(reflection token)」と呼ぶ特殊なトークンを追加し、LLM が回答を書きながら、「ここで検索するべきか」「この文書は質問に関係があるか」「いま書いた文は文書で裏付けられるか」「回答は役に立つか」を、普通の単語と同じように生成するように学習させます。推論では、反省トークンの確率を読んで、検索するかどうかを決め、複数の回答の候補から最も良いものを選びます。判定を外に出すのではなく、モデルの中に入れてしまう(内在化する)のが、Self-RAG の考え方です。
次の節で、従来の RAG がどんな質問にも検索し、検索結果をそのまま信じる様子を、実際に確かめます。
従来の RAG は、いつも検索して、検索結果を信じる
実験には、CRAG の記事と同じ、架空の山だけでできた山岳コーパスを使います。
- 社内の山岳ガイド(検索の対象): テスト用の100山のうち、前半の50山(in-KB)は「Mount Suseri rises 2,942 meters above sea level.」のような本人のページがありますが、後半の50山(out-of-KB)にはありません。KB は Knowledge Base(知識ベース)の略です。どの山にも、名前の似た小さな山(Little X)のページがあります。
- 質問: 100山の「How many meters tall is Mount X?(X 山の高さは何メートルですか?)」に加えて、検索を必要としない一般的な指示を20個用意します。「次の文を受け身に書き換えてください」「15 + 27 はいくつですか?」のような、言い換え・計算・創作の指示です。
まず、従来の RAG と同じく、どの質問でも社内ガイドから上位5件を検索し、Qwen2.5-7B-Instruct に読ませて答えさせます。山の質問は、回答に正解の標高があれば correct、検索した上位5件の文書にある別の数値(名前の似た山や小さな山の標高など)を答えれば chimera(キメラ)、どちらでもなければ(作り話の数値や、答えられないという回答) other と数えます。一般の指示は、回答に検索した山の話(「Mount」「meters」など)が混ざったかを数えます。
準備:Google Colab の GPU で動かす
従来の RAG の Generator に Qwen2.5-7B-Instruct(bf16、約15GB)、Self-RAG に公開されている学習済みモデル selfrag/selfrag_llama2_7b(fp16、約13.5GB)を使います。2つのモデルは順番に読み込むので、Google Colab の「ランタイム」→「ランタイムのタイプを変更」から、メモリが 24GB ある L4 GPU を選んでください(Colab の有料プランが必要です)。追加のパッケージはありません。記事の数値は、L4 GPU で、transformers 5.20.2・sentence-transformers 5.7.0・torch 2.11.0 を使って実行したものです。
- 実験1は、モデルのダウンロード(約17GB)を含めて約10分です。生成は120回です。
- 実験2は、Self-RAG のモデルのダウンロード(約13.5GB)を含めて約4分です。
- 実験3は、検索した質問ごとに5件の文書で並列に生成するので、約520回の生成で約6分です。
- 生成はすべて貪欲法(greedy)で、乱数のシードも固定しているので、同じ環境なら何度実行しても同じ数値になります。ただし、GPU の種類やライブラリのバージョンが違うと、数値が多少変わることがあります。
実験1:従来の RAG で答える
import random
import re
import numpy as np
import torch
from sentence_transformers import SentenceTransformer
from transformers import AutoTokenizer, AutoModelForCausalLM

# 1. 架空の山岳コーパス(CRAG の記事と同じ作り方)
SYLLABLES = ["ka", "ra", "se", "mo", "ri", "to", "na", "shi", "ku", "yo",
             "ha", "ne", "ta", "mi", "su", "ho", "ki", "no", "wa", "fu"]
RANGES = ["Hoshimi", "Akatsuki", "Kirisame", "Tsukishiro", "Hayate", "Shiranami"]
VILLAGES = ["Oda", "Kanbe", "Minase", "Toyoura", "Ishida", "Yanagi", "Sakaki", "Hirano"]


def build_mountains(n=300, seed=0):
    rng = random.Random(seed)
    names, mountains = set(), []
    heights = rng.sample(range(1500, 3999), n)          # 山頂の標高(重複なし)
    littles = rng.sample(range(400, 1499), n)           # 名前の似た小さな山の標高
    for i in range(n):
        while True:
            name = "".join(rng.choice(SYLLABLES) for _ in range(3)).capitalize()
            if name not in names:
                names.add(name)
                break
        mountains.append({
            "name": name, "range": rng.choice(RANGES), "village": rng.choice(VILLAGES),
            "height": f"{heights[i]:,}", "little": f"{littles[i]:,}",
            "hut": f"{heights[i] - rng.randint(300, 700):,}", "year": rng.randint(1880, 1960),
        })
    return mountains


def guide_page(m):
    # 「{name}山は {range} 山脈の峰です。{name}山の標高は {height} メートルです。
    #   {name}山の山小屋は標高 {hut} メートルにあります。主な登山道は {village} 村から始まります。」
    return (f"Mount {m['name']} is a peak in the {m['range']} Range. "
            f"Mount {m['name']} rises {m['height']} meters above sea level. "
            f"The mountain hut on Mount {m['name']} stands at {m['hut']} meters. "
            f"The main trail starts from the village of {m['village']}.")


def little_page(m):
    # 「小{name}山は、{name}山にちなんで名付けられた小さな峰です。小{name}山の標高は {little} メートルです。
    #   {village} 村から半日で登れる人気の山です。」
    return (f"Little {m['name']} is a smaller peak named after Mount {m['name']}. "
            f"Little {m['name']} rises {m['little']} meters above sea level. "
            f"It is a popular half-day hike from the village of {m['village']}.")


mountains = build_mountains()
train, test = mountains[:200], mountains[200:]
in_kb = test[:50]   # 後半の50山は、ガイドに本人のページがない
guide = [guide_page(m) for m in train + in_kb] + [little_page(m) for m in train + test]

rng = random.Random(1)
templates = ["How many meters tall is Mount {}?", "What is the elevation of Mount {}?"]
# 「{}山の高さは何メートルですか?」「{}山の標高はいくつですか?」
questions = [{"question": rng.choice(templates).format(m["name"]), "mountain": m,
              "type": "in-KB" if m in in_kb else "out-of-KB"} for m in test]

# 検索を必要としない指示(言い換え・計算・創作など)
GENERAL = [
    "Rewrite this sentence in the passive voice: The cat chased the mouse.",
    "What is 15 plus 27?",
    "Write a two-line poem about the sea.",
    "Translate 'good morning' into French.",
    "Give three tips for staying focused while studying.",
    "Sort these numbers from smallest to largest: 8, 3, 15, 1.",
    "Suggest a name for a friendly robot.",
    "Leave odd one out: apple, banana, carrot.",
    "Write a short thank-you message to a colleague.",
    "Explain the word 'umbrella' to a child in one sentence.",
    "Convert 3 hours into minutes.",
    "Give an antonym of 'generous'.",
    "Write a one-sentence story about a lost key.",
    "Make this sentence more polite: Give me the report.",
    "List three colors of a rainbow.",
    "What is the plural of 'mouse'?",
    "Write a slogan for a bakery.",
    "Summarize in five words: The meeting was moved to next Monday because of the holiday.",
    "Create a riddle about the moon.",
    "Count the vowels in the word 'education'.",
]
# 「次の文を受け身に書き換えてください:猫がネズミを追いかけた。」「15 + 27 はいくつですか?」「海についての2行の詩を書いてください。」
# 「『おはよう』をフランス語に訳してください。」「勉強に集中するコツを3つ挙げてください。」「8, 3, 15, 1 を小さい順に並べてください。」
# 「親しみやすいロボットの名前を考えてください。」「仲間はずれを選んでください:りんご、バナナ、にんじん。」
# 「同僚への短いお礼のメッセージを書いてください。」「『傘』という言葉を子どもに1文で説明してください。」「3時間を分に直してください。」
# 「『気前がよい』の反対語を挙げてください。」「なくした鍵についての1文の物語を書いてください。」「この文を丁寧にしてください:報告書をよこせ。」
# 「虹の色を3つ挙げてください。」「『mouse』の複数形は何ですか?」「パン屋のキャッチコピーを書いてください。」
# 「5語で要約してください:会議は祝日のため来週の月曜日に移動しました。」「月についてのなぞなぞを作ってください。」「『education』の母音を数えてください。」
questions += [{"question": g, "type": "general"} for g in GENERAL]

# 2. Retriever(bge-large-en-v1.5)
encoder = SentenceTransformer("BAAI/bge-large-en-v1.5", device="cuda")
QUERY_PREFIX = "Represent this sentence for searching relevant passages: "
# 「関連するパッセージを検索するために、この文を表現してください:」
guide_emb = encoder.encode(guide, normalize_embeddings=True)


def search(query, k=5):
    q_emb = encoder.encode([QUERY_PREFIX + query], normalize_embeddings=True)[0]
    return [guide[j] for j in np.argsort(-(guide_emb @ q_emb))[:k]]


def numbers(text):
    """文章に出てくる数値(3桁以上。カンマは取り除く)"""
    return {n.replace(",", "") for n in re.findall(r"\d[\d,]*\d", text)}


def judge(q, pred):
    """正解の標高なら correct、検索した上位5件の文書にある別の数値なら chimera、それ以外(作り話・答えない)は other"""
    nums = numbers(pred)
    if q["mountain"]["height"].replace(",", "") in nums:
        return "correct"
    if nums & set().union(*(numbers(d) for d in search(q["question"]))):
        return "chimera"
    return "other"


def mentions_mountain(pred):
    """検索しなくてよい指示の回答に、検索した山の話が混ざったか"""
    return bool(re.search(r"Mount|Little [A-Z]|meters|peak", pred))


# 3. 従来の RAG:どの質問でも検索し、上位5件の文書を読ませて答えさせる(Generator は Qwen2.5-7B-Instruct)
GEN_ID = "Qwen/Qwen2.5-7B-Instruct"
qwen_tok = AutoTokenizer.from_pretrained(GEN_ID)
qwen = AutoModelForCausalLM.from_pretrained(GEN_ID, dtype=torch.bfloat16, device_map="cuda")


@torch.no_grad()
def qwen_answer(question, docs, max_new_tokens=48):
    context = "\n".join(f"[{i + 1}] {d}" for i, d in enumerate(docs))
    # 「以下の文書だけを使って質問(指示)に答えてください。文書:… 質問:…」
    messages = [{"role": "user", "content": "Answer the question using only the documents below.\n\n"
                                            f"Documents:\n{context}\n\nQuestion: {question}"}]
    inputs = qwen_tok.apply_chat_template(messages, add_generation_prompt=True,
                                          return_tensors="pt", return_dict=True).to(qwen.device)
    out = qwen.generate(**inputs, max_new_tokens=max_new_tokens, do_sample=False)
    return qwen_tok.decode(out[0, inputs["input_ids"].shape[1]:], skip_special_tokens=True).strip()


naive = [qwen_answer(q["question"], search(q["question"])) for q in questions]
for t in ["in-KB", "out-of-KB"]:
    res = [judge(q, p) for q, p in zip(questions, naive) if q["type"] == t]
    print(f"{t:9s}  correct: {res.count('correct') / 50:.2f}  chimera: {res.count('chimera') / 50:.2f}"
          f"  other: {res.count('other') / 50:.2f}")
gen = [p for q, p in zip(questions, naive) if q["type"] == "general"]
print(f"general    検索した山の話が混ざった回答: {sum(map(mentions_mountain, gen))} / {len(gen)}")

# 4. 例:検索しなくてよい指示
general_idx = [j for j, q in enumerate(questions) if q["type"] == "general"]
i = next((j for j in general_idx if mentions_mountain(naive[j])), general_idx[0])
print("\nInstruction:", questions[i]["question"])
print("Retrieved:", search(questions[i]["question"], k=1)[0][:100], "...")
print("Answer:", naive[i])

# 5. Generator をメモリから外す(次の実験で Self-RAG のモデルを読み込むため)
del qwen
torch.cuda.empty_cache()
架空の山岳コーパスと一般の指示を用意し、従来の RAG で答えさせて、山の質問の正誤と、一般の指示への山の話の混入を数えるコードです。
- コーパス: build_mountains・guide_page・little_page は、CRAG の記事と同じです。300山のうち、後半の100山をテストに使います。社内ガイド guide には、in-KB の50山の本人のページがあり、out-of-KB の50山の本人のページはありません。CRAG の記事と同じコーパスにするのは、同じキメラの起きやすい条件で、2つの手法の直し方を比べられるようにするためです。
- 一般の指示: GENERAL は、検索を必要としない20個の指示です。type を "general" にして、山の質問と区別します。検索の要らない指示を混ぜるのは、従来の RAG が「検索が必要か」を判断せずに、どんな入力にも検索した文書を読ませてしまう問題を再現し、Self-RAG の Retrieve の判断(実験2)と比べるためです。
- 検索: search は、bge-large-en-v1.5 で、社内ガイドから類似度の高い上位 k 件を返します。
- 判定: numbers は、文章に出てくる3桁以上の数値を、カンマを除いて取り出します。judge は、回答の数値に正解の標高があれば correct、その質問で検索した上位5件の文書にある別の数値(名前の似た山・小さな山・山小屋の標高など)があれば chimera、どちらもなければ other とします。chimera を「読ませた文書にある数値」に限ることで、LLM が作った数値がたまたま別の山の数値と一致した場合を、chimera に数えないようにしています。mentions_mountain は、回答に「Mount」「Little」「meters」「peak」が出てくるかを調べます。
- 従来の RAG: qwen_answer は、検索した上位5件に番号を付けて並べ、質問と一緒に Qwen2.5-7B-Instruct に渡して、貪欲法で答えさせます。山の質問にも一般の指示にも、同じように検索します。一般の指示にも検索するのは、従来の RAG の「いつも検索する」という動きをそのまま再現するためです。
- メモリの解放: 最後に del qwen で Generator を外し、次の実験で Self-RAG のモデルを読み込めるようにします。
実行結果
in-KB      correct: 1.00  chimera: 0.00  other: 0.00
out-of-KB  correct: 0.00  chimera: 0.90  other: 0.10
general    検索した山の話が混ざった回答: 6 / 20

Instruction: Write a two-line poem about the sea.
Retrieved: Little Nomise is a smaller peak named after Mount Nomise. Little Nomise rises 764 meters above sea l ...
Answer: Whispers of the deep, where waves embrace,
Below the peaks that touch the sky's grace.
(和訳)
- 指示:「海についての2行の詩を書いてください。」
- 検索の1位:「小 Nomise 山は、Nomise 山にちなんで名付けられた小さな峰です。小 Nomise 山の標高は 764 メートルです。…」
- 回答:「深海のささやき、波が抱きしめるところ/空の優美さに触れる峰々の下で」
従来の RAG は、本人のページがある in-KB の山にはすべて正しく答えました。一方、本人のページがない out-of-KB の山では、90% の回答が、名前の似た小さな山や別の山の標高をそのまま答えるキメラでした。CRAG の記事の実験と同じく、検索した文書が質問の山についてのものかを確かめずに、そこにある数値を答えています。
もう1つの問題は、検索を必要としない一般の指示です。20個のうち6個の回答に、検索した山の話が混ざりました。例の「海についての2行の詩」では、検索の1位に小 Nomise 山のページが来て、詩の2行目に「峰々」が入り込んでいます。指示には必要のない文書でも、プロンプトに入っていれば、LLM はそれを使おうとします。
従来の RAG には、「この質問に検索は必要か」「この文書は質問に役立つか」「この回答は文書で裏付けられるか」を判断する仕組みがありません。Self-RAG は、この3つの判断を、LLM 自身に学習させます。
Self-RAG の仕組み
反省トークン
Self-RAG は、次の4種類の反省トークンを語彙に追加します。
| 種類 | 入力 | 出力 | 役割 |
|---|---|---|---|
| Retrieve | 質問 (と、それまでの生成 ) | Yes([Retrieval])/No([No Retrieval])/Continue([Continue to Use Evidence]) | 検索するべきか |
| IsREL | 質問 、文書 | Relevant / Irrelevant | 文書 は質問に答えるのに役立つか |
| IsSUP | 質問 、文書 、生成した文 | Fully supported / Partially supported / No support | 文 の内容は文書 で裏付けられるか |
| IsUSE | 質問 、生成した回答 | Utility:5 〜 Utility:1 | 回答は質問に対して役に立つか(5が最高) |
Self-RAG の生成の中では、反省トークンが次の図のように並びます。
(図は、diagram-designで作成)
反省トークンも、普通の単語と同じく「次のトークン」として生成されます。そのため、生成の各ステップの確率分布から、たとえば「次に [Relevant] を出す確率」と「[Irrelevant] を出す確率」を読み出せます。これが、Self-RAG の推論で判定に使う値です。
学習:critic モデルの蒸留と、反省トークン付きの学習データ
LLM に反省トークンを生成させるには、反省トークンが入った学習データが必要です。原著論文は、これを2段階で作りました。
- critic モデルを学習する まず、GPT-4 に、反省トークンの種類ごとの指示と例を見せて、検索の要否・文書の関連・裏付け・有用性を判定させます。種類ごとに 4,000〜20,000 件の判定を集め、それを真似るように Llama 2 7B を学習したものが critic モデルです(GPT-4 の判定の蒸留)。critic と GPT-4 の判定の一致率は、Retrieve で 93.8%、IsSUP で 93.5%、IsREL で 80.2%、IsUSE で 73.5% でした。
- 生成モデル(generator)の学習データを作る 指示と回答の組(約15万件)の回答に、critic を使って反省トークンを挿入します。検索が必要な箇所には [Retrieval] と検索した文書を入れ、その後に IsREL、回答の文の後に IsSUP、最後に IsUSE を入れます。この拡張したデータで、generator(Llama 2 7B・13B)を、普通の次のトークンの予測で学習します。検索した文書の部分は、予測の対象から外します(損失を計算しません)。
推論のときに critic は使いません。critic の判定は、学習データを通じて generator の中に取り込まれています。プロンプトに例を見せて判定させる方法(In-Context Learning)とは違い、判定の仕方をモデルの重みに学習させている点が重要です。
推論:検索するかを決め、候補の中から選ぶ
推論の流れは、次の図のとおりです。
(図は、diagram-designで作成)
検索するかどうか は、質問を入れて最初のトークンを生成するときの、[Retrieval] と [No Retrieval] の確率で決めます。学習データでは回答の先頭に Retrieve のトークンが置かれているので、モデルは回答の1トークン目でほぼこのどちらかを出します。ただし、モデルが出すのは普通の単語も含めた語彙全体の確率分布なので、その中からこの2つのトークンの確率だけを取り出します。2つの確率を足しても、ほかのトークンに確率が少し残るのでぴったり1にはなりません。そこで、合計1に正規化した
が閾値 を超えれば検索します。原著論文の既定値は です。
検索した場合 は、上位 件の文書 ごとに、並列に回答の候補 を生成します。候補 のスコアは、
です。 は候補の生成確率(トークンごとの確率の幾何平均)、 は反省トークンの確率から計算した値で、
- :[Relevant] の確率を、[Relevant] と [Irrelevant] の確率の合計で割った値
- :[Fully supported] の確率 + 0.5 × [Partially supported] の確率(3つの合計で正規化)
- :Utility:1〜5 の確率に、 の重みを掛けて足した値(5つの合計で正規化)
です。重み の既定値は、、、 です。最もスコアの高い候補を出力します。長い回答では、この選択を文(セグメント)ごとに繰り返し、ビーム幅2のビームサーチで回答を組み立てます。
推論時に振る舞いを変えられる
閾値 と重み は、推論のときに変えられます。学習し直す必要はありません。 を上げれば検索の回数が減り、下げれば増えます。 を大きくすれば、文書で裏付けられた候補を優先し、引用の正確さを重視した回答になります。 を大きくすれば、質問への有用性を重視した回答になります。原著論文は、ASQA で を大きくすると、引用の適合率が上がる代わりに、流暢さ(MAUVE)が下がることを示しています。用途に合わせて、この配分を選べるのが Self-RAG の特徴です。
実験2:反省トークンを読む
公開されている Self-RAG の学習済みモデル(Llama 2 7B)を読み込み、反省トークンの確率を読み出します。実験1のコードを実行した後に、続けて実行してください。
# 1. Self-RAG の学習済みモデル(Llama 2 7B に反省トークンを学習させたもの)
MODEL_ID = "selfrag/selfrag_llama2_7b"
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, padding_side="left")
tokenizer.pad_token = tokenizer.unk_token
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, dtype=torch.float16, device_map="cuda")
model.eval()


def format_prompt(instruction, paragraph=None):
    """Self-RAG の学習時と同じ形式。文書は [Retrieval]<paragraph>…</paragraph> で囲んで入れる"""
    # 「### 指示:(質問) ### 応答:」
    prompt = f"### Instruction:\n{instruction}\n\n### Response:\n"
    if paragraph is not None:
        prompt += f"[Retrieval]<paragraph>{paragraph}</paragraph>"
    return prompt


@torch.no_grad()
def generate(prompts, max_new_tokens=48):
    """貪欲法で生成し、生成したトークン列と、各ステップの次トークンの確率分布を返す"""
    enc = tokenizer(prompts, return_tensors="pt", padding=True).to(model.device)
    out = model.generate(**enc, max_new_tokens=max_new_tokens, do_sample=False,
                         output_scores=True, return_dict_in_generate=True,
                         pad_token_id=tokenizer.pad_token_id)
    seqs = out.sequences[:, enc["input_ids"].shape[1]:]          # sequences はプロンプト+生成なので、プロンプトを落とす
    probs = torch.stack(out.scores, dim=1).float().softmax(-1)   # (件数, ステップ数, 語彙数)。scores は生成したステップの分だけ
    # プロンプト(バッチの b 件目)ごとに、生成したトークン ID の列 seqs[b] と確率分布 probs[b] の組を取り出す
    return [(seqs[b].tolist(), probs[b]) for b in range(len(prompts))]


def clean(ids):
    """反省トークンや文書の目印を取り除いて、回答の本文だけにする"""
    text = tokenizer.decode(ids, skip_special_tokens=False)
    text = re.sub(r"<paragraph>.*?</paragraph>", "", text, flags=re.S)
    return re.sub(r"\[[^\]]*\]|</s>|<unk>|<paragraph>|</paragraph>", "", text).strip()


# 2. 反省トークンのトークン ID
RET = {t: tokenizer.convert_tokens_to_ids(t) for t in ["[Retrieval]", "[No Retrieval]"]}
REL = {t: tokenizer.convert_tokens_to_ids(t) for t in ["[Relevant]", "[Irrelevant]"]}
SUP = {t: tokenizer.convert_tokens_to_ids(t)
       for t in ["[Fully supported]", "[Partially supported]", "[No support / Contradictory]"]}
USE = {t: tokenizer.convert_tokens_to_ids(t) for t in [f"[Utility:{i}]" for i in range(1, 6)]}


def normalized(p, tokens, step):
    """step 番目の確率分布から、反省トークンの確率だけを取り出して合計1に正規化する"""
    v = {t: p[step, i].item() for t, i in tokens.items()}
    s = sum(v.values())
    return {t: x / s for t, x in v.items()}


def first_step(ids, tokens):
    """生成したトークン列の中で、tokens のどれかが最初に出たステップ"""
    return next((k for k, t in enumerate(ids) if t in tokens.values()), None)


# 3. Retrieve:検索するかどうかを、モデル自身が1トークン目で判断する
def retrieve_prob(question):
    _, p = generate([format_prompt(question)], max_new_tokens=1)[0]
    return normalized(p, RET, 0)["[Retrieval]"]


p_ret = [retrieve_prob(q["question"]) for q in questions]
for t in ["in-KB", "out-of-KB", "general"]:
    ps = [p for q, p in zip(questions, p_ret) if q["type"] == t]
    print(f"{t:9s}  p(Retrieval) の平均: {np.mean(ps):.2f}  0.2 を超えた割合: {np.mean(np.array(ps) > 0.2):.2f}")


# 4. IsREL・IsSUP・IsUSE:文書ごとに、関連・裏付け・有用性をモデル自身が判定する
def critique(ids, p):
    sup_step, use_step = first_step(ids, SUP), first_step(ids, USE)
    sup = normalized(p, SUP, sup_step) if sup_step is not None else None
    use = normalized(p, USE, use_step) if use_step is not None else None
    return {
        "rel": normalized(p, REL, 0)["[Relevant]"],
        "sup": sup["[Fully supported]"] + 0.5 * sup["[Partially supported]"] if sup else 0.0,
        "use": sum(w * use[f"[Utility:{i + 1}]"] for i, w in enumerate([-1, -0.5, 0, 0.5, 1])) if use else 0.0,
    }


for k in [0, 50]:   # in-KB と out-of-KB の最初の山
    q = questions[k]
    docs = search(q["question"])
    print(f"\nQuestion: {q['question']}(正解: {q['mountain']['height']} m)")
    print("   rel   sup   use  文書の先頭 / 回答")
    for d, (ids, p) in zip(docs, generate([format_prompt(q["question"], d) for d in docs])):
        c = critique(ids, p)
        print(f"  {c['rel']:.2f}  {c['sup']:.2f}  {c['use']:+.2f}  {d[:42]}... / {clean(ids)[:40]}")
Self-RAG のモデルを読み込み、検索の要否(Retrieve)の確率と、文書ごとの IsREL・IsSUP・IsUSE を読み出すコードです。
- プロンプトの形式: format_prompt は、Self-RAG の学習時と同じく「### Instruction: 指示 ### Response:」の形にします。文書を読ませるときは、その後に [Retrieval]<paragraph>文書</paragraph> を付けます。モデルは、その続きとして反省トークンと回答を生成します。
- 確率の記録: generate は、output_scores=True で生成の各ステップのロジットを受け取り、softmax で次のトークンの確率分布にします。out.scores は、ステップごとの(件数, 語彙数)のロジットが並んだタプルなので、torch.stack(..., dim=1) で(件数, ステップ数, 語彙数)の1つのテンソルにまとめ、精度を保つために float32 に変えてから、語彙の軸で softmax をかけます。戻り値は、プロンプトごとの「生成したトークン ID の列 ids」と「各ステップの確率分布 p(ステップ数 × 語彙数)」の組です。p[t] は、ids[t] を選んだときの分布で、あとで反省トークンが出たステップ t の p[t] から、その確率を読み出します。複数のプロンプトは左詰めのパディング(padding_side="left")でまとめて生成するので、どのプロンプトも入力の長さがそろい、out.sequences から同じ位置でプロンプトの部分を切り落とせます。out.sequences にはプロンプトと生成したトークンの両方が入っていますが、out.scores には生成した各ステップのロジットしか入っていないので、プロンプトを落とすのは seqs だけで、seqs[b, t] と probs[b, t] のステップがそろいます。
- 反省トークンの ID: RET・REL・SUP・USE は、4種類の反省トークンのトークン ID です。語彙に追加された特殊トークンなので、convert_tokens_to_ids で ID が分かります。
- 正規化: normalized は、あるステップの確率分布から、指定した反省トークンの確率だけを取り出し、合計1に正規化します。正規化するのは、確率が語彙のすべてのトークンに分かれているので、「Relevant と Irrelevant のどちらか」のように、同じ種類の反省トークンの中だけで比べるためです。
- Retrieve: retrieve_prob は、文書なしのプロンプトで1トークンだけ生成し、その確率から を計算します。1トークンだけ生成するのは、Self-RAG が、回答の最初のトークンとして [Retrieval] か [No Retrieval] を出すように学習されているためです。
- IsREL・IsSUP・IsUSE: critique は、文書を読ませて生成したトークン列から、IsREL は1トークン目、IsSUP と IsUSE はそれぞれのトークンが最初に出たステップの確率を読み、・・ を計算します。first_step が、そのステップを探します。
- 例の表示: 本人のページがある山とない山で、反省トークンの値がどう違うのかを見るため、in-KB の最初の山(Suseri 山)と、out-of-KB の最初の山(Nokiho 山)について、検索した上位5件の文書ごとに、3つの値と回答を表示します。
実行結果
in-KB      p(Retrieval) の平均: 0.82  0.2 を超えた割合: 1.00
out-of-KB  p(Retrieval) の平均: 0.83  0.2 を超えた割合: 1.00
general    p(Retrieval) の平均: 0.15  0.2 を超えた割合: 0.20

Question: How many meters tall is Mount Suseri?(正解: 2,942 m)
   rel   sup   use  文書の先頭 / 回答
  0.99  0.69  +1.00  Mount Suseri is a peak in the Akatsuki Ran... / Mount Suseri is 2,942 meters tall.
  0.97  0.40  +0.99  Little Suseri is a smaller peak named afte... / Mount Suseri is 3,867 meters tall.
  0.95  0.54  +0.99  Mount Sushimi is a peak in the Akatsuki Ra... / Mount Suseri is 2,527 meters tall.
  0.97  0.70  +0.99  Mount Serimi is a peak in the Hayate Range... / Mount Suseri is 3,850 meters tall.
  0.91  0.22  +0.99  Little Serimi is a smaller peak named afte... / Mount Suseri is 3,842 meters tall.

Question: How many meters tall is Mount Nokiho?(正解: 1,509 m)
   rel   sup   use  文書の先頭 / 回答
  0.98  0.17  +0.95  Little Nokiho is a smaller peak named afte... / Mount Nokiho is a mountain located in th
  0.98  0.53  +0.99  Mount Nohoho is a peak in the Hoshimi Rang... / Mount Nokiho is 2,495 meters tall.
  0.96  0.31  +0.99  Mount Nofuho is a peak in the Shiranami Ra... / Mount Nokiho is 3,562 meters tall.
  0.87  0.10  +0.99  Little Nofuho is a smaller peak named afte... / Mount Nokiho is 2,458 meters tall.
  0.83  0.03  +0.99  Mount Hakuho is a peak in the Tsukishiro R... / Mount Nokiho is 3,190 meters tall.
(和訳)
- 質問:「Suseri 山の高さは何メートルですか?」「Nokiho 山の高さは何メートルですか?」
- 回答の例:「Suseri 山の高さは 2,942 メートルです。」「Nokiho 山は中国地方にある山です…」
[Retrieval] の確率の平均を並べると、次のようになります。
(図は、diagram-designで作成)
Retrieve は、検索の要否をよく見分けました。 山の質問では、[Retrieval] の確率 が平均 0.82〜0.83 で、すべて閾値の 0.2 を超えました。一般の指示では平均 0.15 で、閾値を超えたのは20個中4個(フランス語への翻訳、勉強のコツ、「傘」の説明、反対語)だけでした。知識を問う質問かどうかを、モデル自身が判断しています。
IsSUP は、本人のページの回答に高い値を付けました。 in-KB の Suseri 山では、本人のページを読んだ回答(正解の 2,942m)の IsSUP は 0.69 で、小 Suseri 山のページを読んだ回答(0.40)より高くなっています。ただし、名前の似た Serimi 山のページを読んで、その山の標高 3,850m をそのまま Suseri 山の標高として答えた候補(キメラ)にも 0.70 が付きました。3番目の候補の 2,527m も、Sushimi 山のページの標高を写したものです。IsREL は、5件すべてで 0.9 前後と高く、名前の似た山のページも「関係がある」と判定しています。
本人のページがないときは、判定が甘くなります。 out-of-KB の Nokiho 山では、小 Nokiho 山のページを読んだ回答(「中国地方にある山で、正確な高さは公開されていない」という作り話)の IsSUP は 0.17 と低い一方、名前の似た Nohoho 山(Nokiho に似ているが Nohoho で、質問の Nokiho 山とは別の山です)のページから、その標高 2,495m を Nokiho 山の標高として答えた候補に、5件の中で最も高い 0.53 が付きました。別の山の数値を写した回答を、7B のモデルは「一部は裏付けられている」と判断してしまっています。
なお、この2つの例では、小さな山のページを読んだ候補は、そのページの数値ではなく、Suseri 山の 3,867m のように、どの文書にもない数値を答えていました。文書が質問の山とは違うことには気付いても、答えを知らないので、事前学習の知識で数値を作ってしまっています。
実験3:Self-RAG で答える
反省トークンの確率を使って、Self-RAG の推論で答えさせます。重みを変えた3つの設定と、閾値を変えたときの検索の割合も比べます。実験2のコードを実行した後に、続けて実行してください。
# 1. 候補の生成:検索すると判断した質問は、上位5件の文書ごとに並列に答えを生成し、反省トークンの確率を記録する
THRESHOLD = 0.2
candidates = []
for q, pr in zip(questions, p_ret):
    if pr > THRESHOLD:
        docs = search(q["question"])
        outs = generate([format_prompt(q["question"], d) for d in docs])
        cands = []
        for ids, p in outs:
            n = len(ids) if tokenizer.eos_token_id not in ids else ids.index(tokenizer.eos_token_id) + 1
            logp = torch.log(p[torch.arange(n), torch.tensor(ids[:n])]).mean().item()
            cands.append({"answer": clean(ids), "seq": np.exp(logp), **critique(ids, p)})
        candidates.append(cands)
    else:
        ids, _ = generate([format_prompt(q["question"]) + "[No Retrieval]"])[0]
        candidates.append([{"answer": clean(ids), "seq": 1.0, "rel": 0.0, "sup": 0.0, "use": 0.0}])


# 2. 候補のスコア:生成確率 + 反省トークンの重み付き和で、最も高い候補を答えにする
def select(cands, w_rel=1.0, w_sup=1.0, w_use=0.5):
    score = lambda c: c["seq"] + w_rel * c["rel"] + w_sup * c["sup"] + w_use * c["use"]
    return max(cands, key=score)


# 3. 重みを変えて比べる(推論時に振る舞いを変えられる)
settings = {"批判なし(生成確率だけ)": (0.0, 0.0, 0.0),
            "Self-RAG(既定の重み)": (1.0, 1.0, 0.5),
            "IsSUP を重視": (1.0, 3.0, 0.5)}
print(f"検索した質問: {sum(len(c) > 1 for c in candidates)} / {len(candidates)}")
print(f"{'設定':24s} {'in-KB 正答率':>11s} {'out-of-KB 正答率':>15s} {'out-of-KB キメラ':>15s} {'山の話の混入':>8s}")
for name, w in settings.items():
    preds = [select(c, *w)["answer"] for c in candidates]
    row = {t: [judge(q, p) for q, p in zip(questions, preds) if q["type"] == t] for t in ["in-KB", "out-of-KB"]}
    gen = sum(mentions_mountain(p) for q, p in zip(questions, preds) if q["type"] == "general")
    print(f"{name:24s} {row['in-KB'].count('correct') / 50:>11.2f} {row['out-of-KB'].count('correct') / 50:>15.2f}"
          f" {row['out-of-KB'].count('chimera') / 50:>15.2f} {gen:>8d} / 20")

# 4. 選ばれた回答の IsSUP:文書で裏付けられていない回答を、モデル自身の判定で見分けられるか
for t in ["in-KB", "out-of-KB"]:
    sups = [select(c)["sup"] for q, c in zip(questions, candidates) if q["type"] == t]
    print(f"{t:9s}  IsSUP の平均: {np.mean(sups):.2f}  0.5 未満(裏付けが弱い): {np.mean(np.array(sups) < 0.5):.2f}")

# 5. 検索の閾値を変えると、検索する質問の割合が変わる(推論時に振る舞いを変えられる)
for th in [0.1, 0.2, 0.5, 0.8]:
    rate = {t: np.mean([pr > th for q, pr in zip(questions, p_ret) if q["type"] == t])
            for t in ["in-KB", "out-of-KB", "general"]}
    print(f"閾値 {th:.1f}: 検索する割合  山の質問 {(rate['in-KB'] + rate['out-of-KB']) / 2:.2f}  一般の指示 {rate['general']:.2f}")

# 6. 例:本人のページがない山で、各候補のスコア
print("\nQuestion:", questions[50]["question"])
for c in candidates[50]:
    print(f"  rel {c['rel']:.2f}  sup {c['sup']:.2f}  use {c['use']:+.2f}  seq {c['seq']:.2f}  {c['answer'][:50]}")
Self-RAG の推論(検索の判断、候補の生成、スコアによる選択)を行い、重みや閾値を変えて結果を比べるコードです。
- 検索の判断: 実験2で求めた p_ret が閾値 THRESHOLD()を超えた質問だけ、上位5件の文書で候補を作ります。超えなかった質問は、プロンプトの後に [No Retrieval] を付けて、文書なしで答えさせます(原著論文の公式実装と同じです)。 は、原著論文の既定値です。
- 候補の生成確率: 生成したトークンそれぞれの確率の対数を、終わりのトークン(eos_token_id)まで平均し、np.exp で戻します。トークンごとの確率の幾何平均で、 にあたります。確率の積ではなく幾何平均にするのは、積だと長い候補ほど確率が小さくなり、短い候補が有利になってしまうためです。
- 候補の選択: select は、直前に示した の式で各候補のスコアを計算し、最も高い候補を返します。
- 3つの設定: 反省トークンを使わない「批判なし」(重みがすべて0で、生成確率だけで選ぶ)、既定の重み、IsSUP の重みを3倍にした設定を比べます。候補は同じものを使い、選び方だけを変えています。既定の重みは原著論文の既定値です。IsSUP の重みを3倍にした設定を加えるのは、文書で裏付けられた候補を強く優先すれば、キメラの候補を避けられるかを確かめるためです(原著論文は、 を大きくすると引用の適合率が上がることを示しています)。
- IsSUP の分布: 既定の重みで選んだ回答の を、in-KB と out-of-KB に分けて集計します。本人のページがない out-of-KB の山で、IsSUP が低い値になる(「文書が裏付けていない」と気づける)かを確かめるためです。
- 閾値と検索の割合: p_ret の閾値を 0.1〜0.8 に変えたときに、検索する質問の割合がどう変わるかを数えます。閾値 を変えるだけで、学習し直さずに検索の回数を調整できることを確かめるためです。0.1〜0.8 は、既定値の 0.2 の前後から、山の質問でも検索をやめ始める大きな値までを見るために選んでいます。
実行結果
検索した質問: 104 / 120
設定                         in-KB 正答率   out-of-KB 正答率   out-of-KB キメラ   山の話の混入
批判なし(生成確率だけ)                    0.98            0.00            0.58        0 / 20
Self-RAG(既定の重み)                 0.96            0.00            0.64        0 / 20
IsSUP を重視                       0.96            0.00            0.64        0 / 20
in-KB      IsSUP の平均: 0.86  0.5 未満(裏付けが弱い): 0.00
out-of-KB  IsSUP の平均: 0.71  0.5 未満(裏付けが弱い): 0.18
閾値 0.1: 検索する割合  山の質問 1.00  一般の指示 0.30
閾値 0.2: 検索する割合  山の質問 1.00  一般の指示 0.20
閾値 0.5: 検索する割合  山の質問 0.98  一般の指示 0.15
閾値 0.8: 検索する割合  山の質問 0.57  一般の指示 0.10

Question: How many meters tall is Mount Nokiho?
  rel 0.98  sup 0.17  use +0.95  seq 0.70  Mount Nokiho is a mountain located in the Chugoku
  rel 0.98  sup 0.53  use +0.99  seq 0.80  Mount Nokiho is 2,495 meters tall.
  rel 0.96  sup 0.31  use +0.99  seq 0.71  Mount Nokiho is 3,562 meters tall.
  rel 0.87  sup 0.10  use +0.99  seq 0.62  Mount Nokiho is 2,458 meters tall.
  rel 0.83  sup 0.03  use +0.99  seq 0.66  Mount Nokiho is 3,190 meters tall.
従来の RAG と Self-RAG の結果を並べると、次のようになります。
(図は、diagram-designで作成)
検索の判断の効果は大きい。 Self-RAG が検索したのは120問中104問(山の質問100問と、一般の指示4問)でした。一般の指示16問は検索せずに答え、検索した4問も含めて、山の話が混ざった回答は0個でした。従来の RAG の 6/20 から、なくなっています。
本人のページがない質問は、Self-RAG でも答えられない。 out-of-KB の正答率は、どの設定でも 0.00 でした。Self-RAG は、外部の知識源を探しに行く仕組みを持たないので、社内ガイドに答えがない質問には答えられません。キメラの割合は 0.64 で、従来の RAG(0.90)より減りましたが、残りの多くは、実験2で見た作り話の数値です。
このコーパスでは、反省トークンによる選択はほとんど効かなかった。 反省トークンを使わない「批判なし」は、in-KB 0.98、out-of-KB のキメラ 0.58 で、既定の重み(0.96、0.64)とほとんど変わらず、むしろわずかに良い結果でした。IsSUP の重みを3倍にしても、選ばれる候補は変わりませんでした。実験2の Nokiho 山のように、名前の似た山のページから数値を写した候補に IsSUP が高い値を付けるので、重みを上げても誤った候補が選ばれます。このコーパスは、名前の似た山がわざと検索されるように作った、Self-RAG にとって厳しい条件です。原著論文が実際のデータで示した改善は、次の節で見ます。
IsSUP は、裏付けの弱さの手がかりにはなる。 選ばれた回答の IsSUP の平均は、in-KB で 0.86、out-of-KB で 0.71 で、out-of-KB の方が低くなりました。0.5 未満の回答は、in-KB では0%、out-of-KB では18%でした。見分けられたのは一部だけですが、IsSUP の低い回答を「裏付けが弱い」として人の確認に回すような使い方はできます。
閾値と検索する割合の関係を描くと、次のようになります。
(図は、diagram-designで作成)
閾値で検索の回数を調整できる。 閾値を 0.1 から 0.8 に上げると、一般の指示で検索する割合は 0.30 から 0.10 に、山の質問でも 1.00 から 0.57 に下がりました。学習し直さずに、推論のときに検索の回数を変えられます。
原著論文は何を示したか
原著論文は、短い答えの質問応答(PopQA・TriviaQA)、事実の検証(PubHealth)、推論の選択問題(ARC-Challenge)、伝記の生成(Biography)、引用付きの長い回答(ASQA)の6つのタスクで評価しました。主な結果は、次のとおりです(ASQA は正しさの EM recall と、引用の適合率・再現率)。
| モデル | PopQA | TriviaQA | PubHealth | ARC | Biography(FactScore) | ASQA(EM / 引用の適合率 / 再現率) |
|---|---|---|---|---|---|---|
| ChatGPT | 29.3 | 74.3 | 70.1 | 75.3 | 71.8 | 35.3 / – / – |
| 検索付き ChatGPT | 50.8 | 65.7 | 54.7 | 75.3 | – | 40.7 / 65.1 / 76.6 |
| 検索付き Llama2-chat 13B | 51.8 | 59.8 | 52.1 | 37.9 | 79.9 | 32.8 / 19.8 / 36.1 |
| Self-RAG 7B | 54.9 | 66.4 | 72.4 | 67.3 | 81.2 | 30.0 / 66.9 / 67.8 |
| Self-RAG 13B | 55.8 | 69.3 | 74.5 | 73.1 | 80.2 | 31.7 / 70.3 / 71.3 |
ASQA の引用の適合率と再現率を並べると、次のようになります。
(図は、diagram-designで作成)
Self-RAG 13B は、同じ規模の検索付き Llama2-chat 13B を、ASQA の EM recall を除くすべてのタスクで上回り、7B のモデルでも同様でした。特に ASQA の引用の適合率は、検索付き Llama2-chat 13B の 19.8 に対して、Self-RAG 7B は 66.9 で、検索付き ChatGPT(65.1)も上回っています。IsSUP で裏付けを学習した効果が、引用の質に表れています。
どの部品が効いているか
7B のモデル(学習データ5万件)での部品を外す実験では、PopQA の正答率は、Self-RAG の 45.5 に対して、推論で検索をしないと 24.7、反省トークンで選ばずに上位1件の文書だけを使うと 41.8、ビームサーチの IsSUP を外すと 44.1 に下がりました。critic を使わずに学習すると、ASQA の EM recall が 32.1 から 18.1 に大きく下がっています。反省トークンの学習と、それを使った推論の両方が、性能に効いています。
部品を外したときの PopQA の正答率を並べると、次のようになります。
(図は、diagram-designで作成)
閾値で検索の回数を調整できる
閾値 を変えると、検索する割合が大きく変わります。原著論文によると、検索を減らしたときの性能の低下は、PubHealth では小さく、PopQA では大きくなりました。知識を問う質問ほど、検索の要否の判断が性能を左右するということです。
CRAG との違い
Self-RAG と CRAG は、どちらも「検索結果を評価して、使い方を変える」手法ですが、評価する場所が違います。
| CRAG | Self-RAG | |
|---|---|---|
| 評価者 | 外部の軽量モデル | LLM 自身(学習済み) |
| 学習 | Generator の学習は不要(小さな評価器だけを学習) | 必要(反省トークンの学習) |
| 既存の RAG への接続 | 後付けできる | モデルごと入れ替える |
| 判定する対象 | 取得した文書の質 | 検索の要否 + 文書の質 + 回答の裏付け |
| 制御のしかた | 閾値の調整 | 推論時の重みと閾値の調整 |
CRAG は、評価器を Retriever と Generator の間に差し込むだけなので、使っている LLM をそのまま残せます。一方、Self-RAG は、反省トークンを学習した LLM に入れ替える必要がありますが、そのかわりに、検索するかどうかの判断と、生成した文が裏付けられているかの判定まで、1つのモデルの中で行えます。CRAG の仕組みの詳細は、CRAG の記事を参照してください。
ALCE の指標との関係
IsSUP は、ALCE の記事で扱った 引用の再現率 と、ほぼ同じことを判定しています。引用の再現率は、回答の文が、引用した文書で裏付けられているかを NLI のモデルで外から判定する指標でした。IsSUP は、同じ判定を、生成する LLM 自身が文ごとに行い、その結果を候補の選択に使います。原著論文が ASQA で引用の適合率と再現率を大きく改善できたのは、評価の物差しとほぼ同じ判定を、生成の中に組み込んだからだと言えます。ただし、IsSUP はモデル自身の判定なので、評価には ALCE のような外部の物差しを使って、別に確かめる必要があります。
Self-RAG の限界
- モデルを入れ替える必要がある: 反省トークンは、学習した LLM でしか使えません。使っている LLM が別のモデルなら、反省トークンのデータで学習し直す必要があります。学習データを作るための GPT-4 の判定と critic の学習にも、コストがかかります。
- 自分の判定を誤ることがある: 実験2・3のように、名前の似た別の山の文書でも、IsREL は「関係がある」と判定し、IsSUP も高い値を付けることがありました。7B のモデルが自分で判定する以上、判定の精度にはモデルの能力の限界が表れます。
- 知識を補う手段がない: Self-RAG は、検索した文書が使えないと判断しても、別の知識源を探しには行きません。答えを持つ文書が見つからない質問では、正しく答えられません。
- トークンの確率を読む必要がある: 推論で反省トークンの確率を読むので、生成の確率分布を取り出せる環境(自分で動かすモデル、確率を返す API)が必要です。
- 計算量が増える: 検索した質問では、 件の文書ごとに候補を生成するので、生成の回数が 倍になります。
実務上の指針
- 検索が要らない入力が多いなら、検索の判断を入れる 雑談、言い換え、計算のような入力が多いシステムでは、毎回検索すると、無駄な計算や、関係のない文書が回答に混ざる危険が増えます。Self-RAG の Retrieve のように、検索するかを先に判断する仕組みが役立ちます。
- 閾値と重みは、評価データで選ぶ と は、検索の回数・正確さ・流暢さのバランスを決めます。引用の正確さが大事な用途では を、検索のコストを抑えたい用途では を上げるなど、評価用の質問で確かめながら選びます。
- 反省トークンの値を、回答と一緒に記録する 選んだ候補の IsREL や IsSUP の値を記録しておくと、裏付けの弱い回答を後から見つけたり、人の確認に回したりできます。ただし、その値はモデル自身の判定なので、うのみにはしないでください。
- 既存の LLM を変えられないなら、CRAG のような外付けの評価から始める モデルを入れ替えられない場合や、社内の文書に答えがない質問が多い場合は、外付けの評価器と外部の知識源を組み合わせる CRAG の方が導入しやすいことがあります。
まとめ
本記事では、検索の要否と検索結果・回答の評価を、反省トークンとして LLM 自身に学習させる Self-RAG を、公開されている学習済みモデルで確かめました。
どの質問にも検索する従来の RAG は、検索を必要としない一般の指示20個のうち6個で、関係のない山の話を回答に混ぜ、社内ガイドに答えがない山では、90% の回答で別の山の標高を答えました。Self-RAG のモデルは、反省トークン [Retrieval] の確率で、山の質問はすべて検索し、一般の指示は8割を検索せずに答えたので、山の話が混ざった回答はなくなりました。一方、名前の似た山のページを読んだ候補にも IsREL や IsSUP が高い値を付けることがあり、このコーパスでは、反省トークンによる候補の選択はほとんど効きませんでした。社内ガイドに答えがない質問には、外部の知識源を持たない Self-RAG は答えられません。
Self-RAG の主張は、検索の要否判定と品質判定を外付けするのではなく、特殊トークンとしてモデルに学習させて内在化する、ということです。反省トークンの確率は推論のときに読み出せるので、閾値と重みを変えるだけで、検索の回数や、裏付けと有用性の重視の度合いを調整できます。
参考文献
- A. Asai, Z. Wu, Y. Wang, A. Sil, H. Hajishirzi (2024). Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection. ICLR 2024.
- Qwen Team (2024). Qwen2.5-7B-Instruct. Hugging Face(Apache License 2.0).
- BAAI (2023). bge-large-en-v1.5. Hugging Face(MIT License).
本記事の文章・構成の一部に生成AIを使用しています。