SigLIPとは?
(画像は、Geminiで作成)
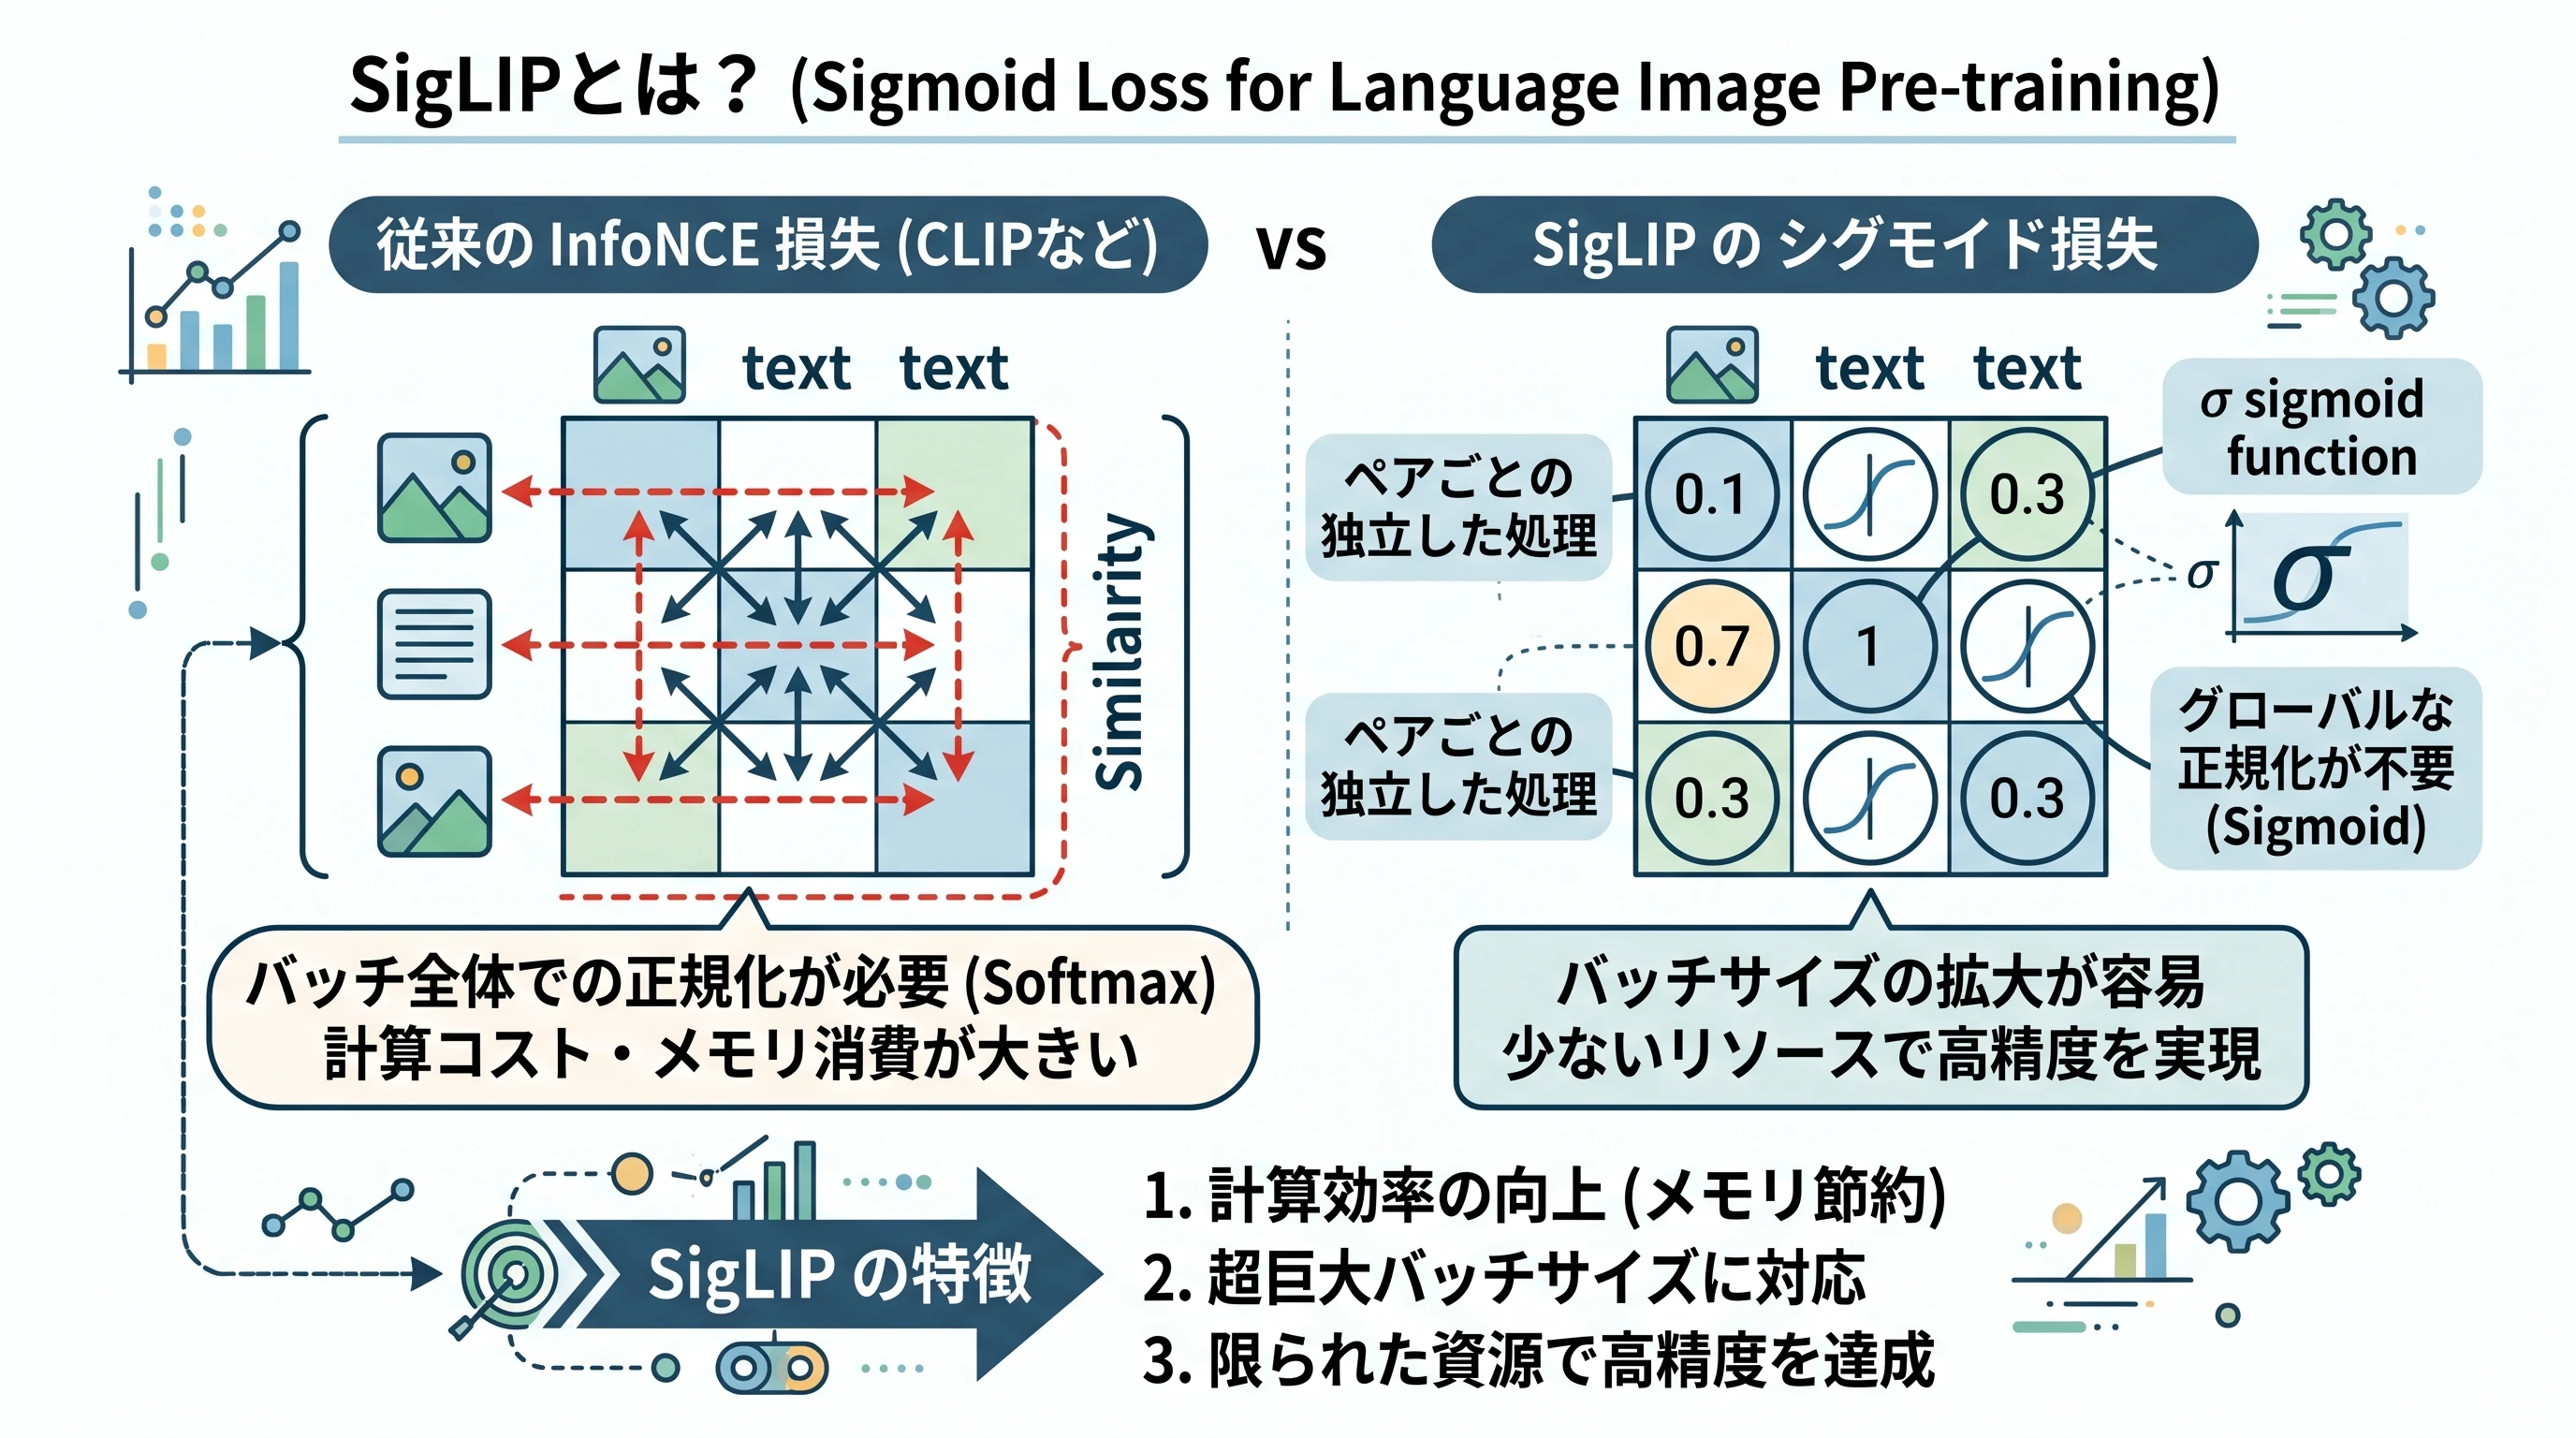
CLIP のソフトマックス損失を、画像とテキストのペアごとに独立に判定するシグモイド損失に置き換えることで、バッチ全体での正規化が不要になり、少ないメモリで大きなバッチで学習できる SigLIP の仕組みを理解すること。PyTorch で MAP Head を持つ ViT・シグモイド損失・チャンク化した損失の計算をスクラッチ実装し、Hugging Face の学習済みモデルで、各ペアが独立した確率として出力されることを確かめること。
SigLIPの概要
SigLIP (Sigmoid Loss for Language Image Pre-Training) は、Google DeepMindのXiaohua Zhaiらによって提案された、画像とテキストのマルチモーダルモデルのための新しい事前学習手法です。
CLIPなどの従来のモデルは、画像とテキストの対応関係を学習するために、ソフトマックス関数を用いたコントラスト学習(InfoNCE損失)を採用していました。しかし、ソフトマックス損失はバッチ全体に対するペアワイズ類似度のグローバルな視点を必要とするため、バッチサイズを拡大する際のメモリ消費や計算コストが大きなボトルネックとなっていました。
SigLIPは、この問題を解決するために、単純な ペアワイズのシグモイド損失(Sigmoid Loss) を導入しました。これにより、画像とテキストのペアごとの独立した処理として学習を行うことが可能となり、正規化のためにグローバルな視点を必要としません。結果として、バッチサイズのさらなる拡大を可能にしつつ、小さなバッチサイズでもより優れたパフォーマンスを発揮することが示されています。限られたハードウェアリソース(例えば4つのTPUv4チップなど)でも効率的に大規模なバッチサイズでの学習が可能になり、短期間で高い精度を達成しています(Locked-image Tuning(画像タワーを凍結する手法)と組み合わせた SigLiT では、2日間の学習でImageNetゼロショット精度84.5%を達成)。
SigLIPの処理概要
(図は、diagram-designで作成)
SigLIPのアーキテクチャ自体は、基本的にはCLIPと同様に独立した画像エンコーダ(Vision Transformerなど)とテキストエンコーダ(Transformerなど。仕組みはTransformer の記事)から構成されます。しかし、両者の特徴量を用いて損失を計算するプロセスが異なります。
ソフトマックスを用いた従来手法では、画像とテキストの特徴量ペアの類似度行列を計算した後、「すべての画像」および「すべてのテキスト」にまたがって2回ソフトマックス正規化を行います。これは実装上、すべてのデバイス間で特徴量を同期(All-Gather)し、(はバッチサイズ)の巨大な類似度行列をメモリ上に展開する必要があります。
一方SigLIPでは、計算された類似度に対してシグモイド関数を適用し、それぞれの「画像-テキスト」の組み合わせがマッチしているか否かを独立して判定します。この損失は個別のペアごとに完全に独立しているため、バッチサイズとタスクの定義を概念的に切り離すことができます。
SigLIPの構成技術要素(詳細)
SigLIPの論文「Sigmoid Loss for Language Image Pre-Training」で提案されている主要な技術要素を解説します。
-
ペアワイズ・シグモイド損失 (Pairwise Sigmoid Loss)
- SigLIPの最も重要な要素は、損失関数をソフトマックスベースからシグモイドベースに変更したことです。
- モデルに与えられたミニバッチ内の各画像とテキストのペアについて、本来の正しいペアには正のラベル(1)、それ以外のすべての組み合わせには負のラベル(-1)を与え、標準的な2値分類問題に効果的に変換します。
- ソフトマックス損失では、ある画像の正しいテキストを予測するために「バッチ内のすべてのテキストとの類似度の合計」を分母として計算(正規化)する必要があり、デバイス間での特徴量の同期(All-Gather)が不可欠でした。
- 一方、シグモイド損失では、各ペアがマッチしているか否かを個別に独立して判定するため、他のペアのスコアに依存しません。これにより、バッチ全体にわたるグローバルな正規化係数の計算が不要になり、デバイス間の通信コストやメモリ消費を大幅に削減できます。
-
学習可能なバイアス項 (Learnable Bias Term)
- バッチサイズを とすると、モデルには 個の画像と 個のテキストが入力されます。考えられるすべての組み合わせ( 個)のうち、元々セットだった正しいペア(正例)は 個です。したがって、残りの間違った組み合わせである負例ペアは 個となり、正例に比べて圧倒的に多くなります。シグモイド損失ではすべてのペアを独立して評価するため、この大量の負例の損失が全体を支配し、学習初期にモデルが「すべて負である」と過剰に学習してしまう問題が生じます。
- これを防ぐため、類似度スコアの計算に温度パラメータ()と学習可能なバイアス項()を導入し、スコアを として計算します。
- 論文では、温度を の形で学習し、(つまり温度 )、バイアスを に初期化します。学習の最初は画像とテキストの特徴量がほぼ無関係で、内積はおよそ0なので、スコアは になり、シグモイドの出力はほぼ0(負例の正解に近い値)になります。大量の負例から生じる初期の損失が最初から小さく抑えられ、負例による過剰な補正を避けて、安定して学習を始められます。
画像とテキストの特徴量が、長さ 1 にL2正規化された2次元ベクトルだと仮定します。 初期状態として、学習するパラメータ から温度 、バイアス と設定されています。
1. 負例ペア(無関係なペア)の場合
- 画像: 、テキスト:
- 内積:
- スコア
- シグモイド出力:
2. 正例ペア(完全に一致するペア)の場合
- 画像: 、テキスト:
- 内積: (最大値)
- スコア
- シグモイド出力:
このように、内積が最大()のペアでも、出力はちょうど0.5です。内積が0付近の無関係なペアは、ほぼ0になります。学習の最初は特徴量がまだ揃っていないので、正例ペアの内積も0付近で、出力はほぼ0になり、正例側に損失が出ます。一方、負例ペアは 個あってバッチの大部分を占めますが、その損失は最初からほぼ0です。そのため、学習初期に大量の負例から大きな勾配を受けることがなく、正例の内積を上げる方向に学習を始められます。正例の確率を0.5より大きくするには、内積を1に近づけるだけでは足りず、温度 を大きくするか、バイアス を上げる必要があります。
【学習進行後のパラメータの変化】 温度パラメータ()とバイアス項()は定数ではなく、ニューラルネットワークの学習可能なパラメータとして毎ステップ更新されていきます。
- バイアス項 (): 負例が大多数であることを反映した、ロジット全体の「底上げ量」です。負例が多い状況は学習が進んでも変わらないので、大きな負の値のまま保たれることが多く、本記事の実験でも 付近からほとんど動きません(後述)。正例と負例は、主に温度 で広げた内積の差によって分けられます。
- 温度パラメータ (): 特徴量ベクトルの内積の差を増幅させる「スケール(倍率)」の役割を持ちます。学習が進むにつれて一般的に値が大きくなり、正例と負例のわずかな内積の差を大きなスコア差に増幅させ、よりシャープで自信を持った予測を行うようになります。
計算例の2つのペアを並べると、次のようになります。
(図は、diagram-designで作成)
- 効率的なチャンク化実装 (Efficient "chunked" implementation)
- SoftmaxからSigmoidに変更したことで、各ペアの損失計算が「他のペアの結果に依存しない完全に独立した項」となりました。これにより、分散学習時の通信とメモリ効率が劇的に向上します。
- 従来のSoftmaxでは分母の計算のために、全デバイスからすべての特徴量を一箇所に集約する「全同期(All-Gather)」が必要であり、巨大なバッチサイズではメモリ(VRAM)が即座にパンクしてしまっていました。
- 一方SigLIPでは、各デバイスは「今自分が持っている少量の特徴量(チャンク)」だけで部分的な損失を計算します。計算が終わると、特徴量をバケツリレーのように隣のデバイスへ順次交換(Permute)し、新しい特徴量を受け取って再び損失を計算して足し合わせます。
- このバケツリレー方式により、デバイスが任意の瞬間にメモリに保持すべきデータ量を大幅に削減でき、最大100万という極端なバッチサイズでの検証すら可能になりました(※ただし論文では、実用上はバッチサイズ32k付近で性能が飽和すると報告されています。SigLIPの真価は巨大バッチの実現よりも、「小さなバッチサイズでも高い性能を発揮し、通信コストやメモリを劇的に削減できる点」にあります)。
SigLIPのスクラッチ実装
ここでは、SigLIPの仕組みを理解するために、PyTorchを用いて最小限のサイズのSigLIPモデル(MiniSigLIP)をスクラッチで実装します。画像エンコーダにはViT(Vision Transformer)、テキストエンコーダには単純なTransformerを用い、ペアワイズ・シグモイド損失を用いて学習を行います。モデルが正しく構築できているかを確認するため、Fashion-MNISTデータセットの少数のサンプル(10ペア)を用いて過学習させ、損失が下がり精度が100%になるかを見るサニティチェックを行います。
構造(ViT + MAP head、双方向のテキストエンコーダ、シグモイド損失)は論文と同じですが、大きさは仕組みを確かめるための最小限にしています。記事の後半で使う本物のモデル(google/siglip-base-patch16-224)との違いは次のとおりです。
| 項目 | 本物のモデル(siglip-base-patch16-224) | MiniSigLIP(本記事) |
|---|---|---|
| 画像エンコーダ | ViT-B/16:12層・768次元・12ヘッド | 4層・192次元・4ヘッド |
| 入力画像とパッチ | 224×224のカラー画像、16×16のパッチ196個 | 28×28の白黒画像、4×4のパッチ49個 |
| テキストエンコーダ | 12層・768次元、最大64トークン | 2層・192次元、最大16トークン |
| トークナイザ | SentencePiece(語彙32,000) | 同じもの(語彙32,000) |
| パラメータ数 | 約2億300万 | 約931万(うち約614万は語彙32,000の埋め込み) |
| 学習データ | WebLI(数十億の画像とテキスト)、バッチ32k | Fashion-MNISTの10ペア |
本物のモデルの値は、Hugging Faceの設定ファイル(書かれていない項目はtransformersの既定値)によります。MiniSigLIPのパラメータ数は、コードの層の定義から数えた値です。
MiniSigLIPクラスの定義
以下のコードでは、画像とテキストの特徴量をそれぞれ抽出し、シグモイド損失計算用のロジットを算出するモデルの全体クラス(MiniSigLIP)を定義します。モデル全体の構成は次の図のとおりです(各部品は、この後のコードで定義します)。
(図は、diagram-designで作成)
import math
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
from torchvision import datasets
import matplotlib.pyplot as plt
from transformers import AutoTokenizer


class MiniSigLIP(nn.Module):
    # 大きさ(dim・層の数・ヘッドの数)は、10 ペアの暗記を CPU で数分で確かめられる小ささにしている
    # patch=4 で 28×28 の画像を 7×7=49 個のパッチに分ける。max_len=16 は論文のテキストの最大長
    def __init__(self, vocab_size, dim=192, img_size=28, patch=4,
                 v_depth=4, t_depth=2, heads=4, max_len=16):
        super().__init__()
        self.vision = VisionTower(img_size, patch, 1, dim, v_depth, heads)
        self.text = TextTower(vocab_size, max_len, dim, t_depth, heads)
        # 論文の初期値: 学習するのは t' = log(10)(温度 t = exp(t') = 10)と、バイアス b = -10
        self.t_prime = nn.Parameter(torch.tensor(math.log(10.0)))
        self.b = nn.Parameter(torch.tensor(-10.0))

    def encode_image(self, images):
        # 画像特徴量を抽出し、L2正規化を行う
        return F.normalize(self.vision(images), dim=-1)

    def encode_text(self, ids, eos_pos, key_padding_mask=None):
        # テキスト特徴量を抽出し、L2正規化を行う
        return F.normalize(self.text(ids, eos_pos, key_padding_mask), dim=-1)

    def forward(self, images, ids, eos_pos, key_padding_mask=None):
        zi = self.encode_image(images)                          # (B, D)
        zt = self.encode_text(ids, eos_pos, key_padding_mask)   # (B, D)
        # 行列積で類似度を計算し、温度によるスケーリングとバイアスを加算
        logits = zi @ zt.t() * self.t_prime.exp() + self.b      # (B, B)
        return logits, zi, zt
MiniSigLIPの全体像: 画像エンコーダ(VisionTower)とテキストエンコーダ(TextTower)を初期化し、論文で推奨されている学習可能なパラメータ(温度 t_prime とバイアス b)を定義しています。
大きさの決め方: 目的は、モデルとシグモイド損失が正しく組めているかを、10ペアを暗記できるかで確かめることです。そのため、大きさはCPUで数分で学習できるように小さくしています(dim=192 はViTの最小構成ViT-Tiの幅と同じ)。暗記できるかどうかは、この程度の大きさなら大きく変わりません。テキストの最大長 max_len=16 は論文の設定と同じです。
温度を exp(t′) で持つ理由: 温度 をそのまま学習すると、更新の途中で0以下になり得ます。 を学習して とすれば、常に正の値になります。
ロジットの計算: forward メソッドにおいて、画像とテキストの特徴量に対してL2正規化(F.normalize)を適用した後、行列積を用いて類似度行列を計算します。L2正規化を行いベクトルの長さを 1 に揃えることで、異なるモダリティ(画像とテキスト)の出力の大きさに依存せず、純粋な「ベクトルの向きの一致度(コサイン類似度: -1.0〜1.0)」として内積を評価できるようになります。この類似度にスケール(温度)を掛け、バイアスを足すことで、後のシグモイド損失計算のための準備を整えます。
Transformerの共通部品
画像側とテキスト側で共通して使うブロックです。SigLIPはPre-LN(LayerNormを残差ブランチの入口に置く構成)を採用しています。原著の Transformer は、足した後に正規化する Post-LN です(Transformer の記事)。
class MHSA(nn.Module):
    """マルチヘッド自己注意"""
    def __init__(self, dim, heads):
        super().__init__()
        self.h, self.dh = heads, dim // heads
        self.qkv = nn.Linear(dim, dim * 3)
        self.proj = nn.Linear(dim, dim)

    def forward(self, x, key_padding_mask=None):
        B, N, D = x.shape
        # 入力xからQuery, Key, Valueを一括で生成し、マルチヘッドの形状に変形
        q, k, v = self.qkv(x).reshape(B, N, 3, self.h, self.dh).permute(2, 0, 3, 1, 4)
        attn_mask = None
        if key_padding_mask is not None:
            # True = 参照してよい位置。PAD の列だけを落とす
            attn_mask = key_padding_mask[:, None, None, :].expand(B, self.h, N, N)
        # PyTorchの組み込み関数で効率的にアテンションを計算
        o = F.scaled_dot_product_attention(q, k, v, attn_mask=attn_mask)
        # 元の形状に戻して線形変換
        return self.proj(o.transpose(1, 2).reshape(B, N, D))


class MLP(nn.Module):
    def __init__(self, dim, ratio=4):
        super().__init__()
        self.fc1, self.fc2 = nn.Linear(dim, dim * ratio), nn.Linear(dim * ratio, dim)

    def forward(self, x):
        # 隠れ層の次元を拡大してGELUを適用し、元の次元に縮小
        return self.fc2(F.gelu(self.fc1(x), approximate="tanh"))


class Block(nn.Module):
    """Pre-LN Transformer ブロック"""
    def __init__(self, dim, heads):
        super().__init__()
        self.ln1, self.ln2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.attn, self.mlp = MHSA(dim, heads), MLP(dim)

    def forward(self, x, key_padding_mask=None):
        # 残差接続とともにマルチヘッド自己注意を適用 (Pre-LN)
        x = x + self.attn(self.ln1(x), key_padding_mask)
        x = x + self.mlp(self.ln2(x))
        return x
Pre-LNの採用: ブロックの入口で層正規化(LayerNorm)を行うPre-LN構造を採用しており、深いネットワークでも勾配が安定して伝播するようにしています。
マルチヘッド自己注意とパディング: MHSA クラスでは F.scaled_dot_product_attention を用いて高速にアテンションを計算します。key_padding_mask を用いることで、テキスト入力時にPADトークンが計算に影響を与えないよう適切にマスク処理を施しています。
画像エンコーダ(ViT + MAP head)の定義
ここがCLIPとSigLIPで明確に異なる部分です。CLIPは[CLS]トークンの出力を画像特徴として使いますが、SigLIPは MAP head(Multihead Attention Pooling)を使います。
MAP headは、学習可能な1本のクエリベクトル(probe)が全パッチトークンに注意を向けて情報を集約する仕組みです。[CLS]のように「全層を通して1トークン分の計算を余分に払う」必要がなく、最終層で1回だけプーリングします。
class MAPHead(nn.Module):
    """Multihead Attention Pooling: 学習可能な probe で系列を1ベクトルに集約"""
    def __init__(self, dim, heads):
        super().__init__()
        self.probe = nn.Parameter(torch.randn(1, 1, dim) * 0.02)
        self.attn = nn.MultiheadAttention(dim, heads, batch_first=True)
        self.ln = nn.LayerNorm(dim)
        self.mlp = MLP(dim)

    def forward(self, x):
        # バッチサイズに合わせてprobeを拡張
        q = self.probe.expand(x.shape[0], -1, -1)      # (B, 1, D)
        # probeをQueryとし、xをKey/Valueとしてアテンションを計算
        h, _ = self.attn(q, x, x, need_weights=False)
        h = h + self.mlp(self.ln(h))
        return h[:, 0]


class VisionTower(nn.Module):
    def __init__(self, img_size=28, patch=4, in_ch=1, dim=192, depth=4, heads=4):
        super().__init__()
        self.patch_embed = nn.Conv2d(in_ch, dim, kernel_size=patch, stride=patch)
        n_pos = (img_size // patch) ** 2
        # 位置埋め込みの初期化スケールは big_vision に合わせて 1/sqrt(dim)
        self.pos = nn.Parameter(torch.randn(1, n_pos, dim) / math.sqrt(dim))
        self.blocks = nn.ModuleList([Block(dim, heads) for _ in range(depth)])
        self.ln = nn.LayerNorm(dim)
        self.head = MAPHead(dim, heads)

    def forward(self, x):
        # 入力画像をパッチに分割
        x = self.patch_embed(x)              # (B, D, 7, 7)
        # (B, パッチ数, パッチの次元) の形状に変形
        x = x.flatten(2).transpose(1, 2)     # (B, 49, D)
        x = x + self.pos  # 位置エンコーディングを加算
        for blk in self.blocks:
            x = blk(x)    # 全てのTransformerブロックを適用
        # MAP Headで系列全体を1つのベクトルに集約
        return self.head(self.ln(x))         # (B, D)
画像エンコーダの構造: VisionTower では、入力画像を patch_embed によってパッチ化し、Transformerブロックの処理対象となる系列データに変換しています。
MAP Headの採用: CLIPのように [CLS] トークンを用いるのではなく、MAPHead を使用しています。probe と呼ばれる学習可能な単一のクエリベクトルが、すべてのパッチ特徴量に対して注意を向け、最終的に1つのベクトル(画像特徴)として集約します。これにより、系列長を余分に増やさずに効率的なプーリングを実現しています。
テキストエンコーダの定義
SigLIPのテキストエンコーダには、2つの重要なポイントがあります。
- 因果マスクを使わない:CLIPのテキストエンコーダは自己回帰的な因果マスクを持ちますが、SigLIPは双方向に注意を向けます。文全体から1つのベクトルを作るタスクなので、未来のトークンを隠す理由がありません。
- 系列の末尾位置をプーリングに使う:画像側のようなMAP headではなく、EOS位置の出力に線形層を通したものを文ベクトルとします。
class TextTower(nn.Module):
    def __init__(self, vocab_size, max_len=16, dim=192, depth=2, heads=4, pad_id=0):
        super().__init__()
        self.pad_id = pad_id
        self.tok = nn.Embedding(vocab_size, dim)
        self.pos = nn.Parameter(torch.randn(1, max_len, dim) / math.sqrt(dim))
        self.blocks = nn.ModuleList([Block(dim, heads) for _ in range(depth)])
        self.ln = nn.LayerNorm(dim)
        self.head = nn.Linear(dim, dim)

    def forward(self, ids, eos_pos, key_padding_mask=None):
        # マスクは外から渡せるようにする。SigLIPのトークナイザは
        # pad_token_id == eos_token_id なので、ids から素朴に作ると
        # EOS までPAD扱いになってしまう
        if key_padding_mask is None:
            key_padding_mask = ids.ne(self.pad_id)   # True = 実トークン
        # トークンIDを埋め込みベクトルに変換し、位置エンコーディングを加算
        x = self.tok(ids) + self.pos[:, : ids.shape[1]]
        for blk in self.blocks:
            x = blk(x, key_padding_mask=key_padding_mask)
        x = self.ln(x)
        # 系列の末尾(EOS)位置の特徴量を抽出
        pooled = x[torch.arange(x.shape[0], device=x.device), eos_pos]
        return self.head(pooled)                # (B, D)
因果マスクの排除: テキスト全体の意味を捉えるため、次の単語を予測する自己回帰モデルのような因果マスク(Causal Mask)は使用せず、双方向の自己注意を行っています。
EOSプーリング: 最終層の出力から、各バッチにおける系列の末尾(EOSトークン)の位置(eos_pos)の特徴量を抽出し、これを線形層(self.head)に通すことでテキスト全体の特徴ベクトルとしています。なお、Hugging Faceの公式実装では系列の最終位置([:, -1, :])を素朴に取得していますが(max_lengthパディングかつpad==eosのため結果的にEOSと一致)、本記事の実装ではより正確に本来のEOS位置を動的に求めています。
シグモイド損失
SigLIPの中核です。論文の定義に加えて、クラス分類データを使う場合に必要な修正を入れます。
def sigmoid_loss(logits, labels):
    """labels は +1 / -1 の行列"""
    # ロジットと正負ラベルの積に対してlogsigmoidを適用し、バッチ平均をとる
    return -F.logsigmoid(labels * logits).sum() / logits.shape[0]


def make_labels(class_ids):
    """同じクラスのペアはすべて正例とする(偽陰性の回避)"""
    # クラスIDのブロードキャスト比較で同一クラスのペアをTrueとし、+1/-1に変換
    return class_ids[:, None].eq(class_ids[None, :]).float() * 2 - 1
シグモイド損失の計算: sigmoid_loss 関数では、入力ロジットと正負のラベル(+1 / -1)を掛け合わせた値に対し、-F.logsigmoid() を適用して損失を算出します。これはペアごとの独立した2値分類問題として扱っていることを意味します。
ラベル行列の作成: make_labels 関数では、同じクラスIDを持つペアをすべて正例(+1)、それ以外を負例(-1)として行列を作成します。これにより、バッチ内に同じクラスの異なる画像が含まれている場合の偽陰性(False Negative)を防ぎます。
チャンク化実装
論文の技術的な貢献のひとつが、 の類似度行列を一度に作らずに済むチャンク化実装です。シグモイド損失は各ペアが独立した項なので、行列を列方向のブロックに分割して損失を足し合わせるだけで厳密に同じ値が得られます。
分散環境がなくても、1台のマシン上で同じ分解を再現できます。
def chunked_sigmoid_loss(zi, zt, class_ids, t, b, n_chunk=2):
    """テキスト側をチャンクに分けて損失を累積する(分散実装の1デバイス版)"""
    total = 0.0
    # テキスト側の特徴量とラベル行列をチャンクごとに分割して処理
    for ztk, idk in zip(zt.chunk(n_chunk), class_ids.chunk(n_chunk)):
        # チャンク単位で類似度(ロジット)を計算
        lg = zi @ ztk.t() * t + b                              # (B, B/n_chunk)
        # チャンク単位でラベル行列を作成
        lb = class_ids[:, None].eq(idk[None, :]).float() * 2 - 1
        # 損失を加算
        total = total + -F.logsigmoid(lb * lg).sum()
    return total / zi.shape[0]
チャンク化によるメモリ削減: テキスト側の特徴量とラベル行列を n_chunk 個に分割し、分割されたブロックごとに損失を計算して累積します。巨大な類似度行列を一括でメモリ上に展開する必要がなくなるため、バッチサイズを極端に大きくした際のアウトオブメモリ(OOM)を回避する実践的な実装です。
学習率スケジューラの定義
def lr_at(step, total, base_lr, warmup):
    """線形ウォームアップ + コサイン減衰"""
    if step < warmup:
        # ウォームアップ期間中は線形に学習率を増加させる
        return base_lr * step / max(1, warmup)
    # ウォームアップ後はコサインカーブに従って滑らかに減衰させる
    p = (step - warmup) / max(1, total - warmup)
    return base_lr * 0.5 * (1 + math.cos(math.pi * min(1.0, p)))
学習率のスケジューリング: 学習開始直後の不安定な勾配を防ぐための線形ウォームアップ(warmup ステップまで徐々に学習率を上げる)と、その後学習率を滑らかに下げるコサイン減衰(Cosine Decay)を組み合わせたスケジューラを定義しています。
データセットの準備
Fashion-MNISTの各クラスに、CLIPやSigLIPのゼロショット分類で使われる定番のプロンプトテンプレート a photo of a {class} を当てはめて、画像とテキストのペアを作ります。
CLASSES = ["t-shirt", "trouser", "pullover", "dress", "coat",
           "sandal", "shirt", "sneaker", "bag", "ankle boot"]

ds = datasets.FashionMNIST(root="data", train=True, download=True)
imgs = ds.data.numpy()          # (60000, 28, 28) uint8
labels = ds.targets.numpy()     # (60000,)

captions = [f"a photo of a {c}" for c in CLASSES]


def to_tensor(batch_uint8, device="cpu"):
    x = torch.from_numpy(batch_uint8.copy()).to(device)
    # [0, 1]の範囲に正規化し、チャネル次元を追加
    x = x.float().unsqueeze(1) / 255.0      # (B, 1, 28, 28)
    # [-1, 1]の範囲にスケール変換
    return (x - 0.5) / 0.5
データセットとテキストの準備: Fashion-MNISTデータセットをダウンロードし、10種類のクラスラベルに対して a photo of a {class} というプロンプトテンプレートを適用してキャプションを作成しています。
画像テンソルの前処理: uint8型の画像データをPyTorchのテンソルに変換し、[0, 1]の範囲に正規化した上で、[-1, 1]の範囲へとスケールを合わせています。
トークナイズの落とし穴
SigLIP公式のトークナイザは SentencePiece ベースで、a を ['▁', 'a'] の2トークンに分割します。そのため a photo of a というテンプレートだけで6トークンを消費し、max_length=8 ではクラス名に使える枠が実質1トークンしか残りません。
実際にトークナイズすると、t-shirt / trouser / sandal の3つが まったく同一の系列 ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁', '</s>'] になります。同じ入力に対して異なる画像へ +1 / -1 のラベルを要求することになるため、この3ペアの損失は原理的に下がりません。
もうひとつの罠が、SigLIPのトークナイザでは pad_token_id == eos_token_id(どちらも1)であることです。「PAD以外のトークン数 − 1」でEOS位置を求めると1つ手前を指してしまい、さらにPADマスクがEOS自身を参照不能にしてしまいます。
学習に入る前に、この2点を必ず確認しておきましょう。
# SigLIP公式のSentencePieceトークナイザーをロード
tok = AutoTokenizer.from_pretrained("google/siglip-base-patch16-224")

print("pad", tok.pad_token_id, "eos", tok.eos_token_id)
for c in captions:
    # 指定した最大長でトークナイズし、切り捨て(truncation)を有効にする
    row = tok(c, padding="max_length", max_length=8,
              truncation=True)["input_ids"]
    # IDを文字列のトークンに変換して確認
    print(f"{c:28s}", tok.convert_ids_to_tokens(row))
SentencePieceトークナイザの初期化: AutoTokenizer.from_pretrained を用いて、事前学習済みSigLIPのトークナイザをロードしています。
トークン化の確認: 各キャプションを固定長(ここでは max_length=8)でトークン化し、中身を確認しています。SigLIP特有の ▁ を含むサブワード分割や、PADとEOSが同じID(1)になっている点など、後続の処理に影響を与える重要な挙動をここで可視化してチェックします。
実行結果
pad 1 eos 1
a photo of a t-shirt         ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁', '</s>']
a photo of a trouser         ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁', '</s>']
a photo of a pullover        ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁pull', '</s>']
a photo of a dress           ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁dress', '</s>']
a photo of a coat            ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁coat', '</s>']
a photo of a sandal          ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁', '</s>']
a photo of a shirt           ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁shirt', '</s>']
a photo of a sneaker         ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁sneak', '</s>']
a photo of a bag             ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁bag', '</s>']
a photo of a ankle boot      ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁ankle', '</s>']
実行結果を見ると、t-shirt と trouser、そして sandal の3つが ['▁', 'a', '▁photo', '▁of', '▁', 'a', '▁', '</s>'] と全く同じトークン列になってしまっていることが分かります。これは max_length=8 の制限によりクラス名部分の文字が切り捨て(Truncation)られたためです。また、PADとEOSのIDがともに1であることも確認できます。実際の学習時には max_length を十分に長く設定する必要があります。
max_length = 8 のトークン列を並べると、次のようになります。
(図は、diagram-designで作成)
モデルの学習
各クラスから1枚ずつ選んだ10ペアを暗記できるかを確認します。
# キャプションのトークナイズ
#    テンプレートだけで6トークン消費するため、max_length は余裕をもって取る
MAXLEN = 16
enc = tok(captions, padding="max_length", max_length=MAXLEN,
          truncation=True, return_tensors="pt")
ids = enc["input_ids"]

# 切り詰めが起きていないこと・キャプションが重複していないことを保証する
#    pad_token_id == eos_token_id なので、EOS の後ろに本物のPADが
#    最低1つ残っているかどうかで truncation を判定する
real = ids.ne(tok.pad_token_id)                 # True = 内容トークン
assert (real.sum(1) + 1 < MAXLEN).all(), "まだ truncation が起きています"
assert len(set(map(tuple, ids.tolist()))) == len(captions), "同一のキャプションがあります"

# EOS位置とアテンションマスクを作る
#    「PAD以外の数」は EOS を含まないので、そのままEOS自身のインデックスになる
eos = real.sum(1)
attn_mask = real.clone()
attn_mask[torch.arange(len(ids)), eos] = True   # EOS を参照可能にする

# 各クラスから1枚ずつ(バッチ内でキャプションが重複しないようにする)
sel = [int(np.where(labels == c)[0][0]) for c in range(10)]
x = to_tensor(imgs[sel])
class_ids = torch.tensor(labels[sel])
lab = make_labels(class_ids)

# モデルの初期化 (語彙サイズをSentencePieceトークナイザーのものに変更)
torch.manual_seed(0)
model = MiniSigLIP(tok.vocab_size, max_len=MAXLEN)

# TextTowerのpad_idを、読み込んだトークナイザーのpad_token_idに合わせて上書き
model.text.pad_id = tok.pad_token_id

# 温度 t とバイアス b、位置埋め込みなどは weight decay の対象から外す
#    (論文実装の big_vision に合わせる。decay させると b が 0 方向へ
#      引きずられ、負例側のロジットが持ち上がってしまう)
decay, no_decay = [], []
for n, p in model.named_parameters():
    (no_decay if (p.ndim <= 1 or n in ("t_prime", "b")
                  or "pos" in n or "probe" in n) else decay).append(p)
# 学習率 1e-3 は論文の値。AdamW は 1 ステップに「学習率 × weight_decay」だけ重みを縮めるので、
# weight_decay=0.1 で 1e-3 × 0.1 = 1e-4 となり、論文(big_vision)の weight decay 1e-4 と同じ強さになる
opt = torch.optim.AdamW([{"params": decay,    "weight_decay": 0.1},
                         {"params": no_decay, "weight_decay": 0.0}], lr=1e-3)

# 1000 ステップ(R@1 は 100 ステップで 100% になり、損失も 900 ステップでほぼ止まる)。ウォームアップはその 5%
T = 1000
for s in range(1, T + 1):
    for g in opt.param_groups:
        g['lr'] = lr_at(s, T, 1e-3, warmup=50)

    logits, zi, zt = model(x, ids, eos, attn_mask)
    loss = sigmoid_loss(logits, lab)
    opt.zero_grad(); loss.backward(); opt.step()

    if s == 1 or s % 100 == 0:
        sim = (zi @ zt.t()).detach()
        # 最も類似度の高いテキストインデックスが正解(対角線)と一致するかで精度を計算
        acc = (sim.argmax(-1) == torch.arange(len(x), device=sim.device)).float().mean().item()
        off = ((sim.sum() - sim.diag().sum()) / 90).item()
        print(f'step {s:4d} loss {loss.item():7.4f} R@1 {acc:6.1%} '
              f'diag {sim.diag().mean():+.3f} off {off:+.3f} '
              f't {model.t_prime.exp().item():5.2f} b {model.b.item():+.2f}')
データ準備とトークン化: トークンの切り捨てを防ぐため MAXLEN = 16 としてトークン化を行い、PADトークンの判定から正しいEOS位置(eos)とアテンションマスク(attn_mask)を生成しています。
オプティマイザの最適化設定: バイアスや位置エンコーディング、温度パラメータなどが重み減衰(Weight Decay)によって0に引きずられるのを防ぐため、これらを no_decay グループに分けて AdamW オプティマイザに渡しています。論文の実装(big_vision)も、既定では重み行列だけを縮めます。
値の決め方: 学習率 1e-3 は論文と同じ値です。weight decay は、論文の実装では学習率を掛けずに1ステップに だけ重みを縮めますが、PyTorchの AdamW は「学習率 × weight_decay」だけ縮めます。そこで weight_decay=0.1 として、 と論文と同じ強さにしています。なお、オプティマイザ自体は論文(ScalingViT-Adafactor)と違い、PyTorchで広く使われるAdamWにしています。ステップ数 T = 1000 は、下の結果のとおり、R@1が100ステップで100%になり、損失が900ステップでほぼ下がりきる長さです。ウォームアップはその5%の50ステップで、10ペアの暗記ではこの長さに結果は大きく左右されません。
学習ループ: ロジットを計算し、先ほど定義した sigmoid_loss で誤差逆伝播を行ってパラメータを更新します。定期的に類似度(sim)を計算し、精度(Recall@1)や対角成分・非対角成分の値、温度・バイアスの推移を監視しています。
実行結果
モデルの学習コードを実行すると以下が出力されます。
step    1 loss 10.4317 R@1  10.0% diag -0.043 off -0.044 t 10.00 b -10.00
step  100 loss  0.5559 R@1 100.0% diag +0.989 off -0.073 t 10.53 b -9.97
step  200 loss  0.1679 R@1 100.0% diag +1.000 off -0.106 t 11.69 b -9.89
step  300 loss  0.0881 R@1 100.0% diag +1.000 off -0.107 t 12.32 b -9.86
step  400 loss  0.0574 R@1 100.0% diag +1.000 off -0.107 t 12.73 b -9.83
step  500 loss  0.0426 R@1 100.0% diag +1.000 off -0.108 t 13.02 b -9.82
step  600 loss  0.0350 R@1 100.0% diag +1.000 off -0.109 t 13.21 b -9.81
step  700 loss  0.0310 R@1 100.0% diag +1.000 off -0.109 t 13.32 b -9.80
step  800 loss  0.0290 R@1 100.0% diag +1.000 off -0.109 t 13.39 b -9.80
step  900 loss  0.0283 R@1 100.0% diag +1.000 off -0.109 t 13.42 b -9.80
step 1000 loss  0.0281 R@1 100.0% diag +1.000 off -0.109 t 13.42 b -9.80
学習が進むにつれて損失(loss)が順調に減少し、わずか100ステップで正解率(R@1)が100%に到達していることがわかります。また、バイアス(b)は初期値の-10付近(-9.80)にとどまったまま、温度(t)が10から13.42に上昇しています。正例と負例の区別は、バイアスではなく、温度で広げた内積の差(diag +1.000 と off -0.109)によってついています。類似度の対角成分(diag)が+1.000に、非対角成分(off)がマイナス値になっていることから、画像と正しいテキストのペアでは正例(+1)、誤ったペアでは負例(-1)として、シグモイド損失を用いた学習が意図通りに機能し、正しく過学習できていることが確認できました。
温度とバイアスの推移を図にすると、次のようになります。
(図は、diagram-designで作成)
chunked_sigmoid_loss の動作検証
以下のコードでは、バッチ全体で一括計算したシグモイド損失(フル計算版)と、メモリ削減のために分割計算したチャンク版(chunked_sigmoid_loss)の出力が厳密に一致するかを検証します。
with torch.no_grad():
    logits, zi, zt = model(x, ids, eos, attn_mask)
    l_full = sigmoid_loss(logits, lab)
    l_chunk = chunked_sigmoid_loss(zi, zt, class_ids, model.t_prime.exp(), model.b, n_chunk=2)
print(l_full.item(), l_chunk.item())
チャンク版の等価性検証: torch.no_grad() 環境下で、先ほどの過学習に用いた特徴量とラベルを使って通常の sigmoid_loss を計算し、同時に chunked_sigmoid_loss にテキストを2分割(n_chunk=2)するように渡して損失を計算しています。
実行結果
0.02814009226858616 0.0281401164829731
実行結果を見ると、フル計算版の損失とチャンク版の損失が共に 0.028140... となり、ほぼ完全に一致していることが分かります。末尾に見える 2e-9 程度の微小な差は float32 の加算順序による浮動小数点の丸め誤差によるものであり、数学的には厳密に同一の式を計算しています。これにより、巨大な類似度行列を一気に展開せずとも、チャンク化によってメモリを節約しながら全く同じ損失を計算できることが実証されました。
モデルの予測
以下のコードでは、過学習させたモデルを用いて実際に10ペアの画像とテキストを入力し、推論(予測確率の計算)を行って、その結果を画像付きで可視化します。
# --- 画像プレビュー付きの推論結果表示 ---
model.eval()  # 評価モードに切り替え
with torch.no_grad():
    image_features = model.encode_image(x)
    text_features = model.encode_text(ids, eos, attn_mask)
    logits = image_features @ text_features.t() * model.t_prime.exp() + model.b
    probs = torch.sigmoid(logits)

# 2行5列で10枚の画像をプロット
fig, axes = plt.subplots(2, 5, figsize=(15, 6))
axes = axes.flatten()

for i in range(len(x)):
    # オリジナルの画像データ (0-255のnumpy配列) を取得
    # imgs[sel] に元の画像データが格納されています
    img = imgs[sel[i]]

    p = probs[i]
    pred_idx = p.argmax().item()  # 最も確率の高いクラスのインデックスを取得
    pred_prob = p[pred_idx].item()

    true_label = CLASSES[class_ids[i]]
    pred_label = CLASSES[pred_idx]

    # 描画
    ax = axes[i]
    ax.imshow(img, cmap='gray')

    # 正解なら緑色、不正解なら赤色でタイトルを表示
    color = "green" if true_label == pred_label else "red"
    ax.set_title(f"True: {true_label}\nPred: {pred_label}\nProb: {pred_prob:.3f}", color=color)
    ax.axis('off')

plt.tight_layout()
plt.show()
予測確率の算出: torch.no_grad() で勾配計算を無効化し、画像とテキストの特徴量をエンコードして類似度(ロジット)を計算します。最後に torch.sigmoid(logits) を適用して、各ペアの予測確率を算出しています。
結果の描画: matplotlibを用いて元の画像をプロットし、予測されたテキストの確率とともに表示します。予測が正解ラベルと一致していれば緑色、間違っていれば赤色でタイトルを描画します。
実行結果
上記のコードを実行すると、以下の結果が得られます。
学習済みのMiniSigLIPモデルによる推論結果の画像が表示されます。10種類すべての画像において、実際のクラス(True)と予測されたクラス(Pred)が完全に一致しており、それぞれ約97.4%(0.974)という極めて高い独立した確率で正解を引き当てていることがわかります。学習が進んで対角成分(類似度)が 1.0 に張り付いても確率が 97.4% で頭打ちになるのは、学習済みのバイアス b がロジットを押し下げているためです(シグモイド関数への入力が 1.000 × 13.42 - 9.80 ≒ 3.62 となり、sigmoid(3.62) ≒ 0.974 となります)。Softmaxと異なり確率の合計が1にならない点も確認できます。
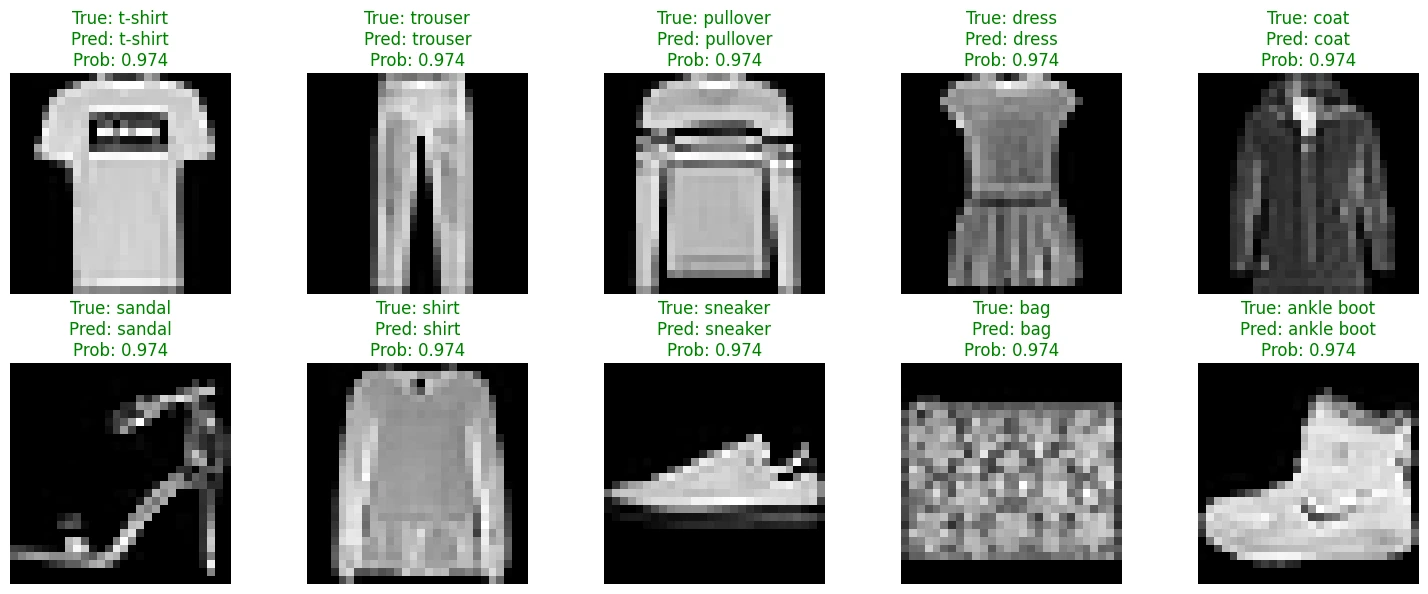
実際のHugging Faceモデルを用いた推論テスト
Hugging Faceの transformers ライブラリを利用して、事前学習済みの本物のSigLIPモデル(Google提供)で推論を行ってみます。CLIPと比較して、ソフトマックス関数ではなくシグモイド関数を用いて確率を算出する点に注目してください。
推論に利用する画像
以下の画像を cat.jpg として保存し、以下のコードと同じフォルダに配置して下さい。
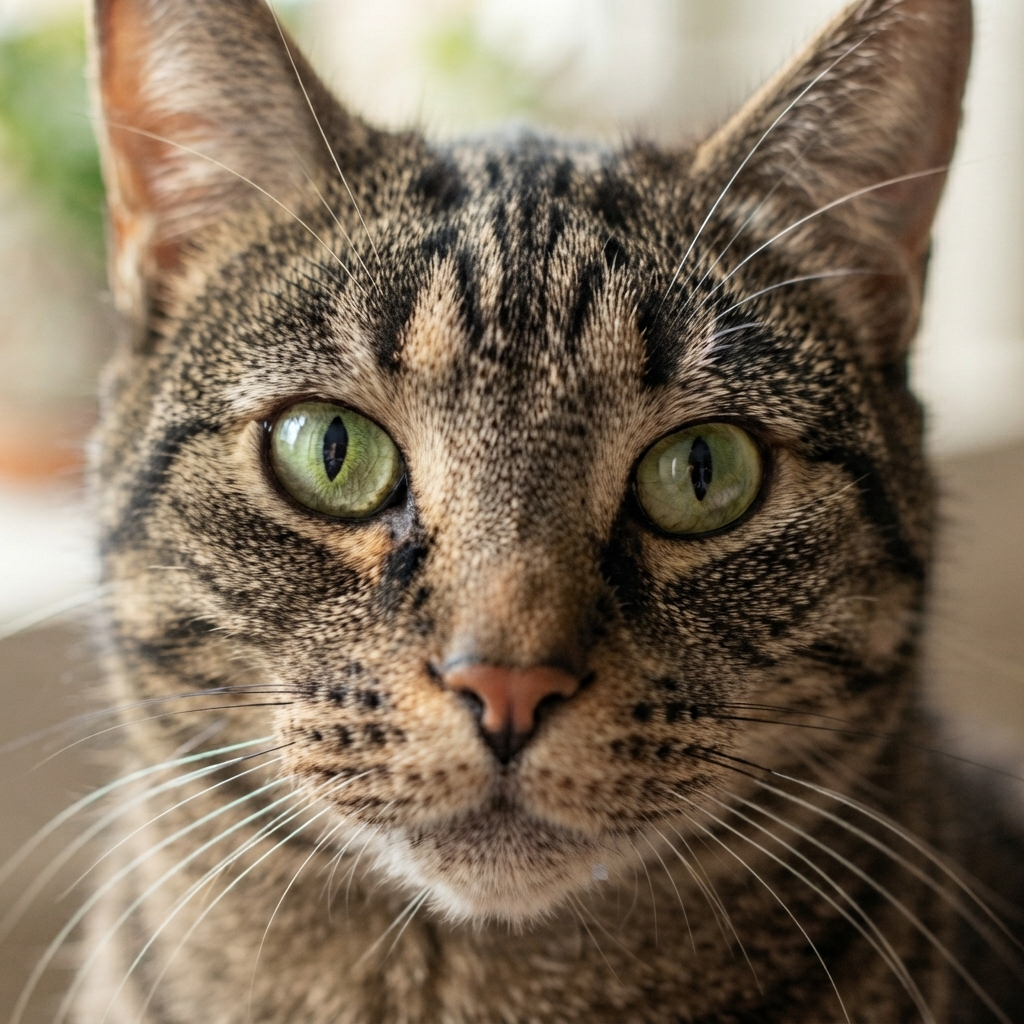
(画像は、Geminiで作成)
ここでは、Hugging Faceの transformers ライブラリを使用してGoogleが提供する実際の事前学習済みSigLIPモデルを読み込み、猫の画像に対して異なる3つのテキスト候補を与えて予測確率を検証します。
from transformers import SiglipProcessor, SiglipModel
import torch
from PIL import Image
import matplotlib.pyplot as plt

# 1. SigLIPのモデルとプロセッサの読み込み
model_name = "google/siglip-base-patch16-224"
model = SiglipModel.from_pretrained(model_name)
processor = SiglipProcessor.from_pretrained(model_name)

# 2. 画像の読み込み
image = Image.open("cat.jpg")

# 3. テキスト候補の用意
texts = ["a photo of a cat", "a photo of a dog", "a photo of a car"]

# 4. 前処理と推論
inputs = processor(text=texts, images=image, padding="max_length", return_tensors="pt")
with torch.no_grad():
    outputs = model(**inputs)

# 5. SigLIPはSoftmaxではなくSigmoidで確率を計算する
logits_per_image = outputs.logits_per_image
probs = torch.sigmoid(logits_per_image)  # ここがCLIPとの決定的な違い

# 6. 結果の表示
print("【SigLIPによる予測確率】")
for i in range(len(texts)):
    print(f"{texts[i]} : {probs[0,i]:.1%}")

# サンプル画像の可視化
plt.figure(figsize=(6, 6))
plt.imshow(image)
plt.axis("off")
plt.tight_layout()
plt.show()
モデルとプロセッサの準備: SiglipModel と SiglipProcessor を用いてモデルと前処理器を初期化し、比較したいテキスト候補を準備します。推論時の padding="max_length" は必須で、SigLIPのテキストエンコーダが固定長系列を前提としているためです。
推論とシグモイド関数の適用: 入力画像とテキストをモデルに渡し、出力されたロジットに対して torch.sigmoid() を適用することで、各テキストが画像とマッチする独立した確率を算出しています。これはCLIPにおけるソフトマックス関数とは決定的に異なる処理です。
上記のコードを実行すると以下の結果が得られます。
【SigLIPによる予測確率】
a photo of a cat : 55.3%
a photo of a dog : 0.1%
a photo of a car : 0.0%
ここで押さえておきたいのは、手順5の torch.sigmoid を torch.softmax に書き換えてはいけないという点です。
SigLIPのロジットには学習済みのバイアス が加算されており、シグモイドを通して初めて「この画像とこのテキストは対応しているか」という独立した確率として解釈できます。ソフトマックスを適用すると、候補どうしの相対比較に潰れてしまい、バイアスの情報も失われます。
SigLIPでは各テキストが画像に一致するかどうかが「独立した確率」として計算されるため、 合計が100%になる必要はありません。正解の「猫の写真」には高い確率が割り当てられ、それ以外は0%に近い確率が個別に割り当てられていることがわかります。
3つの候補の確率を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、画像とテキストのマルチモーダルモデルのための新しい事前学習手法であるSigLIPについて解説しました。
記事を通じて、以下の内容を学習・実践しました。
- SigLIPの理論とメリット: 従来のソフトマックス損失からペアワイズ・シグモイド損失に変更することで、グローバルな正規化を不要にし、省メモリかつ巨大なバッチサイズでの学習が可能になる仕組みを学びました。
- スクラッチ実装による検証: PyTorchを用いて、MAP Headを持つViTとテキストエンコーダ、シグモイド損失、およびメモリ効率の良いチャンク化処理を実装し、過学習を用いたサニティチェックで正しく学習できることを確認しました。
- Hugging Faceモデルを利用した推論:
transformersライブラリを使用して実際の学習済みモデルを読み込み、ソフトマックスではなくシグモイド関数を用いて各ペアが独立した確率として予測されることを検証しました。
SigLIPのアプローチは、計算リソースの制約が厳しい環境でも効率的に大規模なマルチモーダル学習を行うための重要なパラダイムシフトです。ぜひ実際のプロジェクトやファインチューニングにも応用してみてください。
参考文献
- X. Zhai, B. Mustafa, A. Kolesnikov, L. Beyer (2023). Sigmoid Loss for Language Image Pre-Training. ICCV 2023.
- Google. google/siglip-base-patch16-224. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。
- Dataset License: 本記事のコード(スクラッチ実装)で使用している
Fashion-MNISTデータセットは、Zalando SE によって MIT License の下で公開されています。 - Model License: 推論テストで使用している
google/siglip-base-patch16-224モデルは、Google によって Apache License 2.0 の下で公開されています。