SigLIP 2とは?
(画像は、Geminiで作成)
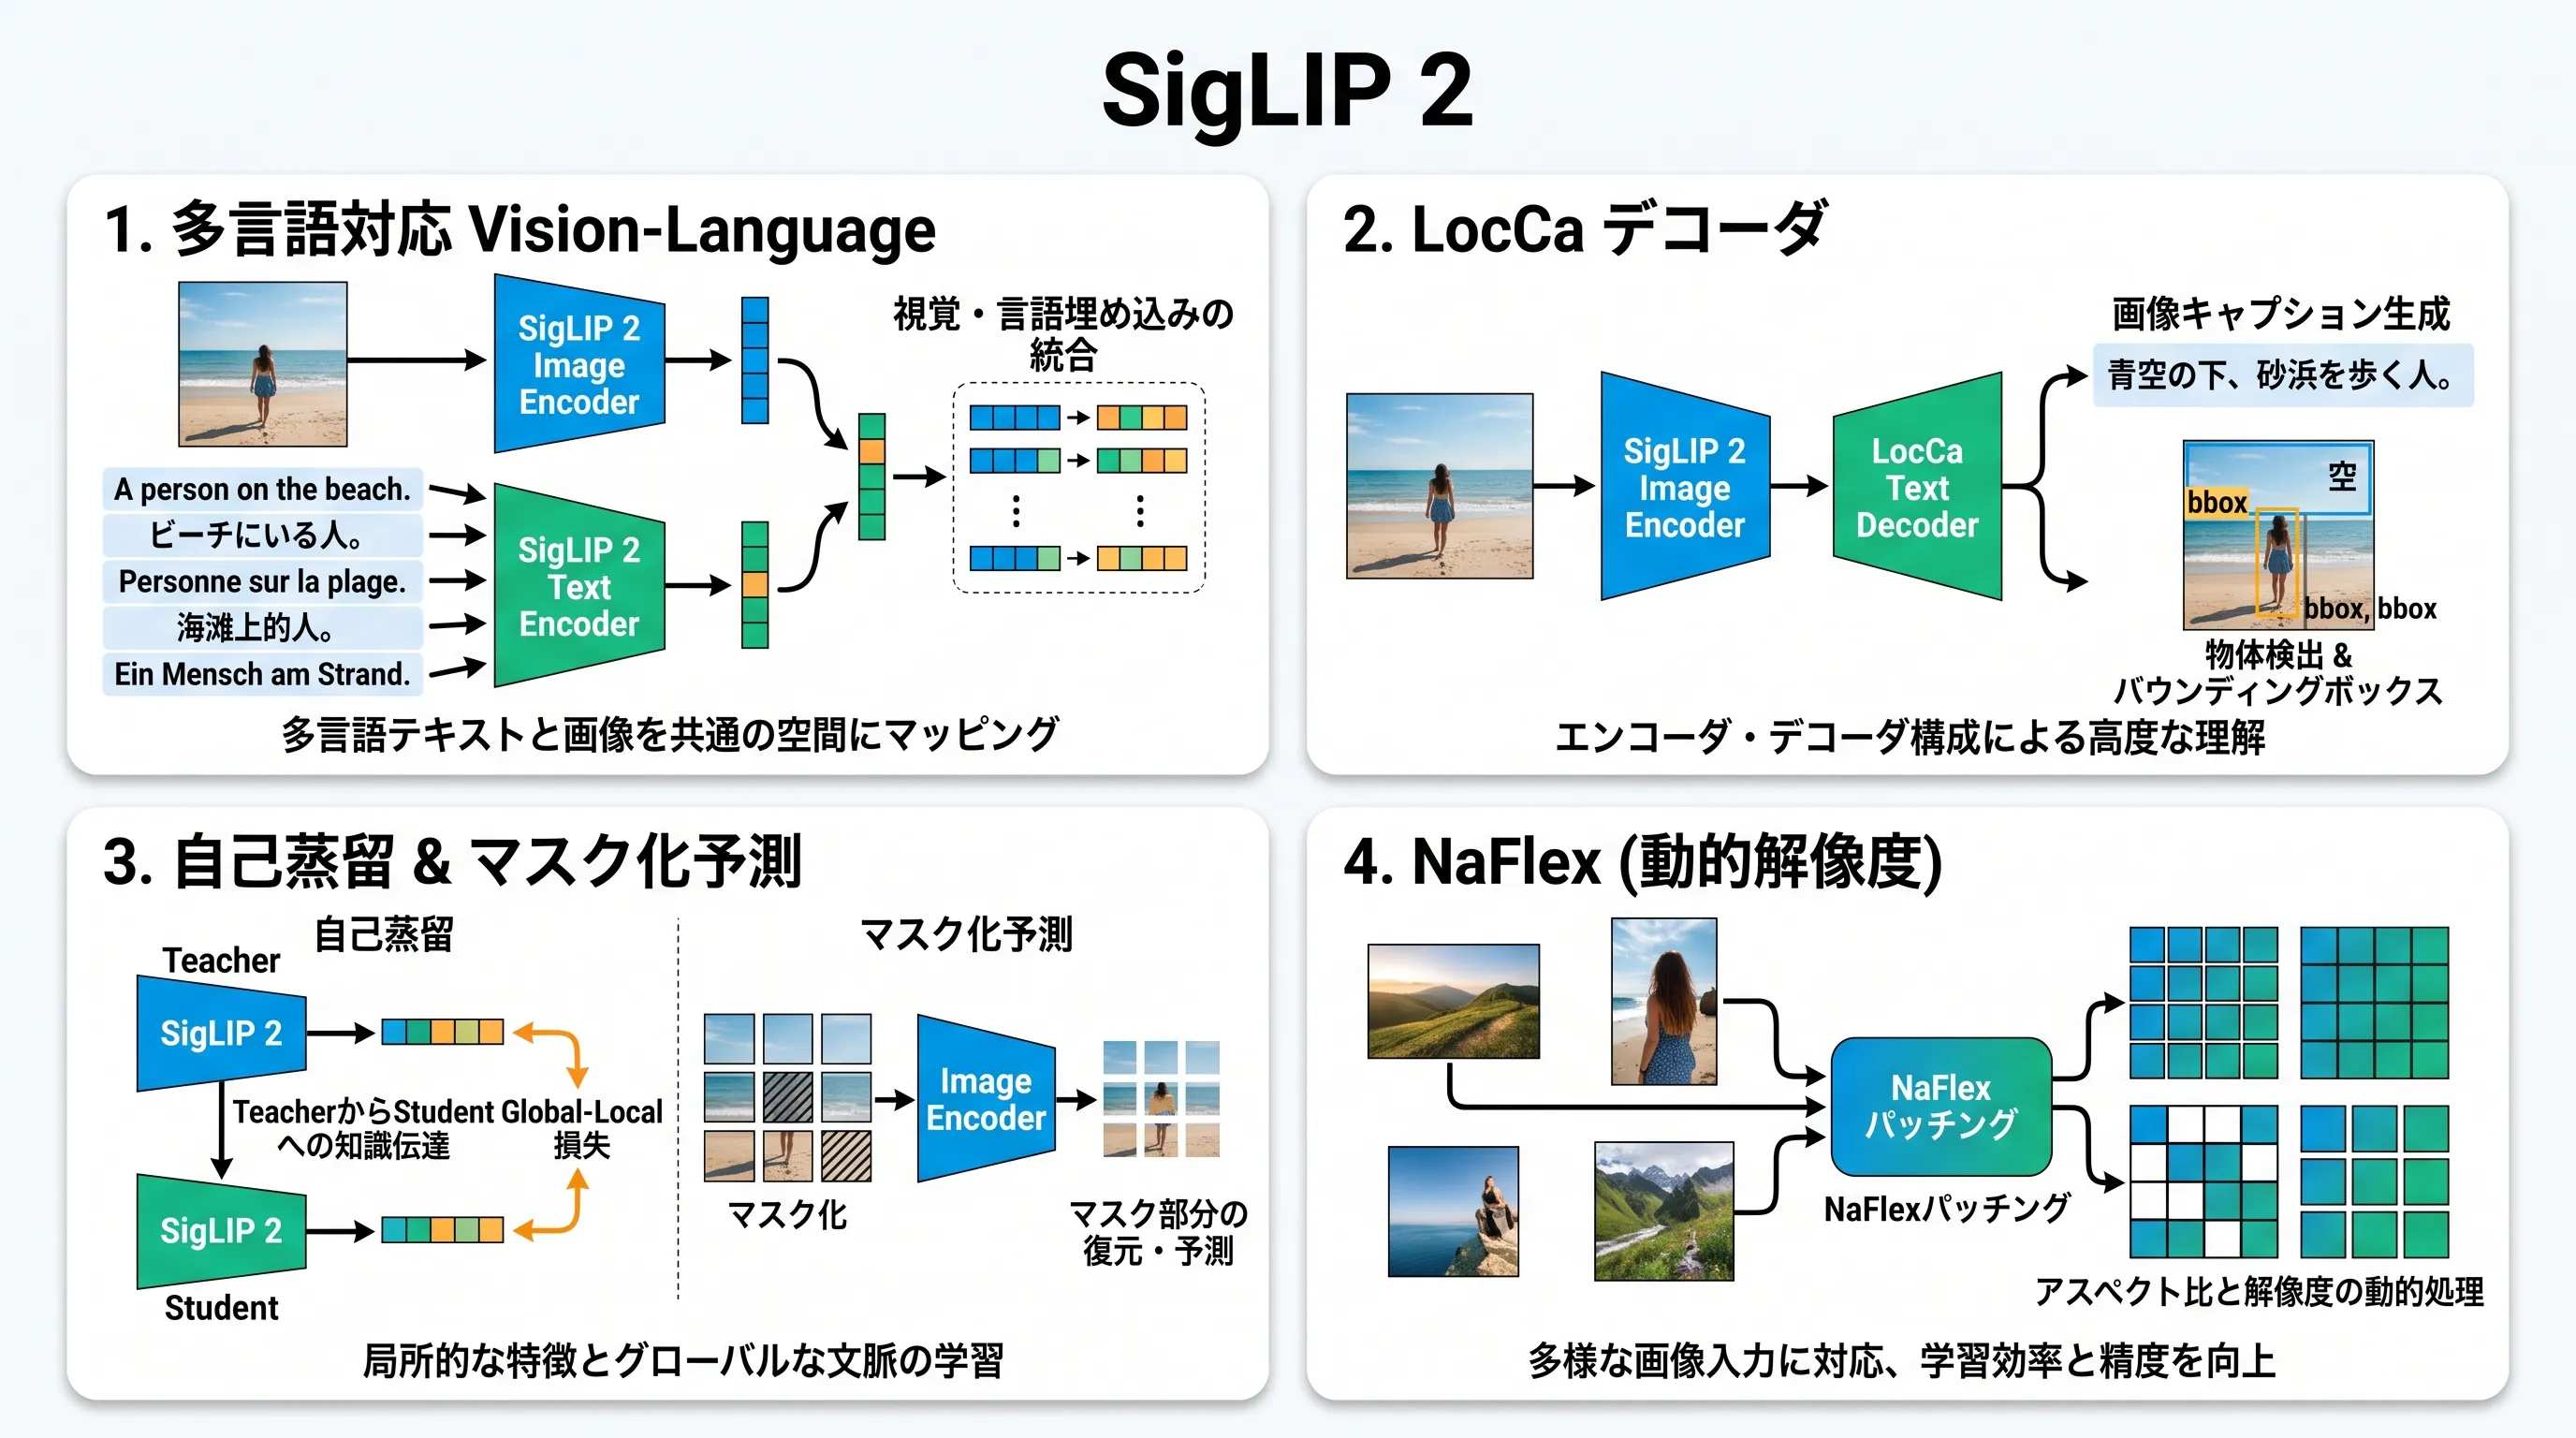
SigLIP のシグモイド損失に、キャプション学習(LocCa)・自己蒸留・マスク化予測を加えることで、意味の理解・位置の特定・密な特徴を向上させた SigLIP 2 の構成と、NaFlex による解像度とアスペクト比への対応、多言語への対応を理解すること。PyTorch でそれぞれの学習目標をスクラッチ実装して小さなデータで学習できることを確かめ、Hugging Face の学習済みモデルで画像の埋め込みを取り出せるようになること。
SigLIP 2の概要
SigLIP 2 (Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features) は、Google DeepMindによって開発された、多言語対応の視覚・言語(Vision-Language)エンコーダの最新モデルファミリです。
前モデルである初代SigLIPの成功をベースに、セマンティック理解、ローカリゼーション、および密な特徴量(Dense Features)の抽出能力を向上させるための複数の新しい学習目標が組み込まれています。これにより、初代SigLIPを上回る性能をすべてのモデル規模で発揮します。また、ゼロショット分類、画像・テキスト検索、さらにはVision-Language Models(VLMs)の特徴抽出器としての転移性能など、コアとなる機能全般において大幅なスコア向上が確認されています。さらに、動的な解像度に対応する「NaFlex」バリアントも追加されており、アスペクト比や解像度の歪みに敏感なタスク(ドキュメント理解やOCRなど)にも最適化されています。
SigLIP 2の処理概要
SigLIP 2のアーキテクチャ自体は、基本的に後方互換性を保つために初代SigLIPと同じ構造を採用しています。これにより、既存のユーザーはモデルの重みと多言語化されたトークナイザを差し替えるだけで、容易に幅広いタスクでパフォーマンスの向上を享受できます。
処理における最大の進化は、これまでの画像・テキストのコントラスト学習(Sigmoid Loss)に対して、「デコーダを用いたキャプション生成事前学習」や、「自己蒸留(Self-distillation)およびマスク化予測(Masked prediction)」といった、個別に開発されてきた複数の手法を統一されたレシピとして統合した点にあります。この新しい学習手法により、より構造化された、きめ細かく強力な視覚表現を獲得できるようになりました。
SigLIP 2の構成技術要素(詳細)
SigLIP 2の論文「SigLIP 2: Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features」で提案されている主要な追加学習目標や技術要素を解説します。
デコーダの追加 (LocCa損失)
画像エンコーダとテキストエンコーダに加えて、テキストデコーダを追加するというシンプルな工夫を取り入れています。 このデコーダには3つの目的があります:画像全体の包括的なキャプション予測、特定の画像領域を説明するキャプションからバウンディングボックスの座標を予測すること、およびバウンディングボックスの座標から領域固有のキャプションを予測することです。
これにより、視覚エンコーダに追加のシグナルが提供され、位置情報を認識できるようになります。結果として、参照表現の理解などのローカリゼーションタスクの性能が大きく向上します。
3つのタスクの入力と予測する系列を、記事の実装の例で並べると、次のようになります。
(図は、diagram-designで作成)
自己蒸留とマスク化予測 (Global-Local Loss & Masked Prediction Loss)
画像表現のきめ細かい局所的セマンティクス(セグメンテーションや深度推定などの密な予測タスクに必要)を向上させるために、自己教師あり学習から着想を得た「自己蒸留(Global-Local Loss)」と「マスク化予測(Masked Prediction Loss)」を導入しています。
- 自己蒸留(Global-Local Loss): 教師モデルと生徒モデルを用意し、毎ステップごとに教師モデルのパラメータを生徒モデルの指数移動平均(EMA)で更新します。生徒ネットワークは画像の局所的なビュー(論文では8枚)を入力として受け取り、全画像から得られた教師モデルの表現と一致するように学習します。一致は、別に用意したMLPのヘッドで写した高次元の特徴量の上で測ります。
- マスク化予測: 生徒ネットワーク内の画像パッチの50%をマスクトークンに置き換え、マスクされた位置での教師モデルの特徴量と一致するように生徒モデルに学習させます。生徒と教師はどちらも画像全体を見ます(生徒はマスクを除いて)。
これらの追加損失は計算コストが高いため、学習の最初の80%はSigmoid損失とデコーダ損失のみで訓練し、最後の20%の段階でこれらの自己教師あり損失を追加しています。このとき、教師は生徒のパラメータで初期化します。
教師と生徒の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
異なる解像度への適応 (NaFlexバリアント)
画像モデルは解像度やアスペクト比の変化に対して非常に敏感です。これに対処するため、SigLIP 2ではFlexiViTやNaViTのアイデアを取り入れた動的解像度バリアントである「NaFlex」バリアントを提供しています。
NaFlexは、1つのViTで複数の系列長(128・256・576・784・1024)を扱うFlexiViTの考え方と、画像を元のアスペクト比のまま処理するNaViTの考え方を組み合わせたものです。通常版の学習の90%の時点から、アスペクト比を保ったリサイズと、ミニバッチごとに選んだ系列長で学習を続けて作ります。
小さいモデルの強化(ACIDによる暗黙の蒸留)
NaFlexとは別に、ViT-B/16やB/32のような小さいモデルは、学習の最後に「データを通した暗黙の蒸留」で精度を上げています。ACIDと呼ばれる方法で、多様なデータで学習した強い教師モデル(So400m)と学習中のモデルの両方で各サンプルの「学習可能性(learnability)」を採点し、大きな候補の中から32kのバッチを選んで学習します。教師の出力をまねさせる明示的な蒸留をしなくても、教師が得意なデータを選ぶことで、その知識を取り込めます。
文化的対応と公平性向上のためのデータセット
モデルの文化的多様性を高めるため、英語のウェブサイトからの画像テキストペアを90%、英語以外のページから10%を抽出した多言語データ(WebLI)を用いて学習しています。
さらに、ジェンダー表現の不均衡や特定の職業との偏った結びつきなどの社会的バイアスを軽減するデータ除バイアス技術を組み込んでおり、公平性が大きく向上しています。
SigLIP 2のスクラッチ実装
ここでは、SigLIP 2の仕組みを理解するために、PyTorchを用いて最小限のサイズのSigLIP 2モデル(MiniSigLIP2)をスクラッチで実装します。初代SigLIPの記事で実装した「MAP headを持つViT + テキストエンコーダ + ペアワイズ・シグモイド損失」に対して、SigLIP 2の新規性である以下の3点を追加します。
- LocCaデコーダ: 画像パッチ特徴量を参照するテキストデコーダを追加し、「画像→説明文」「説明文→座標」「座標→説明文」の3タスクを学習させます。
- 自己蒸留(Global-Local): EMAで更新される教師モデルを用意し、画像の局所ビューから全体ビューの表現を予測させます。
- マスク化予測: パッチの50%をマスクトークンに置き換え、マスクした位置の教師特徴量を予測させます。
データセットにはFashion-MNISTを使いますが、位置情報の学習を確認できるように28×28の服飾画像を56×56のキャンバス上のランダムな位置に貼り付け、その位置を正解のバウンディングボックスとして扱います。またキャプションは、SigLIP 2の多言語対応にならって英語と日本語の2言語を用意します。10クラス×2言語=20ペアを過学習させ、損失が下がり検索精度が100%になるか、デコーダが説明文と座標を正確に再現できるかを見るサニティチェックを行います。
構造は論文と同じですが、大きさは仕組みを確かめるための最小限にしています。記事の後半で使う本物のモデル(google/siglip2-so400m-patch14-384)との違いは次のとおりです。
| 項目 | 本物のモデル(siglip2-so400m-patch14-384) | MiniSigLIP2(本記事) |
|---|---|---|
| 画像エンコーダ | So400m/14:27層・1152次元・16ヘッド | 4層・192次元・4ヘッド |
| 入力画像とパッチ | 384×384のカラー画像、14×14のパッチ729個 | 56×56の白黒画像、7×7のパッチ64個 |
| テキストエンコーダ | 27層・1152次元、最大64トークン | 2層・192次元、最大12トークン |
| トークナイザ | Gemma(語彙256,000、多言語) | 自作(語彙79、英語と日本語) |
| デコーダ(LocCa) | 学習のときだけ使い、公開モデルには含まれない | 2層・192次元 |
| パラメータ数 | 約11億4,000万(デコーダを除く) | 約441万(デコーダ約122万を含む) |
| 学習データ | WebLI(100億枚の画像、109言語)、バッチ32k | Fashion-MNISTの20ペア(10クラス×英日2言語) |
本物のモデルの値は、Hugging Faceの設定ファイルと論文によります。MiniSigLIP2のパラメータ数は、コードの層の定義から数えた値です。
実装するモデル全体の構成と、4つの損失を使う時期は、次の2つの図のとおりです。
(図は、diagram-designで作成)
(図は、diagram-designで作成)
必要なライブラリのインストール
本記事のスクラッチ実装では、推論結果を可視化する際に日本語キャプションを文字化けさせずにグラフへ描画するため、japanize-matplotlib を使用します。実行環境(Google Colabなど)に合わせて事前に以下のコマンドを実行し、インストールしてください。
!pip install japanize-matplotlib
MiniSigLIP2クラスの定義
まず、画像・テキスト・デコーダの3つの塔を束ねる全体クラスを定義します。初代との最大の違いは、forward がプーリング後のベクトルだけでなくプーリング前のパッチ特徴量も返す点です。
import math
import copy
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
from torchvision import datasets
import matplotlib.pyplot as plt
import japanize_matplotlib  # 日本語キャプションの表示用


class MiniSigLIP2(nn.Module):
    def __init__(self, vocab_size, dim=192, img_size=56, patch=7,
                 v_depth=4, t_depth=2, d_depth=2, heads=4, max_len=12, dec_len=20):
        super().__init__()
        # 画像・テキスト・デコーダの3つの塔を初期化
        self.vision = VisionTower(img_size, patch, 1, dim, v_depth, heads)
        self.text = TextTower(vocab_size, max_len, dim, t_depth, heads)
        self.decoder = TextDecoder(vocab_size, dec_len, dim, d_depth, heads)

        # 初代SigLIPと同じ初期値: 温度(t_prime)は log(10)、バイアス(b)は -10
        self.t_prime = nn.Parameter(torch.tensor(math.log(10.0)))
        self.b = nn.Parameter(torch.tensor(-10.0))

    def encode_image(self, images, patch_mask=None):
        # 画像から特徴量を抽出し、最後にL2正規化して返す(推論用)
        return F.normalize(self.vision(images, patch_mask), dim=-1)

    def encode_text(self, ids, eos_pos, key_padding_mask=None):
        # テキストから特徴量を抽出し、最後にL2正規化して返す(推論用)
        return F.normalize(self.text(ids, eos_pos, key_padding_mask), dim=-1)

    def forward(self, images, ids, eos_pos, key_padding_mask=None):
        # --- 学習用の順伝播 ---

        # 1. 画像からプーリング前のパッチ特徴量を取得 (B, N, D)
        # ※ このパッチ特徴量はデコーダのクロスアテンションで参照される
        tokens = self.vision.extract_features(images)

        # 2. パッチ特徴量をMAP headでプーリングしてL2正規化 (B, D)
        zi = F.normalize(self.vision.head(tokens), dim=-1)

        # 3. テキストからL2正規化された特徴量を取得 (B, D)
        zt = self.encode_text(ids, eos_pos, key_padding_mask)

        # 4. 内積 × 温度 + バイアスでロジット(類似度行列)を計算 (B, B)
        logits = zi @ zt.t() * self.t_prime.exp() + self.b

        # ロジット、各ベクトル、パッチ特徴量のすべてを返す
        return logits, zi, zt, tokens

    def decode(self, tokens, dec_in, img_idx):
        # --- デコーダの推論/学習用 ---
        # img_idx で「どの系列がどの画像を参照するか」を指定して特徴量を割り当てる
        return self.decoder(dec_in, tokens[img_idx])
大きさの決め方: 目的は20ペアの暗記で仕組みを確かめることなので、初代SigLIPの記事と同じく、CPUで十数分で学習できる小ささにしています。画像は56×56なので、patch=7 で8×8=64個のパッチに分けます。テキストの最大長 max_len=12 とデコーダの系列長 dec_len=20 は、後のデータで使う最長の系列(キャプションと4つの座標トークン、タスク指示)が収まる長さです。
3つの塔の構成: 画像エンコーダ(VisionTower)とテキストエンコーダ(TextTower)に加えて、SigLIP 2で追加されたテキストデコーダ(TextDecoder)を保持します。温度 t_prime とバイアス b は初代と同じ初期値を用います。
特徴量の共有: シグモイド損失で使う画像ベクトルとデコーダが参照するパッチ特徴量は、extract_features の出力を使い回します。1回の画像エンコードで両方の損失をまかなえるため、計算量が増えません。
img_idxによる対応付け: 1枚の画像に対して後述の3タスク分の系列を作るため、decode では img_idx で「系列 → 画像」の対応を指定し、同じ画像特徴量を複数の系列で共有します。
Transformerの共通部品
画像側・テキスト側・デコーダ側で共通して使うブロックです。初代SigLIPと同様にPre-LN構成を採用しつつ、デコーダ用に因果マスクとクロスアテンションを追加します。因果マスクとクロスアテンションの仕組みは、Transformer の記事で図と一緒に解説しています。
class MHSA(nn.Module):
    """マルチヘッド自己注意(因果マスクにも対応)"""
    def __init__(self, dim, heads):
        super().__init__()
        self.h, self.dh = heads, dim // heads
        # Q, K, V を一度に計算する線形層
        self.qkv = nn.Linear(dim, dim * 3)
        self.proj = nn.Linear(dim, dim)

    def forward(self, x, key_padding_mask=None, causal=False):
        B, N, D = x.shape
        # qkvを展開し、Q, K, Vに分割してヘッドごとに整形
        q, k, v = self.qkv(x).reshape(B, N, 3, self.h, self.dh).permute(2, 0, 3, 1, 4)

        # パディングトークンを無視するためのマスク作成
        attn_mask = None
        if key_padding_mask is not None:
            attn_mask = key_padding_mask[:, None, None, :].expand(B, self.h, N, N)

        # PyTorchの最適化されたAttention関数を使用 (causal=Trueで因果マスク適用)
        o = F.scaled_dot_product_attention(q, k, v, attn_mask=attn_mask, is_causal=causal)

        # ヘッドを結合して元の次元に戻す
        return self.proj(o.transpose(1, 2).reshape(B, N, D))


class CrossAttn(nn.Module):
    """テキスト側をQuery、画像パッチ列(mem)をKey/Valueとするクロスアテンション"""
    def __init__(self, dim, heads):
        super().__init__()
        self.h, self.dh = heads, dim // heads
        # Queryはテキスト側から、Key/Valueは画像側(mem)から計算
        self.q = nn.Linear(dim, dim)
        self.kv = nn.Linear(dim, dim * 2)
        self.proj = nn.Linear(dim, dim)

    def forward(self, x, mem):
        B, N, D = x.shape
        M = mem.shape[1]
        # Queryの計算
        q = self.q(x).reshape(B, N, self.h, self.dh).transpose(1, 2)
        k, v = self.kv(mem).reshape(B, M, 2, self.h, self.dh).permute(2, 0, 3, 1, 4)
        o = F.scaled_dot_product_attention(q, k, v)
        return self.proj(o.transpose(1, 2).reshape(B, N, D))


class MLP(nn.Module):
    def __init__(self, dim, ratio=4):
        super().__init__()
        self.fc1, self.fc2 = nn.Linear(dim, dim * ratio), nn.Linear(dim * ratio, dim)

    def forward(self, x):
        return self.fc2(F.gelu(self.fc1(x), approximate="tanh"))


class Block(nn.Module):
    """Pre-LN Transformer ブロック(エンコーダ用)"""
    def __init__(self, dim, heads):
        super().__init__()
        self.ln1, self.ln2 = nn.LayerNorm(dim), nn.LayerNorm(dim)
        self.attn, self.mlp = MHSA(dim, heads), MLP(dim)

    def forward(self, x, key_padding_mask=None):
        x = x + self.attn(self.ln1(x), key_padding_mask)
        x = x + self.mlp(self.ln2(x))
        return x


class DecoderBlock(nn.Module):
    """因果自己注意 → 画像へのクロスアテンション → MLP"""
    def __init__(self, dim, heads):
        super().__init__()
        self.ln1, self.ln2, self.ln3 = (nn.LayerNorm(dim) for _ in range(3))
        self.self_attn = MHSA(dim, heads)
        self.cross_attn = CrossAttn(dim, heads)
        self.mlp = MLP(dim)

    def forward(self, x, mem):
        x = x + self.self_attn(self.ln1(x), causal=True)
        x = x + self.cross_attn(self.ln2(x), mem)
        x = x + self.mlp(self.ln3(x))
        return x
エンコーダとデコーダの注意機構の違い: エンコーダ側は双方向の自己注意(causal=False)ですが、デコーダ側は次のトークンを予測する自己回帰モデルなので causal=True を指定し、未来のトークンを参照できないようにします。
クロスアテンションの役割: CrossAttn は、デコーダの各位置を Query、画像のパッチ列を Key/Value として計算します。これによりデコーダは「画像のどの領域を見て次の単語を出すか」を選べるようになり、この勾配が画像エンコーダに位置情報を学習させるシグナルになります。
画像エンコーダ(ViT + MAP head + マスクトークン)
初代SigLIPと同じMAP head構成ですが、SigLIP 2ではさらにプーリング前のパッチ特徴量を取り出す口と、マスク化予測用のマスクトークンが必要になります。
class MAPHead(nn.Module):
    """Multihead Attention Pooling: 学習可能な probe で系列を1ベクトルに集約"""
    def __init__(self, dim, heads):
        super().__init__()
        # 学習可能なプーリング用のトークン(probe)
        self.probe = nn.Parameter(torch.randn(1, 1, dim) * 0.02)
        self.attn = nn.MultiheadAttention(dim, heads, batch_first=True)
        self.ln = nn.LayerNorm(dim)
        self.mlp = MLP(dim)

    def forward(self, x):
        # バッチサイズに合わせてprobeを展開
        q = self.probe.expand(x.shape[0], -1, -1)
        # probeをQuery、パッチ列全体をKey/Valueとしてアテンションを計算
        h, _ = self.attn(q, x, x, need_weights=False)
        h = h + self.mlp(self.ln(h))
        # 系列長1のベクトルとして取り出す
        return h[:, 0]


class VisionTower(nn.Module):
    def __init__(self, img_size=56, patch=7, in_ch=1, dim=192, depth=4, heads=4):
        super().__init__()
        # 画像をパッチ分割して線形埋め込み
        self.patch_embed = nn.Conv2d(in_ch, dim, kernel_size=patch, stride=patch)
        n_pos = (img_size // patch) ** 2
        self.pos = nn.Parameter(torch.randn(1, n_pos, dim) / math.sqrt(dim))

        # マスク化予測で、隠したパッチの埋め込みを置き換えるためのトークン
        self.mask_token = nn.Parameter(torch.zeros(1, 1, dim))
        self.blocks = nn.ModuleList([Block(dim, heads) for _ in range(depth)])
        self.ln = nn.LayerNorm(dim)
        self.head = MAPHead(dim, heads)

    def extract_features(self, x, patch_mask=None):
        """プーリング前のパッチ単位の特徴量(密な特徴量)を返す"""
        x = self.patch_embed(x).flatten(2).transpose(1, 2)     # (B, N, D)

        # マスク化予測時、マスクされた位置のパッチをmask_tokenに置き換える
        if patch_mask is not None:
            x = torch.where(patch_mask[..., None], self.mask_token.to(x.dtype), x)

        x = x + self.pos
        for blk in self.blocks:
            x = blk(x)
        return self.ln(x)                                      # (B, N, D)

    def forward(self, x, patch_mask=None):
        # MAP headを通して1本のベクトル(Global feature)にする
        return self.head(self.extract_features(x, patch_mask))  # (B, D)
密な特徴量の取り出し口: extract_features はMAP headに通す前のパッチ列をそのまま返します。SigLIP 2で強調されている「Dense Features」に相当し、デコーダのクロスアテンション先、そしてマスク化予測の予測対象として使われます。
マスクトークン: patch_mask が True の位置のパッチ埋め込みを、学習可能な mask_token に置き換えます。位置エンコーディングはマスク後に加算するため、モデルは「どの位置が隠されているか」だけを手がかりに、その位置の特徴量を復元することになります。
テキストエンコーダの定義
テキストエンコーダは初代SigLIPからの変更点がなく、因果マスクを使わない双方向Transformerと、EOS位置のプーリングをそのまま使います。
class TextTower(nn.Module):
    def __init__(self, vocab_size, max_len=12, dim=192, depth=2, heads=4, pad_id=0):
        super().__init__()
        self.pad_id = pad_id
        self.tok = nn.Embedding(vocab_size, dim)
        self.pos = nn.Parameter(torch.randn(1, max_len, dim) / math.sqrt(dim))
        self.blocks = nn.ModuleList([Block(dim, heads) for _ in range(depth)])
        self.ln = nn.LayerNorm(dim)
        self.head = nn.Linear(dim, dim)

    def forward(self, ids, eos_pos, key_padding_mask=None):
        # PADトークンを無視するマスクを生成
        if key_padding_mask is None:
            key_padding_mask = ids.ne(self.pad_id)

        x = self.tok(ids) + self.pos[:, : ids.shape[1]]
        for blk in self.blocks:
            x = blk(x, key_padding_mask=key_padding_mask)
        x = self.ln(x)

        # 各系列ごとに、文末(EOS/EOT)トークンの位置の特徴量を抽出(プーリング)
        pooled = x[torch.arange(x.shape[0], device=x.device), eos_pos]
        return self.head(pooled)                               # (B, D)
後方互換性: SigLIP 2はアーキテクチャの後方互換性を重視しているため、テキスト側は初代とまったく同じ構造です。変わったのは中身(多言語トークナイザと学習データ)であり、実装としては差分がありません。
テキストデコーダの定義(LocCa)
SigLIP 2で新しく加わった部分です。因果自己注意で系列を左から右へ処理しつつ、各層で画像パッチ列にクロスアテンションします。
class TextDecoder(nn.Module):
    """LocCa用の自己回帰デコーダ"""
    def __init__(self, vocab_size, max_len=20, dim=192, depth=2, heads=4):
        super().__init__()
        self.tok = nn.Embedding(vocab_size, dim)
        self.pos = nn.Parameter(torch.randn(1, max_len, dim) / math.sqrt(dim))
        self.blocks = nn.ModuleList([DecoderBlock(dim, heads) for _ in range(depth)])
        self.ln = nn.LayerNorm(dim)
        # 次の単語を予測するための語彙サイズ分の線形層
        self.out = nn.Linear(dim, vocab_size)

    def forward(self, ids, mem):
        # 1. 単語埋め込み + 位置エンコーディング
        x = self.tok(ids) + self.pos[:, : ids.shape[1]]

        # 2. デコーダブロックを通す(内部で自己注意 + 画像パッチ(mem)とのクロスアテンションを実行)
        for blk in self.blocks:
            x = blk(x, mem)

        # 3. 語彙の確率分布(ロジット)に変換して出力
        return self.out(self.ln(x))                            # (B, L, V)
デコーダの入出力: 入力はトークン列 ids と画像パッチ特徴量 mem で、出力は各位置における次トークンの語彙上のロジットです。学習時は教師強制(teacher forcing)で系列全体を一括処理し、推論時は1トークンずつ生成します。
エンコーダとの結合: デコーダはロジットを出すだけですが、クロスアテンション経由で画像エンコーダへ勾配が流れます。SigLIP 2でデコーダを付けた狙いは、デコーダ自体を使うことよりも、この勾配で画像エンコーダに位置と細部を覚えさせることにあります。
損失関数
シグモイド損失は初代からそのまま流用し、そこにLocCa損失(キャプションのクロスエントロピー)と、自己蒸留・マスク化予測で使う特徴量一致損失を追加します。
def sigmoid_loss(logits, labels):
    """labels は +1 / -1 の行列(初代SigLIPと同じ)"""
    return -F.logsigmoid(labels * logits).sum() / logits.shape[0]


def make_labels(class_ids):
    """同じクラスのペアはすべて正例とする(偽陰性の回避)"""
    # 同じIDならTrue(=1.0)、違えばFalse(=0.0)になり、そこから2倍して1を引くことで +1 / -1 に変換
    return class_ids[:, None].eq(class_ids[None, :]).float() * 2 - 1


def caption_loss(logits, targets):
    """LocCa損失: 予測対象でない位置は -100 で無視する"""
    # パディングなど不要な位置(target=-100)は損失計算から除外される仕様を利用
    return F.cross_entropy(logits.reshape(-1, logits.shape[-1]),
                           targets.reshape(-1), ignore_index=-100)


def feat_match_loss(student, teacher):
    """生徒と教師の特徴量をコサイン類似度で一致させる"""
    # L2正規化したあとの内積はコサイン類似度となる
    s, t = F.normalize(student, dim=-1), F.normalize(teacher, dim=-1)
    # 最大化(=損失を最小化)するため 1 - 類似度 とする
    return (1 - (s * t).sum(-1)).mean()


class EMATeacher:
    """生徒モデルの指数移動平均で更新される教師モデル"""
    def __init__(self, vision):
        # 生徒の初期状態をディープコピーして教師モデルを作成
        self.model = copy.deepcopy(vision)
        for p in self.model.parameters():
            p.requires_grad_(False) # 教師は勾配計算を行わない
        self.model.eval()

    @torch.no_grad()
    def update(self, vision, m=0.99):
        # 生徒(vision)のパラメータに(1-m)の比率で引っ張られるように更新する
        for tp, sp in zip(self.model.parameters(), vision.parameters()):
            tp.mul_(m).add_(sp.detach(), alpha=1 - m)
        # バッファ(BatchNormの統計量など)はそのままコピー
        for tb, sb in zip(self.model.buffers(), vision.buffers()):
            tb.copy_(sb)
プロンプト部分の除外: caption_loss では、ラベルが -100 の位置を無視します。たとえば「説明文→座標」タスクでは説明文は与えられた条件なので、損失は座標トークン以降にのみかけます。
特徴量一致損失: 論文の自己蒸留はプロトタイプ上のソフトマックスとシャープニングを用いますが、ここでは仕組みを見やすくするため、L2正規化した特徴量のコサイン類似度を最大化する簡易版(feat_match_loss)を使います。値が0に近いほど生徒と教師の表現が一致していることを意味します。
教師モデルの更新: EMATeacher は生徒モデル(画像エンコーダ)のコピーとして初期化され、勾配を持ちません。毎ステップ update で生徒のパラメータを指数移動平均(m=0.99)として取り込み、生徒より少し遅れて動く安定した目標を提供します。
学習率スケジューラの定義
def lr_at(step, total, base_lr, warmup):
    """線形ウォームアップ + コサイン減衰"""
    if step < warmup:
        # ウォームアップ中は0からbase_lrまで徐々に上げる
        return base_lr * step / max(1, warmup)
    # ウォームアップ後はコサインカーブで0まで減衰させる
    p = (step - warmup) / max(1, total - warmup)
    return base_lr * 0.5 * (1 + math.cos(math.pi * min(1.0, p)))
学習率のスケジューリング: 初代の記事と同じく、線形ウォームアップとコサイン減衰を組み合わせます。SigLIP 2では自己教師あり損失が学習の後半(残り20%)から加わるため、その時点の学習率はすでにかなり小さくなっている点に注意してください。
データセットの準備
Fashion-MNISTの28×28画像を56×56のキャンバス上のランダムな位置に貼り付け、その位置を正解バウンディングボックスとして保持します。キャプションは英語と日本語の2種類を用意します。
なお、実際のSigLIP 2は多言語のGemmaトークナイザ(語彙数25.6万)を使いますが、ミニモデルの埋め込み層と出力層をこの語彙数で持つのは現実的ではないため、ここではキャプションと座標トークンだけを含む小さな語彙を自作します。日本語は1文字ずつ、英語は空白区切りで分割する簡易トークナイザです。
torch.manual_seed(0)
rng = np.random.default_rng(0)

# 多言語対応のクラスリスト
CLASSES = ["t-shirt", "trouser", "pullover", "dress", "coat",
           "sandal", "shirt", "sneaker", "bag", "ankle boot"]
CLASSES_JA = ["Tシャツ", "ズボン", "セーター", "ドレス", "コート",
              "サンダル", "シャツ", "スニーカー", "かばん", "ブーツ"]
# キャンバス幅 / 物体幅 / 座標の量子化数(物体は 29×29 通りの位置に置ける。32 段階なら 1 段階が 1.75 ピクセル)
CANVAS, OBJ, NBIN = 56, 28, 32
# 特殊トークンの定義
SPECIALS = ["<pad>", "<bos>", "<eos>", "<cap>", "<ref>", "<grd>"]


def tokenize_words(text):
    """空白区切り。非ASCIIの語は1文字ずつに分ける(簡易な多言語トークナイザ)"""
    out = []
    for w in text.split():
        out += [w] if all(ord(ch) < 128 for ch in w) else list(w)
    return out


def build_vocab(caps):
    vocab = list(SPECIALS) + [f"<loc{i}>" for i in range(NBIN)]
    for c in caps:
        for w in tokenize_words(c):
            if w not in vocab:
                vocab.append(w)
    return {w: i for i, w in enumerate(vocab)}


ds = datasets.FashionMNIST(root="data", train=True, download=True)
imgs, labels = ds.data.numpy(), ds.targets.numpy()

# 英語10文 + 日本語10文(同じクラスを2言語で表現する)
captions = [f"a photo of a {c}" for c in CLASSES] + [f"{c} の 写真" for c in CLASSES_JA]
stoi = build_vocab(captions)
itos = {i: w for w, i in stoi.items()}
V = len(stoi)

# 各クラスから2枚ずつ(1枚目に英語キャプション、2枚目に日本語キャプションを対応させる)
sel = [int(np.where(labels == c)[0][k]) for k in range(2) for c in range(10)]
class_ids = torch.tensor(labels[sel]).long()

# 56x56 のキャンバスにランダム配置し、その位置を正解バウンディングボックスとする
canvas = np.zeros((len(sel), CANVAS, CANVAS), dtype=np.uint8)
boxes = []
for i, s in enumerate(sel):
    y0, x0 = rng.integers(0, CANVAS - OBJ + 1, size=2)
    canvas[i, y0:y0 + OBJ, x0:x0 + OBJ] = imgs[s]
    boxes.append([y0, x0, y0 + OBJ, x0 + OBJ])
boxes = np.array(boxes)
x = torch.from_numpy(canvas).float().unsqueeze(1) / 255.0
x = (x - 0.5) / 0.5                                    # [-1, 1] に正規化

# キャプションを [BOS] ... [EOS] の固定長に整形
MAXLEN = 12
ids = torch.zeros(len(sel), MAXLEN, dtype=torch.long)
eos = torch.zeros(len(sel), dtype=torch.long)
for i, c in enumerate(captions):
    t = [stoi["<bos>"]] + [stoi[w] for w in tokenize_words(c)] + [stoi["<eos>"]]
    assert len(t) <= MAXLEN
    ids[i, :len(t)] = torch.tensor(t)
    eos[i] = len(t) - 1                                # EOS の位置
attn_mask = ids.ne(stoi["<pad>"])

print("語彙数", V, "| 先頭12語", [itos[i] for i in range(12)])
print(captions[0], "->", tokenize_words(captions[0]))
print(captions[10], "->", tokenize_words(captions[10]))
キャンバスへの配置: 貼り付け位置 y0, x0 をそのまま正解ボックスとして boxes に保存します。物体が毎回違う場所に現れるため、画像全体を1ベクトルに潰すだけのモデルでは座標を答えられず、位置情報の学習が必要になります。
キャンバスの大きさ: 28×28の物体を56×56のキャンバスに置くと、置ける位置は縦横29通りずつになり、位置を当てる問題として十分に難しくなります。座標は32段階に量子化します(1段階は56÷32=1.75ピクセル)。
語彙の設計: 特殊トークン(pad / bos / eos とタスク指示の3種)に加えて、座標を32段階に量子化した位置トークンを語彙に含めます。初代SigLIPで問題になった「PADとEOSが同じID」という罠は、自作語彙では別IDに分けているため発生しません。
実行結果
語彙数 79 | 先頭12語 ['<pad>', '<bos>', '<eos>', '<cap>', '<ref>', '<grd>', '<loc0>', '<loc1>', '<loc2>', '<loc3>', '<loc4>', '<loc5>']
a photo of a t-shirt -> ['a', 'photo', 'of', 'a', 't-shirt']
Tシャツ の 写真 -> ['T', 'シ', 'ャ', 'ツ', 'の', '写', '真']
語彙は79語(特殊トークン6 + 座標トークン32 + 英日のキャプション語彙41)とごく小さく収まりました。英語は単語単位、日本語は文字単位に分割されており、同じ語彙で2言語を扱えていることが確認できます。
LocCa用の3タスク系列の作成
デコーダに学習させる3つのタスクを、1本のトークン列として表現します。先頭に付けるタスク指示トークンで、どのタスクかを切り替えます。
DECLEN = 20


def loc_tokens(box):
    """(y0, x0, y1, x1) を NBIN 段階に量子化して座標トークンにする"""
    q = (box / CANVAS * NBIN).astype(int).clip(0, NBIN - 1)
    return [stoi[f"<loc{v}>"] for v in q]


dec_in, dec_tgt = [], []
for i in range(len(sel)):
    cap = [stoi[w] for w in tokenize_words(captions[i])]
    loc = loc_tokens(boxes[i])
    for task, prompt, target in [("<cap>", [], cap + [stoi["<eos>"]]),   # 画像→説明文
                                 ("<ref>", cap, loc + [stoi["<eos>"]]),  # 説明文→座標
                                 ("<grd>", loc, cap + [stoi["<eos>"]])]: # 座標→説明文
        full = [stoi["<bos>"], stoi[task]] + prompt + target
        inp, tgt = full[:-1], [-100] * (len(full) - 1 - len(target)) + target
        pi = torch.zeros(DECLEN, dtype=torch.long)
        pt = torch.full((DECLEN,), -100, dtype=torch.long)
        pi[:len(inp)], pt[:len(tgt)] = torch.tensor(inp), torch.tensor(tgt)
        dec_in.append(pi); dec_tgt.append(pt)
        if i == 0:
            print(f"{task}  in : {' '.join(itos[t] for t in inp)}")
            print(f"       out: {' '.join('_' if t == -100 else itos[t] for t in tgt)}")
dec_in, dec_tgt = torch.stack(dec_in), torch.stack(dec_tgt)
img_idx = torch.arange(len(sel)).repeat_interleave(3)   # 系列 → 画像の対応
3タスクの表現: 論文のLocCaに対応して、キャプション生成(<cap>)、参照表現からの座標予測(<ref>)、座標からの領域キャプション生成(<grd>)の3種類を用意します。いずれも「画像を条件に、指示トークンに続く系列を予測する」という同じ形式に落とし込まれています。
プロンプトと予測対象の分離: 入力系列 inp は1つずらした教師強制用の系列、tgt は予測対象です。プロンプト部分(<ref> における説明文、<grd> における座標)は -100 で埋めて損失から除外しています。
実行結果
<cap>  in : <bos> <cap> a photo of a t-shirt
       out: _ a photo of a t-shirt <eos>
<ref>  in : <bos> <ref> a photo of a t-shirt <loc13> <loc10> <loc29> <loc26>
       out: _ _ _ _ _ _ <loc13> <loc10> <loc29> <loc26> <eos>
<grd>  in : <bos> <grd> <loc13> <loc10> <loc29> <loc26> a photo of a t-shirt
       out: _ _ _ _ _ a photo of a t-shirt <eos>
アンダースコアが損失を計算しない位置です。<cap> は画像だけを手がかりに説明文全体を、<ref> は説明文を読んだうえで座標4つを、<grd> は座標を与えられたうえで説明文を予測する、という3つの異なる問題が同じ系列形式で表現できていることが分かります。
モデルの学習
いよいよ学習です。論文のレシピにならい、最初の80%はシグモイド損失とデコーダ損失のみで学習し、最後の20%で自己蒸留とマスク化予測を追加します。
model = MiniSigLIP2(V, max_len=MAXLEN, dec_len=DECLEN)
teacher = EMATeacher(model.vision)
lab = make_labels(class_ids)

decay, no_decay = [], []
for n, p in model.named_parameters():
    (no_decay if (p.ndim <= 1 or n in ("t_prime", "b") or "pos" in n
                  or "probe" in n or "mask_token" in n) else decay).append(p)
# 学習率 1e-3 は論文の値。AdamW は 1 ステップに「学習率 × weight_decay」だけ重みを縮めるので、
# 0.1 で 1e-3 × 0.1 = 1e-4 となり、論文の weight decay 1e-4 と同じ強さになる
opt = torch.optim.AdamW([{"params": decay, "weight_decay": 0.1},
                         {"params": no_decay, "weight_decay": 0.0}], lr=1e-3)


def local_views(x, rng=rng):
    """画像の一部を切り出して元サイズに拡大した「局所ビュー」を作る"""
    out = []
    for i in range(x.shape[0]):
        s = int(rng.integers(36, 49))   # 一辺 36〜48 ピクセル(画像の約 4〜7 割の面積)。物体(28×28)が一部欠けることがある大きさ
        y0, x0 = (int(rng.integers(0, CANVAS - s + 1)) for _ in range(2))
        crop = x[i:i + 1, :, y0:y0 + s, x0:x0 + s]
        out.append(F.interpolate(crop, size=(CANVAS, CANVAS), mode="bilinear",
                                 align_corners=False))
    return torch.cat(out)


# 監視用の固定バッチ(毎ステップ乱数を引くと値が暴れるため、
# サニティチェックでは常に同じ局所ビュー・同じマスクで評価する)
N_PATCH = model.vision.pos.shape[1]
gen = torch.Generator().manual_seed(123)
mon_views = local_views(x, np.random.default_rng(123))
mon_mask = torch.rand(x.shape[0], N_PATCH, generator=gen) < 0.5


@torch.no_grad()
def monitor():
    t_tok = teacher.model.extract_features(x)
    gl = feat_match_loss(model.vision(mon_views), teacher.model.head(t_tok))
    mp = feat_match_loss(model.vision.extract_features(x, patch_mask=mon_mask)[mon_mask],
                         t_tok[mon_mask])
    return gl.item(), mp.item()


# 750 ステップ(R@1 が 200 ステップで 100% になり、その後も損失が下がる様子を見られる長さ)
T, SSL_START = 750, 600                 # 論文と同じく、最後の 20% で自己教師あり損失を追加する
for s in range(1, T + 1):
    for g in opt.param_groups:
        g["lr"] = lr_at(s, T, 1e-3, warmup=30)

    # (1) シグモイド損失 + (2) LocCa(デコーダ)損失
    logits, zi, zt, vtok = model(x, ids, eos, attn_mask)
    l_sig = sigmoid_loss(logits, lab)
    l_dec = caption_loss(model.decode(vtok, dec_in, img_idx), dec_tgt)
    loss = l_sig + l_dec

    # (3) 自己蒸留 + (4) マスク化予測
    if s > SSL_START:
        with torch.no_grad():
            t_tok = teacher.model.extract_features(x)
            t_pool = teacher.model.head(t_tok)
        l_gl = feat_match_loss(model.vision(local_views(x)), t_pool)
        pm = torch.rand(x.shape[0], N_PATCH) < 0.5
        l_mp = feat_match_loss(model.vision.extract_features(x, patch_mask=pm)[pm],
                               t_tok[pm])
        loss = loss + l_gl + l_mp

    opt.zero_grad(); loss.backward(); opt.step()
    teacher.update(model.vision, m=0.99)    # 教師は毎ステップ生徒のEMAで更新(0.99 なら約 100 ステップで生徒に追いつく)

    if s == 1 or s % 50 == 0:
        with torch.no_grad():
            sim = zi @ zt.t()
            acc = (class_ids[sim.argmax(-1)] == class_ids).float().mean().item()
        gl, mp = monitor()
        print(f"step {s:4d} sig {l_sig.item():6.3f} dec {l_dec.item():6.3f} "
              f"gl {gl:5.3f} mp {mp:5.3f} R@1 {acc:6.1%} "
              f"t {model.t_prime.exp().item():5.2f} b {model.b.item():+.2f}", flush=True)
4つの損失の合成: シグモイド損失(l_sig)とLocCa損失(l_dec)は最初から、自己蒸留(l_gl)とマスク化予測(l_mp)は SSL_START を超えてから加算します。論文が後半にだけ自己教師あり損失を入れるのは、これらの計算コストが高いためです。
局所ビューの生成: local_views は画像の一部を切り出して元サイズへ拡大します。生徒はこの一部しか見えない状態で、全体を見ている教師の表現を当てにいくことになり、これが自己蒸留(Global-Local Loss)の学習信号になります。
教師の更新タイミング: teacher.update は学習の最初から毎ステップ呼びます。自己蒸留が始まる時点で教師が初期状態のまま取り残されていると、生徒がランダムな表現を追いかけることになってしまうためです。論文は、80%の時点で教師を生徒のパラメータで初期化してから更新を始めます。最初から更新を続けておけば、80%の時点で教師はほぼ生徒と同じになるので、狙いは同じです。
監視用の固定バッチ: 毎ステップ乱数で局所ビューやマスクを引くと損失値が大きく揺れて傾向が読めないため、monitor では常に同じ局所ビュー・同じマスクで生徒と教師の一致度を測り、ログに出しています。
値の決め方: 学習率 1e-3 と weight decay(AdamWで 0.1、論文の と同じ強さ)、自己教師あり損失を最後の20%から加えること、マスクの割合50%は論文と同じです。EMAの係数 m=0.99 は、論文は参照先(SILC)の設定に従うとしているだけなので、本記事で決めた値です。自己教師あり損失を使う期間は150ステップしかないため、教師が約100ステップで生徒に追いつく速さにしています。ステップ数750とウォームアップ30(4%)は、20ペアの暗記には十分な長さで、結果はこれらに大きく左右されません。
オプティマイザの設定: 初代と同様、バイアス・位置エンコーディング・温度に加えて、新設した mask_token も重み減衰の対象から外しています。
論文の設定と本記事の実装の主な違いは、次のとおりです。
| 項目 | 論文 | 本記事のスクラッチ実装 |
|---|---|---|
| 自己蒸留の局所ビュー | 1枚の画像につき8枚 | 1枚 |
| 自己蒸留の一致の測り方 | 別のMLPヘッドの高次元の特徴量で、SILCの損失を使う | MAP headの出力のコサイン類似度 |
| 教師の初期化 | 80%の時点で生徒のパラメータをコピー | 最初にコピーし、毎ステップEMAで更新 |
| キャプションの予測 | 50%の確率で、全トークンを並列に予測(因果マスクなし) | 常に1トークンずつの自己回帰 |
| トークナイザ | Gemma(語彙256k)、最大64トークン | 自作(語彙79)、最大12トークン |
| 勾配のクリップ | ノルム1 | なし |
実行結果
モデルの学習コードを実行すると以下が出力されます。
step    1 sig 21.468 dec  4.555 gl 0.015 mp 0.400 R@1  10.0% t 10.00 b -10.00
step   50 sig  6.504 dec  0.266 gl 0.060 mp 0.151 R@1  15.0% t 10.03 b -10.00
step  100 sig  6.346 dec  0.037 gl 0.062 mp 0.936 R@1  30.0% t 10.03 b -10.00
step  150 sig  3.384 dec  0.022 gl 0.691 mp 0.305 R@1  60.0% t 10.06 b -9.99
step  200 sig  1.760 dec  0.004 gl 0.955 mp 0.630 R@1 100.0% t 10.53 b -9.98
step  250 sig  3.527 dec  0.149 gl 1.022 mp 0.622 R@1  65.0% t 11.05 b -9.96
step  300 sig  0.449 dec  0.003 gl 1.022 mp 0.582 R@1 100.0% t 11.59 b -9.93
step  350 sig  0.289 dec  0.002 gl 0.940 mp 0.564 R@1 100.0% t 12.03 b -9.91
step  400 sig  0.235 dec  0.002 gl 0.839 mp 0.551 R@1 100.0% t 12.30 b -9.90
step  450 sig  0.185 dec  0.001 gl 0.823 mp 0.565 R@1 100.0% t 12.48 b -9.89
step  500 sig  0.150 dec  0.001 gl 0.815 mp 0.587 R@1 100.0% t 12.61 b -9.88
step  550 sig  0.138 dec  0.001 gl 0.824 mp 0.580 R@1 100.0% t 12.70 b -9.88
step  600 sig  0.132 dec  0.001 gl 0.837 mp 0.576 R@1 100.0% t 12.75 b -9.87
step  650 sig  0.142 dec  0.001 gl 0.803 mp 0.308 R@1 100.0% t 12.78 b -9.87
step  700 sig  0.143 dec  0.001 gl 0.783 mp 0.289 R@1 100.0% t 12.79 b -9.87
step  750 sig  0.142 dec  0.001 gl 0.786 mp 0.284 R@1 100.0% t 12.79 b -9.87
シグモイド損失(sig)は 21.468 から 0.142 まで下がり、200ステップで検索精度(R@1)が100%に到達しています。250ステップ目では一時的に sig 3.527・R@1 65.0% と悪化していますが、300ステップ目には戻っています。学習率がピークに近い時期に、20ペアしかない小さなデータで更新が大きく揺れたためで、その後は安定しています。デコーダ損失(dec)はさらに速く収束し、3つのタスクをすべて暗記できていることが分かります。
注目したいのは601ステップ目からの変化です。自己教師あり損失が加わると、マスク化予測(mp)は600ステップ目の 0.576 から 650ステップ目に 0.308、750ステップ目に 0.284 とはっきり下がりました。自己蒸留(gl)も 0.837 → 0.803 → 0.786 と下がっていますが、下がり方は小さめです。局所ビューは毎ステップ乱数で切り出し方が変わり、一部しか見えない画像から全体の表現を当てる難しい問題なので、150ステップでは下がりきらないためです。それ以前の区間で gl・mp が下がっていないのは、これらが損失に含まれておらず、シグモイド損失とデコーダ損失にとって「たまたま最適化されるとは限らない」性質だからです。追加した損失が効いていることが、この折れ目から確認できます。
自己教師あり損失の推移を図にすると、次のようになります。
(図は、diagram-designで作成)
検証1: 画像-テキスト検索と多言語の対応
まず、初代SigLIPと同じくシグモイド損失による検索が機能しているかを確認します。今回は同じクラスに英語・日本語の2つのキャプションがあるため、正解は対角成分ではなく同一クラスかどうかで判定します。
model.eval()
with torch.no_grad():
    zi = model.encode_image(x)
    zt = model.encode_text(ids, eos, attn_mask)
    sim = zi @ zt.t()
    probs = torch.sigmoid(sim * model.t_prime.exp() + model.b)

pos = class_ids[:, None].eq(class_ids[None, :])
acc = (class_ids[sim.argmax(-1)] == class_ids).float().mean().item()
print(f"R@1 (クラス一致) {acc:.1%}")
print(f"正例ペア sim {sim[pos].mean():+.3f}  prob 平均 {probs[pos].mean():.3f} / 最小 {probs[pos].min():.3f}")
print(f"負例ペア sim {sim[~pos].mean():+.3f}  prob 平均 {probs[~pos].mean():.3f} / 最大 {probs[~pos].max():.3f}")
for j in (0, 10, 1, 11):
    print(f"  画像0 × {captions[j]:20s} {probs[0, j]:.3f}")
確率の計算: 初代SigLIPと同じく、ロジットに torch.sigmoid を適用して各ペアが独立に一致する確率を求めます。ソフトマックスではないので、確率の合計は1になりません。
多言語の確認: 画像0(英語キャプションと対応させたTシャツ画像)に対して、英語と日本語の両方のキャプションの確率を並べて表示し、言語をまたいで同じクラスに反応するかを見ています。
実行結果
R@1 (クラス一致) 100.0%
正例ペア sim +0.996  prob 平均 0.946 / 最小 0.940
負例ペア sim -0.103  prob 平均 0.002 / 最大 0.021
  画像0 × a photo of a t-shirt 0.947
  画像0 × Tシャツ の 写真            0.947
  画像0 × a photo of a trouser 0.000
  画像0 × ズボン の 写真             0.000
20枚すべてで最も類似度の高いキャプションが正しいクラスのものになり、R@1は100%です。正例ペアの類似度は+0.996、負例ペアは-0.103で、はっきり分離できています。
確率を見ると、正例は平均0.946、負例は平均0.002とごく小さな値です。正例が1.0に張り付かないのは初代と同じ理由で、学習済みのバイアス がロジットを押し下げているためです( で、)。そして画像0は、英語の "a photo of a t-shirt" と日本語の「Tシャツ の 写真」のどちらにも同じ0.947を返しています。同じクラスのペアを言語によらず正例として扱った結果、2言語の埋め込みが同じ位置に重なったことが確認できます。
検証2: デコーダによる説明文と座標の生成
次にSigLIP 2で追加されたLocCaデコーダを、貪欲法(greedy decoding)で実際に動かします。
@torch.no_grad()
def generate(img, prompt, max_new=12):
    """画像1枚を条件に、プロンプトの続きを貪欲法で生成する"""
    mem = model.vision.extract_features(img[None])       # (1, N, D)
    seq = list(prompt)
    for _ in range(max_new):
        nxt = int(model.decoder(torch.tensor(seq)[None], mem)[0, -1].argmax())
        seq.append(nxt)
        if nxt == stoi["<eos>"]:
            break
    return seq[len(prompt):]


ok = {"<cap>": 0, "<ref>": 0, "<grd>": 0}
for i in range(len(x)):
    cap = [stoi[w] for w in tokenize_words(captions[i])]
    loc = loc_tokens(boxes[i])
    g_cap = generate(x[i], [stoi["<bos>"], stoi["<cap>"]])
    g_ref = generate(x[i], [stoi["<bos>"], stoi["<ref>"]] + cap, max_new=6)
    g_grd = generate(x[i], [stoi["<bos>"], stoi["<grd>"]] + loc)
    ok["<cap>"] += g_cap[:-1] == cap
    ok["<ref>"] += g_ref[:-1] == loc
    ok["<grd>"] += g_grd[:-1] == cap
    if i in (0, 10):
        print(f"[画像{i}]")
        print("  <cap> :", " ".join(itos[t] for t in g_cap))
        print("  <ref> :", " ".join(itos[t] for t in g_ref),
              "| 正解", " ".join(itos[t] for t in loc))
        print("  <grd> :", " ".join(itos[t] for t in g_grd))
n = len(x)
print(f"キャプション生成 {ok['<cap>']}/{n}  座標予測 {ok['<ref>']}/{n}  領域キャプション {ok['<grd>']}/{n}")
貪欲法による生成: generate は画像特徴量を一度だけ計算し、あとは最も確率の高いトークンを1つずつ付け足して EOS が出るまで繰り返します。プロンプトを差し替えるだけで3つのタスクを切り替えられます。
一致率の集計: 生成結果から末尾のEOSを除いた部分が正解列と完全に一致した件数を数えます。座標予測(<ref>)については、量子化した4つの座標トークンが1つも間違っていないことを条件にしています。
実行結果
[画像0]
  <cap> : a photo of a t-shirt <eos>
  <ref> : <loc13> <loc10> <loc29> <loc26> <eos> | 正解 <loc13> <loc10> <loc29> <loc26>
  <grd> : a photo of a t-shirt <eos>
[画像10]
  <cap> : T シ ャ ツ の 写 真 <eos>
  <ref> : <loc4> <loc13> <loc20> <loc29> <eos> | 正解 <loc4> <loc13> <loc20> <loc29>
  <grd> : T シ ャ ツ の 写 真 <eos>
キャプション生成 20/20 座標予測 20/20 領域キャプション 20/20
3つのタスクすべてが20枚中20枚で完全一致しました。特に注目すべきは <ref> タスクで、画像を見て物体が貼り付けられた位置を4つの座標トークンとして正確に言い当てています。画像全体を1つのベクトルに潰すだけでは不可能な予測であり、クロスアテンション経由で画像エンコーダが位置情報を保持した特徴量を学習したことの証拠になります。
日本語キャプションを割り当てた画像10でも、同じデコーダが日本語の文字列を正しく生成できています。
検証3: 予測結果の可視化
最後に、20枚すべてについて予測キャプションとその確率、そしてデコーダが予測したバウンディングボックスを重ねて描画します。
fig, axes = plt.subplots(4, 5, figsize=(15, 13))
for i, ax in enumerate(axes.flatten()):
    ax.imshow(canvas[i], cmap="gray")
    # <ref> タスクで予測させた座標トークンを画像上の矩形に戻す
    cap = [stoi[w] for w in tokenize_words(captions[i])]
    g_ref = generate(x[i], [stoi["<bos>"], stoi["<ref>"]] + cap, max_new=6)
    box = [int(itos[t][4:-1]) / NBIN * CANVAS for t in g_ref if itos[t].startswith("<loc")]
    if len(box) == 4:
        y0, x0, y1, x1 = box
        ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0,
                                   fill=False, edgecolor="lime", lw=2))
    j = int(probs[i].argmax())
    ok_cls = class_ids[j].item() == class_ids[i].item()
    ax.set_title(f"True: {captions[i]}\nPred: {captions[j]}\nProb: {probs[i, j]:.3f}",
                 color="green" if ok_cls else "red", fontsize=9)
    ax.axis("off")
plt.tight_layout()
plt.show()
座標トークンの復元: 生成された <loc13> のようなトークンから数値を取り出し、量子化の逆変換(NBIN 段階からピクセル座標へ)を行って矩形として描画しています。
タイトルの表示: 予測キャプションは20文すべてのうち最も確率が高いものを選んでいます。予測が正解と同じクラスであれば緑、違えば赤でタイトルを表示します。
実行結果
上記のコードを実行すると、以下の結果が得られます。
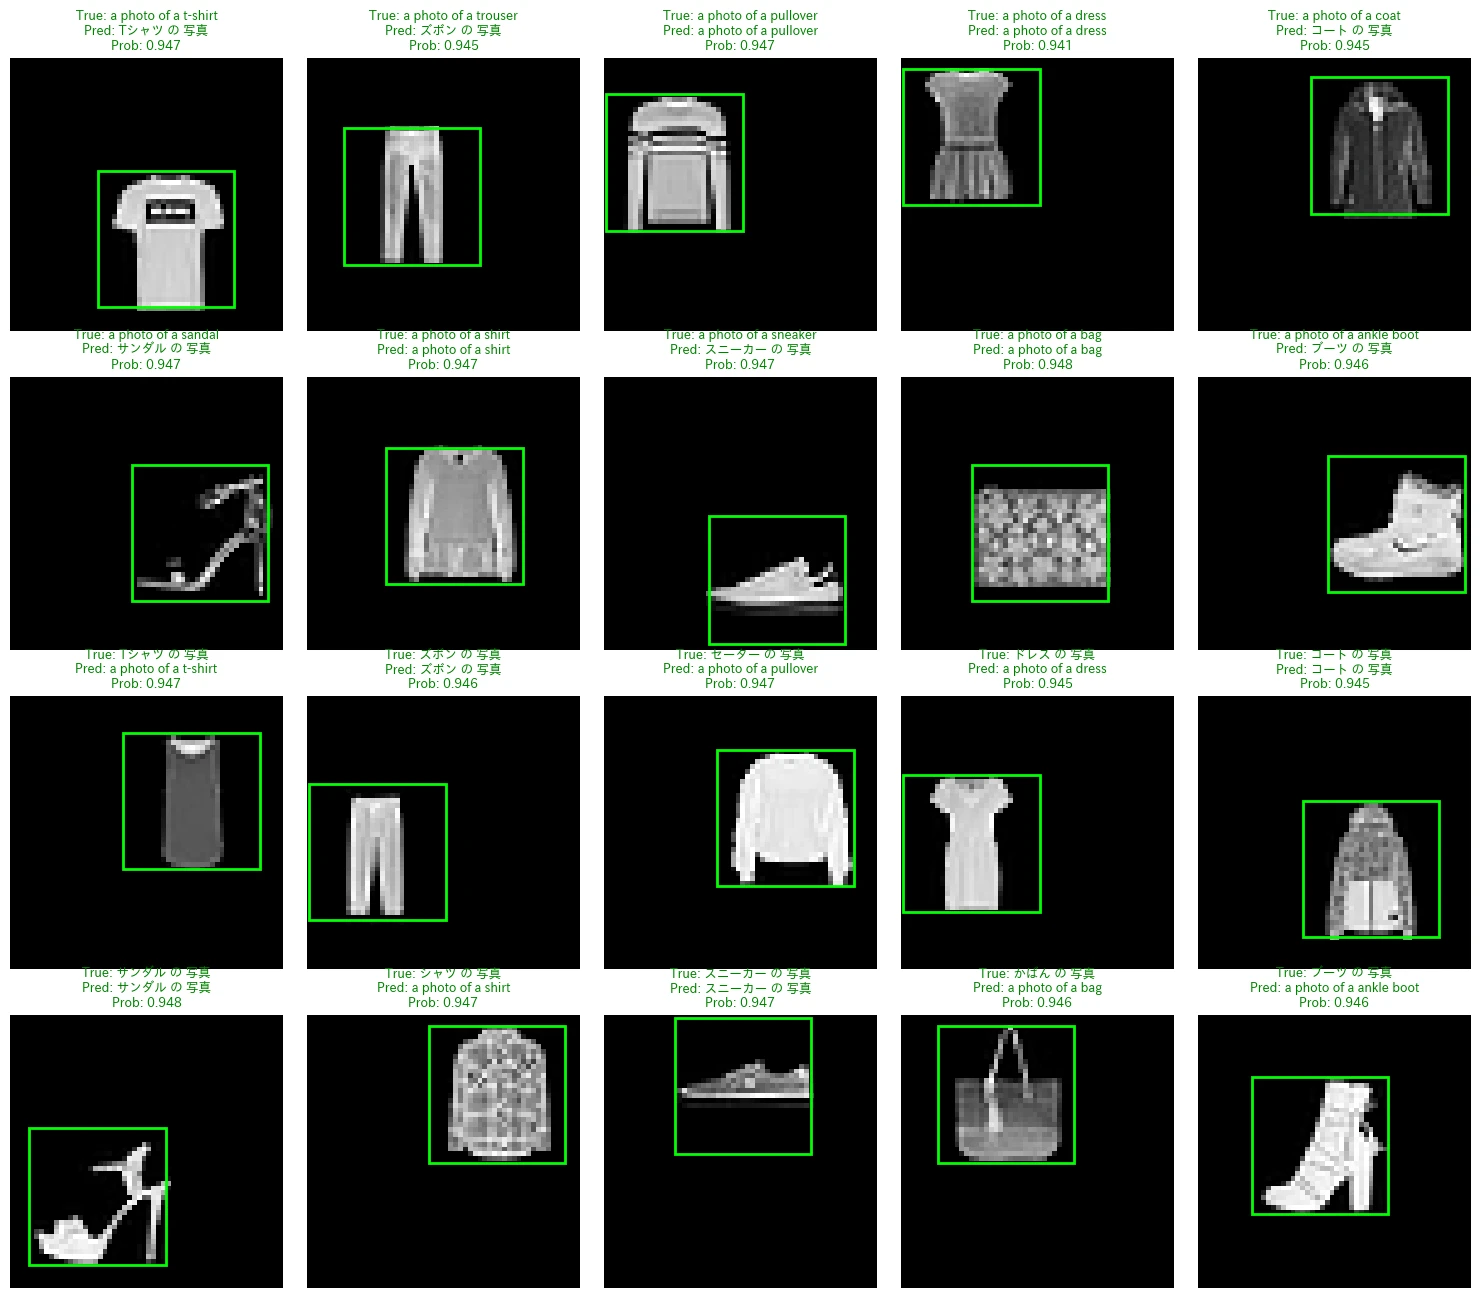
20枚すべてでタイトルが緑になっており、クラスの判定は全問正解です。緑の矩形はデコーダが予測した位置で、キャンバスのどこに物体が置かれていても正確に囲めています。
面白いのは「True」と「Pred」で言語が入れ替わっている画像が多い点です。たとえば英語キャプションを割り当てたTシャツの画像(左上)の予測が「Tシャツ の 写真」になっていますが、これは誤りではありません。同じクラスの英語文と日本語文はどちらも正例として学習しており、検証1の画像0のように両者の確率がほぼ同じ値(0.947対0.947)に並んだ結果、わずかな差でどちらかが選ばれているだけです。SigLIP 2の多言語エンコーダが、言語をまたいで同じ意味を同じ表現に写像している様子が、この小さなモデルでも再現できています。
実際のHugging Faceモデルを用いた推論テスト
Hugging Faceの transformers ライブラリを利用して、事前学習済みの実際のSigLIP 2モデルで推論を行ってみます。ここで使う google/siglip2-so400m-patch14-384 は、解像度を384×384に固定した通常版のモデルです(NaFlex版は別のチェックポイントとして公開されています)。
ゼロショット分類の実行
以下の画像を cat.jpg として保存し、以下のコードと同じフォルダに配置して下さい。
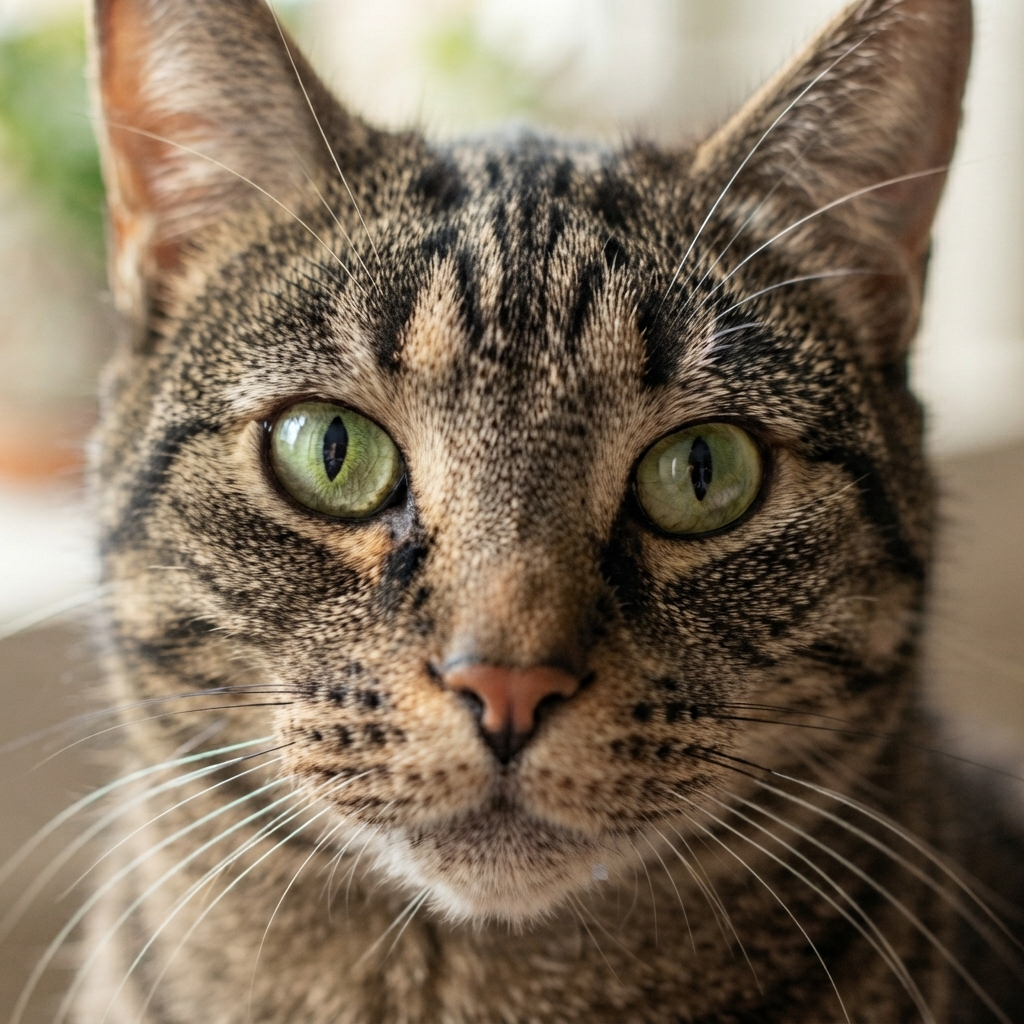
(画像は、Geminiで作成)
ここでは、Hugging Faceの pipeline APIを用いて直感的にゼロショット分類を行います。
from transformers import pipeline
from PIL import Image
import matplotlib.pyplot as plt

# SigLIP 2のモデルを用いたゼロショット分類のパイプライン作成
# ※ 'google/siglip2-so400m-patch14-384' は400Mパラメータのモデル
ckpt = "google/siglip2-so400m-patch14-384"
pipe = pipeline(model=ckpt, task="zero-shot-image-classification")

# 画像とテキスト候補の用意
image = Image.open("cat.jpg")
texts = [
    "a photo of a cat",
    "a photo of a dog",
    "a bunch of cats"
]

# 推論の実行
outputs = pipe(image, candidate_labels=texts)

print("【SigLIP 2による予測確率】")
for out in outputs:
    print(f"{out['label']} : {out['score']:.1%}")

# サンプル画像の可視化
plt.figure(figsize=(6, 6))
plt.imshow(image)
plt.axis("off")
plt.tight_layout()
plt.show()
パイプラインの利用: zero-shot-image-classification のパイプラインを使うと、プロセッサの初期化やパディング設定を意識せずに推論できます。SigLIP系のモデルでは、スコアはソフトマックスではなくシグモイドで計算されるため、候補どうしの合計は100%になりません。
多言語での確認: SigLIP 2は多言語対応なので、texts に日本語の候補(例:「猫の写真」)を混ぜても動作します。初代SigLIPとの違いを実感したい場合は試してみてください。
実行結果
【SigLIP 2による予測確率】
a photo of a cat : 8.4%
a bunch of cats : 0.4%
a photo of a dog : 0.0%
実行結果を確認すると、「a photo of a cat」の確率が最も高くなっていますが、確率は8.4%と一見低い値に見えます。しかしこれはSigLIP系のシグモイド損失に由来する特徴です。CLIPのようなソフトマックスとは異なり、合計が100%になるように計算されないため、「他の選択肢に比べてどれくらい尤もらしいか」ではなく、「その画像とテキストのペア単体が絶対評価としてどの程度対応しているか」という独立した確率が算出されます。そのため、無関係なテキスト(dogなど)に対しては厳密にほぼ0.0%が割り当てられており、閾値を設けることでマルチラベル分類などにも適応しやすくなっています。
3つの候補の確率を並べると、次のようになります。
(図は、diagram-designで作成)
ダウンストリームタスク用の画像エンコード(抽出)
セグメンテーションタスクやVLM(PaliGemma 2など)での利用に向けて、SigLIP 2から密な画像埋め込み(Dense Features)を抽出することも簡単に行なえます。
import torch
from transformers import AutoModel, AutoProcessor
from transformers.image_utils import load_image

# モデルとプロセサの初期化
ckpt = "google/siglip2-so400m-patch14-384"
model = AutoModel.from_pretrained(ckpt, device_map="auto").eval()
processor = AutoProcessor.from_pretrained(ckpt)

# 画像の読み込みと前処理
image = load_image("cat.jpg")
inputs = processor(images=[image], return_tensors="pt").to(model.device)

# 勾配計算を無効にして画像特徴量(embeddings)を抽出
with torch.no_grad():
    vision_outputs = model.vision_model(**inputs)

image_embeddings = vision_outputs.pooler_output       # MAP headでプーリングした1本のベクトル
dense_features = vision_outputs.last_hidden_state     # パッチ単位の密な特徴量

print(f"画像埋め込みの形状: {image_embeddings.shape}")    # 1 枚の画像を 1 本のベクトルに
print(f"パッチ特徴量の形状: {dense_features.shape}")     # 384÷14 = 27 → 27×27 = 729 パッチ
2種類の特徴量: model.vision_model の出力には2種類の特徴量が入っています。pooler_output はMAP headでプーリングした1本のベクトルで、スクラッチ実装の encode_image(正規化の前)にあたります。last_hidden_state はパッチごとの特徴量(Dense Features)で、スクラッチ実装の extract_features にあたります。用途に応じて使い分けます。
実行結果
画像埋め込みの形状: torch.Size([1, 1152])
パッチ特徴量の形状: torch.Size([1, 729, 1152])
画像全体を表すのは1152次元のベクトル1本で、ゼロショット分類や検索に使います。パッチ特徴量は、384×384の画像を14×14のパッチに分けた27×27=729個のパッチごとに1152次元を持つ、密な特徴量(Dense Features)です。セグメンテーションのようにピクセル単位の空間理解が要るタスクや、PaliGemma 2のようなVLMの視覚トークンには、こちらを使います。
2種類の出力を図にすると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、多言語対応の強力な視覚・言語エンコーダであるSigLIP 2について解説しました。記事を通じて、以下の内容を学習・実践しました。
- SigLIP 2の進化: 従来のシグモイド損失に加え、デコーダを用いたキャプション学習(LocCa)や、自己蒸留およびマスク化予測(SILC/TIPSなどの自己教師あり学習)を統合し、ゼロショット分類、ローカリゼーション、および密な特徴抽出の性能が大幅に向上しました。
- スクラッチ実装による検証: PyTorchを用いて、クロスアテンション付きのLocCaデコーダ、EMA教師による自己蒸留、マスク化予測を実装し、過学習によるサニティチェックで、検索精度100%・3タスクすべてで20/20の完全一致・言語をまたいだ同一表現の獲得を確認しました。
- NaFlexと多言語対応: ネイティブのアスペクト比を保持したまま様々なシーケンス長に適応できる動的解像度バリアントや、除バイアス技術を用いた優れた多言語対応能力および公平性の向上を実現しています。
- Hugging Faceモデルを利用した推論: transformers ライブラリの pipeline や AutoModel を使用することで、容易に強力な画像埋め込みを抽出し、PaliGemma 2などのVLMを含む様々なダウンストリームタスクに統合できることを確認しました。
SigLIP 2は、より構造化された、きめ細かく強力な視覚表現を持っています。このモデルは、計算効率と柔軟性を兼ね備えた次世代のビジョンエンコーダとして、今後マルチモーダルAI開発の中核となるでしょう。
参考文献
- M. Tschannen et al. (2025). SigLIP 2: Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features. arXiv:2502.14786.
- Google. google/siglip2-so400m-patch14-384. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。
- Dataset License: 本記事のコード(スクラッチ実装)で使用している
Fashion-MNISTデータセットは、Zalando SE によって MIT License の下で公開されています。 - Model License: 推論テストで使用している
google/siglip2-so400m-patch14-384モデルは、Google によって Apache License 2.0 の下で公開されています。