焼きなまし法(Simulated Annealing)とは?
 (画像は、Geminiで作成)
山登り法が局所解から抜け出せない問題に対して、メトロポリス基準で一時的に悪くなる移動も確率的に受け入れ、温度を下げながら探索を絞り込む焼きなまし法の仕組みを理解すること。山登り法と同じ関数で2つの方法の探索の軌跡を比べ、温度や近傍の幅といったハイパーパラメータが結果を左右することを確かめ、温度を固定したときに MCMC になるという関係を説明できるようになること。
焼きなまし法(Simulated Annealing)の概要
焼きなまし法(Simulated Annealing:SA) は、組み合わせ最適化問題において、実用上十分な「良い解」を高速に見つけ出すための強力なメタヒューリスティクス(近似解法)の一つです。
局所探索(山登り法)で解説したように、配送ルート最適化などの実社会の課題では、すべてのパターンを計算する「全探索」では現実的な時間内に解を得られないという課題があります。この課題を解決する基礎的な手法として、現在の解の近傍を探索して改善を繰り返す「山登り法(局所探索)」が存在します。
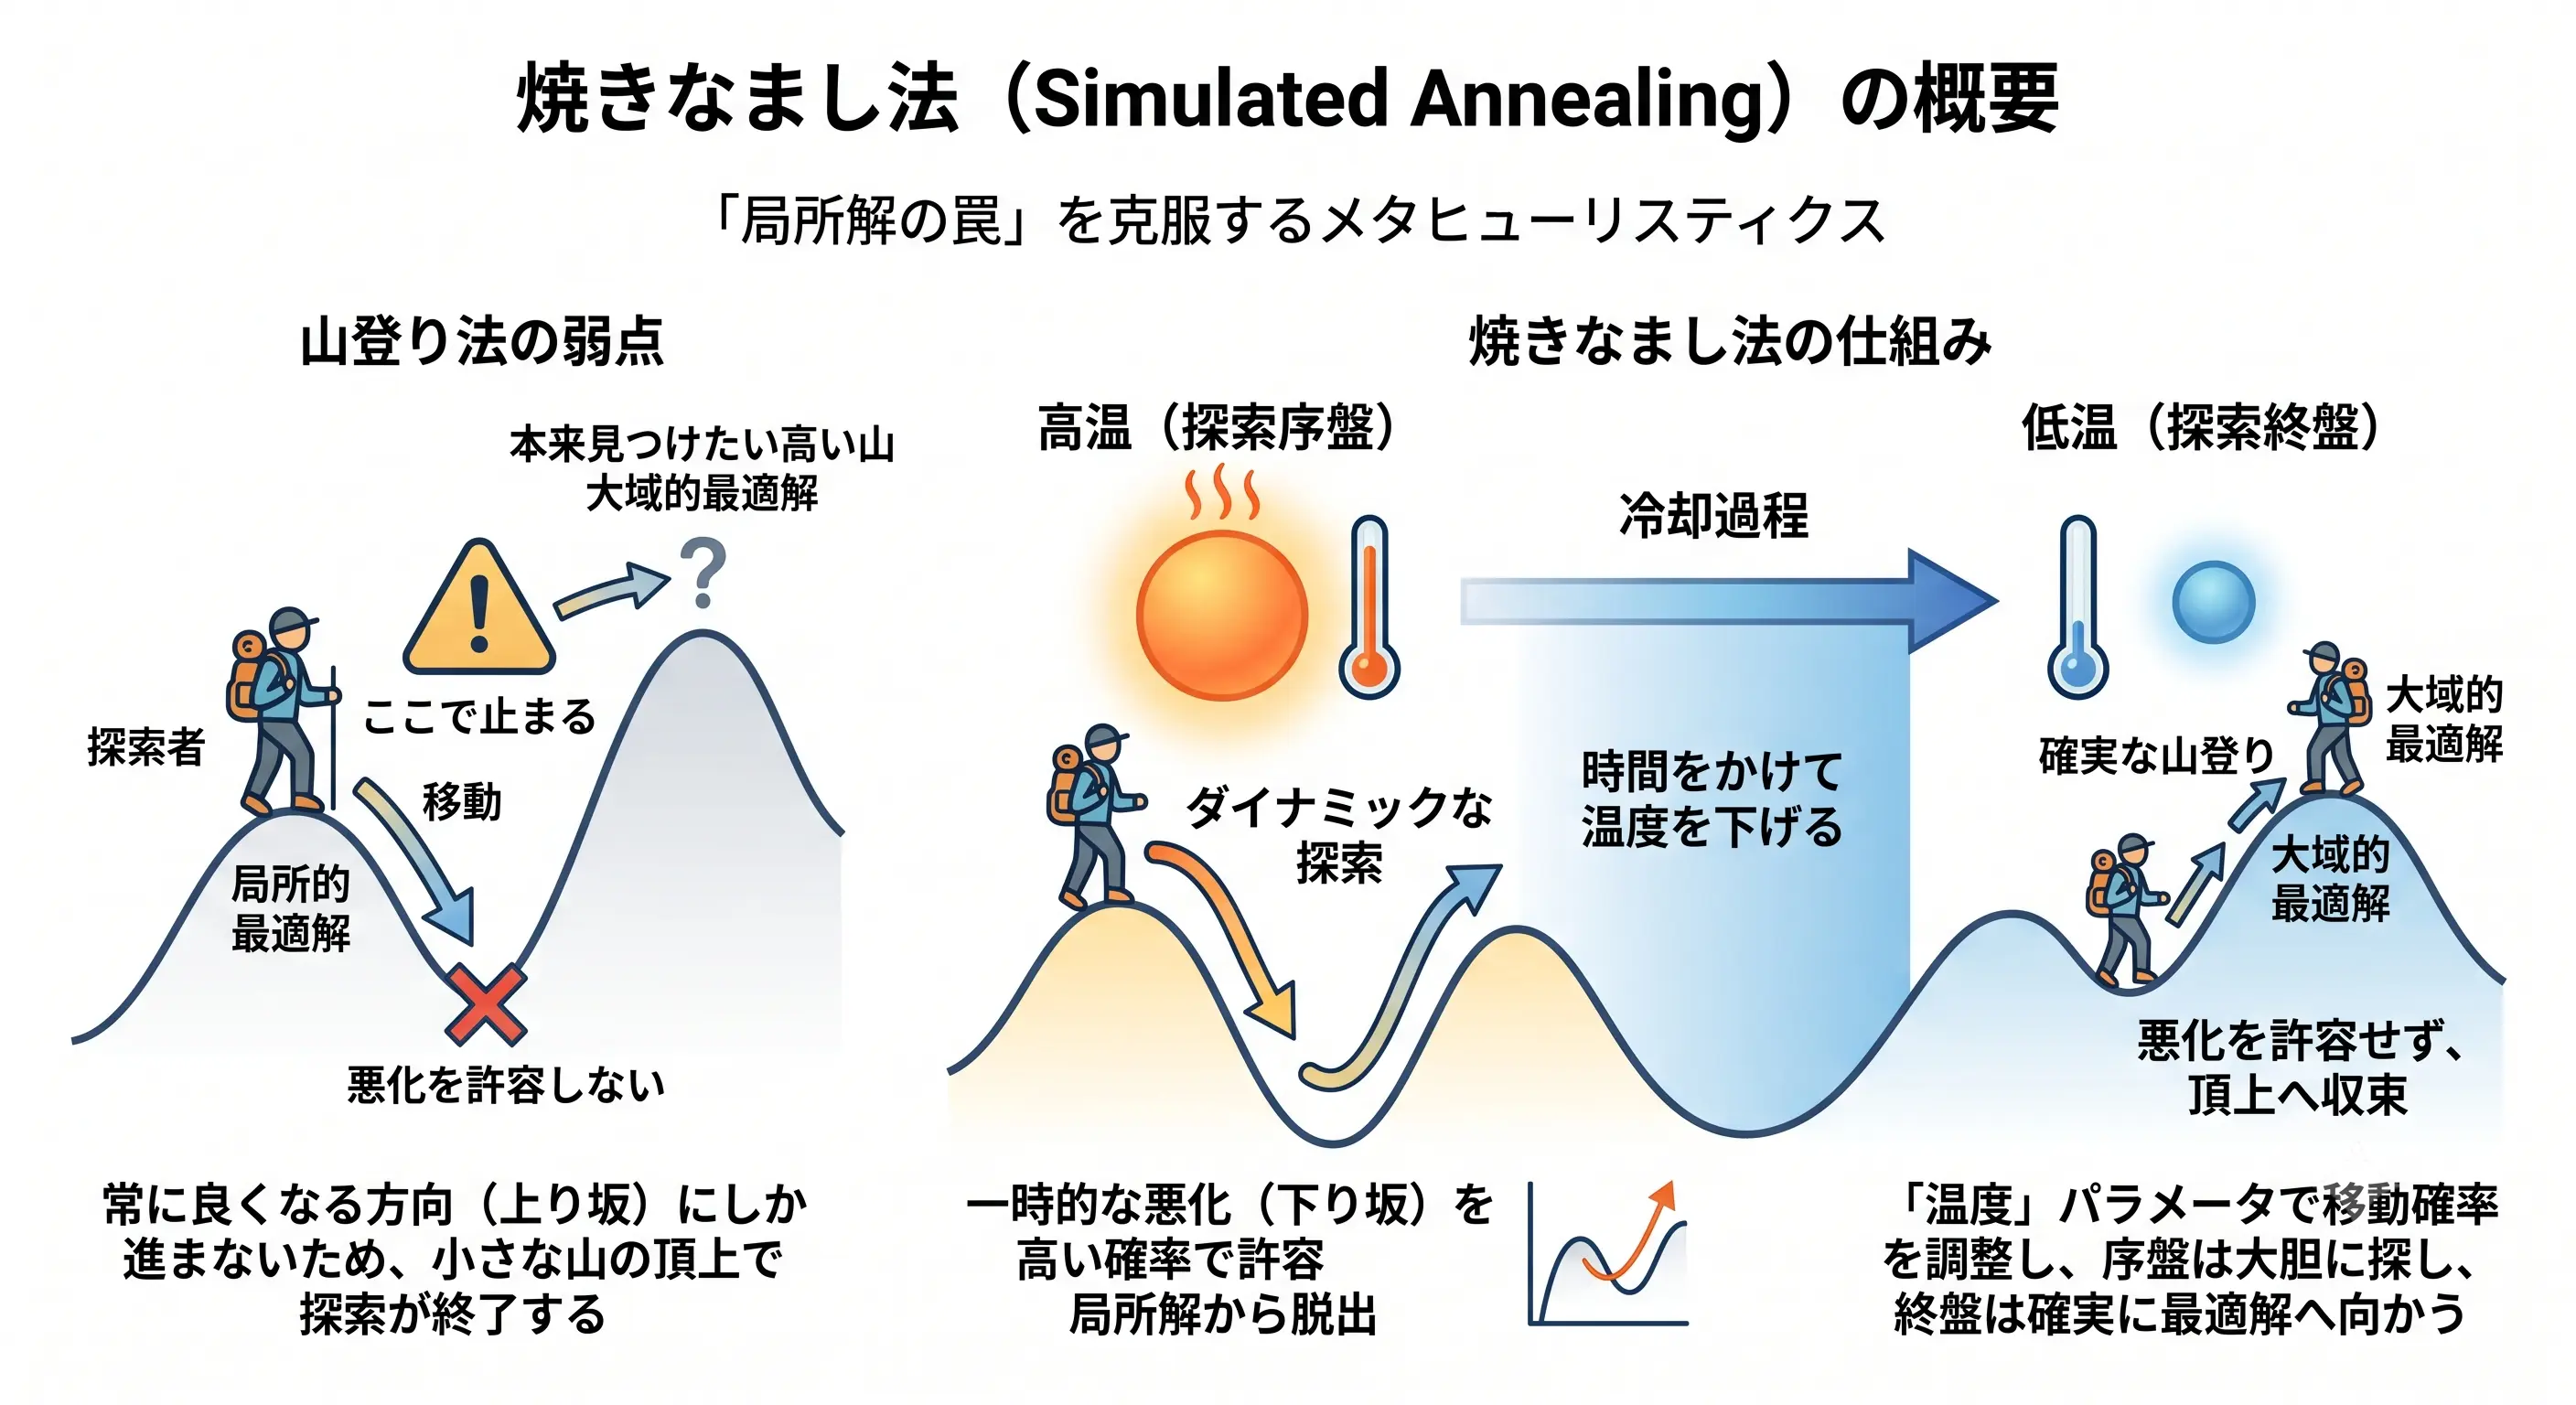
しかし、山登り法には決定的な弱点がありました。それは、常に評価が改善する方向へしか進まないため、小さな山の頂上である局所的最適解(Local Optimum) に到達すると、遠くにもっと高い山(大域的最適解)があっても探索が止まってしまうという問題です。
この「局所解の罠」を克服するために考案されたのが、焼きなまし法です。その最大の特長は、探索の過程で一時的な改悪を許容するという点にあります。
この手法の名前は、金属工学における「焼きなまし(Annealing)」という熱処理に由来します。金属を高温に熱して原子を自由に動ける状態にした後、ゆっくりと時間をかけて冷却することで、原子が最も安定した結晶構造(エネルギーが最小の状態)に落ち着くという物理現象をアルゴリズムとして模倣しています。
このアルゴリズムでは、「温度(Temperature)」というパラメータを用いて解の移動確率をコントロールします。
- 探索の序盤(高温状態): スコアが悪化する方向への移動を高い確率で許容し、探索空間をダイナミックに飛び回って局所解から脱出します。
- 探索の終盤(低温状態): スコアが悪化する移動を次第に許容しなくなり、最終的には山登り法のように局所的な頂上へと収束していきます。
このように「最初は柔軟に広く探し、徐々に厳密に山を登る」というプロセスを経ることで、山登り法ではたどり着けなかった最も高い山の頂上(大域的最適解)を発見できる確率を飛躍的に高めているのです。
温度のスケジュールを図にすると、次のようになります。
(図は、diagram-designで作成)
山登り法と焼きなまし法の違い(遷移確率)
両者の違いを、解を更新する際のルール(遷移確率)から見てみましょう。 最適化したい評価関数を とし、その最大化を目的とします。現在の解 から近傍の解 へ移動する際の評価値の差分を とします。
山登り法 (Hill Climbing)
局所探索(山登り法)の記事で解説した通り、山登り法は常に良くなる方向へしか進みません。
- 更新条件:
評価が良くなる()なら確実に移動し、悪くなる()なら絶対に移動しない、という非常に貪欲な戦略です。
焼きなまし法 (Simulated Annealing)
一方、焼きなまし法ではスコアが悪化する場合でも一定の確率で移動を許容します。この判定には一般的にメトロポリス基準(Metropolis Criterion) が用いられます。
- 更新条件:
ここで、 は現在の温度(Temperature) を表すパラメータで、 です。
この数式から、焼きなまし法の重要な性質が3つ見えてきます。
- 改悪の許容: (スコアが悪化)であっても、確率 で移動を受け入れます。これが局所解から脱出する原動力となります。
- 温度の影響: 温度 が高いほど確率は に近づき(改悪を許容しやすい)、 が低いほど確率は に近づきます(改悪を許容しにくい)。これにより、探索の進行度に応じた振る舞いの制御が可能になります。
- 改悪幅の影響: 悪化の度合い( のマイナス幅)が大きいほど、確率は指数関数的に低くなります。「少しの改悪」は受け入れやすく、「大幅な改悪」は受け入れにくいという、直感的に理解しやすい性質を持っています。
2つの受理確率を、温度を変えてグラフにすると、次のようになります。
(図は、diagram-designで作成)
コードによる挙動の確認
次に、Pythonコードを使って、これら2つのアルゴリズムの挙動を実際に確認してみましょう。局所探索(山登り法)の記事と同じく、評価関数 の最大化問題を題材にします。
まずは準備として、この評価関数を定義し、グラフにプロットして形状を可視化します。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。japanize-matplotlib は distutils を使うので、Python 3.12 以降で import エラーになる場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import math
import random
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフ日本語表示用

# 評価関数(目的関数)
def f(x):
    return math.sin(x) + math.cos(0.5 * x)

# 探索空間の設定
x_min, x_max = 0.0, 10.0
step_size = 0.1  # 近傍への移動距離

print("--- 準備 ---")
print(f"探索範囲: {x_min} から {x_max}")

# --- 可視化のためのデータ生成 ---
# 探索範囲内のx値のリストを作成
x_vals = [i * step_size for i in range(int(x_max / step_size) + 1)]

# 各xに対応する評価関数f(x)の値を計算
y_vals = [f(x) for x in x_vals]

# グラフの描画
plt.figure(figsize=(10, 6))
plt.plot(x_vals, y_vals, color='#1f77b4', linewidth=2, label='目的関数 f(x)')
plt.title("評価関数 f(x) = sin(x) + cos(0.5x) の形状", fontsize=14, fontweight='bold')
plt.xlabel("変数 x", fontsize=12)
plt.ylabel("評価値 f(x)", fontsize=12)
plt.grid(True, linestyle='--', alpha=0.6)
plt.legend()
plt.show()
評価関数の定義と探索範囲の設定、関数の形状の可視化を行っています。
- 評価関数: f(x) は を返す関数で、これを最大にする を探します。周期の異なる2つの波を足し合わせることで、高さの違う山が複数ある「局所解のある地形」を作っています。
- 探索空間と近傍の幅: 探索範囲を x_min から x_max(0〜10)に限定し、step_size = 0.1 を山登り法で1回に移動する距離(近傍の幅)として定義しています。0〜10 にするのは、一番高い山()と低い山()の両方を含め、その間に谷()を挟むためです。0.1 は、山登り法の記事と同じ値で、結果を山登り法の記事と比べられるようにしています。
- 形状の可視化: x_vals に0.1刻みの を並べ、各点の評価値 y_vals を計算して折れ線で描いています。探索アルゴリズム自身はこの全体像を知らずに探索しますが、結果の良し悪しを判断できるよう、先に地形の全体像を確認しておきます。
実行結果
--- 準備 ---
探索範囲: 0.0 から 10.0
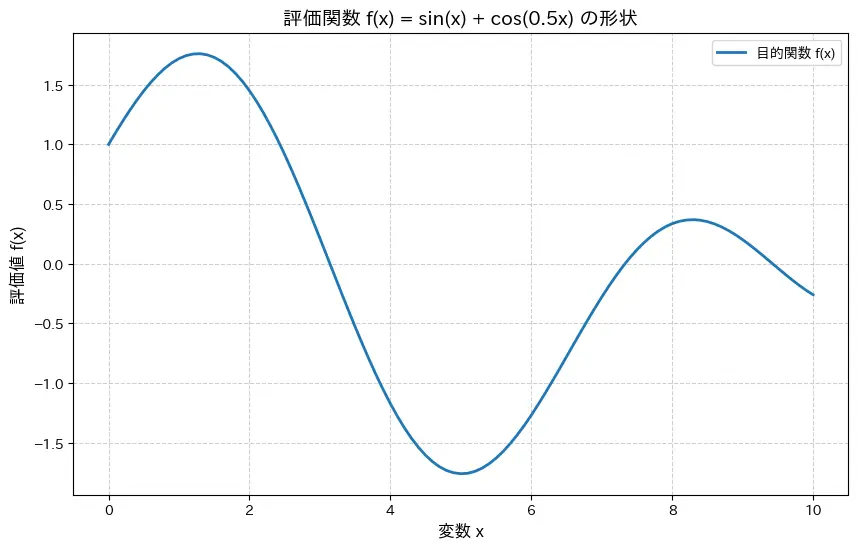
このプロットからわかるように、評価関数 には複数の山が存在します。 具体的には、 付近に最も高い大域的最適解があり、 付近にそれよりは低い局所的最適解が存在します。 ここからは、山登り法と焼きなまし法が、この関数をどのように探索していくかを見ていきましょう。
山登り法による探索(失敗例)
最初に、山登り法で探索します。意図的に局所解に陥りやすいよう、初期値を 8.0 に設定して探索を開始します。
# 初期解(局所解に陥りやすいスタート地点として 8.0 に設定)
current_x_hc = 8.0

while True:
    # 近傍の生成:現在の位置から左右にステップ幅だけ移動した2つの候補点
    neighbors = [current_x_hc - step_size, current_x_hc + step_size]

    # 探索空間の範囲内に収まっている候補点のみにフィルタリング
    valid_neighbors = [nx for nx in neighbors if x_min <= nx <= x_max]

    # 暫定の最良候補を現在の位置に設定
    best_neighbor = current_x_hc
    best_neighbor_score = f(current_x_hc)

    # 有効な近傍候補点を順番に評価
    for nx in valid_neighbors:
        score = f(nx)
        # より良いスコアが見つかれば最良近傍候補を更新
        if score > best_neighbor_score:
            best_neighbor_score = score
            best_neighbor = nx

    # 近傍のどれを探索しても改善しない場合はループを終了
    if best_neighbor_score <= f(current_x_hc):
        break

    # 現在地を最良近傍に更新
    current_x_hc = best_neighbor

print(f"山登り法の解: x = {current_x_hc:.2f}, スコア = {f(current_x_hc):.4f}")
print("❌ 課題: スタート地点によっては小さな山の頂上で止まってしまう。")
山登り法で、初期値8.0から探索しています。
- 初期値: current_x_hc = 8.0 は、右側の小さな山(局所解)の裾野にあたる地点です。山登り法の弱点を確認するため、意図的に局所解に陥りやすい場所から始めています。
- 近傍の生成: neighbors は、現在位置から左右に step_size だけ動いた2点です。探索範囲の外に出た点は、valid_neighbors で除外しています。
- 最良近傍の選択: 現在地を暫定の最良候補とし、近傍の中に現在より高いスコアの点があれば best_neighbor を更新して、そこへ移動します。
- 終了条件: best_neighbor_score が現在地のスコアを上回らない、つまりどの近傍に動いても改善しない時点で break します。山頂に着いたら必ず止まるこの仕組みが、局所解で探索が終わってしまう原因です。
実行結果
山登り法の解: x = 8.30, スコア = 0.3690
❌ 課題: スタート地点によっては小さな山の頂上で止まってしまう。
この結果が示すように、探索は の地点で終了しました。これはグラフ上の小さな山(局所的最適解)の頂上であり、より高い山(大域的最適解, )には到達できていません。このように、スタート地点によっては最良の解を見つけられないのが山登り法の課題です。
焼きなまし法による探索
次に、焼きなまし法を使って、この「局所解の罠」から脱出できるか試してみましょう。山登り法が失敗したのと同じ 8.0 からスタートします。
# --- 焼きなまし法(SA)のパラメータ設定 ---
initial_temp = 10.0      # 初期温度:高いほど改悪を許容する
final_temp = 0.01        # 終了温度:この温度を下回ったら探索終了
cooling_rate = 0.99      # 冷却率:1ループごとに温度に掛ける値
sa_step = 1.5            # 近傍の幅:現在位置から ±sa_step の範囲で次の候補を選ぶ

# 初期解(山登り法が失敗した「8.0」をスタート地点とする)
current_x = 8.0
current_score = f(current_x)

# 最良解の保持用(探索中に見つけた一番良いスコアを記憶しておく)
best_x = current_x
best_score = current_score

# 温度の初期化と乱数シードの固定(再現性のため)
T = initial_temp
random.seed(1)

print("--- 焼きなまし法の探索開始 ---")

# 温度が終了温度を下回るまでループ
while T > final_temp:
    # 近傍の生成:現在位置からランダムに少し移動した地点を次の候補とする
    nx = current_x + random.uniform(-sa_step, sa_step)

    # 探索範囲内に収める(はみ出したら境界の値にする)
    nx = max(x_min, min(nx, x_max))

    # 候補地点のスコアを計算し、差分を求める
    next_score = f(nx)
    delta_f = next_score - current_score

    # 遷移判定(メトロポリス基準)
    if delta_f > 0 or random.random() < math.exp(delta_f / T):
        # 現在位置とスコアを更新(移動を受け入れる)
        current_x = nx
        current_score = next_score

        # これまでのベストスコアを上回っていれば記録を更新
        if current_score > best_score:
            best_score = current_score
            best_x = current_x

    # 温度を下げる(冷却)
    T *= cooling_rate

print(f"焼きなまし法の最適解: x = {best_x:.2f}, スコア = {best_score:.4f}")
print("⭕ 利点: 一時的な改悪を許容することで、局所解から脱出し、大域的最適解に到達できる。")
焼きなまし法で、山登り法と同じ初期値8.0から探索しています。
- 温度のスケジュール: initial_temp(初期温度)から始め、ループの最後に T *= cooling_rate で温度を少しずつ下げ、final_temp(終了温度)を下回ったら終了します(while T > final_temp:)。今回の設定では、約690回の移動が行われます。初期温度の 10.0 は、この関数で起こりうる最大の改悪(約 )でも、受け入れる確率が になる高さで、序盤は、ほぼどこへでも動けるようにするためです。終了温度の 0.01 では、 の小さな改悪でも、受け入れる確率は になり、終盤は、山登り法と同じように上り坂だけを進むようになります。冷却率の 0.99 は、この2つの温度の間を約690回のループで下げる値で、1回で下げる幅を小さくして、温度が急に下がって途中の山に捕まるのを避けるためです。
- 近傍の幅: sa_step = 1.5 により、現在位置から ±1.5 の範囲で次の候補 nx をランダムに選びます。山登り法では左右 だけ隣の点を調べていましたが、焼きなまし法では一度により遠くまで動けるようにしています(この幅が重要な理由は、すぐ後で確認します)。範囲外にはみ出した候補は、max(x_min, min(nx, x_max)) で境界の値に丸めています。
- 遷移判定(メトロポリス基準): delta_f > 0(改善)なら必ず移動し、改悪の場合も、一様乱数 random.random() が math.exp(delta_f / T) より小さければ移動します。温度 T が高いうちは改悪でも移動しやすく、温度が下がるにつれて改悪を受け入れにくくなります。
- 最良解の記録: 焼きなまし法は改悪も受け入れるため、最後にいた場所が最良とは限りません。そのため、探索中に見つけた最高スコアの点を best_x と best_score に記録しておき、これを答えとします。
- 乱数の固定: random.seed(1) で乱数を固定し、実行のたびに同じ結果が得られるようにしています。シードの 1 は、結果が良くなるように選んだ値ではありません。次の節で、0〜9 の10通りのシードでも、±1.5 なら10回すべてで同じ山に着くことを確かめます。
実行結果
--- 焼きなまし法の探索開始 ---
焼きなまし法の最適解: x = 1.27, スコア = 1.7602
⭕ 利点: 一時的な改悪を許容することで、局所解から脱出し、大域的最適解に到達できる。
結果は明らかです。山登り法では局所解に捕らわれたのに対し、焼きなまし法は大域的最適解である を発見できました。
2つの手法の結果を並べると、次のようになります。
(図は、diagram-designで作成)
近傍の幅も重要なハイパーパラメータ
ここで、「近傍の幅」を山登り法と同じ にしたらどうなるかを確認しておきましょう。また、1回の成功がたまたまではないかを確かめるため、乱数のシードを10通り変えて実行します。
def simulated_annealing(step, seed, start_x=8.0):
    """焼きなまし法を1回実行し、探索中に見つけた最良解の x を返す"""
    random.seed(seed)
    current_x, current_score = start_x, f(start_x)
    best_x, best_score = current_x, current_score
    T = initial_temp
    while T > final_temp:
        nx = max(x_min, min(current_x + random.uniform(-step, step), x_max))
        delta_f = f(nx) - current_score
        if delta_f > 0 or random.random() < math.exp(delta_f / T):
            current_x, current_score = nx, f(nx)
            if current_score > best_score:
                best_x, best_score = current_x, current_score
        T *= cooling_rate
    return best_x

# 近傍の幅を変えて、それぞれ10通りのシードで実行
for step in [0.1, 0.5, 1.5]:
    results = [simulated_annealing(step, seed) for seed in range(10)]
    n_success = sum(abs(x - 1.27) < 0.1 for x in results)  # 大域的最適解の近くに到達した回数
    print(f"近傍の幅 ±{step}: 大域的最適解に到達 {n_success}/10 回  到達点: {[round(x, 2) for x in results]}")
焼きなまし法を関数にまとめ、近傍の幅と乱数のシードを変えて繰り返し実行しています。
- 関数化: simulated_annealing は、近傍の幅 step と乱数のシード seed を引数に取り、探索中に見つけた最良解の を返します。中身は先ほどの焼きなまし法と同じで、温度のスケジュール(initial_temp、final_temp、cooling_rate)も共通です。
- シードの切り替え: 関数の冒頭で random.seed(seed) を呼ぶため、seed を変えると乱数の流れが変わり、別の探索経路をたどります。range(10) の10通りのシードで実行することで、成功が「たまたま」ではないかを確かめられます。
- 成功の判定: 到達した と大域的最適解(約1.27)との差が0.1未満なら「到達」とみなし、sum(...) で成功した回数を数えています。差を 0.1 未満とするのは、一番高い山の頂上(1.27)と低い山の頂上(8.29)がはっきり分かれる幅で、山登り法の1歩の大きさとも同じだからです。
- 比較する近傍の幅: 山登り法と同じ ±0.1、中間の ±0.5、先ほどの焼きなまし法と同じ ±1.5 の3通りを比べています。中間の ±0.5 を入れるのは、近傍の幅を広げるにつれて、成功の回数がどう変わるかを見るためです。
実行結果
近傍の幅 ±0.1: 大域的最適解に到達 0/10 回  到達点: [8.29, 8.29, 8.29, 8.29, 8.29, 8.29, 8.3, 8.29, 8.29, 8.29]
近傍の幅 ±0.5: 大域的最適解に到達 2/10 回  到達点: [8.29, 1.27, 8.29, 8.29, 8.29, 8.29, 8.29, 1.27, 8.29, 8.29]
近傍の幅 ±1.5: 大域的最適解に到達 10/10 回  到達点: [1.28, 1.27, 1.27, 1.27, 1.22, 1.27, 1.27, 1.27, 1.27, 1.26]
近傍の幅が だと、10回すべてが の局所解に留まりました。温度が高く改悪を許容していても、1回の移動が小さすぎるため、約690回の移動では局所解と大域的最適解を隔てる広い谷を渡りきれないのです。幅を にすると10回中2回、 まで広げると10回すべてで大域的最適解に到達しています。
このように、焼きなまし法の性能は温度のスケジュールだけでなく、「1回にどれだけ遠くまで動けるか」という近傍の設計 にも大きく左右されます。
実問題での近傍設計の例として、MMMによる予算配分の最適化の記事では、「あるチャネルから別のチャネルへ予算を移す」ことを1回の移動として焼きなまし法を適用しています。そこでも、移す金額(近傍の幅)が小さすぎると、TVのS字カーブが作る谷を越えられずに局所解に留まることを確認しています。
10回の到達点を並べると、次のようになります。
(図は、diagram-designで作成)
探索軌跡の可視化
最後に、焼きなまし法がどのように「谷を下り、より高い山を目指したのか」、その探索の軌跡をグラフで確認してみましょう。
import numpy as np

# NumPy用の評価関数の定義
def f_np(x):
    return np.sin(x) + np.cos(0.5 * x)

# グラフ描画用の背景データ生成
x_vals_np = np.linspace(0, 10, 200)
y_vals_np = f_np(x_vals_np)

# --- 焼きなまし法の軌跡シミュレーション ---
T = initial_temp
current_x_path = 8.0
path_x = [current_x_path]  # 軌跡を保存するリスト

random.seed(1)
while T > final_temp:
    nx = current_x_path + random.uniform(-sa_step, sa_step)
    nx = max(x_min, min(nx, x_max))

    delta_f = f(nx) - f(current_x_path)
    if delta_f > 0 or random.random() < math.exp(delta_f / T):
        current_x_path = nx

    path_x.append(current_x_path) # 現在位置を記録
    T *= cooling_rate

# 軌跡のy座標を計算
path_y = [f_np(x) for x in path_x]

# --- グラフの描画 ---
plt.figure(figsize=(10, 6))
plt.plot(x_vals_np, y_vals_np, color='#1f77b4', linewidth=2, label='目的関数 f(x)')
plt.plot(path_x, path_y, marker='o', color='orange', markersize=4, linestyle='-', alpha=0.3, label='焼きなまし法の軌跡')
plt.plot(path_x[0], path_y[0], marker='s', color='black', markersize=8, label='スタート地点')
plt.plot(path_x[-1], path_y[-1], marker='*', color='red', markersize=12, label='最終到達地点')

plt.title("焼きなまし法の探索プロセス(局所解からの脱出)", fontsize=14, fontweight='bold')
plt.xlabel("変数 x", fontsize=12)
plt.ylabel("評価値 f(x)", fontsize=12)
plt.legend()
plt.grid(True, linestyle='--', alpha=0.6)
plt.show()
焼きなまし法の探索経路を記録し、評価関数のグラフの上に描いています。
- NumPy版の評価関数: f_np は配列をまとめて計算できる評価関数で、np.linspace(0, 10, 200) の200点で背景の曲線を滑らかに描くために使っています。
- 軌跡の記録: 探索のロジックは先ほどと同じです。同じ random.seed(1) と sa_step を使うため、先ほどと同じ経路をたどります。各ステップの現在位置を path_x に追加しており、移動が棄却されたステップでも同じ位置を記録するため、同じ場所に留まった様子も軌跡に残ります。
- 描画: 軌跡を半透明のオレンジの線(alpha=0.3)で重ねることで、何度も通った場所ほど色が濃く見えるようにしています。スタート地点を四角(marker='s')、最後にいた地点を星印(marker='*')で示しています。
実行結果
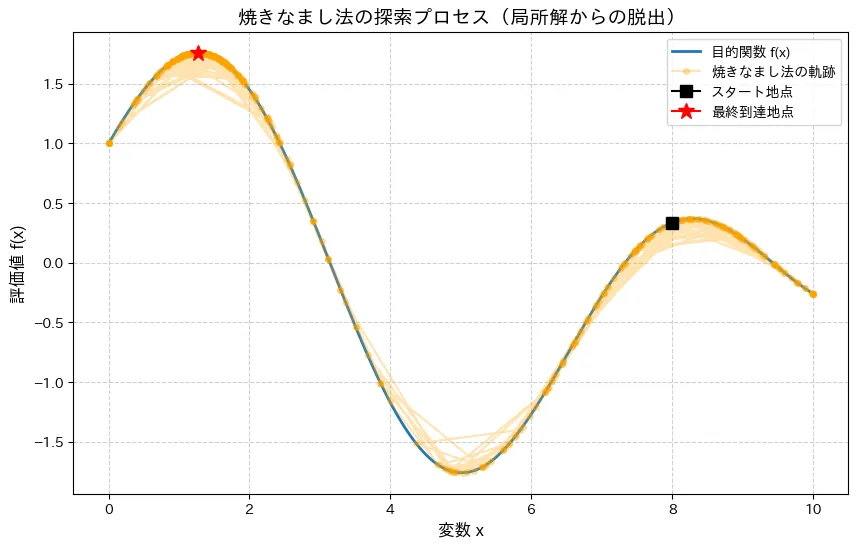
山登り法の探索軌跡と比較すると、その違いは一目瞭然です。
- 序盤(高温期): スタート直後、グラフのオレンジ色の線は評価が下がる谷底へ向かうなど、大きくダイナミックに動いています。これにより、 の局所解に捕らわれずに谷を越えることができています。
- 終盤(低温期): グラフの左側にある最も高い山(付近)に到達した後は、温度が下がっているため改悪を許容しにくくなり、山登り法のように山の頂上付近に収束していきます。
発展:焼きなまし法とMCMCの関係
焼きなまし法で使ったメトロポリス基準は、もともと最適化のために考案されたものではありません。1953年に Metropolis らが、統計物理学で「粒子の配置を、そのエネルギーに応じた確率分布からサンプリングする」ために提案した方法が起源です。これを1983年に Kirkpatrick らが最適化問題に転用したのが、焼きなまし法です。
温度 を固定したままメトロポリス基準で移動を繰り返すと、十分に長く続けた後に解 を訪れる頻度は、次の分布に従うことが知られています(候補の出し方が対称な場合)。
この式から、温度の役割がよく分かります。
- 温度を下げていく():評価値の高い場所ほど指数関数的に訪れやすくなり、最終的には最も高い山の頂上に集中します。これが焼きなまし法、つまり 最適化 です。
- 温度を固定する():評価関数を (ある確率分布の対数)とすると、訪問頻度は そのものになります。つまり、同じアルゴリズムで確率分布 からのサンプルが得られます。これが メトロポリス法 で、ベイズ統計で事後分布を求めるための MCMC(マルコフ連鎖モンテカルロ法) の出発点です。
焼きなまし法が「一番良い1点」を探すのに対し、MCMCは「どのあたりがどれくらいありそうか」という分布全体を描き出します。CausalImpactの記事で使った PyMC のサンプリングも、この考え方を発展させたアルゴリズム(NUTS)によるものです。焼きなまし法のコードを改造してメトロポリス法を実装する方法は、MCMCの記事で詳しく解説しています。
温度の扱いによる違いを図にすると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、山登り法の弱点を克服する強力なメタヒューリスティクスである「焼きなまし法(Simulated Annealing)」について、その理論と実践を解説しました。
- 確率的な改悪の許容: 焼きなまし法は、メトロポリス基準に基づいて一時的にスコアが悪化する移動を受け入れることで、山登り法が陥りがちな局所的最適解から脱出します。
- 温度による探索制御: 探索序盤は「高温」で大胆に広い範囲を探り、終盤は「低温」で厳密に最適解を絞り込むという、物理現象を模倣した洗練されたアルゴリズムです。
焼きなまし法は非常に強力ですが、一方で「初期温度」「終了温度」「冷却率」「近傍の幅」といったハイパーパラメータの設定が性能を大きく左右するという側面も持ちます。これらのパラメータを問題の性質に合わせて慎重にチューニングすることが、良い解を得るための鍵となります。
また、焼きなまし法の土台であるメトロポリス基準は、温度を固定すると確率分布からのサンプリング手法(MCMC)になります。この関係を出発点に、ベイズ推定を支えるMCMCの仕組みや収束診断を知りたい方は、MCMCの記事もあわせてご覧ください。焼きなまし法を実際のマーケティングの問題(広告予算の配分)に適用した例は、MMMによる予算配分の最適化の記事で紹介しています。
参考文献
- S. Kirkpatrick, C. D. Gelatt, M. P. Vecchi (1983). Optimization by Simulated Annealing. Science, 220(4598), 671–680.
- N. Metropolis, A. W. Rosenbluth, M. N. Rosenbluth, A. H. Teller, E. Teller (1953). Equation of State Calculations by Fast Computing Machines. The Journal of Chemical Physics, 21(6), 1087–1092.
本記事の文章・構成の一部に生成AIを使用しています。