Stable Diffusion (Latent Diffusion) とは?
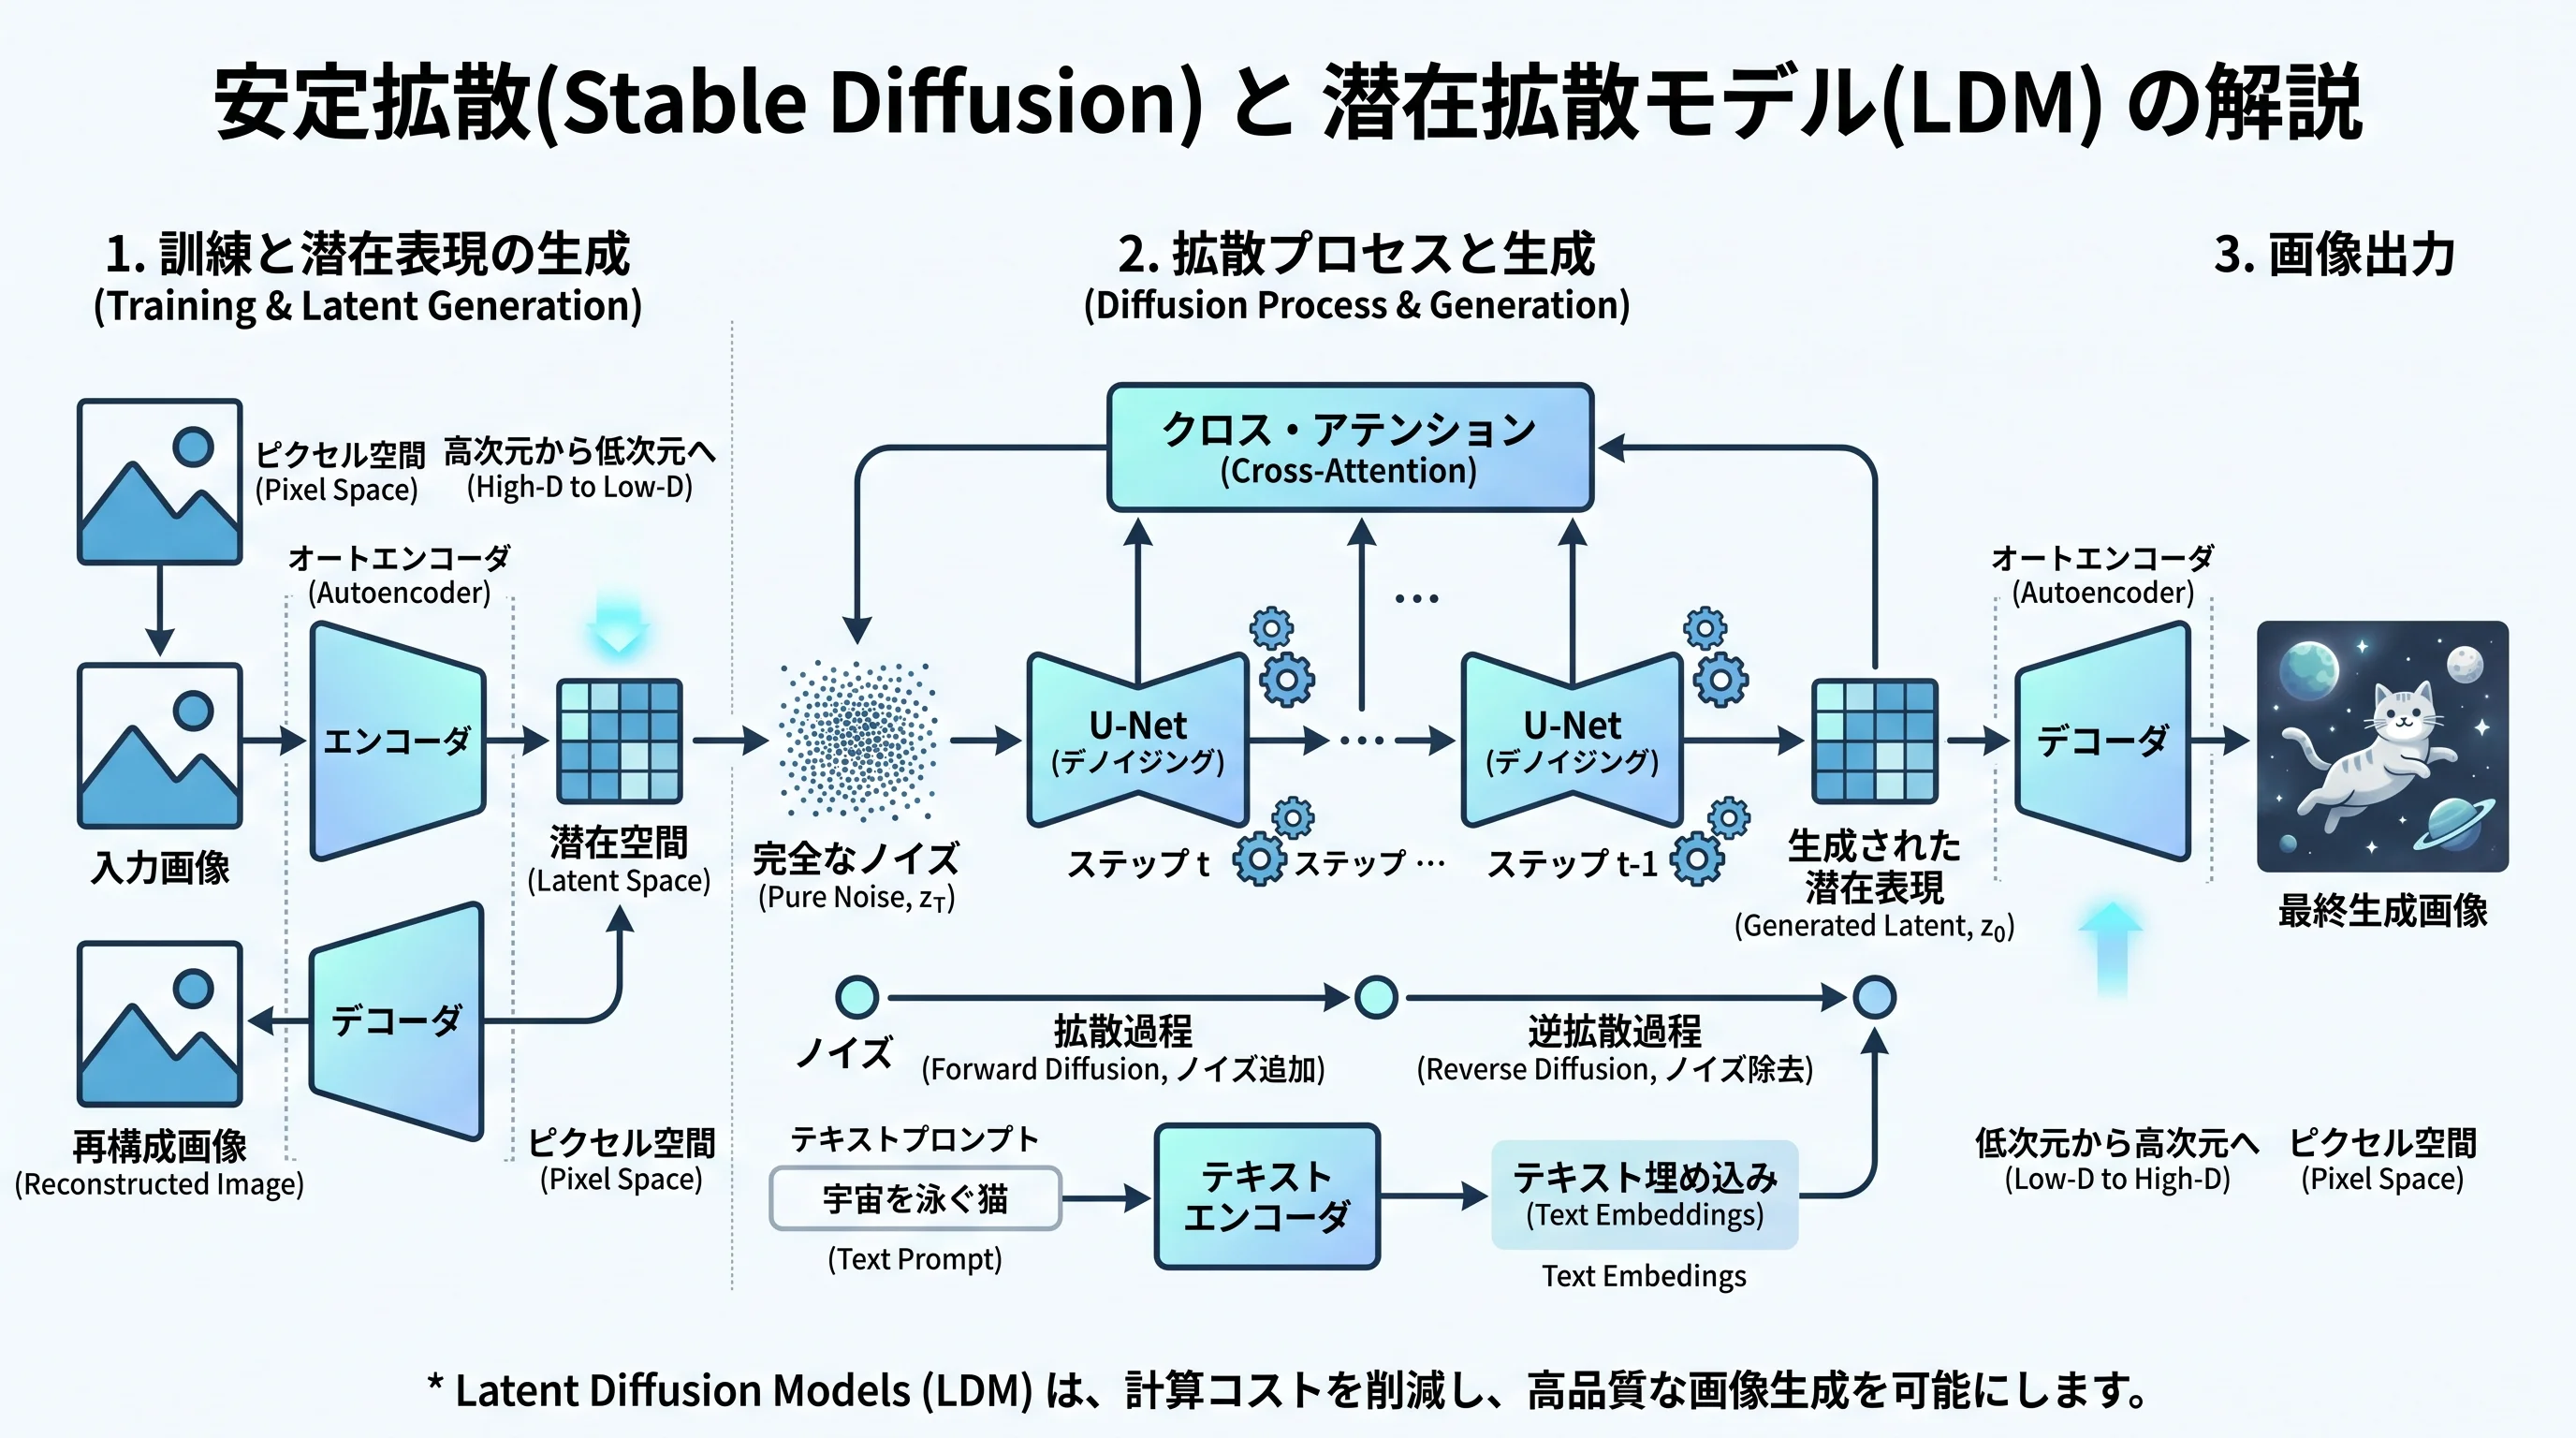 (画像は、Geminiで作成)
オートエンコーダで画像を潜在空間に圧縮し、その中で拡散モデルを動かす Latent Diffusion(Stable Diffusion)の仕組みと、知覚的な圧縮と意味的な圧縮を分けることで計算量を減らす考え方を理解すること。クロスアテンションによるテキストでの条件付けと Classifier-Free Guidance を説明でき、オートエンコーダ・潜在空間の U-Net・DDIM サンプラーのスクラッチ実装で、同じ大きさのテンソルを扱いながら、より高い解像度の画像を生成できることを確かめること。
Stable Diffusion (LDM) の概要
Stable Diffusionの基盤技術であるLDM(Latent Diffusion Models:潜在拡散モデル) は、事前学習された強力なオートエンコーダの「潜在空間(Latent space)」上で拡散モデルを適用する画像生成手法です。この手法は、限られた計算資源での拡散モデルの学習を可能にしつつ、品質と柔軟性を維持するために論文「High-Resolution Image Synthesis with Latent Diffusion Models」で開発されました。
DDPMなどの従来の拡散モデルは、ピクセル空間で直接動作するため、強力なモデルの最適化には数百のGPUデイズを消費することが多く、逐次的な評価が必要なため推論(画像生成)にも多大なコストがかかっていました。LDMは画像形成プロセスを自己符号化器(Autoencoder)と潜在空間での拡散モデルに分離することで、計算量の削減とディテールの保持のほぼ最適なバランスを達成し、視覚的な忠実度を大幅に向上させました。
さらに、モデルアーキテクチャに「クロスアテンション(Cross-attention)層」(仕組みはTransformer の記事)を導入することで、テキストやバウンディングボックスなどの一般的な条件付け入力に対応できる強力で柔軟なジェネレータへと進化しました。これにより、高解像度の画像合成が畳み込み(convolutional)の手法で可能になりました。
ピクセルベースのDDPMとの違い(2つの圧縮フェーズ)
(図は、diagram-designで作成)
デジタル画像のビットの大部分は、人間の目には知覚できない(あるいは意味を持たない)細部に対応しています。従来のピクセルベースのDDPMは、この知覚できない細部のモデリングに不釣り合いなほどのモデル容量(と計算資源)を費やしてしまうという課題がありました。
LDMは、この問題を解決するために、学習を以下の「2つの明確なフェーズ」に分離しました。
- 知覚的圧縮(Perceptual Compression)
- 最初のステージでは、高周波のディテール(知覚できない細部)を削除するオートエンコーダを学習します。
- この段階では、意味的な変動(セマンティクス)はほとんど学習しません。
- これにより、計算に適した低次元の表現空間(潜在空間)が得られます。
- 意味的圧縮(Semantic Compression)
- 第2のステージにおいて、実際の生成モデル(拡散モデル)がデータの意味的・概念的な構成を学習します。
- 知覚的に等価でありながら計算効率の良い潜在空間で拡散モデルを訓練することで、モデルはデータの重要な意味的ビットに集中することができます。
過度な空間的圧縮に依存していたVQGAN+自己回帰モデルのような従来の二段階手法とは対照的に、LDMは画像特有の帰納的バイアス(2D畳み込み層の構造など)を活用できるため、過度な圧縮レベルを必要としません。
Latent Diffusionの処理概要
LDMの処理プロセスは、主に「オートエンコーダによる圧縮・復元」と「潜在空間でのノイズ予測(U-Net)」から構成されます。
-
オートエンコーダによる潜在空間へのマッピング
RGB空間の画像 が与えられたとき、エンコーダ は を潜在表現 にエンコードします。デコーダ はこの潜在表現から画像を再構成し、 を出力します。 エンコーダは画像を係数 でダウンサンプリングします。ダウンサンプリング係数として などを検証した結果、 および が効率と知覚的忠実度の良いバランスをもたらすことが示されています。 -
潜在空間での拡散プロセス (Diffusion Process)
高次元のピクセル空間を離れることで、モデルはデータの重要な意味的ビットに焦点を当てることができ、計算効率の非常に高い低次元空間で学習を行うことができます。 潜在空間の表現 に対してノイズを付加し、それを除去するU-Netベースのモデル を学習します。目的関数は以下の通りです。
順伝播プロセス(ノイズ付加)は固定されているため、学習中はエンコーダ から得た に対して順過程の閉形式 から を効率的にサンプルでき、生成された からのサンプルはデコーダ を1回通過させるだけで画像空間にデコードできます。 LDMの目的関数 は、DDPMにおけるピクセル空間での目的関数 の計算の舞台を、「高次元のピクセル空間」から「計算効率の良い低次元の潜在空間」へと置き換えたものです。 DDPM(ピクセル空間) 元の画像データ に対して直接ノイズを加えて
を作り、ニューラルネットワーク
がピクセル空間上でノイズを予測します。 LDM / Stable Diffusion(潜在空間) 元の画像データ をまずエンコーダ を通して潜在変数 (DDPM でいう に相当)に圧縮します。
そして、この潜在空間上でノイズを加えた を作り、ニューラルネットワーク が潜在空間上でノイズを予測します。 つまり、LDMは「ノイズを予測する」という非常に強力で安定したDDPMの学習アプローチをそのまま活かしつつ、計算効率を劇的に向上させています。補足:DDPMの目的関数()との関係
DDPM と LDM の損失の計算の違いを図にすると、次のようになります。
(図は、diagram-designで作成)
テキストによる条件付け(Cross-Attention機構)
Stable Diffusionの最大の特徴は、「テキスト(プロンプト)から画像を生成できる」ことです。これを実現しているのが、U-Netアーキテクチャに組み込まれたクロスアテンション(Cross-attention)メカニズムです。
- 言語プロンプトなど様々なモダリティからの入力 を前処理するために、ドメイン固有のエンコーダ を導入します。
- このエンコーダは を中間表現 に投影します。
- 投影された表現は、クロスアテンション層を介してU-Netの中間層にマッピングされます。
クロスアテンションは以下の数式で実装されます。
ここで、 はU-Netの潜在表現 から生成され、 と は条件付け入力(テキストの埋め込みなど) から生成されます。 ドメイン固有の専門家(言語表現を学習するためのTransformerなど)と視覚的合成を組み合わせることで、ユーザーが定義した複雑なテキストプロンプトにうまく汎用する強力なモデルが実現します。
Query と Key・Value の作り方を図にすると、次のようになります。
(図は、diagram-designで作成)
Classifier-Free Guidance(生成の忠実度向上)
テキスト条件付けをさらに強力にするためのテクニックが Classifier-Free Guidance (CFG) です。これは、生成される画像をプロンプトの指示により強く従わせるための手法であり、現在の拡散モデルにおいて事実上の標準となっています。
通常、条件付き拡散モデルは「テキスト条件 に基づくノイズ予測 」を学習します。しかし、これだけではモデルがテキストの指示を無視して無難な画像を生成してしまうことがあります。 そこでCFGでは、学習中に一定の確率(例えば10%)でテキスト条件を空()にして学習させます。これにより、1つのモデルで「条件付き」と「無条件」の両方のノイズ予測ができるようになります。
推論(生成)時には、同じノイズに対して「条件付き予測 」と「無条件予測 」の両方を計算し、以下の式で最終的なノイズ を決定します。
ここで、(Guidance Scale)はプロンプトへの忠実度を制御するパラメータです。 は「テキスト条件によって予測がどちらに動いたか」という方向ベクトルを表しており、これを で外挿(強調)することで、画像の多様性を多少犠牲にする代わりに、プロンプトの指示に非常に忠実な画像を引き出すことができます。
2つの予測と外挿の関係を図にすると、次のようになります。
(図は、diagram-designで作成)
LDMのスクラッチ実装
ここからは、これまで解説してきた理論をPyTorchのみでゼロから実装していきます。 diffusers のような高レベルなライブラリは一切使わず、「KL正則化オートエンコーダ」「クロスアテンション付き潜在U-Net」「条件付けエンコーダ 」「DDIMサンプラー」をすべて自前で構築し、DDPMの記事と同じ4枚の猫画像から画像を生成できるところまでを確認します。
実装方針:どこまで論文に忠実にするか
Stable Diffusionの本家は数億枚規模のデータセットで数十万GPU時間をかけて学習されており、そのままの再現は不可能です。 そこで本実装では、「アーキテクチャと学習アルゴリズムは論文どおり、データ規模と層の幅だけを縮小する」 という方針を取ります。Google ColabのL4またはA100で、全体の学習が概ね20〜30分以内に収まるように設計しています。
| 構成要素 | LDM / Stable Diffusion 本家 | 本実装 |
|---|---|---|
| 第1段階 | KL正則化オートエンコーダ(, は4ch) | 同じ構造(圧縮率のみ に変更、幅を縮小) |
| 第1段階の損失 | L1 + LPIPS + PatchGAN敵対的損失 + KL | L1 + VGG知覚損失 + KL(敵対的損失は省略) |
| 潜在変数の正規化 | 標準偏差が1になるよう再スケール | 同じ(データから自動計算) |
| 第2段階 | 潜在空間のU-Net + Cross-Attention | 同じ設計(幅と深さを縮小) |
| 条件付け | Transformer(LDM)/CLIP(SD) | Transformerを同時学習(LDM論文と同じ方式) |
| ノイズスケジュール | scaled-linear (の平方根が線形) | 同じ |
| 目的関数 | (ノイズ予測のMSE) | 同じ |
| 生成時の工夫 | Classifier-Free Guidance + DDIM | 同じ |
| 重みの平滑化 | EMA | 同じ |
| 学習データ | LAION等の大規模データセット | 猫画像4枚(+左右反転で8枚) |
完全に省略したのはPatchGANによる敵対的損失のみで、LPIPSについてはVGG特徴量を用いた簡易版の知覚損失で代替しています。敵対的損失はオートエンコーダの高周波なテクスチャをさらに鮮明にするための仕組みですが、学習が不安定になりやすく時間もかかるため今回は省いています。
本実装は学習データがわずか4枚(反転を含めて8枚)のため、モデルは実質的にその4枚を「記憶」します。これはDDPMの記事と同じく、理論とアルゴリズムの動作を最小構成で確認するためのものであり、未知の画像に汎化する能力を検証するものではない点にご注意ください。
ライブラリのインストール
!pip install torch torchvision pillow matplotlib
スクラッチ実装のため、必要なのはPyTorch本体と画像の読み書き・可視化ライブラリだけです。diffusers は使用しません。
設定と共通部品の定義
まずハイパーパラメータと、オートエンコーダ・U-Netの両方で使い回す基本ブロックを定義します。
import math
import torch
import torch.nn as nn
import torch.nn.functional as F
from PIL import Image
from torchvision import transforms
import matplotlib.pyplot as plt

torch.manual_seed(0)
torch.set_float32_matmul_precision("high")   # Ampere以降のTF32を有効化して高速化
device = "cuda" if torch.cuda.is_available() else "cpu"

# ===== ハイパーパラメータ =====
IMAGE_SIZE = 128                        # 生成画像の解像度 (H = W)
F_FACTOR = 4                            # ダウンサンプリング係数 f = H/h
Z_CHANNELS = 4                          # 潜在空間のチャンネル数
LATENT_SIZE = IMAGE_SIZE // F_FACTOR    # 潜在空間の解像度 (128/4 = 32)
AE_STEPS = 3000                         # 第1段階(オートエンコーダ)の学習ステップ数
DM_STEPS = 8000                         # 第2段階(潜在拡散)の学習ステップ数
T = 1000                                # 拡散のタイムステップ数

# ===== 共通部品 =====
def Normalize(ch, groups=32):
    """LDM実装で標準的に使われる GroupNorm。チャンネル数を割り切れる最大のグループ数を選ぶ"""
    while ch % groups != 0:
        groups //= 2
    return nn.GroupNorm(num_groups=groups, num_channels=ch, eps=1e-6, affine=True)

def zero_module(module):
    """出力層の重みをゼロ初期化する(残差の初期値を恒等写像にして学習を安定化)"""
    for p in module.parameters():
        p.detach().zero_()
    return module

class Downsample(nn.Module):
    """stride 2 の畳み込みで解像度を半分にする"""
    def __init__(self, ch):
        super().__init__()
        self.conv = nn.Conv2d(ch, ch, 3, stride=2, padding=0)
    def forward(self, x):
        return self.conv(F.pad(x, (0, 1, 0, 1), mode="constant", value=0))

class Upsample(nn.Module):
    """最近傍補間で2倍に拡大してから畳み込む"""
    def __init__(self, ch):
        super().__init__()
        self.conv = nn.Conv2d(ch, ch, 3, padding=1)
    def forward(self, x):
        return self.conv(F.interpolate(x, scale_factor=2.0, mode="nearest"))

class AEResBlock(nn.Module):
    """オートエンコーダ用の残差ブロック(タイムステップ埋め込みを持たない)"""
    def __init__(self, in_ch, out_ch):
        super().__init__()
        self.norm1 = Normalize(in_ch)
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.norm2 = Normalize(out_ch)
        self.conv2 = nn.Conv2d(out_ch, out_ch, 3, padding=1)
        self.skip = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()
    def forward(self, x):
        h = self.conv1(F.silu(self.norm1(x)))
        h = self.conv2(F.silu(self.norm2(h)))
        return self.skip(x) + h

class AttnBlock(nn.Module):
    """特徴マップ上のセルフアテンション(オートエンコーダの最低解像度で使用)"""
    def __init__(self, ch):
        super().__init__()
        self.norm = Normalize(ch)
        self.q = nn.Conv2d(ch, ch, 1)
        self.k = nn.Conv2d(ch, ch, 1)
        self.v = nn.Conv2d(ch, ch, 1)
        self.proj_out = nn.Conv2d(ch, ch, 1)
    def forward(self, x):
        h = self.norm(x)
        q, k, v = self.q(h), self.k(h), self.v(h)
        b, c, hh, ww = q.shape
        # [B, C, H, W] -> [B, H*W, C] に並べ替えてアテンションを計算
        q = q.reshape(b, c, hh * ww).permute(0, 2, 1)
        k = k.reshape(b, c, hh * ww).permute(0, 2, 1)
        v = v.reshape(b, c, hh * ww).permute(0, 2, 1)
        h = F.scaled_dot_product_attention(q, k, v)
        h = h.permute(0, 2, 1).reshape(b, c, hh, ww)
        return x + self.proj_out(h)
- 解像度とダウンサンプリング係数 IMAGE_SIZE, F_FACTOR: 論文では効率と知覚的忠実度のバランスが良い係数として と が推奨されています。ここでは再構成品質が安定しやすい を採用し、128×128の画像を 32×32×4 の潜在表現に圧縮します。ピクセル数で言えば 次元が 次元へと約12分の1になります。 DDPMの記事ではピクセル空間で直接32×32の画像を扱っていましたが、LDMでは拡散モデルが扱うテンソルの大きさをほぼ変えずに、16倍のピクセル数を持つ128×128の画像を生成できる点がポイントです。
- 潜在チャンネル数 Z_CHANNELS: Stable Diffusionと同じく4チャンネルとしています。空間構造を保った「小さな画像」のような潜在表現になるため、U-Netの2D畳み込みという帰納的バイアスをそのまま活かせます。
- Normalize(GroupNorm): 拡散モデルの実装では、バッチサイズに依存しないGroupNormが標準的に使われます。今回のようにバッチサイズが8と小さい場合、BatchNormでは統計量が不安定になるため特に重要です。
- zero_module(ゼロ初期化): 残差ブロックやアテンションブロックの出力層の重みをゼロで初期化するテクニックです。学習開始時点でそのブロックが恒等写像として振る舞うため、深いネットワークでも勾配が壊れず安定して学習が進みます。LDMの公式実装でも多用されています。
- AttnBlock: DDPMの記事で解説した「16×16解像度でのセルフアテンション」と同じ役割で、画像全体のグローバルな依存関係を捉えます。ここでは F.scaled_dot_product_attention を用いることで、数式 を高速かつ省メモリに計算しています。
第1段階:KL正則化オートエンコーダ(知覚的圧縮)
LDMの第1フェーズである「知覚的圧縮」を担うオートエンコーダ , を実装します。この段階の役割は、高解像度のピクセル画像を、計算効率の良い「小さな潜在画像(Latent)」に圧縮し、あとから元の画像に復元できるようにすることです。ここでの学習が成功することで、後段のモデルは少ない計算量で高品質な画像生成を行うための「キャンバス」を得ることができます。 論文ではVQ正則化版とKL正則化版が提案されていますが、Stable Diffusionで採用されているKL正則化版(VAEと同じく潜在変数を対角ガウス分布として扱う方式) を実装します。
KL正則化(Kullback-Leibler regularization)は、エンコーダが出力する潜在変数の分布が、あらかじめ設定した事前分布(通常は平均0、分散1の標準正規分布)に近づくようにペナルティ(KLダイバージェンス)を課す手法です。 これにより、潜在空間の分布が極端に偏ったり発散したりするのを防ぎ、連続的で滑らかな空間を形成できるため、拡散モデルなどの後段の生成プロセスが安定します。
class Encoder(nn.Module):
    """画像 x を潜在分布のパラメータ(平均・対数分散)にエンコードする"""
    def __init__(self, ch=64, ch_mult=(1, 2, 4), z_ch=Z_CHANNELS):
        super().__init__()
        self.conv_in = nn.Conv2d(3, ch, 3, padding=1)
        blocks = []
        cur = ch
        for i, m in enumerate(ch_mult):
            out = ch * m
            blocks.append(AEResBlock(cur, out))
            blocks.append(AEResBlock(out, out))
            cur = out
            if i != len(ch_mult) - 1:      # 最終段以外でダウンサンプリング
                blocks.append(Downsample(cur))
        self.blocks = nn.Sequential(*blocks)
        self.mid = nn.Sequential(AEResBlock(cur, cur), AttnBlock(cur), AEResBlock(cur, cur))
        self.norm_out = Normalize(cur)
        # 平均と対数分散をまとめて出力するため 2 * z_ch チャンネル
        self.conv_out = nn.Conv2d(cur, 2 * z_ch, 3, padding=1)
    def forward(self, x):
        h = self.mid(self.blocks(self.conv_in(x)))
        return self.conv_out(F.silu(self.norm_out(h)))

class Decoder(nn.Module):
    """潜在変数 z から画像を再構成する"""
    def __init__(self, ch=64, ch_mult=(1, 2, 4), z_ch=Z_CHANNELS):
        super().__init__()
        cur = ch * ch_mult[-1]
        self.conv_in = nn.Conv2d(z_ch, cur, 3, padding=1)
        self.mid = nn.Sequential(AEResBlock(cur, cur), AttnBlock(cur), AEResBlock(cur, cur))
        blocks = []
        for i, m in enumerate(reversed(ch_mult)):
            out = ch * m
            blocks.append(AEResBlock(cur, out))
            blocks.append(AEResBlock(out, out))
            cur = out
            if i != len(ch_mult) - 1:      # 最終段以外でアップサンプリング
                blocks.append(Upsample(cur))
        self.blocks = nn.Sequential(*blocks)
        self.norm_out = Normalize(cur)
        self.conv_out = nn.Conv2d(cur, 3, 3, padding=1)
    def forward(self, z):
        h = self.blocks(self.mid(self.conv_in(z)))
        return self.conv_out(F.silu(self.norm_out(h)))

class DiagonalGaussian:
    """エンコーダ出力を対角ガウス分布 q(z|x) として扱うためのヘルパー"""
    def __init__(self, parameters):
        self.mean, self.logvar = torch.chunk(parameters, 2, dim=1)
        self.logvar = torch.clamp(self.logvar, -30.0, 20.0)   # 数値的な発散を防ぐ
        self.std = torch.exp(0.5 * self.logvar)
    def sample(self):
        # Reparameterization trick: z = mu + sigma * eps
        return self.mean + self.std * torch.randn_like(self.mean)
    def kl(self):
        # 標準正規分布 N(0, I) との KL ダイバージェンス
        return 0.5 * torch.sum(
            self.mean.pow(2) + self.logvar.exp() - 1.0 - self.logvar, dim=[1, 2, 3]).mean()

class AutoencoderKL(nn.Module):
    """LDM の第1段階モデル(知覚的圧縮)"""
    def __init__(self):
        super().__init__()
        self.encoder = Encoder()
        self.decoder = Decoder()
        self.quant_conv = nn.Conv2d(2 * Z_CHANNELS, 2 * Z_CHANNELS, 1)
        self.post_quant_conv = nn.Conv2d(Z_CHANNELS, Z_CHANNELS, 1)
    def encode(self, x):
        return DiagonalGaussian(self.quant_conv(self.encoder(x)))
    def decode(self, z):
        return self.decoder(self.post_quant_conv(z))
    def forward(self, x):
        posterior = self.encode(x)
        return self.decode(posterior.sample()), posterior

class VGGPerceptual(nn.Module):
    """VGG16の中間特徴量の一致を測る知覚損失(LPIPSの簡易版)"""
    def __init__(self):
        super().__init__()
        from torchvision.models import vgg16, VGG16_Weights
        vgg = vgg16(weights=VGG16_Weights.IMAGENET1K_V1).features.eval()
        self.slices = nn.ModuleList([vgg[:4], vgg[4:9], vgg[9:16], vgg[16:23]])
        for p in self.parameters():
            p.requires_grad = False       # 特徴抽出器は固定
        self.register_buffer("mean", torch.tensor([0.485, 0.456, 0.406]).view(1, 3, 1, 1))
        self.register_buffer("std", torch.tensor([0.229, 0.224, 0.225]).view(1, 3, 1, 1))
    def forward(self, x, y):
        # [-1, 1] -> [0, 1] -> ImageNetの正規化
        x = ((x.clamp(-1, 1) + 1) / 2 - self.mean) / self.std
        y = ((y.clamp(-1, 1) + 1) / 2 - self.mean) / self.std
        loss = 0.0
        for s in self.slices:
            x, y = s(x), s(y)
            loss = loss + F.mse_loss(x, y)
        return loss
このブロックが、論文の「知覚的圧縮」フェーズそのものです。
- エンコーダの構造 Encoder: ch_mult=(1, 2, 4) は解像度の段階ごとのチャンネル倍率で、最終段を除く各段でダウンサンプリングを行います。つまり段数が3ならダウンサンプリングは2回となり、 が実現されます。 にしたい場合は ch_mult=(1, 2, 4, 4) のように段数を1つ増やします。 最低解像度の mid ブロックにセルフアテンションを挟むのは、LDM公式実装と同じ構成です。
- 対角ガウス分布 DiagonalGaussian: エンコーダは潜在変数を1点に決め打ちするのではなく、平均 と対数分散 を出力します。sample() はVAEでおなじみの再パラメータ化トリック です。 ここで重要なのは、KL項の重みを極めて小さく設定する点です。VAEでは強いKL制約が「情報ボトルネック」となり画像をぼやけさせる原因でしたが、LDMのオートエンコーダは「潜在空間の分散が発散しないよう軽く抑える」程度の役割しか担わせません。再構成品質を最大限に優先し、意味的な生成モデリングは第2段階の拡散モデルに任せる、という役割分担になっています。
- 知覚損失 VGGPerceptual (LPIPS): オートエンコーダの学習において、生成された画像と元の画像が「どれくらい似ているか」を評価する必要があります。ここで単純なピクセル単位の差分(L1損失やMSE)だけを最適化しようとすると、ピクセル単位の損失は、あり得る複数のディテールを平均化・平滑化した出力で最小化されやすいため、モデルは無難な「ぼやけた平均的な画像」を出力してしまい、結果として高周波のディテール(細かいテクスチャやエッジ)が失われてしまいます(平均化のジレンマ)。 これを防ぐのがLPIPS (Learned Perceptual Image Patch Similarity) などの知覚損失です。画像分類タスク(ImageNetなど)で十分に学習されたニューラルネットワーク(VGGなど)に2つの画像を入力し、その中間層から得られる特徴マップ同士の差分を計算します。中間層は「エッジ」「模様」「パーツの形状」といった意味的な特徴を抽出しているため、これらを比較することで、人間の視覚に近い「見た目の鮮明さや構造の自然さ」を保ったまま圧縮・復元を行う効果があります。本実装の VGGPerceptual はこのLPIPSの簡易版として機能しています。
第1段階の学習と潜在空間の統計量
猫画像を読み込み、オートエンコーダを学習させます。
# ----------------------------------------------------
# 猫の画像 (cat1.jpg ~ cat4.jpg) の読み込みと前処理
# ※Google Colabで実行する場合は、事前にファイルブラウザからカレントディレクトリへ cat1.jpg ~ cat4.jpg をアップロードしておいてください。
# ----------------------------------------------------
transform = transforms.Compose([
    transforms.Resize((IMAGE_SIZE, IMAGE_SIZE)),
    transforms.ToTensor(),
    transforms.Normalize((0.5,) * 3, (0.5,) * 3)   # [0, 1] -> [-1, 1]
])

paths = ["cat1.jpg", "cat2.jpg", "cat3.jpg", "cat4.jpg"]
# 各画像に対応するキャプション(条件付け入力 y)
captions = [
    "a calico cat on a white sofa",
    "a silver tabby cat with green eyes on a white sofa",
    "a grey cat with orange eyes on a white sofa",
    "a fluffy cream cat with blue eyes on a white sofa",
]

imgs = []
for p in paths:
    im = Image.open(p).convert("RGB")
    imgs.append(transform(im))

x_all = torch.stack(imgs).to(device)
# 左右反転を加えてデータを8枚に拡張(キャプションは同じものを流用)
x_all = torch.cat([x_all, torch.flip(x_all, dims=[3])], dim=0)
caps_all = captions + captions
print("images:", tuple(x_all.shape))

# ----------------------------------------------------
# 第1段階の学習
# ----------------------------------------------------
ae = AutoencoderKL().to(device)
opt_ae = torch.optim.AdamW(ae.parameters(), lr=2e-4, betas=(0.5, 0.9))
percep = VGGPerceptual().to(device)

for step in range(AE_STEPS):
    ae.train()
    rec, posterior = ae(x_all)

    rec_loss = (rec - x_all).abs().mean()          # L1 再構成損失
    p_loss = percep(rec, x_all)                    # 知覚損失
    kl_loss = posterior.kl()                       # KL 正則化
    loss = rec_loss + 0.1 * p_loss + 1e-6 * kl_loss

    opt_ae.zero_grad()
    loss.backward()
    opt_ae.step()

    if (step + 1) % 500 == 0:
        print(f"[AE] {step+1}/{AE_STEPS} - loss: {loss.item():.4f}")

# ----------------------------------------------------
# 潜在変数の取得とスケーリング係数の計算
# ----------------------------------------------------
ae.eval()
for p in ae.parameters():
    p.requires_grad = False                        # 第2段階では固定

with torch.no_grad():
    z_all = ae.encode(x_all).mean                  # 分布の平均を潜在表現として使用
    scale_factor = 1.0 / z_all.std().item()        # 標準偏差が1になるよう再スケール
    z_all = z_all * scale_factor

print("latents:", tuple(z_all.shape), "scale_factor:", round(scale_factor, 4))
学習に使用する画像は、DDPMの記事と同じ以下の4枚です。
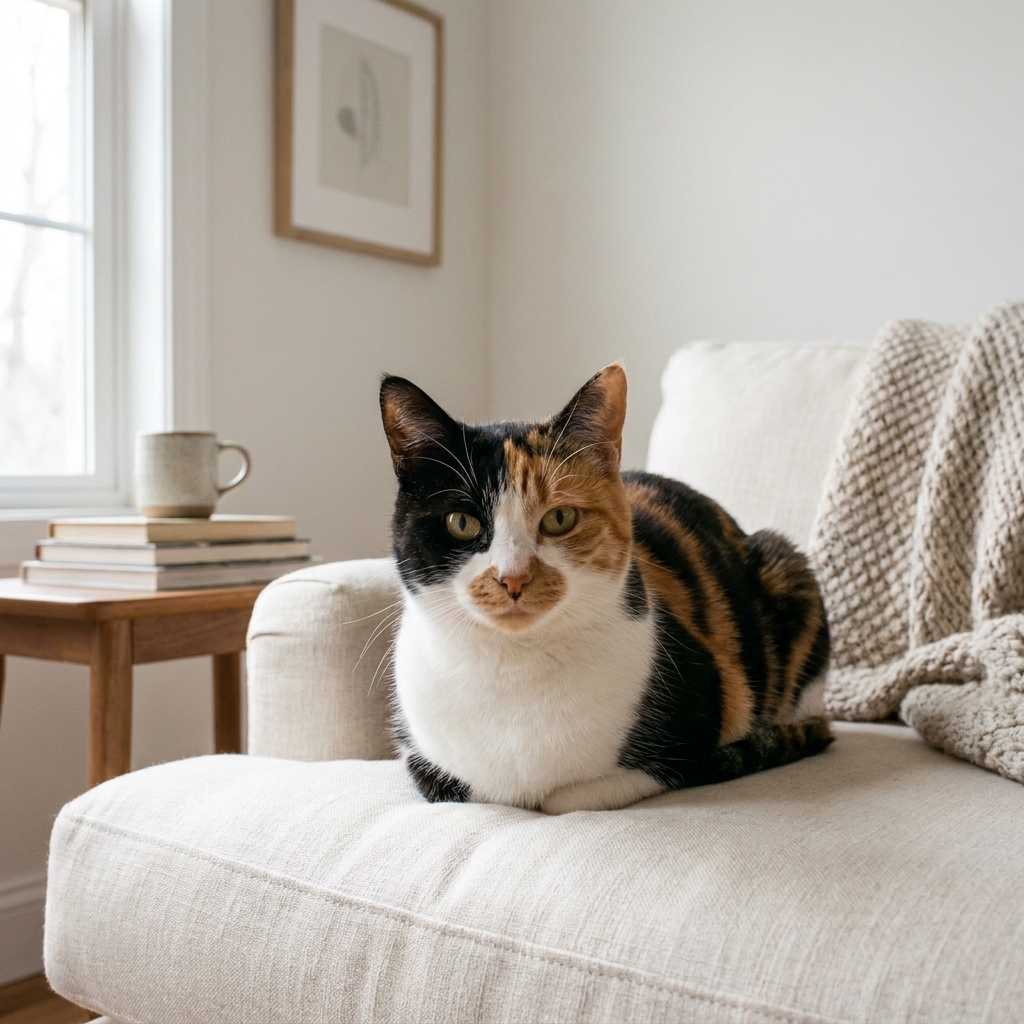
cat1.jpg
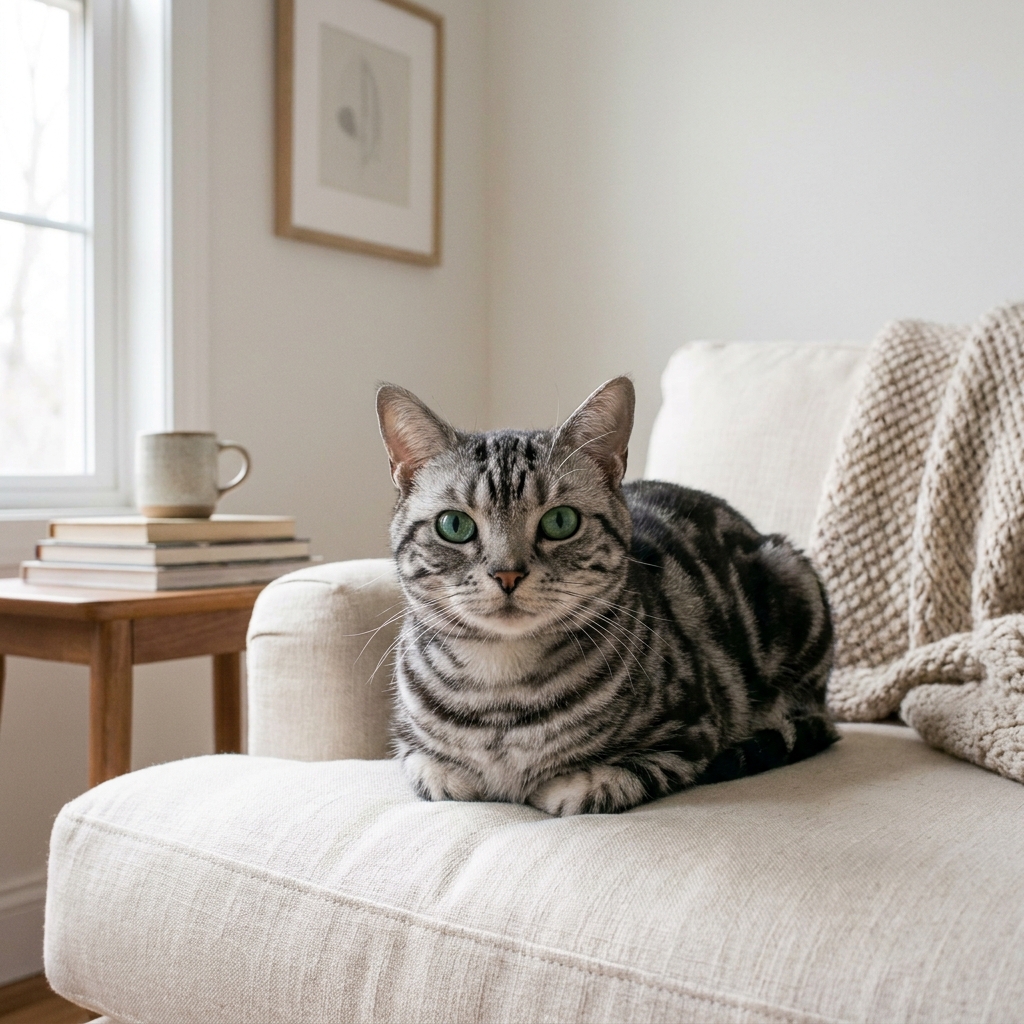
cat2.jpg
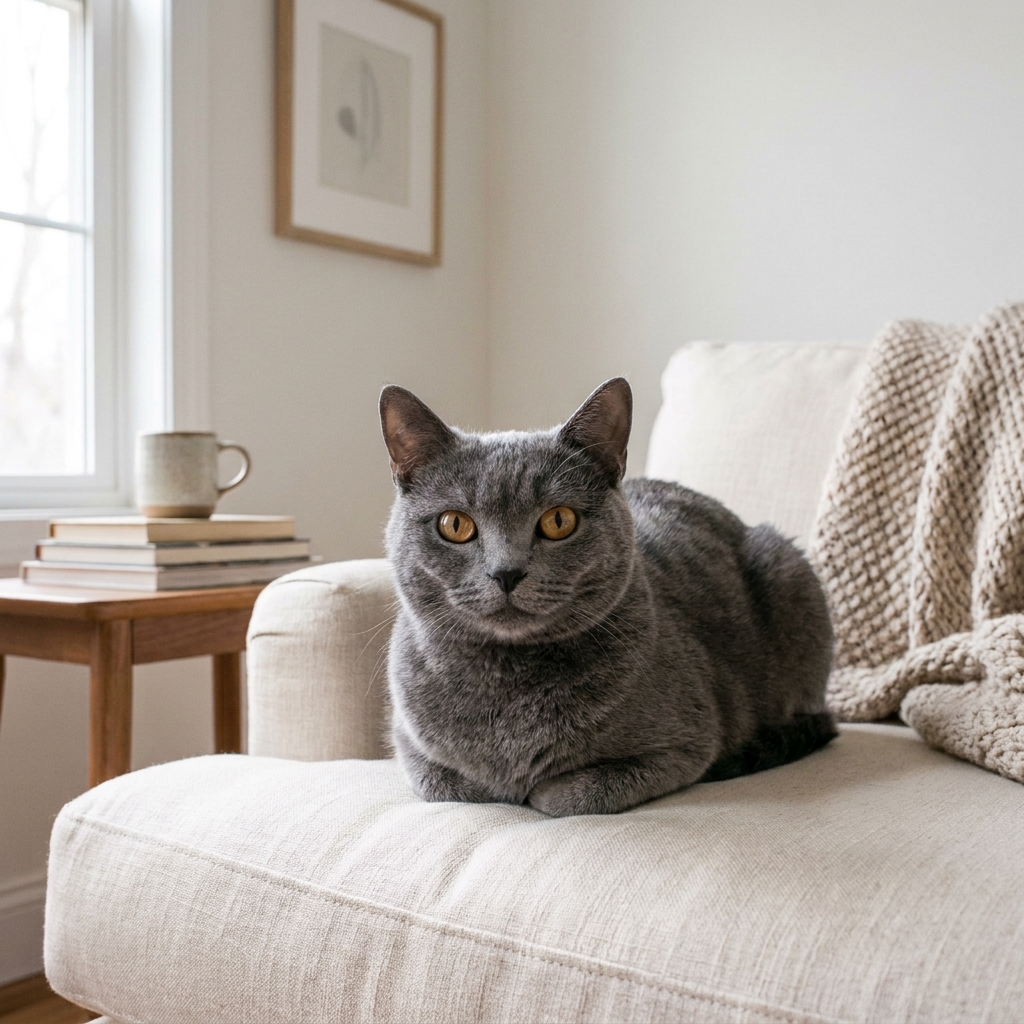
cat3.jpg
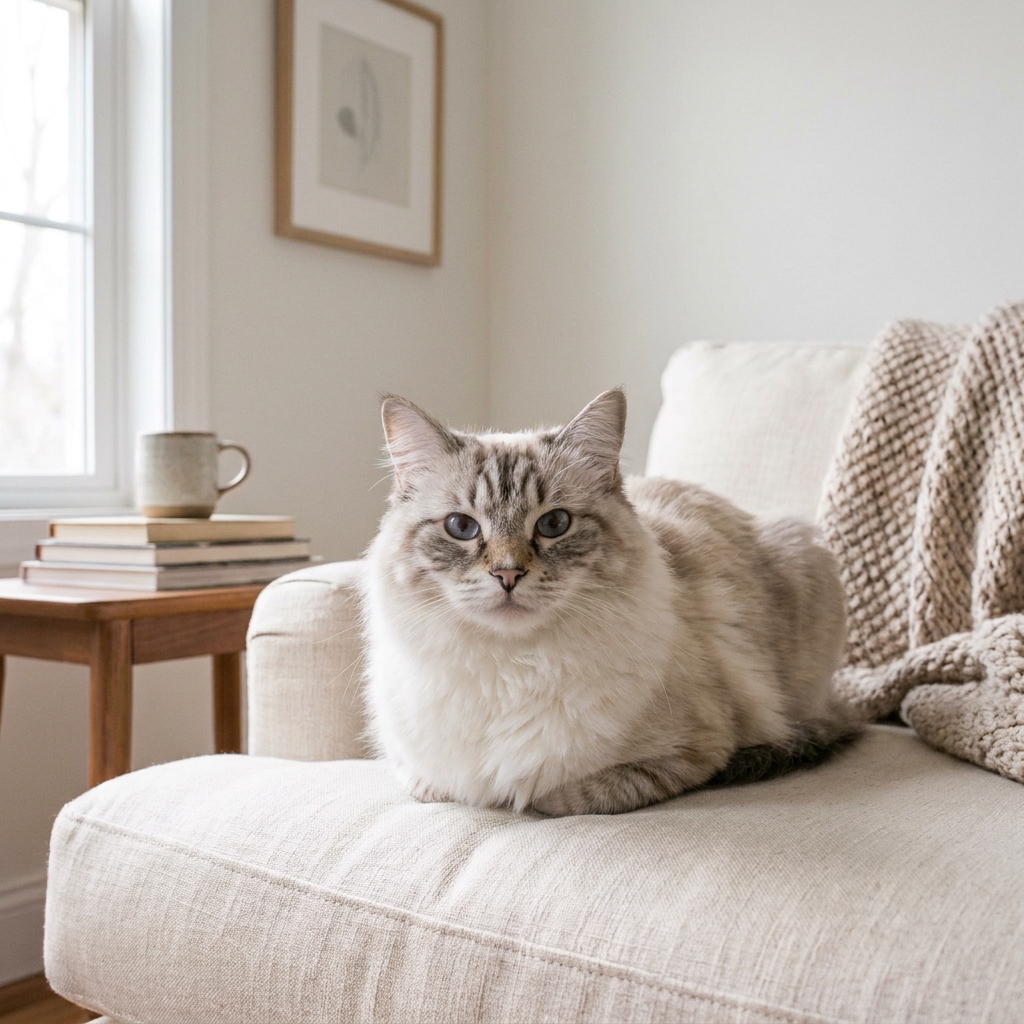
cat4.jpg
(Google AI Studioで生成)
処理の要点を解説します。
- キャプションの付与: DDPMは無条件生成でしたが、LDMは条件付き生成モデルです。そこで4枚の画像それぞれに、毛色や目の色を表す短い英語のキャプション(条件付け入力 )を与えています。これが後段のクロスアテンションでK, Vとして参照されます。
- 損失関数の重み付け: rec_loss + 0.1 * p_loss + 1e-6 * kl_loss という構成です。注目すべきはKL項の重み で、再構成損失に比べて桁違いに小さく設定されています。これは論文の設定に倣ったもので、前述のとおり「潜在空間を緩く正規化するだけ」という意図を反映しています。
- オプティマイザの設定 betas=(0.5, 0.9): AdamWのパラメータとして betas=(0.5, 0.9) を設定しています。これは本来、PatchGANによる敵対的損失を併用する際の設定(GANの学習を安定させるための慣例)です。敵対的損失を省いた本実装では、デフォルトの (0.9, 0.999) の方が素直ですが、LDM論文の実装に合わせる形で設定を残しています。
- 学習ステップ数 AE_STEPS, DM_STEPS: オートエンコーダ(AE_STEPS = 3000)は、画像を再構成するだけなので、損失がほぼ下がり切る3,000ステップで足ります。拡散モデル(DM_STEPS = 8000)は、1000の時刻すべてでノイズの予測を覚える必要があるので、より長い8,000ステップにしています。
- オートエンコーダの凍結: 学習が終わったら requires_grad = False でパラメータを固定します。LDMの2段階学習では、第1段階を学習し終えたら以降は一切更新しません。これにより、第2段階では画像のエンコードを1度だけ行い、その結果を使い回せます。
- スケーリング係数 scale_factor: ここが実装上の重要なポイントです。オートエンコーダが出力する潜在変数の分散は、そのままでは1から大きくずれています。一方、拡散モデルのノイズスケジュールはデータの分散が1であることを暗黙に前提としています。そこで潜在変数全体の標準偏差で割り、分散を1に揃えてから拡散モデルに渡します。 Stable Diffusionの実装で定数として登場する 0.18215 という謎めいた数値は、まさにこの係数を事前に計算したものです。本実装では手持ちのデータから自動的に算出しています。
- 潜在表現に平均を使う理由: 本家のSD/LDMでは、第2段階の学習中も posterior.sample() から確率的にサンプリングを行いますが、本実装では簡略化のため分布の平均 .mean を使っています。KL項の重みが極小のため分散はほぼ無視できる大きさになっており、この簡易な決定的表現でも学習に実害はほぼなく安定して動作します。
第2段階:クロスアテンション付き潜在U-Net(意味的圧縮)
LDMの心臓部であり、記事前半で解説した「意味的圧縮」を担う条件付きノイズ予測器 を実装します。この段階の役割は、データの意味的・概念的な構成を学習し、ノイズだらけの潜在表現から元の表現を予測(ノイズを除去)して「画像を生成できるようにする」こと、そしてテキスト(プロンプト)の指示に従って生成内容を制御する「プロンプトへの対応」を実現することです。 DDPMのU-Netとの決定的な違いは、このテキストプロンプトの指示を画像生成プロセスに注入するために、各解像度に SpatialTransformer(自己注意 + クロスアテンション + フィードフォワード)が挿入されている点です。
def timestep_embedding(t, dim, max_period=10000):
    """タイムステップ t の正弦波位置埋め込み"""
    half = dim // 2
    freqs = torch.exp(-math.log(max_period) * torch.arange(half, device=t.device).float() / half)
    args = t.float()[:, None] * freqs[None]
    return torch.cat([torch.cos(args), torch.sin(args)], dim=-1)

class CrossAttention(nn.Module):
    """Attention(Q, K, V) = softmax(QK^T / sqrt(d)) V
       context=None ならセルフアテンション、context を渡せばクロスアテンションになる"""
    def __init__(self, query_dim, context_dim=None, heads=4, dim_head=64):
        super().__init__()
        inner = heads * dim_head
        context_dim = context_dim or query_dim
        self.heads = heads
        self.to_q = nn.Linear(query_dim, inner, bias=False)      # Q は潜在表現から
        self.to_k = nn.Linear(context_dim, inner, bias=False)    # K は条件付け入力から
        self.to_v = nn.Linear(context_dim, inner, bias=False)    # V は条件付け入力から
        self.to_out = nn.Linear(inner, query_dim)
    def forward(self, x, context=None):
        context = x if context is None else context
        b, n, _ = x.shape
        dh = self.to_q.out_features // self.heads
        q = self.to_q(x).view(b, -1, self.heads, dh).transpose(1, 2)
        k = self.to_k(context).view(b, -1, self.heads, dh).transpose(1, 2)
        v = self.to_v(context).view(b, -1, self.heads, dh).transpose(1, 2)
        out = F.scaled_dot_product_attention(q, k, v)
        out = out.transpose(1, 2).reshape(b, n, -1)
        return self.to_out(out)

class GEGLU(nn.Module):
    """LDMのTransformerブロックで使われるゲート付き活性化"""
    def __init__(self, dim_in, dim_out):
        super().__init__()
        self.proj = nn.Linear(dim_in, dim_out * 2)
    def forward(self, x):
        x, gate = self.proj(x).chunk(2, dim=-1)
        return x * F.gelu(gate)

class BasicTransformerBlock(nn.Module):
    """セルフアテンション -> クロスアテンション -> フィードフォワード"""
    def __init__(self, dim, context_dim, heads=4, dim_head=64):
        super().__init__()
        self.norm1 = nn.LayerNorm(dim)
        self.attn1 = CrossAttention(dim, None, heads, dim_head)          # 画像内の関係
        self.norm2 = nn.LayerNorm(dim)
        self.attn2 = CrossAttention(dim, context_dim, heads, dim_head)   # テキストとの関係
        self.norm3 = nn.LayerNorm(dim)
        self.ff = nn.Sequential(GEGLU(dim, dim * 4), nn.Linear(dim * 4, dim))
    def forward(self, x, context):
        x = self.attn1(self.norm1(x)) + x
        x = self.attn2(self.norm2(x), context) + x
        return self.ff(self.norm3(x)) + x

class SpatialTransformer(nn.Module):
    """特徴マップをトークン列に変換してTransformerブロックを適用する"""
    def __init__(self, ch, context_dim, heads=4, dim_head=64):
        super().__init__()
        self.norm = Normalize(ch)
        self.proj_in = nn.Conv2d(ch, ch, 1)
        self.block = BasicTransformerBlock(ch, context_dim, heads, dim_head)
        self.proj_out = zero_module(nn.Conv2d(ch, ch, 1))   # ゼロ初期化
    def forward(self, x, context):
        b, c, h, w = x.shape
        res = x
        x = self.proj_in(self.norm(x))
        x = x.reshape(b, c, h * w).permute(0, 2, 1)         # [B, H*W, C] のトークン列へ
        x = self.block(x, context)
        x = x.permute(0, 2, 1).reshape(b, c, h, w)          # 特徴マップに戻す
        return self.proj_out(x) + res

class ResBlock(nn.Module):
    """タイムステップ埋め込みを注入する残差ブロック"""
    def __init__(self, in_ch, out_ch, emb_dim):
        super().__init__()
        self.norm1 = Normalize(in_ch)
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.emb_proj = nn.Linear(emb_dim, out_ch)
        self.norm2 = Normalize(out_ch)
        self.conv2 = zero_module(nn.Conv2d(out_ch, out_ch, 3, padding=1))
        self.skip = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()
    def forward(self, x, emb):
        h = self.conv1(F.silu(self.norm1(x)))
        h = h + self.emb_proj(F.silu(emb))[:, :, None, None]   # 時間情報を加算
        h = self.conv2(F.silu(self.norm2(h)))
        return self.skip(x) + h

class TimestepEmbedSequential(nn.Sequential):
    """層の種類に応じて (x, emb) / (x, context) / (x) を渡し分けるコンテナ"""
    def forward(self, x, emb, context):
        for layer in self:
            if isinstance(layer, ResBlock):
                x = layer(x, emb)
            elif isinstance(layer, SpatialTransformer):
                x = layer(x, context)
            else:
                x = layer(x)
        return x

class LatentUNet(nn.Module):
    """潜在空間で動作する条件付きノイズ予測器 eps_theta(z_t, t, context)"""
    def __init__(self, in_ch=Z_CHANNELS, model_ch=128, ch_mult=(1, 2, 4),
                 num_res_blocks=2, attn_levels=(1, 2), context_dim=256, heads=4):
        super().__init__()
        emb_dim = model_ch * 4
        self.model_ch = model_ch
        self.time_embed = nn.Sequential(
            nn.Linear(model_ch, emb_dim), nn.SiLU(), nn.Linear(emb_dim, emb_dim))

        # ---- Encoder 側 ----
        self.input_blocks = nn.ModuleList([
            TimestepEmbedSequential(nn.Conv2d(in_ch, model_ch, 3, padding=1))])
        chans = [model_ch]        # スキップ接続用のチャンネル数を記録
        cur = model_ch
        for level, mult in enumerate(ch_mult):
            for _ in range(num_res_blocks):
                layers = [ResBlock(cur, model_ch * mult, emb_dim)]
                cur = model_ch * mult
                if level in attn_levels:
                    layers.append(SpatialTransformer(cur, context_dim, heads, cur // heads))
                self.input_blocks.append(TimestepEmbedSequential(*layers))
                chans.append(cur)
            if level != len(ch_mult) - 1:
                self.input_blocks.append(TimestepEmbedSequential(Downsample(cur)))
                chans.append(cur)

        # ---- Bottleneck ----
        self.middle_block = TimestepEmbedSequential(
            ResBlock(cur, cur, emb_dim),
            SpatialTransformer(cur, context_dim, heads, cur // heads),
            ResBlock(cur, cur, emb_dim))

        # ---- Decoder 側 ----
        self.output_blocks = nn.ModuleList()
        for level, mult in list(enumerate(ch_mult))[::-1]:
            for i in range(num_res_blocks + 1):
                layers = [ResBlock(cur + chans.pop(), model_ch * mult, emb_dim)]
                cur = model_ch * mult
                if level in attn_levels:
                    layers.append(SpatialTransformer(cur, context_dim, heads, cur // heads))
                if level != 0 and i == num_res_blocks:
                    layers.append(Upsample(cur))
                self.output_blocks.append(TimestepEmbedSequential(*layers))

        self.out = nn.Sequential(Normalize(cur), nn.SiLU(),
                                 zero_module(nn.Conv2d(cur, in_ch, 3, padding=1)))

    def forward(self, x, t, context):
        emb = self.time_embed(timestep_embedding(t, self.model_ch))
        hs = []
        h = x
        for module in self.input_blocks:
            h = module(h, emb, context)
            hs.append(h)                          # スキップ接続を保存
        h = self.middle_block(h, emb, context)
        for module in self.output_blocks:
            h = torch.cat([h, hs.pop()], dim=1)   # スキップ接続を結合
            h = module(h, emb, context)
        return self.out(h)
このU-Netが、記事前半で示したクロスアテンションの数式をそのままコードにしたものです。
- QとK, Vの出どころ CrossAttention: to_q は入力 x(U-Netの潜在表現 )から、to_k と to_v は context(条件付け入力 )から射影しています。これは論文の「 は から生成され、 と は から生成される」という記述の忠実な実装です。 なお context を渡さなければ がすべて 由来となり、通常のセルフアテンションとして機能します。同じクラスを両方に使い回せるのがこの設計の巧みな点です。
- BasicTransformerBlock の3層構造: 「セルフアテンション(画像内のどこを見るか)」→「クロスアテンション(テキストのどの単語を見るか)」→「フィードフォワード」という並びで、いずれも残差接続を持つPre-Norm構成です。Stable DiffusionのU-Net内部にあるブロックと同じ構造になっています。
- SpatialTransformer による橋渡し: 畳み込みが扱う特徴マップ [B, C, H, W] を、Transformerが扱えるトークン列 [B, H*W, C] に並べ替え、処理後に元の形へ戻します。出力層 proj_out をゼロ初期化しているため、学習開始直後はこのブロックが何も足さない(=純粋な畳み込みU-Netとして振る舞う)状態から始まり、徐々に条件付けの寄与を学習していきます。
- アテンションを入れる解像度 attn_levels=(1, 2): 32×32の潜在空間に対し、レベル1(16×16)とレベル2(8×8)にクロスアテンションを配置しています。最も高い解像度(32×32)で省略しているのは計算コストの削減のためで、Stable Diffusionでも同様に低解像度側にアテンションを集中させています。
- スキップ接続の帳尻合わせ chans: Encoder側で出力した各ブロックのチャンネル数をリストに積み、Decoder側で chans.pop() しながら結合後のチャンネル数を決めています。LDM公式実装と同じ管理方法で、これによりブロック数や倍率を変えても自動的に整合が取れます。
条件付けエンコーダ とEMA
テキストを中間表現に変換するドメイン固有エンコーダ を実装します。 Stable DiffusionはCLIPの学習済みテキストエンコーダを凍結して使いますが、LDM論文のオリジナル設定では をU-Netと同時に学習します。今回は語彙が極小のため、後者(同時学習)の方式を採ります。
class TextEncoder(nn.Module):
    """条件付けエンコーダ tau_theta: トークン列を [B, M, d_tau] の中間表現へ射影する"""
    def __init__(self, vocab_size, width=256, max_len=16, layers=2, heads=4):
        super().__init__()
        self.token_emb = nn.Embedding(vocab_size, width)
        self.pos_emb = nn.Parameter(torch.zeros(1, max_len, width))
        layer = nn.TransformerEncoderLayer(width, heads, width * 4, dropout=0.0,
                                           activation="gelu", batch_first=True, norm_first=True)
        self.transformer = nn.TransformerEncoder(layer, layers, enable_nested_tensor=False)
        self.ln_final = nn.LayerNorm(width)
    def forward(self, tokens):
        x = self.token_emb(tokens) + self.pos_emb[:, :tokens.shape[1]]
        return self.ln_final(self.transformer(x))

class EMA:
    """重みの指数移動平均。生成品質を安定させるために拡散モデルでは標準的に使われる"""
    def __init__(self, model, decay=0.999):
        self.decay = decay
        self.shadow = {k: v.detach().clone().float() for k, v in model.state_dict().items()}
    @torch.no_grad()
    def update(self, model):
        for k, v in model.state_dict().items():
            if v.dtype.is_floating_point:
                self.shadow[k].mul_(self.decay).add_(v.detach().float(), alpha=1 - self.decay)
            else:
                self.shadow[k] = v.detach().clone()
    @torch.no_grad()
    def copy_to(self, model):
        sd = model.state_dict()
        for k in sd:
            sd[k].copy_(self.shadow[k].to(sd[k].dtype))

# ----------------------------------------------------
# 単語単位の簡易トークナイザ
# ----------------------------------------------------
words = sorted({w for c in captions for w in c.split()})
vocab = {"<pad>": 0}
for w in words:
    vocab[w] = len(vocab)
MAX_LEN = 16

def tokenize(text):
    ids = [vocab[w] for w in text.split()][:MAX_LEN]
    return ids + [0] * (MAX_LEN - len(ids))       # <pad> で固定長に揃える

tok_all = torch.tensor([tokenize(c) for c in caps_all], device=device)
tok_uncond = torch.tensor([tokenize("")], device=device)   # 空文字列 = 無条件を表すトークン列
print("vocab size:", len(vocab))
- の役割:幅256・最大16トークンの小さなエンコーダにするのは、キャプションが「a calico cat on a white sofa」のような数語の短い文で、4種類しかないためです。本家のCLIPのテキストエンコーダ(幅768・77トークン)ほどの大きさは要りません。 論文の記述どおり、入力 を中間表現 に射影します。ここでは (最大トークン長)、 です。この出力がそのまま LatentUNet の context となり、各 SpatialTransformer のK, Vになります。
- 同時学習という選択: U-Netと のパラメータを1つのオプティマイザでまとめて最適化します。損失 の勾配はクロスアテンションを逆流して にも届くため、「画像を再現するのに役立つテキスト表現」がゼロから獲得されていくことになります。
- 無条件トークン tok_uncond: 空文字列をトークナイズすると全てが <pad> の列になります。これが後述のClassifier-Free Guidanceにおける「条件なし」を表す入力です。
- EMAの効果: 学習中の重みをそのまま使うと、勾配ノイズの影響でサンプル品質が振れます。減衰率0.999の指数移動平均を保持し、生成時にはその平滑化された重みを使うことで、生成が安定します。DDPMやLDMの公式実装でも必ず使われている手法です。
第2段階の学習( の最小化)
ノイズスケジュールを定義し、潜在空間で拡散モデルを学習します。
# ----------------------------------------------------
# ノイズスケジュール(Stable Diffusion と同じ scaled-linear)
# ----------------------------------------------------
betas = torch.linspace(0.00085 ** 0.5, 0.012 ** 0.5, T, device=device) ** 2
alphas_bar = torch.cumprod(1.0 - betas, dim=0)
sqrt_ab = alphas_bar.sqrt()                 # sqrt(alpha_bar_t)
sqrt_1mab = (1.0 - alphas_bar).sqrt()       # sqrt(1 - alpha_bar_t)

# ----------------------------------------------------
# モデルと最適化の準備
# ----------------------------------------------------
unet = LatentUNet().to(device)
tenc = TextEncoder(len(vocab)).to(device)
print("U-Net params: %.1fM" % (sum(p.numel() for p in unet.parameters()) / 1e6))

params = list(unet.parameters()) + list(tenc.parameters())
opt = torch.optim.AdamW(params, lr=1e-4)
ema_unet, ema_tenc = EMA(unet), EMA(tenc)
B = z_all.shape[0]

# ----------------------------------------------------
# 訓練ループ
# ----------------------------------------------------
for step in range(DM_STEPS):
    unet.train(); tenc.train()

    # 1. タイムステップ t を一様分布からサンプリング
    t = torch.randint(0, T, (B,), device=device).long()

    # 2. ガウスノイズ epsilon を生成
    noise = torch.randn_like(z_all)

    # 3. Forward process: 潜在変数にノイズを付加(閉形式で一発計算)
    z_t = sqrt_ab[t].view(-1, 1, 1, 1) * z_all + sqrt_1mab[t].view(-1, 1, 1, 1) * noise

    # 4. Classifier-Free Guidance のため、10%の確率でキャプションを捨てる
    tok = tok_all.clone()
    drop = torch.rand(B, device=device) < 0.1
    tok[drop] = tok_uncond

    # 5. 条件付け入力をエンコードし、U-Netでノイズを予測
    context = tenc(tok)
    pred_noise = unet(z_t, t, context)

    # 6. L_LDM = || epsilon - eps_theta(z_t, t, tau(y)) ||^2
    loss = F.mse_loss(pred_noise, noise)

    opt.zero_grad()
    loss.backward()
    torch.nn.utils.clip_grad_norm_(params, 1.0)
    opt.step()
    ema_unet.update(unet); ema_tenc.update(tenc)

    if (step + 1) % 1000 == 0:
        print(f"[DM] {step+1}/{DM_STEPS} - loss: {loss.item():.4f}")

# 学習済みの重みをEMAの平滑化された重みで置き換える
ema_unet.copy_to(unet)
ema_tenc.copy_to(tenc)
DDPMの train_step と見比べると、構造がほとんど同じであることが分かります。違いは「入力が画像 ではなく潜在変数 であること」と「条件付け入力が加わったこと」だけです。これこそが、LDMが「ピクセル空間での拡散を、そのまま潜在空間に移した」手法であることの表れです。
- scaled-linear スケジュール: DDPMでは を から まで線形に増やしていましたが、Stable Diffusionでは終端が とやや小さく設定され、さらに の平方根が線形になるようスケジュールされています(linspace(...) ** 2 の部分)。これにより、初期だけでなく終端まで含めてノイズ注入が全体的に緩やかになり、潜在空間のような低次元データでも情報が急激に失われにくくなります。
- 順過程の閉形式: z_t = sqrt_ab[t] * z_all + sqrt_1mab[t] * noise は、DDPMの を潜在変数に適用したものです。オートエンコーダは凍結済みで潜在変数 z_all は事前計算されているため、毎ステップのエンコード処理が不要になり、学習が高速に回ります。
- 条件のドロップアウト(10%): Classifier-Free Guidanceの肝となる部分です。学習中に一定確率でキャプションを空文字列に置き換えることで、1つのモデルに「条件付きのノイズ予測 」と「無条件のノイズ予測 」の両方を同時に習得させます。別途分類器を用意する必要がないため "Classifier-Free" と呼ばれます。
- 勾配クリッピング: clip_grad_norm_ により勾配のノルムを1に制限しています。データ数が極端に少ない状況では損失が跳ねやすいため、安定化のために入れています。
推論の実行(DDIM + Classifier-Free Guidance)
学習済みモデルを使い、テキストから画像を生成します。 サンプラーには、LDM論文でも使用されているDDIM(決定論的サンプリング) を実装します。
DDIMの数式や、なぜ少ないステップ数でも高品質な画像生成が可能なのかといった詳細な理論については、別記事「DDIM (Denoising Diffusion Implicit Models) とは?」にて解説していますので、併せてご参照ください。
@torch.no_grad()
def sample(prompts, steps=50, guidance=3.0):
    unet.eval(); tenc.eval()
    n = len(prompts)

    # 1. 条件付き / 無条件の2種類のコンテキストを用意
    tok = torch.tensor([tokenize(p) for p in prompts], device=device)
    ctx_cond = tenc(tok)
    ctx_uncond = tenc(tok_uncond.repeat(n, 1))

    # 2. T ステップから steps 個を等間隔で抜き出す(DDIMによる高速化)
    seq = torch.linspace(0, T - 1, steps).long().flip(0).to(device)

    # 3. 純粋なガウスノイズ z_T から出発
    z = torch.randn(n, Z_CHANNELS, LATENT_SIZE, LATENT_SIZE, device=device)

    for i, ti in enumerate(seq):
        t = ti.repeat(n)

        # 4. Classifier-Free Guidance: 2回の予測を外挿して条件への忠実度を高める
        eps_c = unet(z, t, ctx_cond)
        eps_u = unet(z, t, ctx_uncond)
        eps = eps_u + guidance * (eps_c - eps_u)

        # 5. DDIM の更新式
        ab_t = alphas_bar[ti]
        ab_prev = alphas_bar[seq[i + 1]] if i < steps - 1 else torch.tensor(1.0, device=device)
        z0_pred = (z - (1 - ab_t).sqrt() * eps) / ab_t.sqrt()      # 予測された z_0
        z = ab_prev.sqrt() * z0_pred + (1 - ab_prev).sqrt() * eps  # 次のステップへ

    # 6. デコーダ D で潜在変数を画像に戻す(スケーリングを元に戻してから)
    x = ae.decode(z / scale_factor)
    return (x.clamp(-1, 1) + 1) / 2

# ----------------------------------------------------
# 学習に使った4つのキャプションから画像を生成
# ----------------------------------------------------
generated = sample(captions).permute(0, 2, 3, 1).cpu().numpy()

fig, axes = plt.subplots(1, 4, figsize=(14, 4))
titles = ["calico", "silver tabby", "grey", "fluffy cream"]
for idx, img in enumerate(generated):
    axes[idx].imshow(img)
    axes[idx].axis("off")
    axes[idx].set_title(titles[idx], fontsize=10)

plt.tight_layout()
plt.show()
生成プロセスの各段階を解説します。
- Classifier-Free Guidance の外挿: eps = eps_u + guidance * (eps_c - eps_u) がその実装です。 は「テキスト条件によってノイズ予測がどちらに動いたか」という方向ベクトルであり、それを guidance 倍だけ強調しています。値を大きくするとプロンプトへの忠実度が上がる一方、多様性が失われ色が飽和しやすくなります。理論編で解説した Guidance Scale (後述の diffusers ライブラリにおける guidance_scale)に相当するパラメータであり、Stable Diffusionの既定値は7.5前後です(今回はデータが少ないため3.0程度が適切です)。
- DDIMによるステップ削減: DDPMのサンプリングは ステップすべてを辿る必要がありましたが、DDIMはサンプリング過程を決定論的にすることで、途中のステップを飛ばしても破綻しない性質を持ちます。ここでは1000ステップから50ステップを等間隔で抜き出しており、生成が20倍高速になります。
- 更新式の意味: z0_pred は、現在の と予測ノイズから逆算した「今の時点で推定される最終出力」です。DDIMはこれを一度求めた上で、改めて1つ前のノイズレベル に対応する量のノイズを載せ直します。DDPMと違い乱数(ガウスノイズ)を加えないため、同じ初期ノイズからは常に同じ画像が得られます。
- 潜在空間から画像へ: 最後に ae.decode(z / scale_factor) を1回呼ぶだけで、32×32×4の潜在変数が128×128×3の画像に戻ります。論文が述べている「生成されたサンプルはデコーダ を1回通過させるだけで画像空間にデコードできる」という記述そのものです。
実行結果
上記のコードを実行すると、以下のようなログが出力されます。
images: (8, 3, 128, 128)
[AE] 500/3000 - loss: 0.1014
[AE] 1000/3000 - loss: 0.0642
[AE] 1500/3000 - loss: 0.0433
[AE] 2000/3000 - loss: 0.0289
[AE] 2500/3000 - loss: 0.0304
[AE] 3000/3000 - loss: 0.0249
latents: (8, 4, 32, 32) scale_factor: 1.5292
vocab size: 17
U-Net params: 96.8M
[DM] 1000/8000 - loss: 0.0104
[DM] 2000/8000 - loss: 0.0207
[DM] 3000/8000 - loss: 0.0037
[DM] 4000/8000 - loss: 0.0056
[DM] 5000/8000 - loss: 0.0361
[DM] 6000/8000 - loss: 0.0022
[DM] 7000/8000 - loss: 0.0027
[DM] 8000/8000 - loss: 0.0015
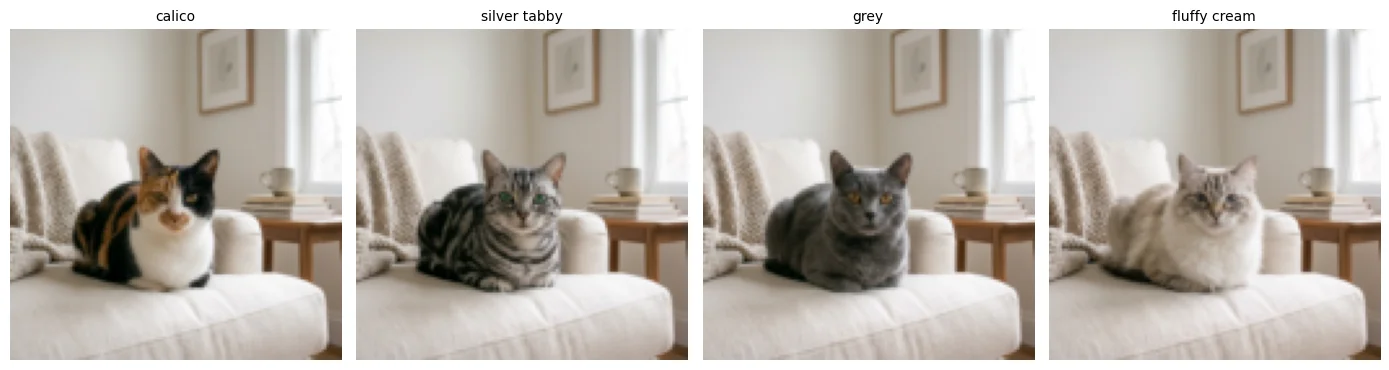
DDPMの記事では32×32ピクセルの画像しか生成できませんでしたが、今回は128×128ピクセル(16倍のピクセル数)の画像が生成できています。これは拡散モデルが扱うテンソルが、DDPMでは32×32×3、LDMでは32×32×4とほぼ同じ大きさに保たれているためです。今回はU-Netのモデル規模やアテンション層を大幅に増やしているため実際の学習時間は増えていますが、ピクセル空間で128×128を直接扱う場合に比べれば桁違いに軽く、拡散モデルが扱うテンソルの大きさを変えずに出力解像度を引き上げられるというLDMの核心的な効率性が現れています。
さらに、生成された4枚はそれぞれプロンプトで指定した毛色や目の色に対応しています。無条件生成だったDDPMとは異なり、クロスアテンションを通じてテキストの意味が画像生成を制御できていることが確認できます。
なお、生成された画像の中には元の画像に対して左右が反転しているものが含まれることがあります。これは、今回の学習データの前処理において、データ拡張として左右反転した画像を追加した際、キャプション(プロンプト)は元の画像と全く同じものを与えて学習させたためです。モデルは「同じプロンプトに対して、右向きも左向きも正解」として学習しているため、今回のプロンプトでは向きを制御することができず、生成時の初期ノイズの偶然によって向きが決定されています。
さらに試してみる
- guidance の値を1.0(ガイダンスなし)から7.5まで変化させると、プロンプトへの忠実度と多様性のトレードオフを体感できます。
- IMAGE_SIZE = 256、F_FACTOR = 8 とし、Encoder/Decoder の ch_mult を (1, 2, 4, 4) に変更すると、Stable Diffusion本家と同じ圧縮率 で256×256の画像を生成できます。潜在空間のサイズは32×32のままなので、拡散モデル側の学習時間はほとんど変わりません。
- キャプションの単語を組み替えて(例: "a grey cat with green eyes on a white sofa")学習データにない組み合わせを与えると、クロスアテンションがどの程度概念を分離して学習したかを確認できます。なお、今回の簡易トークナイザは未知の単語を処理できないため、必ず学習データのキャプションに含まれている単語のみを組み合わせてください(語彙外の単語を含めると KeyError となります)。
スクラッチ実装の2段階の学習を図にまとめると、次のようになります。
(図は、diagram-designで作成)
実際のHugging Faceモデルを用いた推論テスト
現在、Stable Diffusionを利用する最も一般的な方法は、Hugging Faceが提供する diffusers ライブラリを使用することです。LDMの複雑なパイプライン(VAE、テキストエンコーダ、U-Net、スケジューラ)が数行のコードに抽象化されています。
ライブラリのインストール
!pip install torch diffusers transformers accelerate
推論(画像生成)の実行
StableDiffusionPipeline を使用すると、論文で説明されている「テキスト条件付けされた潜在空間でのノイズ除去」と「画像空間へのデコード」を簡単に実行できます。
import torch
from diffusers import StableDiffusionPipeline
import matplotlib.pyplot as plt

# 1. パイプラインの読み込み
# 事前学習済みのStable Diffusionの重みをロード
model_id = "stable-diffusion-v1-5/stable-diffusion-v1-5"
pipe = StableDiffusionPipeline.from_pretrained(
    model_id,
    torch_dtype=torch.float16 # メモリ節約のために半精度を使用
)
pipe = pipe.to("cuda")

# 2. プロンプトの定義 (言語による条件付け)
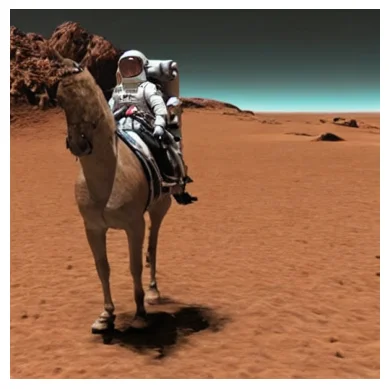
prompt = "a photo of an astronaut riding a horse on mars"

# 3. 画像生成の実行
# 内部処理:
# - promptがCLIPテキストエンコーダでベクトル化 (tau_theta)
# - 純粋なノイズ(z_T)が生成される
# - U-NetがCross-Attentionを用いてテキストを参照しながらノイズを除去 (Reverse Process)
# - VAEのデコーダが潜在変数をピクセル画像(x_0)に変換
image = pipe(prompt, num_inference_steps=50, guidance_scale=7.5).images[0]

# 4. 画像の表示
plt.imshow(image)
plt.axis("off")
plt.show()
スクラッチ実装と対応させると、このパイプラインの中身が何をしているかが明確になります。
- pipe.vae は、先ほど実装した AutoencoderKL に相当します(本家は 、512×512の画像を64×64×4の潜在変数へ圧縮)。
- pipe.text_encoder は にあたり、本家では学習済みのCLIPテキストエンコーダが凍結された状態で使われます。
- pipe.unet は LatentUNet に相当し、内部には同じ SpatialTransformer(自己注意 + クロスアテンション)が積まれています。
- num_inference_steps=50 は、スクラッチ実装のDDIMで50ステップを抜き出したのと同じ意味です。
- guidance_scale=7.5 は、Classifier-Free Guidanceの外挿係数 guidance と同一のパラメータです。
かつて広く使われていた runwayml/stable-diffusion-v1-5 は、2024年8月にRunway社がHugging Faceの組織ごと削除したため現在は利用できません。同じ重みがコミュニティによって stable-diffusion-v1-5/stable-diffusion-v1-5 として再公開されているため、そちらを指定します。
guidance_scale(Classifier-free guidance)などのテクニックを組み合わせることで、プロンプトの指示に対する忠実度をコントロールしながら、非常に高品質な画像を生成することが可能です。
実行結果
上記のコードを実行すると、以下のような画像が生成されます。
まとめ
本記事では、現在の画像生成AIのデファクトスタンダードとなっている Stable Diffusion (Latent Diffusion Models) について、理論からスクラッチ実装までを解説しました。
記事を通じて、以下の内容を学習しました。
- 2段階の圧縮による計算効率化: ピクセルベースのDDPMが抱えていた計算コストの課題を、オートエンコーダによる「知覚的圧縮」と拡散モデルによる「意味的圧縮」の分離によって解決した点。また、KL正則化や知覚損失(LPIPS)を用いることで、画像の鮮明さを保ちつつ安定した潜在空間を作る工夫を学びました。
- 畳み込み処理への適応: 過度な空間圧縮を避け、空間情報を保持した潜在空間を使用することで、U-Netなどの画像特有の帰納的バイアスを活かし、細部を保持した高品質な生成を実現したこと。
- クロスアテンションによる柔軟な条件付け: U-Net内部にクロスアテンション層を導入し、言語モデル(Transformerなど)と組み合わせることで、強力な「テキストからの画像生成(Text-to-Image)」が可能になった点。
- PyTorchによるスクラッチ実装: オートエンコーダから潜在U-Net、DDIMサンプラーまでをゼロから構築し、限られた計算資源でもLDMの全パイプラインが動作することを確認しました。また、生成結果(左右反転の例)を通じて、学習時のプロンプトと画像データの対応関係がいかに重要であるかも確認できました。
- 潜在空間へ移すことの効果: DDPMと同じ32×32のテンソルを扱いながら、出力解像度を128×128(16倍のピクセル数)に引き上げられることを実測で確認しました。
DDPMで確立された「ノイズ除去の反復」という数学的アプローチを、より本質的で軽量な潜在空間へと移したLatent Diffusionの登場は、画像生成AIの歴史を大きく前進させました。
参考文献
- R. Rombach, A. Blattmann, D. Lorenz, P. Esser, B. Ommer (2022). High-Resolution Image Synthesis with Latent Diffusion Models. CVPR 2022.
- stable-diffusion-v1-5. stable-diffusion-v1-5/stable-diffusion-v1-5. Hugging Face.
本記事の文章・構成の一部に生成AIを使用しています。