サロゲートインデックスとは? 短期の実験から長期効果を推定
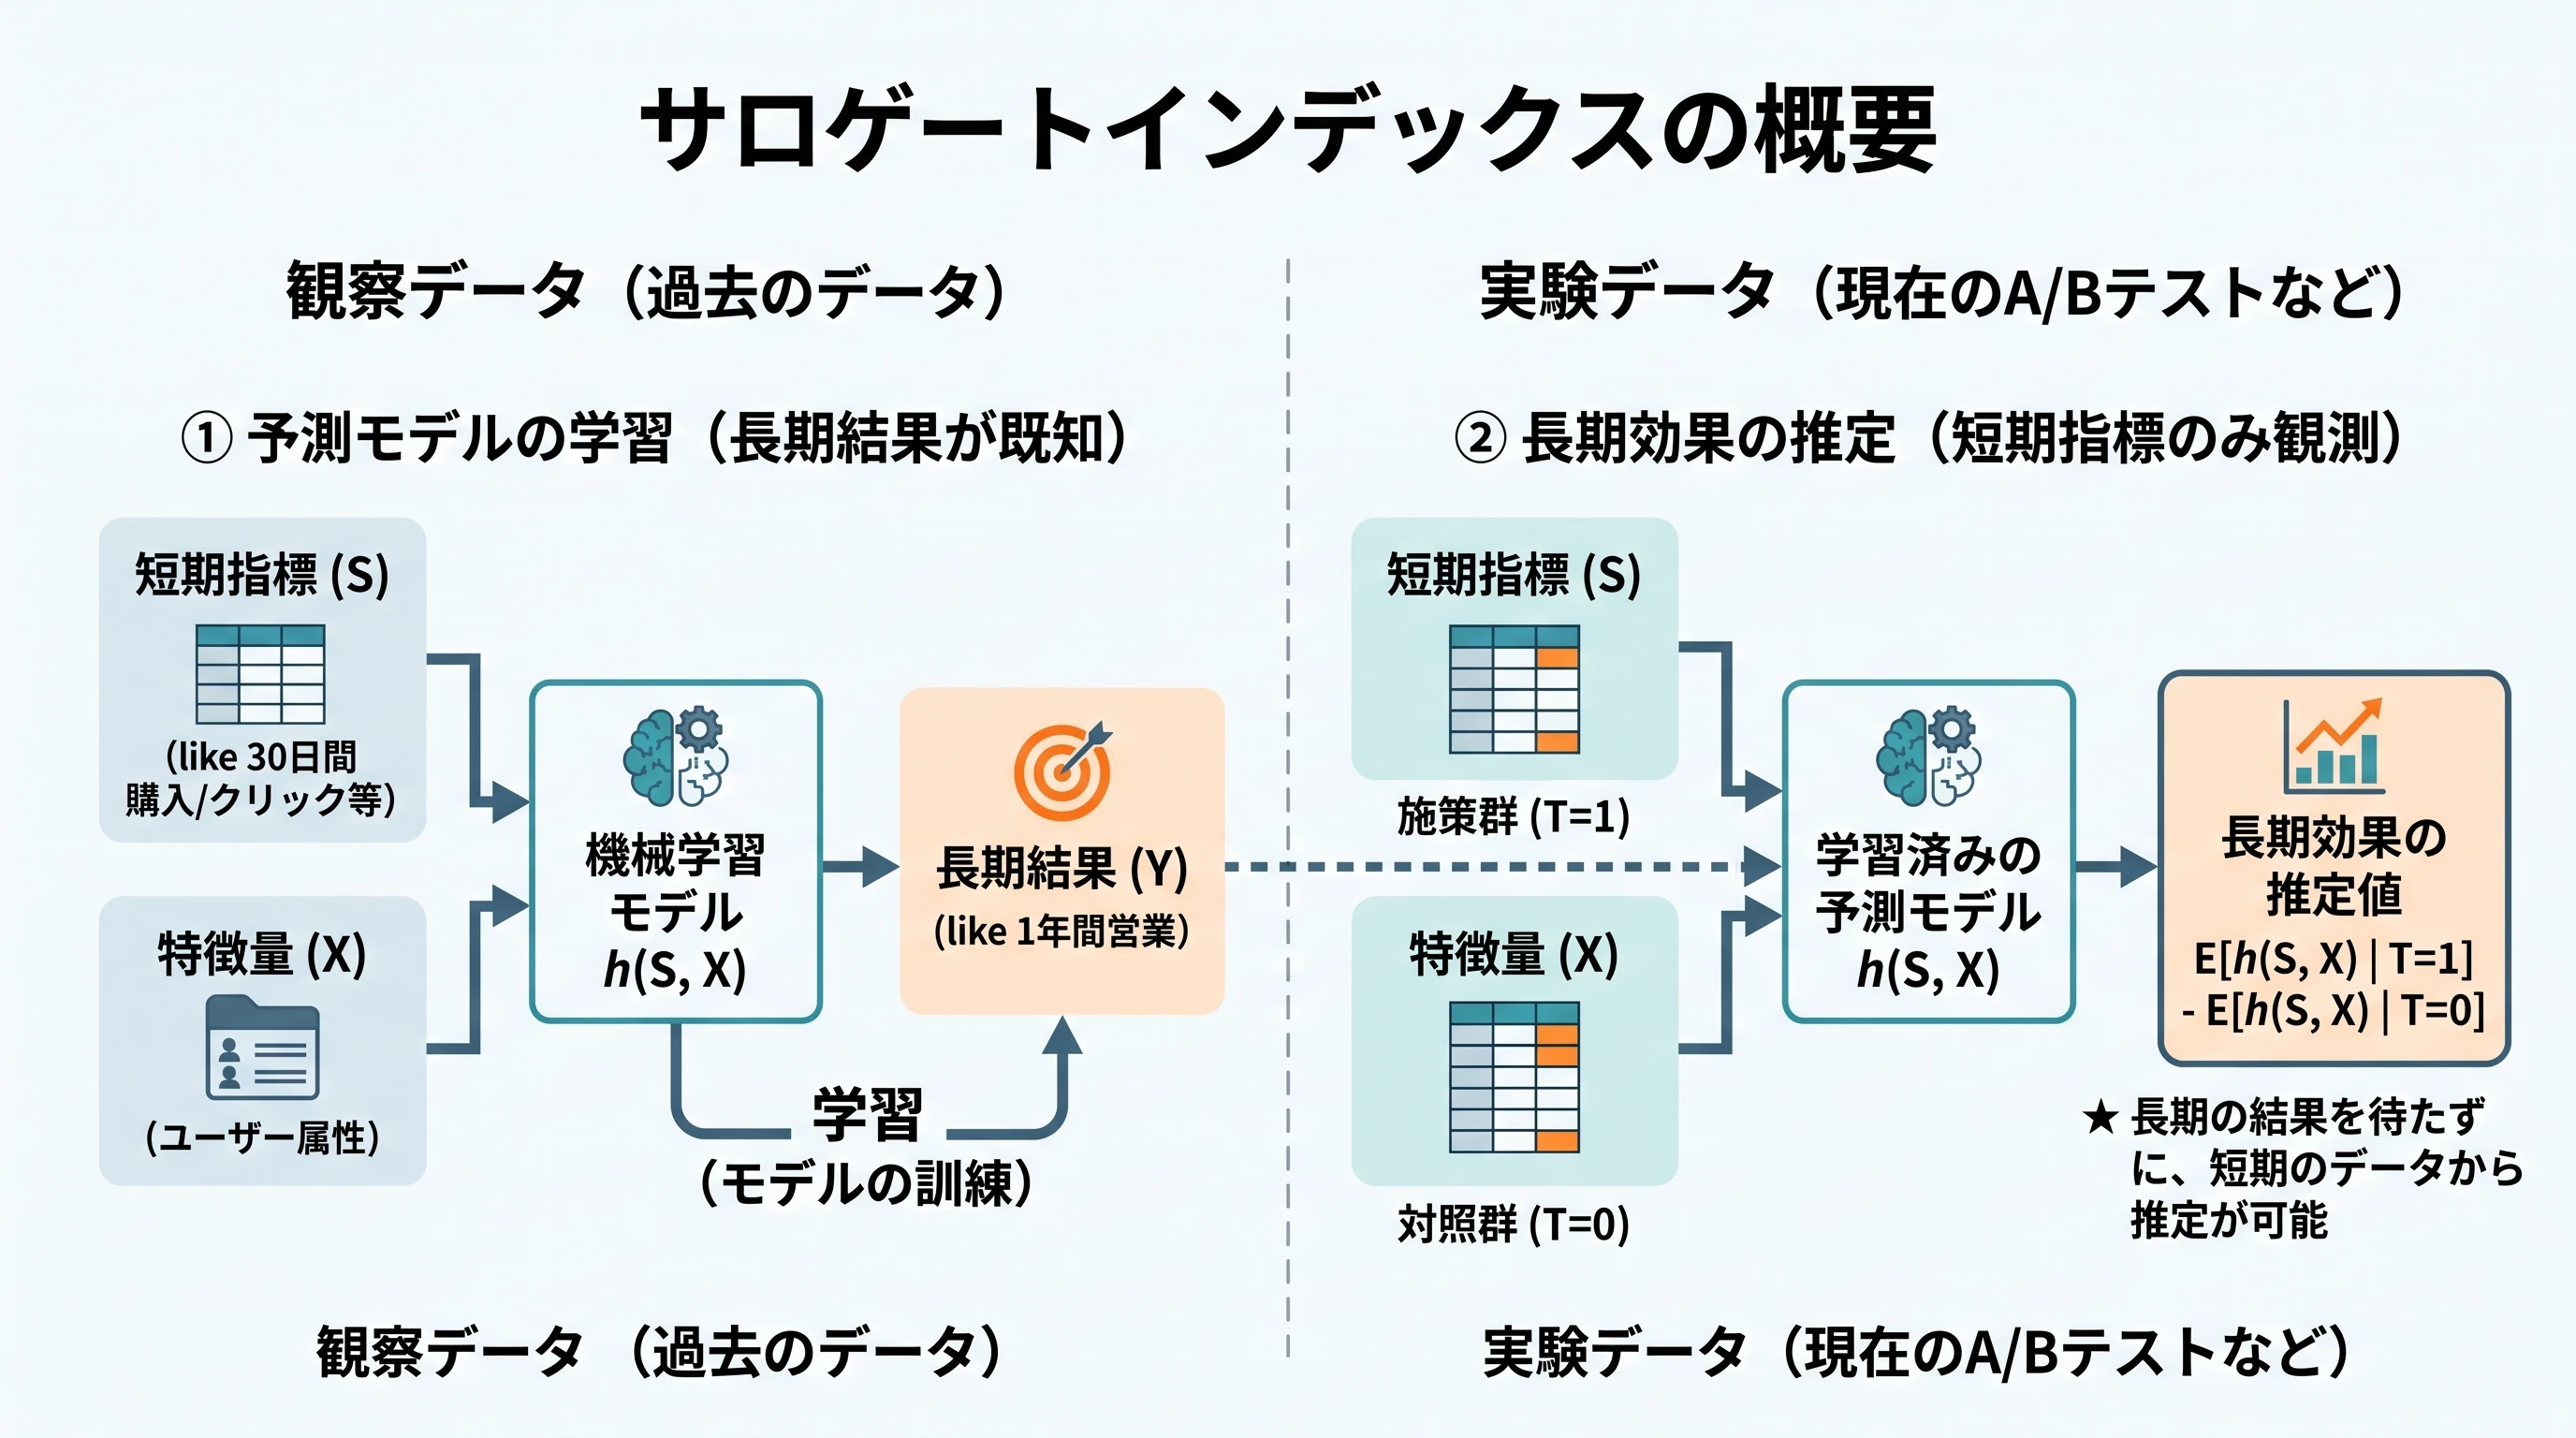 (画像は、Geminiで作成)
実験期間中には観測できない長期の効果(1年後の売上や顧客生涯価値への効果)を、短期の指標から推定できるようになること。そのために、短期のCV率だけで施策を評価する危うさ、単一のサロゲート指標の問題(Prentice基準)、サロゲートインデックスの考え方と仮定(サロゲート性・比較可能性)を、真の長期効果を仕込んだダミーデータで確かめること。
概要
アップリフトモデルの評価の記事では、クーポンを配って「30日以内に買ったか」という短期の成果で、配布のルールを評価しました。しかし、マーケティングの最終的な目的は、30日の購買ではなく、顧客の長期的な価値(RFMの記事で定義した CLV)を高めることです。
短期の成果と長期の成果は、同じ方向を向くとは限りません。値引きのクーポンで30日以内の購買は増えても、それは「どうせ買うはずだった購買を前倒ししただけ」かもしれません。逆に、30日の購買はあまり増えなくても、クーポンをきっかけに顧客が定着し、1年後の売上が大きく増えることもあります。短期の CV率だけで施策を評価していると、長期の価値を損なう施策を選んでしまうおそれがあるのです。
では、長期の効果を測るには、1年待つしかないのでしょうか。1年待てば、実験の結果を待つ間に次の施策を決められず、意思決定が大きく遅れます。そこで、Athey, Chetty, Imbens & Kang (2019) が提案したのが サロゲートインデックス(surrogate index) です。「短期の指標から長期の結果を予測するモデル」を、長期の結果まで観測できている過去のデータで作り、それを実験の短期の結果に当てはめることで、長期の効果を推定します。
本記事では、次の順に解説します。
- サロゲート指標と Prentice基準、サロゲートインデックスの考え方と成立のための仮定
- 短期の効果と長期の効果がずれる例(ダミーデータでの確認)
- 1つの短期指標を長期の代わりにすると、何が起きるか
- サロゲートインデックスの実装と、真の長期効果との比較
本記事のコードは、Python 3.13、NumPy 2.4.6、pandas 3.0.5、SciPy 1.18.1、LightGBM 4.7.0、matplotlib 3.11.2 で動作を確認しました。
サロゲート指標とサロゲートインデックス
短期の実験から長期の効果を推定する考え方と、そのために必要な条件を、先にまとめます。後の節で、真の長期効果を仕込んだダミーデータを使って確かめます。
サロゲート指標
長期の結果がまだ出ていないとき、実務でよく行われるのは、「CV1件あたりの長期の価値」を過去のデータから計算し、実験で増えた CV の件数に掛ける方法です。過去のデータで「30日以内に買った顧客は、買わなかった顧客より1年間で平均◯円多く買っている」と分かれば、「クーポンで30日の購買率が10ポイント上がったので、1年の売上は ◯円 × 0.11 増えるはず」と考えるわけです。
このように、1つの短期指標を長期の結果の代わりにすることを、サロゲート指標(代替指標、surrogate endpoint)を使うといいます。もともとは医学の臨床試験で、「死亡率」のような長期の結果の代わりに、「血圧」や「腫瘍の大きさ」のような短期に測れる指標を使うことから生まれた考え方です。
Prentice基準
1つの短期指標 が、長期の結果 のサロゲート指標として正しく働くための条件は、Prentice基準(Prentice, 1989)として知られています。その核心は、次の条件です。
「短期指標 の値が同じなら、施策 を受けたかどうかで、長期の結果 の分布は変わらない」という意味です。言い換えると、施策が長期の結果に与える効果は、すべて短期指標を通って伝わる、ということです。
後の節で、30日以内に買ったか(cv30)を1つのサロゲート指標にすると、この条件が崩れることをダミーデータで確かめます。
考え方:複数の短期指標を「長期の結果の予測値」にまとめる
Athey et al. (2019) のサロゲートインデックスは、1つの短期指標の代わりに、複数の短期指標を組み合わせて、長期の結果を予測するモデルを使います。
- 観察データで、長期の結果を予測するモデルを作る:短期指標 (本記事では、後で作る cv30・n60・sales60・visits_31_60 の4つ)と、施策の前から分かっている特徴量 から、長期の結果 (1年間の売上)を予測するモデル を学習します。この予測値 を、サロゲートインデックスと呼びます。
- 実験データに当てはめる:実験データの顧客の短期指標と特徴量から、サロゲートインデックスを計算します。
- 施策群と対照群で比べる:サロゲートインデックスの平均の差が、長期の効果の推定値です。
は実験データの施策群と対照群の人数です。実験データでは長期の結果 を観測していませんが、「その顧客の短期指標から予測した長期の結果」を代わりに使うわけです。短期指標を1つの「長期の価値」という物差しにまとめるので、「インデックス(指標)」と呼ばれます。なお、長期の結果を予測するモデルには、CLV予測の記事の機械学習の手法をそのまま使えます。
推定の流れを図にまとめます。長期の結果まで観測できている観察データでモデルを作り、長期の結果がまだない実験データに同じモデルを当てはめます。
(図は、diagram-designで作成)
成立のための2つの仮定
サロゲートインデックスが長期の効果を偏りなく推定するには、次の2つの仮定が必要です。
- サロゲート性(surrogacy):実験データで、。短期指標と特徴量が同じなら、施策を受けたかどうかで長期の結果は変わらない、という仮定です。Prentice基準と同じ形ですが、1つの指標ではなく複数の短期指標と特徴量の組に対して求める点が違います。指標を増やすほど、施策が長期の結果に影響する経路を捉えやすくなり、仮定が成り立ちやすくなります。
- 比較可能性(comparability):「短期指標と特徴量から長期の結果への関係」 が、観察データと実験データで同じ、という仮定です。観察データが別の時期や別の顧客層のものだと、この関係が変わっているかもしれません。本記事のダミーデータでは、同じ顧客の集団をランダムに分けて観察データと実験データを作るので、この仮定は成り立ちます。
観察データの施策(過去のキャンペーン)は、ランダムに配られていなくても構いません。観察データで学習するのは「施策の効果」ではなく「短期指標から長期の結果への予測」だからです。必要なのは、その予測が、施策を受けた顧客にも受けなかった顧客にも当てはまること(サロゲート性)です。
単一のサロゲート指標とサロゲートインデックスの違いを、施策が長期の結果に届く経路で比べると、次のようになります。1つの短期指標では、それを通らない経路が残りやすく、Prentice基準が崩れます。複数の短期指標と特徴量を使うと、それらを通らない経路が小さくなり、サロゲート性が成り立ちやすくなります。
(図は、diagram-designで作成)
検証用ダミーデータの生成
顧客ワールド・特徴量・クーポンの施策データの再生成
RFMの記事から使っている「顧客ワールド」、CLV予測の記事の行動ログの特徴量、アップリフトモデルの評価の記事のクーポンの施策データを、同じコードで生成します。生成は、次の3つのコードで行います。
- 顧客ワールド:顧客ごとの隠れた性質と購買ログを生成する(1つ目のコード)
- 購買履歴の集計と、行動ログの特徴量を作る(2つ目のコード)
- クーポンの施策データ:潜在的結果と、2つのシナリオの割り当てを生成する(3つ目のコード)
顧客ワールドの生成式
コードはRFMの記事と同じです。生成の規則を式でまとめると、次のとおりです。
顧客 の隠れた性質は、次の分布から1つずつ引きます(ガンマ分布は形状とレートで書きます。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、コードではレートの逆数を渡しています)。
(lam)は1日あたりの購買ペース、(p_drop)は繰り返し購買の直後に離脱する確率、(nu)は購買金額の尺度、(first_day)は初回購買日です。
購買ログは、初回購買日 から、次の規則で730日目まで作ります。
は 回目の購買から次の購買までの日数(平均 日)、 は1回ごとの購買金額です(形状6は p_gg)。2回目以降の購買(繰り返し購買)の直後には、確率 で離脱し、それ以降は買いません。初回購買の直後には離脱の判定をしません。1回あたりの平均購買金額は (truth['mean_amount'])で、離脱した日(death_day)が365日目以降なら、基準日に生存している(truth['alive'])とします。
購買と離脱の部分は BG/NBDモデル、購買金額の部分は Gamma-Gammaモデルの生成過程で、BTYDの記事で詳しく説明しています。
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は日)
rng = np.random.default_rng(42)
N = 10_000          # 顧客数
CALIB_END = 365     # 0〜364日目: 分析に使う期間(前半1年)
OBS_END = 730       # 365〜729日目: 答え合わせ用のホールドアウト期間(後半1年)

# 2. 顧客ごとの隠れた性質(分析者には観測できない「答え」)
r, alpha = 0.6, 25.0                         # 購買ペースのばらつきを決めるパラメータ
a, b = 0.8, 3.0                              # 離脱のしやすさのばらつきを決めるパラメータ
p_gg, q_gg, gamma_gg = 6.0, 4.0, 1500.0      # 購買金額のばらつきを決めるパラメータ
lam = rng.gamma(r, 1 / alpha, size=N)        # 購買ペース(1日あたりの平均購買回数)
p_drop = rng.beta(a, b, size=N)              # 2回目以降の購買の直後に離脱する確率
nu = rng.gamma(q_gg, 1 / gamma_gg, size=N)   # 購買金額の尺度(平均購買金額は p_gg / nu)
first_day = rng.uniform(0, CALIB_END, size=N)  # 初回購買日(最初の1年で少しずつ獲得)

# 3. 購買ログの生成
records = []
death_day = np.full(N, np.inf)   # 離脱した日(観測期間内に離脱しなければ inf)
for i in range(N):
    t = first_day[i]
    records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))   # 初回購買
    while True:
        t += rng.exponential(1 / lam[i])   # 次の購買までの待ち時間
        if t >= OBS_END:
            break
        records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))
        if rng.uniform() < p_drop[i]:      # 購買の直後に、一定の確率で離脱する
            death_day[i] = t
            break

# 4. 分析者が観測できる購買ログ(購買日は整数の日付、金額は10円単位)
log = pd.DataFrame(records, columns=['customer_id', 'day', 'amount'])
log['day'] = np.floor(log['day']).astype(int)
log['amount'] = log['amount'].round(-1).astype(int)

# 5. 答え合わせ用の真値(分析には使わない)
truth = pd.DataFrame({
    'lam': lam,                          # 購買ペース
    'p_drop': p_drop,                    # 購買の直後に離脱する確率
    'mean_amount': p_gg / nu,            # 平均購買金額
    'alive': death_day >= CALIB_END,     # ホールドアウト期間の開始時点で生存しているか
})

# 6. RFMの記事と同じデータになっていることの確認
print(f"購買ログの件数: {len(log):,} 件、ホールドアウト期間の開始時点で生存している顧客: {truth['alive'].mean():.1%}")
これまでの記事と同じコードで、顧客ワールドを生成しています。生成の仕組みは、BTYDの記事の「生成過程:4つの仮定」で説明したとおりです。
- 乱数と観測期間の設定: np.random.default_rng(42) で乱数生成器 rng を作り、シードを固定しているので、何度実行しても同じデータになります。顧客数は N = 10_000、時間の単位は日で、CALIB_END = 365 より前(0〜364日目)を分析に使う期間、OBS_END = 730 まで(365〜729日目)をホールドアウト期間とします。本記事では、365日目にクーポンを配り、ホールドアウト期間の1年間を「長期」として扱います。
- 顧客ごとの隠れた性質: 購買ペース lam を rng.gamma(r, 1 / alpha, size=N)(ガンマ分布)、離脱確率 p_drop を rng.beta(a, b, size=N)(ベータ分布)、購買金額の尺度 nu を rng.gamma(q_gg, 1 / gamma_gg, size=N)(ガンマ分布)から、顧客ごとに1つずつ引いています。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、レート alpha・gamma_gg は逆数にして渡しています。初回購買日 first_day は、最初の1年の一様分布 rng.uniform(0, CALIB_END, size=N) から引きます。
- 購買ログの生成: 顧客ごとに、初回購買日から t += rng.exponential(1 / lam[i]) で指数分布の待ち時間だけ時間を進め、次の購買を records に追加する処理を、OBS_END に達するまで繰り返します。1回の購買金額は rng.gamma(p_gg, 1 / nu[i]) で引き、顧客 の平均購買金額は p_gg / nu[i] になります。2回目以降の購買の直後に rng.uniform() < p_drop[i] なら離脱としてループを抜け、その日を death_day[i] に記録します。離脱しなかった顧客の death_day は np.inf のままです。
- 観測できる購買ログ: log には、顧客ID・購買日・金額の3列だけを入れます。購買日は np.floor で整数の日付に、金額は round(-1) で10円単位に丸めています。
- 答え合わせ用の真値: truth には、購買ペース・離脱確率・平均購買金額(p_gg / nu)と、離脱した日が365日目以降かどうか(death_day >= CALIB_END。基準日に生存しているか)を入れています。分析には使わず、本記事では施策の効果や長期の結果を作るときに使います。lam・p_drop・nu・death_day も、分析者には観測できない値です。
- 確認: 購買ログの件数と、基準日に生存している顧客の割合を表示し、これまでの記事と同じデータになっていることを確かめています。
実行結果
購買ログの件数: 57,667 件、ホールドアウト期間の開始時点で生存している顧客: 67.8%
購買ログの件数(57,667件)と生存している顧客の割合(67.8%)は、これまでの記事と同じです。 コードはCLV予測の記事と同じです。作り方を式でまとめると、次のとおりです。 基準日に生存しているかを (生存していれば1、離脱していれば0。alive_now)、シグモイド関数を とすると、5つの特徴量は次のように作ります。 、 は顧客ごとのノイズです。左辺は順に visits_30d(直近30日のサイト訪問回数)、cart_30d(直近30日のカート追加回数)、email_open_rate(24通のメールの開封率)、viewed_price(閲覧した商品の平均価格。10円単位に丸める)、app_user(アプリを利用しているか)で、 は visit_rate、 は open_prob です。乱数は、顧客ワールドとは別の乱数生成器 rng_feat(シード43)で引きます。行動ログの特徴量の生成式
# 1. 分析に使う期間と、答え合わせ用のホールドアウト期間に分ける
calib = log[log['day'] < CALIB_END]
holdout = log[log['day'] >= CALIB_END]

# 2. 顧客ごとに x, t_x, T と、1回あたりの平均購買金額を集計する
g = calib.groupby('customer_id')
summary = pd.DataFrame({
    'first_day': g['day'].min(),
    'last_day': g['day'].max(),
    'n_purchases': g['day'].size(),     # 購買回数(RFMの F)
    'monetary': g['amount'].mean(),     # 1回あたりの平均購買金額(RFMの M)
})
summary['x'] = summary['n_purchases'] - 1                       # 繰り返し購買の回数
summary['t_x'] = summary['last_day'] - summary['first_day']     # 初回購買から最後の購買までの日数
summary['T'] = CALIB_END - summary['first_day']                 # 初回購買から基準日までの日数
summary['recency'] = summary['T'] - summary['t_x']              # RFMの R(基準日から最後の購買までの日数)

# 3. 予測の対象: ホールドアウト期間(翌1年)の購買回数と売上
summary['holdout_n'] = holdout.groupby('customer_id').size().reindex(summary.index, fill_value=0)
summary['holdout_sales'] = holdout.groupby('customer_id')['amount'].sum().reindex(summary.index, fill_value=0)

# ---- 行動ログの特徴量(CLV予測の記事と同じ) ----
# 1. 特徴量は別の乱数生成器で作る(顧客ワールドの値を変えないため)
rng_feat = np.random.default_rng(43)
alive_now = truth['alive'].values

# 2. 直近30日のサイト訪問回数とカート追加回数(生存している顧客は購買ペースに応じて行動する)
visit_rate = np.where(alive_now, 0.01 + 3 * lam, 0.005)     # 1日あたりの訪問回数の平均
features = pd.DataFrame(index=summary.index)
features['visits_30d'] = rng_feat.poisson(30 * visit_rate)
features['cart_30d'] = rng_feat.poisson(30 * 1.5 * lam * alive_now)

# 3. メールマガジン(24通)の開封率(離脱しにくい顧客ほど開封し、離脱した顧客はあまり開封しない)
open_prob = 1 / (1 + np.exp(-(1.0 - 5 * p_drop + rng_feat.normal(0, 0.5, size=N)))) * np.where(alive_now, 1.0, 0.3)
features['email_open_rate'] = rng_feat.binomial(24, open_prob) / 24

# 4. 閲覧した商品の平均価格(平均購買金額のまわりでばらつく)と、アプリの利用(購買ペースが高いほど使う)
features['viewed_price'] = np.round(truth['mean_amount'].values * np.exp(rng_feat.normal(0, 0.35, size=N)), -1)
features['app_user'] = rng_feat.binomial(1, 1 / (1 + np.exp(-(np.log(lam * 365) - 2.0))))

# 5. モデルに使う特徴量の行列(購買履歴の6列 + 行動ログの5列)
X = pd.concat([summary[['x', 't_x', 'T', 'recency', 'n_purchases', 'monetary']], features], axis=1)
print(X.shape)
print(X.head().round(2).to_string())
アップリフトモデルの評価の記事と同じコードで、購買履歴の集計と行動ログの特徴量を作り、特徴量の行列 X にまとめています。
- 期間の分割: log['day'] < CALIB_END で、購買ログを分析に使う期間の calib と、ホールドアウト期間(365〜729日目)の holdout に分けています。holdout は、この記事では「クーポンを受け取らなかった場合」の購買ログとして使います。
- 購買履歴の集計: calib.groupby('customer_id') で顧客ごとにまとめ、初回購買日(g['day'].min())・最後の購買日(g['day'].max())・購買回数(g['day'].size())・1回あたりの平均購買金額(g['amount'].mean())を summary に入れます。そこから、繰り返し購買の回数 x(購買回数 − 1)、初回購買から最後の購買までの日数 t_x、初回購買から基準日までの日数 T、基準日から最後の購買までの日数 recency(T - t_x)を計算しています。
- ホールドアウト期間の集計: holdout.groupby('customer_id') で、翌1年の購買回数と売上を集計しています。ホールドアウト期間に買わなかった顧客は集計結果に現れないので、reindex(summary.index, fill_value=0) で全員の行をそろえ、0で埋めています(この記事では、長期の結果は後で別に計算します)。
- 行動ログの特徴量: 顧客ワールドの rng とは別の乱数生成器 rng_feat(シード43)で作ります。rng から続けて乱数を引くと、これまでの記事とデータが変わってしまうためです。alive_now は基準日に生存しているかで、生存している顧客は購買ペースに応じてサイトを訪問し(visits_30d)、カートに入れます(cart_30d)。メールの開封率(email_open_rate)は離脱確率が低いほど高く、閲覧した商品の平均価格(viewed_price)は平均購買金額のまわりでばらつき、アプリの利用(app_user)は購買ペースが高いほど1になりやすくしています。それぞれの式は、下の折りたたみにまとめました。
- 特徴量の行列: pd.concat([...], axis=1) で、購買履歴の6列(x・t_x・T・recency・n_purchases・monetary)と行動ログの5列を横につなぎ、合計11列の X を作っています。いずれもクーポンを配る前(基準日まで)に分かる値で、サロゲートインデックスの「特徴量 」として使います。
実行結果
(10000, 11)
             x  t_x    T  recency  n_purchases  monetary  visits_30d  cart_30d  email_open_rate  viewed_price  app_user
customer_id
0            6  114  147       33            7   1348.57           2         0             0.79        2450.0         0
1            4   85  297      212            5   3708.00           0         0             0.21        2690.0         0
2            0    0  139      139            1   1630.00           0         0             0.33        3740.0         0
3            2   13   24       11            3   3146.67           3         3             0.83        1730.0         1
4            0    0  338      338            1   2180.00           0         0             0.79        2740.0         0
10,000人 × 11列の特徴量の行列ができました。値はアップリフトモデルの評価の記事と同じです。
続いて、アップリフトモデルの評価の記事と同じコードで、クーポンの施策データを生成します。生成は、コードの手順に沿って次の流れで行います。
- クーポンの効果を決める3つの確率と、真のCATE(tau_true)を計算する(手順1)
- 3つの確率と乱数から、潜在的結果 y0・y1 を作る(手順2)
- シナリオA(RCT)とシナリオB(過去のキャンペーン)の割り当てを作り、観測される結果を選ぶ(手順3・4)
- 30日以内の購買率と配布率を確認する(手順5)
手順1で使う3つの確率、クーポンがなくても30日以内に買う確率 (p_natural)、クーポンで買う気になる確率 (p_induced)、クーポンで買う気をなくす確率 (p_annoyed)は次のとおりです( はシグモイド関数、 は購買ペース、 は離脱確率、 は平均購買金額で、離脱した顧客はすべて0)。
30日以内に買うかどうかは、受け取らなかった場合(y0)は顧客ワールドの購買ログで決まり、受け取った場合(y1)は「受け取らなくても買い、かつ買う気をなくさない(annoyed でない)」または「買う気になる(induced)」ときに買います。
シナリオB(過去のキャンペーン)でクーポンを配る確率 (e_true)は、(v)、(rc)を標準化した (平均を引いて標準偏差で割ったもの)から、次のように決めます。最近訪問し、最近買った顧客ほど配られやすくなります。
はシグモイド関数(sigmoid)、 は値を0.05〜0.95に収める操作です。この確率で決まる割り当て T_obs は、後で観察データ側(1年前のキャンペーン)の顧客の割り当てとして使います。観察データの割り当てがランダムでなくても構わないことは、成立のための2つの仮定で説明したとおりです。 コードはアップリフトモデルの評価の記事と同じデータを作るため、そちらで使う値も計算しています。本記事の記号で書くと、次のとおりです。 「買う気をなくす」出来事を (annoyed)、「買う気になる」出来事を (induced)とし、それぞれ確率 、 で起こします。30日以内に買うかの潜在的結果は、受け取らなかった場合 (y0)が顧客ワールドの購買ログで決まり、受け取った場合 (y1)は次のようになります( は「または」、 は「でない」)。 tau_true は、30日以内の購買率へのクーポンの効果(短期の真のCATE) で、3つの確率から次のように計算します。 式の導出は、アップリフトモデルの評価の記事にあります(同じ記事では、 を 、 を 、 を と書いています)。 本記事では、tau_true と、観測される30日以内の購買 Y_rct・Y_obs は、この後の分析に使いません。y0・y1 は、後で購買ログから作る短期指標 cv30 と一致することの確認に使い、annoyed・induced は長期の結果を作るときに使います。答え合わせに使う長期の真の効果は、後で作る tau_long です。コードにある潜在的結果と真のCATE(tau_true)の式(本記事の分析では使いません)
# 1. クーポンの効果を決める確率(分析者には観測できない「答え」)
rng_treat = np.random.default_rng(44)
def sigmoid(z):
    return 1 / (1 + np.exp(-z))

mean_amount = truth['mean_amount'].values
p_natural = alive_now * (1 - np.exp(-30 * lam))                     # クーポンがなくても30日以内に買う確率
p_induced = alive_now * 0.5 * (1 - p_drop) * sigmoid(2 * (np.log(3000) - np.log(mean_amount)))   # クーポンで買う気になる確率
p_annoyed = alive_now * 0.4 * sigmoid(3 * (np.log(mean_amount) - np.log(6000)))                 # クーポンで買う気をなくす確率
tau_true = p_natural * (1 - p_annoyed) + (1 - p_natural * (1 - p_annoyed)) * p_induced - p_natural   # 真のCATE

# 2. 潜在的結果:Y(0) は顧客ワールドの購買ログ、Y(1) はそこにクーポンの効果を加えたもの
day = log['day'].values
y0 = np.zeros(N, dtype=int)
y0[np.unique(log.loc[(day >= CALIB_END) & (day < CALIB_END + 30), 'customer_id'])] = 1
annoyed = rng_treat.uniform(size=N) < p_annoyed
induced = rng_treat.uniform(size=N) < p_induced
y1 = (((y0 == 1) & ~annoyed) | induced).astype(int)

# 3. シナリオA:RCT(半数にランダムに配布)
T_rct = rng_treat.binomial(1, 0.5, size=N)
Y_rct = np.where(T_rct == 1, y1, y0)

# 4. シナリオB:過去のキャンペーン(最近訪問し、最近買った顧客ほど配られやすい)
v = np.log1p(features['visits_30d'].values)
rc = np.log1p(summary['recency'].values)
e_true = np.clip(sigmoid(-0.3 + (v - v.mean()) / v.std() - 0.8 * (rc - rc.mean()) / rc.std()), 0.05, 0.95)
T_obs = rng_treat.binomial(1, e_true)
Y_obs = np.where(T_obs == 1, y1, y0)

# 5. 確認(アップリフトモデルの評価の記事と同じ値)
print(f"30日以内の購買率: 全員に配らない {y0.mean():.1%}、全員に配る {y1.mean():.1%}、RCT の配布率 {T_rct.mean():.1%}、過去のキャンペーンの配布率 {T_obs.mean():.1%}")
アップリフトモデルの評価の記事と同じコードで、クーポンの施策データを生成しています。
- 乱数とシグモイド関数: 施策の効果と割り当ての乱数は、別の乱数生成器 rng_treat(シード44)で引きます。sigmoid は で、どんな値も0〜1の確率に変換します。
- 3つの確率: p_natural は 1 - np.exp(-30 * lam) で、購買ペース のポアソン過程で30日以内に1回以上買う確率です。p_induced は、(1 - p_drop)(離脱しにくい顧客ほど大きい)と、sigmoid(2 * (np.log(3000) - np.log(mean_amount)))(平均購買金額が3,000円より小さいほど大きい)の積に0.5を掛けたものです。p_annoyed は sigmoid(3 * (np.log(mean_amount) - np.log(6000))) に0.4を掛けたもので、平均購買金額が6,000円を超えるあたりから大きくなります。どれにも alive_now を掛けているので、離脱した顧客(alive_now が False)は0です。
- 潜在的結果: y0 と y1 は、クーポンを受け取らなかった場合・受け取った場合に、30日以内に購買するかどうかです。y0 は、手順2の y0[np.unique(log.loc[(day >= CALIB_END) & (day < CALIB_END + 30), 'customer_id'])] = 1 の1行で、次の3段階で作っています。
- 条件の絞り込み: log.loc[(day >= CALIB_END) & (day < CALIB_END + 30), ...] で、全員の購買ログから、購買日が基準日(CALIB_END = 365日目)以降かつ30日未満(365〜394日目)の購買だけを取り出します。
- 該当する顧客の特定: 取り出した購買の顧客ID(customer_id)を np.unique で重複なしにし、「30日以内に買った顧客」のIDの一覧を作ります。同じ顧客が30日以内に何回買っても、1回として数えます。
- フラグの更新: np.zeros(N, dtype=int) で全員0(買わない)に初期化した配列 y0 のうち、一覧の顧客IDの位置を1(買う)に書き換えます。顧客IDは0〜9,999の連番で、配列の位置(インデックス)と一致するので、IDの一覧をそのまま位置の指定に使えます。
- クーポンの効果の出来事: rng_treat.uniform(size=N) < p_annoyed は、0〜1の一様乱数が確率より小さいときに True になるので、各顧客が確率 p_annoyed で「買う気をなくす」(annoyed)ことになります。induced も同じように、確率 p_induced で「買う気になる」顧客です。y1 は ((y0 == 1) & ~annoyed) | induced で、「受け取らなくても買い、かつ買う気をなくさない」または「買う気になる」ときに1です。annoyed と induced は、この記事で長期の結果を作るときにも使います。
- シナリオA(RCT): rng_treat.binomial(1, 0.5, size=N) で、各顧客に確率0.5でクーポンを配ります(T_rct)。np.where(T_rct == 1, y1, y0) は、配った顧客では y1、配らなかった顧客では y0 を選ぶ処理で、観測される30日以内の購買 Y_rct になります。
- シナリオB(過去のキャンペーン): 直近30日の訪問回数と recency を np.log1p(。0回でも計算できる)で変換して v・rc とし、(v - v.mean()) / v.std() のように標準化してから、上の式の を計算します。np.clip(..., 0.05, 0.95) は、配布確率を0.05〜0.95に収める処理です。rng_treat.binomial(1, e_true) で、顧客ごとに確率 e_true でクーポンを配り(T_obs)、Y_obs も Y_rct と同じように選びます。
- 確認: アップリフトモデルの評価の記事の答え合わせ(4つのタイプなど)の表示は省き、全員に配らない場合(y0.mean())と全員に配る場合(y1.mean())の30日以内の購買率と、2つのシナリオの配布率だけを表示しています。
実行結果
30日以内の購買率: 全員に配らない 18.5%、全員に配る 29.5%、RCT の配布率 50.3%、過去のキャンペーンの配布率 41.9%
30日以内の購買率(全員に配らない18.5%、全員に配る29.5%)と配布率は、アップリフトモデルの評価の記事と同じです。
長期の結果の生成:習慣になる顧客と、値引き目当ての顧客
アップリフトモデルの評価の記事では、クーポンの効果を「30日以内に買ったか」だけで表していました。ここに、1年間の売上への効果を加えます。クーポンの効果は、短期と長期で次のように異なるようにします。
- クーポンで買う気になった顧客は、2種類に分かれる
- 習慣になる顧客:クーポンでの購買をきっかけに、その後も購買のペースが上がります(離脱するまで続く)。1年間の売上が大きく増えます。メールをよく読む(離脱しにくい)顧客や、1回あたりの購買金額が大きい顧客ほど、習慣になりやすいとします。
- 値引き目当ての顧客:クーポンで買った分、次の購買がなくなります(購買の前倒し)。30日以内の購買は増えますが、1年間の売上はほとんど増えず、値引きの分だけ減ることもあります。
- クーポンで買う気をなくした顧客は、購買が遅れるだけ:30日以内にするはずだった購買を、30日遅らせます。30日の購買は減りますが、1年間の売上は変わりません。
- クーポンでの購買は2割引き:クーポンで買った購買の金額は、通常の8割です。
こうして、全員について「クーポンを受け取った場合」と「受け取らなかった場合」の、ホールドアウト期間(365〜729日目)の購買ログを作り、次の値を計算します。
| 種類 | 値 | 意味 |
|---|---|---|
| 短期指標(サロゲート) | cv30 | 配布から30日以内に購買したか(アップリフトモデルの評価の記事の成果) |
| n60 | 配布から60日以内の購買回数 | |
| sales60 | 配布から60日以内の売上 | |
| visits_31_60 | 配布後31〜60日のサイト訪問回数 | |
| 長期の結果 | sales1y | 配布から1年間(365〜729日目)の売上 |
さらに、サロゲートインデックスの考え方に合わせて、顧客をランダムに半分ずつに分けます。観察データでモデルを作り、実験データに当てはめるためです。
- 観察データ:1年前に、アップリフトモデルの評価の記事のシナリオB(担当者の判断)でクーポンを配った顧客です。すでに1年たっているので、短期指標と長期の結果の両方が観測できます。
- 実験データ:今回、RCT(シナリオA)でクーポンを配った顧客です。まだ60日しかたっていないので、観測できるのは短期指標だけです。
本記事の目的は、実験データの短期指標だけから、クーポンの1年間の売上への効果を推定することです。長期の結果の乱数は、これまでのデータとは別の乱数生成器(シード45)で作ります。
生成は、コードの手順に沿って次の流れで行います。
- ① 習慣になる確率と、上乗せされる購買ペースを決め、顧客を観察データ側と実験データ側に分ける(手順1)
- ホールドアウト期間の購買ログに、クーポンの効果(遅らせる・前倒しする・上乗せする)を加えて、受け取った場合の購買ログを作る(手順2)
- 受け取らなかった場合(M0)と受け取った場合(M1)の、短期指標と長期の結果を計算する。② 31〜60日のサイト訪問回数もここで作る(手順3)
- ③ 割り当てに応じて、観測される値を選ぶ(手順4)
- 短期と長期の真の効果で答え合わせをする(手順5)
①〜③を、式で示します。
① 習慣になる確率と、上乗せされる購買ペース
顧客 の購買ペースを (lam)、離脱確率を (p_drop)、平均購買金額を (mean_amount)、シグモイド関数を とすると、クーポンで買う気になった顧客が習慣になる確率 (p_habit)と、習慣になった顧客に上乗せされる1日あたりの購買ペース (extra_rate)は次のとおりです(ホールドアウト期間の開始時点で離脱している顧客は 。生存しているかは alive_now)。
② 31〜60日のサイト訪問回数
31〜60日のサイト訪問回数は、ポアソン分布 に従うとし、1日あたりの訪問率 は、受け取らなかった場合 (visit_rate0)と受け取った場合 (visit_rate1)で次のようにします(離脱している顧客は )。
は、条件を満たす顧客で1、満たさない顧客で0になる指示関数です。クーポンで買う気になり(induced。確率 で決まる)、かつその購買が習慣になる(habit。確率 で決まる)顧客だけが1で、コードでは habit & induced に当たります。np.where(habit & induced, 3 * extra_rate, 0) で、1の顧客にだけ を足しています。つまり、クーポンを受け取って31〜60日のサイト訪問が増えるのは習慣になった顧客だけで、買う気になっても値引き目当てだった顧客や、買う気にならなかった顧客の訪問率は のままです。
③ 割り当てに応じて、観測される値を選ぶ
クーポンを受け取ったかを (T_all)、短期指標を (S_all)、長期の結果を (Y_long)とし、受け取った場合を 、受け取らなかった場合を で表すと( は M1 の列、 は M0 の列)、観測される値と真の長期効果 (tau_long)は次のとおりです。
from scipy.stats import poisson

# 1. 長期の効果を決める性質(分析者には観測できない「答え」)
rng_long = np.random.default_rng(45)
nu_i = p_gg / mean_amount                               # 購買金額の尺度(顧客ワールドの nu と同じ値)
in_obs = rng_long.uniform(size=N) < 0.5                  # 観察データ側(1年前のキャンペーン)の顧客
p_habit = alive_now * 0.8 * (1 - p_drop) * sigmoid(2 * (np.log(mean_amount) - np.log(3000)))
habit = rng_long.uniform(size=N) < p_habit               # クーポンをきっかけに、購買が習慣になるか
coupon_day = CALIB_END + rng_long.uniform(0, 30, size=N)              # クーポンで買う日
coupon_amount = np.round(rng_long.gamma(p_gg, 1 / nu_i) * 0.8, -1)    # クーポンでの購買金額(2割引き)
extra_rate = 0.5 * lam + 0.003                           # 習慣になった顧客に上乗せされる購買ペース(1日あたり)
end_day = np.minimum(death_day, OBS_END)                 # 離脱した顧客は、離脱した日以降は買わない

# 2. クーポンを受け取った場合の購買ログ(受け取らなかった場合は、ホールドアウト期間の購買ログそのもの)
holdout_events = {cid: grp for cid, grp in holdout.groupby('customer_id')}
events1 = []
for i in range(N):
    grp = holdout_events.get(i)
    days = grp['day'].values.astype(float) if grp is not None else np.array([])
    amounts = grp['amount'].values.astype(float) if grp is not None else np.array([])
    if annoyed[i]:                      # 買う気をなくした顧客:最初の30日の購買を30日遅らせる
        days = np.where(days < CALIB_END + 30, days + 30, days)
    if induced[i]:
        if not habit[i]:                # 値引き目当て:クーポン以降の次の購買がなくなる(前倒し)
            later = np.where(days >= coupon_day[i])[0]
            if len(later) > 0:
                j = later[np.argmin(days[later])]
                days, amounts = np.delete(days, j), np.delete(amounts, j)
        days, amounts = np.append(days, coupon_day[i]), np.append(amounts, coupon_amount[i])
        if habit[i]:                    # 習慣になる:クーポン以降、離脱するまで購買ペースが上乗せされる
            t = coupon_day[i]
            while True:
                t += rng_long.exponential(1 / extra_rate[i])
                if t >= end_day[i]:
                    break
                days = np.append(days, t)
                amounts = np.append(amounts, np.round(rng_long.gamma(p_gg, 1 / nu_i[i]), -1))
    events1 += [(i, int(np.floor(d)), amt) for d, amt in zip(days, amounts) if d < OBS_END]
log1 = pd.DataFrame(events1, columns=['customer_id', 'day', 'amount'])

# 3. 短期指標と長期の結果(受け取らなかった場合 M0、受け取った場合 M1)
def outcomes(events):
    out = pd.DataFrame(index=range(N))
    d = events['day']
    out['cv30'] = (events[d < CALIB_END + 30].groupby('customer_id').size().reindex(out.index, fill_value=0) > 0).astype(int)
    out['n60'] = events[d < CALIB_END + 60].groupby('customer_id').size().reindex(out.index, fill_value=0)
    out['sales60'] = events[d < CALIB_END + 60].groupby('customer_id')['amount'].sum().reindex(out.index, fill_value=0)
    out['sales1y'] = events.groupby('customer_id')['amount'].sum().reindex(out.index, fill_value=0)
    return out

M0, M1 = outcomes(holdout[['customer_id', 'day', 'amount']]), outcomes(log1)
u_visit = rng_long.uniform(size=N)                       # 同じ一様乱数から、両方の場合の訪問回数を作る
visit_rate0 = np.where(alive_now, 0.01 + 3 * lam, 0.005)
visit_rate1 = visit_rate0 + np.where(habit & induced, 3 * extra_rate, 0)
M0['visits_31_60'] = poisson.ppf(u_visit, 30 * visit_rate0).astype(int)
M1['visits_31_60'] = poisson.ppf(u_visit, 30 * visit_rate1).astype(int)

# 4. 観測できるデータ:観察データ側は過去のキャンペーン(T_obs)、実験データ側は今回の RCT(T_rct)
S_COLS = ['cv30', 'n60', 'sales60', 'visits_31_60']
T_all = np.where(in_obs, T_obs, T_rct)
S_all = pd.DataFrame(np.where(T_all[:, None] == 1, M1[S_COLS].values, M0[S_COLS].values), columns=S_COLS)
Y_long = np.where(T_all == 1, M1['sales1y'].values, M0['sales1y'].values)   # 実験データ側では、まだ観測できない
tau_long = (M1['sales1y'] - M0['sales1y']).values                          # 真の長期効果(答え合わせ用)
is_exp = ~in_obs

# 5. 答え合わせ:短期と長期の真の効果
print(f"観察データ {in_obs.sum():,} 人、実験データ {is_exp.sum():,} 人")
print(f"30日以内の購買(cv30)が y1・y0 と一致: {(M1['cv30'].values == y1).all() and (M0['cv30'].values == y0).all()}")
print(f"クーポンで買う気になった顧客のうち、習慣になる {(induced & habit).sum():,} 人、値引き目当て {(induced & ~habit).sum():,} 人")
print("\n真の平均効果(全員)")
for c in S_COLS + ['sales1y']:
    print(f"  {c:13s}: {(M1[c] - M0[c]).mean():+10.3f}")
クーポンの長期の効果を作り、短期指標と長期の結果を計算しています。
-
長期の効果を決める性質: 長期の結果の乱数は、別の乱数生成器 rng_long(シード45)で引きます。nu_i = p_gg / mean_amount は平均購買金額から購買金額の尺度を戻したもので、顧客ワールドの nu と同じ値です。in_obs は rng_long.uniform(size=N) < 0.5 で、顧客を観察データ側(True)と実験データ側(False)に半分ずつ分けます。p_habit は、上の式の をそのまま計算したもので、habit は確率 p_habit で True(習慣になる)になります。
-
クーポンでの購買: coupon_day は、クーポンで買う日で、配布日(365日目)から30日以内の一様分布 CALIB_END + rng_long.uniform(0, 30, size=N) で決めます。coupon_amount は、顧客ワールドと同じガンマ分布 rng_long.gamma(p_gg, 1 / nu_i) で引いた金額を2割引き(* 0.8)にし、10円単位に丸めたものです。
-
上乗せの購買ペースと購買の終わり: extra_rate = 0.5 * lam + 0.003 は、習慣になった顧客に上乗せされる1日あたりの購買ペース です。end_day = np.minimum(death_day, OBS_END) は、離脱した日と観測期間の終わりの早い方で、上乗せの購買もこの日までしか起きません。離脱しなかった顧客の death_day は np.inf なので、end_day は730日目になります。
-
受け取った場合の購買ログ: holdout.groupby('customer_id') で、ホールドアウト期間の購買ログを顧客ごとの辞書 holdout_events にしておき、for i in range(N) で1人ずつ、次の3つの変更を加えます。購買のない顧客は holdout_events.get(i) が None になるので、空の配列から始めます。
- 買う気をなくした顧客(annoyed[i]): np.where(days < CALIB_END + 30, days + 30, days) で、最初の30日の購買を30日遅らせます。購買が遅れるだけなので、1年間の購買回数は変わりません。
- 買う気になった顧客(induced[i]): クーポンでの購買(coupon_day[i]・coupon_amount[i])を np.append で加えます。値引き目当ての顧客(not habit[i])は、先に np.where(days >= coupon_day[i])[0] でクーポンの日以降の購買を探し、その中で最も早い購買(np.argmin)を np.delete で1つ消します。もともとの購買を前倒ししただけ、という設定です。
- 習慣になる顧客(habit[i]): クーポンの日から、t += rng_long.exponential(1 / extra_rate[i]) で指数分布の待ち時間だけ時間を進めて購買を加える処理を、end_day[i] に達するまで繰り返します。顧客ワールドの購買ログの作り方と同じで、購買ペース extra_rate[i] の購買が上乗せされます。
最後に、購買日を np.floor で整数の日付にし、730日目より前の購買だけを events1 に追加して、受け取った場合の購買ログ log1 にまとめます。
-
短期指標と長期の結果: 関数 outcomes は、購買ログから4つの値を計算します。cv30 は365〜394日目の購買回数が1回以上なら1(> 0 の True/False を astype(int) で1/0に変換)、n60・sales60 は365〜424日目(配布から60日以内。d < CALIB_END + 60)の購買回数と売上、sales1y はホールドアウト期間全体の売上です。どれも reindex(out.index, fill_value=0) で、購買のなかった顧客を0で埋めています。受け取らなかった場合(holdout から計算した M0)と受け取った場合(log1 から計算した M1)の両方を計算しておくのが、ダミーデータならではの「答え」です。
-
31〜60日の訪問回数: 受け取らなかった場合の訪問率 visit_rate0 は、行動ログの特徴量と同じ式(生存していれば 0.01 + 3 * lam、離脱していれば0.005)、受け取った場合の visit_rate1 は、習慣になった顧客(habit & induced)にだけ 3 * extra_rate を足したものです。訪問回数は、同じ一様乱数 u_visit を、2つの場合のポアソン分布の累積分布関数の逆関数 poisson.ppf(u_visit, 30 * visit_rate) に通して作っています。同じ乱数を使うと、訪問率が同じ顧客では2つの場合の訪問回数が必ず一致し、違いが「習慣になったことによる訪問の増加」だけになります。乱数を別々に引くと、偶然のばらつきで差が出てしまいます。
-
観測できるデータ: np.where(in_obs, T_obs, T_rct) で、観察データ側の顧客には過去のキャンペーンの割り当て、実験データ側の顧客には今回の RCT の割り当てを使い、T_all とします。短期指標の4列(S_COLS)は、np.where(T_all[:, None] == 1, M1[S_COLS].values, M0[S_COLS].values) で、割り当てに応じて M1 か M0 の値を選びます(T_all[:, None] は、1次元の割り当てを4列に当てはめるために、縦長の形に変える書き方です)。長期の結果 Y_long も同じように選びますが、実験データ側の値は「まだ観測できない」値として、分析には使いません。tau_long は、全員の真の長期効果 です。
-
答え合わせ: 観察データと実験データの人数、cv30 がアップリフトモデルの評価の記事の y1・y0 と一致するか、習慣になる顧客と値引き目当ての顧客の人数、そして全員についての短期指標と長期の結果の真の平均効果((M1[c] - M0[c]).mean())を表示しています。
実行結果
観察データ 4,970 人、実験データ 5,030 人
30日以内の購買(cv30)が y1・y0 と一致: True
クーポンで買う気になった顧客のうち、習慣になる 395 人、値引き目当て 1,303 人

真の平均効果(全員)
  cv30         :     +0.110
  n60          :     +0.144
  sales60      :   +272.736
  visits_31_60 :     +0.041
  sales1y      :   +448.438
- 短期指標の定義の確認: クーポンを受け取った・受け取らなかった場合の cv30 は、アップリフトモデルの評価の記事の y1・y0 と完全に一致しています。
- 2種類の顧客: クーポンで買う気になった顧客のうち、習慣になるのは395人で、残りの1,303人は値引き目当てです。
- 短期と長期の効果: クーポンの真の平均効果は、30日以内の購買率で +11.0ポイント、60日以内の売上で +273円、1年間の売上で +448円です。1年間の売上の平均(約7,250円)に比べると、長期の効果はわずか6%ほどです。
短期の効果と長期の効果はずれる
クーポンの効果は、顧客によって違いました。そこで、閲覧した商品の平均価格(viewed_price)の中央値で顧客を2つのグループに分け、短期の効果(30日以内の購買率)と長期の効果(1年間の売上)を、真の値で比べます。
グループ (mask)の真の効果は、その顧客の「受け取った場合 − 受け取らなかった場合」の平均です。
ここで は cv30( は M1['cv30'] - M0['cv30'])、 は1年間の売上( は tau_long)です。
# 1. 閲覧価格の中央値で、顧客を2つのグループに分ける
price_high = features['viewed_price'].values >= np.median(features['viewed_price'].values)

# 2. グループごとの、短期と長期の真の効果
rows = {}
for name, mask in [('閲覧価格が低い', ~price_high), ('閲覧価格が高い', price_high)]:
    rows[name] = {
        '人数': mask.sum(),
        '30日購買率への効果(ポイント)': (M1['cv30'] - M0['cv30'])[mask].mean() * 100,
        '1年売上への効果(円)': tau_long[mask].mean(),
        '習慣になる顧客の割合': (induced & habit)[mask].mean(),
        '値引き目当ての顧客の割合': (induced & ~habit)[mask].mean(),
    }
print(pd.DataFrame(rows).T.round(3).to_string())
閲覧価格の中央値で顧客を2つに分け、グループごとに短期と長期の真の効果を比べています。
- グループ分け: np.median(features['viewed_price'].values) で閲覧した商品の平均価格の中央値を求め、それ以上の顧客を True とする配列 price_high を作っています。~price_high は True と False を反転したもので、閲覧価格が低いグループです。閲覧価格は施策の前に観測できる特徴量なので、実務でも同じ分け方ができます。
- グループごとの真の効果: for name, mask in [...] で2つのグループを順に取り出し、[mask] でグループの顧客だけに絞ってから平均をとっています。30日購買率への効果は (M1['cv30'] - M0['cv30'])[mask].mean() に100を掛けてポイントにし、1年売上への効果は tau_long[mask].mean() です。どちらも全員の潜在的結果を使った真の値で、実験データと観察データの区別はしていません。
- 顧客のタイプの割合: (induced & habit)[mask].mean() は、グループの中で「クーポンで買う気になり、習慣になる」顧客の割合です。True/False の配列の平均は、True の割合になります。(induced & ~habit) は、買う気になったが習慣にならない、値引き目当ての顧客です。
- 表示: pd.DataFrame(rows).T で、グループを行、指標を列にした表にしています。
実行結果
             人数  30日購買率への効果(ポイント)  1年売上への効果(円)  習慣になる顧客の割合  値引き目当ての顧客の割合
閲覧価格が低い  4977.0            14.888      311.738       0.040         0.176
閲覧価格が高い  5023.0             7.147      583.886       0.039         0.085
- 短期の効果は「閲覧価格が低い」グループが2倍: 30日購買率への効果は、閲覧価格が低いグループで +14.9ポイント、高いグループで +7.1ポイントでした。値引きに敏感な顧客ほど、クーポンに反応するからです。
- 長期の効果は逆に「閲覧価格が高い」グループが2倍近く: 1年売上への効果は、閲覧価格が低いグループで +312円、高いグループで +584円でした。閲覧価格が低いグループでは、クーポンに反応した顧客の多く(17.6%)が値引き目当てで、前倒しの購買をしただけだからです。閲覧価格が高いグループは、値引き目当ての顧客が少なく(8.5%)、1回の購買金額も大きいので、習慣になった顧客の上乗せの売上が大きくなります。
短期の効果で配布先を選ぶと、長期の効果の小さい方のグループを選んでしまうのです。CV率だけを見て施策を評価する危うさが、ここにあります。
2つのグループの短期と長期の効果を並べると、次のようになります。
(図は、diagram-designで作成)
単一のサロゲート指標の危うさ
よくある誤り:30日の購買率で長期の効果を見積もる
サロゲート指標の考え方で、cv30 を1つのサロゲート指標として、長期の効果を見積もってみます。
式で書くと、単一のサロゲート指標 (ここでは cv30)による長期の効果の見積もりは、次の2つの差の積です(1つ目の括弧は value_per_cv、2つ目の括弧は cv_effect)。 は観察データ(obs)で の顧客の1年間の売上の平均、 は実験データで の顧客(施策群は exp_t、対照群は exp_c)の cv30 の平均です。
この式は、「過去のデータから分かっている CV1件あたりの『価値』」を、「今回の実験で増えた CV の『件数』」に当てはめる、という考え方です。数値例で考えてみます。
- 短期の効果(実験データ):クーポンを配る実験をした結果、30日以内に買う顧客の割合が、配らなかった場合より10ポイント(0.1)増えたとします。
- CV1件あたりの長期の価値(観察データ):過去のデータを見ると、30日以内に買った顧客は、買わなかった顧客より、1年間で平均10,000円多く買っていたとします。
この2つを掛け合わせると、「クーポンで30日以内に買う顧客が10ポイント増えたのだから、増えた顧客も1人あたり10,000円多く買ってくれるはずだ。だから、1年間の売上への効果は 10,000円 × 0.1 = 1,000円 だろう」と見積もれます。これが上の式の成り立ちで、計算も直感的です。
この見積もりが正しいためには、「cv30 の値が同じなら、クーポンを受け取ったかどうかで1年間の売上は変わらない」という条件、 が必要です(Prentice基準)。言い換えると、「クーポンが1年間の売上に与える影響は、すべて『30日以内に買ったか』という関所を通って伝わる」という前提です。具体的には、次の2つを仮定していることになります。
- cv30 = 1 の顧客は、みな同じ価値を持つ:クーポンをきっかけに買った顧客も、クーポンがなくても自分から買った顧客も、同じ「cv30 = 1」なので、等しく「CV1件あたりの長期の価値」だけ多く買うはずだ。
- cv30 = 0 の顧客には、長期の影響もない:クーポンを受け取っても30日以内に買わなかった顧客には、クーポンは1年間の売上に一切影響しないはずだ。コードの最後(4.)では、実験データの顧客のうち、受け取っても受け取らなくても cv30 が同じ値 になる顧客()について、 の平均と の平均を真の値で比べ、この条件が成り立っているかを確かめます。
# 1. 観察データで、30日以内に買った顧客と買わなかった顧客の、1年間の売上の差(CV1件あたりの長期の価値)
obs = in_obs
value_per_cv = Y_long[obs & (S_all['cv30'] == 1)].mean() - Y_long[obs & (S_all['cv30'] == 0)].mean()

# 2. 実験データでの、30日以内の購買率の差(短期の効果)
exp_t, exp_c = is_exp & (T_all == 1), is_exp & (T_all == 0)
cv_effect = S_all['cv30'][exp_t].mean() - S_all['cv30'][exp_c].mean()

# 3. 単一のサロゲート指標による、長期の効果の見積もり
print(f"CV1件あたりの1年間の売上の差(観察データ): {value_per_cv:,.0f} 円")
print(f"30日以内の購買率への効果(実験データ)  : {cv_effect:+.1%}")
print(f"→ 1年間の売上への効果の見積もり         : {value_per_cv * cv_effect:+,.0f} 円")
print(f"真の長期効果(実験データの顧客)        : {tau_long[is_exp].mean():+,.0f} 円")

# 4. 答え合わせ:同じ「30日以内に買った」顧客でも、クーポンの有無で1年間の売上が違う(実験データの真の値)
for cv in [1, 0]:
    m = is_exp & (M1['cv30'].values == cv) & (M0['cv30'].values == cv)
    print(f"クーポンの有無にかかわらず cv30 = {cv} の顧客 {m.sum():,} 人: 1年売上 受け取った場合 {M1['sales1y'][m].mean():,.0f} 円、"
          f"受け取らなかった場合 {M0['sales1y'][m].mean():,.0f} 円")
単一のサロゲート指標(cv30)で長期の効果を見積もり、真の値と比べています。
- CV1件あたりの長期の価値: obs = in_obs は観察データ側の顧客を表す True/False の配列です。obs & (S_all['cv30'] == 1) で「観察データのうち30日以内に買った顧客」を選び、その1年間の売上 Y_long の平均から、30日以内に買わなかった顧客の平均を引いて value_per_cv とします。式の に当たります。
- 短期の効果: is_exp & (T_all == 1) で実験データの施策群 exp_t、is_exp & (T_all == 0) で対照群 exp_c を選び、cv30 の平均の差を cv_effect とします。実験データの短期指標は観測できるので、これは正しい推定です。
- 見積もり: value_per_cv * cv_effect が、単一のサロゲート指標による長期の効果の見積もりです。比較のため、実験データの顧客の真の長期効果 tau_long[is_exp].mean() も表示しています。
- 答え合わせ: is_exp & (M1['cv30'].values == cv) & (M0['cv30'].values == cv) で、実験データの顧客のうち、クーポンを受け取っても受け取らなくても cv30 が同じ値 cv になる顧客を選びます。その顧客について、受け取った場合の1年間の売上 M1['sales1y'][m].mean() と、受け取らなかった場合の M0['sales1y'][m].mean() を比べます。Prentice基準が成り立っていれば、cv30 が同じなら、1年間の売上も同じになるはずです。
実行結果
CV1件あたりの1年間の売上の差(観察データ): 17,672 円
30日以内の購買率への効果(実験データ)  : +11.1%
→ 1年間の売上への効果の見積もり         : +1,957 円
真の長期効果(実験データの顧客)        : +432 円
クーポンの有無にかかわらず cv30 = 1 の顧客 861 人: 1年売上 受け取った場合 23,149 円、受け取らなかった場合 22,213 円
クーポンの有無にかかわらず cv30 = 0 の顧客 3,479 人: 1年売上 受け取った場合 3,470 円、受け取らなかった場合 3,470 円
- 長期の効果を4.5倍に過大評価: 観察データでは、30日以内に買った顧客は、買わなかった顧客より1年間で17,672円多く買っています。これに短期の効果(+11.1%)を掛けると、長期の効果は +1,957円 と見積もられますが、真の値は +432円 です。
- cv30 が同じでも、長期の結果は違う: クーポンの有無にかかわらず30日以内に買う顧客(861人)でも、クーポンを受け取った場合の1年間の売上(23,149円)は、受け取らなかった場合(22,213円)より936円多くなっています。この顧客の中には、もともと買う予定だったうえにクーポンでも買い、そのまま習慣になった顧客がいるからです。施策が、cv30 を通らない経路で長期の結果に影響しているのです。一方、どちらの場合も買わない顧客(3,479人)では、1年間の売上は同じでした。上の2つの前提のうち、このデータでは2つ目(cv30 = 0 の顧客には長期の影響もない)は成り立っていますが、1つ目(cv30 = 1 の顧客はみな同じ価値を持つ)が崩れているのです。
単一サロゲートの見積もりを図にすると、次のようになります。
(図は、diagram-designで作成)
なぜ過大評価になるのか:Prentice基準の崩れ
上の結果は、Prentice基準の条件 が崩れていることを示しています。施策が長期の結果に影響する経路は、30日の購買だけではありません。
- 前倒しを見落とす:30日以内に買った顧客の中にも、習慣になってその後も買い続ける顧客と、「来月買う予定だったものを、クーポンがあるから今月買った」だけの顧客がいます。どちらも cv30 = 1 ですが、長期の結果はまったく違います。前倒しで買っただけの顧客は、短期の CV は増えても1年間の売上は増えず、値引きの分だけ減ることさえあります。
- 買い控えを見落とす:買う気をなくした顧客は、cv30 では効果が負に見えますが、購買が遅れただけなので、長期の結果は変わりません。
さらに、「CV1件あたりの長期の価値」の計算には、もう1つの問題があります。30日以内に買う顧客は、そもそも購買ペースが高い(もともと価値の高い)顧客です。観察データでの「買った顧客と買わなかった顧客の差」の大部分は、30日に買ったことの効果ではなく、もともとの顧客の違いです。もともと価値の高い常連客だから最初の30日にもよく買う、というだけかもしれません。クーポンで増えた「1件の CV」(値引きにつられて買った顧客を含みます)に、常連客を含めた差をそのまま掛けると、効果を大きく過大評価してしまいます。
まとめると、単一のサロゲート指標による見積もりは、「増えた CV の件数」に「過去の CV1件あたりの平均の価値」を掛けるだけの直感的な計算ですが、「クーポンにつられて買った顧客の価値」と「自分から買った顧客の価値」を区別できません。そのため、今回のデータのように、長期の効果を何倍にも過大評価してしまうことがあります。
サロゲートインデックスによる推定
実装
観察データで、2つのモデルを LightGBM で学習します。
- (h_SX):短期指標と特徴量から、1年間の売上を予測するモデル(サロゲートインデックス)
- (g_X):特徴量だけから、1年間の売上を予測するモデル
は、推定のばらつきを減らすために使います。なぜ特徴量だけのモデルが必要なのかを、順に整理します。
知りたいのは、施策群と対照群の差:知りたいのは「クーポンのおかげで、1年間の売上がどれだけ上乗せされたか」です。つまり、実験データの施策群(配った顧客)と対照群(配らなかった顧客)の、長期の結果の差を正確に測ることが目的です。
そのまま比べると、偶然の偏りが混ざる:実験でランダムに分けたとはいえ、偶然、もともとよく買う顧客(特徴量 から見て価値が高い顧客)が施策群に多く入ることがあります。そのまま予測値 (si_SX)の平均を比べると、差が「クーポンの効果」なのか「たまたま価値の高い顧客が多かったから」なのかを区別できず、その回の実験では効果を過大評価(あるいは過小評価)してしまいます。割り当てをやり直すたびに偏りの向きは変わるので、平均すれば偏りはなくなりますが、1回の実験の推定値は大きくばらつきます。
を差し引く意味:(g_hat)は、施策の前に分かっている特徴量だけから予想される1年間の売上、いわば「その顧客がもともと持っている売上の見込み」です。大まかに言えば、2つのモデルの予測値は次のように分けて考えられます。
- = もともとの見込み + 短期指標から読み取れる上乗せ
- = もともとの見込み
- (si_SX - g_hat)= 短期指標から読み取れる上乗せ
施策群と対照群をこの「上乗せ」で比べれば、もともとの見込みの分は差から消えるので、どちらかの群に価値の高い顧客が偶然多く入った影響を打ち消せます。しかも、 は施策の前に決まる値なので、施策群と対照群の差の期待値は0です。差し引いても、推定を偏らせることはありません。
特徴量の効果まで消えてしまわないか:消えるのは、施策とは関係のない「もともとの見込み」の分だけです。 は短期指標 と特徴量 の両方を見ているので、たとえば「普段から高単価の商品を見ている顧客(特徴量)が、クーポンで買った(短期指標)場合は、習慣になってその後も売上が大きく伸びる」といった、特徴量と短期指標の組み合わせによる効果も予測に含まれます。 には短期指標の情報がないので、この組み合わせの効果を差し引いてしまうことはありません。特徴量の情報で予測の精度を上げつつ、顧客の偶然の偏りだけを取り除けるのです。
比較のため、短期指標だけを使ったサロゲートインデックス (h_S。予測値 は si_S)も作ります。答え合わせには、真の長期効果と、「1年待って、実験データの長期の結果を直接比べた場合」の推定値を使います。
コードが計算する推定値を、式でまとめます。和はすべて実験データの顧客についてとり( の施策群は exp_t、 の対照群は exp_c)、 は施策群と対照群の人数です。どれも「施策群の平均 − 対照群の平均」(関数 diff)の形で、1つ目は考え方の節の の再掲、2つ目は を差し引いたもの、3つ目は1年待って直接比べる推定値( は Y_after_1y)です。
import lightgbm as lgb

params = dict(n_estimators=300, learning_rate=0.05, num_leaves=15, min_child_samples=50,
              random_state=0, n_jobs=1, verbose=-1)
X_all = X.reset_index(drop=True)
SX_all = pd.concat([S_all, X_all], axis=1)

# 1. 観察データで、長期の結果を予測する3つのモデルを学習する
h_SX = lgb.LGBMRegressor(**params).fit(SX_all[obs], Y_long[obs])      # 短期指標 + 特徴量 → 1年売上
h_S = lgb.LGBMRegressor(**params).fit(S_all[obs], Y_long[obs])         # 短期指標だけ → 1年売上
g_X = lgb.LGBMRegressor(**params).fit(X_all[obs], Y_long[obs])         # 特徴量だけ → 1年売上

# 2. 実験データに当てはめて、施策群と対照群の平均の差をとる
def diff(values, t_mask, c_mask):
    return values[t_mask].mean() - values[c_mask].mean()

si_SX = h_SX.predict(SX_all)
Y_after_1y = np.where(T_all == 1, M1['sales1y'].values, M0['sales1y'].values)   # 1年待てば実験データでも観測できる長期の結果
si_S = h_S.predict(S_all)
g_hat = g_X.predict(X_all)
estimates = {
    '単一サロゲート(cv30 × CV1件の価値)': value_per_cv * cv_effect,
    'サロゲートインデックス(短期指標だけ)': diff(si_S, exp_t, exp_c),
    'サロゲートインデックス(短期指標 + 特徴量)': diff(si_SX, exp_t, exp_c),
    'サロゲートインデックス(+ 特徴量の分を差し引く)': diff(si_SX - g_hat, exp_t, exp_c),
    '1年待って直接比べる': diff(Y_after_1y, exp_t, exp_c),
}
print(f"真の長期効果(実験データの顧客): {tau_long[is_exp].mean():+,.0f} 円\n")
for name, value in estimates.items():
    print(f"{name:28s}: {value:+8,.0f} 円")
観察データで3つのモデルを学習し、実験データでサロゲートインデックスを計算しています。
- ハイパーパラメータ: params は、3つのモデルに共通の LightGBM の設定です。木の数 n_estimators=300、学習率 learning_rate=0.05、1本の木の葉の数の上限 num_leaves=15、1つの葉に入る顧客の最小数 min_child_samples=50 とし、1年間の売上のようにばらつきの大きい目的変数に過学習しないよう、木を小さめにしています。random_state=0 と n_jobs=1 は結果を再現するため、verbose=-1 は学習中のログを表示しないための設定です。
- 入力の行列: X.reset_index(drop=True) で特徴量の行番号を0〜9,999にそろえ(X_all)、pd.concat([S_all, X_all], axis=1) で短期指標の4列と特徴量の11列を横につないで SX_all を作っています。
- 3つのモデル: lgb.LGBMRegressor(**params).fit(SX_all[obs], Y_long[obs]) のように、どれも観察データ(obs)の行だけで、1年間の売上 Y_long を予測する回帰モデルを学習しています。入力は、h_SX が短期指標と特徴量、h_S が短期指標だけ、g_X が特徴量だけです。観察データの顧客は、過去のキャンペーンでクーポンを受け取った顧客と受け取らなかった顧客の両方を含みます。
- 差をとる関数: diff(values, t_mask, c_mask) は、values[t_mask].mean() - values[c_mask].mean()、つまり施策群の平均から対照群の平均を引く関数です。
- サロゲートインデックス: h_SX.predict(SX_all) で全員の予測値 si_SX を計算し、diff(si_SX, exp_t, exp_c) で実験データの施策群と対照群の平均の差をとります。全員について予測していますが、差をとるときに exp_t・exp_c で実験データの顧客だけを使います。si_S は短期指標だけのモデルの予測値、g_hat は特徴量だけのモデルの予測値で、si_SX - g_hat が「特徴量の分を差し引いた」サロゲートインデックスです。
- 答え合わせ: np.where(T_all == 1, M1['sales1y'].values, M0['sales1y'].values) は、1年待てば実験データでも観測できる長期の結果 Y_after_1y で、その施策群と対照群の差が「1年待って直接比べる」推定値です。5つの推定値を辞書 estimates にまとめ、真の長期効果と並べて表示しています。
実行結果
真の長期効果(実験データの顧客): +432 円

単一サロゲート(cv30 × CV1件の価値)     :   +1,957 円
サロゲートインデックス(短期指標だけ)         :     +294 円
サロゲートインデックス(短期指標 + 特徴量)     :     -100 円
サロゲートインデックス(+ 特徴量の分を差し引く)   :     +282 円
1年待って直接比べる                  :     +827 円
- 単一サロゲートより、ずっと真の値に近い: サロゲートインデックスの推定値は、短期指標だけで +294円、特徴量の分を差し引いたもので +282円 と、真の値(+432円)に比べてやや小さいものの、単一サロゲート(+1,957円)よりはるかに近い値です。
- 短期指標 + 特徴量は −100円: 特徴量を加えたサロゲートインデックスは、この1回の実験では −100円 と、符号まで逆になりました。これは、今回の割り当てで、偶然、もともと価値の高い(特徴量から予想される売上が高い)顧客が対照群に多く入ったためです。特徴量の分を差し引くと、この偏りが取り除かれて +282円 になります。
- 1年待っても +827円: 1年待って直接比べた推定値も、真の値の2倍近くになっています。1年間の売上は顧客ごとのばらつきが非常に大きいので、5,000人の実験では、長期の効果の推定がこれだけぶれるのです。
1回の実験の結果だけでは、どの方法が良いかは判断できません。次の節で、実験を何度もやり直した場合を確かめます。
5つの推定値を並べると、次のようになります。
(図は、diagram-designで作成)
実験をやり直したら、推定値はどれだけぶれるか
上の結果は、1回の実験(1通りのランダムな割り当て)での推定値です。推定方法の良し悪しを比べるには、実験を何度もやり直したときに、推定値が平均して真の値に近いか(偏り)と、どれだけばらつくかを見る必要があります。
ダミーデータでは、全員について「受け取った場合」と「受け取らなかった場合」の結果が分かっているので、実験データの顧客へのクーポンの割り当てだけをランダムにやり直すことで、実験を何度でも再現できます。観察データで学習したモデルはそのまま使い、割り当てを300通りに変えて、各推定方法の分布を比べます。
回目(、)の割り当てを (t)とすると、各顧客の観測値(pick)は「受け取った場合」と「受け取らなかった場合」の値の組(pot)から選び直されます。たとえばサロゲートインデックスなら( と の組は pot['h_SX'])、次のようになります。
これを上の推定式に入れて 回目の推定値 を計算し( は施策で変わらないので、g_exp をそのまま使います)、300回分(sim)の平均・標準偏差と、真の長期効果 (true_effect。実験データの顧客の の平均)との差(偏り)を求めます。
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 実験データの顧客について、受け取った場合・受け取らなかった場合の各値を用意する
idx = np.where(is_exp)[0]
SX1 = pd.concat([M1[S_COLS], X_all], axis=1).iloc[idx]
SX0 = pd.concat([M0[S_COLS], X_all], axis=1).iloc[idx]
pot = {
    'h_SX': (h_SX.predict(SX1), h_SX.predict(SX0)),
    'h_S': (h_S.predict(M1[S_COLS].iloc[idx]), h_S.predict(M0[S_COLS].iloc[idx])),
    'Y': (M1['sales1y'].values[idx], M0['sales1y'].values[idx]),
    'cv': (M1['cv30'].values[idx], M0['cv30'].values[idx]),
}
g_exp = g_hat[idx]

# 2. 割り当てを300通りにやり直して、各推定方法の推定値を計算する
re_rng = np.random.default_rng(7)
records = []
for _ in range(300):
    t = re_rng.binomial(1, 0.5, size=len(idx)) == 1
    pick = {k: np.where(t, v1, v0) for k, (v1, v0) in pot.items()}
    records.append({
        '単一サロゲート': value_per_cv * (pick['cv'][t].mean() - pick['cv'][~t].mean()),
        'SI(短期指標だけ)': diff(pick['h_S'], t, ~t),
        'SI(短期指標 + 特徴量)': diff(pick['h_SX'], t, ~t),
        'SI(+ 特徴量の分を差し引く)': diff(pick['h_SX'] - g_exp, t, ~t),
        '1年待って直接比べる': diff(pick['Y'], t, ~t),
    })
sim = pd.DataFrame(records)
true_effect = tau_long[is_exp].mean()
summary_table = pd.DataFrame({'平均': sim.mean(), '標準偏差': sim.std(), '平均 − 真の値': sim.mean() - true_effect})
print(f"真の長期効果: {true_effect:+,.0f} 円\n")
print(summary_table.round(0).to_string())

# 3. 推定値の分布を箱ひげ図で比べる(単一サロゲートは値が大きいので除く)
cols = ['SI(短期指標だけ)', 'SI(短期指標 + 特徴量)', 'SI(+ 特徴量の分を差し引く)', '1年待って直接比べる']
plt.figure(figsize=(10, 5.5))
plt.boxplot([sim[c] for c in cols], tick_labels=cols, vert=False)
plt.axvline(true_effect, color='C3', linestyle='--', label=f'真の長期効果({true_effect:+,.0f} 円)')
plt.xlabel('1年間の売上への効果の推定値(円)')
plt.title('割り当てを300通りにやり直したときの推定値の分布')
plt.legend()
plt.grid(True, axis='x', alpha=0.3)
plt.tight_layout()
plt.show()
実験データの割り当てを300通りにやり直し、各推定方法の分布を比べています。
- 実験データの顧客: np.where(is_exp)[0] で、実験データ側の顧客の位置(インデックス)の一覧 idx を作り、以降は .iloc[idx] や [idx] でこの顧客だけを取り出します。
- 両方の場合の値: SX1・SX0 は、短期指標を「受け取った場合(M1)」と「受け取らなかった場合(M0)」の値にした入力の行列です。pot は、サロゲートインデックス('h_SX'・'h_S')、1年間の売上('Y')、cv30('cv')について、2つの場合の値を組にした辞書です。観察データで学習したモデルは、ここで一度だけ予測に使い、やり直しのたびに学習し直すことはしません。g_exp は、実験データの顧客の g_hat です。特徴量だけの予測なので、割り当てによって変わりません。
- 割り当てのやり直し: 乱数生成器 re_rng(シード7)で、re_rng.binomial(1, 0.5, size=len(idx)) == 1 により新しい割り当て t(True が施策群)を作ります。np.where(t, v1, v0) は、施策群の顧客では受け取った場合の値 v1、対照群では受け取らなかった場合の値 v0 を選ぶ処理で、pick がその回の観測値になります。対照群は ~t です。潜在的結果は変わらないので、真の長期効果(432円)も変わりません。
- 各回の推定値: 単一サロゲートは、観察データで計算した value_per_cv に、その回の cv30 の差を掛けます。サロゲートインデックスと「1年待って直接比べる」は、diff でその回の施策群と対照群の平均の差をとります。300回分を sim にまとめます。
- 集計: sim.mean()(平均)、sim.std()(標準偏差)、sim.mean() - true_effect(平均と真の値の差、つまり偏り)を表 summary_table にしています。
- 可視化: plt.boxplot(..., vert=False) で、4つの方法の推定値の分布を横向きの箱ひげ図で描いています。単一サロゲートは値が大きく、他の方法の違いが見えなくなるので除いています。plt.axvline で引いた赤い破線が、真の長期効果です。
実行結果
真の長期効果: +432 円

                      平均   標準偏差  平均 − 真の値
単一サロゲート           2077.0  209.0    1645.0
SI(短期指標だけ)         623.0  466.0     191.0
SI(短期指標 + 特徴量)     414.0  479.0     -18.0
SI(+ 特徴量の分を差し引く)   412.0  229.0     -19.0
1年待って直接比べる         444.0  518.0      13.0
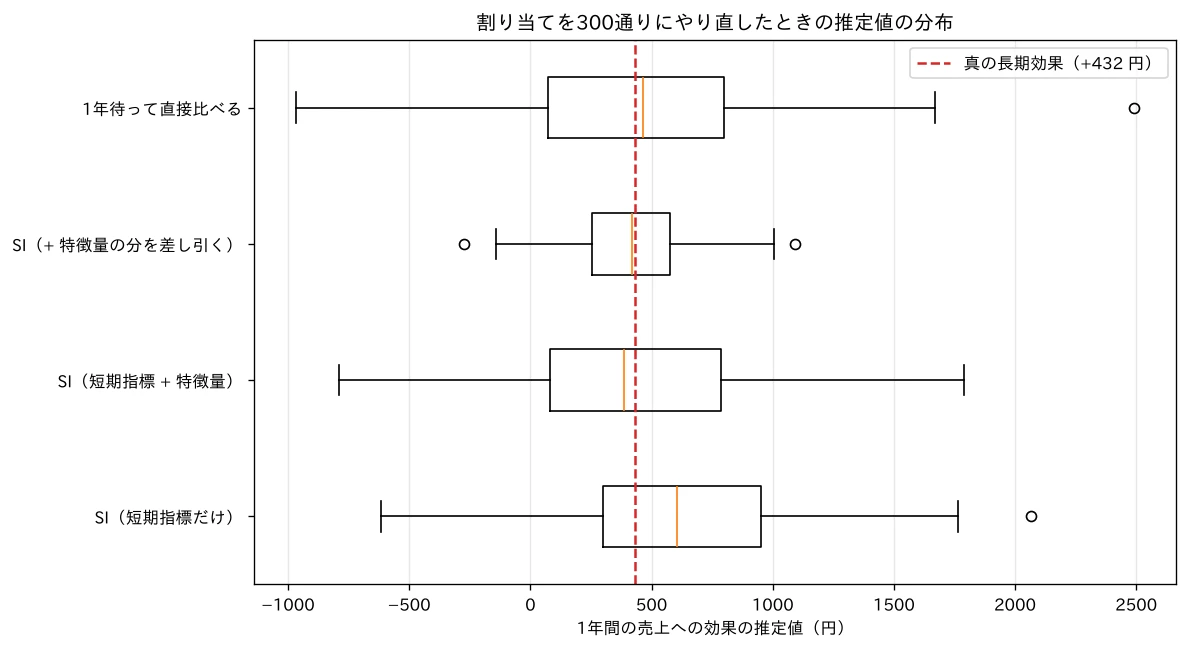
- 単一サロゲートは大きく偏る: 平均は2,077円で、真の値より1,645円も大きくなりました。実験を何度やり直しても、この偏りは消えません。
- 短期指標だけのサロゲートインデックスも、やや偏る: 平均は623円で、真の値より191円大きくなりました。短期指標だけでは、習慣になる顧客と値引き目当ての顧客を十分に見分けられず、サロゲート性が成り立っていないためです。
- 特徴量を加えると偏りが消える: 短期指標と特徴量を使うサロゲートインデックスの平均は414円で、偏りは −18円 とほぼ0になりました。特徴量(たとえばメールの開封率や閲覧価格)が、習慣になりやすい顧客かどうかの手がかりを補い、サロゲート性が成り立ちやすくなったのです。
- 特徴量の分を差し引くと、ばらつきが半分以下になる: ただし、そのままでは標準偏差が479円と、1年待って直接比べる場合(518円)とあまり変わりません。特徴量の分を差し引くと、偏りはほぼ0(−19円)のまま、標準偏差は229円と、1年待って直接比べる場合の半分以下になりました。
つまり、サロゲートインデックスは、1年待たずに推定できるだけでなく、1年待って直接比べるよりも正確になりえます。長期の結果のばらつきの大部分は、施策と関係のない顧客ごとの違いで、それを短期指標と特徴量で説明できるからです。これは Athey et al. (2019) が論文のタイトルで「more rapidly and precisely(より早く、より正確に)」と述べている点です。
顧客のグループごとの長期効果
最後に、「短期の効果と長期の効果はずれる」の節で見た2つのグループについて、サロゲートインデックスで長期の効果を推定し、30日の購買率への効果と比べます。
推定式は、実装の節の の和(和の中の は si_adj)を、グループ (mask)に入る実験データの顧客だけに絞ったものです(グループ内の施策群・対照群の顧客は t_m・c_m、その人数が )。短期の効果も同じように、グループ内で cv30 の平均の差をとります。
# 1. グループごとに、短期の効果(cv30)と、サロゲートインデックスによる長期の効果を推定する
si_adj = si_SX - g_hat
rows = {}
for name, mask in [('閲覧価格が低い', ~price_high), ('閲覧価格が高い', price_high)]:
    t_m, c_m = exp_t & mask, exp_c & mask
    rows[name] = {
        '30日購買率への効果(推定、ポイント)': diff(S_all['cv30'].values, t_m, c_m) * 100,
        '1年売上への効果(SI推定、円)': diff(si_adj, t_m, c_m),
        '1年売上への効果(真の値、円)': tau_long[is_exp & mask].mean(),
    }
table = pd.DataFrame(rows).T
print(table.round(1).to_string())

# 2. 可視化:短期の効果と長期の効果を並べる
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))
axes[0].bar(table.index, table['30日購買率への効果(推定、ポイント)'], color='C0')
axes[0].set_title('短期:30日購買率への効果(実験データ)')
axes[0].set_ylabel('ポイント')
pos = np.arange(len(table))
axes[1].bar(pos - 0.2, table['1年売上への効果(SI推定、円)'], width=0.4, color='C1', label='サロゲートインデックスの推定')
axes[1].bar(pos + 0.2, table['1年売上への効果(真の値、円)'], width=0.4, color='gray', label='真の値')
axes[1].set_xticks(pos, table.index)
axes[1].set_title('長期:1年間の売上への効果')
axes[1].set_ylabel('円')
axes[1].legend()
for ax in axes:
    ax.grid(True, axis='y', alpha=0.3)
plt.tight_layout()
plt.show()
2つのグループごとに、短期の効果とサロゲートインデックスによる長期の効果を推定しています。
- 推定に使う値: si_adj = si_SX - g_hat は、実装の節で最も成績の良かった「特徴量の分を差し引いた」サロゲートインデックスです。
- グループごとの推定: exp_t & mask・exp_c & mask で、実験データの施策群・対照群を、さらにグループ(mask)の顧客に絞り込み(t_m・c_m)、diff で差をとっています。短期の効果は、観測できる cv30 の差(diff(S_all['cv30'].values, t_m, c_m))に100を掛けたもの、長期の効果は diff(si_adj, t_m, c_m) です。答え合わせ用に、グループの実験データの顧客の真の長期効果 tau_long[is_exp & mask].mean() も並べます。
- 可視化: plt.subplots(1, 2) で2つのグラフを横に並べ、左に30日購買率への効果、右に1年間の売上への効果を描いています。右のグラフでは、np.arange(len(table)) で作った棒の位置 pos を -0.2・+0.2 ずらし、サロゲートインデックスの推定と真の値を、グループごとに並べています。
実行結果
         30日購買率への効果(推定、ポイント)  1年売上への効果(SI推定、円)  1年売上への効果(真の値、円)
閲覧価格が低い                 14.8              75.4            304.8
閲覧価格が高い                  7.3             487.2            555.8
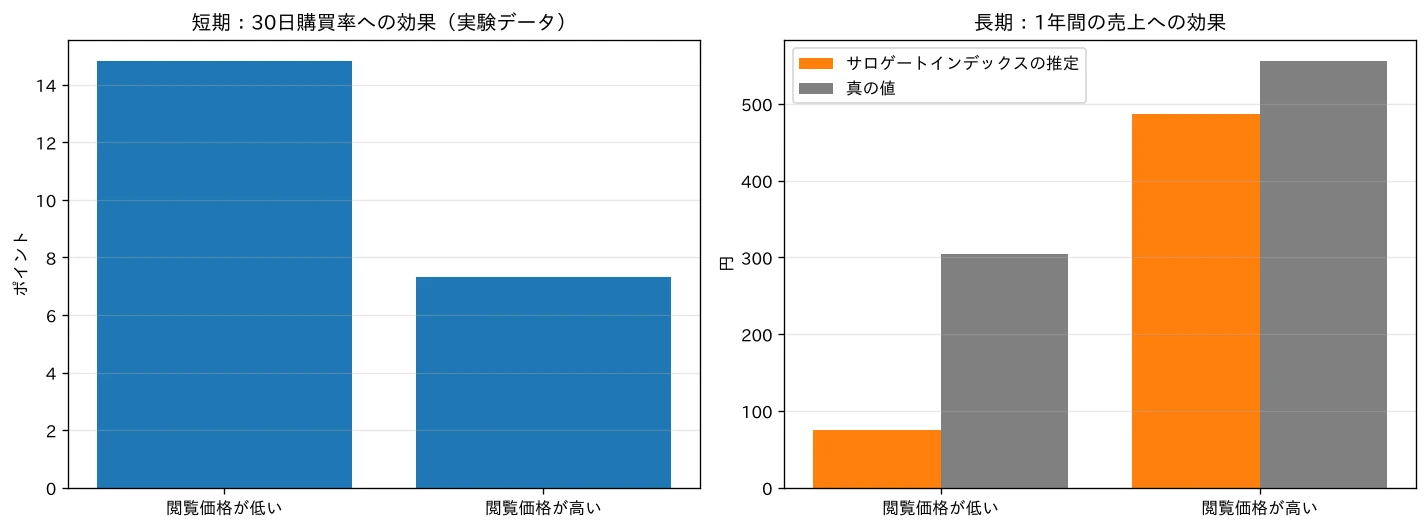
- 短期の効果: 実験データで推定した30日購買率への効果は、閲覧価格が低いグループで +14.8ポイント、高いグループで +7.3ポイントです。短期の効果で選べば、閲覧価格が低いグループにクーポンを配ることになります。
- 長期の効果: サロゲートインデックスによる1年売上への効果の推定は、閲覧価格が低いグループで +75円、高いグループで +487円 でした。真の値(+305円、+556円)と比べると、低いグループの推定値は小さめですが、「長期の効果は閲覧価格が高いグループの方が大きい」という順序は正しく捉えています。
グループごとに分けると人数が半分になるので、推定のばらつきはさらに大きくなります。それでも、短期の効果だけを見ていたら気づけなかった「逆転」を、1年待たずに見つけられるのが、サロゲートインデックスの価値です。
実務で使うときの注意
- サロゲート性は検証できない部分が残る:サロゲート性は、実験データの長期の結果が分からない限り、直接は確かめられません。実務では、過去に長期の結果まで測った実験があれば、その実験でサロゲートインデックスの推定と実際の長期効果を比べて、確かめておきます。施策が長期の結果に影響する経路(定着、前倒し、ブランドへの印象など)を考え、それを捉える短期指標を加えることが重要です。
- 比較可能性に注意する:観察データが古すぎると、商品・価格・顧客層の変化によって、短期指標と長期の結果の関係が変わっているかもしれません。できるだけ最近の、実験と同じ顧客層のデータを使います。
- 新しい種類の施策には慎重に:これまでにない種類の施策は、過去のデータにない経路で長期の結果に影響するかもしれません。その場合、過去のデータで学習したサロゲートインデックスは、その経路を捉えられません。
オンラインの実験基盤でも、サロゲート指標の考え方は広く使われています。たとえば LinkedIn は、長期の指標の代わりに使うサロゲート指標を作り、実験の評価に使った事例と、その注意点をまとめています(Duan et al., 2021)。
発展:MMMへの応用
サロゲートインデックスの考え方は、マーケティングミックスモデル(MMM)のような広告効果の測定にも使えます。広告の効果には、すぐに現れる短期の効果だけでなく、ブランドの認知や好意が高まることで数か月〜数年かけて現れる長期の効果があります。ジオ実験の実施期間は数週間〜数か月が普通なので、長期の効果は実験期間中には測れません。
そこで、検索数やサイトへの訪問、新規顧客の数など、広告の長期の効果につながる短期指標を実験で測り、過去のデータで作った「短期指標 → 長期の売上」のモデルに当てはめることで、広告の長期の効果を推定する、という使い方が考えられます。
まとめ
本記事では、短期の実験から長期の効果を推定する サロゲートインデックス を解説しました。
- 短期と長期の効果はずれる:クーポンは、閲覧価格の低い顧客の30日の購買率を大きく上げましたが、その多くは値引き目当ての前倒しで、1年間の売上への効果は、閲覧価格の高い顧客の方が大きくなりました。短期の CV率だけで施策や配布先を選ぶと、長期の価値を損なうことがあります。
- 単一のサロゲート指標は危うい:「CV1件あたりの長期の価値 × CV の増加」で長期の効果を見積もると、大きく過大評価しました。施策が長期の結果に影響する経路が CV だけではないこと(Prentice基準の崩れ)と、「CV1件あたりの価値」がもともとの顧客の違いを含んでいることが原因です。
- サロゲートインデックス:観察データで「複数の短期指標と特徴量 → 長期の結果」を予測するモデルを作り、実験データに当てはめることで、1年待たずに長期の効果を推定できました。特徴量から予想される分を差し引くと、1年待って直接比べるよりも、推定のばらつきを小さくできました。
- 2つの仮定:短期指標と特徴量が同じなら施策の有無で長期の結果が変わらないこと(サロゲート性)と、観察データと実験データで短期指標と長期の結果の関係が同じこと(比較可能性)が必要です。
ここまでのHVA関連の記事で、顧客の将来の価値の予測(CLV予測)、施策の効果の予測と評価(アップリフトモデルの評価)、そして施策の長期の効果の推定(本記事)の道具がそろいました。HVAの記事では、これらを組み合わせて、「価値が高く、かつ施策によって価値が上がる顧客」── HVA(High Value Audience) ── を定義し、予算の制約のもとで施策の対象を選ぶ方法を扱います。
参考文献
- S. Athey, R. Chetty, G. Imbens, H. Kang (2016). Estimating Treatment Effects using Multiple Surrogates: The Role of the Surrogate Score and the Surrogate Index. arXiv:1603.09326.
- R. L. Prentice (1989). Surrogate endpoints in clinical trials: Definition and operational criteria. Statistics in Medicine, 8(4), 431–440.
- W. Duan, S. Ba, C. Zhang (2021). Online Experimentation with Surrogate Metrics: Guidelines and a Case Study. Proceedings of the 14th ACM International Conference on Web Search and Data Mining, 193–201.
本記事の文章・構成の一部に生成AIを使用しています。