生存時間分析とは?
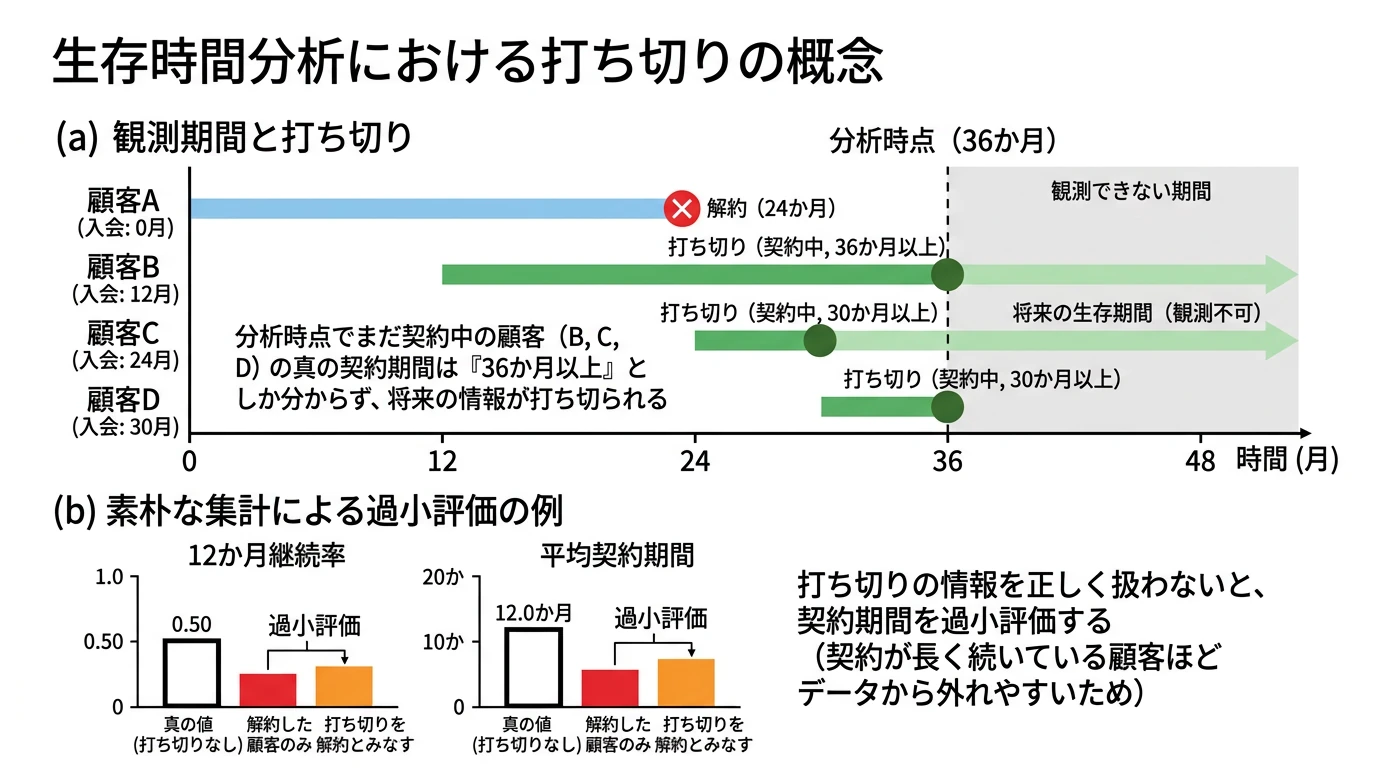 (画像は、Geminiで作成)
打ち切り(censoring)のあるデータで「顧客がいつ解約するか」をモデル化し、顧客生涯価値(CLV)のうち「顧客がどれだけ長く残るか」の部分を推定できるようになること。そのために、生存関数とハザード関数、カプラン・マイヤー推定、Cox比例ハザードモデル(比例ハザード性の確認を含む)、sBGモデルを、真値を仕込んだダミーデータで実装して理解すること。
概要
RFM分析の記事では、顧客生涯価値(CLV)を、将来の各期間の利益を「その時点まで顧客が残っている確率 」で重み付けし、割引率で現在価値に直したものとして定義しました(CLVの定義)。また、ビジネスを、解約の手続きによって離脱が観測できる契約型と、離脱が観測できない非契約型に分けました。
本記事では、このうち契約型のビジネス、たとえば動画配信や会員制サービスのようなサブスクリプションを対象に、CLVの式の ── 顧客がいつまで残るか ── を推定する方法を扱います。この「ある出来事(ここでは解約)が起きるまでの時間」を分析する統計手法を、生存時間分析(Survival Analysis) と呼びます。名前は医学研究で患者の生存期間を分析してきた歴史に由来しますが、解約、機械の故障、転職など、「いつ起きるか」を扱うあらゆる問題に使われます。
契約型なら解約日が記録に残るので、「平均して何か月で解約するか」は簡単に計算できそうに見えます。ところが、分析の時点でまだ解約していない顧客 ── いわば「物語の途中」の顧客 ── が必ず含まれるため、単純な平均では答えが大きく歪みます。この問題を 打ち切り(censoring) と呼び、生存時間分析のすべての手法は、打ち切りを正しく扱うために作られています。
本記事では、真値を仕込んだサブスクリプションのダミーデータを使い、次の順に解説します。
- 打ち切りとは何か
- 生存関数とハザード関数(生存時間分析の基本となる2つの関数)
- 打ち切りを無視すると、どれだけ答えが歪むか(ダミーデータでの検証)
- カプラン・マイヤー推定(顧客全体の生存曲線)
- Cox比例ハザードモデル(顧客の属性ごとの解約のしやすさ)と、比例ハザード性の確認
- sBGモデル(観測期間の先まで解約を予測し、CLVを計算する)
本記事のコードは、Python 3.13、NumPy 2.5.3、pandas 3.0.5、SciPy 1.18.1、matplotlib 3.11.2、lifelines 0.30.3 で動作を確認しました。lifelines は、pip install lifelines でインストールできます。
打ち切り(Censoring)とは何か
「まだ解約していない」顧客をどう扱うか
サブスクリプションの顧客データを、ある日(分析時点)に集計したとします。顧客は次の2種類に分かれます。
- 解約した顧客:入会から解約までの期間(契約期間)が分かる
- まだ契約中の顧客:「少なくとも分析時点までは続いている」ことしか分からない。この先いつ解約するかは不明
後者のように、出来事(解約)が起きる前に観測が終わってしまうことを 右側打ち切り(right censoring) と呼びます。「右側」とは、時間軸の右(未来)側の情報が欠けている、という意味です。たとえば、3か月前に入会してまだ契約中の顧客の契約期間は「3か月」ではなく「3か月以上」です。
打ち切りが起きる理由はさまざまですが、サブスクリプションで最も典型的なのは、入会の時期が顧客ごとに違うことです。最近入会した顧客ほど観測できた期間が短く、打ち切られやすくなります。
打ち切りのあるデータを扱うときによくある誤りは、次の2つです。
- 方法A:解約した顧客だけで計算する まだ契約中の顧客を除くと、「長く続いている顧客」ほど除かれやすいため、契約期間を過小評価します。
- 方法B:分析時点を解約日とみなす まだ契約中の顧客の「3か月以上」を「3か月」として扱うため、やはり契約期間を過小評価します。
どちらの誤りも、どれくらい大きいのかは、データを見ただけでは分かりません。後の節で、真の契約期間を知っているダミーデータを使って確かめます。その前に、打ち切りのあるデータを扱うための道具として、生存時間分析の基本となる2つの関数を導入します。
打ち切りのある契約期間を、後のカプラン・マイヤー推定と同じ5人の例で図にすると、次のようになります。
(図は、diagram-designで作成)
生存関数とハザード関数
打ち切りを正しく扱うために、生存時間分析では「契約期間の分布」を2つの関数で表します。
生存関数
顧客の契約期間(解約するまでの時間)を確率変数 とします。生存関数(survival function) は、時点 を過ぎても契約が続いている確率です。
から始まり、時間とともに減っていく関数です。「12か月継続率」は 、「契約期間の中央値」は となる です。CLVの定義に現れた は、顧客 の生存関数そのものです。
ハザード関数
ハザード関数(hazard function) は、「時点 まで契約を続けてきた顧客が、その直後に解約する勢い」を表します。
ポイントは、「時点 まで残っている顧客」に限った条件付きの解約率だという点です。たとえば月単位で考えると、 は「 か月目まで続いた顧客のうち、次の1か月で約5%が解約する」という意味です。実務の「月次解約率(チャーンレート)」は、このハザードに相当します。
ハザードを0から まで積み上げたものを 累積ハザード と呼びます。生存関数と累積ハザードの間には、次の関係があります。
詳細な式展開(生存関数と累積ハザードの関係)
式展開は、次の3つのステップで進めます。
- ハザード を、確率密度関数 と生存関数 で表す:
- を生存関数の微分で表す:
- 1と2を組み合わせて積分する:
ステップ1:
ハザード関数の定義は、次の式でした。
分子の条件付き確率は、条件付き確率の定義 で書き換えられます。ここで、出来事 は「(時点 の直後に解約する)」、出来事 は「(時点 まで残っている)」です。 が起きれば も必ず起きているので、 です。したがって、
となります。この右辺の分子と分母を、それぞれ書き換えます。
- 分子:契約期間 の確率密度関数を とすると、短い区間 に が入る確率は、区間の幅に比例して です(高さ 、幅 の細長い長方形の面積)。
- 分母: は連続的な値をとるので、ちょうど になる確率は0です。そのため です。
これらをハザード関数の定義に代入すると、
となります。分子の と、分母の が約分されて消えるので、極限をとる対象から がなくなり、
が得られます。
厳密には、 は近似で、 に比べて十分に小さい誤差が残ります。しかし、 で割ってから とすると、その誤差は0に近づき、 が正確に成り立ちます(これは確率密度関数の定義そのものです)。
この式は、「時点 に解約する顧客の割合 」を、「時点 まで残っている顧客の割合 」で割ったもの、と読めます。ハザードが「残っている顧客に限った」解約の勢いであることが、分母の に表れています。
ステップ2:
の累積分布関数を とします。 は「時点 の時点で、すでに解約している」という意味なので、 は時点 までに解約した顧客の割合です。生存関数はその残り(まだ解約していない顧客の割合)なので、
です。両辺を で微分すると、積分の上端 で微分した値は被積分関数そのもの(微分積分学の基本定理)なので、
となります。生存関数が減っていく速さが、そのまま解約の確率密度になっている、という関係です。
ステップ3:積分して
ステップ1の式にステップ2の を代入すると、
です。合成関数の微分により なので、右辺は の微分にマイナスを付けたものです。
両辺を0から まで積分します。左辺は累積ハザード の定義そのもので、右辺は の差になります。
入会した時点では全員が契約中なので 、つまり です。したがって、
が得られます。
確認:ハザードが一定の場合
ハザードが時間によらず一定 なら、累積ハザードは なので、 です。これは、契約期間が指数分布に従うときの生存関数で、ハザードの形:ワイブル分布の の場合に当たります。
時間を月単位で区切って考えると、この関係はもっと直感的になります。 か月目のハザード(月次解約率)を とすると、 か月後まで残るには、1か月目から か月目まで毎月「解約しない」必要があるので、
となります。この「各期間の解約しない確率の掛け算」という形が、後で扱うカプラン・マイヤー推定の土台になります。
ハザードの形:ワイブル分布
ハザードが時間によらず一定()なら、契約期間は指数分布に従い、 です。しかし実際のサブスクリプションでは、入会直後に解約が集中し、長く続いた顧客ほど解約しにくくなることがよくあります。
ハザードの形を柔軟に表せる代表的な分布が ワイブル分布(Weibull distribution) です。形状 (kk。後で作るサブスクワールドの生成コードの k と区別するため)と尺度 (eta)を使って、次のように表します( は関数 weibull_hazard、 は weibull_survival)。
- :ハザードが時間とともに下がる(入会直後が最も解約しやすい)
- :ハザードが一定(指数分布)
- :ハザードが時間とともに上がる(機械の摩耗による故障など)
後で作るサブスクワールドでは、ベースラインを 、 のワイブル分布にします。3つの形を比べてみましょう。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. ワイブル分布のハザード関数と生存関数(尺度 eta = 15 か月)
def weibull_hazard(t, kk, eta=15.0):
    return (kk / eta) * (t / eta) ** (kk - 1)

def weibull_survival(t, kk, eta=15.0):
    return np.exp(-(t / eta) ** kk)

# 2. 形状 k の異なる3つの分布で、時点ごとの値を確認する
shapes = {'k = 0.7(下がる)': 0.7, 'k = 1.0(一定)': 1.0, 'k = 1.5(上がる)': 1.5}
for label, kk in shapes.items():
    print(f"{label}: h(1) = {weibull_hazard(1, kk):.3f}, h(24) = {weibull_hazard(24, kk):.3f}, "
          f"S(12) = {weibull_survival(12, kk):.3f}")

# 3. 可視化
t = np.linspace(0.05, 36, 400)
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
for (label, kk), color in zip(shapes.items(), ['C0', 'C1', 'C2']):
    axes[0].plot(t, weibull_hazard(t, kk), color=color, label=label)
    axes[1].plot(t, weibull_survival(t, kk), color=color, label=label)
axes[0].set_title('ハザード関数 h(t)')
axes[0].set_ylim(0, 0.2)
axes[1].set_title('生存関数 S(t)')
for ax in axes:
    ax.set_xlabel('契約期間(月)')
    ax.legend()
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
ワイブル分布の形状 を変えて、ハザード関数と生存関数の違いを確認しています。
- ライブラリ: グラフの日本語表示のために japanize_matplotlib を読み込んでいます。
- 関数の定義: weibull_hazard は 、weibull_survival は をそのままコードにしたものです。尺度 eta は、サブスクワールドと同じ15か月にそろえています。
- 時点ごとの値: 1か月目と24か月目のハザード(月次解約率に相当)と、12か月継続率 を表示しています。形状を 0.7・1.0・1.5 にするのは、1を挟んで、ハザードが「下がる」「一定」「上がる」の3つの形を比べるためです。
- 可視化: ではハザードが の近くで非常に大きくなるため、左の図は縦軸を0〜0.2に制限しています。横軸の始まりを0.05にしているのも、 でハザードが無限大になるのを避けるためです。
実行結果
k = 0.7(下がる): h(1) = 0.105, h(24) = 0.041, S(12) = 0.425
k = 1.0(一定): h(1) = 0.067, h(24) = 0.067, S(12) = 0.449
k = 1.5(上がる): h(1) = 0.026, h(24) = 0.126, S(12) = 0.489
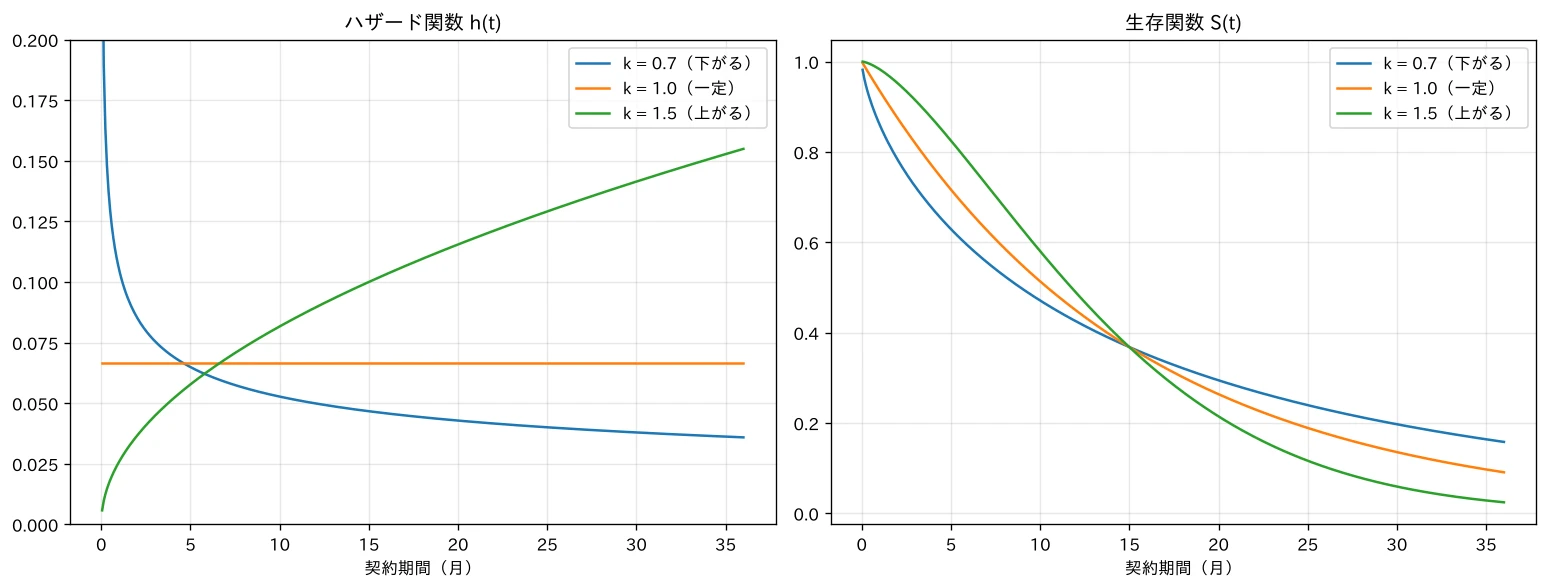
- (サブスクワールドのベースライン): 1か月目のハザードは0.105(月に約10%が解約)ですが、24か月目には0.041まで下がります。入会直後に解約が集中し、続いた顧客ほど解約しにくくなる形です。
- : ハザードは常に0.067で一定です。
- : ハザードは0.026から0.126へと上がっていきます。
一方、12か月継続率 は0.425〜0.489と、3つの分布でそれほど変わりません。右の図でも、3本の生存曲線は似た形に見え、 か月で同じ点()を通ります。これは、累積ハザード が、 では によらず になるためです。つまり、15か月までに積み上がった解約の総量(左の図の曲線の下の面積)は、3つとも同じです。一方、15か月時点のハザード は、 で0.047、 で0.067、 で0.100 と違います。総量は同じでも、 は入会直後に解約が集中し、 は時間がたつほど解約が増える、というように、解約が起きる時期の配分 がまったく違うのです。その違いは15か月より先に現れ、右の図のとおり、15か月時点でハザードが最も高い が、その後最も速く顧客を失います。生存曲線だけを見ていると気づきにくい違いが、ハザードには、はっきり現れる のです。解約対策を「入会直後に集中させるべきか」「長期の顧客にも向けるべきか」は、ハザードの形で決まります。
ダミーデータで確かめる:打ち切りの影響
生存関数とハザード関数を使って、真の契約期間が分かっているダミーデータを作り、方法A・方法Bの誤りの大きさを確かめます。
検証用ダミーデータの生成:サブスクワールド
動画配信のような月額制のサブスクリプション「サブスクワールド」を想定し、5,000人の顧客データを生成します。顧客はいつでも解約でき、解約するまで毎月料金を払います。
- 入会時期:サービス開始から36か月の間に、顧客が少しずつ入会します。分析はサービス開始から36か月後に行うので、早く入会した顧客は最大36か月、最近入会した顧客は数日しか観測できません。
- 顧客の属性(分析者も観測できる):広告経由で入会したか、初月の利用日数(0〜30日)、初月無料キャンペーンで入会したか
- 解約のしやすさ(分析者には観測できない「答え」):「その時点まで残っている顧客が、直後に解約する勢い」である ハザード を使って、次のように決めます。
- 解約のしやすさは、入会直後が最も高く、契約が長くなるほど下がっていく
- 広告経由で入会した顧客は、そうでない顧客より解約しやすい
- 初月によく利用した顧客ほど、解約しにくい
- 初月無料キャンペーンで入会した顧客は、無料期間(最初の1か月)だけとても解約しやすく、無料期間が終わった後は、キャンペーンを使わなかった顧客と変わらない
最後の性質は、Cox比例ハザードモデルの前提(比例ハザード性)を確認するときに使う「仕掛け」です。
生成は、コードの手順に沿って次の流れで行います。
- 顧客の属性(入会時期・広告経由か・初月の利用日数・初月無料か)を乱数で決める(手順1・2)
- ① 属性から、真の解約のしやすさ(累積ハザード)を決める(手順3)
- ② 累積ハザードと乱数から、実際の契約期間を作る(手順4)
- 分析時点で契約が続いている顧客を打ち切り、観測できるデータにする(手順5・6)
①と②を、式で示します。
① 属性から、真の解約のしやすさ(累積ハザード)を決める
生存関数とハザード関数の節で見たとおり、ハザード を積み上げた累積ハザード から、生存関数が で求まります。顧客 の属性を とすると、サブスクワールドの真の累積ハザード(コードの関数 true_cum_hazard)は、基準となる形 に「属性による倍率」を掛けて、次のように決めます。
顧客の属性 のうち、(ad)は広告経由で入会したら1、そうでなければ0のバイナリの変数、(usage)は初月の利用日数で、0〜30の整数です。初月無料キャンペーンで入会したか(trial)もバイナリの変数で、式の中では下の の形で入ります。
- (H0。 は H0_1)、(k)、(eta):ベースライン(基準となる顧客)の累積ハザード。ワイブル分布の累積ハザードで、 なので入会直後ほどハザードが大きくなります(ハザードの形:ワイブル分布で比べた の曲線です)
- (beta_ad):広告経由で入会すると、ハザードが 倍になる
- (beta_usage):初月の利用日数が1日多いと、ハザードが 倍になる(10日多いと約0.61倍)
- (顧客ごとの値は m):初月無料キャンペーンで入会した顧客は4.0(trial_hr_first)、それ以外は1.0。最初の1か月()のハザードだけを 倍する
広告経由と利用日数は、ハザードを時間によらず一定の倍率( 倍、1日あたり 倍)で動かし、初月無料だけが最初の1か月のハザードを4倍します。この「時間によらず一定の倍率」という構造は、後で扱う Cox比例ハザードモデルの前提そのもので、初月無料だけがそれを満たしていません。
② 累積ハザードと乱数から、実際の契約期間を作る
次に、①で決めた累積ハザードに従う契約期間 (T_true)を、乱数から作ります。使うのは、ほしい分布に従う乱数を一様乱数から作る 逆関数法 です。
逆関数法の考え方
時点 までに解約する確率(累積分布関数)は、生存関数の残りなので、
です。 は、 で0から始まり、時間とともに1に向かって増えていく関数です。そこで、0〜1の一様乱数 を引き、
を満たす を逆算して、解約の時点とします。こうして作った は、確かに累積分布関数 に従います。 は増えていく関数なので「」と「」は同じ出来事で、一様乱数では なので、
となるからです。
逆関数法で本当に に従う乱数が作れるかを、図で確かめます。ここでは簡単のため、属性による倍率がかからない基準となる顧客(広告経由でなく、初月の利用日数が0日で、初月無料でない顧客)を考えます。このとき なので、累積分布関数とその逆関数は
です。 はコードの関数 F_base、 は F_base_inv、一様乱数 は U、逆関数法で作った は T_from_U です。比較に使う真の確率密度は、生存関数と累積ハザードの関係の で、 と の積(density)です。 逆関数 は、「 となる 」を返す関数です。そこで、次の式を について解きます。 1. 指数関数の部分だけを左辺に残す:両辺から1を引いて を掛けると、 です。左辺は生存関数 なので、「 まで残っている確率が になる時点を探す」という式になっています。 2. 自然対数をとって、指数を外す:両辺の自然対数をとると、 なので です。 なら も0と1の間にあり、その対数は負なので、マイナスを付けた右辺は正の値です。この右辺は、累積ハザード の値でもあります。 3. 乗して、 乗を外す:両辺を 乗すると、 なので です。 4. を掛ける: が得られます。 たとえば 、、 では、、 なので、 か月です。下の図の「 か月」と一致します。この は、半数が解約するまでの期間(契約期間の中央値)でもあります。詳細な式展開(逆関数 の導出)
# 1. 基準となる顧客(広告経由でなく、初月の利用日数0日、初月無料でない)の累積分布関数 F(t) = 1 - exp(-H_0(t))
k, eta = 0.7, 15.0

def F_base(t):
    return 1 - np.exp(-(t / eta) ** k)

def F_base_inv(u):
    """F(t) = u を t について解いた式(逆関数)"""
    return eta * (-np.log(1 - u)) ** (1 / k)

# 2. 一様乱数 U から、逆関数法で契約期間 T を作る(サブスクワールドの生成とは別の乱数生成器を使う)
rng_demo = np.random.default_rng(0)
U = rng_demo.uniform(size=10_000)
T_from_U = F_base_inv(U)

# 3. 確認:作った T のうち t 以下の割合が、F(t) と一致するか
for t in [1, 12, 36]:
    print(f"t = {t:2d} か月: T が t 以下の割合 {np.mean(T_from_U <= t):.3f}、F(t) = {F_base(t):.3f}")

# 4. 可視化:左は逆関数法の手順、右は作った T の分布と真の確率密度 f(t) = h(t) S(t)
t_grid = np.linspace(0.05, 60, 400)
density = (k / eta) * (t_grid / eta) ** (k - 1) * np.exp(-(t_grid / eta) ** k)
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
axes[0].plot(t_grid, F_base(t_grid), color='C0', label='累積分布関数 F(t)')
for u, color in zip([0.2, 0.5, 0.8], ['C1', 'C2', 'C3']):
    t_u = F_base_inv(u)
    axes[0].plot([0, t_u], [u, u], color=color, linestyle='--')
    axes[0].plot([t_u, t_u], [u, 0], color=color, linestyle='--')
    axes[0].annotate(f'U = {u} → T = {t_u:.1f} か月', xy=(t_u, u), xytext=(t_u + 2, u - 0.07), color=color)
axes[0].set_xlim(0, 60)
axes[0].set_ylim(0, 1)
axes[0].set_xlabel('契約期間 t(月)')
axes[0].set_ylabel('F(t)')
axes[0].set_title('逆関数法:F(T) = U となる T を読み取る')
axes[1].hist(T_from_U, bins=np.arange(0, 61, 1), density=True, color='C0', alpha=0.5, label='一様乱数から作った T(1万人)')
axes[1].plot(t_grid, density, color='black', label='真の確率密度 f(t)')
axes[1].set_xlim(0, 60)
axes[1].set_ylim(0, 0.12)
axes[1].set_xlabel('契約期間 t(月)')
axes[1].set_title('作った T の分布')
for ax in axes:
    ax.legend()
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
逆関数法で1万人分の契約期間を作り、その分布が と一致するかを確かめています。
- 逆関数: F_base_inv は、 を について解いた式です。 の両辺の対数をとると になり、両辺を 乗して を掛けると得られます。、 は、サブスクワールドのベースラインと同じ値です。
- 乱数: サブスクワールドの生成に使う乱数(シード42)に影響しないよう、別の乱数生成器 rng_demo(シード0)を使っています。
- 確認: 1か月・12か月・36か月の各時点で、作った のうち 以下の割合と、 を並べています。1か月・12か月・36か月を選ぶのは、入会直後、1年、サブスクワールドの観測期間の終わりの3つの時点で、一致するかを確かめるためです。
- 可視化: 左の図は、縦軸の一様乱数 から横に進んで の曲線に当たったところで下に降り、横軸の を読み取る、という逆関数法の手順を、 の3つで描いたものです。右の図は、作った のヒストグラムと真の確率密度 の比較です。
実行結果
t =  1 か月: T が t 以下の割合 0.142、F(t) = 0.139
t = 12 か月: T が t 以下の割合 0.575、F(t) = 0.575
t = 36 か月: T が t 以下の割合 0.845、F(t) = 0.842
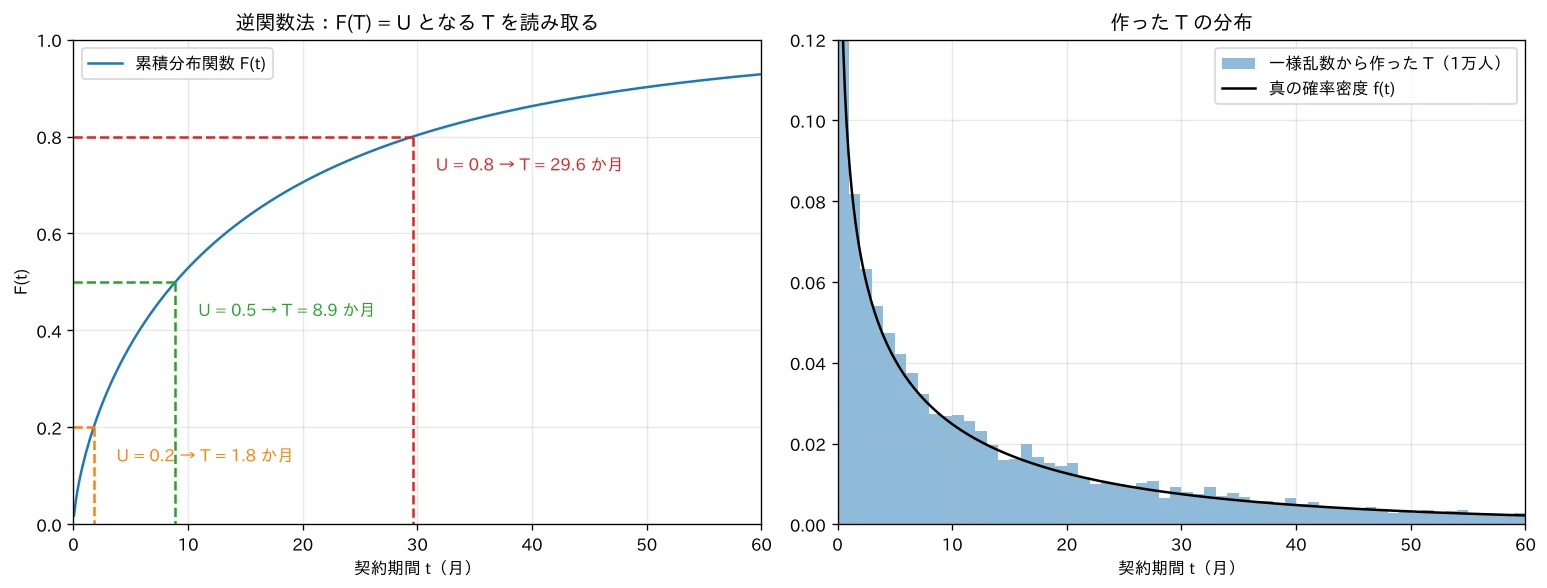
- 割合が と一致する: 作った契約期間のうち12か月以下の割合は0.575で、 と一致しています。1か月・36か月でも、乱数のばらつきの範囲で一致しています。
- 左の図: は入会直後に急に立ち上がるので、一様乱数 が小さい(0.2)と は1.8か月と短く、 が大きい(0.8)と29.6か月と長くなります。 は0〜1に均等に散らばりますが、 の傾きが急な入会直後には が密集し、傾きが緩やかな時期には がまばらになります。これが、 の形をそのまま の分布に写し取る仕組みです。
- 右の図: ヒストグラムは真の確率密度 の曲線に沿っており、入会直後に解約が集中するワイブル分布()の形が再現されています。
指数分布の乱数で書き直す
を、累積ハザードについて解きます。
右辺の は、パラメータ1の指数分布 に従う乱数です。 とおくと、 となり、これは の生存関数そのものだからです。そこで、一様乱数を経由せずに、指数分布の乱数 (E)を直接引き、 パラメータ の指数分布 の基本となる式は、次のとおりです。 確率密度関数(PDF):ある値 が出る確率の密度を表す式です。 累積分布関数(CDF):値が 以下になる確率を表す式です。確率密度関数を0から まで積分すると、 なので、 です。値が を超える確率(生存関数)は、その残りの ()です。 一般のパラメータ の指数分布 では、、 です。ハザードは で一定になり、ハザードの形:ワイブル分布の の場合に当たります。 が に従う理由: について、 が を超える確率を、 についての確率に1段ずつ書き換えます。 これは の生存関数 と同じなので、 は に従います。詳細な式展開(指数分布 の式と、 が に従う理由)
を満たす を解約の時点とします。「顧客ごとに、解約までに耐えられる累積ハザードの量 が乱数で決まっていて、累積ハザードがそこに達した時点で解約する」と読むこともできます。
この2つのことも、図で確かめます。1つ目は、一様乱数を変換した が に従うことです。2つ目は、指数分布の乱数 を直接引いて を解いても、一様乱数から作った場合と同じ分布の が得られることです。基準となる顧客では、 を解くと
です。コードでは、 が E_from_U、直接引いた が E_direct、そこから作った が T_from_E です。
# 1. 一様乱数を変換した E = -log(1 - U) は、指数分布 Exp(1) に従う
E_from_U = -np.log(1 - U)

# 2. 指数分布の乱数 E を直接引き、H_0(T) = E を解いて T を作る(H_0(t) = (t / eta)^k なので T = eta E^(1/k))
E_direct = rng_demo.exponential(1.0, size=10_000)
T_from_E = eta * E_direct ** (1 / k)

# 3. 確認
print(f"E = -log(1 - U): 平均 {E_from_U.mean():.3f}、E が1を超える割合 {np.mean(E_from_U > 1):.3f}"
      f"(Exp(1) では平均1、割合 e^-1 = {np.exp(-1):.3f})")
for t in [1, 12, 36]:
    print(f"t = {t:2d} か月まで残る割合: 一様乱数から {np.mean(T_from_U > t):.3f}、"
          f"指数分布の乱数から {np.mean(T_from_E > t):.3f}、S(t) = {1 - F_base(t):.3f}")

# 4. 可視化:左は E = -log(1 - U) の分布、右は2つの作り方で作った T の生存曲線
h_grid = np.linspace(0, 6, 300)
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
axes[0].hist(E_from_U, bins=np.arange(0, 6.01, 0.2), density=True, color='C0', alpha=0.5, label='E = -log(1 - U)(1万個)')
axes[0].plot(h_grid, np.exp(-h_grid), color='black', label='Exp(1) の確率密度 e^(-h)')
axes[0].set_xlabel('E')
axes[0].set_title('一様乱数を変換すると、指数分布になる')
axes[1].plot(t_grid, (T_from_U[:, None] > t_grid).mean(axis=0), color='C0', label='一様乱数から作った T')
axes[1].plot(t_grid, (T_from_E[:, None] > t_grid).mean(axis=0), color='C1', linestyle='--', label='指数分布の乱数から作った T')
axes[1].plot(t_grid, 1 - F_base(t_grid), color='black', linestyle=':', label='真の生存関数 S(t)')
axes[1].set_xlabel('契約期間 t(月)')
axes[1].set_ylabel('t を過ぎても残っている割合')
axes[1].set_title('2つの作り方の比較')
for ax in axes:
    ax.legend()
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
一様乱数を変換した値が指数分布に従うことと、2つの作り方で同じ分布の契約期間が得られることを確かめています。
- 変換: E_from_U は、前のコードの一様乱数 U を で変換したものです。
- 直接引く: rng_demo.exponential(1.0, ...) で の乱数を直接引き、 で契約期間にしています。サブスクワールドの生成コードも、この作り方です。
- 確認: の平均( では1)と、 が1を超える割合( では )を表示しています。あわせて、2つの作り方で、各時点まで残っている顧客の割合を真の と比べています。
- 可視化: 右の図の生存曲線は、各時点 について「 の顧客の割合」を、(T_from_U[:, None] > t_grid).mean(axis=0) でまとめて計算しています(1万人 × 400時点の比較を一度に行い、時点ごとに平均をとります)。
実行結果
E = -log(1 - U): 平均 1.000、E が1を超える割合 0.370(Exp(1) では平均1、割合 e^-1 = 0.368)
t =  1 か月まで残る割合: 一様乱数から 0.858、指数分布の乱数から 0.866、S(t) = 0.861
t = 12 か月まで残る割合: 一様乱数から 0.425、指数分布の乱数から 0.422、S(t) = 0.425
t = 36 か月まで残る割合: 一様乱数から 0.155、指数分布の乱数から 0.154、S(t) = 0.158
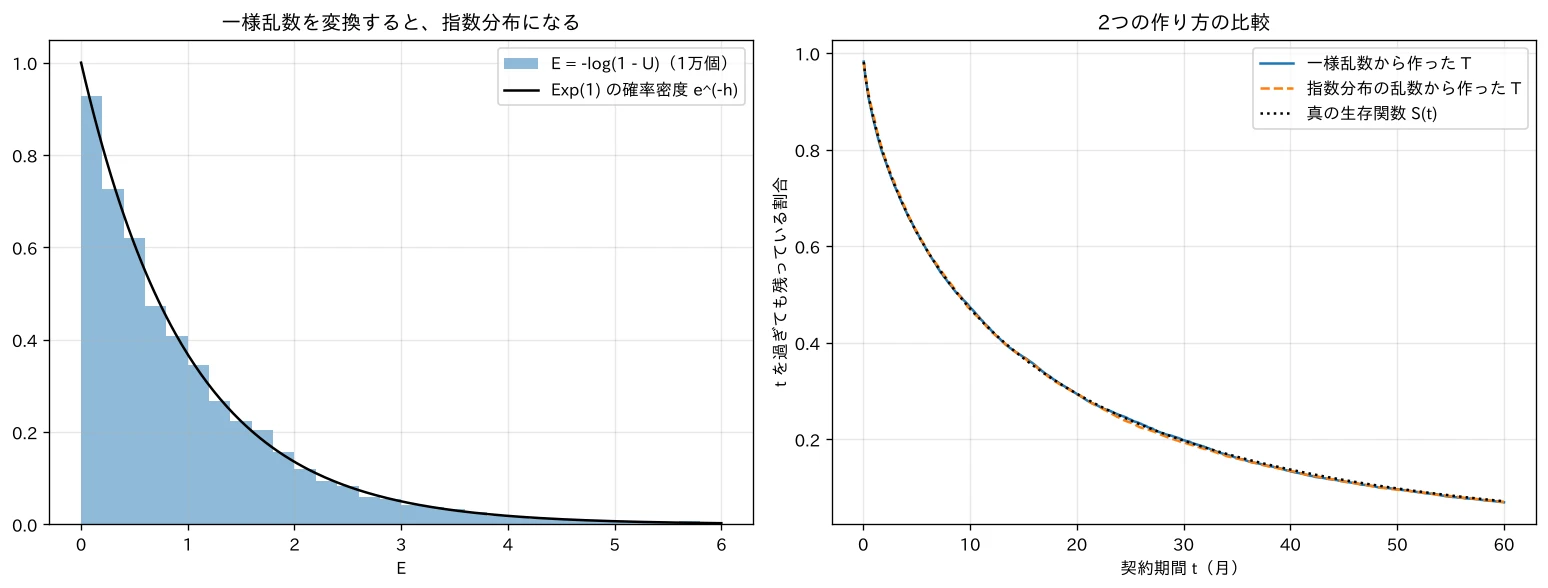
- は に従う: 平均は1.000、1を超える割合は0.370で、 の値(1、0.368)と一致しています。左の図でも、ヒストグラムが の曲線に沿っています。
- 2つの作り方は同じ分布になる: 一様乱数から作った場合と、指数分布の乱数から作った場合の、各時点まで残っている割合は、乱数のばらつきの範囲で一致しています。右の図でも、2本の生存曲線と真の がほぼ重なっています。サブスクワールドの生成では、一様乱数を経由せず、指数分布の乱数を直接引く後者の作り方を使います。
について解く
最後に、 を について解きます。両辺を属性による倍率 で割った値を (A)とおくと、結果は次のとおりです(途中の計算は下の折りたたみにまとめました)。
コードの手順4は、この3段階(指数分布の乱数 E を引く → 属性の倍率で割って A を作る → 場合分けの式で T_true を計算する)をそのまま実装しています。 ①の累積ハザードの式を に代入し、両辺を属性による倍率 で割ると、左辺は場合分けの部分だけになり、右辺は になります。 左辺は について増えていく関数で、ちょうど1か月の時点で になります。そのため、 がこの値以下なら解約は1か月以内(上の場合)、この値より大きければ1か月より後(下の場合)です。 どちらの場合も、最後に を について解きます。 の両辺を 乗すると 、つまり なので、 となり、本文の式が得られます。初月無料でない顧客()では、どちらの場合も になり、場合分けは不要です。詳細な式展開( を について解く)
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は月。1か月 = 30日とする)
rng = np.random.default_rng(42)
N = 5_000          # 顧客数
END = 36           # サービス開始から36か月後に分析する

# 2. 顧客の属性(分析者も観測できる)
join_month = rng.uniform(0, END, size=N)            # 入会した時期(サービス開始からの月数)
ad = rng.binomial(1, 0.4, size=N)                   # 広告経由で入会したか(1: 広告経由)
usage = rng.binomial(30, rng.beta(2, 3, size=N))    # 初月の利用日数(0〜30日)
trial = rng.binomial(1, 0.3, size=N)                # 初月無料キャンペーンで入会したか

# 3. 真のハザードのパラメータ(分析者には分からない「答え」)
k, eta = 0.7, 15.0          # ベースライン(基準となる顧客)のワイブル分布の形状と尺度
beta_ad = 0.5               # 広告経由の効果(対数ハザード比)
beta_usage = -0.05          # 初月の利用日数1日あたりの効果(対数ハザード比)
trial_hr_first = 4.0        # 初月無料キャンペーンのハザード比(最初の1か月だけ。以降は1.0)

def true_cum_hazard(t, ad, usage, trial):
    """真の累積ハザード H(t | x)。初月無料の効果は最初の1か月だけかかる"""
    H0 = (t / eta) ** k                  # ベースラインの累積ハザード
    H0_1 = (1 / eta) ** k                # 1か月時点のベースラインの累積ハザード
    m = np.where(trial == 1, trial_hr_first, 1.0)
    shape = np.where(t <= 1, m * H0, m * H0_1 + (H0 - H0_1))
    return np.exp(beta_ad * ad + beta_usage * usage) * shape

# 4. 真の契約期間 T を生成する(累積ハザードが指数分布の乱数 E に達した時点で解約する)
E = rng.exponential(1.0, size=N)
A = E / np.exp(beta_ad * ad + beta_usage * usage)
m = np.where(trial == 1, trial_hr_first, 1.0)
H0_1 = (1 / eta) ** k
T_true = np.where(A <= m * H0_1,
                  eta * (A / m) ** (1 / k),
                  eta * (A - (m - 1) * H0_1) ** (1 / k))

# 5. 打ち切り:分析時点でまだ解約していない顧客は、入会から分析時点までしか観測できない
censor_month = END - join_month
observed = np.minimum(T_true, censor_month)
days = np.ceil(observed * 30).astype(int)          # 観測できるのは日単位の契約日数

# 6. 分析者が観測できるデータ(T_true は含めない)
df = pd.DataFrame({
    'duration': days / 30,                           # 契約期間(月)
    'event': (T_true <= censor_month).astype(int),   # 1: 解約した, 0: 打ち切り(契約中)
    'ad': ad,
    'usage': usage,
    'trial': trial,
})

# 7. データの性質の確認
print(df.head())
print(f"\n解約した顧客: {df['event'].sum():,} 人({df['event'].mean():.1%})、打ち切り(契約中): {(1 - df['event']).sum():,} 人")
print(f"真の12か月継続率: {(T_true > 12).mean():.1%}、真の契約期間の中央値: {np.median(T_true):.1f} か月")
サブスクワールドの顧客データを生成しています。
- 観測期間と属性: 時間の単位は月で、乱数は default_rng(42) で固定しています。入会時期 join_month は0〜36か月の一様分布、広告経由 ad は40%、初月無料 trial は30%の顧客に当てはまります。初月の利用日数 usage は、顧客ごとの利用のしやすさをベータ分布から引き、それを確率とする二項分布(30日中何日使ったか)で作っています。顧客数を5,000人、観測期間を36か月にすると、解約した顧客は約半分(53.2%)になります。打ち切りが約半分あると、打ち切りを無視したときの偏り(次の節)がはっきり出ます。
- 真のハザード: true_cum_hazard は、顧客の属性から真の累積ハザード を計算する関数で、コードの直前に示した式をそのまま実装しています。後の節で、真の生存関数 を描くときにも使います。
- 係数の大きさ: 初月無料のハザード比を4.0と大きくしているのは、後の節の比例ハザード性の検定で、違反がはっきり見つかるようにするためです。広告経由の割合(40%)、初月無料の割合(30%)、利用日数のベータ分布 、、 は、Cox モデルの推定値を真の値と比べるための例で、結果の傾向はこれらの値に大きく左右されません。
- 契約期間の生成: 指数分布の乱数 E を引き、累積ハザードが E に達する時点を解いて、真の契約期間 T_true を作っています。A は E を属性の倍率で割ったもので、無料期間(1か月)の中で A に達するかどうかで、式を切り替えています。
- 打ち切り: 入会から分析時点までの期間 censor_month と真の契約期間の短い方が、観測できる期間です。観測は日単位で行う想定で、np.ceil(observed * 30) で日数に切り上げてから月に換算しています(入会当日の解約も「1日」として記録されます)。
- 観測できるデータ: df には、契約期間 duration、解約したかどうか event(1: 解約、0: 打ち切り)と3つの属性だけを入れています。T_true は答え合わせ用で、推定には使いません。
実行結果
    duration  event  ad  usage  trial
0   8.166667      0   0      1      0
1  20.233333      0   1     10      0
2   5.100000      0   1     22      0
3  10.900000      0   0     14      1
4  29.000000      1   0     17      0

解約した顧客: 2,660 人(53.2%)、打ち切り(契約中): 2,340 人
真の12か月継続率: 51.0%、真の契約期間の中央値: 12.6 か月
- 約半分が打ち切り: 5,000人のうち、解約した顧客は2,660人(53.2%)で、残りの2,340人は分析時点でまだ契約中です。たとえば先頭の顧客は契約期間8.2か月で event が0なので、「8.2か月以上」続いていることしか分かりません。
- 真の値: 打ち切りのない真の契約期間で計算すると、12か月継続率は51.0%、契約期間の中央値は12.6か月です。次の節では、この値を、打ち切りのあるデータから正しく求められるかを確かめます。
打ち切りを無視すると何が起きるか
方法A・方法Bで「12か月継続率」と「契約期間の中央値」を計算し、真の値と比べます。あわせて、最初の20人の観測の様子を、カレンダーの時間軸の上に描きます。
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. 真の値(打ち切りのない T_true から計算。現実には分からない)
results = {'真の値': ((T_true > 12).mean(), np.median(T_true))}

# 2. 方法A:解約した顧客だけで計算する
churned = df[df['event'] == 1]
results['方法A(解約者のみ)'] = ((churned['duration'] > 12).mean(), churned['duration'].median())

# 3. 方法B:分析時点を解約日とみなす(打ち切りを無視する)
results['方法B(打ち切りを解約とみなす)'] = ((df['duration'] > 12).mean(), df['duration'].median())

for name, (s12, median) in results.items():
    print(f"{name:18s}: 12か月継続率 {s12:6.1%}、契約期間の中央値 {median:5.1f} か月")

# 4. 最初の20人の観測の様子(横軸はサービス開始からの月数)
fig, ax = plt.subplots(figsize=(11, 6))
for i in range(20):
    start = join_month[i]
    end = start + df['duration'][i]
    ax.plot([start, end], [i, i], color='C0' if df['event'][i] else 'C2', linewidth=2)
    if df['event'][i]:
        ax.plot(end, i, 'x', color='C3', markersize=9)
    else:
        ax.plot(end, i, 'o', color='C2', markersize=7)
        ax.plot([end, start + T_true[i]], [i, i], color='gray', linestyle=':', linewidth=1)
ax.axvline(END, color='black', linestyle='--', label='分析時点(36か月後)')
ax.plot([], [], 'x', color='C3', label='解約(観測できる)')
ax.plot([], [], 'o', color='C2', label='打ち切り(契約中)')
ax.plot([], [], ':', color='gray', label='分析時点より後の真の契約期間(観測できない)')
ax.set_xlim(0, END + 15)
ax.set_yticks(range(0, 20, 2))
ax.set_xlabel('サービス開始からの月数')
ax.set_ylabel('顧客(行番号)')
ax.set_title('打ち切りの様子(最初の20人)')
ax.legend(loc='upper center', bbox_to_anchor=(0.5, -0.12), ncol=2)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
素朴な2つの方法で12か月継続率と中央値を計算し、観測の様子を図にしています。
- 真の値: 打ち切りのない T_true から、12か月を超えて続いた割合と中央値を計算しています。現実には手に入らない値です。
- 方法A: event が1の顧客(解約した顧客)だけを取り出して計算しています。
- 方法B: 打ち切られた顧客の duration を、そのまま契約期間とみなして全員で計算しています。
- 観測の様子の図: 最初の20人について、横軸をサービス開始からの月数(カレンダーの時間)にとり、入会から観測の終わりまでを線で描いています。解約した顧客は×、打ち切られた顧客は○で示し、打ち切られた顧客には、分析時点より後の真の契約期間(観測できない部分)を点線で描き足しています。
実行結果
真の値               : 12か月継続率  51.0%、契約期間の中央値  12.6 か月
方法A(解約者のみ)        : 12か月継続率  16.4%、契約期間の中央値   2.9 か月
方法B(打ち切りを解約とみなす)  : 12か月継続率  34.2%、契約期間の中央値   6.7 か月
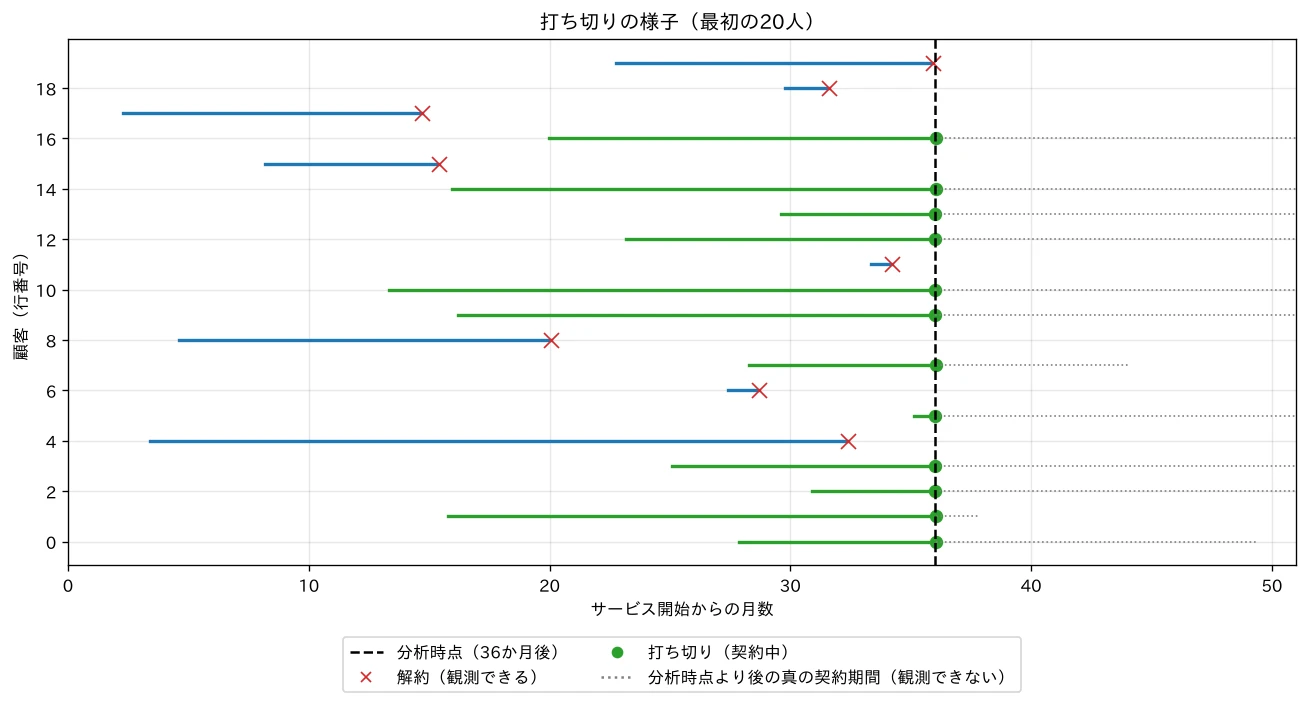
どちらの素朴な方法も、真の値を大きく下回りました。
- 方法A(解約者のみ): 12か月継続率は16.4%、中央値は2.9か月で、真の値(51.0%、12.6か月)とはまったく違います。解約した顧客だけを集めると、「早く解約した顧客」ばかりが残るためです。図でも、×の付いた線(解約した顧客)は、○の付いた線(打ち切り)より短いものが目立ちます。
- 方法B(打ち切りを解約とみなす): 12か月継続率は34.2%、中央値は6.7か月です。方法Aよりはましですが、まだ大きく過小評価しています。図の点線のように、打ち切られた顧客の多くは分析時点より後も契約を続けますが、方法Bはその部分を切り捨てています。
偏りの大きさは、打ち切られた顧客の割合や、入会時期の分布によって変わります。サービスが急成長していて最近の入会者が多いほど、打ち切りが増え、素朴な方法の偏りも大きくなります。
カプラン・マイヤー推定
推定の考え方
カプラン・マイヤー推定(Kaplan-Meier estimator) は、打ち切りのあるデータから生存関数を推定する、最も基本的な方法です(Kaplan & Meier, 1958)。分布の形を仮定しない(ノンパラメトリックな)方法で、ハザード関数の節で見た「各期間の解約しない確率の掛け算」をそのまま使います。
解約が起きた時点を小さい順に とし、各時点 について次の2つを数えます。
- :時点 の直前まで契約が続いていた顧客の数(リスク集合の大きさ)
- :時点 に解約した顧客の数
時点 のハザードを で推定し、それを掛け合わせたものが、カプラン・マイヤー推定量です。
打ち切りの扱いは、この に現れます。打ち切られた顧客は、打ち切りの時点まではリスク集合に入り、それ以降は外れます。「3か月以上続いた」という情報は、「3か月目までは解約しなかった」という形で、3か月目までの にきちんと反映されるのです。
小さな例で確かめてみましょう。5人の顧客の契約期間が「2か月(解約)」「3か月(打ち切り)」「4か月(解約)」「5か月(解約)」「6か月(打ち切り)」だったとします。
| 時点 | リスク集合 | 解約 | ||
|---|---|---|---|---|
| 2か月 | 5 | 1 | 4/5 | 0.80 |
| 4か月 | 3 | 1 | 2/3 | |
| 5か月 | 2 | 1 | 1/2 |
3か月で打ち切られた顧客は、2か月の時点のリスク集合(5人)には入っていますが、4か月の時点のリスク集合(3人)からは外れています。打ち切られた顧客を「解約した」とも「いなかった」ともみなさず、分かっている範囲だけを使っているわけです。
この仕組みが正しく働くには、打ち切りが、解約のしやすさと無関係に起きている(独立な打ち切り)という仮定が必要です。サブスクワールドの打ち切りは入会時期だけで決まるので、この仮定を満たしています。一方、「解約しそうな顧客ほど、途中でデータが取れなくなる」ような場合は、この仮定が崩れ、カプラン・マイヤー推定も偏ります。
この例の計算を、生存曲線と表にすると次のようになります。
(図は、diagram-designで作成)
スクラッチ実装とlifelinesによる推定
カプラン・マイヤー推定量を NumPy でスクラッチ実装し、生存時間分析のライブラリ lifelines の結果、および真の生存関数と比べます(lifelinesのドキュメント)。実装するのは、推定の考え方で示した推定量 (survival。解約が起きた時点 は times、リスク集合の大きさ は at_risk、解約数 は deaths、積は np.cumprod)と、答え合わせ用の真の生存関数 (true_surv。顧客ごとの真の累積ハザードから計算した の全顧客 人での平均)です。
from lifelines import KaplanMeierFitter

# 1. カプラン・マイヤー推定のスクラッチ実装
def kaplan_meier(duration, event):
    times = np.unique(duration[event == 1])                                 # 解約が起きた時点
    at_risk = np.array([(duration >= t).sum() for t in times])              # リスク集合の大きさ n_j
    deaths = np.array([((duration == t) & (event == 1)).sum() for t in times])  # 解約の数 d_j
    survival = np.cumprod(1 - deaths / at_risk)                             # 掛け合わせる
    return times, survival

def step_value(times, survival, t):
    """階段関数として、時点 t の生存確率を返す"""
    idx = np.searchsorted(times, t, side='right') - 1
    return 1.0 if idx < 0 else survival[idx]

km_times, km_surv = kaplan_meier(df['duration'].values, df['event'].values)

# 2. lifelines による推定
kmf = KaplanMeierFitter()
kmf.fit(df['duration'], event_observed=df['event'])
diff = np.abs(kmf.survival_function_.loc[km_times, 'KM_estimate'].values - km_surv).max()
print(f"スクラッチ実装と lifelines の差の最大値: {diff:.2e}")

# 3. 真の生存関数(全顧客の exp(-H(t | x_i)) の平均)
grid = np.linspace(0, END, 361)
true_surv = np.exp(-true_cum_hazard(grid[:, None], ad, usage, trial)).mean(axis=1)

# 4. 12か月継続率と中央値を比較する
print(f"\n12か月継続率: スクラッチ {step_value(km_times, km_surv, 12):.1%}、lifelines {kmf.predict(12):.1%}、"
      f"真の値 {np.interp(12, grid, true_surv):.1%}")
lo, hi = kmf.confidence_interval_survival_function_.loc[:12].iloc[-1]
print(f" 95%信頼区間(lifelines): [{lo:.1%}, {hi:.1%}]")
print(f"契約期間の中央値: lifelines {kmf.median_survival_time_:.1f} か月、真の値 {grid[np.argmax(true_surv <= 0.5)]:.1f} か月")

# 5. 可視化:カプラン・マイヤー推定・真の生存関数・方法B
fig, ax = plt.subplots(figsize=(10, 6))
kmf.plot_survival_function(ax=ax, label='カプラン・マイヤー推定(95%信頼区間)')
ax.plot(grid, true_surv, color='black', linestyle='--', label='真の生存関数')
naive_surv = [(df['duration'] > g).mean() for g in grid]
ax.plot(grid, naive_surv, color='C3', alpha=0.8, label='方法B(打ち切りを解約とみなす)')
ax.set_xlabel('契約期間(月)')
ax.set_ylabel('生存確率 S(t)')
ax.set_title('カプラン・マイヤー推定と真の生存関数')
ax.set_ylim(0, 1.02)
ax.legend()
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
カプラン・マイヤー推定量をスクラッチで実装し、lifelines と真の生存関数と比べています。
- スクラッチ実装: kaplan_meier は、解約が起きた時点 times ごとに、その時点でまだ観測が続いている顧客の数 at_risk(。契約期間がその時点以上の顧客)と、その時点の解約数 deaths()を数え、np.cumprod(1 - deaths / at_risk) で掛け合わせています。打ち切られた顧客は、duration >= t の条件によって、打ち切りの時点までリスク集合に入ります。
- 階段関数としての値: カプラン・マイヤー推定量は、解約が起きた時点でだけ値が変わる階段関数です。step_value は、np.searchsorted で「時点 t 以前で最後に解約が起きた時点」を探し、その値を返します。
- lifelines: KaplanMeierFitter の fit に契約期間と event_observed(解約したかどうか)を渡すと、推定した生存関数が survival_function_ に、95%信頼区間が confidence_interval_survival_function_ に入ります。スクラッチ実装と同じ時点の値を取り出して、差の最大値を計算しています。
- 真の生存関数: grid[:, None] で時点を縦方向に並べ、true_cum_hazard に全顧客の属性を渡すと、(時点の数, 顧客数) の行列ができます。mean(axis=1) で顧客について平均したものが、顧客全体の真の生存関数です。これは「この5,000人の属性のもとでの理論上の期待値」なので、最初のコードで表示した、実際に生成された契約期間の値(51.0%、12.6か月)とは、偶然のばらつきの分だけわずかに異なります。
- 可視化: カプラン・マイヤー推定(信頼区間つき)、真の生存関数、方法B(各時点で duration がそれを超える割合)を重ねています。
実行結果
スクラッチ実装と lifelines の差の最大値: 4.88e-15

12か月継続率: スクラッチ 50.7%、lifelines 50.7%、真の値 50.8%
 95%信頼区間(lifelines): [49.2%, 52.2%]
契約期間の中央値: lifelines 12.4 か月、真の値 12.5 か月
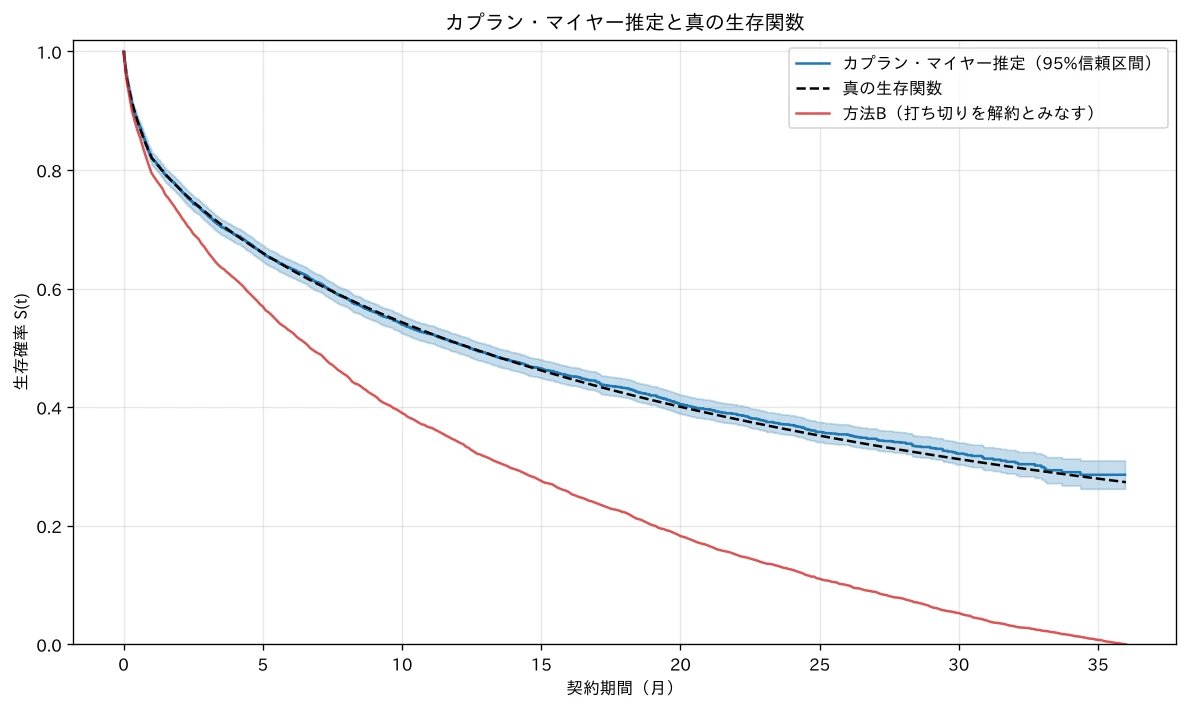
- スクラッチ実装は lifelines と一致: 差の最大値は で、計算誤差の範囲で一致しました。
- 真の値を復元できた: 12か月継続率は50.7%(95%信頼区間 [49.2%, 52.2%])で、真の値50.8%を区間に含んでいます。中央値も12.4か月(真の値12.5か月)です。方法A・Bで大きく外れたのと同じデータから、打ち切りを正しく扱うだけで、ほぼ真の値が得られました。
- 図: カプラン・マイヤー推定は、観測期間の終わり(36か月)まで真の生存関数(黒の破線)にほぼ重なっています。一方、方法Bの曲線は大きく下にずれ、36か月で0になっています。打ち切りを解約とみなすと、「36か月より長く続く顧客はいない」ことになってしまうためです。
なお、契約期間が長い部分ほど信頼区間が広がっています。長く観測できているのは早い時期に入会した顧客だけで、リスク集合が小さくなるためです。
グループの比較とログランク検定
カプラン・マイヤー推定は、顧客のグループごとに生存曲線を比べるのにも使えます。「広告経由かどうか」「初月無料キャンペーンを使ったかどうか」で顧客を分け、生存曲線を比べます。2つの生存曲線に差があるかどうかは、ログランク検定(log-rank test) で確かめるのが一般的です。ログランク検定は、解約が起きた各時点で「各グループの解約数が、両グループのハザードが等しい場合の期待値からどれだけずれているか」を全時点で集計する検定です。
式で書くと、解約が起きた各時点 で、全体のリスク集合の大きさを 、解約数を 、グループ1(たとえば広告経由)のリスク集合の大きさを 、解約数を とします(グループ0は )。ハザードが等しければ、グループ1の解約数の期待値は 、分散は です。ログランク検定の統計量 (lifelines の logrank_test が計算し、test_statistic に入る)は、ずれを全時点で足して標準化したもので、自由度1のカイ二乗分布で評価したp値は p_value に入ります。
from lifelines.statistics import logrank_test

# 1. グループごとにカプラン・マイヤー推定を行い、ログランク検定で比べる
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
for ax, col, labels in [
    (axes[0], 'ad', {0: '広告経由でない', 1: '広告経由'}),
    (axes[1], 'trial', {0: '初月無料なし', 1: '初月無料あり'}),
]:
    for value, label in labels.items():
        g = df[df[col] == value]
        KaplanMeierFitter().fit(g['duration'], g['event'], label=f"{label}({len(g):,}人)").plot_survival_function(ax=ax)
    g0, g1 = df[df[col] == 0], df[df[col] == 1]
    result = logrank_test(g0['duration'], g1['duration'], g0['event'], g1['event'])
    print(f"{col:5s}: ログランク検定の統計量 {result.test_statistic:7.1f}、p値 {result.p_value:.1e}")
    ax.set_xlabel('契約期間(月)')
    ax.set_ylabel('生存確率 S(t)')
    ax.set_ylim(0, 1.02)
    ax.grid(True, alpha=0.3)
axes[0].set_title('広告経由かどうか')
axes[1].set_title('初月無料キャンペーンを使ったかどうか')
plt.tight_layout()
plt.show()
属性ごとにカプラン・マイヤー推定を行い、ログランク検定で比べています。
- グループごとの推定: df[df[col] == value] でグループの顧客を取り出し、それぞれ KaplanMeierFitter で推定して、plot_survival_function で同じ図に描いています。凡例には各グループの人数も入れています。
- ログランク検定: logrank_test に、2つのグループの契約期間と解約の有無を渡しています。帰無仮説は「2つのグループのハザード(生存曲線)は等しい」で、test_statistic は自由度1のカイ二乗分布に従う統計量、p_value はそのp値です。
実行結果
ad   : ログランク検定の統計量   174.7、p値 6.9e-40
trial: ログランク検定の統計量   161.7、p値 4.7e-37
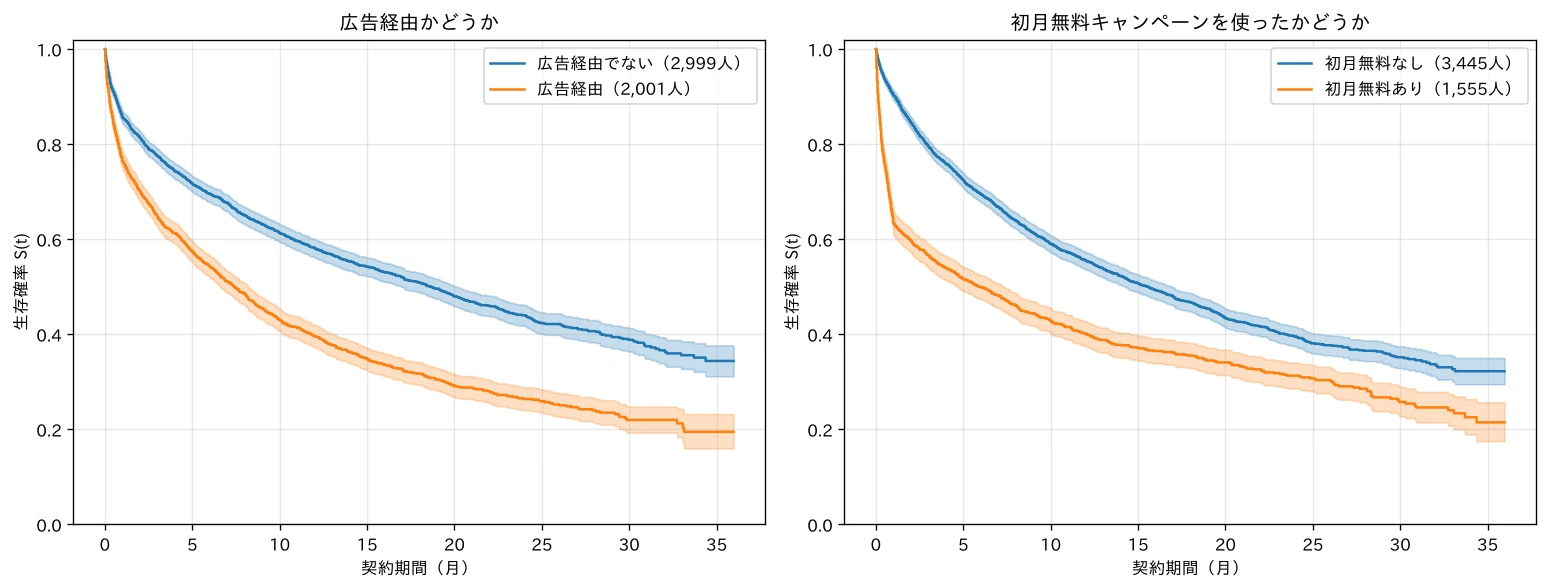
- 広告経由: 広告経由の顧客の生存曲線は、最初から最後まで下にあり、ログランク検定のp値も非常に小さくなっています()。
- 初月無料キャンペーン: 初月無料ありの顧客は、最初の1か月で生存確率が約0.63まで急落し、その後は初月無料なしの顧客と同じようなペースで減っていきます。真のデータの「無料期間だけ解約しやすい」性質が、曲線の形に現れています。ログランク検定でも、差は明らかです(p値 )。
ただし、ログランク検定が教えてくれるのは「差があるかどうか」だけで、「差がいつ生じているか」や「どれくらいの倍率か」は分かりません。また、初月無料のグループには広告経由の顧客も含まれているため、1つの属性で分けた比較では、他の属性の影響が混ざります。複数の属性の効果を同時に測るために、次の節で Cox比例ハザードモデルを使います。
Cox比例ハザードモデル
モデルの考え方
カプラン・マイヤー推定でグループを比べる方法は、属性が1つか2つなら有効です。しかし、「広告経由で、初月の利用日数が5日で、初月無料なし」のように属性の組み合わせが増えると、各グループの人数が足りなくなります。また、「利用日数が1日増えると、解約のしやすさはどれだけ変わるか」のような連続的な属性の効果も測れません。
そこで、属性がハザードに与える影響を回帰モデルで表したのが、Cox比例ハザードモデル(Cox proportional hazards model) です(Cox, 1972)。顧客 の属性を とすると、ハザードを次のように表します。
- :ベースラインハザード。すべての属性が0の顧客のハザードで、時間とともにどう変わるかは自由(形を仮定しない)
- :属性による倍率。時間 を含まない
- :係数。属性 が1増えると、ハザードが 倍になる。この を ハザード比(hazard ratio) と呼ぶ
このモデルの最大の特徴は、2人の顧客のハザードの比が、
のように、時間 によらず一定になることです。たとえば「広告経由の顧客は、入会1か月後でも2年後でも、常に1.65倍解約しやすい」という仮定です。これを 比例ハザード性(proportional hazards) と呼びます。サブスクワールドでは、広告経由と利用日数はこの仮定を満たしていますが、初月無料キャンペーン(最初の1か月だけ4倍)は満たしていません。
部分尤度による推定
ベースラインハザード の形を決めずに、どうやって だけを推定するのでしょうか。Cox は、解約が起きた各時点で「リスク集合の中で、なぜ他の誰でもなくこの顧客が解約したのか」という条件付き確率に注目しました。
時点 に顧客 が解約したとします。その直前まで契約が続いていた顧客の集合(リスク集合)を とすると、「解約したのが顧客 である」確率は、ハザードの比で表せます。
分母と分子の が打ち消し合い、 だけの式になりました。これをすべての解約について掛け合わせたものを 部分尤度(partial likelihood) と呼び、これを最大にする を推定値とします。
打ち切られた顧客は、分子には現れませんが、打ち切りの時点までは分母のリスク集合に入ります。カプラン・マイヤー推定と同じく、「そこまでは解約しなかった」という情報を使っているわけです。なお、同じ日に複数の顧客が解約した場合(同順位)の扱いにはいくつかの近似があり、lifelines は Efron の近似を使います。
lifelinesによる推定と真値の比較
まずは、比例ハザード性を気にせず、3つの属性をそのまま入れて推定します。モデルは で(真の係数 は生成時の beta_ad・beta_usage)、直前の部分尤度 を最大にする (coef の列。ハザード比 は exp(coef) の列)を求めます。
from lifelines import CoxPHFitter

# 1. Cox比例ハザードモデルの推定(3つの属性をそのまま入れる)
cph = CoxPHFitter()
cph.fit(df, duration_col='duration', event_col='event')

# 2. 推定した係数と真値を並べる
summary = cph.summary[['coef', 'exp(coef)', 'coef lower 95%', 'coef upper 95%']].copy()
summary['真の係数'] = [beta_ad, beta_usage, np.nan]   # trial の真の効果は時間で変わる(1か月目だけ log 4.0)
print(summary.round(3).to_string())
print(f"\nC-index(順位の当てはまり): {cph.concordance_index_:.3f}")
3つの属性を使って Cox比例ハザードモデルを推定し、真の係数と比べています。
- 推定: CoxPHFitter の fit に、データフレームと、契約期間の列名 duration_col・解約の有無の列名 event_col を渡しています。残りの列(ad・usage・trial)が属性 として使われます。内部では部分尤度を最大化しており、ベースラインハザードの形は推定しません。
- 推定結果の表: summary から、係数 (coef)、ハザード比 (exp(coef))、係数の95%信頼区間を取り出し、真の係数を並べています。trial の真の効果は時間によって変わる(1か月目だけ 、以降は0)ため、1つの値として書けないので空欄(NaN)にしています。
- C-index: concordance_index_ は、2人の顧客を比べたとき、「先に解約した顧客の予測ハザードの方が高い」組の割合です。0.5ならランダム、1.0なら完全に順位を当てています。打ち切りがあっても計算できる、生存時間分析の代表的な評価指標です。
実行結果
            coef  exp(coef)  coef lower 95%  coef upper 95%  真の係数
covariate
ad         0.568      1.766           0.492           0.645  0.50
usage     -0.050      0.952          -0.056          -0.043 -0.05
trial      0.571      1.770           0.492           0.650   NaN

C-index(順位の当てはまり): 0.648
- 広告経由と利用日数は、真の係数を復元できた: 広告経由の係数は0.568(95%信頼区間 [0.492, 0.645]、真値0.5)、利用日数は −0.050(真値 −0.05)です。どちらも信頼区間が真値を含んでいます。ハザード比で言えば、広告経由の顧客は約1.8倍解約しやすく、初月の利用日数が1日多いと、解約のしやすさは約0.95倍になります。
- 初月無料の係数は「平均」になる: 初月無料の係数は0.571(ハザード比1.77)でした。真の効果は「最初の1か月だけ4.0倍、その後は1.0倍」なので、1.77倍という値は、どの時点にも当てはまりません。比例ハザードモデルは、時間によって変わる効果を、無理やり1つの倍率に平均してしまうのです。この結果をうのみにすると、「初月無料の顧客は、ずっと1.8倍解約しやすい」と誤解してしまいます。
- C-index は0.648: 解約の順番をある程度は当てていますが、偶然の要素が大きい解約を、3つの属性だけで完全に予測することはできません。
このように、係数の推定値を見ただけでは、比例ハザード性が崩れていることには気づけません。次に、比例ハザード性を確認します。
係数の推定値と真の値を並べると、次のようになります。
(図は、diagram-designで作成)
比例ハザード性の確認
Cox比例ハザードモデルを使うときは、比例ハザード性が成り立っているかを必ず確認します。確認の方法は2つあります。
- Schoenfeld残差による検定:比例ハザード性が成り立っていれば、各解約時点での「解約した顧客の属性」と「リスク集合の属性の重み付き平均」のずれ(Schoenfeld残差)は、時間と無関係にばらつくはずです。残差と時間の相関を検定し、有意なら比例ハザード性が崩れていると判断します。lifelines の proportional_hazard_test で計算できます。
- 二重対数プロット: なので、両辺の対数を2回とると となります。グループごとにカプラン・マイヤー推定した を描くと、比例ハザード性が成り立っていれば、曲線どうしは上下に平行移動した形になります。
from lifelines.statistics import proportional_hazard_test

# 1. Schoenfeld残差による比例ハザード性の検定
ph_test = proportional_hazard_test(cph, df, time_transform='rank')
print(ph_test.summary[['test_statistic', 'p']].round(4).to_string())

# 2. 二重対数プロット:log(-log S(t)) を log(t) に対して描く
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
for ax, col, labels in [
    (axes[0], 'ad', {0: '広告経由でない', 1: '広告経由'}),
    (axes[1], 'trial', {0: '初月無料なし', 1: '初月無料あり'}),
]:
    for value, label in labels.items():
        g = df[df[col] == value]
        sf = KaplanMeierFitter().fit(g['duration'], g['event']).survival_function_['KM_estimate']
        sf = sf[(sf > 0) & (sf < 1)]
        ax.plot(np.log(sf.index), np.log(-np.log(sf.values)), drawstyle='steps-post', label=label)
    ax.axvline(np.log(1), color='gray', linestyle=':', label='1か月(無料期間の終わり)')
    ax.set_xlabel('log(契約期間)')
    ax.set_ylabel('log(-log S(t))')
    ax.legend()
    ax.grid(True, alpha=0.3)
axes[0].set_title('広告経由かどうか')
axes[1].set_title('初月無料キャンペーンを使ったかどうか')
plt.tight_layout()
plt.show()
比例ハザード性を、検定と図の2つの方法で確認しています。
- Schoenfeld残差の検定: proportional_hazard_test に、推定したモデルとデータを渡しています。time_transform='rank' は、残差との相関を調べる「時間」として、解約時点の順位を使う設定です(時間の値そのものを使うと、長い契約期間の少数の顧客に結果が引きずられるため)。帰無仮説は「その属性について比例ハザード性が成り立つ」です。
- 二重対数プロット: グループごとにカプラン・マイヤー推定を行い、横軸に 、縦軸に をとって描いています。 が0や1のときは対数が計算できないので、0より大きく1より小さい値だけを残しています。
- 無料期間の終わり: 横軸の (1か月)の位置に縦の点線を引き、その前後で曲線の関係が変わるかを見やすくしています。
実行結果
       test_statistic       p
ad             2.8260  0.0928
trial        214.8206  0.0000
usage          0.2185  0.6402
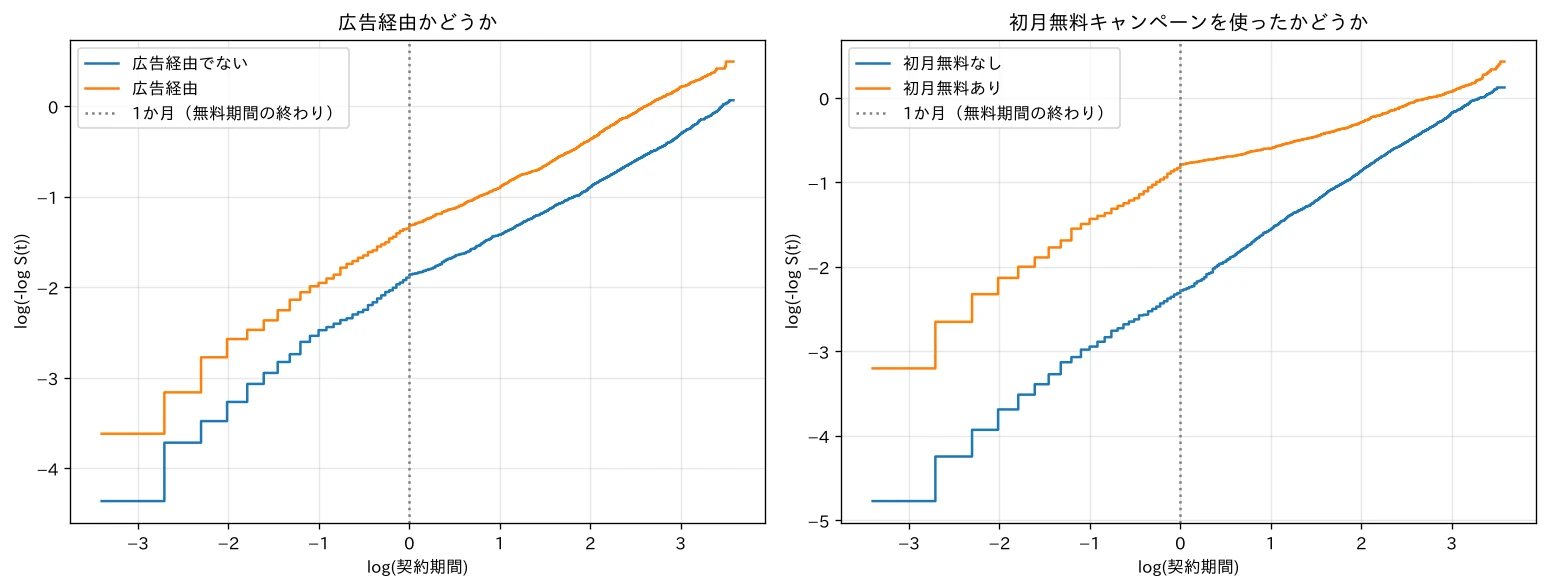
- 初月無料は比例ハザード性が崩れている: 検定統計量は214.8、p値はほぼ0で、比例ハザード性ははっきり否定されました。右の図でも、2本の曲線の差は、1か月(点線)より前では大きく、その後は少しずつ縮まって近づいていきます。比例ハザード性が成り立っていれば、差は一定(平行)のはずです。
- 広告経由と利用日数は問題なし: p値は0.093と0.640で、5%水準では比例ハザード性は否定されません。左の図でも、広告経由の2本の曲線は、ほぼ平行に並んでいます。
実務のデータでは、無料期間や最低契約期間、キャンペーンなど、「ある時期だけ効く」要因がよくあります。Cox比例ハザードモデルを使うときは、係数を解釈する前に、比例ハザード性を必ず確認しましょう。
比例ハザード性が崩れているときの対処
比例ハザード性が崩れている属性への代表的な対処法は、次の2つです。
- 層別化(stratification):その属性のグループごとに、別々のベースラインハザード を認める方法です。属性の効果は「時間とともにどう変わってもよい」ベースラインに吸収されるので、他の属性の係数を、比例ハザード性の崩れに引きずられずに推定できます。ただし、層別化した属性そのものの効果(ハザード比)は推定できません。
- 時間で区切る(時間依存の効果):観測期間を区間に分け、区間ごとに別々の係数を推定する方法です。属性の効果が時間とともにどう変わるかを、数字として知ることができます。
まず層別化で他の属性の係数を推定し直し、顧客の属性ごとの生存曲線 を予測します。初月無料の有無で決まる層を (。コードでは strata=['trial'] で指定)とすると、層別化したモデルと、そこから予測する生存曲線 (pred。真の は true_curve)、36か月以内の平均継続月数(生存曲線の下の面積を np.trapezoid で積分したもの。制限付き平均生存時間)は次のとおりです。
は層ごとのベースラインの累積ハザードです。
# 1. 初月無料キャンペーンで層別化して推定し直す
cph_strat = CoxPHFitter()
cph_strat.fit(df, duration_col='duration', event_col='event', strata=['trial'])
summary = cph_strat.summary[['coef', 'coef lower 95%', 'coef upper 95%']].copy()
summary['真の係数'] = [beta_ad, beta_usage]
print(summary.round(3).to_string())

# 2. 2人の顧客の生存曲線を予測し、真の生存曲線と比べる
profiles = pd.DataFrame({'ad': [0, 1], 'usage': [20, 3], 'trial': [0, 1]},
                        index=['顧客A(広告経由でない・利用20日・無料なし)', '顧客B(広告経由・利用3日・無料あり)'])
grid = np.linspace(0, END, 361)
pred = cph_strat.predict_survival_function(profiles, times=grid)

fig, ax = plt.subplots(figsize=(10, 6))
for (name, row), color in zip(profiles.iterrows(), ['C0', 'C3']):
    true_curve = np.exp(-true_cum_hazard(grid, row['ad'], row['usage'], row['trial']))
    ax.plot(grid, pred[name], color=color, label=f'{name}:Cox(層別化)')
    ax.plot(grid, true_curve, color=color, linestyle='--', label=f'{name}:真の値')
    # 3. 12か月継続率と、36か月以内の平均継続月数(生存曲線の下の面積)を比べる
    print(f"\n{name}")
    print(f"  12か月継続率     : 予測 {np.interp(12, grid, pred[name]):.1%}、真の値 {np.interp(12, grid, true_curve):.1%}")
    print(f"  36か月以内の平均継続月数: 予測 {np.trapezoid(pred[name], grid):.1f} か月、真の値 {np.trapezoid(true_curve, grid):.1f} か月")
ax.set_xlabel('契約期間(月)')
ax.set_ylabel('生存確率 S(t)')
ax.set_title('属性ごとの生存曲線の予測(Cox比例ハザードモデル・層別化)')
ax.set_ylim(0, 1.02)
ax.legend(fontsize=9)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
初月無料で層別化した Cox モデルを推定し、2人の顧客の生存曲線を予測しています。
- 層別化: strata=['trial'] を指定すると、初月無料あり・なしの2つのグループ(層)で、別々のベースラインハザードを推定します。部分尤度のリスク集合も層ごとに作られ、ad と usage の係数は、全層に共通の値として推定されます。trial の係数は推定されないので、真の係数は2つだけ並べています。
- 生存曲線の予測: predict_survival_function に顧客の属性(profiles)と時点 times を渡すと、各顧客の が、(時点, 顧客) の表として返ってきます。層別化したモデルでは、属性に含めた trial の値で、どちらの層のベースラインを使うかが決まります。
- 2人の顧客: 顧客Aは解約しにくい属性、顧客Bは解約しやすい属性の組み合わせです。真の生存曲線は、true_cum_hazard にそれぞれの属性を渡して計算しています。
- 平均継続月数: 生存曲線の下の面積 は、「36か月以内に限った、平均の継続月数」です(制限付き平均生存時間)。np.trapezoid で台形公式を使って計算しています。毎月の利益が一定で割引を無視すれば、「36か月分の CLV ÷ 月額の利益」に相当します。
実行結果
            coef  coef lower 95%  coef upper 95%  真の係数
covariate
ad         0.550           0.473           0.627  0.50
usage     -0.049          -0.055          -0.043 -0.05

顧客A(広告経由でない・利用20日・無料なし)
  12か月継続率     : 予測 73.6%、真の値 73.0%
  36か月以内の平均継続月数: 予測 24.9 か月、真の値 24.5 か月

顧客B(広告経由・利用3日・無料あり)
  12か月継続率     : 予測 14.2%、真の値 15.7%
  36か月以内の平均継続月数: 予測 5.1 か月、真の値 5.4 か月
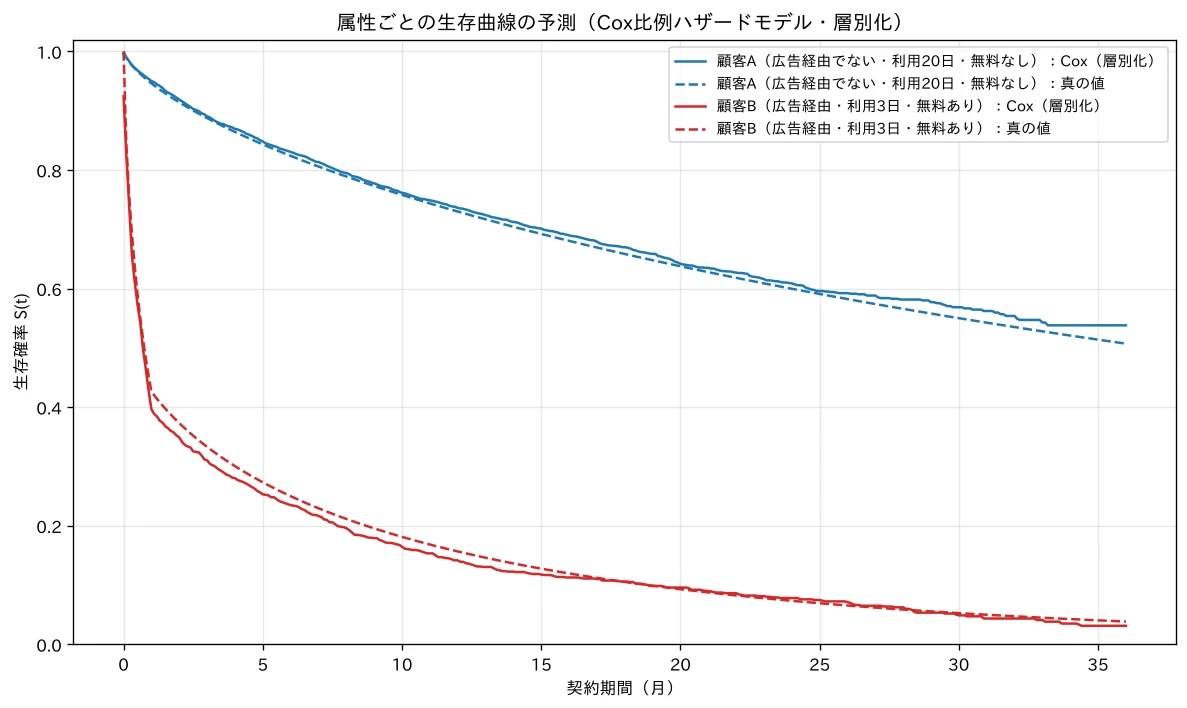
- 係数の推定: 層別化すると、広告経由の係数は0.550(95%信頼区間 [0.473, 0.627])、利用日数は −0.049 となり、どちらも真値を区間に含んでいます。初月無料の効果は、層ごとのベースラインハザードが吸収しています。
- 顧客Aの予測: 12か月継続率は73.6%(真の値73.0%)、36か月以内の平均継続月数は24.9か月(真の値24.5か月)と、よく一致しています。
- 顧客Bの予測: 12か月継続率は14.2%(真の値15.7%)、平均継続月数は5.1か月(真の値5.4か月)です。図を見ると、最初の1か月の急落も含めて、真の曲線の形を捉えています。顧客Bの属性(広告経由・初月無料あり・利用日数3日)を持つ顧客は少ないため、顧客Aより推定の誤差が大きくなっています。
同じサービスの顧客でも、属性によって平均継続月数は約5倍違います。CLVの式の を顧客ごとに推定することで、「この顧客を獲得・維持するためにいくらまで使ってよいか」を、顧客ごとに考えられるようになります。
次に、初月無料キャンペーンの効果が時間とともにどう変わるかを、時間で区切る方法で推定します。各顧客の観測期間を「最初の1か月」と「それ以降」の2つの区間に分け、区間ごとに別々の係数 (coef として推定)を持たせます。推定するモデルは次のとおりです( は最初の区間の列 trial_first、 は2つ目の区間の列 trial_after)。
は条件を満たすとき1、満たさないとき0になる関数です。真の値は 、 です。lifelines では、このように1人の顧客を複数の行(区間)に分けたデータを CoxTimeVaryingFitter で推定できます。
from lifelines import CoxTimeVaryingFitter

# 1. 各顧客の観測期間を「最初の1か月」と「それ以降」の2つの区間に分ける
first = df.assign(start=0.0, stop=np.minimum(df['duration'], 1.0),
                  churn=np.where(df['duration'] <= 1.0, df['event'], 0),
                  trial_first=df['trial'], trial_after=0)
after = df[df['duration'] > 1.0].assign(start=1.0, stop=lambda d: d['duration'], churn=lambda d: d['event'],
                                        trial_first=0, trial_after=lambda d: d['trial'])
episodes = pd.concat([first, after]).reset_index(names='id')
print(f"区間に分けたデータ: {len(df):,} 人 → {len(episodes):,} 行")
print(episodes.loc[episodes['id'] == 0, ['id', 'start', 'stop', 'churn', 'ad', 'usage', 'trial_first', 'trial_after']].to_string())

# 2. 区間ごとに初月無料の係数を分けて推定する
ctv = CoxTimeVaryingFitter()
ctv.fit(episodes[['id', 'start', 'stop', 'churn', 'ad', 'usage', 'trial_first', 'trial_after']],
        id_col='id', event_col='churn', start_col='start', stop_col='stop')
summary = ctv.summary[['coef', 'exp(coef)', 'exp(coef) lower 95%', 'exp(coef) upper 95%']].copy()
summary['真のハザード比'] = [np.exp(beta_ad), np.exp(beta_usage), trial_hr_first, 1.0]
print()
print(summary.round(3).to_string())
観測期間を区間に分けて、初月無料の効果を区間ごとに推定しています。
- 区間への分割: first は全員の「0〜1か月」の区間で、終わり stop は契約期間と1か月の短い方です。1か月以内に解約した顧客だけ、この区間の churn が1になります。after は、1か月より長く観測された顧客の「1か月〜観測の終わり」の区間です。初月無料の属性を、最初の区間では trial_first、2つ目の区間では trial_after という別の列に入れることで、区間ごとに別の係数を推定できるようにしています。
- 顧客ID: reset_index(names='id') で、元のデータの行番号を顧客ID id として残しています。表示している顧客0は、8.2か月で打ち切られた顧客で、2つの行(0〜1か月、1〜8.2か月)に分かれています。
- 推定: CoxTimeVaryingFitter は、各行の区間 [start, stop] の間だけ、その行の属性でリスク集合に入る、という形で部分尤度を計算します。属性が途中で変わる(ここでは初月無料の列が切り替わる)データを扱えます。
- 真のハザード比との比較: 広告経由は 、利用日数は 、初月無料は1か月目が4.0、それ以降は1.0です。
実行結果
区間に分けたデータ: 5,000 人 → 8,977 行
      id  start      stop  churn  ad  usage  trial_first  trial_after
0      0    0.0  1.000000      0   0      1            0            0
5000   0    1.0  8.166667      0   0      1            0            0

              coef  exp(coef)  exp(coef) lower 95%  exp(coef) upper 95%  真のハザード比
covariate
ad           0.550      1.733                1.606                1.871    1.649
usage       -0.049      0.952                0.947                0.958    0.951
trial_first  1.524      4.590                4.006                5.259    4.000
trial_after -0.009      0.991                0.887                1.107    1.000
- 初月無料の効果が時間とともに変わる様子を復元できた: 最初の1か月のハザード比は4.59(95%信頼区間 [4.01, 5.26]、真値4.0)、それ以降は0.991([0.887, 1.107]、真値1.0)で、どちらも真値を区間に含んでいます。比例ハザードモデルの1.77という「平均」の値とは違い、「無料期間が終わる前に解約が集中するが、無料期間を越えた顧客は、キャンペーンを使わなかった顧客と変わらない」という実態が、数字で分かります。
- 他の属性: 広告経由のハザード比は1.733(真値1.649)、利用日数は0.952(真値0.951)で、層別化したモデルと同じ値です。
この結果は、施策の判断にもつながります。「初月無料で入会した顧客は解約しやすい」と一律に考えるのではなく、「無料期間の終わりに解約が集中する」と分かれば、対策は「無料期間の終わる前のフォロー」に絞れます。
ただし、ここでは「1か月で効果が切り替わる」ことを知っていたので、区切る位置を1か月にしました。実務では、二重対数プロットやカプラン・マイヤー推定の曲線を見て、区切る位置の見当をつけます。
sBGモデル:観測期間の先まで解約を予測する
カプラン・マイヤー推定とCoxモデルの限界
ここまでの方法で、観測できた期間の生存曲線は正しく推定できました。しかし、CLVを計算するには、観測期間の先の も必要です。サービス開始から3年しかたっていなければ、4年目、5年目の継続率はデータに含まれていません。
カプラン・マイヤー推定は、データのある範囲でしか生存曲線を描けません。Cox比例ハザードモデルも、ベースラインハザード の形を仮定しないので、観測期間の外には延ばせません。観測期間の先を予測するには、生存曲線の形を決める確率モデルが必要です。
継続率はなぜ上がっていくのか
素朴な方法は、「毎期の解約率は一定」と仮定することです。RFMの記事の契約型の単純な例でも、継続率 を一定とおいて CLV を計算しました。
ところが実際のデータでは、コホート(同じ時期に入会した顧客の集団)全体の継続率は、時間とともに上がっていくことがよく知られています。サブスクワールドのベースラインハザードが時間とともに下がっていたのと同じ現象です。この現象には2つの説明が考えられます。
- 一人ひとりの顧客が、時間とともに解約しにくくなる(愛着がわく、乗り換えが面倒になる、など)
- 顧客ごとに解約のしやすさが違い、解約しやすい顧客から先にいなくなる
2つ目の説明では、一人ひとりの解約確率は時間がたっても変わりません。それでも、コホートに残っている顧客の顔ぶれが「解約しにくい顧客」に偏っていくため、全体の継続率は上がります。この「顧客の異質性による選別」を数式にしたのが、sBGモデル(shifted-Beta-Geometric model) です(Fader & Hardie, 2007)。
2つ目の説明を、2種類の顧客がいる説明用の例で図にすると、次のようになります。
(図は、diagram-designで作成)
sBGモデルの定義
sBGモデルは、年会費制の会員サービスや年契約の保険のように、決まった更新のタイミングでしか解約できない契約(離散時間の契約型)のためのモデルです。次の2つの仮定を置きます。
- 一人ひとりの解約は幾何分布に従う:顧客 は、更新のたびに確率 で解約する。 は時間がたっても変わらないので、 回目の更新で解約する確率と、 期後まで残る確率は次のとおり。
- 解約確率は顧客ごとにベータ分布に従ってばらつく:
分析者は一人ひとりの を知らないので、 をベータ分布で平均(積分)すると、コホート全体の生存関数と、 期目に解約する確率が求まります。
ここで はベータ関数です。さらに、 期目の継続率( 期まで残った顧客が、 期目も残る割合)は、
となり、 が大きくなるほど1に近づいていきます。一人ひとりの解約確率は一定なのに、選別によって全体の継続率が上がっていく様子が、式に現れています。 の確率密度は です。 をこの分布で平均すると、 となります。最後の等号は、ベータ関数の定義 そのものです。同様に、 です。継続率は、ベータ関数の性質 を使うと、 と簡単になります。詳細な式展開(ベータ分布による平均)
Fader & Hardie (2007) の原論文では、解約確率を 、ベータ分布のパラメータを と書いています。本記事では、Cox比例ハザードモデルの係数 と区別するため、また後の記事で扱うBG/NBDモデルの記法にそろえるため、解約確率を 、ベータ分布のパラメータを と書きます。
検証用ダミーデータの生成:年契約のコホート
年会費制の会員サービスに、ある年に1,000人が入会したとします。真の解約確率 (p_churn)は (、 は a_true・b_true)に従ってばらつき、平均は です。12回目の更新まで生成しますが、分析者が観測できるのは5回目の更新までとし、6回目以降は予測の答え合わせに使います。
生成と答え合わせに使う式は、sBGモデルの定義で示した次の3つです( は何回目の更新で解約するかで churn_period、 は関数 sbg_survival、 は betaln)。
from scipy.special import betaln

# 1. 真のパラメータと観測期間の設定(時間の単位は年)
rng_sbg = np.random.default_rng(42)
N_COHORT = 1_000
a_true, b_true = 0.7, 2.5      # 解約確率のばらつき(ベータ分布)
T_OBS, T_ALL = 5, 12           # 5回目の更新まで観測し、12回目まで答え合わせに使う

# 2. 顧客ごとの解約確率と、何回目の更新で解約するかを生成する
p_churn = rng_sbg.beta(a_true, b_true, size=N_COHORT)
churn_period = rng_sbg.geometric(p_churn)            # 1, 2, ... 回目の更新で解約

# 3. 各期の残存顧客数(t = 0 は入会時点)
periods = np.arange(T_ALL + 1)
alive = np.array([(churn_period > t).sum() for t in periods])
observed_alive = alive[:T_OBS + 1]                   # 分析者が観測できるのはここまで

# 4. 真の生存関数 S(t) = B(a, b + t) / B(a, b)
def sbg_survival(t, a, b):
    return np.exp(betaln(a, b + t) - betaln(a, b))

print("期      :", periods)
print("残存数  :", alive)
print("真の期待値:", np.round(N_COHORT * sbg_survival(periods, a_true, b_true)).astype(int))
print(f"\n観測できる残存数(5回目の更新まで): {observed_alive}")
print(f"観測期間の継続率: {np.round(observed_alive[1:] / observed_alive[:-1], 3)}")
sBGモデルに従って、1,000人のコホートの残存数を生成しています。
- 観測期間の設定: 時間の単位は年(更新の回数)です。乱数は、サブスクワールドとは別の default_rng(42) の生成器 rng_sbg で固定しています。5回目の更新までで推定し、12回目まで比べるのは、観測の外(6〜12回目)の予測で、sBGモデルと幾何分布モデルの差が広がることを確かめるためです(原著論文は、7年分で推定して12年目まで予測しています)。コホートを1,000人にするのは、Fader & Hardie (2007) の例のコホートと同じ人数にするためです。
- 解約の生成: 顧客ごとの解約確率 p_churn をベータ分布から引き、rng_sbg.geometric(p_churn) で「何回目の更新で初めて解約するか」を生成しています。NumPy の幾何分布は1から始まる(1回目の更新で解約する確率が )ので、sBGモデルの と一致します。、 は、原著論文の2つのコホートの推定値(regular:、、high end:、)を参考にした値です。
- 残存数: 各期 t について、解約の時期が t より後の顧客を数えています。observed_alive は、分析者が観測できる5期目までの残存数です。
- 真の生存関数: sbg_survival は です。ベータ関数は大きな値で桁あふれしやすいので、対数ベータ関数 betaln の差をとってから np.exp で戻しています。
実行結果
期      : [ 0  1  2  3  4  5  6  7  8  9 10 11 12]
残存数  : [1000  764  629  534  484  433  392  364  330  307  287  264  248]
真の期待値: [1000  781  651  563  500  451  413  381  355  333  314  297  283]

観測できる残存数(5回目の更新まで): [1000  764  629  534  484  433]
観測期間の継続率: [0.764 0.823 0.849 0.906 0.895]
- 残存数: 1年目の更新で236人が解約し、5年後の残存数は433人です。12年後には248人が残っています。
- 真の期待値との比較: 真のパラメータから計算した残存数の期待値は、12年後で283人です。実際の残存数(248人)とのずれは、1,000人という有限の顧客数による偶然のばらつきです。
- 継続率は上がっていく: 観測期間の継続率は、1年目の0.764から、4〜5年目には0.9前後まで上がっています。一人ひとりの解約確率は一定なのに、継続率が上がっていく ── これが、解約しやすい顧客から先にいなくなる「選別」の効果です。
最尤法による推定と、観測期間の先の予測
観測できた5年分のデータから、sBGモデルのパラメータ (推定値 は a_hat・b_hat)を最尤法で推定します。 期目に解約した顧客の数を (churned_per_period)、5期目の時点でまだ残っている顧客の数を (observed_alive の最後の要素)とすると、対数尤度は次のとおりです(コードでは符号を反転した を関数 sbg_neg_loglik で計算)。
第1項は解約した顧客、第2項はまだ残っている(打ち切られた)顧客の寄与です。ここでも、打ち切られた顧客は「5期目までは解約しなかった」という の形で尤度に入ります。 と にsBGモデルの定義の式を入れ、対数ベータ関数で書くと、各項(log_p・log_s)は次のようになります。
比較のために、「毎年の解約率は一定」とする幾何分布モデル(異質性を考えないモデル)も推定します。解約率の推定値 (p_const)は、観測期間中の解約数の合計を、のべの在籍顧客数(各期のはじめに残っていた顧客数の合計)で割ったものです。 期のはじめ( 期の終わり)の残存数を ( は observed_alive)とすると、推定値と予測は次のとおりです。
右の図に描く真の継続率は、sBGモデルの定義の です。
from scipy.optimize import minimize

# 1. sBGモデルの負の対数尤度
churned_per_period = -np.diff(observed_alive)      # 各期の解約数 n_t
def sbg_neg_loglik(log_params):
    a, b = np.exp(log_params)                        # a, b > 0 を保証するため対数で探索する
    t = np.arange(1, T_OBS + 1)
    log_p = betaln(a + 1, b + t - 1) - betaln(a, b)  # log P(T = t)
    log_s = betaln(a, b + T_OBS) - betaln(a, b)      # log S(5)
    return -(churned_per_period @ log_p + observed_alive[-1] * log_s)

# 2. 最尤推定
res = minimize(sbg_neg_loglik, x0=[0.0, 0.0], method='Nelder-Mead')
a_hat, b_hat = np.exp(res.x)
print(f"sBGモデル : a = {a_hat:.3f}(真値 {a_true})、b = {b_hat:.3f}(真値 {b_true})")

# 3. 比較:解約率一定の幾何分布モデル
p_const = churned_per_period.sum() / observed_alive[:-1].sum()
print(f"幾何分布モデル: 毎年の解約率 = {p_const:.3f}")

# 4. 12年目までの予測と実際の残存数を比べる
pred_sbg = N_COHORT * sbg_survival(periods, a_hat, b_hat)
pred_geo = N_COHORT * (1 - p_const) ** periods
print("\n期     :", periods)
print("実際の残存数:", alive)
print("sBGモデル  :", np.round(pred_sbg).astype(int))
print("幾何分布  :", np.round(pred_geo).astype(int))

# 5. 可視化:残存数と継続率
fig, axes = plt.subplots(1, 2, figsize=(13, 5))
axes[0].plot(periods, alive, 'ko-', label='実際の残存数')
axes[0].plot(periods, pred_sbg, 'C0--', label='sBGモデル')
axes[0].plot(periods, pred_geo, 'C3--', label='幾何分布モデル(解約率一定)')
axes[1].plot(periods[1:], alive[1:] / alive[:-1], 'ko-', label='実際の継続率')
axes[1].plot(periods[1:], (b_true + periods[1:] - 1) / (a_true + b_true + periods[1:] - 1), color='gray',
             linestyle=':', label='真の継続率')
axes[1].plot(periods[1:], pred_sbg[1:] / pred_sbg[:-1], 'C0--', label='sBGモデル')
axes[1].plot(periods[1:], np.full(T_ALL, 1 - p_const), 'C3--', label='幾何分布モデル(解約率一定)')
for ax, title, ylabel in [(axes[0], '残存数の予測', '残存顧客数'), (axes[1], '継続率の予測', '継続率 r_t')]:
    ax.axvspan(0, T_OBS, color='gray', alpha=0.1, label='推定に使った期間')
    ax.set_title(title)
    ax.set_xlabel('期(年)')
    ax.set_ylabel(ylabel)
    ax.legend()
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
5年分の観測データから sBGモデルと幾何分布モデルを推定し、12年目まで予測しています。
- 負の対数尤度: sbg_neg_loglik は、本文の対数尤度の符号を反転したものです。churned_per_period(各期の解約数 )と log_p()の内積が第1項、5期目の残存数と log_s()の積が第2項です。
- 対数での探索: は正の値しかとらないので、log_params()を探索し、関数の中で np.exp で戻しています。こうすると、制約のない最適化として解けます。初期値は ( で0)、最適化には微分を使わない Nelder-Mead 法を使っています。
- 幾何分布モデル: 解約率 p_const は、観測期間の解約数の合計を、各期のはじめに残っていた顧客数の合計(のべの在籍顧客数)で割ったものです。これは、解約率一定の幾何分布モデルの最尤推定値になっています。
- 予測: sBGモデルは sbg_survival に推定した を入れ、幾何分布モデルは で、12年目までの残存数を計算しています。
- 可視化: 左は残存数、右は継続率(前の期に対する残存数の比)です。灰色の帯が推定に使った期間で、その右側が観測期間の外の予測です。右の図には、真のパラメータから計算した継続率 も点線で描いています。
実行結果
sBGモデル : a = 0.665(真値 0.7)、b = 2.137(真値 2.5)
幾何分布モデル: 毎年の解約率 = 0.166

期     : [ 0  1  2  3  4  5  6  7  8  9 10 11 12]
実際の残存数: [1000  764  629  534  484  433  392  364  330  307  287  264  248]
sBGモデル  : [1000  762  629  542  480  433  396  366  341  320  302  286  273]
幾何分布  : [1000  834  695  580  483  403  336  280  234  195  162  135  113]
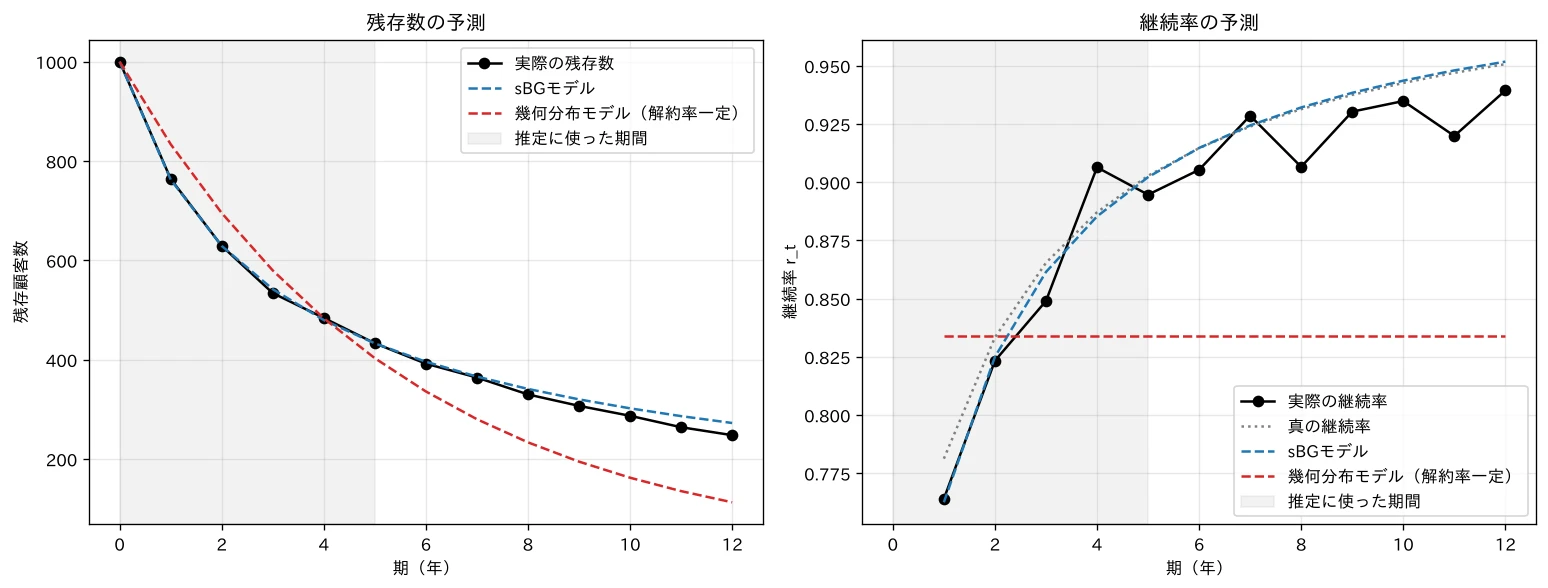
- パラメータの推定: (真値0.7)、(真値2.5)でした。5期分のデータでは、 と を個別に精度よく決めるのは難しく、「解約確率の平均」と「ばらつき」の組み合わせとして似た曲線を描く値が選ばれます。
- sBGモデルは観測期間の先も予測できる: 12年後の残存数の予測は273人で、実際の248人に近く、真の期待値283人とはさらに近い値です。右の図でも、sBGモデルの継続率は、真の継続率(点線)にほぼ重なりながら上がっていきます。
- 幾何分布モデルは長期を大きく過小評価する: 解約率を一定(0.166)とすると、12年後の残存数は113人と、実際の半分以下になりました。観測期間の平均的な解約率を将来にもそのまま当てはめるため、選別によって解約率が下がっていく効果を捉えられないのです。
なお、観測期間の中(灰色の帯)では、幾何分布モデルも残存数にそれなりに当てはまっています。観測期間の中の当てはまりだけでは、どちらのモデルが正しいかを判断できない 点に注意してください。
CLVの計算
最後に、推定した生存関数をCLVの定義式に当てはめます。会費(利益)(m)は毎年1万円で、入会時()に1年目の会費を受け取り、その後は更新のたびに受け取るとします。割引率 (d)は年10%です(時点 は t_long で0〜199、分母の は discount)。
には、真のパラメータと推定したパラメータによる sbg_survival と、幾何分布モデルの を入れます。
# 1. CLVの計算(m = 1万円/年、割引率 d = 10%/年、200年分を足せば無限和とみなせる)
m, d = 10_000, 0.1
t_long = np.arange(200)
discount = (1 + d) ** t_long
clv = {
    '真の値': np.sum(m * sbg_survival(t_long, a_true, b_true) / discount),
    'sBGモデル': np.sum(m * sbg_survival(t_long, a_hat, b_hat) / discount),
    '幾何分布モデル(解約率一定)': np.sum(m * (1 - p_const) ** t_long / discount),
}
for name, value in clv.items():
    print(f"{name:16s}: {value:7,.0f} 円(真の値との差 {value / clv['真の値'] - 1:+.1%})")
3つの生存関数から、CLV を計算しています。
- CLVの計算: から199年目までの「会費 × 生存確率 ÷ 割引」を足し合わせています。200年後の項は事実上0なので、無限和とみなせます。discount は各期の割引の分母 です。 万円、 は、RFM の記事の CLV の例と同じ値で、結果を比べられるようにしています。
- 3つの生存関数: 真のパラメータによる sBGモデル(真の値)、推定した sBGモデル、解約率一定の幾何分布モデルの生存関数を、同じ式に入れています。
実行結果
真の値             :  49,949 円(真の値との差 +0.0%)
sBGモデル          :  48,600 円(真の値との差 -2.7%)
幾何分布モデル(解約率一定)  :  41,318 円(真の値との差 -17.3%)
- sBGモデルの CLV は真の値に近い: 推定した sBGモデルの CLV は48,600円で、真の値49,949円との差は −2.7% でした。
- 解約率一定のモデルは CLV を過小評価する: 幾何分布モデルの CLV は41,318円で、真の値より17.3%も低くなりました。この値は、RFMの記事の契約型の例の公式 に、継続率 を入れたものと同じです。
CLVは、顧客を獲得するための広告費や、解約を防ぐための施策にいくらまで使ってよいかの上限を決める指標です。解約率を一定とみなして CLV を2割近く低く見積もると、本来は採算のとれる顧客の獲得や維持への投資を、見送ってしまうことになります。
3つの CLV を並べると、次のようになります。
(図は、diagram-designで作成)
発展:機械学習による生存時間分析
本記事では、生存時間分析の基本となる3つの方法を扱いました。実務では、より多くの特徴量や複雑な関係を扱うために、機械学習を使った方法も使われています。
- ランダムサバイバルフォレスト(Random Survival Forest):ランダムフォレストを生存時間分析に拡張した方法です(Ishwaran et al., 2008)。決定木の分岐の基準にログランク検定の統計量などを使い、各葉でカプラン・マイヤー推定(やネルソン・アーレン推定)を行います。比例ハザード性を仮定せず、属性の交互作用も自動的に捉えられます。Python では scikit-survival などで使えます。
- DeepSurv:Cox比例ハザードモデルの の部分を、ニューラルネットワークの出力に置き換えた方法です(Katzman et al., 2018)。部分尤度をそのまま損失関数として使うので、属性の非線形な効果を表現できます。ただし、比例ハザード性の仮定は残ります。
どちらの方法でも、本記事で見た「打ち切りを正しく扱う」「評価には生存時間分析用の指標(C-indexなど)を使う」という基本は変わりません。
また、sBGモデルは「一人ひとりの解約確率は時間がたっても変わらない」と仮定していました。現実には、契約が長くなるほど一人ひとりも解約しにくくなる(あるいは、しやすくなる)効果もありえます。こうした効果を sBGモデルに加える拡張も提案されています(Fader et al., 2018)。
まとめ
本記事では、契約型のビジネスで「顧客がいつ解約するか」を扱う 生存時間分析 を解説しました。
- 打ち切り:分析時点でまだ契約中の顧客は「少なくともそこまでは続いた」ことしか分かりません。解約した顧客だけで計算したり、打ち切りを解約とみなしたりすると、契約期間を大きく過小評価することを確認しました。
- 生存関数とハザード関数:生存関数 は CLV の式に現れる「残っている確率」、ハザード は「残っている顧客の中での解約の勢い」で、 でつながっています。
- カプラン・マイヤー推定:各時点の「解約しない確率」を、打ち切りを含むリスク集合から推定して掛け合わせることで、分布の形を仮定せずに生存関数を推定できました。
- Cox比例ハザードモデル:ベースラインハザードの形を決めずに、属性がハザードに与える影響(ハザード比)を部分尤度で推定し、真の係数を復元できることを確認しました。また、Schoenfeld残差の検定と二重対数プロットで比例ハザード性の崩れを見つけ、層別化と時間で区切る方法で対処しました。
- sBGモデル:顧客ごとの解約確率のばらつきをベータ分布で表すことで、「継続率が時間とともに上がる」現象を説明し、5年分のデータから12年先までの残存数を予測できました。解約率一定のモデルでは、長期の残存数と CLV を過小評価することも確認しました。
契約型のビジネスでは、解約という「出来事」が観測できるので、生存時間分析の道具を使って を推定できます。しかし、ECのような非契約型のビジネスでは、顧客が離脱したかどうかそのものが観測できません。最後の購買から時間がたっている顧客は、離脱したのでしょうか、それともたまたま間が空いているだけなのでしょうか。
「BG/NBDモデルとGamma-Gammaモデルとは?」の記事では、この問いに答える確率モデル BG/NBDモデル と、購買金額を表す Gamma-Gammaモデル を扱います。本記事の sBGモデルの「ベータ分布 × 幾何分布」による離脱の表現は、BG/NBDモデルの「BG(Beta-Geometric)」の部分として、そのまま再登場します。
参考文献
- E. L. Kaplan, P. Meier (1958). Nonparametric Estimation from Incomplete Observations. Journal of the American Statistical Association, 53(282), 457–481.
- D. R. Cox (1972). Regression Models and Life-Tables. Journal of the Royal Statistical Society Series B: Statistical Methodology, 34(2), 187–202.
- P. S. Fader, B. G. Hardie (2007). How to project customer retention. Journal of Interactive Marketing, 21(1), 76–90.
- H. Ishwaran, U. B. Kogalur, E. H. Blackstone, M. S. Lauer (2008). Random survival forests. The Annals of Applied Statistics, 2(3), 841–860.
- J. Katzman, U. Shaham, J. Bates, A. Cloninger, T. Jiang, Y. Kluger (2018). DeepSurv: Personalized Treatment Recommender System Using A Cox Proportional Hazards Deep Neural Network. BMC Medical Research Methodology, 18, 24.
- P. S. Fader, B. G. S. Hardie, Y. Liu, J. Davin, T. Steenburgh (2018). “How to Project Customer Retention” Revisited: The Role of Duration Dependence. Journal of Interactive Marketing, 43, 1–16.
- C. Davidson-Pilon (2019). lifelines: survival analysis in Python. Journal of Open Source Software, 4(40), 1317.
本記事の文章・構成の一部に生成AIを使用しています。