Swin Transformer とは?
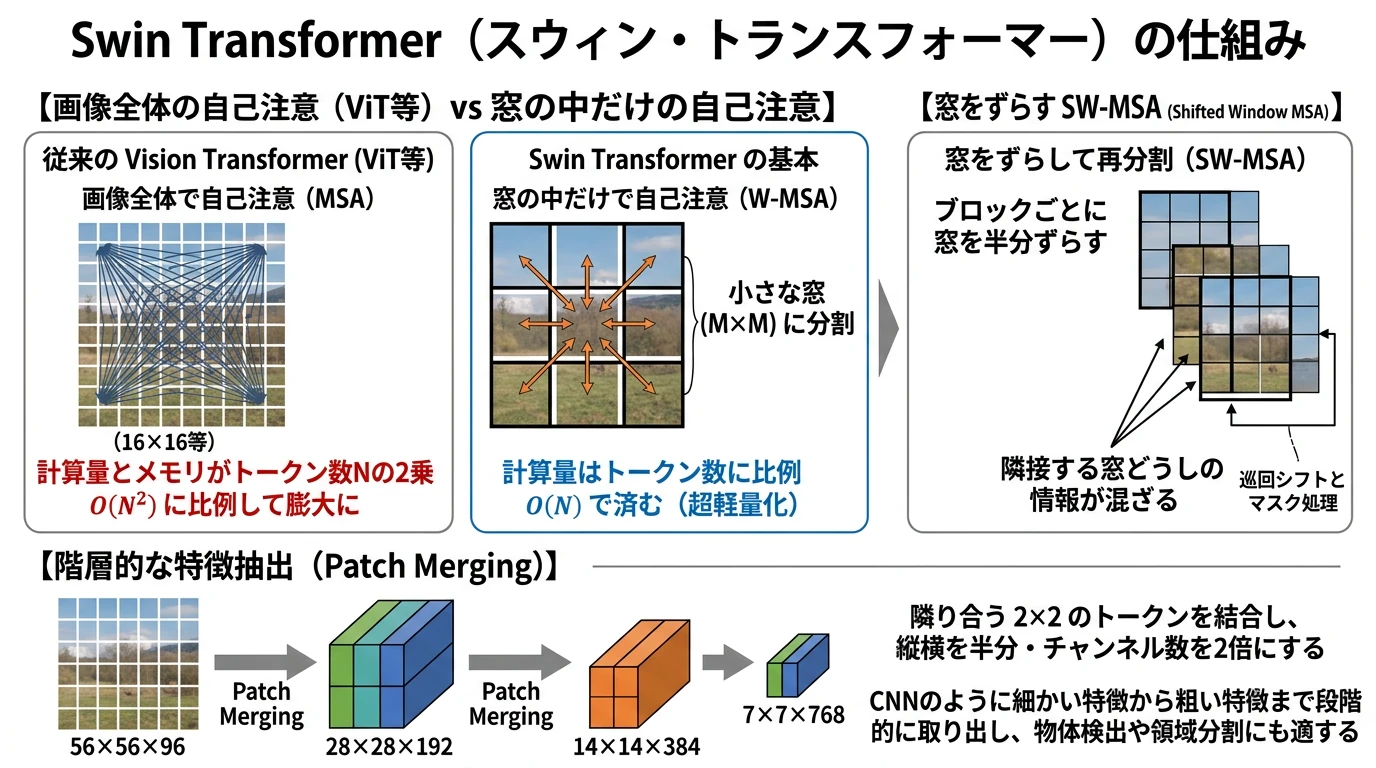 (画像は、Geminiで作成)
画像を小さな窓に区切って、窓の中だけで自己注意を計算する Swin Transformer の仕組みを、PyTorch のスクラッチ実装で確かめること。画像全体の自己注意はトークン数の2乗で重くなるのに対し、窓の中だけなら比例で済むことを手元で測り、窓をずらす SW-MSA・相対位置バイアス・Patch Merging を自分で実装できるようになること。
原著論文: Swin Transformer: Hierarchical Vision Transformer using Shifted Windows (Liu, Lin, Cao, Hu, Wei, Zhang, Lin, Guo, ICCV 2021)
概要
Vision Transformer(ViT)は、画像を 16×16 のパッチに切り、パッチを単語のように並べて Transformer に入れます。すべてのパッチの組の間で自己注意を計算するので(自己注意の仕組みはTransformer の記事)、パッチ(トークン)の数を とすると、計算量とメモリは に比例して増えます。画像を2倍の大きさにするとトークンは4倍、注意の計算は16倍です。物体検出や領域分割(セグメンテーション)では、細かい物体を捉えるために大きな画像を細かいパッチに切りたいのですが、ViT ではそれが重すぎます。また、ViT は最初から最後まで同じ解像度のトークンを扱うので、CNN のように「細かい特徴から粗い特徴まで」を段階的に取り出せず、それを前提にした検出や分割の仕組みにそのままでは繋げられません。
Swin Transformer(Liu et al., ICCV 2021)は、画像を の小さな窓に区切り、窓の中だけで自己注意を計算します(W-MSA)。1つのトークンが注意する相手は窓の中の 個だけになるので、計算量はトークン数に比例するだけで済みます。窓の外が見えなくなる問題は、次のブロックで 窓を半分ずらして区切り直す ことで解決します(SW-MSA)。さらに、段の間で隣り合う 2×2 のトークンをまとめて(Patch Merging)、CNN と同じく 1/4・1/8・1/16・1/32 の4段の特徴を作ります。Swin Transformer は、画像分類だけでなく、物体検出(COCO)や領域分割(ADE20K)のバックボーンとしても、当時の最高の精度を出しました。
次の節で、画像全体の自己注意と窓の中だけの自己注意について、トークン数を増やしたときの計算量と GPU のメモリを実際に測ります。
画像全体の自己注意は、トークン数の2乗で重くなる
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU(メモリ 40GB)で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。後半の CIFAR-10 の学習は、A100 で約1時間かかります。L4 GPU でも動きますが、時間は2倍ほどかかります。
グラフの日本語表示には japanize-matplotlib を使います。新しいセッションで、次を実行してください。Python 3.12 以降で import 時にエラーが出ないよう、setuptools も一緒にインストールします。torch・torchvision・transformers は、Colab に入っているものを使います。
!pip install -q japanize-matplotlib setuptools
実験1:MSA と W-MSA の計算量・時間・メモリを比べる
原著論文は、 個のトークン(チャンネル数 )に対する、画像全体の自己注意(MSA)と、 の窓の中だけの自己注意(W-MSA)の計算量を、次の式で比べています。
1つ目の項 は、各トークンを Q・K・V に変換する線形層()と、注意の結果を戻す線形層()の分で、どちらの方式でも同じです。違うのは2つ目の項で、Q と K の内積を取る計算と、注意の重みで V を足し合わせる計算の分です。MSA では、 個のトークンがそれぞれ 個の相手と内積を取るので に比例します。W-MSA では、相手が窓の中の 個だけなので、 に比例します。
次のコードで、Swin-T の1段目と同じ 、ヘッド数 3、窓 の自己注意を、トークンの縦横 を 14・28・56・112 と変えて動かし、式の計算量と、実際の時間・GPU のメモリを測ります。
import time
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
import japanize_matplotlib

device = "cuda"


def windowed_self_attention(x, ws, qkv, proj, num_heads):
    """x: (1, H, W, C) を ws×ws の窓に区切り、窓の中だけで自己注意を計算する(ws = H なら画像全体の自己注意)"""
    B, H, W, C = x.shape
    x = x.view(B, H // ws, ws, W // ws, ws, C).permute(0, 1, 3, 2, 4, 5).reshape(-1, ws * ws, C)
    n_win, N = x.shape[0], ws * ws
    q, k, v = qkv(x).reshape(n_win, N, 3, num_heads, C // num_heads).permute(2, 0, 3, 1, 4)
    attn = (q @ k.transpose(-2, -1)) * (C // num_heads) ** -0.5     # (窓の数, ヘッド, N, N):トークンの組ごとの重み
    out = (attn.softmax(dim=-1) @ v).transpose(1, 2).reshape(n_win, N, C)
    return proj(out)


# Swin-T の 1 段目と同じチャンネル数・ヘッド数・窓の大きさ
C, num_heads, M = 96, 3, 7
qkv, proj = nn.Linear(C, 3 * C).to(device), nn.Linear(C, C).to(device)

rows = []
with torch.no_grad():
    for hw in [14, 28, 56, 112]:              # 56×56 が 224×224 の画像、112×112 が 448×448 の画像の 1 段目
        N = hw * hw
        x = torch.randn(1, hw, hw, C, device=device)
        row = {"hw": hw, "N": N,
               "GFLOPs_MSA": (4 * N * C**2 + 2 * N**2 * C) / 1e9,       # 論文の式 (1)
               "GFLOPs_W-MSA": (4 * N * C**2 + 2 * M**2 * N * C) / 1e9}  # 論文の式 (2)
        for name, ws in [("MSA", hw), ("W-MSA", M)]:
            for _ in range(3):                # 最初の数回は GPU の準備で遅いので、測る前に空回しする
                windowed_self_attention(x, ws, qkv, proj, num_heads)
            torch.cuda.synchronize()
            torch.cuda.reset_peak_memory_stats()
            t0 = time.time()
            for _ in range(10):
                windowed_self_attention(x, ws, qkv, proj, num_heads)
            torch.cuda.synchronize()
            row[f"ms_{name}"] = (time.time() - t0) / 10 * 1000
            row[f"MB_{name}"] = torch.cuda.max_memory_allocated() / 2**20
        rows.append(row)
        print(f"{hw:3d}×{hw:<3d} トークン {N:6d} | GFLOPs MSA {row['GFLOPs_MSA']:6.2f}  W-MSA {row['GFLOPs_W-MSA']:5.2f}"
              f" | 時間 MSA {row['ms_MSA']:6.2f} ms  W-MSA {row['ms_W-MSA']:5.2f} ms"
              f" | メモリ MSA {row['MB_MSA']:5.0f} MB  W-MSA {row['MB_W-MSA']:3.0f} MB")

fig, axes = plt.subplots(1, 2, figsize=(11, 4))
n = [r["N"] for r in rows]
for ax, key, ylabel in [(axes[0], "GFLOPs", "計算量(GFLOPs)"), (axes[1], "MB", "GPU メモリの最大使用量(MB)")]:
    ax.plot(n, [r[f"{key}_MSA"] for r in rows], "o-", label="MSA(画像全体)")
    ax.plot(n, [r[f"{key}_W-MSA"] for r in rows], "s-", label="W-MSA(7×7 の窓)")
    ax.set_xscale("log")
    ax.set_yscale("log")
    ax.set_xlabel("トークン数 h×w")
    ax.set_ylabel(ylabel)
    ax.grid(alpha=0.3)
    ax.legend()
plt.tight_layout()
plt.show()
画像全体の自己注意と、窓の中だけの自己注意を同じ関数で動かし、トークン数を増やしたときの計算量・時間・メモリの増え方を比べるコードです。
- windowed_self_attention: 窓の大きさ ws を変えるだけで、両方の方式を同じコードで計算します。ws をトークンの縦横 hw と同じにすると窓が1つになり、画像全体の自己注意(MSA)になります。同じ関数を使うのは、違いを窓の大きさだけにして比べるためです。attn の形は(窓の数, ヘッド, N, N)で、N は1つの窓の中のトークン数です。MSA では N = hw なので、この行列の要素は に比例して増えます。
- 設定の値: 、ヘッド数 3、 は、原著論文の Swin-T の1段目の設定です。トークンの縦横を 14〜112 にするのは、224×224 の画像を 4×4 のパッチに切ったときの 56×56 を中心に、その 1/4・1/2 と、2倍(448×448 の画像。物体検出では、これ以上の大きさの画像も使います)まで動かして、増え方の違いを見るためです。どの大きさも 7 で割り切れるので、W-MSA の窓にちょうど分かれます。
- 計算量: 論文の式をそのまま計算します。時間とメモリは、同じ処理を GPU で実際に動かして測ります。
- 時間とメモリの測り方: GPU は命令を非同期に実行するので、torch.cuda.synchronize() で計算が終わるのを待ってから時間を読みます。最初の3回は、GPU の準備で遅くなるので測らずに空回しし、続く10回の平均を取ります。メモリは torch.cuda.max_memory_allocated で、測っている間の最大の使用量を読みます。
- グラフ: 両軸を対数にしています。対数のグラフでは、トークン数に比例する量は傾き1、2乗に比例する量は傾き2の直線になるので、増え方の違いが傾きの違いとして見えます。
実行結果
 14×14  トークン    196 | GFLOPs MSA   0.01  W-MSA  0.01 | 時間 MSA   0.27 ms  W-MSA  0.32 ms | メモリ MSA    11 MB  W-MSA  10 MB
 28×28  トークン    784 | GFLOPs MSA   0.15  W-MSA  0.04 | 時間 MSA   0.30 ms  W-MSA  0.33 ms | メモリ MSA    25 MB  W-MSA  12 MB
 56×56  トークン   3136 | GFLOPs MSA   2.00  W-MSA  0.15 | 時間 MSA   1.34 ms  W-MSA  0.33 ms | メモリ MSA   240 MB  W-MSA  21 MB
112×112 トークン  12544 | GFLOPs MSA  30.67  W-MSA  0.58 | 時間 MSA  16.34 ms  W-MSA  0.33 ms | メモリ MSA  3634 MB  W-MSA  55 MB
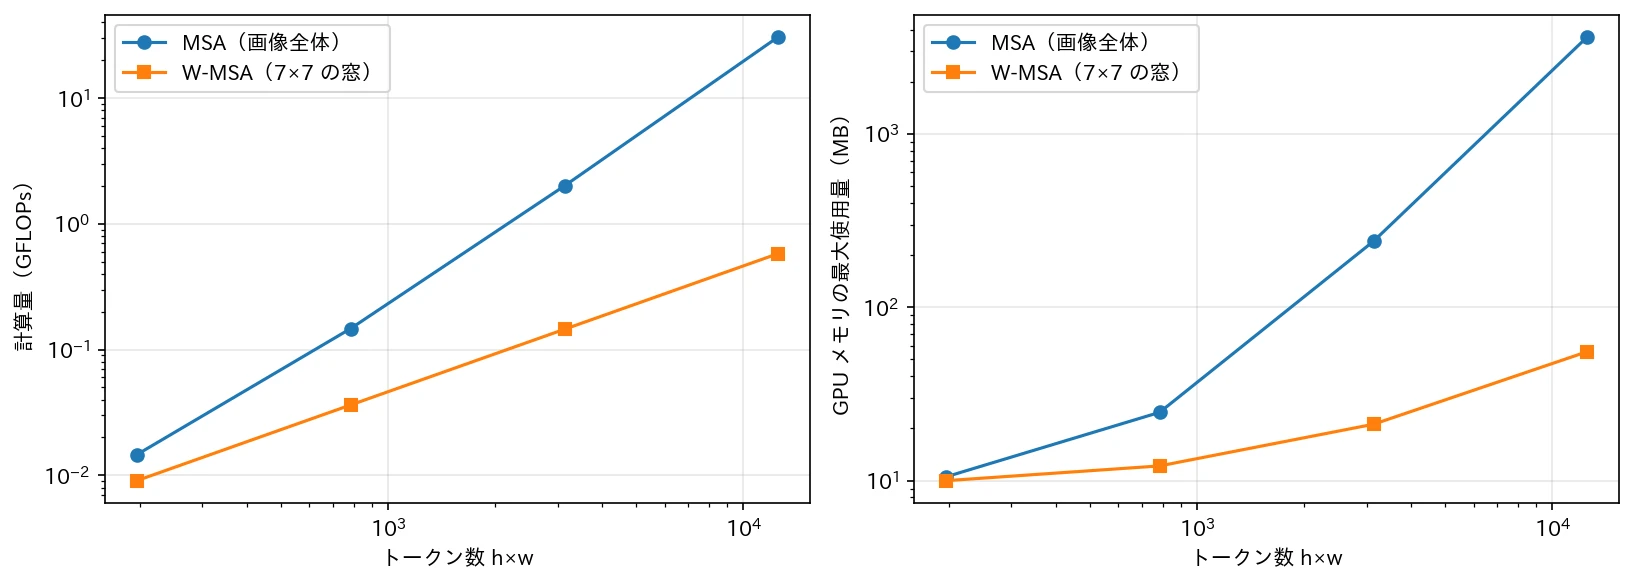
トークンが 196 個(14×14)のときは、MSA と W-MSA の計算量はほぼ同じ(0.01 GFLOPs)です。トークン数が4倍になるごとに、W-MSA の計算量は約4倍(0.04 → 0.15 → 0.58)にしかなりませんが、MSA は16倍に近づきます(0.15 → 2.00 → 30.67)。差は、56×56(224×224 の画像)で約13倍、112×112 で約53倍です。
GPU のメモリの差は、さらにはっきりしています。112×112 では、MSA が 3,634 MB、W-MSA が 55 MB でした。MSA は、(ヘッド × トークン数 × トークン数)の注意の重みの行列を丸ごと持つので、それだけで 3 × 12,544 × 12,544 × 4 バイト ≒ 1.8 GB、softmax の前と後で2つ分の約 3.6 GB が必要です。W-MSA の注意の重みは(256 個の窓 × 3 × 49 × 49)で、要素の数はトークン数に比例します。
時間は、W-MSA がどの大きさでも約 0.33 ms で、ほとんど変わりませんでした。この大きさの計算では GPU の計算能力に余裕があり、命令を出す手間の方が時間の大部分を占めるためです。MSA は、56×56 で 1.34 ms、112×112 で 16.34 ms と、計算量に合わせて急に増えます。
ViT のように 224×224 の画像を 16×16 のパッチに切れば、トークンは 196 個で、MSA でも問題はありません。しかし、4×4 の細かいパッチに切ると 3,136 個になり、画像をさらに大きくすると、MSA はすぐに GPU に載らなくなります。窓の中だけで注意を計算すれば、この増え方をトークン数に比例する程度に抑えられます。
Swin Transformer の仕組み
全体の構成
Swin Transformer の全体は、次の図のとおりです(図は、後で実装する SwinTransformer クラスの Swin-T の設定です)。
(図は、diagram-designで作成)
- PatchEmbed: 画像を 4×4 画素のパッチに切り、パッチごとに 96 次元のベクトル(トークン)にします。224×224 の画像は 56×56 個のトークンになります。ViT の 16×16 より細かく切るのは、物体検出や領域分割に使う細かい特徴を残すためです。
- Stage: SwinBlock を重ねたものです。Stage の中では、トークンの数もチャンネル数も変わりません。
- PatchMerging: Stage の間で、隣り合う 2×2 のトークンを1つにまとめ、縦横を半分、チャンネル数を2倍にします。CNN のプーリングやストライド2の畳み込みにあたる処理で、これにより 1/4・1/8・1/16・1/32 の解像度の特徴ができます。窓の大きさ(7×7 のトークン)は変えないので、段が進むほど1つの窓が画像の広い範囲を覆います。
- 分類ヘッド: 最後の Stage の出力を、縦横で平均して 768 次元のベクトルにし、線形層でクラスのスコアにします。ViT の CLS トークンは使いません。
W-MSA と SW-MSA を交互に重ねる
Stage の中では、次の図のように、W-MSA のブロックと SW-MSA のブロックを1組にして重ねます。
(図は、diagram-designで作成)
W-MSA だけを重ねると、どれだけ層を重ねても、ある窓のトークンが別の窓のトークンを見ることはありません。そこで、次のブロックでは窓の区切りを窓の半分(7×7 なら 3 トークン)ずらします。ずらした窓は前の窓の境界をまたぐので、隣の窓どうしの情報が混ざります。
ただし、区切りをずらすと、画像の端に小さな窓ができて、窓の数が増えます(56×56 のトークンを 7×7 の窓で区切ると 64 個ですが、ずらすと 81 個)。窓の大きさがそろわないと、まとめて1回の行列計算にできません。原著論文は、次の図のように、トークンを 巡回シフト(はみ出した分を反対側に回すずらし方)してから、元と同じ区切りで窓に分けることで、窓の数と大きさを変えずにずらした窓を計算します。
(図は、diagram-designで作成)
巡回シフトをすると、(c) の右下の窓のように、元の画像では離れていたトークン(画像の右端と左端など)が同じ窓に入ります。そこで、番号の違うトークンの組の注意の重みに -100 を足して、softmax の後でほぼ 0 にします(マスク)。計算が終わったら、逆向きに巡回シフトしてトークンを元の位置に戻します。
相対位置バイアス
ViT は、トークンに位置埋め込み(絶対位置)を足します。Swin Transformer は、代わりに、注意の重みに 2つのトークンの相対位置で決まる値 を足します。
は1ヘッドあたりの次元数です。窓の中の2つのトークンの縦の差・横の差は、どちらも から の 通りなので、 行の表を学習し、トークンの組ごとに対応する行の値を として使います。同じ相対位置(例えば「1つ右」)には、どの窓でも同じ値が足されるので、「近くのトークンを強く見る」のような、画像のどこでも成り立つ性質を学べます。原著論文の ImageNet の実験では、絶対位置の埋め込みより相対位置バイアスの方が精度が高くなりました。
相対位置バイアスの表の引き方を図にすると、次のようになります。
(図は、diagram-designで作成)
Swin Transformer のスクラッチ実装
ここからは、Swin Transformer を部品ごとに実装します。実装は、Microsoft の公式の Swin-Transformer リポジトリ(MIT License / Copyright (c) Microsoft Corporation)と同じ構造・同じ計算にしています。後の実験2で、公式の学習済みの重みを読み込み、Hugging Face の実装と同じ出力になることを確かめます。
パッチ埋め込み
import torch
import torch.nn as nn


class PatchEmbed(nn.Module):
    """画像を patch_size×patch_size の小さな正方形(パッチ)に切り、1 つずつを embed_dim 次元のベクトルにする"""

    def __init__(self, patch_size=4, in_chans=3, embed_dim=96):
        super().__init__()
        # カーネルとストライドをパッチの大きさにした畳み込みは、「パッチごとに切って同じ線形変換をかける」のと同じ計算
        self.proj = nn.Conv2d(in_chans, embed_dim, kernel_size=patch_size, stride=patch_size)
        self.norm = nn.LayerNorm(embed_dim)

    def forward(self, x):                      # x: (B, 3, H, W)
        x = self.proj(x)                       # (B, C, H/p, W/p)
        x = x.permute(0, 2, 3, 1)              # (B, H/p, W/p, C):以降はチャンネルを最後の軸に置く
        return self.norm(x)
画像をパッチに切り、パッチごとにベクトル(トークン)にするコードです。
- 畳み込みでパッチに切る: カーネルとストライドをどちらも patch_size にした nn.Conv2d は、重ならずに並んだ 4×4 画素の領域ごとに、同じ重みの線形変換をかけます。これは、画像をパッチに切って並べ、各パッチ(4 × 4 × 3 = 48 個の値)に 48→96 の線形層をかけるのと同じ計算で、切り出しの処理を書かずに済みます。224×224 の画像は (B, 96, 56, 56) になります。
- チャンネルを最後の軸に置く: permute(0, 2, 3, 1) で (B, 56, 56, 96) にします。後に続く LayerNorm と線形層は最後の軸に対して計算するので、以降はこの形のまま扱います。ViT のように (B, トークン数, C) に平らにせず縦横の軸を残しておくのは、窓に区切る・巡回シフトする・2×2 をまとめるといった、位置に基づく操作をするためです。
- LayerNorm: 公式の実装と同じく、埋め込みの直後に正規化します。
- 値: patch_size=4・embed_dim=96 は、Swin-T の設定です。
窓への分割と復元
def window_partition(x, ws):
    """(B, H, W, C) を、ws×ws の窓を並べた (B×窓の数, ws×ws, C) にする"""
    B, H, W, C = x.shape
    x = x.view(B, H // ws, ws, W // ws, ws, C)
    return x.permute(0, 1, 3, 2, 4, 5).reshape(-1, ws * ws, C)


def window_reverse(windows, ws, H, W):
    """window_partition の逆:(B×窓の数, ws×ws, C) を (B, H, W, C) に戻す"""
    C = windows.shape[-1]
    B = windows.shape[0] // ((H // ws) * (W // ws))
    x = windows.view(B, H // ws, W // ws, ws, ws, C)
    return x.permute(0, 1, 3, 2, 4, 5).reshape(B, H, W, C)


x = torch.arange(2 * 8 * 8 * 3, dtype=torch.float32).view(2, 8, 8, 3)
w = window_partition(x, 4)
print("窓に分けた形:", tuple(w.shape))
print("元に戻すと一致するか:", torch.equal(window_reverse(w, 4, 8, 8), x))
(B, H, W, C) のトークンを窓ごとのまとまりに並べ替え、計算の後で元の並びに戻すコードです。
- window_partition: view で縦を(窓の行, 窓の中の行)、横を(窓の列, 窓の中の列)に分け、permute で窓の行と窓の列を前に集めてから、窓の中の ws × ws 個を1列に並べます。窓ごとの (ws × ws, C) のトークンの列がバッチの方向に並ぶので、すべての窓の注意を1回の行列積で計算できます。
- window_reverse: 同じ並べ替えを逆にたどって、(B, H, W, C) に戻します。
- 確かめ: 8×8 のトークン(チャンネル 3)2枚を、4×4 の窓に分けます。1枚あたり窓は4つなので、窓の数は 2 × 4 = 8 です。値には通し番号を入れ、戻したものが元と完全に一致するかを torch.equal で確かめます。
実行結果
窓に分けた形: (8, 16, 3)
元に戻すと一致するか: True
窓の数 8・窓の中のトークン 16 個の形になり、元に戻すと完全に一致しました。
相対位置バイアス付きの Window Attention
class WindowAttention(nn.Module):
    """窓の中だけで計算する、相対位置バイアス付きの Multi-Head Self-Attention"""

    def __init__(self, dim, window_size, num_heads, use_rel_bias=True):
        super().__init__()
        self.ws, self.num_heads = window_size, num_heads
        self.scale = (dim // num_heads) ** -0.5
        self.qkv = nn.Linear(dim, dim * 3)
        self.proj = nn.Linear(dim, dim)
        self.use_rel_bias = use_rel_bias
        # 窓の中の 2 つのトークンの相対位置 (dy, dx) は、縦横それぞれ -(ws-1)〜ws-1 の 2ws-1 通り。表の行数は (2ws-1)^2
        self.relative_position_bias_table = nn.Parameter(torch.zeros((2 * window_size - 1) ** 2, num_heads))
        nn.init.trunc_normal_(self.relative_position_bias_table, std=0.02)
        # 窓の中のトークンの組ごとに、表の何行目を使うかを前もって計算しておく
        coords = torch.stack(torch.meshgrid(torch.arange(window_size), torch.arange(window_size), indexing="ij"))
        coords = coords.flatten(1)                                         # (2, N):各トークンの (y, x)
        rel = (coords[:, :, None] - coords[:, None, :]).permute(1, 2, 0)   # (N, N, 2):組ごとの (dy, dx)
        rel[:, :, 0] += window_size - 1                                    # 0 始まりにずらす
        rel[:, :, 1] += window_size - 1
        rel[:, :, 0] *= 2 * window_size - 1                                # (dy, dx) を 1 つの行番号にする
        self.register_buffer("relative_position_index", rel.sum(-1), persistent=False)

    def forward(self, x, mask=None):           # x: (B×窓の数, N=ws×ws, C)
        Bw, N, C = x.shape
        qkv = self.qkv(x).reshape(Bw, N, 3, self.num_heads, C // self.num_heads).permute(2, 0, 3, 1, 4)
        q, k, v = qkv[0], qkv[1], qkv[2]       # 各 (Bw, ヘッド, N, C/ヘッド)
        attn = (q * self.scale) @ k.transpose(-2, -1)                      # (Bw, ヘッド, N, N)
        if self.use_rel_bias:                  # 論文の式 (4) の B:相対位置ごとに学習した値を足す
            bias = self.relative_position_bias_table[self.relative_position_index.view(-1)]
            attn = attn + bias.view(N, N, -1).permute(2, 0, 1).unsqueeze(0)
        if mask is not None:                   # SW-MSA:同じ窓に入ったが、元の画像では隣り合っていない組を消す
            nW = mask.shape[0]
            attn = attn.view(Bw // nW, nW, self.num_heads, N, N) + mask[None, :, None]
            attn = attn.view(Bw, self.num_heads, N, N)
        attn = attn.softmax(dim=-1)
        x = (attn @ v).transpose(1, 2).reshape(Bw, N, C)
        return self.proj(x)


attn = WindowAttention(dim=96, window_size=7, num_heads=3)
print("相対位置バイアスの表:", tuple(attn.relative_position_bias_table.shape))
print("組ごとの行番号:", tuple(attn.relative_position_index.shape), "最小", attn.relative_position_index.min().item(),
      "最大", attn.relative_position_index.max().item())
print("出力の形:", tuple(attn(torch.randn(64, 49, 96)).shape))
窓の中のトークンどうしで、相対位置バイアス付きの自己注意を計算するコードです。W-MSA と SW-MSA の両方で使います。
- Q・K・V: self.qkv で C 次元を 3C 次元に変換し、Q・K・V とヘッドに分けます。形は (Bw, ヘッド, N, C/ヘッド) で、Bw は「バッチ × 窓の数」です。窓をバッチの方向に並べてあるので、窓ごとの注意を、ふつうの Multi-Head Attention と同じ行列積で一度に計算できます。self.scale は、式の です。
- 相対位置バイアスの表: relative_position_bias_table は、(2ws - 1)² 行 × ヘッド数の、学習するパラメータです。ヘッドごとに別の値を持たせるのは、ヘッドごとに「どの距離の相手を強く見るか」が違ってよいからです。初期値は、公式の実装と同じく標準偏差 0.02 の切断正規分布です。
- 組ごとの行番号: relative_position_index は、窓の中のトークン i と j の相対位置 (dy, dx) を、表の行番号 (dy + ws - 1) × (2ws - 1) + (dx + ws - 1) に変換したものです。学習しない値なので、register_buffer でモデルに持たせ、GPU に移すときに一緒に移るようにします。persistent=False にして、保存する重みには含めません。毎回同じ計算で作れるからです。
- バイアスを足す: 表から N × N 個の行を引き、(ヘッド, N, N) に並べ替えて、すべての窓の注意の重みに同じものを足します。
- マスク: SW-MSA のときだけ、窓ごとのマスク(窓の数, N, N)を足します。attn を(バッチ, 窓の数, ヘッド, N, N)に分けてから足すのは、画像が違っても、同じ位置の窓には同じマスクを使うためです。
- use_rel_bias: 実験3で、相対位置バイアスを外したときの精度を比べるための切り替えです。
- 確かめ: Swin-T の1段目と同じ dim=96・窓 7・ヘッド 3 で作り、表の大きさと行番号の範囲、出力の形を確かめます。入力の 64 は、56×56 のトークンを 7×7 の窓で区切ったときの窓の数です。
実行結果
相対位置バイアスの表: (169, 3)
組ごとの行番号: (49, 49) 最小 0 最大 168
出力の形: (64, 49, 96)
表は (2 × 7 - 1)² = 169 行 × 3 ヘッドで、49 × 49 の組の行番号は 0〜168 と、表のすべての行を使っています。64 個の窓を入れると、同じ形で出力されます。
SW-MSA のマスク
def make_shift_mask(H, W, ws, shift):
    """巡回シフトの後で、元の画像では隣り合っていなかったトークンの組に -100 を入れるマスク (窓の数, N, N)"""
    img_mask = torch.zeros(1, H, W, 1)
    cnt = 0
    for hs in (slice(0, -ws), slice(-ws, -shift), slice(-shift, None)):
        for wsl in (slice(0, -ws), slice(-ws, -shift), slice(-shift, None)):
            img_mask[:, hs, wsl, :] = cnt      # ずらした区切りでできる 9 つの窓に、別々の番号を付ける
            cnt += 1
    mw = window_partition(img_mask, ws).squeeze(-1)                       # (窓の数, N)
    diff = mw[:, None, :] - mw[:, :, None]                                # 番号が違う組 = 元の画像で別の窓
    return diff.masked_fill(diff != 0, -100.0).masked_fill(diff == 0, 0.0)


# 図と同じ 8×8 のトークン、窓 4×4、ずらす量 2 で確かめる
mask = make_shift_mask(8, 8, 4, 2)
print("マスクの形:", tuple(mask.shape))
for i in range(4):
    print(f"窓 {i}: 消す組の数 {(mask[i] < 0).sum().item():3d} / {mask[i].numel()}")

fig, axes = plt.subplots(1, 4, figsize=(14, 3.8))
for i, ax in enumerate(axes):
    ax.imshow(mask[i], cmap="Greys_r", vmin=-100, vmax=0)
    ax.set_title(f"窓 {i}(16×16 の組)")
    ax.set_xlabel("キー(注意される側)")
    ax.set_xticks([])
    ax.set_yticks([])
axes[0].set_ylabel("クエリ(注意する側)")
fig.suptitle("白:注意してよい組(0) 黒:消す組(-100)")
plt.tight_layout(rect=(0, 0, 1, 0.92))
plt.show()
SW-MSA で、巡回シフトの後に同じ窓に入った「元の画像では別の窓だったトークンの組」を消すマスクを作り、図の例で確かめるコードです。
- 9つの窓に番号を付ける: 縦と横をそれぞれ「0 から H - ws」「H - ws から H - shift」「H - shift から H」の3つに分け、その組み合わせの9つの領域に 0〜8 の番号を付けます。これは、巡回シフトした後の位置で見た、ずらした区切りの9つの窓です(図の (c) の数字)。
- 組ごとに番号を比べる: 番号の地図を window_partition で窓に分け、窓の中のトークンの組ごとに番号の差を取ります。差が 0 でない組は元の画像で別の窓なので -100、同じ窓の組は 0 にします。-100 を足した重みは、softmax で 倍になり、ほぼ 0 になります。-100 は、公式の実装と同じ値です。
- マスクは1回だけ作る: マスクは特徴マップと窓の大きさだけで決まり、画像によらないので、後の SwinBlock では、作るときに1回だけ計算して持たせます。
- 確かめ: 図と同じ 8×8 のトークン・窓 4・ずらす量 2 で作り、窓ごとに消す組の数を数えて、白黒の図にします。
実行結果
マスクの形: (4, 16, 16)
窓 0: 消す組の数   0 / 256
窓 1: 消す組の数 128 / 256
窓 2: 消す組の数 128 / 256
窓 3: 消す組の数 192 / 256
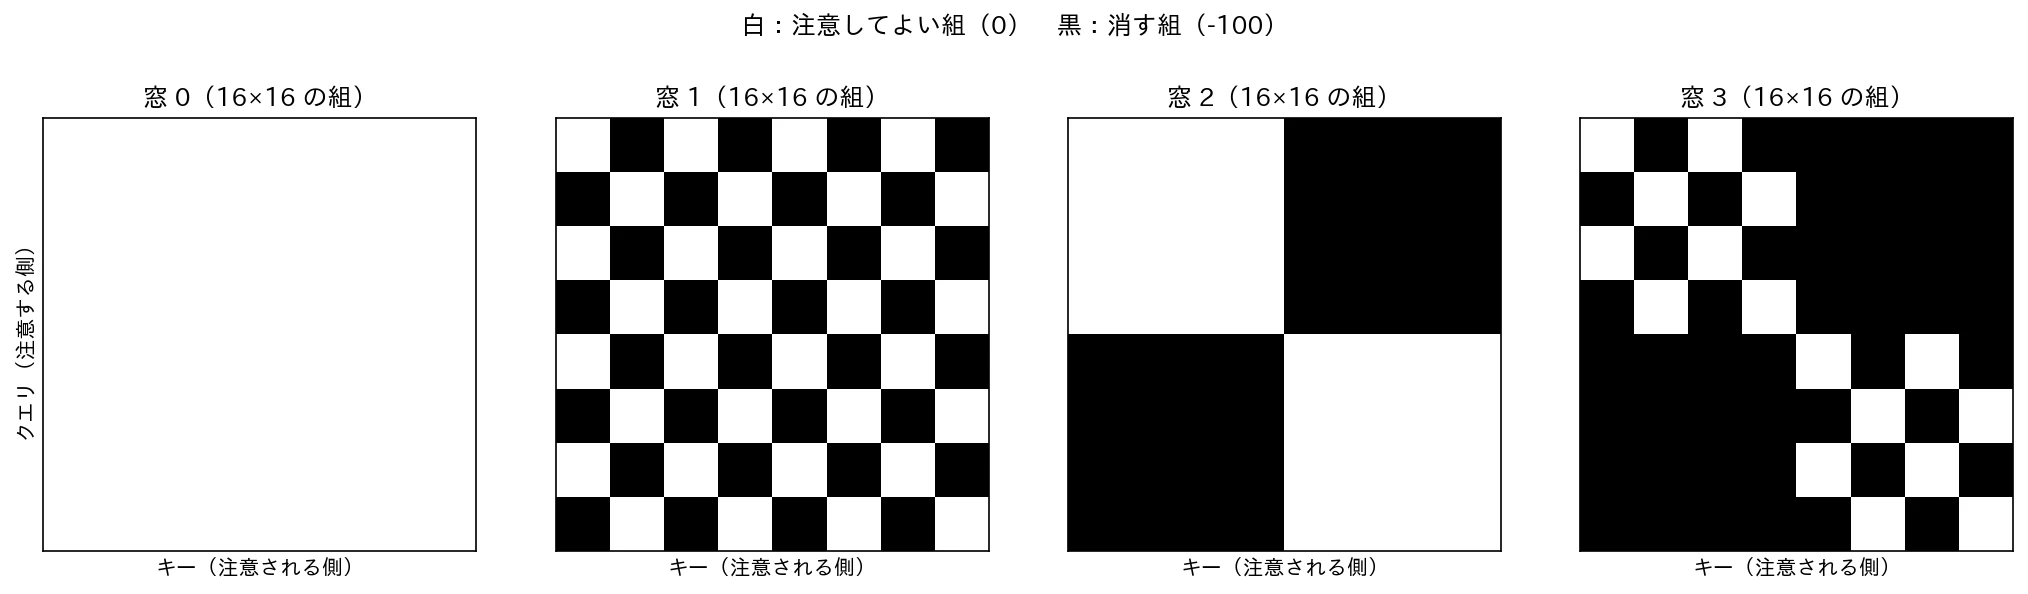
窓 0(左上)は1つの領域だけなので、消す組はありません。窓 1(右上)と窓 2(左下)は、8 トークンずつの2つの領域を含むので、別の領域どうしの 2 × 8 × 8 = 128 組を消します。窓 3(右下)は、4 トークンずつの4つの領域を含むので、同じ領域どうしの 4 × 4 × 4 = 64 組以外の 192 組を消します。窓 1 が市松模様になるのは、窓の中のトークンを行ごとに並べると、領域の番号が「1, 1, 2, 2」と2つずつ交互に並ぶためです。
SwinBlock と Patch Merging
class DropPath(nn.Module):
    """学習中だけ、残差の枝をサンプルごとに確率 p で丸ごと捨てる(Stochastic Depth)"""

    def __init__(self, p=0.0):
        super().__init__()
        self.p = p

    def forward(self, x):
        if self.p == 0.0 or not self.training:
            return x
        keep = torch.rand(x.shape[0], *([1] * (x.dim() - 1)), device=x.device) >= self.p
        return x * keep / (1 - self.p)         # 残した枝を 1/(1-p) 倍して、期待値を変えない


class SwinBlock(nn.Module):
    """shift_size = 0 なら W-MSA、shift_size > 0 なら SW-MSA のブロック"""

    def __init__(self, dim, resolution, num_heads, window_size=7, shift_size=0,
                 mlp_ratio=4.0, drop_path=0.0, use_rel_bias=True):
        super().__init__()
        H, W = resolution
        if min(H, W) <= window_size:           # 特徴マップが窓より小さければ、全体を 1 つの窓にし、ずらさない
            window_size, shift_size = min(H, W), 0
        self.ws, self.shift = window_size, shift_size
        self.norm1 = nn.LayerNorm(dim)
        self.attn = WindowAttention(dim, window_size, num_heads, use_rel_bias)
        self.drop_path = DropPath(drop_path)
        self.norm2 = nn.LayerNorm(dim)
        self.mlp = nn.Sequential(nn.Linear(dim, int(dim * mlp_ratio)), nn.GELU(), nn.Linear(int(dim * mlp_ratio), dim))
        mask = make_shift_mask(H, W, window_size, shift_size) if shift_size > 0 else None
        self.register_buffer("attn_mask", mask, persistent=False)

    def forward(self, x):                      # x: (B, H, W, C)
        B, H, W, C = x.shape
        h = self.norm1(x)
        if self.shift > 0:                     # 巡回シフト:左上へ shift だけずらし、はみ出した分を右下に回す
            h = torch.roll(h, shifts=(-self.shift, -self.shift), dims=(1, 2))
        h = window_partition(h, self.ws)
        h = self.attn(h, mask=self.attn_mask)
        h = window_reverse(h, self.ws, H, W)
        if self.shift > 0:                     # シフトを元に戻す
            h = torch.roll(h, shifts=(self.shift, self.shift), dims=(1, 2))
        x = x + self.drop_path(h)
        return x + self.drop_path(self.mlp(self.norm2(x)))


class PatchMerging(nn.Module):
    """隣り合う 2×2 のトークンを 1 つにまとめ、縦横を半分・チャンネルを 2 倍にする"""

    def __init__(self, dim):
        super().__init__()
        self.norm = nn.LayerNorm(4 * dim)
        self.reduction = nn.Linear(4 * dim, 2 * dim, bias=False)

    def forward(self, x):                      # x: (B, H, W, C)
        x0, x1 = x[:, 0::2, 0::2], x[:, 1::2, 0::2]
        x2, x3 = x[:, 0::2, 1::2], x[:, 1::2, 1::2]
        x = torch.cat([x0, x1, x2, x3], dim=-1)                          # (B, H/2, W/2, 4C)
        return self.reduction(self.norm(x))                              # (B, H/2, W/2, 2C)
W-MSA または SW-MSA の自己注意と MLP を残差接続でつないだ SwinBlock と、段の間で解像度を半分にする PatchMerging のコードです。
- DropPath: 学習中、サンプルごとに確率 p で、自己注意や MLP の枝の出力を 0 にします(Stochastic Depth)。ブロックを丸ごと飛ばした浅いネットワークを混ぜて学習することになり、深いモデルの過学習を抑えます。原著論文の学習でも使われています。推論のときは何もしません。
- 小さな特徴マップ: 特徴マップの縦横が窓以下なら、窓を特徴マップ全体にして、ずらしません。公式の実装と同じ扱いです。実験3の 32×32 の画像では、3段目(4×4)と4段目(2×2)がこれに当たります。
- SW-MSA: torch.roll で縦横に -shift だけ巡回シフトし、窓に分けて注意を計算した後、+shift で元に戻します。マスクは、作るときに1回だけ計算して register_buffer で持たせます。ずらさないブロックでは None を入れておき、注意の計算でマスクを足しません。
- 残差接続: 自己注意と MLP の前に LayerNorm を置き、出力を入力に足します(図の破線)。ViT と同じ形です。MLP は 4 倍の次元に広げて GELU を通し、元の次元に戻します。
- PatchMerging: x[:, 0::2, 0::2] などで 2×2 の4つの位置のトークンを取り出し、チャンネルの方向に連結して 4C 次元にします。LayerNorm の後、線形層で 2C 次元に減らします。並べる順番(左上・左下・右上・右下)は、公式の実装と同じです。順番が違うと、実験2で学習済みの重みを読み込んだときに、線形層の重みと入力の対応がずれます。
モデル全体
class SwinTransformer(nn.Module):
    """パッチ埋め込み → 4 段のステージ(間に Patch Merging)→ 平均プーリング → 分類ヘッド。既定値は Swin-T"""

    def __init__(self, img_size=224, patch_size=4, in_chans=3, num_classes=1000, embed_dim=96,
                 depths=(2, 2, 6, 2), num_heads=(3, 6, 12, 24), window_size=7, mlp_ratio=4.0,
                 drop_path_rate=0.2, use_shift=True, use_rel_bias=True):
        super().__init__()
        self.patch_embed = PatchEmbed(patch_size, in_chans, embed_dim)
        dpr = torch.linspace(0, drop_path_rate, sum(depths)).tolist()     # 深いブロックほど枝を捨てる確率を上げる
        res = img_size // patch_size
        self.stages = nn.ModuleList()
        self.downsamples = nn.ModuleList()
        k = 0
        for i, (depth, heads) in enumerate(zip(depths, num_heads)):
            dim = embed_dim * 2 ** i
            self.stages.append(nn.Sequential(*[
                SwinBlock(dim, (res, res), heads, window_size,
                          shift_size=(window_size // 2 if (j % 2 == 1 and use_shift) else 0),   # 奇数番目だけずらす
                          mlp_ratio=mlp_ratio, drop_path=dpr[k + j], use_rel_bias=use_rel_bias)
                for j in range(depth)]))
            k += depth
            if i < len(depths) - 1:            # 最後のステージの後には Patch Merging を置かない
                self.downsamples.append(PatchMerging(dim))
                res //= 2
        self.num_features = embed_dim * 2 ** (len(depths) - 1)
        self.norm = nn.LayerNorm(self.num_features)
        self.head = nn.Linear(self.num_features, num_classes)

    def forward(self, x):
        x = self.patch_embed(x)
        for i, stage in enumerate(self.stages):
            x = stage(x)
            if i < len(self.downsamples):
                x = self.downsamples[i](x)
        x = self.norm(x)                       # (B, H/32, W/32, 8C)
        return self.head(x.mean(dim=(1, 2)))   # 縦横で平均して、クラスのスコアにする


model = SwinTransformer().eval()
x = torch.randn(2, 3, 224, 224)
with torch.no_grad():
    h = model.patch_embed(x)
    print("PatchEmbed     :", tuple(h.shape))
    for i, stage in enumerate(model.stages):
        h = stage(h)
        print(f"Stage {i + 1}        :", tuple(h.shape))
        if i < len(model.downsamples):
            h = model.downsamples[i](h)
            print(f"PatchMerging {i + 1} :", tuple(h.shape))
    print("出力           :", tuple(model(x).shape))
print(f"パラメータ数: {sum(p.numel() for p in model.parameters()):,}")
部品を組み立てて Swin Transformer 全体を作り、224×224 の画像を入れて、段ごとの形とパラメータ数を確かめるコードです。
- 既定値: 引数の既定値は、原著論文の Swin-T(C = 96、段の深さ (2, 2, 6, 2)、ヘッド数 (3, 6, 12, 24)、窓 7、MLP の倍率 4、Stochastic Depth の最大の確率 0.2)です。ヘッドあたりの次元は、どの段も 32 になります。
- ずらすブロック: 各段の中で、偶数番目(0, 2, ...)は W-MSA、奇数番目は窓の半分(window_size // 2)だけずらす SW-MSA にします。use_shift=False にすると、すべて W-MSA になります(実験3の比較用)。
- Stochastic Depth の確率: torch.linspace で、最初のブロックの 0 から最後のブロックの 0.2 まで、深さに比例して上げます。公式の実装と同じ設定です。
- 段の作り方: 段 i のチャンネル数は 96 × 2^i です。トークンの縦横は段ごとに半分にして、SwinBlock に渡します。マスクの大きさを決めるためです。最後の段の後には Patch Merging を置きません。
- 分類: 最後の LayerNorm の後、縦横で平均し、線形層で 1000 クラスのスコアにします。
- 確かめ: 段ごとに形を表示し、パラメータの数を数えます。
実行結果
PatchEmbed     : (2, 56, 56, 96)
Stage 1        : (2, 56, 56, 96)
PatchMerging 1 : (2, 28, 28, 192)
Stage 2        : (2, 28, 28, 192)
PatchMerging 2 : (2, 14, 14, 384)
Stage 3        : (2, 14, 14, 384)
PatchMerging 3 : (2, 7, 7, 768)
Stage 4        : (2, 7, 7, 768)
出力           : (2, 1000)
パラメータ数: 28,288,354
図の全体構成どおり、56×56×96 → 28×28×192 → 14×14×384 → 7×7×768 と、Patch Merging のたびに縦横が半分、チャンネル数が2倍になりました。パラメータ数は 28,288,354 で、原著論文の Swin-T の 28M と一致します。
実験2:公式の学習済みの重みで、Hugging Face と同じ出力になるか
スクラッチ実装が公式の Swin Transformer と同じ計算をしているかを、ImageNet-1K で学習した Swin-T の重み(microsoft/swin-tiny-patch4-window7-224)を読み込んで確かめます。重みの名前は Hugging Face の実装とスクラッチ実装で違うので、対応を付けて読み込む関数を用意します。
def load_hf_swin(model, hf_state):
    """Hugging Face の SwinForImageClassification の重みを、スクラッチ実装の名前に付け替えて読み込む
    (transformers の 4 系と 5 系で層の名前が違うので、どちらの名前でも読めるようにする)"""
    def get(*keys):
        for k in keys:
            if k in hf_state:
                return hf_state[k]
        raise KeyError(keys)

    sd = {"patch_embed.proj.weight": get("swin.embeddings.patch_embeddings.projection.weight"),
          "patch_embed.proj.bias": get("swin.embeddings.patch_embeddings.projection.bias"),
          "patch_embed.norm.weight": get("swin.embeddings.norm.weight"),
          "patch_embed.norm.bias": get("swin.embeddings.norm.bias")}
    for i, stage in enumerate(model.stages):
        for j in range(len(stage)):
            p, q = f"swin.encoder.layers.{i}.blocks.{j}.", f"stages.{i}.{j}."
            a4, a5 = p + "attention.self.", p + "attention."        # 4 系と 5 系の注意層の名前
            for t in ("weight", "bias"):
                sd[q + "norm1." + t] = get(p + "layernorm_before." + t)
                sd[q + "norm2." + t] = get(p + "layernorm_after." + t)
                # Hugging Face は Q・K・V を別々の線形層で持つので、縦に連結して 1 つの qkv にする
                sd[q + "attn.qkv." + t] = torch.cat([get(f"{a4}{n}.{t}", f"{a5}{n[0]}_proj.{t}")
                                                     for n in ("query", "key", "value")])
                sd[q + "attn.proj." + t] = get(f"{p}attention.output.dense.{t}", f"{a5}o_proj.{t}")
                sd[q + "mlp.0." + t] = get(f"{p}intermediate.dense.{t}", f"{p}mlp.fc1.{t}")
                sd[q + "mlp.2." + t] = get(f"{p}output.dense.{t}", f"{p}mlp.fc2.{t}")
            sd[q + "attn.relative_position_bias_table"] = get(
                a4 + "relative_position_bias_table", a5 + "relative_position_bias.relative_position_bias_table")
        if i < len(model.downsamples):
            p = f"swin.encoder.layers.{i}.downsample."
            sd[f"downsamples.{i}.norm.weight"] = get(p + "norm.weight")
            sd[f"downsamples.{i}.norm.bias"] = get(p + "norm.bias")
            sd[f"downsamples.{i}.reduction.weight"] = get(p + "reduction.weight")
    sd["norm.weight"], sd["norm.bias"] = get("swin.layernorm.weight"), get("swin.layernorm.bias")
    sd["head.weight"], sd["head.bias"] = get("classifier.weight"), get("classifier.bias")
    model.load_state_dict(sd)                  # 名前や形が 1 つでも合わなければ、ここでエラーになる
    return model
Hugging Face の Swin-T の重みを、スクラッチ実装の層の名前に付け替えて読み込む関数です。
- 名前の対応: Hugging Face の実装は、層の名前がスクラッチ実装と違います。例えば、自己注意の前の LayerNorm は、Hugging Face では layernorm_before、スクラッチ実装では norm1 です。sd に、スクラッチ実装の名前をキーにして、対応する重みを入れていきます。
- 4系と5系の両方の名前: transformers は、5系で自己注意の層の名前を変えました(attention.self.query が attention.q_proj になるなど)。Colab に入っている transformers の版によらず読めるよう、get に両方の名前を渡し、あった方を使います。
- Q・K・V の連結: Hugging Face は Q・K・V を別々の線形層で持ち、スクラッチ実装は1つの qkv の層で持ちます。qkv の出力は Q・K・V の順に並ぶので、重みとバイアスを Q・K・V の順に縦に連結すれば、同じ計算になります。
- 読み込みの確認: load_state_dict は、既定で名前と形が完全に一致することを求めます。対応の付いていない層が1つでもあれば、ここでエラーになります。相対位置の行番号とマスクは、persistent=False にしてあるので、読み込む対象に含まれません。
推論に利用する画像
以下の画像を cat.jpg として保存し、Colab のファイル一覧(左の📁)にアップロードしてください。
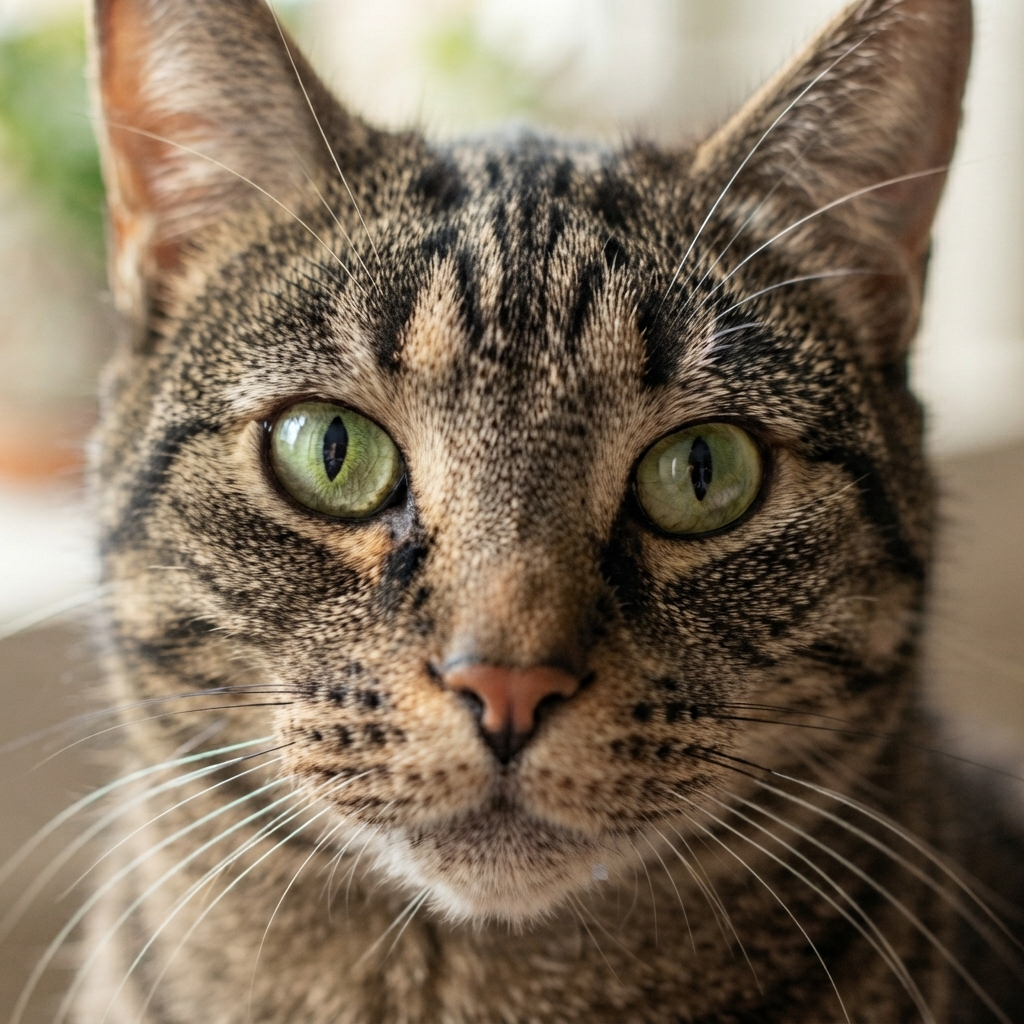
(画像は、Google AI Studioを用いて作成)
from PIL import Image
from transformers import AutoImageProcessor, SwinForImageClassification

name = "microsoft/swin-tiny-patch4-window7-224"
processor = AutoImageProcessor.from_pretrained(name)
hf_model = SwinForImageClassification.from_pretrained(name).eval()
ours = load_hf_swin(SwinTransformer(), hf_model.state_dict()).eval()

image = Image.open("cat.jpg").convert("RGB")
x = processor(images=image, return_tensors="pt")["pixel_values"]   # 224×224 にして正規化した (1, 3, 224, 224)
with torch.no_grad():
    logits_hf = hf_model(pixel_values=x).logits
    logits_ours = ours(x)
print("ロジットの差の最大値:", f"{(logits_hf - logits_ours).abs().max().item():.2e}")
print("ロジットの大きさ    :", f"{logits_hf.abs().max().item():.2f}")

probs = logits_ours.softmax(dim=-1)[0]
top = probs.topk(5)
print("\nスクラッチ実装の予測(上位 5 クラス)")
for p, i in zip(top.values, top.indices):
    print(f"  {hf_model.config.id2label[i.item()]:<35s} {p.item():.3f}")
同じ重みを読み込んだスクラッチ実装と Hugging Face の実装に同じ猫の画像を入れて、出力(ロジット)が一致するかを確かめ、予測したクラスを表示するコードです。
- 前処理: AutoImageProcessor が、学習時と同じ前処理(224×224 への縮小と、ImageNet の平均・標準偏差での正規化)をして、(1, 3, 224, 224) のテンソルにします。両方のモデルに同じテンソルを入れるので、違いはモデルの計算だけになります。
- スクラッチ実装: 既定値の Swin-T を作ってから重みを読み込み、eval() で DropPath を止めます。
- ロジットの差: 1000 クラスのロジットについて、差の絶対値の最大を表示します。ロジットの大きさも一緒に表示するのは、差が小さいかどうかを、値そのものの大きさと比べて判断するためです。
- 上位5クラス: スクラッチ実装のロジットを softmax で確率にし、確率の高い5クラスを、モデルの設定にある ImageNet のクラス名(id2label)で表示します。
実行結果
Loading weights: 100%|██████████| 221/221 [00:00<00:00, 3727.52it/s]
ロジットの差の最大値: 2.26e-06
ロジットの大きさ    : 8.22

スクラッチ実装の予測(上位 5 クラス)
  tabby, tabby cat                    0.488
  tiger cat                           0.269
  Egyptian cat                        0.105
  lynx, catamount                     0.003
  Siamese cat, Siamese                0.001
ロジットの差の最大は 2.26e-06 で、大きさ 8.22 のロジットに対して、浮動小数点の計算の順番の違いで生じる程度の誤差です。スクラッチ実装は、窓の分割、巡回シフトとマスク、相対位置バイアス、Patch Merging の並び順まで、公式の Swin Transformer と同じ計算をしていることが分かります。予測は tabby cat(トラ猫、0.488)、tiger cat(0.269)、Egyptian cat(0.105)と、上位3つがすべて猫のクラスでした。
スクラッチ実装の予測の上位 5 クラスを並べると、次のようになります。
(図は、diagram-designで作成)
実験3:CIFAR-10 で、窓のシフトと相対位置バイアスの効果を確かめる
最後に、スクラッチ実装を CIFAR-10(32×32 のカラー画像、10クラス、学習用 50,000 枚・テスト用 10,000 枚)でゼロから学習し、Swin Transformer の2つの工夫を外すと精度がどう変わるかを比べます。
- 論文どおり(full): W-MSA と SW-MSA を交互に使い、相対位置バイアスも使います。
- ずらさない(no_shift): すべてのブロックを W-MSA にします。窓の外の情報は、Patch Merging で窓が広がるまで入ってきません。
- 相対位置バイアスなし(no_relbias): 注意の重みに を足しません。位置の情報を何も与えないことになります。
実装方針:論文の設定との違い
ImageNet の 224×224 の画像を前提にした Swin-T を、32×32 の CIFAR-10 に合わせるため、次のように変えています。
| 項目 | 原著論文・公式の実装(ImageNet-1K の Swin-T) | 本記事(CIFAR-10) |
|---|---|---|
| 入力画像 | 224×224、1000 クラス | 32×32、10 クラス |
| パッチの大きさ | 4×4 | 2×2(1段目のトークンを 16×16 にするため) |
| 窓の大きさ | 7×7 | 4×4(1・2段目を複数の窓に分けるため) |
| 各段のトークン | 56×56 → 28×28 → 14×14 → 7×7 | 16×16 → 8×8 → 4×4 → 2×2 |
| チャンネル数・段の深さ・ヘッド数 | 96、(2, 2, 6, 2)、(3, 6, 12, 24) | 同じ |
| エポック | 300 | 50(3つの設定を A100 で約1時間で学習するため) |
| バッチ | 1024 | 128 |
| 学習率 | 1e-3 | 5e-4(公式の実装の基準の学習率) |
| ウォームアップ | 20 エポック | 3 エポック(全体に対する割合をそろえる) |
| 最適化・重み減衰 | AdamW、0.05 | 同じ |
| Stochastic Depth | 0.2 | 同じ |
| データの水増し | RandAugment・Mixup・CutMix・Random Erasing など | ランダムな切り抜きと左右反転だけ |
| ラベル平滑化・勾配のクリップ | 0.1、5.0 | 同じ |
データと学習の関数
import math
import torchvision
import torchvision.transforms as T

# CIFAR-10 の学習データの平均と標準偏差で正規化する。学習時は、ずらして切り抜く・左右反転で水増しする
mean, std = (0.4914, 0.4822, 0.4465), (0.2470, 0.2435, 0.2616)
train_tf = T.Compose([T.RandomCrop(32, padding=4), T.RandomHorizontalFlip(), T.ToTensor(), T.Normalize(mean, std)])
test_tf = T.Compose([T.ToTensor(), T.Normalize(mean, std)])
train_set = torchvision.datasets.CIFAR10("./data", train=True, download=True, transform=train_tf)
test_set = torchvision.datasets.CIFAR10("./data", train=False, download=True, transform=test_tf)

EPOCHS, WARMUP, BATCH = 50, 3, 128


def train(variant):
    """variant: "full"(論文どおり)/ "no_shift"(ずらさない)/ "no_relbias"(相対位置バイアスなし)"""
    torch.manual_seed(0)                       # 3 つの設定で、重みの初期値とデータの順番をそろえる
    train_loader = torch.utils.data.DataLoader(train_set, batch_size=BATCH, shuffle=True, num_workers=8, drop_last=True)
    test_loader = torch.utils.data.DataLoader(test_set, batch_size=512, num_workers=8)
    # 32×32 の画像向けに、パッチを 2×2、窓を 4×4 にする(チャンネル数・段の深さ・ヘッド数は Swin-T のまま)
    model = SwinTransformer(img_size=32, patch_size=2, num_classes=10, window_size=4,
                            use_shift=(variant != "no_shift"), use_rel_bias=(variant != "no_relbias")).to(device)
    # LayerNorm・バイアス(1 次元のパラメータ)と相対位置バイアスの表には、公式コードと同じく重み減衰をかけない
    no_decay = [p for n, p in model.named_parameters() if p.ndim == 1 or "relative_position_bias_table" in n]
    decay = [p for n, p in model.named_parameters() if not (p.ndim == 1 or "relative_position_bias_table" in n)]
    opt = torch.optim.AdamW([{"params": decay, "weight_decay": 0.05}, {"params": no_decay, "weight_decay": 0.0}], lr=5e-4)
    steps, warm = EPOCHS * len(train_loader), WARMUP * len(train_loader)
    sched = torch.optim.lr_scheduler.LambdaLR(     # 直線で上げてから、コサインで 0 まで下げる
        opt, lambda s: s / warm if s < warm else 0.5 * (1 + math.cos(math.pi * (s - warm) / (steps - warm))))
    criterion = nn.CrossEntropyLoss(label_smoothing=0.1)

    log = []
    for epoch in range(1, EPOCHS + 1):
        model.train()
        t0, total = time.time(), 0.0
        for x, y in train_loader:
            x, y = x.to(device, non_blocking=True), y.to(device, non_blocking=True)
            with torch.autocast("cuda", dtype=torch.bfloat16):
                loss = criterion(model(x), y)
            opt.zero_grad(set_to_none=True)
            loss.backward()
            torch.nn.utils.clip_grad_norm_(model.parameters(), 5.0)
            opt.step()
            sched.step()
            total += loss.item()
        model.eval()
        correct = 0
        with torch.no_grad(), torch.autocast("cuda", dtype=torch.bfloat16):
            for x, y in test_loader:
                correct += (model(x.to(device)).argmax(1) == y.to(device)).sum().item()
        log.append({"epoch": epoch, "loss": total / len(train_loader), "acc": correct / len(test_set),
                    "sec": time.time() - t0})
        if epoch % 10 == 0 or epoch == 1:
            print(f"[{variant:10s}] エポック {epoch:2d}  学習の損失 {log[-1]['loss']:.3f}  テストの正解率 {log[-1]['acc']:.4f}"
                  f"  ({log[-1]['sec']:.0f} 秒)")
    return log
CIFAR-10 を読み込み、設定(variant)を受け取ってスクラッチ実装をゼロから学習し、エポックごとにテストの正解率を記録する関数を定義するコードです。
- 前処理: CIFAR-10 の学習データの平均と標準偏差で正規化します。学習データにだけ、4画素の余白を付けてランダムに 32×32 を切り抜く処理と、左右反転をかけます。CIFAR-10 の学習でよく使われる水増しで、5万枚の画像だけでは、Transformer はすぐに過学習してしまうため入れています。原著論文は RandAugment・Mixup・CutMix なども使いますが、ここで比べたいのはモデルの構造の違いなので、水増しは最小限にしています。
- シード: torch.manual_seed(0) を設定ごとに呼びます。3つの設定はパラメータの数と作る順番が同じなので(相対位置バイアスの表は、使わない設定でも作ります)、重みの初期値、データの順番、水増しの乱数がそろい、違いは use_shift と use_rel_bias だけになります。ただし、GPU の計算の細かな誤差による違いは残ります。
- モデルの大きさ: 32×32 の画像を 4×4 のパッチに切ると 8×8 のトークンしかできず、2段目で窓1つ分になってしまいます。パッチを 2×2 にして1段目を 16×16 のトークンにし、窓を 4×4 にすると、1段目は16個、2段目(8×8)は4個の窓に分かれ、SW-MSA が意味を持つ段が2つできます。チャンネル数・段の深さ・ヘッド数は Swin-T のままにしています。
- 最適化の設定: AdamW、重み減衰 0.05、ラベル平滑化 0.1、勾配のクリップ 5.0、LayerNorm・バイアス・相対位置バイアスの表に重み減衰をかけないことは、公式の実装と同じ設定です。学習率 5e-4 は、公式の実装の基準の学習率の値です。
- 学習率の変化: 最初の3エポックで 0 から 5e-4 まで直線で上げ(ウォームアップ)、その後コサインで 0 まで下げます。原著論文の「300 エポック中 20 エポック(約7%)のウォームアップの後にコサインで下げる」に合わせて、50 エポック中 3 エポックにしています。Transformer は、学習の始めから大きな学習率を使うと不安定になりやすいため、ウォームアップを入れます。
- エポックとバッチ: 50 エポックは、3つの設定を A100 で合わせて約1時間で学習できる長さです。バッチ 128 は、CIFAR-10 の学習でよく使われる大きさです。
- bf16: torch.autocast で、行列計算を bfloat16 で行います。A100 で学習を速くするためです。bfloat16 は float32 と同じ範囲の指数を持つので、float16 のときのような損失のスケーリングは要りません。
- num_workers=8: Colab の A100 のランタイム(CPU 12 コア)で、画像の水増しが GPU の待ち時間にならないよう、8つのプロセスで並行して画像を用意します。
- 評価: エポックの終わりに、model.eval() で DropPath を止めてから、テスト用の1万枚で正解率を測ります。表示は1エポック目と10エポックごとだけにし、すべてのエポックの値を log に残します。
3つの設定を学習する
logs = {}
for variant in ["full", "no_shift", "no_relbias"]:
    logs[variant] = train(variant)

print()
for variant, log in logs.items():
    best = max(r["acc"] for r in log)
    print(f"{variant:10s} 最終エポックの正解率 {log[-1]['acc']:.4f}  最高 {best:.4f}")
3つの設定を順に学習し、最後のエポックのテストの正解率と、全エポックの中で最も高かった正解率を表示するコードです。
- 比べる値: 主に、最後のエポックの正解率を比べます。最も高かった正解率は、テストのデータを見て選んだ値になるので、参考として表示しています。
- 時間: 1エポックは A100 で約22秒で、3つの設定を合わせて約1時間かかります。
実行結果
[full      ] エポック  1  学習の損失 1.968  テストの正解率 0.4029  (22 秒)
[full      ] エポック 10  学習の損失 1.217  テストの正解率 0.6733  (22 秒)
[full      ] エポック 20  学習の損失 1.037  テストの正解率 0.7591  (21 秒)
[full      ] エポック 30  学習の損失 0.898  テストの正解率 0.8075  (22 秒)
[full      ] エポック 40  学習の損失 0.795  テストの正解率 0.8390  (22 秒)
[full      ] エポック 50  学習の損失 0.758  テストの正解率 0.8485  (21 秒)
[no_shift  ] エポック  1  学習の損失 1.984  テストの正解率 0.3616  (21 秒)
[no_shift  ] エポック 10  学習の損失 1.265  テストの正解率 0.6582  (22 秒)
[no_shift  ] エポック 20  学習の損失 1.084  テストの正解率 0.7218  (22 秒)
[no_shift  ] エポック 30  学習の損失 0.942  テストの正解率 0.7800  (22 秒)
[no_shift  ] エポック 40  学習の損失 0.830  テストの正解率 0.8166  (22 秒)
[no_shift  ] エポック 50  学習の損失 0.795  テストの正解率 0.8252  (22 秒)
[no_relbias] エポック  1  学習の損失 1.968  テストの正解率 0.4023  (20 秒)
[no_relbias] エポック 10  学習の損失 1.214  テストの正解率 0.6818  (21 秒)
[no_relbias] エポック 20  学習の損失 1.043  テストの正解率 0.7550  (20 秒)
[no_relbias] エポック 30  学習の損失 0.905  テストの正解率 0.8003  (21 秒)
[no_relbias] エポック 40  学習の損失 0.801  テストの正解率 0.8374  (20 秒)
[no_relbias] エポック 50  学習の損失 0.764  テストの正解率 0.8458  (20 秒)

full       最終エポックの正解率 0.8485  最高 0.8491
no_shift   最終エポックの正解率 0.8252  最高 0.8254
no_relbias 最終エポックの正解率 0.8458  最高 0.8458
labels = {"full": "論文どおり(W-MSA と SW-MSA、相対位置バイアスあり)",
          "no_shift": "ずらさない(W-MSA だけ)", "no_relbias": "相対位置バイアスなし"}
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
for variant, log in logs.items():
    ep = [r["epoch"] for r in log]
    axes[0].plot(ep, [r["loss"] for r in log], label=labels[variant])
    axes[1].plot(ep, [r["acc"] for r in log], label=labels[variant])
axes[0].set_ylabel("学習の損失")
axes[1].set_ylabel("テストの正解率")
axes[1].set_ylim(0.6, 0.87)                # 3つの差が見えるよう、正解率が 0.6 を超えた範囲を拡大する
for ax in axes:
    ax.set_xlabel("エポック")
    ax.grid(alpha=0.3)
handles, names = axes[0].get_legend_handles_labels()
fig.legend(handles, names, loc="lower center", ncol=3)   # 凡例は2つのグラフで共通なので、下に1つだけ置く
plt.tight_layout(rect=(0, 0.08, 1, 1))
plt.show()
3つの設定の学習の損失とテストの正解率を、エポックごとに並べて描くコードです。
- 2つのグラフ: 学習の損失で学習データへの当てはまりの速さを、テストの正解率で初めて見る画像への性能を比べます。損失はラベル平滑化を含むので、すべて正解しても 0 にはなりません。
実行結果
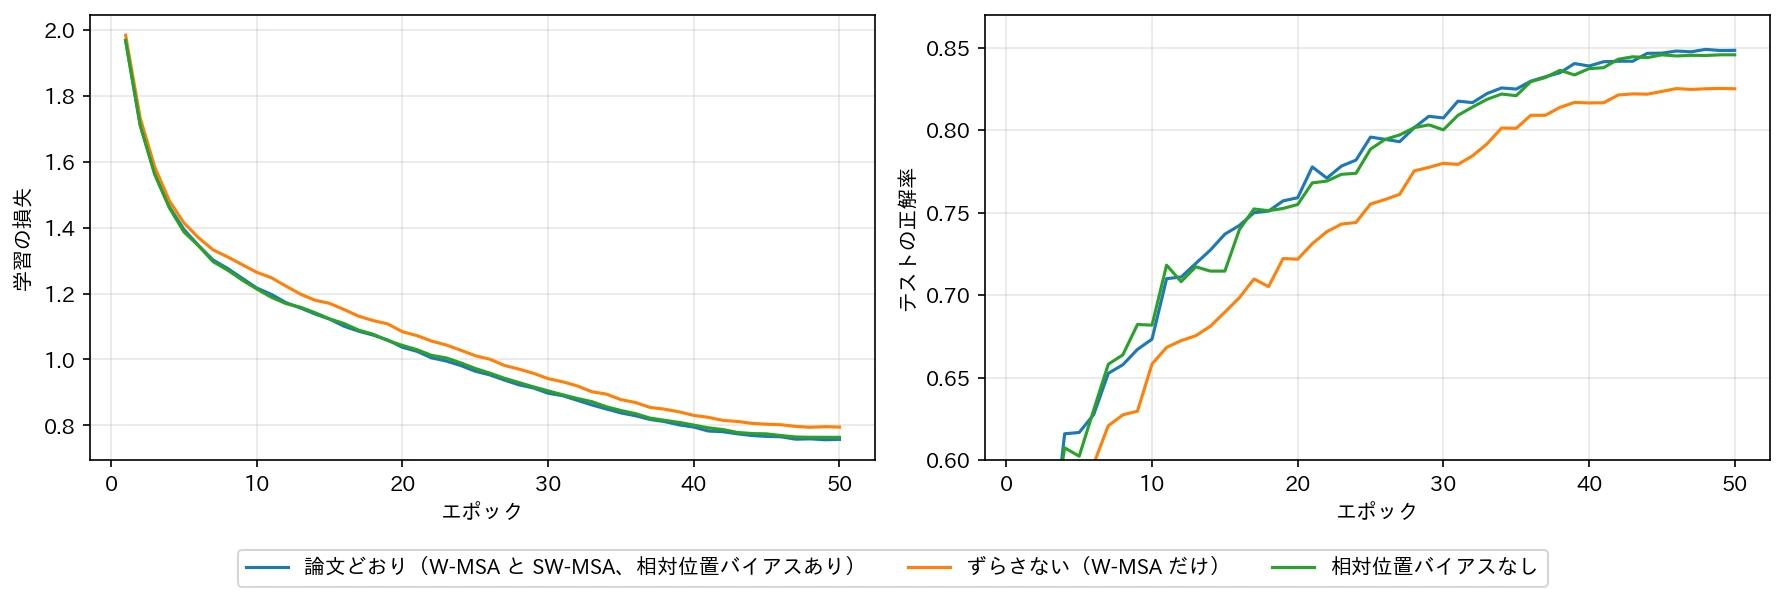
論文どおりの設定は、50 エポックでテストの正解率 84.85% になりました。すべてのブロックを W-MSA にした(ずらさない)設定は 82.52% で、2.3 ポイント低くなりました。学習の損失も、ずらさない設定(オレンジ)だけが最初から最後まで高いままで、学習データへの当てはまりも遅れています。このモデルでは、3段目以降は特徴マップが窓1つ分になるので、ずらさない設定では、1・2段目で窓の外の情報がまったく入らず、3段目になって初めて画像全体が混ざります。SW-MSA で隣の窓の情報を早い段から混ぜることが、精度に効いています。原著論文の ImageNet の Swin-T でも、ずらさないと正解率が 81.3% から 80.2% に、1.1 ポイント下がっています。
相対位置バイアスを外した設定は 84.58% で、論文どおりとの差は 0.27 ポイントでした。正解率の曲線もほとんど重なっていて、この差は、1回だけの学習では、GPU の計算の細かな誤差などで変わりうる程度の大きさです。原著論文の ImageNet では、位置の情報をまったく与えないと 81.3% から 80.1% に下がりましたが、この実験でははっきりした差は見えませんでした。窓が 4×4 と小さく、3段目以降は 16 個・4 個のトークンしかないので、32×32 の小さな画像では、相対位置の手がかりが効く場面が少ないためと考えられます。
3つの設定の最終的な正解率を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、画像を小さな窓に区切り、窓の中だけで自己注意を計算する Swin Transformer を、PyTorch のスクラッチ実装で確かめました。
実験1では、トークンを 112×112 個に増やすと、画像全体の自己注意(MSA)の計算量は、窓の中だけの自己注意(W-MSA)の約53倍(30.67 GFLOPs と 0.58 GFLOPs)になりました。GPU のメモリは 3,634 MB と 55 MB で、約66倍の差です。窓の中だけで計算すれば、計算量とメモリはトークン数に比例する程度に収まります。実験2では、部品ごとに実装したモデルに公式の Swin-T の重みを読み込み、Hugging Face の実装とロジットの差が 2.26e-06 以内で一致することを確かめました。実験3では、CIFAR-10 でゼロから学習し、窓をずらさないと正解率が 84.85% から 82.52% に下がりました。窓を半分ずらして隣の窓の情報を混ぜる SW-MSA は、窓に区切ったことで見えなくなる情報を補う、欠かせない工夫です。一方、相対位置バイアスを外したときの差は 0.27 ポイントで、32×32 の小さな画像では、はっきりした効果は見えませんでした。
窓に区切って計算量を抑え、Patch Merging で 1/4 から 1/32 までの階層的な特徴を作る Swin Transformer の設計は、CNN と同じ形の特徴を出せるので、物体検出や領域分割の仕組みにそのまま組み込めます。画像の Transformer を高解像度のタスクに使うための、基本的な設計の1つです。
出典・ライセンスについて
- Swin Transformer の実装: Microsoft の Swin-Transformer(MIT License / Copyright (c) Microsoft Corporation)を参考に実装しています。
- 学習済みのモデル: Hugging Face で公開されている microsoft/swin-tiny-patch4-window7-224(Apache License 2.0)を使用しています。
- CIFAR-10 データセット: Alex Krizhevsky、Vinod Nair、Geoffrey Hinton による CIFAR-10 を使用しています。
参考文献
- Z. Liu et al. (2021). Swin Transformer: Hierarchical Vision Transformer using Shifted Windows. ICCV 2021.
- Microsoft. microsoft/Swin-Transformer. GitHub.
- Microsoft. microsoft/swin-tiny-patch4-window7-224. Hugging Face.
- A. Krizhevsky (2009). Learning Multiple Layers of Features from Tiny Images. Technical Report, University of Toronto.
本記事の文章・構成の一部に生成AIを使用しています。