合成コントロール法とジオ実験とは?
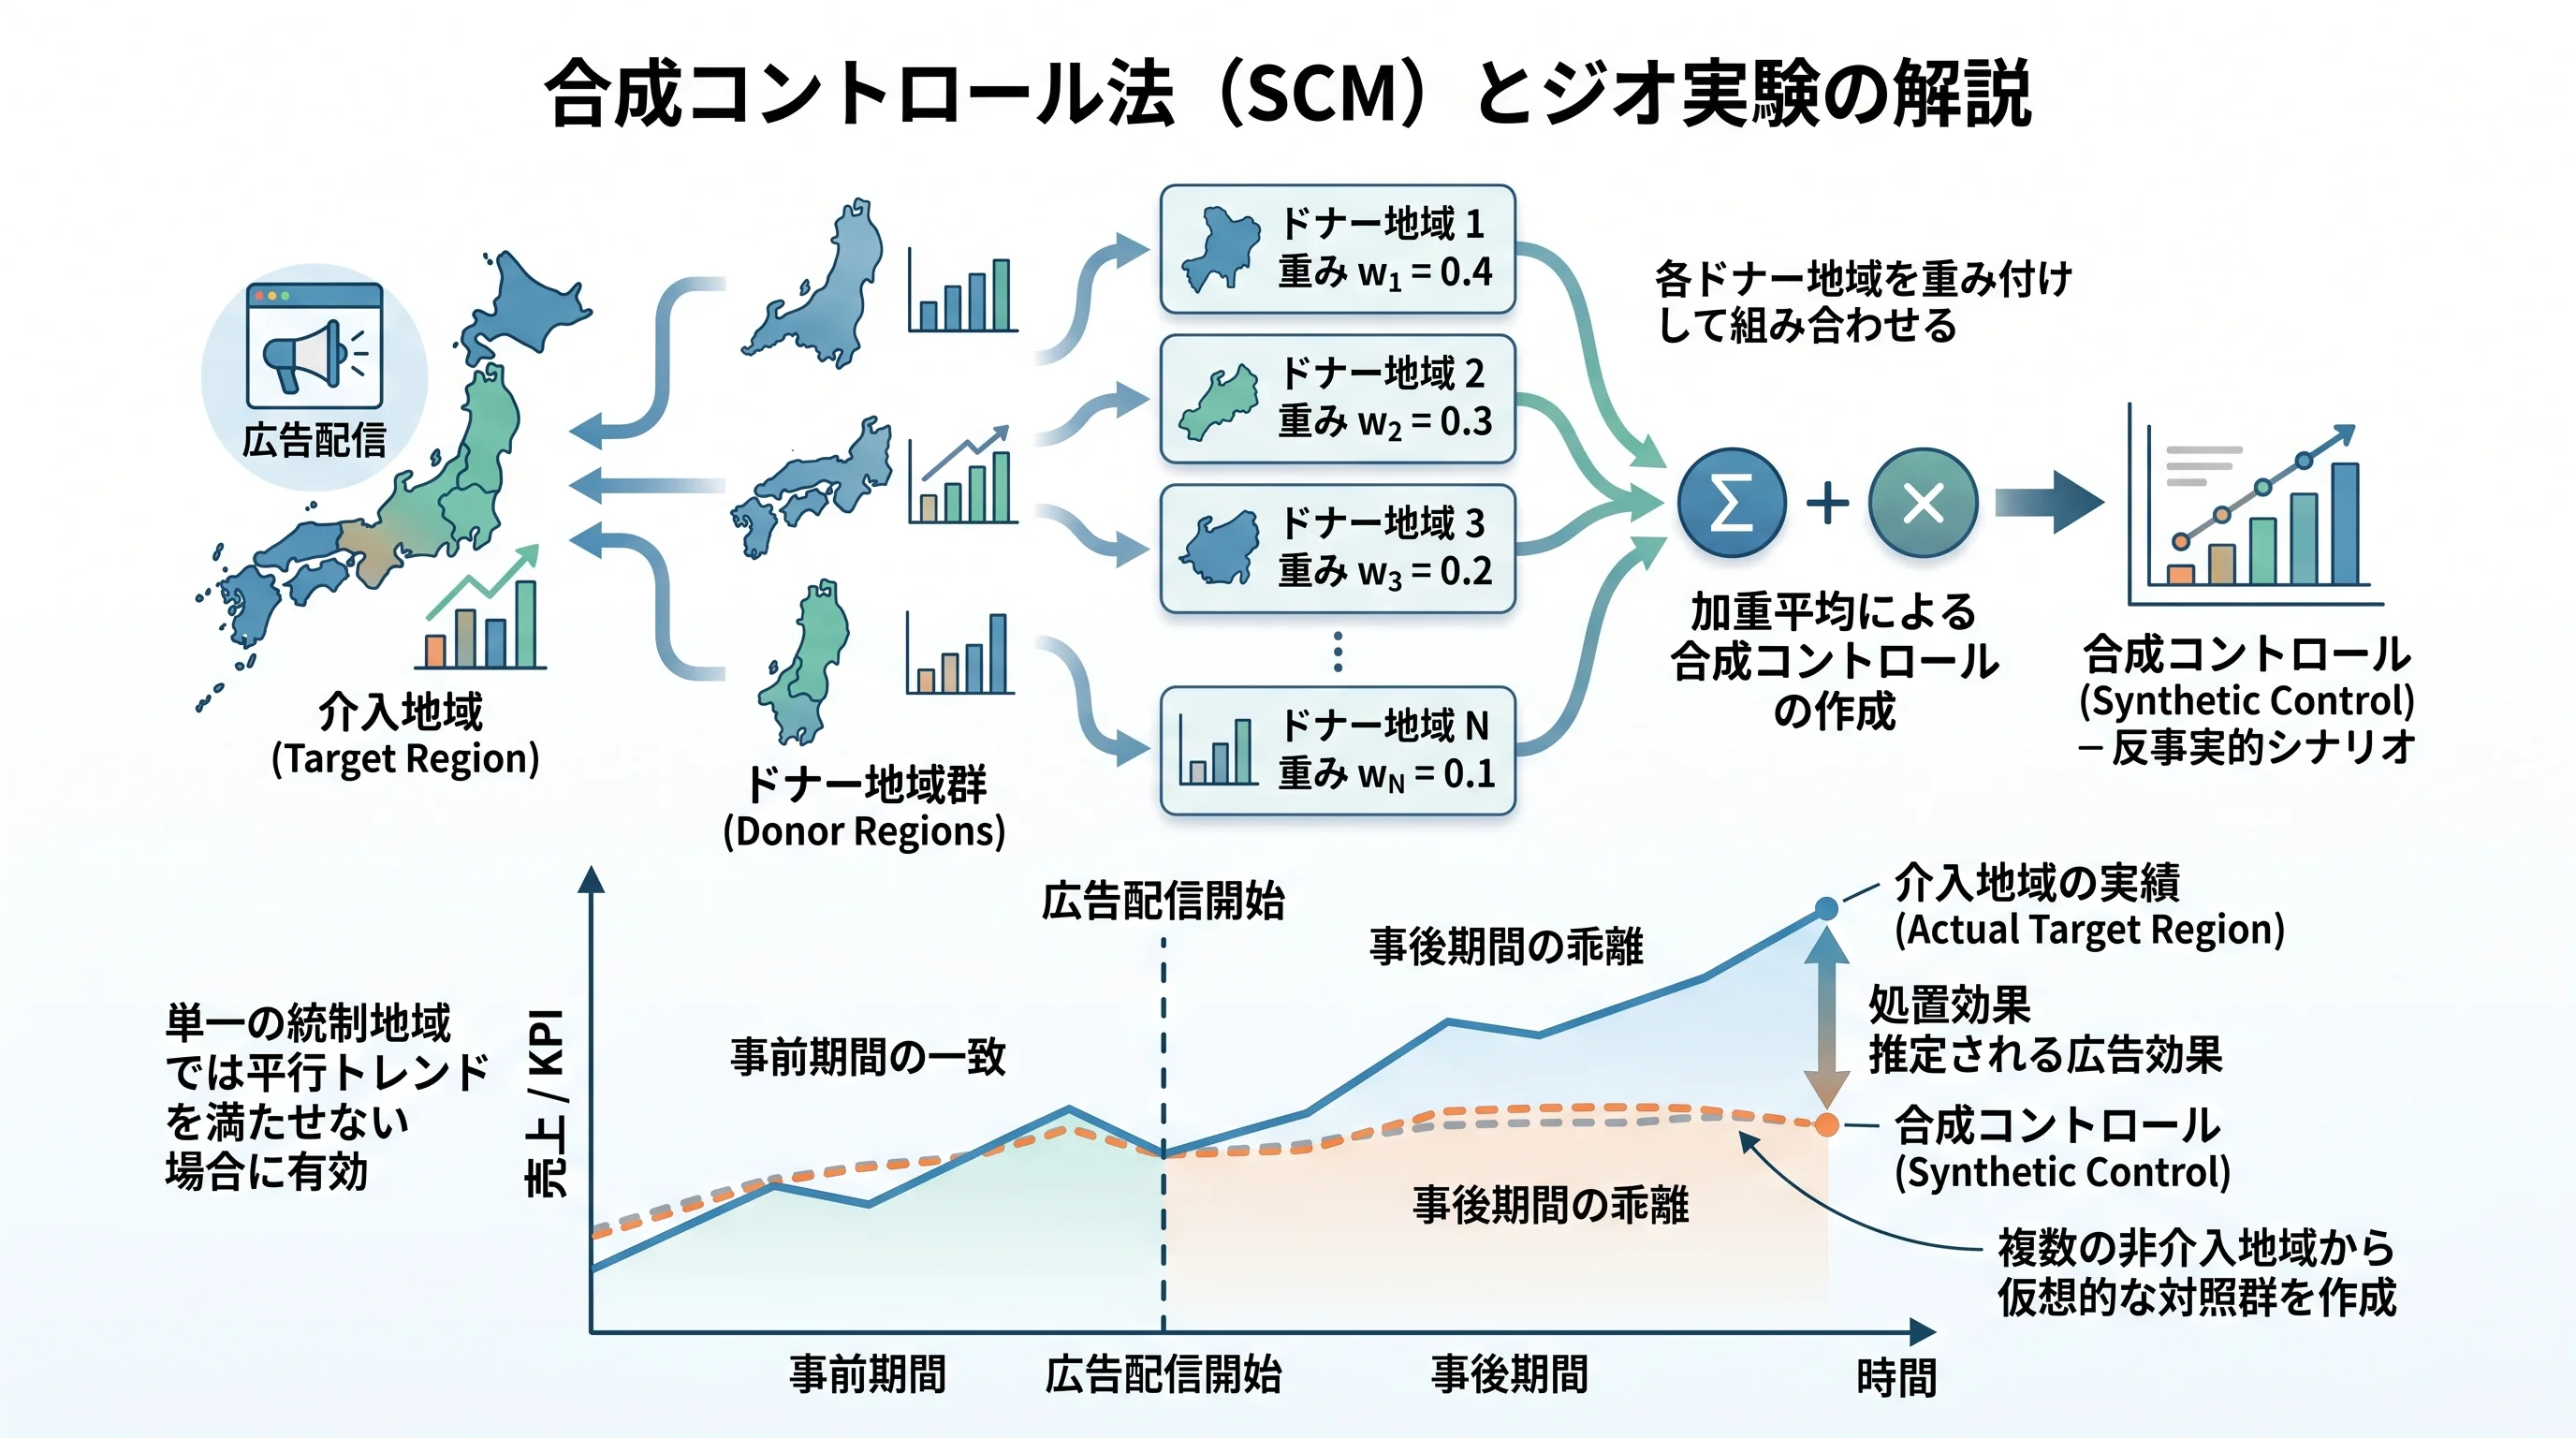 (画像は、Geminiで作成)
はじめに ── 単一の統制群では測れない広告効果
「観察データにおける広告効果の内生性とは?」の記事では、観察データから広告効果を回帰分析などで推定しようとすると、企業の予算配分行動や消費者の需要変動、プラットフォームのターゲティングによって 内生性(endogeneity) が生じ、広告効果が大きく過大推定されてしまうメカニズムを見ました。内生性によるバイアスは、どれほどサンプルサイズを増やしても消えることはありません。
この内生性を根本から断ち切る唯一の確実なアプローチが、実験によって処置(広告配信)を外生的にコントロールすることです。
しかし、テレビCM、屋外広告、あるいは検索連動型広告のように、ユーザー単位で「広告を見せる人」と「見せない人」をランダムに割り当てるランダム化比較試験(RCT)が技術的・倫理的・ビジネス的に困難なケースは多々存在します。Cookie規制(SafariのITPや、サードパーティCookieの利用制限)が進む現代においては、デジタル広告であってもユーザー単位の追跡に基づくRCTは容易ではありません。
そこで実務の標準として広く採用されているのが、国や都道府県、都市といった地域単位で広告出稿の有無をコントロールする「ジオ実験(Geo Experiment)」(Vaver & Koehler, 2011)です。
しかし、地域単位の実験には因果推論上の大きな壁が立ちはだかります。それは、 「介入地域とまったく同じトレンドをたどる完璧な統制地域など、現実には存在しない」 という点です。
差の差法(DiD)の記事で確認したように、DiDが正しく効果を推定するためには「もし介入がなければ両グループは同じ傾きで推移していた」という平行トレンドの仮定が不可欠です。しかし、介入地域だけに独自の成長トレンドが存在する場合、DiDは真値から大きく乖離した偏った推定値を返してしまいます。
【DiDにおける平行トレンド違反の例(DiDの記事より)】
  真の効果: 15.00
  DiDの推定値: 19.82(95%信頼区間: [18.36, 21.28])
  事前トレンド検定: p = 0.0035(平行トレンドが棄却される)
では、単一の統制地域では平行トレンドが成り立たない場合、私たちはどのようにして「もし広告を出していなかったらどうなっていたか」という反事実(Counterfactual)を知ればよいのでしょうか?
その答えとなるのが、本記事の主題である合成コントロール法(Synthetic Control Method: SCM)(Abadie et al., 2010)です。1つの地域だけでは似ていなくても、 「複数の非介入地域を適切に重み付けして組み合わせる(合成する)」 ことで、介入前の推移を極めて高い精度で再現する仮想のコントロール地域を作り出すことができます。
- ジオ実験の基本設計(割り付け・期間・持ち越し効果・検出力)を理解する
- 合成コントロール法の数理(凸結合・内挿制約の意義)を把握する
- Pythonでジオ実験データを生成し、合成コントロール法をゼロから実装して真のリフトを復元する
- プラセボ検定(並べ替え検定)を用いた統計的推論の手法を習得する
- DiD・CausalImpact・合成コントロール法の明確な使い分け基準を身につける
合成コントロール法の数理 ── 凸結合による反事実の再構成
基本的なセッティングと記法
分析対象として、全部で 個の地域が存在するとします。
- 介入地域(Target Region): 地域 (施策期間中に広告を出稿した地域)
- ドナープール(Donor Pool): 地域 (施策期間中も広告を出していない非介入地域の候補群)
観測期間は の全 時点とし、施策は時点 から開始されるものとします。すなわち、
- 事前期間(Pre-treatment Period):
- 事後期間(Post-treatment Period):
地域 の時点 における売上(KPI)を と表します。介入地域(地域0)がもし広告を出していなかった場合の潜在的結果(反事実)を と書くと、私たちが推定したい時点 ()における因果効果(処置効果) は次の引き算で定義されます。
しかし、施策後の反事実 は現実には観測できません。合成コントロール法では、この未知の反事実を ドナー地域の加重平均(合成コントロール) として推定します。
ここで、 は各ドナー地域に割り当てられる重みベクトルです。
重みに対する「2つの制約」:なぜ凸結合なのか?
合成コントロール法の最も本質的な特徴は、重みベクトル に対して次の2つの制約を課す点にあります(Abadie et al., 2010)。
数学的に、この制約を満たす重み付けは 凸結合(Convex Combination) と呼ばれます。なぜ単なる線形回帰のように自由な係数を許さず、わざわざ非負かつ合計1の制約を課すのでしょうか?
経済学者の Alberto Abadie は、その理論的・実践的理由を次のように説明しています(Abadie, 2021)。
- 「外挿(Extrapolation)」を防ぎ「内挿(Interpolation)」に限定する: 制約のない通常の重回帰(OLS)では、負の重みや極端に大きな正の重み(例:地域Aに 、地域Bに )が許容されます。これはデータの存在しない領域へと予測を無理やり伸ばす「外挿」であり、施策前の過学習を招くだけでなく、施策後の予測が激しく不安定になります。凸結合の制約を課すことで、合成反事実は常にドナー地域の観測範囲の内部(凸包: Convex Hull)に収まるため、極端で非現実的な予測を防ぐことができます。
- 透明性と説明責任(解釈可能性): 「介入地域の反事実は、北海道45%、静岡県30%、広島県25%の組み合わせで作られています」という説明は、ビジネスの現場や経営陣に対しても直感的で極めて透明性が高くなります。どの地域がどの程度寄与しているかが一目瞭然です。
- 疎な解(Sparsity)の獲得: 凸結合の最適化問題を解くと、多数のドナー地域の中から本当に介入地域と似ている少数の地域にだけ正の重みが集中し、無関係な大半のドナー地域の重みは自然と厳密に 0 になります(L1正則化に似た効果)。
凸結合と制約のない回帰の違いを図にすると、次のようになります(地域1〜3の重みは後のダミーデータの真の値です)。
(図は、diagram-designで作成)
最適な重みの決定アルゴリズム
重みベクトル は、事前期間()における介入地域の実績と合成コントロールの乖離(二乗予測誤差)を最小化することによって決定されます。
これは線形等式制約と不等式制約を持つ 制約付き2次計画問題(Quadratic Programming) です。目的関数が凸であるため、局所解に陥ることなく大域的最適解を高速に計算できます(事前期間のドナーデータが一次独立など、目的関数が強凸になる条件のもとでは解は一意に定まります)。制約付き2次計画問題の定式化、KKT条件、疎な解が得られる仕組みについては、別の記事で詳しく解説する予定です。
ここで押さえておきたいのは、事前期間の近似は「重みを決めるための学習」であり、本当に知りたいのは施策後の反事実であるという点です。事前期間()の売上(KPI)は介入地域でそのまま観測されているため、それを再計算する必要はありません。事前期間で「介入地域の動きを、ドナー地域の組み合わせでどれだけ忠実に再現できるか」を確認しておくことで、 施策を行わなかった場合の施策後の売上(KPI) を推定できるようにします。
この推定は、「事前期間に成り立っていた介入地域とドナー地域の関係は、施策後も変わらない」という仮定に基づいています。介入地域の値が施策前と同じ水準で続くと仮定するわけではなく、施策後にドナー地域の売上が変動すれば、合成コントロールもその動きに連動して変化します。この仮定が妥当であるためには、次の条件が必要です。
- 事前期間における当てはまりが十分に良いこと
- ドナー地域が施策の影響(波及・スピルオーバー)を受けていないこと
- 施策期間中に、介入地域だけに影響する別のショック(他施策・天候・競合の動きなど)が発生していないこと
事前期間で最適な重み が求まれば、この重みを固定したまま施策後期間()の反事実をドナー地域の実績データから直接計算し、実績値との差分を取ることで因果効果を測定します。
また、施策期間全体の累積効果(総リフト)は、日々の推定効果の合計値として求められます。
なぜ内生性が消えるのか ── 実験と合成コントロール法の役割分担
ここで、冒頭の問いに立ち返っておきましょう。合成コントロール法を使うと、なぜ内生性の記事で見た内生性によるバイアスを避けられるのでしょうか。
正確に言うと、合成コントロール法そのものが内生性を消すわけではありません。内生性を断つのはジオ実験という設計であり、合成コントロール法は実験だけでは残る「介入地域と比較対象の違い」を補正する役割を担います。両者の分担は次のとおりです。
① ジオ実験が断つもの:「広告の出し方が売上の見込みに反応する」経路
観察データで内生性が生じるのは、「需要が高い時期・地域ほど予算を増やす」「買いそうな人にプラットフォームが配信する」というように、広告量が売上の見込みに合わせて決まるからでした。その結果、広告と売上の相関に「もともと売れるはずだった分」が混ざってしまいます。
ジオ実験では、出稿する地域・期間・量を事前に設計で固定します。施策期間中に需要が上がっても下がっても出稿は変わらないため、「需要 → 広告量」という逆向きの矢印がなくなります。また、比較は地域全体の売上で行います。地域内で誰が広告を見たかに関係なく、広告を見ていない人も含めた地域合計を比べるため、ターゲティングによる「買いそうな人に配信された」偏りも比較に入り込みません。
② 合成コントロール法が補正するもの:観測できない地域差
実験をしても、比べる相手が介入地域と似ていなければ、差の中に「地域の違い」が混ざります。地域数が少ないジオ実験では、ランダムに割り付けても偶然の偏りが残りやすい点は、後述の「地域の割り付け」で見るとおりです。
Abadie et al. (2010) は、施策がなかった場合の売上を、次の因子モデルで表して合成コントロール法の妥当性を示しています。
- : 全地域に共通するショック(景気、季節、全国的な需要変動など)
- : 観測できない地域固有の特性(客層、競合の強さ、成長性など)
- : その特性が売上に効く強さ。時期によって変わってよい
- : 地域・時点ごとのランダムなノイズ
このモデルのもとで、合成コントロール法は2種類の要因に次のように対処します。
- 共通ショック : ドナー地域にも同じだけ含まれるため、重みの合計が1である合成コントロールにもそのまま含まれ、介入地域との差を取ると消えます。
- 観測できない特性 : 直接は測れません。しかし、もし重み付けたドナーの が介入地域と異なれば、 が時期ごとに変わるのに合わせて推移がずれていくはずです。逆に言えば、長い事前期間の推移をぴったり再現できたなら、合成コントロールは介入地域とほぼ同じ を持っていると考えられます。Abadie らは、事前期間 が長く当てはまりが良いほど、残るバイアスが小さくなることを示しています。
これがDiDとの本質的な違いです。DiDが差の差で消せるのは、時間によって変わらない地域差(固定効果)だけです。一方、合成コントロール法は、事前期間の推移そのものを合わせることで、時期によって効き方が変わる観測できない要因、すなわち平行トレンドを崩す要因にも対処できます。
それでも残るもの
次のような場合は、合成コントロール法を使ってもバイアスが残ります。いずれも、前述の「この仮定が妥当であるための条件」に対応しています。
- 施策後に介入地域だけに起きたショック: 事前期間のデータに現れていないため、合成コントロールでは再現できません。
- スピルオーバー: ドナー地域に効果が漏れると、比較対象そのものが汚れてしまいます。
- 将来の伸びを見込んだ地域選び: 「来月伸びそうだからこの地域で施策をする」という選び方は、介入地域の選択が将来のショックと相関するため、観察データの内生性と同じ構造に戻ってしまいます。地域の割り付けにランダム化やマッチドペア法が推奨されるのはこのためです。
- ジオ実験: 出稿を設計で固定し、「広告量が需要に反応する」経路(内生性の源)を断つ
- 合成コントロール法: 事前期間の推移を合わせることで、共通ショックと観測できない地域差を打ち消し、比較対象を介入地域に近づける
ジオ実験と合成コントロール法の役割分担を図にすると、次のようになります。
(図は、diagram-designで作成)
ジオ実験の設計 ── 実務で失敗しないための4大要素
合成コントロール法の数理を理解したところで、それを適用する土台となる「ジオ実験(Geo Experiment)」の実験設計について整理しておきましょう。Google(Vaver & Koehler, 2011、Kerman et al., 2017)やMeta(Meta GeoLift)の研究に基づき、実務で不可欠な4つの設計要素を解説します。
① 地域の割り付け(Assignment)
地域をどのように「介入群」と「統制群(ドナー候補)」に分けるかは、実験の成否を決定づけます。
| 割り付け手法 | 概要 | メリット・デメリット |
|---|---|---|
| 完全ランダム化 | 各地域をコイン投げのように無作為に介入・統制に分ける | 理論的に最も素朴だが、地域数が数十程度と少ないジオ実験では偶然の偏り(規模の不均衡など)が生じやすい |
| マッチドペア法 | 過去の売上規模や成長トレンドが似ている地域同士でペアを作り、ペア内でランダムに一方を介入にする | 規模やトレンドのバランスが取れやすい。古くから実務で広く利用される(Vaver & Koehler, 2011) |
| 最適化ベースの割り付け | 事前データにおいて「ドナー候補の合成コントロールが介入群の推移を最もよく再現できる地域の組み合わせ」をアルゴリズムで逆算・選定する | 施策前の予測精度が極大化され、より小さなリフトでも検出しやすくなる。最新のツール(Meta GeoLiftなど)が採用 |
② 期間の設計と「分析期間の罠」
ジオ実験は通常、次の3つの期間で設計されます。
| <------- 事前期間 (Pre-test) -------> | <--- 施策期間 (Test) ---> | <-- 施策後観察期間 (Post/Cooldown) --> |
0                                     T_0                        T_1                                      T
- 事前期間(Pre-test: 通常6〜12週間以上): ドナー地域の重みを学習し、モデルの予測精度を担保するための十分な長さが必要です。
- 施策期間(Test: 通常2〜6週間): 広告キャンペーンを実際に集中投下(または停止)する期間です。
- 施策後観察期間(Cooldown: 通常2〜4週間): DiDやCausalImpactの記事で学んだ 持ち越し効果(アドストック) を捉えるための期間です。
広告の効果は、施策終了日()で突然ゼロになるわけではありません。消費者の記憶や認知にとどまり、施策後も数週間にわたってじわじわと売上を生み続けます。施策終了日で効果測定を打ち切ってしまうと、持ち越された効果(施策や商材によっては、総効果の無視できない割合を占めます。本記事のダミーデータでも約13%です)を取りこぼし、施策のROIを大きく過小評価してしまいます。
本記事のダミーデータの期間を、この3つに当てはめると次のようになります。
(図は、diagram-designで作成)
③ 検出力(MDE: Minimum Detectable Effect)の事前計算
ジオ実験を行う前に最も重要な問いは、 「この実験規模で、何%の売上増があれば統計的に検出できるのか?」 です。これを 最小検出可能効果(MDE: Minimum Detectable Effect) と呼びます。
顧客単位のA/Bテストと異なり、地域単位の売上データはサンプルサイズ(地域数)が限られており、地域固有のノイズも大きいため、MDEは大きくなりがちです。もし期待される広告リフトが なのに、実験設計上のMDEが であった場合、その実験は「最初から有意な結果を得られない運命」にあります。施策前に事前データを用いてシミュレーションを行い、介入地域の数や期間を調整することが不可欠です。
④ スピルオーバー(波及効果・干渉)の制御
ジオ実験における最大の脅威の1つが、CausalImpactの前提条件でも登場した スピルオーバー(Spillover) です。
- テレビ電波の越境: 関東広域圏のように、特定の県だけにテレビCMを流すことができないエリアがある
- 通勤・移動による購買: 神奈川県で広告を見たユーザーが、東京都内の店舗で購入する
- デジタル配信の地域判定の漏れ: IPアドレスや位置情報の誤差により、統制地域の一部に広告が配信されてしまう
もしドナー地域に広告効果が漏れてしまうと、ドナー地域の売上が上がってしまい、差し引きの因果効果が過小評価されます。実務では、生活圏・通勤圏をひとまとめにした広域エリア(米国のDMA: Designated Market Areaなど)単位で地域を定義するか、介入地域とドナー地域の間に「緩衝地帯(バッファ地域)」を設けて分析対象から除外する工夫が取られます。
検証用ダミーデータの生成:ジオワールド
それでは、合成コントロール法の実装と検証に進みましょう。
本記事の検証用の世界として、以下の仕様を満たす 「ジオワールド」 をPythonで生成します(2次計画法の記事でも同じデータを使います)。
- 地域数: 20地域(地域0が介入地域、地域1〜19がドナー候補)
- 期間: 120日間(日次データ)
- (70日間): 事前期間
- (30日間): 施策期間(広告出稿)
- (20日間): 施策後観察期間(持ち越しの減衰を観測)
- 真のデータ構造:
- 共通の成長トレンドと曜日周期(7日周期の季節性)
- 各地域固有のベースライン、トレンド感応度、AR(1)型の自己相関ノイズ
- 介入地域(地域0)の真の反事実は、地域1(重み0.5)+地域2(重み0.3)+地域3(重み0.2)の凸結合にわずかなノイズを加えたもの
- 真の施策効果:
- DiDやCausalImpactと揃えた持ち越し効果(アドストック減衰率 )
- 施策期間中にインパルスが加わり、最大約 のリフトに到達したのち、施策停止後に滑らかに減衰する
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフの日本語表示用
from scipy.optimize import minimize

# 1. 乱数シードの固定とパラメータ設定
rng = np.random.default_rng(42)
n_regions = 20
n_days = 120
pre_days = 70
treat_start = 70
treat_end = 100  # 70〜99日目が施策期間(30日間)

time = np.arange(n_days)

# 2. 共通トレンドと曜日周期(7日周期)
common_trend = 0.2 * time
weekday_effect = 3.0 * np.sin(2 * np.pi * time / 7)

# 3. ドナー地域(地域1〜19)のデータ生成
Y_all = np.zeros((n_days, n_regions))
for j in range(1, n_regions):
    base = 50.0 + rng.uniform(-15, 15)
    trend_factor = rng.uniform(0.7, 1.3)
    noise = rng.normal(0, 1.5, n_days)
    # 地域ごとの自己相関を持つゆらぎ(AR(1)過程)
    ar_noise = np.zeros(n_days)
    for t in range(1, n_days):
        ar_noise[t] = 0.5 * ar_noise[t-1] + rng.normal(0, 1.0)
    Y_all[:, j] = base + trend_factor * common_trend + weekday_effect + noise + ar_noise

# 4. 介入地域(地域0)の真の反事実(地域1, 2, 3の凸結合 + 微小ノイズ)
true_weights = np.zeros(n_regions - 1)
true_weights[0] = 0.5  # ドナー行列の0列目 = 地域1
true_weights[1] = 0.3  # ドナー行列の1列目 = 地域2
true_weights[2] = 0.2  # ドナー行列の2列目 = 地域3

# 地域1〜3のデータを指定の比率でブレンドし、「もし施策がなかった場合の仮想的な地域0」を作成
Y_target_counterfactual = Y_all[:, 1:] @ true_weights + rng.normal(0, 0.8, n_days)

# 5. 施策効果の生成(持ち越し効果 theta=0.8, 最大約15)
theta = 0.8
scale = 15.0
c = np.zeros(n_days)
s = np.zeros(n_days)
s[treat_start:treat_end] = 1.0
for t in range(1, n_days):
    c[t] = s[t] + theta * c[t-1]

true_effect = scale * (1 - theta) * c

# 介入地域の実績値(反事実 + 施策効果)
Y_all[:, 0] = Y_target_counterfactual + true_effect

# 真の累積効果の計算
true_cum_campaign = np.sum(true_effect[treat_start:treat_end])
true_cum_total = np.sum(true_effect[treat_start:])
carryover_ratio = (true_cum_total - true_cum_campaign) / true_cum_total * 100

print(f"真の累積効果(施策期間中 70〜99日): {true_cum_campaign:.2f}")
print(f"真の累積効果(全期間 70〜119日):     {true_cum_total:.2f}")
print(f"施策後の持ち越し効果の割合:        {carryover_ratio:.1f}%")
- 乱数生成器と期間設計: rng = np.random.default_rng(42) で再現性を確保し、全120日間のうち事前70日、施策30日、施策後20日を割り当てています。地域を20にするのは、並べ替えp値の最小値が になり、5%の基準で効果を判定できる数だからです。事前期間を70日にするのは、19のドナー地域の重みを推定するのに、ドナーの数より十分に長い期間を取るためです。施策後の20日は、持ち越し効果が減っていく様子を見るためです。
- 時系列の構造化: common_trend と weekday_effect でマクロな市場動向と曜日周期を再現し、さらに ar_noise(自己回帰係数0.5)によって地域ごとの時間的相関(日々の売上の引きずり)を模倣しています。地域ごとの水準(50 ± 15)とトレンドの傾き(0.7〜1.3倍)をばらつかせるのは、介入地域とそっくりな地域が1つもなく、ドナーを組み合わせないと再現できない状況を作るためです。
- 真の反事実の合成構造: 介入地域の反事実 Y_target_counterfactual は、ドナー地域のうち地域1に50%、地域2に30%、地域3に20%の重みを掛け合わせたものとして定義しています。この真値が推定によって復元できるかが検証の焦点となります。19のドナーのうち3つだけに重みを置くのは、合成コントロール法が「少数のドナーの組み合わせ」を正しく見つけられるかを確かめるためです。
- 持ち越し効果の定式化: 施策フラグ s からアドストック状態 c[t] = s[t] + theta * c[t-1] を計算し、最大約15のリフトを与えています。施策終了後も効果が持続するため、全期間の総効果は施策期間中より大きくなります。減衰率0.8では、効果は1日ごとに8割が残り、施策の終了から約3日で半分になります。施策後の20日の間に、効果が減っていく様子がはっきり見える値です。
実行結果
真の累積効果(施策期間中 70〜99日): 390.07
真の累積効果(全期間 70〜119日):     449.31
施策後の持ち越し効果の割合:        13.2%
施策期間中の累積効果は 390.07 ですが、施策が終わった後の20日間にも全体の 13.2%(59.24分)の効果が持ち越されています。この数値を合成コントロール法が正しく復元できるかを確認しましょう。
Pythonによるスクラッチ実装:合成コントロール法
合成コントロール法の重み最適化を、SciPyの minimize 関数を用いて実装します。
# 1. 事前期間のデータを抽出
y_pre_target = Y_all[:pre_days, 0]        # 介入地域の事前データ (70,)
y_pre_donors = Y_all[:pre_days, 1:]       # ドナー地域の事前データ (70, 19)
n_donors = y_pre_donors.shape[1]

# 2. 目的関数(二乗誤差平方和)の定義
def loss_func(w):
    diff = y_pre_target - y_pre_donors @ w
    return np.sum(diff ** 2)

# 3. 制約条件と境界条件(凸結合制約)
# 境界: 各重みは 0 以上 1 以下
bounds = [(0.0, 1.0) for _ in range(n_donors)]
# 等式制約: 重みの合計は 1.0
constraints = {'type': 'eq', 'fun': lambda w: np.sum(w) - 1.0}

# 初期値: 等配分
w0 = np.ones(n_donors) / n_donors

# 4. 最適化の実行(SLSQP法)
res = minimize(loss_func, w0, method='SLSQP', bounds=bounds, constraints=constraints)
est_weights = res.x

# 5. 反事実の予測と因果効果の算出
Y_synthetic = Y_all[:, 1:] @ est_weights
est_effect = Y_all[:, 0] - Y_synthetic

# 精度指標の確認
pre_rmse = np.sqrt(np.mean((Y_all[:pre_days, 0] - Y_synthetic[:pre_days]) ** 2))
est_cum_campaign = np.sum(est_effect[treat_start:treat_end])
est_cum_total = np.sum(est_effect[treat_start:])

print("=" * 60)
print("合成コントロール法:推定結果")
print("=" * 60)
print(f"最適化ステータス: {'成功' if res.success else '失敗'}")
print(f"事前期間の当てはまり (RMSE): {pre_rmse:.4f}")
print(f"")
print("【推定されたドナー重み(0.01以上のみ抜粋)】")
for j in range(n_donors):
    if est_weights[j] > 0.01:
        print(f"  地域 {j+1:2d}: 推定重み = {est_weights[j]:.4f}  (真値: {true_weights[j]:.4f})")
print(f"")
print("【因果効果(累積リフト)の復元精度】")
print(f"  施策期間中 (70〜99日):  推定 = {est_cum_campaign:.2f} (真値: {true_cum_campaign:.2f}, 誤差 = {est_cum_campaign - true_cum_campaign:+.2f})")
print(f"  全期間     (70〜119日): 推定 = {est_cum_total:.2f} (真値: {true_cum_total:.2f}, 誤差 = {est_cum_total - true_cum_total:+.2f})")
- 目的関数の設計: loss_func では、事前期間のターゲット系列 y_pre_target と、ドナー行列に行列積を掛けた合成系列との残差平方和を計算しています。
- 制約条件の適用: bounds で各重みを 0 から 1 の範囲に収め、constraints で総和が 1.0 になる等式制約を指定しています。これにより凸結合の条件が厳密に満たされます。
- 逐次二次計画法: method='SLSQP'(Sequential Least Squares Programming)を指定することで、等式および不等式制約を持つ非線形最適化問題を効率的に解いています。
- 反事実の全期間予測: 事前データだけで決定した最適な重み est_weights を、全期間のドナー行列 Y_all[:, 1:] に掛け合わせることで、施策期間以降の反事実を再構成しています。重みを0.01以上のものだけ表示するのは、SLSQPの数値誤差で、ほぼ0の重みが多数残るためです。
実行結果
============================================================
合成コントロール法:推定結果
============================================================
最適化ステータス: 成功
事前期間の当てはまり (RMSE): 0.8653

【推定されたドナー重み(0.01以上のみ抜粋)】
  地域  1: 推定重み = 0.4474  (真値: 0.5000)
  地域  2: 推定重み = 0.2294  (真値: 0.3000)
  地域  3: 推定重み = 0.2865  (真値: 0.2000)
  地域 12: 推定重み = 0.0341  (真値: 0.0000)

【因果効果(累積リフト)の復元精度】
  施策期間中 (70〜99日):  推定 = 391.98 (真値: 390.07, 誤差 = +1.91)
  全期間     (70〜119日): 推定 = 448.95 (真値: 449.31, 誤差 = -0.36)
真に反事実を構成していた「地域1(0.5)」「地域2(0.3)」「地域3(0.2)」の3つに重みが集中し、他の16地域にはほぼゼロの重みが割り当てられました(地域12にわずか0.034の重みが入ったのみ)。
なお、個々の重みは真値からずれています(地域2は0.30に対して0.23、地域3は0.20に対して0.29)。地域2と地域3のようにドナー同士の推移が似ていると、「どの地域にどれだけ重みを置くか」には複数の似た解があり、個々の重みは一意に決まりません。それでも、重みを掛け合わせた合成コントロール(反事実)そのものは精度よく再現されるため、効果の推定には影響しません。重みは「反事実を作るための道具」であり、それ自体を解釈しすぎないことが大切です。
その結果、全期間の累積リフトの推定値は 448.95 となり、真値の 449.31 に対する誤差はわずか -0.36(誤差率0.1%未満) という極めて高い精度で因果効果が復元されました。
ただし、今回のダミーデータは、介入地域の反事実がドナーのちょうど凸結合になるように作っており、合成コントロール法にとって理想的な状況です。現実のデータでは、ドナーの組み合わせで介入地域を完全に再現できるとは限りません。事前期間の当てはまり(RMSE)や下段のギャップの推移を必ず確認し、事前期間でギャップが大きく揺れている場合は、推定結果を慎重に扱う必要があります。
推定された重みと累積効果を並べると、次のようになります。
(図は、diagram-designで作成)
推定結果の可視化
実績値と合成コントロールの推移、および推定された因果効果をグラフ化して確認してみましょう。
# 1. 可視化の準備
days = np.arange(n_days)
fig, axes = plt.subplots(2, 1, figsize=(11, 8), sharex=True)

# 2. 上段: 介入地域の実績と合成コントロール
axes[0].plot(days, Y_all[:, 0], color='royalblue', linewidth=2, label='介入地域の実績')
axes[0].plot(days, Y_synthetic, color='red', linestyle='--', linewidth=2, label='合成コントロール(反事実の推定)')
axes[0].plot(days, Y_target_counterfactual, color='gray', linestyle=':', linewidth=1.5, label='真の反事実')
axes[0].set_title('介入地域の実績と合成コントロール')
axes[0].set_ylabel('売上')

# 3. 下段: 推定された効果(ギャップ)と真の効果
axes[1].plot(days, est_effect, color='red', linewidth=2, label='推定された効果(実績 − 合成コントロール)')
axes[1].plot(days, true_effect, color='black', linestyle=':', linewidth=2, label='真の効果')
axes[1].axhline(0, color='gray', linewidth=1)
axes[1].set_title('推定された効果と真の効果')
axes[1].set_xlabel('日')
axes[1].set_ylabel('効果の大きさ')

# 4. 施策期間の帯と凡例
for ax in axes:
    ax.axvspan(treat_start, treat_end, color='orange', alpha=0.15, label='施策期間')
    ax.axvline(treat_start, color='orange', linestyle='--', linewidth=1)
    ax.legend(loc='upper left')
    ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
- 上段の比較: 介入地域の実績(青)、推定した合成コントロール(赤の破線)、答え合わせ用の真の反事実 Y_target_counterfactual(灰色の点線)を重ねています。事前期間で赤と青が重なっているほど、重みの学習がうまくいっていることを意味します。
- 下段の比較: 実績から合成コントロールを引いた est_effect が、推定された日ごとの効果です。真の効果 true_effect(黒の点線)と重ねることで、持ち越しによる減衰まで捉えられているかを確認できます。
- 施策期間の表示: ax.axvspan で施策期間(70〜99日目)をオレンジの帯で示し、施策終了後の効果の残り方が分かるようにしています。
実行結果
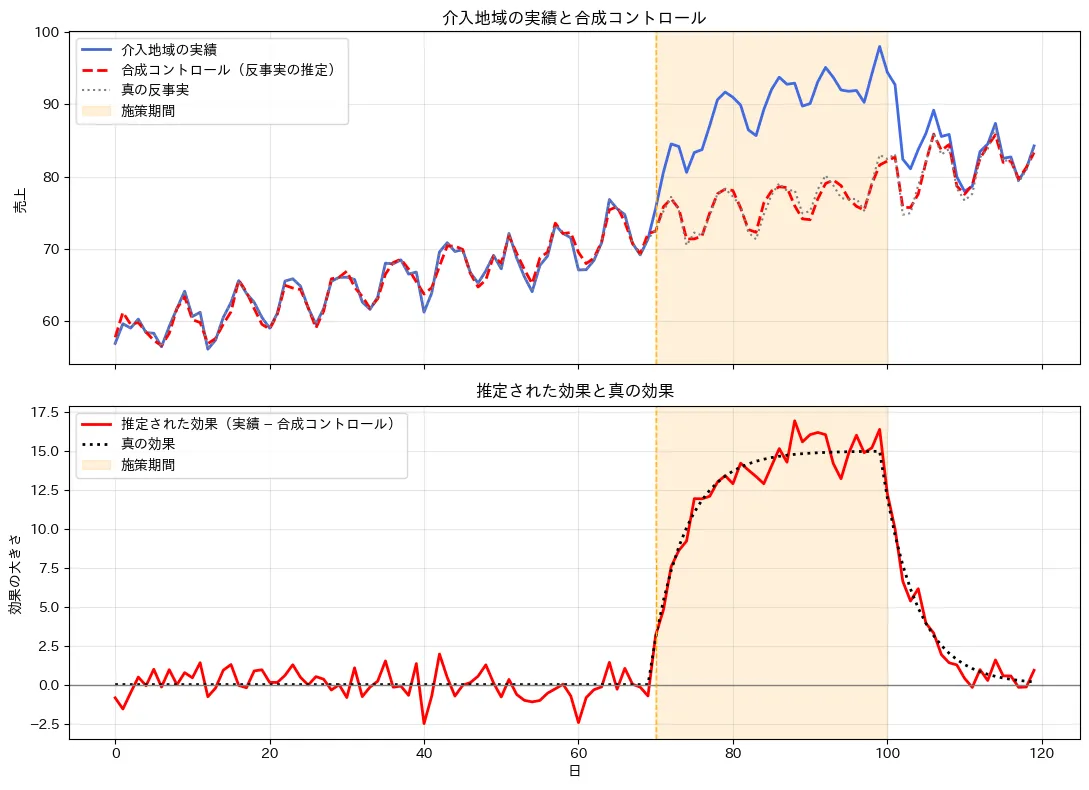
グラフから以下のポイントが明確に見て取れます。
- 事前期間(0〜69日目): 青い実績線と赤い破線の合成コントロールがほぼ重なり合っており、曜日周期の波やトレンドがよくトレースされています(下段のギャップがゼロ付近で推移)。
- 施策期間(70〜99日目): 施策の開始とともに実績値が急激に上方に乖離し、山なりのリフトを描いています。
- 施策後期間(100〜119日目): 施策が停止した後も、効果が即座にゼロには戻らず、真の減衰曲線(黒い点線)に沿って徐々に反事実に収束していく様子が捉えられています。
推論と仮説検定:プラセボ検定(並べ替え検定)
「地域数が少ない」ときの標準誤差の限界
因果効果の点推定値(累積効果 約449)が得られましたが、この効果は統計的に有意と言えるのでしょうか? 単なる偶然のノイズでこれほどの差が開いた可能性はないのでしょうか?
ここで、DiDの記事の「標準誤差の落とし穴」節で指摘した重大な問題を思い出す必要があります。
通常の大規模データであれば、回帰分析のt値やクラスタロバスト標準誤差を用いてp値を算出します。しかし、ジオ実験のように 「介入地域が1つや数地域しか存在しない」場合、大標本漸近理論に基づく標準誤差の計算は破綻し、p値が過小になりやすく、偽陽性を招きます。
この問題に対して、Alberto Abadie らが提案した合成コントロール法の公式な推論手法が 「プラセボ検定(Placebo Test / 並べ替え検定: Permutation Test)」 です(Abadie et al., 2010)。
空間プラセボ検定(In-space Placebo Test)のロジック
空間プラセボ検定の手順は非常に明快です。
- ドナープールに属する各地域 に対して、 「もしこの地域が本当は施策地域だったとしたら?」 という架空の仮定を置く。
- その地域をターゲットとし、残りの地域をドナーとして、全く同じ手順で合成コントロール法を適用する。
- すべての地域について、施策前後の 平均二乗予測誤差(MSPE: Mean Squared Prediction Error) を計算する。
- 各地域の Post-MSPE / Pre-MSPE 比 を求める。
もしドナー地域の中に、そもそも事前期間の当てはまりが非常に悪い地域が存在した場合、施策後にも偶然大きな残差が生じてしまい、あたかも大きな効果があったように見えてしまいます。事前期間の当てはまり(Pre-MSPE)で割って標準化することで、「施策前に比べて施策後に異常な乖離が起きた度合い」を公平に比較できるのです。
もし本当の介入地域における が、施策を一切受けていないドナー地域の と比べて突出して大きければ、「この効果が偶然生じる確率は極めて低い」と結論づけられます。
並べ替えp値の導出
では、「突出して大きい」をどのようにp値という確率に置き換えるのでしょうか。並べ替え検定のp値は、次の3ステップで導かれます。
① 帰無仮説を置く
「施策の効果はどの地域にもまったくない」という帰無仮説 を置きます。この仮定のもとでは、介入地域(地域0)のデータも、他の地域と同じく「施策なし」のデータです。つまり、介入地域は統計的に特別な地域ではありません。
② 「どの地域が介入地域になったか」はランダムだったと考える
さらに、介入地域は全 地域の中から等確率(各 )で選ばれた、と考えます。「地域0が介入地域になったのは、くじ引きでたまたまそうなっただけ」という見方です。
①と②を合わせると、各地域をターゲットにして計算した 個の比率 の中で、介入地域の比率 は、 個の値から無作為に1つ選んだ値と同じ扱いになります。このため は 個の中で何番目の大きさにもなり得て、どの順位になる確率も です。
③ p値を数える
p値は「帰無仮説のもとで、実際に観測した値以上に極端な値が出る確率」です。 は 個の値から等確率で選ばれるため、この確率は数え上げで求まります。
分子の「 以上の比率を持つ地域の数」は、比率を大きい順に並べたときの介入地域の順位 に等しくなります(介入地域自身も数に含まれるので、最小値は1です)。したがって、並べ替えp値は次式で求まります。
例えば20地域中で介入地域が1位なら です。「効果がないのに、たまたま介入地域が最も大きな比率になる確率は 1/20」という意味になります。
この導出は、②の「介入地域がランダムに選ばれた」という仮定に基づいています。実務のジオ実験では、介入地域を意図的に選ぶことも多くあります。その場合、このp値は厳密な確率ではありません。「プラセボと比べて介入地域がどれだけ突出しているか」を示す指標として解釈するのが妥当です。
プラセボ検定のPython実装
全20地域に対して空間プラセボ検定をループ実行してみましょう。
# 各地域をターゲットとした合成コントロールの関数
def fit_synthetic_control(target_idx, data_matrix, treated_idx=0):
    y_target = data_matrix[:, target_idx]
    # ドナーから「ターゲット自身」と「本当の介入地域」を除く
    # (介入地域は施策効果を含むため、プラセボのドナーに入れると効果が漏れ込む)
    donor_idx = [j for j in range(data_matrix.shape[1]) if j not in (target_idx, treated_idx)]
    y_donors = data_matrix[:, donor_idx]

    y_pre_t = y_target[:pre_days]
    y_pre_d = y_donors[:pre_days, :]
    n_d = y_donors.shape[1]

    # 目的関数
    loss = lambda w: np.sum((y_pre_t - y_pre_d @ w) ** 2)
    w_init = np.ones(n_d) / n_d
    bnds = [(0.0, 1.0) for _ in range(n_d)]
    cons = {'type': 'eq', 'fun': lambda w: np.sum(w) - 1.0}

    res_fit = minimize(loss, w_init, method='SLSQP', bounds=bnds, constraints=cons)
    y_synth = y_donors @ res_fit.x
    gaps = y_target - y_synth

    # Pre-MSPE と Post-MSPE の計算
    pre_mspe = np.mean(gaps[:pre_days] ** 2)
    post_mspe = np.mean(gaps[pre_days:] ** 2)
    ratio = post_mspe / pre_mspe
    return gaps, ratio

# 全20地域でプラセボ検定を実行
all_gaps = []
all_ratios = []

for i in range(n_regions):
    g, r = fit_synthetic_control(i, Y_all)
    all_gaps.append(g)
    all_ratios.append(r)

all_ratios = np.array(all_ratios)
treated_ratio = all_ratios[0]

# 順位とp値の算出
rank = np.sum(all_ratios >= treated_ratio)
p_val = rank / n_regions

print("=" * 60)
print("空間プラセボ検定(並べ替え検定)の結果")
print("=" * 60)
print(f"介入地域(地域0)の Post/Pre MSPE比: {treated_ratio:.2f}")
print(f"全20地域中での順位:                   {rank}位 / {n_regions}地域")
print(f"並べ替え検定のp値:                  p = {p_val:.4f}")
- 汎用関数の切り出し: fit_synthetic_control では、指定した地域インデックス target_idx をターゲットとし、残りの地域をドナープールとして合成コントロール法を適用しています。
- 介入地域をドナーから除く: donor_idx を作るときに、ターゲット自身に加えて、本当の介入地域 treated_idx(地域0)も除いています。介入地域の施策期間のデータには広告効果が含まれているため、プラセボのドナーに入れると、その効果がプラセボ側の合成コントロールに漏れ込み、プラセボの比率を不当に押し上げてしまうからです。介入地域自身を推定するとき(target_idx = 0)は、ドナーは地域1〜19で、前の節と同じ設定になります。なお、この工夫により、介入地域のドナー数は19、プラセボのドナー数は18となり、厳密にはすべての地域に完全に同じ手続きを適用しているわけではありません。効果の漏れ込みを防ぐための実務的なトレードオフです。
- 誤差比率の算出: 各地域のギャップ系列から、事前期間の二乗平均誤差 pre_mspe と事後期間の二乗平均誤差 post_mspe を求め、その比率 ratio を返しています。
- 並べ替えp値の定義: 介入地域の比率 treated_ratio 以上の値を持つ地域の数をカウントし、全地域数 n_regions(20)で割ることで、前の節で導出した並べ替えp値 を計算しています。この「以上の数」が、そのまま介入地域の順位になります。
実行結果
============================================================
空間プラセボ検定(並べ替え検定)の結果
============================================================
介入地域(地域0)の Post/Pre MSPE比: 156.16
全20地域中での順位:                   1位 / 20地域
並べ替え検定のp値:                  p = 0.0500
並べ替え p値の考え方を図にすると、次のようになります。
(図は、diagram-designで作成)
プラセボ検定結果の可視化
プラセボ検定の結果を、全地域のギャップ推移とMSPE比の棒グラフで可視化します。
# 1. 可視化の準備
fig, axes = plt.subplots(1, 2, figsize=(14, 5.5))

# 2. 左: 全地域のギャップ推移(灰色 = プラセボ、赤 = 介入地域)
for i in range(1, n_regions):
    axes[0].plot(days, all_gaps[i], color='gray', alpha=0.5, linewidth=1)
axes[0].plot(days, all_gaps[0], color='red', linewidth=2.5, label='介入地域(地域0)')
axes[0].plot([], [], color='gray', alpha=0.5, label='プラセボ(地域1〜19)')
axes[0].axvspan(treat_start, treat_end, color='orange', alpha=0.15, label='施策期間')
axes[0].axhline(0, color='black', linewidth=1)
axes[0].set_title('全地域のギャップ(実績 − 合成コントロール)')
axes[0].set_xlabel('日')
axes[0].set_ylabel('ギャップ')
axes[0].legend(loc='upper left')
axes[0].grid(True, alpha=0.3)

# 3. 右: Post/Pre MSPE比を大きい順に並べた棒グラフ
order = np.argsort(all_ratios)[::-1]
colors = ['red' if i == 0 else 'gray' for i in order]
axes[1].barh([f'地域{i}' for i in order], all_ratios[order], color=colors)
axes[1].invert_yaxis()
axes[1].set_xscale('log')
axes[1].set_title('Post/Pre MSPE比(対数目盛り)')
axes[1].set_xlabel('Post-MSPE / Pre-MSPE')
axes[1].grid(True, axis='x', alpha=0.3)

plt.tight_layout()
plt.show()
- 左図のギャップ: all_gaps には、各地域をターゲットにしたときの「実績 − 合成コントロール」が入っています。プラセボ(地域1〜19)を灰色の細線、介入地域を赤の太線で描いています。凡例用に、データのない空の線 axes[0].plot([], []) を1本だけ加えています。
- 右図の並べ替え: np.argsort(all_ratios)[::-1] で比率の大きい順に地域を並べ、介入地域だけを赤で塗っています。介入地域の比率は他の地域より桁違いに大きいため、set_xscale('log') で横軸を対数目盛りにし、プラセボ同士の違いも見えるようにしています。
実行結果
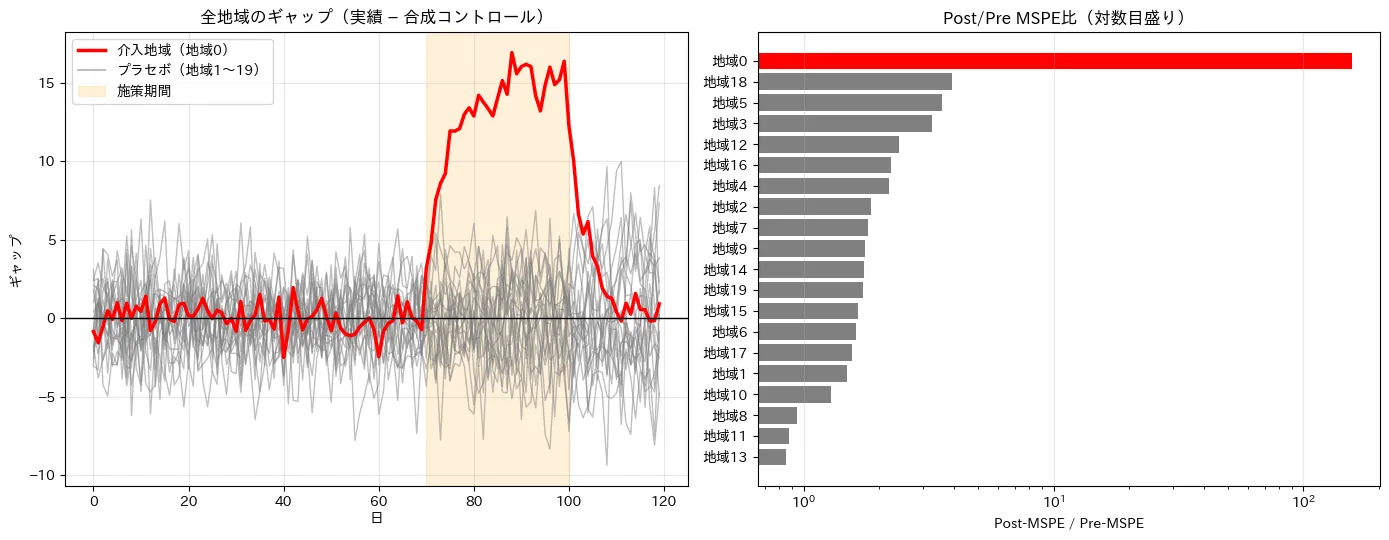
- 左図(ギャップ推移): 施策を受けていない19のドナー地域のプラセボ(灰色の線)は、施策期間以降もゼロの上下でランダムに揺れ動いているのに対し、本当の介入地域(赤い太線)だけが施策開始と同時に圧倒的なプラス方向へと突き抜けています。
- 右図(Post/Pre MSPE比): ドナー地域の比率はいずれも 4 以下(最も高い地域18でも3.91)にとどまる中、介入地域の比率は 156.16 と他を圧倒して 第1位 にランクインしました。
全20地域の中で1位であるため、p値は となりました。「この広告効果は偶然のノイズでは説明しにくい」ことを示す結果です。
並べ替え検定のp値は「全地域中の順位 ÷ 地域数」なので、地域が20しかない今回の実験では、どれほど効果が大きくても p = 0.05 より小さくなりません。1位という結果は、この実験で得られる最も強い証拠であると同時に、有意水準5%のぎりぎりでもあります。地域数が少ないジオ実験では、p値だけでなく、比率が他の地域と比べてどれだけ突出しているか(今回は約40倍)もあわせて判断材料にするのが実務的です。より細かい推論が必要な場合は、コンフォーマル推論など、合成コントロール法向けに提案されている他の推論手法も選択肢になります。
空間プラセボのほかに、時間プラセボ検定も実務で頻繁に行われます。これは「施策開始日(70日目)より前の架空の時点(例:35日目)」を介入日と見立てて合成コントロール法を適用するテストです。もし施策を行っていない過去の日付で大きなリフトが検出されてしまった場合、そのモデルは何らかの偽陽性を拾っている(モデルの前提が崩れている)危険信号となります。
DiD・CausalImpact・合成コントロール法の詳細比較
本サイトでは、時系列データを用いた因果効果測定の代表的な3手法を学んできました。実務のマーケティング分析や広告効果測定において、これらをどのように使い分けるべきか、詳細な比較表で整理します。
| 比較項目 | DiD(差の差法) | CausalImpact(BSTS) | 合成コントロール法(SCM) |
|---|---|---|---|
| 主たる統計基盤 | 頻度論(OLS・固定効果モデル) | ベイズ統計(状態空間モデル) | 最適化(制約付き2次計画法) |
| 必要な統制群の条件 | 介入地域と「平行トレンド」を満たす単一〜少数の地域 | 施策の影響を受けない「共変量」(他地域の売上や検索量など) | 介入地域を凸包の内側に含められる「複数のドナー地域」 |
| 重み付けの制約 | 一律(固定効果による平行シフト) | なし(スパイク・スラブ事前分布による回帰係数の縮減) | 厳格な凸結合(、内挿のみ) |
| 外挿リスク | 高い(平行トレンドが外れるとバイアス) | 中程度(事前分布が過学習を抑えるが外挿は可能) | 極めて低い(ドナーの観測範囲内に制約される) |
| 動的なトレンド・季節性 | 時間固定効果で共通変動のみ吸収 | ランダムウォークや三角関数で動的かつ柔軟に追随 | ドナー地域の時系列そのものの組み合わせで再現 |
| 不確実性(有意性)の評価 | クラスタロバスト標準誤差(地域数が多い場合のみ有効) | MCMC事後分布から直感的な信用区間を算出 | プラセボ検定(並べ替え検定)。地域数が少なくても使えるが、p値の下限は 1 / 地域数 |
| 主な弱点・注意点 | 平行トレンドの破綻に極めて脆弱 | 内部構造が複雑でブラックボックス化しやすい | 介入地域がドナー地域の範囲を外れる場合(極端な大都市・小規模地域など)は合成できない |
| 最適なビジネスシーン | 属性や規模がそっくりなA地域とB地域が存在するシンプルな施策 | 外部トレンドの変動が激しく、施策の影響を受けない多数の共変量が利用できる場合 | 都道府県・都市単位で少数のエリアに広告を集中投下するジオ実験 |
合成コントロールの発展形:Synthetic DiD(SDID)
合成コントロール法には「介入地域がドナー地域のどの地域よりも売上が大きい場合(例えば東京都単独での施策など)、凸結合では再現できない」という弱点(凸包の限界)があります。
この弱点を克服するために考案された最新の発展手法が、Synthetic Difference-in-Differences(SDID)(Arkhangelsky et al., 2021)です。SDIDは、合成コントロール法の「地域方向の重み付け」に、DiDの「切片(平行シフト)」の自由度を組み合わせ、さらに「時間方向の重み付け」も同時に最適化することで、ベースラインが大きく異なる地域同士であっても高精度に効果を測定できるハイブリッド手法として近年非常に注目されています。
また、欠損値補完の観点からパネルデータの反事実を推定する行列補完アプローチ(Athey et al., 2021)など、計量経済学と機械学習が融合した高度な手法の研究も急速に進んでいます。
実務におけるエコシステムとライブラリ
合成コントロール法やジオ実験を実務の大規模データに適用する際、有用なツールやライブラリが存在します。
Metaの「GeoLift」
Metaがオープンソースとして公開している GeoLift は、広告効果測定のためのジオ実験に特化したRパッケージです。
- 市場選定の自動化: 事前データから、どの地域を介入群にし、どの地域を統制群にすれば最も高い検出力(MDE)が得られるかをアルゴリズムで探索
- 高度なモデリング: 標準の分析には、合成コントロール法に回帰による補正を加えて、ドナーの凸包の外にある介入地域にも対応しやすくした 拡張合成コントロール法(Augmented Synthetic Control Method)(Ben-Michael, Feller & Rothstein, 2021)が使われており、推論にはコンフォーマル推論が用いられます(詳細は公式ドキュメントを参照してください)
- 診断レポートの出力: プラセボ検定やMDEの推移グラフを自動生成
Pythonでの実装ライブラリ
Pythonエコシステムにおいては、本記事で行ったような scipy.optimize によるスクラッチ実装のほか、以下のパッケージが利用されます。
- pysyncon: Abadie論文に準拠した古典的合成コントロール法および penalized synthetic control を提供するパッケージ
- cvxpy: より柔軟な制約条件(L1ペナルティの付加や、切片項を許容する拡張など)を組み込んだ凸最適化モデルを構築するのに最適
まとめ
本記事では、観察データの最大の課題である「内生性」を打ち破るためのジオ実験(地域単位の実験) と、その分析手法である合成コントロール法について解説しました。
本記事の重要ポイント
- 内生性の克服: ユーザー単位のRCTが困難なマス広告や検索広告でも、地域単位で出稿を制御するジオ実験によって、因果関係を直接識別できる。
- 凸結合と内挿制約: 重みを「非負かつ合計1」に縛ることで、線形回帰のような外挿を排除し、透明で現実的な反事実をドナー地域の組み合わせとして再構成する。
- 持ち越し効果と分析期間: 広告効果は施策終了後も持続する(本実験では13.2%が持ち越し)。分析期間を施策終了日で打ち切ると効果を過小評価する。
- プラセボ検定による推論: 介入地域が単一であっても、全ドナー地域に対する空間プラセボ(並べ替え検定)を行うことで、標準誤差に頼らずにp値を評価できる(ただし、p値の下限は 1 / 地域数)。
発展:実験からMMM(マーケティングミックスモデル)へ
ジオ実験と合成コントロール法は、広告の因果効果を測定するための極めて強力な武器です。
しかし、冷静に考えると、「すべての広告チャネル(テレビ、YouTube、SNS、検索、屋外)で、常にジオ実験を実施し続けること」は不可能です。広告を止めることによる売上機会の損失は大きく、テスト地域を確保するコストも膨大になります。また、複数チャネルが同時に動いている場合の「相互作用」や「最適な予算配分」には、単一チャネルのジオ実験だけでは答えられません。
そこで実務の最先端(GoogleやMeta)では、 「基本は観察データに基づくMMM(マーケティングミックスモデル)で全チャネルを同時にモデル化しつつ、時折実施したジオ実験の確実な測定結果をモデルの“事前情報(事前分布や尤度)”として組み込む(キャリブレーションする)」 という統合アプローチが採用されています。
この「実験結果を事前情報として取り込む」ために不可欠な統計的基盤が、ベイズ推定とMCMC(マルコフ連鎖モンテカルロ法) です(MCMCの記事で解説しています)。焼きなまし法との深い関係からMCMCのメカニズムを紐解き、PyMCによるサンプリングの仕組みをゼロから攻略していきます。
参考文献
- A. Abadie (2021). Using Synthetic Controls: Feasibility, Data Requirements, and Methodological Aspects. Journal of Economic Literature, 59(2), 391–425.
- D. Arkhangelsky, S. Athey, D. A. Hirshberg, G. W. Imbens, S. Wager (2021). Synthetic Difference in Differences. American Economic Review, 111(12).
- S. Athey, M. Bayati, N. Doudchenko, G. Imbens, K. Khosravi (2021). Matrix Completion Methods for Causal Panel Data Models. Journal of the American Statistical Association, 116(536).
- J. Vaver, J. Koehler (2011). Measuring Ad Effectiveness Using Geo Experiments. Google Research.
- A. Abadie, A. Diamond, J. Hainmueller (2010). Synthetic Control Methods for Comparative Case Studies: Estimating the Effect of California's Tobacco Control Program. Journal of the American Statistical Association, 105(490), 493–505.
- J. Kerman, P. Wang, J. Vaver (2017). Estimating Ad Effectiveness using Geo Experiments in a Time-Based Regression Framework. Google Research.
- Meta. GeoLift. GitHub.
本記事の文章・構成の一部に生成AIを使用しています。