タブー探索(Tabu Search)とは?
 (画像は、Geminiで作成)
最近たどった解をタブーリストに記録して一定期間戻らないようにすることで、決定的なルールのまま局所解から抜け出すタブー探索の仕組みと、アスピレーション基準の役割を、山登り法・焼きなまし法との違いとともに理解すること。同じ関数で山登り法とタブー探索の探索の軌跡を比べ、タブー期間と反復回数が結果にどう影響するかを確かめること。
タブー探索(Tabu Search)の概要
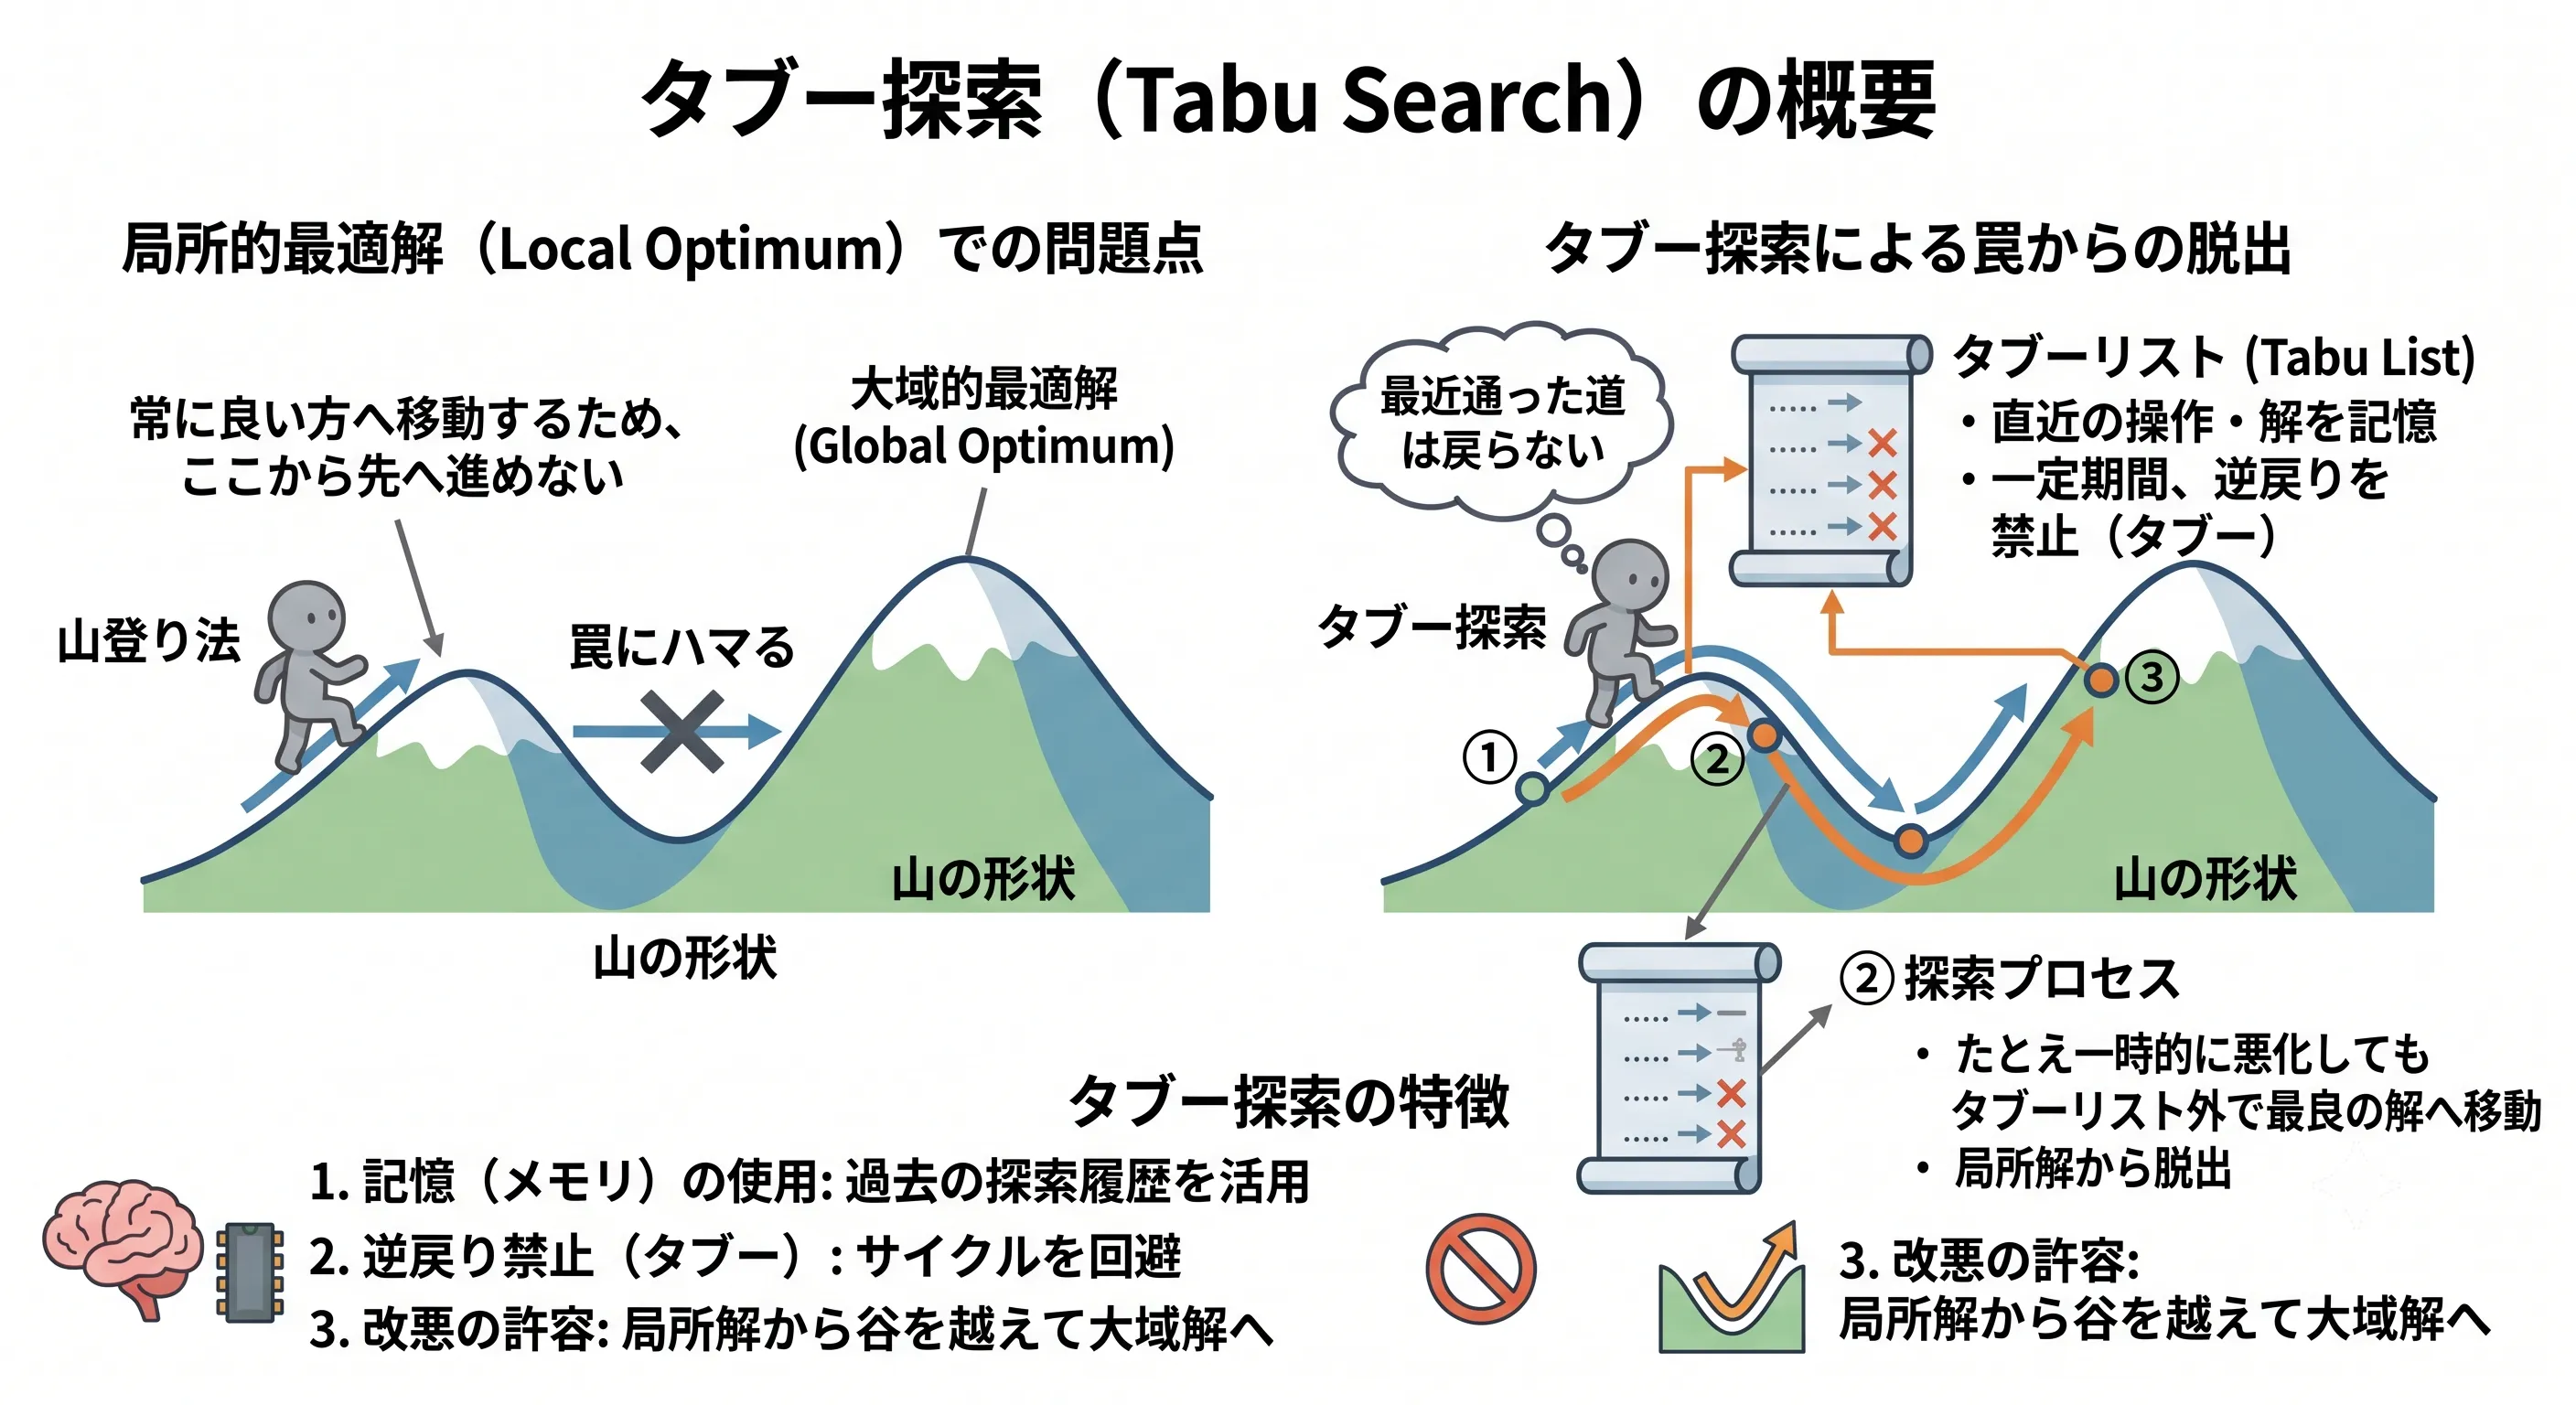
タブー探索(Tabu Search:TS) は、組み合わせ最適化問題において、局所的最適解に陥るのを防ぎながら効率的に「良い解」を探索するための強力なメタヒューリスティクス(近似解法)の一つです。
局所探索(山登り法)の記事で解説したように、山登り法は常に評価が改善する方向へしか進まないため、小さな山の頂上である局所的最適解(Local Optimum)に到達すると探索が止まってしまうという決定的な弱点がありました。 この罠を抜け出すため、焼きなまし法では「確率的に一時的な改悪を許容する」というアプローチをとりました。
タブー探索は、これらとは全く異なるアプローチで局所解の罠を克服します。最大の特徴は、探索の過程に 「記憶(Memory)」 を持たせる点です。
人間の行動に例えてみましょう。迷路で行き止まり(局所解)にぶつかったとき、人は「さっき通った道には戻らないようにしよう」と記憶を頼りに別のルートを探します。タブー探索も同様に、直近に訪問した解や実行した操作を 「タブーリスト(Tabu List)」 と呼ばれるメモリに一定期間記録し、その状態への逆戻り(ループ)を 「タブー(禁じ手)」 として禁止します。
- タブーリスト(Tabu List): 最近訪れた解を一定数記憶しておくリスト。
- タブー期間(Tabu Tenure): リストに記憶しておく期間(長さ)。この期間が過ぎるとタブーは解除され、再びその解に移動できるようになります。
これにより、「今よりスコアが悪化しても、タブーリストに載っていない新しい場所なら移動する」というルールを適用でき、来た道を戻る無限ループを防ぎながら局所解の谷を乗り越えることができるのです。
タブーリストの働きを図にすると、次のようになります。
(図は、diagram-designで作成)
山登り法・焼きなまし法との違い(探索のルール)
各アルゴリズムが、現在の解 から近傍の解 へどのように移動するかを比較してみましょう。近傍の集合を とします。
山登り法 (Hill Climbing)
常に良くなる方向へ進み、改善できなくなれば終了します。
- 探索範囲: のすべて
- 移動条件: となる最大の を選ぶ。なければ終了。
焼きなまし法 (Simulated Annealing)
温度 に基づく確率(メトロポリス基準)によって、悪化する方向への移動も許容します。
- 探索範囲: からランダムに選んだ
- 移動条件: なら移動、 でも確率 で移動。
タブー探索 (Tabu Search)
タブーリスト に含まれない近傍の中で、最も良い解(たとえ現在より悪化しても) へ確実に移動します。
- 探索範囲: (近傍からタブーリストにある解を除外したもの)
- 移動条件: 探索範囲の中で最もスコアが良い を選び、無条件で移動する。
※実際には、タブーリストに含まれていても、これまでの最高スコアを更新するような非常に良い解であれば特別に移動を許可する「アスピレーション条件(Aspiration Criterion)」という例外ルールを設けるのが一般的です。
3つの手法の移動のルールを並べると、次のようになります。
(図は、diagram-designで作成)
コードによる挙動の確認
それでは、Pythonコードを使ってタブー探索の挙動を確認してみましょう。山登り法・焼きなまし法の記事と同じく、評価関数 の最大化問題を使用します。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の「!」を付けたまま、ターミナルでは「!」を外して実行します)。japanize-matplotlib は distutils を使うので、Python 3.12 以降で import エラーになる場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
import math
import random
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフ日本語表示用

# 評価関数(目的関数)
def f(x):
    return math.sin(x) + math.cos(0.5 * x)

# 探索空間の設定
x_min, x_max = 0.0, 10.0
step_size = 0.1  # 近傍への移動距離

print("--- 準備 ---")
print(f"探索範囲: {x_min} から {x_max}")

# --- 可視化のためのデータ生成 ---
# 探索範囲内のx値のリストを作成
x_vals = [i * step_size for i in range(int(x_max / step_size) + 1)]

# 各xに対応する評価関数f(x)の値を計算
y_vals = [f(x) for x in x_vals]

# グラフの描画
plt.figure(figsize=(10, 6))
plt.plot(x_vals, y_vals, color='#1f77b4', linewidth=2, label='目的関数 f(x)')
plt.title("評価関数 f(x) = sin(x) + cos(0.5x) の形状", fontsize=14, fontweight='bold')
plt.xlabel("変数 x", fontsize=12)
plt.ylabel("評価値 f(x)", fontsize=12)
plt.grid(True, linestyle='--', alpha=0.6)
plt.legend()
plt.show()
評価関数の定義と探索範囲の設定、関数の形状の可視化を行っています。
- 評価関数: f(x) は を返す関数で、これを最大にする を探します。周期の異なる2つの波を足し合わせることで、高さの違う山が複数ある「局所解のある地形」を作っています。
- 探索空間と近傍の幅: 探索範囲を x_min から x_max(0〜10)に限定し、step_size = 0.1 を山登り法で1回に移動する距離(近傍の幅)として定義しています。0〜10 にするのは、一番高い山()と低い山()の両方を含め、その間に谷()を挟むためです。0.1 は、山登り法の記事と同じ値で、結果を山登り法の記事と比べられるようにしています。
- 形状の可視化: x_vals に0.1刻みの を並べ、各点の評価値 y_vals を計算して折れ線で描いています。探索アルゴリズム自身はこの全体像を知らずに探索しますが、結果の良し悪しを判断できるよう、先に地形の全体像を確認しておきます。
実行結果
--- 準備 ---
探索範囲: 0.0 から 10.0
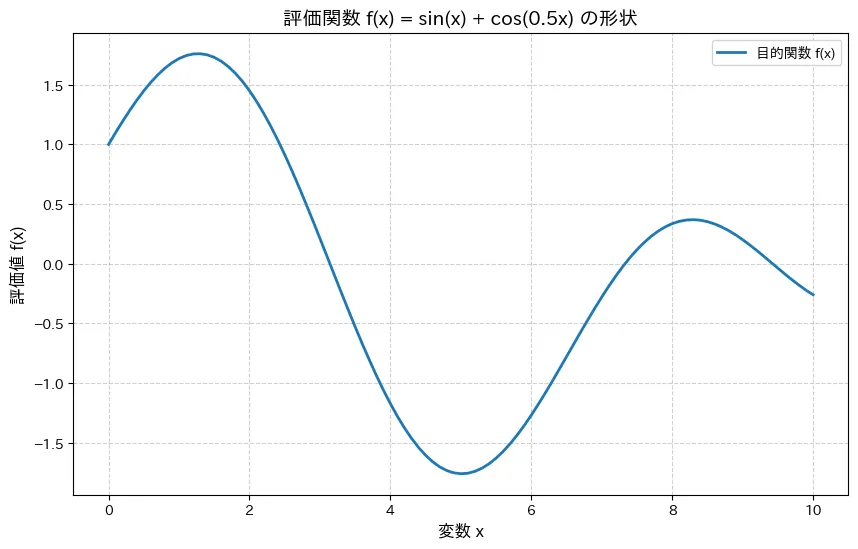
このプロットからわかるように、評価関数 には複数の山が存在します。 具体的には、 付近に最も高い大域的最適解があり、 付近にそれよりは低い局所的最適解が存在します。 ここからは、山登り法とタブー探索が、この関数をどのように探索していくかを見ていきましょう。
山登り法による探索(失敗例)
最初に、山登り法で探索します。意図的に局所解に陥りやすいよう、初期値を 8.0 に設定して探索を開始します。
# 初期解(局所解に陥りやすいスタート地点として 8.0 に設定)
current_x_hc = 8.0

while True:
    # 近傍の生成:現在の位置から左右にステップ幅だけ移動した2つの候補点
    neighbors = [current_x_hc - step_size, current_x_hc + step_size]

    # 探索空間の範囲内に収まっている候補点のみにフィルタリング
    valid_neighbors = [nx for nx in neighbors if x_min <= nx <= x_max]

    # 暫定の最良候補を現在の位置に設定
    best_neighbor = current_x_hc
    best_neighbor_score = f(current_x_hc)

    # 有効な近傍候補点を順番に評価
    for nx in valid_neighbors:
        score = f(nx)
        # より良いスコアが見つかれば最良近傍候補を更新
        if score > best_neighbor_score:
            best_neighbor_score = score
            best_neighbor = nx

    # 近傍のどれを探索しても改善しない場合はループを終了
    if best_neighbor_score <= f(current_x_hc):
        break

    # 現在地を最良近傍に更新
    current_x_hc = best_neighbor

print(f"山登り法の解: x = {current_x_hc:.2f}, スコア = {f(current_x_hc):.4f}")
print("❌ 課題: スタート地点によっては小さな山の頂上で止まってしまう。")
山登り法で、初期値8.0から探索しています。
- 初期値: current_x_hc = 8.0 は、右側の小さな山(局所解)の裾野にあたる地点です。山登り法の弱点を確認するため、意図的に局所解に陥りやすい場所から始めています。
- 近傍の生成: neighbors は、現在位置から左右に step_size だけ動いた2点です。探索範囲の外に出た点は、valid_neighbors で除外しています。
- 最良近傍の選択: 現在地を暫定の最良候補とし、近傍の中に現在より高いスコアの点があれば best_neighbor を更新して、そこへ移動します。
- 終了条件: best_neighbor_score が現在地のスコアを上回らない、つまりどの近傍に動いても改善しない時点で break します。山頂に着いたら必ず止まるこの仕組みが、局所解で探索が終わってしまう原因です。
実行結果
山登り法の解: x = 8.30, スコア = 0.3690
❌ 課題: スタート地点によっては小さな山の頂上で止まってしまう。
この結果が示すように、探索は の地点で終了しました。これはグラフ上の小さな山(局所的最適解)の頂上であり、より高い山(大域的最適解, )には到達できていません。このように、スタート地点によっては最良の解を見つけられないのが山登り法の課題です。
タブー探索による探索
山登り法が局所解()で止まってしまった初期値 8.0 からスタートし、タブーリストを使って大域的最適解へたどり着けるか試します。
# --- タブー探索(TS)のパラメータ設定 ---
tabu_tenure = 15      # タブーの期間(この手数だけ過去の解を記憶する)
max_iterations = 100  # 探索の最大繰り返し回数

# 初期解(山登り法が失敗した「8.0」をスタート地点とする)
current_x = 8.0
current_score = f(current_x)

# 探索全体を通しての最良解を記録する変数
best_x = current_x
best_score = current_score

# タブーリスト(最近訪れた解の記録)を初期化
tabu_list = []

print("--- タブー探索開始 ---")

for i in range(max_iterations):
    # 近傍の生成(今回は左右の点だけでなく、少し広めの範囲を近傍とします)
    # 左右1点ずつだと、登ってきた点がタブーになって右の端へ押し出されるため
    neighbors = [current_x + step_size * d for d in [-3, -2, -1, 1, 2, 3]]
    valid_neighbors = [nx for nx in neighbors if x_min <= nx <= x_max]

    best_candidate = None
    best_candidate_score = -float('inf')

    for nx in valid_neighbors:
        score = f(nx)

        # 丸め誤差を防ぐため、小数点以下1桁でタブー判定
        nx_rounded = round(nx, 1)

        # タブーリストに含まれていない、またはアスピレーション条件(過去の全体ベストを更新)を満たすか
        is_tabu = nx_rounded in tabu_list
        aspiration = score > best_score

        if (not is_tabu) or aspiration:
            if score > best_candidate_score:
                best_candidate_score = score
                best_candidate = nx

    # 移動先がない場合(すべてタブーなど)は終了
    if best_candidate is None:
        break

    # 現在地を更新
    current_x = best_candidate
    current_score = best_candidate_score

    # タブーリストに現在の位置を追加
    tabu_list.append(round(current_x, 1))
    # リストが上限を超えたら、一番古い記憶を消す
    if len(tabu_list) > tabu_tenure:
        tabu_list.pop(0)

    # 全体のベストスコアを更新
    if current_score > best_score:
        best_score = current_score
        best_x = current_x

print(f"タブー探索の最適解: x = {best_x:.2f}, スコア = {best_score:.4f}")
print("⭕ 利点: 過去の軌跡を記憶することで、来た道を戻らずに局所解の谷を下ることができる。")
タブー探索で、山登り法と同じ初期値8.0から探索しています。
- パラメータと初期化: tabu_tenure(タブーリストの長さ)と max_iterations(最大繰り返し回数)を設定します。探索は山登り法が局所解に陥った current_x = 8.0 から開始し、探索全体で見つかった最も良い解を best_x と best_score に記録します。タブー期間の 15 は、後の「タブー期間と反復回数の影響」で確かめるとおり、5以上なら大域的最適解に着くので、余裕を持たせた値です。反復回数の 100 は、谷を渡るのに60回かかるので、それより多くした値です。実際には、60回で動ける近傍がなくなって終わります。
- 近傍の生成: 現在位置 current_x から左右に1〜3ステップ分(最大 ±0.3)離れた6点を候補(neighbors)とします。山登り法と異なり、少し離れた点も探索対象に含めています。左右1点ずつにすると、登ってきた左側の点がタブーになるので、山頂(8.3)を越えて右の端()まで下り、20回で動けなくなります。左右3点ずつなら、8.0 から一度に山頂へ跳ぶので、左側の点がタブーにならず、左の谷へ下りられます。
- タブー判定: nx_rounded in tabu_list で、その候補がタブーリスト(最近訪問した点の記録)に含まれているか(is_tabu)を判定します。浮動小数点数の比較誤差を避けるため、round() で丸めてから判定しています。
- アスピレーション条件: score > best_score で、その候補がこれまでの探索全体での最高スコアを更新するか(aspiration)を判定します。これを入れるのは、タブーの点でも、これまでで最も良い点なら、移動を禁じる理由がないためです。
- 最良候補の選択: (not is_tabu) or aspiration を満たす候補、つまり「タブーではない」か「タブーであっても最高スコアを更新する」候補の中から、最もスコアが高いものを best_candidate として選びます。このルールにより、たとえ現在のスコアより悪化しても、タブーでなければ移動が許可されます。移動できる候補が1つもなければ、探索を終了します。
- 状態の更新: current_x を best_candidate に更新し、新しい位置を tabu_list に追加します。リストの長さが tabu_tenure を超えた場合は、tabu_list.pop(0) で最も古い記憶を削除します。
- 全体最適解の更新: 新しいスコアが best_score を上回れば、最良解を更新します。
このプロセスを繰り返すことで、短期的なループを防ぎながら、局所解の谷を越えて広範囲な探索を実現します。
実行結果
--- タブー探索開始 ---
タブー探索の最適解: x = 1.30, スコア = 1.7596
⭕ 利点: 過去の軌跡を記憶することで、来た道を戻らずに局所解の谷を下ることができる。
山登り法では で停止してしまいましたが、タブー探索は見事に谷を乗り越え、最も高い山(大域的最適解)の頂上 を発見することができました(0.1刻みで移動しているため、真の頂上 に最も近い点が得られています)。 2つの手法の結果を並べると、次のようになります。
(図は、diagram-designで作成)
探索軌跡の可視化
タブー探索が局所解の罠をどのように回避したのか、グラフで軌跡を確認しましょう。
import math
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib  # グラフ日本語表示用

# 評価関数(目的関数)
def f(x):
    return math.sin(x) + math.cos(0.5 * x)

# NumPy用の評価関数の定義(背景のグラフ描画用)
def f_np(x):
    return np.sin(x) + np.cos(0.5 * x)

# --- パラメータ設定 ---
x_min, x_max = 0.0, 10.0
step_size = 0.1
tabu_tenure = 15      # タブーリストの長さ
max_iterations = 100  # 最大探索回数

# --- タブー探索の軌跡シミュレーション ---
current_x = 8.0  # 山登り法が失敗した初期解
best_x = current_x
best_score = f(current_x)
tabu_list = []

# 軌跡を保存するリスト(スタート地点を初期登録)
path_x = [current_x]

for i in range(max_iterations):
    # 近傍の生成
    neighbors = [current_x + step_size * d for d in [-3, -2, -1, 1, 2, 3]]
    valid_neighbors = [nx for nx in neighbors if x_min <= nx <= x_max]

    best_candidate = None
    best_candidate_score = -float('inf')

    for nx in valid_neighbors:
        score = f(nx)
        nx_rounded = round(nx, 1)

        is_tabu = nx_rounded in tabu_list
        aspiration = score > best_score

        # タブーリストにない、または全体ベスト更新(アスピレーション)なら許可
        if (not is_tabu) or aspiration:
            if score > best_candidate_score:
                best_candidate_score = score
                best_candidate = nx

    if best_candidate is None:
        break

    current_x = best_candidate
    current_score = best_candidate_score

    # タブーリストの更新
    tabu_list.append(round(current_x, 1))
    if len(tabu_list) > tabu_tenure:
        tabu_list.pop(0)

    if current_score > best_score:
        best_score = current_score
        best_x = current_x

    # 現在位置を軌跡リストに記録
    path_x.append(current_x)

# 軌跡のy座標を計算
path_y = [f(x) for x in path_x]

print(f"実際の反復回数: {len(path_x) - 1} 回(上限 {max_iterations} 回)")
print(f"最終位置: x = {path_x[-1]:.2f}, スコア = {path_y[-1]:.4f}")
print(f"探索中の最良解: x = {best_x:.2f}, スコア = {best_score:.4f}")

# --- グラフの描画 ---
# 背景となる目的関数のデータ生成
x_vals_np = np.linspace(0, 10, 200)
y_vals_np = f_np(x_vals_np)

plt.figure(figsize=(10, 6))
plt.plot(x_vals_np, y_vals_np, color='#1f77b4', linewidth=2, label='目的関数 f(x)')

# 軌跡を緑色でプロット
plt.plot(path_x, path_y, marker='o', color='green', markersize=4, linestyle='-', alpha=0.6, label='タブー探索の軌跡')

# スタート地点、最終位置、探索中の最良解を強調してプロット
plt.plot(path_x[0], path_y[0], marker='s', color='black', markersize=8, linestyle='None', label='スタート地点')
plt.plot(path_x[-1], path_y[-1], marker='X', color='gray', markersize=10, linestyle='None', label='最終位置(探索の終了地点)')
plt.plot(best_x, best_score, marker='*', color='red', markersize=15, linestyle='None', label='探索中の最良解')

plt.title("タブー探索の探索プロセス(記憶による局所解の回避)", fontsize=14, fontweight='bold')
plt.xlabel("変数 x", fontsize=12)
plt.ylabel("評価値 f(x)", fontsize=12)
plt.legend()
plt.grid(True, linestyle='--', alpha=0.6)
plt.show()
前のセクションと同じタブー探索を実行しながら、探索の経路を記録して描いています。
- 自己完結のための再定義: このコードだけで実行できるよう、評価関数 f、背景描画用の f_np、パラメータを定義し直しています。探索のロジックは前のセクションと同じです。
- 軌跡と最良解の記録: 各ステップの現在位置を path_x に追加するとともに、最高スコアを更新したときの位置を best_x に記録しています。タブー探索は悪化する方向にも移動し続けるため、「最後にいた場所」と「最良解」を分けて記録する必要があります。
- 実行状況の表示: len(path_x) - 1 で実際に移動した回数を数えています。移動できる近傍がなくなると上限の max_iterations より前に終了するため、その確認のために表示しています。
- 描画: 背景に目的関数を描いた上で、plt.plot(path_x, path_y, ...) で探索の軌跡を緑色の線でプロットしています。スタート地点は四角(marker='s')、探索が終了した最終位置はバツ印(marker='X')、探索中に見つかった最良解は星印(marker='*')です。linestyle='None' を指定しているのは、凡例に線を付けず、マーカーだけを表示するためです。
実行結果
実際の反復回数: 60 回(上限 100 回)
最終位置: x = 0.00, スコア = 1.0000
探索中の最良解: x = 1.30, スコア = 1.7596
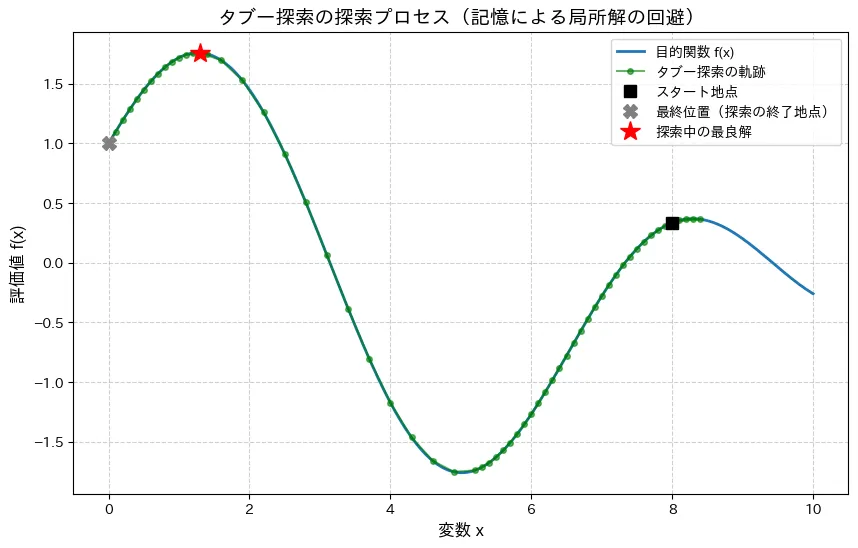
軌跡を見ると、スタート地点から右側の小さな山の頂上()付近に到達した後、山登り法のように停止せず、スコアが悪化するにもかかわらず谷を下って左へ移動していることがわかります。山頂付近の点はすでにタブーリストに載っているため、タブーでない点の中で最も良い点、つまり左側の坂を下る方向へ進むしかなかったからです。結果として谷を越え、大域的最適解の山へと辿り着きました。
ここで注目したいのは、最終位置(バツ印)と最良解(星印)が一致していない 点です。タブー探索は「タブーでない近傍の中で最良の点へ、たとえ悪化しても必ず移動する」ため、大域的最適解の頂上に到達した後も止まらず、そのまま左の坂を下り続けます。最後は探索範囲の端()に到達し、移動できる近傍がすべてタブーになったところで、上限の100回より前に探索が終了しました。
つまり、タブー探索の答えは「最後にいた場所」ではなく、探索の途中で記録しておいた最良解 です。コード中で best_x と best_score を毎回更新しているのは、このためです。
タブー期間と反復回数の影響
タブー探索の性能は、tabu_tenure(タブー期間)と max_iterations(反復回数)に左右されます。それぞれを変えて、同じ初期値 8.0 から探索した結果を比較してみましょう。
def tabu_search(tabu_tenure, max_iterations, start_x=8.0):
    """タブー探索を実行し、探索中に見つけた最良解を返す"""
    current_x = start_x
    best_x, best_score = current_x, f(current_x)
    tabu_list = []
    for _ in range(max_iterations):
        neighbors = [current_x + step_size * d for d in [-3, -2, -1, 1, 2, 3]]
        best_candidate, best_candidate_score = None, -float('inf')
        for nx in neighbors:
            if not (x_min <= nx <= x_max):
                continue
            score = f(nx)
            if (round(nx, 1) not in tabu_list) or (score > best_score):
                if score > best_candidate_score:
                    best_candidate, best_candidate_score = nx, score
        if best_candidate is None:
            break
        current_x = best_candidate
        tabu_list.append(round(current_x, 1))
        if len(tabu_list) > tabu_tenure:
            tabu_list.pop(0)
        if best_candidate_score > best_score:
            best_x, best_score = current_x, best_candidate_score
    return best_x, best_score

# 1. タブー期間を変える(反復回数は100回で固定)
for tenure in [1, 3, 5, 15]:
    bx, bs = tabu_search(tabu_tenure=tenure, max_iterations=100)
    print(f"タブー期間 {tenure:2d}: 最良解 x = {bx:.2f}, スコア = {bs:.4f}")

# 2. 反復回数を変える(タブー期間は15で固定)
for iters in [20, 40, 60, 100]:
    bx, bs = tabu_search(tabu_tenure=15, max_iterations=iters)
    print(f"反復回数 {iters:3d}: 最良解 x = {bx:.2f}, スコア = {bs:.4f}")
タブー探索を関数にまとめ、タブー期間と反復回数を変えて結果を比べています。
- 関数化: tabu_search は、tabu_tenure と max_iterations を引数に取り、探索中に見つけた最良解を返します。中身は前のセクションのタブー探索と同じです。
- 範囲外の候補の扱い: 前のセクションではリスト内包表記で範囲内の候補を先に絞り込んでいましたが、ここでは continue でループの中で読み飛ばしています。書き方が違うだけで、処理の結果は同じです。
- 乱数を使わない比較: タブー探索は乱数を使わない決定的なアルゴリズムなので、同じ設定なら何度実行しても同じ結果になります。そのため、焼きなまし法のようにシードを変えて試す必要はなく、パラメータだけを変えて比較しています。
- 2つの実験: 1つ目のループでは反復回数を100回に固定してタブー期間を1・3・5・15と変え、2つ目のループではタブー期間を15に固定して反復回数を20・40・60・100と変えています。タブー期間を1・3・5・15にするのは、短い期間で局所解から抜け出せなくなる境目と、既定の15とを比べるためです。反復回数を20・40・60・100にするのは、谷を渡りきるのに何回必要かを、20回刻みで見るためです。
実行結果
タブー期間  1: 最良解 x = 8.30, スコア = 0.3690
タブー期間  3: 最良解 x = 8.30, スコア = 0.3690
タブー期間  5: 最良解 x = 1.30, スコア = 1.7596
タブー期間 15: 最良解 x = 1.30, スコア = 1.7596
反復回数  20: 最良解 x = 8.30, スコア = 0.3690
反復回数  40: 最良解 x = 8.30, スコア = 0.3690
反復回数  60: 最良解 x = 1.30, スコア = 1.7596
反復回数 100: 最良解 x = 1.30, スコア = 1.7596
- タブー期間が短すぎる(1〜3)と、局所解から抜け出せない: 近傍は左右3点ずつ(最大0.3の移動)なので、記憶が短いとすぐにタブーが解除され、局所解の山頂付近を行ったり来たりするだけになります。今回の設定では、タブー期間を5以上にすると大域的最適解に到達できました。
- 反復回数が足りないと、谷を渡りきれない: 局所解から大域的最適解まで、0.3ずつの移動で谷を渡るには数十回の移動が必要です。今回は40回では足りず、60回で到達しました。
焼きなまし法における温度のスケジュールや近傍の幅と同じように、タブー探索でも「どれだけ記憶するか」「どれだけ探索を続けるか」を問題の規模に合わせて設定することが重要です。
設定ごとの結果を並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、「記憶」を活用して局所的最適解を回避するメタヒューリスティクス「タブー探索(Tabu Search)」について解説しました。
- タブーリストによる逆戻り防止: 過去に訪問した状態への遷移を一定期間禁止することで、探索が同じ場所をループするのを防ぎ、強制的に未探索の領域へ押し出します。
- 改悪の許容とアスピレーション: タブーでない範囲で最良の選択肢を選び続けるため、結果的に谷を下る(改悪する)ことができます。また、圧倒的に良い解を見つけた場合は例外を認める柔軟性も持っています。
焼きなまし法が「確率と温度」を利用するのに対し、タブー探索は「リストによる決定的な制限」を利用します。問題の性質に応じて、これらのメタヒューリスティクスを使い分けたり、組み合わせたりすることが、実用的な最適化システムを構築する上での鍵となります。
参考文献
- F. Glover (1986). Future paths for integer programming and links to artificial intelligence. Computers & Operations Research, 13(5), 533–549.
- F. Glover (1989). Tabu Search—Part I. ORSA Journal on Computing, 1(3), 190–206.
- F. Glover, M. Laguna (1997). Tabu Search. Springer.
本記事の文章・構成の一部に生成AIを使用しています。