TD学習(時間的差分学習)とは?
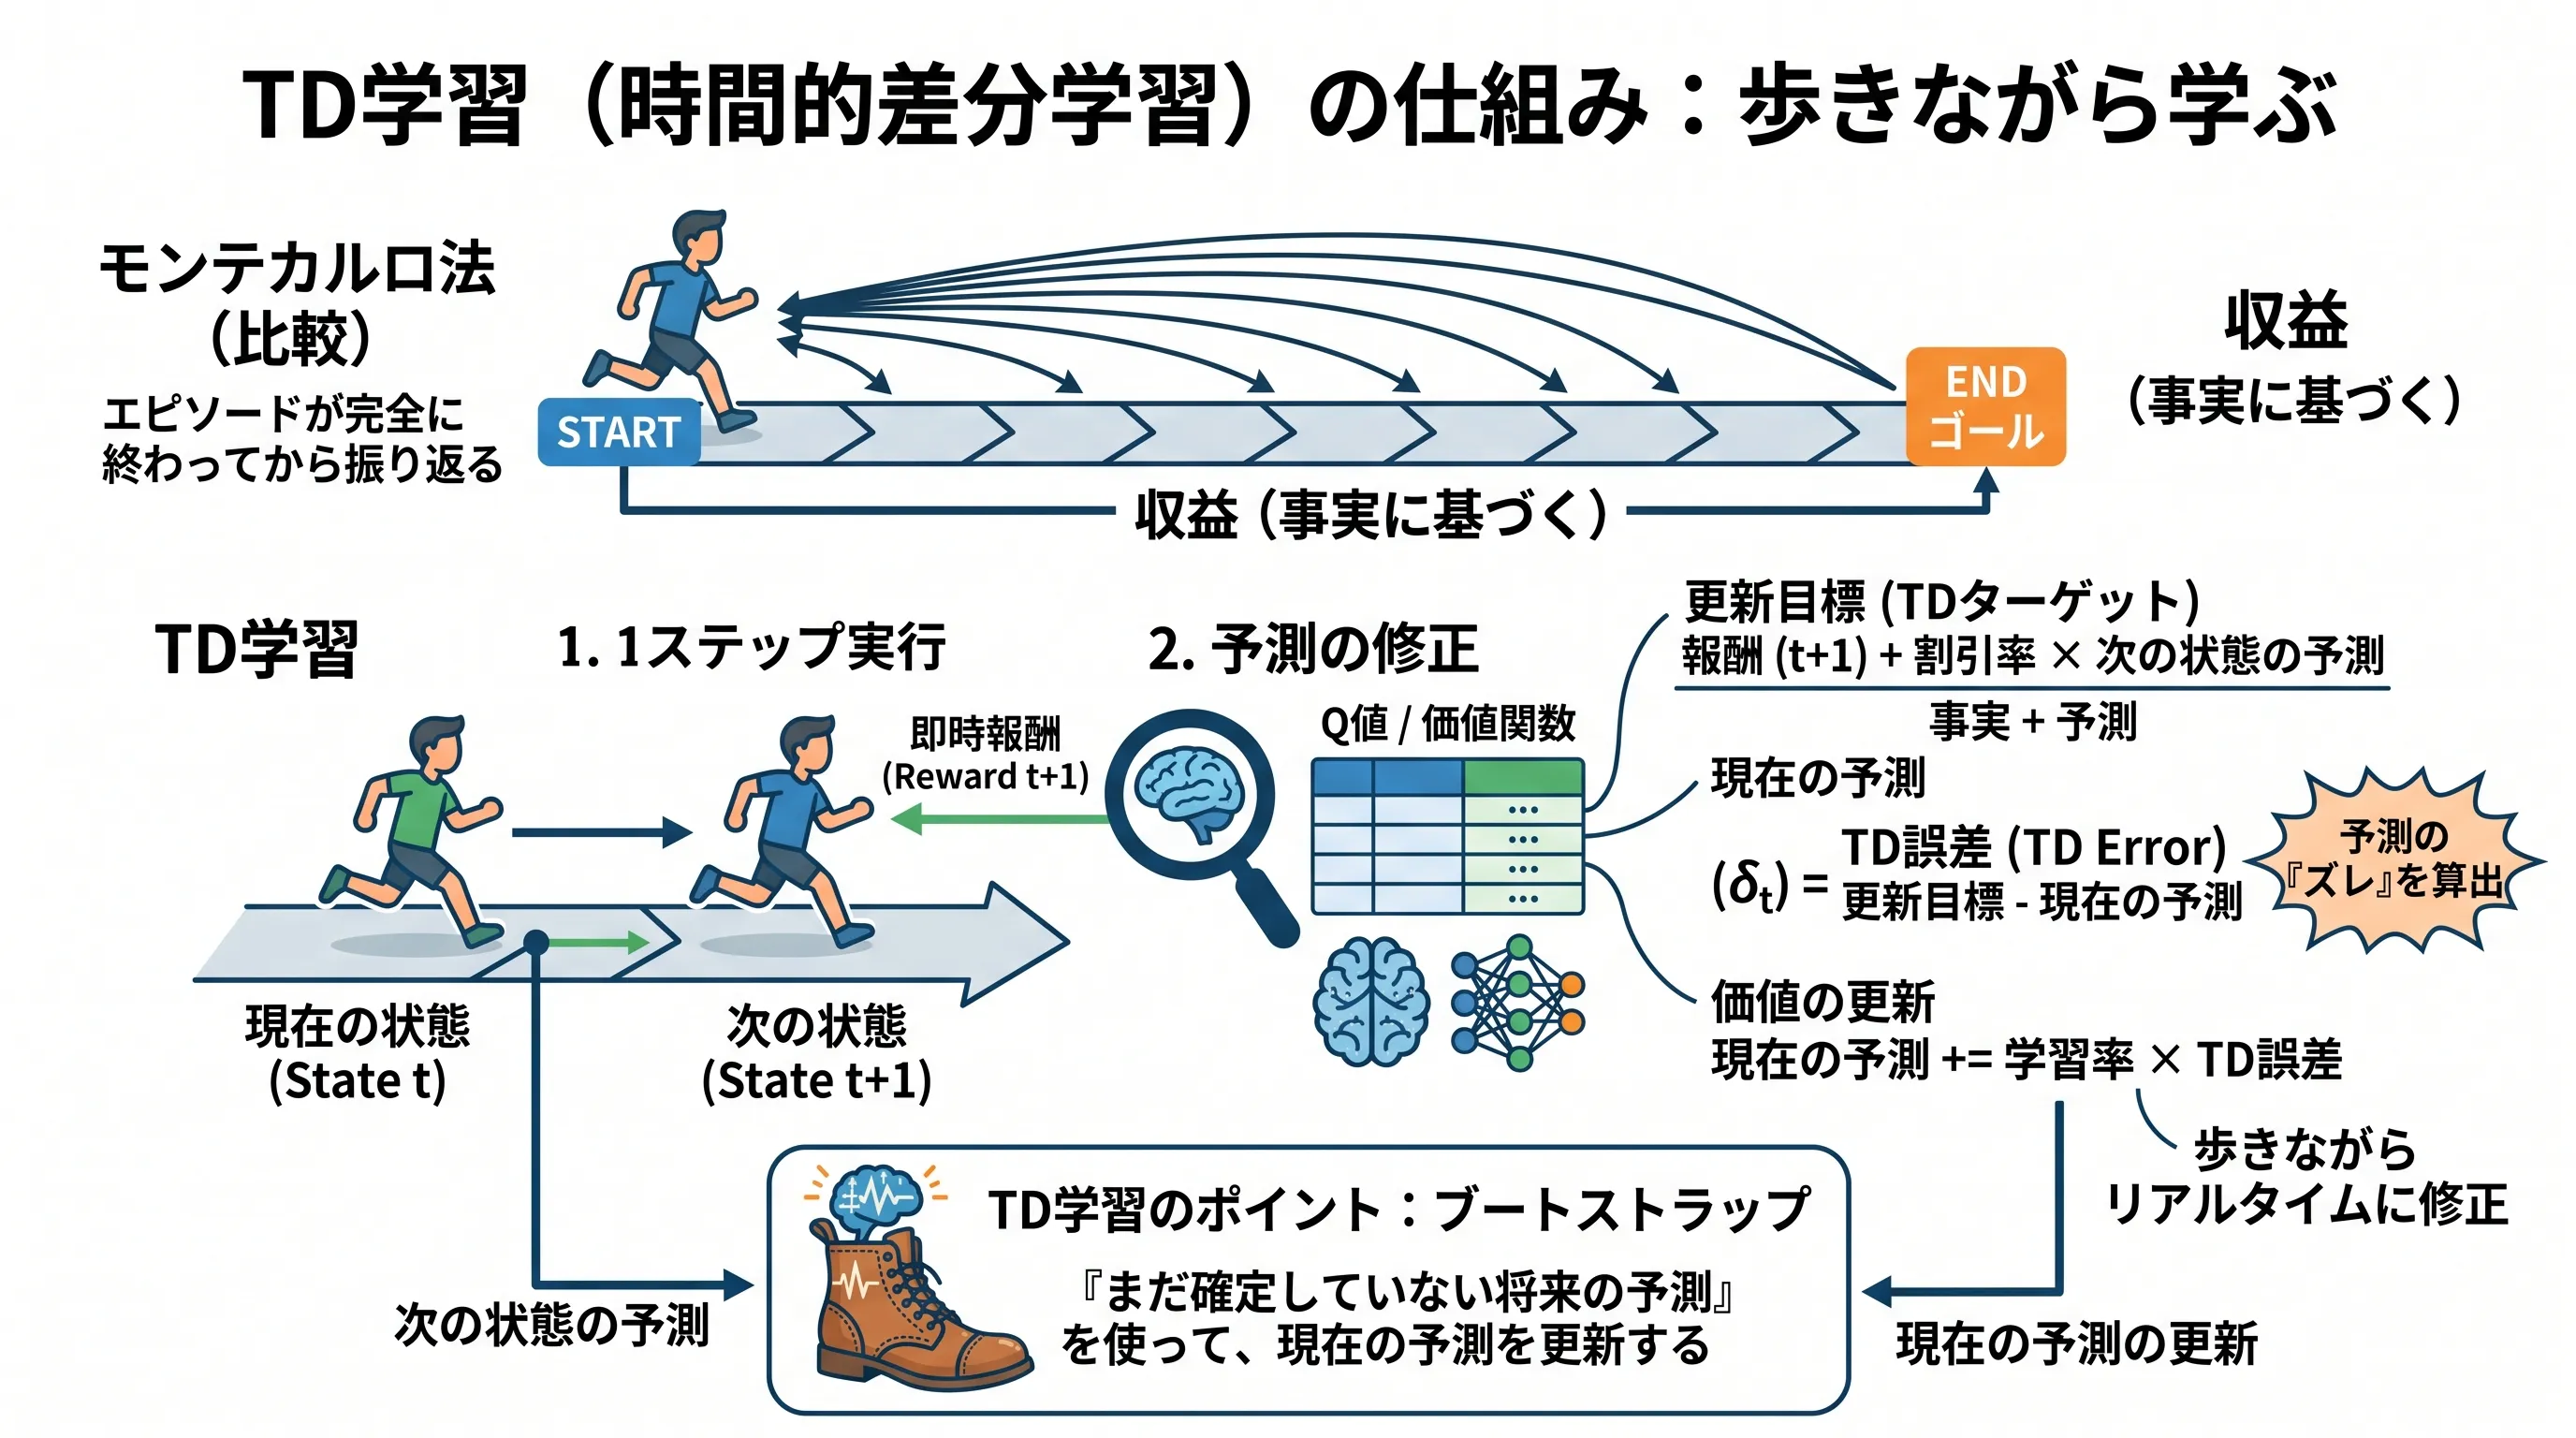 (画像は、Geminiで作成)
1ステップごとに「報酬 + 1歩先の予測」で今の予測を直す TD 学習の考え方(ブートストラップと TD 誤差)を理解すること。FrozenLake でモンテカルロ法と同じ課題を解き、真の価値との誤差を比べて、2つの手法のバイアスと分散の違いを説明できるようになること。
TD学習の概要
TD学習(Temporal Difference Learning:時間的差分学習)は、モンテカルロ法と並ぶ強化学習の最も基礎的かつ重要なアルゴリズムの一つです。
モンテカルロ法が「エピソードが最後まで終わるのを待ってから振り返る」アプローチだったのに対し、TD学習は 「1ステップ行動するたびに、直近の報酬と『1歩先の予測』を使って、現在の予測を歩きながら修正していく」 というアプローチをとります。
例えるなら、「目的地に到着してからカーナビの所要時間予測が正しかったかを確認する」のがモンテカルロ法、「渋滞に巻き込まれた(1ステップ進んだ)時点で、到着予想時刻を逐次アップデートする」のがTD学習です。
本記事では、TD学習のコアとなる「TD誤差」の仕組みを数式とともに解説し、Pythonによるスクラッチ実装を通じてモンテカルロ法との挙動の違いを学びます。この概念は、Q学習やDQN、そしてPPOなどの最先端アルゴリズムを理解するための必須知識となります。
はじめに:モンテカルロ法の弱点とTD学習のアプローチ
モンテカルロ法の記事では、実際に得られた合計報酬(収益 )の平均をとることで状態価値 を正確に学習できることを学びました。しかし、モンテカルロ法には2つの大きな弱点がありました。
- 最後まで待たないと学習できない: エピソードが終了するまで一切の学習が行えないため、1プレイが非常に長いゲームや、永遠に終わらないタスクには適用できません。
- 分散(データのブレ)が大きい: エピソードの最後まで行動するため、途中の「まぐれ」や「不運」といったランダムな要素がすべて結果に乗っかってしまい、学習が安定するまでに時間がかかります。(参考: モンテカルロ法の分散の爆発)
これらに対処するのがTD学習です。エピソードの終了を待たず、ステップごとの「予測の差分」を使って学習を進めることで、終わりのないタスクでも学習でき、1 回の更新に乗るばらつきも小さくなります。ただし、その代わりに予測の誤りが目標に入り込みます(後半で、モンテカルロ法と実際に比べます)。
TD学習のコア技術
TD学習(ここでは最も基本的な TD(0) を扱います)は、以下の要素で構成されています。
1. ブートストラップ(予測で予測を更新する)
TD学習の最大の特徴はブートストラップ(Bootstrapping) と呼ばれる性質です。これは「まだ確定していない将来の予測値を使って、現在の予測値を更新する」ことを意味します。
ある状態 にいて、行動を起こして次の状態 に移り、即時報酬 を得たとします。 このとき、「状態 の本当の価値」は、平均すると 「今もらった報酬 」+「割引率 を掛けた次の状態の価値 」 に等しくなります(ベルマン方程式)。TD 学習は、この関係を 1 回の経験に当てはめて、次の状態の今の予測 を使って を直します。
2. TDターゲットとTD誤差
この考え方に基づき、TD学習では更新の目標値(正解ラベルのようなもの)を以下のように定めます。これを TDターゲット と呼びます。
(※ は将来の報酬を割り引く割引率です) モンテカルロ法ではこの目標値が「エピソードの最後まで足し合わせた実際の収益 」でしたが、TD学習では「1歩先の報酬+1歩先の予測価値」で代用します。
そして、このTDターゲットと「現在の予測 」とのズレを TD誤差(TD Error:) と呼びます。PPOなど多くのアクタークリティック手法で登場する非常に重要な数式です。
3. 価値の更新
算出したTD誤差を使って、状態価値を1ステップごとに以下のように更新します。
または、展開して以下のように書くことも一般的です。
(※ は学習率です) これにより、エピソードの途中であっても1ステップ進むごとにリアルタイムで学習を行うことが可能になります。モンテカルロ法との違いを図にすると、次のようになります。
TD学習の実装(概念的な実装)
理論を理解したところで、モンテカルロ法の時と同じように、滑る氷の床の上を歩いてゴールを目指す FrozenLake-v1 を用いてTD学習を実装してみましょう。
FrozenLakeのルール
FrozenLakeは4x4のグリッドで構成されており、S(スタート)から始まり、H(穴)を避けてG(ゴール)を目指します。
| 行 \ 列 | 0 | 1 | 2 | 3 |
|---|---|---|---|---|
| 0 | S (スタート) | F (氷) | F (氷) | F (氷) |
| 1 | F (氷) | H (穴) | F (氷) | H (穴) |
| 2 | F (氷) | F (氷) | F (氷) | H (穴) |
| 3 | H (穴) | F (氷) | F (氷) | G (ゴール) |
報酬のルール:
- ゴール(G)に到達した場合:報酬 +1 を得てエピソード終了。
- 穴(H)に落ちた場合:報酬 0 でエピソード終了(ペナルティ値はありませんが、ゴール報酬も得られません)。
- その他の氷(F)を移動中:報酬 0。
ライブラリのインストール
!pip install gymnasium numpy matplotlib
ここでは、強化学習の標準的な環境を提供する gymnasium、配列計算を高速に行う numpy、そして学習結果をヒートマップとして可視化するための matplotlib をインストールしています。
TDAgentの定義
以下のコードでは、状態価値 をTD学習によって更新するエージェントを定義します。
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from collections import defaultdict

# TDAgent: TD学習を用いて状態価値 V(s) を学習するエージェント
class TDAgent:
    def __init__(self, gamma=0.99, alpha=0.1):
        self.gamma = gamma    # 割引率
        self.alpha = alpha    # 学習率

        # 状態価値 V(s) を保存するテーブル。初期値はすべて0.0
        self.V = defaultdict(float)

    def learn(self, state, reward, next_state, done):
        """
        1ステップの経験(s, r, s')を受け取り、リアルタイムに状態価値を更新する
        """
        # 終了状態(ゴールまたは穴)の場合、その先の価値は存在しないため0とする
        next_v = 0.0 if done else self.V[next_state]

        # TDターゲットの計算: 数式の R_{t+1} + γV(S_{t+1}) に該当
        td_target = reward + self.gamma * next_v

        # TD誤差の計算: 数式の [TDターゲット - V(S_t)] に該当
        td_error = td_target - self.V[state]

        # 価値の更新式: V(S_t) <- V(S_t) + α * [R_{t+1} + γV(S_{t+1}) - V(S_t)]
        self.V[state] += self.alpha * td_error
TD(0) の更新式 を、1 ステップ分の経験を受け取る関数にしたコードです。
- 価値のテーブル: defaultdict(float) で、まだ訪れていない状態の価値を 0.0 から始めます。FrozenLake の状態は 16 マスだけなので、ニューラルネットワークを使わず表で持てます(モンテカルロ法の記事と同じ形です)。
- 1 ステップ分の入力: learn は、state・reward・next_state・done だけを受け取ります。モンテカルロ法の learn がエピソード全体の履歴を必要としたのと違い、次の状態に着いた時点で更新できます。
- 終了状態: done が真(ゴールまたは穴)のときは、その先がないので next_v を 0.0 にします。ゴールに着いたステップでは、TD ターゲットが報酬の 1 だけになり、そこから価値が手前のマスへ伝わっていきます。
- TD ターゲットと TD 誤差: td_target が 、td_error が です。予測が目標より小さければ は正になり、alpha 倍だけ価値を上げます。
- 値の選び方: 割引率 0.99 は、モンテカルロ法の記事と同じ値にして、結果を比べられるようにしています。学習率 0.1 は、よく使われる値です。学習率の大きさで結果がどう変わるかは、後半の比較で 0.01 とも比べます。
訓練ループ
エージェントに FrozenLake-v1 をプレイさせます。ループの構造がモンテカルロ法からどう変わったかに注目してください。
env = gym.make('FrozenLake-v1', is_slippery=False)
agent = TDAgent(gamma=0.99, alpha=0.1)

EPISODES = 2000

# 乱数を固定して、実行結果を再現できるようにします(行動の選択は環境の乱数を使う)
env.action_space.seed(0)

print("--- TD学習 学習開始 ---")
for episode_num in range(EPISODES):
    state, _ = env.reset(seed=0 if episode_num == 0 else None)
    done = False

    # エピソードが終了するまでループ
    while not done:
        # ランダムに行動を選択
        action = env.action_space.sample()
        next_state, reward, terminated, truncated, _ = env.step(action)
        done = terminated or truncated

        # ★ ここが重要:1ステップ進むたびに、即座に学習(learn)を行う!
        agent.learn(state, reward, next_state, done)

        # 状態を更新して次のステップへ
        state = next_state

print("--- TD学習 学習完了 ---")
ランダムな方策で FrozenLake を 2,000 エピソード歩かせ、1 ステップごとに TD 学習で状態価値を更新するコードです。
- 環境の設定: is_slippery=False は、選んだ方向に必ず進む設定です。モンテカルロ法の記事と同じ設定・同じ 2,000 エピソードにして、2 つの方法を同じ条件で比べられるようにしています。
- 方策は固定: 行動は env.action_space.sample() で 4 方向から等確率に選び、学習しても変えません。ここで求めるのは「ランダムに歩いたときの状態の価値」で、方策を良くするのではなく、決まった方策の価値を当てる問題(予測の問題)です。
- 即時学習: env.step(action) の直後に agent.learn(...) を呼びます。モンテカルロ法のように履歴をためておく episode_history は要りません。
- 乱数の固定: env.action_space.seed(0) で行動の選び方を、最初の env.reset(seed=0) で環境を固定し、実行結果を再現できるようにします。
実行結果と可視化
学習によって得られた状態価値 を、モンテカルロ法と全く同じ方法でヒートマップ化して確認します。
# FrozenLakeのマップ配置 (S:スタート, F:氷, H:穴, G:ゴール)
lake_map = [
    ['S', 'F', 'F', 'F'],
    ['F', 'H', 'F', 'H'],
    ['F', 'F', 'F', 'H'],
    ['H', 'F', 'F', 'G']
]

V_grid = np.zeros((4, 4))
for state in range(16):
    row, col = divmod(state, 4)
    V_grid[row, col] = agent.V[state]

plt.figure(figsize=(6, 6))
plt.imshow(V_grid, cmap='hot', interpolation='nearest')
plt.colorbar(label='State Value V(s)')
plt.title("FrozenLake State Values (TD Learning)")

for i in range(4):
    for j in range(4):
        cell_text = f"{lake_map[i][j]}\n{V_grid[i, j]:.3f}"
        plt.text(j, i, cell_text, ha="center", va="center", color="cyan", fontweight="bold")

plt.xticks([])
plt.yticks([])
plt.show()
学習した状態価値を、モンテカルロ法の記事と同じヒートマップで表示するコードです。
- グリッドへの変換: 状態の番号 0〜15 を divmod(state, 4) で (行, 列) にし、4×4 の V_grid に並べます。
- 文字の重ね書き: plt.text() で、マスの種類(S, F, H, G)と価値を各マスに書きます。穴とゴールは終了状態なので、価値は 0 のままです。
実行結果
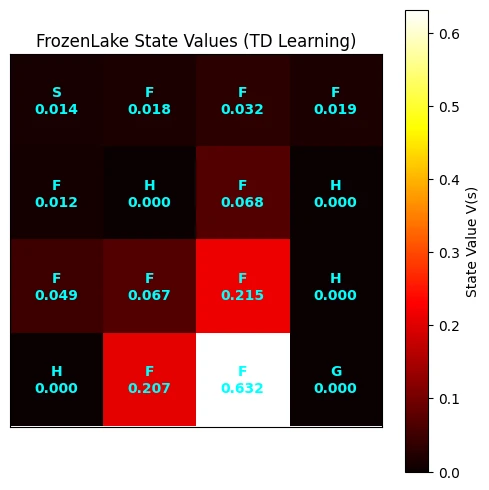
モンテカルロ法と同様に、ゴールに近いマスほど価値が高く学習できています。ゴールのすぐ左のマスが 0.632、その左が 0.207、ゴールの上のマスが 0.215 で、スタートは 0.014 です。ゴールから離れるほど、ランダムに歩いてゴールにたどり着く見込みが小さいので、価値も小さくなります。
ただし、この値が正しいかどうかは、図だけでは分かりません。次の節で、本当の価値と比べます。
モンテカルロ法との比較(本当の価値との誤差)
FrozenLake は、どの行動でどのマスに移るかが分かっているので、ランダムな方策の本当の状態価値を計算で求められます。それを正解にして、モンテカルロ法と TD 学習の推定が、エピソードを重ねるごとにどれだけ近づくかを比べます。モンテカルロ法の MCAgent は、モンテカルロ法の記事のものをそのまま使います。
# MCAgent: モンテカルロ法を用いて状態価値 V(s) を学習するエージェント
class MCAgent:
    def __init__(self, gamma=0.99):
        self.gamma = gamma    # 割引率

        # 状態価値 V(s) を保存するテーブル。初期値はすべて0.0
        self.V = defaultdict(float)
        # 各状態の更新回数 N(s)。学習率 α = 1/N(s) の計算に使う
        self.N = defaultdict(int)

    def learn(self, episode):
        """
        1エピソード分の履歴を受け取り、状態価値を更新する
        episode: [(state, reward), (state, reward), ...] のリスト
        """
        G = 0  # 収益の初期化
        states = [s for s, _ in episode]  # エピソード中に訪れた状態の時系列

        # エピソードの終端から開始地点に向かって逆順に計算する
        # (数式: G_t = R_{t+1} + γR_{t+2} + ... を効率よく再帰計算)
        for t in reversed(range(len(episode))):
            state, reward = episode[t]

            # 収益 G の計算 (1ステップ戻るごとに割引率γを掛け、その時点の報酬を足す)
            G = self.gamma * G + reward

            # 初回訪問MC法 (First-visit MC):
            # S_t がそれより前(S_0〜S_{t-1})に現れていない=時刻tが最初の訪問である場合のみ更新する
            if state not in states[:t]:
                self.N[state] += 1
                alpha = 1.0 / self.N[state]  # 学習率 α = 1/N(s) で標本平均と一致させる
                # 価値の更新式: V(S_t) <- V(S_t) + α * [G_t - V(S_t)]
                self.V[state] = self.V[state] + alpha * (G - self.V[state])

# 1. ランダムな方策の「本当の状態価値」を、環境の遷移確率から求める
#    env.unwrapped.P[s][a] は (確率, 次の状態, 報酬, 終了) のリスト。ベルマン方程式を収束するまで繰り返し当てはめる
P = env.unwrapped.P
V_true = np.zeros(16)
for _ in range(1000):
    V_new = np.zeros(16)
    for s in range(16):
        for a in range(4):                       # ランダムな方策:4 方向を 1/4 ずつ
            for prob, s2, r, done in P[s][a]:
                V_new[s] += 0.25 * prob * (r + 0.99 * (0.0 if done else V_true[s2]))
    V_true = V_new
print("本当の状態価値(ランダムな方策):")
print(np.round(V_true.reshape(4, 4), 3))

# 誤差を測るのは、スタートと氷のマス(穴とゴールは終了状態で、価値は常に 0)
nonterminal = [s for s in range(16) if lake_map[s // 4][s % 4] in "SF"]

# 2. 同じランダムな方策で学習し、20 エピソードごとに本当の価値との誤差(RMSE)を記録する
def run(make_agent, kind, seed, episodes=2000, record_every=20):
    env = gym.make('FrozenLake-v1', is_slippery=False)
    env.action_space.seed(seed)
    agent = make_agent()
    errors = []
    for ep in range(episodes):
        state, _ = env.reset(seed=seed if ep == 0 else None)
        done, history = False, []
        while not done:
            action = env.action_space.sample()
            next_state, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            if kind == "td":
                agent.learn(state, reward, next_state, done)   # 1 ステップごとに更新
            else:
                history.append((state, reward))                # エピソードの最後にまとめて更新
            state = next_state
        if kind == "mc":
            agent.learn(history)
        if (ep + 1) % record_every == 0:
            v = np.array([agent.V[s] for s in nonterminal])
            errors.append(np.sqrt(np.mean((v - V_true[nonterminal]) ** 2)))
    return np.array(errors)

# 3. 乱数の種を 20 通り変えて平均し、1 回ごとの偶然のばらつきを均す
methods = {
    "MC (alpha = 1/N)": (lambda: MCAgent(gamma=0.99), "mc"),
    "TD (alpha = 0.1)": (lambda: TDAgent(gamma=0.99, alpha=0.1), "td"),
    "TD (alpha = 0.01)": (lambda: TDAgent(gamma=0.99, alpha=0.01), "td"),
}
curves = {name: np.mean([run(f, kind, seed) for seed in range(20)], axis=0) for name, (f, kind) in methods.items()}
x = np.arange(20, 2001, 20)
for name, c in curves.items():
    print(f"{name:18s} RMSE  100 エピソード: {c[4]:.4f}  500: {c[24]:.4f}  2000: {c[-1]:.4f}")

plt.figure(figsize=(9, 4.5))
for name, c in curves.items():
    plt.plot(x, c, label=name)
plt.xlabel("Episode"); plt.ylabel("RMSE to true V(s)")
plt.title("FrozenLake (random policy): MC vs TD, mean of 20 seeds")
plt.grid(True); plt.legend()
plt.show()
本当の状態価値を計算で求め、モンテカルロ法と TD 学習の推定の誤差(RMSE)の推移を、乱数の種 20 通りの平均で比べるコードです。
- 本当の価値: env.unwrapped.P[s][a] は、状態 s で行動 a を取ったときの (確率, 次の状態, 報酬, 終了) のリストです。ランダムな方策では 4 方向を 1/4 ずつ選ぶので、(ベルマン方程式)を、値が変わらなくなるまで繰り返し当てはめます(1,000 回で十分に収束します)。
- 誤差の測り方: 穴とゴールは価値が常に 0 なので除き、スタートと氷の 11 マスで、推定と本当の価値の差の 2 乗平均の平方根(RMSE)を 20 エピソードごとに記録します。
- 比べる方法: モンテカルロ法(初回訪問、学習率 で標本平均と一致)と、TD 学習の学習率 0.1・0.01 の 3 つです。TD 学習は学習率を固定するので、学習率で結果が変わるかも見ます。
- 20 通りの平均: 1 回の実行では、たまたまゴールにたどり着いた回数で結果が大きく変わるので、乱数の種を 0〜19 に変えて平均します。
実行結果
本当の状態価値(ランダムな方策):
[[0.012 0.01  0.019 0.009]
 [0.015 0.    0.039 0.   ]
 [0.033 0.084 0.138 0.   ]
 [0.    0.17  0.434 0.   ]]
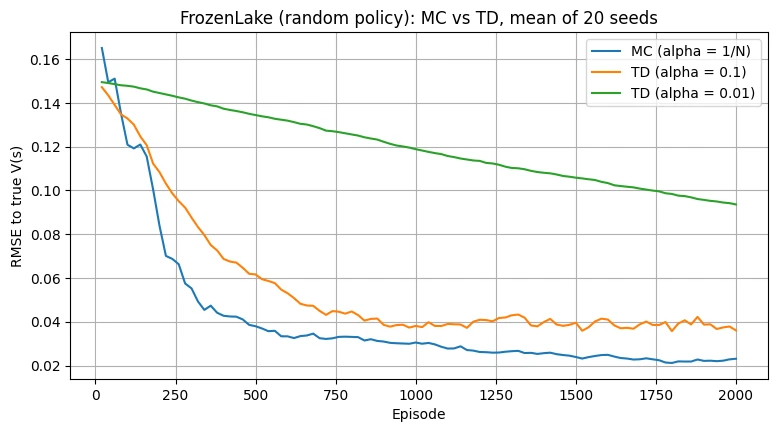
MC (alpha = 1/N)   RMSE  100 エピソード: 0.1209  500: 0.0379  2000: 0.0231
TD (alpha = 0.1)   RMSE  100 エピソード: 0.1329  500: 0.0616  2000: 0.0360
TD (alpha = 0.01)  RMSE  100 エピソード: 0.1478  500: 0.1345  2000: 0.0936
- 本当の価値と先ほどの図: ゴールのすぐ左のマスの本当の価値は 0.434 ですが、先ほどの TD 学習(1 回の実行)は 0.632 と、大きく外れていました。ゴールの上のマスも、本当は 0.138 に対して 0.215 です。学習率を 0.1 に固定しているので、最後の数回のエピソードの結果に引っ張られ、値が揺れ続けるためです。
- この課題ではモンテカルロ法の方が正確: 2,000 エピソード後の誤差は、モンテカルロ法が 0.0231、TD 学習(学習率 0.1)が 0.0360 で、500 エピソードの時点でもモンテカルロ法の方が小さくなりました。FrozenLake は 1 エピソードが短く(ランダムに歩くと数ステップで穴に落ちる)、報酬がゴールの 1 回だけなので、終了まで待つモンテカルロ法でも分散があまり大きくなりません。一方、TD 学習はゴールの報酬が 1 マスずつ手前に伝わるのを待つ必要があり、その間は予測の誤り(バイアス)が残ります。
- 学習率の影響: TD 学習の学習率 0.1 は、700 エピソードあたりで誤差が 0.04 前後から下がらなくなりました。学習率を固定すると、値が本当の価値の周りで揺れ続けるためです。学習率 0.01 は揺れが小さい代わりに、2,000 エピソードでも誤差が 0.0936 と、まだ下がりきっていません。
TD 学習が有利になるのは、エピソードが長いタスクや終わりのないタスクのように、終了まで待つと収益のばらつきが大きくなる場合や、そもそも終了を待てない場合です。どちらが速く正確になるかは、課題と学習率によって変わります。
TD 学習の1回の推定と本当の価値を並べると、次のようになります。
(図は、diagram-designで作成)
MC法とTD法の比較(バイアスと分散のジレンマ)
強化学習において避けて通れないのが、バイアス(Bias: 予測の偏り・間違い)と分散(Variance: データのブレ・ばらつき)のトレードオフです。 両極端に位置するMC法とTD法を比較してみましょう。
| アルゴリズム | 学習のタイミング | 更新の目標値(ターゲット) | バイアス(予測の偏り) | 分散(データのブレ) |
|---|---|---|---|---|
| モンテカルロ(MC)法 | エピソード終了後 | 実際の収益 | なし(結果の事実に基づくため) | 大(途中のノイズが蓄積するため) |
| TD学習 | 毎ステップ | あり( の予測が正しくなるまで) | 小(1歩分のノイズしか入らないため) |
TD学習は、1ステップ先のデータしか使わないためデータのブレ(分散)が小さくなります。しかし、初期段階では「次の状態の予測価値 」自体が完全にデタラメであるため、間違った予測をベースに現在の価値を更新してしまうバイアス(思い込みの連鎖)が発生します。
PPOとQ学習への橋渡し
この「バイアスと分散のジレンマ」をどのように克服し、より複雑な問題を解くかが、現代の強化学習アルゴリズムの進化の歴史です。
- Q学習・DQNへの進化:今回学んだTD学習は「状態の価値 」を評価するものでしたが、これを「ある状態で特定の行動をとった時の価値 」に拡張し、価値が最も高い行動を常に選ぶようにしたのが Q学習 であり、それをディープラーニングと組み合わせたのが DQN です。DQNの記事で登場する「TDターゲット」という言葉は、まさにこの記事で解説した概念です。
- PPO(GAE)への進化:「MC法(分散が大)」と「TD法(バイアスが大)」の間には、2歩先、3歩先まで見てから予測を混ぜる「ステップTD学習」という中間のアプローチが存在します。これを究極に推し進め、1歩先のTD誤差、2歩先のTD誤差、3歩先のTD誤差…と未来のTD誤差を、パラメータ (ラムダ)で重みを付けて足し合わせ、バイアスと分散の釣り合いを調整できるようにしたのが、PPO の記事で登場する GAE(Generalized Advantage Estimation: 一般化アドバンテージ推定) です。
ここで登場する こそが、本記事で学んだ「TD誤差」に他なりません。
TD 学習とモンテカルロ法の間にある手法を、1本の軸に並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、強化学習のもう一つの柱である「TD学習(時間的差分学習)」について解説しました。
エピソードの終了を待たず、1歩先の「予測」を用いて「現在の予測」を更新(ブートストラップ)するTD誤差の仕組みを学びました。FrozenLake でランダムな方策の本当の価値と比べると、1 エピソードが短いこの課題では、2,000 エピソード後の誤差はモンテカルロ法(0.0231)の方が TD 学習(学習率 0.1 で 0.0360)より小さく、TD 学習は予測の誤り(バイアス)と、学習率を固定したことによる揺れが残りました。TD 学習の強みは、終了を待たずに更新できることと、1 回の更新に乗るばらつきが小さいことで、エピソードが長いタスクや終わりのないタスクで生きてきます。
モンテカルロ法とTD学習という2つの基礎を理解したことで、いよいよ実用的なアルゴリズムである「Q学習」や「DQN」、そして「PPO」のメカニズムを深く理解するための準備が整いました。ぜひ次のステップへ進んでみてください。
参考文献
- R. S. Sutton (1988). Learning to predict by the methods of temporal differences. Machine Learning, 3(1), 9–44.
- C. J. C. H. Watkins, P. Dayan (1992). Q-learning. Machine Learning, 8(3-4), 279–292.
- R. S. Sutton, A. G. Barto (2018). Reinforcement Learning: An Introduction (2nd ed.). MIT Press.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
本記事の文章・構成の一部に生成AIを使用しています。