Transformer とは? Attention だけの Encoder-Decoder
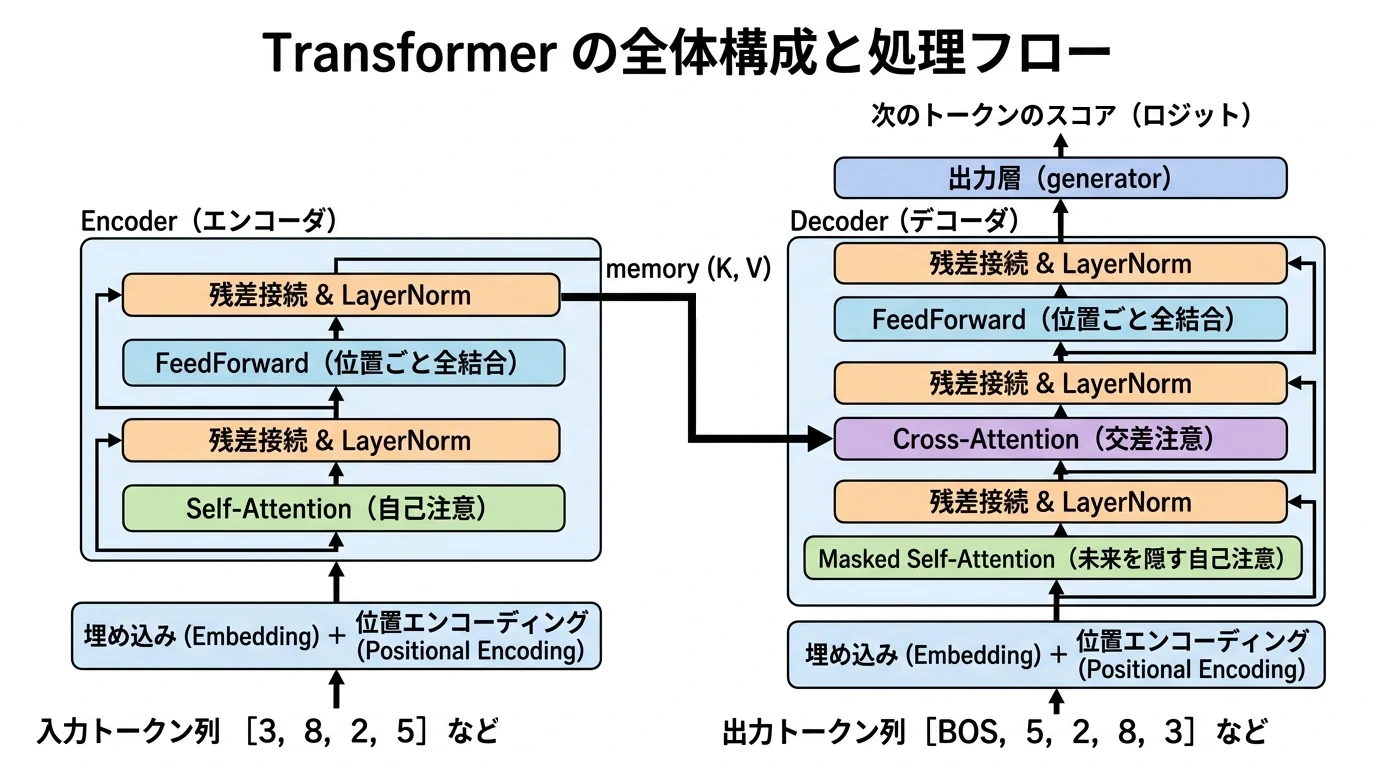 (画像は、Geminiで作成)
Transformer の Encoder-Decoder を、Attention・位置エンコーディング・マスクといった部品から PyTorch で組み立て、入力のトークン列が次のトークンの確率になるまでに、テンソルの形がどう変わるかを追えるようになること。小さなタスクで学習し、自己回帰生成と Cross-Attention の重みで、モデルが何をしているかを確かめること。
原著論文: Attention Is All You Need (Vaswani, Shazeer, Parmar, Uszkoreit, Jones, Gomez, Kaiser, Polosukhin, NeurIPS 2017)
本記事のコードは、CPU(2コア)で、Python 3.13.18、torch 2.15.0、matplotlib 3.11.2 を使って実行しました。モデルが小さいので GPU は要らず、学習(20エポック)は約2分で終わります。Google Colab で動かす場合も、CPU のランタイムで足ります。乱数のシードを固定していますが、GPU で動かしたり、torch の版が違ったりすると、計算の順番の違いで、損失や完全一致率の値が本記事と少し変わることがあります。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
概要
Transformer は、2017年に機械翻訳のモデルとして発表されました。それまでの翻訳モデルの中心だった RNN(再帰型ニューラルネットワーク)は、文を先頭から1単語ずつ読み、前の単語までの情報を隠れ状態に詰めて次へ渡します。この順番の処理は並列にできないので、長い文ほど計算に時間がかかり、遠く離れた単語どうしの関係も、何段もの受け渡しを経ないと伝わりません。
Transformer は、再帰をやめ、Attention(注意機構)だけ で文を読みます。Attention は、系列のすべての位置の組について「どれだけ関係があるか」を内積で計算し、関係の強い位置の情報を集めます。すべての組を一度の行列積で計算できるので、GPU で並列に処理でき、どれだけ離れた位置どうしでも1段でつながります。原著論文では、英語からドイツ語への翻訳(WMT 2014)で 28.4 BLEU と、当時の最高の精度を出しました。Attention 自体は、RNN の翻訳モデルで、訳語を出すたびに元の文のどこを見るかを決める仕組みとして、それ以前に提案されていました(Bahdanau et al., 2015)。Transformer は、それを補助ではなく、モデルの中心に据えたものです。
その後、Transformer は翻訳を超えて、BERT や GPT のような大規模言語モデル、画像の Vision Transformer、画像と文書を扱うマルチモーダルなモデルの土台になりました。本サイトでも、RoPE・Swin Transformer・Donut・RT-DETR・CLIP など、多くの記事が Transformer を前提にしています。本記事では、原著論文の Encoder-Decoder を、PyTorch の基本的なテンソル演算だけでスクラッチ実装します。部品ごとに出力の形を確かめ、最後に「数字の列を逆に並べる」小さなタスクで学習して、1トークンずつの生成と、Cross-Attention の重みを見ます。
RNN と Self-Attention の違い
RNN と Self-Attention の違いを、図で比べます。RNN は隠れ状態を1トークンずつ順に計算するので、系列が長いほど順番の計算が増え、離れた位置の情報は何段もの受け渡しを経て伝わります。Self-Attention は、すべての位置の組を1回の行列積で計算するので、順番の計算は1回で、どの2つの位置も1段でつながります。
(図は、diagram-designで作成)
原著論文の Table 1 では、1層の計算量は Self-Attention が 、RNN が です( は系列の長さ、 はベクトルの次元)。翻訳の文のように が より小さい場合が多いので、Self-Attention は並列にできるだけでなく、1層の計算量でも RNN より小さくなります。一方、 に比例するので、画像のように系列がとても長くなると重くなります。この問題への対策の1つが、窓の中だけで Attention を計算する Swin Transformer です。
Transformer の全体の構成
(図は、diagram-designで作成)
Transformer は、入力の系列を読む Encoder と、出力の系列を1トークンずつ作る Decoder からなります。図は、本記事で実装するモデル(層の数 2、埋め込みの次元 64)の構成です。
- Encoder: 入力のトークン列を、埋め込み(Embedding)でベクトルにし、位置の情報(Positional Encoding)を足します。続けて、入力の系列どうしの Self-Attention と、位置ごとの FeedForward を、ブロックの数だけ繰り返します。出力(memory)は、入力の各トークンを、文全体の文脈を踏まえて表したベクトルの列です。
- Decoder: それまでに出力したトークン列を同じように埋め込み、3つの処理をブロックの数だけ繰り返します。
- Masked Self-Attention: 出力したトークンどうしの Attention です。まだ出力していない未来の位置を見ないように、マスクで隠します。
- Cross-Attention: Decoder 側から、Encoder の memory を見る Attention です。翻訳なら「次の単語を出すために、元の文のどこを見るか」にあたります。
- FeedForward: Encoder と同じ、位置ごとの全結合です。
- 出力: 最後の線形層(generator)で、語彙のトークンごとのスコア(ロジット)を出します。softmax をかけると、次のトークンの確率になります。
各処理(サブレイヤー)は、入力を出力に足す 残差接続(Add)と、LayerNorm(Norm)で包まれています。次の節から、部品ごとに、数式・コード・実行結果の順で実装します。
Transformer のスクラッチ実装
ここからは、各部品を PyTorch で実装し、出力の形を確かめながら組み立てます。
Scaled Dot-Product Attention
Attention は、3つの行列 (Query、q)・(Key、k)・(Value、v)から、次の式で計算します。(d_k)は、Query と Key のベクトルの次元です。
- : 情報を集める側の各位置が、「どんな情報がほしいか」を表すベクトルを並べた行列です。形は(系列長 , )です。
- : 集められる側の各位置が、「自分がどんな情報を持っているか」を表すベクトルです。形は(, )です。
- : 集められる側の各位置が、実際に渡す情報です。形は(, )です。
は、すべての Query とすべての Key の内積を並べた(, )の行列で、内積が大きいほど、その組の関係が強いとみなします。各行に softmax をかけると、行ごとに合計1の重みになり、その重みで の行を平均したものが出力です。Self-Attention では ・・ をすべて同じ系列から作り、Cross-Attention では を Decoder 側、・ を Encoder の memory から作ります。
(図は、diagram-designで作成)
数値例: で、Query 、2つの Key ・ とします。内積は ・ で、 で割ると 1 と 0 です。softmax をかけると、重みは と になり、出力は です。Query と向きの近い の Value が、多く混ざります。
で割る理由: と の成分が、平均0・分散1で互いに独立だとすると、内積 は、平均0・分散 になります。次元 が大きいと内積の値が大きくばらつき、softmax がほぼ1か所だけに重みを置く状態になります。この状態では、重み以外の位置への勾配がほとんど0になり、学習が進みにくくなります。 で割ると、内積の分散が によらず1に戻ります。
次のコードで、この式を関数 scaled_dot_product_attention として実装し、 で割る理由を数値で確かめます。 を 4・64・512 と変え、平均0・分散1の乱数で作った1つの Query と10個の Key の内積について、分散と、softmax の最大の重みを、割らない場合と割る場合で比べます。
import math
import torch
import torch.nn as nn
import torch.nn.functional as F

torch.manual_seed(0)


def scaled_dot_product_attention(q, k, v, mask=None):
    """Attention(Q, K, V) = softmax(QK^T / √d_k) V。mask が False の位置には注意を向けない"""
    d_k = q.size(-1)
    scores = q @ k.transpose(-2, -1) / math.sqrt(d_k)             # (..., L_q, L_k):すべての組の内積
    if mask is not None:
        scores = scores.masked_fill(~mask, float("-inf"))         # softmax の後で重みが 0 になる
    weights = scores.softmax(dim=-1)                              # 各行(クエリ)で、キーへの重みの合計が 1
    return weights @ v, weights                                   # (..., L_q, d_v):値の重み付き平均


# √d_k で割る理由:成分が平均0・分散1のとき、内積の分散は d_k になり、softmax が1か所に偏る
for d_k in [4, 64, 512]:
    q, k = torch.randn(1000, d_k), torch.randn(1000, 10, d_k)
    dots = (q[:, None, :] * k).sum(-1)                            # (1000, 10):1つのクエリと10個のキーの内積
    raw_max = dots.softmax(-1).max(-1).values.mean()
    scaled_max = (dots / math.sqrt(d_k)).softmax(-1).max(-1).values.mean()
    print(f"d_k={d_k:3d}: 内積の分散 {dots.var():7.1f}  最大の重み(割らない){raw_max:.3f}  (√d_k で割る){scaled_max:.3f}")
Attention の式を関数にし、 で割ることの効果を、乱数で確かめるコードです。
- scaled_dot_product_attention: 式 をそのまま書いたものです。
- q @ k.transpose(-2, -1): です。transpose(-2, -1) で、最後の2つの軸だけを入れ替えるので、前にバッチやヘッドの軸が付いていても、その軸ごとに(, )の内積の行列ができます。後の Multi-Head Attention では、(バッチ, ヘッド, 系列長, )の4次元のテンソルをそのまま渡します。
- masked_fill(~mask, float("-inf")): mask は「注意してよい位置」が True の真偽値のテンソルで、False の位置を にします。softmax で になり、その位置の重みが0になります。形は scores と同じでなくてよく、ブロードキャストできる形(例:(バッチ, 1, 1, ))なら、ヘッドとクエリの軸に同じマスクが使われます。
- softmax(dim=-1): 最後の軸(Key の軸)で正規化するので、各 Query について、Key への重みの合計が1になります。
- 返り値: 出力に加えて重み weights も返すのは、後で Cross-Attention の重みを図にするためです。
- の確かめ: 1,000個の Query のそれぞれについて、10個の Key との内積を計算します。
- q[:, None, :] * k は、(1000, 1, )と(1000, 10, )のかけ算で、ブロードキャストにより、Query ごとに10個の Key との成分ごとの積になります。最後の軸で足すと、内積の(1000, 10)の行列です。
- raw_max・scaled_max: 10個の Key への softmax の重みのうち最大のものを、1,000個の Query で平均した値です。重みが均等なら 0.1、1か所に集中するほど1に近づきます。
- の 4・64・512 は、小さい値から、原著論文の各ヘッドの次元(64)、論文の (512)までを並べたものです。
実行結果
d_k=  4: 内積の分散     3.9  最大の重み(割らない)0.494  (√d_k で割る)0.304
d_k= 64: 内積の分散    63.8  最大の重み(割らない)0.857  (√d_k で割る)0.321
d_k=512: 内積の分散   515.5  最大の重み(割らない)0.953  (√d_k で割る)0.319
- 内積の分散は になる: 分散は 3.9・63.8・515.5 で、どれも (4・64・512)とほぼ同じでした。
- 割らないと、softmax が1か所に偏る: 最大の重みは、 で 0.953 です。10個の Key があっても、ほぼ1つだけに重みが置かれ、ほかの9個の重みは合わせて 0.05 程度しかありません。このとき softmax の勾配は、ほとんどの位置で0に近くなります。
- 割ると、 によらずそろう: で割ると、最大の重みは 0.30〜0.32 で、 を変えてもほぼ同じでした。次元を大きくしても、Attention の重みの広がり方が変わらないので、学習が安定します。
Multi-Head Attention
1つの Attention では、各位置が集める情報は1種類の重みの平均だけです。Multi-Head Attention は、入力を 個の別々の線形変換で小さな部分空間に写し、それぞれで Attention を計算してから、結果をつなげます。
は、(d_model)次元を 次元に写す行列で、 はヘッドの数(num_heads)です。 個の を横に並べた行列を w_q(・ も同様に w_k・w_v)、つなげた結果に掛ける を w_o とします。ヘッドごとに別の部分空間で内積を取るので、「直前の位置を見るヘッド」「同じ単語を見るヘッド」のように、異なる関係を同時に捉えられます。各ヘッドの次元を にしているので、計算量は、 次元の Attention 1つとほぼ同じです。
(図は、diagram-designで作成)
図の形は、本記事のモデル(、、各ヘッド32次元)のものです。原著論文の base モデルは、、 で、各ヘッドは64次元です。
次のコードで、Multi-Head Attention を実装し、Self-Attention と Cross-Attention のそれぞれで、出力と重みの形を確かめます。
class MultiHeadAttention(nn.Module):
    """h 個のヘッドで、別々の部分空間に射影して注意を計算し、結果をつなげて戻す"""

    def __init__(self, d_model, num_heads):
        super().__init__()
        assert d_model % num_heads == 0
        self.h, self.d_k = num_heads, d_model // num_heads
        self.w_q = nn.Linear(d_model, d_model)                    # 全ヘッドの W^Q を横に並べた1つの線形層
        self.w_k = nn.Linear(d_model, d_model)
        self.w_v = nn.Linear(d_model, d_model)
        self.w_o = nn.Linear(d_model, d_model)                    # つなげたヘッドの出力を d_model に戻す W^O
        self.attn_weights = None                                  # 可視化のため、直前の注意の重みを残す

    def split_heads(self, x):                                     # (B, L, d_model) → (B, h, L, d_k)
        B, L, _ = x.shape
        return x.view(B, L, self.h, self.d_k).transpose(1, 2)

    def forward(self, query, key, value, mask=None):
        q = self.split_heads(self.w_q(query))                     # (B, h, L_q, d_k)
        k = self.split_heads(self.w_k(key))                       # (B, h, L_k, d_k)
        v = self.split_heads(self.w_v(value))                     # (B, h, L_k, d_k)
        out, weights = scaled_dot_product_attention(q, k, v, mask)  # out: (B, h, L_q, d_k)
        self.attn_weights = weights.detach()
        B, _, L_q, _ = out.shape
        out = out.transpose(1, 2).reshape(B, L_q, self.h * self.d_k)  # ヘッドをつなげる:(B, L_q, d_model)
        return self.w_o(out)


mha = MultiHeadAttention(d_model=64, num_heads=2)
x_dec, x_enc = torch.randn(2, 5, 64), torch.randn(2, 7, 64)
print("Self-Attention の出力:", tuple(mha(x_dec, x_dec, x_dec).shape), " 重み:", tuple(mha.attn_weights.shape))
print("Cross-Attention の出力:", tuple(mha(x_dec, x_enc, x_enc).shape), " 重み:", tuple(mha.attn_weights.shape))
print("パラメータ数:", sum(p.numel() for p in mha.parameters()))
個のヘッドの Attention を、まとめて計算するコードです。
- 線形層を1つにまとめる: 式では、ヘッドごとに ()がありますが、 個を横に並べると の1つの行列になります。そこで、w_q を1つの nn.Linear(d_model, d_model) にし、出力を 個に切り分けます。ヘッドごとに線形層を作ってループで回すより、1回の行列積で済むので速く、書くのも簡単です。
- split_heads: (B, L, 64)を view で(B, L, 2, 32)にし、transpose(1, 2) で(B, 2, L, 32)にします。ヘッドの軸を系列の軸より前に出すのは、scaled_dot_product_attention が最後の2つの軸(系列長, )で行列積を取るので、ヘッドをバッチと同じ扱いにして、全ヘッドを一度に計算するためです。
- ヘッドをつなげる: Attention の出力(B, 2, , 32)を、transpose(1, 2) で(B, , 2, 32)に戻し、reshape で(B, , 64)にします。これが式の で、最後に w_o()をかけます。
- transpose の後のテンソルはメモリ上で連続していないので、view ではなく、必要ならコピーを作る reshape を使っています。
- attn_weights: 直前に計算した重み(B, , , )を残しておきます。後で、学習したモデルの Cross-Attention の重みを図にするためです。detach() で計算グラフから外し、学習のメモリを使わないようにしています。
- 確かめ: Decoder 側を長さ5、Encoder 側を長さ7の系列として、Self-Attention(query・key・value がすべて Decoder 側)と Cross-Attention(key・value が Encoder 側)の形を比べます。値の ・ は、後の実験のモデルと同じです。
実行結果
Self-Attention の出力: (2, 5, 64)  重み: (2, 2, 5, 5)
Cross-Attention の出力: (2, 5, 64)  重み: (2, 2, 5, 7)
パラメータ数: 16640
- 出力の形は Query の系列で決まる: 出力は、どちらも(2, 5, 64)でした。Attention は Query の位置ごとに情報を集めるので、出力の長さは Query の長さ(5)になり、Key・Value の長さ(7)にはよりません。
- 重みの形は(バッチ, ヘッド, , ): Self-Attention では(2, 2, 5, 5)、Cross-Attention では(2, 2, 5, 7)で、Decoder の5つの位置それぞれが、Encoder の7つの位置に重みを持ちます。
- パラメータ数: 4つの線形層がそれぞれ 個のパラメータを持つので、合わせて 16,640 個です。ヘッドの数を変えても、この数は変わりません。
Positional Encoding
Attention は、位置の組の内積しか見ないので、系列の順番を入れ替えても、各位置の出力は(入れ替わるだけで)変わりません。「3 8 2」と「2 8 3」が区別できないと、語順の意味が失われます。そこで、埋め込みに、位置ごとに決まったベクトル(Positional Encoding)を足します。原著論文は、次のサインとコサインの値を使います。
は位置(pos)、 は次元の番号で、 をまとめて計算したものを inv_freq とします。次元が小さいほど速く変化する波(波長 )、大きいほどゆっくり変化する波(波長 )になり、時計の秒針・分針・時針のように、位置を複数の周期の組み合わせで表します。論文は、ずらす量 を決めると が の線形変換で書けるので、相対的な位置の関係を学びやすいと考えて、この形を選びました。学習する位置埋め込みでも、精度はほぼ同じだったと報告しています。
(図は、diagram-designで作成)
位置の表し方には、その後、Attention の内積の中で Query と Key を位置に応じて回転させる RoPE などが提案されています(RoPE の記事、画像の2次元に広げた 2D RoPE の記事)。
次のコードで、この位置エンコーディングを計算して埋め込みに足すモジュールを実装し、位置エンコーディングどうしの内積が位置の差だけで決まるかを確かめます。値は図にもします。
import matplotlib.pyplot as plt
import japanize_matplotlib


class PositionalEncoding(nn.Module):
    """PE(pos, 2i) = sin(pos / 10000^{2i/d_model})、PE(pos, 2i+1) = cos(pos / 10000^{2i/d_model}) を埋め込みに足す"""

    def __init__(self, d_model, max_len=512, dropout=0.1):
        super().__init__()
        pos = torch.arange(max_len).unsqueeze(1)                              # (max_len, 1)
        inv_freq = torch.exp(torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model))  # 1 / 10000^{2i/d_model}
        pe = torch.zeros(max_len, d_model)
        pe[:, 0::2] = torch.sin(pos * inv_freq)                               # 偶数番目の次元
        pe[:, 1::2] = torch.cos(pos * inv_freq)                               # 奇数番目の次元
        self.register_buffer("pe", pe, persistent=False)                      # 学習しない値
        self.dropout = nn.Dropout(dropout)

    def forward(self, x):                                                     # x: (B, L, d_model)
        return self.dropout(x + self.pe[: x.size(1)])


pe = PositionalEncoding(d_model=64, dropout=0.0).pe
print("位置エンコーディングの形:", tuple(pe.shape))
for a, b in [(10, 13), (30, 33), (10, 20), (30, 40)]:
    print(f"PE({a}) と PE({b}) の内積(距離 {b - a}): {pe[a] @ pe[b]:.3f}")

plt.figure(figsize=(8, 3.5))
plt.imshow(pe[:50].T, aspect="auto", cmap="RdBu", vmin=-1, vmax=1)
plt.xlabel("位置 pos")
plt.ylabel("次元")
plt.colorbar()
plt.title("Sinusoidal Positional Encoding(d_model = 64、位置 0〜49)")
plt.tight_layout()
plt.show()
位置エンコーディングを計算して、埋め込みに足すモジュールです。
- inv_freq: 式の を、 について並べたものです。torch.arange(0, d_model, 2) が にあたり、 を と対数を通して計算しています。べき乗を直接計算しても、同じ値になります。
- pe[:, 0::2]・pe[:, 1::2]: pos * inv_freq は、(512, 1)と(32,)のブロードキャストで(512, 32)になり、各位置・各周波数の角度です。そのサインを偶数番目の次元に、コサインを奇数番目の次元に入れます。
- register_buffer: 位置エンコーディングは学習しない値なので、パラメータではなくバッファとして持たせます。モデルを GPU に移すと一緒に移ります。persistent=False にして、保存する重みには含めません。毎回同じ計算で作れるからです。
- max_len=512: 前もって計算しておく位置の数です。使う系列の長さ以上であれば結果は変わらないので、余裕を持たせて 512 にしています。
- forward: 入力の長さ の分だけ self.pe[: x.size(1)] を切り出して足します。(, 64)は、(B, , 64)にブロードキャストされ、バッチのすべての系列に同じ位置のベクトルが足されます。原著論文と同じく、足した後に Dropout をかけます。
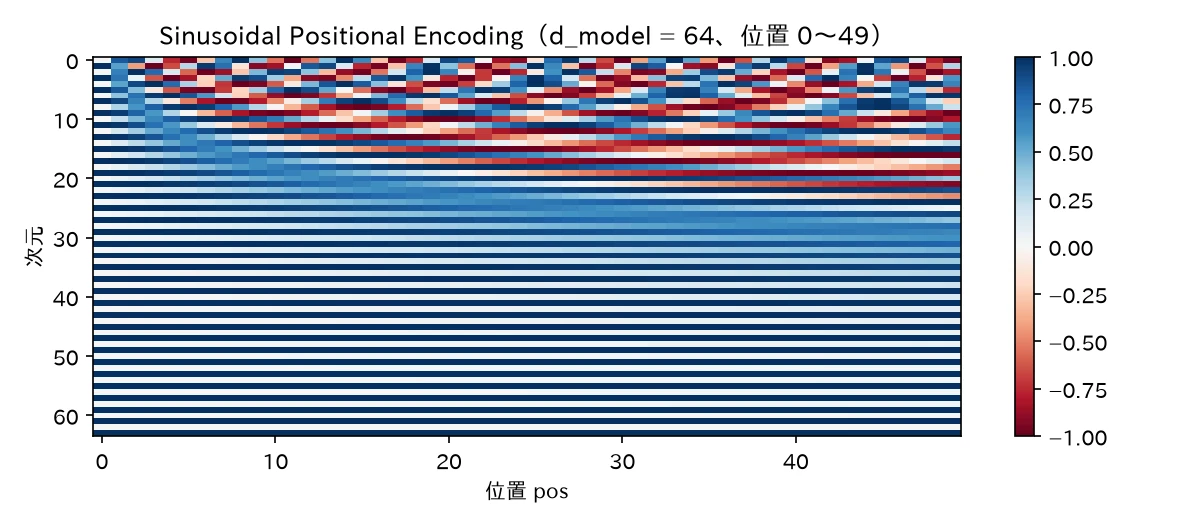
- 確かめ: 距離が同じ2組(10と13、30と33)と(10と20、30と40)で、位置エンコーディングどうしの内積を比べます。図は、位置 0〜49 の値を、横軸を位置、縦軸を次元にして色で表したものです。
実行結果
位置エンコーディングの形: (512, 64)
PE(10) と PE(13) の内積(距離 3): 25.587
PE(30) と PE(33) の内積(距離 3): 25.587
PE(10) と PE(20) の内積(距離 10): 21.052
PE(30) と PE(40) の内積(距離 10): 21.052
- 内積は、距離だけで決まる: 距離3の組は、位置が10からでも30からでも、内積が 25.587 で同じでした。距離10の組も 21.052 で同じです。
- 同じ周波数 のサインとコサインの組について、 が成り立つので、内積は になり、位置の差 だけで決まります。同じ位置どうしなら、32個の の和で32です。距離が離れるほど、内積は小さくなる傾向があります。
- これは、位置エンコーディングの値そのものの性質です。モデルの Attention は、埋め込みに足した後のベクトルを線形変換して内積を取るので、相対位置だけを見るとは限りません。Attention の内積が相対位置だけで決まるように作り直したのが、RoPE です。
- 図の見方: 上の方の次元(番号が小さい)は、位置が1つ進むたびに色が大きく変わる、速い波です。下の方の次元ほどゆっくり変わり、番号40以降は、位置 0〜49 の範囲ではほとんど変わりません(サインの次元は0付近、コサインの次元は1付近)。速い波で近くの位置を、遅い波で遠くの位置を区別する仕組みです。
FeedForward と EncoderBlock・DecoderBlock
FeedForward(Position-wise Feed-Forward Network)は、各位置のベクトルに、同じ2層の全結合を別々にかけます。
Attention が位置の間で情報を混ぜるのに対し、FFN は、位置ごとに、集めた情報を非線形に変換します。中間の次元 (d_ff)は、原著論文では の4倍(512 に対して 2048)です。
(図は、diagram-designで作成)
残差接続と LayerNorm: Attention と FFN の各サブレイヤーの出力は、入力 に足してから、LayerNorm で正規化します。
残差接続があると、各サブレイヤーは「入力をどれだけ変えるか」だけを学べばよく、層を重ねても勾配が入力側まで伝わります。LayerNorm は、各位置のベクトルを、その位置の中で平均0・分散1にそろえて、層を重ねても値の大きさが崩れないようにします。原著論文は、足した後に正規化する、この形(Post-LN)です。
3種類の Attention: Encoder と Decoder のブロックでは、同じ Multi-Head Attention を、Q・K・V を作る系列とマスクを変えて、3通りに使います。
(図は、diagram-designで作成)
- ① Encoder の Self-Attention: 入力の系列どうしで、前後のすべての位置を見ます。
- ② Decoder の Masked Self-Attention: 出力済みのトークンどうしで、自分以前の位置だけを見ます。
- ③ Cross-Attention: Decoder 側の各位置が、入力(memory)のどこを見るかを決めます。翻訳なら、訳語と原文の単語の対応にあたります。後の実験で、この重みを図にします。
次のコードで、FeedForward と、Encoder・Decoder の1ブロック分を実装し、ブロックを通しても形が変わらないことを確かめます。
class FeedForward(nn.Module):
    """FFN(x) = max(0, x W1 + b1) W2 + b2:位置ごとに同じ2層の全結合を、別々にかける"""

    def __init__(self, d_model, d_ff, dropout=0.1):
        super().__init__()
        self.net = nn.Sequential(nn.Linear(d_model, d_ff), nn.ReLU(), nn.Dropout(dropout), nn.Linear(d_ff, d_model))

    def forward(self, x):                                                     # (B, L, d_model) → (B, L, d_model)
        return self.net(x)


class EncoderBlock(nn.Module):
    """Self-Attention と FFN の2つのサブレイヤー。それぞれ LayerNorm(x + Dropout(Sublayer(x)))"""

    def __init__(self, d_model, num_heads, d_ff, dropout=0.1):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.ffn = FeedForward(d_model, d_ff, dropout)
        self.norm1, self.norm2 = nn.LayerNorm(d_model), nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, x, src_mask):
        x = self.norm1(x + self.dropout(self.self_attn(x, x, x, src_mask)))   # (a) 入力の系列どうしで注意
        return self.norm2(x + self.dropout(self.ffn(x)))                      # (b) 位置ごとの FFN


class DecoderBlock(nn.Module):
    """Masked Self-Attention・Cross-Attention・FFN の3つのサブレイヤー"""

    def __init__(self, d_model, num_heads, d_ff, dropout=0.1):
        super().__init__()
        self.self_attn = MultiHeadAttention(d_model, num_heads)
        self.cross_attn = MultiHeadAttention(d_model, num_heads)
        self.ffn = FeedForward(d_model, d_ff, dropout)
        self.norm1, self.norm2, self.norm3 = nn.LayerNorm(d_model), nn.LayerNorm(d_model), nn.LayerNorm(d_model)
        self.dropout = nn.Dropout(dropout)

    def forward(self, y, memory, src_mask, tgt_mask):
        y = self.norm1(y + self.dropout(self.self_attn(y, y, y, tgt_mask)))            # (a) 出力済みのトークンだけに注意
        y = self.norm2(y + self.dropout(self.cross_attn(y, memory, memory, src_mask)))  # (b) Q は出力側、K・V は Encoder の出力
        return self.norm3(y + self.dropout(self.ffn(y)))                              # (c) 位置ごとの FFN


enc_block, dec_block = EncoderBlock(64, 2, 256), DecoderBlock(64, 2, 256)
memory = enc_block(torch.randn(2, 7, 64), src_mask=None)
print("EncoderBlock の出力:", tuple(memory.shape))
print("DecoderBlock の出力:", tuple(dec_block(torch.randn(2, 5, 64), memory, None, None).shape))
print("パラメータ数: EncoderBlock", sum(p.numel() for p in enc_block.parameters()),
      " DecoderBlock", sum(p.numel() for p in dec_block.parameters()))
FeedForward と、Encoder・Decoder の1ブロック分を実装するコードです。
- FeedForward: 64 → 256 → ReLU → 64 の2層の全結合です。nn.Linear は最後の軸だけにかかるので、(B, , 64)の入力に対して、位置ごとに同じ重みの全結合が別々にかかります。式の です。中間の Dropout は、論文には書かれていませんが、公開されている実装でよく使われる形にならったものです。
- EncoderBlock: (a) Self-Attention と (b) FFN の2つのサブレイヤーです。どちらも、norm(x + dropout(sublayer(x))) の形で、式の に、原著論文と同じくサブレイヤーの出力への Dropout を加えたものです。
- Self-Attention には、self_attn(x, x, x, src_mask) と、Query・Key・Value のすべてに同じ x を渡します。src_mask は、入力の PAD に注意を向けないための Padding Mask です。
- DecoderBlock: 3つのサブレイヤーです。
- (a) Masked Self-Attention: 出力側の系列 y どうしの Attention で、tgt_mask(Causal Mask と Padding Mask)で、未来の位置と PAD を隠します。
- (b) Cross-Attention: Query は (a) の出力 y、Key と Value は Encoder の出力 memory です。マスクには、Encoder 側の PAD を隠す src_mask を使います。Key が Encoder 側なので、マスクも Encoder 側の系列に合わせます。
- (c) FFN: Encoder と同じです。
- (a) を (b) より先に置くのは、まず出力済みのトークンから「次に何が必要か」をまとめ、それを Query にして入力を探すためです。
- 確かめ: 長さ7の入力を EncoderBlock に通して memory を作り、長さ5の出力側の系列と一緒に DecoderBlock に通します。ここではマスクを使わない(None)で、形だけを確かめます。
実行結果
EncoderBlock の出力: (2, 7, 64)
DecoderBlock の出力: (2, 5, 64)
パラメータ数: EncoderBlock 49984  DecoderBlock 66752
- 形は変わらない: どちらのブロックも、入力と同じ(B, , 64)を出力しました。残差接続で入力に足すために、各サブレイヤーは入力と同じ形を返す必要があり、ブロックを何回重ねても形は同じです。
- パラメータ数: EncoderBlock は、Multi-Head Attention(16,640)、FFN()、LayerNorm 2つ()で 49,984 個です。DecoderBlock は、Multi-Head Attention が2つと LayerNorm が3つなので、66,752 個です。
マスクとモデル全体、テンソルの形の追跡
Attention の重みを、特定の位置について0にするのがマスクです。softmax の前に、その位置の値を にすると、 なので重みが0になります。
- Padding Mask: 長さの違う系列をまとめて計算するため、短い系列の後ろを PAD という詰め物のトークンで埋めます。PAD は意味を持たないので、Key としての PAD に注意を向けないようにします。
- Causal Mask(Look-ahead Mask): Decoder の学習では、正解の出力系列をまとめて入れ、すべての位置の「次のトークン」を一度に予測させます。このとき、位置 が 以降の正解を見られると、答えを写すだけになってしまいます。そこで、位置 からは 以前だけを見られるように、下三角の形のマスクをかけます。生成のときは未来のトークンがまだないので、学習と生成で同じ条件になります。
(図は、diagram-designで作成)
埋め込みと出力層の重みの共有: 原著論文は、入力の埋め込み・出力側の埋め込み・最後の線形層(generator)の3か所で、(語彙数, ) の重み行列を1つ共有します。埋め込みは ID の行を取り出し、generator は Decoder の出力と各行の内積でトークンごとのスコアを出すので、同じ行列を「トークンの意味を表すベクトル」として、読むときと書くときに使い回せます。本記事も、入力と出力が同じ語彙(数字と特別なトークン)なので、同じように共有します。
(図は、diagram-designで作成)
次のコードで、2つのマスクを作る関数と、部品を組み合わせたモデル全体を実装し、入力のトークン列が次のトークンのロジットになるまでの形の変化を、主な部品ごとに表示します。
PAD, BOS, EOS = 0, 1, 2                                                       # 特別なトークンの ID。数字 0〜9 は 3〜12


def make_src_mask(src):
    """Padding Mask:PAD のキーに注意を向けない。(B, 1, 1, L_src) で、全ヘッド・全クエリに同じものを使う"""
    return (src != PAD)[:, None, None, :]


def make_tgt_mask(tgt):
    """Padding Mask と Causal Mask の両方が True の位置だけ注意できる。(B, 1, L_tgt, L_tgt)"""
    L = tgt.size(1)
    causal = torch.tril(torch.ones(L, L, dtype=torch.bool, device=tgt.device))  # 下三角:自分と前の位置だけ
    return (tgt != PAD)[:, None, None, :] & causal


class Transformer(nn.Module):
    def __init__(self, vocab_size, d_model=64, num_heads=2, num_layers=2, d_ff=256, dropout=0.1):
        super().__init__()
        self.d_model = d_model
        self.src_embed = nn.Embedding(vocab_size, d_model)
        self.tgt_embed = nn.Embedding(vocab_size, d_model)
        self.pos_enc = PositionalEncoding(d_model, dropout=dropout)
        self.encoder = nn.ModuleList([EncoderBlock(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
        self.decoder = nn.ModuleList([DecoderBlock(d_model, num_heads, d_ff, dropout) for _ in range(num_layers)])
        self.generator = nn.Linear(d_model, vocab_size)                       # 次のトークンのロジット
        # 原著論文と同じく、2つの埋め込みと出力層で、(語彙数, d_model) の重み行列を1つ共有する
        self.src_embed.weight = self.generator.weight
        self.tgt_embed.weight = self.generator.weight

    def encode(self, src, src_mask):                                          # src: (B, L_src) → (B, L_src, d_model)
        x = self.pos_enc(self.src_embed(src) * math.sqrt(self.d_model))
        for block in self.encoder:
            x = block(x, src_mask)
        return x

    def decode(self, tgt, memory, src_mask, tgt_mask):                        # tgt: (B, L_tgt) → (B, L_tgt, d_model)
        y = self.pos_enc(self.tgt_embed(tgt) * math.sqrt(self.d_model))
        for block in self.decoder:
            y = block(y, memory, src_mask, tgt_mask)
        return y

    def forward(self, src, tgt):                                              # → (B, L_tgt, vocab_size)
        src_mask, tgt_mask = make_src_mask(src), make_tgt_mask(tgt)
        memory = self.encode(src, src_mask)
        return self.generator(self.decode(tgt, memory, src_mask, tgt_mask))


# 形の追跡:主な部品の出力の形を、forward フックで表示する
model = Transformer(vocab_size=13)
src = torch.tensor([[6, 11, 5, 8, 0, 0], [4, 9, 3, 12, 7, 10]])              # 2文。1文目は長さ4で、PAD を2つ詰めている
tgt = torch.tensor([[1, 8, 5, 11, 6, 0, 0], [1, 10, 7, 12, 3, 9, 4]])        # BOS で始め、正解を1つ右にずらした入力
names = ["src_embed", "pos_enc", "encoder.0", "encoder.1", "tgt_embed", "decoder.0.self_attn",
         "decoder.0.cross_attn", "decoder.0", "decoder.1", "generator"]
modules = dict(model.named_modules())
hooks = [modules[n].register_forward_hook(lambda m, i, o, n=n: print(f"{n:22s} {tuple(o.shape)}")) for n in names]
logits = model(src, tgt)
for h in hooks:
    h.remove()
print("Cross-Attention の重み:", tuple(model.decoder[0].cross_attn.attn_weights.shape))
print("1文目の Causal + Padding Mask:\n", make_tgt_mask(tgt)[0, 0].int())
print("パラメータ数:", sum(p.numel() for p in model.parameters()))
部品を組み合わせてモデル全体を作り、主な部品の出力の形を表示するコードです。
- 特別なトークン: PAD(0)は長さをそろえる詰め物、BOS(1)は Decoder の入力の先頭に置く「生成の開始」、EOS(2)は「生成の終わり」です。数字 0〜9 は、ID 3〜12 に当てます。語彙は全部で13個です。
- make_src_mask: 入力が PAD でない位置を True にした(B, 1, 1, )のマスクです。2つの1の軸は、ヘッドと Query の軸で、ブロードキャストにより、すべてのヘッド・すべての Query に同じ「PAD の Key を見ない」が使われます。
- make_tgt_mask: torch.tril で作った下三角の Causal Mask(, )と、出力側の Padding Mask(B, 1, 1, )の論理積です。両方が True の位置、つまり「自分以前で、かつ PAD でない」位置だけに注意を向けられます。
- Transformer:
- 埋め込み: 入力用 src_embed と出力用 tgt_embed の2つです。原著論文と同じく、埋め込みに (ここでは8)をかけてから、位置エンコーディングを足します。位置エンコーディングの値は −1〜1 なので、埋め込みの値の大きさをそれと釣り合わせるためです。
- 重みの共有: self.src_embed.weight = self.generator.weight のように代入すると、2つの埋め込みと generator が、同じ (13, 64) の Parameter を指します。どこから勾配が来ても、1つの行列が更新されます。初期値は generator の nn.Linear の既定(±1/√64 = ±0.125 の一様分布)なので、埋め込みに √64 = 8 をかけると ±1 になり、−1〜1 の位置エンコーディングと大きさがそろいます。
- encode・decode: Encoder と Decoder を別のメソッドに分けています。生成のときは、Encoder を1回だけ計算し、Decoder だけを1トークンごとに何度も呼ぶためです。
- nn.ModuleList: ブロックをリストにして、for で順に通します。ふつうの Python のリストに入れると、パラメータがモデルに登録されず、学習されません。
- forward: 学習で使う、正解の出力系列をまとめて入れる計算です。出力は(B, , 13)で、すべての位置の「次のトークン」のロジットを一度に出します。
- 形の追跡: register_forward_hook は、モジュールの forward が終わるたびに呼ばれる関数を登録します。ここでは、出力の形を表示する関数を、主な部品に付けます。モデルのコードに print を書き足さずに中を覗けるのが利点で、確かめ終わったら remove() で外します。
- lambda m, i, o, n=n: の n=n は、ループの変数 n の、その時点の値を関数に覚えさせるための書き方です。これがないと、すべての関数が、ループが終わった後の最後の名前(generator)を表示してしまいます。
- 入力の例: 2文をまとめたバッチです。1文目は、入力が数字
[3, 8, 2, 5](ID 6, 11, 5, 8)で、2文目(長さ6)に合わせて PAD を2つ詰めています。出力側の tgt は、BOS の後に正解(逆順)を並べたものです。
実行結果
src_embed              (2, 6, 64)
pos_enc                (2, 6, 64)
encoder.0              (2, 6, 64)
encoder.1              (2, 6, 64)
tgt_embed              (2, 7, 64)
pos_enc                (2, 7, 64)
decoder.0.self_attn    (2, 7, 64)
decoder.0.cross_attn   (2, 7, 64)
decoder.0              (2, 7, 64)
decoder.1              (2, 7, 64)
generator              (2, 7, 13)
Cross-Attention の重み: (2, 2, 7, 6)
1文目の Causal + Padding Mask:
 tensor([[1, 0, 0, 0, 0, 0, 0],
        [1, 1, 0, 0, 0, 0, 0],
        [1, 1, 1, 0, 0, 0, 0],
        [1, 1, 1, 1, 0, 0, 0],
        [1, 1, 1, 1, 1, 0, 0],
        [1, 1, 1, 1, 1, 0, 0],
        [1, 1, 1, 1, 1, 0, 0]], dtype=torch.int32)
パラメータ数: 234317
- 形の流れ: 入力の(2, 6)は、埋め込みで(2, 6, 64)になり、Encoder の2つのブロックを通っても(2, 6, 64)のままです。出力側の(2, 7)も、埋め込みから Decoder の最後まで(2, 7, 64)で、最後の generator で語彙の数の(2, 7, 13)になります。
- pos_enc が2回出てくるのは、Encoder と Decoder で、同じ位置エンコーディングのモジュールを使っているからです。
- Decoder の中の Cross-Attention の出力も(2, 7, 64)で、Key・Value の長さ(6)ではなく、Query である出力側の長さ(7)になっています。
- Cross-Attention の重み: (2, 2, 7, 6)で、Decoder の7つの位置それぞれが、入力の6つの位置への重みを、2つのヘッドごとに持っています。
- マスク: 1文目の出力側は、BOS と4つの数字の5トークンで、後ろの2つは PAD です。
- 1〜5行目は下三角で、 番目の位置からは、 番目以前だけを見られます。
- 6・7行目(PAD の位置)は、5列目までが1です。PAD の位置からの予測は損失に入れないので、この行の値は結果に影響しません。PAD の列(6・7列目)は、すべての行で0になっています。
- パラメータ数: 合わせて 234,317 個です。内訳は、共有の重み行列()と generator のバイアス(13)、EncoderBlock 2つ(99,968)、DecoderBlock 2つ(133,504)です。重みを共有しなければ、埋め込み2つの分(1,664)が増えて 235,981 個になります。原著論文の base モデル(約6,500万)の、約280分の1です。
実験:数字の列を逆に並べるタスクを学習する
実装したモデルを、入力の数字の列を逆の順に並べて出力するタスクで学習します。たとえば、入力 [3, 8, 2, 5] に対して [5, 2, 8, 3] を出力します。
このタスクを選んだのは、出力の 番目が「入力の後ろから 番目」という決まった位置にあり、Cross-Attention がどこを見るべきかが前もってわかるからです。学習がうまくいけば、Cross-Attention の重みは、入力の後ろから前へと動く斜めの線になるはずです。また、正解が1つに決まるので、生成した系列が正解と完全に一致した割合(完全一致率)で、素直に評価できます。
論文の設定との違い
原著論文の base モデルと、本記事の設定を比べます。
| 項目 | 論文(base モデル) | 本記事 |
|---|---|---|
| タスク・データ | 英独翻訳(WMT 2014、約450万の文の組) | 数字の列の反転(1万件) |
| 層の数 | 6 | 2 |
| 512 | 64 | |
| 2048 | 256 | |
| ヘッドの数 () | 8(64) | 2(32) |
| Dropout | 0.1 | 0.1 |
| Label Smoothing | 0.1 | 使わない |
| 埋め込みと出力層の重み | 2つの埋め込みと出力層で共有 | 同じ |
| 最適化 | Adam(、、) | 同じ |
| ウォームアップ | 4,000 ステップ | 400 ステップ |
| 学習の長さ | 10万ステップ | 3,140 ステップ(20エポック) |
| バッチ | 入力・出力それぞれ約25,000トークン | 64系列 |
| パラメータ数 | 約6,500万 | 約23万 |
| 計算 | P100 GPU 8枚で約12時間 | CPU で約2分 |
- モデルの大きさ: 語彙が13個、系列の長さが10以下のタスクなので、層の数・次元・ヘッドの数を小さくし、CPU で数分で学習できる大きさにしました。 は、論文と同じく の4倍です。
- Label Smoothing: 正解の確率を 0.9 にして、残りを他のトークンに分ける正則化です。翻訳のように言い換えの多いタスクでは精度が上がりますが、本記事のタスクは正解が1つに決まるので使いません。使うと損失が0に近づかなくなり、学習の進み具合を損失で読みにくくなるためでもあります。
- ウォームアップ: 論文の4,000ステップは、学習全体の10万ステップの4%です。本記事の学習は全部で3,140ステップなので、4,000 にすると、学習の終わりまで学習率が上がり続けてしまいます。そこで、400 にしました。
データ
次のコードで、学習とテストのデータを作ります。作り方は次のとおりです。
- 長さ 3〜10 の数字の列をでたらめに作り、重複なしで11,000個集める(make_reverse_data)
- それぞれを逆に並べた列と組にし、1万件を学習、1,000件をテストに分ける
- 数字を ID にし、Decoder の入力 tgt_in(BOS + 正解)と、予測の正解 tgt_out(正解 + EOS)を作って、PAD で長さをそろえる(to_batch)
長さをばらつかせたのは、PAD でそろえる処理と Padding Mask が実際に効くようにするためです。
import random


def make_reverse_data(n, min_len=3, max_len=10, seed=0):
    """数字 0〜9 の系列(長さ min_len〜max_len)と、それを逆に並べた系列の組を、重複なしで n 個作る"""
    rng = random.Random(seed)
    seqs = set()
    while len(seqs) < n:
        seqs.add(tuple(rng.randint(0, 9) for _ in range(rng.randint(min_len, max_len))))
    seqs = sorted(seqs)
    rng.shuffle(seqs)
    return [(list(s), list(reversed(s))) for s in seqs]


def to_batch(pairs):
    """数字を ID(+3)にし、PAD で長さをそろえる。tgt_in は BOS + 正解、tgt_out は 正解 + EOS"""
    src = [[d + 3 for d in s] for s, _ in pairs]
    tgt_in = [[BOS] + [d + 3 for d in t] for _, t in pairs]
    tgt_out = [[d + 3 for d in t] + [EOS] for _, t in pairs]
    pad = lambda rows: torch.tensor([r + [PAD] * (max(map(len, rows)) - len(r)) for r in rows])
    return pad(src), pad(tgt_in), pad(tgt_out)


pairs = make_reverse_data(11000)
train_pairs, test_pairs = pairs[:10000], pairs[10000:]                        # 重複なしで作ったので、テストの系列は学習に出てこない
print("学習:", len(train_pairs), "テスト:", len(test_pairs))
print("例:", train_pairs[0])
src, tgt_in, tgt_out = to_batch(train_pairs[:2])
print("src:\n", src, "\ntgt_in:\n", tgt_in, "\ntgt_out:\n", tgt_out)
学習とテストのデータを作るコードです。
- make_reverse_data: 長さ min_len〜max_len の数字の列をでたらめに作り、それを逆に並べた列と組にします。
- set に入れて重複を除くのは、学習とテストに同じ系列が入らないようにするためです。11,000個を重複なしで作ってから分けるので、テストの系列は、学習で一度も見ていないものになります。長さ3の系列は 通りしかないので、重複を除かないと、テストに学習と同じ系列が混ざりやすくなります。
- sorted してから並べ替えるのは、set の並び順が実行ごとに変わりうるので、シードを固定したときに同じデータになるようにするためです。
- 長さ 3〜10 は、PAD でそろえる処理と Padding Mask が効く程度に長さがばらつき、CPU で数分で学習できる範囲にしたものです。後で、学習にない長さ(11以上)も試します。
- to_batch: 系列の組のリストを、モデルに入れるテンソルにします。
- src: 入力の数字を ID(数字 + 3)にしたものです。
- tgt_in: Decoder に入れる系列で、先頭に BOS を付けた正解です。
- tgt_out: 予測の正解で、正解の後ろに EOS を付けたものです。tgt_in を1つ左にずらした形になっていて、Decoder の位置 の出力が、tgt_out の位置 (= 次のトークン)を当てるように学習します。この「正解を1つずらして入れる」学習を、Teacher Forcing と呼びます。
- pad: バッチの中で一番長い系列に合わせて、後ろを PAD(0)で埋めます。
実行結果
学習: 10000 テスト: 1000
例: ([9, 8, 5, 8], [8, 5, 8, 9])
src:
 tensor([[12, 11,  8, 11,  0,  0,  0],
        [ 6, 11,  8,  4,  6,  9,  3]])
tgt_in:
 tensor([[ 1, 11,  8, 11, 12,  0,  0,  0],
        [ 1,  3,  9,  6,  4,  8, 11,  6]])
tgt_out:
 tensor([[11,  8, 11, 12,  2,  0,  0,  0],
        [ 3,  9,  6,  4,  8, 11,  6,  2]])
- データの数: 学習が10,000件、テストが1,000件です。
- ずらした形: 1つ目の例
[9, 8, 5, 8]の正解は[8, 5, 8, 9]で、ID にすると[11, 8, 11, 12]です。tgt_in は先頭に BOS(1)を付けた[1, 11, 8, 11, 12]、tgt_out は後ろに EOS(2)を付けた[11, 8, 11, 12, 2]で、1つずれています。バッチの2文目(長さ7)に合わせて、1文目の後ろは PAD(0)で埋まっています。
自己回帰生成と評価の関数
次のコードで、学習したモデルで系列を1トークンずつ生成する関数と、生成した系列が正解と完全に一致した割合(完全一致率)を測る関数を作ります。生成は、各ステップで、それまでに出したトークン と入力 から、確率が最大のトークンを選ぶ貪欲法です。
学習と生成では、Decoder への入れ方が違います。学習では、正解を1つずらした系列をまとめて入れて、すべての位置を一度に予測します(Teacher Forcing)。生成では正解がないので、自分が出したトークンを後ろにつなげながら、1トークンずつ予測します。
(図は、diagram-designで作成)
@torch.no_grad()
def greedy_decode(model, src, max_len):
    """BOS から始め、各ステップで確率が最大のトークンを1つずつ足していく(自己回帰生成)"""
    model.eval()
    src_mask = make_src_mask(src)
    memory = model.encode(src, src_mask)                                      # Encoder は1回だけ計算する
    ys = torch.full((src.size(0), 1), BOS, dtype=torch.long, device=src.device)
    for _ in range(max_len):
        logits = model.generator(model.decode(ys, memory, src_mask, make_tgt_mask(ys)))  # (B, L_ys, vocab)
        next_token = logits[:, -1].argmax(-1, keepdim=True)                   # 最後の位置の予測だけを使う
        ys = torch.cat([ys, next_token], dim=1)
        if (ys == EOS).any(dim=1).all():                                      # 全員が EOS を出したら終える
            break
    return ys[:, 1:]                                                          # BOS を除く


def to_digits(ids):
    """EOS の手前までを数字の列に戻す"""
    out = []
    for i in ids.tolist():
        if i == EOS:
            break
        out.append(i - 3)
    return out


def exact_match(model, pairs, device, batch_size=500):
    """生成した系列が正解と完全に一致した割合"""
    hits = 0
    for i in range(0, len(pairs), batch_size):
        chunk = pairs[i:i + batch_size]
        src, _, _ = to_batch(chunk)
        pred = greedy_decode(model, src.to(device), max_len=src.size(1) + 1)  # 正解の長さ + EOS まで生成できれば足りる
        hits += sum(to_digits(p) == t for p, (_, t) in zip(pred.cpu(), chunk))
    return hits / len(pairs)
学習したモデルで系列を生成し、正解と比べる関数です。
- greedy_decode: 自己回帰生成のループです。
- Encoder は1回: 入力の系列は生成の間に変わらないので、memory は最初に1回だけ計算し、使い回します。
- 1トークンずつ足す: BOS だけの系列 ys から始め、Decoder に通して、最後の位置のロジット logits[:, -1] で一番大きいトークンを選び(貪欲法)、ys の後ろにつなげます。次のステップでは、伸びた ys 全体をもう一度 Decoder に通します。
- 毎回すべての位置を計算し直す理由: Decoder の Self-Attention は、各位置が前の位置を見るので、新しいトークンを足すと、最後の位置の計算に前のすべての位置が必要です。ここでは、わかりやすさを優先して、毎ステップ ys 全体を計算し直しています。前のステップの Key と Value を保存して使い回し、新しい位置だけを計算するのが、KV キャッシュと呼ばれる高速化です。
- 終わり方: バッチのすべての系列が EOS を出したら、ループを抜けます。上限 max_len は、EOS を出さないときにも止まるためのものです。
- @torch.no_grad() は、生成では勾配が要らないので、計算グラフを作らずにメモリと時間を節約するためです。model.eval() で Dropout を止め、毎回同じ結果になるようにします。
- to_digits: 生成した ID の列を、最初の EOS の手前で切り、数字に戻します。EOS の後ろに出たトークンは無視します。
- exact_match: 系列を500件ずつ生成し、正解と完全に一致した割合を返します。
- max_len=src.size(1) + 1 は、反転した系列の長さが入力と同じなので、「入力の長さ + EOS」まで生成できれば足りるからです。バッチの中で一番長い入力に合わせています。
学習
次のコードで、モデルを作り、原著論文の学習率のスケジュールで学習します。エポックごとに、テストの1,000件で完全一致率を測ります。学習率は、(64)、ステップ数 、ウォームアップのステップ数 (warmup)から、次の式で決めます。
、 のとき、学習率は次の図のように変わります。
(図は、diagram-designで作成)
損失は、PAD を除いたすべての位置 での、正解のトークン の確率の対数の平均を、符号を反対にした交差エントロピーです。
import time

device = "cuda" if torch.cuda.is_available() else "cpu"
torch.manual_seed(0)
model = Transformer(vocab_size=13, d_model=64, num_heads=2, num_layers=2, d_ff=256, dropout=0.1).to(device)

# 原著論文の学習率の式:lrate = d_model^-0.5 × min(step^-0.5, step × warmup^-1.5)
warmup = 400
optimizer = torch.optim.Adam(model.parameters(), lr=1.0, betas=(0.9, 0.98), eps=1e-9)
scheduler = torch.optim.lr_scheduler.LambdaLR(
    optimizer, lambda step: 64 ** -0.5 * min((step + 1) ** -0.5, (step + 1) * warmup ** -1.5))
criterion = nn.CrossEntropyLoss(ignore_index=PAD)                             # PAD の位置は損失に入れない

batch_size, epochs = 64, 20
history = []
start = time.time()
for epoch in range(1, epochs + 1):
    model.train()
    random.Random(epoch).shuffle(train_pairs)
    total, count = 0.0, 0
    for i in range(0, len(train_pairs), batch_size):
        src, tgt_in, tgt_out = (t.to(device) for t in to_batch(train_pairs[i:i + batch_size]))
        logits = model(src, tgt_in)                                           # (B, L_tgt, vocab):全位置を一度に予測
        loss = criterion(logits.reshape(-1, logits.size(-1)), tgt_out.reshape(-1))
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        scheduler.step()
        total, count = total + loss.item(), count + 1
    em = exact_match(model, test_pairs, device)
    history.append((epoch, total / count, em))
    print(f"epoch {epoch:2d}  損失 {total / count:.4f}  テストの完全一致率 {em:.3f}  ({time.time() - start:.0f}秒)")
モデルを作り、原著論文の学習率のスケジュールで学習するコードです。エポックごとに、テストの1,000件で完全一致率を測ります。
- 重みの初期化: PyTorch の既定のままにしています。原著論文は初期化の方法を書いていません。埋め込みの大きさは、重みの共有で generator の初期値(±0.125)になり、√64 をかけて ±1 と、位置エンコーディングと釣り合っています(モデル全体のコードの解説を参照)。
- 学習率のスケジュール: コードの直前に示した、原著論文の式です。
- 最初の warmup ステップは学習率を直線的に上げ、その後はステップ数の平方根に反比例して下げます。学習の初めは、Adam の勾配の統計がまだ安定しないので、小さな学習率から始めます。
- LambdaLR は、最適化の学習率(lr=1.0)に、関数の値をかけたものを使います。基準を1にしておくと、関数の値がそのまま学習率になります。step + 1 にしているのは、LambdaLR のステップ数が0から始まり、0の 乗が計算できないためです。
- 学習率の最大は、400ステップ目の です。
- Adam の設定: ・ は、原著論文の設定です。
- 損失: 交差エントロピーで、ignore_index=PAD により、正解が PAD の位置は損失に入れません。logits の(B, , 13)と tgt_out の(B, )を、reshape で(B × , 13)と(B × )にして、すべての位置をまとめて計算します。
- 学習のループ: Causal Mask があるので、正解の系列をまとめて入れても、各位置は自分より前の正解しか見ません。1回の forward で、すべての位置の「次のトークン」を同時に学習できます。RNN では1トークンずつ順に計算する必要があったところを並列にできるのが、Transformer の学習が速い理由です。
- エポックごとに random.Random(epoch) で学習データを並べ替えるのは、バッチの組み合わせを毎回変えつつ、実行するたびに同じ順番になるようにするためです。
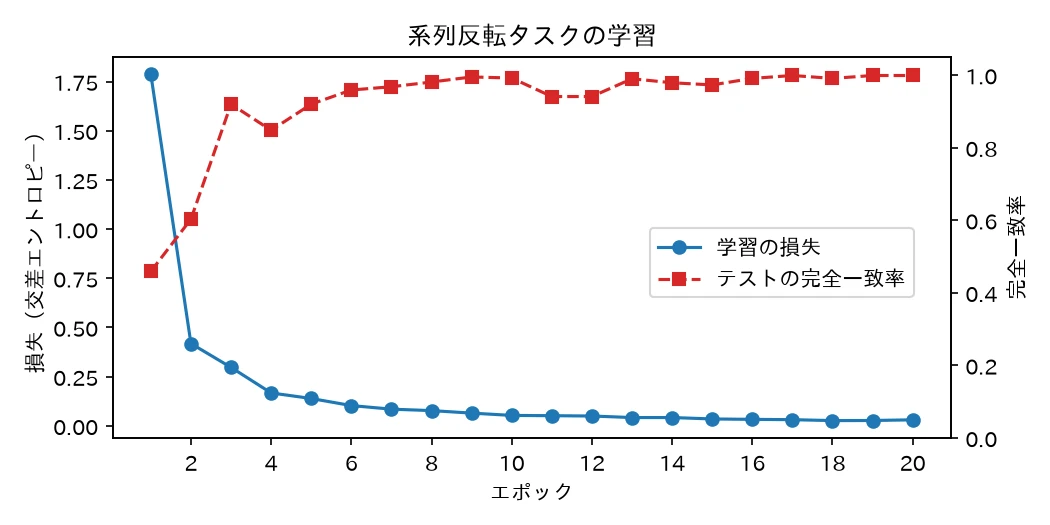
- 値: バッチサイズ64・20エポックは、1エポックが157ステップ(10,000 / 64 を切り上げ)、全体で3,140ステップになり、CPU で約2分で学習が終わる量です。テストの完全一致率は9エポック目で 0.995 になりますが、その後も上下するので、安定するかを見るために、20エポックまで回しています。
実行結果
epoch  1  損失 1.7868  テストの完全一致率 0.459  (6秒)
epoch  2  損失 0.4183  テストの完全一致率 0.603  (12秒)
epoch  3  損失 0.2971  テストの完全一致率 0.920  (18秒)
epoch  4  損失 0.1673  テストの完全一致率 0.848  (24秒)
epoch  5  損失 0.1391  テストの完全一致率 0.920  (30秒)
epoch  6  損失 0.1030  テストの完全一致率 0.959  (36秒)
epoch  7  損失 0.0848  テストの完全一致率 0.968  (43秒)
epoch  8  損失 0.0775  テストの完全一致率 0.981  (48秒)
epoch  9  損失 0.0647  テストの完全一致率 0.995  (54秒)
epoch 10  損失 0.0530  テストの完全一致率 0.992  (61秒)
epoch 11  損失 0.0516  テストの完全一致率 0.941  (67秒)
epoch 12  損失 0.0500  テストの完全一致率 0.941  (73秒)
epoch 13  損失 0.0421  テストの完全一致率 0.990  (79秒)
epoch 14  損失 0.0422  テストの完全一致率 0.979  (85秒)
epoch 15  損失 0.0351  テストの完全一致率 0.973  (90秒)
epoch 16  損失 0.0330  テストの完全一致率 0.991  (96秒)
epoch 17  損失 0.0313  テストの完全一致率 0.999  (102秒)
epoch 18  損失 0.0267  テストの完全一致率 0.991  (109秒)
epoch 19  損失 0.0272  テストの完全一致率 0.999  (115秒)
epoch 20  損失 0.0307  テストの完全一致率 0.999  (121秒)
- 損失: 1エポック目の 1.7868 から、20エポック目には 0.0307 まで下がりました。最初の損失は、13個のトークンを当てずっぽうで選んだときの より小さく、1エポックの間にも学習が進んでいます。
- 完全一致率: 1エポック目は 0.459 でしたが、3エポック目で 0.920、16エポック目以降は 0.991〜0.999 になり、最後は 0.999(1,000件中999件)でした。系列のすべてのトークンが合わないと一致にならないので、損失が小さくなっても、すぐには1になりません。
- 途中の上下: 4エポック目(0.848)や11・12エポック目(0.941)のように、一時的に下がることがあります。数十件の系列で1トークンだけ間違えても、完全一致にならないためです。学習率が下がるにつれて、上下は小さくなっています。
- 時間: 20エポックで約2分でした。
学習の推移と生成の結果
次のコードで、学習の推移を図にし、テストの系列と、学習にない長さ(11以上)の系列で生成を確かめます。
# 1. 損失と完全一致率の推移
ep, loss_hist, em_hist = zip(*history)
fig, ax1 = plt.subplots(figsize=(7, 3.5))
ax1.plot(ep, loss_hist, "o-", color="tab:blue", label="学習の損失")
ax1.set_xlabel("エポック")
ax1.set_xticks(range(2, len(ep) + 1, 2))
ax1.set_ylabel("損失(交差エントロピー)")
ax2 = ax1.twinx()
ax2.plot(ep, em_hist, "s--", color="tab:red", label="テストの完全一致率")
ax2.set_ylabel("完全一致率")
ax2.set_ylim(0, 1.05)
fig.legend(loc="center right", bbox_to_anchor=(0.88, 0.5))
plt.title("系列反転タスクの学習")
plt.tight_layout()
plt.show()

# 2. テストの系列を生成してみる
src, _, _ = to_batch(test_pairs[:5])
pred = greedy_decode(model, src.to(device), max_len=src.size(1) + 1).cpu()
for (s, t), p in zip(test_pairs[:5], pred):
    print(f"入力 {s}\n  正解 {t}\n  生成 {to_digits(p)}  {'○' if to_digits(p) == t else '×'}")

# 3. 学習に出てこない長さ(11〜14)の系列を入れると
for L in [10, 11, 12, 14]:
    longer = make_reverse_data(200, min_len=L, max_len=L, seed=L)
    src, _, _ = to_batch(longer)
    pred = [to_digits(p) for p in greedy_decode(model, src.to(device), max_len=L + 1).cpu()]
    em = sum(p == t for p, (_, t) in zip(pred, longer)) / len(longer)
    print(f"長さ {L:2d}: 完全一致率 {em:.3f}  生成した長さの平均 {sum(map(len, pred)) / len(pred):.1f}")
    if L == 12:
        print(f"  例:入力 {longer[0][0]}\n       正解 {longer[0][1]}\n       生成 {pred[0]}")
学習の推移を図にし、テストの系列と、学習にない長さの系列で生成を確かめるコードです。
- 1. 推移の図: 左の縦軸に損失、右の縦軸に完全一致率をとり、エポックごとの値を1枚に重ねます。twinx は、横軸を共有して、右側に別の縦軸を作る関数です。
- 2. テストの系列: テストの最初の5件を生成し、正解と並べて表示します。
- 3. 学習にない長さ: 学習の系列は長さ 3〜10 でした。長さ10(学習にある最長)と、11・12・14(学習にない長さ)の系列を200件ずつ作り、完全一致率と、生成した系列の長さの平均を測ります。長さ12は、1件の例も表示します。
- seed=L で長さごとに別のシードにし、学習・テストとは別の系列にしています。
実行結果
入力 [0, 8, 3, 4]
  正解 [4, 3, 8, 0]
  生成 [4, 3, 8, 0]  ○
入力 [2, 2, 3, 4, 0, 1, 2, 0, 9, 0]
  正解 [0, 9, 0, 2, 1, 0, 4, 3, 2, 2]
  生成 [0, 9, 0, 2, 1, 0, 4, 3, 2, 2]  ○
入力 [8, 5, 9, 9, 0, 0, 3, 7]
  正解 [7, 3, 0, 0, 9, 9, 5, 8]
  生成 [7, 3, 0, 0, 9, 9, 5, 8]  ○
入力 [9, 1, 7, 3, 4, 9, 3, 6, 3]
  正解 [3, 6, 3, 9, 4, 3, 7, 1, 9]
  生成 [3, 6, 3, 9, 4, 3, 7, 1, 9]  ○
入力 [9, 1, 7, 5, 3]
  正解 [3, 5, 7, 1, 9]
  生成 [3, 5, 7, 1, 9]  ○
長さ 10: 完全一致率 1.000  生成した長さの平均 10.0
長さ 11: 完全一致率 0.000  生成した長さの平均 10.0
長さ 12: 完全一致率 0.000  生成した長さの平均 10.0
  例:入力 [8, 2, 3, 7, 2, 0, 1, 7, 3, 7, 8, 2]
       正解 [2, 8, 7, 3, 7, 1, 0, 2, 7, 3, 2, 8]
       生成 [7, 3, 7, 1, 0, 2, 7, 3, 2, 8]
長さ 14: 完全一致率 0.000  生成した長さの平均 10.1
- 推移の図: 損失は最初の2エポックで急に下がり、その後はゆっくり0に近づきました。完全一致率は、3エポック目に 0.920 と、0.9 を超えています。
- テストの系列: 5件とも、正解と完全に一致しました。長さ10の
[2, 2, 3, 4, 0, 1, 2, 0, 9, 0]のように、同じ数字が何度も出てくる系列も、正しく逆に並べています。数字の値ではなく、位置をたどって並べていることがわかります。 - 学習にない長さは、まったくできない: 長さ10では完全一致率が 1.000 でしたが、長さ11以上では 0.000 でした。生成した系列の長さの平均は 10.0〜10.1 で、モデルはほぼ「10トークン出したら EOS を出す」ように学習していました。
- 長さ12の例では、生成した
[7, 3, 7, 1, 0, 2, 7, 3, 2, 8]は、正解[2, 8, 7, 3, 7, 1, 0, 2, 7, 3, 2, 8]の後ろの10個と同じです。入力の先頭から10個[8, 2, 3, 7, 2, 0, 1, 7, 3, 7]を逆に並べたもので、入力の11・12番目の8, 2を読み飛ばしています。Cross-Attention が、学習で一度も見なかった11番目以降の位置に向かなかったことがわかります。 - 原著論文は、サインとコサインの位置エンコーディングなら、学習より長い系列にも対応できるかもしれないと期待していました。しかし、この小さな実験では、学習で見たことのない位置(11番目以降)の出力を、モデルは作れませんでした。どの位置も Encoder と Decoder の両方で一度も学習していないので、位置エンコーディングの形を工夫するだけでは補えなかったと考えられます。長い系列への対応は、RoPE のような相対位置の表し方や、学習の後で位置の範囲を広げる手法の課題です(RoPE の記事)。
- 長さ12の例では、生成した
Cross-Attention の重みを見る
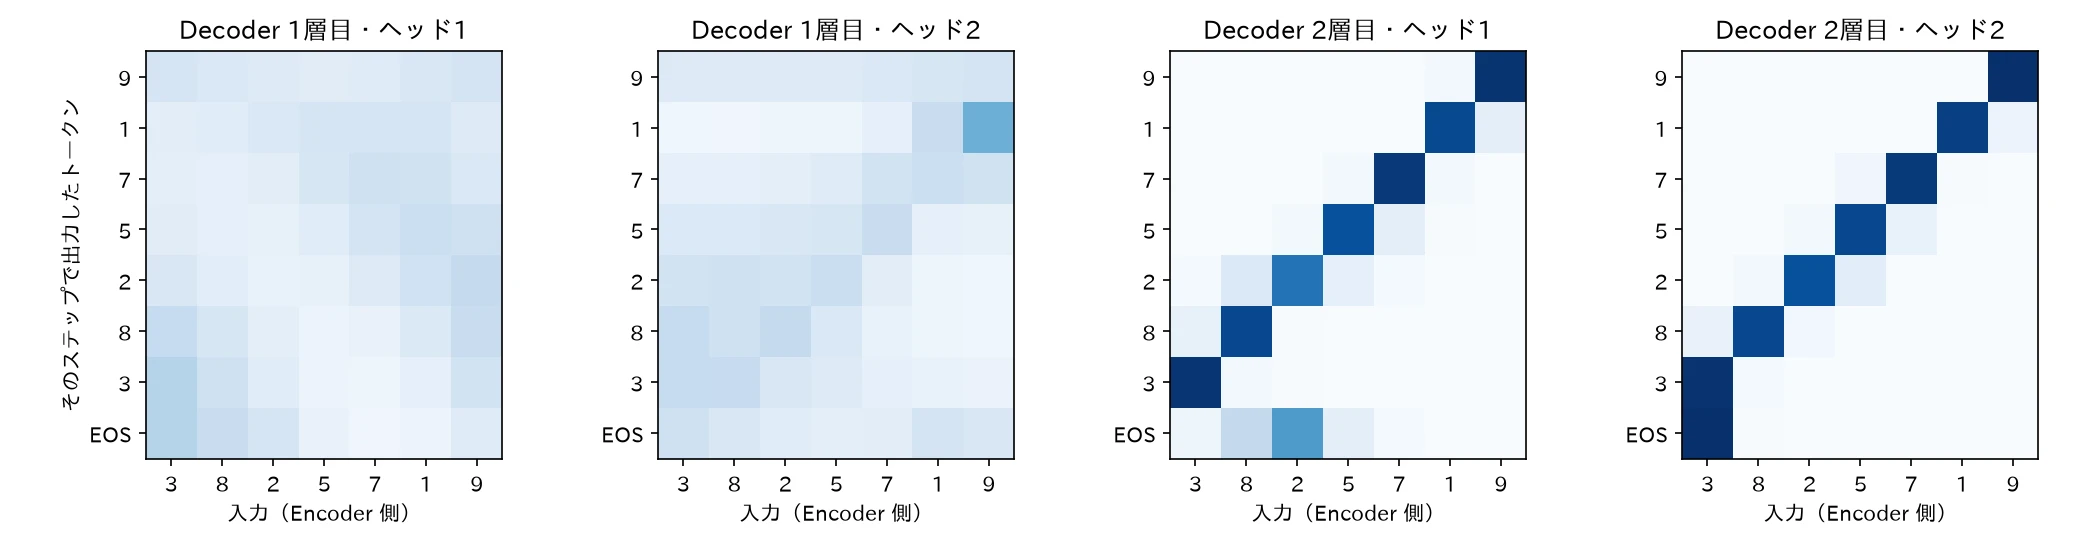
次のコードで、学習したモデルに長さ7の系列を入れて生成し、Decoder の Cross-Attention の重みを図にして、各ステップが入力のどの位置を見ているかを確かめます。
# Cross-Attention の重み:デコーダの各ステップが、入力のどの位置を見ているか
s = [3, 8, 2, 5, 7, 1, 9]
src = torch.tensor([[d + 3 for d in s]], device=device)
out = greedy_decode(model, src, max_len=len(s) + 1)                          # 最後のステップの forward の重みが残る
print("入力:", s, " 生成:", to_digits(out[0].cpu()))

fig, axes = plt.subplots(1, 4, figsize=(14, 3.6))
outputs = [str(d) for d in to_digits(out[0].cpu())] + ["EOS"]                # 各ステップで出力したトークン
for ax, (layer, head) in zip(axes, [(0, 0), (0, 1), (1, 0), (1, 1)]):
    w = model.decoder[layer].cross_attn.attn_weights[0, head].cpu()          # (生成のステップ数, 入力の長さ)
    ax.imshow(w, cmap="Blues", vmin=0, vmax=1)
    ax.set_xticks(range(len(s)), [str(d) for d in s])
    ax.set_yticks(range(len(outputs)), outputs)
    ax.set_xlabel("入力(Encoder 側)")
    ax.set_title(f"Decoder {layer + 1}層目・ヘッド{head + 1}")
axes[0].set_ylabel("そのステップで出力したトークン")
plt.tight_layout()
plt.show()
学習したモデルに長さ7の系列を入れて生成し、Decoder の Cross-Attention の重みを図にするコードです。
- 入力: 実験の冒頭の例
[3, 8, 2, 5]に3つを足した[3, 8, 2, 5, 7, 1, 9]です。重みの斜めの線が見やすいように、少し長くしています。 - 重みの取り出し: greedy_decode は、最後のステップで、BOS と生成した7トークンの計8トークンを Decoder に通します。そのときの各ブロックの cross_attn.attn_weights には、8つの位置それぞれの、入力の7つの位置への重みが残っています。Causal Mask により、各位置の計算はそれより後のトークンに影響されないので、この8行は、各ステップで実際に使った重みと同じです。
- 図: 2つのブロック × 2つのヘッドの4枚を並べます。横軸が入力の位置、縦軸が各ステップ(行)で、行のラベルには、そのステップで出力したトークンを書いています。1行目は BOS から「9」を出したステップ、最後の行は「3」の後で EOS を出したステップです。
実行結果
入力: [3, 8, 2, 5, 7, 1, 9] 生成: [9, 1, 7, 5, 2, 8, 3]
- 生成:
[3, 8, 2, 5, 7, 1, 9]に対して[9, 1, 7, 5, 2, 8, 3]を生成し、正しく逆に並べました。 - 斜めの線: 2つ目のブロックの2つのヘッドには、右上から左下への斜めの線が、くっきり見えます。「9」を出すステップでは入力の最後の「9」に、「1」を出すステップでは後ろから2番目の「1」に重みが集まっていて、各ステップが、次に出すべき数字のある入力の位置を見ています。
- ブロックによる違い: 1つ目のブロックの2つのヘッドは、重みが入力全体に薄く広がっていて、斜めの線はほとんど見えません。どの位置の数字をコピーするかを決めているのは、2つ目のブロックだと読めます。1つ目のブロックは、Self-Attention と合わせて、出力済みのトークンの情報をまとめる段階だと考えられます。
- EOS のステップ: 最後の「3」を出した後のステップでは、2つ目のブロックのヘッド2が、入力の先頭の「3」に重みを置いています。入力の先頭まで読み終えたことが、EOS を出す手がかりになっていると考えられます。
まとめ
本記事では、Transformer の Encoder-Decoder を、Attention・位置エンコーディング・FeedForward・残差接続と LayerNorm・2つのマスクから PyTorch でスクラッチ実装し、数字の列を逆に並べるタスクで学習しました。
- で割る理由: Query と Key の内積の分散は と同じになり( で 515.5)、割らないと softmax の最大の重みが 0.953 まで1か所に偏りました。 で割ると、 によらず 0.30〜0.32 にそろいました。
- 位置エンコーディングは、位置の差を表す: 位置エンコーディングどうしの内積は、位置の差だけで決まりました(距離3なら、どこでも 25.587)。
- テンソルの形は のまま流れる: 入力の(2, 6)と出力側の(2, 7)は、埋め込みから最後のブロックまで の形を保ち、generator で語彙の数の(2, 7, 13)になりました。Cross-Attention の出力の長さは、Key・Value ではなく Query の側で決まります。
- 小さなモデルでも、短時間で学習できる: 埋め込みと出力層の重みを原著論文と同じく共有した、約23万個のパラメータのモデルは、CPU で約2分(20エポック)の学習で、学習に使っていないテストの系列の完全一致率が 0.999 になりました。
- Cross-Attention は、コピーする位置を探す: 2つ目のブロックの Cross-Attention の重みは、各ステップで、次に出す数字のある入力の位置を見る斜めの線になりました。1つ目のブロックの重みは、入力全体に薄く広がっていました。
- 学習で見た長さを超えられない: 長さ11以上の系列では完全一致率が0で、モデルは入力の先頭の10個だけを逆に並べて止まりました。学習で見なかった位置には、Cross-Attention が向きませんでした。
Transformer は、再帰をやめ、すべての位置の組を Attention で一度に結ぶことで、並列に学習でき、離れた位置どうしも1段でつながるようにしたモデルです。Encoder だけを使えば BERT や ViT、Decoder だけを使えば GPT のような言語モデルになり、本記事で実装した部品は、それぞれの土台になっています。
参考文献
- A. Vaswani et al. (2017). Attention Is All You Need. NeurIPS 2017.
- K. He, X. Zhang, S. Ren, J. Sun (2016). Deep Residual Learning for Image Recognition. CVPR 2016.
- J. L. Ba, J. R. Kiros, G. E. Hinton (2016). Layer Normalization. arXiv preprint.
- D. Bahdanau, K. Cho, Y. Bengio (2015). Neural Machine Translation by Jointly Learning to Align and Translate. ICLR 2015.
本記事の文章・構成の一部に生成AIを使用しています。