TRPO (Trust Region Policy Optimization) とは?
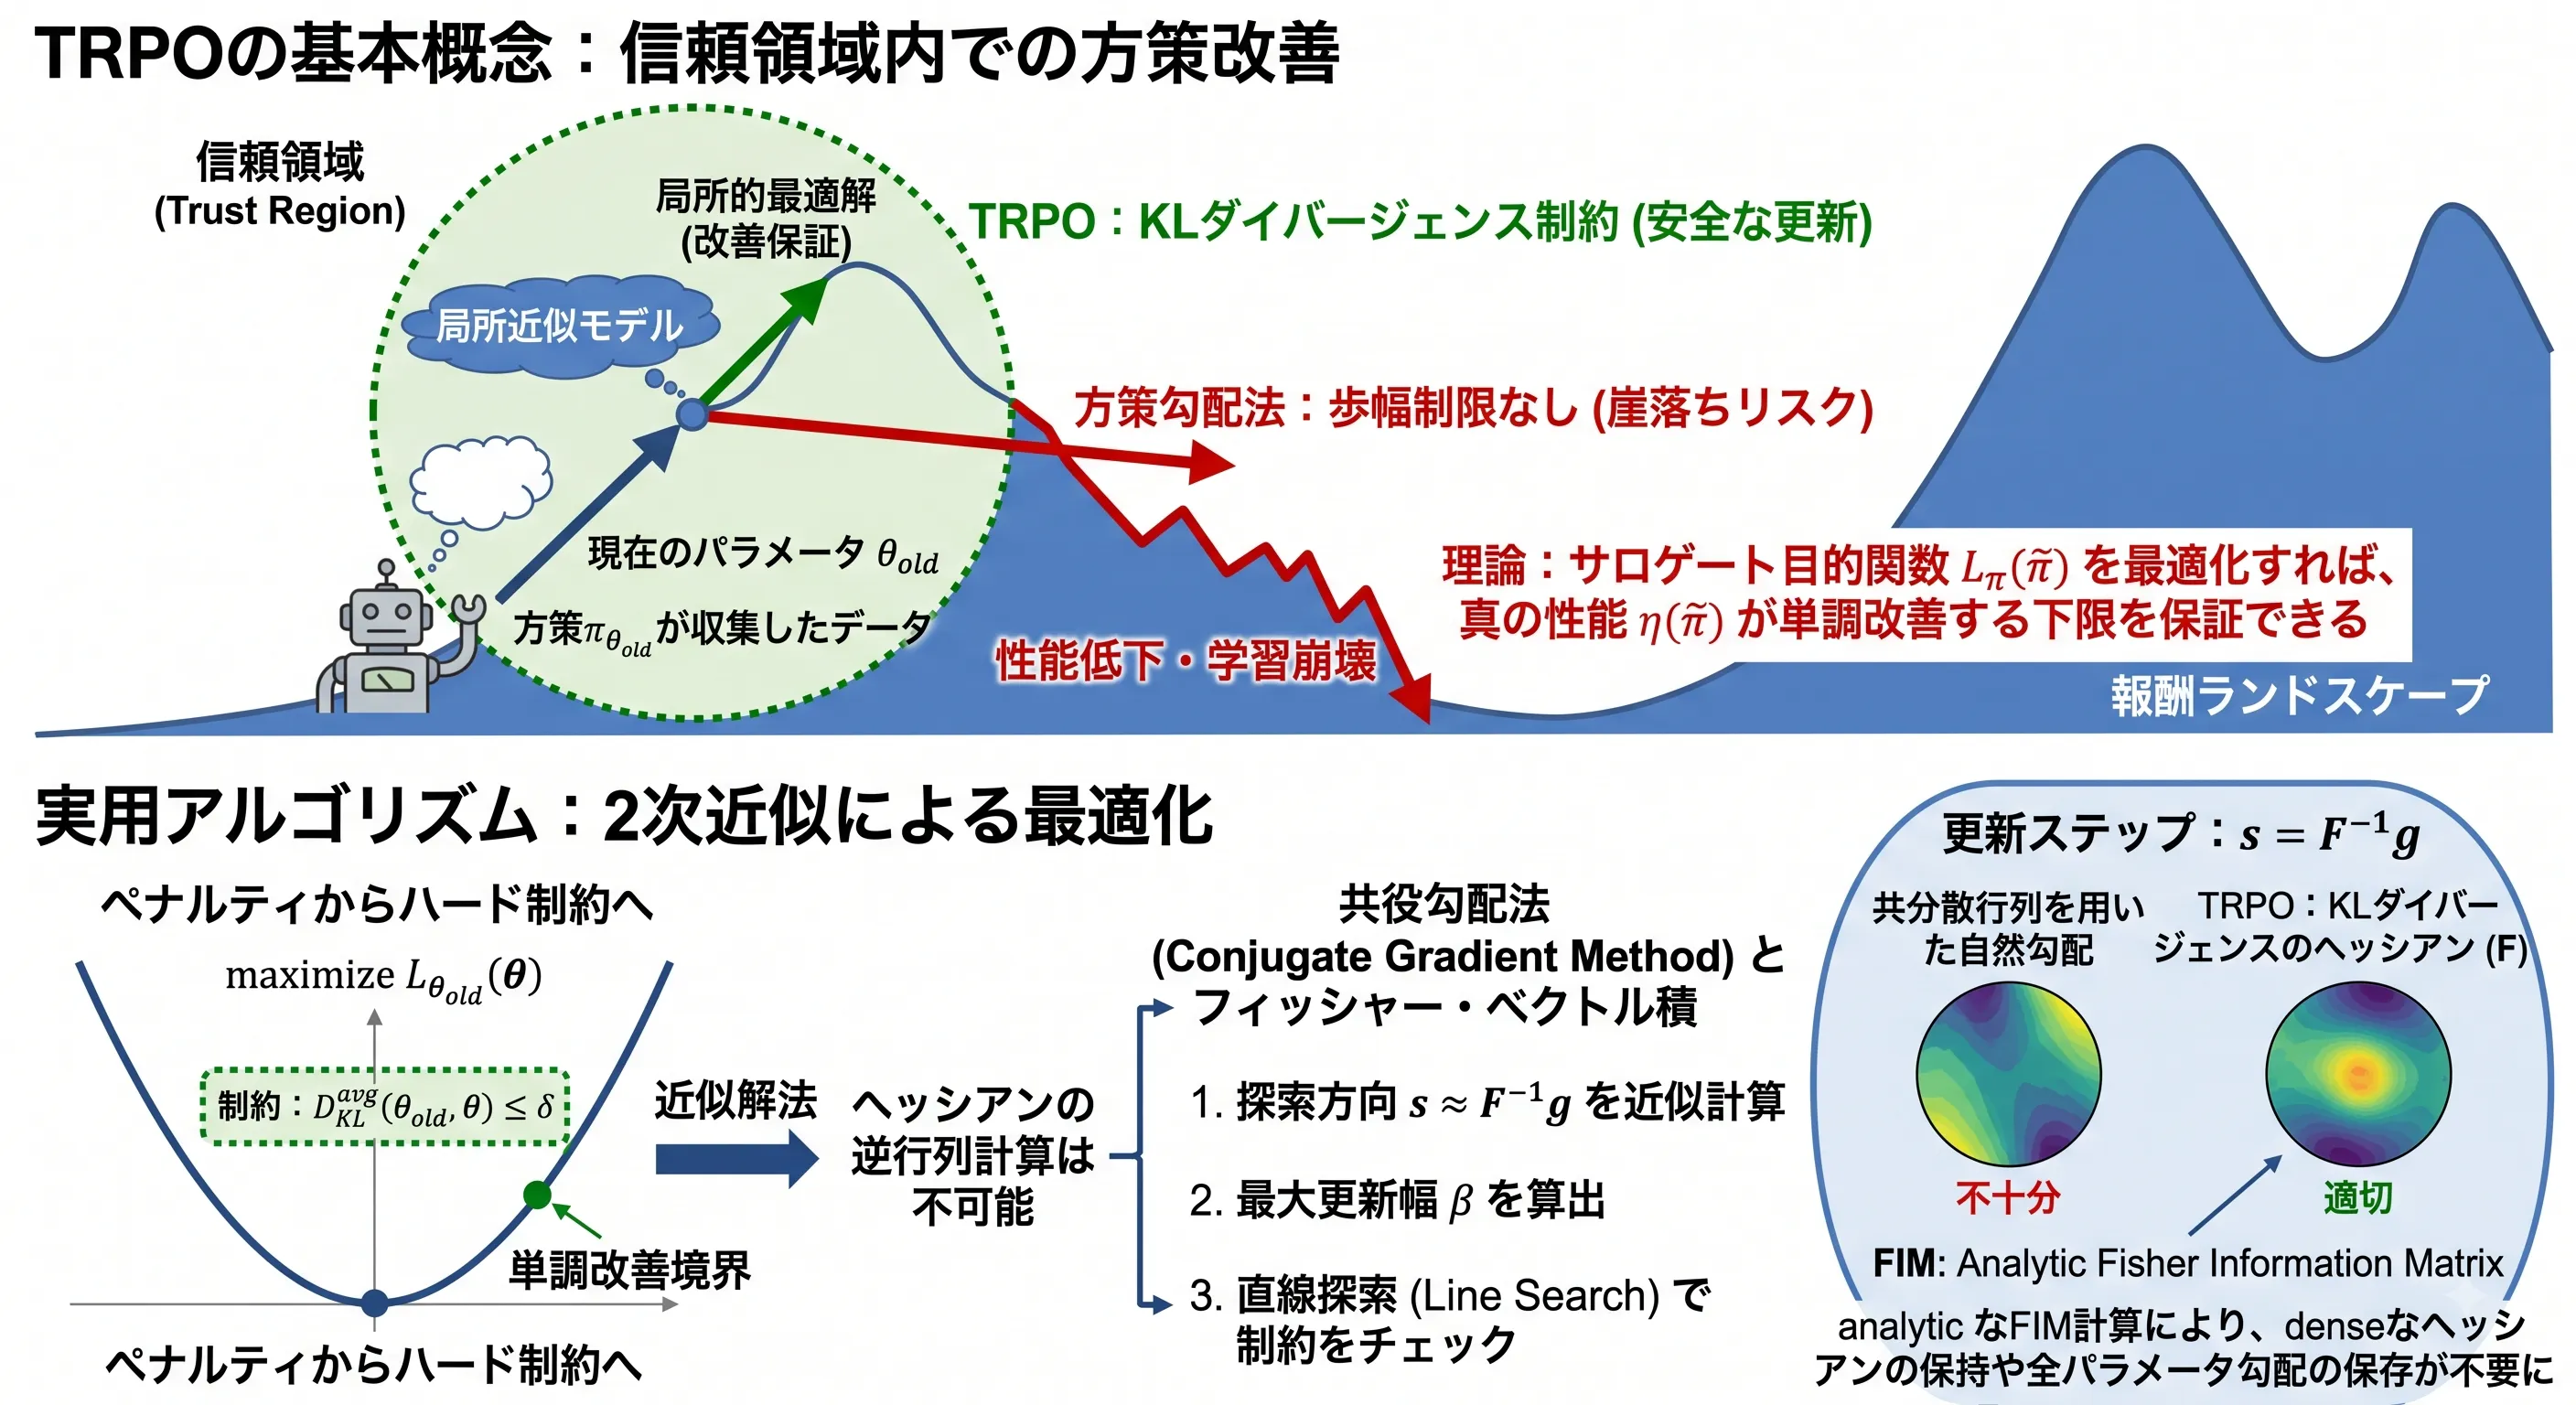
(画像は、Geminiで作成)
方策を一度に大きく更新すると崩壊するという問題に対して、KL ダイバージェンスの制約(信頼領域)で更新幅を抑える TRPO の理論(サロゲート目的関数と性能改善の下限)を理解すること。フィッシャー情報行列・共役勾配法・直線探索で制約付きの最適化を解く手順を、CartPole でのスクラッチ実装と sb3-contrib で確かめ、学習率を使わずに更新幅が決まる仕組みを説明できるようになること。
TRPOの概要
A2Cの記事では、方策(Actor)と価値(Critic)を組み合わせることで分散を抑え、学習を安定させる手法を学びました。 しかし、方策ベースの手法には共通して「 1回の更新でパラメータを大きく変更しすぎると、方策が崩壊し二度と元に戻らなくなる 」 という致命的な弱点が存在します。
本記事では、この「歩幅制限(ステップサイズの調整)」の数理的難題を解決し、 現在主流となっているPPOの直接の基盤となった革新的なアルゴリズム TRPO (Trust Region Policy Optimization) について、 論文の理論をもとに解説します。
方策崩壊の問題とTRPOの誕生
方策勾配法の「崖落ち」リスク
REINFORCEやA2Cのような従来の方策勾配法は、現在のパラメータで収集したデータを用いて学習を行う「オンポリシー(On-policy)」手法です。 これらの手法では、一度の学習ステップでパラメータを大きく更新しすぎると、新しい方策が全く役に立たないものに劣化してしまうことがあります。 一度劣化すると、その劣化した方策で新しいデータを集めなければならないため、学習が完全に停止してしまいます。 これを防ぐためには学習率を極端に小さくするしかなく、学習に膨大な時間がかかっていました。(※この現象がいかに簡単に起きるかについては、A2Cの記事における「方策の崩壊(Policy Collapse)のシミュレーション」で実際にデモンストレーションしています)
Trust Region(信頼領域)による解決
TRPOは、この問題を解決するために 「Trust Region(信頼領域)」 という概念を導入しました。 これは、更新前の方策と更新後の方策の間の「KLダイバージェンス(確率分布の差異)」が一定の閾値()以下に収まるように制約をかけながら、 目的関数を最大化する手法です。これにより、「方策が大きく変わらない範囲(信頼領域)の中で、できるだけ大きなステップを踏む」ことが可能になります。 理論上は、後述するペナルティ付きの目的関数を最大化すれば、方策の性能が単調に改善すること(Monotonic Improvement)が保証されます。実際のTRPOは、この理論をいくつか近似した実用版なので、厳密な保証はなくなりますが、大きな性能の落ち込みを防ぐ効果は残ります。
TRPOのコア概念
TRPOの理論は、マイナーマイゼーション・マキシマイゼーション(MM)アルゴリズムの一種として定式化されています。
期待収益とアドバンテージの関係性(REINFORCE・A2Cとの繋がり)
REINFORCEアルゴリズムやA2Cの理論的な背景、期待収益とアドバンテージの基礎的な概念を詳細に学びたい方は、あらかじめ解説記事 REINFORCEアルゴリズムとは? および A2C (Advantage Actor-Critic) とは? をお読みいただくことを強くおすすめします。
まず、TRPOの理論の出発点として、新しい方策 の期待収益 は、古い方策 の期待収益と、状態ごとのアドバンテージ(優位性)の和として以下のように表すことができるという定理があります。
この数式は、REINFORCEが目指した「総収益の最大化」と、A2Cで導入された「アドバンテージ関数」を数学的に直結させた非常に重要な意味を持っています。数式の各項の意味は以下の通りです。
- : 新しい方策による期待収益(REINFORCEの目標値 と同義)
- : 古い方策による期待収益(現在のベースライン)
- : 新しい方策でプレイしたときの各状態 の訪問頻度
- : 新しい方策で状態 のときに行動 をとる確率
- : 古い方策 を基準としたときの行動 のアドバンテージ
数式の後半部分 は、「新しい方策 に従って行動を選んだとき、それが古い方策 から見てどれくらい『平均より良い行動(アドバンテージ)』になっているかの期待値」を表します。
つまりこの定理は、 「新しい方策のスコア は、古い方策のスコア に対して、『新しい方策が古い方策よりもどれだけプラスのアドバンテージを稼げるか』の合計を足した値と完全に一致する」 という画期的な事実を証明しています。A2Cでは「アドバンテージがプラスなら行動確率を上げよう」というヒューリスティック(直感的・経験的)なアプローチをとっていましたが、TRPOではこの数式により「新しい方策が訪れるすべての状態で、アドバンテージの期待値が0以上になるように新しい方策を作れば、スコアは下がらない」という理論的裏付けを得たのです。 この等式は、Kakade & Langford (2002) の「Performance Difference Lemma(性能差補題)」として知られる基礎的な定理です。以下のように 望遠和(隣接する項が次々と相殺し合う和) を用いて導出されます。 1. アドバンテージ関数の定義とベルマン方程式 ここで、ベルマン期待方程式より が成り立つため、アドバンテージは即時報酬 と次状態の価値 を用いて以下のように表せます。 2. 新しい方策 での割引アドバンテージ総和 3. 望遠和(テレスコーピング和)による相殺 割引率 かつ状態価値関数 が有界であるため、極限項 となります。 4. 状態訪問頻度による総和への変形 が得られます。左辺を各ステップで状態 を訪れる確率の割引総和 (非割引状態訪問頻度)を用いて各状態・行動の和に書き直すと、 となります。両辺に を加えることで、目的の定理の式が厳密に導出されます。補足:なぜこの式になるのか?(期待収益とアドバンテージの関係式の導出過程)
古い方策 における行動価値関数 と状態価値関数 に対し、アドバンテージ関数は次のように定義されます。
新しい方策 に従って生成された軌跡 に対し、時間 から無限大までの割引アドバンテージの期待値を計算します。
したがって、初期状態 について期待値をとると、(古い方策の期待収益)だけが残ります。
以上の結果をまとめると、
サロゲート目的関数と性能の単調改善
しかし、この完璧に見える数式にも1つだけ厄介な部分があります。それが (新しい方策による状態訪問頻度)です。「新しい方策でゲームをプレイしたらどの局面に遭遇するか」は、実際に新しい方策でプレイしてみるまで計算できず、直接最適化するのは困難です。
そこでTRPOでは、「方策をほんの少ししか更新しない(Trust Region: 信頼領域)」という制約をかけることで、「方策があまり変わらないなら、状態の訪問頻度も古い方策のとき()とほぼ同じだろう」と仮定します。 このようにして未知の を既知の に置き換えた局所的な近似(サロゲート目的関数) を導入します。
真の性能 とサロゲート目的関数 を項ごとに並べると、違いは状態の訪問頻度だけです。
(図は、diagram-designで作成)
論文では、この を最適化する際に、 新しい方策と古い方策の間の最大KLダイバージェンス()に対するペナルティを引いた値が、真の性能の単調な向上を保証する下限(Lower Bound)になることを数学的に証明しています。
下限(Lower Bound)の証明プロセス
TRPOの理論的基盤となるこの不等式は、元論文のAppendix Aにおいて以下のステップで導出されます。
- 近似誤差の評価
真の性能 と近似関数 の誤差は、新しい方策 と古い方策 の状態訪問頻度の違いから生じます。この違いを評価するために、2つの方策間の最大の違いを Total Variation (TV) ダイバージェンス として定義します。TVダイバージェンスは、2つの確率分布 について で定義される値です。
ここから真の性能 と近似関数 の誤差を計算するために、確率論のカップリング(Coupling)手法を用います。 カップリングとは、2つの方策 と が「同じ乱数シード」を使って行動を選択したと仮定し、2つの軌跡を同期させて比較する手法です。TVダイバージェンスの定義から、適切なカップリングを行えば「ある状態 において2つの方策が異なる行動をとる確率」を 以下に抑えることができます()。
この性質を使うと、各ステップ において生じるアドバンテージの期待値の誤差は、次の2つの積で上から抑えられることが分かります。
- 少なくとも一度は異なる行動をとる確率:
- その行動の分岐によって生じる期待アドバンテージの差の最大値:
ここで、 をアドバンテージの最大絶対値、 を割引率とします。誤差を引くことで、最終的に以下の不等式が得られます。
補足:なぜこの式になるのか?(各項目の導出理由と数式展開)
1. 少なくとも一度は異なる行動をとる確率: 時間ステップ に到達するまでに「少なくとも一度は方策が異なる行動をとってしまう確率」を計算します。1回のステップで2つの方策が異なる行動をとる確率は最大でも なので、逆に「同じ行動をとる確率」は少なくとも となります。そのため、時間ステップ に到達するまで、すべてのステップで完全に同じ行動を取り続ける確率は、毎ステップの確率を掛け合わせて 以上になります。 「少なくとも一度は異なる行動をとってしまう確率」は、「すべてのステップで完全に同じ行動をとる確率」の余事象(1から引いた値)となるため、これが最大でも になるというわけです。裏を返せば、それまで完全に同じ行動をとっていれば、その時点で状態は完全に一致しており、アドバンテージの差は生まれません。
2. 期待アドバンテージの差の最大値: 方策が異なる行動を取り、状態遷移の軌跡が分岐した場合、更新前と更新後の方策で行き着く状態にズレが生じます。アルゴリズムの誤差の上限(Lower Bound)を数学的に証明するためには、このズレによって生じるアドバンテージの差が「最も大きくなる最悪のケース」を想定する必要があります。 あらゆる状態 において、期待アドバンテージ は必ず の範囲に収まります。最悪のケースとは、一方が最も期待アドバンテージが高い状態()に行き着き、もう一方が最も低い状態()に行き着く状況です。この極端な2地点間の差の最大値は、一番上の値と一番下の値の距離である となります。これが、誤差を評価する際の最大振幅として使われている理由です。
3. 全体の誤差の最大値の導出プロセス まず、真の性能 と近似関数 の定義式の差分をとります。
この2つの式の差を計算すると、共通の が消去され、状態分布( と )の差だけが残ります。ここで とすると、次のように変形できます。
状態分布 は、時間ステップ から無限大までの各ステップで状態 を訪れる確率の割引総和として表せるため、各時間ステップごとの差の総和に分解できます。 ある状態 での期待アドバンテージ は、行動が異なる確率 を用いて と評価できます。ここで、軌跡が分岐した際に生じる期待アドバンテージの差が最大となるのは、一方が上限値()、もう一方が下限値()をとる最悪のケースです。したがって、その差の最大値はこの絶対値の2倍である となります。この最大振幅と、前述の「少なくとも一度は異なる行動をとる確率」を掛け合わせることで、各ステップ の誤差期待値の上限が になることが導かれます。
これを時間 から無限大まで、割引率 を掛けて足し合わせたものが全体の誤差の最大値となります。
この式を無限等比級数の和の公式()を利用して展開します。
ここで分母の について、 であるため、 となります。したがって、分母を小さく見積もる(分数全体をより大きくする)ことで、次のようにさらにシンプルな形でバウンドされます。
この絶対値を外し、近似関数 から誤差の最大値を引く形に変形することで、最終的な目的である「真の性能の保証(Lower Bound)」が得られます。
- TVダイバージェンスから KLダイバージェンスへの変換
TVダイバージェンス はニューラルネットワークでの計算や微分が困難であるため、ピンサーの不等式(Pinsker's inequality)などの情報理論の関係式を利用し、より扱いやすい KLダイバージェンスに変換します。TVダイバージェンスの2乗は KLダイバージェンスで上から抑えられるという性質を利用します。
補足:なぜTVからKLへ変換できるのか?(ピンサーの不等式による変換過程)
TVダイバージェンスとKLダイバージェンスの関係
全変動(Total Variation, TV)ダイバージェンス は、2つの確率分布の「最大の差」を表す指標です。本論文では、あらゆる状態における2つの方策間のTVダイバージェンスの最大値を と定義しています。
情報理論における ピンサーの不等式(Pinsker's inequality) は、このTVダイバージェンスをカルバック・ライブラー(KL)ダイバージェンスで上から抑える以下の定理です。
両辺を2乗すると です。KLダイバージェンスは0以上なので、右辺の を外した次の不等式も成り立ちます(係数を外す分だけ緩い不等式ですが、正しい不等式です。原論文はこの形を Pollard (2000) から引用しています)。
したがって、すべての状態 において が成り立ちます。 左辺の最大値である は、右辺の最大値 によって上から抑えられるため、最終的に という変換が可能になります。
したがって、 となります。これを先ほどの不等式に代入し、定数部分をまとめて と置くことで、最終的な下限の式が完成します。
補足:なぜこの式になるのか?(最終的な式の代入過程)
Lower Bound の完成
ステップ1の最後に導出した不等式は以下の通りです。
この式の に、ピンサーの不等式から得られた を代入します。すると、引く値(ペナルティ項)が大きくなるため、不等式の下限はさらに次のようにバウンドされます。
ここで、複雑な係数部分を一つの定数 にまとめます。
これを代入することで、TRPOの論文で提示されている最もシンプルで美しい最終形態が得られます。
この数式は、「ペナルティを引いた を最大化すれば、真の性能 も確実にそれ以上になる」 ことを保証しています。現在の方策 のとき右辺は と等しくなるので、右辺を最大化した新しい方策の性能は、少なくとも今の性能を下回りません。これが、原論文が「性能が単調に改善する」と示した理論上のアルゴリズム(原論文の Algorithm 1)です。ただし、次に説明するように、実際のTRPOはこの理論をいくつか近似しているため、単調な改善が厳密に保証されるわけではありません。
下限を最大化すると性能が下がらない理由を、模式図で表すと次のようになります。
(図は、diagram-designで作成) 本記事で解説した係数 は、TRPO原論文(2015)の主張をそのまま正確に再現したものです。しかし後年、Achiam et al. (2017) による CPO (Constrained Policy Optimization) 論文などにおいて、この境界は が1に近づくと発散してしまう(縮退する)問題が指摘され、より精密な理論的境界が提案されています。補足:定数 の精緻化(発展的な話題)
ペナルティからハード制約へ
理論上は上記のようにKLダイバージェンスのペナルティを引いて最適化すれば良いのですが、
実際のペナルティ係数 を使うとステップサイズが非常に小さくなり実用的ではありません。
そこでTRPOは、理論的なペナルティをハード制約(Hard Constraint)に置き換えるというヒューリスティックな近似を行います。原論文の実験では、すべてのタスクで を使っています。
さらに、すべての状態での最大KLダイバージェンスを計算するのは非現実的であるため、
平均KLダイバージェンス が 以下になるように制約を緩和します。
補足:なぜこの式になるのか?(理論の下限式からハード制約への移行とサロゲート目的関数の導出)
1. 理論の下限式との関係
先ほど証明した理論上の下限式は以下の通りでした。
理論上は、右辺の式全体を最大化(つまり、 を増やしつつペナルティ を小さくする)すれば真の性能の向上が保証されます。 しかし、このペナルティ方式(ソフト制約)ではステップ幅の調整が困難なため、TRPOでは以下のように2つの変更を加えた「ハード制約」の問題に変形しています。
- ペナルティから制約への変換: からペナルティを引くのではなく、「KLダイバージェンスを一定の閾値 以下に抑える」という絶対的な制約(
subject to)の枠内で近似関数を最大化する形に置き換えています。 - 最大値から平均値への緩和: すべての状態の最大値 を計算するのは非現実的なため、過去の軌跡から計算できる平均KLダイバージェンス に緩和しています。
2. 理論式からサロゲート目的関数(期待値)への変形
理論式 を、手元のデータ(古い方策のデータ)を使ってニューラルネットワークで計算できるように、不要な定数を省き、重要度サンプリングのテクニックを使って期待値に変形したものがサロゲート目的関数 になります。その変換は以下の3ステップで行われます。
ステップ1:定数項の除外
まず、理論式である は以下の形をしています。
ここで、新しい方策 を学習(最適化)してこの値を最大化したいと考えたとき、右辺の第一項 (古い方策の期待収益)は単なる固定された定数です。そのため、最大化問題を解く上では無視して構いません。したがって、実質的に最大化すべきは後半のシグマ()の部分になります。
ステップ2:和()から期待値()と「重要度比」への変換
次に、後半のシグマの部分を考えます。
強化学習では、すべての状態や行動を網羅してシグマ(合計)を計算することは不可能なため、実際にプレイして集めたサンプルの「平均(期待値 )」で近似します。
- 状態 について: 古い方策で集めた状態の出現確率 に従うので、そのまま期待値 に直せます。
- 行動 について: 式の中には新しい方策の確率 がありますが、手元にあるデータは古い方策 でプレイして集めた行動データです。そこで、古い方策の確率 を分母と分子に掛けて式を変形します。
すると、 の部分は「古い方策で行動を選んだときの期待値 」になり、カッコの中身が重要度比()として残ります。これらをまとめると、シグマの式は次のような期待値の式に書き換えることができます。
ステップ3:表記の置き換え
最後に、文字の表記を「プログラムのパラメータ 」を主語にした形に置き換えます。
- 古い方策 パラメータ更新前の方策
- 新しい方策 パラメータ更新後の方策
これを先ほどの期待値の式に当てはめると、最終的な目的関数と完全に一致します。
この重要度比 を用いることで、古い方策でサンプリングしたデータ(状態と行動)をそのまま使って、新しい方策での期待リターンを近似計算(Off-policyな評価)することができます。これが、TRPOのスクラッチ実装で実際に勾配を計算する際の核となる数式です。
理論の下限から、実際に解く問題までに入れた近似を並べると、次のようになります。
(図は、diagram-designで作成)
フィッシャー情報行列と共役勾配法(Conjugate Gradient)
この制約付き最適化問題を解くために、TRPOは目的関数を線形近似(勾配 )し、KLダイバージェンス制約を二次近似(フィッシャー情報行列 を利用)します。これにより、理想的なパラメータの探索方向 は方程式 を解くこと(つまり )で得られます。 元の最適化問題は以下の通りです。 巨大なニューラルネットワークにおいて、この非線形な目的関数と制約条件を直接解くことは非常に困難です。そこでTRPOでは、更新前のパラメータ の周辺でテイラー展開を用いて近似を行い、問題を扱いやすくします。 1. 目的関数の線形近似(勾配 ) ここで、目的関数の勾配を 、パラメータの更新量(探索方向)を と置くと、次のようにシンプルに表せます。 は定数であるため、目的関数を最大化するということは、実質的に を最大化することと同義になります。 2. KL制約の二次近似(フィッシャー情報行列 ) この式の各項は次のように評価されます。 これらを踏まえると、0次項と1次項が完全に消去されるため、KLダイバージェンス制約は2次項のみが残り、次のようにシンプルな二次形式で近似されます。 したがって、TRPOが解くべき問題は以下の極めてシンプルな制約付き二次最適化問題へと帰着されます。 前述の近似最適化問題: を解くために、ラグランジュの未定乗数法を適用します。 1. ラグランジュ関数の定義と停留条件 この関数を について微分し、0とおくことで停留条件を求めます。 この式は、「探索方向 はフィッシャー情報行列の逆行列を勾配に掛けた方向(:自然勾配方向)と完全に平行でなければならない」 ことを意味しています。 2. 制約条件への代入と最大歩幅の決定 は対称行列()であるため、 となります。 これを に戻すと、最適な更新ベクトル は以下のようになります。 ここで、方程式 の解(探索方向ベクトル)を と置くと、 と表せるため、更新量は次のように「ステップ幅 」と「方向ベクトル 」の積に分解できます。 このようにして、方程式 を解いて方向 を求め、最大歩幅 を掛けることで、制約 を満たしながら最大の目的関数改善を達成する更新量が解析的に導き出されます。補足:なぜこの式になるのか?(TRPOの数学的背景:近似最適化問題への変換過程)
まず、目的関数 を の周りで1次のテイラー展開(線形近似)します。
次に、KLダイバージェンスの制約を の周りで2次のテイラー展開(二次近似)します。式に書き出すと以下のようになります。
補足:なぜこの式になるのか?(ラグランジュ未定乗数法による探索方向と最大歩幅の導出過程)
ラグランジュ乗数を とすると、ラグランジュ関数は以下のように定義されます。
最適化の解では境界条件 が等号で成立するため、 を制約式に代入してスカラー を決定します。
近似した問題の解を、2次元の模式図と手順で表すと次のようになります。
(図は、diagram-designで作成)
しかし、巨大なニューラルネットワークにおいて巨大なフィッシャー情報行列 を直接メモリ上に構築し、さらにその逆行列 を求めるのは、計算量およびメモリの観点から完全に不可能です。
これを解決するため、TRPOは共役勾配法(Conjugate Gradient Method) を利用します。共役勾配法は、逆行列 を明示的に求めることなく、方程式 を満たす探索方向 を反復計算によって近似的に解くことができるアルゴリズムです。
さらに、反復計算の途中で必要になる とベクトルの掛け算についても、フィッシャー・ベクトル積(Fisher-vector product) というテクニックを使うことで、フル行列をメモリに保持することなく効率的に計算します。 共役勾配法(CG法)は、正定値対称行列を係数とする大規模な連立一次方程式 を高速に解くための反復法です。
単純な勾配降下法で方程式を解こうとすると、目的関数の等高線が楕円形に歪んでいる場合にジグザグと無駄な探索を繰り返し、収束が著しく遅くなる問題があります。CG法は、行列 に対して「共役(互いに独立・非干渉)」という特別な直交性を持つ探索方向を次々と生成することで、一度探索した成分のロスを再発させることなく効率的に最適解へと向かいます。理論上はパラメータ次元数以下の反復で厳密解に到達しますが、TRPOでは通常10回程度の少ない反復で打ち切り、計算コストを抑えつつ実用的な近似解 を得ます。
また最大の利点として、アルゴリズムの計算過程で必要になるのは「行列 とベクトル の掛け算()」の演算結果だけであり、巨大な行列 の全成分や逆行列 を直接メモリに展開・計算する必要が一切ありません。 さらに詳しい仕組みや、最急降下法との探索軌跡の視覚的な比較については、共役勾配法(CG)とは? をご覧ください。 フィッシャー・ベクトル積(FVP)は、巨大なヘッシアン(フィッシャー情報行列 )を直接計算・保持することなく、任意のベクトル との掛け算 の結果だけを極めて効率的に取得するテクニックです。
ニューラルネットワークにおいて、パラメータ数が の場合、行列 は の巨大なサイズになり、計算もメモリ保持も不可能になります。しかし、PyTorchなどの自動微分フレームワークが持つ性質(Hessian-vector product)を利用すると、「KLダイバージェンスの勾配(1階微分)とベクトル の内積」を計算し、そのスカラー値をさらにもう一度微分(二重逆伝播)することで、行列 を一度もメモリ上に構築することなく直接 のベクトルを得ることができます。
前述の共役勾配法は「行列とベクトルの掛け算」さえできれば方程式を解けるため、このFVPの手法と組み合わせることで、巨大なモデルであってもメモリをほとんど消費せずにTRPOの最適化を完了できるという、非常にエレガントな仕組みになっています。 フィッシャー情報行列自体の概念や、なぜそれが「確率分布の曲率」となるのか等については、フィッシャー情報行列(Fisher Information Matrix)とは? の記事で詳しく解説しています。補足:共役勾配法(Conjugate Gradient Method)の仕組み
補足:フィッシャー・ベクトル積(Fisher-vector product)の仕組み
最後に、求まった探索方向 に沿って、KLダイバージェンスの制約 を満たしつつ目的関数が改善される最大のステップ幅を見つけるため、直線探索(Line Search) を行い、安全な範囲内でパラメータを更新します。 直線探索(とりわけTRPOで用いられる後退代入法:Backtracking Line Search)は、近似計算によって導き出した「理論上の最大歩幅」が、実際の非線形な関数においても本当に安全かどうかを確認し、必要に応じて歩幅を縮めるプロセスです。
共役勾配法で求めた探索方向 と、二次近似から解析的に求めた最大歩幅 を掛け合わせたパラメータ更新量 は、あくまで「KL制約が綺麗な二次関数である」という仮定(近似)に基づいた値です。そのため、実際にその分だけパラメータを大きく動かすと、テイラー展開の近似誤差によって実際のKLダイバージェンスが閾値 を超過してしまったり、目的関数が逆に悪化してしまう危険性があります。
これを防ぐため、TRPOではまず最大の歩幅 でパラメータの更新を仮実行し、その状態での「実際のKLダイバージェンス」と「実際の目的関数の変化」を評価します。もし制約を満たさなかったり性能が悪化している場合は、歩幅を一定割合(例:0.5倍など)に縮めて(後退して)再度評価を繰り返します。両方の条件をクリアする安全な歩幅が見つかった時点で初めて更新を確定させるため、TRPOは「方策の崖落ち(崩壊)」を極めて強固に防ぐことができるのです。 直線探索のより一般的な概念や、Armijo条件を用いた後退代入法のPythonによる視覚的なシミュレーションについては、直線探索(Line Search)とは? の記事をご覧ください。 原論文のAppendix Cに記載されている通り、TRPOはこの理論をもとに以下の手順で最適化を実行します。 要約すると、「線形近似」と「二次近似」は、そのままでは計算不可能な元の最適化問題を、解析的に解ける(共役勾配法に落とし込める)形に変換するための数学的な橋渡しとして機能しています。補足:直線探索(Line Search)の仕組み
補足:全体の計算プロセス(原論文との繋がり)
TRPOの実装(CartPoleでのスクラッチ実装)
具体的なコード例として、gymnasiumのCartPole-v1環境を用いたTRPOのPyTorch実装を示します。
A2Cの実装が「損失関数を定義してoptimizer.step()を呼ぶ」というシンプルな形だったのに対し、
TRPOは 勾配降下法(Adam等)を方策の更新に一切使いません 。
代わりに、上で解説した理論をそのままコードに落とし込んだ以下の手順で更新を行います。
ネットワーク定義
ActorとCriticの独立したネットワークを定義します。
- 価値関数(Critic)の独立学習 : Actorは信頼領域法で、Criticは通常の回帰(MSE + Adam)で別々に更新。
import torch
import torch.nn as nn
import torch.optim as optim
from torch.distributions import Categorical
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt

# 実行結果を再現できるように、PyTorch と NumPy の乱数シードを固定する(値そのものに意味はない)
torch.manual_seed(0)
np.random.seed(0)

# TRPOでは方策と価値を「別ネットワーク」にするのが基本。
# 直線探索で方策パラメータだけを何度も差し替えるため、重み共有すると扱いが煩雑になる。
# 隠れ層 64 ユニット × 2 層は、Stable Baselines3 の MlpPolicy の既定値に合わせている
class PolicyNet(nn.Module):
    """Actor: 状態 -> 行動のロジット(方策 π_θ(a|s) を表す)"""
    def __init__(self, state_dim, action_dim, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(state_dim, hidden), nn.Tanh(),
            nn.Linear(hidden, hidden), nn.Tanh(),
            nn.Linear(hidden, action_dim),
        )

    def forward(self, x):
        return self.net(x)

    def dist(self, x):
        return Categorical(logits=self.forward(x))


class ValueNet(nn.Module):
    """Critic: 状態 -> 状態価値 V(s)"""
    def __init__(self, state_dim, hidden=64):
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(state_dim, hidden), nn.Tanh(),
            nn.Linear(hidden, hidden), nn.Tanh(),
            nn.Linear(hidden, 1),
        )

    def forward(self, x):
        return self.net(x).squeeze(-1)
TRPOの実装では、状態から行動確率 を出力する方策ネットワーク(PolicyNet)と、状態価値 を出力する価値ネットワーク(ValueNet)を完全に独立させて定義します。 A2Cなどのアルゴリズムでは特徴量抽出層(重み)を共有することが多いですが、TRPOでは方策パラメータのみを直線探索の過程で何度も「一時的に変更しては戻す」という処理(後退代入法)を行うため、ネットワークを完全に分離しておくことで実装がシンプルになり、計算のバグを防ぐことができます。
パラメータのベクトル化ユーティリティ
TRPO特有の、ニューラルネットワークのパラメータ全体を1本のベクトルとして扱うためのユーティリティ関数群です。
# TRPOは「パラメータ全体を1本の巨大なベクトル」として扱い、
# 共役勾配法や直線探索で直接操作する。
# 数式: \theta を1次元ベクトルとして扱う
def get_flat_params(model):
    return torch.cat([p.data.view(-1) for p in model.parameters()])


def set_flat_params(model, flat_params):
    idx = 0
    for p in model.parameters():
        n = p.numel()
        p.data.copy_(flat_params[idx:idx + n].view_as(p))
        idx += n


def flat_grad(loss, model, retain_graph=False, create_graph=False):
    # 数式: g = \nabla_\theta L(\theta) を計算し、1次元ベクトルとして返す
    grads = torch.autograd.grad(loss, model.parameters(),
                                retain_graph=retain_graph, create_graph=create_graph)
    return torch.cat([g.reshape(-1) for g in grads])
ここでは、PyTorchの各レイヤーに分散しているパラメータ群(重みやバイアス)を、1本の巨大な1次元ベクトルとして束ねる(get_flat_params)、あるいは逆にベクトルから各レイヤーへ書き戻す(set_flat_params)関数を定義しています。 これは、TRPOにおける理論式(テイラー展開やヘッセ行列)が「パラメータ が1つの大きなベクトル空間にある」ことを前提としているためです。探索方向 や歩幅 といった計算をベクトル演算(共役勾配法など)として直接扱うために、このような平坦化(Flatten)処理が必須となります。flat_grad 関数は、同様に損失関数の勾配 を1本のベクトルとして取得するためのものです。
フィッシャー・ベクトル積(Fisher-vector product)と共役勾配法
逆行列の計算を避けるため、方程式を近似的に解くアルゴリズムです。 巨大なフィッシャー情報行列 の逆行列を直接計算するのではなく、「行列とベクトルの掛け算()」の結果だけを利用して、連立方程式 の解 (探索方向)を反復的に求める共役勾配法(CG法)を実装します。
# Hx = g を解いて x = H^(-1)g を得る。
# 反復回数 nsteps=10 は原論文の設定(k=10 で十分で、増やしても改善は速くならなかった)。
# Hを行列として構築せず、「Hとベクトルの積」を計算する関数(Avp_fn)だけで解けるのがポイント。
def conjugate_gradient(Avp_fn, b, nsteps=10, tol=1e-10):
    x = torch.zeros_like(b)
    # 数式: 残差 r = b - Hx (初期値は x=0 なので r = b)
    r = b.clone()
    p = b.clone()   # 探索方向
    rr = torch.dot(r, r)
    for _ in range(nsteps):
        # 数式: Ap = Hp (フィッシャー・ベクトル積)
        Ap = Avp_fn(p)
        alpha = rr / (torch.dot(p, Ap) + 1e-8)   # 1e-8 は 0 除算を防ぐための小さな値
        x += alpha * p
        r -= alpha * Ap
        rr_new = torch.dot(r, r)
        if rr_new < tol:   # 残差が十分小さくなったら、10回を待たずに打ち切る
            break
        p = r + (rr_new / rr) * p
        rr = rr_new
    return x
conjugate_gradient は、行列 とベクトルの積を返す関数(Avp_fn)と、目的関数の勾配ベクトル(b=数式上の )を受け取ります。 内部では、残差 r と探索方向 p を用いて反復的に解 x(数式上の自然勾配 )を更新していきます。Ap = Avp_fn(p) の部分で、フィッシャー情報行列を直接メモリに展開することなく、間接的に を計算しているのが最大のポイントです。TRPOにおいてはこの反復回数(nsteps)を10回程度で打ち切ることで、計算コストと精度のバランスを取っています。
ハイパーパラメータと学習ループ
TRPOの学習ループ全体です。データ収集から始まり、サロゲート目的関数の計算、探索方向の決定、そして直線探索による歩幅の調整までを含みます。1回の方策更新の流れを図にすると、次のようになります。
(図は、diagram-designで作成)
コードのコメントにある (a)〜(e) は、図の③〜⑥に対応しています。
- マスク処理(
terminatedの使用) :masks_buf.append(1.0 - terminated)として、真の失敗(terminated)のみでマスク処理を行っています。時間切れ(truncated)の場合は本来エピソードが継続しうるため、ゼロでマスクせずにCriticの予測値で価値をブートストラップするという、実装上の重要なベストプラクティスを採用しています。 - GAE(Generalized Advantage Estimation) : サロゲート目的関数に必要なアドバンテージ を低分散で推定。
- サロゲート目的関数 : 重要度比 を用いて を計算。
- フィッシャー・ベクトル積(FVP) : KLダイバージェンスの2階微分(ヘッシアン)を、行列を保持せずベクトル積としてのみ計算。
- 直線探索(Line Search) : 制約 を満たし、かつ目的関数が実際に改善する歩幅まで後退(backtracking)。
原論文と本記事のスクラッチ実装では、タスクの規模やアドバンテージの推定方法が違います。主な違いは次の通りです。
| 項目 | 原論文(Schulman et al., 2015) | 本記事のスクラッチ実装 |
|---|---|---|
| タスク | MuJoCo の歩行ロボット(Swimmer・Hopper・Walker)、Atari | CartPole-v1 |
| 1回の更新のサンプル数 | 5万〜100万ステップ(MuJoCo)、10万〜40万ステップ(Atari) | 2,048ステップ(8環境 × 256) |
| 方策の更新回数 | 200回(MuJoCo)、500回(Atari) | 100回 |
| アドバンテージの推定 | モンテカルロ推定(single path / vine) | GAE(λ = 0.95) |
| 信頼領域の半径 δ | 0.01 | 0.01 |
| 共役勾配法の反復回数 | 10回 | 10回 |
| 直線探索 | 歩幅を指数的に縮め、目的関数が改善したら採用 | 歩幅を 0.5 倍ずつ最大10回縮め、KL ≤ 1.5δ かつ目的関数が改善したら採用 |
CartPoleは状態が4次元・行動が2つの小さなタスクなので、1回のサンプル数を2,048に減らしても学習できます。GAEは、原論文の後に同じ著者らが提案した推定方法(Schulman et al., 2015b)で、現在のTRPO・PPOの実装(Stable Baselines3 など)で標準的に使われているため、本記事でも使っています。直線探索の「KL ≤ 1.5δ」と縮小率 0.5、damping 0.1、価値関数の設定は、OpenAI Baselines の TRPO 実装(trpo_mpi の MuJoCo 用の既定値)に合わせています。
# 値の出どころ:δ と CG の反復回数は原論文、damping・直線探索・価値関数の設定は
# OpenAI Baselines の trpo_mpi(MuJoCo 用の既定値)、λ と 1回のサンプル数は Stable Baselines3 の既定値
num_envs = 8            # 並列環境数
num_steps = 256         # 1回の更新あたり 8*256 = 2048 サンプル(SB3 の TRPO の n_steps の既定値と同じ)
gamma = 0.99            # 割引率(原論文の連続制御タスクと同じ)
gae_lambda = 0.95       # GAEのλ(SB3 の既定値)
max_kl = 0.01           # 信頼領域の半径 δ(原論文の全実験の値)
damping = 0.1           # フィッシャー行列の数値安定化項(Baselines の MuJoCo 用の既定値)
cg_iters = 10           # 共役勾配法の反復回数(原論文の値)
backtrack_iters = 10    # 直線探索の最大後退回数(Baselines と同じ)
backtrack_coeff = 0.5   # 後退時の縮小率(Baselines と同じ)
vf_iters = 5            # 価値関数の更新回数(Baselines の MuJoCo 用の既定値)
vf_lr = 1e-3            # 価値関数の学習率(Baselines の MuJoCo 用の既定値)
total_updates = 100     # 約20万ステップ。500に届いた後も保てるかを確かめられる長さ

envs = gym.make_vec("CartPole-v1", num_envs=num_envs)
state_dim = envs.single_observation_space.shape[0]
action_dim = envs.single_action_space.n

policy = PolicyNet(state_dim, action_dim)
value_net = ValueNet(state_dim)
vf_optimizer = optim.Adam(value_net.parameters(), lr=vf_lr)

state, _ = envs.reset(seed=0)
episode_rewards = np.zeros(num_envs)
recent_scores = []
history_updates, history_scores = [], []
n_rejected = 0          # 直線探索で更新を破棄した回数

for update in range(total_updates):
    # ========== 1. データ収集(オンポリシー) ==========
    states_buf, actions_buf, rewards_buf, masks_buf, values_buf = [], [], [], [], []
    for step in range(num_steps):
        s_t = torch.FloatTensor(state)
        with torch.no_grad():
            dist = policy.dist(s_t)
            action = dist.sample()
            value = value_net(s_t)
        next_state, reward, terminated, truncated, _ = envs.step(action.numpy())
        done = terminated | truncated

        states_buf.append(s_t)
        actions_buf.append(action)
        rewards_buf.append(torch.FloatTensor(reward))
        masks_buf.append(torch.FloatTensor(1.0 - terminated))
        values_buf.append(value)

        state = next_state
        episode_rewards += reward
        for i in range(num_envs):
            if done[i]:
                recent_scores.append(episode_rewards[i])
                episode_rewards[i] = 0

    with torch.no_grad():
        next_value = value_net(torch.FloatTensor(state))

    # ========== 2. GAEによるアドバンテージ推定 ==========
    values_buf.append(next_value)
    advantages = torch.zeros(num_steps, num_envs)
    gae = torch.zeros(num_envs)
    for t in reversed(range(num_steps)):
        delta = rewards_buf[t] + gamma * values_buf[t + 1] * masks_buf[t] - values_buf[t]
        gae = delta + gamma * gae_lambda * masks_buf[t] * gae
        advantages[t] = gae
    returns = advantages + torch.stack(values_buf[:-1])   # 価値関数の学習ターゲット

    states = torch.cat(states_buf)
    actions = torch.cat(actions_buf)
    advantages = advantages.reshape(-1)
    returns = returns.reshape(-1)
    # アドバンテージを平均0・標準偏差1に正規化し、更新ごとの報酬の大きさの違いに歩幅が左右されにくくする
    advantages = (advantages - advantages.mean()) / (advantages.std() + 1e-8)

    # ========== 3. 方策更新(TRPOの中核) ==========
    # 更新前の方策 π_old を固定して保存しておく
    with torch.no_grad():
        old_logits = policy(states)
        old_log_probs = Categorical(logits=old_logits).log_prob(actions)
        old_dist_detached = Categorical(logits=old_logits)

    # サロゲート目的関数 L(θ) = E[ (π_θ / π_old) * A ]
    def surrogate_loss():
        log_probs = policy.dist(states).log_prob(actions)
        ratio = torch.exp(log_probs - old_log_probs)
        return (ratio * advantages).mean()

    # 制約条件となる平均KLダイバージェンス
    # 数式: D_KL(θ_old || θ)
    def mean_kl():
        new_dist = policy.dist(states)
        return torch.distributions.kl_divergence(old_dist_detached, new_dist).mean()

    # (a) 目的関数の勾配 g(=目的関数の線形近似)
    # 数式: g = \nabla_\theta L(\theta) |_{θ=θ_old}
    loss = surrogate_loss()
    g = flat_grad(loss, policy, retain_graph=True).detach()

    # (b) フィッシャー・ベクトル積(=KL制約の二次近似)
    #     KLの1階微分をcreate_graph=Trueで保持し、
    #     「勾配とベクトルの内積」をもう一度微分することでHvを得る(二重逆伝播)
    # 数式: H = \nabla_\theta^2 D_KL(θ_old || θ)
    kl = mean_kl()
    kl_grad = flat_grad(kl, policy, retain_graph=True, create_graph=True)

    def fisher_vector_product(v):
        kl_v = torch.dot(kl_grad, v)
        hvp = flat_grad(kl_v, policy, retain_graph=True).detach()
        return hvp + damping * v   # dampingで数値的な安定性を確保

    # (c) 共役勾配法で自然勾配方向 s = H^(-1)g を求める
    # 数式: s \approx H^{-1}g
    step_dir = conjugate_gradient(fisher_vector_product, g, nsteps=cg_iters)

    # (d) KL制約 (1/2)sᵀHs = δ を満たす最大歩幅を解析的に計算
    # 数式: \beta = \sqrt{ 2\delta / (s^T H s) }
    shs = 0.5 * torch.dot(step_dir, fisher_vector_product(step_dir))
    step_size = torch.sqrt(max_kl / (shs + 1e-8))
    full_step = step_size * step_dir

    # (e) 直線探索:近似誤差で制約を破っていないか実際に確認しながら後退
    old_params = get_flat_params(policy)
    old_loss = loss.item()
    success = False
    for i in range(backtrack_iters):
        frac = backtrack_coeff ** i
        # 探索方向へ一定割合で進んだ新しいパラメータ候補をセット
        set_flat_params(policy, old_params + frac * full_step)
        with torch.no_grad():
            new_loss = surrogate_loss().item()
            new_kl = mean_kl().item()
        # 「目的関数が実際に改善」かつ「KL制約を満たす」場合のみ採用
        # KLの許容を δ の1.5倍にしているのは OpenAI Baselines と同じ(二次近似の誤差を少しだけ許す)
        if new_kl <= max_kl * 1.5 and new_loss - old_loss > 0:
            success = True
            break
    if not success:
        # どの歩幅でも条件を満たさなければ更新を破棄(安全側に倒す)
        set_flat_params(policy, old_params)
        n_rejected += 1

    # ========== 4. 価値関数(Critic)の更新 ==========
    for _ in range(vf_iters):
        vf_loss = (value_net(states) - returns).pow(2).mean()
        vf_optimizer.zero_grad()
        vf_loss.backward()
        vf_optimizer.step()

    # ========== ログ ==========
    # 5回の更新ごとに、直近20エピソードの平均スコアと、その更新でのKLを表示する
    if (update + 1) % 5 == 0:
        avg = np.mean(recent_scores[-20:]) if recent_scores else 0.0
        history_updates.append(update + 1)
        history_scores.append(avg)
        print(f"Update {update+1:4d}\tAverage Score: {avg:6.1f}\tKL: {new_kl:.4f}")

envs.close()
print(f"直線探索で更新を破棄した回数: {n_rejected} / {total_updates}")

# --- グラフの描画 ---
plt.figure(figsize=(10, 5))
plt.plot(history_updates, history_scores, label='Average Score (Last 20 Episodes)', color='blue')
plt.xlabel('Updates')
plt.ylabel('Score')
plt.title('TRPO Training Progress on CartPole-v1')
plt.grid(True)
plt.legend()
plt.show()
ここでは、これまでに解説した理論がそのままコードに落とし込まれています。
- サロゲート目的関数: surrogate_loss() が に対応します。理論式の は、古い方策で集めたサンプルから期待値を計算するため、重要度比(importance ratio) を掛ける形に書き換えられています。
- フィッシャー情報行列を「持たない」: fisher_vector_product() が本実装の技術的な核心です。KLダイバージェンスの1階微分を create_graph=True で計算グラフごと保持しておき、「KL勾配とベクトル の内積」をもう一度微分することで、ヘッシアンとベクトルの積 だけを取り出しています。
- 歩幅の解析的な決定: 制約は という二次形式で近似されるため、制約ギリギリまで進む最大歩幅は と閉じた形で求まります。これが step_size です。A2Cのような「学習率」というハイパーパラメータが存在せず、歩幅がKL制約から自動的に決まる のがTRPO最大の特徴です。
- 直線探索(Line Search): full_step はあくまで「近似式の上での」最大値なので、実際には制約を破る可能性があります。そこで backtrack_coeff=0.5 を掛けながら歩幅を半分ずつ縮め、「実際のKLが 以内」かつ「実際に目的関数が改善している」ことを確認できた時点で採用します。
- GAEの利用: アドバンテージは一般化アドバンテージ推定(GAE)で求めています。λ = 0.95 は Stable Baselines3 の既定値で、λ を1に近づけるほどバイアスが小さく分散が大きく、0に近づけるほど分散が小さくバイアスが大きくなります。前述の通り、原論文はGAEではなくモンテカルロ推定を使っています。
- ハイパーパラメータの値: コード冒頭のコメントの通り、δ と共役勾配法の反復回数は原論文、damping・直線探索・価値関数の設定は OpenAI Baselines、λ・1回のサンプル数・隠れ層の大きさは Stable Baselines3 の既定値に合わせています。total_updates = 100(約20万ステップ)は、スコアが上限の500に届いた後もしばらく保てるかを確かめられる長さです。
- 破棄の回数: 直線探索でどの歩幅も条件を満たさず、更新を破棄した回数を n_rejected で数えています。破棄が多ければ、δ が大きすぎるか、二次近似が合っていないことを示します。
実行結果
Colab の CPU ランタイム(Python 3.13、gymnasium 1.4.0、torch 2.11.0)で実行した結果です。PyTorch や gymnasium の版が違うと、乱数の流れが変わり、数値が少し変わることがあります。
Update    5	Average Score:   70.0	KL: 0.0079
Update   10	Average Score:  228.7	KL: 0.0050
Update   15	Average Score:  207.1	KL: 0.0053
Update   20	Average Score:  356.9	KL: 0.0087
Update   25	Average Score:  491.9	KL: 0.0083
Update   30	Average Score:  500.0	KL: 0.0045
Update   35	Average Score:  488.8	KL: 0.0076
Update   40	Average Score:  500.0	KL: 0.0073
Update   45	Average Score:  500.0	KL: 0.0093
Update   50	Average Score:  486.2	KL: 0.0064
Update   55	Average Score:  498.8	KL: 0.0064
Update   60	Average Score:  448.5	KL: 0.0049
Update   65	Average Score:  473.3	KL: 0.0057
Update   70	Average Score:  500.0	KL: 0.0079
Update   75	Average Score:  488.6	KL: 0.0029
Update   80	Average Score:  467.6	KL: 0.0021
Update   85	Average Score:  490.2	KL: 0.0089
Update   90	Average Score:  497.3	KL: 0.0075
Update   95	Average Score:  494.0	KL: 0.0046
Update  100	Average Score:  480.4	KL: 0.0068
直線探索で更新を破棄した回数: 0 / 100
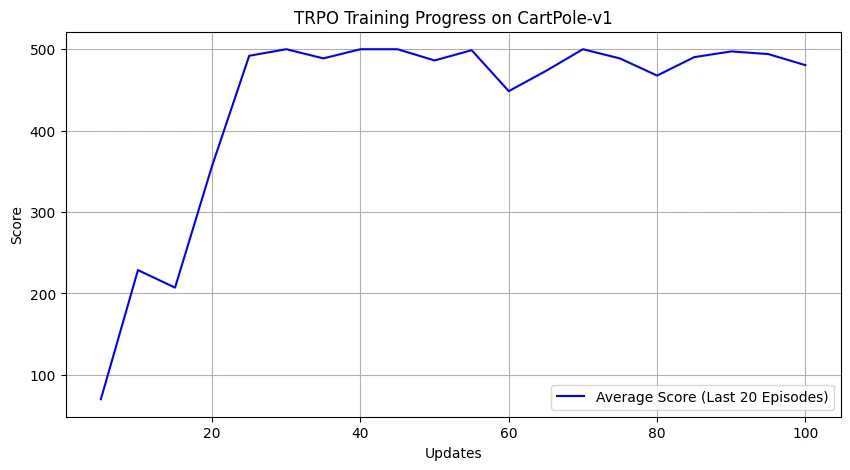
注目すべきは以下の3点です。
- 学習の速さと安定性 : 直近20エピソードの平均スコアは、25回目の更新で491.9、30回目の更新(約6万ステップ)で上限の500に届きました。その後も100回目まで448.5〜500.0の間にとどまっています。A2Cの記事のスクラッチ実装では、500に届くまでに約22万ステップかかり、その後の更新で175.1まで崩れました。「制約が許す範囲で最大の歩幅」を毎回踏みつつ、方策が大きく変わりすぎないため、速く学習し、学習後も崩れにくくなっています。
- KLの安定性 : ログに出力されるKLダイバージェンス(その更新で採用した歩幅での値)は、0.0021〜0.0093で、すべて設定した 以下に収まっています。歩幅を δ から決めているため、方策が1回の更新で変わる大きさが一定の範囲に保たれています。
- 更新の破棄は0回 : 100回の更新のうち、直線探索で更新を破棄した回数は0回でした。CartPoleのような小さなタスクでは、二次近似で求めた歩幅(または、それを何回か半分にした歩幅)で、ほぼ毎回条件を満たせています。
スコアと KL の推移を並べると、次のようになります。
(図は、diagram-designで作成)
Stable Baselines3(sb3-contrib)を使ったTRPO実装
実務でTRPOを利用する場合は、ライブラリを用いるのが一般的です。
ただし注意点として、 TRPOはStable Baselines3の本体には含まれておらず、拡張パッケージであるsb3-contribで提供されています 。
sb3-contrib は、Stable Baselines3 の本体に入れるほどは使われていない、実験的なアルゴリズムを集めたパッケージです。後継のPPOがTRPOと同等以上の性能をより単純な実装で達成できるため、TRPOはこちらに置かれています。
ライブラリのインストール
!pip install sb3-contrib "gymnasium[classic-control]"
本記事では、sb3-contrib 2.9.2(Stable Baselines3 2.9.2)で実行しています。
sb3-contrib を用いたTRPO実装
import gymnasium as gym
from sb3_contrib import TRPO
from stable_baselines3.common.env_util import make_vec_env
from stable_baselines3.common.evaluation import evaluate_policy
from stable_baselines3.common.monitor import Monitor

# 複数の環境を並列化して作成
vec_env = make_vec_env("CartPole-v1", n_envs=8, seed=0)

# TRPOモデルの定義と学習(スクラッチ実装と同じ値にそろえ、それ以外は SB3 の既定値のまま)
# - target_kl:     信頼領域の半径 δ(スクラッチ実装の max_kl に対応)
# - n_steps:       1環境あたりの収集ステップ数(8環境 × 256 = 2048サンプル/更新)
# - cg_max_steps:  共役勾配法の反復回数
# - gae_lambda:    GAEのλ
model = TRPO(
    "MlpPolicy",
    vec_env,
    n_steps=256,
    target_kl=0.01,
    gamma=0.99,
    gae_lambda=0.95,
    cg_max_steps=10,
    verbose=1,
    seed=0,        # 実行結果を再現できるように乱数シードを固定する
)
model.learn(total_timesteps=100000)  # 10万ステップ(rl-baselines3-zoo の CartPole-v1 の設定と同じ)

# 学習したモデルの評価
eval_env = Monitor(gym.make("CartPole-v1"))
eval_env.reset(seed=0)  # 評価エピソードの初期状態を固定する
mean_reward, std_reward = evaluate_policy(model, eval_env, n_eval_episodes=10)
print(f"Mean reward: {mean_reward:.1f} +/- {std_reward:.1f}")

# 学習したモデルの可視化(Google Colab向け)
from matplotlib import animation
from IPython.display import HTML
import matplotlib.pyplot as plt

env = gym.make("CartPole-v1", render_mode="rgb_array")
obs, _ = env.reset(seed=0)
frames = []

for i in range(1000):  # CartPole-v1 は最大500ステップなので、1000 は十分な上限
    frames.append(env.render())
    action, _states = model.predict(obs, deterministic=True)
    obs, reward, terminated, truncated, info = env.step(action)
    if terminated or truncated:
        break  # 1エピソード終了でストップ

env.close()

# アニメーションを作成し、Colab上に表示する
fig = plt.figure(figsize=(frames[0].shape[1] / 72.0, frames[0].shape[0] / 72.0), dpi=72)
ax = fig.add_subplot(111)
ax.axis('off')
patch = ax.imshow(frames[0])

def animate(i):
    patch.set_data(frames[i])

anim = animation.FuncAnimation(fig, animate, frames=len(frames), interval=50)
plt.close(fig)

HTML(anim.to_jshtml())
SB3 の TRPO は、スクラッチ実装と同じ値にそろえた引数(8環境 × 256ステップ、δ、γ、λ、共役勾配法の反復回数)以外は、既定値のままです。スクラッチ実装と違う主な既定値は、直線探索の縮小率(0.8)、価値関数の更新(ミニバッチ128件で10回)、damping(0.1、スクラッチ実装と同じ)です。seed=0 と、評価・可視化の環境の reset(seed=0) は、実行結果を再現できるようにするためです。
実行結果
学習中のログには、TRPO特有の指標が表示されます。最後の更新(49回目)のログと評価の結果は次の通りです。
----------------------------------------
| rollout/                  |          |
|    ep_len_mean            | 500      |
|    ep_rew_mean            | 500      |
| time/                     |          |
|    fps                    | 4690     |
|    iterations             | 49       |
|    time_elapsed           | 21       |
|    total_timesteps        | 100352   |
| train/                    |          |
|    explained_variance     | -1.16    |
|    is_line_search_success | 1        |
|    kl_divergence_loss     | 0.00595  |
|    learning_rate          | 0.001    |
|    n_updates              | 48       |
|    policy_objective       | 0.00365  |
|    value_loss             | 2.3e-05  |
----------------------------------------
Mean reward: 500.0 +/- 0.0

- is_line_search_success が
1になっているのは、直線探索が制約を満たす歩幅を発見できた(=更新が破棄されなかった)ことを意味します。今回は48回の更新すべてで1でした。ここが0になることが多い場合は、target_klが小さすぎるか、学習が不安定になっているサインです。 - kl_divergence_loss は実際に更新前後で生じたKLダイバージェンスです。48回の更新で 0.0034〜0.0098 の範囲にあり、すべて
target_kl=0.01を下回っていることから、信頼領域の制約が守られていることが確認できます。 - ep_rew_mean(直近100エピソードの平均スコア)は、39回目の更新(約8万ステップ)で500に届き、最後まで500のままでした。
学習後の評価では、10エピソードすべてで上限の500ステップまでポールを立て続けました(平均報酬500.0、標準偏差0.0)。上の図は、可視化したエピソードの0・250・499ステップ目のフレームを並べたものです。最初から最後まで、カートはほとんど動かず、ポールはほぼ垂直のまま保たれています。
PPOへの橋渡し:TRPOの実用上の課題
TRPOは「単調な性能改善の保証」という強力な理論的裏付けを持ちますが、実用面では以下の課題が残りました。
- 実装の複雑さ : 上記のコードが示すとおり、共役勾配法・フィッシャー・ベクトル積・直線探索といった実装が必要で、
loss.backward()だけでは済みません。 - 計算コスト : 1回の更新ごとに共役勾配法を回すため、1ステップあたりの計算が重くなります。
- アーキテクチャの制約 : 二重逆伝播を扱う都合上、ActorとCriticの重み共有や、Dropout・パラメータノイズなどとの相性が良くありません。
これらを解決するために、「KL制約を厳密に解く」代わりに「 重要度比を単純にクリッピングすることで、結果的に方策が大きく変わらないようにする 」という驚くほど単純なアイデアを採用したのが、PPO (Proximal Policy Optimization) です(PPOの記事)。PPOはTRPOとほぼ同等の安定性を、通常の勾配降下法だけで実現しました。
TRPO と PPO の1回の更新の手順を並べると、違いがはっきりします。
(図は、diagram-designで作成)
まとめ
- 問題意識 : オンポリシーの方策勾配法は、1回の更新幅が大きすぎると方策が崩壊し、二度と回復できなくなる。
- 理論的基盤 : 新しい方策の期待収益は「古い方策の収益 + アドバンテージの期待値」と厳密に一致する。状態訪問頻度 が未知であるため、方策が大きく変わらないと仮定してサロゲート目的関数 で代用する。最大KLのペナルティを引いた下限を最大化すれば、理論上は性能が単調に改善する。
- Trust Region(信頼領域) : 理論上のKLペナルティは歩幅が小さすぎて実用的でないため、平均KLダイバージェンスに対するハード制約 に置き換える。
- 解法 : 目的関数を線形近似、KL制約を二次近似(フィッシャー情報行列)し、共役勾配法 とフィッシャー・ベクトル積 で逆行列計算を回避。最後に直線探索 で実際の制約充足を確認する。
- 実装上の特徴 : 方策側に「学習率」というハイパーパラメータが存在せず、歩幅は から自動的に決まる。CartPoleのスクラッチ実装では、30回の更新(約6万ステップ)で直近20エピソードの平均スコアが500に届き、その後も448.5〜500.0を保った。KLはすべて 以下で、直線探索による更新の破棄は0回だった。
TRPOによって、強化学習は「恐る恐る小さく更新する」時代から「安全が保証された範囲で大胆に更新する」時代へと移行しました。次はこの思想をより簡潔かつ実用的に昇華させた PPO の世界へ進みます。
参考文献
- J. Schulman, S. Levine, P. Moritz, M. I. Jordan, P. Abbeel (2015). Trust Region Policy Optimization. ICML 2015.
- M. Towers et al. (2024). Gymnasium: A Standard Interface for Reinforcement Learning Environments. arXiv:2407.17032.
- A. Raffin, A. Hill, A. Gleave, A. Kanervisto, M. Ernestus, N. Dormann (2021). Stable-Baselines3: Reliable Reinforcement Learning Implementations. Journal of Machine Learning Research, 22(268), 1–8.
本記事の文章・構成の一部に生成AIを使用しています。