t検定とは?
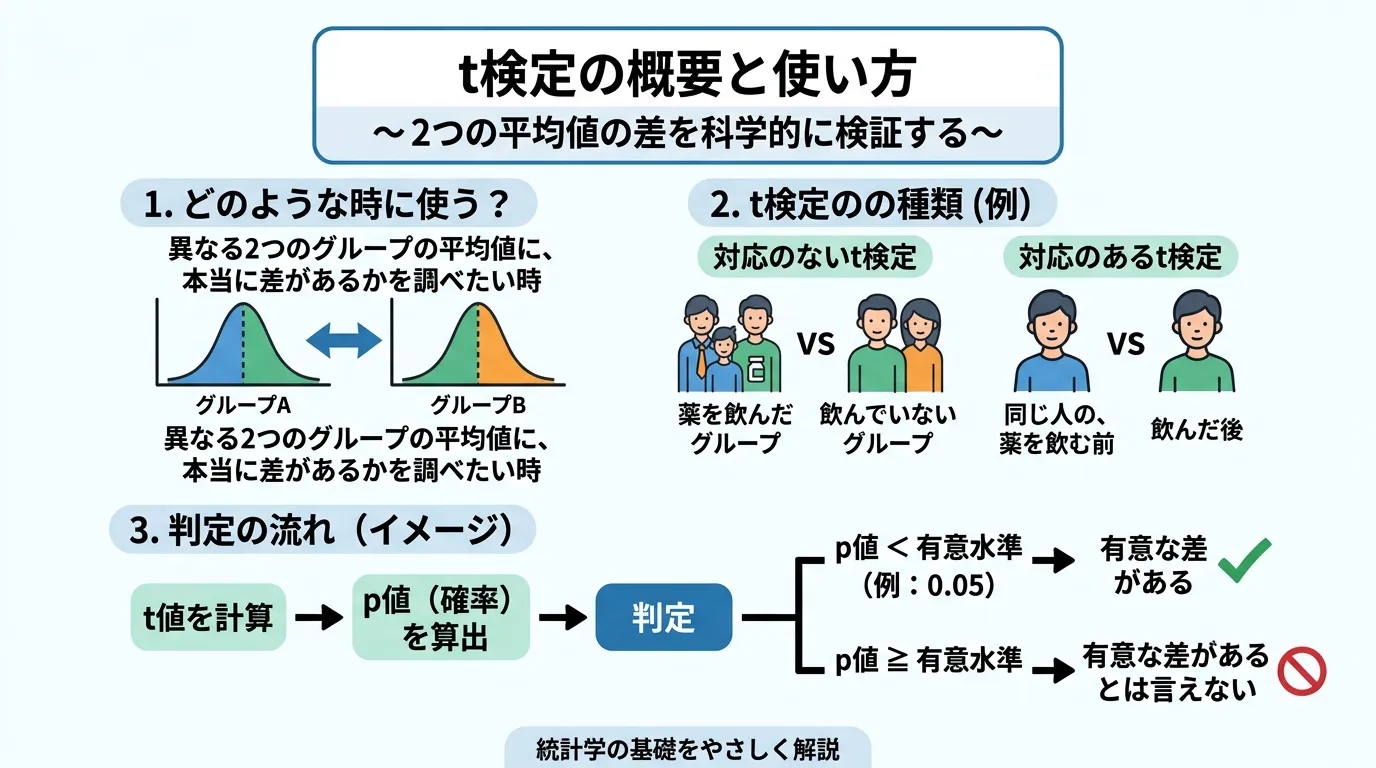
(画像は、Geminiで作成)
2つのグループの平均の差が偶然のばらつきなのかを判定する t 検定の考え方と、母標準偏差を標本標準偏差で置き換えると t 分布になる理由を理解すること。NumPy で t 値と p 値を計算して SciPy と一致させ、シミュレーションで、スチューデントの t 検定とウェルチの t 検定の誤りの率を比べて、実務でウェルチの t 検定と SMD を使う理由を説明できるようになること。
t検定の概要
データ分析や効果検証の現場において、「2つのグループ間に見られる平均値の差は、本当に意味のある差なのか?」という問いに答えるための代表的な手法が t検定(t-test) です。
ビジネスにおけるA/Bテストや、因果推論のゴールドスタンダード(最高峰の基準)と呼ばれる ランダム化比較試験(RCT) において、t検定は意思決定の根幹を支える重要な役割を担っています。RCTでは、対象となるユーザーを「施策を受けるグループ(処置群)」と「施策を受けないグループ(対照群)」に完全にランダム(無作為)に割り振ります。そして、一定期間経過後に両グループの平均値(売上やコンバージョン率など)を比較することで、施策の真の効果を測定します。
この一連のプロセスにおいて、t検定は主に以下の2つの重要なフェーズで活用されます。
-
共変量バランスの確認(バランスチェック) RCTが正しく成立するためには、ランダム割り当てによって、結果に影響を与える背景要因である交絡因子(Confounding factor)が両グループで均等に分散され、比較可能性が担保されている必要があります。年齢や過去の購買履歴といった特徴量(共変量)の平均値に偏りがないかを客観的に確認する際、t検定が用いられます。
-
施策の効果検証 施策実施後に得られた目標変数の平均値に差が生じた場合、それが施策による「真の効果」なのか、それとも有限のデータから生じた単なる誤差なのかを判定する必要があります。t検定を用いることで、得られた差が統計的に有意であるかを評価し、偶然による見逃しや誤認を防ぐことができます。
この2つの使い方は、RCTの記事と回帰による効果推定の記事で実際のダミーデータに対して実行しています。本記事は、そこで呼び出している stats.ttest_ind が内部で何を計算しているのかを解説する位置づけです。
背景と課題
偶然のばらつきと「真の差」の見極め
データ分析やA/Bテストにおいて、2つのグループ(例えば、新しい施策を受けた処置群と、受けていない対照群)の指標を比較する際、最も直感的なアプローチは「平均値の差」を計算することです。
しかし、単純な平均値の比較だけで結論を下すことには大きな落とし穴が潜んでいます。私たちが手元で観測しているデータは、常に全体である「母集団(Population)」から抽出された一部の「標本(Sample)」に過ぎないからです。
データを抽出する過程で必然的に生じるデータの偏りや誤差を、「偶然のばらつき(Random variation)」あるいは「ノイズ(Noise)」と呼びます。私たちがデータから計算する「観測された差」は、常に以下の要素の足し合わせで構成されています。
観測された差を目の当たりにしたとき、常に以下の2つの可能性を天秤にかける必要があります。
- 真の効果(True effect): 施策がユーザーの行動を実際に変化させ、その結果として平均値に差が生じた。
- 偶然のばらつき(Random variation): 施策には何の効果もないが、たまたま一方のグループに偏りが生じたため、見かけ上の差が現れた。
単なる平均値の引き算だけでは、目の前にある差が「意味のある真の差」なのか、「単なる偶然の産物」なのかを区別することは原理的に不可能です。データに基づく正しい意思決定を行うためには、この「偶然のばらつき」がどの程度の規模で起こり得るものなのかを定量的に評価し、観測された差がノイズの範囲を超えているかを客観的に見極めるための数学的なアプローチが必要となります。
t分布とは
t検定の話に入る前に、その名前の由来である t分布 がどのような分布なのかを押さえておきます。結論から言えば、t分布は 「正規分布の親戚」 であり、裾が少しだけ重い正規分布だと考えて差し支えありません。
まずは正規分布と「標準化」の復習
身長、テストの点数、売上といった量は、多くの場合おおよそ正規分布に従います。ただし正規分布と一口に言っても、平均 と標準偏差 の組み合わせによって形も位置もバラバラです。「身長170cm」と「点数70点」を同じ土俵で比べることはできません。
そこで用いるのが 標準化(standardization) です。平均を引いて標準偏差で割るだけの操作です。
この は「平均から標準偏差何個分ずれているか」を表す無次元の値で、平均0・標準偏差1の標準正規分布に従います。単位が消えるため、身長でも点数でも売上でも、同じ物差しで「珍しさ」を語れるようになります。 なら上下合わせて約5%の珍しさ、というあの基準はここから来ています。
同じ発想は「平均そのもの」にも適用できます。標本平均 は、母集団が正規分布であれば厳密に、そうでなくてもサンプルサイズ が十分大きければ近似的に(中心極限定理)、母平均 ・標準偏差 の正規分布に従います。そこで、
とすれば、やはり標準正規分布になります。
母標準偏差がわからないと、t分布になる
ところが実務には決定的な問題があります。上の式に出てくる母標準偏差 は、現実には誰も知らないのです。手元にあるのは標本から計算した標準偏差 だけです。
そこで の代わりに を使います。
形はまったく同じ「標準化」です。しかし中身は変わっています。 は動かない定数でしたが、 はデータを取り直すたびに変わる確率変数です。分子だけでなく分母までブレるため、この値は標準正規分布からわずかにはみ出します。
直感的には次のように理解できます。たまたま を小さく見積もったとき、小さい数で割ることになるので の絶対値は大きく跳ね上がります。この「たまに極端な値が出る」性質が、正規分布より裾の重い分布を生みます。これが t分布(t-distribution) です。
裾の重さは、 の推定にどれだけデータを使えたかで決まります。この「 を計算するのに使える情報量」が 自由度(degree of freedom) で、1群のデータであれば です。自由度が大きいほど は に近づくので、t分布は標準正規分布へ近づいていきます。
自由度ごとに描いてみる
言葉だけではイメージが湧かないので、実際にプロットしてみます。
import numpy as np
import matplotlib.pyplot as plt
import japanize_matplotlib
from scipy import stats

x = np.linspace(-5, 5, 1000)
# 自由度は、裾が極端に重い 1・2、少なめの 5、標準正規分布とほぼ同じになる 30 の 4 つ
dfs = [1, 2, 5, 30]
colors = ['#C44E52', '#DD8452', '#55A868', '#4C72B0']

fig, axes = plt.subplots(1, 2, figsize=(12, 4.5))

# 左:分布全体の形
ax = axes[0]
ax.plot(x, stats.norm.pdf(x), 'k--', lw=2.5, label='標準正規分布')
for df, c in zip(dfs, colors):
    ax.plot(x, stats.t.pdf(x, df), color=c, lw=1.8, label=f't分布(自由度={df})')
ax.set_title('t分布と標準正規分布')
ax.set_xlabel('値')
ax.set_ylabel('確率密度')
ax.legend()

# 右:右の裾だけを拡大
ax = axes[1]
xt = np.linspace(2, 5, 500)
ax.plot(xt, stats.norm.pdf(xt), 'k--', lw=2.5, label='標準正規分布')
for df, c in zip(dfs, colors):
    ax.plot(xt, stats.t.pdf(xt, df), color=c, lw=1.8, label=f't分布(自由度={df})')
ax.axvline(1.96, color='gray', ls=':', lw=1.5)
ax.set_title('右の裾の拡大(自由度が小さいほど裾が重い)')
ax.set_xlabel('値')
ax.set_ylabel('確率密度')
ax.legend()

plt.tight_layout()
plt.show()
- 確率密度関数の描画: stats.t.pdf(x, df) で自由度 df のt分布の密度を、stats.norm.pdf(x) で標準正規分布の密度を計算しています。t分布は自由度というパラメータを1つ持つ点が正規分布との違いです。
- 裾の拡大表示: 左のグラフでは差が見えにくいため、右では の範囲だけを描いています。分布の違いは中心付近ではなく裾で効くので、検定にとって重要なのはこちらの領域です。
- 基準線の描画: ax.axvline(1.96) は標準正規分布における両側5%の基準値です。t分布の曲線がこの線より右側で上にあることが、「同じ1.96でも、t分布ではもっと高い確率で超えてしまう」ことを意味します。
実行結果
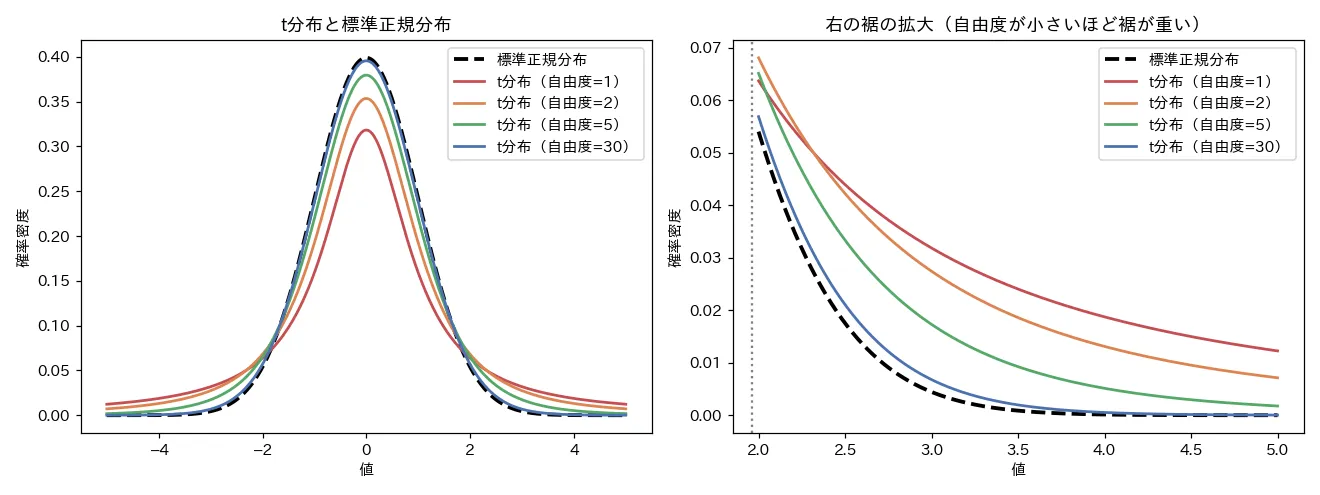
左のグラフを見ると、自由度が30もあればt分布は標準正規分布とほぼ見分けがつきません。一方、自由度が1や2と小さいときは、中心が低く裾が持ち上がっています。右の拡大図では、その裾の差がはっきり見て取れます。
この「裾の重さ」を数値でも確認しておきましょう。
print("=== 両側95%の臨界値(この値を超えたら有意) ===")
for df in [1, 2, 5, 10, 30, 100, 1000]:
    print(f"自由度 {df:>5}: {stats.t.ppf(0.975, df):.4f}")
print(f"標準正規分布 : {stats.norm.ppf(0.975):.4f}")

print()
print("=== 絶対値が1.96を超える確率 ===")
for df in [1, 2, 5, 10, 30, 100]:
    print(f"自由度 {df:>5}: {2 * stats.t.sf(1.96, df):.4f}")
print(f"標準正規分布 : {2 * stats.norm.sf(1.96):.4f}")
- 臨界値の算出: stats.t.ppf(0.975, df) はパーセント点関数(分位点関数)で、「下側97.5%にあたる値」を返します。両側検定ではこの値を超えたときに有意と判定します。
- 上側確率の算出: stats.t.sf(1.96, df) は生存関数(上側確率)で、「1.96より大きい値が出る確率」を返します。両側にするため2倍しています。
実行結果
=== 両側95%の臨界値(この値を超えたら有意) ===
自由度     1: 12.7062
自由度     2: 4.3027
自由度     5: 2.5706
自由度    10: 2.2281
自由度    30: 2.0423
自由度   100: 1.9840
自由度  1000: 1.9623
標準正規分布 : 1.9600

=== 絶対値が1.96を超える確率 ===
自由度     1: 0.3003
自由度     2: 0.1891
自由度     5: 0.1073
自由度    10: 0.0784
自由度    30: 0.0593
自由度   100: 0.0528
標準正規分布 : 0.0500
自由度が大きくなるにつれ、臨界値が へ、確率が へと着実に近づいていきます。逆にサンプルが極端に少ないとき(自由度1)は、有意と判定するのに という桁違いの値が必要になります。データが少ないほど慎重に判断するという常識が、分布の形として自動的に組み込まれているわけです。
シミュレーションで確かめる
「 を に置き換えたからt分布になる」という話を、実際に乱数で再現してみます。母平均50・母標準偏差10の正規分布から5個だけサンプリングする、という作業を20万回繰り返します。
np.random.seed(42)

# n=5(自由度 4)は、σ と s の違いがはっきり出るほど少ないサンプル数。20 万回なら、ヒストグラムが理論曲線と比べられるほど滑らかになる
n, n_sim = 5, 200000
samples = np.random.normal(loc=50, scale=10, size=(n_sim, n))

xbar = samples.mean(axis=1)              # 標本平均
s = samples.std(axis=1, ddof=1)          # 不偏分散の平方根

z = (xbar - 50) / (10 / np.sqrt(n))      # 母標準偏差10が「既知」だとして標準化
t = (xbar - 50) / (s / np.sqrt(n))       # 標本標準偏差sで代用して標準化

print(f"zの標準偏差: {z.std(ddof=1):.4f}")
print(f"tの標準偏差: {t.std(ddof=1):.4f}")
print(f"|z| > 1.96 の割合: {np.mean(np.abs(z) > 1.96):.4f}")
print(f"|t| > 1.96 の割合: {np.mean(np.abs(t) > 1.96):.4f}")

x = np.linspace(-6, 6, 1000)
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5), sharey=True)

axes[0].hist(z, bins=200, range=(-6, 6), density=True,
             color='#4C72B0', alpha=0.6, label='シミュレーション')
axes[0].plot(x, stats.norm.pdf(x), 'k--', lw=2, label='標準正規分布')
axes[0].set_title('母標準偏差σを使って標準化(σが既知の場合)')

axes[1].hist(t, bins=200, range=(-6, 6), density=True,
             color='#DD8452', alpha=0.6, label='シミュレーション')
axes[1].plot(x, stats.t.pdf(x, n - 1), color='#C44E52', ls='--', lw=2,
             label=f't分布(自由度={n-1})')
axes[1].plot(x, stats.norm.pdf(x), 'k:', lw=1.5, label='標準正規分布(参考)')
axes[1].set_title('標本標準偏差sを使って標準化(実際に起きること)')

for ax in axes:
    ax.set_xlabel('標準化した値')
    ax.legend()
axes[0].set_ylabel('確率密度')
plt.tight_layout()
plt.show()
- 2通りの標準化: 唯一の違いは分母です。z は真の値である母標準偏差 10 で割り、t はサンプルごとに計算し直した s で割っています。分子はどちらも同じです。
- ベクトル化した試行: size=(n_sim, n) で20万行×5列の乱数を一度に生成し、axis=1 で行方向に集計することで、ループを書かずに20万回の試行を実行しています。
- 理論分布との重ね描き: ヒストグラムに density=True を指定して密度に正規化し、理論上の確率密度関数を重ねています。シミュレーション結果が理論曲線と一致すれば、導出が正しいことの裏付けになります。
実行結果
zの標準偏差: 1.0005
tの標準偏差: 1.4135
|z| > 1.96 の割合: 0.0501
|t| > 1.96 の割合: 0.1216
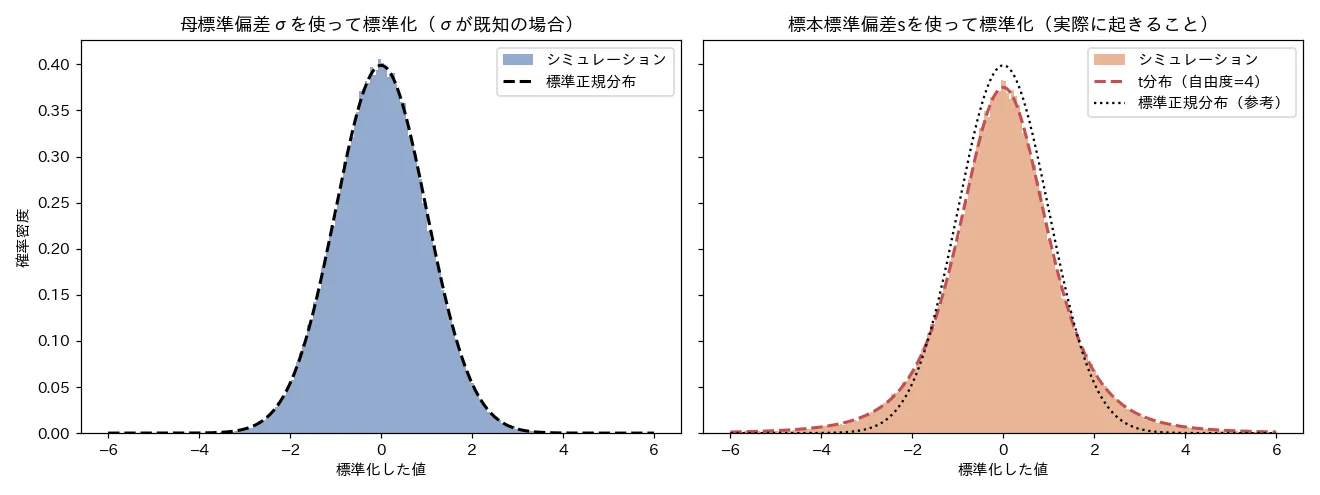
結果は明快です。
- が既知なら、標準化した値はぴったり標準正規分布に従います(標準偏差 1.0005、 の割合は 5.01%)。
- で代用した途端、分布は横に広がります(標準偏差 1.4135)。そして自由度4のt分布の曲線と完全に重なります。
- このとき となる割合は 12.16% です。標準正規分布のつもりで 1.96 を基準にすると、本当は差がないのに12%も「有意差あり」と誤判定してしまうことになります。
t分布を使う理由はまさにここにあります。自由度4での正しい基準値は 1.96 ではなく 2.7764 であり、この値を使えば誤判定の確率はきちんと5%に収まります。
- 正規分布とほぼ同じもの:左右対称の釣鐘型で、自由度が30を超えたあたりからは見た目の区別がつきません。
- 違いは裾の重さだけ:母標準偏差 の代わりに標本標準偏差 を使うことで生じる「余分な不確実性」を、裾の重さとして吸収しています。
- 標準化の発想は正規分布と共通:「(値 − 期待値)÷ ばらつき」という形は同じです。分母に を使えば正規分布、 を使えばt分布になる、というだけの違いです。
- 自由度が形を決める:データが少ないほど裾が重くなり、有意と判定するための基準が厳しくなります。
核心アイデア
仮説検定とt分布
「偶然のばらつき」を客観的に評価し、データに潜む「真の差」を見極めるための統計的なアプローチの核心は、仮説検定(Hypothesis Testing) の枠組みと、前節で確認した t分布 の性質を組み合わせることにあります。
t検定では、あえて逆の仮定を置き、背理法のような論理展開で差の有無を判定します。このプロセスは、大きく以下のステップで進行します。
-
帰無仮説と対立仮説の設定 まず、「2つのグループの母平均に差はない(差はゼロである)」という前提を置きます。これを 帰無仮説(Null Hypothesis) と呼びます。一方で、本当に証明したい「2つのグループの母平均には差がある」という主張を 対立仮説(Alternative Hypothesis) と呼びます。
-
t値(t統計量)の計算 次に、観測されたデータから「2群の平均の差」が、データの持つ「偶然のばらつき」に対して相対的にどれくらい大きいかを示す指標を計算します。これが t値(t-value) です。
t値の絶対値が大きいほど、偶然のノイズに対して平均の差が際立っていることを意味します。
-
t分布による評価とp値の導出 帰無仮説が正しい(本当に差がない)とした場合、無作為にサンプルを抽出してt値を計算する作業を繰り返すと、そのt値は前節で見た t分布 に従います。このt分布において、今回観測されたt値、あるいはそれ以上に極端なt値が得られる確率が p値(p-value) です。
-
有意水準との比較による結論 最後に、算出されたp値を事前に定めた基準値である 有意水準(Significance Level)(実務では一般的に0.05や0.01)と比較します。 もしp値が有意水準を下回った場合(例:)、「本当に差がないのだとしたら、こんなに極端なデータが偶然得られる確率は非常に稀である」と解釈し、帰無仮説を 棄却(Reject) して対立仮説を採択します。
4つのステップを、本記事のスクラッチ実装の結果とあわせて図にすると、次のようになります。
(図は、diagram-designで作成)
数式による定式化
独立2群のt検定の数式
実務において最も標準的に用いられる、2群の母分散が等しいと仮定しない「ウェルチのt検定(Welch's t-test)」の数式を定義します。
比較したい2つのグループ(群1、群2)から得られた観測データに対して、以下の統計量を用います。
- :それぞれの群の 標本平均(Sample mean)
- :それぞれの群の 不偏分散(Unbiased variance)
- :それぞれの群の サンプルサイズ(Sample size)
独立した2群の平均の差を評価するためのt値は、以下の数式で定義されます。
- 分子():2つのグループの「標本平均の差」を表します。厳密には、帰無仮説(2群の真の差は0である)を前提としているため、「観測された差 」から「期待される差 」を引いています。
- 分母():この平均の差が、データのばらつきによって「偶然どれくらい変動しうるか」を示す 標準誤差(Standard error) を表します。
つまりt値とは、期待値からどれだけ離れているかを示す「観測された平均の差(分子)」を、「偶然生じうるばらつきの大きさ(分母)」で割ることで標準化し、スケールを統一した無次元化された値です。
後のスクラッチ実装の値を当てはめると、t値は次のように計算されます。
(図は、diagram-designで作成)
t値が算出できたら、次はその値が従うt分布の形状を決定する 自由度(Degree of freedom) を計算します。等分散を仮定しないウェルチのt検定においては、ウェルチ・サタスウェイトの式(Welch-Satterthwaite equation) と呼ばれる近似式を用いて、有効な自由度 を計算します。
t値とウェルチ・サタスウェイトの式の導出
1. t値の分母(標準誤差)の導出
t値の分母は、分子である「標本平均の差 」がどれくらいばらつくかを示す標準誤差(分散の平方根)です。
各グループの標本平均 の分散は、独立な 個の値の平均の分散が元の分散の になる、という分散の性質より以下となります( は母分散。この式は中心極限定理を使わずに成り立ちます)。
2つのグループは互いに独立しているため、その「差の分散」は、それぞれの分散の「和」になります(分散の加法性)。
実際のデータ分析では真の母分散 は未知であるため、代わりにデータから計算した不偏分散 で代用します。これに平方根をとることで、t値の分母である標準誤差が得られます。
2. 2群の差への標準化の適用
ここまでで、t値の分子は「期待値0からのズレ」、分母は「そのズレのばらつき」であることが確認できました。つまりt値の計算式は、t分布とはの節で見た標準化 を、1群の平均から2群の平均の差へ置き換えただけのものです。
- 分子:1群では 、2群の差では (帰無仮説より期待値は )
- 分母:1群では 、2群の差では
分母に真の母分散から導かれた標準誤差を使えれば標準正規分布に従うが、実際には不偏分散で代用するためt分布になる、という構図も同じです。違いは自由度の決まり方だけで、それを扱うのが次の3です。
3. ウェルチ・サタスウェイトの式の導出(概要)
等分散を仮定するスチューデントのt検定では自由度は厳密に と求まりますが、等分散を仮定しない場合、統計量 は厳密な意味でのt分布には従いません。
そこで、ウェルチは の分母にある分散の推定量 が、ある定数 と自由度 を用いて の形(カイ二乗分布を用いた形)で近似できると仮定しました(サタスウェイトの近似)。
不偏分散 は自由度 のカイ二乗分布と関連しており、 という性質を持ちます。 分散の推定量 の分散を計算し、それをカイ二乗分布の分散の公式と照らし合わせて自由度 について解くことで、以下の有効自由度の近似式が導かれます。
ここでも未知の母分散 を不偏分散 で代用したものが、実務で用いられるウェルチ・サタスウェイトの式となります。
スクラッチ実装
NumPyによるt値とp値の計算
前節で定式化したロジックを、外部の統計ライブラリ(SciPyなど)に頼らず、数値計算ライブラリであるNumPyとPythonの標準ライブラリのみを用いてゼロから実装します。
import numpy as np
import math

# 乱数シードの固定
np.random.seed(42)

# 1. ダミーデータの生成(正規分布)
# 処置群(施策あり)と対照群(施策なし)を想定
# 真の差 2 は標準偏差 10 の 0.2 倍(効果量 d=0.2)。各群 100 人では検出力が約 29% しかない状況を作る
n1, n2 = 100, 100
group1 = np.random.normal(loc=52, scale=10, size=n1) # 処置群
group2 = np.random.normal(loc=50, scale=10, size=n2) # 対照群

# 2. 標本平均と不偏分散の計算
# ddof=1 を指定することで不偏分散(n-1で割る)を計算
mean1, mean2 = np.mean(group1), np.mean(group2)
var1, var2 = np.var(group1, ddof=1), np.var(group2, ddof=1)

# 3. t値の計算
t_value = (mean1 - mean2) / np.sqrt(var1 / n1 + var2 / n2)

# 4. ウェルチの近似による自由度の計算
df_num = (var1 / n1 + var2 / n2)**2
df_den = (var1 / n1)**2 / (n1 - 1) + (var2 / n2)**2 / (n2 - 1)
df = df_num / df_den

# 5. p値の計算(t分布の確率密度関数を数値積分)
def t_pdf(x, df):
    # t分布の確率密度関数 (Probability Density Function)
    coef = math.gamma((df + 1) / 2) / (math.sqrt(df * math.pi) * math.gamma(df / 2))
    return coef * (1 + x**2 / df)**(-(df + 1) / 2)

# 積分範囲の設定(-|t| から |t| まで)
t_abs = np.abs(t_value)
x = np.linspace(-t_abs, t_abs, 10000)   # 1 万点あれば、p 値は小数第 4 位まで正確(SciPy の値 0.57559 と一致)
y = t_pdf(x, df)

# 台形公式(np.trapezoid)による積分で、-|t| から |t| までの確率(内側の面積)を計算
# ※ NumPy 1.x では np.trapz、NumPy 2.0 以降は np.trapezoid を使用します
prob_inside = np.trapezoid(y, x)

# 両側p値は、全体(1)から内側の確率を引いたもの
p_value = 1 - prob_inside

print(f"群1 - 平均: {mean1:.2f}, 不偏分散: {var1:.2f}")
print(f"群2 - 平均: {mean2:.2f}, 不偏分散: {var2:.2f}")
print(f"t値: {t_value:.4f}")
print(f"自由度: {df:.4f}")
print(f"p値: {p_value:.4f}")
- ダミーデータの作り方: 真の母平均の差は2(群1が52、群2が50)、標準偏差は両群とも10です。差は標準偏差の0.2倍(効果量 、コーエンの基準で「小」)で、各群100人のとき、有意水準5%のウェルチのt検定で差を見つけられる確率(検出力)は約29%しかありません。検出力を慣例の80%にするには、各群約394人が必要です。「本当は差があるのに見つからない」ことがよく起こる状況を、あえて作っています。
- 要約統計量の算出: np.mean で標本平均を、np.var(ddof=1) で不偏分散を算出しています。ddof=1 を指定しないと母分散( で割る)になってしまうため、t検定では必ず指定が必要です。
- t値と自由度の導出: 前節で定義した数式に要約統計量をそのまま代入し、t値とウェルチ・サタスウェイトの近似による自由度を計算しています。
- 数値積分によるp値の算出: t分布の確率密度関数(PDF)を t_pdf として自前で定義し、np.trapezoid(台形公式)で から までを積分しています。両側p値は「全体の確率1から、その内側の面積を引いた値」として求まります。
df についてコード内に登場する変数 df は、pandas などでよく用いられる DataFrame(データフレーム)の略ではなく、自由度(degree of freedom) を意味しています。
実行結果
群1 - 平均: 50.96, 不偏分散: 82.48
群2 - 平均: 50.22, 不偏分散: 90.95
t値: 0.5608
自由度: 197.5287
p値: 0.5756
真の母平均は群1が52、群2が50であり、本来は2の差が存在します。それにもかかわらず標本平均は 50.96 と 50.22 でほとんど差がなく、p値も 0.58 と有意になりませんでした。サンプルサイズ100程度では、標準偏差10に対して2の差を検出するには力(検出力)が足りないという、実務でも頻繁に遭遇する状況が再現されています。この条件の検出力は約29%なので、同じ実験を繰り返しても、7割ほどの回は今回のように有意になりません。
実行結果の解釈
前節のスクラッチ実装の出力結果を用いて、「2つのグループ間に意味のある差が存在するか」を統計的な観点から解釈していく手順を解説します。
-
帰無仮説と対立仮説の設定
- 帰無仮説():「2群の母平均に差はない()」
- 対立仮説():「2群の母平均に差がある()」
-
有意水準の設定 帰無仮説を棄却するための基準となる 有意水準() をあらかじめ定めます。実務においては、慣例的に (5%)が用いられます。
-
t値と自由度の確認 出力された t値 は となっています。この値が から遠く離れているほど、偶然のノイズに対して平均の差が際立って大きいことを意味します。自由度 は と小数になっており、等分散を仮定しないウェルチの近似式によって算出されたことがわかります。
-
p値の評価と結論の導出 今回の出力では p値 が となっています。このp値と有意水準 を比較します。
p値が有意水準以上であるため、帰無仮説を棄却できず、「観測された平均値の違いは偶然のばらつきの範囲内であり、意味のある差があるとは言えない(有意差なし)」という結論になります。
ここで注意したいのは、「有意差なし」は「差がないことの証明」ではないという点です。今回のデータには実際に2の差が埋め込まれていましたが、サンプルサイズが足りずに検出できなかっただけです。帰無仮説検定で言えるのは「差があるとは言えなかった」までであり、「差はなかった」ではありません。
この判断を t分布の上で表すと、次のようになります。
(図は、diagram-designで作成)
統計的背景と性質
スチューデントのt検定とウェルチのt検定の違い
独立2群の平均値の差を評価するt検定には、データの背後にある母集団の性質に対してどのような仮定を置くかによって、いくつかのバリエーションが存在します。
スチューデントのt検定(等分散を仮定)
スチューデントのt検定は、比較する2つのグループの母分散が等しい(等分散性:Homoscedasticity)という強い仮定に基づいています。この仮定を置くことで、2つのグループのデータを統合し、共通の分散である「プールされた分散(Pooled variance)」を推定して計算に用いることができます。 しかし、現実のビジネスデータにおいて「2つのグループの分散が完全に等しい」という状況は稀です。分散が大きく異なり、さらに2つのグループの人数も違うデータに適用してしまうと、第一種過誤(実際には差がないのに有意差があると誤って判定してしまう確率)が設定した有意水準から大きく乖離します(人数が同じなら、ずれは小さく済みます)。
ウェルチのt検定(等分散を仮定しない)
一方、ウェルチのt検定は、2つのグループの母分散が等しいという仮定を置きません(非等分散性を許容します)。そのため、プールされた分散は計算せず、各グループの不偏分散 をそのまま用いてt値を算出します。等分散を仮定しない代償として、自由度は「ウェルチ・サタスウェイトの式」と呼ばれる複雑な近似式を用いて算出されます。
シミュレーションで確かめる:誤りの率の違い
スチューデントのt検定の誤りの率が本当にずれるのかを、乱数で確かめます。2つの群の母平均を同じにして(本当は差がない状態)、検定を2万回繰り返し、有意水準5%で「差あり」と判定してしまった割合を数えます。正しい検定なら、この割合は5%になるはずです。
from scipy import stats
import numpy as np

rng = np.random.default_rng(0)
n_sim = 20000   # 2 万回なら、誤りの率を ±0.3 ポイントほどの誤差で測れる

# 2 つの群の母平均は同じ(本当は差がない)。人数と標準偏差の組み合わせだけを変える
conditions = [
    ("人数が少ない群のばらつきが大きい", 30, 15, 120, 10),
    ("人数が多い群のばらつきが大きい", 100, 10, 120, 15),
    ("人数もばらつきも同じ", 100, 10, 100, 10),
]

print(f"{'条件':<20} スチューデント  ウェルチ")
for label, n1, sd1, n2, sd2 in conditions:
    student, welch = 0, 0
    for _ in range(n_sim):
        a = rng.normal(50, sd1, n1)
        b = rng.normal(50, sd2, n2)
        student += stats.ttest_ind(a, b).pvalue < 0.05                  # 等分散を仮定(既定)
        welch += stats.ttest_ind(a, b, equal_var=False).pvalue < 0.05   # 等分散を仮定しない
    print(f"{label:<20} {student / n_sim:>10.1%} {welch / n_sim:>9.1%}")
- 母平均を同じにする:どちらの群も母平均は50なので、「差あり」と判定したら必ず誤りです。その割合が、その検定の実際の第一種過誤の率になります。
- 3つの条件:人数の少ない群のばらつきが大きい場合、その逆の場合、人数もばらつきも同じ場合を比べます。人数とばらつきの組み合わせによって、ずれる向きが変わることを見るためです。
- 2万回:誤りの率(5%前後)を、±0.3ポイントほどの誤差で測れる回数です。
実行結果
条件                   スチューデント  ウェルチ
人数が少ない群のばらつきが大きい          11.8%      4.9%
人数が多い群のばらつきが大きい            4.1%      4.9%
人数もばらつきも同じ                 4.8%      4.8%
人数の少ない群のばらつきが大きいとき、スチューデントのt検定は、本当は差がないのに11.8%の回で「差あり」と判定しました。有意水準5%のつもりが、実際には2倍以上誤っています。少ない群の大きなばらつきを、人数の多い群の小さなばらつきと混ぜて(プールして)しまうため、標準誤差を小さく見積もるからです。逆に、人数の多い群のばらつきが大きいと、4.1%と控えめな側にずれます(その分、本当の差を見逃しやすくなります)。人数もばらつきも同じなら、どちらも約5%で違いはありません。ウェルチのt検定は、3つの条件のどれでも4.8〜4.9%で、ほぼ5%に保たれています。
3つの条件の誤りの率を並べると、次のようになります。
(図は、diagram-designで作成)
実務における選択基準と「事前検定」の罠
過去には、「まずF検定などで等分散性を検定し、分散が等しければスチューデントのt検定、異なればウェルチのt検定を行う」という2段階のフローが推奨されることがありました。
しかし、現代の実務においてこの 「事前の等分散性検定」は強く非推奨 とされています。
- 多重検定の問題: 検定を2回繰り返すことで、全体の第一種過誤の確率がコントロールできなくなります。
- ウェルチのt検定の汎用性: ウェルチのt検定は、仮に母分散が等しかった場合であっても、スチューデントのt検定とほぼ同等の検出力を維持できることが示されています。
これらの理由から、事前の等分散性検定を行わず、最初から等分散を仮定しない「ウェルチのt検定」をデフォルトとして選択することが、最も安全かつ合理的なスタンダード となっています。
2段階のフローと現在の推奨を並べると、次のようになります。
(図は、diagram-designで作成)
実践的な実装例
SciPy (stats.ttest_ind) による実装と結果比較
実務のデータ分析において、数式からゼロベースでt検定をスクラッチ実装することは稀です。通常は、Pythonの代表的な科学技術計算ライブラリである SciPy の stats モジュールを使用します。
独立2群の平均の差の検定には scipy.stats.ttest_ind を用います。引数に equal_var=False を指定するだけで、内部的にウェルチの近似を用いたt値と自由度の計算が行われます。
ここでは、スクラッチ実装で定義した数式ロジックと、SciPyの内部実装が全く同じ計算を行っていることを証明するために、両者の計算結果の「差分」を出力して完全に一致することを確認します。
import numpy as np
from scipy import stats

# 再現性のための乱数シード固定
np.random.seed(42)

# ダミーデータを生成(サンプルサイズと分散が異なる2群)
n1, n2 = 100, 120
group1 = np.random.normal(loc=50.0, scale=10.0, size=n1)
group2 = np.random.normal(loc=55.0, scale=15.0, size=n2)

# --- 1. SciPyによるウェルチのt検定 ---
# equal_var=False を指定することで、等分散を仮定しないウェルチのt検定が実行されます
res_scipy = stats.ttest_ind(group1, group2, equal_var=False)

# --- 2. スクラッチ実装 ---
mean1, mean2 = np.mean(group1), np.mean(group2)
var1, var2 = np.var(group1, ddof=1), np.var(group2, ddof=1)

# t値と自由度の計算
t_scratch = (mean1 - mean2) / np.sqrt(var1/n1 + var2/n2)
df_num = (var1/n1 + var2/n2)**2
df_den = ((var1/n1)**2 / (n1 - 1)) + ((var2/n2)**2 / (n2 - 1))
df_scratch = df_num / df_den

# p値の計算(SciPyのt分布の生存関数 sf を使用して両側確率を算出)
p_scratch = stats.t.sf(np.abs(t_scratch), df_scratch) * 2

# --- 3. 結果の比較 ---
print("=== スクラッチ実装とSciPyの結果比較 ===")
print(f"t値の差分: {np.abs(t_scratch - res_scipy.statistic):.10f}")
print(f"p値の差分: {np.abs(p_scratch - res_scipy.pvalue):.10f}")
print(f"自由度の差分: {np.abs(df_scratch - res_scipy.df):.10f}")

if np.isclose(t_scratch, res_scipy.statistic) and np.isclose(p_scratch, res_scipy.pvalue):
    print("=> スクラッチ実装とSciPy(stats.ttest_ind)の結果が完全に一致しました!")
- データの作り方: 人数(100と120)と標準偏差(10と15)の両方を変えています。等分散を仮定するかどうかで結果が変わる条件にして、スクラッチ実装がウェルチの計算と一致すること(スチューデントの計算ではないこと)を確かめるためです。
- ウェルチの指定: stats.ttest_ind(group1, group2, equal_var=False) の equal_var=False が、等分散を仮定しないウェルチのt検定を選択する指定です。この引数を省略するとスチューデントのt検定になる点に注意してください。
- p値の算出方法: スクラッチ側では数値積分の代わりに stats.t.sf(生存関数:上側確率)を使い、* 2 して両側p値にしています。前節の台形公式より高速かつ高精度です。
- 一致の確認: np.isclose と差分の出力によって、数式通りの実装とライブラリ実装が同じ計算をしていることを検証しています。
実行結果
=== スクラッチ実装とSciPyの結果比較 ===
t値の差分: 0.0000000000
p値の差分: 0.0000000000
自由度の差分: 0.0000000000
=> スクラッチ実装とSciPy(stats.ttest_ind)の結果が完全に一致しました!
実行結果から分かる通り、数式通りに記述したスクラッチ実装と、SciPyの stats.ttest_ind による出力結果は、t値・p値・自由度のすべてにおいて小数点以下の精度で完全に一致します。
実務の現場では、stats.ttest_ind(group1, group2, equal_var=False) という簡潔なコードを呼び出すだけで、堅牢な効果検証を行うことができます。
実務での注意事項
実務のデータ分析においてt検定(およびp値)を扱う際には、「サンプルサイズへの強い依存性」 について重大な注意が必要です。
t値の計算式には分母にサンプルサイズ が含まれているため、データ数が大きくなればなるほど標準誤差は限りなくゼロに近づきます。その結果、実務的には全く意味を持たない微小な差であっても、計算されるt値は巨大になり、p値は一般的な有意水準を簡単に下回ってしまいます。
この問題を回避し、より妥当な意思決定を行うためには、t検定によるp値の評価に加えて、標準化平均差(SMD:Standardized Mean Difference) などの「効果量(Effect Size)」を併用することが不可欠です。
SMDは、2群の平均の差をプールした標準偏差で割ることで算出されます。この定義式にはサンプルサイズ が直接現れないため、データ量が増えても推定値が系統的に膨張することはなく、「純粋な差の大きさ」を評価することができます。
判断の目安は用途によって異なります。RCTや傾向スコア分析で共変量のバランスを確認する場合は、慣例的に であれば「バランスが取れている(実質的な差がない)」と判断されます。一方、施策の効果の大きさそのものを評価する場合は、コーエンの基準として / / をそれぞれ小・中・大の目安とすることが一般的です。
なお、このSMDは因果推論の各手法で共通のバランス評価指標として使われます。実際の計算とLoveプロットによる可視化はRCTの記事で、マッチング後・重み付け後への応用はPSM・IPTWの各記事で扱っています。
実際のデータ分析においては、「t検定(p値)」によってその差が偶然ではないことを統計的に担保しつつ、「効果量(SMDなど)」によってその差がビジネスにおいて意味のある大きさなのかを評価する、という両輪のアプローチが求められます。
まとめ
- t検定の役割: 2つのグループ間の平均値の差が、単なる「偶然のばらつき」か「統計的に意味のある差(有意差)」かを客観的に判定する手法。
- t分布の正体: 正規分布と同じ「(値 − 期待値)÷ ばらつき」という標準化を行うが、未知の母標準偏差 を標本標準偏差 で代用するため、正規分布より裾が重くなった分布。自由度が大きくなるほど標準正規分布に収束する。
- 実務での活用場面: RCTにおける共変量バランスの確認(交絡因子の偏りチェック)や、A/Bテストにおける施策の真の効果検証に用いられる。観察データを扱う場合も、回帰による効果推定などの前段でバランスの確認に使われる。
- 仮説検定のロジック: 「差はない」という帰無仮説を立て、観測データから算出したt値とt分布を用いてp値を導出し、有意水準と比較して結論を出す。
- ウェルチのt検定の推奨: 実務では等分散性を仮定しない「ウェルチのt検定」をデフォルトで使用することが最も安全かつ合理的である(事前の等分散性検定は非推奨)。シミュレーションでは、人数の少ない群のばらつきが大きいとき、スチューデントのt検定の誤りの率は5%のはずが11.8%になり、ウェルチは4.9%に保たれた。
- 効果量(SMD)の併用: 大規模データでは微小な差でもp値が有意になりやすいため、サンプルサイズに依存しない標準化平均差(SMD)を併用して実質的な差の大きさを評価することが不可欠である。
参考文献
- Student (1908). The Probable Error of a Mean. Biometrika, 6(1), 1–25.
- B. L. Welch (1947). The Generalization of 'Student's' Problem when Several Different Population Variances are Involved. Biometrika, 34(1-2), 28–35.
- J. Cohen (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates.
本記事の文章・構成の一部に生成AIを使用しています。