アップリフトモデルの評価と方策価値とは?
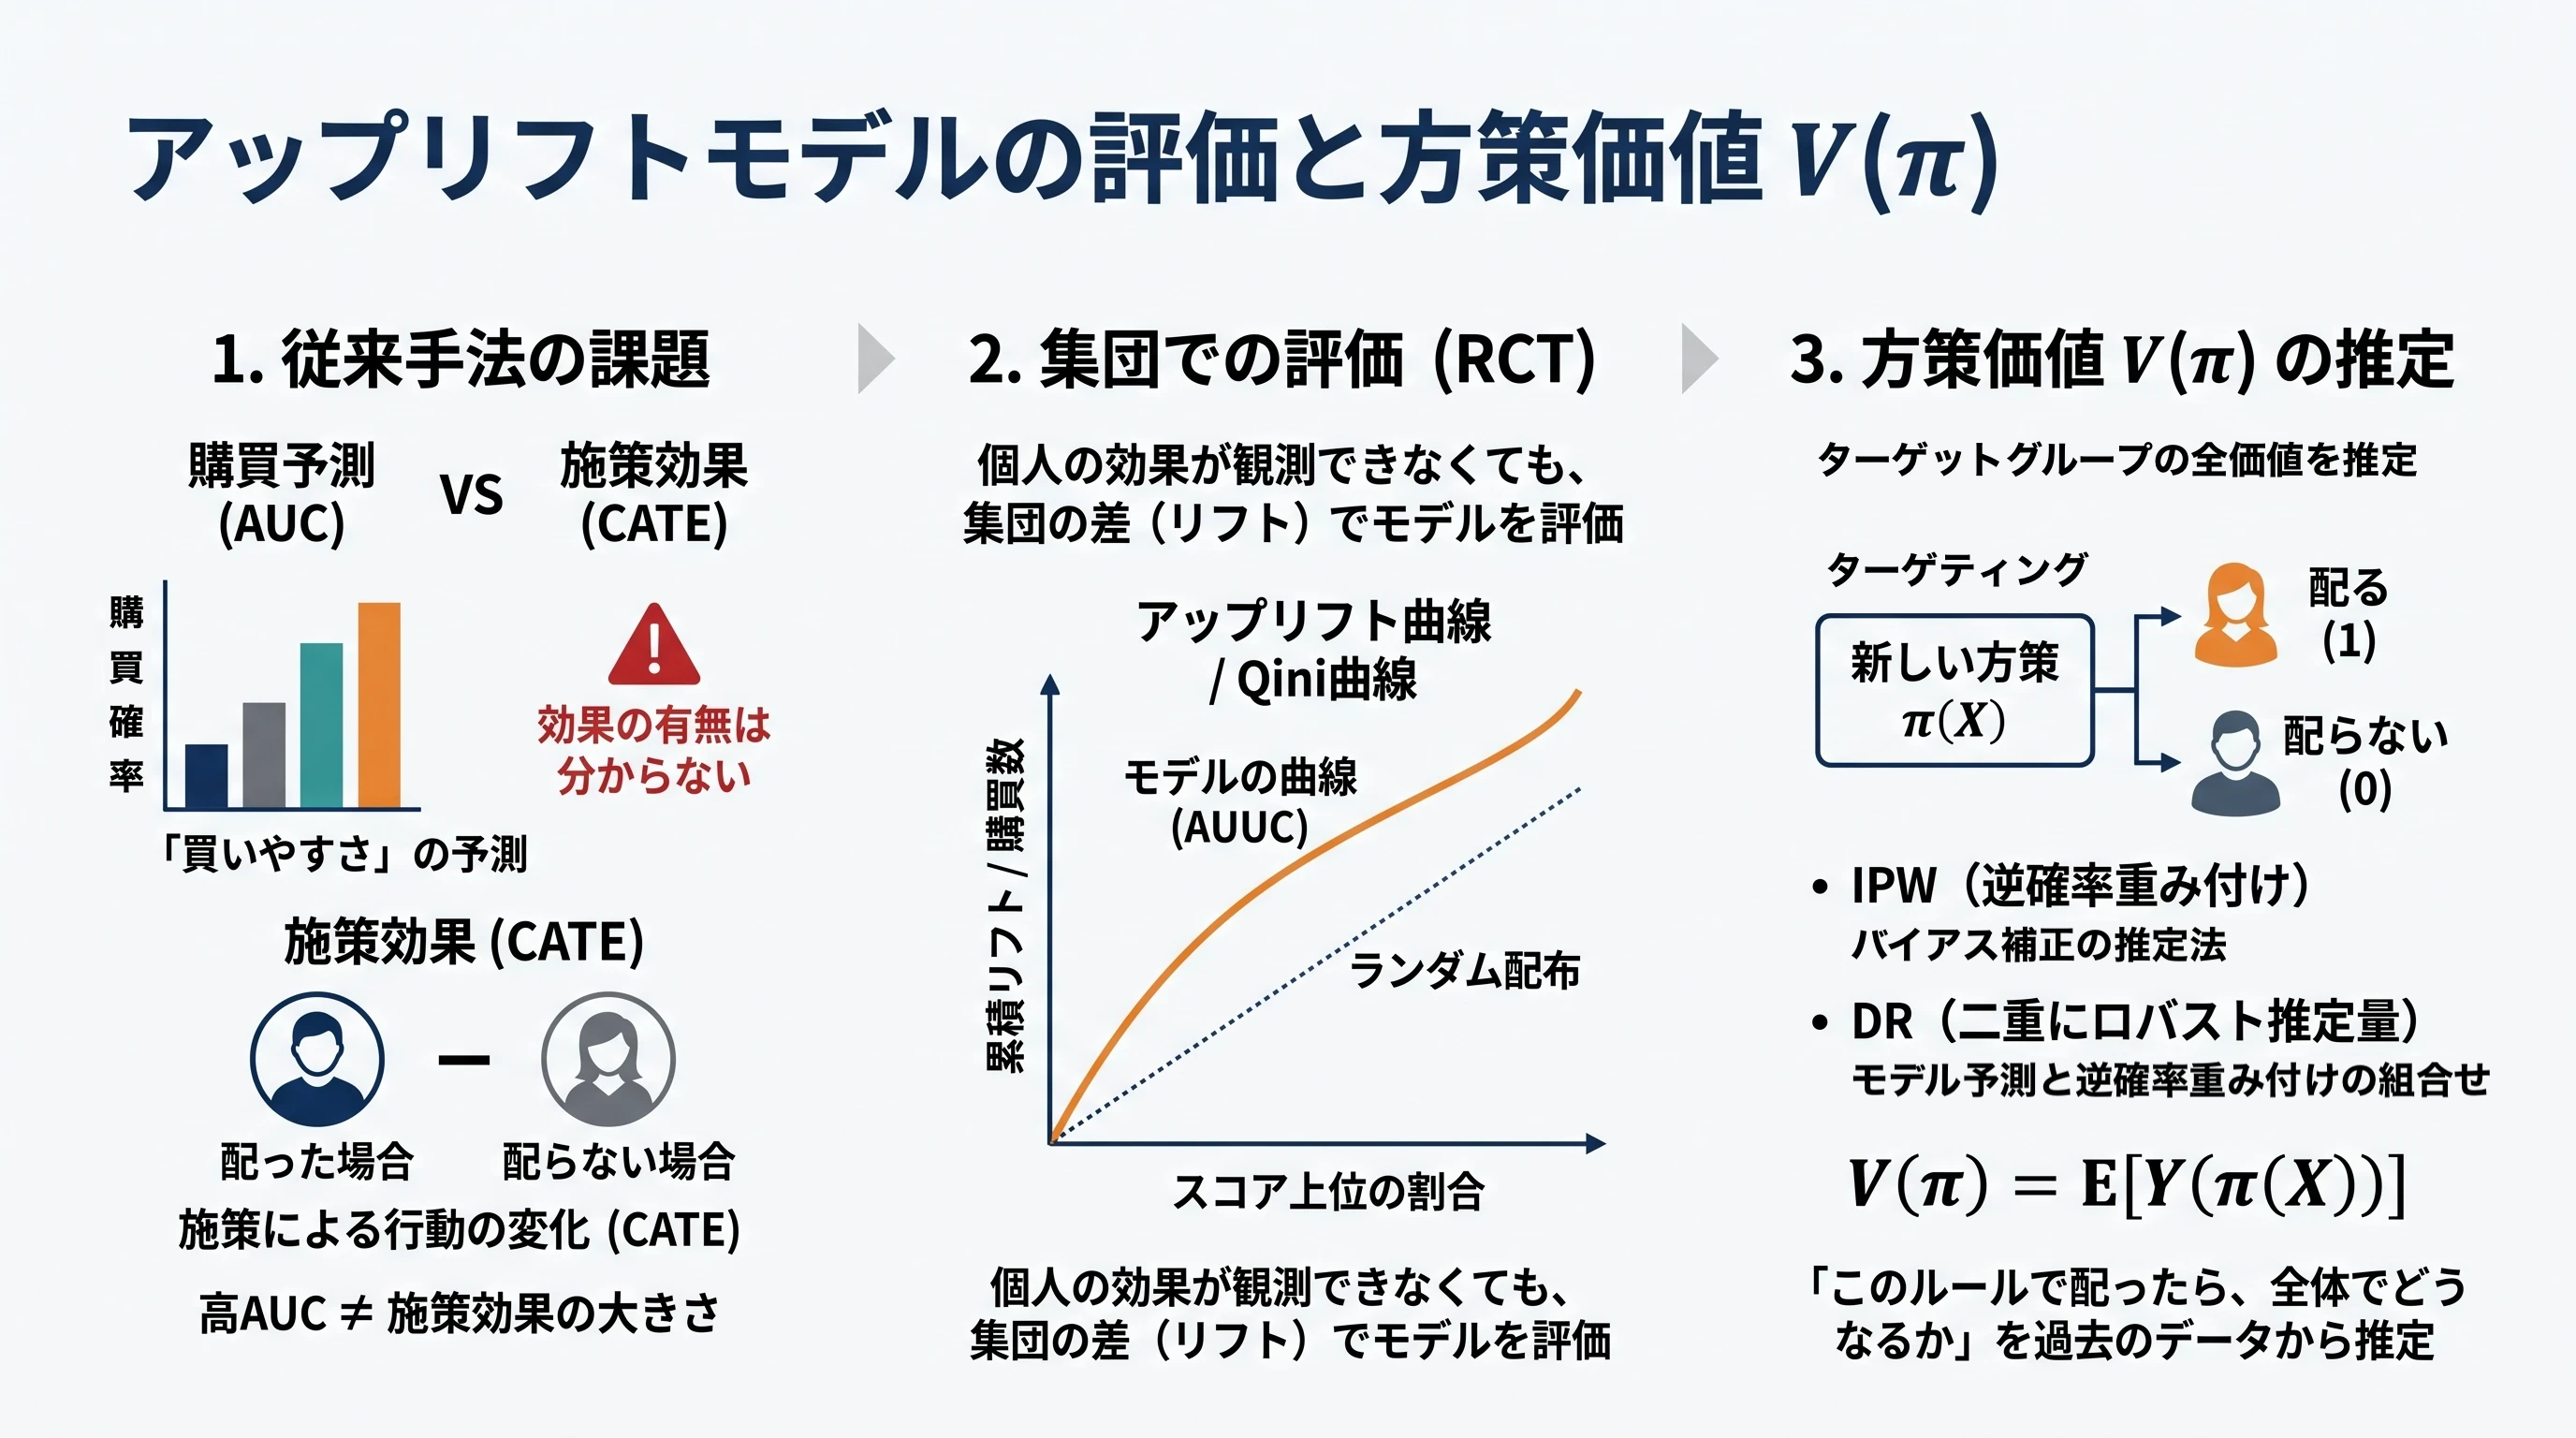 (画像は、Geminiで作成)
個人の施策効果は観測できないという前提のもとで、アップリフトモデル(誰に施策を打つかを決めるターゲティング方策)の良し悪しを評価できるようになること。具体的には、AUCなどの通常の予測精度では評価できない理由を理解し、RCTデータ上の Qini曲線・アップリフト曲線・AUUC と、方策価値 を使って評価できるようになること。さらに、施策の対象が偏った観察データでも、IPW と DR(AIPW)で方策価値を推定できることを、真の効果を仕込んだダミーデータで確かめること。
概要
機械学習によるCLV予測の記事までで、「どの顧客の将来の価値が高いか」を予測できるようになりました。しかし、クーポンや広告のような施策の対象を決めるときに本当に知りたいのは、「価値が高い顧客」でも「買いそうな顧客」でもありません。施策によって行動が変わる顧客です。買いそうな顧客にクーポンを配っても、クーポンがなくても買っていたなら、値引きの分だけ損をします。
顧客ごとの施策の効果(CATE)を予測する方法は、メタラーナーの記事で扱いました。メタラーナーの記事の後半では、推定した CATE の検証として、十分位ごとの実測リフトとアップリフト曲線も紹介しました。本記事では、この評価のステップを掘り下げ、Qini曲線との違い、「配布ルールの成果」を表す方策価値、そして観察データでの IPW と DR による推定までを、体系的に扱います。
ここに、因果推論ならではの難しさがあります。ある顧客の施策の効果は「クーポンを配った場合の行動 − 配らなかった場合の行動」ですが、1人の顧客について観測できるのは、どちらか一方だけです。正解(個人の効果)が観測できないので、普通の機械学習のように「予測と正解を比べる」ことができないのです。
本記事では、真の効果を仕込んだダミーデータを使い、次の順に評価の方法を解説します。
- AUC などの通常の予測精度で、アップリフトモデルを評価できない理由
- RCT のデータを使った評価:Qini曲線・アップリフト曲線・AUUC
- 方策価値 :「このルールで施策を打ったら、全体でどれだけの成果になるか」
- 施策の対象が偏った観察データでの方策価値の推定:IPW と DR(AIPW)
本記事のコードは、Python 3.13、NumPy 2.4.6、pandas 3.0.5、SciPy 1.18.1、scikit-learn 1.9.1、LightGBM 4.7.0、matplotlib 3.11.2 で動作を確認しました。
本記事では、メタラーナーの記事に合わせて、施策の有無を (1: 施策あり、0: なし)と書きます。二重にロバストな推定法の記事では同じものを と書いているので、注意してください。傾向スコア(施策を受ける確率)は、IPTWの記事や二重にロバストな推定法の記事と同じく と書きます(メタラーナーの記事では )。また、コードの特徴量に含まれる列 T は、BTYDの記事の「初回購買から基準日までの日数」で、施策の とは関係ありません。
検証用ダミーデータの生成
顧客ワールドと特徴量の再生成
RFMの記事から使っている「顧客ワールド」と、CLV予測の記事で追加した行動ログの特徴量を、同じコードで生成します。 コードはRFMの記事と同じです。生成の規則を式でまとめると、次のとおりです。 顧客 の隠れた性質は、次の分布から1つずつ引きます(ガンマ分布は形状とレートで書きます。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、コードではレートの逆数を渡しています)。 (lam)は1日あたりの購買ペース、(p_drop)は繰り返し購買の直後に離脱する確率、(nu)は購買金額の尺度、(first_day)は初回購買日です。 購買ログは、初回購買日 から、次の規則で730日目まで作ります。 は 回目の購買から次の購買までの日数(平均 日)、 は1回ごとの購買金額です(形状6は p_gg)。2回目以降の購買(繰り返し購買)の直後には、確率 で離脱し、それ以降は買いません。初回購買の直後には離脱の判定をしません。1回あたりの平均購買金額は (truth['mean_amount'])で、離脱した日(death_day)が365日目以降なら、基準日に生存している(truth['alive'])とします。 購買と離脱の部分は BG/NBDモデル、購買金額の部分は Gamma-Gammaモデルの生成過程で、BTYDの記事で詳しく説明しています。顧客ワールドの生成式
import numpy as np
import pandas as pd

# 1. 乱数と観測期間の設定(時間の単位は日)
rng = np.random.default_rng(42)
N = 10_000          # 顧客数
CALIB_END = 365     # 0〜364日目: 分析に使う期間(前半1年)
OBS_END = 730       # 365〜729日目: 答え合わせ用のホールドアウト期間(後半1年)

# 2. 顧客ごとの隠れた性質(分析者には観測できない「答え」)
r, alpha = 0.6, 25.0                         # 購買ペースのばらつきを決めるパラメータ
a, b = 0.8, 3.0                              # 離脱のしやすさのばらつきを決めるパラメータ
p_gg, q_gg, gamma_gg = 6.0, 4.0, 1500.0      # 購買金額のばらつきを決めるパラメータ
lam = rng.gamma(r, 1 / alpha, size=N)        # 購買ペース(1日あたりの平均購買回数)
p_drop = rng.beta(a, b, size=N)              # 2回目以降の購買の直後に離脱する確率
nu = rng.gamma(q_gg, 1 / gamma_gg, size=N)   # 購買金額の尺度(平均購買金額は p_gg / nu)
first_day = rng.uniform(0, CALIB_END, size=N)  # 初回購買日(最初の1年で少しずつ獲得)

# 3. 購買ログの生成
records = []
death_day = np.full(N, np.inf)   # 離脱した日(観測期間内に離脱しなければ inf)
for i in range(N):
    t = first_day[i]
    records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))   # 初回購買
    while True:
        t += rng.exponential(1 / lam[i])   # 次の購買までの待ち時間
        if t >= OBS_END:
            break
        records.append((i, t, rng.gamma(p_gg, 1 / nu[i])))
        if rng.uniform() < p_drop[i]:      # 購買の直後に、一定の確率で離脱する
            death_day[i] = t
            break

# 4. 分析者が観測できる購買ログ(購買日は整数の日付、金額は10円単位)
log = pd.DataFrame(records, columns=['customer_id', 'day', 'amount'])
log['day'] = np.floor(log['day']).astype(int)
log['amount'] = log['amount'].round(-1).astype(int)

# 5. 答え合わせ用の真値(分析には使わない)
truth = pd.DataFrame({
    'lam': lam,                          # 購買ペース
    'p_drop': p_drop,                    # 購買の直後に離脱する確率
    'mean_amount': p_gg / nu,            # 平均購買金額
    'alive': death_day >= CALIB_END,     # ホールドアウト期間の開始時点で生存しているか
})

# 6. RFMの記事と同じデータになっていることの確認
print(f"購買ログの件数: {len(log):,} 件、ホールドアウト期間の開始時点で生存している顧客: {truth['alive'].mean():.1%}")
RFMの記事・BTYDの記事・CLV予測の記事と同じコードで、顧客ワールドを生成しています。生成の仕組みは、BTYDの記事の「生成過程:4つの仮定」で説明したとおりです。
- 乱数と観測期間の設定: np.random.default_rng(42) で乱数生成器 rng を作り、シードを固定しているので、何度実行しても同じデータになります。顧客数は N = 10_000、時間の単位は日で、CALIB_END = 365 より前(0〜364日目)を分析に使う期間、OBS_END = 730 まで(365〜729日目)をホールドアウト期間とします。
- 顧客ごとの隠れた性質: 購買ペース lam を rng.gamma(r, 1 / alpha, size=N)(ガンマ分布)、離脱確率 p_drop を rng.beta(a, b, size=N)(ベータ分布)、購買金額の尺度 nu を rng.gamma(q_gg, 1 / gamma_gg, size=N)(ガンマ分布)から、顧客ごとに1つずつ引いています。NumPy の rng.gamma は形状と尺度(レートの逆数)を引数にとるので、レート alpha・gamma_gg は逆数にして渡しています。初回購買日 first_day は、rng.uniform(0, CALIB_END, size=N) で最初の1年の一様分布から引きます。
- 購買ログの生成: death_day を np.full(N, np.inf) で全員無限大(離脱しない)に初期化し、for i in range(N) で1人ずつ、初回購買を記録してから、t += rng.exponential(1 / lam[i]) で指数分布の待ち時間だけ時間を進めて次の購買を records に追加する処理を、OBS_END に達するまで繰り返します。1回の購買金額は rng.gamma(p_gg, 1 / nu[i]) で引き、顧客 の平均購買金額は p_gg / nu[i] になります。2回目以降の購買の直後に rng.uniform() < p_drop[i] なら(確率 p_drop[i] で)離脱としてループを抜け、その日を death_day[i] に記録します。初回購買の直後には離脱の判定をしません。
- 観測できる購買ログ: log には、顧客ID・購買日・金額の3列だけを入れます。購買日は np.floor で整数の日付に、金額は round(-1) で10円単位に丸めています。顧客IDは0〜9,999の連番で、配列 lam などの位置(インデックス)と一致します。
- 答え合わせ用の真値: truth には、購買ペース・離脱確率・平均購買金額(p_gg / nu)と、離脱した日が365日目以降かどうか(death_day >= CALIB_END。基準日に生存しているか)を入れています。lam(購買ペース)、p_drop(離脱確率)とあわせて、分析者には観測できない値です。この記事では、クーポンの効果を決めるときに使います。
- 確認: 購買ログの件数と、基準日に生存している顧客の割合(truth['alive'].mean())を表示し、これまでの記事と同じデータになっていることを確かめています。
実行結果
購買ログの件数: 57,667 件、ホールドアウト期間の開始時点で生存している顧客: 67.8%
購買ログの件数(57,667件)と生存している顧客の割合(67.8%)は、これまでの記事と同じです。 コードはCLV予測の記事と同じです。作り方を式でまとめると、次のとおりです。 基準日に生存しているかを (生存していれば1、離脱していれば0。alive_now)、シグモイド関数を とすると、5つの特徴量は次のように作ります。 、 は顧客ごとのノイズです。左辺は順に visits_30d(直近30日のサイト訪問回数)、cart_30d(直近30日のカート追加回数)、email_open_rate(24通のメールの開封率)、viewed_price(閲覧した商品の平均価格。10円単位に丸める)、app_user(アプリを利用しているか)で、 は visit_rate、 は open_prob です。乱数は、顧客ワールドとは別の乱数生成器 rng_feat(シード43)で引きます。行動ログの特徴量の生成式
# 1. 分析に使う期間と、答え合わせ用のホールドアウト期間に分ける
calib = log[log['day'] < CALIB_END]
holdout = log[log['day'] >= CALIB_END]

# 2. 顧客ごとに x, t_x, T と、1回あたりの平均購買金額を集計する
g = calib.groupby('customer_id')
summary = pd.DataFrame({
    'first_day': g['day'].min(),
    'last_day': g['day'].max(),
    'n_purchases': g['day'].size(),     # 購買回数(RFMの F)
    'monetary': g['amount'].mean(),     # 1回あたりの平均購買金額(RFMの M)
})
summary['x'] = summary['n_purchases'] - 1                       # 繰り返し購買の回数
summary['t_x'] = summary['last_day'] - summary['first_day']     # 初回購買から最後の購買までの日数
summary['T'] = CALIB_END - summary['first_day']                 # 初回購買から基準日までの日数
summary['recency'] = summary['T'] - summary['t_x']              # RFMの R(基準日から最後の購買までの日数)

# 3. 予測の対象: ホールドアウト期間(翌1年)の購買回数と売上
summary['holdout_n'] = holdout.groupby('customer_id').size().reindex(summary.index, fill_value=0)
summary['holdout_sales'] = holdout.groupby('customer_id')['amount'].sum().reindex(summary.index, fill_value=0)

# ---- 行動ログの特徴量(CLV予測の記事と同じ) ----
# 1. 特徴量は別の乱数生成器で作る(顧客ワールドの値を変えないため)
rng_feat = np.random.default_rng(43)
alive_now = truth['alive'].values

# 2. 直近30日のサイト訪問回数とカート追加回数(生存している顧客は購買ペースに応じて行動する)
visit_rate = np.where(alive_now, 0.01 + 3 * lam, 0.005)     # 1日あたりの訪問回数の平均
features = pd.DataFrame(index=summary.index)
features['visits_30d'] = rng_feat.poisson(30 * visit_rate)
features['cart_30d'] = rng_feat.poisson(30 * 1.5 * lam * alive_now)

# 3. メールマガジン(24通)の開封率(離脱しにくい顧客ほど開封し、離脱した顧客はあまり開封しない)
open_prob = 1 / (1 + np.exp(-(1.0 - 5 * p_drop + rng_feat.normal(0, 0.5, size=N)))) * np.where(alive_now, 1.0, 0.3)
features['email_open_rate'] = rng_feat.binomial(24, open_prob) / 24

# 4. 閲覧した商品の平均価格(平均購買金額のまわりでばらつく)と、アプリの利用(購買ペースが高いほど使う)
features['viewed_price'] = np.round(truth['mean_amount'].values * np.exp(rng_feat.normal(0, 0.35, size=N)), -1)
features['app_user'] = rng_feat.binomial(1, 1 / (1 + np.exp(-(np.log(lam * 365) - 2.0))))

# 5. モデルに使う特徴量の行列(購買履歴の6列 + 行動ログの5列)
X = pd.concat([summary[['x', 't_x', 'T', 'recency', 'n_purchases', 'monetary']], features], axis=1)
print(X.shape)
print(X.head().round(2).to_string())
CLV予測の記事と同じコードで、購買履歴の集計と行動ログの特徴量を作り、モデルに使う特徴量の行列 X にまとめています。CLV予測の記事の手順5(隠れた性質との相関の表示)は省き、代わりに特徴量の行列を作っています。
-
期間の分割: log[log['day'] < CALIB_END] で分析に使う期間の購買 calib を、log['day'] >= CALIB_END でホールドアウト期間(365〜729日目)の購買 holdout を取り出しています。
-
購買履歴の集計: calib.groupby('customer_id') で顧客ごとにまとめ、初回購買日(g['day'].min())・最後の購買日(g['day'].max())・購買回数(g['day'].size())・1回あたりの平均購買金額(g['amount'].mean())を summary に入れます。そこから、繰り返し購買の回数 x(購買回数 − 1)、初回購買から最後の購買までの日数 t_x、初回購買から基準日までの日数 T、基準日から最後の購買までの日数 recency(T - t_x)を計算しています。
-
ホールドアウト期間の集計: holdout.groupby('customer_id') で、翌1年の購買回数(holdout_n)と売上(holdout_sales)を集計しています。翌1年に買わなかった顧客は集計結果に現れないので、reindex(summary.index, fill_value=0) で全員の行をそろえ、0で埋めています。この記事では使いません。
-
行動ログの特徴量: 顧客ワールドの rng とは別の乱数生成器 rng_feat(シード43)で作ります。rng から続けて乱数を引くと、これまでの記事とデータが変わってしまうためです。alive_now は基準日に生存しているか(True/False)です。
- 訪問とカート: 1日あたりの訪問回数の平均 visit_rate を、np.where(alive_now, 0.01 + 3 * lam, 0.005) で生存している顧客は購買ペースに応じた値、離脱した顧客は0.005にし、rng_feat.poisson(30 * visit_rate) で直近30日の訪問回数 visits_30d を引きます。カート追加 cart_30d は、生存している顧客だけが購買ペースの1.5倍のペースで行います(lam * alive_now は、離脱した顧客で0になります)。
- メールの開封率: 開封確率 open_prob は、1.0 - 5 * p_drop に顧客ごとのノイズ rng_feat.normal(0, 0.5, size=N) を加えてシグモイド関数 1 / (1 + np.exp(-z)) に通し、離脱した顧客は0.3倍にしたものです。rng_feat.binomial(24, open_prob) / 24 で、24通のうち開封した割合にしています。
- 閲覧価格とアプリ: viewed_price は、真の平均購買金額に対数正規のノイズ np.exp(rng_feat.normal(0, 0.35, size=N)) を掛けて10円単位に丸めたもの、app_user は、年間の購買ペースの対数 np.log(lam * 365) から2を引いた値をシグモイド関数に通した確率で1になる2値の特徴量です。
それぞれの式は、下の折りたたみにまとめました。
-
特徴量の行列: pd.concat([...], axis=1) で、購買履歴の6列(x・t_x・T・recency・n_purchases・monetary)と行動ログの5列を横につなぎ、合計11列の X を作っています。いずれもクーポンを配る前(基準日まで)に分かる値で、アップリフトモデルの特徴量として使います。X.shape で行列の形(行数, 列数)を、X.head() で先頭5人の値を表示しています。
実行結果
(10000, 11)
             x  t_x    T  recency  n_purchases  monetary  visits_30d  cart_30d  email_open_rate  viewed_price  app_user
customer_id
0            6  114  147       33            7   1348.57           2         0             0.79        2450.0         0
1            4   85  297      212            5   3708.00           0         0             0.21        2690.0         0
2            0    0  139      139            1   1630.00           0         0             0.33        3740.0         0
3            2   13   24       11            3   3146.67           3         3             0.83        1730.0         1
4            0    0  338      338            1   2180.00           0         0             0.79        2740.0         0
10,000人 × 11列の特徴量の行列ができました。たとえば顧客3は、24日前に入会して3回買い、直近30日に3回訪問し、3回カートに商品を入れ、メールの83%を開封しています。
施策データの生成:クーポンの効果
基準日(365日目)に、顧客にクーポンをメールで配るとします。評価したい成果は、配布から30日以内に購買したかどうか( または )です。
クーポンの効果は、顧客の隠れた性質によって次のように変わるようにします。
- クーポンで買う気になる:生存している顧客は、確率 でクーポンに反応して購買します。 は、メールを読む(離脱しにくい)顧客ほど、また1回あたりの購買金額が小さい(値引きに敏感な)顧客ほど大きくなります。
- クーポンで買う気をなくす:1回あたりの購買金額が大きい顧客は、値引きのメールを嫌い、確率 で、本来するはずだった購買をやめてしまいます。
- 離脱した顧客には効かない:すでに離脱した顧客は、クーポンを受け取っても買いません。
クーポンがない場合に30日以内に買うかどうか()は、顧客ワールドのホールドアウト期間の購買ログそのものです。クーポンがある場合()は、そこに上の2つの効果を加えて作ります。このように、1人の顧客について2つの潜在的結果 を両方作っておくのが、ダミーデータならではの「答え」です。
さらに、施策の割り当て方の違う2つのシナリオを作ります。
- シナリオA:RCT:顧客の半数に、ランダムにクーポンを配る
- シナリオB:過去のキャンペーン(観察データ):担当者の判断で、最近サイトを訪問し、最近買った顧客ほど配られやすい
施策の割り当てと効果の乱数は、顧客ワールドや特徴量とは別の乱数生成器(シード44)で作ります。
生成は、コードの手順に沿って次の流れで行います。
- ① クーポンの効果を決める3つの確率と、真のCATEを計算する(手順1)
- ② 潜在的結果 を作る(手順2)
- ③ 2つのシナリオで施策を割り当て、観測できる成果を作る(手順3・4)
- 答え合わせ用に、真の効果と4つのタイプを集計し、2つのシナリオでの単純な差を確かめる(手順5・6)
①〜③を、式で示します。
① クーポンの効果を決める3つの確率と、真のCATE
クーポンがなくても30日以内に買う確率 (p_natural)、クーポンで買う気になる確率 (p_induced)、クーポンで買う気をなくす確率 (p_annoyed)を、基準日の生存 (生存していれば1、離脱していれば0。alive_now)、購買ペース (lam)、離脱確率 (p_drop)、平均購買金額 (mean_amount)と、シグモイド関数 (sigmoid)を使って、次の式で作ります。
クーポンがある場合は、「本来の購買が、買う気をなくさずに残る」か「クーポンで買う気になる」かのどちらかで買います。クーポンがある場合とない場合の購買確率の差 が、真のCATE (tau_true)で、3つの確率から次のように計算します。
詳細な式展開(クーポンがある場合の購買確率と、真のCATE)
クーポンがある場合に買うのは、「本来の購買が、買う気をなくさずに残る」(確率 )か、「クーポンで買う気になる」(確率 )かのどちらかが起きたときです。2つの出来事は独立に起きるので、
です。ここから を引いたものが、上の真のCATE の式です。
② 潜在的結果を作る
(y0)は、365〜394日目に購買ログがあれば1です。「買う気をなくす」出来事 (annoyed)と「買う気になる」出来事 (induced)を、それぞれ確率 、 で起こし、(y1)を次のように作ります( は「または」、 は「でない」)。
③ 2つのシナリオで施策を割り当てる
施策の有無 を、シナリオA では確率0.5で(T_rct)、シナリオB では真の傾向スコア (e_true)で割り当てます。(v)、(rc)とし、 をそれぞれの標準化(平均を引いて標準偏差で割ったもの)とすると、
です。観測できる成果は、実際に配られた側の潜在的結果 (Y_rct・Y_obs)です。
# 1. クーポンの効果を決める確率(分析者には観測できない「答え」)
rng_treat = np.random.default_rng(44)
def sigmoid(z):
    return 1 / (1 + np.exp(-z))

mean_amount = truth['mean_amount'].values
p_natural = alive_now * (1 - np.exp(-30 * lam))                     # クーポンがなくても30日以内に買う確率
p_induced = alive_now * 0.5 * (1 - p_drop) * sigmoid(2 * (np.log(3000) - np.log(mean_amount)))   # クーポンで買う気になる確率
p_annoyed = alive_now * 0.4 * sigmoid(3 * (np.log(mean_amount) - np.log(6000)))                 # クーポンで買う気をなくす確率
tau_true = p_natural * (1 - p_annoyed) + (1 - p_natural * (1 - p_annoyed)) * p_induced - p_natural   # 真のCATE

# 2. 潜在的結果:Y(0) は顧客ワールドの購買ログ、Y(1) はそこにクーポンの効果を加えたもの
day = log['day'].values
y0 = np.zeros(N, dtype=int)
y0[np.unique(log.loc[(day >= CALIB_END) & (day < CALIB_END + 30), 'customer_id'])] = 1
annoyed = rng_treat.uniform(size=N) < p_annoyed
induced = rng_treat.uniform(size=N) < p_induced
y1 = (((y0 == 1) & ~annoyed) | induced).astype(int)

# 3. シナリオA:RCT(半数にランダムに配布)
T_rct = rng_treat.binomial(1, 0.5, size=N)
Y_rct = np.where(T_rct == 1, y1, y0)

# 4. シナリオB:過去のキャンペーン(最近訪問し、最近買った顧客ほど配られやすい)
v = np.log1p(features['visits_30d'].values)
rc = np.log1p(summary['recency'].values)
e_true = np.clip(sigmoid(-0.3 + (v - v.mean()) / v.std() - 0.8 * (rc - rc.mean()) / rc.std()), 0.05, 0.95)
T_obs = rng_treat.binomial(1, e_true)
Y_obs = np.where(T_obs == 1, y1, y0)

# 5. 答え合わせ:真の効果と、潜在的結果の組み合わせによる4つのタイプ
print(f"30日以内の購買率: 全員に配らない {y0.mean():.1%}、全員に配る {y1.mean():.1%}、真の平均効果 {(y1 - y0).mean():+.1%}")
types = pd.Series(np.select([(y0 == 0) & (y1 == 1), (y0 == 1) & (y1 == 1), (y0 == 0) & (y1 == 0), (y0 == 1) & (y1 == 0)],
                            ['配ると買う(説得可能)', '配らなくても買う(鉄板)', '配っても買わない(無関心)', '配ると買わなくなる(天邪鬼)'], default=''))
print(types.value_counts().to_string())
print(f"\n真のCATEが負の顧客: {(tau_true < 0).mean():.1%}")

# 6. 2つのシナリオでの、施策群と対照群の単純な差
for name, T_, Y_ in [('シナリオA(RCT)', T_rct, Y_rct), ('シナリオB(観察データ)', T_obs, Y_obs)]:
    print(f"{name}: 配布率 {T_.mean():.1%}、購買率の差(施策群 − 対照群) {Y_[T_ == 1].mean() - Y_[T_ == 0].mean():+.1%}")
クーポンの効果を決め、2つのシナリオの施策データを生成しています。
- 乱数とシグモイド関数: 施策の効果と割り当ての乱数は、顧客ワールドや特徴量とは別の乱数生成器 rng_treat(シード44)で引きます。sigmoid は で、どんな値も0〜1の確率に変換します。
- 3つの確率: p_natural は 1 - np.exp(-30 * lam) で、クーポンがなくても30日以内に買う確率です。生存している顧客の購買は購買ペース lam のポアソン過程なので、30日以内に1回以上買う確率は です。p_induced は、(1 - p_drop)(メールを読む、離脱しにくい顧客ほど大きい)と、sigmoid(2 * (np.log(3000) - np.log(mean_amount)))(平均購買金額が3,000円より小さいほど大きい)の積に0.5を掛けたものです。p_annoyed は sigmoid(3 * (np.log(mean_amount) - np.log(6000))) に0.4を掛けたもので、平均購買金額が6,000円を超えるあたりから大きくなります。どれにも alive_now を掛けているので、離脱した顧客(alive_now が False)は0です。
- 真のCATE: tau_true は、コードの前に示した の式を、3つの確率からそのまま計算したものです。
- 潜在的結果 Y(0): y0 は、ホールドアウト期間の最初の30日(365〜394日目)に購買ログがある顧客を1にしたものです。np.zeros(N, dtype=int) で全員0に初期化し、log.loc[(day >= CALIB_END) & (day < CALIB_END + 30), 'customer_id'] でその期間に買った顧客のIDを取り出し、np.unique で重複をなくしてから、その位置を1に書き換えています。顧客IDは0〜9,999の連番で配列の位置と一致するので、IDの一覧をそのまま位置の指定に使えます。
- 潜在的結果 Y(1): rng_treat.uniform(size=N) < p_annoyed は、0〜1の一様乱数が確率より小さいときに True になるので、各顧客が確率 p_annoyed で「買う気をなくす」(annoyed)ことになります。induced も同じように、確率 p_induced で「買う気になる」顧客です。y1 は ((y0 == 1) & ~annoyed) | induced で、本来の購買から「買う気をなくした」顧客を除き(~ は否定、& は「かつ」)、「クーポンで買う気になった」顧客を加えたもの(| は「または」)です。astype(int) で True/False を1/0にしています。
- シナリオA(RCT): rng_treat.binomial(1, 0.5, size=N) で、各顧客に確率0.5でクーポンを配ります(T_rct)。np.where(T_rct == 1, y1, y0) は、配った顧客では y1、配らなかった顧客では y0 を選ぶ処理で、観測できる成果 Y_rct になります。
- シナリオB(過去のキャンペーン): 直近30日の訪問回数と recency を np.log1p(。0回でも計算できる)で変換して v・rc とし、(v - v.mean()) / v.std() のように標準化してから、コードの前の式の を計算します。np.clip(..., 0.05, 0.95) は、配布確率を0.05〜0.95に収める処理です。rng_treat.binomial(1, e_true) で、顧客ごとに確率 e_true でクーポンを配り(T_obs)、Y_obs も Y_rct と同じように選びます。
- 4つのタイプ: np.select は、条件のリストを上から順に調べ、最初に当てはまった条件に対応するラベルを返す関数です。潜在的結果の組み合わせ で、顧客を4つのタイプに分け、value_counts() で人数を数えています。コードのラベルの括弧内は、アップリフトモデリングでの呼び名 Persuadables(説得可能)、Sure things(鉄板)、Lost causes(無関心)、Sleeping dogs(天邪鬼)に対応しています。Sleeping dogs は「寝た子を起こすな」に由来し、施策でかえって反応しなくなる顧客を指します。(tau_true < 0).mean() は、真のCATEが負の顧客の割合です。
- 単純な差: 2つのシナリオそれぞれで、配布率(T_.mean())と、施策群と対照群の購買率の差 Y_[T_ == 1].mean() - Y_[T_ == 0].mean() を表示しています。RCT なら真の平均効果に近く、観察データなら偏ることを確かめます。
実行結果
30日以内の購買率: 全員に配らない 18.5%、全員に配る 29.5%、真の平均効果 +11.0%
配っても買わない(無関心)     6958
配らなくても買う(鉄板)      1762
配ると買う(説得可能)       1190
配ると買わなくなる(天邪鬼)      90

真のCATEが負の顧客: 5.5%
シナリオA(RCT): 配布率 50.3%、購買率の差(施策群 − 対照群) +10.7%
シナリオB(観察データ): 配布率 41.9%、購買率の差(施策群 − 対照群) +33.4%
- クーポンの効果: 全員に配らなければ30日以内の購買率は18.5%、全員に配れば29.5%で、真の平均効果は +11.0ポイントです。
- 4つのタイプ: 配ると買う顧客(説得可能)は1,190人だけで、配らなくても買う顧客(鉄板)が1,762人、配っても買わない顧客(無関心)が6,958人です。配ると買わなくなる顧客(天邪鬼)も90人います。クーポンを配るべきなのは説得可能な顧客だけですが、どの顧客がこのタイプかは、1人の と の片方しか観測できない現実のデータでは分かりません。なお、真のCATEが負の顧客は5.5%いますが、実際に「天邪鬼」になったのはその一部(90人)です。CATEは確率の差(期待値)なので、効果が負の顧客でも、実際に購買をやめるかどうかは偶然で決まります。
- RCTは偏らない: シナリオA(RCT)の施策群と対照群の差は +10.7ポイントで、真の平均効果(+11.0ポイント)に近い値です。
- 観察データは大きく偏る: シナリオB(過去のキャンペーン)の差は +33.4ポイントで、真の平均効果の3倍になりました。最近訪問し、最近買った顧客ほどクーポンが配られていたので、施策群にはもともと買いやすい顧客が集まっていたのです。
潜在的結果の組み合わせによる4つのタイプを、図にまとめます。
(図は、diagram-designで作成)
アップリフトモデルを作る
反応モデルとメタラーナー
シナリオA(RCT)のデータで、顧客ごとのスコアを予測するモデルを4つ作ります。
- 反応モデル:クーポンを配った顧客のデータだけで、「配ったら買うか」を予測する分類モデルです。スコアは です。施策の効果ではなく「買いやすさ」を予測するモデルですが、実務では、これで配布先を決めてしまうことがよくあります。
- S-Learner・T-Learner・X-Learner:メタラーナーの記事の3つの手法で、CATE を予測します。成果が0/1なので、ベースのモデルには LightGBM の分類モデルを使い、予測確率の差を CATE とします。
CLV予測の記事と同じく、5分割交差適合で全員のスコアを作ります。コードの手順1〜4で計算する各モデルのスコアの式と、手順5で比較に使う指標は次のとおりです(メタラーナーの詳しい考え方はメタラーナーの記事を参照してください)。
- 手順1 反応モデル:施策群だけで学習した分類モデル resp の予測確率 がスコアです。
- 手順2 S-Learner:施策の有無 も特徴量に入れた1つのモデル (s_model)で、 とします。
- 手順3 T-Learner:施策群で学習したモデル (m1)と、対照群で学習したモデル (m0)で、 とします。
- 手順4 X-Learner:T-Learner の2つのモデルを使って、施策群の顧客には (D1)、対照群の顧客には (D0)という擬似的な効果を作ります。
それぞれを特徴量から予測する回帰モデル (tau1)と (tau0)を学習し、重み (g)で加重平均します。メタラーナーの記事では に推定した傾向スコアを使いましたが、ここでは RCT で配布確率が0.5と分かっているので、 です。
- 手順5 比較(AUC):各スコアの良し悪しを、まず分類モデルの評価でよく使う AUC(Area Under the ROC Curve)で測ります。AUC は、実際に買った顧客 ()と買わなかった顧客 ()を1人ずつ選んだとき、買った顧客の方に高いスコアが付いている確率です。買った顧客の集合を ( 人)、買わなかった顧客の集合を ( 人)、スコアを とすると、すべての組み合わせ 通りの平均として次のように計算できます(同点は半分と数えます)。
は、条件を満たすとき1、満たさないとき0になる指示関数です。買った顧客全員を、買わなかった顧客全員より上位に並べられれば AUC = 1、スコアがでたらめなら(ランダムに並べたのと同じなら)AUC = 0.5 です。AUC はスコアの順位だけで決まり、スコアの値の大きさ(確率として正しいかどうか)には影響されません。コードでは、実際の購買 (Y_rct)とスコアから、scikit-learn の roc_auc_score で計算します。あわせて、ダミーデータだから計算できる、真のCATE (tau_true)とスコアの相関も求めます。 AUC は、その名のとおり ROC曲線(Receiver Operating Characteristic curve)の下側の面積です。スコアがしきい値 以上の顧客を「買う」と判定するとき、 をそれぞれ真陽性率(買った顧客のうち「買う」と判定できた割合)と偽陽性率(買わなかった顧客のうち誤って「買う」と判定した割合)といいます。しきい値 を大きい値から小さい値へ動かすと、点 は から まで動きます。この軌跡が ROC曲線です。 しきい値を1人ずつ下げていくと考えると、買わなかった顧客 を1人「買う」側に入れるたびに、ROC曲線は横に だけ進みます。そのときの高さ は、「スコアが より高い、買った顧客の割合」です。したがって、ROC曲線の下の面積は、 となり、本文の「買った顧客の方に高いスコアが付いている確率」と一致します(同点があると、ROC曲線が斜めに進むので、その分が になります)。補足:AUC と ROC曲線の関係
import lightgbm as lgb
from sklearn.model_selection import KFold
from sklearn.metrics import roc_auc_score

kf = KFold(n_splits=5, shuffle=True, random_state=0)
params = dict(n_estimators=200, learning_rate=0.05, num_leaves=15, min_child_samples=50,
              random_state=0, n_jobs=1, verbose=-1)
scores = {name: np.zeros(N) for name in ['反応モデル', 'S-Learner', 'T-Learner', 'X-Learner']}

for train_idx, test_idx in kf.split(X):
    X_tr, X_te = X.iloc[train_idx], X.iloc[test_idx]
    T_tr, Y_tr = T_rct[train_idx], Y_rct[train_idx]
    treated, control = T_tr == 1, T_tr == 0

    # 1. 反応モデル:配った顧客だけで「買うか」を予測する
    resp = lgb.LGBMClassifier(**params).fit(X_tr[treated], Y_tr[treated])
    scores['反応モデル'][test_idx] = resp.predict_proba(X_te)[:, 1]

    # 2. S-Learner:施策の有無を特徴量の1つとして、1つのモデルで学習する
    s_model = lgb.LGBMClassifier(**params).fit(X_tr.assign(treat=T_tr), Y_tr)
    scores['S-Learner'][test_idx] = (s_model.predict_proba(X_te.assign(treat=1))[:, 1]
                                     - s_model.predict_proba(X_te.assign(treat=0))[:, 1])

    # 3. T-Learner:施策群と対照群で別々のモデルを学習する
    m1 = lgb.LGBMClassifier(**params).fit(X_tr[treated], Y_tr[treated])
    m0 = lgb.LGBMClassifier(**params).fit(X_tr[control], Y_tr[control])
    scores['T-Learner'][test_idx] = m1.predict_proba(X_te)[:, 1] - m0.predict_proba(X_te)[:, 1]

    # 4. X-Learner:擬似的な効果を予測するモデルを、傾向スコアで加重平均する(RCTなので傾向スコアは0.5)
    D1 = Y_tr[treated] - m0.predict_proba(X_tr[treated])[:, 1]
    D0 = m1.predict_proba(X_tr[control])[:, 1] - Y_tr[control]
    tau1 = lgb.LGBMRegressor(**params).fit(X_tr[treated], D1)
    tau0 = lgb.LGBMRegressor(**params).fit(X_tr[control], D0)
    g = 0.5
    scores['X-Learner'][test_idx] = g * tau0.predict(X_te) + (1 - g) * tau1.predict(X_te)

# 5. 比較:成果 Y を当てる力(AUC)と、真のCATEとの相関
scores['真のCATE(神の視点)'] = tau_true
for name, s in scores.items():
    print(f"{name:14s}: 購買を当てるAUC {roc_auc_score(Y_rct, s):.3f}、真のCATEとの相関 {np.corrcoef(s, tau_true)[0, 1]:.3f}")
シナリオA(RCT)のデータで、4つのモデルのスコアを5分割交差適合で作っています。
-
交差適合の準備: KFold(n_splits=5, shuffle=True, random_state=0) で顧客をランダムに5つに分け、kf.split(X) が返す学習用とテスト用の位置の組で、学習と予測を5回繰り返します。各回でテスト用の顧客のスコアだけを scores[name][test_idx] に書き込むので、最後には全員のスコアが、その顧客を学習に使っていないモデルの予測でそろいます。params は LightGBM の設定で、木の数200本、学習率0.05、葉の数15、1つの葉に最低50人です。treated・control は、学習データのうち施策群・対照群を表す True/False の配列です。
-
反応モデル: 施策群(treated)だけで学習した分類モデルの、購買する確率 predict_proba(X_te)[:, 1] をスコアにしています。
-
S-Learner: X_tr.assign(treat=T_tr) で施策の有無を特徴量に加えて1つのモデルを学習し、全員の treat を1にした予測確率と0にした予測確率の差を CATE としています。
-
T-Learner: 施策群のモデル m1()と対照群のモデル m0()の予測確率の差です。
-
X-Learner: m1・m0 から擬似的な効果 D1・D0 を作り、それを予測する回帰モデル tau1・tau0 を学習しています。最後の加重平均の重み g は、メタラーナーの記事では傾向スコアを推定していましたが、ここでは RCT で配布確率が0.5と分かっているので、その値をそのまま使っています。
-
比較: 各スコアについて、実際の購買 Y_rct を当てる AUC(roc_auc_score)と、真のCATE tau_true との相関を計算しています。比較のため、真のCATEそのものもスコアとして加えています。AUC は購買したかどうかを当てる力、相関は CATE(効果)の大小を当てる力を表します。
実行結果
反応モデル         : 購買を当てるAUC 0.824、真のCATEとの相関 0.355
S-Learner     : 購買を当てるAUC 0.568、真のCATEとの相関 0.801
T-Learner     : 購買を当てるAUC 0.551、真のCATEとの相関 0.660
X-Learner     : 購買を当てるAUC 0.561、真のCATEとの相関 0.748
真のCATE(神の視点)  : 購買を当てるAUC 0.579、真のCATEとの相関 1.000
- AUC が最も高いのは反応モデル: 反応モデルの AUC は0.824で、メタラーナー(0.551〜0.568)を大きく上回りました。真のCATEそのもの(0.579)よりも高い値です。
- 真のCATEとの相関は反応モデルが最も低い: 一方、真のCATEとの相関は、反応モデルが0.355で最も低く、S-Learner(0.801)・X-Learner(0.748)・T-Learner(0.660)の方がはるかに高くなりました。
- AUC と効果の順位付けは、逆向きになりうる: 真のCATEを完璧に知っていても、AUC は0.579にしかなりません。「買うかどうか」を当てる力と、「クーポンで買うようになるか」を当てる力は、まったく別のものなのです。
2つの指標を並べると、次のようになります。
(図は、diagram-designで作成)
なぜAUCやRMSEで評価できないのか
この結果は、アップリフトモデルの評価の難しさをよく表しています。
- AUC が測っているのは「買いやすさ」の順位:AUC は「実際に買った顧客に、買わなかった顧客より高いスコアを付けられたか」を測ります。反応モデルの AUC が高いのは、もともと買いやすい顧客(配らなくても買う「鉄板」の顧客)を正しく上位に置いているからです。しかし、そうした顧客にクーポンを配っても、購買はほとんど増えません。
- CATE の正解が観測できない:CATE を予測するモデルを、予測と正解の差(RMSE)で評価したくても、正解である個人の効果 は観測できません。本記事のダミーデータでは真のCATEとの相関を計算できましたが、現実のデータではこの計算はできません。
そこで、個人の効果が観測できないことを前提に、顧客の集団としての効果を使って評価します。その道具が、次の節の Qini曲線とアップリフト曲線です。
RCTデータでの評価:Qini曲線・アップリフト曲線・AUUC
考え方
個人の効果は観測できなくても、集団の平均効果なら、RCTのデータで推定できます。ランダムに配ったので、施策群と対照群は(クーポン以外は)同じような顧客の集まりになっているからです(RCTの記事を参照)。
そこで、モデルのスコアの高い順に顧客を並べ、上位 (たとえば上位30%)の顧客の中で、施策群と対照群の購買を比べます。スコアの高い顧客に本当に効果の大きい顧客が集まっていれば、上位の顧客ほど、施策群と対照群の差が大きくなるはずです。
上位 の顧客のうち、施策群の人数を 、そのうち購買した人数を 、対照群の人数を 、そのうち購買した人数を とします。
- アップリフト曲線(uplift curve):上位 の顧客「全員」に配った場合に増える購買数の推定値です。施策群と対照群の購買率の差に、上位 の人数 を掛けます。
- Qini曲線(Radcliffe, 2007。アップリフトの評価方法のまとめは Gutierrez & Gérardy, 2017 を参照):上位 の施策群の購買数から、施策群と同じ人数に換算した対照群の購買数を引いたものです。「上位 の施策群で、クーポンのおかげで増えた購買数」を表します。
どちらの曲線も、ランダムな順番で配った場合は、原点と右端(全員に配った場合)を結ぶ直線になります。モデルの曲線がこの直線より上にあるほど、効果の大きい顧客を上位に集められています。Qini曲線とランダムの直線の間の面積を Qini係数、アップリフト曲線とランダムの直線の間の面積を AUUC(Area Under the Uplift Curve)と呼び、1つの数値でモデルを比べるのに使います。AUUC の定義はメタラーナーの記事と同じです。文献やライブラリによっては、ランダムの直線を引かずに、アップリフト曲線の下の面積そのものを AUUC と呼ぶこともあるので、数値を比べるときは定義を確認してください。
実装
ダミーデータでは真のCATE が分かるので、スコアの高い順に を足し合わせた「真の累積効果」も計算できます。アップリフト曲線は、この真の累積効果を、個人の効果を知らずに RCT のデータだけから推定したものです。
グラフの日本語表示には japanize-matplotlib を使います。インストールされていない場合は、事前に次のコマンドを実行してください(Google ColabやJupyterでは先頭の ! を付けたまま、ターミナルでは ! を外して実行します)。Python 3.12 以降で import 時にエラーが出る場合は、setuptools も一緒にインストールしてください。
!pip install japanize-matplotlib setuptools
コードで計算する式( は qini_curve、 は uplift_curve)を、考え方の式と合わせてまとめておきます。割合 の代わりに上位の人数 (、)で計算し、上位 人の施策群の人数 (n_t)、対照群の人数 (n_c)、施策群の購買数 (y_t)、対照群の購買数 (y_c)は、いずれも の配列です。
答え合わせ用の真の累積効果 (true_gain_curve)は、スコアの 番目に高い顧客の真のCATEを として、 です。Qini係数・AUUC(area_above_random)は、曲線 と、原点と右端を結ぶ直線 の差を、 で平均したもの(1人あたりの面積)です。
に を入れると Qini係数、 を入れると AUUC、 を入れると「真の累積効果の面積」になります。
import matplotlib.pyplot as plt
import japanize_matplotlib

# 1. スコアの高い順に並べたときの、上位 k 人までの累積値
def cumulative_counts(score, Y, T):
    order = np.argsort(-score, kind='stable')
    Yo, To = Y[order], T[order]
    n_t, n_c = np.cumsum(To), np.cumsum(1 - To)
    y_t, y_c = np.cumsum(Yo * To), np.cumsum(Yo * (1 - To))
    return n_t, n_c, y_t, y_c

def qini_curve(score, Y, T):
    n_t, n_c, y_t, y_c = cumulative_counts(score, Y, T)
    ratio = np.divide(n_t, n_c, out=np.zeros(len(n_t)), where=n_c > 0)
    return np.concatenate([[0], y_t - y_c * ratio])

def uplift_curve(score, Y, T):
    n_t, n_c, y_t, y_c = cumulative_counts(score, Y, T)
    rate_t = np.divide(y_t, n_t, out=np.zeros(len(n_t)), where=n_t > 0)
    rate_c = np.divide(y_c, n_c, out=np.zeros(len(n_c)), where=n_c > 0)
    return np.concatenate([[0], (rate_t - rate_c) * np.arange(1, len(Y) + 1)])

def true_gain_curve(score):
    order = np.argsort(-score, kind='stable')
    return np.concatenate([[0], np.cumsum(tau_true[order])])

def area_above_random(curve):
    """曲線と、原点と右端を結ぶ直線の間の面積(1人あたり)"""
    return (curve - np.linspace(0, curve[-1], len(curve))).mean()

# 2. 各モデルの Qini係数・AUUC と、上位30%での推定値と真の値を比べる
k30 = int(N * 0.3)
rows = {}
for name, s in scores.items():
    q, u, tg = qini_curve(s, Y_rct, T_rct), uplift_curve(s, Y_rct, T_rct), true_gain_curve(s)
    rows[name] = {'Qini係数': area_above_random(q), 'AUUC': area_above_random(u), '真の累積効果の面積': area_above_random(tg),
                  '上位30%: アップリフト曲線': u[k30], '上位30%: 真の累積効果': tg[k30]}
print(pd.DataFrame(rows).T.round(1).to_string())

# 3. Qini曲線とアップリフト曲線を描く
phi = np.linspace(0, 1, N + 1)
fig, axes = plt.subplots(1, 2, figsize=(14, 5.5))
for name, s in scores.items():
    style = dict(color='black', linestyle='--') if name.startswith('真の') else {}
    axes[0].plot(phi, qini_curve(s, Y_rct, T_rct), label=name, **style)
    axes[1].plot(phi, uplift_curve(s, Y_rct, T_rct), label=name, **style)
for ax, title, ylabel in [(axes[0], 'Qini曲線', '施策群で増えた購買数'), (axes[1], 'アップリフト曲線', '全員に配った場合に増える購買数(推定)')]:
    ax.plot([0, 1], [0, ax.lines[0].get_ydata()[-1]], color='gray', linestyle=':', label='ランダム')
    ax.set_title(title)
    ax.set_xlabel('スコアの高い順に選んだ顧客の割合')
    ax.set_ylabel(ylabel)
    ax.grid(True, alpha=0.3)
axes[0].legend(fontsize=9)
plt.tight_layout()
plt.show()
Qini曲線・アップリフト曲線・真の累積効果を計算し、モデルを比べています。
- 累積値: cumulative_counts は、スコアの高い順に並べたとき、上位 人までの施策群・対照群の人数(n_t・n_c)と購買数(y_t・y_c)を、np.cumsum でまとめて計算します。上位 人ごとに数え直すと時間がかかるので、累積和で全員分を一度に求めています。
- Qini曲線とアップリフト曲線: コードの前に示した と の式をそのまま計算しています。上位の数人では対照群が0人のこともあるので、np.divide の where で0で割らないようにしています。曲線の先頭には、0人のときの値0を付け加えています。
- 真の累積効果: true_gain_curve は、スコアの高い順に真のCATE tau_true を足し合わせたもので、「上位 人全員に配った場合に増える購買数の期待値」です。アップリフト曲線の答えに当たります。
- Qini係数と AUUC: area_above_random は、曲線と、原点と右端を結ぶ直線(ランダム)の差の平均で、Qini曲線に使えば Qini係数、アップリフト曲線に使えば AUUC になります。真の累積効果の曲線にも同じ計算をして、AUUC の答え合わせに使います。
- 上位30%の比較: k30 = int(N * 0.3) は上位30%の人数で、u[k30]・tg[k30] で、上位30%まで選んだときのアップリフト曲線の値と真の累積効果を取り出しています(曲線の先頭に0人の値を付けているので、位置 k30 が「k30 人選んだとき」に当たります)。
- 可視化: np.linspace(0, 1, N + 1) で横軸(選んだ顧客の割合)を作り、左に Qini曲線、右にアップリフト曲線を描いています。真のCATEの曲線だけ linestyle='--' の黒い破線にしています。ランダムな場合の直線は、原点と曲線の右端(ax.lines[0].get_ydata()[-1])を結ぶ点線です。
実行結果
              Qini係数   AUUC  真の累積効果の面積  上位30%: アップリフト曲線  上位30%: 真の累積効果
反応モデル           73.5  143.7      156.7            411.8          430.3
S-Learner      147.5  292.9      280.9            741.8          704.3
T-Learner      120.0  235.4      236.2            663.9          650.6
X-Learner      132.6  267.8      260.0            721.9          679.2
真のCATE(神の視点)   188.0  372.4      334.3            838.6          786.5
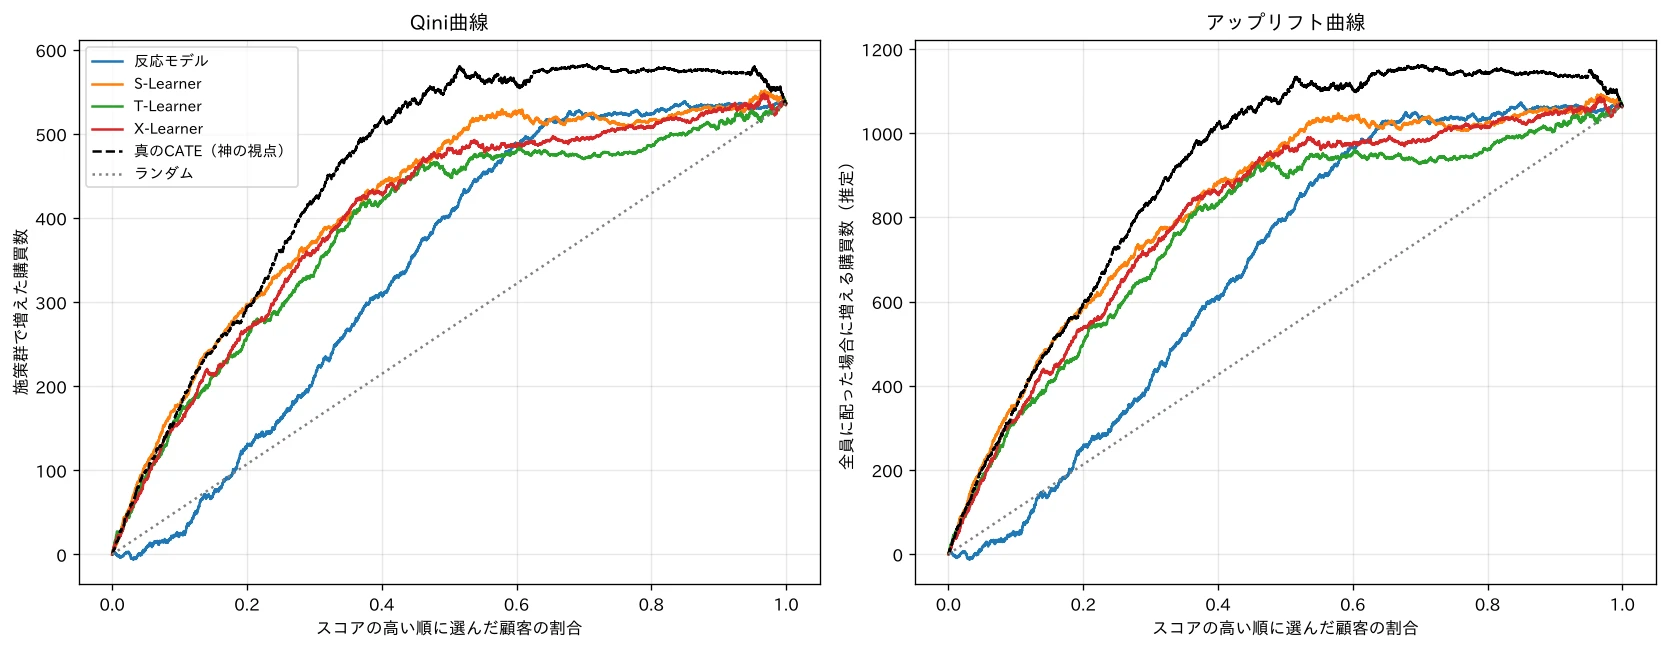
- モデルの順位は、真のCATEとの相関と同じ: Qini係数は、S-Learner(147.5)、X-Learner(132.6)、T-Learner(120.0)、反応モデル(73.5)の順で、真のCATEとの相関の順位と一致しました。RCTのデータがあれば、個人の効果を知らなくても、どのモデルが効果の大きい顧客を上位に集められているかを正しく比べられます。
- アップリフト曲線は真の累積効果をよく再現する: 上位30%に配った場合に増える購買数は、X-Learner でアップリフト曲線の推定値が721.9件、真の累積効果が679.2件、反応モデルで411.8件と430.3件でした。偶然のばらつきはありますが、RCTのデータだけから、真の効果の規模を推定できています。
- 反応モデルは、最初はランダムより悪い: 図の反応モデルの曲線は、上位15%ほどまで、ランダムの直線の下を通っています。スコアの上位に、配らなくても買う「鉄板」の顧客が集まっているためです。
- 最後の方で曲線が下がる: 真のCATE の曲線は、右端の近くで下がっています。スコアの最も低い顧客には、配ると買わなくなる顧客が集まっているので、その顧客にまで配ると、購買数が減ってしまうのです。
AUUC は、Qini係数とほぼ同じ順位になり、値はおよそ2倍です。Qini曲線が「施策群(約半数)で増えた購買数」を数えるのに対し、アップリフト曲線は「全員に配った場合」に換算しているためです。AUUC は真の累積効果の面積とも近い値で(X-Learner で267.8と260.0)、RCT のデータだけから、モデルの順位付けの良さを金額や件数の規模で推定できることが分かります。
方策価値 V(π)
定義
Qini曲線は「スコアの順位付けの良さ」を測るものでした。実務で最終的に知りたいのは、「このルールで配布先を決めたら、顧客全体でどれだけの成果が得られるか」です。
顧客の特徴量 から、施策を打つかどうか(1 または 0)を決めるルールを 方策(policy) と呼びます。たとえば「X-Learner のスコアが上位30%なら配る」は1つの方策です。方策 の良さを表すのが、方策価値(policy value)です。
全員がその方策に従って施策を受けた(または受けなかった)場合の、成果の平均です。本記事なら、「その方策で配ったときの、30日以内の購買率」です。
は、方策が選んだ側の潜在的結果です。
方策価値を知りたいのは、新しい配布ルールを実際に使う前です。たとえば「来月から X-Learner のスコアの上位30%に配る」と決める前に、その成果を見積もりたいわけです。このとき手元にあるのは、過去に別のルールで配ったデータ(本記事なら、先月ランダムに配った RCT のデータ。現実には、担当者の判断で配った観察データのことも多い)だけです。評価したい方策は、まだ一度も実行されていない仮想の配布ルールなので、そのデータを使い回して評価するしかありません。
データの中の実際の施策 は、評価したい方策 とは無関係に決まったもの(RCT ならランダム)です。そのため、方策の選択 (「この方策なら配る/配らない」)と、過去に実際に行われた施策 (「実際に配った/配らなかった」)は、顧客によって一致したり、しなかったりします。方策が「配る」と決めた顧客が、過去のデータでは配られていなかった、ということが起きるのはこのためです。
| 方策の選択 | 実際の施策 | 観測できる結果 | 方策価値の計算に |
|---|---|---|---|
| 配る(1) | 配られた(1) | 使える | |
| 配る(1) | 配られていない(0) | 使えない(必要なのは ) | |
| 配らない(0) | 配られていない(0) | 使える | |
| 配らない(0) | 配られた(1) | 使えない(必要なのは ) |
たとえば RCT のデータで「上位30%(3,000人)に配る」方策を評価すると、その3,000人のうち実際に配られていたのは、ランダムに選ばれた約半分(約1,500人)だけです。残りの約1,500人は、方策では配る予定なのに実際には配られていないので、必要な が観測できません。
そこで、実際の施策が方策の選択と一致した顧客だけを使い、その結果で、一致しなかった顧客の分も補って推定します。RCT では配布がランダムなので、一致した約半分と一致しなかった約半分は、特徴量も潜在的結果も平均的に同じです。そのため、一致した顧客の結果を、方策が選んだ側の施策を受ける確率(RCT なら0.5)で割る(つまり2倍する)と、一致しなかった顧客の分まで含めた合計を推定できます。これが IPW(逆確率重み付け、IPTWの記事と同じ考え方)による方策価値の推定量です。
が、実際の施策と方策の選択が一致した顧客だけを残す部分です。 は、方策が選んだ側の施策を実際に受ける確率です。方策が「配る」なら 、「配らない」なら です。RCT なら、全員 です。観察データでは、たとえば買いそうな顧客ほど配られやすいといった偏りがあるので、一致した顧客は一致しなかった顧客の代わりになりません。その場合は、顧客ごとに推定した配布確率 で割って偏りを補正します(観察データでの方策価値の推定の節で扱います)。また、一致した顧客(RCT ならおよそ半分)しか使わないので、推定は平均的には正しい(不偏)ものの、ばらつきは大きくなります。
方策価値の定義と、データで使える行を図にすると、次のようになります。
(図は、diagram-designで作成)
RCTデータでの方策価値
各モデルのスコアの上位 に配る方策 (方策の選択 は top_k_policy が作る0/1の配列 pi)について、方策価値を IPW(ipw_value)で推定し、真の値(true_value)と比べます。ダミーデータでは、全員の (y1・y0)が分かるので、真の方策価値を直接計算できます。
コードで計算する式は、次の2つです( は e で、RCT なので全員0.5の e_rct。 は prob、 は (T == pi))。
真の方策価値(true_value):全員の と を両方使うので、潜在的結果がすべて分かるダミーデータでしか計算できません。
IPW による推定(ipw_value):実際に観測された結果 と実際の施策 だけを使うので、現実のデータでも計算できます。
IPW の式には、真の値の に当たる部分がないように見えますが、 の中に「配る」側と「配らない」側の2つの場合がまとめて入っています。 となるのは、「 かつ 」(観測された は 、分母は )と、「 かつ 」(観測された は 、分母は )の2通りです。この2通りを分けて書くと、真の値と同じ形になります。
第1項では、 の顧客の は で、配布はランダムなので です。そのため の期待値は になります。第2項も同じく、 なので の期待値は です。つまり IPW の推定は、平均的には真の値と一致します。コードの prob = np.where(pi == 1, e, 1 - e) が、方策が「配る」顧客は 、「配らない」顧客は で割る、という場合分けに当たります。
# 1. スコアの上位 k% に配る方策
def top_k_policy(score, frac):
    pi = np.zeros(N, dtype=int)
    pi[np.argsort(-score, kind='stable')[: int(N * frac)]] = 1
    return pi

# 2. 真の方策価値(全員の潜在的結果が分かるダミーデータだからできる)と、IPW による推定
def true_value(pi):
    return np.mean(np.where(pi == 1, y1, y0))

def ipw_value(pi, Y, T, e):
    prob = np.where(pi == 1, e, 1 - e)              # 方策が選んだ側の施策を受ける確率
    return np.mean((T == pi) * Y / prob)

fracs = np.arange(0, 1.01, 0.05)
e_rct = np.full(N, 0.5)
curves = {}
for name in ['反応モデル', 'X-Learner', '真のCATE(神の視点)']:
    curves[name] = {
        '真の値': [true_value(top_k_policy(scores[name], f)) for f in fracs],
        'IPW推定': [ipw_value(top_k_policy(scores[name], f), Y_rct, T_rct, e_rct) for f in fracs],
    }

# 3. 主な方策の比較
print(f"全員に配らない: {true_value(np.zeros(N, dtype=int)):.1%}、全員に配る: {true_value(np.ones(N, dtype=int)):.1%}")
for name, c in curves.items():
    best = int(np.argmax(c['真の値']))
    print(f"{name:14s}: 上位30%に配る → 真の値 {c['真の値'][6]:.1%}(IPW推定 {c['IPW推定'][6]:.1%})、"
          f"真の値が最大になるのは上位{fracs[best]:.0%}({c['真の値'][best]:.1%})")

# 4. 配布割合と方策価値の関係を描く
plt.figure(figsize=(9, 5.5))
for (name, c), color in zip(curves.items(), ['C0', 'C3', 'black']):
    plt.plot(fracs, c['真の値'], color=color, label=f'{name}(真の値)')
    plt.plot(fracs, c['IPW推定'], 'o', color=color, markersize=4, label=f'{name}(IPW推定)')
plt.xlabel('配布する顧客の割合(スコアの上位から)')
plt.ylabel('方策価値(30日以内の購買率)')
plt.title('方策価値:スコアの上位 k% に配った場合の購買率')
plt.legend(fontsize=9)
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
スコアの上位 に配る方策について、方策価値の真の値と IPW による推定値を計算しています。
- 方策: top_k_policy は、np.zeros(N, dtype=int) で全員0(配らない)の配列を作り、np.argsort(-score, kind='stable')[: int(N * frac)] で求めたスコアの上位 frac の割合の顧客の位置を1(配る)に書き換えて返します。
- 真の方策価値: true_value は、np.where(pi == 1, y1, y0) で、配ると決めた顧客の y1 と、配らないと決めた顧客の y0 を選んで平均したものです。全員の潜在的結果を知っているダミーデータでしか計算できません。
- IPW による推定: ipw_value はコードの前に示した の式です。(T == pi) が、実際の施策と方策の選択が一致した顧客を表し、その顧客の購買を、方策が選んだ側の施策を受ける確率 prob で割っています。RCT なので、確率はすべて0.5(e_rct)です。
- 配布割合を変える: fracs で、配る割合を0%から100%まで5%刻みで変え、反応モデル・X-Learner・真のCATE の3つのスコアについて方策価値を計算しています。c['真の値'][6] は、fracs の7番目、つまり30%の値です。np.argmax(c['真の値']) で、真の方策価値が最大になる配布割合も求めています。
- 可視化: 3つのスコアそれぞれについて、真の方策価値を線、IPW 推定を点('o')で描き、推定が真の値をどれだけ再現できているかを見ています。
実行結果
全員に配らない: 18.5%、全員に配る: 29.5%
反応モデル         : 上位30%に配る → 真の値 22.8%(IPW推定 23.3%)、真の値が最大になるのは上位95%(29.5%)
X-Learner     : 上位30%に配る → 真の値 25.7%(IPW推定 25.5%)、真の値が最大になるのは上位100%(29.5%)
真のCATE(神の視点)  : 上位30%に配る → 真の値 26.6%(IPW推定 26.8%)、真の値が最大になるのは上位95%(29.8%)
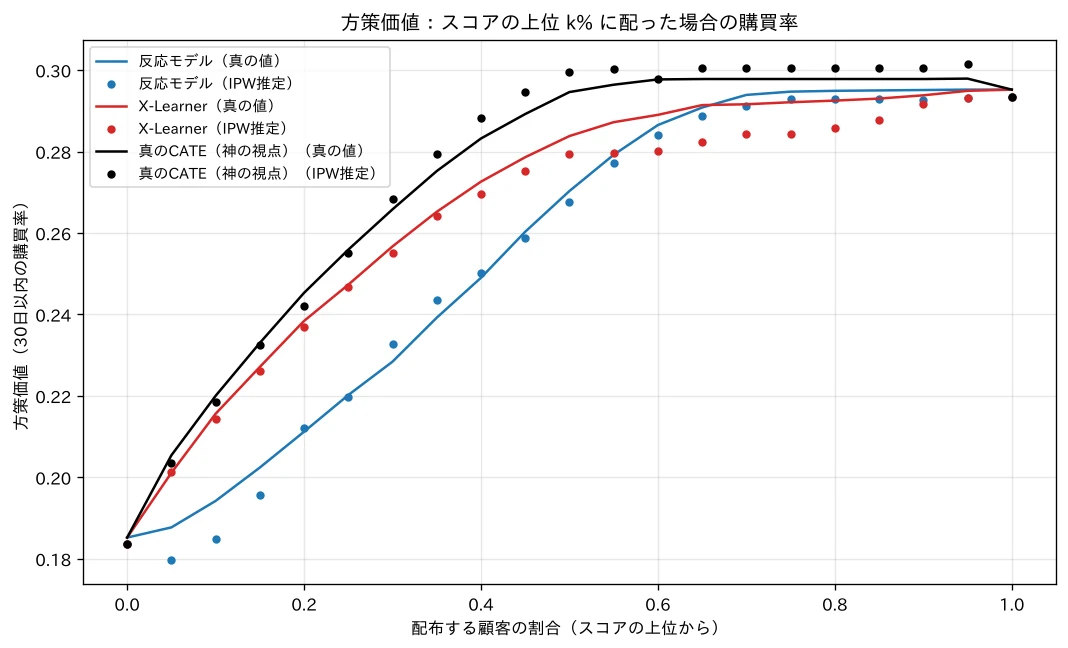
- IPW の推定は真の値に近い: 上位30%に配る方策の購買率は、X-Learner で真の値25.7%に対して IPW の推定が25.5%、反応モデルで22.8%に対して23.3%でした。図でも、点(IPW の推定)は線(真の値)のまわりにあります。RCT のデータがあれば、まだ実施していない配布ルールの成果を、事前に推定できるのです。
- 同じ配布数でも、選び方で成果が変わる: 上位30%(3,000人)に配る場合、反応モデルで選ぶと購買率は22.8%(全員に配らない場合の18.5%から +4.3ポイント)ですが、X-Learner で選ぶと25.7%(+7.2ポイント)になり、真のCATE(26.6%)に迫ります。クーポンの配布数に上限があるときほど、アップリフトモデルの価値が大きくなります。
- 配る割合を増やしても、成果は頭打ちになる: 真のCATE で選ぶと、上位60%あたりで購買率はほぼ最大値(29.8%)に達し、そこから先はほとんど増えません。残りの顧客は、配っても買わないか、配らなくても買う顧客だからです。全員に配ると、配ると買わなくなる顧客にまで配るので、29.5%と、かえってわずかに下がります。クーポンにコストがあるなら、全員に配るのは明らかに無駄です(予算の制約のもとで配布先を決める方法は、HVA分析の記事で扱います)。
観察データでの方策価値の推定:IPWとDR
観察データで単純に比べると何が起きるか
RCTは、いつでも実施できるわけではありません。手元にあるのが、担当者の判断で配った過去のキャンペーンのデータ(シナリオB)だけ、ということもよくあります。シナリオBでは、最近訪問し、最近買った顧客ほどクーポンが配られやすくなっていました。こうした顧客は、クーポンがなくても買いやすい顧客です。
このデータで、方策の選択と実際の施策が一致した顧客の購買率を、重み付けせずにそのまま平均すると(単純な推定)、配られやすい顧客の成果が過大に反映されてしまいます。そこで、傾向スコア を推定し、IPW で補正します。
さらに、IPW を改良した DR(Doubly Robust)推定量 も使います。二重にロバストな推定法の記事の AIPW を、方策価値に当てはめたものです(Dudík, Langford & Li, 2011)。
は、施策を受けた場合・受けなかった場合の成果を予測するモデル(アウトカムモデル)です。まずアウトカムモデルの予測を置き、方策の選択と実際の施策が一致した顧客の予測誤差を、逆確率で重み付けして足し戻します。傾向スコアのモデルとアウトカムモデルのどちらか一方が正しければ偏りなく推定できる、という二重のロバスト性があります(理由は二重にロバストな推定法の記事を参照してください)。 1. 記号の意味: は、方策が選んだ側のアウトカムモデルの予測です。方策が「配る」()なら 、「配らない」()なら です。 2. 2つの場合に分けて書く:IPW の式と同じく、 を「 かつ 」と「 かつ 」の2通りに分けると、顧客 の項は次のようになります( は推定した傾向スコア)。 どちらも「アウトカムモデルの予測」+「予測誤差の補正」という形です。 なお、アウトカムモデルを (何も予測しない)とすると、第1項が消えて第2項が になり、IPW と一致します。DR は、IPW の を「予測誤差 」に置き換え、予測分を別に足したものと読めます。予測誤差は そのものより小さいので、逆確率で大きく重み付けされても、推定のばらつきが小さくなります。 3. 二重のロバスト性: の場合で確かめます( も同じです)。特徴量 を固定したとき、施策 は潜在的結果と無関係に決まり(観察データでは、交絡がすべて に含まれているという仮定)、 なら です。真の傾向スコアを 、真の成果の平均を とおくと、補正の項の期待値は です( と が独立なので、 と の積になる)。したがって、顧客 の項の期待値は です。これが真の値 になるのは、次のどちらかが成り立つときです。 どちらか一方が正しければ偏りなく推定できる、というのが「二重に(doubly)ロバスト」の意味です。詳細な式展開(DR推定量の読み方と、二重のロバスト性)
実装
シナリオBのデータで、傾向スコアのモデル(ロジスティック回帰)とアウトカムモデル(LightGBM)を、5分割交差適合で推定します。評価する方策は、シナリオA(RCT)で学習した反応モデルと X-Learner の上位30%に配る方策、全員に配る方策、全員に配らない方策の4つです。最後に、ブートストラップ(顧客を復元抽出して計算し直すことを繰り返す方法)で、IPW と DR の推定のばらつき(標準誤差)を比べます。
コードの手順ごとに、計算する式をまとめておきます。
手順1・2:傾向スコアとアウトカムモデル。傾向スコアは、変換・標準化した特徴量 のロジスティック回帰 ( は e_hat)で推定し、 に制限します。アウトカムモデルは、施策群で学習した ( は mu1_hat)と、対照群で学習した ( は mu0_hat)です。
手順3:3つの推定量。方策の選択 (pi)、一致の指示関数 ((T == pi)。単純な推定では match)、(方策が「配る」なら 、「配らない」なら 。prob)、(方策が選んだ側のアウトカムモデルの予測。mu_pi)を使います。単純な推定(naive_value)は、一致した顧客の成果の重みなしの平均です。
IPW(ipw_value、定義で示した式と同じで、RCT の節の関数をそのまま使います)と DR(dr_value、上の式)は次のとおりです。
手順4:ブートストラップの標準誤差。顧客を復元抽出したデータで推定し直した値を (、)、その平均を とすると、標準誤差は次のとおりです(np.std(vals))。
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler

# 1. 傾向スコアの推定(シナリオBのデータで、配られたかどうかを特徴量から予測する)
X_log = X.copy()
for c in ['x', 't_x', 'T', 'recency', 'n_purchases', 'visits_30d', 'cart_30d']:
    X_log[c] = np.log1p(X_log[c])
for c in ['monetary', 'viewed_price']:
    X_log[c] = np.log(X_log[c])

e_hat = np.zeros(N)
mu1_hat, mu0_hat = np.zeros(N), np.zeros(N)
for train_idx, test_idx in kf.split(X):
    scaler = StandardScaler().fit(X_log.iloc[train_idx])
    ps_model = LogisticRegression(max_iter=1000).fit(scaler.transform(X_log.iloc[train_idx]), T_obs[train_idx])
    e_hat[test_idx] = ps_model.predict_proba(scaler.transform(X_log.iloc[test_idx]))[:, 1]
    # 2. アウトカムモデル:施策群・対照群で別々に、30日以内に買うかを予測する
    tr_t, tr_c = train_idx[T_obs[train_idx] == 1], train_idx[T_obs[train_idx] == 0]
    mu1_hat[test_idx] = lgb.LGBMClassifier(**params).fit(X.iloc[tr_t], Y_obs[tr_t]).predict_proba(X.iloc[test_idx])[:, 1]
    mu0_hat[test_idx] = lgb.LGBMClassifier(**params).fit(X.iloc[tr_c], Y_obs[tr_c]).predict_proba(X.iloc[test_idx])[:, 1]
e_hat = np.clip(e_hat, 0.01, 0.99)
print(f"推定した傾向スコア: 最小 {e_hat.min():.3f}、最大 {e_hat.max():.3f}、真の傾向スコアとの相関 {np.corrcoef(e_hat, e_true)[0, 1]:.3f}")

# 3. 3つの推定量
def naive_value(pi, Y, T):
    match = T == pi
    return Y[match].mean()                          # 一致した顧客の単純平均(重みなし)

def dr_value(pi, Y, T, e, mu1, mu0):
    mu_pi = np.where(pi == 1, mu1, mu0)
    prob = np.where(pi == 1, e, 1 - e)
    return np.mean(mu_pi + (T == pi) * (Y - mu_pi) / prob)

policies = {
    '全員に配らない': np.zeros(N, dtype=int),
    '全員に配る': np.ones(N, dtype=int),
    '反応モデルの上位30%': top_k_policy(scores['反応モデル'], 0.3),
    'X-Learnerの上位30%': top_k_policy(scores['X-Learner'], 0.3),
}
table = {}
for name, pi in policies.items():
    table[name] = {'真の値': true_value(pi), '単純な推定': naive_value(pi, Y_obs, T_obs),
                   'IPW': ipw_value(pi, Y_obs, T_obs, e_hat), 'DR': dr_value(pi, Y_obs, T_obs, e_hat, mu1_hat, mu0_hat)}
print()
print((pd.DataFrame(table).T * 100).round(1).to_string())

# 4. ブートストラップによる標準誤差(X-Learnerの上位30%に配る方策)
pi = policies['X-Learnerの上位30%']
boot_rng = np.random.default_rng(0)
boot = {'IPW': [], 'DR': []}
for _ in range(500):
    idx = boot_rng.integers(0, N, size=N)
    boot['IPW'].append(ipw_value(pi[idx], Y_obs[idx], T_obs[idx], e_hat[idx]))
    boot['DR'].append(dr_value(pi[idx], Y_obs[idx], T_obs[idx], e_hat[idx], mu1_hat[idx], mu0_hat[idx]))
print()
for name, vals in boot.items():
    print(f"{name:3s}: 標準誤差 {np.std(vals) * 100:.2f} ポイント")
シナリオB(観察データ)で傾向スコアとアウトカムモデルを推定し、4つの方策の方策価値を、単純な推定・IPW・DR で推定しています。
- 特徴量の変換: X_log = X.copy() で特徴量の表をコピーし、回数や日数の列を np.log1p、金額の列を np.log で変換しています。ロジスティック回帰は特徴量の大きさに影響されるので、裾の重い値をそのまま入れないようにするためです。
- 傾向スコア: 変換した特徴量を、StandardScaler で標準化してから、LogisticRegression で配られたかどうか(T_obs)を予測しています。標準化は学習データだけで行い(fit)、テストデータには同じ変換を当てはめています(transform)。max_iter=1000 は、最適化の反復回数の上限です。predict_proba(...)[:, 1] の2列目が、配られる確率です。推定した傾向スコア e_hat は、np.clip(e_hat, 0.01, 0.99) で0.01〜0.99に制限しています。傾向スコアが0や1に近いと、逆数の重みが極端に大きくなるためです。
- アウトカムモデル: 施策群(tr_t)と対照群(tr_c)で別々に LightGBM の分類モデルを学習し、全員について (mu1_hat)と (mu0_hat)を予測しています。T-Learner の2つのモデルと同じものです。傾向スコアとアウトカムモデルは、どちらも交差適合で、自分のデータを学習に使っていないモデルの予測にしています。
- 3つの推定量: naive_value は、実際の施策と方策の選択が一致した顧客の購買率を、重み付けせずに平均したものです。dr_value はコードの前に示した の式で、方策が選んだ側のアウトカムモデルの予測 mu_pi に、一致した顧客の予測誤差を逆確率で重み付けして足し戻しています。
- 表示: 4つの方策について、真の値と3つの推定値を pd.DataFrame(table).T * 100 で百分率の表にしています。
- 評価する方策: 反応モデルと X-Learner のスコアは、シナリオA(RCT)で学習したものをそのまま使っています。過去のキャンペーンのデータで、RCTで作った配布ルールの成果を推定する、という設定です。
- ブートストラップ: boot_rng.integers(0, N, size=N) で顧客を復元抽出し、IPW と DR の推定を500回やり直して、その標準偏差(np.std(vals))を標準誤差としています。pi[idx] のように、方策・成果・施策・傾向スコア・アウトカムモデルの予測を、同じ idx でそろえて取り出しています。傾向スコアとアウトカムモデルは推定し直していないので、モデルの推定のばらつきは含んでいません。
実行結果
推定した傾向スコア: 最小 0.082、最大 0.990、真の傾向スコアとの相関 0.999

                  真の値  単純な推定   IPW    DR
全員に配らない          18.5    8.9  21.3  19.0
全員に配る            29.5   42.3  29.7  29.9
反応モデルの上位30%      22.8   22.4  22.6  22.7
X-Learnerの上位30%  25.7   16.5  28.5  26.2

IPW: 標準誤差 2.26 ポイント
DR : 標準誤差 0.81 ポイント
- 傾向スコアは正しく推定できた: 推定した傾向スコアと真の傾向スコアの相関は0.999です。真の配布確率は、変換した訪問回数と最後の購買からの日数のロジスティック関数だったので、ロジスティック回帰で正しい形を当てられたのです。
- 単純な推定は大きく偏る: 全員に配る方策の購買率は、真の値29.5%に対して、単純な推定では42.3%になりました。施策群には、もともと買いやすい顧客が集まっていたからです。逆に、全員に配らない方策は8.9%(真の値18.5%)と過小評価され、X-Learner の上位30%に配る方策も16.5%(真の値25.7%)と、大きく外れました。この推定を信じると、「全員に配れば購買率が33ポイント以上も上がる」と誤った結論を出してしまいます。
- IPW と DR は偏りを取り除く: 全員に配る方策は、IPW で29.7%、DR で29.9%と、真の値(29.5%)に近づきました。X-Learner の上位30%に配る方策は、DR が26.2%(真の値25.7%)と近い一方、IPW は28.5%と、まだ2.8ポイントずれています。
- DR の方がばらつきが小さい: ブートストラップの標準誤差は、IPW が2.26ポイント、DR が0.81ポイントでした。IPW のずれ(2.8ポイント)は、この標準誤差の範囲の偶然のばらつきと考えられます。配られる確率が0.99に近い顧客が「配られなかった」場合など、重みが極端に大きくなる顧客がいると、IPW の推定は大きくぶれます。DR は、アウトカムモデルの予測を出発点にして、重み付けするのは予測誤差だけなので、ばらつきが小さくなるのです。
4つの方策の推定値を並べると、次のようになります。
(図は、diagram-designで作成)
発展:オフポリシー評価とバンディット・強化学習
本記事で扱った「ある方策(配布のルール)で集めたデータを使って、別の方策の価値を推定する」問題は、オフポリシー評価(Off-Policy Evaluation, OPE)と呼ばれ、推薦システムや広告配信、強化学習で広く研究されています。
- バンディット問題:広告配信のように、施策を打つたびに結果を見て、次の施策を決める問題です。過去の配信ログ(ある方策で配信したデータ)から、新しい配信ルールの価値を推定するとき、本記事と同じ IPW や DR 推定量が使われます(Dudík, Langford & Li, 2011)。
- 強化学習:PPOの記事で登場した「重要度サンプリング(古い方策で集めたデータを、新しい方策の確率の比で重み付けして使う)」は、本記事の IPW と同じ考え方です。
また、本記事では「スコアの上位 に配る」という単純な方策を評価しましたが、方策価値を直接最大化するように方策を学習する方法(方策学習)もあります。予算の制約のもとで方策を決める方法と方策学習の紹介は、HVA分析の記事で扱います。
まとめ
本記事では、個人の施策効果が観測できないという前提のもとで、アップリフトモデルを評価する方法を解説しました。
- AUCでは評価できない:「配ったら買うか」を予測する反応モデルは、AUC が最も高いのに、施策の効果の大きい顧客を選べませんでした。AUC が測るのは「買いやすさ」の順位であり、「施策で行動が変わるか」ではありません。
- Qini曲線・アップリフト曲線・AUUC:RCT のデータで、スコアの上位の顧客の施策群と対照群を比べることで、個人の効果を知らなくても、モデルの順位付けの良さを評価できました。アップリフト曲線は、真の累積効果をよく再現しました。
- 方策価値:「このルールで配ったら、全体の購買率はどうなるか」を表す方策価値を、RCT のデータから IPW で推定し、真の値と一致することを確かめました。配る割合を増やすほど成果が上がるとは限らず、効果が負の顧客を避けることも大切です。
- 観察データでの推定:配布先が偏った過去のキャンペーンのデータでは、単純な推定は大きく偏りました。傾向スコアで重み付けする IPW と、アウトカムモデルで補う DR によって、偏りを取り除けました。DR は IPW よりばらつきも小さくなりました。
本記事で評価した成果は「30日以内に買ったか」という短期の指標でした。しかし、クーポンで30日以内の購買が増えても、それが1年後の売上や顧客生涯価値を増やすとは限りません。値引きで買うことに慣れて、定価では買わなくなるかもしれないからです。「サロゲートインデックスとは?」の記事では、実験期間中には観測できない長期の効果を、短期の指標から推定する サロゲートインデックス を扱います。
参考文献
- M. Dudik, J. Langford, L. Li (2011). Doubly Robust Policy Evaluation and Learning. ICML 2011.
- P. Gutierrez, J.-Y. Gérardy (2017). Causal Inference and Uplift Modelling: A Review of the Literature. Proceedings of The 3rd International Conference on Predictive Applications and APIs, PMLR 67, 1–13.
本記事の文章・構成の一部に生成AIを使用しています。