YOLO11とは?
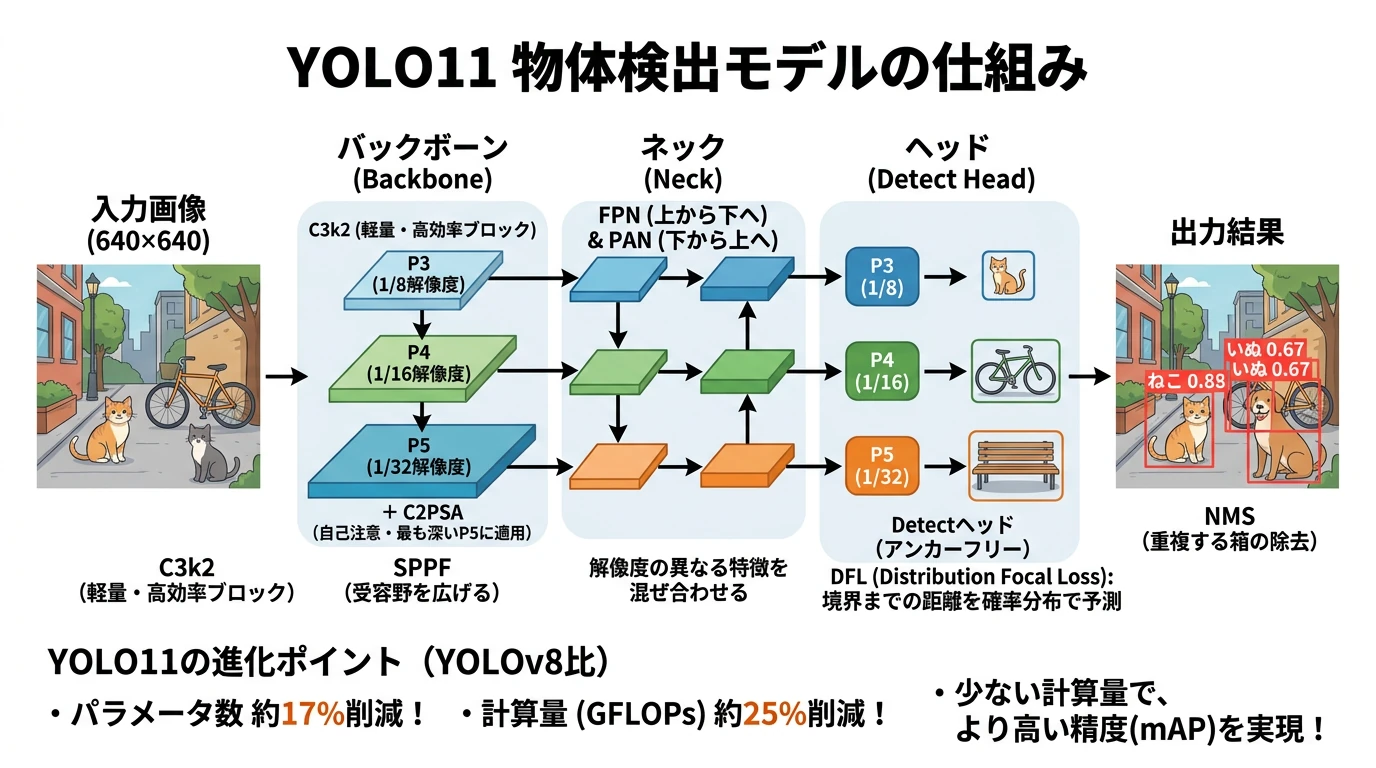 (画像は、Geminiで作成)
Ultralytics の物体検出モデル YOLO11 を部品ごとに PyTorch で実装し、公式の学習済みの重みを読み込んで同じ検出結果になることを確かめること。C3k2・C2PSA・FPN と PAN・DFL の役割を理解し、Task-Aligned Assigner を使った損失でゼロから学習できるようになること。
参考資料: YOLO11 には原著論文がなく、Ultralytics の 公式リポジトリ(AGPL-3.0)と 公式ドキュメント で公開されています。構成の解説には YOLOv11: An Overview of the Key Architectural Enhancements (Khanam, Hussain, arXiv 2024) があります。
概要
物体検出は、画像の中の物体を囲む箱(バウンディングボックス)とそのクラスを当てるタスクです。監視カメラや自動運転、ロボットのように、動画を1コマずつその場で処理する用途では、精度と同じくらい速さが求められます。YOLO(You Only Look Once)は、画像を1回ネットワークに通すだけで、すべての位置の箱とクラスを同時に出す1段階の検出器で、精度と速さの釣り合いを世代ごとに改良してきました。
YOLO11(Ultralytics, 2024)は、前の世代の YOLOv8 の骨組み(解像度の違う3段の特徴を混ぜる Neck と、アンカーの箱を使わない Detect ヘッド)を引き継ぎつつ、主なブロックを C3k2 に替え、最も深い段に自己注意のブロック C2PSA を加えました。少ないパラメータと計算量で、YOLOv8 より高い精度を出しています。
次の節で、YOLOv8n と YOLO11n のパラメータ数・計算量・推論時間を実際に測ります。
YOLOv8n と YOLO11n を比べる
準備:Google Colab の GPU で動かす
本記事のコードは、Google Colab の A100 GPU で実行しました。「ランタイム」→「ランタイムのタイプを変更」から A100 GPU を選んでください(Colab の有料プランが必要です)。後半の学習は、A100 で約30分かかります。L4 GPU でも動きますが、時間はもっとかかります。
新しいセッションで、次を実行してください。ultralytics は、公式のモデルとの比較と、学習済みの重みの読み込みに使います。グラフの日本語表示には japanize-matplotlib を使い、Python 3.12 以降で import 時にエラーが出ないよう setuptools も入れます。
!pip install -q ultralytics japanize-matplotlib setuptools
実験1:パラメータ数・計算量・推論時間
import time
import torch
from ultralytics import YOLO
from ultralytics.utils.torch_utils import get_flops


def latency(net, dev, n):
    """640×640 の画像 1 枚の推論時間(ミリ秒)。最初の数回は準備で遅いので、測る前に空回しする"""
    x = torch.rand(1, 3, 640, 640, device=dev)
    with torch.no_grad():
        for _ in range(10):
            net(x)
        if dev == "cuda":
            torch.cuda.synchronize()
        t0 = time.time()
        for _ in range(n):
            net(x)
        if dev == "cuda":
            torch.cuda.synchronize()
    return (time.time() - t0) / n * 1000


for name in ["yolov8n.pt", "yolo11n.pt"]:
    net = YOLO(name).model.eval()                       # 初回は学習済みの重みをダウンロードする
    n_params = sum(p.numel() for p in net.parameters())
    gflops = get_flops(net, imgsz=640)                  # 640×640 の画像 1 枚あたりの計算量
    t_cpu = latency(net, "cpu", 30)
    t_gpu = latency(net.to("cuda"), "cuda", 200)
    print(f"{name:11s} パラメータ数 {n_params / 1e6:.2f}M  計算量 {gflops:.1f} GFLOPs  "
          f"推論時間 CPU {t_cpu:6.1f} ms  GPU(A100){t_gpu:5.2f} ms")

device = "cuda"
Ultralytics の公式の YOLOv8n と YOLO11n を読み込み、パラメータ数・計算量・推論時間を同じ条件で比べるコードです。
- 比べるモデル: どちらも最も小さい n(nano)の大きさで、COCO(80 クラス)で学習済みの検出モデルです。YOLO11 が前の世代からどれだけ軽くなったかを見るため、同じ大きさどうしで比べます。
- 計算量: get_flops は、640×640 の画像 1 枚を通したときの浮動小数点演算の回数(GFLOPs)を数えます。公式の性能表と同じ画像の大きさです。
- 推論時間: GPU は命令を非同期に実行するので、torch.cuda.synchronize() で計算が終わるのを待ってから時間を読みます。最初の 20 回は GPU の準備で遅くなるので測らずに空回しし、続く 200 回の平均を取ります。画像 1 枚ずつにするのは、カメラの映像を 1 コマずつ処理する使い方を想定しているためです。測るのはネットワークの計算だけで、前処理と NMS は含みません。
実行結果
yolov8n.pt  パラメータ数 3.16M  計算量 8.9 GFLOPs  推論時間 CPU   50.6 ms  GPU(A100) 8.99 ms
yolo11n.pt  パラメータ数 2.62M  計算量 6.7 GFLOPs  推論時間 CPU   61.8 ms  GPU(A100)12.28 ms
YOLO11n は YOLOv8n より、パラメータ数が 17%(3.16M → 2.62M)、計算量が 25%(8.9 → 6.7 GFLOPs)少なくなっています。公式の性能表では、COCO の mAP50-95 も 37.3 から 39.5 に上がっており、少ない計算で高い精度を出せるようになったことが、YOLO11 のいちばんの改良点です。
ところが、PyTorch でそのまま測った推論時間は、YOLO11n の方が長くなりました(CPU で 50.6 ms と 61.8 ms、A100 で 8.99 ms と 12.28 ms)。YOLO11n は、C3k2 の中の C3k、C2PSA の自己注意、Detect の深さ方向の畳み込みのように、計算の小さな層をたくさん重ねています。1 枚ずつの小さなモデルの推論では、計算そのものより、層を 1 つずつ呼び出す手間が時間の多くを占めるので、計算量の少なさがそのまま速さにはなりません。公式の性能表の速さは、層をまとめて最適化する ONNX(CPU で 80.4 ms と 56.1 ms)や TensorRT(T4 で 1.47 ms と 1.5 ms)で測ったものです。計算量の少なさを速さに変えられるかは、実行の環境によって変わるので、速さが大事な用途では、実際に使う環境で測って選ぶ必要があります。
次の節から、少ない計算で精度を上げた YOLO11 の構成を、部品ごとに見ていきます。
2 つのモデルの値を表に並べると、次のようになります。
(図は、diagram-designで作成)
YOLO11 の仕組み
全体の構成
YOLO11n の全体は、次の図のとおりです(図は、後で実装する YOLO11 クラスの構成です)。
(図は、diagram-designで作成)
- Backbone: ストライド2の畳み込み(Conv)で縦横を半分にするたびに、C3k2 で特徴を作ります。1/8・1/16・1/32 の解像度の特徴を、それぞれ P3・P4・P5 と呼びます。最も深い P5 には、受容野を広げる SPPF と、自己注意の C2PSA をかけます。
- Neck: 深い層の特徴は「何が写っているか」をよく表しますが、解像度が低く、細かい位置が分かりません。浅い層の特徴はその逆です。そこで、P5 を拡大して P4・P3 と連結する経路(FPN、上から下へ)で深い特徴を浅い層に運び、さらに縮小して連結する経路(PAN、下から上へ)で浅い特徴を深い層に運びます。
- Head(Detect): Neck の3つの出力の各位置で、箱とクラスを出します。1/8 の P3 は小さな物体、1/32 の P5 は大きな物体を受け持ちます。
C3k2 と C2PSA
(図は、diagram-designで作成)
- C3k2: チャンネルを2つに分け、片方にだけ Bottleneck を重ねて、途中の出力をすべて連結します(CSP の考え方)。すべてのチャンネルに畳み込みを重ねるより計算が少なく、浅い特徴もそのまま後ろに渡せます。YOLOv8 の C2f と同じ形ですが、深い段では Bottleneck の代わりに、さらに CSP の形をした C3k を入れます。
- C2PSA: P5(640×640 の画像で 20×20 の位置)のチャンネルの半分にだけ、全位置の間の自己注意をかけます。畳み込みでは近くの位置しか混ざりませんが、自己注意なら画像の離れた場所どうしの関係も取り込めます。位置の数が少ない P5 だけにかけるので、計算は増えません。
Detect ヘッドと DFL
(図は、diagram-designで作成)
YOLO11 は、あらかじめ決めた大きさの箱(アンカーの箱)を使いません。格子点(各位置の中心)ごとに、箱の左・上・右・下の辺までの距離を直接出します。距離は1つの値ではなく、0〜15 の 16 区間のどこにあるかの確率分布として出し、その期待値を距離とします(DFL:Distribution Focal Loss)。
は1辺あたり 16 個の出力、 は格子の単位の距離で、ストライド(P3 なら 8 画素)を掛けると画素の距離になります。境界のはっきりしない物体では分布が広がるので、値を1つだけ出すより、辺の位置のあいまいさを表しやすくなります。
YOLO11 のスクラッチ実装
ここからは、YOLO11n(物体検出)を部品ごとに実装します。部品の構造・チャンネル数・計算の順番は、Ultralytics の公式の実装と同じにしています。実験2で、公式の学習済みの重みを読み込み、同じ出力になることを確かめます。
基本の部品:Conv・Bottleneck・C3k・C3k2・SPPF
import math
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F


class Conv(nn.Module):
    """畳み込み → バッチ正規化 → SiLU。YOLO のほぼすべての層の最小単位"""

    def __init__(self, c1, c2, k=1, s=1, g=1, act=True):
        super().__init__()
        self.conv = nn.Conv2d(c1, c2, k, s, k // 2, groups=g, bias=False)   # padding = k//2 で、stride 1 なら縦横を保つ
        self.bn = nn.BatchNorm2d(c2, eps=1e-3, momentum=0.03)                # 公式の実装と同じ eps・momentum
        self.act = nn.SiLU() if act else nn.Identity()

    def forward(self, x):
        return self.act(self.bn(self.conv(x)))


class Bottleneck(nn.Module):
    """3×3 の畳み込み 2 つと残差接続"""

    def __init__(self, c1, c2, shortcut=True, e=0.5):
        super().__init__()
        c_ = int(c2 * e)
        self.cv1 = Conv(c1, c_, 3)
        self.cv2 = Conv(c_, c2, 3)
        self.add = shortcut and c1 == c2

    def forward(self, x):
        y = self.cv2(self.cv1(x))
        return x + y if self.add else y


class C3k(nn.Module):
    """CSP の形のブロック:半分は Bottleneck を 2 つ通し、残り半分はそのまま通して連結する"""

    def __init__(self, c1, c2, n=2, e=0.5):
        super().__init__()
        c_ = int(c2 * e)
        self.cv1 = Conv(c1, c_, 1)
        self.cv2 = Conv(c1, c_, 1)
        self.cv3 = Conv(2 * c_, c2, 1)
        self.m = nn.Sequential(*(Bottleneck(c_, c_, e=1.0) for _ in range(n)))

    def forward(self, x):
        return self.cv3(torch.cat((self.m(self.cv1(x)), self.cv2(x)), 1))


class C3k2(nn.Module):
    """YOLO11 の主なブロック。チャンネルを 2 つに分け、片方に部品を順に重ねて、途中の出力をすべて連結する"""

    def __init__(self, c1, c2, n=1, c3k=False, e=0.5):
        super().__init__()
        self.c = int(c2 * e)
        self.cv1 = Conv(c1, 2 * self.c, 1)
        self.cv2 = Conv((2 + n) * self.c, c2, 1)
        self.m = nn.ModuleList(C3k(self.c, self.c, 2) if c3k else Bottleneck(self.c, self.c) for _ in range(n))

    def forward(self, x):
        y = list(self.cv1(x).chunk(2, 1))
        for m in self.m:
            y.append(m(y[-1]))
        return self.cv2(torch.cat(y, 1))


class SPPF(nn.Module):
    """5×5 の最大値プーリングを 3 回重ねて、受容野の違う特徴を連結する"""

    def __init__(self, c1, c2, k=5):
        super().__init__()
        c_ = c1 // 2
        self.cv1 = Conv(c1, c_, 1)
        self.cv2 = Conv(c_ * 4, c2, 1)
        self.m = nn.MaxPool2d(kernel_size=k, stride=1, padding=k // 2)

    def forward(self, x):
        y = [self.cv1(x)]
        for _ in range(3):
            y.append(self.m(y[-1]))
        return self.cv2(torch.cat(y, 1))
YOLO11 の多くの層で使う、畳み込みのブロックを定義するコードです。
- Conv: 畳み込み・バッチ正規化・SiLU を 1 つにまとめた、最小の単位です。padding = k // 2 にして、ストライド 1 なら縦横を変えず、ストライド 2 なら半分にします。畳み込みにバイアスを付けないのは、直後のバッチ正規化がずらしを受け持つからです。バッチ正規化の eps=1e-3・momentum=0.03 は公式の実装の値で、実験2で学習済みの重みを読み込んだときに同じ出力にするために合わせています。
- Bottleneck: 3×3 の畳み込み 2 つの出力を入力に足します(残差接続)。e は中間のチャンネル数の割合で、既定の 0.5 なら途中で半分に絞ります。
- C3k: 入力を 1×1 の畳み込み 2 つで半分ずつのチャンネルにし、片方にだけ Bottleneck を 2 つ重ねて、もう片方と連結します(CSP の形)。C3k2 の中に入れて、深い段の表現力を上げるのに使います。
- C3k2: cv1 の出力を chunk(2, 1) で a・b に分け、b に部品(Bottleneck、または c3k=True なら C3k)を順に重ねます。y に a・b と各部品の出力をすべて残して連結するので、浅い特徴と深い特徴の両方が cv2 に届きます。
- SPPF: 5×5 の最大値プーリング(ストライド 1)を 3 回重ねます。重ねるごとに見る範囲が 5・9・13 と広がり、4 つの出力を連結することで、大きさの違う範囲の情報をまとめて P5 に持たせます。13×13 のプーリングを直接するより計算が軽く、結果は同じです。
自己注意の部品:Attention・PSABlock・C2PSA
class Attention(nn.Module):
    """特徴マップの全位置の間の自己注意。V には 3×3 の深さ方向の畳み込み(位置の手がかり)を足す"""

    def __init__(self, dim, num_heads, attn_ratio=0.5):
        super().__init__()
        self.num_heads = num_heads
        self.head_dim = dim // num_heads
        self.key_dim = int(self.head_dim * attn_ratio)
        self.scale = self.key_dim ** -0.5
        self.qkv = Conv(dim, dim + 2 * self.key_dim * num_heads, 1, act=False)
        self.proj = Conv(dim, dim, 1, act=False)
        self.pe = Conv(dim, dim, 3, g=dim, act=False)

    def forward(self, x):
        B, C, H, W = x.shape
        N = H * W
        q, k, v = self.qkv(x).view(B, self.num_heads, 2 * self.key_dim + self.head_dim, N).split(
            [self.key_dim, self.key_dim, self.head_dim], dim=2)
        attn = ((q * self.scale).transpose(-2, -1) @ k).softmax(dim=-1)          # (B, ヘッド, N, N)
        x = (v @ attn.transpose(-2, -1)).view(B, C, H, W) + self.pe(v.reshape(B, C, H, W))
        return self.proj(x)


class PSABlock(nn.Module):
    """自己注意と、1×1 の畳み込み 2 つ(FFN)を、それぞれ残差接続でつなぐ"""

    def __init__(self, c, num_heads):
        super().__init__()
        self.attn = Attention(c, num_heads, attn_ratio=0.5)
        self.ffn = nn.Sequential(Conv(c, c * 2, 1), Conv(c * 2, c, 1, act=False))

    def forward(self, x):
        x = x + self.attn(x)
        return x + self.ffn(x)


class C2PSA(nn.Module):
    """チャンネルの半分にだけ PSABlock(自己注意)をかけ、残り半分と連結する"""

    def __init__(self, c1, c2, n=1, e=0.5):
        super().__init__()
        self.c = int(c1 * e)
        self.cv1 = Conv(c1, 2 * self.c, 1)
        self.cv2 = Conv(2 * self.c, c1, 1)
        self.m = nn.Sequential(*(PSABlock(self.c, num_heads=max(self.c // 64, 1)) for _ in range(n)))

    def forward(self, x):
        a, b = self.cv1(x).split((self.c, self.c), dim=1)
        return self.cv2(torch.cat((a, self.m(b)), 1))
P5 に自己注意をかける C2PSA と、その部品を定義するコードです。
- Attention: 1×1 の畳み込み qkv で Q・K・V を作り、特徴マップの全位置(N = H × W)の間で注意の重みを計算します。Q・K はヘッドあたりの次元の半分(attn_ratio=0.5)にして、計算を軽くしています。pe は V にかける 3×3 の深さ方向の畳み込みで、自己注意だけでは分からない位置の手がかりを足します。
- PSABlock: 自己注意と、チャンネルを 2 倍に広げて戻す FFN(1×1 の畳み込み 2 つ)を、どちらも残差接続でつなぎます。Transformer のブロックと同じ形を、畳み込みで書いたものです。
- C2PSA: cv1 の出力を半分に分け、b にだけ PSABlock をかけて a と連結します。自己注意の計算は位置の数の 2 乗で重くなるので、チャンネルの半分だけにかけ、位置の数が最も少ない P5(640×640 の画像で 20×20)だけに置きます。ヘッド数は max(self.c // 64, 1) で、yolo11n では 128 チャンネルなので 2 です。
Detect ヘッド
def make_anchors(feats, strides, offset=0.5):
    """各スケールの格子の中心(アンカーポイント)と、そのストライドを並べる"""
    points, stride_list = [], []
    for f, s in zip(feats, strides):
        h, w = f.shape[2:]
        sy, sx = torch.meshgrid(torch.arange(h, device=f.device, dtype=f.dtype) + offset,
                                torch.arange(w, device=f.device, dtype=f.dtype) + offset, indexing="ij")
        points.append(torch.stack((sx, sy), -1).view(-1, 2))
        stride_list.append(torch.full((h * w, 1), s, device=f.device, dtype=f.dtype))
    return torch.cat(points), torch.cat(stride_list)


class Detect(nn.Module):
    """P3・P4・P5 の各位置で、箱(4 辺までの距離の分布)とクラスのスコアを出す"""

    def __init__(self, nc, ch, strides, reg_max=16):
        super().__init__()
        self.nc, self.reg_max, self.strides = nc, reg_max, strides
        c2 = max(16, ch[0] // 4, reg_max * 4)         # 箱の枝のチャンネル数
        c3 = max(ch[0], min(nc, 100))                 # クラスの枝のチャンネル数
        self.box_head = nn.ModuleList(
            nn.Sequential(Conv(x, c2, 3), Conv(c2, c2, 3), nn.Conv2d(c2, 4 * reg_max, 1)) for x in ch)
        self.cls_head = nn.ModuleList(
            nn.Sequential(nn.Sequential(Conv(x, x, 3, g=x), Conv(x, c3, 1)),
                          nn.Sequential(Conv(c3, c3, 3, g=c3), Conv(c3, c3, 1)),
                          nn.Conv2d(c3, nc, 1)) for x in ch)
        self.register_buffer("proj", torch.arange(reg_max, dtype=torch.float), persistent=False)

    def forward(self, feats):
        B = feats[0].shape[0]
        box = torch.cat([h(f).view(B, 4 * self.reg_max, -1) for h, f in zip(self.box_head, feats)], -1)
        cls = torch.cat([h(f).view(B, self.nc, -1) for h, f in zip(self.cls_head, feats)], -1)
        return box, cls                                # (B, 64, A), (B, nc, A)

    def decode(self, box, cls, feats):
        """分布の期待値で 4 辺までの距離を求め、アンカーポイントから箱 (cx, cy, w, h) を作る"""
        anchors, stride = make_anchors(feats, self.strides)
        B, _, A = box.shape
        dist = box.view(B, 4, self.reg_max, A).softmax(2).transpose(2, 3) @ self.proj   # (B, 4, A)
        lt, rb = dist[:, :2], dist[:, 2:]
        a = anchors.T.unsqueeze(0)
        x1y1, x2y2 = a - lt, a + rb
        xywh = torch.cat(((x1y1 + x2y2) / 2, x2y2 - x1y1), 1) * stride.T
        return torch.cat((xywh, cls.sigmoid()), 1)    # (B, 4 + nc, A)
Neck の 3 つの出力から、箱とクラスを出す Detect ヘッドを定義するコードです。
- make_anchors: 各スケールの特徴マップの格子点の座標(中心なので 0.5 をずらす)と、そのストライドを並べます。640×640 の画像なら、P3 の 80×80、P4 の 40×40、P5 の 20×20 で、合わせて 8,400 個の格子点ができます。
- 箱の枝(box_head): 3×3 の畳み込み 2 つと 1×1 の畳み込みで、各格子点の 4 辺それぞれについて 16 区間の値(64 チャンネル)を出します。チャンネル数 c2 は公式の実装と同じ式で決め、yolo11n では 64 です。
- クラスの枝(cls_head): 3×3 の深さ方向の畳み込み(g=x、チャンネルごとに別の 3×3 をかける)と 1×1 の畳み込みを 2 回重ね、クラスの数だけ出します。深さ方向の畳み込みは、ふつうの 3×3 よりパラメータと計算がずっと少なく、YOLOv8 からの変更点の 1 つです。
- decode: 4 辺の 16 区間の値に softmax をかけ、0〜15 の重み proj との内積で期待値(格子の単位の距離)を出します(DFL の式)。格子点から左・上に引いた点と右・下に足した点を箱の角にし、中心と幅・高さ (cx, cy, w, h) にしてストライドを掛け、画素の座標にします。クラスの出力は sigmoid で 0〜1 の確率にします。クラスごとに独立した確率にするのは、学習でクラスごとに 2 値の損失(BCE)を使うためです。
- proj: 学習しない値なので register_buffer で持たせ、保存する重みには含めません。
モデル全体
class YOLO11(nn.Module):
    """YOLO11n(物体検出)。チャンネル数は公式の yolo11n と同じ"""

    def __init__(self, nc=80, use_p3=True):
        super().__init__()
        # Backbone
        self.b0 = Conv(3, 16, 3, 2)                   # 1/2
        self.b1 = Conv(16, 32, 3, 2)                  # 1/4
        self.b2 = C3k2(32, 64, 1, False, 0.25)
        self.b3 = Conv(64, 64, 3, 2)                  # 1/8  → P3
        self.b4 = C3k2(64, 128, 1, False, 0.25)
        self.b5 = Conv(128, 128, 3, 2)                # 1/16 → P4
        self.b6 = C3k2(128, 128, 1, True)
        self.b7 = Conv(128, 256, 3, 2)                # 1/32 → P5
        self.b8 = C3k2(256, 256, 1, True)
        self.b9 = SPPF(256, 256)
        self.b10 = C2PSA(256, 256)
        # Neck(FPN:上から下へ)
        self.up = nn.Upsample(scale_factor=2, mode="nearest")
        self.n13 = C3k2(256 + 128, 128, 1, False)
        self.n16 = C3k2(128 + 128, 64, 1, False)
        # Neck(PAN:下から上へ)
        self.n17 = Conv(64, 64, 3, 2)
        self.n19 = C3k2(64 + 128, 128, 1, False)
        self.n20 = Conv(128, 128, 3, 2)
        self.n22 = C3k2(128 + 256, 256, 1, True)
        self.use_p3 = use_p3
        self.detect = Detect(nc, (64, 128, 256) if use_p3 else (128, 256), (8, 16, 32) if use_p3 else (16, 32))

    def features(self, x):
        x = self.b2(self.b1(self.b0(x)))
        p3 = self.b4(self.b3(x))
        p4 = self.b6(self.b5(p3))
        p5 = self.b10(self.b9(self.b8(self.b7(p4))))
        h13 = self.n13(torch.cat((self.up(p5), p4), 1))
        o3 = self.n16(torch.cat((self.up(h13), p3), 1))
        o4 = self.n19(torch.cat((self.n17(o3), h13), 1))
        o5 = self.n22(torch.cat((self.n20(o4), p5), 1))
        return [o3, o4, o5] if self.use_p3 else [o4, o5]

    def forward(self, x):
        feats = self.features(x)
        box, cls = self.detect(feats)
        return box, cls, feats


model = YOLO11().eval()
x = torch.rand(1, 3, 640, 640)
with torch.no_grad():
    box, cls, feats = model(x)
for name, f in zip(["P3", "P4", "P5"], feats):
    print(f"{name} の出力: {tuple(f.shape)}")
print("箱の出力:", tuple(box.shape), " クラスの出力:", tuple(cls.shape))
print(f"パラメータ数: {sum(p.numel() for p in model.parameters()):,}")
部品をつないで YOLO11n 全体を作り、640×640 の画像を入れて、3 つの出力の形とパラメータ数を確かめるコードです。
- チャンネル数: 公式の設定ファイル(yolo11.yaml)のチャンネル数に、n の大きさの倍率 0.25 を掛けた値です。段の繰り返しの回数も、倍率 0.5 を掛けて C3k2 の中の部品は 1 つずつになります。最初の 2 つの C3k2 だけ e=0.25 にして中間を細くし、深い段(b6・b8・n22)だけ C3k を使うのも、設定ファイルのとおりです。
- features: Backbone で P3・P4・P5 を作り、Neck の FPN で P5 を拡大(nn.Upsample)して P4・P3 と連結し、PAN でストライド 2 の畳み込みで縮小して連結します。連結の相手と順番は、公式の実装と同じです。順番が違うと、実験2で重みを読み込んだときに、チャンネルの対応がずれます。
- use_p3: 実験3で、P3 の出力を外したモデルを作るための切り替えです。外しても Neck の計算はそのまま(P3 の特徴は PAN の経路で P4 に渡る)で、Detect に渡す出力だけが P4・P5 になります。
- 確かめ: 乱数の画像を入れ、3 つの出力の形と、Detect の出力の形を表示します。
実行結果
P3 の出力: (1, 64, 80, 80)
P4 の出力: (1, 128, 40, 40)
P5 の出力: (1, 256, 20, 20)
箱の出力: (1, 64, 8400)  クラスの出力: (1, 80, 8400)
パラメータ数: 2,624,064
P3・P4・P5 の出力は、80×80・40×40・20×20 の位置に、64・128・256 チャンネルを持ちます。格子点は合わせて 8,400 個で、箱の出力は格子点ごとに 64(4 辺 × 16 区間)、クラスの出力は 80 クラスです。パラメータ数 2,624,064 は、公式の yolo11n の 2,624,080 から、学習しない DFL の重み(16 個)を除いた数と一致します。
Detect の出力の形を図にすると、次のようになります。
(図は、diagram-designで作成)
実験2:公式の学習済みの重みで、Ultralytics と同じ検出になるか
公式の重みの読み込み
def load_ultralytics(model, sd):
    """Ultralytics の yolo11n の重み(model.<層の番号>.…)を、スクラッチ実装の名前に付け替えて読み込む"""
    names = {0: "b0", 1: "b1", 2: "b2", 3: "b3", 4: "b4", 5: "b5", 6: "b6", 7: "b7", 8: "b8", 9: "b9",
             10: "b10", 13: "n13", 16: "n16", 17: "n17", 19: "n19", 20: "n20", 22: "n22", 23: "detect"}
    out = {}
    for k, v in sd.items():
        i, rest = k.split(".", 2)[1], k.split(".", 2)[2]
        if "num_batches_tracked" in rest or rest.startswith("dfl"):
            continue
        rest = rest.replace("cv2.", "box_head.", 1) if i == "23" and rest.startswith("cv2.") else rest
        rest = rest.replace("cv3.", "cls_head.", 1) if i == "23" and rest.startswith("cv3.") else rest
        out[f"{names[int(i)]}.{rest}"] = v
    missing, unexpected = model.load_state_dict(out, strict=False)
    missing = [m for m in missing if "num_batches_tracked" not in m]
    assert not missing and not unexpected, (missing, unexpected)
    return model
Ultralytics の yolo11n の重みを、スクラッチ実装の層の名前に付け替えて読み込む関数です。
- 名前の対応: 公式の実装は、層を model.0・model.1… と通し番号で持ちます。names で番号をスクラッチ実装の名前(b0〜b10・n13〜n22・detect)に対応させます。11・12・14・15・18・21 番は拡大と連結の層で、重みを持たないので出てきません。
- Detect の名前: 公式の Detect は箱の枝を cv2、クラスの枝を cv3 と呼ぶので、box_head・cls_head に付け替えます。DFL の重み(0〜15 の固定値)は、スクラッチ実装では proj として持っているので読み込みません。
- 読み込みの確認: スクラッチ実装に、対応の付かない層や形の違う層が 1 つでもあれば、エラーで止めます。バッチ正規化の更新回数(num_batches_tracked)は推論に使わないので除きます。
前処理と後処理
import cv2
import torchvision


def letterbox(img, size=640, pad_value=114):
    """縦横比を保って長い辺を size にし、足りない分を灰色で埋めて size×size にする"""
    h, w = img.shape[:2]
    r = size / max(h, w)
    nh, nw = round(h * r), round(w * r)
    img = cv2.resize(img, (nw, nh), interpolation=cv2.INTER_LINEAR)
    top, left = (size - nh) // 2, (size - nw) // 2
    out = np.full((size, size, 3), pad_value, dtype=np.uint8)
    out[top:top + nh, left:left + nw] = img
    x = torch.from_numpy(out).permute(2, 0, 1).float().unsqueeze(0) / 255
    return x, r, (left, top)


def postprocess(pred, conf=0.25, iou=0.7, max_det=300):
    """pred: (4 + nc, A)。スコアの低い候補を捨て、クラスごとに NMS をかける"""
    boxes, scores = pred[:4].T, pred[4:].T
    score, label = scores.max(1)
    keep = score > conf
    boxes, score, label = boxes[keep], score[keep], label[keep]
    xyxy = torch.cat((boxes[:, :2] - boxes[:, 2:] / 2, boxes[:, :2] + boxes[:, 2:] / 2), 1)
    idx = torchvision.ops.batched_nms(xyxy, score, label, iou)[:max_det]
    return xyxy[idx], score[idx], label[idx]
画像をモデルに入る形にする前処理と、モデルの出力から検出結果を取り出す後処理です。
- letterbox: 縦横比を保ったまま長い辺を 640 画素にし、足りない部分を灰色(114)で埋めて 640×640 にします。引き伸ばして縦横比を変えると、物体の形がゆがんで学習時と違って見えるためです。灰色の 114 は、公式の実装と同じ値です。返す r(縮小の倍率)と余白の幅は、検出した箱を元の画像の座標に戻すのに使います。
- postprocess: 格子点ごとに最も確率の高いクラスを選び、確率が conf 未満の候補を捨てます。残った箱を (x1, y1, x2, y2) にし、torchvision.ops.batched_nms で、クラスごとに重なりが iou 以上の箱のうち確率の低い方を消します(NMS)。YOLO は 1 つの物体の周りの複数の格子点が同じ物体の箱を出すので、NMS で 1 つにまとめます。conf=0.25・iou=0.7・max_det=300 は、Ultralytics の推論の既定値です。
推論に利用する画像
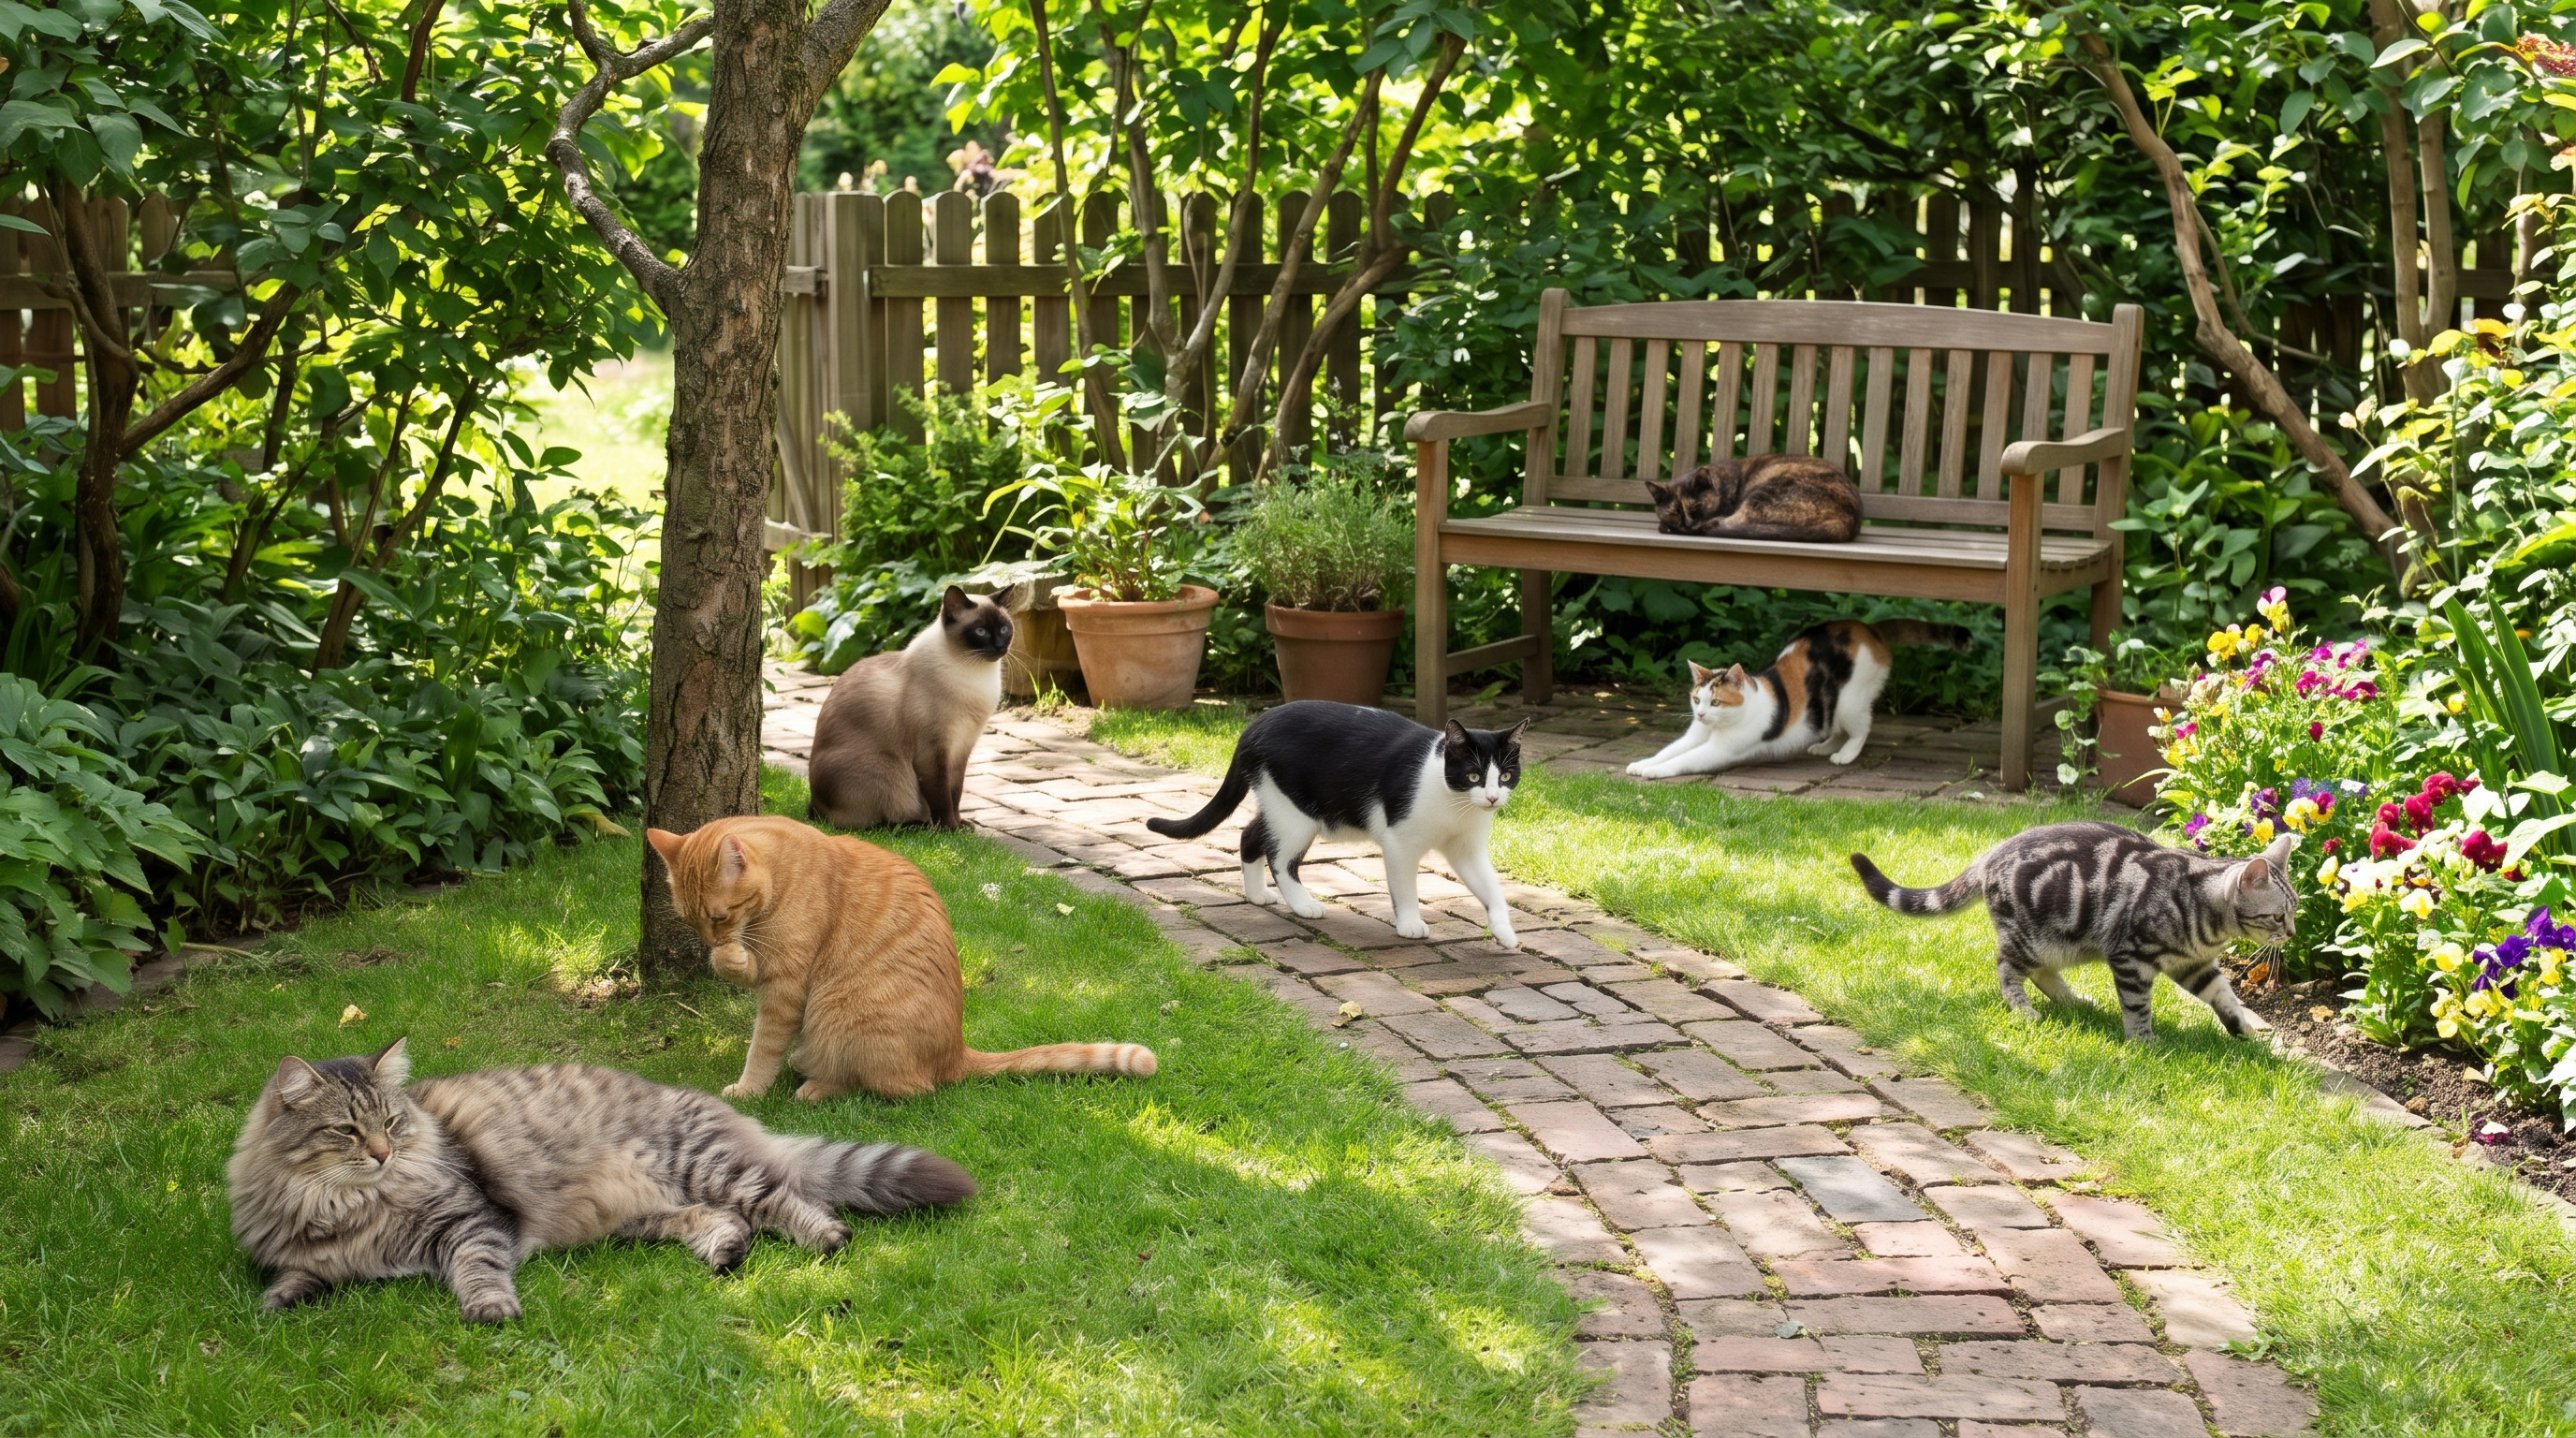
以下の画像を cats.jpg として保存し、Colab のファイル一覧(左の📁)にアップロードしてください。
(画像は、Geminiで作成)
出力の一致を確かめる
from PIL import Image

official = YOLO("yolo11n.pt").model.float().eval()
ours = load_ultralytics(YOLO11(), official.state_dict()).eval()

img = np.array(Image.open("cats.jpg").convert("RGB"))
x, r, (pad_x, pad_y) = letterbox(img)                  # (1, 3, 640, 640)、値は 0〜1
with torch.no_grad():
    y_official = official(x)[0]                         # (1, 84, 8400):箱 (cx, cy, w, h) と 80 クラスの確率
    box, cls, feats = ours(x)
    y_ours = ours.detect.decode(box, cls, feats)
print("出力の形:", tuple(y_ours.shape))
print("公式の出力との差の最大値:", (y_official - y_ours).abs().max().item())
公式の yolo11n の重みを読み込んだスクラッチ実装と Ultralytics のモデルに、同じ前処理をした cats.jpg を入れて、出力が一致するかを確かめるコードです。
- 公式のモデル: YOLO("yolo11n.pt").model で、Ultralytics の PyTorch のモデルを取り出します。推論モードでは、Detect まで計算して箱 (cx, cy, w, h) と 80 クラスの確率を並べた (1, 84, 8400) を返すので、スクラッチ実装の decode の出力と同じ形で比べられます。
- 同じ入力: どちらにも、同じ letterbox の出力を入れます。違いはモデルの計算だけになります。
実行結果
出力の形: (1, 84, 8400)
公式の出力との差の最大値: 0.0
2 つのモデルの出力(8,400 個の格子点 × 84 の値)は、差の最大値が 0.0 で、完全に一致しました。部品の構造、チャンネルの分け方と連結の順番、バッチ正規化の設定、DFL の期待値の計算まで、公式の実装と同じ計算をしているので、浮動小数点の誤差も出ません。
検出結果
import matplotlib.pyplot as plt
import japanize_matplotlib

names = YOLO("yolo11n.pt").names                        # COCO の 80 クラスの名前
xyxy, score, label = postprocess(y_ours[0])
xyxy = (xyxy - torch.tensor([pad_x, pad_y, pad_x, pad_y])) / r     # 640×640 の座標を元の画像の座標に戻す
for b, s, l in zip(xyxy, score, label):
    print(f"{names[int(l)]:<13s} {s:.3f}  箱 {[round(v) for v in b.tolist()]}")

# 同じ入力を Ultralytics の推論(NMS まで含む)にも通して、検出の数と箱が同じかを確かめる
res = YOLO("yolo11n.pt").predict(x, conf=0.25, iou=0.7, verbose=False)[0]
same = len(res.boxes) == len(xyxy) and torch.allclose(
    (res.boxes.xyxy.cpu() - torch.tensor([pad_x, pad_y, pad_x, pad_y])) / r, xyxy, atol=1e-3)
print(f"\nUltralytics の検出 {len(res.boxes)} 個、スクラッチ実装の検出 {len(xyxy)} 個、箱が一致するか: {same}")

fig, ax = plt.subplots(figsize=(12, 7))
ax.imshow(img)
for b, s, l in zip(xyxy, score, label):
    x0, y0, x1, y1 = b.tolist()
    ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color="red", lw=2))
    ax.text(x0, y0 - 8, f"{names[int(l)]} {s:.2f}", color="white", fontsize=11, backgroundcolor="red")
ax.axis("off")
plt.tight_layout()
plt.show()
スクラッチ実装の出力に NMS をかけて検出結果を表示し、Ultralytics の推論(NMS まで含む)と結果が同じかを確かめて、画像に箱を描くコードです。
- 座標を戻す: 640×640 の画像での箱から余白の幅を引き、縮小の倍率で割って、元の画像(2576×1438)の座標に戻します。
- Ultralytics の推論との比較: predict に前処理済みのテンソルを渡すと、Ultralytics は前処理をせずにそのまま推論し、NMS までかけます。検出の数と、すべての箱の座標が 0.001 画素以内で一致するかを確かめます。
実行結果
bench         0.926  箱 [1399, 289, 2148, 798]
cat           0.882  箱 [225, 1037, 976, 1327]
cat           0.787  箱 [640, 813, 1158, 1110]
cat           0.766  箱 [1856, 817, 2310, 1040]
dog           0.678  箱 [1148, 698, 1531, 948]
potted plant  0.674  箱 [1220, 436, 1419, 705]
cat           0.569  箱 [804, 584, 1018, 829]
cat           0.420  箱 [1618, 615, 1891, 784]
potted plant  0.323  箱 [1037, 375, 1254, 711]

Ultralytics の検出 9 個、スクラッチ実装の検出 9 個、箱が一致するか: True
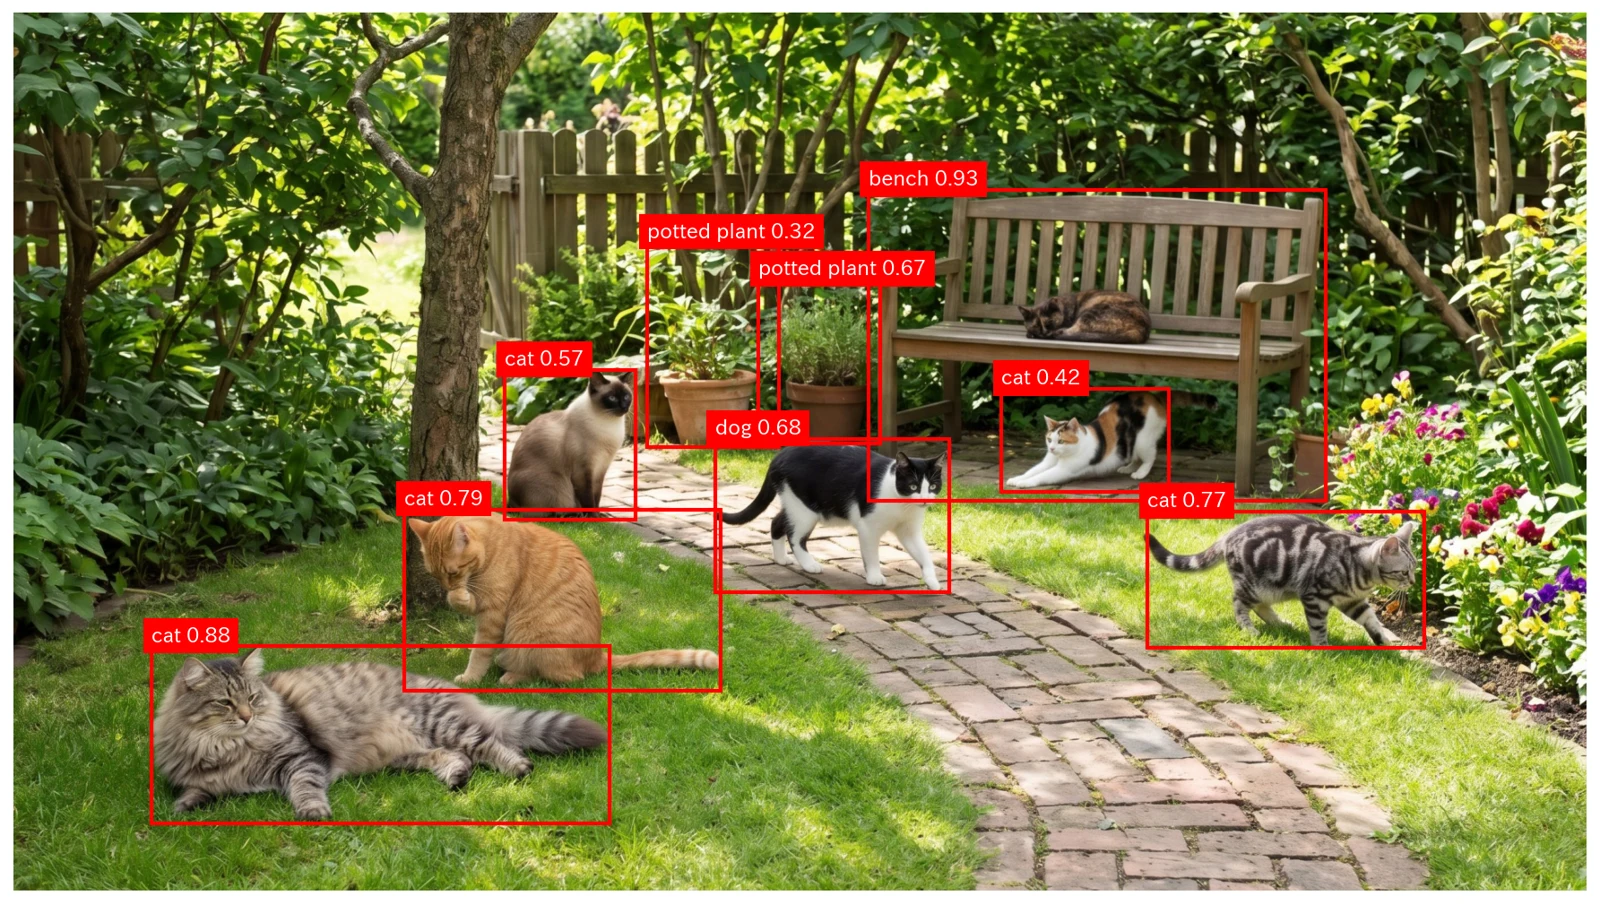
スクラッチ実装の検出は 9 個で、Ultralytics の推論と、数・クラス・確率・箱の座標がすべて一致しました。
画像には 7 匹の猫がいますが、猫として検出できたのは 5 匹でした。黒白の猫は dog(0.68)と判定され、ベンチの上で丸まっている猫は、ベンチ(0.93)の箱に含まれてしまい、猫としては検出されませんでした。いちばん小さな yolo11n(パラメータ 260 万)は速さを優先したモデルで、COCO の mAP50-95 も 39.5 にとどまります。丸まって形の分かりにくい猫や、犬と模様の似た猫の区別は、より大きなモデル(yolo11s・m など)の方が得意です。
DFL の分布を見る
# 確率がいちばん高い猫の箱について、4 辺までの距離の分布(16 区間)を取り出す
with torch.no_grad():
    pred = y_ours[0]
    cat_id = [k for k, v in names.items() if v == "cat"][0]
    a = int(pred[4 + cat_id].argmax())                  # 猫の確率がいちばん高い格子点
    n3, n4 = feats[0].shape[2] * feats[0].shape[3], feats[1].shape[2] * feats[1].shape[3]
    stride = 8 if a < n3 else 16 if a < n3 + n4 else 32
    dist = box[0, :, a].view(4, 16).softmax(-1)         # 左・上・右・下の、それぞれ 16 区間の確率
expect = (dist * torch.arange(16)).sum(-1)
print(f"格子点 {a}(ストライド {stride})")
for side, e in zip(["左", "上", "右", "下"], expect):
    print(f"  {side}の辺までの距離の期待値 {e:.2f} 区間 = {e * stride:.1f} 画素")

fig, axes = plt.subplots(1, 4, figsize=(14, 3), sharey=True)
for ax, side, d, e in zip(axes, ["左", "上", "右", "下"], dist, expect):
    ax.bar(range(16), d.numpy(), color="tab:blue")
    ax.axvline(e, color="red", ls="--", label=f"期待値 {e:.2f}")
    ax.set_title(f"{side}の辺までの距離")
    ax.set_xticks(range(0, 16, 3))
    ax.set_xlabel("区間(× ストライド = 画素)")
    ax.legend()
axes[0].set_ylabel("確率")
plt.tight_layout()
plt.show()
猫の確率が最も高い格子点を選び、DFL が出した 4 辺までの距離の分布(16 区間)を取り出して描くコードです。
- 格子点の選び方: pred[4 + cat_id] は全 8,400 個の格子点の猫の確率なので、その最大の位置を選びます。格子点の番号は P3・P4・P5 の順に並んでいるので、番号からどのスケール(ストライド)の格子点かが分かります。
- 分布と期待値: 箱の出力を 4 辺 × 16 区間に並べて softmax をかけると、各辺の距離の確率分布になります。期待値にストライドを掛けると、格子点から辺までの画素の距離です。
実行結果
格子点 8264(ストライド 32)
  左の辺までの距離の期待値 2.75 区間 = 88.0 画素
  上の辺までの距離の期待値 1.04 区間 = 33.3 画素
  右の辺までの距離の期待値 3.08 区間 = 98.5 画素
  下の辺までの距離の期待値 1.21 区間 = 38.6 画素
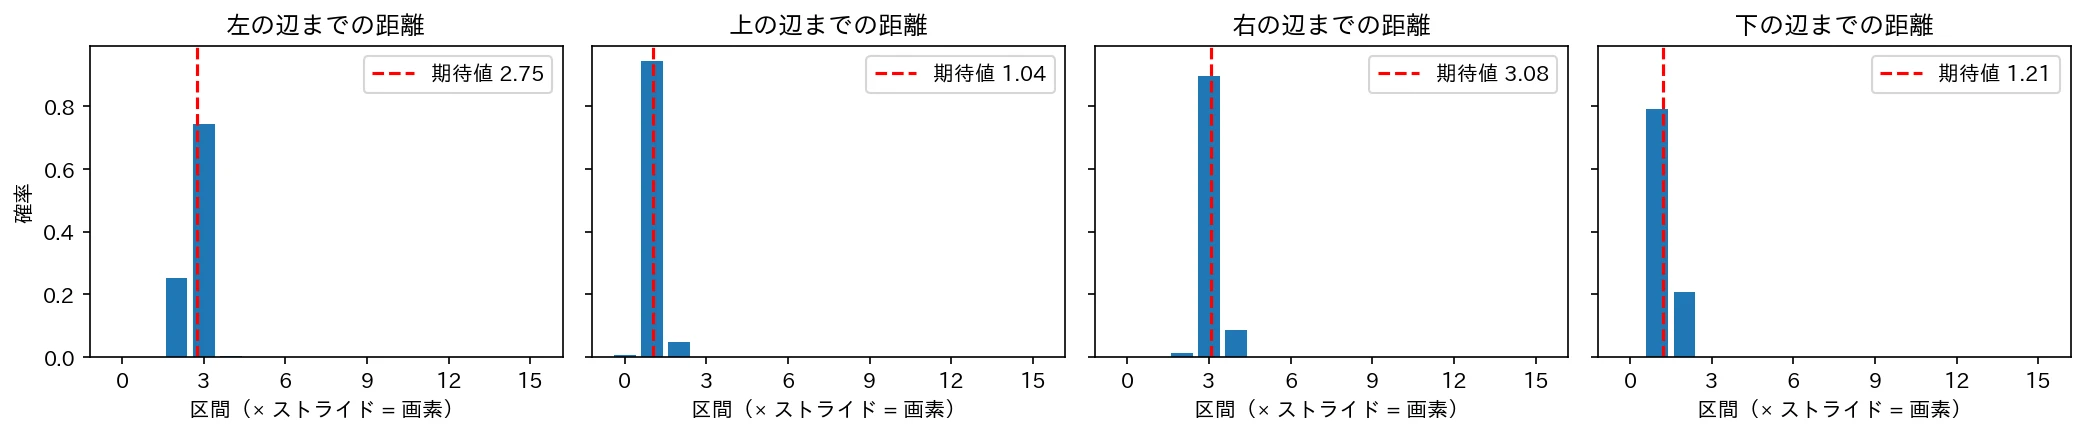
選ばれたのは、左下の長毛の猫(0.88)の箱を出した、P5(ストライド 32)の格子点でした。各辺の分布は、隣り合う 1〜2 個の区間に集中しています。例えば左の辺は、区間 2 に 0.25、区間 3 に 0.74 の確率があり、期待値は 2.75 区間(88.0 画素)です。DFL は、正解の距離を挟む 2 つの区間に重みを分ける形で学習するので(実験3の損失)、区間の境目にない距離も、隣り合う区間の確率の割合で細かく表せます。左右の距離(88.0 と 98.5 画素)を足した 186.5 画素を、640×640 から元の画像への倍率で戻すと 751 画素で、検出した箱の幅(225〜976)と一致します。
実験3:ゼロから学習し、P3 の出力の効果を確かめる
最後に、スクラッチ実装をゼロから学習します。学習には、丸・四角・三角を描いた合成画像を使います。合成画像なら、物体の大きさを自由に決められ、正解の箱も正確に分かります。比べるのは、次の2つです。
- P3 あり: 公式どおり、P3・P4・P5 の3つの出力で検出します。
- P3 なし: P3 の出力を外し、P4・P5 だけで検出します。Neck の計算は同じで、Detect に渡す出力だけが違います。
実装方針:公式の学習との違い
| 項目 | Ultralytics の学習の既定値(COCO など) | 本記事(合成データ) |
|---|---|---|
| データ | COCO など実際の写真(COCO は 80 クラス) | 丸・四角・三角の合成画像 2 万枚(3 クラス、大きさを自由に決められるため) |
| 入力画像 | 640×640 | 256×256(合成画像の物体に合わせた大きさ) |
| モデル | yolo11n | 同じ(クラス数だけ 3) |
| エポック | 100 | 20(2 つの設定を A100 で約 30 分で学習するため) |
| バッチ | 16 | 64(1 回に見る画素の数を既定と同じくらいにする) |
| 最適化 | 自動(学習の回数などで SGD か AdamW を選ぶ) | AdamW、学習率 1e-3(Adam・AdamW の推奨値) |
| 学習率の変化・ウォームアップ | 直線で 1/100 まで下げる、3 エポック | 同じ |
| 重み減衰・勾配のクリップ | 5e-4、10.0 | 同じ |
| 損失 | TAL(上位 10 個、α = 0.5、β = 6)、CIoU 7.5・BCE 0.5・DFL 1.5 | 同じ |
| データの水増し | Mosaic・色の変化・左右反転など | なし(毎回違う配置の合成画像を作るため) |
| 重みの平滑化 | EMA | なし(比較を単純にするため) |
| 混合精度 | float16(AMP) | bfloat16(A100 で損失のスケーリングが要らないため) |
合成データ
import math
import time

IMG, NC = 256, 3
CLASSES = ["丸", "四角", "三角"]


def make_shapes(seed, size=IMG):
    """背景のグラデーションとノイズの上に、丸・四角・三角を大きさをばらつかせて描く"""
    rng = np.random.default_rng(seed)
    c0, c1 = rng.integers(0, 256, 3), rng.integers(0, 256, 3)
    t = np.linspace(0, 1, size)[None, :, None]
    img = (c0 * (1 - t) + c1 * t).repeat(size, 0)
    img = np.clip(img + rng.normal(0, 12, img.shape), 0, 255).astype(np.uint8).copy()
    boxes, labels = [], []
    for _ in range(rng.integers(1, 10)):
        for _try in range(20):
            s = math.exp(rng.uniform(math.log(6), math.log(96)))      # 一辺 6〜96 画素(対数で一様)
            x0, y0 = rng.uniform(0, size - s, 2)
            b = np.array([x0, y0, x0 + s, y0 + s])
            if not any(overlap(b, o) for o in boxes):                  # ほかの物体と重ならないように置く
                break
        else:
            continue
        k = int(rng.integers(0, NC))
        color = tuple(int(v) for v in rng.integers(0, 256, 3))
        x0, y0, x1, y1 = b
        if k == 0:
            cv2.circle(img, (int(round((x0 + x1) / 2)), int(round((y0 + y1) / 2))), int(round(s / 2)), color, -1, cv2.LINE_AA)
        elif k == 1:
            cv2.rectangle(img, (int(round(x0)), int(round(y0))), (int(round(x1)), int(round(y1))), color, -1)
        else:
            pts = np.array([[(x0 + x1) / 2, y0], [x0, y1], [x1, y1]]).round().astype(np.int32)
            cv2.fillPoly(img, [pts], color, cv2.LINE_AA)
        boxes.append(b)
        labels.append(k)
    return img, np.array(boxes, dtype=np.float32).reshape(-1, 4), np.array(labels, dtype=np.int64)


def overlap(a, b, gap=2):
    """2 つの箱が、gap 画素より近づいているか(重なっているか)"""
    return not (a[2] + gap <= b[0] or b[2] + gap <= a[0] or a[3] + gap <= b[1] or b[3] + gap <= a[1])


class Shapes(torch.utils.data.Dataset):
    def __init__(self, n, offset):
        self.n, self.offset = n, offset

    def __len__(self):
        return self.n

    def __getitem__(self, i):
        img, boxes, labels = make_shapes(self.offset + i)
        return torch.from_numpy(img).permute(2, 0, 1), torch.from_numpy(boxes), torch.from_numpy(labels)


def collate(batch):
    """箱の数が画像ごとに違うので、いちばん多い画像に合わせて 0 で埋め、有効な箱の印 mask を付ける"""
    imgs = torch.stack([b[0] for b in batch]).float() / 255
    m = max(1, max(len(b[1]) for b in batch))
    boxes = torch.zeros(len(batch), m, 4)
    labels = torch.zeros(len(batch), m, dtype=torch.long)
    mask = torch.zeros(len(batch), m, dtype=torch.bool)
    for i, (_, b, l) in enumerate(batch):
        boxes[i, :len(b)], labels[i, :len(l)], mask[i, :len(b)] = b, l, True
    return imgs, boxes, labels, mask


# 学習データの例を 6 枚、正解の箱を付けて表示する
fig, axes = plt.subplots(1, 6, figsize=(18, 3.4))
for ax, seed in zip(axes, range(6)):
    im, bx, lb = make_shapes(seed)
    ax.imshow(im)
    for (x0, y0, x1, y1), k in zip(bx, lb):
        ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color="red", lw=1))
    ax.set_title(f"物体 {len(bx)} 個")
    ax.axis("off")
plt.tight_layout()
plt.show()

sides = np.concatenate([(lambda b: (b[:, 2:] - b[:, :2]).max(1))(make_shapes(s)[1]) for s in range(1000)])
print(f"1,000 枚の物体 {len(sides)} 個のうち、小(16 画素未満){(sides < 16).mean():.1%}  "
      f"中(16〜48){((sides >= 16) & (sides < 48)).mean():.1%}  大(48 以上){(sides >= 48).mean():.1%}")
丸・四角・三角を描いた合成画像と正解の箱を、乱数の種(seed)から作るデータセットを定義し、例を表示するコードです。
- 背景: 2 色のグラデーションに、標準偏差 12 のノイズを足します。真っ白な背景だと、色の境目を見つけるだけで検出できてしまうので、物体と背景の区別を少し難しくしています。
- 物体の大きさ: 一辺を 6〜96 画素の範囲で、対数で一様に選びます。P4 のストライド(16 画素)より小さな物体を十分に含めて、P3 の出力の効果を確かめるためです。対数で選ぶのは、小さな物体から大きな物体まで、どの桁の大きさも同じくらいの数にするためです。
- 物体の数と置き方: 1 枚に 1〜9 個置き、すでに置いた物体と重ならない(箱どうしが 2 画素以上離れた)位置を探します。20 回試して見つからなければ、その物体は置きません。後から描いた図形が前の図形を覆い隠すと、見えない物体が正解に残り、検出の失敗の原因が分かりにくくなるためです。
- 正解の箱: 描いた図形を囲む箱(x1, y1, x2, y2)です。三角形は二等辺三角形で、箱の上の辺の中央に頂点があります。
- Shapes: 画像の番号を乱数の種にして、毎回同じ画像を作ります。学習用は 0 番から、テスト用は 1,000,000 番からにして、テストの画像を学習に使わないようにします。DataLoader の複数のプロセスで並行して作るので、画像を前もって保存しておく必要はありません。
- collate: 画像ごとに物体の数が違うので、バッチの中で最も多い数に合わせて 0 で埋め、どれが本物の箱かを mask で表します。
実行結果
1,000 枚の物体 4917 個のうち、小(16 画素未満)41.2% 中(16〜48)40.2% 大(48 以上)18.6%
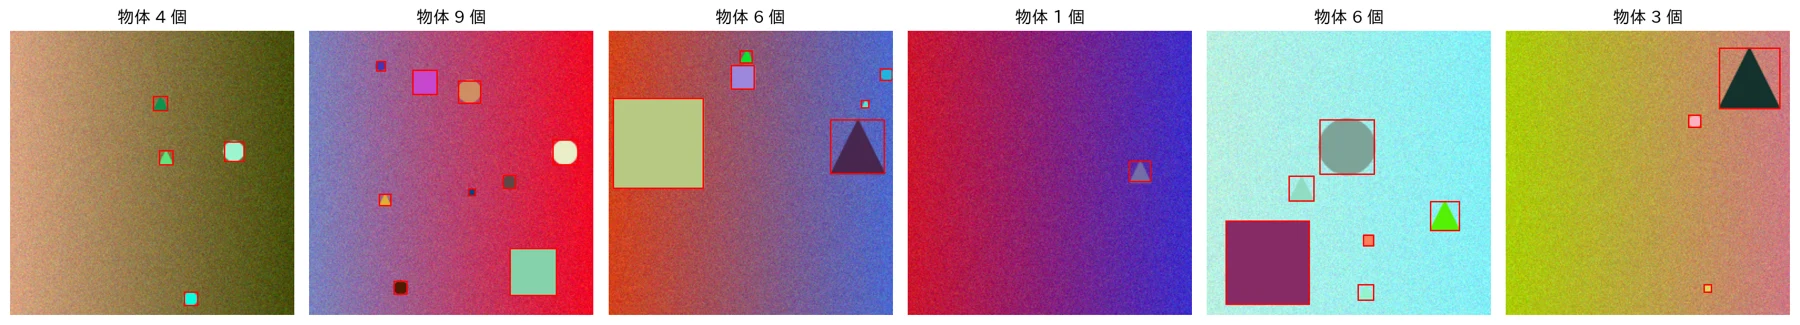
1,000 枚に 4,917 個の物体があり、一辺 16 画素未満の小さな物体が 41.2%、16〜48 画素が 40.2%、48 画素以上が 18.6% でした。大きな物体が少ないのは、ほかの物体と重ならない場所を見つけにくく、置けずに飛ばされることが多いためです。
損失:Task-Aligned Assigner・CIoU・DFL
学習では、格子点ごとの出力のうち、どれをどの正解の箱の担当にするか(割り当て)を決めてから、担当の格子点に損失をかけます。YOLO11 は、YOLOv8 と同じ Task-Aligned Assigner(TAL)で割り当てます。正解の箱の中にある格子点について、その箱のクラスの確率 と、予測した箱と正解の箱の重なり (CIoU)から、
を計算し、 の大きい上位 10 個を担当にします(、)。クラスの確率が高く、箱もよく重なっている格子点を選ぶので、分類と箱の両方に向いた格子点が学習されます。損失は、箱の重なり(CIoU)・クラス(BCE)・DFL の 3 つの重み付きの和です。
def ciou(b1, b2, eps=1e-7):
    """CIoU = IoU - 中心の距離の罰 - 縦横比の違いの罰(箱は x1, y1, x2, y2)"""
    w1, h1 = b1[..., 2] - b1[..., 0], b1[..., 3] - b1[..., 1] + eps
    w2, h2 = b2[..., 2] - b2[..., 0], b2[..., 3] - b2[..., 1] + eps
    inter = ((torch.min(b1[..., 2], b2[..., 2]) - torch.max(b1[..., 0], b2[..., 0])).clamp(0) *
             (torch.min(b1[..., 3], b2[..., 3]) - torch.max(b1[..., 1], b2[..., 1])).clamp(0))
    union = w1 * h1 + w2 * h2 - inter + eps
    iou = inter / union
    cw = torch.max(b1[..., 2], b2[..., 2]) - torch.min(b1[..., 0], b2[..., 0])
    ch = torch.max(b1[..., 3], b2[..., 3]) - torch.min(b1[..., 1], b2[..., 1])
    c2 = cw ** 2 + ch ** 2 + eps
    rho2 = ((b2[..., 0] + b2[..., 2] - b1[..., 0] - b1[..., 2]) ** 2 + (b2[..., 1] + b2[..., 3] - b1[..., 1] - b1[..., 3]) ** 2) / 4
    v = (4 / math.pi ** 2) * (torch.atan(w2 / h2) - torch.atan(w1 / h1)) ** 2
    with torch.no_grad():
        alpha = v / (v - iou + (1 + eps))
    return iou - (rho2 / c2 + v * alpha)


@torch.no_grad()
def tal_assign(pd_scores, pd_boxes, anchors, gt_labels, gt_boxes, gt_mask, topk=10, alpha=0.5, beta=6.0, eps=1e-9):
    """Task-Aligned Assigner:GT の箱の中にあるアンカーのうち、スコア^α × IoU^β が大きい topk 個を、その GT の担当にする
    pd_scores (B, A, nc)・pd_boxes (B, A, 4)・anchors (A, 2) は画素単位、gt_* は (B, M, …)"""
    B, A, nc = pd_scores.shape
    M = gt_boxes.shape[1]
    lt = anchors[None, None] - gt_boxes[..., None, :2]
    rb = gt_boxes[..., None, 2:] - anchors[None, None]
    in_gt = (torch.cat((lt, rb), -1).amin(-1) > eps) & gt_mask[..., None]           # (B, M, A)
    score = pd_scores.gather(2, gt_labels[:, None, :].expand(-1, A, -1)).transpose(1, 2)   # (B, M, A)
    iou = ciou(gt_boxes[:, :, None, :], pd_boxes[:, None, :, :]).clamp(0) * in_gt
    metric = score.pow(alpha) * iou.pow(beta) * in_gt
    top = metric.topk(topk, dim=-1).indices
    pos = torch.zeros_like(metric, dtype=torch.bool).scatter_(-1, top, True) & in_gt   # (B, M, A)
    # 1 つのアンカーが複数の GT に選ばれたら、IoU のいちばん大きい GT だけに担当させる
    multi = pos.sum(1, keepdim=True) > 1
    best = F.one_hot(iou.argmax(1), M).permute(0, 2, 1).bool()
    pos = torch.where(multi, best, pos)
    fg = pos.any(1)                                                                  # (B, A)
    gt_idx = pos.float().argmax(1)                                                   # (B, A)
    t_boxes = gt_boxes.gather(1, gt_idx[..., None].expand(-1, -1, 4))
    t_labels = gt_labels.gather(1, gt_idx)
    # 分類の目標は 0/1 ではなく、GT ごとに正規化した揃い具合(最大で、その GT の最大 IoU)にする
    metric, iou = metric * pos, iou * pos
    norm = (metric * iou.amax(-1, keepdim=True) / (metric.amax(-1, keepdim=True) + eps)).amax(1)   # (B, A)
    t_scores = F.one_hot(t_labels, nc).float() * (norm * fg)[..., None]
    return t_boxes, t_scores, fg


def yolo_loss(model, box, cls, feats, gt_boxes, gt_labels, gt_mask, reg_max=16):
    """box 7.5・cls 0.5・dfl 1.5 の重みは、Ultralytics の既定値"""
    anchors, stride = make_anchors(feats, model.detect.strides)
    pred_dist = box.permute(0, 2, 1)                                                 # (B, A, 4*16)
    pred_scores = cls.permute(0, 2, 1)                                               # (B, A, nc)
    B, A, _ = pred_dist.shape
    dist = pred_dist.view(B, A, 4, reg_max).softmax(-1) @ model.detect.proj          # (B, A, 4):格子の単位の距離
    pred_boxes = torch.cat((anchors - dist[..., :2], anchors + dist[..., 2:]), -1)  # 格子の単位の x1y1x2y2
    t_boxes, t_scores, fg = tal_assign(pred_scores.detach().sigmoid(), pred_boxes.detach() * stride,
                                       anchors * stride, gt_labels, gt_boxes, gt_mask)
    tss = t_scores.sum().clamp(min=1)
    loss_cls = F.binary_cross_entropy_with_logits(pred_scores, t_scores, reduction="none").sum() / tss
    w = t_scores.sum(-1)[fg][:, None]
    t_grid = t_boxes / stride                                                         # 格子の単位にそろえる
    iou = ciou(pred_boxes[fg], t_grid[fg])[:, None]
    loss_box = ((1 - iou) * w).sum() / tss
    a = anchors[None].expand(B, -1, -1)[fg]
    t_ltrb = torch.cat((a - t_grid[fg][:, :2], t_grid[fg][:, 2:] - a), -1).clamp(0, reg_max - 1 - 0.01)
    tl = t_ltrb.long()
    wl = (tl + 1) - t_ltrb
    logp = F.log_softmax(pred_dist[fg].view(-1, 4, reg_max), -1)
    dfl = -(logp.gather(-1, tl[..., None]).squeeze(-1) * wl + logp.gather(-1, (tl + 1)[..., None]).squeeze(-1) * (1 - wl))
    loss_dfl = (dfl.mean(-1, keepdim=True) * w).sum() / tss
    return 7.5 * loss_box + 0.5 * loss_cls + 1.5 * loss_dfl, (loss_box.item(), loss_cls.item(), loss_dfl.item())


def bias_init(model, img=IMG):
    """箱の出力のバイアスを 2.0、クラスの出力のバイアスを「画像に物体が少ない」前提の小さな確率にする(公式と同じ考え方)"""
    for bh, ch, s in zip(model.detect.box_head, model.detect.cls_head, model.detect.strides):
        bh[-1].bias.data[:] = 2.0
        ch[-1].bias.data[:] = math.log(5 / model.detect.nc / (img / s) ** 2)
CIoU・Task-Aligned Assigner・YOLO の損失・出力のバイアスの初期値を定義するコードです。設定の値は、Ultralytics の既定値です。
- ciou: 2 つの箱の IoU から、中心どうしの距離(2 つの箱を囲む最小の箱の対角線で割ったもの)と、縦横比の違いの罰を引きます。IoU だけだと、重なっていない箱どうしでは 0 で、どちらに動かせばよいかが分かりません。中心の距離の罰があれば、離れた箱にも近づける向きの勾配が出ます。
- tal_assign: 3 つの段階で割り当てます。(1) 格子点が正解の箱の中にあるか(in_gt)、(2) metric()の上位 10 個か、(3) 1 つの格子点が複数の箱に選ばれたら IoU の最も大きい箱だけを残す、です。予測の確率と箱は学習中のモデルの出力なので、学習が進むと担当の格子点も変わります。@torch.no_grad() にして、割り当ての計算には勾配を流しません。
- 分類の目標: 担当の格子点の目標を 1 ではなく、正解の箱ごとに正規化した metric(最大で、その箱の最大の IoU)にします。箱がよく合っている格子点ほど高い確率を出すように学習させ、NMS で確率の高い箱を残したときに、位置の正確な箱が残るようにするためです。
- yolo_loss: 分類は、すべての格子点・クラスについての BCE の和を、目標の合計 tss で割ります。箱と DFL は担当の格子点だけで計算し、目標の確率で重みを付けます。DFL は、正解の距離(例えば 3.3 区間)を挟む 2 つの区間(3 と 4)に、近さに応じた重み(0.7 と 0.3)で交差エントロピーをかけ、分布の期待値が正解の距離になるように学習させます。
- bias_init: 箱の出力のバイアスを 2.0、クラスの出力のバイアスを、画像 1 枚に物体が数個しかない前提の小さな確率にします。学習の始めに、ほぼすべての格子点が「物体なし」を出すようにして、損失が大きく暴れないようにするためです。公式の実装と同じ式で、画像の大きさだけ 256 にしています。
割り当てと損失の流れを図にすると、次のようになります。
(図は、diagram-designで作成)
評価:mAP50 と大きさ別の再現率
def box_iou(a, b):
    lt = torch.max(a[:, None, :2], b[None, :, :2])
    rb = torch.min(a[:, None, 2:], b[None, :, 2:])
    inter = (rb - lt).clamp(0).prod(-1)
    area = lambda x: (x[:, 2:] - x[:, :2]).prod(-1)
    return inter / (area(a)[:, None] + area(b)[None] - inter)


@torch.no_grad()
def evaluate(model, loader):
    """クラスごとの AP50(IoU 0.5 以上で正解)の平均 mAP50 と、大きさ別の再現率(スコア 0.25 以上で見つけた割合)"""
    model.eval()
    dets = {c: [] for c in range(NC)}             # (score, 正解か)
    n_gt = np.zeros(NC)
    found = {"小 (6〜16)": [0, 0], "中 (16〜48)": [0, 0], "大 (48〜96)": [0, 0]}
    for imgs, boxes, labels, mask in loader:
        box, cls, feats = model(imgs.to(device))
        pred = model.detect.decode(box.float(), cls.float(), feats)
        for i in range(len(imgs)):
            xyxy, score, label = postprocess(pred[i], conf=0.001, iou=0.7)
            g, gl = boxes[i][mask[i]].to(device), labels[i][mask[i]].to(device)
            for c in range(NC):
                n_gt[c] += (gl == c).sum().item()
            used = torch.zeros(len(g), dtype=torch.bool, device=device)
            ious = box_iou(xyxy, g) if len(g) and len(xyxy) else torch.zeros(len(xyxy), len(g), device=device)
            hit_025 = torch.zeros(len(g), dtype=torch.bool, device=device)
            for j in range(len(xyxy)):            # スコアの高い順に、まだ使っていない同じクラスの GT と対応づける
                ok = (gl == label[j]) & ~used
                if len(g) and ok.any():
                    v, k = (ious[j] * ok).max(0)
                    if v >= 0.5:
                        used[k] = True
                        if score[j] >= 0.25:
                            hit_025[k] = True
                        dets[int(label[j])].append((score[j].item(), 1))
                        continue
                dets[int(label[j])].append((score[j].item(), 0))
            side = (g[:, 2:] - g[:, :2]).max(1).values
            for name, lo, hi in [("小 (6〜16)", 0, 16), ("中 (16〜48)", 16, 48), ("大 (48〜96)", 48, 1e9)]:
                sel = (side >= lo) & (side < hi)
                found[name][0] += hit_025[sel].sum().item()
                found[name][1] += sel.sum().item()
    aps = []
    for c in range(NC):
        d = sorted(dets[c], key=lambda t: -t[0])
        tp = np.cumsum([t[1] for t in d])
        fp = np.cumsum([1 - t[1] for t in d])
        rec = tp / max(n_gt[c], 1)
        prec = tp / np.maximum(tp + fp, 1e-9)
        mrec = np.concatenate(([0], rec, [1]))
        mpre = np.concatenate(([1], prec, [0]))
        mpre = np.flip(np.maximum.accumulate(np.flip(mpre)))
        idx = np.where(mrec[1:] != mrec[:-1])[0]
        aps.append(np.sum((mrec[idx + 1] - mrec[idx]) * mpre[idx + 1]))
    return float(np.mean(aps)), {k: v[0] / max(v[1], 1) for k, v in found.items()}
テスト用の 1,000 枚で、mAP50 と、物体の大きさ別の再現率を計算するコードです。
- mAP50: クラスごとに、すべての検出を確率の高い順に並べ、まだ対応のない同じクラスの正解と IoU 0.5 以上で重なれば正解、そうでなければ誤りとします。適合率と再現率の曲線の下の面積(AP)を、3 クラスで平均します。conf=0.001 と低い閾値で検出を集めるのは、確率の低い検出まで含めて曲線を描くためで、Ultralytics の評価の既定値と同じです。
- 大きさ別の再現率: 実際に使うときの閾値(確率 0.25 以上)で、正解の物体のうち見つけられた割合を、一辺の長さで 3 つに分けて数えます。16 画素は P4 のストライドで、これより小さな物体は P4 の格子点の間にすっぽり入ってしまいます。48 画素を境に、中くらいと大きな物体を分けます。
学習の関数
EPOCHS, N_TRAIN, BATCH, WARMUP = 20, 20000, 64, 3


def train(use_p3):
    torch.manual_seed(0)
    train_loader = torch.utils.data.DataLoader(Shapes(N_TRAIN, 0), batch_size=BATCH, shuffle=True,
                                               num_workers=8, collate_fn=collate, drop_last=True, persistent_workers=True)
    test_loader = torch.utils.data.DataLoader(Shapes(1000, 10**6), batch_size=100, num_workers=8, collate_fn=collate)
    model = YOLO11(nc=NC, use_p3=use_p3).to(device)
    bias_init(model)
    decay = [p for n, p in model.named_parameters() if p.ndim > 1]
    no_decay = [p for n, p in model.named_parameters() if p.ndim <= 1]
    opt = torch.optim.AdamW([{"params": decay, "weight_decay": 5e-4}, {"params": no_decay, "weight_decay": 0.0}], lr=1e-3)
    steps, warm = EPOCHS * len(train_loader), WARMUP * len(train_loader)
    sched = torch.optim.lr_scheduler.LambdaLR(
        opt, lambda s: s / warm if s < warm else (1 - (s - warm) / (steps - warm)) * (1 - 0.01) + 0.01)
    log = []
    for epoch in range(1, EPOCHS + 1):
        model.train()
        t0, tot = time.time(), np.zeros(3)
        for imgs, boxes, labels, mask in train_loader:
            imgs, boxes, labels, mask = imgs.to(device), boxes.to(device), labels.to(device), mask.to(device)
            with torch.autocast("cuda", dtype=torch.bfloat16):
                box, cls, feats = model(imgs)
            loss, parts = yolo_loss(model, box.float(), cls.float(), [f.float() for f in feats], boxes, labels, mask)
            opt.zero_grad(set_to_none=True)
            loss.backward()
            torch.nn.utils.clip_grad_norm_(model.parameters(), 10.0)
            opt.step()
            sched.step()
            tot += parts
        if epoch % 5 == 0 or epoch == 1:
            m, rec = evaluate(model, test_loader)
            log.append({"epoch": epoch, "loss": (tot / len(train_loader)).tolist(), "map50": m, "recall": rec})
            print(f"[P3 {'あり' if use_p3 else 'なし'}] エポック {epoch:2d}  損失(box, cls, dfl) "
                  f"{', '.join(f'{v:.3f}' for v in tot / len(train_loader))}  mAP50 {m:.3f}  "
                  + "  ".join(f"{k} {v:.3f}" for k, v in rec.items()) + f"  ({time.time() - t0:.0f} 秒)", flush=True)
    return model, log
use_p3 を受け取ってモデルをゼロから学習し、5 エポックごとにテストで評価する関数です。
- シード: torch.manual_seed(0) を設定ごとに呼びます。ただし、2 つの設定は Detect の層の数が違い、乱数の使われ方が変わるので、Detect の重みの初期値とデータの順番は同じになりません。画像そのものは、番号を種にして作るので同じです。
- 最適化: AdamW、学習率 1e-3、重み減衰 5e-4(バッチ正規化とバイアスには減衰をかけない)、勾配のクリップ 10.0 は、Ultralytics の既定値(学習率は Adam・AdamW のときの推奨値)です。最初の 3 エポックで学習率を 0 から上げ(ウォームアップ)、その後は最後に 1/100 になるまで直線で下げるのも、公式の既定の学習率の変え方です。
- エポックとバッチ: 20 エポックは、2 つの設定を A100 で合わせて約 30 分で学習できる長さです。バッチ 64 は、1 回の更新で見る画素の数(64 × 256 × 256)を、公式の既定(16 × 640 × 640)と同じくらいにする大きさです。1 エポックは 2 万枚(312 回の更新)です。
- bf16: モデルの計算は torch.autocast で bfloat16 にして速くし、損失は float32 で計算します。割り当ての IoU の 6 乗のように、細かな値の差が効く計算の精度を保つためです。
2 つの設定を学習する
results = {}
for use_p3 in [True, False]:
    results[use_p3] = train(use_p3)

print()
for use_p3, (model, log) in results.items():
    last = log[-1]
    print(f"P3 {'あり' if use_p3 else 'なし'}  mAP50 {last['map50']:.3f}  " + "  ".join(f"{k} {v:.3f}" for k, v in last["recall"].items()))
P3 あり・P3 なしの 2 つの設定を順に学習し、最後の評価を並べて表示するコードです。比べたいのは小さな物体の見つけやすさなので、全体の mAP50 と、大きさ別の再現率を並べます。
実行結果
[P3 あり] エポック  1  損失(box, cls, dfl) 0.388, 7.603, 1.847  mAP50 0.715  小 (6〜16) 0.275  中 (16〜48) 0.889  大 (48〜96) 0.934  (76 秒)
[P3 あり] エポック  5  損失(box, cls, dfl) 0.052, 0.555, 0.535  mAP50 0.973  小 (6〜16) 0.891  中 (16〜48) 0.999  大 (48〜96) 0.998  (37 秒)
[P3 あり] エポック 10  損失(box, cls, dfl) 0.043, 0.429, 0.523  mAP50 0.988  小 (6〜16) 0.930  中 (16〜48) 1.000  大 (48〜96) 1.000  (35 秒)
[P3 あり] エポック 15  損失(box, cls, dfl) 0.039, 0.378, 0.518  mAP50 0.990  小 (6〜16) 0.939  中 (16〜48) 1.000  大 (48〜96) 1.000  (36 秒)
[P3 あり] エポック 20  損失(box, cls, dfl) 0.031, 0.317, 0.515  mAP50 0.989  小 (6〜16) 0.938  中 (16〜48) 1.000  大 (48〜96) 1.000  (35 秒)
[P3 なし] エポック  1  損失(box, cls, dfl) 0.486, 12.181, 1.660  mAP50 0.599  小 (6〜16) 0.116  中 (16〜48) 0.813  大 (48〜96) 0.980  (50 秒)
[P3 なし] エポック  5  損失(box, cls, dfl) 0.047, 0.462, 0.523  mAP50 0.815  小 (6〜16) 0.389  中 (16〜48) 0.995  大 (48〜96) 1.000  (35 秒)
[P3 なし] エポック 10  損失(box, cls, dfl) 0.036, 0.352, 0.514  mAP50 0.828  小 (6〜16) 0.440  中 (16〜48) 0.997  大 (48〜96) 1.000  (35 秒)
[P3 なし] エポック 15  損失(box, cls, dfl) 0.031, 0.297, 0.511  mAP50 0.819  小 (6〜16) 0.456  中 (16〜48) 0.998  大 (48〜96) 1.000  (34 秒)
[P3 なし] エポック 20  損失(box, cls, dfl) 0.023, 0.230, 0.508  mAP50 0.796  小 (6〜16) 0.427  中 (16〜48) 0.996  大 (48〜96) 1.000  (34 秒)

P3 あり  mAP50 0.989  小 (6〜16) 0.938  中 (16〜48) 1.000  大 (48〜96) 1.000
P3 なし  mAP50 0.796  小 (6〜16) 0.427  中 (16〜48) 0.996  大 (48〜96) 1.000
fig, axes = plt.subplots(1, 2, figsize=(12, 4))
for use_p3, (model, log) in results.items():
    ep = [r["epoch"] for r in log]
    lab = "P3 あり(公式どおり)" if use_p3 else "P3 なし(P4・P5 だけ)"
    axes[0].plot(ep, [r["map50"] for r in log], "o-", label=lab)
    axes[1].plot(ep, [r["recall"]["小 (6〜16)"] for r in log], "o-", label=lab)
axes[0].set_ylabel("mAP50(テスト 1,000 枚)")
axes[1].set_ylabel("小さな物体(一辺 16 画素未満)の再現率")
for ax in axes:
    ax.set_xlabel("エポック")
    ax.set_ylim(0, 1)
    ax.grid(alpha=0.3)
    ax.legend()
plt.tight_layout()
plt.show()

# テスト画像 3 枚で、2 つのモデルの検出を並べる(スコア 0.25 以上)
fig, axes = plt.subplots(2, 3, figsize=(13, 9))
for row, (use_p3, (model, _)) in enumerate(results.items()):
    model.eval()
    for col, seed in enumerate([10**6, 10**6 + 1, 10**6 + 2]):
        im, gt, _ = make_shapes(seed)
        with torch.no_grad():
            b, c, f = model(torch.from_numpy(im).permute(2, 0, 1)[None].float().div(255).to(device))
            xyxy, s, l = postprocess(model.detect.decode(b, c, f)[0])
        ax = axes[row, col]
        ax.imshow(im)
        for x0, y0, x1, y1 in xyxy.tolist():
            ax.add_patch(plt.Rectangle((x0, y0), x1 - x0, y1 - y0, fill=False, color="red", lw=1.5))
        ax.set_title(f"P3 {'あり' if use_p3 else 'なし'}:正解 {len(gt)} 個、検出 {len(xyxy)} 個")
        ax.axis("off")
plt.tight_layout()
plt.show()
2 つの設定の学習の経過と、テスト画像での検出結果を並べて描くコードです。
- 学習の経過: 5 エポックごとの mAP50 と、小さな物体の再現率を描きます。差がいつから開くか、最後まで縮まらないかを見るためです。
- 検出結果: テスト画像 3 枚に、確率 0.25 以上の検出を描きます。上の段が P3 あり、下の段が P3 なしです。
実行結果
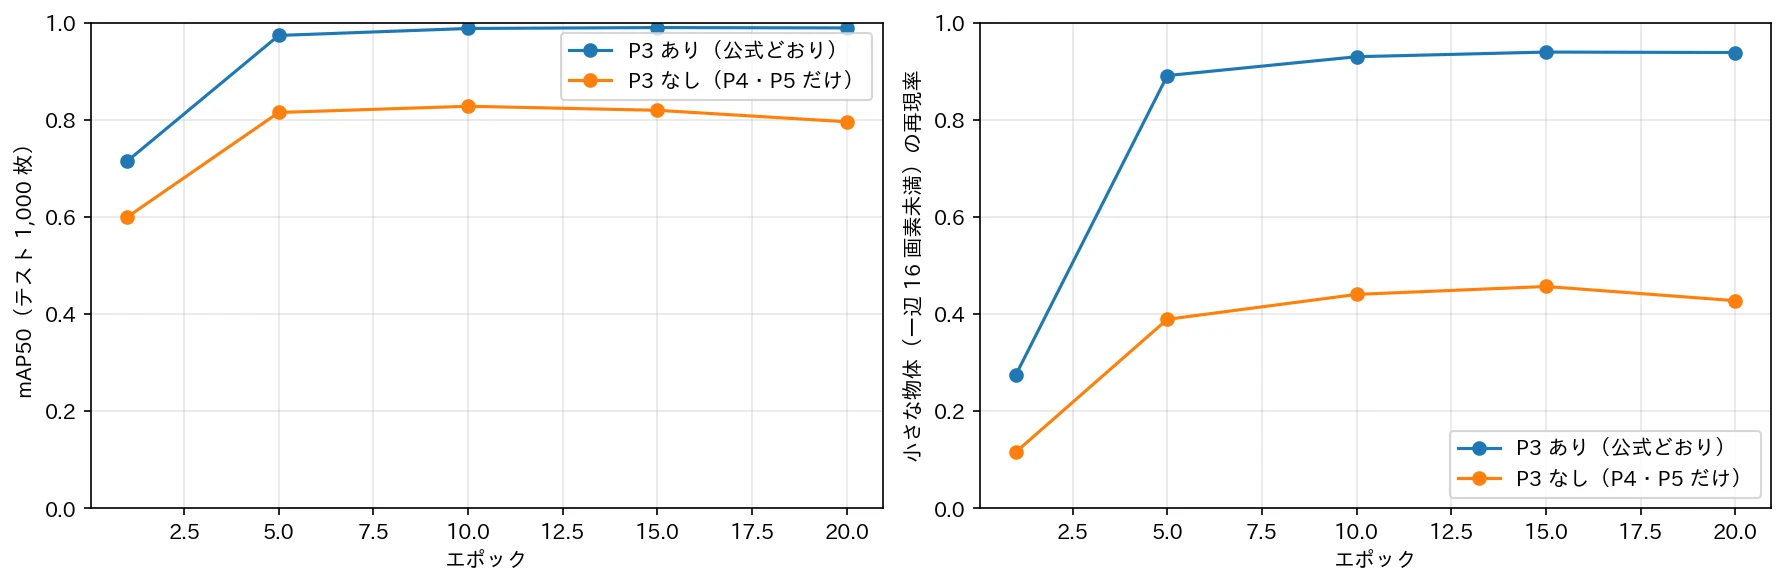
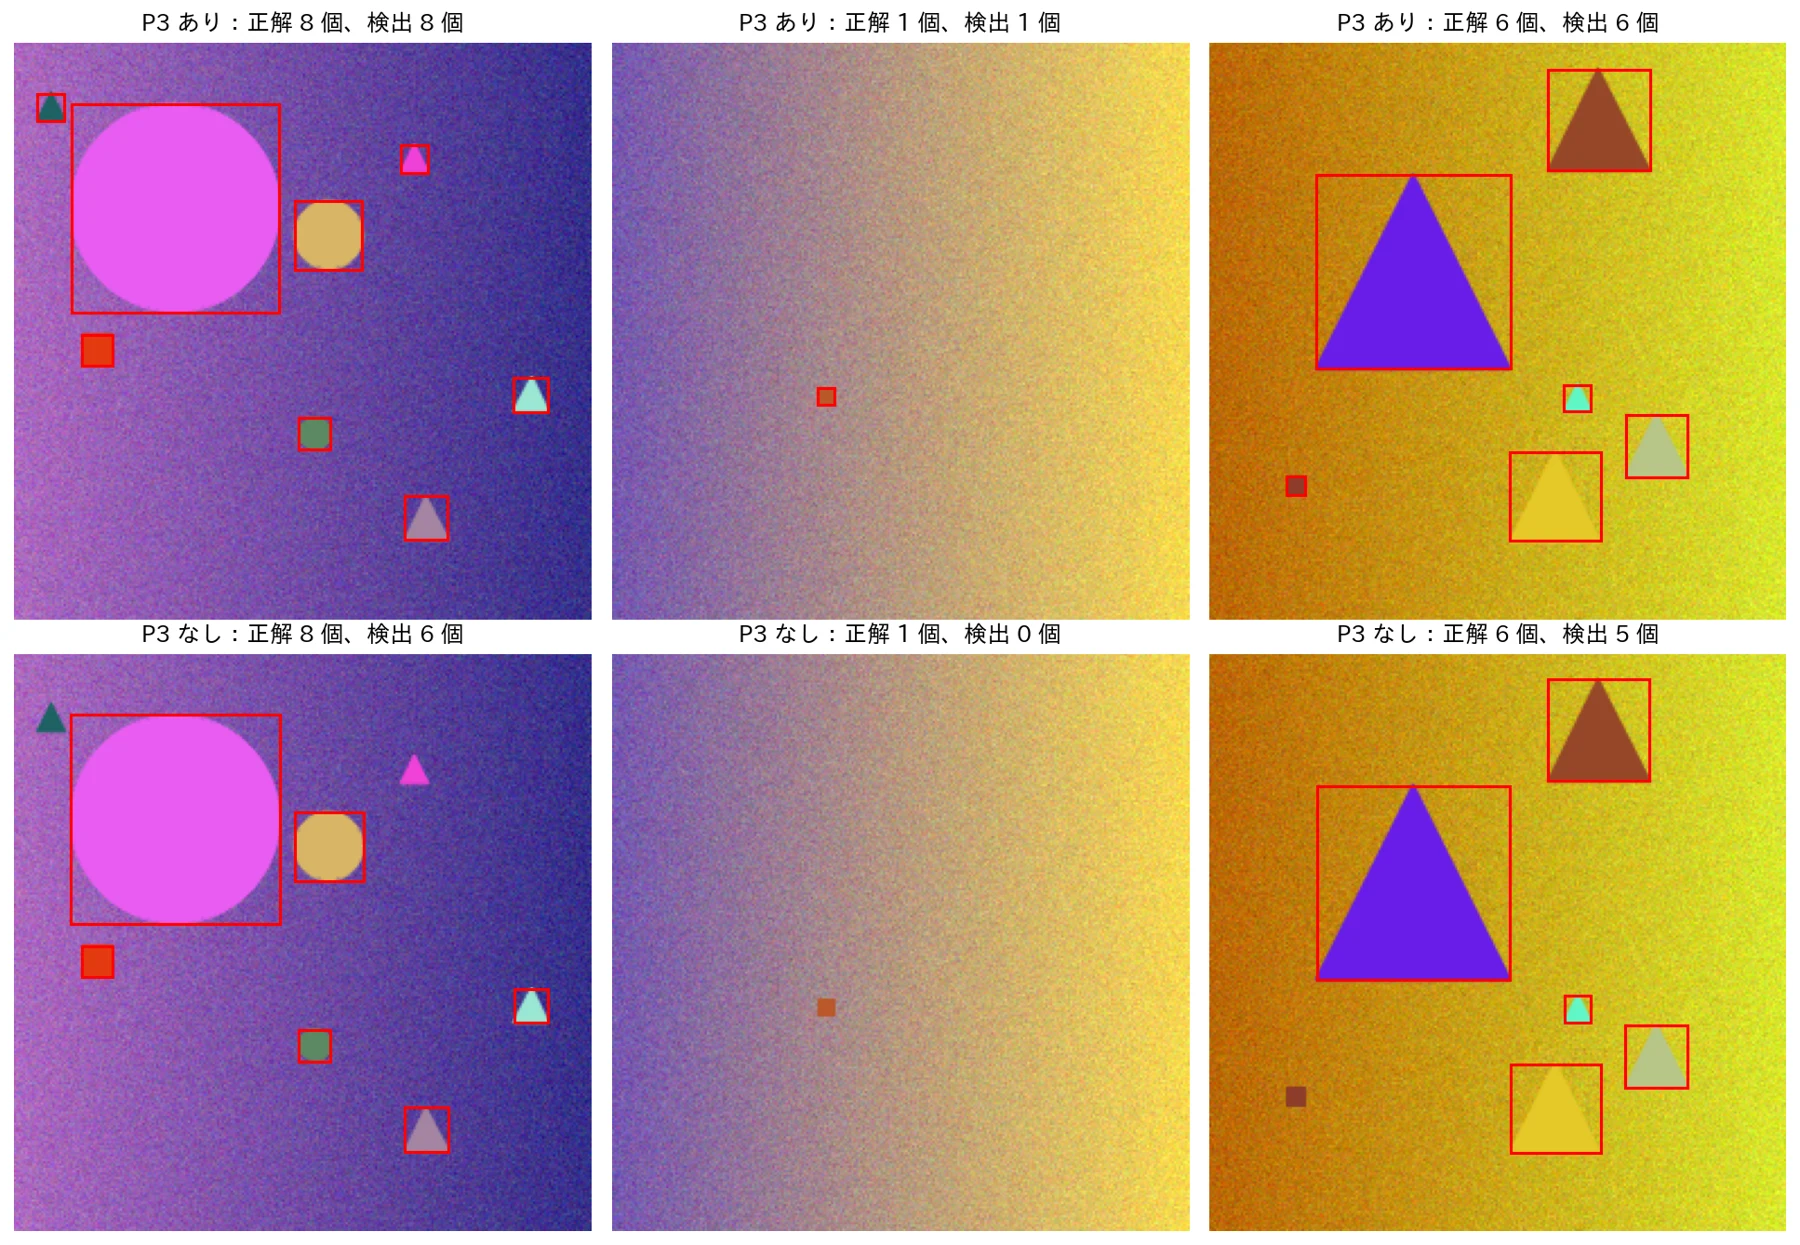
P3 ありの mAP50 は 0.989、P3 なしは 0.796 でした。差のほとんどは小さな物体で、一辺 16 画素未満の物体の再現率は 0.938 と 0.427 です。16 画素以上の物体は、どちらもほぼすべて見つけています。検出結果の図でも、P3 なし(下の段)は、小さな三角形や四角形を見逃しています。
P3 なしで小さな物体を見つけられないのは、学習の割り当てが原因です。Task-Aligned Assigner は、格子点が正解の箱の中にあるときだけ、その格子点をその箱の担当にします。P4 の格子点は 16 画素おきに並んでいるので、一辺 8 画素の箱の中に P4 の格子点が入る確率は (8 / 16)² = 25% しかありません。格子点が入らなかった小さな物体は、学習中どの格子点の担当にもならず、むしろ周りの格子点は「物体なし」として学習されます。P3 なしの mAP50 が 10 エポック目の 0.828 から 20 エポック目の 0.796 に下がっているのも、見つけられない小さな物体を「物体なし」と答えるように学習が進んだためと考えられます。8 画素おきの P3 があれば、一辺 8 画素以上の箱には必ず格子点が入ります。
YOLO11 が P3(1/8)・P4(1/16)・P5(1/32)の 3 つの出力を持つのは、このように、物体の大きさに合った細かさの格子点を用意するためです。なお、最新の Ultralytics の割り当てでは、ストライドより小さな箱は候補を選ぶときに箱を広げて、格子点が必ず入るようにする工夫も加えられています。
2 つの設定の再現率を大きさ別に並べると、次のようになります。
(図は、diagram-designで作成)
まとめ
本記事では、Ultralytics の物体検出モデル YOLO11 を、PyTorch のスクラッチ実装で確かめました。
実験1では、YOLO11n が YOLOv8n よりパラメータ数で 17%、計算量で 25% 少ないことを確かめました。一方、PyTorch でそのまま測った推論時間は YOLO11n の方が長く(A100 で 8.99 ms と 12.28 ms)、計算量の少なさが速さになるかは、ONNX や TensorRT などの実行の環境しだいでした。実験2では、C3k2・SPPF・C2PSA の Backbone、FPN と PAN の Neck、DFL で箱を出す Detect ヘッドを部品ごとに実装し、公式の yolo11n の重みを読み込んで、出力の差が 0.0、cats.jpg の検出結果(9 個)も Ultralytics と完全に一致することを確かめました。実験3では、Task-Aligned Assigner・CIoU・DFL の損失で合成データからゼロから学習し、P3 の出力を外すと、mAP50 が 0.989 から 0.796 に、一辺 16 画素未満の物体の再現率が 0.938 から 0.427 に下がりました。
YOLO11 は、YOLOv8 の「解像度の違う 3 段の特徴を混ぜて、格子点ごとに箱とクラスを出す」骨組みを保ったまま、C3k2 と C2PSA で少ない計算から高い精度を引き出したモデルです。小さな物体を見つけるには、物体の大きさに合った細かさの格子点が必要で、P3・P4・P5 の 3 つの出力と、格子点を正解に割り当てる Task-Aligned Assigner が、その役割を担っています。
ライセンスに関する注意点:AGPL-3.0
Ultralytics の YOLO11(ソースコードと、yolo11n.pt などの学習済みの重み)は、AGPL-3.0 で公開されています。利用するときは、次の点に注意してください。
- ソースコードの開示義務(強いコピーレフト): AGPL-3.0 のソフトウェアを改変したり、組み込んだりしたソフトウェアを配布する場合、そのソフトウェア全体のソースコードも AGPL-3.0 で公開する義務があります。
- ネットワーク経由の利用にも適用される: 自分のサーバーで動かし、ネットワーク経由でサービスとして提供する場合(画像認識の API など)にも、ソースコードの開示義務がかかります。
- 商用利用: ソースコードを公開したくない製品やサービスに組み込む場合のために、Ultralytics は有償の商用ライセンス(Enterprise License)を提供しています。
本記事のスクラッチ実装は、学習済みの重みを読み込めるように、公式の実装と同じ構造・同じ計算になるよう書いたものです。公式のコードを写したものではありませんが、構造は公式の実装に基づいているので、記事のコードや学習済みの重みを製品やサービスに組み込む場合は、AGPL-3.0 の扱いを確認してください。本記事の説明は一般的な解釈で、法的な助言ではありません。 実際に利用する場合は、ライセンスの条文を確認するか、法務の担当者や専門家に相談してください。
出典・ライセンスについて
- YOLO11 の実装: Ultralytics の ultralytics(AGPL-3.0)の構造を参考に、スクラッチで実装しています。
- 学習済みのモデル: Ultralytics が公開している yolo11n.pt・yolov8n.pt(AGPL-3.0)を使用しています。
- 推論に利用した画像: Gemini で作成した画像です。
@software{yolo11_ultralytics,
  author = {Glenn Jocher and Jing Qiu},
  title = {Ultralytics YOLO11},
  version = {11.0.0},
  year = {2024},
  url = {https://github.com/ultralytics/ultralytics},
  orcid = {0000-0001-5950-6979, 0000-0003-3783-7069},
  license = {AGPL-3.0}
}
参考文献
- R. Khanam, M. Hussain (2024). YOLOv11: An Overview of the Key Architectural Enhancements. arXiv:2410.17725.
- Ultralytics (2024). ultralytics/ultralytics. GitHub.
- Ultralytics. YOLO11. 公式ドキュメント.
- T.-Y. Lin et al. (2014). Microsoft COCO: Common Objects in Context. ECCV 2014.
本記事の文章・構成の一部に生成AIを使用しています。